从检索到类型化决策:基于生物医学句子编码器的校准System One模型 From Retrieval to Typed Decisions: Calibrated System One Models from Biomedical Sentence Encoders
把生物医学检索句编码器改造成单次前向、可校准的类型化决策模型,交叉熵胜过RLCD配方。
前置知识
System One 模型与类型化决策(typed decisions)
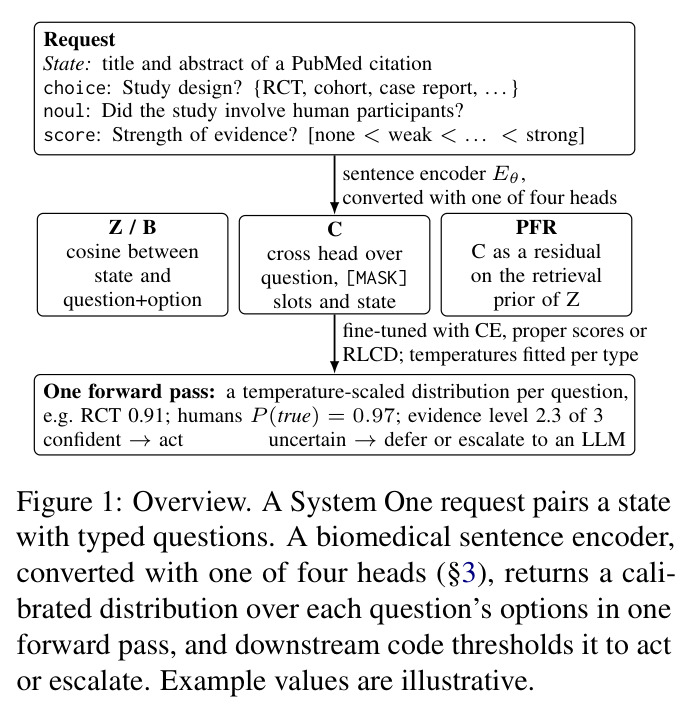
一种非自回归决策接口:给定状态文本 $s$ 和一组带类型的提问 $q=(\tau,x,o_{1:K})$,模型单次前向返回每个选项的分布。类型有三种:choice(从 schema 键中选一)、score(在有序量规上输出分布,答案取期望档位)、noul('某陈述是否成立',输出 $p(\text{true})$)。下游代码用最大概率 $\max_k p_k$ 作为置信度做阈值化:高置信直接执行,低置信转人工或升级到大模型。
本文的整个研究对象就是这个接口:作者要把检索句编码器改造成符合该 schema 的 System One 模型,所有指标(准确率、ECE、延迟)都围绕'一次前向 + 可阈值化置信度'展开。
Sentence-Transformers 句编码器与对比检索训练
把 transformer 输出池化(mean 或 [CLS])并 $L_2$ 归一化得到句向量 $e_\theta(\cdot)$,用余弦相似度衡量语义相关性。在 MS MARCO、PubMed 搜索日志等查询-段落对上做对比训练后,编码器成为稠密检索器,如 S-PubMedBERT-MS-MARCO 和 MedCPT。它们的相似度可以零样本判断'假设文本与状态是否匹配'。
本文的核心问题就是:这种为检索对比训练的编码器,是不是比普通 MLM(PubMedBERT 等)更好的决策模型初始化点,以及这种优势何时保留、何时消失。
交叉编码器与 [MASK] 槽位打分头
与双编码器分别编码两段文本不同,交叉编码器把状态和问题拼成一个序列(如 $[\text{CLS}]\ \tau\ x\ [\text{SEP}]\ [\text{MASK}]\ o_1\cdots[\text{MASK}]\ o_K\ [\text{SEP}]\ s\ [\text{SEP}]$)整体编码,再用小型 MLP 在每个 $[\text{MASK}]$ 位置的隐状态上打出该选项的 logit。它能建模选项与状态的细粒度交互,精度更高但每选项都要重新前向。
论文比较的 C 头就是一个刻意复刻 Laya 的 [MASK] 槽位头(可互载权重),PFR 头是它加上检索先验残差;理解这个头才能理解'转换'到底改了什么。
严格恰当评分规则(strictly proper scoring rules)
一类奖励诚实概率的损失:当且仅当报告真实分布时期望得分最大,包括 log 分(即交叉熵的负数)、Brier 分、球面分 $\|p\|_2$ 和等级概率分 RPS(对序数量规额外惩罚把概率放在相距很远的档位上)。形式化地,报告分布 $p$ 对目标 $t$ 的得分 $S(p,t)$ 满足期望在 $p=t$ 时最优。
RLCD 用恰当评分规则当奖励做策略梯度,本文证明它其实在对噪声平滑后的评分 $J_\sigma$ 做随机上升,且发布实现把平滑项权重放大了 5–20 倍——这一整套分析都以恰当评分规则为语言。
温度缩放与期望校准误差(ECE)
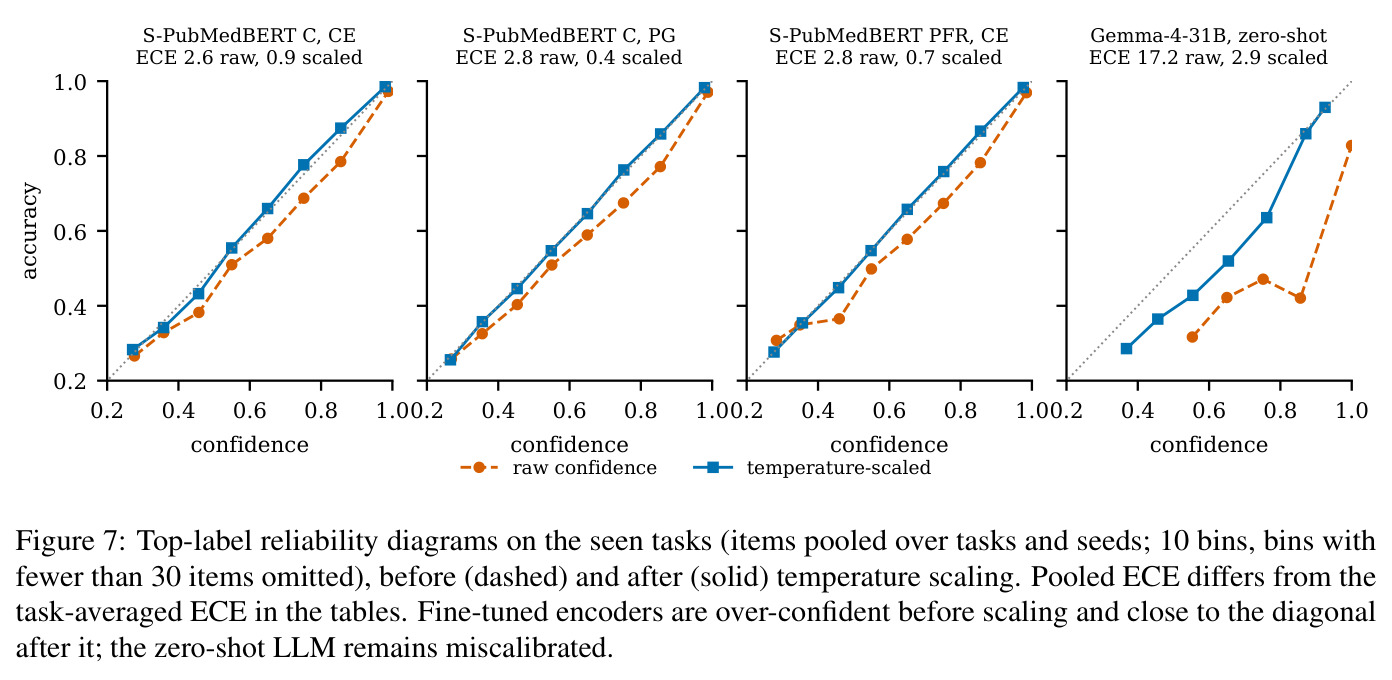
温度缩放对 logit 做后验校正 $p=\mathrm{softmax}(z/T)$,在留出校准集上最小化 NLL 拟合 $T$,是简单有效的校准手段。ECE 衡量置信度与经验准确率的偏差(按置信度分桶)。判断'某训练目标带来校准收益'必须以温度缩放之后仍然存在为准,否则只是 logit 尺度的差异。
论文的关键结论之一是:RLCD 的 raw ECE 更低(7.0 vs 9.3),但温度缩放后所有目标 ECE 都落在 3.6–4.4,校准优势完全消失——不懂得'缩放后再比较'这一原则就看不懂 RQ3 的结论。
REINFORCE 与组基线策略梯度(GRPO / RLCD)
策略梯度用奖励的采样估计来更新离散输出:$\hat g=\frac{1}{G\sigma^2}\sum_{g=1}^G (R^{(g)}-\bar R)\,\epsilon^{(g)}$,其中 $\epsilon$ 是对 logit 的高斯噪声,$\bar R$ 是组内均值基线。GRPO 用同组均值当基线降低方差;RLCD(Laya 的配方)进一步把优势除以组内奖励标准差 $d$ 做归一化。
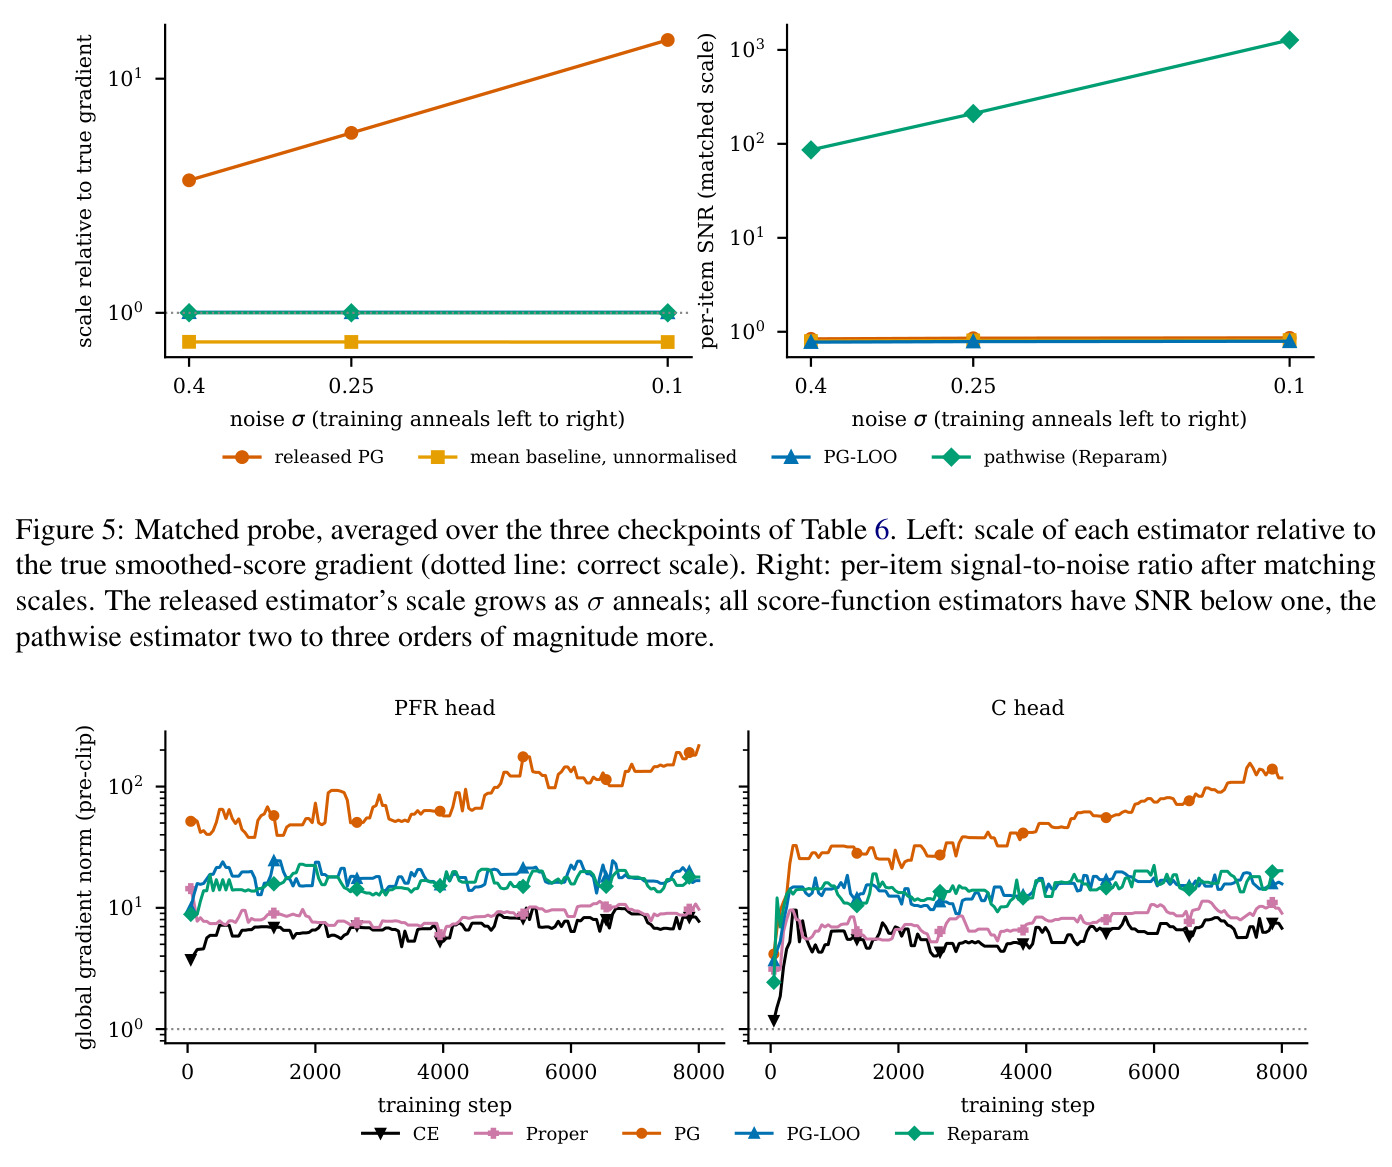
本文逐项解剖了 RLCD:同样本均值基线让估计期望缩小 $(G-1)/G=3/4$,除以 $d$ 又让有效尺度随噪声退火按 $1/\sigma$ 膨胀,最终评分项压过交叉熵 5–20 倍,这就是精度落后的根源。
研究动机
生物医学软件中的大部分语言处理其实是小型、有边界的决策:这篇摘要是否报告了随机对照试验?证据是否支持这条健康声明?这段话是否报告了不良反应?这些答案由下游代码消费,因此必须遵守 schema 且附带可阈值化的置信度(执行/搁置/升级)。System One 模型正是为此设计的接口,但现有模型全部是通用领域、从 MLM 或 decoder 检查点出发:Jev(闭源,训练目标未公开)和 Laya(首个开源实现,用 ModernBERT-large 421M 参数加 [MASK] 槽位头,以交叉熵加组基线策略梯度的 RLCD 目标训练)。另一方面,生物医学界已有大量为检索对比训练的句编码器(S-PubMedBERT-MS-MARCO、MedCPT),它们从未被作为决策模型的起点系统评估过;同时 Laya 发布的 RLCD 配方是否真比普通交叉熵更好,也没人验证过。
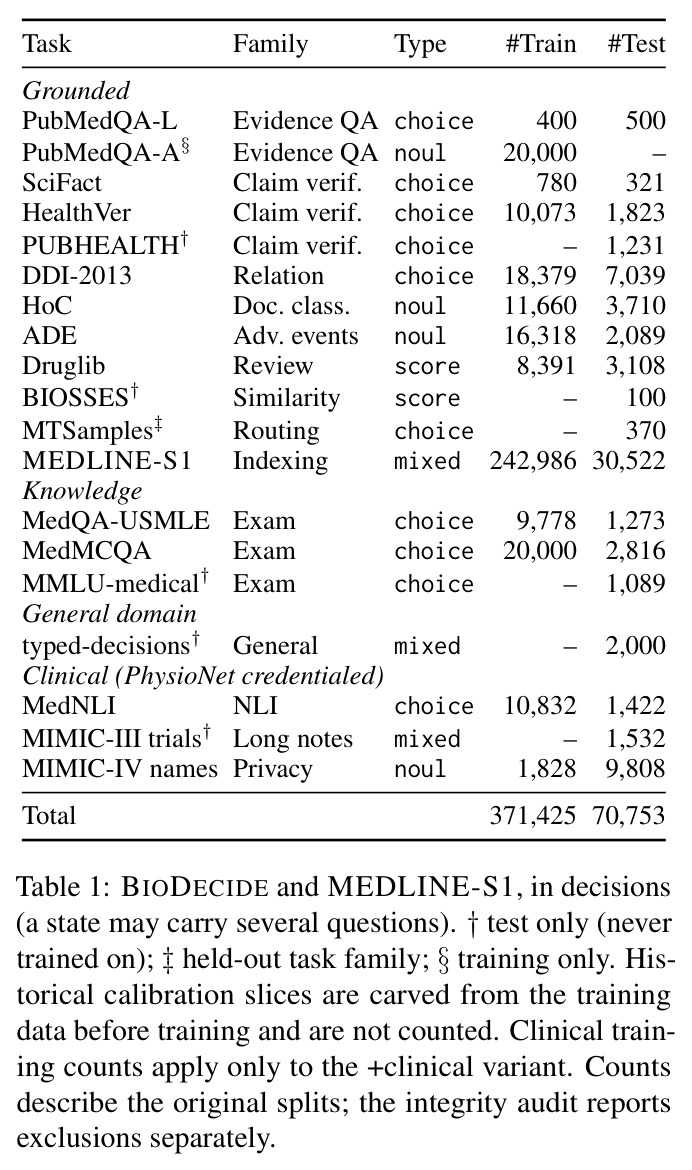
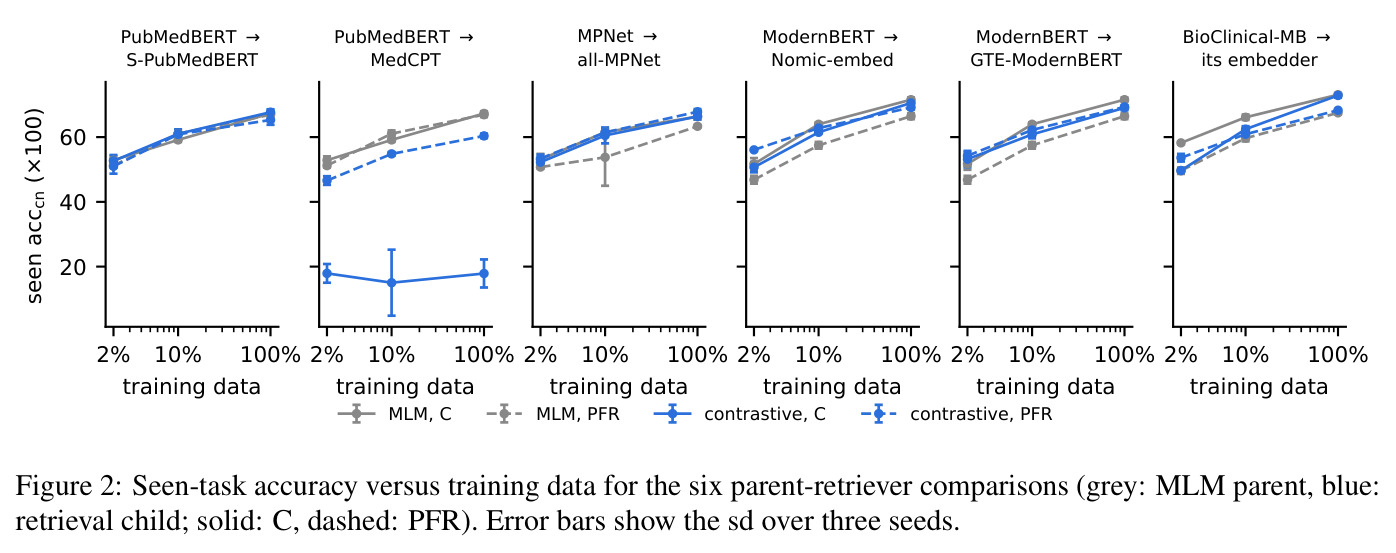
本文的目标是本文要做四件事:(1) 提出 SBERT2S1 框架,把任意 Sentence-Transformers 编码器转换为类型化决策模型,包含四种转换头——零样本先验 Z、双编码器 B、交叉头 C、以及新设计的先验融合残差头 PFR;(2) 发布 BIODECIDE 生物医学类型化决策套件(public、knowledge、clinical 三条 track,共 371,425 训练决策 / 70,753 测试决策)和 MEDLINE-S1——242,986 条直接从 NLM 人工标引导出而非 LLM 教师生成的多问题训练数据;(3) 在 11 个编码器、6 对共享父检查点的 parent–retriever 比较、以及 2 头 × 5 目标的匹配网格上,系统回答三个研究问题:检索初始化何时有帮助(RQ1)、四种转换如何权衡精度/鲁棒性/成本/检索保留(RQ2)、RLCD 的哪个成分在温度拟合后仍然重要(RQ3);(4) 从梯度估计器层面解释 RLCD 的精度差距来源并给出修复。
与已有工作不同的是,独特切入角度有三点。第一,把'检索器→决策模型'变成受控实验:用六个共享父检查点(如 PubMedBERT 与它的检索后代 S-PubMedBERT、ModernBERT 与 Nomic/GTE embedder)配对比较,隔离对比检索训练这一单一变量的贡献,并在 2%/10%/100% 三档数据量上画学习曲线。第二,训练标签不走 LLM 教师路线,而是直接复用 NLM 图书管理员几十年的人工 MEDLINE 标引(研究方向、疾病树、人/动物受试者、不良反应等),避免教师模型的系统性错误成为训练目标。第三,对 RLCD 做了形式化解剖(Proposition 1 + 逐 checkpoint 的梯度探针),证明发布版估计器方向正确但尺度膨胀,从而把精度差距精确定位到奖励归一化,而不是评分规则本身或估计方差。
核心方法
直觉上,类型化决策'假设 $h_k=x\oplus o_k$(指令拼接选项)是否被状态 $s$ 支持'与检索同构:把假设当 query、状态当 passage,用余弦相似度 $c_k=\langle e_\theta(s), e_\theta(h_k)\rangle$ 就能零样本打分,所以检索编码器天然是一个决策器。但要编码否定、序数判断和校准真值,需要在它上面加可训练的头。技术路线:设 $e_\theta(\cdot)$ 为 Sentence-Transformers 编码器的归一化池化嵌入,四种转换为——Z:冻结 $\theta$,$z_k=\alpha_\tau c_k$,只拟合每类型尺度;B:训练 $\theta$ 和 $\alpha$,状态嵌入可预计算,适合语料筛选;C:交叉头,把 $[\text{CLS}]\ \tau\ x\ [\text{SEP}]\ [\text{MASK}]\ o_1\cdots[\text{MASK}]\ o_K\ [\text{SEP}]\ s\ [\text{SEP}]$ 送入编码器,两层带类型嵌入的 transformer $\phi$ 上下文化后用 MLP 在第 $k$ 个 $[\text{MASK}]$ 处打分,结构与 Laya 完全一致故可互载权重;PFR:$z_k=r_{\theta,\phi}(s,q)_k+\alpha_\tau c_k$,先验作为残差融合。训练后在按类型×选项数桶划分的校准切片上拟合温度 $T_{\tau,K}$。
核心创新有二。其一是 PFR(prior-fused residual)头:打分器最后一层零初始化,使未训练的 PFR 精确等于校准的零样本检索器 Z,训练只学'检索先验之上的交叉注意力修正量',默认共享编码器、也可冻结一份先验副本以完整保留检索器。这带来两个实际收益——对选项顺序近乎免疫(0.3% vs 交叉头 15.7% 的答案翻转率),以及在 MedCPT 这类掩码槽位退化(同一输入内所有 [MASK] 隐状态相同)时仍能工作(60.4 vs 交叉头 17.9)。其二是把 RLCD 形式化为对噪声平滑恰当评分 $J_\sigma(z)=\mathbb{E}_{\epsilon\sim N(0,\sigma^2\Pi_K)}[S(\mathrm{softmax}(z+\epsilon),t)]$ 的随机上升,并指出发布实现的两处偏差:同样本均值基线 $\bar R$ 含自身奖励使期望估计缩小 $(G-1)/G=3/4$ 倍;除以组内奖励标准差 $d$ 使有效尺度随噪声退火按 $1/\sigma$ 增长,评分项相对交叉熵的权重从 1.3 倍膨胀到 5–20 倍。提出 PG-LOO(留一基线、不归一化)这一无偏版本即可收回大部分差距。
方法步骤详情
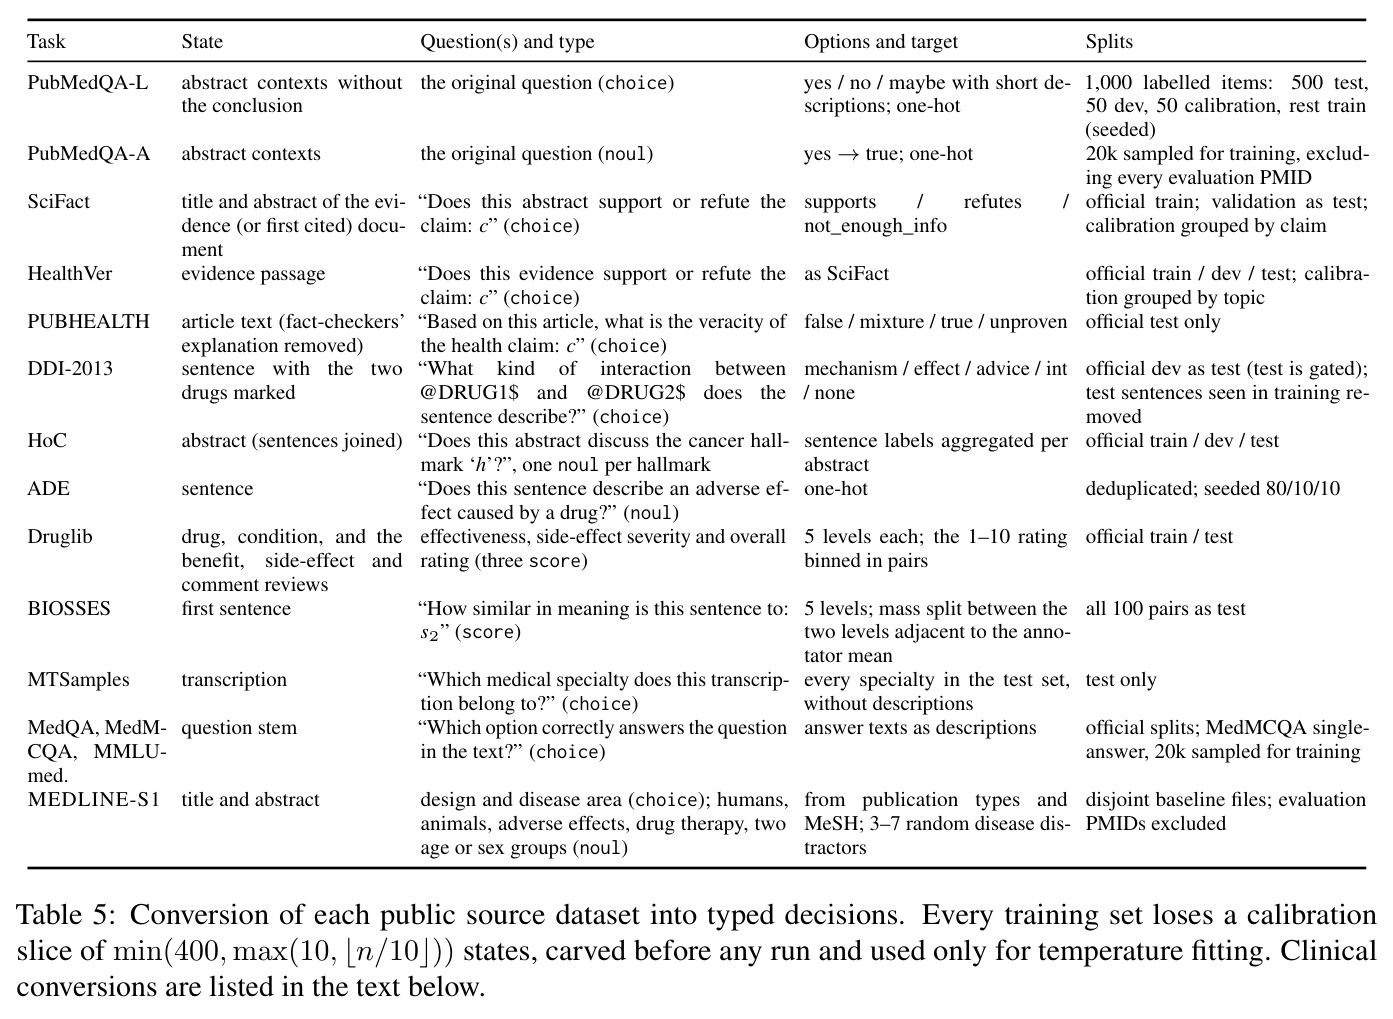
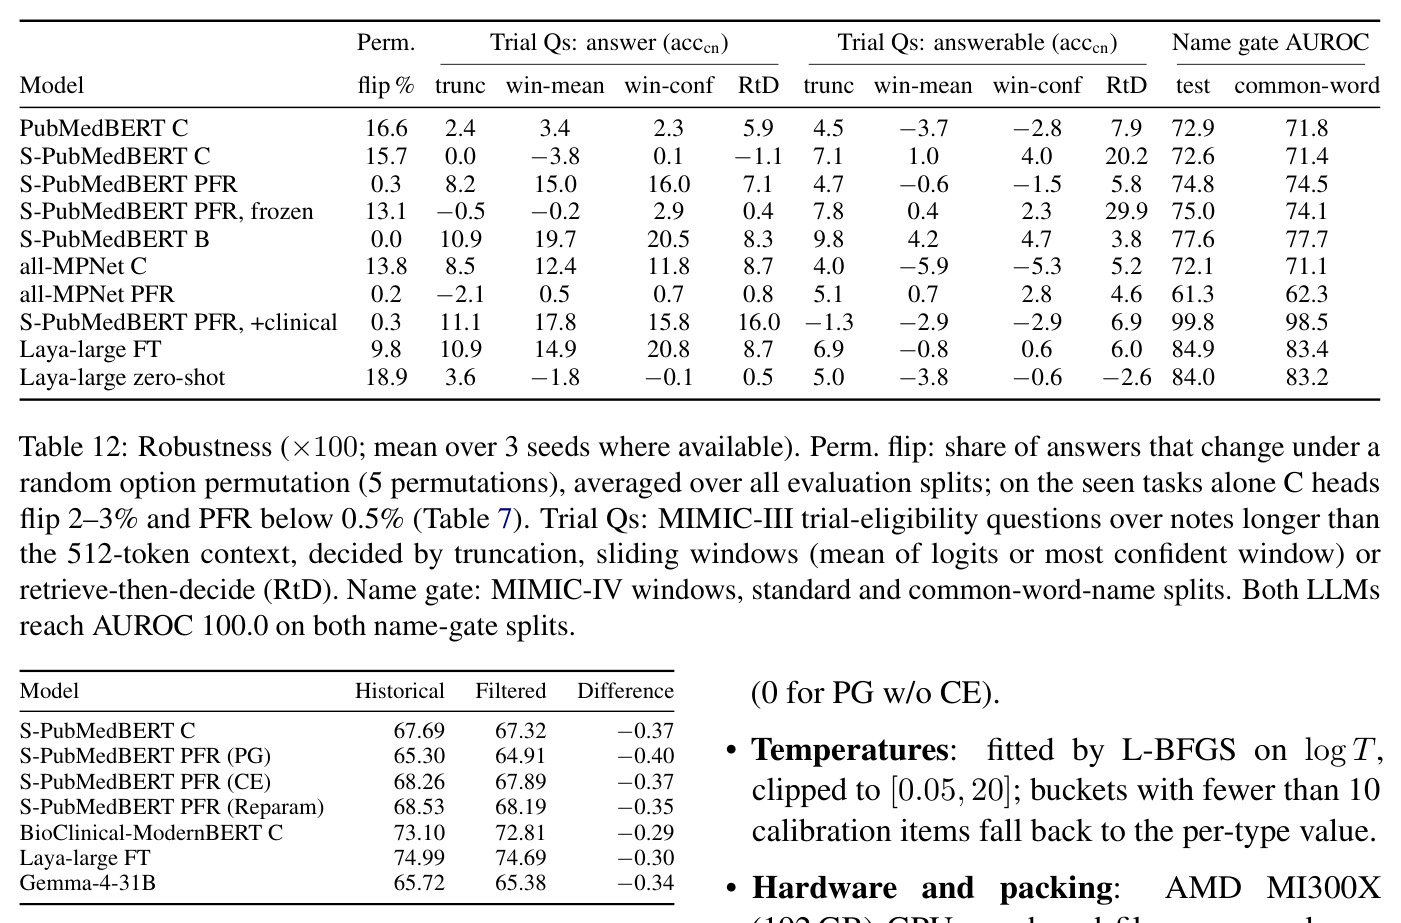
完整流程如下。(1) 数据构建:每个源样本转成一条记录 {状态文本, 一组类型化问题, 每题的 gold 分布};例如 HoC 摘要变 10 个 noul 问题、Druglib 评论变 3 个 score 问题、MEDLINE-S1 为每篇摘要生成研究设计(6 类)、疾病领域(MeSH 主类对 3–7 个随机干扰项)、人/动物受试者、不良反应/药物治疗、两个人口学组等问题,训练集 40k 摘要共 242,986 决策,测试集 5k 摘要 30,522 决策,并排除所有 BIODECIDE 评测 PMID。(2) 划分:官方 split 保留,训练前切出约 10%(≤400 状态、按 claim/topic 分组)的校准切片专用于温度拟合。(3) 选择转换头之一并训练:任务按 $\propto n_t^{1/2}$ 采样,8000 步 batch 32(最多 8 epoch),AdamW(编码器 lr $2.5\times10^{-5}$、头 $10^{-4}$、$\alpha$ $5\times10^{-2}$),bf16 autocast,梯度范数裁剪到 1,选项随机乱序但序数量规保持顺序。(4) RLCD 目标细节:每条样本对 logits 加 $G=4$ 次限制在 softmax 变化方向子空间的高斯噪声($\sigma$ 从 0.4 线性退火到 0.1),用 $S=\langle t,p\rangle+0.75\|p\|_2-\text{RPS}$ 打分,优势 $(R^{(g)}-\bar R)/d$ 加权重 1 的交叉熵。(5) 校准:L-BFGS 在校准切片上按类型×选项数桶(2 / 3–5 / 6–10 / ≥11)拟合 $T_{\tau,K}$,截断于 $[0.05,20]$,桶内不足 10 条回退到每类型值。(6) 评估:机会归一化准确率 $\text{acc}_{cn}=(\text{acc}-1/K)/(1-1/K)$、温度缩放前后的 top-label ECE 与 NLL、序数 MAE、选项置换翻转率、BEIR SciFact/NFCorpus nDCG@10 检索保留,文档簇配对 bootstrap(10,000 次)加 Holm 校正。
技术新颖性
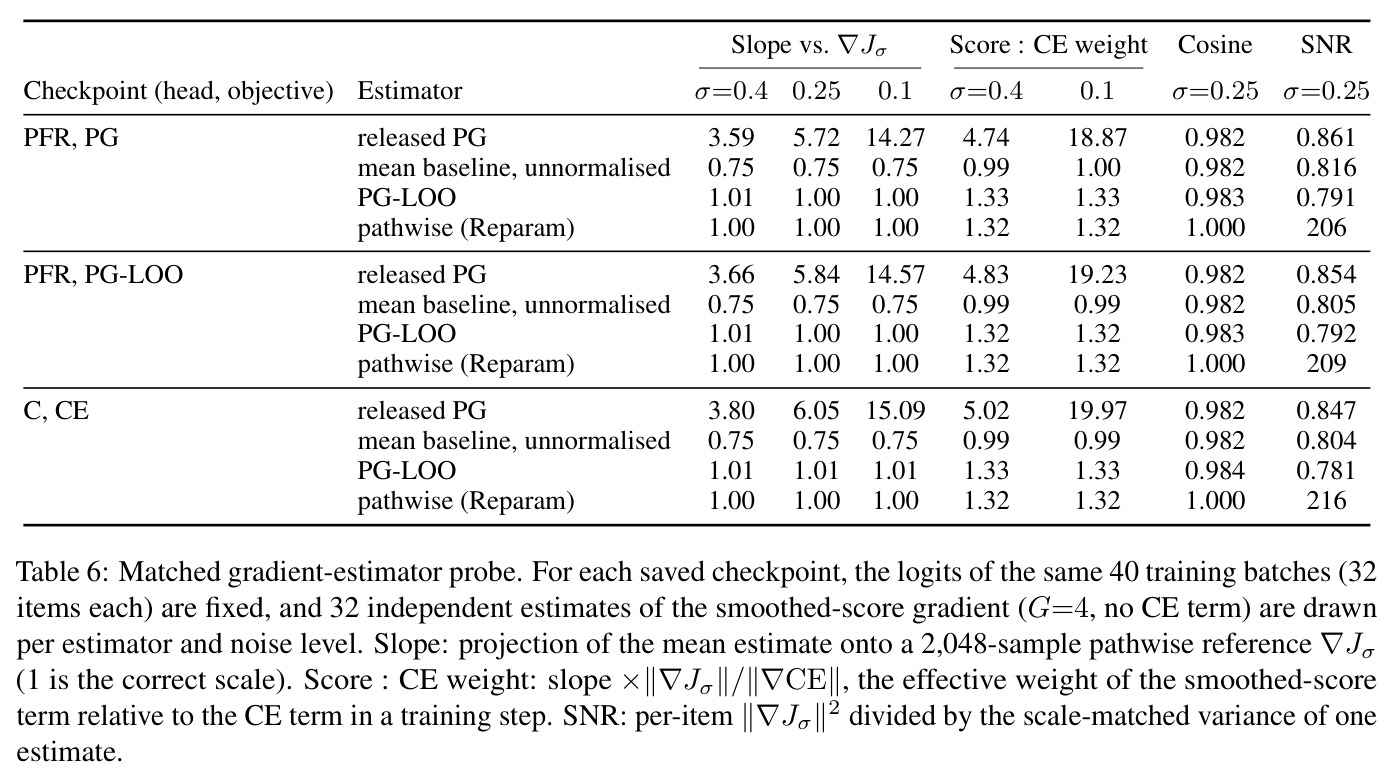
新颖性分析:(1) 与 Laya 的差异刻意不在头结构——交叉头被精确复刻(可互载权重,且复现了 Laya 报告的零样本精度 0.3615 vs 0.362),保证比较公平;创新在于把'检索初始化'变成受控变量,六个 parent–retriever 对共享父检查点、只在检索语料上不同,这在 System One 文献中是首次。(2) PFR 残差头是新设计,零初始化技巧使其从校准检索器平滑出发,同时统一了'零样本检索器'与'微调决策模型'两个范式,并首次量化了转换对检索能力的破坏(SciFact nDCG@10 从 67.6 跌到 24.6–43.3)与冻结先验的完全保留。(3) 对 RLCD 的理论解剖是本文最重要的贡献:Proposition 1 证明平滑评分的梯度有 score-function 和 pathwise 两种无偏形式,指出同样本均值基线的 $(G-1)/G$ 偏差与 $1/\sigma$ 尺度膨胀,配合 Table 6 的匹配探针(方向余弦 0.982、尺度过大 3.6–15 倍、每步都被裁剪故只差方向)把归因做成了可验证的链条,而 PG-LOO 修复实验(+1.5/+2.5 点)完成了闭环。(4) 用 NLM 人工标引替代 LLM 教师生成多问题训练数据,是数据构建层面的独立贡献。
实验结果
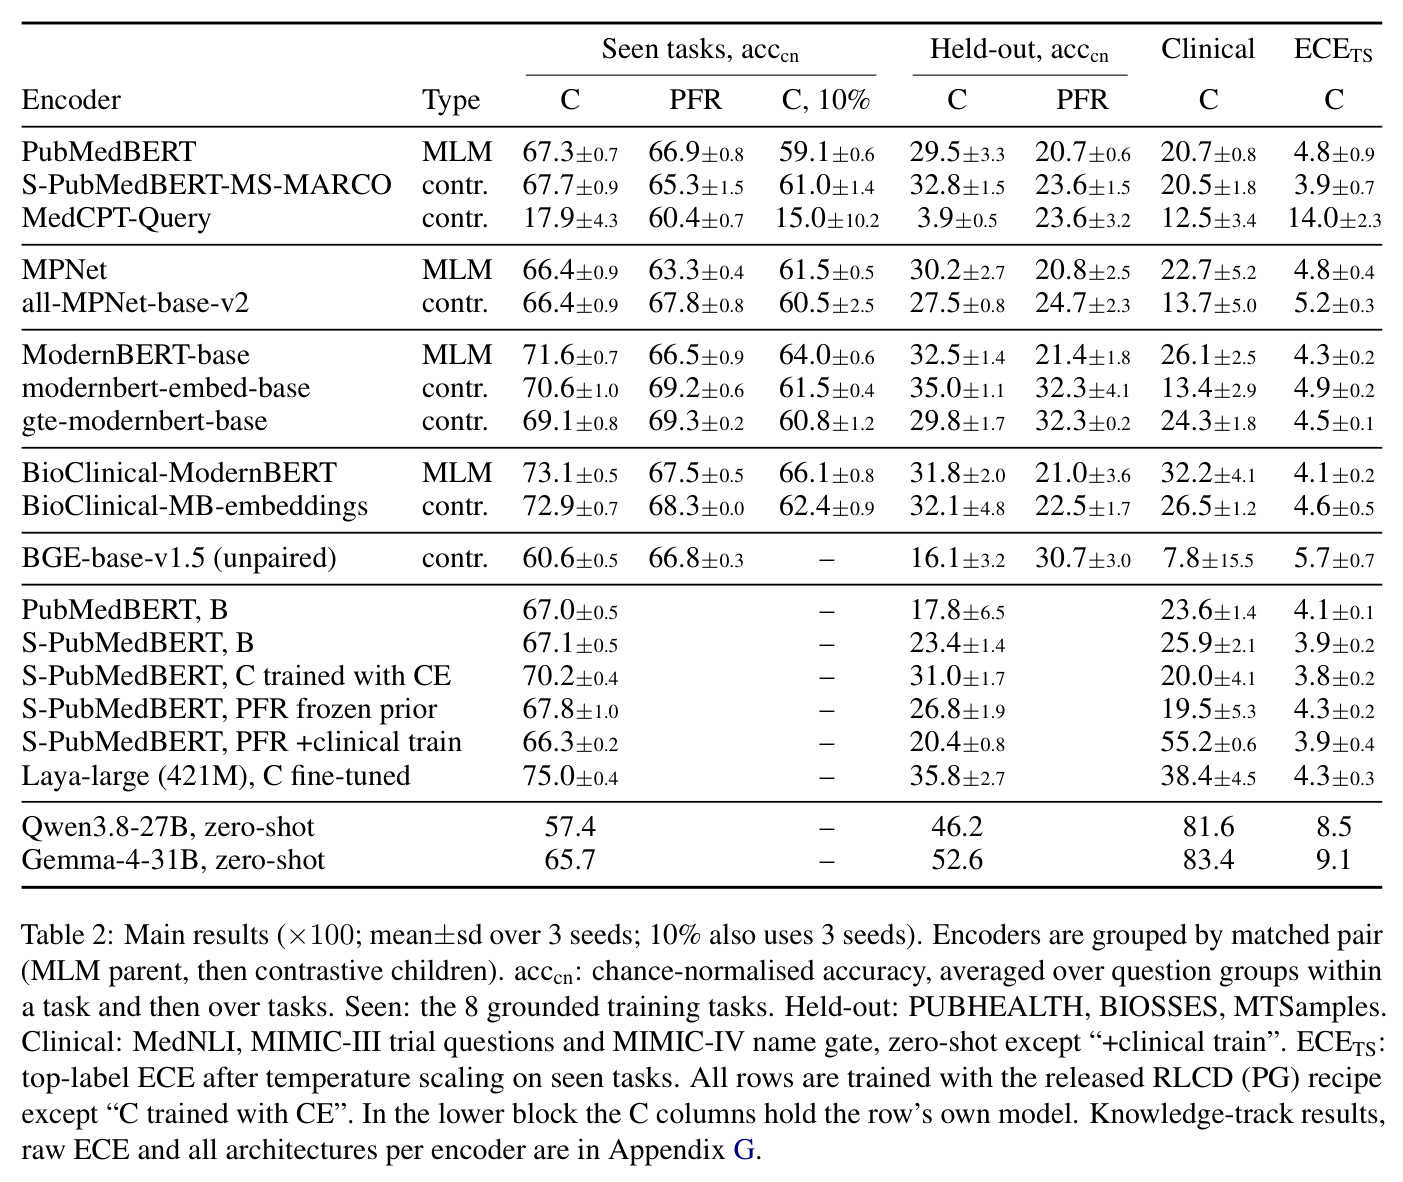
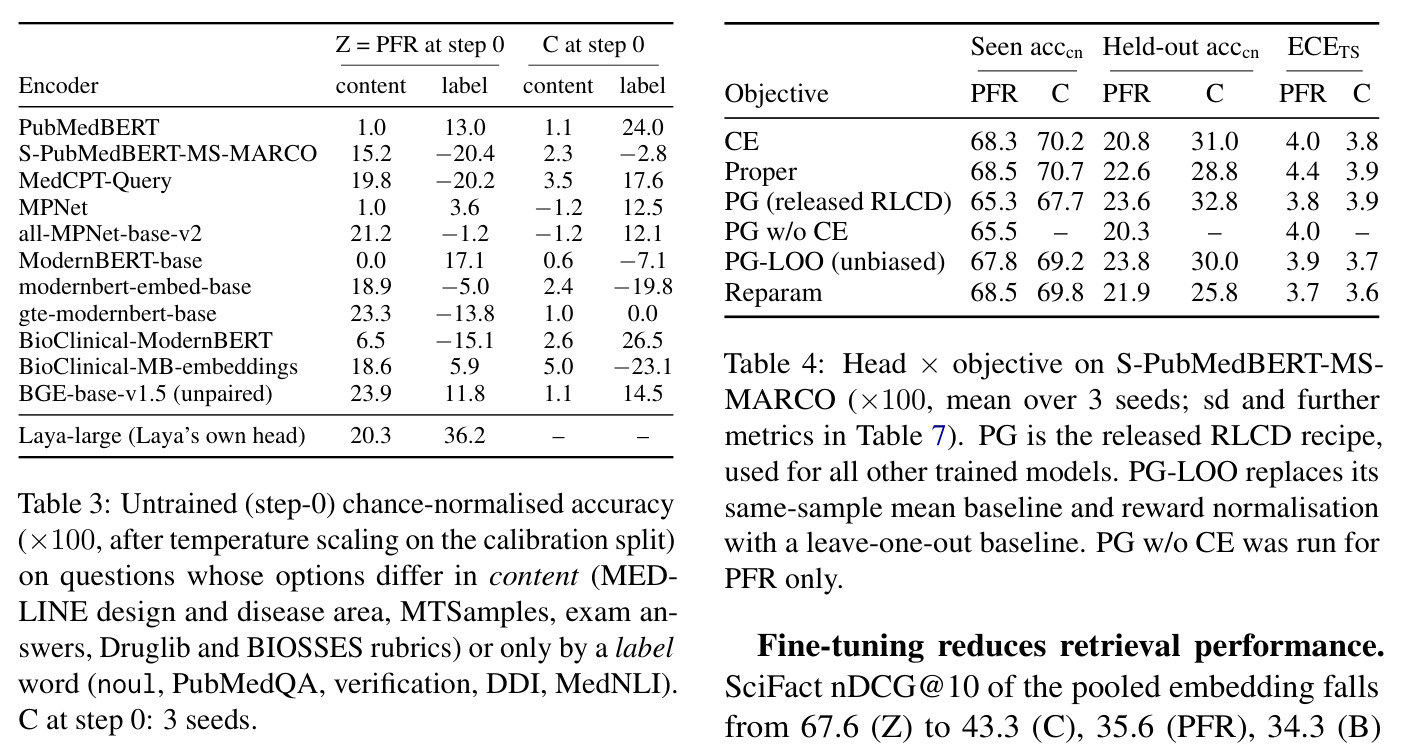
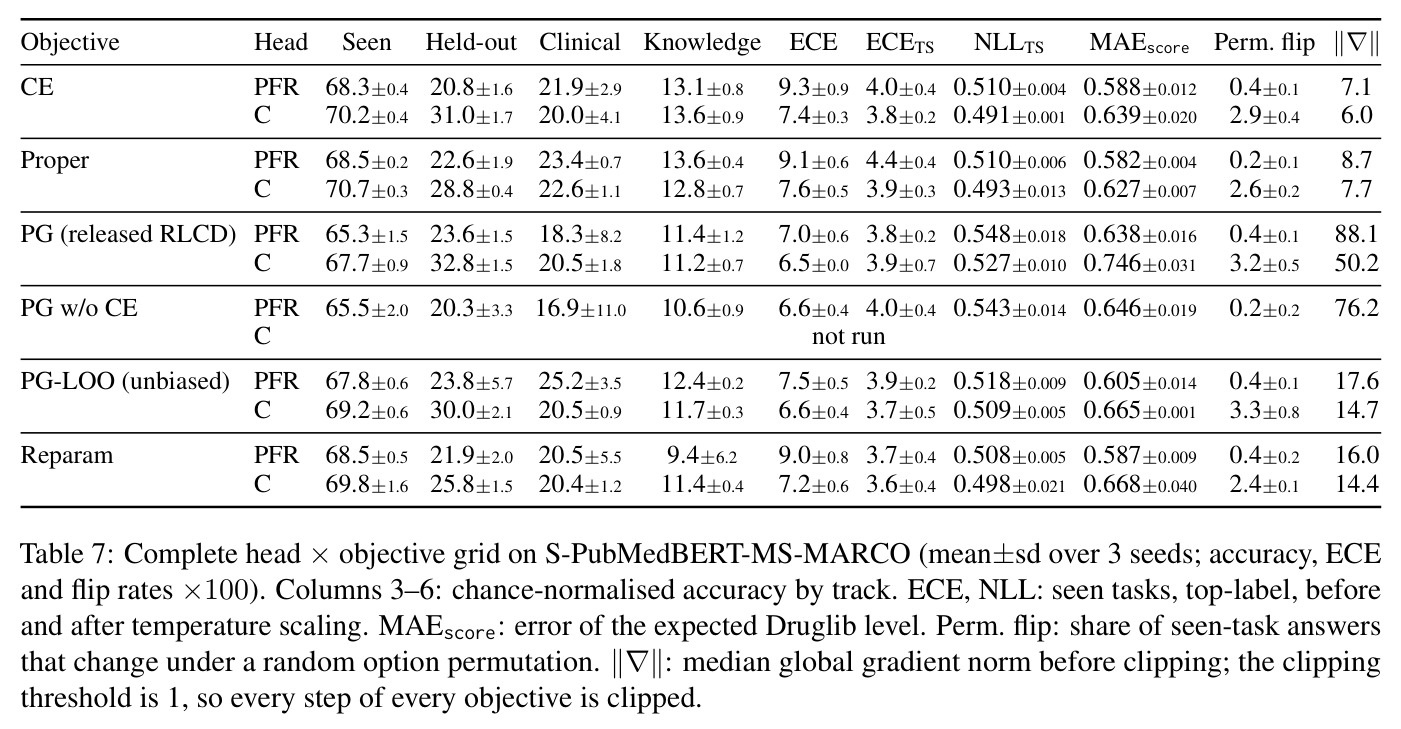
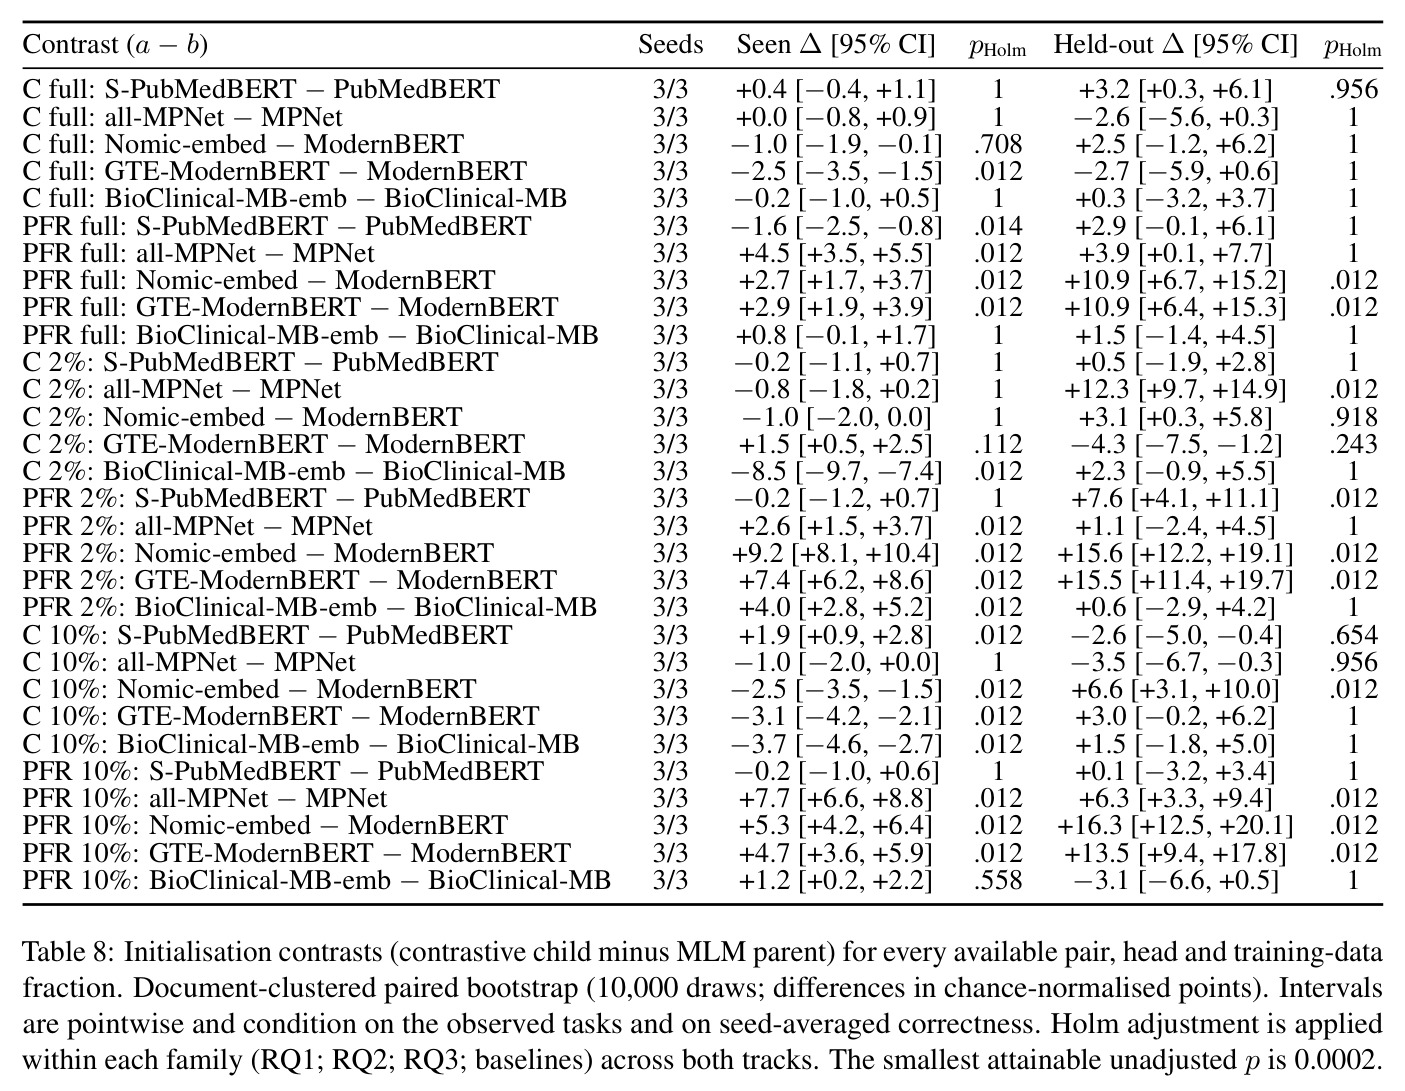
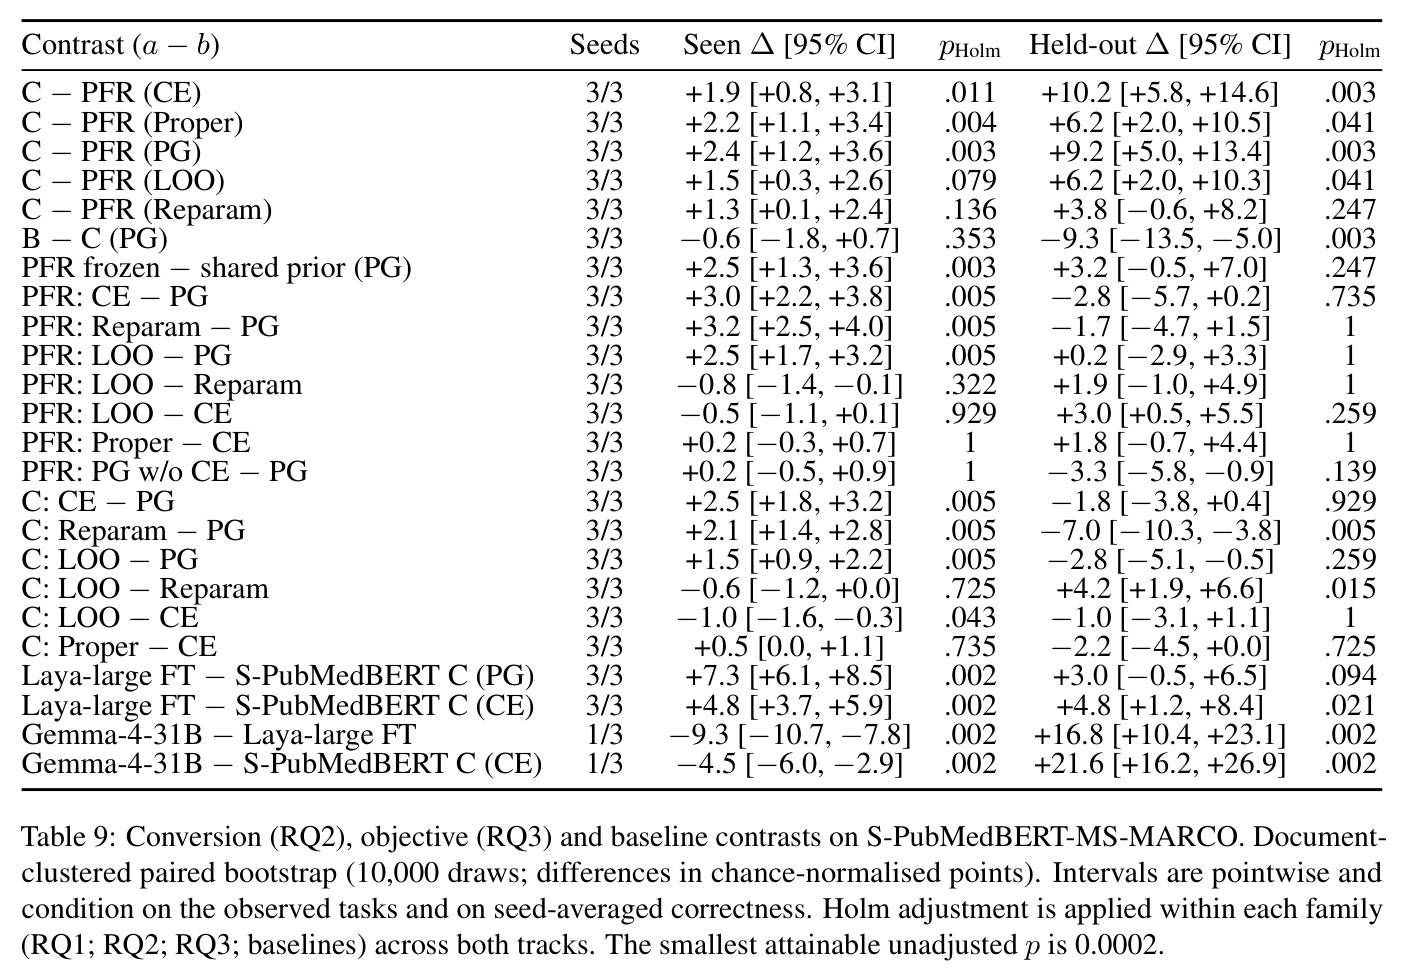
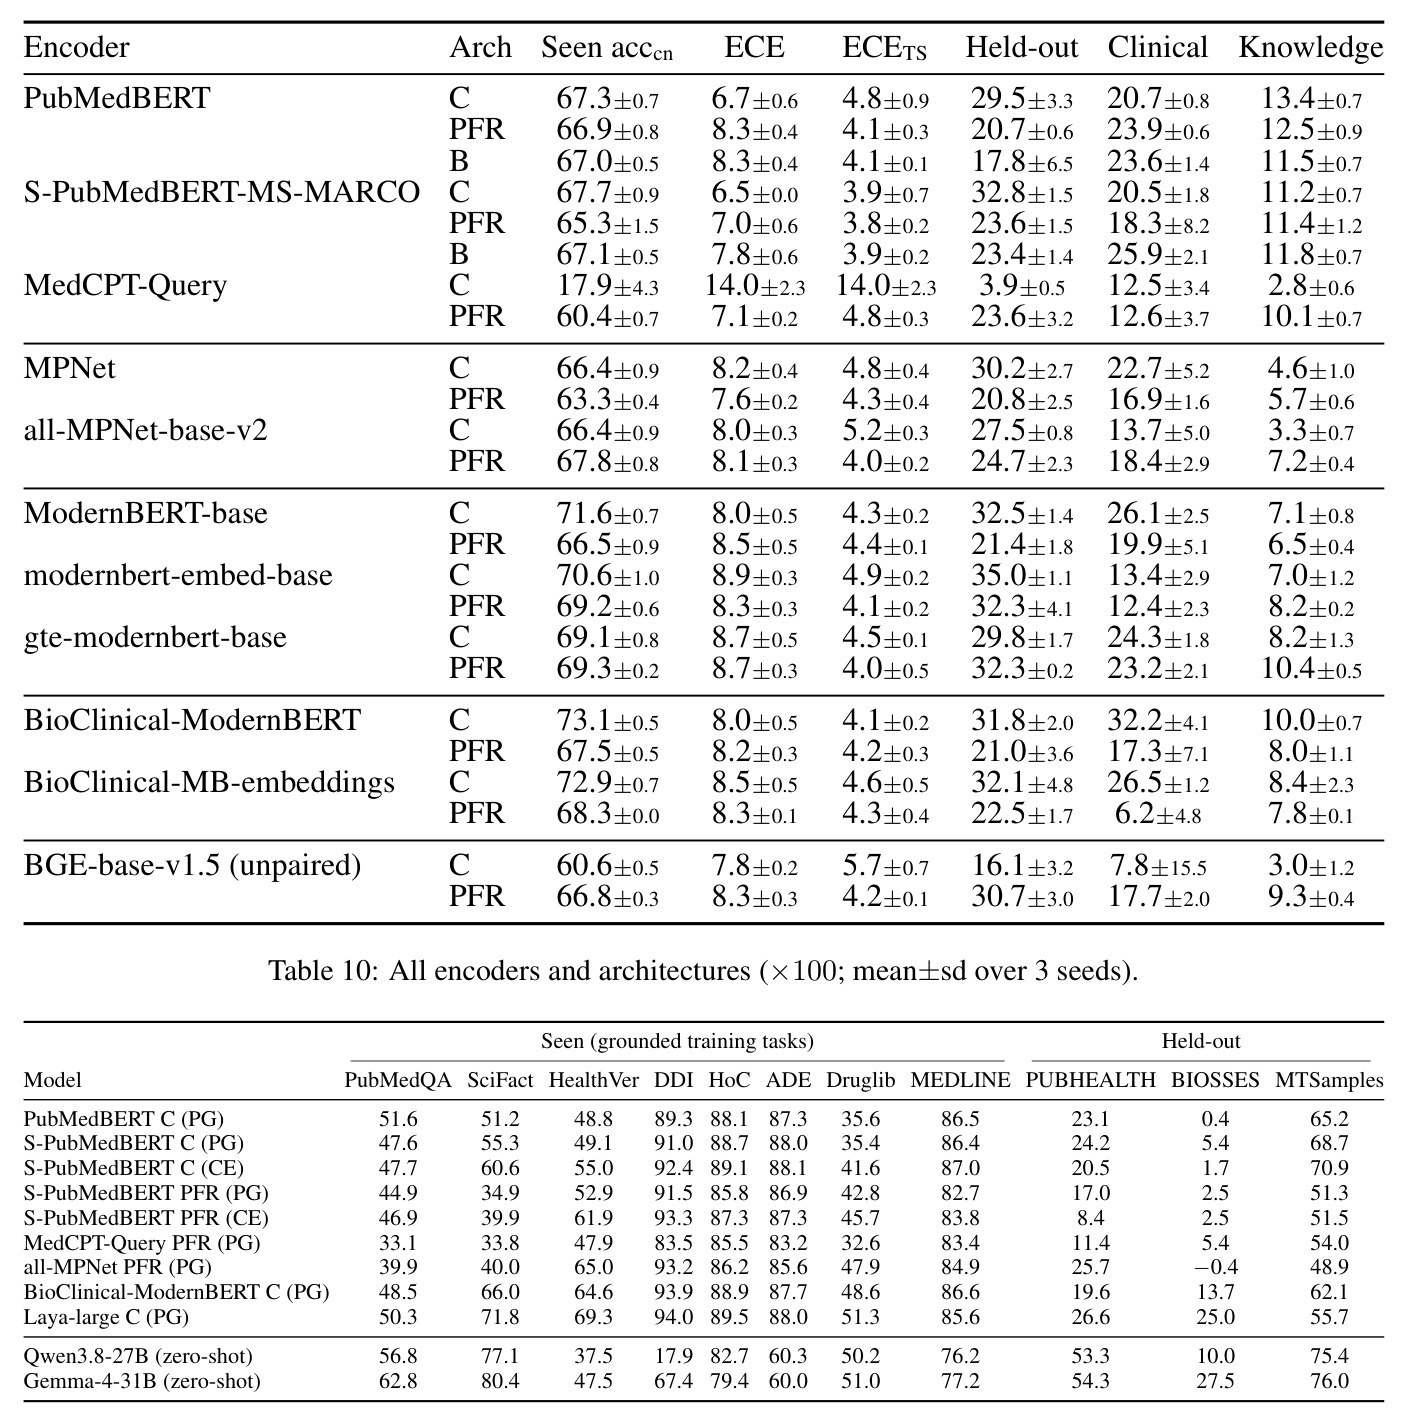
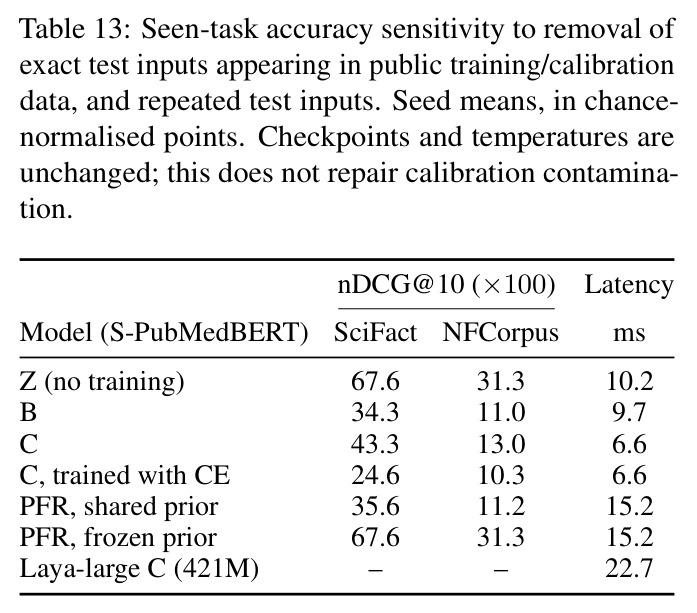
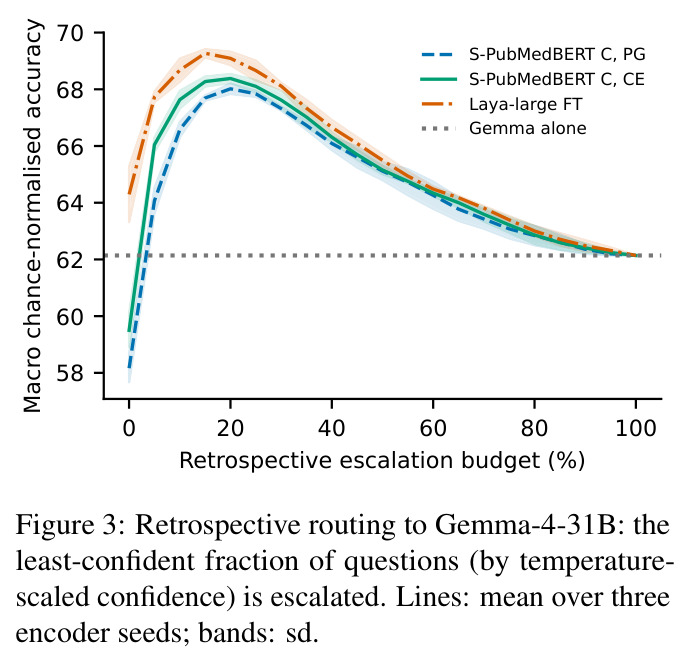
RQ1(检索初始化):零样本层面,所有对比检查点在内容差异型选项上达 15–24 机会归一化点,MLM 父检查点仅 0–7,Laya-large 20.3(Table 3);但在仅差一个标签词的选项(yes/no、true/false)上余弦差距只有 $10^{-3}$ 量级,所有编码器都在随机水平。微调后结论取决于头:全量数据下 C 头使检索阶段大致中性(S-PubMedBERT 67.7 vs PubMedBERT 67.3),唯一 Holm 显著的差异还是负的(GTE −2.5);PFR 头则 5 对中 3 对检索器显著更好(all-MPNet +4.5、Nomic +2.7、GTE +2.9,$p_{\text{Holm}}$=.012);低数据(10%/2%)时 PFR 在 4/5 对上领先(Nomic +5.3/+9.2、GTE +4.7/+7.4、held-out 最多 +16.3),C 头反而 ModernBERT 系检索器落后父模型 2.5–3.7 点。15 个对×数据量比较中:PFR 10 胜 1 负,C 仅 1 胜 5 负。RQ2(转换):匹配网格中 C 在全部 5 个共享目标上超过 PFR——seen +1.3 至 +2.4(CE/Proper/PG 的 $p_{\text{Holm}}$≤.011)、held-out +3.8 至 +10.2;B 与 C 在 seen 打平(−0.6 不显著)但 held-out 输 9.4 点;冻结先验使 PFR +2.5。PFR 把选项置换翻转率压到 0.3%(C 为 15.7%,held-out 17%、考试 28%)。MedCPT-Query 的 [MASK] 状态在输入内完全相同,交叉头只达 17.9 而 PFR 达 60.4。最强 base 模型是 BioClinical-ModernBERT 交叉头 73.1,接近 Laya-large 微调的 75.0,参数量约三分之一。RQ3(目标):CE、Proper、Reparam 相互差距小于 1 点;发布版 PG 落后 CE 3.0(PFR)/ 2.5(C)点($p_{\text{Holm}}$=.005)且 PFR 种子标准差 3.7 倍大(1.5 vs 0.4);PG-LOO 比 PG 高 2.5/1.5 点、与 Reparam 差距小于 0.8(不显著)。梯度探针揭示机制:发布估计器方向正确(与真实平滑梯度余弦 0.982)但在 $\sigma$=0.4/0.25/0.1 时尺度过大 3.6–3.8/5.7–6.1/14–15 倍,评分项相对 CE 权重 4.7–20 倍(应为 1.3 倍);由于所有目标的梯度范数都超过裁剪阈值,每步步长固定、只差方向。pathwise 估计器信噪比高 100–1500 倍但 PG-LOO 训练效果几乎相同,说明方差是次要因素、归一化偏差才是主因。校准:PG 的 raw ECE 最低(7.0 vs CE 9.3),但温度缩放后所有目标落在 3.6–4.4 且 PG 的 NLL 最差——RLCD 的校准收益在缩放后不存在。LLM 对比与路由:seen 上 S-PubMedBERT C(CE) 70.2 和 Laya-large 75.0 超过零样本 Gemma-4-31B(65.7)和 Qwen3.8-27B(57.4),且校准更好(缩放后 ECE 3.8–4.3 vs 8.5–9.1);但 LLM 在 held-out(52.6 vs 31.0)、临床 track(81.6–83.4 vs 零样本最多 38.4、+临床训练 55.2)和考试题上明显更强。两者互补:把温度缩放置信度最低的 20% 问题升级给 Gemma,S-PubMedBERT C 宏平均从 59.5 升到 68.4、Laya-large 从 64.3 到 69.1,均超过 Gemma 单独的 62.1。此外 +临床训练把 MIMIC-IV 姓名门控 AUROC 从约 75 提到 99.8;MIMIC-III 长笔记决策对 base 编码器仍接近随机(最好组合也仅 20–30 点);知识型考试题无任何 base 编码器超过 15 点。数据完整性:9 条 DDI 和 7 条 Druglib 校准记录、2 条 SciFact 和 13 条 Druglib 测试记录与训练集精确重复;剔除后所有模型 seen 分数统一降 0.3–0.4 点,排名不变。检索保留:微调把 SciFact nDCG@10 从 67.6(Z)打到 43.3(C)、35.6(PFR)、34.3(B)、24.6(C+CE),只有冻结先验完整保住 67.6。延迟:10 题请求 C 6.6ms、PFR 15.2ms、Laya-large 22.7ms(MI300X,batch 1)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BIODECIDE seen(8 个 grounded 训练任务,RLCD 配方) | 机会归一化准确率 acc_cn ×100(3 种子) | BioClinical-ModernBERT 交叉头 73.1±0.5 | Laya-large(421M)微调 75.0±0.4;零样本 Gemma-4-31B 65.7;零样本 Qwen3.8-27B 57.4 | 以约 1/3 参数量距 Laya-large 仅 −1.9 点,超零样本 Gemma +7.4 点 |
| held-out(PUBHEALTH / BIOSSES / MTSamples,从未训练) | acc_cn ×100 | modernbert-embed-base 交叉头 35.0±1.1;S-PubMedBERT C(CE) 31.0 | 零样本 Gemma-4-31B 52.6;Qwen3.8-27B 46.2 | 落后 Gemma 17.6–21.6 点,分布外场景 LLM 占优 |
| S-PubMedBERT 交叉头训练目标对比 | seen acc_cn ×100(3 种子,Holm 校正) | 交叉熵 CE 70.2±0.4 | 发布版 RLCD(PG)67.7±0.9;无偏 PG-LOO 69.2±0.6;Reparam 69.8 | CE 比 PG +2.5 点(p_Holm=.005),PG-LOO 收回其中 1.5 点 |
| 零样本内容型选项匹配(研究设计/疾病域/分诊/考试答案等) | acc_cn ×100(温度缩放后,未训练) | 对比检查点 15–24 | MLM 父检查点 0–7;Laya-large 20.3 | 检索预训练对零样本决策有决定性优势;但标签词型选项(yes/no)上所有编码器均在随机水平 |
| 检索能力保留(BEIR SciFact,池化嵌入) | nDCG@10 ×100 | PFR 冻结先验 67.6(与未训练 Z 完全一致) | C 43.3;PFR 共享先验 35.6;B 34.3;C(CE) 24.6 | 冻结先验零损失,共享先验损失 32.0 点 |
| 推理延迟(单请求 10 个问题,batch 1,MI300X) | p50 前向延迟 ms | C 6.6ms;PFR 15.2ms | Laya-large 22.7ms | base 交叉头快约 3.4 倍 |
| 置信度路由(最低置信 20% 升级给 Gemma-4-31B,回顾性) | 宏平均 acc_cn ×100 | S-PubMedBERT C(CE) 59.5→68.4;Laya-large 64.3→69.1 | Gemma-4-31B 单独 62.1 | 级联净赚 +6.3 / +7.0 点,验证'校准小模型作第一级'的架构 |
| 校准(seen 任务,温度缩放后 top-label ECE ×100) | ECE_TS ×100 | 微调编码器 3.6–4.4(所有目标);S1-PubMedBERT 3.8–4.3 | 零样本 Gemma-4-31B 8.5–9.1(raw 17.2) | RLCD 的 raw ECE 优势(7.0 vs 9.3)在缩放后消失,所有训练目标无显著校准差异 |
| 临床 track(MedNLI + MIMIC-III 试验问题 + MIMIC-IV 姓名门控) | acc_cn ×100 / AUROC | 零样本最高 38.4;+临床训练 PFR 55.2;姓名门控 AUROC 75→99.8(+临床训练) | 零样本 Gemma-4-31B 83.4;Qwen3.8-27B 81.6;LLM 姓名门控 AUROC 100.0 | 临床长文本场景 LLM 优势 28–46 点;专项训练可把姓名门控补到 99.8 |
局限与改进
作者明确承认的局限:只覆盖 base 规模编码器(约 110–150M)、单一训练预算(8000 步)且超参继承自 Laya,五个目标未分别调参;头×目标网格只在一个编码器(S-PubMedBERT)上运行;六对 parent–retriever 共享父检查点,不是六个独立重复实验;置信区间条件于观察到的任务且不做混合效应或等价性分析。数据层面 MEDLINE-S1 是弱标签(标引缺失不代表为假、标引者可看全文),且存在少量精确重复:9 条 DDI 和 7 条 Druglib 校准记录、2 条 SciFact 和 13 条 Druglib 测试记录出现在训练数据中,剔除后 seen 分数统一降 0.3–0.4 点但校准污染未修复;考试题对 LLM 的预训练污染未测量。校准结论仅限 seen 任务,held-out 上多个模型校准很差,交叉头的选项顺序敏感性在分布偏移下还会扩大。临床测试规模小(如 MIMIC-III 试验问题仅 532+1,000 条)、来自单一医院系统、使用代用名;长笔记的所有策略对 base 编码器都接近随机;作者强调这不是经过验证的临床设备。我自己的观察:温度按'类型×选项数桶'拟合是相当粗的校准粒度,逐问题温度或 conformal 方法可能更好;RPS/球面项权重(0.75/1)为沿用 Laya 的魔数,未消融;与闭源 Jev 无法直接比较;学习曲线只有 2% 和 10% 两个中间点,低数据区的结论较粗糙;所有结论限于生物医学领域,向其他领域迁移完全未验证;LLM 基线禁用了 thinking 的单次前向,对 LLM 的比较偏保守这一点文中未讨论。
独立分析的弱点
独立分析的弱点及改进方向:(1) PFR 若要完整保留检索器需要冻结一份编码器副本,内存翻倍;且先验尺度 $\alpha_\tau$ 因温度截断在 $[0.05,20]$ 而被硬编码为 20,先验与残差的权衡完全交给训练——可改为可学习门控(gated fusion)或低秩残差,显式控制先验强度。(2) 交叉头的选项顺序敏感性在 held-out 达 17%、考试题 28%,对依赖稳定输出的生产系统是实际风险——可在训练中加入选项置换增强或对称化打分(对选项集合取平均)。(3) 长文本是明显短板:MIMIC-III 长笔记上截断/滑窗/retrieve-then-decide 大多接近随机,512 token 上限对临床记录完全不够——应换用原生长上下文编码器(如 8k 的 BioClinical-ModernBERT 已在套件中却未用于长笔记专项微调)。(4) 知识型问题全面失败(≤15 点)说明该范式只适合'状态内证据匹配'类决策,不能做知识推理——应在接口层显式区分两类问题,或对知识题检索增强。(5) MEDLINE-S1 弱标签 one-hot 化丢失了'缺标签≠假'的不确定性——可用标签噪声鲁棒损失或软目标。(6) RLCD 偏差分析的结论依赖 G=4 和特定退火调度:当 G 增大时 $(G-1)/G\to1$、归一化偏差形式也会变,普适性未验证。(7) 校准评估只有 top-label ECE,score 型问题的序数校准(如分位数覆盖)着墨很少,而医疗场景里'低置信'的语义恰恰需要分位数校准。
未来方向
作者提出的方向:实现 RLCD 时应使用独立基线(如留一法),这直接可推广到 Laya 及更大规模模型;把校准的 System One 模型作为 LLM 级联(FrugalGPT 式)的第一级,回答高置信案例、升级其余,本文的回顾性路由实验(20% 升级预算使宏平均超纯 Gemma 6–7 点)已验证可行性但需在真实部署中用验证集确定阈值。基于本文成果可延伸的研究:(1) 逐问题或 conformal 校准替代粗粒度桶温度,并报告序数/score 题的覆盖保证;(2) 长上下文方案:在 BioClinical-ModernBERT 这类 8k 编码器上重跑 PFR,或把 retrieve-then-decide 与分层注意力结合,攻克临床长笔记;(3) 把 PG-LOO/Reparam 的无偏估计器应用到 GRPO 类后训练流程,检验归一化偏差是否同样存在于 RLHF 场景;(4) MEDLINE-S1 可随标引体系扩展(出版类型随年代变化、更多 MeSH 维度),做成持续更新的免费多问题训练源,甚至替代部分 LLM 蒸馏数据;(5) 选项顺序敏感性的因果分析与置换一致训练;(6) PFR 残差融合思想迁移到通用领域检索器与安全/内容审核等非医学决策场景;(7) 在人机环中验证阈值化置信度的实际效用(作者在伦理声明中已建议对升级案例人工复核)。
复现评估
复现条件非常好。开源三件套:(1) 代码 github.com/pritamdeka/sbert2s1(Apache 2.0),包含四种转换、五个训练目标(含修复版 PG-LOO)、温度拟合、长文本策略、BIODECIDE 数据构建器和从 PubMed 恢复 MEDLINE-S1 摘要的脚本;(2) 数据 huggingface.co/datasets/pritamdeka/MEDLINE-S1(CC BY 4.0),发布 PMID、问题和标签而不含摘要文本,脚本可重建;(3) 模型 huggingface.co/pritamdeka/S1-PubMedBERT,推理只是单文件纯 PyTorch(sbert2s1.py),可从 Hub 直接加载,另有兼容 Laya 布局的导出(但注意继承基座的 CC BY-NC 2.0,非商业)。论文附录给了全部超参(lr、G=4、$\sigma$ 退火 0.4→0.1、$\delta=10^{-4}$、裁剪阈值 1)、三个种子、配对 bootstrap(10,000 次)与 Holm 校正细节。算力门槛低:整个 125 次运行的初始实验约 36 GPU 小时(3×AMD MI300X 192GB,多任务打包),单次 base 训练仅 11.7–16.3GB 显存、吞吐 223–326 items/s,一张 24GB 消费级卡即可复现主要结论。风险点:临床 track(MedNLI/MIMIC-III/MIMIC-IV)需 PhysioNet 凭证且只发布了聚合指标与转换代码/哈希,临床结论复现需 institutional 审批;LLM 基线需要 27–31B 模型的推理资源;数据去重后需重训或至少重拟合温度才能得到完全干净的数字(作者未做)。综合评估:公共数据部分复现难度中低,临床部分难度中高。
论文图表
MEDLINE-S1 一条训练记录的 JSON 示例(节选):状态为 PubMed 引文标题+摘要,包含 design(choice,6 个 publication type 选项)和 humans(noul)两个问题,gold 是选项键上的分布(design: randomized_trial=1.0;humans: true=1.0)。
让读者精确理解'从 NLM 标引导出的多问题训练数据'长什么样,以及 Jev/Laya 共享请求 schema 的具体格式,对复现和数据扩展必不可少。
训练过程中裁剪前全局梯度范数的中位数轨迹:所有目标的范数都超过裁剪阈值 1(即步步长被固定、只差方向),发布版 PG 的范数比 CE 高一个数量级且随噪声退火增长。
解释了为什么'估计器尺度过大'会直接转化为'优化方向被评分项主导':步长固定时只有方向起作用,是连接 Figure 5 探针与最终精度差距的因果桥梁。
在 S-PubMedBERT 上的 2 头 × 5 目标匹配网格:C 头在所有目标上高于 PFR(seen 70.2 vs 68.3 等),发布 PG 落后 CE(67.7/65.3 vs 70.2/68.3),PG-LOO(69.2/67.8)接近 Reparam(69.8/68.5)。
RQ2 和 RQ3 的核心受控实验表,'C 优于 PFR'和'RLCD 落后于 CE'两个关键结论在此第一次以匹配条件呈现。
逐任务分解:交叉头对 PFR 的优势集中在需要细粒度双文本比较的任务(SciFact 55–71 vs 35–40;MTSamples 51–71 vs 51),单文本分类任务(DDI、HoC、ADE、MEDLINE)两头只差几个点;LLM 在 PUBHEALTH(53–54)和 BIOSSES(10–28)上表现两极。
揭示了'哪类任务该用哪个头/哪个模型',是理解 C 与 PFR 分工和任务级误差结构的唯一来源。
转换后的检索保留与延迟:SciFact nDCG@10 从 Z 的 67.6 降至 C 43.3、PFR 35.6、B 34.3、C(CE) 24.6,冻结先验保持 67.6;NFCorpus 同趋势。延迟:C 6.6ms、PFR 15.2ms、Laya-large 22.7ms。
量化了'转换会破坏检索器'这一被以往工作忽视的代价,并给出冻结先验的解决方案和部署延迟数据,直接支撑 RQ2 的成本-收益讨论。