StartLux-Decision:基于强化学习的校准审慎决策模型(Instant 单遍与 AutoThink 自适应推理) StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions
0.8B–27B 决策模型家族:单遍预测+置信度引导推理,RLCD2 大幅提升推理终止率与效率
前置知识
选项字母概率读出(Option-Letter Probability Readout)
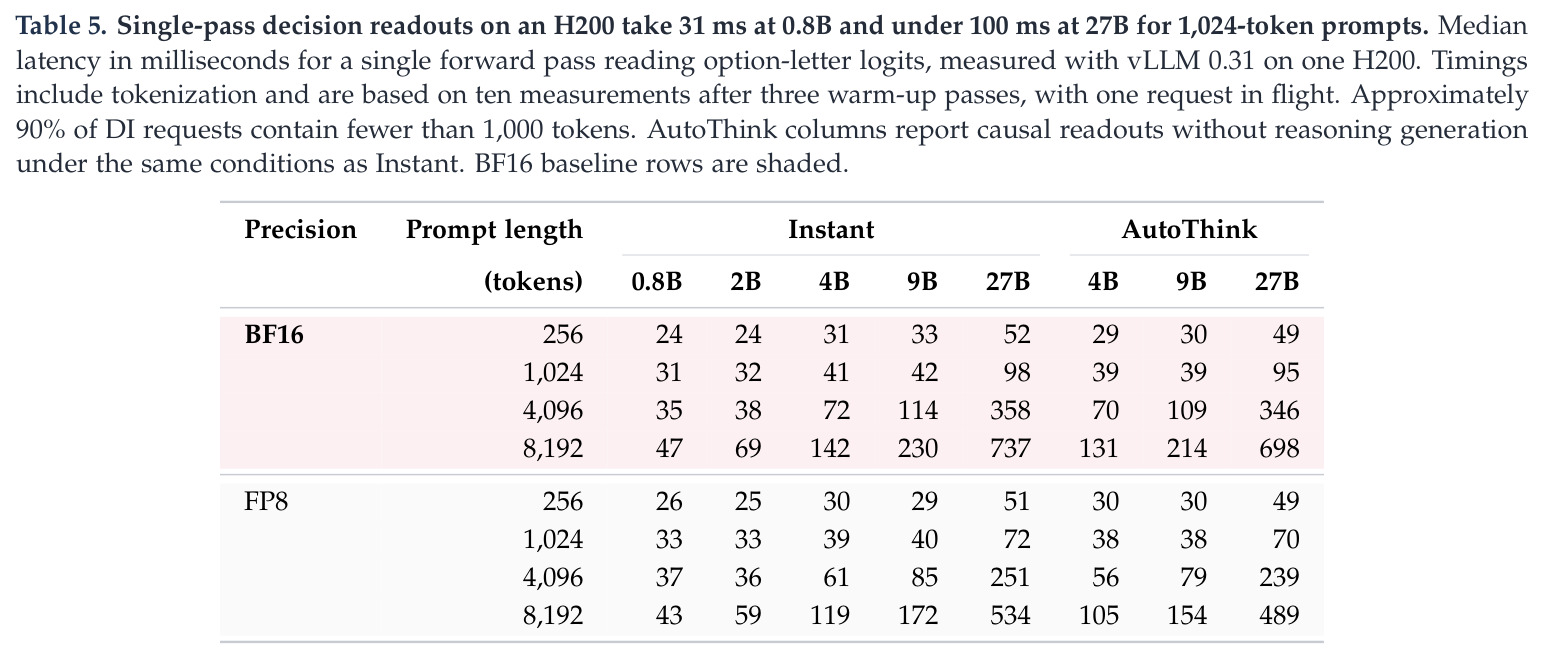
把一道决策题(输入状态+问题+候选选项)格式化成一个 prompt,每个选项标注字母 A–Z,然后在 prompt 最后一个位置直接读取语言模型输出投影层上这些字母 token 的 logits $z_k$,经温度缩放后 softmax 得到选项概率:$p_k = \exp(z_k/T) / \sum_{j=1}^{K} \exp(z_j/T)$。整个过程只需一次前向传播,不生成任何 token,也不需要额外训练预测头,因此延迟极低(H200 上 0.8B 约 31ms、27B 约 98ms,1,024-token prompt)。
这是 StartLux-Decision 全家族共享的概率接口:Instant 的单遍预测、AutoThink 的推理前后两次读出、RLCD2 的奖励计算都建立在同一个读出机制上,理解它才能理解训练目标与推理流程。
严格合适评分规则(Proper Scoring Rules)
评估整个预测概率分布质量(而非仅 top-1 对错)的准则。若预测分布 $p$ 越接近真实分布 $t$ 得分越高,且诚实报告真实分布时期望得分最大,则该规则是合适的;唯一最大化时是严格合适的。典型例子有 Brier 分数 $S_B(p,t) = -\|p-t\|_2^2$ 和对数分数 $S_L(p,t) = \sum_k t_k \log p_k$。本文还采用决策加权的变体 $S_D$,通过对 $w(c)$ 加权积分,强调操作置信阈值附近的概率误差。
RLCD2 的核心奖励就是推理前后决策分布的合适评分差,它奖励的是概率质量(含校准)的改善而非答案对错;不懂合适评分规则就无法理解 RLCD2 为什么能同时改善终止、长度和校准。
概率校准(Calibration)与温度缩放
校准指模型报告的置信度与实际正确率一致:声称 80% 置信的预测里应约有 80% 正确。常用可靠性图(按置信分桶比较置信与经验准确率)和校准误差(如 ECE)度量。温度缩放是最简单的后校准方法:对 logits 除以拟合温度 $T$ 再 softmax,$T>1$ 使分布更平滑、降低过自信,且不改变选项排序。
本文一半的篇幅在讲概率可靠性:训练后按问题类型拟合温度(全部 $T>1$,说明普遍过自信)、用 Brier 分数选择融合权重、以及 policy-aware 校准,都依赖校准这一概念。
组相对策略优化(GRPO 式 RL)
一种免价值网络的策略梯度强化学习:对同一 prompt 采样 $G$ 条推理轨迹,在组内对奖励做中心化得到相对优势,再用 PPO 式裁剪代理目标更新策略,并加 KL 正则防止偏离参考策略。与 PPO 的区别是不训练价值网络;与部分实现的区别是本文不做组内标准差归一化,使奖励差异小的组贡献更小的更新。
RLCD2 的策略优化阶段(公式 6)就采用这种组相对梯度,优势裁剪到 $[-5,5]$,训练只针对初始置信低于 0.9 的问题;理解组内中心化才能明白为什么初始分数会被抵消、长度惩罚如何相对抬升早停轨迹。
双向注意力与因果注意力
标准解码器使用因果(下三角)注意力掩码,每个 token 只能看到自己及之前的 token,这是自回归生成的前提。双向注意力取消该掩码,允许每个位置看到整个序列。对于「prompt 全部可见、只在末位读出概率、不生成 token」的单遍决策任务,prompt 内双向注意力让前面的问题表示能利用后面的选项信息,类似 BERT 式编码。
Instant 模型的关键设计就是在 full-attention 层启用 prompt 内双向注意力(线性注意力层仍因果),受控实验显示 5 个规模中 4 个提升、最多 +2.4 分;同时这也是需要为 vLLM/llama.cpp/MLX 分别适配的部署难点。
研究动机
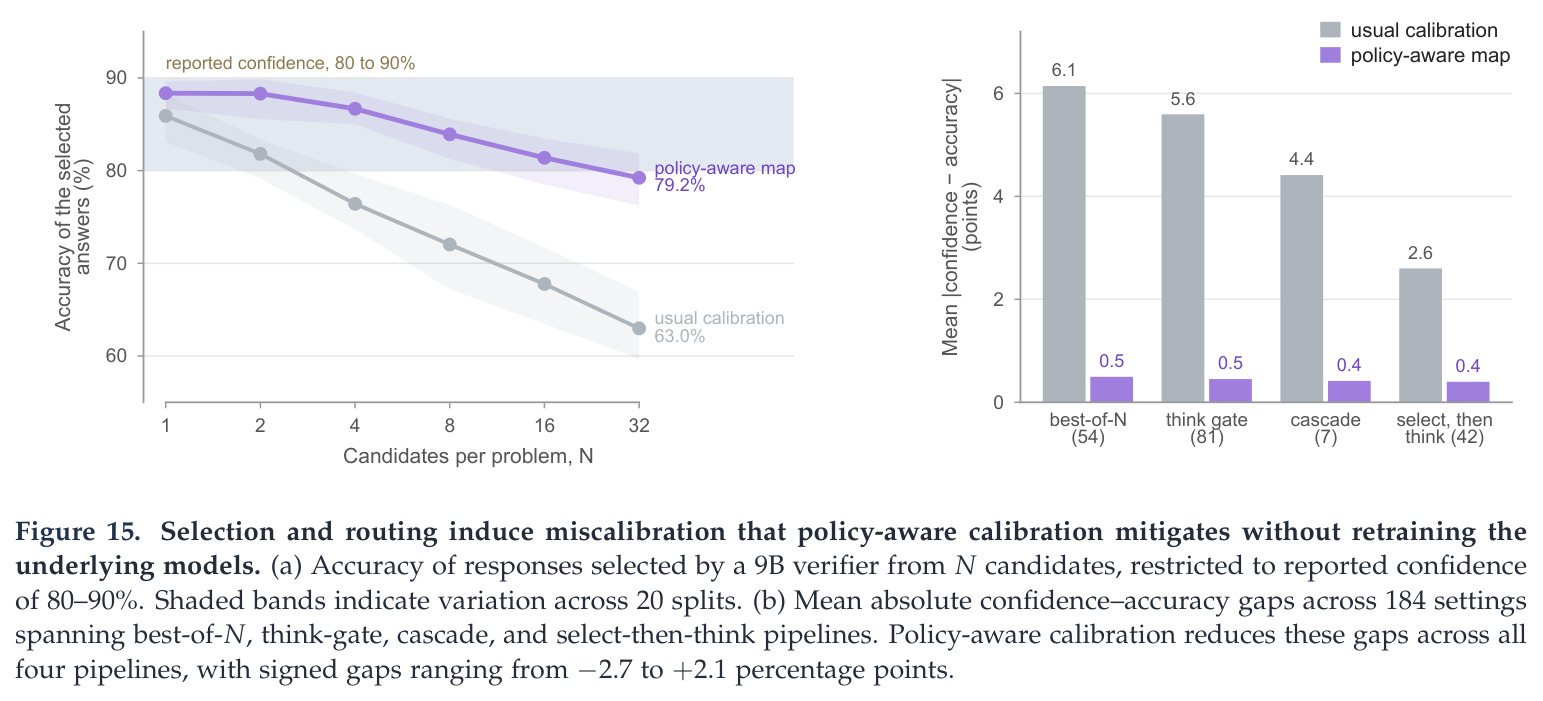
决策模型(decision model)是现代 LLM 系统的基础组件,支撑请求路由、检索评估、工具调用校验、智能体结果核验等任务,它需要对输入状态回答类型化问题并输出候选选项上的概率分布,下游系统据此决定自主执行、调用更强模型还是转人工。现有开源决策模型(如 Cloudflare、Perplexity Decider 等)几乎全部采用单遍预测(single-pass),即一次前向传播直接读出选项概率,不生成任何推理 token——高效,但在涉及算术、调度、流程验证的计算密集型决策上会失手,因为这类决策本质上需要多步推理。更麻烦的是,作者观察到一个此前被忽视的现象:决策导向的训练会严重损害模型生成并可靠终止推理轨迹的能力——决策训练后的 4B 模型在约 40% 被要求推理的问题上几乎不产出推理,而 9B 模型则在约 70% 的问题上一直生成到长度上限也不终止;仅仅放开 token 生成权限并不足以恢复有效推理。此外还有可靠性层面的隐患:即使模型个体预测校准良好,下游的选择/路由策略也会扭曲置信度-准确率关系——用 9B 模型做 verifier 时,80–90% 置信区间的个体预测准确率是 92%,但从 32 个候选中选最高分后,同区间的准确率跌到 78%。
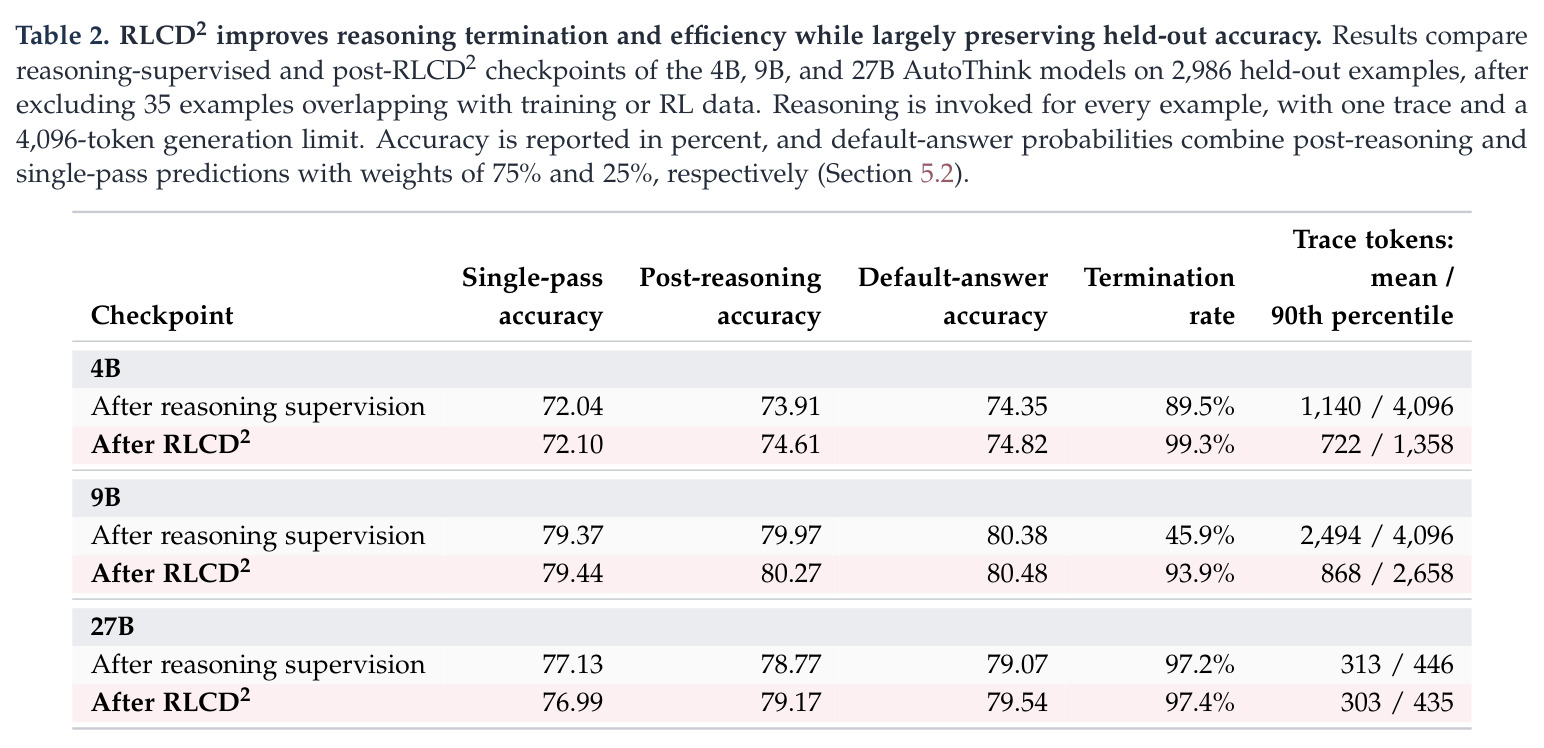
本文的目标是本文要构建一个 0.8B–27B 参数、统一概率接口的决策模型家族 StartLux-Decision,同时解决质量、效率与可靠性三个目标。具体而言:(1)Instant 变体保留单遍推理效率(0.8B 读出约 31ms、27B 约 98ms),并通过双向注意力提升单遍决策精度,目标是在 Decision Index 0.3 公开子集上全面超过同规模最强开源决策模型;(2)AutoThink 变体只对不确定的决策调用显式推理(置信度门控 $g=0.9$),让计算密集型决策受益于推理而简单决策不受拖累;(3)提出 RLCD2 强化学习,解决决策模型「不生成推理」和「推理不终止」两类失败模式,目标是将推理轨迹在生成上限内终止的比例最多提升 48 个百分点、平均推理长度最多缩短 65%,同时基本不损失决策精度;(4)在可靠性侧,提出 policy-aware 校准,使部署策略(选择/路由)下的置信度-准确率差距在 184 个设置中收窄到 ±2.7 个百分点以内。
与已有工作不同的是,已有工作的格局是:开源决策模型全走单遍路线;带推理的通用大模型又太慢、不输出校准概率;决策导向的强化学习虽有先例——RLCD 随闭源托管模型 Jev 提出(训练过程未公开),OpenJev-RLCD 探索了先校准事后读出再用合适评分规则优化推理的两阶段法——但都没有系统处理推理的生成与终止失败、推理长度与决策质量的权衡。本文的独特切入有五点:第一,明确指出并量化「决策训练损害推理能力」这一现象,用三阶段流水线分而治之;第二,RLCD2 不奖励答案对错,而是用冻结的模型副本测量推理前后合适评分的差值,直接优化「这次推理给决策概率质量带来的增量」,并叠加软长度惩罚;第三,把双向注意力引入单遍决策读出(prompt 内双向、生成保持因果),并给出同数据同检查点的受控对照;第四,形式化指出个体校准不能迁移到 best-of-N、级联、think-gate 等下游策略,提出在策略输出上做校准与阈值认证;第五,构建 DecisionPivot——程序化可验证、由仅一个改变答案的细节区分的对比对(contrast pairs)组成的基准,专测模型对关键细节的敏感性。
核心方法
直觉上,这像一个有经验的审核员:简单的申请件扫一眼直接签字(单遍预测),拿不准的才铺开草稿纸演算(显式推理),演算完也不是全盘推翻第一印象,而是把两次判断按权重综合。技术路线上,模型基于 Qwen3.5/Qwen3.8 基座,采用选项字母概率读出:每道决策题格式化为含输入状态、问题和 A–Z 标注选项的 prompt,在 prompt 末位读取字母 logits 经温度缩放 softmax 得到概率,支持最多 26 个选项(更长列表按每组至多 25 个并行分组,各组前三名进入决赛轮),上下文最长 262,144 token,视觉塔冻结处理图像。家族分两个变体:Instant 在 full-attention 层启用 prompt 内双向注意力,单次前向传播出结果;AutoThink 保持因果注意力,先单遍读出 $p_0$,若 $\max_k p_{0,k} < g=0.9$ 则重新处理 prompt 生成至多 4,096 token 的推理轨迹,读出推理后分布 $p_1$,最终答案为 $p_{\text{default}} = (1-\alpha)p_0 + \alpha p_1$($\alpha=0.75$),置信则直接返回 $p_0$。训练分三阶段:Stage 1 全参数 SFT(Lux-Release,0.8B–9B 约 270 万样本、27B 约 80 万)用软交叉熵直接优化选项概率分布;Stage 2 在 Lux-Rounds(约 170 万)上训练 adapter 后合并,Instant 加双向注意力、每个模型由 3–4 个不同随机种子的独立 run 做权重平均;Stage 3 先用 Lux-Think(每模型约 4,000–21,000 条)做推理监督,再用 RLCD2 强化学习优化推理的决策贡献与终止效率。
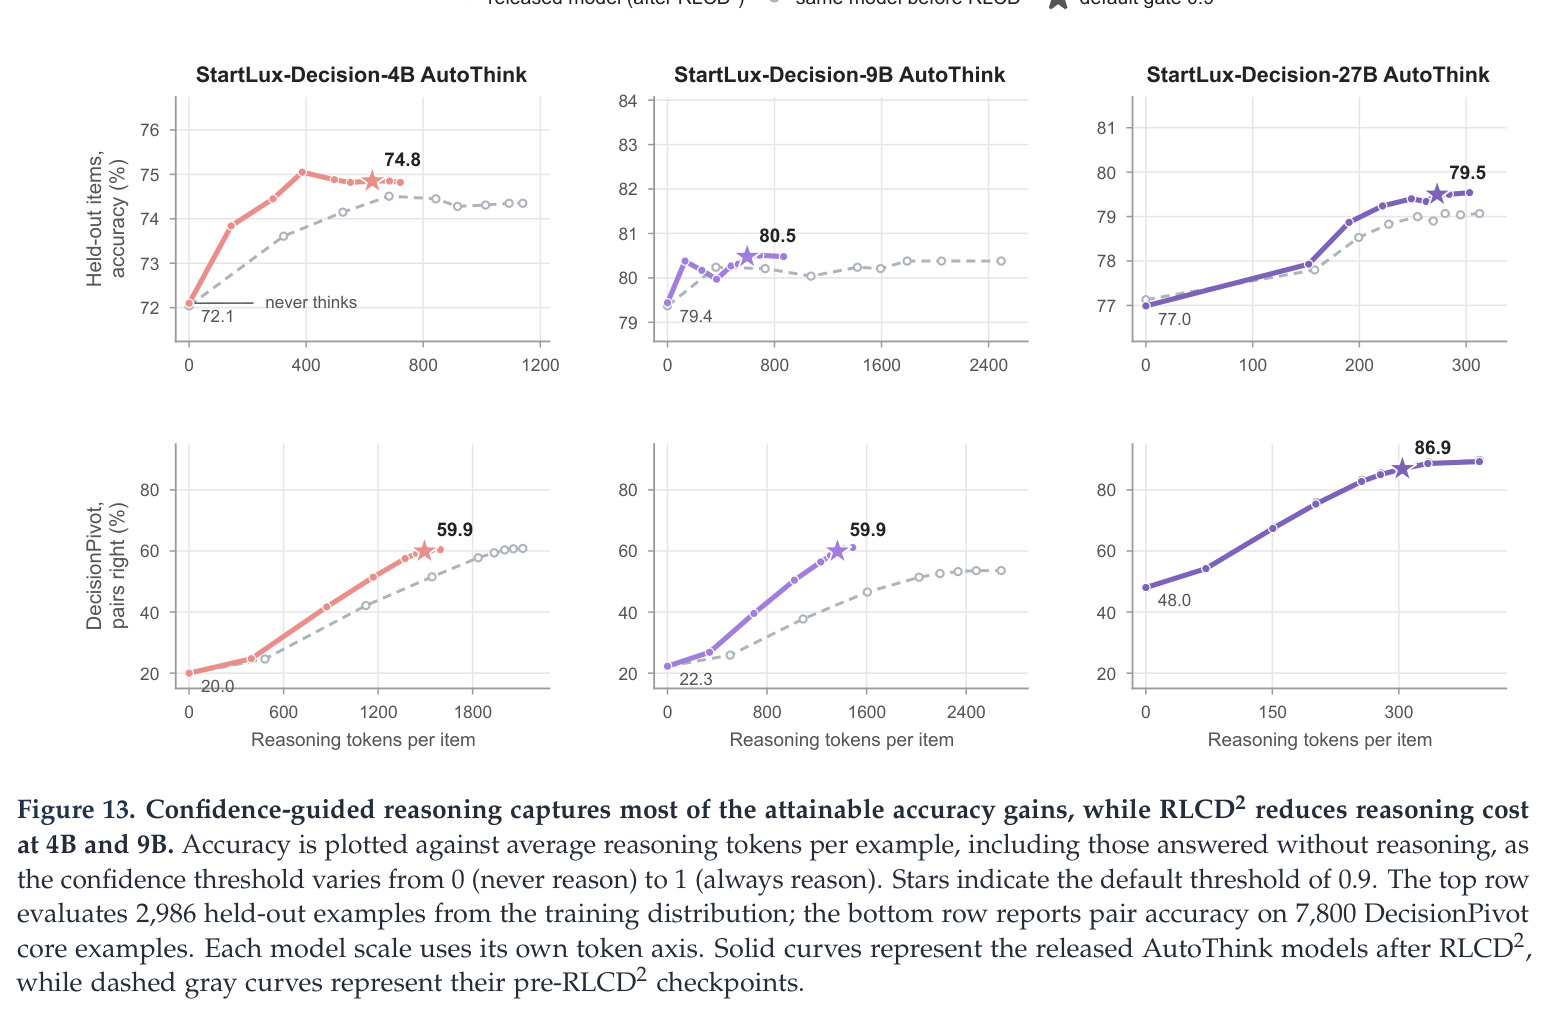
全文最核心的创新是 RLCD2 的奖励设计。与主流推理 RL(GRPO、DAPO 等)奖励答案正确性不同,RLCD2 奖励的是「推理对概率质量的增量贡献」:$r(x,\tau) = S(p_1(x,\tau), t) - S(p_0(x), t) - \lambda \max(0, |\tau| - B)$,其中 $p_0$ 和 $p_1$ 由启动模型的冻结副本读出,$S$ 是决策加权的合适评分规则,$B=3072$ 是软预算,$\lambda=10^{-4}$ 是每 token 惩罚。评分规则采用均匀分布与 Beta(8,2) 的等权混合作为权重函数 $w(c)$,强调操作置信阈值附近的概率误差,可证明期望得分在真实正确概率处唯一最大化。这个设计的妙处有三层:奖励衡量的是分布质量(含校准)而非 top-1 对错;冻结副本保证奖励信号稳定可比;组内奖励中心化后初始分是常数被抵消,相对优势只取决于推理后得分与长度惩罚,「早停且概率变好」的轨迹自然胜出。第二个关键创新是 Read-or-Think 的预测融合:不直接采纳推理后答案,而是 $0.25 p_0 + 0.75 p_1$——因为单遍预测校准更好而推理后预测偏过自信(4B 模型推理后过自信 4.0 个百分点),融合权重是用 held-out 数据上 Brier 分数最小化选出来的,而非追求基准分数最大化。第三是 Instant 的 prompt 双向注意力:单遍决策时整个 prompt 已可见,允许早期表示看到后面的选项能带来最多 +2.4 分的提升。
方法步骤详情
第一步,Stage 1 全参数 SFT:输入是类型化决策样本(输入状态+问题+字母标注选项),目标是选项字母分布上的软交叉熵,直接优化概率读出而不加预测头;用哈希确定性置换选项位置防止答案位置偏差;排除与 Decision Index 测试集、231 个公开 JevBench v1.4.2 条目及其同父组重叠的样本;训练后按问题类型在 held-out 数据上拟合温度(全部 $T>1$,印证训练后普遍过自信)。第二步,Stage 2 adapter 决策训练:在 Lux-Rounds 约 170 万样本(基准训练划分、程序生成的流程决策与 select-all 题、API 生成样本——需两个独立验证器一致才保留、教师标注决策)上用同一目标训练 adapter 后合并进权重;Instant 在 32 层中的 8 个 full-attention 层(4B/9B)启用双向注意力且训练时就用该掩码(对因果训练的模型仅推理时换掩码会破坏预测);每个 Instant 模型由 0.8B 三个、2B–27B 四个不同种子的 run 均匀平均权重,再重拟合温度;AutoThink 用同样数据但保持因果注意力。第三步,Stage 3a 推理监督:针对 4B 约 40% 不生成推理、9B 约 70% 不终止的失败模式,在 Lux-Think(每模型 4,000–21,000 条监督推理样本)上训练 adapter,使所有 AutoThink 模型推理后精度超过单遍。第四步,Stage 3b RLCD2:只训练初始最高选项概率低于 0.9 的问题(与推理时门控一致);每个 prompt 采样 $G$ 条轨迹,组内奖励中心化、优势裁剪 $A_i = \text{clip}(r_i - \bar{r}, -5, 5)$,用带 KL 正则的 PPO 式代理目标(公式 6)更新全部语言模型参数;8 token 内终止视为空推理记零奖励,不做组内标准差归一化。第五步,推理:Instant 一次前向;AutoThink 按公式(2)执行 Read-or-Think,门控逐问题独立应用,到生成上限仍未终止的轨迹由运行时直接截断。
技术新颖性
与已有技术相比,本文的新颖性体现在组合与机制层面而非单一模块。决策模型 + 置信门控自适应推理的组合在开源决策模型中是首次(现有开源模型全为单遍);RLCD2 相对 RLCD/OpenJev-RLCD 的推进在于三要素的组合——冻结概率打分器、决策加权合适评分、软长度预算——且消融实验干净地分离了各组件贡献:即使把预测奖励换成随机噪声,长度惩罚也几乎能让所有轨迹终止,但校准改善完全依赖合适评分奖励(换成仅准确率奖励或终止奖励都无校准收益),说明「长度惩罚驱动终止、proper-score 驱动校准」。双向 prompt 注意力与 Perplexity Decider v1.1 思路相近,但本文提供了同数据、同 Stage 1 检查点的受控对照(5 个规模中 4 个提升、最高 +2.4,同配置随机种子波动仅 0.2–0.7),证据更扎实。Policy-aware 校准是概念层面的贡献:它形式化了 best-of-N 选择与「最优者诅咒」(optimizer's curse)类似的选择诱导过自信,并用 44/67 个生成器-验证器对的阈值认证违例证明个体校准不能替代策略条件校准。DecisionPivot 则以程序化生成+单细节对比对+成对判对(pair accuracy)的严格度量,补上了聚合分数无法反映的细节敏感性维度。
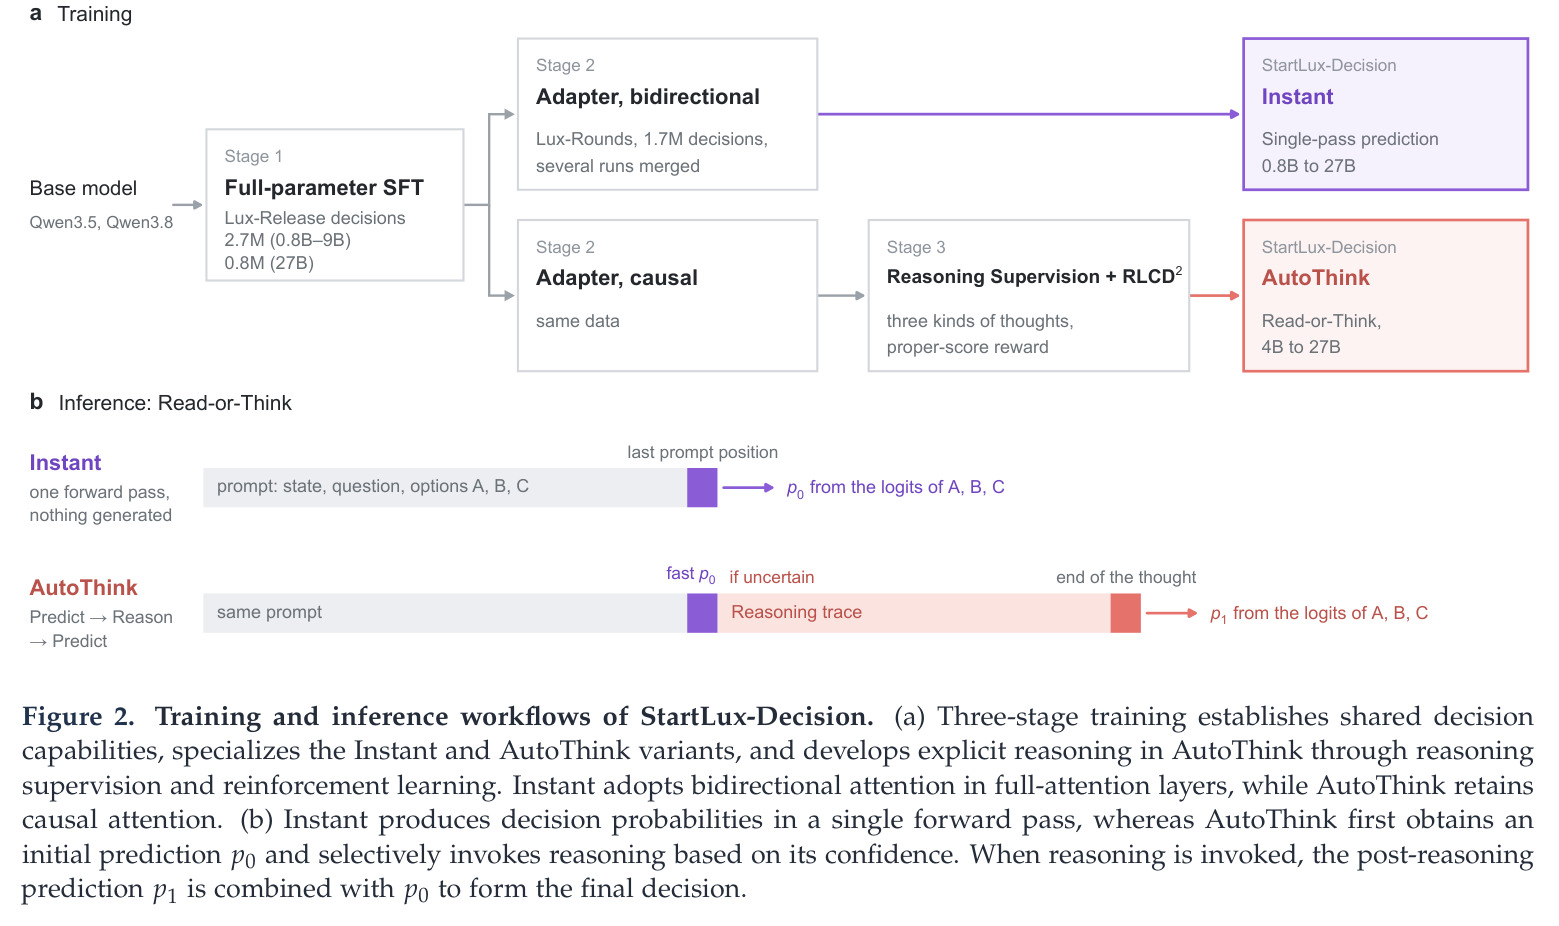
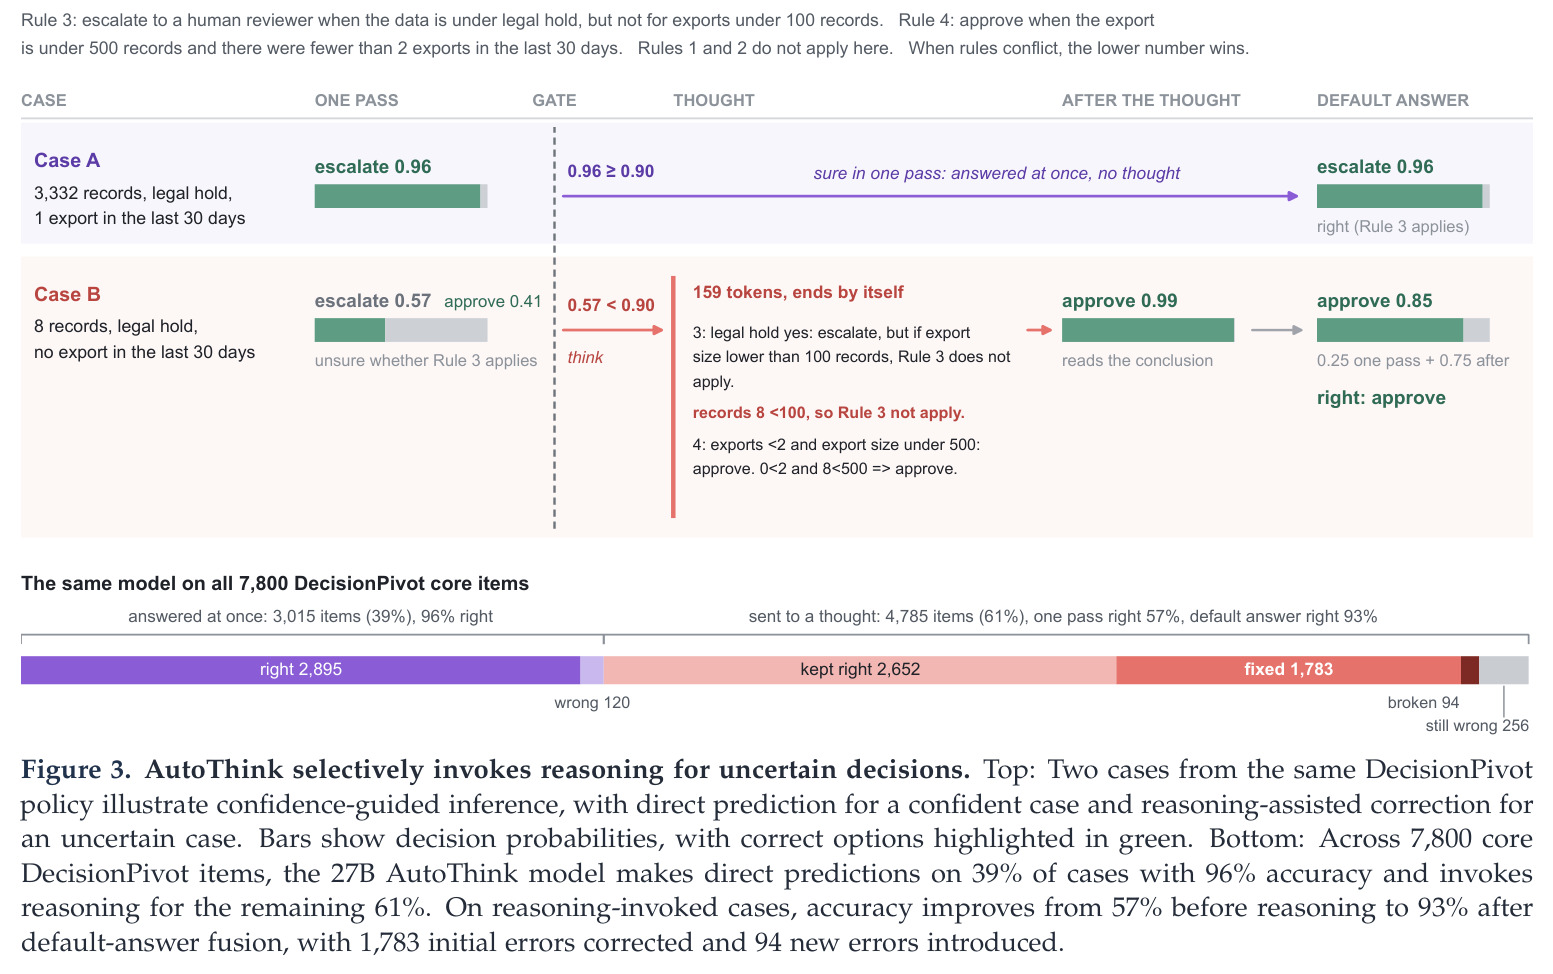
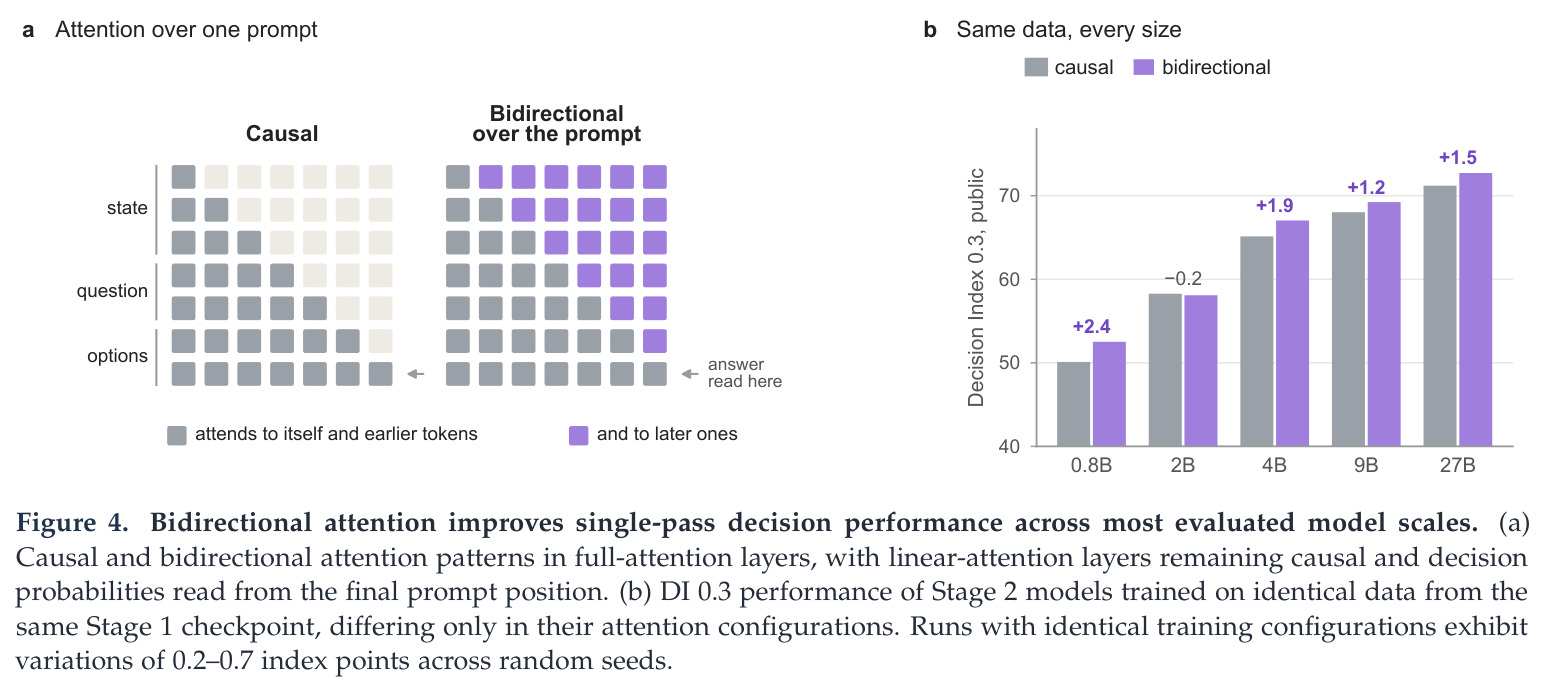
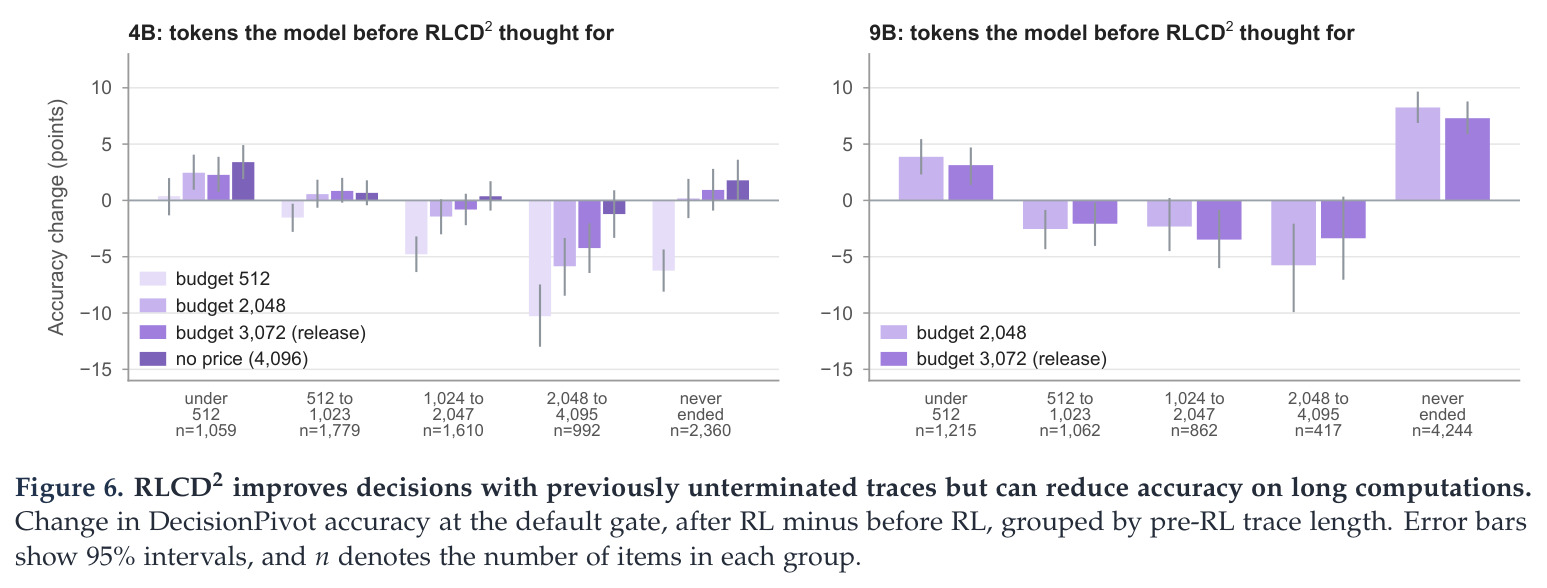
实验结果
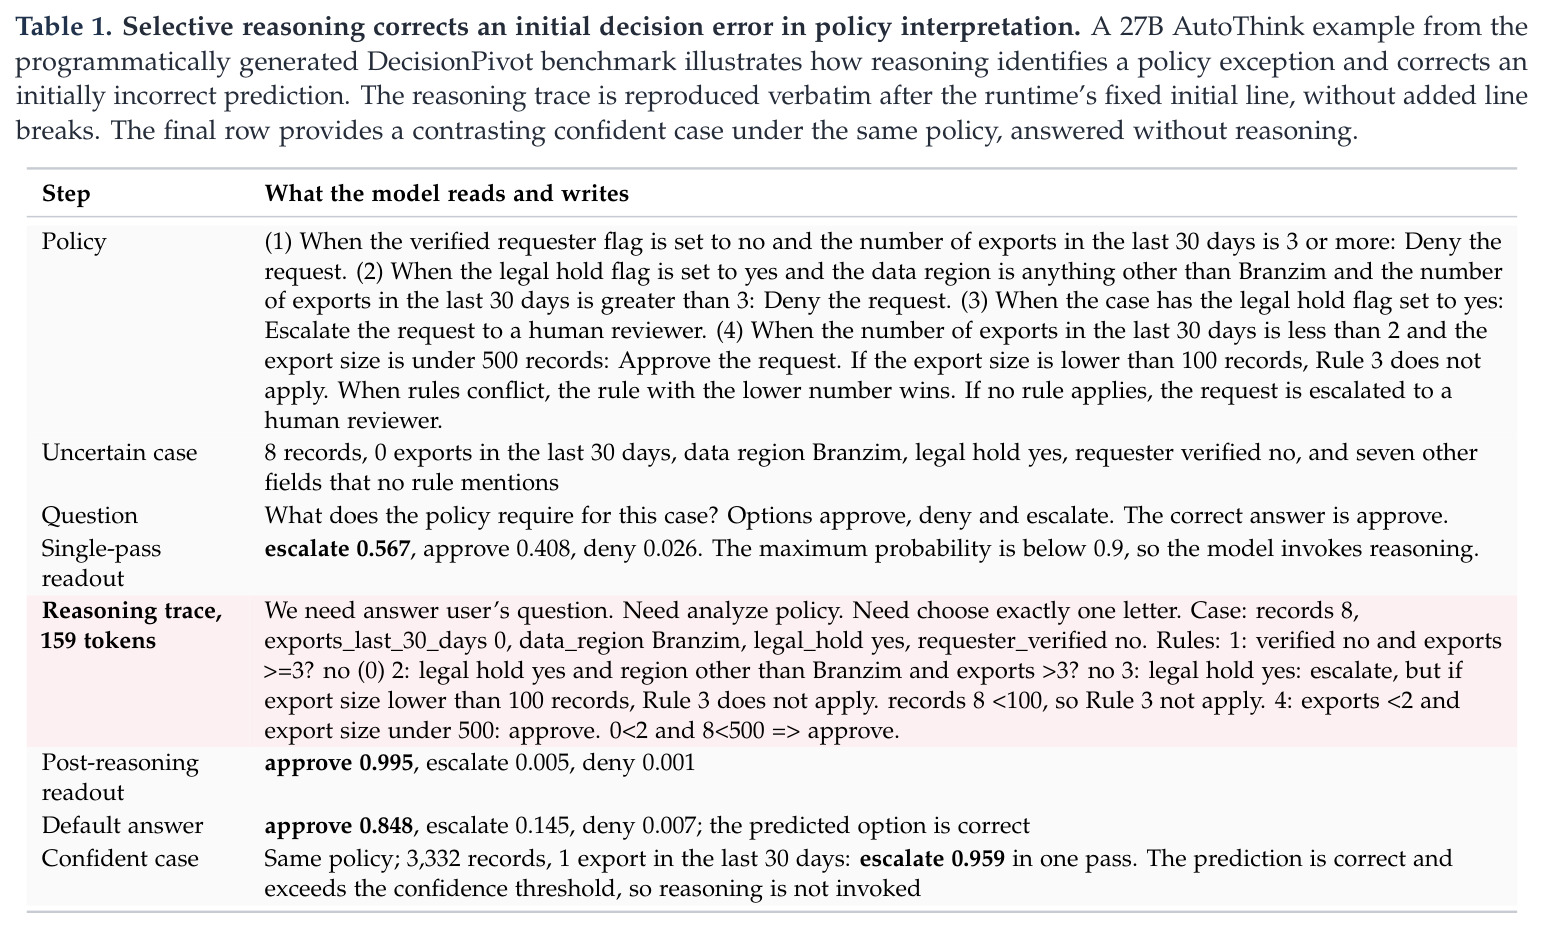
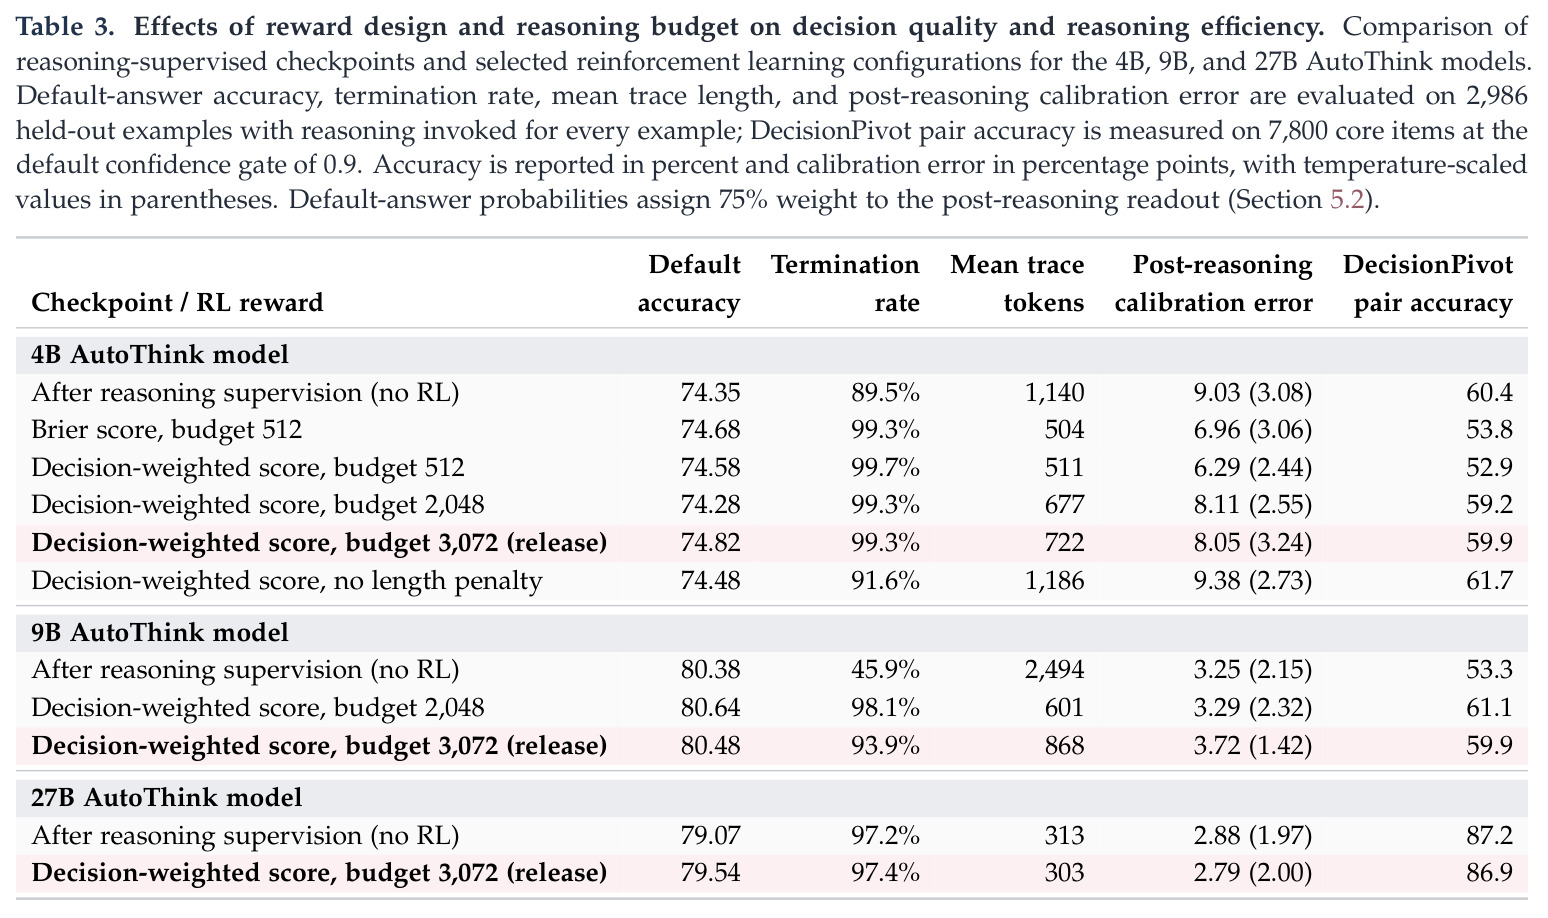
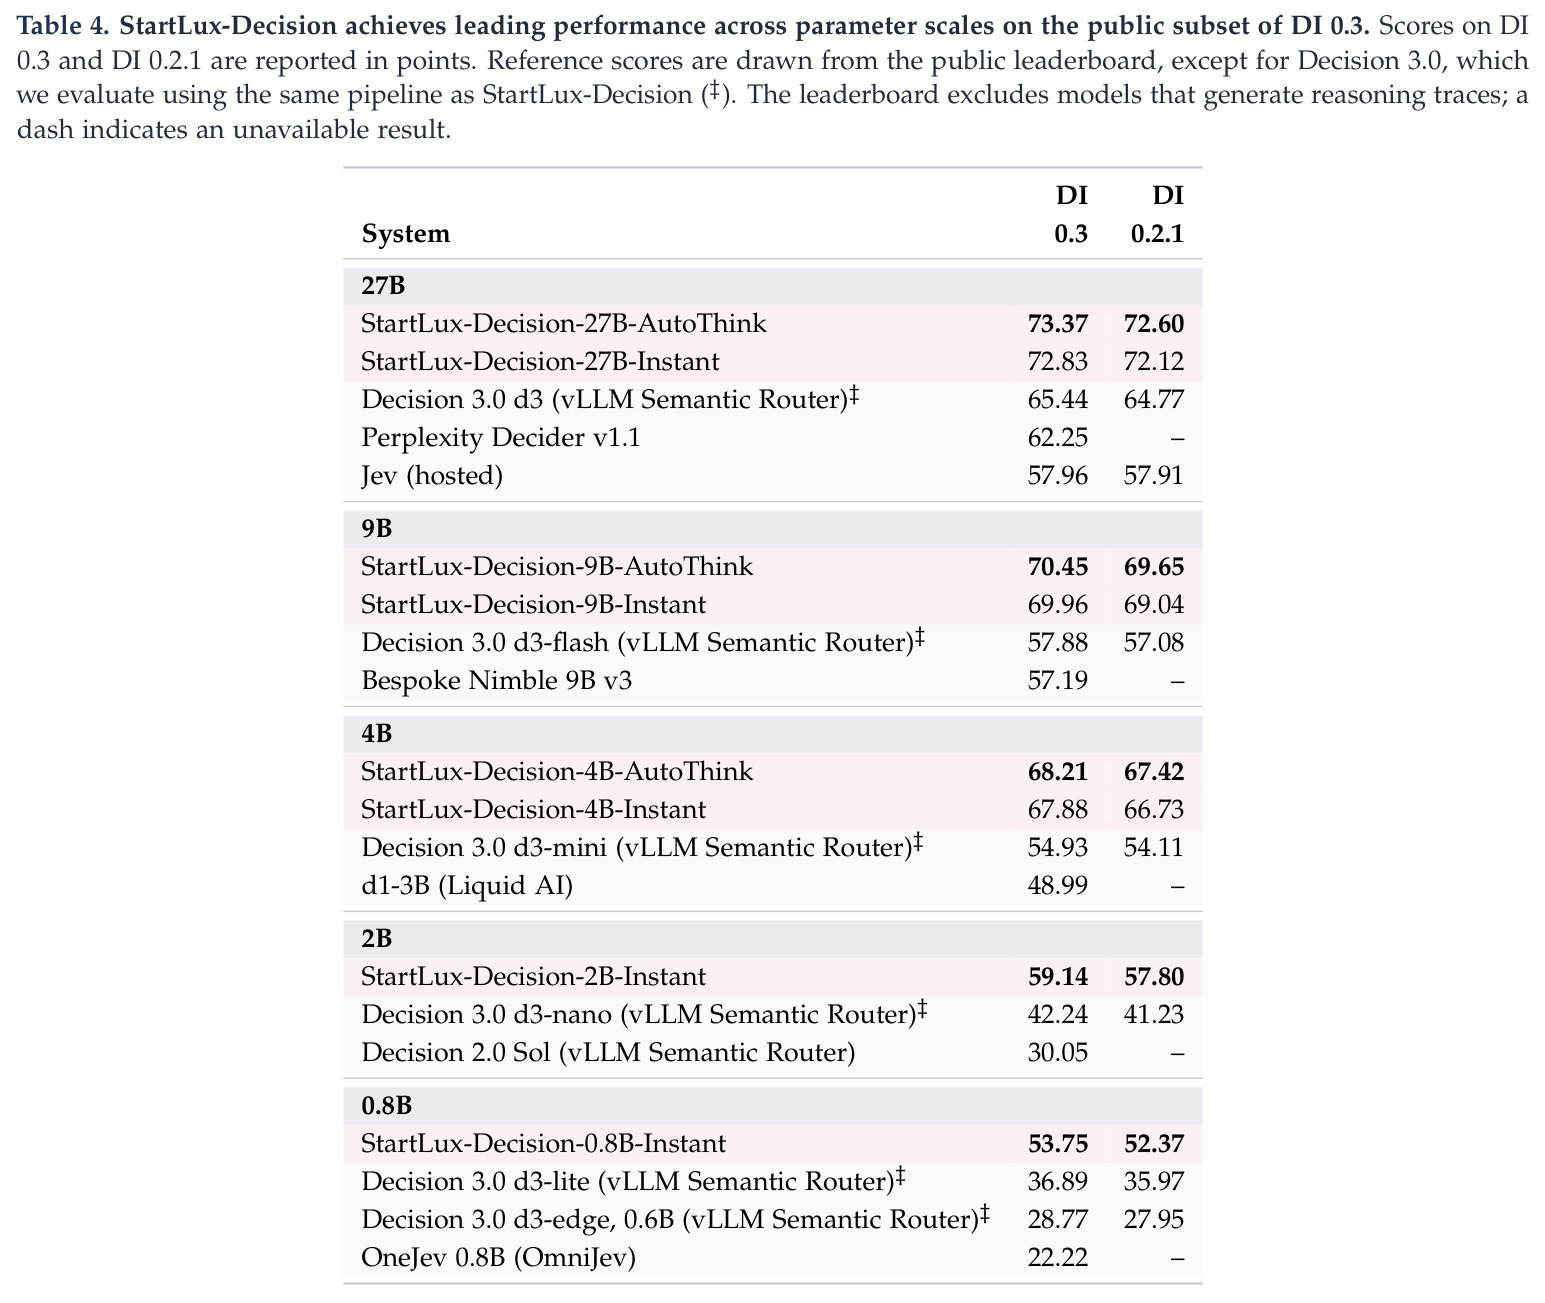
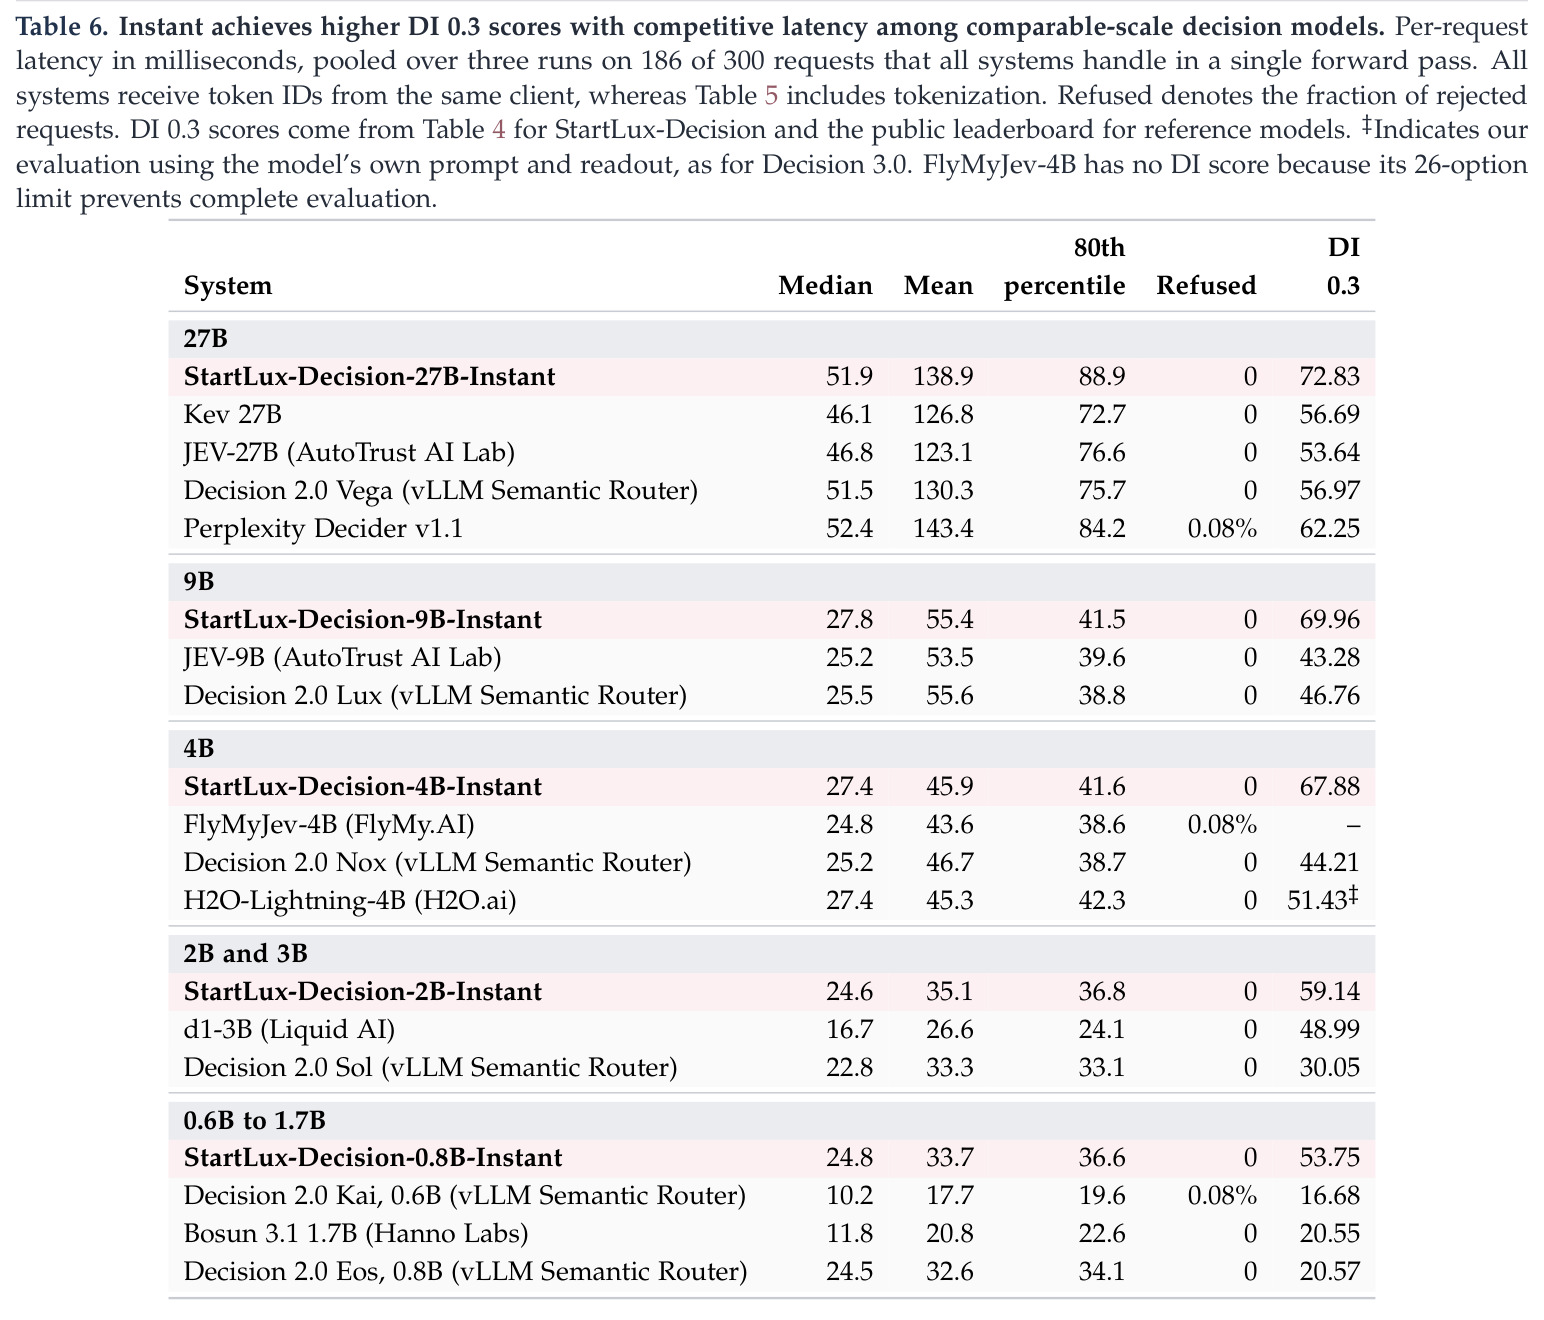
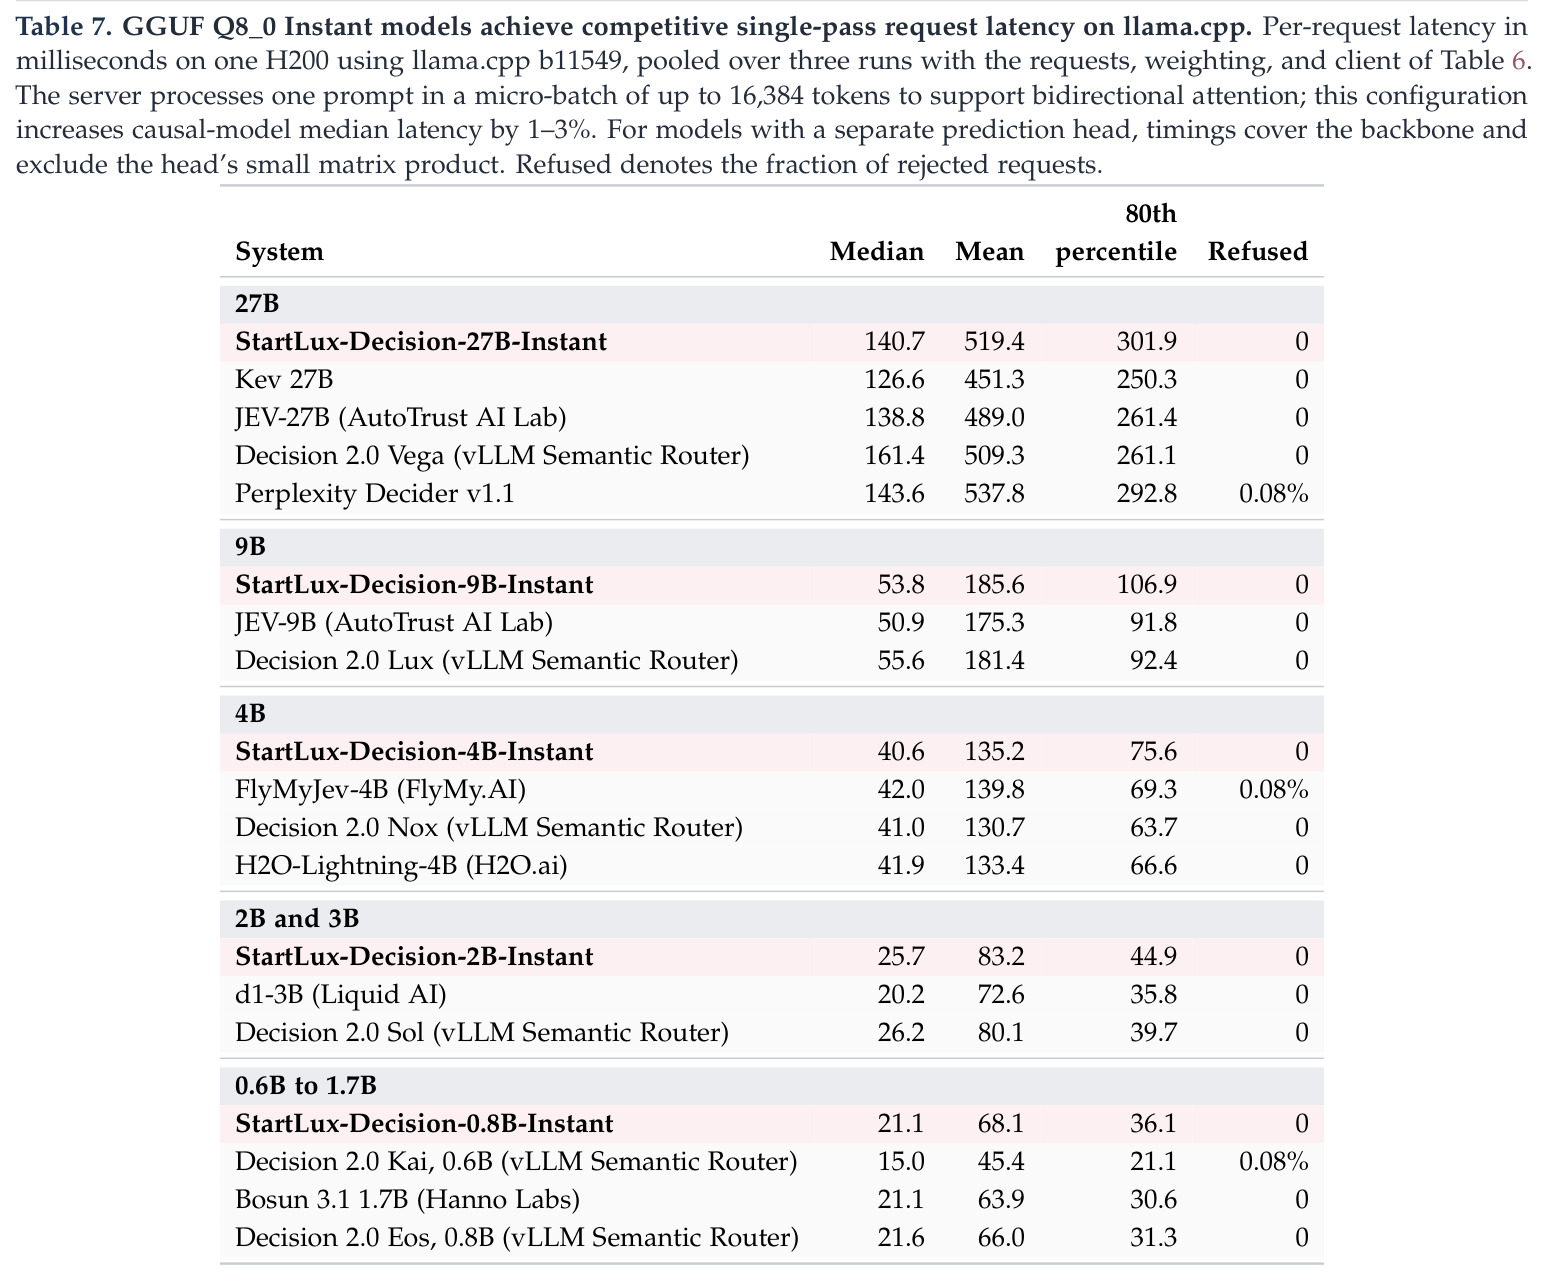
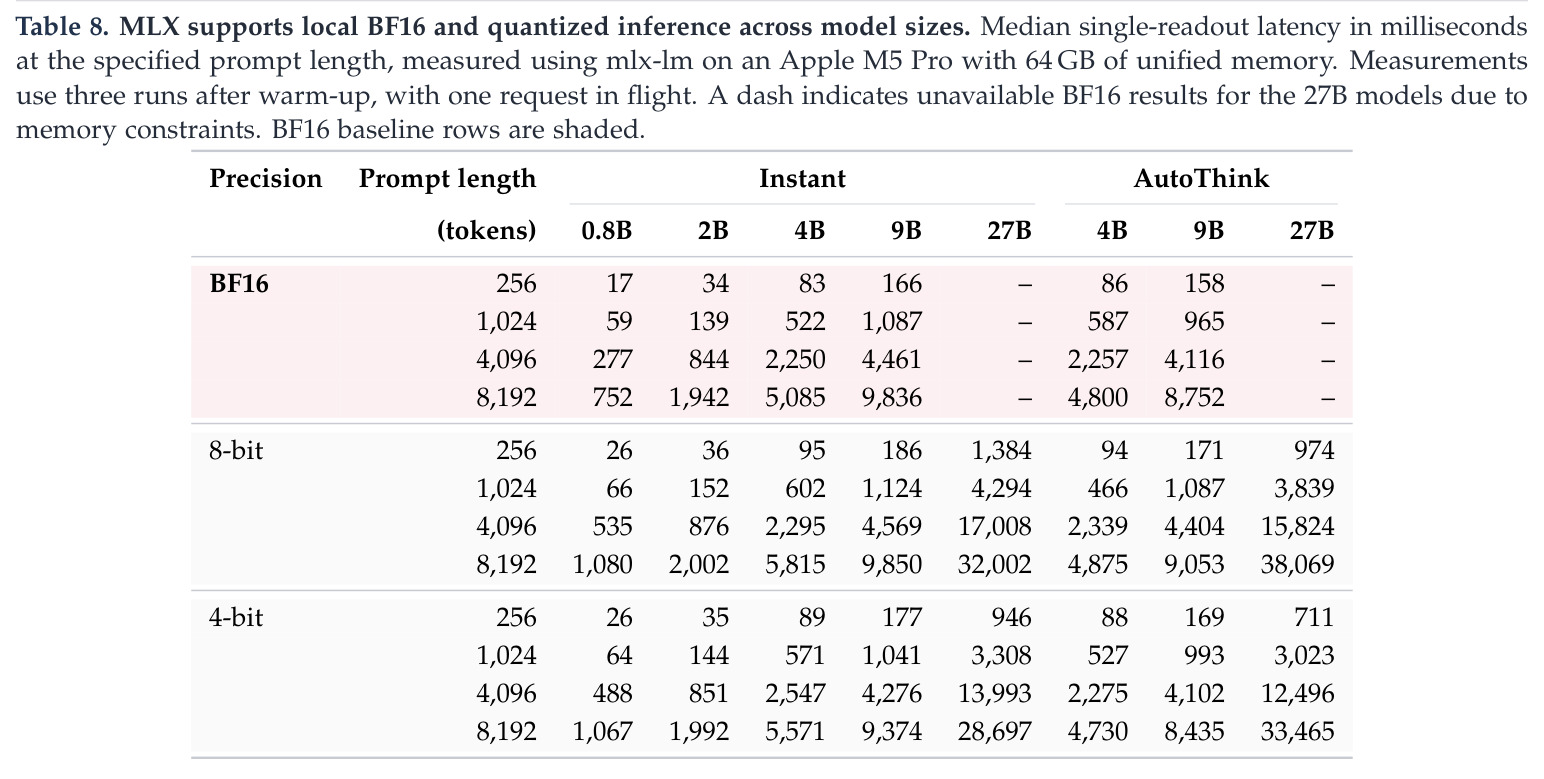
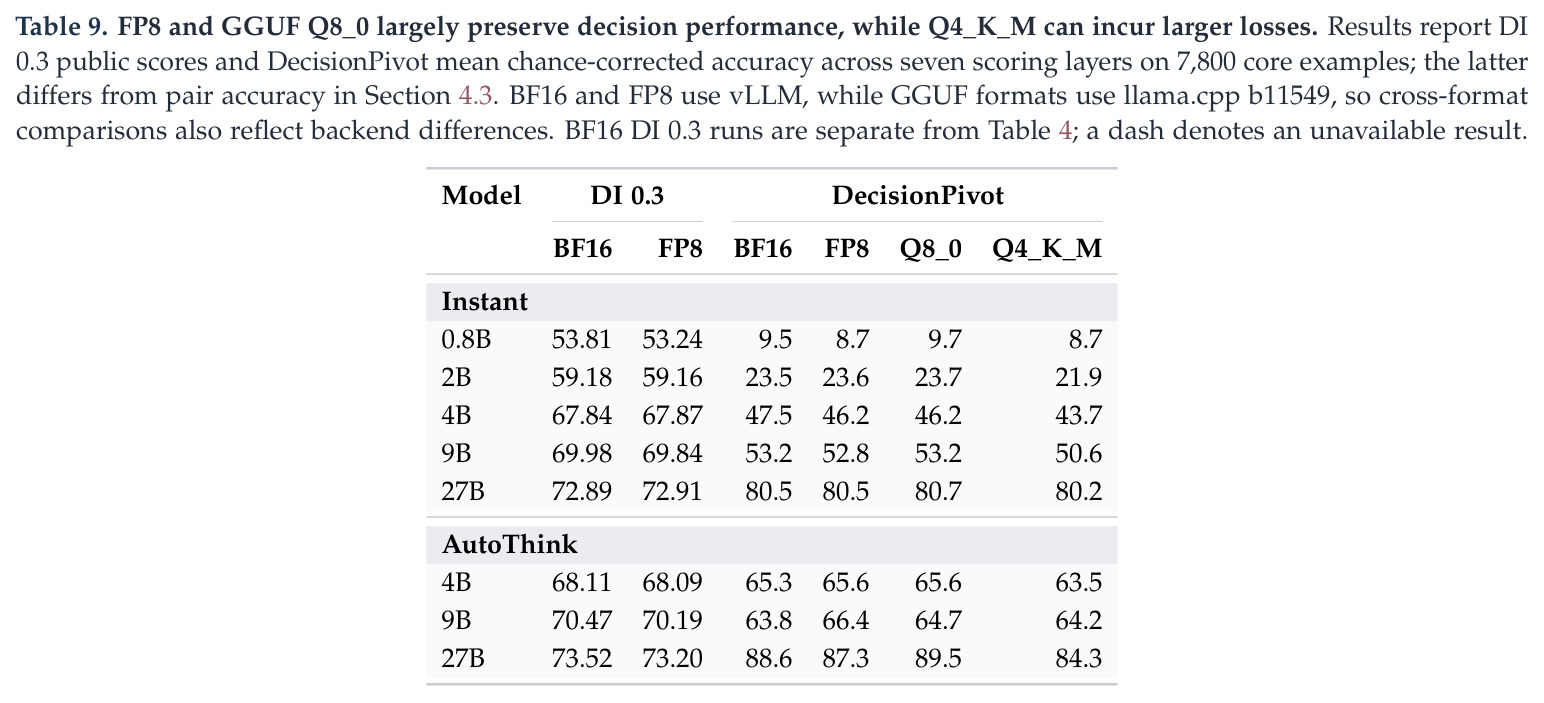
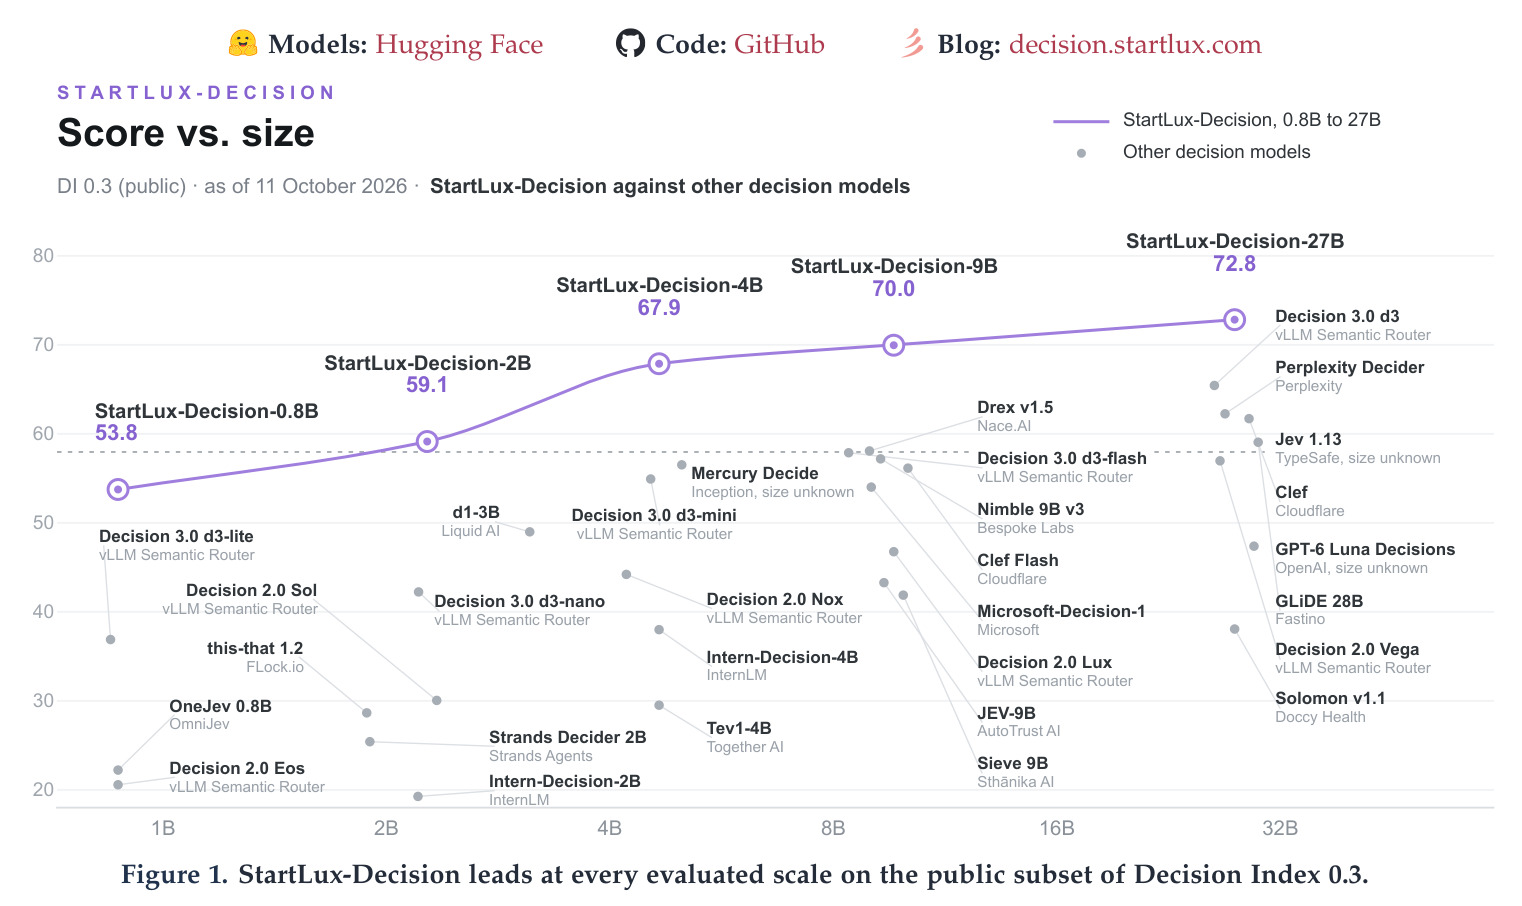
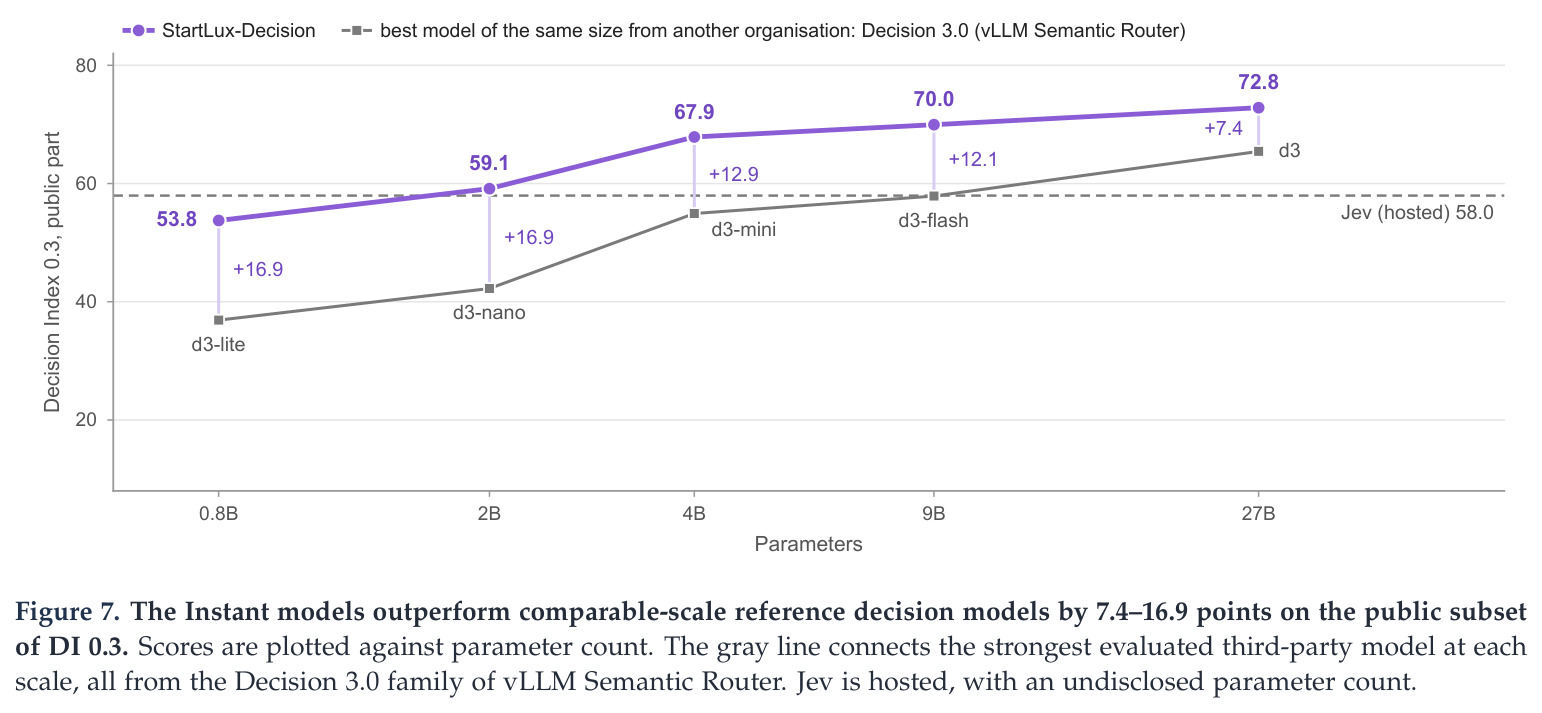
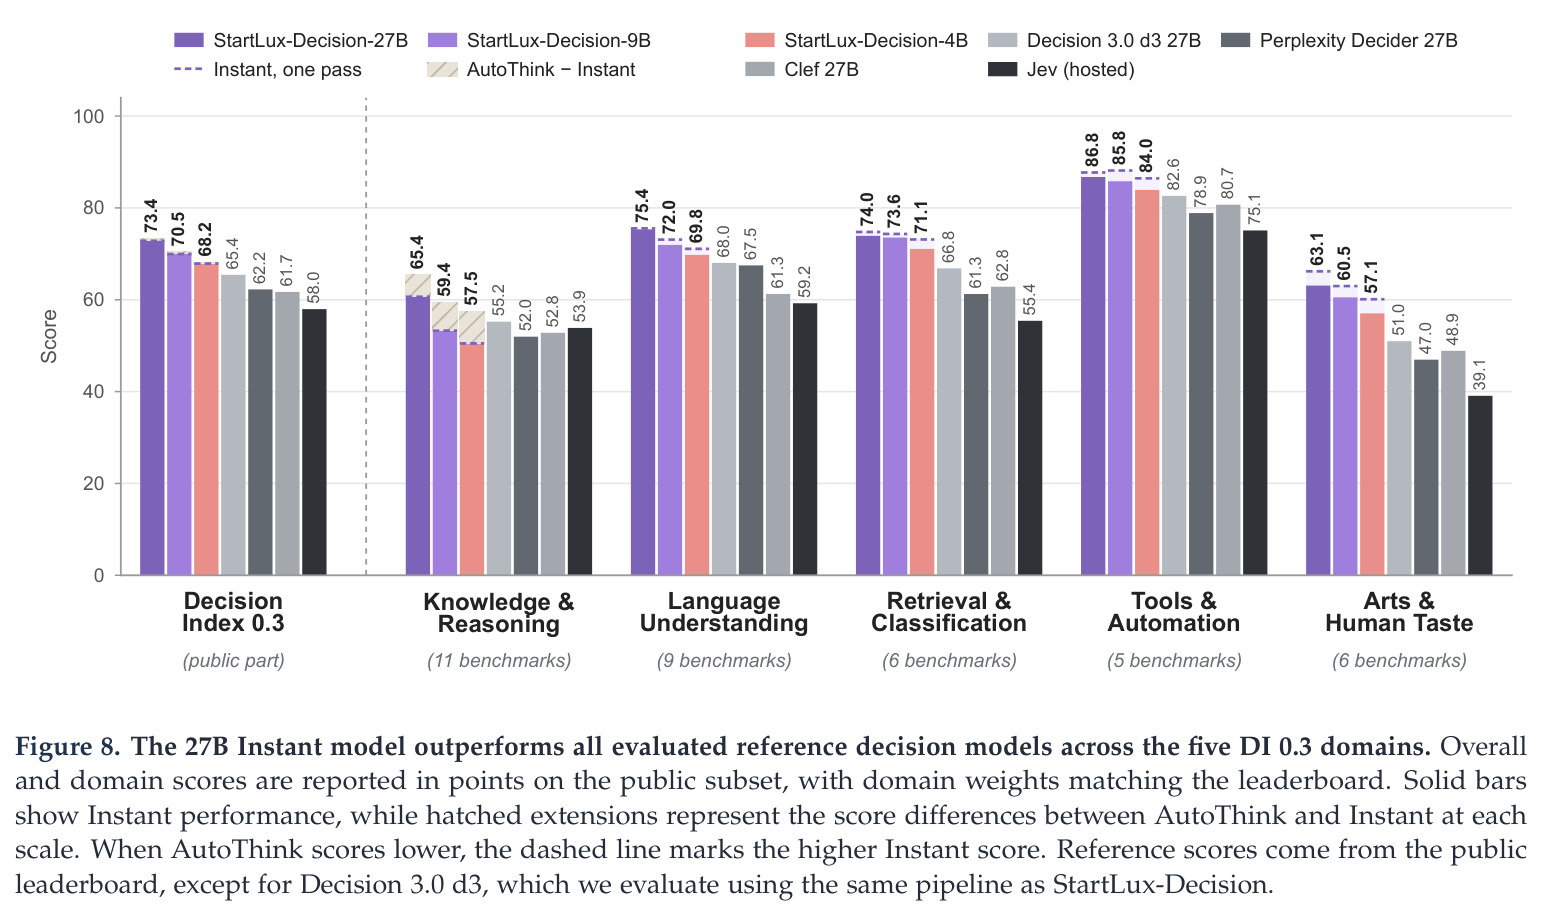
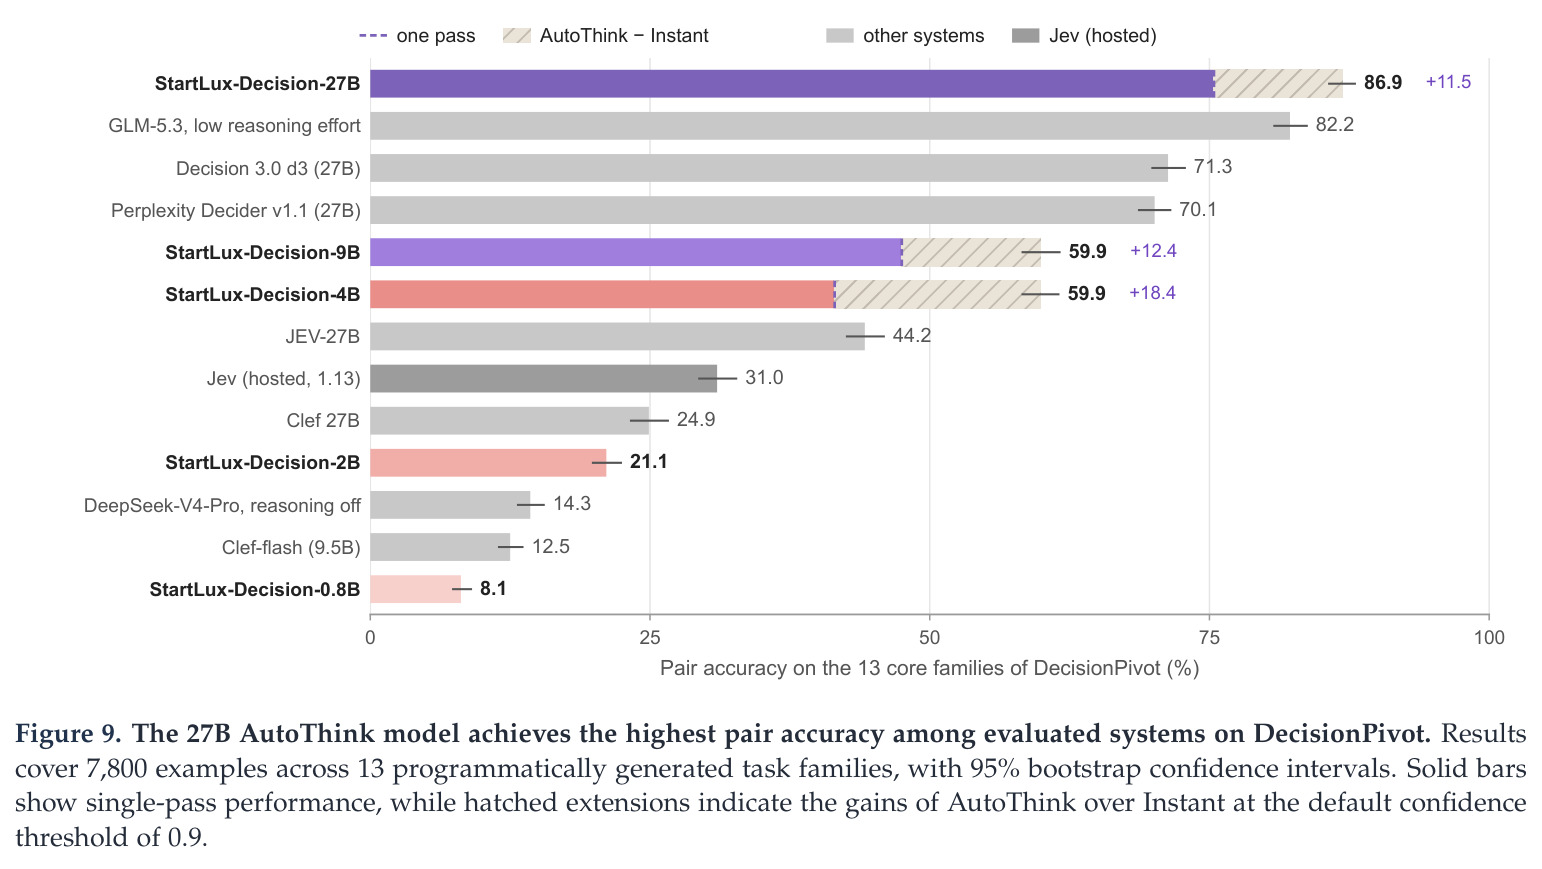
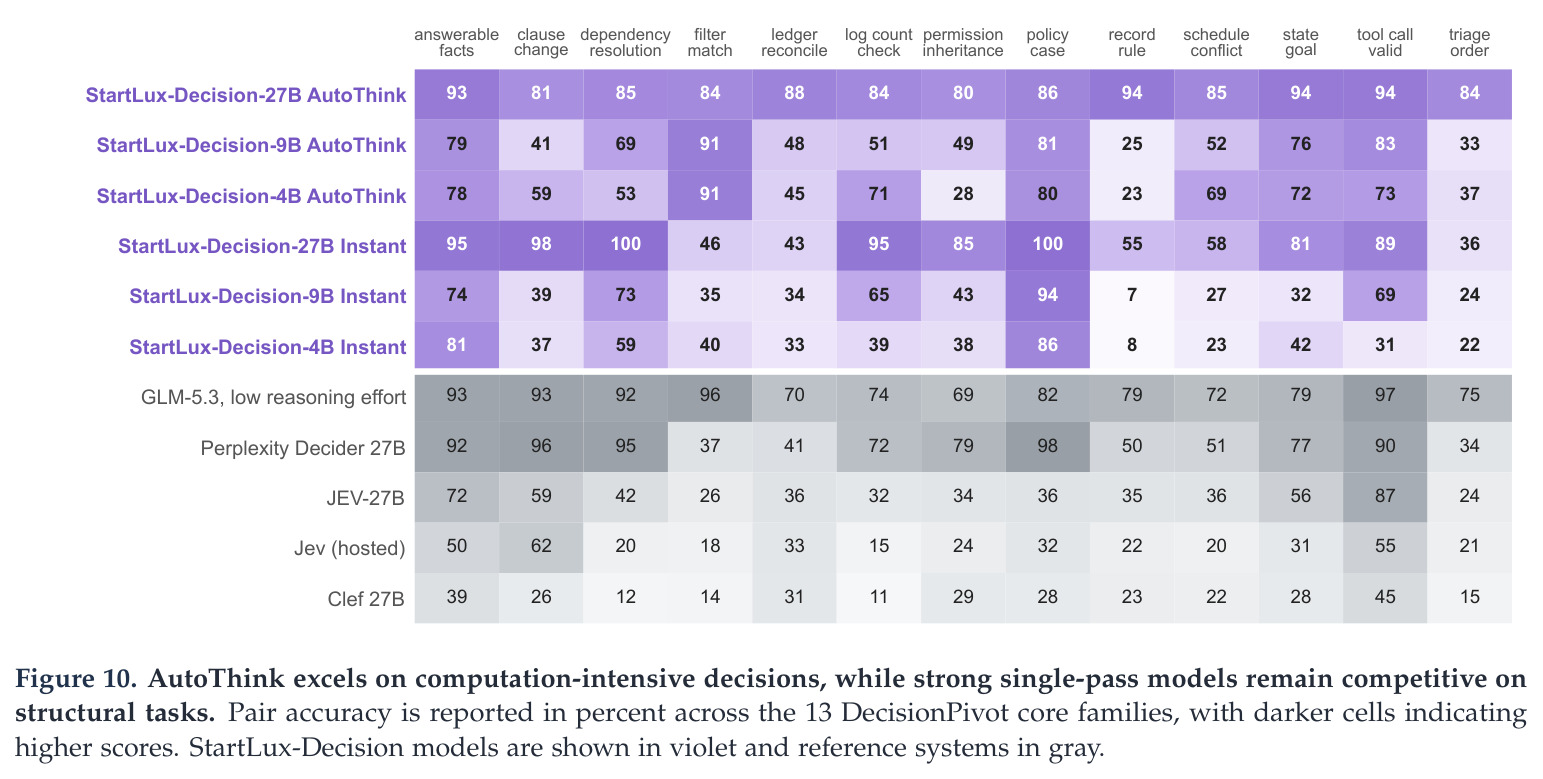
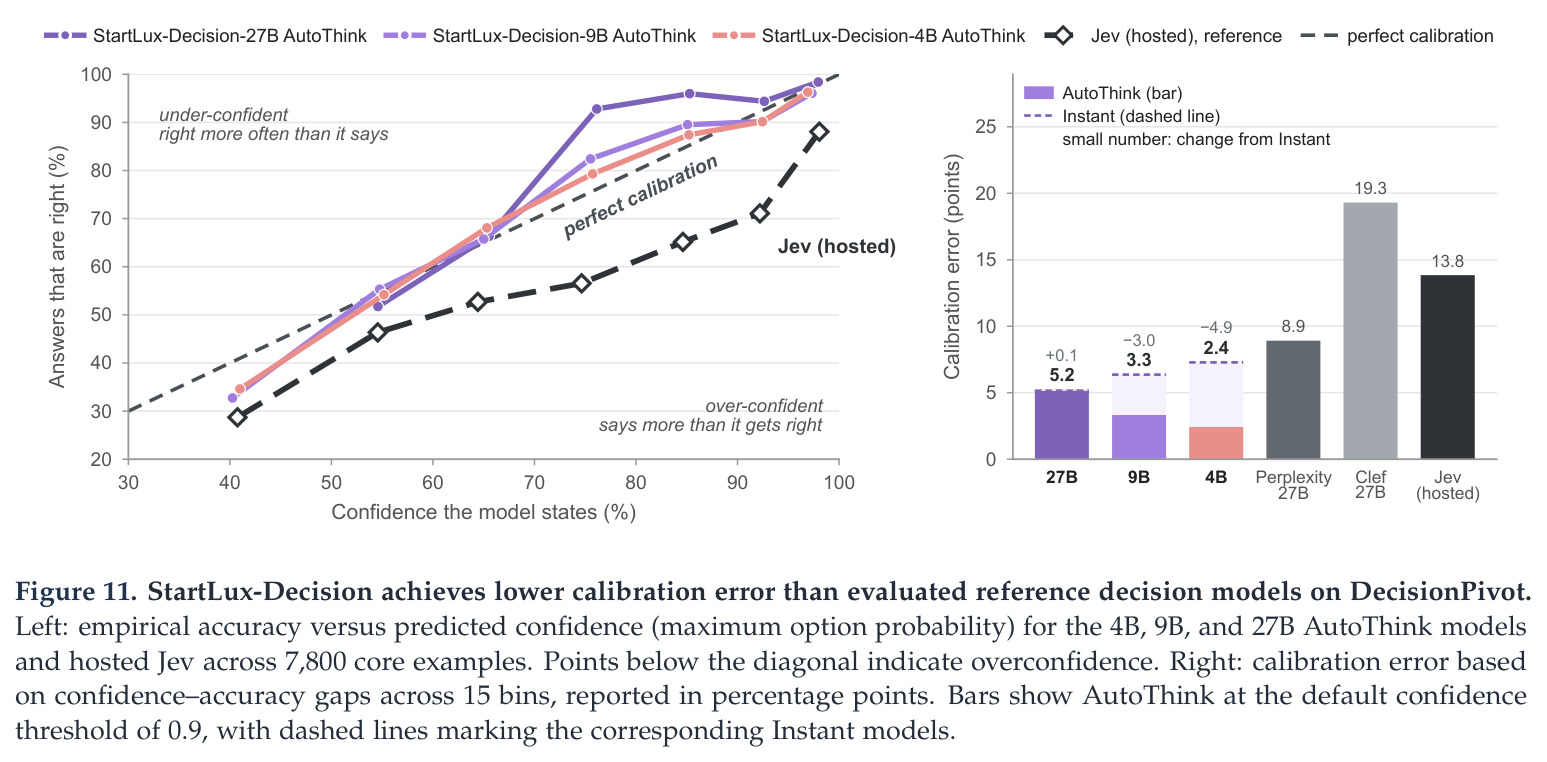
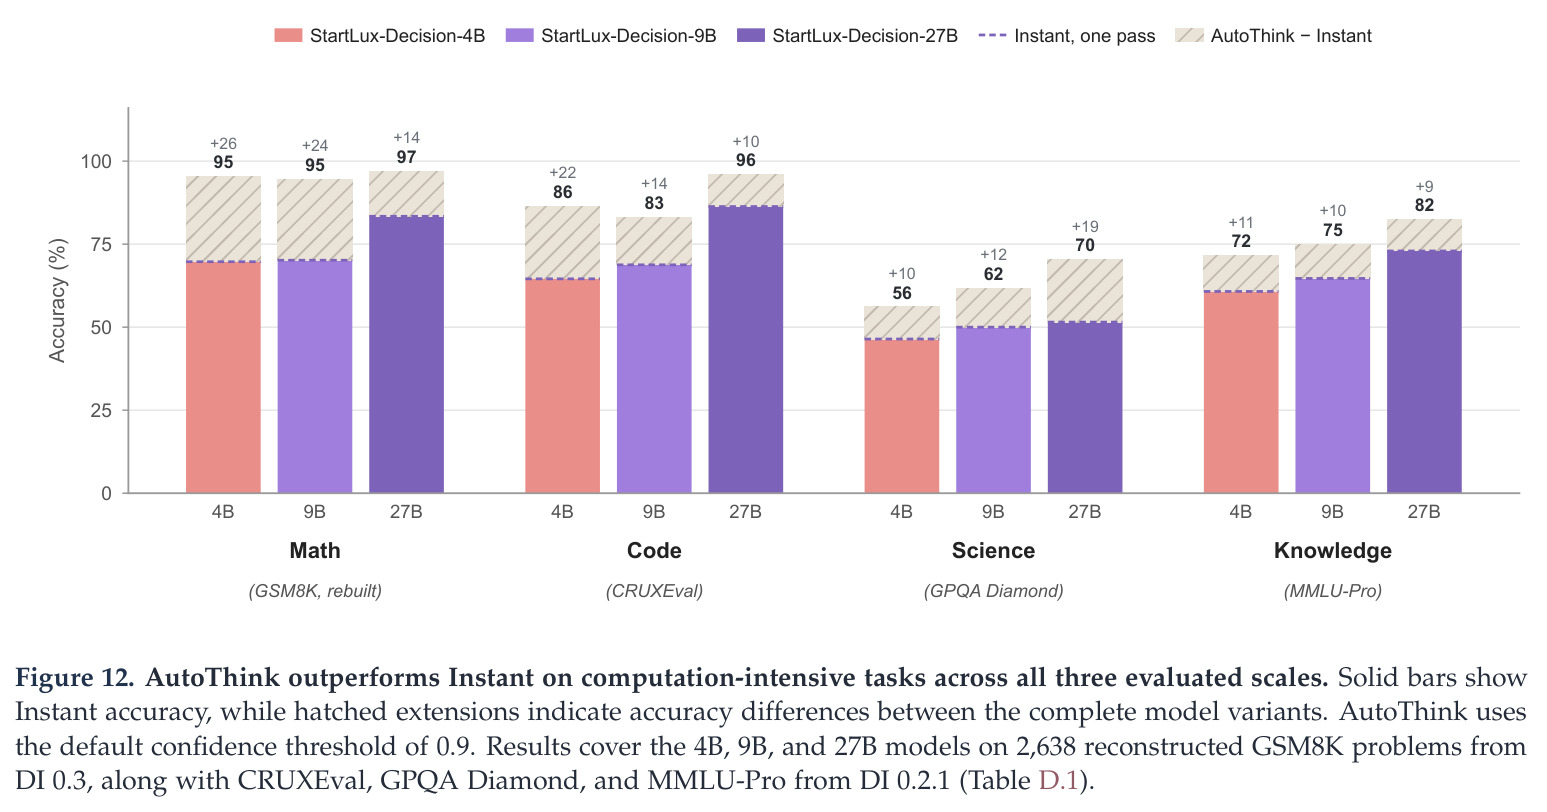
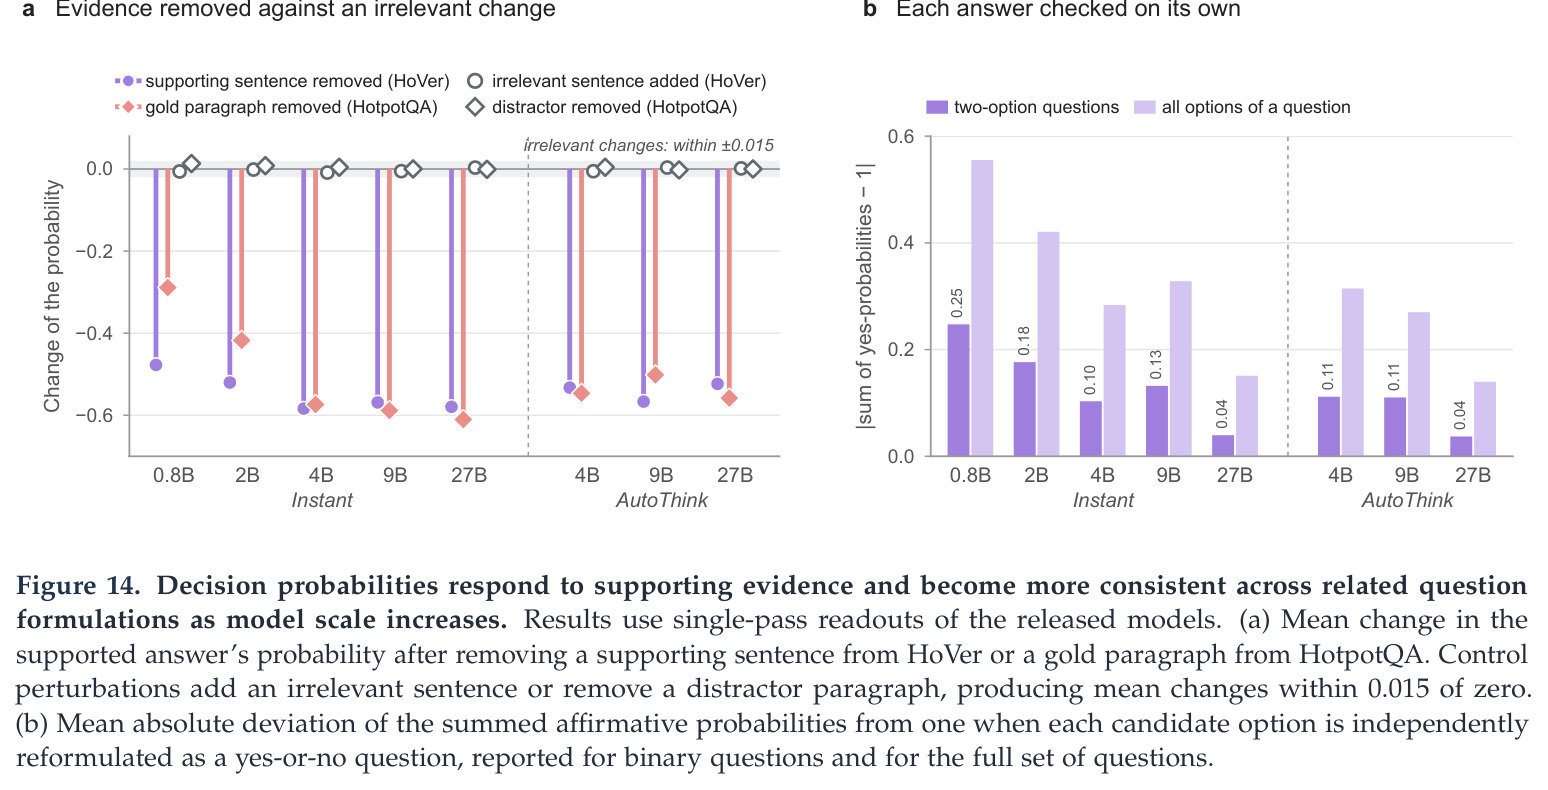
决策指数(DI 0.3 公开子集):Instant 在全部五个参数规模领先,超出同规模最强第三方决策模型(全部来自 vLLM Semantic Router 的 Decision 3.0 家族)7.4–16.9 分——0.8B Instant 53.75 vs Decision 3.0 d3-lite 36.89(+16.9);2B 59.14 vs d3-nano 42.24(+16.9);4B 67.88 vs d3-mini 54.93,且超过所有被评估的参考模型(含更大的 Perplexity Decider v1.1 的 62.25 和托管 Jev 的 57.96);9B 69.96 vs d3-flash 57.88(+12.1);27B Instant 72.83、AutoThink 73.37 vs d3 65.44(+7.4/+12.9)。27B Instant 在五个领域全部领先;最难的 Knowledge & Reasoning 域中 AutoThink 比 Instant 高 7.0(4B)和 6.2(9B)分。DecisionPivot(7,800 核心题、13 个程序生成任务族、成对判对):27B Instant 75.4% 超过 Decision 3.0 d3(71.3%)、Perplexity Decider(70.1%),远超托管 Jev(31.0%);带低强度推理的 GLM-5.3 达 82.2%;而 27B AutoThink 达 86.9%,领先所有被评估系统。AutoThink 相对 Instant 的成对准确率提升为 4B +18.4、9B +12.4、27B +11.5 个百分点;4B/9B AutoThink 均为 59.9%。族级分析显示增益集中在计算密集任务:filtering +51/+56、goal-state 验证 +30/+44、schedule-conflict +46/+25(4B/9B),而政策解释、条款变更、依赖解析等结构性任务单遍已很强。27B AutoThink 在 7,800 题上 39% 直接回答(96% 正确),61% 触发推理,单遍 57% → 融合后 93%(修正 1,783 个初始错误、引入 94 个新错误)。RLCD2 效果(Table 2,2,986 条 held-out):9B 终止率 45.9%→93.9%(+48pp),平均轨迹 2,494→868 token(−65%);4B 终止 89.5%→99.3%,长度 1,140→722(−37%),90 分位 4,096→1,358;27B 本已 97.2%/313,变化不大;held-out default 精度变化均不显著(区间含 0),4B 原始校准误差 9.0→8.1,9B 在 DecisionPivot 上成对准确率 53.3%→59.9%(区间 [+5.0,+8.3])。预算消融(Table 3):4B 预算 512 把推理长度减半但成对准确率跌到 52.9%;3,072 恢复到 59.9%(与无 RL 差 −0.4,区间 [−1.8,+0.8]);去掉长度惩罚到 61.7% 但轨迹长 40%、约三分之一不终止。自适应推理收益(Figure 12):4B AutoThink 比 Instant 高 26 分(重建 GSM8K)、22(CRUXEval)、10(GPQA Diamond)、11(MMLU-Pro);27B GSM8K 从 83% 再 +13.6。校准(Figure 11):AutoThink 校准误差 2.4/3.3/5.2 个百分点(4B/9B/27B),优于 Instant 的 7.3/6.4/5.1,而 Perplexity Decider 8.9、Jev 13.8、Clef 19.3 且系统性过自信。Policy-aware 校准(Figure 15):9B verifier 80–90% 置信的个体准确率 92% 在 best-of-32 后降至 78%;N=16 时 113 个生成器-验证器对中 111 个过自信;best-of-16 目标 5% 错误率时 67 对中 44 个的个体认证阈值失效;184 个设置的有符号置信-准确率差从 [−11.7, +20.5] 缩至 [−2.7, +2.1] 个百分点。部署(Table 5–9):H200 BF16、1,024-token prompt 下 Instant 读出 0.8B 31ms 到 27B 98ms,FP8 在 8k token 时为 9B/27B 省 25–30%;vLLM/llama.cpp 中位延迟与最快同规模参考相当(4B/9B 差 3ms 内);FP8 与 Q8_0 基本无损,Q4_K_M 最多让 27B AutoThink 在 DecisionPivot 掉 4.3 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Decision Index 0.3 公开子集(27B 档) | 指数分 | 73.37(AutoThink)/ 72.83(Instant) | Decision 3.0 d3 65.44;Perplexity Decider v1.1 62.25;托管 Jev 57.96 | +7.4(Instant)~+12.9(AutoThink)分 |
| Decision Index 0.3 公开子集(0.8B/2B 档) | 指数分 | 0.8B 53.75;2B 59.14 | Decision 3.0 d3-lite 36.89;d3-nano 42.24 | +16.9 分(两档均为最大领先) |
| Decision Index 0.3 公开子集(4B 档) | 指数分 | 67.88(Instant),超过全部被评估参考模型 | 同规模最强 Decision 3.0 d3-mini 54.93;全榜最强非自家模型 Perplexity Decider v1.1 62.25 | 对同规模 +13.0 分,并超越所有更大参考模型 |
| DecisionPivot 成对准确率(7,800 核心题) | pair accuracy (%) | 86.9(27B AutoThink) | GLM-5.3(低推理努力)82.2;Decision 3.0 d3 71.3;托管 Jev 31.0 | 领先所有被评估系统,比自家 Instant 高 11.5pp |
| DecisionPivot:AutoThink 对 Instant 提升 | pair accuracy 增量(pp) | +18.4(4B)/ +12.4(9B)/ +11.5(27B) | 对应 Instant 单遍模型 | 最大 18.4 个百分点 |
| RLCD2 推理终止率(9B,held-out 2,986 例) | termination rate (%) | 93.9 | 推理监督后(无 RL)45.9 | +48.0 个百分点 |
| RLCD2 推理长度(9B,held-out) | 平均轨迹 token 数 | 868 | 2,494(推理监督后) | −65% |
| DecisionPivot 校准误差 | 置信-准确率差(pp) | AutoThink 2.4/3.3/5.2(4B/9B/27B) | Perplexity Decider 8.9;托管 Jev 13.8;Clef 19.3 | 比托管 Jev 低 8.6–11.4 个百分点 |
| 下游策略下的置信可靠性(184 个设置) | 有符号置信-准确率差(pp) | [−2.7, +2.1](policy-aware 校准后) | [−11.7, +20.5](常规个体校准) | 区间宽度从 32.2 缩到 4.8 个百分点 |
| vLLM 单遍读出延迟(H200,BF16,1,024-token) | 中位延迟(ms) | 0.8B 31;4B 41;27B 98 | 同规模参考模型中位延迟(4B/9B 差 3ms 内,27B 差约 6ms) | 延迟持平的同时 DI 0.3 分数高 12–26 分 |
局限与改进
作者明确承认的局限:第一,DI 0.3 公开子集在开发中被用于模型选择(比较 Stage 2 数据配方、注意力变体、种子平均),因此这些分数不是独立测试结果,且公开子集只占排行榜的 20%,其余 80% 是私有评估;只有 DecisionPivot 是完全独立的评估。第二,训练呈任务族特化:新增 Stage 2 数据使对应 18 个任务的复用任务集提升 8.6 分,族外任务仅 +0.3,没有清晰的跨族迁移证据。第三,RLCD2 用长度换终止对长计算不利:预 RL 轨迹在 2,048–4,095 token 区间的例子,4B 损失 4.2–5.9 分、9B 损失 3.4–5.8 分(Figure 6)。第四,policy-aware 校准对分布漂移敏感,把在 held-out 分布上拟合的校准映射迁移到未见数据集时残留最高 6.1 个百分点的过自信。第五,自适应推理有额外生成成本,DI 上 4B/9B/27B 分别在 33%/29%/28% 的问题上触发推理。我自己的观察:DecisionPivot 是程序生成的合成基准,任务族(过滤、台账核对、排程冲突等)模板化程度高,与真实业务决策(模糊的自然语言政策、多模态输入)的距离未知;置信门 $g=0.9$、融合权重 $\alpha=0.75$、预算 $B=3072$ 都是在训练分布的 held-out 上选的,换分布是否最优没有验证;对比中多个基线(Decision 3.0 系列)是作者用自己的 pipeline 评估的(表中标 ‡),托管 Jev 参数量未公开,横向比较的公平性依赖其评估管线;RLCD2 的奖励完全依赖冻结副本的概率质量,若副本在某些问题上系统性校准差,奖励信号可能系统性误导;26 选项上限与分组决赛机制可能损失长选项列表下的精度。
独立分析的弱点
第一,奖励信号的天花板受制于冻结打分器。RLCD2 用启动模型的冻结副本读出 $p_0$/$p_1$ 计算评分差,如果副本在某类问题上校准系统性偏差,奖励会鼓励「让概率看起来更好」而非真实改善的推理。改进方向:用指数滑动平均周期性更新打分器,或集成多个不同阶段的检查点作为打分委员会,并对奖励本身做校准诊断。第二,固定超参的跨分布脆弱性。$g=0.9$、$\alpha=0.75$、$B=3072$ 全部来自训练分布,DI 上的推理触发率 28–33% 到了未知分布可能过高或过低(例如全部触发推理也「无进一步收益」只在 held-out 上验证过)。改进方向:按输入域在线校准门限,或训练一个轻量的「推理增益预测器」替代固定阈值。第三,长计算的精度损失是结构性代价。Figure 6 显示 RLCD2 对预 RL 轨迹 2,048–4,095 token 的例子造成 3.4–5.9 分损失,本质是统一预算对难度异质的问题一刀切。改进方向:难度感知的预算分配(对初始概率极低或多约束的例子放宽 $B$),或改为多轮「读-想-读」迭代细化而非单条长轨迹。第四,合成基准与真实分布的差距。DecisionPivot 的 13 个族由程序生成,表面形式单一,真实企业决策(邮件里的政策问答、含图表的合规判断)未必复现 86.9% 的优势。改进方向:构建真实工业决策回放集并区分「结构性」与「计算性」错误来源。第五,部署生态负担。双向注意力需要 vLLM 插件、llama.cpp 服务端补丁、自研 MLX 后端三套实现,且与 KV cache 前缀复用等推理优化存在兼容风险;长期看可以把双向 Instant 蒸馏回因果架构以换取生态兼容。第六,4B 的选择性覆盖很低:5% 目标错误率下 default 预测只接受约 2%(改用 post-reasoning 路由也仅 23%),说明小模型的区分度(discrimination)而非校准是瓶颈,值得专门优化排序能力。
未来方向
作者在结论中给出的方向是:超越已表示任务族的泛化能力,以及分布漂移下鲁棒的概率可靠性。基于本文成果还可以延伸:一是把 RLCD2 的增量决策质量奖励推广到多问题联合决策与级联系统,让 reward 显式考虑下游策略(选择/路由)的效用而非单题评分;二是学习式/动态推理预算——用元控制器按问题难度分配 $B$,缓解长计算损失;三是把 policy-aware 校准做成在线更新流程并结合 conformal 预测,给出有限样本下的覆盖率保证,解决 6.1 个百分点的分布迁移残留;四是多模态决策——目前视觉塔冻结,若允许决策梯度流入视觉侧或加入多模态推理数据,可覆盖图像合规审查等场景;五是利用 Instant 的双向读出构建更强 verifier,与 AutoThink 组成自验证闭环;六是把「决策训练损害推理生成/终止」的现象推广研究——它是更广泛的灾难性能力遗忘的一个具体实例,或可用正则化/数据回放从根上缓解;七是 262k 长上下文下的注意力成本优化,以及双向注意力与推测解码、前缀缓存等推理加速技术的兼容方案。
复现评估
推理与部署层面的复现性很好:模型权重在 Hugging Face 公开(0.8B–27B 的 Instant 与 4B–27B 的 AutoThink),推理代码在 GitHub 开源,支持 vLLM、llama.cpp(GGUF Q8_0/Q4_K_M)、MLX(8-bit/4-bit)三种后端并给出 FP8/量化无损性数据,延迟测量条件(H200、M5 Pro、prompt 长度、请求并发)描述完整,论文还提供 27B AutoThink 的完整推理案例(Table 1)便于对拍。DecisionPivot 基准由 StartLux 发布,程序化生成且可验证,独立评估可信。但训练层面的复现门槛高:训练数据 Lux-Release(约 270 万/80 万)、Lux-Rounds(约 170 万)、Lux-Think(每模型 4,000–21,000)只公开了构成描述(附录 A)与去重/排除规则,正文仅承诺公开「模型权重与推理代码」,训练代码与数据集未明确开源;27B 全参数 SFT、每模型 3–4 个种子的重复训练加权重平均、以及 GRPO 式 RL(RLLC2)都需要可观算力,GPU 时未披露。第三方可以完整复现评测结论(DI 公开子集 + DecisionPivot),但要复现训练全过程,需要自行重建约 440 万条决策数据和多阶段 RL 基础设施,难度较大。另外注意 DI 0.3 排行榜 80% 权重在私有评估上,外部只能验证公开 20%。
论文图表
(a) 9B verifier 在 80–90% 报告置信区间内,best-of-N 选择后的准确率随 N 增大从 92%(N=1)跌到 78%(N=32);(b) 覆盖 best-of-N、think-gate、cascade、select-then-think 四种管线 184 个设置:常规校准的有符号置信-准确率差为 [−11.7, +20.5]pp,policy-aware 校准后收窄到 [−2.7, +2.1]pp。
论文可靠性贡献的支柱图:证明「校准必须在部署策略输出上做」,并给出不重训练模型的通用修法。