SearchJev:面向搜索智能体的快速且校准良好的系统一决策模型 SearchJev: A Fast and Calibrated System-1 Model for Search Agents
单token读出直接输出六类搜索决策,比自回归快5.2倍且校准误差最高降74%
前置知识
System 1 / System 2(认知双系统)
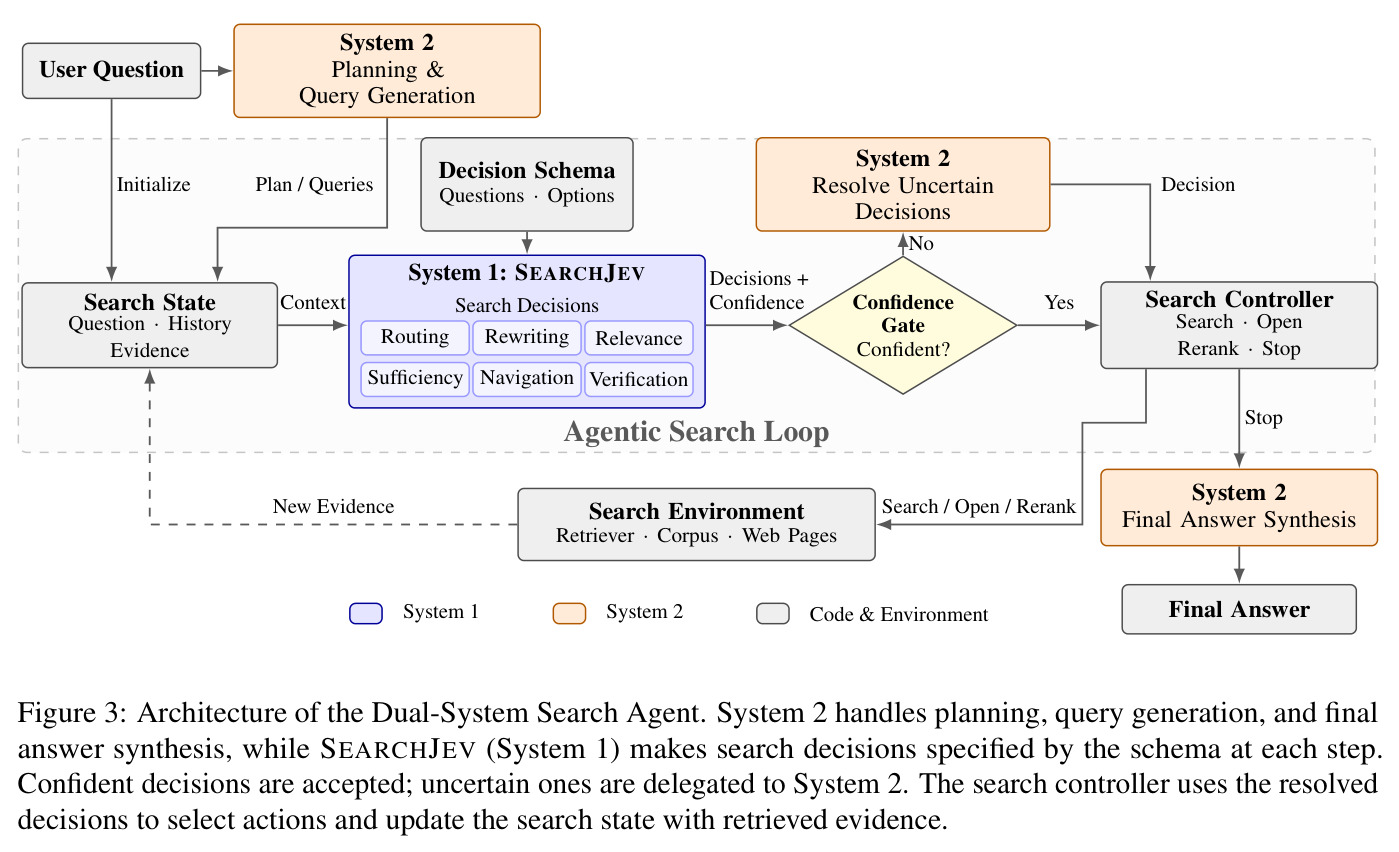
Kahneman《思考,快与慢》提出的认知框架:System 1 是快速、直觉化、低耗的自动判断;System 2 是慢速、需要刻意推理的高耗思考。本文将其映射到搜索智能体架构:判断“这篇文档相关吗、证据够吗、下一个点哪条链接”这类高频短决策归给 System 1(小模型直接打分),而规划、查询生成、答案写作归给 System 2(27B 大模型)。
论文的命名、架构分工和“不确定时上交大模型”的机制全部建立在这一区分之上,不理解双系统就无法理解其设计动机。
置信度校准与 ECE
校准指模型输出的概率与其预测的实际正确频率一致:预测置信 0.8 的判断应约 80% 正确。ECE(Expected Calibration Error,期望校准误差)把样本按预测置信度分桶,计算每桶平均置信度与实际准确率之差的加权平均,数值越低越校准。生成式 LLM 的置信度(无论口头报告还是 token 概率)普遍校准不良。
本文的核心卖点之一是把平均 ECE 相对自回归基线降低 41–74%,且置信门控完全依赖校准后的概率。
严格适当评分规则
一类损失函数(如交叉熵/对数损失、Brier 分数),数学性质是:当且仅当预测分布等于真实条件分布时损失取唯一最小值。因此用它训练能让模型学出具有真实概率含义的分布,而不只是把类别分对。
SLCD 的训练目标是交叉熵加 $\lambda_B$ 倍 Brier 损失,正因为两者都是严格适当评分规则,学出的决策分布才有可靠的概率语义,这是后续温度校准有效的前提。
温度缩放
最常用的事后校准方法:把 logits 除以温度 $T$ 再做 softmax,$T>1$ 使分布更平滑(降低过度自信),$T<1$ 使其更尖锐。在留出验证集上最小化负对数似然拟合单个标量 $T$,不改变选项排序,只调整置信度水平。
SearchJev 按 Choice/Score/Noul 三种输出类型各拟合一个温度(如 Choice 1.11、Noul 0.82–0.88),是 SLCD 流水线的最后一步,也是智能体使用的最终概率。
选择性预测与置信门控
Selective prediction:模型对低置信输入弃权,把判断交给更强的系统,用覆盖率换准确率。本文的规则是:当 $\max_{v \in V(f)} \tilde{p}_f(v) \ge \delta$ 时接受 System 1 的决策,否则该字段上交 System 2 重新判断,阈值 $\delta$ 控制上交比例。
这是双系统智能体协调快慢两个系统的核心机制,其收益(既快又准)直接建立在 System 1 校准良好的假设上。
研究动机
LLM 搜索智能体在执行轨迹中要反复做大量短决策:这篇文档相关吗?证据足以回答了吗?下一个该探索哪条链接?这些判断决定了哪些证据被采用、搜索如何推进。现有做法有两类困境:其一,为每类决策训练专用模型(如 monoT5 式重排器、Adaptive-RAG 式查询复杂度分类器),不同决策需要不同的模型和监督,异构且难以复用;其二,直接提示通用 LLM 以自回归方式生成 JSON 式判断,为高频短决策引入逐 token 顺序解码开销。更关键的是,生成式 LLM 的置信度——无论口头表达还是 token 概率——普遍校准不良(Kadavath et al. 2022;Tian et al. 2023;Xiong et al. 2024),而可靠的置信度恰恰是判断“这个决策能否直接接受、还是需要升级到更强推理”的前提。代价在端到端非常直观:在 BrowseComp-Plus 深度搜索任务上,System-2-only 智能体(27B)平均每题需 90.3 次 System-2 调用、73.7k 输出 token、中位活跃时间 4080 秒,其中大量算力被这些本可快速判断的短决策消耗。
本文的目标是本文要构建一个统一的、快速且校准良好的 System-1 搜索决策模型 SearchJev:给定搜索状态和决策 schema,不经自回归生成,直接从预训练 LM 的 logits 在合法选项上归一化出决策分布;用 Soft-Label Learning for Calibrated Decisions(SLCD)从带不确定性的软标签监督中学习这些分布并校准置信度;再把其嵌入双系统搜索智能体,System 1 处理短决策,System 2(27B)保留规划、查询生成与答案写作。量化目标有三:在同尺寸自回归基线上同时提升六类决策质量并降低 ECE;决策延迟提速 5 倍以上;端到端在 BrowseComp-Plus 上大幅缩短搜索时间且不降低(最好提升)答案准确率。
与已有工作不同的是,本文的独特切入有三点。第一,受 Jev(Almeida 2026,闭源的 System One 自动化模型)启发但完全独立设计,把“类型化概率输出”的思想引入搜索智能体场景,并补上 Jev 缺失的显式“不确定时上交慢推理”机制。第二,现有搜索决策监督散落在异构资源中、格式各异,本文将其统一形式化为“状态-schema 对 + 字段级软标签”,让一个模型同时覆盖路由、改写、相关、充分性、导航、验证六类决策和 Choice/Score/Noul 三种输出类型,而不是一类决策一个模型。第三,多数加速工作只看延迟,本文把决策质量、校准、延迟三者同时作为目标,并用置信门控把校准与端到端效率在机制上连接起来——校准不再只是报告指标,而是决定何时调用大模型的运行时信号。
核心方法
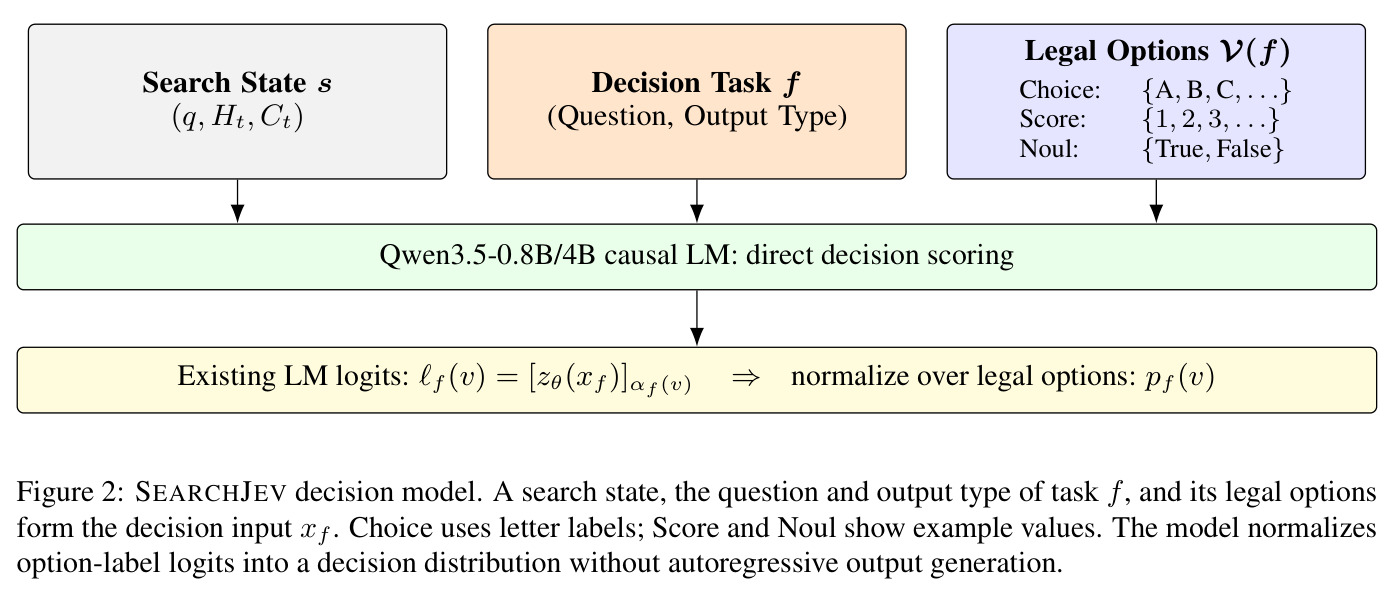
直觉:人做搜索时大部分判断是“扫一眼就知道”的快思考——这个结果相关吗?证据够吗?点哪条链接?这些不该每次都惊动会写长推理的大模型。SearchJev 把这类判断变成条件多分类问题:为每个决策任务(字段 $f$)列出全部合法选项 $V(f)$,每个选项绑定词表中现成的单 token 标签(如 A/B、True/False),把搜索状态、任务问题、输出类型和选项列表拼成输入 $x_f$,在第一个输出位置直接读取合法标签 token 的 logits $\ell_f(v) = [z_\theta(x_f)]_{\alpha_f(v)}$,仅在合法选项上 softmax 归一化得到 $p_f(v)$——零自回归解码、零新增参数(复用原 LM head)。训练用 SLCD:以软目标 $t_f$ 表达监督源的不确定性,用加权交叉熵加 Brier 损失拟合分布,再按输出类型各拟合一个温度 $T_{\kappa(f)}$ 校准。最后嵌入双系统智能体:置信度 $\max_v \tilde{p}_f(v) \ge \delta$ 就接受决策,否则上交 System 2,后者保留规划、查询生成与答案写作。
核心创新是把“生成式判断”分解为“schema 条件化的直接概率预测 + 软标签学习 + 分类型校准 + 不确定上交”,并用一个模型统一六类决策。与已有方法的本质区别:(1) 相比逐 token 生成 JSON 的自回归基线,SearchJev 不生成任何输出 token,只对合法标签做一次 logit 读出,把决策延迟从 144–195ms 压到 27–37ms,同时天然免除 JSON 解析;(2) 相比每类决策一个专用模型(重排器、意图分类器),schema 把决策问题、合法选项写进输入文本,同一骨干换 schema 即可切换任务,一个模型服务多种判断;(3) 相比直接拿 LM token 概率当置信度,SLCD 用按监督源赋权的软标签加上两个严格适当评分规则(交叉熵 + Brier)再叠加按输出类型的温度校准,让输出分布具有可靠概率语义——论文还给出 Proposition 1:对二值决策,当校准误差为零时,基于该分数的决策规则期望效用与“用同一分数能构造的最优规则”之差不超过 $2 U_{max} \cdot \mathrm{ECE}(\rho)$,把校准和决策效用定量挂钩。
方法步骤详情
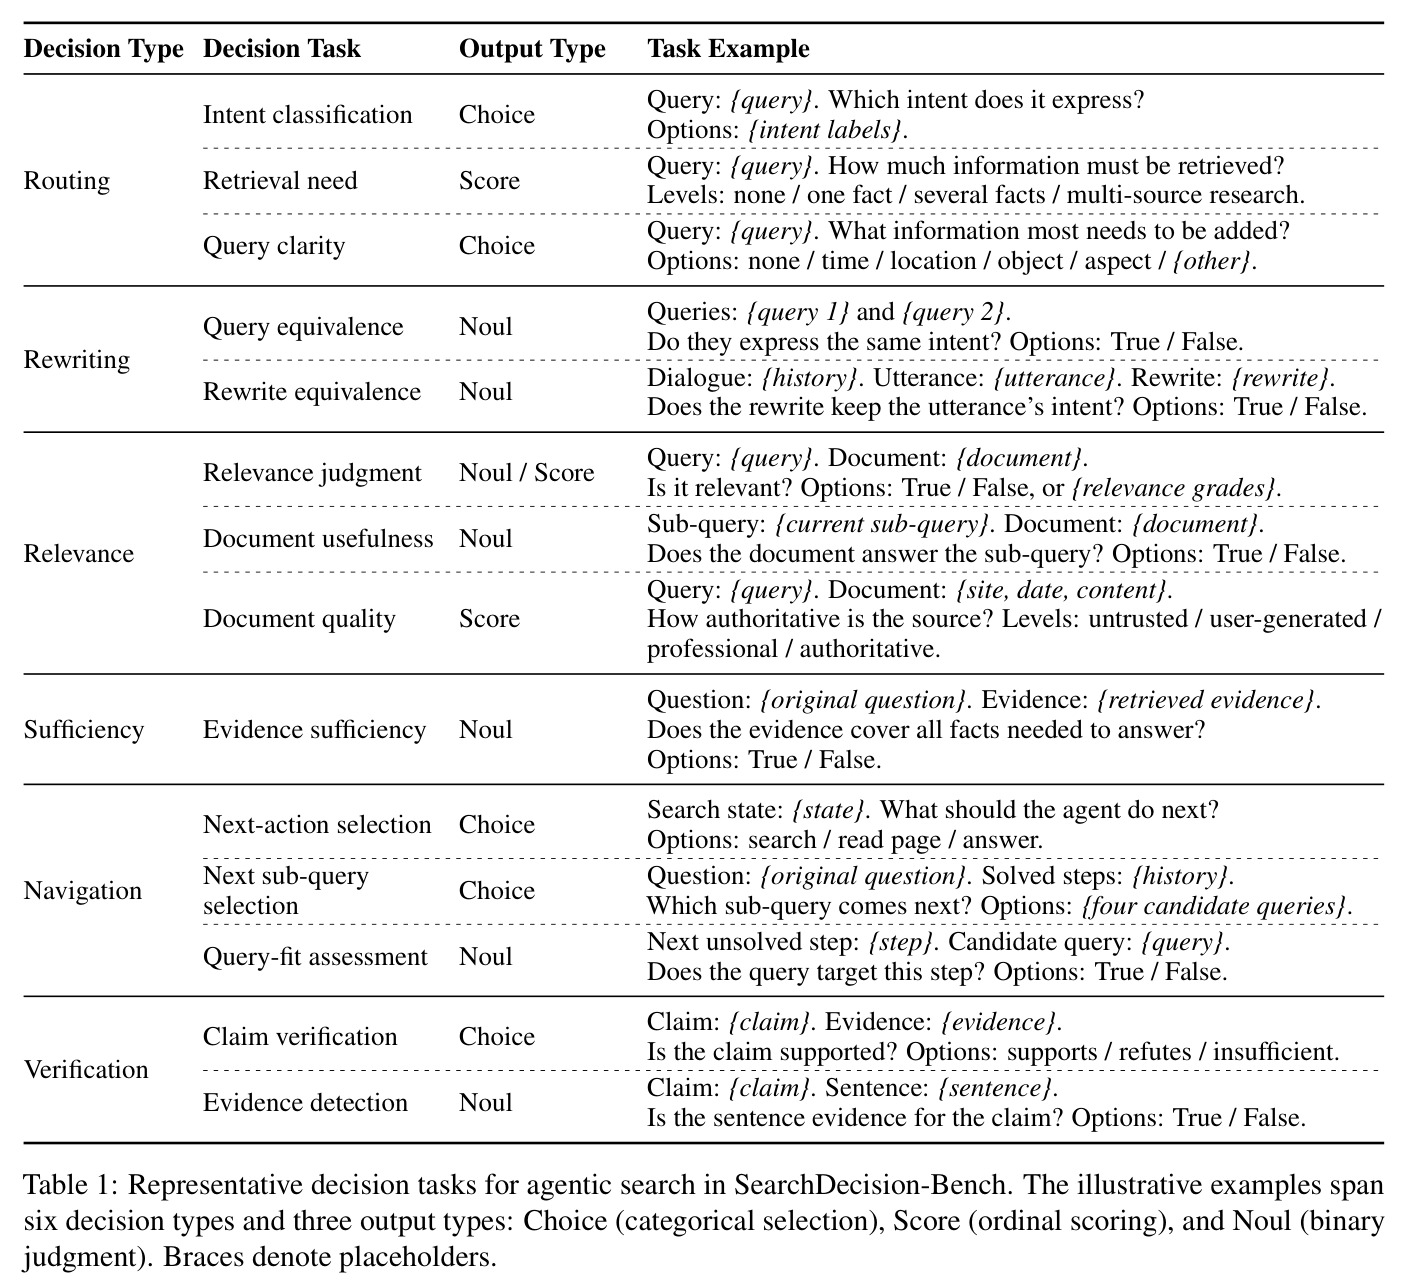
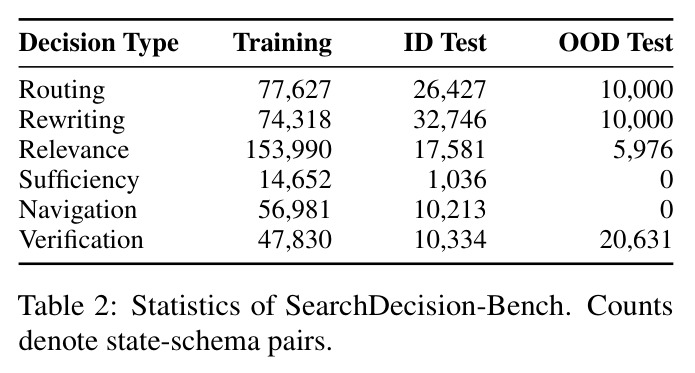
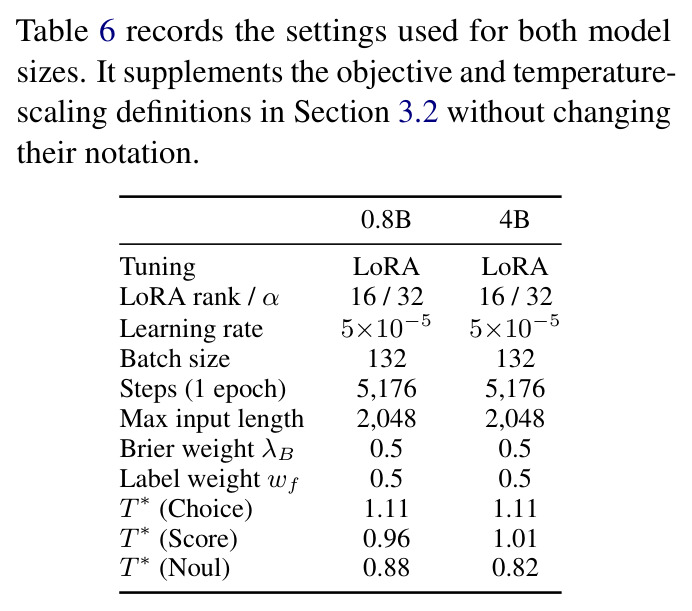
第一步,构建 SearchDecision-Bench:把 BANKING77、LCQMC、T2Ranking、DuReader-Retrieval、MuSiQue、VitaminC 等异构资源统一转换为“序列化状态 + schema 字段 + 软目标”,覆盖路由、改写、相关、充分性、导航、验证六类,共 487,012 条训练行、683,130 条训练决策(中文约 63.7%);LLM 标注的 33.7% 训练行及演示、构造改写在损失中权重 $w_f=0.5$,其余为 1,并做中英改写增强与选项排列去偏。第二步,训练:从 Qwen3.5-0.8B/4B 初始化,LoRA(rank 16、$\alpha$=32),学习率 $5\times10^{-5}$、batch 132、1 epoch(5,176 步)、输入上限 2,048 token,损失为 $w_f$ 加权的交叉熵加 $\lambda_B=0.5$ 倍 Brier 损失。第三步,校准:在 5,000 条验证决策上按输出类型拟合温度 $T$(Choice 1.11、Score 0.96–1.01、Noul 0.82–0.88),得 $\tilde{p}_f(v) \propto \exp(\ell_f(v)/T_{\kappa(f)})$。第四步,双系统执行:System 2 规划并生成查询,检索器返回文档;System 1 按 schema 批量输出相关性、充分性等分布;置信门控把高置信决策交给搜索控制器执行 search/open/rerank/stop,不确定的上交 System 2(关闭思考、约束 JSON 输出);停止后由 System 2 综合证据作答,验证字段的支持概率作为答案支持分。
技术新颖性
技术组件大多有先例,新颖性体现在组合与任务形式化层面。Token-logit 读出在 GLiNER/GLiClass 等 schema 条件化分类器中已出现,但 SearchJev 面向的是搜索智能体的序贯决策场景,支持 Choice/Score/Noul 三种类型,且接口约束极轻——只要求选项标签为单 token,选项描述可以是多 token。SLCD 的组合是新的:软目标按监督源赋信度权重、交叉熵与 Brier 联合拟合、按输出类型分桶做温度校准,形成“学概率→校准概率”的完整管线,区别于传统的硬标签分类或纯事后校准。把选择性预测(Geifman & El-Yaniv 2017)用作双系统切换规则,把校准与端到端智能体效率在机制上挂钩,也是文献中少见的做法。与闭源 Jev 相比,本文给出了可复现的开放实现路线,并发布了统一六类决策、含 ID/OOD 划分的基准。局限在于没有单组件级的方法创新(LoRA、温度缩放、proper scoring rules 均为已知技术),理论保证(Proposition 1)也只覆盖二值决策。
实验结果
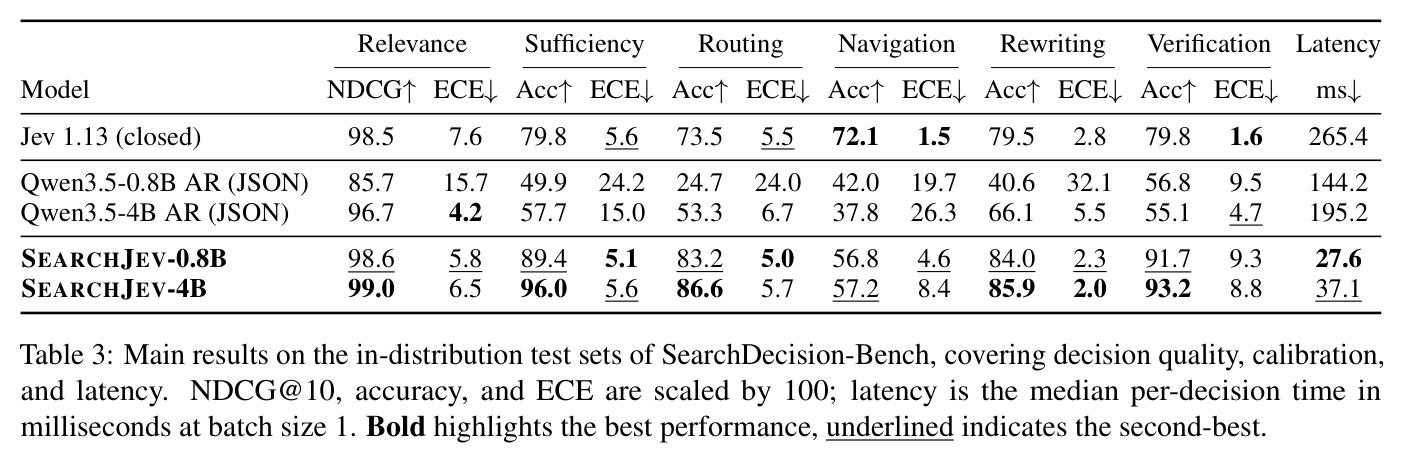
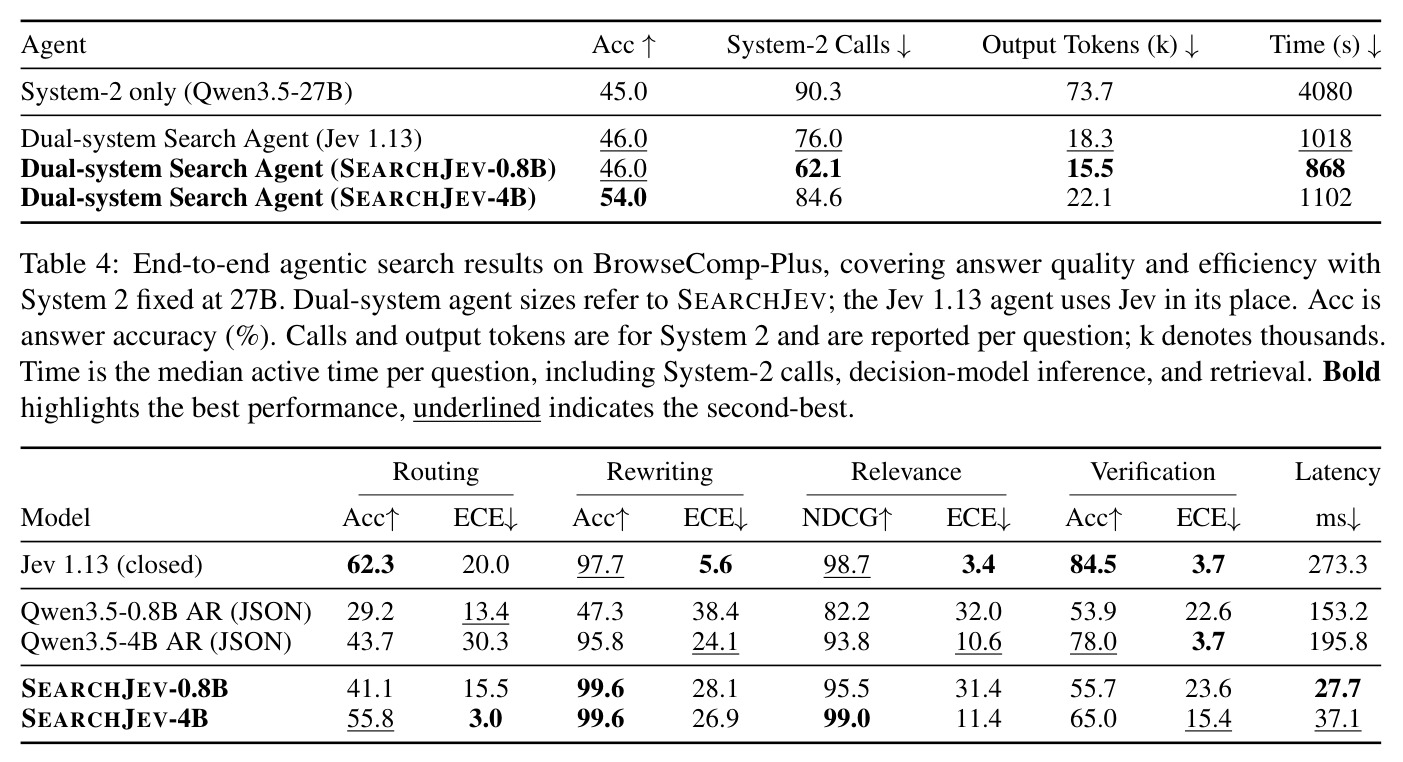
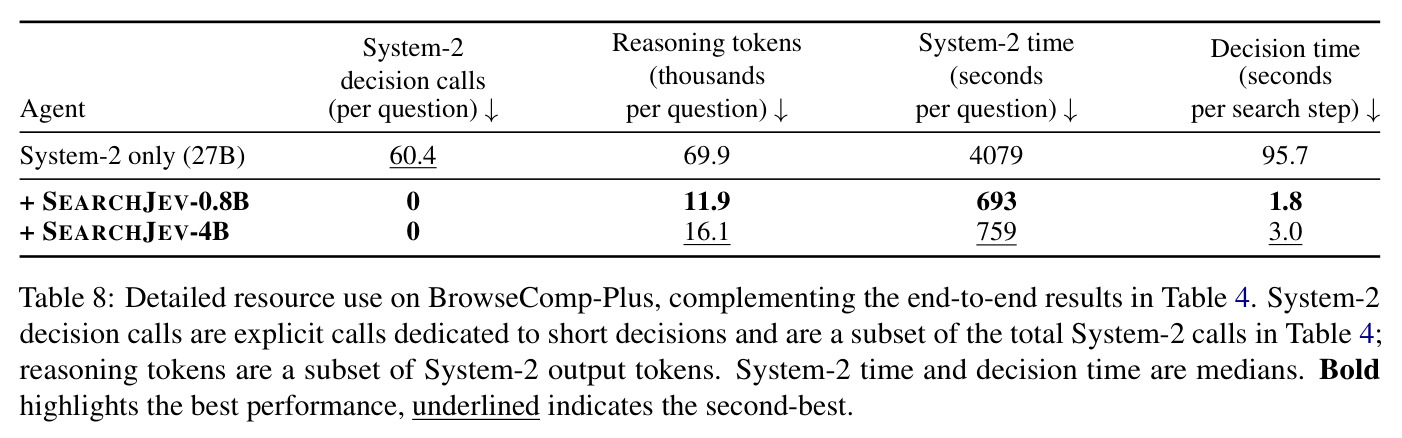
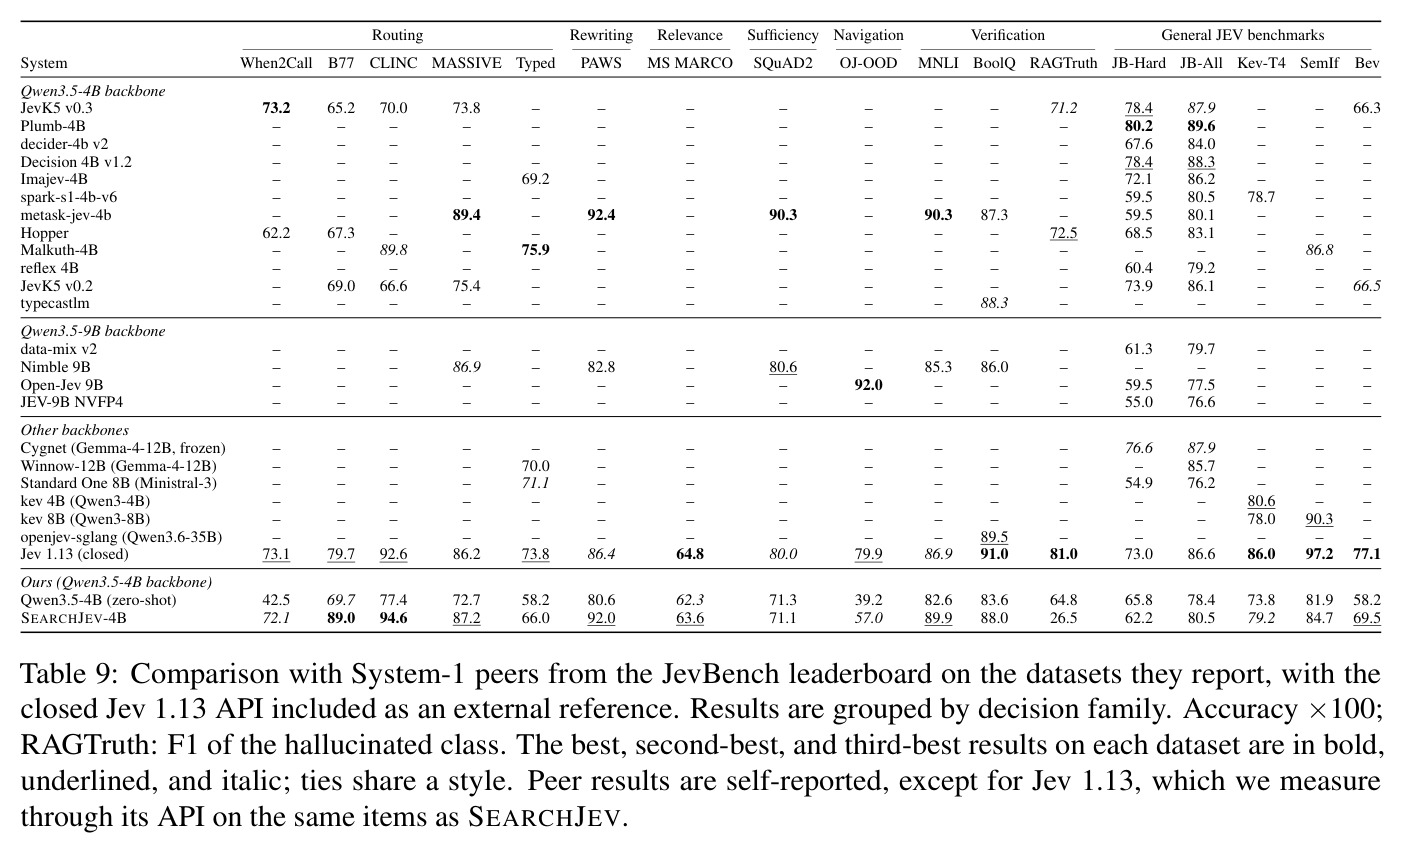
决策级(Table 3,ID 测试):SearchJev-0.8B/4B 全面超过同尺寸 Qwen3.5 AR (JSON);对 Jev 1.13,充分性 96.0 vs 79.8、路由 86.6 vs 73.5、改写 85.9 vs 79.5、验证 93.2 vs 79.8,相关性相当(99.0 vs 98.5 NDCG@10),导航较弱(57.2 vs 72.1)。平均 ECE 较同尺寸 AR 降 74.4%/40.7%;延迟 27.6/37.1ms,比 AR(144.2/195.2ms)快 5.2–5.3 倍、比 Jev(265.4ms)快 7.2–9.6 倍。端到端(Table 4,BrowseComp-Plus 100 题,System 2 固定 27B+BM25):System-2-only 45.0% 准确、90.3 次 System-2 调用/题、73.7k 输出 token、4080s 中位活跃;SearchJev-0.8B 智能体 46.0%、62.1 次、15.5k、868s;SearchJev-4B 智能体 54.0%(较 Jev 智能体 +8.0 个百分点)、84.6 次、22.1k、1102s——相对基线加速 3.7–4.7 倍、token 少 3.3–4.8 倍。Table 8:短决策的显式 System-2 调用从 60.4 次/题降为 0,每搜索步决策时间 95.7s → 1.8/3.0s。OOD(Table 5):路由较同尺寸 AR 高 11.9–12.1 个百分点、改写超 Jev(99.6 vs 97.7)、相关性 4B 领先(99.0),但 Jev 在路由与验证上仍更强。JevBench 横评(Table 9):BANKING77 89.0、CLINC150 94.6 为最高报告分,但 RAGTruth F1 仅 26.5(对手 71.2–81.0)、JB-Hard 62.2 低于 zero-shot 骨干 65.8,提示部分分布存在训练回退。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六类搜索短决策(SearchDecision-Bench ID) | 平均 ECE | SearchJev-0.8B/4B | 同尺寸 Qwen3.5 AR (JSON) | 平均 ECE 下降 74.4%(0.8B)/ 40.7%(4B) |
| 单决策延迟(batch=1) | 中位延迟 ms | 27.6(0.8B)/ 37.1(4B) | AR (JSON) 144.2/195.2;Jev 1.13 265.4 | 比 AR 快 5.2–5.3×,比 Jev 快 7.2–9.6× |
| 证据充分性判断 | 准确率(×100) | 96.0(SearchJev-4B) | Qwen3.5-4B AR 57.7;Jev 1.13 79.8 | +38.3 vs 同尺寸 AR;+16.2 vs Jev |
| 端到端 agentic search(BrowseComp-Plus) | 答案准确率 % | 54.0(SearchJev-4B 双系统) | System-2-only 45.0;Jev 1.13 双系统 46.0 | +9.0 vs System-2-only;+8.0 vs Jev 智能体 |
| 端到端搜索效率(BrowseComp-Plus) | 中位活跃时间/输出 token | 868s/15.5k(0.8B);1102s/22.1k(4B) | System-2-only 4080s/73.7k | 加速 3.7–4.7×,token 减少 3.3–4.8× |
| OOD 路由(FRAMES 等 held-out 集) | 准确率(×100) | 55.8(4B)/ 41.1(0.8B) | Qwen3.5 AR (JSON) 43.7 / 29.2 | +12.1 / +11.9 个百分点 |
局限与改进
作者承认的(Section H):仅评估中英文文本搜索决策,端到端只在 BrowseComp-Plus 的 100 题上单次运行;决策接口假设合法选项可在 schema 中枚举,开放式生成仍留给 System 2;其他语言、模态、领域待验证;约三分之一训练行由 LLM 标注、派生标签依赖过滤模型,数据偏差可能影响泛化。我的独立观察:其一,导航是六类中唯一全面弱于 Jev 的(ID 57.2 vs 72.1),暗示“选下一个子查询”这类带任务级规划色彩的决策可能不适合压缩进 System 1;其二,OOD 校准迁移不稳定——准确率迁移好于校准迁移,4B 的 OOD ECE(改写 26.9、验证 15.4)反而高于 ID,置信门控在分布外可能失灵;其三,Table 9 中 RAGTruth F1 26.5、JB-Hard 低于 zero-shot 骨干,提示 SLCD 训练可能带来过度自信或对训练 schema 的过拟合;其四,端到端仅 100 题单次运行,54.0% vs 46.0% 的差距统计置信有限,且置信阈值 $\delta$ 的取值论文承认无法从日志恢复、未披露。
独立分析的弱点
弱点一:置信门控依赖未披露的标量阈值 $\delta$ 且全字段统一——附录 D.3 承认日志无法恢复 $\delta$;生产环境中漏判与误上交的代价因任务而异,静态阈值难适配。改进:以代价敏感效用直接优化上交策略,或按字段在验证集上自动选 $\delta$。弱点二:温度按三种输出类型全局共享,而同类型内字段难度差异巨大(相关性 ID ECE 5.8 vs 验证 OOD 23.6)。改进:按字段或字段簇拟合温度,或用输入自适应的温度网络。弱点三:单 token 标签使每字段只能输出单一选项分布,无法表达选项间依赖或 top-k 结构化输出,合法选项过多时也受限。改进:为需联合判断的字段组引入轻量结构化头,必要时回退受限自回归。弱点四:端到端评测规模小且基线窄——只对比了自家框架消融,未与 Self-RAG、FLARE、Adaptive-RAG 等自适应检索方法在相同 System 2 下比较,100 题单次运行放大方差。改进:扩到 500 题以上、多种子重复、补齐外部基线。弱点五:约三分之一标签来自 LLM,噪声权重固定 0.5 而非估计噪声率。改进:用置信学习估计各源噪声率并据此设置 $w_f$,或先做一致性过滤再训练。
未来方向
作者在附录 J 中提出:把 SearchJev 扩展到 agent-centric 信息访问、购物智能体、对话推荐、多智能体信息抽取、科学发现、rubric 式研究评估、法律问答等更广的决策场景;探索知识感知微调(KnowTuning)与偏好对齐(DPO、MACPO)进一步提升决策质量;并建议配合认知偏差审计(Binz & Schulz 2023)与公平性、透明性检查。基于其成果还可延伸:(1) 把 SLCD 推广为校准的过程奖励模型,为 System 2 的每步生成打置信分,实现步级提前退出或投机式双系统执行;(2) 在线自改进闭环——System 2 裁决的上交样本是高价值反馈,可用于持续微调 System 1 以逐步降低上交率;(3) 把 schema 条件化直接预测推广到多模态状态(截图、表格、API 返回)与工具调用决策;(4) 理论上把 Proposition 1 从二值决策推广到多类与序数 Score 的效用界,为阈值选择提供原则性依据。
复现评估
论文在 Ethics Statement 承诺开源代码(页面有 Code/Models 占位,写作时点仓库尚未确认放出)。数据方面,SearchDecision-Bench 由约 40 个公开数据集拼装(中英文意图分类、改写等价、段落检索、事实验证等),Table 10 逐一核查了许可证:多数为 Apache-2.0/MIT/CC 系列,但 LCQMC、BQ、AFQMC、ATEC 等未声明许可证,MS MARCO 限非商业研究;query 评估与 query-document quality 子集为自建。训练开销很低:0.8B/4B 均 LoRA(rank 16),单 epoch 5,176 步、batch 132、输入 2,048 token、bf16,单卡可承受;推理只需一次前向的 logits 读出。复现难点集中在三处:数据管线(状态序列化、软标签赋信度、LLM 过滤与改写增强)、端到端协议(BrowseComp-Plus 100 题、LLM judge、$\delta$ 未披露)、以及依赖 Jev 1.13 闭源 API 的对比(2026 年 10 月版本,结果可能随版本变化)。总体:决策级实验复现难度中等偏易,端到端智能体实验中等偏难。
论文图表
结果总览图。(a) 在 SearchDecision-Bench 上,SearchJev 相对同尺寸 Qwen3.5 自回归模型取得 5.2–5.3 倍决策加速,同时六类决策准确率更高;(b) 在 BrowseComp-Plus 上,双系统智能体(27B System 2 + SearchJev)以 3.3–4.8 倍更少输出 token、3.7–4.7 倍更快活跃时间,把答案准确率从 45% 提升到最高 54%。
一图浓缩论文两大层面的核心结论(决策级提速提质、端到端提速提准),是快速判断论文价值的入口。