Chinese-Jev:面向中文语言的系统一决策模型 Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
统一概率目标+轻量编码器,中文决策任务精度超闭源Jev且快20倍
前置知识
系统一(System One)决策模型
与逐 token 生成开放回复的生成式大模型不同,系统一模型只输出受限的决策结果。论文中的 Jev 定义了三种决策形式:choice 在候选选项中选择、noul 判断命题真伪、score 给出有序评分,并附带每个候选的概率。这类模型通常基于小型编码器,在单次前向中完成决策,延迟和成本比调用大模型低一两个数量级,输出结构化概率可直接被下游软件消费。
全文的模型形态、数据格式与评价指标(ACC/ECE/延迟)都围绕这三种决策类型展开,理解它们是读懂数据构造、读出方式与实验设计的全部前提。
编码器-only 骨干与候选打分头
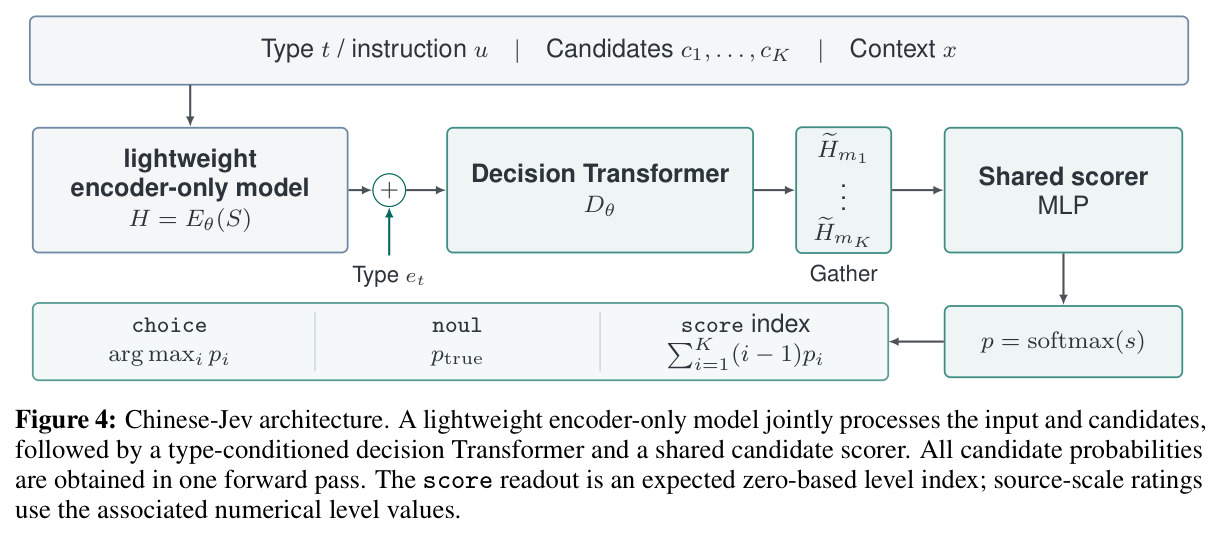
中文-Jev 用 mmBERT-base(22 层、隐藏维 768)双向编码器把指令、全部候选与上下文串成一条序列 $S$,在每个候选 $c_i$ 前插入标记,取标记位置表示,经两层决策 Transformer 加类型嵌入 $e_t$ 后,由共享 MLP $f_\theta$ 打分,softmax 得 $p_i = \exp(s_i)/\sum_j \exp(s_j)$,一次前向同时完成所有候选打分。
这是模型能保持 14ms 中位延迟的架构根源,也是理解它与 LLM 打分基线(Qwen3.5-2B,280ms)在速度上差 20 倍的关键。
期望校准误差(ECE)
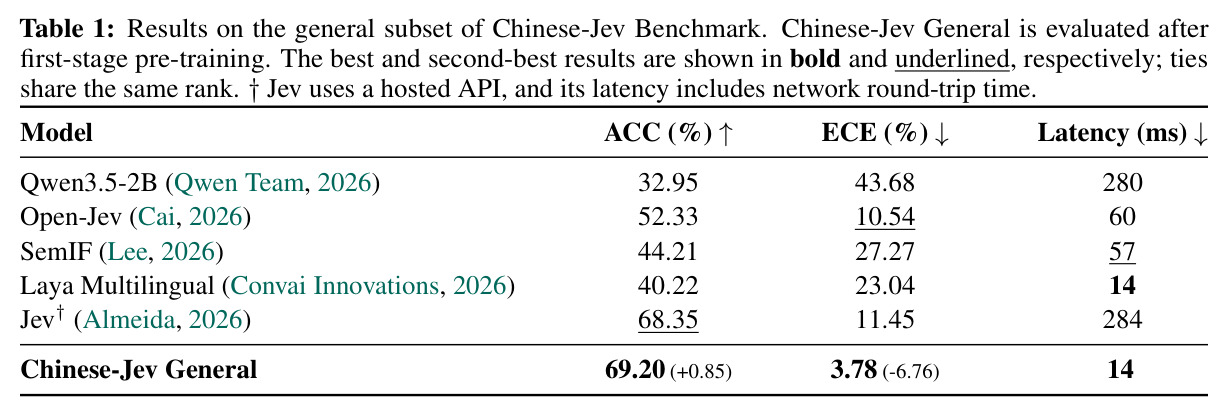
ECE 衡量模型置信概率与真实正确率的差距:按预测置信度分 15 个等宽 bin,计算每格内置信度与经验正确率之差的加权平均。ECE 高意味着模型说'90% 确信'时实际往往没这么准。论文中闭源 Jev 的 ECE 为 11.45%,中文-Jev 通用模型降到 3.78%。由于系统一模型的概率被软件直接使用,校准与精度同等重要。
论文多处用 ECE 支撑核心卖点(11.45%→3.78%,降 67%),且领域微调后校准不一致是其重要局限,不懂 ECE 无法理解这些结论。
RLCD(基于候选分布扰动的强化微调)
训练目标为 $\mathcal{L} = \mathcal{L}_{CE} + \mathcal{L}_{RL}$:除对目标分布 $y$ 的交叉熵 $\mathcal{L}_{CE} = -\frac{1}{B}\sum_b\sum_i y_b^i \log p_b^i$ 外,RLCD 对每个决策的候选 logits 采样 4 次中心化高斯扰动(复用同一前向),用 log/spherical 分数衡量扰动后与目标分布的一致性作为奖励,有序评分任务额外加入排序概率分数 RPS,再做带 detached advantage 的策略梯度更新。
这是训练配方的核心组成,也是中文-Jev 相对仅用交叉熵的 Laya 初始化(40.22%)提升到 69.20% 的关键环节之一,复现时不可绕过。
研究动机
路由用户请求、判断段落相关性、从候选中选答案这类任务只需要一个标签或分数,却被普遍实现成反复调用生成式大模型:论文测得 Qwen3.5-2B 在中文决策基准上单次延迟约 280ms,闭源 Jev 托管 API 因含网络往返高达 284ms,高并发场景成本可观。更关键的是现有模型在中文上的决策能力薄弱:Laya Multilingual 在 CJ-Bench 通用子集只有 40.22% 精度、ECE 高达 23.04%,Qwen3.5-2B 仅 32.95%;闭源 Jev 虽达 68.35% 但延迟高、未针对中文语料优化。已有的中文开源尝试也都很窄:Qwen3-1.7B-Jev 只做足球领域问答,MacJev 只覆盖双语工具路由与任务状态检查,缺少覆盖通用任务加垂直领域的统一中文系统一模型。
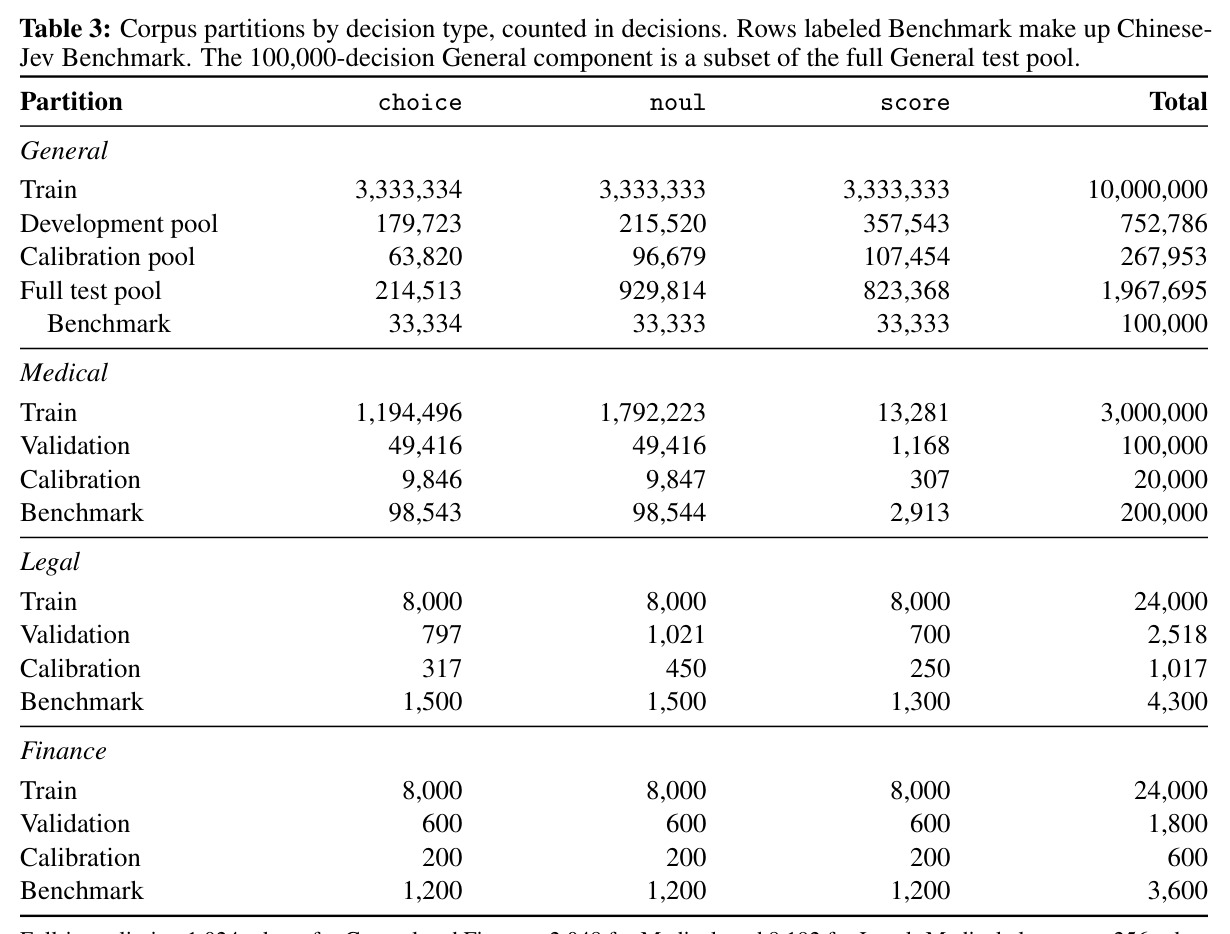
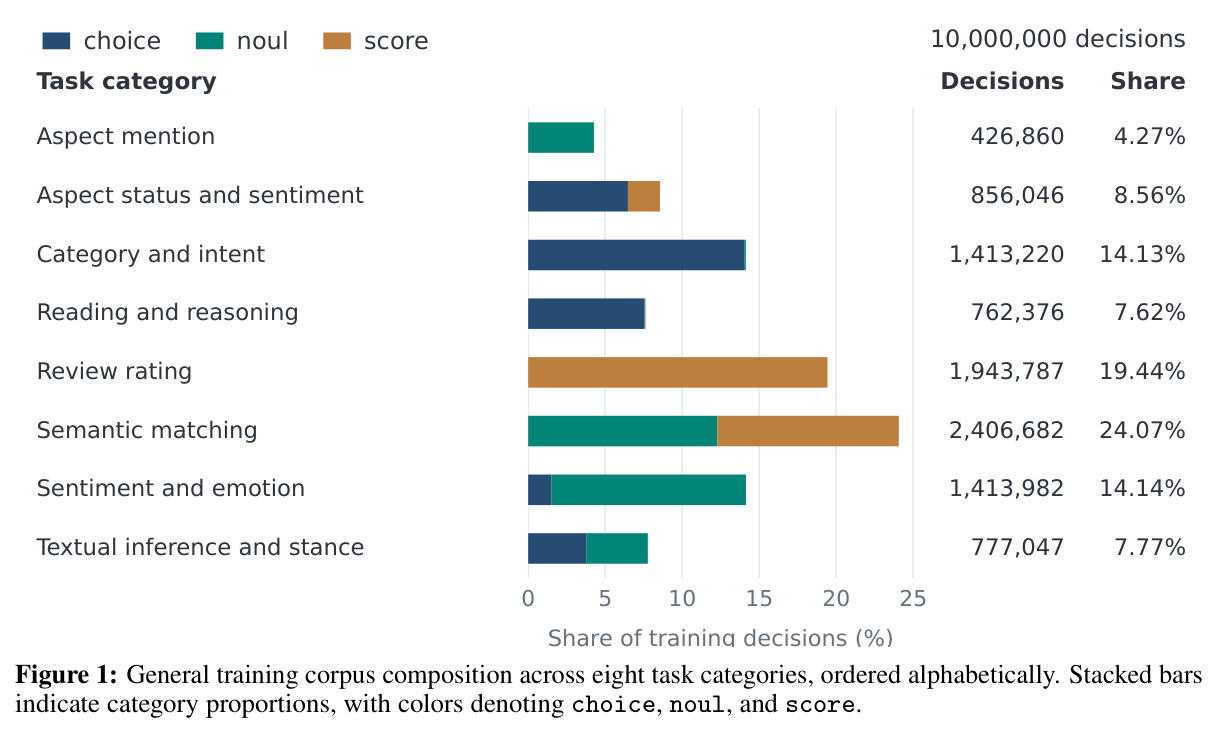
本文的目标是构建一个覆盖通用任务及医疗、法律、金融三大领域的中文系统一模型:把异构中文标注统一转换成候选选项上的概率目标,用轻量 encoder-only 骨干实现单次前向的候选打分;先在 1000 万条通用决策语料上预训练出中文-Jev General,再分别微调出三个领域专家模型;同时发布 CJ-Bench(30.79 万条 held-out 决策,通用 10 万、医疗 20 万、法律 4300、金融 3600 条)统一评测精度、校准与延迟;并验证 INT8 量化后在手机浏览器上约 1 秒/次的端侧推理可行性,承诺开源模型、数据、基准与代码。
与已有工作不同的是,本文的独特切入有三点:一是监督形式——不同于把分类、命题判断、有序评分当作不同任务分别建模,统一表达为候选上的概率分布 $y$,多标注数据(如 USTS 的 19 个人工评分)可转成软目标,保留评分者间方差;二是训练路线——针对多语言预训练与中文下游场景的错配,采用'通用预训练→独立领域微调'两阶段,全程不改架构、不加参数、不换接口,应用方以同一方式调用通用与专家模型;三是评测协议——CJ-Bench 完全取自自建语料的 held-out 测试分区,同一源材料强制进入同一分区以杜绝源级泄漏,并同时报告 ACC、ECE 与同机实测延迟,避免只报精度造成误导。
核心方法
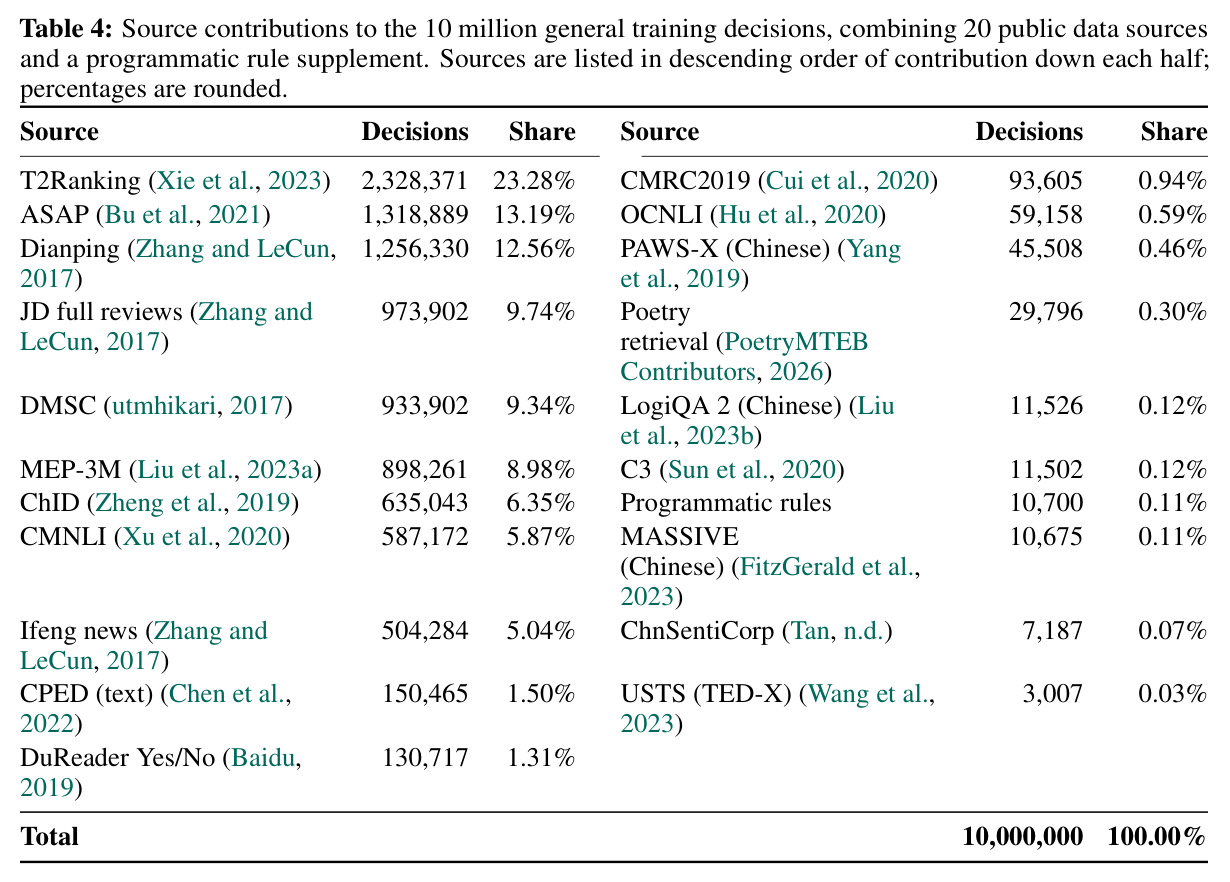
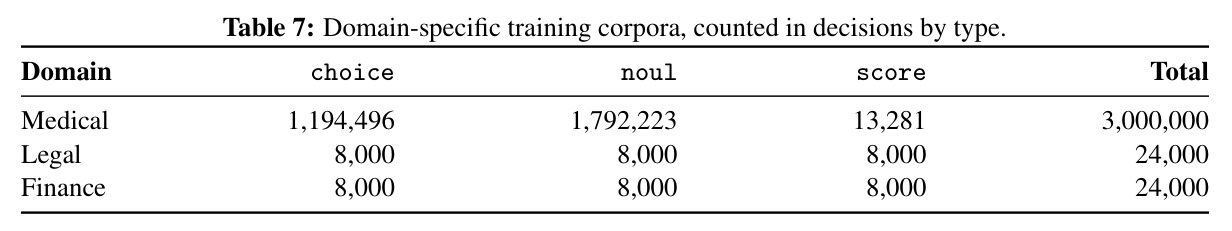
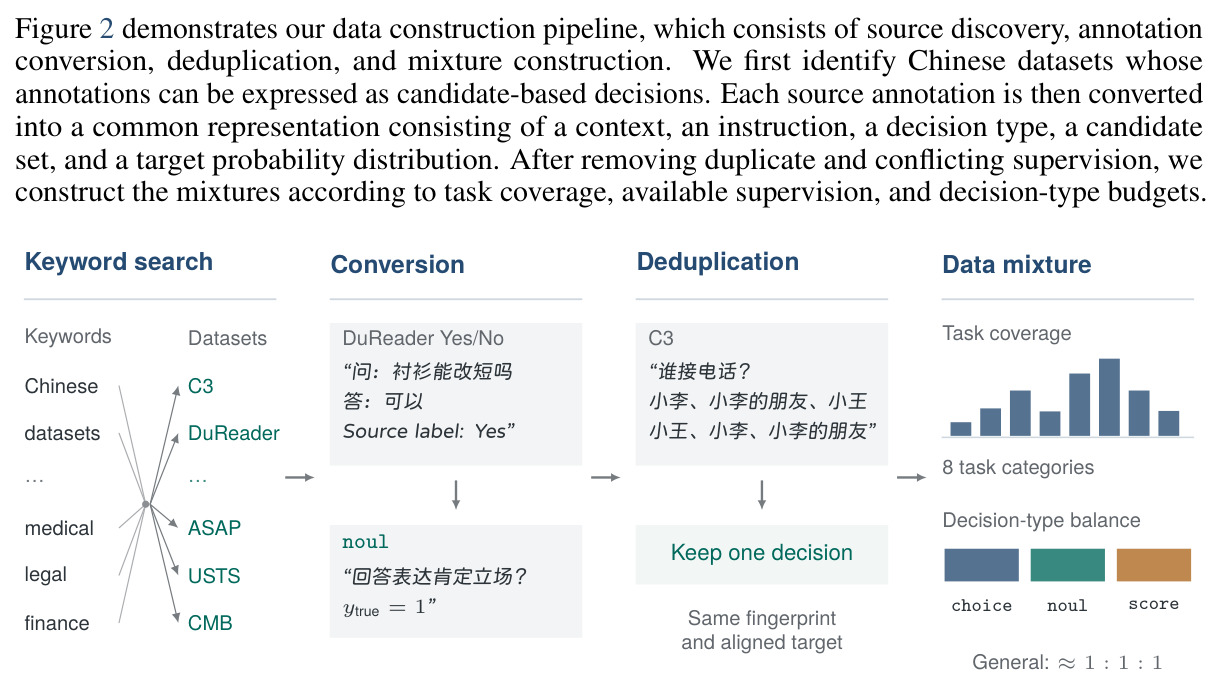
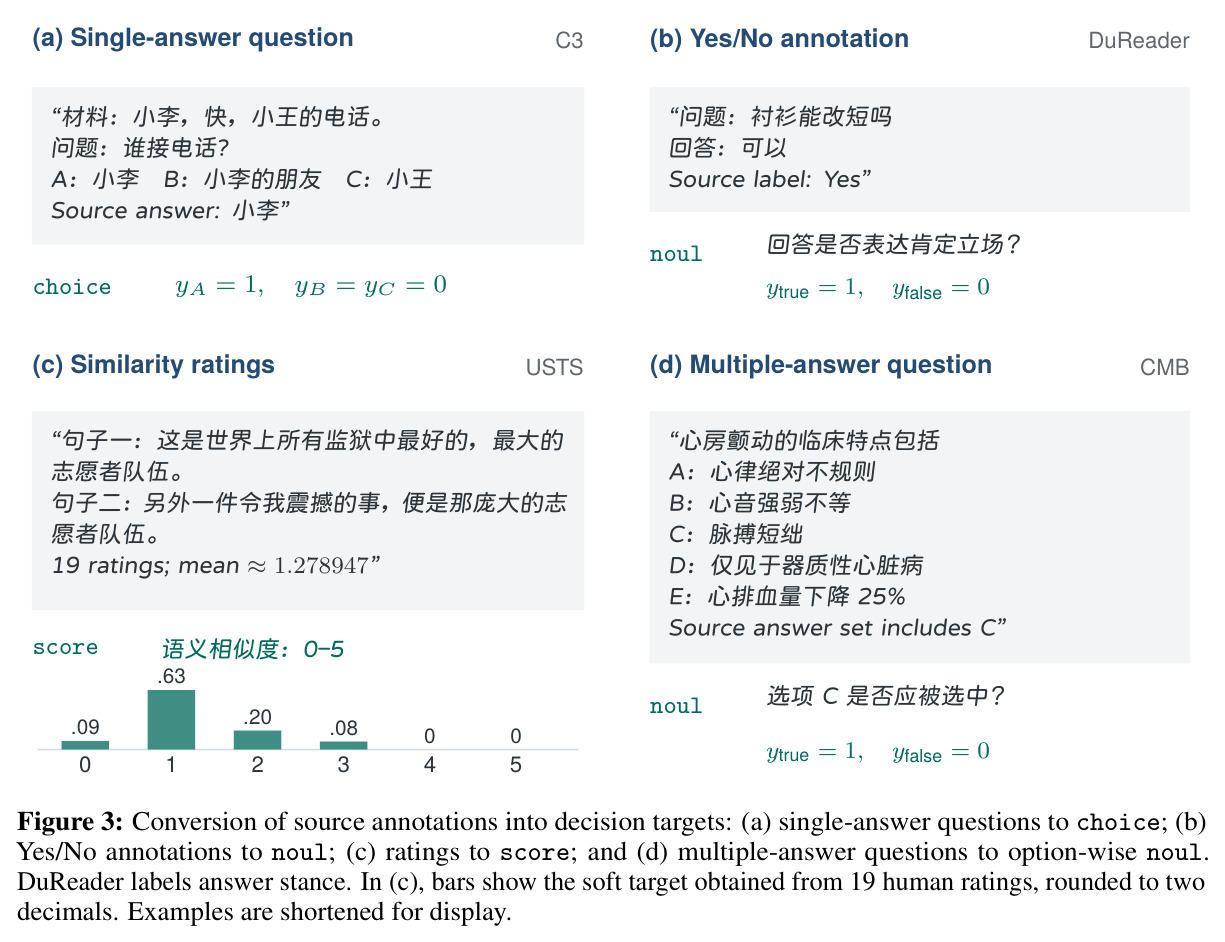
整体思路是'统一格式 + 轻量骨干 + 两阶段训练'。直觉上,把所有中文决策任务改写成同一个问题:给定上下文 $x$、指令 $u$、类型 $t$ 和候选列表 $C=(c_1,\ldots,c_K)$,预测候选上的目标分布 $y$。技术上分四步:(1) 数据管线:按中文/任务/领域关键词检索公开数据集(C3、T2Ranking、ASAP、USTS、CMB、LeCaRDv2、FinRE 等)并追溯聚合集到原始源;(2) 标注转换:单答案题转 choice、是非标注转 noul、评分转 score、多选题拆成逐选项 noul,另构造 1.07 万条规则合成决策;(3) 去重与分区:按指纹哈希去冲突,同源材料进同一分区;(4) 模型与训练:mmBERT-base 编码整条序列,类型嵌入加两层决策 Transformer 后用共享 MLP 对全部候选一次打分,以交叉熵加 RLCD 为目标,在 8×H200 上先对 1000 万条通用语料训 1 epoch,再对医疗(300 万条)、法律/金融(各 2.4 万条)各微调 4 epoch。
核心创新是把异构中文监督统一为候选概率目标,并用类型条件化的编码器一次前向完成决策。与 NLI 式分类器把输入当前提、每个标签当假设的做法不同,中文-Jev 把类型 $t$、指令 $u$、全部候选与上下文 $x$ 串接为单序列 $S$,在候选前放标记位置 $m_i$,编码得 $H = E_\theta(S)$,加类型嵌入 $e_t$ 后过决策 Transformer $D_\theta$ 得 $\tilde{H}$,共享 MLP 输出 $s_i = f_\theta(\tilde{H}_{m_i})$,softmax 后得到候选概率 $p$。读出方式随类型而定:choice 取 $\arg\max_i p_i$,noul 输出 $p_{true}$,score 读出期望零基等级索引 $\sum_{i=1}^{K}(i-1)p_i$(源量表上为 $\sum_i v_i p_i$)。这一设计使三种决策、八个任务类别共享同一接口,领域专家化时模型结构与调用方式完全不变。
方法步骤详情
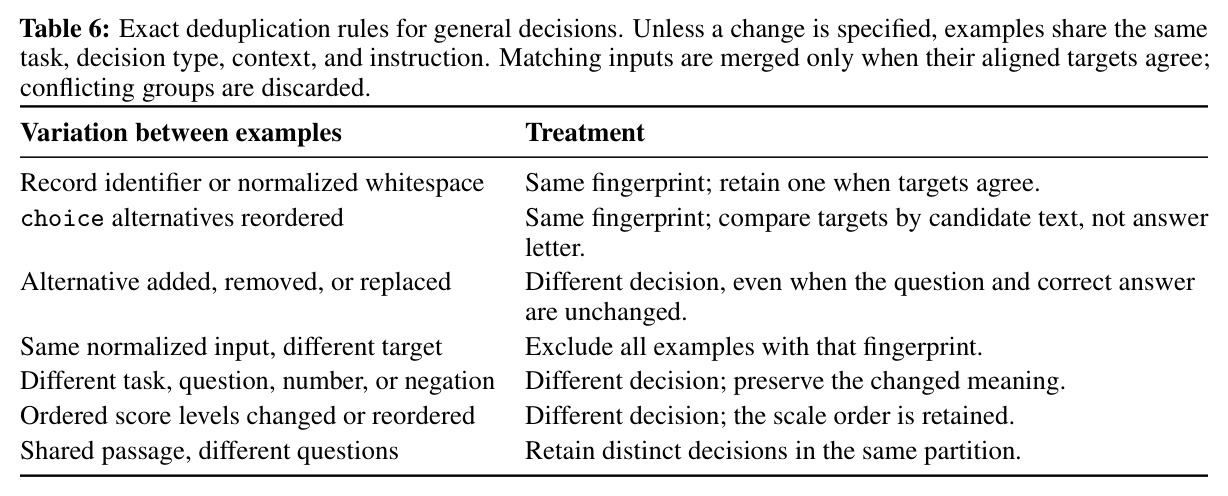
数据构造四阶段:源发现——按中文/任务/领域关键词检索论文与 Hugging Face,保留可表达为候选决策的中文标注;标注转换——单答案/类别标签给正确候选概率 1,是非标注映射为 $y=(1-z,z)$,离散评分全质量压到标注级,连续评分(USTS)在相邻整数级间分配概率再按 19 个评分者平均成软目标,多选题按 $y^{(j)}=(1-z_j,z_j)$ 拆成逐选项 noul;决策级去重——归一化后 choice 候选排序、noul/score 保序,计算指纹 $h=H(r,t,N(x),N(u),\hat{C}_t)$,刻意排除目标以检测冲突监督:目标一致保留一条、冲突整组丢弃;混合构建——通用语料约 1000 万条、八类任务,choice:noul:score≈1:1:1。训练阶段从 Laya Multilingual 初始化 mmBERT-base 加两层决策头共约 3.22 亿参数,全参微调:通用 1 epoch,领域各 4 epoch;RLCD 每决策采 4 次扰动 logits,奖励含 log、spherical 分数,score 任务加 RPS。
技术新颖性
技术新颖性体现在四点:(1) 统一概率目标——把类别标签、命题判断、有序评分、多评分者分布全部表达为候选概率目标,软目标保留评分者方差与均值,这是中文决策语料构建上前所未有的系统做法;(2) 决策级去重协议——指纹中刻意不含目标分布以便检测冲突监督,choice 按候选文本排序使指纹对独立选项的排列不变(同时保留对内容的敏感性),同源材料强制同分区,从数据层面堵住训练/评测泄漏,这套协议本身可作为可复用贡献;(3) 类型条件化决策头——在不动编码器延迟特性的前提下,加 2 层决策 Transformer 与类型嵌入,使 3.22 亿参数模型在 14ms 延迟下把 Laya 的 40.22% 提到 69.20%,证明错配主要在监督信号而非容量;(4) RLCD 奖励为有序评分引入 RPS,使策略梯度与等级间距离对齐,而非只看分布匹配。
实验结果
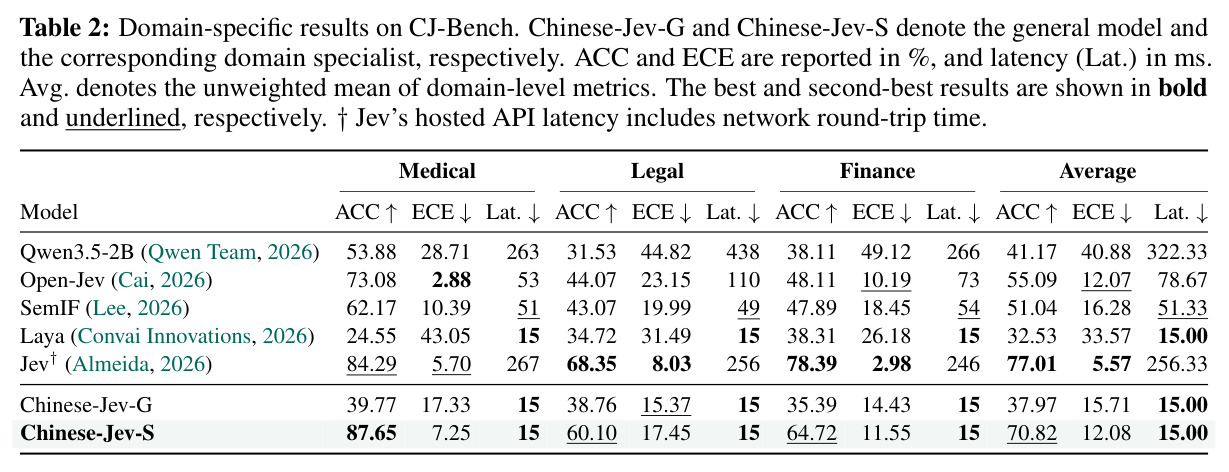
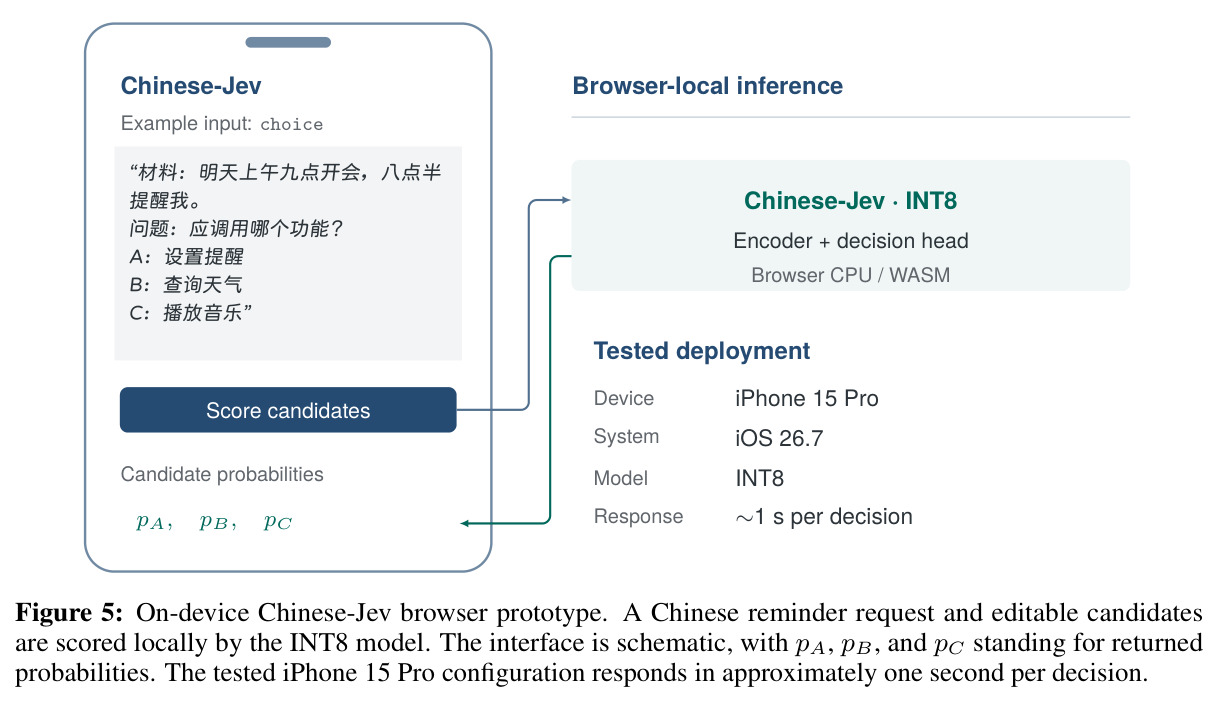
通用子集(Table 1):中文-Jev General 达 69.20%,超闭源 Jev 的 68.35%(相对 +1.24%),ECE 从 11.45% 降至 3.78%(降 67.0%),中位延迟 14ms,为 Jev API(284ms,含网络往返)的 1/20.3;相比初始化 Laya(40.22%)提升 28.98 个百分点且延迟持平,说明增益来自中文监督而非架构;比 Qwen3.5-2B(32.95%)快约 20 倍且精度翻倍。领域结果(Table 2):相对 General 模型(三域仅 39.77/38.76/35.39%,金融甚至低于 Laya 的 38.31%),医疗/法律/金融专家分别提升 47.88、21.34、29.33 个百分点;医疗专家 87.65%,超 Jev 的 84.29% 达 3.36 个百分点(相对 +4.0%);法律 60.10%、金融 64.72% 仍落后 Jev(68.35%、78.39%)但超全部开源基线;三域平均 70.82% 为 Jev 的 92.0%,延迟恒定 15ms(约 1/17)。端侧 INT8 在 iPhone 15 Pro 浏览器本地推理约 1 秒/次。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CJ-Bench 通用子集(10 万条 held-out 决策) | ACC (%) / ECE (%) / 中位延迟 | 中文-Jev General:69.20% / 3.78% / 14ms | 闭源 Jev API:68.35% / 11.45% / 284ms;Laya:40.22% / 23.04% / 14ms | ACC 相对 +1.24%,ECE 降 67.0%,延迟 20.3 倍加速 |
| CJ-Bench 医疗子集(20 万条决策) | ACC (%) / ECE (%) / 延迟 | 中文-Jev 医疗专家:87.65% / 7.25% / 15ms | Jev:84.29% / 5.70% / 267ms;Open-Jev:73.08% / 2.88% / 53ms | ACC +3.36 个百分点(相对 +4.0%),延迟约 1/18,但 ECE 略逊于 Jev |
| CJ-Bench 法律子集(4300 条决策) | ACC (%) / ECE (%) | 中文-Jev 法律专家:60.10% / 17.45% | Jev:68.35% / 8.03%;最强开源 Open-Jev:44.07% | 超全部开源基线 16 个百分点以上,但仍落后 Jev 8.25 个百分点,且 ECE 反升 |
| CJ-Bench 金融子集(3600 条决策) | ACC (%) / ECE (%) | 中文-Jev 金融专家:64.72% / 11.55% | Jev:78.39% / 2.98%;最强开源 Open-Jev:48.11% | 超最强开源基线 16.6 个百分点,但仍落后 Jev 13.67 个百分点 |
| 端侧推理(iPhone 15 Pro / iOS 26.7 浏览器) | 单次决策延迟(本地) | INT8 量化约 1 秒/次,分词+推理全本地,模型缓存离线可用 | 闭源 Jev API 267–284ms(需联网,含网络往返) | 离线可用、隐私友好,代价是延迟高于云端 API |
局限与改进
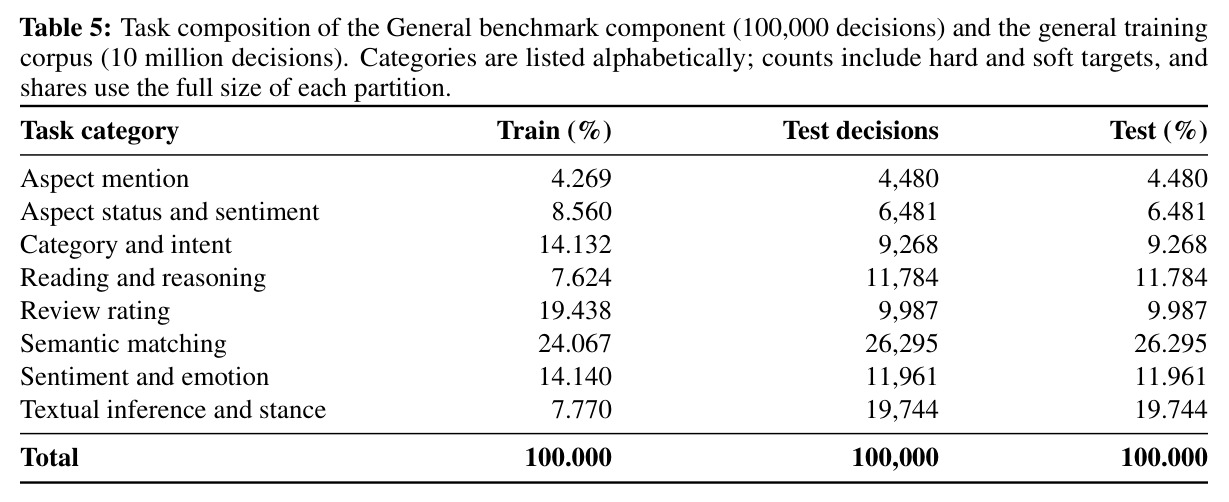
作者承认的局限:法律(60.10% 对 68.35%)与金融(64.72% 对 78.39%)仍落后 Jev 8–14 个百分点;领域微调后校准改善不一致——医疗 ECE 从 17.33% 降到 7.25%、金融从 14.43% 降到 11.55%,但法律反而从 15.37% 升到 17.45%,三域平均 ECE 12.08% 明显差于 Jev 的 5.57%,说明领域适配不能只盯精度。我的补充观察:其一,CJ-Bench 全部取自自建语料的 held-out 分区,任务分布与训练数据同源(语义匹配类占训练 24.07%),缺少 CLUE、C-Eval 等外部独立基准对照,通用性结论可能被高估;其二,20.3×/17× 加速是与含网络往返的托管 API 相比,纯模型速度对比应看同机数字,论文虽已脚注但仍易误读;其三,医疗专家用了 300 万条训练数据而法律/金融各只有 2.4 万条,领域间数据规模悬殊 125 倍,'医疗超 Jev'部分是数据量的胜利而非方法在低资源下的胜利;其四,322M 参数在浏览器 WASM 上需 1 秒/次,对高频交互场景仍不够实时。
独立分析的弱点
第一,法律/金融精度缺口与数据量直接相关:每域仅 2.4 万条微调数据,是医疗(300 万条)的 1/125,弱域更可能反映数据稀缺而非方法上限,改进方向是合成数据扩充、从医疗专家做跨域迁移,或对通用模型做低秩渐进微调以在小数据下保留通用能力。第二,校准随领域漂移:法律 ECE 不降反升(15.37%→17.45%),作者未给出解释,可能与该域任务配比或 RLCD 奖励对排序的偏置有关,可在领域微调中加入校准分区联合优化或微调后做温度缩放。第三,评测同源风险:CJ-Bench 与训练语料同池分区,训练集见过的源类型评测集也会出现,应补充外部零样本基准(如 CLUE 相关任务)验证泛化。第四,加速对比口径:与本地 Qwen3.5-2B 相比是 17.5–29.2 倍,与含网络的 Jev API 相比是 20.3 倍,两种口径混排易被断章取义,建议统一报告同机无网数字。第五,端侧 1 秒/次的延迟来自 322M 参数跑在 CPU/WASM 上,若目标是实时 agent 决策,需蒸馏到更小骨干或改用 WebGPU/NPU 加速。
未来方向
作者提出的方向:继续改进法律/金融的领域适配与置信校准。基于成果可延伸的方向:(1) 数据侧——用通用模型预标注加人工抽检低成本扩充法律/金融语料,验证精度是否随数据规模逼近医疗的水平;(2) 校准侧——在 RLCD 奖励中加入校准惩罚项,或对专家模型在 calibration 分区上做后处理校准(AnyJev 已示范此类轻量方法的可行性);(3) 模型侧——探索 mmBERT-large 等更大骨干与蒸馏小模型的精度-延迟帕累托前沿,明确 322M 是否为甜点位;(4) 应用侧——把 choice/noul/score 接口接入 agent 工具路由、RAG 检索相关性过滤、内容审核等流水线,与 LLM 组成'系统一快速筛选 + 系统二深度处理'的混合架构;(5) 多语言推广——数据管线天然语言无关,可复制到其他低资源语言,检验统一概率目标范式的普适性。
复现评估
作者承诺开源模型、训练数据、CJ-Bench 基准与数据构建代码,项目页为 gulucaptain.github.io/Chinese-Jev,但截至论文写作尚未见实际发布,复现需等待资源放出。训练需要 8×NVIDIA H200 做全参微调:通用阶段 1 epoch(1000 万条)、领域各 4 epoch(医疗 300 万条、法律/金融各 2.4 万条),RLCD 每决策 4 次扰动,算力门槛中等偏上,但小得多的单卡配置可缩减数据规模复现主要趋势。推理侧极友好:单卡批量 1 中位 14ms,CPU 端侧可跑 INT8。数据管线依赖公开中文数据集(C3、T2Ranking、ASAP、USTS、CMB、LeCaRDv2、FinRE 等)加 1.07 万条规则合成样本,来源清晰、可复现性较好;去重协议(公式 (2)(3) 的指纹定义)与分区规则描述完整。总体判断:资源开源后属中低难度复现——评测在消费级设备即可完成;主要风险是部分源数据集使用条款、去重后规模与硬/软目标细节可能限制完全重建。
论文图表