DecisionPivot:LLM系统决策模型的诊断型基准 DecisionPivot: A Diagnostic Benchmark for Decision Models in LLM Systems
用可控对比组与独立验证的答案,暴露聚合分数掩盖的决策模型可靠性差距
前置知识
决策模型(Decision Model)
输入一个状态 $s$、一个类型化问题 $q$ 和有限选项集 $O$,输出各选项概率分布 $p(o|s,q,O)$ 的专门模型,预测答案取 $\hat{y}=\arg\max_{o\in O} p(o|s,q,O)$。许多决策模型单次前向即可给出预测,用于请求路由、策略护栏、输出校验和 Agent 目标检查等环节,并能按置信度把不确定案例转交人工或更强推理。
本文的评测对象就是这类模型,全部任务与指标(条目/组级准确率、概率排序、校准、选择性覆盖)都围绕其输入输出接口设计,不了解接口就读不懂评分协议。
对比组(Contrast Group)
由共享上下文、仅在一个关键事实上不同、正确答案随之翻转的相关案例组成的组,组内可有 2 到 4 个成员。判分要求组内每个成员都答对,任一成员出错整组记零。均匀猜测的组级基线按 $\prod_{i\in g}|O_i|^{-1}$ 累乘,因此远低于条目级基线:本文中条目机会基线 39.6%,组级仅 16.1%。
组级准确率(pair accuracy)是本文的核心指标,所有主要结论(如参考分只差 2.6 分的两个模型组级相差 25.9 个百分点)都建立在对比组之上。
选择性预测与经验覆盖率(Selective Prediction & Coverage)
按置信度 $c_i=\max_o p(o|s_i,q_i,O_i)$ 从高到低排序,找经验误差不超过 $\epsilon$ 的最长前缀,覆盖率定义为 $\hat{C}(\epsilon)=\max\{k/n:\hat{R}(k)\le\epsilon\}$,衡量'可以放心自动化的请求比例'。本文按族分别计算并报告 $\hat{C}(0.05)$,即 5% 错误率下的自动化覆盖率,属于回溯性指标,部署前需独立校准。
auto at 5% 是论文三大结果指标之一,它揭示了两类条目准确率相同、但可自动化比例相差数倍的模型,是理解第 4.2 节结论的钥匙。
校准(Calibration)
预测置信度与实际正确率的一致程度。本文把置信度分成 15 桶,计算预测置信度与桶内实际正确率之间的平均差距作为校准误差;另报告置信度不低于 0.90 的子集的准确率及其占总条目的比例,专门检测'高置信错误'这种过度自信现象。
决策模型要直接驱动路由、护栏等自动化动作,校准不好意味着高置信错误会绕过人工复核直接造成业务损失,这是论文强调'可靠置信'的动机。
内容盲基线与捷径学习(Content-blind Baseline & Shortcut Learning)
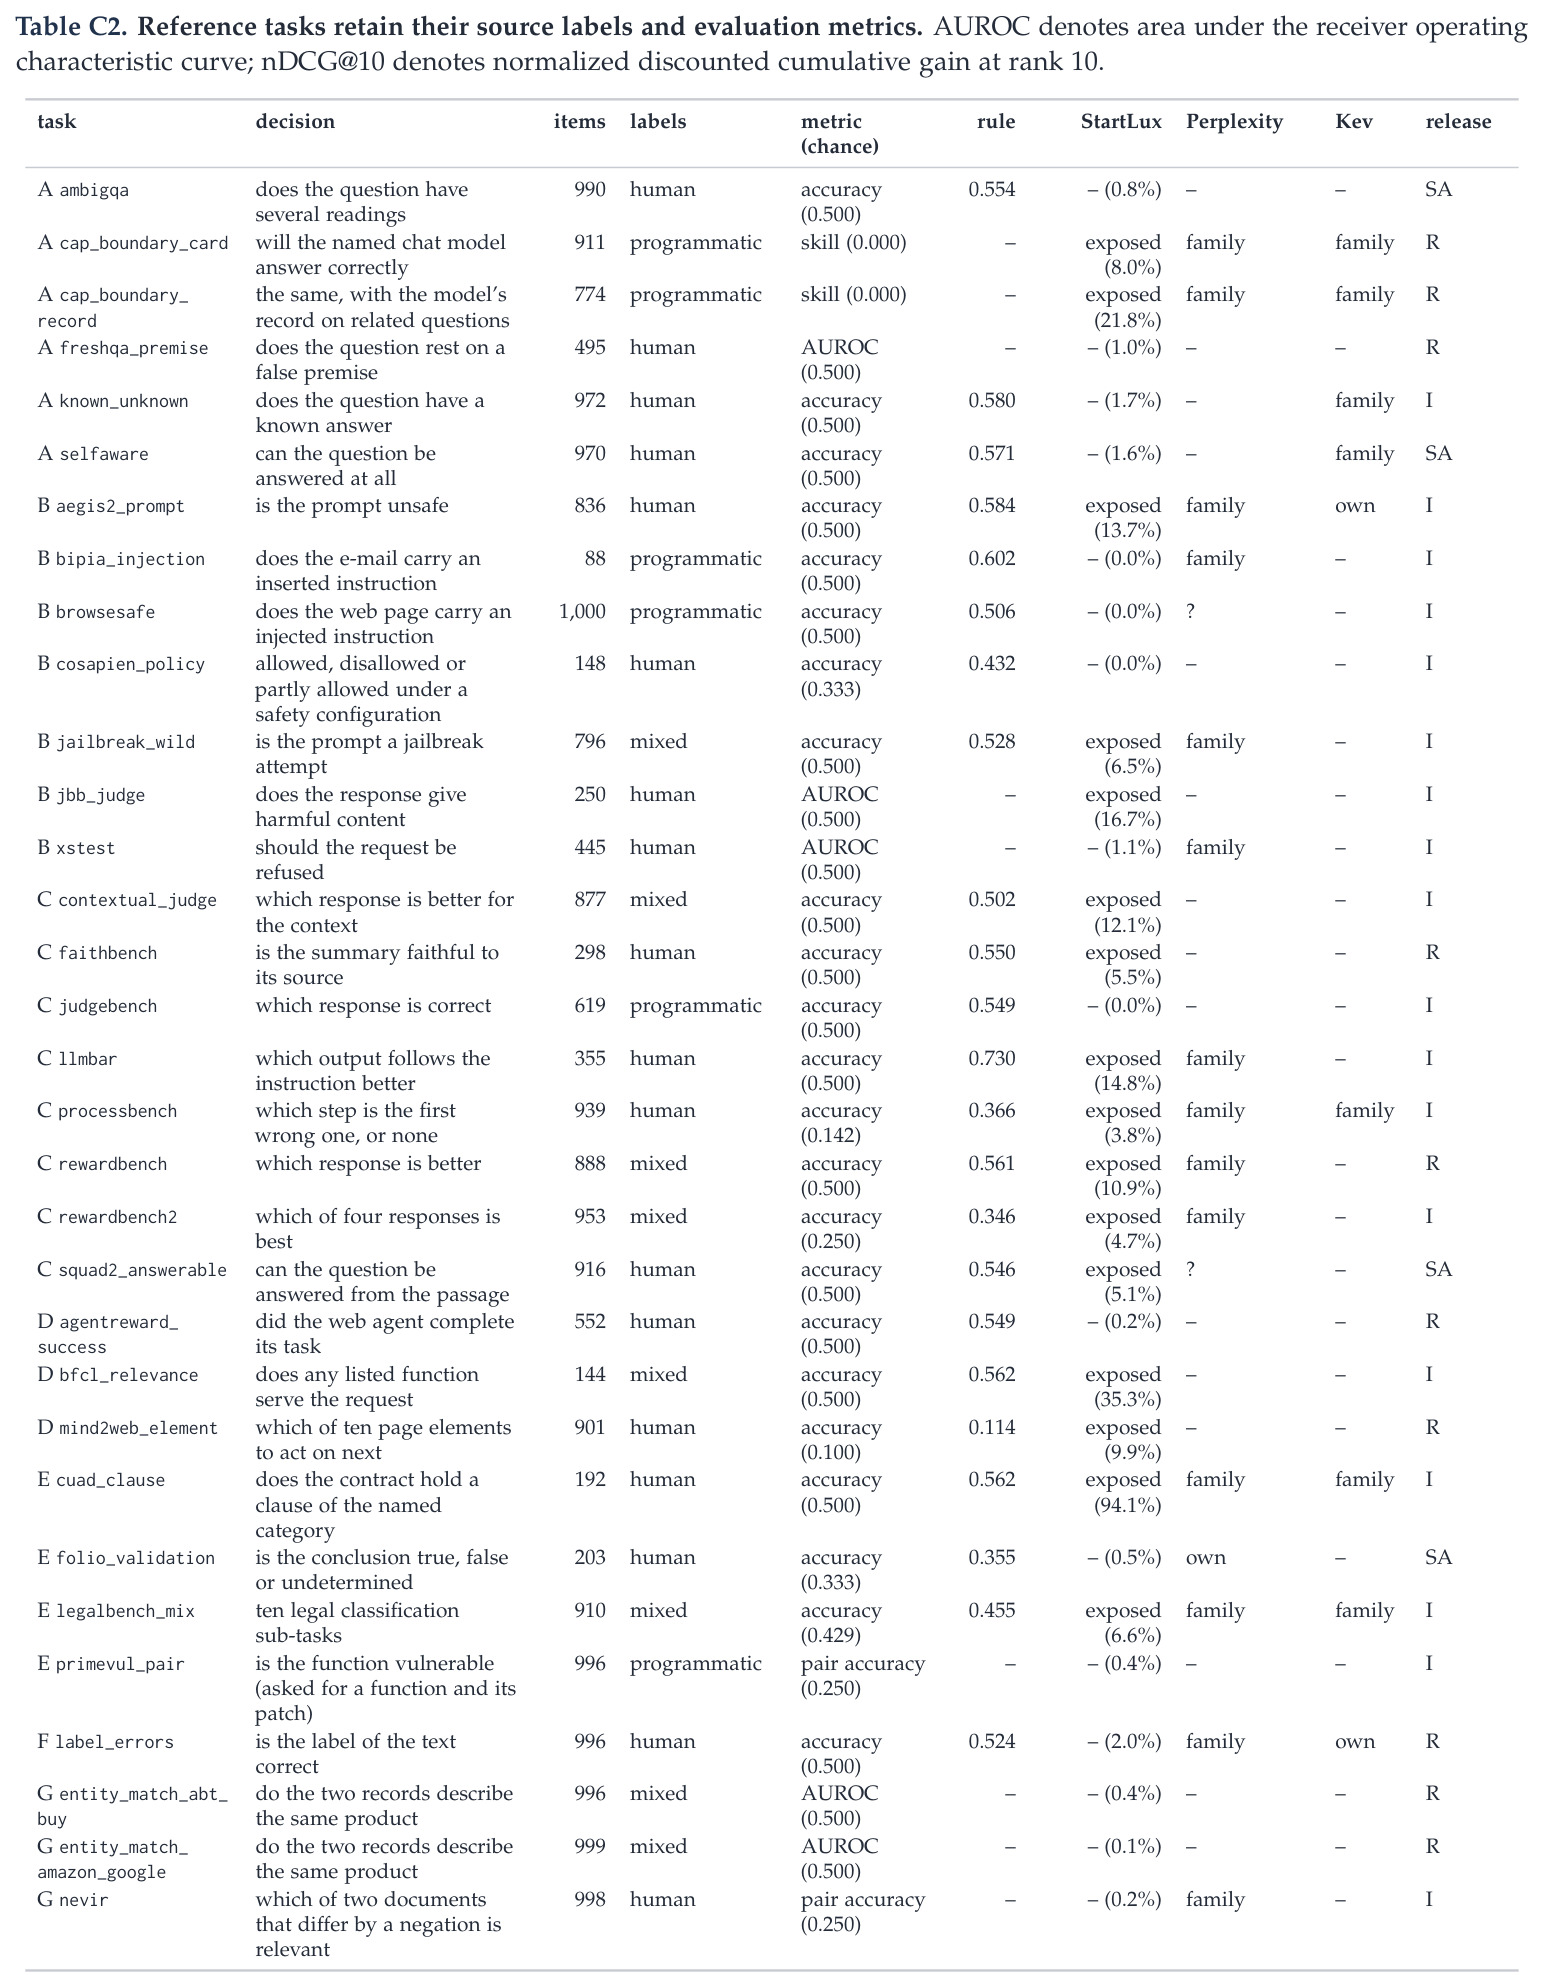
不看语义内容、只利用表面统计线索(选项分布、问题措辞、状态长度、行数、词袋)即可得分的规则。若内容盲基线远高于机会水平,说明任务可被捷径攻克:例如一个内容盲规则在 llmbar 上达到 73.0% 准确率(机会为 50%)。DecisionPivot 对 13 个核心任务族逐一做了这类探针审计。
判断基准分数反映'真能力'还是'刷捷径'的前提;表 2 与附录 E 的审计结果(如只查 schema 在 toolcall_valid 上可达 91.7%)直接影响对所有分数的解读。
训练数据污染(Training-data Contamination)
评测条目出现在模型训练集中导致分数虚高。本文从自家最终 27B 模型的训练文件中检测并移除 3,016 条重叠参考条目(占 8.5%),对其他模型只做来源级标记——记录公开文档是否提及某任务来源或相关数据族,缺失或不确定即记为 unknown,无法做到条目级验证。
参考轨使用 35 个公开测试集,天然面临污染质疑;理解本文'自家条目级过滤 + 他家来源级标记'的策略边界,才能正确解读参考轨分数的可信度。
研究动机
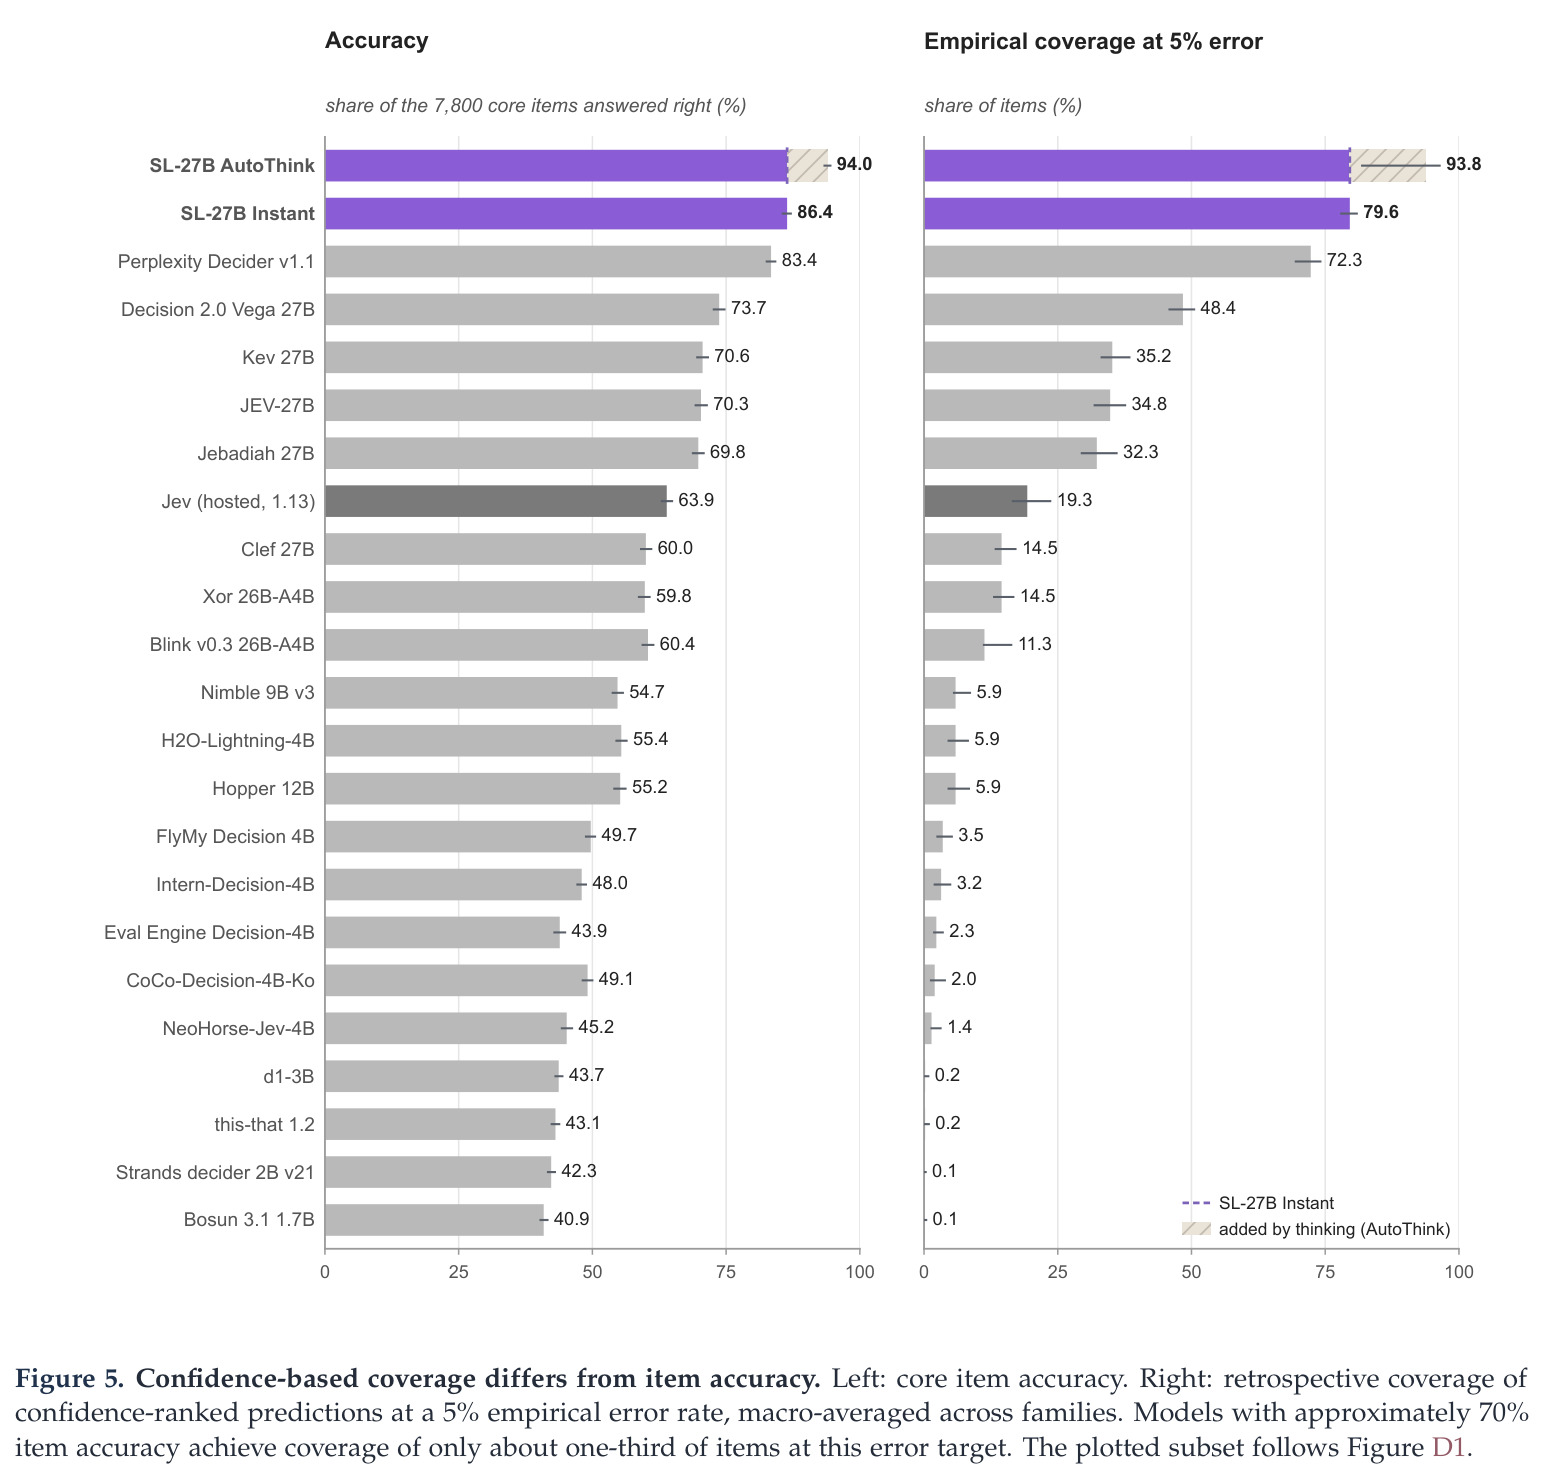
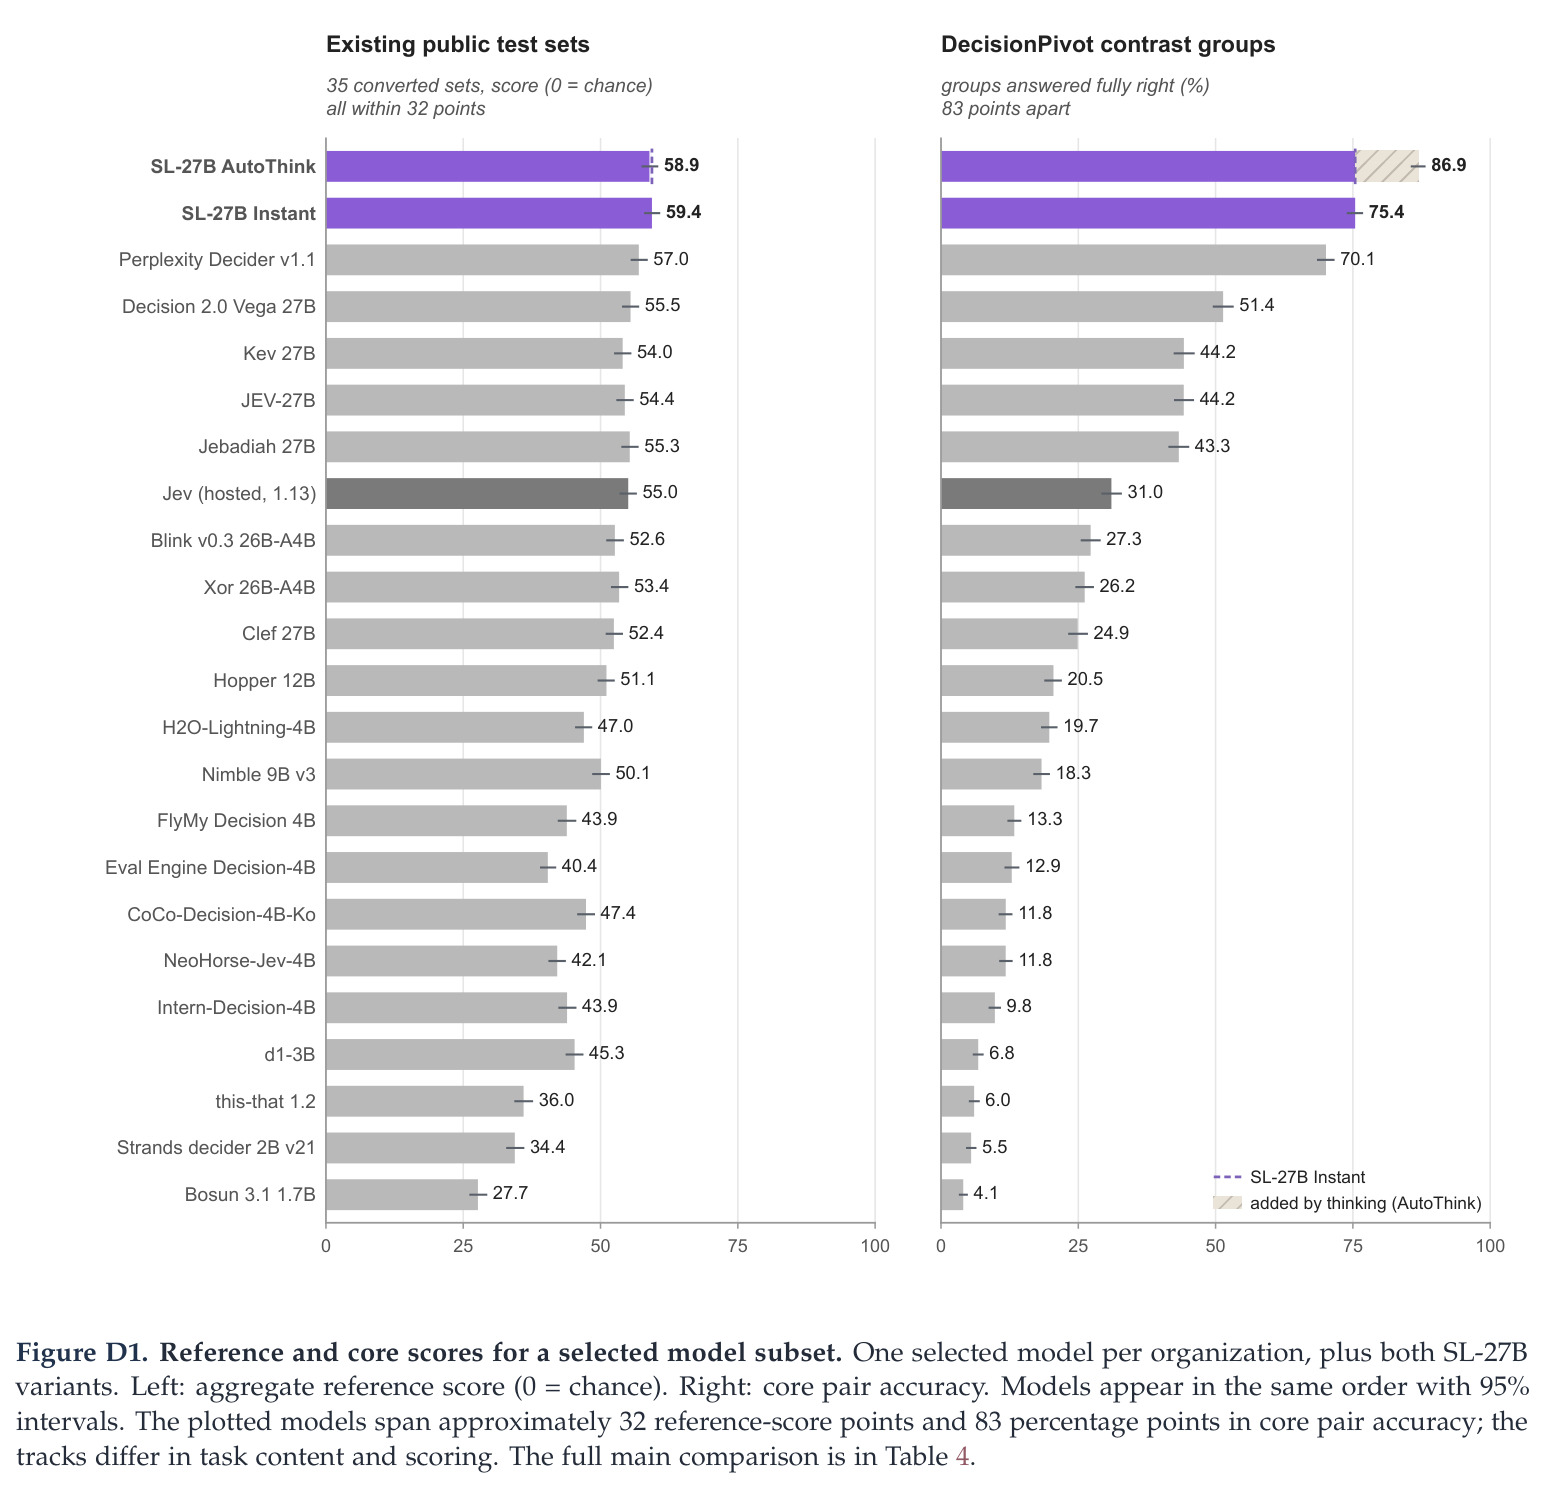
现有评测大多把公开测试集改造成决策任务,再用总体条目准确率与校准指标来排名,这留下三个盲区。其一,聚合分数无法说明模型是否'成组'地答对:同一上下文里只改变一个关键细节、正确答案随之翻转的对比组,只要有一个成员答错就应判为失败,但条目准确率对此完全失明,预测 yes/yes 的模型在 Box 1 那样的二元对上条目准确率仍有 50%,组级却是 0。其二,表层统计捷径会虚增分数:一个不看内容的规则在 llmbar 上能达到 73.0% 准确率(机会基线 50%),说明公开任务的分数可能被捷径撑高。其三,污染难以判断:公开文档往往只写明训练数据来源、不说明具体哪些评测条目被纳入训练。此外,条目准确率接近的模型(如 Kev 27B 的 70.6% 与 JEV-27B 的 70.3%)在高置信预测可靠性上可能差异巨大,单一聚合分数把这些决策质量差距全部掩盖了。
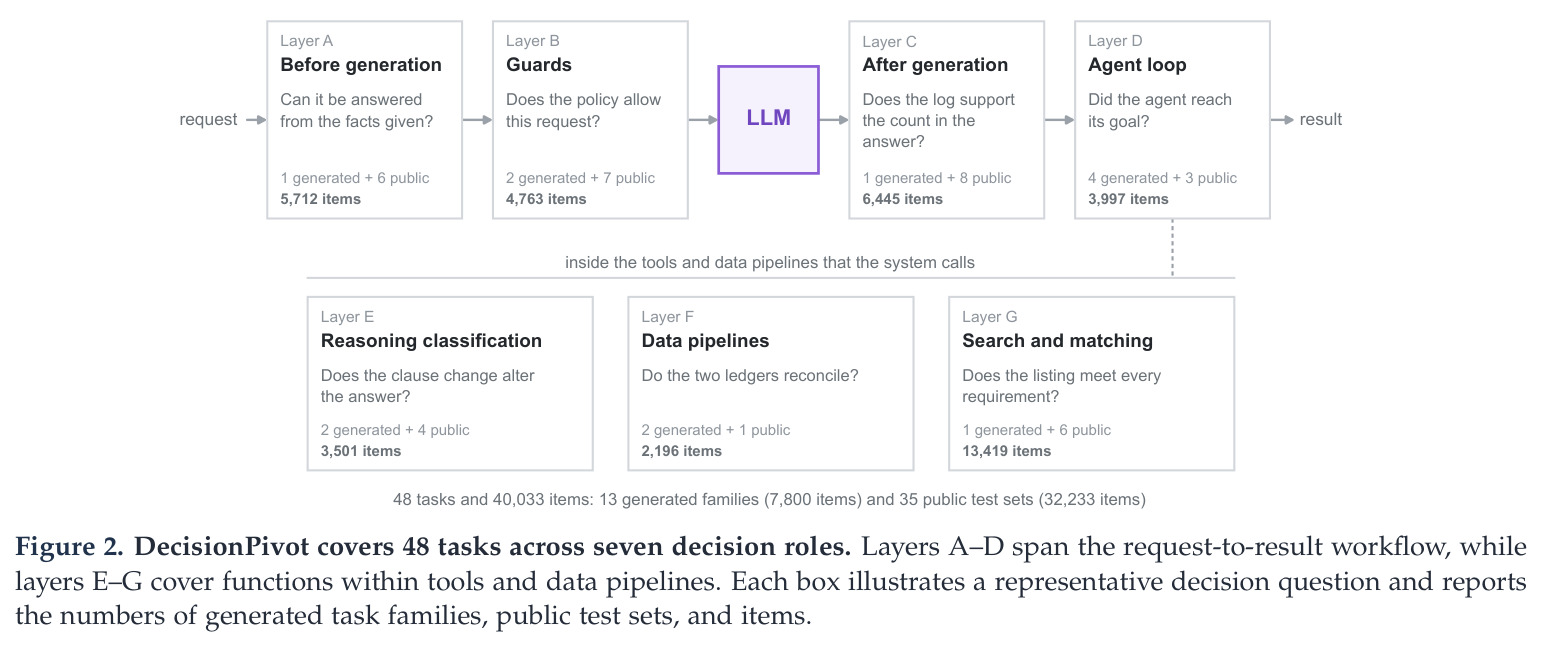
本文的目标是论文目标是构建一个'诊断型'而非单纯'排名型'的基准 DecisionPivot:覆盖 LLM 系统中七类决策角色(生成前可答性与路由 A、策略护栏 B、生成后输出校验 C、Agent 循环中的工具校验与目标检查 D、推理分类 E、数据管道对账 F、搜索匹配 G),共 48 个任务、40,033 个条目。它要同时回答四个问题:单个预测是否正确(条目准确率)、整组相关案例是否全部答对(对比组准确率,含最高难度 Level 3)、概率排序是否正确(pair direction)、置信度是否可靠(15 桶校准误差、0.90 置信度准确率、5% 错误率下的经验覆盖率)。评测对象为 40 个决策模型与 14 个通用模型,全部使用文档化的模型专属协议;并通过难度分级(Level 1–3)与'关键变化类型'标注(如 20 类约束、13 类完整性规则),把错误归因到具体失败模式,帮使用者判断哪些环节可自动化、哪些必须保留人工复核。
与已有工作不同的是,相关工作各占一角但从未合并:Deußer 等在 37 个公开数据集上评测托管决策模型的校准与选择性预测;Decision Index 0.3 把公开基准汇总成机会校正指数;JevBench 1.6 关注校准、速度与成本;AbstentionBench 专研弃答;对比集与反事实增强数据研究标签翻转的敏感性;GSM-Symbolic 用模板生成数学变体;LiveBench 定期换题限制污染。DecisionPivot 的独特切入是把'类型化决策接口、程序化计算的答案、独立求解器验证、对比组、难度分级、概率评分、选择性决策、污染控制'八项特征第一次集成在同一基准中(Table 1 里只有本文八项全为 ✓),并且首次把 pair direction 与 pair accuracy 并置,把'概率排序正确'与'两个成员都答对'明确区分开——此前这两者常被默认等同。
核心方法
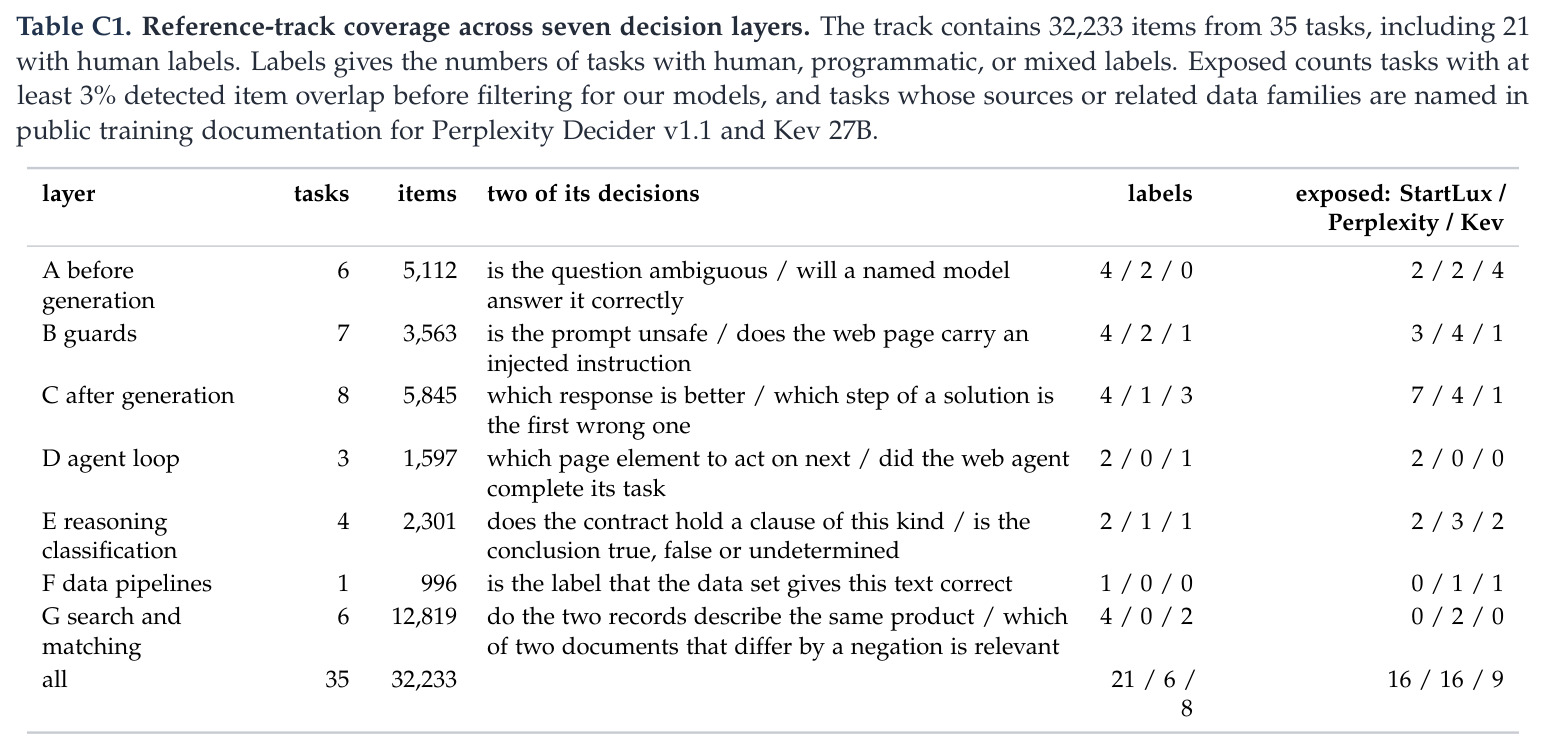
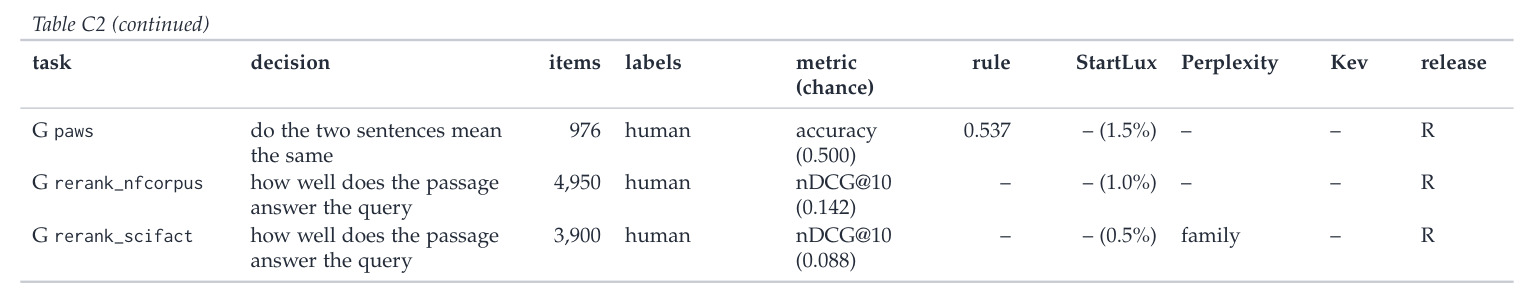
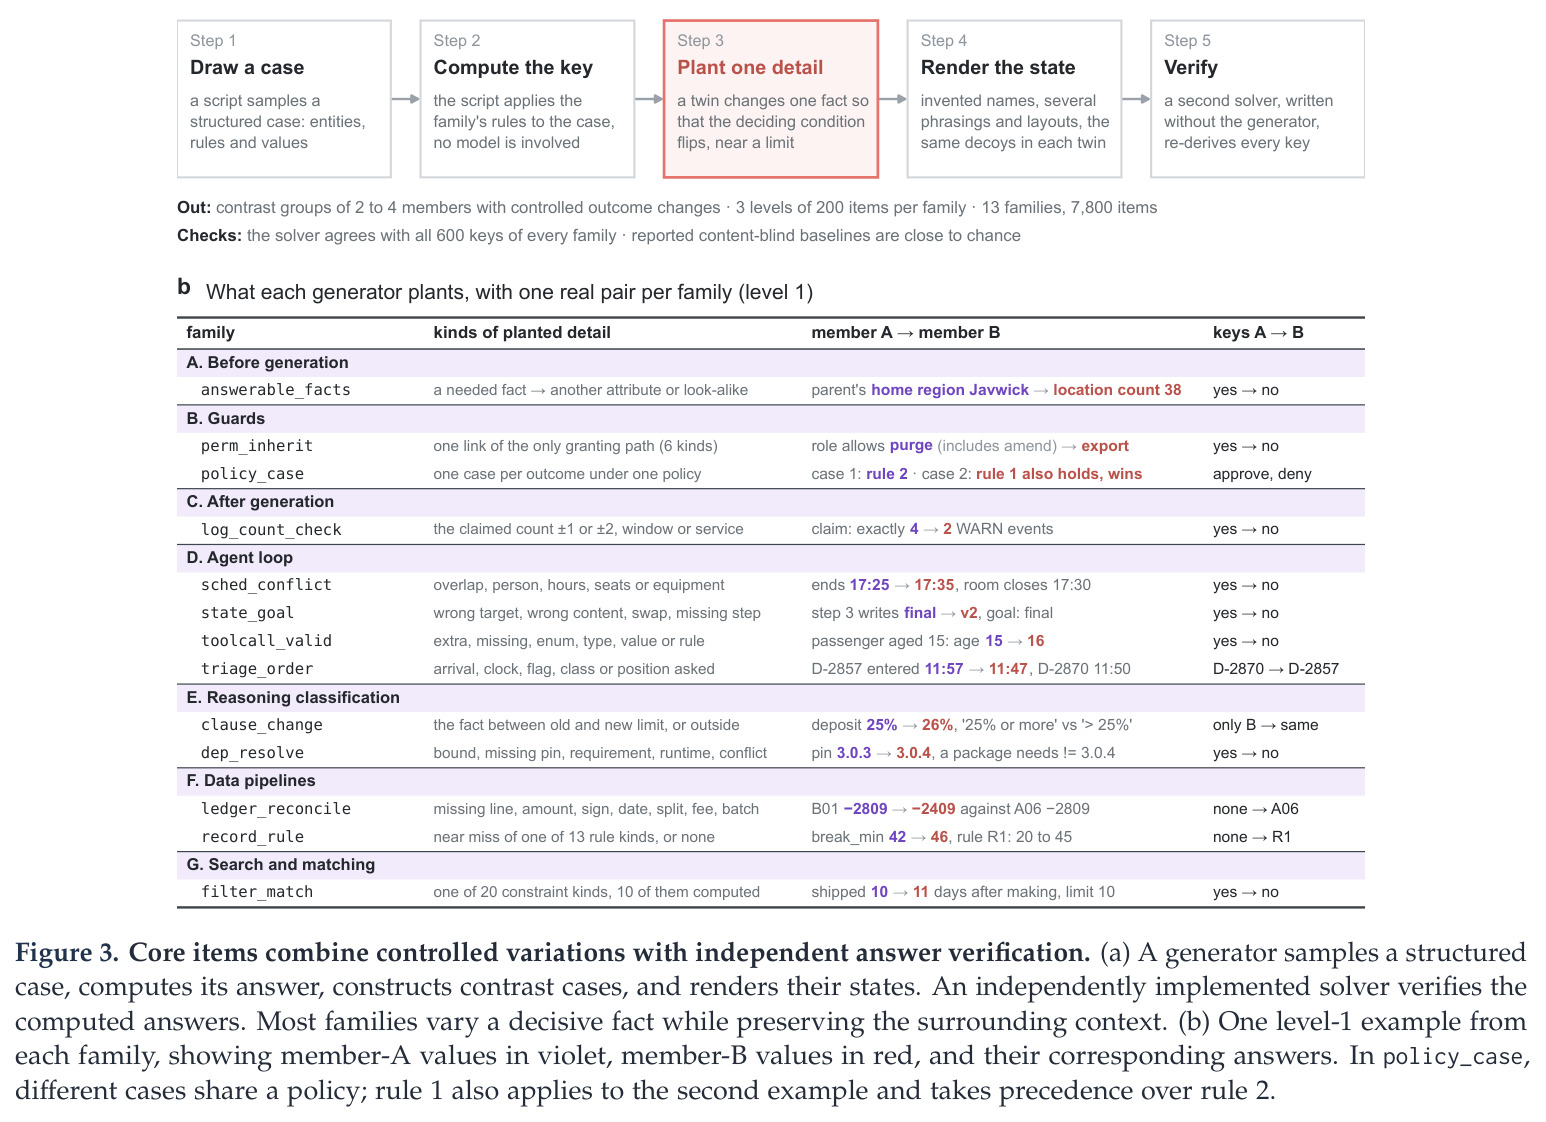
DecisionPivot 采用双轨制。核心轨由 13 个 Python 生成器构造:每个任务族 600 条(3 个难度级各 200 条),生成器先采样结构化案例(实体、规则、数值),再由程序按族规则算出答案——全程无模型参与;然后'种下'一个关键细节制造孪生案例使答案翻转,用虚构实体名与多样措辞渲染状态,孪生成员共享相同干扰项;最后由未读过生成器的作者独立实现求解器,核对全部 600 个答案。核心轨状态中位长度 1,647 到 4,975 字符,选项 2 到 10 个,对比组规模 2 到 4。参考轨把 35 个公开测试集转换到统一决策接口并保留原始评分(21 个人工标注、6 个程序化标签、8 个混合),每任务至多约 1,000 条(重排任务为 100 查询 × 50 候选),机会校正分数为 $100(v_t-b_t)/(1-b_t)$,按七层平均。两轨合计 48 任务、40,033 条,覆盖 A–G 七层(G 层搜索匹配 13,419 条、C 层生成后校验 6,445 条)。评测在文档化协议下进行,共评 40 个决策模型与 14 个通用模型。
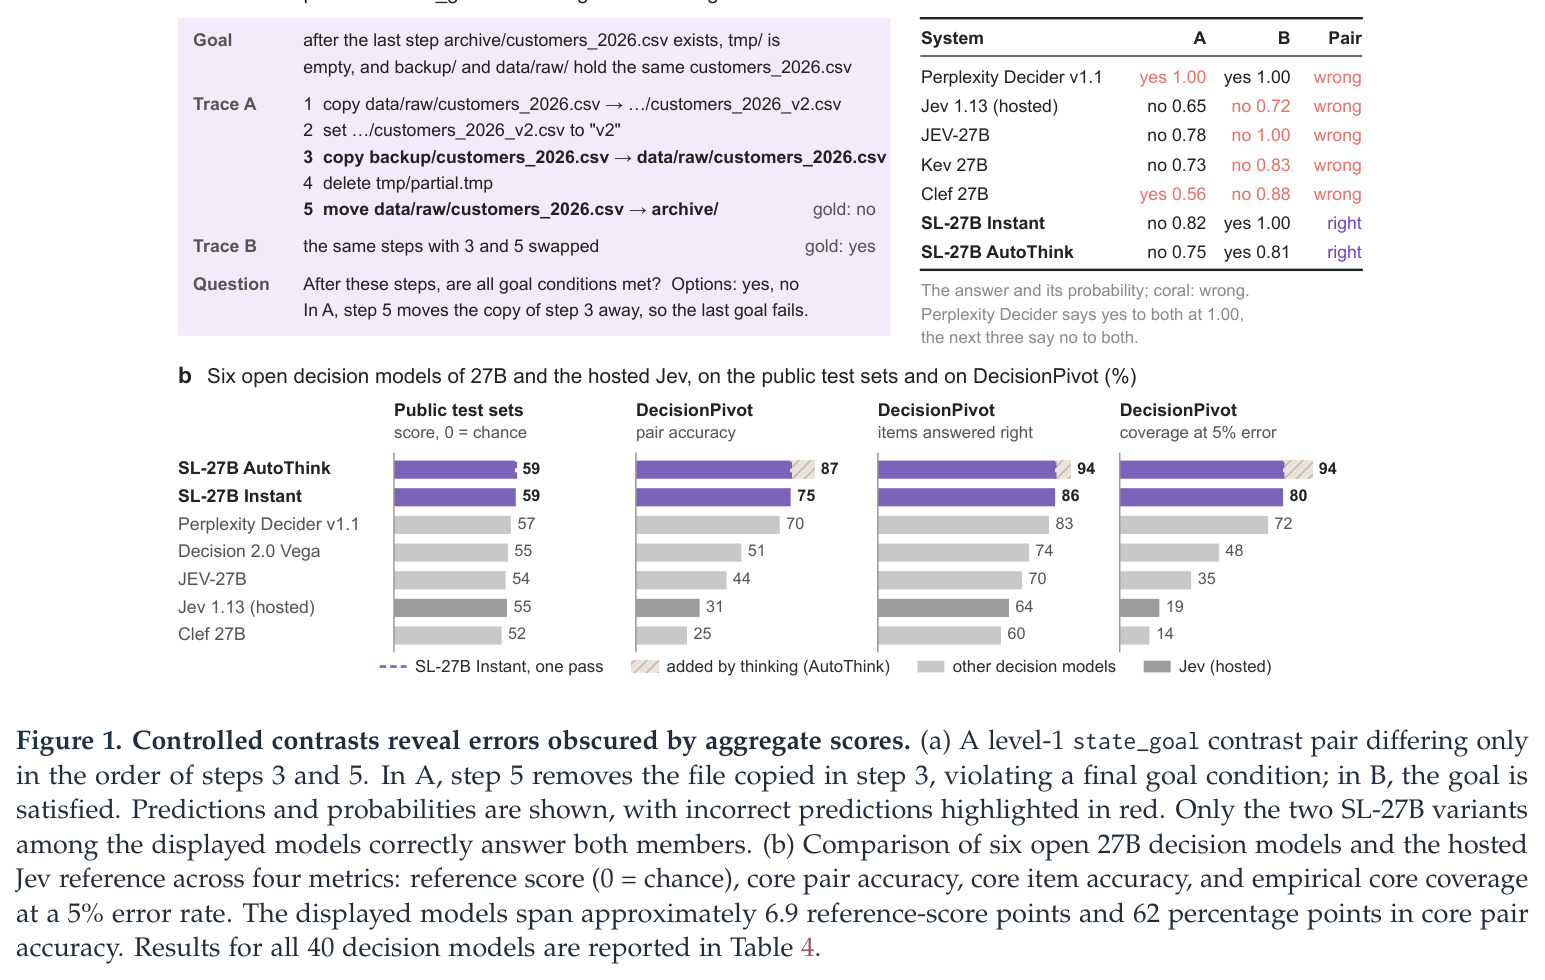
核心创新是'关键细节对比组 + 组级判分'。绝大多数任务族中,孪生成员只在决定性事实上不同:例如 Box 1 的 filter_match 对,仅把运费从 24.03 改为 24.05 SEK,使总价从限值 500.84 之下的 500.83 翻到其上的 500.85,答案由 yes 变 no;阈值类任务的正负例都贴着决策边界构造。判分用组级准确率 $$\mathrm{PairAcc}_f=\frac{1}{|G_f|}\sum_{g\in G_f}\prod_{i\in g}\mathbf{1}[\hat{y}_i=y_i]$$ 组内任一成员答错即整组记零:均匀猜测的条目基线 39.6%,组级按 $\prod_{i\in g}|O_i|^{-1}$ 累乘后仅 16.1%。配套的 pair direction 只要求正例的 $p^+=p(\text{yes}|s^+)$ 高于负例的 $p^-=p(\text{yes}|s^-)$,而两边都答对需要 $p^+>0.5>p^-$——Box 1 中 Decider 给出 0.86/0.84,方向正确但两个都答错。这组指标第一次把'会排序但不会决策'的失败显式暴露出来。
方法步骤详情
构建与评测分五步:(1) 采样——生成器抽取结构化案例(实体、规则、数值);(2) 计算答案——按族内规则程序化推导,无模型参与;(3) 种入关键变化——构造孪生案例使判定条件在边界附近翻转(如 state_goal 交换第 3、5 步);(4) 渲染——虚构实体名、多样措辞与布局,孪生成员共享干扰信息;(5) 验证——独立求解器核对全部答案,每条条目至少两名人工评审加 AI 辅助筛查,v1.1 修订了 10 个任务族的缺陷条目。捷径审计显示仅看选项在 triage_order 上只有 21.3%(机会 20.0%),但只查 schema 就能在 toolcall_valid 拿到 91.7%。评分端计算 PairAcc、经验覆盖率 $$\hat{C}(\epsilon)=\max\{k/n:\hat{R}(k)\le\epsilon\}$$(按族取置信前缀,报告 $\hat{C}(0.05)$)、0.90 置信度准确率与 15 桶校准误差,用组级 bootstrap 给 95% 区间;参考轨保留原始指标并做机会校正。污染控制上,作者从自家 27B 训练文件移除 3,016 条重叠参考条目(8.5%);7 个带种子的生成器另抽 4,200 条新样本,排名 Spearman ρ=0.994。
技术新颖性
与已有工作的本质区别在'验证来源'与'判分单位'两方面。公开基准的标签来自人工标注或原始论文,无法程序化重推;DecisionPivot 的核心答案由规则计算,并由独立实现的求解器交叉验证,错误答案在发布前即可排除。判分从'条目'升级为'对比组',配合难度分级(Level 1–3 同时增大案例规模与规则复杂度)与关键变化类型标注(filter_match 20 类约束、record_rule 13 类完整性规则),能把失败定位到具体算子,如总价比较、时序重叠、权限链继承。它还首次把 pair direction 与 pair accuracy 并置,量化'排序-决策鸿沟'(Perplexity Decider 92.3% 对 74.1%),并用内容盲基线(各族接近机会水平,如 record_rule 12.2% 对机会 12.0%)与训练重叠过滤(移除 8.5% 条目)双重控制虚高。相比之下,对比集研究不做类型化概率输出,GSM-Symbolic 不评校准与选择性预测,Deußer 等的评测没有可控对比与独立验证。
实验结果
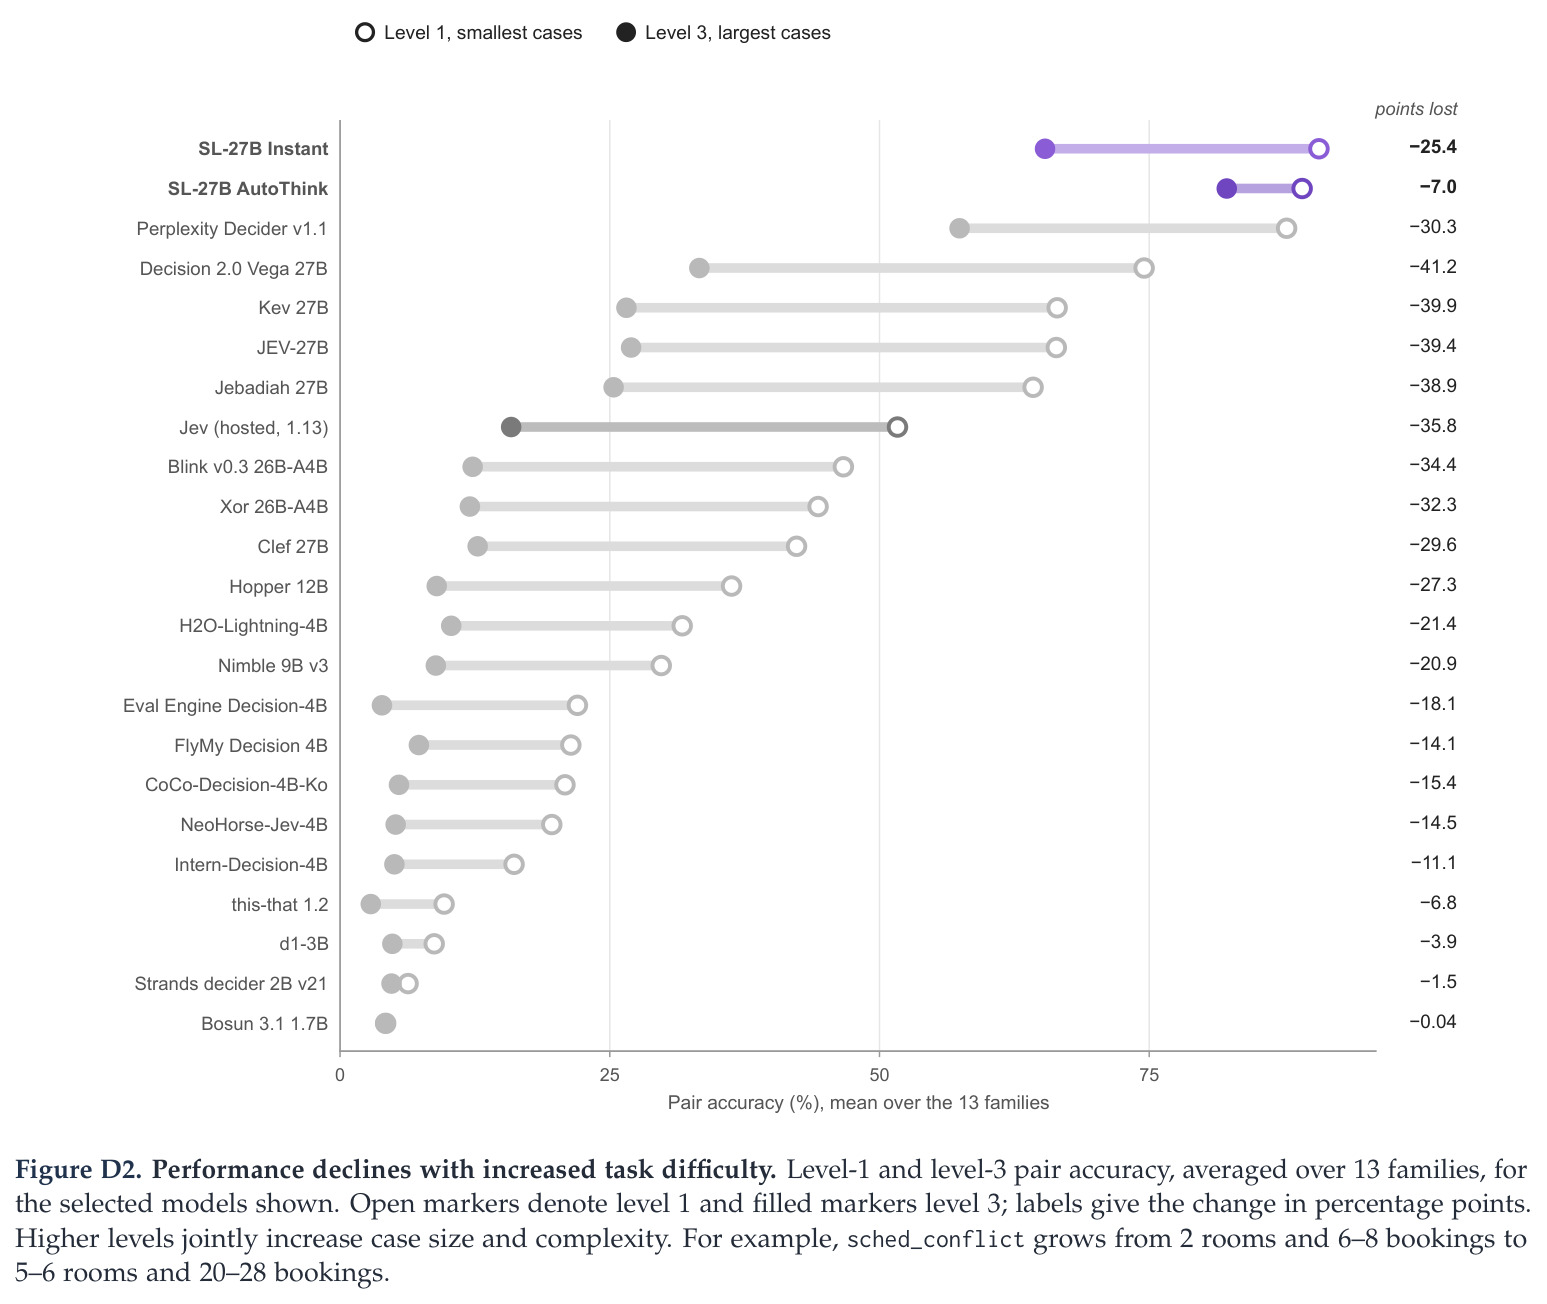
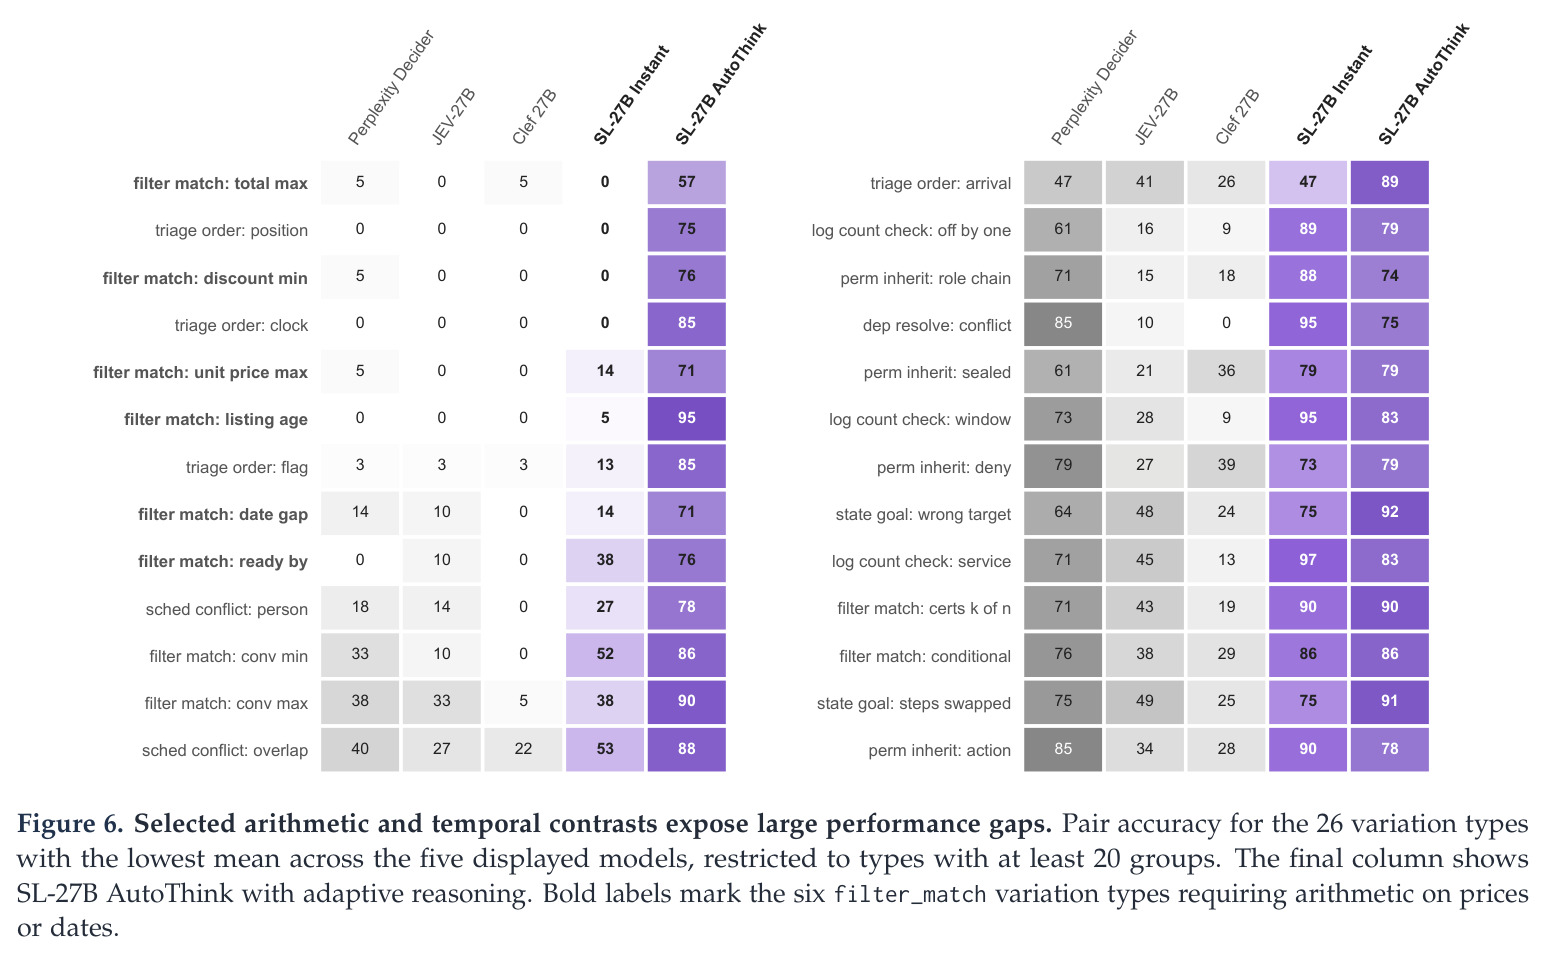
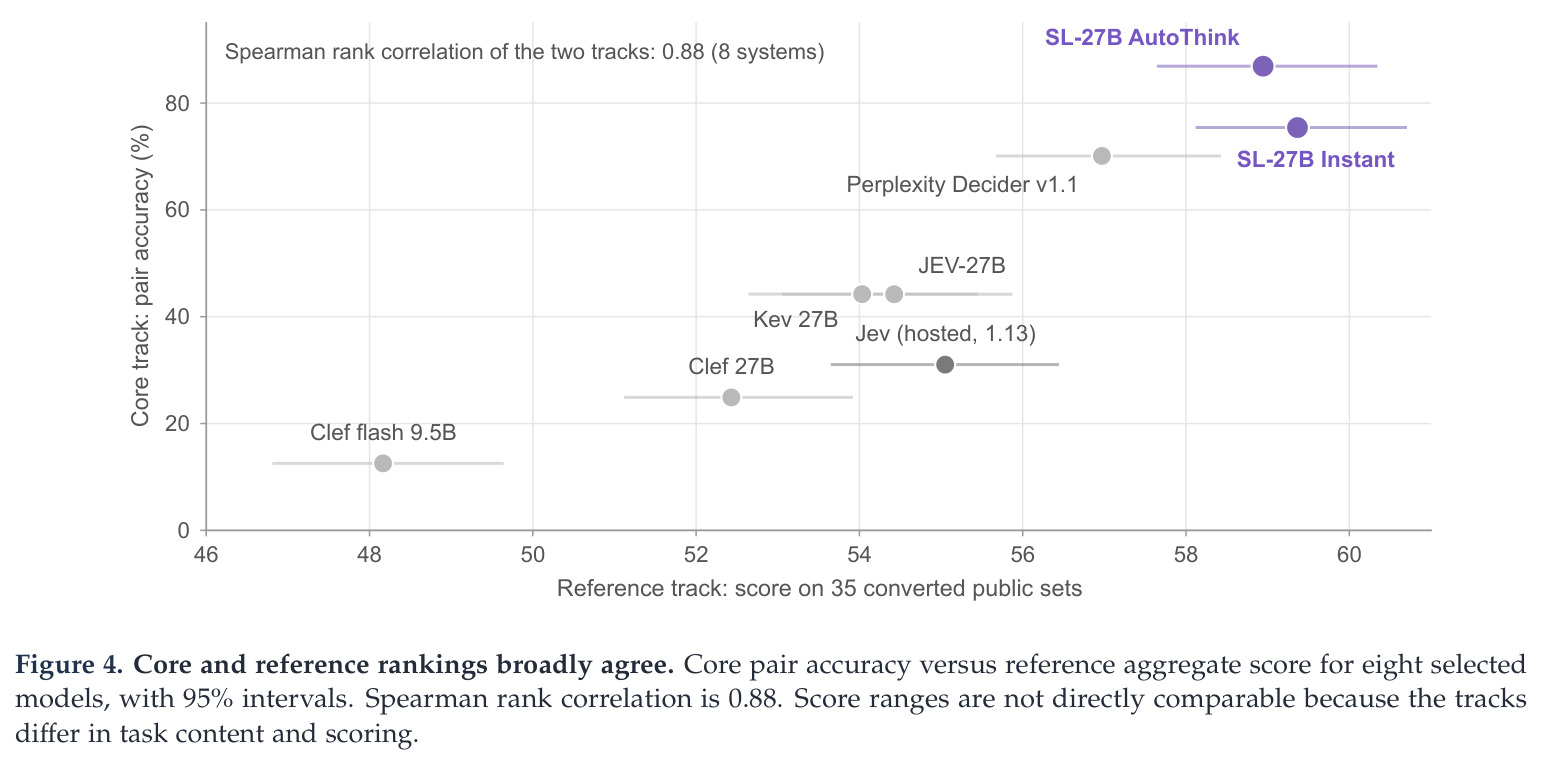
核心轨上模型分层远比参考轨陡峭:SL-27B AutoThink 以 86.9% 组级准确率居首(条目 94.0%,5% 错误率覆盖率 93.8%),单次前向的 Instant 为 75.4%,两者参考分却几乎持平(58.9 对 59.4)。最戏剧性的是 Perplexity Decider 与 JEV-27B:参考分仅差 2.6(57.0 对 54.4),组级却相差 25.9 个百分点(70.1% 对 44.2%)。40 个模型中 19 个低于 16.1% 的均匀猜测组级基线,Level 3 上有 30 个。排序-决策鸿沟显著:2,400 个二元对比对上 Decider 方向正确率 92.3%,两边都对仅 74.1%;Clef 27B 方向 78.6% 而组级仅 25.0%。置信度可靠性同样分化:Kev 27B 与 JEV-27B 条目准确率几乎相同(70.6% 对 70.3%),但 0.90 以上置信预测正确率为 93.8%(覆盖 34.1% 条目)对 88.9%(覆盖 47.4%)。推理档位收益明确:GLM-5.3 在 1,296 条子集上从最低档 81.5% 升至高档 93.5%(推理 token 121→265)。难度敏感性差异大:Decider 从 Level 1 的 87.7% 跌至 Level 3 的 57.4%,AutoThink 仅从 89.2% 降至 82.2%。算术与时序对比是普遍弱点:总价与最低折扣变体上四个单次模型组级至多 5%,triage_order 当前时刻变体全为 0%;输入扰动下自然措辞最高翻转 20.7% 的预测。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 核心轨对比组准确率(13 族宏平均) | pair accuracy | SL-27B AutoThink 86.9% [85.7, 88.0] | 均匀随机猜测 16.1% | +70.8 个百分点;同为 27B 的 JEV-27B 仅 44.2% |
| 参考轨 35 个公开任务 | 机会校正分数(0=随机水平) | SL-27B Instant 59.4 | Perplexity Decider v1.1 57.0 | +2.4 分,配对比较 95% 区间 [1.6, 3.2],但组级准确率 Instant 高出 5.3 个百分点 |
| 二元对比对(8 个二元族共 2,400 对) | pair direction / 两成员全对率 | Perplexity Decider 方向 92.3%,全对 74.1% | Clef 27B 方向 78.6%,全对 25.0% | 量化出'排序正确 ≠ 决策正确',Decider 两指标差 18.2 个百分点 |
| 核心轨最高难度 Level 3 | pair accuracy | SL-27B AutoThink 82.2% | Perplexity Decider 57.4%(Level 1 为 87.7%) | +24.8 个百分点,且 AutoThink 仅从 Level 1 的 89.2% 小幅回落 |
| 5% 错误率下的自动化覆盖率 | auto at 5%(按族置信前缀) | SL-27B AutoThink 93.8%、Instant 79.6% | Jev 1.13(托管)19.3%、Clef 27B 14.5% | +74.5 个百分点;条目准确率约 70% 的 Kev 27B / JEV-27B 只覆盖约 35% |
| 推理档位对比(1,296 条平衡子集) | pair accuracy | GLM-5.3 高推理档 93.5% [91.7, 95.3] | GLM-5.3 最低档 81.5% [78.4, 84.6] | +12.0 个百分点,平均推理长度从 121 增至 265 token |
局限与改进
作者明确承认:基准评的是书面案例而非端到端系统运行;难度分级把案例规模与规则复杂度绑在一起,无法区分'变长'与'变难';各模型接口在概率读出、输入上限与推理设置上不同,且大部分只跑一次;输入敏感性分析基于 v1.0 条目;覆盖率是回溯性指标,部署前需独立校准;参考轨沿用原始标签可能含噪声;训练重叠只对自家模型做了条目级过滤,其他模型仅有来源级标记;DecisionPivot 与 StartLux-Decision 同队开发,独立评测与更多案例设计是必要的补充。我补充两点:其一,把缺失或截断预测记为错误(表 4 中带 † 的 8 个模型)会把'输入兼容性'与'决策能力'混进同一个分数,例如 Eval Engine Decision-4B 的 43.9% 里有多少来自截断无法拆分;其二,预测只取 argmax,丢弃完整分布信息,可能低估多选任务(如 record_rule 的 7–10 选项)上的真实区分度。
独立分析的弱点
第一,利益相关偏差:榜首两个模型(AutoThink 86.9%、Instant 75.4%)与基准同队开发,尽管做了重叠过滤与协议文档化,第三方复评仍是唯一解药,建议公开逐条预测并推动独立排行榜。第二,难度混淆:Level 3 同时加大规模与复杂度,作者自己承认无法分离两因素;改进方向是因子化设计,分别只变实体数、条件数或计算步数,才能定位失败源于'上下文过长'还是'推理过深'。第三,缺失预测并入错误:应单列'可评测率'与兼容性调整分数,否则小模型(如多个 0.6B–4B 模型组级仅 3%–12%)的排名可能主要反映 tokenizer 与上下文窗口限制而非决策能力。第四,部分信息捷径未堵全:只查 schema 就能在 toolcall_valid 达 91.7% 条目准确率,建议为每族设'半信息基线'门槛,超过阈值的族重新设计。第五,全局阈值分析是事后最优选择(把 Decider 组级从 74.1% 提到 74.2%、Clef 提到 30.6%),作者也说明这不构成留出校准证据;应改为在留出集上学阈值、测试集上报结果。第六,全英文且实体均为虚构,跨语言与真实生产日志上的迁移性未知。
未来方向
作者提出的方向包括:独立第三方评测、更多样的案例设计、端到端系统评测、多语言与推理效率。在此基础上有几条可延伸的路。其一,把 92.3% 对 74.1% 的'排序-决策鸿沟'本身变成研究对象:用对比对做留出校准、序数校准或对比目标微调,检验能否在不增加推理成本的前提下把排序优势转化为决策正确。其二,利用 20 类约束、13 类完整性规则等关键变化标注做定向补强——为护栏模型生成弱点专项训练数据,或生成错误归因报告。其三,7 个带种子的生成器天然支持 LiveBench 式滚动评测,配合金丝雀条目可持续监测污染,把 4,200 条新样本的一次性稳定性检查升级为常态机制。其四,把 state_goal、toolcall_valid、sched_conflict 等族接入真实 Agent 框架的生产轨迹,检验书面诊断分数与实际故障率的相关性,弥补作者承认的'非端到端'缺口。其五,探索因子化难度设计,分离上下文长度与推理深度对失败率的贡献。
复现评估
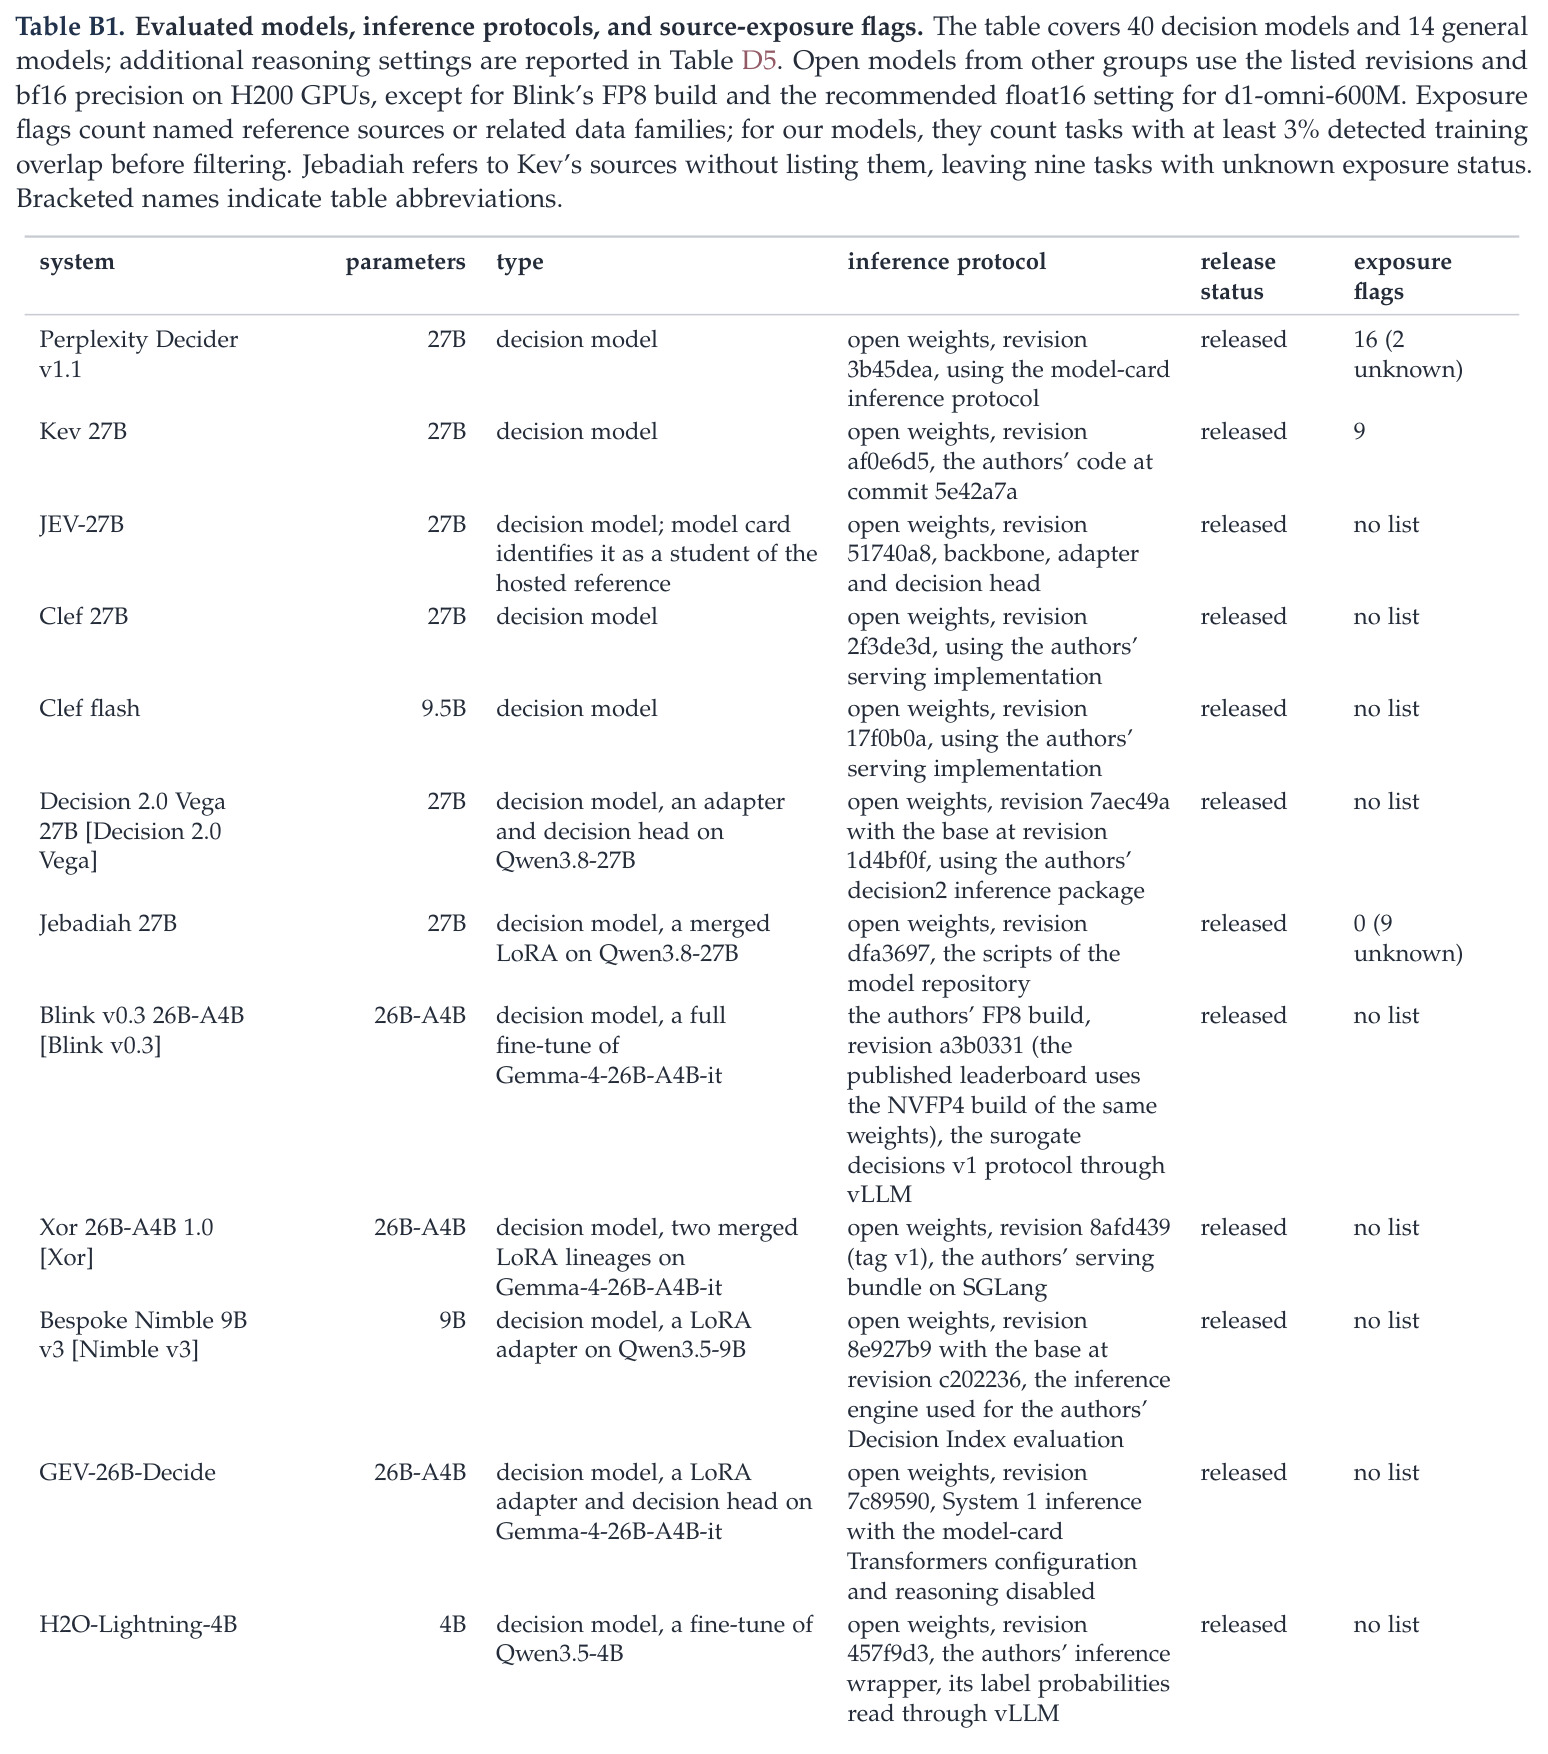
复现条件较好:数据以 CC BY 4.0 发布、代码以 Apache-2.0 发布,Hugging Face 与 GitHub 双入口;13 个核心任务族全部开源生成器,其中 7 个支持可配置随机种子,论文展示了用它们抽取 4,200 条新样本的稳定性实验;35 个参考任务中 13 个附重建脚本。算力需求低——无需任何训练,主要是推理:27B 开源模型单卡(80GB 级)即可运行,4B 以下模型消费级显卡可跑;闭源模型(Perplexity Decider v1.1、Jev 1.13 托管版、GLM-5.3 等)需对应 API。真正的难点在于忠实复刻各模型的文档化协议:概率读出方式、输入截断规则、推理档位各不相同(附录 B 的 Table B1 专门记录输入限制),为此作者提供运行校验——检查条目覆盖率与核心条目文件哈希——防止评错数据版本。注意许可限制:条目仅限评测用途。整体属于中等偏易的复现,主要成本在 API 费用与 40 余个模型的工程对接。
论文图表
(a) 展示 state_goal 的一个 level-1 对比对:Trace A 与 Trace B 仅第 3、5 步顺序不同,A 中第 5 步把第 3 步复制的文件移走导致最终目标条件失败(gold: no),B 中目标满足(gold: yes);六个 27B 决策模型加托管 Jev 的预测与概率显示,Perplexity Decider 对两者都说 yes(1.00),接下来三个模型都对两者说 no,只有两个 SL-27B 变体双双答对。(b) 用四项指标(参考分、组级准确率、条目正确率、5% 错误率覆盖率)对比这七个系统:参考分只跨约 6.9 分,组级准确率却从 AutoThink 的 87% 跌到托管 Jev 的 31%,跨度约 62 个百分点。
这张图一图讲清全文动机与核心结论:聚合分数接近的模型在受控对比上的差距可以大到完全改变排名,组级、条目、覆盖率三个指标各自揭示不同维度的失败。