SanSi:面向 System 1.5 思维的循环式类型化决策模型 SanSi: A Looped Typed Decision Model for System 1.5 Thinking
同一组层循环8次并逐环读出概率,以算力换参数,1.4B决策模型比同形状单次模型高13.5点
前置知识
类型化决策模型(Typed Decision Model)
一类不生成文本、直接输出决策的模型:调用方给定状态(一段文本、规则或记录)、问题和预先声明的 K 个选项,模型在单次前向传播中为每个选项返回一个概率,例如判断一条消息是否为垃圾邮件。商业 Jev API 与其开源复现 Kev 都遵循这一契约,返回的概率被下游系统用于接受、升级或路由决策。
SanSi 就是一个类型化决策模型,全文评估的正是这种选项概率的质量(准确率、校准、证据察觉),循环机制必须在不破坏这一契约的前提下叠加算力。
循环 Transformer(Looped Transformer)
不堆叠不同层,而是让同一组 Transformer 层反复作用于自己的隐状态:$h_t = NF_\theta(h_{t-1})$,每过一遍就精炼一次表示。思想源自 Universal Transformers,可学习迭代算法并对更长输入泛化。Ouro 就是为循环而预训练的语言模型(预训练时用 4 个循环)。
SanSi 的全部增益来自把这个栈循环 8 次,且消融证明:若骨干没有循环预训练,事后给它加环毫无收益,这是理解本文结论边界的关键。
System 1.5 与潜在推理(Latent Reasoning)
认知双系统中 System 1 是快速直觉(对应单次前向),System 2 是慢速深思(对应生成思维链文本)。潜在推理指在隐状态空间中迭代计算而不生成 token,介于两者之间,故称 System 1.5:比单次多花算力,但不付生成文本的 token、延迟和解析代价。
这是论文的概念框架——循环被定位为 System 1.5,理解它才能明白作者为何反复强调不生成 token、保持类型化契约。
LoRA(低秩适配)
冻结预训练权重,只训练注入到注意力与前馈投影中的低秩矩阵(如 rank 64 的 $U_tV_t$ 修正),可训练参数量和显存开销很小,效果接近全量微调。
SanSi 冻结骨干、只训 60.6M 的 LoRA 适配器与 0.27M 读出头(共 61M),这使循环带来的增益不会被新参数混淆,也让训练成本极低、复现门槛小。
严格评分规则(Cross-Entropy 与 Brier 分数)
评分规则衡量概率预测与目标分布的差距,严格指当且仅当预测恰等于目标分布时损失最小。交叉熵 $-\sum_k y^*_k\log p_k$ 只看正确选项的概率、重罚自信的错误;Brier 分数 $\sum_k (p_k-y^*_k)^2$ 考虑所有选项且有界。两者都是严格评分规则。
SanSi 每环的损失是 CE+Brier 之和;消融显示去掉 Brier 项校准变差、无答案项更敢乱答,而 RL 奖励在期望上等价于半个 Brier 的策略梯度,这是读懂消融章节的钥匙。
ECE 与 AUROC(校准与排序指标)
ECE(期望校准误差)把样本按置信度分桶,比较每桶平均置信度与准确率之差,衡量说 90% 是否真有 90% 对;AUROC 是按分数把两类样本排开的概率,0.5 为随机、1 为完美。本文用 AUROC 检验置信度能否区分答对/答错、有证据/无证据的样本。
RQ3 的结论全靠这两个指标:校准只在第 3 环最好,置信度对错题同样上升(区分对错的 AUROC 仅从 0.760 到 0.795),读这些数字需要这两个概念。
GRPO 与无金标准奖励
GRPO 是策略梯度强化学习算法:同一问题采样一组答案,以组内平均奖励为基线计算优势后更新策略,不需要价值网络。当任务没有可验证的金标准答案时,可用另一个模型(裁判)对候选输出打分作为奖励信号。
第 8 节把冻结的 SanSi 当作唯一奖励来训练生成器,验证循环概率作为裁判的价值;其中奖励=正确性减去自报概率的设计,正与 Brier 梯度的理论联系相呼应。
研究动机
越来越多的语言模型调用要的不是文本而是一个决策:这条消息是不是垃圾、这个案例是否满足政策、四个答案中哪一个能从文档推出。类型化决策模型(商业 Jev API 及开源复现 Kev)正是为此设计:调用方声明选项,模型单次前向传播返回每个选项的概率,无需生成和解析文本。但单次前向给每个决策的计算量是固定的,很多决策需要多步依赖推理——例如 Omar 诚实、Bert 说 Omar 说真话、Ben 说 Bert 说谎这样的链。Jev API 在此类链式任务上 1 步准确率 100%,3 步降至 62.5%,6 步起接近随机水平。想提高准确率只有两条路:换更大的模型(增加参数与显存),或生成思维链(增加 token 和延迟,且失去类型化契约与校准概率)。
本文的目标是本文要在单次前向(System 1)与生成式推理(System 2)之间寻找中间态:循环(looping),即把同一组 Transformer 层递归地作用于自己的隐状态若干次后再做一次类型化读出,作者称之为 System 1.5 思维。具体目标是构建 SanSi 模型族,并系统回答四个问题:(1) 循环到底带来多少准确率、付出什么代价(RQ1);(2) 答案如何随循环逐次演变、何时定型(RQ2);(3) 循环对调用方赖以决策的概率做了什么——置信度、校准、对缺失证据的察觉(RQ3);(4) 循环能否买到推理深度、是否泛化到训练未见深度(RQ4)。
与已有工作不同的是,已有工作的切入各有限制:Jev-LCT 只循环非循环模型最上面两层且早早退出,无法说明完整循环栈的潜力;循环语言模型研究集中于预训练方法、稳定性、停机准则和架构变体;把循环嫁接到非循环预训练模型的工作(如 Retrofitted Recurrence)需要远大于微调的训练预算。SanSi 的独特之处在于:起点是整个网络都为循环而预训练的 Ouro 主干;每个循环都读出并用严格评分规则(交叉熵+Brier)训练,使一个模型同时服务 1 到 8 环的任意预算;并用同一数据、同一配方、同一随机种子做受控对照(同形状的 SmolLM2、更新家族的 Qwen3.5、对手官方配方的 Kev-4B),把循环的贡献与参数量、骨干强弱、训练配方干净地剥离。
核心方法
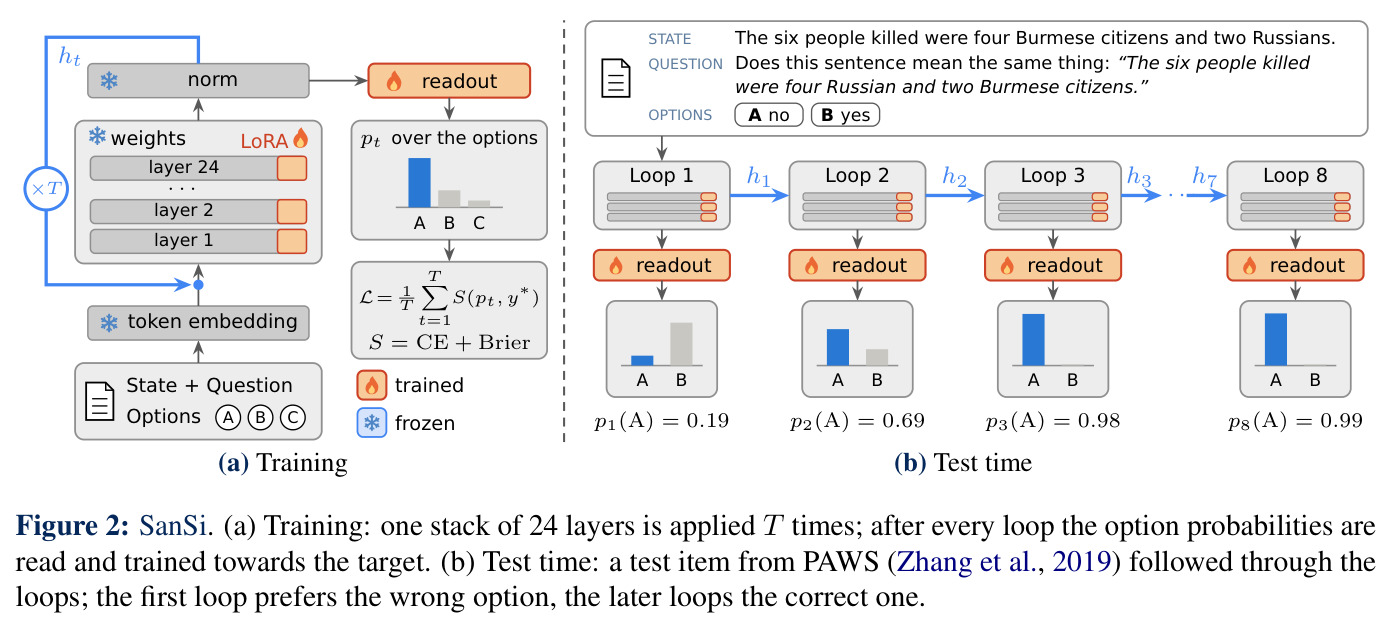
直觉上,SanSi 让小模型遇到难题时多想几遍:把 24 层 Transformer 栈反复套用自己的隐状态,每转一圈就重新读一次选项概率,答案从错误逐步修正到正确(图 2b 的 PAWS 例子中选项 A 的概率从 0.19 到 0.69 再到 0.98)。技术路线上:以预训练为循环而生的 Ouro-1.4B/2.6B 为骨干并冻结,只训练 LoRA 适配器(rank 64,60.6M 参数,所有环共享)和每环一个小读出头(0.27M);递归定义为 $h_t = NF_\theta(h_{t-1})$,$t=1,\dots,T$,输入 token 不再注入;在第 $t$ 环的末提示 token 上读出选项概率;训练时每个环都计算损失 $\mathcal{L}=\frac{1}{T}\sum_{t=1}^{T}\big[-\sum_k y^*_k\log p_{t,k}+\sum_k(p_{t,k}-y^*_k)^2\big]$,每环损失的梯度反传穿过之前所有环。$T=8$,是 Ouro 预训练循环数的两倍。
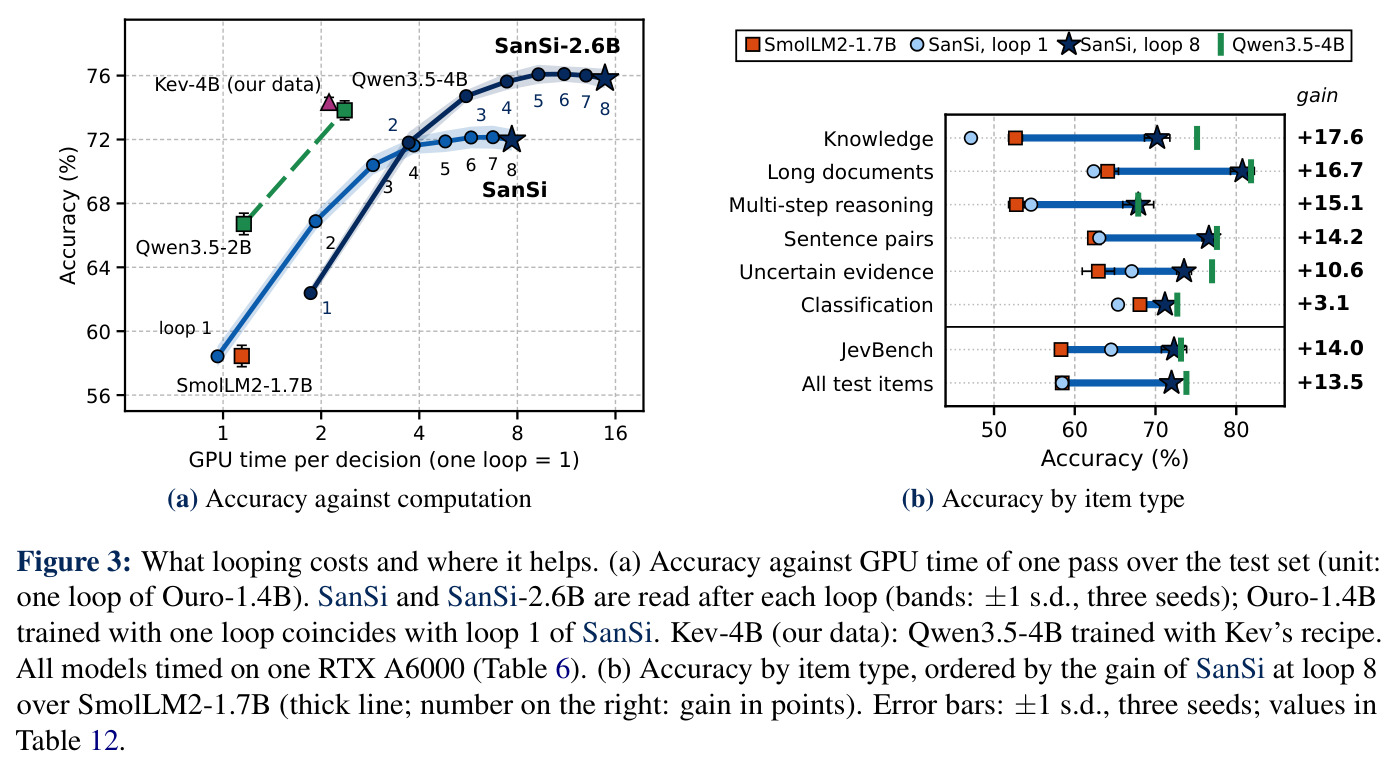
核心创新有二。其一是每环都读、每环都训:以往循环或早退模型只在最终深度输出,而 SanSi 在每个循环后都读出选项概率并用严格评分规则训练,使同一模型天然成为 anytime 模型——一次前向同时产生预算 1 到 8 的全部决策,调用方按算力预算取用第几环即可。其二是用计算换参数且不破坏类型化契约:同样的层跑 $T$ 遍,每环都是完整一次前向,推理成本 7.7 倍但参数不变,调用方拿到的仍是校准的选项概率而非生成文本。这与 Jev-LCT 只循环顶部两层、与自适应计算/早退研究提出停机规则都不同——SanSi 不提停机规则,预算由调用方显式选择。消融进一步揭示关键前提:把循环加到非循环预训练的 SmolLM2 上训练毫无收益(第 8 环 58.3% 对单次 58.4%),收益根植于 Ouro 的循环预训练,配方只是把这种潜力转化为决策能力。
方法步骤详情
第一步,任务渲染:每条决策渲染为提示词,依次是状态、Question: 加问题、Options: 加形如 (A)…(B)… 的选项、Answer:,在最后一个 token 处读出;选项由单个字母 token 命名,最多 26 个。第二步,循环计算:token 嵌入 $h_0$ 经 $h_t=NF_\theta(h_{t-1})$ 递归 8 次,$N$ 是模型最终归一化层,成本为 $T$ 次前向。第三步,读出:取 $h_t$ 在末提示 token 的行 $z_t$,$\ell_t=(W+U_tV_t)z_t/\tau_t$,$p_t=\mathrm{softmax}(\ell_t)$,只保留 K 个声明选项;$W$ 是冻结语言模型头中选项字母对应的行,rank-16 修正 $U_tV_t$ 与温度 $\tau_t$ 每环一套、初始化为恒等。第四步,训练目标:目标分布为 one-hot(有正确项)、均匀分布(关键证据被移除的无答案项)或众包标注分布;损失为 CE+Brier 按环平均。第五步,优化:AdamW,LoRA 学习率 $10^{-4}$、读出 $10^{-3}$,1,000 步、每步 16 条,bfloat16;主模型训练约 313 GPU 分钟(单张 RTX A6000 约 5.2 小时)。
技术新颖性
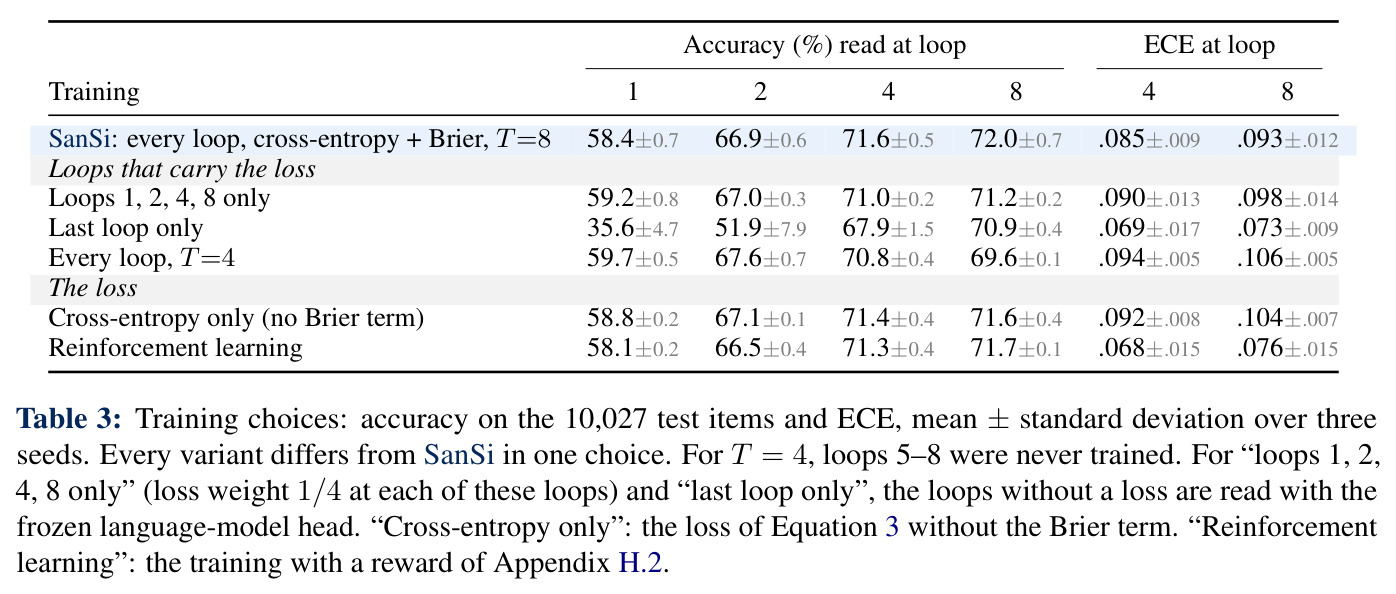
技术新颖性有四。第一,把循环从预训练技巧升级为类型化决策模型的测试时算力旋钮,并证明其有效性依赖于为循环而预训练的骨干——这与 Universal Transformers、Retrofitted Recurrence 等在训练期引入循环的工作本质不同。第二,anytime 读出设计:每环一个从冻结 LM 头恒等初始化出发的 rank-16 读出头,使读哪一环成为部署时而非训练时的选择;消融显示只在最后一环放损失会使早期环崩溃(第 1 环仅 35.6%)。第三,训练目标的理论刻画:正确性减去自报概率的 REINFORCE 奖励在期望上等价于半个 Brier 得分的策略梯度,作者据此实现 Jev 式 RL 训练(71.7% 对监督 72.0%),并发现 RL 版本校准更好(ECE 0.076 对 0.093)但漏检缺失证据更差(证据 AUROC 0.919 对 0.935)。第四,评估方法学:以同形状同配方对照、以更新家族做参照、以对手官方配方做公平性检验,并按题型与训练距离分格报告,使循环增益的归因非常干净。
实验结果
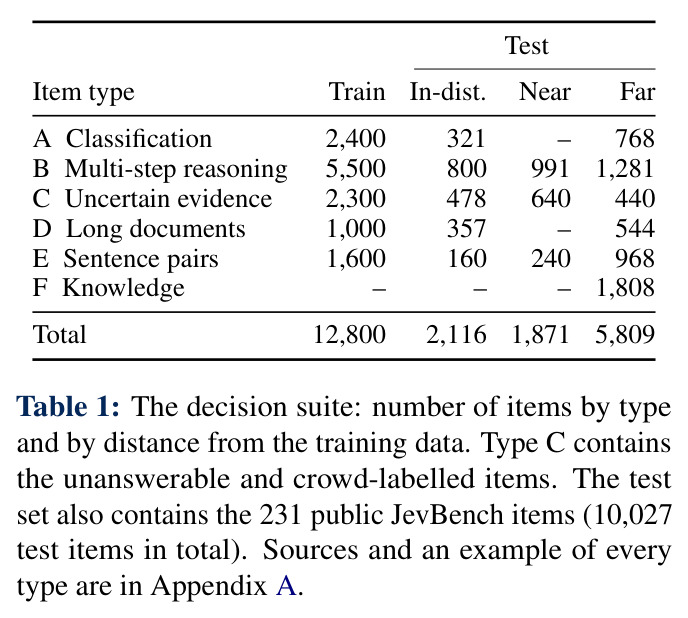
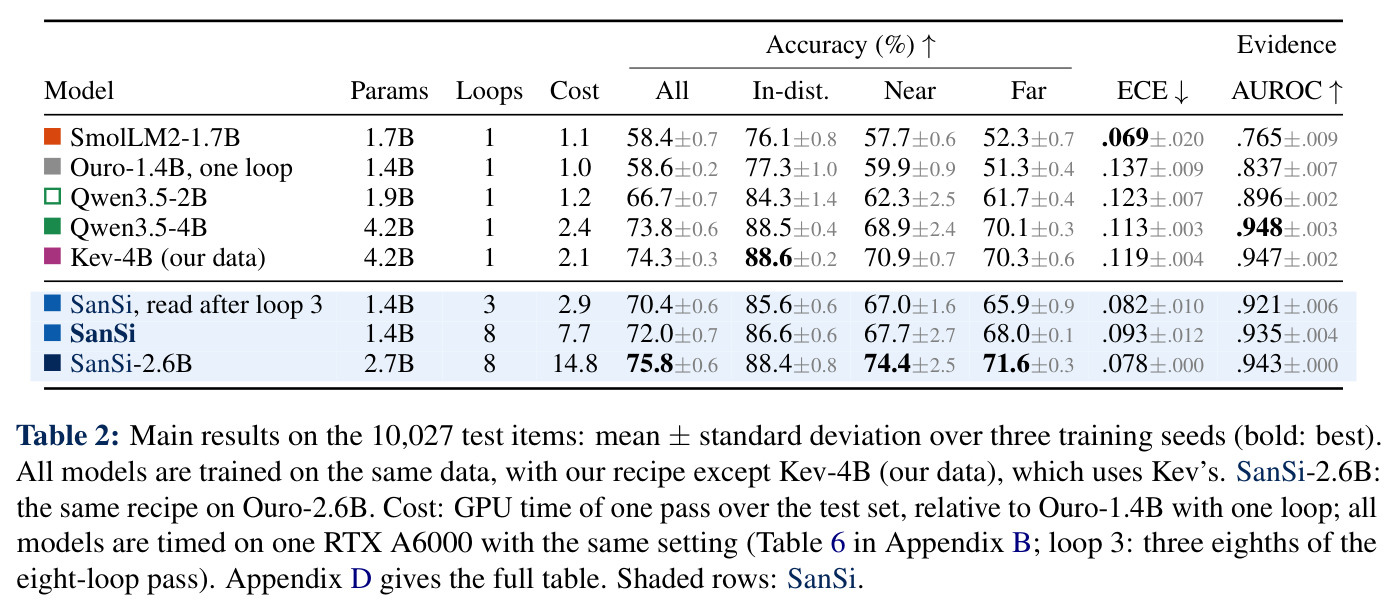
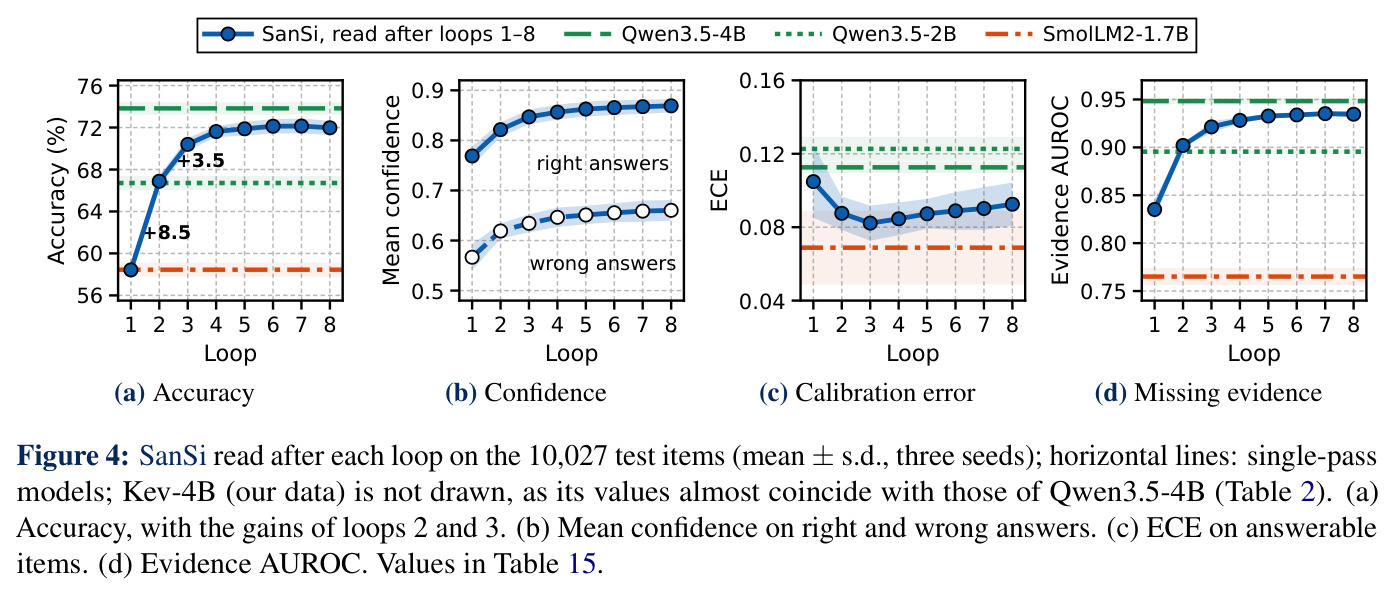
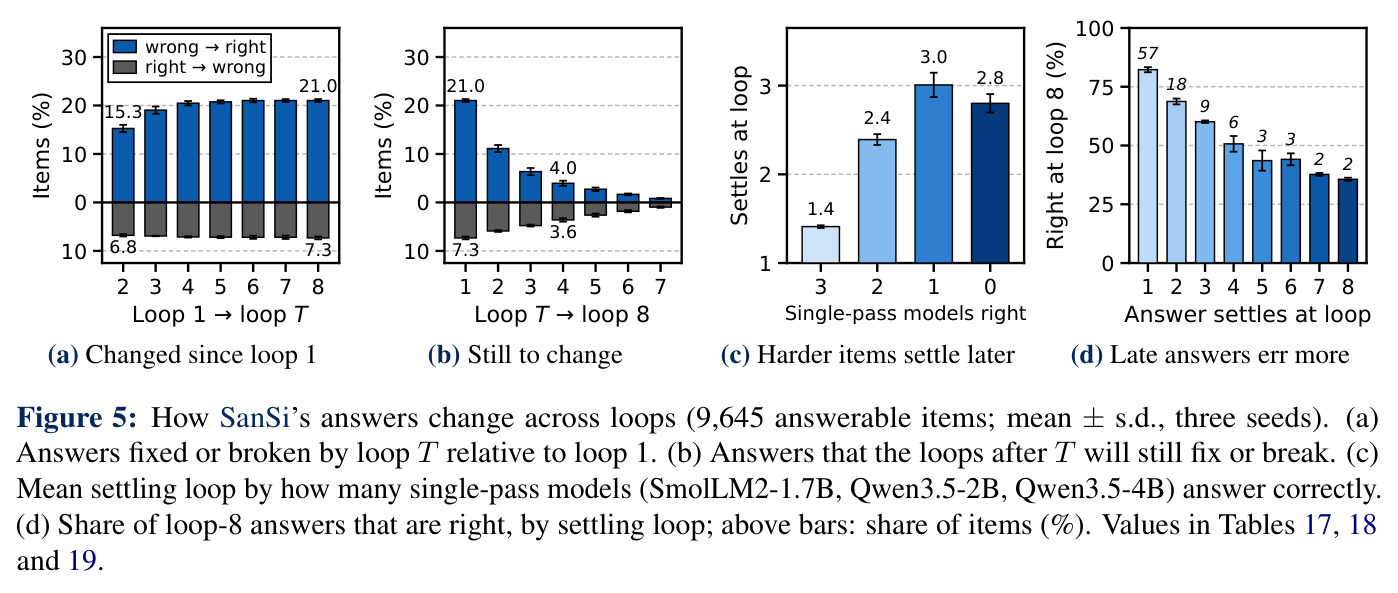
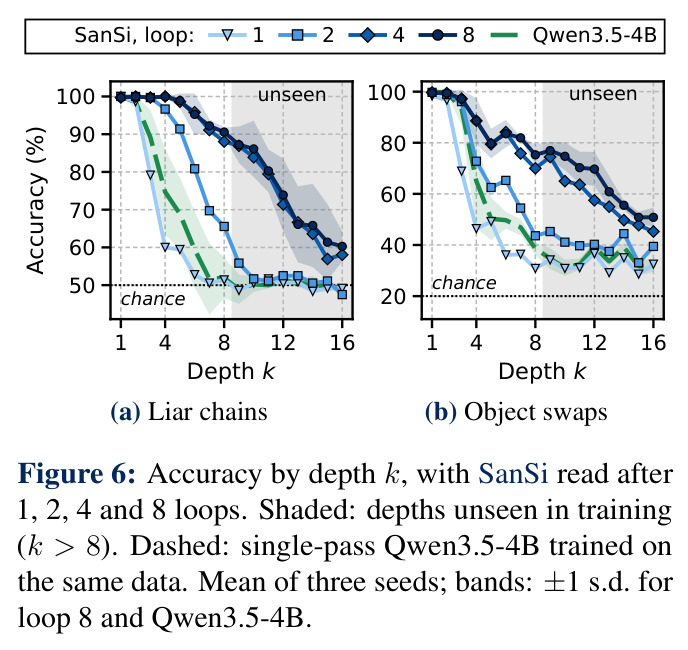
在 10,027 条测试决策(59 个来源)上,SanSi 达 72.0%:比同形状同数据同配方的 SmolLM2-1.7B(58.4%)高 13.5 点(95% 区间 [12.5, 14.5],三个种子 12.9–14.8),比同规模较新的 Qwen3.5-2B 高 5.3 点,仅比三倍参数的 Qwen3.5-4B(73.8%)低 1.8 点;Ouro-1.4B 单环只达 58.6%,证明增益来自循环而非骨干。增益随任务而变:分类仅 +3.1,多步推理 +15.1、长文档 +16.7、知识 +17.6(该类型只在测试集出现,第 1 环 47.1% 到第 8 环 70.2%)。代价是推理 7.7 倍、训练 9.5 倍 GPU 时间;3 环即拿 88% 增益(70.4%)。逐环看:第 2 环 +8.5、第 3 环 +3.5、第 4 环 +1.2、5–8 环合计 +0.4;第 8 环累计修正 21.0%、破坏 7.3%,约三比一。概率上,证据 AUROC 从 0.835 升至 0.935,对 382 个无答案项给硬答案的比例从 27.1% 降至 17.5%,但置信度在对错题上都上升(0.769→0.869 与 0.567→0.660),ECE 第 3 环最优(0.082)、第 8 环回升至 0.093。深度任务(训练 k≤8、测试 k≤16):谎者链未见深度 SanSi 72.6%,Qwen3.5-4B 仅 50.0%(随机水平);对象交换 63.7% 对 34.2%。作无金标准 RL 裁判时,第 8 环奖励把生成器 F1 从 39.5 提到 47.3(+7.7),第 1 环奖励反而损害(29.1)。
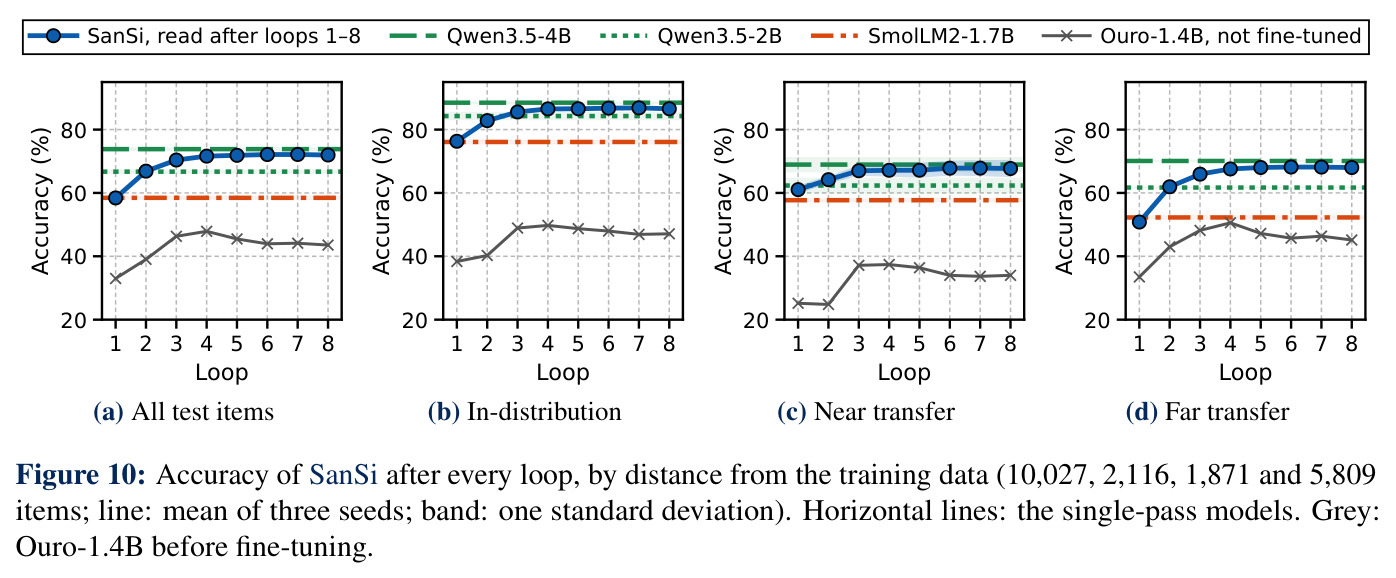
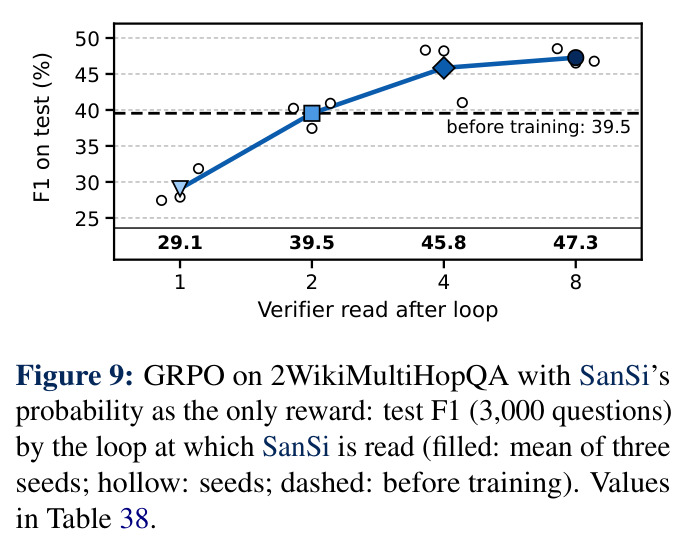
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 10,027 条类型化决策套件(全量) | 准确率 | SanSi 72.0% | SmolLM2-1.7B(同形状同配方)58.4% | +13.5 点 |
| 同套件,对比同规模较新骨干 | 准确率 | SanSi 72.0%(第 8 环) | Qwen3.5-2B 66.7% | +5.3 点(第 2 环即持平) |
| 同套件,对比三倍参数单次模型 | 准确率(参数仅 1/3,算力 3.3×) | SanSi 72.0% | Qwen3.5-4B 73.8% | −1.8 点(落后但接近) |
| 同套件,对手官方配方对照 | 准确率 | SanSi 72.0% | Kev-4B(our data)74.3% | −2.4 点(参数仅 1/3;SanSi-2.6B 反超 +1.5) |
| 缺失证据察觉(786 条可答/无答案配对项) | 证据 AUROC / 硬答案率 | 0.935 / 17.5%(第 8 环) | 0.835 / 27.1%(第 1 环) | +0.099 / −9.7 点 |
| 谎者链,未见深度 k=9–16 | 准确率(随机 50%) | SanSi 第 8 环 72.6% | Qwen3.5-4B 单次 50.0% | +22.6 点 |
| 对象交换,未见深度 k=9–16 | 准确率(随机 20%) | SanSi 第 8 环 63.7% | Qwen3.5-4B 单次 34.2% | +29.5 点 |
| SanSi 作唯一奖励的 GRPO(2WikiMultiHopQA) | 生成器 token F1 | 47.3(第 8 环奖励) | 无验证器训练 39.5 | +7.7 点 |
局限与改进
作者承认的限制:结论建立在单一循环预训练家族 Ouro(1.4B/2.6B)上,多数分析用 1.4B;增益依赖循环预训练,能否推广到其他或更大骨干是开放问题;读固定环数、无早退或停机规则;深度结论基于两个程序生成任务;验证器案例只用一个数据集一个生成器;套件仅英语且由既有数据集拼成,无法排除骨干预训练时见过部分公开数据;每组只 3 个种子,小子集差异需结合区间读。我自己的观察:其一,等算力下大模型仍赢(3 环时 Qwen3.5-4B 领先 3.4 点),8 环推理 7.7 倍、2.6B 版 14.8 倍成本,部署经济性存疑;其二,答案定型后置信度继续攀升,ECE 从第 3 环的 0.082 回升到 0.093,近迁移组尤其糟(0.053→0.149),过度自信风险真实;其三,11.7% 的题曾在某些环正确、最终环却错,但论文未给选环规则,放弃了 83.3% 的理论上限;其四,跑超过训练环数会掉点(第 16 环 70.1%),深度扩展有硬上限;其五,纯知识缺失仍会全程高置信答错(ARC 例 0.96→0.99),循环无法替代检索。
独立分析的弱点
独立分析的弱点:(1) 固定环数无停机——56.7% 的答案第 1 环后再不变,却仍要跑满 8 环付 7.7 倍算力,而晚定型的答案错误率更高(第 8 环定型者仅 35.6% 正确)且置信度虚高,改进方向是引入 PonderNet 式的每环停机概率,或用定型环号作为人工审核的触发信号;(2) 置信度对错题同样上升,区分对错能力几乎没变(AUROC 0.760→0.795),说明循环修正答案但不教自我怀疑,改进方向是在定型后惩罚置信度增长,或默认平均 8 环概率(论文显示这一免费操作把 ECE 从 0.093 砍到 0.044);(3) 循环不弥补知识缺口:知识题仍落后 Qwen3.5-4B 4.9 点,缺知识的题全程高置信答错,改进方向是与检索增强结合,让循环负责整合、检索负责知道;(4) 无法事后加装循环:给 SmolLM2 加环要么训不动(33.5%)要么不用(58.3%),限制了配方对存量非循环模型的适用性,改进方向是参照 McLeish 等用大预算继续预训练植入循环;(5) RL 版本漏检证据变差(硬答案 21.6% 对 17.5%),若用于安全关键的路由决策应保留 Brier 监督项或混合两种目标。
未来方向
作者提出的方向:为每个条目选择循环数的规则——11.7% 的题曾在某环正确而最终错误,理想选环上限可达 83.3%;把发现推广到更多、更大的循环预训练骨干;把无金标准奖励下的验证器(judge)规模化。基于成果可延伸的:把定型环号用作难度感知路由——易题 1 环即走、难题多环并触发升级到人或生成式推理,把 anytime 特性变成真正的自适应计算;构建 System 1/1.5/2 可切换的频谱,用 SanSi 概率决定何时升级到显式思维链;探索每环差异化训练而非共享同一套 LoRA;在多语言和真实生产数据(内容审核、合规检查)上验证套件结论;对循环中学到的迭代算法(如谎者链上真值逐链翻转)做机制可解释性分析;以及把循环骨干与外部检索、工具调用结合以弥补知识短板。
复现评估
复现条件相当友好。骨干 Ouro-1.4B/2.6B 是公开的预训练模型;评估套件由公开数据集(AG News、MNLI、FOLIO、BBH、MMLU、QuALITY 等 59 个测试源)组装,附录 A/B 给出完整来源、数量与提示渲染格式;两个深度任务为程序生成并附防捷径检验;深度可控、无答案项与众包分布目标都有精确定义。训练只动 61M 参数(LoRA rank 64 加读出),1,000 步、每步 16 条,单张 RTX A6000 约 5.2 小时(313 GPU 分钟)即可复现主模型,Kev-4B 对照每种子约 3.9 小时;测试集一次完整前向约 43 分钟(2,571 秒)。三种子均值、标准差与分组自助法区间都完整报告。论文列有项目页但正文未明确承诺开源代码与数据套件;若放出则复现难度很低,即便只按论文实现,主要工程量也在数据拼装与格式对齐,总体属于小算力可复现的研究。
论文图表
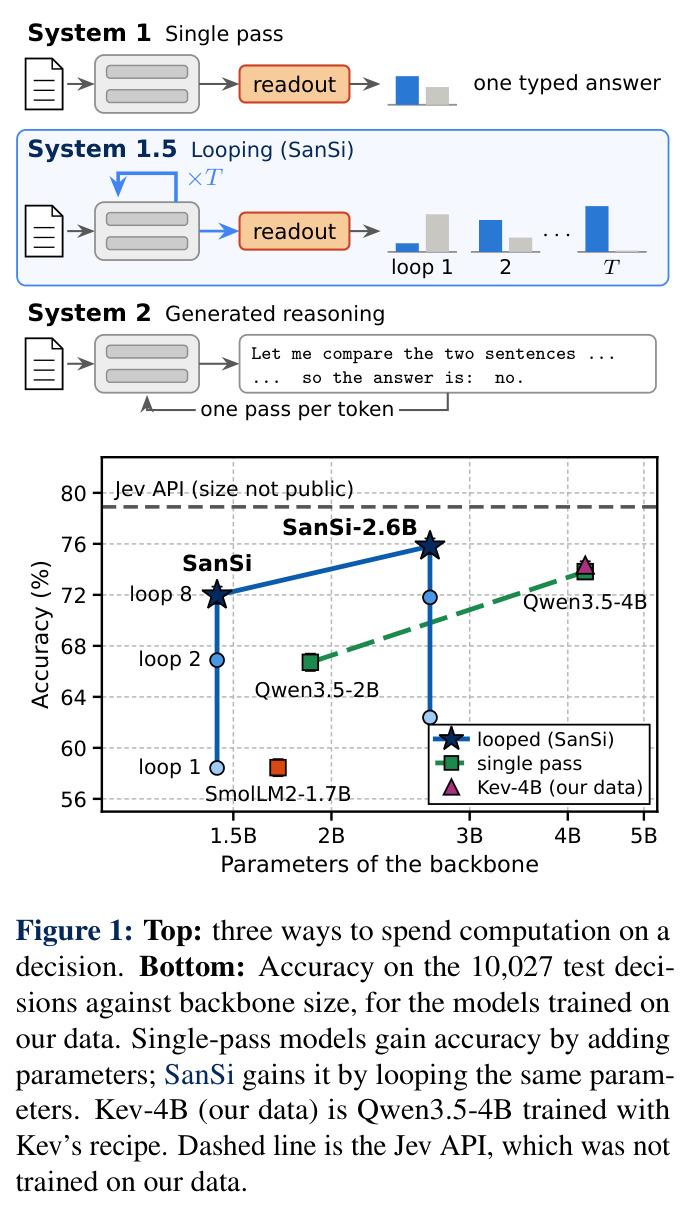
上半部分对比三种花费算力的方式:System 1 单次前向直接读出一个类型化答案;System 1.5(SanSi)同一组层循环 T 次后一次读出;System 2 生成式推理每个 token 一次前向。下半部分是 10,027 条测试决策上准确率对骨干参数量的图:单次模型(SmolLM2-1.7B、Qwen3.5-2B、Qwen3.5-4B、Kev-4B our data)靠加参数横向涨点,SanSi 靠循环同一组参数沿环数 1→8 纵向涨到 72.0%,虚线为未在本数据上训练的 Jev API。
一张图道出论文主旨:计算与参数是两种可以互换的货币,以及 SanSi 在这条坐标里的位置,是理解全文动机与定位的钥匙。
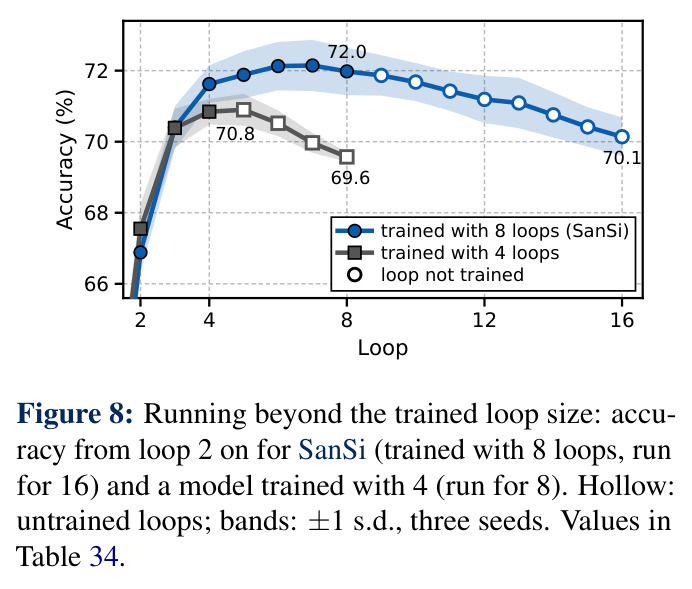
训练 8 环的 SanSi 被跑到 16 环、训练 4 环的模型被跑到 8 环的准确率曲线:超过最后受训环后双双下滑——SanSi 从第 8 环 72.0% 降到第 16 环 70.1%(ECE 0.093→0.105),4 环模型从 70.8% 降到 69.6%;空心点为未受训的环。在深度任务上 16 环也不比 8 环多解任何深度。
揭示方法的硬边界:模型可以读早但不能读晚,受训环数封顶了可用算力,这是部署时必须记住的限制。