PyRUA-REAL:真实世界中的具身递归自我改进与机器人探索自适应学习 PyRUA-REAL: Robot Exploration and Adaptive Learning through RSI in the Real World
双智能体通过真机探索把经验沉淀为可复用技能与冻结程序,8任务平均成功率91.1%
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指智能体在不更新底层模型参数的前提下,通过持续积累经验、反思失败、修改自身程序(脚手架、技能库、记忆)来让后续表现逐轮提升的机制。改进的产物以代码和记忆形式持久化,每一轮迭代都能站在上一轮的肩膀上,形成『改代码→跑实验→记录经验→再改代码』的闭环。
本文的『具身 RSI』就是把这一软件智能体概念搬到物理机器人域,理解 RSI 是读懂全文问题定义(公式 $U_\theta$ 的改进算子)和六个假设 H1–H6 的前提。
Code as Policies(代码即策略)
用 LLM 生成的可执行 Python 程序直接作为机器人策略:程序内组合感知原语(目标检测、位姿估计)、运动原语(抓取、放置、推)和控制逻辑,通过实时观察闭环输出动作。相比端到端神经网络策略,代码可读、可改、可复用,且部署时不依赖模型推理。
PyRUA-REAL 的最终产物就是这类冻结程序,『离线编码 vs 在线编码 vs 在线动作推理』三模式对比(H6)完全建立在理解代码策略这一范式之上。
持久经验记忆与技能库
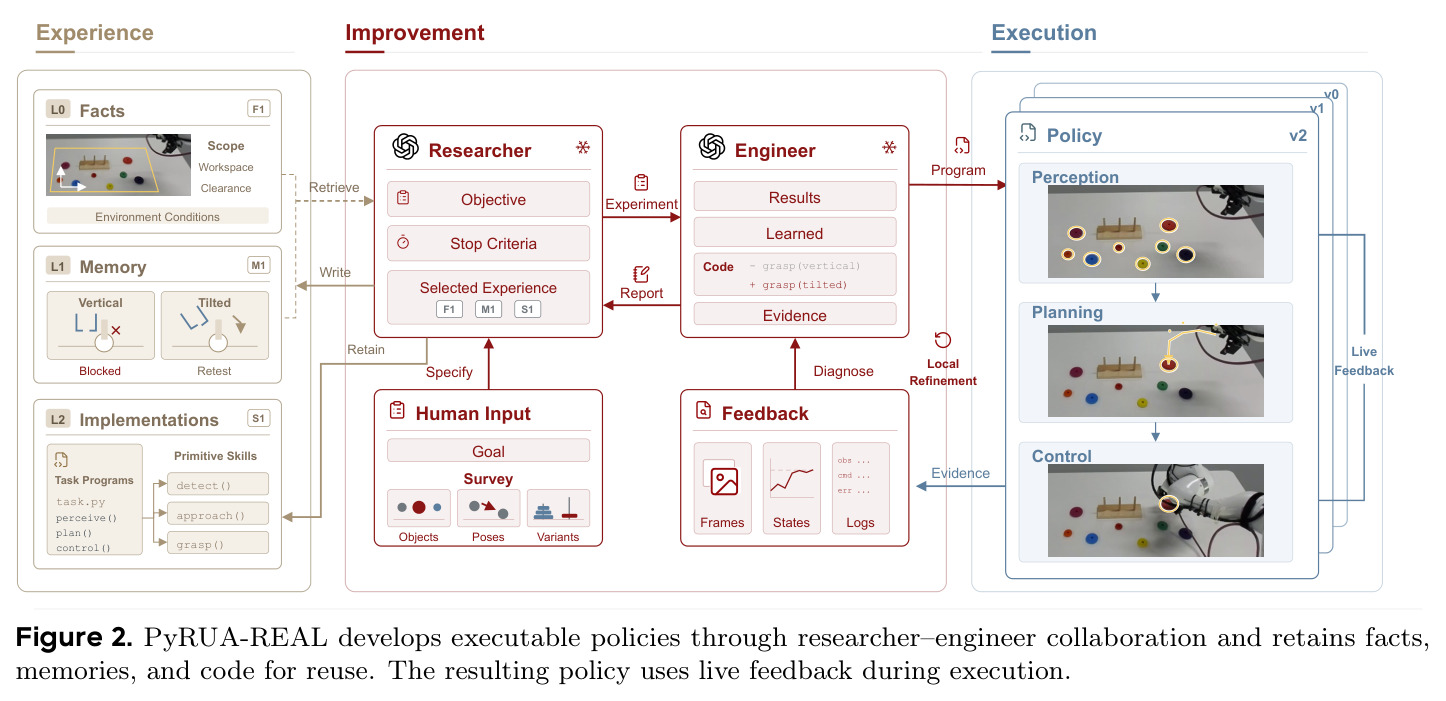
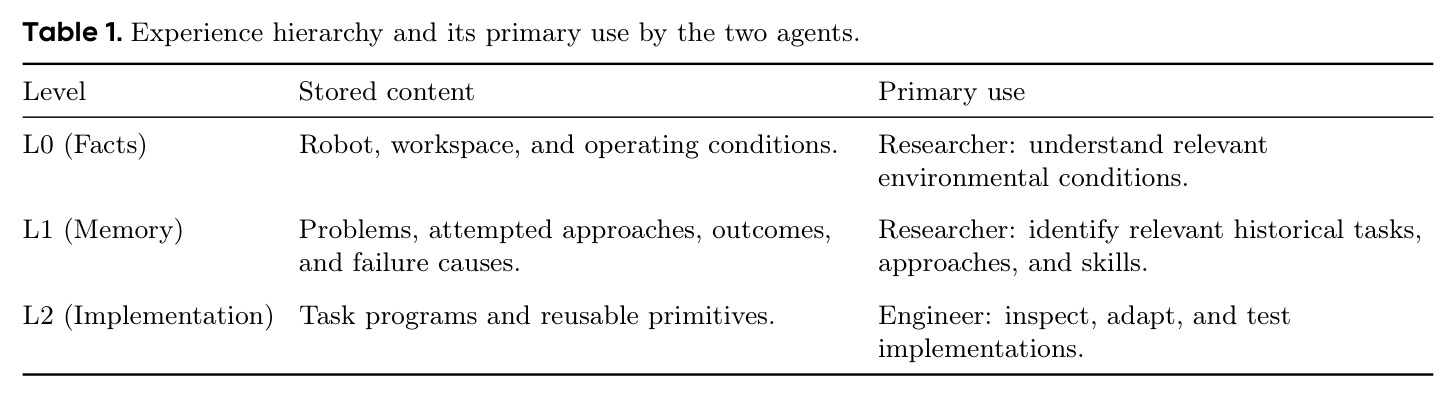
把智能体在环境交互中的事实、试错记录、失败原因、可运行代码片段写入持久存储,供后续任务检索复用,而非只停留在对话上下文里。典型分层是:环境事实层、过程记忆层(问题-方案-结果)、实现层(可执行原语与任务程序)。
本文经验库的 L0/L1/L2 三级分层(Table 1)是方法核心结构,researcher 和 engineer 对三层的不同用法决定了跨任务迁移(H5)能否发生。
双臂操作与接触富任务
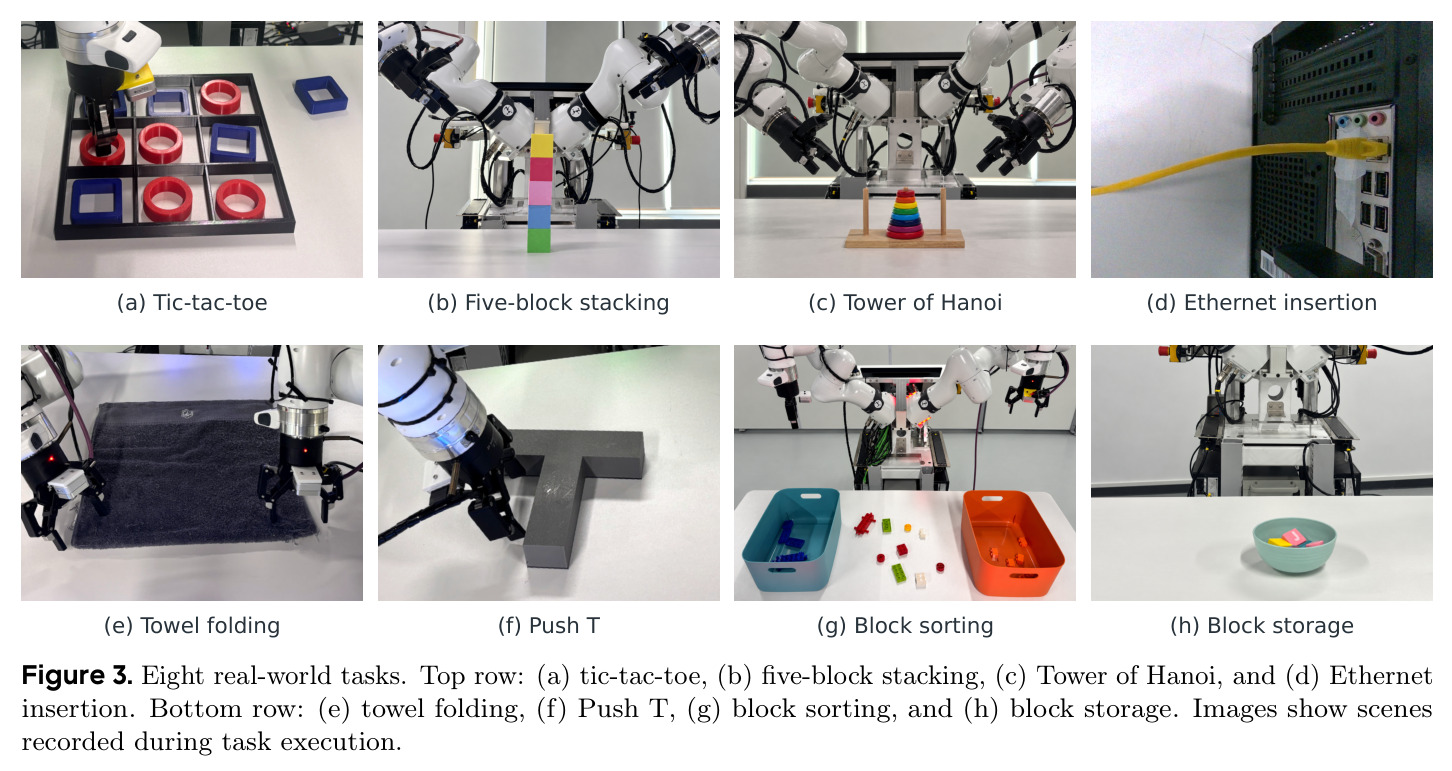
双臂 Franka 平台(两台 Franka Research 3 机械臂 + Robotiq-85 平行夹爪)可做双手协调任务(如毛巾折叠);接触富任务指以太网插线这类需要亚毫米级对准并处理物理接触的任务,通常需要柔顺控制与在线纠偏,是操作领域公认的难点。
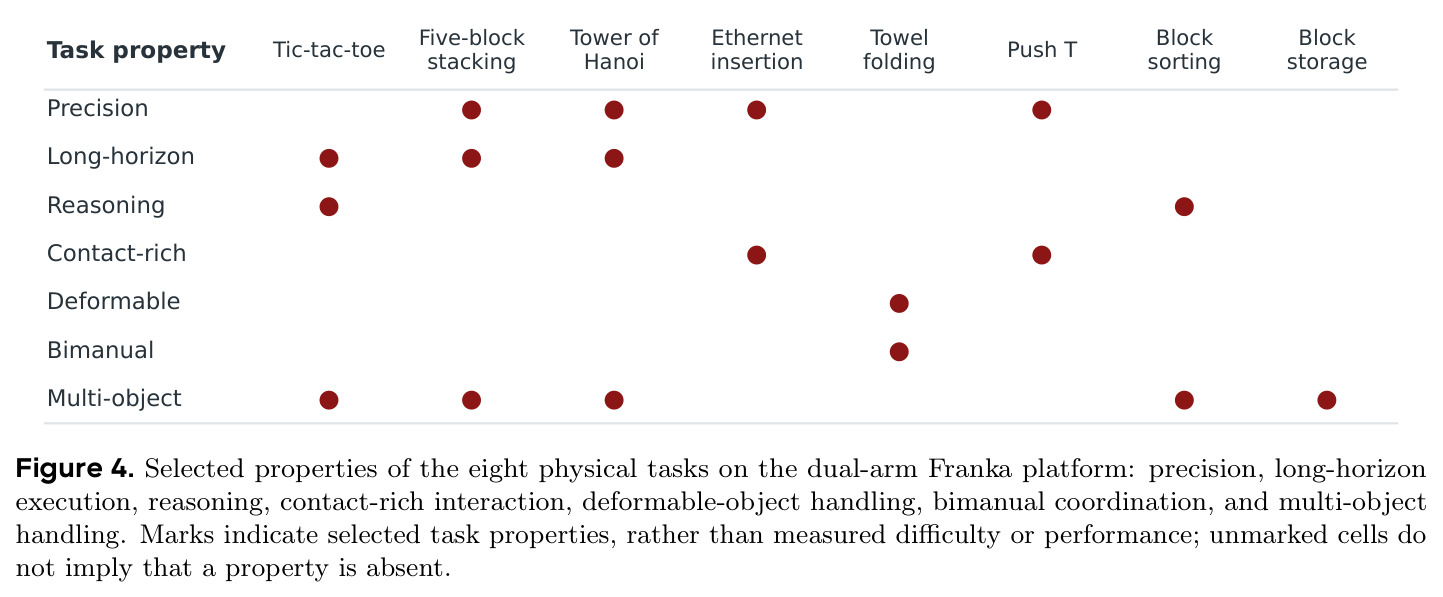
8 个真实任务覆盖推理、长时程、精确、可变形、双手等多个维度,以太网插线的失败案例(240 小时无解)是论文承认的关键局限,理解任务特性才能读懂实验设计。
RoboDojo 基准
包含 42 个基础任务的机器人操作仿真基准,按五个能力组划分:泛化(物体与布局变化)、记忆(状态与序列记忆)、精确操作(精细对准)、长时程(多阶段执行)、开放任务(指令接地与推理),支持冻结程序在 held-out 场景上的标准化评测。
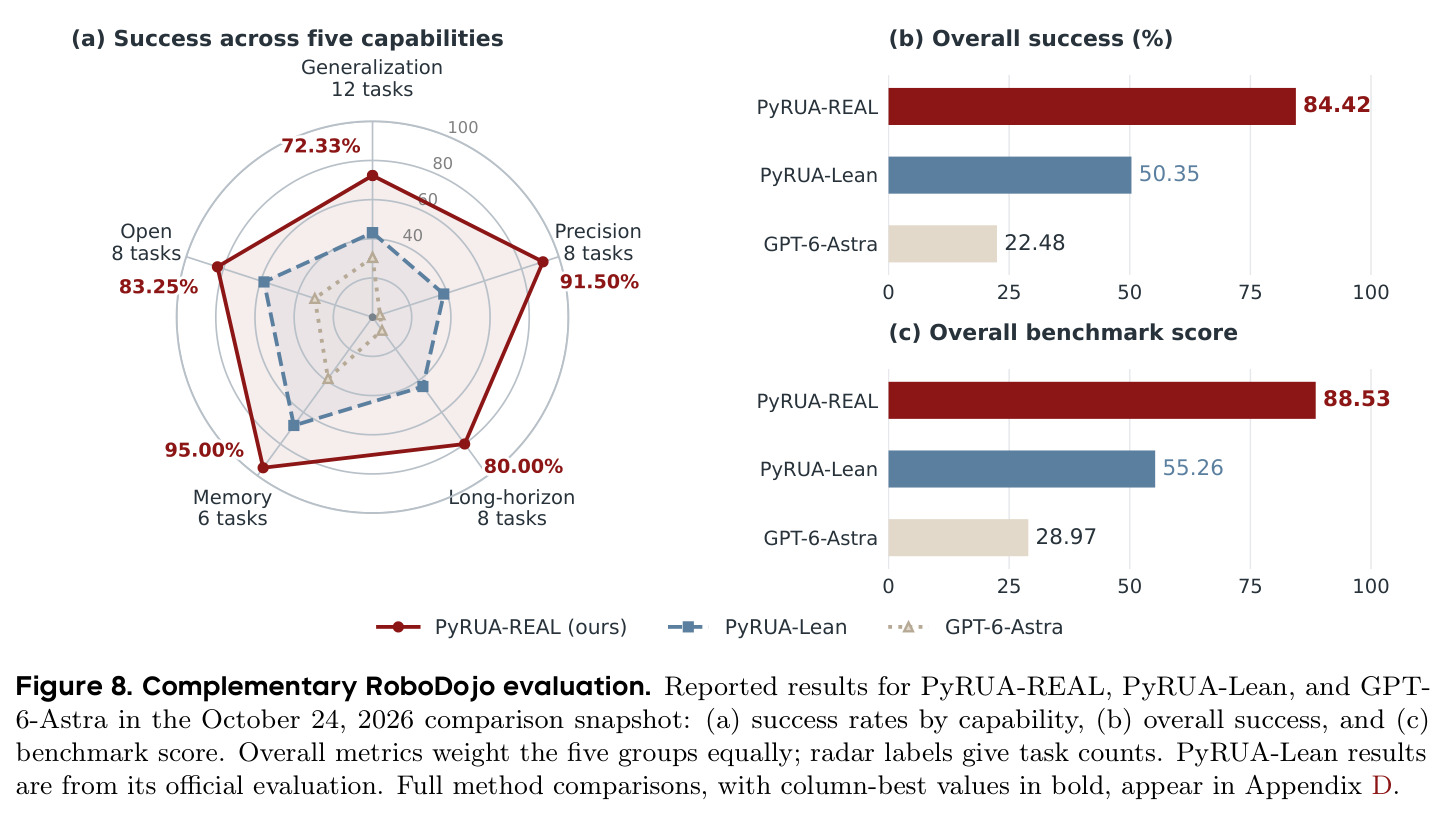
论文用 RoboDojo 做补充评估并与 PyRUA-Lean(50.35%)、GPT-6-Astra(22.48%)等基线对比,H3/H4/H5 的对照实验也在此基准的子集上进行。
研究动机
当前用 LLM 驱动机器人的两条主流路线各有硬伤。其一是『在线智能体决策』:GPT-6-Astra 这类编码智能体在任务执行中逐步观察、写码、看反馈、再行动,但在 RoboDojo 基准上仅取得 22.48% 的成功率,且频繁模型推理带来巨大时延——真实任务中智能体思考占执行时间的 63–90%,120 分钟都完不成一个汉诺塔。其二是『仿真中自我改进再迁移』:EmbodiedEvo 等方法在虚拟环境里进化技能,但难以跨越 sim-to-real 差距。直接在真实世界做递归自我改进(RSI)则面临多层挑战:智能体要决定跑哪些实验、改哪些实现细节、何时推翻底层技术路线,重复局部修补可能让不合适的感知或控制策略原封不动地存活;执行反馈本身有歧义——表面失败可能源于运动、感知或成功判定逻辑,例如井字棋中两枚相触的圆环被检测器误判为非法落子;单一配置下的成功也不代表对物体位置、朝向变化的鲁棒性。最刺眼的证据是以太网插线:无在线智能体参与的探索在 240 小时(10 天)后仍未获得一次成功执行。
本文的目标是本文要回答的核心研究问题是:编码智能体如何把物理交互经验转化为可持续改进、可复用、且部署时无需在线语言模型决策的机器人能力?作者将其拆解为六个可检验的假设:H1——把执行经验保留为记忆和可执行技能,能否支撑超越首次成功的持续改进;H2——researcher/engineer 等专业分工的多智能体协调能否提升 RSI 效率;H3——视频加关节轨迹这类丰富执行反馈能否比纯结果反馈更有效地支撑失败诊断与代码修订;H4——显式给出物体、布局、任务变体的规范能否提升程序在未见场景上的鲁棒性;H5——先前任务获得的原语技能库能否正向迁移到新任务;H6——把探索成果固化为可执行程序能否显著降低部署时的执行时间。作者不仅要在 8 个真实任务上证明『能不能做到』(开发记录平均成功率 91.1%),还要追踪『如何做到』:能力如何获取、首次成功之后如何继续精炼速度与精度、冻结程序部署时的行为与代价。
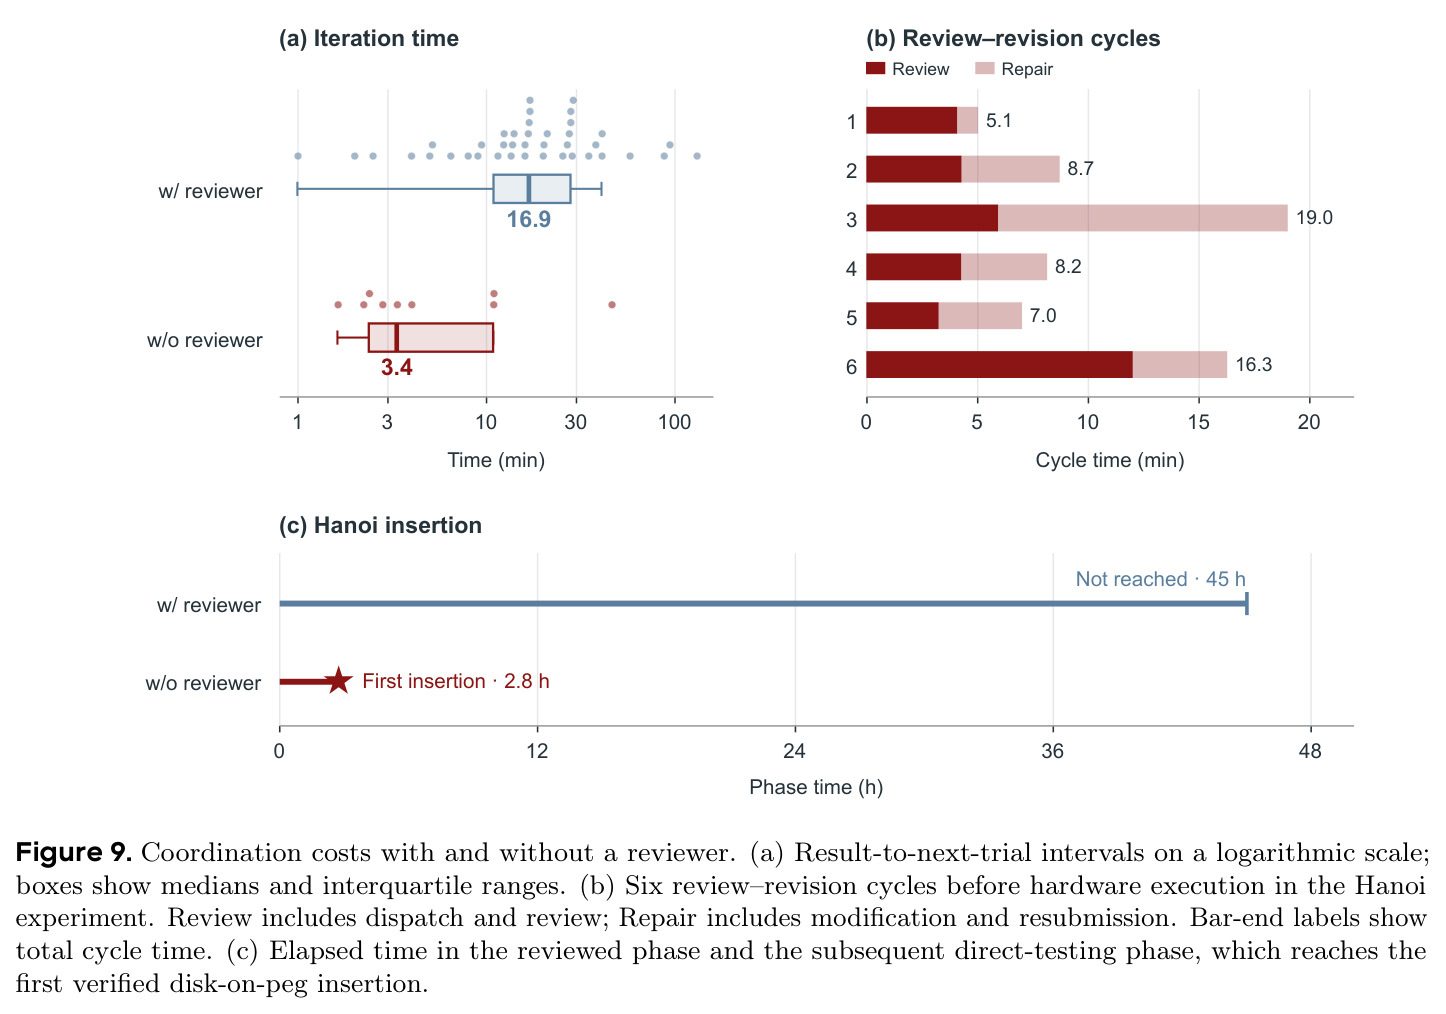
与已有工作不同的是,已有具身 RSI 工作大致分三类:仿真中心的技能与智能体框架进化(如 EmbodiedEvo、仿真练习后真机部署)、通过直接物理实验做策略改进的工作、以及可复用程序库与分层技能精炼。它们的共同短板是把物理机器人仅当作最终验证平台,或把改进过程留在仿真里。本文的独特切入是坚持『真实世界全流程』:探索、改进、部署全部发生在真机上,物理交互本身就是改进的驱动力而非验收环节。方法上,它把软件工程中的 agentic RSI(智能体迭代改写自身脚手架与执行逻辑)系统性地搬进物理操作域,改进载体是『能在真机上跑的程序』。实证上,它量化了此前很少被严肃讨论的设计问题:例如给 engineer 加一个独立审查者智能体,结果到下一次物理试验的中位间隔反而从 3.4 分钟涨到 16.9 分钟——这类带负结果的对照证据,以及 10 个『任务级重估打破局部修订死锁』的案例,为后续系统设计提供了少有的经验依据。
核心方法
PyRUA-REAL 的直觉是:让机器人能力像软件项目一样被『研发』出来,而不是每次任务都靠大模型现场思考。系统由三大组件构成。改进组件包含两个分工明确的编码智能体:researcher 负责任务级决策——选择技术路线、定义实验目标与停止准则、检索并更新经验;engineer 负责实现——写代码、上真机跑试验、诊断失败、做局部修订,底层模型参数 $\theta$ 全程冻结,所有改进都以记忆和代码形式沉淀。经验组件是三级持久存储:L0 事实(机器人、工作空间、操作条件)、L1 记忆(问题、尝试过的方案、结果与失败原因)、L2 实现(任务程序与可复用原语函数)。执行组件独立运行最终程序,调用本地部署的 SigLIP、SAM 做感知,通过实时观察闭环控制。形式化地,任务 $\tau$ 下动作由程序与共享技能库 $\mathcal{L}$ 生成:$a_t = \pi_\tau(o_{\leq t}; \mathcal{L})$;第 $k$ 轮改进算子更新策略、技能库与经验库:$(\pi_\tau^{k+1}, \mathcal{L}^{k+1}, M^{k+1}) = U_\theta(\tau, \pi_\tau^k, \mathcal{L}^k, M^k, E_k)$,其中 $E_k$ 为执行证据,目标是在交互预算 $B_{int}$ 与计算预算 $B_{comp}$ 内最大化期望回报 $J_\tau(\pi) = \mathbb{E}_{\xi \sim P^\tau}[R_\tau(\xi)]$。真机平台为双臂 Franka Research 3、Robotiq-85 夹爪、ZED Mini 头部相机与腕部 RealSense D405,标定与控制器均需在探索中自行建立。
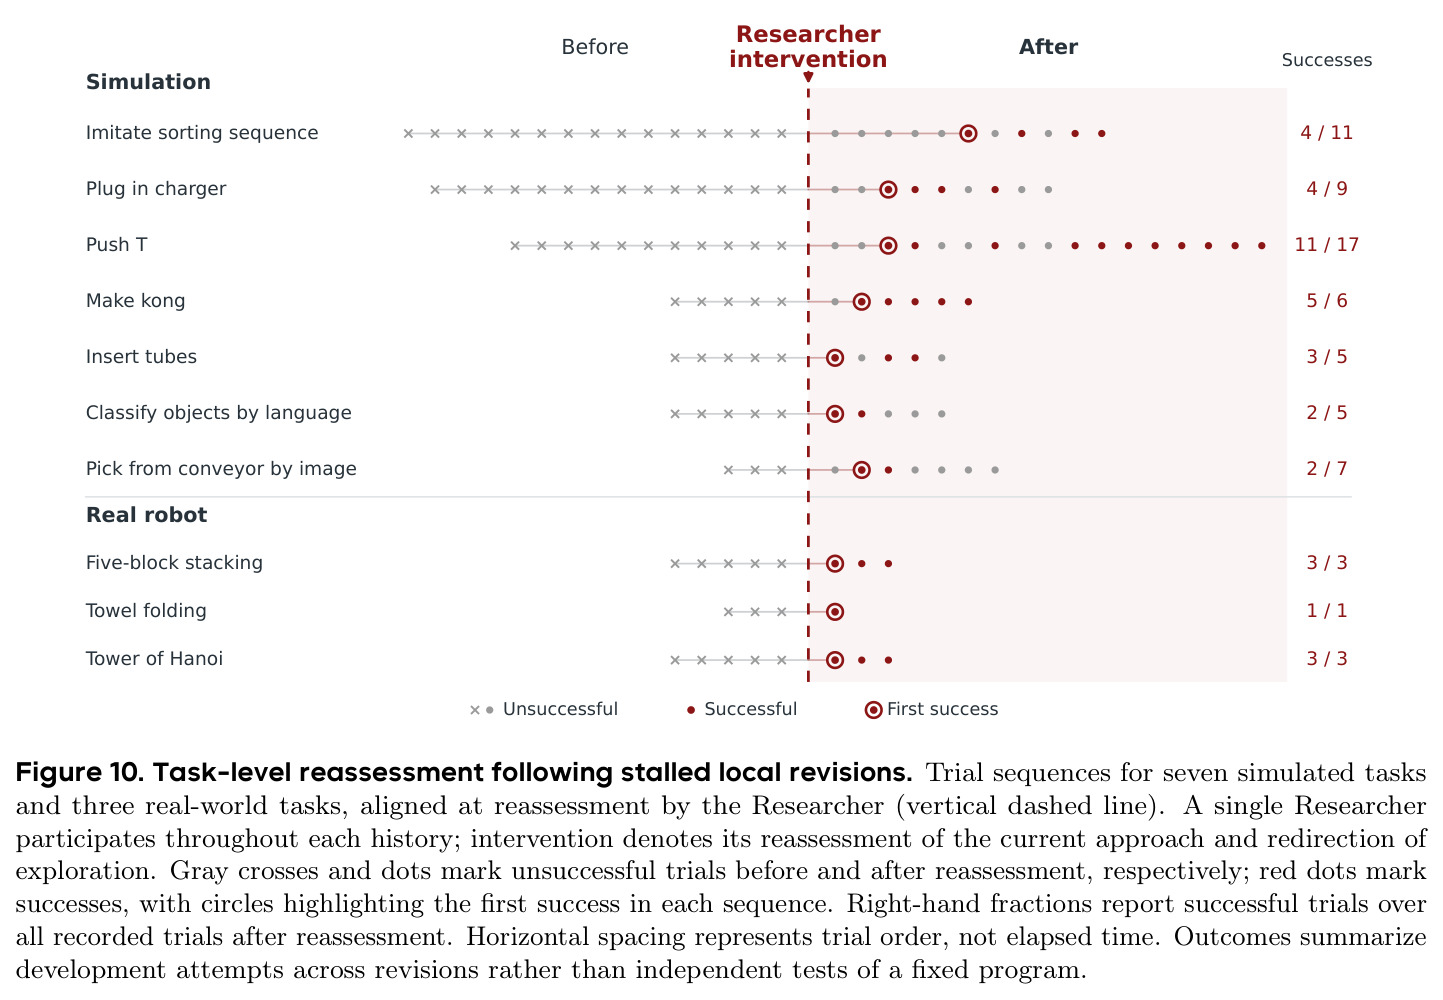
核心创新有三点。第一,把『实验(experiment)』作为 researcher–engineer 协调的基本单位:每个实验带目标、停止准则和精选经验,engineer 在实验内部可多次改码和聚焦测试而不必每次跑完整任务(例如发现某一步物体识别不可靠时,只在该环节对比不同识别方法),遇到假设被否决、技术瓶颈或反复修订无进展就交回 researcher 做任务级重估——这直接化解了局部修补死锁,论文记录的 10 个案例中重估后紧接着的试验即成功(真机三个案例 stacking 3/3、毛巾折叠 1/1、汉诺塔 3/3)。第二,经验的三级分层把环境知识(L0)、试错记录(L1)与可执行代码(L2)显式链接:researcher 用 L0/L1 判断哪些历史任务和技能相关,engineer 沿引用去检视、适配 L2 代码并强制在当前环境重新测试,从而实现跨任务技能迁移。第三,也是与 PyRUA-Lean 等『部署时写码』方法的本质区别——离线编码(offline coding):开发期通过物理探索打磨出的程序被冻结,部署时零 LLM 调用,仅靠程序内置的感知、控制与恢复逻辑响应实时观察,把智能体思考时间从执行路径上彻底剥离。
方法步骤详情
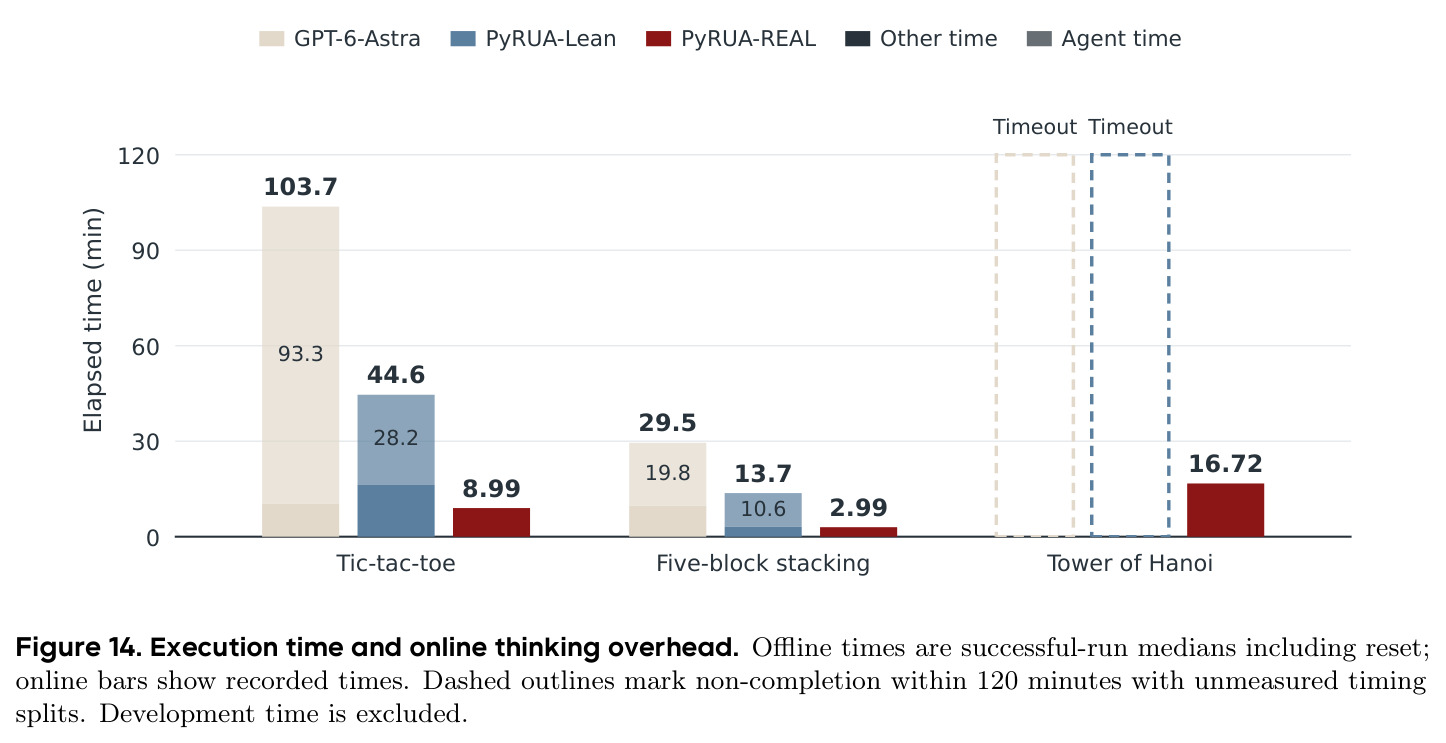
流程分六步。第一步,人类输入任务目标与任务规范:规范明确要求覆盖的物体、位置、朝向和任务变体范围。第二步,researcher 发起实验:从 L0 事实与 L1 记忆检索相关历史(例如『垂直抓取失败过、倾斜抓取曾成功』),指定本次实验的技术路线、目标与停止准则——除任务完成外,还包括假设被否决、遇到需要换路线的瓶颈、反复修订无进展。第三步,engineer 实现:基于 L2 实现库中的原语(如 $\text{detect}()$、$\text{approach}()$、$\text{grasp(vertical)}$、$\text{grasp(tilted)}$)编写任务程序并上真机执行,可在实验内部做聚焦测试而非每次完整跑任务。第四步,诊断与修订:利用执行帧、状态与日志定位问题,先区分失败来自运动、感知还是验证逻辑——如井字棋误检案例中修正检测器后同一图像通过原验收标准,机器人无需移动;叠块案例中发现相机视角选错导致虚高的回块误差。第五步,实验收尾:engineer 返回报告(结果、学到的经验、执行证据、最终代码),researcher 决定精炼当前路线、换方向还是进入任务下一阶段,并把成功与失败尝试中的有用发现都写入经验库,记录技能的适用条件与局限(技能按最终实现采用的算一次使用,中间修订不重复计数)。第六步,部署:程序冻结后在 8 个真实任务上零 LLM 调用独立运行,井字棋、叠块、汉诺塔的中位成功周期分别为 8.99、2.99、16.72 分钟。
技术新颖性
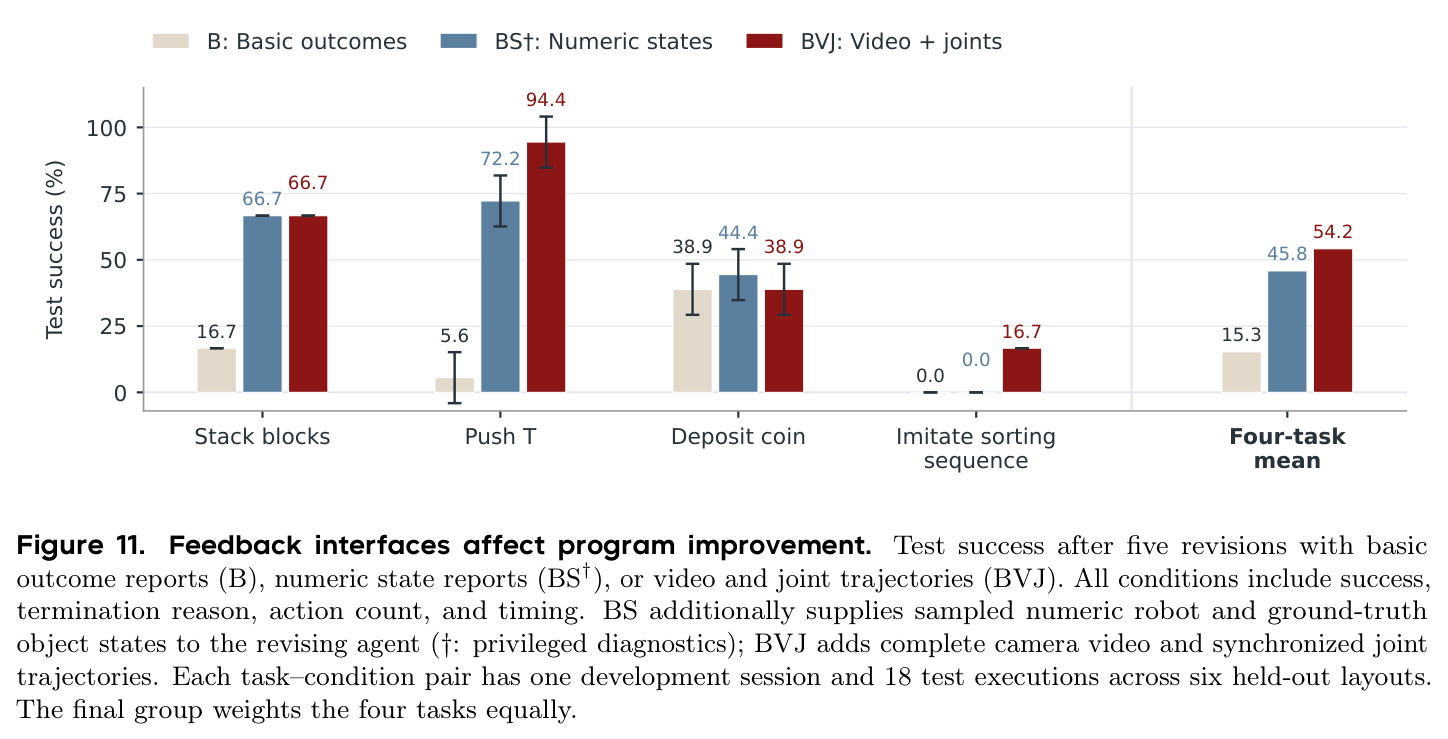
技术新颖性体现在四个层面。其一,问题定位新颖:首次把 agentic RSI 从纯软件域(智能体优化自己的脚手架与搜索流程)扩展到物理操作域,且以真机全流程而非『仿真改进+真机验收』的方式展开。其二,架构结论务实且有反直觉发现:对照实验表明慎用额外审查者——审查者把结果到下次试验的中位间隔从 3.4 分钟拖到 16.9 分钟(40 次与 9 次转换的记录),汉诺塔 6 次提交-驳回-修改循环每次耗时 5.1–19.0 分钟(中位 8.5 分钟),45 小时审查期内零次验证插入,转入直接测试后 2.8 小时即首次插入。其三,反馈工程实证细致:在每任务固定 5 轮修订预算下对比三种反馈接口——纯结果 B、数值状态 BS、视频+关节轨迹 BVJ,四任务均值成功率 15.3%/45.8%/54.2%,且 BVJ 的优化器时间(25.4 分钟)反而低于 B(31.8 分钟),打破『更多反馈更慢』的直觉。其四,对部署模式做了显式命名与拆解:offline coding(PyRUA-REAL)、deployment-time coding(PyRUA-Lean)、online action inference(GPT-6-Astra)三种模式的时间被分解到『智能体思考占在线执行时间 63–90%』这一粒度,而非只报总时间。
实验结果
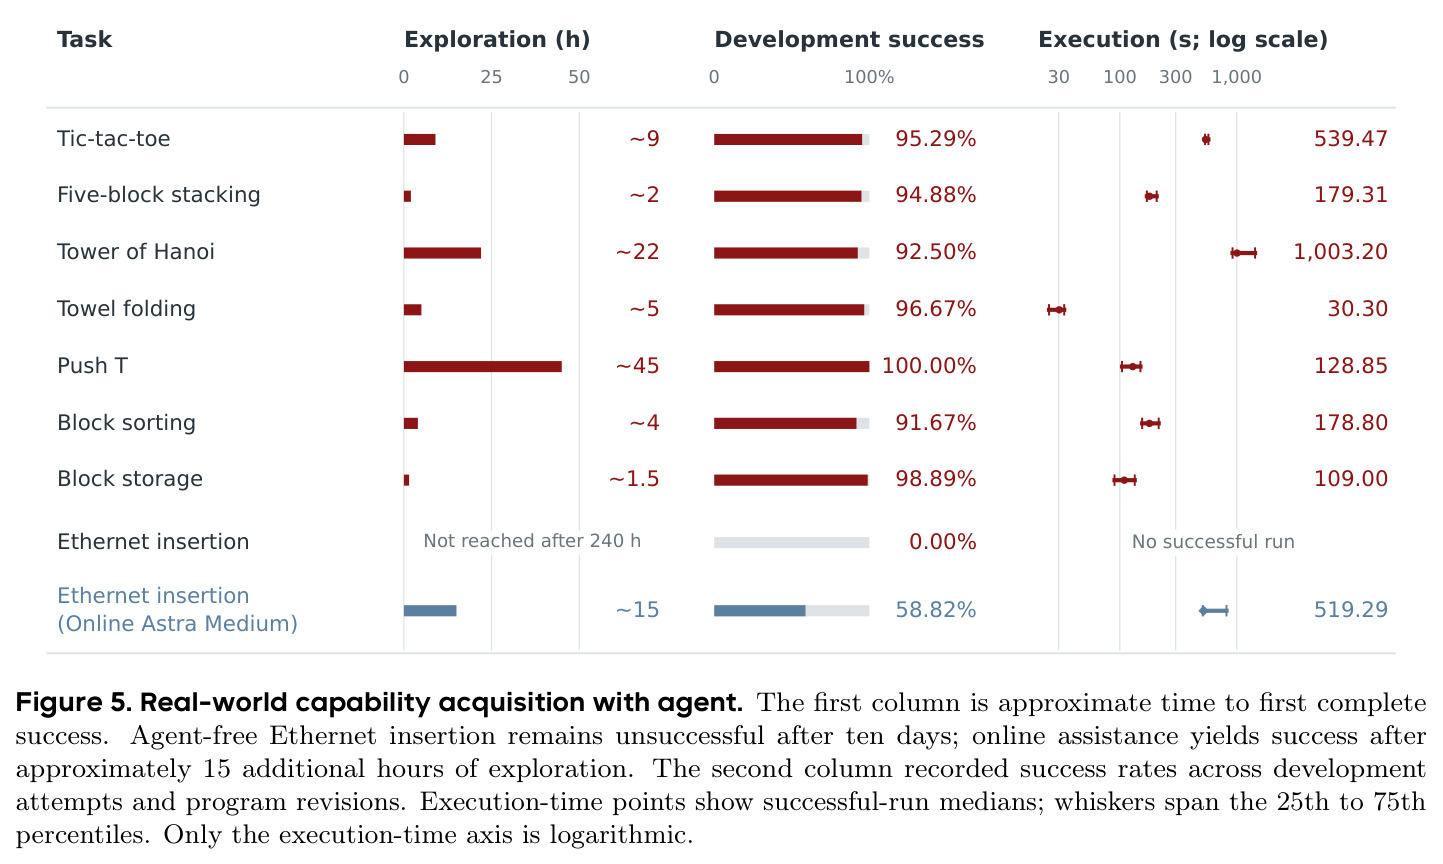
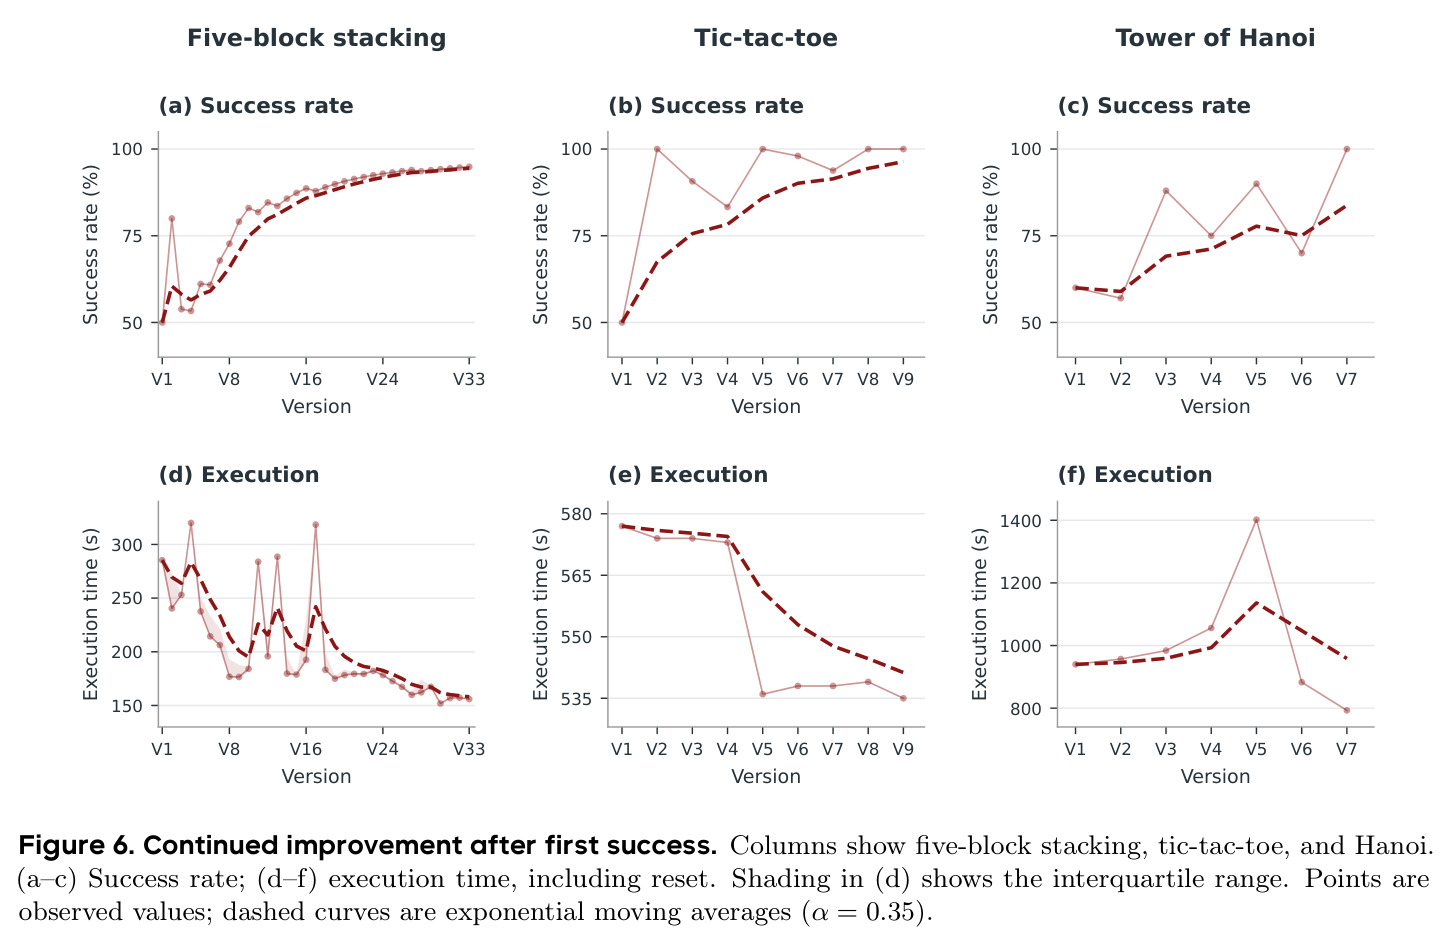
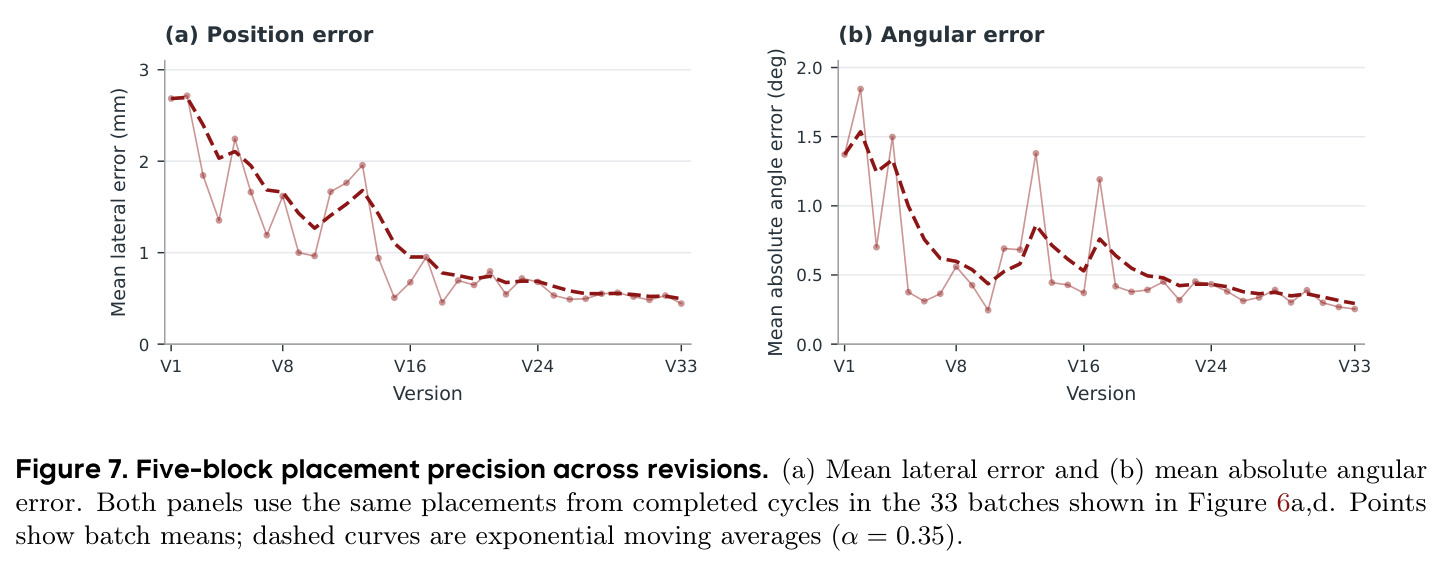
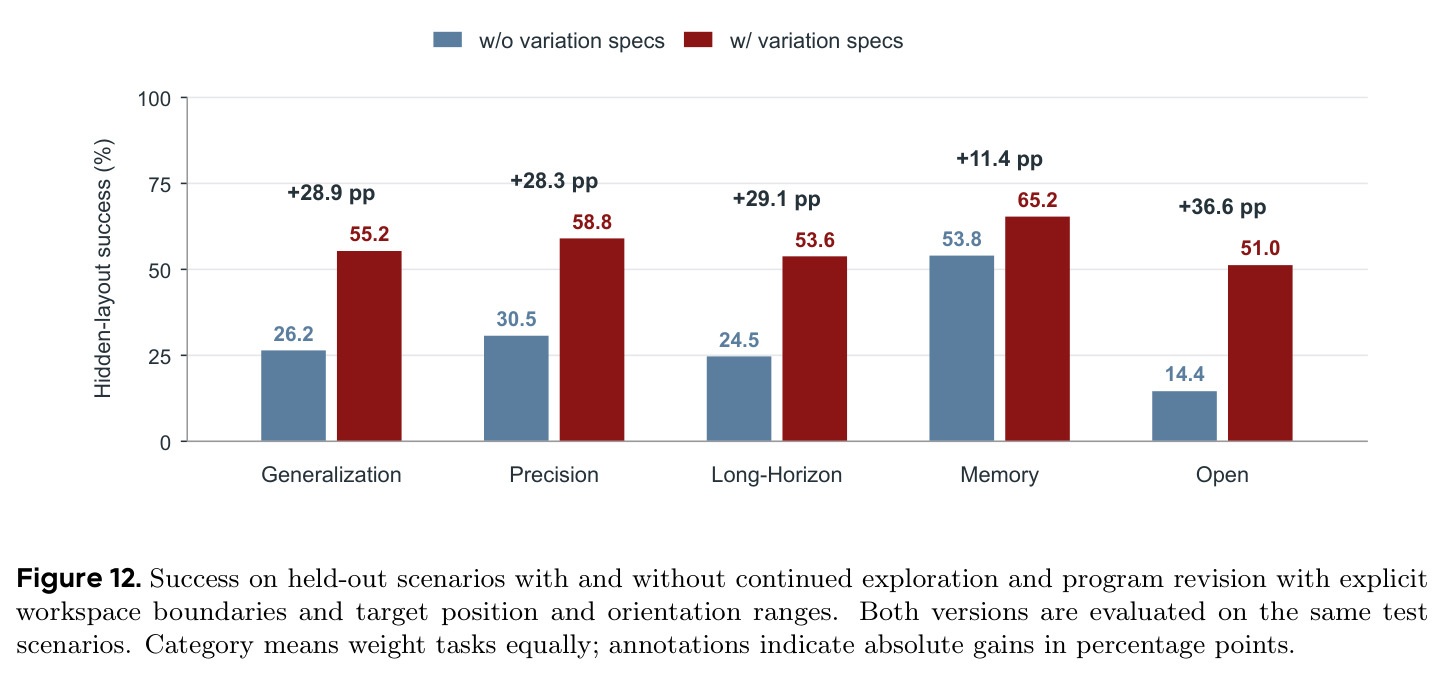
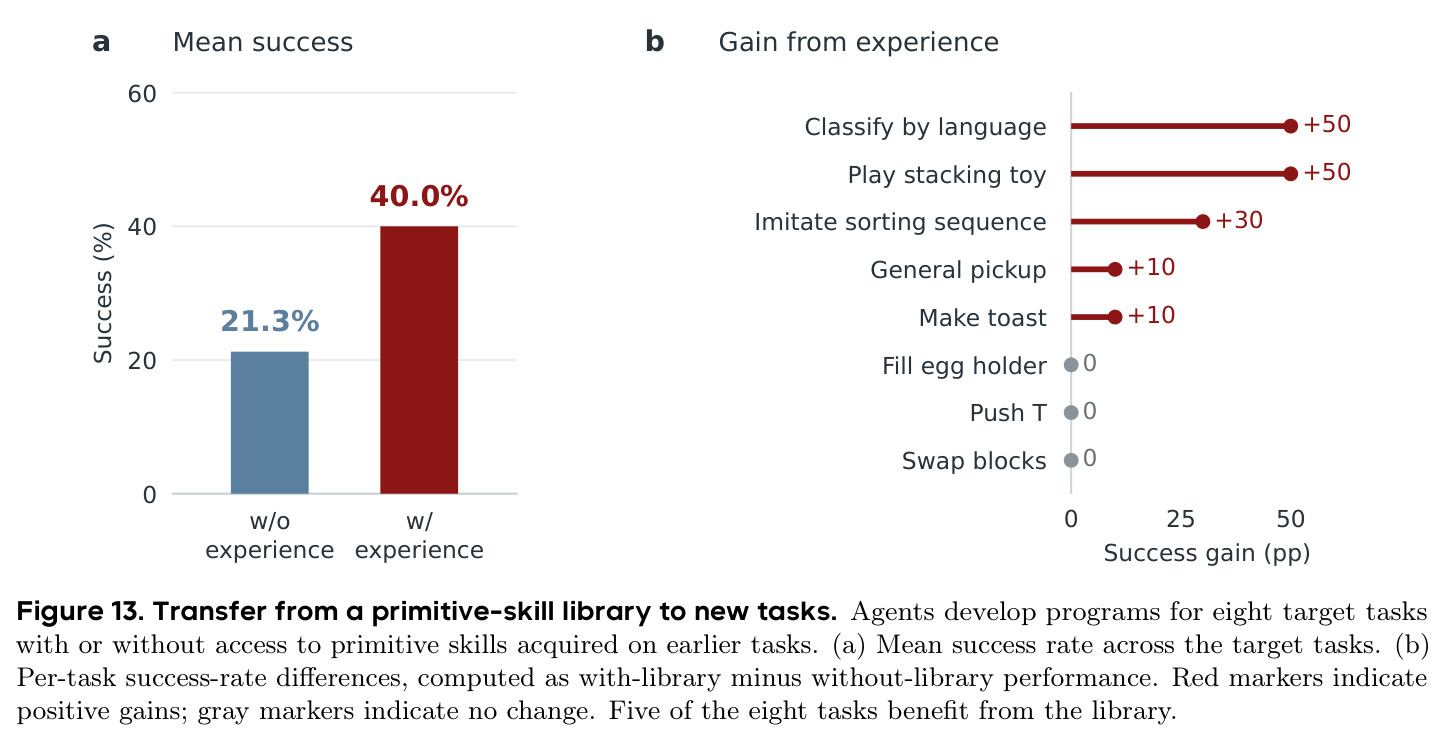
核心结果分六块。真实世界能力获取(H1):8 个双臂 Franka 任务中 7 个获得无智能体程序,首次成功时间从 block storage 的 1.5 小时到 Push T 的 45 小时,开发记录成功率 91.67%–100%(平均 91.1%);以太网插线无辅助探索 240 小时未成功,改用 GPT-6-Astra Medium 在线决策的工作流约 15 小时见效,成功率 58.82%(脚本执行仅 0/4,在线辅助 10/17)。持续改进(H1):叠块中位周期从 285.3 降到 156.0 秒,视觉估计横向误差 2.69→0.44 mm、角度误差 1.37°→0.25°,两阶段全周期成功率 88.7%→98.7%;井字棋 V1 50%→V2 100%,V4→V5 把多次抬升路径点换成单个 JointMotion 后时间从 573 降到 536 秒(总 577→535 秒);汉诺塔先求稳(1402 秒)再提速到 793 秒,成功率 60%→100%。RoboDojo 补充评估:42 任务五个能力组等权平均 84.42%,对比 PyRUA-Lean 50.35%、GPT-6-Astra 22.48%;总分 88.53 vs 55.26 vs 28.97;优势集中在 Precision(74.00% vs 38.25%)与 Long-Horizon(56.00% vs 43.75%),Generalization 略低(41.17% vs 43.17%)。反馈研究(H3):B/BS/BVJ 四任务均值 15.3%/45.8%/54.2%,BVJ 优化器时间 25.4 分钟低于 B 的 31.8 分钟,token 用量 3.65M vs 3.54M。任务规范(H4):五类全部提升 11.4–36.6 个百分点,Open 14.4%→51.0%,Memory 53.8%→65.2%,Stack bowls 0→86.4%,Fasten screws 9.1%→81.8%,但 Swap blocks 68.2%→59.1% 为反例。迁移(H5):带原语库 40.0% vs 无库 21.3%,8 个目标任务中 5 个受益(classify by language、play stacking toy 各 +50pp,imitate sorting +30pp)。部署效率(H6):离线编码井字棋 8.99 分钟、叠块 2.99 分钟、汉诺塔 16.72 分钟;PyRUA-Lean 慢 4.6–5.0 倍、GPT-6-Astra 慢 9.9–11.5 倍,两个在线基线 120 分钟内完不成汉诺塔;叠块上 PyRUA-Lean 的 13.7 分钟里 10.6 分钟在思考。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 8 个真实世界双臂操作任务(井字棋、五块叠塔、汉诺塔、毛巾折叠、Push T、积木分拣、积木收纳等 7 个无智能体任务) | 开发记录成功率(跨程序修订累积) | 平均 91.1%(单任务 91.67%–100%,Push T 100%、毛巾折叠 96.67%) | 无直接基线(以太网插线无辅助为 0.00%) | 7/8 任务获得零 LLM 调用的可部署程序 |
| RoboDojo 42 个仿真任务(五个能力组等权) | 成功率 | 84.42%(总分 88.53) | PyRUA-Lean 50.35%(55.26);GPT-6-Astra 22.48%(28.97) | 较最强基线 +34.07 个百分点 |
| RoboDojo 反馈接口对照(4 任务 × 6 held-out 布局 × 18 次执行) | 测试成功率 / 优化器时间 | BVJ 54.2%,25.4 分钟 | B(纯结果)15.3%,31.8 分钟;BS(数值状态)45.8% | +38.9 个百分点且优化时间更短 |
| RoboDojo 变体规范鲁棒性实验(5 个能力组 held-out 场景) | 成功率提升 | 五组全部提升 11.4–36.6 pp(Open 14.4%→51.0%) | 无变体规范版本(如 Stack bowls 0.0%、Fasten screws 9.1%) | 平均 +11.4 至 +36.6 个百分点 |
| 8 个新任务的原语技能库迁移对照 | 平均成功率 | 带技能库 40.0%(5/8 任务受益,最高 +50pp) | 无技能库 21.3% | +18.7 个百分点 |
| 真实任务部署效率(井字棋/叠块/汉诺塔) | 成功周期中位时间(含重置) | 8.99 / 2.99 / 16.72 分钟(零 LLM 调用) | PyRUA-Lean 慢 4.6–5.0 倍;GPT-6-Astra 慢 9.9–11.5 倍且汉诺塔 120 分钟超时 | 5–10 倍执行时间压缩 |
局限与改进
作者明确承认的局限包括:以太网插线这类高精度接触任务仍无法脱离在线智能体,成功一次的 502.7 秒中 220.8 秒(44%)消耗在阶段间检查与决策间隙,且其中含人工审查,无法全部归因于模型思考;任务级重估与随后成功的相关性无法隔离因果(阶段是顺序执行的,后期可能受益于前期探索的积累);RoboDojo 对比使用的是不同或未指明随机种子的已报告结果,严格可比性存疑;每个任务-条件组合只有一个开发会话,跨会话方差未测量;叠块放置误差是视觉估计而非独立物理测量。我补充几点观察:其一,所有实验绑定单一双臂 Franka 平台与特定相机配置,L0 经验的平台特异性很强,跨机器人本体迁移完全未验证;其二,『平均 91.1%』是混合了多个程序版本尝试的开发期累积记录,不能解读为某个冻结程序的可靠性,冻结程序在 held-out 场景的系统性表现只在 RoboDojo 上有报告;其三,人类介入(建议 SigLIP、解围假接触检测、帮助以太网插线)出现在多个关键节点,自主性的边界依赖案例叙述而非系统量化。
独立分析的弱点
第一,探索成本极高且任务间方差巨大:Push T 需 45 小时、汉诺塔 22 小时才首次成功,以太网插线 10 天无解。改进方向:先用仿真或世界模型廉价预筛技术路线,把真机时间留给最终验证;或对失败模式自动聚类,提前触发 researcher 重估而不是等停止准则慢慢生效。第二,经验库检索靠 researcher 的语义判断完成,论文未描述任何向量化索引或规模实验——当技能库从几十条涨到上千条时,上下文窗口与检索精度都会成为瓶颈,可引入嵌入检索加适用条件元数据过滤。第三,审查者实验只有『有/无』二元对照,未探索更轻量的中间方案(如仅审查关键变更、或让审查者直接给出修改建议而非驳回重写),设计空间完全空白。第四,验证逻辑歧义(成功判定本身出错导致假失败/假成功,如井字棋圆环粘连误检、叠块相机视角选错)只是案例式讨论,缺少系统性的『测量校准』机制,可对验收标准本身做单元测试与交叉验证。第五,H4 的鲁棒性规范需要人工给出数值化的变化范围与工作空间边界,这是不小的先验注入,如何让智能体自动归纳『我的程序该覆盖什么变体』并主动向人类确认,尚未解决。
未来方向
作者指出的开放问题主要有两个:一是何时调用在线智能体——理想部署策略是高效离线执行与在线兜底结合,但判定『程序无法自行处理当前局面』的触发条件尚未解决;二是能否把在线智能体的临场决策回灌为可复用代码,形成『离线为主、在线补课、定期固化』的闭环。基于本文成果还可延伸:把人工干预显式建模——作者自己呼吁报告应写清人类贡献了什么、程序独立完成了什么,进而研究最优干预时机与最小干预集;将三级经验库与语义检索、知识图谱结合,支持跨平台(不同机械臂、不同夹爪)的技能迁移;探索多机器人共享经验库的联邦式 RSI;把 H4 的任务规范自动化,让智能体从失败分布中归纳未知变体并主动询问人类;在仿真环境中预筛方法组合以缓解 Push T 45 小时这类高成本探索;以及把『方法反复失败时显式比较备选感知与控制策略』(如通用抓取中人类建议 SigLIP 的案例)制度化为 researcher 的强制动作。
复现评估
复现门槛较高。硬件上需要双 Franka Research 3 机械臂、Robotiq-85 夹爪、ZED Mini 头部相机、双腕 RealSense D405,整套设备在数十万元人民币量级,且论文明确说明平台标定结果、任务专用控制器与求解器都不预先提供,复现者需要自己走一遍探索流程。软件上,论文未声明开源代码,项目页仅为介绍页;底层依赖 GPT-6-Astra(Medium)这一未公开的模型,即使拿到代码也无法完全对齐实验条件;感知用的 SigLIP 与 SAM 是开源模型可自行部署。仿真部分可行性显著更高:RoboDojo 是公开基准(42 个基础任务、五个能力组),H3 反馈接口对照与 H4 变体规范实验的协议在附录 A/B 有详细描述,单会话初始生成加 5 轮修订约 25–32 分钟优化器时间、350 万 token 量级,主要成本是 API 调用与 GPU 时间。总体建议:先在 RoboDojo 上复现 H3/H4/H5 的相对结论,真机部分因硬件与模型双重门槛,仅适合拥有同款平台和相应 API 权限的实验室。
论文图表
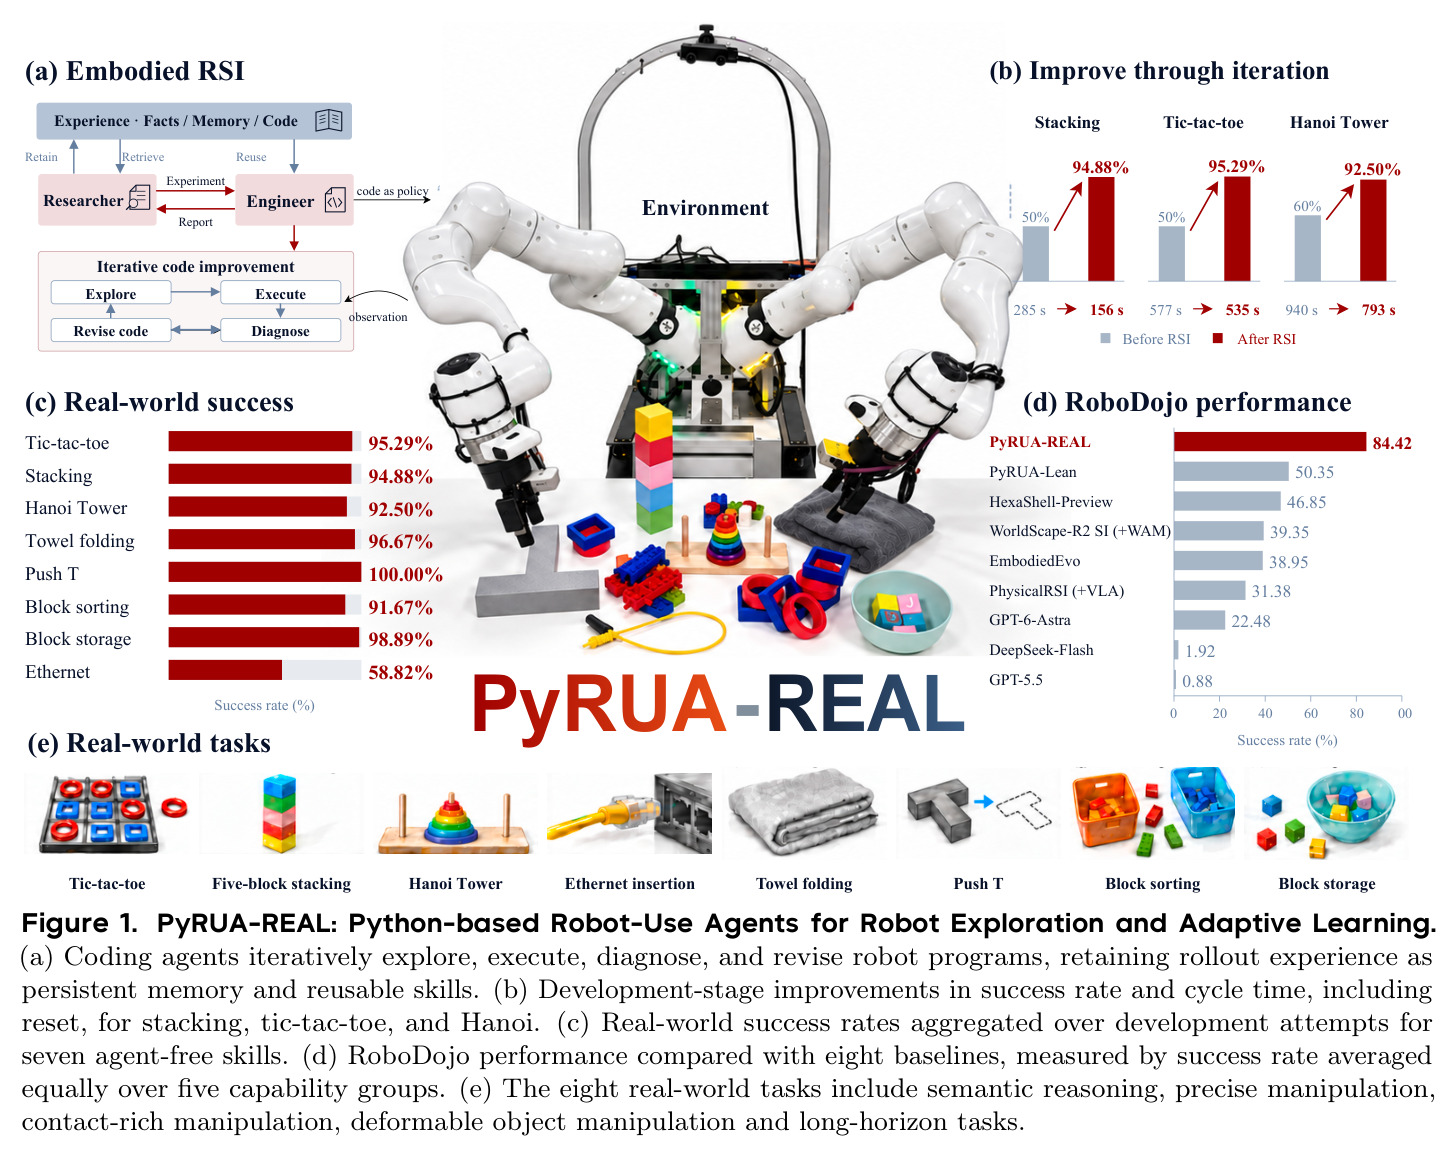
五联总览图:(a) 具身 RSI 流程——researcher 与 engineer 在『保留-检索-复用』的经验循环中迭代探索、执行、诊断、修订代码,把 rollout 经验存为持久记忆与可复用技能;(b) 叠塔、井字棋、汉诺塔在开发阶段前后对比,成功率约 50–60% 升至 92.50–95.29%,周期时间从 285/577/940 秒降至 156/535/793 秒;(c) 七个无智能体技能的真实成功率(58.82%–100%);(d) RoboDojo 上对比八个基线,PyRUA-REAL 84.42% 领先 PyRUA-Lean 50.35% 与 GPT-6-Astra 22.48%;(e) 八个真实任务照片。
一图读懂全文:方法闭环、改进前后量化对比、真机与仿真两套结果和任务谱系全部在列,是论文的门面和叙事主线。