RSIAgent:通过自主探索在新环境中实现递归自我改进 RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
免训练多智能体框架,通过广度+深度自主探索构建可复用记忆,让开源模型超越GPT-6等闭源前沿模型。
前置知识
递归自我改进(RSI)
指智能体系统利用自身产生的经验循环地提升自己的范式:先决定学什么,再与环境交互收集经验,最后把验证过的结果沉淀为知识供下一轮使用,如此迭代。与依赖基准分数反馈的自我修改研究(如 DGM)不同,本文的 RSI 不更新模型参数,改进全部发生在上下文记忆层面。
这是全文的核心命题:理解 RSI 的循环结构(探索→验证→记忆→再探索)才能看懂 RSIAgent 的三智能体分工与两阶段探索设计。
代码即策略(Code-as-Policy / CodeAct)
把智能体的每个动作表示为一段可执行程序(本文为 Python 或 Bash),运行时返回 stdout+stderr 与退出码,而不是输出点击坐标等原子操作。程序可以驱动 GUI 应用、处理文件、调用 API,并可根据执行反馈修改重试,为异构软件系统提供统一控制接口。
RSIAgent 的行动者完全通过提交程序与环境交互(提示词直言'你看不到屏幕,唯一行动方式是写程序'),探索积累的记忆也多是可复用脚本与流程。
验证者接地与生成-验证分离
由独立上下文中的验证者智能体对照任务要求检查行动者的产出,其判断只能基于环境证据(文件、进程、GUI 状态、导出流),与行动者的私有推理和记忆隔离,以降低相关错误。本文还引入 UNVERIFIED 第三态,并用 QEMU 检查点保护探查过程,防止验证行为污染被评候选。
整个 RSI 闭环的知识可靠性都建立在验证接地之上;失败模式分析显示验证不完整(33.3% 接地缺口)会让错误结论进入记忆并向后续轮次传播。
自动课程生成
由课程者智能体根据目标、当前记忆与历史结果自动设计练习任务:挑选前置技能、有信息量的变体、失败驱动的专项训练与压力测试,并决定何时停止(如 BRS 的 SATURATED 决策)。类似 Voyager 的自动课程,但面向通用数字环境且与验证反馈深度耦合。
先广后深探索的'方向'完全由课程决定;失败分析表明探索不聚焦(target-skill mismatch 占 75%)是自我改进失效的首要机制。
智能体持久记忆与经验调和
跨任务保留的可复用知识库,本文中是行动者自有的文件集合(无固定 schema、无长度限制)。每条经验经两步写入:蒸馏(从轨迹与验证报告中提取流程、约束、失败教训,要求只在证据支持时做因果断言并保留不确定性)与调和(检查新旧条目矛盾、过时环境假设与超出证据的过度概括,允许改写或删除)。
记忆是 RSI 的载体;理解'经验自有学习'与'规范记忆所有权'(课程者与验证者均无权改写记忆)是读懂方法章节权责设计的前提。
部分得分与二元准确率
评测数字智能体的两个互补指标:对归一化任务得分 $s_i \in [0,1]$,$\text{Partial} = 100 \times \frac{1}{N}\sum_{i=1}^{N} s_i$ 衡量平均完成度;$\text{Binary} = 100 \times \frac{1}{N}\sum_{i=1}^{N} \mathbf{1}\{s_i = 1\}$ 只统计获得满分的任务比例,两者均以百分比报告。
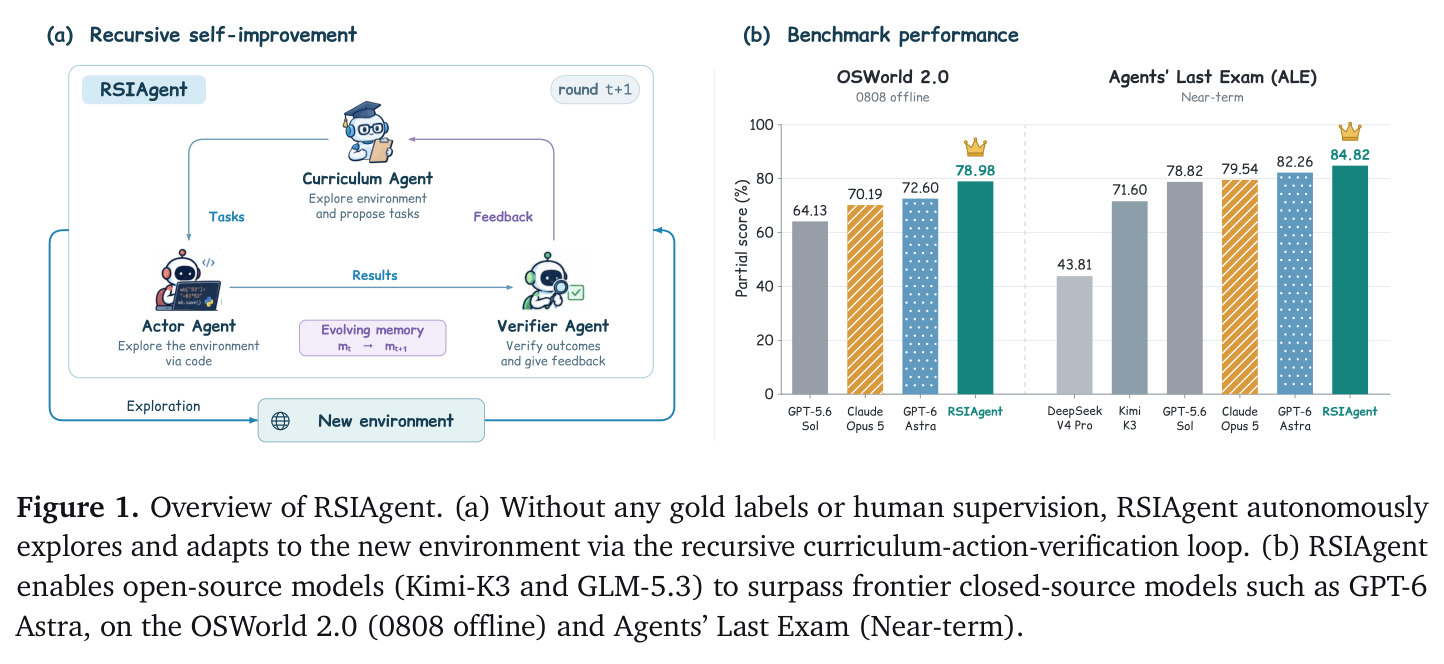
主表同时报告两个指标:RSI 的提升在部分得分上更明显(ALE 上 84.82 对 82.26),而二元指标上仍低于 GPT-6 Astra(50.75 对 52.24),理解这点才能准确解读'反超闭源'的结论边界。
研究动机
数字智能体一旦进入预训练知识未覆盖的新软件环境,性能会显著下降:OSWorld 2.0 的任务横跨 WPS 表格修复、REAPER 音频制作、FreeCAD 三维建模、3D Slicer 肝脏分割等专业软件,开源旗舰 Kimi-K3 在 OSWorld 2.0(0808 offline,82 任务)上的部分得分仅 58.30%,落后闭源前沿 GPT-6 Astra(72.60)超过 14 个百分点。主流适应路线是收集交互数据后再训练:OpenCUA 依赖人类演示、UI-TARS-2 采用多轮强化学习、EvoCUA 结合合成经验与策略优化,这类范式数据与算力成本高昂,且难以应用于私有或持续变化的环境。另一类免训练方法只是把成功轨迹或技能堆入上下文,既不验证结论是否可复用,也不提炼动作、条件与后果之间的稳定因果关系,遇到隐藏约束和边界条件时容易失败。论文由此提出核心问题:智能体能否在没有外部奖励和标注的情况下,从新环境中自主发现因果关系并整理成可复用记忆,实现真正的自我改进?
本文的目标是本文目标是构建一个不更新任何模型参数的递归自我改进框架:给定新环境 $\mathcal{E}$,智能体系统自主探索并构建持久记忆 $M$,其中沉淀可复用流程脚本、隐藏约束、失败教训,以及动作—条件—后果之间的因果关系;探索结束后冻结 $M$,直接复用于下游任务。具体诉求有三:其一,无需黄金标签、人工监督或基准分数反馈,改进信号完全来自验证者对环境反馈的接地判断;其二,探索既要广覆盖(并行发现多样环境结构),也要深挖掘(难例、隐藏约束、边界条件与未知因果依赖);其三,在 OSWorld 2.0 与 Agents' Last Exam 上验证该机制能让 GLM-5.3、Kimi-K3 等开源模型在部分得分上反超 GPT-6 Astra、Claude Opus 5 等闭源前沿模型,从而证明智能体级自我改进可以在不动参数的情况下显著缩小乃至逆转开源与闭源基础模型的差距。
与已有工作不同的是,本文的独特切入角度有三点。其一,把'适应新环境'重新表述为智能体因果发现:不是记录'哪条轨迹成功了',而是主动设计对照性练习,推断哪些因素决定成功、失败与状态迁移,并把结论连同适用条件一起写入记忆——这直接回应了只堆轨迹的记忆方法无法泛化的问题。其二,提出先广后深的两阶段探索(BRS/DRS),类比现代 LLM 开发中预训练-后训练的范式:先并行铺开多样性覆盖建立全局认识,再针对重要方向做定向深挖。其三,与 DGM、HGM、Hyperagents 等需要基准分数指导自我改进的工作不同,RSIAgent 完全不依赖外部奖励或标注;同时在系统层面规定了清晰的权责边界:记忆由行动者自己蒸馏与调和,验证者与课程者均不得改写记忆,验证者在检查点保护下独立核查,这与其调研的所有已有工作都不同。
核心方法
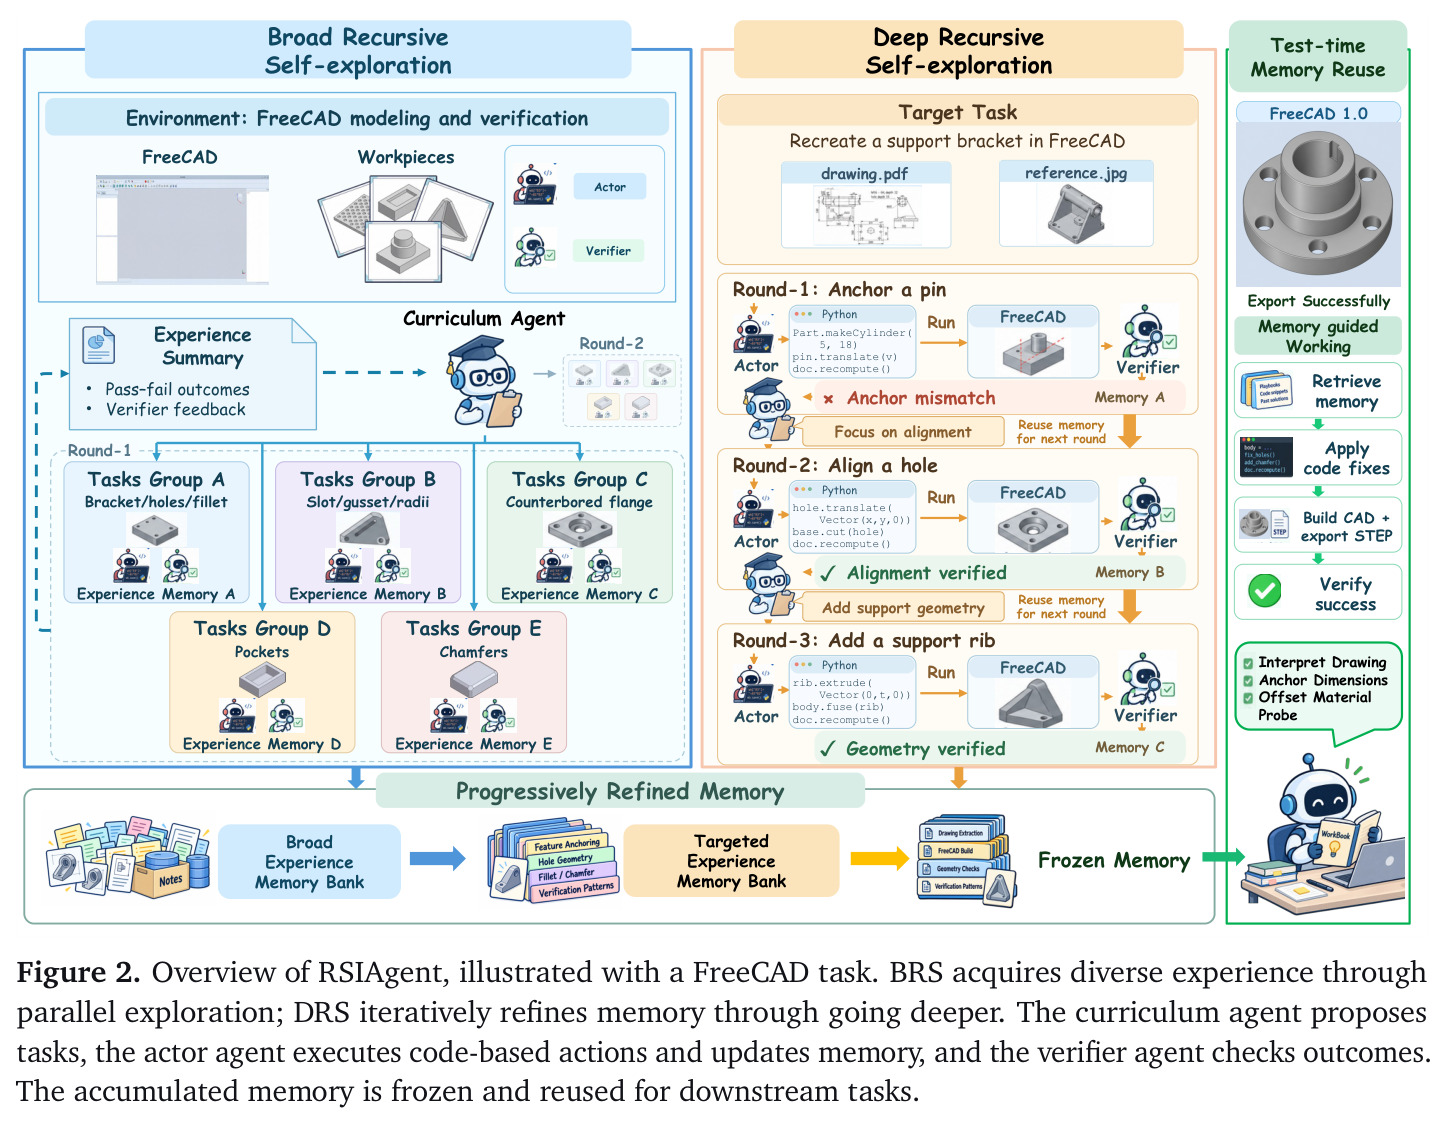
直觉上像人学新软件:先到处点点看建立全局认识,再针对搞不懂的地方反复试错,最后把经验写成笔记留着用。技术上,RSIAgent 是一个免训练的多智能体框架,采用代码即策略:每步动作 $a_t$ 是一段可执行的 Python/Bash 程序,运行时返回合并的 stdout+stderr 与退出码。系统由三个角色组成:课程智能体根据目标查询与当前记忆提出练习任务;行动者(默认 GLM-5.3)执行程序并拥有可演化记忆;验证者(Kimi-K3,独立上下文)在 QEMU 检查点保护的副本上核查候选结果,给出 PASS/FAIL/UNVERIFIED。探索分两阶段:BRS(广度递归自我探索)以 8 个项目的名义预算、最多 4 个并发,分波次并行探索;DRS(深度递归自我探索)串行进行,按 curriculum_review 停止策略决定是否继续练习。探索结束后记忆被冻结(记录文件树哈希),重置环境后由行动者-验证者循环直接复用,官方评测器(GPT-5.4 评分、GPT-4o 用户模拟)在所有智能体上下文之外打分,全程模型参数固定。
核心创新是把自我改进的原料从'成功轨迹'升级为'经过独立验证的因果知识',并用三重机制保证知识可靠性。第一,验证接地:验证者与行动者的私有推理和记忆完全隔离,只能基于任务要求与环境证据作判断,并在检查点副本上探查以防止污染候选;UNVERIFIED 第三态确保未决结论不会变成学习样本。第二,经验自有学习:产生经验的行动者本人在完整验证报告下先蒸馏(提取流程、约束与失败教训,被明确要求'只有证据支持时才做因果断言、保留不确定性')再调和(检查新旧条目矛盾、过时假设与过度概括),失败经验可以贡献证据但不得记为成功。第三,先广后深:BRS 各项目从同一波前记忆快照出发、彼此不可见,保证多样性不被同质化;DRS 则让课程者基于验证结果与学习诊断递进地提出更难的任务。本质区别于以往只堆成功轨迹、或依赖外部奖励与基准分数的自我改进方法。
方法步骤详情
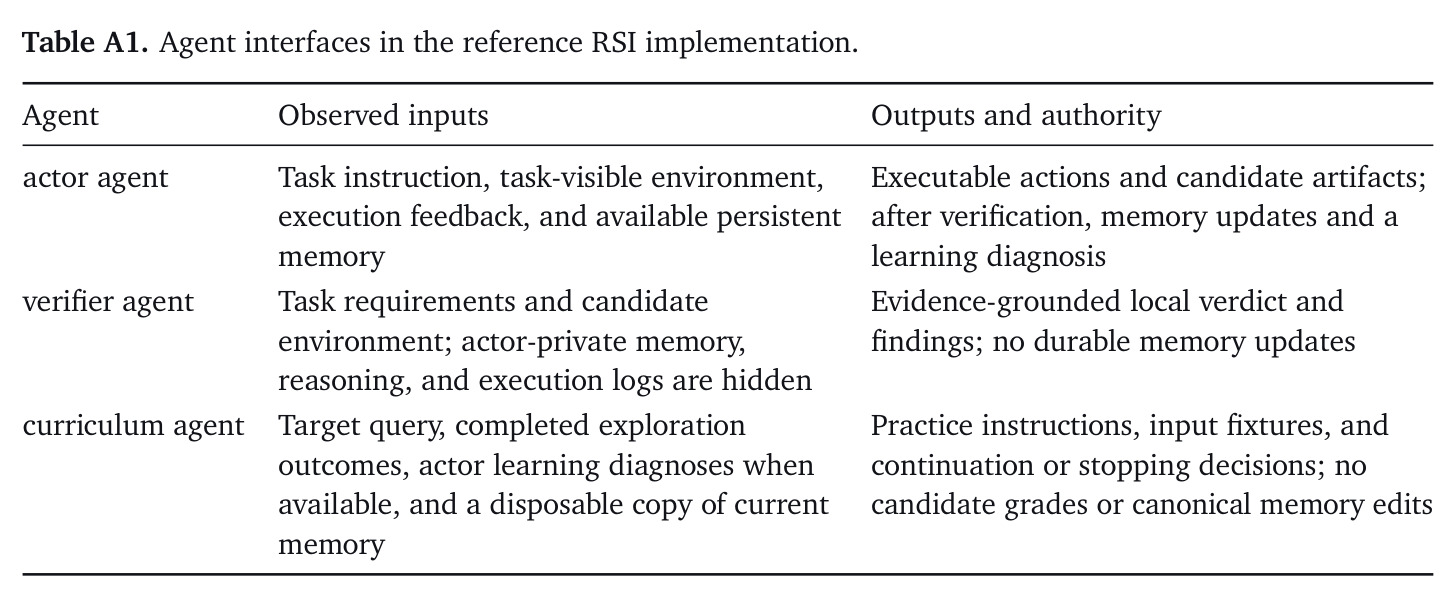
完整流程按算法 A1 概括。(1) 初始化规范记忆 $M \leftarrow M_0$。(2) BRS 循环:课程者基于目标查询 $q$、记忆 $M$ 与已完成波次的结果,生成一批带唯一 ID、自包含说明与输入 fixtures 的项目(只给目标不给解法);所有项目从同一不可变波前快照出发,在隔离环境中并行执行(最多 4 并发,名义预算 8 项目,波次结束后才检查预算);验证者对每个项目给出接地判定(练习接口无同项目返修循环);全部判定返回后,原行动者上下文按课程者排定顺序逐个复苏,先蒸馏再调和,把经验合并进最新规范记忆。(3) DRS 循环:重置环境后用当前记忆首次尝试目标 $q$,验证者判定,行动者整合结果;课程者审阅验证结果、学习诊断与更新后记忆,决定继续安排练习(调查失败或检验成功流程中的不确定假设)还是返回目标;每个练习整合记忆后才做下一个决定,直到课程者认为无更高期望价值的练习(READY)或 STALLED(允许最后一次目标尝试)。(4) 冻结评估:记录记忆文件树哈希、复制进评测环境、禁用课程决策与记忆写回,行动者-验证者循环尝试目标后,由官方评测器在智能体上下文之外打分。目标尝试限 500 次迭代、36,000 秒看门狗,练习限 2,000 次迭代、86,400 秒。
技术新颖性
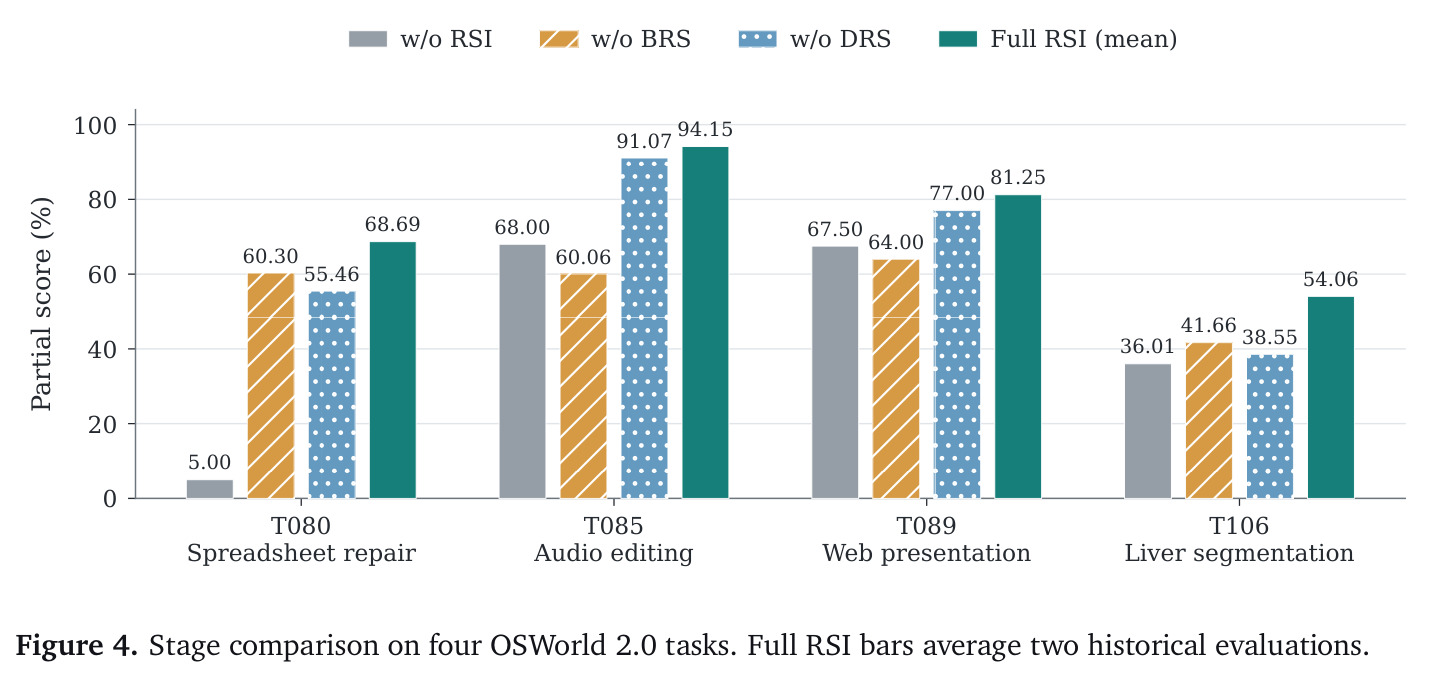
与最相关工作的差异清晰可辨。相比 DGM、HGM、Hyperagents 等以基准分数为反馈信号的自我修改研究,RSIAgent 无需任何标注或外部奖励,验证信号完全来自环境反馈本身。相比 Voyager 的自动课程与技能库(面向 Minecraft),RSIAgent 面向通用数字环境(办公、音视频、CAD、医学软件),并把记忆内容从'可执行技能'扩展为带适用条件的因果知识与失败教训;相比 EchoTrailGUI、ZhuLong 的经验采集与 CoEvoSkills、Recuris 的验证反馈精炼,本文明确提出并通过消融验证了先广后深两阶段结构——消融显示只用深度探索(w/o BRS)在 T085、T089 上甚至低于空记忆基线,而两阶段组合在全部四个评测任务上最优。工程设计上也有新颖之处:UNVERIFIED 第三态阻断未决证据进入学习、QEMU 检查点保护式验证、并行工作+串行调和的记忆写回协议、课程者只能查看一次性记忆副本而无权改写。据作者定位,这是首个在无外部奖励条件下于真实计算机使用环境中实现递归自我改进、并使开源模型反超闭源前沿模型的框架。
实验结果
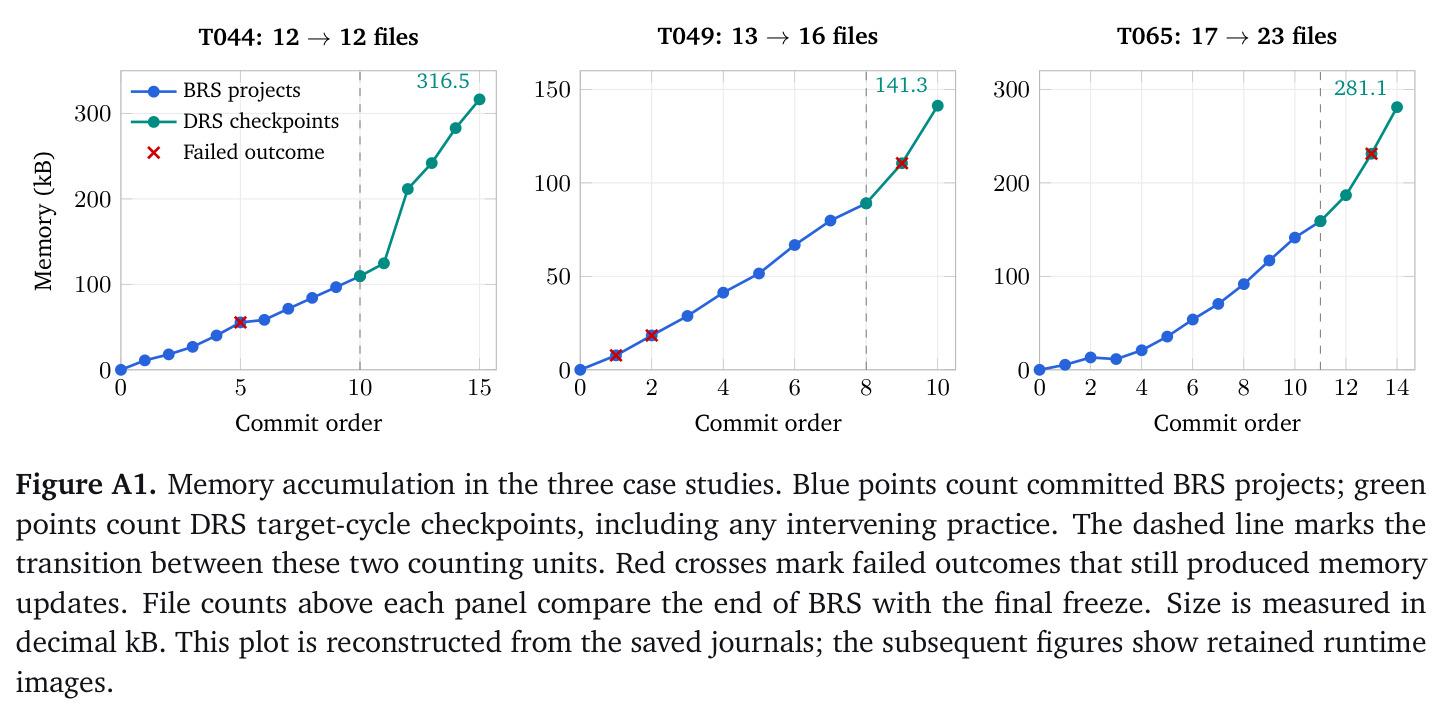
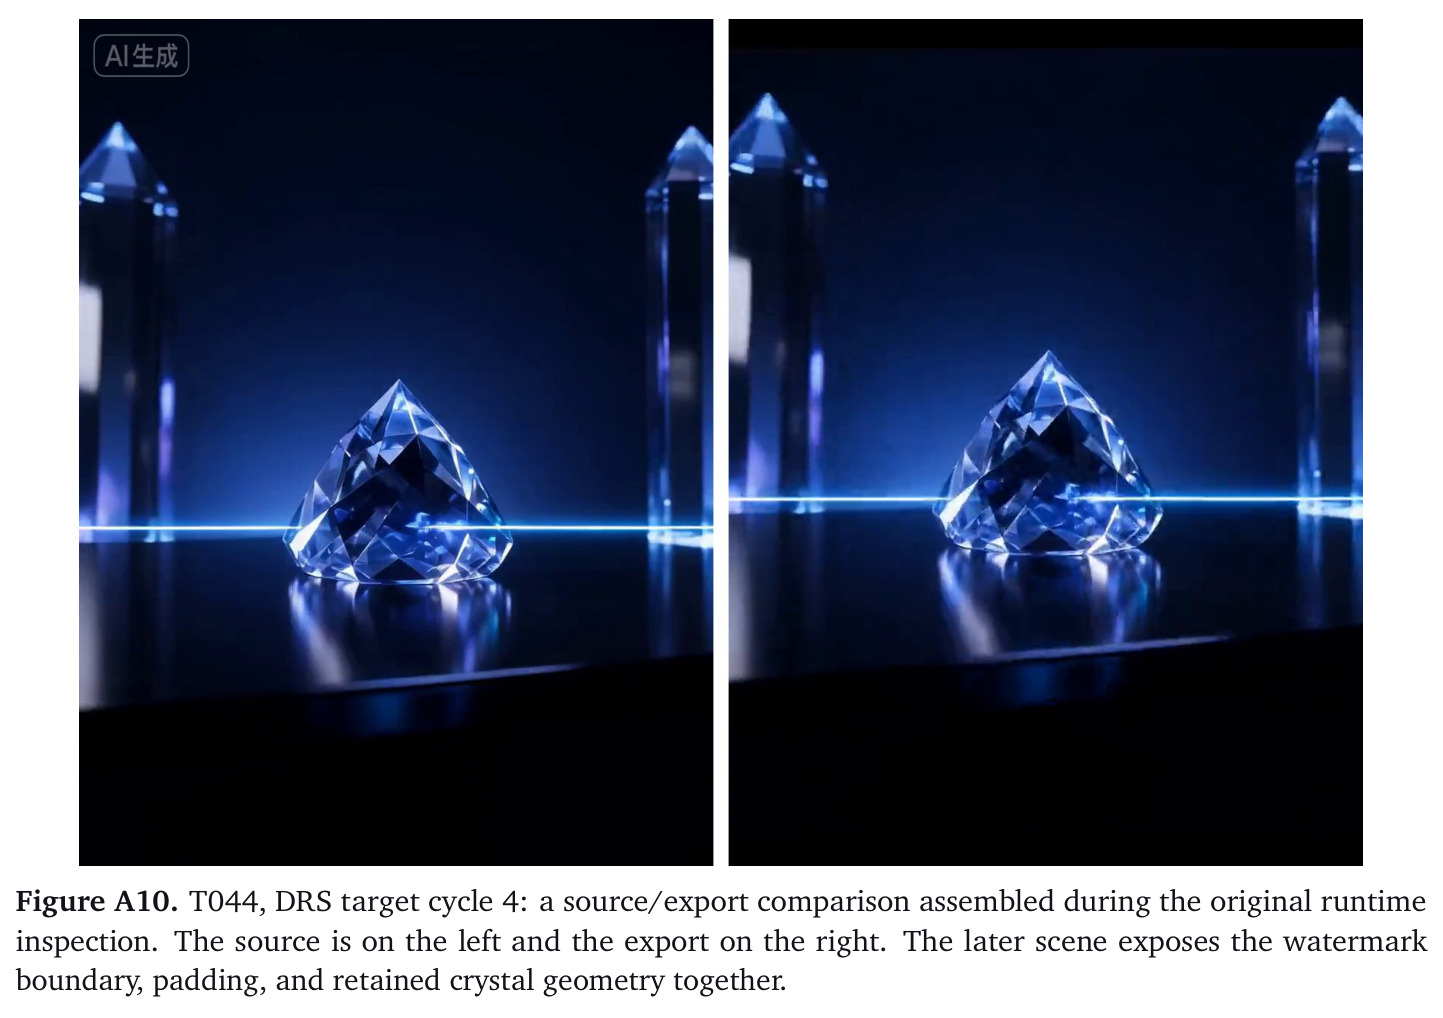
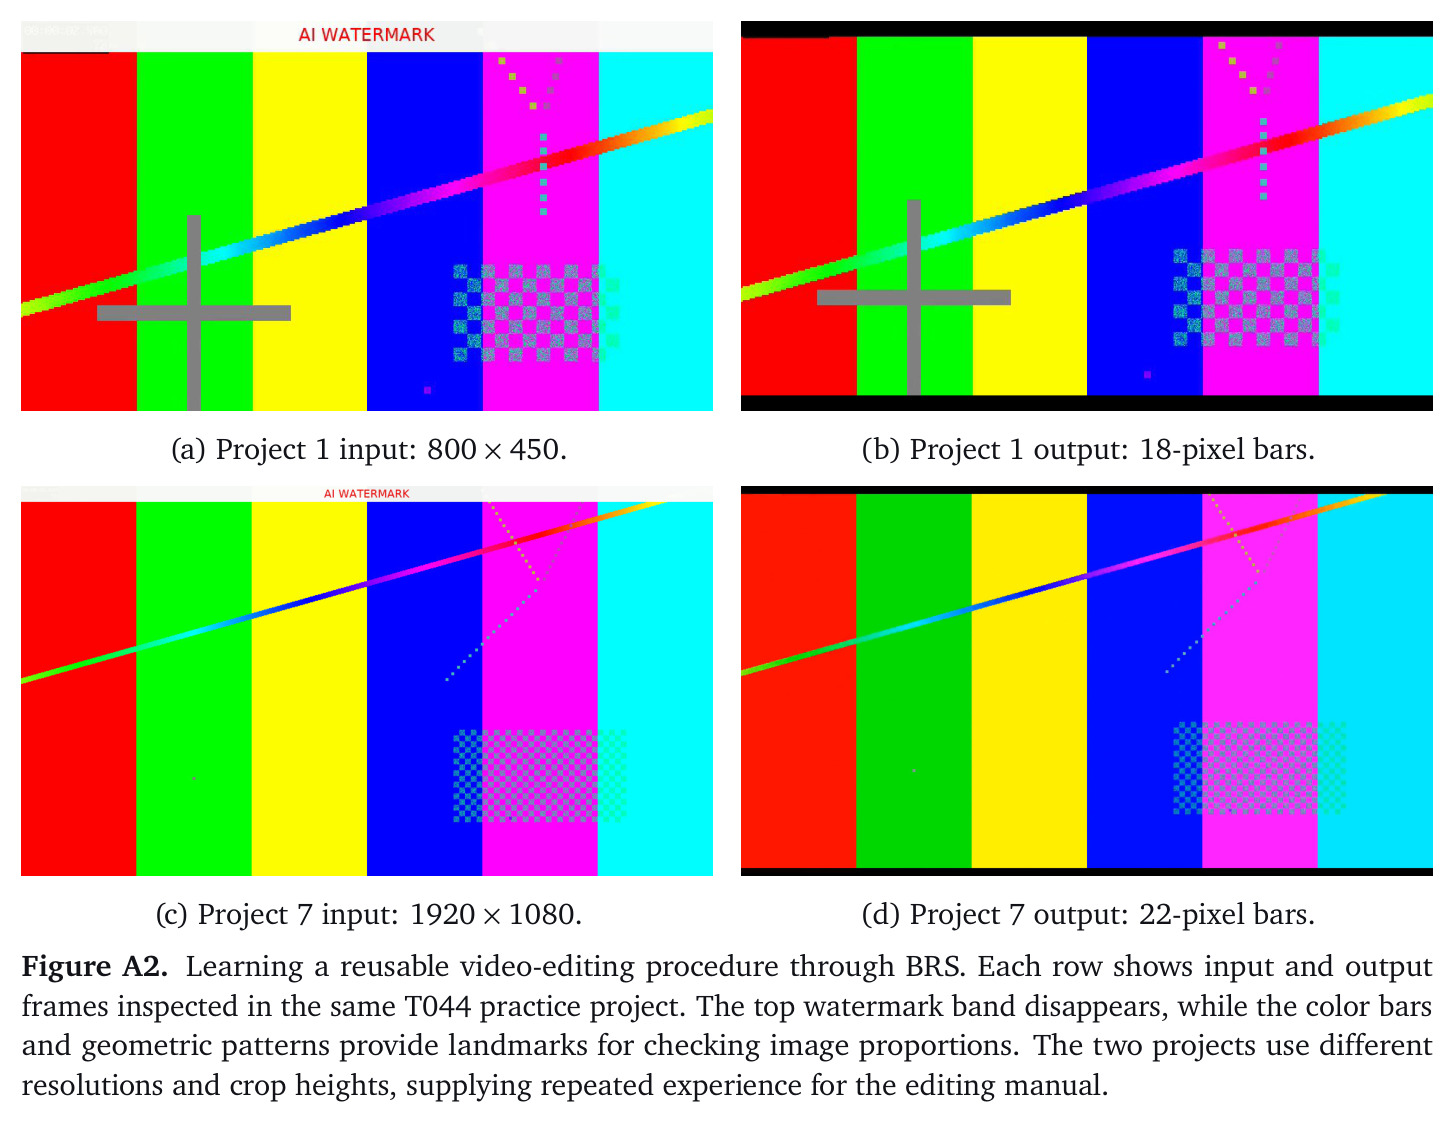
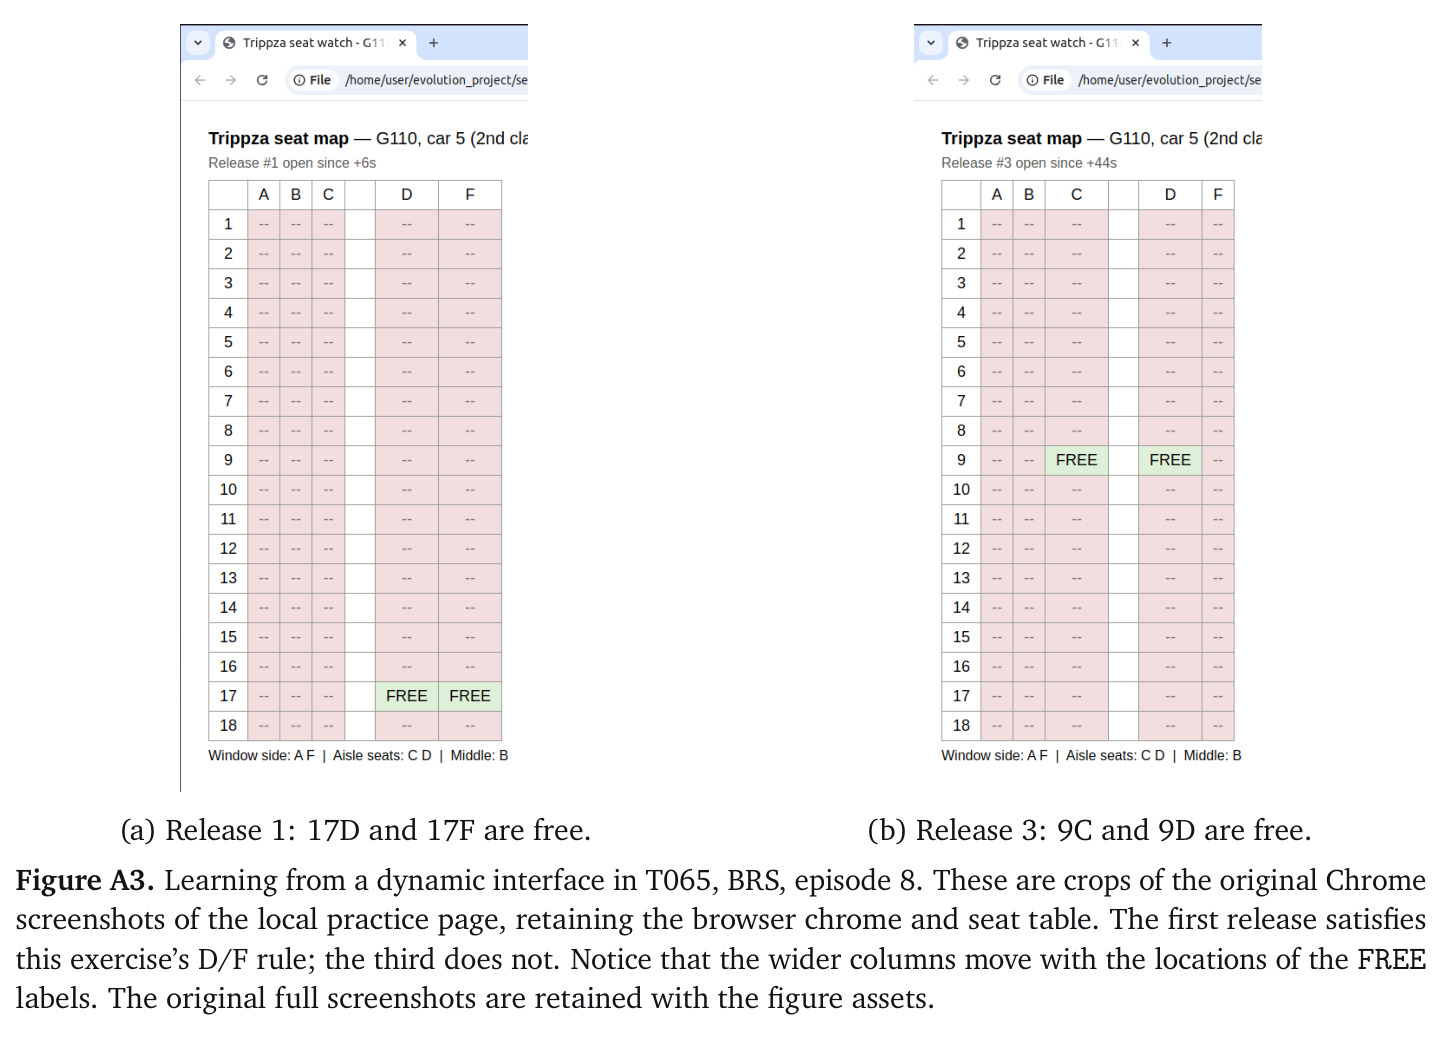
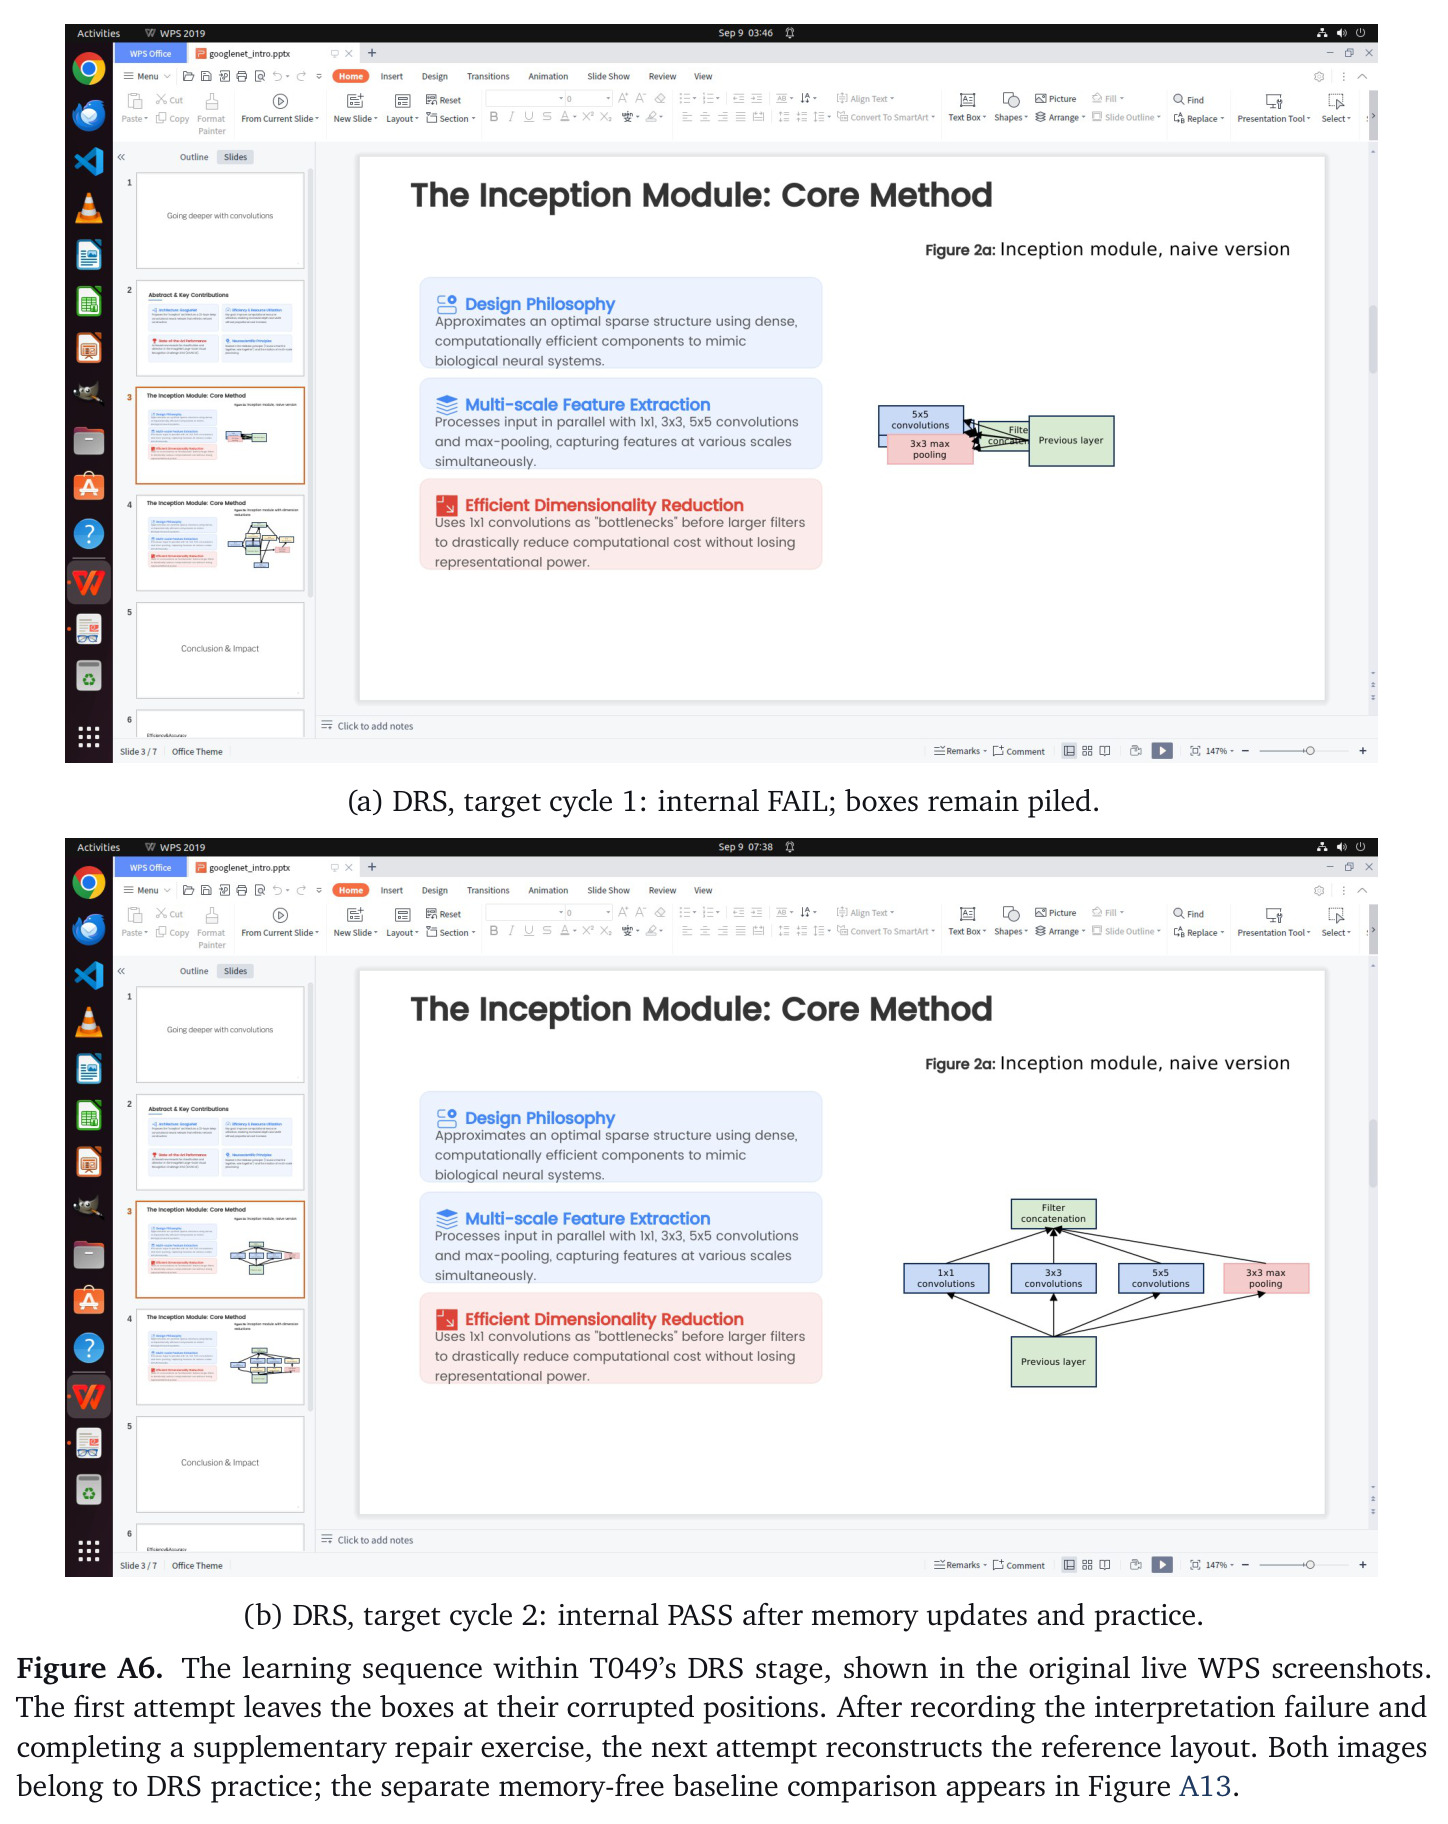
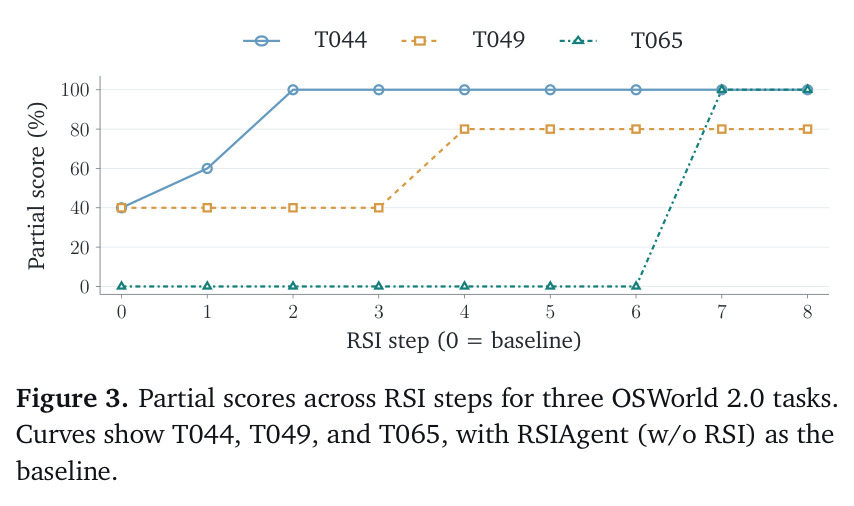
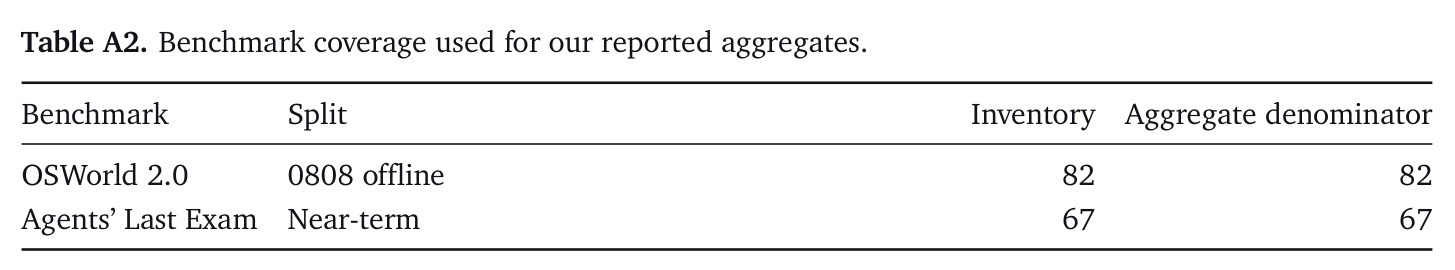
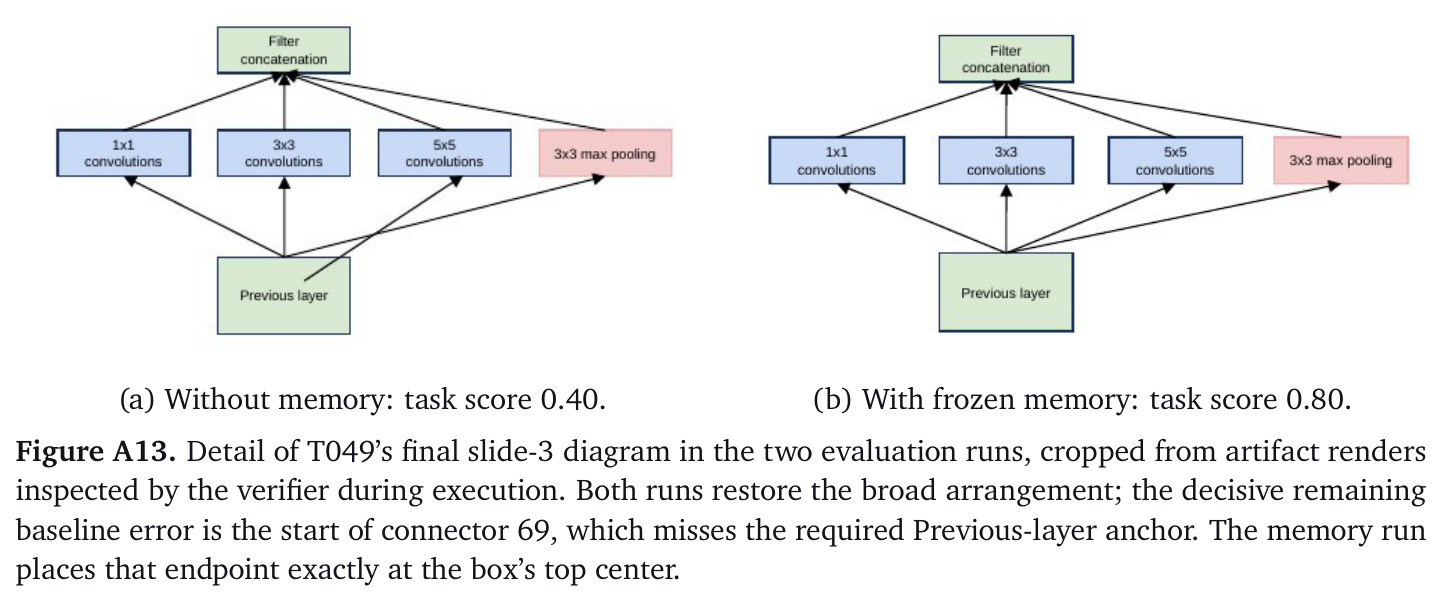
主结果(Table 1):GLM-5.3 任行动者、Kimi-K3 任验证者与课程者的 RSIAgent 在 OSWorld 2.0(82 任务)上取得 78.98% 部分得分与 42.68% 二元准确率,比同框架无探索基线(71.97/37.80)高 7.01 和 4.88 个百分点,并超过 GPT-6 Astra(72.60)、Claude Opus 5(70.19);在 ALE(67 任务)上达 84.82/50.75,部分得分超 GPT-6 Astra 2.56 分,但二元准确率仍低于其 52.24。轮次效应(Figure 3):T044/T049/T065 到第 8 步分别达 100%/80%/100%。消融(Figure 4):完整 RSI 四任务均值 74.54%,高于仅广度 65.52% 与仅深度 56.50%,且仅深度在 T085、T089 上低于基线,证明先广后深缺一不可。游戏环境(Table 2):四个生成器分组全部提升,如 GLM-5.3-Flash 组 30.55→48.72;对照方法 Play2Code 在最强组反而退化到 51.05。案例研究给出机制证据:T049 从 0.40→0.80,根因是连接线 69 起点偏移 121,104/145,345 EMU(超 100,000 容差),复用记忆后归零,迭代从 35 降到 19、耗时从 5,105.5 秒降到 2,697.0 秒;T044 从 0.40→1.00,关键是记忆让行动者选用 Shotcut 原生 crop 滤镜(top=76、center=0)而非不被评分器识别的 avfilter.crop;T085 从 0.68→0.9415,T103 从 0.25→0.6789。记忆规模:T044 经 10 个 BRS 项目积累 109,647 字节,冻结时达 316,541 字节。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 2.0(0808 offline,82 任务) | Partial(%) | 78.98 | GPT-6 Astra 72.60;同框架 w/o RSI 71.97 | 超 GPT-6 Astra +6.38,超自身基线 +7.01 |
| OSWorld 2.0(0808 offline,82 任务) | Binary(%) | 42.68 | 同框架 w/o RSI 37.80 | +4.88 |
| Agents' Last Exam(Near-term,67 任务) | Partial(%) | 84.82 | GPT-6 Astra 82.26;Claude Opus 5 79.54 | 超 GPT-6 Astra +2.56 |
| Agents' Last Exam(Near-term,67 任务) | Binary(%) | 50.75 | GPT-6 Astra 52.24;自身 w/o RSI 49.25 | 比 GPT-6 Astra 低 1.49(未反超),比自身基线 +1.50 |
| OSWorld 2.0 四任务消融(T080/T085/T089/T106) | Partial 均值(%) | 完整 RSI 74.54 | 仅广度 65.52;仅深度 56.50 | 比仅广度 +9.02,比仅深度 +18.04 |
| GameCraft-Bench 40 任务(Codex+GPT-5.5 生成组) | Overall | 61.28 | 原始基线 52.77;Play2Code 51.05 | +8.51(Play2Code 反而 -1.72) |
| GameCraft-Bench 40 任务(GLM-5.3-Flash 生成组) | Overall | 48.72 | 原始基线 30.55;Play2Code 38.25 | +18.17 |
局限与改进
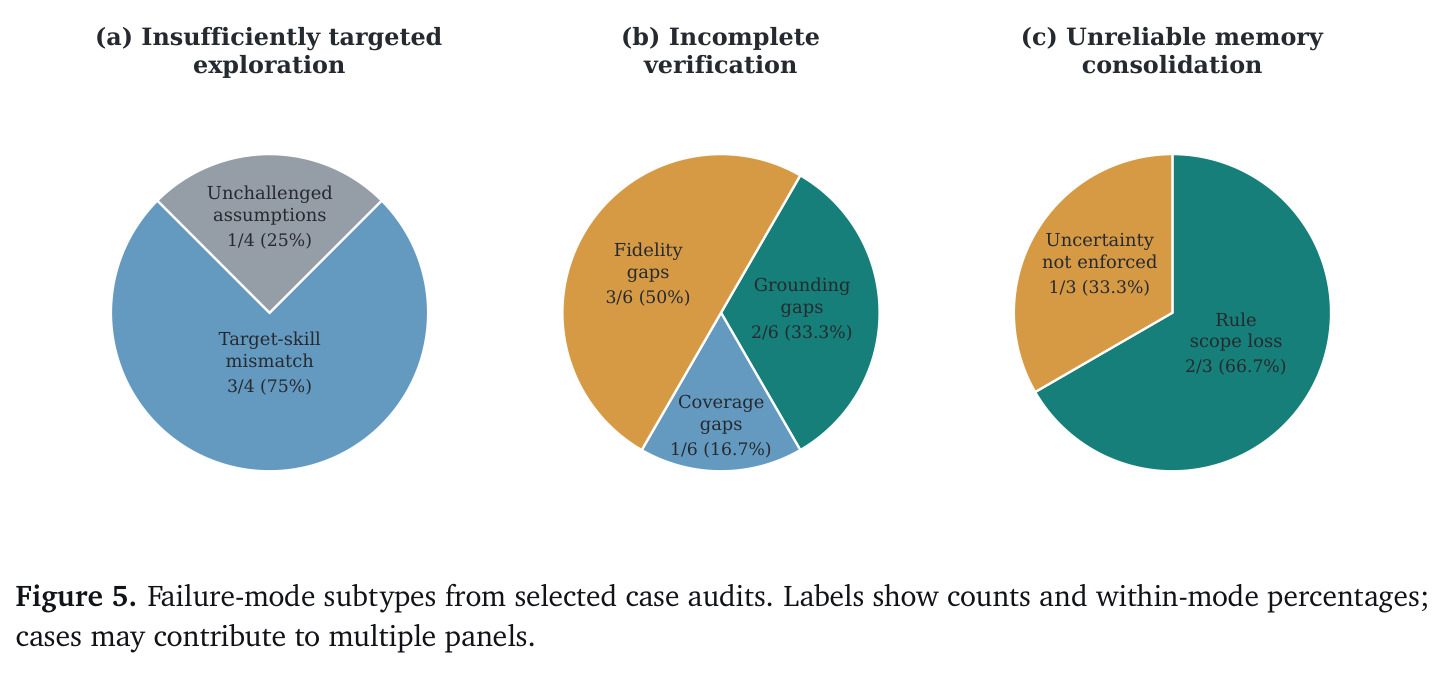
作者承认四点局限:(1) 递归自我改进需要额外测试时探索与实践,计算开销可观(目标尝试 500 次迭代/36,000 秒看门狗,练习高达 2,000 次迭代/86,400 秒);(2) 表现依赖有限探索预算、停止策略与记忆质量;(3) 基于模型的验证者可能误判并把错误传播到后续探索与记忆更新;(4) 不同环境需要不同工具、验证信号与探索策略,当前实验未完全隔离各组件贡献。失败模式分析(Figure 5)量化了风险:探索案例中 75% 目标技能错配、25% 未挑战假设;验证案例 33.3% 有接地缺口;记忆整合案例 66.7% 存在规则范围丢失。我的补充观察:报告协议也削弱说服力——OSWorld 的 RSI 行用 41 个非诊断 RSI 分数替换基线、其余保留基线,ALE 行混合 19 个 RSI 分数与 48 个基线分数,作者自认'并非匹配协议的比较';T065 的 0→1 依赖显式日期澄清(基线订到 2027 年);探索只针对有提升空间的任务,聚合分母却含未探索任务,整体提升难以精确归因;与排行榜对比沿用各系统原 harness 与预算,公平性存疑。
独立分析的弱点
独立分析五点弱点。(1) 单模型验证偏差:Kimi-K3 同时担任验证者与课程者(虽分上下文),错误可能相关;失败分析显示验证者会在字段值无支撑时返回 PASS。改进:多验证者集成、强制证据级证明(截图、哈希、重放)、高风险结论独立复检。(2) 记忆无界增长且无检索压力测试:案例中 141KB-317KB 可整体读入上下文,但跨环境长期积累后索引与检索会成为瓶颈。改进:引入压缩、遗忘与重要性评分,或借鉴 HyMEM 混合图结构。(3) 因果断言不可证伪:蒸馏依赖 LLM 自我判断,'保留不确定性'只是提示词约束;T065 中'把缺失数据标记当有效答案'的坏规则长期存留即为例证。改进:给每条规则附置信度与反例测试,由课程者定期安排规则审计练习。(4) 成本未量化:论文未报告 token 消耗、API 费用与端到端时长;T044 带记忆反而用更多迭代(42 对 26),说明记忆并非总省时间。改进:给出成本-收益曲线与自适应预算分配。(5) 跨环境记忆迁移未研究:每个新环境从空记忆冷启动,重复付费,限制 RSI 的复利效应。
未来方向
作者提出的方向是把递归自我改进扩展到数字计算机使用之外的更广交互领域,包括 AI for Science(智能体需学习专业工具、工作流与科学流程)和游戏(复杂且持续演化的环境,适合研究长程探索、适应与自我改进)。基于本文成果还可自然延伸:其一,跨环境记忆迁移与'元记忆'——把 FreeCAD 案例中'先分类输入再执行'这类通用流程抽象为环境无关知识,缩短新环境冷启动;其二,用验证过的经验做轻量后训练(如对 PASS 轨迹做拒绝采样微调),检验记忆型 RSI 与参数型 RSI 的互补性;其三,形式化 RSI 的收敛与安全性:给定验证器错误率 $\varepsilon$,分析错误知识在记忆中存活的条件,设计能主动证伪坏规则的课程;其四,多智能体社会性自我改进——让多个 RSIAgent 实例交换记忆并就一致性相互验证,扩大经验来源;其五,把 UNVERIFIED 状态扩展为可量化的证据强度评分,接入概率化验证(如对动态 GUI 状态做统计检验),进一步压低 33.3% 的接地缺口率。
复现评估
复现条件中等偏上。有利方面:代码已在 GitHub 开源(github.com/AetherLabsAI/RSIAgent)并有项目主页;三个基准公开(OSWorld 2.0 的 0808 离线 82 任务子集、ALE Near-term 67 任务、GameCraft-Bench 抽样的 40 任务);附录完整给出智能体接口(Table A1)、提示词模板(P1-P7)、参考配置(GLM-5.3 行动者、Kimi-K3 验证者/课程者,温度 1.0、top-p 1.0、65,536 token 响应上限)与算法 A1 伪代码;记忆是无固定 schema 的文件集合,便于人工审查。不利方面:需同时调用 GLM-5.3 与 Kimi-K3 API 并维护 QEMU 沙箱,计算开销大(目标尝试 36,000 秒看门狗、练习 86,400 秒,单任务谱系含 8-11 个 BRS 项目加多轮 DRS);官方评分依赖 GPT-5.4 与 GPT-4o,本身带噪声;部分结果为历史运行、含重试与选定检查点,主表聚合混合 RSI 分数与保留的基线分数,严格复现 Table 1 需完全一致的任务选择与报告约定。总体判断:复现单任务案例研究(T049、T044、T085)现实可行,完整复现主表并精确对齐协议难度较高。
论文图表
三类失败机制的子类型占比:探索不聚焦(目标技能错配 3/4=75%、未挑战假设 1/4=25%)、验证不完整(接地缺口 2/6=33.3%、覆盖缺口 1/6=16.7%)、记忆整合不可靠(规则范围丢失 2/3=66.7%、未保留不确定性 1/3=33.3%、保真缺口 3/6=50%)。
揭示 RSI 失效的内在机理,对设计更稳健的自我改进系统有直接指导意义。
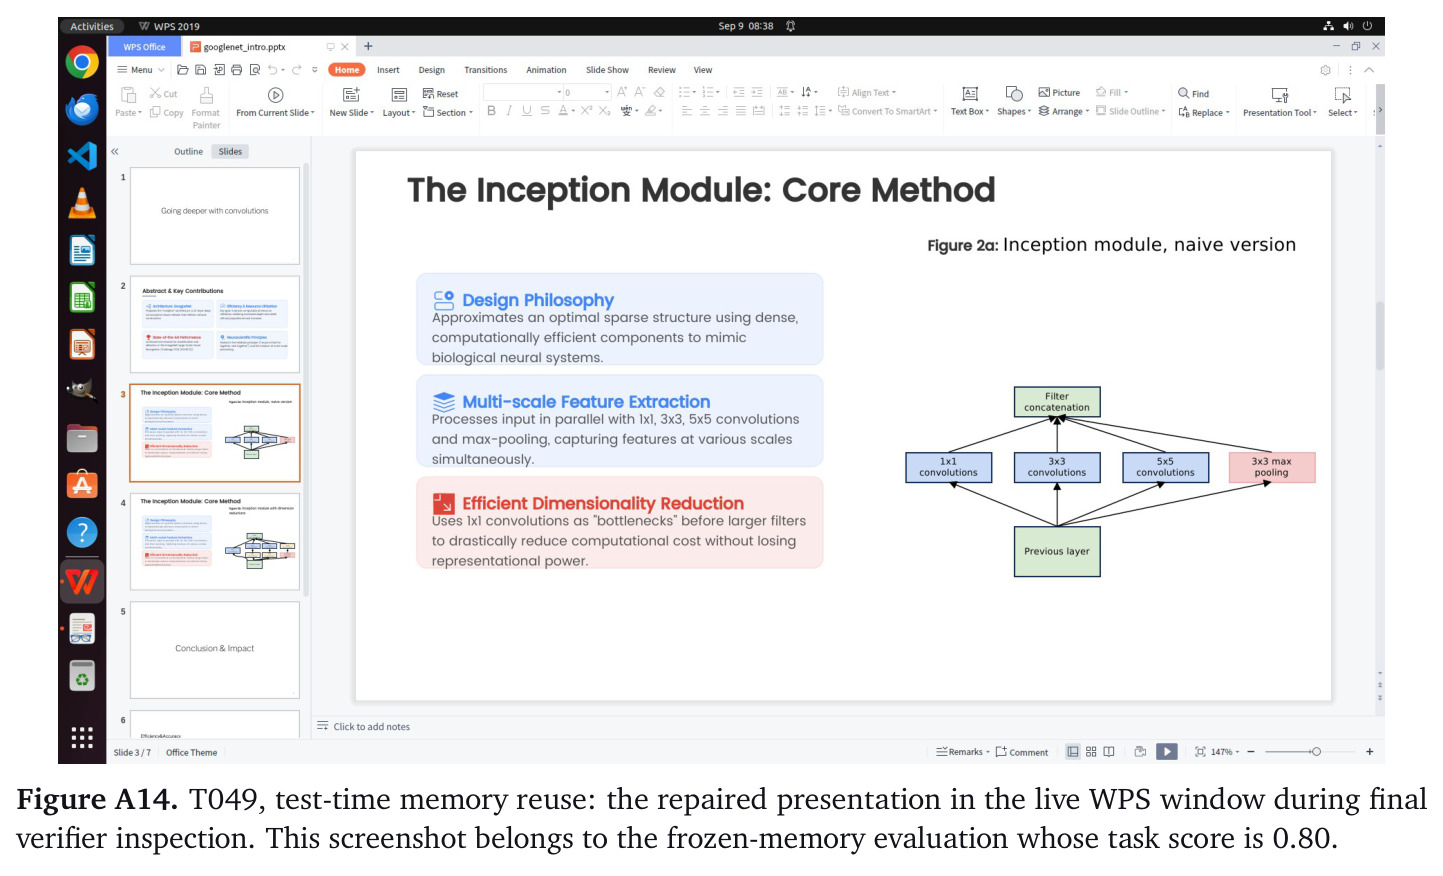
冻结记忆评测中 WPS 窗口内已修复演示文稿的验证者实时检查画面,任务得分 0.80;该运行迭代数从 35 降到 19、墙钟时间从 5,105.5 秒降到 2,697.0 秒。
配合 Table A7 说明记忆既提高分数又降低执行成本(T049 情形)。
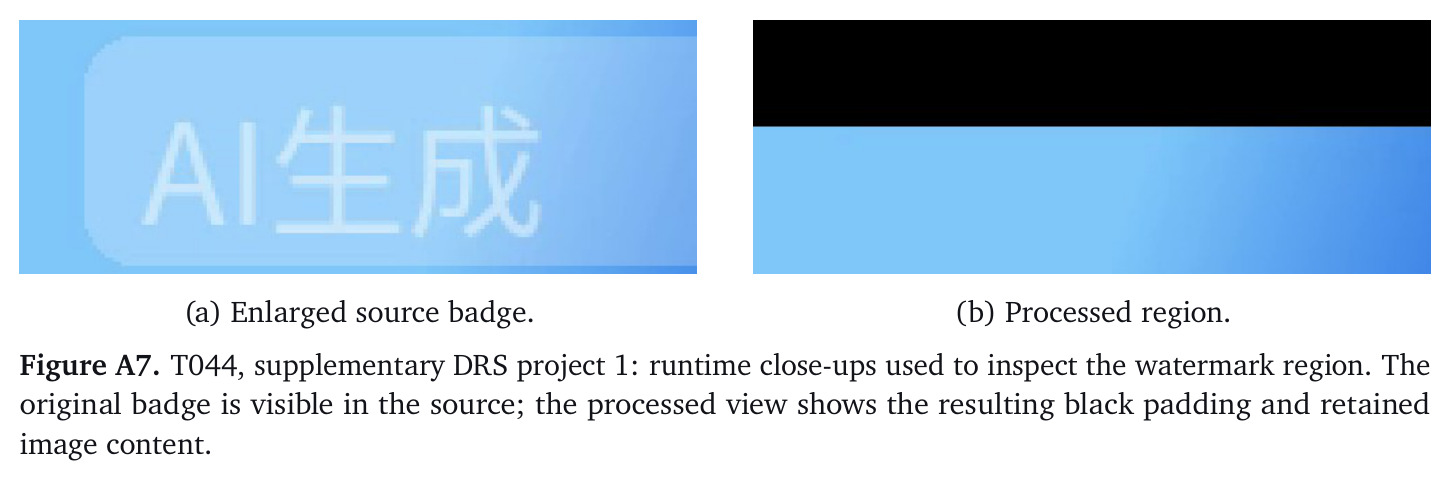
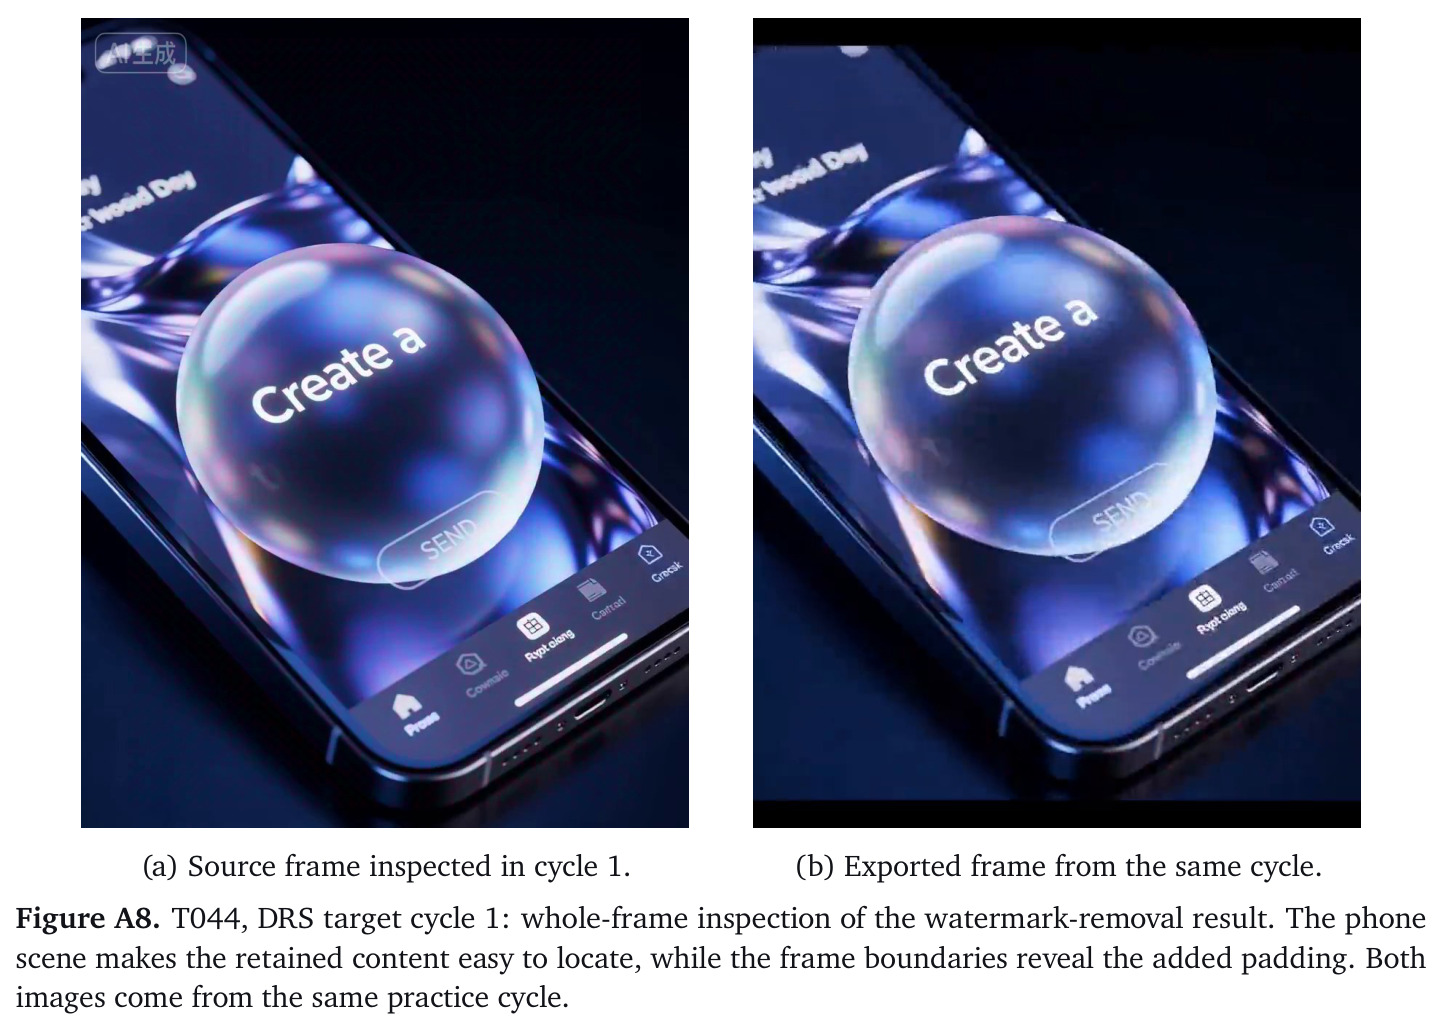
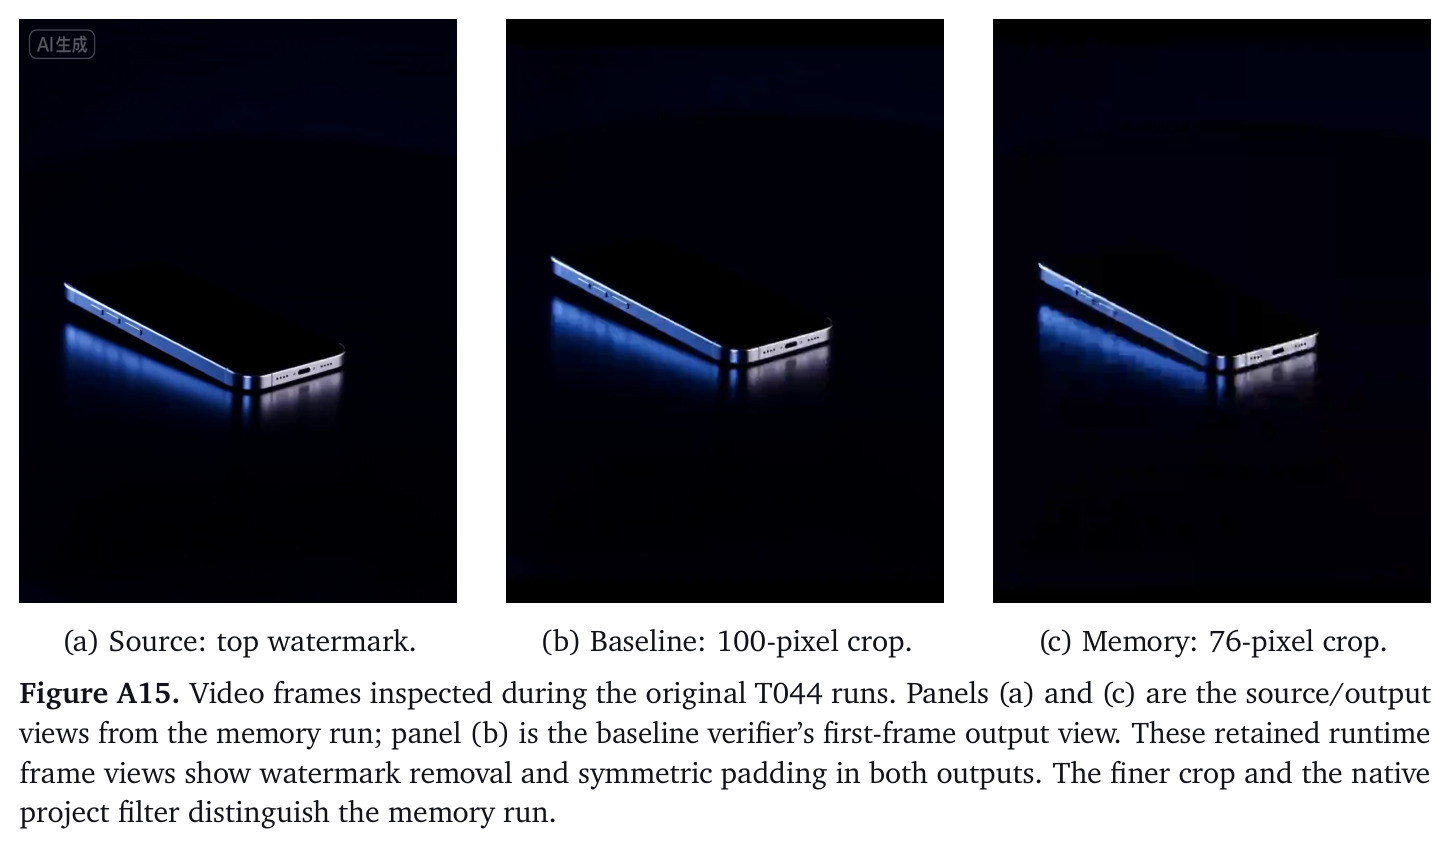
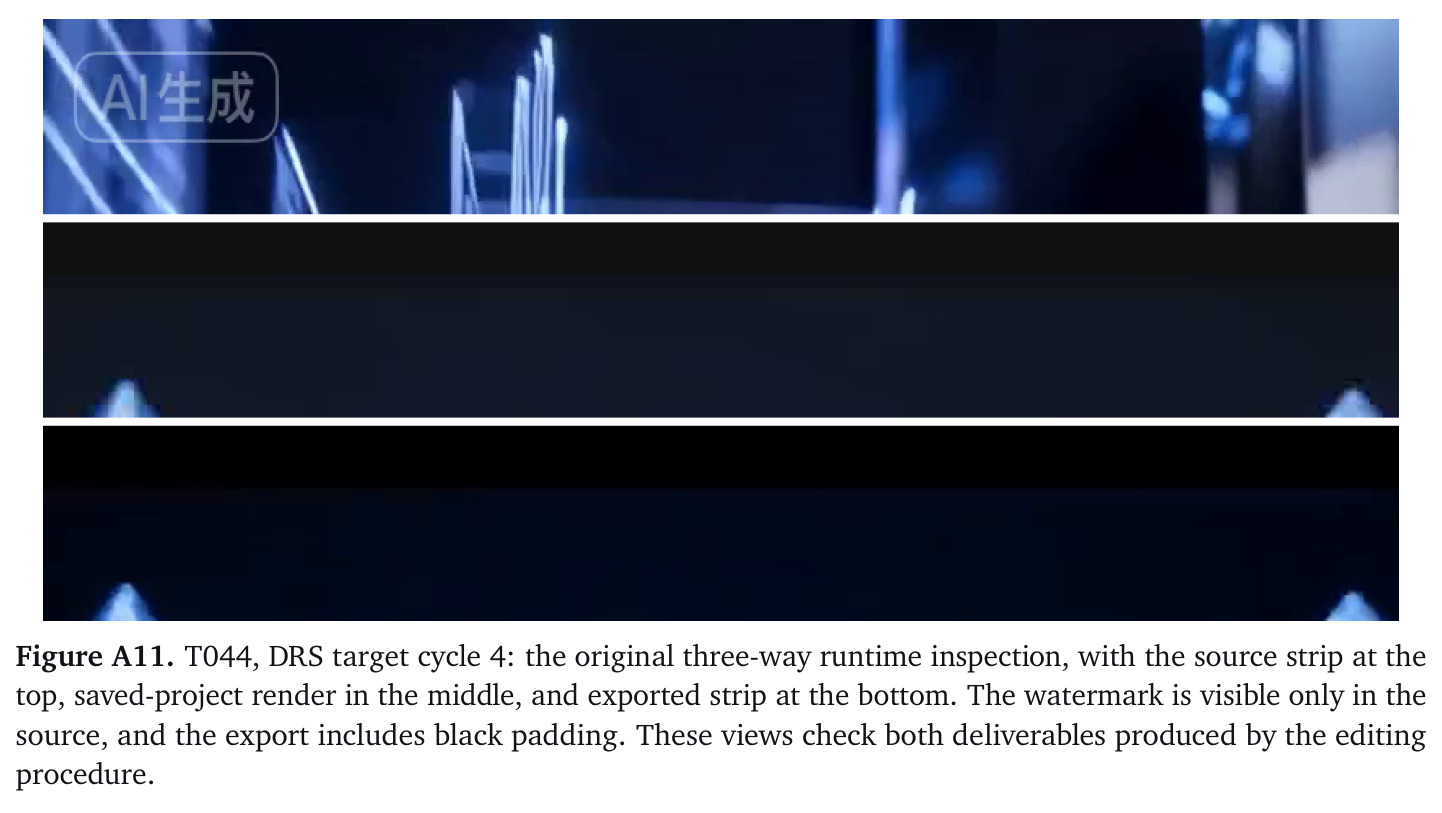
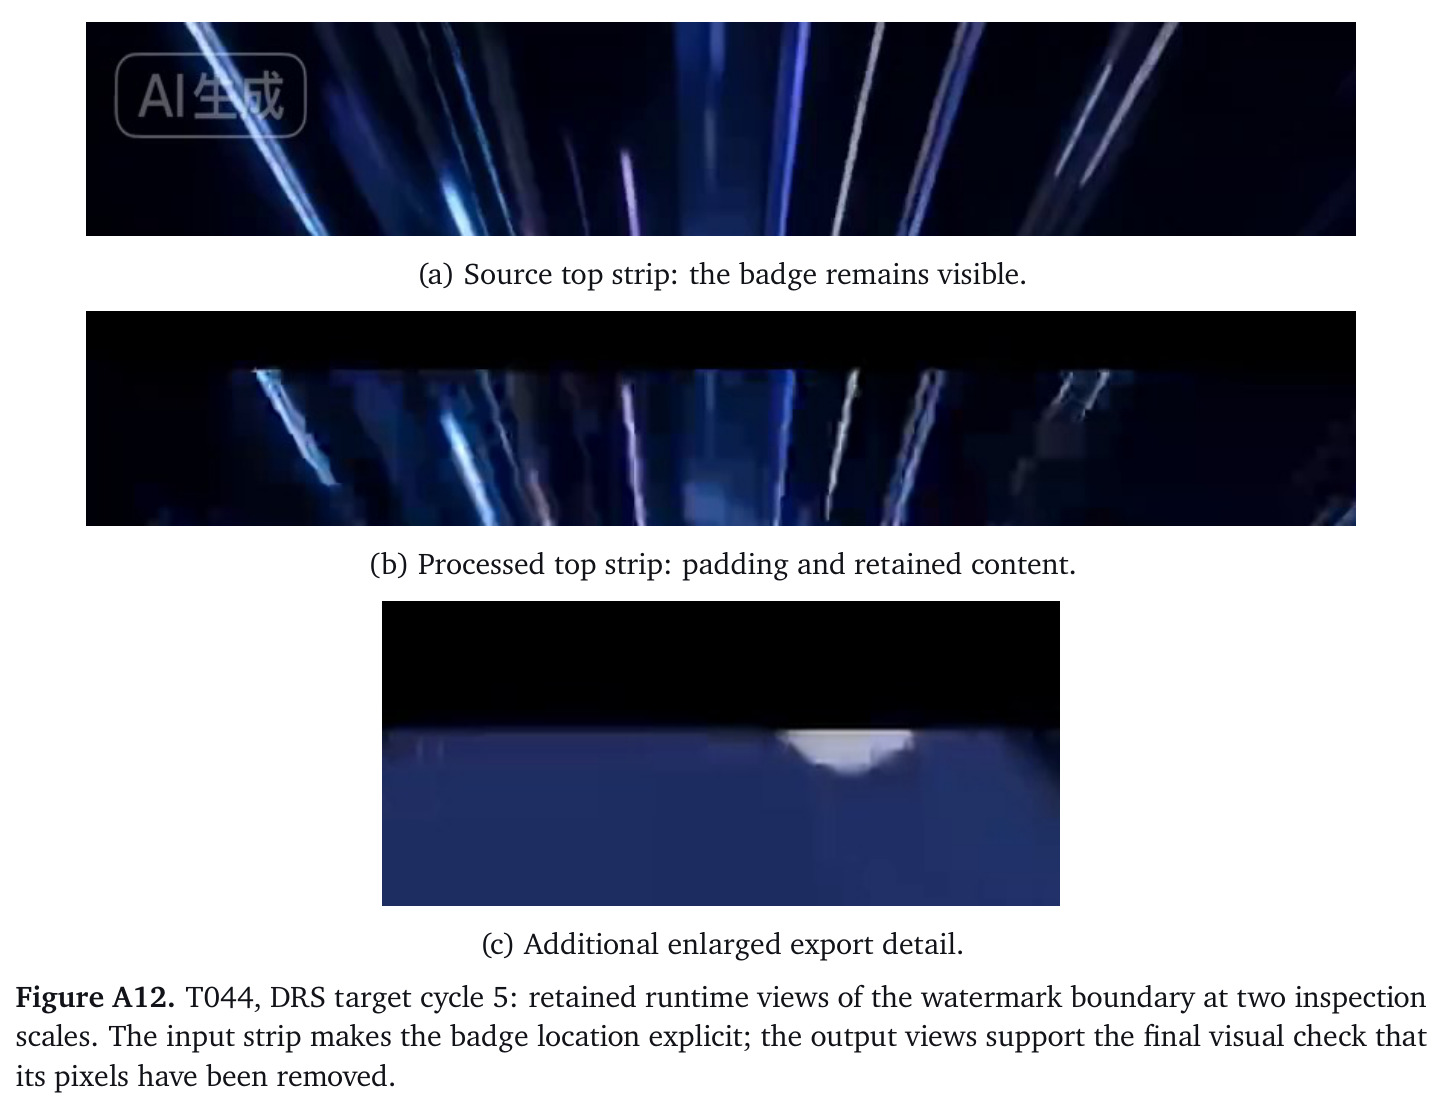
三帧对比:源帧(顶部水印)、基线输出(avfilter.crop 裁 100 像素、50 像素对称黑边)、记忆运行输出(原生 crop top=76、38 像素对称黑边);基线因使用非原生滤镜丢失 0.40+0.20 分量,总分 0.40→1.00。
解释 T044 满分的关键机制:记忆让行动者选用了评分器认可的 Shotcut 原生工作流。
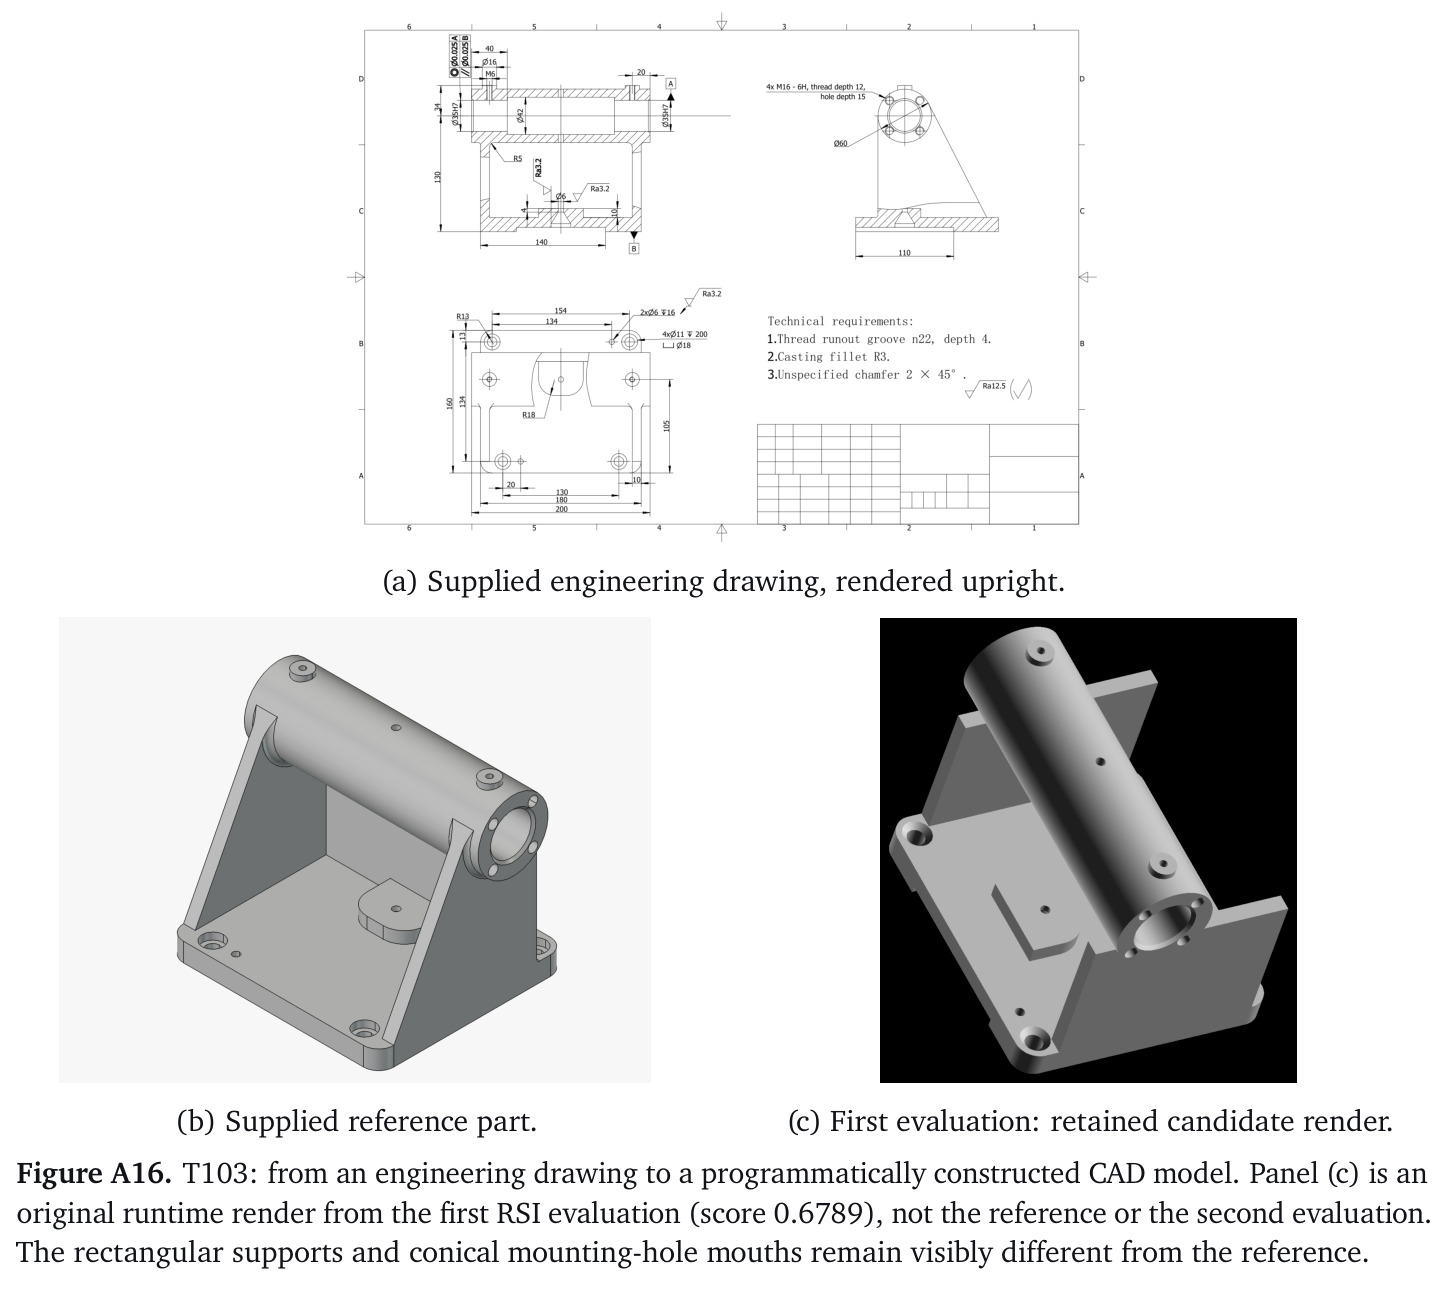
FreeCAD 支架重建任务的输入(工程图纸 PDF 与参考零件图)与首次冻结记忆评测的候选渲染(得分 0.6789):矩形支撑与锥形沉孔口仍与参考有差异,显示改进后仍有未完成的几何。
诚实展示 RSI 提升后残余差距(0.25→0.6789 但未满分),避免过度宣称。
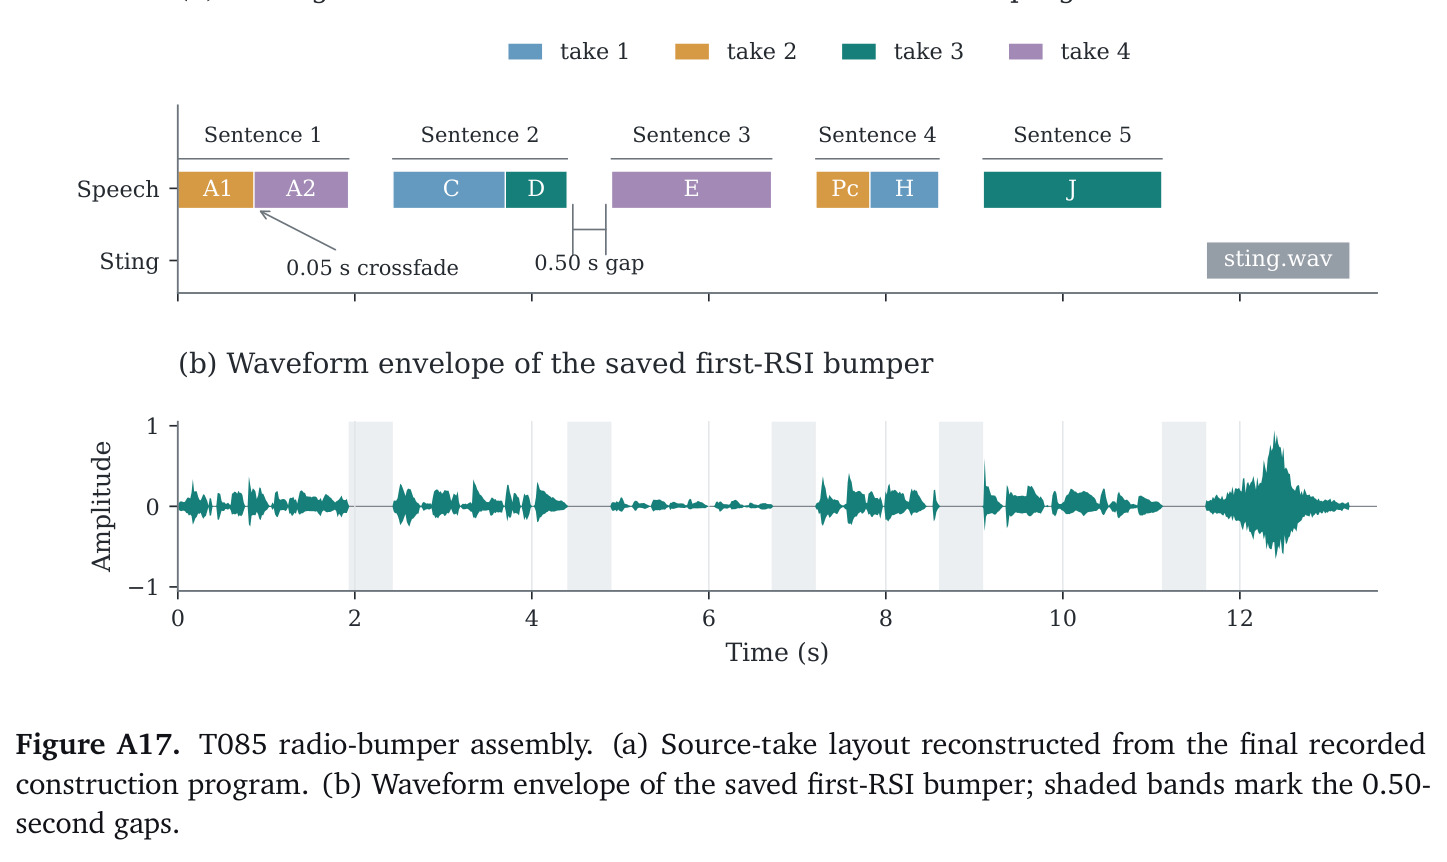
上半部为从最终构建程序重建的素材时间线(4 个 take、5 句、sting、0.05 秒交叉淡化与 0.50 秒句间隙);下半部为保存音频的波形包络,阴影带标出 0.50 秒间隙。
可视化 REAPER 案例中记忆指导下的精确音频组装结果。
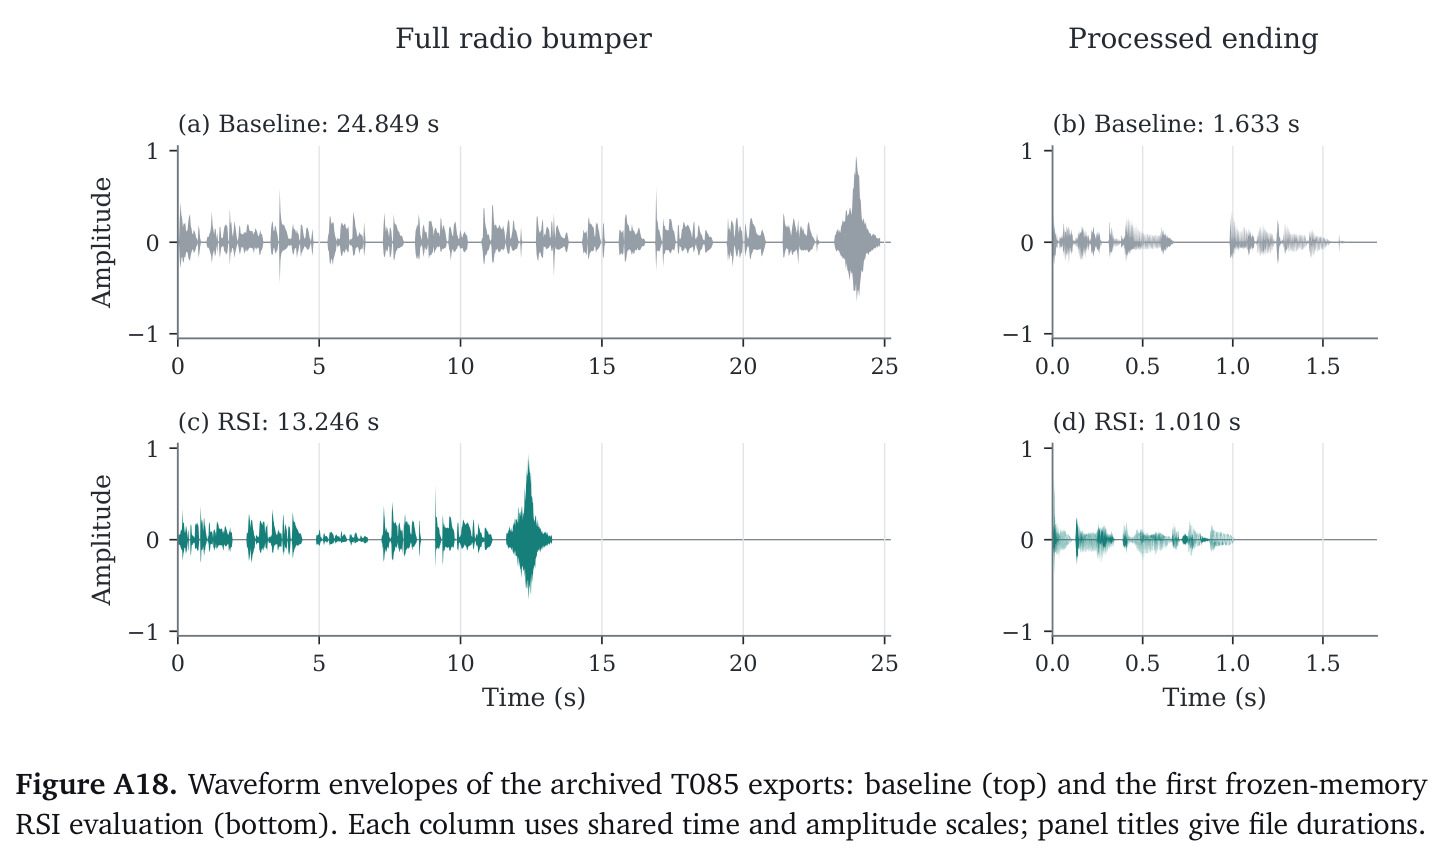
基线完整 bumper 24.849 秒、结尾处理 1.633 秒;RSI 分别为 13.246 秒与 1.010 秒,对应句间隙分量 0.8250→1.0000、结尾处理分量 0.2837→0.8996,整体 0.6800→0.9417。
用波形直观对照基线与 RSI 交付物差异,支撑 T085 的分量级归因。
两个主案例的分数对比:T049 基线 0.40→记忆 0.80(新增幻灯片 3 箭头检查通过),T044 基线 0.40→1.00(原生裁剪高度 +0.40、Center-off +0.20)。
汇总'哪些新增评分项带来增益',是案例研究结论的总表。
逐项分解 T049:幻灯片 2 两次均 0;幻灯片 3 布局两次均 Pass 但箭头 Fail→Pass,分量 0→0.40;幻灯片 4 两次均 0.40;连接线 69 起点误差从 121,104/145,345 EMU 降为 0,总分 0.40→0.80。
提供可复算的评分分解(重放评分函数可复现历史总分),展示最严格的归因分析。
T085 分量得分:素材顺序两次均 0.9062,句间隙 0.8250→1.0000,结尾 sting 两次均 1.0000,处理后末句 0.2837→0.8996,总 partial 分 0.6800→0.9417(含基准权重与 0.68 封顶被解除)。
展示 RSI 增益精确落在哪些评分分量上,并说明评分器用声学活动近似句边界的度量局限。