具身图灵机:面向机器人递归自我改进的有状态代码策略 Embodied Turing Machines: Stateful Code for Robot Recursive Self-Improvement
策略写成跨回合复用的状态化代码,运行时零模型,RoboDojo 成功率 70.24% 大幅领先。
前置知识
VLA(视觉-语言-动作模型)
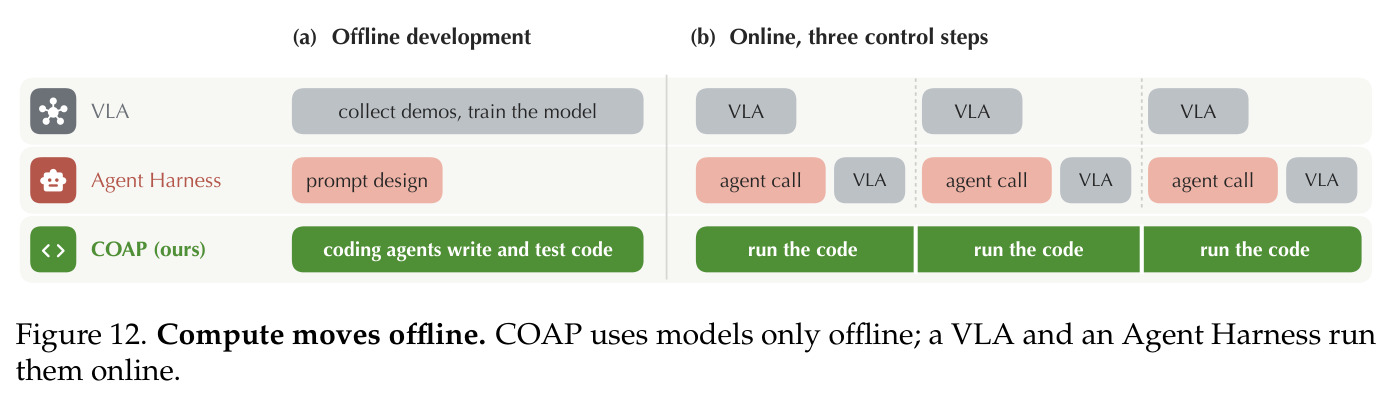
VLA 是端到端训练的神经网络,输入相机图像和语言指令,直接输出机器人动作序列,如 RT-2、OpenVLA、π0、π0.5。观测到动作的映射隐式编码在网络权重中,改进它需要收集新数据并重新训练,无法直接检视或编辑其内部决策过程。
VLA 是本文比较的三大策略范式之一,理解其'权重即状态'的黑盒特性,才能明白 COAP 用显式代码变量存状态的优势所在。
Agent Harness(智能体框架)
指让 VLM 大模型在运行时参与机器人决策的系统,包括 Agent-as-Policy(VLM 直接控制机器人)和 Harness VLA(VLM 指挥一个 VLA 执行)。任务记忆以文本形式存在模型上下文中,但每次决策仍依赖模型推理,同一提示词在不同调用下可能产生不同动作。
Agent Harness 是 RoboDojo 榜单上最强基线类别(PhysicalRSI 达 31.38%),本文的显式状态、可控执行等优势论证都以此为对照。
图灵机
图灵 1936 年提出的计算模型:一条存储符号的纸带(tape)加上一组固定的读写规则,规则固定而纸带内容可变,同一套规则即可处理任意输入。它是'用有限规则处理无限输入'这一抽象的理论基石。
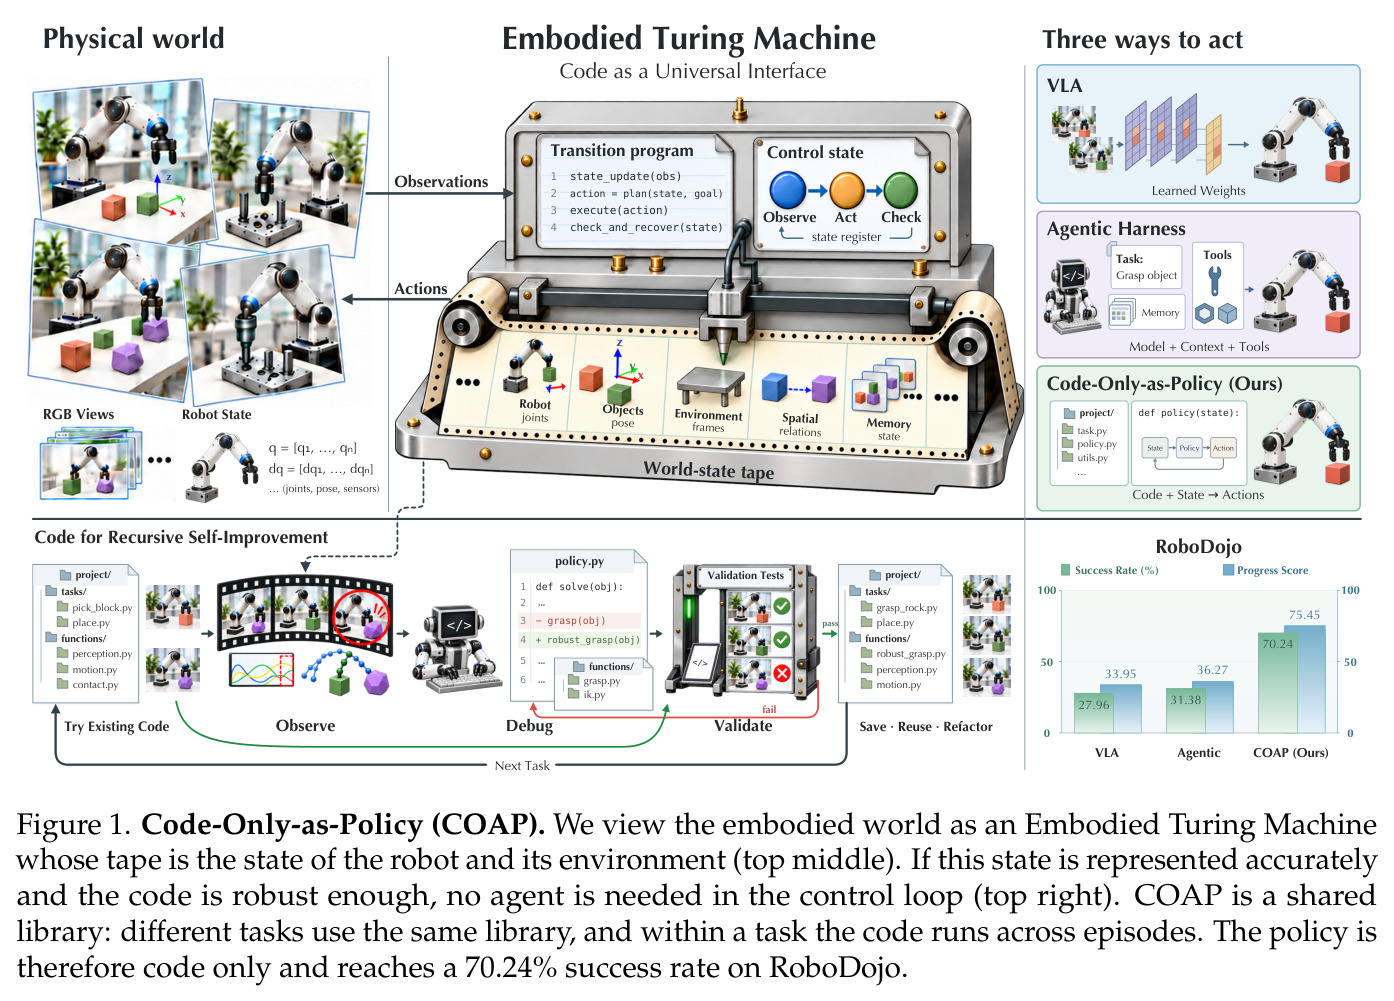
本文的核心隐喻:世界状态是纸带,策略代码是规则——物体重排只是换了纸带内容,同一程序即可运行所有回合,这直接引出'代码跨回合复用'的设计。
Code-as-Policy(代码即策略)
让大模型生成调用感知与控制 API 的代码来驱动机器人的思路,代表工作有 Code as Policies、VoxPoser。后续工作分两支:一是模型在每个回合在线逐轮写代码(PyRUA-Lean、Skill2Real);二是离线写好一个程序但状态来自 SAM/Molmo 等感知模型或仿真器 oracle(RHO、EmbodiedSWE)。
COAP 与这些先驱的区别是本文的贡献定位:代码自己测量状态(不用外部感知模型),且同一程序跨所有回合复用(模型不在线逐轮写码),读懂这条脉络才能理解 Figure 2 的对比。
递归自我改进(RSI, Recursive Self-Improvement)
智能体改进自身策略并不断累积能力的闭环过程:发现失败、修改策略、验证有效后保留改动、进入下一轮。关键要求是每次改动可见、可控、可验证且不破坏已有能力,否则改进会在迭代中退化。
本文论证代码(相比权重或文本记忆)是 RSI 的理想媒介:每处改动是可审查的 diff,验证集达标才合并,能力单调累积。RSI 闭环是全文方法部分的骨架。
逆运动学(IK)与碰撞检测
逆运动学由期望的末端执行器位姿反解各关节角度;碰撞检测检查规划路径上机器人连杆与物体是否干涉。两者是基于模型的操作代码的基础组件,通常依赖已知机器人 mesh 和物体几何。
COAP 的 motion 层(IK、规划、碰撞)和开发期的 CPU 预检查都建立在这些经典工具上,也是其'依赖仿真器公开资产'这一局限的来源。
RoboDojo 基准
一个统一仿真与真机的双臂操作基准,含 42 个任务,覆盖记忆、精度、开放指令、泛化、长时程五个维度;每个任务用 3 个随机种子各评 50 个布局,泛化任务有一半布局随机化(新物体实例、新房间外观、最多 20 个干扰物)。官方提供评估客户端、裁判与汇总脚本。
本文全部主实验在该基准上完成,与官方排行榜 23 个条目直接对比;其记忆/精度任务天然考验'状态能否被精确持久保存',正中 COAP 长处。
研究动机
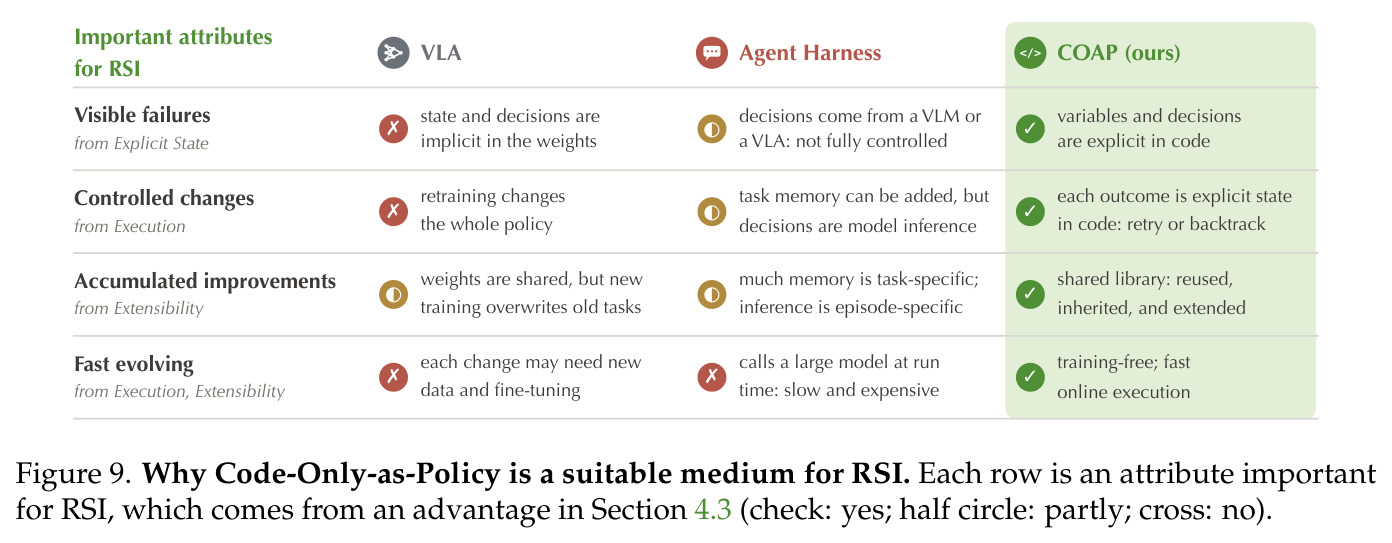
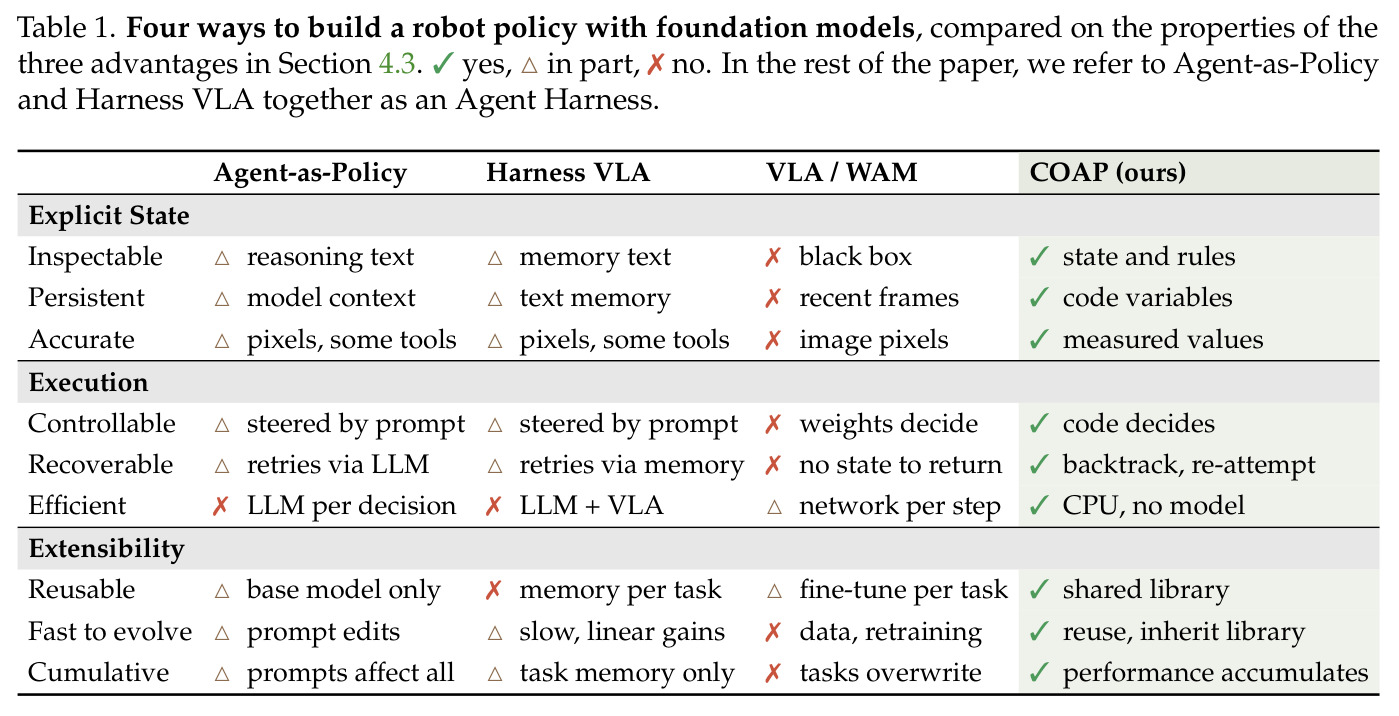
现有机器人策略几乎都把模型留在控制回路内,带来三类具体麻烦。第一类是 VLA:观测到动作的映射隐式存在权重里,不可检视、不可编辑,每次改进都要新数据加重新训练,而且持续学习会灾难性遗忘——论文引用的实验显示,对 π0.5 在五个真实任务上顺序微调后,平均分从 86.9 暴跌到 31.4;LIBERO-PRO 还表明基准高分可能只是记住了训练配置。第二类是 Agent Harness(Agent-as-Policy / Harness VLA):VLM 在每个回合反复推理,同样提示词每次调用的输出仍有随机性,且每个回合因大量模型调用而代价高昂。第三类是已有代码策略:要么让模型在回合运行中逐轮在线写代码(CaP、PyRUA-Lean、Skill2Real),每回合都不同;要么代码只写逻辑、状态却来自 SAM/Molmo 等黑盒感知模型(RHO)或仿真器 oracle(EmbodiedSWE),不确定性不受代码控制。这些缺陷在 RoboDojo 基准上体现为:42 个双臂任务上,此前最强方法 PhysicalRSI(agent+VLA)总体成功率仅 31.38%,最强世界动作模型 Awomo-0.5 为 29.64%,最强 VLA Simate-beta 仅 27.96%;尤其在依赖状态保存与精确测量的 Memory 和 Precision 维度,最好的基线分别只有 50.3% 和 33.5%——像素和文本记忆存不住'杯子下面是什么颜色'和'毫米级位姿'这类状态。
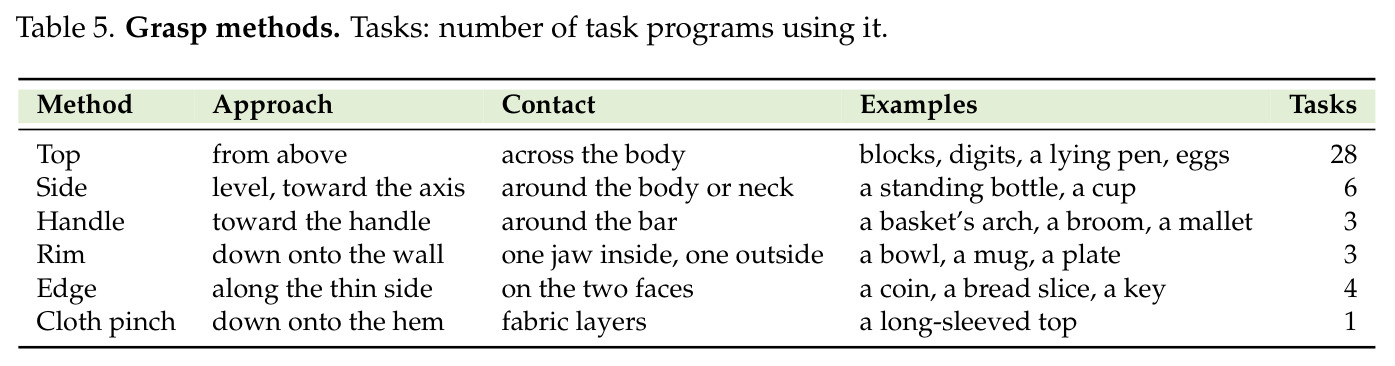
本文的目标是本文要探索'纯代码作为策略'(Code-Only-as-Policy, COAP)这一新范式的上限。具体目标分为四层。其一,概念层:把机器人及其环境建模为'具身图灵机'——世界状态是纸带,策略是读写纸带的固定规则,从而当物体重排(不同回合)时只有纸带变化,同一套规则照常适用。其二,系统层:构建一个由代码自己从 RGB 相机和本体感知中测量、跟踪并更新状态的共享代码库,任务程序、物体族、操作、感知、运动分层组织,同一任务的所有回合运行同一个冻结程序,不同任务共享同一个库,运行时完全不需要 VLM 或 VLA。其三,开发层:设计一个由编码智能体(Claude Opus 5.5)主导的闭环 RSI 流程,在固定规则约束下(不许为单个回合 hack、测试时不用 oracle 状态、开发不接触基准测试集)自动写码、调试、验证并合并改动,且每次改动显式可控、不回归旧任务。其四,验证层:在 RoboDojo 的 42 个双臂任务上与官方榜单全面对比,并系统分析代码策略在显式状态、执行、可扩展性上相对 VLA 和 Agent Harness 的优势。
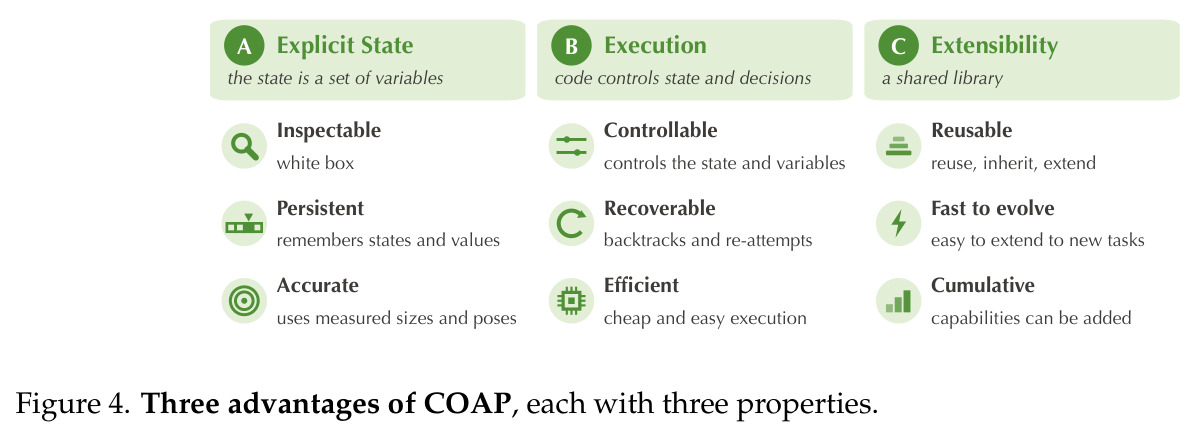
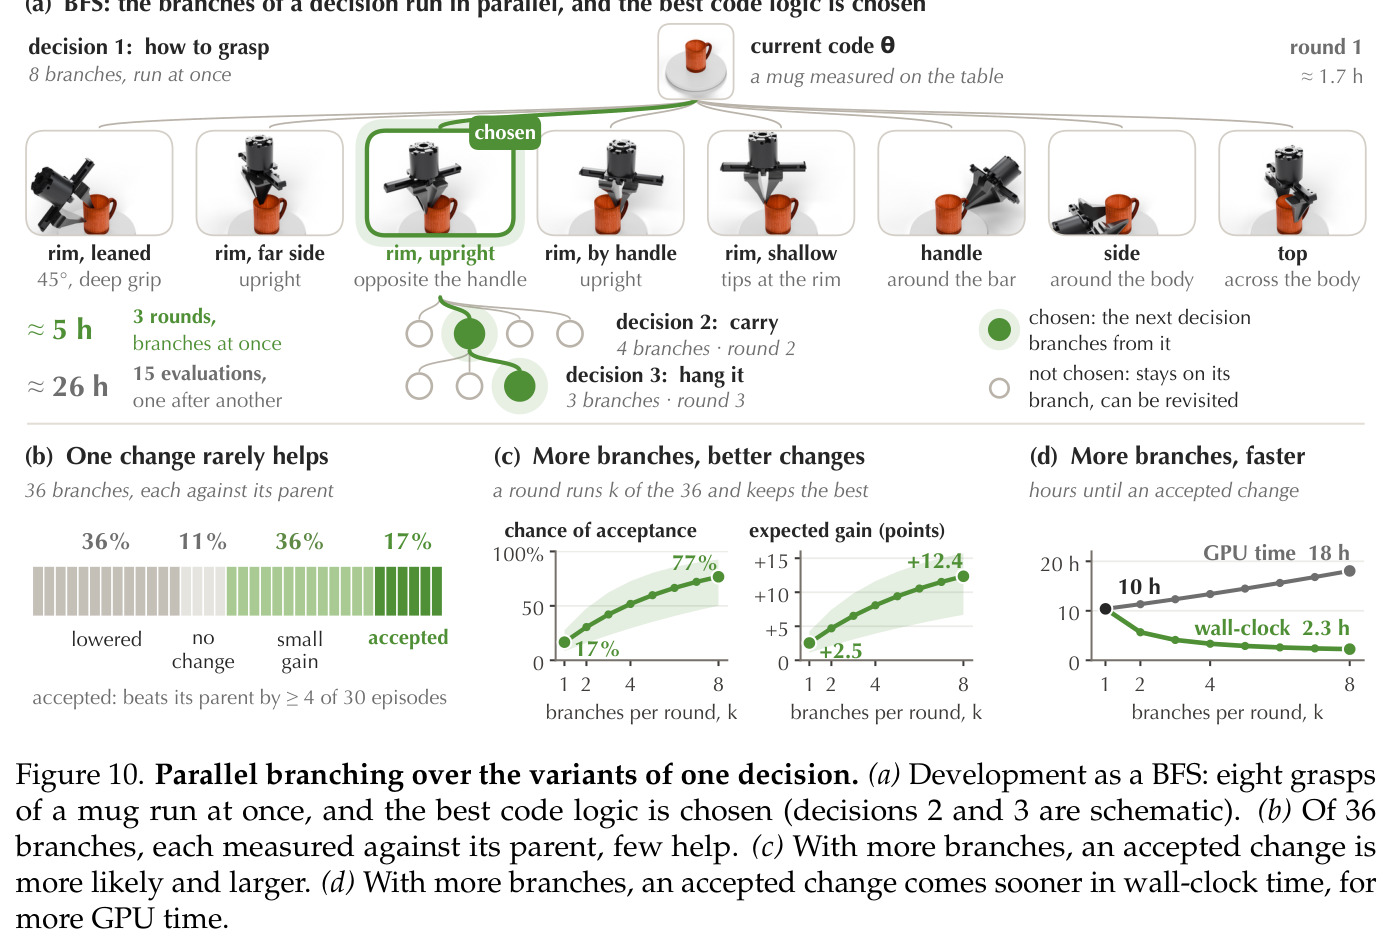
与已有工作不同的是,本文的独特切入在于回答'谁来提供状态、谁来决策'这两个被现有工作回避的问题。VLA 把状态藏在权重里,Agent Harness 把状态放在文本记忆和模型上下文里,而既有的 code-as-policy 工作要么让模型在线逐回合写码、状态交给外部检测器,要么离线写好程序但读取 SAM/Molmo 或仿真器 oracle——无论哪种,黑盒感知的不确定性都不在代码掌控之中,测过的行为不等于运行时的行为,RSI 的验证因此不可靠。COAP 的关键转变是:感知本身也是用 NumPy 和 OpenCV 写的普通代码,建立在基准公开的相机参数、机器人 mesh、物体几何等常量之上,状态因此成为可编程对象——测量错了,编码智能体直接修测量代码,而不是换一个更大的检测器。在这个设定下,被测试的行为就是运行时的行为,RLI 的每次改动都可在离线验证后可靠部署;同时由于每个代码变体都是完整可运行的程序、无需训练,决策 variants 可以像广度优先搜索一样并行评估,这是 VLA(一个分支等于一次训练)和 Agent Harness(每次 rollout 都要调用大模型)做不到的。论文还进一步把 COAP 定位为可复用、可复现的数据引擎,反哺 VLA 与 Agent Harness 的训练。
核心方法
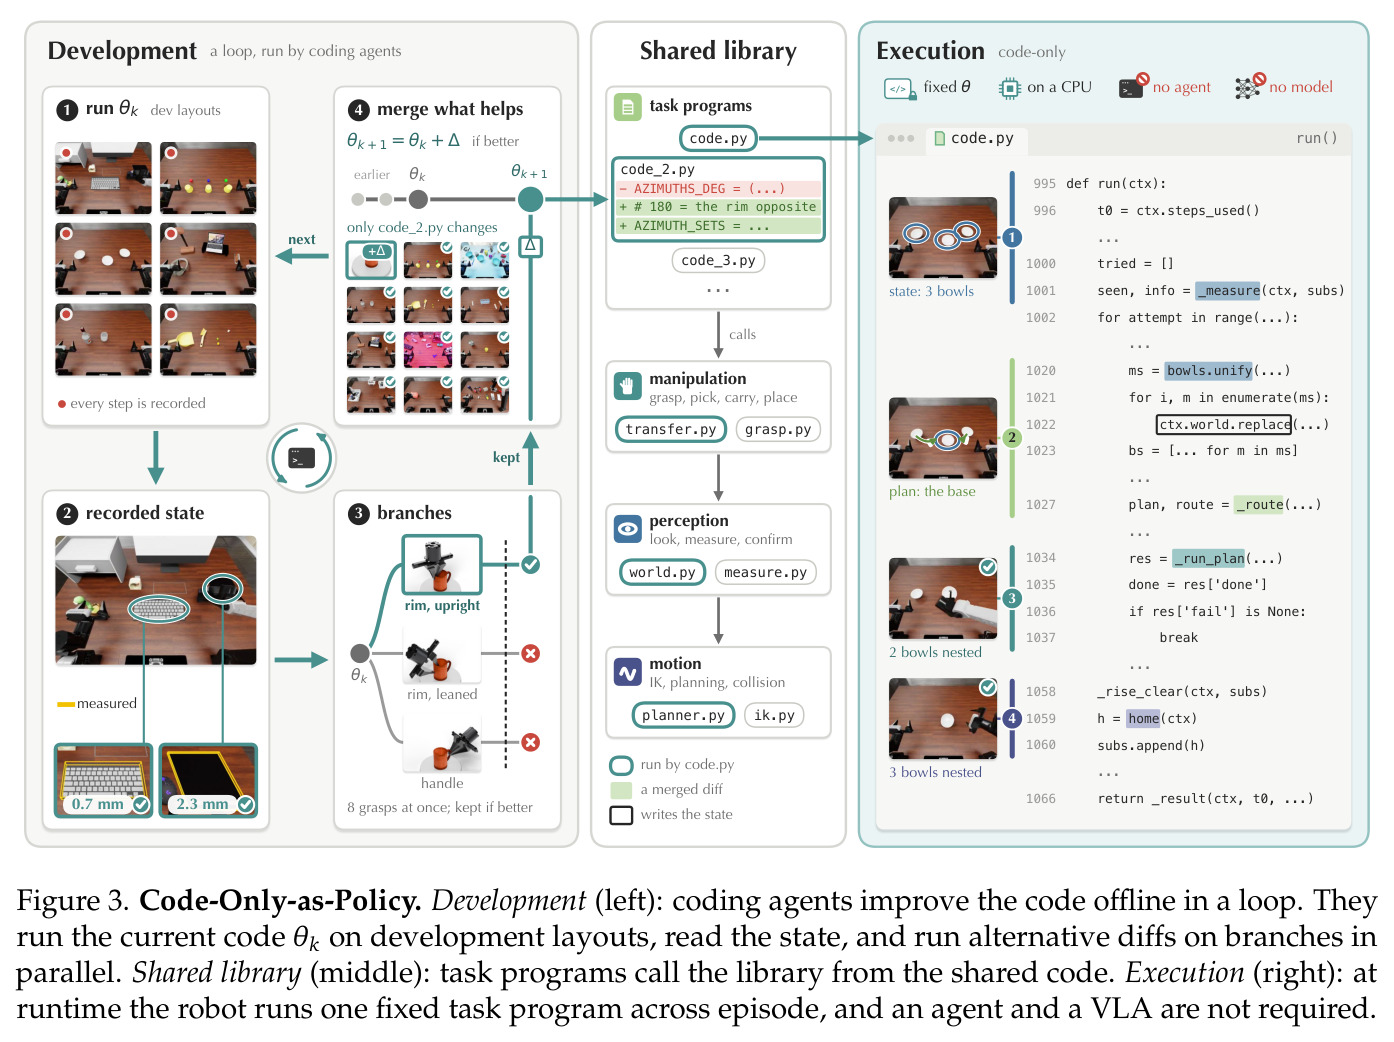
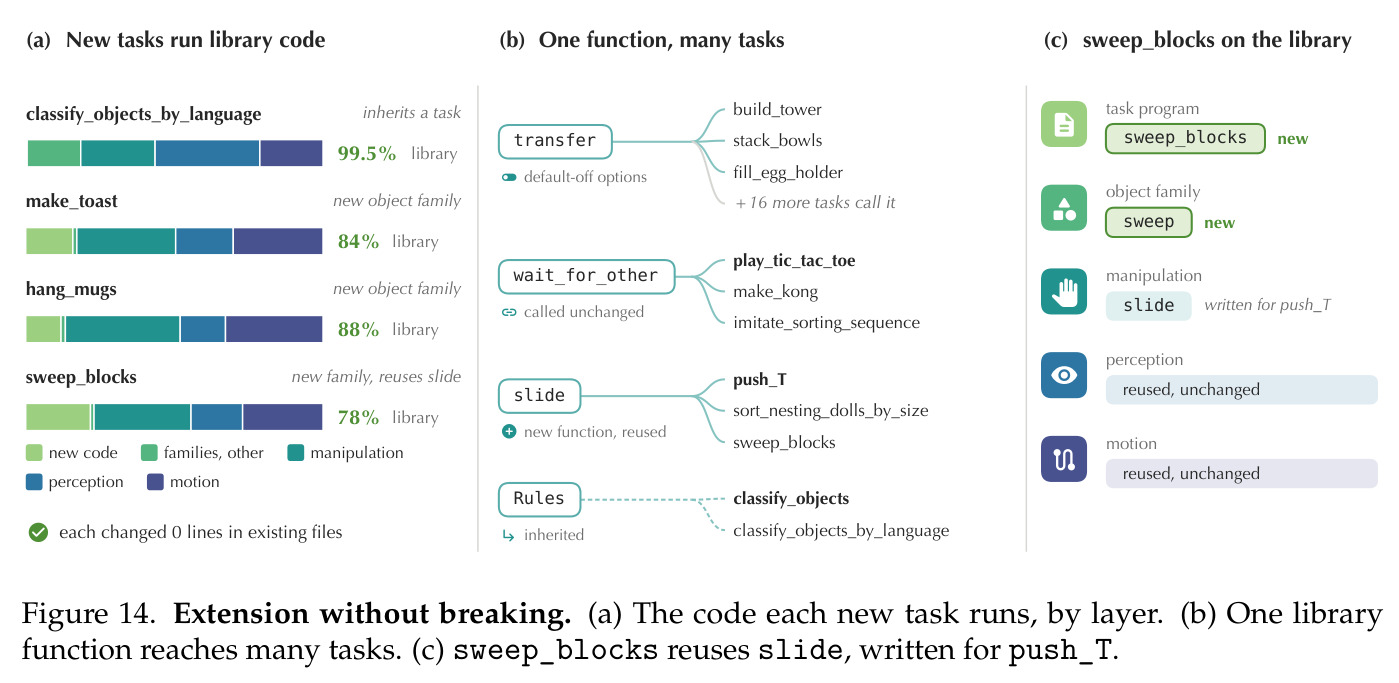
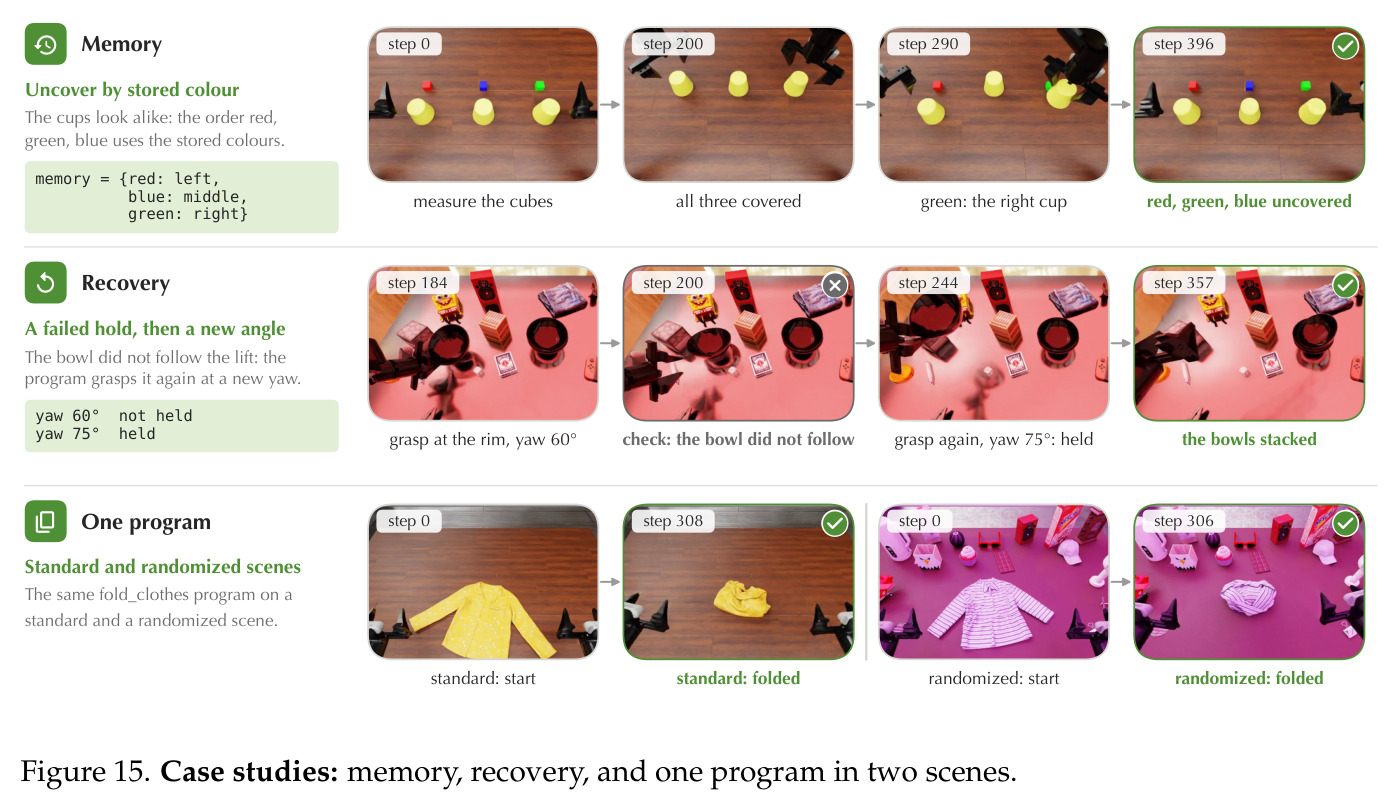
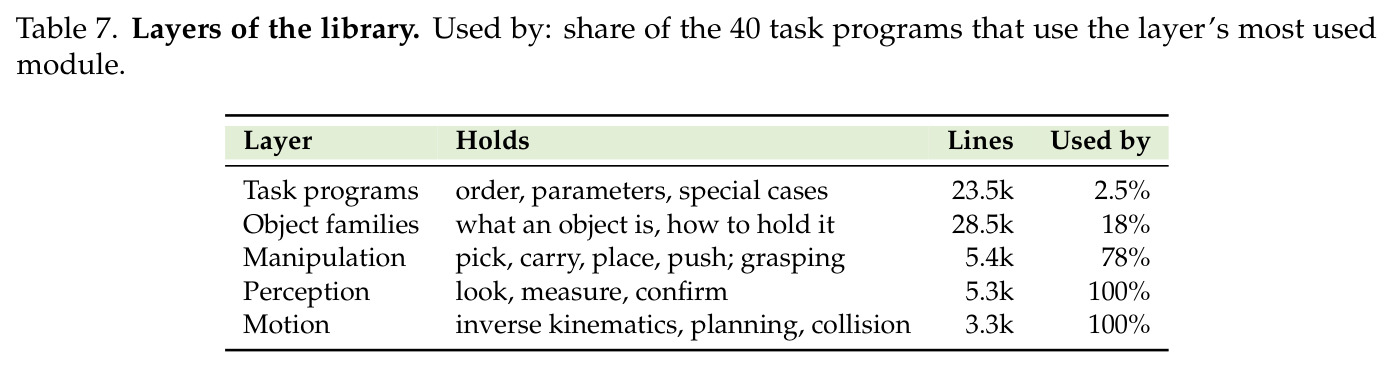
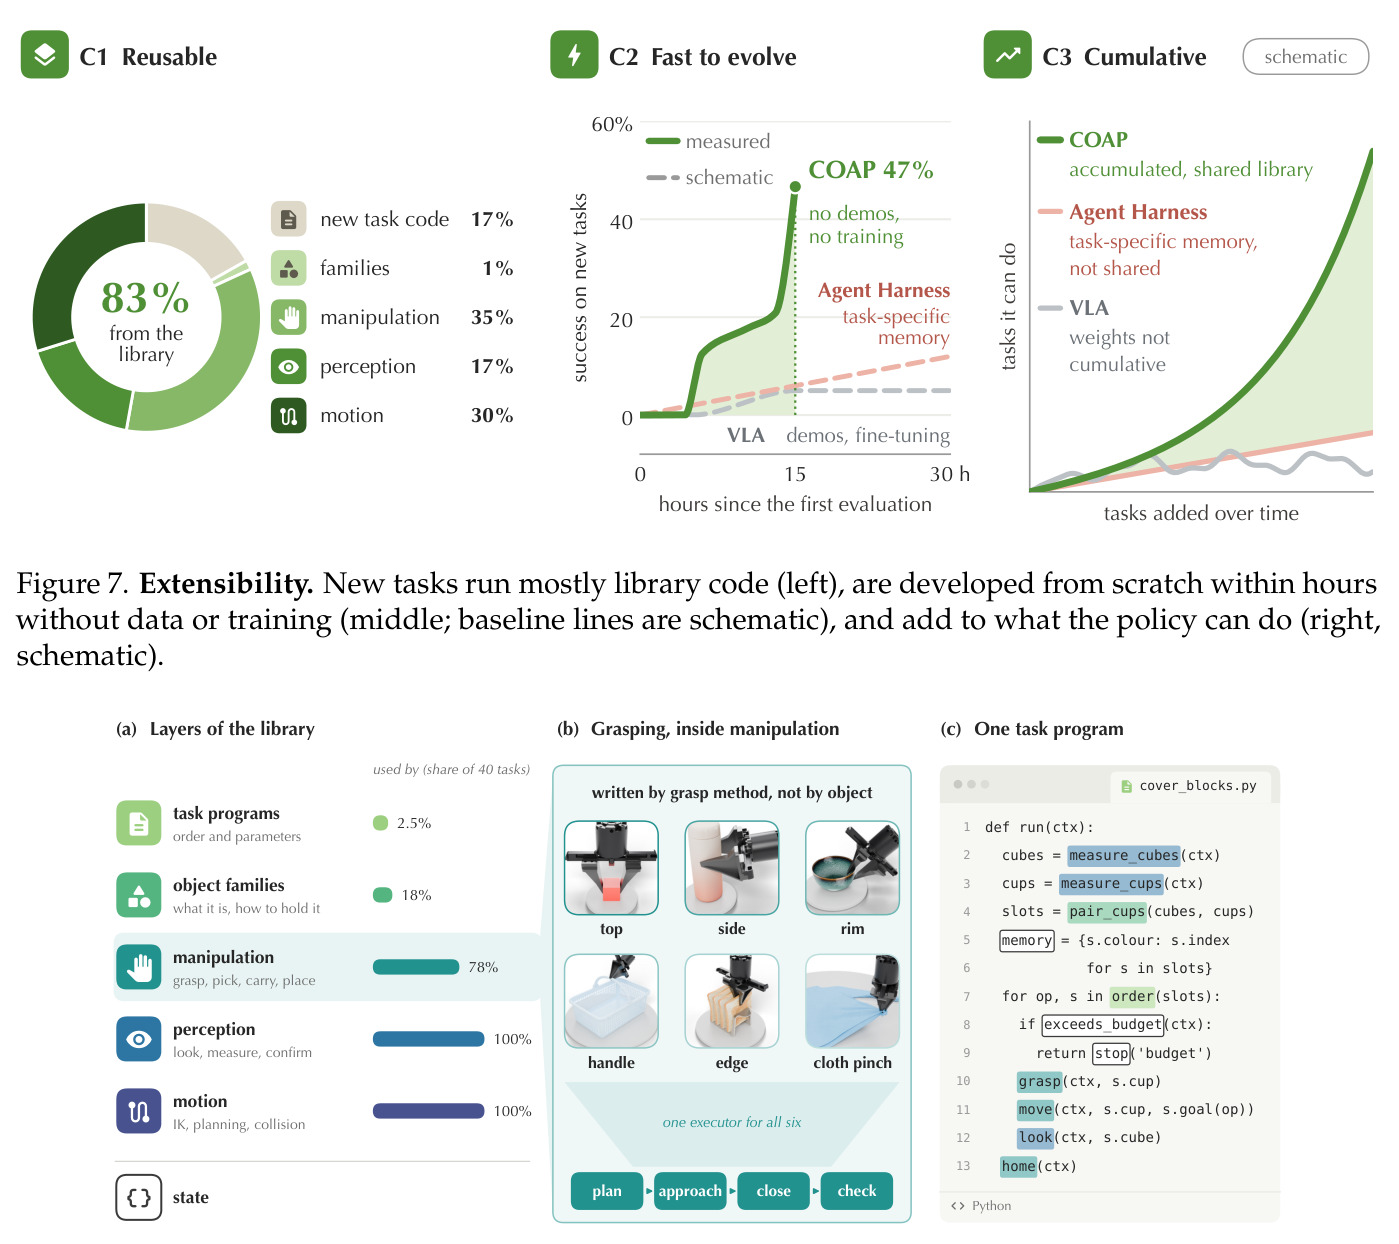
先说直觉:任务固定时,机器人决策所需的世界状态其实是可以被精确测量的——机器人自身状态由本体感知(关节角、末端位姿、夹爪开度)直接给出,物体位姿可以由 RGB 图像加已知物体几何恢复。既然状态可以准、逻辑可以写对,控制回路里就不必保留任何模型。技术路线由此展开为三块。第一,显式状态:程序维护环境状态(物体位姿、尺寸、类别及空间关系,每条记录还带测量误差、来源与时间戳)、机器人状态(各臂关节角、末端位姿、夹爪开度及可达位姿集合)、任务状态(当前阶段、臂的分配、重试次数、以及必须记住的信息如各杯下颜色)三部分,状态转移写作 $(x_{t+1}, a_t) = F_\theta(x_t, o_t)$,其中 $o_t$ 是观测、$a_t$ 是下一段轨迹、$\theta$ 是冻结的代码。第二,分层共享库:任务程序调用物体族代码,物体族调用操作层(grasp/pick/carry/place/push/pour),操作层再调用感知层(look/measure/confirm)与运动层(IK/规划/碰撞),依赖只向下,新任务 83% 的执行代码来自库。第三,离线 RSI 闭环:编码智能体在 git worktree 中检查失败回合的状态记录、定位出错变量、提出 diff,分支经 CPU 预检查后在验证布局上并行评估,达到提升边距才合并为新的 $\theta_{k+1}$;运行时则在一个 CPU 核上执行冻结代码,无任何模型调用。
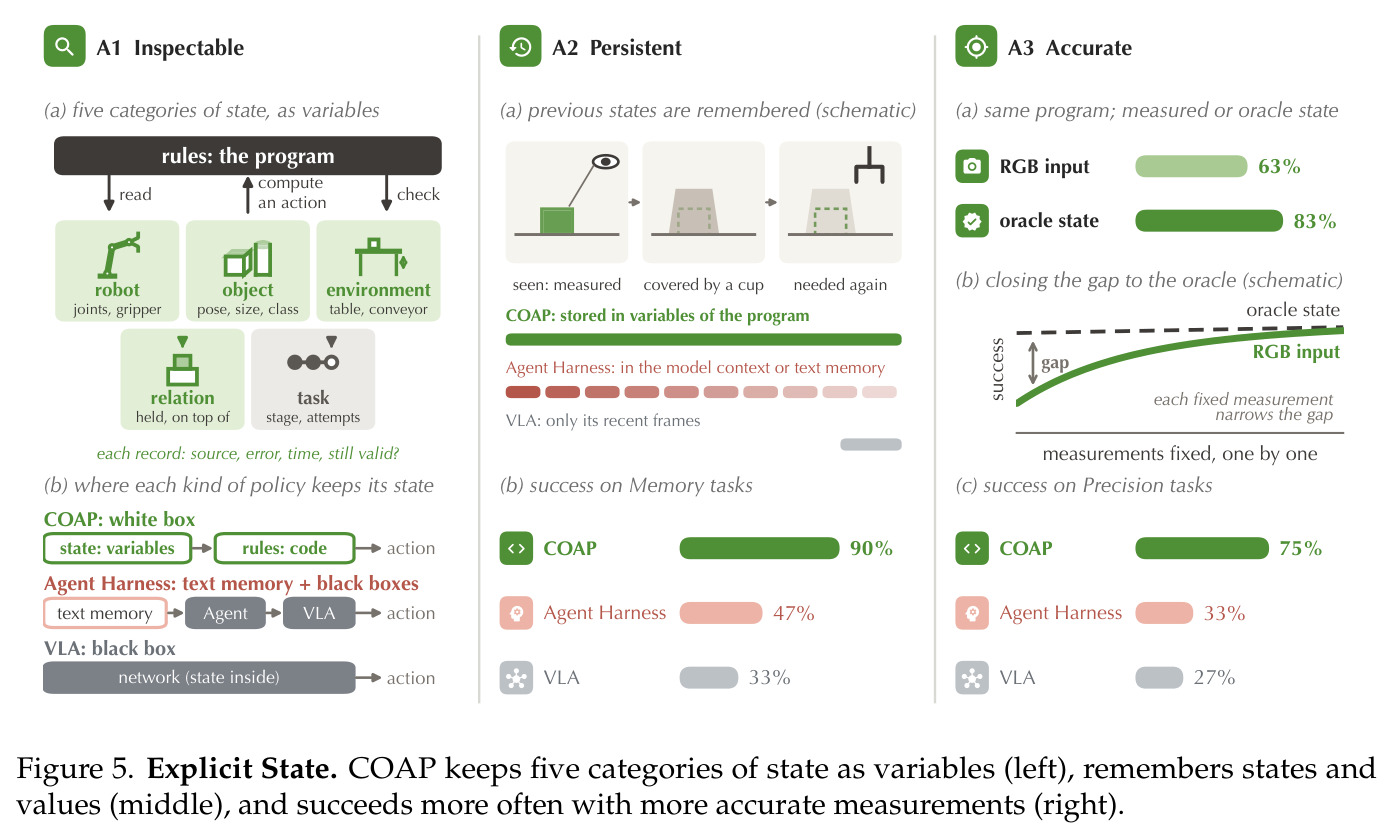
核心创新点有两个,且互相成就。第一是'代码测量状态'带来的状态可编程性。此前所有代码策略(RHO、EmbodiedSWE、PyRUA-Lean 等)的状态都来自代码之外的模型或 oracle,感知误差是外部黑盒;COAP 的感知就是库里的普通函数——把机器人 mesh 按实测关节角投影进图像做掩膜,取非桌面色像素为候选区域,边界像素射线与桌面平面求交得落点 $p = c + \lambda d$,$\lambda = (z_0 - c_z)/d_z$,再用已知 3D 形状在候选附近搜索位置与偏航、保留重叠最大者。测量错误可以像修任何 bug 一样被定位到变量并修复,状态因此随开发单调变准(同一程序在测量状态 63%、oracle 状态 83%,每次修好一个测量都在缩小差距)。第二是'一个程序跑一个任务的所有回合'。因为任务固定、状态显式,足够鲁棒的代码不需要模型兜底——如果还需要模型在环,说明代码还不够鲁棒。这与'模型在线逐回合写码'形成本质区别:离线测试通过的行为就是线上行为,RSI 的验证-部署因此闭合。配合 default-off 参数的形式化兼容保证 $B_i(\theta+\delta, o) = B_i(\theta, o)\ \forall o \in \mathcal{O}_{\text{test}}$,每个被接受的改动都不破坏旧任务,改进得以单调累积。
方法步骤详情
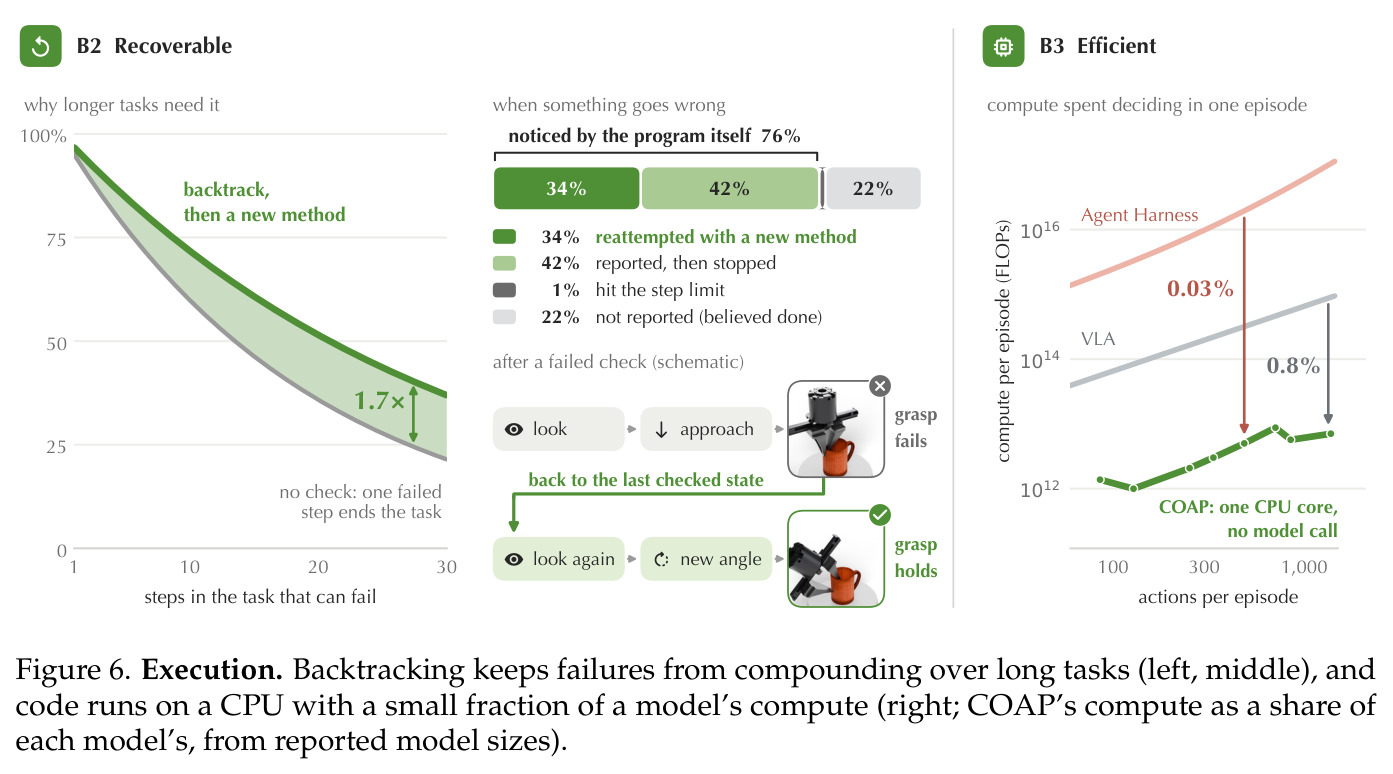
整个系统分执行与开发两条线。执行线(运行时,单 CPU 核,无模型):第 1 步,读取观测 $o_t$,包括语言指令、三路 RGB(头相机加两个腕相机)、关节角、末端位姿与夹爪指令回显。第 2 步,更新状态:机器人状态每步从本体感知刷新;环境状态由感知层测量——mesh 投影掩膜、候选区域检测、射线-桌面求交、形状匹配,输出带类别、位置、偏航、尺寸、置信度的物体记录,存进回合级 WorldState,被手臂遮挡的物体保留最近一次测量位姿,毫米级任务在最终接近前用腕相机复测;任务状态由任务代码写入,例如 Code Example 1 中 cover_blocks 先把三立方体与三杯配对排序进 slots,把颜色存入 memory 字典,杯子盖住后凭 memory 决定揭开顺序。第 3 步,决策执行:任务程序按阶段调用库函数,一次 transfer 调用会展开为抓取候选生成、逆运动学、碰撞过滤、预抓取复测、接近、闭合、带保持检查的短提升、搬运、放置、释放、最终验证,每一步返回带证据的结果。第 4 步,失败恢复:程序检查每步结果,失败则回溯到最后一个已验证状态,换方法重试(如换抓取偏航角),或在用尽方法后自行报告终止。开发线(RSI 闭环):设 $\theta_k$ 为第 $k$ 轮被接受的代码,智能体们各自在 git worktree 中提出 diff,构成可运行分支集合 $\mathcal{C}_k = \{\theta_k + \Delta_{k,1}, \dots, \theta_k + \Delta_{k,m}\}$;每个分支先过两项 CPU 检查(数值场景执行确认各阶段可达目标、mesh 逐路点查 IK 解与碰撞),然后在验证布局上并行评估;接受准则为 $J_q(\theta_k + \Delta; V_q) \ge J_q(\theta_k; V_q) + \epsilon_q$,边距 $\epsilon_q$ 为 4/30 个回合(高于 1-3 个回合的重跑噪声),通过则成为新的基底,否则丢弃。开发只用智能体自建的开发布局调试,选择只用验证布局比较,测试布局全程不接触。
技术新颖性
技术新颖性可从四个层面评估。范式层面:此前社区默认'模型必须在环',本文首次系统论证并实证了运行时零模型的代码策略可以大幅超越 VLA 与 Agent Harness——在 RoboDojo 上 70.24% 对 31.38%,而且五个维度全部第一,这直接挑战了'端到端学习是唯一路径'的叙事。状态层面:与 RHO/EmbodiedSWE 的'外部感知或 oracle 喂状态'不同,感知被收编为库内普通代码,状态成为可编程、可归因、可修复的对象,这是'白盒'的完整含义——不止决策白盒,测量也白盒。软件工程层面:把 API 演进的兼容性思想引入机器人策略,用形式化的 default-off 保证(公式 3)确保扩展不回归,并用 Cochran–Mantel–Haenszel 检验(p=0.16)实证旧任务成功率未显著变化,这种'性能可累积'的证据在机器人学习文献中罕见。搜索层面:RSI 被组织成决策级广度优先搜索——由于每个变体是免训练的完整程序,八个抓取方案可同布局并行评估后择优,论文还用 36 个真实分支的统计(仅 17% 被接受、分支数 1→8 时接受率 17%→77%、期望增益 +2.5→+12.4 分)定量刻画了这一搜索过程的性质。局限在于:整体仍是'针对已知任务家族的工程化搜索',想法本身并不解决开放世界感知,新颖性更多在系统与范式综合而非单点算法。
实验结果
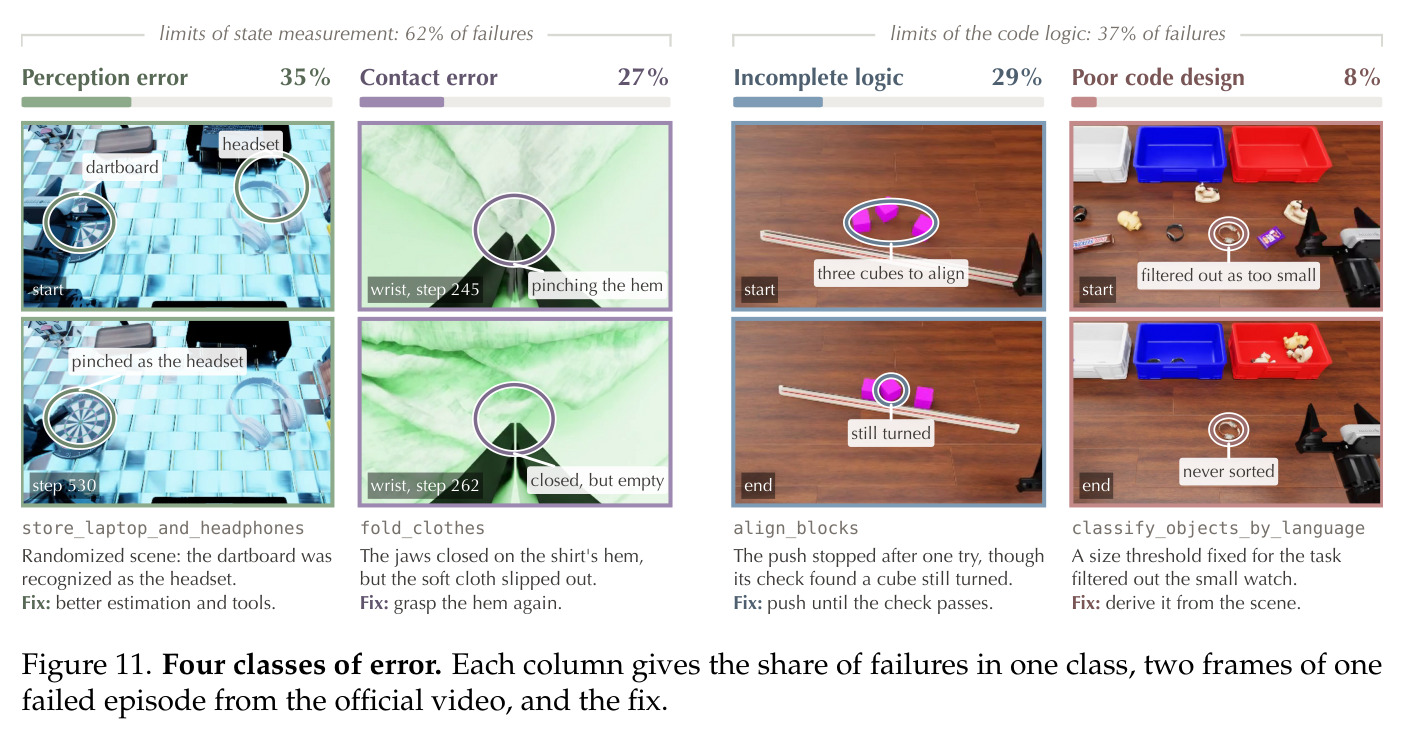
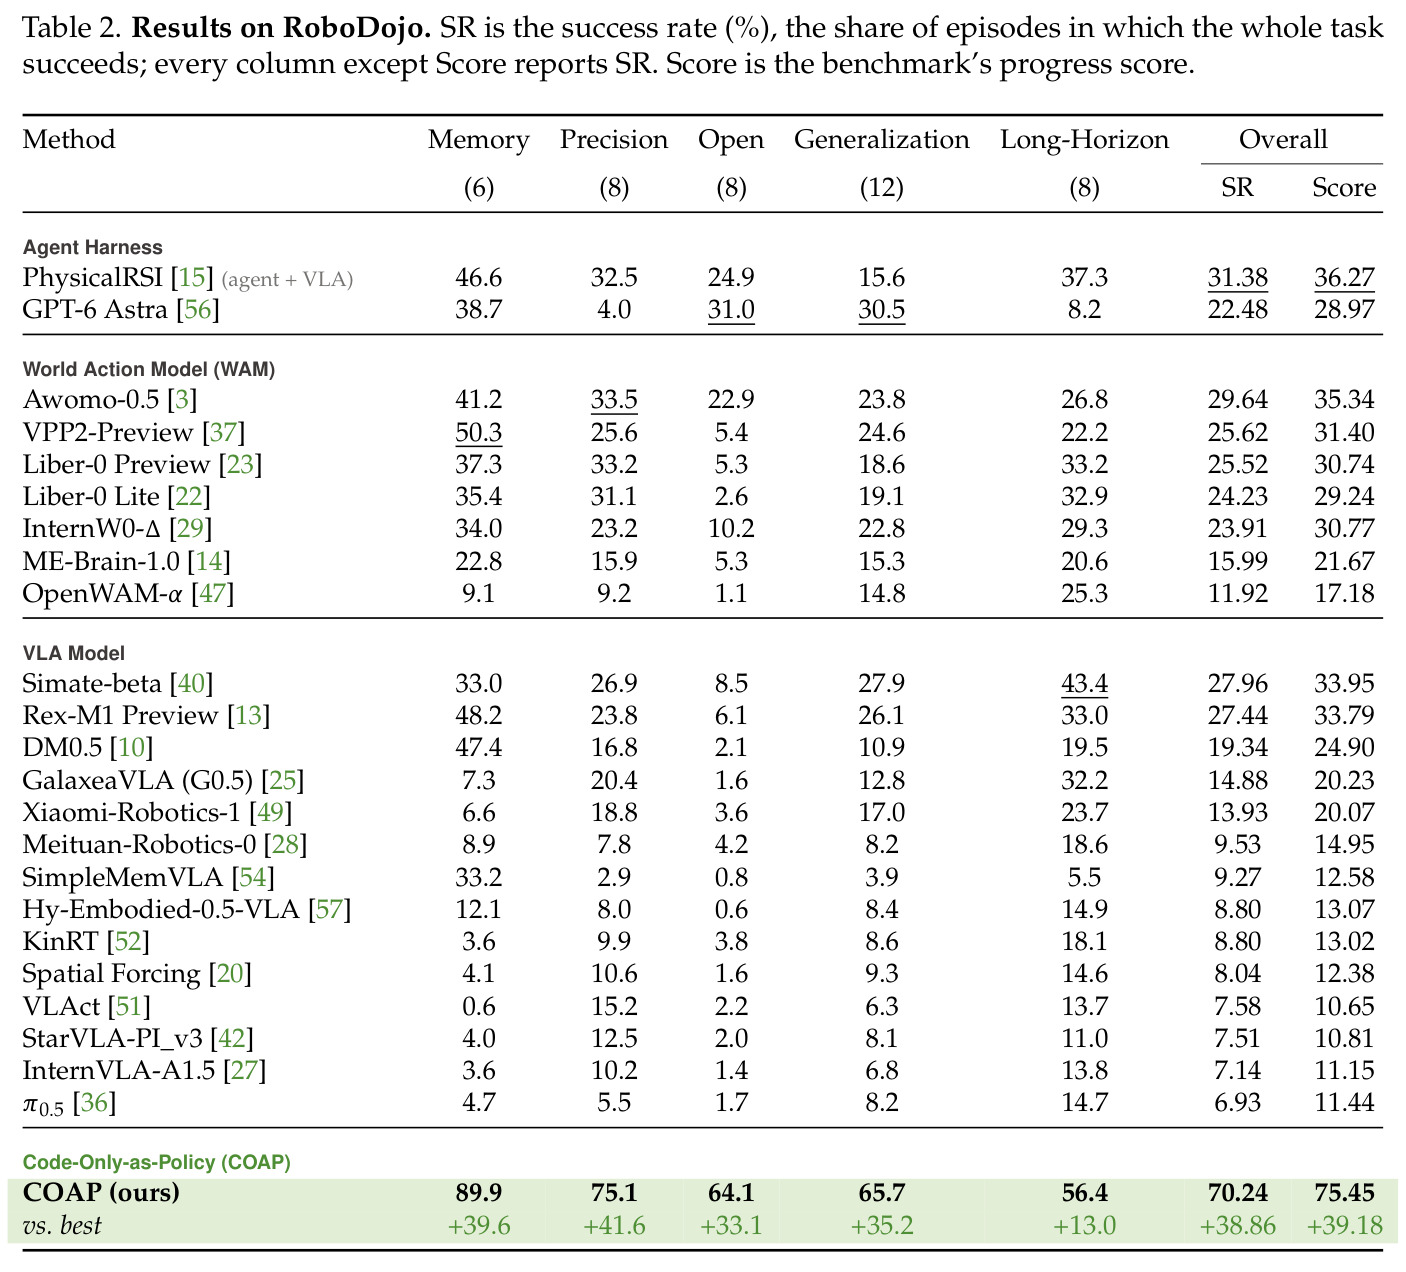
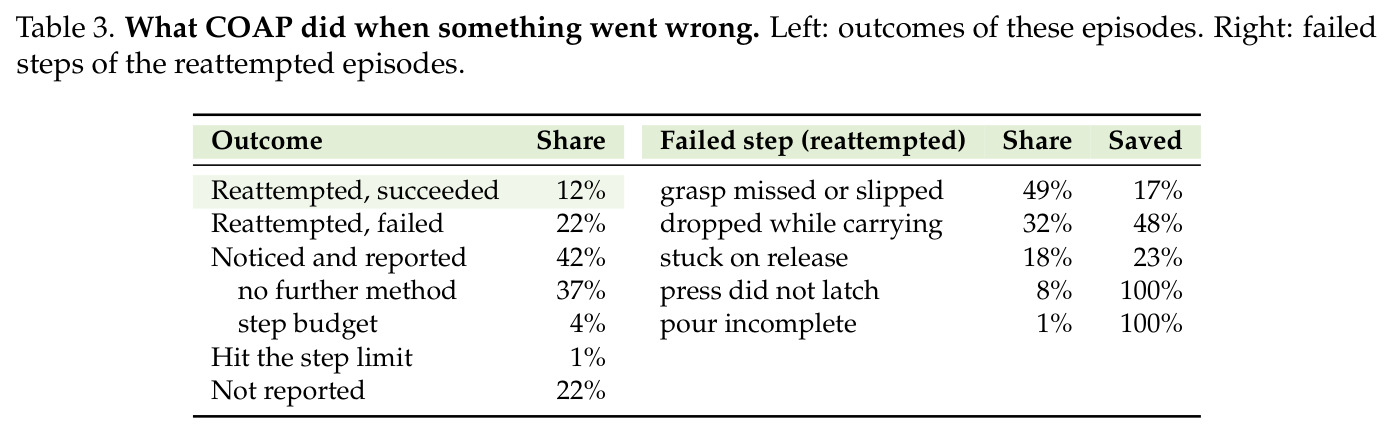
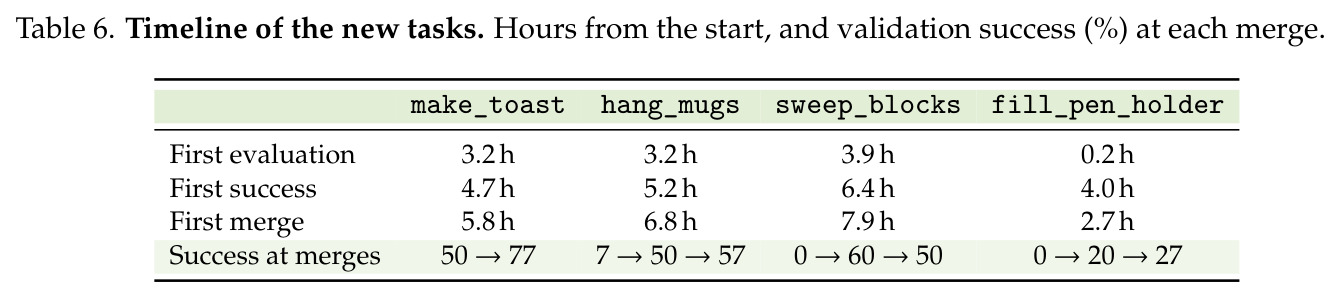
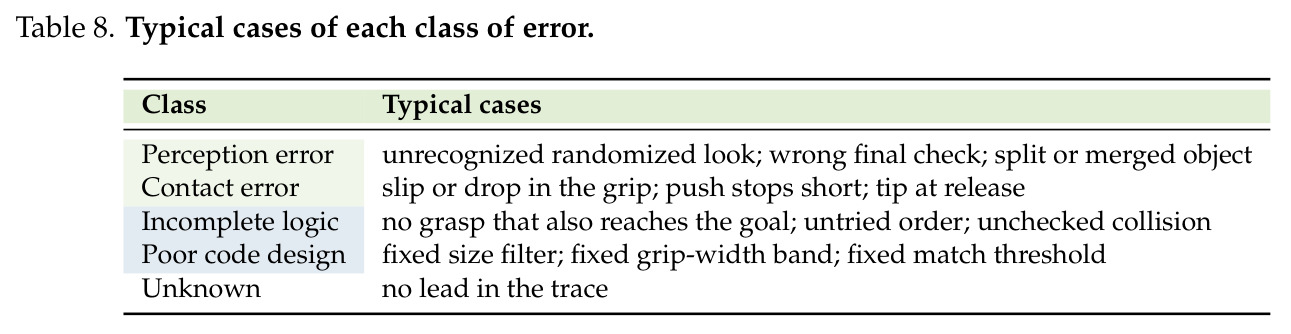
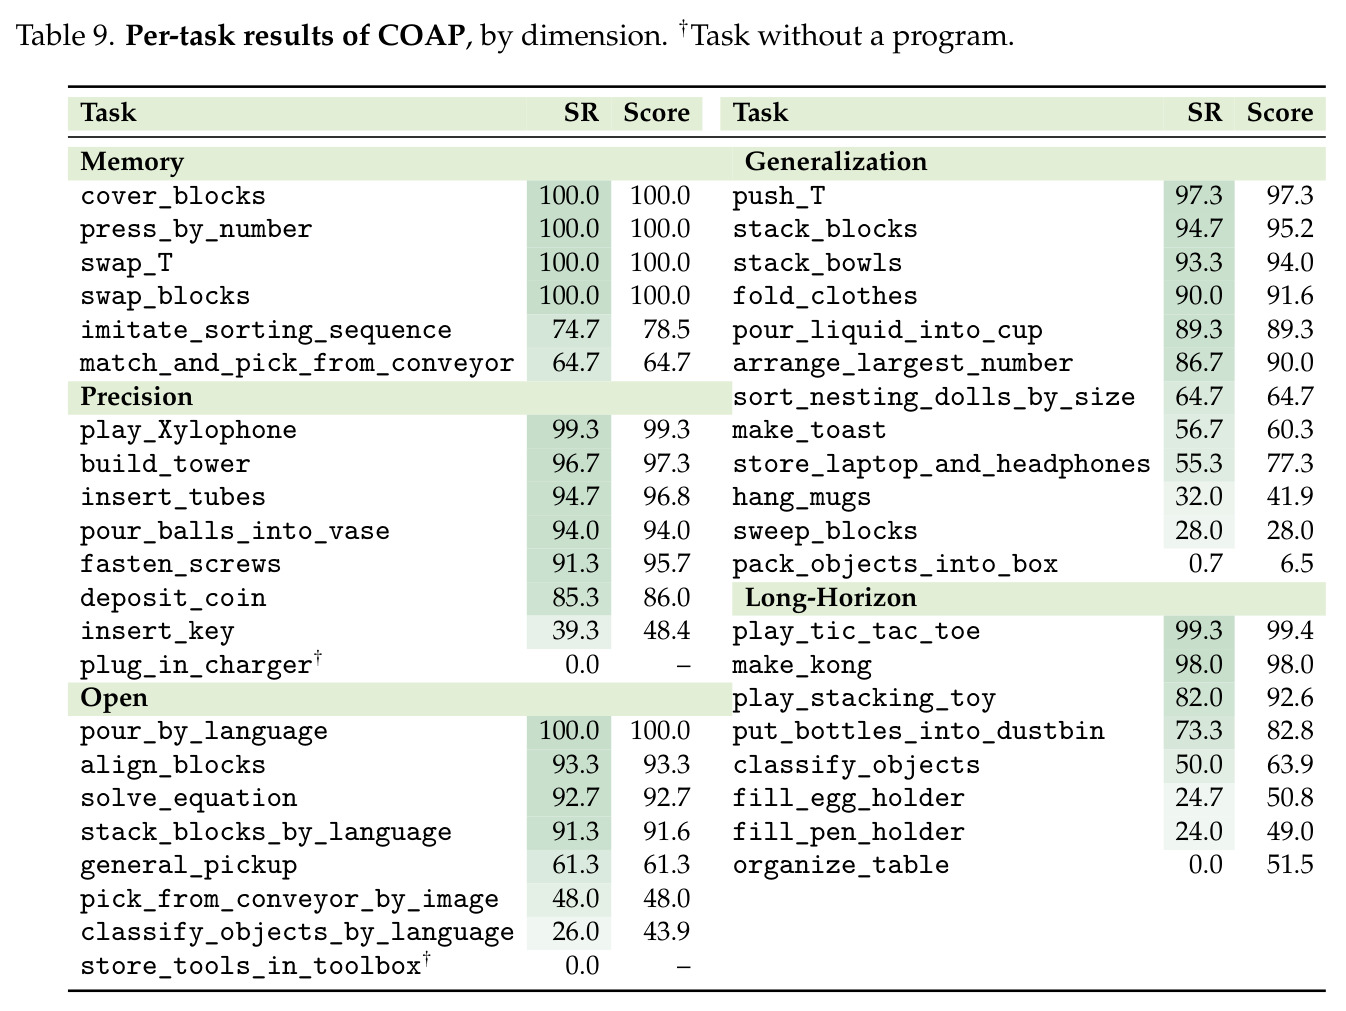
核心实验有六组,逐一分析。第一,主结果(Table 2):在 RoboDojo 42 个双臂任务上(每任务 3 种子 × 50 布局),COAP 总体成功率 70.24%、进度分 75.45,比此前最佳 PhysicalRSI(agent+VLA,31.38%/36.27)高 38.86 个百分点,超过最强世界动作模型 Awomo-0.5(29.64%)与最强 VLA Simate-beta(27.96%)逾 40 分;五个维度全部第一——Memory 89.9%(+39.6)、Precision 75.1%(+41.6)、Open 64.1%(+33.1)、Generalization 65.7%(+35.2,标准布局 77.3%、随机化布局 54.1%)、Long-Horizon 56.4%(+13.0),其中长时程优势最小。第二,显式状态消融(Figure 5):Memory 任务上 COAP 90%、Agent Harness 47%、VLA 33%;Precision 任务上 75%、33%、27%;同一程序在 oracle 状态下 83%、自测状态下 63%,量化了感知差距即提升空间。第三,执行质量(Figure 6、Table 3):出错回合中 76% 由程序自行发现、34% 换新方法重试,重试后成功的回合占 12%;决策调用中位延迟 0.3 ms,每回合中位 352 次决策而约 25 次'重活'占 99.4% 决策时间;每回合计算量为 VLA 的 0.8–2.4%、Agent Harness 的不到 0.1%。第四,可扩展性(Figure 7、14,Table 6):新任务运行代码的 83% 来自共享库;库冻结时无程序的 4 个新任务在 15 小时内平均达 47%(零数据零训练,对照 OpenVLA 每任务 5–15 小时 8×A100 微调、最强 VLA 仅 4.7%);旧任务在代码未动时 78.4%→79.9%(CMH 检验 p=0.16,无显著变化);库冻结后逐个合并任务更新,总体从 66.5% 稳步升至 70.24%;验证到测试的迁移损失很小(标准 76.7%→74.9%,随机化 55.2%→52.8%)。第五,并行分支统计(Figure 10):36 个分支中仅 17% 被接受(36% 无效果、11% 变差、36% 小幅改善);每轮分支数从 1 增到 8,接受概率 17%→77%、期望增益 +2.5→+12.4 分、wall-clock 时间从约 18 小时缩至 2.3 小时(代价是更多 GPU 时间);用两个以上变体尝试的决策有五分之四找到了被接受的改动;最忙开发窗口 12 个任务并行评估,仅耗串行 17% 的时间。第六,错误分析(Figure 11):感知错误占 35%、接触错误 27%(状态测量类共 62%),逻辑不完整 29%、糟糕代码设计 8%(逻辑类共 37%);逐任务看,cover_blocks、press_by_number、swap_T、swap_blocks 满分 100%,play_tic_tac_toe 99.3%,而 organize_table 0%、pack_objects_into_box 0.7%、plug_in_charger 与 store_tools_in_toolbox 两个任务未写出程序记 0。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboDojo 42 任务总体成功率 | Success Rate (%) | 70.24 | PhysicalRSI (agent+VLA) 31.38(此前最佳) | +38.86 个百分点 |
| RoboDojo 进度分 | Progress Score | 75.45 | PhysicalRSI 36.27 | +39.18 |
| Memory(记忆)维度 | Success Rate (%) | 89.9 | VPP2-Preview (WAM) 50.3 | +39.6 个百分点 |
| Precision(精度)维度 | Success Rate (%) | 75.1 | Awomo-0.5 (WAM) 33.5 | +41.6 个百分点 |
| Open(开放指令)维度 | Success Rate (%) | 64.1 | GPT-6 Astra (Agent Harness) 31.0 | +33.1 个百分点 |
| Generalization(泛化)维度 | Success Rate (%) | 65.7(标准 77.3 / 随机化 54.1) | GPT-6 Astra 30.5 | +35.2 个百分点 |
| Long-Horizon(长时程)维度 | Success Rate (%) | 56.4 | Simate-beta (VLA) 43.4 | +13.0 个百分点 |
| Memory 类任务(优势分析子实验) | Success Rate (%) | 90 | Agent Harness 47 / VLA 33 | 相对最强基线 +43 个百分点 |
| Precision 类任务(优势分析子实验) | Success Rate (%) | 75 | Agent Harness 33 / VLA 27 | 相对最强基线 +42 个百分点 |
| 同程序:oracle 状态 vs 自测状态 | Success Rate (%) | 83(oracle) | COAP 自测状态 63 | 20 个百分点差距即感知改进空间 |
| 新任务冷启动(4 个无程序任务) | 15 小时内平均验证成功率 (%) | 47(无数据无训练) | 最强 VLA 训练后 4.7(OpenVLA 微调需 5–15h×8×A100) | +42.3 个百分点且免训练 |
| 顺序微调灾难性遗忘(引用实验) | π0.5 五任务平均分 | COAP 旧任务 78.4→79.9(不降) | π0.5 微调后 86.9→31.4 | 代码库天然无遗忘 |
局限与改进
作者明确承认三点。第一,仅限仿真:COAP 的感知依赖基准公开的相机参数、机器人 mesh、物体尺寸等资产,真机上这些都得自行测量标定,夹持宽度、搬运速度等接触参数也需重新调优。第二,离线开发成本:在线执行虽快,但每轮代码迭代都要评估与修订,不像 GPT 那样可以拿来即用作策略,每个新任务都有开发开销。第三,泛化受限:随机化布局成功率 54.1% 对标准布局 77.3%,硬编码值、未覆盖的边角逻辑在未见布局上暴露。我自己的观察补充四点。其一,感知管线建立在'桌面纯色、物体几何已知且刚性'的强假设上,真实世界的杂乱背景、透明反光物体、形变与堆叠会让第 3.2 节那套几何匹配大幅退化,62% 的失败源于状态测量这一点在真机上只会更严重。其二,任务状态里的'记忆'(如杯下颜色)本质是把认知问题转写成工程约定,开放指令维度 64.1% 的天花板说明面对语言多样性时,逐任务写代码的扩展成本仍高。其三,两个任务(plug_in_charger、store_tools_in_toolbox)未能在开发期内写出可用程序、直接记 0,说明该范式对任务难度有硬边界,且榜单对比中基线未必享有同样的'已知物体几何+相机标定'先验,公平性值得斟酌。其四,'开发不接触测试集'的可信度依赖开发/验证布局与测试布局同分布,这在仿真协议中成立,推广到真机数据收集时难以保证。
独立分析的弱点
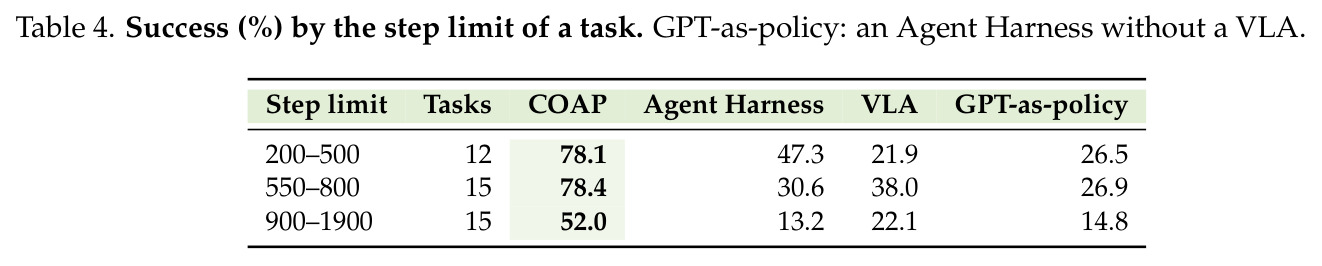
独立分析出五个弱点,各配改进方向。弱点一,感知脆弱性(占失败 35%,最大单类):RGB 加已知几何的测量流程在候选区域粘连/分裂、随机化外观误识别(飞镖盘被认成耳机)时直接污染状态。改进方向:把开放词汇感知模型(SAM 3、Molmo 类)包装成'可修的库函数'纳入感知层,让代码在其置信度低时触发复测或多视角确认,并把测量误差显式写入状态记录用于风险感知的决策。弱点二,接触与可形变物体表示粗糙(占 27%):夹爪捏住衬衫下摆后布料滑出,程序无法判断'物体当前如何被握住'。改进方向:引入接触状态估计模块(哪怕基于视觉的抓取保持判别器),或在状态中增加六维力/滑移的估计量;对布料类引入低维形变参数化而非逐点表示。弱点三,代码设计缺陷(8%):固定尺寸阈值把小手表过滤掉、硬编码'下移一厘米'等。改进方向:在 RSI 闭环中加入'常量提取'静态检查——凡字面量必须能追溯到状态推导或标定文件,配参数扫描单元测试。弱点四,长时程衰减:步数上限 900–1900 的任务组成功率 52.0%,最长的失败链来自误差累积与预算耗尽。改进方向:把回溯做成显式回滚树(保存多个已验证检查点而非线性栈),并为子目标预算建立效用模型动态分配步数。弱点五,任务级泛化天花板:每个新任务仍需任务专属逻辑(17%),本质上 COAP 是'任务家族内的完全泛化、家族间的工程扩展'。改进方向:让 COAP 作为数据引擎为 VLA 产出轨迹,再用 VLA 反过来处理代码覆盖不到的长尾请求,形成代码-学习混合系统;或学习'任务程序骨架'的生成先验,压缩那 17% 的成本。
未来方向
作者提出的方向有二。其一,数据引擎:任务程序一旦可用即在 CPU 上免模型运行、可多布局并行,成功轨迹高产且可复现,且每条轨迹自带显式状态与每个动作背后的决策依据,可直接训练 VLA、或监督 Agent Harness 内的模型,论文视其为连接代码范式与学习范式的桥梁。其二,上限随编码智能体提升:当前失败有 37% 属于代码逻辑不够鲁棒,随着编码智能体变强,这条上限会自然抬升。基于其成果还可延伸四个方向。第一,真机化:自动标定相机外参与机器人 mesh、在线估计物体 CAD 或用类别级形状先验替代已知几何,把'仿真资产常量'换成'可自校准的代码'。第二,混合策略:让 VLA 兜底处理代码检测到自身无法处理的情形(如接触类失败),失败时把控制权交给模型、恢复后交还代码,兼得两者。第三,持续学习的形式化:论文用 CMH 检验验证'不回归',这套统计验收可推广为代码策略的持续学习协议,甚至给 VLA 的 continual learning 提供对照组。第四,在线与多机器人 RSI:当前 RSI 完全离线,若把验证布局换成线上流量并加安全围栏,即可研究部署中的自我改进;代码库的 git 结构天然支持多智能体并发开发,值得研究合并冲突与能力竞争。此外,把 62% 的状态测量失败作为下一步主攻点——引入学习型感知但保持'不确定性写入状态、由代码消费'的接口约定——可能是最直接的增量路径。
复现评估
复现评估:中等偏高难度。有利条件:论文为技术报告,基准 RoboDojo 为公开统一仿真-真机基准,官方提供评估客户端、裁判与汇总脚本,主表对比直接取自官方排行榜;感知所依赖的相机模型、机器人 mesh、物体尺寸与桌面高度均由基准发布,且在回合间不变,这意味着感知代码的先验是公开可得、无需自行采集的。不利条件:其一,论文未说明 COAP 代码库本身是否开源,而库的工程质量(约 14k 行共享的 manipulation/perception/motion 代码、23.5k 行任务程序、28.5k 行物体族)正是结果的主要载体,若无开源,复刻工作量巨大。其二,开发过程强依赖 Claude Opus 5.5 编码智能体,属于商用闭源模型,API 成本与智能体行为的不可复刻性使得'自动长出这个库'的过程难以精确重放;论文给出的过程数据(36 个分支、每轮 4/30 接受边距、最忙窗口 12 任务并行、18 小时 GPU)提示需要可观的并行仿真与算力预算。其三,许多结论性的对比数字(Agent Harness 47%、VLA 33% 等)部分引用自先前文献而非统一重跑,复现者需自行对齐配置。综合建议:若代码开源,中等难度可复现主结果(仿真环境固定、评估协议官方化);若不开源,则复现重心应放在'用本文描述的 RSI 协议在 RoboDojo 上重新生长一个库',这更像一项工程研究而非参数复现,预计需要数十 GPU 时与大量编码智能体调用的预算。
论文图表
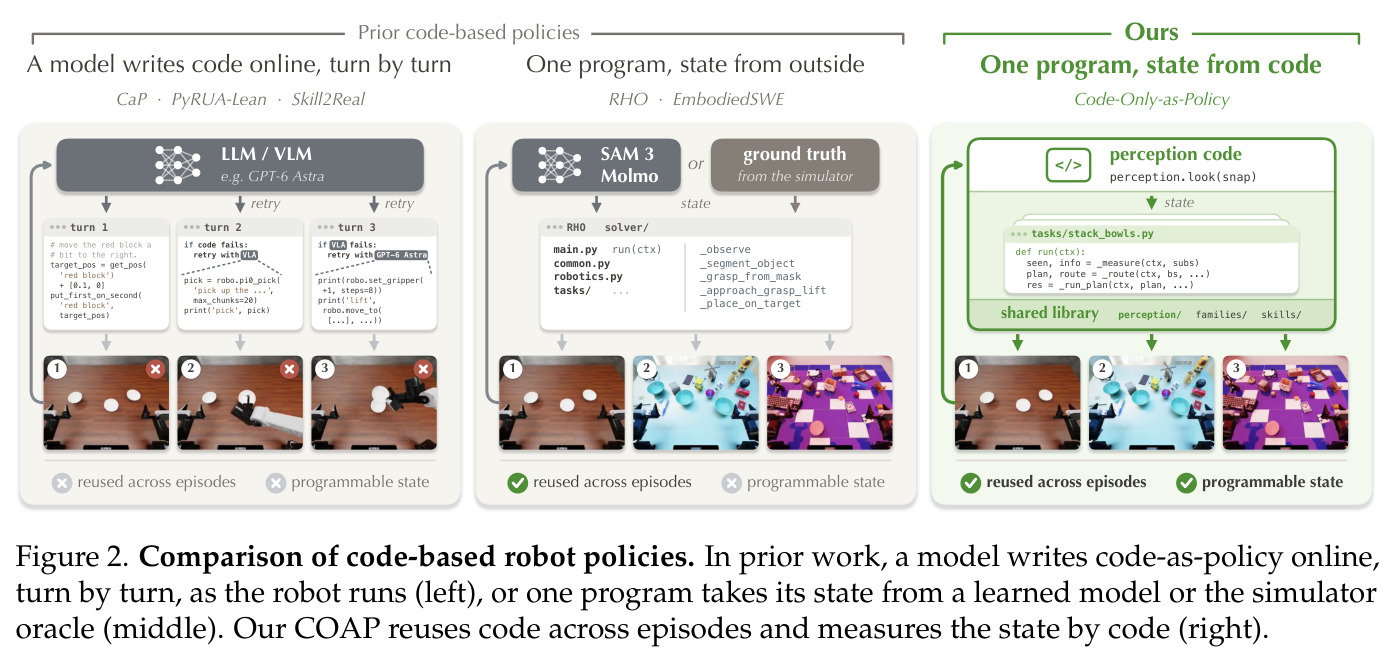
三栏对比既有代码策略与 COAP:左栏 CaP/PyRUA-Lean/Skill2Real 由 LLM/VLM(如 GPT-6 Astra)在回合运行中逐轮在线写代码;中栏 RHO/EmbodiedSWE 离线写一个程序但状态来自 SAM 3/Molmo 等模型或仿真器 oracle;右栏 COAP 用自己的感知代码测量状态,同一程序跨回合复用且状态可编程。
精准定位本文在 code-as-policy 谱系中的差异化位置——'谁来提供状态'是理解其贡献的关键坐标轴。
失败归因四分图,各列给出占比、失败回合两帧官方视频截图与修法:感知错误 35%(随机化场景中飞镖盘被识别为耳机→需更好估计与工具);接触错误 27%(夹爪捏衬衫下摆后软布滑出→需重新抓握);逻辑不完整 29%(推方块检查发现未转正却只推一次→应推到检查通过为止);糟糕代码设计 8%(固定尺寸阈值滤掉小手表→应从场景推导阈值)。左右合计:状态测量限制 62%、代码逻辑限制 37%。
论文对自身失败的坦诚解剖,直接指出 COAP 上限的两个决定因素(状态表示精度与代码逻辑鲁棒性),是评估该范式改进空间的依据。
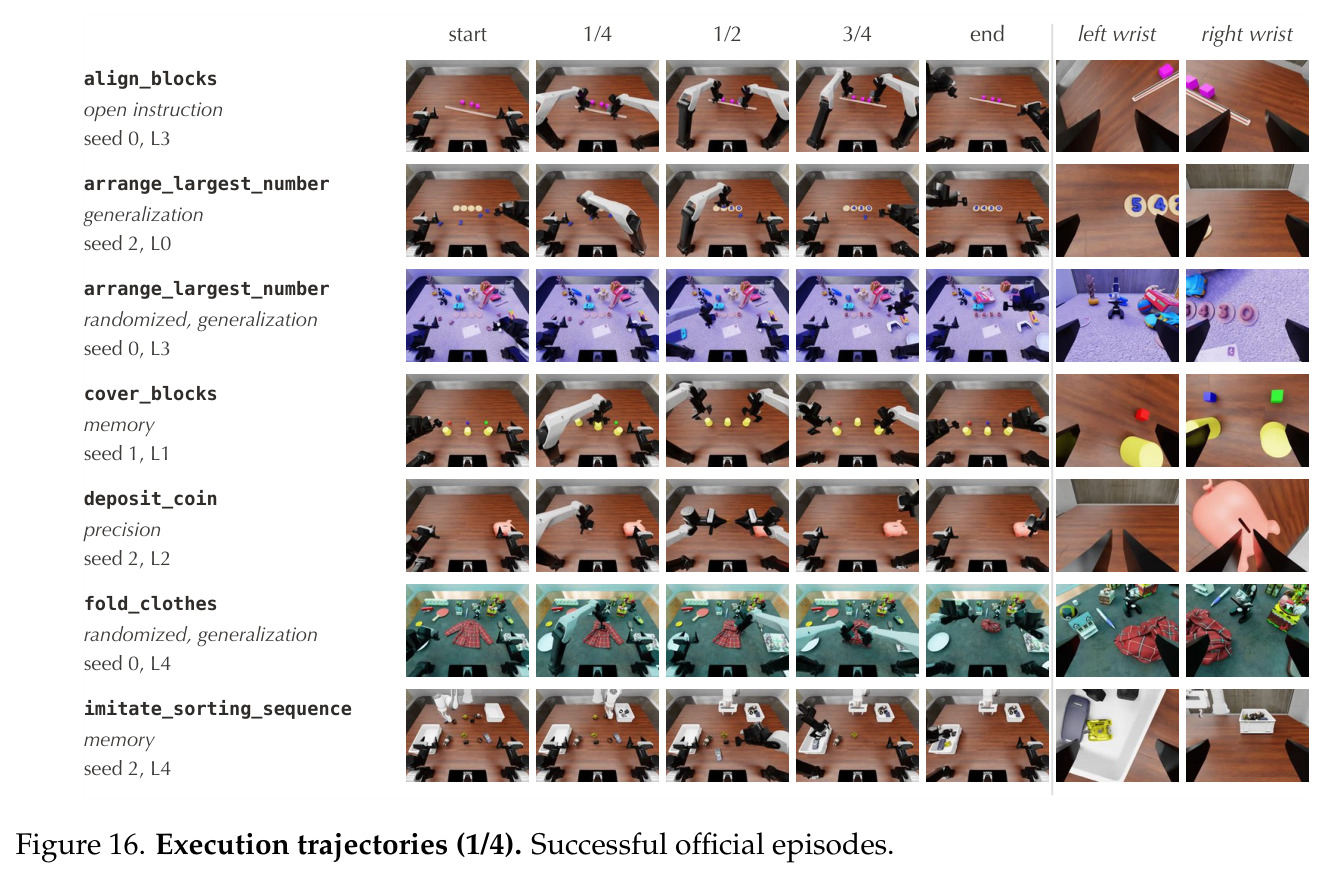
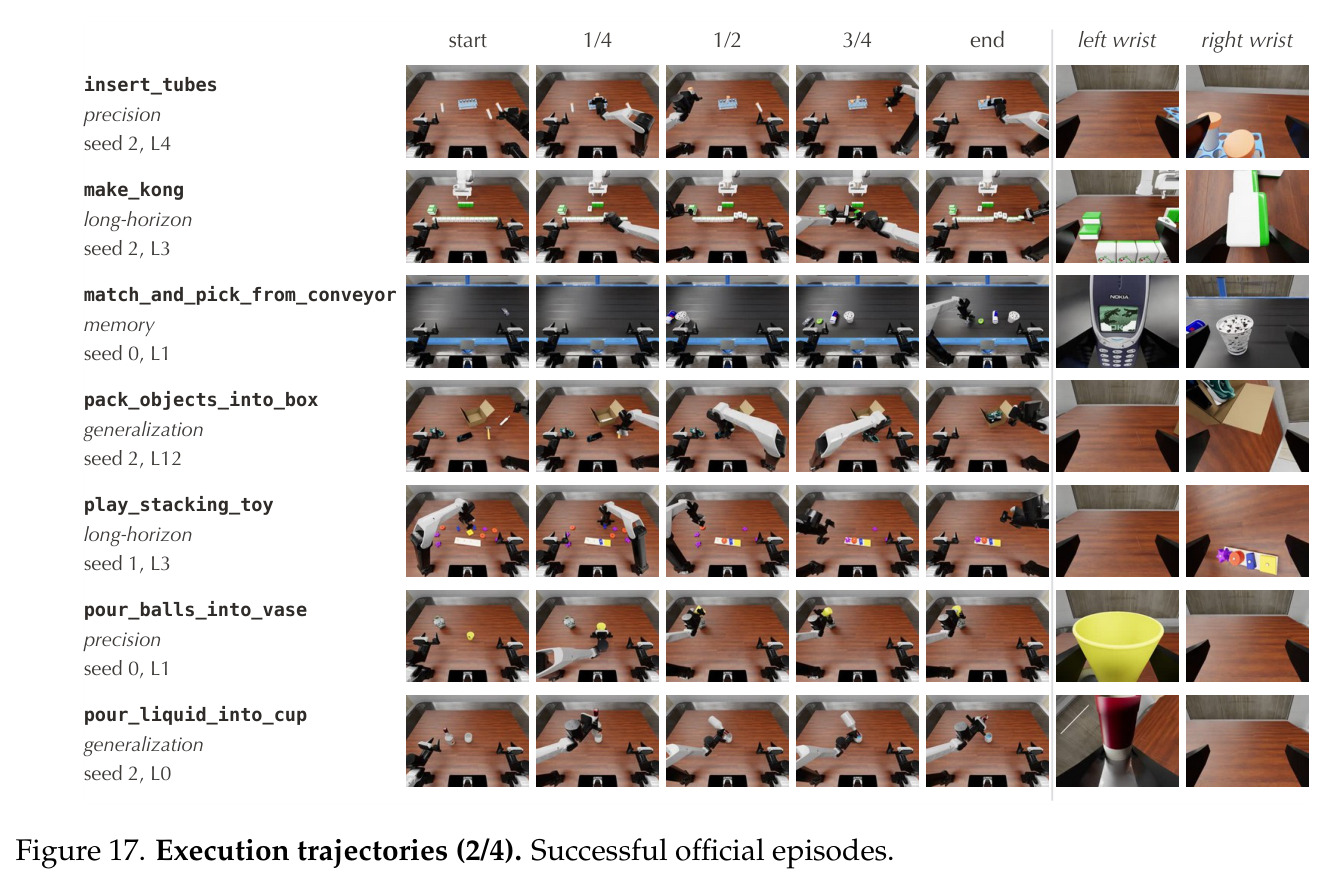
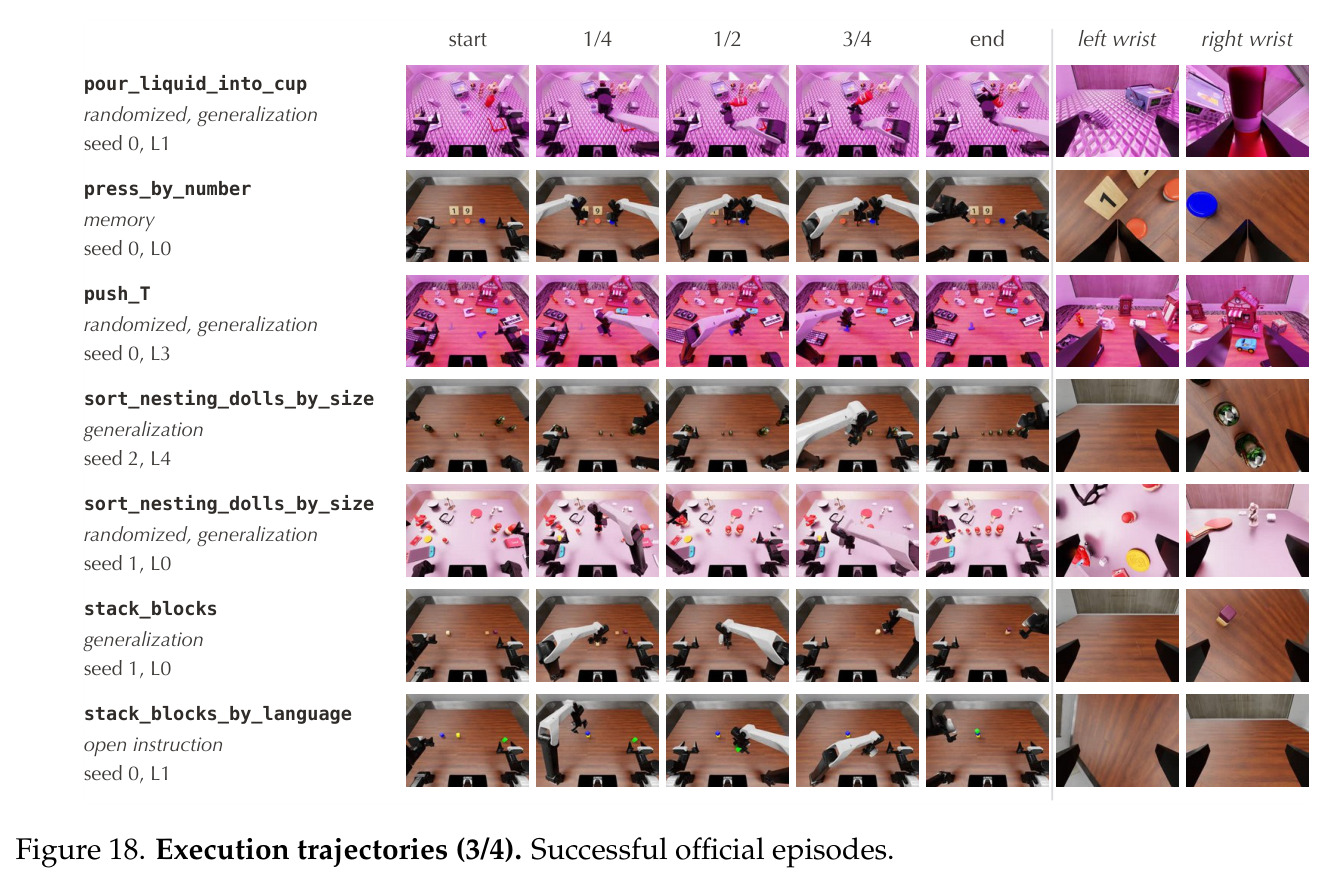
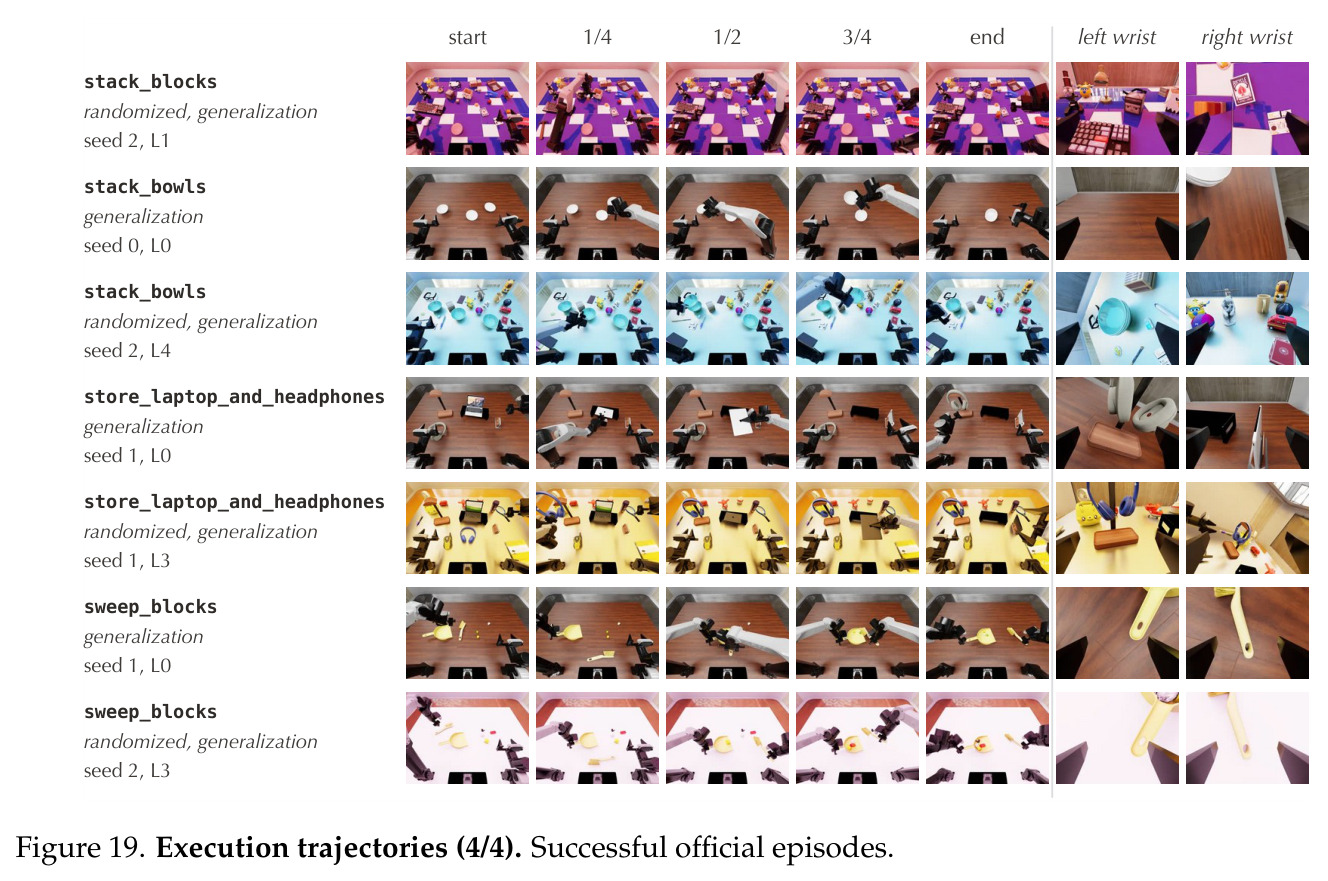
轨迹集锦第四辑:stack_blocks 与 stack_bowls(随机化)、store_laptop_and_headphones(标准与随机化)、sweep_blocks(标准与随机化)等任务的成功官方回合帧序列。
集锦收尾,覆盖泛化维度中成功率偏低的任务在标准布局下的成功样本,便于对照其失败模式。