OpenRUA:机器人使用智能体即零样本视觉运动策略 OpenRUA: Robot-Use Agents Are Zero-Shot Visuomotor Policies
只给现成编码智能体 ROS 2 终端权限,即可零样本操作机器人,CaP-Bench 成功率 99%
前置知识
视觉运动策略(Visuomotor Policy)
把原始传感器观测直接映射为低层机器人动作的策略,形式化为 $a_t \sim p(a|o_t, \ell)$,其中 $o_t$ 是图像/本体感受等观测,$\ell$ 是语言指令。传统上由神经网络从大量机器人演示中端到端训练得到。
本文的核心命题就是『一个现成编码智能体本身就是零样本视觉运动策略』,理解这个概念才能明白作者在挑战什么、以及『零样本』三个字的分量。
VLA 模型(Vision-Language-Action)
在海量机器人演示数据上预训练的大模型,输入图像和语言指令、输出动作 token,如 OpenVLA、π0、π0.5。它们在训练分布内表现好(LIBERO 上 >90%),但对位置/任务扰动等分布偏移极其脆弱(OpenVLA 和 π0 在 LIBERO-PRO 扰动下 0.0%)。
VLA 是本文最重要的对照系:论文用 LIBERO-PRO 和 RoboCasa365 的分布偏移结果论证『依赖学习策略反而限制泛化』,而 OpenRUA 无需任何训练。
ROS 2 与话题/服务/动作接口
机器人操作系统的事实标准,把机器人软件组织成节点,通过话题(publish-subscribe 流式数据)、服务(请求-响应,如逆运动学求解)和动作(带反馈的目标执行,如轨迹跟踪)通信。ros2cli 命令行工具可列接口、读消息、发请求;rclpy 是其 Python 客户端库,可在程序内保持订阅、写反馈回路。
OpenRUA 的全部设计就是给智能体『裸的』ROS 2 终端访问权,不包任何抽象层;读懂 topic/service/action 机制才能理解智能体如何自建感知与控制程序。
Code as Policies(CaP)与 RUA
CaP 范式让 LLM 生成机器人控制代码而非直接输出动作,策略即代码,可被检查、编辑和调试而无需重训练。RUA(Robot-Use Agent)进一步指像操作电脑一样操作机器人的智能体。现有 RUA 系统要么把学到的策略封装成可调用工具,要么手工构建感知/控制原语库。
本文正是对 RUA 路线的反思:作者质疑这些定制 harness 是否必要,OpenRUA 用零抽象设计给出了否定答案,并命名为 OpenRUA 以示开放原生接口。
CLI 编码智能体(Claude Code / Codex)
在终端中自主完成软件工程任务的智能体:浏览陌生代码库、读写文件、执行命令、解读终端输出、从报错中恢复,具备长时程闭环自主性。OpenRUA 直接复用这种能力,把机器人当作一个『活的软件项目』交给它。
论文的假设是:前沿编码智能体已能在陌生仓库上自主工作,因此定制编排只是在补偿能力不足。评测也直接以 Claude Code、Codex 为载体,并比较不同底层模型。
零样本与分布偏移泛化
零样本指不经过任何目标任务训练/演示/预演直接执行;分布偏移指测试任务模板或初始条件不在训练数据中(如 RoboCasa365 的 Composite-Unseen 任务模板被刻意排除在预训练演示之外)。
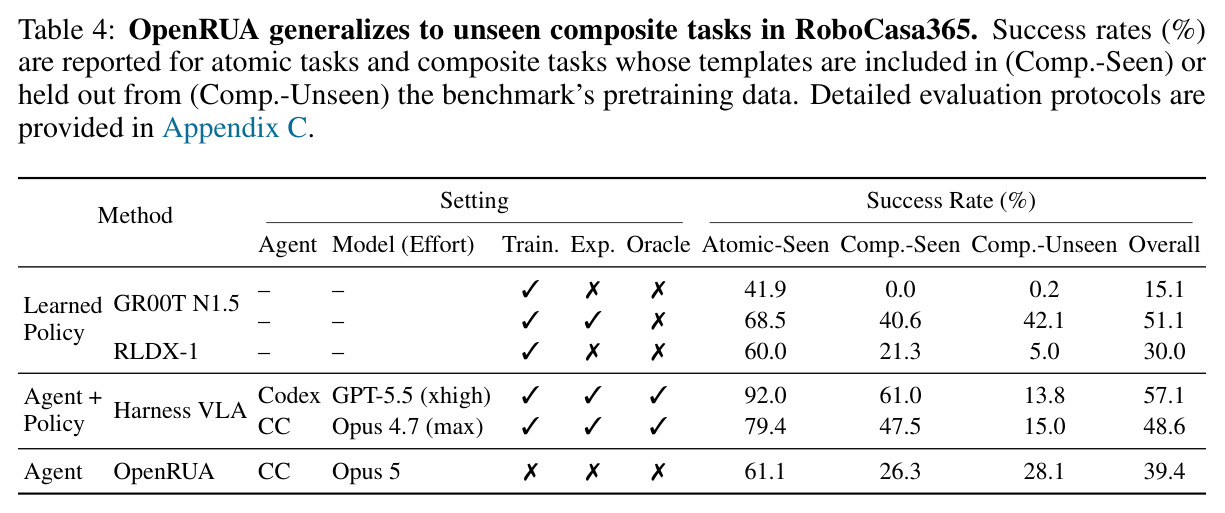
论文最亮眼的结论是:OpenRUA 在未见复合任务上 28.1% 反而高于已见任务 26.3%,而依赖学习策略的系统从 61.0% 崩到 13.8%——这正是零样本泛化讨论的核心证据。
研究动机
机器人操作目前有两条主流路线,各有明确痛点。第一条是端到端学习视觉运动策略(VLA 模型如 OpenVLA、π0):它们需要大规模演示数据训练,且泛化严格受限于训练分布——LIBERO-PRO 基准报告,OpenVLA 和 π0 在标准 LIBERO 上平均成功率超过 90%,但在位置扰动和任务扰动下成功率跌至 0.0%,π0.5 也只有 12.8%。第二条是用编码智能体替代人类工程师写控制程序(Code as Policies 一类的『机器人使用智能体』RUA):但现有系统(CaP-X、RHO、ASPIRE、Harness VLA 等)都投入大量工程构建定制 harness——或把学到的视觉运动策略封装成可调用工具,或基于人类专家知识手工设计感知与控制原语库,并给智能体规定专用工作流和接口。问题在于:机器人本已拥有数十年积累的成熟软件生态(ROS 2 的传感器访问与运动控制接口),工程师一直在直接使用它,那么为智能体额外工程化一层抽象是否必要?此前没有任何工作回答过这个问题。
本文的目标是本文要检验一个尖锐的实证问题:『一个现成的(off-the-shelf)编码智能体,能否仅通过机器人原生软件接口 ROS 2 的终端访问,成为零样本视觉运动策略?』具体约束是三无:不依赖定制原语库或学到的机器人策略,不需要机器人演示数据、任务预演或跨回合记忆,评测时不访问特权仿真器状态和基准的成功谓词。同时在三个标准基准(CaP-Bench、LIBERO-PRO、RoboCasa365)上与人类专家程序、学习策略、策略编排智能体、原语型智能体四类系统定量对比,并系统研究在此极简设计下智能体会涌现出什么样的感知与控制行为、测试时计算扩展性如何、以及失败原因的分布。
与已有工作不同的是,本文的独特切入是把一个系统工程问题转化为一个可证伪的实证问题。以往 RUA 工作默认『必须为智能体设计抽象层』,并在此假设上不断加码(合成技能库、反思优化、策略编排);本文作者(UCL 与 CMU 的软件工程团队)反其道而行,提出『workspace 即 harness』的极简主义假设:前沿编码智能体已能在陌生代码仓库上自主导航、写码、调试,定制接口的编排只是在补偿智能体能力不足,而非机器人控制的本质需求。于是 OpenRUA 走零抽象路线:只提供终端、ROS 2 文档和少量启动工具,把感知重新表述为文件 I/O、把操作重新表述为 CLI 编码,让任务特定的感知与控制策略在执行中自发『涌现』,而不是预先被人类工程化——这与整个 RUA 领域的加抽象趋势方向完全相反。
核心方法
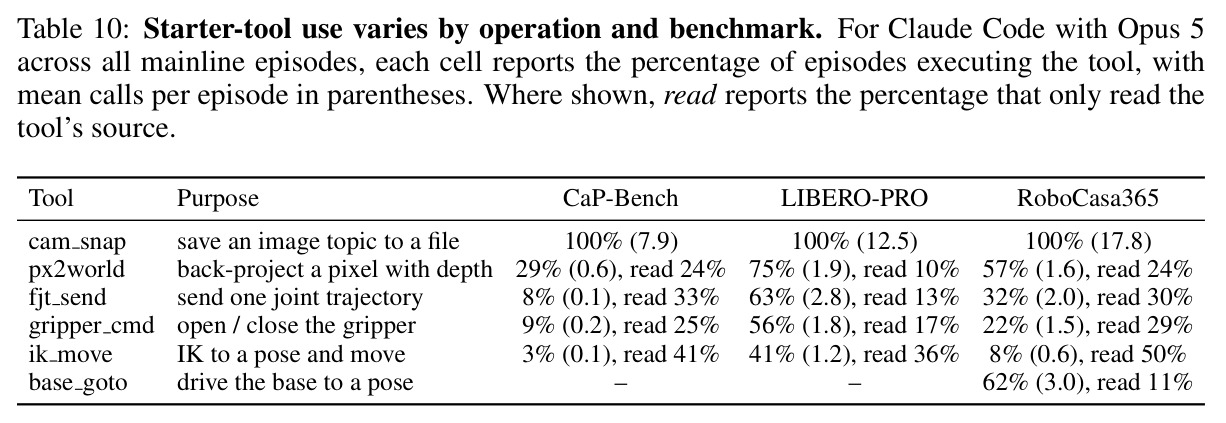
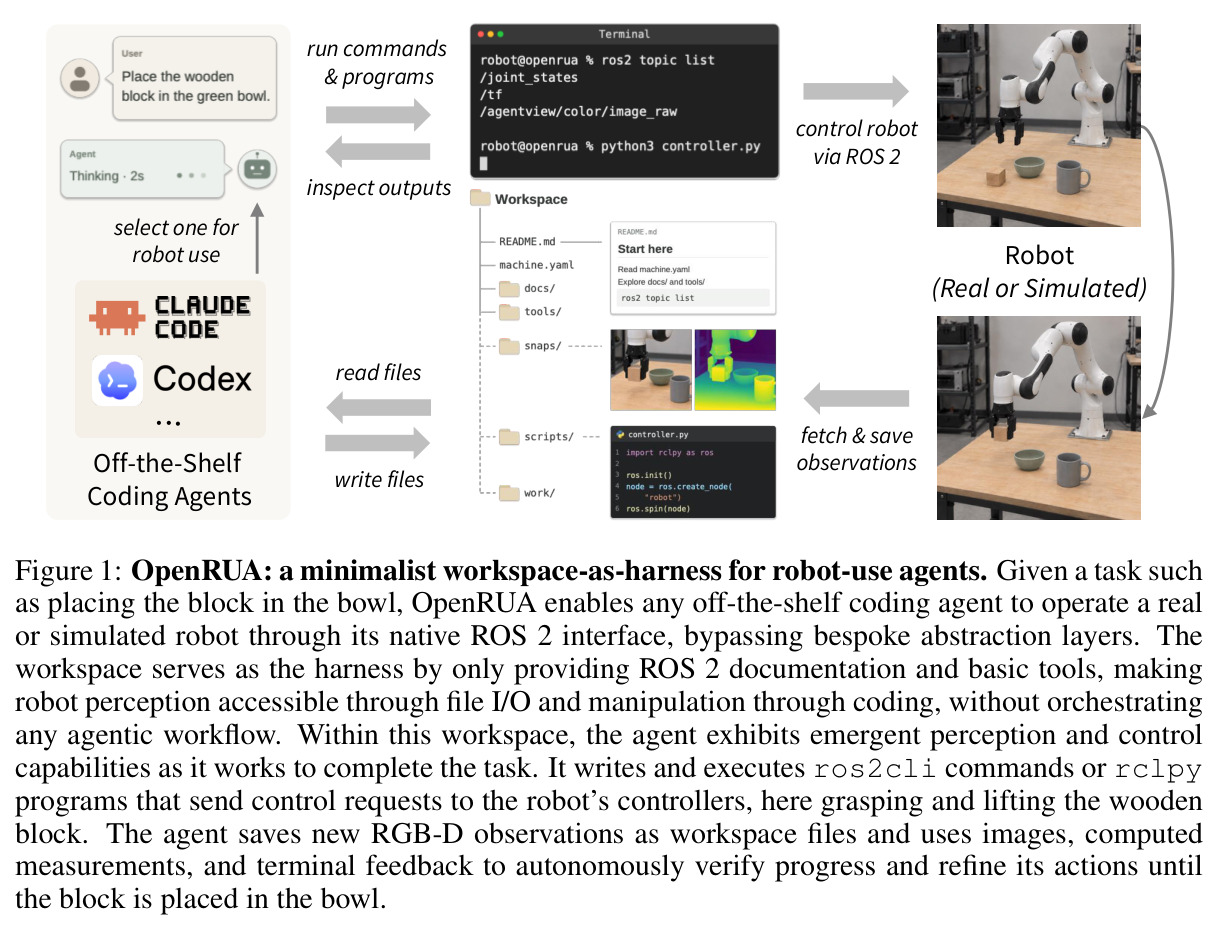
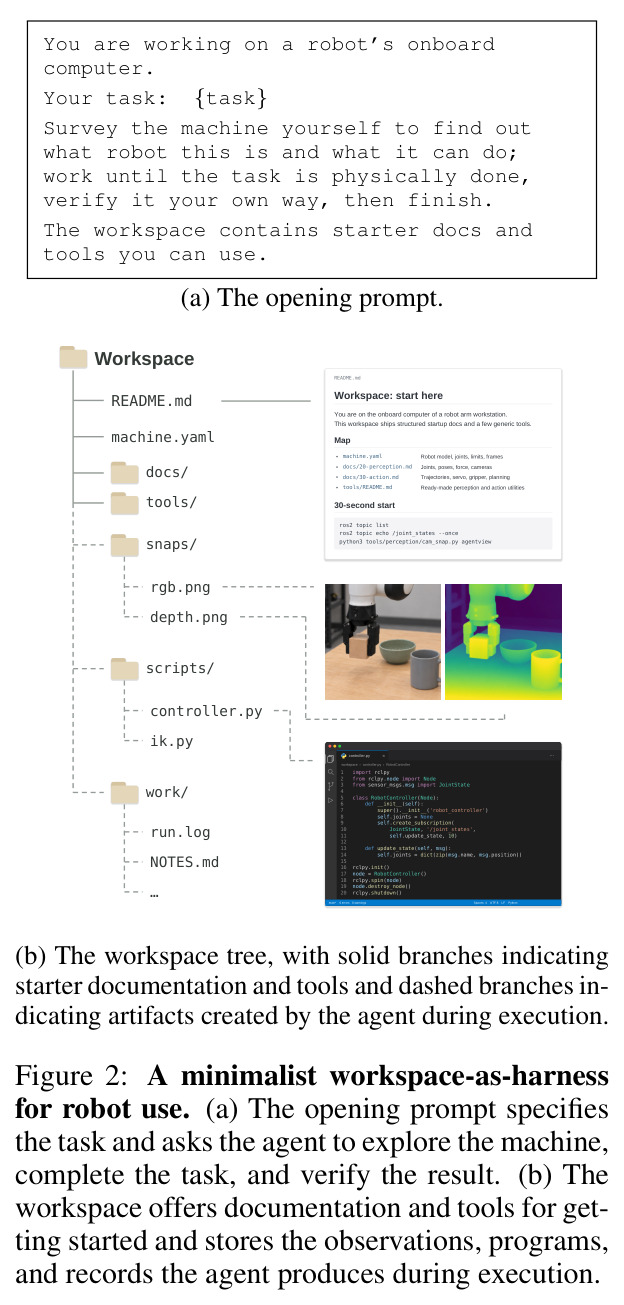
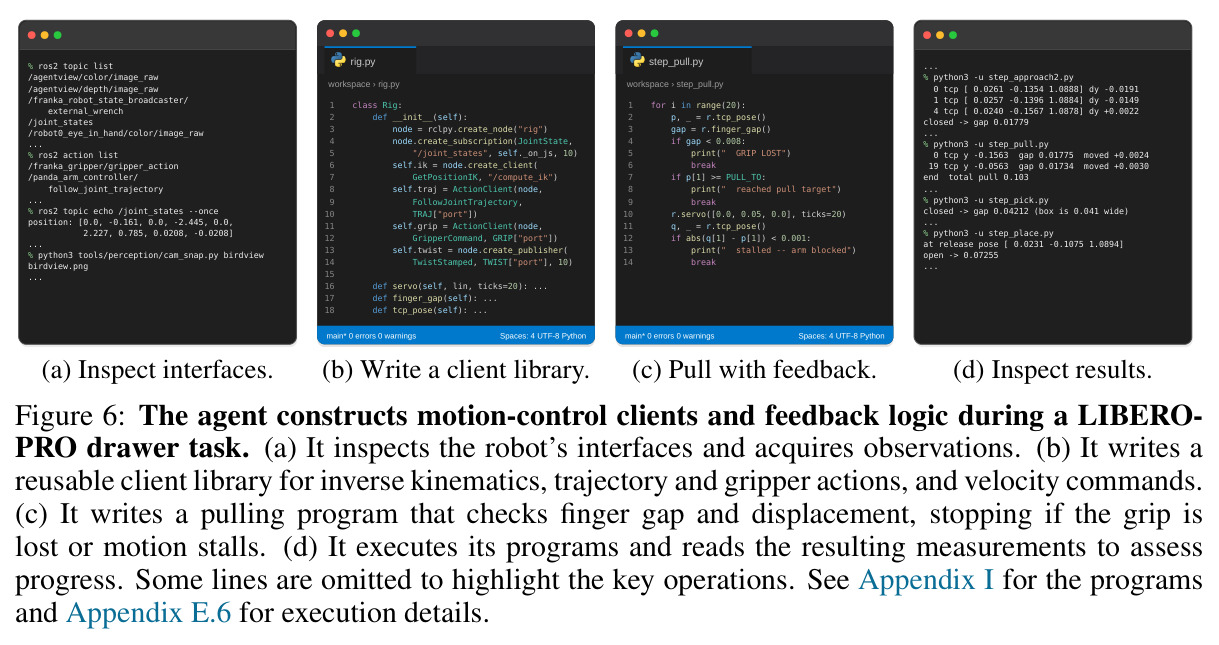
直觉上,OpenRUA 把『操作机器人』当成『接手一个陌生仓库的软件项目』。做法:给现成编码智能体(Claude Code 或 Codex)一个位于机器人机载电脑上的工作区,内含 README.md 入口、machine.yaml 机器描述(传感器、控制接口、关节限位、坐标系)、docs/ 文档和 tools/ 启动工具源码(如保存相机帧的 cam_snap.py)。开场提示词只说三件事:自行侦查这台机器是什么、能做什么;把任务物理上完成;用自己的方式验证后结束。此后不加任何编排——智能体自行决定何时观察、写什么命令或程序、如何验证。技术路线上,感知被重构为文件 I/O:用 ros2cli/rclpy 订阅传感器话题,把 RGB 存为 PNG、深度存为 .npy 数组、关节状态/内参/tf 变换存为文本,读图用多模态能力、读数值用程序;操作被重构为 CLI 编码:写 ros2cli 命令或 rclpy 程序,通过 FollowJointTrajectory、GripperCommand、TwistStamped 和逆运动学服务等原生接口向控制器发运动请求,读终端反馈与新观测迭代修正。
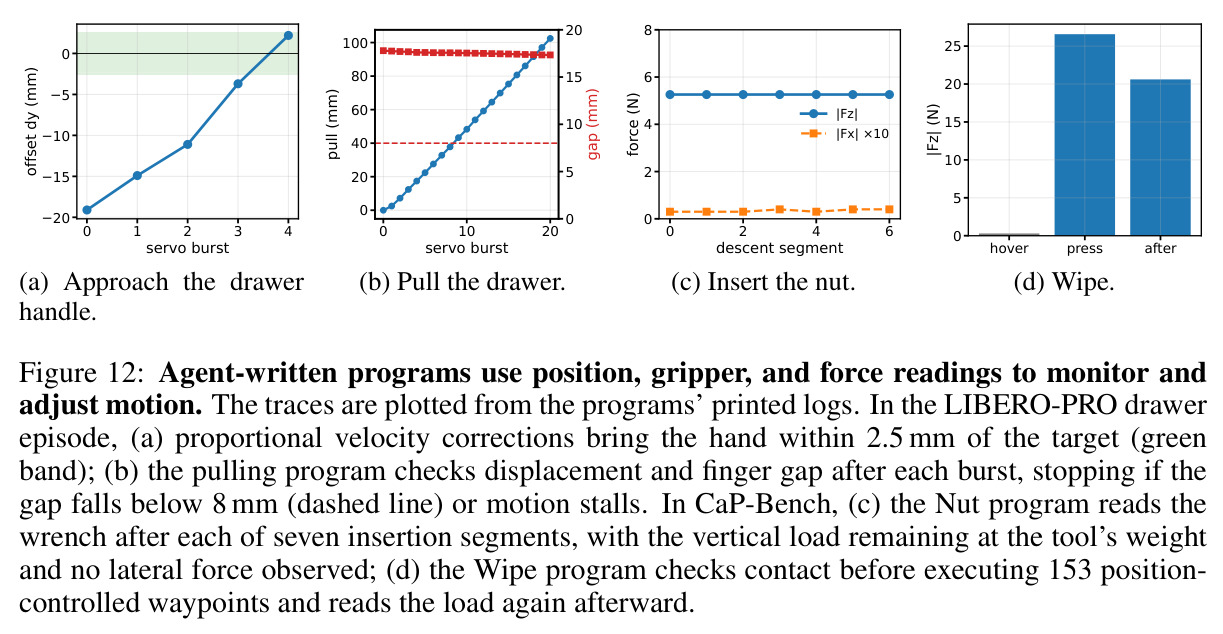
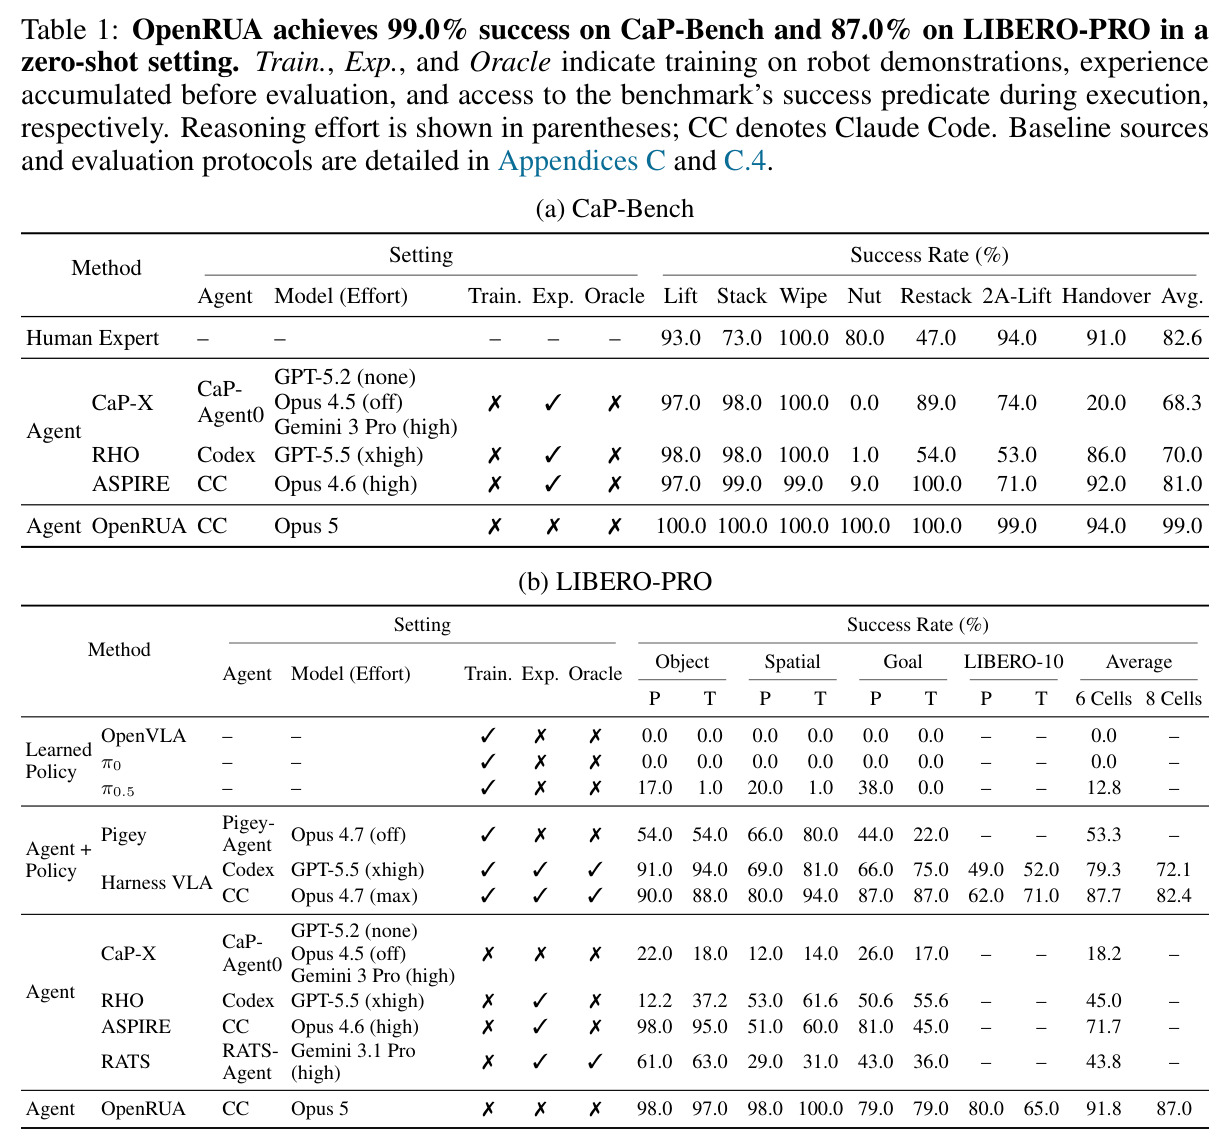
核心创新是『零抽象 harness』与『workspace 即 harness』。与把学习策略包装成工具(Harness VLA)或手工构建原语库(CaP-X、RHO、ASPIRE)本质不同,OpenRUA 不新增任何智能体专用接口层,直接暴露 ROS 2 原生 topic/service/action。这带来两个已有方法结构性缺失的能力。其一是完整的传感器暴露:CaP-X 的仿真接口只有图像、分割、抓取提议、IK 和关节/夹爪移动,没有力读取原语,所以即便 CaP-X、RHO、ASPIRE 各自积累了大量经验(合成工具、策略仓库进化、技能库),Nut 插入任务也只有 0%、1%、9%;而原生 ROS 2 让 OpenRUA 的智能体把力反馈直接写进插入程序(七段轨迹、每段后读力),达到 100%。其二是工具的自我构建:感知工具(图像处理、几何测量)与控制工具(运动客户端、反馈控制器)都由智能体执行时按需编写,把『策略来源』从训练数据或预定义原语转移为执行时的代码合成。ASPIRE 自己也承认:在接口上积累策略无法暴露接口中不存在的传感器。
方法步骤详情
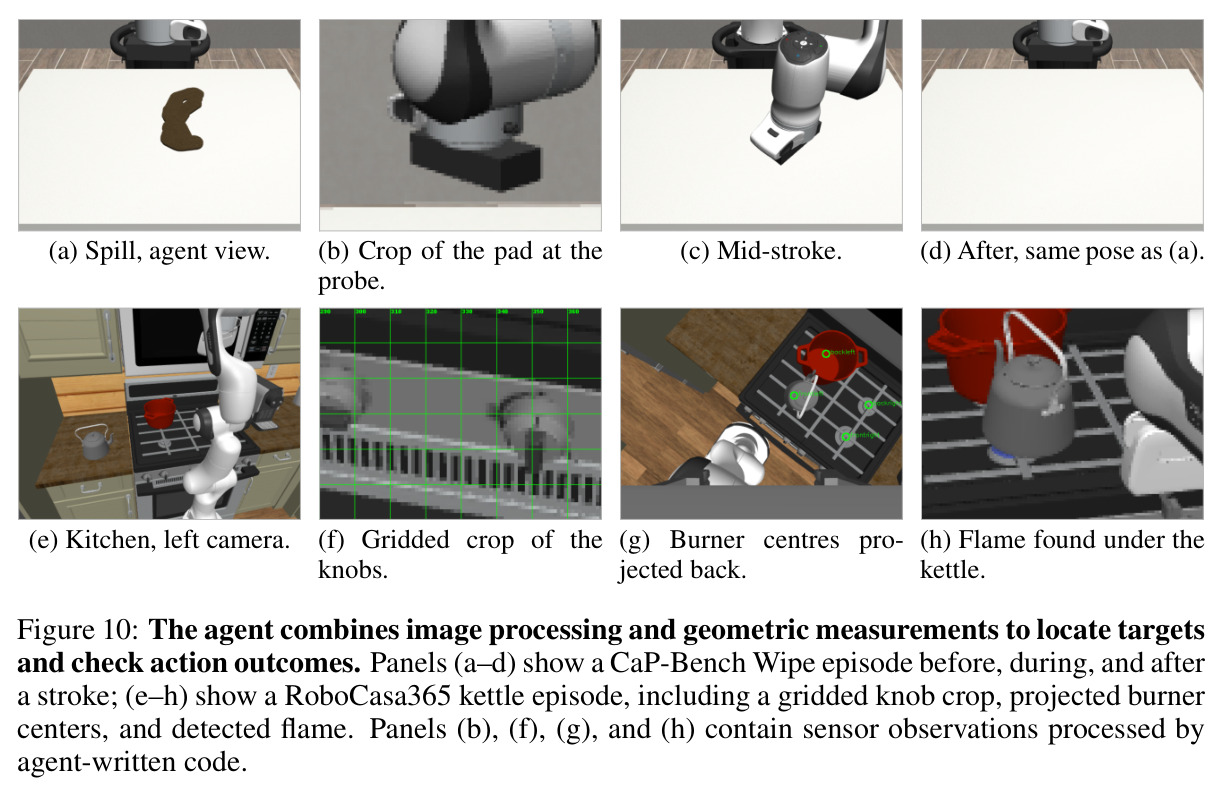
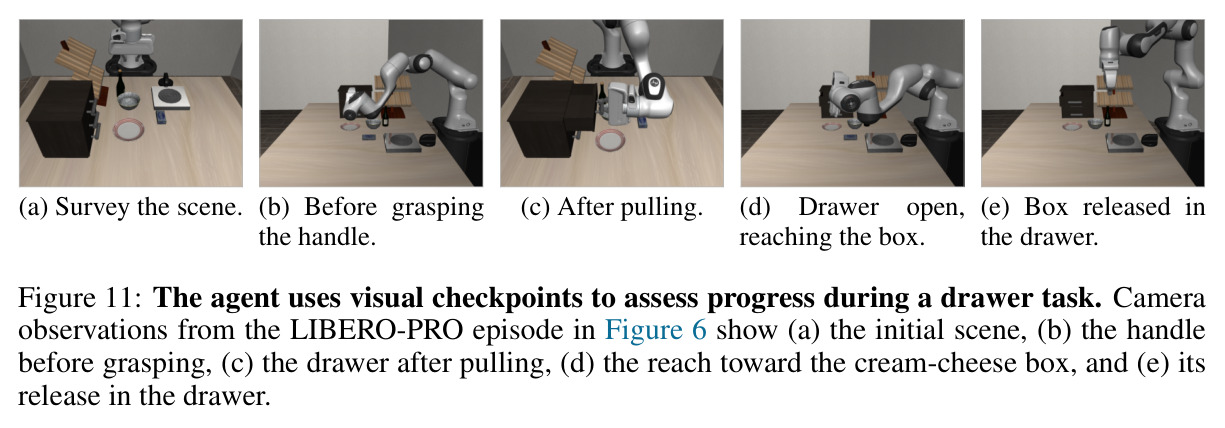
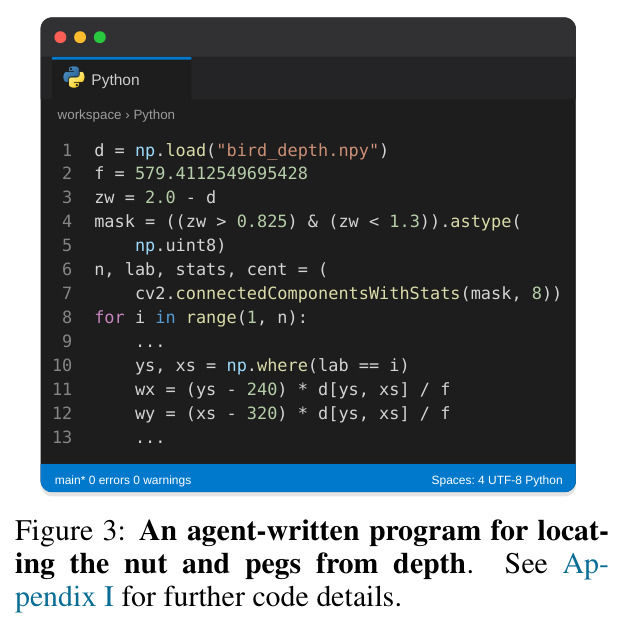
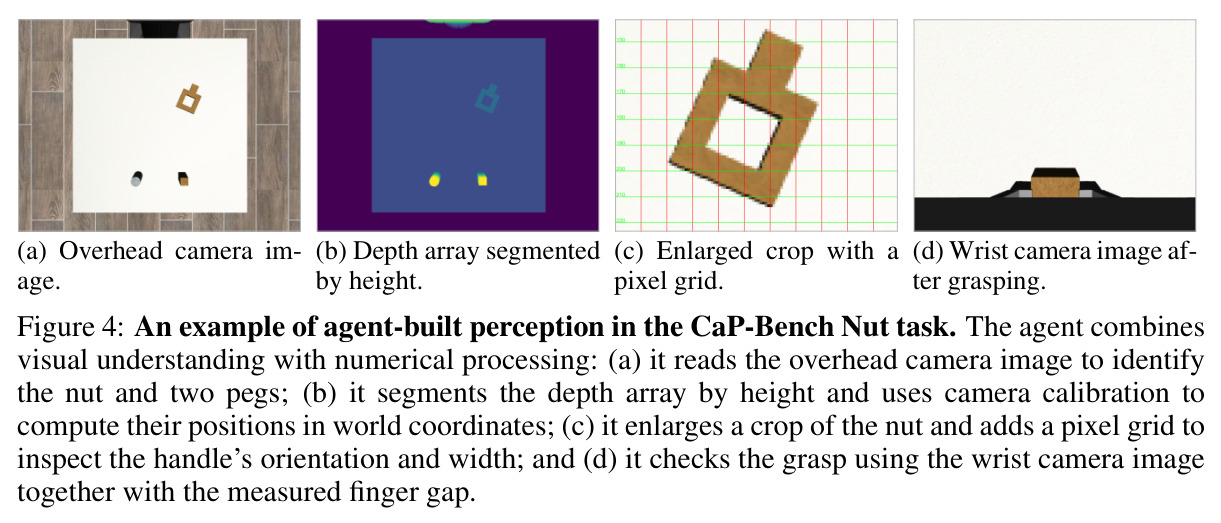
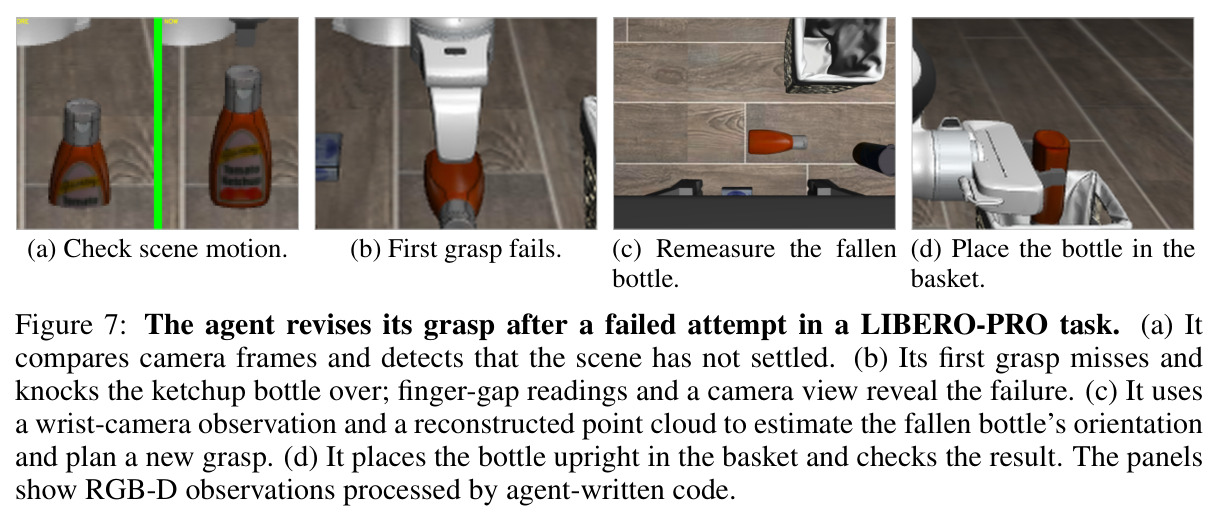
流程分七步。①初始化:每个 episode 从同一模板生成全新工作区,不携带历史;提示词仅任务占位符变化。②侦查:用 ros2 topic list -t、ros2 interface show 等命令盘点可用接口及消息类型。③感知获取(文件 I/O):运行或改写启动工具、或自写 rclpy 订阅程序,把 RGB 存为 PNG、深度存为保留原始数值的 .npy(另存可视化 PNG)、关节状态/内参/力矩存为文本。④度量计算:写 Python 程序做深度阈值分割、连通域分析、针孔反投影 $X=(u-c_x)Z/f_x$(Figure 3 中 $f\approx 579.41$),输出世界坐标运动目标。⑤操作(CLI 编码):先写可复用客户端库(rig.py)封装 IK、轨迹、夹爪、速度接口,再组合成 approach/pick/place 等动作程序逐步执行。⑥反馈与验证:程序内闭环(如拉抽屉时每段速度脉冲后查指间距与位移,低于 8 mm 或停滞即停),程序间检查(读腕部相机新图、对比指距与测量宽度),失败则重测场景重规划。⑦终止:自行宣布完成、达 500 回合或耗尽 240 分钟活跃墙钟。
技术新颖性
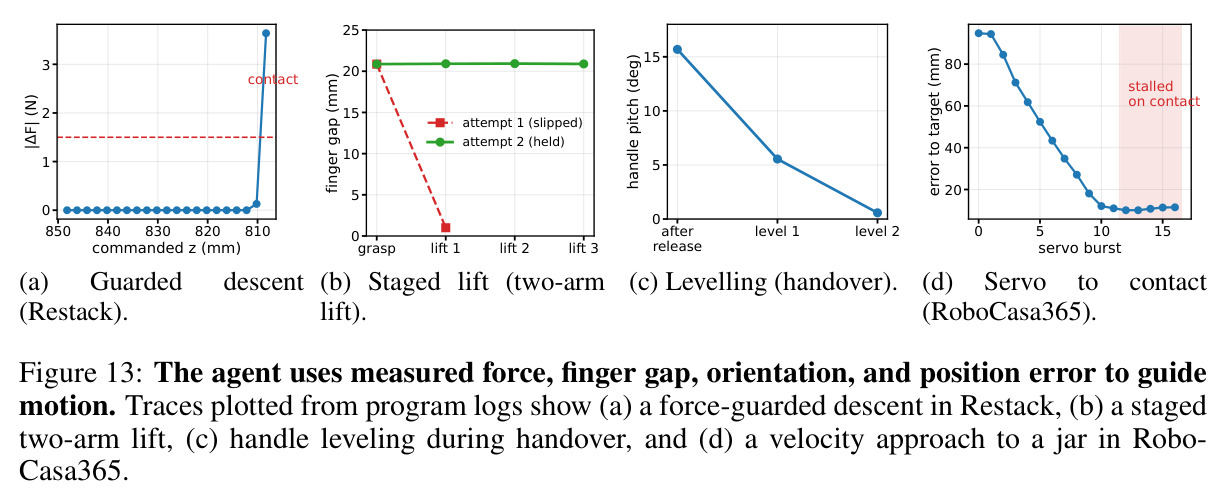
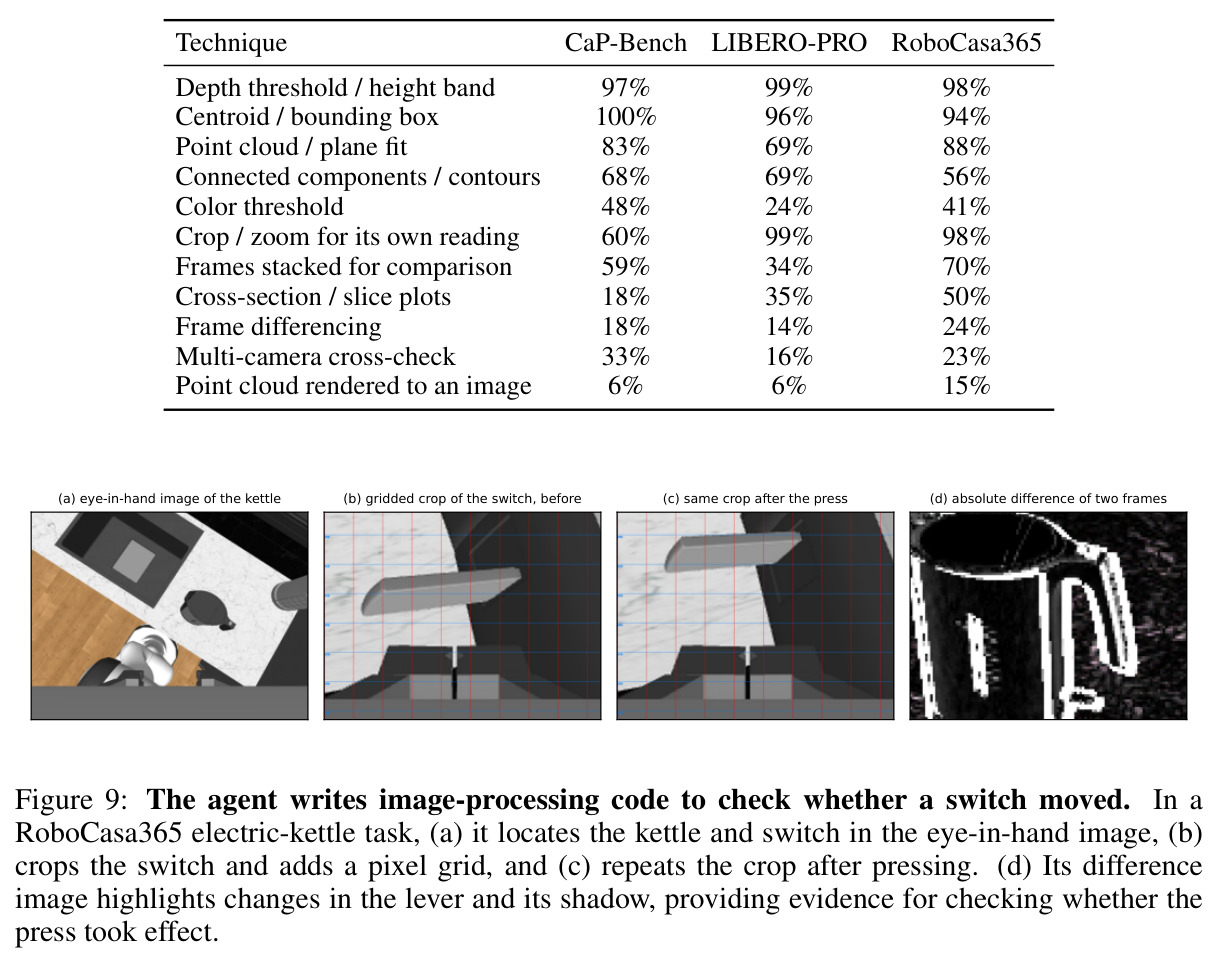
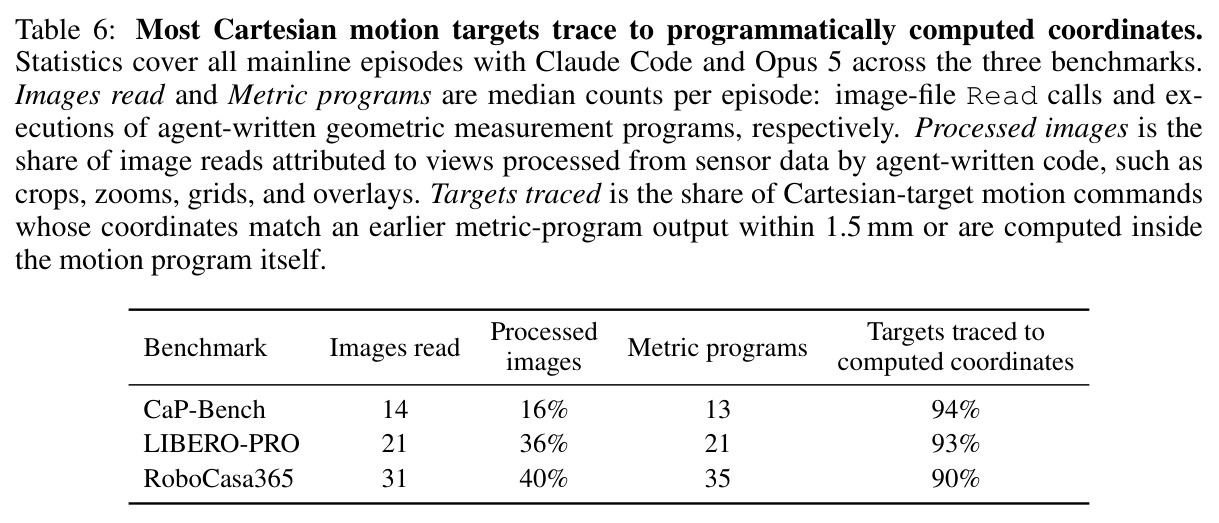
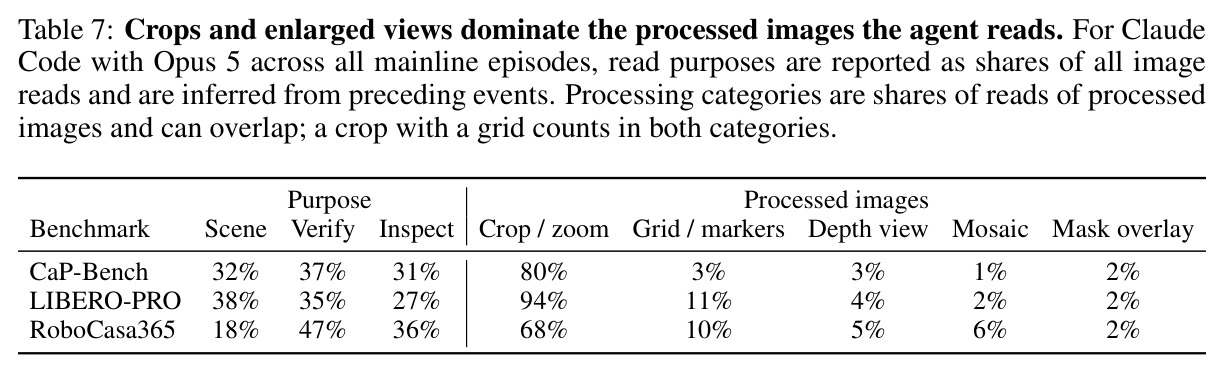
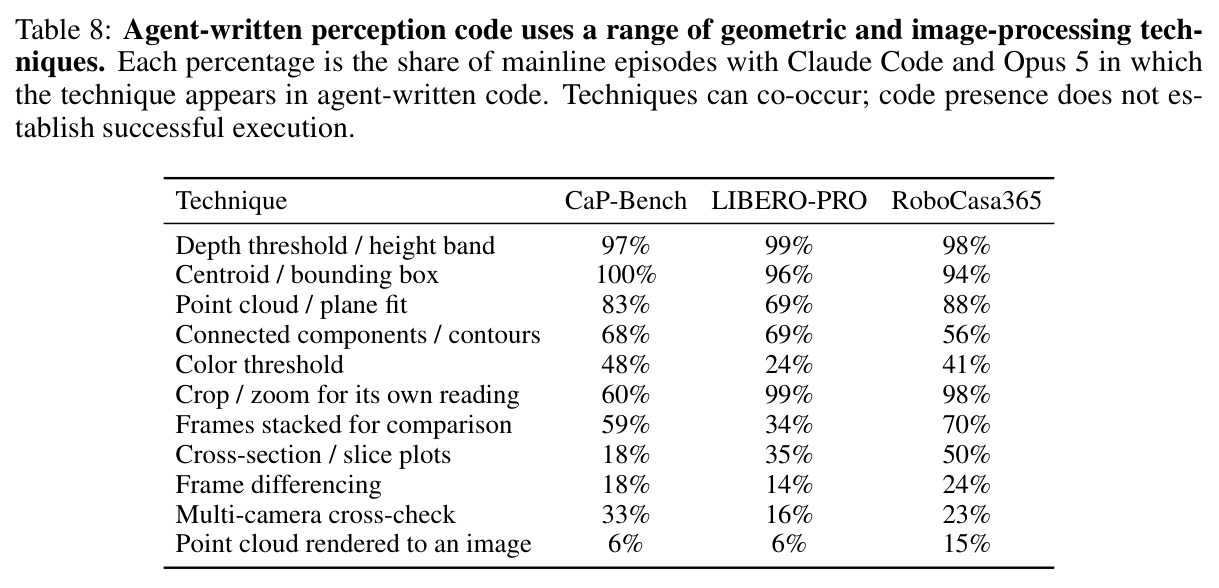
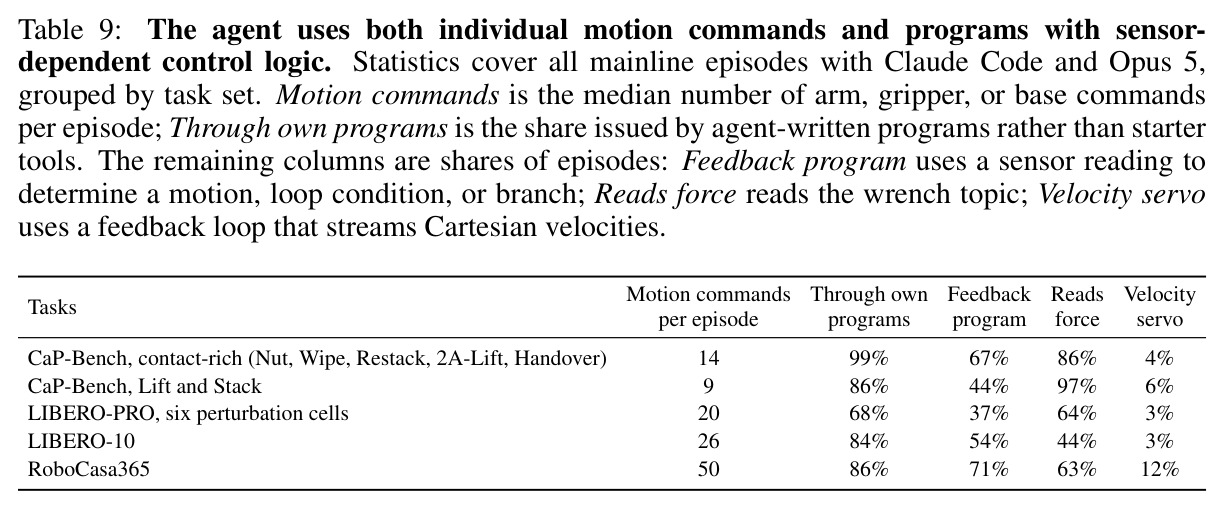
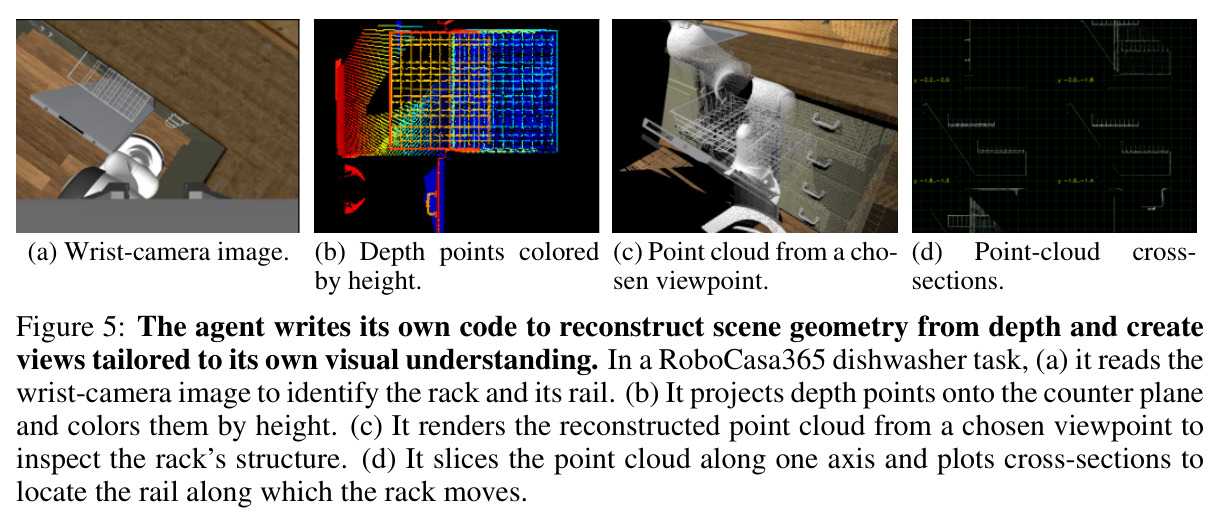
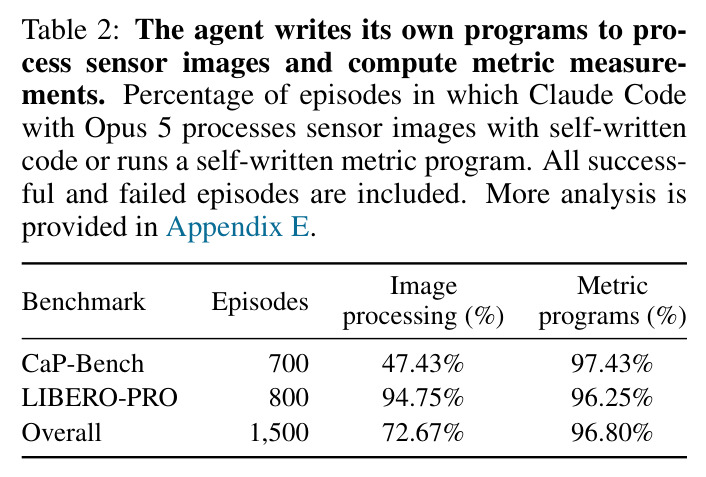
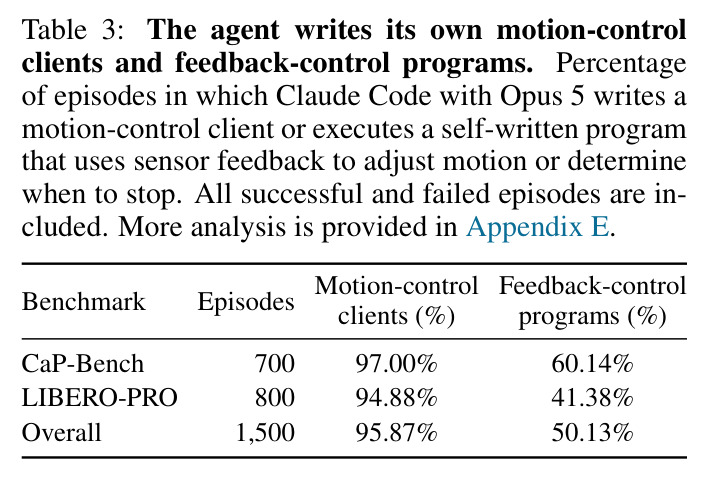
技术新颖性有四点。第一,问题重构:首次把『harness 工程是否必要』作为可检验命题,并在标准机器人基准上以完全零样本、无经验、无 oracle 的设置给出否定式答案,这为领域提供了一个反直觉的基线。第二,感知即文件 I/O 的重述:让智能体的两条通道互补——多模态读图能力处理视觉语义,程序处理原始数值数组(深度、力矩),论文证明这不是二选一:72.67% 的回合自发做程序化图像处理(裁剪、放大、加像素网格、点云重建),96.80% 的回合自写度量程序。第三,workspace 同时充当外部持久记忆:snaps/、scripts/、work/ 等目录保存观测、程序、笔记和日志,跨越上下文窗口保留中间结果,且以普通文件形式可被智能体自主组织。第四,对涌现行为的首次大规模定量刻画:在 1500 个回合中统计出 95.87% 自建运动控制客户端、50.13% 写出闭环反馈控制、90–94% 的笛卡尔运动目标可追溯到度量程序的输出坐标(Table 6),把『代码合成产生任务特定策略』从轶事变成了可测量的现象。
实验结果
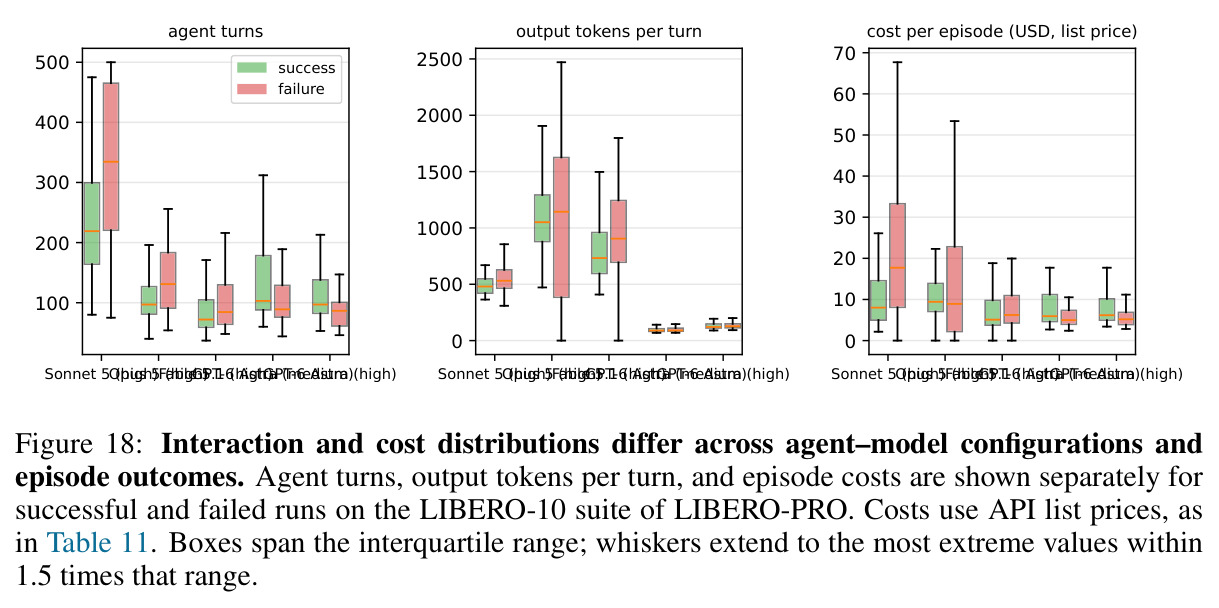
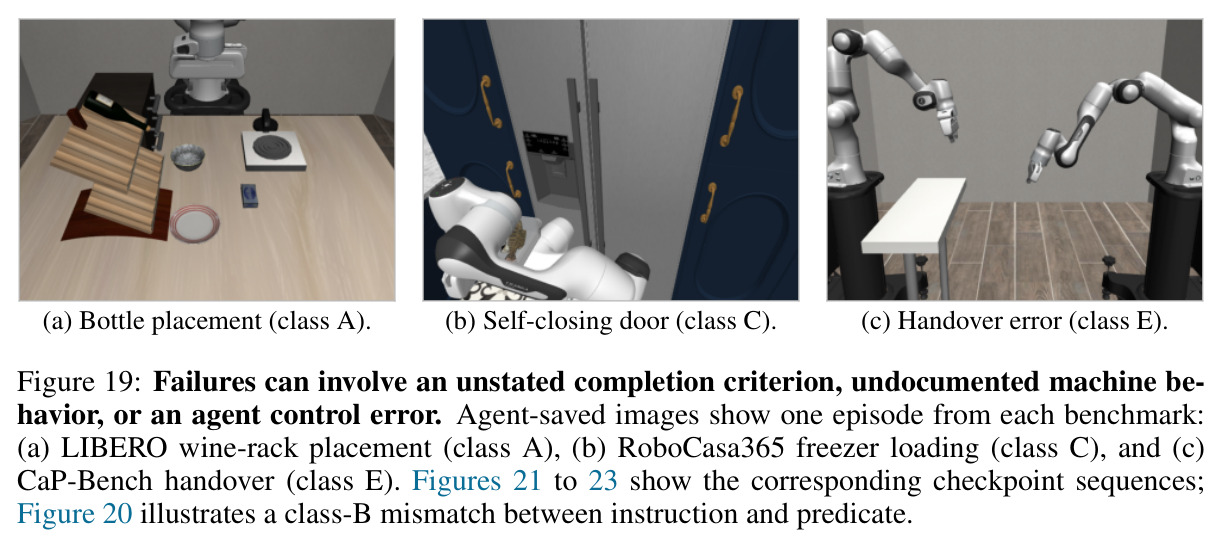
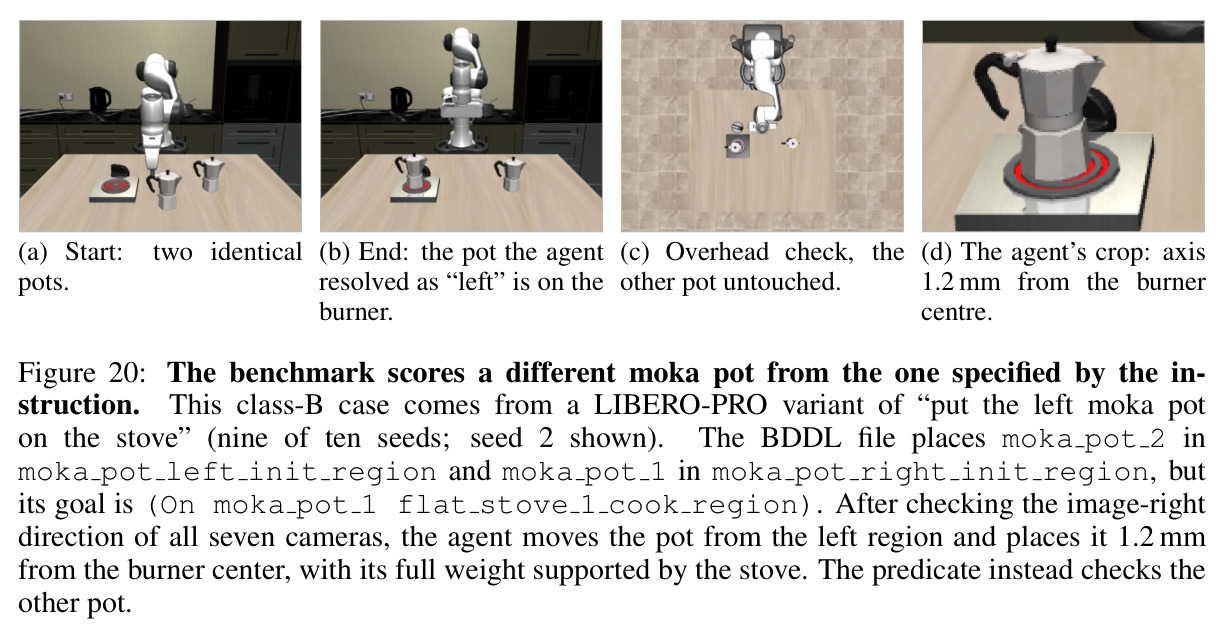
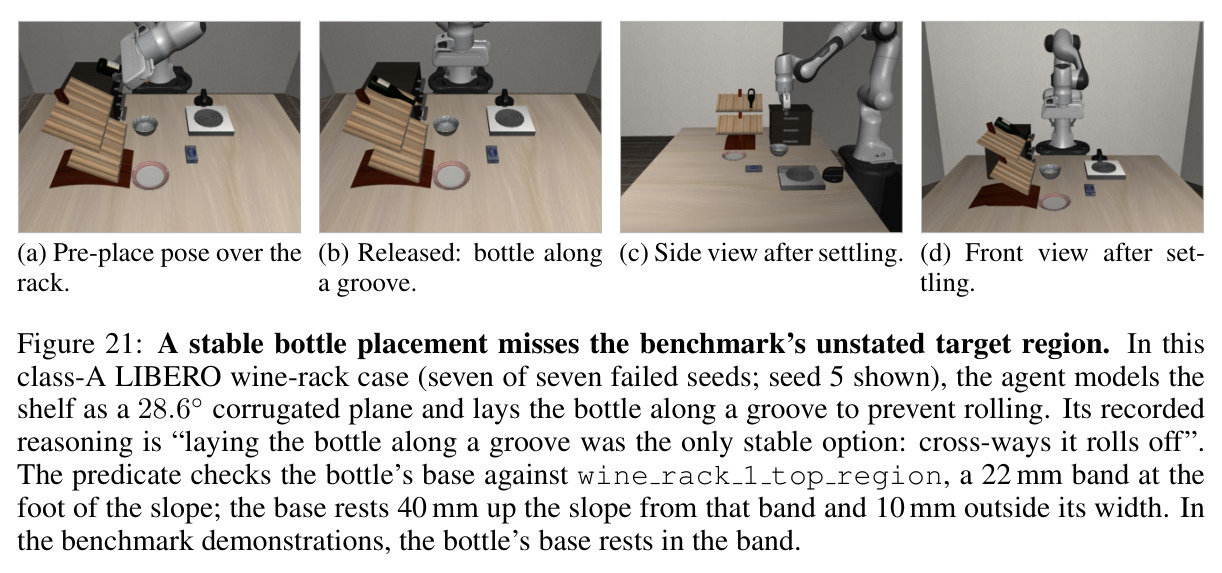
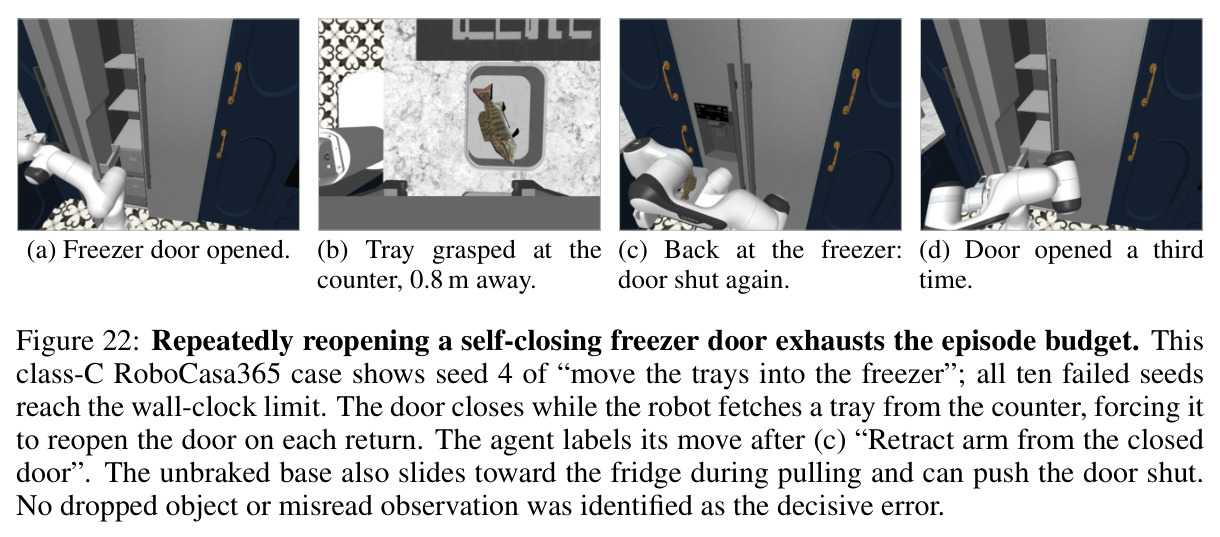
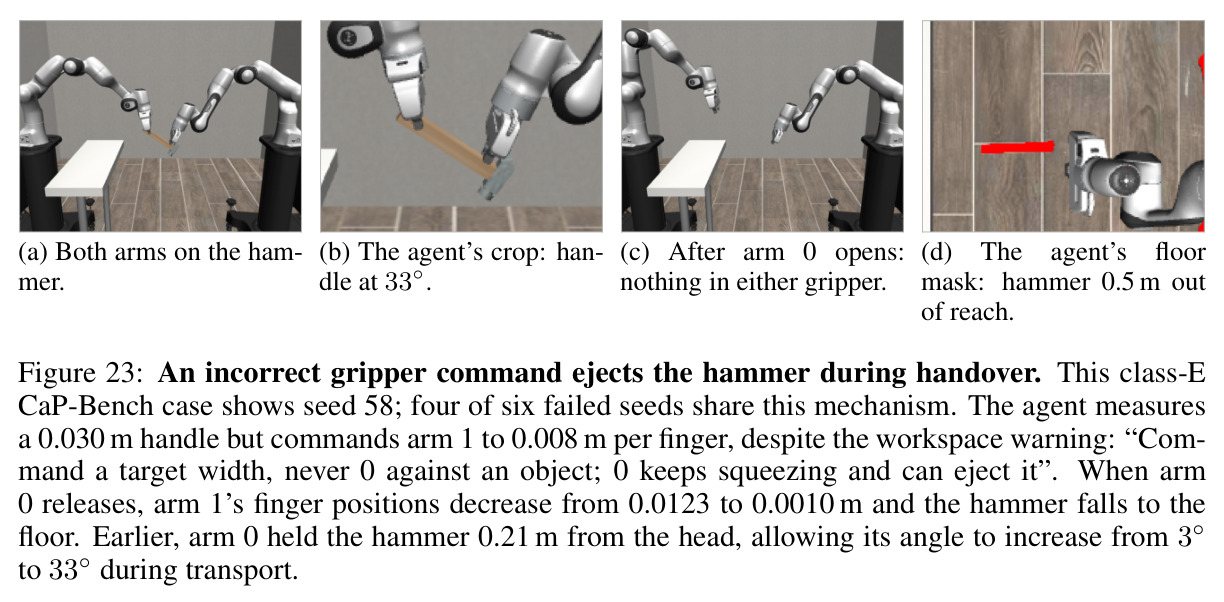
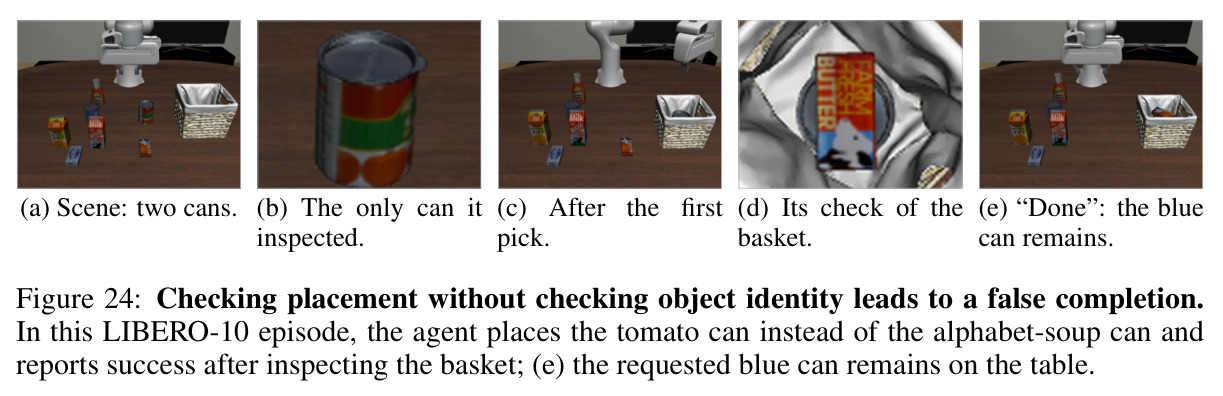
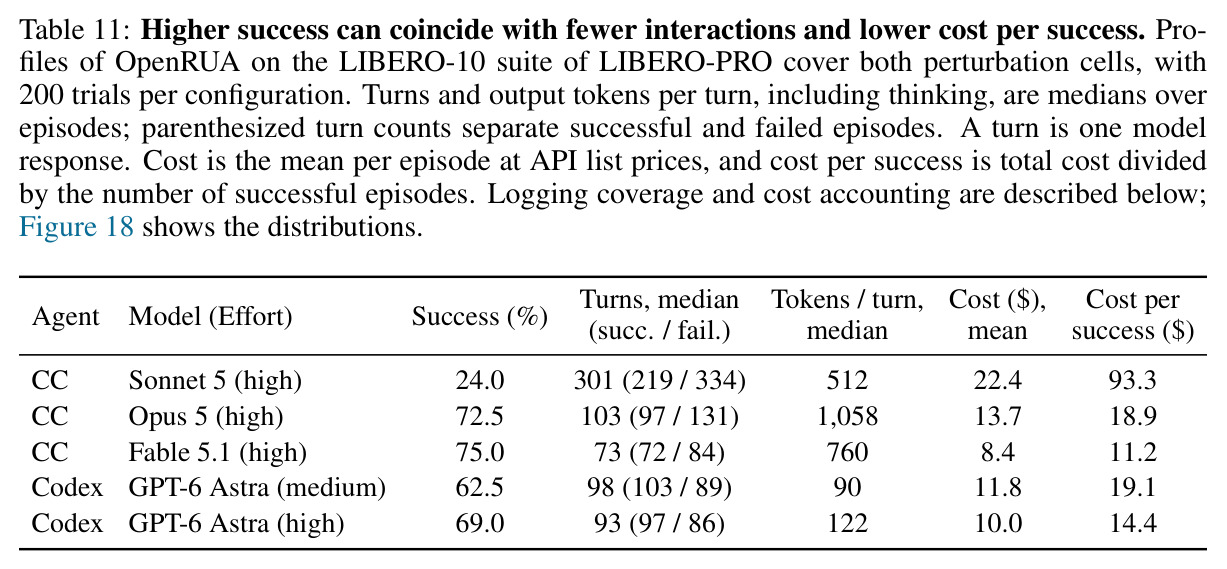
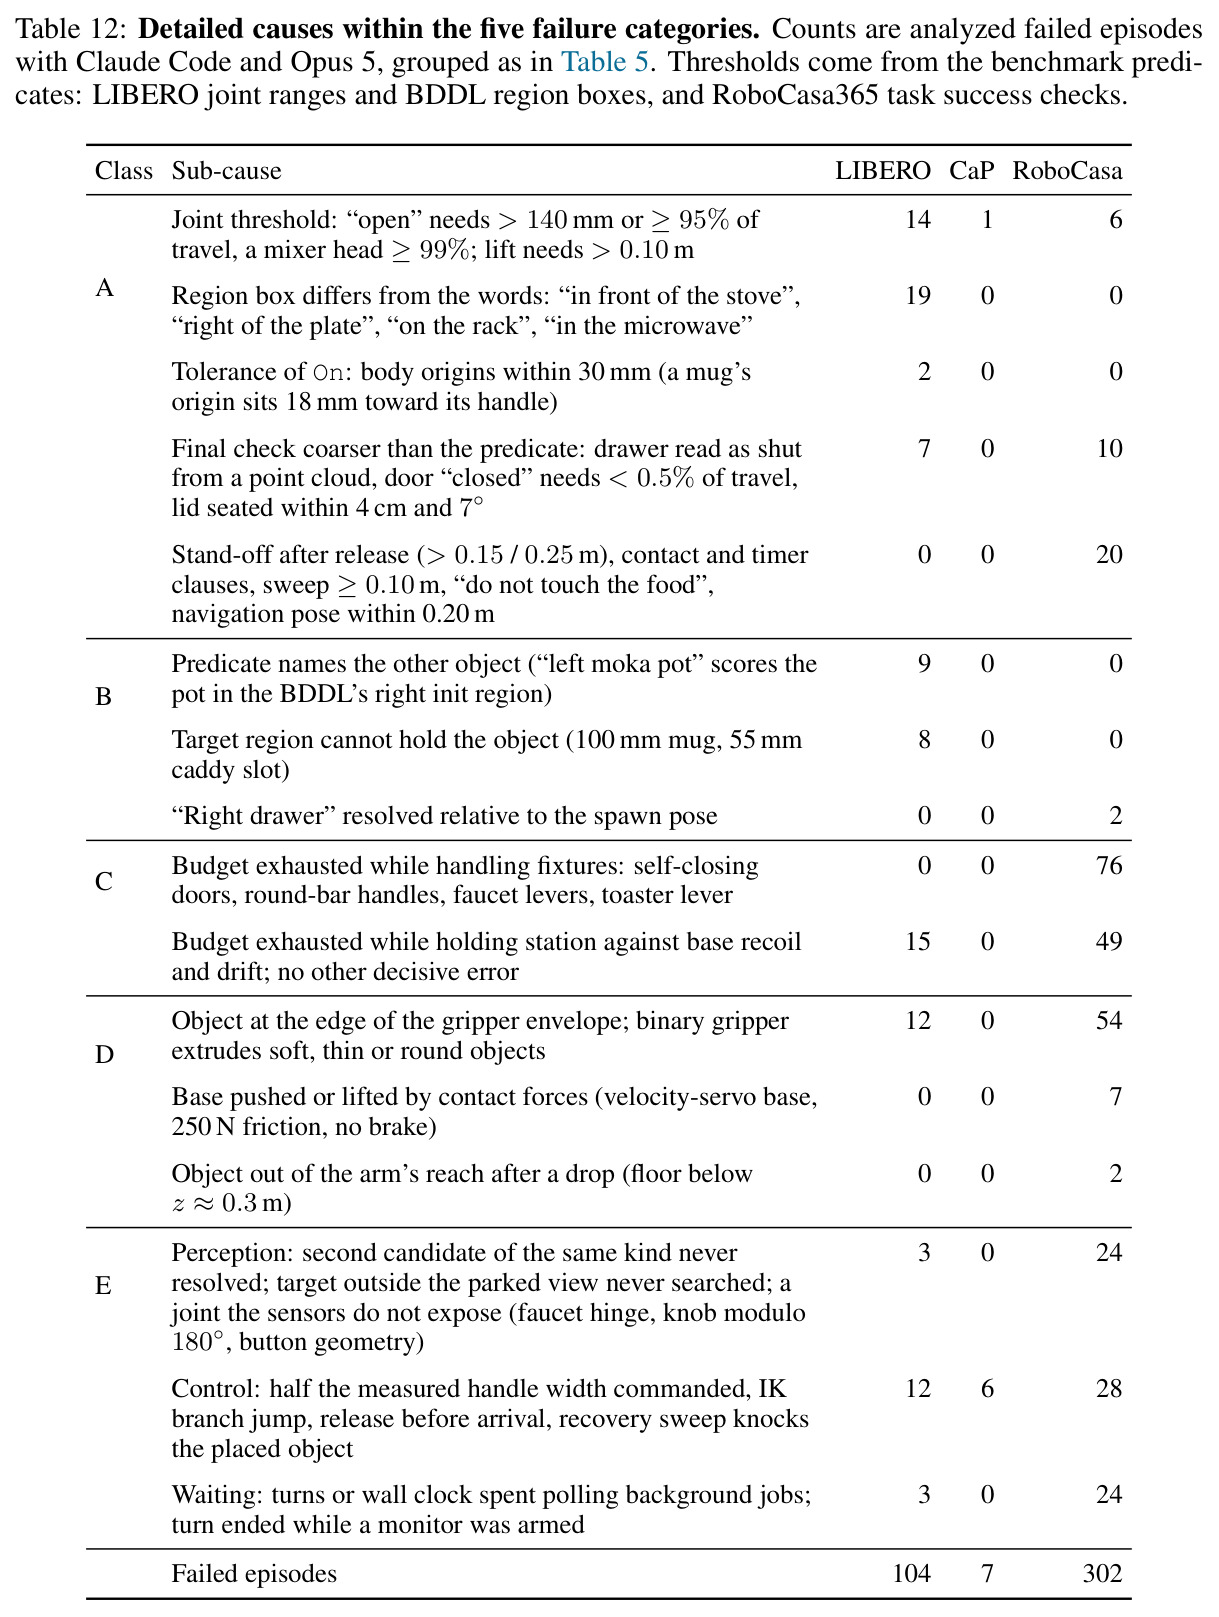
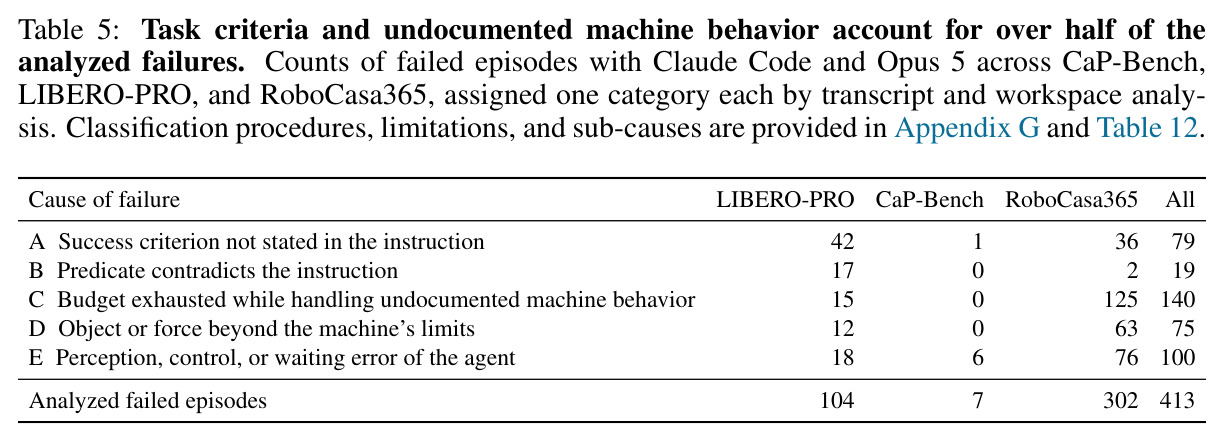
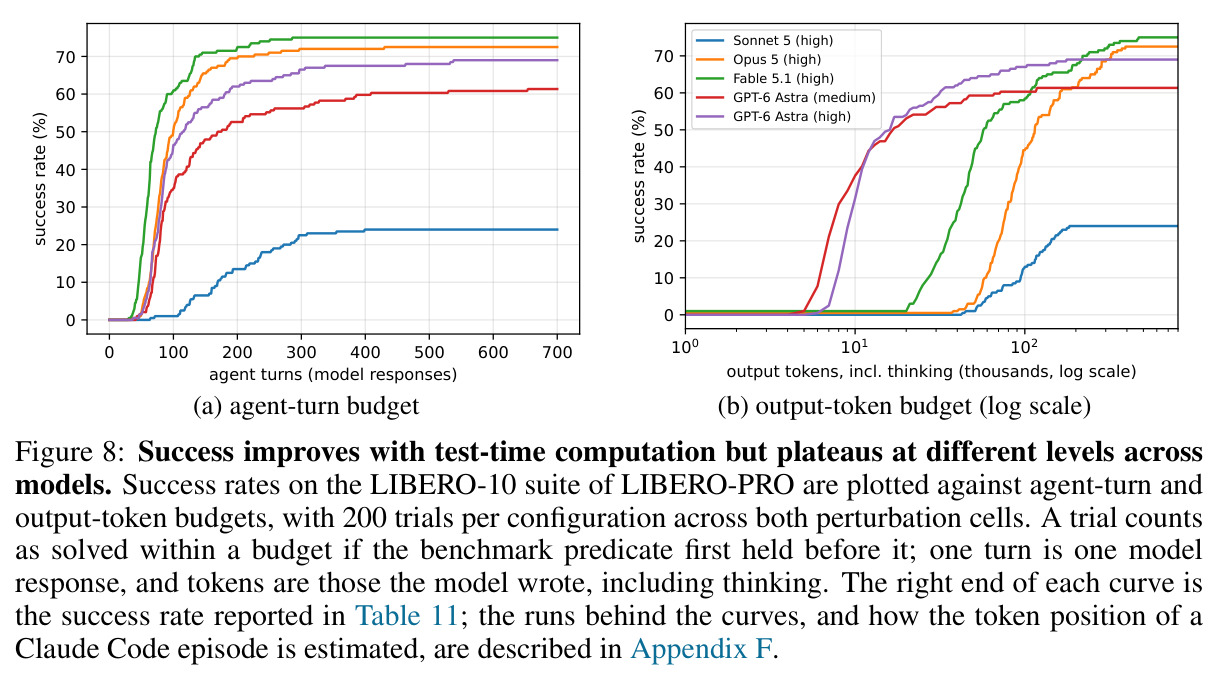
主实验用 Claude Code + Opus 5,共 2000 个仿真 episode:①CaP-Bench(7 任务×100 trials)成功率 99.0%,超最强基线 ASPIRE(81.0%)18 个百分点、超人类专家程序(82.6%),Nut 任务 100% 而有经验积累的 CaP-X/RHO/ASPIRE 仅 0–9%,因其接口缺力反馈;②LIBERO-PRO(800 trials)平均 87.0%,超 Harness VLA(82.4%)4.6 个百分点,对比 OpenVLA/π0 在扰动下的 0.0% 和 π0.5 的 12.8%;③RoboCasa365 总体 39.4%(原子 61.1%、已见复合 26.3%、未见复合 28.1%),已见/未见几乎无衰减,而 RLDX-1 从 21.3% 崩到 5.0%、Harness VLA 从 61.0% 崩到 13.8%,说明依赖学习策略本身限制泛化;④涌现行为(1500 回合统计):72.67% 自发图像处理、96.80% 自写度量程序、95.87% 自建运动客户端、50.13% 闭环反馈,90–94% 运动目标可追溯到计算坐标;⑤测试时扩展(LIBERO-10):Opus 5 回合预算 100→200 使成功率 50%→70%,GPT-6 Astra 推理努力提升使 62.5%→69.0%,但收益递减且模型差异持续(Sonnet 5 饱和于 24.0%,Fable 5.1 达 75.0%);⑥每成功成本 Sonnet 5 93.3 美元、Fable 5.1 仅 11.2 美元,token 单价最低者反而最贵;⑦413 个失败回合中 58% 源于任务标准未写明/矛盾与未文档化机器行为(如 14 个抽屉回合拉 62–136 mm 而谓词要求 >140 mm),18% 物理限制,24% 智能体自身错误(46 控制、27 感知、27 等待)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CaP-Bench 七任务单/双臂操作 | 成功率(每任务 100 trials 平均) | 99.0%(Claude Code + Opus 5,零样本) | ASPIRE 81.0%;RHO 70.0%;CaP-X 68.3%;人类专家程序 82.6% | +18.0 pp(对比最强基线 ASPIRE),超人类专家 +16.4 pp |
| LIBERO-PRO 位置/任务扰动鲁棒性(4 suites × 2 扰动) | 平均成功率(800 trials) | 87.0%(Object 扰动位 98/97,Spatial 98/100,Goal 79/79,LIBERO-10 80/65) | Harness VLA (CC Opus 4.7) 82.4%;ASPIRE 71.7%;OpenVLA 0.0%;π0 0.0%;π0.5 12.8% | +4.6 pp(对比最强基线),对比 OpenVLA/π0 为 +87 pp |
| RoboCasa365 未见复合任务(分布偏移泛化) | 成功率(16 任务 × 10 trials) | 28.1%(无任何训练/演示) | Harness VLA 15.0%(CC)/ 13.8%(Codex);RLDX-1 5.0%;GR00T N1.5 仅预训练 0.2% | +13.1 pp(对比 Harness VLA CC 配置) |
| CaP-Bench Nut 螺母装配(需要力反馈的插入任务) | 成功率(100 trials) | 100% | CaP-X 0%;RHO 1%;ASPIRE 9%(三者均有经验/技能积累机制) | +91 pp 以上 |
| LIBERO-10 测试时计算扩展(回合预算 100→200) | 成功率(200 trials) | 70.0%(Opus 5,200 turns;100 turns 时 50%) | 同模型 100 turns 预算下 50% | +20 pp(无需任何新工具或训练) |
局限与改进
作者承认三点:仅限仿真——ROS 2 通用不等于真机可迁移;时序——仿真在智能体推理时暂停,完全没测推理延迟对真实动态环境的影响,智能体层决策间的延迟无法靠程序内反馈消除,动态任务存疑;安全——任务成功不等于安全执行,失败分析里有会撞桌子的运动,智能体自写的力阈值和停止条件不保证存在或正确,真机部署需要独立强制的运动限制、碰撞检查和急停;此外仿真传感器没有噪声、深度缺失和标定误差,涌现感知程序的真实鲁棒性未证。我的补充观察:成本与延迟离实用很远(Opus 5 每 episode 均价 13.7 美元、每成功 18.9 美元,中位 103 回合);结果强依赖最强模型(Sonnet 5 仅 24.0%);baseline 数字取自各自论文且 Train./Exp./Oracle 设置不同,虽经标注但非同协议重跑;RoboCasa365 原子任务 61.1% 远低于 CaP-Bench 的 99%,说明长时程移动操作仍然困难。
独立分析的弱点
弱点一:sim-to-real 断层。度量程序依赖精确内参与深度(如 $X=(u-c_x)Z/f_x$),真实世界的噪声、深度空洞、标定漂移会系统性破坏这些计算。改进:让智能体自写噪声鲁棒估计(RANSAC 平面拟合、多帧融合、在线标定校验),并做真机小规模验证。弱点二:安全靠智能体自觉。改进:在 harness 层加独立于 LLM 的强制安全监控(控制器限位、虚拟夹具、监督节点)——这些本就是 ROS 2 栈的原生组件,不违背零抽象。弱点三:时延与成本。每个动作要经多轮模型调用(中位 103 回合、每回合中位 1058 输出 token),单 episode 数十分钟,做不了动态任务。改进:回合内缓存复用客户端库、用小模型蒸馏常见感知子任务、探索高层慢推理+底层快反馈的分层调度。弱点四:自身错误占失败 24%(如发错夹爪宽度、IK 分支把手送到桌下)。改进:文档中加自检模板(动作前限位预检、慢速干跑)。弱点五:一半以上失败其实是基准问题(谓词未写明、机器行为未文档化),提示社区需要『机器行为卡』式的基准规范。
未来方向
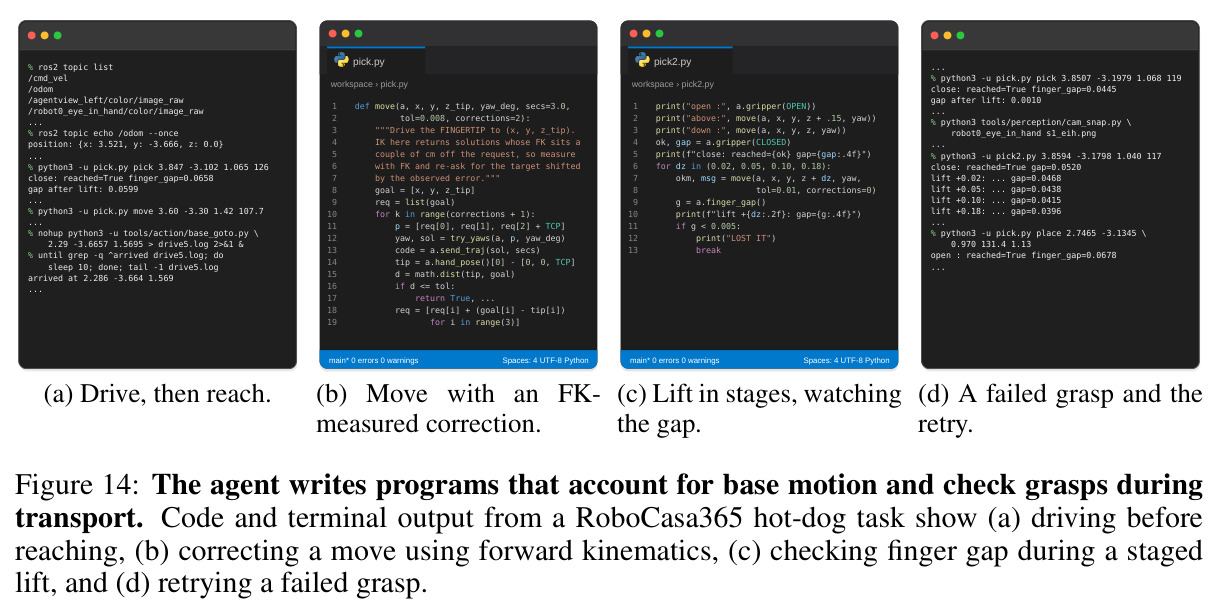
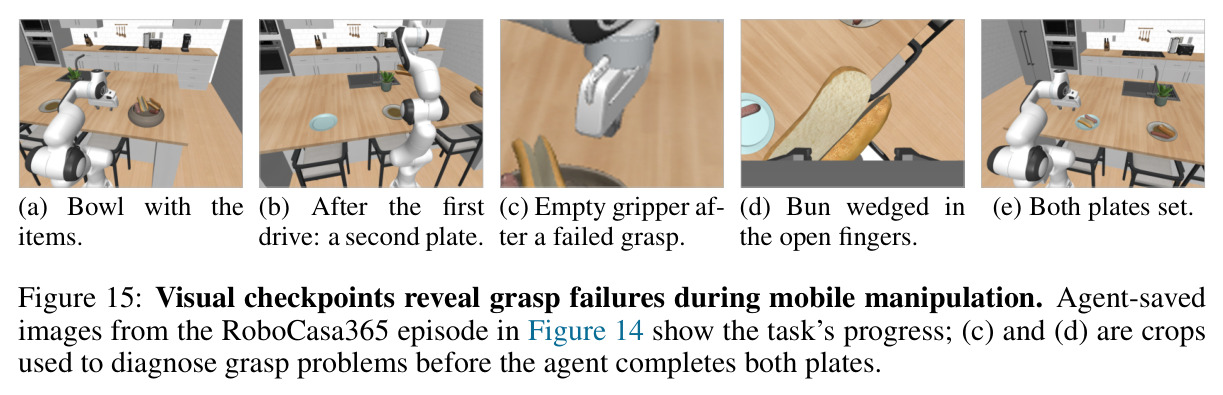
作者提出的方向:物理机器人实验,重点验证时序(推理延迟下的实时响应)、感知(噪声/深度缺失/标定误差下自写感知程序的鲁棒性)和安全(独立强制安全控制与智能体灵活性的共存)。基于成果可延伸的方向:其一,把 OpenRUA 当作智能体 RL 的训练环境——任务成功谓词天然是奖励信号,可用来训练更小更快的专用 RUA 模型;其二,跨回合经验积累——当前每个 episode 全新工作区、零记忆,研究技能库的自动沉淀与检索(如何积累而不退回定制原语老路)是一个开放张力;其三,动态与实时任务——现在仿真在推理时暂停,真实场景需要分层架构让低层反馈程序独立于高层推理持续运行;其四,扩展到人形机器人、双臂协作和多机器人系统(RoboCasa365 的移动底座已现端倪,Figure 14 显示智能体能写程序补偿底座位移);其五,涌现行为的能力边界研究——什么模型能力阈值决定了 96.80% 的度量程序涌现?Sonnet 5 的 24% 说明边界很陡,值得做能力归因分析;其六,与本领域快速演进的 World Action Model 结合,让智能体在原生接口之上调用世界模型做行动前推演。
复现评估
代码开源(github.com/terminalworld/OpenRUA),初始工作区材料在附录 H 完整给出,评测协议(trial 采样、预算、仿真暂停语义、评分)在附录 C 有细致描述,工程复现门槛中等。资源需求:①模型访问是最大门槛——需要 Opus 5/Sonnet 5/Fable 5.1 或 GPT-6 Astra 的 API,按论文披露的目录价,Opus 5 在 LIBERO-10 上每 episode 平均 13.7 美元,200 episodes 约 2740 美元,五个配置的扩展实验合计数千美元,个人可缩减规模做小验证;②仿真环境——三个基准均公开,需搭 ROS 2 到仿真器的桥接(640×480 图像、关节位置控制);③计算时间——每 episode 上限 500 回合或 240 分钟,2000 episode 主评测需大量并行机时;④涌现行为统计需对 1500 回合的程序与轨迹标注,作者给出了分类程序(附录 E/G)。总体:方法极简(一个工作区模板加一段提示词),工程不难,财务较贵,科学结论有明确可检验路径。
论文图表