PhysEvo:让冻结大模型在物理世界中递归自我改进的机器人操作框架 PhysEvo: Astra Can Act, Let It
冻结大模型借物理执行反馈递归改进工具与技能,无需更新权重即可大幅提升机器人成功率
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指智能体利用自身运行产生的经验来修改自身系统(提示词、工具、代码、诊断资源),且修改后的系统又能参与下一轮改进,形成「改进的过程本身也被改进」的递归链条。与 Reflexion 这类单次自我反思(只保留文字反馈到上下文)不同,RSI 强调改动的持久性、可测试性与可继承性。
PhysEvo 的核心贡献就是把 RSI 从纯数字环境(写代码、改提示词)搬到物理机器人上,论文的所有设计与实验都围绕「物理经验产生的修订能否被测试并继承」展开,不理解 RSI 就无法理解标题与动机。
Harness(任务框架/脚手架)
包裹在大模型外围的整套软件设施:观测接口(相机、本体感知)、动作工具(API)、执行反馈机制、技能文档、记忆与复盘工具。当模型权重固定时,harness 决定了模型「能看到什么、能做什么、失败后能知道什么」,是能力与可靠性之间的桥梁。
论文的核心论点是「失败源于 harness 而非模型能力」——倒水失败和手臂折叠都不是模型不会,而是接口没给通道。PhysEvo 进化的对象正是两套 harness,理解这个概念才能明白它改的是什么。
VLA(视觉-语言-动作模型)
在机器人演示数据上端到端训练的大模型,直接从图像和语言指令输出低层动作,代表工作有 RT-2、OpenVLA、π0.5。它们需要昂贵的机器人数据训练一个专门的动作策略(action policy),泛化到新任务依赖训练分布。
PhysEvo 的主要对照方法就是 VLA 和直接调用大模型的 agent。它展示了一条「零训练、无专门动作策略」的路线在 42 个任务上超过 VLA 基线,理解 VLA 的训练代价才能评估这条路线的意义与局限。
TCP 控制与逆运动学(IK)
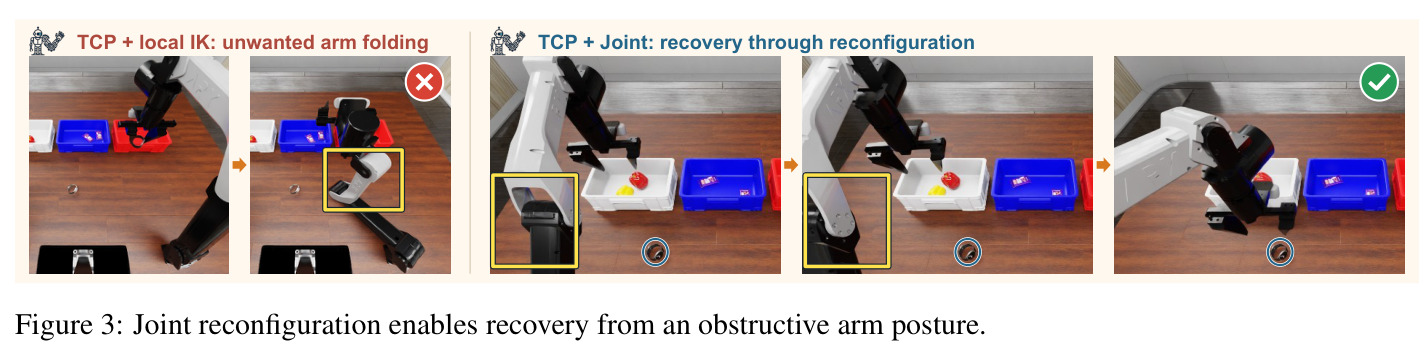
TCP(Tool-Center-Point)控制只让模型指定末端执行器的目标位姿,关节角度由逆运动学求解器自动反解。问题在于 IK 解不唯一,局部求解器可能选出自遮挡、自碰撞或遮挡视野的关节构型,而模型对此既不知情也无权干预。
论文的第一个失败案例与第一项关键改进(关节级控制)正是针对 TCP+局部 IK 的这一缺陷。论文用「TCP 得分 40 vs Joint 得分 100」的对照实验证明让姿态成为策略的显式决定是必要的。
RoboDojo 基准
一个双臂机器人仿真评测平台,包含 42 个基础任务,覆盖泛化、精度、长程执行、记忆、开放指令遵循五个能力维度。任务原生分数 0-100,成功率(SR)定义为得满分 100 的尝试比例。平台有公开排行榜,收录数十种机器人策略与语言模型策略。
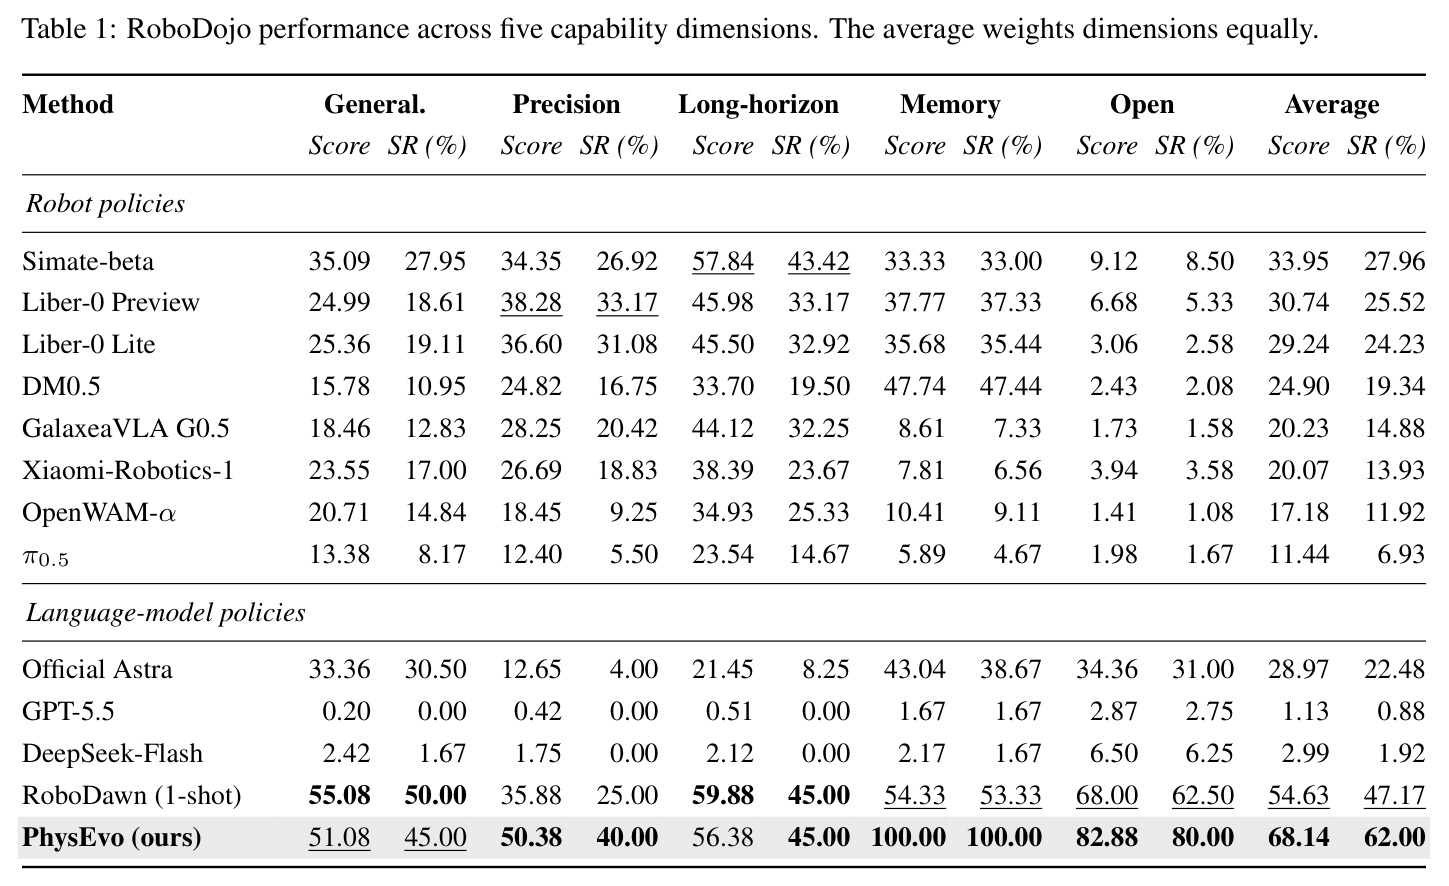
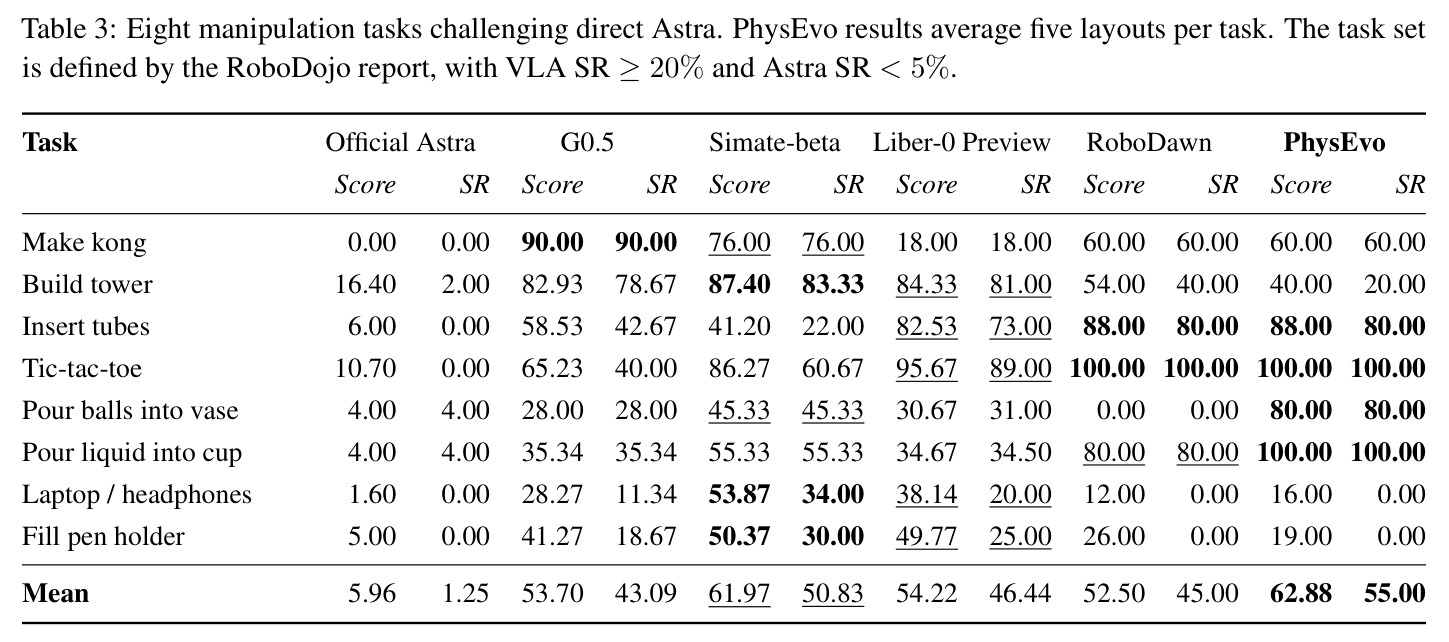
论文的主实验全部在 RoboDojo 上进行,头条数字(62.00% SR vs 47.17%)都基于其五维等权评分体系;八个「挑战直接 Astra」任务子集也由 RoboDojo 官方报告定义,读表 1/3 必须懂这套评分。
研究动机
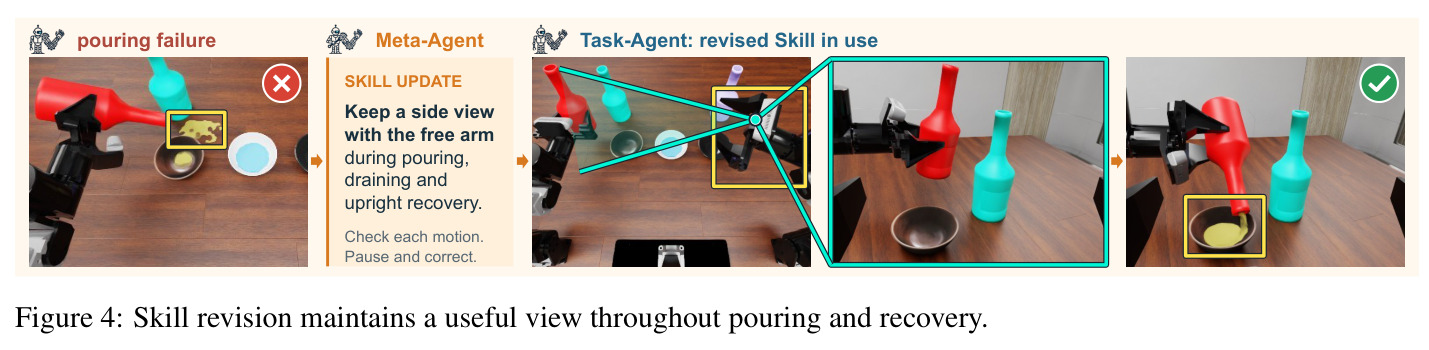
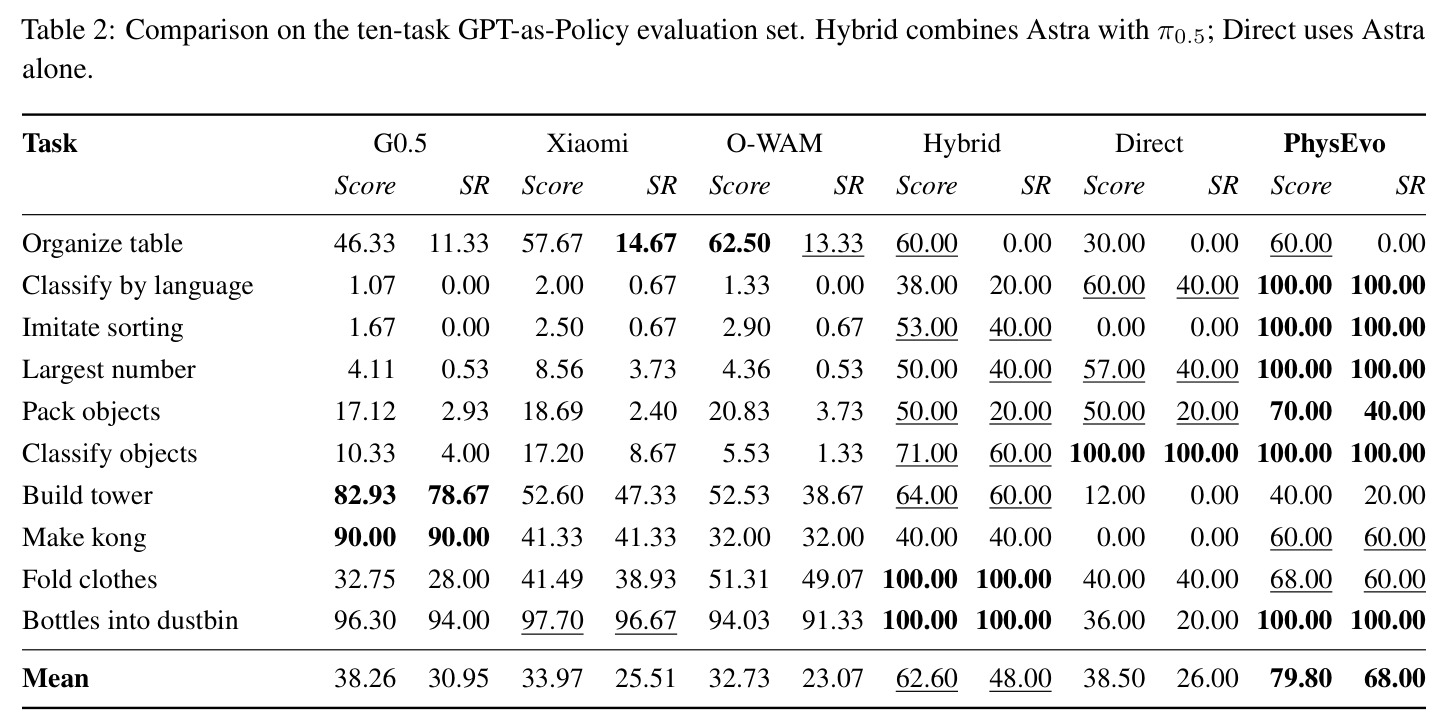
直接用 Astra 这类前沿大模型控制机器人时存在「有能力但不可靠」的矛盾:在 GPT-as-Policy 的十任务评测中,直接 Astra 在语言条件物体分类这类任务上能拿到 100% 成功,但整体成功率只有 26%;接入专门训练的 VLA 策略 π0.5 组成混合系统也只提升到 48%。论文复盘执行记录后发现瓶颈出在 harness 层而非模型能力:倒水时,握持的瓶子会挡住持瓶臂腕部相机监控水流落点的视野,模型无法看到自己动作的后果;使用 TCP 接口时,局部逆运动学会把把手臂折成遮挡抓取目标的姿态,而 Astra 没有任何显式渠道去选择或修正关节构型。这些失败模式说明:单纯换一个更强的动作模型、沿用不变的接口无法解决问题,agent 需要的是有用的视野或对姿态的直接控制权——即系统层面的修订,而不是能力层面的补课。
本文的目标是本文的目标是构建一个围绕单个冻结模型的「物理递归自我改进」(Physical RSI)框架:任务 agent 负责观察和控制机器人执行任务;元 agent 利用产生的轨迹诊断失败、修订工具与技能、测试修正,并且还能改进自己的诊断工具,使保留的修订同时服务于后续的动作执行和后续的自我改进。整个过程不更新模型权重、不训练任何专门的动作策略,而是让系统自主发展出三项能力:关节级控制(把姿态选择权交给策略)、主动寻证与历史回看的观测方式、可复用的操作技能。最终在 42 个 RoboDojo 仿真任务上与最强已发表参考对比,并验证仿真进化出的框架能否部署到 AgileX PiPER 真机上继续适配。
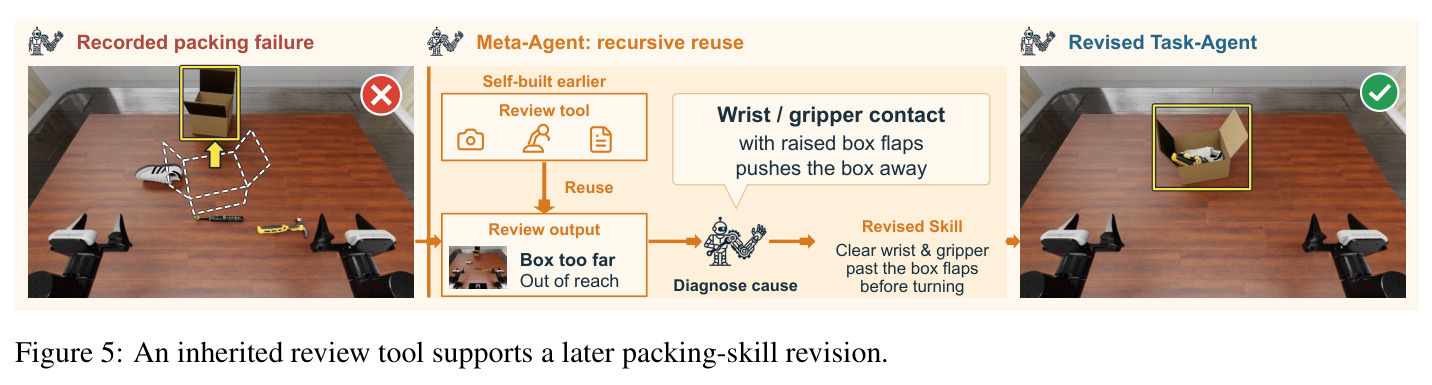
与已有工作不同的是,已有的自我改进 agent(Reflexion、GEPA、ADAS、SICA、DGM 等)全部停留在数字环境(改提示词、改代码),不面对物理世界的不可逆执行;已有的具身自进化工作各有保留——SHAPER 用同一个冻结模型做规划器和优化器但固定动作接口与执行器,Zetta 围绕冻结的动作策略进化批评者和工具,Hyperagents 的机器人实验是为 PPO 控制器进化奖励函数(用独立优化器),RHO 进化多文件机器人仓库但未将诊断资源本身纳入递归。PhysEvo 的独特切入是:同一个冻结模型同时承担「机器人决策者」和「软件修订者」两个角色,进化的对象同时覆盖技能、面向机器人的动作与观测接口、以及诊断资源本身——一轮改进中自建的轨迹复盘工具,可以在后续轮次被复用去诊断另一个完全不同的失败。系统继承的不只是「怎么行动」,还有「怎么改进」,这正是标题中 recursive 的确切含义。
核心方法
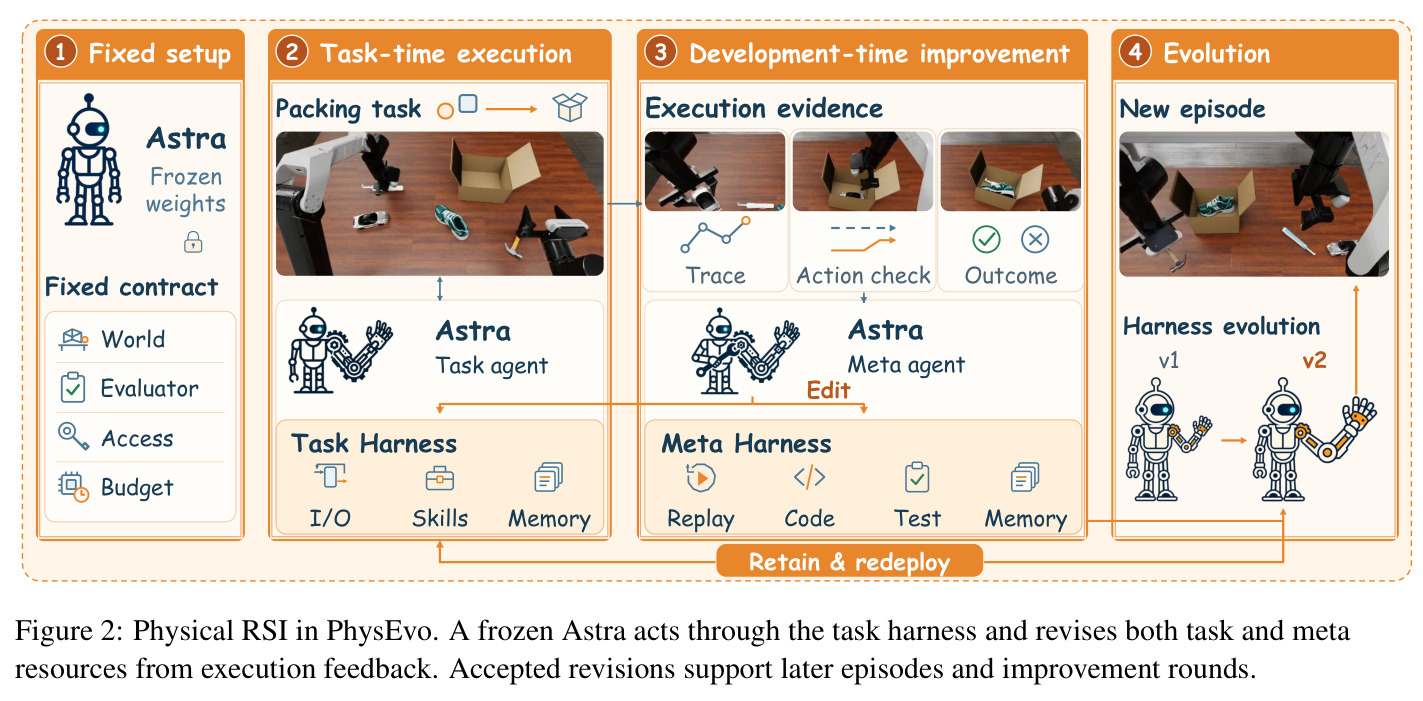
直觉上,论文把「模型能力已存在但执行不可靠」归因于模型外围的两层可编辑软件,然后让物理执行的结果作为证据,驱动模型自己迭代修这两层软件。技术上,设 $M_\theta$ 为参数冻结的 Astra,第 $r$ 轮迭代的持久系统为 $H^r = (H^r_{\text{task}}, H^r_{\text{meta}})$:任务 harness 提供观测、动作工具、执行反馈与技能文档;元 harness 提供代码查看与编辑、轨迹复盘、诊断实验与修订测试能力。任务执行时模型按 $a_t \sim M_\theta(\cdot \mid P_{H^r_{\text{task}}}(\ell, o_{\le t}, m_t))$ 选择工具调用,$(o_{t+1}, f_t) = \text{RunTool}_{H^r_{\text{task}}}(a_t)$ 返回新观测与反馈,其中 $\ell$ 是指令、$o_{\le t}$ 是历史观测、$m_t$ 是回合记忆。每个改进轮次执行「修订-测试-选择」三步:$\tilde{H}^r \leftarrow \text{Revise}_{M_\theta, H^r_{\text{meta}}}(H^r, E^r)$,$y^r \leftarrow \text{Test}(\tilde{H}^r, H^r)$,$H^{r+1} \leftarrow \text{Select}(H^r, \tilde{H}^r, y^r)$。模型权重、机器人动力学和任务评测器不可编辑。初始化只提供 TCP+局部 IK 的最小观测-动作闭环和一个通用代码编辑工作区——关节级控制、专门的观测工具、可复用技能全部是进化产物。
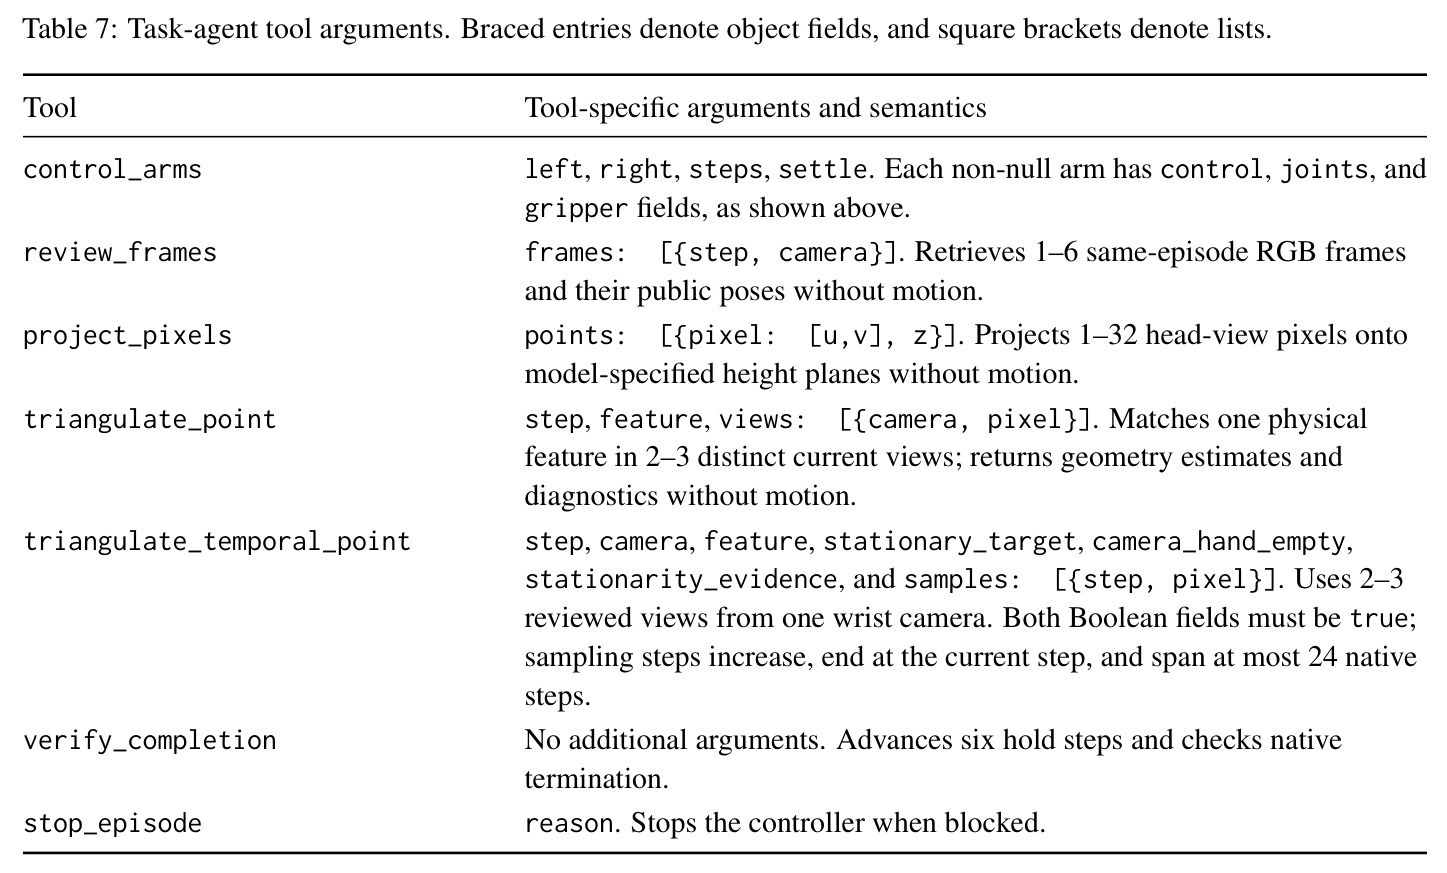
核心创新有三个相互咬合的点。第一,回溯诊断的信息优势:为什么同一个模型能修好它没能预防的失败?因为轨迹包含动作选择时不可得的「后果证据」——对齐的图像、机器人状态和代码能把最终症状(盒子够不着)追到具体前因(手腕或夹爪碰到了立起的盒盖)。第二,关节级控制把「姿态」从 IK 求解器的隐式决定变成策略的显式决定:进化出的 control_arms 接受 12 个绝对臂关节目标角和 2 个连续夹爪指令,支持双臂且持物时仍可用,模型可以主动调整遮挡构型并继续操作,而不是反复从不适姿态请求同一个末端目标。第三,也是「递归」二字的来源:修订既可作用于任务 harness 也可作用于元 harness——一轮改进中自建的轨迹复盘工具(对齐图像、状态与决策)在后续轮次被复用去诊断另一个失败,改进流程继承了它自己的机器。此外一个细致的设计是:工具改动时其技能文档同步修订,agent 继承的是「能力 + 使用说明」的绑定的整体。
方法步骤详情
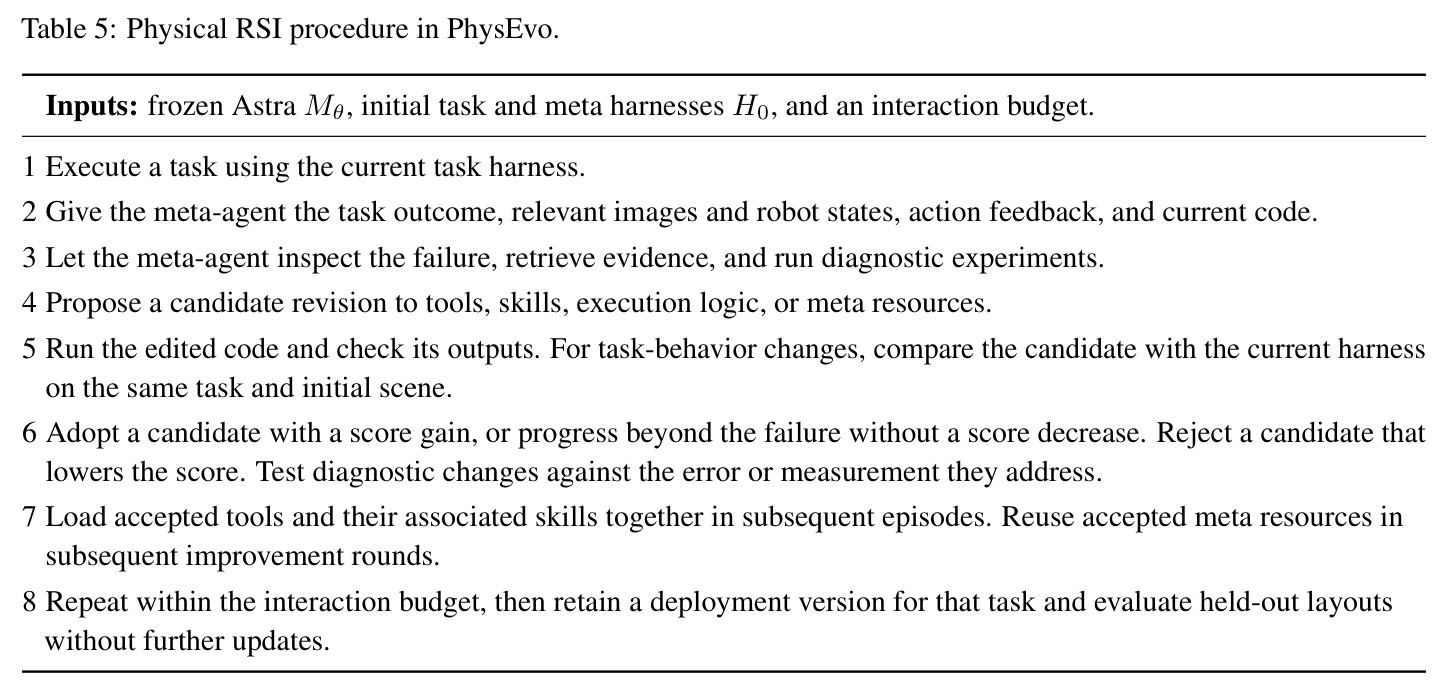
完整流程对应论文 Table 5 的八步。步骤 1,任务 agent 用当前任务 harness 执行任务,期间可在线纠错并回看本回合历史帧(review_frames 取回早前图像与对齐状态但不推进物理;project_pixels、triangulate_point、triangulate_temporal_point 用相机标定和机器人几何做确定性几何计算,不使用隐藏物体坐标)。步骤 2-3,元 agent 获得任务结果、相关图像、机器人状态、动作反馈和当前代码,检查失败、检索证据、运行诊断实验。步骤 4,提出候选修订,可改变动作/观测工具、执行逻辑、技能或元资源。步骤 5,先运行编辑后的代码验证输出,行为类改动则与当前 harness 在同一任务同一初始场景上对比。步骤 6 是采纳准则:得分提升、或「越过原失败点且不降分」则采纳,降分则拒绝;诊断工具类修订对照它要解决的误差或测量目标验证。步骤 7,被接受的工具连同其配套技能在后续回合一起加载,被接受的元资源在后续改进轮复用。步骤 8,在交互预算内重复,最终为每个任务固定一个部署版本,在 5 个 held-out 布局上评分且不再更新。评分前重置会话上下文、历史帧索引和可写记忆;开发资源跨任务共享,但任务 agent 层面只共享工具与任务无关技能,任务特定技能保持任务本地。
技术新颖性
逐条对比已有工作可见其新颖性。相对 Reflexion(保留文字反馈)和 GEPA(从轨迹进化提示词),PhysEvo 修改的是可执行的工具代码且直接连到物理动作;相对 SICA、Darwin Gödel Machine 等代码 agent 自我修改,修订后果是不可逆的物理执行,测试协议必须包含真实回滚场景对比;相对 Hyperagents 的机器人实验(为 PPO 控制器进化奖励,优化器独立于执行者),PhysEvo 用同一个冻结模型既做机器人决策又做软件修订,没有独立优化器或训练循环;相对 SHAPER(冻结模型任规划器+优化器但固定动作接口与执行器),PhysEvo 连动作与观测接口本身也被进化——论文证明关节级控制、review_frames、三角测量工具都是 RSI 的产物而非人工预设;相对 Zetta(围绕冻结动作策略进化批评者与恢复机制),PhysEvo 完全没有冻结的动作策略,所有动作经由修订过的接口由模型闭环产生;相对 HarnessPAI(每个 rollout 内固定高层程序),PhysEvo 的部署版本只在任务内固定、跨回合持续演化诊断能力。「工具与其技能指导绑定更新」和「诊断资源的递归复用」是工程与概念上的双重贡献。
实验结果
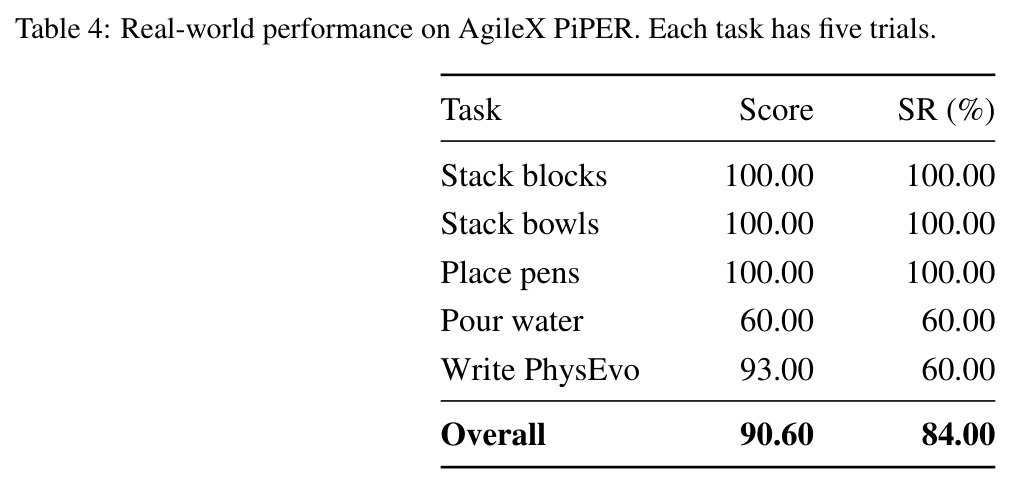
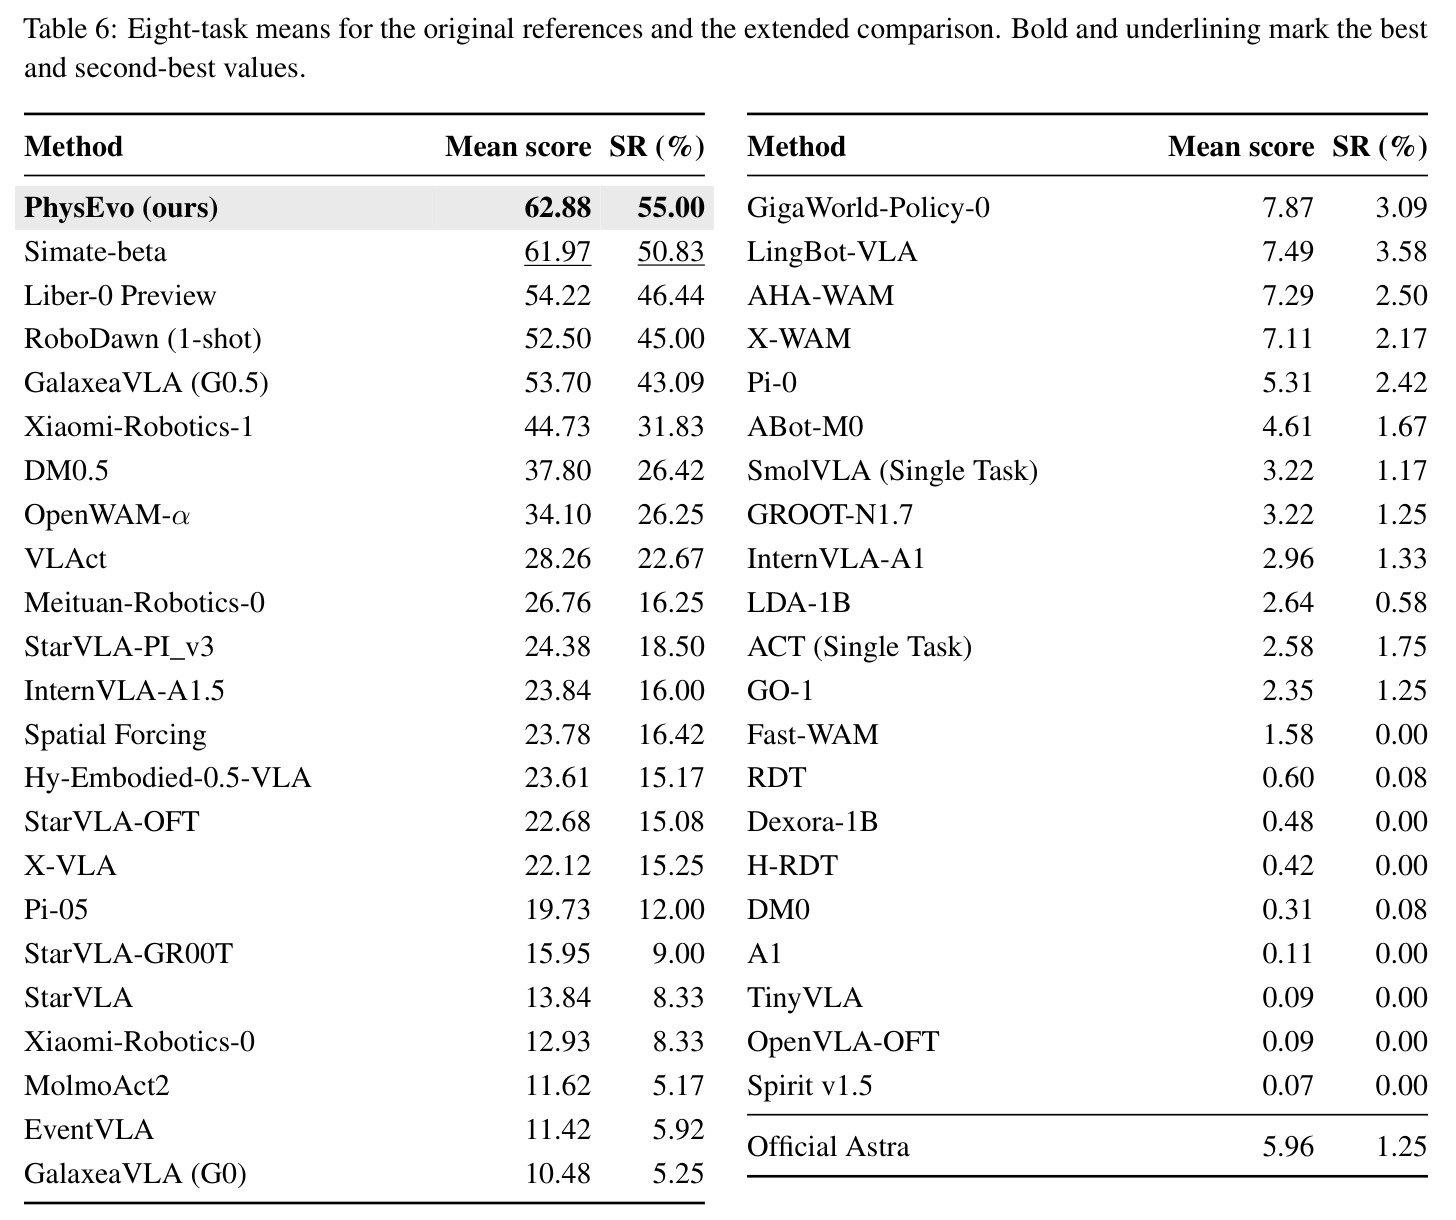
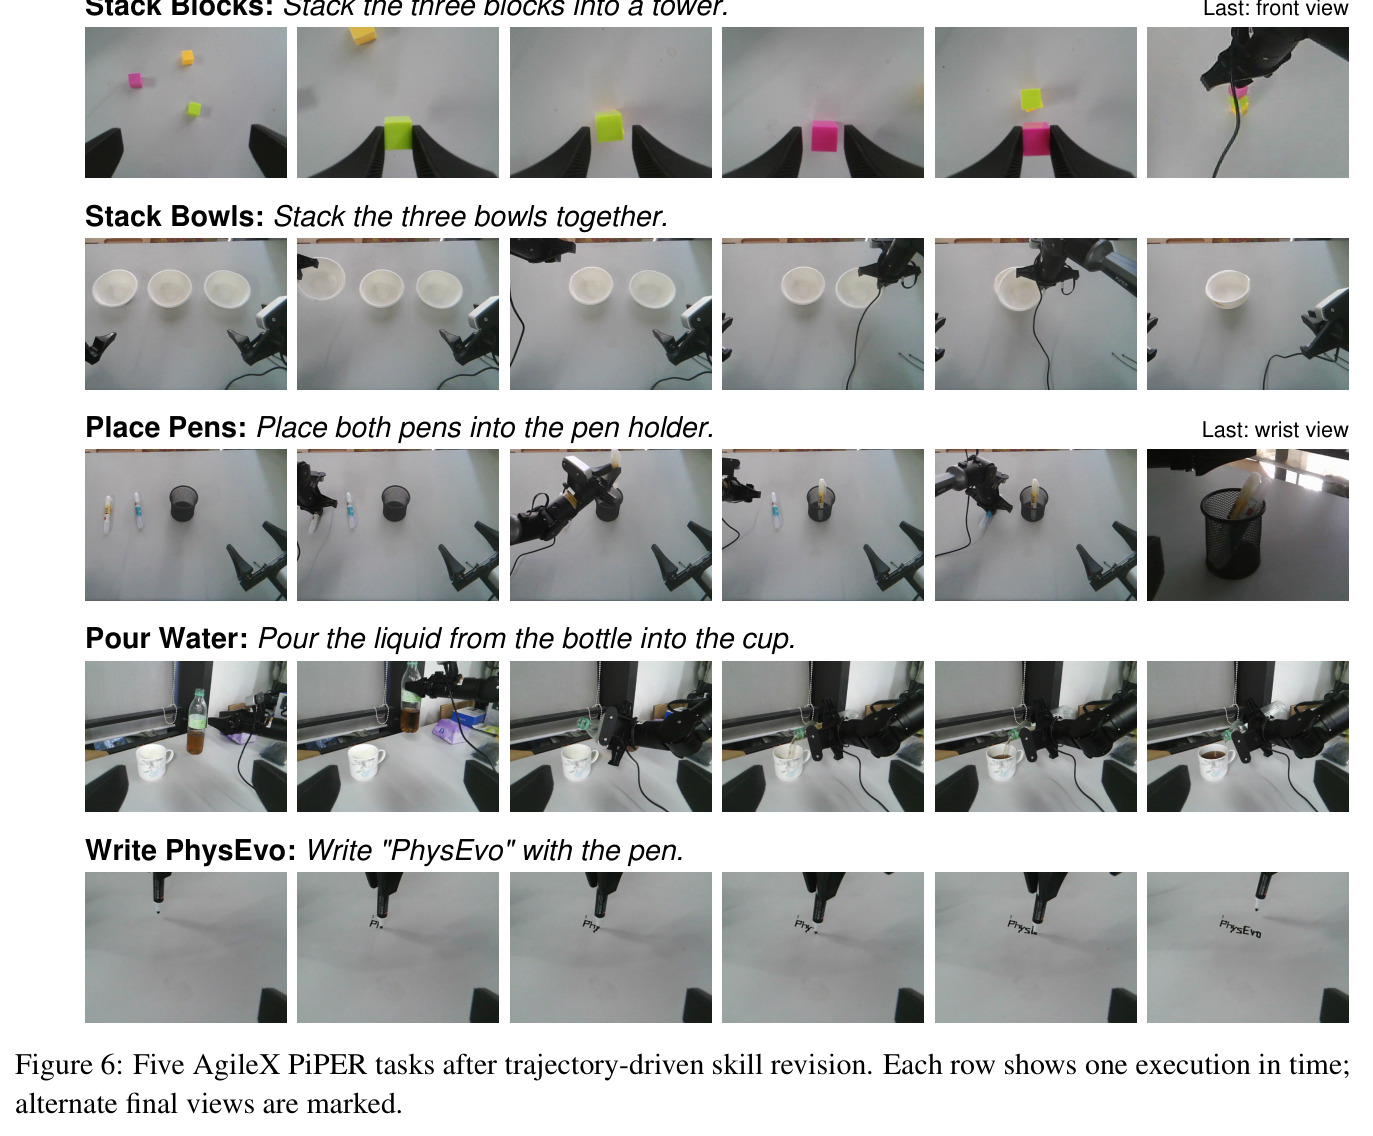
论文跑了四组仿真实验加一组真机实验。(1)RoboDojo 42 任务五维等权加权:PhysEvo 得 68.14/100 分、62.00% 成功率,比最强已发表参考 RoboDawn one-shot Astra(54.63 分、47.17% SR)高 14.83 个百分点;分维度看,记忆维度 100% vs 53.33%(+46.67pp)、开放任务 80.00% vs 62.50%(+17.50pp)、精度 40.00% vs 25.00%(+15.00pp);若 42 任务等权平均则为 65.00 分、58.57% SR。(2)十任务 GPT-as-Policy 集合:PhysEvo 79.80 分、68.00% SR,超过 Direct Astra(38.50、26.00%)和 Hybrid Astra+π0.5(62.60、48.00%),相对 Direct 在 8 个任务提升、2 个持平,其中语言分类、模仿排序、最大数排布均达 100% SR。(3)由 RoboDojo 官方报告定义的八个「挑战直接 Astra」操作任务(VLA SR≥20% 且 Astra SR<5%):PhysEvo 62.88 分、55.00% SR,对比官方 Astra 的 5.96 分、1.25%(+53.75pp),也超过 Simate-beta 的 50.83%、Liber-0 Preview 的 46.44%、RoboDawn 的 45.00% 和 GalaxeaVLA G0.5 的 43.09%;倒球入瓶从 RoboDawn 的 0% 提到 80%,倒液入杯从 80% 提到 100%。(4)十任务与八任务并集共 16 个不同任务、80 次尝试:75.06 分、65.00% SR。(5)真机 AgileX PiPER 上部署仿真进化框架并继续修订技能,5 任务×5 试验共 25 次:平均 90.60/100 分、84.00% SR,叠块/叠碗/放笔各 100%,倒水和写「PhysEvo」各 60%。(6)机制层面:控制接口对照实验(固定模型、技能、初始化与预算,2 布局 6 回合)TCP=40、Joint=100、Both=55,说明工具菜单更大不等于更好;几何工具合成标记测试接受 8/12 个点,中位误差 0.615mm、95 分位 1.437mm,腕部相机平移约 57.525mm 时标记误差约 2.14mm。三个案例研究分别展示了姿态控制权(TCP 折臂→关节重构恢复)、动作中的证据维持(倒水技能改为自由臂全程保持侧视后成功)和诊断工具的递归继承(复用早前自建复盘工具定位装箱失败根源)。
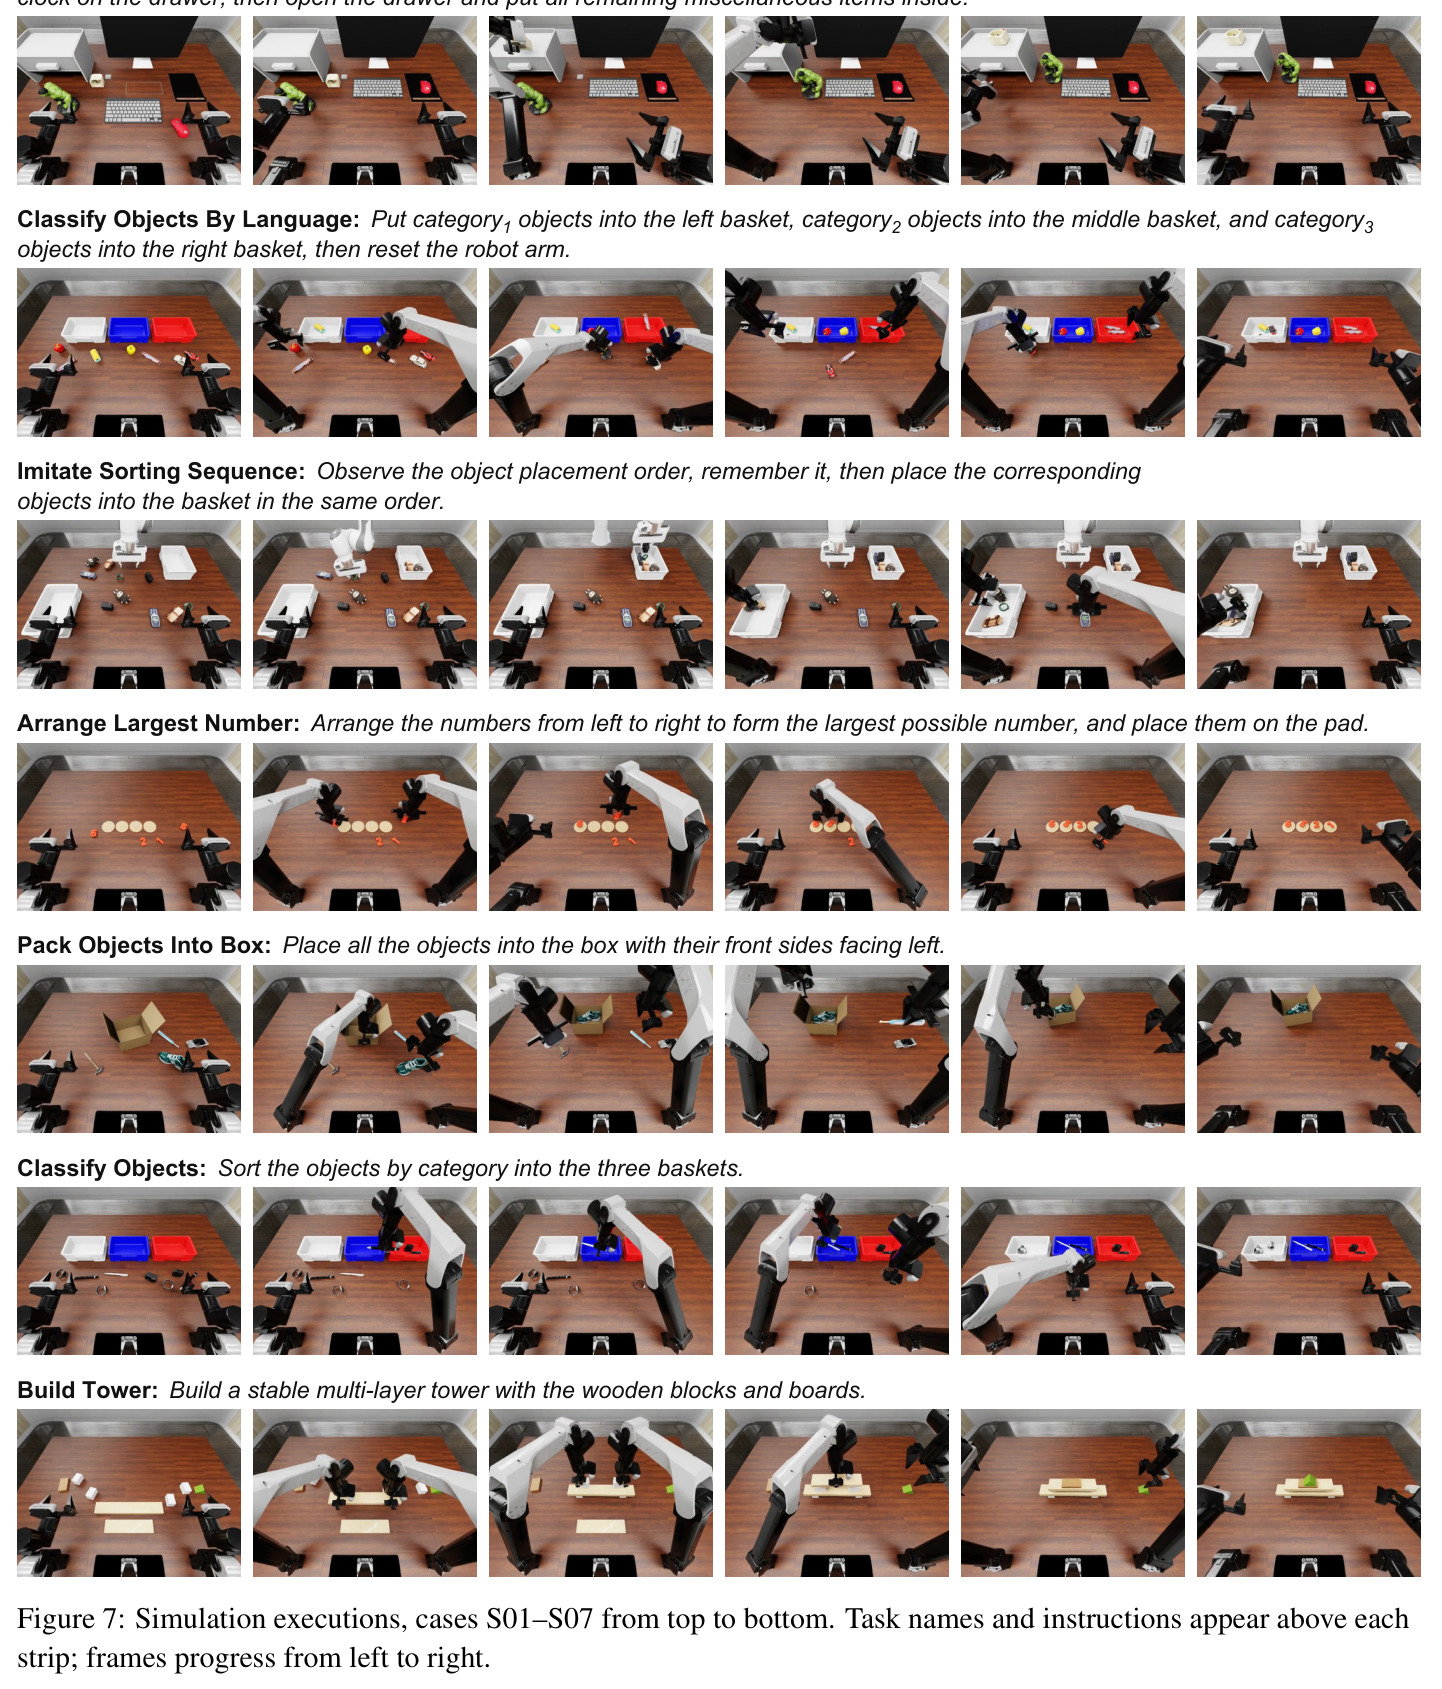
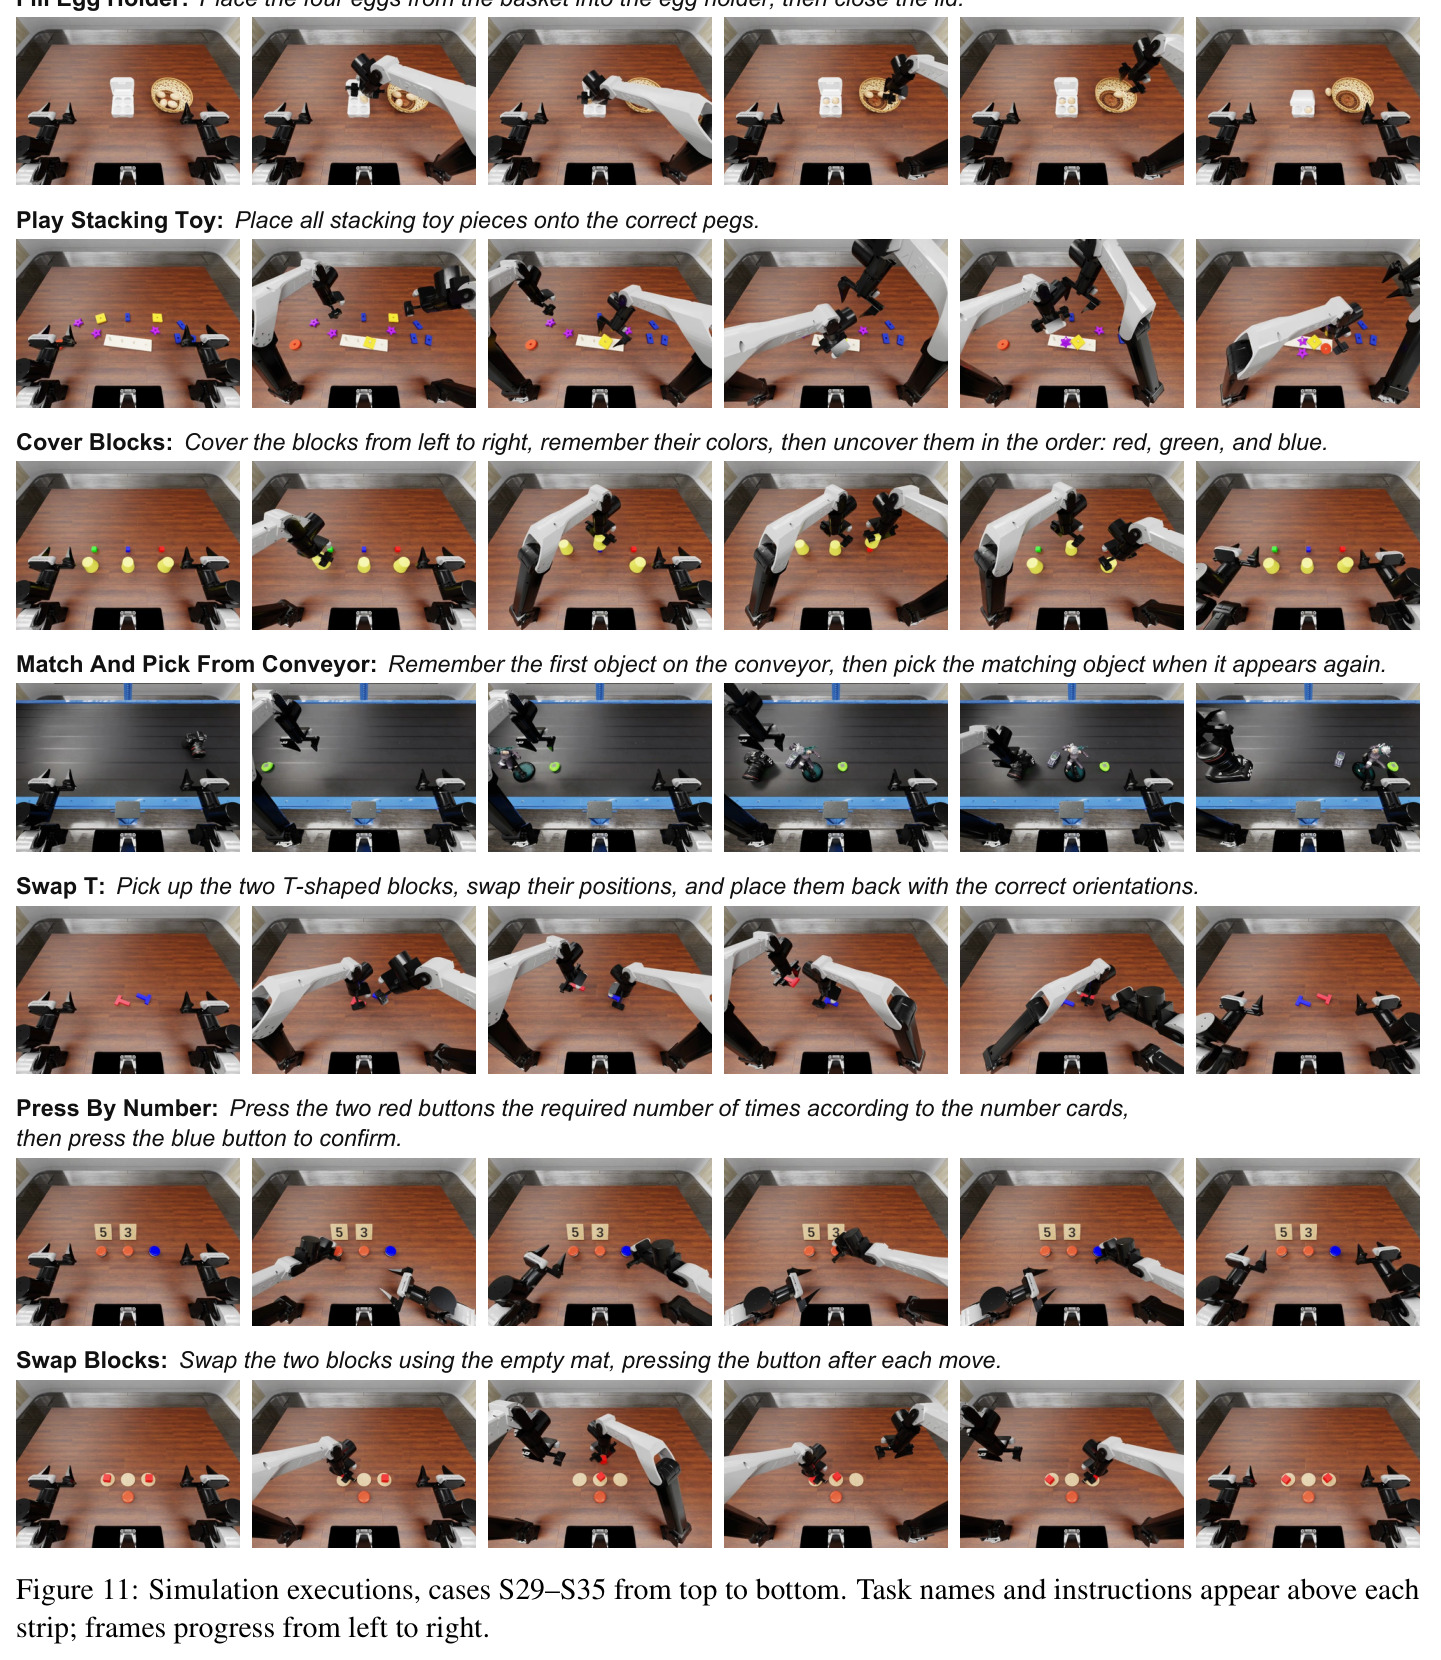
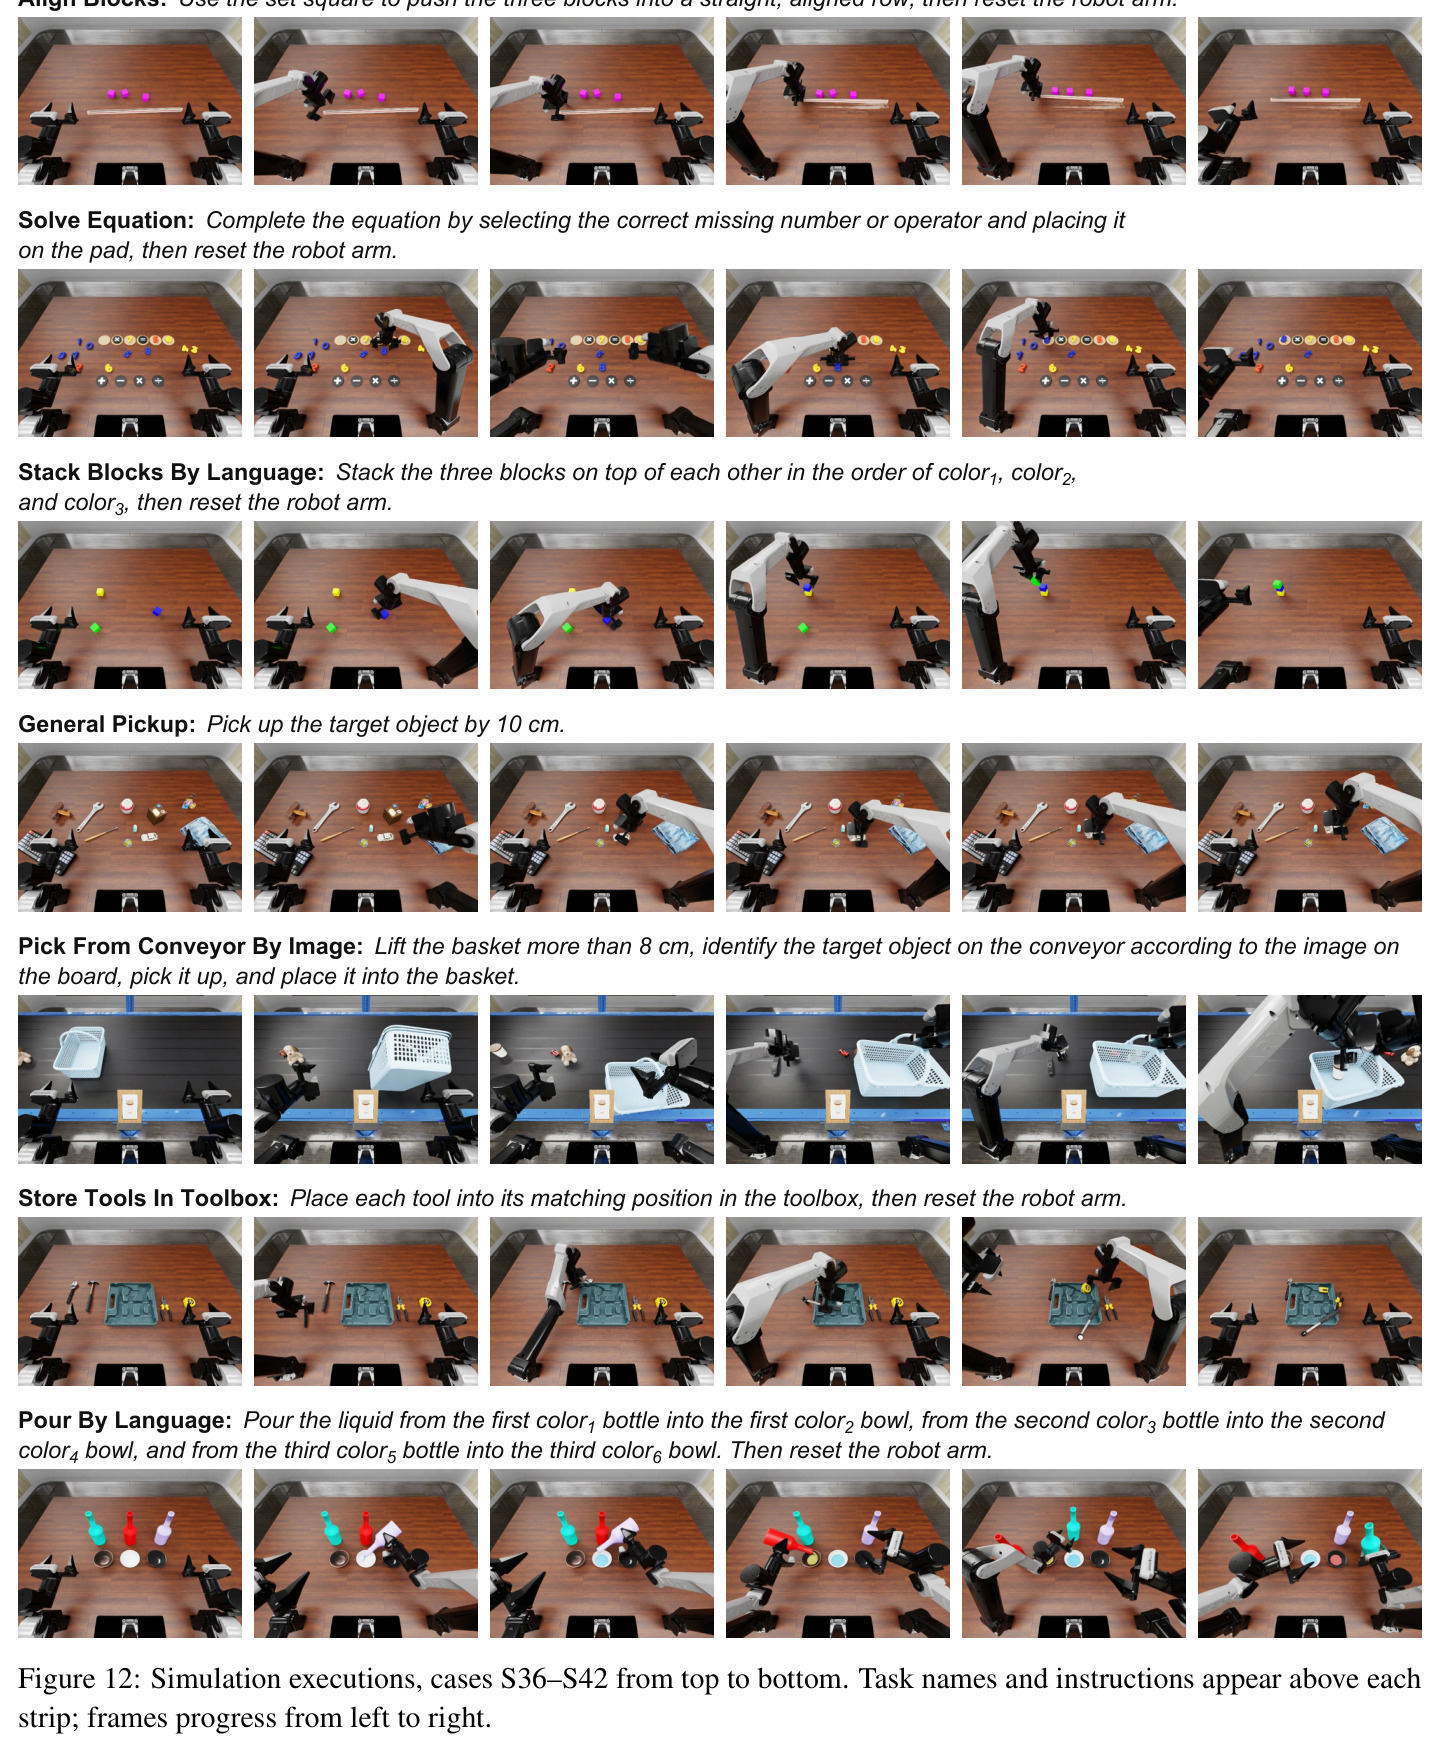
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboDojo 42 任务(五维等权加权) | 成功率 SR (%) | 62.00 | RoboDawn one-shot Astra 47.17(最强已发表参考) | +14.83 个百分点 |
| RoboDojo 42 任务(五维等权加权) | Score (/100) | 68.14 | RoboDawn one-shot Astra 54.63 | +13.51 分 |
| RoboDojo 记忆维度 | 成功率 SR (%) | 100.00 | RoboDawn one-shot 53.33 | +46.67 个百分点 |
| 十任务 GPT-as-Policy 集合 | 成功率 SR (%) | 68.00(Score 79.80) | Hybrid Astra+π0.5 48.00;Direct Astra 26.00 | 较 Hybrid +20.00pp,较 Direct +42.00pp |
| 八任务操作挑战集(Astra SR<5%) | 成功率 SR (%) | 55.00(Score 62.88) | Direct Astra 1.25;最强机器人策略 Simate-beta 50.83 | 较 Direct +53.75pp,较 Simate-beta +4.17pp |
| 倒液入杯 / 倒球入瓶(八任务子集) | 成功率 SR (%) | 100 / 80 | RoboDawn one-shot 80 / 0 | +20pp / +80pp |
| 真机 AgileX PiPER 五任务(部署后继续适配) | 成功率 SR (%) / Score | 84.00 / 90.60 | 无同设置对照(直接 Astra 类方法在该类任务上接近失败) | — |
| 控制接口对照(语言分类任务,6 回合) | 平均 Score | Joint=100 | TCP=40,TCP+Joint=55 | Joint 较 TCP +60 分 |
局限与改进
作者承认的局限:真机验证仅覆盖 5 个任务、每任务 5 次试验,且倒水与写字两个任务只有 60% 成功率,说明精细操作在真机上仍不稳定;仿真进化与真实评测之间存在 sim-to-real 差距,论文用「部署后继续修订技能」缓解而非消除。我自己观察到的局限:其一,每个任务保留独立部署版本、任务特定技能保持任务本地,意味着跨任务知识迁移有限,42 个任务各自消耗开发预算,成本随任务数线性增长;其二,修订采纳以评测分数为标准,虽然 held-out 布局防止了对评分场景的过拟合,但任务集合固定,改进可能过拟合于这 42 个任务的结构与评测器偏好;其三,全系统依赖 GPT-6 Astra 这一前沿专有模型,更弱或更小的模型能否驱动同样的诊断-修订循环完全未验证;其四,部分高灵巧任务仍大幅落后于专门 VLA——建塔只有 20%(G0.5 为 78.67%)、笔筒填充 0%,说明纯「接口进化」路线在需要连续灵巧操作的任务上有天花板;其五,真机上自我修改 harness 的安全性(误修订导致的危险动作)未被系统讨论;最后,开发阶段消耗的仿真交互总量(多少回合、多少 token)未在正文量化,性价比难以评估。
独立分析的弱点
第一,任务本地化的技能存储:任务特定技能不跨任务共享,倒水任务学到的「补偿液流动量」教训无法自动惠及类似的倾倒任务。改进方向是建立带检索的技能库,按任务语义相似度推荐可迁移技能,或让元 agent 沉淀「如何为新任务写技能」的元技能。第二,分数驱动的修订选择有过拟合评测器的风险:采纳准则只看同一场景的分数变化,一个修订可能在测试场景有效但在细微变化下失效。改进方向是为每个修订跑一个小型回归测试套件(多个扰动布局),或引入对修订幅度的正则化(如 RRSI 的做法)。第三,对 GPT-6 Astra 的强依赖:诊断-修订循环要求模型具备很强的长上下文代码理解和视觉推理能力。改进方向是研究自我改进能力的模型规模相变点,或把成功的诊断-修订轨迹蒸馏到更小的开源模型。第四,真机安全缺位:元 agent 直接修改真机执行的代码与技能,一个坏修订可能造成硬件损坏。改进方向是给元修订加沙箱化验证(几何可达性检查、力矩/速度包络约束、安全边界内的受控测试)。第五,高灵巧度任务的天花板:建塔、笔筒等任务上明显落后于 G0.5 等 VLA。改进方向是混合架构——用进化出的 harness 在 VLA 之上做监控、恢复与纠错,或让 PhysEvo 的成功轨迹自动生成 VLA 微调数据,形成两条路线的互补。
未来方向
作者明确指向的方向:真实世界的长期持续部署——目前真机部分只是「部署后继续适配」的初步演示,更长周期、更多任务、非平稳环境下的持续自进化是自然延伸。基于论文成果可延伸的方向:(1)把「诊断资源的递归继承」形式化为可度量指标(诊断工具库的覆盖率、复用率、每次诊断的平均工具调用数),研究其与改进效率的因果关系;(2)跨机器人本体迁移:PiPER 上学到的技能文档和观测策略能否迁移到其他臂型,检验「技能=工具使用条件知识」这一表示的普适性;(3)自动扩展任务集:结合 Dream-RSI 式的世界进化,让系统在仿真中自动发现新任务与新失败模式,摆脱对人工设计任务集的依赖,也缓解对固定评测器的过拟合;(4)观测策略反哺硬件:进化出的「自由臂保持侧视」等观测行为可以反过来指导固定相机的最优布置方案;(5)多 agent 协同:让多个任务 agent 共享一个元 agent 的改进成果,研究改进的并行化与冲突消解;(6)理论层面,为「修订-测试-采纳」循环建立收敛性或安全性的形式保证。
复现评估
中等偏难。有利因素:评测基准 RoboDojo 公开(有公开排行榜与 Astra 评测报告,robodojo-benchmark.com),RoboDawn 的评测记录公开(robodawn.top),论文中所有对比数字均可核验;附录 A/B 给出了完整的 RSI 流程、评分聚合公式与信息访问边界;附录 F 极其详细地给出了任务 agent 的输入上下文 JSON、函数调用格式和全部 7 个工具的参数语义(如 triangulate_temporal_point 要求 stationary_target 与 camera_hand_empty 两个布尔前提及 24 步内的采样约束),相当于一份可实现的接口规格书。不利因素:PhysEvo 本身在论文正文中没有给出代码或进化出的 harness 开源链接;整个系统依赖 GPT-6 Astra 这一专有前沿模型(API 可得性与成本是硬门槛),且进化开发阶段消耗的仿真交互预算总量未披露;真机部分需要 AgileX PiPER 双臂平台、相机标定与五任务评分规程。合理的复现预期:用 RoboDojo 公开环境加一个强 VLM API,按附录 F 重写任务/元 harness 骨架,可以方向性地验证「RSI 提升成功率」这一结论(例如在 3-5 个任务上),但 42 任务的完整数字、具体的工具与技能代码、每个任务的部署版本都无法直接获得,完整复现成功率数字的可能性较低。
论文图表
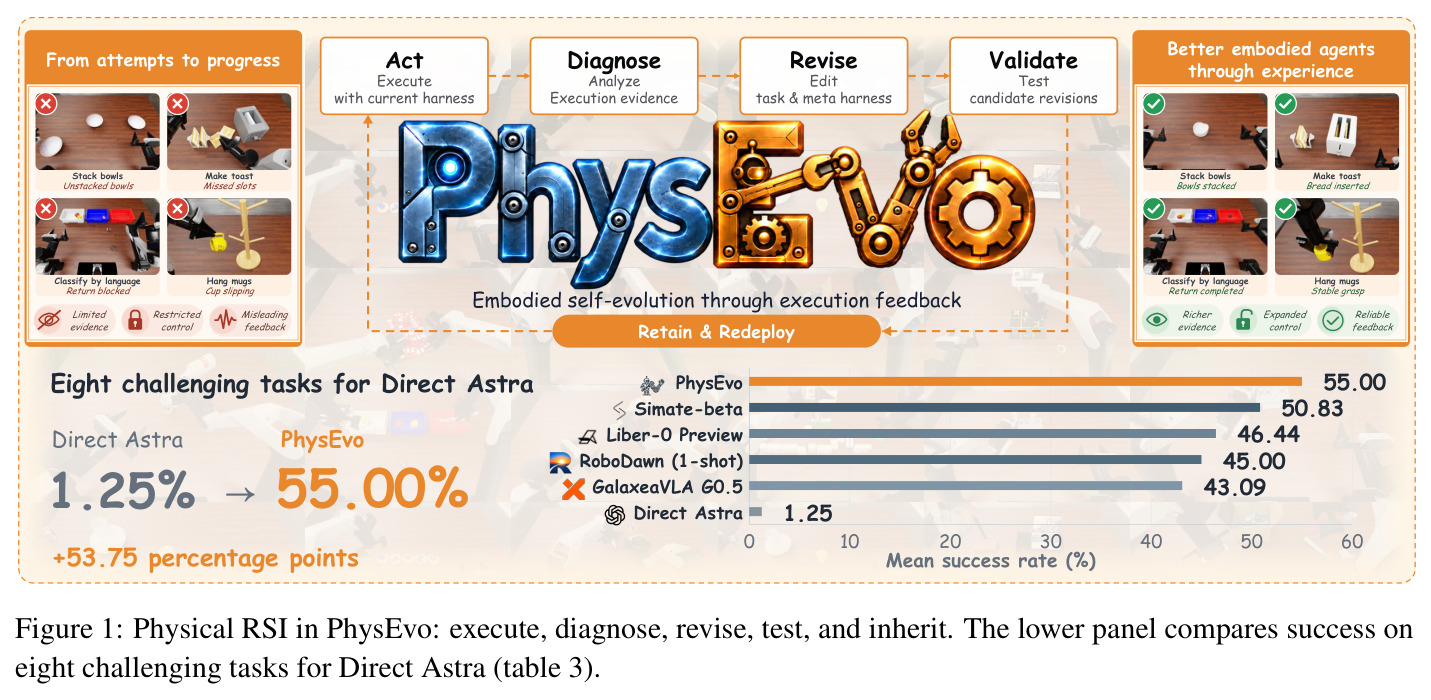
上半部分展示 PhysEvo 的闭环:Act(用当前 harness 执行)→ Diagnose(分析任务与元 harness 的执行证据)→ Revise(编辑候选修订)→ Validate(测试)→ Retain & Redeploy(保留并重部署),中间穿插倒水、装箱、语言分类、挂杯四个任务的失败与修复对照;下半部分条形图给出八个挑战任务的平均成功率:PhysEvo 55.00%、Simate-beta 50.83%、Liber-0 Preview 46.44%、RoboDawn (1-shot) 45.00%、GalaxeaVLA G0.5 43.09%、Direct Astra 仅 1.25%。
一张图同时呈现论文的核心概念(物理 RSI 循环)和最抓眼球的头条结果(1.25% → 55%,+53.75 个百分点),是读者建立全局认知的入口。
执行图集第二部分(S08–S14):麻将补杠、叠衣服、瓶子入垃圾桶(含交接)、插管、井字棋、倒球入瓶、倒液入杯。倒液入杯 100% SR 与倒球入瓶 80% SR 的任务就在此列。
包含论文重点分析的倒水任务,可对照 Figure 4 的技能修订理解改进前后行为差异。
执行图集第三部分(S15–S21):收纳笔记本与耳机、填充笔筒、叠碗、推 T 形块对齐、挂杯子、扫积木(交接扫帚+簸箕)、烤面包。
覆盖了八个挑战任务中的笔记本/耳机收纳与笔筒填充——这两个任务 PhysEvo 仍为 0% SR,是理解方法局限的直观材料。
执行图集第四部分(S22–S28):按尺寸排套娃、叠积木、拧螺丝、插充电器、敲木琴、投硬币、插钥匙并转动。
展示精度类任务的实际执行质量,对应五维加权中精度维度 40% SR 的构成。