BrickBench:评测智能体文本条件乐高设计能力的基准 BrickBench: Evaluating Agentic Brick Design
首个评测编码智能体按文本搭建可真实拼插乐高作品能力的基准
前置知识
LDraw
社区维护的数字乐高建模标准与零件库,每个官方零件都有精确几何模型与配色;装配表示为文本文件,每个实例由零件类型、颜色和 6D 位姿(位置加姿态)定义。LDraw 只负责描述,本身不判定装配是否成立——能否拼上、稳不稳需要外部工具验证,这正是本文要补上的环节。
本文全部输入输出都在 LDraw 世界里:智能体产出 LDraw 装配文件,BrickAgent 环境与校验器也构建在其零件库(BrickNet 支持 14,441 种零件类型)之上,不懂 LDraw 就无法理解任务的表示层。
BrickNet 类型化连接器系统
把每个 LDraw 零件标注上一组连接器,每个连接器有类型、子型、极性和坐标系。兼容的连接器对(如凸点配孔、杆配夹)在容差内对齐即判定两零件连接;极性用于区分铰链、球关节的两半,必须相反才能接。五种类型决定自由度:stud 允许绕轴转,hinge 允许转动加翻转,axle 额外允许滑动,ball 自由转动,fixed 无自由度。装配的连接关系因此构成零件图。
连通性判定、稳定性仿真的刚体划分(按连通分量)、以及 BrickAgent 按连接器放置零件的工具全部建立在这个表示上,它是全文物理验证的地基。
Bradley–Terry 模型与 ELO
从成对比较的胜负记录估计每个对象强度的统计模型,假设 $i$ 胜 $j$ 的概率为 $P(i \succ j) = e^{R_i}/(e^{R_i}+e^{R_j})$,用极大似然拟合出各对象相对分。ELO 分差可解释为胜率:相差约 400 分对应约 91% 的胜率。本文把 VLM 对装配对的两两判决喂给该模型,得到 Align ELO 与 Design ELO。
论文最核心的结论(如 GLM 与 Astra 的 Design ELO 相差 545 点、约 96% 配对偏好 Astra)都建立在这个模型的分数解释上,不懂它就读不懂结果表。
DSG 问题图
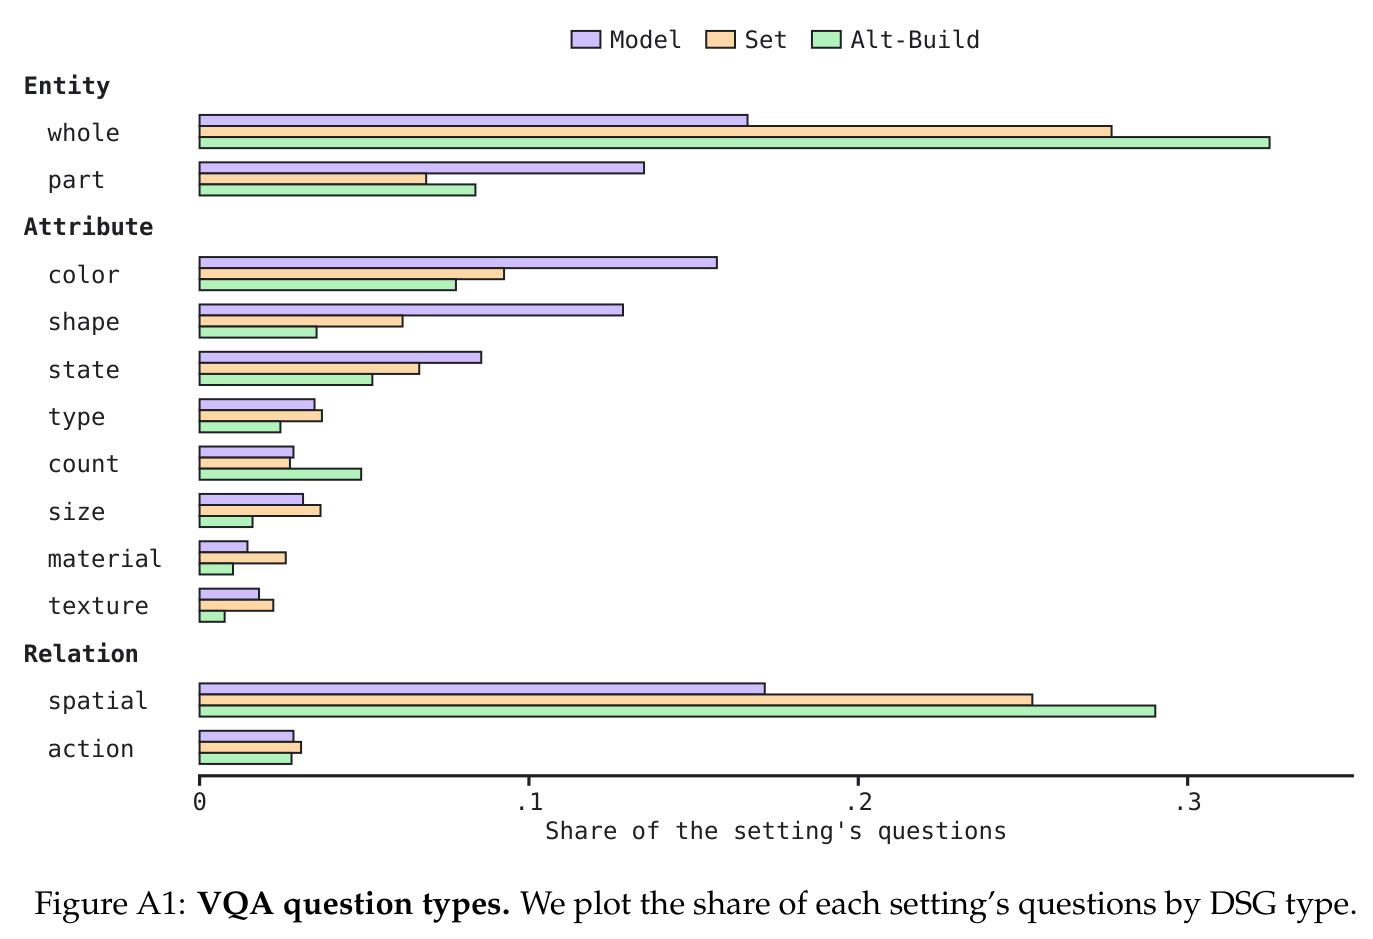
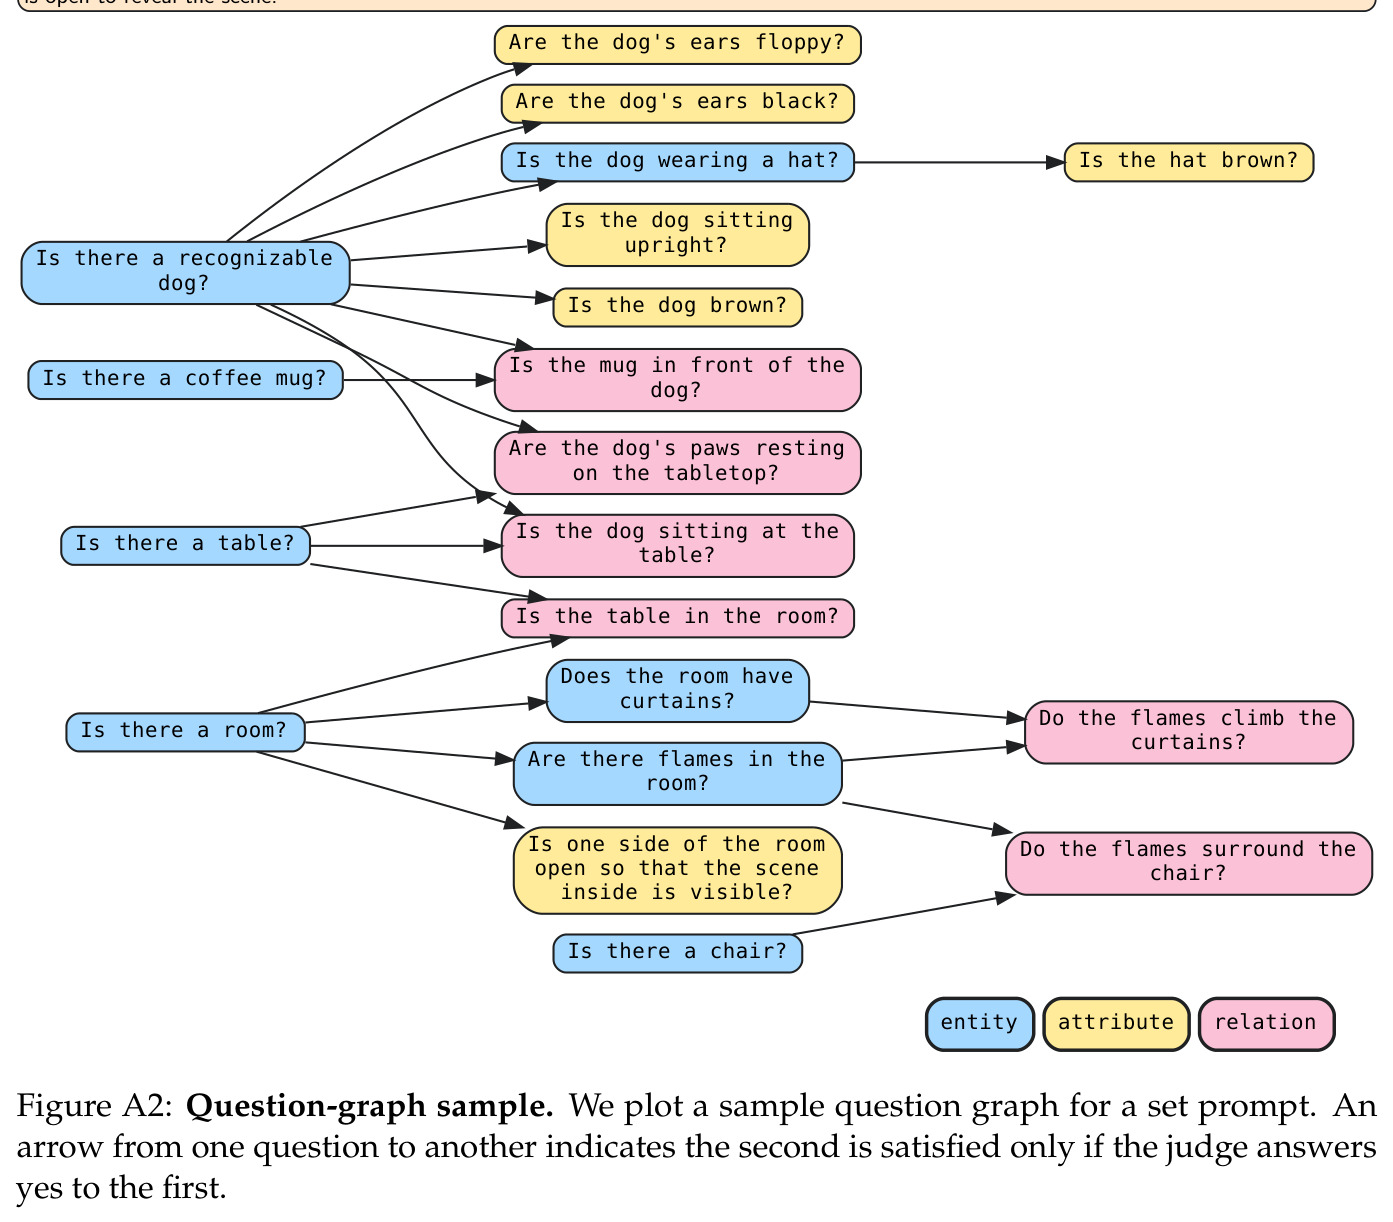
一种文本生成评测协议:用 LLM 把提示词分解成原子化的 yes/no 问题,并按依赖关系组织成图——先问实体是否存在,再问其属性、实体间关系;上游失败时下游问题自动失效。例如骑士的存在未确认前,不问其盔甲颜色。最后用 VLM 按图逐题作答,得分为满足问题比例。
本文的 VQA 指标完全采用该协议,理解它才能明白 0.954(Astra)与 0.590(GLM)这些数字到底在度量什么、为什么它比整体渲染相似度更可靠。
PyBullet 稳定性仿真
开源物理引擎。本文把装配的每个连通分量当作均质刚体,设置高摩擦、零弹性(分量间接触不滑不弹),施加重力仿真:任何一点位移超过 3 LDU(约一个凸点高度的 3/4)即判不稳定;有碰撞的装配在仿真前直接判无效。凸点夹持力、轴的旷量等效应不建模。
Valid 指标的物理基础全在这里,也是作者自认的最大局限(未建模连接强度)所在,是理解评测口径与现实可搭性之间距离的关键。
研究动机
现有乐高生成评测存在两个断层。其一是物理复杂度不足:专用模型 BrickGPT 与 BrickNet 只在至多 100 个零件的小物体上评测(BrickNet 验证集仅 512 条图注),与真实零售套装动辄数百上千个互连零件、且受零件库存约束的场景相去甚远。其二是评测维度缺失:现有指标只覆盖“能不能拼”(有效性)和“像不像”(对齐),完全没有度量“值不值得搭”的设计质量——用件巧思、形状比例、表面细节,而设计质量恰恰没有 pass/fail 判据。作者先做了个诊断实验:GPT-5.6 Luna 在 BrickNet 验证集上取得 PE 0.313、SigLIP 2 0.818、VQAScore 0.732,与真值装配(GT 为 0.315/0.826/0.748)差距不足 0.02,已实质饱和;而专用基线 BrickGPT 三项只有 0.157/0.052/0.050,BrickNet-14B 也仅 0.283/0.625/0.602。这说明通用编码智能体已碾碎旧基准的区分度,必须转向更大规模、带库存约束、且能评测设计质量的新基准。
本文的目标是本文目标是构建 BrickBench——面向智能体“文本条件乐高套装设计”的基准,并在三个层面给出可信评分:物理有效性(零件数约束、无碰撞、PyBullet 重力仿真下稳定)、语义对齐(把提示词分解为 DSG 式原子问题图,VLM 逐题判 yes/no)、设计质量(VLM 成对判决拟合 Bradley–Terry 模型得到 ELO,分 Align 与 Design 两问,并用人类研究校准裁判)。基准包含 300 条提示词、三种设定(Model 至多 400 件、Set 400–4000 件、Alt-Build 固定 783 件库存的套装 10698),并配套 BrickAgent 构建环境。作者还要系统评测 11 个前沿编码智能体与 2 个专用生成模型,定量回答四个问题:有效性是否已解决?对齐是否饱和?设计质量与人类差距多大?成本与性能是否成正比?
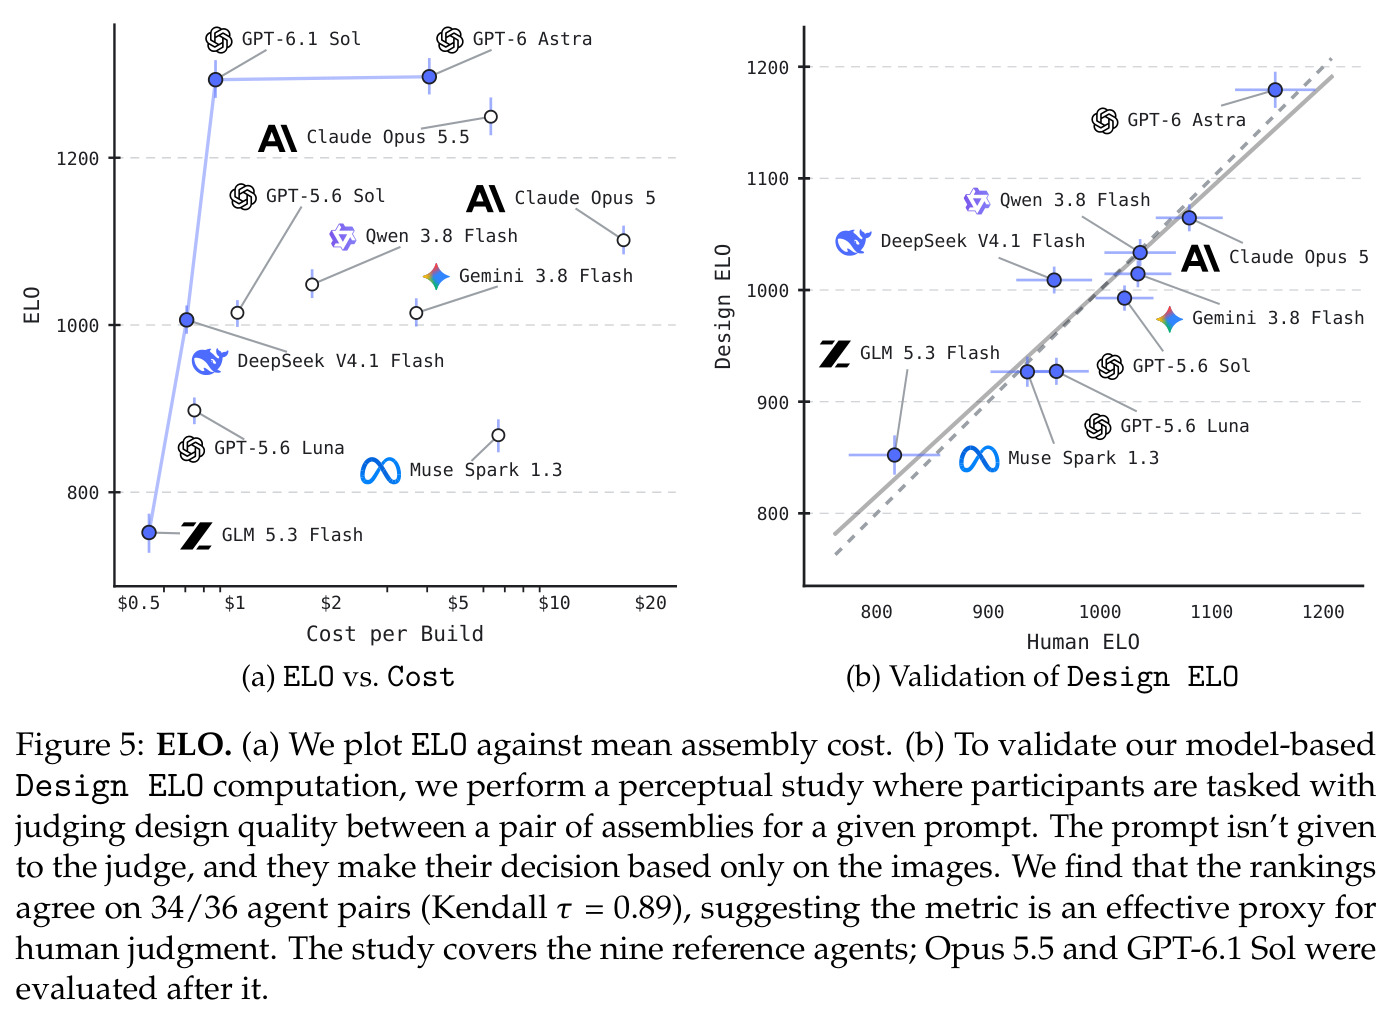
与已有工作不同的是,本文的独特切入在于把乐高设计形式化为“地板可验证、天花板开放”的任务:地板是能被程序自动检验的物理有效性(连通图、碰撞、仿真稳定),天花板是没有唯一答案的设计品味。作者不训练专用模型,而是押注“通用编码智能体 + 领域工具环境”这一新范式——智能体写程序、执行、渲染检查、修订,如同软件工程,这与 BrickGPT/BrickNet 的端到端生成路线本质不同。评测设计上首次把三个层次拆开打分:有效性用三重硬校验;对齐用依赖问题图避免连锁失效;设计用与 102 名人类标注者 4080 次判断校准过的成对 ELO(与人类排序 34/36 对一致,Kendall $\tau = 0.89$)。Alt-Build 设定强制使用零售套装 10698 的真实库存(783 件、104 种零件),在乐高基准中属首创,专门考察资源受限下的设计能力。
核心方法
直觉是:让通用编码智能体在一个提供乐高领域工具的环境里“写代码搭积木”,再分别用可自动验证的物理判据、可分解的语义判据和与人类校准过的审美判据打分。技术路线:底层数据采用 LDraw 社区零件库(BrickNet 支持其中 14,441 种零件类型),装配表示为零件实例(类型、颜色、6D 位姿)的集合,连接关系由 BrickNet 类型化连接器系统推断——两个零件的兼容连接器在容差内对齐即连接,连接图构成装配结构。BrickAgent 环境提供程序化工具:零件搜索、按位置/按连接器放置、镜像、测量、子组件定义与组合、任意视角渲染,以及一个可解释校验器(连通、碰撞、稳定三重检查并指名失败零件)。300 条提示词按 10 个主题类(城堡、载具、火车、太空、艺术、建筑、植物、动物、海盗、历史)组织,每类 10 条。智能体(多数跑在 Codex CLI、Opus 跑在 Claude Code)在三种设定下搭建,产出 LDraw 文件送入评测协议。
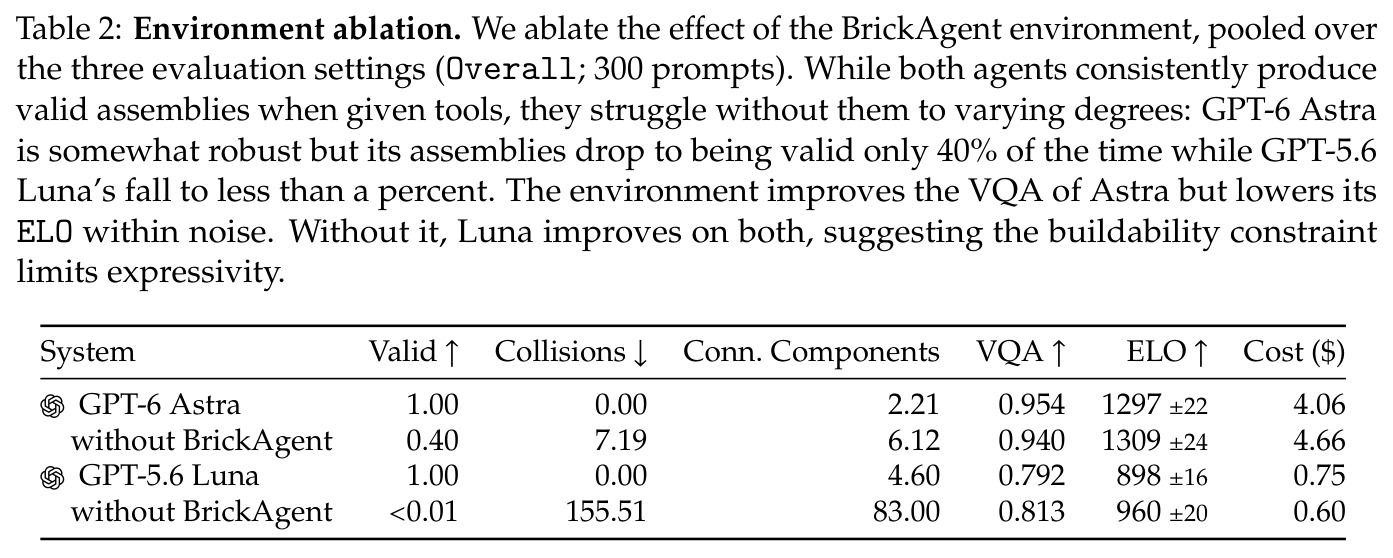
核心创新有三层。第一,范式判断:作者先证明 GPT-5.6 Luna 无需任何任务训练,在 BrickNet 验证集上全面超过专用模型(PE 0.313 对 BrickGPT 的 0.157、BrickNet-14B 的 0.283,逼近 GT 的 0.315),宣告专用生成模型路线被通用智能体取代,评测重心必须转向真实套装规模与设计质量。第二,把乐高设计拆成三个可测目标:有效性 = 零件数约束 + 碰撞容差检查 + 稳定性仿真(连通分量视为均质刚体,高摩擦零弹性,位移超过 3 LDU 判不稳);对齐 = DSG 式问题图,8 视角渲染交 Gemma 4 31B 单次作答;设计 = 成对判决,Align 问给提示词、Design 问只看图按官方套装标准评用件,双向消除位置偏差,Bradley–Terry 拟合 $P(i \succ j) = e^{R_i}/(e^{R_i}+e^{R_j})$ 得 ELO,以 9 个参考智能体锚定刻度。第三,环境本身是被评测变量:消融证明去掉 BrickAgent 工具后有效性从 100% 崩到 40%(Astra)甚至低于 1%(Luna)。
方法步骤详情
流程七步。1) 提示词构建:LLM 生成加人工校验,每设定 100 条、10 主题类各 10 条,平均长度 Alt-Build 31 词、Model 45 词、Set 57 词。2) 用 LLM 把每条提示词分解为 DSG 式问题图,覆盖实体、属性、关系并按依赖组织。3) 智能体搭建:在 Codex CLI 或 Claude Code 容器内进入 BrickAgent,搜索零件、放置或定义子组件、渲染自检、调用校验器、提交 LDraw 装配,每条提示词预算 300 轮;推理档位 Astra/Opus/Sol 用 high、Luna 用 max。4) 有效性判定:零件数是否符合设定、两两几何是否超容差碰撞、PyBullet 中各连通分量作刚体在重力下位移是否不超过 3 LDU。5) VQA:8 视角渲染,Gemma 4 31B 单次调用回答问题图全部问题,得分为满足问题比例。6) ELO:每条提示词上跨系统两两配对,Align/Design 两问各以两种顺序判,Bradley–Terry 拟合,锚定 9 个参考智能体。7) 成本按官方 token 牌价折算美元,BrickGPT 按 GPU 时折算。
技术新颖性
与已有工作的区别:对 SWE-bench、OSWorld、BlenderGym、BenchCAD 等执行式基准,BrickBench 的输出不是测试通过或渲染相似,而是真实 LDraw 零件装配,须通过连通、碰撞、仿真稳定三重物理验证;对 BuildArena、PhyBlock 等物理仿真基准,本文使用真实社区零件库与类型化连接器,规模上探到 4000 件;对 BrickGPT、BrickNet 等专用模型,本文首次给出“通用智能体 vs 专用模型”的同台对比与成本维度(900–6800 倍差距)。评测方法上,用 Bradley–Terry 把 VLM 成对判决聚合成 ELO 并非首创,但用 102 名标注者、4080 次判断验证裁判可信度(34/36 对排序一致、Kendall $\tau = 0.89$),再用“辨别人类作品”实验(323/360)量化设计差距,在乐高与 3D 智能体评测中是新的。环境消融设计(同一 CLI、同一容器、同一任务要求,只去掉工具)干净地隔离了“可验证反馈”的贡献,这一实验设计本身就是贡献。
实验结果
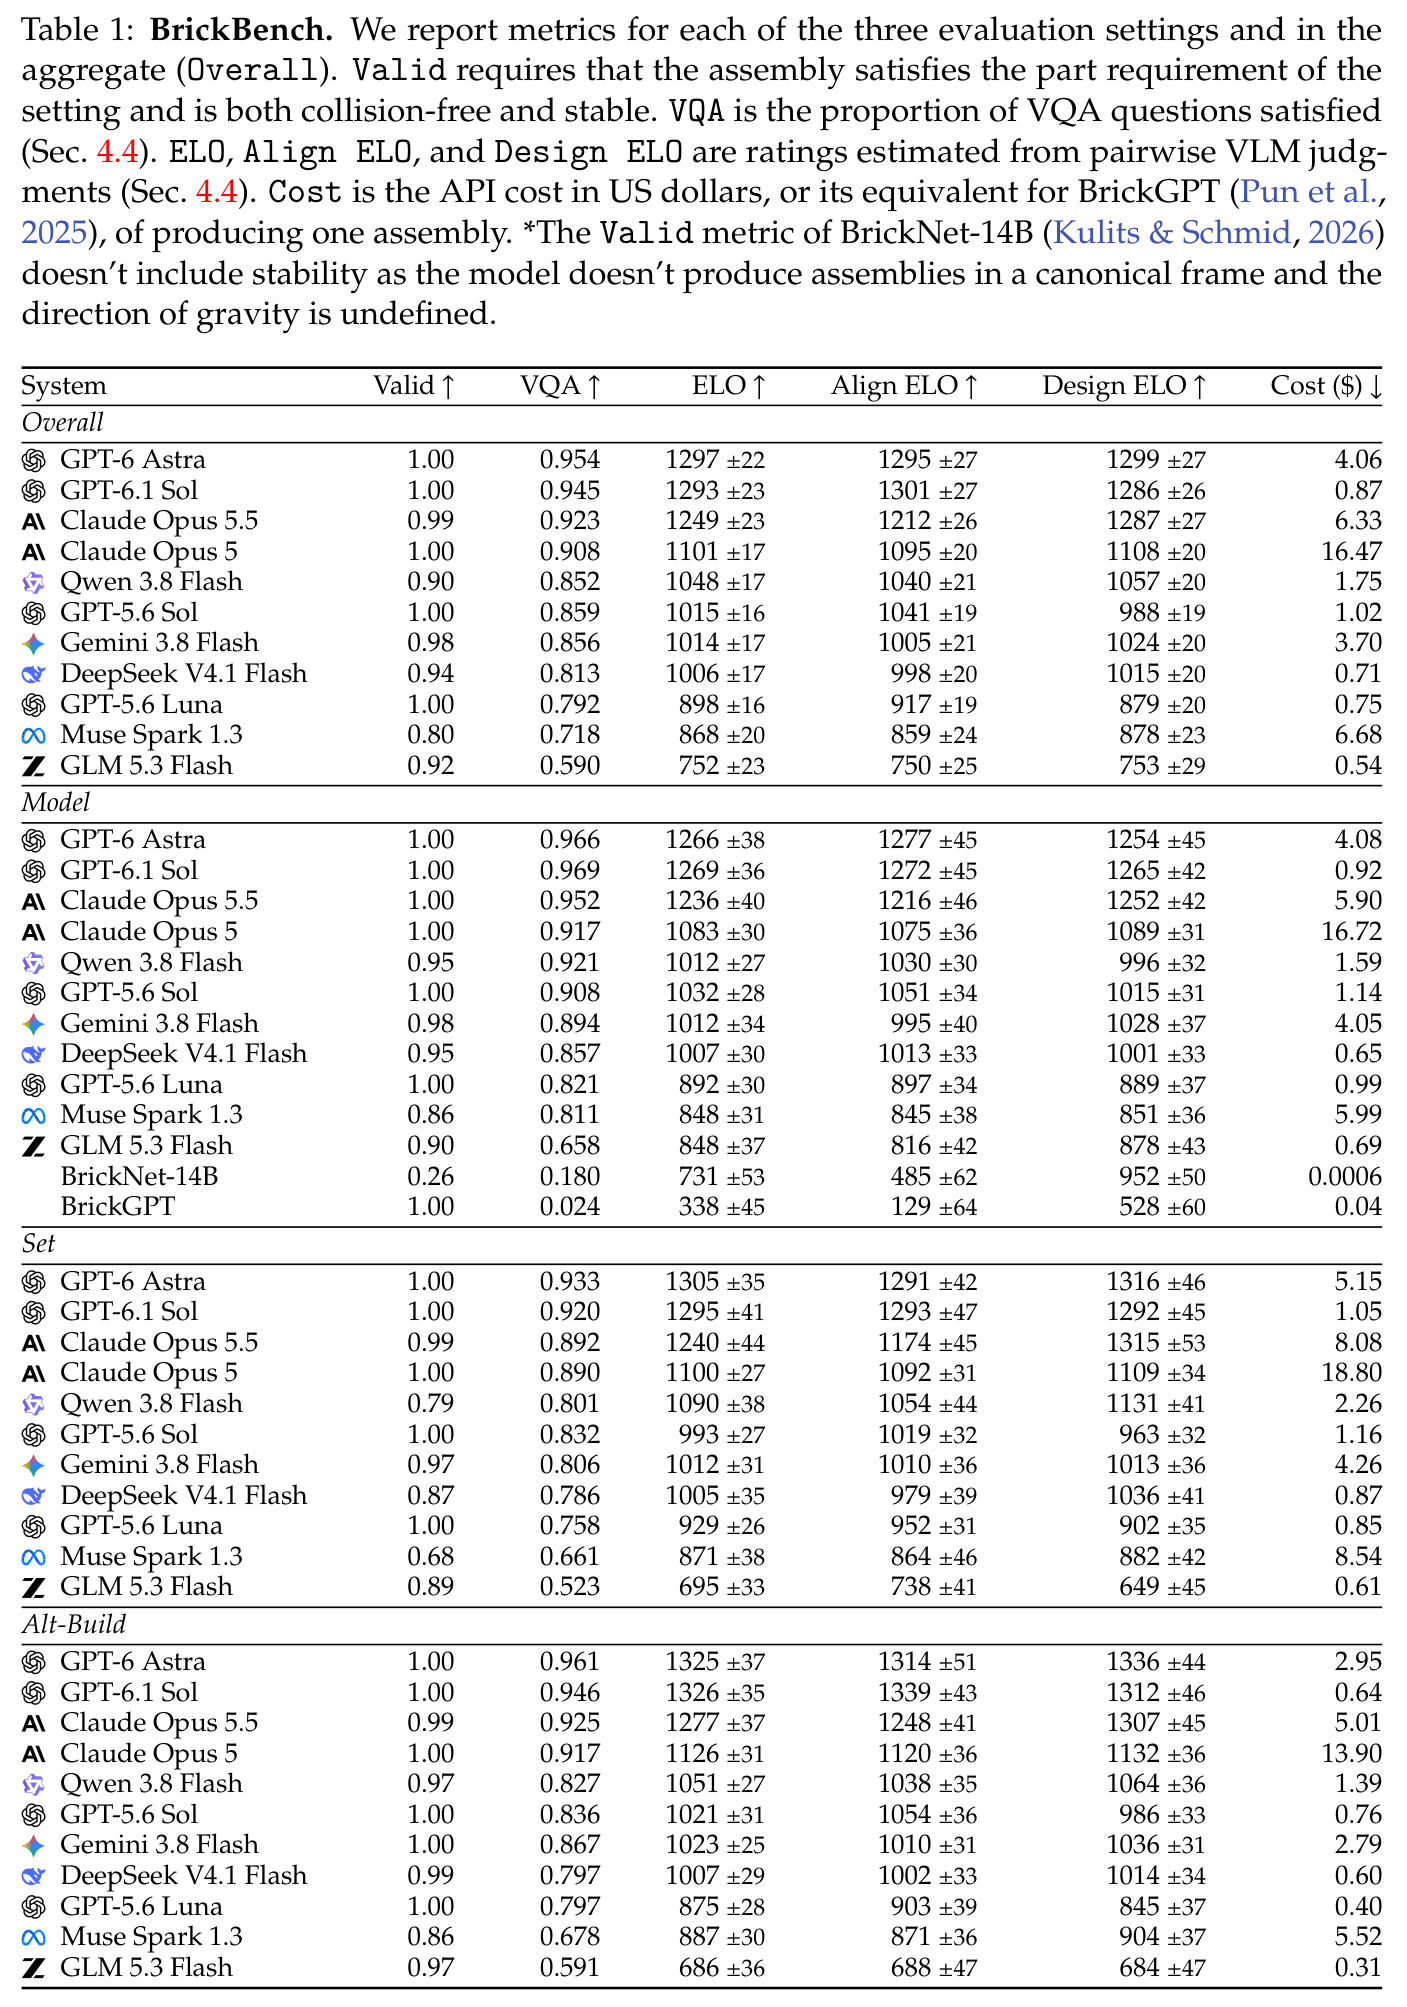
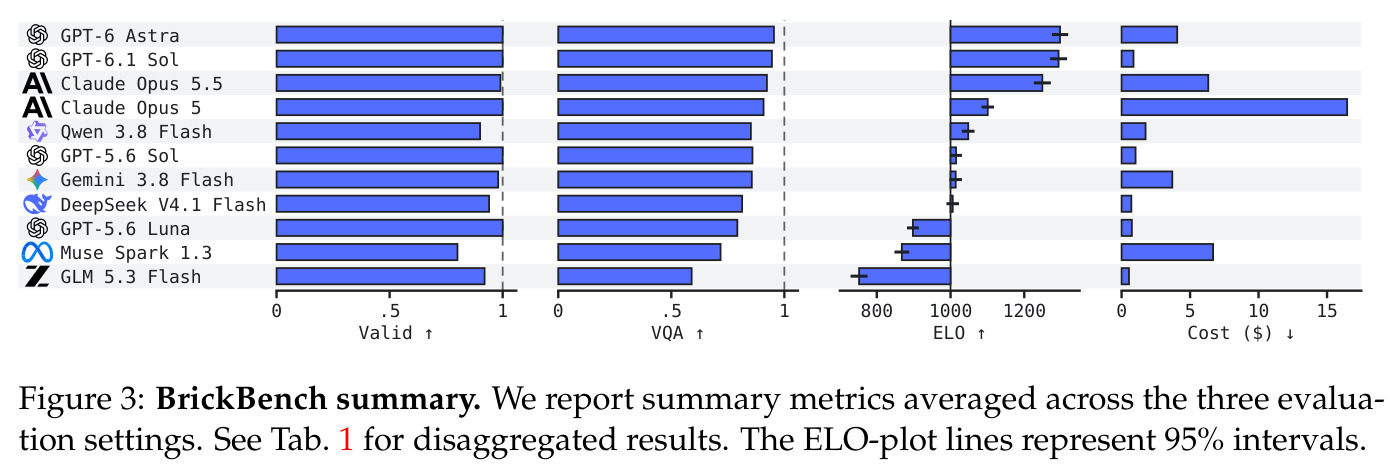
五组核心发现。1) 有效性基本解决:11 个智能体中 5 个在全部 300 条提示词上产出有效装配,最低的 Muse 也有 0.80;137 个无效装配中 44 个未交付、41 个稳定失败、31 个碰撞、21 个违反零件约束。GPT-6 Astra 全指标领先(Valid 1.00、VQA 0.954、ELO 1297±22、$4.06/件);GPT-6.1 Sol 以约 1/5 成本($0.87)达到统计持平的 ELO 1293;Opus 5.5 比 Opus 5 高 148 ELO 且成本仅 40%;GLM 5.3 Flash 垫底(VQA 0.590、ELO 752)。2) 对齐饱和、设计分化:VQA 只拉开 0.59–0.95,Design ELO 却从 GLM 到 Astra 相差 545 点,约等于裁判 96% 配对偏好 Astra;颜色问题所有智能体至少 91% 满足,纹理仅 49–83%。3) 专用模型惨败:BrickNet-14B 仅 26% 无碰撞(其 Valid 不含稳定性)、ELO 731;BrickGPT 虽 100% 有效但 VQA 仅 0.024、ELO 338。4) 环境消融:去掉 BrickAgent 后 Astra Valid 降至 0.40(平均 7.19 对碰撞、6.12 个连通分量),Luna 降至 <0.01(155.51 对碰撞、83 个分量);但 Luna 的 VQA 反升 0.02、ELO 升 62 点——不可搭建的作品反而“好看”。5) 与人类差距:360 次人判中 323 次正确选中人类作品,没有任何智能体被误认为人超过五分之一(最高的 Astra 也只有 4/21)。设定上 Set 最难(Muse Valid 0.68、Qwen 0.79),弱智能体平均拆成 23–40 个连通分量而强智能体仅 2.2–4.2;Alt-Build 成本最低、有效性最高。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本条件乐高装配设计(Overall,300 条提示词) | 物理有效率 Valid | GPT-6 Astra 1.00(11 个智能体中 5 个达到 1.00,最低 Muse 0.80) | BrickNet-14B 0.26(且不含稳定性检验),BrickGPT 1.00 | 在含稳定性、碰撞、零件约束的完整口径下,顶尖智能体把有效率从专用模型的 0.26 提升到 1.00 |
| 文本条件乐高装配设计(Overall) | VQA 语义对齐(DSG 问题图满足率) | GPT-6 Astra 0.954,GPT-6.1 Sol 0.945 | BrickNet-14B 0.180,BrickGPT 0.024 | 最强智能体比最强专用基线高 0.351(0.954 对 BrickNet-14B 0.603 之外更好的 0.180),比 BrickGPT 高约 40 倍 |
| 文本条件乐高装配设计(Overall) | ELO(Bradley–Terry 成对判决) | GPT-6 Astra 1297±22(Design ELO 1299),GPT-6.1 Sol 1293±23 | BrickNet-14B 731±53,BrickGPT 338±45 | 比 BrickNet-14B 高约 566 ELO,比 BrickGPT 高约 959 ELO;设计维度上 GLM 到 Astra 拉开 545 点,约 96% 配对偏好 Astra |
| 单件装配生成成本 | 成本(美元/件) | GPT-6 Astra $4.06,GPT-6.1 Sol $0.87,GLM 5.3 Flash $0.54 | BrickNet-14B $0.0006,BrickGPT $0.04 | 通用智能体以 900–6800 倍成本取代专用模型;性价比上 Sol 以 1/5 成本匹配 Astra 的 ELO |
| 设计质量人机对比(Model + Set 设定) | 人类作品被正确识别率 | 人类作品在 323/360 次判断中被正确选中;最强 Astra 仅 4/21 被误认为人 | 随机基线 50%(180/360) | 所有智能体的误认率都显著低于随机,量化了智能体与人类设计品味的明确差距 |
局限与改进
作者承认的局限:物理稳定性是代理指标——连接强度未建模,理论上平衡的刚体即通过,实物可能下垂散架,需要连接力上限或有限元模型,而现有工作(如销钉力模型、FEM 评估)不通用,强行集成会严重限制可用零件目录;人机对比仅按零件数匹配、未按提示词匹配(BrickBench 提示词没有对应人类作品),要真正公平对比需委托人类设计,作者留作未来工作;Opus 5.5 与 GPT-6.1 Sol 在人类研究之后发布,只有自动指标、未经人类验证。我的补充观察:其一,VQA 与 ELO 均依赖单一裁判 Gemma 4 31B,其渲染理解与审美盲区会系统性进入分数,纹理类问题 49–83% 的满足率可能部分反映裁判而非装配的问题;其二,ELO 刻度锚定在本研究的 9 个参考智能体上,跨论文不可比;其三,提示词由 LLM 生成再人工校验,主题分布与真实用户需求可能有偏差;其四,成本只计 token 牌价,未计环境调用、渲染与失败重试的隐性开销;其五,Set 设定下多个智能体贴着 400 件下限搭最小场景,说明部分约束可被“钻空子”,有效性判据有待加固。
独立分析的弱点
独立分析的弱点:1) 物理验证过于理想化——高摩擦、零弹性、均质刚体假设忽略了销钉旷量、轴的滑移与夹持力,3 LDU 阈值也偏宽松,可能放过现实中站不住的作品;改进方向是引入每连接力上限的简化结构仿真,或分级输出“可搭/勉强/不可搭”。2) 设计 ELO 依赖 VLM 审美,可能被“渲染讨喜但用件平庸”的装配骗过;改进是把结构化设计特征(连接器复用率、SNOT 技巧使用、零件类型多样性、比例先验)作为辅助客观指标,与 ELO 交叉验证。3) 人机对比不同题:人类样本取自 BrickNet 数据集且未按提示词匹配,差距估计可能混入题材难度差异;改进是委托专业设计师在相同提示词子集上创作对照集。4) 单一裁判风险:Gemma 4 31B 的系统偏差直接进入 ELO;改进用多裁判集成并持续与人类偏好校准。5) 成本口径不完整:不含工具调用延迟、渲染与重试成本,对“性价比”结论(如 Sol 匹配 Astra)有潜在影响。6) 弱智能体在 Set 设定拆成数十个连通分量、贴 400 件下限搭最小场景,说明零件数约束可被钻空;改进是加入“场景完整性/单件最大占比”等惩罚项。
未来方向
作者提出的方向:集成连接力模型或有限元以获得通用且严格的结构稳定性评估;委托提示词匹配的人类设计来完成真正公平的人机对比。基于本文成果可延伸:1) 把 Design ELO 作为奖励信号,用 BrickAgent 的校验与渲染反馈做强化学习或自博弈训练,专门优化“乐高品味”,有望缩小 900–6800 倍的成本差距;2) 将基准扩展到更多实体创作域——MOC 微缩景观、加入齿轮传动与功能评测的可动机械装置、K'NEX 等其他拼插系统;3) 多智能体协作设计:结构工程师与外观设计师角色分工,检验分工能否缩小与人类 90% 辨识率的差距;4) 引入真实机器人搭建闭环,把“可搭性”从仿真验证升级为物理验证;5) 人在环路的设计迭代:让 VLM 裁判给出可操作的批评而非仅分数,研究批评驱动的改版能否提升 Design ELO;6) 研究提示词复杂度、零件目录规模与设计质量之间的标度关系,为“设计能力”建立更细粒度的刻画。
复现评估
作者在 http://www.brickben.ch 发布基准与 BrickAgent 环境。复现要点:数据侧,300 条提示词、LDraw 库(BrickNet 支持 14,441 种零件)、BrickNet 连接器标注与验证集(512 条)均来自开源生态,PyBullet 仿真开源;模型侧需 11 个商业模型 API(Codex CLI/Claude Code),单个智能体跑完 300 条提示词的 token 成本按 Overall 每件 $0.54–16.47 估算约 $160–4900,中等偏高但可行;基线 BrickNet-14B 需 GPU 推理(服务成本仅 $0.0006/件)。主要门槛:VLM 裁判(Gemma 4 31B)的提示词、渲染管线(8 视角、固定渲染设置)与 DSG 问题图需严格对齐;ELO 锚定集与 Bradley–Terry 拟合、以及 102 名 Prolific 标注者的人类研究难以完全复制。总结:跑自己的智能体在公开基准上难度中等,逐表复现论文全部数字难度较高;论文正文未给出代码许可证细节,需访问官网确认。
论文图表
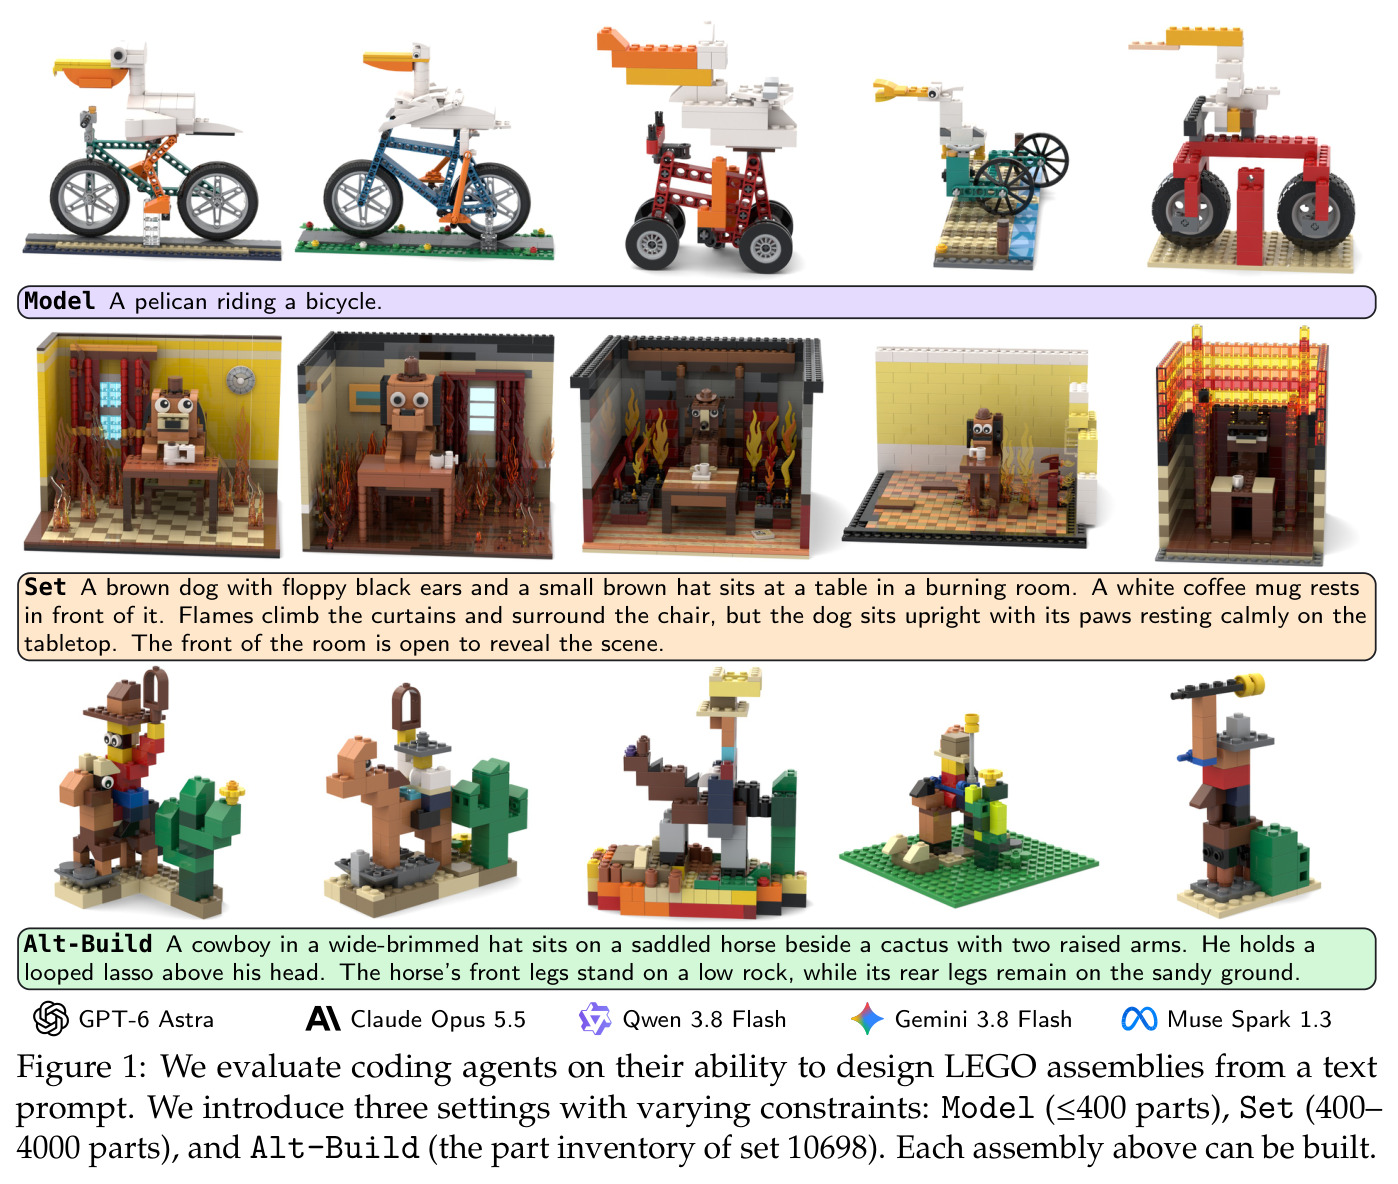
题图。展示三种设定下可实际搭建的装配示例:Model 设定(≤400 零件,如骑自行车的鹈鹕)、Set 设定(400–4000 零件,如燃烧房间里戴帽子的狗)、Alt-Build 设定(套装 10698 的 783 件固定库存,如骑马的牛仔),并列出被评测的五个代表性智能体(GPT-6 Astra、Claude Opus 5.5、Qwen 3.8 Flash、Gemini 3.8 Flash、Muse Spark 1.3)。
一图看懂任务定义与三种设定的差异,是理解全文评测对象(智能体而非专用模型)和约束设计(零件数、库存)的入口。
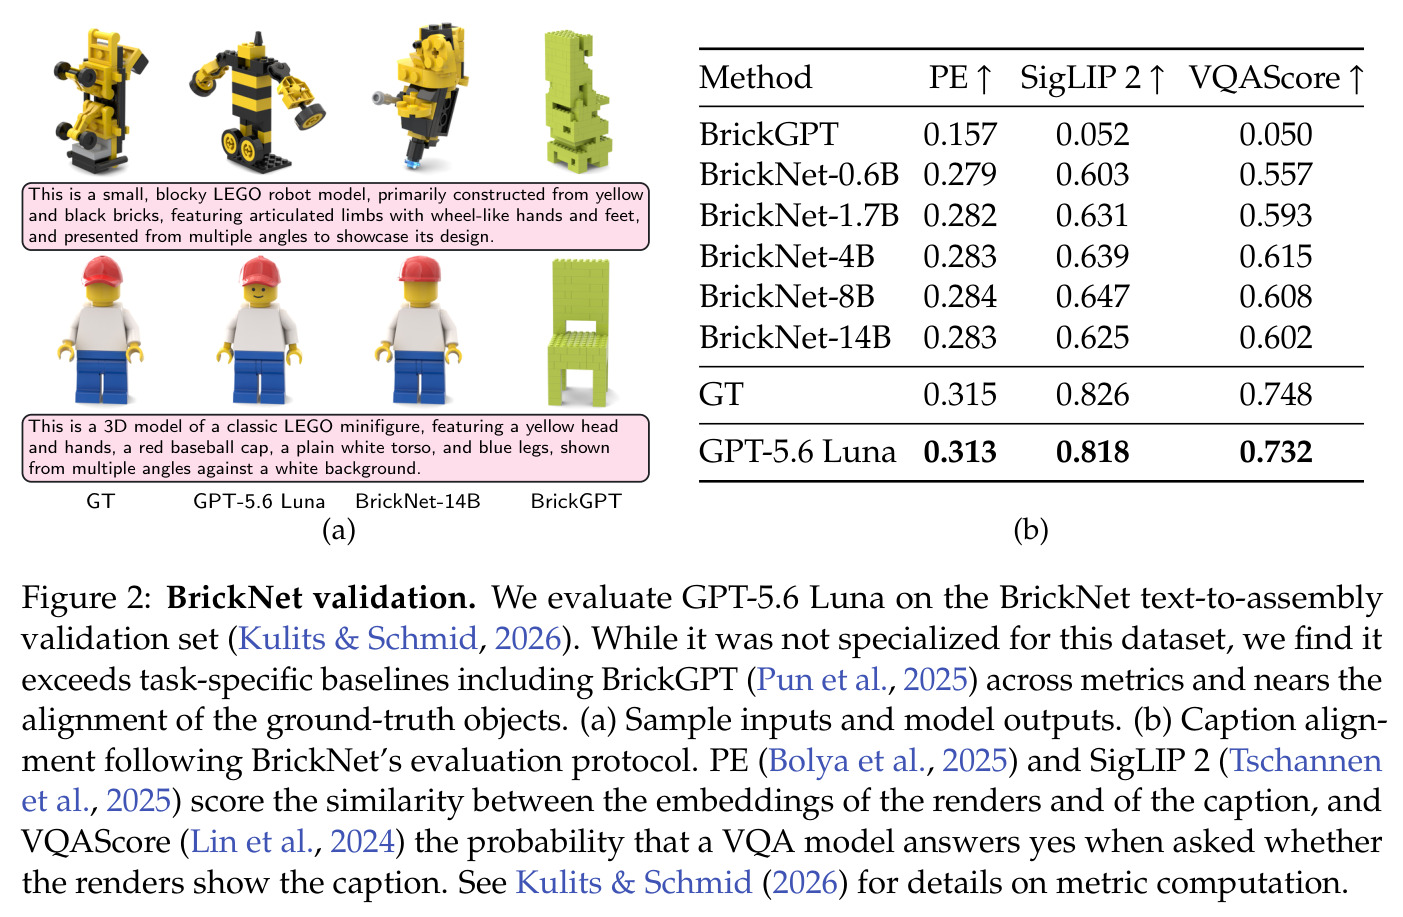
在 BrickNet 验证集(512 条图注、≤100 零件)上评测 GPT-5.6 Luna:(a) 输入图注与 GT/Luna/BrickNet-14B/BrickGPT 输出的渲染对比;(b) 指标对比——Luna 取 PE 0.313、SigLIP 2 0.818、VQAScore 0.732,全面超过 BrickNet 系列(0.6B–14B 的 PE 0.279–0.284)与 BrickGPT(0.157/0.052/0.050),逼近真值装配的 0.315/0.826/0.748。
这是论文的动机证据:通用编码智能体不经训练就碾碎专用模型并使旧基准饱和,直接论证了构建更大规模、能评设计质量的新基准的必要性。