Co-Design Bench:面向智能体模型的多模态协同编码评测基准 Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models
基于2.6万真实编码会话构建273个任务,检验编码智能体能否完整交付多模态改版需求
前置知识
编码智能体与共享脚手架
编码智能体是在循环中调用工具完成编程任务的 LLM 系统:读代码、改文件、跑构建、打开浏览器看渲染,再根据观察决定下一步。脚手架是包裹模型的固定运行框架,如论文统一采用的 Claude Code,规定了系统提示、工具接口、容器环境和轮次上限。同一模型换脚手架成绩可能显著不同。
全部评测都在同一 Claude Code 脚手架下进行,理解脚手架与模型的关系才能读懂实验设置和 harness 消融的结论。
代理式执行与分数饱和
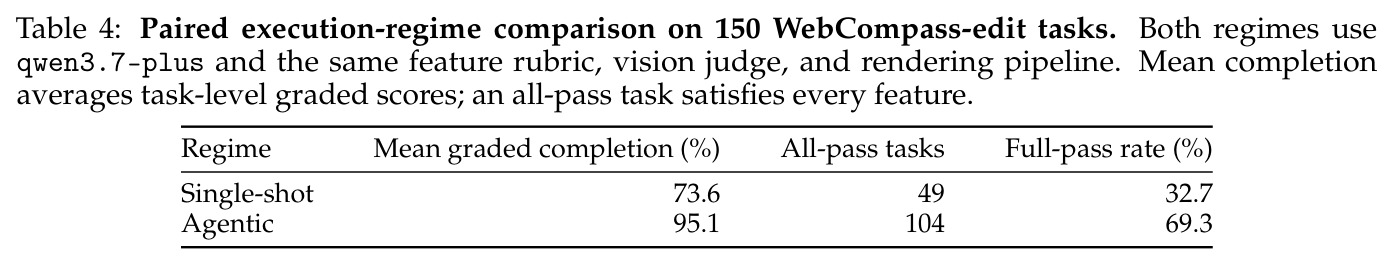
单轮执行指模型一次性输出完整答案;代理式执行指在多轮工具调用中迭代修改。论文实测同一 qwen3.7-plus 在 150 个 WebCompass-edit 任务上,单轮均分 73.6% 换成代理式执行后涨到 95.1%,opus-4-8 更达 99.4%——旧基准在该区间已无法区分强模型,出现天花板效应。
这一饱和现象是论文选题的直接动因:需要一个更贴近真实交付的更难基准来重新拉开模型差距。
无参考评估
传统前端基准依赖参考页面截图或黄金代码作对照。无参考评估只给可运行的改版前基线应用加一段用户请求,评分标准是隐藏的专家验收准则,任何满足结果要求的实现都算对。这更贴近真实协同设计:用户关心改完后的行为,而不是某份标准答案代码。
Co-Design Bench 的验收完全建立在无参考协议上,这是它区别于 Design2Code、WebCompass 等基准的本质特征。
判分-反驳式对抗验证
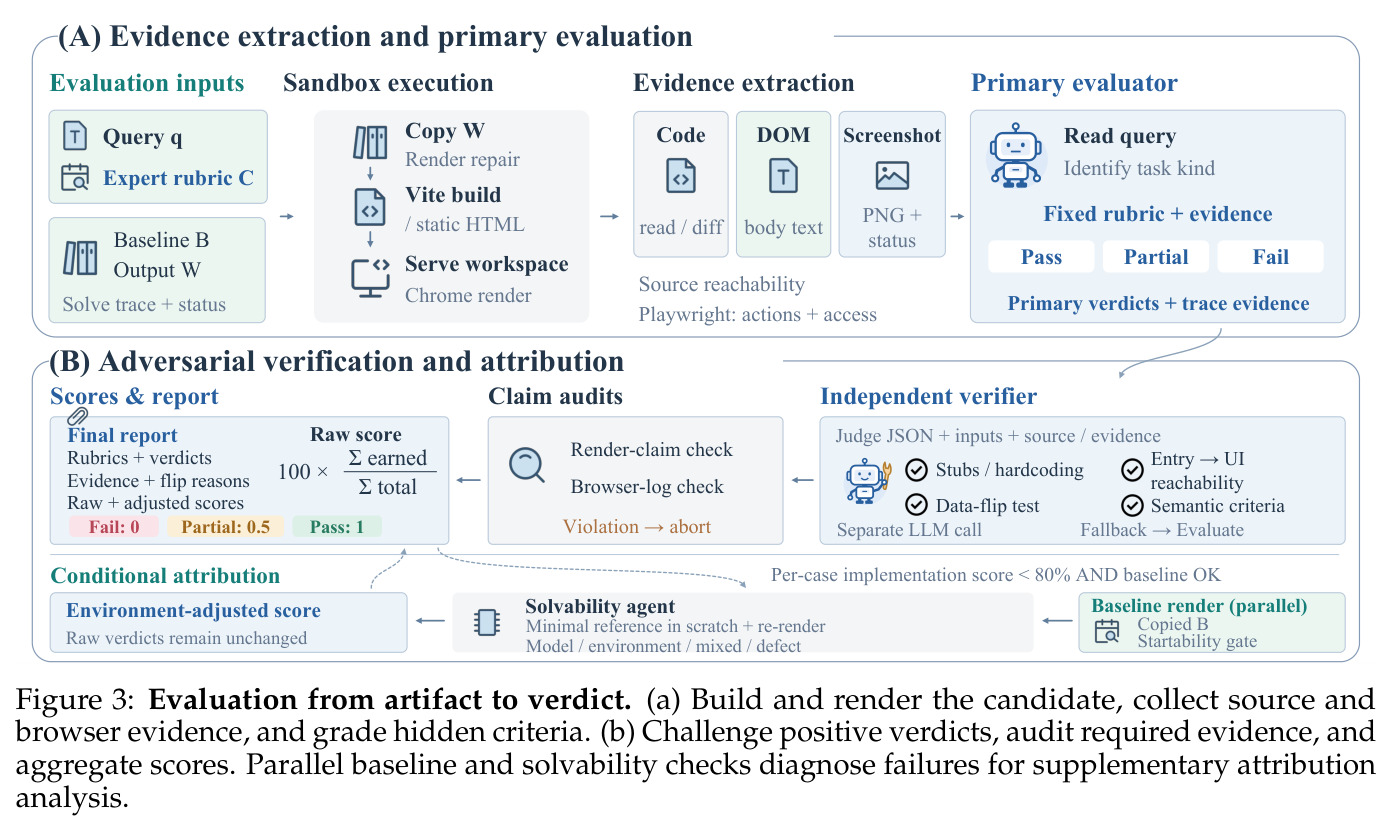
先由固定的 agentic evaluator 依据源码 diff、渲染页面和 Playwright 轨迹给每条准则打 PASS/PARTIAL/FAIL;再由独立 LLM 验证者专门挑战 PASS 与 PARTIAL 判决,查找桩代码、硬编码输出、不可达入口等虚假完成;最后强制证据审计:视觉声明必须有截图、交互声明必须有浏览器操作日志,证据缺失直接中止评测。
这是评分可信度的核心保障,理解它才能判断 69.9% 这类分数的水分有多大。
Strict / Graded / Full-Pass 三指标
对任务 $t$ 的 $n_t$ 条准则,Strict 只数全过:$R_t=\frac{1}{n_t}\sum_{i=1}^{n_t}\mathbb{1}[v^i_t=\mathrm{PASS}]$;Graded 给部分完成记 0.5 分;Full-Pass Rate 是整任务所有准则全部通过的比例。恒有 $\bar{R}\geq F$,两者差值刻画了每条都沾边但整体没交付的普遍程度。
论文的核心发现『准则覆盖高、完整交付低』正是靠这三个指标的落差量化的。
研究动机
现有 web 编码基准在两个层面上失效。其一是任务来源失真:Design2Code、WebRenderBench 等做参考重建,WebCompass 的编辑子集从预定义编辑池构造查询,SWE-bench 系列来自 GitHub issue——都不是从真实用户编码会话中提炼的复合改版需求,例如『剪辑数量与时长封顶、缩放时保持锚点对齐、删除或拆分剪辑后重新启用添加按钮』这类多条要求相互耦合的真实请求。其二是评估已饱和:同一 qwen3.7-plus 在 150 个 WebCompass-edit 任务上,从单轮执行的 73.6% 均分跳到代理式执行的 95.1%(rubric、judge、渲染管线全部固定),opus-4-8 更达 99.4%,说明这些基准已无法区分头部模型。此外只报平均完成率会掩盖部分交付:模型每条要求都改了一点但任务整体不可用,69.9% 的准则覆盖率与 26.4% 的完整交付率在旧口径下看不出区别。
本文的目标是论文要构建一个 reference-free 的应用改版评测基准 Co-Design Bench:从 26,314 个真实用户编码会话的 37,463 条去重查询中精选 273 个有界任务,配套 2,331 条隐藏的专家验收准则,覆盖两个互补赛道——100 题多模态编辑 ME(带图像/音频/视频/文档附件的局部修改)和 173 题仓库编辑 RE(跨组件、路由、状态、数据流的协同修改)。评估协议要求在共享 Claude Code 脚手架下对 10 个模型端点做代理式评测,每题上限 3 小时、120 轮;同时报告准则满足率和完整任务成功率两类指标,量化『部分满足与完整交付』的鸿沟,并检验附件模态、编辑广度和主能力维度上的表现差异。
与已有工作不同的是,独特切入有三点。第一,任务全部回收自生产环境编码会话,并恢复出可运行的改版前应用、保留附件与会话上下文,而非合成改写或预定义操作池。第二,评估引入 judge-then-refute 协议:主评判者必须做到『证据匹配声明』——源码只能证静态属性,视觉要求必须有截图,交互可达必须有录制的浏览器动作;随后独立 LLM 验证者专门攻击 PASS/PARTIAL 判决,最后证据审计不达标直接中止评测而不是照常计分。第三,报告口径上把 Strict、Graded、Full-Pass 三个指标并列,通过 $\bar{R}-F$ 差值把『准则学分』和『完整交付』显式解耦,这一现象在此前的前端编码基准中从未被系统量化。
核心方法
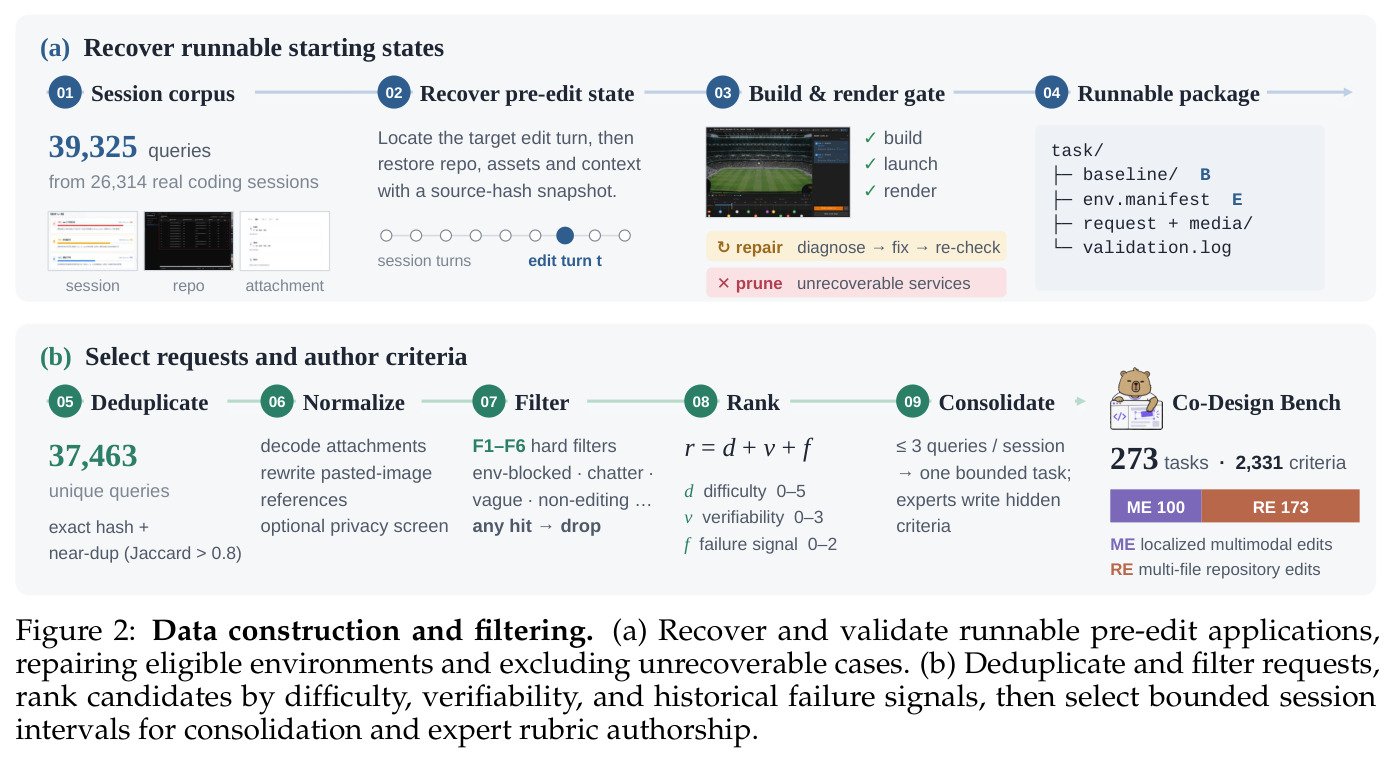
论文把一次真实的人机协同设计循环改造成可复现的考试。直觉是:用户对着一个能跑的网页应用说『给体育剪辑工具加条数和时长上限、缩放时锚点对齐、删剪辑后重新启用添加按钮』,智能体要读懂多模态请求、在代码库里做联动修改、改完还得能跑起来。技术路线分三步:第一步,从 39,325 条生产查询中恢复可运行的改版前状态,过依赖、构建、容器启动、Playwright 渲染四道验证门;第二步,去重得到 37,463 条候选后过滤、按难度与可验证性排序,整合成 273 个有界任务,专家撰写隐藏准则;第三步,智能体在共享脚手架下编辑应用,评测管线按 judge-then-refute 打分。任务形式化为 $t=(S,I,C)$:$S=(B,E)$ 是可运行基线加容器环境,$I=(q,X,K)$ 是归一化请求、多模态附件与会话历史,$C$ 是隐藏准则集,求解器产生轨迹 $\tau$ 并输出改版后应用 $\hat{S}$。
最本质的创新是『以改版前应用为锚的无参考验收 + 对抗式证据审计』的组合。已有基准要么对比参考截图(Design2Code、DesignBench),要么跑预定义功能测试(SWE-bench 的可执行测试、SWE-Lancer 的端到端测试)。本文不给黄金代码也不给目标截图:专家只写『结果应该是什么样』的验收准则,允许任何合理实现,改版前基线只用来锚定哪些东西必须变、哪些必须保留。为让 LLM 评分可信,协议设三层防线:主评判必须证据匹配声明(截图证视觉、操作日志证交互,只有源码不足以证明功能可达);独立验证者专门反驳 PASS/PARTIAL,抓桩代码、硬编码、不可达入口;证据审计违规直接中止评测而非扣分。再把部分满足显式建模为 PARTIAL 记 0.5 分并单独报告 Full-Pass Rate $F$,使『平均覆盖高但完整交付低』第一次被量化——最强端点 69.9% 对 26.4%,差 43.5 分。
方法步骤详情
数据构建:39,325 条查询(26,314 个会话)→ 源码哈希快照定位改版轮次并恢复仓库、资产与上下文 → 过依赖安装、构建、容器启动、Playwright 渲染四道门,不可恢复即剔除 → 去重(精确哈希 + Jaccard>0.8)剩 37,463 条 → 隐私筛查与硬过滤 → 按 $r=d+v+f$ 排序(难度/可验证性/失败信号)→ 每会话至多 3 条整合为有界任务 → 专家撰写隐藏准则。最终 ME 100 题 553 条准则(均值 5.5、最高 11),RE 173 题 1,778 条(均值 10.3、最高 46)。评测:候选应用隔离构建渲染,agentic evaluator 依源码 diff、DOM、截图与 Playwright 轨迹打 PASS/PARTIAL/FAIL;独立验证者反驳积极判决;证据审计违规则中止;按 $R_t$、$G_t=\frac{1}{n_t}\sum_i g(v^i_t)$(PASS/PARTIAL/FAIL 记 1/0.5/0)聚合;对 $G_t<0.8$ 的案例用 solvability 探针与 startability 门归因为模型缺陷、环境阻断、混合原因或起始工件缺陷。
技术新颖性
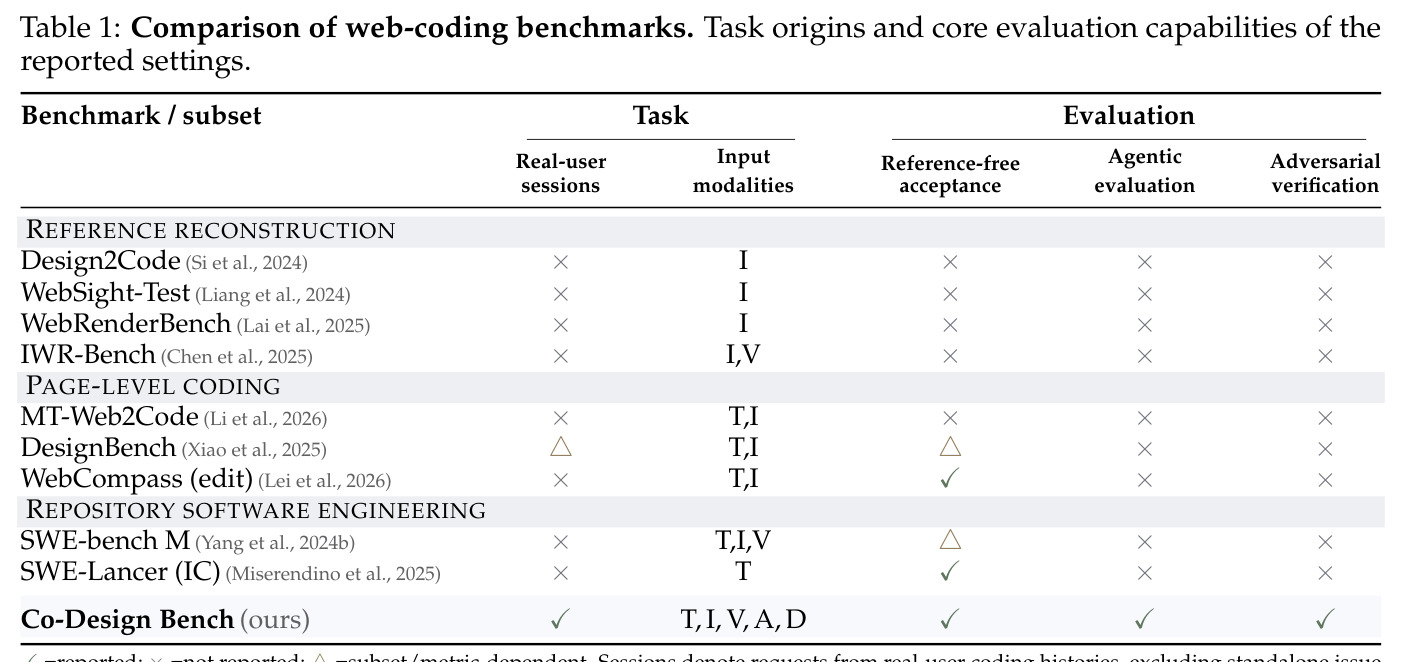
与已有工作的三点本质区别。其一,任务来源:SWE-bench 取自 GitHub issue,DesignBench 从 V0 版本历史抽相邻版本对,WebCompass 从预定义编辑池构造查询,本文则从生产会话恢复完整任务(含附件与上下文),在 Table 1 的五项维度(真实用户会话、多模态输入、无参考验收、代理式评估、对抗验证)上全部打勾,是首个全覆盖的 web 编码基准。其二,评估协议:Agent-as-a-Judge 有 agentic 评判但无独立反驳环节,WebCompass 用 checklist 判分但无强制证据审计,本文的 judge-then-refute 加审计中止机制是新的。其三,指标设计:同时报告 Strict/Graded/Full-Pass 并分析差值,把部分交付从平均分中解耦,配合失败归因(模型/环境/混合/起始缺陷四分),使分数可解释、可追责。
实验结果
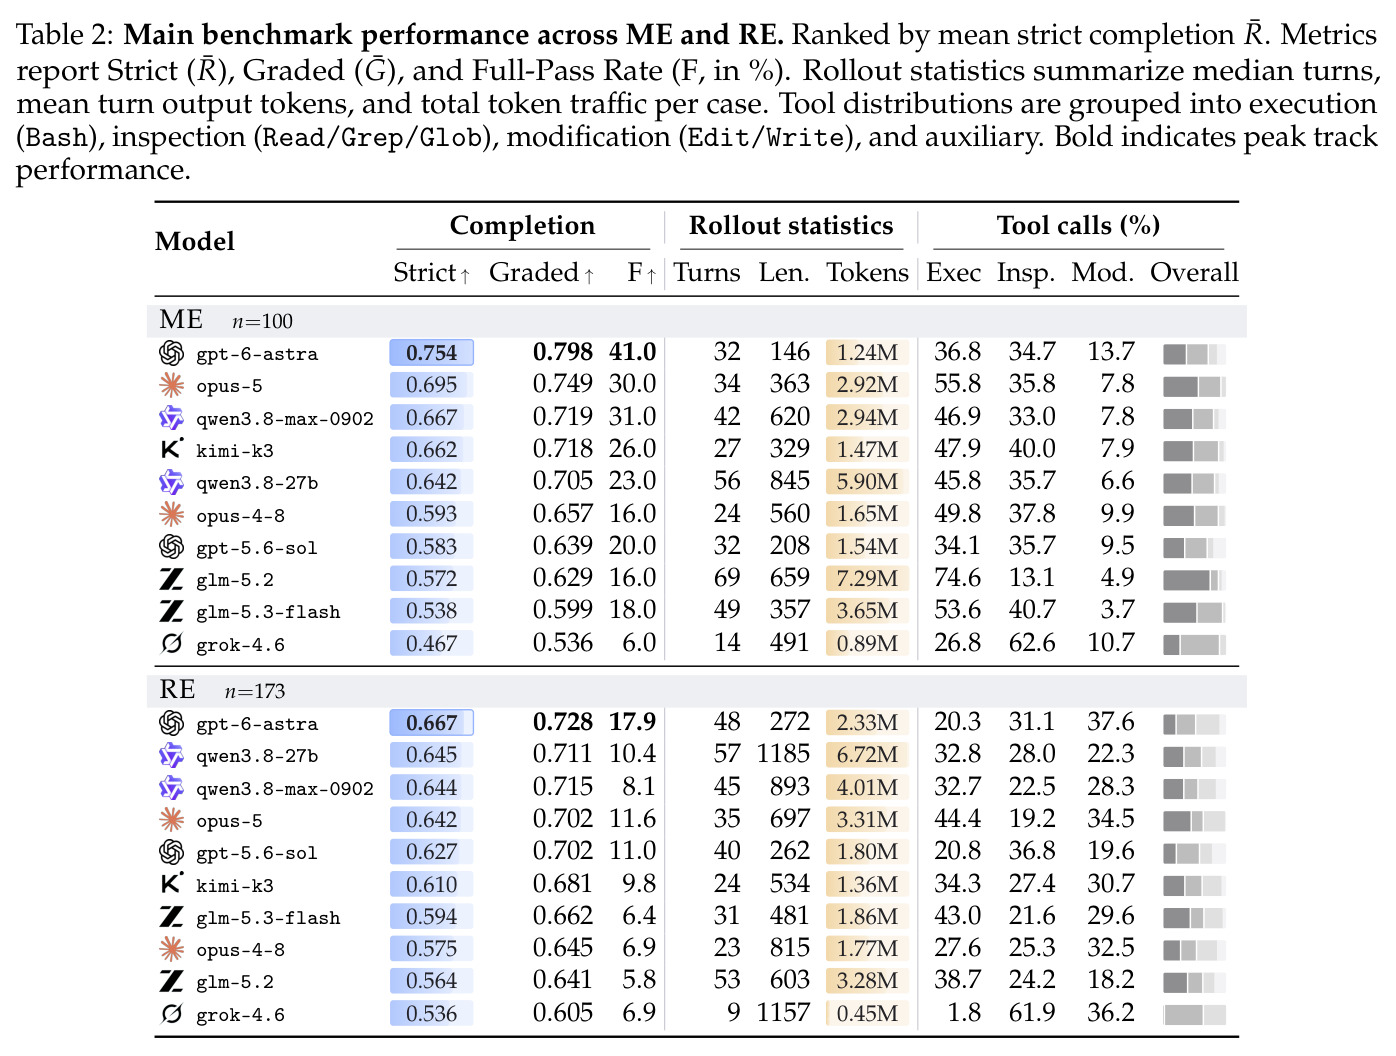
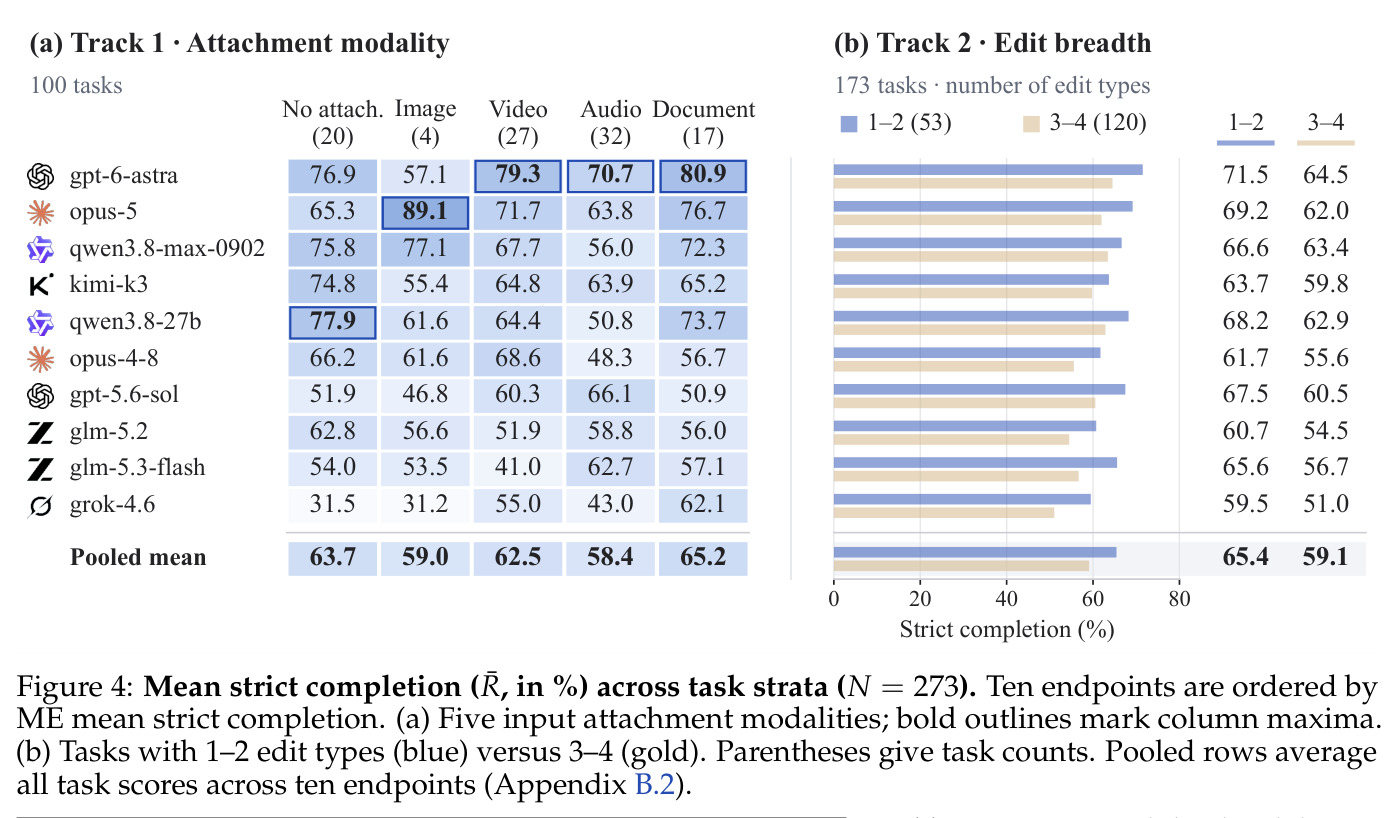
十个端点在 273 题上共 2,730 个评估对。最强 gpt-6-astra:ME strict 0.754(full-pass 41.0%)、RE 0.667(full-pass 17.9%),合并均值 0.699、full-pass 仅 26.4%——73.6% 的任务至少留一条未满足准则。ME 榜单其后为 opus-5 0.695、qwen3.8-max-0902 0.667、kimi-k3 0.662、grok-4.6 垫底 0.467;RE 榜单重排:qwen3.8-27b 以 0.645 升至第二(opus-5 0.642),两榜 Spearman ρ=0.818,端点分差 ME 28.7 分、RE 仅 13.0 分。编辑广度:RE 任务跨 3–4 种编辑类型时 pooled strict 0.591,低于 1–2 种的 0.654(差 6.3 分),十端点全部下降,零通过率从 0.9% 升至 5.8%。附件模态:文档 pooled 0.652 最高但 full-pass 仅 18.2%(纯文本 37.0%);qwen3.8-27b 领跑纯文本 0.779,opus-5 领跑图像 0.891。能力维度:Functional Implementation 最大组(126 题)strict 0.619 最高但 full-pass 最低 10.3%。执行成本:gpt-6-astra 在 ME 用 32 轮、1.24M token 得 0.754,glm-5.2 花 69 轮、7.29M token 才 0.572;工具上 OpenCV 出现在 68.5% 视频轨迹、ffmpeg 占 25.0% 音频,说明智能体会主动执行感知工具解读媒体输入。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态编辑 ME(100 题) | Strict Completion | gpt-6-astra 0.754 | grok-4.6 0.467(十端点最低) | 端点间分差 28.7 个百分点 |
| 仓库编辑 RE(173 题) | Strict Completion | gpt-6-astra 0.667 | 第二名 qwen3.8-27b 0.645 | +2.2 分 |
| 全 273 题 | Full-Pass Rate | gpt-6-astra 26.4% | 其自身 strict 均值 69.9% | 暴露 43.5 分的部分交付鸿沟 |
| RE 编辑广度 3–4 种 vs 1–2 种 | Pooled Strict Completion | 0.591 vs 0.654 | 全部十个端点在宽编辑组均下降 | 广度鸿沟 6.3 分 |
| WebCompass-edit 150 题(消融) | Graded feature completion | 代理式执行 95.1% | 单轮执行 73.6%(同一模型) | +21.5 分,证明执行制度影响得分 |
局限与改进
作者承认的局限:任务不模拟执行过程中的进一步用户反馈,只评估固定请求;三大能力分组与赛道归属强重叠(97.1% 任务有多个能力标签),能力分解是描述性的而非因果;模态与广度比较反映任务池构成差异,不能隔离感知或编辑工具的因果效应;反驳与审计能减少但不能消除评判错误;token 流量按 API 口径含重试与缓存,不是统一货币成本。我补充的观察:其一,准则质量依赖专家,论文只对 200 个 task–model 输出做了人工抽检,没有报告系统性的判分与人类判断的一致率;其二,full-pass 对准则数量敏感,RE 均值 10.3 条、最高 46 条,长任务天然更难全过,跨任务比较有混杂;其三,ME 的图像附件只有 4 题,模态层面的结论统计功效很弱;其四,评估 judge 与被评模型可能来自相似生态,自偏好风险未讨论。
独立分析的弱点
独立分析五点弱点。第一,评估管线成本高:每题要做构建、渲染、agentic 评判、独立反驳与证据审计,全网格 2,730 次评估的工程复杂度和 API 开销都很大——改进方向是蒸馏轻量判分模型或对证据做缓存增量评分。第二,PARTIAL=0.5 的赋值是约定而非校准,0.5 分是否真实反映部分完成对用户的价值缺乏验证——可让真实用户对部分完成的应用打分来校准函数 $g$。第三,会话历史 $K$ 的注入量没有消融:给多少历史上下文会显著影响成绩,这本身是个值得研究的变量。第四,基线缺陷的检测只到『能否启动』层面,若基线能跑但存在隐蔽行为错误,评估可能把模型引入的回归误记在模型头上——可增加基线行为快照比对。第五,273 题平均每题约 8.5 条准则,对边角行为(异常输入、并发状态)覆盖有限,模型可能靠过拟合常见路径得分。
未来方向
作者提出的方向:利用准则级证据研究完整交付的训练信号,例如把 2,331 条验收准则转成强化学习的奖励;继续做 harness 消融——消融显示闭环验证对成绩有决定性作用,可据此设计自动验证循环;保留的判决与证据链支持失败归因,可构建前端编码错误类型学。基于成果可延伸的方向:把 judge-then-refute 协议移植到其他 agentic 基准(如 SWE-bench 的 PR 评审与测试生成);引入多轮真实用户反馈的动态任务版本,测智能体在需求漂移下的表现;用 2,730 个评估对训练过程奖励模型来指导前端编码智能体;研究被评模型自检准则满足情况的自一致性差距,检验 self-verification 的可靠性。
复现评估
论文提供了项目主页 codesignbench.github.io,正文未明确说明数据与评测代码的开源状态,复现难度取决于基准是否放出。若开源,复现评测需要:每题的容器化环境(env.manifest)、Claude Code 脚手架、Playwright 与浏览器渲染栈,以及 10 个模型端点的 API 配额;按论文统计最重的单题消耗可达 7.29M token,全网格 2,730 次评估是数十亿 token 量级,个人复现不现实,但跑 1–2 个端点的 273 题完全可行。判分依赖特定 LLM judge,好在消融显示更换 judge 后相对排名与分数分布稳健,降低了复现时的 judge 绑定风险。最难复刻的是数据恢复管线:从会话日志还原可运行应用需要源码哈希快照、依赖修复和渲染验证四道门,这部分工程量最大。总体评估:跑分容易、协议复刻中等、数据重建困难。
论文图表
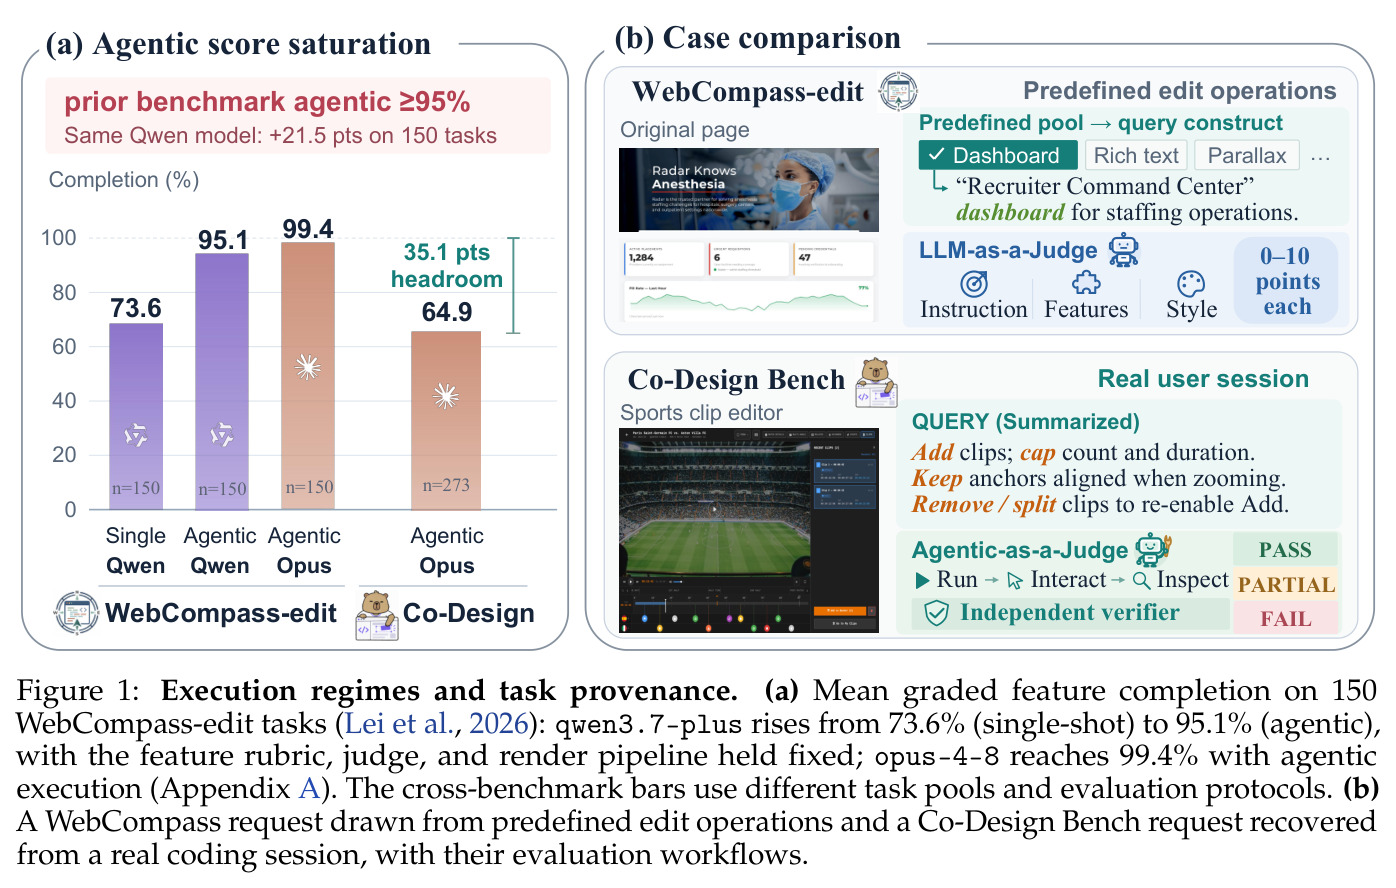
(a) 在 150 个 WebCompass-edit 任务上,同一 qwen3.7-plus 从单轮 73.6% 升到代理式 95.1%,opus-4-8 达 99.4%,仅剩 0.6 分 headroom;Co-Design Bench 上最强端点 full-pass 26.4%,留有大空间。(b) 对比 WebCompass 从预定义编辑池构造的查询与本文从真实会话恢复的查询(体育剪辑编辑器案例),以及两者评估流程:LLM-as-a-Judge 0–10 分 vs agentic PASS/PARTIAL/FAIL 加独立验证者。
这张图给出论文的两个立论基础:旧基准分数饱和、任务来源失真,是理解全文动机的入口。