Frontier3DBench:面向物体、场景与交互开放世界 3D 创作的编码智能体评测基准 Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds
145个任务的统一3D创作基准,揭示参考保真与活动协调是编码智能体瓶颈
前置知识
编码智能体与 Harness
以大模型为核心、能在循环中写代码并执行的系统:模型接收任务,调用编辑器、终端等工具生成程序,观察运行结果,再迭代修复,直到自行判断可提交。Codex、Claude Code、Kimi CLI、DSH、ZCode 等官方 harness 提供沙箱、文件系统与反馈通道;同一个模型配不同 harness 会表现出不同的实际能力。
本文评测对象正是「模型×harness」的 11 种配置,不理解 harness 就无法理解实验设置、分数差异与成本差异的来源。
程序化 3D 构建(Blender / Unreal Engine)
通过代码而非手工建模创建 3D 内容:Blender 提供 Python API(bpy),可用脚本生成网格、材质、灯光与机械装配,工程文件可再编辑;Unreal Engine 以工程文件承载关卡、蓝图交互逻辑与资产,运行时支持角色移动、动作触发与状态存取。
基准要求每个任务都提交可执行、可编辑的引擎工程文件(L1/L2 用 Blender、L3 用 UE),这是任务形式化与三层评分体系的物质基础。
参考重建 vs 文本生成
文本生成只需按指令产出合理内容,自由度大;参考重建还必须与给定图像在几何、布局、部件数量与色调上对齐,需要跨视角一致性估计。本文用图像相似度 I 与目标定位 L 等组件专门度量后者,用需求满足度 R 度量前者。
「重建比生成难」是全文最重要的实证发现,理解两者区别才能读懂 Text2Code 最高 84.05 与 Img2Code 最佳仅 69.61 之间落差的含义。
Kendall $\tau_b$ 一致性系数
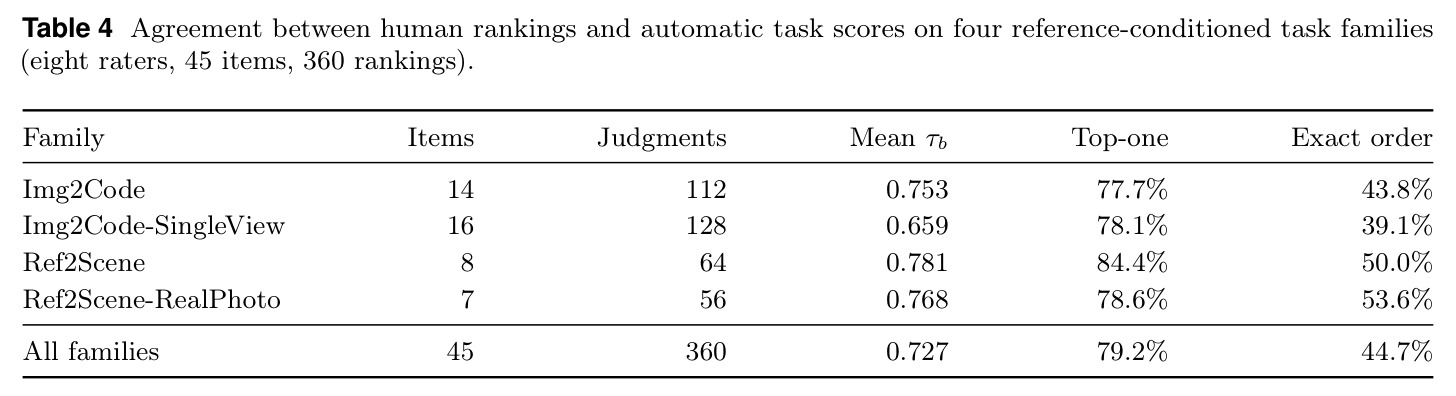
衡量两条排序一致程度的等级相关系数,取值 $[-1,1]$:1 表示完全同序,0 表示无相关,并对并列值做了修正。论文用它比较自动分数给出的排序与 8 名人工标注者的排序,并辅以 Top-1 命中率与完全同序率两个更严格的指标。
它是「用 GPT-6-astra 当裁判到底可信吗」这一问题的量化答案,直接决定整个基准结论的可信度上限。
Pareto 前沿
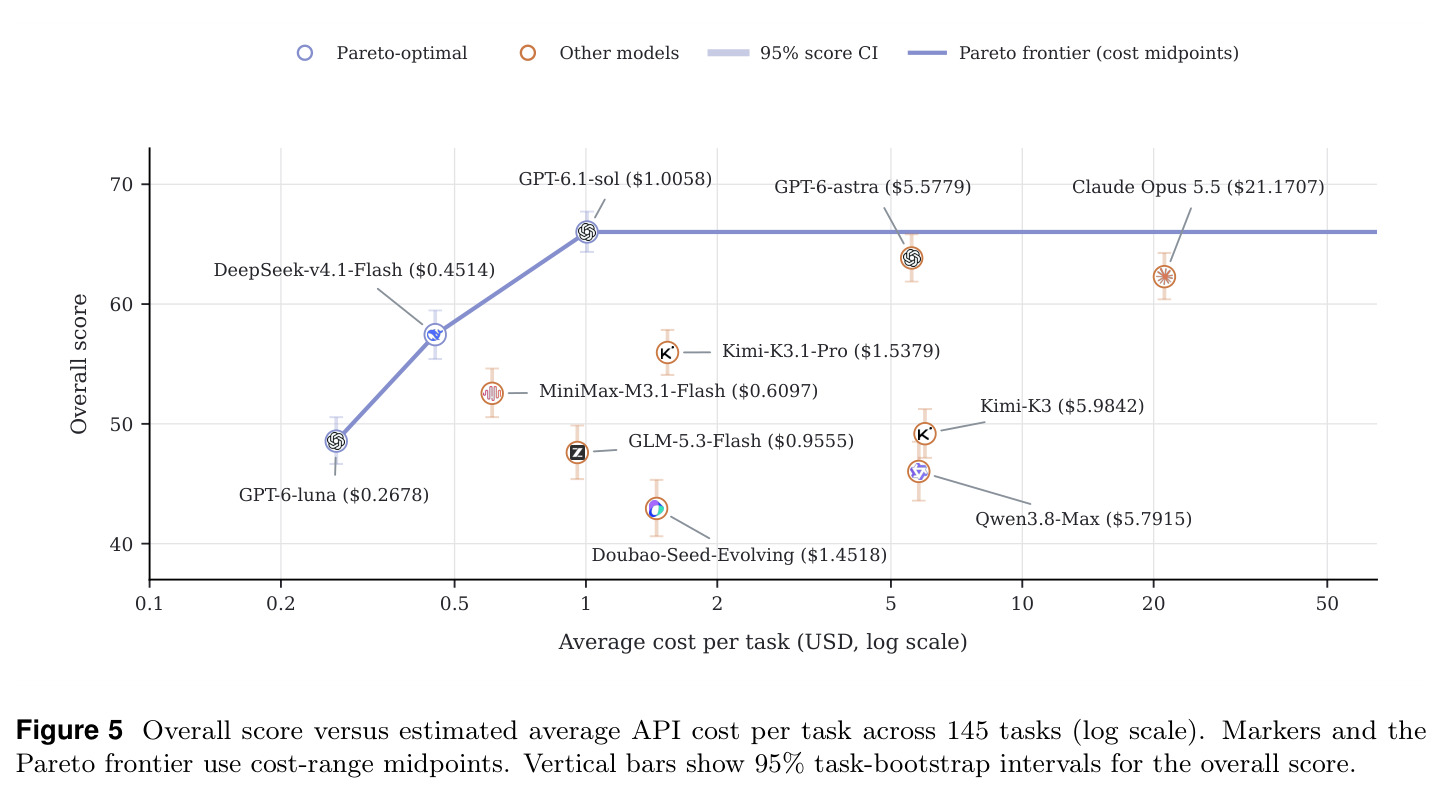
多目标优化中不被其他点同时支配的点集合:在分数-成本平面上,若不存在另一个配置既更便宜又得分更高,则该点位于前沿。论文在每任务平均 API 成本(对数轴)与总分坐标中标出各配置位置并连接前沿点。
它把「哪个模型性价比最高」从口碑变成可计算的问题,是实际部署时选择配置的核心依据,也是本文成本分析章节的骨架。
研究动机
以 Codex、Claude Code 为代表的编码智能体把视觉理解与程序执行结合起来,声称能通过写代码直接完成 3D 重建、生成与编辑,甚至构建可交互的游戏世界。但现有评测高度碎片化:物体与场景类基准(BlenderGym、VIGA、3DCodeBench、Code4Scene 等)只评几何与视觉保真,可执行世界与游戏类基准(Code2Games、ExeWorldBench、CEGame-Bench 等)只评机械依赖与玩法完成度,任务范围和评测协议互不兼容,结果无法拼出智能体跨层级能力的完整画像。单一总分还会掩盖失败模式——一个配置可能只是参考对不齐,也可能完全不会组织场景或实现所需行为,这三者的改进路径完全不同。此外,实践中普遍观察到「生成看起来合理的内容容易、复现指定几何难」,但此前没有基准在统一协议下把这一差距量化出来。
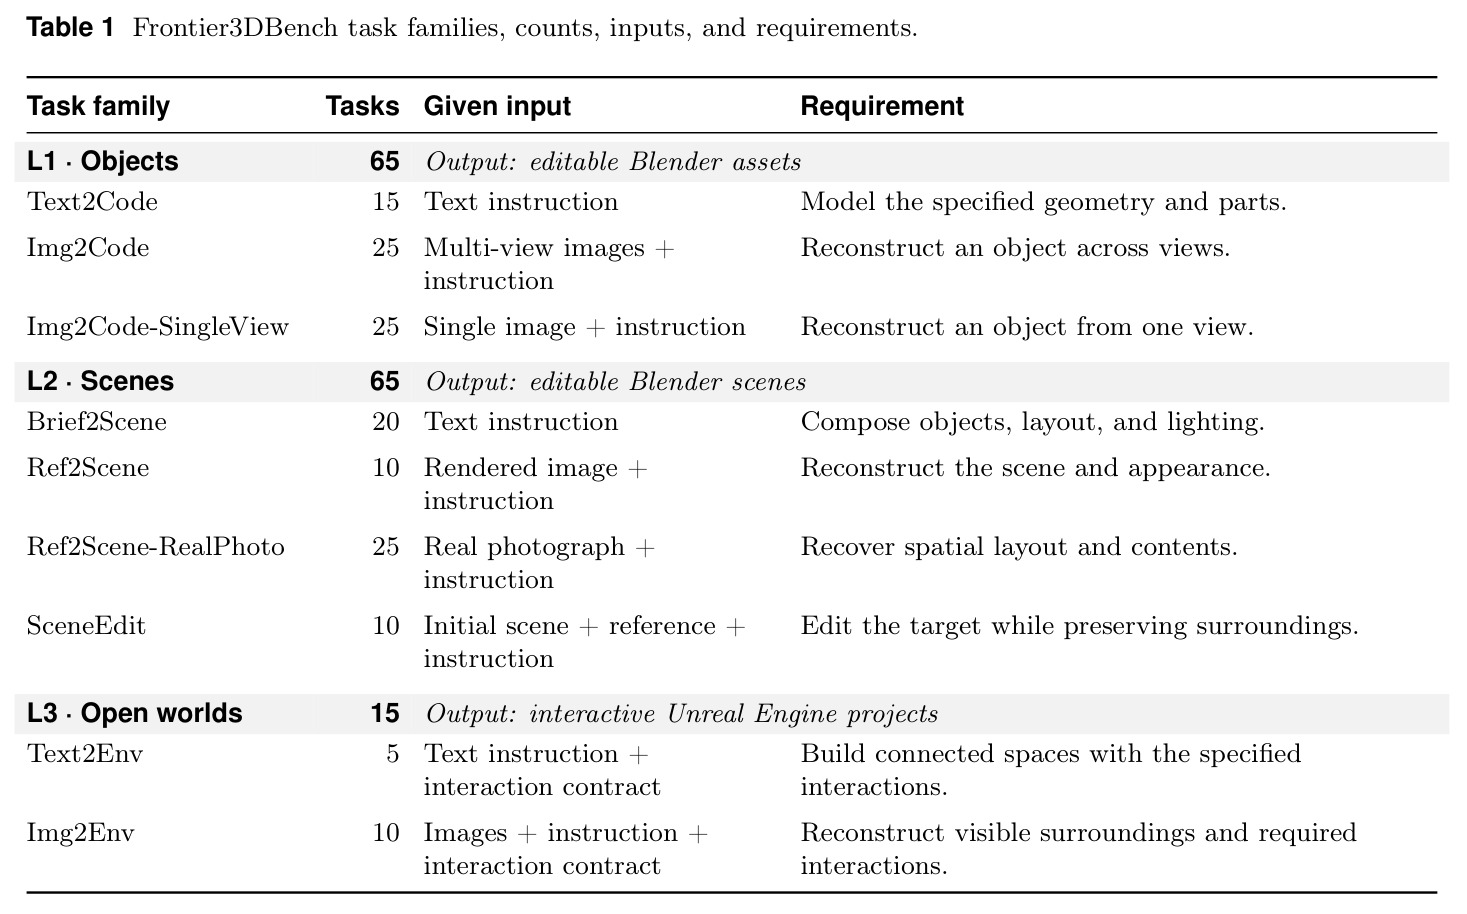
本文的目标是本文要构建统一的 Frontier3DBench:145 个任务、9 个类别、三个构建层级——L1 物体层 65 任务(Text2Code 15、Img2Code 25、Img2Code-SingleView 25)、L2 场景层 65 任务(Brief2Scene 20、Ref2Scene 10、Ref2Scene-RealPhoto 25、SceneEdit 10)、L3 交互开放世界层 15 任务(Text2Env 5、Img2Env 10)。每个层级都要求提交可执行、可编辑的 Blender 或 Unreal Engine 工程文件,并对外观、结构、行为三个维度做联合打分,最终用总分 $S_{overall}$ 排名 11 个「模型×harness」配置,系统回答「编码智能体在 3D 创作上走到了哪一步」,并定位核心瓶颈。
与已有工作不同的是,本文的独特切入有四点。其一,按「被构建单元」组织层级:物体→场景→连通世界,考察要求从几何零件、空间布局递进到带持久状态的交互活动,而非像以往工作各评一段、互不衔接。其二,把 3D 创作统一表述为「从任务规格到引擎工程文件的代码生成」,让重建、生成、编辑共享同一工作流与协议,输入形式化为 $x=(d,I,a_0)$。其三,强调三路互补证据:渲染图判断外观、原生场景检查测结构、独立观察者运行时测试行为。其四,附带成本效率分析(每任务 $0.27–$21.17)与 360 条人工排序的一致性验证($\tau_b$=0.727),让能力、成本与评测可信度同时可量化。
核心方法
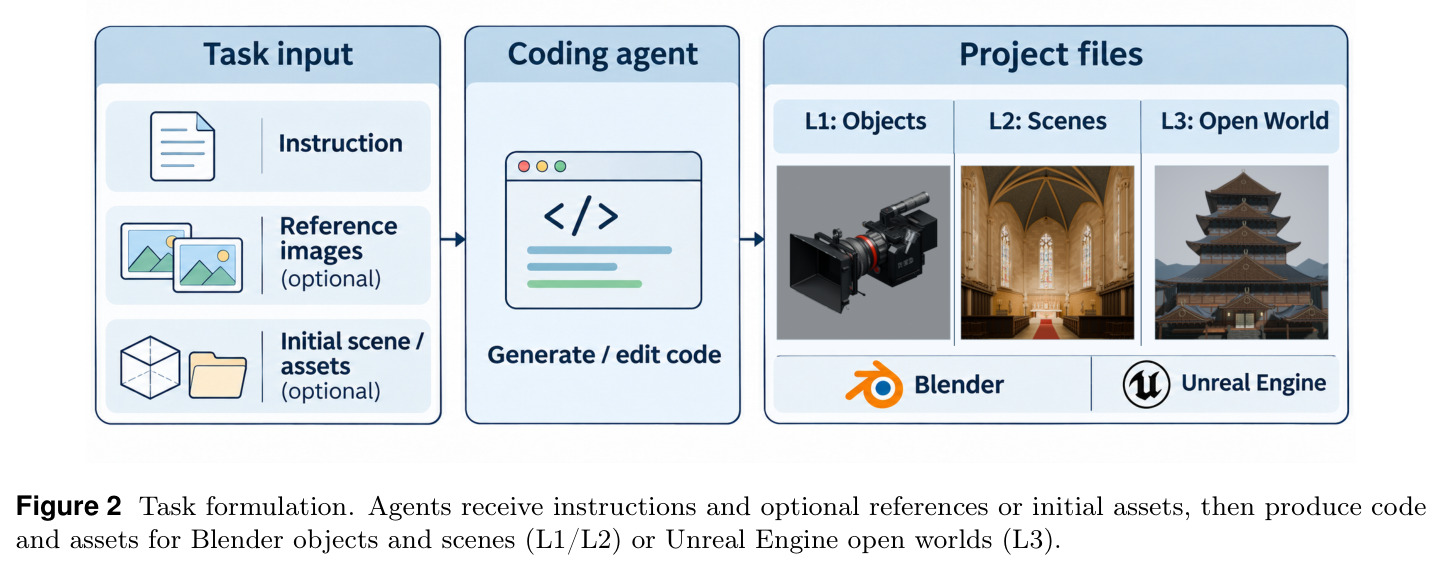
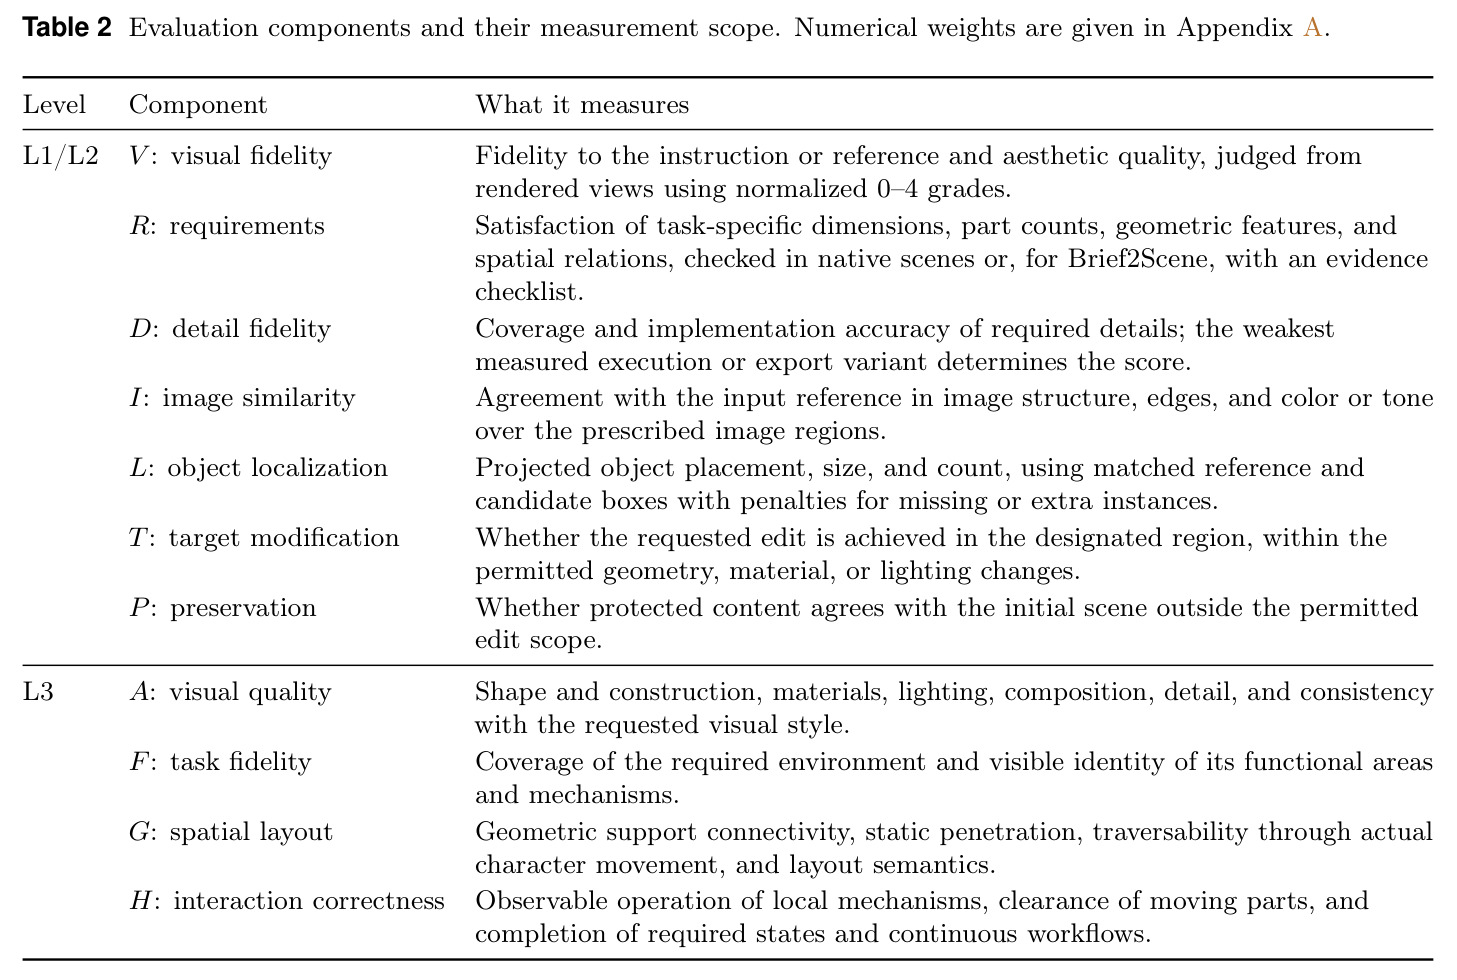
直觉上,这像给编码智能体办一场三级「3D 建造师资格考试」:第一级照图纸或文字造单个零件与机械装配,第二级布置整个房间并处理灯光构图,第三级建一个能走、能玩、状态会保存的小世界。技术路线是把 3D 创作形式化为映射 $x=(d,I,a_0)\rightarrow y$:输入为指令 $d$、可选参考图像 $I$ 与初始代码/资产 $a_0$,输出为 Blender(L1/L2)或 Unreal Engine(L3)工程文件。评分上,L1 文本生成用视觉保真 V、需求满足 R、细节保真 D;参考重建把 R 换成图像相似度 I 与目标定位 L;SceneEdit 另加目标修改 T 与保留 P。L3 用视觉质量 A、任务保真 F、空间布局 G、交互正确性 H。总分按 $S_{overall}=0.30S_{L1}+0.30S_{L2}+0.40S_{L3}$ 合成,开放世界权重最高,以强调视觉建造、交互机制与完整活动的综合集成。
核心洞察:成功的 3D 创作必须同时做到外观忠实、结构连贯、行为可用,三者需要不同的检查手段。已有基准各取一隅,而 Frontier3DBench 在同一套任务族里联合检查三者:渲染视图交由 GPT-6-astra(中等推理强度、隐藏生成者身份)评分;原生场景做几何、部件数、定位框等程序化测量;L3 再由独立观察者实际操控角色,测试交互动作效果与状态持久化。最关键的设计是把 H 拆成三个子项——局部机制、运动间隙、状态化工作流——把「零件能动」与「完整活动能跑通」分开计量。这一拆分直接暴露出 83.08 对 20.82/30.26 的巨大落差:单个机制通常可用,但需要协调动作与持久状态的完整活动仍普遍失败,这是传统总分永远看不到的结论。
方法步骤详情
第一步,构建数据:收集公开 3D 模型(主要 .glb 与部分 .blend)、公开数据集图像与作者实拍照片,游戏截图与全景图作为 L3 视觉参考,全景图投影为同一视点多方向的直线视图;有源模型的任务用 Blender 渲染出参考视图。第二步,生成指令:定义创作目标后由 GPT-6-astra 扩写成显式描述几何、外观与空间关系的任务指令;编辑任务附一个与源场景在指定部件上不同的初始 Blender 工程、目标渲染图与修改/保留说明;L3 另配交互契约,规定功能区域、实体初始状态、可用操作与动作前置条件。第三步,运行智能体:11 个模型各在其官方 harness 中执行,推理强度取最高档(Qwen 为 xhigh,其余为 max),若提交未通过公开执行与交付检查,可在固定时间预算内凭报错重试(不给分数反馈)。第四步,评分:综合渲染证据(LLM 判分)、原生场景测量与 L3 独立观察者的运行时行为测试,按各任务组件权重合成 0–100 分,并在层内平均(含零分)。第五步,汇总三个能力维度 $S_{vis}$、$S_{str}$、$S_{task}$,并做成本分析与人机一致性研究。
技术新颖性
与已有工作的本质区别有三。其一,覆盖范围:BlenderGym、VIGA、3DCodeBench、GeoCodeBench、VoxelCodeBench 等只覆盖物体或场景单层,Code4Scene 只评 UE 场景构建,游戏基准只评玩法;本文把物体、场景、开放世界放进同一套 145 任务、9 类别的套件,共享输入形式与协议,可跨层比较同一配置的强弱迁移。其二,证据结构:渲染判断+原生场景测量+运行时观察者三路互补,而非仅靠渲染图或静态检查;L3 要求「会话内跨动作序列的状态持久化」,超过多数基准的单步交互。其三,配套分析:11 配置的 API 成本分析给出 Pareto 前沿(Luna $0.27、DeepSeek $0.45、Sol $1.01),加上 8 名标注者 360 条排序的一致性验证(Top-1 79.2% 高于人与人的 0.679),使「分数是否可信、性价比如何」都变成可检验的量。
实验结果
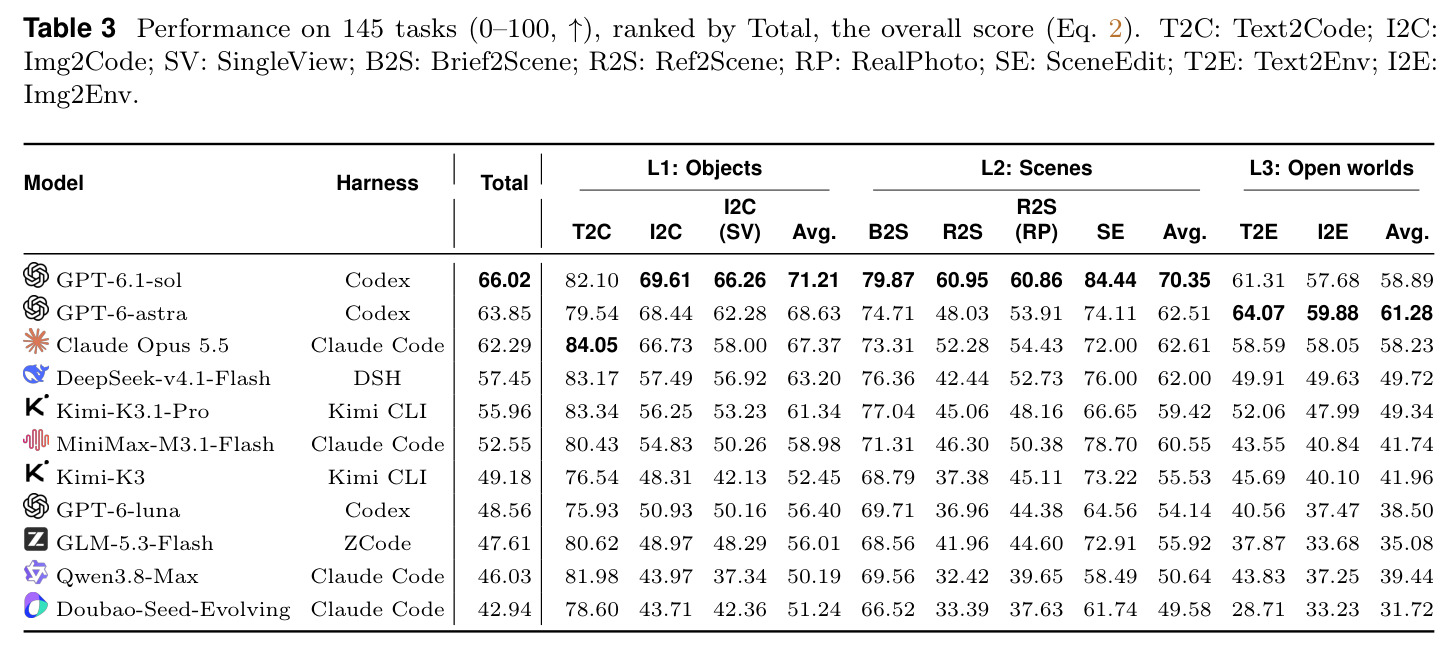
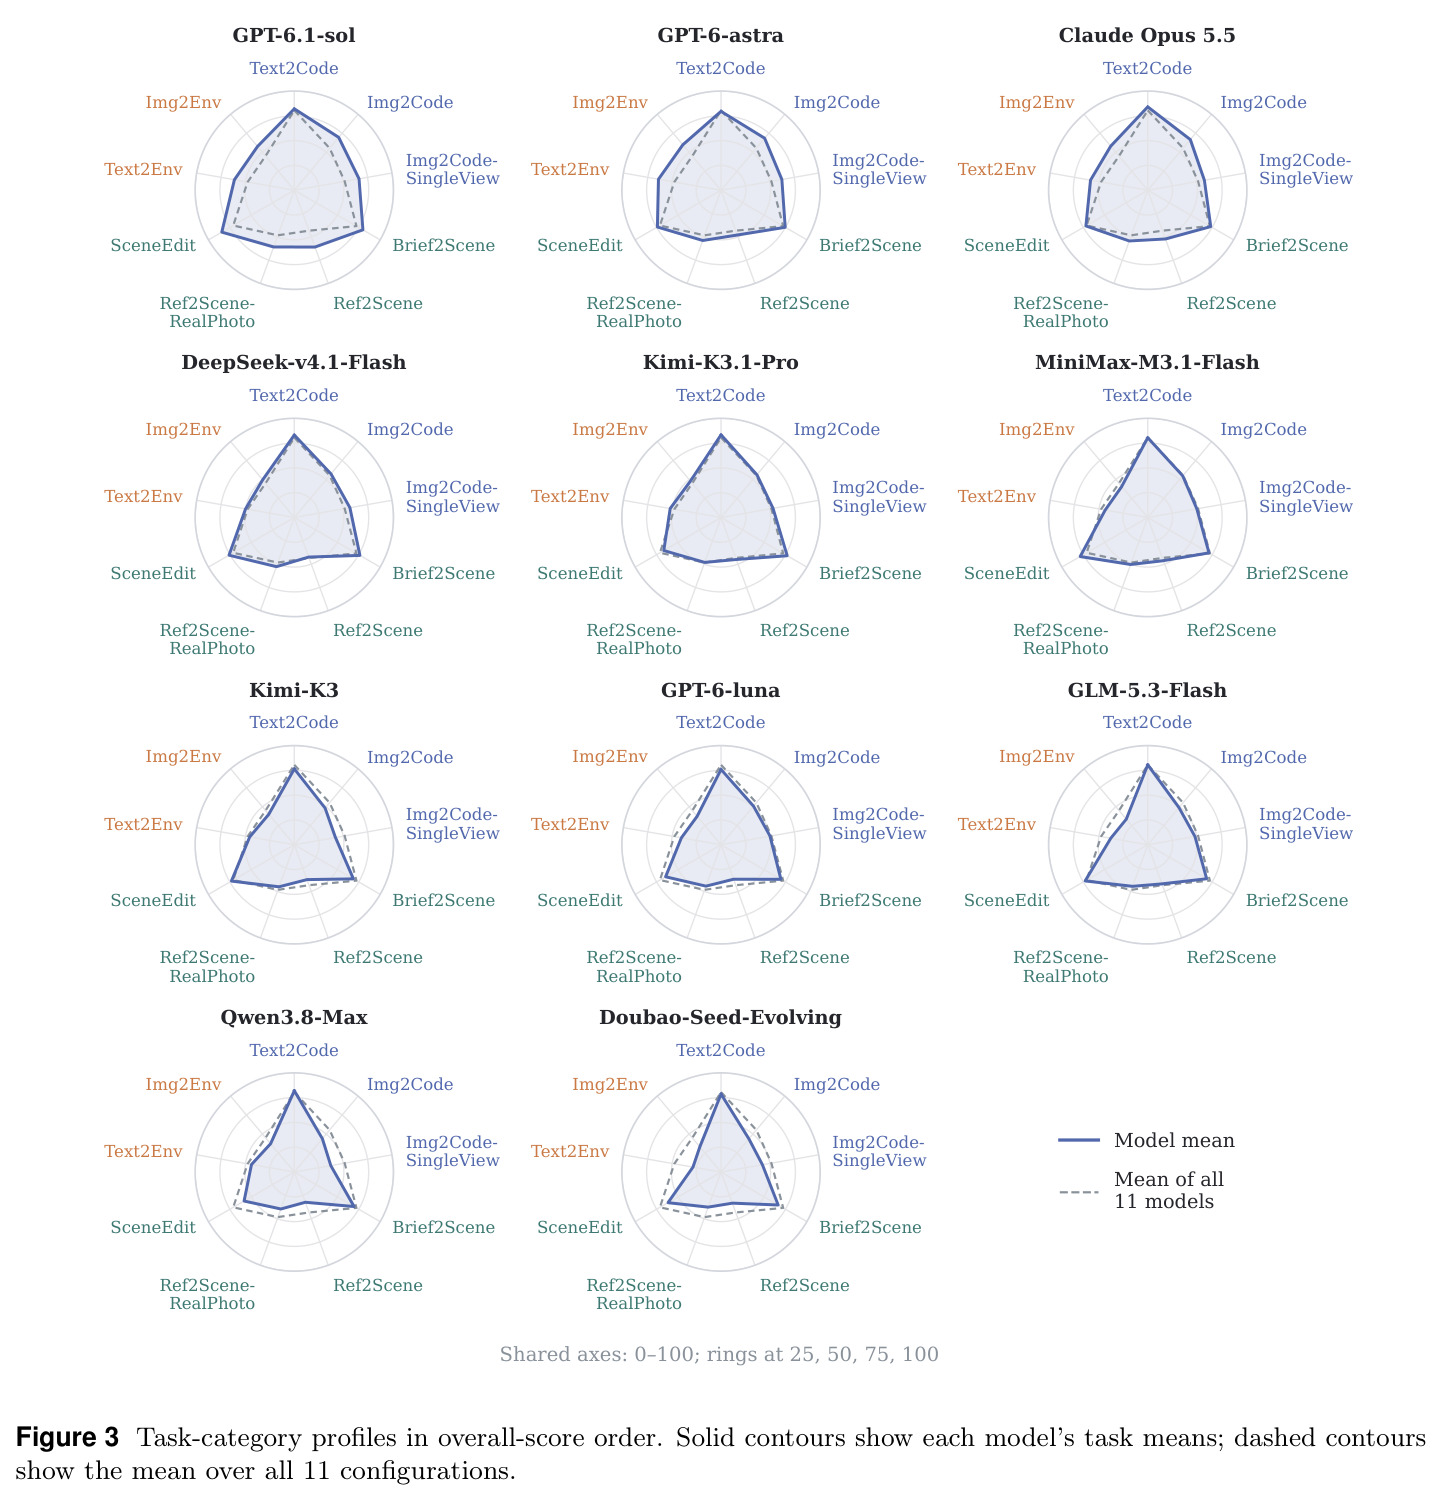
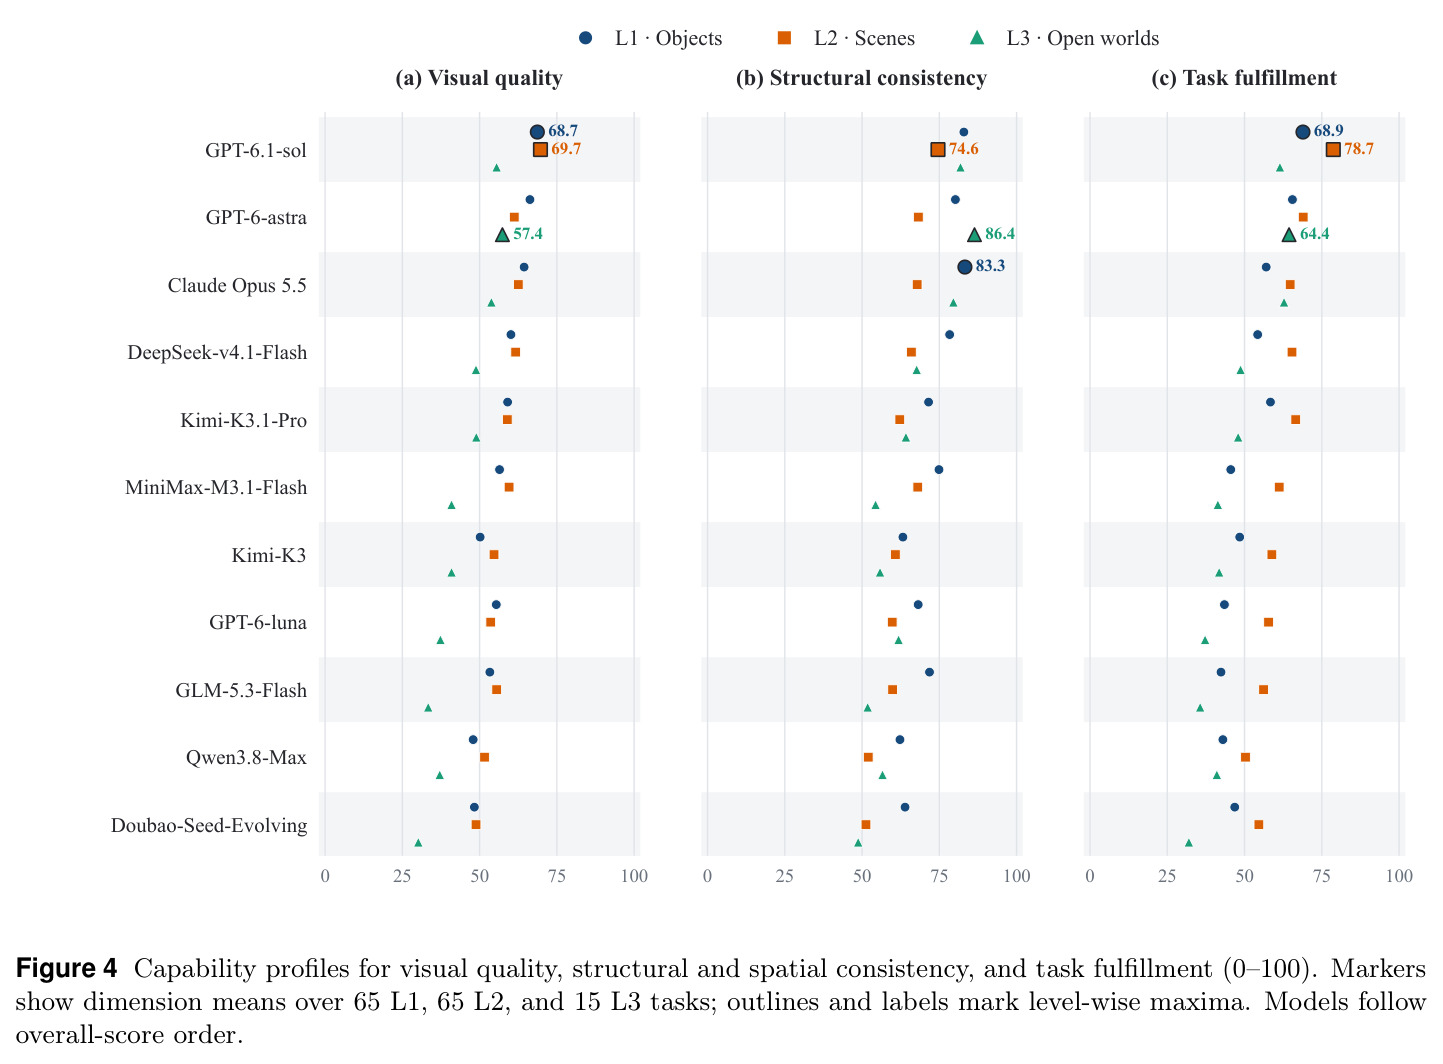
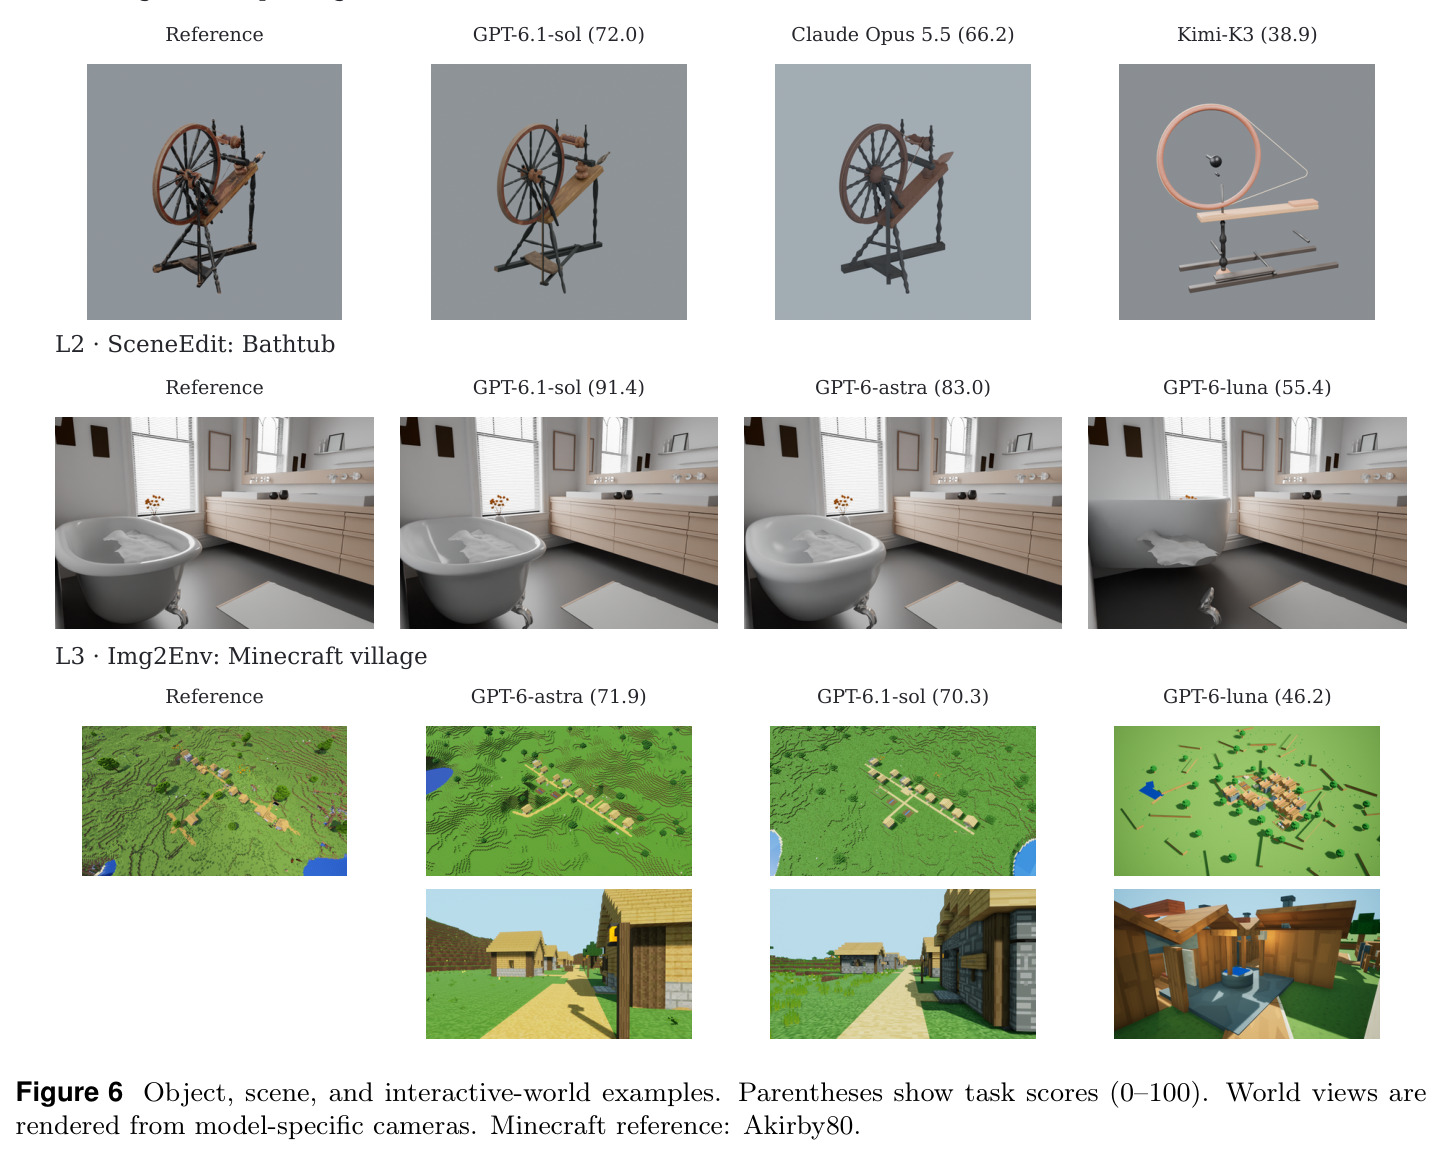
三项核心发现均带硬数字。第一,强弱随层级转移:GPT-6.1-sol(Codex)以 66.02 居总分第一(L1 71.21、L2 70.35、L3 58.89),领先第二名 2.17 分;但 GPT-6-astra 以 61.28 领跑 L3,Claude Opus 5.5 拿下最高的 Text2Code 84.05,9 个类别中 Sol 只领先 6 个。第二,参考重建普遍弱于文本生成:Text2Code 区间 75.93–84.05,而最佳 Img2Code 仅 69.61、最佳 SingleView 仅 66.26;Qwen3.8-Max 反差最极端——Text2Code 81.98 几乎追平 Sol 的 82.10,Img2Code 却跌到 43.97、SingleView 37.34。能力维度上,L1 结构平均 72.77,远高于视觉 57.28 与任务达成 52.15,说明粗粒度摆放容易、完整外观与细节难。第三,交互协调是最大瓶颈:165 份 L3 提交中,交互正确性 H 的局部机制平均 83.08,运动间隙仅 20.82,状态化工作流 30.26——零件能动但完整活动跑不通。成本端,Luna 约 $0.27 得 48.56、DeepSeek $0.45 得 57.45、Sol $1.01 得 66.02 构成 Pareto 前沿;Astra($5.58、63.85)与 Opus($21.17、62.29)花更多钱分反而更低。人机一致性:自动分与 8 名标注者 360 条排序的平均 Kendall $\tau_b$ 为 0.727,Top-1 一致 79.2%,高于人与人的 0.679。定性案例中,纺车重建 Sol 72.0 而 Kimi-K3 退化为环杆结构仅 38.9;浴缸编辑 Sol 91.4、Luna 55.4;Minecraft 村庄 Astra 71.9、Luna 46.2。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 145 任务总评(0.30/0.30/0.40 加权) | Overall 分数 (0–100) | 基准论文无自建模型;榜首为 GPT-6.1-sol(Codex)66.02 | 第二名 GPT-6-astra 63.85;最低 Doubao-Seed-Evolving 42.94 | 领先第二名 2.17 分,其中 L2 场景建造贡献最大加权优势 |
| L3 开放世界(Text2Env + Img2Env,15 任务) | L3 层均值 (0–100) | GPT-6-astra:61.28(类目最佳) | 总分冠军 GPT-6.1-sol 仅 58.89,Claude Opus 5.5 为 58.23 | 比总分冠军高 2.39 分,证明物体/场景的强项不会自动迁移到交互世界 |
| Text2Code(文本到物体,15 任务) | 任务均值 (0–100) | Claude Opus 5.5:84.05(类目最佳) | GPT-6.1-sol 82.10、Kimi-K3.1-Pro 83.34、最低 GPT-6-luna 75.93 | 全配置区间 75.93–84.05,是 9 个类别中最容易的任务 |
| 参考重建 vs 文本生成(Img2Code / SingleView) | 任务均值 (0–100) | 最佳 Img2Code 69.61、最佳 SingleView 66.26(均为 GPT-6.1-sol) | Text2Code 区间 75.93–84.05;Qwen3.8-Max T2C 81.98 | 重建普遍落后生成约 6–18 分;Qwen 的 SingleView 仅 37.34,反差最大 |
| L3 交互正确性 H 子项(165 份提交统计) | 子项均值 (0–100) | 局部机制 83.08 / 运动间隙 20.82 / 状态化工作流 30.26 | 跨 11 配置的总体统计,无单一基线 | 局部机制与协调行为落差超 50 分,直接指认瓶颈所在 |
| 成本效率(145 任务平均 API 成本) | 美元/任务(对数轴) | Pareto 前沿:Luna $0.27→48.56;DeepSeek $0.45→57.45;Sol $1.01→66.02 | Opus $21.17→62.29、Astra $5.58→63.85(均非前沿) | DeepSeek→Sol 以 2.2 倍成本换 8.57 分;更高花费不保证更高分 |
| 自动评分 vs 人工排序一致性 | Kendall $\tau_b$ / Top-1 一致率 | $\tau_b$=0.727,Top-1 79.2%,完全同序 44.7%(360 条排序) | 人与人之间的 $\tau_b$=0.679(1260 个同条目对) | 自动评审至少与单个标注者同样可信,分差越大一致性越高(0.793) |
局限与改进
作者承认与可观察到的局限。其一,任务指令与交互契约均由 GPT-6-astra 生成,而 Astra 本身既是参赛者又是 LLM 评审,存在同源偏置与潜在利益冲突;评审固定在中等推理强度,判分稳定性未做消融。其二,L3 只有 15 个任务,层均值对个别失败高度敏感(每任务约占层内 6.7 分)。其三,DeepSeek-v4.1-Flash 的用量记录不完整,$0.45 的成本估计只是下界,成本结论部分依赖不完整数据。其四,人机一致性研究仅覆盖 4 个参考类 L1/L2 任务族的 45 项,行为类任务没有任何人工验证。其五,状态持久化只在单会话内检验,不含跨会话存档;成本只计最终成功尝试的用量。我另观察到:模型与 harness 绑定评测,无法归因分数属于模型还是框架工程;结构分依赖程序化测量,对非刚性或艺术化形变的容忍度未知;重试机制允许凭执行报错修复,会系统性抬高所有配置的分数。
独立分析的弱点
独立分析四点弱点。1)评审循环性:GPT-6-astra 既写指令、又当裁判、又是参赛配置,若其审美与知识有系统性偏好,排名可能向自家配置倾斜——改进方向是引入多裁判集成、人工仲裁子集,或至少报告裁判换型后的排名稳定性。2)L3 样本太少且每任务权重高达层内 6.7 分,一次环境构建崩溃即可重排名次,应扩充到 50+ 任务并对层均值报告置信区间(论文只给了总分的 bootstrap 区间)。3)运动间隙均值仅 20.82,可能部分来自观察者测试定义的严格而非真实能力缺失,论文缺少失败根因分解(碰撞体缺失?蓝图逻辑错误?资产穿透?),难以指导针对性改进。4)成本分析只计 token 费用,未计 UE 工程构建、渲染与人工检查的墙钟时间,也未计入重试浪费的失败尝试花费,对实际部署决策的指导有限——建议补充端到端时间与人工介入次数两个维度。
未来方向
作者明确指向两大开放挑战:参考保真(匹配指定几何、布局与视觉细节)与协调活动完成(运动部件、动作序列与持久状态的协同)。可延伸方向包括:一是把「修复循环」本身作为研究对象——当前重试不提供分数反馈,可探索自动评分引导的迭代修复对重建类任务的增益;二是把 L3 扩展到更长时程、多 NPC 协作与跨会话存档的活动,检验状态管理能否规模化;三是引入物理仿真校验(碰撞、重力、摩擦)补充 G 项的纯几何测量;四是利用统一协议做能力归因,拆分模型先验与 harness 工程各自的贡献(例如同一模型跨 Codex/Claude Code 运行);五是基于成本-分数曲线做任务级路由,按层级动态选择配置(重建类交给 Sol、世界类交给 Astra、低成本批量任务交给 Luna 或 DeepSeek)。
复现评估
复现门槛中等偏高。基准有公开主页(https://lab.einsia.ai/frontier3dbench),任务素材来自公开 3D 模型、公开图像数据集与作者实拍,Blender 免费且 Unreal Engine 可获取;若评测脚本、交互契约与初始场景随主页开源,任务侧可复现。真正的成本在模型侧:11 个前沿模型的 API 调用,按论文均价每任务 $0.27–$21.17、每配置 145 任务计,单配置约 $39–$3070,完整复跑 11 个配置需数千美元;LLM 评审依赖 GPT-6-astra 访问权;L3 需要搭建 UE 自动构建与独立观察者代理的基础设施,工程量不小。研究者若只测 1–2 个配置并集中于 L1/L2(无需 UE 观察者),成本可控制在百美元级,可行性较高;完整复现 L3 行为评测则需要游戏工程与自动化测试经验。
论文图表
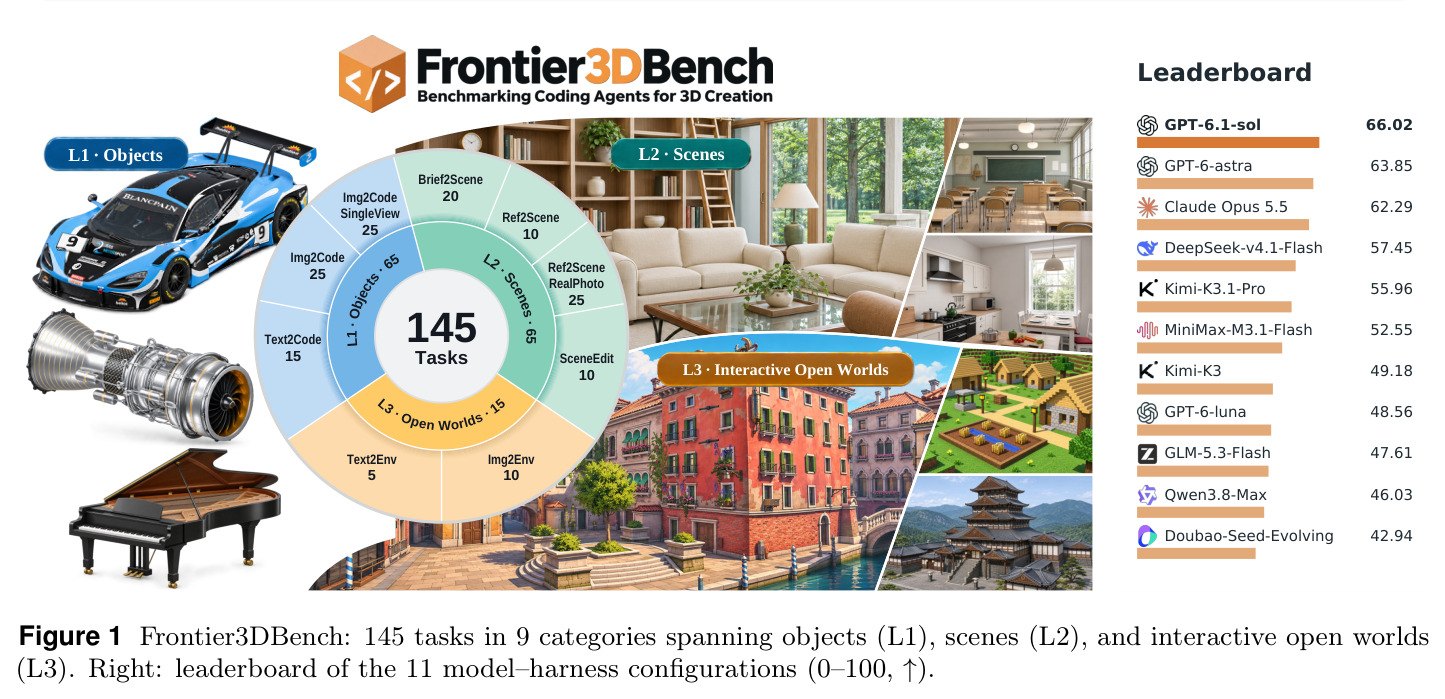
左侧是三层任务树:L1 物体 65 任务、L2 场景 65 任务、L3 开放世界 15 任务;右侧排行榜显示 GPT-6.1-sol 以 66.02 居首,依次到 Doubao-Seed-Evolving 的 42.94。
一图给出基准全貌与主排行榜,是理解论文评测范围与核心结论的入口。