LMBuild:评估 LLM 智能体生成可建造且可功能结构的基准 LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
首个评估 LLM 智能体生成可建造、可运行 3D 结构的四层级基准
前置知识
LLM Agent 与工具调用(Tool Calling)
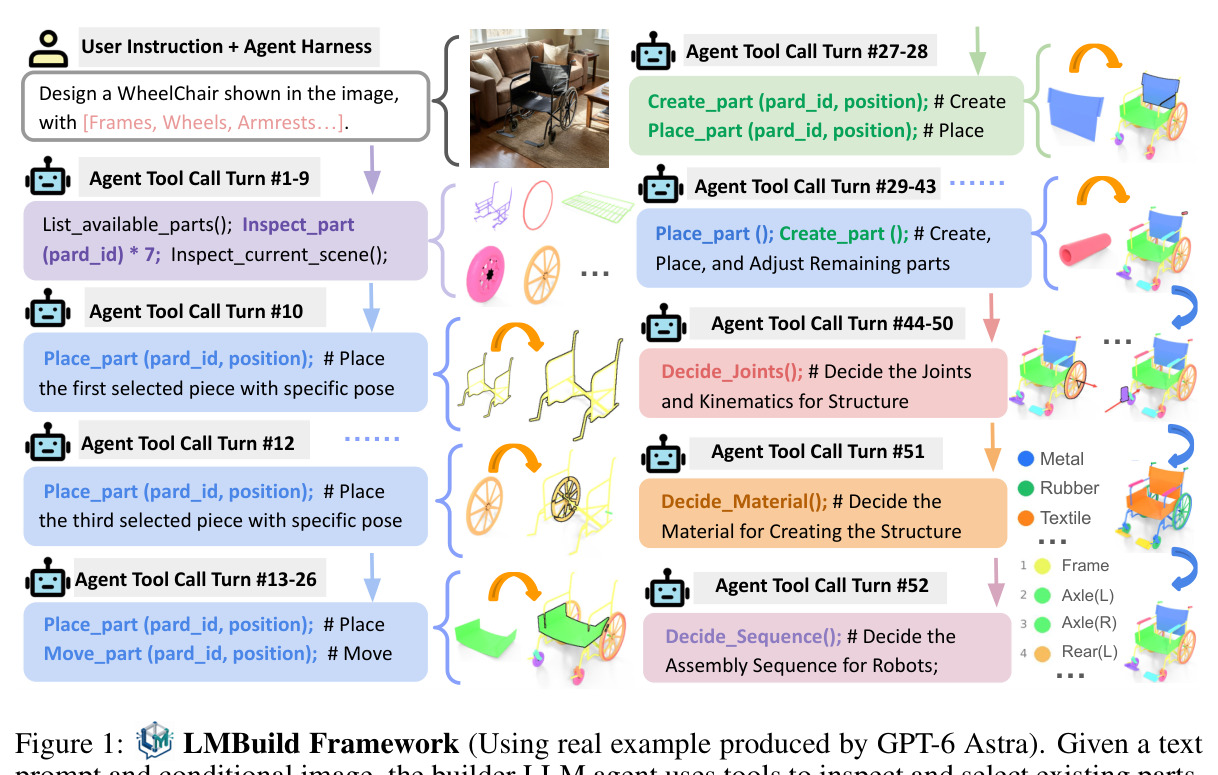
大模型智能体通过生成结构化的工具调用来与外部环境交互:环境执行动作后返回文本或图像观察,模型再决定下一步,形成“感知—决策—执行”循环。LMBuild 提供了 19 个工具(如 list_parts 检索零件、create_part 创建零件、place_part 放置、add_joint 声明关节、check/render 检查渲染),并对每轮交互设置预算(每轮最多 160 次调用、6 次 check、4 次 render、80 个已放置零件)。
本文的评测对象就是智能体本身,理解其交互协议、回合制修改机制与调用预算,是读懂实验设置和后续失败模式分析(如“引用从未放置的零件”这类接口错误)的前提。
构造实体几何(CSG, Constructive Solid Geometry)
一种声明式三维造型方法:用长方体、圆柱、球、圆环、拉伸、旋转等基元,通过并、差、交、壳等布尔运算组合出复杂形状,可表示为有向无环图(DAG)。LMBuild 的 create_part 工具接受最多 96 个节点的 CSG 程序,由 manifold3d 内核编译,保证输出是水密(watertight)的流形实体,参数范围限制在 0.5mm–3m。
智能体“创造新零件”的唯一途径就是写 CSG 程序。论文发现开源模型创建成功率仅 51.7%,且大部分失败源于违反 CSG/工具约定(顶点顺时针、嵌套节点、引用未定义节点),理解 CSG 才能明白这些失败的本质。
关节与运动学(Joints & Kinematics)
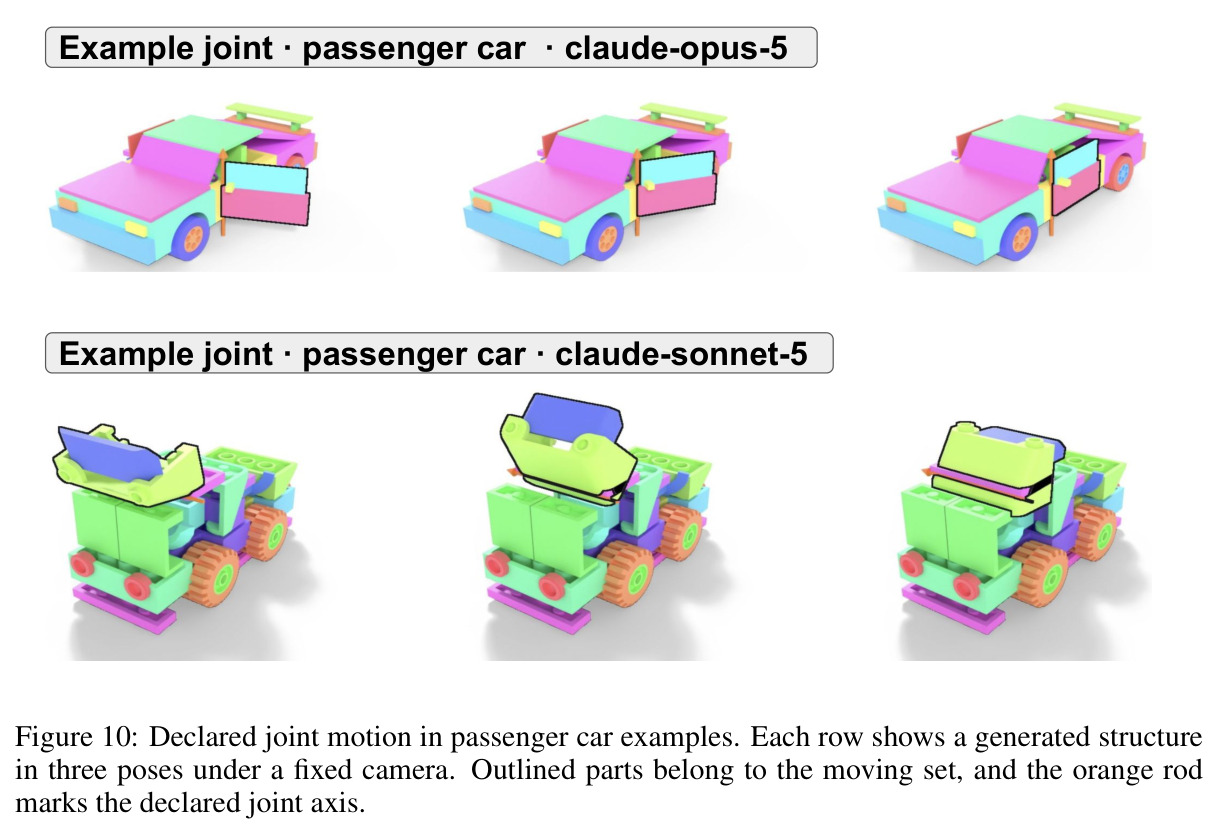
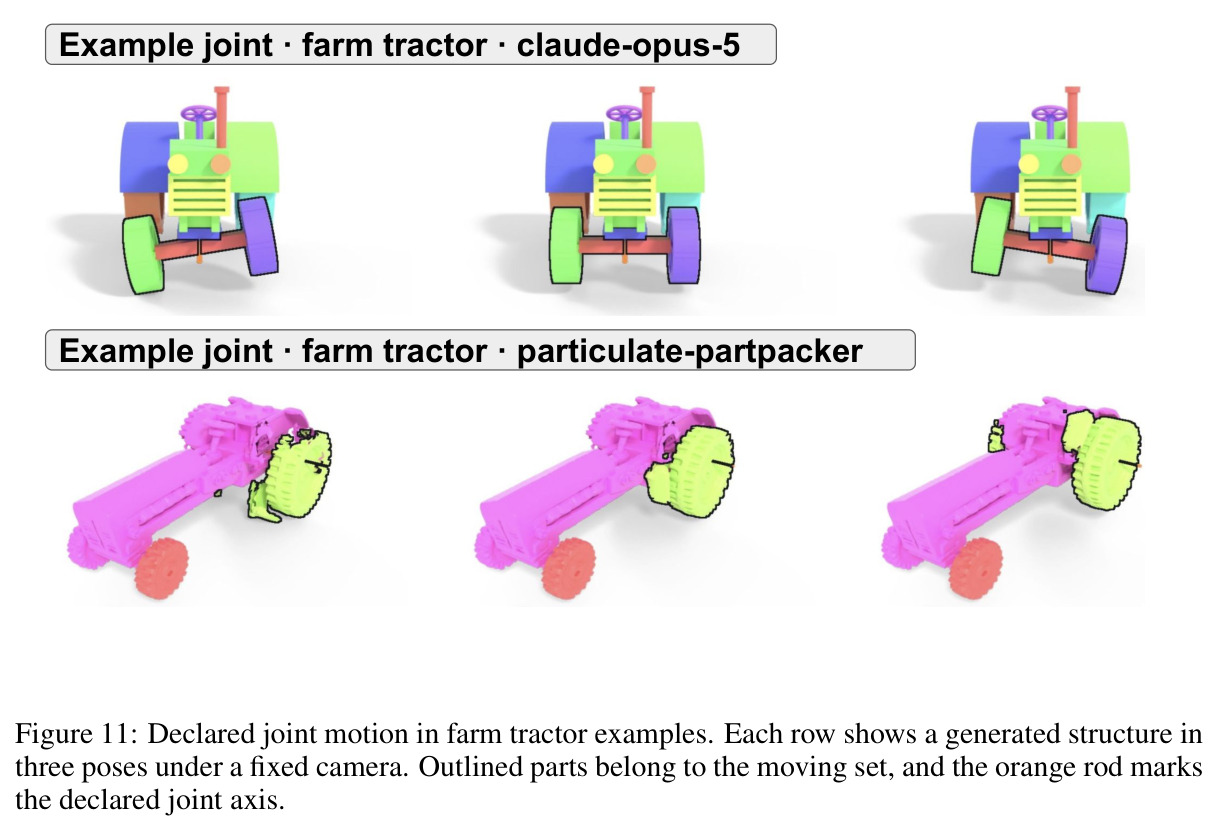
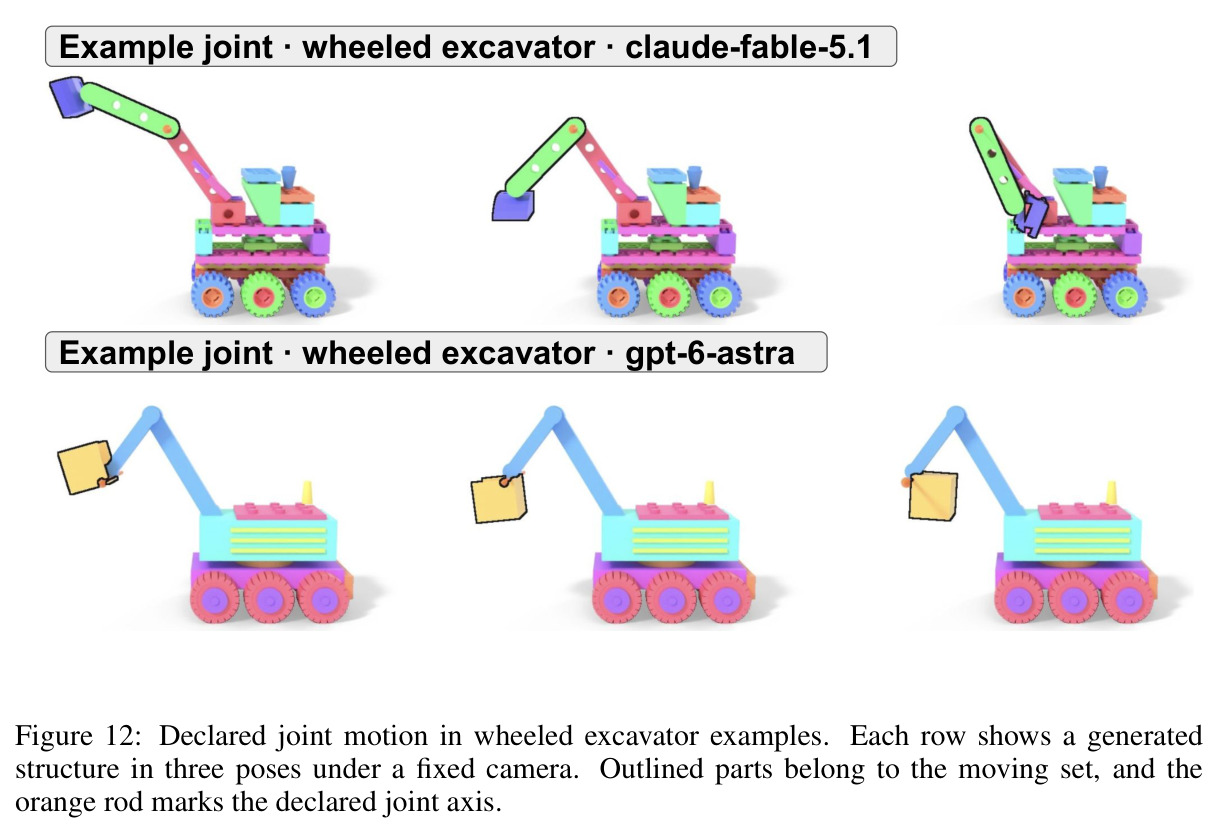
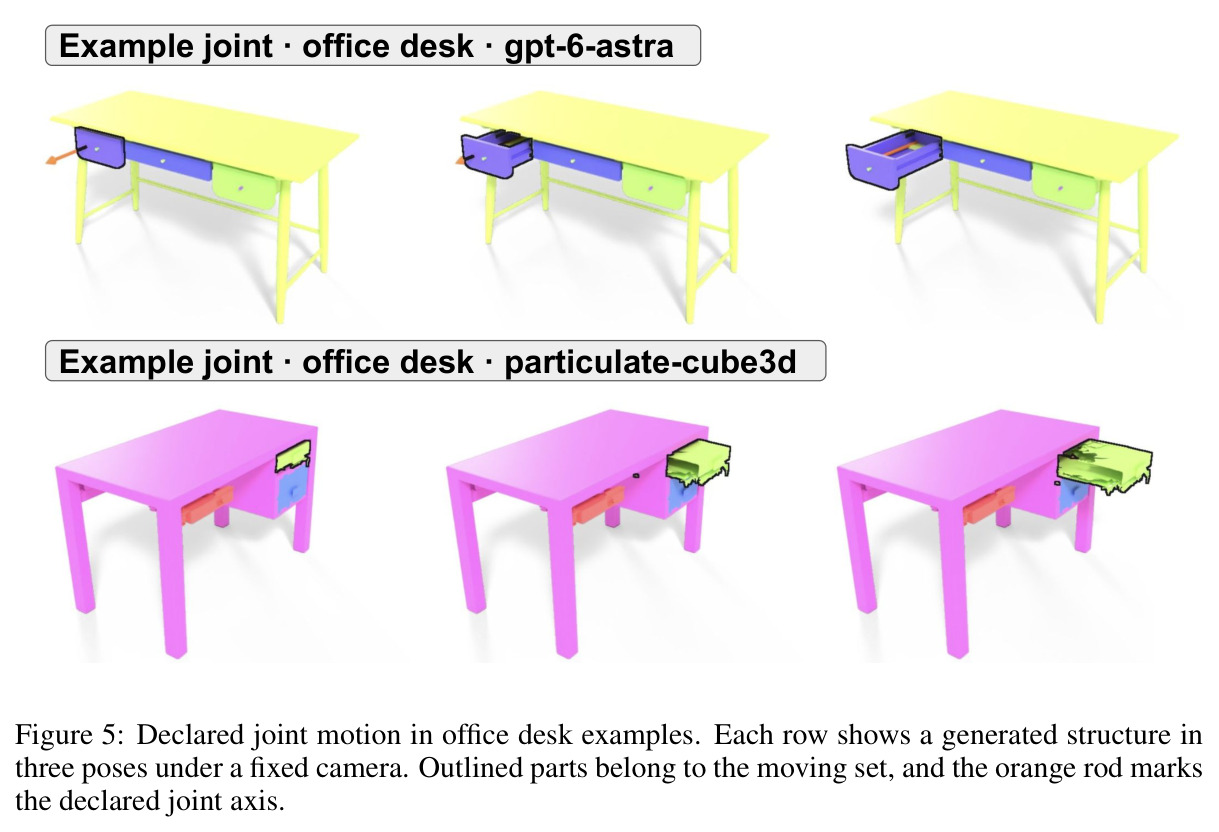
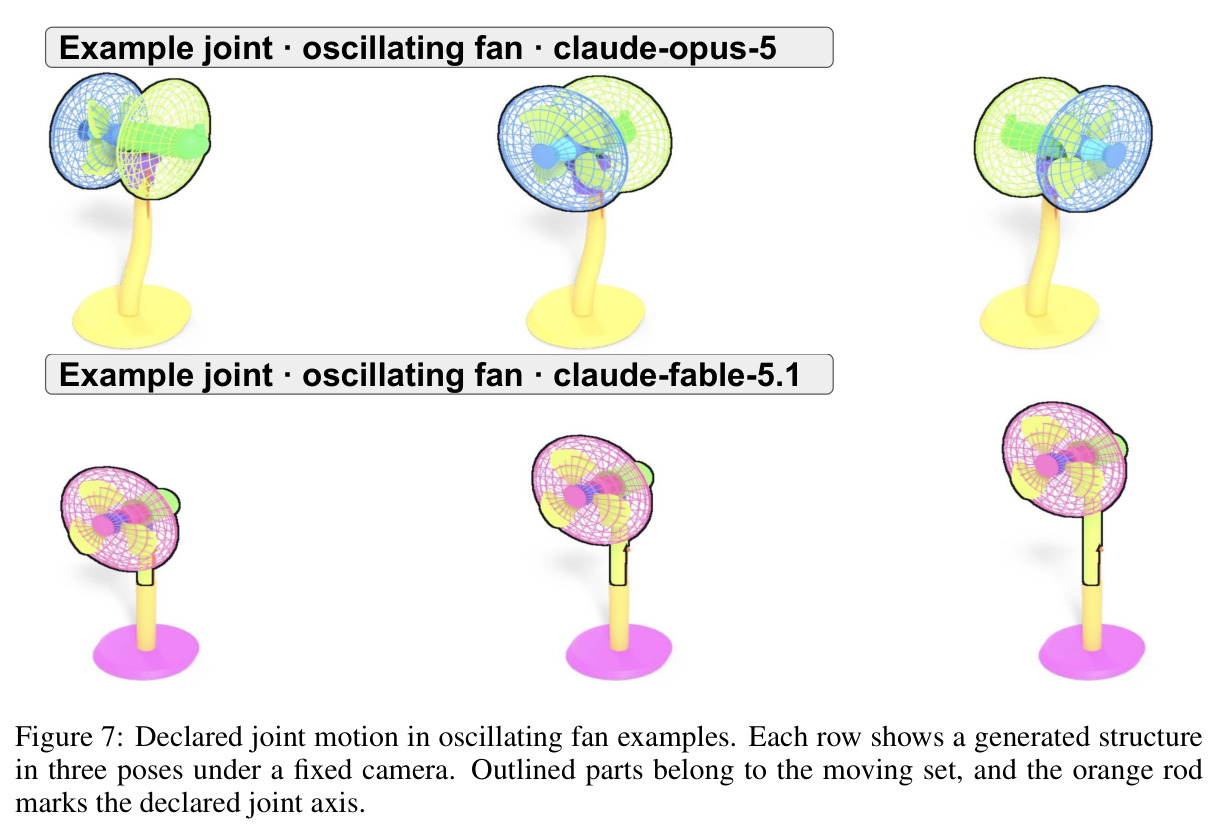
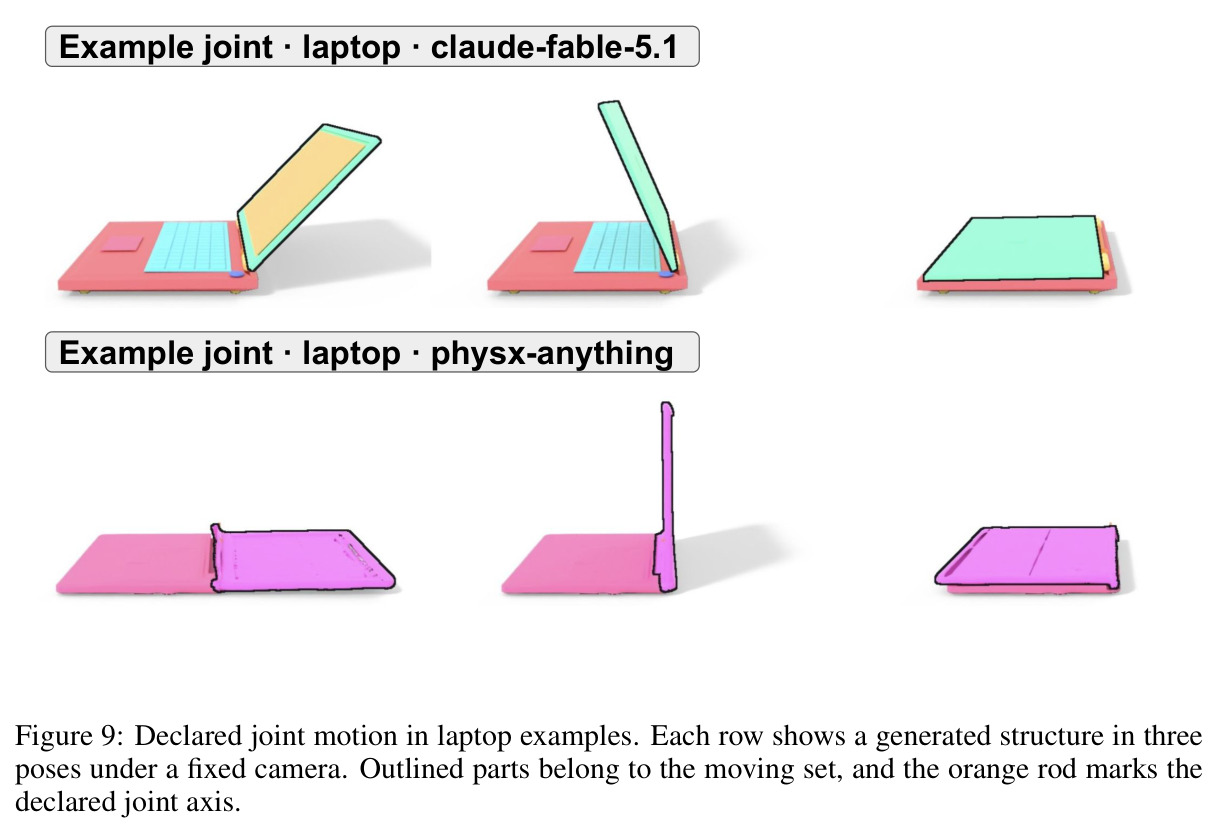
关节描述两个零件之间允许的相对运动方式,常见类型包括固定(fixed)、转动(revolute)、连续旋转(continuous)、滑动(prismatic)、圆柱(cylindrical)和球型(ball)关节;运动学则由关节的类型、轴向(axis)、原点(origin)和限位(limits)共同决定物体各部分如何运动。LMBuild 用 add_joint(type, parent, child, axis, origin, limits) 显式声明,并要求关节原点距两个零件表面各 2cm 以内才算有效连接。
A.3 运动学正确性是全文最难的指标(最佳闭源系统仅 42.7 分),也是“功能可供性是最大短板”这一核心结论的直接证据来源。
功能可供性(Functional Affordance)
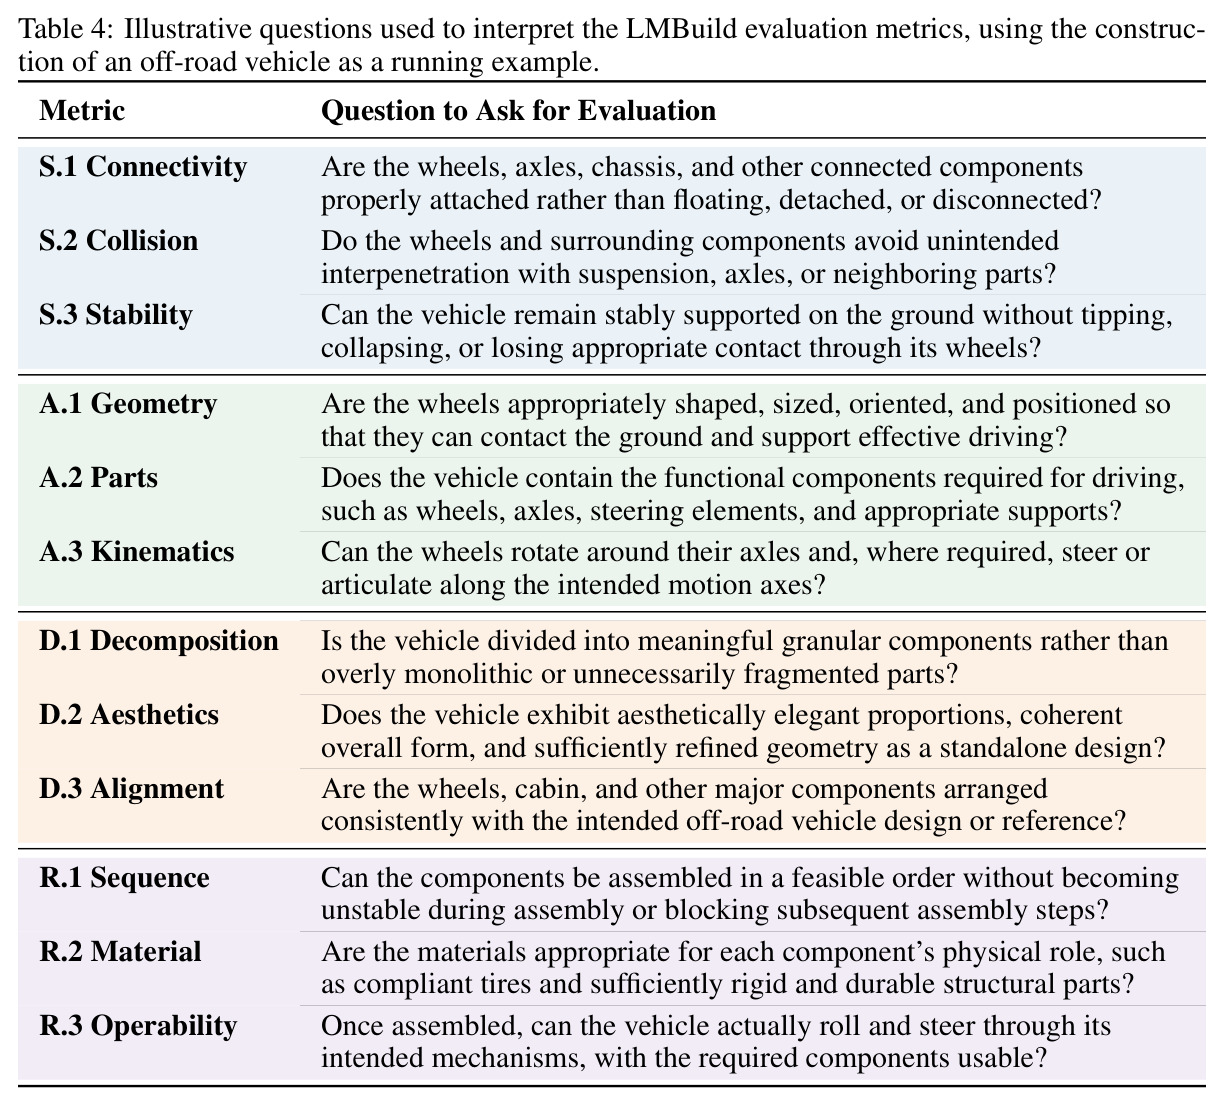
指物体为其预期用途所提供的功能支撑,源自 Gibson 的生态心理学概念,即“物体允许使用者做什么”。在本文语境下包括三个子项:A.1 整体几何能否支撑功能(如车轮形状尺寸能否着地)、A.2 是否包含该类别应有的功能零件(如轮椅的车架、轮子、扶手)、A.3 关节与运动学是否支持预期动作。
可供性是本文区别于以往“看图打分”式 3D 评测的核心维度,也是主要发现的落点——几何质量已不再是瓶颈,可供性与物理可操作性才是真正拉开差距的地方。
刚体仿真与可操作性检验(R.3 Operability)
在给定密度、摩擦、碰撞几何和执行器参数下,用物理引擎驱动已声明的关节,检验装配完成的物体能否真实完成预期动作(车轮能否滚转、抽屉能否拉开、转向机构能否偏转)。LMBuild 按“最弱所需环节”给每项功能能力打分:功能描述中引用的任何一个零件缺失,该项能力直接记零。
R.3 是四层级评测的顶层指标,六个闭源 API 平均仅 18.3 分、约 30%–40% 的任务没有任何功能能跑通,直接支撑了“物理可操作性是最大能力鸿沟”的结论。
研究动机
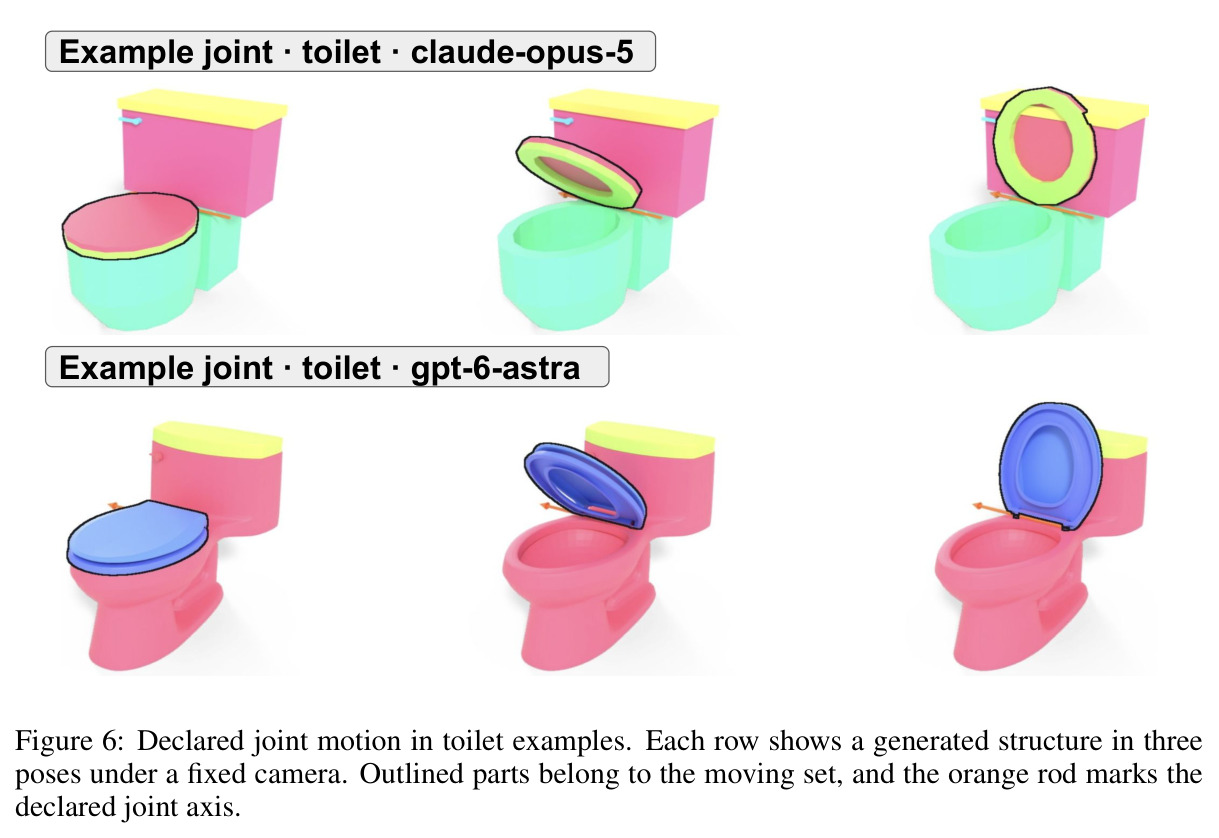
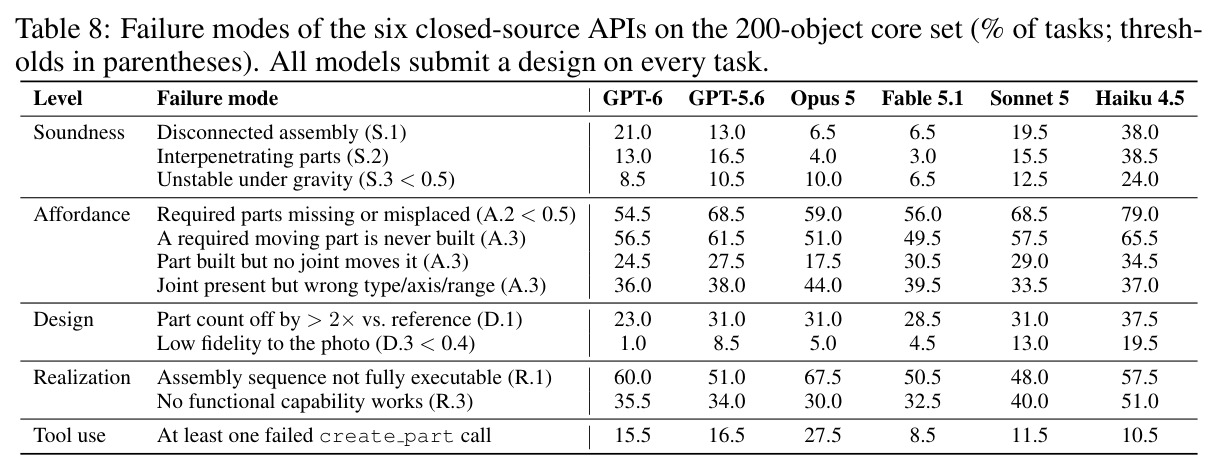
现有 3D 生成评测几乎只关注几何质量、视觉一致性和语义对齐——打分模型生成的物体像不像目标、表面光不光滑、与文本描述吻不吻合。但“看起来像”与“能造出来、能用起来”是两回事:一个结构可以视觉上令人信服,却无效、不可用甚至无法建造。论文给出了鲜明的定性例子:Claude Opus 5 能生成带面包槽的烤面包机,却漏掉了拨杆、定时器、温控传感器和弹出机构;能生成带座圈铰链的马桶,却没有桶盖和冲水把手。定量数据同样触目:在 200 个核心物体上,即使最强的闭源模型,也有 54.5%–68.5% 的设计缺失或错位了至少一半的必需功能零件,48%–68% 的装配顺序不可完全执行,约 30%–40% 的任务中没有任何一个声明的功能能力能在仿真中跑通(Claude Haiku 4.5 高达 51%)。而这些决定物体“生死”的维度,恰恰处于现有评测体系的盲区。
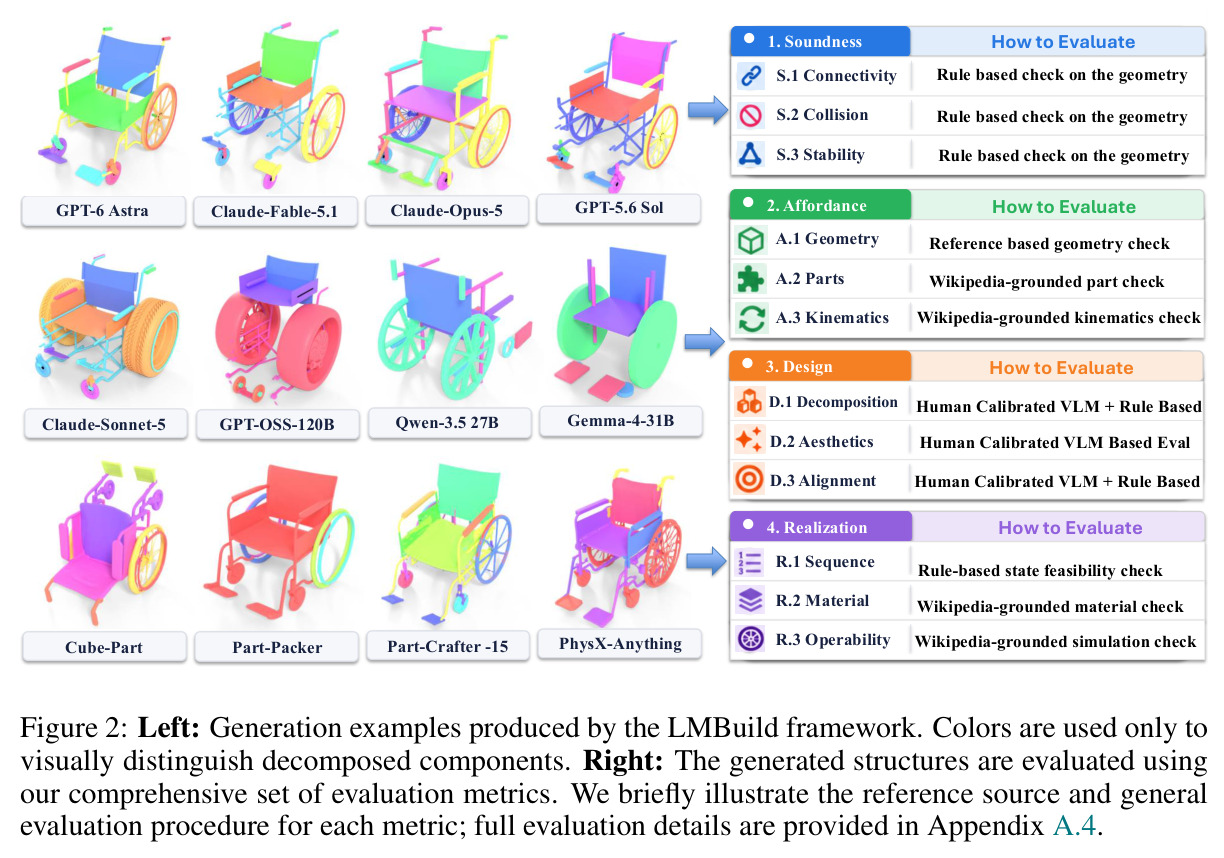
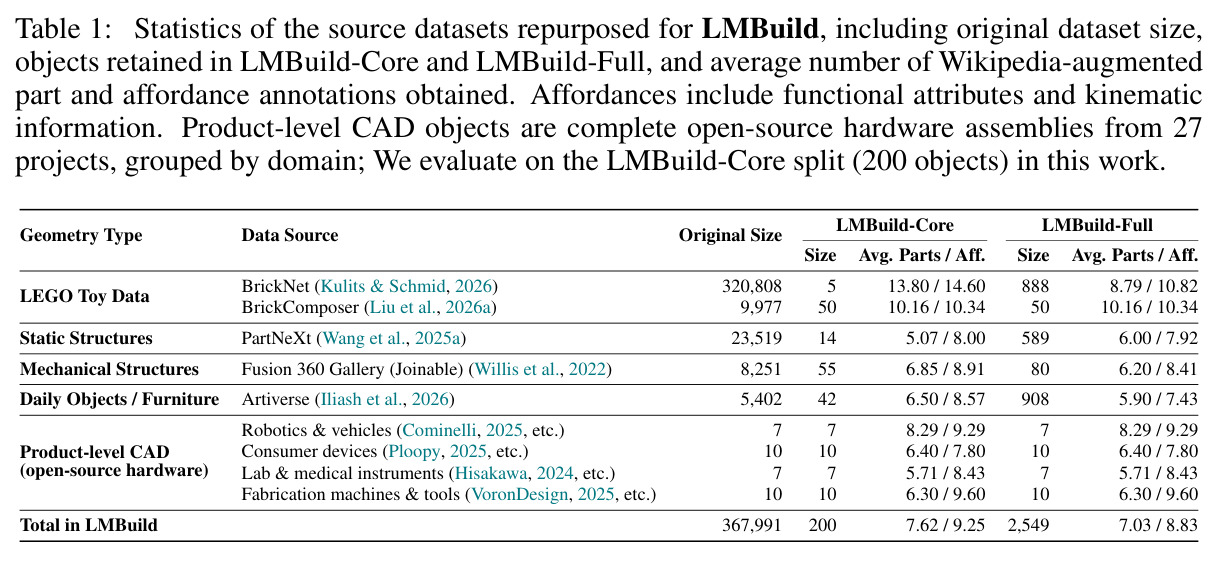
本文的目标是本文的目标是构建首个系统评测 LLM 智能体生成“可建造且可功能”结构的统一基准 LMBuild。具体包含四件事:第一,把生成对象表示为完整的装配规格——有意义的零件分解、关节与运动学、材料、以及机器人可执行的装配顺序;第二,提供可复现的交互环境(19 个工具、预算受控、可检查点重放),让智能体通过检索、创建、放置零件来“把结构说出来就有”;第三,把约 36.8 万个候选 3D 物体精筛成 2,549 个全集和 200 个核心集,并用 Wikipedia 真实世界知识(平均每个物体 7.62 个功能零件、9.25 条可供性标注)作为评测锚点;第四,提出结构稳固性、功能可供性、设计质量、物理实现四层级共 12 个子指标的评测框架,并在 30 个系统(6 个闭源 API、13 个开源 LLM、11 个领域专用生成器)上诊断能力边界与失败模式。
与已有工作不同的是,本文的独特切入有三点。其一,评测对象从“单件几何”升级为“完整装配规格”:要求模型同时输出零件分解、关节/运动学、材料与装配序列,并首次用仿真检验可操作性,而以往工作至多覆盖其中一两环。其二,用异构数据源刻意覆盖不同的“建造范式”——从乐高积木(可复用零件库存)、工程 CAD 装配(Fusion 360)、铰接日常物件(Artiverse)到 27 个开源硬件项目的整机 CAD(四足机器人、Curra 机械计算器、PolyVent 呼吸机、Voron 3D 打印机等),使评测贴近“造出能用的真实产品”这一终极目标。其三,把 LLM 智能体与领域专用生成器放在同一把尺子下,通过检索/创建/混合三种环境档位、多轮修改、显式功能提示等受控实验,分离出“检索依赖 vs 创造能力”“规格不足 vs 能力不足”等以往无法观测的机制性结论。
核心方法
直觉上,要评测“能不能造”,需要一个让模型真正动手搭积木的沙盒,以及一套不依赖主观印象的验收标准。LMBuild = 交互环境 + 数据集 + 分层指标。环境是有状态的纯 Python 工具系统:+Z 向上、地面 z=0、米制单位。智能体先通过 list_parts / inspect_part 检索零件池(至少 3 倍冗余),需要时用 create_part 提交最多 96 节点的 CSG 程序创建新零件(manifold3d 保证水密实体),用 place_part / attach / move_part 摆放微调,用 add_joint 声明六类关节,从 9 大类 23 种子材料中选材,再 set_assembly_sequence 给出装配顺序。渲染由无头 Blender(6 固定视角)完成,几何反馈来自统一的 4mm 体素内核。预算为每轮 160 次调用、6 次 check、4 次 render;submit 后返回六视图与规则诊断,至多 3 轮修订。评测端综合规则几何检查、Wikipedia 知识锚点、经人类校准的 VLM 评委与刚体仿真自动打分。
核心创新是把“可建造性与功能性”操作化为可自动复现的四层级、12 项指标体系,并把“创建新零件”作为独立能力维度分离出来。与以往工作的本质区别在细节定义上:其一,连通性不看零件是否挨着,而要求物理证据——有效关节(原点距两零件表面 ≤2cm)、几何互锁或乐高凸点连接才算数,$S1.1$ 由最大连通分量体积占比 $V(C_1)/V$、碎片度 $1-(m-1)/(n-1)$ 与有效连接数三项合成;其二,碰撞检测只惩罚体积 $O_{ik}>1\,\text{cm}^3$ 且占较小零件比例超过 $\tau_{ik}$(有关节 0.25、无关节 0.10)的恶性互穿;其三,稳定性用临界倾角 $\theta=\arctan(d/h_c)$ 估计倾覆风险;其四,R.3 可操作性按“最弱环节”打分——缺一个定时器,整个功能记零,与工程师验收产品的方式一致。检索-only/混合/创建-only 三档环境则让“创造能力”首次被单独度量。
方法步骤详情
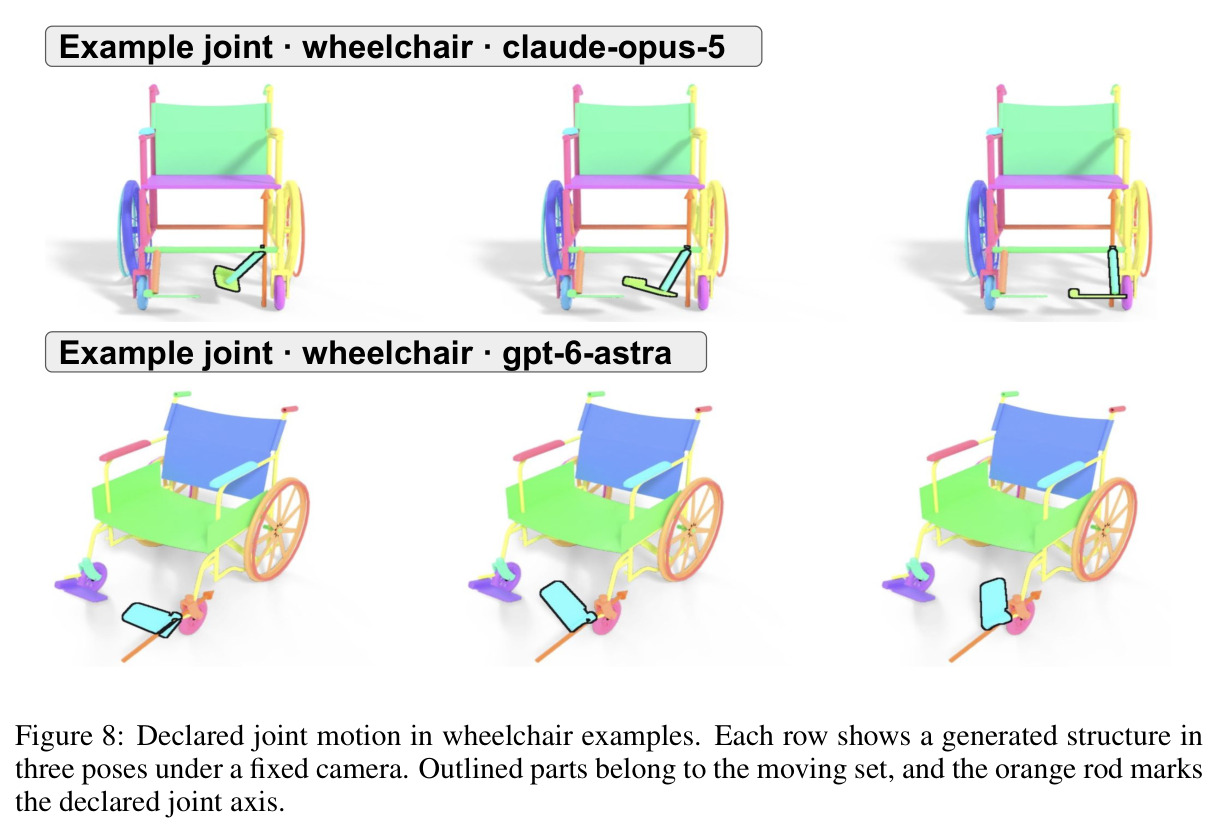
一次完整 episode 的流程如下。第一步(感知):智能体接收目标类别标签与参考图(如“根据图 W2 建造一辆轮椅”),调用 list_parts、list_materials 了解资源。第二步(选取/创建):从至少 3 倍冗余的零件池中逐一 inspect 挑选零件,或无合适零件时用 create_part 编写 CSG 程序造新件;以 GPT-6 Astra 建轮椅的真实轨迹为例,第 1–9 轮检索检查零件,第 10–26 轮放置车架、轮子、扶手并微调位姿。第三步(声明):add_joint 声明轮轴的 revolute/continuous 关节及 axis、origin、limits,set-part-info 指定零件角色和材料。第四步(装配规划):set_assembly_sequence 输出可执行装配顺序及每步插入方向(如 [0,0,-1] 表示自上而下)。第五步(提交迭代):submit 后环境返回六视图与规则诊断(碰撞、断连、失稳、缺功能角色),至多 3 轮修订。闭源模型走 shell 命令、开源走 OpenAI 兼容接口;领域系统保持原生管线,缺关节信息时用 Particulate 补齐再评测。
技术新颖性
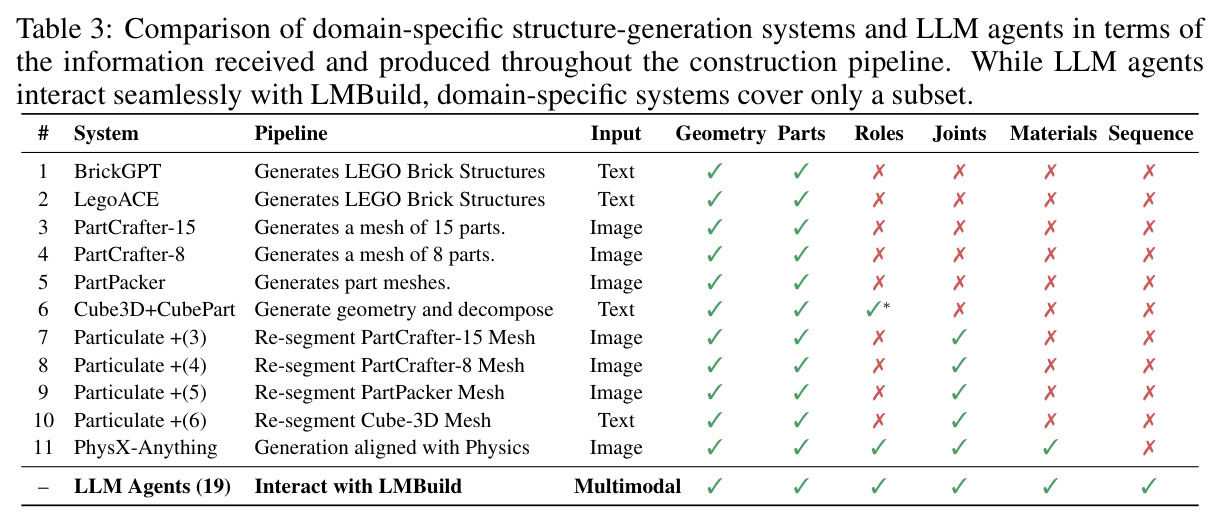
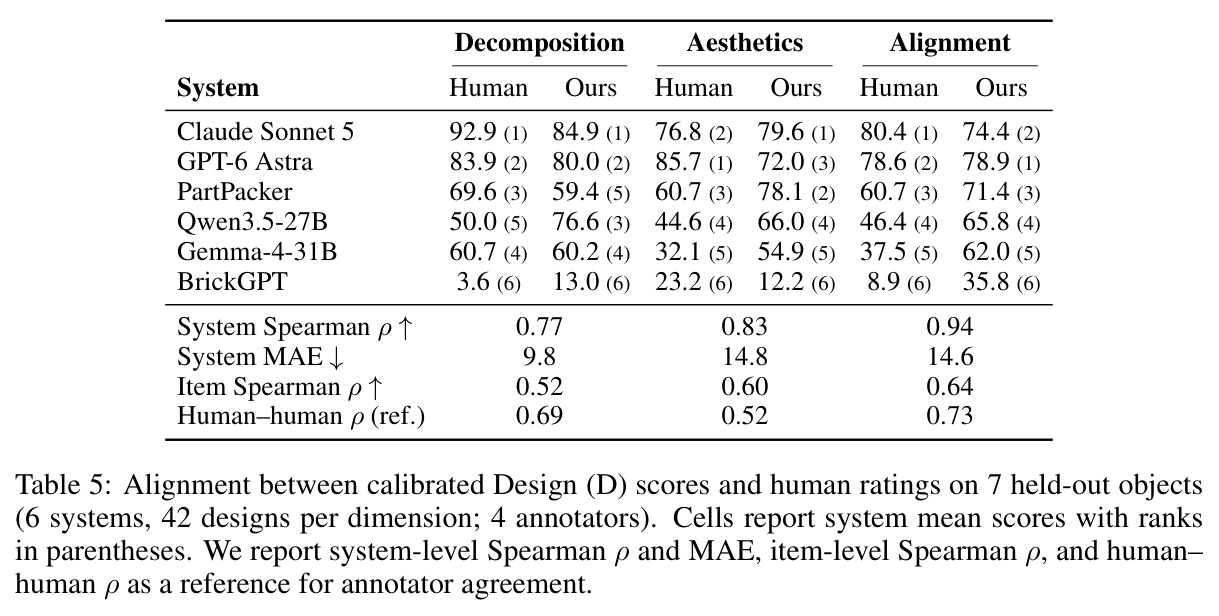
技术新颖性体现在四个层面。数据工程:从 368K 候选经五阶段流水线(结构有效性过滤后剩 74.7K)筛出基准,坚持“覆盖导向”而非频率采样——每个类别在核心集中至多出现一次、每物体至少 4 个零件、跨越六种机构族(静载、铰链、滑动、旋转、串联运动链、多关节铰接),并完整保留 34 个通过筛选的开源硬件整机 CAD,因为它们是“造出真实可用产品”的最接近代理。知识接地:零件清单、运动学与材料合理性不以参考模型为唯一标准,而是锚定从 Wikipedia 提炼的事实断言,使评测可审计、可跨几何域泛化。评测学:12 个子指标在乐高/CAD/自由网格等异构表示间保持统一定义;设计质量维度用“先校准后评测”程序把 VLM 评委对齐到 4 名人类标注者的评分尺度,系统级 Spearman ρ 达 0.77–0.94。实证发现:首次揭示“强模型创造、弱模型检索”的能力分野,以及“显式功能规格比多轮修改更有效”的结论——这些洞见是只看几何质量的旧评测范式在原理上无法产出的。
实验结果
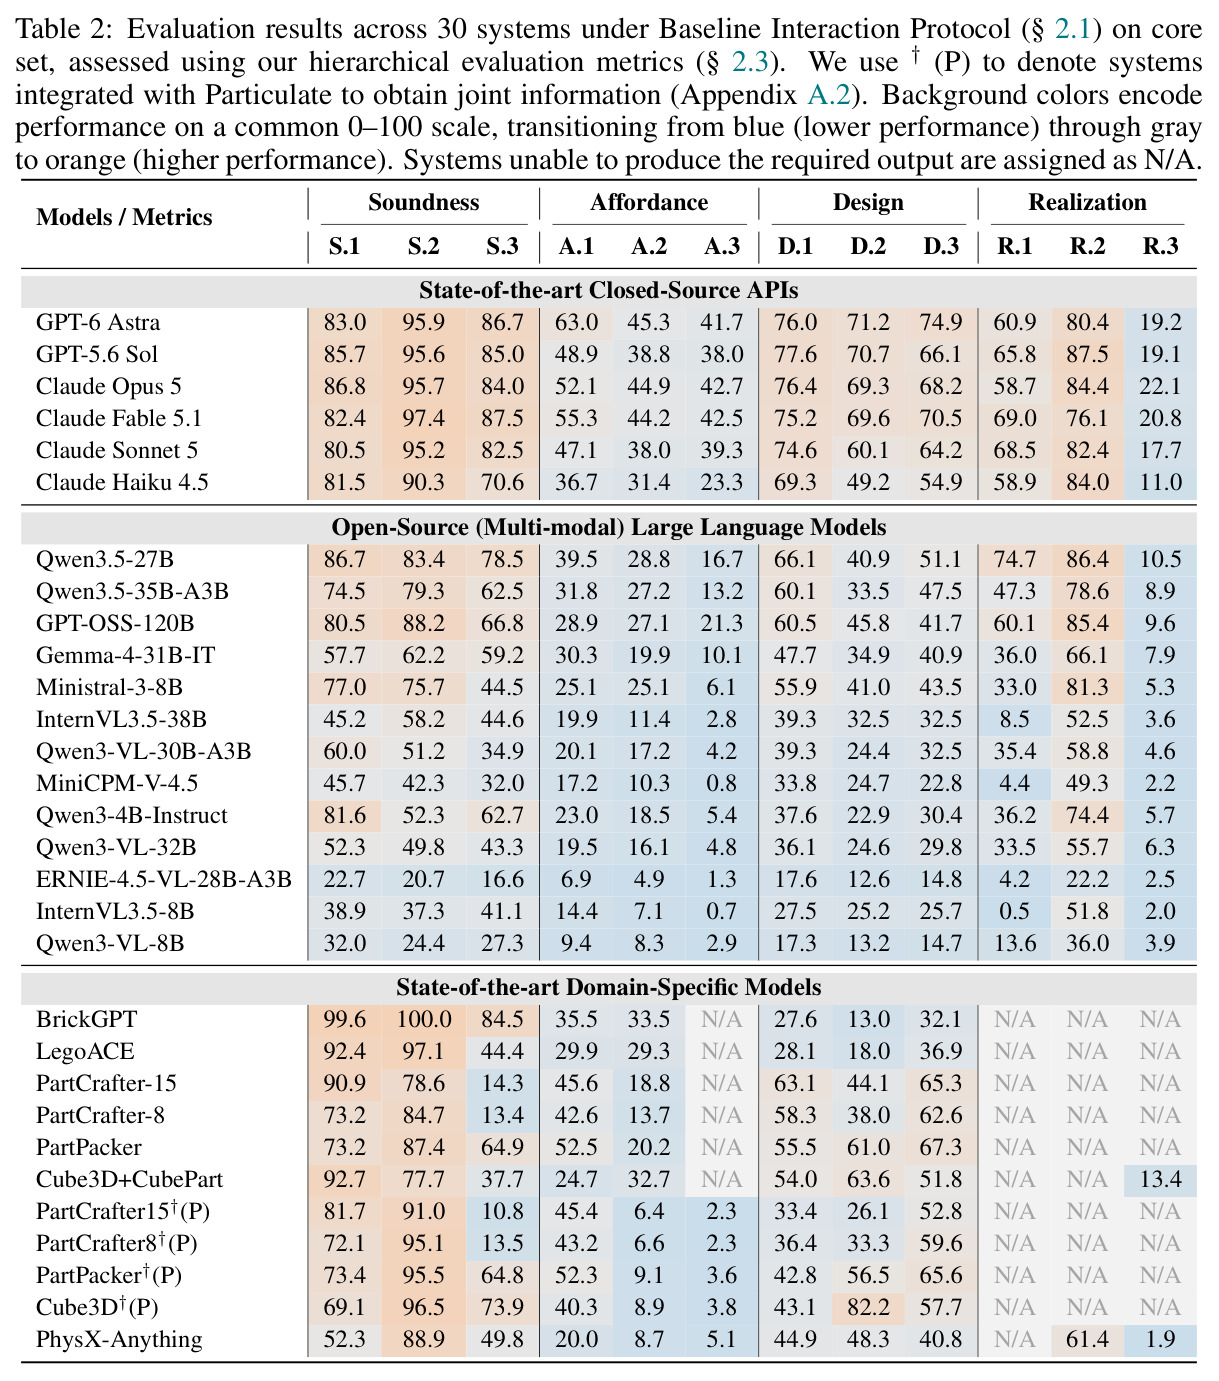
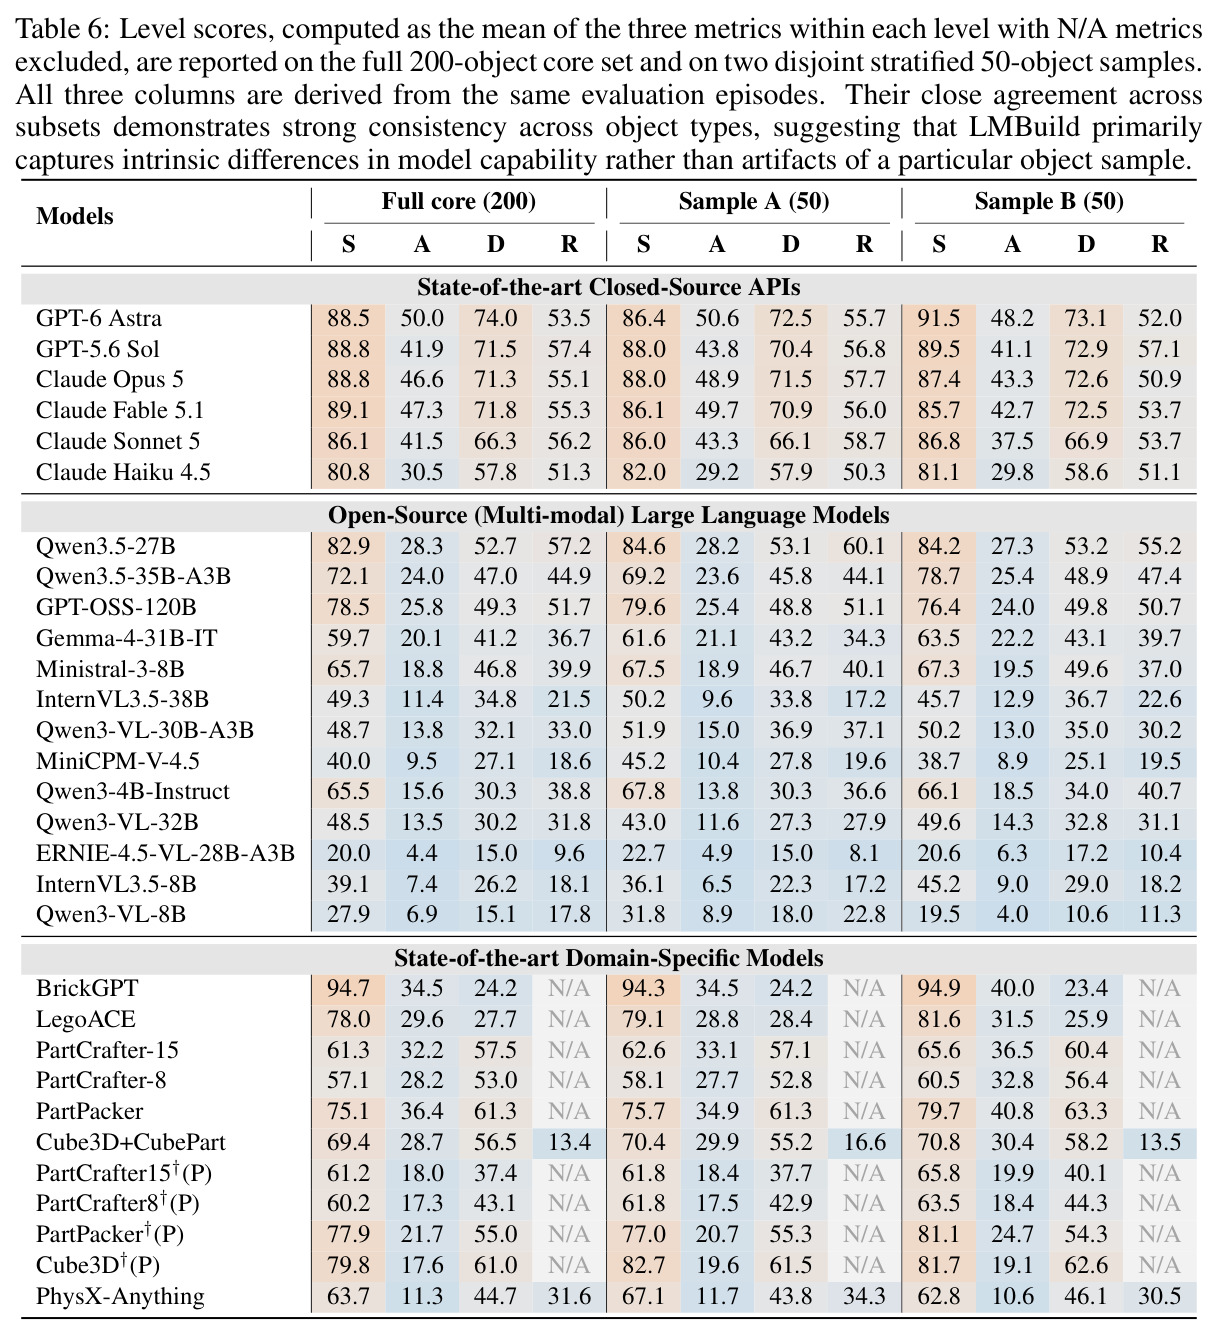
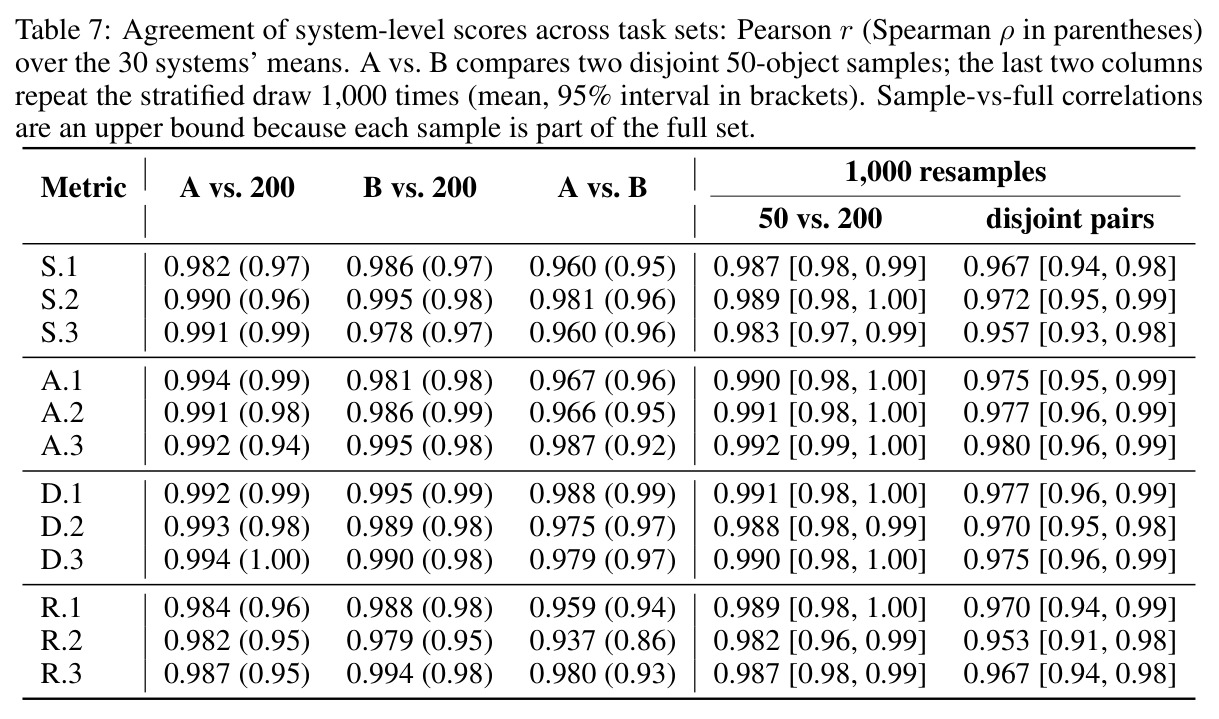
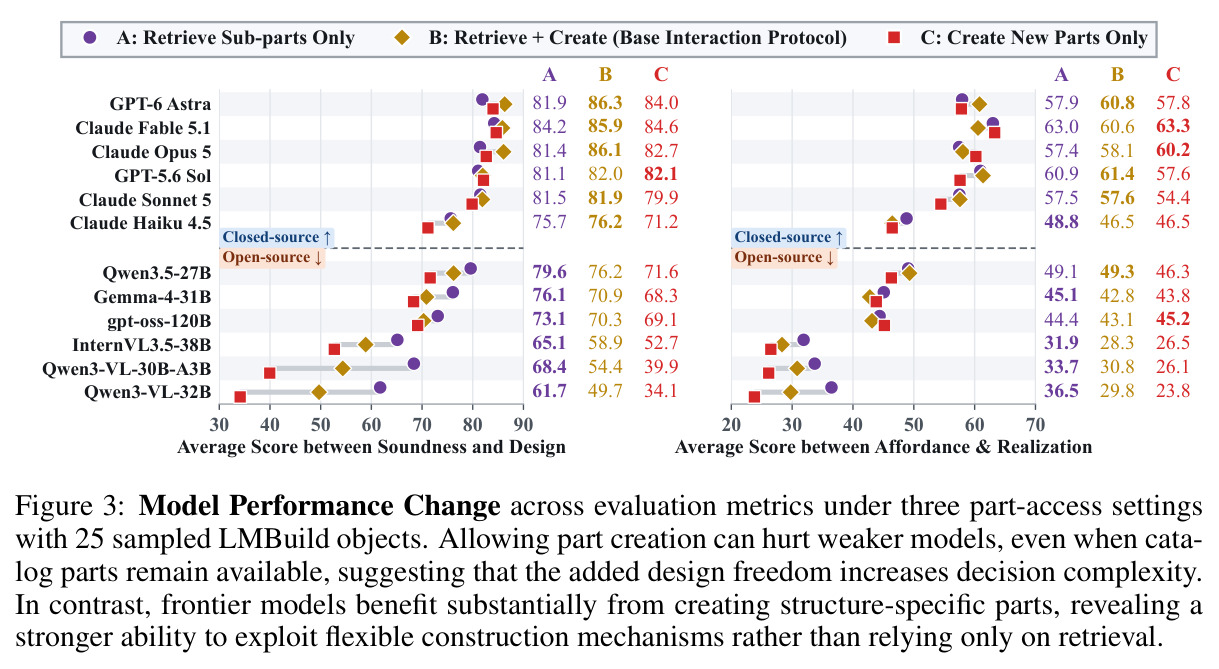
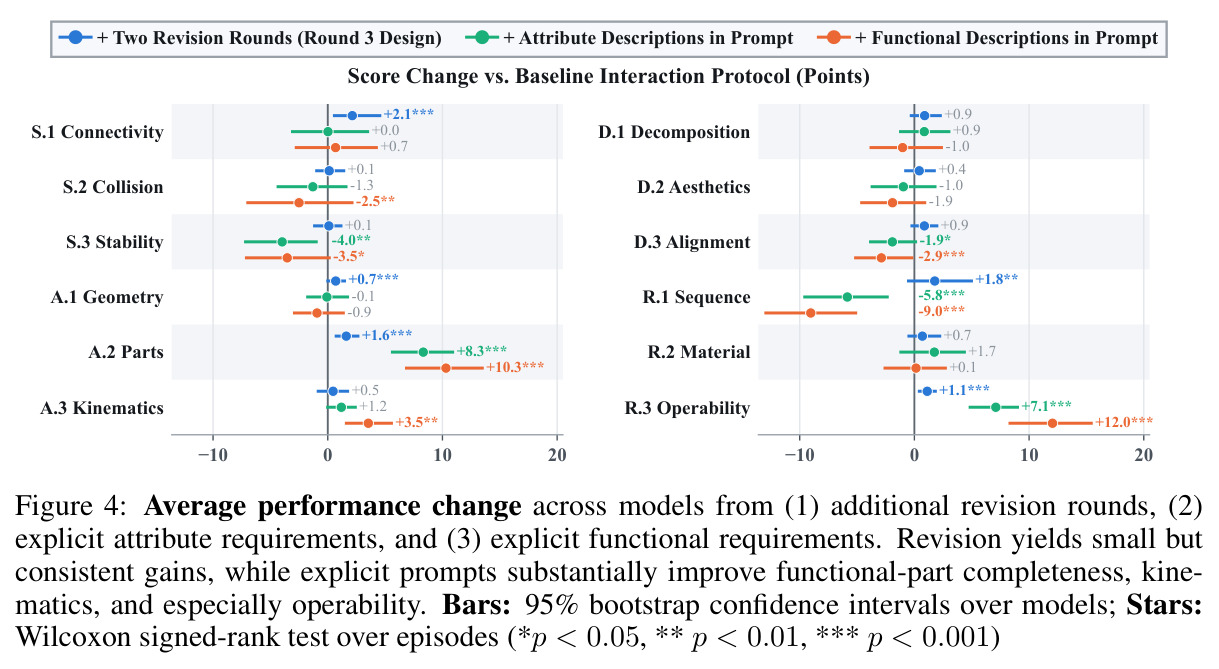
核心发现逐条来看。表 2(200 物体、基线协议、30 系统):闭源旗舰全面领先且趋同——GPT-6 Astra 四层级得分为 S 88.5 / A 50.0 / D 74.0 / R 53.5,与 Claude Opus 5(88.8/46.6/71.3/55.1)接近;S.2 碰撞控制达 95.9,说明稳固性与视觉对齐已非瓶颈。但功能侧惨淡:A.2 最佳仅 45.3,A.3 运动学 41.7(多数开源低于 25),R.3 可操作性全表最高仅 22.1(Opus 5),六闭源平均 18.3。开源最强 Qwen3.5-27B 在 S(82.9)和 R.1(74.7)上具竞争力,但 A 仅 28.3。图 3:GPT-6 Astra 允许创建时 S+D 均分从 81.9 升至 86.3,而 Qwen3-VL-32B 从 61.7(仅检索)跌至 34.1(仅创建),确立“强模型创造、弱模型检索”的分野。图 4:3 轮迭代修改仅 +2%;显式功能描述使 A.2 +10.3、R.3 +12.0(p<0.001),但 R.1 反而 -9.0。表 8:56.5%–65.5% 的运动目标因“该动件从未被生成”而失败;零件创建成功率闭源 95.7% vs 开源 51.7%;场景状态跟踪错误开源 7.2 次/百调用 vs 闭源 0.3。表 5/6/7 证明设计类指标与人类排序高度一致(ρ=0.77–0.94),50 物体子样本即可稳定复现 200 物体排名(r=0.937–0.988)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 功能零件完整性 A.2(基线协议,LMBuild-Core 200 物体) | 归一化分数 0–100 | GPT-6 Astra 45.3(闭源最佳) | 开源最佳 Qwen3.5-27B 28.8;闭源六系统在 54.5%–68.5% 的任务中缺失/错位过半必需零件 | 闭源领先开源约 16.5 分,但绝对值仍低于 50,属最大短板之一 |
| 关节运动学正确性 A.3(基线协议) | 归一化分数 0–100 | Claude Opus 5 42.7(全表最佳) | 多数开源模型低于 25;部分领域系统(接 Particulate 后)仅 2.3–5.1 | 最佳系统也仅略超 50 的一半水平,是可供性维度中最难项 |
| 仿真可操作性 R.3(基线协议) | 归一化分数 0–100 | Claude Opus 5 22.1(全表最佳) | 六个闭源 API 平均 18.3;约 30%–40% 任务无任何功能可运行(Haiku 4.5 达 51%) | 全系统最高仅约 22,构成最大的能力鸿沟 |
| 零件创建调用成功率 | 成功率 % | 闭源模型 95.7% | 开源模型 51.7%(唯一例外 Qwen3.5-27B 达 89.4%) | 闭源领先约 44 个百分点,失败多为违反 CSG/工具约定而非几何推理错误 |
| 显式功能描述提示 vs 基线(A.2 / R.3) | 分数变化(点) | A.2 +10.3,R.3 +12.0(均 p<0.001) | 基线交互协议(仅类别标签+参考图) | 显式规格化收益远超 3 轮迭代修改(整体仅约 +2%) |
| 仅检索 vs 仅创建(S+D 均分,25 物体) | 归一化分数 0–100 | GPT-6 Astra:81.9 → 84.0(仅创建仍强) | Qwen3-VL-32B:61.7(仅检索)→ 34.1(仅创建) | 揭示强模型受益于创造、弱模型依赖检索的能力分野 |
| 评测稳定性(两个不相交 50 物体子样本 vs 200 全集) | Pearson r(30 系统均值) | r = 0.937–0.988 | 1000 次分层重采样不相交对均值 0.953–0.980,95% 区间下界 ≥0.91 | 证明 50 物体即可低成本复现完整排名 |
局限与改进
作者承认的局限:评测不建模制造公差、紧固件强度、弹性变形、断裂疲劳、走线与流体管路、执行器极限与持续载荷,因此分数只代表基准标准下的比较性证据,而非工程可部署性证明;稳定性仅考察倾覆、装配可行性用离散化插入路径与中间支撑检查、可操作性用标准化参数的刚体仿真,换用其他参数可能改写个别分数;Wikipedia 能力表可能遗漏冷门零件或替代实现;设计质量类指标仅由 4 名标注者校准,条目级相关只有 0.52–0.64(低于人与人一致性 0.52–0.73 的水平);每对模型-任务只跑一条最终轨迹,置信区间只反映任务间而非运行间方差。此外附录 A.6 存在笔误(称实验用“50 物体核心集”,与正文 200 不符)。我的补充观察:领域专用系统在多数 R 维度记 N/A,跨家族比较实际只发生在共享子集上,普通读者易误读为“LLM 全面胜出”;零件池 3 倍冗余的设定天然偏向检索型策略,创建-only 结果又受 30/60 次调用上限约束,创建成本与预算的交互未被解耦;4mm 体素、2cm 关节容差等固定阈值虽经校准,对某些建模范式(如粗网格生成器)仍可能引入系统性偏置。
独立分析的弱点
弱点一:可操作性失败的根因是“内部零件缺失”——烤面包机缺拨杆、马桶缺冲水把手、越野车有转动车轮却无铰接转向拉杆——说明模型只从外观推断物体,未推理其工作原理。改进方向:把“需求引出”做成智能体的前置技能(生成前先产出显式功能规格清单,可经轻量检索或反问用户获得),本文 +12.0 的 R.3 收益已证明此路径有效。弱点二:开源模型创建成功率仅 51.7%,错误集中在违反 CSG 约定(顶点顺时针、嵌套节点、用数字 ID、引用未定义节点)而非几何推理差,这是可用工具侧工程手段低成本弥补的——例如内置语法校验的 DSL、自动格式化、模板零件库或受约束解码。弱点三:场景状态跟踪差(开源 7.2 次/百调用引用从未放置的零件、3.2 次重复添加已有实体),指向长程上下文管理缺陷,可引入结构化世界状态缓存或每步状态摘要。弱点四:显式功能提示使 R.1 下降 5.8–9.0 分,说明约束注入与序列规划互相干扰,需要分阶段规划器或联合优化。弱点五:每任务单轨迹设计使 R.3 这类低分指标的方差无法估计,小分数差可能不显著,未来应报告运行级不确定性。
未来方向
作者展望三条主线:其一,把几何约束、装配规则、零件可供性等可复用建造知识内化进模型权重(借鉴文本/多模态策略内化方法),而非推理时临时重新发现;其二,让智能体通过环境探索与递归自我改进积累可复用的程序性技能——如何造关节、如何根据 check 报错补救;其三,支持更具创造性的物理构造:发明功能件、改造复用组件、结合执行反馈形成“提出—测试—修订”闭环。此外建议把 LMBuild 与真实制造闭环:加入增材制造约束(最小特征尺寸、壁厚、悬垂角、公差、打印体积),实测打印成功率、装配可行性与功能表现,做 sim-to-real 校准;把评测扩展到柔顺机构、电子与流体系统,并在 2,549 物体的 LMBuild-Full 上评测。基于本文成果还可延伸:自动需求引出智能体(把显式规格的 +12.0 收益变成默认能力)、检索-创建混合策略学习(动态决定何时创造优于检索)、装配-仿真交替优化,以及把 LMBuild 从纯评测环境升级为智能体训练的 RL 环境。
复现评估
复现条件良好。资源全部公开:代码在 github.com/Lumos-Jiateng/LMBuild,数据在 huggingface.co/datasets/Lumos-Jiateng/LMBuild;论文承诺开源完整代码库、评测环境、评测脚本、全部模型轨迹及复现所需 artifacts。主要门槛是评测成本:即使少于 20 个零件的简单物体单轮也需 50+ 次交互,200 物体 × 30 系统意味着海量 LLM 调用——闭源侧是 API 费用,开源侧需本地算力(GPT-OSS-120B、Qwen3.5-27B 级别需多卡 GPU,8B 级单卡即可)。环境本身是纯 Python、状态可 JSON 序列化、支持逐轮检查点与精确重放,几何检查基于 NumPy/SciPy 单核可跑,Blender 渲染与物理仿真为进程外组件,工程上易于部署。若不重跑全部系统,附录 A.4 给出 12 个指标的完整数学定义与固定超参,可直接套用到新系统。总体难度中等偏上:环境复现容易,全套数字复现需要可观预算;但表 6/7 证明 50 物体分层子样本即可稳定复现排名,低成本验证主要结论完全可行。
论文图表