LEGO-Anything:面向3D场景重建的编程智能体 LEGO-Anything: Coding Agents for 3D Scene Reconstruction
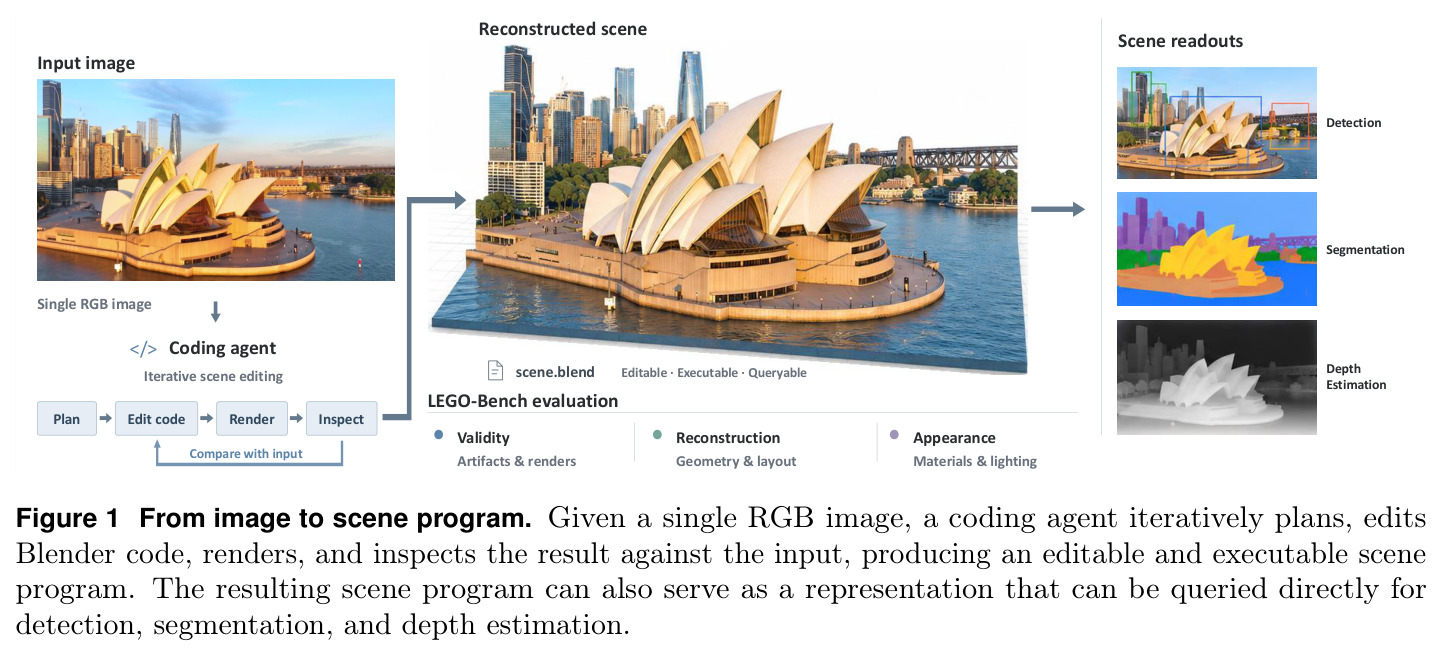
编程智能体迭代写Blender代码,把单张图像重建为可编辑、可查询的3D场景程序
前置知识
编程智能体(Coding Agent)与 Harness
以大语言模型为核心、配备代码读写、命令执行、文件管理等工具的自主系统。它把“写代码—运行—观察结果—修改”作为基本工作循环;harness(运行框架)负责组织工具调用、维护执行上下文并把环境反馈回传给模型,代码因此既是输出也是规划与交互的接口。典型代表有 Codex、Claude Code 等。
本文的主角就是通用编程智能体,实验全部在 Codex harness 下进行;只有理解 harness/工具/执行反馈三者分工,才能明白 LEGO-Plugin 为什么以“MCP 工具 + 技能 + 运行时钩子”的形式外挂接入而不改动模型本身。
Blender 与 Blender-MCP
Blender 是开源 3D 创作套件,场景保存在 .blend 文件中,可用 Python API(bpy)脚本化地建模、布光、设相机、渲染并导出 glb;Blender-MCP 把这些能力封装为 MCP 工具服务器,供智能体以工具调用方式操作场景。
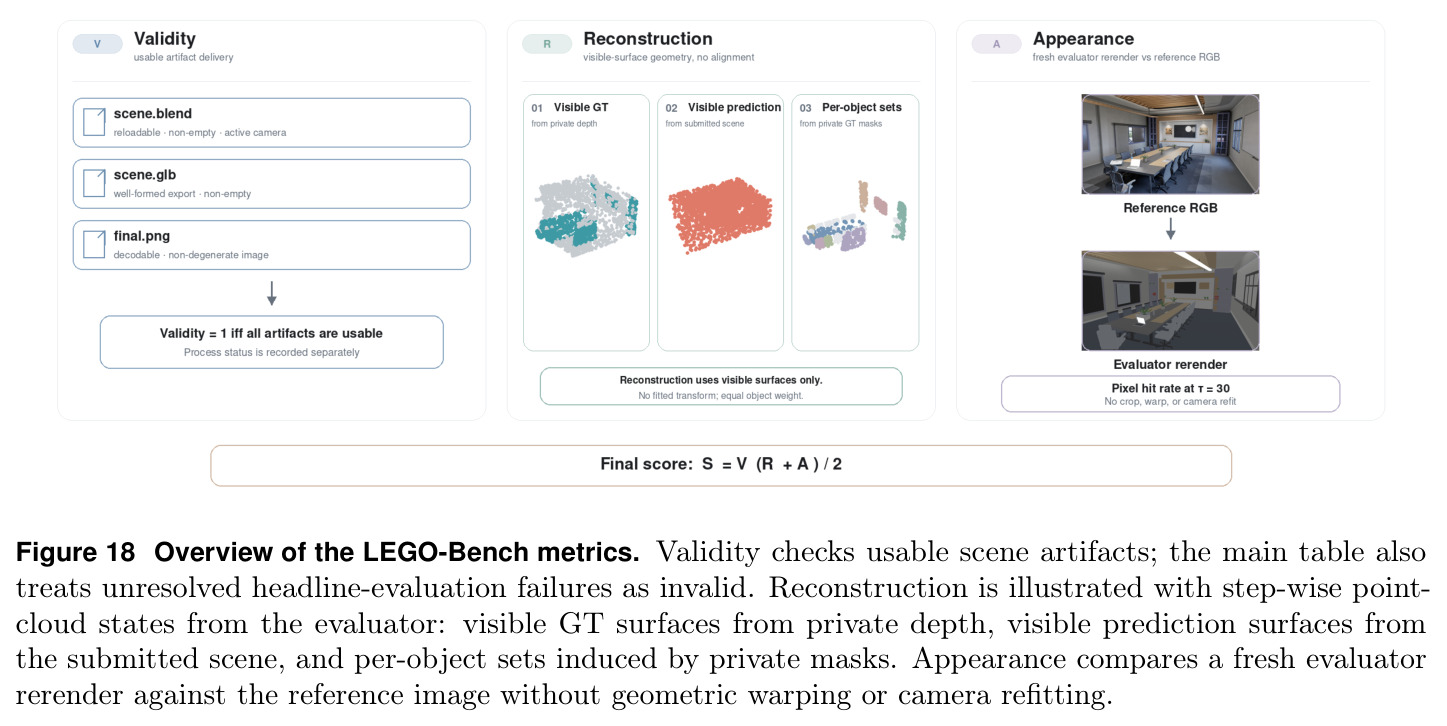
本文的执行环境 E 就是 Blender(实验用 5.0.1 版),智能体写的是 bpy 代码,最终提交 scene.blend、scene.glb、final.png 三个工件;所有评测指标都围绕这组工件定义。
Image-to-Code(图像转代码)范式
把“从图像恢复场景/图形”表述为生成一个可执行程序:程序运行后构造出目标场景。与直接输出 mesh、点云等固定 3D 数据的生成模型不同,代码可被人阅读、检查、编辑、版本化,并且执行产物可与输入逐项比对。
这是全文的表示层选择:LEGO-Bench 的三维指标、LEGO-Plugin 的迭代修订、LEGO-World 的任务读出,全都建立在“场景即程序”这一前提之上。
单图像 3D 重建与视觉基础模型
从一张 RGB 图像恢复几何、布局与外观本质上是病态问题(尺度不定、遮挡不可见)。VGGT、Depth Anything V2、SAM 3 等前馈基础模型可以分别给出相机位姿/几何、相对深度和物体掩码等先验估计。
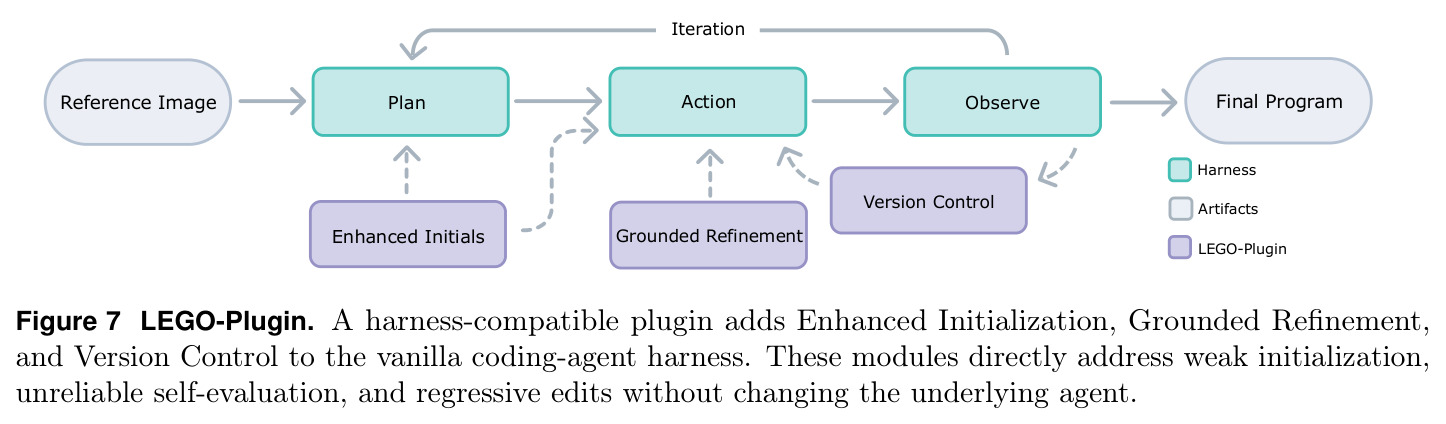
LEGO-Plugin 的三个模块完全依赖这些模型从参考图像提取证据:Enhanced Initialization 用 VGGT 恢复场景框架,Grounded Refinement 用 SAM 3 与 Depth Anything V2 生成显式残差来替代智能体的自我评估。
精确率 / 召回率 / F1
衡量匹配质量的基本指标:精确率是预测点中落在真值容差范围内的比例,召回率是真值点被预测覆盖的比例,F1 是二者的调和平均。本文将其扩展为深度相对容差下的点云逐物体匹配。
LEGO-Bench 的几何指标 $R_i$ 是“无配准、逐物体 F@5%”:对每个物体在 $ au(g)=0.05\,z(g)$ 容差下计算点级精确率/召回率再取 F1 宏平均,读懂该公式需要这些基础概念。
研究动机
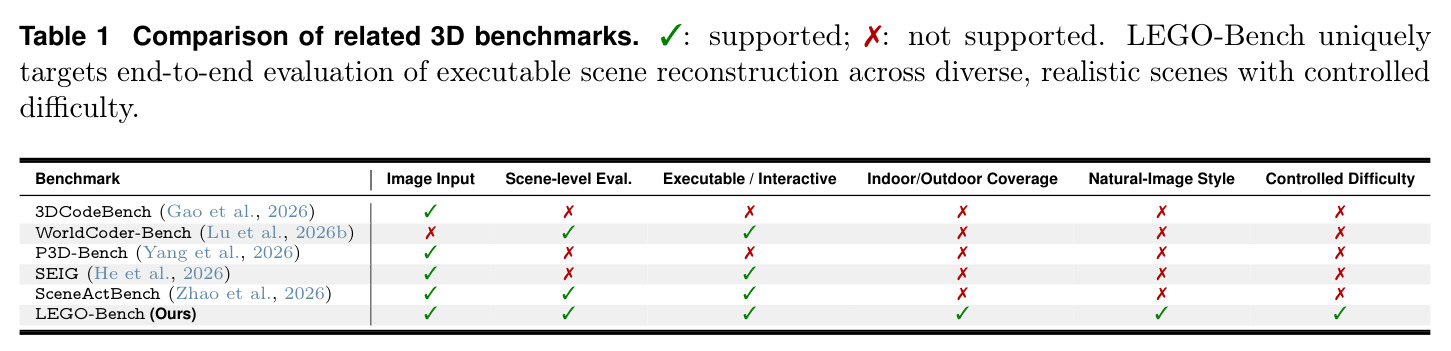
3D 重建结果的表示形式决定了它能被用来做什么。现有系统要么输出 mesh、点云图、物体集合这类固定 3D 产物,要么用模块化流水线拼接感知、资产检索与场景装配,要么用学习模型端到端地映射图像到 3D——这些输出都无法直接“对照输入图像检查结果并修订”。评测侧同样存在空白:3DCodeBench 只评物体级程序化建模,P3D-Bench 只评参数化零件装配,WorldCoder-Bench 用文本而非图像指定世界,SEIG 的定量评估偏物体中心,最接近的 SceneActBench 依赖标定好的多视角室内观测且明确排除房间结构与纹理恢复。更根本的矛盾是:真实照片缺乏精确 3D 真值,而简单合成场景又缺乏自然图像的真实感,导致“单张自然图像的端到端可执行场景重建”这一任务长期无法被精确自动评测。
本文的目标是本文要回答三个递进的问题:(1) 通用编程智能体从单张图像重建场景的保真度到底有多高?(2) 迭代构建过程内部是什么在限制它们?(3) 重建出的场景程序是否精确到能充当自然图像的结构化表示、直接支撑下游视觉任务?为此作者构建了 LEGO-Anything 框架(智能体迭代编写并执行 Blender 程序)、LEGO-Bench 基准(208 张图、104 个场景,分别评分工件有效性、可见表面几何与渲染外观)、失败诊断与免训练插件 LEGO-Plugin,以及检验表示充分性的 LEGO-World 读出实验。
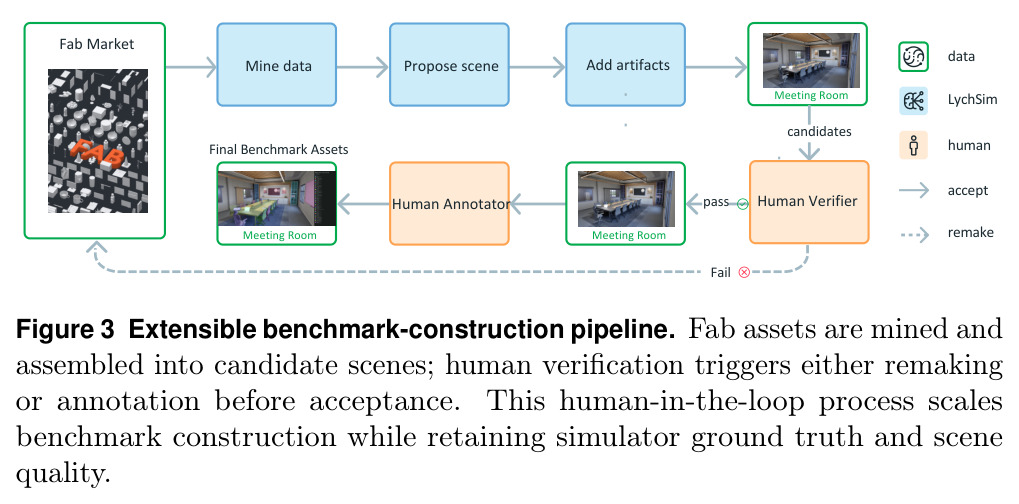
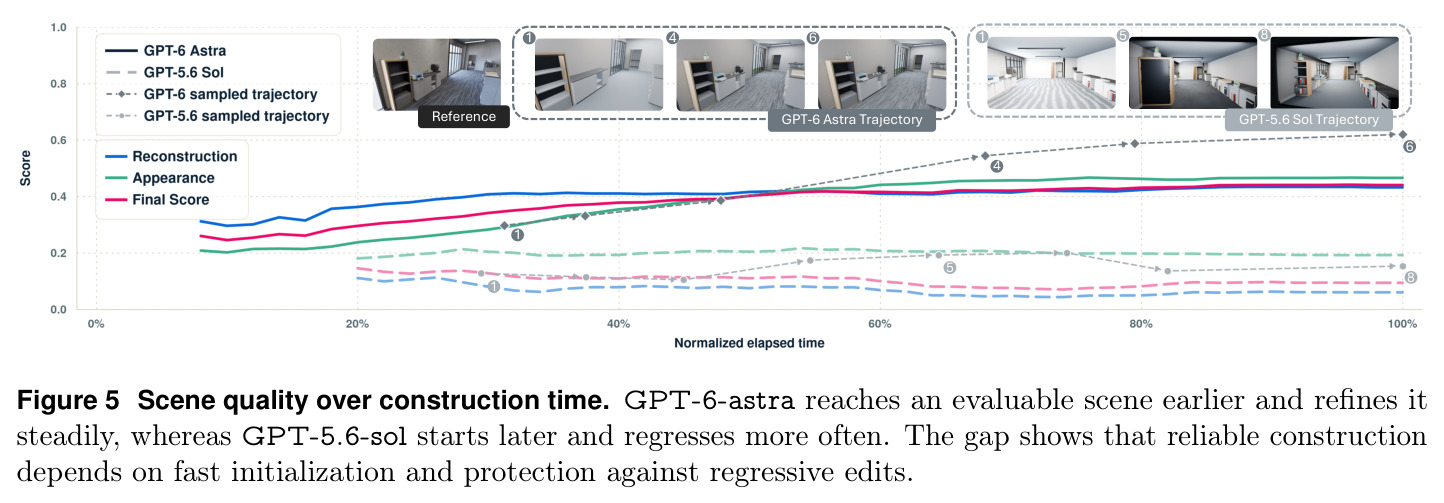
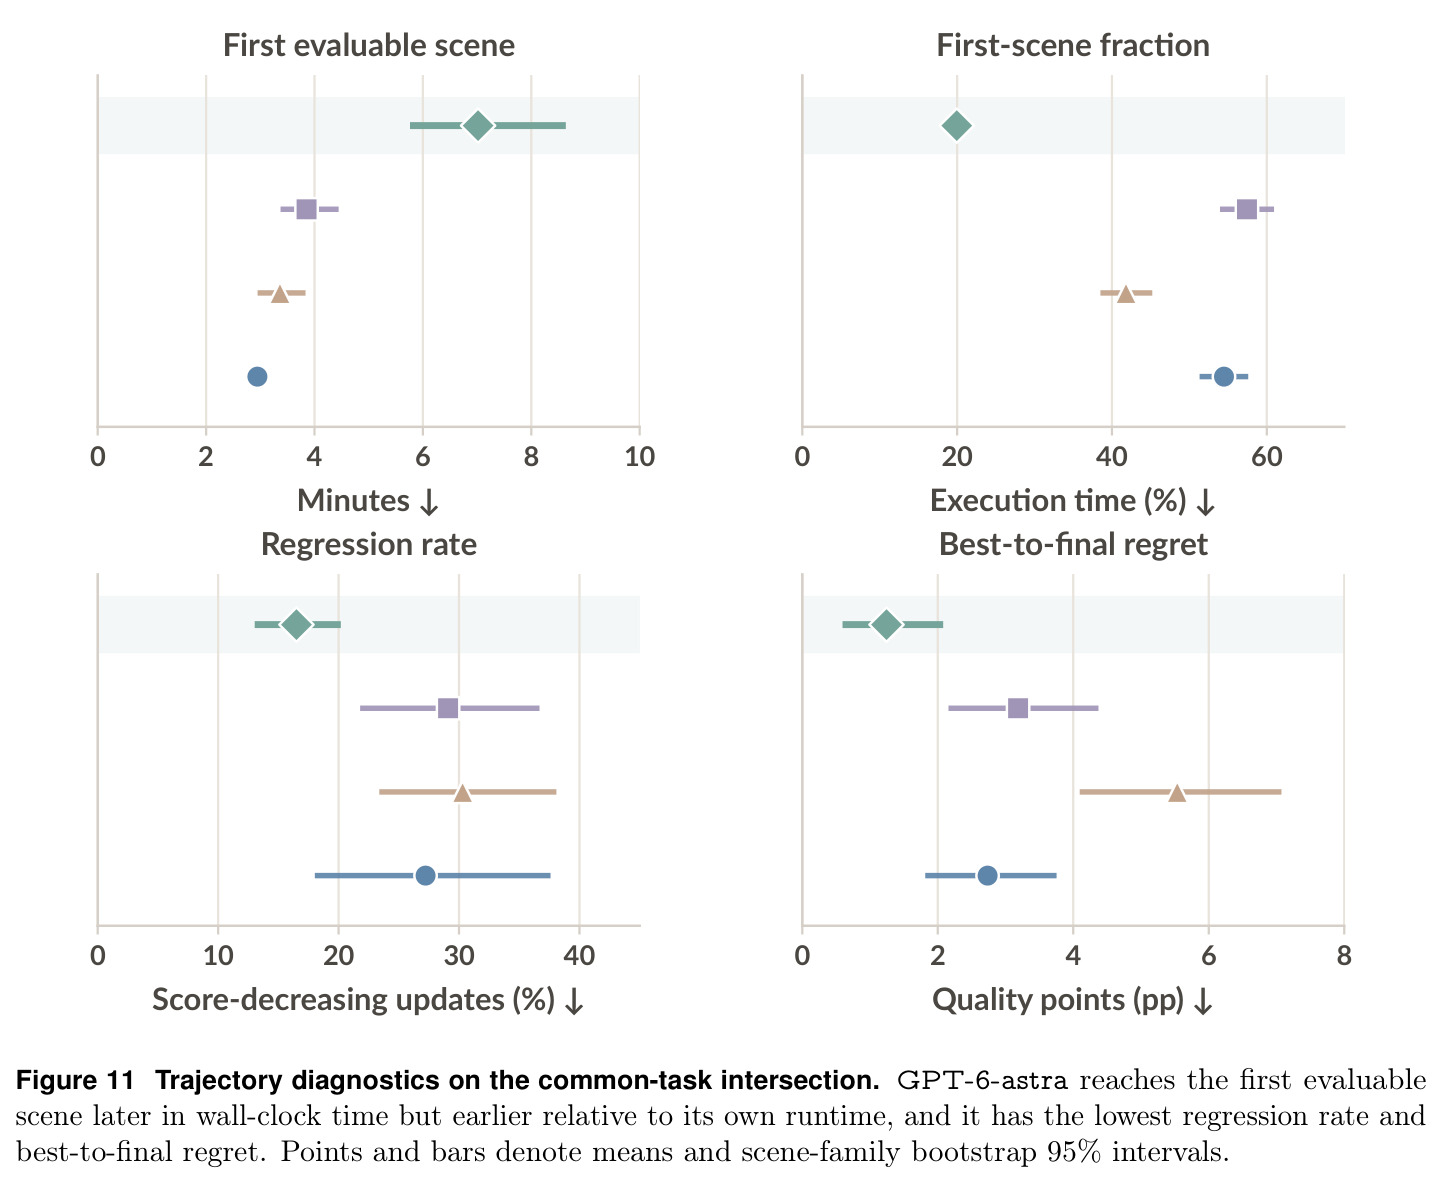
与已有工作不同的是,本文的独特之处有三个层面。表示层面:把单图重建定义为“可执行场景程序”的迭代构建 $P=\pi(I;E)$,执行反馈天然支持逐步对照修订,而非一次性预测固定 3D 输出。评测层面:采用模拟器接地(simulator-grounded)设计——从完全指定的仿真场景渲染出自然图像风格的输入,私有几何、深度、实例掩码与对应关系免费获得,难度可以通过嵌套物体集 Easy⊂Medium⊂Hard 精确控制,且用户可用同一管线无限扩展。诊断层面:不满足于只报告最终分数,而是把构建轨迹本身作为研究对象,定义了首次可评场景时间、降分编辑率、最佳中间分与最终分差距等轨迹级指标,从而把“结果差”归因到“初始化弱、编辑回退、自评不可靠”三个可操作的具体原因上。
核心方法
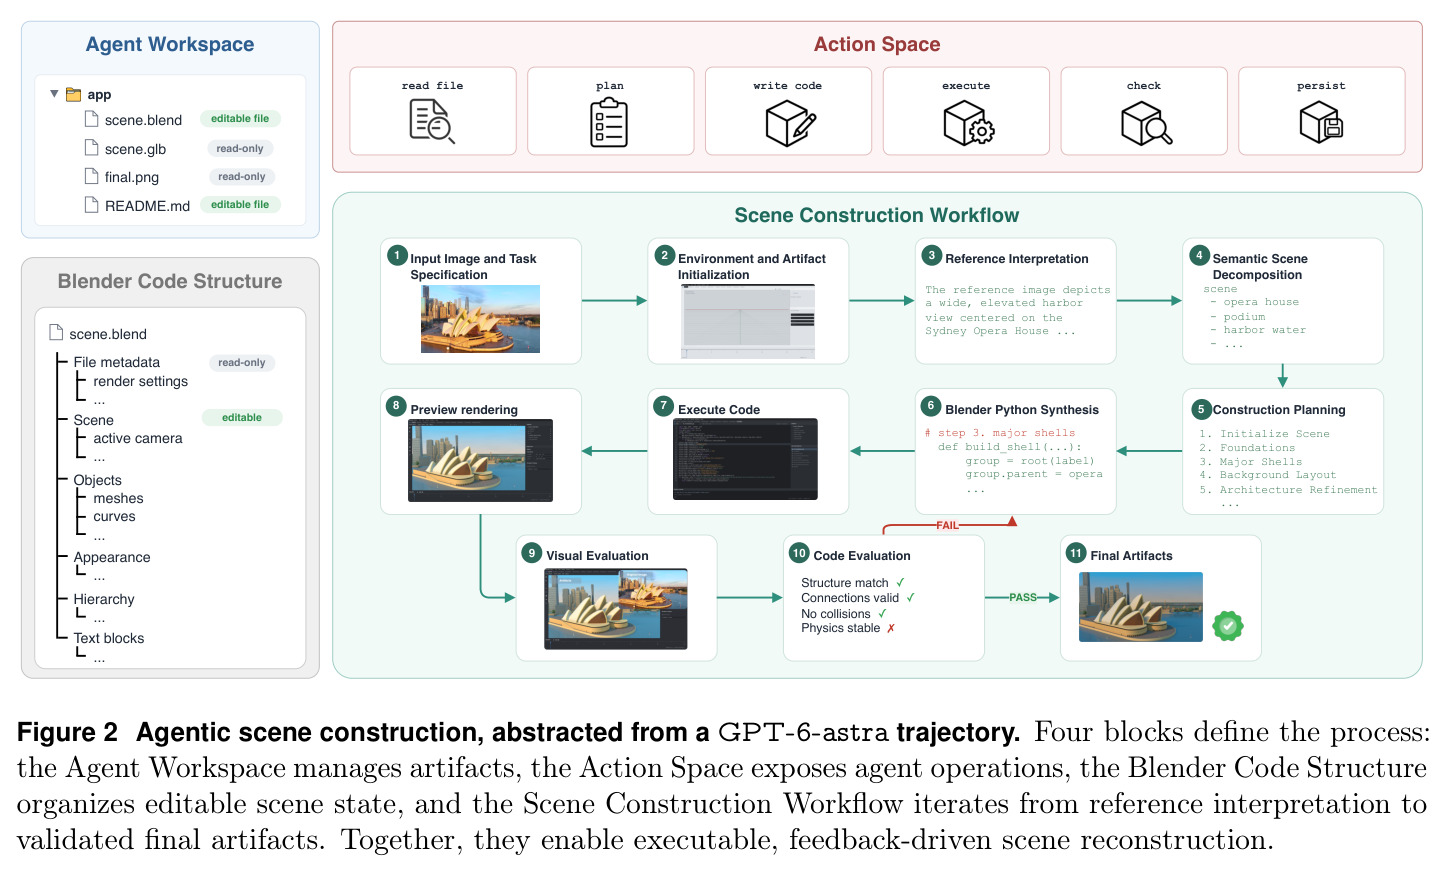
LEGO-Anything 把单图场景重建形式化为:给定 RGB 图像 $I$,通用编程智能体 $\pi$ 与 3D 编辑环境 $E$(Blender + Blender-MCP)交互产生场景程序 $P=\pi(I;E)$,其执行构造场景 $S=\mathrm{Exec}_E(P)$。智能体不是一次性写出程序,而是在“编辑代码—执行—检查场景与渲染—修订”之间循环,形成构建轨迹 $\tau=\{(P_t,S_t,o_t)\}_{t=1}^{T}$。工作区包含可编辑的 scene.blend、只读导出 scene.glb 和渲染 final.png。评测沿三条正交轴:有效性 $V_i$ 检查工件可用性(blend 可打开且含网格与活动相机、glb 非空、png 可解码);重建 $R_i$ 在参考相机系下无配准比较可见表面;外观 $A_i$ 由评测器用固定引擎和分辨率重渲染后按像素误差评分。总分 $S=\frac{1}{N}\sum_i \frac{1}{2}(R_i+A_i)\cdot V_i$,失败尝试也留在分母中计零分。
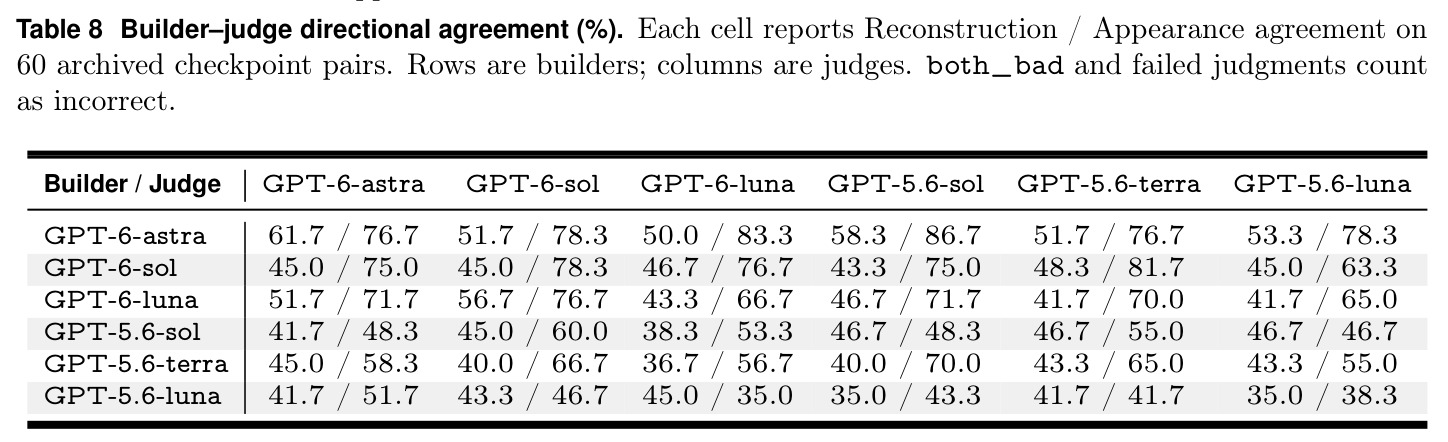
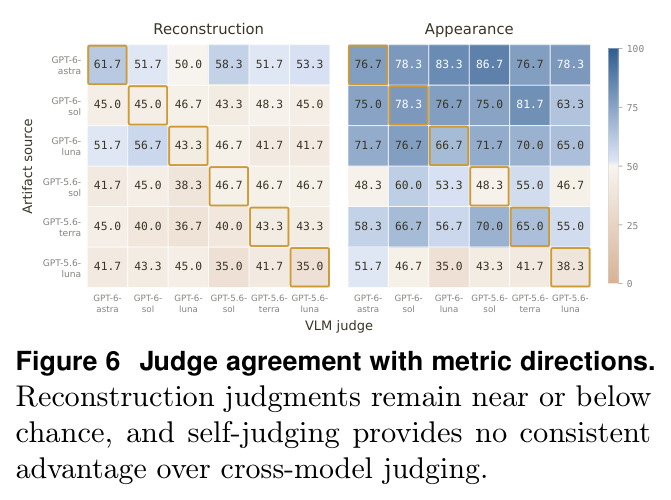
核心创新有三点。其一,输出表示从“固定 3D 产物”换成“可执行程序”,使检查、编辑、版本控制和下游查询都变成代码操作,执行反馈让迭代修订有据可依。其二,模拟器接地基准同时解决了真实感与真值的两难:输入是专业资产在 LychSim 中渲染的自然图像风格图片,评测器却持有完整私有几何/深度/掩码,难度还能在匹配场景族内通过 $O_E\subset O_M\subset O_H$ 的嵌套物体集控制,而建筑、光照、材质、相机全部保持不变。其三,也是与所有“自我反思”式 agent 方法的本质区别:作者用数据证明智能体无法可靠判断自己场景的好坏(几何判断一致率仅 45.8%,低于 50% 随机线),于是 LEGO-Plugin 完全抛弃自我评估,用 VGGT 恢复初始化框架、用 SAM 3 与 Depth Anything V2 提供投影范围、相对深度等确定性残差、用事务快照机制阻止回退性编辑——把自由发挥的修订换成有证据约束的受控更新。
方法步骤详情
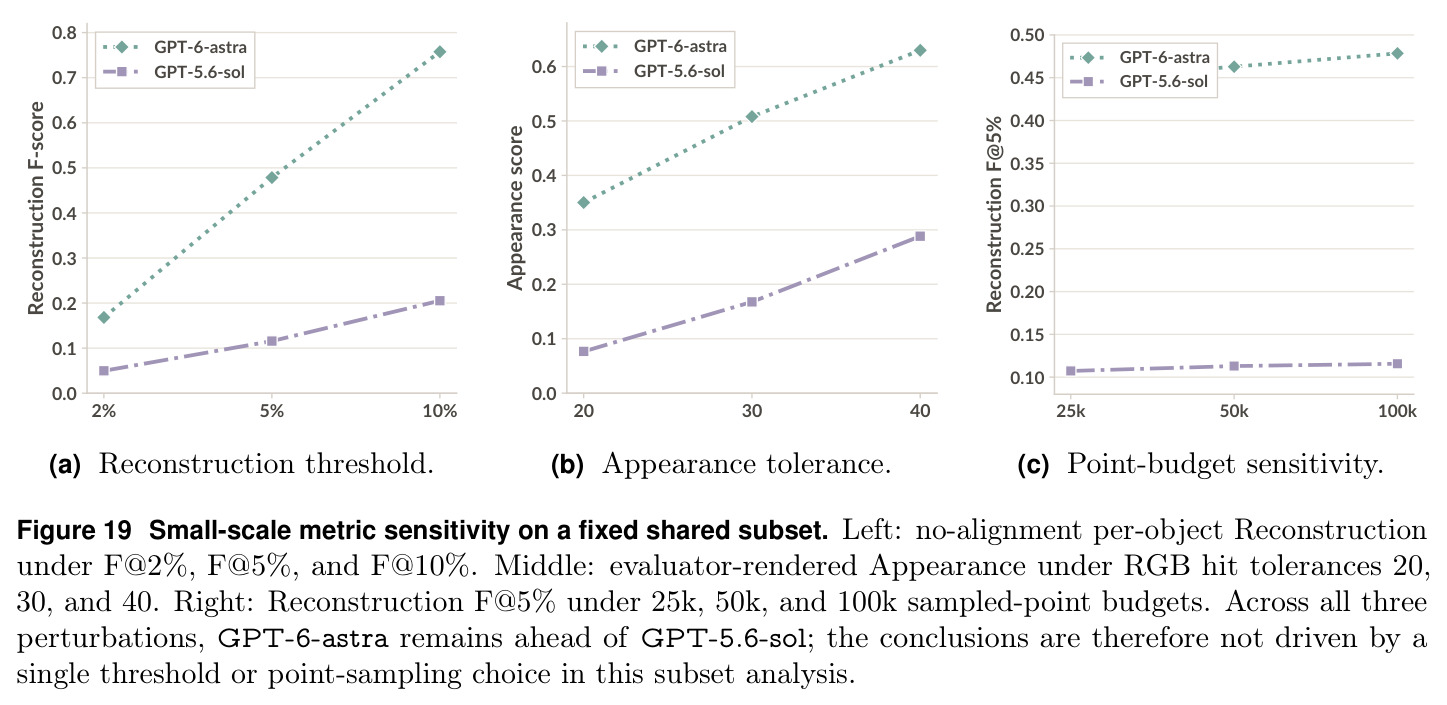
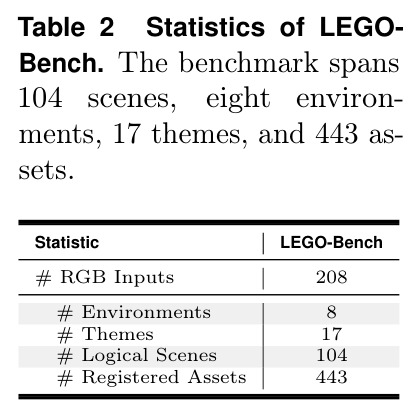
完整流程分四段。基准构建:从 Fab 资产市场挖掘允许 AI 使用的资产→在 LychSim 中提议并装配场景→通过碰撞与稳定性检查→人工验证(通过/重制/标注)→入库,最终得到 208 个输入、104 个场景、8 个环境、17 个主题、443 个注册资产。单次试验:智能体只拿到 RGB 图像、图像尺寸、水平视场角、类别分类体系和输出 schema,然后迭代执行“参考解读→语义分解→构建规划→bpy 代码综合→执行→视觉/代码双评估→导出最终工件”。评测:Reconstruction 在参考相机系下光栅化提交几何得到可见表面点,由私有深度反投影得到参考可见点,按私有实例掩码划分到各物体,容差 $\tau(g)=0.05\,z(g)$ 随深度缩放,逐物体算 F1 后宏平均;Appearance 由评测器保留相机/几何/材质/灯光重渲染,$A_i$ 为最大通道误差 $\le\delta=30$(0–255 制)的像素占比。插件:Enhanced Initialization 从 VGGT 恢复重力对齐的 Z-up Manhattan 框架并生成含归一化质心、投影范围、相对/序数深度的构建计划;Grounded Refinement 校验存在性、支撑、包含、碰撞、朝向、相机可见性、深度顺序、亮度等显式需求,硬需求失败即阻塞接受,每个候选至多两轮修复;Version Control 把每次编辑封装为事务(声明可编辑与受保护实体),编辑前快照场景状态,校验不过即回滚,每例限制 8 个事务、2 次回滚。
技术新颖性
与最近相关工作的差异清晰可辨:SEIG 同样把图像重建为可编辑 Blender 程序,但定量评估是物体中心的,没有场景级端到端指标;SceneActBench 最接近,却依赖标定多视角室内观测且不评房间结构与纹理;LL3M 用多智能体写 Blender 脚本但面向语言驱动的资产生成;VIGA 有 code-render-inspect 循环但是任务特定系统。方法学上的新颖点包括:(1) 无配准评测设计——评测器拒绝拟合任何平移/旋转/缩放/反射变换,相机与尺度错误被直接惩罚而非被对齐吸收;(2) 轨迹级诊断把 agent 评测从“只看终点分数”推进到过程分析,定义了首场景时间、回退率、best-to-final regret 等可复用量;(3) 插件以 MCP 工具、技能和运行时钩子存在,不引入独立规划器,保持与演进中 harness 的兼容性,且所有信号只来自参考图像、绝不接触私有真值,避免了针对评测器的过拟合;(4) 指标经过人类验证:标注者间兼容一致率 86.6%,人-指标兼容率 83.7%。
实验结果
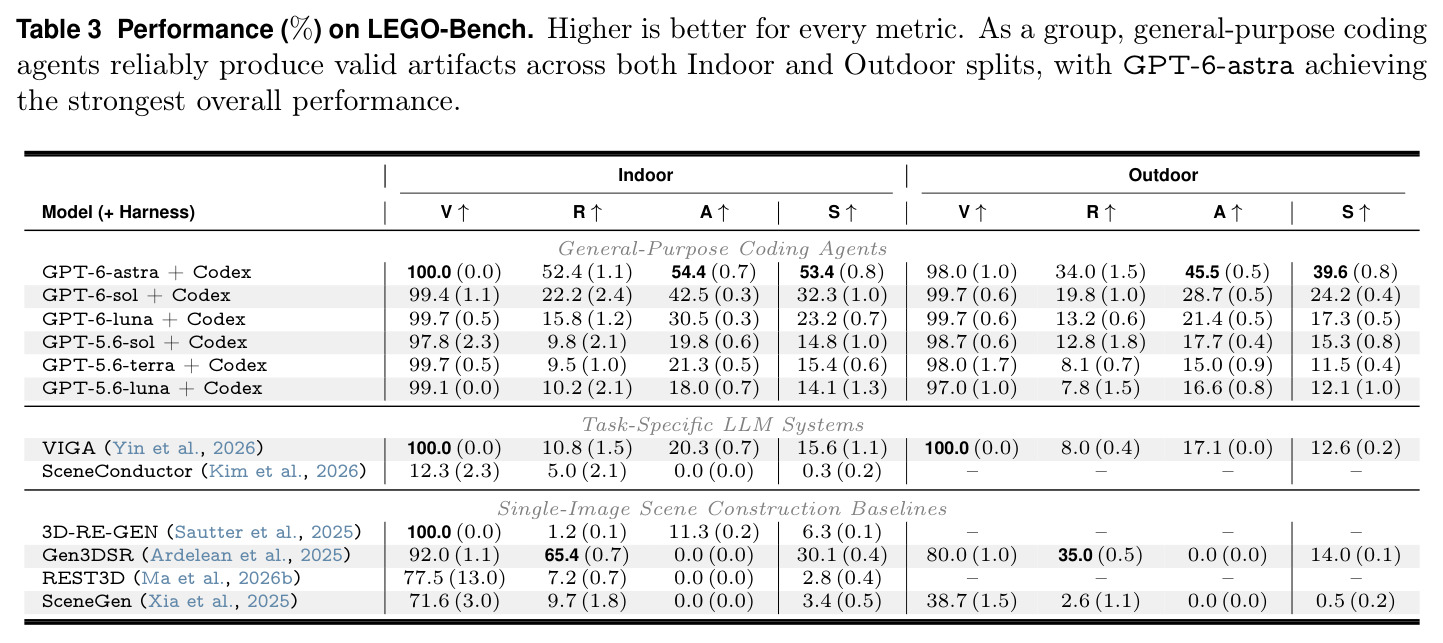
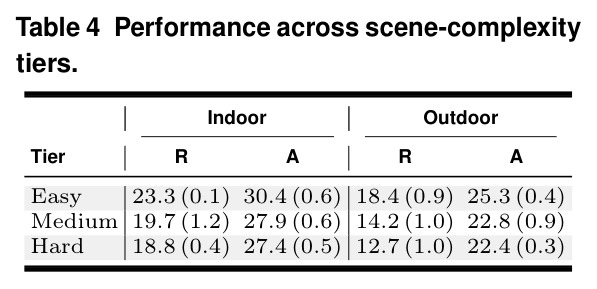
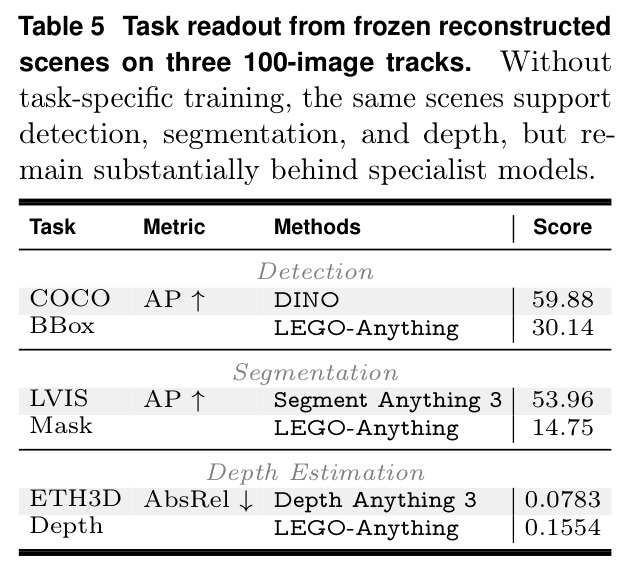
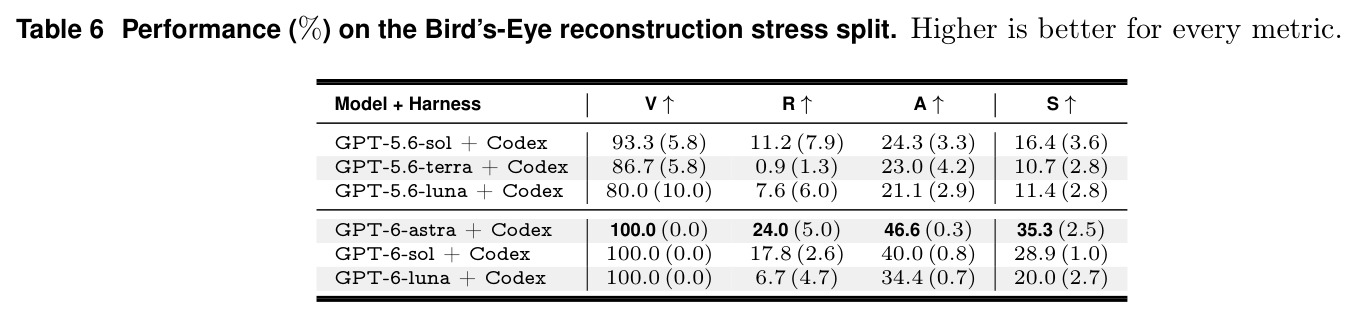
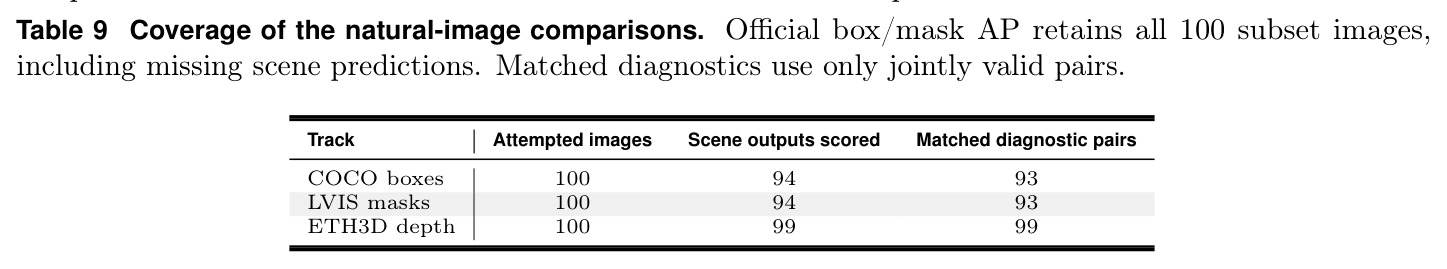
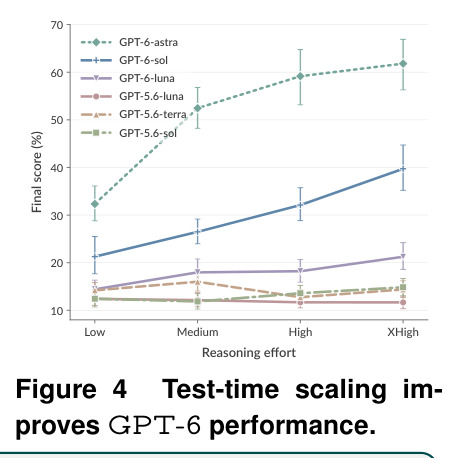
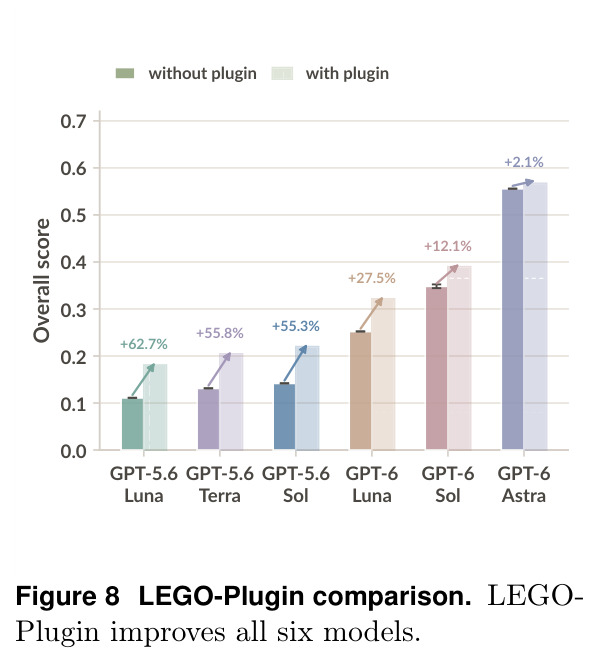
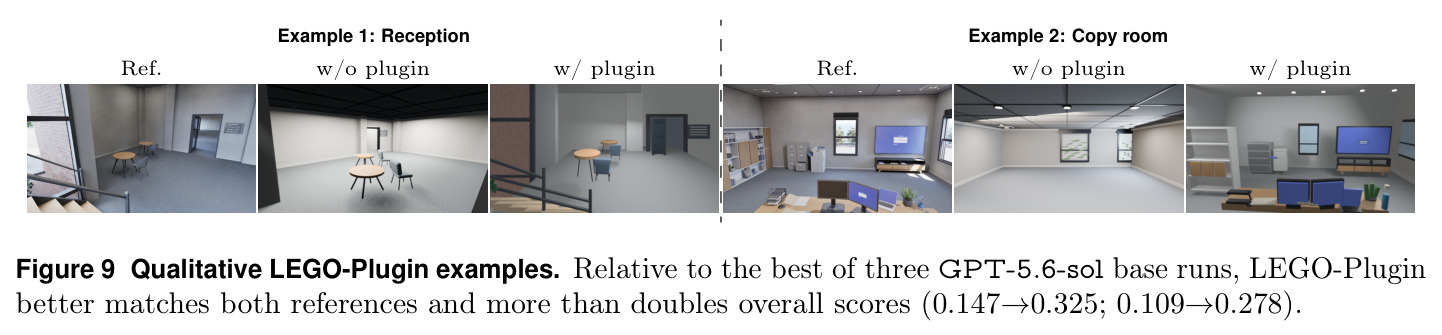
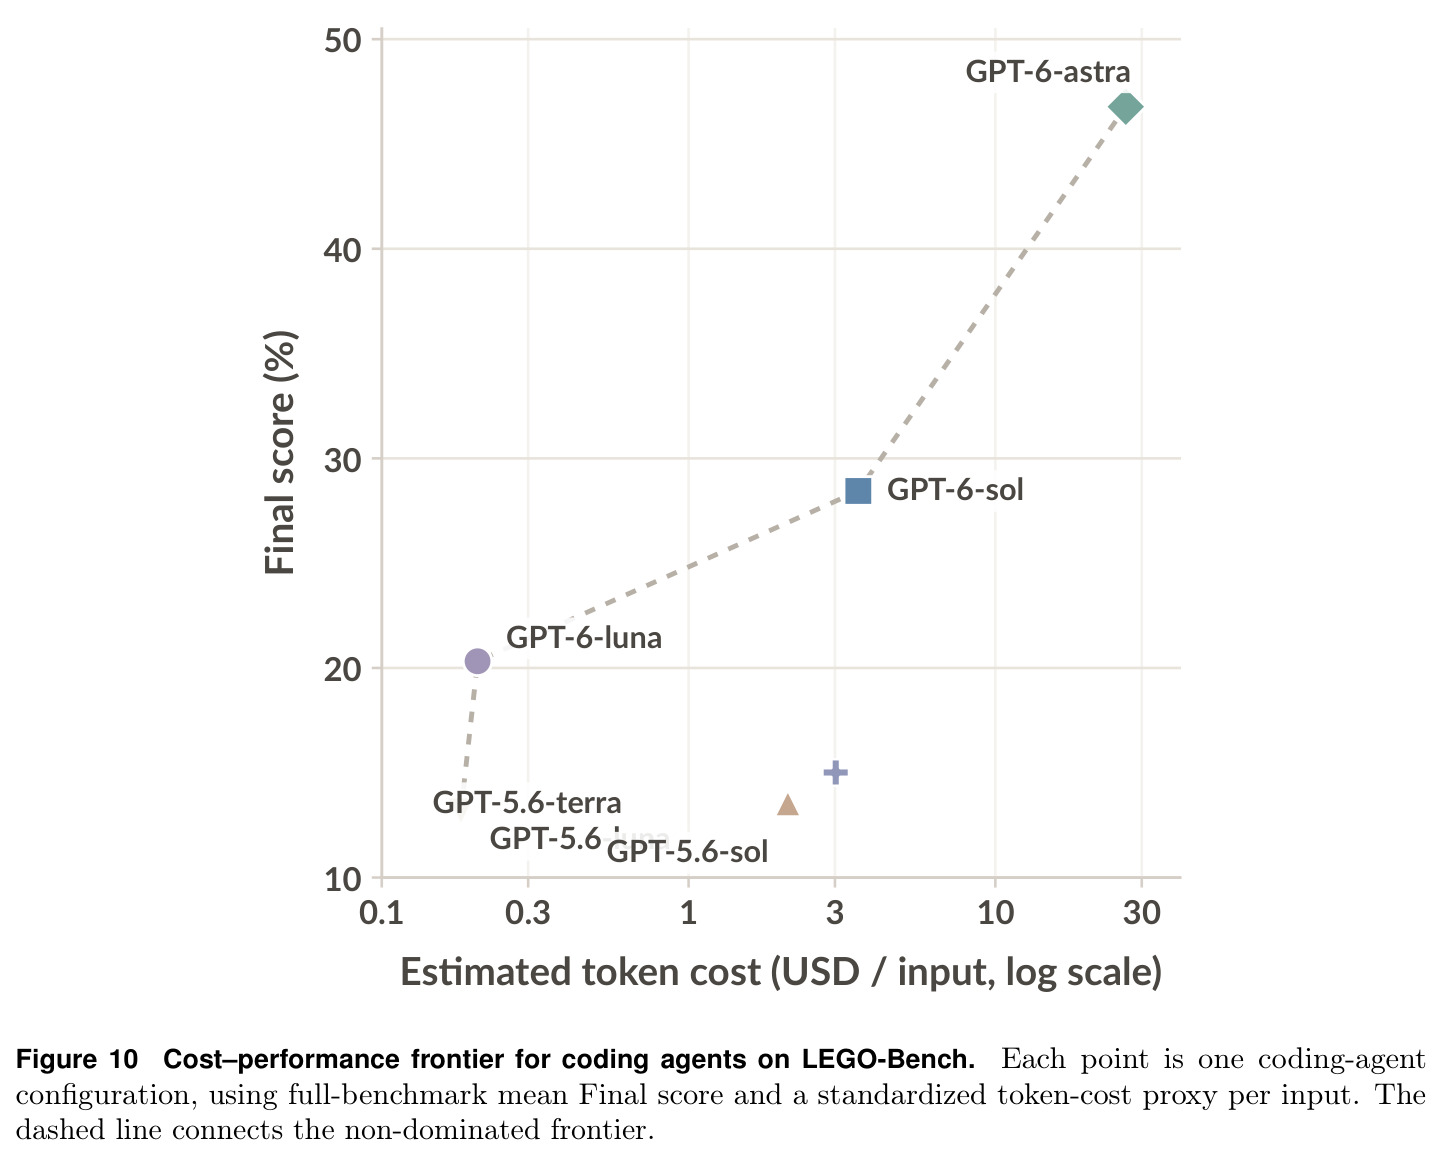
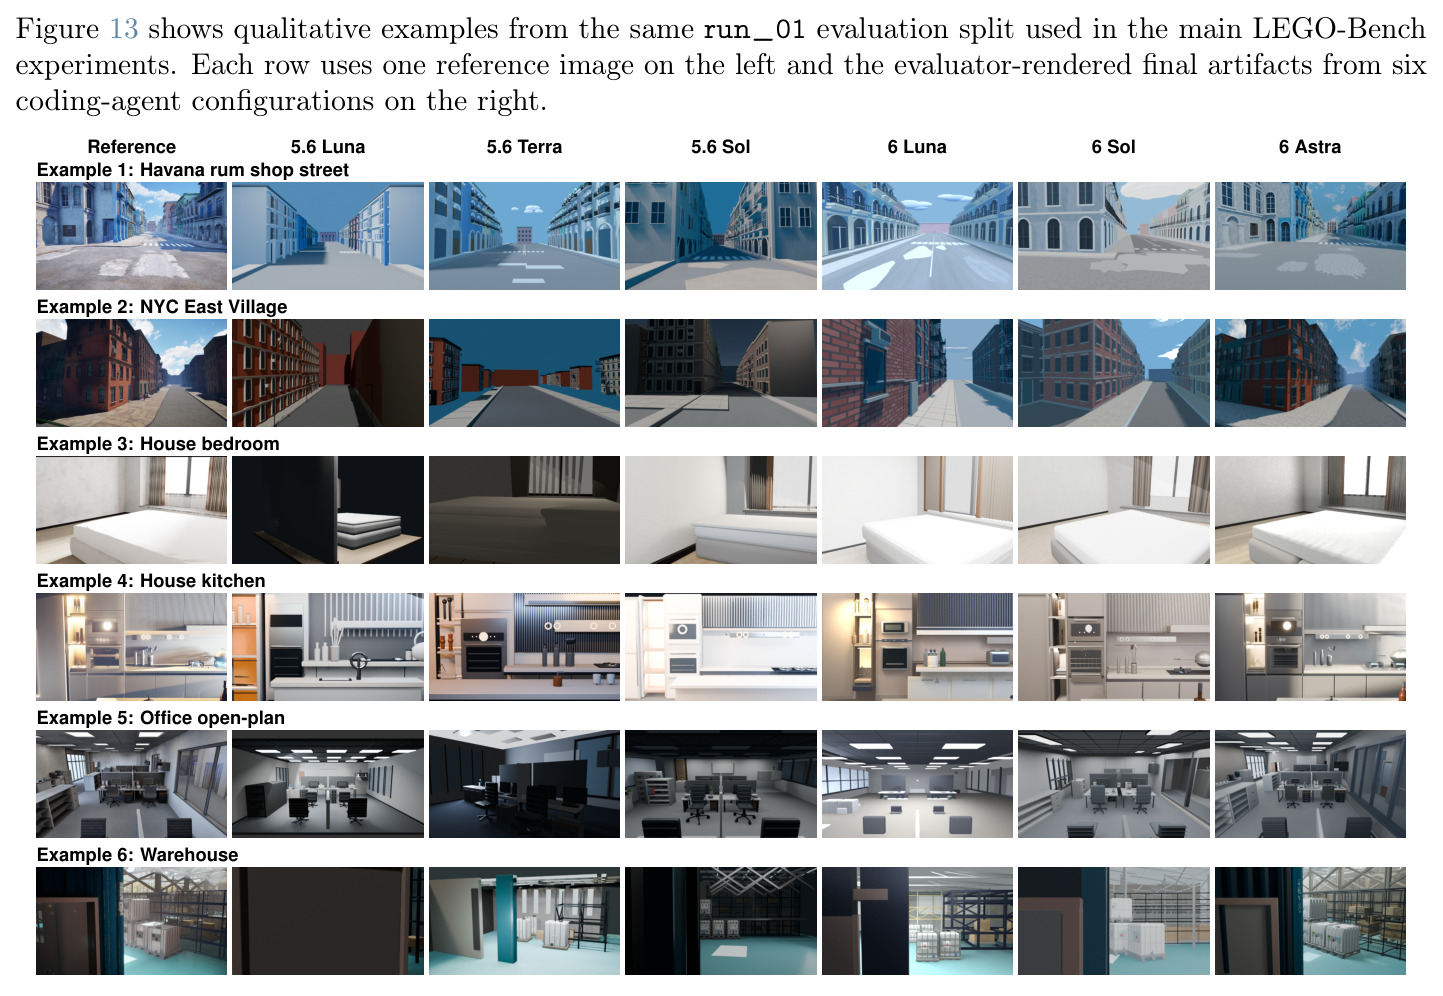
主实验(Table 3):六个 GPT 系编程智能体的工件有效性都接近饱和(97–100%),但保真度分层明显——GPT-6-astra 室内 53.4%、室外 39.6% 全面领先(室内 V/R/A = 100/52.4/54.4),GPT-6-sol 为 32.3/24.2,GPT-6-luna 23.2/17.3,三个 GPT-5.6 模型只有 11.5–15.4。基线方面,Gen3DSR 室内重建分 R=65.4 高于 astra 的 52.4,但外观分为 0(总分 30.1);VIGA 得 15.6/12.6;SceneConductor 有效性仅 12.3%、总分 0.3;SceneGen 室外仅 0.5。复杂度实验(Table 4):六个 GPT 配置平均有效性稳定在 99.5%,总分却从 Easy 24.6% 降到 Medium 21.3%、Hard 20.5%,室外重建从 18.4 掉到 12.7——复杂度伤保真不伤可执行性。测试时扩展(Figure 4):42 例 Office 子集上把推理力度从 Low 提到 XHigh,astra 从 32.3 升到 61.8,sol 从 21.3 到 39.7,luna 从 14.4 到 21.2,而 GPT-5.6 无一致改善。轨迹诊断(Figure 5):astra 在预算前约 1/10 就产出首个可评场景,5.6-sol 需要约 1/5;5.6-sol 有 29.6% 的编辑降低分数,最终提交比最佳中间状态低 3.2 分。自评实验(Figure 6):36 个 builder–judge 组合中,自我判断与确定性指标方向的一致率在几何上仅 45.8%(低于 50% 随机线)、外观上 62.2%,且自评并不优于跨模型互评。插件(Figure 8):六个模型全部提升,GPT-5.6 三模型相对提升 55–63%(约 7–8 个绝对点),GPT-6-luna +27.5%、sol +12.1%,最强的 astra 仅 +2.1%;定性示例中总分从 0.147→0.325、0.109→0.278。LEGO-World(Table 5):用 astra 重建的冻结场景做确定性读出,COCO box AP 30.14 对比 DINO 的 59.88,LVIS mask AP 14.75 对比 SAM 3 的 53.96,ETH3D AbsRel 0.1554 对比 Depth Anything 3 的 0.0783——约为专家模型一半水平。附录补充:Bird's-Eye 大尺度压力测试中 astra 总分 35.3 但 F@2% 几何仅 24.0;成本-性能前沿由 GPT-6 家族定义,GPT-5.6-sol/terra 位于前沿之外。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LEGO-Bench 室内场景端到端重建 | 总分 S(有效性门控的 R/A 均值,%) | GPT-6-astra:53.4(V=100.0,R=52.4,A=54.4) | 最强任务特定基线 VIGA 15.6;最强单图基线 Gen3DSR 30.1 | 较 Gen3DSR 高 23.3 个绝对点(约 +77%),较 VIGA 高 37.8 个点(约 3.4 倍) |
| LEGO-Bench 室外场景端到端重建 | 总分 S(%) | GPT-6-astra:39.6(V=98.0,R=34.0,A=45.5) | Gen3DSR 14.0;VIGA 12.6(其余三个基线不支持室外) | 较 Gen3DSR 高 25.6 个绝对点(约 2.8 倍) |
| LEGO-Bench 室内可见表面几何 | Reconstruction F@5%(%) | GPT-6-astra:52.4 | Gen3DSR 65.4(其外观分为 0);VIGA 10.8 | 几何上 Gen3DSR 反超 13.0 个点,说明纯几何检索类方法与外观建模存在取舍,编程智能体是唯一两轴均衡的方案 |
| Office 子集免训练插件增益 | 总分相对提升(%) | LEGO-Plugin:GPT-5.6 三模型 +55~63,GPT-6-luna +27.5,GPT-6-sol +12.1,GPT-6-astra +2.1 | 各模型无插件版本 | 最弱模型最高 +62.7% 相对提升(约 7–8 个绝对点);定性示例 0.147→0.325、0.109→0.278 |
| COCO val2017 目标检测(冻结场景读出) | Box AP(等置信度协议) | LEGO-Anything:30.14 | DINO(R50-4scale-24ep):59.88 | 约为专家检测器的 50.3%;无任何任务特定训练 |
| LVIS v1 实例分割(冻结场景读出) | Mask AP(等置信度协议) | LEGO-Anything:14.75 | SAM 3:53.96 | 约为专家分割器的 27.3% |
| ETH3D 相对深度(冻结场景读出) | AbsRel(越低越好) | LEGO-Anything:0.1554 | Depth Anything 3(DA3MONO-LARGE):0.0783 | 误差约为专家深度模型的 2 倍 |
| Bird's-Eye 大尺度俯视压力测试(10 例 NYC 俯视) | 总分 S(%)与 F@2% 几何 | GPT-6-astra:S=35.3,R(F@2%)=24.0 | GPT-5.6-sol S=16.4,GPT-5.6-luna S=11.4 | astra 领先,但严格 F@2% 阈值下所有模型几何都显著退化,暴露大尺度重建的几何精度缺口 |
局限与改进
作者明确承认的局限:室外场景显著更难(最强模型也只有 39.6 分,且每个模型室外都比室内差);场景复杂度上升持续侵蚀保真度;LEGO-World 读出虽然非平凡但远低于专用视觉模型,说明当前场景程序“有前景但尚不精确”;Bird's-Eye 严格 F@2% 下几何分数大幅缩水;场景级铰链(articulation)试点评测中提交场景得 0 分,作者坦言该方向“需要进一步探索”。我自己的观察还有六点:(1) 模型面板单一——正式实验全部是 GPT 家族加 Codex harness,结论对 Claude、Gemini 或开源 agent 是否成立未知;(2) 输入是仿真渲染图,与真实照片存在域差距,真实照片评测完全缺失;(3) 外观指标是 $\delta=30$ 的像素阈值比例,对光照与材质的全局漂移敏感,但并非感知质量度量;(4) LEGO-World 的 AP 采用等置信度 1.0 加确定性排序的兼容性诊断协议,与带校准置信度的检测器比较并不完全公平,且类别集来自目标数据集、相当于给了智能体任务提示;(5) 基准规模 208 图/104 场景、每配置 3 次运行,部分基线方差很大(如 REST3D 有效性的标准差达 13.0);(6) Reconstruction 只评参考视角可见表面,遮挡区域的错误几何完全不受惩罚。
独立分析的弱点
独立分析出的弱点及改进方向:(1) 环境强绑定 Blender——智能体的表现可能部分来自对 bpy API 的记忆而非场景理解,换到 USD/Omniverse 等环境可能骤降,值得做跨 DCC 迁移评测;(2) 插件增益与基础能力负相关(astra 仅 +2.1%),说明外挂脚手架存在天花板,前沿模型的失败模式已经越出“初始化/回退/自评”三类,需要把证据式修订内化为训练目标,例如用模拟器真值做奖励的强化学习;(3) Grounded Refinement 依赖 VGGT/SAM 3/Depth Anything V2,单目深度的系统性误差会传导为错误残差,在弱纹理或镜面区域可能把编辑引向错误方向,可引入不确定性加权或多假设一致性检验;(4) 事务机制限制每例 8 个事务、2 次回滚是经验值,复杂大场景(如 Bird's-Eye 城市)可能远不够,且 Figure 12 显示即使最强模型也会在后期大改中从 33.9% 崩到 4.35%,可以引入分层检查点和变更影响预估;(5) 等置信度 AP 无法反映读出的排序质量,可让智能体输出基于遮挡/可见性的粗置信度;(6) 总分是几何与外观的简单平均,可能掩盖“几何对但材质全错”或反之的失败,应报告两轴的联合诊断与相关性。每个弱点都对应一个可操作的后续实验设计。
未来方向
作者层面提出的方向:借助同一构建管线扩展基准——新环境、新难度层级、新视角都可在不改评测协议的情况下加入;完善场景级铰链评测(当前 14 个目标全得 0 分的试点说明匹配与评分协议尚未成熟);继续沿着测试时扩展曲线推进更强智能体,并把可执行场景程序确立为可测量、可诊断的研究目标。基于本文成果可延伸的方向:把 LEGO-World 的三个读出反过来接入构建循环,让检测框、深度残差直接驱动下一轮编辑,形成感知—行动闭环;用模拟器真值作为奖励信号训练专门的 3D 构建智能体,而不是依赖通用模型的零样本能力;从“用几何基元写场景”走向“检索资产库+程序化装配”的混合表示,可能同时提升几何与外观保真度;把任务扩展到多视角、视频输入与动态场景;探索重建场景对具身仿真、图像编辑(BlenderFusion 式合成)等下游任务的支撑能力;与 world model 研究对接,检验显式程序化场景能否替代隐式神经场景作为可解释的世界状态。
复现评估
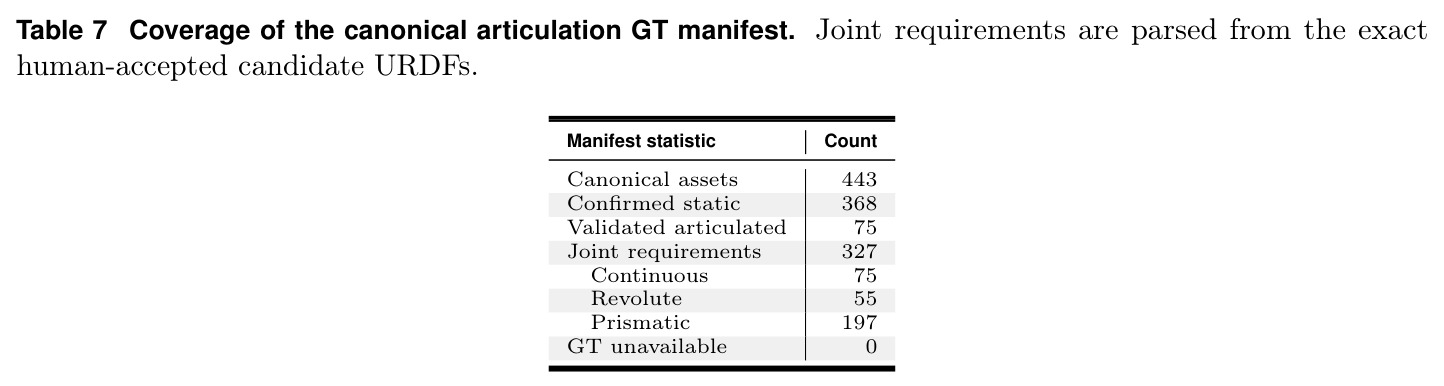
复现条件总体透明但门槛不低。资产方面:项目页为 lego-anything.com,基准管线只需注册资产加场景规范即可生成新评测用例,私有真值由评测器持有、公开侧只有图像、尺寸、水平 FOV、类别体系与输出 schema。基础设施方面:基于 Harbor 框架的 Docker/Compose 隔离环境,Blender 5.0.1 + Xvfb + 每试验一个 Blender-MCP 监听,提示词、评测器、超时策略全部冻结并在附录中完整公开(包括指标公式、实现细节、人类验证研究和失败核算规则),统计报告规范(均值±标准差、bootstrap 95% 置信区间)。成本方面:主表每配置 3 次独立运行,推理力度扫描共 1008 次评分,成本-性能图显示单输入 token 成本横跨约 0.1–30 美元的对数区间,完整复现六模型矩阵需要 GPT-6/GPT-5.6 的 API 访问(经 Amazon Bedrock);LEGO-Plugin 依赖的 VGGT、SAM 3、Depth Anything V2 均为公开模型;铰链标注经历了 15 轮人工审核(443 资产全部裁决为 368 静态 + 75 铰接)。综合评估:协议与工程规范极佳,复现难度中等偏高,主要障碍是前沿模型调用费用与人工标注成本,而非方法黑箱。
论文图表
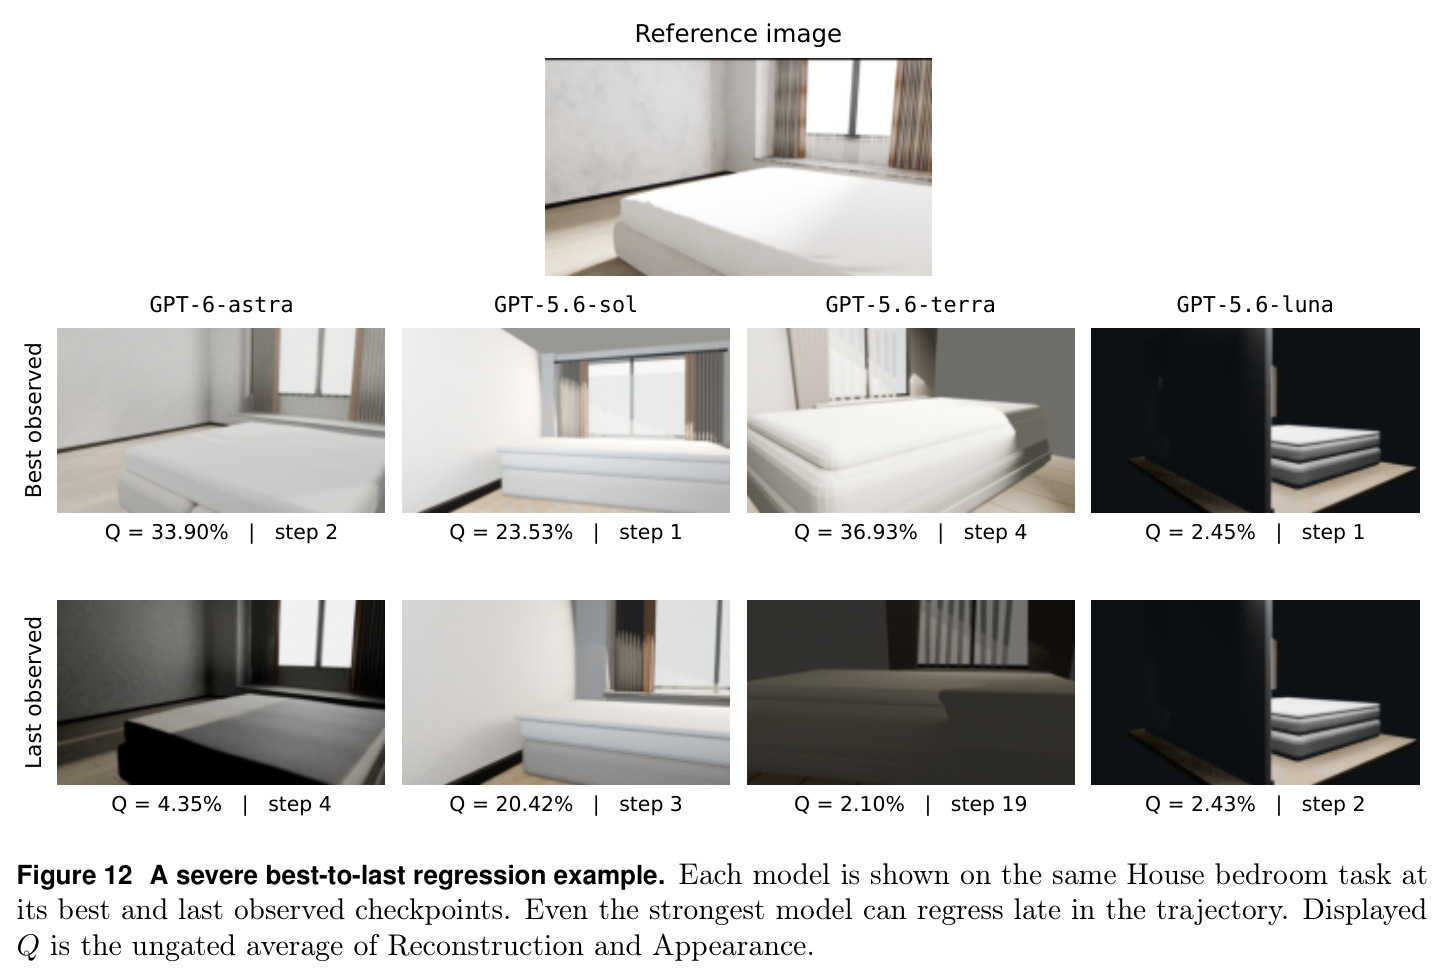
同一 House bedroom 任务上四个模型的最佳与最后检查点对比:GPT-6-astra 从最佳步的 33.90% 崩到最后的 4.35%,GPT-5.6-luna 从 2.45% 到 2.43% 几乎无进展,展示即使最强模型也会在后期编辑中严重回退。
以最极端案例具象化 best-to-final regret,直观说明为什么需要 Version Control 式的回滚保护,也提醒“最终提交”不等于“最佳状态”。