LEV:用循环决策模型实现快而深的思考 LEV: Thinking Fast and Deep with Looped Decision Models
在原生循环骨干上每步读出选项并联训所有深度,让决策模型按题加深循环步数,兼顾延迟与精度
前置知识
决策模型(decision model)
对固定选项集合打分的判别式模型:把状态和带分隔符选项的问题打包进一条序列,一次前向传播后在 $\langle \mathrm{decide}\rangle$ 位置与各选项收尾符的隐状态之间做指针头内积,经 softmax 输出每个选项一个概率,不生成任何文本。代表如 Jev/Kev,单题延迟数十毫秒,概率可用单一温度缩放校准。
LEV 就是这类模型。理解其“一次前向、深度在训练时固定”的本质,才能理解本文要解决的算力分配问题:简单题和难题花同样的计算。
循环 Transformer(looped transformer)
把同一组 $L$ 层解码器 $F_\theta$ 重复跑 $R$ 次:$h^{(t)}=\mathrm{Norm}(F_\theta(h^{(t-1)}))$,以 $L\cdot R$ 层的等效深度换取仅 $L$ 层的参数量。“原生循环”指 Ouro 等模型在预训练阶段(每步都带语言建模损失,共 7.7T token)就以循环形式训练,而非事后把现成模型的若干层圈起来重跑。
LEV 的全部“思考深度”来自重跑原生循环骨干。论文用控制实验证明后补循环基本无效,只有预训练即循环的骨干才“从出生就开着”。
早退与自适应计算
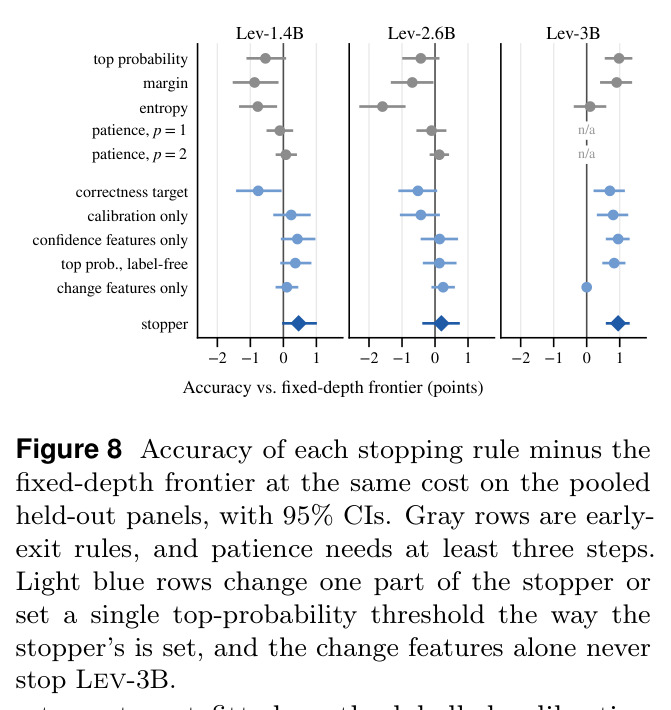
让不同输入消耗不同算力的技术总称:早退(early exit)在某个中间层置信度足够时直接输出;margin/entropy 阈值、patience 规则同理;级联(cascade)则把不确定样本转给更大的第二个模型。已知缺陷是浅层出口未被训练、在新数据上过度自信(confidently wrong)。
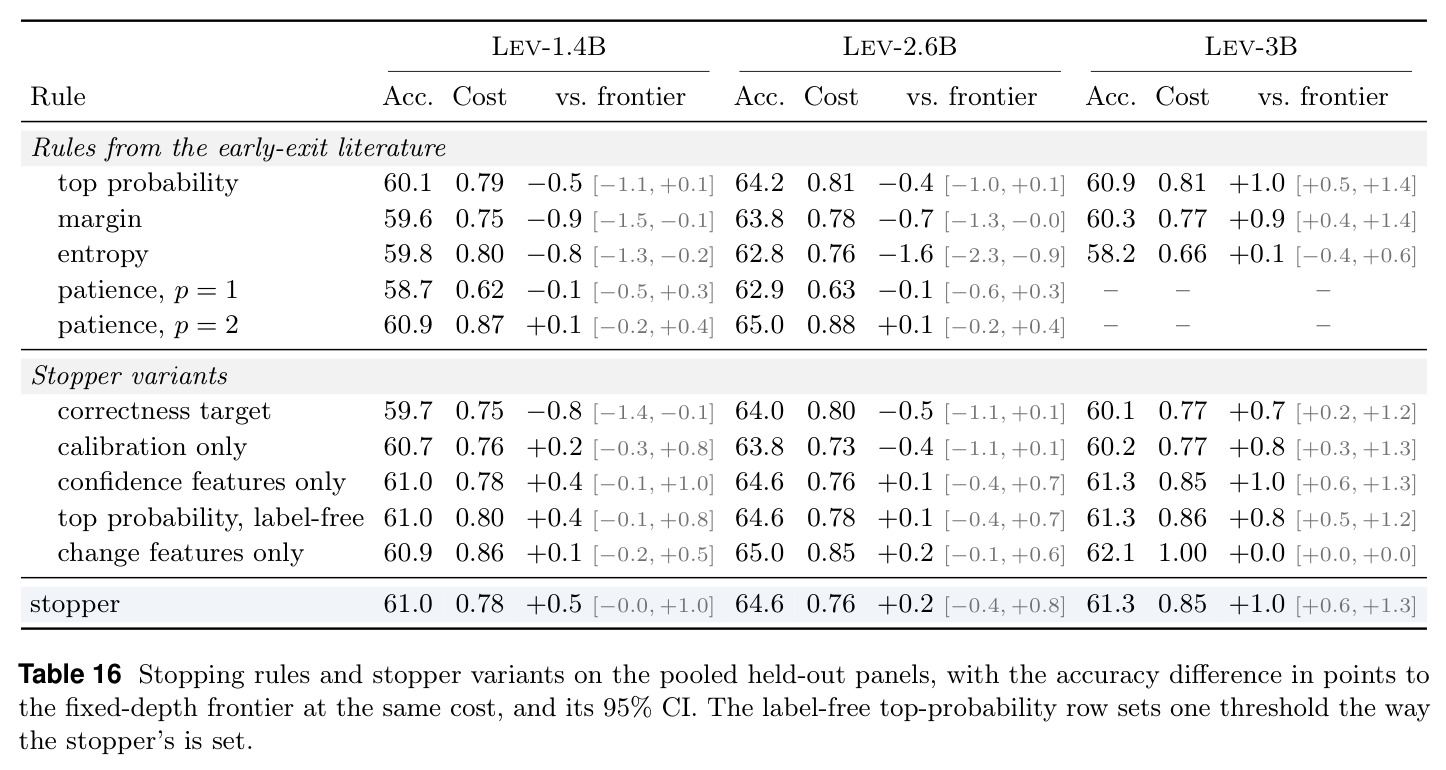
LEV 的按需深度与停止器正是对这套思路的改造。文中图 8、表 16 与这些基线规则逐一对比,不懂它们的形态就无法理解对比结论。
指针头(pointer head)
源自 Pointer Network 的打分方式:对问题表示 $h_{dec}$ 与每个选项的收尾符表示 $h_k$ 各做线性投影后计算 $z_k=(W_K h_k)^\top(W_Q h_{dec})/\sqrt{d_p}$,softmax 后即各选项概率。它把“从词表选词”换成“直接在给定选项上形成分布”,避免生成式模型对选项顺序和标签的敏感性。
LEV 在每个循环步后都接同一个共享指针头读出,这是“每步可读、一套权重服务所有深度”的关键部件。
一致性目标与无标注阈值拟合(CATs)
CATs 的思想:不预测“当前答案对不对”,而预测“提前停下会不会与跑完的完整模型结论一致”,即 $y_k=\mathbb{1}[\hat{o}^{(k)}=\hat{o}^{(R)}]$。因为目标由模型自身最深答案定义,拟合分类器与调阈值都不需要任何人工标注;阈值取满足“≥98% 最终答案与最深一致”的最小值。
这是本文停止规则的灵魂,也是“部署方可在自家无标注流量上零成本适配”这一卖点的根据,与在标注数据上调阈值的传统早退形成对照。
双过程理论(System 1 / System 2)
Kahneman 提出的认知框架:System 1 快而省、凭直觉即刻作答;System 2 慢而深、付出串行推理的代价。本文把单次前向的决策模型类比为 System 1、生成式思维链类比为 System 2,并把 LEV 定位为 System 1.5——按题在循环步数上连续调节深浅。
论文标题 “Thinking Fast and Deep” 与全部叙事都建立在这对概念上,理解它才能把握文章的定位语言。
研究动机
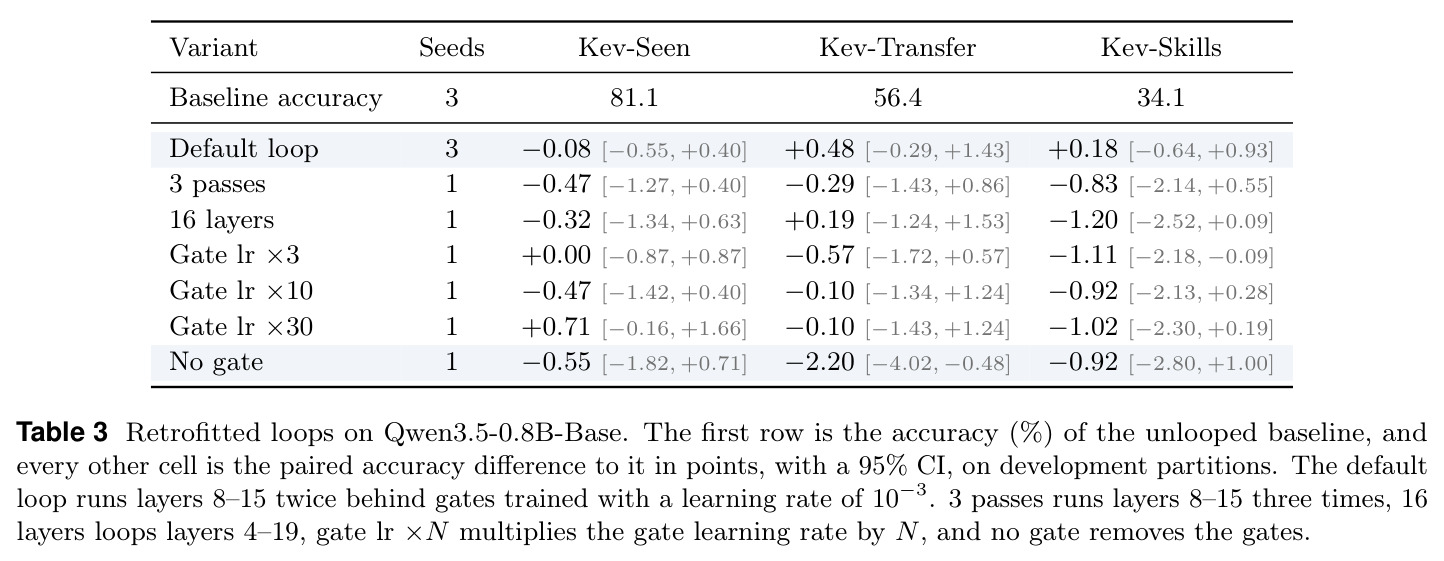
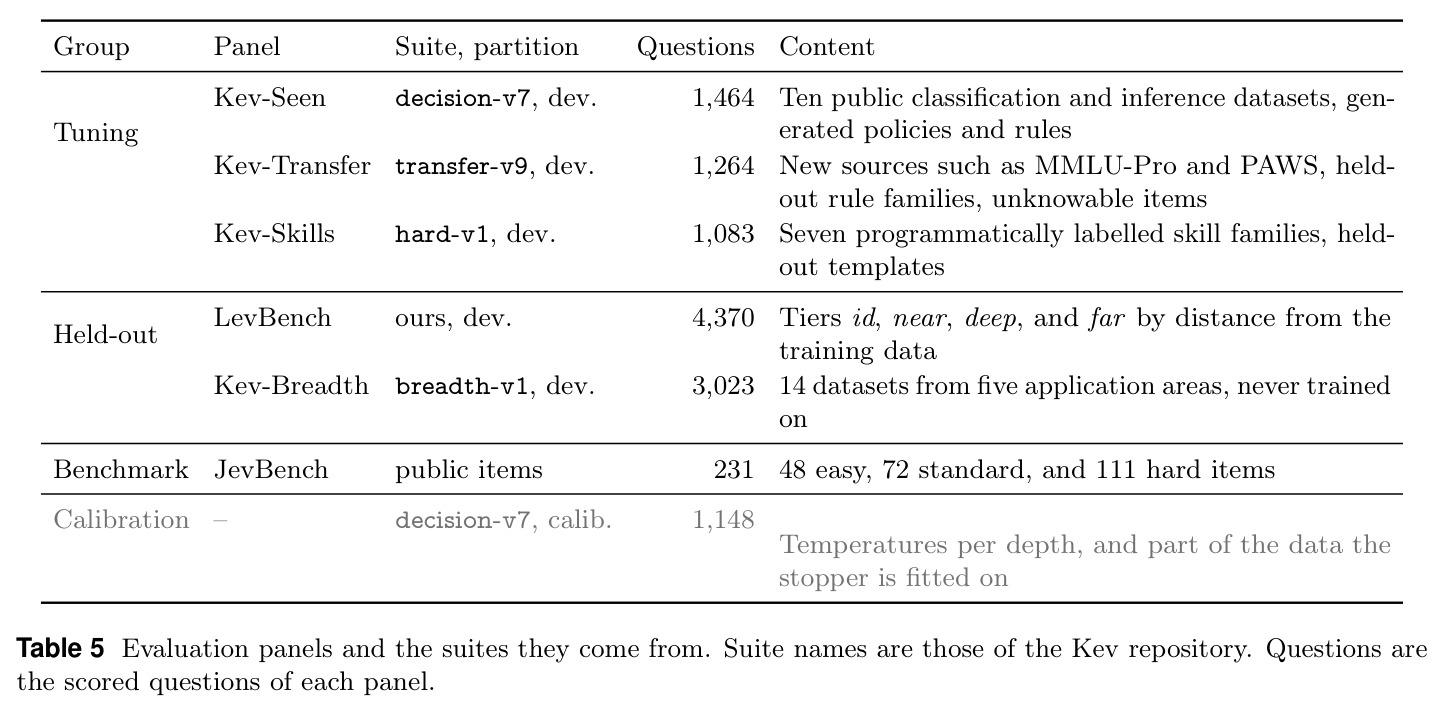
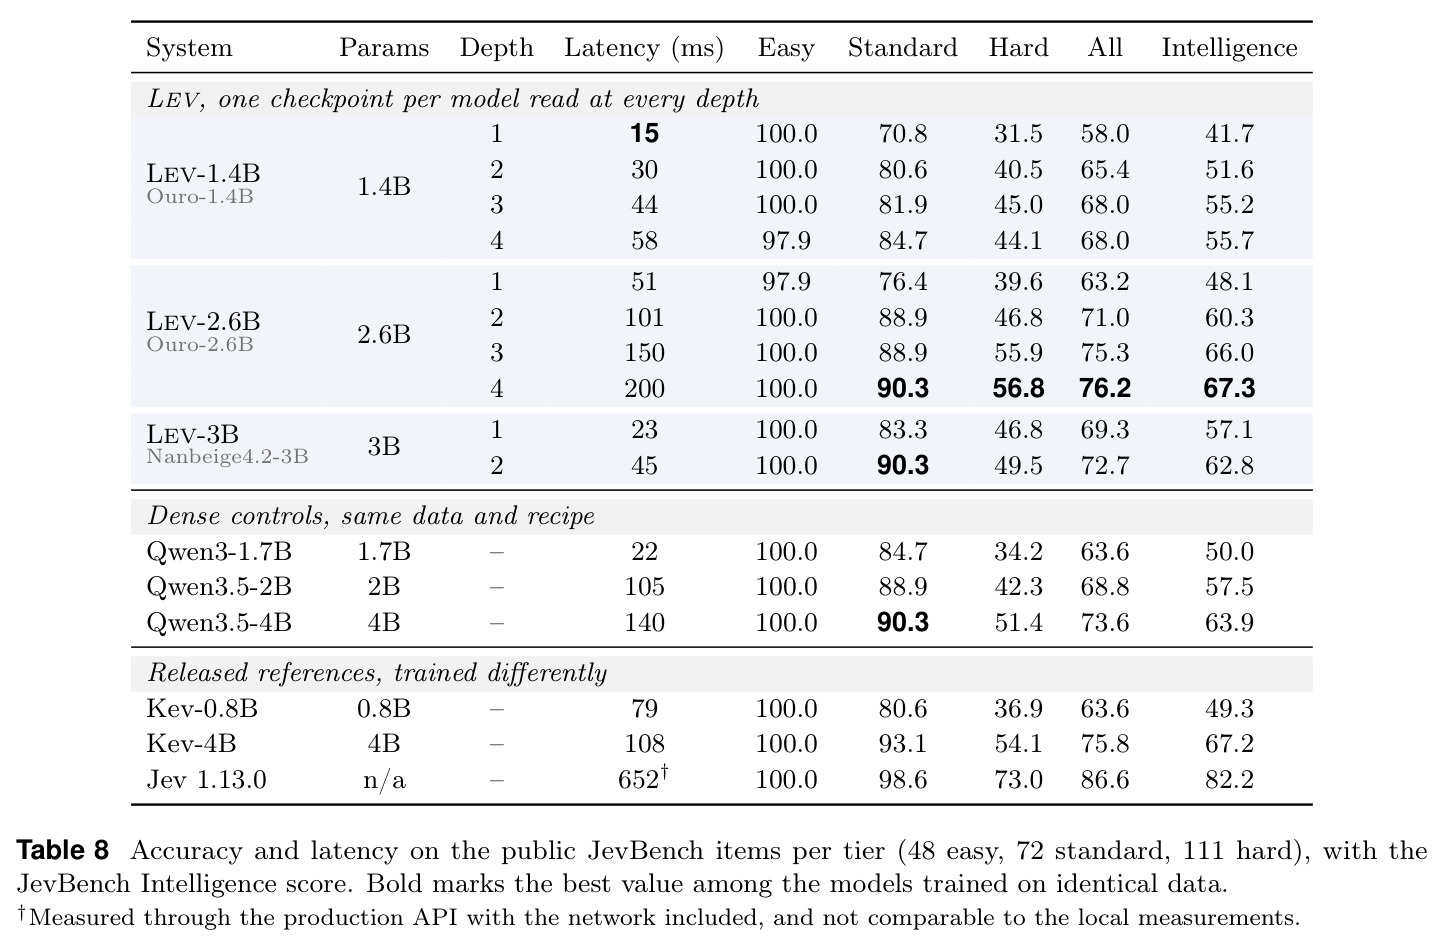
决策模型(如 Jev/Kev)一次前向就给出每个选项的概率,速度快但计算深度在训练时固定:简单题和难题消耗同样的算力。作者在 JevBench 的 231 道公开题上逐题对比同源训练的 Kev-0.8B 与 Kev-4B:后者多答对 28 题,且增益全部来自 standard 与 hard 档(easy 档两者均已全对),而两模型结论不同的只有 42 题——大模型的额外参数被浪费在大多数题上。现有加算力的方案各有硬伤:级联要重读输入并需要第二个模型(Kev-0.8B 中位延迟 79ms、Kev-4B 108ms,被升级的请求比大模型单独跑还慢);生成式思考在 hard 档提升 9–13 分,但 hard 题中位延迟慢 3–4 倍,且简单题也要为推理文本付费(djev 思考模式把 48 道 easy 题做错 2 道,534 个决策里 72 个超 8,192 token 预算无有效答案);中间层早退的浅层读出没被训练过,在新数据上自信地出错;把循环“改装”到普通预训练模型上,ReZero 门控训练后平均幅度仅约 0.006,循环基本不开启,去掉门控反而让新数据掉 2.2 分。
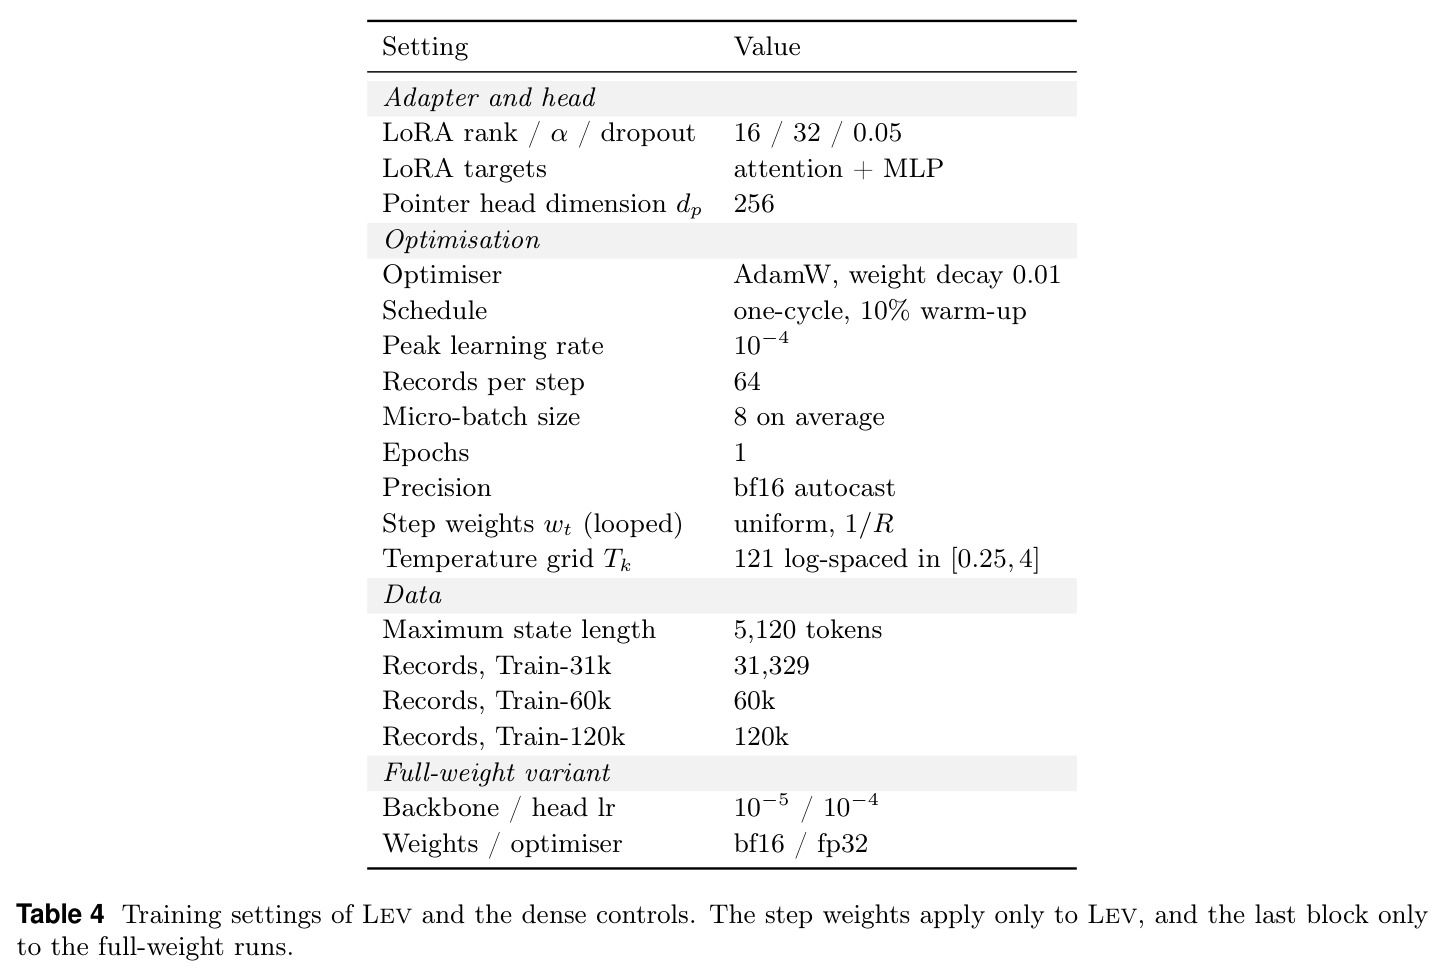
本文的目标是本文要造一个“按需深度”的决策模型:同一个 checkpoint 在每道题上可选择循环步数 $k\in\{1,\dots,R\}$,简单题一次前向即答,难题自动多跑几步;加深的过程不生成 token、不引入第二个模型、不重读输入(从上一步隐状态继续)。同时,任一深度的读出都必须是训练过的合格决策模型(而非顺便看一眼的中间层),使一个模型覆盖延迟-精度曲线上的多个工作点;决定“何时再跑一步”的停止器,其阈值必须能在完全无标注的真实流量上拟合,让部署方零成本适配自己的数据分布。
与已有工作不同的是,独特切入有三点。其一,不在预训练模型上后补循环(作者实测门控趋零、循环关死),而是直接构建在预训练阶段就以循环形式训练的原生循环语言模型(Ouro、Nanbeige4.2)之上,决策微调只需“激活”而非“塑造”循环。其二,在每一步循环后都用同一个共享指针头读一次选项,并把 $R$ 步的 log loss 联合平均训练($\mathcal{L}=\frac{1}{R}\sum_t \ell(p^{(t)},y)$),使每个深度都是合格的决策模型。其三,停止器不预测“当前答案是否正确”(浅层在新数据上过度自信、正确性阈值迁移差),而预测“当前答案是否与最深答案一致”(CATs 一致性目标);该目标源自模型自身,因此阈值可以在无标注请求上以“≥98% 与最深答案一致”的准则拟合,这是此前早退文献没有在决策模型上做过的组合。
核心方法
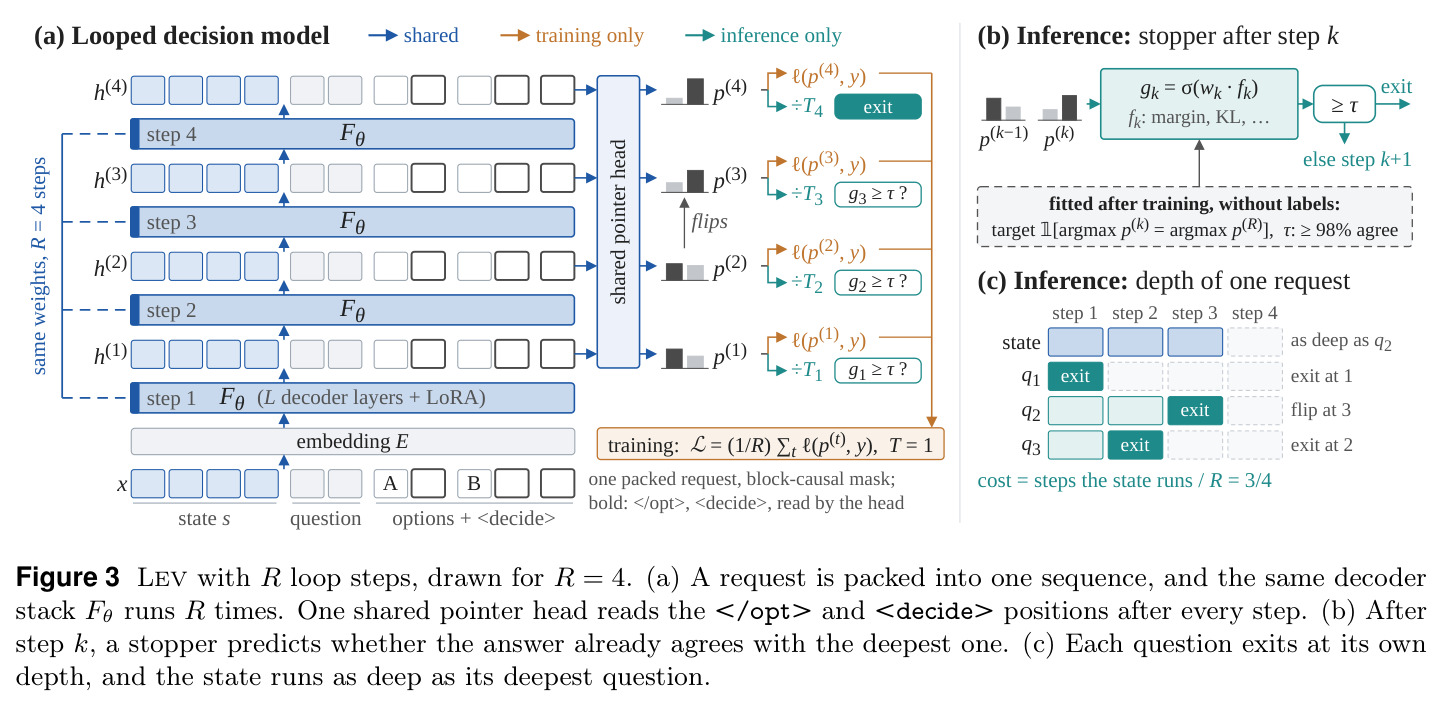
直觉:把“再想一会儿”从生成文本改成重跑同一组层。LEV 把决策模型的骨干换成原生循环语言模型,让同一解码栈 $F_\theta$ 跑 $R$ 次,每步之后都用一个共享指针头读一次选项,得到该深度的分布 $p^{(t)}=\mathrm{softmax}(z^{(t)}/T_t)$。请求打包成一条序列:状态 $s$ 在前,各问题连同选项以分隔符 token 包裹并以 $\langle\mathrm{decide}\rangle$ 结尾跟随;块因果掩码让每个问题只看到状态和自己的 token,位置索引在状态后重排,相当于各问题被独立作答而状态只编码一次。训练时对所有步的损失取平均 $\mathcal{L}=\frac{1}{R}\sum_{t=1}^{R}\ell(p^{(t)},y)$,指针头与 LoRA(rank 16)跨步共享;推理时先只跑 1 步,随后一个轻量逻辑回归停止器在每步后判断哪些问题还需加深,加深从上一步隐状态继续而不重读输入;每个深度各拟合一个温度 $T_k$ 做校准。请求的计算代价定义为“状态实际跑到的深度 / $R$”,按 token 数加权平均。
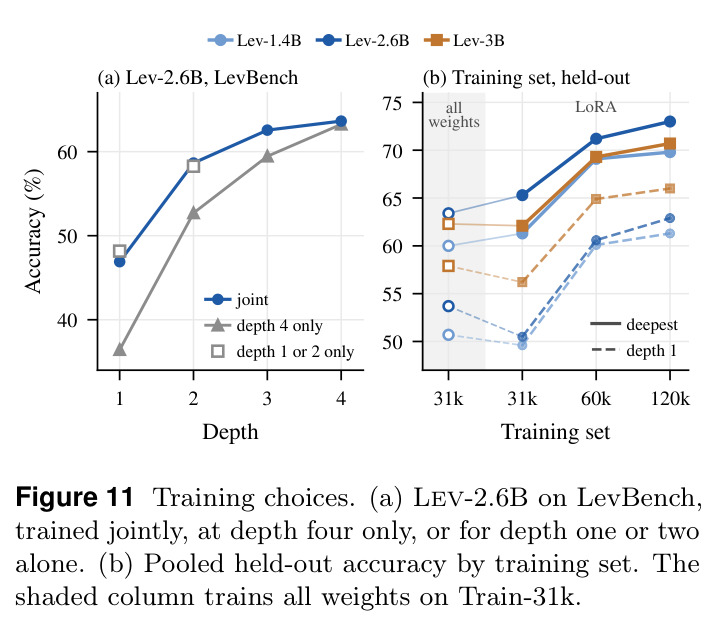
核心创新有三。其一:每步可读、逐步联合训练。以往循环要么后补(门控趋零、形同虚设),要么只有最后一步被监督(实验中只训最后一步的模型 depth-1 只有 36.4%,浅层读出不可用);LEV 让每个循环深度都经过决策训练,因此“一个 checkpoint 服务所有深度”,加深只是继续往前跑。其二:停止目标从“正确性”换成“与最深答案的一致性” $y_k=\mathbb{1}[\hat{o}^{(k)}=\hat{o}^{(R)}]$。正确性目标在标注校准集上调阈值后迁移性差(两个 Ouro 模型都落到固定深度前沿之下),而一致性目标无需标注、可在部署方自己的流量上拟合,阈值 $\tau$ 取满足“≥98% 最终答案与最深一致”的最小值(即最便宜的停止)。其三:加深以整个循环步为单位,不增加序列位置、不重读输入;同一请求内状态与问题一起加深,状态深度为 $d(s)=\max_j d(q_j)$。
方法步骤详情
流程五步。(1) 构造请求:状态 $s$ 置于序列开头,各问题的选项用分隔符 token 包裹并以 $\langle\mathrm{decide}\rangle$ 结尾,块因果掩码保证问题间互不可见。(2) 循环前向:$h^{(t)}=\mathrm{Norm}(F_\theta(h^{(t-1)}))$,每步用共享指针头 $z_k=(W_K h_k)^\top(W_Q h_{dec})/\sqrt{d_p}$ 打分,得各深度读出 $p^{(t)}$ 与答案 $\hat{o}^{(t)}$。(3) 训练:LoRA rank 16 加共享指针头,损失为步平均 $\mathcal{L}=\frac{1}{R}\sum_t\ell(p^{(t)},y)$,1 epoch、31,329 条记录、峰值学习率 $10^{-4}$、至多 4 张 H200。(4) 校准:在校准分区为每个深度拟合温度 $T_k$,不接触任何基准集。(5) 停止:每深度一个逻辑回归 $\hat{y}_k=\sigma(w_k^\top\phi_k+b_k)$,特征 $\phi_k$ 来自前后两步读出:最高概率、选项间边际、归一化熵、与上步答案是否一致、$\mathrm{KL}(p^{(k-1)}\|p^{(k)})$、概率变化量、$\log K$、$k$;阈值在无标注请求上于 $[0.5,1]$ 搜索,取满足“≥98% 与最深答案一致”的最小值;停止深度 $d_\tau(q)=\min\{k<R:\hat{y}_k\ge\tau\}\cup\{R\}$,状态跑到 $d(s)=\max_j d(q_j)$。
技术新颖性
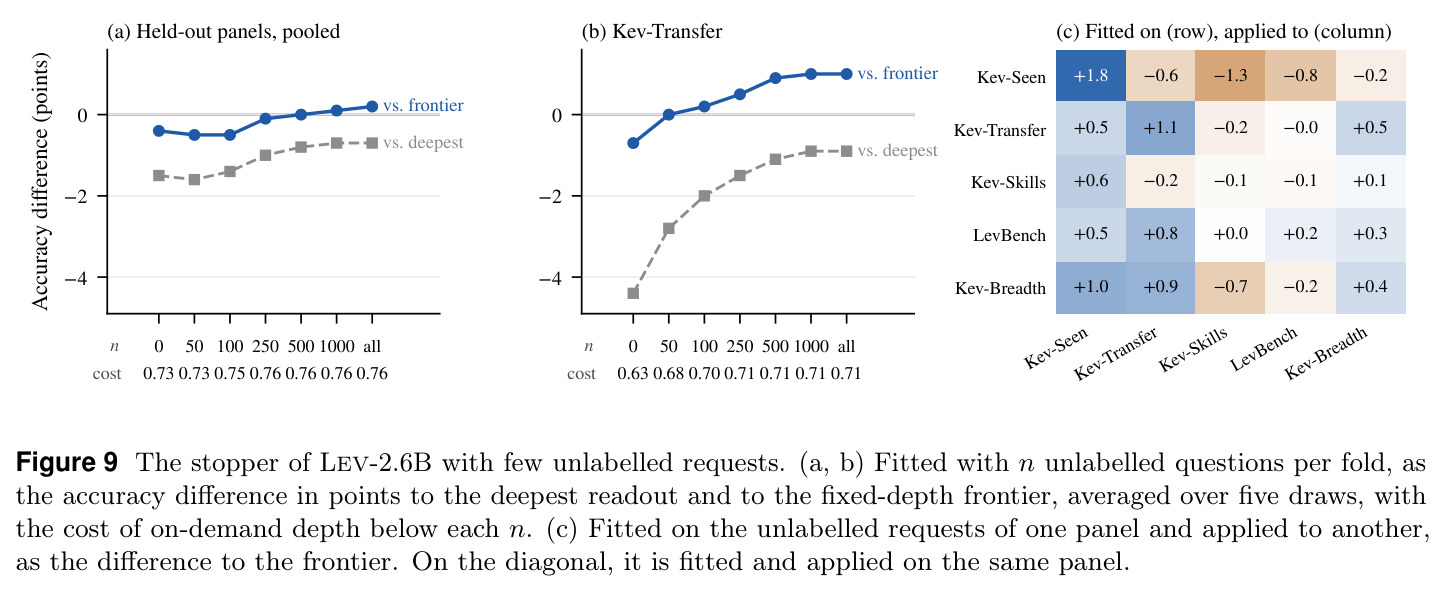
与已有工作的本质区别:相对早退(CALM、BERxiT 等),LEV 的浅层读出是训练过的决策头而非未监督的中间层,且停在整步、不增加位置,阈值无标注可得;相对级联,不需要第二个模型、不重读输入;相对生成式思考(djev/OpenJev),加深成本是整次前向的 $k/R$ 而非逐 token 解码,简单题零额外开销;相对把循环后补到密集模型(作者实测收益不足 0.5 分、门控均值约 0.006),LEV 依赖预训练即循环的骨干(Ouro 以 7.7T token 预训练、每步带语言建模损失),使循环“开箱即用”。此外,把“何时停”形式化为 CATs 式一致性预测、并系统证明无标注阈值拟合足矣(每折 500 条无标注题即达全程拟合 0.2 分以内),以及“冻结配方后再读 held-out 面板”的实验纪律,都是决策模型文献中少见的严谨做法。
实验结果
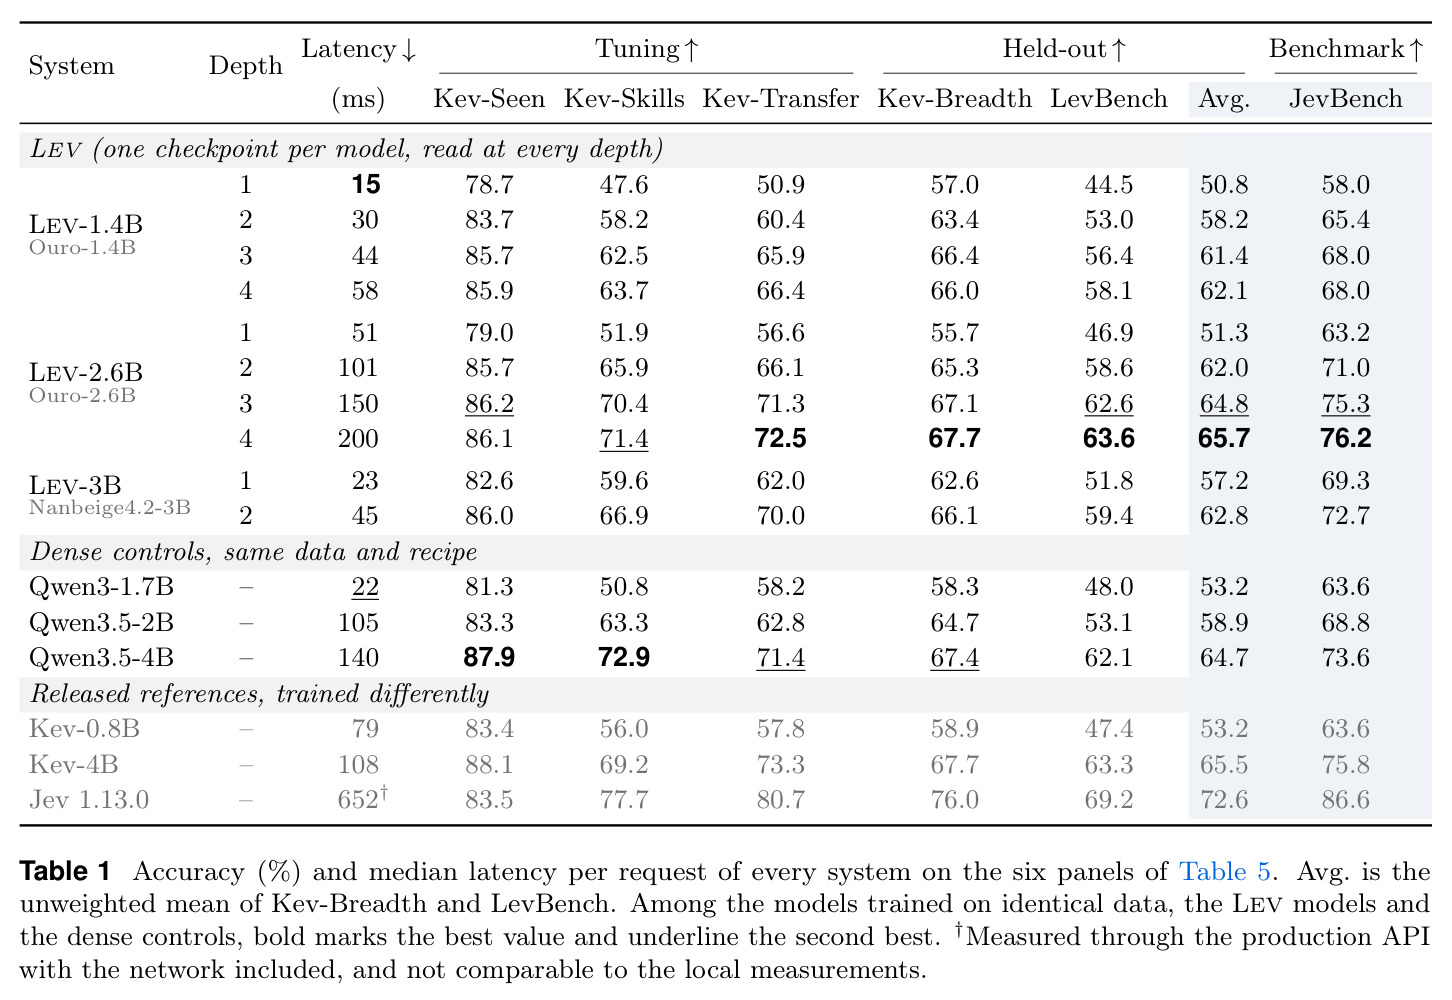
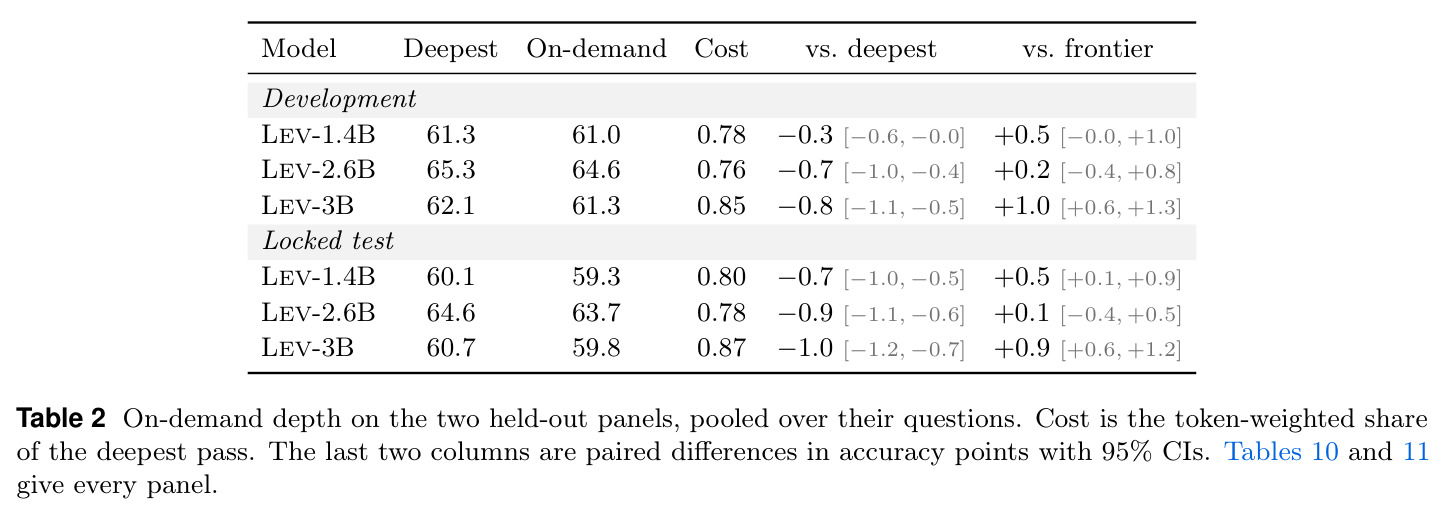
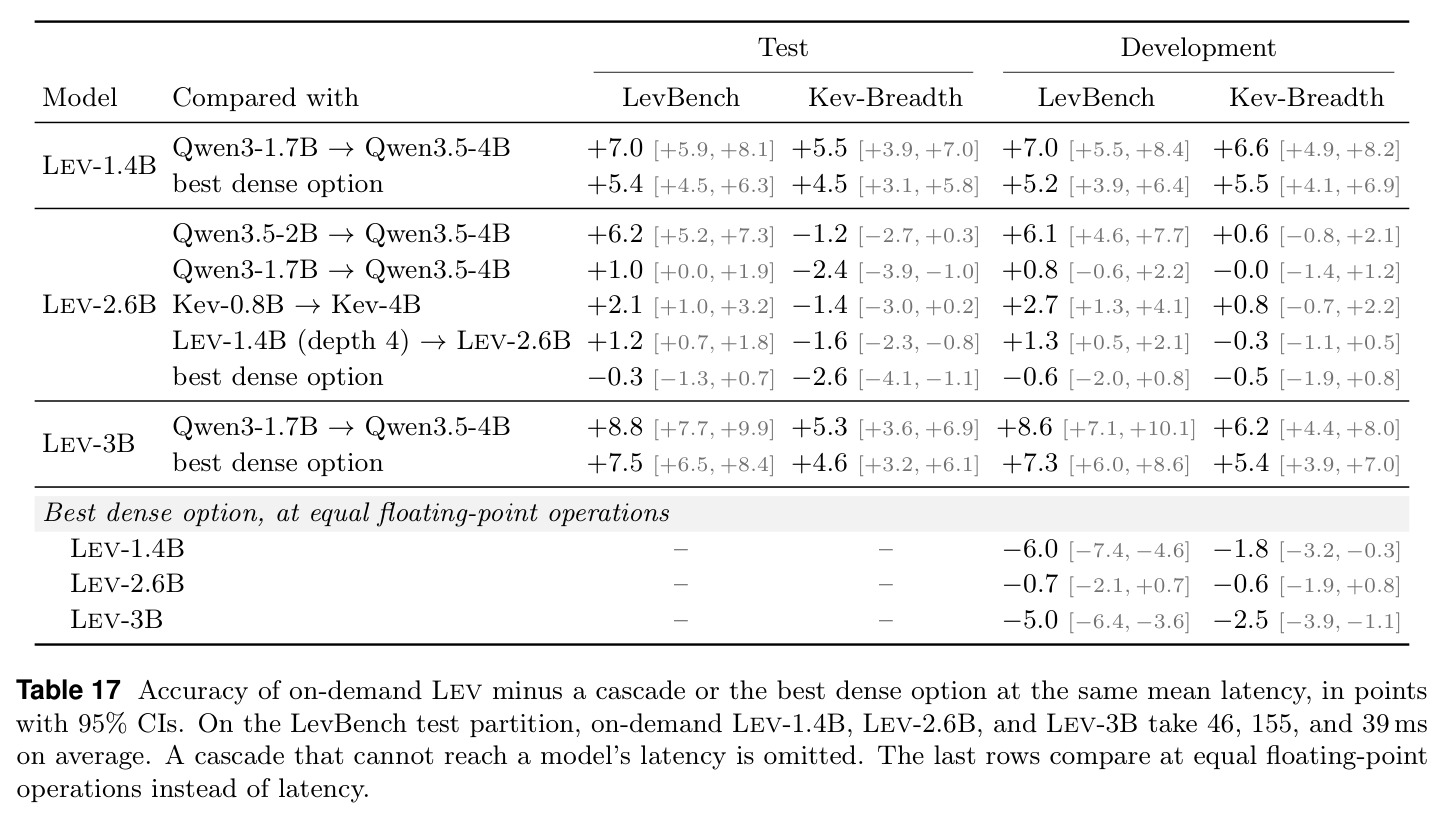
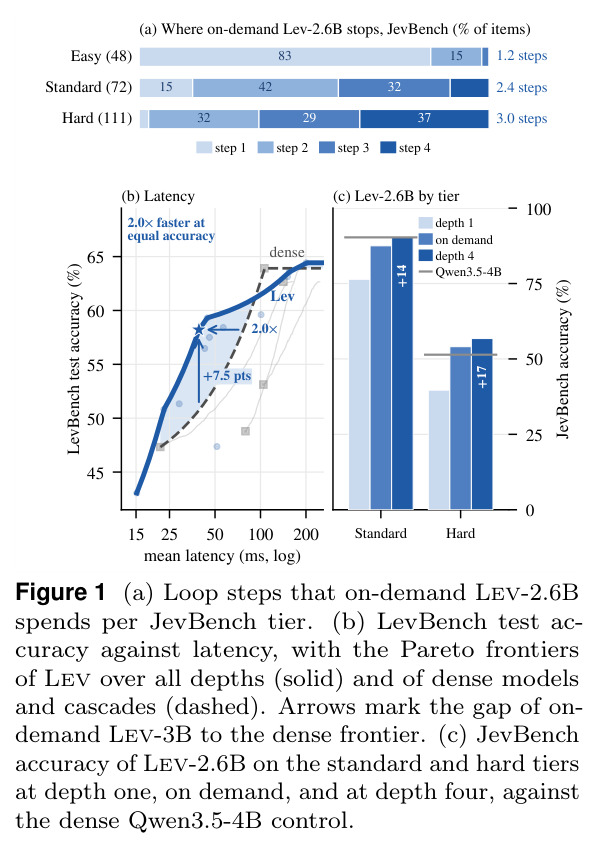
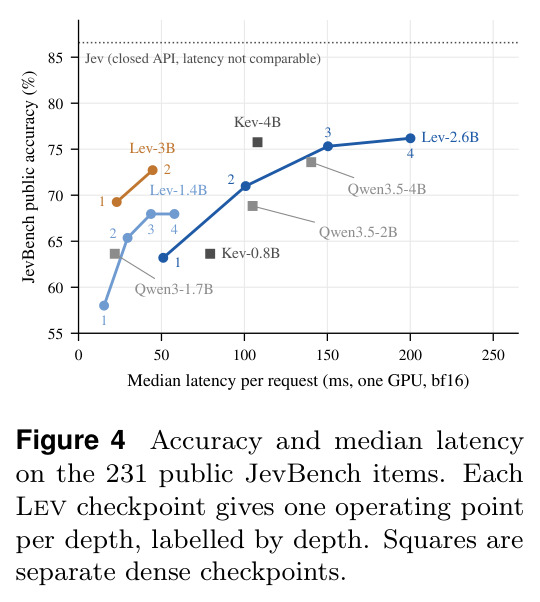
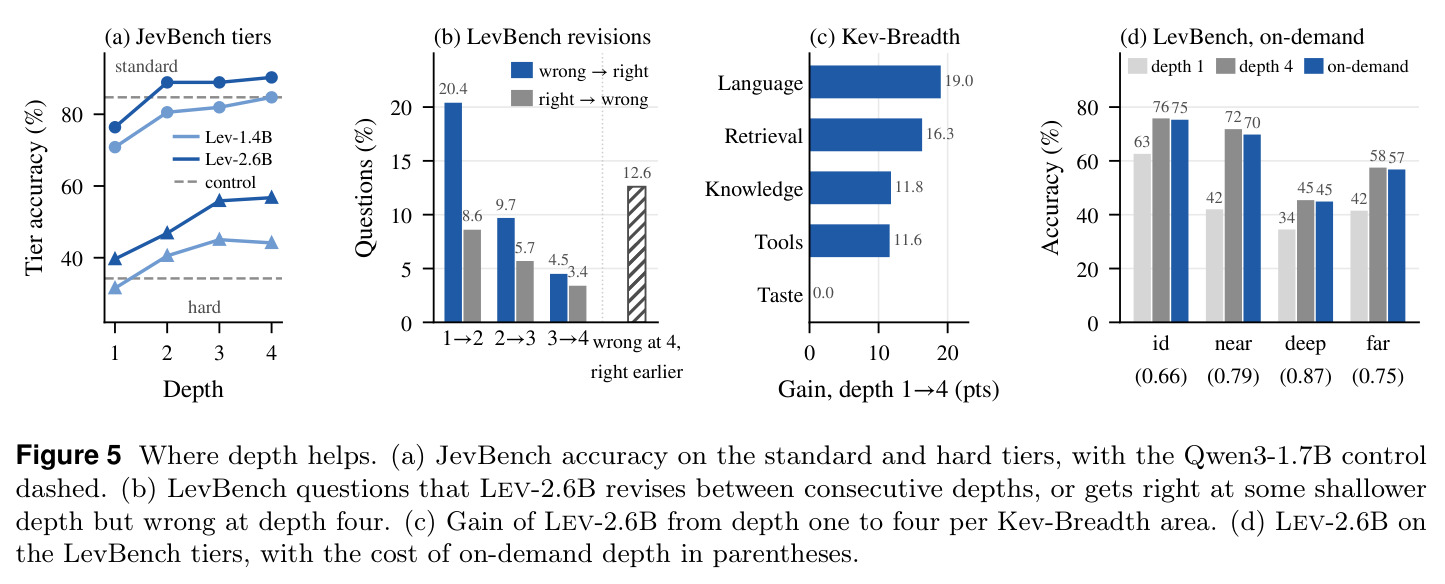
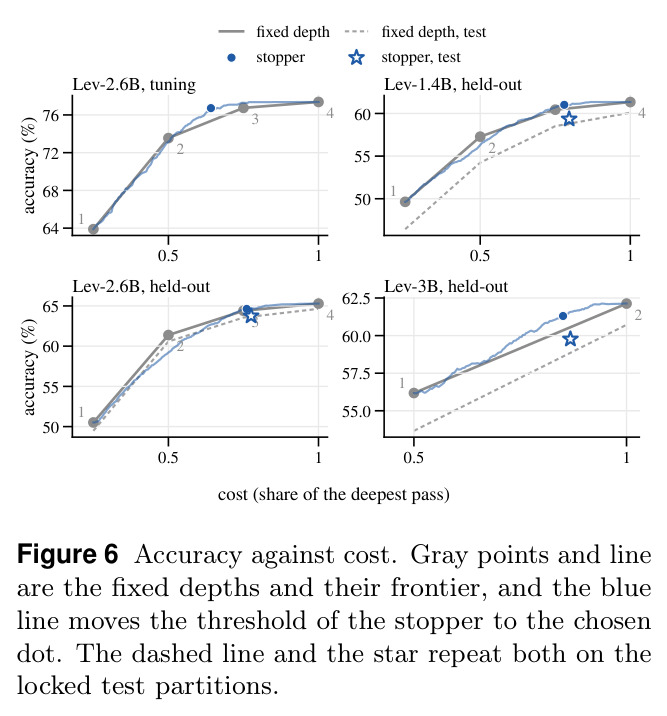
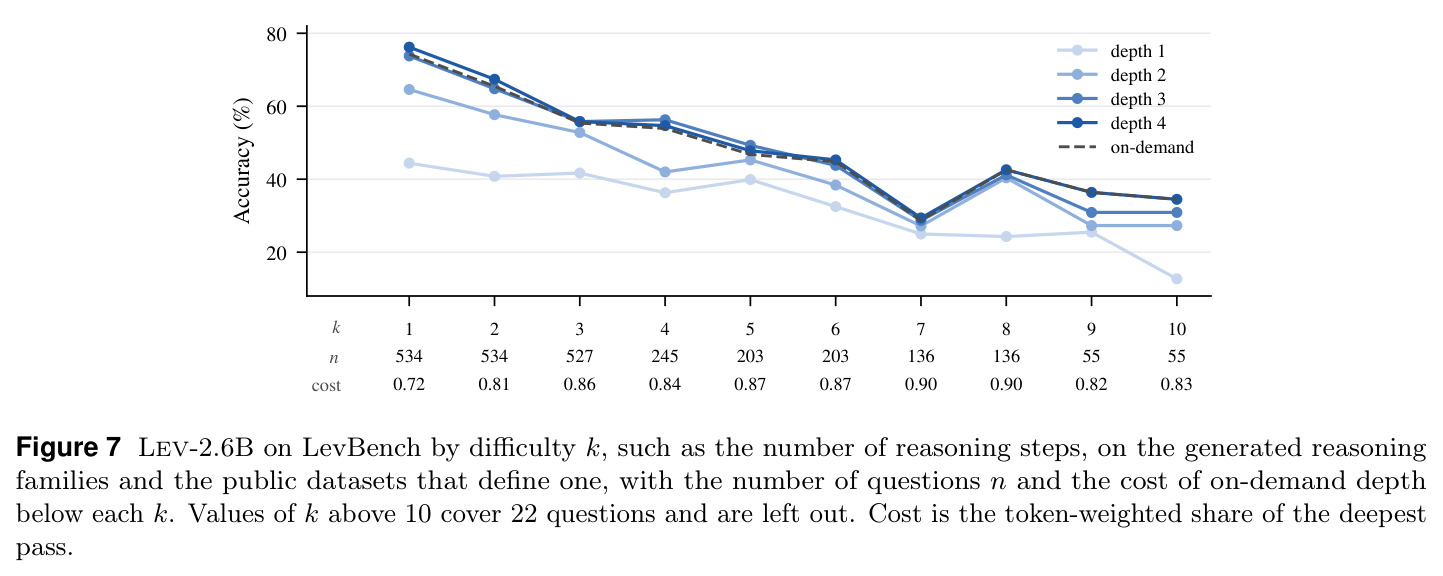
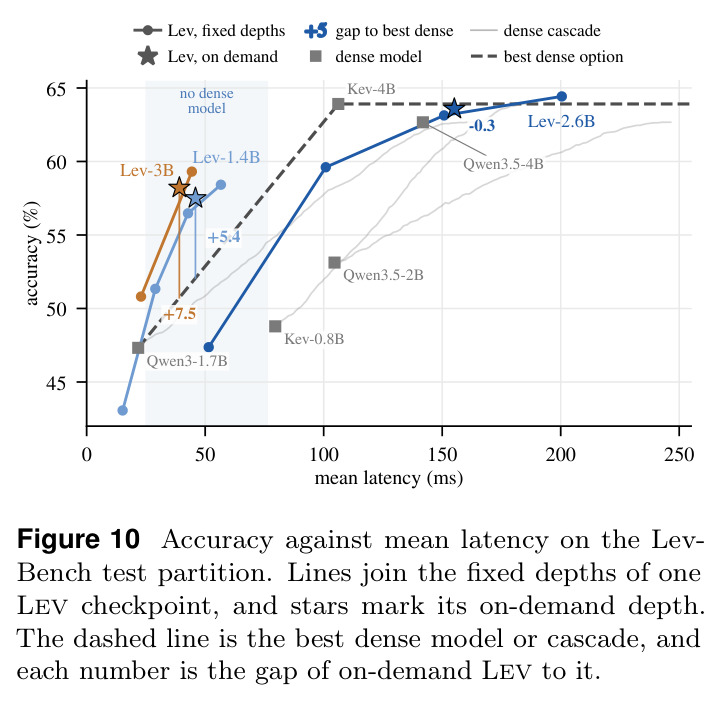
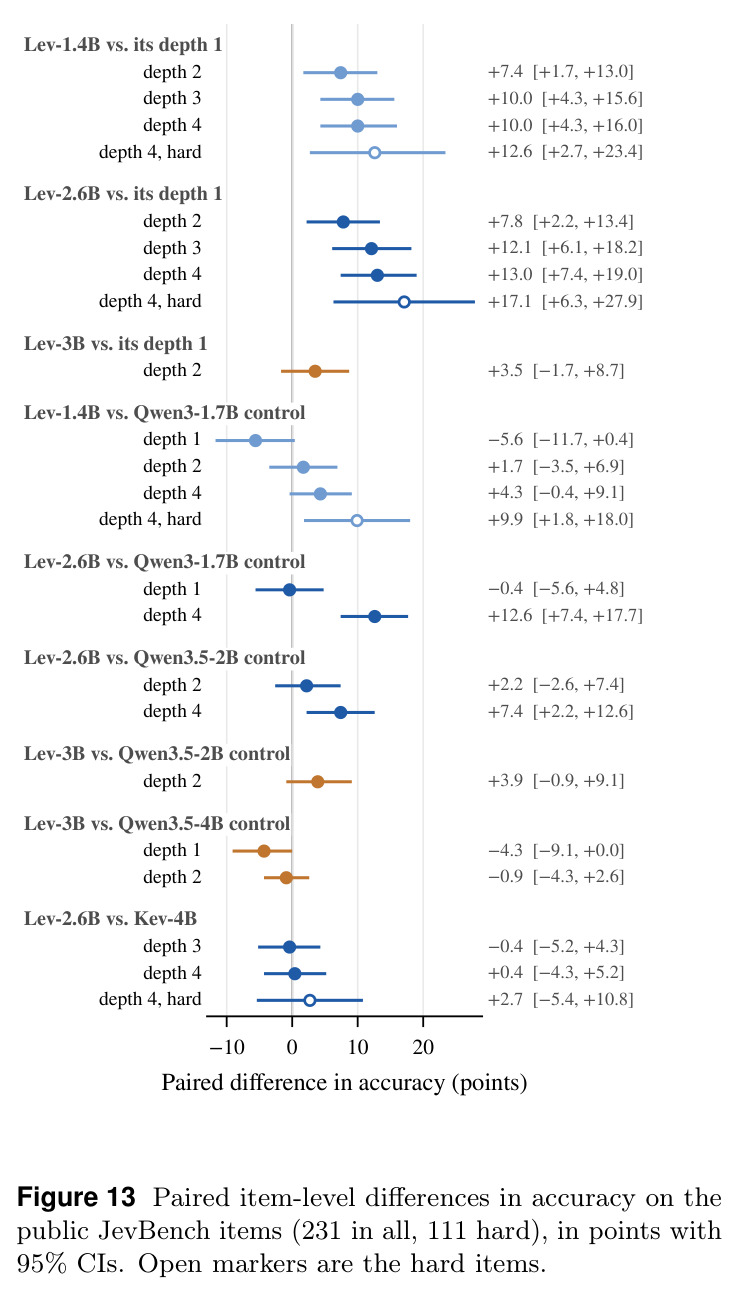
四条结论。(1) 加深提精度、边际递减:LEV-2.6B 在 JevBench 从 63.2%(深度 1)到 76.2%(深度 4,+13.0 分,McNemar $p<0.001$;hard 档 +17.1),LEV-1.4B 58.0→68.0%,两步的 LEV-3B 69.3→72.7%;第一个额外步贡献最大(held-out 均值 51.3→62.0,深度 4 也只 65.7),且离训练数据越远收益越大。(2) 一个 checkpoint 多工作点:LEV-3B 深度 1 在 23ms 比 22ms 的 Qwen3-1.7B 高 4.0 分,LEV-2.6B 深度 2 在 101ms 比 105ms 的 Qwen3.5-2B 高 3.1 分,深度 4 与 Kev-4B 持平(76.2 vs 75.8)。(3) 按需深度省 15%–24% 计算、精度损失不足 1 分(锁定测试 vs 最深 −0.7~−1.0、vs 固定深度前沿 +0.1~+0.9),停止器自动把步数花在难题上:JevBench 三档平均 1.2/2.4/3.0 步。(4) 低延迟占优但优势在延迟而非算力:<50ms 时 LEV-1.4B/3B 比同延迟 dense 与级联高 5.4~8.8 分,dense 选项在 22–79ms 存在空档,按 FLOPs 计 LEV 不占优;闭源 Jev 仍以 86.6% 领先。改判分析显示深度主要在修正而非乱改(hard 档 29 题改对、10 题改错),但 LevBench 上 12.6% 的题浅层对而最深错,是一致性停止器的固有盲区。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| JevBench 多选决策(231 道公开题:48 easy / 72 standard / 111 hard) | 总体准确率 | LEV-2.6B:63.2%(深度 1)→ 76.2%(深度 4) | Kev-4B 75.8%;同数据同配方的 dense 控制 Qwen3.5-4B 73.6% | 较自身深度 1 +13.0 分(hard 档 +17.1);与 Kev-4B 持平(+0.4),超 Qwen3.5-4B +2.6 分 |
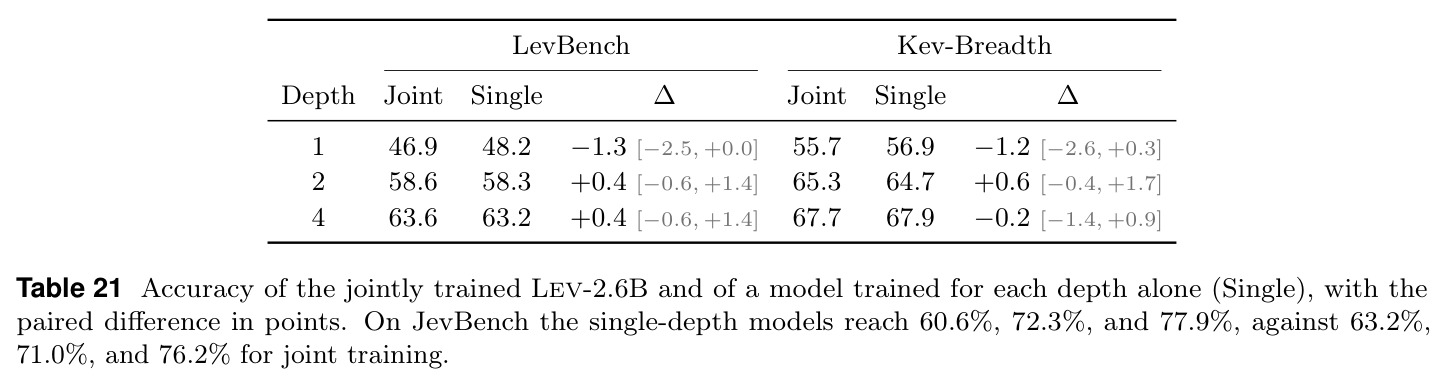
| LevBench(自建冻结 held-out 基准,dev 4,370 题,id/near/deep/far 四档) | 准确率 | LEV-2.6B:46.9%(深度 1)→ 63.6%(深度 4) | Qwen3.5-2B 53.1%;Qwen3.5-4B 62.1%(同配方 dense 控制) | 深度 4 超 Qwen3.5-4B +1.5 分;首个额外步即修对 20.4% 的题 |
| 按需深度(两个 held-out 面板 pooled,锁定测试) | 准确率 / 计算成本(相对最深前向) | 成本 0.78–0.87,精度 59.3–63.7(三模型) | 最深读出(成本 1.0)60.1–64.6 | 省 13%–22% 计算,仅损 0.7–1.0 分;对同成本固定深度前沿 +0.1~+0.9 分 |
| 低延迟区间(LevBench test,按需平均延迟 39–46ms) | 对同延迟最佳 dense/级联的准确率差 | LEV-1.4B / LEV-3B 按需:+5.4 ~ +8.8 分 | Qwen3-1.7B→Qwen3.5-4B 级联及所有 dense 模型的最佳选项 | LEV-3B 对最佳 dense +7.5 [6.5, 8.4],对级联 +8.8 [7.7, 9.9] |
| Kev-Breadth(14 个从未训练的数据集、5 个应用领域,test 3,031 题) | 准确率 | LEV-2.6B 67.7%(深度 4) | 同配方 Qwen3.5-4B 67.4%;Qwen3.5-2B 64.7% | +0.3 分;分领域看语言理解 +19.0、知识 +11.8、工具 +11.6,品味类任务约 0 |
局限与改进
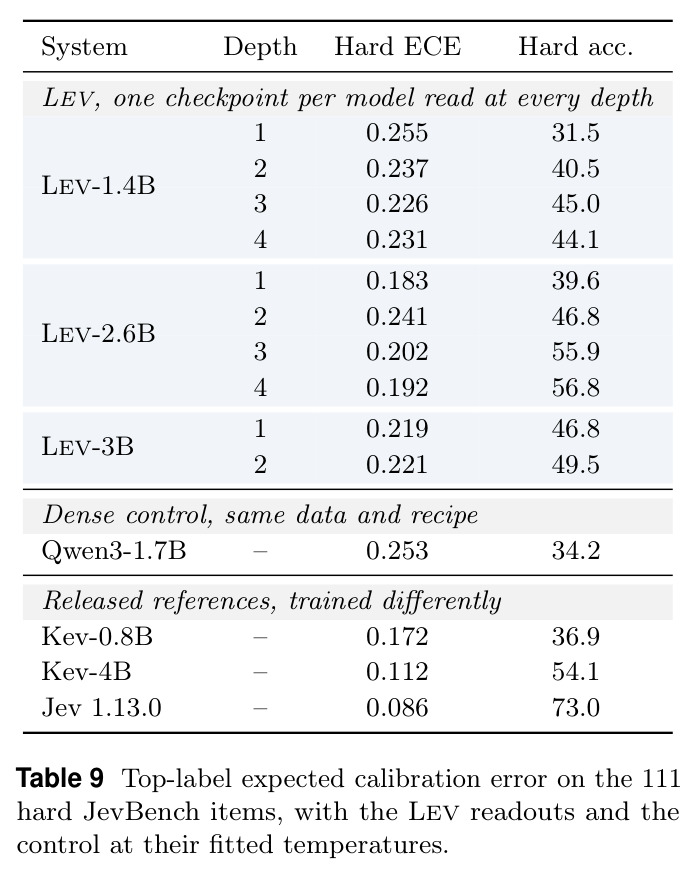
作者承认:骨干仅 1.4B–3B(公开可得者止于此规模),深度曲线能否随规模延伸未知;JevBench 仅 231 道公开题;按需深度按循环步计费,尚无跨深度批处理的服务路径把节省变成墙钟时间;延迟在单请求、无融合核/图捕获/状态缓存下测得,各系统同等欠优化。我的补充:(1) 计算量并不减少——每步都跑完整骨干,FLOPs 口径下 LEV 落后 dense 最多 6.0 分,低延迟优势部分来自 22–79ms 的产品空档;(2) 一致性目标无法挽回“浅层对、深层错”的 12.6% 题,深度 4 还会把 10 道 hard 题改错;(3) 收益集中在前一个额外步,第四步至多 1 分;(4) 温度缩放后 hard 档 ECE 仍 0.18–0.26,远差于 Kev-4B 的 0.112 与 Jev 的 0.086;(5) 与闭源 Jev 绝对差距大(76.2 vs 86.6);(6) 加深让模型对不可知题更自信(top prob ≥0.9 从 0.0% 升到 6.3%),与弃答能力冲突。
独立分析的弱点
(1) 一致性目标的上限是最深读出,浅层对而深层错的 12.6% 题必被牺牲;可加入“加深是否改变答案”的双向预测,对会变的题比较浅/深置信度或做双读集成,并对少量流量始终跑满深度做对冲。(2) 加深非单调改进(hard 档 29 改对/10 改错),只取最深答案浪费中间读出;可用多深度读出加权集成或投票。(3) FLOPs 无优势、延迟优势依赖 dense 空档,一旦 dense 厂商补齐 20–80ms 档位即可能消失;需真正的步间增量计算,如后继步只跑部分层或复用 KV 缓存。(4) 校准差(hard ECE 0.18–0.26)且浅层在新分布过度自信(被停题在校准集 94.8% 正确 vs Kev-Transfer 78.9%),可加跨分布温度再校准或共形预测。(5) 状态须与最深问题同深($d(s)=\max_j d(q_j)$),一题难拖累全请求;可研究问题级状态快照或分组调度。(6) 品味类任务深度零增益,应对其自动退化为深度 1 以省算力。
未来方向
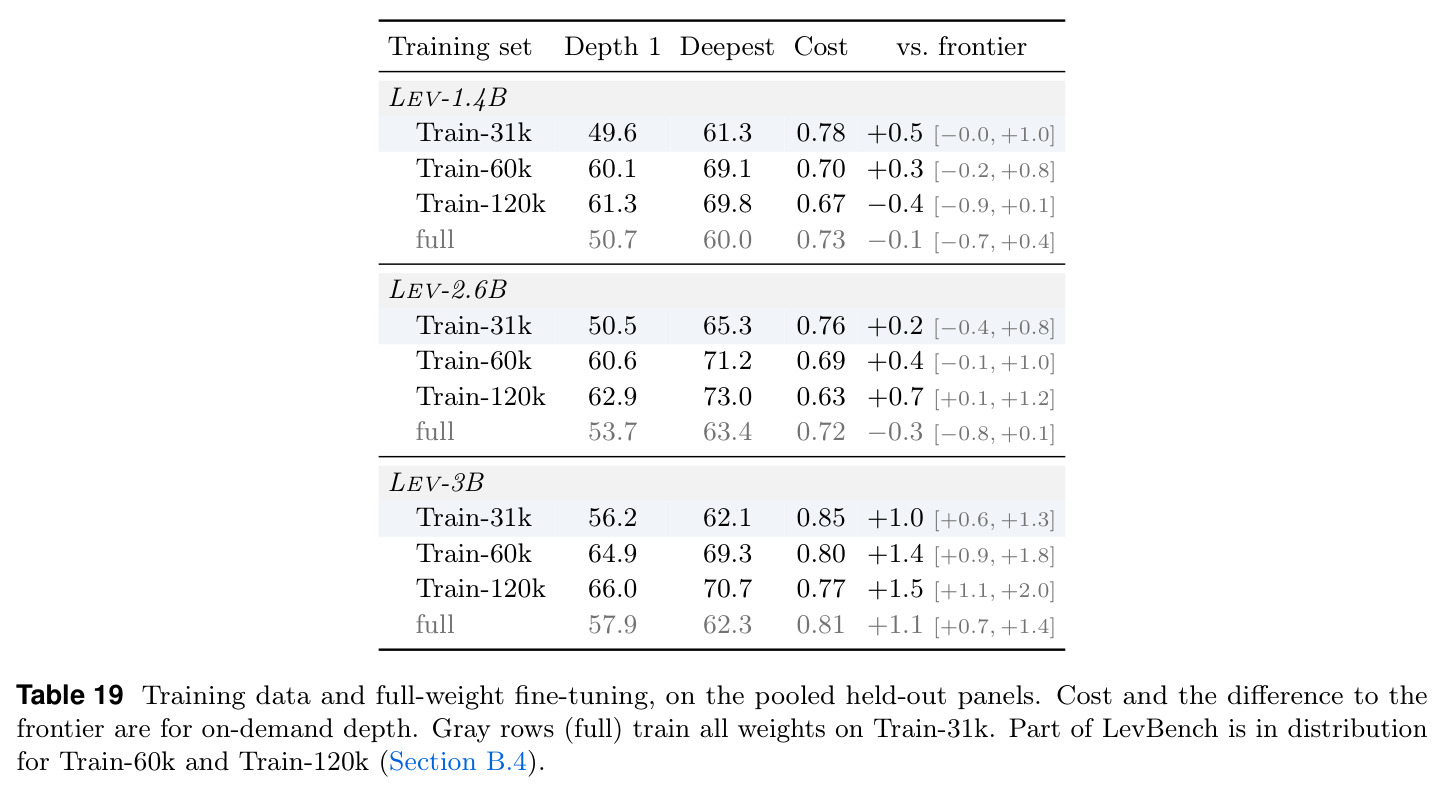
作者明确提出两个方向:设计能挽回“浅层对、深层错”的停止目标,使按需精度超越最深读出;把配方推广到更大的循环骨干,检验难题上的收益是否随规模增长。基于本文成果还可延伸:(1) 服务系统工程——对不同深度请求做连续批处理、融合核、图捕获与隐状态缓存,把步数节省兑现为墙钟时延,这是把论文主张产品化的关键缺口;(2) 把按需深度与“不可知题”检测联合学习“何时加深、何时弃答”(图 14 显示加深反而让模型对不可知题更自信);(3) 停止器的无标注拟合天然适配在线部署,可做持续更新与分布漂移监控(作者已证明跨面板迁移损失 ≤0.7 分,但训练源分布拟合会失效);(4) 训练侧,Train-120k 把 LEV-2.6B 深度 1 从 50.5% 提到 62.9%、按需成本降到 0.63,说明浅层读出可被数据显著强化,值得系统研究数据配比对深度曲线形状的影响;(5) 与生成式推理混合:对停止器判“加深后仍不一致”的少数难题升级为 token 级思考,构造真正的 System 1.5 流水线,兼取两种范式的长处。
复现评估
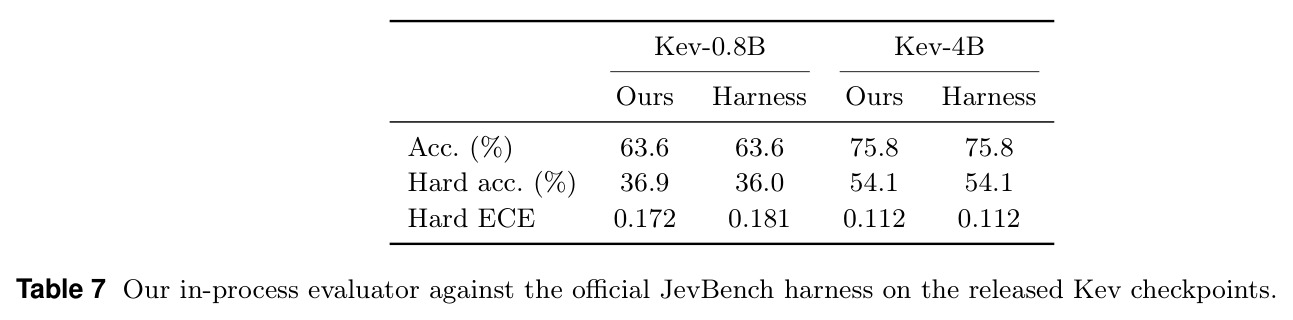
复现条件较好。代码开源于 GitHub(OpenLAIR/lev),三个模型权重发布在 HuggingFace(songdj/lev 集合),另有项目主页。训练成本不高:LoRA rank 16、仅 1 个 epoch、31,329 条记录,峰值学习率 $10^{-4}$,至多 4 张 H200;骨干 Ouro-1.4B/2.6B 与 Nanbeige4.2-3B 均公开。评测协议严谨透明:LevBench 在任何模型读它之前冻结,构建与查重规则写在附录 B.4;自建评测器在官方 Kev checkpoint 上与 JevBench harness 对齐(Kev-4B 完全一致,Kev-0.8B hard 档差不足 1 分);停止器拟合只需每折约 500 条无标注请求。剩余难点:闭源 Jev 无法复现只能引用;延迟数字依赖单张 H200 bf16、无优化 kernel 的特定环境,难以严格对齐;复现锁定测试需遵守其面板划分与“读一次”纪律。总体属中等偏易的复现难度,开放程度在同方向工作中属上乘。
论文图表
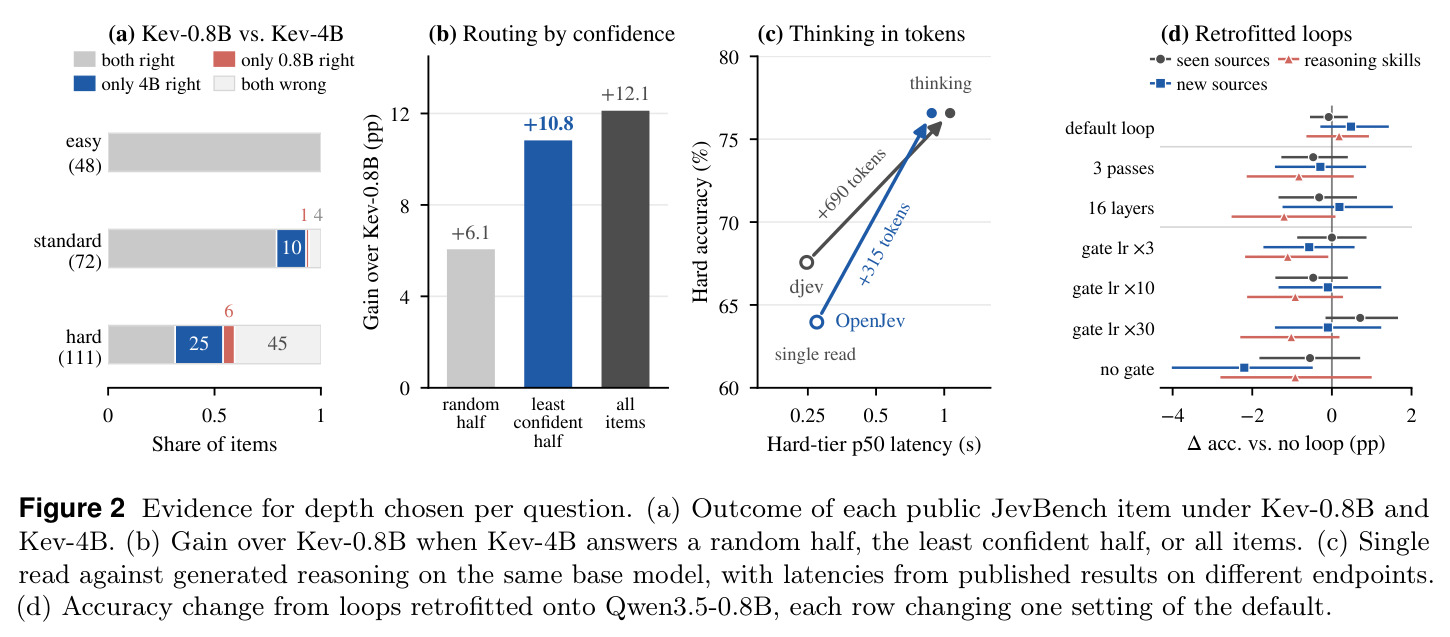
四联动机实验。(a) Kev-0.8B 与 Kev-4B 在 231 题上的逐题结果交叉:Kev-4B 多对 28 题,全部来自 standard/hard 档;(b) 按小模型置信度把题路由给大模型的增益曲线,送出最不自信的一半即 +10.8 分、几乎追平全量大模型;(c) 同基座下单次读 vs 生成式思考:hard 档 +9~13 分但 hard 题中位延迟慢 3–4 倍;(d) 把循环后补到 Qwen3.5-0.8B 的各变体精度变化全部在 ±0.7 分内,门控趋零。
支撑全文立论的两个观察:额外算力只对少数题有用且廉价首读即可找到它们;现有加算力方案要么太贵(token/级联)要么循环不开启(后补循环)。
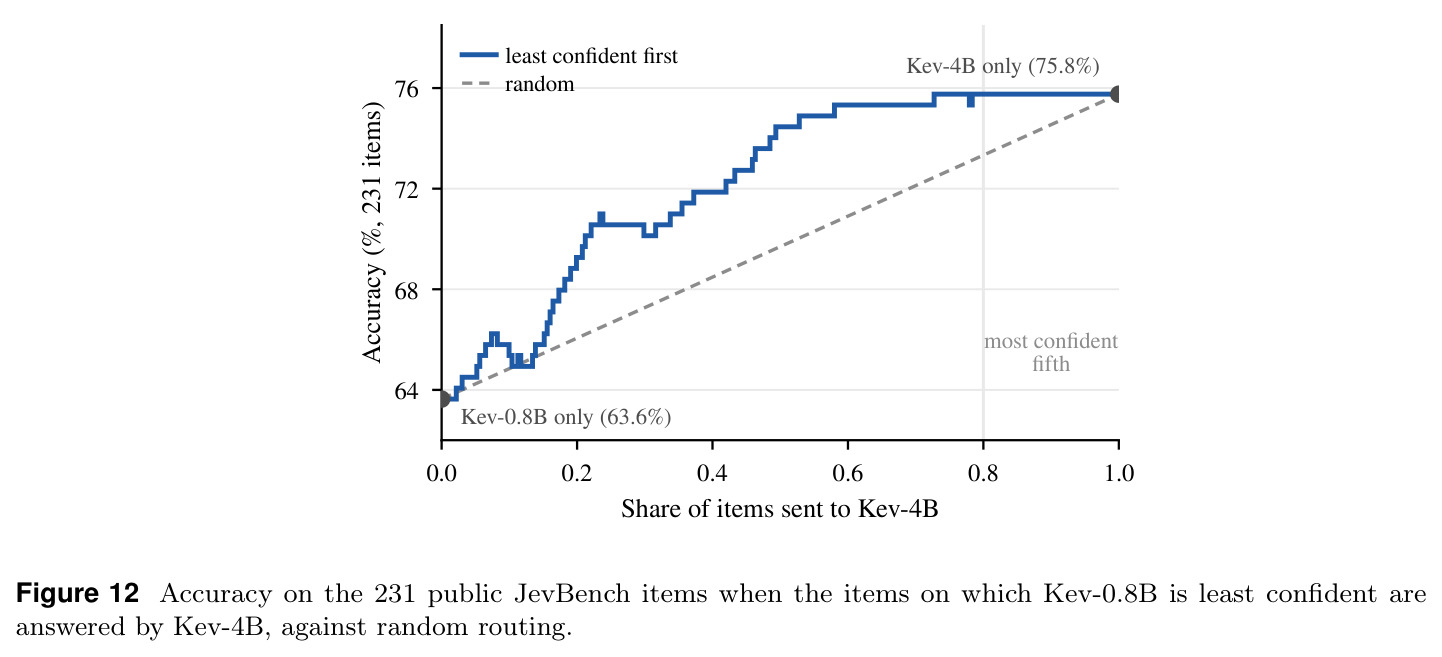
完整路由曲线:按 Kev-0.8B 置信度从低到高把题交给 Kev-4B,总体精度从 63.6%(Kev-0.8B 单独)爬升到 75.8%(Kev-4B 单独);置信路由在送出超过约 1/7 的题后稳定优于随机路由;在最自信的 1/5 题上大模型不改变任何结果(曲线末段平坦)。文中补充:两模型都答对的题上 Kev-0.8B 中位 top probability 0.80,而仅 Kev-4B 答对的题上仅 0.44。
Figure 2b 的完整版本,是“廉价首读的置信度即可定位需要更多算力的题”这一动机观察的直接证据,也是级联对比实验的基础。
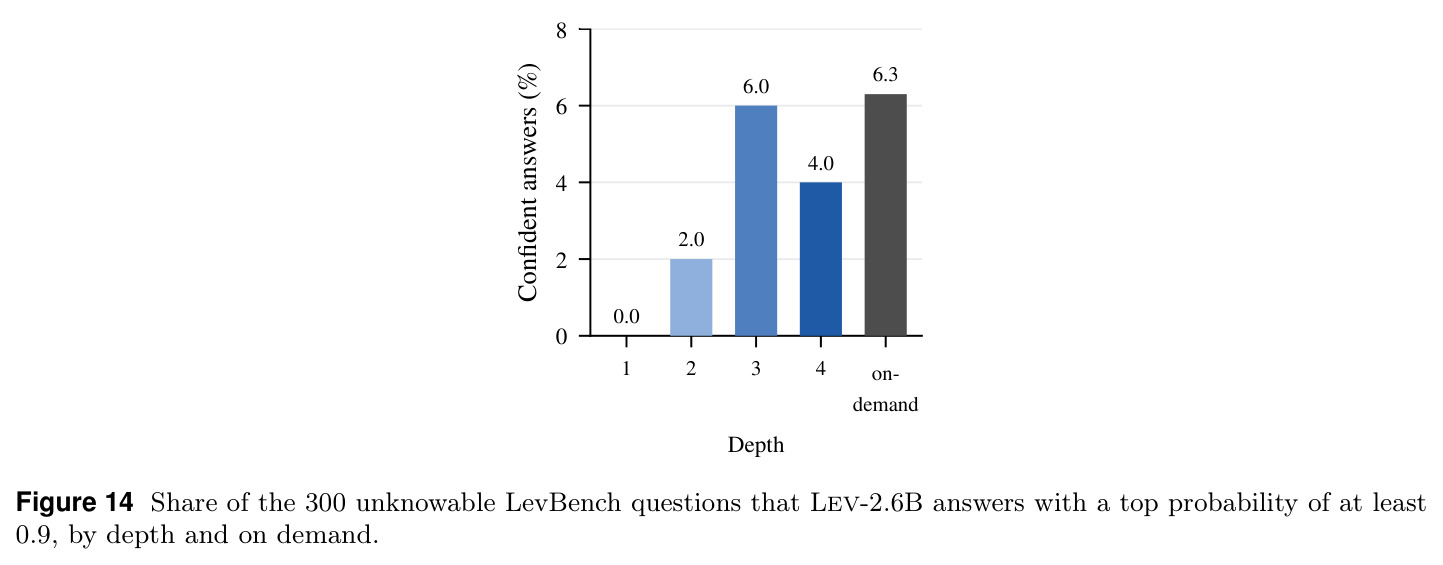
在 300 道“决定性证据被移除”的不可知(unknowable)LevBench 题上,以 top probability ≥0.9 作答(即高自信作答而非弃答)的比例:深度 1 为 0.0%,深度 2 为 2.0%,深度 3 为 6.0%,深度 4 达 6.3%,按需深度约 4.0%。
揭示按需加深的一个副作用:模型越深越容易对“本应承认不知道”的题过度自信,提示按需深度需要与弃答/校准机制联合设计,是作者未展开但值得警惕的问题。