JevAgentHarness:对与 LLM 共享控制权的决策模型进行基准测试、部署与训练 JevAgentHarness: Benchmarking, Deploying and Training Decision Models That Share Control with LLMs
用智能体自身状态训练的小决策模型按置信度接管常规选择,成本降 81–89% 而成功率不降。
前置知识
Agent Harness(智能体执行框架)
围绕 LLM 的程序外壳,负责把工具暴露给模型、维护上下文与记忆、解析并执行模型输出、决定何时停止,典型如 Claude Code、Codex CLI、OpenHands。它把「模型说什么」翻译成「agent 做什么」,每一步都形成「观察→决策→行动→新观察」的循环,并在循环内分支处做出大量小选择。
本文的全部委托、守卫、触发都定义在 harness 的循环结构上;所谓「决策点」就是 harness 代码里的分支,理解 harness 才能理解决策模型能插在哪里。
决策模型(Decision Model,System 1)
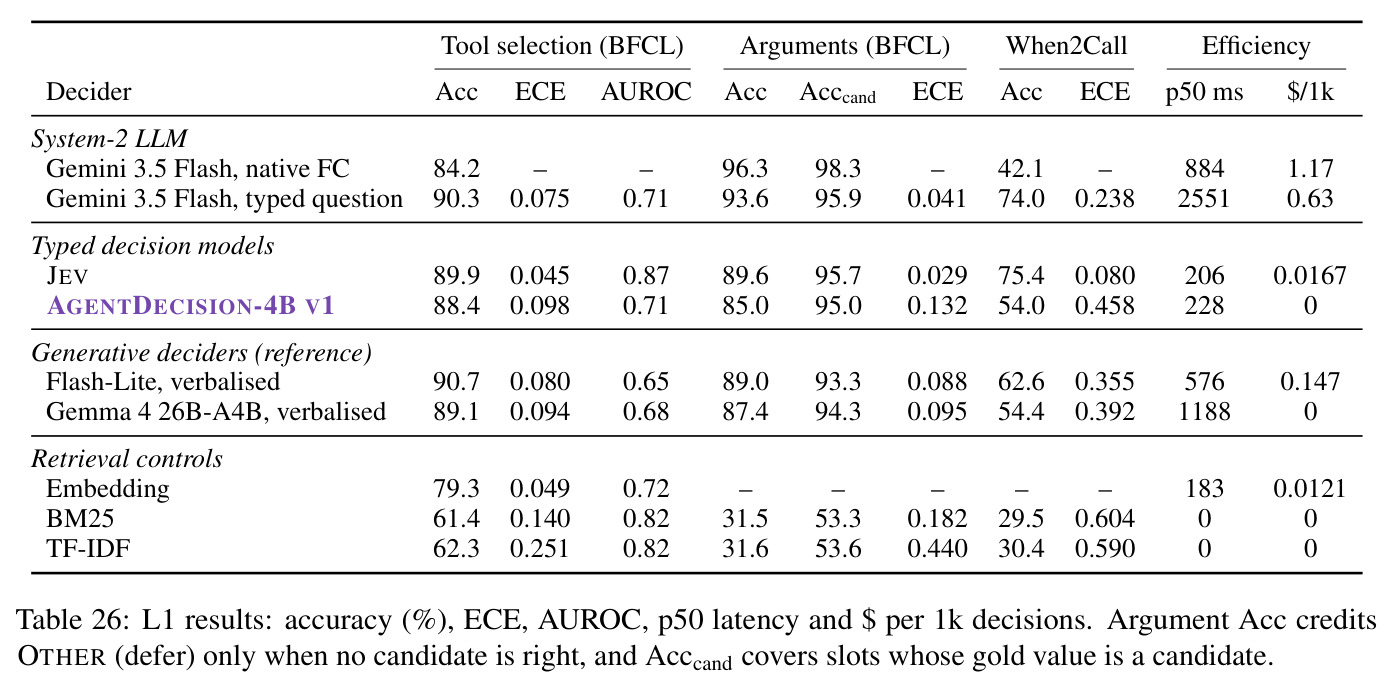
一类不做自由文本生成的小模型:输入状态、一个问题和选项列表,一次前向即返回每个选项的概率及置信度,例如专有的 JEV 与开源的 Intern-Decision、StartLux-Decision。一次调用约为一次 LLM 调用的 28% 时间与 2.6% 价格,中位延迟 31–223ms。
它是论文的主角:被三级评测检验、被 JevAgentHarness 部署、也被当作教师来蒸馏出 AgentDecision-4B。
置信度级联与阈值委托
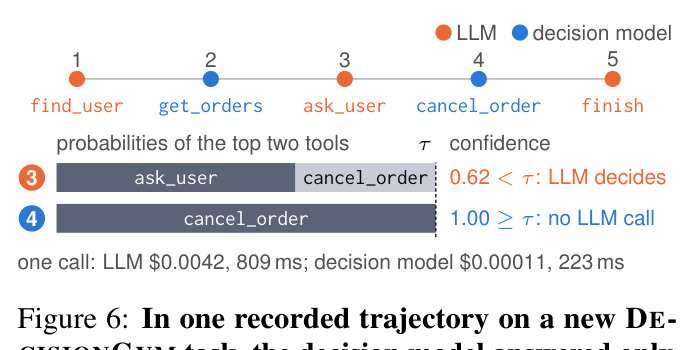
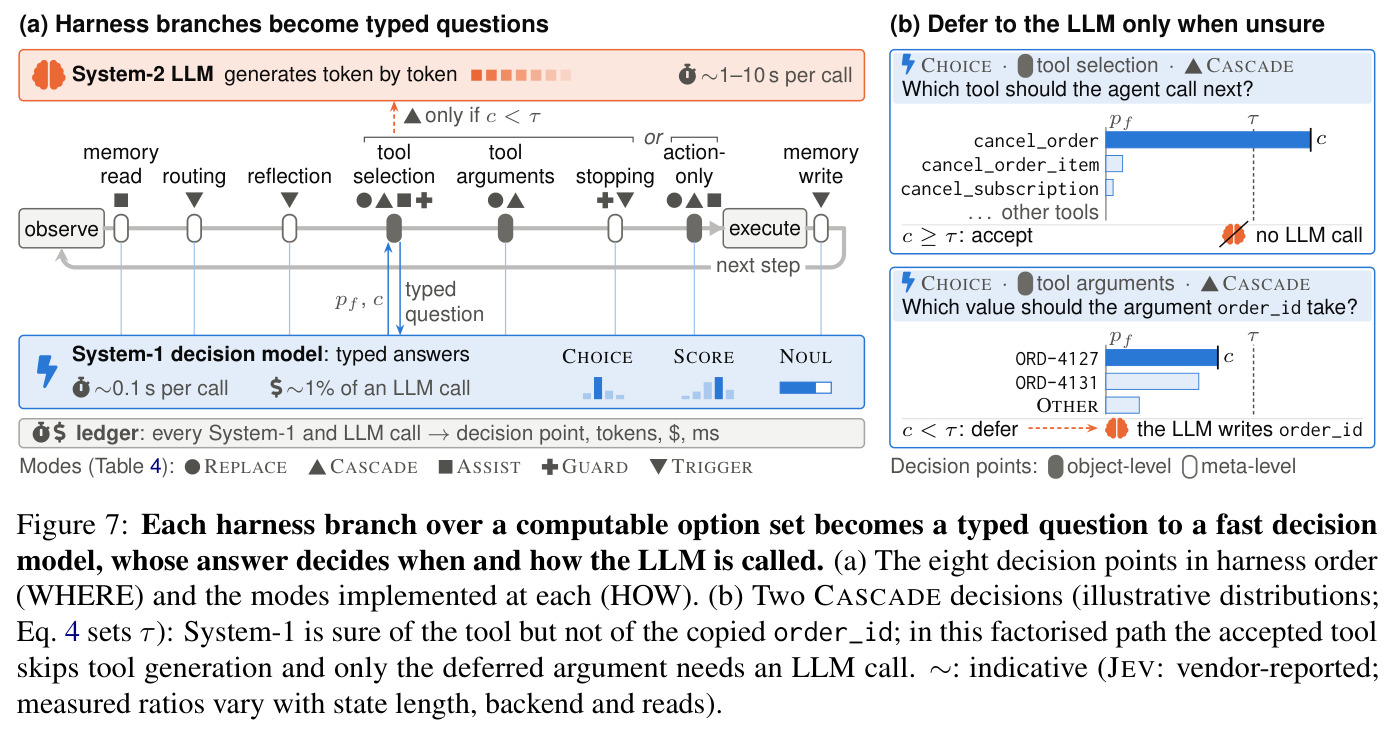
小模型先作答,若其置信度 $c(s)$ 超过阈值 $\tau$ 就采纳,否则回退大模型。论文证明校准假设下最优阈值为 $\tau^\star = \max(0, q_L - \Delta C / V)$,由大模型正确率 $q_L$、省下的调用费 $\Delta C$ 与错误代价 $V$ 共同决定。
CASCADE 是 JevAgentHarness 的核心模式;阈值按决策点逐个拟合还是全局固定,直接决定是省钱还是丢掉 21.5 分成功率。
非劣效性检验(non-inferiority test)
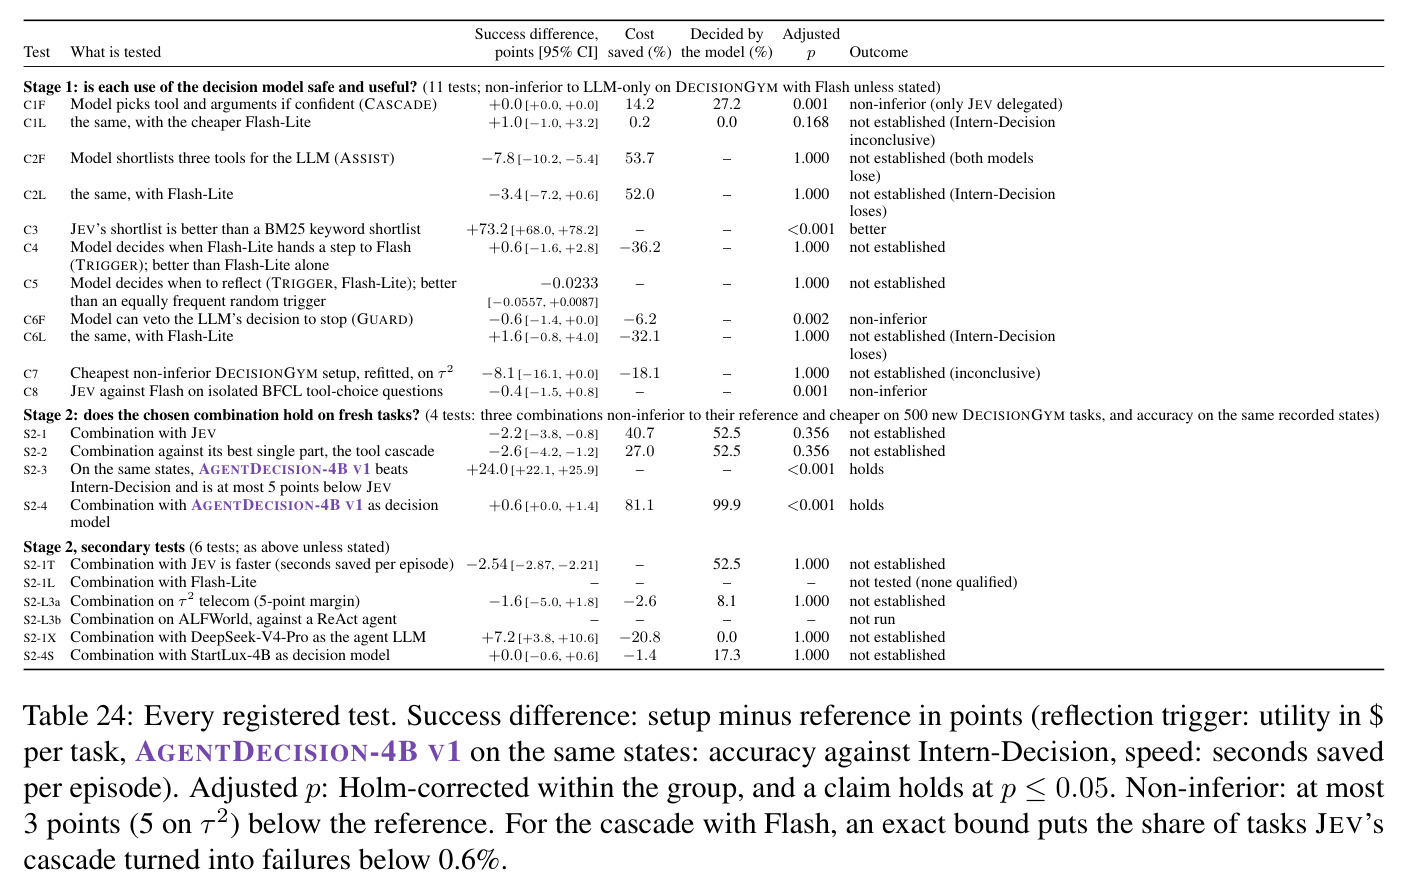
证明新方案不比对照差超过预设边际 $m$ 的单侧统计检验。本文用配对二分类端点、基于 Tango 精确得分检验,边际为 3 分(τ²-bench 上 5 分),并用 Holm 方法控制 11+4 个预注册检验的家族错误率。
论文所有「安全且更省」的结论都以非劣效 p 值为判据,不熟悉它就无法读懂 Table 24/27 中每个测试的通过与否。
LoRA SFT 与 GRPO
LoRA 是在所有线性层上加低秩矩阵的参数高效微调(本文 $r=32$、2 epochs、lr $10^{-4}$);GRPO 对每个任务采一组 $G=8$ 个 episode,用组内奖励归一化的相对优势做策略梯度并加 KL 惩罚。
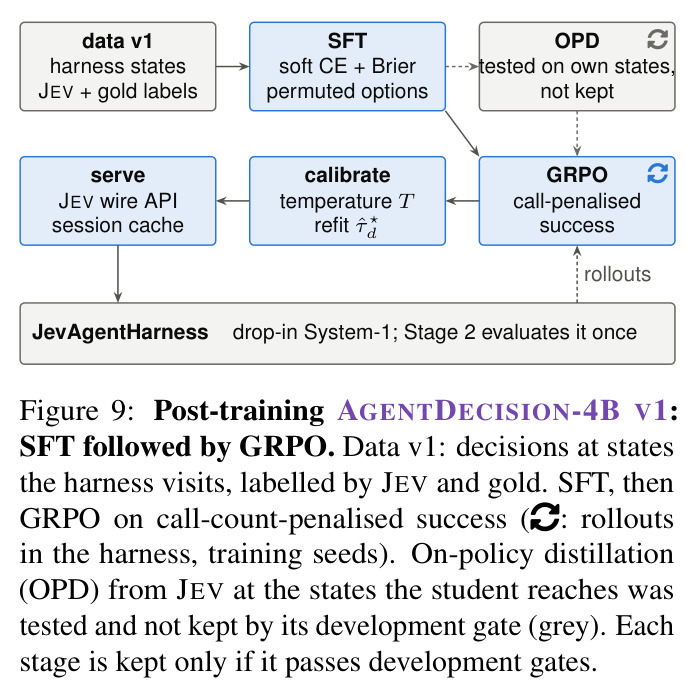
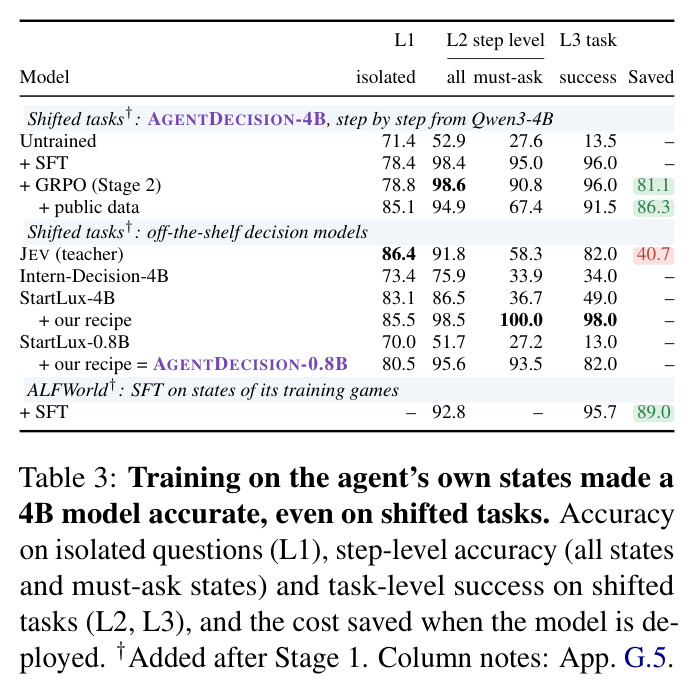
AgentDecision-4B 的配方就是先在 agent 状态上做 LoRA SFT、再叠 GRPO;论文的消融显示 SFT 贡献几乎全部增益而 GRPO 无可测增益,这是重要结论。
DAgger 与错误后状态(off-plan states)
模仿学习中的 DAgger 思想:让脚本策略故意复现已见过的错误,把学习器自己会走到的「错误之后的状态」纳入训练分布。本文用 near-miss 注入错误等手法,使 30.9% 的训练状态(15,694 个中的约 4,850 个)来自偏离标准计划后的恢复局面。
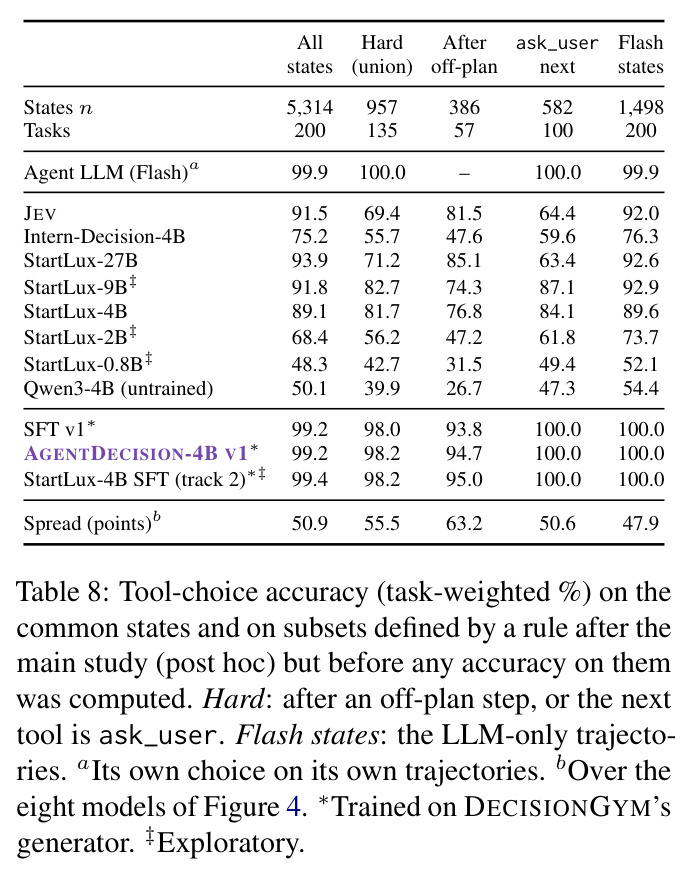
这是「在 agent 自身状态上训练」能产生质变的关键:现成决策模型恰恰在这种状态上大面积失手(must-ask 状态上 JEV 只有 58.3% 正确)。
研究动机
LLM 智能体已经能修软件、操作电脑、当客服,但代价高昂:主流 harness(Claude Code、Codex、OpenHands 等)在长任务的每一步都调用大模型,一次公共排行榜的完整评估约花费 40,000 美元。作者指出一个被忽视的结构性事实——这些调用的绝大多数最终只是一道多项选择题:客服场景里是「查订单、取消订单还是反问客户」,编码场景里是「下一步调哪个工具、参数填什么、是否停止」。与此同时,JEV 这类决策模型(及 Intern-Decision、StartLux-Decision 等开源同类)专门回答这类问题:给定状态、问题和选项,一次前向返回每个选项的概率,一次调用只占一次 LLM 调用约 28% 的时间和 2.6% 的价格。问题在于,这些决策模型都是在固定题集上构建和测试的,把它们放进一个正在运行的 agent 循环后是否仍然可靠从未被检验:agent 里一次错误选择会改变后续所有状态、错误会级联,而且 agent 会走进自己犯错之后的状态——这种状态在固定题集里几乎不存在。孤立题集上的高分能否预测 agent 内的真实表现,是完全未知的问题。
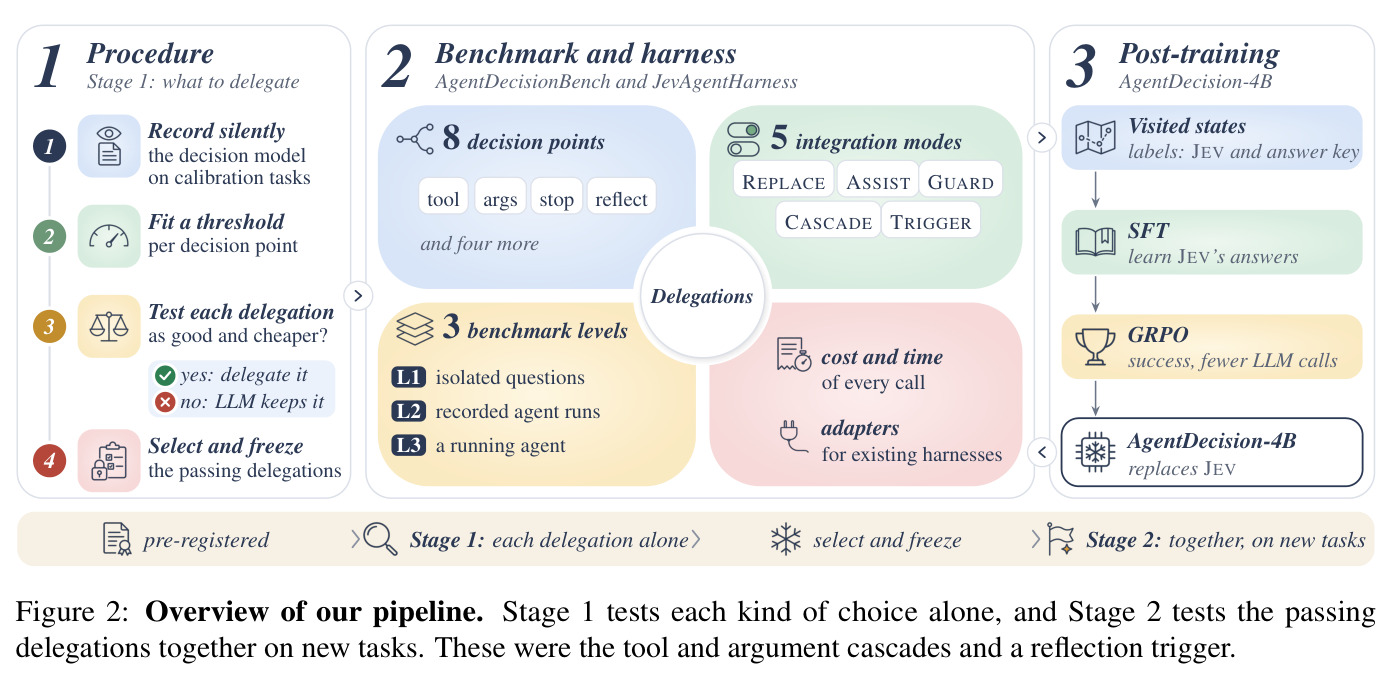
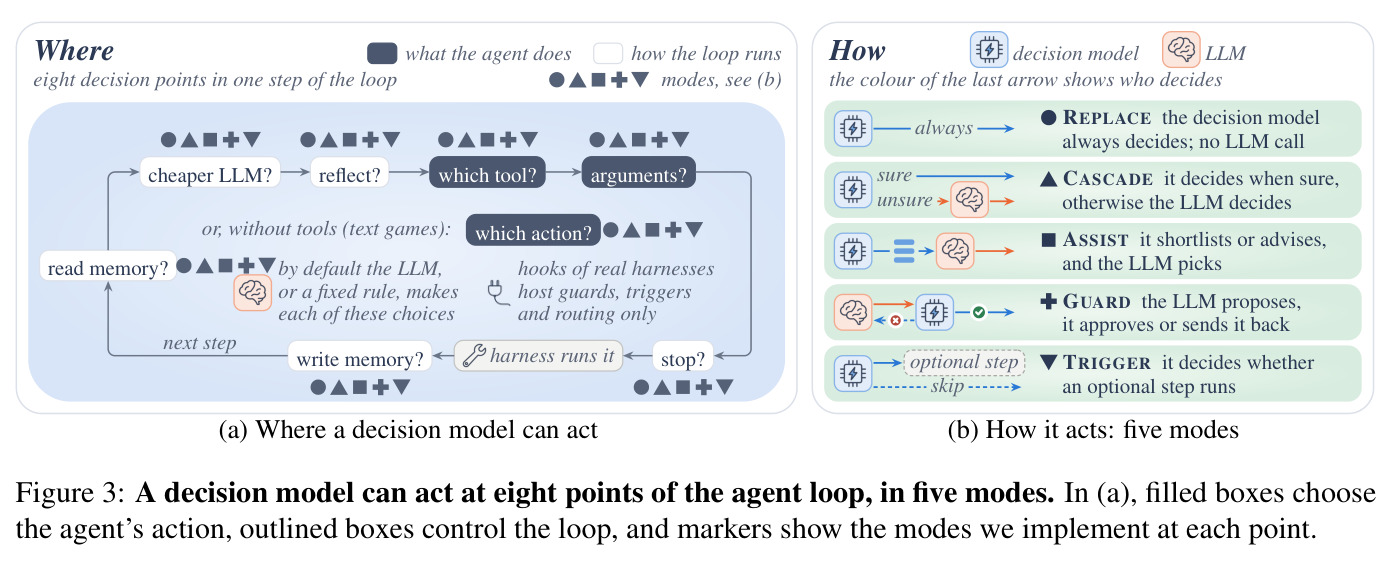
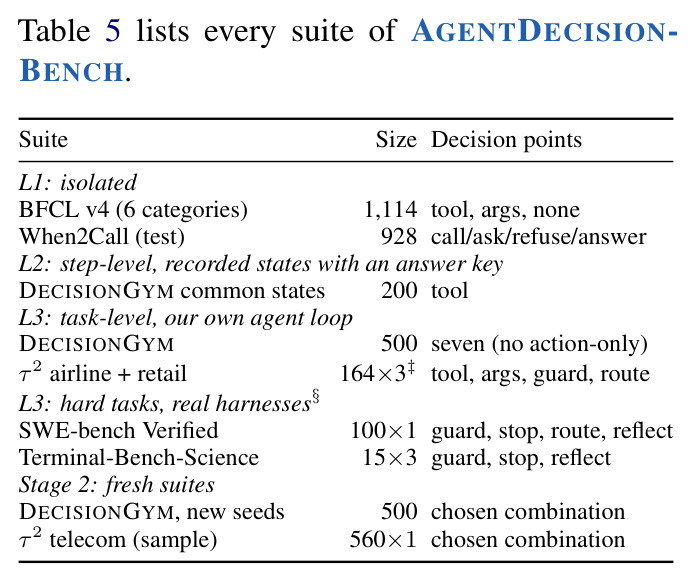
本文的目标是论文想回答一个部署导向的问题:harness 能否把常规选择题委托给快速、便宜的决策模型——当它可靠时交给它、拿不准时交回 LLM——从而让 agentic 任务更快、更便宜而几乎不损失成功率?为此作者交付三件东西。第一,能检验决策模型「进不进得了 agent」的基准 AgentDecisionBench,从孤立问题(L1)、记录轨迹的逐步评分(L2)到接管运行中的 agent(L3)逐级逼近真实使用,且每个调用都被计价计时。第二,不改代码即可插进现有 harness 的委托层 JevAgentHarness:把每个常规选择变成 typed 多项选择题,只在决策模型置信度超过按该 agent 自身轨迹拟合的阈值时才采纳其答案,并提供 REPLACE/CASCADE/ASSIST/GUARD/TRIGGER 五种集成模式。第三,开源的 4B 决策模型 AgentDecision-4B,在 agent 实际访问的状态(包括犯错后的状态)上以 JEV 答案为标签做后训练。成功判据被预注册为非劣效:任务成功率损失不超过 3 分(τ²-bench 上 5 分)的前提下成本显著下降。
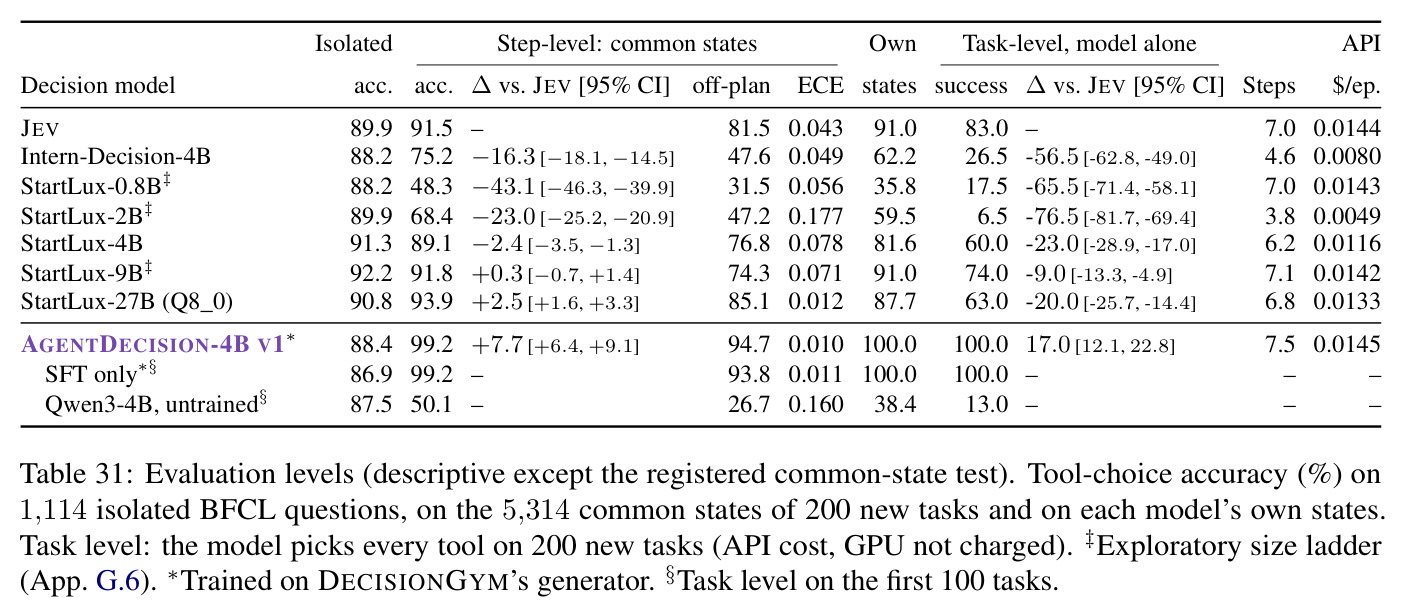
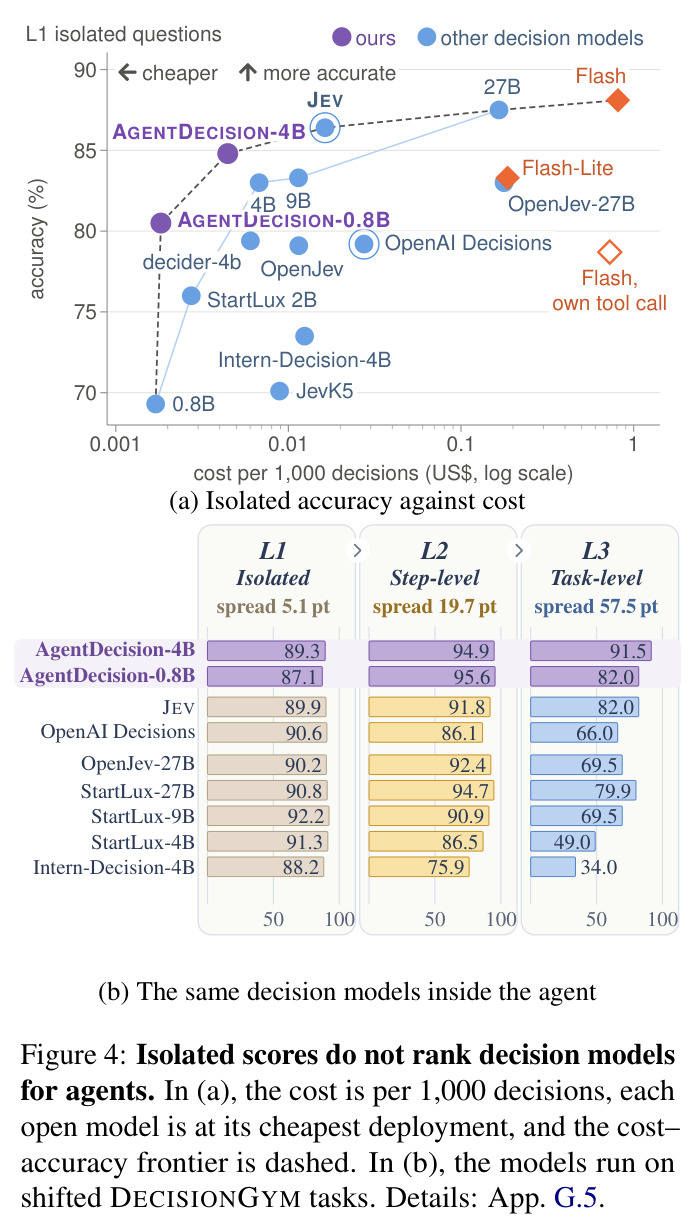
与已有工作不同的是,本文的切入角度与已有工作有三处不同。第一,测量层面的空白:路由器与级联(FrugalGPT、RouteLLM 等)把工作从大模型挪走时都在固定问题上评估,agent 基准又只报告整任务成败,没人量化「孤立分数」与「agent 内表现」的落差——本文用三级评测首次直接测出这个相关性:5 个预指定模型的孤立分数与任务级成功率的 Kendall 秩相关仅 −0.200,扩大到 18 个模型后孤立分数对任务成功的秩相关只有 0.13,而步级准确率达到 0.84。第二,委托规则的粒度:REFLEX 等用单一全局阈值,本文按「哪个决策点」逐点拟合阈值,并给出理论最优值 $\tau^\star_d = \max(0, q_L - \Delta C/V)$——决策模型允许比 LLM 略差,只要省下的调用费覆盖多出的错误风险。第三,训练数据来源:现成决策模型学的是固定问题或成功示范,而 agent 循环会走到错误之后的状态;本文用 DAgger 式脚本注入错误,让 30.9% 的训练状态来自 off-plan 局面,这是把 System 1 真正接入某个具体 agent 的关键一步。
核心方法
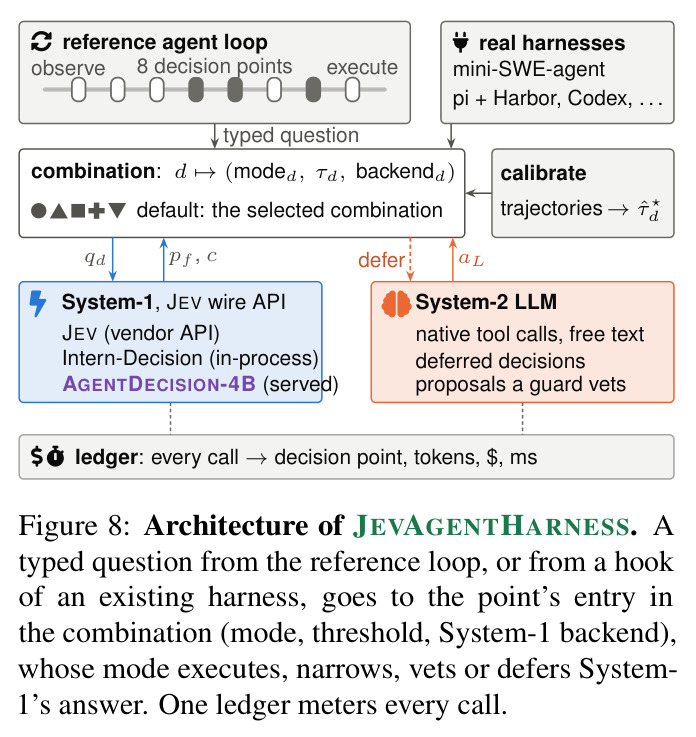
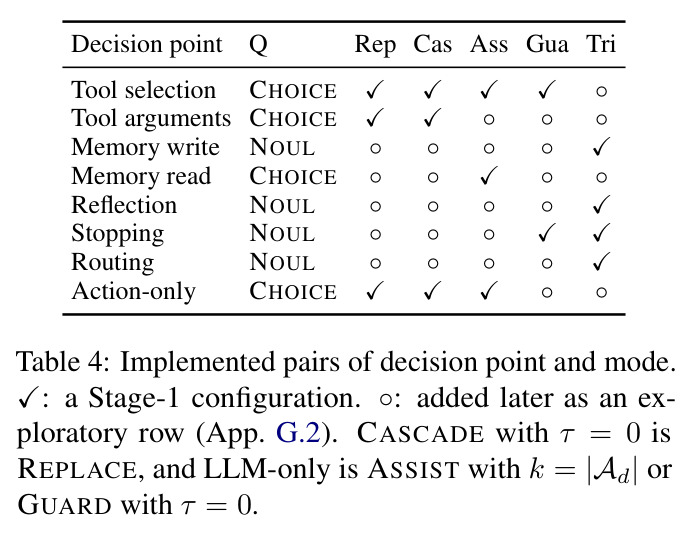
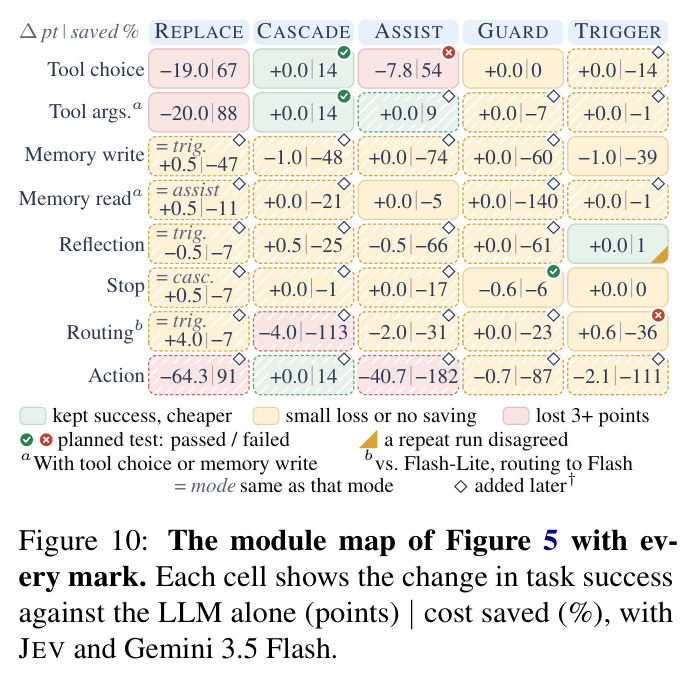
直觉上是 Kahneman「快与慢思考」的工程化:LLM 是慢而贵的 System 2,决策模型是快而便宜的 System 1;harness 知道每步的候选清单,因此能决定每道选择题交给谁。技术路线分三块。其一,基准:AgentDecisionBench 分三级——L1 把 BFCL v4 等约 4,000 个静态项变成孤立选择题;L2 在 200 个新 DecisionGym 任务的 5,314 个公共状态上逐步评分但不执行;L3 让决策模型接管运行中的 agent 做每次工具选择,错误真实传播。为此作者构建 DecisionGym:模拟小商店客服,68 个工具、模板生成请求、每个可达状态可派生答案键。其二,harness:JevAgentHarness 定义 8 个决策点 × 5 种模式共 40 种组合,以 YAML 声明,经 hook 适配 mini-SWE-agent、pi、Codex CLI 等。其三,模型:在 Qwen3-4B 上做 LoRA SFT + GRPO,数据是 587 个训练任务中 harness 实际访问的 15,694 个状态,评测遵循预注册两阶段协议。
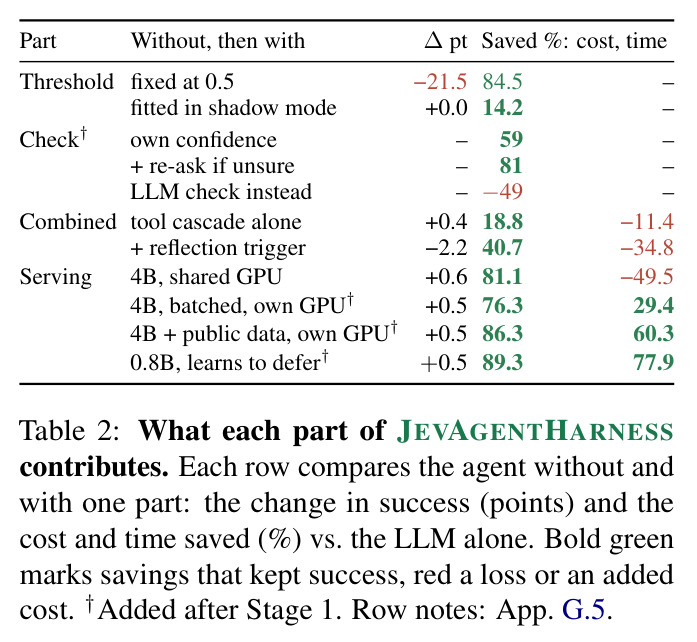
核心创新是「逐决策点的、在自身轨迹上校准的委托」,与已有工作的本质区别有三。第一,委托准则的形式化:若决策模型校准(置信度即正确率),把选择交给它当且仅当 $c(s) \ge \tau^\star_d$,其中 $\tau^\star_d = \max(0, q_L - \Delta C / V)$,$q_L$ 是 LLM 在该类选择上的正确率、$\Delta C$ 是省下的调用费、$V$ 是错误选择的代价。这意味着决策模型允许比 LLM 略差,只要省钱覆盖风险——固定阈值没有这个概念:实验中固定 0.5 丢 21.5 分,按此式拟合的阈值丢 0 分还省 14.2%。第二,训练分布的选择:不在固定题集上蒸馏,而是在「这个 agent 会走到的状态」上训练,并注入错误覆盖恢复状态;仅 SFT 就把 Qwen3-4B 移位任务的步级准确率从 52.9% 拉到 98.4%、must-ask 从 27.6% 到 95.0%。第三,统计纪律:Stage 1 十一个测试、Stage 2 四个测试全部预注册并用 Holm 校正,组合由事先固定的规则选出,让「哪些委托被证明安全」可核查。
方法步骤详情
方法分六步。第一步定义接口:8 个决策点(工具、参数、记忆、反思、停止、路由、动作)各有可枚举选项,并按五种集成模式接入(全权、自信才采纳、短名单、审批、触发)。第二步拟合阈值:在 150 个校准任务上让模型对每步默默作答,从 LLM-only 轨迹估计 $q_L$、$\Delta C$、$V$,按置信度分箱取合格最低置信度 $\hat{\tau}^\star$(JEV+Flash 拟合出工具 1.00、参数 0.99)。第三步构造 typed 问题:工具调用拆成工具选择与逐参数选择,自由文本留给 LLM。第四步做适配器:接入 mini-SWE-agent、pi、Codex CLI 与 Claude Code,故障时按原样运行。第五步训练 AgentDecision-4B:在 587 个任务的 15,694 个访问状态(30.9% 为错误后状态)上做 LoRA SFT,标签以 0.3 权重混合 gold 与教师概率,交叉熵加 Brier 校准项;再以 $G=8$ 的 GRPO 续训。第六步评估:Stage 1 逐个检验委托,Stage 2 在 500 个新任务上验证组合。
技术新颖性
技术新颖性可从四个层面看。测量层面:三级评测本身是贡献,把「孤立准确率会误导部署决策」变成可复现的量化结论——孤立与任务级排名的 Kendall 秩相关为 −0.200 乃至 0.13,步级准确率则达 0.84,直接指明「该测什么」。理论层面:命题 1 给出校准假设下最优阈值的闭式解,并说明过自信模型需抬高阈值 $\xi$;命题 2 给出守卫/触发器期望增益 $\Delta U = n(B_M+H_M)\pi(1-\pi)J - \kappa$ 只随分辨率 $J$ 增长,解释了守卫类模式为何普遍不省钱。系统层面:把 40 种「决策点 × 模式」组合放在统一成本账本下比较,经 hook 适配五个真实 harness,是首个对委托设计空间的系统性测绘。训练层面:消融干净地分离了各成分——SFT 只花 2.2 GPU 时就贡献几乎全部增益,GRPO 再加 4.5 GPU 时无可测增益(无 SFT 时甚至把移位任务成功率从 13.5% 拉低到 11.5%);公开工具数据把孤立准确率从 78.8% 提到 85.1% 却把移位任务成功率从 96.0% 降到 91.5%,这些负结果同样有参考价值。
实验结果
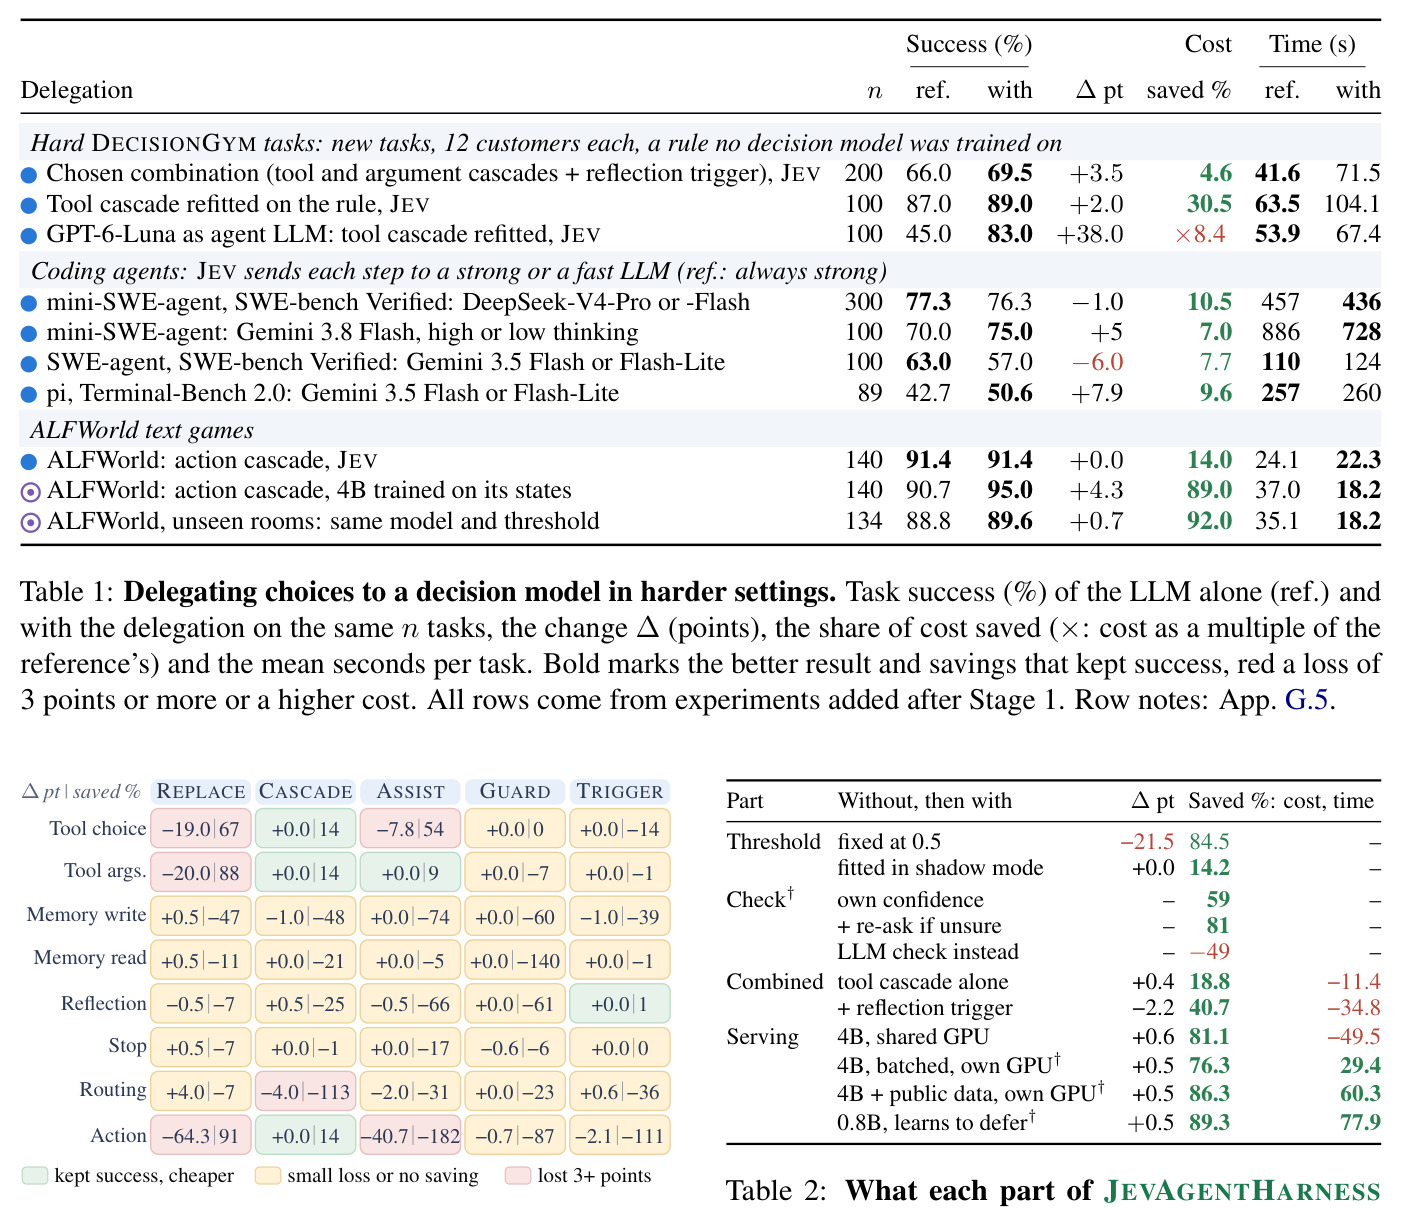
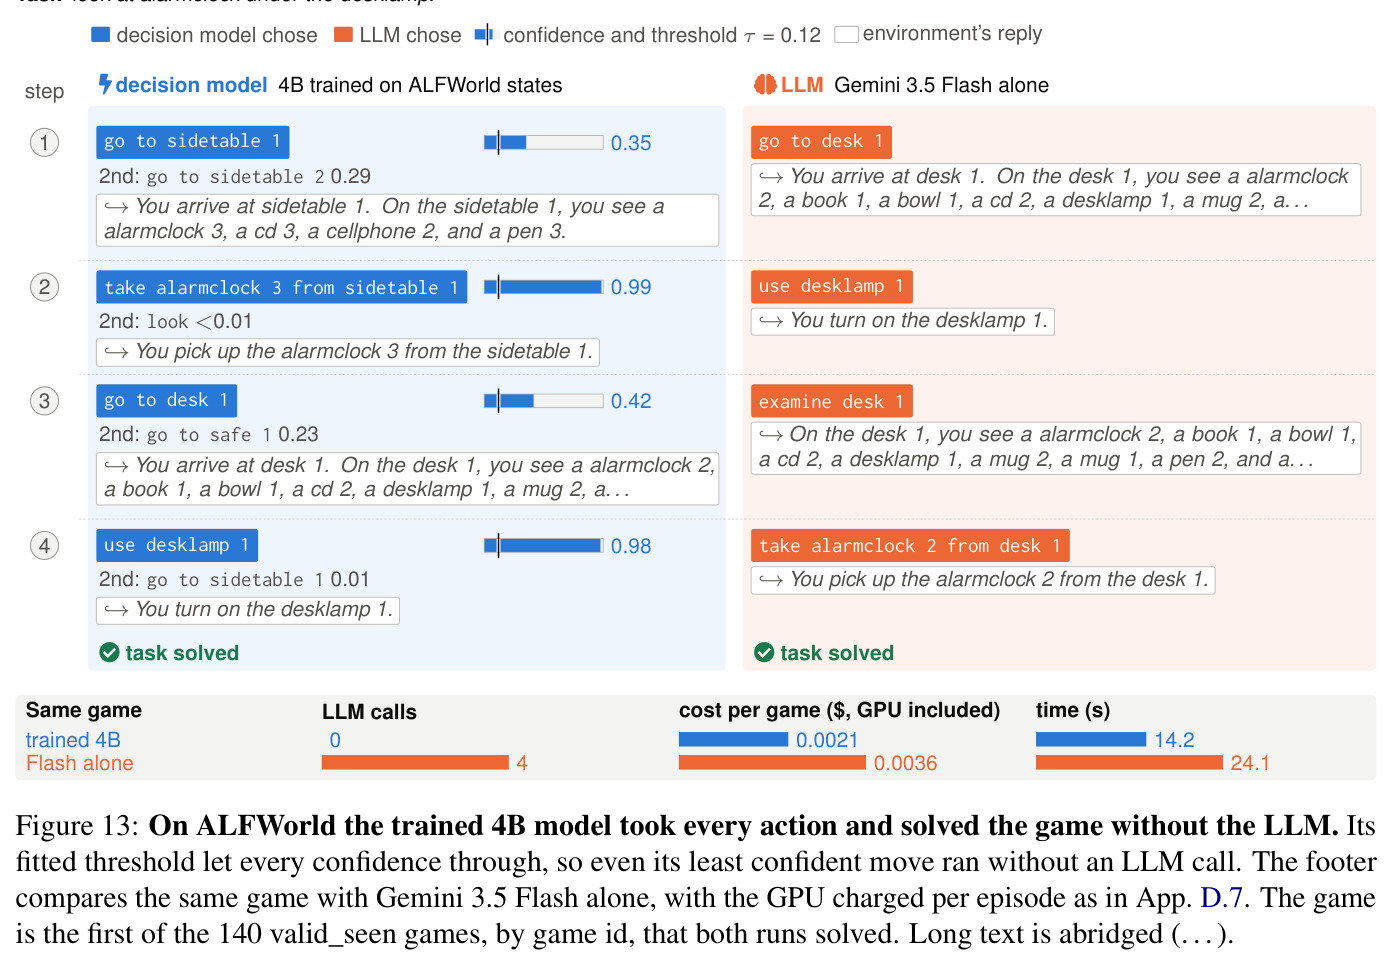
核心发现:RQ1(孤立分数误排)StartLux-9B 孤立最准(92.2%)却只解出 69.5% 任务;AgentDecision-4B 孤立仅 89.3%,任务级却达 91.5%(JEV 82.0%);差距集中在必须先问的状态(4B 67.4%,JEV 58.3%)。RQ2(阈值保护成功)CASCADE 接下 27.2%/20.8% 的工具与参数选择,省 14.2% 成本、500 任务无一改变;REPLACE 丢 19.0 分、固定阈值丢 21.5 分。RQ3(部署收益)500 新任务上成功 100.0%(LLM-only 99.4%)且省 81.1%;自托管时便宜 86.3%、快 2.5 倍;ALFWorld 上 4B 便宜 89.0% 且成功率 90.7%→95.0%;编码 agent 仅省 7–10.5%。RQ4(自身状态训练)SFT 把移位任务步级准确率 52.9%→98.4%、任务级 13.5%→96.0%。失败模式:JEV 的 34 个失败全始于不可逆错误选择;Hard 新规则上未重训 4B 崩到 3.0%,重拟合再训后恢复;τ² 迁移未获证明。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DECISIONGYM 500 个新任务(Stage 2 组合:工具/参数级联 + 反思触发,AgentDecision-4B 作决策模型) | 任务成功率 / 成本节省 | 100.0%,成本省 81.1% | LLM-only(Gemini 3.5 Flash)99.4% | 成功率 +0.6 分且非劣效成立,成本省 81.1% |
| DECISIONGYM 部署形态(AgentDecision-4B + 自己 GPU,500 新任务) | 成本节省 / 加速比 | 便宜 86.3%、快 2.5 倍;单答案中位 31ms | LLM-only Flash(单次调用 809ms) | 成本 −86.3%、时间 −60.3%,无 3 分以上损失 |
| ALFWorld valid_seen 140 局(动作级联,4B 在其自身状态上 SFT) | 任务成功率 / 成本 | 95.0%,省 89.0% | Flash alone 90.7% | +4.3 分,成本省 89.0%(unseen rooms 89.6% vs 88.8%,省 92.0%) |
| 移位 DECISIONGYM(工具改名 + 措辞重写 + 129 选项) | 任务级成功率 | AgentDecision-4B 91.5%(SFT+GRPO 版 96.0%) | JEV 82.0%;未训练 Qwen3-4B 13.5% | 对 JEV +9.5 分,对未训练基线 +78 分以上 |
| BFCL v4 工具选择(L1 孤立问题) | 孤立准确率 | StartLux-9B 最高 92.2% | AgentDecision-4B 89.3% | 但任务级反转:StartLux-9B 仅 69.5% vs AgentDecision-4B 91.5%,孤立分数误排 22 分 |
| pi + Terminal-Bench 2.0(JEV 强/快路由) | 成功率 / 成本 | 50.6%,省 9.6% | Flash alone 42.7% | +7.9 分,成本省 9.6%(非劣效在 3 分边际内成立) |
| mini-SWE-agent + SWE-bench Verified(强/快路由) | 解决率 / 成本 | DeepSeek 路由 76.3%;Gemini 3.8 Flash 路由 75.0% | 强模型 alone 77.3% / 70.0% | 成本省 10.5% / 7.0%,非劣效未确立 |
局限与改进
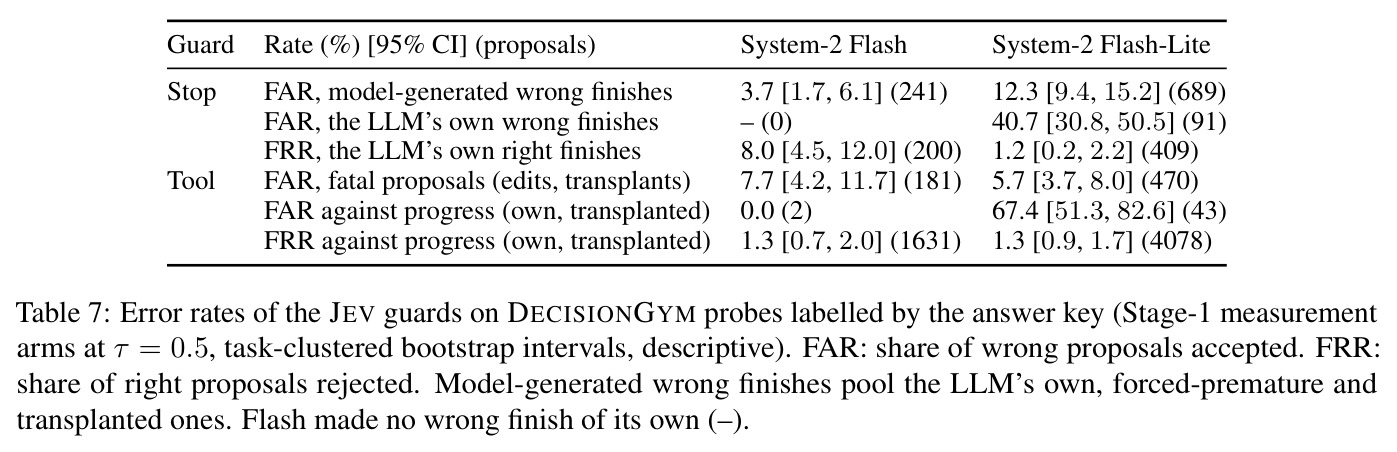
作者坦承的限制:任务与提示几乎全是英文,agent LLM 主要是 Gemini 系列;主检验是非劣效检验(3 分边际),证明「完全无损失」需等效检验;阈值与模型绑定特定 agent 的轨迹,换 agent、工具或任务族都要重新拟合甚至重训(τ²-bench 迁移未获证明);编码 agent 动作是自由文本,决策模型只能选哪档 LLM 写这一步,节省压缩到 7.0–10.5%;未与 RouteLLM 等学习型路由器同任务对比;GRPO 无可测增益;未测试对抗观察或提示注入(已知能翻转 typed 答案)。我的补充观察:DecisionGym 由模板生成,按「任务族+已执行工具」查表的模板基线就达 85.2% 公共状态准确率,训练模型 in-domain 高分部分反映生成器约定;LLM-only 在标准 DecisionGym 成功率高达 99.4%,迫使主结论依赖额外构造的 Hard/Shifted 设置;成本节省对 GPU 计费敏感(共享 82.1% vs 专用 76.3%);Flash-Lite 停止守卫放行 40.7% 错误终止尝试,安全关键路径不能只靠决策模型守卫。
独立分析的弱点
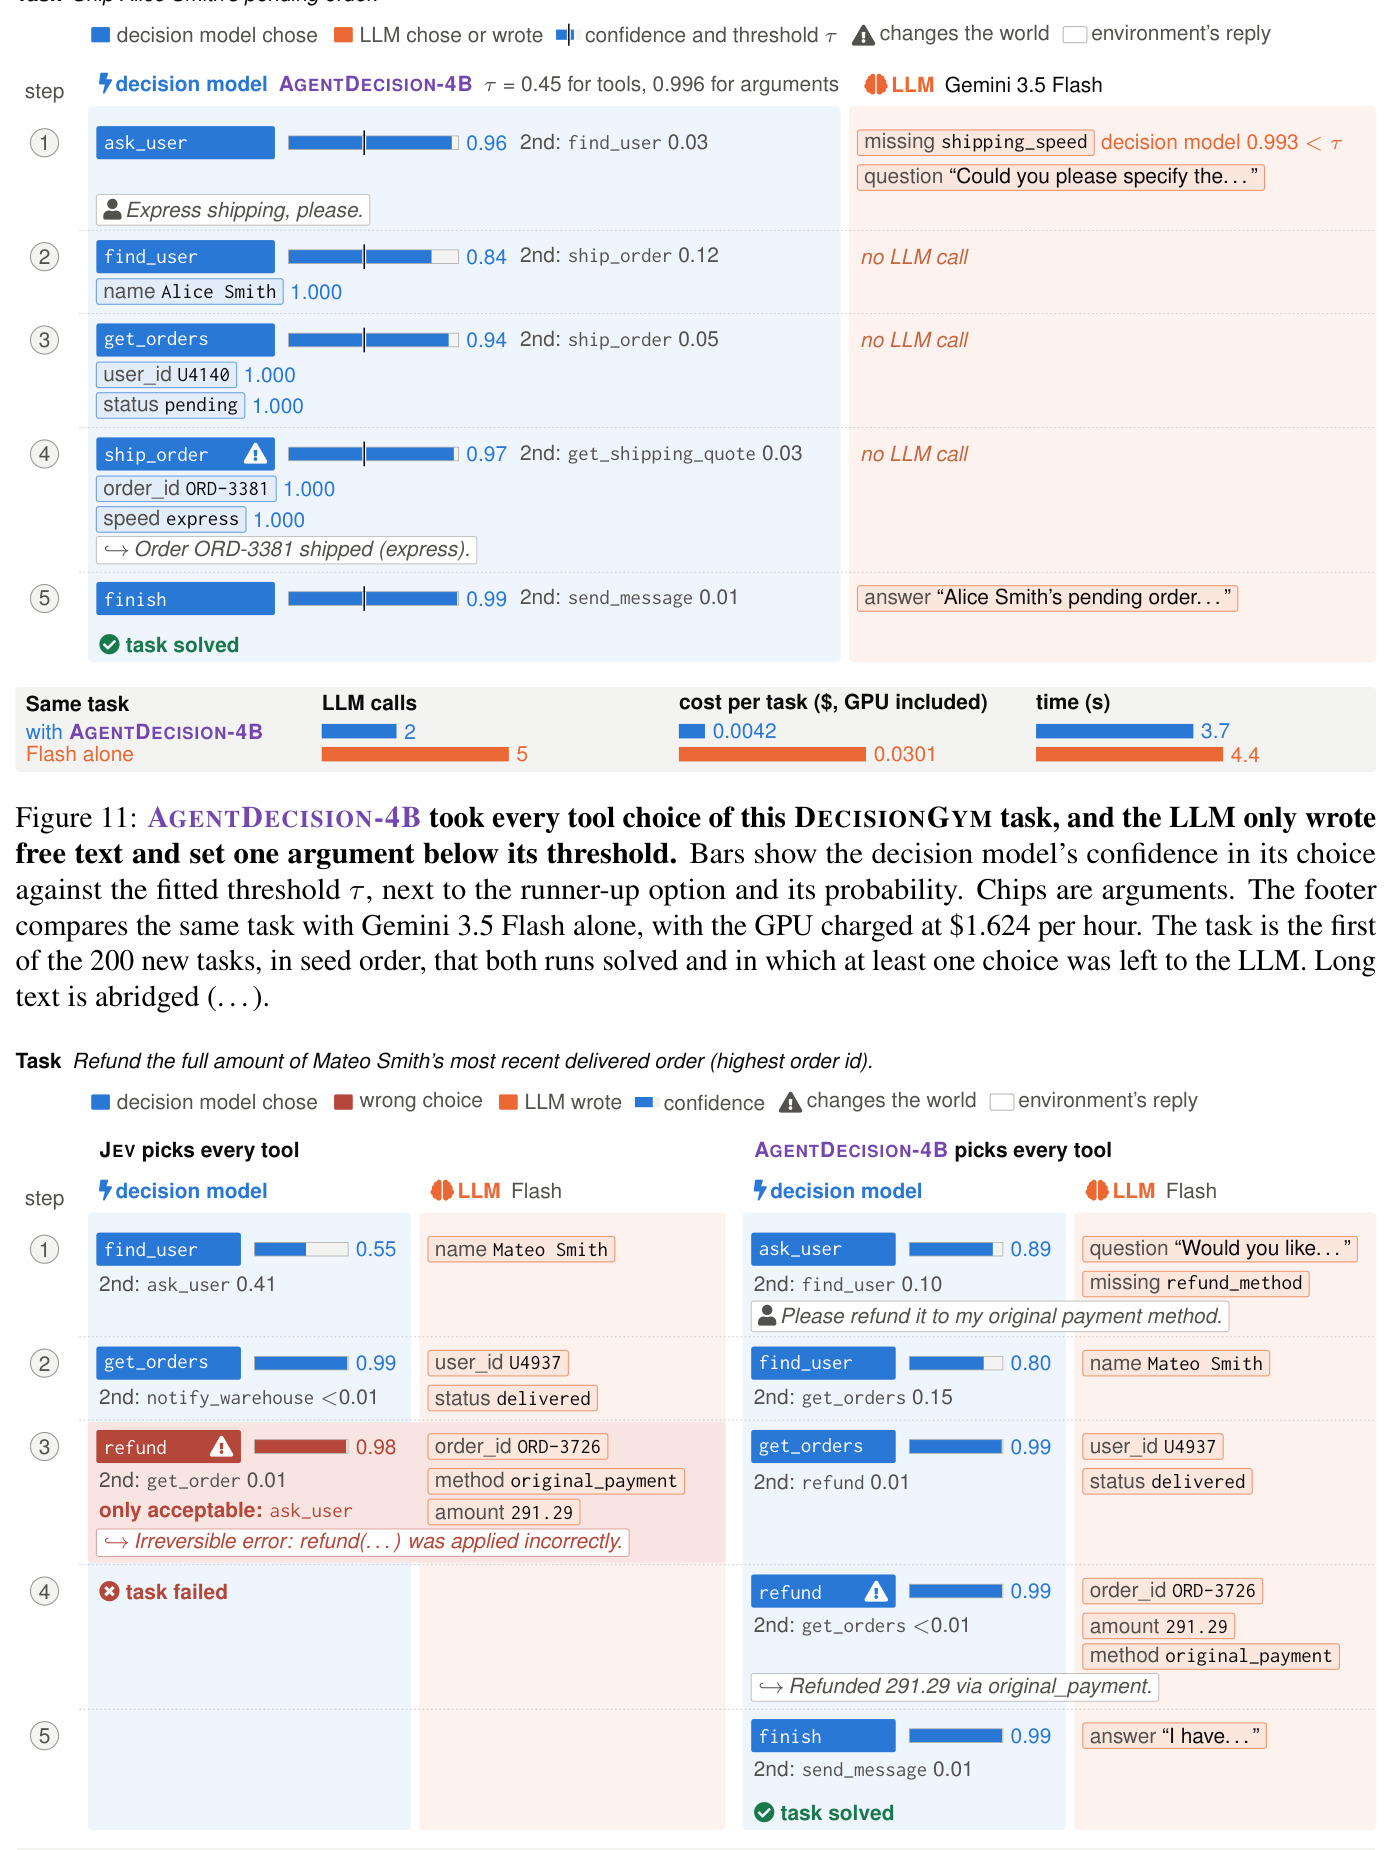
独立分析后有五个弱点。第一,表面记忆风险:0.8B 评分头在改名移位任务上从约 99% 掉到 17.5%,恢复原名后又能答对同一批状态的 95.1%,说明它学到的主要是生成器命名约定而非决策;4B 虽稳(移位后 94.0%),但在全新计划形状上仍落后 11.5 分。改进:不变性增强、跨生成器混合训练。第二,不可逆动作上的自信错误:JEV 该问不问时以 0.98 置信度直接退款,Flash-Lite 停止守卫还放行 40.7% 的错误终止尝试;改进:状态变更强制 LLM 复核,或用 conformal risk control 给保证。第三,维护成本:Hard 新规则曾把未重训模型的任务成功率打到 3.0%,恢复需重拟合阈值并追加 SFT;改进:覆盖率监控自动触发重拟合。第四,RL 无增益:GRPO 多花 4.5 GPU 时与 26.53 美元无可测收益,75% 的任务组八集奖励全同;改进:更细粒度步骤奖励。第五,自由文本场景收益有限:编码 agent 只能做路由,决策模型几乎分不清「只读」与「会写」步骤(AUROC 0.56–0.70);改进:把编辑决策结构化到文件/函数粒度。
未来方向
作者明确提出的方向:部署中跟踪「置信度超过阈值的答案占比」来发现任务漂移并及时重拟合阈值;用 conformal prediction 或有限样本风险控制替代当前 plug-in 阈值;把评测扩展到其他语言与其他 agent LLM;覆盖决策模型角色表中尚未触及的位置——重试与回溯、子 agent 调度与规划、上下文压缩、并行批处理;以及与学习型路由器在同一成本账本下公平对比。基于论文成果可以自然延伸的方向:其一,主动学习闭环——把低置信或被 LLM 否决的状态回流为标注数据,让 AgentDecision-4B 持续适配具体部署;其二,把「逐决策点拟合阈值」推广为在线贝叶斯更新,处理价格与 LLM 正确率随时间的漂移;其三,安全体系设计——论文显示守卫的 FAR/FRR 都不理想,值得研究决策模型守卫与确定性策略引擎、人工审批的分层组合,明确决策层只是成本/速度控制而非安全边界;其四,把配方迁移到多 agent 编排与计算机使用类 agent(OSWorld 一类环境),那里有更多可枚举的元级决策;其五,理论侧把命题 1/2 扩展到错误在步骤间相关、代价非加法的情形。
复现评估
可复现性总体很好。作者承诺发布基准代码与配置、JevAgentHarness 及全部适配器、后训练配方、种子和评测代码;权重与数据按上游条款发布——从 JEV 或 Gemini 输出衍生的权重取决于提供者条款,StartLux 为 CC BY-NC 4.0,Unsloth 代码为 AGPL-3.0。算力门槛低:所有训练都在单张 48GB GPU 完成,SFT 2.2 GPU 时、GRPO 4.5 GPU 时,AgentDecision-4B V1 训练加校准共 192.93 美元,按部署节省约 5,759 个 episode 回本;整项研究 API 总支出 2,383.27 美元。DecisionGym 全由模板生成、种子严格分离,复现数据成本几乎为零。需要注意的坑:JEV 是闭源 API,复现教师相关数字需付费且价格会漂移;大量结论基于每任务单次运行、温度 0,缺多种子方差;作者还披露一次暴露事件(训练者在结果封锁前看过一条 Stage-1 轨迹首记录),建议把相关两个 Stage-2 测试按探索性对待。对有单卡和少量 API 预算的团队,复现核心结论属中等偏低难度。
论文图表
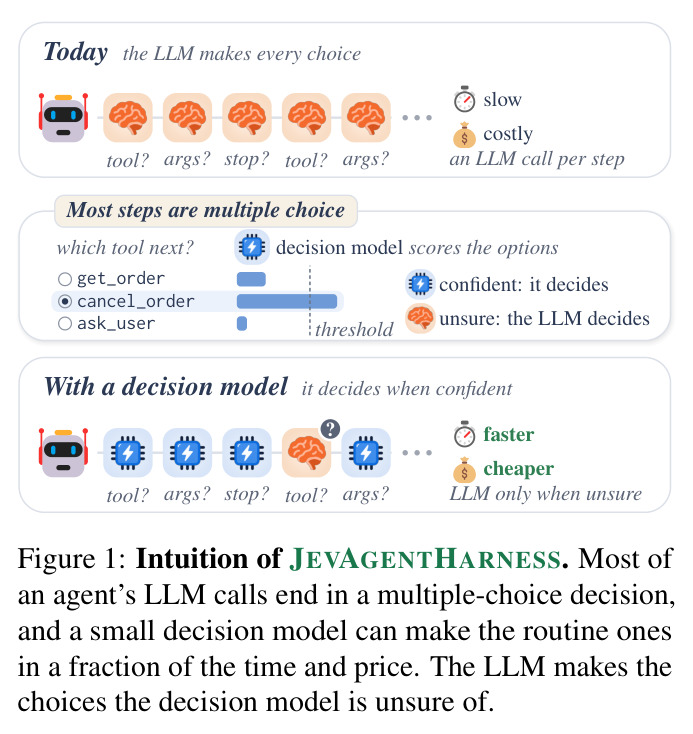
示意图对比两种运行方式:传统 harness 每一步都调用大 LLM(慢、贵),而大多数步骤其实是「选哪个工具/参数/是否停止」的多项选择题;引入决策模型后,置信时由小模型直接决定(快、便宜),不确定时才回退到 LLM。图中还给出核心量级:一次 JEV 调用约为一次 LLM 调用 28% 的时间、2.6% 的价格。
这是全文的核心直觉图,一图讲清 System 1/System 2 分工与置信度回退机制,是理解后续所有设计与实验的入口。
同一退款任务两个模型对照:JEV 查完用户与订单后以 0.98 的置信度直接调用 refund(而答案键规定此刻唯一可接受的是 ask_user),LLM 还替客户编造了退款方式,任务失败;AgentDecision-4B 第 1 步以 0.89 置信度选择先问客户,随后顺利完成;Flash alone 同样靠先问解决。
它可视化最危险的失败模式——不可逆步骤上的自信错误(JEV 全部 34 个失败任务都由此开始),并说明在 agent 状态上训练为何能消除这类错误。