野外环境中的Jev:Jev模型功能、应用与生态系统的数据驱动分析 Jev in the Wild: A Data-Driven Analysis of the Jev Model's Functionality, Applications and Ecosystem
基于2170个GitHub项目的实证分析,揭示Jev决策模型生态的爆发式增长与注意力错配
前置知识
Jev 及其三种接口(Choice/Noul/Score)
Jev 是 2026 年 9 月 15 日发布的快速、低成本决策模型:开发者用自然语言定义一个决策问题和候选输出,模型直接返回结果。它提供三种接口——Choice 在候选选项中做分类选择,Noul 做二元判断(是/否),Score 按预定义等级给输入打分。
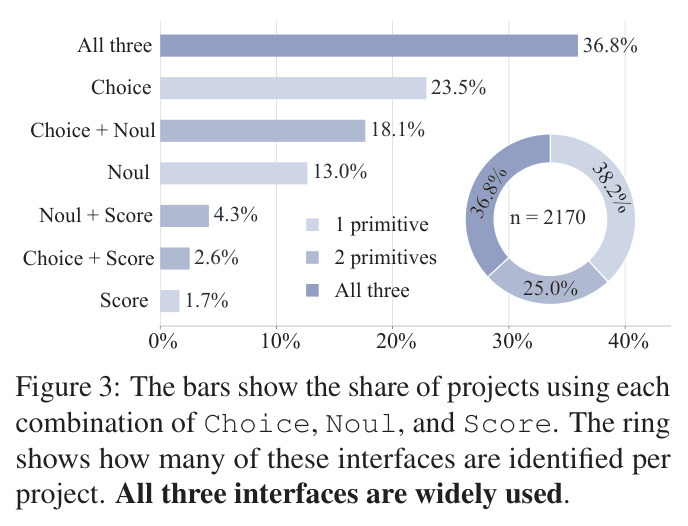
全文对 2,170 个项目的标注和统计都围绕这三种接口的采用率与组合方式展开,不懂三接口就无法理解图 3 和核心结论。
零样本泛化(zero-shot generalization)
指模型不经任务特定训练即可直接处理新任务的能力。传统监督分类器需要为每个任务收集标注数据并训练,标签空间一变就要重新收集和再训练;大语言模型则通过自然语言指令直接完成任务。
这是论文动机部分的立论基础:Jev 的定位就是结合 LLM 的零样本泛化与远低于自回归生成的延迟成本,理解它才能明白 Jev 填补的市场空档。
模型/工具路由(routing)
在多模型、多工具系统中,由一个轻量决策组件根据当前请求判断该调用哪个模型或工具。路由决策输出空间小但频率极高,因此对延迟和成本极其敏感,是决策类模型的典型应用场景。
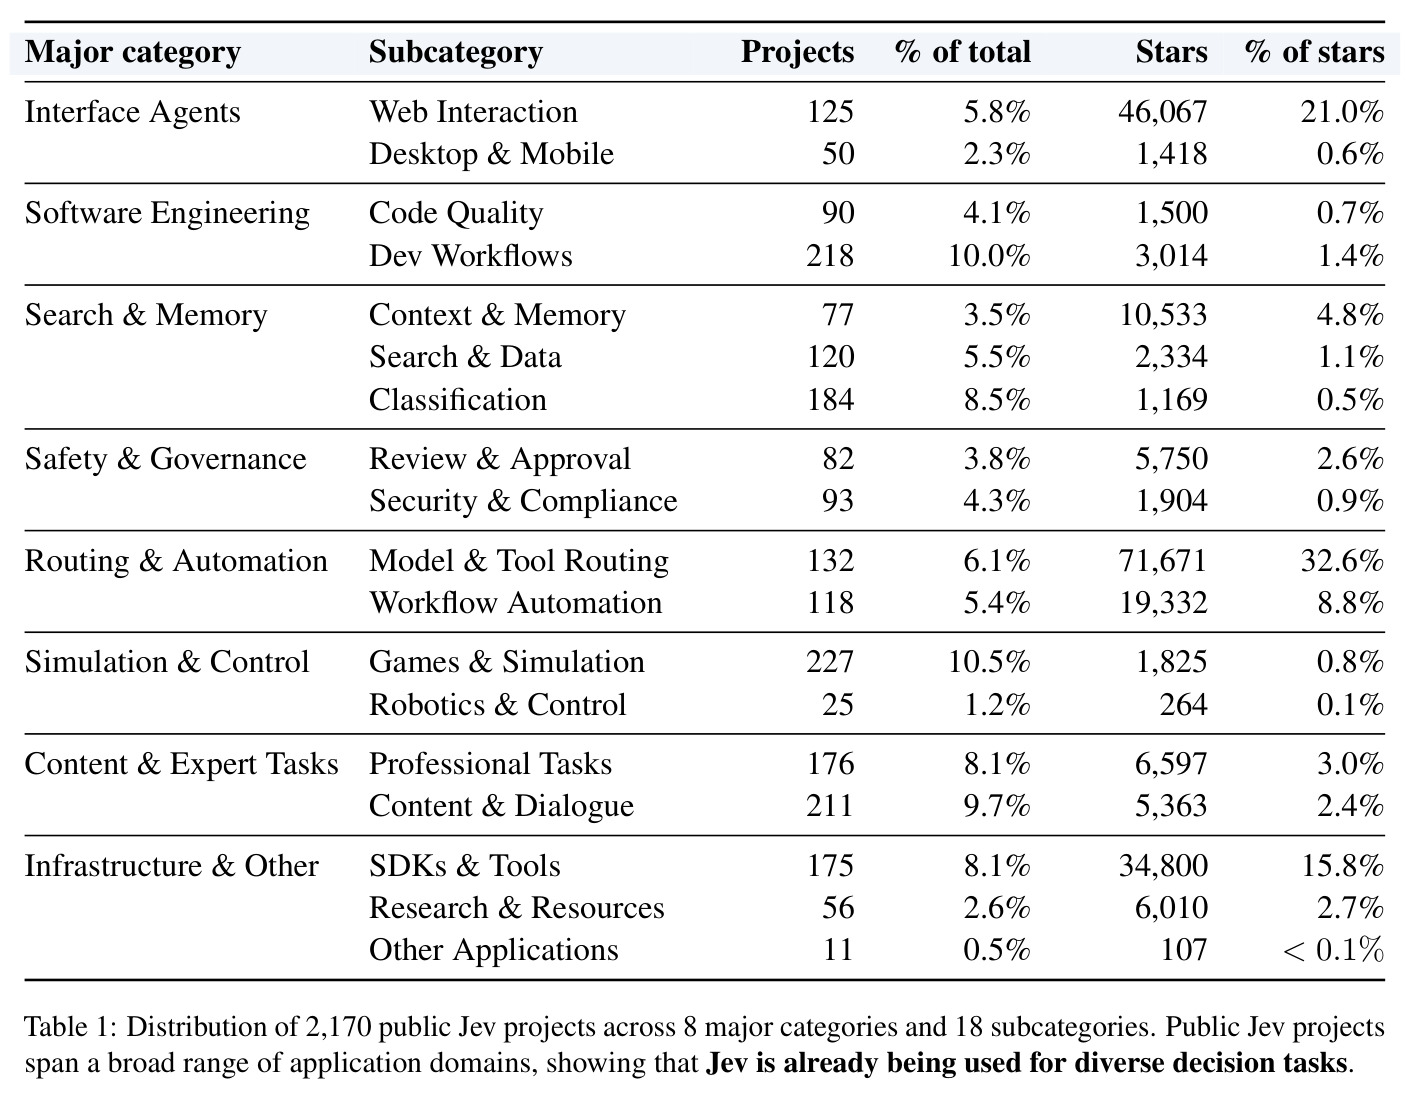
路由是本文最重要的发现之一:Model & Tool Routing 子类只有 132 个项目却拿走全部星标的 32.6%,理解路由的含义才能读懂注意力错配的结论。
GitHub Stars 与代理指标
Star 是 GitHub 用户对仓库表达兴趣的计数,常被用作项目热度的代理指标(proxy)。但它度量的是对整个仓库的兴趣,可能集中于少数明星项目,且受营销和曝光影响,并不能直接等同于使用量或需求缺口。
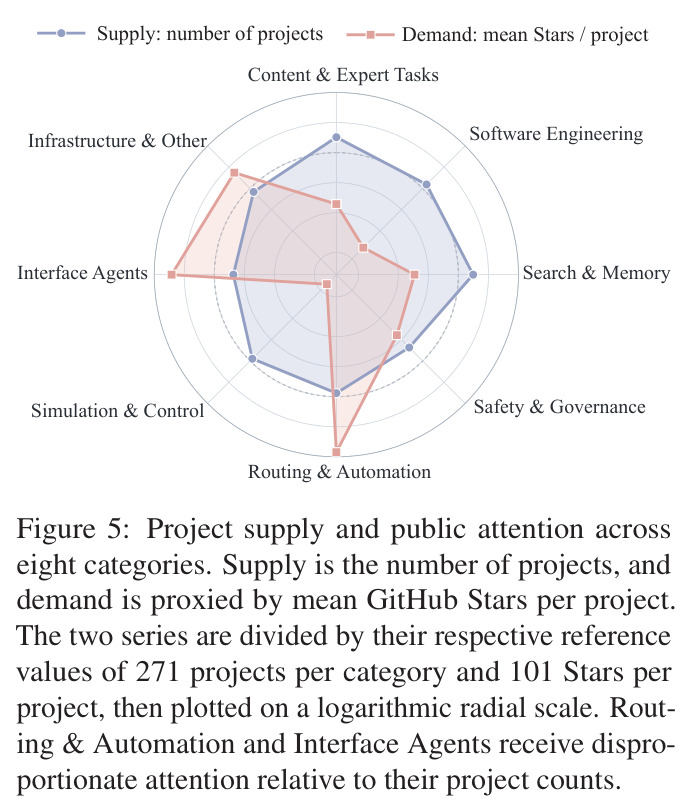
论文用项目数作供给、平均星标作需求代理来做供需对比,作者明确提醒星标反映的是可见度不均而非未满足需求,这是正确解读图 5 的关键。
研究动机
现代应用系统中大量存在频繁、轻量级的决策点:该走哪条分支、这段内容是否合规、给这个输出打几分、该调用哪个模型或工具。传统做法是为每个决策训练一个监督分类器,但这要求任务特定的标注数据与专门训练;更麻烦的是,一旦标签空间发生变化(比如新增一个意图类别),就必须重新收集数据并再训练模型。通用大语言模型虽然具备零样本泛化能力、免去了任务特定训练,但其自回归生成机制会引入可观的延迟与推理成本,对输出空间很小的简单决策而言是明显的浪费。Jev 正是针对这一空档设计的快速低成本决策模型:开发者用自然语言定义决策问题和候选输出,模型返回选项、二元判断或分数。它在 2026 年 9 月 15 日发布后生态急剧膨胀——一周内新增 1,865 个 GitHub 仓库、另有 305 个既有仓库集成、新增 43,750 颗星——但在如此快速的增长背后,它究竟在真实应用中被用来做什么、公众关注落在哪里,此前完全缺乏系统性的定量证据。
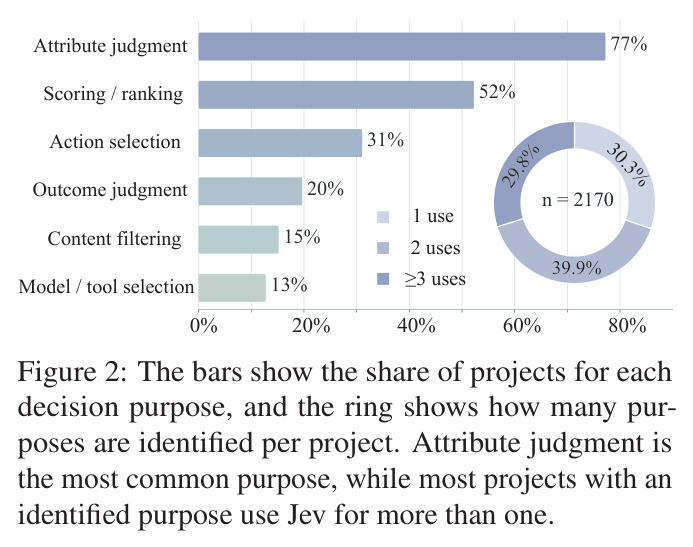
本文的目标是本文的目标是对 Jev 这个新兴决策模型的公开生态做一次大规模、数据驱动的定量解剖,回答三个递进的问题。第一,生态增长:模型发布后公开项目数量和 GitHub 星标如何随时间累积?第二,使用模式:这 2,170 个项目分布在哪些应用领域?Jev 在每个系统中承担什么决策目的(属性判断、评分排序、动作选择、结果判断、内容过滤、模型与工具选择)?三种接口 Choice、Noul、Score 各自和组合起来的采用率如何?第三,注意力对齐:以项目数为供给侧、以平均星标为需求侧代理,公众关注是否跟随项目数量的分布?通过这三问,作者希望为通用决策模型的功能设计(例如是否该同时支持选择、判断与评分)和评估基准的构造(是否覆盖了低可见度应用)提供实证依据。
与已有工作不同的是,已有研究基本沿两条线走:一是改进决策组件本身,如监督分类器或通用 LLM 的提示工程,关注模型在固定基准任务上的能力;二是宏观的 LLM 生态调查,但很少下沉到「某一个具体模型的第三方应用到底长什么样」这个粒度。本文的独特切入点恰恰是把「单一模型发布后形成的生态」本身当作研究对象:不问 Jev 有多聪明,而问它在 2,170 个真实仓库里被放在工作流的哪个位置、干了什么活。方法上它做了一个此前没人做的关键区分——把项目供给(一个领域有多少项目)与公众需求(星标如何分布)解耦、各自独立归一化后再对比——从而能量化「注意力并不跟踪项目数量」这一反直觉现象:Routing & Automation 与 Interface Agents 两个类别以 19.6% 的项目拿走了 63.0% 的星标。
核心方法
论文的方法本质上是一条「agent 辅助的生态普查流水线」,分三个阶段把 GitHub 上的原始仓库变成可分析的结构化数据集。第一阶段候选检索:用预定义的 GitHub 搜索查询(覆盖 Jev 相关关键词、API 端点与 SDK 引用)同时做仓库搜索和代码搜索,再用 GitHub 仓库 ID 去重,得到候选仓库集合。第二阶段项目验证:由一个 GPT-6 Luna Max agent 逐一检查候选仓库的公开代码与文档,只有当存在清晰证据表明 Jev 被用于某个具体任务时才纳入,仅提到 Jev、或只提供通用 wrapper/SDK 而无实际应用的仓库一律剔除。第三阶段标注:由 agent 为每个纳入项目标注主要应用领域、决策目的、接口使用等属性,其中关键纳入决策和应用领域标签由第二个 GPT-6 Luna Max agent 独立复核,出现分歧时回看原始仓库材料裁决。三个阶段最终产出 2,170 个已验证项目,随后在其上做增长趋势、用途与接口统计、以及供给-需求对比分析。
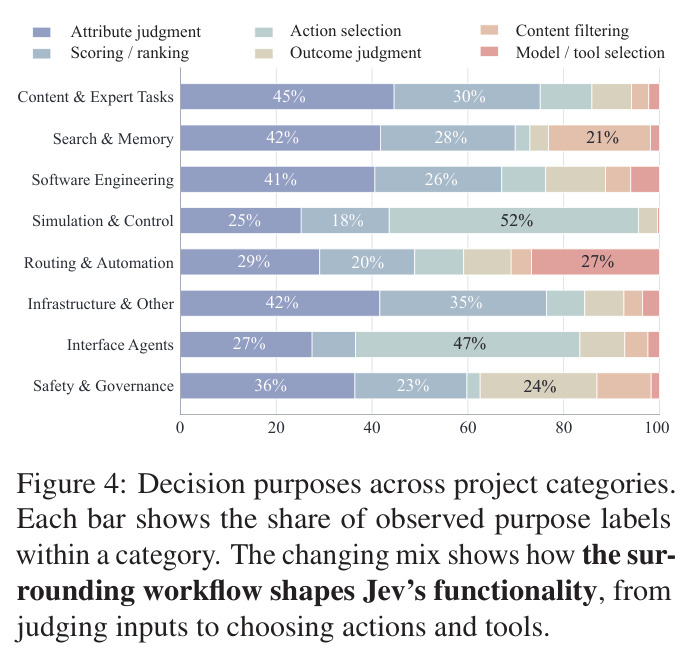
核心创新是把「生态学」的研究范式搬到了模型生态上:不是评测模型能力,而是给一个模型的全部公开应用做人口普查。为此论文设计了一套三维标注体系——应用领域(8 大类 18 子类,描述项目是做什么的)、决策目的(6 种,描述 Jev 在项目里扮演的角色)、接口采用(Choice/Noul/Score 的组合,描述用了哪些原语)——把「项目属于什么领域」与「Jev 在其中承担什么功能」解耦,这样才能发现「同一功能在不同领域占比迥异、而属性判断在 8 类中的 6 类都居首」这类结构性规律。第二个关键设计是供给-需求分离度量:项目数衡量供给侧,平均星标衡量需求侧代理,两组数值各自除以参考值(每类 271 个项目、每项目 101 颗星)后放在对数径向图上,偏离中心的距离直接暴露错配。这与以往把 star 数简单当作热度排名的做法有本质区别。
方法步骤详情
第一步,候选检索:输入预定义的 GitHub 搜索查询集合,覆盖 Jev 关键词、API 端点与 SDK 引用三类线索,同时使用仓库搜索与代码搜索两个入口,输出按 GitHub 仓库 ID 去重的候选仓库列表。第二步,项目验证:GPT-6 Luna Max agent 逐一审读候选仓库的公开代码与文档,判定标准是「是否有清晰证据表明 Jev 被用于具体任务」,仅提及 Jev 或只提供通用 wrapper/SDK 而无实际应用者剔除,输出已验证项目集合。第三步,标注:agent 为每个项目标注应用领域(8 大类/18 子类)、决策目的(属性判断、评分/排序、动作选择、结果判断、内容过滤、模型/工具选择,可多选)与接口使用(Choice/Noul/Score 的组合);关键纳入决策与领域标签由第二个 GPT-6 Luna Max agent 独立复核,分歧回看原始仓库材料裁决。第四步,分析:在 2,170 个已标注项目上统计发布后一周的新增仓库与星标增长、各决策目的与接口的占比及组合分布、跨类别用途构成,并做供给(项目数)-需求(平均星标)的独立归一化对比。
技术新颖性
技术上这篇论文没有提出新算法,其新颖性体现在三个层面。其一是研究对象与范式的创新:首次对一个新生决策模型的完整公开生态做快照式普查(2,170 个项目、8 大类 18 子类),把生态学式的测量引入 AI 系统研究,与以往只评测模型在固定基准上表现的路线形成互补。其二是流程创新:用 GPT-6 Luna Max agent 完成「验证 + 标注」的规模化人工替代,并加入第二 agent 独立复核与人工仲裁机制来约束单 agent 的判断噪声,形成一条可审计的 agent-in-the-loop 标注流水线。其三是度量设计创新:供给(项目数)与需求(平均星标)各自独立归一化后以对数径向图并置,使「Simulation & Control 与 Routing & Automation 项目数几乎相同(252 对 250)但平均星标 8 对 364」这类错配一目了然;同时论文明确指出星标度量的是整仓可见度而非需求缺口,避免了常见的过度解读。
实验结果
增长方面:Jev 于 2026 年 9 月 15 日发布,一周内 2,170 个已验证项目中 1,865 个为新建仓库、305 个为既有仓库集成,同期新增 43,750 颗星。用途方面(图 2):属性判断以 77% 居首,其后为评分/排序 52%、动作选择 31%、结果判断 20%、内容过滤 15%、模型/工具选择 13%;69.7% 的项目承担两种以上用途。接口方面(图 3):Choice 进入 81.0% 的项目、Noul 72.2%、Score 45.4%;36.8% 三者全用,仅 25.0% 单接口。跨领域差异(图 4):动作选择占 Simulation & Control 用途标签的 52%、Interface Agents 的 47%;模型/工具选择在 Routing & Automation 占 27% 而在 Software Engineering 仅 6%;属性判断在 8 类中的 6 类居首。注意力错配(图 5):项目最多的 Content & Expert Tasks(387 个)与 Search & Memory(381 个)平均仅 31 与 37 星;Routing & Automation(250 个)平均 364 星、独占 41.4% 星标,与 Interface Agents 合计以 19.6% 项目拿走 63.0% 星标,集中度约为均匀分布的 $\frac{63.0\%}{19.6\%} \approx 3.2$ 倍;项目数几乎相同的 Simulation & Control 与 Routing & Automation 平均星标 8 对 364。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 生态增长刻画(发布后第一周,2026-09-15 至 09-22) | 新增 GitHub 仓库数 | 1,865 个新仓库,另有 305 个既有仓库集成 Jev,合计 2,170 个已验证项目 | 无(首次对该生态做全量测量) | 提供了 Jev 生态的首个定量基线,显示新开发与既有项目集成并存 |
| 社区关注度增长 | 一周新增 GitHub Stars | 43,750 颗(一周内突破 40K,约 2K 项目积累 40K+ 星) | 无 | 量化了罕见的爆发式早期势头 |
| 决策目的分布与多用途使用 | 项目占比 / 用途数分布 | 属性判断 77%、评分排序 52%、动作选择 31%;69.7% 的项目承担两种以上用途 | 无先前定量估计 | 首次揭示 Jev 作为可复用判断组件的多用途本质 |
| 供给-需求错配度量 | 星标份额 vs 项目份额 | Routing & Automation + Interface Agents 以 19.6% 项目占 63.0% 星标(约 3.2 倍);平均星标 364 vs 8(Routing vs Simulation,项目数 250 vs 252) | 均匀分布假设(两类份额应相等) | 量化证明公众注意力不跟踪项目数量 |
局限与改进
作者明确承认三点局限。第一,这是截至 2026 年 9 月 22 日的单点快照,生态仍在高速演化,项目数量、使用模式与注意力分布都可能随时间改变,结论外推需要谨慎。第二,数据只覆盖公开的 GitHub 仓库,私有仓库与商业落地应用完全在分析范围之外,因此它给出的是公开生态的画像而非 Jev 采用情况的全貌。第三,星标度量的是对整个仓库的兴趣,可能集中在少数明星项目上,论文自己也强调 364 对 8 的差距反映的是「可见度不均」而非「未被满足的需求」。在我观察来还有几点值得补充:候选检索依赖预定义关键词,只能发现代码或文档中显式提到 Jev 的项目,存在系统性召回偏差;agent 验证与标注的准确率、第二 agent 复核的一致性指标(如仲裁比例、人工抽检规模)均未报告,标注质量无法外部评估;横断面数据无法支撑任何因果或动态演化推断;此外分析没有度量使用深度(Jev 是核心依赖还是一次性调用)与项目活跃度(commit、issue、下载量),而这些对理解真实生态可能比 star 更有信息量。
独立分析的弱点
独立来看,本文最值得推敲的弱点有四个。第一,检索与纳入偏差:GitHub 搜索天然偏向命名规范、文档完善的项目,且「有清晰证据用于具体任务」的纳入标准由 agent 主观判断,可能系统性遗漏嵌入在大型系统内部、仅在代码深层调用 Jev 的项目;改进方向是用包管理器依赖图(如 PyPI/npm 的反向依赖查询)做补充召回。第二,标注可靠性未量化:双 agent 复核是好的设计,但论文没有报告两者的一致率、分歧率与仲裁结果分布,读者无法给 77% 这类核心数字配上误差棒;改进方向是抽样人工标注并报告 Cohen's kappa 一致性系数。第三,star 作为需求代理噪音很大:star 受营销、榜单、教程引用影响,且是仓库级而非「Jev 使用」级信号;改进方向是结合下载量、fork 后代码中的实际 API 引用等行为指标构建复合需求度量。第四,快照设计丢掉了演化信息:既然爬虫能拿到仓库创建时间,完全可以做逐日面板分析来区分「蹭热点的浅集成」与「持续维护的深度集成」,论文止步于累计曲线,浪费了数据中本可提取的时间维度。
未来方向
作者在结论部分给出的方向是:由于星标注意力高度集中于路由与接口 agent 类应用,构造通用决策模型的评估基准时应主动纳入低可见度应用,保证基准同时覆盖「重复出现的决策目的」与「真实应用上下文」两个维度;其数据集与分类法也为后续筛选评估场景提供了底座。在此基础上可以延伸出几条更进一步的路线:一是纵向追踪,把快照升级为逐周面板,研究生态的 S 曲线、留存与淘汰,识别哪些用途是昙花一现的风口、哪些是长期刚需;二是跨平台取证,把 PyPI 下载量、HuggingFace 引用、npm 依赖纳入供给-需求框架,修正 GitHub star 的可见度偏差;三是案例深挖,对每个子类的头部项目做代码级案例研究,回答「Jev 替代了什么组件、节省了多少延迟与成本」;四是反向影响模型设计,把「69.7% 项目多用途、36.8% 三接口全用」的发现转化为决策模型的接口设计准则与基准任务配比。
复现评估
复现难度中等偏高,主要门槛在数据与标注环节而非算力。有利条件:论文承诺其数据集与分类法将作为后续研究的基础对外提供,且数据源是公开的 GitHub 仓库;检索的三类线索(关键词、API 端点、SDK 引用)在文中有描述,方法论上可跟随;分类体系(8 大类 18 子类、6 种决策目的、3 接口)定义清晰,可直接复用。不利条件:正文未给出具体的搜索查询串、纳入标准的完整 prompt、以及 GPT-6 Luna Max agent 的调用成本与标注耗时;验证与标注依赖该闭源 agent,复现者需要同类模型加人工复核才能逼近其判定质量;GitHub API 有速率限制,全量检索加 agent 审查 2,000 多个仓库需要多天的流水线运行。总体而言,重新收集数据并复现表 1 与图 2 至图 5 的统计是可行的,但数字不会逐位一致;若作者如文中所称开源了标注数据集,复现成本会大幅下降。
论文图表
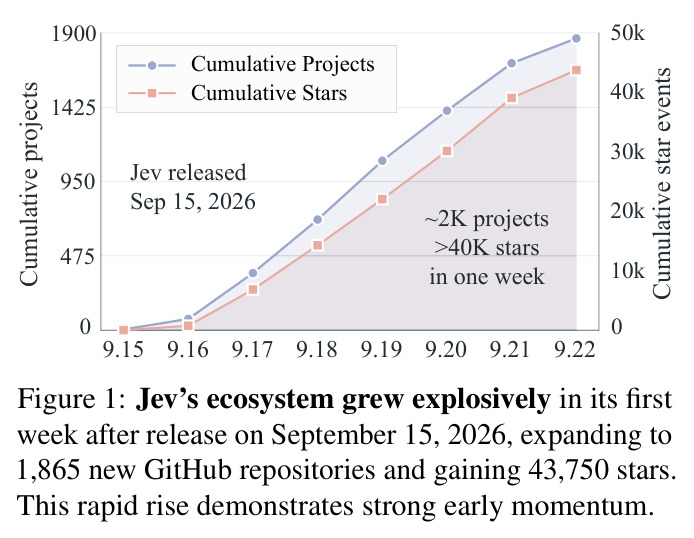
双轴时间序列图,横轴为 9 月 15 日至 22 日的一周,左轴显示累计项目数(从发布日起攀升至约 1,900,其中 1,865 个为新建仓库、305 个为集成 Jev 的既有仓库),右轴显示累计星标数(一周内从零冲到 43,750,图上还标注了「一周约 2K 项目」「40K+ 星」「2026-09-15 发布」等关键节点)。
这张图是整篇论文的研究动机所在:正是这种爆发式增长使得「Jev 生态里到底在发生什么」成为一个值得系统研究的问题,也是后续所有 2,170 个项目分析的数据基础。