JevGPT:自主研究中的快慢双系统思考 JevGPT: Thinking Fast and Slow in Autonomous Research
以Jev作快速证据判断的系统一、GPT作研究规划的系统二,用更低成本更快完成固定语料问答与文档排序
前置知识
双过程理论(快与慢思考)
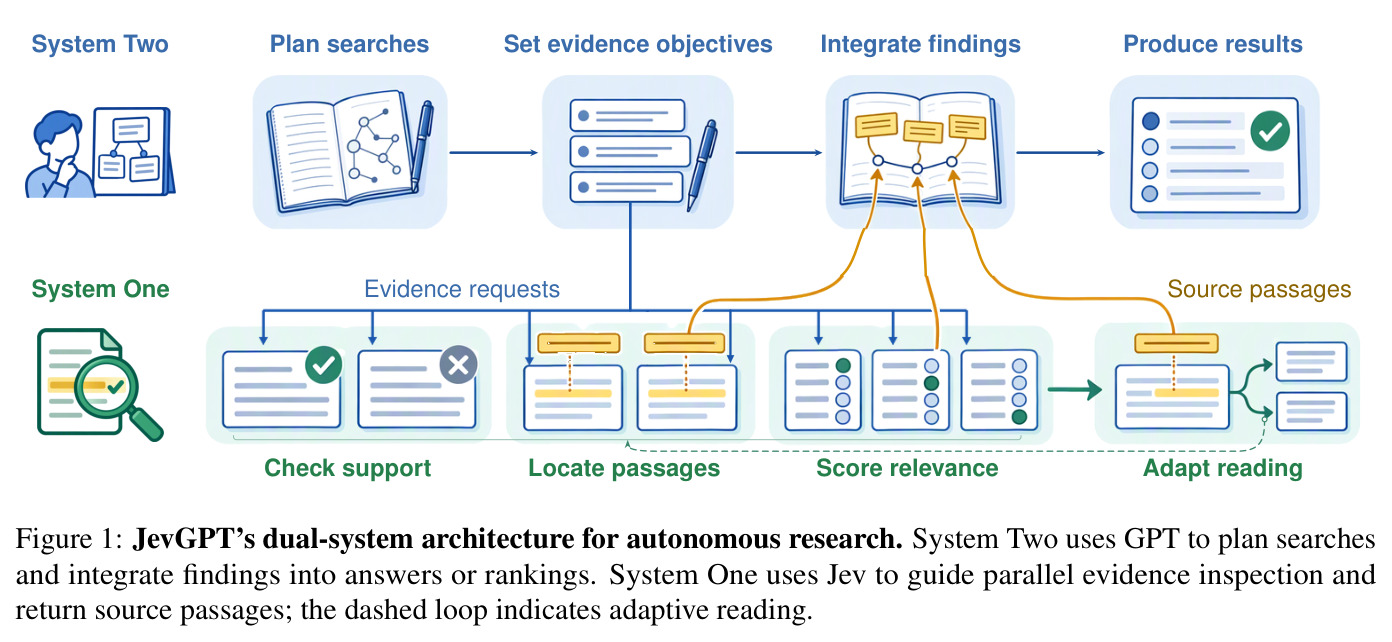
Kahneman 提出的认知框架:'系统一'快速、直觉、低成本地做局部判断,'系统二'缓慢、审慎、高成本地做规划与推理。本文把该隐喻工程化为智能体架构:GPT 担任系统二负责研究规划与证据整合,专用快判断模型 Jev 担任系统一负责逐个来源的局部评估,两者通过显式接口协作。
论文标题与全部设计都围绕快慢分工展开,理解这一框架才能明白为什么要拆成两个系统、各自承担什么,以及效率收益从何而来。
Jev 与三种判定类型
Jev 是 TypeSafe AI 发布的'系统一模型',对给定文本区域做有界输出:Noul 判定返回区域满足某性质的概率,Choice 判定返回有限选项上的分布(如选哪个文本块、是否继续阅读),Score 判定返回有序等级上的分布(如 0-3 四级相关性)。目标与输出类型被显式约束,因此又快又便宜。
它是本文的系统一,证据定位、相关性评估与主动发现三大模块全部建立在这三种判定原语之上;Table 7 的替换实验也围绕它展开。
Agentic Search 与 Deep Research
让 LLM 智能体循环执行'生成查询→检索→阅读来源→整合'来自主回答问题的范式,代表工作有 ReAct、IRCoT、Search-R1、WriteHERE 等。与传统单轮 RAG 不同,中间发现会改变后续搜索方向,因此证据处理效率直接决定有限预算内能追踪多少条线索。
本文的实验设置(固定语料问答与文档排序、300 秒预算)以及六个基线(BCP/ReAct、Pi-Serini、Agentica 等)全部来自这一研究脉络。
BM25 与混合检索
BM25 是经典词频检索函数,用逆文档频率与长度归一化给查询-文档打分。混合检索指融合文档级与段落级两路 BM25:本文对两路分数分别 min-max 归一化后等权相加,$S(d|s)=\frac{1}{2}\hat{x}_D(d)+\frac{1}{2}\hat{x}_P(d)$。
Hybrid BM25 是 JevGPT 的检索底座,也是消融中准确率增益最大的组件(BrowseComp-Plus 上 +7.47 个百分点),理解它才能读懂消融逻辑。
nDCG@20 与 F1@20
文档排序质量指标:nDCG@20 按分级相关度(本文用官方增益 $g\in\{0,1,3\}$)计算排名前 20 的折扣累计增益并归一化;F1@20 把 $g>0$ 视为相关,取前 20 名精确率与召回率的调和平均,未判定文档计 0 分。两指标均逐主题计算后对主题取平均。
NeuCLIRBench 的全部结论用这两个数字表达,不理解指标就无法判断 nDCG@20 从 0.5240 提升到 0.5390 的实际含义。
BrowseComp-Plus 与 NeuCLIRBench 基准
两个公开固定语料基准:BrowseComp-Plus 含 830 个多跳事实问题与约 100,195 篇文档,考察深度检索问答,以答案准确率评价;NeuCLIRBench 含 105 个主题,用英文查询检索波斯语/俄语/中文文档的英文机器翻译,考察跨语言文档排序。
它们定义了本文的任务形态、时间预算协议(300 秒,210 秒提交提醒)与所有对比数字,是读懂实验部分的直接前提。
研究动机
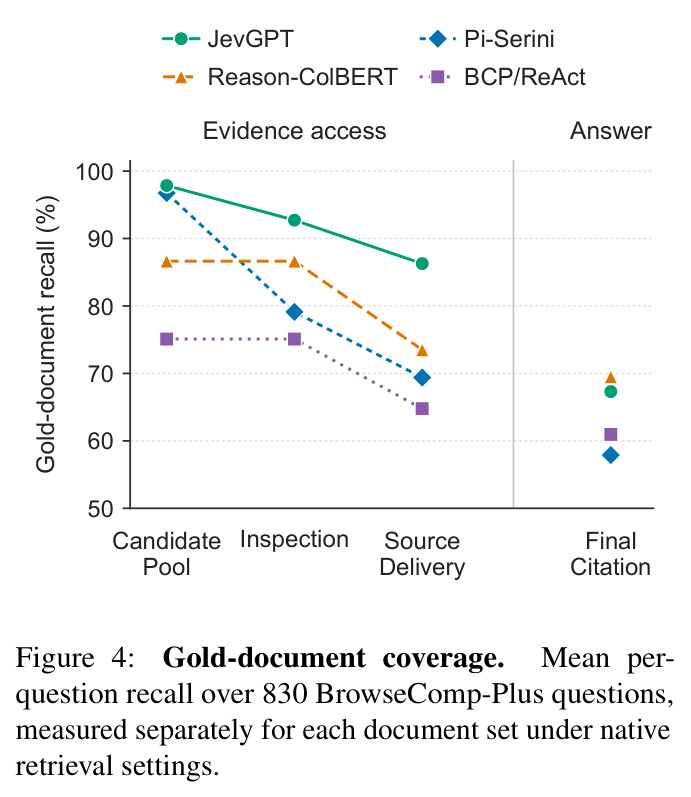
自主研究智能体在固定语料上答题或排序时,每次搜索都会返回大量候选来源,必须逐一检视才能转化为可用证据,而检视成本直接挤占了可追踪的线索数量。现有系统用同一个大模型既做规划又做阅读:BCP/ReAct 在 BrowseComp-Plus 上平均每题消耗 2,169K token、24.87 次搜索、182.1 秒、成本 3.08 美元;即便较新的 Pi-Serini、Agentica、RISE,也要么准确率不足 85%,要么单题花费 0.8-1.6 美元。更关键的是,检索覆盖率并不等于证据利用率——Hsu 等人(2026)发现即使预览召回已经饱和,继续加深检索仍能找回相关来源,但这些来源往往停留在候选池里,从未被打开、从未进入推理,形成'检索覆盖'与'实际使用证据'之间的鸿沟:模型重复搜索、反复翻页,却把真正有用的原文漏在门外。
本文的目标是本文的目标是设计一个在有限研究预算(300 秒、有限 API 成本)内,让快速局部证据判断与审慎研究规划协同工作的自主研究架构。具体而言:规划器(系统二)负责维护不断演化的研究状态、提出搜索查询与证据目标、整合片段产出答案或排序;快速判断模型(系统一)在目标约束下并行完成来源筛选、段落定位、相关性评分与继续阅读决策,且其成本可忽略不计。衡量标准是在 BrowseComp-Plus 全部 830 题问答与 NeuCLIRBench 全部 105 主题排序上同时取得更高的准确率/排序质量、更快的完成速度与更低的 API 总成本,并通过证据分析证明性能来自更广的来源检视与更高的支撑文档覆盖率。
与已有工作不同的是,已有工作的切入方式各有局限:RankGPT、Qwen3-Reranker 把文档处理与推理一次性分离(只重排一轮);CRAG 用轻量评估器触发纠错检索,但局部判断不指导后续研究过程;SwiftSage、MARS 等双系统工作需要联合训练或共优化,面向交互任务而非语料研究。本文的独特之处是用'显式证据请求'把规划器的当前研究状态转化为局部判断的边界条件:每次判定 $J(u,r)$ 的目标 $u$ 可以是局部证据问题或完整主题,输出类型被约束,因此廉价、可并行;判定返回的是带源坐标的原始文本片段而非摘要,并异步回流到研究历史中指导下一步动作。这样局部计算第一次与研究需求全程对齐——检索到的来源被系统性地'用起来',而不是覆盖后闲置。
核心方法
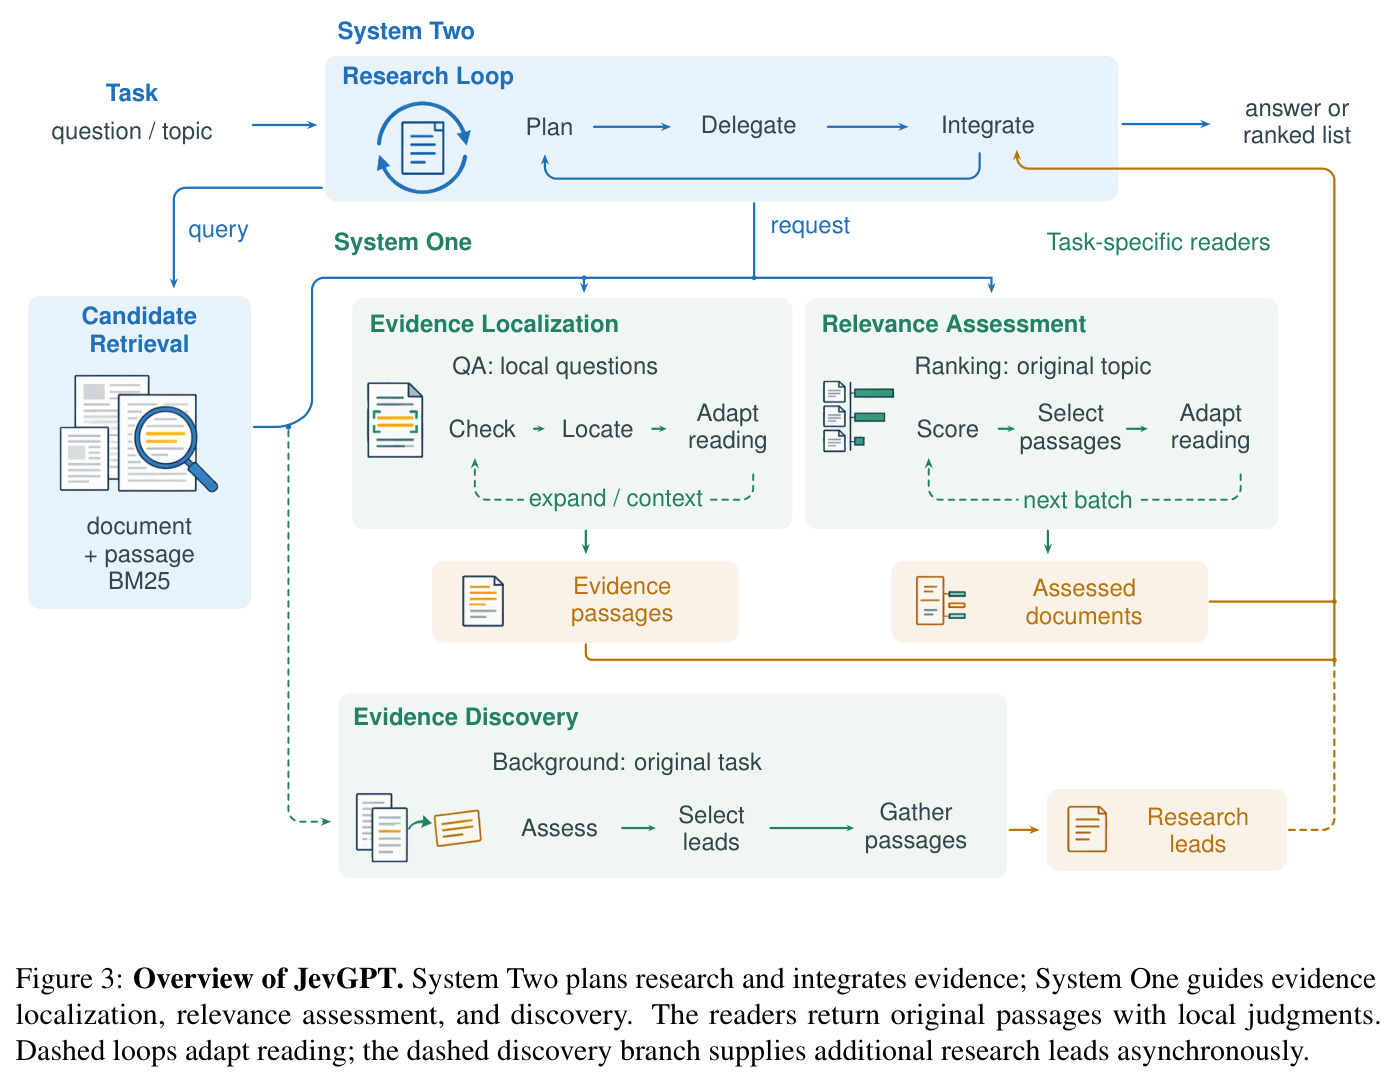
直觉是把 Kahneman 的快慢思考搬进研究智能体:'系统二'(GPT-5.5)擅长规划搜索、提出证据目标、整合片段并产出答案或排序;'系统一'(Jev)擅长对单个来源做快速有界判断,成本几乎为零。技术路线如下:给定问题或主题 $q$ 与固定语料 $D$,系统二维护研究历史 $h_t$,输出动作 $a_t = G(q, h_t)$(搜索查询、证据请求或最终答案/排序);检索返回候选集 $C_t$,系统一对其中每个区域并行产生局部判定 $Z_t = \{J(u_t, r) : r \in \mathrm{Regions}(C_t)\}$;Gather 函数把选中的原始片段合并进证据记忆 $E_t$ 并生成响应 $o_t$ 回流到历史。问答任务使用'证据定位'(针对局部问题的块级定位加自适应阅读),排序任务使用'相关性评估'(对原主题的四级评分加原文页返回),两者共享一条'证据发现'分支,在系统二继续研究的同时异步深挖更多候选来源。
核心创新是'显式证据请求作为局部判断的边界条件'。每个局部判定 $J(u,r)$ 的目标 $u$ 被系统二显式给出(QA 是至多六个局部问题,排序是原始主题),输出类型限定为 Noul(区域满足性质的概率)、Choice(有限选项上的分布)或 Score(有序等级上的分布),因此判断既快又便宜、可大规模并行;而判定结果返回的是带源坐标的原始文本块,直接成为下一步查询或答案验证的依据。与 RankGPT 式一次性重排不同,局部判断贯穿研究的每一轮:Evidence Localization 在 QA 中定位答案片段,Relevance Assessment 在排序中按保留概率 $p_d = P_d(2) + P_d(3) \ge \theta$ 筛选文档并返回原文页,Evidence Discovery 在规划器思考的同时对排名前 $K=60$ 的未检候选异步评估、主动提供研究线索。这使'检索覆盖'与'证据使用'的鸿沟第一次被系统性地填上。
方法步骤详情
第一步,候选检索:系统二发出查询 $s$,混合 BM25 融合文档级与段落级得分 $S(d|s)=\frac{1}{2}\hat{x}_D(d)+\frac{1}{2}\hat{x}_P(d)$。第二步,证据请求:系统二选定待检来源并给出目标,来源按每批 10、每请求最多 60 个检索单元分批。第三步,并行判定:QA 中 Noul 判定估计区域命中率,$e_{u,r}\ge 0.5$ 时 Choice 判定选出原文块(不足时加选次高块),自适应阅读最多扩读两页上下文;排序中 Score 判定输出 $\ell\in\{0,1,2,3\}$ 四级相关性分布,保留 $p_d=P_d(2)+P_d(3)\ge\theta=0.25$ 的文档并附原文页。第四步,证据发现:每次搜索后对前 $K=60$ 名未检候选异步评估;QA 把问题拆成至多六条线索,优先级 $s_q(d)=\sum_{j\in L_q(d)}\frac{1}{n_j}$,返回至多 3 个来源,排序按 $p_d$ 返回至多 10 篇。第五步,整合:系统二把回流片段并入证据记忆 $E_t$,决定下一个动作或产出最终答案/排序。
技术新颖性
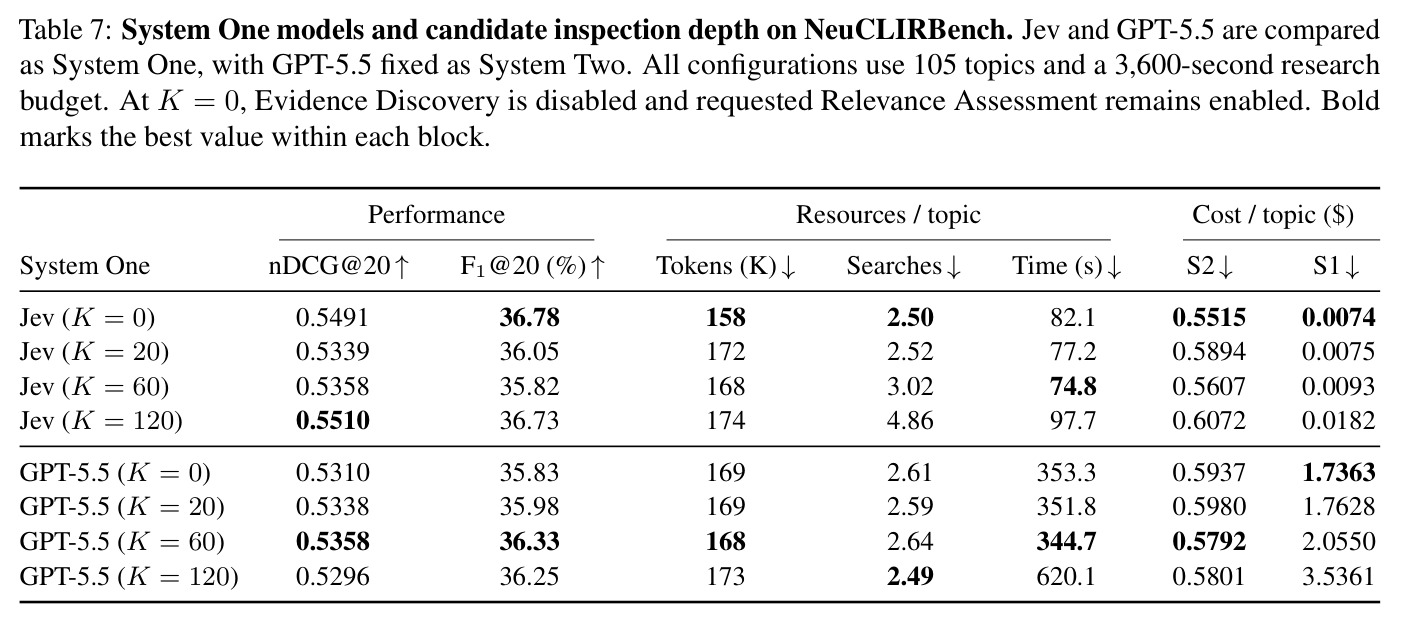
新颖性有四点。其一,架构级双系统分工且零训练:不训练任何新模型,而是把现成的'系统一模型' Jev 作为通用证据处理器插入研究循环,这与 SwiftSage、MARS 需要联合训练或共优化的路线本质不同,即插即用。其二,原始片段回流:判定结果附带源坐标的原文而非摘要,保证证据可验证——案例研究中 Pi-Serini 打开一篇 425.7KB 的学位论文只显示 31 字节就截断,最终答错;JevGPT 则直接把致谢段落送到规划器面前。其三,异步发现分支:在系统二推理的同时并行深挖候选,QA 用线索覆盖率乘特异性的加权 $\sum 1/n_j$ 排序线索,属于'研究进行中'的主动检索而非被动响应。其四,效率论证充分:把系统一从 Jev 换成 GPT-5.5,单主题 S1 成本从 0.0093 美元涨到 2.0550 美元($K=60$ 时约 220 倍)、耗时从 74.8 秒涨到 344.7 秒,而 nDCG@20 完全相同(0.5358),干净地证明了快慢分工的价值主要在计算效率而非判断质量。
实验结果
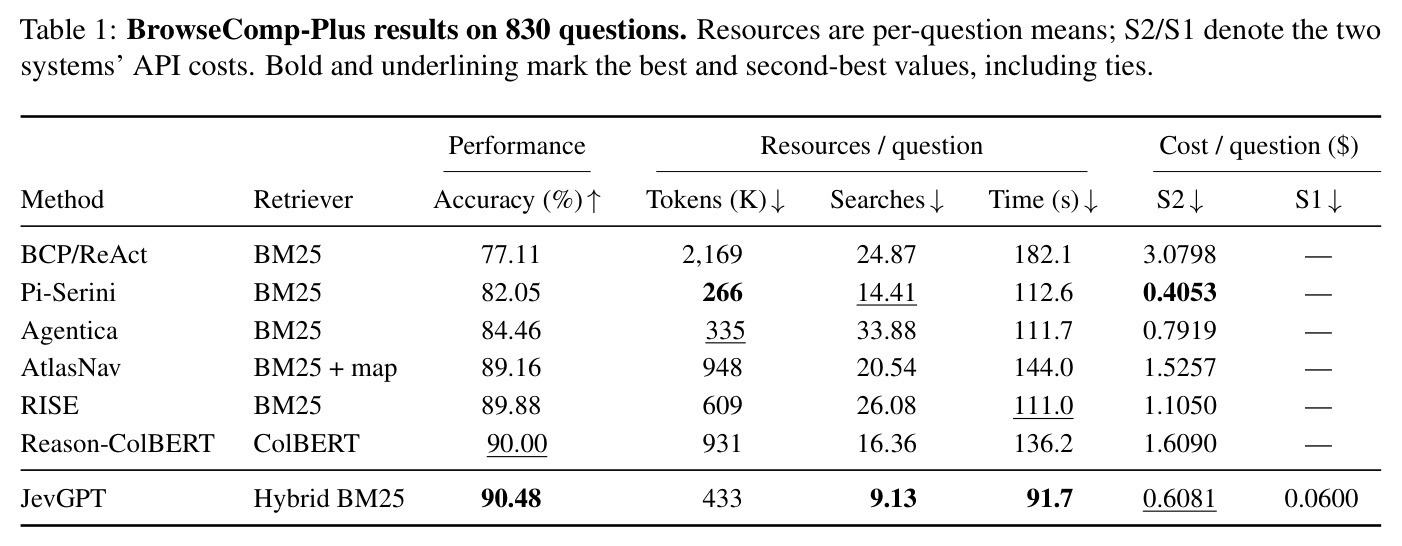
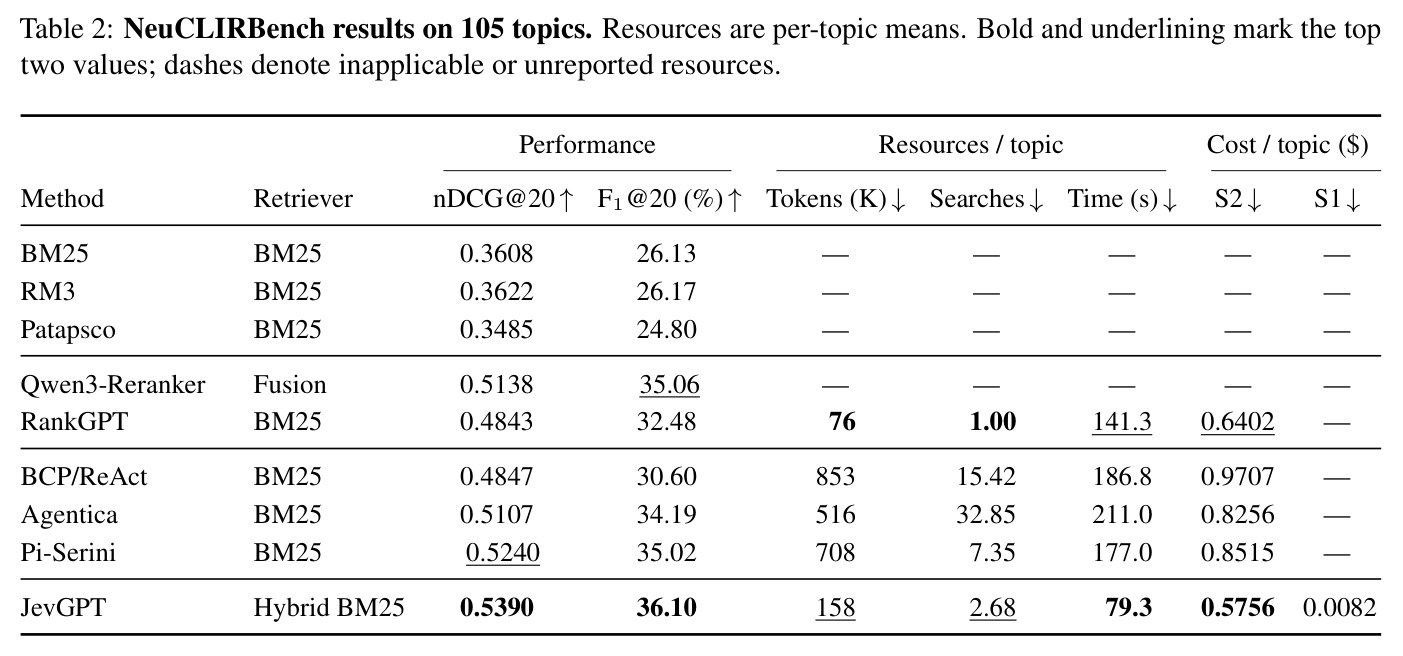
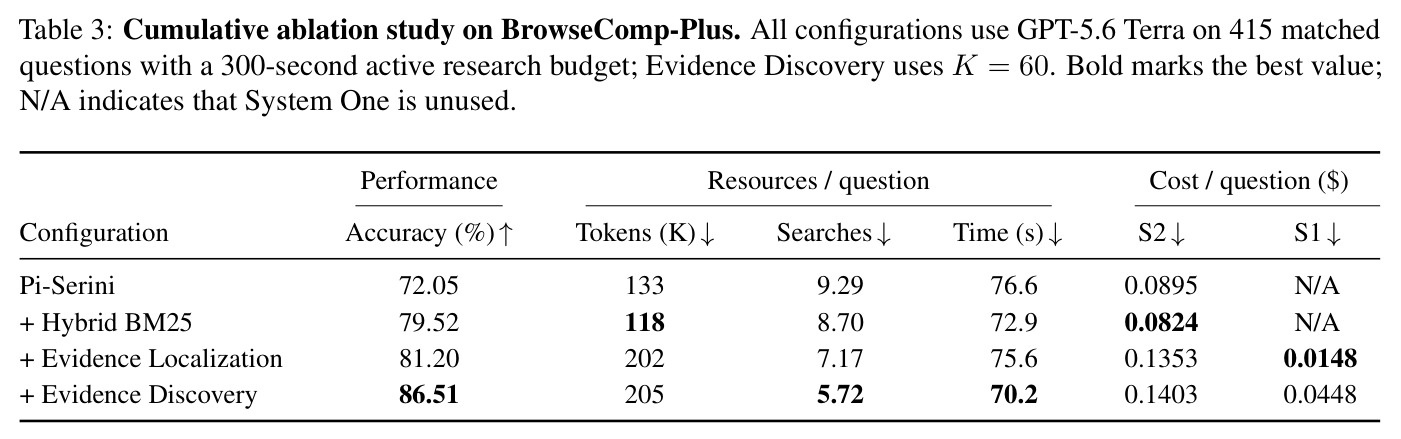
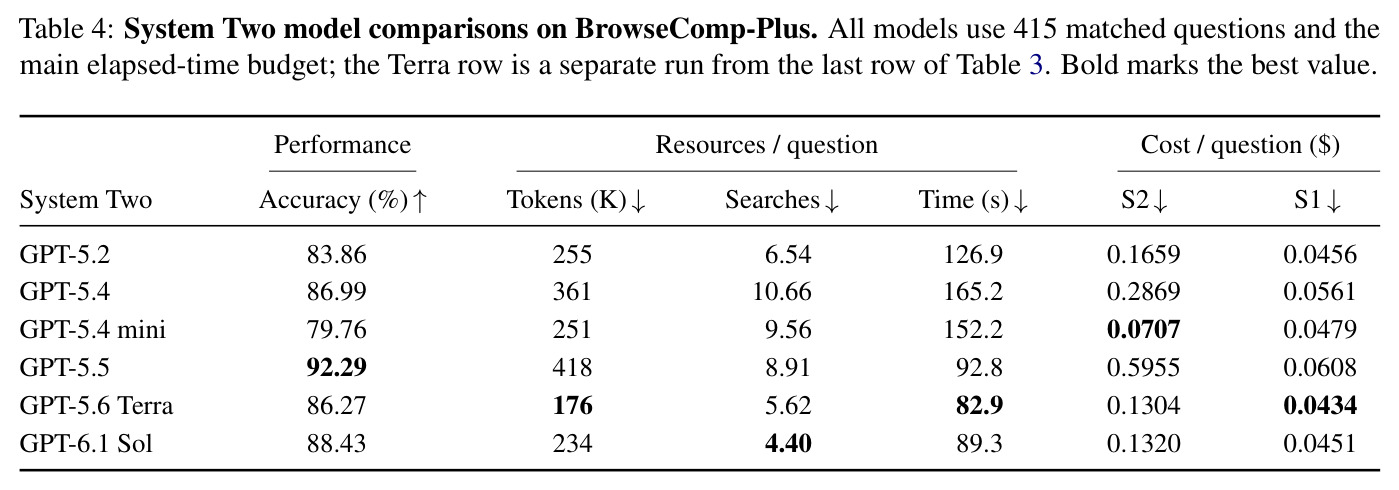
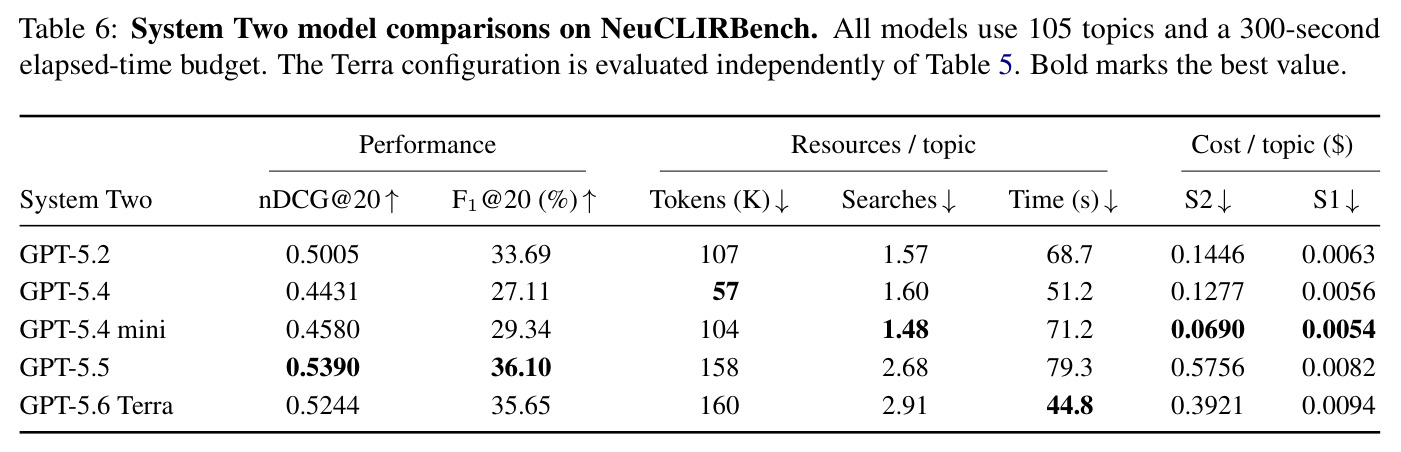
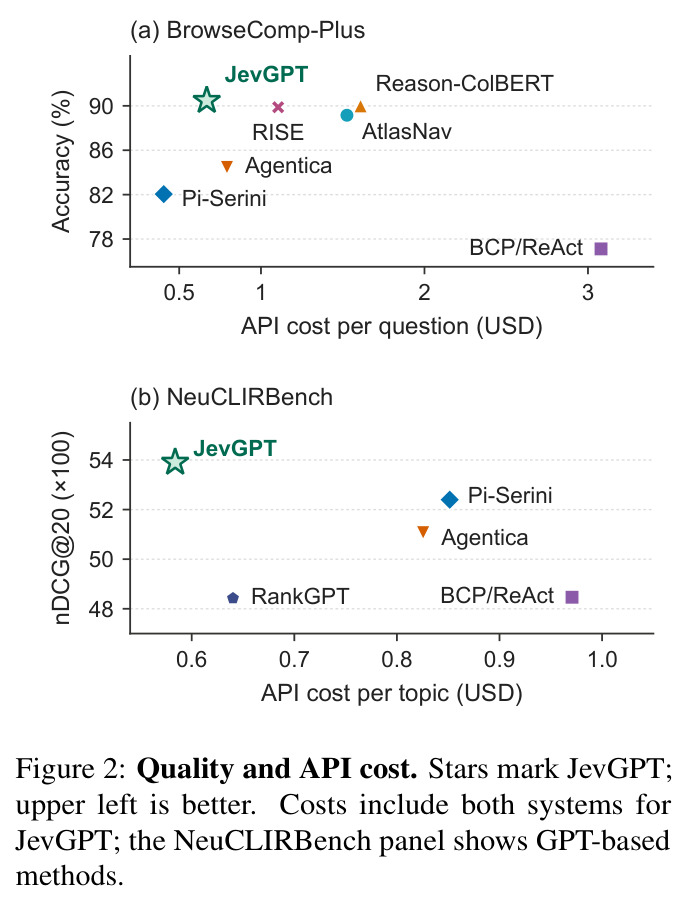
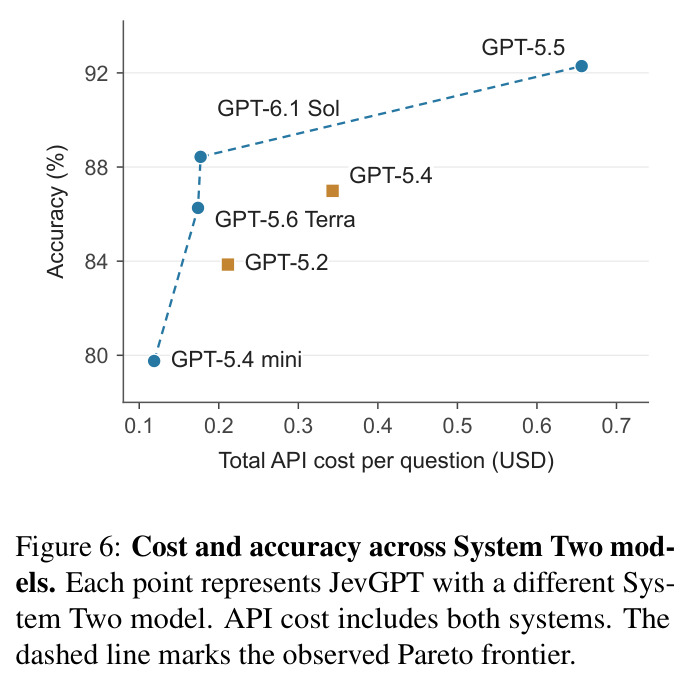
BrowseComp-Plus(830 题):JevGPT 准确率 90.48% 全场最高,超过 Reason-ColBERT 90.00%、RISE 89.88%、AtlasNav 89.16%、Pi-Serini 82.05%;每题仅 9.13 次搜索、91.7 秒、433K token、总成本约 0.668 美元。NeuCLIRBench:nDCG@20 0.5390、F1@20 36.10% 双双第一,超过 Pi-Serini,token 与耗时最低。证据分析(Figure 4)显示两法候选池覆盖相近,但 JevGPT 的金标文档检视率与原文送达率更高,增益来自证据利用而非检索。消融(Table 3):Pi-Serini 72.05%,依次加混合 BM25、证据定位、证据发现后达 86.51%,搜索从 9.29 降至 5.72 次。系统二对比(Table 4):GPT-5.5 最准 92.29%,GPT-6.1 Sol 以约四分之一成本达 88.43%。系统一对比(Table 7):Jev 与 GPT-5.5 质量相当(nDCG@20 同为 0.5358),成本却不足其 1%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BrowseComp-Plus 固定语料问答(830 题) | 答案准确率 Accuracy (%) | 90.48% | Reason-ColBERT 90.00%(次优)、RISE 89.88%、Pi-Serini 82.05%、BCP/ReAct 77.11% | 对次优 +0.48 个百分点;同时每题 token 从 931K 降至 433K、搜索从 16.36 次降至 9.13 次 |
| BrowseComp-Plus 效率与成本 | 每题搜索次数 / 总 API 成本 | 9.13 次、约 $0.668(S2 $0.6081 + S1 $0.0600) | BCP/ReAct 24.87 次、$3.0798;RISE 26.08 次、$1.1050;AtlasNav 20.54 次、$1.5257 | 搜索减少 55%~65%,成本降低 56%~78%,耗时 91.7 秒为全场最低之一 |
| NeuCLIRBench 文档排序(105 主题) | nDCG@20 | 0.5390 | Pi-Serini 0.5240(最强研究基线)、Qwen3-Reranker 0.5138、BM25 0.3608 | 对 Pi-Serini +0.0150,对 BM25 +0.1782 |
| NeuCLIRBench 文档排序(105 主题) | F1@20 (%) 与资源 | 36.10%,158K token,2.68 次搜索,79.3 秒,$0.5838 | Qwen3-Reranker 35.06%;Pi-Serini 35.02%、708K token、7.35 次、177.0 秒 | 质量 +1.04 个百分点,token 降至约 22%,耗时降至约 45% |
| BrowseComp-Plus 累积消融(415 题,GPT-5.6 Terra) | 准确率 (%) / 搜索次数 | 完整系统 86.51%、5.72 次搜索、70.2 秒 | Pi-Serini 复现 72.05%、9.29 次搜索、76.6 秒 | +14.46 个百分点,搜索减少 38%;其中混合 BM25 贡献 +7.47、证据发现贡献 +5.31 |
| NeuCLIRBench 系统一替换实验(105 主题,K=60) | S1 成本/主题 与 耗时 | Jev 作系统一:$0.0093、74.8 秒(nDCG@20 0.5358) | GPT-5.5 作系统一:$2.0550、344.7 秒(nDCG@20 0.5358) | 成本降至约 0.45%、耗时降至约 22%,排序质量完全相同 |
局限与改进
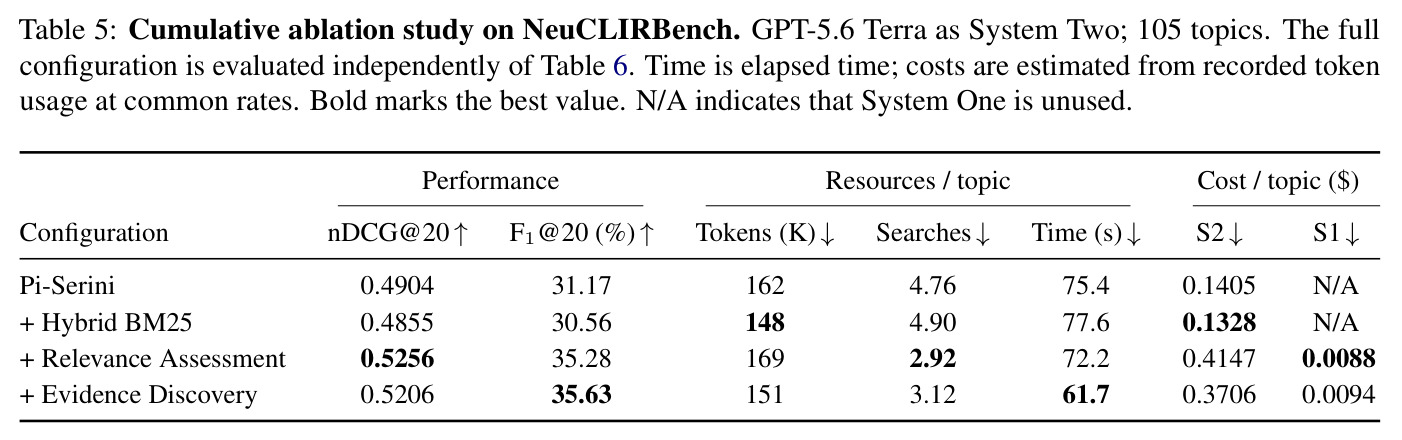
作者承认两点:其一,快慢协调停留在架构层面,何时做快速局部判断、何时延长推理由人工设计而非学习得到,统一的联合训练模型是自然的下一步;其二,评估局限于固定语料上的问答与文档排序,尚未覆盖开放网络研究与长文本综合写作。我的补充观察:第一,系统二仍是成本大头(BrowseComp-Plus 上 S2 0.6081 美元对 S1 0.0600 美元),端到端成本下界受制于规划器选型,论文未给出用更弱规划器时的质量-成本完整权衡;第二,大量阈值($\tau_{loc}=0.5$、$\theta=0.25$、$\tau_{lead}=0.5$、$K=60$、每批 10 单元等)为手工设定且未做敏感性分析,迁移到新语料可能需重新调参;第三,BrowseComp-Plus 上对 Reason-ColBERT 的领先仅 0.48 个百分点,未报告显著性检验;第四,Jev 是第三方专有模型(Jev-1.13.0),其判定质量的稳定性是黑盒;第五,消融显示混合 BM25 在排序任务上反而使 nDCG@20 从 0.4904 微降至 0.4855,说明检索组件收益与任务类型相关,并非普适。
独立分析的弱点
弱点一:证据请求的质量完全依赖系统二提出正确的关系型局部问题。Ancrum 案例中系统二必须显式问'这个村庄的别名叫什么'才能定位到 'Little Lovely';若规划器提不出这样的问题,局部判断可能返回宣传语式的伪证据(基线 Pi-Serini 正是把 'a small village with a big history' 当成别名而答错)。改进方向:从任务中自动抽取关系约束或引入问题分解模板,约束证据目标的覆盖面。弱点二:阈值体系手工且互不联动(定位 0.5、保留 0.25、线索 0.5、继续阅读 0.5),不同语料规模与语言分布下最优值可能漂移;可在小验证集上在线校准,或改学成决策头。弱点三:QA 与排序使用两套异构判定流程(块定位对四级评分),同一系统一模型承担但未验证跨任务泛化;可统一为单一'证据效用'判定。弱点四:发现分支仅在剩余时间不少于 45 秒时启动且每批至多 m 个来源,时间紧张时该分支直接退化不可用;可改为成本感知的动态调度。弱点五:成本统计只含 API 调用,未计 Jev 本地推理的算力开销,若自部署则真实总拥有成本需重估。
未来方向
作者提出两个方向:一是把快慢能力整合进统一模型,通过联合训练学习何时快速局部判断、何时延长推理,使计算分配随调查演化自适应;二是扩展到开放网络研究与长文本综合任务,检验该架构在更广任务谱系上的表现。基于本文成果还可延伸:用系统一廉价的 Noul/Score 判定作为过程奖励信号,以强化学习训练系统二的证据请求策略(类似 Search-R1 但以快模型为可验证环境);将证据记忆 $E_t$ 的组织方式参数化,研究跨问题的记忆复用,与 Jev-Mem、Mnemon 的方向衔接;在更难的多跳与对抗性深检索基准上检验线索拆分(句子/子句边界切分、上限六条)的鲁棒性;探索开源或蒸馏系统一模型,验证这类有界输出能否由 1-3B 小模型承担,进一步压低成本;以及把相关性四级增益与排序指标的映射做成可微接口,让排序任务也能端到端优化。
复现评估
复现难度中等偏难,但协议透明度很高。有利条件:附录 A 完整给出实现细节——GPT-5.5 medium 作系统二、Jev-1.13.0 作系统一、300 秒预算、BM25 参数、批大小、全部阈值($ au_{loc}=0.5$、$ heta=0.25$、$K=60$ 等)与评估模板,六个基线配置逐一说明;BrowseComp-Plus(100,195 篇文档)与 NeuCLIRBench 均为公开基准。不利条件:核心组件 Jev 是 TypeSafe AI 的专有模型,未提供权重或开源替代,系统一无法严格复现;系统二依赖 GPT-5.5/5.6 Terra/6.1 Sol 等闭源模型,结果与 API 定价绑定;论文只给项目主页、未声明开源代码,区域切分、证据记忆管理、异步调度等工程细节需自行实现。算力方面无需训练模型或 GPU 集群,主要开销是 API 调用;若接受用 GPT-5.5 兼任系统一(Table 7 显示质量相近但成本增约两百倍),架构层可以完整复现,预估数千美元 API 预算即可完成主实验。
论文图表
问答案例对比:问题要求给出村庄 Ancrum 的别名。两法都找到 Ancrum 与遗产协会,Pi-Serini 读了协会主页后把宣传语 'a small village with a big history' 当作别名答错;JevGPT 的系统二显式提问'这个村庄的别名是什么',系统一从另一来源(Jedburgh 页面)定位到原句 'Ancrum is a pretty place sometimes known as Little Lovely',系统二随即用该名字搜索验证并答对。
最直观地展示'证据定位'模块的价值:找到正确实体与确立被问的关系是两回事,局部证据目标让这种区分变得可操作。