RobotUse:面向机器人操作的计算、上下文与决策分配 RobotUse: Allocating Computation, Context, and Decisions
把物理动作的选择权留给语言智能体、把几何执行委托给后端的机器人Agent框架
前置知识
Agent Harness(智能体框架)
智能体框架是组织语言模型计算方式与信息流的脚手架:它决定模型能看到什么观测、能调用什么命令、历史如何维护、错误如何反馈。ReAct 交替推理与行动,SWE-agent 通过设计工具与环境反馈塑造行为,Recursive Language Models 把长输入当作可编程检查的外部环境。同一模型配上不同 harness,表现可以相差数倍。
本文的核心论点就是 harness 设计本身:作者把 LLM 领域的计算/上下文分配思想迁移到物理动作,读懂论文需要理解"框架"而非"模型"才是被改进的对象。
Code as Policies(代码即策略)
让 LLM 直接生成调用感知与控制 API 的 Python 程序来驱动机器人,程序可以组合分割、坐标变换、抓取采样等函数。CaP-X 是其基准化版本,还引入 VDM、Molmo 等视觉模型为代码代理描述图像。缺点是智能体必须自己把物理意图和失败翻译成执行逻辑,代码崩溃即任务失败。
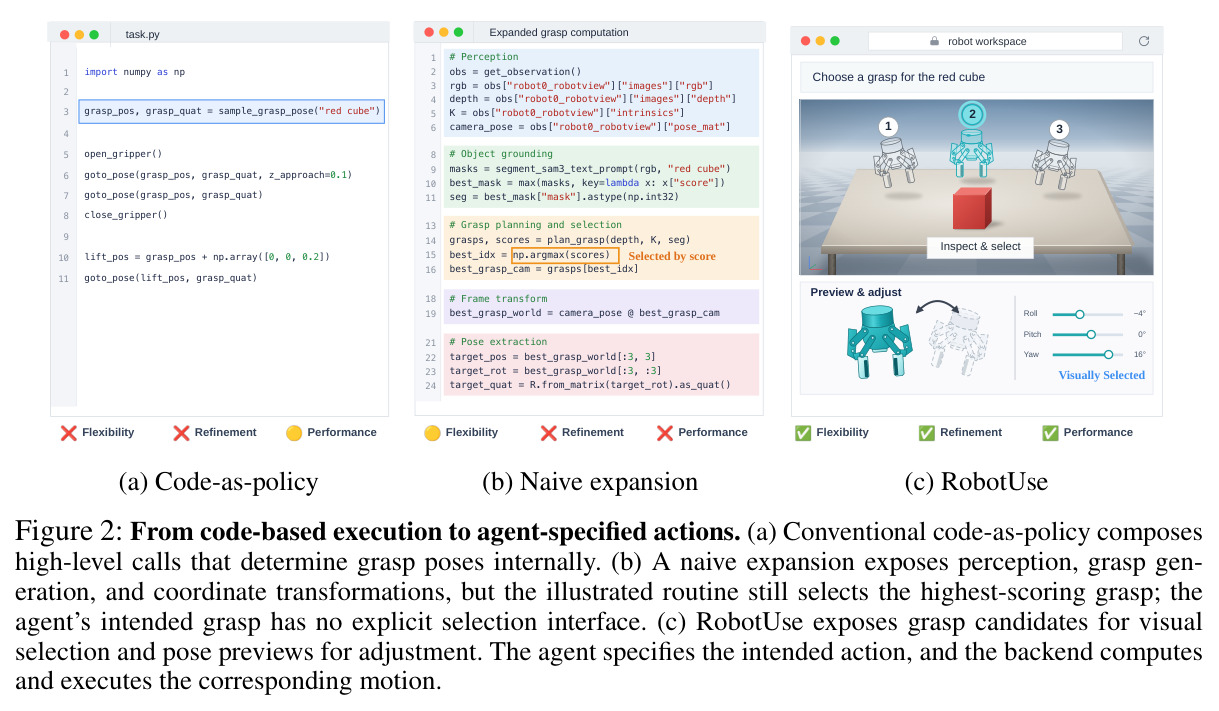
CaP-X 是本文最重要的对照基线(成功率 38.33% 对 RobotUse 的 45.00%),论文图 2 专门剖析了代码接口为何让抓取选择留在 np.argmax 这类内部评分规则里。
VLA 模型(视觉-语言-动作模型)
在大规模机器人演示数据上端到端训练的模型,直接把图像和语言指令映射为机器人动作,如 RT-2、OpenVLA、π0/π0.5。它们推理快但需要微调才能适应新任务,且内部决策难以检查或修正。NVIDIA 的 Cosmos 3 是作为世界模型基线加入对比的。
论文用 π0.5(30.75%)和 Cosmos 3(42.25%)作为"直接动作策略"基线,用来回答"不用语言智能体、纯端到端策略能做到什么"这一对照问题。
子代理与上下文工程
把一个长对话拆成多个独立上下文的代理:主代理维护任务级状态,子代理在全新的消息列表里完成局部细节工作,只把结论以报告形式返回。这避免了历史无限膨胀导致的注意力稀释和 token 成本暴涨,是 Deep Agents、Prime Agent 等 harness 的核心机制。
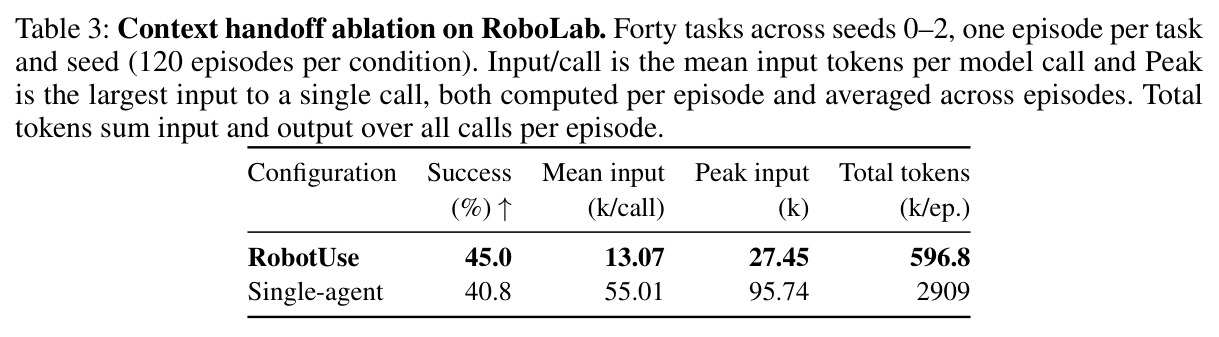
RobotUse 的上下文边界实验(总 token 4.9 倍差距)直接量化了这一机制在机器人领域的价值,是理解论文方法结构和实验设计的前提。
运动规划与逆运动学(IK)
逆运动学把期望的末端位姿解算成各关节角度;运动规划在构型空间中找一条无碰撞路径。本文后端对每条命令做 3mm/0.025rad 分辨率的直线笛卡尔插值,当 IK 无解或相邻路径点关节变化超过 0.2rad 时拒绝执行并返回诊断。
正是这些确定性几何计算被 RobotUse 从智能体上下文中剥离出去;理解"路径检查拒绝"机制才能看懂论文中候选被拒、智能体诊断后调整的闭环交互。
研究动机
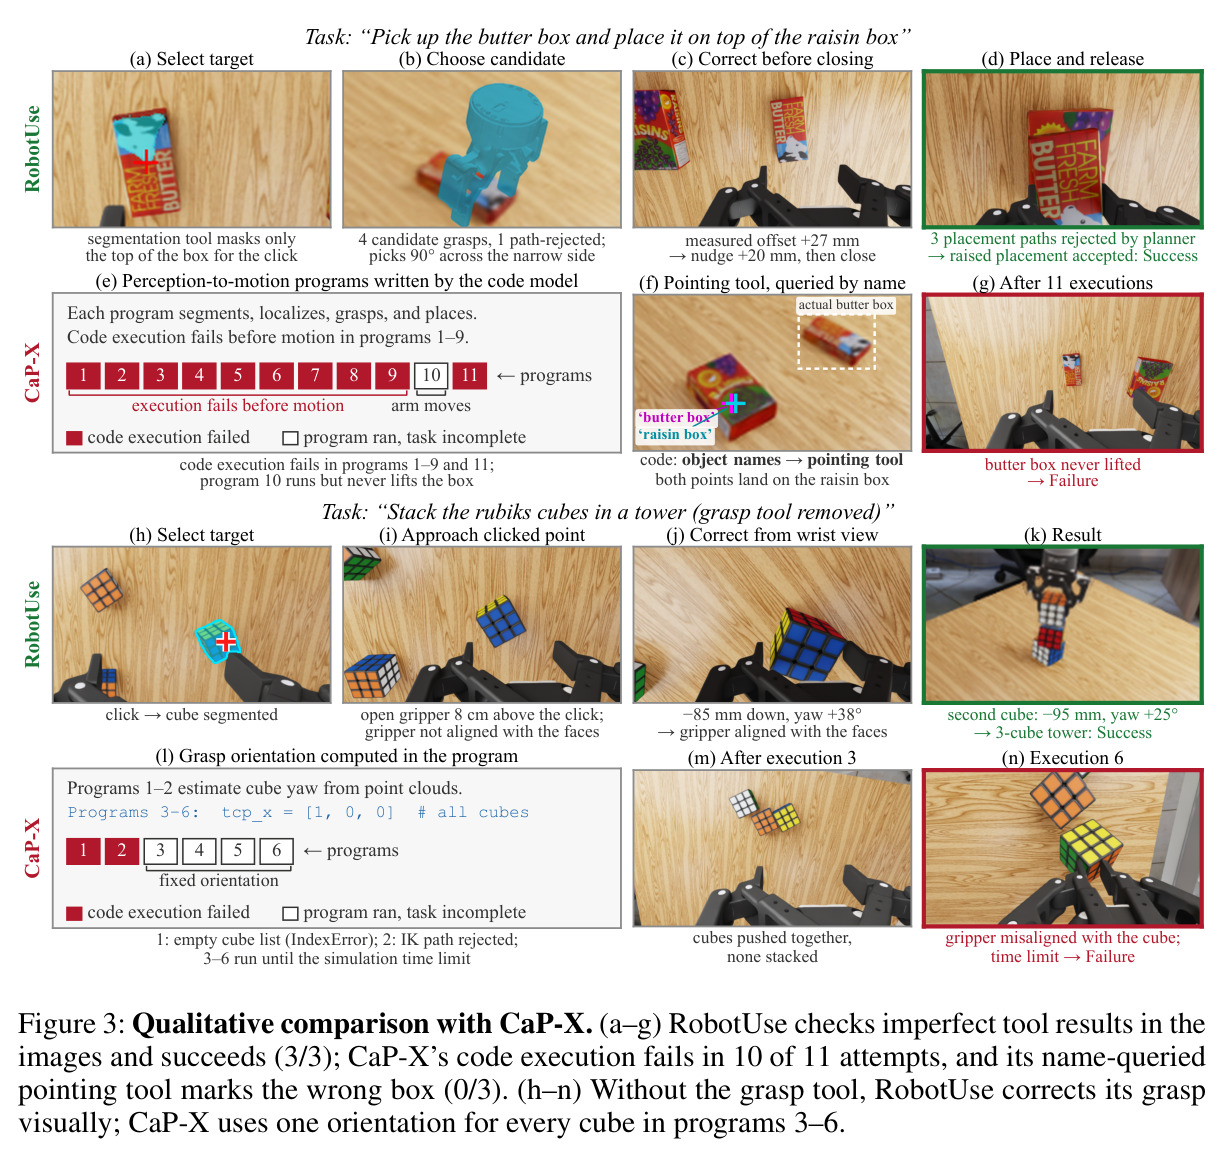
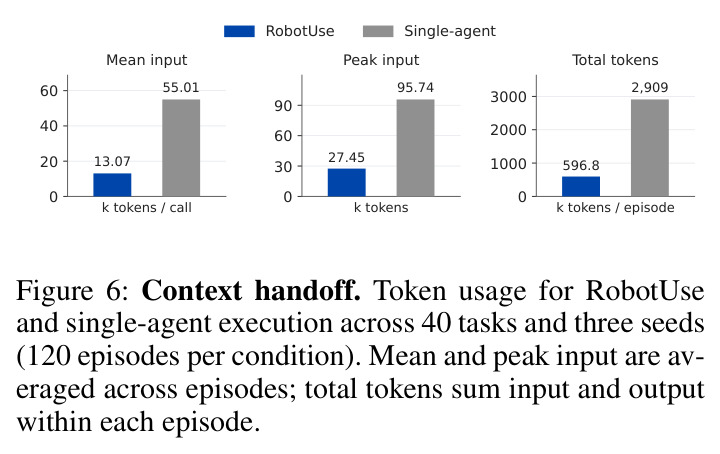
机器人智能体要把"意图"落实到连续、高维的物理动作上,这涉及目标位置、朝向、接近方向等一系列必须随场景和执行结果变化的决策。现有接口把这套决策藏进了工具内部:代码即策略方法(如 Code as Policies、CaP-X)让智能体编写组合感知与控制 API 的程序,高层技能方法(如 SayCan)则直接委托执行。前者要求智能体自己把物理意图与失败翻译成执行逻辑——论文的定性实验中,CaP-X 在黄油盒任务的 11 次程序尝试里有 10 次在运动开始前就因代码执行失败而终止,魔方堆叠任务去掉抓取工具后,程序 3–6 对所有魔方套用同一个固定朝向;后者虽然省心,却把抓取位置、接近方向等关键选择隐藏在评分规则里,智能体无法检查和修正。更麻烦的是失败归因:一次抓取失败可能源于目标选择、接近方向或接触位置中的任何一个。反复交互还会在上下文里堆积大量观测、候选与诊断信息,论文测得单智能体方案平均每次调用输入 55.01k token、单回合峰值 95.74k,总 token 消耗是子代理方案的 4.9 倍。
本文的目标是本文的目标是设计一个"意图导向"的机器人智能体框架,在委托执行复杂性的同时保留任务相关的物理选择。具体拆成三件事:其一,把目标点、候选抓取/放置位姿、位姿微调这些选择保留在智能体接口上,使其成为可视觉检查、可显式修改的对象,而把几何换算、运动规划与控制这些"模型能算但不该用推理算"的工作完全交给固定后端;其二,把详细的局部交互历史隔离在每个子目标内部,只让"结果+原因+当前状态+未解决约束"以报告形式回到主智能体,控制上下文膨胀;其三,通过外循环 refiner 用执行轨迹持续更新一本持久化的 playbook,让经验改变后续决策而不改动任何模型参数或机器人控制代码。评价指标覆盖 RoboLab 40 任务的端到端成功率、token/成本/时间等资源消耗、对工具缺失的鲁棒性,以及 Franka 真机上的快速适应能力。
与已有工作不同的是,本文的独特切入角度来自两支文献的交叉:LLM 智能体 harness 与机器人操作。RLM、Prime Agent、Deep Agents、Continual Harness 等工作已证明"把长输入当作可编程检查的外部环境、用子代理隔离细节、从执行轨迹持续自我更新"在软件工程任务上的威力,但尚无人把这套计算/上下文分配思想系统地搬到物理动作上。物理领域特有的困难在于:动作在时间中展开、结果取决于几何与接触条件,被调用的执行单元往往不是需要修正的那个选择。论文还指出了代码生成路线的一个关键盲点:把高层抓取调用展开成感知与几何 API(naive expansion)看似增加了透明度,但抓取仍由 argmax(scores) 这样的内部评分规则决定,智能体的"意图"依然没有显式的选择接口。RobotUse 让候选位姿和姿态卡成为显式对象,智能体点选目标、挑选候选、按毫米/度编辑位姿,从接口设计层面解决这一问题。
核心方法
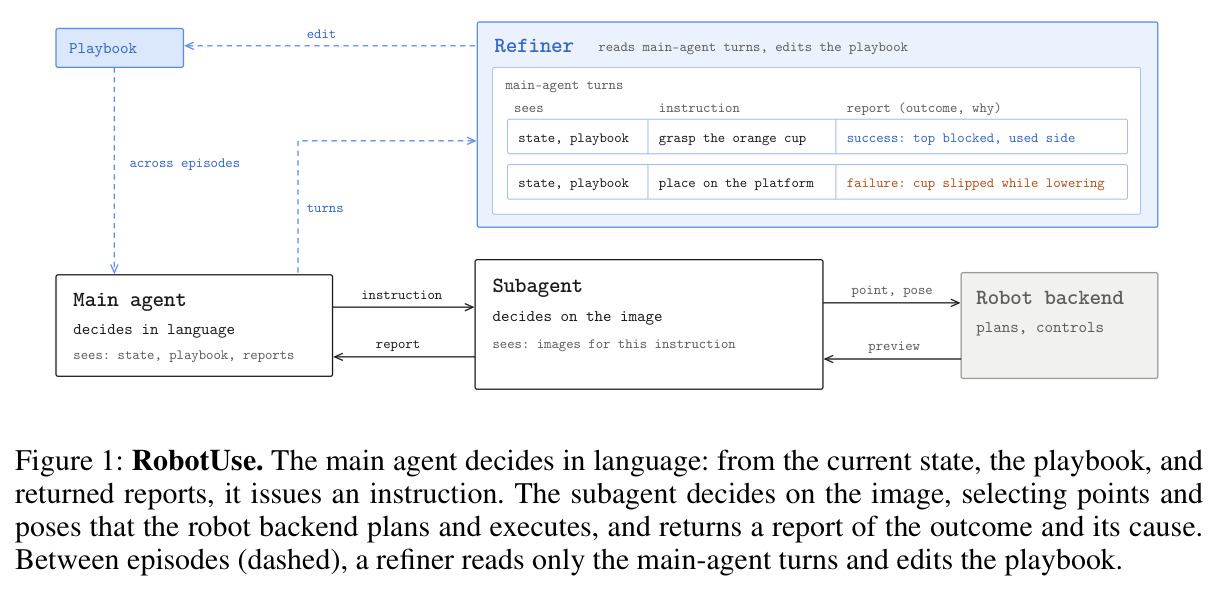
直觉上,RobotUse 把“决定做什么”留给模型,把“怎么动”留给确定性计算。一般 harness 中智能体选择命令 $u_t$、环境给出响应 $s_{t+1}$;RobotUse 把空间命令实例化为规格 $z_t$,拆开选择与实现:$z_t \sim \pi_\theta(\cdot \mid g_i, h_t^{(i)}, \mathcal{P})$,$\xi_t \sim \mathcal{B}(\cdot \mid s_t, z_t)$,其中 $g_i$、$h_t^{(i)}$、$\mathcal{P}$ 分别是子目标、局部历史与 playbook。系统由四个角色组成(图 1):主智能体只看状态、playbook 与报告,用语言下发子目标;子代理在同一模型上开独立上下文,面对图像定点、选候选、改位姿;后端基于标定 RGB-D 完成感知、几何计算、运动规划与控制并回传诊断;外循环 refiner 在回合之间只读主智能体轨迹并编辑 playbook。交接按 $H_{i+1} = H_i \oplus \langle g_i, \rho(h^{(i)}) \rangle$ 进行,$\rho$ 把局部历史压缩成结果与原因报告。
核心创新是把决策边界、上下文边界与经验边界耦合在一起设计。决策边界:候选位姿、定点结果、姿态卡(叠加测量点与夹爪网格的侧视/俯视/闭合平面视图)都是显式对象,智能体可以读取测量偏移(如黄油盒任务的 +27mm)并按机器人基坐标系平移、绕夹爪接触中心旋转下发修正,而不是被动接受后端内部评分规则选出的结果。上下文边界:子目标内的所有观测、选点、修正与诊断都留在子代理局部上下文里,主智能体只拿到结构化报告,实验证明这一隔离把总 token 从 2,909k 降到 596.8k。经验边界:playbook 是带 SHA-256 哈希的版本化 Markdown 文档,refiner 只从主智能体轨迹学习"何种空间选择在何种条件下有效",模型参数与后端代码始终冻结。与 Code as Policies 的本质区别是智能体从不生成或修补控制程序;与 VLA 的区别是没有微调,适应完全通过语言化经验完成。
方法步骤详情
一次任务执行分五步。第一步,主智能体读取状态、playbook 与已有报告,选择子目标 $g_i$ 及其约束作为 handoff 发出,子代理用角色化 prompt 和委派任务初始化全新消息列表。第二步,子代理在图像上用定点工具标注目标(如点击分割出的黄油盒顶部),选点注册为引用供后续候选生成调用,引用检查防止场景变化后旧候选被当作新鲜的可执行选择。第三步,后端生成候选(如 4 个抓取位姿、其中 1 个被路径检查拒绝),子代理检查姿态卡——含测量点与夹爪网格的侧视/俯视/闭合平面视图——可按毫米平移、按度旋转编辑;请求执行时后端把请求解析成位姿,做 3mm/0.025rad 分辨率直线插值的路径检查(IK 失败或关节变化超 0.2rad 即拒绝),执行并返回反馈。第四步,子代理结合新观测与诊断判断进展,可继续修正(如实测 +27mm 偏移则先平移 20mm 再闭合夹爪),需重议约束时带证据返回主智能体。第五步,子目标完成时返回报告(结果、原因、当前图像、未解决问题),回合之间 refiner 读主智能体轨迹,把教训写入 playbook 新版本。
技术新颖性
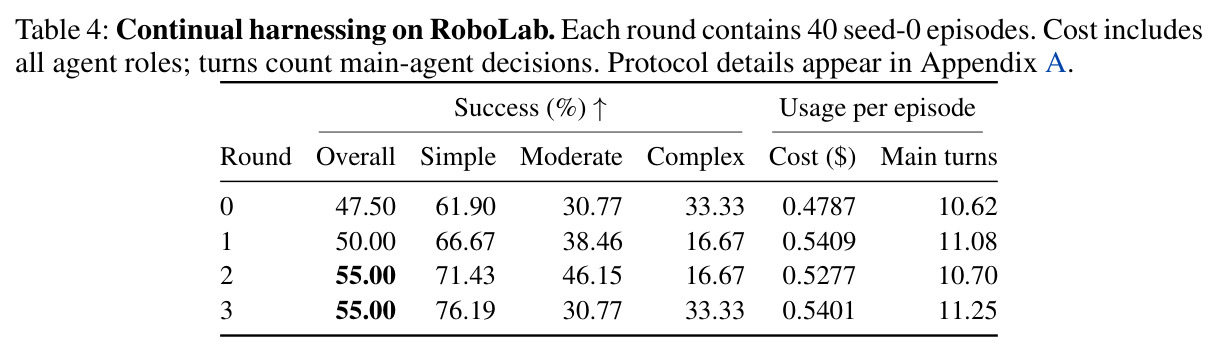
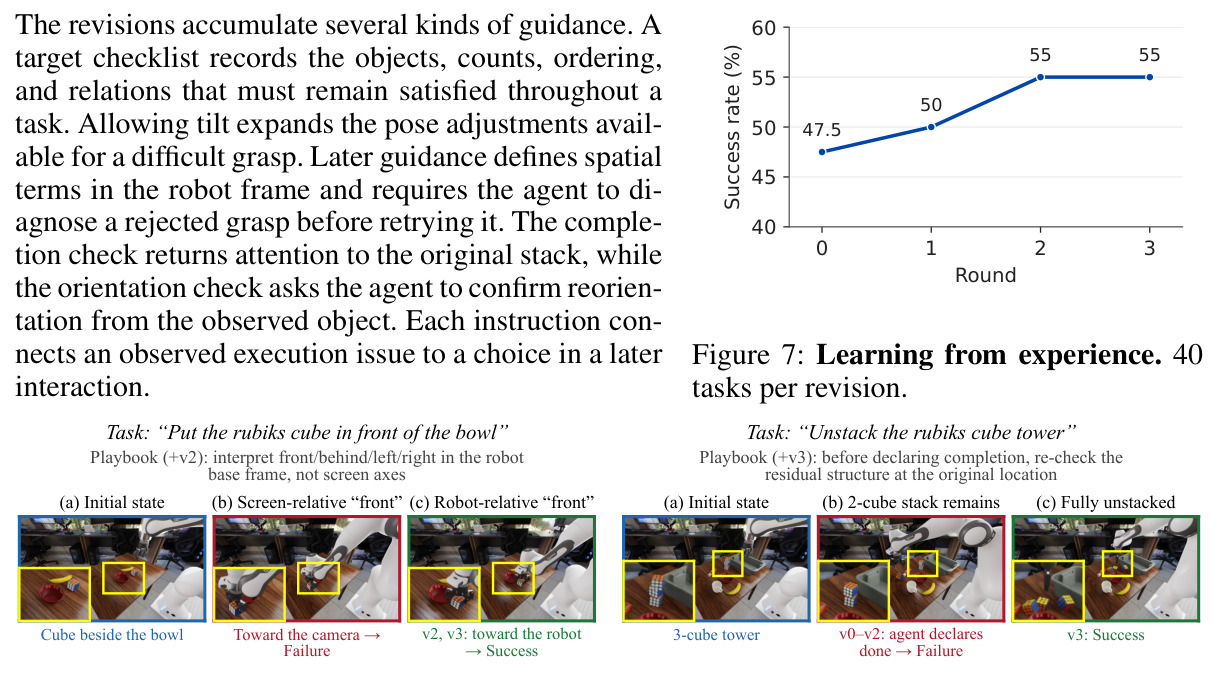
技术新颖性有三点。第一,"意图接口":不同于 PIVOT 把候选动作渲染到图像上让 VLM 迭代细化的纯视觉提示路线,RobotUse 的候选由确定性后端从几何上生成,附测量元数据的姿态卡支持毫米级/度级编辑,形成"检查—修正—执行"闭环,使被选对象同时是审查、修正和运动请求的公共参照。第二,子目标级上下文隔离的实证量化:用同模型、同工具、同指令的单智能体对照实验证明,完整历史堆积使平均输入膨胀 4.2 倍(13.07k→55.01k token)、峰值 3.5 倍、总 token 4.9 倍、API 成本 2.4 倍,且成功率反而从 45.0% 降到 40.8%,说明语言化报告保留了后续决策所需信息。第三,持续 harness 首次系统用于物理领域:Reflexion 只保留言语反馈,Continual Harness 更新 prompt/技能/记忆,RobotUse 则在不改后端代码的前提下,用 playbook 条件化空间选择与恢复策略,并用四个版本的消融(47.50%→55.00%)证明经验确实改变后续决策。
实验结果
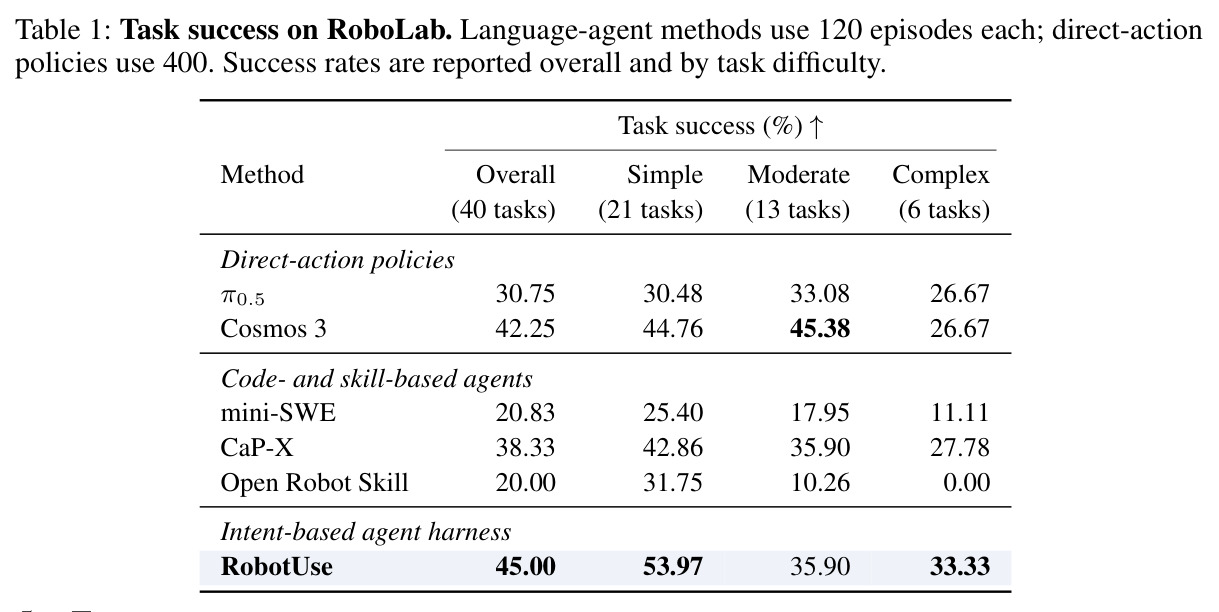
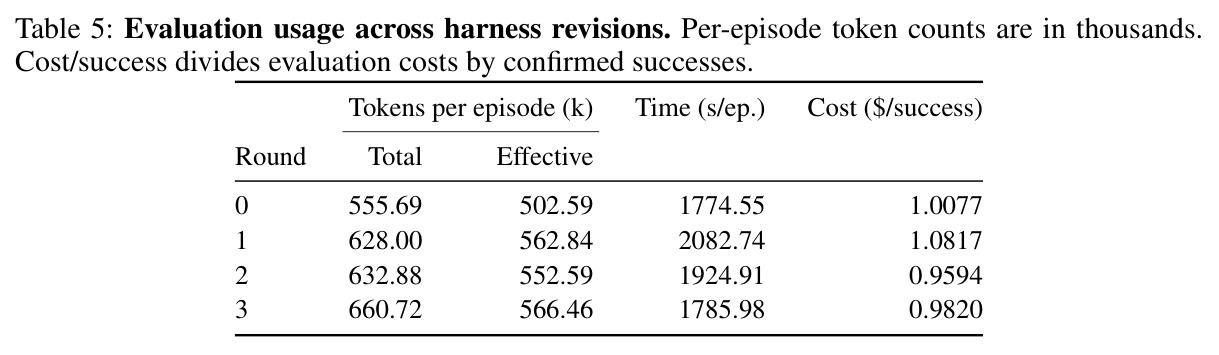
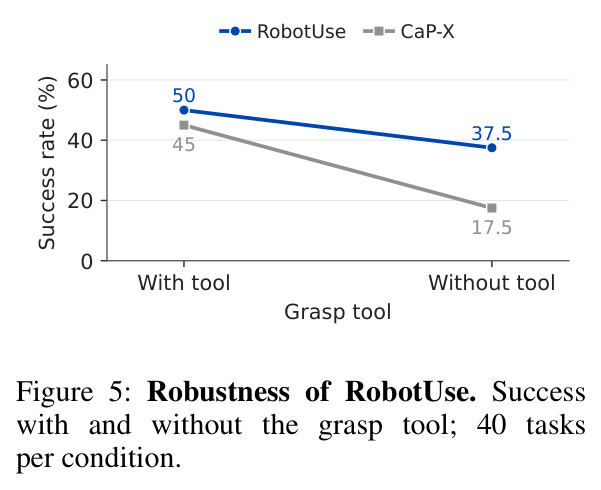
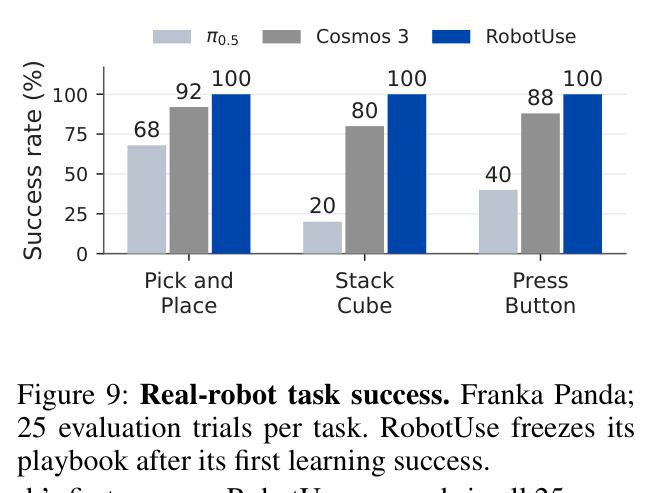
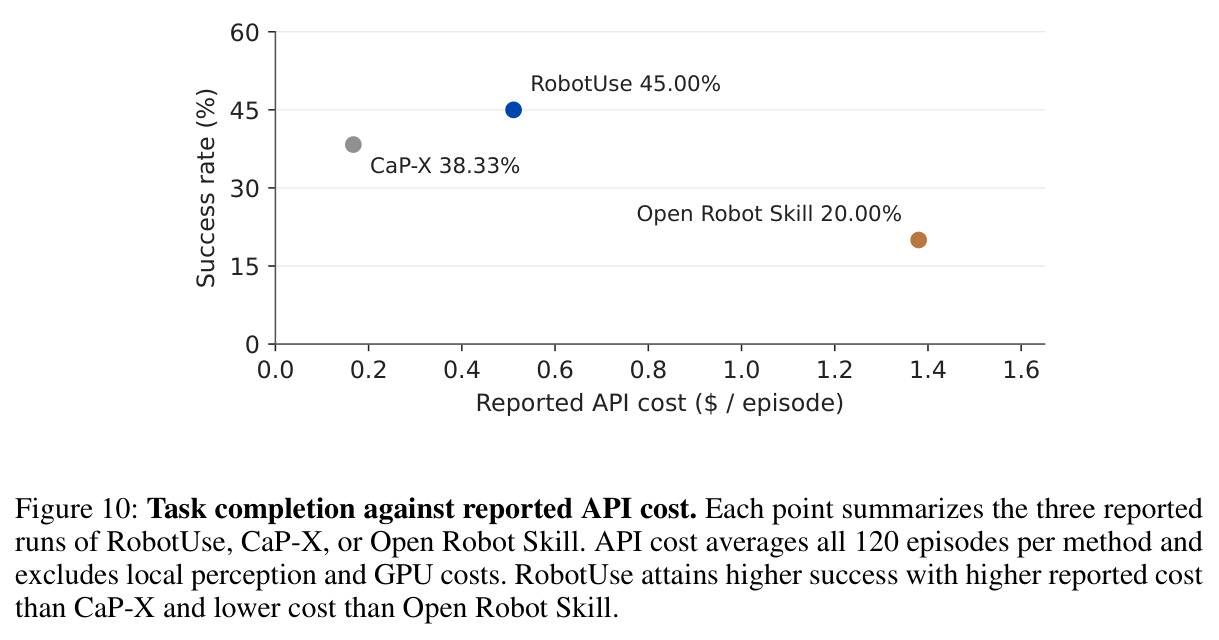
RoboLab 40 任务(每语言代理 120 回合):RobotUse 成功 54/120(45.00%),超 CaP-X 6.67pp、Open Robot Skill 25pp,高于 π0.5 的 30.75% 与 Cosmos 3 的 42.25%;Simple 53.97%、Complex 33.33% 均为最高,Moderate 35.90% 低于 Cosmos 3 的 45.38%。鲁棒性(图 5/表 10):去掉抓取工具后 RobotUse 50.00%→37.50%(降 12.5pp),CaP-X 45.00%→17.50%(降 27.5pp)。上下文消融(表 3):单智能体平均输入 55.01k 对 13.07k token(4.2 倍)、峰值 95.74k 对 27.45k(3.5 倍)、总 token 2,909k 对 596.8k(4.9 倍)、成本 $1.221 对 $0.511(2.4 倍),成功率 40.8% 对 45.0%。经验学习(表 4):四版本成功率 47.50%→50.00%→55.00%→55.00%(19/40→22/40),$/success $1.0077→$0.9820。真机(图 9):Franka Panda 三任务各 25 次评估全部 100%(playbook 首次成功后冻结),微调 π0.5 为 75%/68%/20%,Cosmos 3 为 92%/100%/88%。成本(表 7):$0.511/回合、1880.51 秒、$1.1984/成功,贵于 CaP-X,远低于 Open Robot Skill 的 $1.38/回合与 $7.1346/成功。整体上,性能、鲁棒性与上下文效率三者同向改善,代价是更高的推理开销。
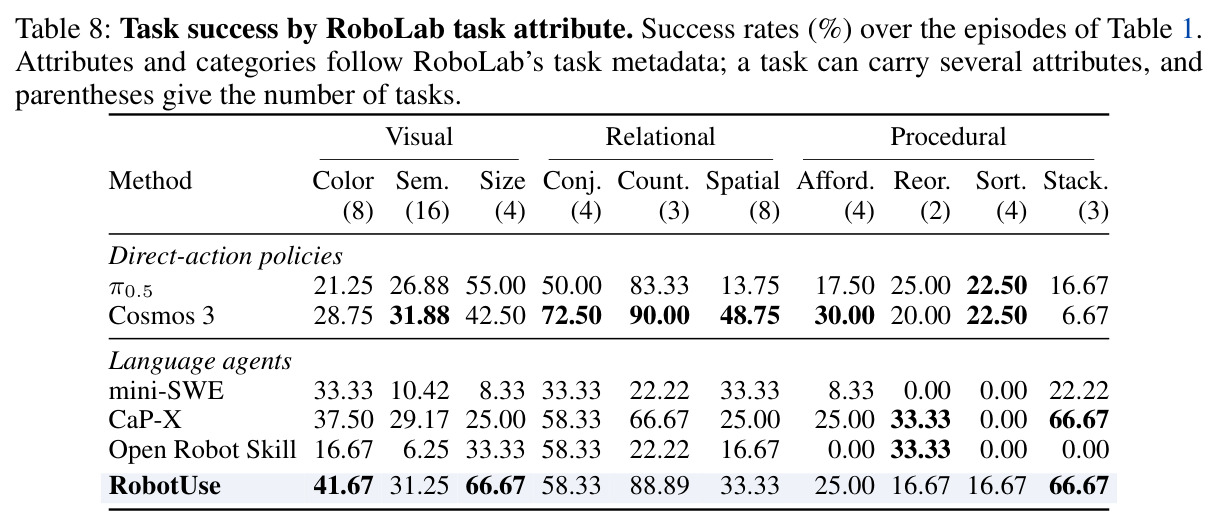
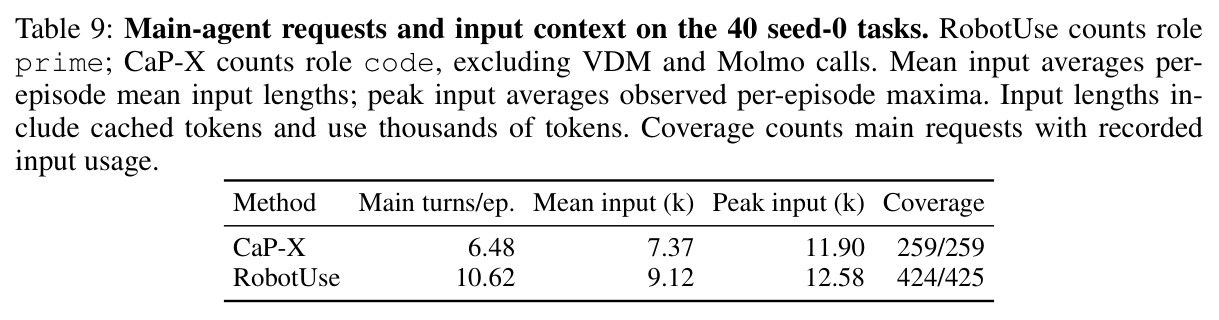
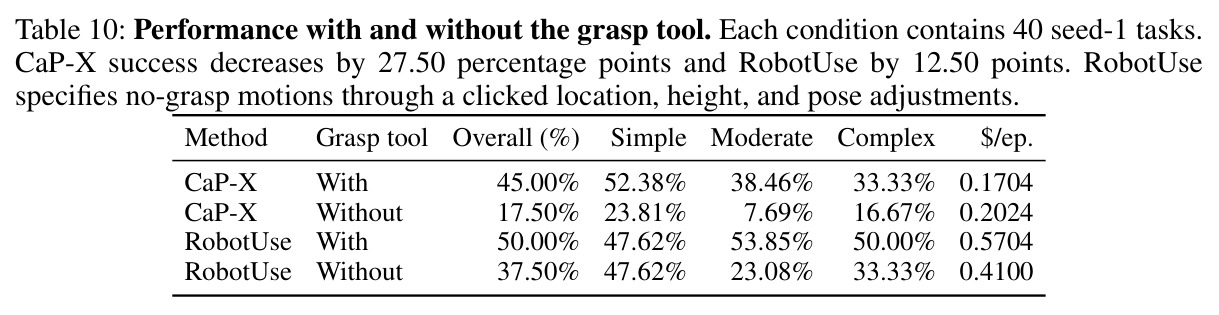
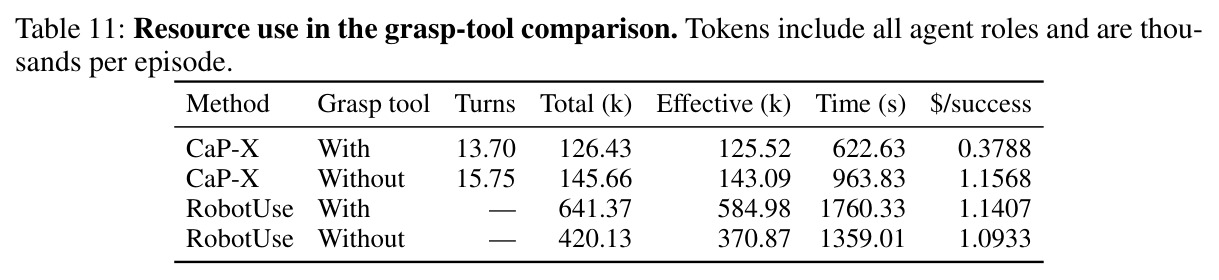
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboLab 40 任务整体成功率 | 任务成功率(120 回合) | 45.00%(54/120),Simple 53.97%、Complex 33.33% 均为最高 | CaP-X 38.33%、Cosmos 3 42.25%、π0.5 30.75%、mini-SWE 20.83%、Open Robot Skill 20.00% | 较最强语言代理基线 CaP-X +6.67pp,较直接动作策略 Cosmos 3 +2.75pp |
| 移除抓取工具后的 RoboLab 40 任务 | 任务成功率(40 回合,seed 1) | 37.50%(原 50.00%,保留 75%) | CaP-X 17.50%(原 45.00%) | 降幅小 15pp(-12.5pp 对 -27.5pp),且成本反而从 $0.5704 降到 $0.4100/回合 |
| 上下文交接消融(同 40 任务、3 种子) | 平均/峰值输入 token、总 token、API 成本 | 13.07k / 27.45k / 596.8k token,$0.511,成功率 45.0% | 单智能体(同模型同工具):55.01k / 95.74k / 2,909k token,$1.221,成功率 40.8% | 输入降 4.2 倍、总 token 降 4.9 倍、成本降 2.4 倍,成功率反升 4.2pp |
| 持续 harness 学习(4 个 playbook 版本,seed 0) | 任务成功率、每成功成本 | 47.50%→50.00%→55.00%→55.00%(19/40→22/40),$/success $1.0077→$0.9820 | 版本 v0 基线 playbook(47.50%) | 四轮修订累计 +7.5pp,每成功成本降约 2.6% |
| Franka 真机:Pick and Place / Stack Cube / Press Button | 任务成功率(每任务 25 次评估) | 三项任务均 100%(playbook 首次成功后冻结;Stack Cube 首试即成,Press Button 第二次尝试成功) | 微调 π0.5 为 75%/68%/20%,Cosmos 3 为 92%/100%/88% | 无需任何模型微调即在最难的按键任务上超过微调基线 12pp |
局限与改进
作者坦承的成本劣势很明显:RobotUse 每回合 $0.511 与 596.8k token 约为 CaP-X 的 3–5 倍,处理时间 1880.51 秒接近 CaP-X 的三倍,且每回合设 60 分钟墙钟上限。学习曲线收益有限:四次修订只把成功率从 47.50% 提到 55.00%,且 round 3 在 Moderate 上从 46.15% 回落到 30.77%,说明 playbook 修订并非单调改进。我自己的观察:其一,评估只有 40 任务、120 回合,45.00% 对 Cosmos 3 的 42.25% 只差约 4 个回合,统计上不稳固且未报告置信区间;其二,真机仅三个简单任务,“首次成功即冻结 playbook”的规则只保留成功版本,或高估稳健性;其三,refiner 的开发协议允许开发探针,playbook 在同一评估目录上迭代,存在对测试分布过拟合的风险;其四,报告映射 $\rho$ 是有损压缩,子代理漏报关键约束时主智能体会系统性误判,论文未消融报告格式的敏感性;其五,链路绑定特定感知工具,图 3 中掩码只盖住盒顶时需智能体视觉兜底,工具质量仍是隐含瓶颈。
独立分析的弱点
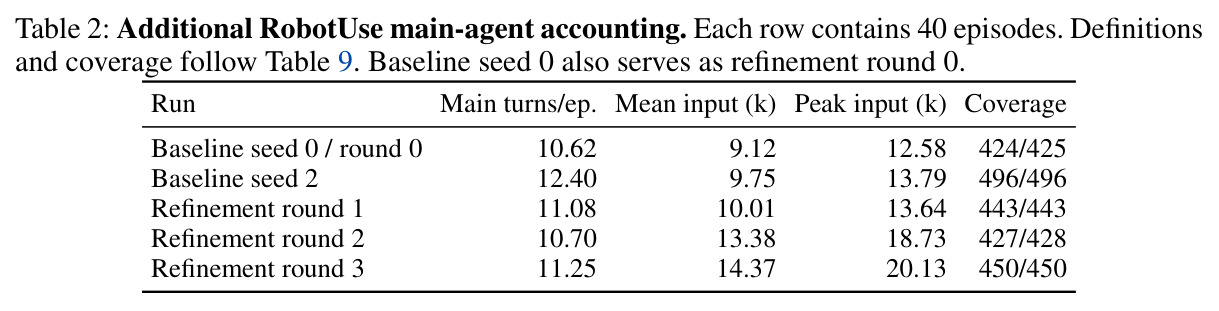
弱点一:推理成本与延迟。每回合 $0.511、1880.51 秒、约 41.6 次模型调用,对实时控制或大规模部署不现实;可把子代理的“检查—修正”模式蒸馏成小型专用策略,或对候选生成做缓存与模型分级路由。弱点二:边际优势的统计可信度。45.00% 对 Cosmos 3 的 42.25% 仅差 3.3 个百分点(约 4 个回合),120 回合下置信区间很可能覆盖两者,应扩充任务目录并报告区间估计。弱点三:playbook 过拟合与可控性。refiner 在评估目录上迭代四轮,round 3 的 Moderate 从 46.15% 掉到 30.77% 即是信号;应做跨目录验证与 playbook 自动回归测试。弱点四:感知工具单点依赖。定点与候选质量取决于分割等下游模型,掩码不完整时全靠智能体视觉兜底;可在后端引入多假设分割与不确定性输出。弱点五:报告的有损性。主智能体每回合平均输入仅 9.12k token 却要做出约 10.62 次决策,报告格式直接决定上限;可引入按需取回局部历史的 RLM 式递归查阅接口。
未来方向
作者指出的方向是把 harness 设计确立为改进机器人智能体的手段:委托几何计算与控制、保留需要修正的物理选择、以可编辑指导的形式积累经验;真机上 playbook 从 Pick and Place 迁移到 Stack Cube 首试即成功,是经验跨任务迁移的初步证据,值得在更大任务谱系上验证。可延伸的方向包括:其一,规格接口的自动化——根据失败统计自动增删工具与候选类型,而非人工设计定点/候选/编辑三件套;其二,与 VLA 融合,用 π0.5 类模型作后端提议器生成候选,RobotUse 做上层规格、验证与修正;其三,长时程与多机器人家庭任务,检验 playbook 在场景漂移、物体变化下的鲁棒性与冲突消解;其四,把回合间的 refiner 升级为在线持续学习,研究 playbook 的遗忘与回滚机制;其五,成本优化,每回合 41.6 次调用中子代理行为高度模式化,可用小模型或轨迹微调压低延迟与费用;其六,从"失败后诊断"走向"执行前风险预测",利用积累的诊断数据训练可行性预测器,提前拦截会被路径检查拒绝的请求。
复现评估
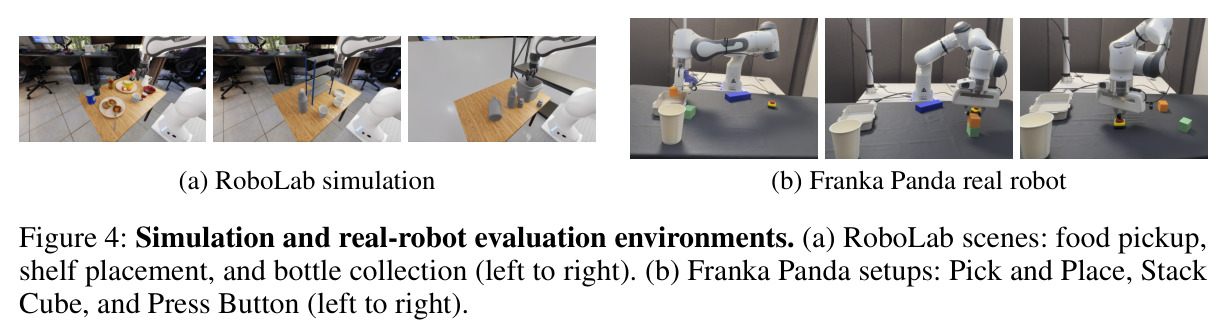
复现生态友好。评测基于公开的 RoboLab 基准(RSS 2026),π0.5 用公开 OpenPI 的 pi05_droid_jointpos checkpoint,mini-SWE 为 v1.17.51 开源版,Open Robot Skill 有 GitHub 仓库,语言模型是经 OpenRouter 的 Gemini-3.8-Flash;真机为 Franka Panda 加腕相机与两个固定相机,50×50cm 工作台。项目页 robotuse-team.github.io 已建,但论文未明确承诺框架代码开源,playbook 全文未随文发布,是最大不确定点。算力上,语言智能体方法只需 API 调用:每方法 120 回合约 $61,三次运行约 $184,另加开发探针;π0.5/Cosmos 3 需本地 GPU(各 400 回合)。难度:仿真部分中等——搭 RoboLab 并按附录 B 复现工具契约与姿态卡渲染;真机部分较高——设备、标定与安全。附录 A 给出详细协议(种子、±0.10m 随机化、停止规则、成本口径),playbook 以 SHA-256 哈希版本化,便于对齐。
论文图表
两个 playbook 教训的定性案例:左侧 v2 规定 front/behind 按机器人基坐标而非屏幕坐标解释,使"放到碗前面"从失败变为成功;右侧 v3 要求宣布完成前复查原位置的残余结构,使拆塔任务真正拆完。
具体说明 playbook 条目如何把执行失败映射为后续交互中的选择修正,是理解经验学习机制的样例。
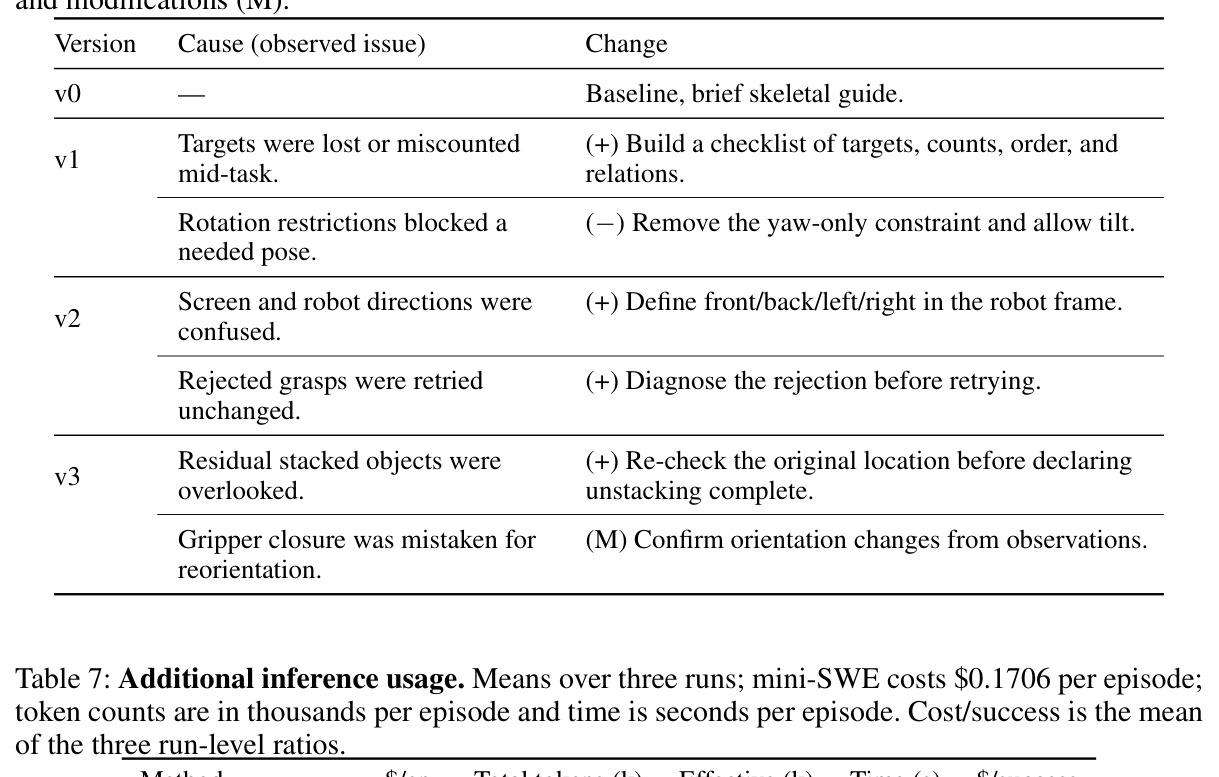
逐版本列出 playbook 变更及诱因:v1 加目标清单、删偏航限制允许倾斜;v2 定义机器人坐标系方向、要求诊断被拒抓取;v3 完成前复查原堆叠、从观测确认姿态变化。
经验学习机制的具体内容,与 Figure 7 的曲线一一对应。