智能体即策略:通用智能体直接驱动的机器人操作 Agent as Policy for Robotic Manipulation
让通用编码智能体直接充当机器人策略,零训练完成装配、搭建、骰子、投掷与叠毛巾等真实操作。
前置知识
视觉-语言-动作(VLA)模型
VLA 模型是在大规模机器人轨迹数据上端到端训练的神经网络,输入图像与语言指令,直接输出机器人动作序列,代表工作包括 RT-2、$\pi_0$、OpenVLA 等。它们通常以扩散模型或自回归方式生成动作块,需要成千上万条示教轨迹,其能力边界由训练数据与模型权重决定,遇到分布外物体或动作往往失效。
本文的核心主张是与 VLA 路线正面对照:AGP 完全不训练动作模型,而是让通用多模态大模型智能体直接充当策略。只有理解 VLA 的工作方式与局限,才能理解作者声称的差别以及付出的时间成本代价。
逆运动学(IK)
逆运动学解决的是:给定末端执行器(夹爪)的目标位置和姿态,反解出机械臂各关节角度应该是多少。本文的机器人接口允许智能体直接下发末端位姿目标,控制器内部用开源库 Mink(基于 MuJoCo)求解关节目标,再在关节速度 20°/s、加速度 40°/s²、笛卡尔 0.03 m/s 等限制下生成轨迹,并由电机反馈闭环跟踪。
智能体发出的 move_ee 动作请求最终全部依赖 IK 落地执行。理解这一层才能分清论文中『智能体决策』与『底层控制』的分工边界:模型负责想,桥和控制器负责安全地动。
代码即策略(Code as Policies)
这条路线让 LLM 在任务执行前一次性生成一段完整程序或计算图,把感知与控制的运行时决策写成显式规则,机器人照章执行。代表工作有 ProgPrompt、Code as Policies、RoboScript 等。其固有缺陷是:程序必须在事前穷举所有分支,难以预料执行中不确定的观测和意外结果(如插轴失败后该怎么补救)。
这是 AGP 的关键对照对象。理解『提前写好程序』的缺陷,才能体会 AGP『边执行边写程序、边看结果边改代码』的本质区别。
RGB-D 相机与手眼标定
RGB-D 相机同时输出彩色图与逐像素深度图。通过手眼标定(相机坐标系与机器人基座坐标系之间的刚体变换),可以把像素反投影成机器人坐标系下的三维点。本文腕部 Intel RealSense D405 提供对齐的 RGB+深度(640×360),顶部固定 Logitech BRIO 提供俯视 RGB(1920×1080),均为 30fps,智能体按需请求取帧。
智能体的『感知』完全建立在标定后的图像+深度之上:定位零件、估计抓取点、验证动作结果都靠它。没有这个背景就无法理解方法章节中的几何估计与坐标系 grounding。
ReAct 式工具调用循环
ReAct 模式指智能体在『思考→调用工具→观察结果→再思考』的循环中逐步完成任务:工具结果写入对话历史,工作区文件提供持久记忆。编码智能体(如 Codex、Claude Code)在此之上增加了写代码、运行代码、读写文件的能力,SWE-agent、OpenHands 都是典型实现。
AGP 的『策略』就是一个编码智能体。论文公式 (1) $u_k \sim \pi_\theta(\cdot \mid g, \mathcal{I}, \mathcal{H}_k, \mathcal{W}_k)$ 正是这个循环的形式化,其中工具调用 $u_k$ 就是动作,理解它才能看懂『策略』在此语境下的含义。
研究动机
让机器人执行操作任务目前有两条主流的智能体化路径,各有硬伤。第一条是『程序生成』:智能体在任务开始前生成一段可执行代码或计算图(如 Code as Policies、RoboScript、ASPIRE),运行时决策全部固化为显式规则。可物理世界充满不确定性:以插轴装配为例,插入失败后机器人可能需要更近的视角、修正后的对齐估计、甚至换一个接近方向,这些动态分支很难在事前用规则穷举。第二条是『策略编排』:智能体只负责挑选和串联已训练好的技能或 VLA 策略(如 RoboClaw、Harness VLA),但运动生成本身仍被所选策略的能力封顶,一旦遇到训练分布外的动作——比如需要绕关节摆臂并定时松爪的投掷、或者可变形毛巾的双臂协同——编排者无能为力。此外作者还观察到,传统 pick-and-place 类任务(如把物体放进碗)对强模型已经不构成任何挑战,社区缺少能区分『真推理』与『背技能』的高难度评测。
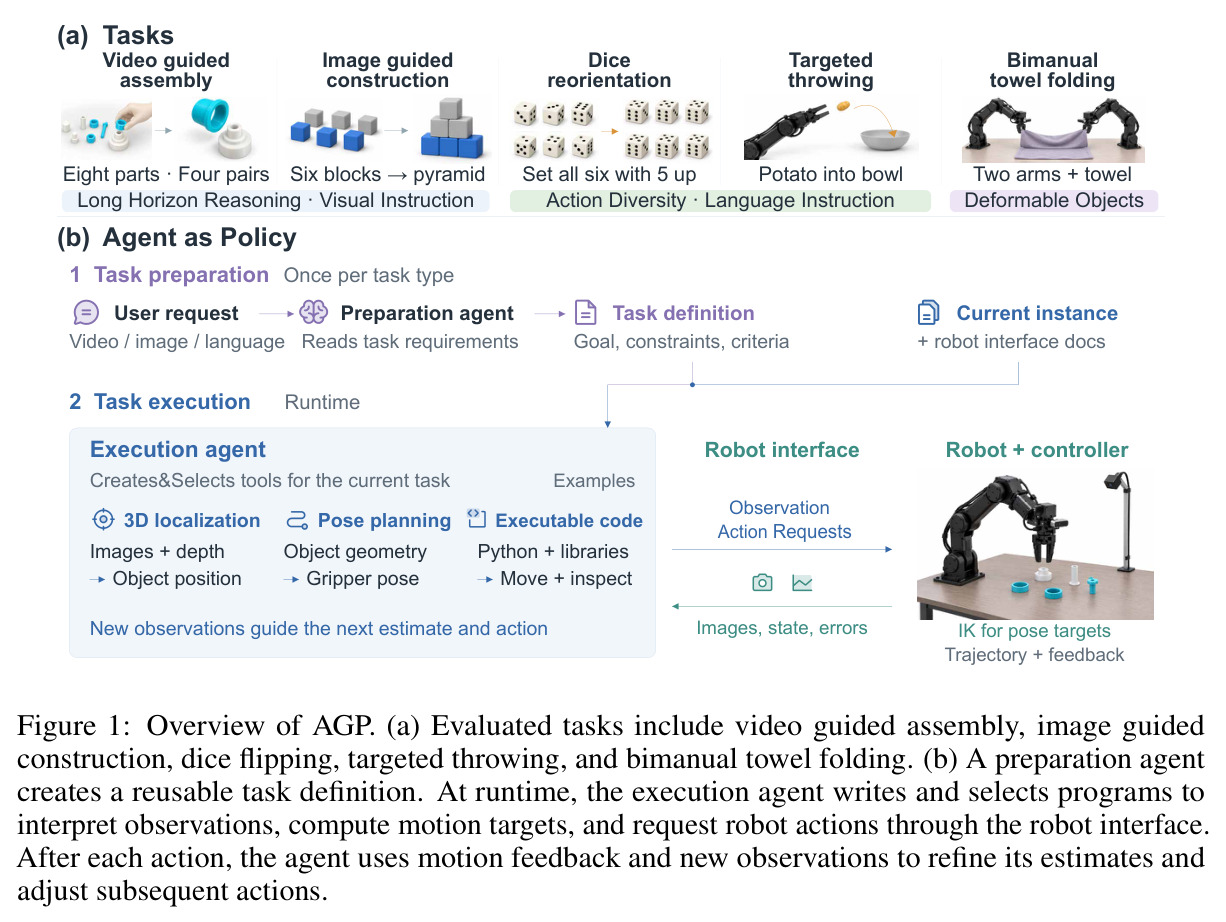
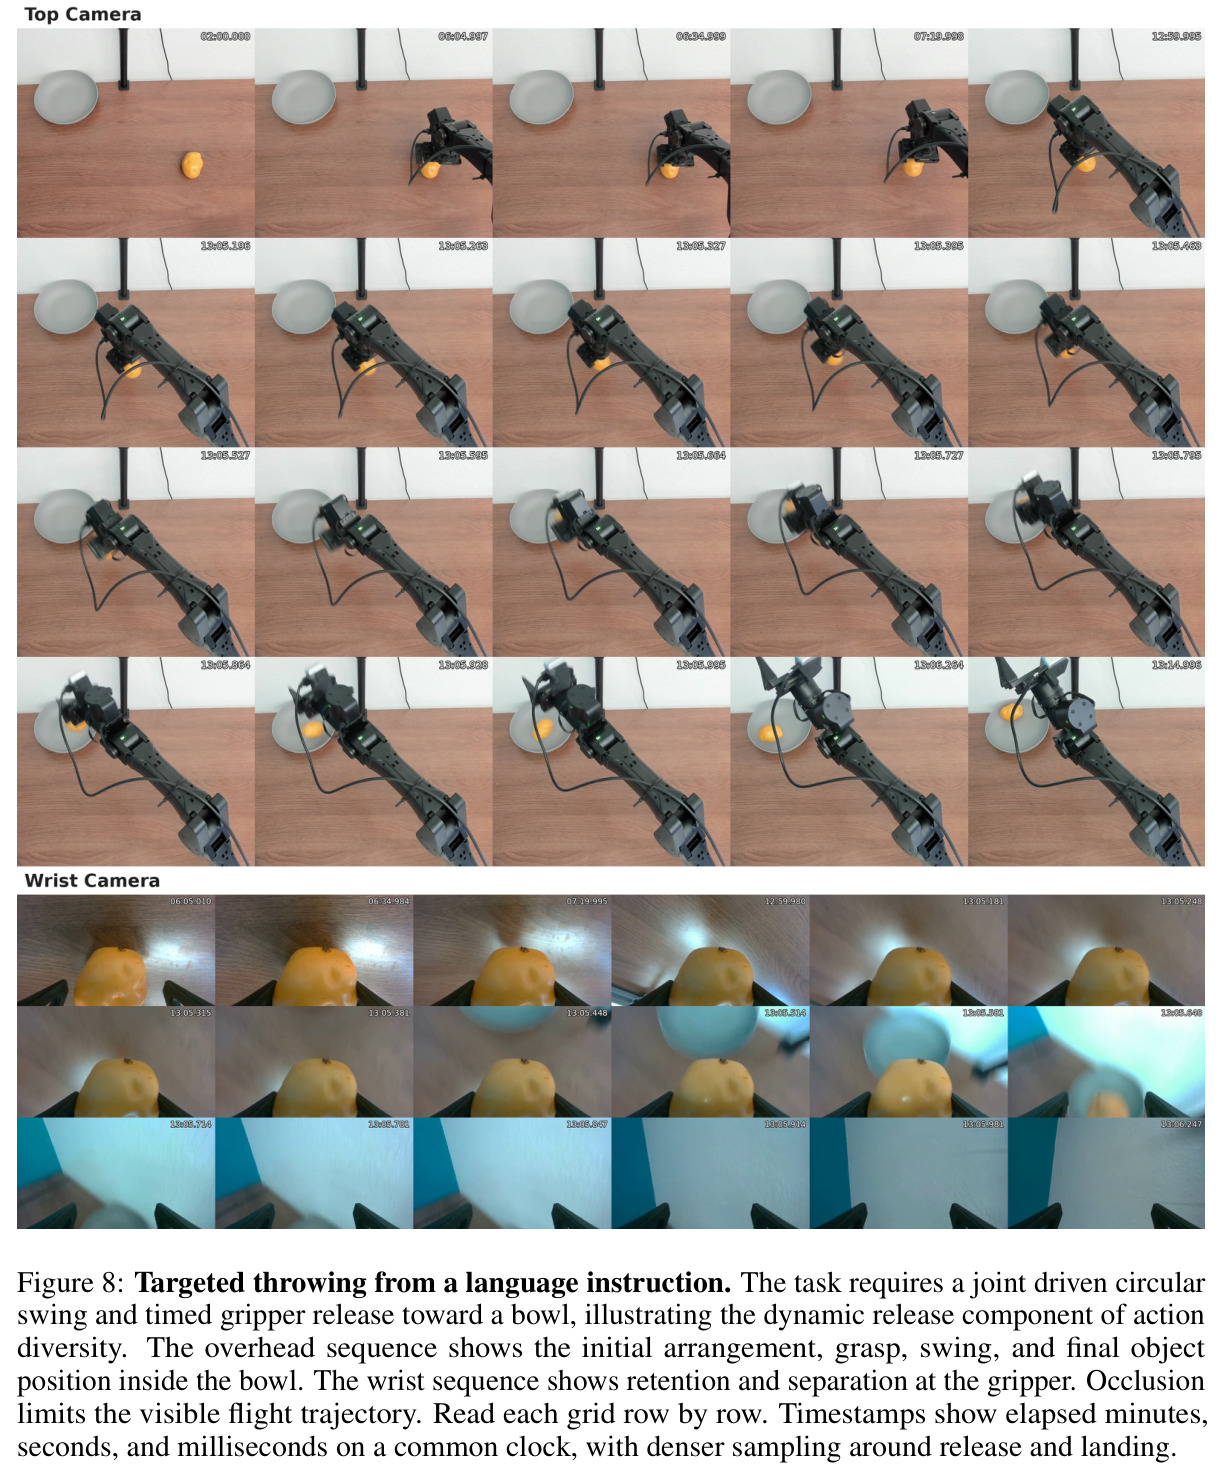
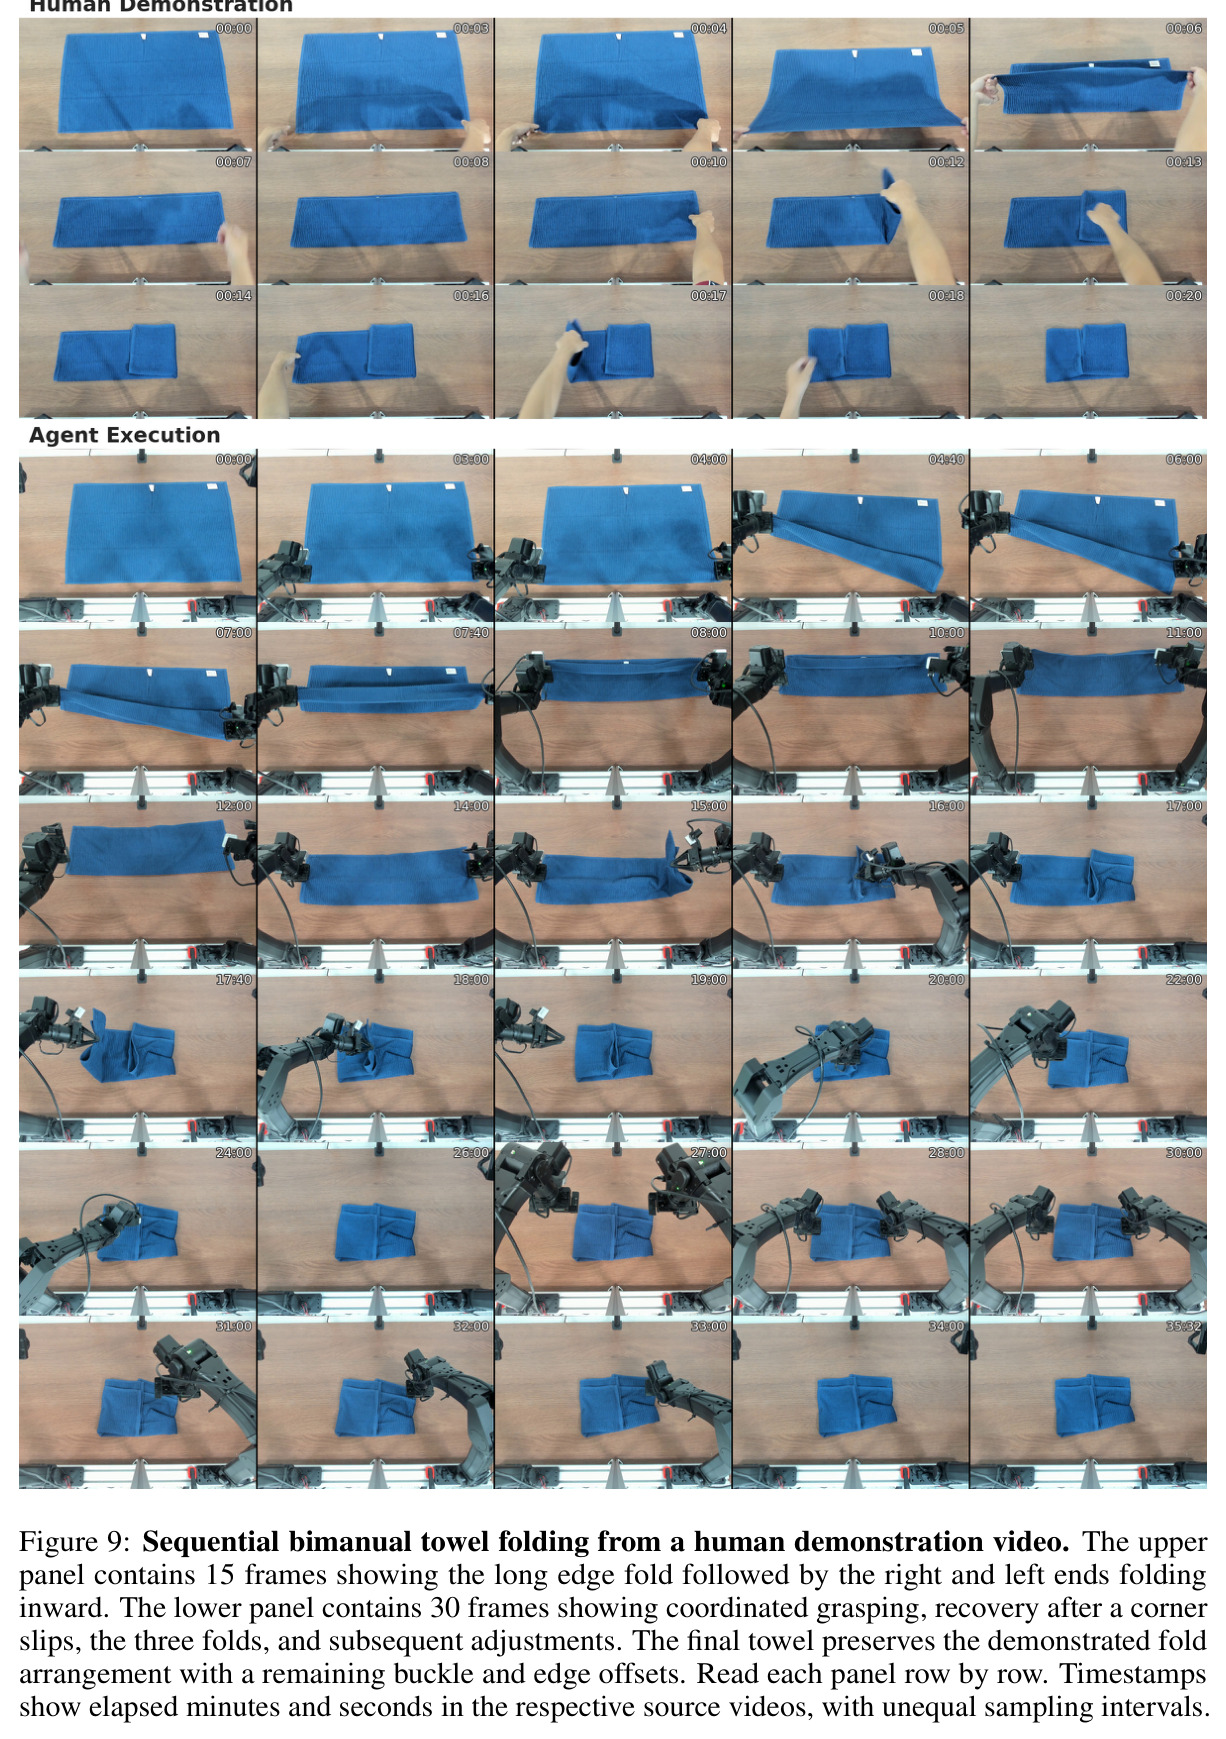
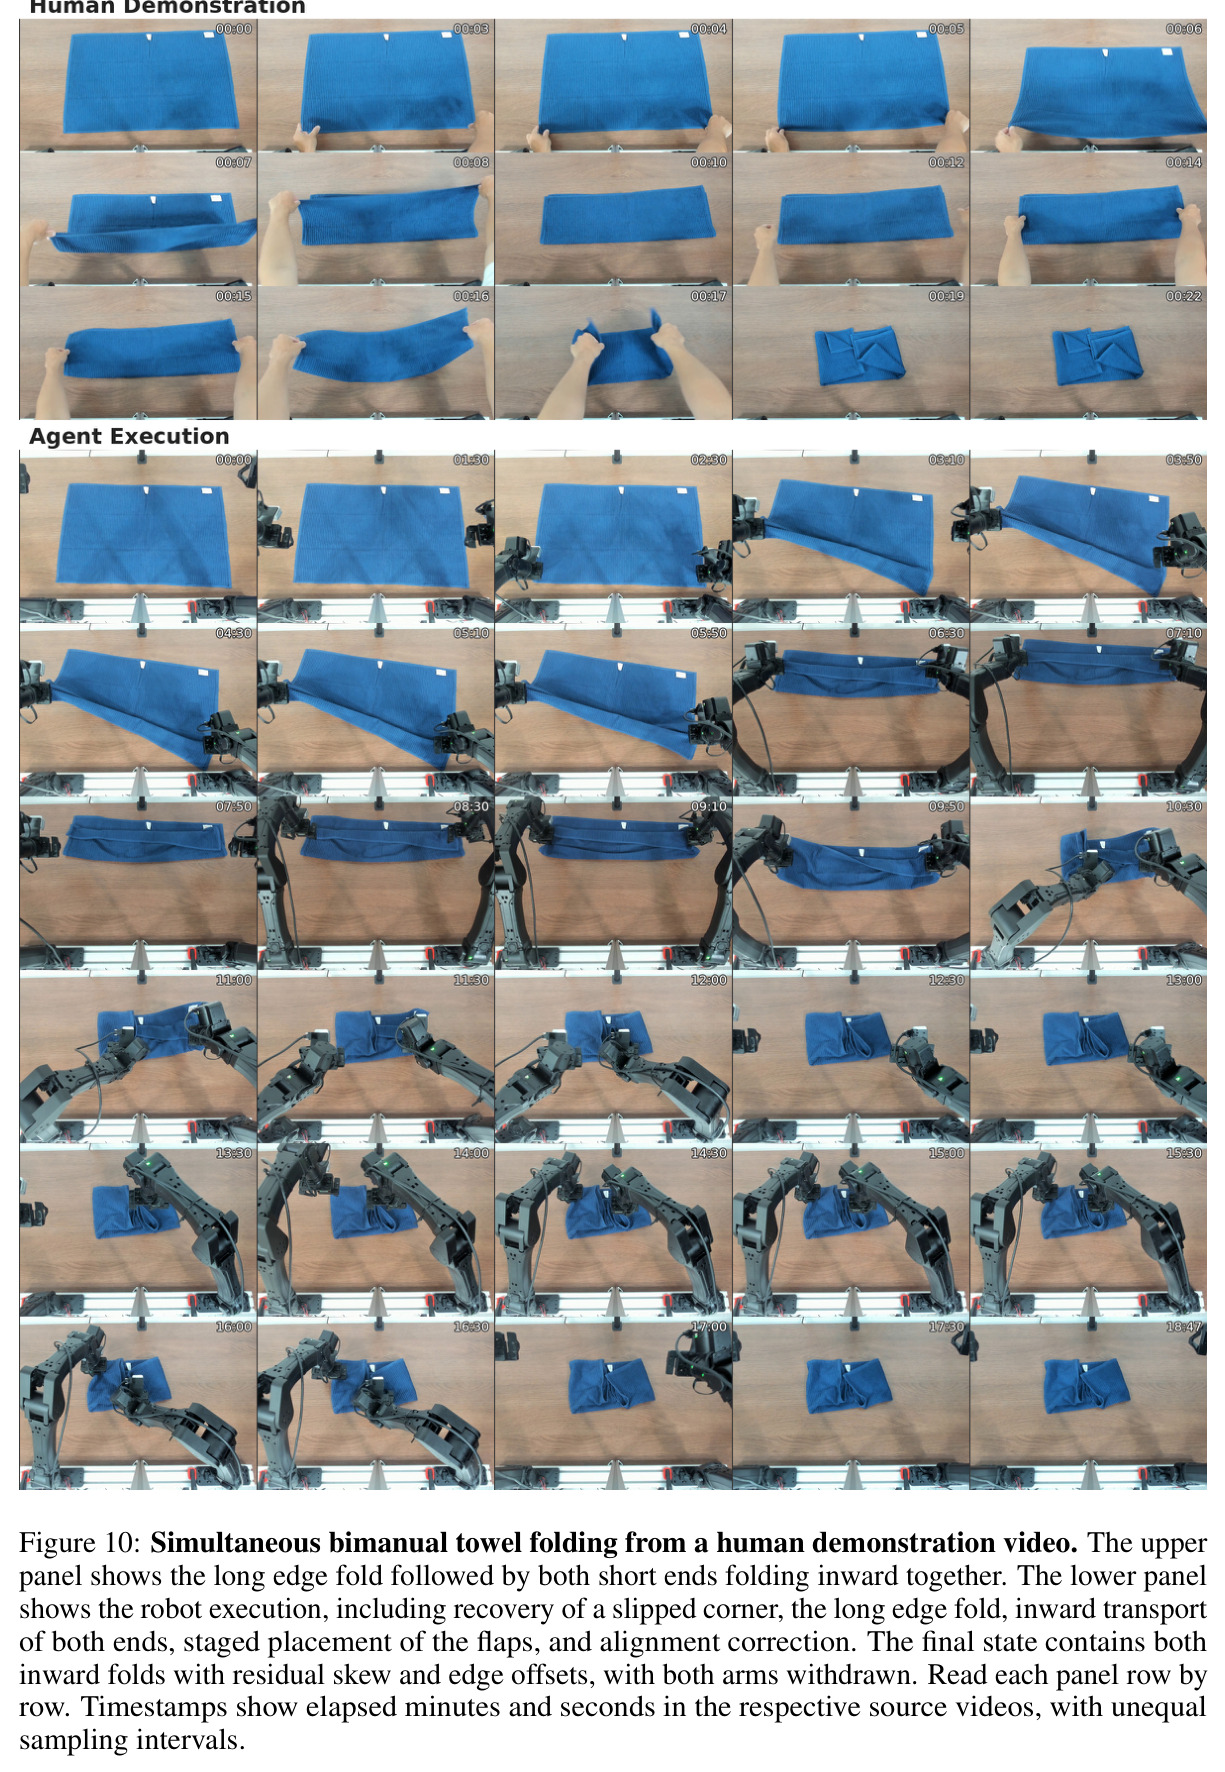
本文的目标是本文想回答一个直接的问题:一个不做任何任务专用或环境专用训练的通用多模态大模型智能体,能否直接充当机器人策略,端到端地完成有难度的真实操作任务?具体目标分三层。其一,把任务规划与执行的全部运行时决策——看什么、怎么解读视觉证据、发什么运动指令、失败后如何恢复——都交给智能体本身,而不是事先写死的程序,也不是预训练的动作策略。其二,用四个任务族覆盖三大能力轴:长程推理(人类视频引导的八件四对装配、目标图像引导的六块积木搭建)、动作多样性(需要抓取依赖翻转的六颗骰子、绕关节圆弧摆动加定时松爪的定向投掷)、物体多样性(双臂折叠可变形毛巾),指令形式覆盖视频、图像、语言三种模态。其三,超越成功率,系统量化耗时、token 用量与推理成本这些通常被回避的部署指标,并探索用经验积累与强弱模型间的经验迁移来压缩这些开销。
与已有工作不同的是,本文的独特之处在于把『智能体』和『策略』两个概念直接画上等号,中间不夹任何训练出来的动作模型。已有工作要么把智能体当代码生成器(生成完就退出决策回路),要么当调度器(只决定下一个技能跑什么,动作仍由被调策略生成);AGP 则让运行时智能体拥有感知、运动生成与恢复的完全自主权:它可以现场决定拍哪张图、写什么 Python 程序来估计几何、发哪种动作请求,并把每次动作的物理反馈用于下一个决策。形式上,策略被定义为工具调用序列:$u_k \sim \pi_\theta(\cdot \mid g, \mathcal{I}, \mathcal{H}_k, \mathcal{W}_k)$,即在任务说明 $g$、机器人接口 $\mathcal{I}$、历史 $\mathcal{H}_k$ 与工作区 $\mathcal{W}_k$ 条件下,由参数固定为 $\theta$ 的模型逐步采样工具调用。这是对『机器人策略边界』的一次重新划分——策略即推理过程本身,动作空间即编程语言。
核心方法
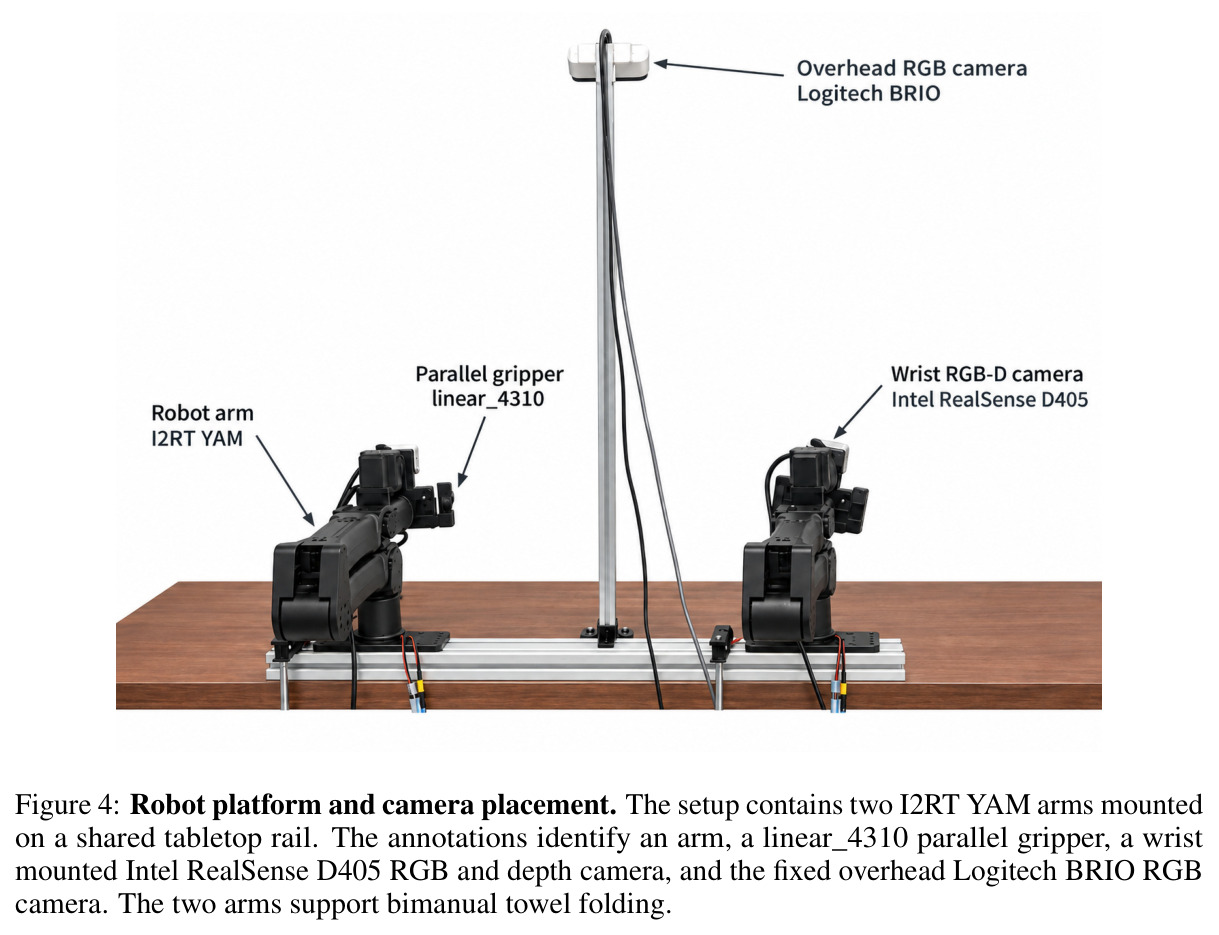
AGP 的架构分两层。第一层是任务准备:每当引入一类新任务,一个独立的准备智能体(同样是编码智能体)根据用户的视频/图像/语言请求,生成一份可复用的任务定义文件,写明目标、参考材料、约束、允许的变化与完成标准,连同接口访问规则、预算与汇报要求;之后同类任务直接带定义启动执行智能体,不必重复准备。第二层是运行时执行:执行智能体通过『智能体-机器人桥』与物理机器人交互。桥向外暴露标定过的相机观测、本体状态与七条命令(state、status、help、frames、move_ee、move_joints、gripper),向内对动作请求做安全校验(径向目标包络 0.12–0.65 m、抓取高度 −0.050–0.60 m、单步笛卡尔位移上限 0.25 m),末端位姿目标经 Mink 逆运动学转成关节轨迹并闭环跟踪。硬件是 I2RT YAM 六自由度机械臂加平行夹爪(最大开口 95.5 mm),双臂共享标定坐标系以支持毛巾折叠;投掷任务另配有时序运动程序接口(50 Hz 插值、关节 4 限速 180°/s)。关键设计是运动执行与监控独立于模型推理进行:智能体在两次工具调用之间思考时机器人保持姿态,同一臂动作按序执行、双臂可并发。
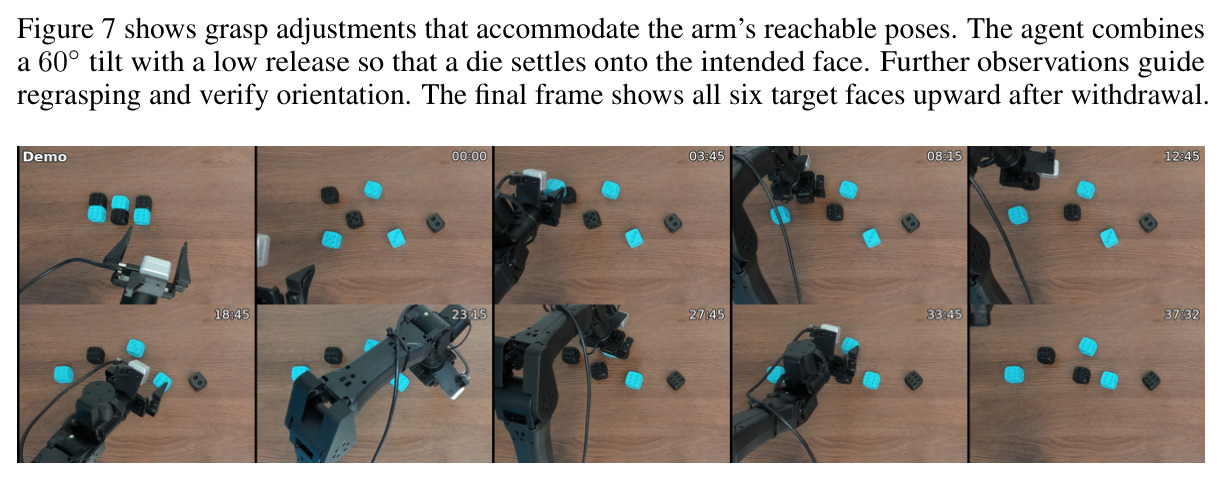
核心创新是把『运行时编程』作为动作空间。与 Code as Policies 在执行前一次性生成程序不同,AGP 的智能体在任务执行过程中持续编写、修改和复用 Python 程序:从腕部深度图采样三点拟合平面并用 SVD 估计法向、把顶部与腕部两台相机的像素光线三角化以定位物体、计算抓取偏移,到把『动臂+拍图+显示』打包进一次工具调用以降低开销。程序输出直接进入物理动作——附录 E 的实例中,程序算出销钉目标位姿 $(0.5133, -0.1582)$ m 与四元数后立即作为 move_ee 请求发出,并利用返回的到位误差迭代修正。与策略编排路线的本质区别在于:这里没有任何预先训练的动作策略,运动完全由『智能体写代码+接口执行』产生,因此能零样本处理接口能力范围内的任意动作,包括骰子翻转中组合 60° 倾斜与低空释放的抓取-旋转-再抓取,以及投掷中的定时松爪。模型参数全程冻结,所有适应都发生在会话内的测量、程序与决策层面;经验还可以沉淀为文件跨会话复用。
方法步骤详情
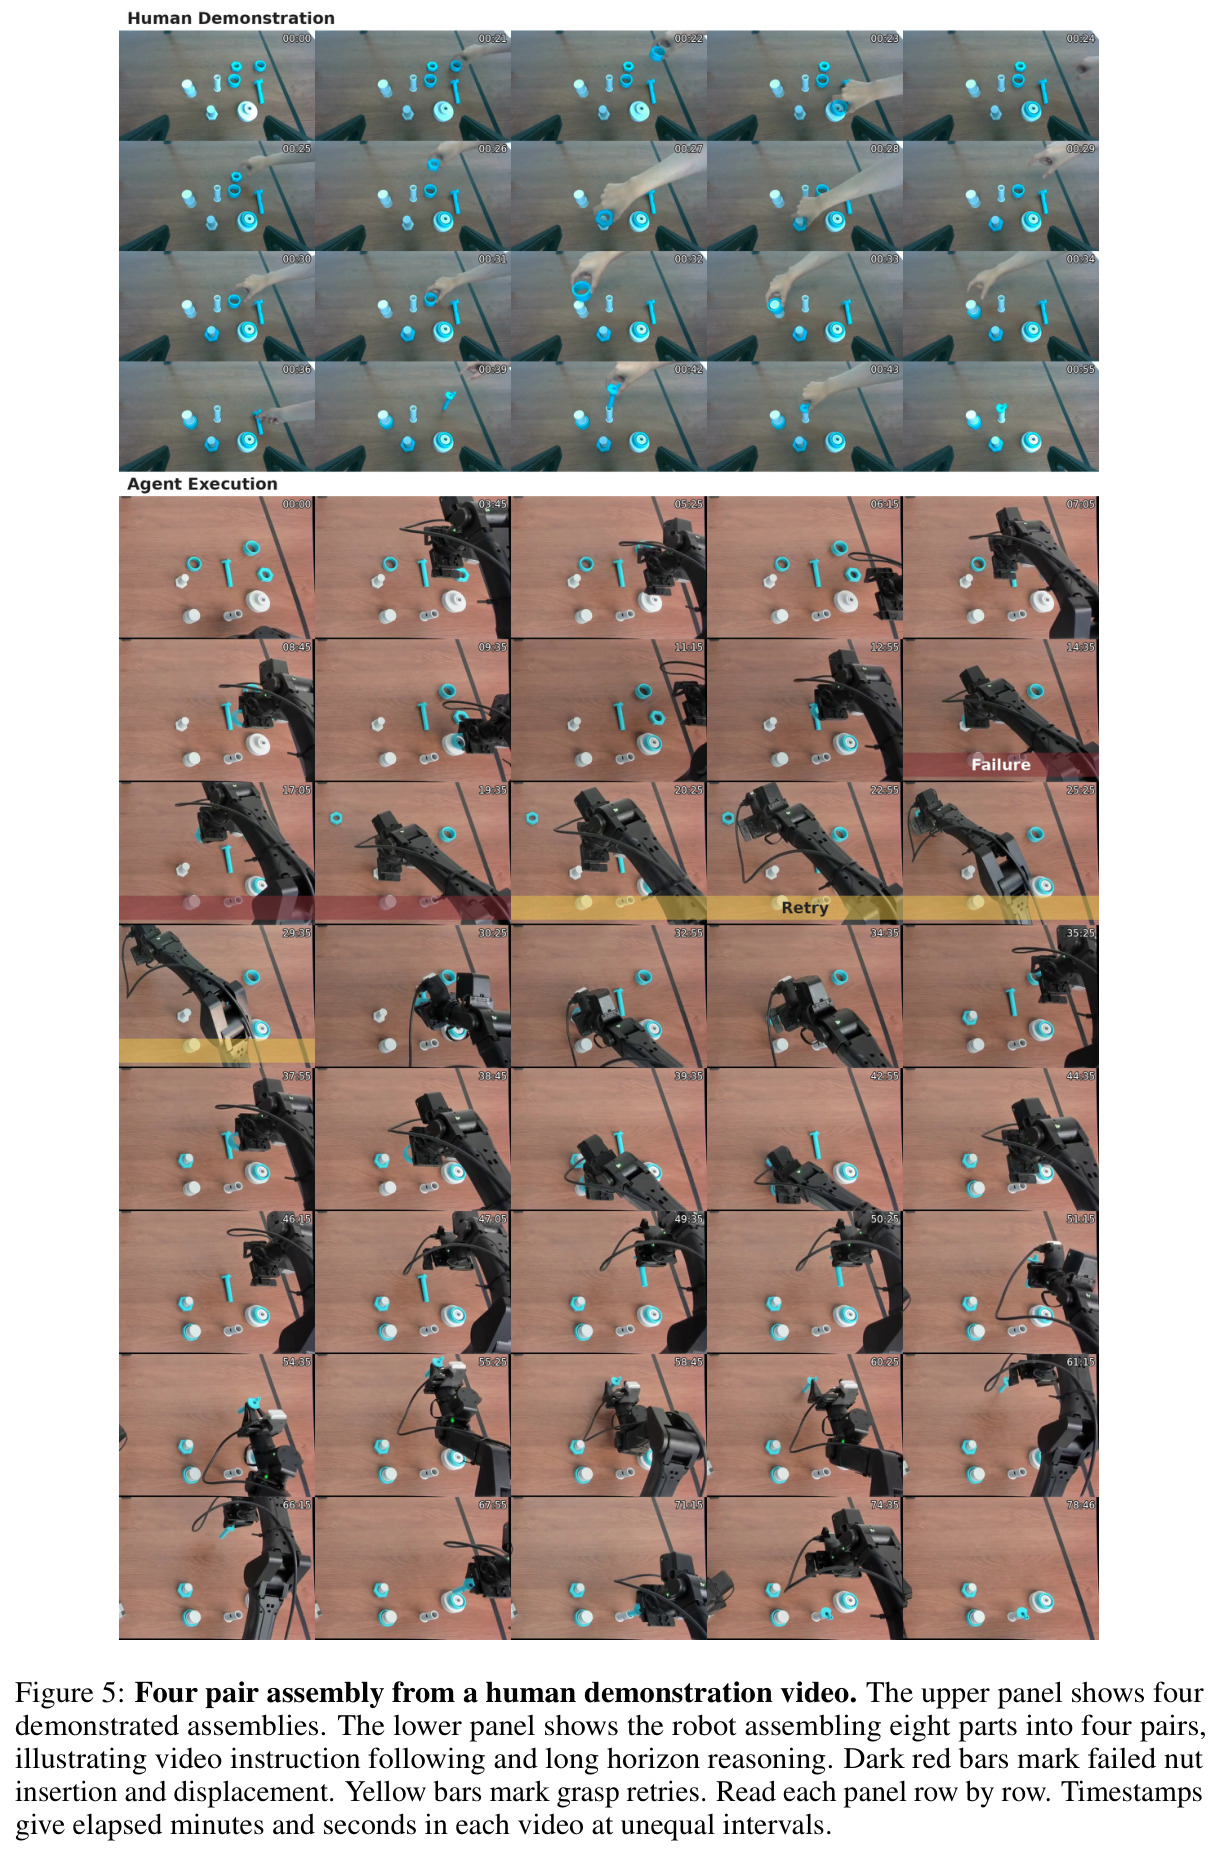
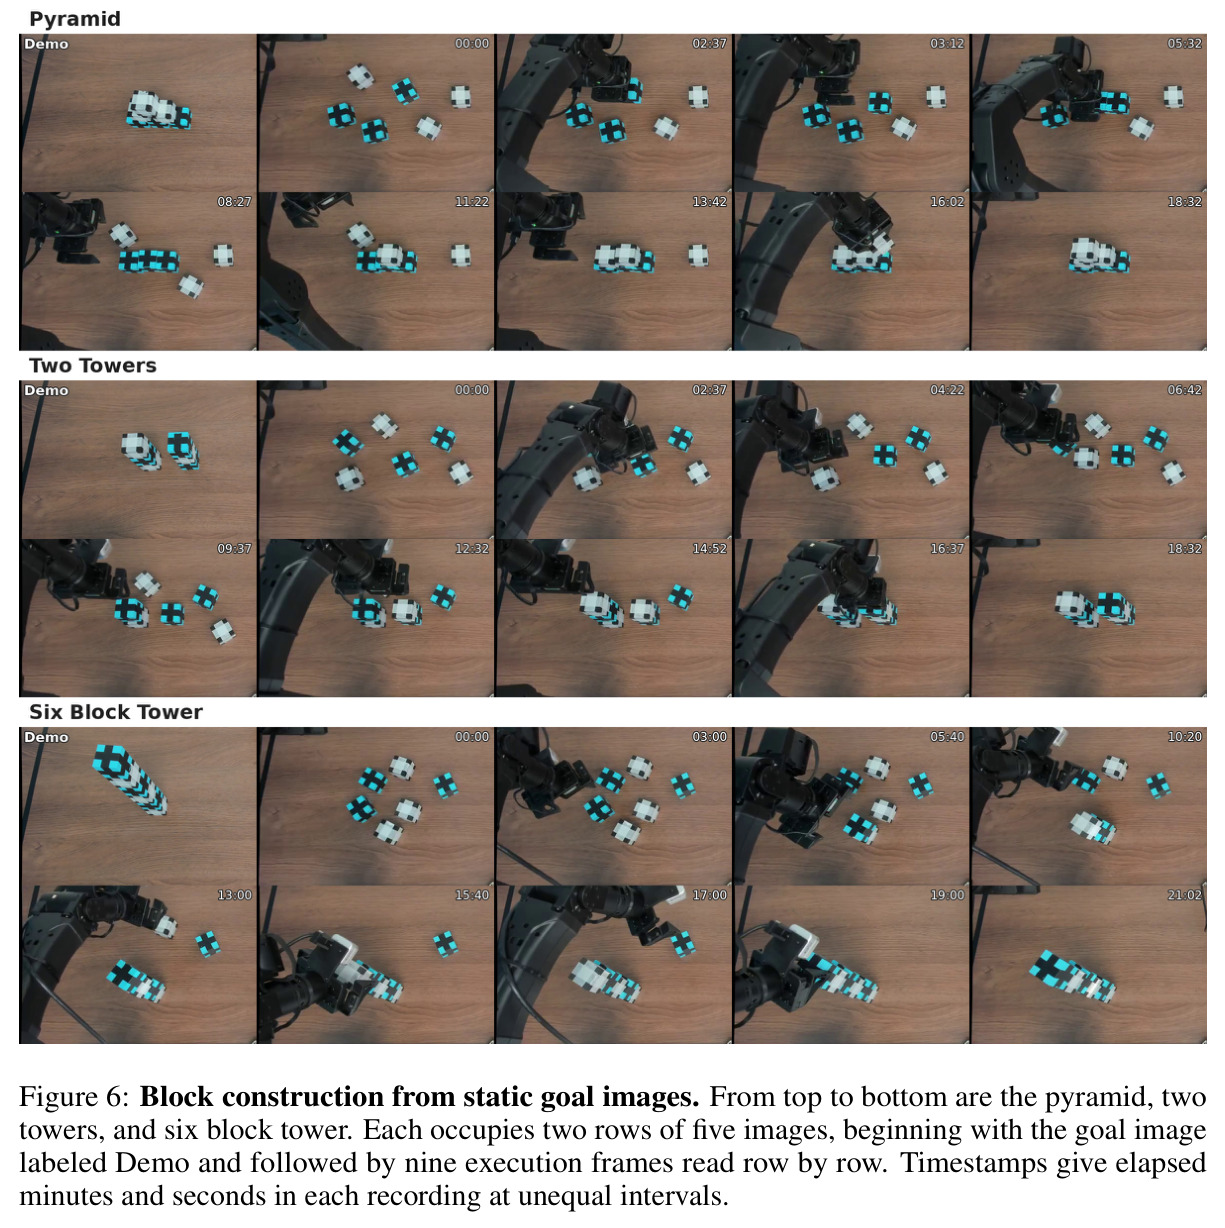
一次完整执行可以拆成五步。第一步,感知建图:用 frames 命令拍摄腕部 RGB-D 与顶部 RGB 图像(带标定与机器人状态),写程序做深度测量、颜色分割、光线与估计平面求交,把物体位置解算到机器人基座坐标系;顶部像素按估计高度平面求交,腕部深度直接映射到臂基座系。第二步,规划与编程:依据任务定义推断装配顺序或搭建次序(金字塔逐层、双塔先立两座塔基再放中层和顶层),计算抓取位姿与放置位姿,必要时先做保留物体的试探动作(投掷前两次 motion probe)。第三步,动作请求:通过 move_ee(末端位置+四元数)或 move_joints 下发目标,控制器经 Mink IK 生成轨迹并跟踪,夹爪开合由 gripper 命令控制;接口返回实际到位位姿与目标误差。第四步,反馈修正:结合新拍的图像判断物理结果——插轴失败则重新估计对齐并改变接近方向重试;毛巾折叠中一角滑落则恢复并修正翻边;骰子翻转后观察确认朝向不对就再抓再翻。第五步,循环直至报告完成或在时间与请求预算内终止;物理成败按预定判据用最终场景与录像核验。每步的输入输出都记录在案,恢复策略何时触发、何时放弃(如方块超出 0.65 m 可达范围时主动判负)也由智能体自行决定。
技术新颖性
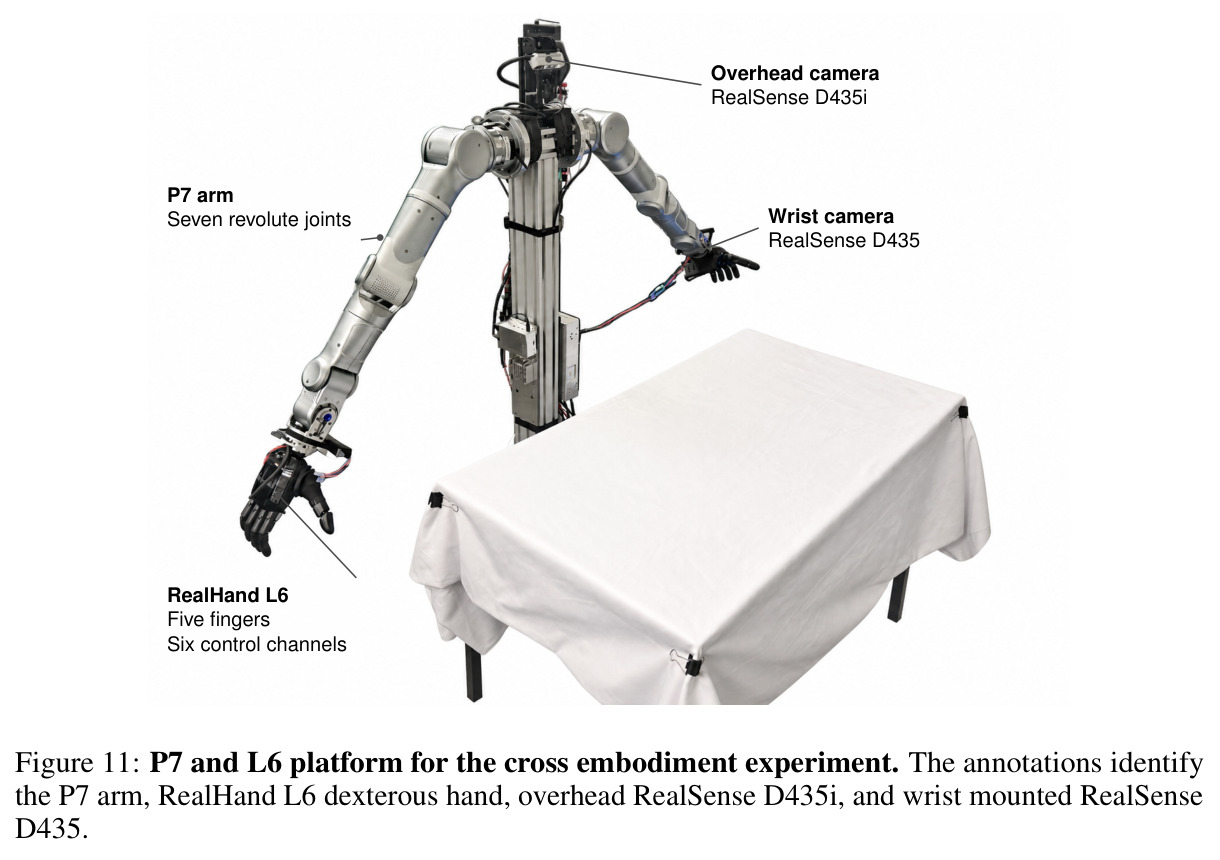
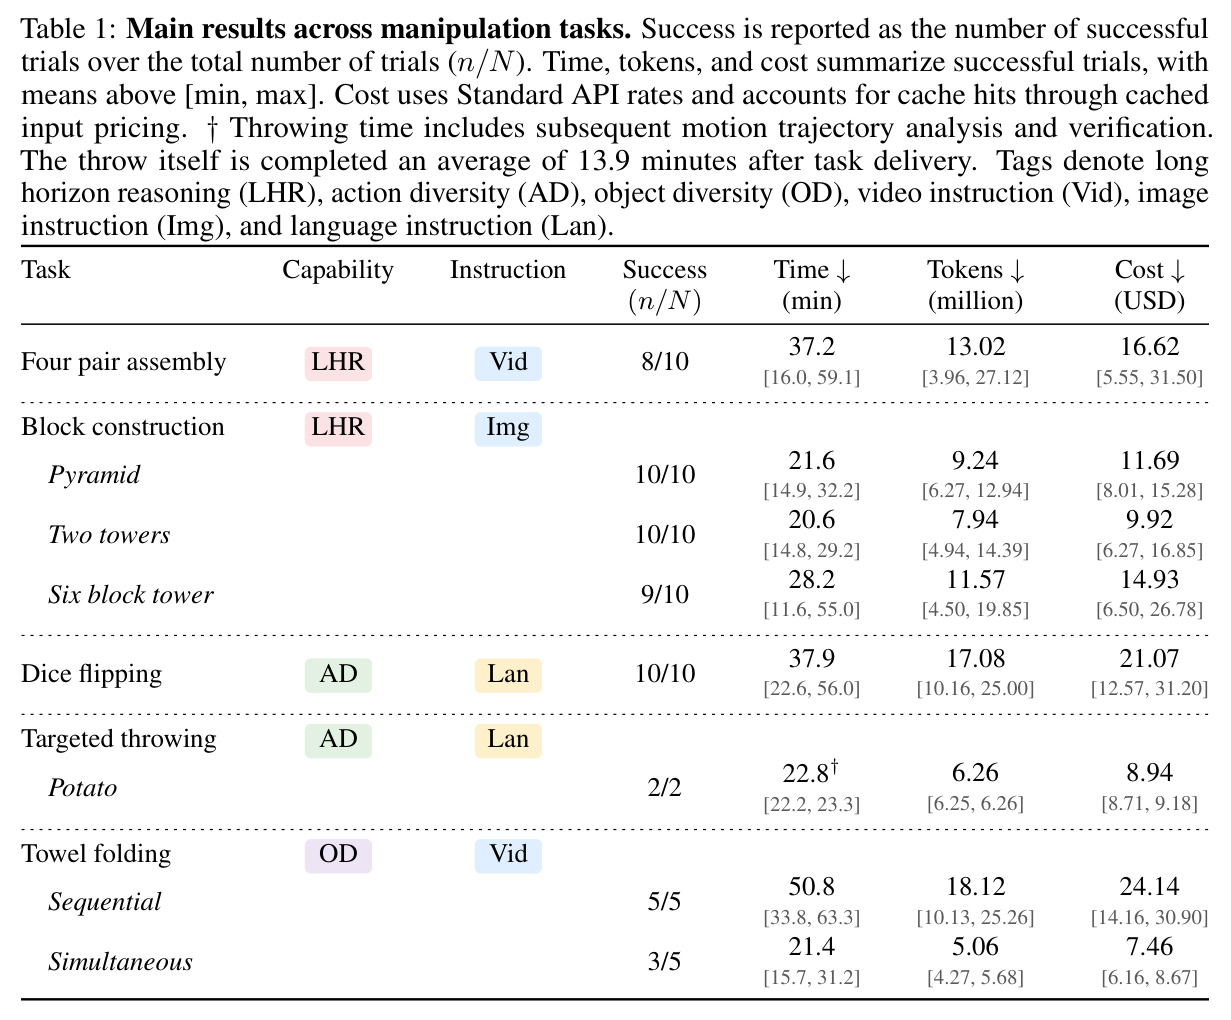
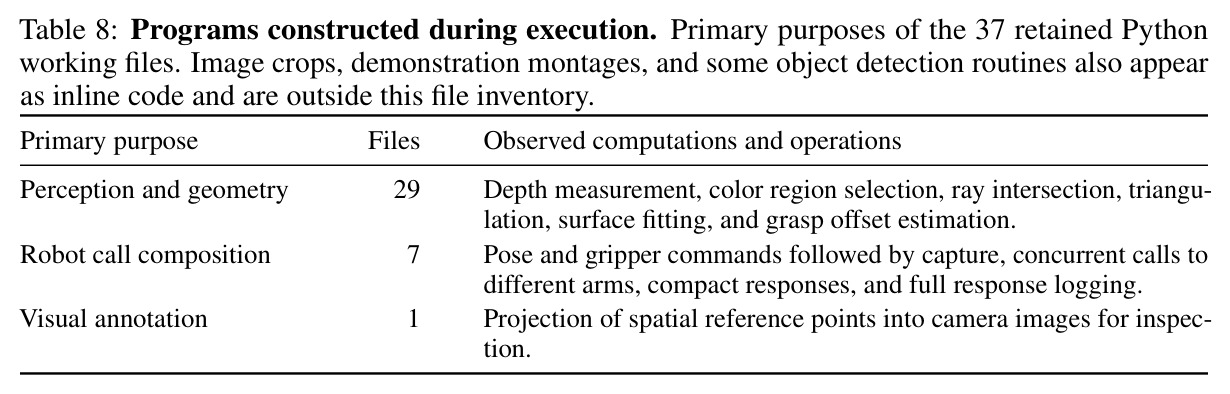
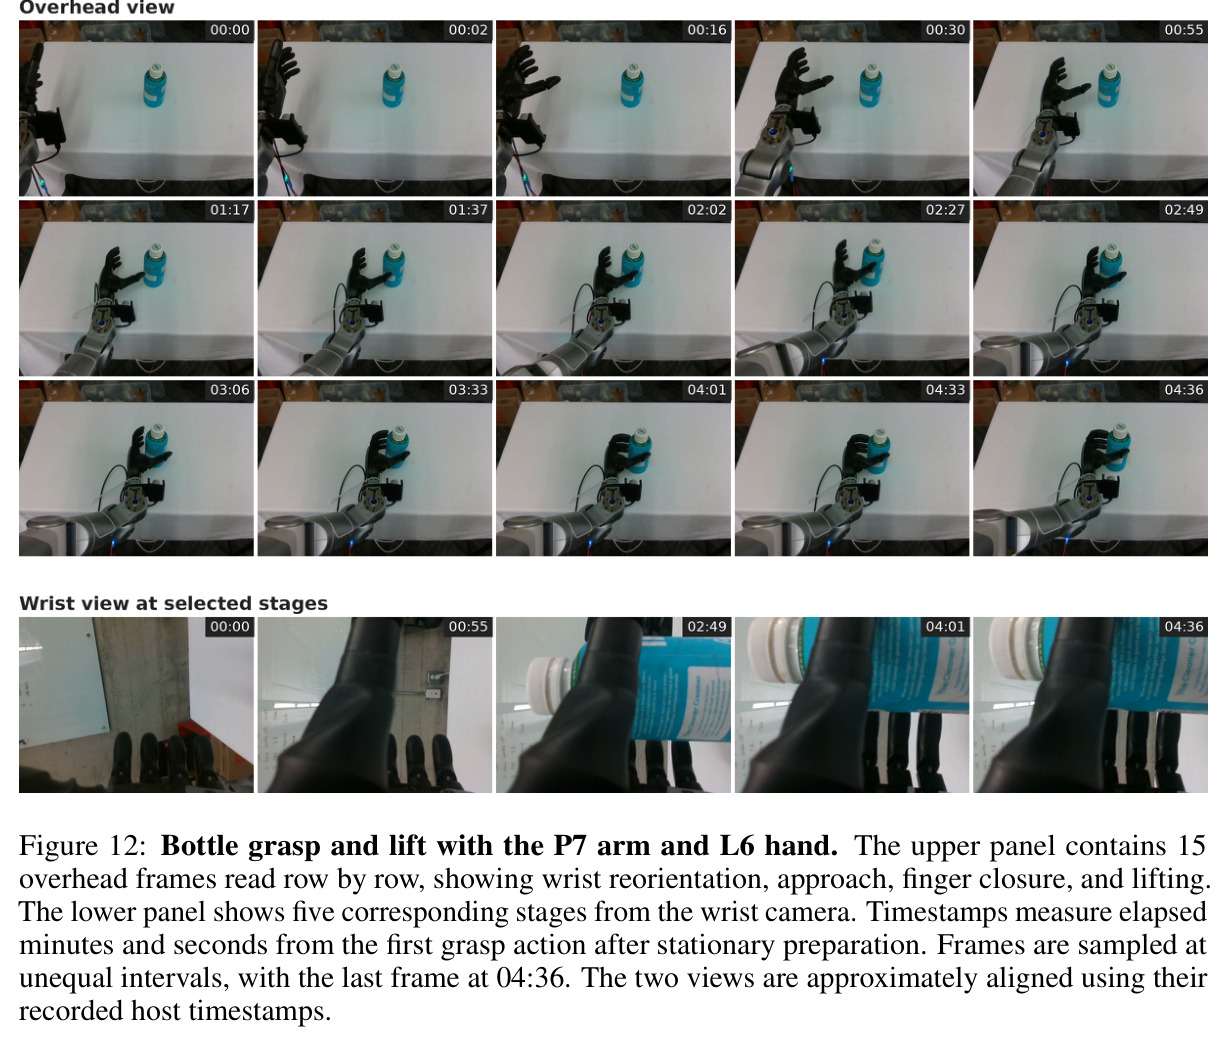
技术新颖性有四点。第一,范式层面系统论证『通用智能体=机器人策略』:不训练、不微调、不仿真预演,同一套 GPT-6 Astra/Codex 系统直接跨五个任务族零样本执行;而表 2 证明换弱模型(Terra 1/5、Luna 0/5)成功率即崩塌,说明瓶颈确实在模型推理能力而非接口工程。第二,『接口即策略边界』的设计观:AGP 把安全校验、坐标标定、IK、轨迹跟踪全部下沉到桥与控制器,智能体只面对文档化命令,这使同一框架可移植到其他本体——附录 G 仅靠更换接口文档,就用 7 关节 P7 臂加 RealHand L6 五指灵巧手完成了抓瓶举起。第三,把『经验』当一等公民:测量、程序、纠错以文件形式持久化,跨会话复用,并首创强弱模型间的经验迁移实验(Astra 采集、Terra 复用),这在机器人学习中是新的机制。第四,评测透明度前所未有:公开每个任务的时间/token/美元成本(如四对装配平均 37.2 分钟、13.02M token、16.62 美元),统计 65 次执行产生的 37 个工作文件构成(感知几何 29 个、机器人调用组合 7 个、可视化 1 个),这种对策略内部行为的量化在同类工作中少见。
实验结果
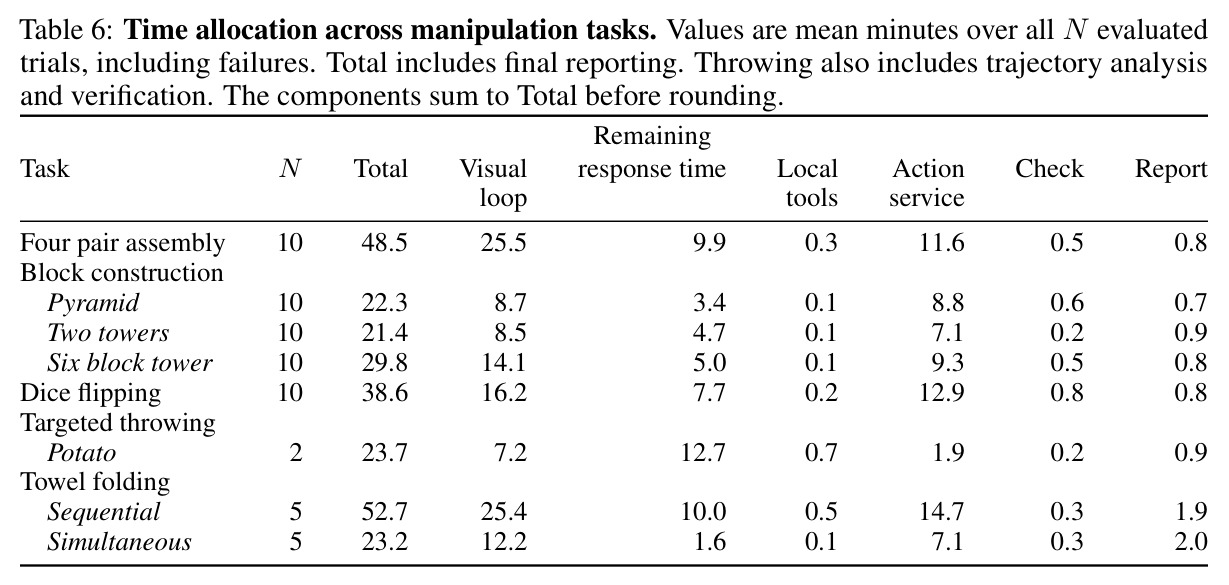
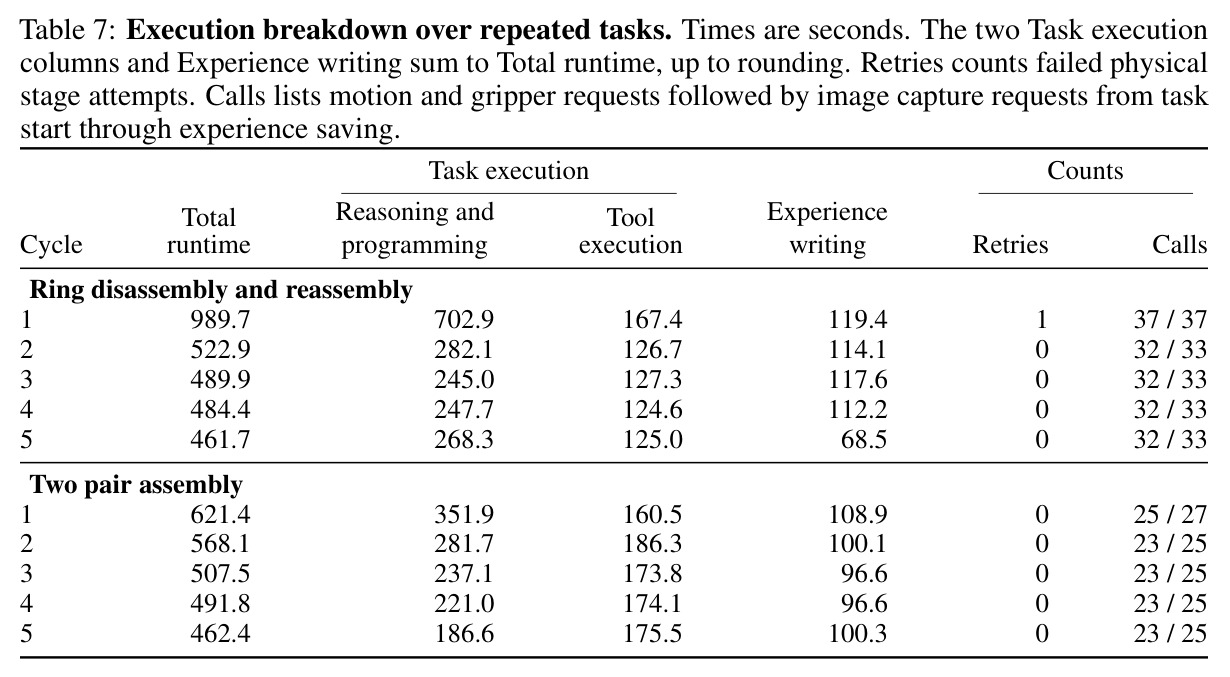
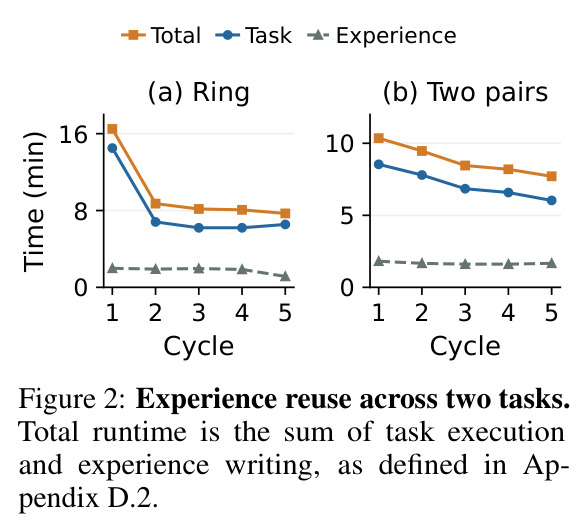
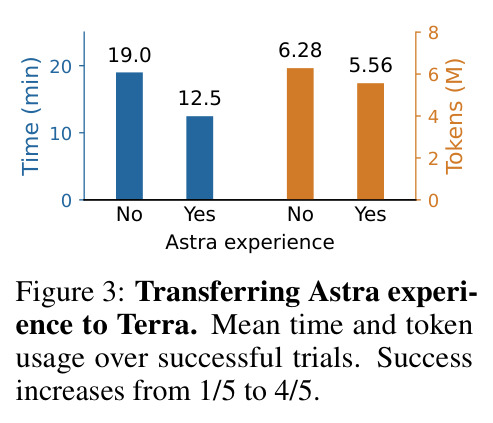
主实验(表 1)显示八个任务配置中七个成功率不低于 80%,其中五个 100%:四对装配 8/10(平均 37.2 分钟、13.02M token、16.62 美元),要求亚毫米配合间隙(最小径向间隙 0.73 mm)的四对 AutoMate 零件全部装配并在撤臂后保持;积木三配置为金字塔 10/10(21.6 分钟)、双塔 10/10(20.6 分钟)、六塔 9/10(28.2 分钟,失败案例是撤臂时倒塌且方块落到 0.65 m 可达范围之外无法恢复);骰子翻转 10/10(37.9 分钟、21.07 美元),六颗骰子全部翻到目标面;投掷 2/2(总 22.8 分钟,其中抛出本身平均 13.9 分钟,后续轨迹分析与验证约占 40%);毛巾折叠顺序版 5/5 但代价全表最高(50.8 分钟、24.14 美元),同时版仅 3/5,是全部配置中最低成功率,暴露可变形物双臂协同的短板。模型对比(表 2,双对装配):Astra 低/中/高三档思考努力全部 5/5(9.2–9.9 分钟、约 4 美元),提升思考档位几乎无增益;Sol 5/5 但更慢更省(14.2 分钟、3.94 美元);Terra 1/5、Luna 0/5;Claude Opus 5 得 5/5(22.2 分钟、9.75 美元),Fable 5.1 仅 3/5 且更贵(11.30 美元)。效率研究:双对装配第 5 次比第 1 次任务时间降 29.3%,其中推理+编程时间降 47.0% 而工具执行反升 9.3%(表 7:351.9→186.6 秒对 160.5→175.5 秒),说明省在『想』而非『动』;环形件拆装在第 1 周期后即大幅下降(总时长 989.7→461.7 秒)。强到弱迁移(图 3):Terra 借助 Astra 的冻结经验从 1/5 升至 4/5,成功 trial 平均耗时与 token 分别降 34.3% 与 11.4%。时间分解(表 6)显示视觉回路是最大开销,四对装配含失败的 48.5 分钟中占 25.5 分钟。
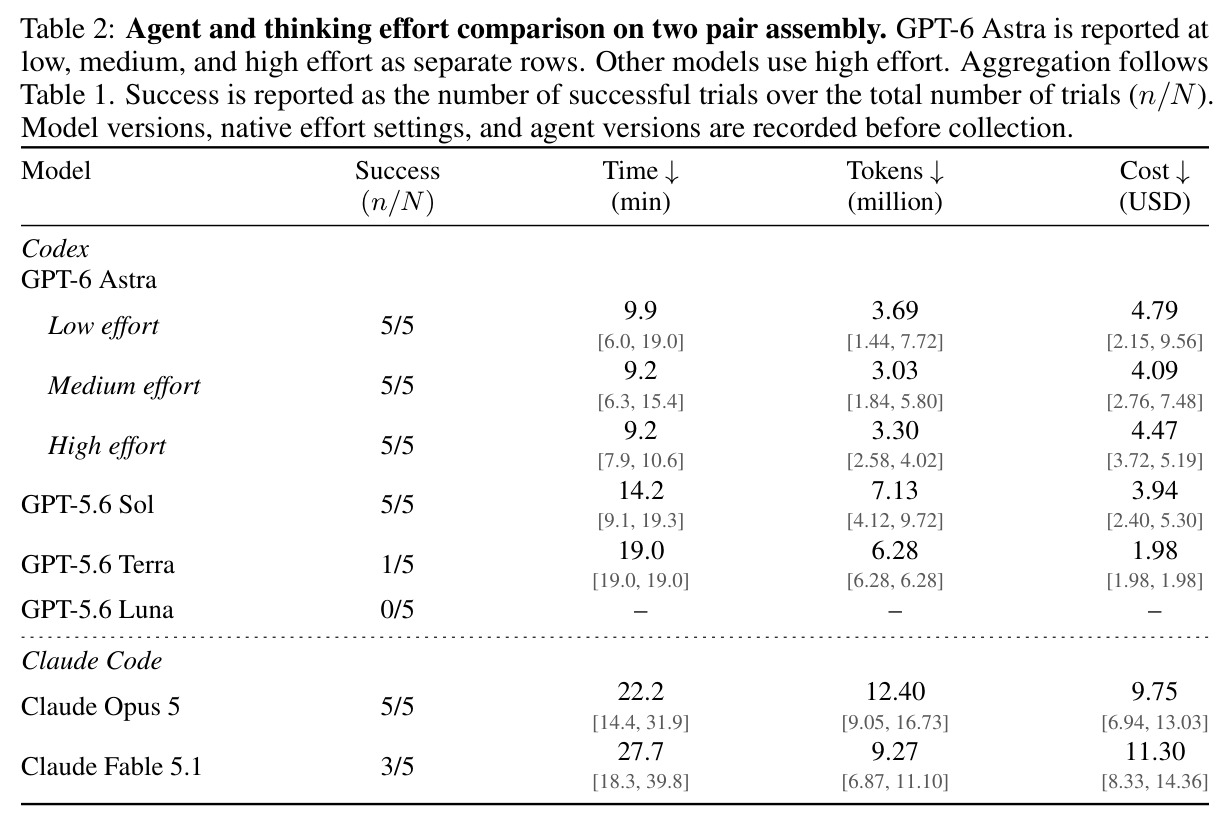
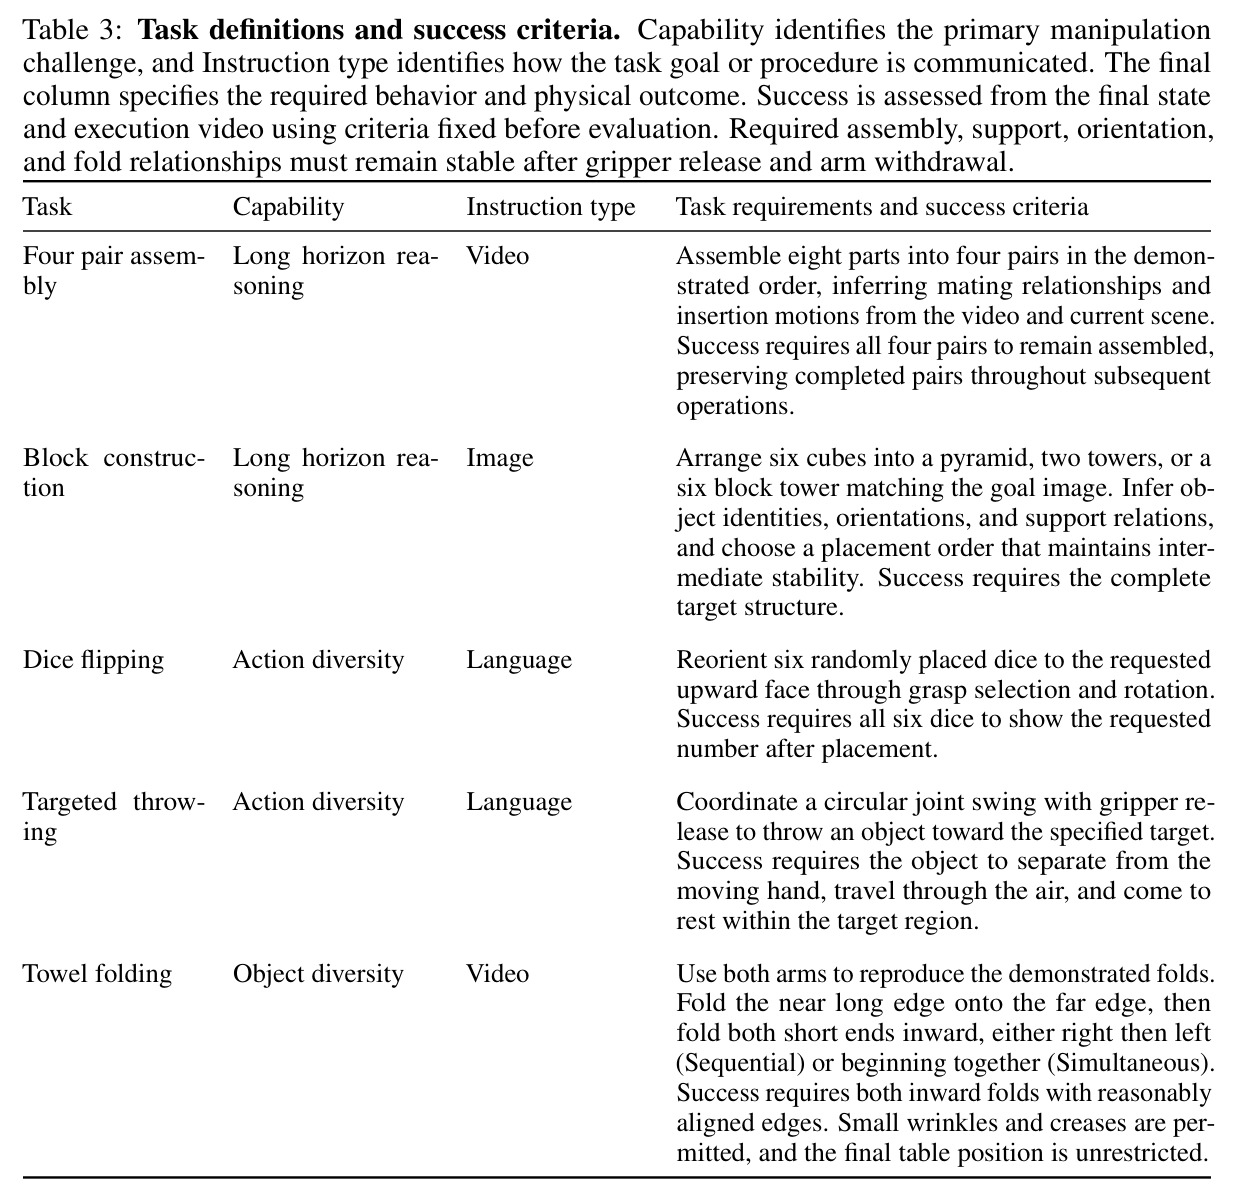
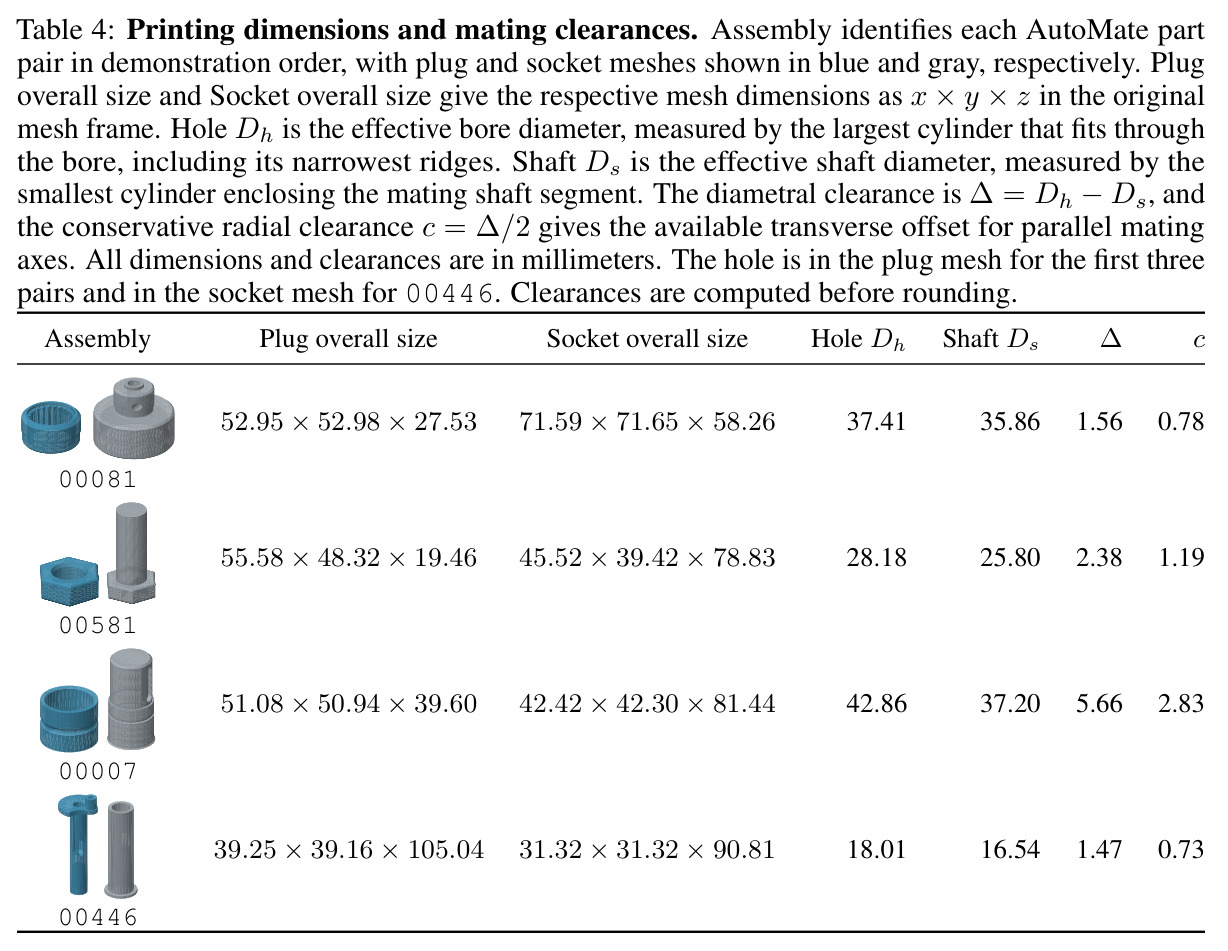
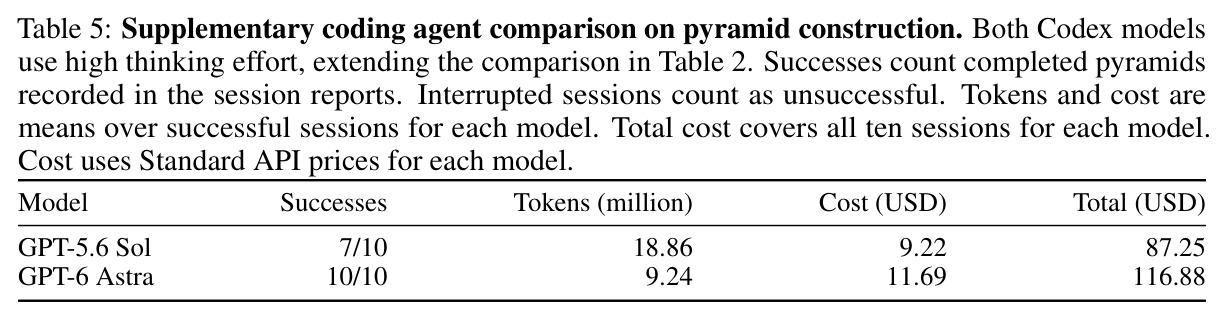
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四对装配(视频指令,长程推理) | 成功率 | 8/10,平均 37.2 分钟、13.02M tokens、16.62 美元 | 无直接可比基线;现有 VLA/编排方法需任务专属训练数据 | 零样本 80%,且孔轴最小径向间隙仅 0.73 mm |
| 积木金字塔搭建(图像指令) | 成功率 | 10/10(21.6 分钟,11.69 美元) | 无训练基线;同任务 GPT-5.6 Sol 仅 7/10(表 5) | 零样本 100%,超 Sol 30 个百分点 |
| 积木双塔搭建 | 成功率 | 10/10(20.6 分钟,9.92 美元) | 无训练基线 | 零样本 100% |
| 积木六塔搭建 | 成功率 | 9/10(28.2 分钟,14.93 美元) | 无训练基线 | 零样本 90%,唯一失败为撤臂倒塌且方块超出可达范围 |
| 骰子翻转(语言指令) | 成功率 | 10/10,六颗骰子目标面全部朝上(37.9 分钟,21.07 美元) | 无训练基线 | 零样本 100%,含抓取依赖的翻转与再抓取 |
| 定向投掷(语言指令) | 成功率 | 2/2,土豆落碗(总 22.8 分钟,抛出平均 13.9 分钟) | 无训练基线 | 零样本完成摆臂+定时松爪的动态动作 |
| 双臂毛巾折叠(视频指令) | 成功率 | 顺序 5/5(50.8 分钟,24.14 美元);同时 3/5(21.4 分钟,7.46 美元) | 无训练基线 | 零样本完成可变形物双臂协同;同时版 60% 为全任务最低 |
| 模型对比:双对装配 | 成功率 | GPT-6 Astra 三档思考努力均 5/5;Claude Opus 5 5/5 | GPT-5.6 Terra 1/5、Luna 0/5、Fable 5.1 3/5 | 证明模型能力而非思考档位决定 AGP 成败 |
| 经验迁移(Astra→Terra,双对装配) | 成功率/时间/tokens | 有经验 4/5;成功 trial 平均时间 −34.3%(19.0→12.5 分钟)、tokens −11.4%(6.28→5.56M) | Terra 空经验 1/5 | 成功率 +60 个百分点,验证经验可跨模型复用 |
局限与改进
作者承认的局限:执行时间与推理成本高企(单次 20–50 分钟、5–31 美元),是实用部署的主要障碍;可变形物体的协同动态操作仍然困难,同时折叠只有 3/5;经验积累实验是依赖性的试验序列(物体位置逐次变化),作者明确指出需要『每次都从空经验开始』的对照才能严格归因于经验复用;迁移研究的样本极小且不等(空经验 1 个成功 trial 对有经验 4 个),作者自己声明观察到的降幅建立在小样本上。我补充几点观察:其一,所有任务都在同一桌面平台、固定相机布局、 predefined 初始场景下完成,杂乱真实环境的泛化未经验证;其二,系统完全依赖商业闭源模型(GPT-6 Astra、Claude Opus 5 等),模型版本迭代即可能改变全部结论,复现窗口很窄;其三,论文没有与任何训练过的 VLA 基线在同一任务集上对比,『零样本相对训练方法到底更好还是更差』缺少定量锚点;其四,没有力觉或触觉反馈,精密插装全靠几何估计与到位误差迭代,摩擦、卡滞等力学现象只能间接推断;其五,动态任务实时性极差,投掷从下达任务到出手要 13.9 分钟,无法用于任何需要秒级响应的场景;其六,安全包络(径向 0.65 m 等)既是保护也是能力上限——六塔失败案例中,塌落的方块恰恰落在包络之外导致智能体只能判负,说明故障恢复能力受接口硬约束。
独立分析的弱点
独立分析的弱点与对应改进方向。第一,延迟与成本的结构性根源是每个决策步骤都要过一次大模型:表 6 显示视觉回路与其余响应时间合计常占总时长一半以上(四对装配 48.5 分钟中占 35.4 分钟)。改进方向是把经验文件中已验证的程序固化成本地技能库,常规步骤不再调用模型,仅在校验与异常时回升到模型,形成『智能体当教练、程序当执行者』的分层架构。第二,视觉回路低效:相机 30fps 采集但每次决策都要完整推理加重新估计,可在两次模型调用之间引入轻量物体跟踪器维持位姿,减少拍图与重估次数。第三,缺乏接触力感知:装配最小径向间隙仅 0.73 mm,纯几何迭代已接近极限(8/10),加入腕部六维力传感器或触觉阵列可直接检测卡滞与滑移,把恢复从『看出来的』变成『摸出来的』。第四,经验文件是自由格式文本加脚本,缺乏 schema 与验证机制,错误经验(如某次失败插装的参数)可能被盲目复用,应增加经验校验、置信度标记与过期淘汰。第五,经验迁移只在同任务、同平台、同接口的场景验证,跨任务抽象(提炼出通用『插装程序模板』)与跨本体迁移(附录 G 的 P7+L6 只是定性演示)均未探索。第六,失败分析单薄:六塔倒塌仅一例且作者承认根因『未解决』,缺乏系统性失败分类学来指导针对性改进。
未来方向
未来方向。作者明确提出两条:一是把 AGP 用作轨迹数据引擎——重复执行时同步记录视觉观测、动作与测量状态,可训练 VLA 策略,失败与恢复片段可支持鲁棒性研究,这实际上把 AGP 定位为具身数据采集的基础设施;二是降低推理成本与延迟、提高可变形物协同的可靠性。在此基础上可以延伸:其一,与低层学习策略混合——几何敏感的精密插装交给 AGP 的运行时编程,高频动态动作(投掷挥摆、抛接)交给扩散策略,用本文的桥做统一接口,兼得两者长处;其二,把经验文件升级为可检索、可验证的技能记忆库,配合已验证的强弱迁移机制,形成『贵模型探索一次、便宜模型执行千次』的生产模式,Terra 从 1/5 到 4/5 的跃升预示了这条路的经济价值;其三,闭环时延优化:流式视觉输入加推测执行,让机器人在模型思考时预行动作,把秒级甚至分钟级的响应压缩到实时;其四,跨本体经验复用的系统研究——接口不变的条件下,Astra 在 YAM 上积累的程序能否少量修改后迁移到 P7+L6 灵巧手平台;其五,安全与验证机制:对智能体生成的程序做形式化边界检查、对动作序列做可逆性分析,这是走向有人环境部署的前提。此外,把本文的运行时编程评测扩展为社区 benchmark(固定任务集、接口与预算)将帮助公平比较不同模型作为机器人策略的能力。
复现评估
复现评估:难度中高、成本中等。有利因素:硬件与底层软件开源——I2RT YAM 机械臂的 i2rt Python 库在 GitHub 公开,IK 使用开源 Mink(基于 MuJoCo),装配零件来自公开的 AutoMate 数据集(论文还给出 asset_plug.obj/asset_socket.obj 的具体路径与表 4 的完整打印尺寸和配合间隙);附录 A–F 对接口七条命令、限速参数、预算、成功判据、指标口径记录得非常细致,甚至给出 SVD 平面拟合与双视线三角化的核心代码片段,跨本体实验与失败案例也完整披露。不利因素:核心依赖闭源商业模型——GPT-6 Astra 需 OpenAI 订阅或 API,Claude Opus 5、Fable 5.1 需 Anthropic 订阅,模型版本会下线更新,长期可复现性差;智能体-机器人桥的代码未提及开源,需要自行实现约七条命令的安全包装层;单次试验成本不低——金字塔 10 次会话 Astra 总成本 116.88 美元(Sol 87.25 美元),主表单次成功 trial 5.5–31.5 美元,完整复现主表 77 次试验约需数百至上千美元 API 费;硬件需要 YAM 臂(毛巾任务需双臂)加 RealSense D405 与 Logitech BRIO 相机。总体而言,拥有机器人平台与 API 预算的实验室可在数周内复现主要结论;无硬件者只能基于公开模型做定性与小规模验证。
论文图表