开源机器人使用智能体的统一框架 uni-robot-agent Democratizing Robot-Use Agents: A Unified Harness with Open Models
统一框架让开源模型机器人操控成绩首超闭源前沿模型,成本降约20倍
前置知识
Robot-Use Agent(RUA,机器人使用智能体)
用多模态大模型充当机器人'大脑'的范式:模型接收图像、本体状态和任务指令,通过调用工具(move、grasp、感知、技能库)来操控机器人,框架负责执行动作并把数值与图像反馈回模型,由模型分解任务、规划、从失败中恢复。它不输出端到端动作序列,而是把通用解题能力迁移到物理世界。
整篇论文构建的就是这样一个 RUA 框架,理解工具调用、反馈循环和 harness 的角色是读懂一切实验的前提。
VLA 与 WAM 模型
VLA(视觉-语言-动作模型)如 π0.5,在异构机器人数据上端到端训练,直接从图像和指令生成动作,通常需要任务示教微调;WAM(世界-动作模型)如 OpenWAM-α、Dream-1,通过联合视频与动作预测建模环境动态来支持规划。二者是本文对比的传统路线基线。
论文反复用 VLA/WAM 的分数衬托开源 RUA 的竞争力,并讨论两类方法在不同任务维度上的强弱,不熟悉这条路线就看不懂对比逻辑。
特权信息
仿真器能提供但真实部署中不可得的输入,例如真值深度图、物体 CAD 模型、隐藏场景标注,以及'任务是否成功'的验证器反馈。很多已有 harness 靠这些信息获得好成绩,导致仿真结论无法迁移到真机。
本文的核心卖点是不用任何特权输入(只用 RGB+相机标定+本体状态),并用消融实验量化深度和技能库的真实贡献。
多视角三角测量与相机标定
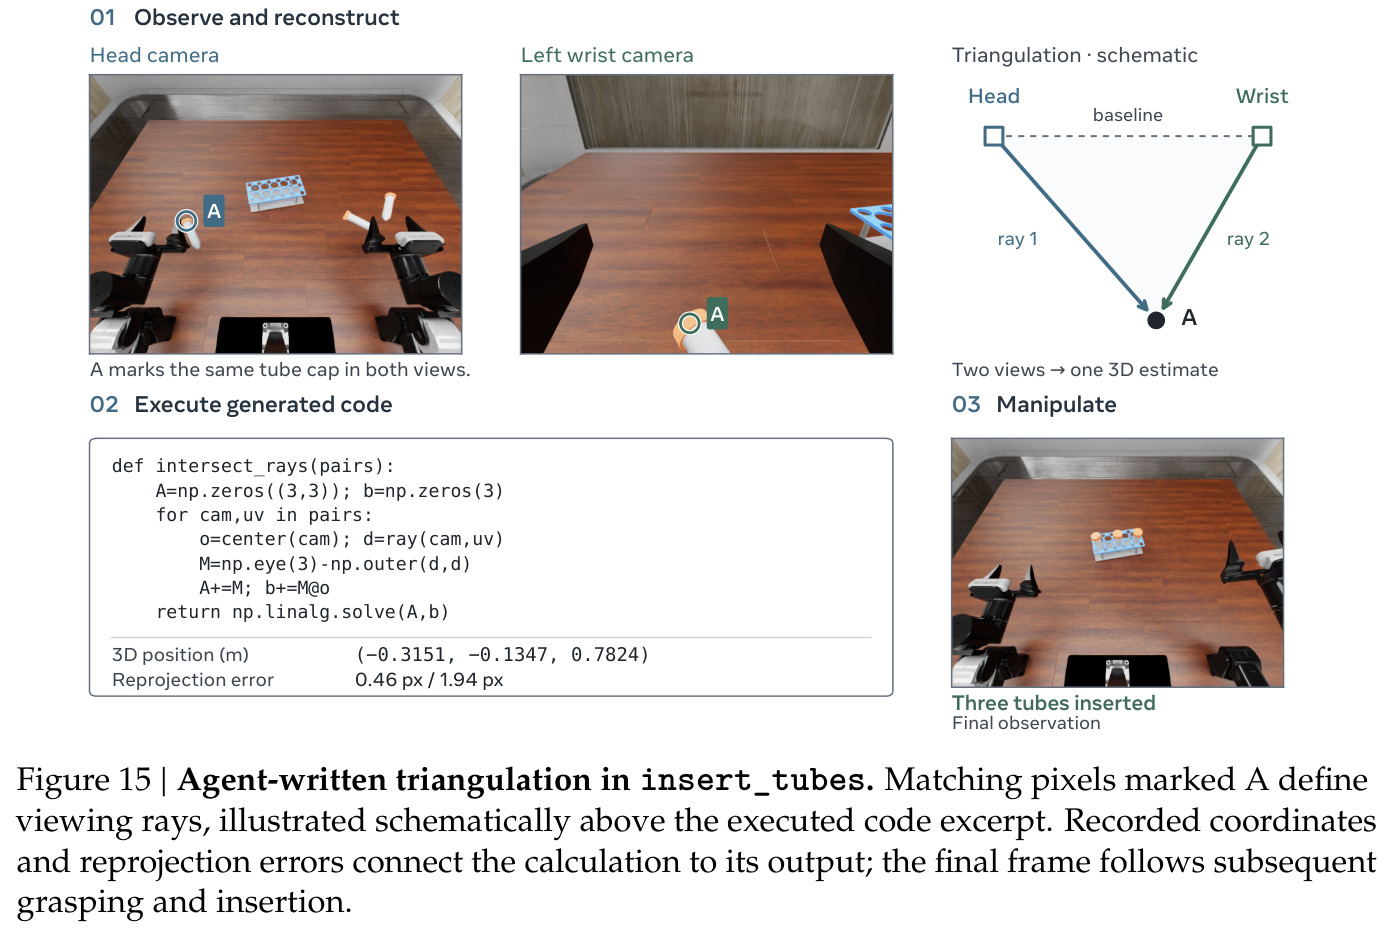
给定相机内外参,让模型在两个及以上相机视图里为同一物理特征选对应像素,通过三角测量解出该点的 3D 坐标。没有深度图时,这是从纯 RGB 恢复空间几何的主要手段;对应点选错会导致重投影误差过大而被工具拒绝。
它解释了为什么去掉深度后性能几乎不掉(模型自己写几何代码做三角测量),也解释了'空间定位失败'这一最大失败模式。
MCP 工具调用与资源互斥调度
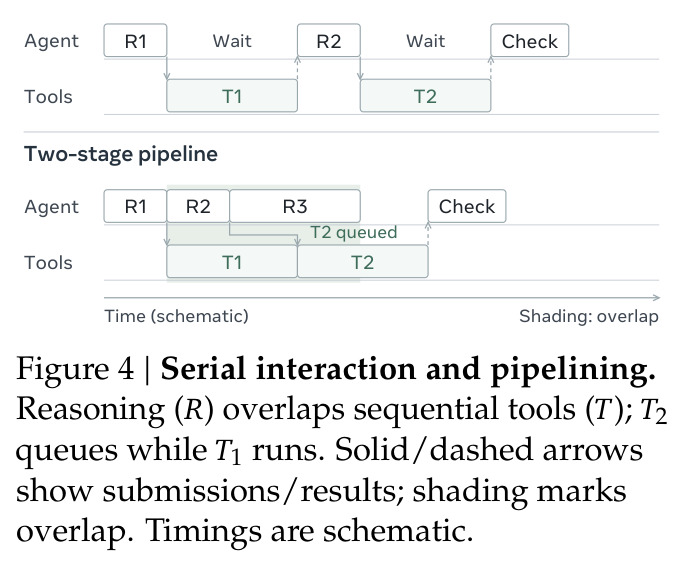
MCP(Model Context Protocol)是标准化的大模型工具调用协议,工具以 Schema+handler 注册。资源互斥调度指共享同一独占资源(如同一机械臂)的调用按提交顺序串行执行,互不冲突的调用(如读已有快照)可并行,后台调用返回 job 句柄供稍后取结果。
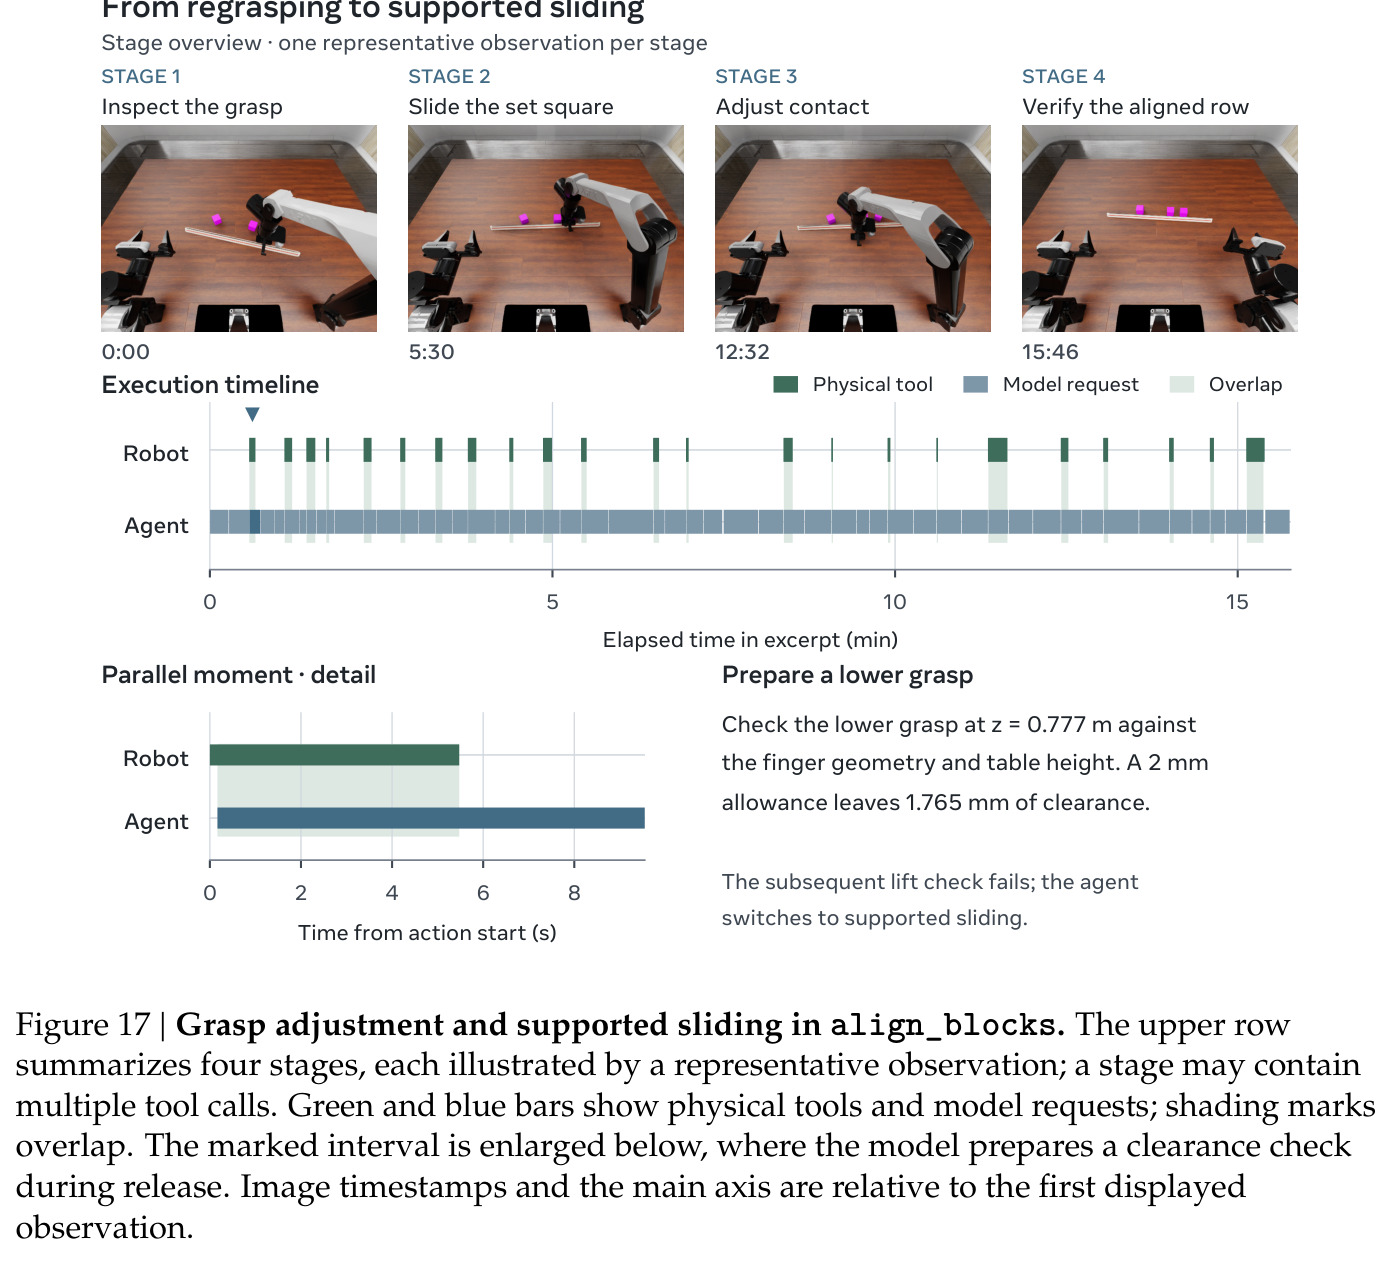
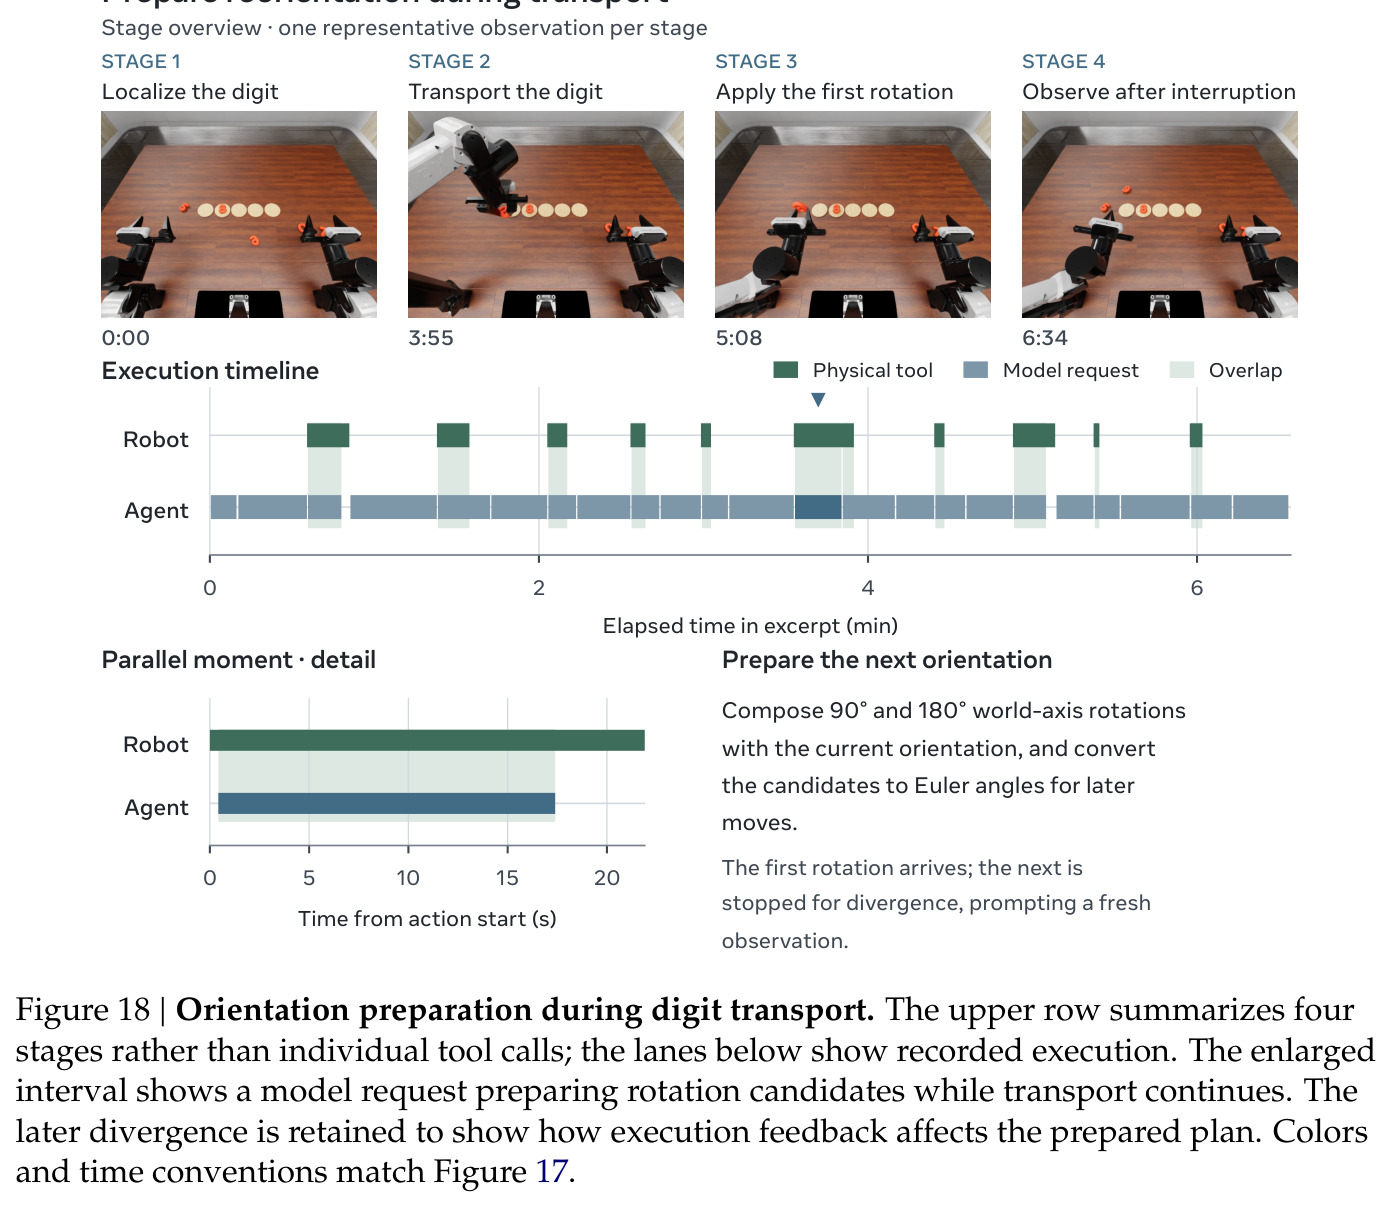
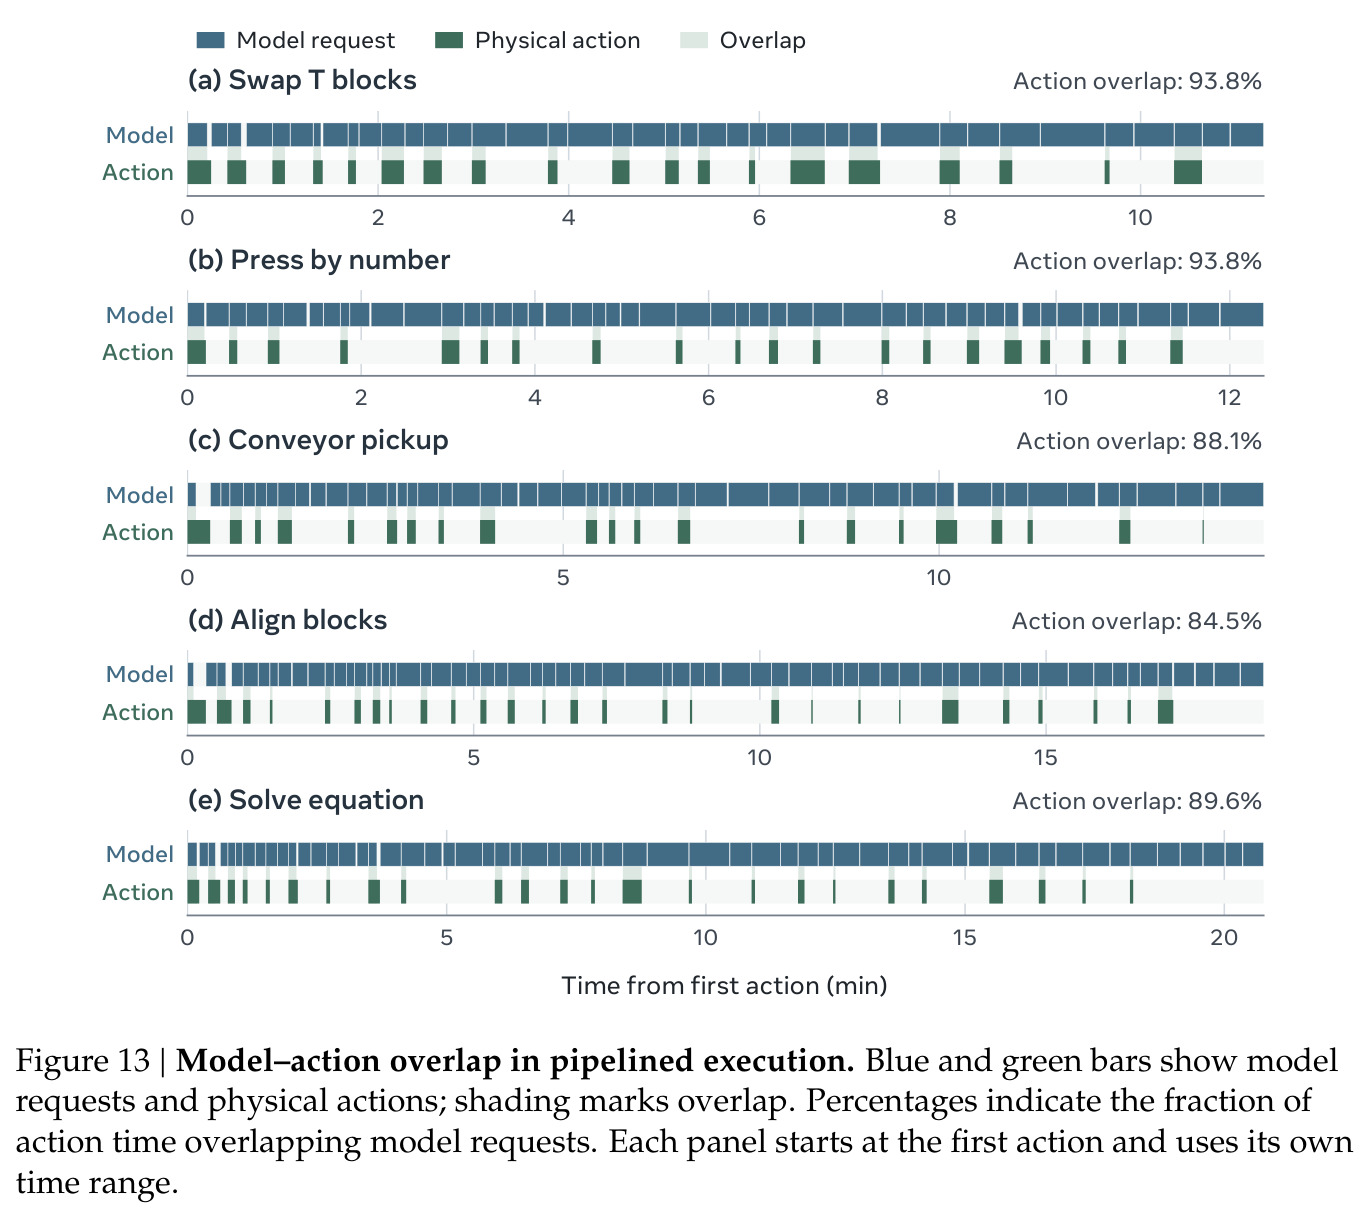
这是 uni-robot-agent 编排层实现'推理与执行重叠'流水线的机制,是论文效率结论(重叠 84.5%–93.8%)的技术基础。
研究动机
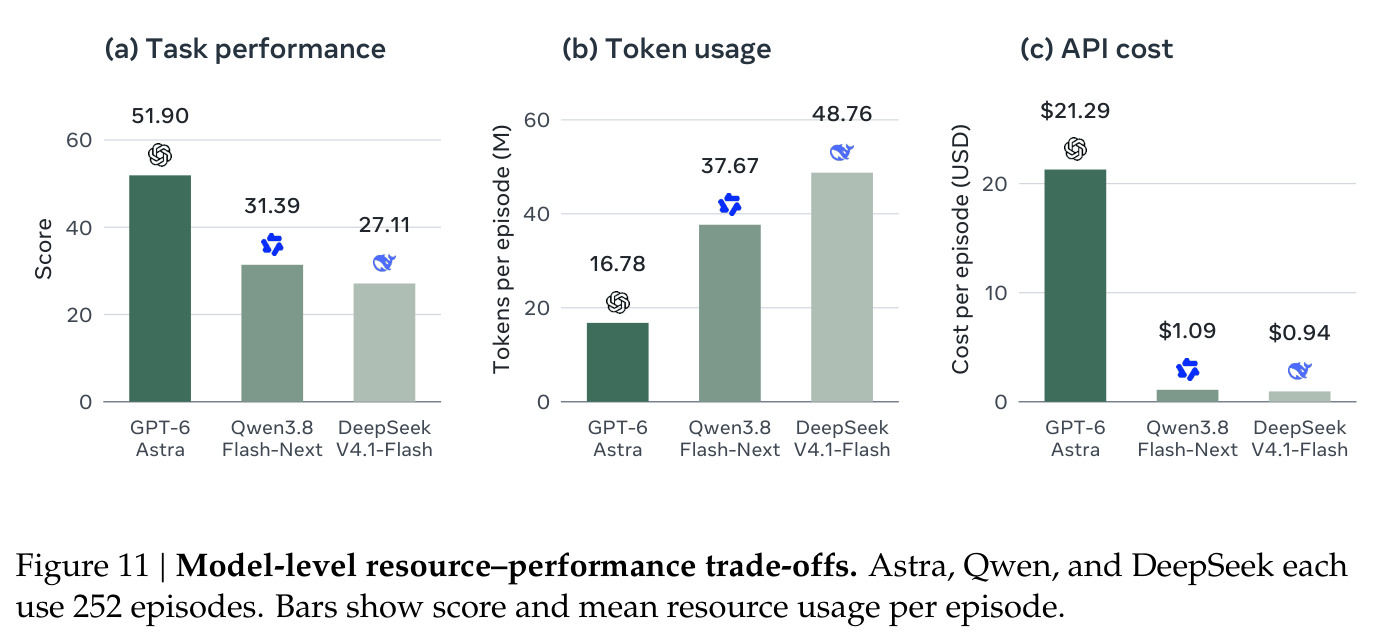
机器人使用智能体(RUA)在零样本操控上展现出惊人能力,但其成功高度依赖 GPT-6 Astra、Opus 5.5 这类闭源前沿模型。由于拿不到权重,研究者只能'用'模型而无法'训练'模型,关于 RUA 进一步训练的研究基本停滞。API 依赖还带来两个现实问题:大规模人机-环境交互成本高昂(本文测得 GPT-6 Astra 平均每回合花费 21.29 美元),且无法做模型级推理优化(如高效缓存),而推理速度恰是 RUA 的主要瓶颈。开源模型本应是出路,但它们与闭源模型存在明显能力差距——机器人使用需要强空间理解与 agentic 能力。于是先前工作纷纷求助于特权信息(仿真器真值深度、任务成功判定反馈)或任务特定技能库,这些在真实部署中要么不可得、要么把系统变成特设补丁的堆砌,掩盖了'框架设计与模型能力究竟谁在起作用'这个根本问题。
本文的目标是本文的目标是'民主化'机器人使用研究:构建统一、模块化、可训练的开源 RUA 框架 uni-robot-agent,使 Qwen、DeepSeek 等开源权重模型在仿真和真机上都达到有竞争力的操控性能,并为未来的机器人专项训练铺路。具体包含三层:(1) 统一性——共享工具在模型、本体、任务、环境之间给出一致语义,交互记录可直接合并用于后续训练;(2) 高效性——让模型推理与工具物理执行重叠,缓解推理速度瓶颈;(3) 真实性——只用真实部署可得的输入(RGB 图像、相机标定、机器人本体感知与描述、任务指令),禁止仿真器深度、CAD 资产、任务验证反馈等特权信息。在此之外,作者还希望系统回答'什么样的能力让模型会操控机器人',为后续训练指明方向。
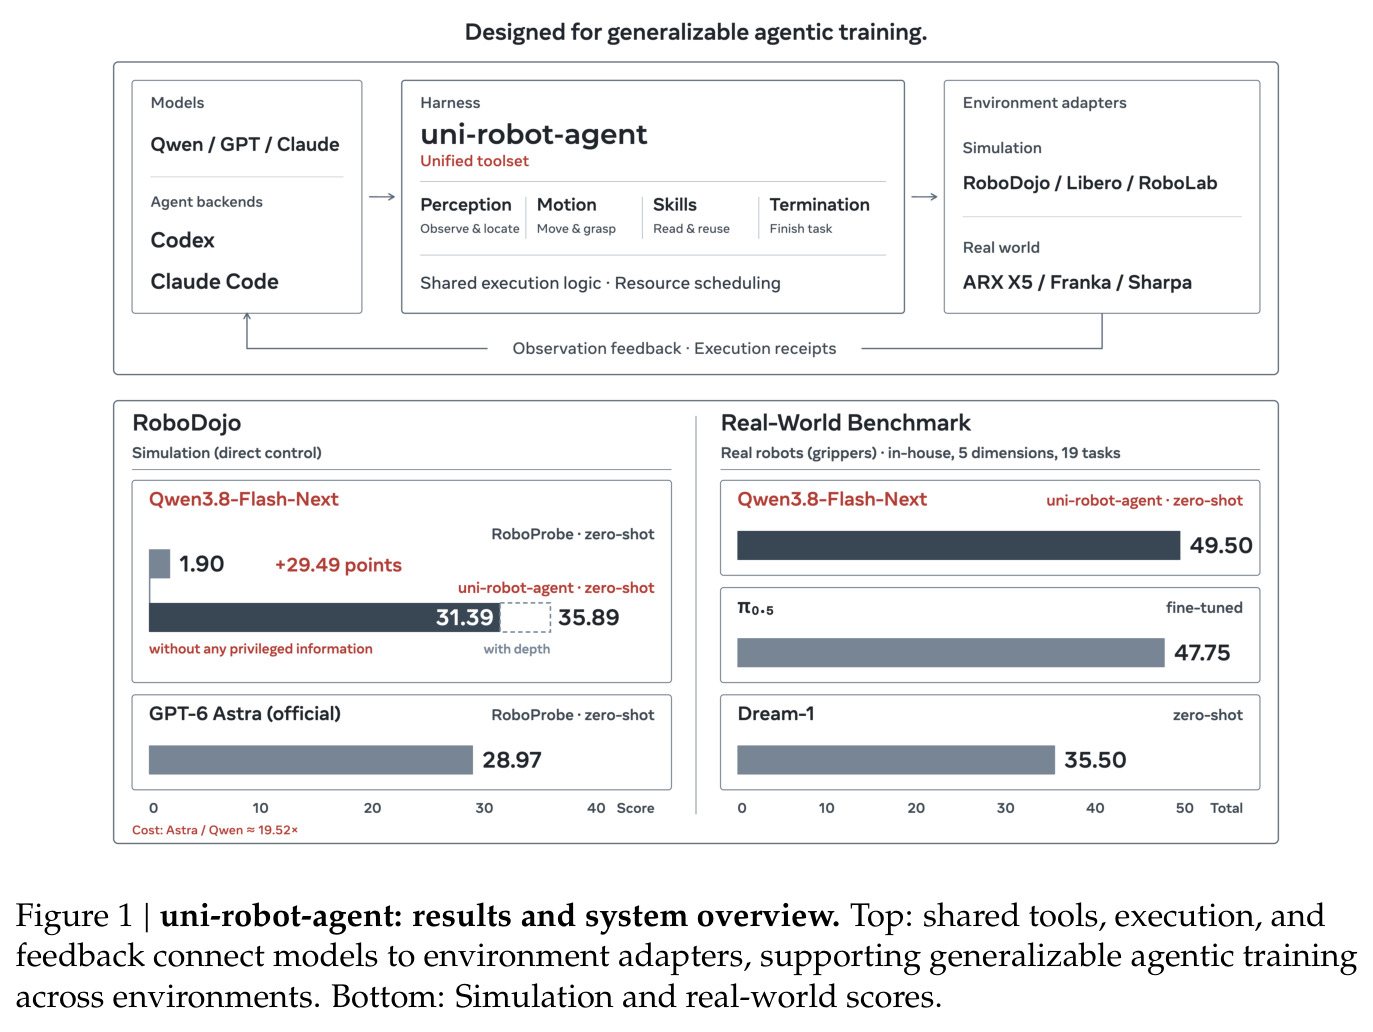
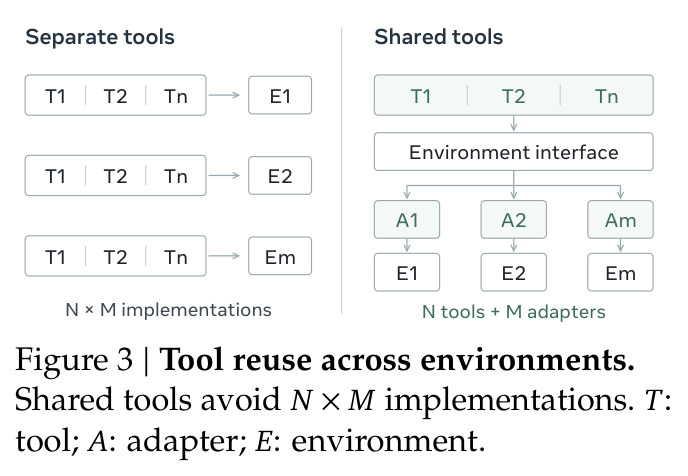
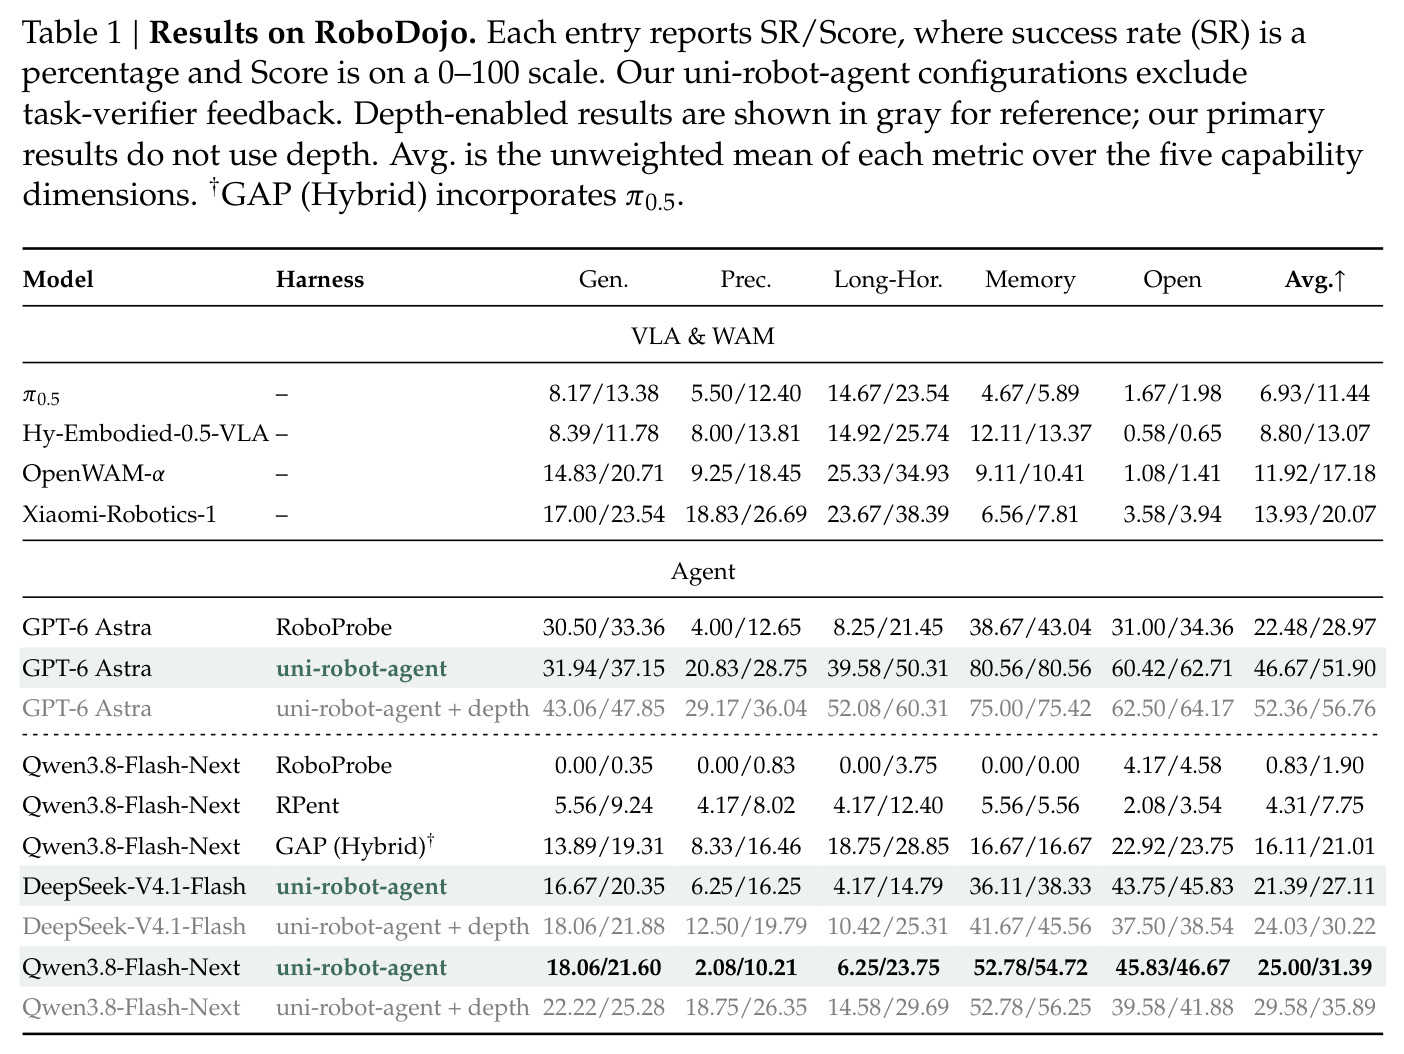
与已有工作不同的是,本文的独特切入角度在于:先不急于指责模型能力不足,而是主张必须先建立一个可泛化且有效的机器人使用框架,系统性地挖掘和最大化开源模型的现有能力,这是讨论'该不该训练、怎么训练'的前提。与先前工作不同,uni-robot-agent 不依赖任何特权输入,也不从闭源模型蒸馏,更不把任务特定技能库当性能支柱(消融显示去掉技能库仅损失 3.4% 的分数)。系统设计上,它用'N 个共享工具 + M 个环境适配器'避免 $N \times M$ 的工具-环境组合实现,并用资源感知的两级流水线让推理与串行执行重叠。最终它在 RoboDojo 上首次用开源模型(无特权信息、无蒸馏)超越闭源模型的公布成绩(GPT-6 Astra + RoboProbe 的 28.97 分),同时把成本压到约二十分之一。
核心方法
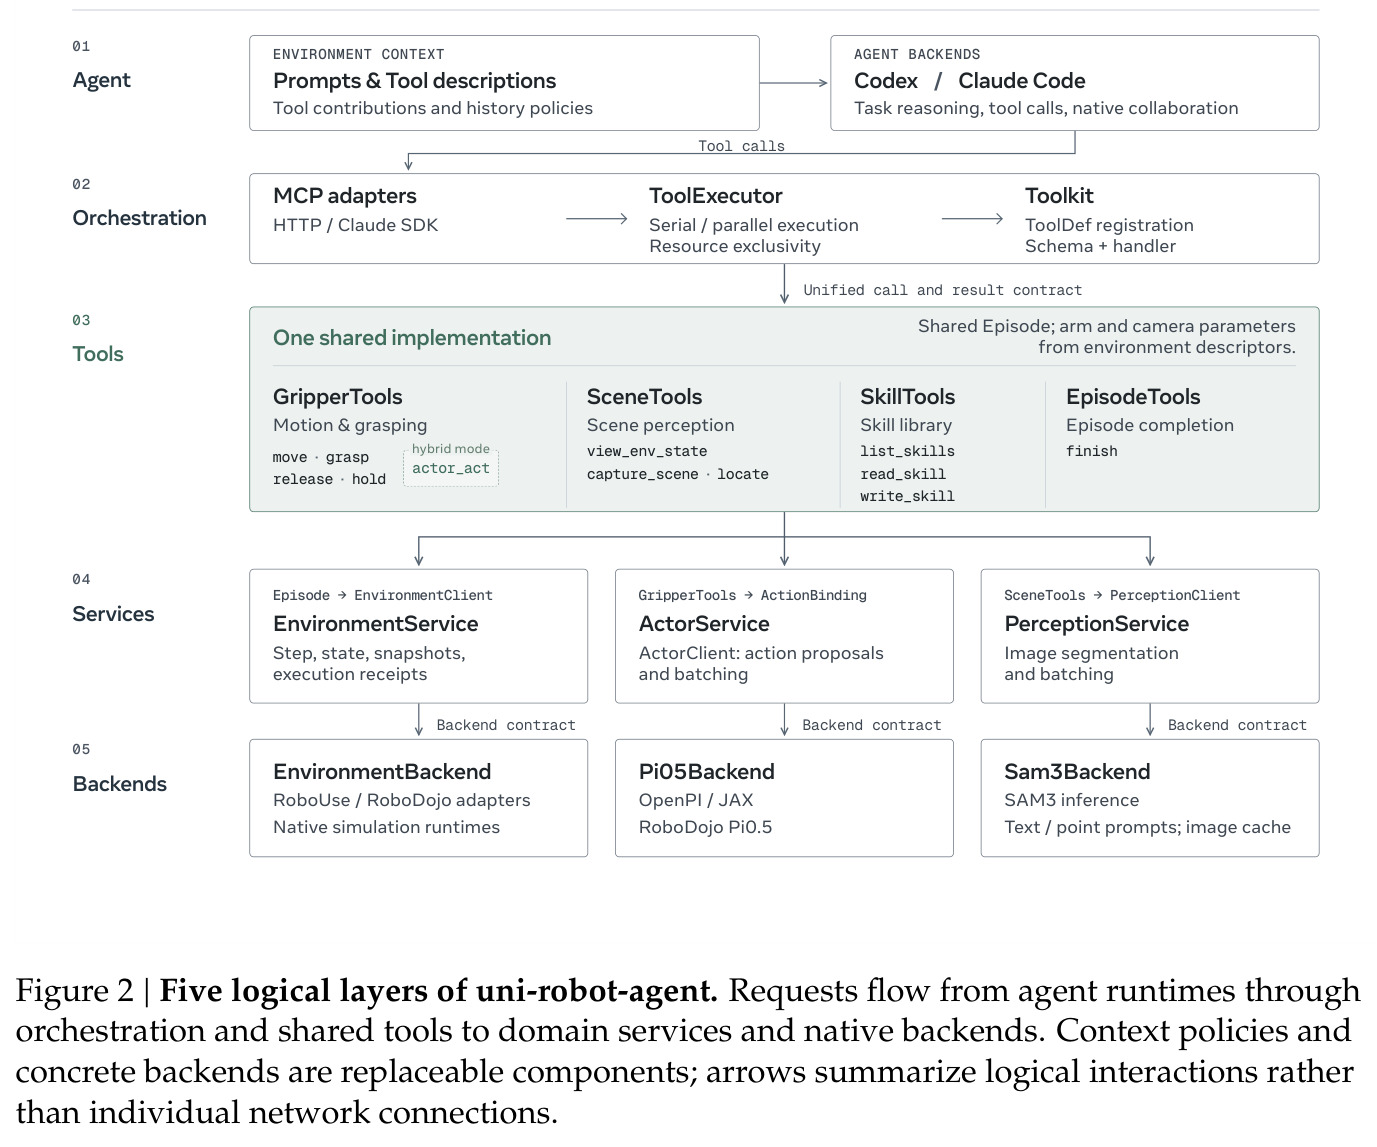
uni-robot-agent 的整体思路是把'模型调用什么'与'环境如何执行'彻底解耦。直觉上,一个会分解任务、会从失败恢复的通用多模态模型,只要拿到结构良好的信息(相机标定、机器人描述)和语义一致、反馈丰富的工具接口,就足以操控机器人。技术上系统分五层:agent 层管理模型交互与上下文(支持 Codex / Claude Code 等运行时);编排层(MCP 适配器 + ToolExecutor)做调度分发、串/并行执行与资源互斥;工具层是共享工具集——GripperTools(move、grasp)、SceneTools(view_env_state、capture_scene、locate)、SkillTools(list/read/write_skill)、EpisodeTools(finish、release、hold);服务层管理环境、感知与动作模型运行时;后端层对接 RoboDojo 等仿真器、OpenPI 的 π0.5 与 SAM3。工具调用沿五层下行、结果原路返回,所有组件按接口可替换。Qwen3.8-Flash-Next 仅凭 RGB+标定在该框架下就拿到 RoboDojo 31.39 分。
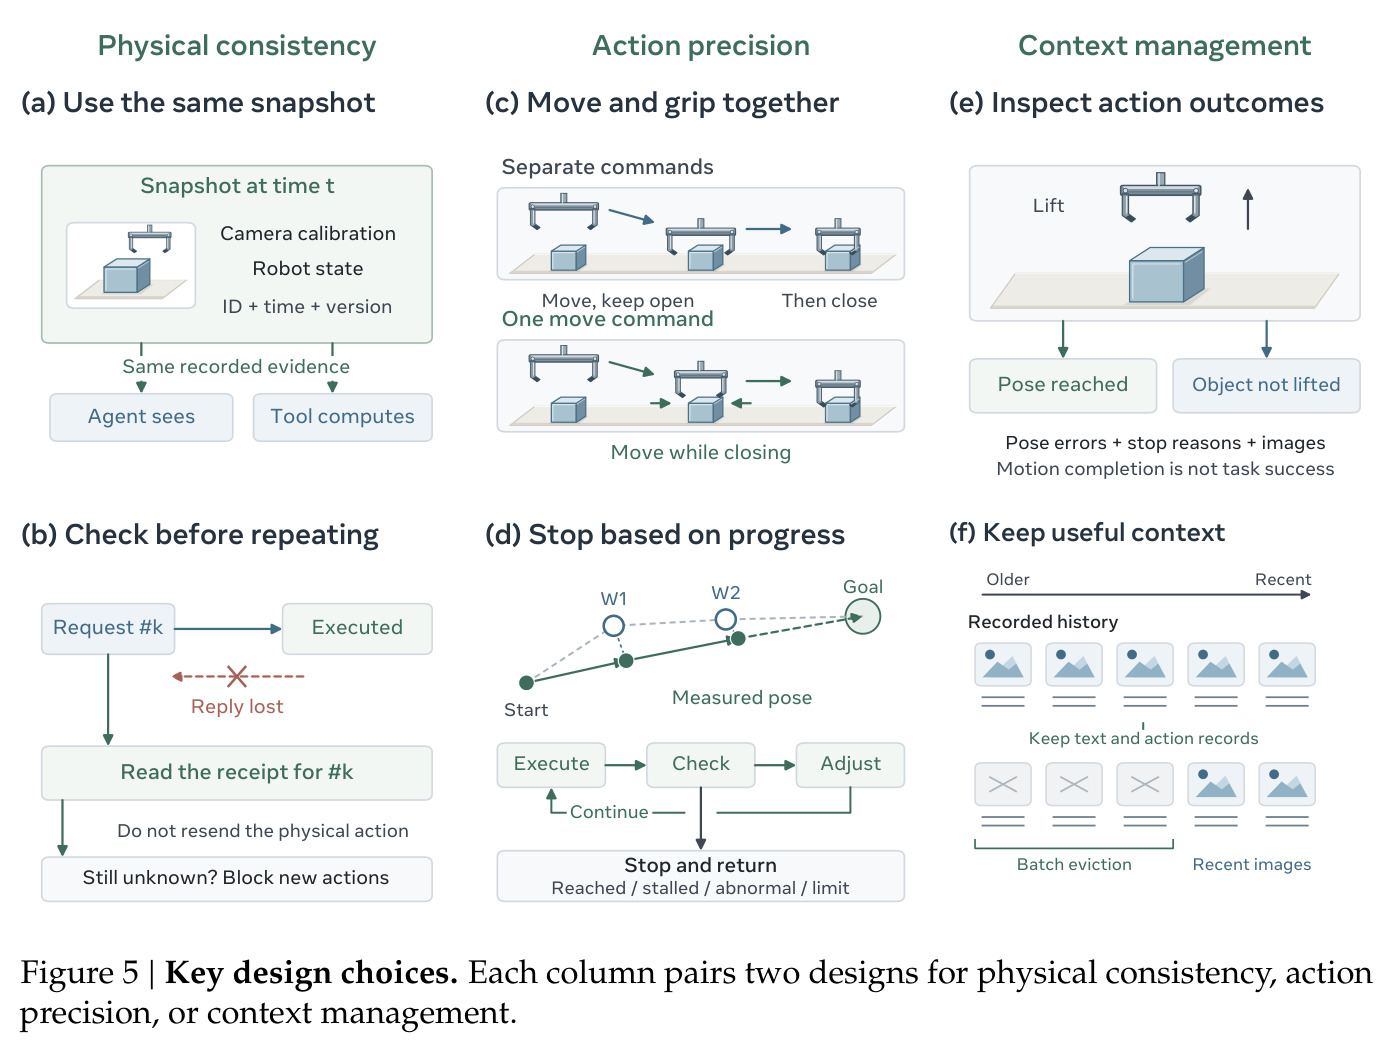
核心创新是'统一交互契约 + 无特权输入 + 流水线执行'三位一体。与为每个环境单独实现一套工具($N \times M$ 份代码)不同,本文把操作语义收敛到 $N$ 个共享工具,用 $M$ 个轻量适配器翻译原生 API:'把夹爪移到位姿'在仿真和真机上含义相同,加环境只需写适配器,统一的请求/反馈格式还让跨环境数据天然可合并训练。与依赖深度或任务验证反馈的 harness 不同,本文只给 RGB、相机内外参、本体状态与描述,逼模型用几何编码和多视角三角测量自行推断 3D 坐标。与串行'推理-等待-执行'不同,两级并发让后台调用返回 job 句柄、推理与执行重叠,同资源调用保序排队,flush_queue 可撤销未启动的动作。再加六大工程设计:快照一致性(图像+标定+状态绑定不可变快照)、请求 ID 与执行记录防重复执行、移动与夹爪开度单指令协调、按测量位姿逐步检查进度的停机策略、位姿误差+停止原因+结果图像的可诊断反馈、滑窗批量淘汰旧图像以稳定缓存前缀。
方法步骤详情
第一步,agent 层接收任务指令、环境描述(可用机械臂、相机与能力清单)和近期观察,生成工具调用。第二步,编排层校验请求:每个请求带 ID 与执行状态记录,通信失败后的重试若对应同一物理动作会被拒收,防止重复执行;状态不确定的请求会显式标记并阻塞新动作。第三步,ToolExecutor 按资源互斥调度:两个针对同一机械臂的 move 按提交顺序执行,读取已有快照可并行;后台调用返回句柄,agent 继续推理,可用批量 wait 收多个结果。第四步,共享 move 工具基于测量位姿生成中间目标并逐步检查进度,按到达/停滞/异常/限位停机,位姿与夹爪开度可同时下发;反馈同时包含数值(位姿误差、停止原因)与结果图像,提示'运动到位不等于任务成功'。第五步,感知走 SceneTools:无深度时跨视图找对应点做三角测量,或调用 SAM3 分割定位;skill 库提供 list/read/write_skill。第六步,上下文管理用滑窗把旧图像替换为文本占位符、批量淘汰保前缀缓存,超预算时用同一模型压缩历史;最后 EpisodeTools.finish 结束回合。全部交互以统一格式落盘,可直接用于后续训练。
技术新颖性
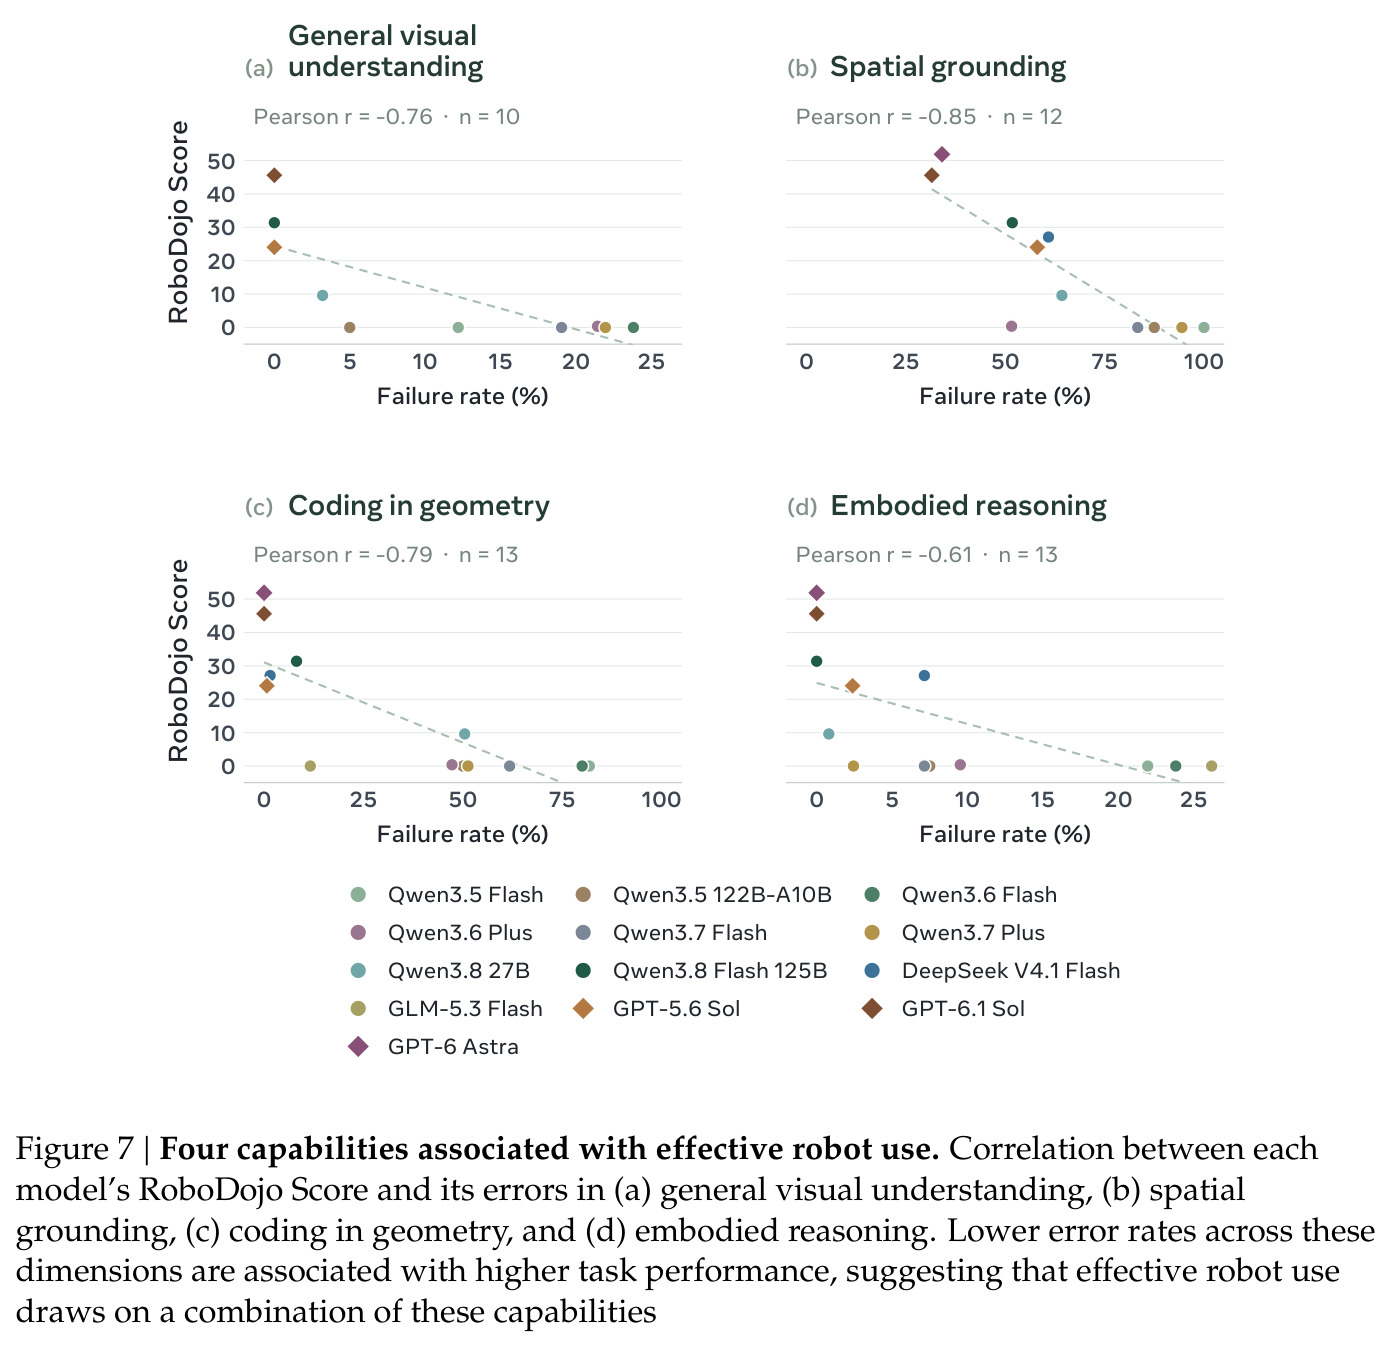
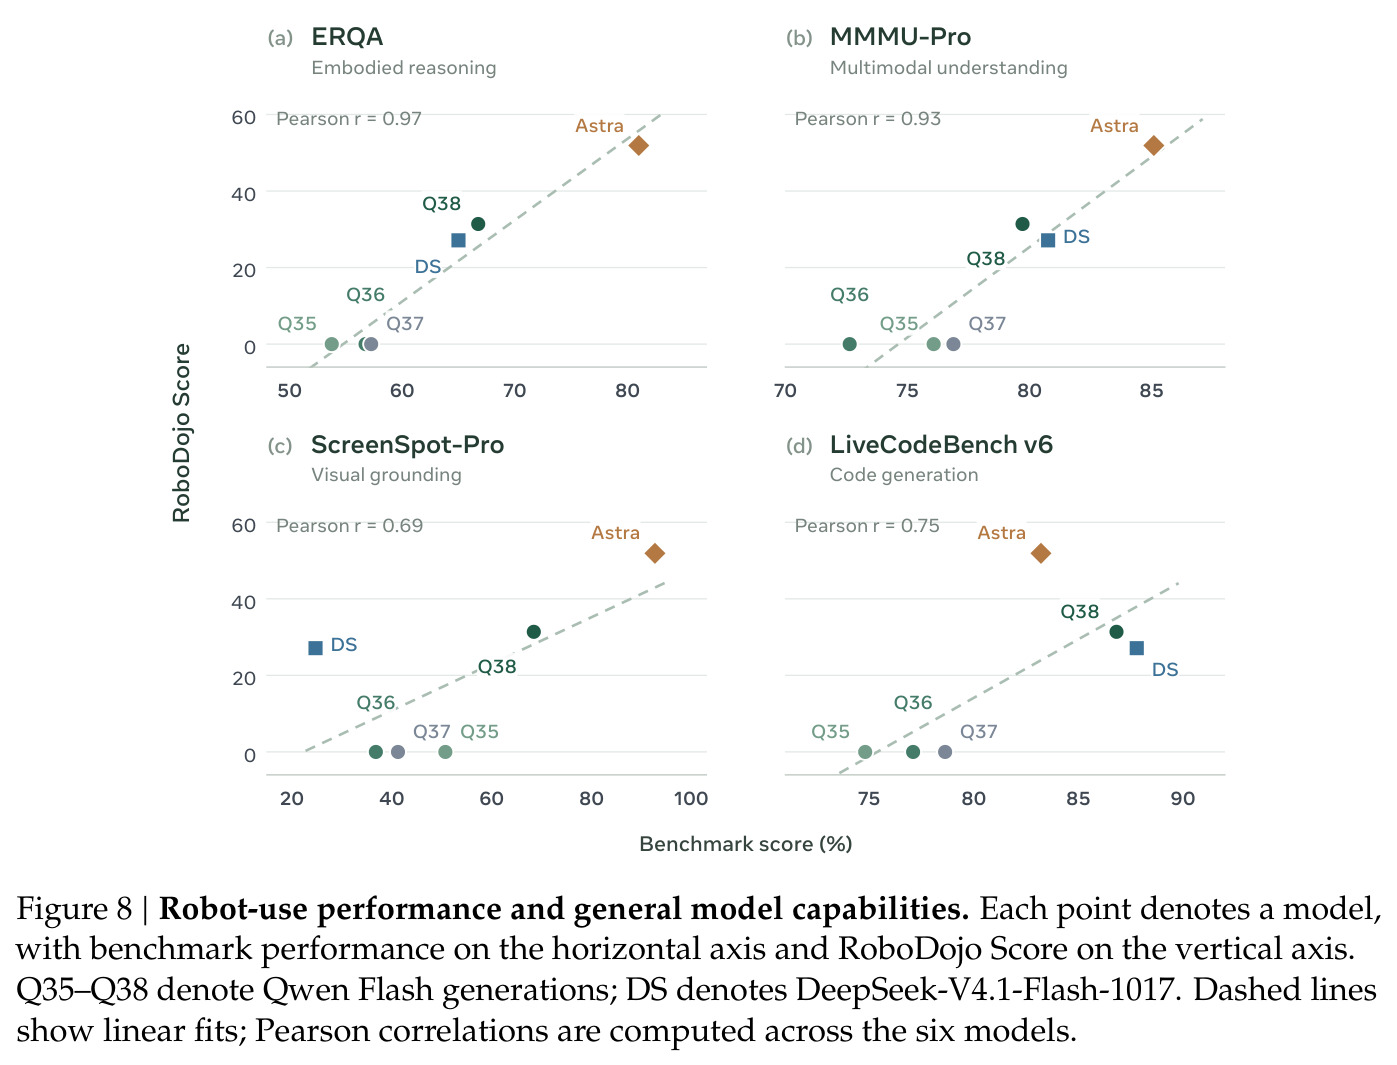
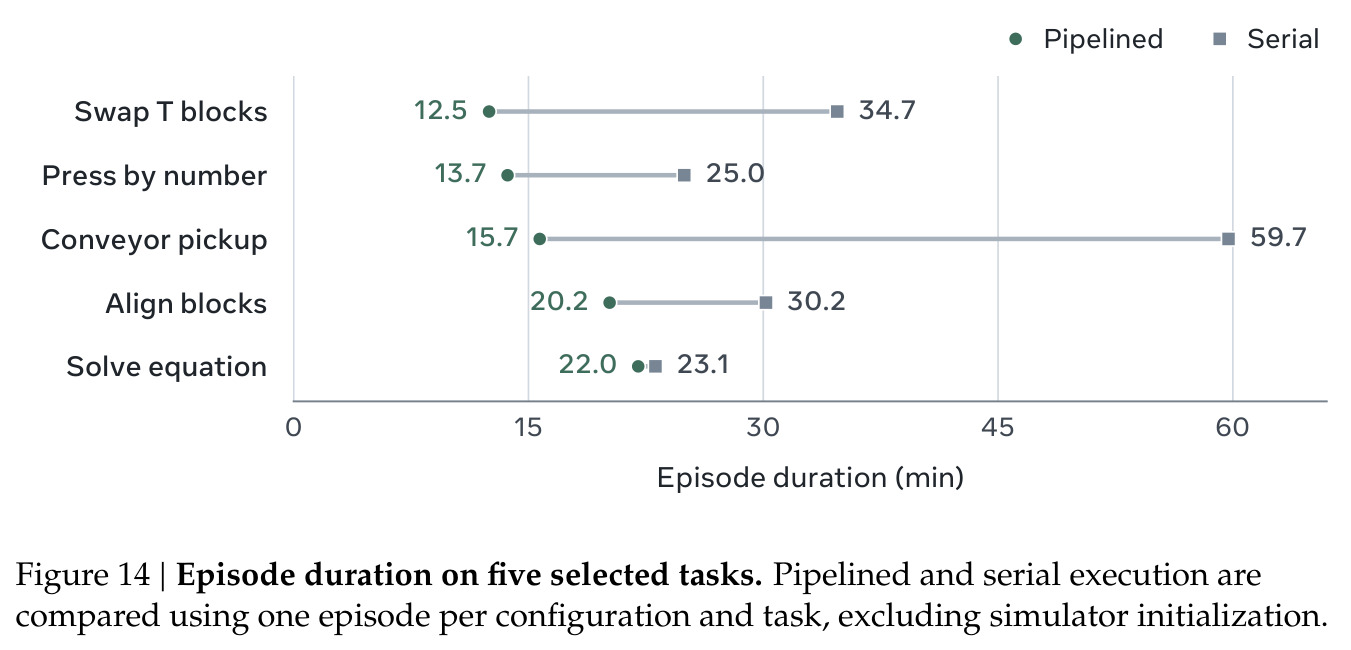
技术新颖性体现在三处。其一是首个'开源模型超越闭源公布成绩'的 RUA 系统:Qwen3.8-Flash-Next 在 RoboDojo 上取得 31.39 分,超过 GPT-6 Astra + RoboProbe 的 28.97 分,且无特权输入、无蒸馏;此前最强的适配式 harness GAP(Hybrid) 只有 21.01 分,换 harness 掉分 10.38。其二是把执行效率当一等公民:物理执行时间与模型请求的重叠率达 84.5%–93.8%,五个任务回合时长缩短 4.8%–73.7%,对以推理速度为瓶颈的 RUA 是实质性工程贡献。其三是分析视角:论文不满足于刷分,而是用 13 个模型的失败轨迹把机器人使用分解为视觉理解(Pearson $r=-0.76$)、空间定位($r=-0.85$)、几何编码($r=-0.79$)与具身推理($r=-0.61$)四项通用能力,并验证其与 MMMU-Pro($r=0.93$)、ERQA($r=0.97$)等通用基准强相关,从而把'RUA 训练'还原为'通用能力联合培养'问题,为开源权重的后续训练研究提供了清晰抓手。
实验结果
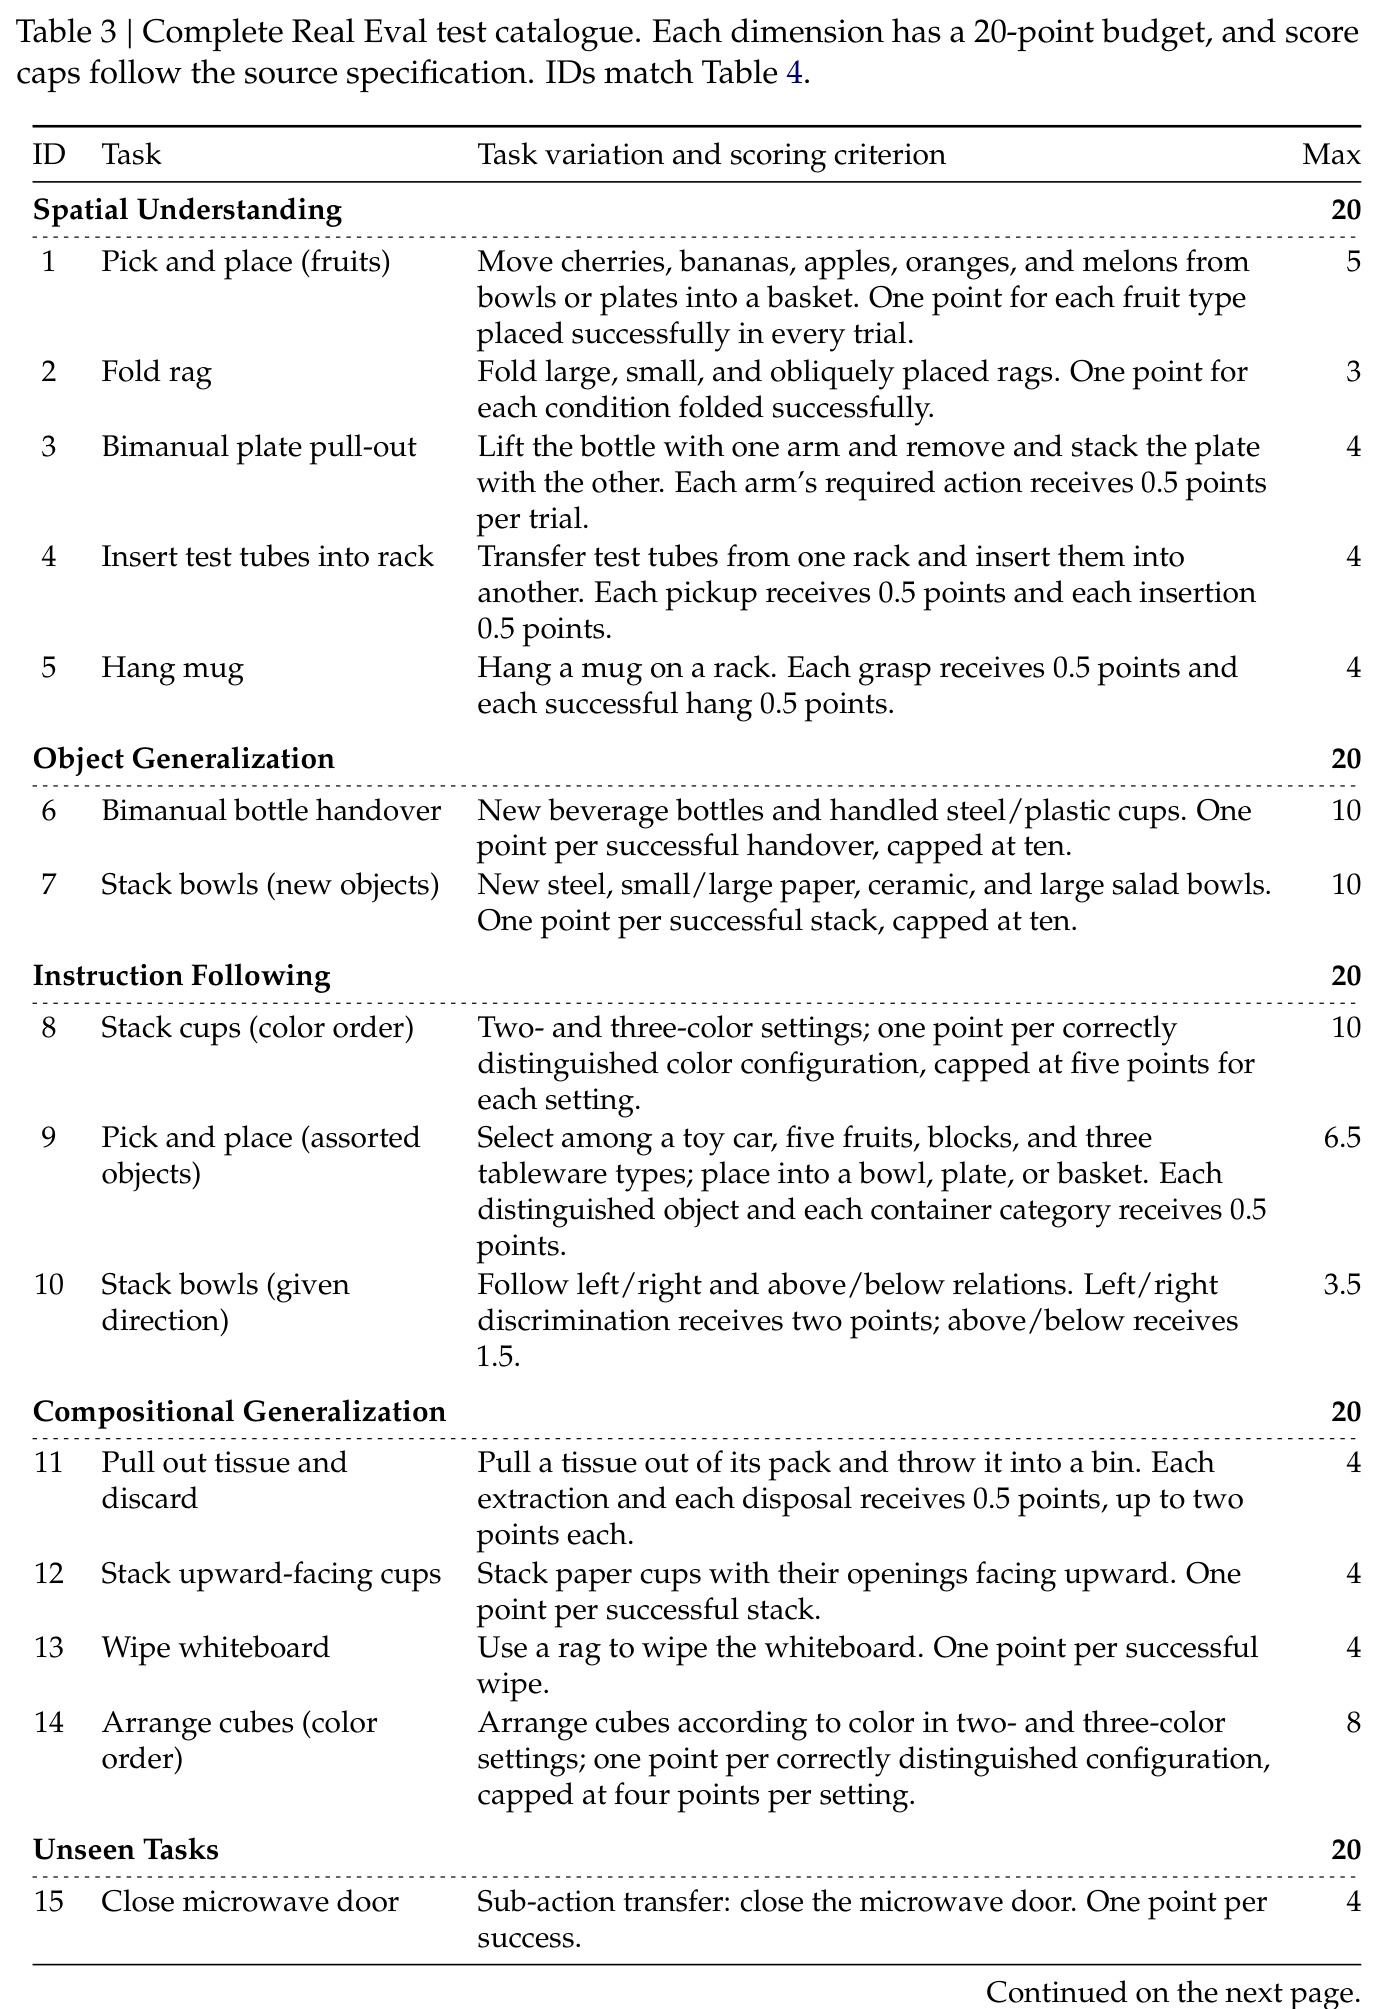
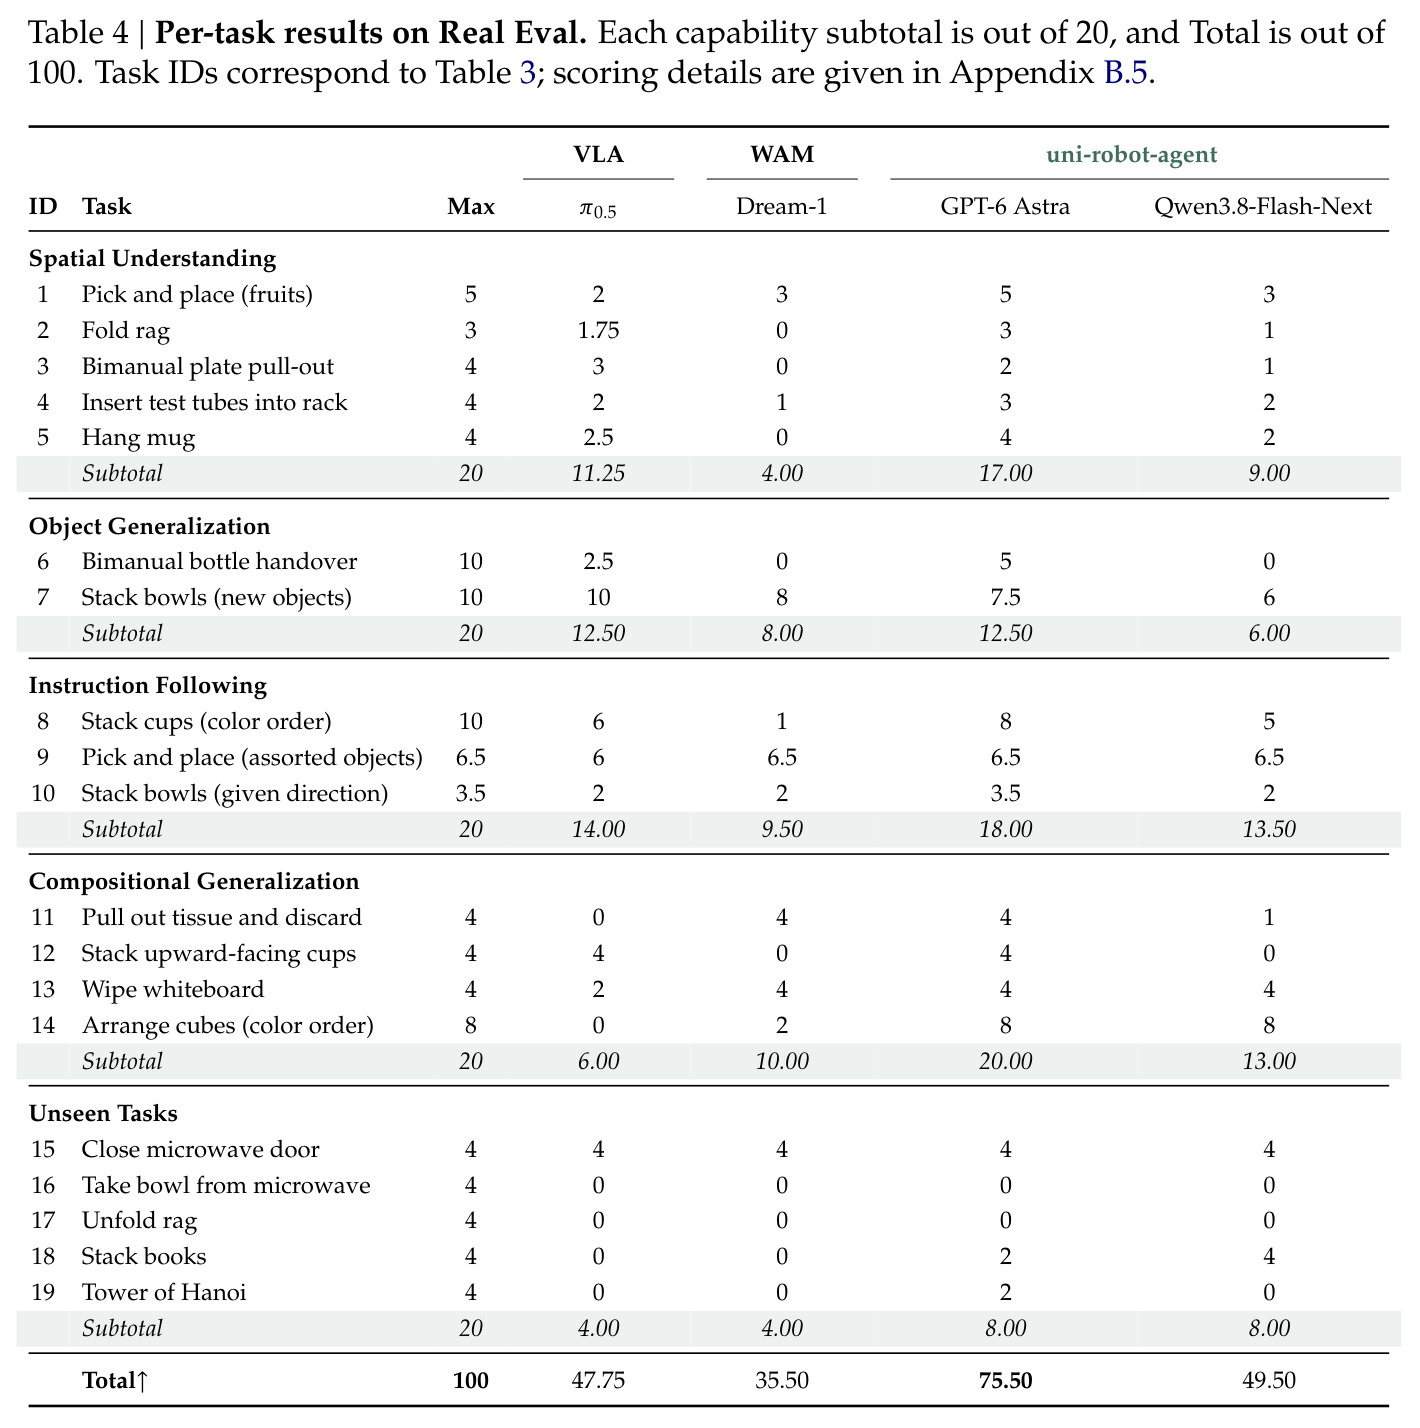
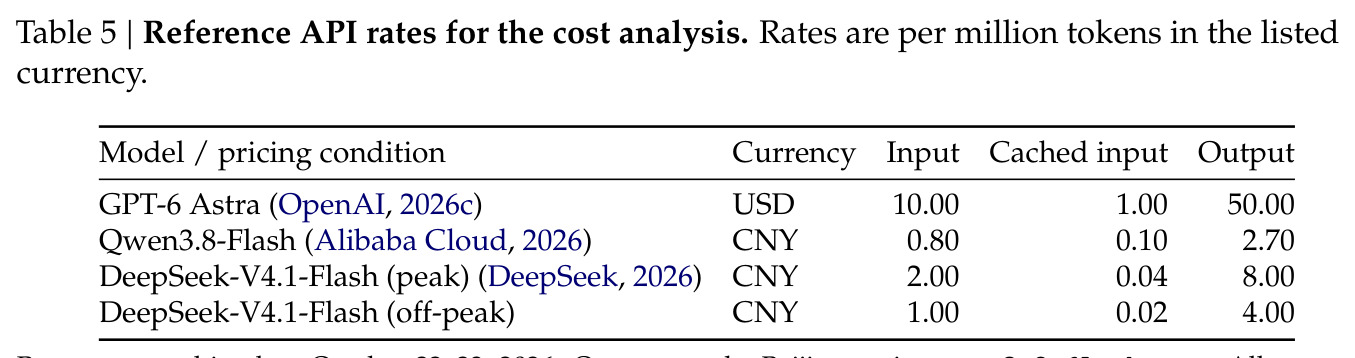
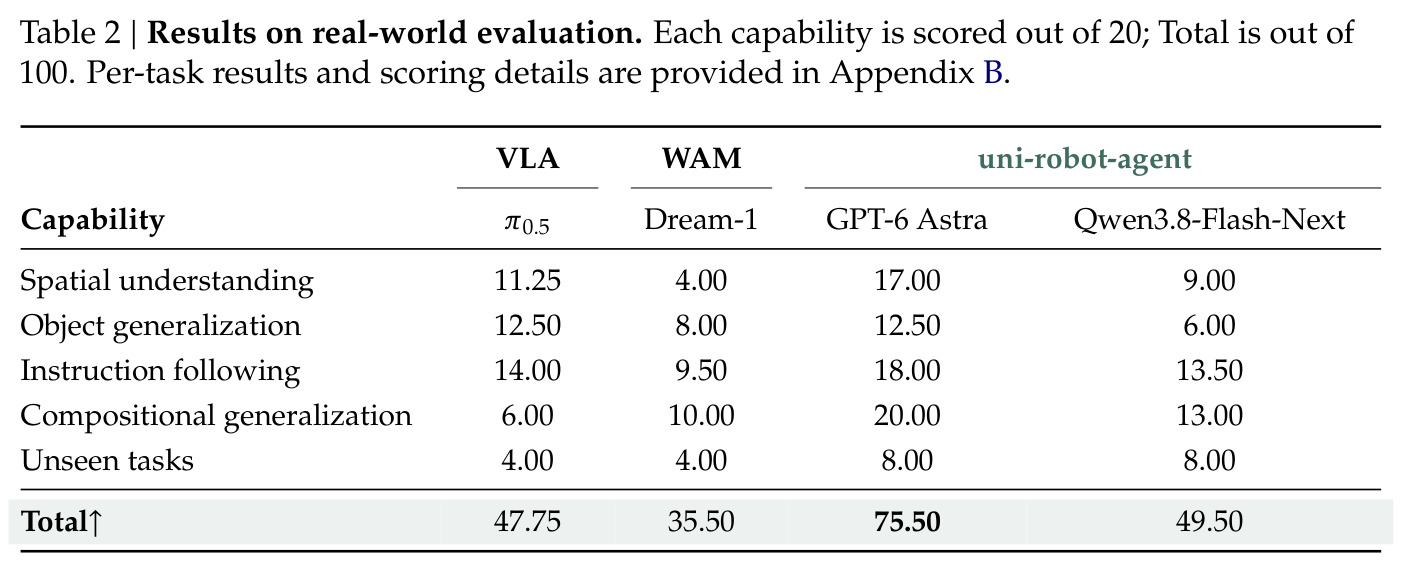
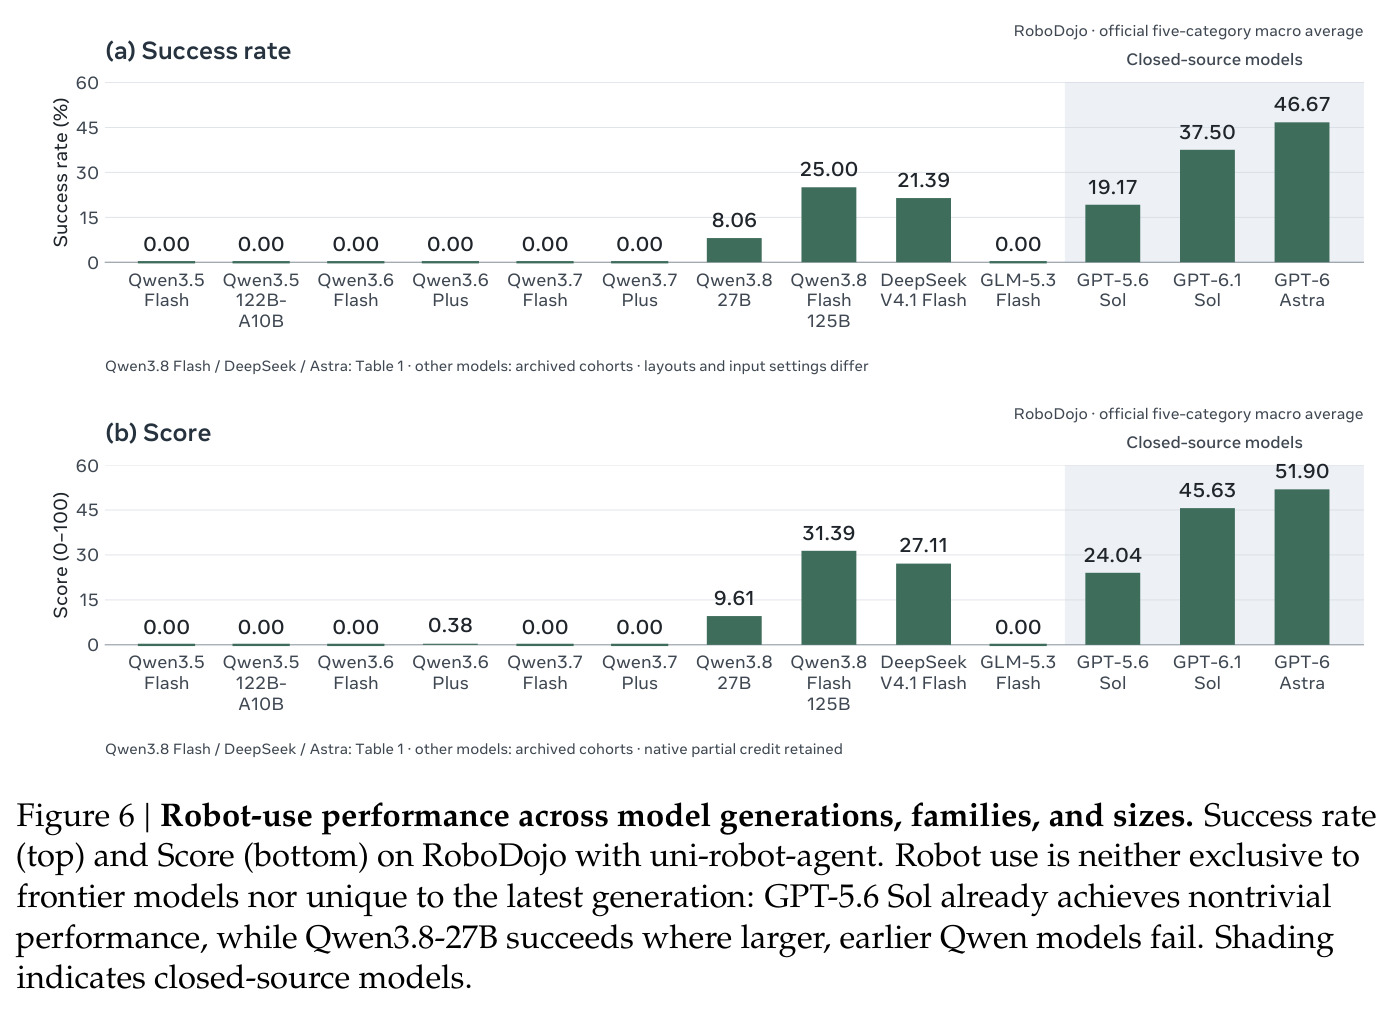
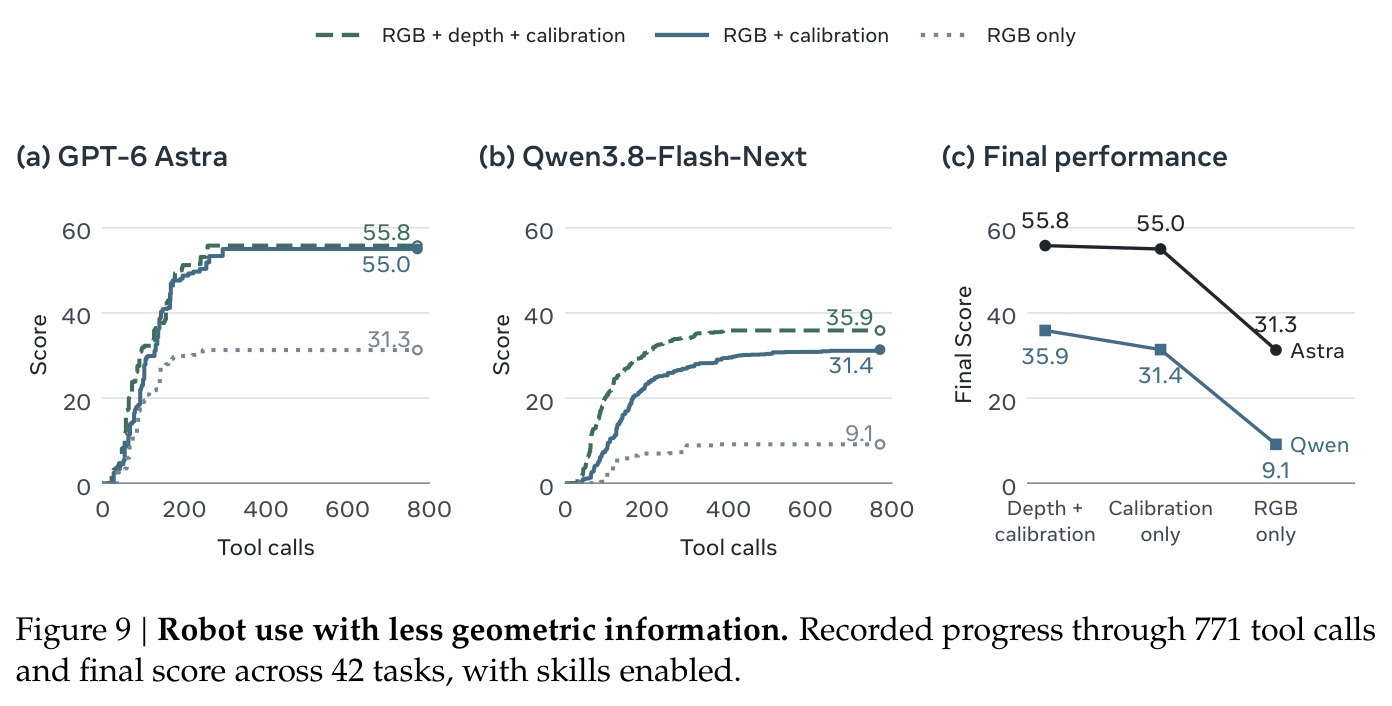
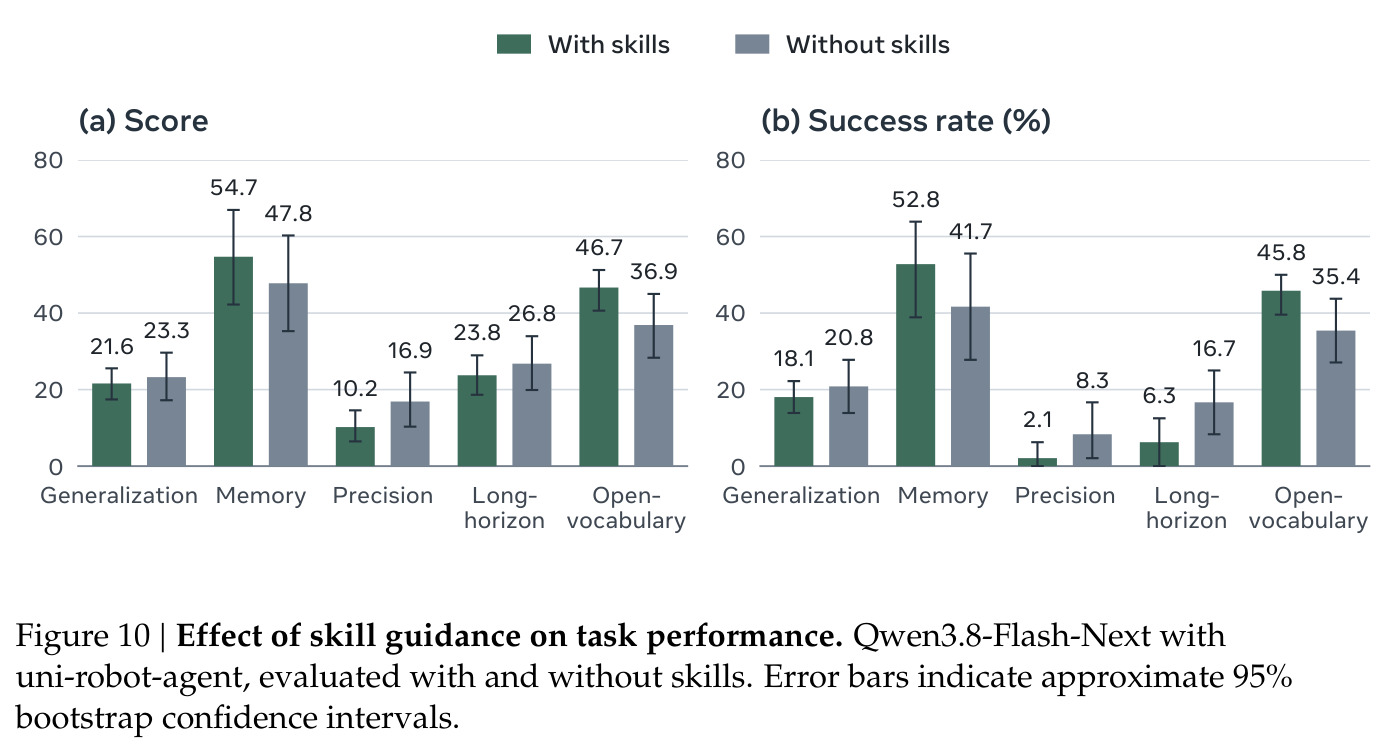
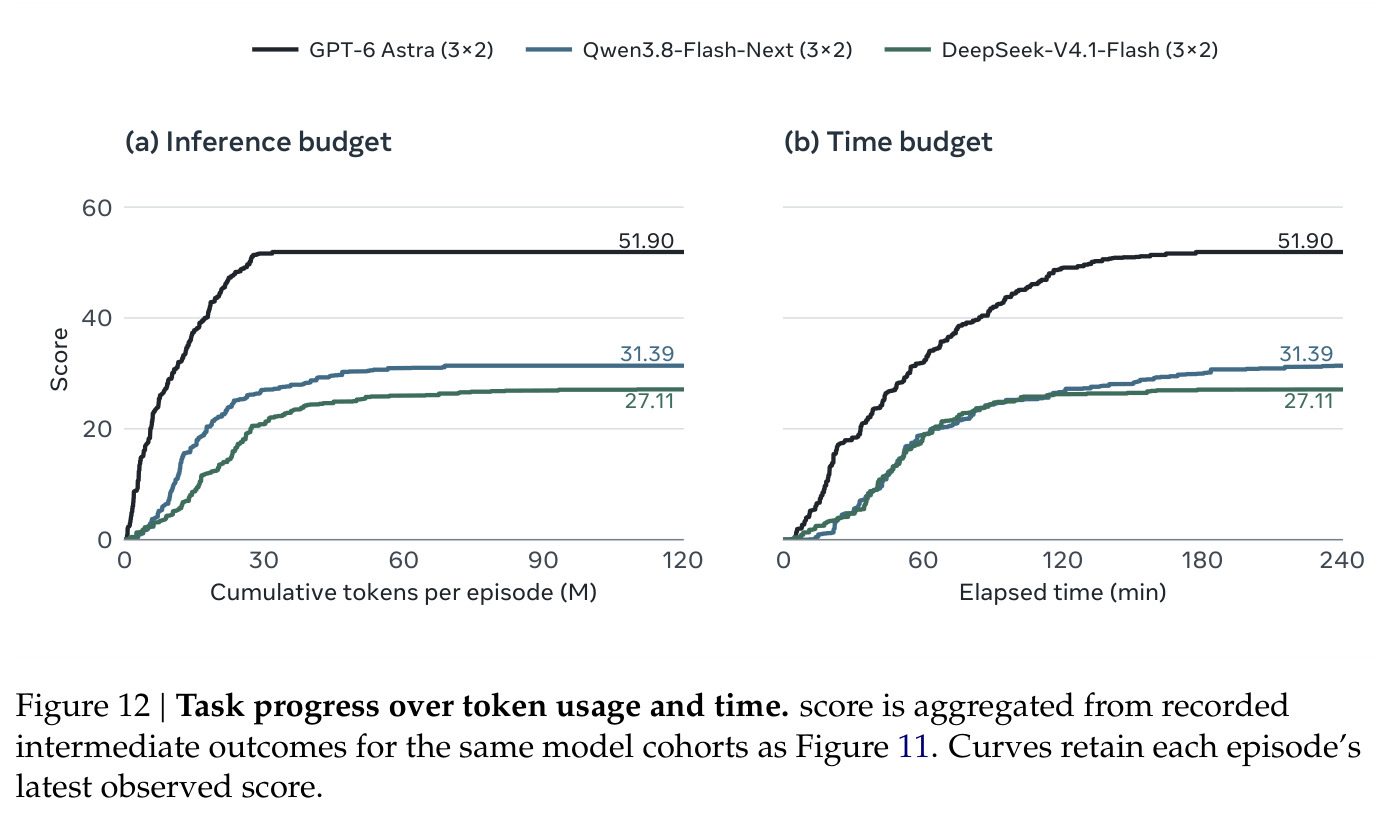
仿真主实验在 RoboDojo 42 个任务、五个维度上进行,每任务 3 种子 × 2 布局共 252 回合。Qwen3.8-Flash-Next + uni-robot-agent 取得 25.00% SR / 31.39 分,超过 GPT-6 Astra + RoboProbe(22.48% / 28.97)和全部 VLA/WAM 基线(π0.5 仅 6.93 / 11.44,最强的 Xiaomi-Robotics-1 为 13.93 / 20.07);换 harness 掉分严重(最强基线 GAP Hybrid 仅 16.11 / 21.01)。DeepSeek-V4.1-Flash 也达 21.39 / 27.11。GPT-6 Astra 套用本框架冲到 46.67 / 51.90,说明设计对闭源模型同样有效。真机 19 任务五维各 20 分:Qwen 拿 49.50,超零样本 Dream-1(35.50)、追平每任务微调 10 小时的 π0.5(47.75);GPT-6 Astra 达 75.50。模型分析显示机器人使用并非最新代独有:GPT-5.6 Sol 已有 19.17% SR / 24.04 分,GPT-6.1 Sol 达 37.50 / 45.63;Qwen3.5–3.7 全零而 Qwen3.8-27B 达 8.06%,训练分布比模型大小更关键。失败模式与分数强相关:空间定位 $r=-0.85$、几何编码 $r=-0.79$、视觉理解 $r=-0.76$、具身推理 $r=-0.61$。特权信息消融:去掉深度,Astra 保留 98.6%(55.83→55.04)、Qwen 保留 87.5%(35.89→31.39),只给 RGB 时 Qwen 崩到 9.13;去掉技能库保留 96.6%(31.39→30.31)。成本上 Qwen 每回合 1.09 美元、Astra 21.29 美元(约 20 倍);达到 25 分需 token:Astra 7.4M、Qwen 23.5M、DeepSeek 49.9M;流水线使动作重叠达 84.5%–93.8%,swap_T 时长从 34.7 分钟降到 12.5 分钟。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboDojo 仿真操控(42 任务、5 维宏平均、252 回合) | 成功率 SR / Score(0–100 部分成功加权) | Qwen3.8-Flash-Next + uni-robot-agent:25.00% / 31.39 | GPT-6 Astra + RoboProbe:22.48% / 28.97;最强 VLA/WAM Xiaomi-Robotics-1:13.93% / 20.07 | SR +2.52pp、Score +2.42,开源模型首次在无特权输入、无蒸馏下超越闭源公布成绩 |
| 真机 19 个桌面操控任务(5 维各 20 分) | 总分(满分 100) | Qwen3.8-Flash-Next + uni-robot-agent:49.50;GPT-6 Astra:75.50 | 微调 π0.5:47.75(每任务 10 小时示教);零样本 Dream-1:35.50 | 零样本超 Dream-1 14.00 分,追平微调 π0.5(+1.75) |
| RoboDojo(同一闭源模型换 harness) | SR / Score | GPT-6 Astra + uni-robot-agent:46.67% / 51.90 | GPT-6 Astra + RoboProbe:22.48% / 28.97;Qwen3.8 + 最强基线 GAP Hybrid:16.11% / 21.01 | 闭源模型上 Score +22.93;开源模型换 harness 提升 Score +10.38 |
| 执行效率(5 个选定任务,流水线 vs 串行) | 回合时长(分钟)与动作-推理重叠率 | swap_T 12.5 分钟(串行 34.7)、conveyor_pickup 15.7(59.7);重叠 84.5%–93.8% | 串行执行(重叠 0%) | 时长缩短 4.8%–73.7%,串行 episode 重叠率全部为 0 |
| API 成本与资源消耗(RoboDojo 252 回合均值) | 美元/回合;达到 Score 25 所需 token 与时间 | Qwen3.8-Flash-Next:$1.09/回合,23.5M token、95.5 分钟达 25 分 | GPT-6 Astra:$21.29/回合,7.4M token、42.6 分钟;DeepSeek-V4.1-Flash:$0.94/回合,49.9M token、99.2 分钟 | 成本比 Astra 低约 19.5 倍,但每分性能耗 token 约为其 3 倍 |
局限与改进
作者坦承两类短板:精密操控与长时程执行仍是弱项——Qwen 的长时程 SR 仅 6.25%(Score 23.75),远低于 OpenWAM-α 的 25.33% 与 Xiaomi-Robotics-1 的 23.67%;精度维度也只有 2.08% SR。即便最好的 GPT-6.1 Sol,空间定位失败率仍高达 31.5%,说明细粒度跨视角对应点选择是普遍瓶颈。我自己的观察:(1) 无相机标定时性能崩塌(Qwen 31.39→9.13),对真实场景标定误差与相机漂移的鲁棒性未知;(2) 真机评估仅 19 个桌面任务,且本文 agent 用了 RealSense D405 深度而 π0.5、Dream-1 只有 RGB,对比并不完全公平;(3) 四大能力与成绩的相关性是观察性统计($n=10$–$13$ 的 Pearson 相关),部分模型来自'layouts and input settings differ'的归档 cohort,可比性存疑;(4) 流水线效率只在 5 个任务各执行 1 次上测量,无方差与置信区间;(5) 成本结论依赖 API 定价,本地部署开源模型的成本结构不同。
独立分析的弱点
第一,几何能力与标定强耦合:只有 RGB 时 Qwen 从 31.39 跌到 9.13,说明系统本质是'以标定为纲';改进方向是引入学习式单目深度估计或视觉自标定,并做标定噪声敏感性实验。第二,失败模式研究样本小且混杂:$n=10$–$13$,部分模型来自输入设置不同的归档 cohort,'四能力联合决定机器人使用'更像假设而非定论;应固定输入协议、扩大模型池,并做受控干预(微调单一能力后测迁移)验证因果。第三,长时程与精密操作差距未解:Qwen 开放词汇维度 SR 达 45.83%、记忆 52.78%,但长时程只有 6.25%,提示需要分层规划或技能组合训练,而非继续堆 token 预算。第四,流水线收益评估过窄:仅 5 任务 × 1 次执行,且与 GPT-6 Astra 中等推理档绑定,应在全部 42 任务 × 多种子下报告置信区间。第五,真机基线输入不对等:本文用深度、基线只用 RGB,应补 RGB-only 真机结果;此外技能库虽非性能支柱,但 write_skill 的质量评估和安全约束讨论不足。
未来方向
作者明确提出的方向是:未来 RUA 训练应联合培养四大通用能力——视觉理解、空间定位、几何编码、具身推理——例如用机器人数据构造针对每项能力的训练任务,而非只拟合动作输出。基于本文成果还可自然延伸:(1) 既然分数与 ERQA($r=0.97$)、MMMU-Pro($r=0.93$)强相关,可先用通用多模态与代码数据'补能力',再用少量机器人数据适配;(2) 建立 3D 空间定位专项基准——现有 ScreenSpot-Pro 是 2D 屏幕定位,相关性只有 $r=0.69$,解释力不足;(3) 利用统一交互格式批量收集跨环境轨迹,做离线强化学习或拒绝采样微调,这正是框架'统一记录可合并'设计的初衷;(4) 把流水线与推测执行推广到真机遥操作和多机器人并发场景;(5) 研究技能库的自动生长与跨环境迁移(write_skill 接口已就位);(6) 针对长时程任务引入分层规划器或在世界模型上做前瞻验证。
复现评估
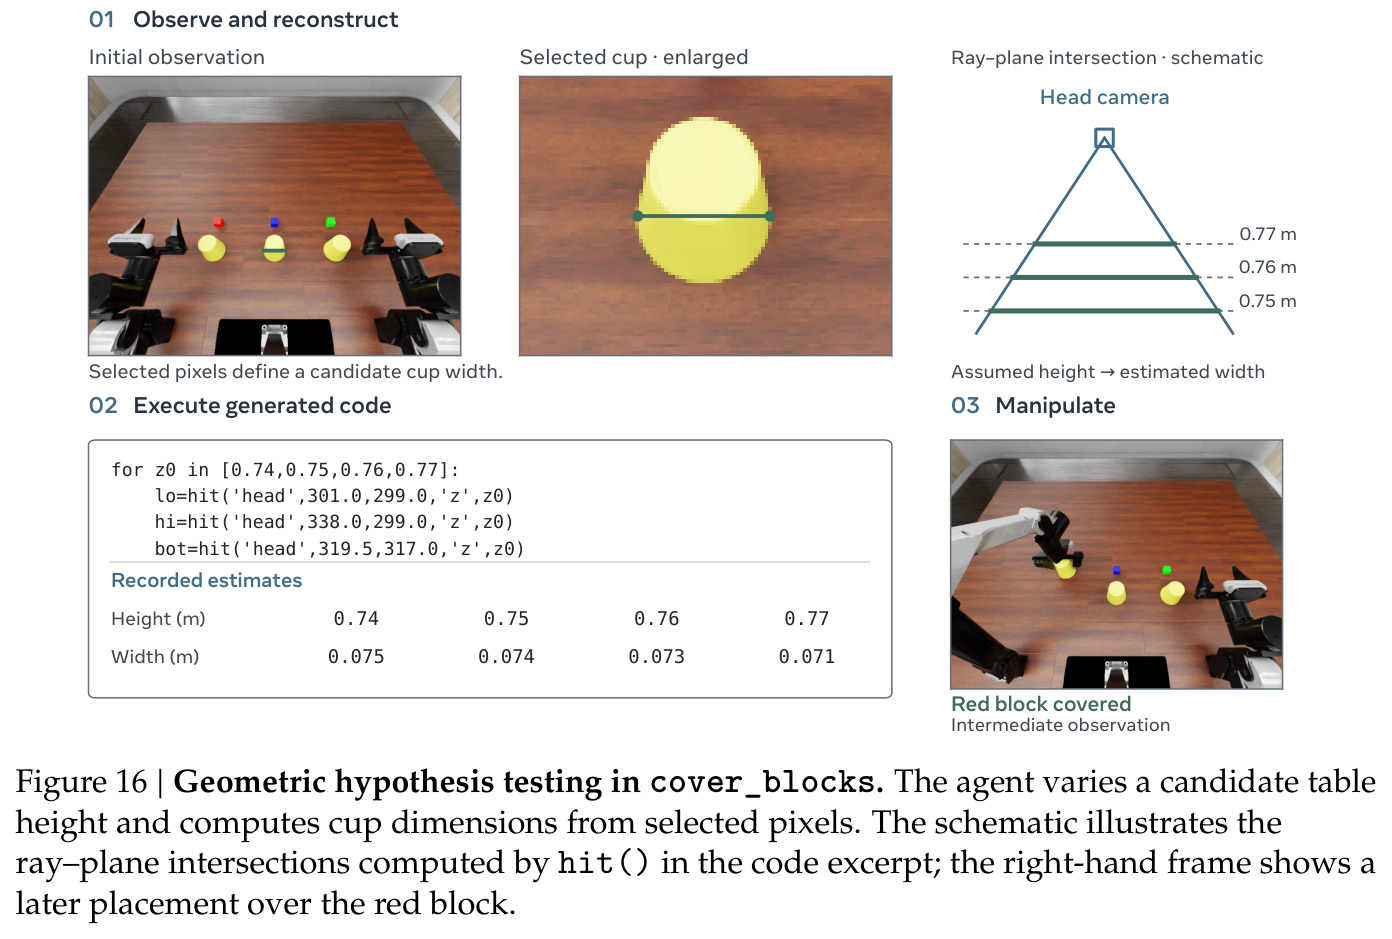
复现条件较好。论文提供 Blog、Code、Website、Documentation 四个入口,框架按五层模块化组织(agent 运行时、MCP 适配器、共享工具、服务、后端),加环境只需写一个适配器。仿真复现依赖 RoboDojo 官方 42 任务协议与排行榜基线,3 种子 × 2 布局、SR 与 Score 聚合方式在附录 A 说明,输入协议明确(仅 RGB+标定+本体状态+指令,并人工核查无特权访问)。主要开销是推理而非训练:252 回合用 Qwen 约 $1.09/回合、Astra $21.29/回合,开源模型可本地部署摊薄费用。真机复现门槛较高:需要双臂平台、Intel RealSense D405、19 任务目录与打分协议(附录 B),π0.5 基线还需每任务 10 小时示教微调。附录还给出 API 成本估算(附录 C)、运动执行与停机算法(附录 D)以及三角测量、搬运等定性案例(附录 E/F),对工程复现相当友好;唯一无法完全复现的是 GPT-6 Astra 等闭源模型的结果。
论文图表