机器人上下文学习:方法与应用 In-Context Learning for Robots: Methods and Applications
按证据到动作的执行接口综述机器人上下文学习,提出四家族分类、评估控制与自改进议程
前置知识
上下文学习(In-Context Learning, ICL)
源自 GPT-3 的概念:模型在推理时从输入中的示例、指令里推断任务要求,而神经参数保持不变。对机器人而言,上下文可以是演示视频、语言纠正、交互历史或场景预览,它们在部署时改变行为但不改动权重 $\theta$,形式化为 $A_t \sim \pi_\theta(\cdot \mid h_t, C_t)$。
这是全文的定义性框架:综述把所有方法按'证据如何在固定参数下改变动作'来组织,不理解 ICL 就无法理解四家族分类和评估设计。
单次模仿学习与元强化学习(One-shot IL / Meta-RL)
两条历史源头。One-shot IL(如 Duan 等人 2017)用配对的演示-执行片段训练网络,使其能从一个演示推断新实例的动作;Meta-RL(如 RL²、PEARL)用循环状态或潜变量在多个片段间推断任务身份或动力学参数,适配信息存储在上下文或记忆中而非权重里。
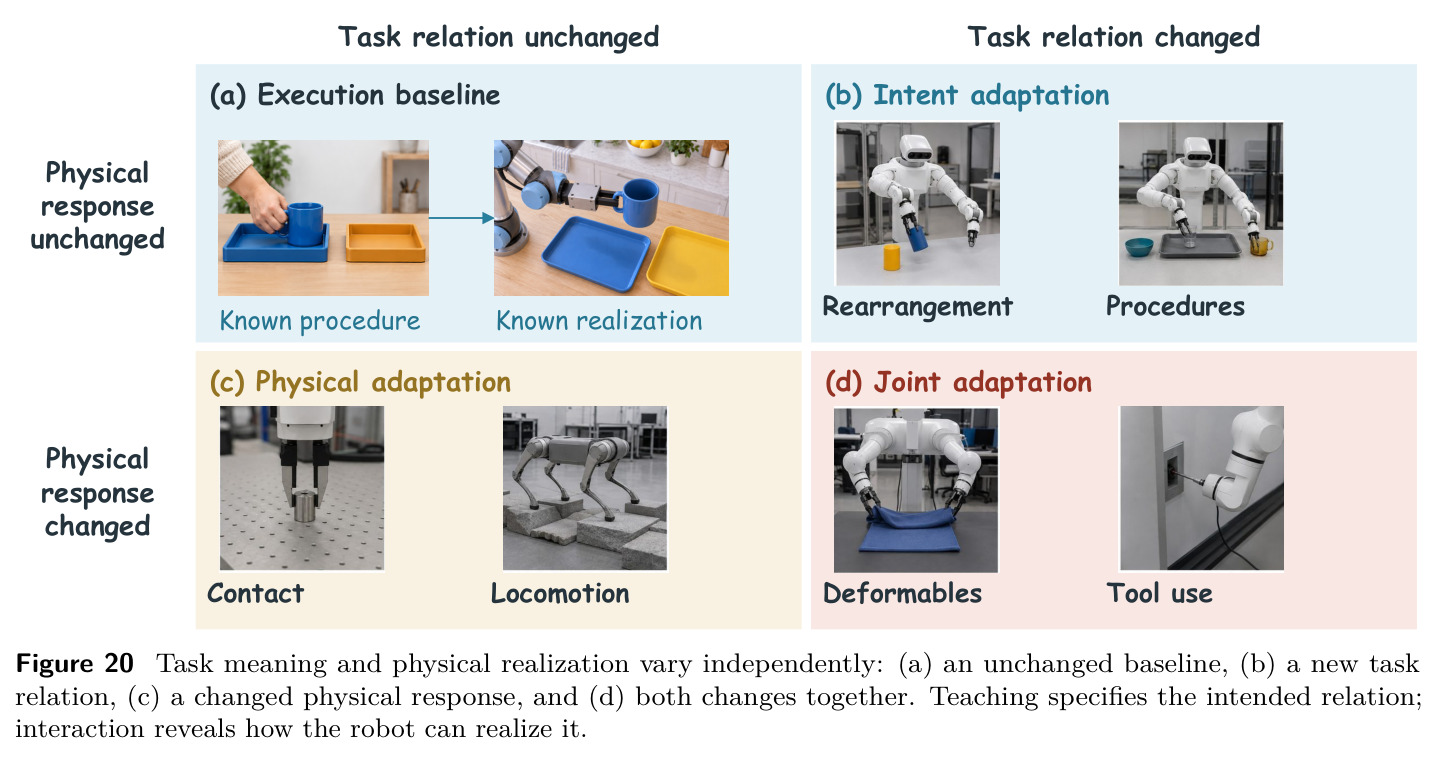
综述明确指出机器人 ICL 由这两条脉络汇聚而成:S4(从教学推断任务)承接 one-shot IL,S3(从交互推断响应)承接 meta-RL,理解二者才能分清'意图适配'与'物理适配'。
视觉-语言-动作模型(VLA)与机器人基础策略
在 Open X-Embodiment、DROID 等大规模多本体数据上预训练的通用策略(RT-X、OpenVLA、π0、GR00T N1 等),把图像、语言映射到机器人动作 token。它们提供可复用的感知与运动能力,是 ICL 发挥作用的'底座'。
综述的出发点是:更广的预训练给了机器人能力,但当前场景仍留有信息缺口(多种可行流程、隐藏事件、未知响应),ICL 的价值就在于用新证据填补这些缺口。
世界模型(World Model)
学习状态转移 $p(v^+ \mid a, h)$ 的模型,能在执行前预测动作的未来后果(图像、潜状态或航点)。用于控制时有两型:先生成'期望的未来'再解码动作(Zero-WAM、Demo-JEPA),或用动力学模型评估候选动作序列(DOMINO、MetaDiffuser 的规划形式)。
世界模型控制是四方法家族之一,其迁移假设是'预测的演化可实现',与直接动作推断、几何迁移的假设本质不同,是理解分类学的关键一环。
SE(3) 位姿与运动重定向(Retargeting)
SE(3) 是三维刚体变换群,用 $W T_X \in SE(3)$ 表示坐标系 $X$ 在世界系 $W$ 下的位姿。几何演示迁移把示教者(人或物体)上的运动描述子 $\zeta$ 通过对应关系变换到当前场景与机器人本体,例如物体相对迁移公式 $W T_{E,b}^q(\sigma) = W T_{Ob}^q (W T_{Ob}^s)^{-1} W T_{E,b}^s(\sigma)$。
几何演示迁移家族(DOME、DITTO、MT3、SemAnCorr 等)的迁移假设'匹配的交互仍适用'完全建立在位姿对应与重定向上,公式是理解该家族的门槛。
扩散策略与流匹配(Diffusion Policy / Flow Matching)
两类生成式动作头:扩散策略通过迭代去噪从高斯噪声生成动作块,流匹配学习速度场把简单分布连续输运到动作分布。它们可实现上下文条件策略的动作生成 $q_a^\theta$,也可作为几何参考跟踪或未来条件解码的执行器。
综述反复强调'表示与生成器是耦合选择':上下文编码保住的区分(顺序、接触)必须在生成式动作头中被恢复,读者需要知道这类动作模型的输入输出才能理解该论断。
遥操作与 UMI 数据采集
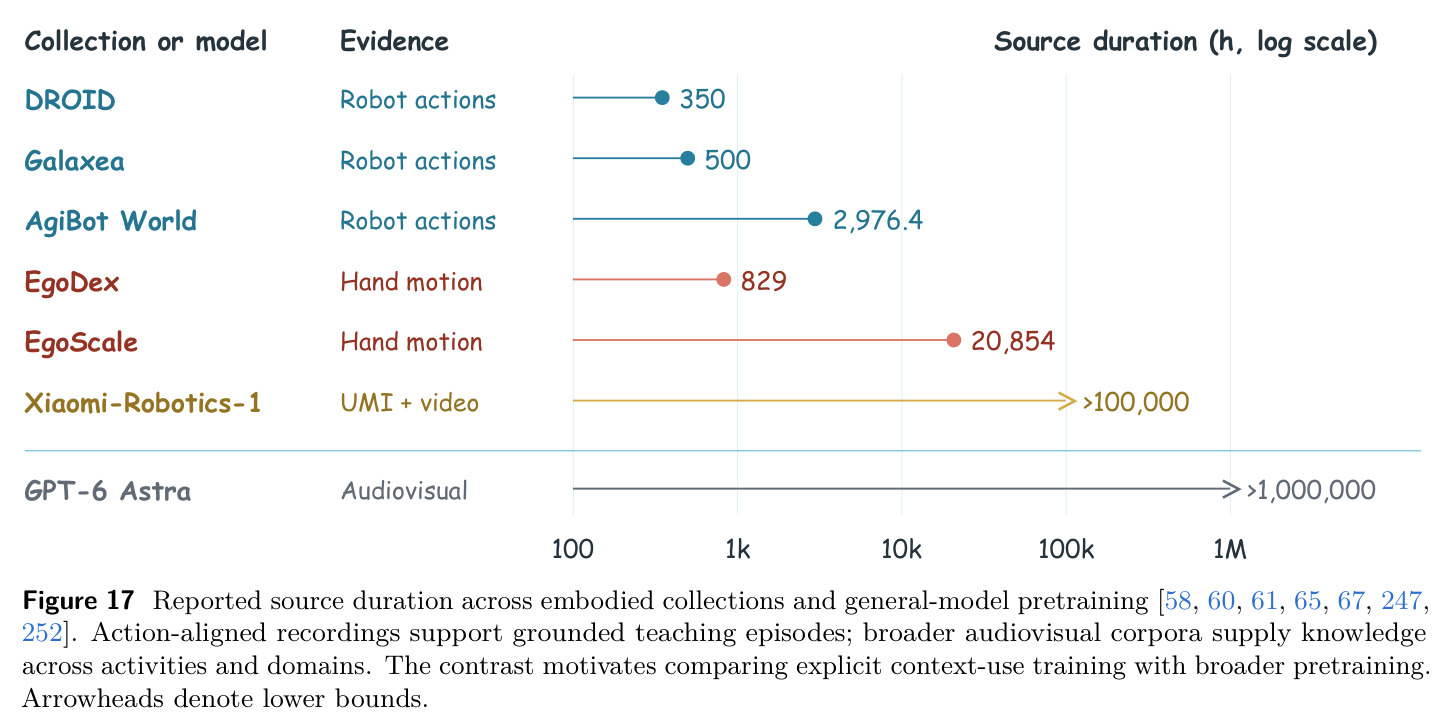
遥操作直接记录机器人观测、指令与测量状态(DROID、AgiBot World);UMI 用手持夹爪式设备采集人类演示,通过 IMU 与视觉跟踪估计末端位姿与开口宽度(UMI、YUBI 报告 8,434 小时/119 任务),无需真实机械臂,代价是限制了演示方式、换取更少的推断不确定性。
第 4 章按采集源组织数据讨论:每个源的测量通道决定了它能提供什么教学-执行关系,这是评估'数据价值'与设计上下文配对的基础。
测试时训练与快权重(Test-Time Training / Fast Weights)
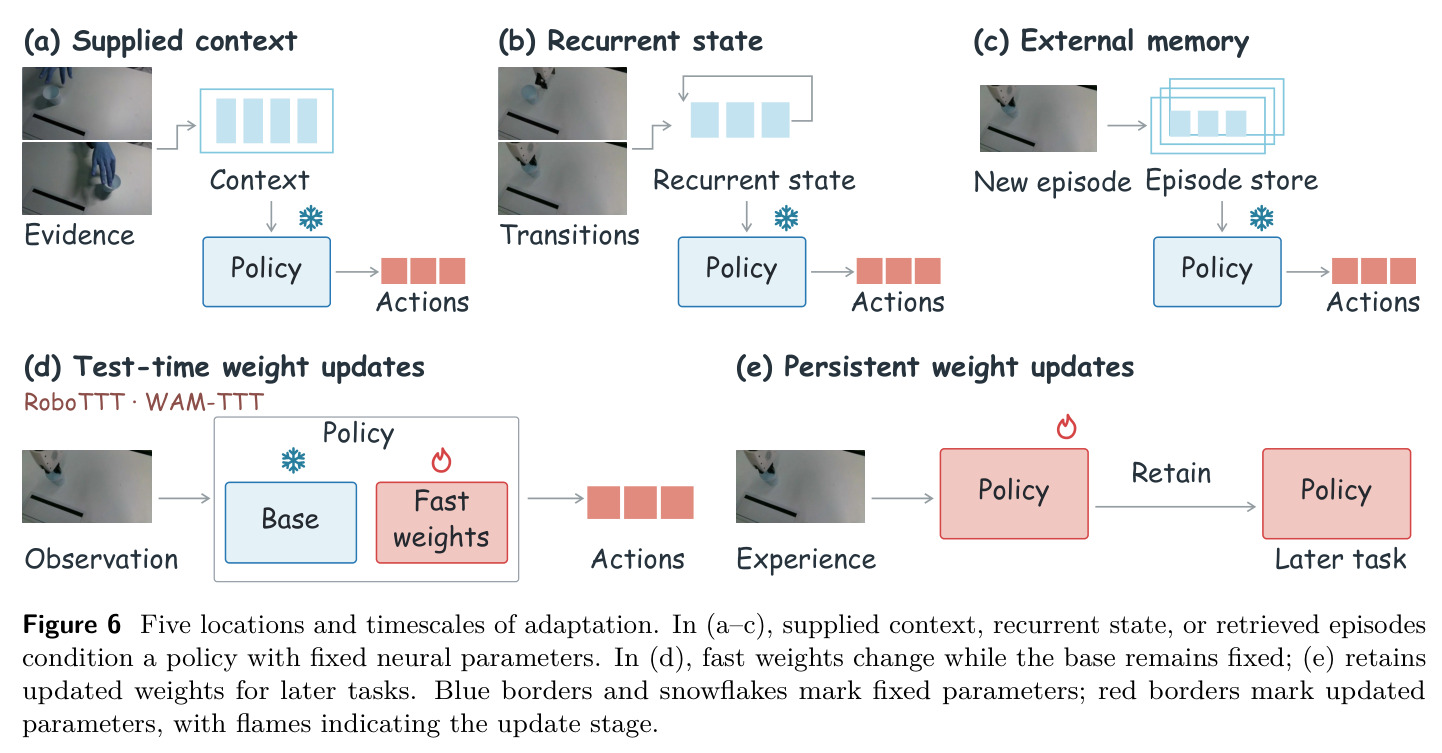
部署期间的参数适配:把 $\theta$ 写为 $(\bar{\theta}, \phi_t)$,冻结主干 $\bar{\theta}$,只更新小子集 $\phi_t$。RoboTTT 在长上下文执行中更新神经子集,WAM-TTT 在 rollout 前用目标域人类视频适配视频侧快权重。
综述用它澄清一个易混点:'one-shot 指教学量而非存储机制'——同一次演示既可做固定权重条件化,也可做参数更新,评估时必须分别归因。
研究动机
通用机器人缺的不是运动能力,而是'当前任务信息'。 packing 机器人可能已会抓取每个零件,却需要演示来确定装配顺序、需要历史来识别已完成的放置、需要接触证据来适应更紧的配合——同样可见的场景可以要求不同动作。更广的预训练(多任务、多本体集合)提供可复用感知与控制,但当前场景可能留下多种可行流程、隐藏更早发生的事件、或对陌生材料的响应一无所知,这些是运动能力本身无法解决的信息缺口。传统解法是微调:把新证据写进权重,代价高、周期长、重置与遗忘难管理。证据的紧迫性也反映在文献上:综述统计 412 篇参考文献中 297 篇自 2024 年后首发、197 篇集中在截至 2026 年 9 月 29 日的部分年度,通用策略、多模态教学与具身智能体的爆发使'如何让已部署模型听懂现场教学'成为核心瓶颈。
本文的目标是本文的目标是系统回答'新证据如何在神经参数固定的前提下改变已部署行为,且这种改变能在物理执行中存活'。具体包括三件事:其一,提出以'执行所消费的中间产物'为轴的四家族分类——上下文条件策略、几何演示迁移、世界模型控制、技能与智能体执行——并刻画贯穿各家族的对应关系(correspondence)与记忆机制;其二,说明训练关系如何建立上下文使用能力,以及物体替换、陌生环境、执行条件变化在何处使迁移失效,把'更广的运动能力'与'更强的通过教学学习的能力'区分开;其三,综合已报告的对比实验与评估控制,把收益分解为对教学的响应、物理迁移、保留经验三类贡献,并在此基础上给出面向组合式任务获取与'物理递归自改进'(S5/S6)的研究议程。
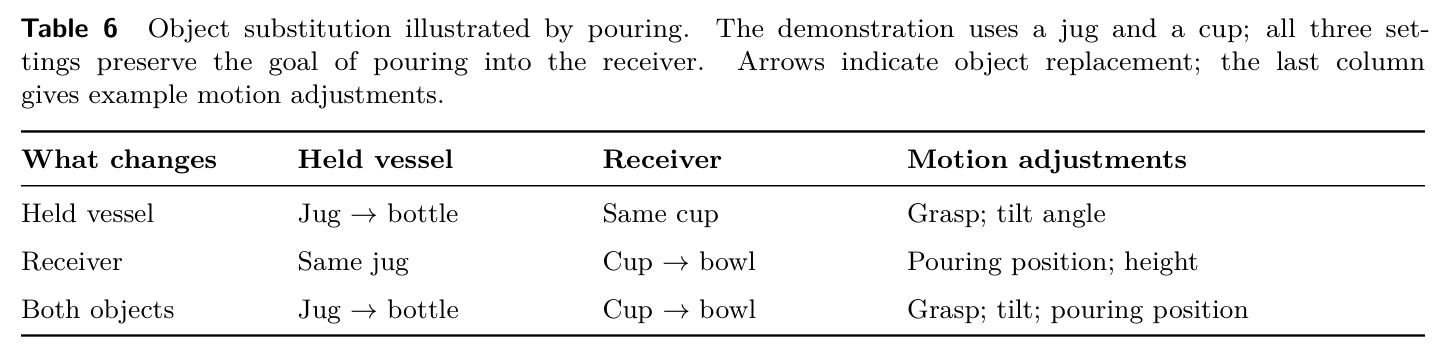
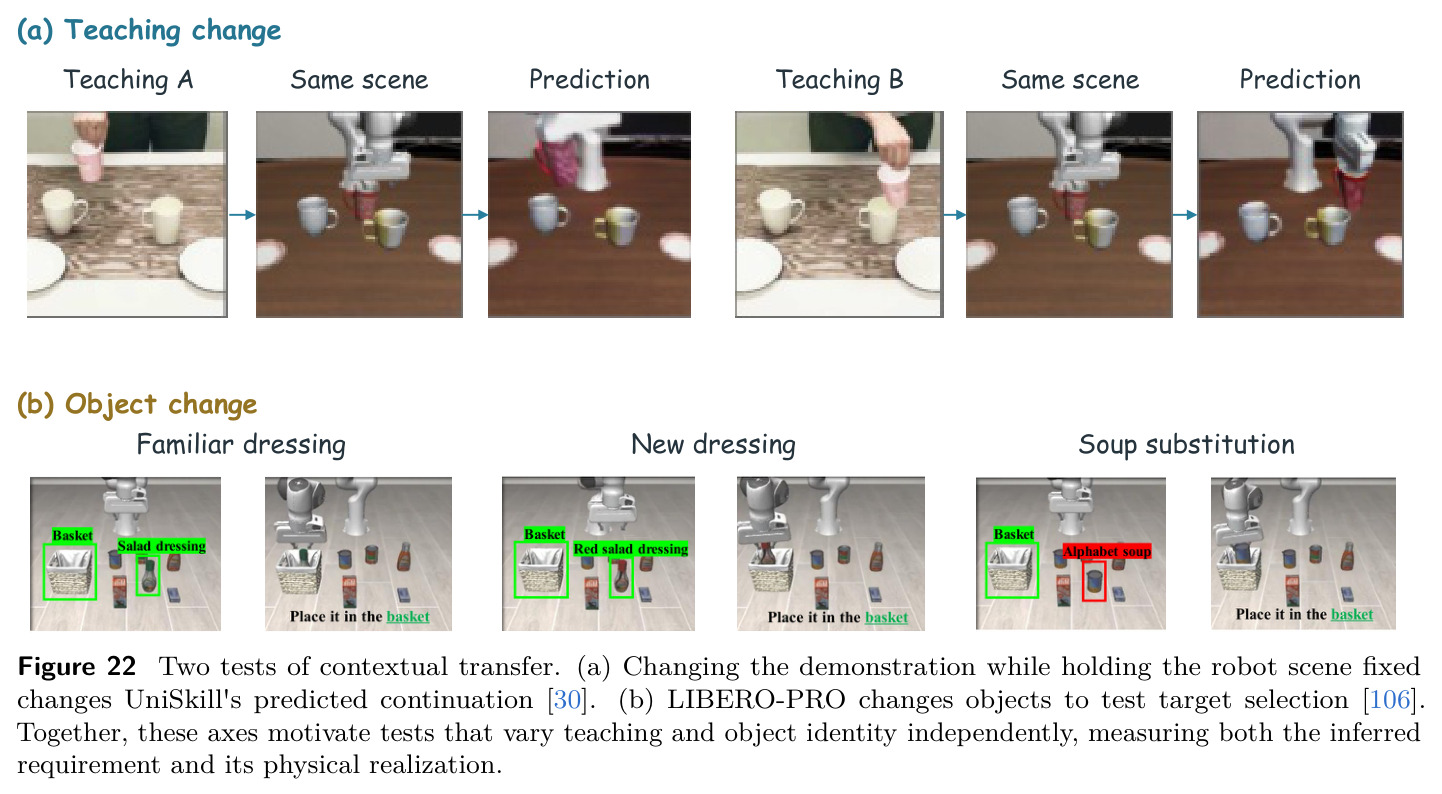
与已有工作不同的是,现有综述各据一角:从示范学习按教学接口与策略组织、ICL/in-context RL 聚焦示例与交互、人类视频综述比较观察到控制的信息转移、操作 ICL 综述按上下文内容与推理目标分类、VLA 综述区分单体与分层架构,另有数据评测、跨本体、预测控制、技能获取等互补视角。本文的独特切入是以部署路径为主线——按上下文到达动作所经过的中间产物(动作分布、运动/接触参考、预测的未来、技能/程序规格)划分方法——并显式追踪'被教的要求'(如把手抓握、先盘后轴的顺序)能否穿过中间表示存活到最终指令。它还提出六学习视界 S1–S6 的能力坐标系与 jug→bottle、cup→bowl 式跨物体替换的迁移测试设计,把'为什么用上下文'与'迁移的机制与边界'首次连成一条论证链。
核心方法
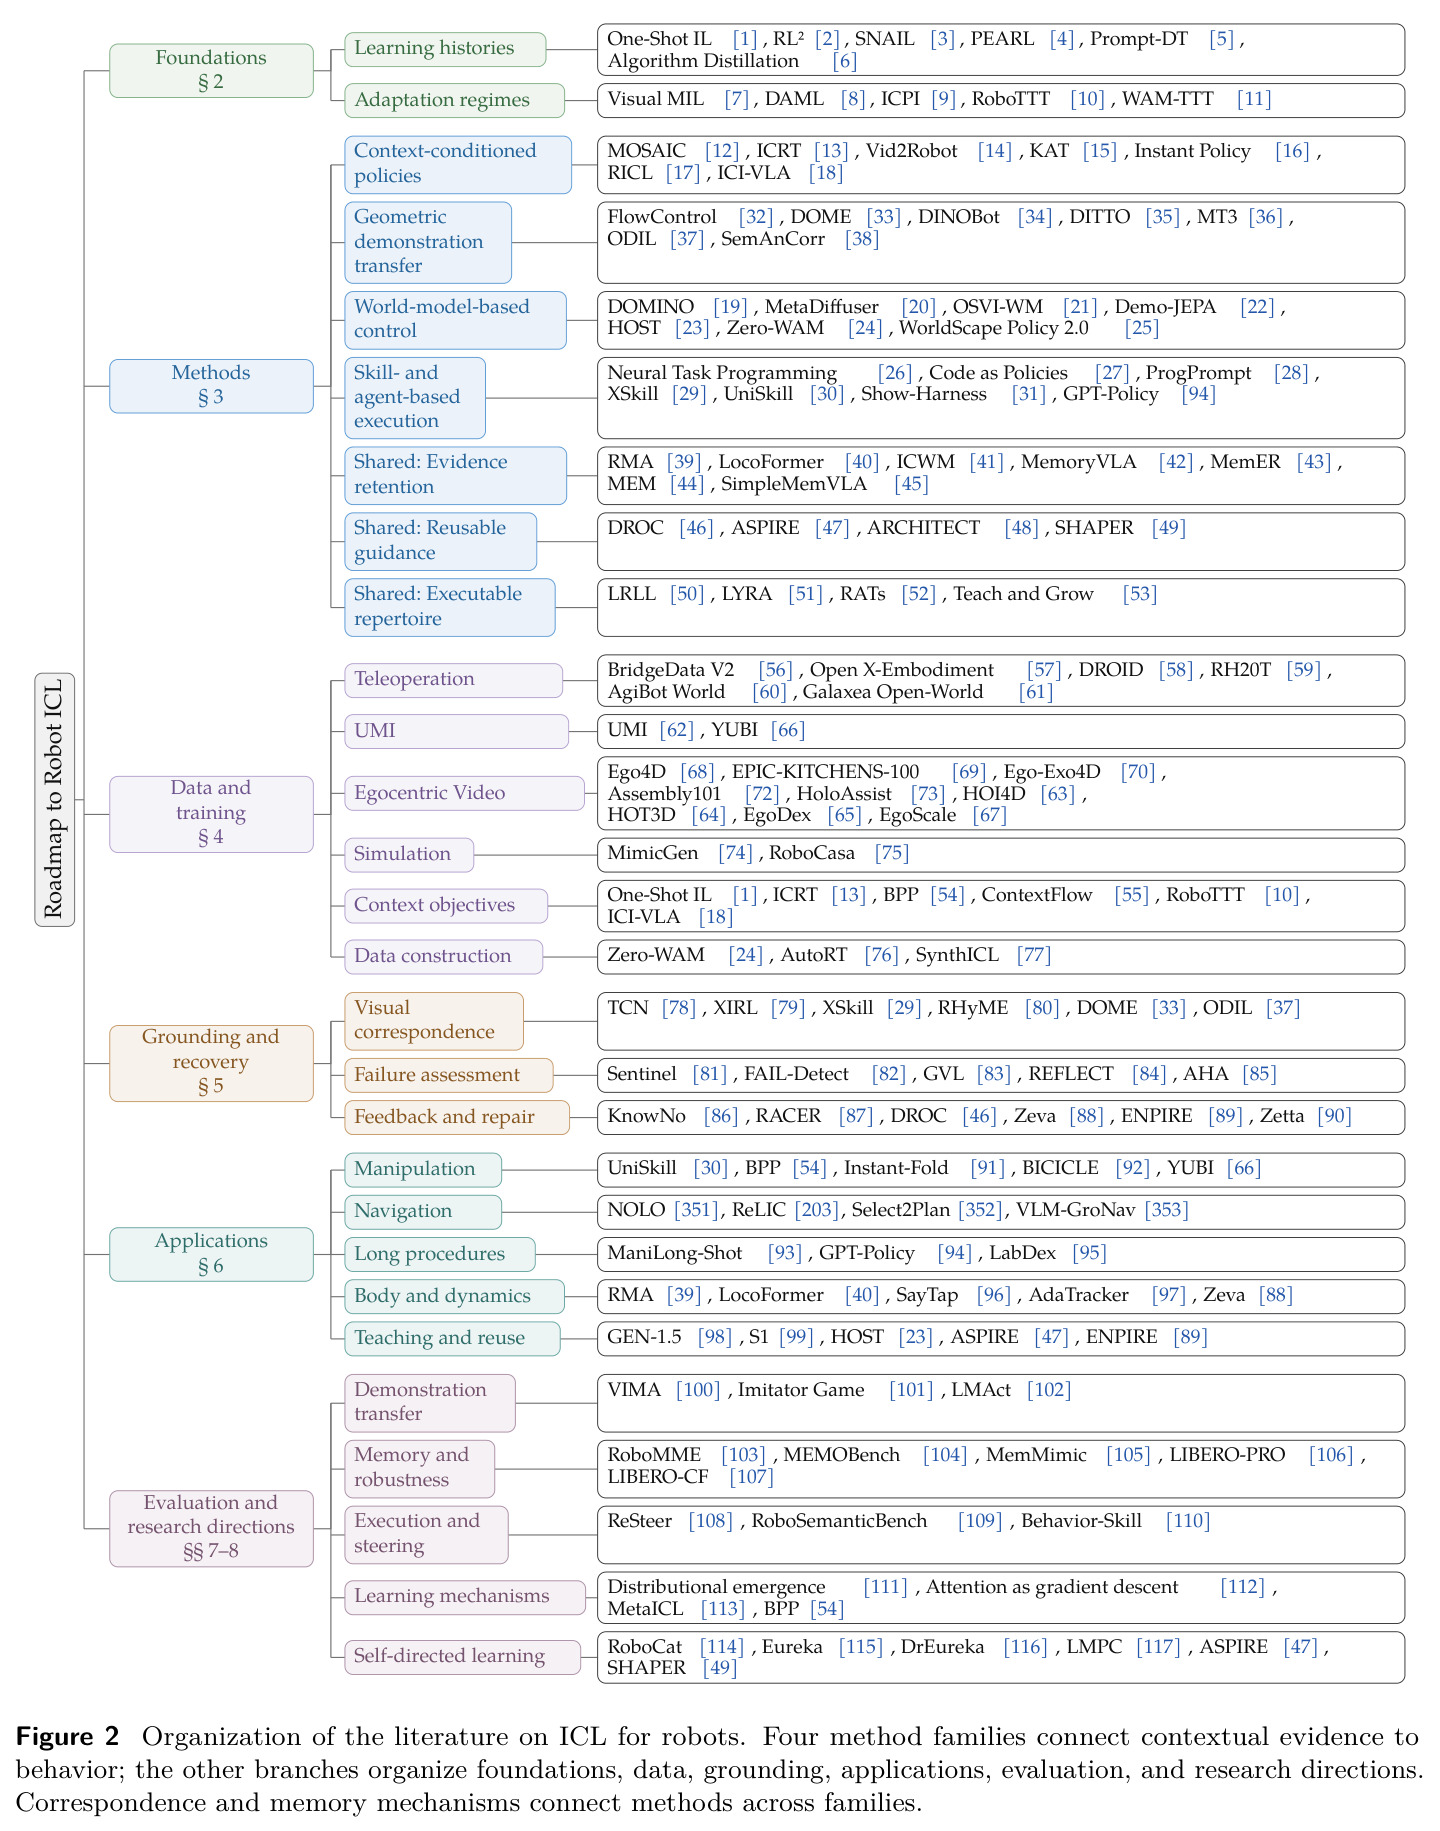
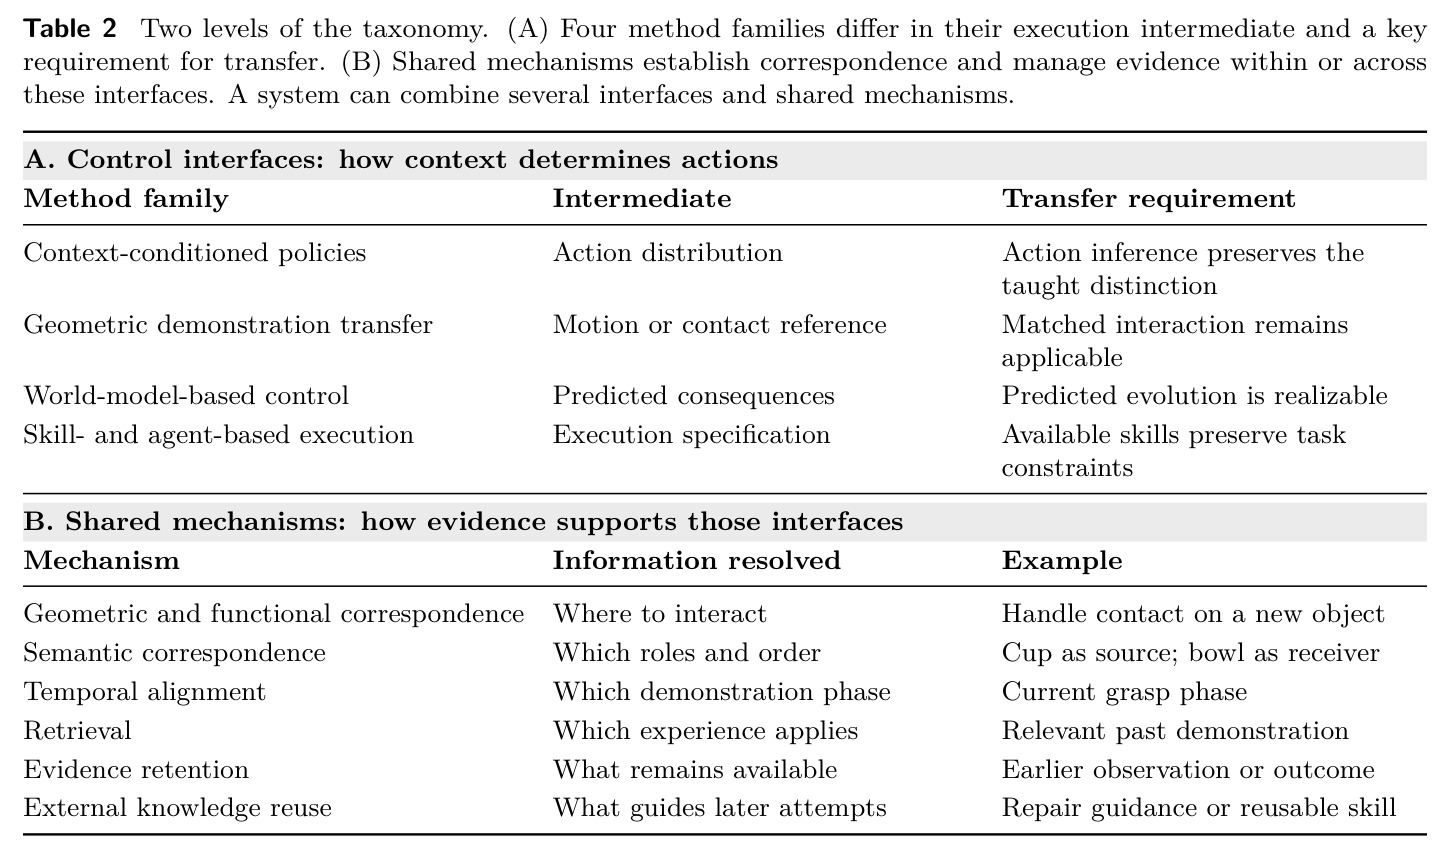
直觉上,上下文学习就是把演示、指令、纠正、交互史等证据注入固定参数模型的输入端,让既有能力'对准'当前任务。技术上综述用统一策略接口刻画:在决策步 $t$,交互史 $h_t=(o_1,a_1,\ldots,o_{t-1},o_t)$,任务上下文 $C_t$ 可含指令、支持演示 $D_s$、纠正或检索记录,策略提出动作块 $A_t=(ba_{t|t},\ldots,ba_{t+H-1|t})$,$A_t\sim\pi_\theta(\cdot\mid h_t,C_t)$;固定参数下 $\theta_{t+1}=\theta_t=\theta_0$,只有证据与外部产物变化,自包含上下文可按 $C_{t+1}=U_\theta(C_t,o_t,a_t,o_{t+1})$ 更新。图 6 区分五种适配位置:供给上下文、循环状态、外部检索记忆三种固定权重载体,加测试时快权重与持久权重更新两类参数适配——存储载体与保留时标相互独立。四大家族对应四种执行中间产物,再由对应关系、记忆、外部知识复用三类共享机制串联(图 5 的工作流:证据获取→上下文构建→上下文执行→结果评估→经验复用)。
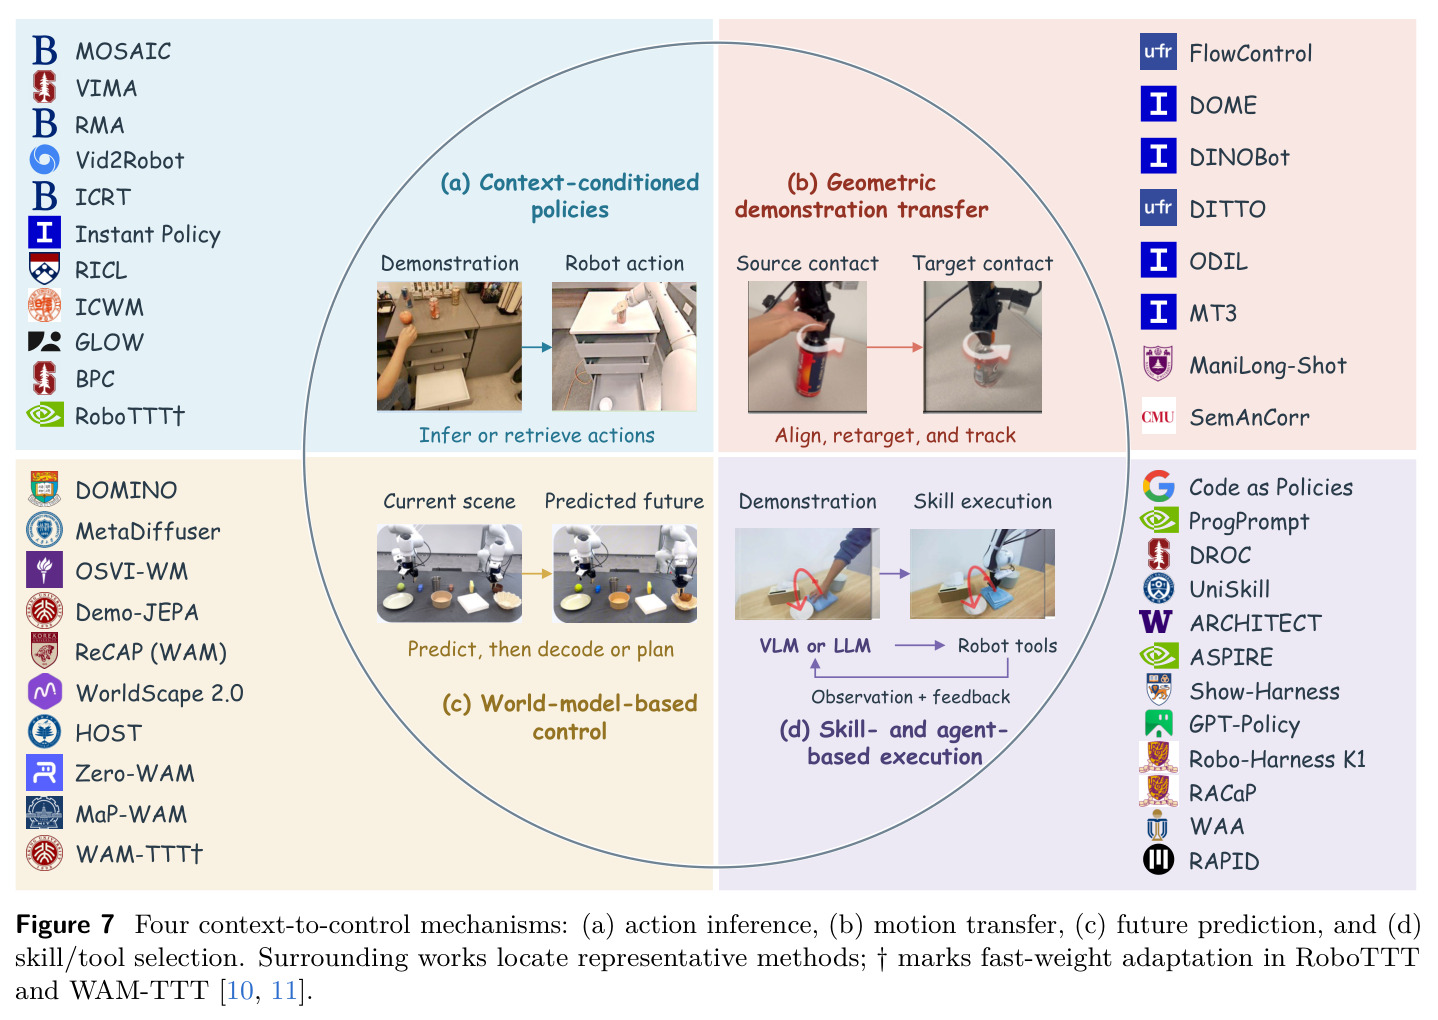
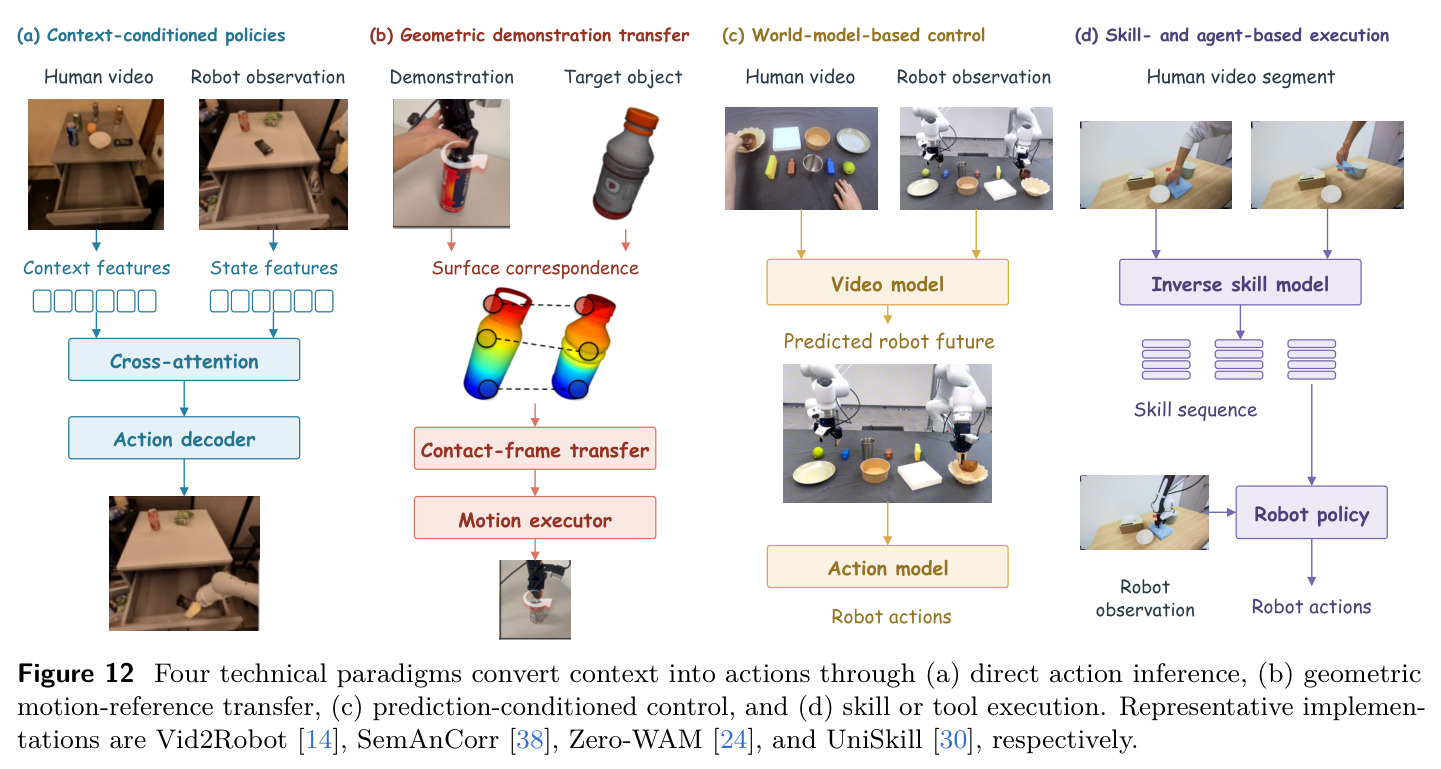
核心创新是以'执行中间产物'为分类轴的机制导向分类法,与按架构或按教学接口分类本质不同,因为这个轴直接绑定每个家族的迁移假设(表 2):上下文条件策略执行 $\pi_\theta(A_t|h_t,C_t)=q_a^\theta(A_t|h_t,r_t)$、$r_t=E_c^\theta(h_t,C_t)$,要求动作推断保留教学区分;几何演示迁移构造参考 $\zeta_{1:L}=E_m^\theta(D_s)$、$g=\mathrm{Retarget}(\zeta_{1:L},o_t,B)$ 后由 $A_t=\kappa(g,o_t)$ 跟踪,要求匹配的交互仍适用;世界模型控制先生成期望未来 $v^+\sim p_v^\theta(\cdot|C_t,h_t)$ 再解码,按全概率 $\pi_\theta=\int q_v^\theta p_v^\theta\,dv^+$,要求预测演化可实现;技能/智能体执行生成规格 $g=f_\theta(C_t,h_t)$ 交执行器,要求可用技能保留任务约束。由此检索与记忆可跨家族比较:检索只选证据,'检索对象如何被用于控制'才决定家族归属。
方法步骤详情
综述的论证步骤如下。第一步(§2)立框架:定义六学习视界——S1 显式控制编程、S2 神经策略学习、S3 基于历史的适配、S4 上下文任务学习(S3/S4 部署时参数固定)、S5 物理递归自改进、S6 集体知识演化,并用表 1 记号统一 $C_t,h_t,A_t,\theta,B_n$。第二步(§3)逐家族剖析并给出公式接口与方法对照表(表 3–5):上下文条件策略分动作复用(VINN 检索回放、BPC 局部延拓)与学习生成(ICRT、Vid2Robot 的注意力读取 $\alpha_t^i$);几何迁移从图像对齐(FlowControl)到物体相对迁移与功能对应(SemAnCorr 把壶嘴倒水迁到玩具杯)、多阶段参考切换(MT3);世界模型比较'生成期望未来'与'评估候选动作' $A_t^\star\in\arg\max\mathbb{E}R(v^+,C_t)$;技能/智能体比较技能组合(UniSkill)与程序/工具生成(Code as Policies、GPT-Policy)。第三步(§3.5–3.6)讲共享机制:记忆读-更新分解 $m_{t+1}=u_\theta(m_t,x_t)$、$R_t=\rho_\theta(h_t,M_t)$,外部产物提议-验证循环 $\tilde B_{n+1}\sim F_\theta(\cdot|B_n,T_n)$。第四步(§4)按采集源(遥操作/UMI/自我中心视频/仿真)与训练组织分析数据,配对监督损失 $\mathcal{L}=\mathbb{E}_{P_{pair}}\frac{1}{|\mathcal{I}_q|}\sum\ell_\theta(A_t^q;h_t^q,D_s)$。第五步(§5–6)接地恢复与应用,第六步(§7–8)评估控制与未来议程。
技术新颖性
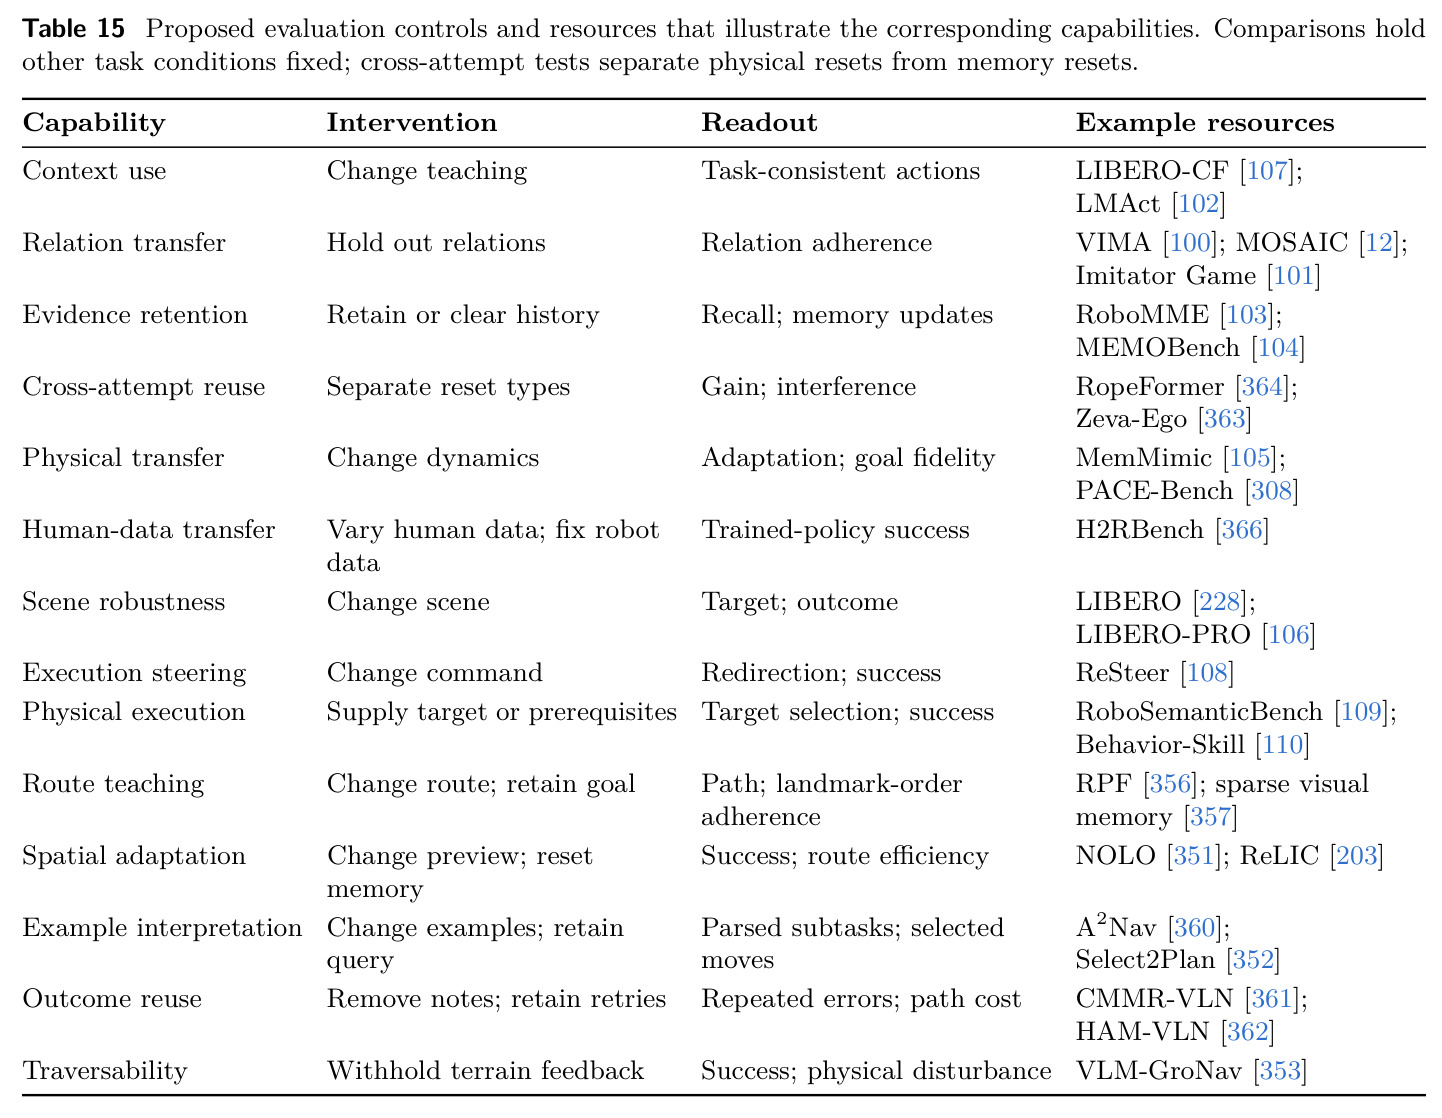
技术新颖性有五点。其一,把 ICL 从 NLP 的'提示示例'严谨扩展到物理场景:明确 one-shot 指教学量而非存储机制,区分固定权重条件化与测试时参数更新(RoboTTT 与 WAM-TTT 同属选择性更新但时机不同)。其二,四家族+共享机制的两级分类使检索、记忆可跨家族复用与比较,混合系统按部署分支归类(如 ReCAP 的 Cosmos Policy 分支归预测类、GPT-Policy 归工具调用类)。其三,提出跨物体替换的三设定(只换持物、只换接收物、双换,表 6)与'意图适配×物理适配'正交象限(图 20),把'新颖性相对示教'与'相对训练'分开。其四,评估学贡献:提出保留增益 $\Delta_{\mathrm{reuse}}^n=S_n^{\mathrm{keep}}-S_n^{\mathrm{reset}}$、checkpoint×context 交叉、中间产物替换诊断、物理复位与记忆复位分离等归因控制。其五,给 S5 物理递归自改进可测定义——以'后继学习者对新教学的响应'(LMPC 的 39.4%→66.3%)而非当前求解能力为指标,并把 S6 集体知识演化表述为双向迁移测量问题。
实验结果
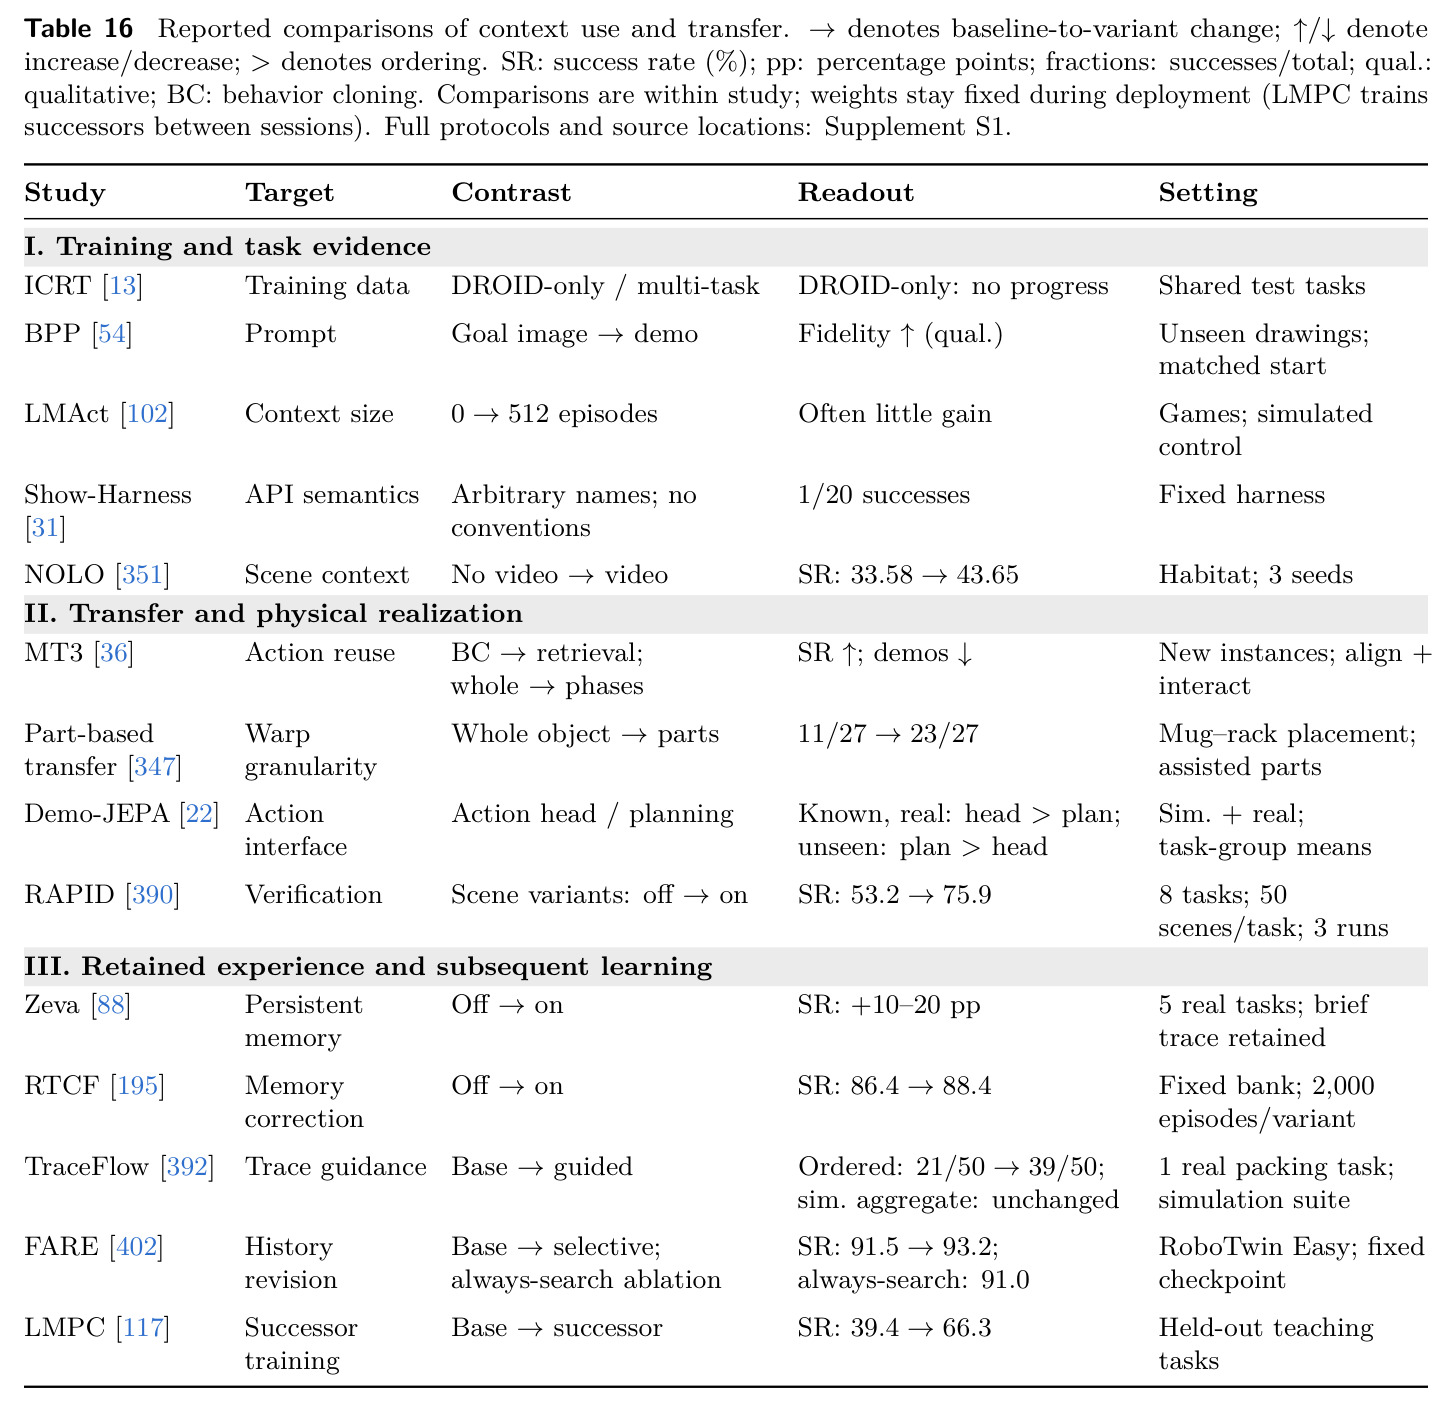
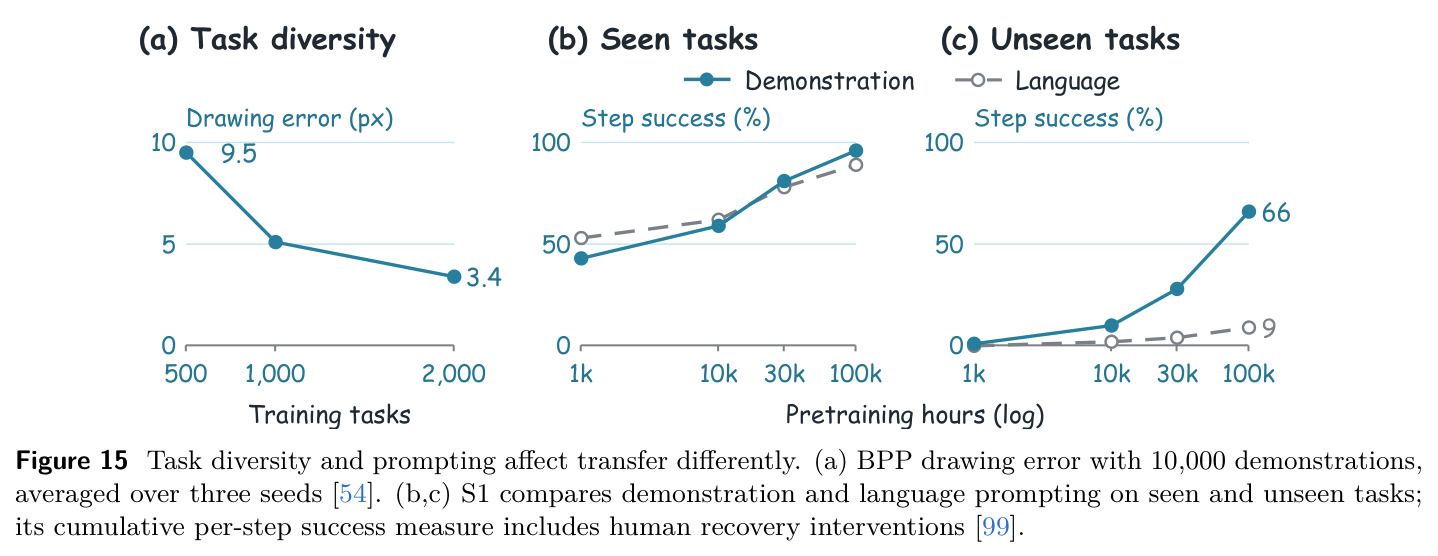
综述的综合发现分四组。结构:412 篇文献中 297 篇自 2024 年首发、197 篇在 2026 部分年度;260 篇方法/对比文献里上下文条件策略 123 篇(47.3%)、技能与智能体执行 91 篇(35.0%)、几何迁移 24 篇(9.2%)、世界模型控制 22 篇(8.5%)。数据:任务多样性比数量关键——BPP 在 10,000 演示固定预算下,500 任务×20 演示的平均 Chamfer 误差 9.5px,1,000×10 降至 5.1px,2,000×5 降至 3.4px;S1 未见任务上视频演示提示从 1k 小时的 1% 升至 100k 小时的 66%,语言提示仅 0%→9%。证据内容:GPT-Policy 插头重插纯视频提示 0/3、加状态-动作参考 2/3;Show-Harness 无约定可依时仅 1/20 成功、23.3% 映射推断正确。迁移与验证:MT3 以不足 24 小时人类演示覆盖 1,000 个单交互任务;RAPID 场景变体验证把成功率 53.2%→75.9%;部件级对应使杯子-架子放置 11/27→23/27。记忆与复用:Zeva 持久记忆 +10–20pp;TraceFlow 排序任务 21/50→39/50(仿真总体持平);FARE 选择性修正 91.5→93.2 而 always-search 反而 91.0;NOLO 场景上下文 33.58→43.65;RoboRSI 代码复用 174/600 vs 129/600;XR-2 折叠 58%→93%。最值得注意的是可教学性:LMPC 跨会话训练后继模型,保留任务成功率 39.4%→66.3%、成功会话平均轮次 2.4→1.9,证明经验能改进'后续学习'本身。
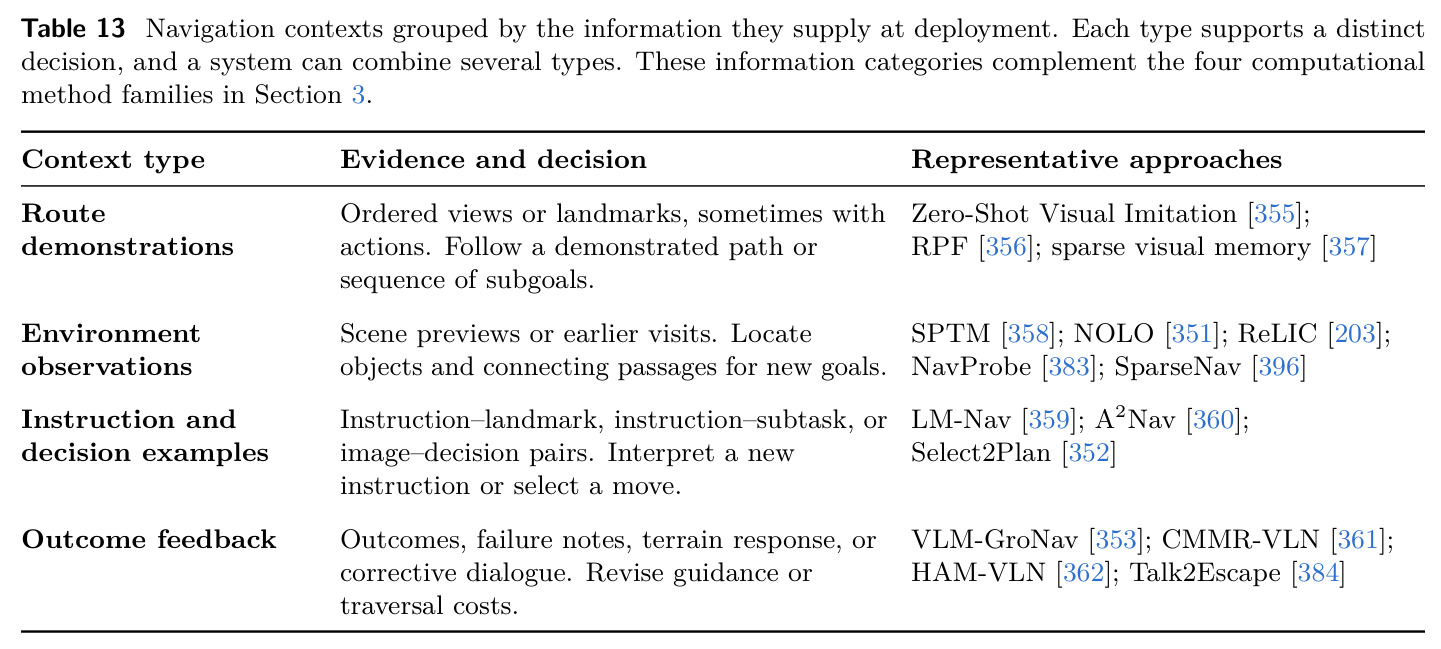
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 绘画任务多样性消融(固定 10,000 演示总预算) | 平均 Chamfer 误差 (px) | 3.4(2,000 任务 × 5 演示) | 9.5(500 任务 × 20 演示) | 误差降低约 64%,证明任务多样性比每任务演示数更关键(BPP) |
| S1 未见任务规模化(1k→100k 训练小时) | 累计逐步成功率(含人工恢复) | 66%(100k 小时 + 视频演示提示) | 9%(同预算语言提示);1%(1k 小时演示提示) | 演示提示比语言提示高 57 个百分点,可见任务表现相近掩盖了新任务教学回报差异 |
| 导航场景上下文(Habitat,3 seeds) | 成功率 (%) | 43.65(提供场景视频) | 33.58(无场景视频) | +10.07 pp(NOLO 场景预览消融) |
| 杯子-架子放置的部件级对应迁移 | 成功数/总数 | 23/27 | 11/27(整物体 warp) | 部件级对应使成功数翻倍(part-based transfer 研究) |
| 非抓取操作程序验证(8 任务 × 50 场景 × 3 次) | 成功率 (%) | 75.9(开启场景变体验证) | 53.2(关闭验证) | +22.7 pp(RAPID 场景变体消融) |
| 真实操作持久记忆(5 个真实任务) | 成功率变化 | +10–20 pp(开启持久记忆) | 关闭记忆 | 短轨迹保留即可稳定提升(Zeva 两时间尺度记忆) |
| 轨迹引导的流匹配修正(真实打包任务) | 排序任务成功数/总数 | 39/50(引导后) | 21/50(基线) | +18 例;但仿真套件总体持平,暴露计数与遮挡缺陷(TraceFlow) |
| 历史修正策略(RoboTwin Easy,固定 checkpoint) | 成功率 (%) | 93.2(选择性修正) | 91.5(基线);always-search 消融 91.0 | 选择性介入优于盲目检索,过度恢复搜索反而劣于基线(FARE) |
| 后继学习者跨会话训练(保留教学任务) | 成功率 (%) / 成功会话平均轮次 | 66.3 / 1.9(训练后继) | 39.4 / 2.4(基座模型) | +26.9 pp 且交互轮次下降,直接度量'可教学性'提升(LMPC) |
| 技能库代码复用(120 任务 × 5 布局) | 成功数/总数 | 174/600(保留可调用代码) | 129/600(关闭) | +45 例(RoboRSI 的 code-on/code-off 对比) |
| 纠错数据重训折叠(XR-2,三轮) | 成功率 (%) | 93(第三轮) | 58(首轮) | +35 pp,531.7h 遥操作 + 约 1,000h 双 UMI 数据上分离策略动作与人工接管 |
局限与改进
作者承认的局限:多数对比是单研究内部、跨研究设置不一(仿真/真实、任务组均值、种子数各异),难以直接横向比较;部分系统(GEN-1.5、S1、GLOW)仅有技术报告或发布报告级证据、定性案例,证据强度低于同行评审论文;S5 物理递归自改进与 S6 集体知识演化是研究目标而非已实现能力,跨本体知识交换的双向迁移尚未验证;阈值化成功率可能掩盖平滑的组件增益,需要关系级结果与连续误差;预训练数据不公开使'新任务'相对于什么新颖不得而知。我的补充观察:四家族边界情形很多,VLM 既可发动作 token 又可调用工具,混合系统按部署分支归类带有主观性;公式多为描述性接口而非可优化目标,对实践者的建模指导有限;成本侧(changeover 时间、反馈到动作延迟、获取-验证代价)只有框架建议(如 SimpleMemVLA 的 1.02→0.68s 调度优化),缺乏统一基准;文献以 2024–2026 年 arXiv 为主,结论稳定性依赖原始论文的可复现质量。
独立分析的弱点
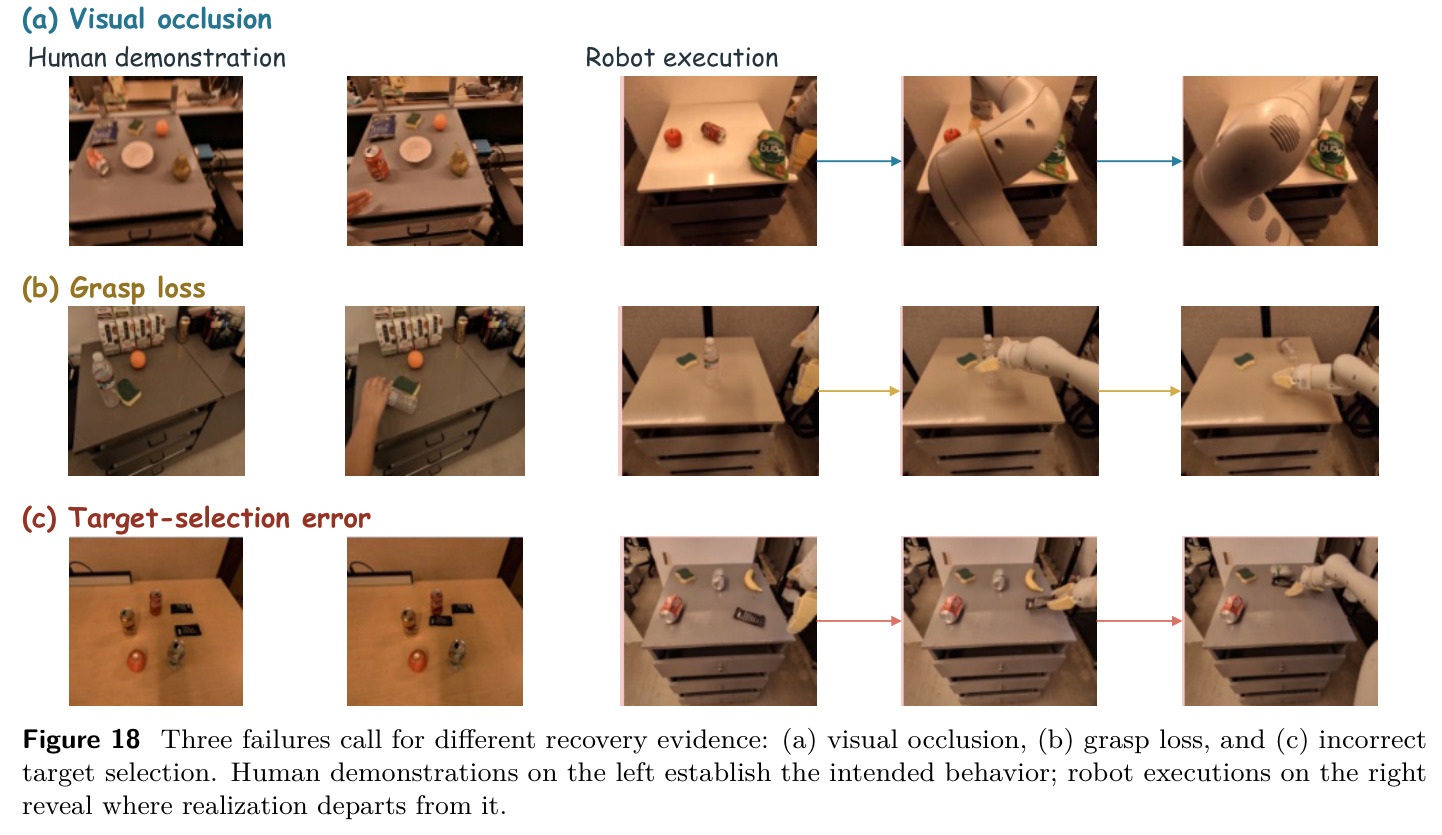
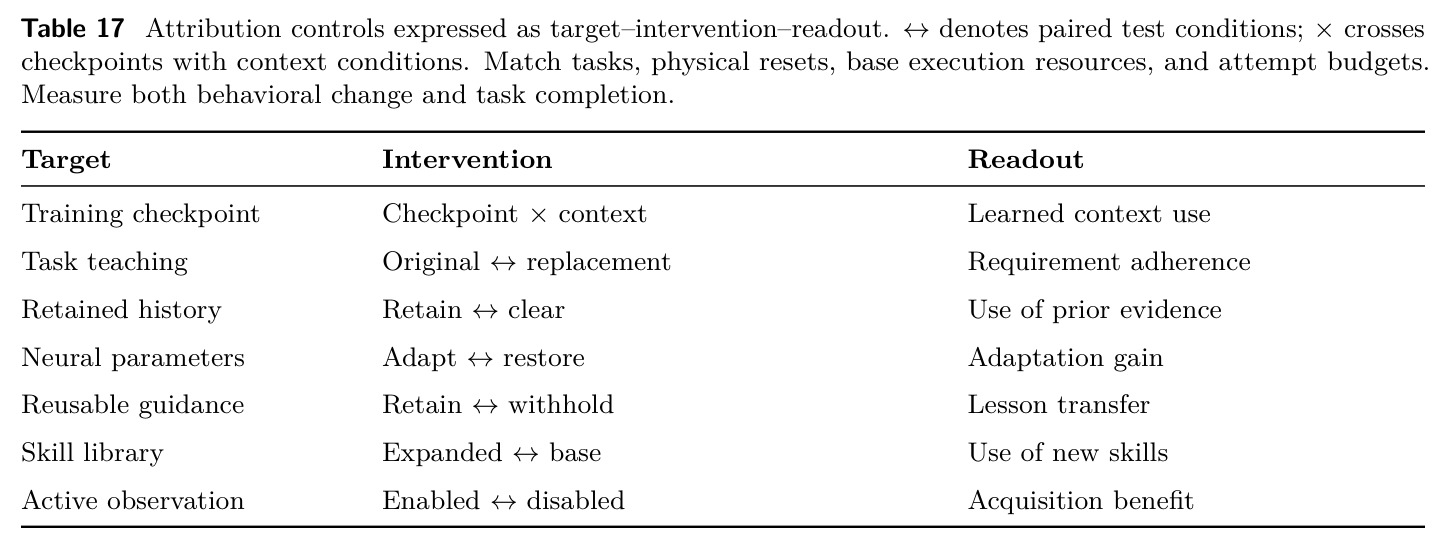
弱点一:分类的可操作性不足。四家族在 VLM 时代边界模糊,同一骨干既可发动作 token 又可调用工具,综述靠'部署分支'人工裁定——建议为'执行消费的中间产物'建立代码级判定标准并发布带机制标注的方法库。弱点二:评估控制多为提议而非实施,表 15/17 的 checkpoint×context 交叉、$\Delta_{\mathrm{reuse}}^n$ 度量缺少开源工具——可发布评估包把物理/记忆复位分离做成 LIBERO/RoboTwin 标准脚本。弱点三:数据侧提出'关系覆盖与运动覆盖贡献不同'但无可操作度量——可定义任务关系核并报告覆盖率曲线。弱点四:失败模式分析偏定性,预测未来不可达、对应错误、记忆过期散见各章,缺少统一的失败分类学与发生率统计。弱点五:S6 集体知识演化缺成本模型,交换演示与验证的通信、标定、重试代价可能超过收益,需要给出收益-成本边界分析而非仅提出双向迁移测量。
未来方向
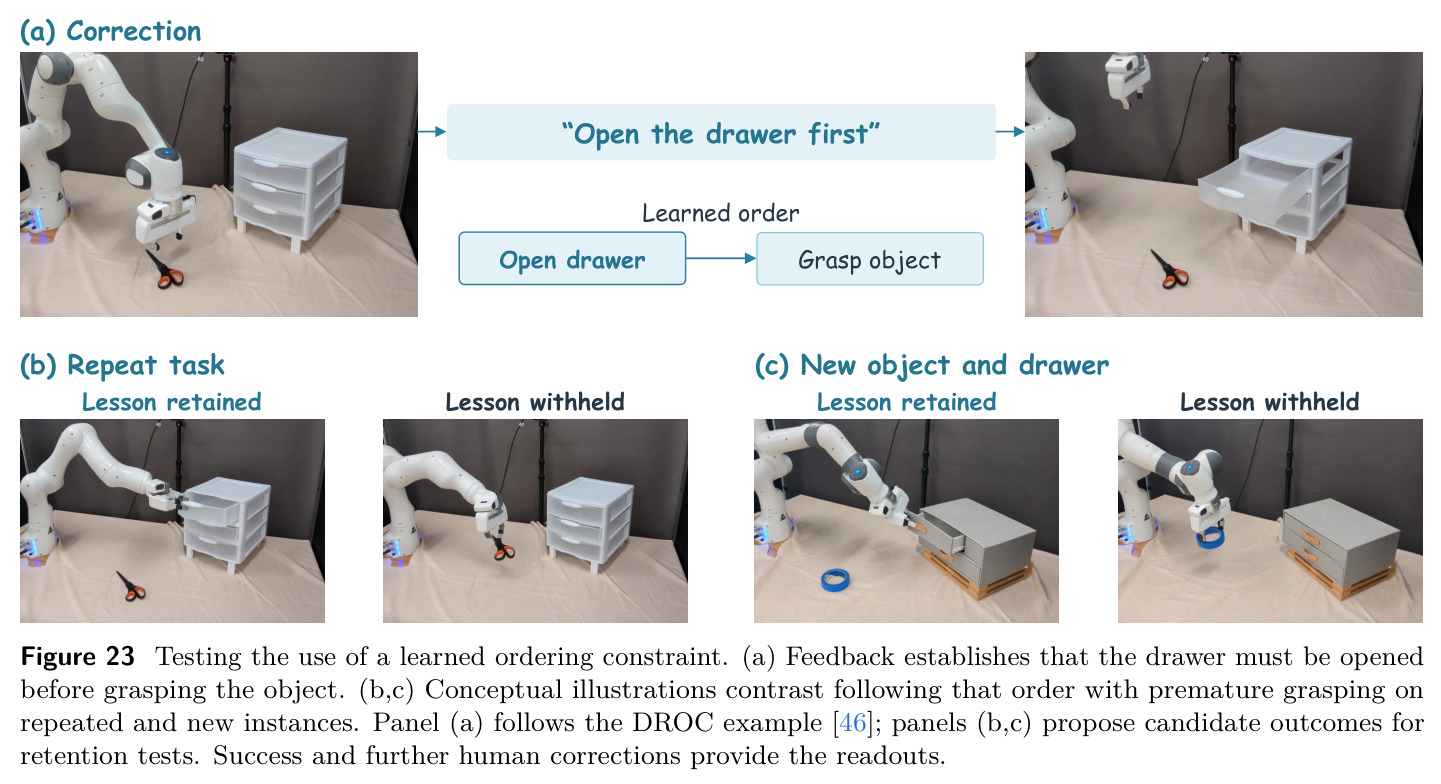
作者提出五条主线(§8):其一,从上下文依赖到可复用学习规则——区分熟悉任务选择、已知关系组合与陌生规则推断(表 18 的 size-to-slot 映射测试),检验预训练广度与显式配对的独立贡献;其二,面向更复杂上下文学习的指令微调——要求绑定与组合(演示'盘先装'顺序×指定 2 盘 3 轴数量)、选择性修正(改目的地 tray A→B 但保留顺序)、决策导向的信息获取(两托盘均可行时主动提问),图 25 给出可测的中间托盘状态;其三,物理变化下保持被教关系——选择性不变性(无把手容器不能保把手抓握)、识别无有效替代物时主动求证;其四,保留教学同时修订过期经验——延迟纠正测试、模型升级后旧教学是否仍生效;其五,物理递归自改进与集体知识演化——以'后继学习者获取率'(LMPC 39.4%→66.3% 为范例)为核心指标。基于成果可延伸:统一四家族接口为中间表示规范;构建含失败-纠正链的公共基准;把 changeover 时间与 $\Delta_{\mathrm{reuse}}$ 纳入 VLA 排行榜。
复现评估
作为综述,'复现'指按其分类与评估议程开展研究的可行性。文献层面:412 篇引用几乎均有 arXiv 或正式版本,项目页提供 GitHub 入口,附录 A 给出条目级参考索引与首发年份编码,补充材料 S1 记录计数规则,附录 B 提供方法/资源对比表(B1–B4),并公开征集纠错——透明度高。评估控制层面:表 15/17 的干预(更换教学、清空历史、恢复权重、保留/隐藏产物)多为实验协议,无需专门算力,在 LIBERO、RoboTwin、RoboCasa 等开源仿真平台上中等难度即可落地。实验层面:执行其推荐的完整研究(如 S1 级 100k 训练小时、跨 checkpoint 上下文干预、后继学习者比较)需要大规模数据与机器人集群,属高成本议程;复现文中引用的具体数字(RAPID 53.2→75.9、Zeva +10–20pp 等)需回到各原始论文核对协议(种子数、复位规则、成功率定义),综述已在表 16 标注设置细节与 Supplement S1 的源位置,降低了这一成本。
论文图表
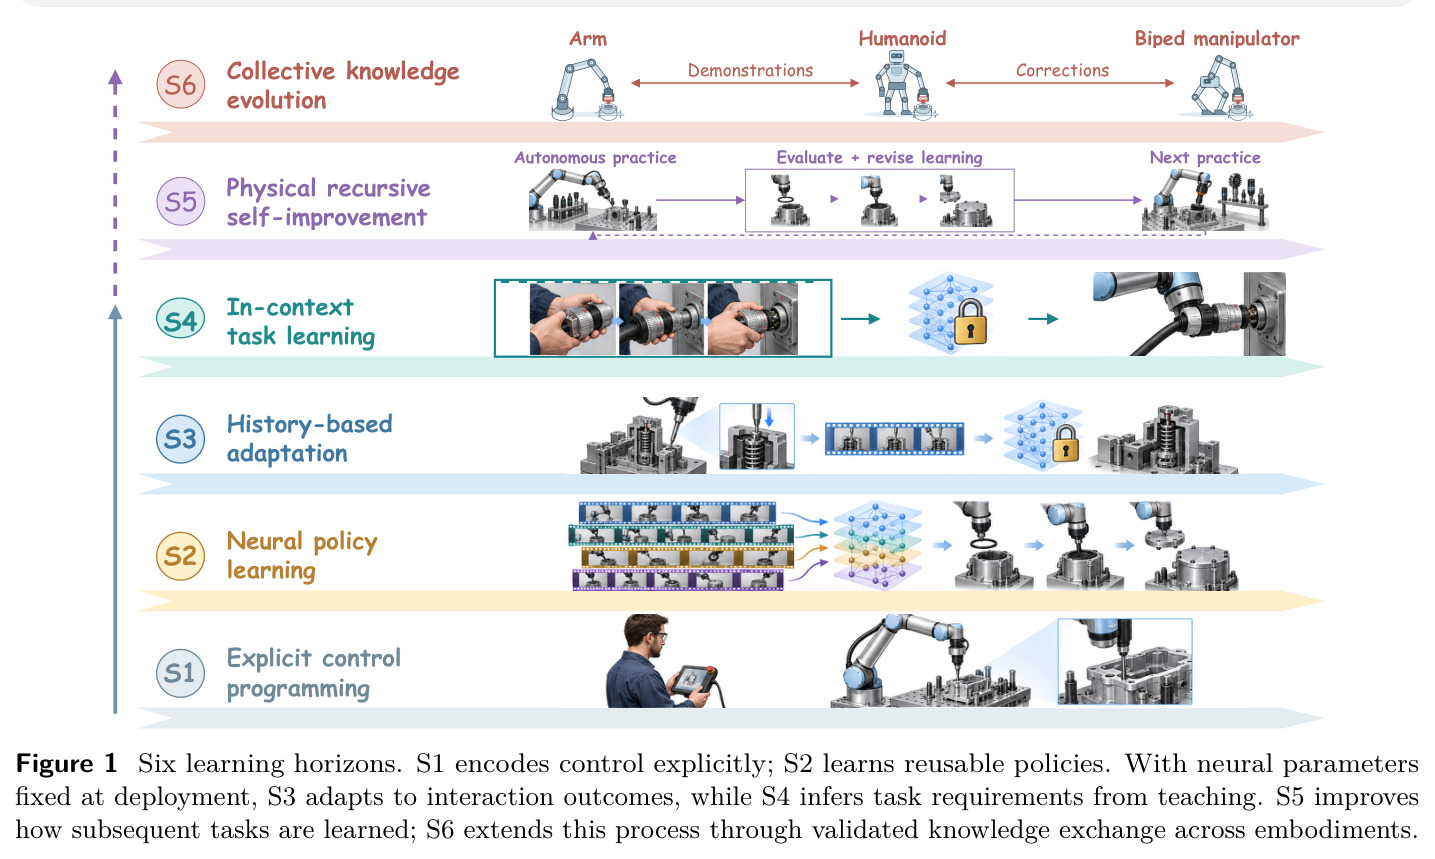
阶梯式图示六个能力层级:S1 编码显式控制(STRIPS、分层 TAMP),S2 学习可复用策略(CNN、RT-1、OpenVLA、π0);S3 在部署时以固定神经参数适配交互结果(RL²、LocoFormer),S4 从教学中推断任务要求(NTP、ICRT、Instant Policy、Zero-WAM);S5 改进后续任务的学习方式(Eureka、ASPIRE、SHAPER),S6 通过跨本体(机械臂/人形/双足)经验证的知识交换扩展该循环,顶部标注'演示、纠正、自主练习、评估+修订学习、下次练习'的闭环。
这是全文的组织坐标系:所有方法、评估与未来方向都挂靠在 S1–S6 上,理解它才能把握综述的问题边界(固定参数适配=被写进 S3/S4)与长期目标(S5/S6 是研究议程而非已有能力)。
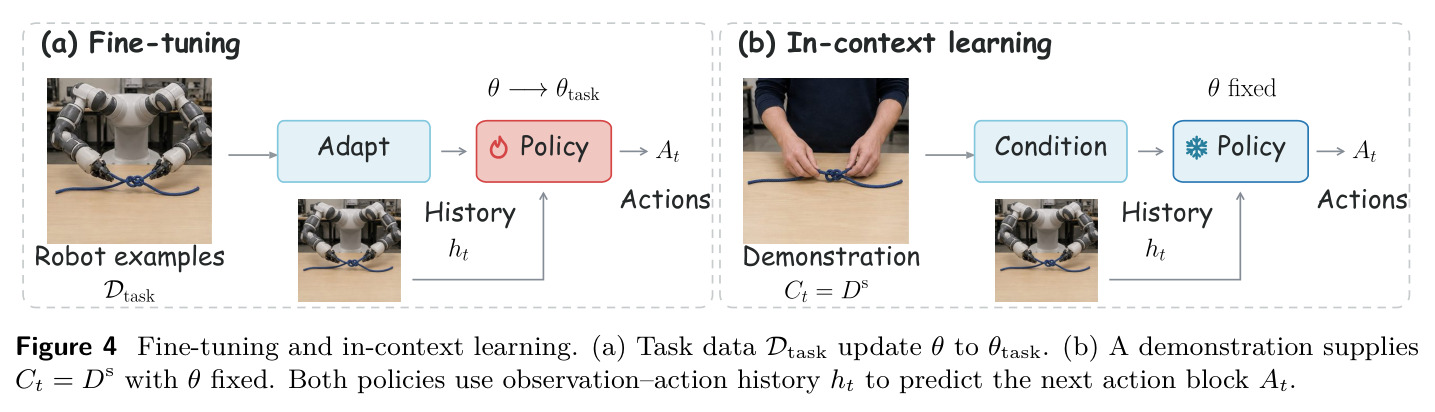
(a) 微调:任务数据 $D_{task}$ 把预训练参数 $\theta$ 更新为 $\theta_{task}$ 后输出动作;(b) 上下文学习:演示作为支持集 $D_s$ 直接构成上下文 $C_t$,$\theta$ 保持固定,两种策略都用观测-动作历史 $h_t$ 预测下一动作块 $A_t$。
用最简方式给出全文的定义性对比:任务信息存进权重还是存进输入决定了获取成本、持久性与重置行为,也是后续所有归因评估(恢复权重 vs 移除上下文)的概念基础。
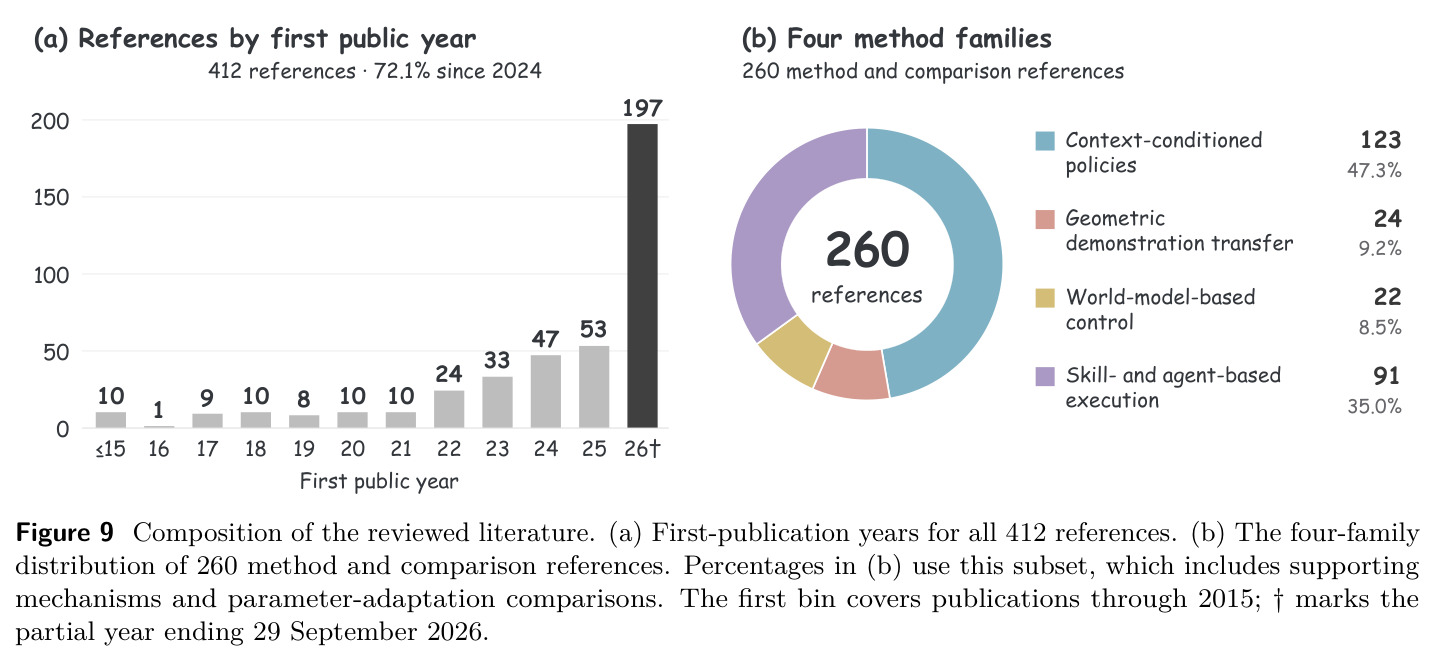
(a) 412 篇参考文献的首发年份分布,2024 年以来占 72.1%(297 篇),仅 2026 年部分窗口就有 197 篇;(b) 260 篇方法/对比文献的四家族分布:上下文条件策略 123 篇(47.3%)、技能与智能体执行 91 篇(35.0%)、几何演示迁移 24 篇(9.2%)、世界模型控制 22 篇(8.5%)。
给出该领域的量化画像:增长集中在通用策略、多模态教学与具身智能体爆发期,且四家族的冷热悬殊本身就说明几何/世界模型路线相对欠探索,是判断研究机会的依据。