基于通用视觉语言模型智能体的机器人上下文学习框架 In-Context Robot Learning with VLM Agents
现成VLM智能体通过上下文即可指导机器人学习新任务,无需梯度更新,但精准执行仍是短板。
前置知识
上下文学习(In-Context Learning, ICL)
大模型在推理时仅凭提示中的示例、演示或交互反馈调整行为,而不更新任何参数的能力,源自 GPT-3 的发现。本文将其扩展到机器人:测试时给策略看人类视频、机器人视频、目标图像,或让它在试错中积累交互历史,全程不做梯度更新或持久的任务参数修改。
本文的核心研究问题就是“现成 VLM 能否完成机器人 ICL”,全部实验设计(五类上下文消融)都围绕这一定义展开。
视觉语言模型智能体(VLM Agent)
具备视觉理解、长链推理、工具调用与多步任务执行能力的通用多模态大模型(如论文中的 GPT-6 Astra、Fable 5.1、Kimi K3)。智能体每一步以结构化 JSON“工具请求”与环境交互,并根据返回的观测和结果决定下一步行动。
GPT-Policy 的策略本体就是一个参数固定的 VLM 智能体,理解“工具调用—反馈—再决策”的循环是读懂其方法与实验的前提。
逆运动学与笛卡尔运动规划
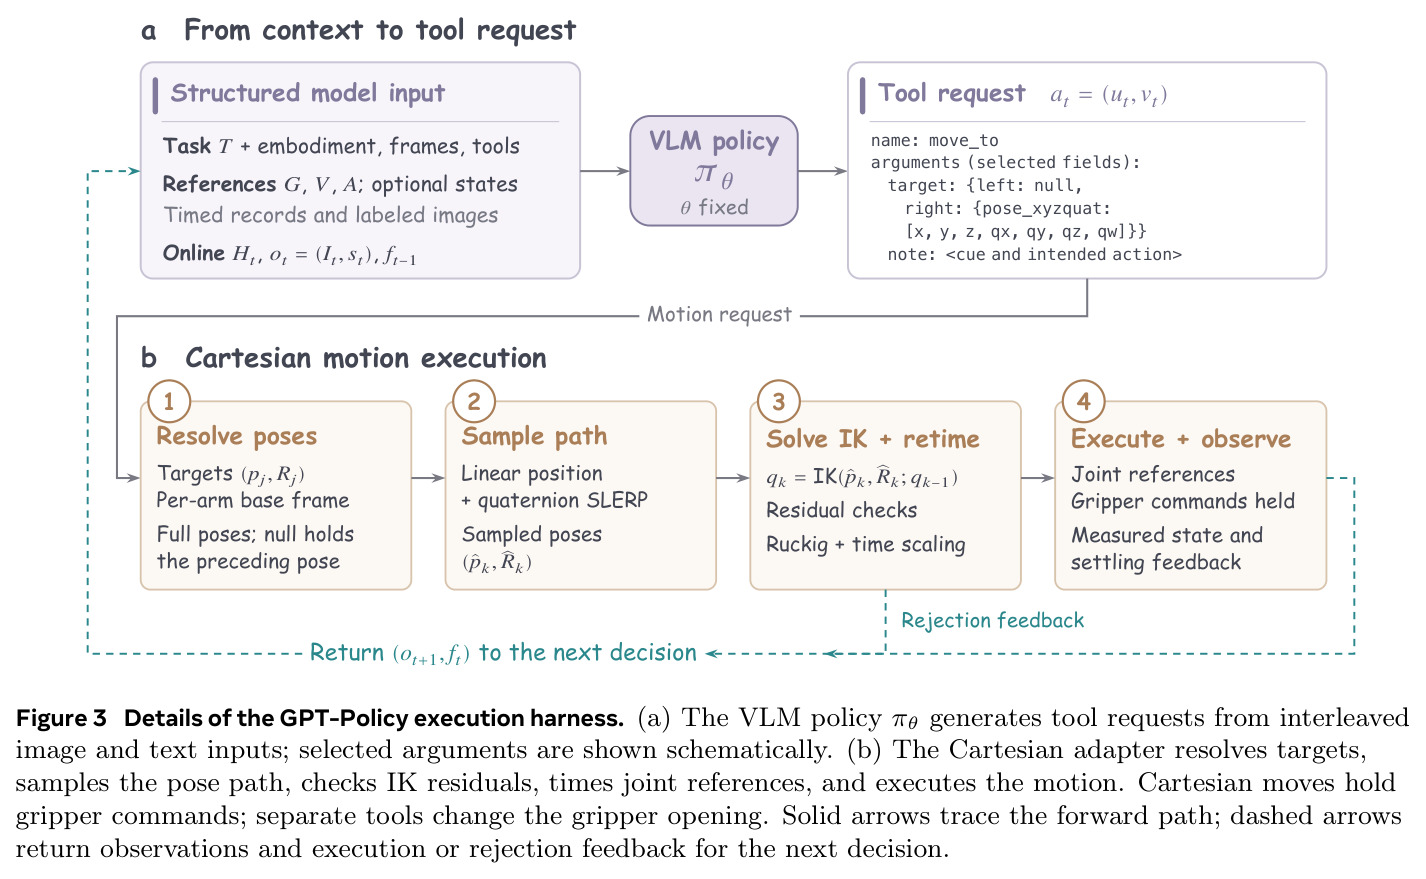
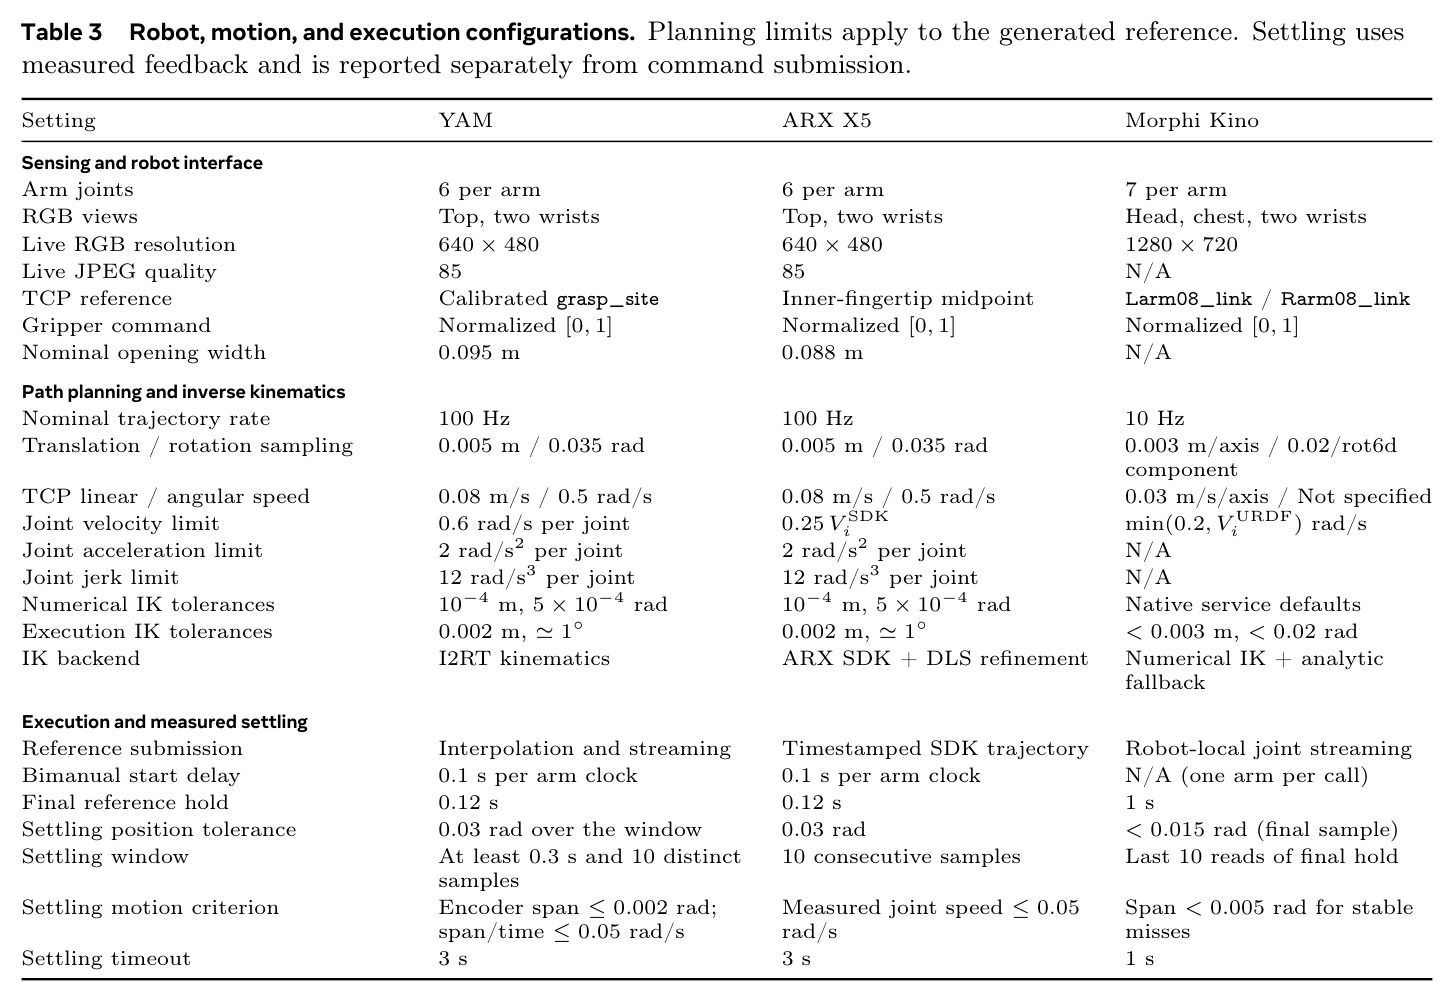
笛卡尔规划在末端(TCP)位姿空间生成路径,逆运动学(IK)把每个采样位姿映射为关节角 $q_k=\mathrm{IK}(\hat p_k,\hat R_k;q_{k-1})$,并要求位置/姿态残差不超过容许误差(本文为 0.002 米与约 1°);再用 Ruckig 等方法做时间参数化以满足速度、加速度与 jerk 限制。
论文的受约束执行层(Fig. 3、附录 A)完全建立在这些概念上,动作拒绝反馈与 settling 稳定判据都由此产生。
四元数与 SLERP 插值
三维姿态常用单位四元数 $[q_x,q_y,q_z,q_w]$ 表示,避免欧拉角奇异性;SLERP(球面线性插值)沿最短旋转弧在两个姿态间插值,本文写作 $R_j(s)=R_j\exp(s\,\mathrm{Log}(R_j^\top R_{j+1}))$,配合位置线性插值构成笛卡尔路径。
VLM 发出的每个 move_to 目标都携带 xyzw 四元数,路径插值与残差公式是方法细节的核心符号。
VLA/机器人基础模型
视觉-语言-动作模型(如 GEN-1.5、S1、Zero-WAM)在大规模机器人数据上端到端训练,从观测直接输出低层动作,推理快、控制精细,但泛化依赖训练分布与具身预训练成本。
本文的动机正是与这类“训练型”路线对照:不训练能走多远、缺什么;讨论部分也把 VLA 视作未来 System 1 低层控制器的候选。
双臂操作与 TCP
双机械臂协同操作中,TCP(Tool Center Point)是末端执行器上的标定参考点,其位姿在各自臂的基坐标系下用位置加四元数表示;双臂请求中一侧为 null 表示保持该臂先前位姿不动,夹爪开合则由独立的 set_gripper 命令控制。
论文工具接口的 left/right 结构、null 保持约定,以及失败分析中反复出现的双臂碰撞,都依赖双臂与 TCP 概念。
研究动机
任何有限的训练演示集都无法覆盖机器人部署后遇到的新任务、新物体摆放与意外交互,而现有机器人策略几乎都依赖大规模专门训练,测试时的上下文学习能力(ICL)在很大程度上仍超出它们的范围。专用机器人基础模型虽然开始展示演示条件泛化——GEN-1.5 报告了来自物理提示的 one-shot 技能适应,S1 用视频演示指定新的原子与长时程任务,Zero-WAM 训练视频-动作模型跟随人类视频——但它们都要付出具身预训练的代价。另一边,商业 VLM(GPT-6 Astra、Claude Fable、Kimi K3、GLM-5.3)已具备推理、工具调用与多步执行能力,却没有被系统回答的问题是:这些通用模型能否在不做任何梯度更新或持久参数修改的情况下,从演示、示例与交互反馈中学习,并生成可执行、可验证的机器人动作?缺少统一的执行框架与对照实验,业界无法区分哪些能力已经“免费”存在于通用模型中、哪些必须依靠专门的具身学习。
本文的目标是本文的目标是构建一个统一的 general-agent 框架 GPT-Policy,把现成 VLM 通过共享的“上下文→动作”闭环接口连接到机器人工具,在完全不更新参数的前提下系统量化上下文对机器人行为的作用。具体要回答三个问题:(1) 每种上下文形式分别提供了什么信息;(2) 这些信息能否提升任务成功率并减少决策数与执行时间;(3) 在细粒度接触敏感操作、可形变物体处理与人机协作中,哪些上下文仍然有效。评估覆盖五大上下文族:跨具身模仿(人类视频)、接触敏感操作(机器人视频±动作参考)、目标图像跟随、主动探索(自交互历史)与在线人机交互,用统一的成功判据、决策计数与执行时间指标进行 matched 模型对比和受控上下文消融,为具身基础模型研究提供经验基础与研究议程。
与已有工作不同的是,本文的独特切入是“不训练、只接线”:不把 VLM 微调成机器人策略,而是用同一个受约束执行 harness 承载所有模型与所有上下文条件,从而把“通用模型里已有的任务理解能力”与“需要专门具身训练的能力”干净地分离。此前的 agentic 系统(ASPIRE、ENPIRE)聚焦离线策略开发与修复,RoboPrompt、Show-Harness 虽做在线控制但未系统研究上下文形式的作用;演示条件策略(ICRT 等)则把 ICL 做进网络权重里。GPT-Policy 反其道而行:演示视频、动作参考、目标图像、交互历史全部作为测试时上下文输入固定参数的 VLM。更重要的是,作者把“机器人 ICL”从宏大愿景变成对感知-动作环路每个环节的实证测量——既报告上下文带来的成功提升,也明确揭示“理解≠执行”的鸿沟:任务理解与动作选择改善并不保证精准接触、可靠结果验证与物理安全,这种诚实的双向证据在同类工作中少见。
核心方法
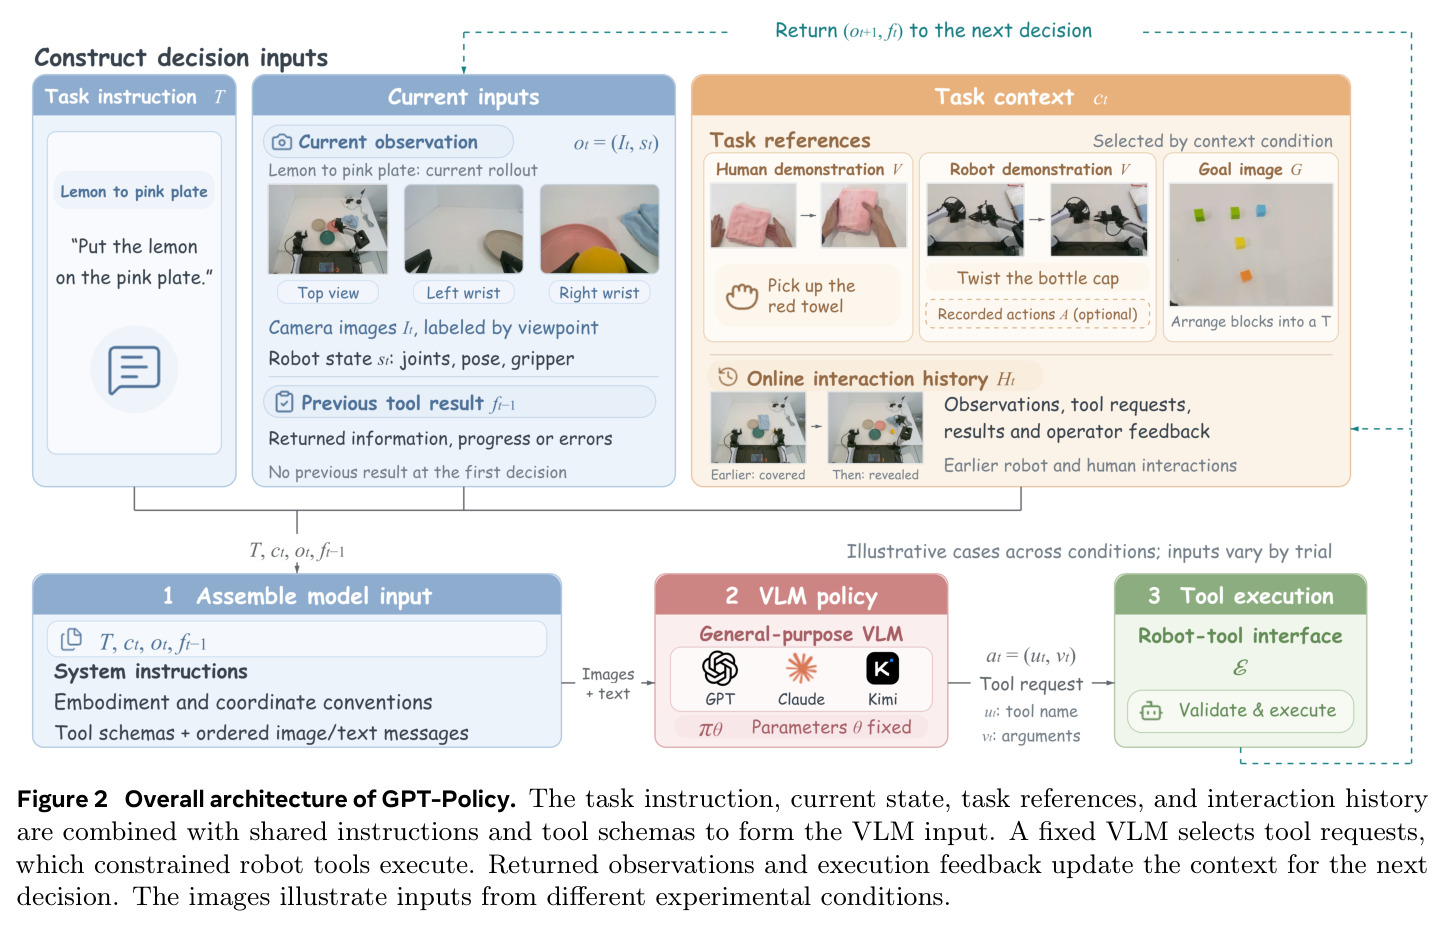
直觉上,GPT-Policy 让通用 VLM 充当“大脑”,配一个严格验证动作的执行层充当“小脑”。技术路线四步:(1) 形式化为闭环工具调用——决策步 $t$ 时策略由任务 $T$、上下文 $c_t$、观测 $o_t=(I_t,s_t)$ 与上步结果 $f_{t-1}$ 采样工具请求 $a_t=(u_t,v_t)$:$a_t\sim\pi_\theta(\cdot\mid T,c_t,o_t,f_{t-1})$,执行后返回 $(o_{t+1},f_t)=E(a_t,o_t)$,参数 $\theta$ 全程固定;(2) 上下文编译器把演示视频编码为时间戳排序的关键帧序列(≤24 帧、48 图),Video+Action 条件再以 0.1 秒容差对齐实测 TCP 状态、夹爪开度与逐秒动作样本;(3) 固定的 VLM 从结构化工具集(move_to、set_gripper、check_path、done 等)中选择并给出位姿参数;(4) Cartesian adapter 直线+SLERP 采样、逐步解 IK 校验残差、Ruckig 配时执行,新观测与执行/拒绝反馈回填下次决策形成闭环。
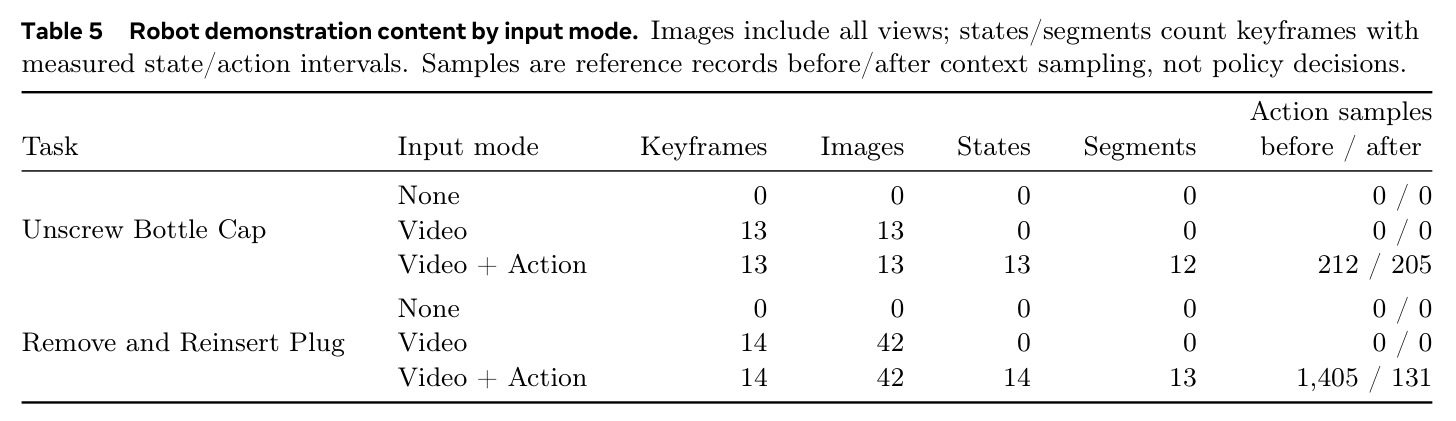
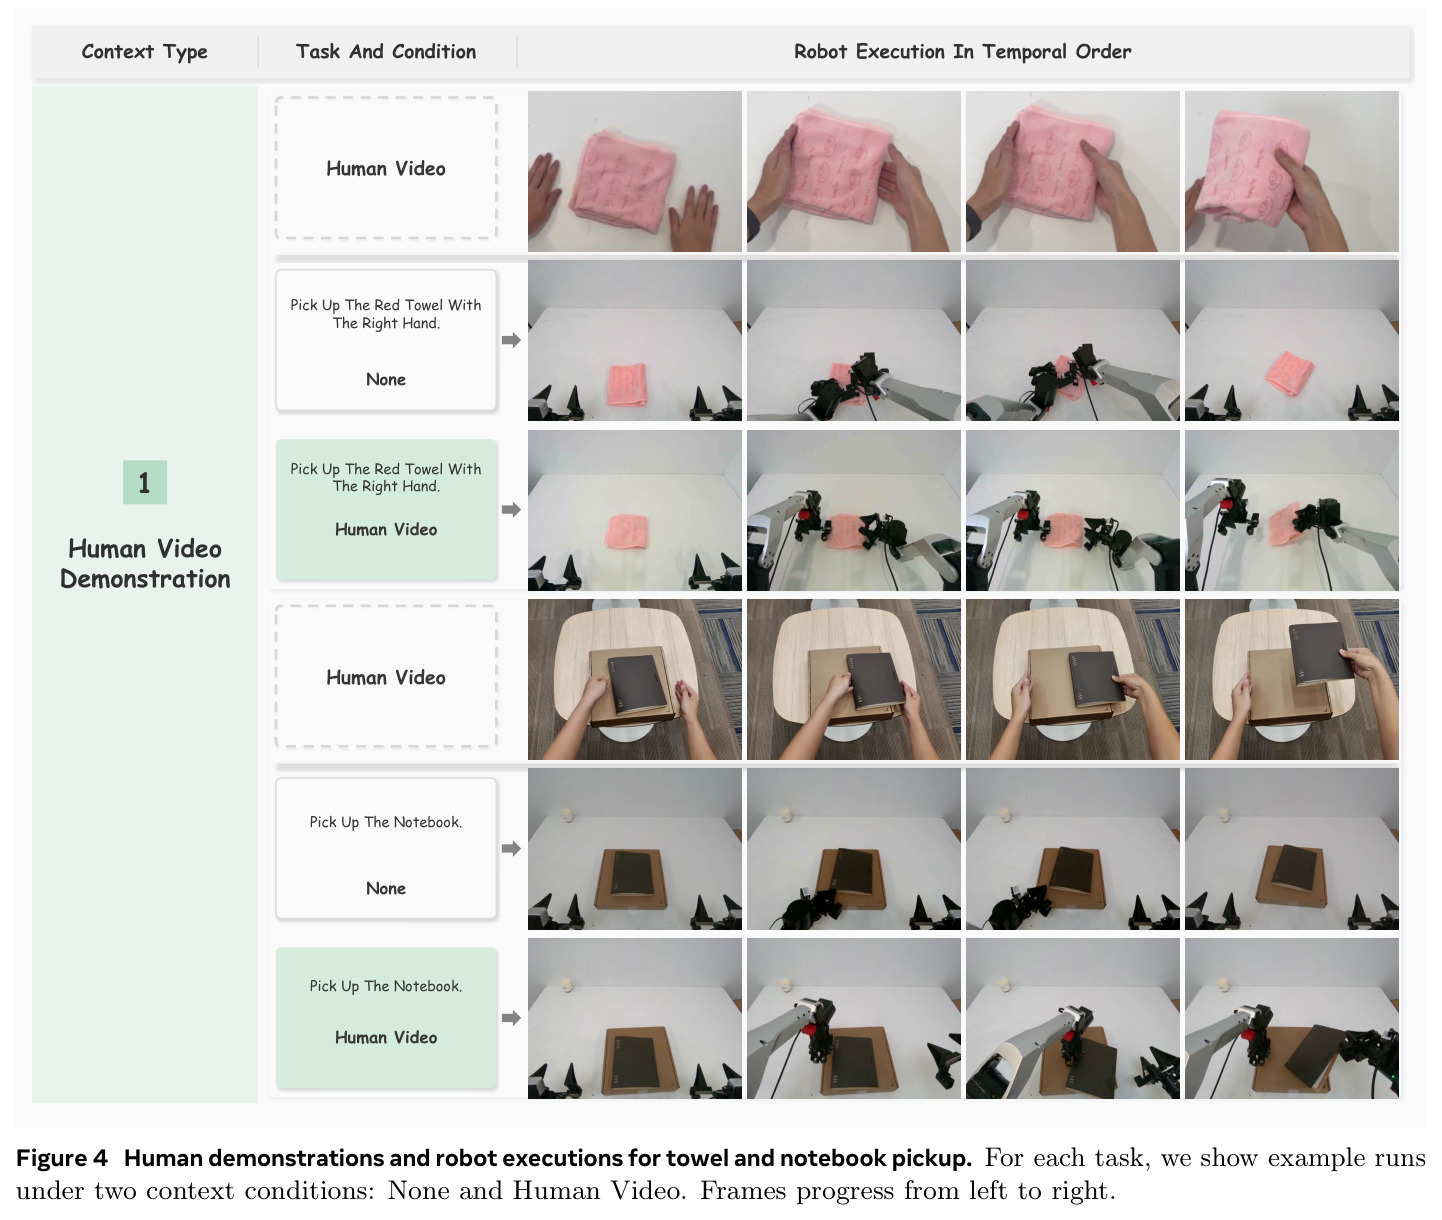
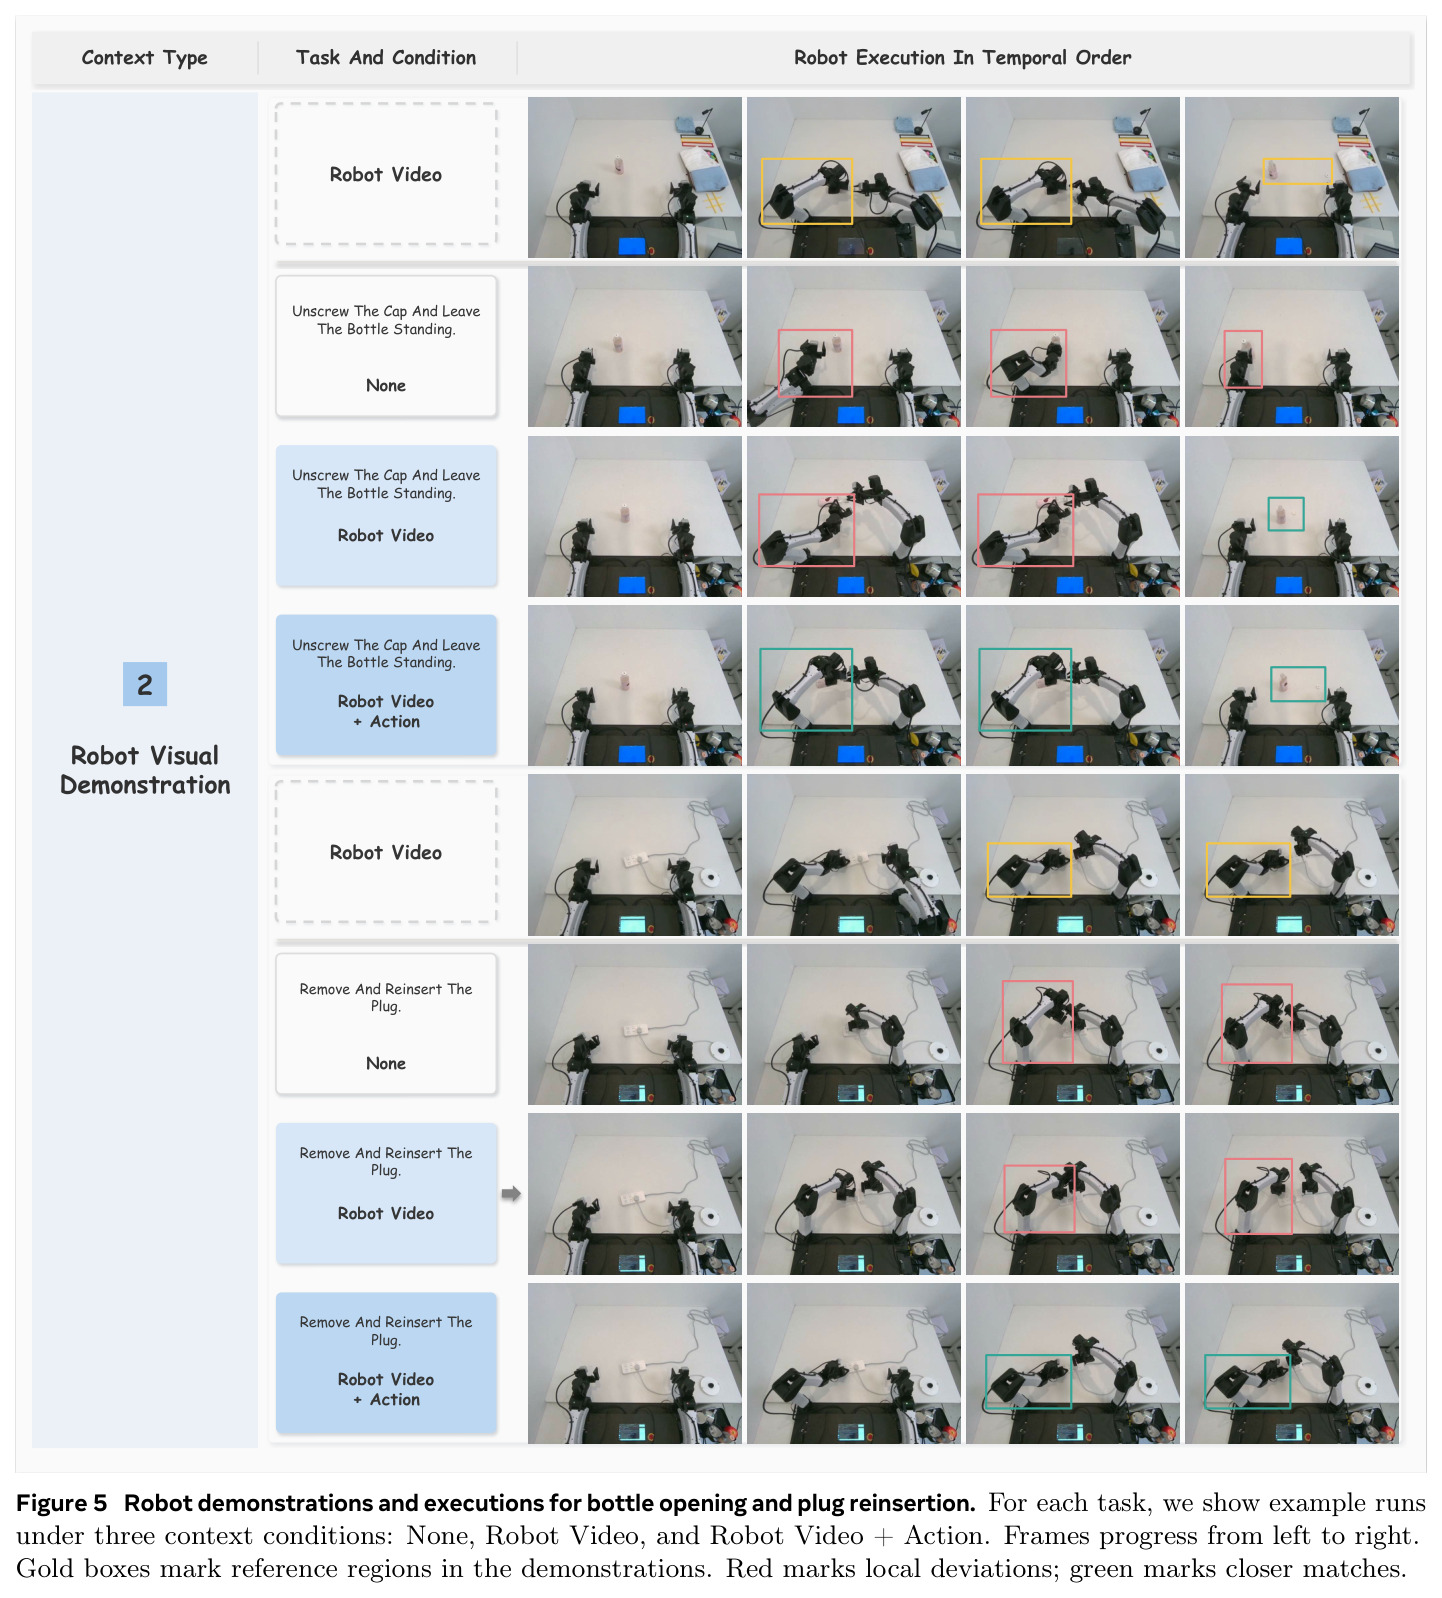
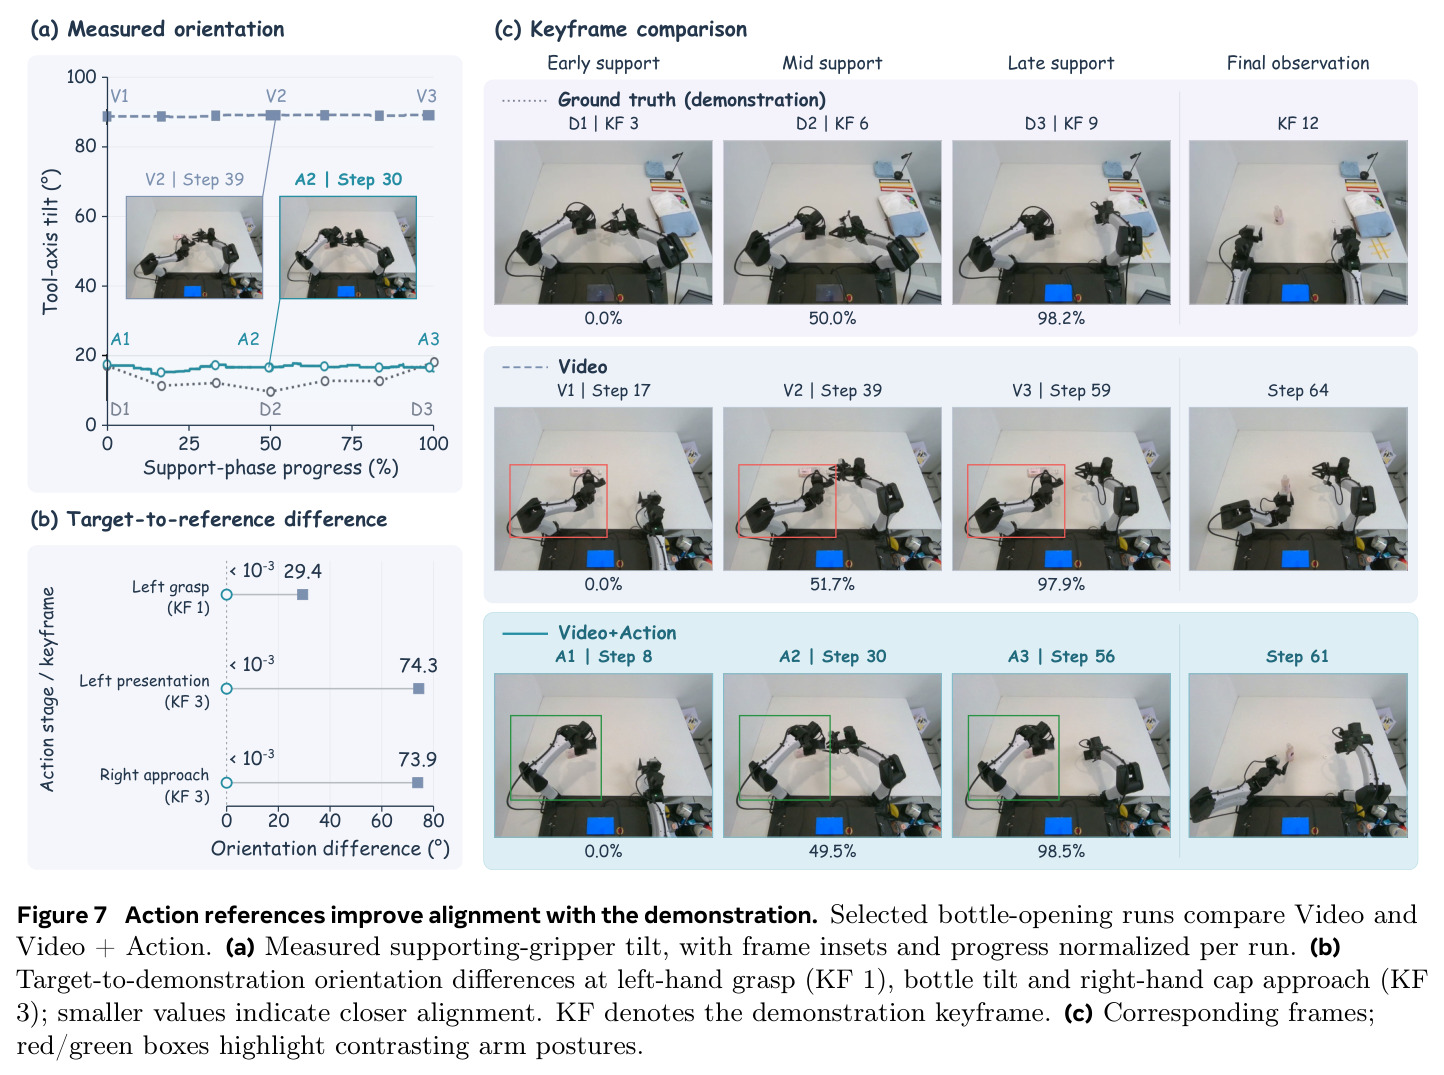
核心创新有三点。其一,把机器人 ICL 严格定义为“测试时依据演示、示例或交互经验调整行为,且不进行梯度更新或持久任务参数修改”,并设计统一的 context-to-action 接口,使不同上下文形式、不同 VLM 可以在同一执行框架下做受控比较——这把 ICL 从能力愿景变成可测量的对象。其二,跨具身策略迁移:人类视频不含任何机器人动作标签,GPT-6 Astra 也能从当前观测生成机器人自己的运动目标并完成任务(毛巾任务 0/3→2/3),说明迁移的是接触方式、手臂角色、阶段顺序等关系性知识而非轨迹回放;上下文编译器刻意保留任务相关的视觉转变(接触、释放、角色切换)而非均匀抽帧。其三,动作参考的密集化:稀疏关键帧把帧间运动留给模型猜测,而时间对齐的实测状态与动作样本(插头任务 14 关键帧配 131 个采样动作样本)显式补上中间指令位姿与夹爪转换,在拧瓶盖、拔插头这类接触敏感任务上把成功率推到最高(3/3 与 2/3)。与已有方法的本质区别是:不做任何具身训练,把全部适应负担交给上下文工程与受约束执行。
方法步骤详情
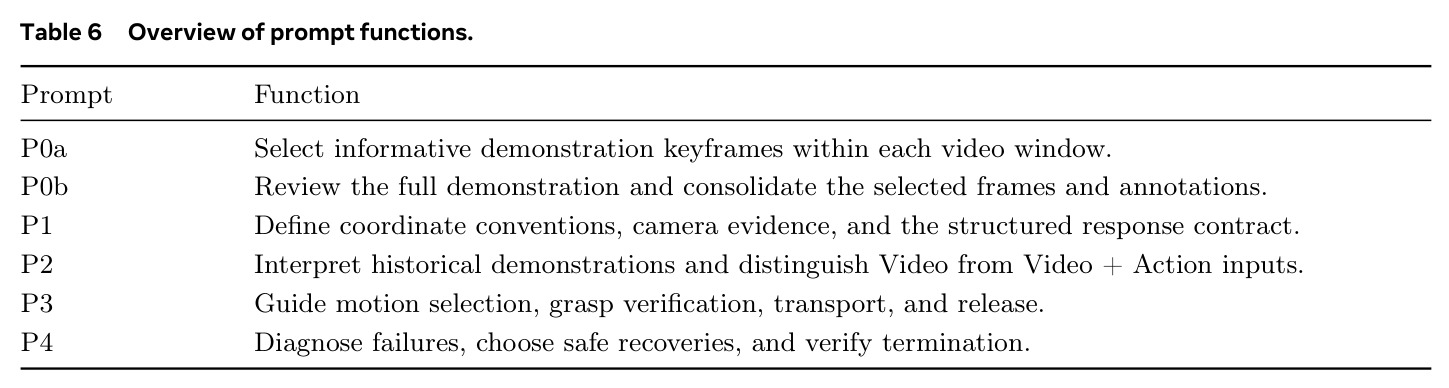
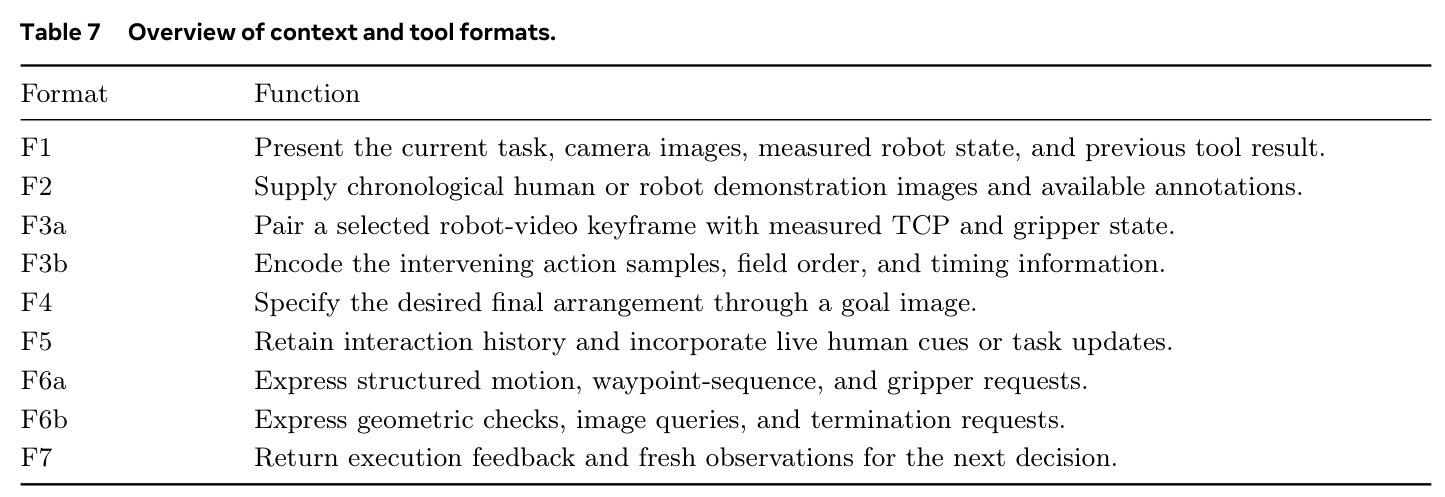
(1) 演示预处理:视觉模型滑窗选帧(P0a)后全局去重审核(P0b),≤24 关键帧、48 图;遥操作同步记录图像、状态与指令。(2) 上下文装配:F1 提供任务、多相机图像、实测状态与上步反馈;按条件追加 F2 演示图像、F3 关键帧状态与逐秒动作样本、F4 目标图像或 F5 历史记录;P1 定义坐标系与响应契约,P2 教模型把演示当历史参考而非待执行指令。(3) 决策:VLM 输出 JSON 工具请求,如 move_to 携带 $[x,y,z,q_x,q_y,q_z,q_w]$ 完整位姿与说明 note,null 臂保持先前位姿。(4) 执行:位置线性插值+SLERP 连接目标 $R_j(s)=R_j\exp(s\,\mathrm{Log}(R_j^\top R_{j+1}))$,逐步解 $q_k=\mathrm{IK}(\hat p_k,\hat R_k;q_{k-1})$,残差须 ≤0.002 米、约 1°,Ruckig 配时缩时,双臂同步到较慢者。(5) 反馈:返回实测状态、误差、settling 诊断或拒绝原因供重规划;done 只是模型自认完成,物理成功由人工标注。
技术新颖性
技术新颖性体现在四个层面。接口层面:不同于 Show-Harness 的离散语义动作或 RoboPrompt 的文本位姿,本文让 VLM 直接发出连续笛卡尔位姿目标,同时用 IK 残差、关节限位、settling 判据与拒绝反馈把自由生成约束在可执行域内,“生成自由+执行保守”的组合设计是新的。上下文工程层面:关键帧自动选择(滑窗选择+全局审核)、0.1 秒容差的图像-状态-动作时间戳对齐、以及用“=”复用上一行数值的动作样本编码,都是为多模态长上下文量身定制的表示细节。实验设计层面:同一 harness 下的 matched 模型对比(GPT-6 Astra vs Fable 5.1 vs Kimi K3)与上下文消融在机器人 ICL 文献中罕见,使“上下文贡献”首次可与“模型能力”分离。概念层面:论文明确把模型自报完成与物理成功区分开(done≠success),并把失败模式(双臂碰撞、接触不精准、结果验证缺失)作为一等公民报告,为后续研究划定了清晰的问题边界。
实验结果
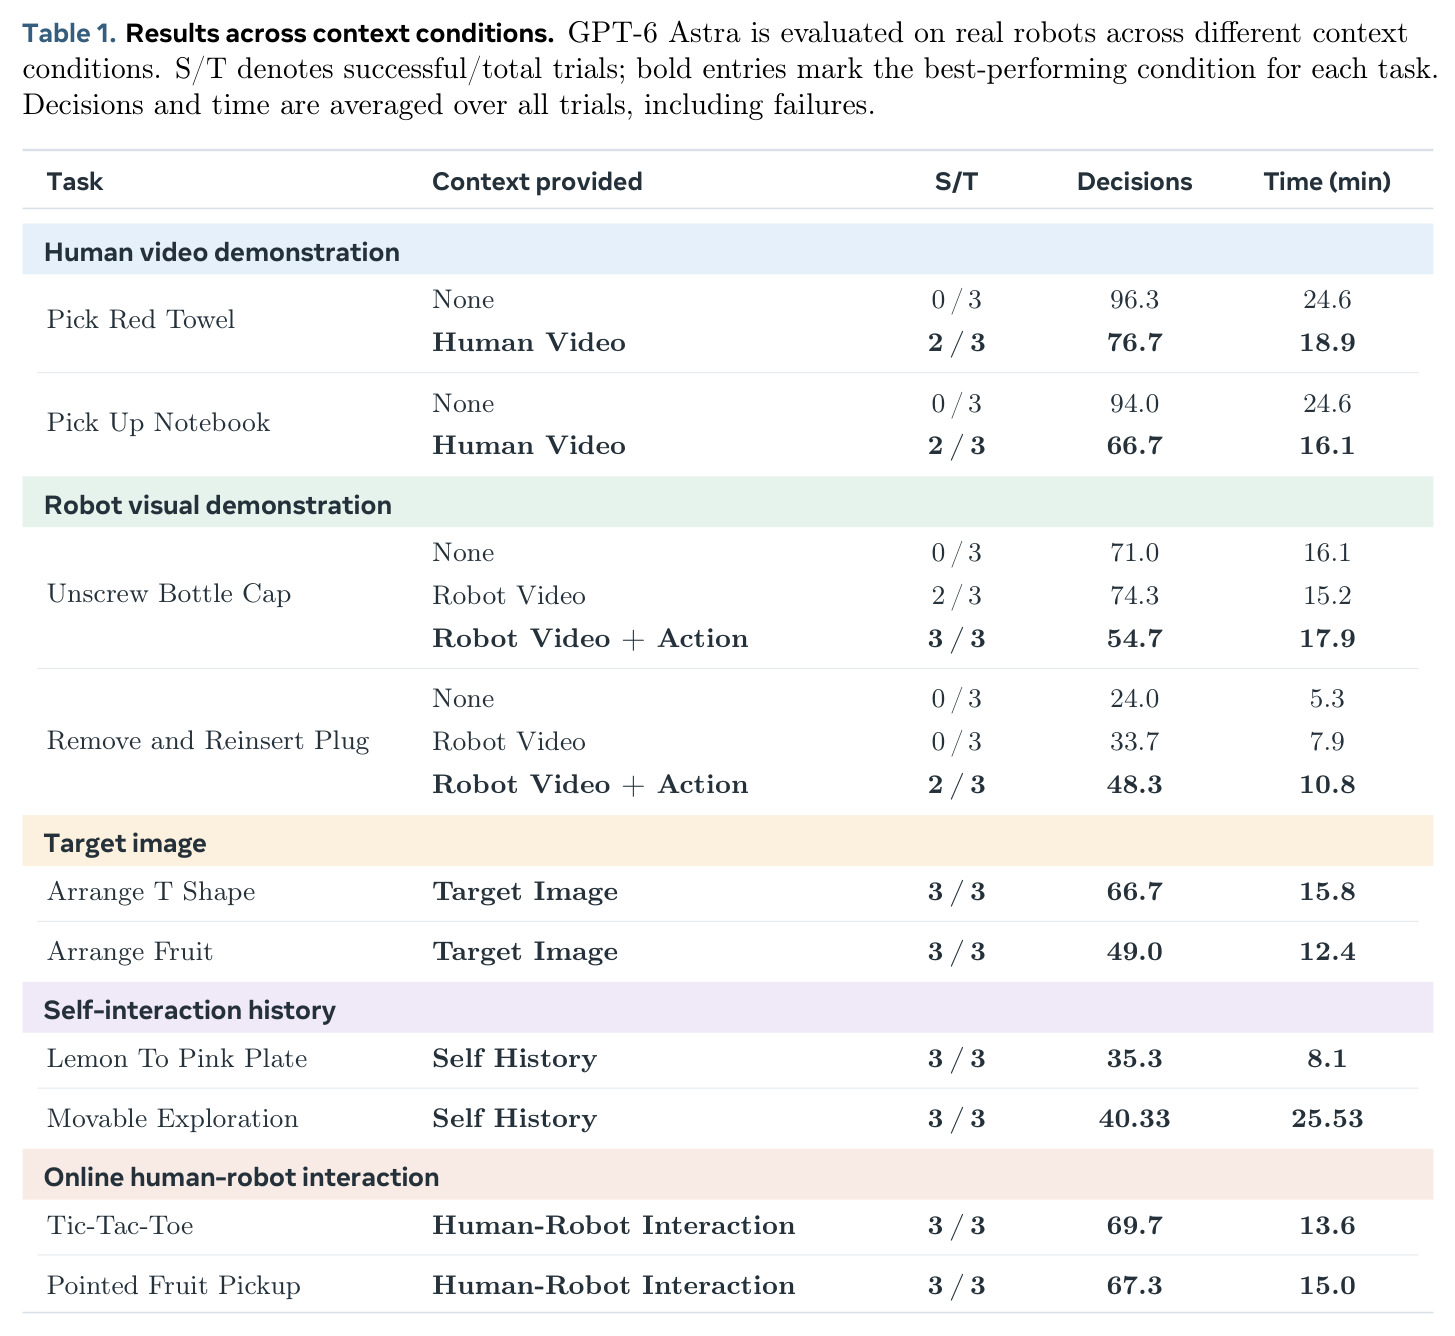
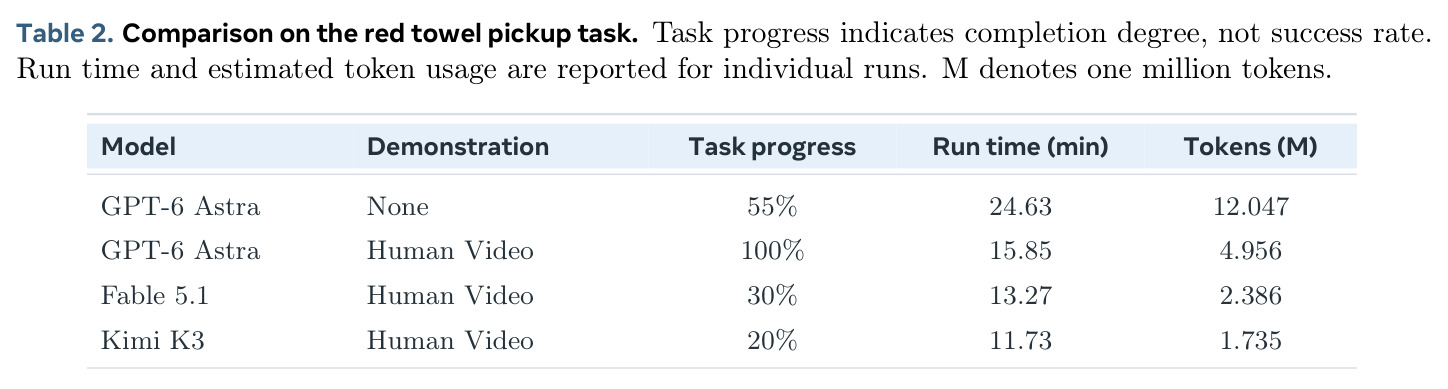
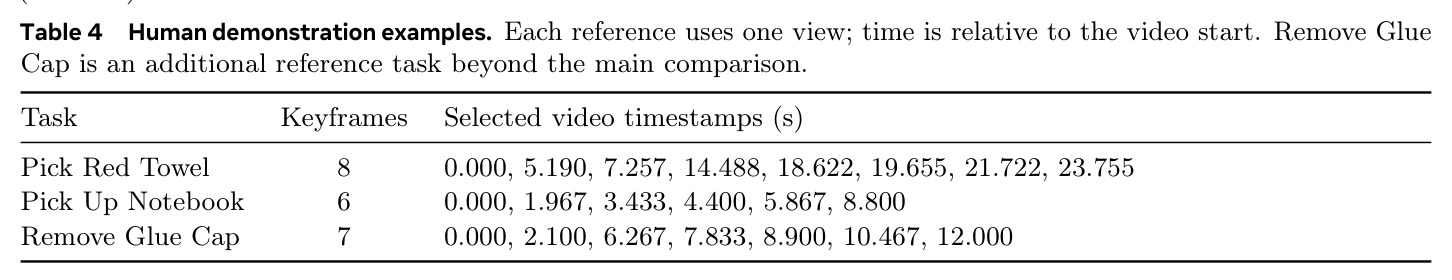
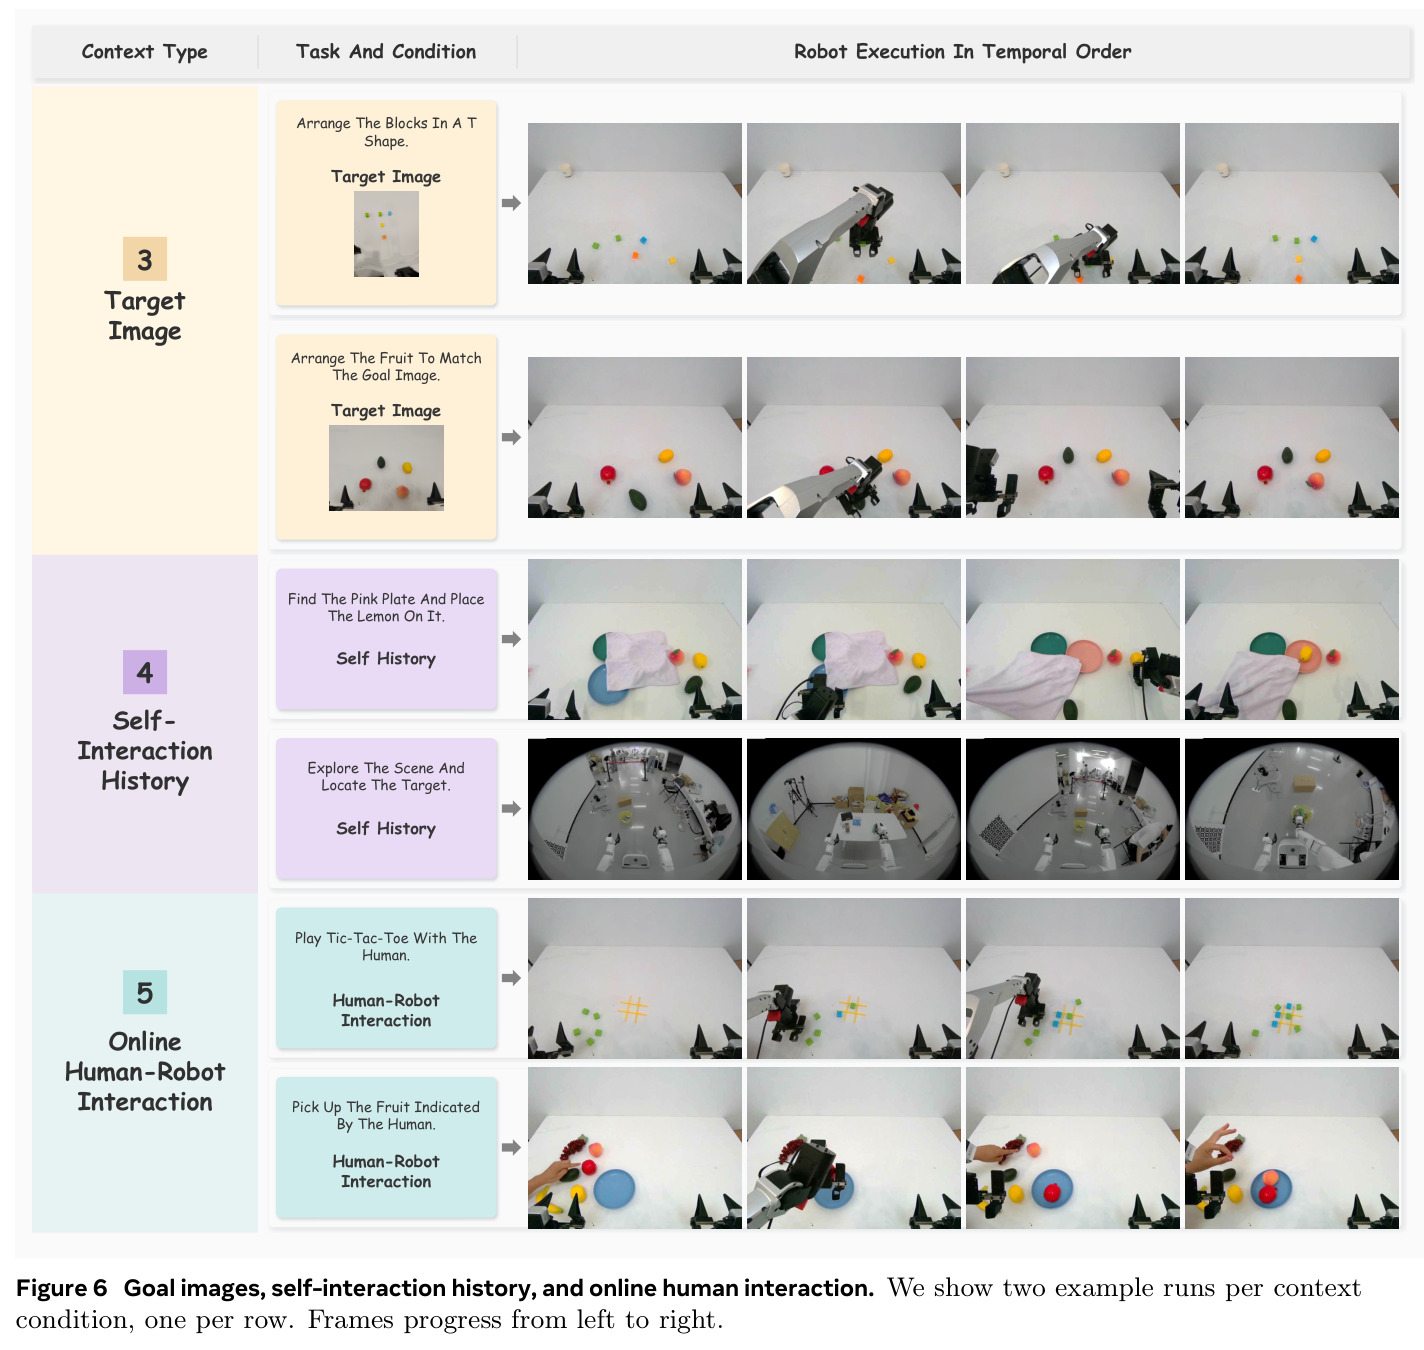
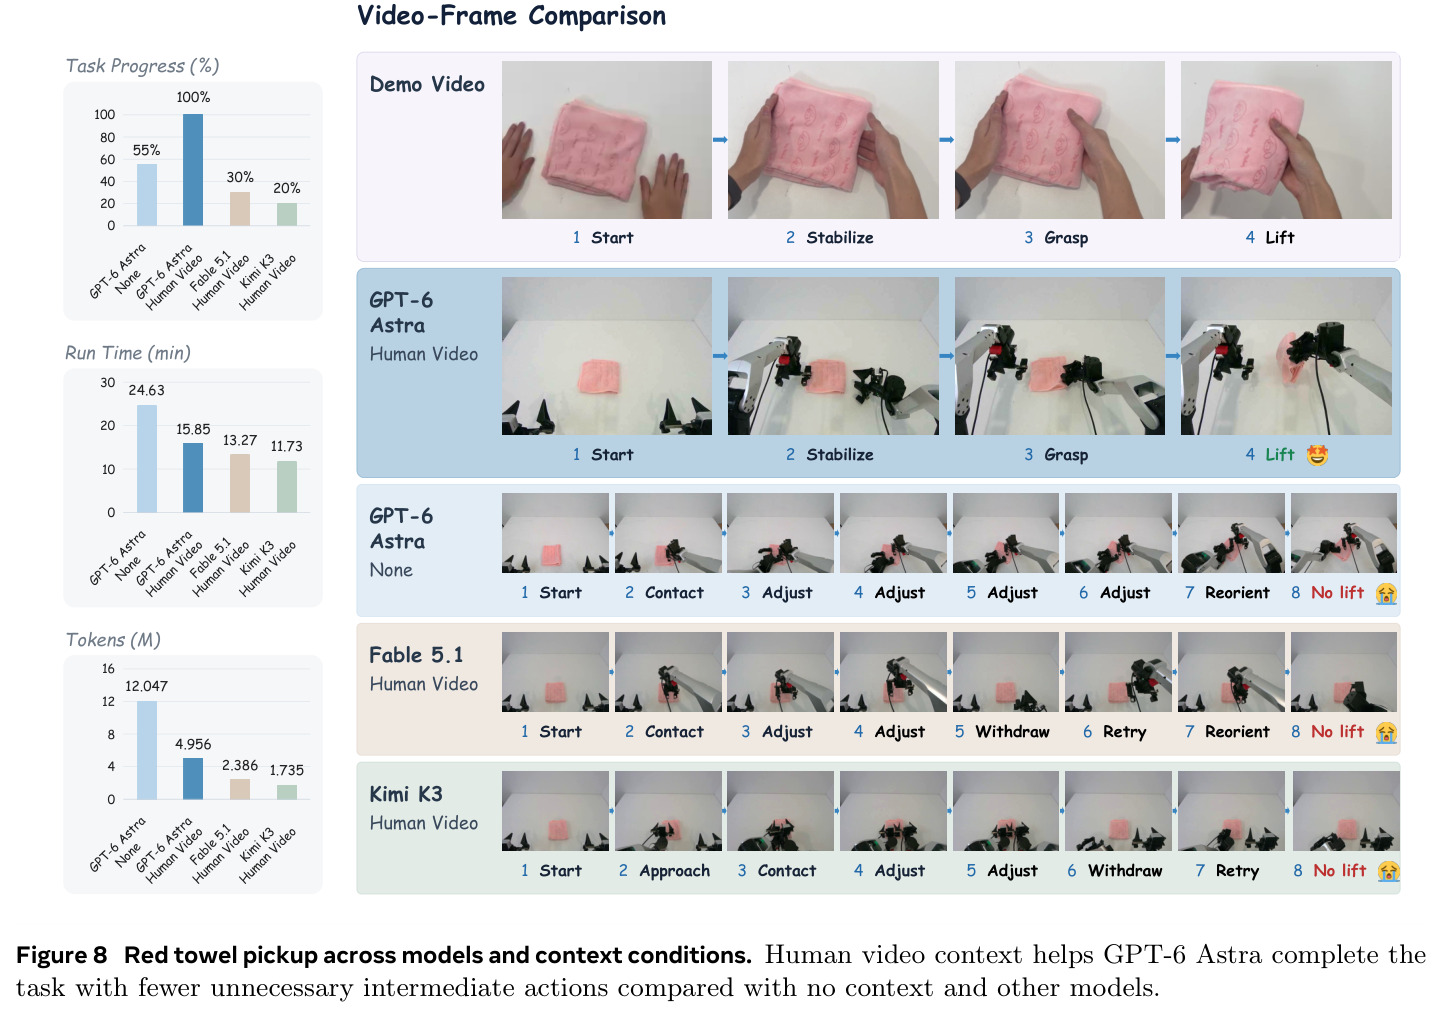
(1) 人类视频(基线均 0/3):毛巾 2/3(决策 96.3→76.7)、笔记本 2/3(94.0→66.7),时间 24.6→18.9/16.1 分。(2) 机器人视频±动作:拧瓶盖 None 0/3→Video 2/3→Video+Action 3/3(决策 54.7);拔插 0/3、0/3、2/3。动作参考成功率最高但成本不一。(3) 目标图像:T 形、水果均 3/3(66.7/49.0 决策)。(4) 自历史:柠檬放粉盘 3/3(35.3、8.1 分)并自主移开遮挡毛巾;移动探索 3/3 但 40.33 决策耗 25.53 分。(5) 在线交互:井字棋 3/3(69.7、13.6)、指认水果 3/3(67.3、15.0)。(6) 跨模型:红毛巾上 Astra+视频进度 100%、15.85 分、4.956M token,较 None(55%、24.63 分、12.047M)省 35.6% 时间、58.9% token;Fable 5.1 仅 30%、Kimi K3 仅 20%。贯穿发现:上下文改善理解与动作选择,但精准接触、结果验证与物理安全仍未解决。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Pick Red Towel(拾取红色毛巾,可形变物体) | 成功率 S/T(附决策数与时间) | 2/3(Human Video),决策 76.7,时间 18.9 分钟 | 0/3(None 无演示),决策 96.3,时间 24.6 分钟 | 成功率 +66.7 个百分点,决策 -20.4%,时间 -23.2% |
| Pick Up Notebook(拾取笔记本) | 成功率 S/T | 2/3(Human Video),决策 66.7,时间 16.1 分钟 | 0/3(None),决策 94.0,时间 24.6 分钟 | 决策 -29.0%,时间 -34.6% |
| Unscrew Bottle Cap(拧开瓶盖,接触敏感双臂任务) | 成功率 S/T | 3/3(Robot Video + Action),决策 54.7 | 0/3(None)/ 2/3(仅 Robot Video) | 动作参考使全部回合成功,决策较 None 降 23% |
| Remove and Reinsert Plug(拔插重插电源插头,精细插入任务) | 成功率 S/T | 2/3(Robot Video + Action),决策 48.3,时间 10.8 分钟 | 0/3(None 与 Robot Video 均完全失败) | 仅时间对齐的动作参考使任务从不可行变为 2/3 成功 |
| Arrange T Shape / Arrange Fruit(目标图像排列) | 成功率 S/T | 3/3 与 3/3(Target Image),决策 66.7 与 49.0 | 论文未报告无目标图像的对照成功率(仅定性比较) | 单张目标图即可指定物体身份、相对位置与间距 |
| Lemon To Pink Plate / Movable Exploration(自历史探索) | 成功率 S/T | 3/3 与 3/3(Self History) | 无对照条件(单条件验证) | 涌现移开遮挡物、主动避障等子目标推理行为 |
| Tic-Tac-Toe / Pointed Fruit Pickup(在线人机交互) | 成功率 S/T | 3/3 与 3/3(Human-Robot Interaction) | 无对照条件(单条件验证) | 实现回合等待、最优走子与手势指认的在线协调 |
| 红毛巾跨模型对比(单回合) | 任务进度 / 运行时间 / Token 用量 | GPT-6 Astra + Human Video:100% 进度、15.85 分钟、4.956M tokens | GPT-6 Astra None:55%、24.63 分钟、12.047M;Fable 5.1:30%、13.27 分钟、2.386M;Kimi K3:20%、11.73 分钟、1.735M | 较自身 None 省 35.6% 时间与 58.9% token;强模型+上下文远超弱模型+上下文 |
局限与改进
作者承认的局限:证据仅覆盖小规模任务序列、单一平台与选定的模型/上下文组合;消融不完整,且无法观察模型预训练数据,因此不能下因果结论或“涌现新技能”断言;上下文质量、观测-动作对齐、执行延迟与人工干预仍是约束;跨具身迁移与可靠自主运行需要更大规模评估;反复出现的双臂碰撞说明现有安全措施不足以支撑自主部署。我的补充观察:每条件仅 3 次重复且无显著性检验,2/3 对 0/3 的差异统计功效极弱;None 基线可能受复杂 prompt(P0–P4)与关键帧选择流程的人工先验影响;除 Fig. 7 的案例级姿态分析外,缺少跨回合的执行精度定量指标(如抓取位姿误差分布);token 与时间成本(单回合最高 12.047M token、24.63 分钟)远超专用 VLA,工程可用性存疑;“决策数”的计数约定依赖任务特定规则,跨任务可比性有限;目标图像、自历史与在线交互三组实验缺少严格的 None 对照,消融并不完整。
独立分析的弱点
(1) 统计可靠性——每格仅 3 回合,2/3 对 0/3 的差异可能落在噪声内,应做自动重置连续评测、每条件 10–20 回合并报置信区间;(2) 执行效率——VLM 每步决策需数秒到数十秒,回合 8–25 分钟,应把位姿细化与双臂协调下放给快速 System 1 VLA 控制器,VLM 只做子目标规划;(3) 接触执行不可验证——夹爪闭合不证明抓取、目标提交不证明到达,应在 harness 内建滑检测、力阈值与抓取稳定性估计,把物理验证做成可调用工具;(4) 安全缺失——规划器不做碰撞检查、双臂碰撞反复发生,需独立于 VLM 的双臂轨迹安全层、不确定性感知执行限幅,并系统报告碰撞/险情/干预;(5) 上下文表示固定——24 关键帧、约 1 Hz 动作采样均为手工设定,缺“上下文多少才够”的缩放研究,可引入可学习压缩与多演示组合;(6) 平台效应混淆——Morphi Kino 与 YAM/ARX 的执行检查与拒绝规则不同,可能把平台差异误读为模型能力差异,应统一执行语义并做跨平台对照。共同主题:把框架从“演示性证据”升级为可统计、可验证、可部署的系统。
未来方向
作者提出六个方向:一是 VLM 驱动操作的物理安全层——双臂联合轨迹检查、执行中分离监测与独立于 VLM 的中断能力,并把碰撞、险情与安全干预纳入评测指标;二是接触感知 harness——暴露抓取稳定性与接触后物体运动,加入滑检测、力感知限幅与局部恢复,使智能体不必逐步推理每个纠正;三是 System 1/System 2 分层——审慎的 VLM 智能体搭配快速 VLA 策略做位姿细化与双臂协调(类似 Hi Robot),关键问题是局部反馈何时应触发重规划;四是通过主动感知实现移动操作——智能体应决定看哪里、站哪里,配合持久空间记忆与底盘-手臂协调,使导航改变可见性与可达性时仍能持续搜索;五是长时程任务的组合式上下文——借鉴 ICRT 的轨迹提示,让智能体从多段演示组合子技能、保留已完成子目标并丢弃过时上下文,而非回放整条轨迹;六是物理动力学的上下文适应——用近期交互在线更新摩擦、柔性与物体响应预测,在接触失败累积前调整动作。基于本文成果还可延伸:更大规模的跨模型/跨平台 ICL 基准、上下文长度与成功率的缩放定律、动作参考的具身无关标准化表示,以及把“结果验证”独立成专用评估模型。
复现评估
复现评估:代码与项目网站开源(github.com/cheng-haha/GPT-Policy,项目页 cheng-haha.github.io/GPT-Policy)。附录 A–D 详尽给出 IK 容差(执行 0.002 米/约 1°,数值 10⁻⁴ 米/5×10⁻⁴ 弧度)、三平台配置(YAM 与 ARX X5 双六关节臂 100 Hz,Morphi Kino 双七关节臂+移动底盘 10 Hz)、关键帧选择协议、0.1 秒时间戳对齐规则、逐秒动作采样格式与全部 prompt 模板(P0a–P4、F1–F7),软件层面的可复现性设计相当好。硬件门槛较高:需要真实双臂机器人、多视角 RGB 相机、手眼标定与遥操作采集设备;演示数据需按论文协议自录(人类视频用第一/第三人称 RGB,遥操作记录图像+状态+指令),论文未提供数据集直接下载。算力主要是 VLM API 成本——单回合 2–12M token,完整复现全部条件×3 回合估计需数千万至上亿 token,但无训练成本。总体难度中高:拥有同等双臂平台的团队按附录可较顺利复现,缺硬件者只能复现接口、prompt 与上下文编码设计。
论文图表
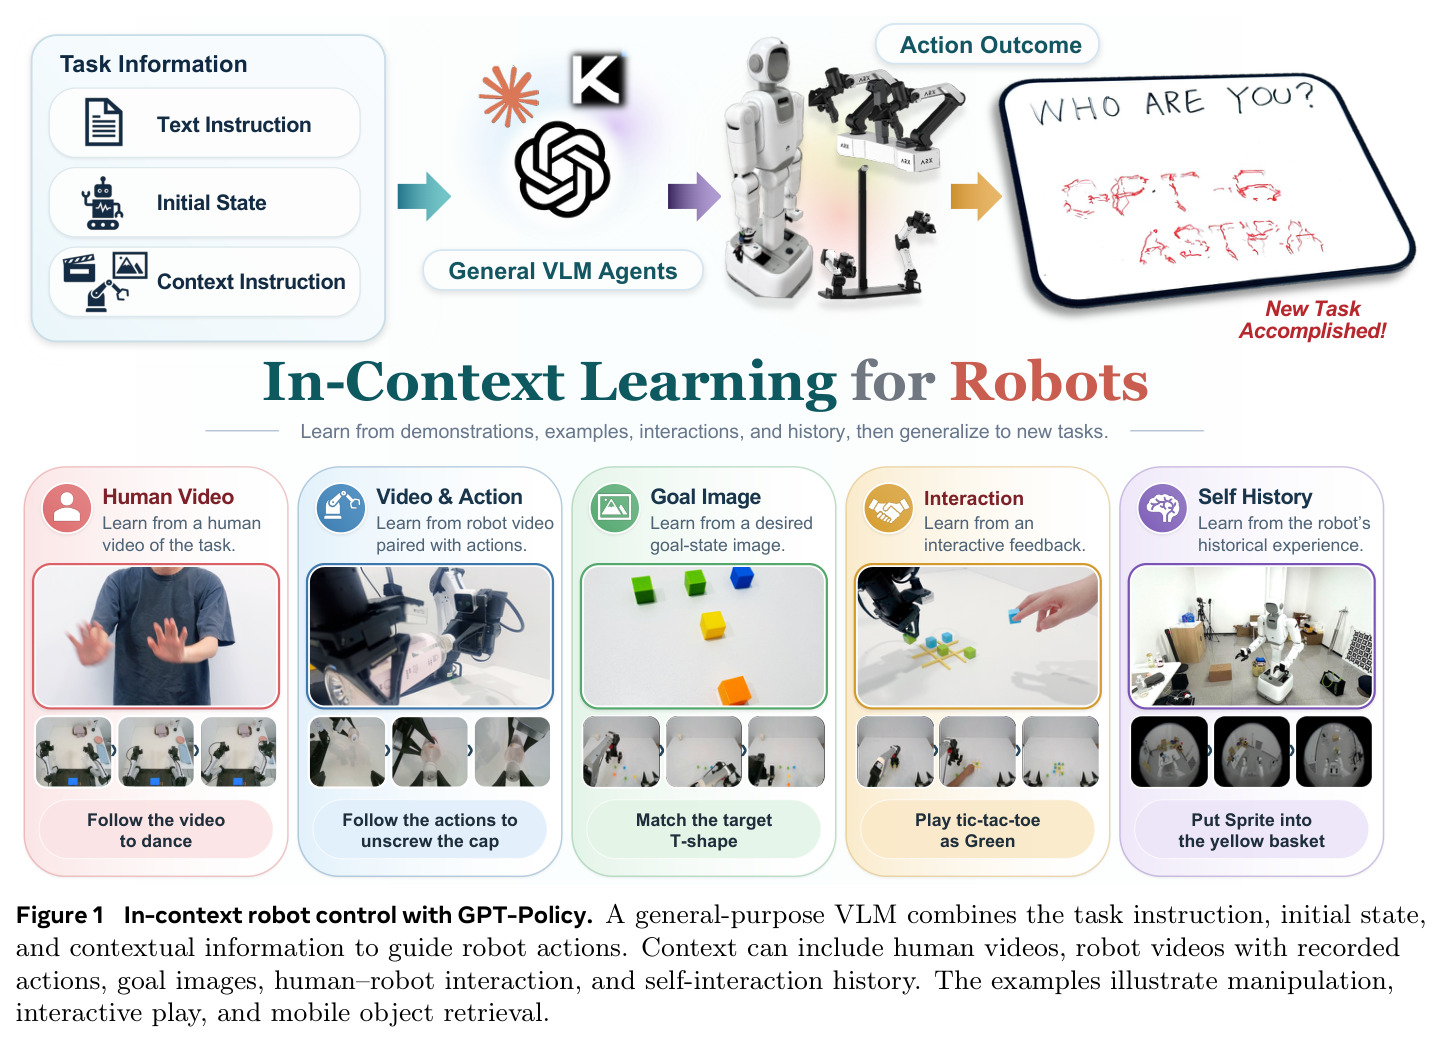
全文总览图:上方展示通用 VLM 智能体接收任务指令与初始状态、结合上下文指令完成新任务;下方一行并列展示五类上下文(人类视频、视频+动作、目标图像、在线人机交互、自历史)及对应示例任务(跟视频跳舞、按动作拧瓶盖、拼 T 形、井字棋执绿方、把雪碧放进黄篮子)。
一图定义了整篇论文的研究框架与实验矩阵:五种上下文族分别对应后文 4.2–4.6 五组实验,读懂此图即抓住论文的问题空间。