MotorMind:为通用视觉语言模型搭建零样本机器人操作的脚手架 MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation
冻结通用VLM身兼五职,配中层动作接口与异步监控,零样本完成模拟与真机操作
前置知识
VLA(视觉-语言-动作模型)
把相机图像和语言指令直接映射为机器人低层动作(动作 token 或轨迹块)的端到端基础模型,代表工作有 π0.5、OpenVLA-OFT、GR00T N1.5、MolmoAct2。它们在专门收集的机器人演示数据上预训练甚至任务级微调,分布内成功率很高(微调后在 LIBERO-PRO 基础套件可达 98% 以上),但换任务、换物体、换布局时性能骤降,且无法直接吸收通用 VLM 的能力进步。
本文的全部对比基线和批判对象都是 VLA 路线,理解其训练依赖性才能理解 MotorMind 走零样本路线的动机和结果表中 zero-shot / fine-tuned 分组的意义。
零样本泛化(Zero-shot)
不在目标任务上做任何微调、演示收集或策略训练,直接把系统部署到新任务和新环境。对机器人而言通常意味着:不接触 LIBERO 演示数据、不为具体任务训练动作头,仅靠模型既有能力加通用执行框架完成任务。这是衡量机器人系统泛化能力最苛刻也最实用的设定。
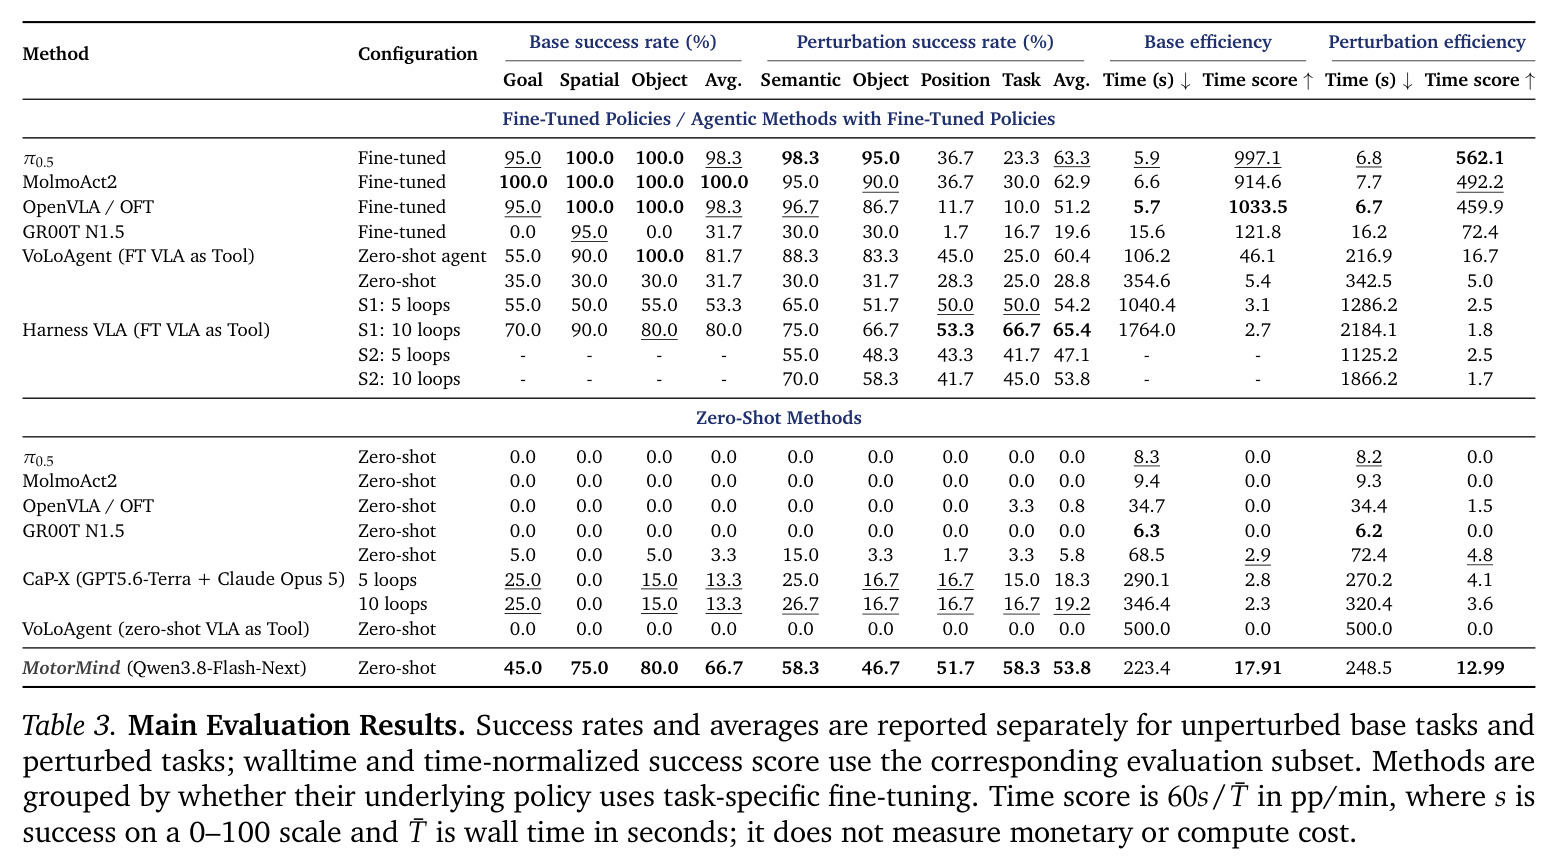
零样本是论文的核心卖点:MotorMind 声称不做任务特定策略训练就在 LIBERO-PRO 拿到 66.7%/53.8%,主表把方法按是否微调严格分组,读表时必须盯住这个标签。
LIBERO-PRO 基准
LIBERO 桌面操作基准的强化版,包含 Goal、Spatial、Object 三套基础任务(各 60 个回合)以及语义、物体、位置、任务四类扰动评测,专门考察指令改写、物体外观、空间配置、任务语义变化下的泛化能力。基础与扰动设置分开报告成功率和平均墙钟时间。
论文主实验、消融和失败分析全部在 LIBERO-PRO 上进行,理解其任务构成才能读懂 Table 3 中 66.7%、53.8% 等数字的含义与口径。
中层动作表示(Mid-level Action Representation)
介于高层语言指令与低层关节指令之间的参数化动作接口:平移(指定方向或轴与距离)、旋转(轴与角度)、夹爪(开/合,可带目标宽度),全部定义在机器人基座坐标系中,形如 $a_{t,k}=(\tau_{t,k},\eta_{t,k})$。VLM 只负责选类型和参数,确定性 Controller 负责校验并解析成笛卡尔运动,并记录实际执行结果。
这是方法的核心接口:它让不需要学动作策略的 VLM 也能精确控制物理世界,同时保证每条提案可解释、可校验、可撤销,是理解全文设计的钥匙。
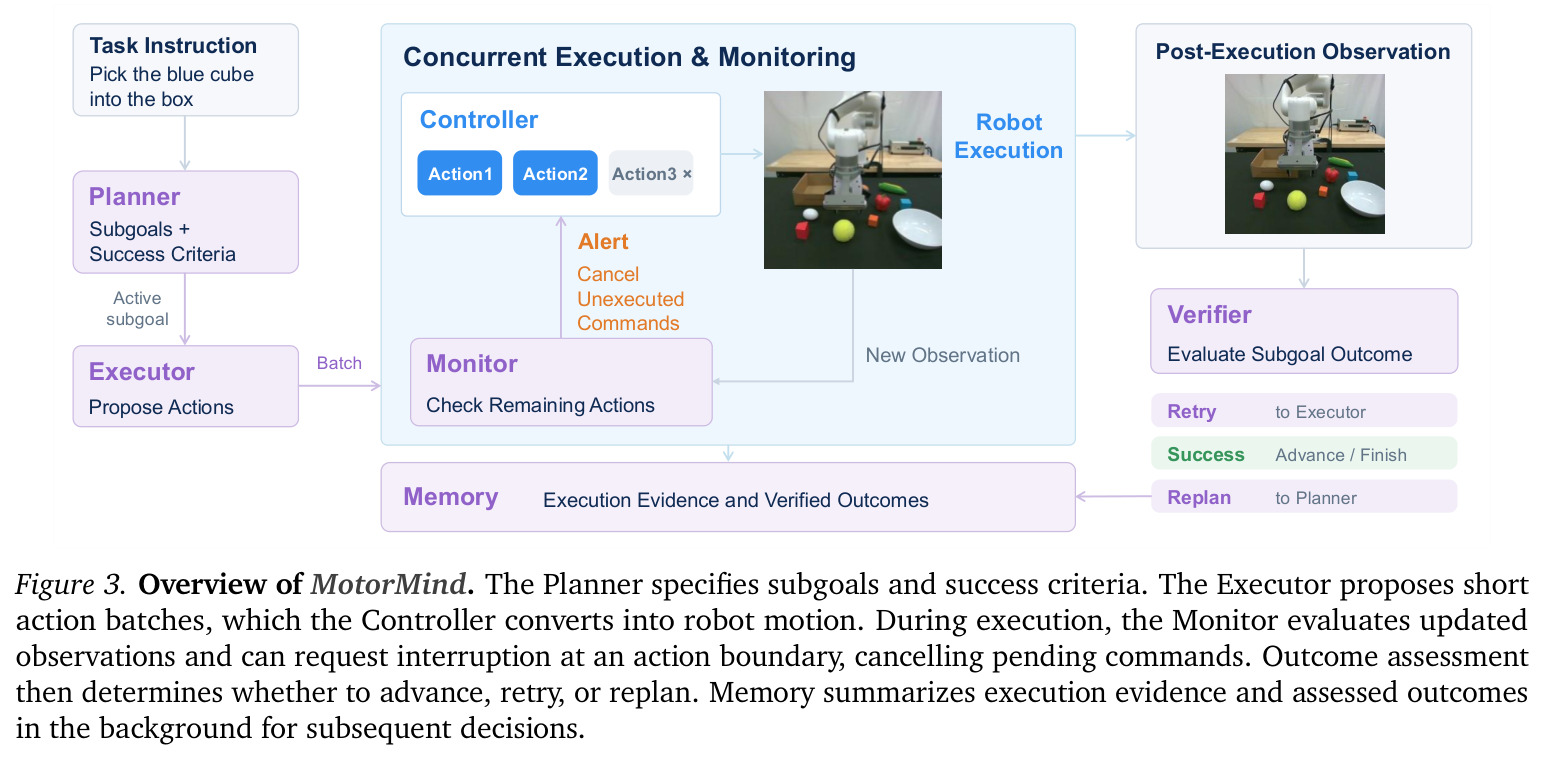
异步调度与动作边界中断
顺序决策主循环(观测-提批-执行)保持串行,而监控(Monitor)与记忆更新(Memory)跑在后台线程。Monitor 周期性和每步运动后检查最新观测,可发出 STOP 告警;STOP 不抢占正在执行的动作,而是让 Controller 走到下一个动作边界后取消并丢弃排队命令。记忆摘要在后台写入,规划与验证只读最新完成版本,未完成请求会被合并。
标题里的 scaffolding 实质就是这个异步执行框架:它让系统获得接近实时的纠错反应(发现抓错物体就不执行排队的放置动作),又不牺牲主循环的可复现性和效率。
TimeScore(时间归一化成功率)
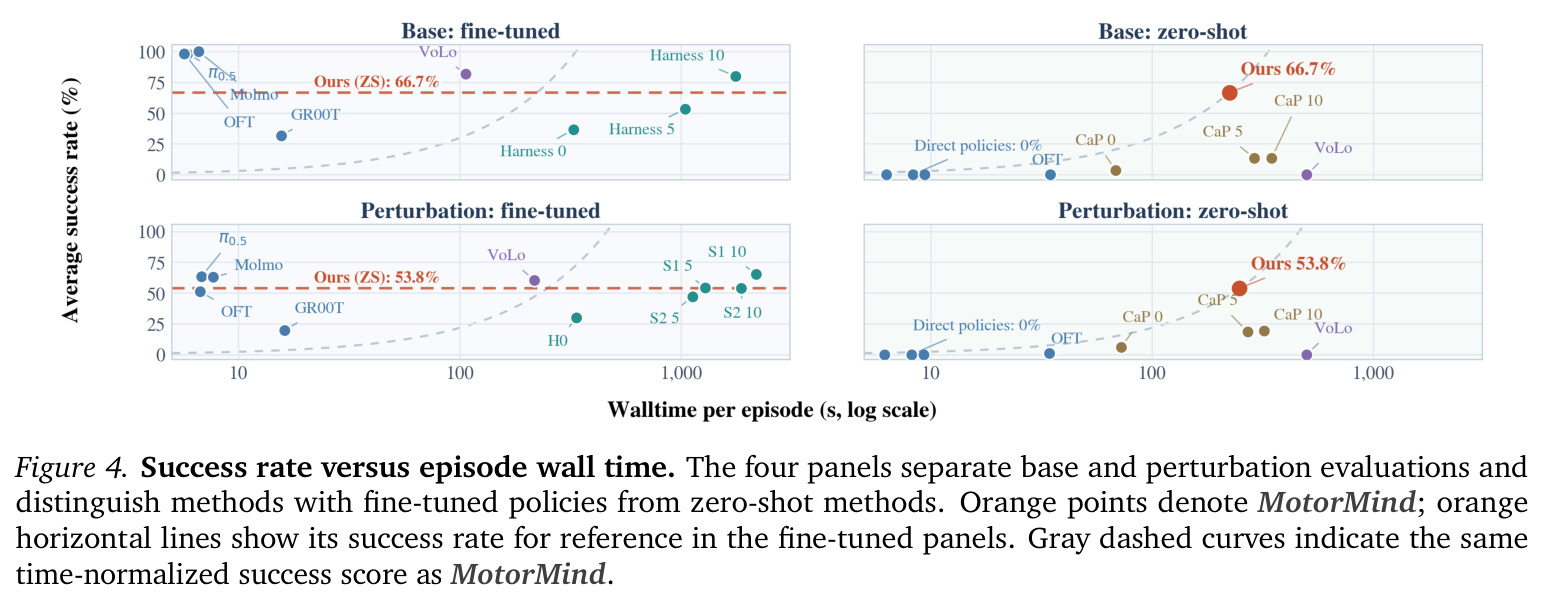
论文提出的描述性综合指标:$\text{TimeScore} = \frac{60 \times s}{\bar{T}}$,其中 $s$ 是 0-100 刻度的成功率数值,$\bar{T}$ 是同一评测子集的平均每集墙钟秒数,单位为 pp/min(百分点/分钟)。例如 66.7% 成功率、223.4 秒对应 17.91 pp/min。它强调快速失败并不能算高效操作。
Table 3 和 Figure 4 都用它来同时呈现成功率与耗时的权衡,读主结果表时需要用它来判断方法是否真的更快更好。
研究动机
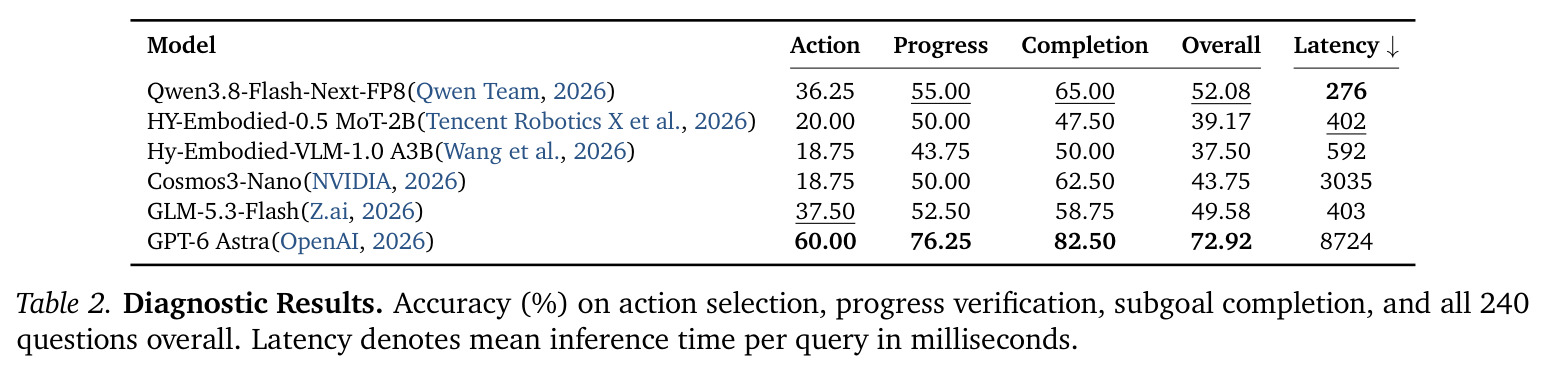
现有两条路线各有硬伤。第一条是视觉-语言-动作(VLA)模型:π0.5、OpenVLA-OFT、GR00T N1.5、MolmoAct2 在训练分布内极强(微调后在 LIBERO-PRO 基础套件成功率 98.3%-100%),但零样本迁移几乎归零——四个 VLA 零样本在基础套件全部 0.0%,扰动下 OpenVLA-OFT 也只有 0.8%;即便微调,位置与任务扰动下 OpenVLA-OFT 仍掉到 11.7% 和 10.0%,且它们依赖专门机器人数据,无法直接吸收通用 VLM 的进步。第二条是智能体化机器人系统:用 VLM 做高层规划,但依赖大量外部组件——学习型动作专家、SAM3 式分割、技能库、运动规划器、编码智能体,系统复杂、成本高。作者的 240 道题具身诊断还显示:通用 VLM 的动作选择准确率仅 18.75%-60.00%,是动作选择/进度评估/子目标完成三项中最弱的(Qwen3.8-Flash-Next 为 36.25%/55.00%/65.00%),且强模型延迟惊人——GPT-6 Astra 单次 8.724 秒,是 Qwen(0.276 秒)的 30 多倍。此前最强零样本方法 CaP-X 也只有 13.3%/19.2%。
本文的目标是论文想回答一个直白而尖锐的问题:能不能让一个冻结的通用 VLM 自己像人类遥操作员那样操作机器人——直接从观测推理、发出动作、并随执行反馈持续调整——而不依赖学习型动作专家、编码智能体或 SAM3 这类外部定位工具?具体目标是构造一个轻量脚手架(harness):用紧凑的中层动作表示把 VLM 的语义决策接到确定性机器人控制层,用异步监控在错误发生时于动作边界打断无效动作,用后台记忆在多次尝试间沉淀执行证据,最终在不做任何任务特定策略训练、不用编码智能体、不用外部感知工具的前提下,在 LIBERO-PRO 模拟环境和 xArm6 真机上完成零样本操作,并量化剩余失败随 VLM 能力增强而减少的趋势。
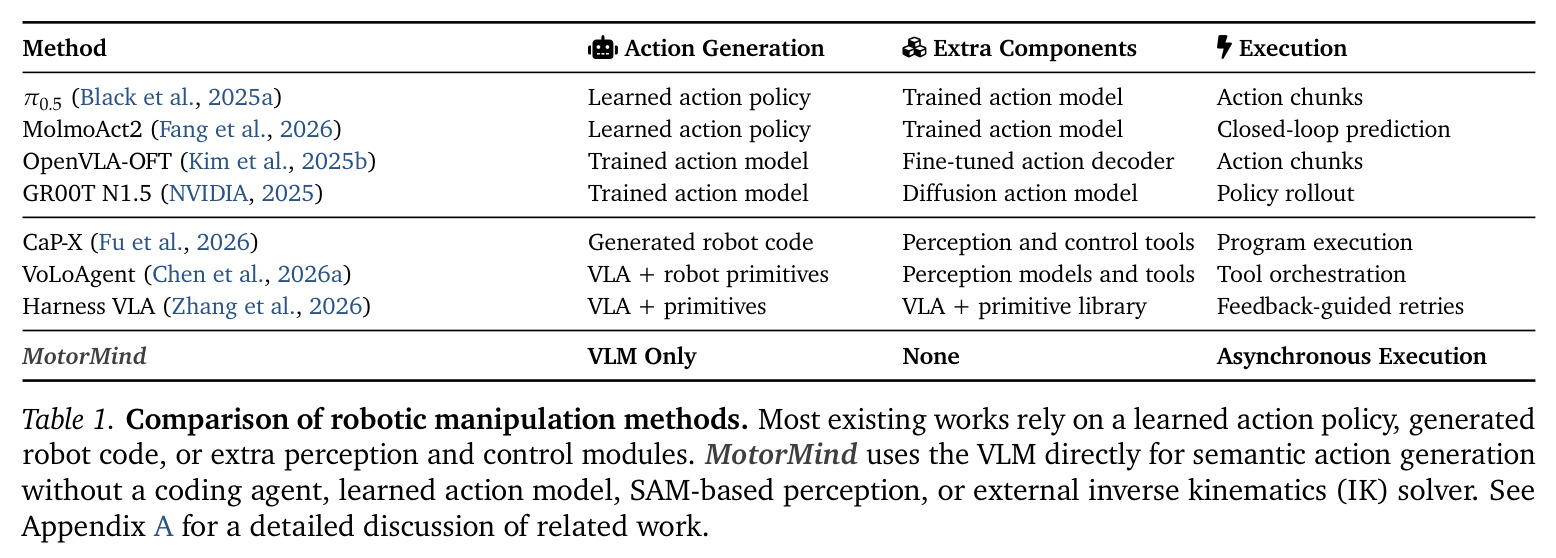
与已有工作不同的是,与智能体路线做加法(外挂感知、技能库、代码执行器)相反,MotorMind 反其道而行做减法:整个系统只有同一个冻结 VLM(Qwen3.8-Flash-Next)轮流扮演 Planner、Executor、Monitor、Verifier、Memory 五个角色,外加一个确定性 Controller,没有编码智能体、没有 SAM、没有外部逆运动学求解器、没有学习型动作头(Table 1 明确对比了这一点)。第二个独特切入是把第 2 章的诊断结论直接翻译成设计原则:动作选择最不可靠,就让 VLM 只提短小、可撤销的动作批次,靠后续观测修正空间误差;进度与完成判断也不完美,就让模型判断必须与机器人实测反馈互相校验;强模型又准又慢,就用快骨干加异步监控来同时保住决策质量与反馈频率。这种'先诊断、后设计'的路径在同类工作中少见。
核心方法
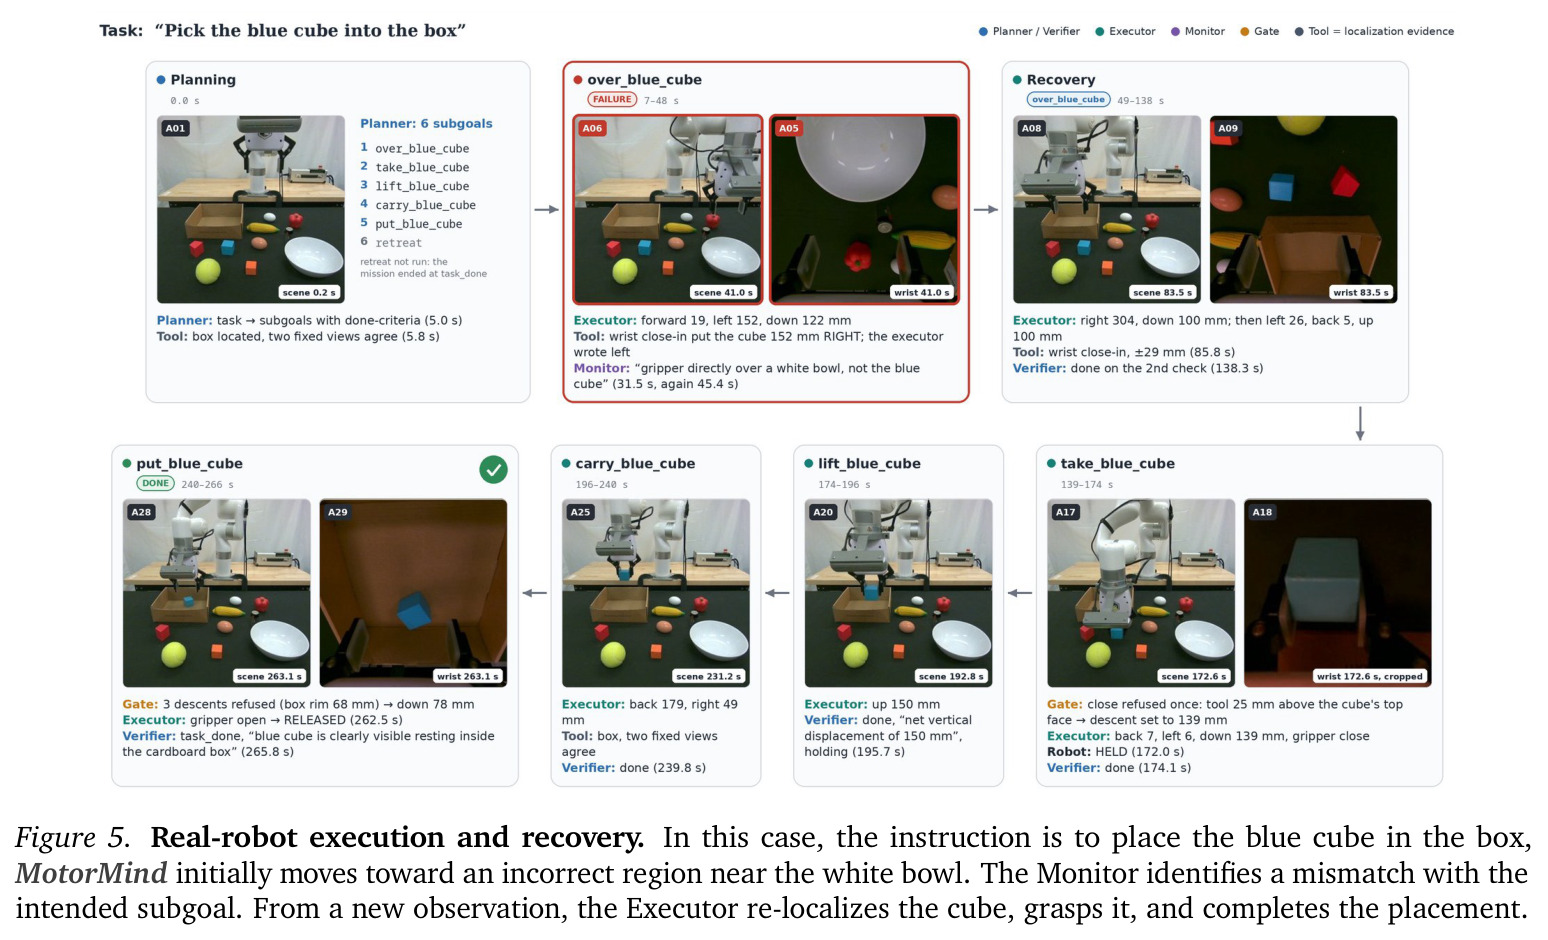
直觉是:与其从演示中端到端学习动作策略,不如给通用 VLM 一层脚手架,把它已有的语义推理翻译成机器人可执行的物理动作。技术上,冻结的 Qwen3.8-Flash-Next 扮演五个角色。Planner 把指令 $\ell$ 分解为有序子目标 $G=(g_1,\ldots,g_M)$,每个子目标规定目标状态变化、目标描述和成功判据(如抓取需要'被握住'的证据,搬运需要'到达目的地且保持抓握')。每个决策周期观测 $o_t=(I_t, r_t)$,即相机图像加实测机器人状态。Executor 输出结构化提案:子目标评估、完成信号、动作批次 $A_t=(a_{t,1},\ldots,a_{t,K_t})$ 与预期结果,其中 $a_{t,k}=(\tau_{t,k}, \eta_{t,k})$,$\tau$ 为动作类型(move/rotate/gripper),$\eta$ 为参数(方向、距离、角度、夹爪宽度)。确定性 Controller 校验每条命令、解析成基座坐标系笛卡尔运动并记录实际结果。Monitor 在后台线程周期性检查更新观测,可发 STOP 告警在动作边界取消排队命令;Verifier 结合观测与实测证据判定推进、重试或重规划;Memory 异步汇总执行证据供后续决策。
核心创新是'中层动作表示 + 异步执行脚手架'的组合。与 VLA 的本质区别:VLA 直接预测低层动作 token,需要专门机器人数据训练;MotorMind 的 VLM 只在语义层选择参数化的平移/旋转/夹爪动作,物理执行交给确定性控制器,并且坚持'意图移动不等于实际移动'——每次新提案都基于新鲜观测、实测反馈和近期执行历史,而不是把计划当结果。与代码生成路线(CaP-X)的本质区别:不生成机器人代码、不依赖感知与控制工具链,动作提案直接可校验可执行。与工具重载智能体的本质区别:完全不用 SAM3、IK 求解器等外挂。第二个关键思想是异步化:监控与记忆更新与顺序主循环并发,STOP 告警只在动作边界生效并丢弃未执行命令(例如发现抓错物体就能阻止排队的放置动作),监控停止时不等在途模型调用、过期告警不会污染新子目标;记忆写入与下一子目标执行重叠,规划/验证读最新完成的笔记。第三个思想是权限分离:Monitor 只报警不指挥,纠正决策留给 Verifier 和 Executor。
方法步骤详情
第一步,诊断建模:构造 240 道具身问答题(三类能力各 80 题),测得动作选择最弱(各模型 18.75%-60.00%,Qwen3.8-Flash-Next 仅 36.25%)、强模型延迟高(GPT-6 Astra 8.724 秒 vs Qwen 0.276 秒),据此确定快骨干、短批次、反复校验的设计。第二步,任务规划:Planner 接收指令,输出子目标序列及成功判据。第三步,提出动作批次:Executor 基于当前图像、实测状态和近期回合历史,输出子目标评估、动作批次 $A_t$、完成信号和预期结果;动作限于 move、rotate、gripper,参数定义在基座坐标系。第四步,物理执行:Controller 校验每条命令、解析为笛卡尔运动、执行并返回实测的运动与夹爪结果。第五步,并发监控:Monitor 持续检查更新观测,信息性告警记为证据,STOP 告警使 Controller 在动作边界取消并丢弃排队命令。第六步,结果评估与恢复:Verifier 用最新观测、实测状态和告警评估成功判据——掉抓、实测释放等直接测量可不经模型判定直接结案;据此推进、重试或交回 Planner 重规划。第七步,异步记忆:后台写手把执行证据与评估结果汇总成紧凑笔记,下一子目标不必等它完成,规划与验证读最新完成版本,积压请求会被合并。
技术新颖性
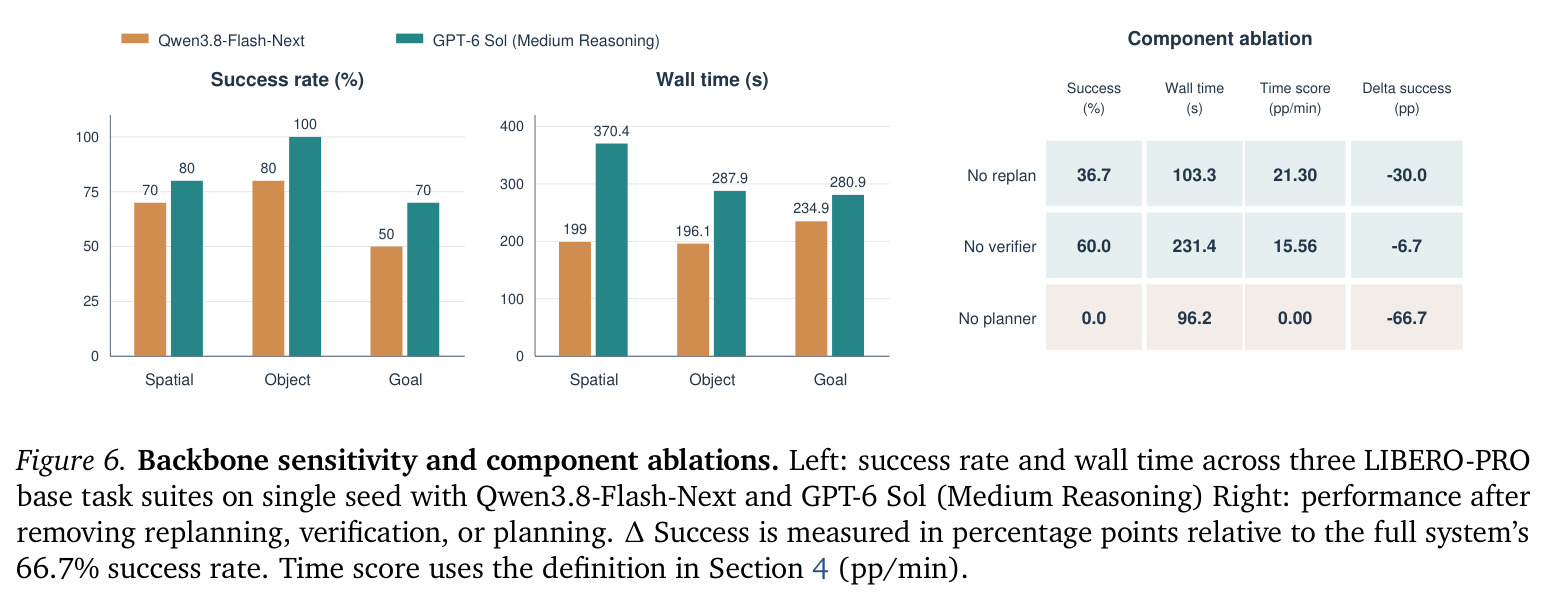
新颖性体现在四个层面。其一,单模型多角色架构:同一个冻结 VLM 以不同上下文和输出权限扮演五个角色,把智能体机器人系统的外部复杂度(感知模型、技能库、规划器、编码智能体)压缩为提示工程与调度问题,同时避开 VLA 的训练成本——Table 1 显示 MotorMind 是唯一'仅 VLM、零额外组件、异步执行'的方案。其二,动作边界中断语义:异步监控不抢占式控制,而是在确定性动作边界请求取消并丢弃排队命令,既保留顺序决策的可复现性,又获得接近实时的纠错反应,这在机器人 agent 系统中是新的调度设计。其三,证据分级机制:模型判断(Verifier)与直接测量(夹爪状态、丢失抓取、实测释放)分层,实测证据可绕过不可靠的模型判定直接结案,精准对冲诊断中完成判断仅 65% 的短板。其四,评价方法学:提出时间归一化分数 TimeScore $= 60 \times s / \bar{T}$(pp/min),把'快速失败不算高效'显式编码进指标。消融证明组件缺一不可:去重规划从 66.7% 跌至 36.7%(-30.0 个百分点),去验证器至 60.0%(-6.7),去规划器直接归零。
实验结果
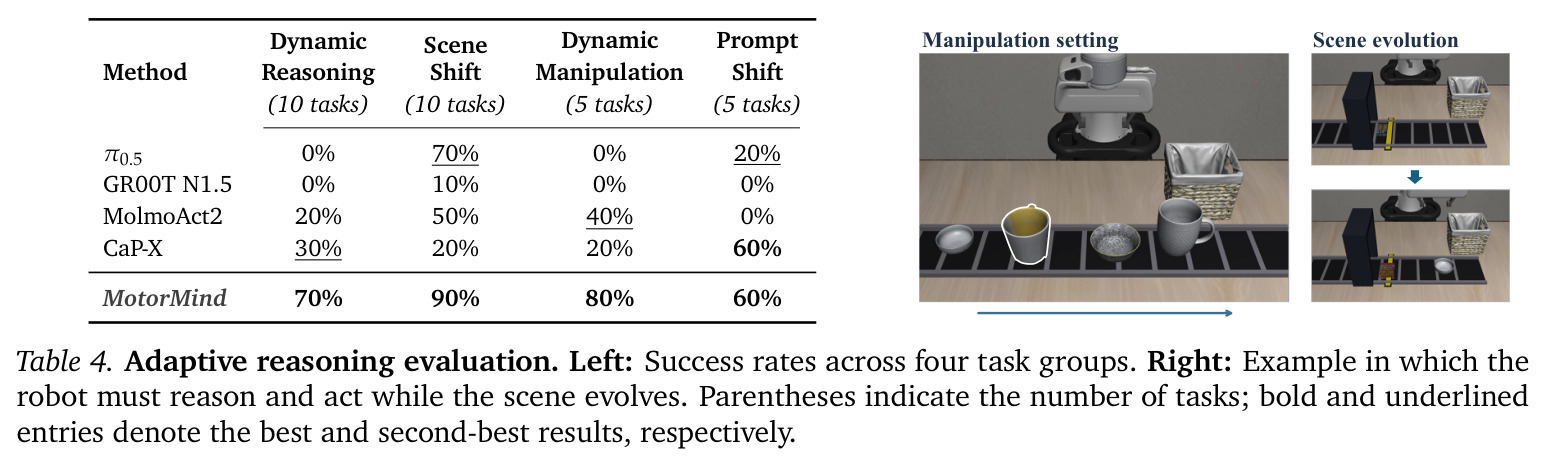
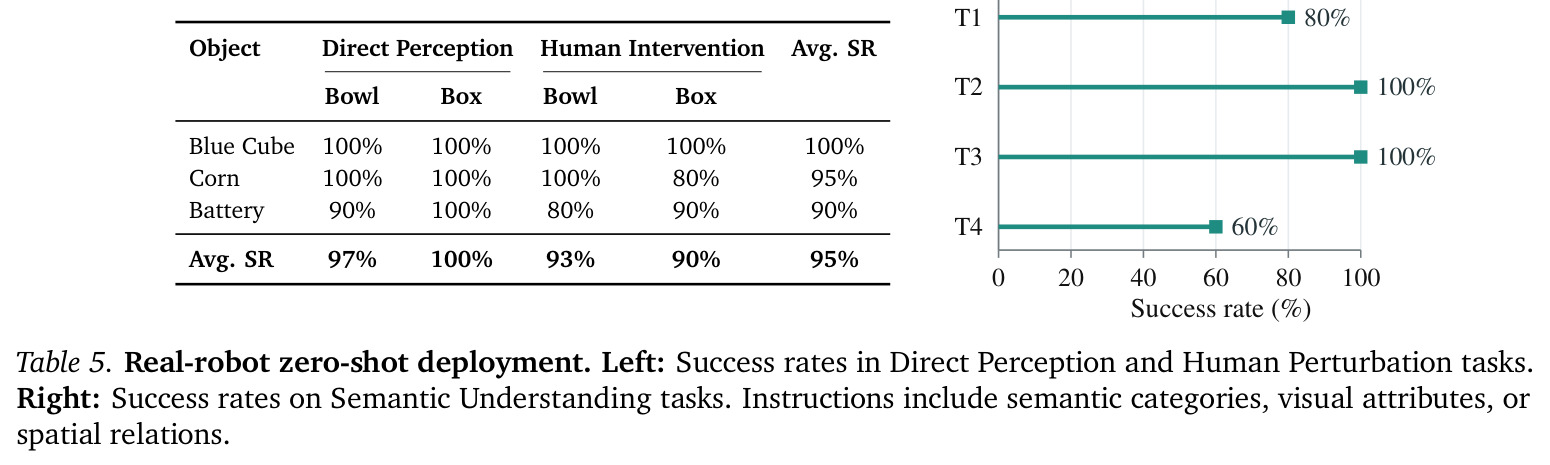
核心发现有七条。第一,LIBERO-PRO 主实验(Table 3):MotorMind 在零样本方法中全面领先,基础套件平均 66.7%(Goal 45.0/Spatial 75.0/Object 80.0),是最强零样本基线 CaP-X 13.3% 的 5 倍;扰动套件平均 53.8%(语义 58.3、物体 46.7、位置 51.7、任务 58.3),远超 CaP-X 的 19.2%,甚至比任务微调的 OpenVLA-OFT(51.2%)高 2.6 个百分点,接近微调的 π0.5(63.3%)。第二,效率:基础/扰动每集平均 223.4/248.5 秒,TimeScore 17.91/12.99 pp/min;CaP-X 10 轮要 346.4 秒、仅 2.3 pp/min。第三,自适应任务(Table 4):动态推理 70%、场景漂移 90%、动态操作 80%、提示漂移 60%,各组最强基线仅 30%/70%/40%/60%。第四,真机部署(Table 5):xArm6 上直接感知约 97%(正文表述 98%)、人为扰动 92%、合计 95%;语义理解任务 80%/100%/100%/60%。第五,骨干敏感性(Figure 6):换 GPT-6 Sol 后 66.7%→83.3%(空间 70→80、物体 80→100、目标 50→70),代价是墙钟变长(空间 199.0→370.4 秒)。第六,消融:去重规划 66.7%→36.7%,去验证器→60.0%,去规划器→0.0%。第七,失败分析(Figure 7):视觉定位错误占比最大,过早宣称完成是任务/物体扰动下的另一主因。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-PRO 基础套件(Goal/Spatial/Object) | 成功率 SR (%) | 66.7%(零样本,Qwen3.8-Flash-Next) | 最佳零样本 CaP-X 13.3%;任务微调 π0.5 98.3%、MolmoAct2 100.0% | 较最强零样本基线提升 53.4 个百分点(约 5 倍) |
| LIBERO-PRO 扰动套件(语义/物体/位置/任务) | 成功率 SR (%) | 53.8%(58.3/46.7/51.7/58.3) | 最佳零样本 CaP-X 19.2%;微调 OpenVLA-OFT 51.2%、π0.5 63.3% | 较最强零样本提升 34.6 个百分点,且超过微调 OpenVLA-OFT 2.6 个百分点 |
| 自适应任务(动态推理/场景漂移/动态操作/提示漂移) | 成功率 SR (%) | 70 / 90 / 80 / 60 | 各组最强基线:CaP-X 30 / π0.5 70 / MolmoAct2 40 / CaP-X 60 | 动态推理 +40、动态操作 +40、场景漂移 +20、提示漂移持平 |
| 真机 xArm6 放置任务(直接感知/人为扰动) | 成功率 SR (%) | 直接感知约 97%、人为扰动 92%、合计 95% | 未设真机零样本对照(VLA 零样本在模拟中已近 0%) | 无需任何微调即在真机复现高成功率 |
| VLM 具身诊断(动作选择/进度/完成) | 240 题总体准确率 (%) 与单次延迟 | Qwen3.8-Flash-Next 52.08% / 276 ms | GPT-6 Astra 72.92% / 8724 ms | 以约 1/30 的延迟换取可接受的决策质量,支撑快骨干选型 |
局限与改进
作者承认的局限:剩余失败主要来自三类 VLM 能力短板——视觉定位不准(选错物体或目标位置)、具身推理错误(误判任务已完成)、动作知识不足(对特定情形反复提出无效动作);Qwen3.8-Flash-Next 的动作选择诊断准确率仅 36.25%,系统上限直接受骨干模型制约,尽管换 GPT-6 Sol 可到 83.3%。我的补充观察:第一,任务域窄,全部是桌面抓放,动作原语只有平移/旋转/夹爪,无法处理铰链物体、工具使用、接触丰富或双手操作;第二,评估规模偏小且 Figure 6 明确注明单种子(single seed),真机每设置仅 5-10 次试验,统计功效有限;第三,Prompt Shift 只有 60%,指令中途变更依赖 Monitor 周期采样发现,存在漏检窗口;第四,每集 220-250 秒的墙钟时间对真实部署偏慢,部分消融变体更快但成功率崩塌,说明时间指标需要谨慎解读;第五,物体类别扰动下只有 46.7%,是最弱扰动项,暗示泛化主要来自语义理解而非感知鲁棒性;第六,真机任务为静态桌面布局的放置类任务,未覆盖杂乱、透明、可变形物体。
独立分析的弱点
弱点一:动作空间表达能力受限。基座坐标系下的平移/旋转/夹爪无法表达力控、柔性物体与工具使用,遇到倒水、插销、折叠衣物等接触丰富任务预计会系统性失败。改进方向:引入力/力矩反馈通道和可扩展的参数化原语库,仍保持'VLM 选参数、控制器落地'的分工。弱点二:监控是周期性采样,物体滑落等瞬态失败可能落在两个采样点之间;STOP 只在动作边界生效,长距离移动中途无法急停。改进:把检查频率与运动事件绑定,或在控制器层加入基于实测状态的硬性安全断言。弱点三:完成判断仍是大短板,任务/物体扰动下'过早宣称完成'高发(Figure 7),而 Verifier 主要依赖视觉证据,遮挡场景易误判。改进:为放置类任务增加轻量物理校验(如容器重量变化、接触检测)。弱点四:真机评估只覆盖静态桌面放置任务,未测杂乱、透明、可变形物体。改进:扩展到 cluttered 与可变形物体基准。弱点五:骨干增益部分依赖专有 API 模型(GPT-6 Sol),本地不可复现且成本与数据隐私受限;Figure 6 为单种子,结论幅度有待多种子确认。改进:蒸馏强模型轨迹到本地开源 VLM。
未来方向
作者指出的方向:随着基础模型持续进步,视觉定位与自验证类错误会自然减少,'轻量脚手架 + 更强 VLM'可能成为通用机器人操作的实用路径——GPT-6 Sol 把成功率从 66.7% 提到 83.3% 且无需改架构或重训,就是直接证据。基于本文成果可延伸的方向:其一,把诊断基准(动作选择/进度/完成三项准确率)作为骨干筛选指标,建立通用模型能力与机器人表现的预测性映射;其二,把 Memory 扩展为跨任务长期技能记忆,让执行证据沉淀为可复用的子目标模板与失败先验;其三,与世界模型结合,在执行前用想象 rollout 预演动作批次,减少物理试错;其四,把中层动作接口与扩散策略混合——语义阶段用 VLM、接触丰富阶段交给学习型策略,兼取两家之长;其五,系统研究监控频率、动作批次长度 $K_t$ 与成功率/延迟的权衡(附录 F 已触及执行预算问题);其六,在移动操作、双臂、多机器人平台验证'具身无关接口'的声明;其七,按 Figure 7 的失败分类构造针对性数据,闭环改进 VLM 的具身定位与完成判断能力。
复现评估
复现难度中等偏上,模拟部分门槛明显低于真机。有利条件:LIBERO-PRO 公开可下载;论文附录给出角色提示词(C.1)、命令字段与辅助动作(C.3)、评测协议(D/E);项目页 motor-mind.github.io 存在;骨干 Qwen3.8-Flash-Next-FP8 单次推理仅 0.276 秒(诊断实测),一张消费级到单卡 A100 级 GPU 即可支撑本地推理,模拟复现不需要机器人硬件。不利条件:论文未明确声明开源代码,异步调度、动作边界取消、记忆合并、在途调用丢弃等系统工程细节实现量大且对结果敏感,提示词的微小差异可能显著影响成功率;真机部分需要 xArm6 机械臂加 RealSense D455 相机,硬件门槛高且每设置需 5-10 次物理试验;骨干对比涉及 GPT-6 Sol/GPT-6 Astra 等专有 API,结果受模型版本漂移影响;Figure 6 为单种子,独立复现应跑多种子取均值。建议路径:先在 LIBERO-PRO 复现 66.7%(基础)与 53.8%(扰动)两个头牌数字并核对墙钟时间,再评估是否投入真机。
论文图表
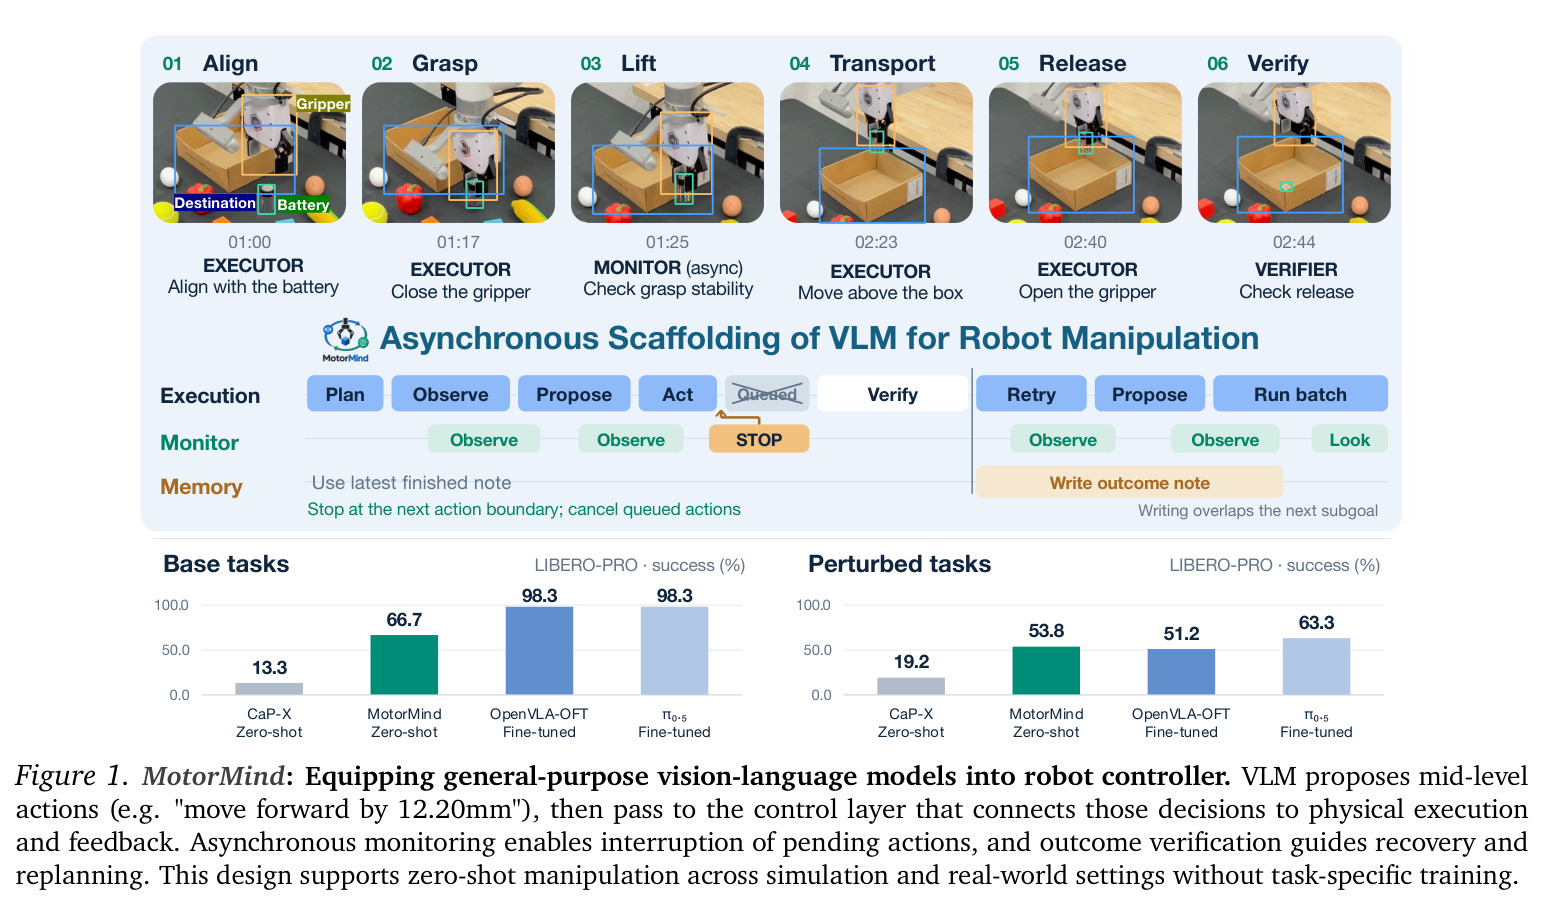
上半部分以电池抓放任务为例展示系统运行时间线:对齐(01:00)、夹取(01:17)、提起(01:25)、搬运(02:23)、释放(02:40)、验证(02:44),各阶段标注由 Executor 顺序执行、MONITOR 异步监控、VERIFIER 收尾验证,并示意'在动作边界停止、取消排队命令'与'后台写执行笔记'两个机制;下半部分柱状图对比 MotorMind(零样本 66.7%/53.8%)与 CaP-X、OpenVLA-OFT、π0.5(微调)在 LIBERO-PRO 基础与扰动套件上的成功率。
这是论文的'一图流':既给出了系统形态的直觉(VLM 提议中层动作 + 控制层执行反馈 + 异步监控打断),又直接亮出零样本反超微调基线的核心战绩,是快速把握全文的入口。
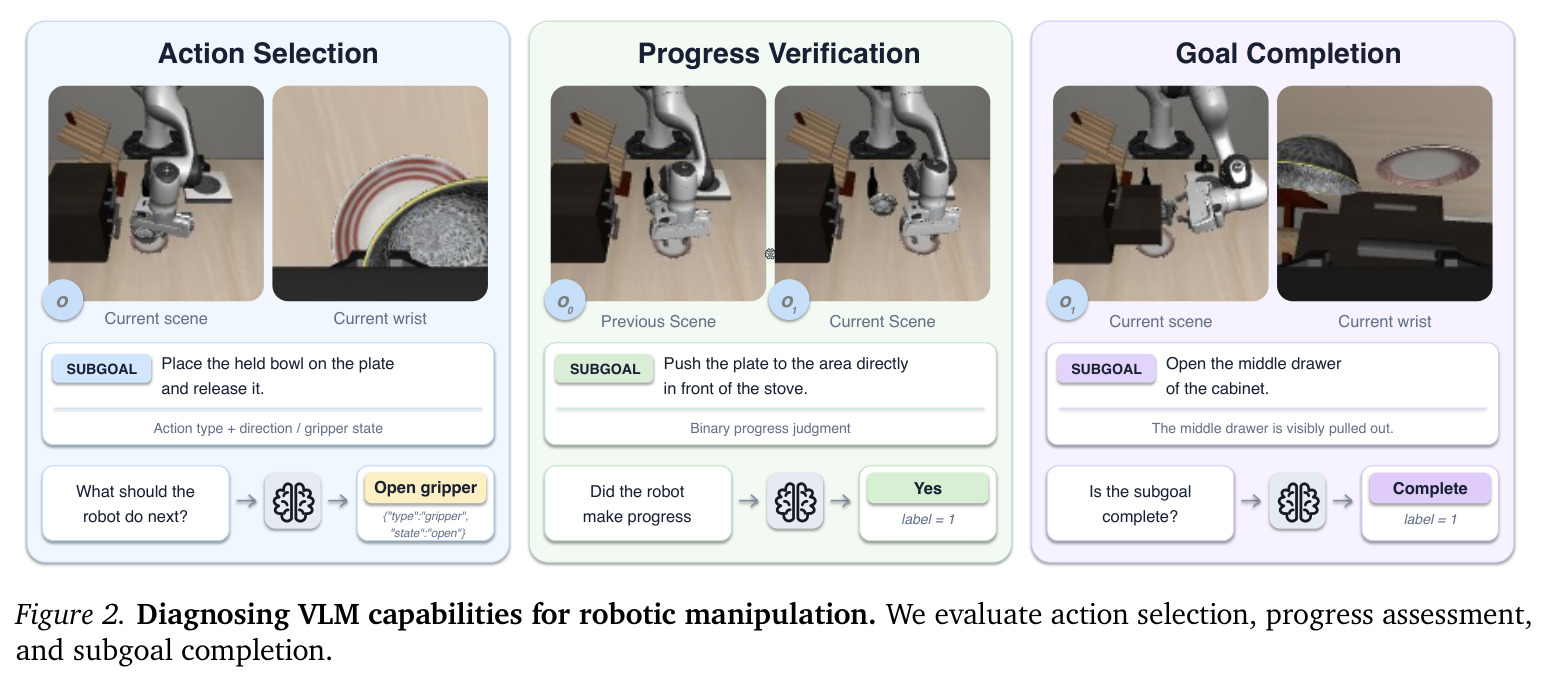
展示三类具身诊断任务的示例:动作选择——根据子目标'把碗放到盘子上并释放'从当前场景和腕部相机判断下一步(答案:开夹爪,输出 {"type":"gripper","state":"open"});进度验证——判断从上一帧到当前帧盘子是否朝炉子方向推进(二元判断);子目标完成——根据当前观测判断'中抽屉是否已拉开'(完成=1)。每个任务给出输入观测、子目标文本、判断形式与标注。
它是第 2 章设计逻辑的证据链起点:正是这类 240 道题的诊断暴露出动作选择(36.25%)远弱于进度/完成判断的问题,直接催生了'短可撤销动作批次 + 反复校验'的核心设计。
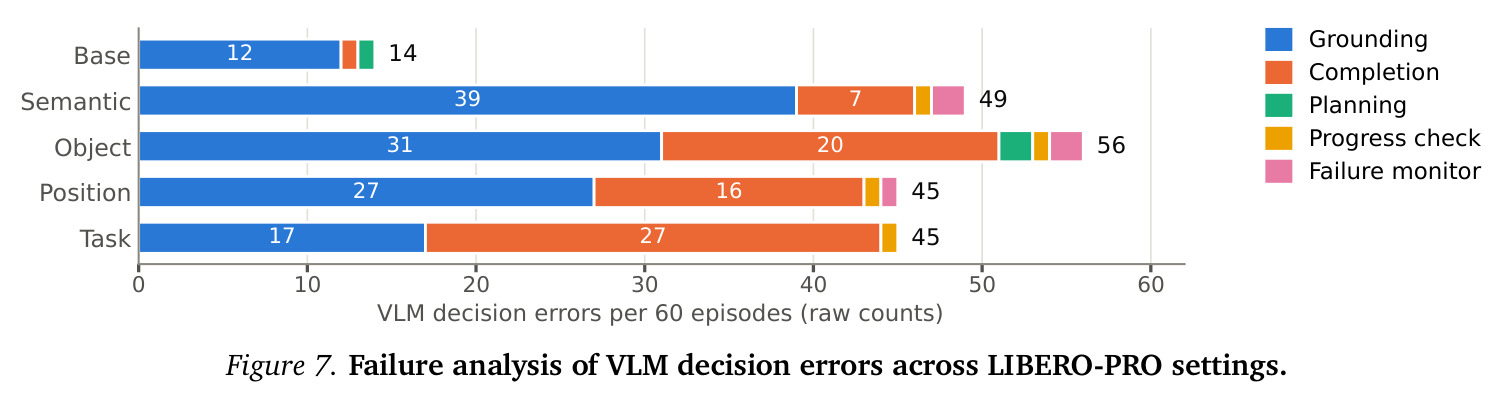
按五类错误(视觉定位 Grounding、完成判断 Completion、规划 Planning、进度检查 Progress check、失败监控 Failure monitor)统计每 60 个回合的 VLM 决策错误原始计数:基础设置约 12-14 起,各扰动设置明显升高——语义扰动定位类错误约 39 起、物体扰动约 31 起、位置扰动约 27 起、任务扰动约 17 起,定位(Grounding)在多数设置中占比最大,过早宣称完成在任务/物体扰动下同样突出。
这张图给出剩余失败的完整归因,直接支撑'瓶颈在 VLM 的视觉定位与自验证、会随模型进步而缓解'的论点,也为后续工作指明优先攻克方向,是 limitations 讨论的核心证据。