迈向基础决策模型:Drex Towards Foundation Decision Models: Drex
开源决策模型家族Drex,无自回归解码直接输出选项概率分布,以极低成本媲美前沿模型
前置知识
决策模型与判别式推理(System One 接口)
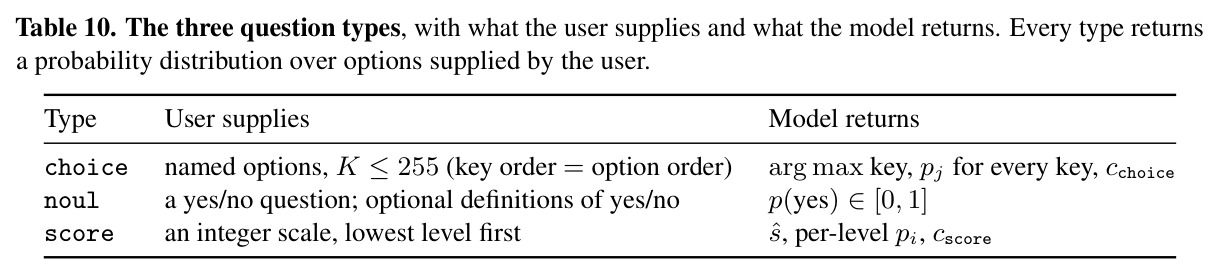
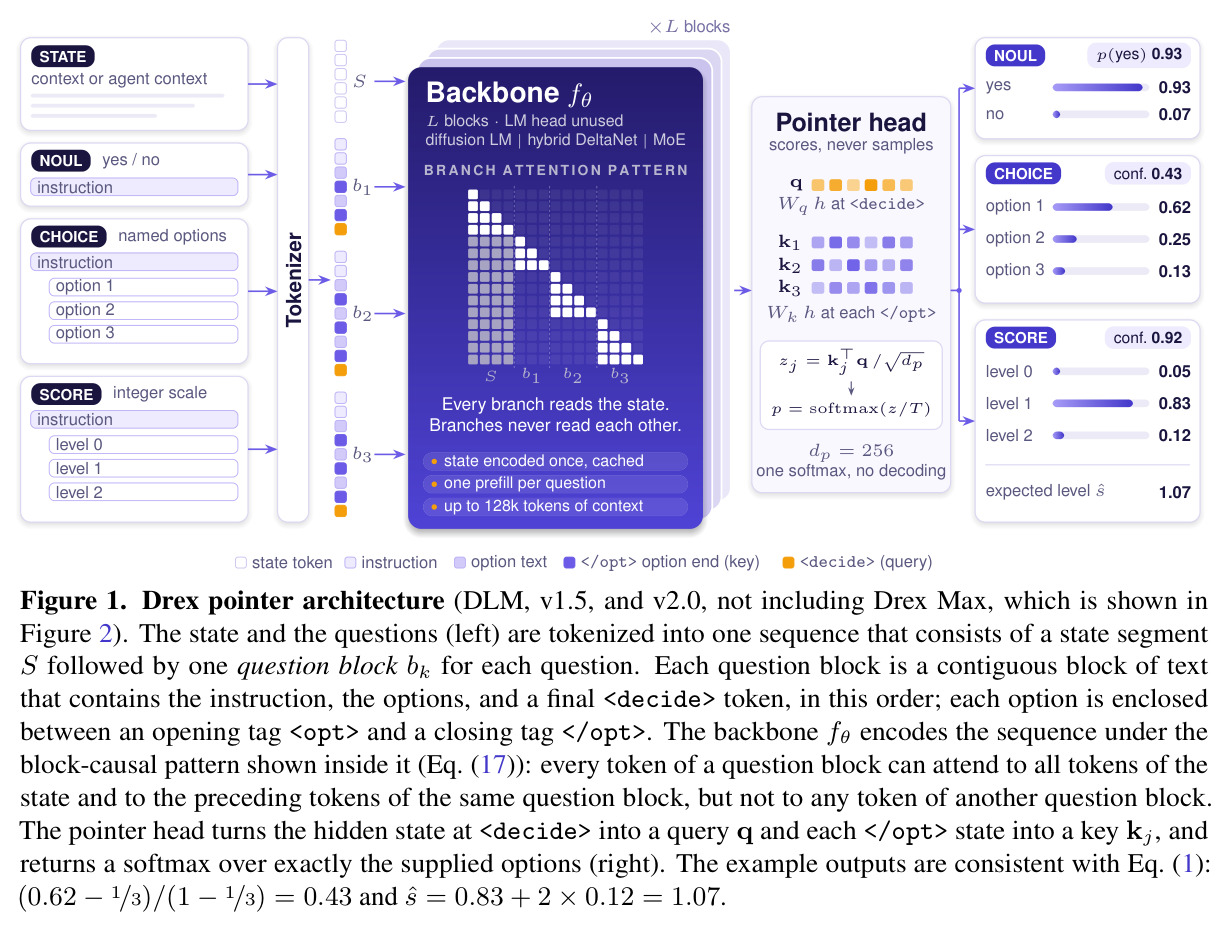
决策模型接收三元组请求(状态 S、可选图像 I、若干问题 $q_k$),每题给定类型(choice 选择题、noul 是非题、score 评分题)与选项列表 $O_k$(至多 255 个),直接返回选项上的概率分布 $p_k$,全程不做自回归解码。输出只在用户给定选项上有定义(封闭世界),各问题相互独立、答案无需文本解析。它沿袭 Jev 提出的 System One 接口约定,置信度按 $c=(\max_j p_j-1/K)/(1-1/K)$ 等公式统一报告。
本文的全部架构设计、训练目标与评估指标(校准、翻转率、选择性精度)都建立在这个接口之上,先理解它才能读懂动机与实验。
指针头与读出头(pointer head / readout head)
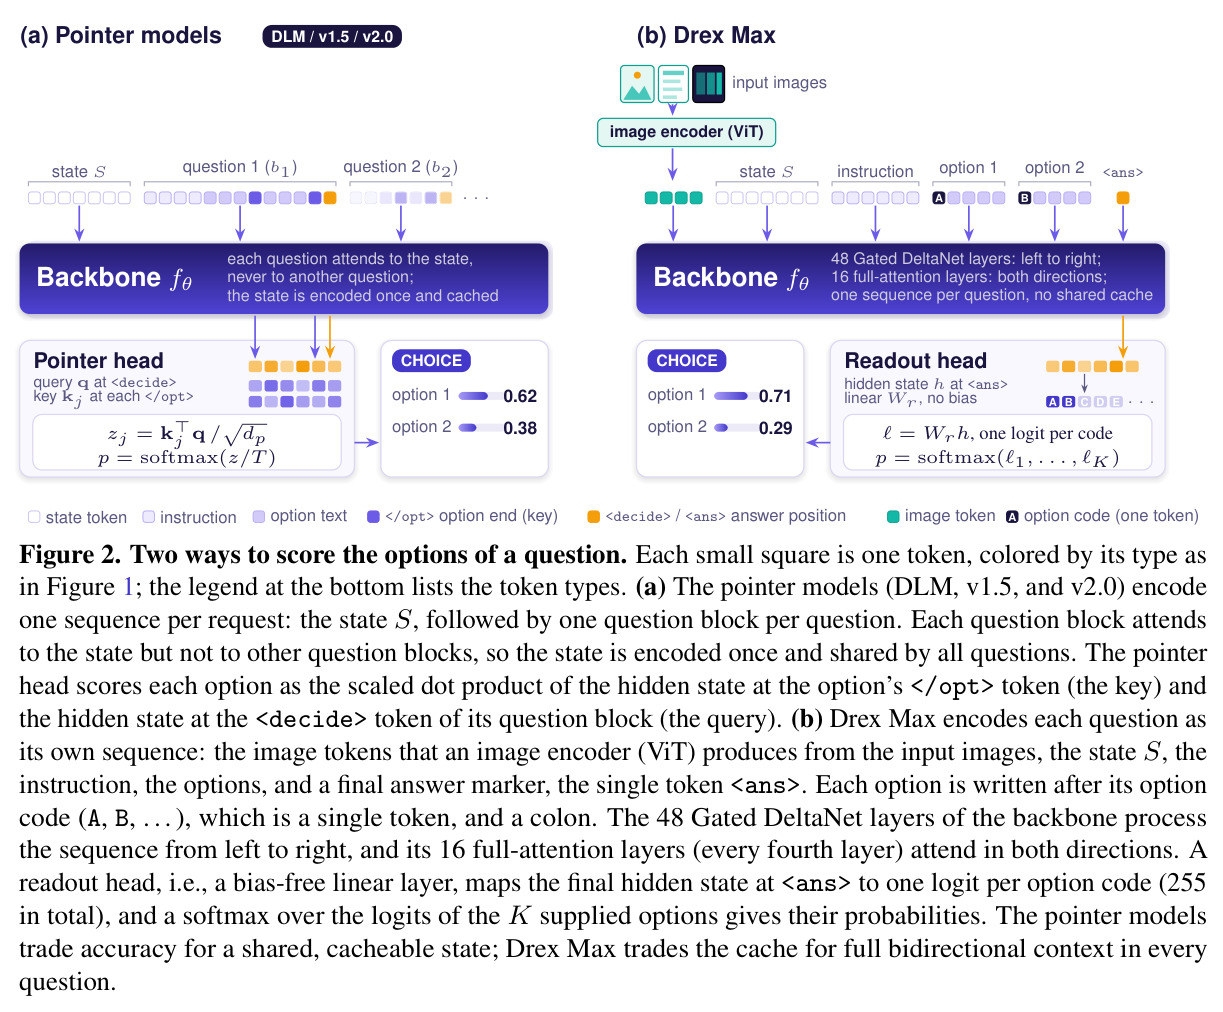
指针头把问题块末尾 处隐状态经 $W_q$ 映为查询向量,把每个选项结尾 处隐状态经 $W_k$ 映为键向量,打分 $z_{k,j}=(W_k h_{o_{k,j}})^\top(W_q h_{d_k})/\sqrt{d_p}$ 后对给定选项做 softmax($d_p=256$,参数不足骨干 0.03%)。读出头(Drex Max)则是无偏置线性层 $W_r\in\mathbb{R}^{255\times d}$,把 处隐状态映成 255 个选项代码(A、B、…)各自的 logit,只保留本题 $K$ 个。前者按选项自身内容打分,后者按代码绑定打分。
两种读出机制是四款模型最本质的架构分歧,也是 RQ4(容量、注意力与模态)讨论和顺序鲁棒性实验的核心对象。
校准与期望校准误差(ECE)、温度缩放
校准指预测概率与经验准确率一致:在预测置信度为 $c$ 的决策子集上,实际正确率应约为 $c$。ECE 把预测置信度分成 15 个等宽桶,计算各桶平均置信度与实际准确率之差的加权平均。温度缩放 $p=\mathrm{softmax}(z/T)$ 用单个参数 $T$ 整体伸缩置信度:$T>1$ 使分布更平、$T<1$ 更尖,但不改变 argmax,$T$ 可在留出集上按最小化 NLL 拟合。
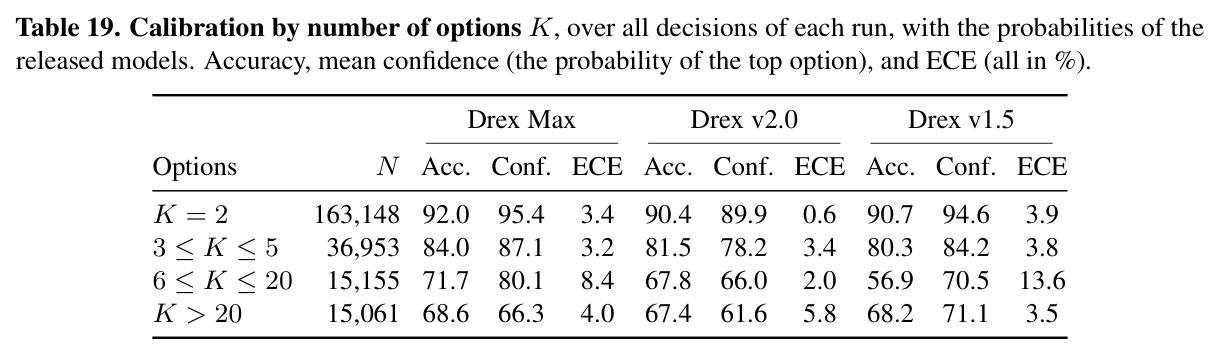
RQ1 整节测校准;生产系统靠置信度阈值决定哪些决策自动执行、哪些送人审,ECE 与选择性精度是部署的关键指标。
恰当评分规则(proper scoring rule)
若结果真实服从分布 $q$,某评分规则的期望值恰在预测 $p=q$ 时最大,则称其为恰当规则。对数损失、Brier 分数、球面分数均属此类;有序标签上的平方 Cramér 距离 $D_C^2(p,q)=\frac{1}{K-1}\sum_{i=1}^{K-1}(\sum_{j\le i}p_j-\sum_{j\le i}q_j)^2$ 即预测文献中的 ranked probability score,惩罚累积分布偏离正确档位。
RLAF 的奖励 $R(p,\tilde q)$ 由若干恰当评分规则组成,这从数学上保证“答得更准”与“概率更校准”被同时激励而非互相牺牲,是方法正确性的根基。
KL 正则化强化学习(RLAF 的形式)
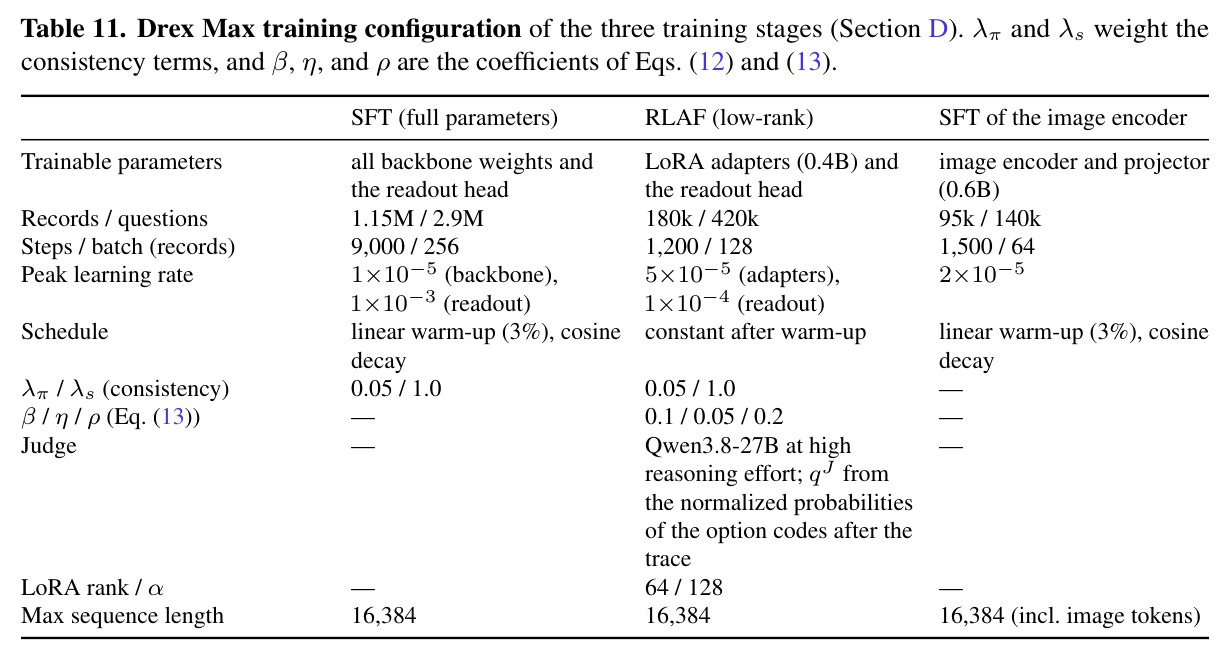
在奖励最大化目标中加入 $\beta\,\mathrm{KL}(\pi_\theta\|\pi_0)$ 惩罚,把策略约束在 SFT 初始模型 $\pi_0$ 附近,防止灾难性遗忘与过拟合。Drex Max 的 RLAF 即此形式:judge(同源 Qwen3.8-27B 生成模型,高推理档)输出分布 $q_J$,奖励为 $r(a)=\rho\,\mathbb{1}[a=y^\star]+\eta\log q_J(a)$($\rho=0.2$、$\eta=0.05$),再优化带 KL 项与两个一致性损失的整体目标 $J(\theta)$。
这是理解 Drex Max 第二阶段训练目标 Eq. (13)、其过自信来源以及 judge 可能压过已验证答案等讨论的必备背景。
研究动机
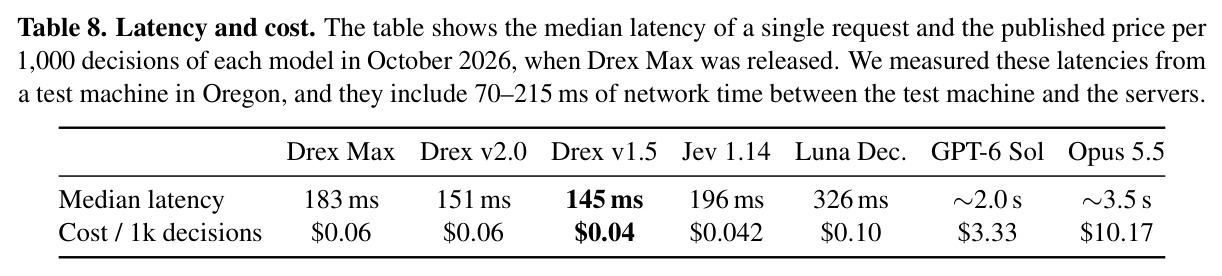
在生产环境中,用自回归大模型做“给定选项选一个”的判别任务问题重重。长思维链(long chain-of-thought)推理已成为默认范式,但一次请求要生成大量中间 token:本文实测 GPT-6 Sol 单请求中位约 2.0 秒、每千次决策 3.33 美元,Claude Opus 5.5 约 3.5 秒、10.17 美元;且答案埋在生成文本里,需要解析,格式还可能不一致。另一条路是约束解码——把生成限制在合法选项字符串内——但逐 token 概率逐步重归一化的结果,与模型赋予“整串选项”的概率并不一致,选项共享前缀或长短不一时尤其如此;若改为对每个选项单独做一次前向再跨选项归一化,成本随选项数线性增长。而现有的判别式方案(固定标签的分类头、每候选一个分数的重排器、一个向量一个输入的嵌入模型)输出形状都在训练时就固定了,无法服务“候选集合在推理时由用户给定”的场景;已有的专用决策模型(如预测销售对话是否成交)则把输出锁死在单一决策上。
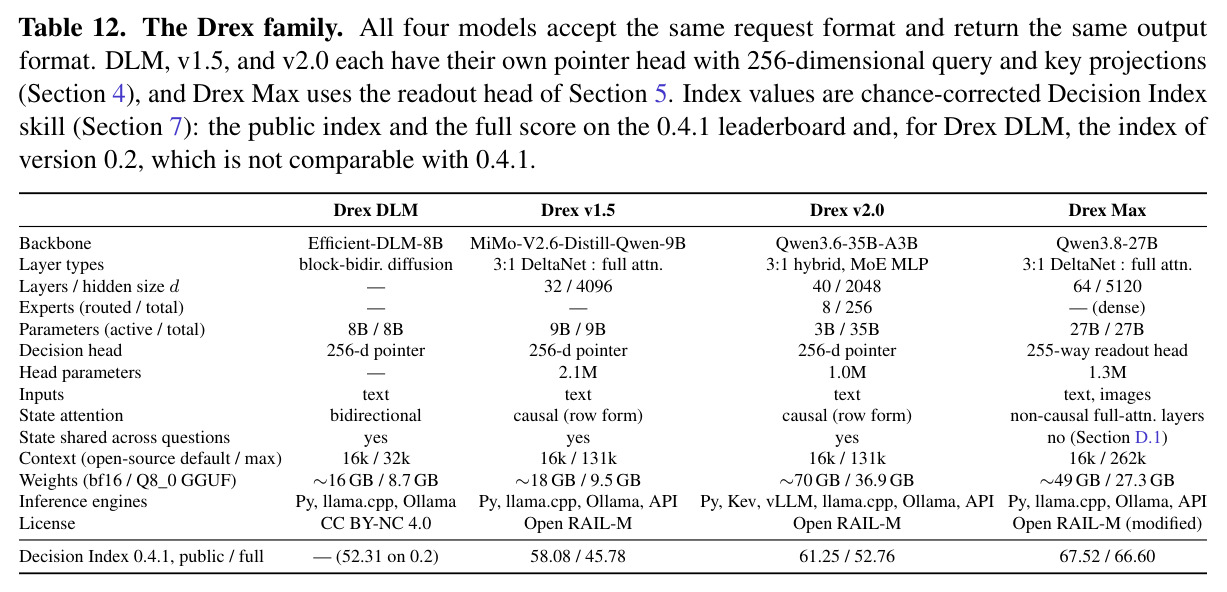
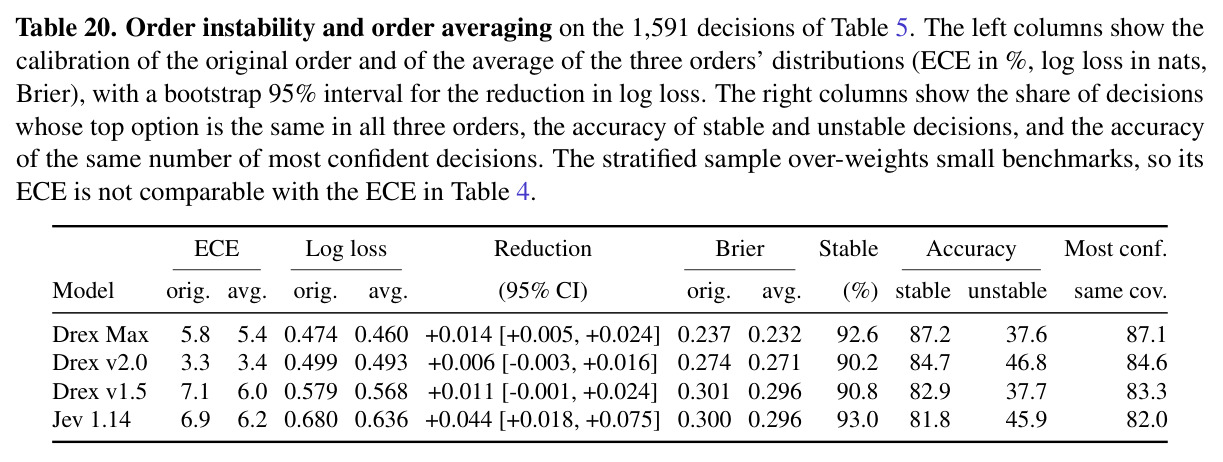
本文的目标是本文要回答一个明确问题:能否用一个模型在推理时服务任意选项集合、输出校准良好的概率,能否在一个长上下文上回答多个相互独立的问题,选项重新排列时保持稳定,并在生产级延迟内完成。为此作者训练并开源了四款统一 System One 接口的决策模型:8B 的 Drex DLM(扩散语言模型骨干)、9B 的 v1.5(Gated DeltaNet 混合骨干)、35B 总参/3B 激活的 v2.0(稀疏 MoE),以及 27B 稠密多模态的 Drex Max。围绕四个研究问题展开系统对照:RQ1 校准(约 23 万决策/模型)、RQ2 选项顺序敏感度(1,591 决策×3 种顺序)、RQ3 各训练阶段贡献(SFT 一致性损失、RLAF、视觉 SFT)、RQ4 容量/注意力/模态(稠密双向骨干 vs 共享状态指针头)。
与已有工作不同的是,本文的独特切入有三点。其一,把“决策”本身当作一等接口:既不做训练时固定标签的分类头,也不依赖约束解码,而是设计指针/读出两类读出机制,让“输出分布只在用户给定选项上定义”由架构直接保证,并显式列出封闭世界输出、问题独立性、顺序鲁棒性、校准、多模态接地五条理想性质。其二,训练配方上的新组合:SFT 阶段加入两个一致性正则(选项排列 KL 损失 $\ell_\pi$、状态句子/字段打乱 KL 损失 $\ell_s$),随后提出 RLAF——用“教师分布+可验证结果”构造调整目标 $\tilde q$,奖励采用恰当评分规则,使准确率与校准被同时优化,对 Max 再加 KL 正则与推理型 judge 的强化学习变体。其三,评估方法学:大规模测量以往少有人量化的性质(flip rate、selective accuracy),并全程使用配对统计(Wilson 区间、5000 次自助重采样、精确 McNemar 检验),把“决策模型该测什么”也立成了范本。
核心方法
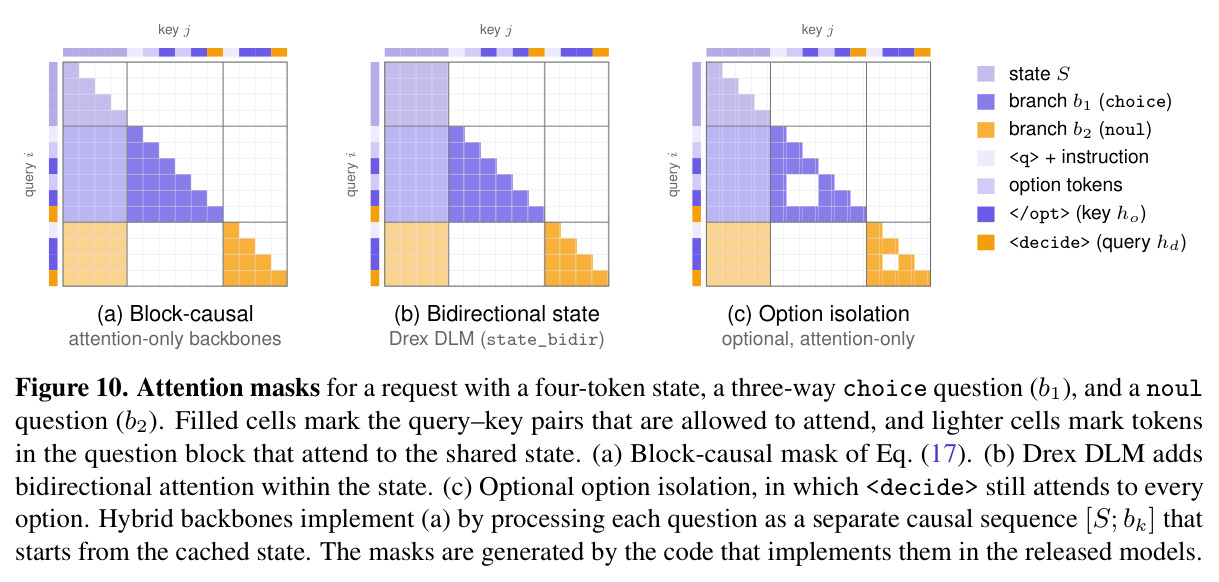
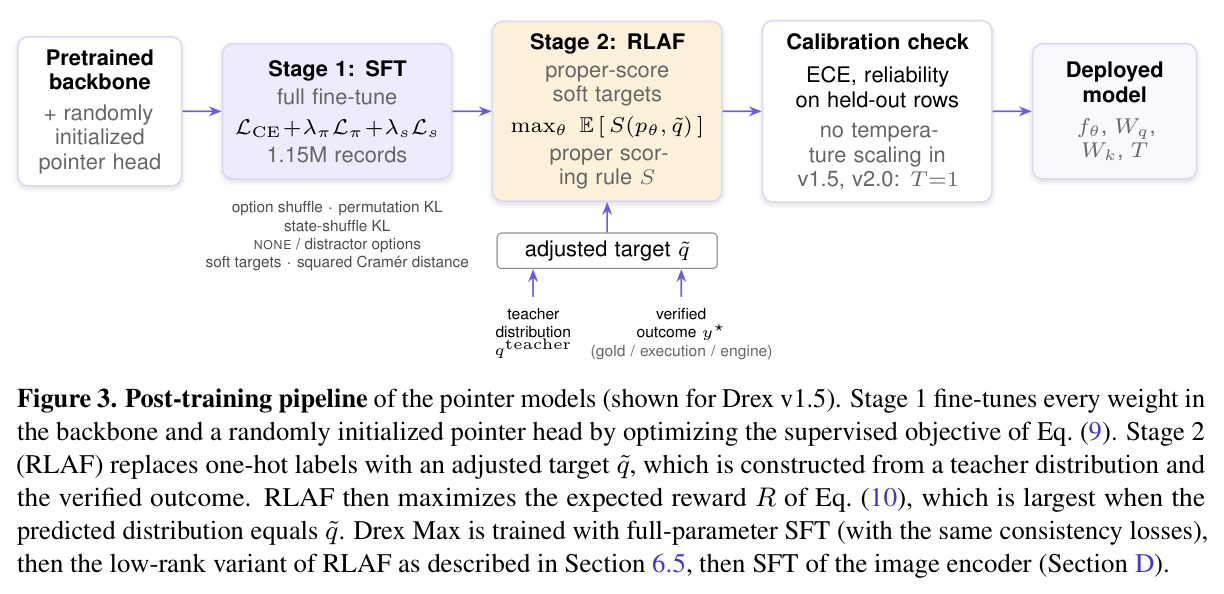
直觉上,Drex 想“只读答案、不生成文本”:把请求(状态 S + 若干问题)一次编码后,直接在选项上读出概率分布。技术路线分两族。指针模型(DLM/v1.5/v2.0)把请求打包成一个序列:状态段之后每题一个块(指令、以 包裹的选项、结尾 ),注意力用块因果掩码或每题独立序列加缓存状态,保证题间独立、状态编码一次共享;指针头以 处隐状态为查询、各 处隐状态为键,按 $z_{k,j}=(W_k h_{o_{k,j}})^\top(W_q h_{d_k})/\sqrt{d_p}$ 打分后 softmax($d_p=256$)。Drex Max 走另一极:Qwen3.8-27B 稠密多模态骨干,64 层中每 4 层一个全注意力层(共 16 层去掉因果掩码做双向注意力),每题重新编码整个请求;每个选项前置单 token 代码(A、B、…共 255 个), 处隐状态经无偏置线性层 $W_r\in\mathbb{R}^{255\times 5120}$ 得到每码 logit,只保留本题 $K$ 个做 softmax(部署温度 $T{=}1.009$)。训练统一三阶段:SFT(含一致性项)→ RLAF →(仅 Max)视觉 SFT。
核心创新一在读出机制本身。指针头以“内容寻址”打分:选项由它自己的隐状态表示,题间独立由构造保证;读出头以“代码绑定”打分:选项仅由 A/B/C 代码标识,骨干必须学会把代码与选项文本绑定(经典的 symbol-binding 问题),选项置换会改变哪个 logit 对应哪个选项,顺序鲁棒性完全靠学习获得;作为交换,双向全注意力层能在计算答案前把所有选项与上下文互相对照,精度更高。核心创新二是 RLAF:监督训练用 one-hot 标签会教出过自信,RLAF 为每题构造调整目标 $\tilde q$——教师(或 judge)先提出分布 $q_{teacher}$,再用可验证结果 $y^\star$(金标、程序执行、游戏引擎)校正,与已知事实一致又保留教师对剩余选项的不确定性;奖励 $R(p,\tilde q)=\sum_j\tilde q_j\log p_j+0.5\cdot\tilde q^\top p/\|p\|_2-\mathbb{1}[\tau{=}score]\,D_C^2(p,\tilde q)$ 每项都是恰当评分规则,期望在 $p=\tilde q$ 时最大,“答对”与“校准”被同时激励。这与 RLHF 靠人类偏好对比、与约束解码只保证格式合法有本质区别。
方法步骤详情
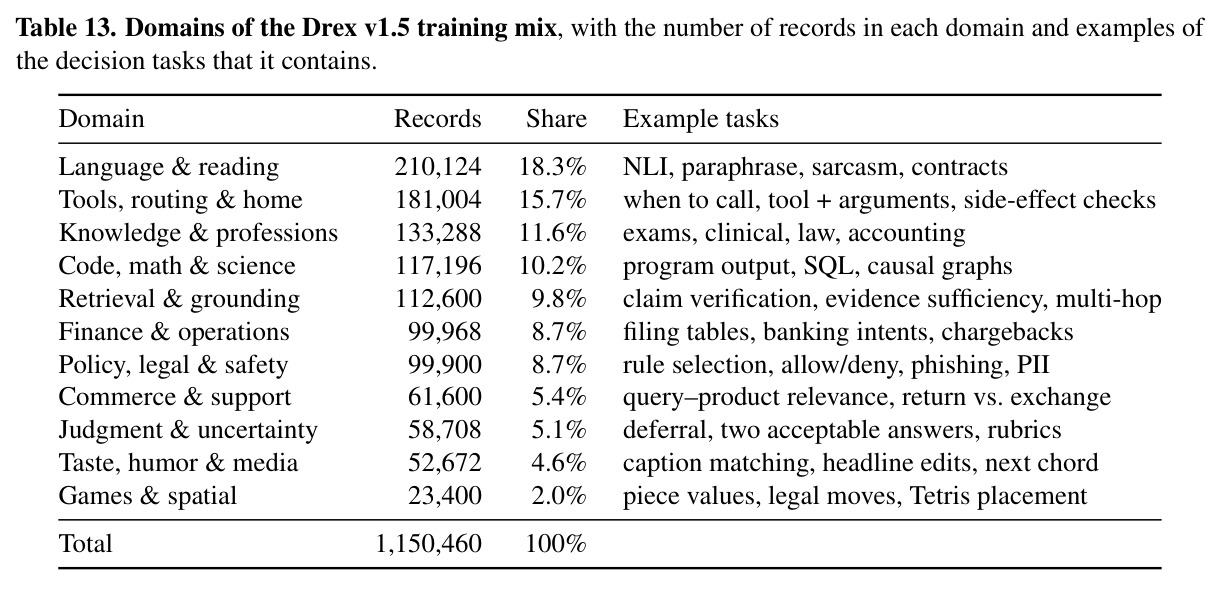
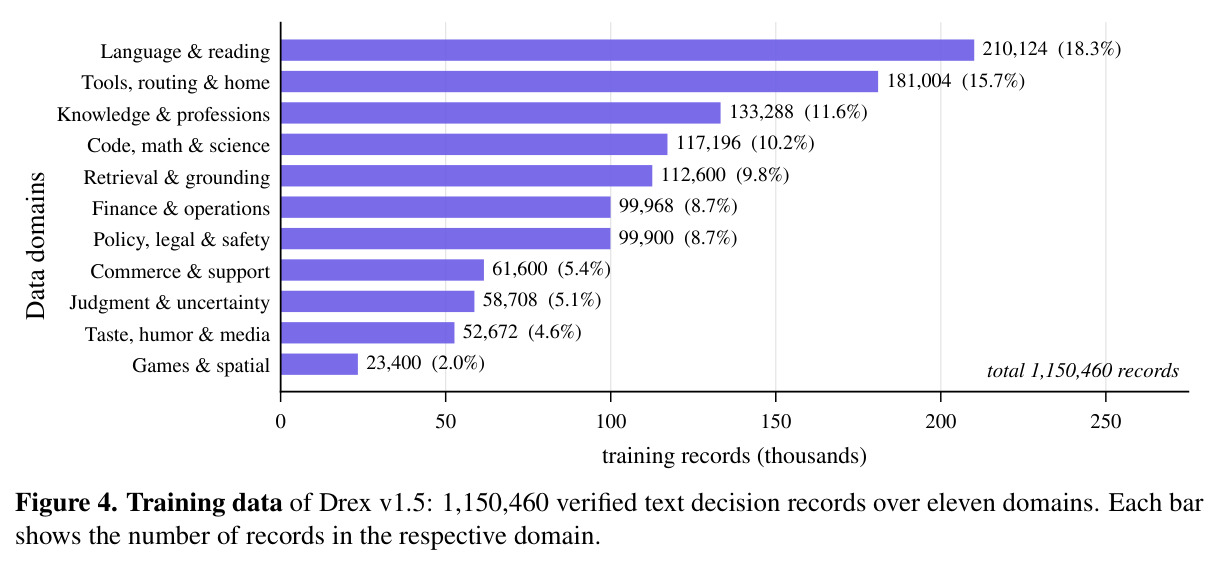
第一步数据:1,150,460 条带验证标签的文本决策记录,覆盖 11 个域(语言与阅读 210,124 条/18.3% 最多,工具路由家居 181,004,知识职业 133,288……游戏空间 23,400 最少),多数由强教师蒸馏,标签对金标、程序执行或引擎校验。第二步 SFT:全参数微调骨干与随机初始化的头,损失 $\mathcal{L}_{SFT}=\mathbb{E}[\ell_{sup}+\lambda_\pi\ell_\pi+\lambda_s\ell_s]$;$\ell_{sup}$ 是对目标 $t$ 的交叉熵,评分题再加 $D_C^2(p,e_y)$(即 ranked probability score);每次见到记录都随机打乱选项,随机插入 NONE 或干扰选项;$\ell_\pi$ 用对称 KL 惩罚选项置换前后的分布差,$\ell_s$ 惩罚状态句子/字段打乱前后的分布差。第三步 RLAF:指针版对奖励 $R(p,\tilde q)$ 直接求导,等价于以 $\tilde q$ 为软目标的确定性损失(REINFORCE 实测无优势);Max 版是 KL 正则强化学习,judge 为同源 27B 生成模型,$r(a)=0.2\,\mathbb{1}[a=y^\star]+0.05\log q_J(a)$;v2.0 另有 LoRA 专项阶段(求解器数据+难例挖掘+回放防遗忘+KL 惩罚)。第四步(仅 Max)SFT 图像编码器及其投影;部署前在留出集上拟合温度(Max 1.009,指针模型 1)。
技术新颖性
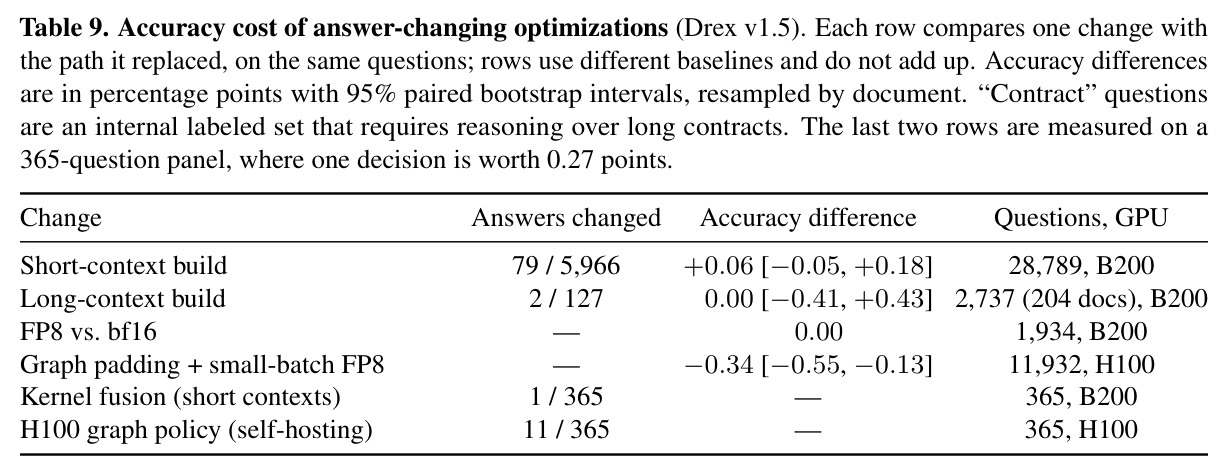
论文主动划清与 Kev/Jev 的继承边界:继承 packed 编码、块因果掩码、指针头与既有损失;其余为新贡献。方法层面,RLAF 把“强化”放在目标 $\tilde q$ 的构造上而非梯度估计上——直接对恰当评分规则求导即可优化,绕开 REINFORCE 的高方差(实测不占优);对 Max 的 KL 正则变体还推导了目标梯度与最优输出分布的闭式解。训练层面,两个一致性损失把“顺序鲁棒性”从架构不可得(混合骨干无法做选项隔离掩码)转化为可学习的正则目标。评估层面,首次在约 23 万决策/模型规模上系统测校准(分域、分选项数、选择性精度、单温度拟合的作用),并在 1,591 决策上量化选项顺序翻转率与“不稳定决策≈低置信决策”的关系。工程层面,无解码循环的推理栈自成一套:共享 prefill 加速 6–12 倍、CUDA Graph 把 1k token 单题延迟砍约三分之二、每个内核改动都设“答案不变或精度在阈值内”的验收门槛,甚至借此抓到一个格式合法但答案错误的 packed-prefill bug。一个接口覆盖扩散 LM、Gated DeltaNet 混合、稀疏 MoE、稠密多模态四种骨干,本身也是少见的工程展示。
实验结果
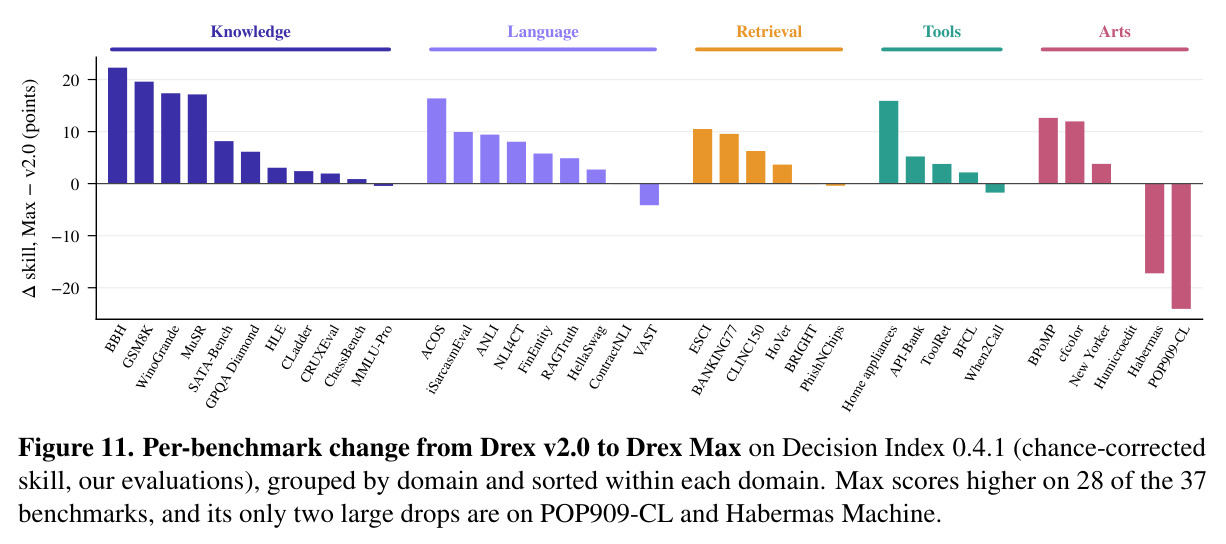
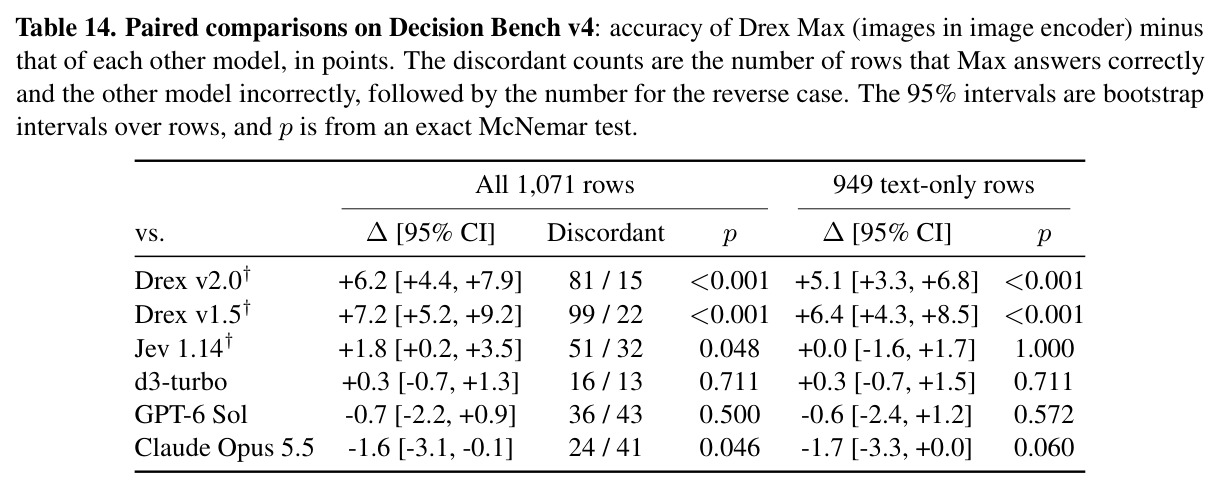
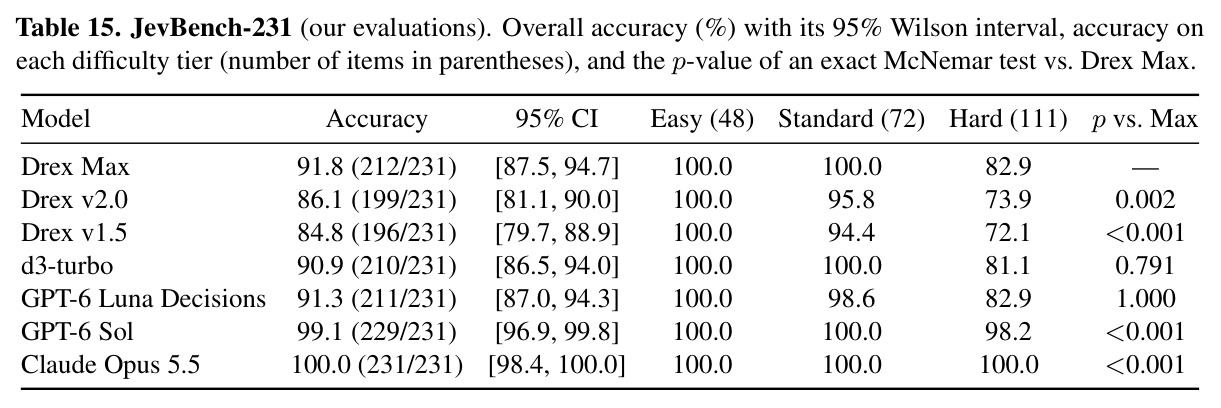
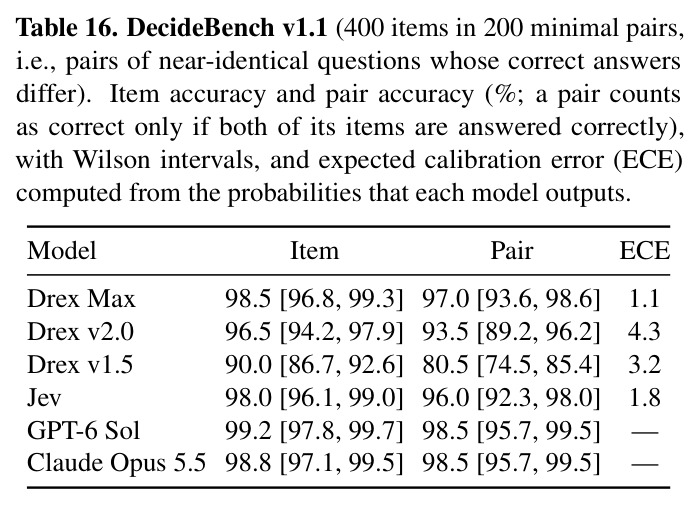
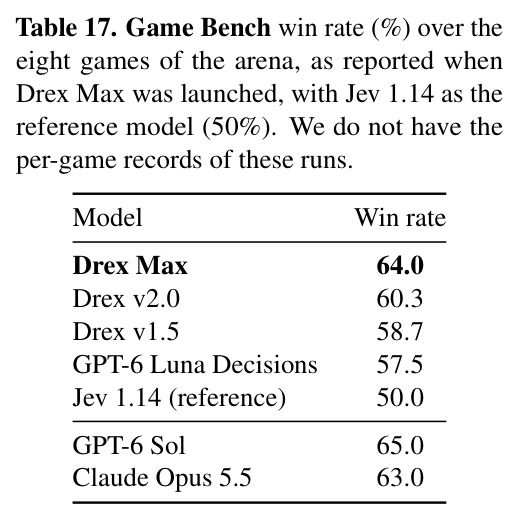
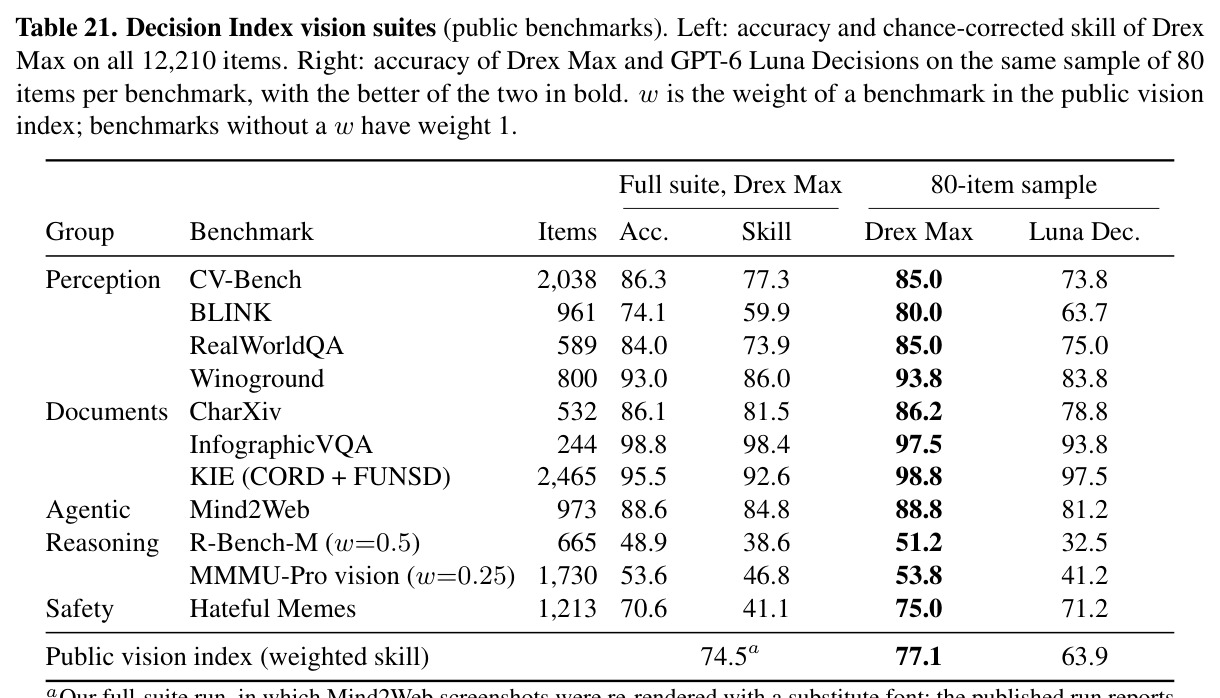
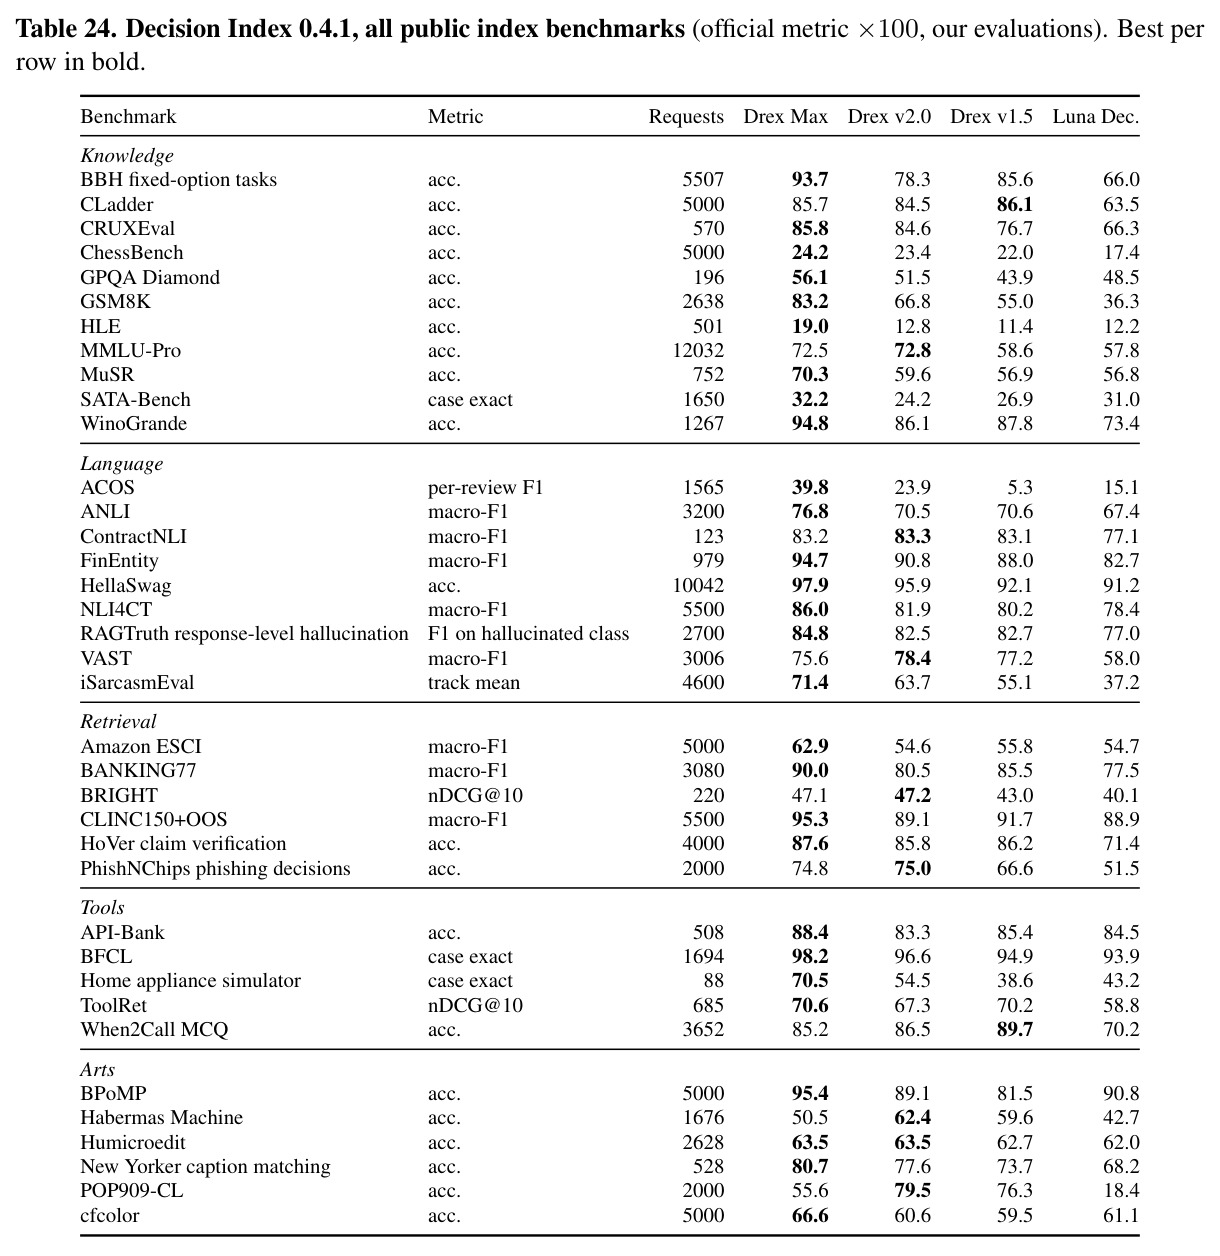
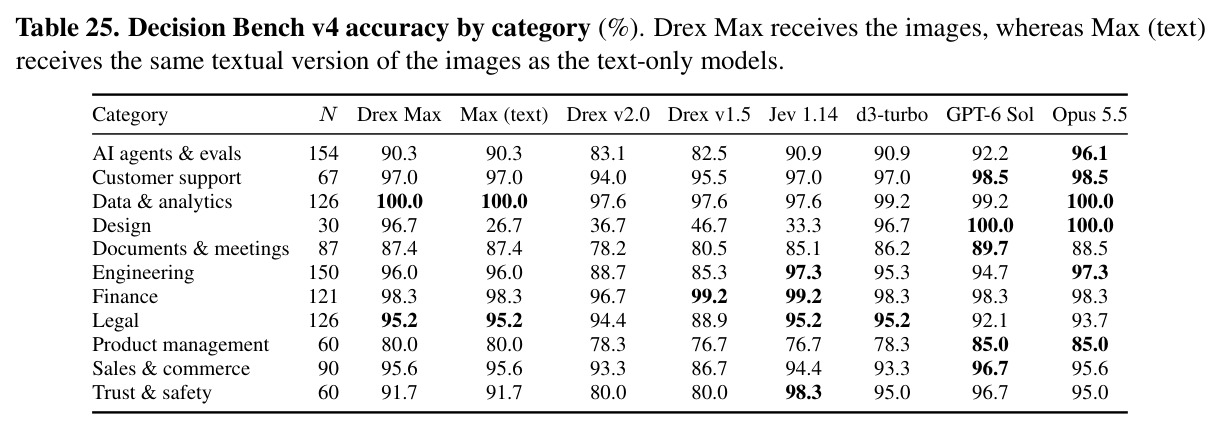
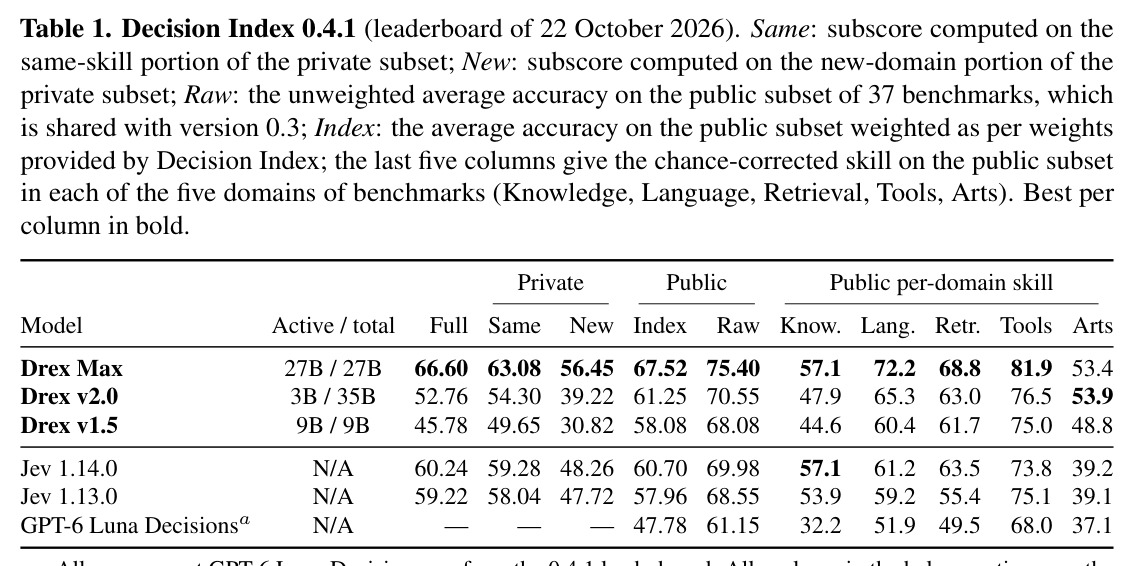
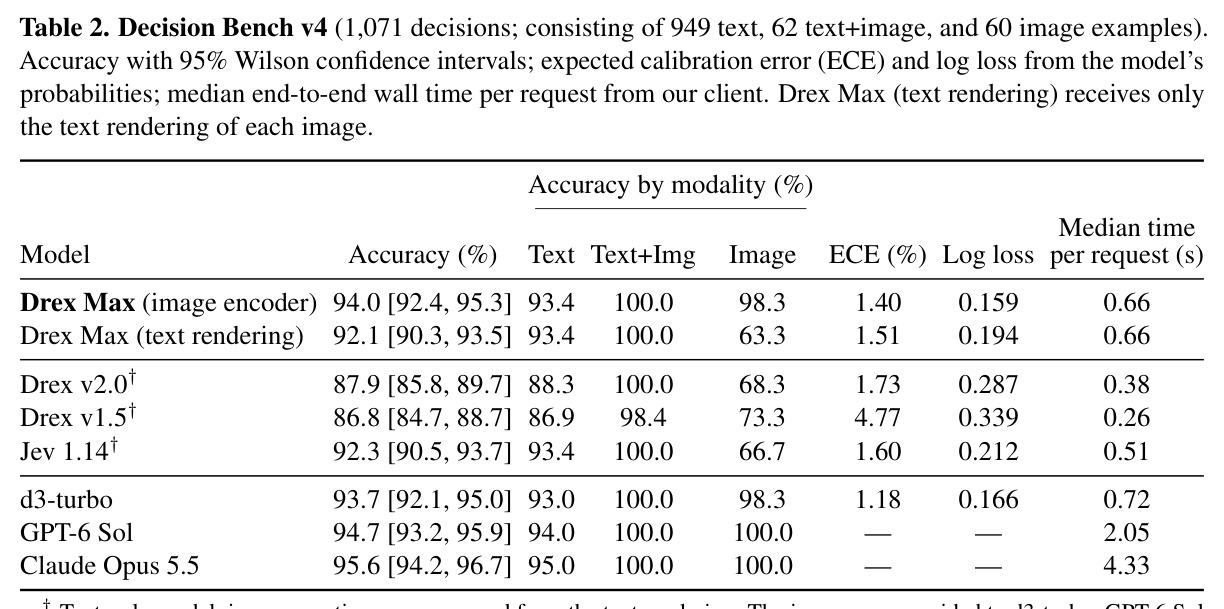
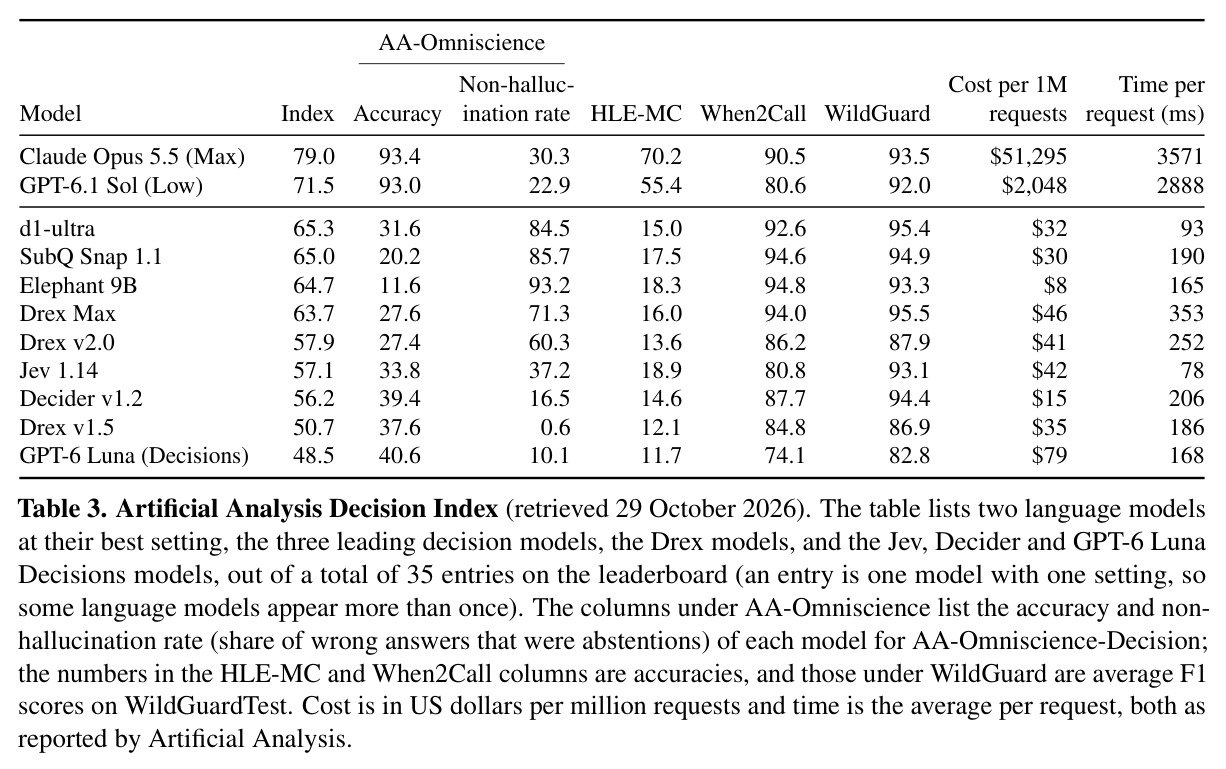
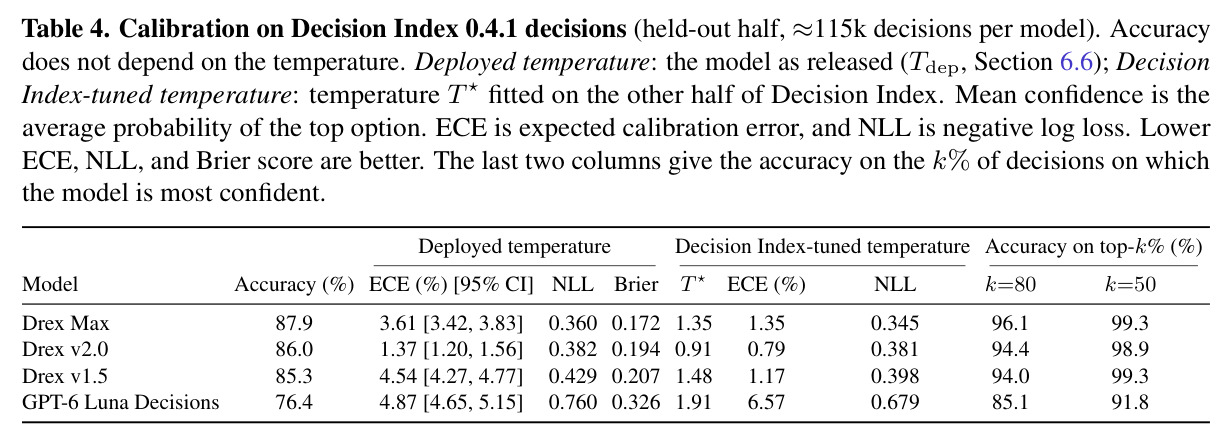
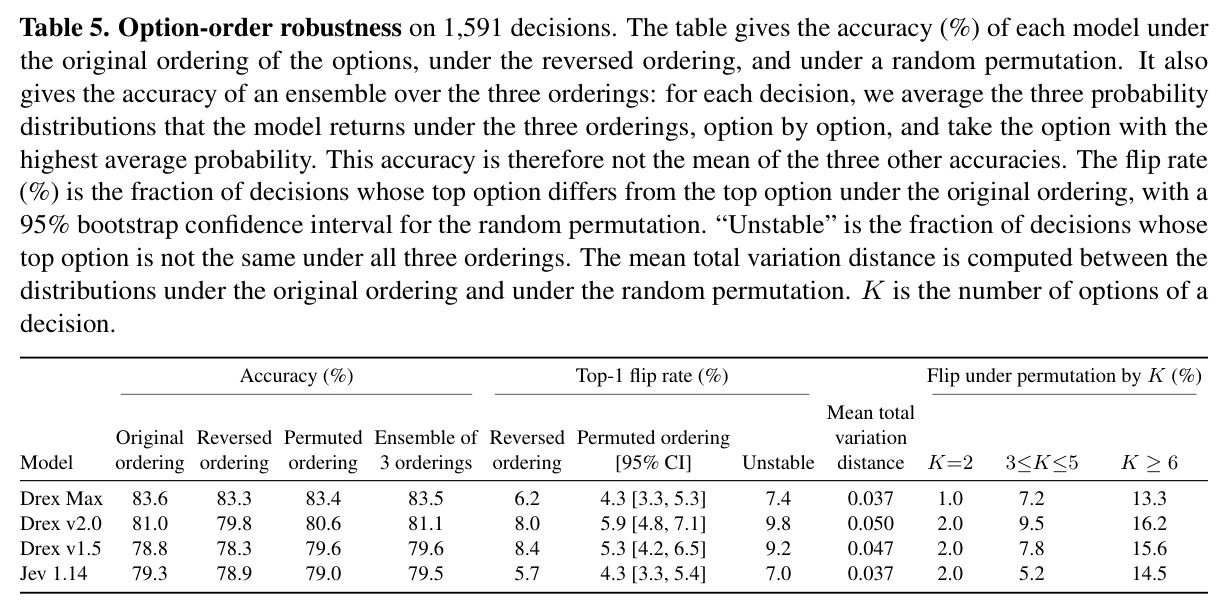
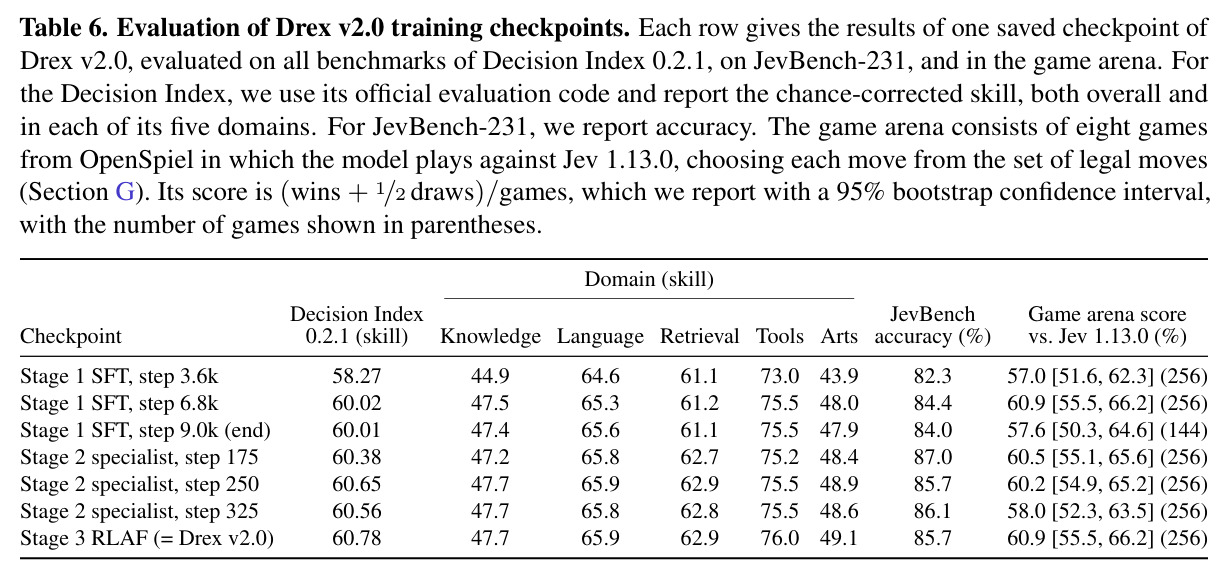
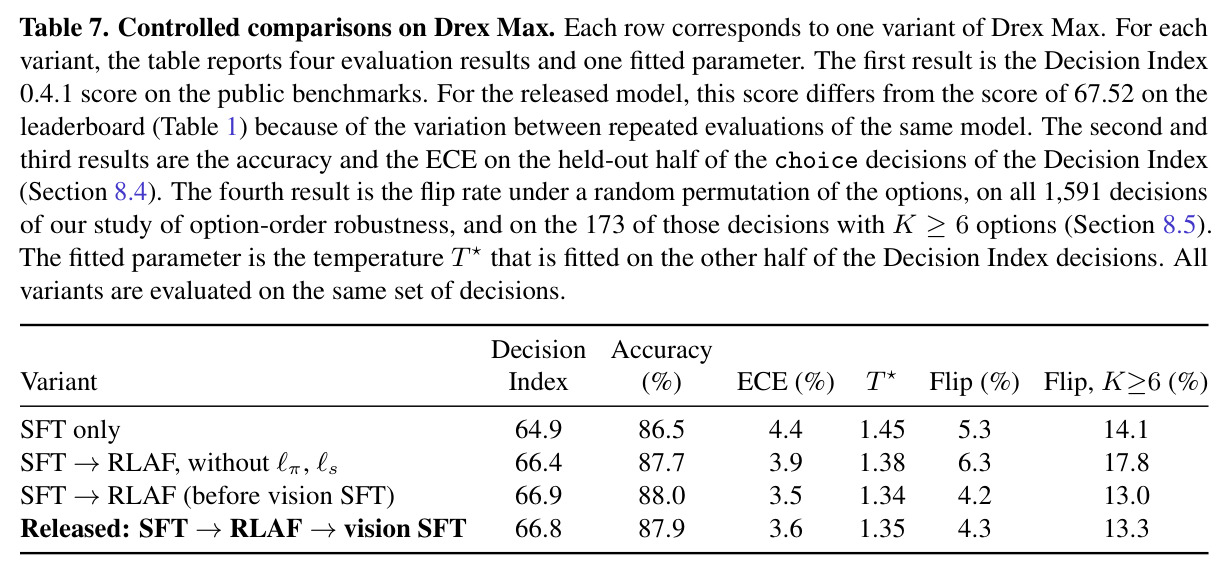
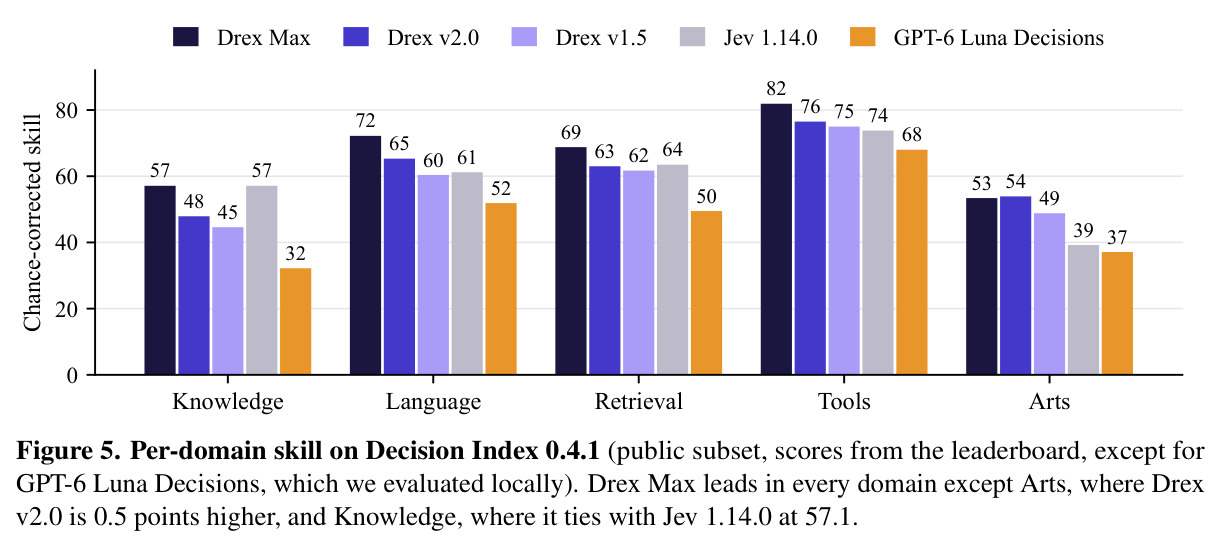
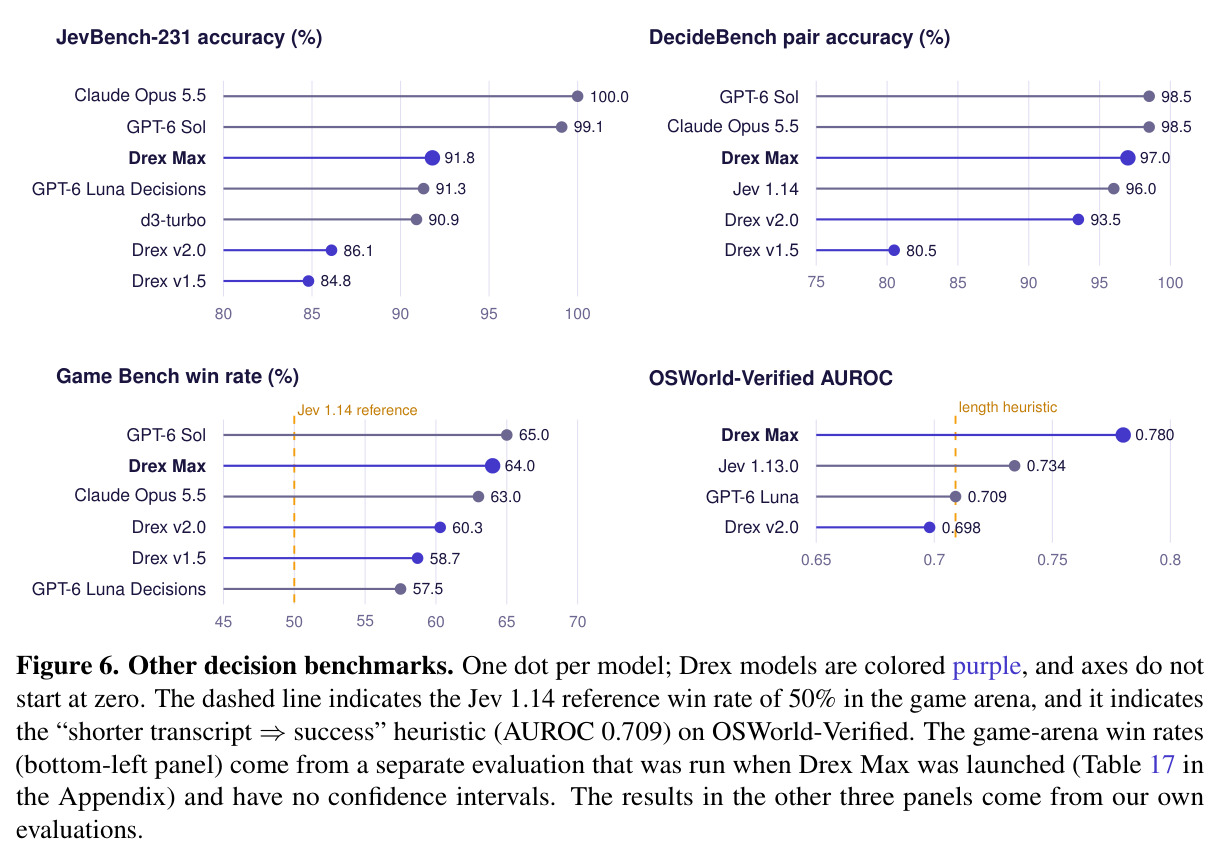
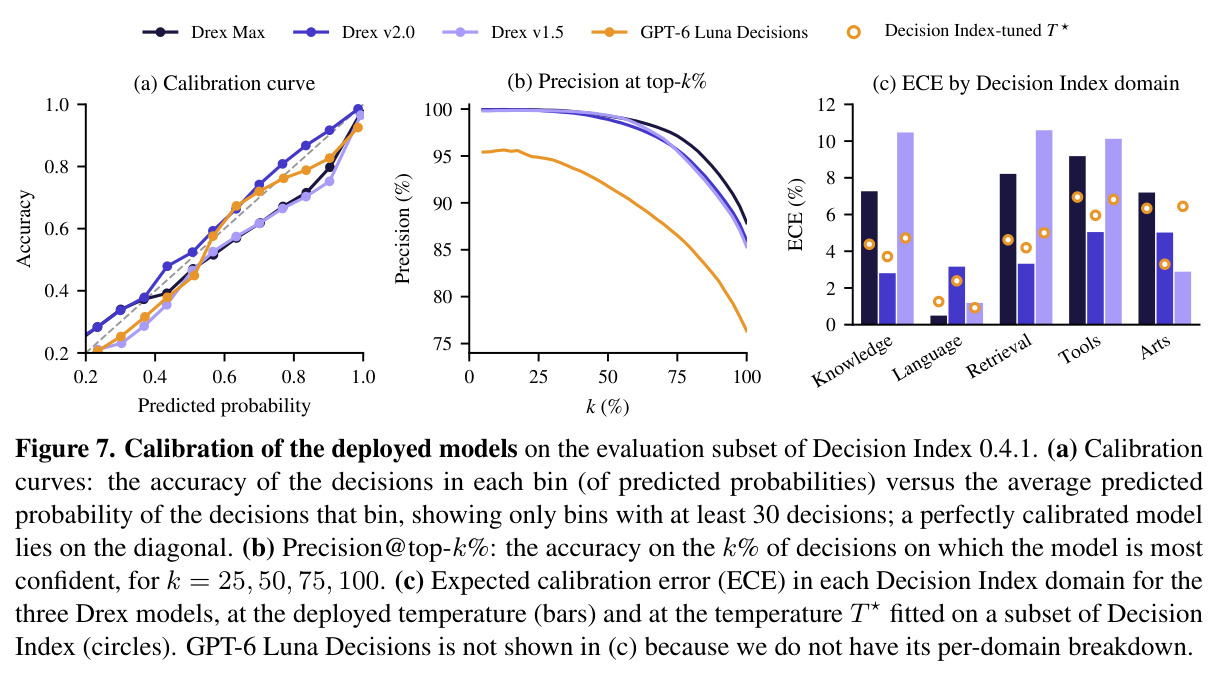
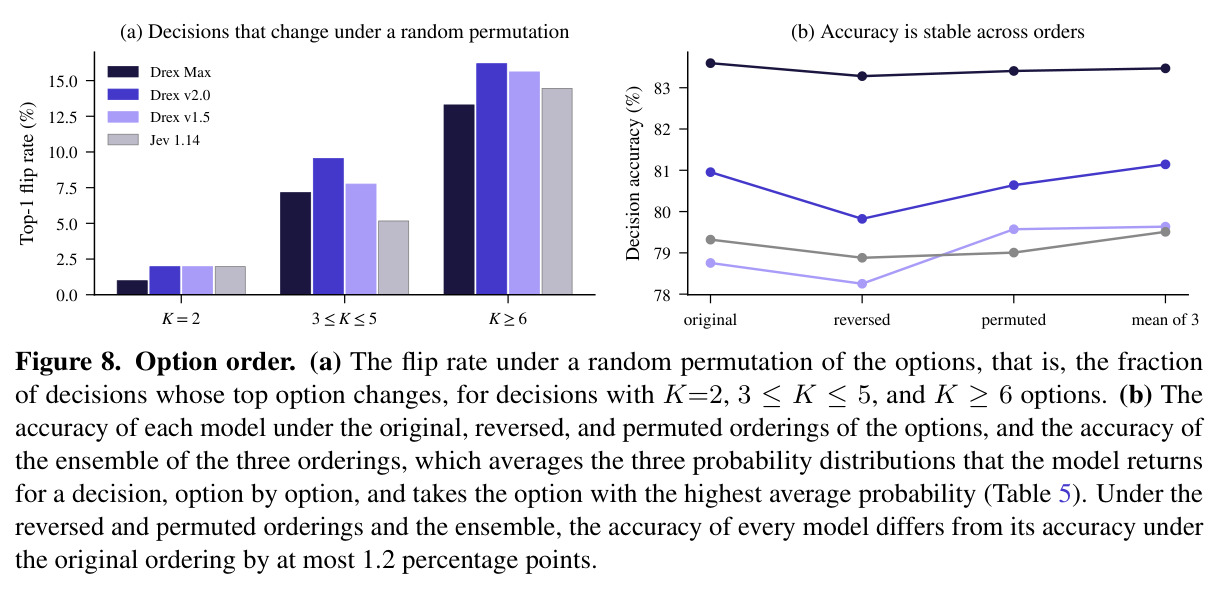
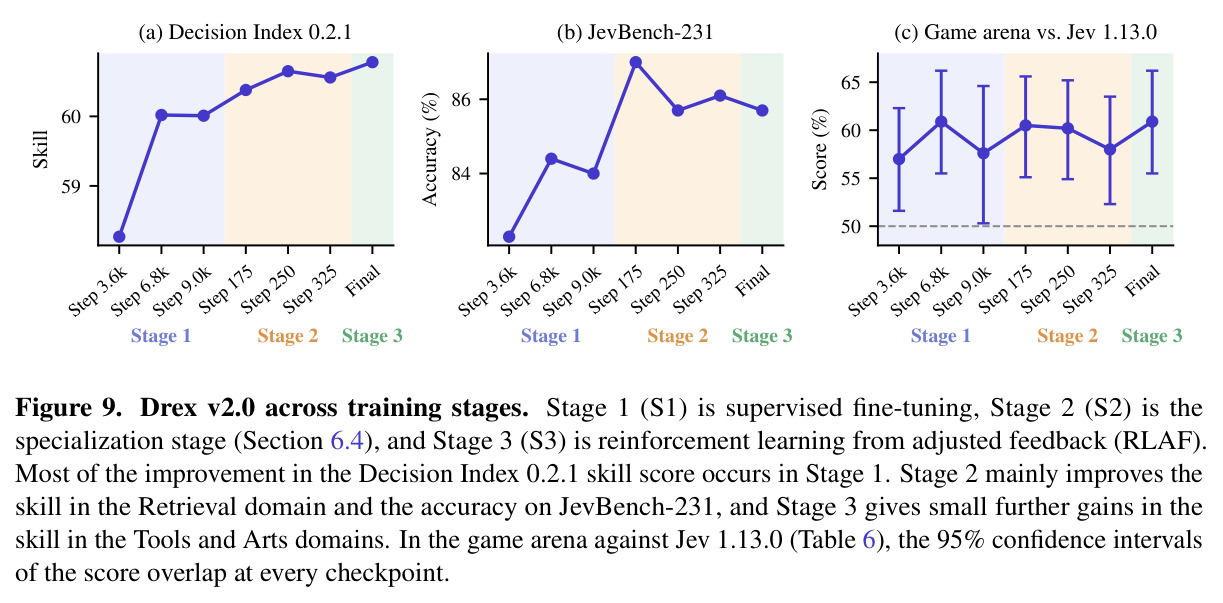
Decision Index 0.4.1 公共子集(37 基准):Max 67.52 创决策模型 SOTA,比 Jev 1.14.0 的 60.70 高 6.8 分(95% CI [3.3,7.8],28/37 基准胜过 v2.0 的 61.25);v1.5 58.08、Luna 47.78。全分 Max 66.60 对 Jev 60.24;新域私有测试 Max 56.45 远超 v2.0 39.22、v1.5 30.82,泛化差距更大。逐决策 Max 比 v2.0 准 1.86 点 [1.72,2.00];GSM8K 66.8→83.2、BBH 78.3→93.7、MuSR 59.6→70.3,但 POP909-CL 79.5→55.6、Habermas Machine 62.4→50.5 倒退。Decision Bench v4(1,071 题):Max 带图像编码器 94.0%,与 d3-turbo 93.7%、GPT-6 Sol 94.7% 统计打平,低于 Claude Opus 5.5 的 95.6%(p=0.046);纯图像题 63.3%→98.3%;ECE 1.40% 仅高于 d3-turbo 的 1.18%;耗时 0.66s 对 2.05s/4.33s。第三方 Artificial Analysis 榜 63.7 居决策模型第二,比 Jev 高 6.6,WildGuard F1 95.5 全榜最高,但 HLE-MC 仅 16.0 对 Claude 70.2。校准:v2.0 最优(ECE 1.37%,调温后 0.79%),Max 过自信 3.61%→1.35%,v1.5 4.54%→1.17%,Luna 调温反恶化至 6.57%;Max 置信 top-50% 精度 99.3%。顺序鲁棒:置换翻转率 4.3–5.9%(K≥6 达 13–16%),准确率变化 ≤1.2 点。消融:RLAF 为 Max 加 2.0 分;一致性项把翻转率 6.3%→4.2%;v2.0 增益主要来自 SFT(58.27→60.02 后趋平)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Decision Index 0.4.1 公共子集(37 基准) | 机会校正技能分 | Drex Max 67.52 | Jev 1.14.0 60.70;Drex v2.0 61.25;GPT-6 Luna Decisions 47.78 | 较最强决策模型 Jev +6.82 分(自身评估 95% CI [3.3,7.8]) |
| Decision Index 0.4.1 全分(含私有测试) | 机会校正技能分 | 66.60(新域子分 56.45) | Jev 1.14.0 60.24(新域 48.26);v2.0 52.76(新域 39.22) | +6.36 分;新域领先 v2.0 达 17.2 分 |
| Decision Bench v4(1,071 题) | 准确率 | 94.0%(图像编码器)[92.4,95.3] | Claude Opus 5.5 95.6%;GPT-6 Sol 94.7%;d3-turbo 93.7%;Jev 1.14 92.3% | 与 GPT-6 Sol、d3-turbo 统计打平,落后 Claude 1.6 点(p=0.046) |
| Decision Bench v4 纯图像题(60 题) | 准确率 | 98.3%(图像编码器输入) | 63.3%(文本渲染);其他文本-only 模型 66.7–73.3% | +35.0 个百分点;DESIGN 类从 26.7% 升至 96.7% |
| Decision Index 校准(约 11.5 万留出决策) | ECE | Max 3.61%→1.35%(调温 T*=1.35);v2.0 1.37%→0.79% | GPT-6 Luna Decisions 4.87%,调温后反而恶化至 6.57% | Drex 系调温后全面低于 1.5%,Luna 无法用单温度修复 |
| 选项顺序鲁棒性(1,591 决策×3 顺序) | 随机置换 top-1 翻转率 | Max 4.3% [3.3,5.3];v2.0 5.9%;v1.5 5.3% | Jev 1.14.0 4.3% [3.3,5.4] | 与 Jev 持平、优于自家指针模型;各模型准确率变化 ≤1.2 点 |
| Artificial Analysis Decision Index | 综合指数(4 项等权) | 63.7(决策模型第二) | d1-ultra 65.3 / SubQ Snap 65.0 / Elephant 9B 64.7(无置信区间不排位);Jev 1.14 57.1;Claude Opus 5.5 Max 79.0 | 较 Jev +6.6 分;WildGuard F1 95.5 全榜最高,成本仅 LLM 的 1/44–1/1100 |
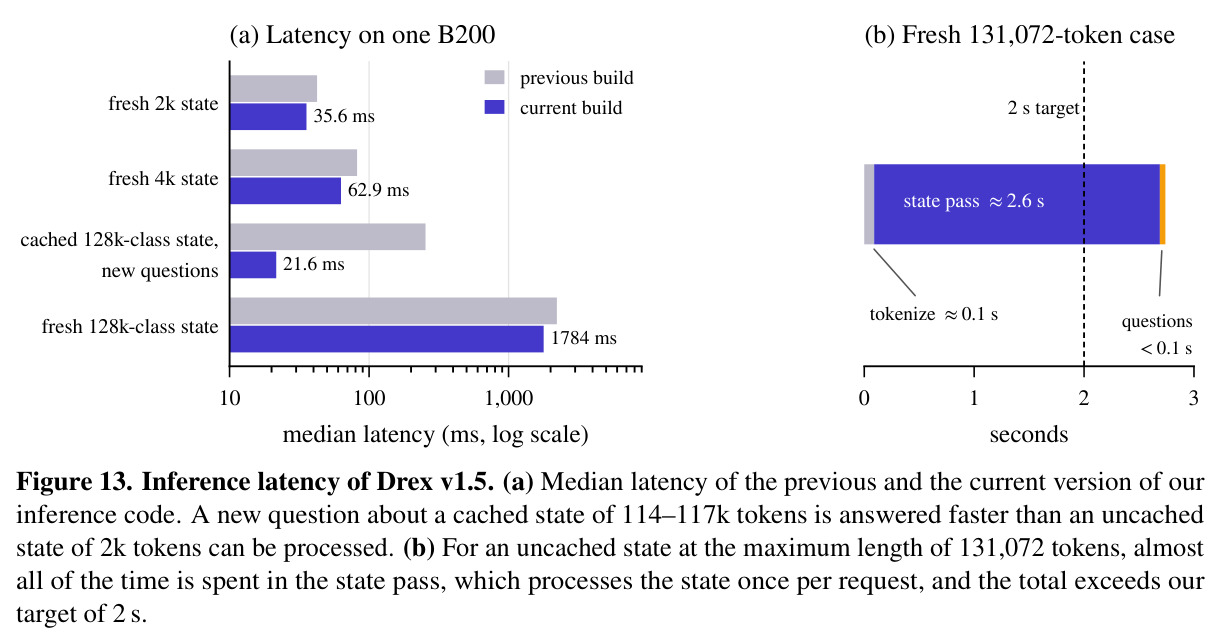
| 端到端延迟(2026 年 10 月实测) | 单请求中位时延 | Drex Max 183 ms(Decision Bench 上 0.66 s) | GPT-6 Sol 约 2.0 s;Claude Opus 5.5 约 3.5 s | 约 11–19 倍加速;每千决策 $0.06 对 $3.33/$10.17 |
| Drex Max 受控消融(同骨干同数据) | Decision Index 公共分 / 置换翻转率 | SFT→RLAF 66.9 分,翻转率 4.2% | 仅 SFT 64.9 分(翻转 5.3%);RLAF 去掉一致性项 66.4 分(翻转 6.3%) | RLAF +2.0 分、ECE -0.9 点;一致性项把翻转率 6.3%→4.2% 而精度不变 |
局限与改进
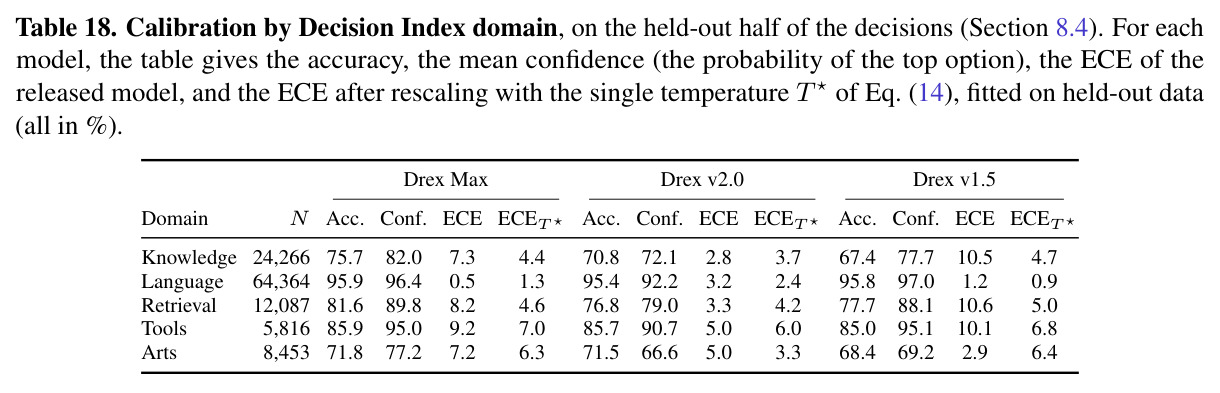
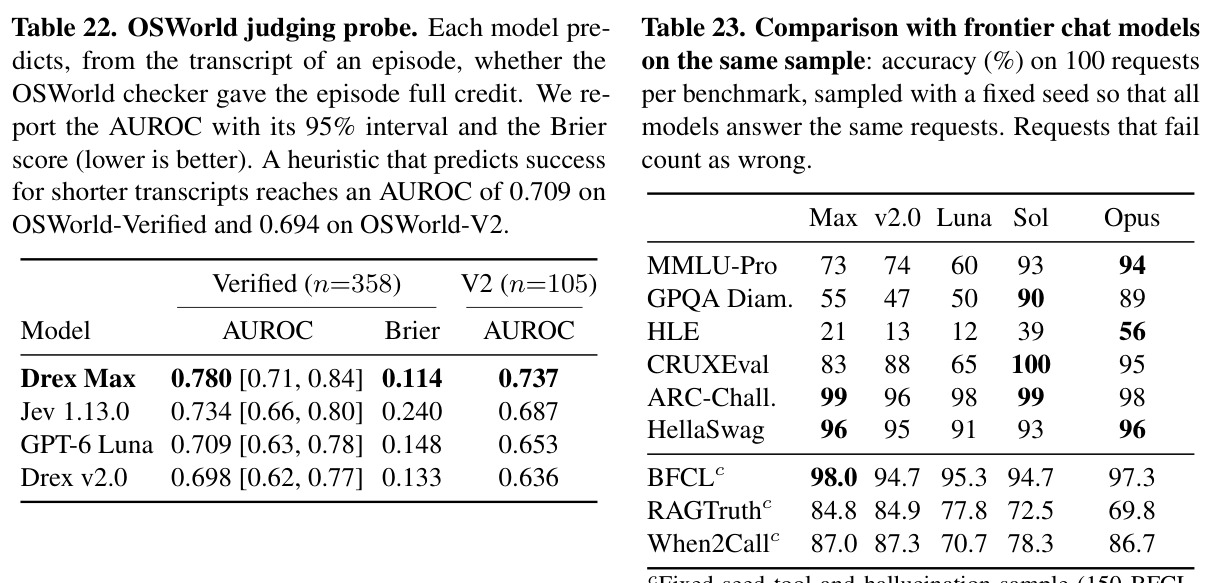
作者承认的局限:所有 Drex 模型在闭卷知识上落后于前沿聊天模型且题越难差距越大(Max HLE 21%、GPQA Diamond 55%,对 GPT-6 Sol 39%/90% 与 Claude 56%/89%);Max 轻度过自信,非语言四域平均置信超准确 5–9 点(分域 ECE 7.2–9.2%),6–20 选项题 ECE 8.4%;部署温度 1.009 与 Decision Index 拟合的 1.35 不一致,单一温度不能替代按工作负载监控;K≥6 选项时 13% 决策在置换下改变 argmax;Max 与指针模型的差异混杂了骨干规模、注意力掩码、输出头、训练数据多个变量,未能解耦。我的观察:RLAF 中 judge 项理论上可压过已验证答案(ρ=0.2、η=0.05),作者未测量发生频率、也未测 judge 偏置是否被蒸馏;顺序鲁棒性研究只有 1,591 决策(K≥6 仅 173 个)且排除结构化选项请求;Max 在依赖长结构化选项的基准上大幅倒退(POP909-CL -23.9、Habermas -11.9),暗示符号绑定是真实短板;统计检验未做多重比较校正;Artificial Analysis 上 Max 准确率(27.6%)反低于 v1.5(37.6%),得分靠非幻觉弃权率(71.3% 对 0.6%)换来,这种“准确率换弃权”值得部署者警惕。
独立分析的弱点
第一,闭卷知识瓶颈是结构性的:读出头只能排序骨干已有的知识,单次前向无法替代长思维链与工具调用(AA-Omniscience 决策准确率仅 27.6%、HLE-MC 16.0%);改进方向是让模型在读出前先生成推理或调用检索,或把知识密集型查询路由给其他系统。第二,校准跨域漂移:整体 ECE 被占 56% 决策的语言域拉低,非语言域 7.2–9.2%、6–20 选项题 8.4%,单一温度不够;可按域/按选项数分段温度或加异质校准目标。第三,选项顺序敏感集中在低置信+多选项决策(K≥6 翻转 13–16%);作者提出的 option-isolation 掩码可从构造上解决但混合骨干不支持,可探索置换不变的选项编码。第四,读出头的符号绑定伤害长结构化选项任务(POP909-CL、Habermas Machine 大幅倒退);可研究指针/读出混合头。第五,Max 无法缓存状态、每题重编码,长文档多题场景成本反超指针模型(后者缓存后每题仅 21.6 ms);可研究选择性重编码。第六,RLAF 的 judge 是同源 27B 模型而非更强教师,其顺序偏好可能在蒸馏中放大翻转率(无一致性项 6.3% 对 4.2%),金标被覆盖频率也未量化;应引入更强或多个 judge 并监控金标覆盖率。
未来方向
作者明确列出的方向:在相同 Qwen3.8-27B 骨干与相同数据上做指针头 vs 读出头、因果 vs 非因果掩码的受控消融,解耦 Max 增益来源;让模型在读出前生成思维链或调用搜索等工具,检验能否缩小闭卷知识差距;把 Max 的选项代码 A/B/C 换成 1/2/3 等其他 token,检验模型对具体代码的依赖;在更大、独立的工作负载上复制顺序鲁棒性结论。基于本文成果可延伸的:把置信度路由(低置信→人审)与按域温度调优做成自动化运维框架——作者已证明 top-50% 置信精度可达 99.3%,这条“人机分工”路线商业价值直接;把 RLAF 的“恰当评分规则奖励+可验证结果”推广到其他判别式输出(回归、排序、多标签);利用“三顺序平均显著降低 log loss(Max -0.014 nats)”构建廉价的多顺序集成推理;为指针模型补上 option-isolation 架构变体并对比;多模态侧从静态图扩展到视频时序编码(目前仅采样帧);用更强教师或长思维链 judge 重做 RLAF 并量化金标覆盖与偏置蒸馏。
复现评估
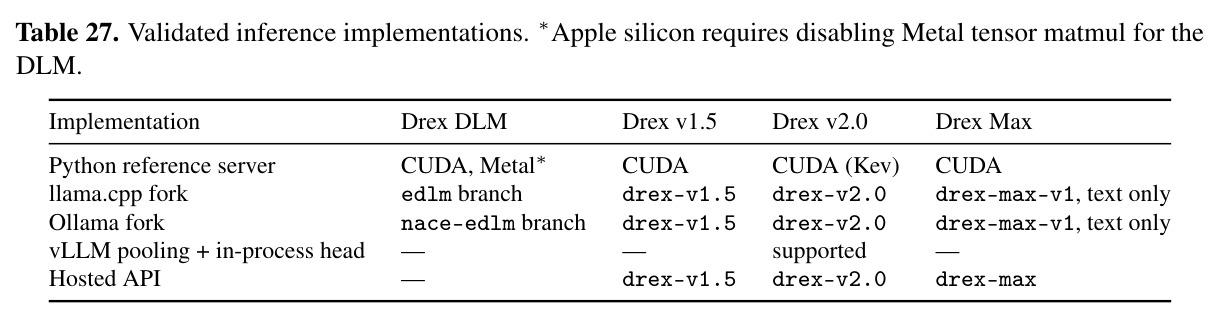
开源程度很高:四款模型权重与推理代码集中在 github.com/nace-ai/drex-decision-models 与 HuggingFace(nace-ai 组织),提供 safetensors 与 GGUF 构建,支持 llama.cpp 与 Ollama 本地运行;Max/v2.0/v1.5 为 Nace.AI Open RAIL-M 许可(Max 为修改版),DLM 沿用骨干的 CC BY-NC 4.0(非商用),仓库代码 Apache-2.0;另有托管 API 与 OpenRouter。推理复现容易:27B 稠密模型多卡工作站即可跑,指针模型更轻(v1.5 9B、v2.0 激活仅 3B),183/145 ms 的延迟数字可自行验证。完整训练复现中等偏难:115 万条记录多数来自强教师蒸馏,数据合成与验证管线未全量开放;训练算力未在正文披露(27B 全参数 SFT+RLAF 估计需多节点 GPU);judge 依赖 Qwen3.8-27B 高推理档生成;Decision Index 私有子集须提交官方评测;与 GPT-6 Sol、Claude Opus 5.5 的对比依赖商业 API。评估方法学(Wilson 区间、5000 次配对自助、精确 McNemar)写得规范,若评估代码随仓库开源,结果核验的可复现性在技术报告里属上乘。
论文图表