MMDM:大规模多任务决策能力基准 MMDM: Measuring Massive Multitask Decision Making
提出5448题、16类任务的决策模型基准,暴露多选完整性与概率校准两大短板
前置知识
System-1 决策模型
指在单次前向传播(或单步解码)中直接对查询给定的选项集合输出结构化概率分布 $p = f_\theta(x) \in \Delta_{K-1}$ 的模型,不做自回归推理、不生成思维链或文本回答。典型代表包括 Jev、Perplexity Decider、Microsoft Decision-1、OpenJev 等,通过决策打分头或单步读出直接给出每个选项的概率。
本文的全部评测对象就是这类模型,理解其“一步出概率”的接口是读懂任务形式化(state–query–options)和所有指标定义的前提。
Brier 分数
衡量预测分布 $p$ 与参考分布 $\pi$ 之间距离的均方误差:$\mathrm{Brier}(p,\pi) = \sum_{j=1}^{K}(p_j - \pi_j)^2$,值越低越好。它评价的是整个分布的保真度,而不只是最高概率选项是否正确,因此能发现“选对了但概率形状错了”的模型。
MMDM 用 Soft Brier 评测软标签任务,是论文核心发现之一——“单选准确率相近但 Brier 相差一倍”的关键度量工具。
期望校准误差(ECE)
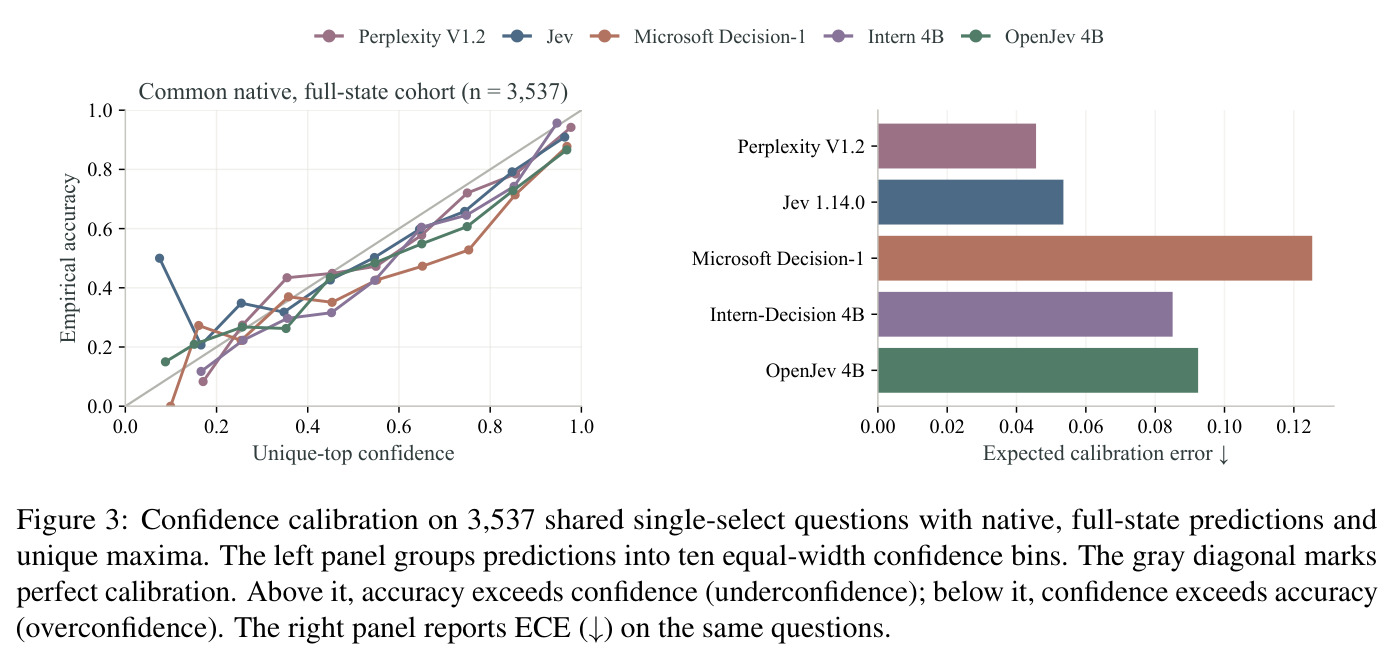
把单选预测按置信度分成十个等宽 bin,计算 $\mathrm{ECE} = \sum_{b=1}^{10} \frac{|B_b|}{L}|\bar{a}_b - \bar{u}_b|$,其中 $\bar{a}_b$ 是 bin 内平均正确率、$\bar{u}_b$ 是平均最高选项概率。ECE 低说明“模型说有多确定,实际就有多准”。
论文用 ECE 和可靠性曲线论证“准确率高不等于校准好”(如 OpenJev 准确率高于 Intern-Decision 但 ECE 更大),这是模型选型的重要维度。
基准污染(test-set contamination)
当评测集直接复用公开数据时,模型可能在训练中见过测试材料,导致分数虚高、无法反映真实泛化能力。防治手段包括重写状态/查询/干扰项但保留答案依据、新建可计算答案的机制化任务等。
污染是 MMDM 的核心动机之一:论文通过 source-grounded 重写加新构任务来降低记忆导致的分数膨胀,理解这一点才能理解其数据构建三条路线。
分离–平衡 F 值(SB-F)
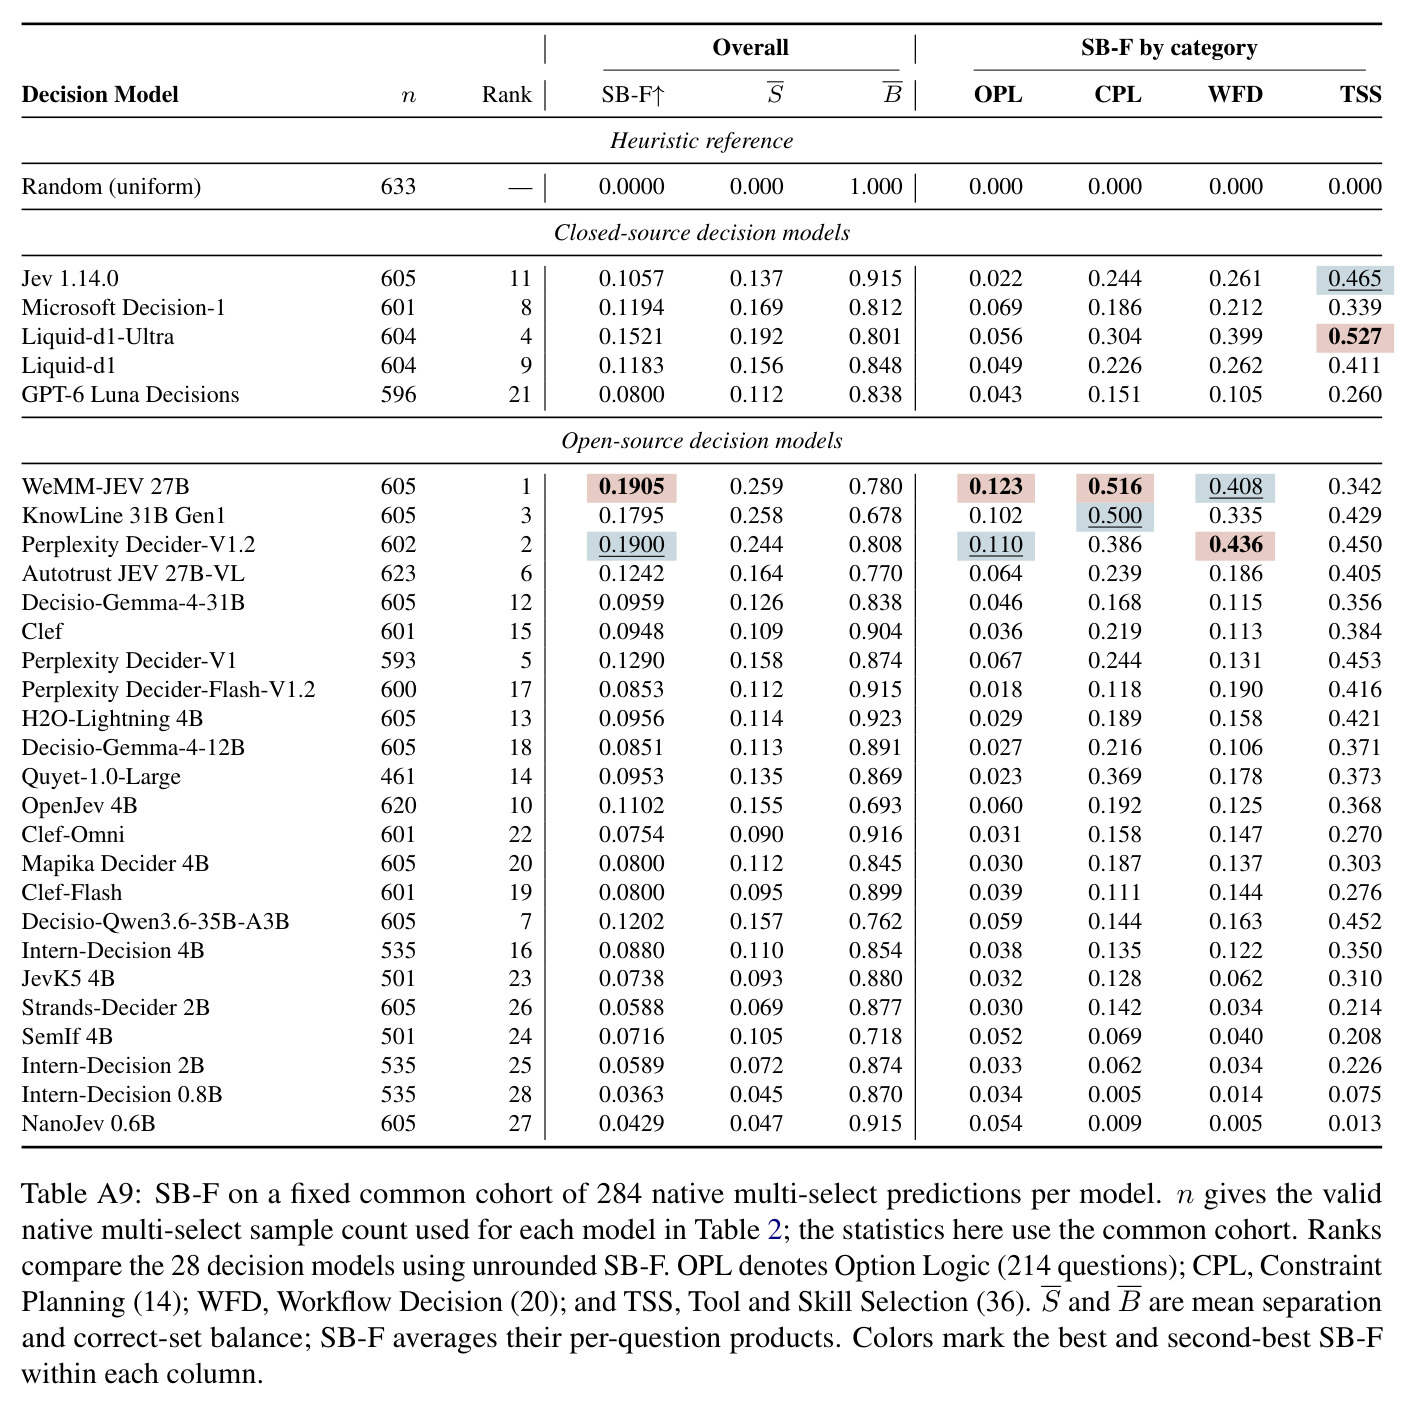
多选题的分布级指标,定义为 $\mathrm{SB-F} = S(p,G)\,B(p,G)$。分离度 $S$ 衡量正确选项概率超过最强干扰项 $b$ 的程度(超出部分才计分),平衡度 $B = 2/\left(|G|\sum_{i\in G} p_i^2\right) \cdot \left(\sum_{i\in G} p_i\right)^2$ 类似基尼系数,惩罚正确集合内部概率分配失衡。取值 $[0,1]$。
它是论文诊断“模型认出一个正确选项但把其余正确选项压在干扰项之下”现象的核心工具,是理解多选失败分析的钥匙。
研究动机
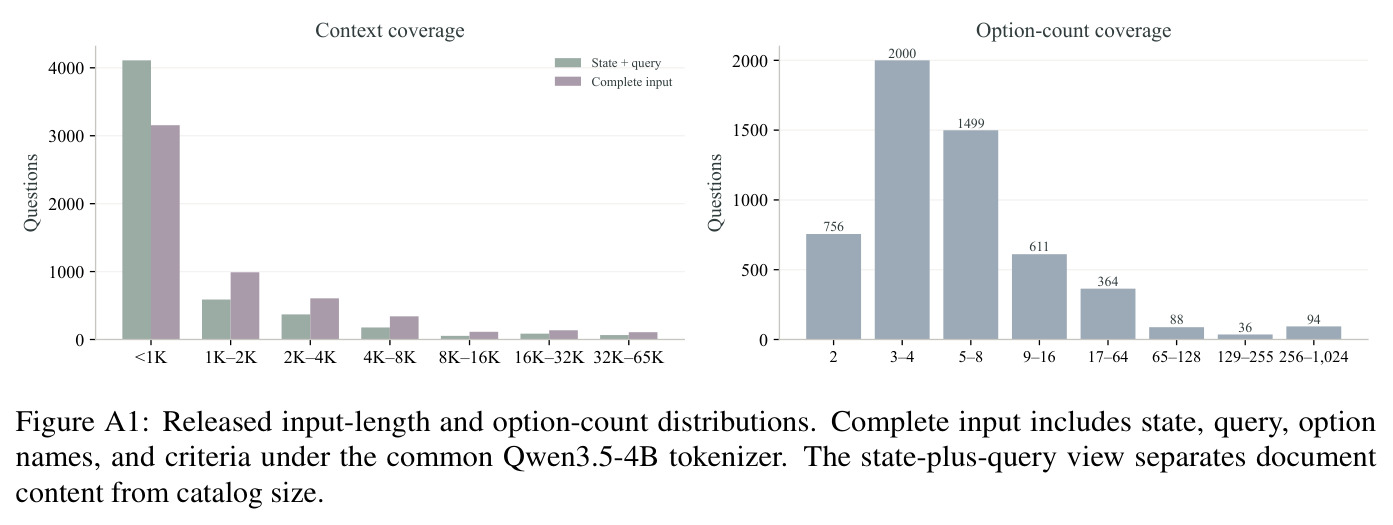
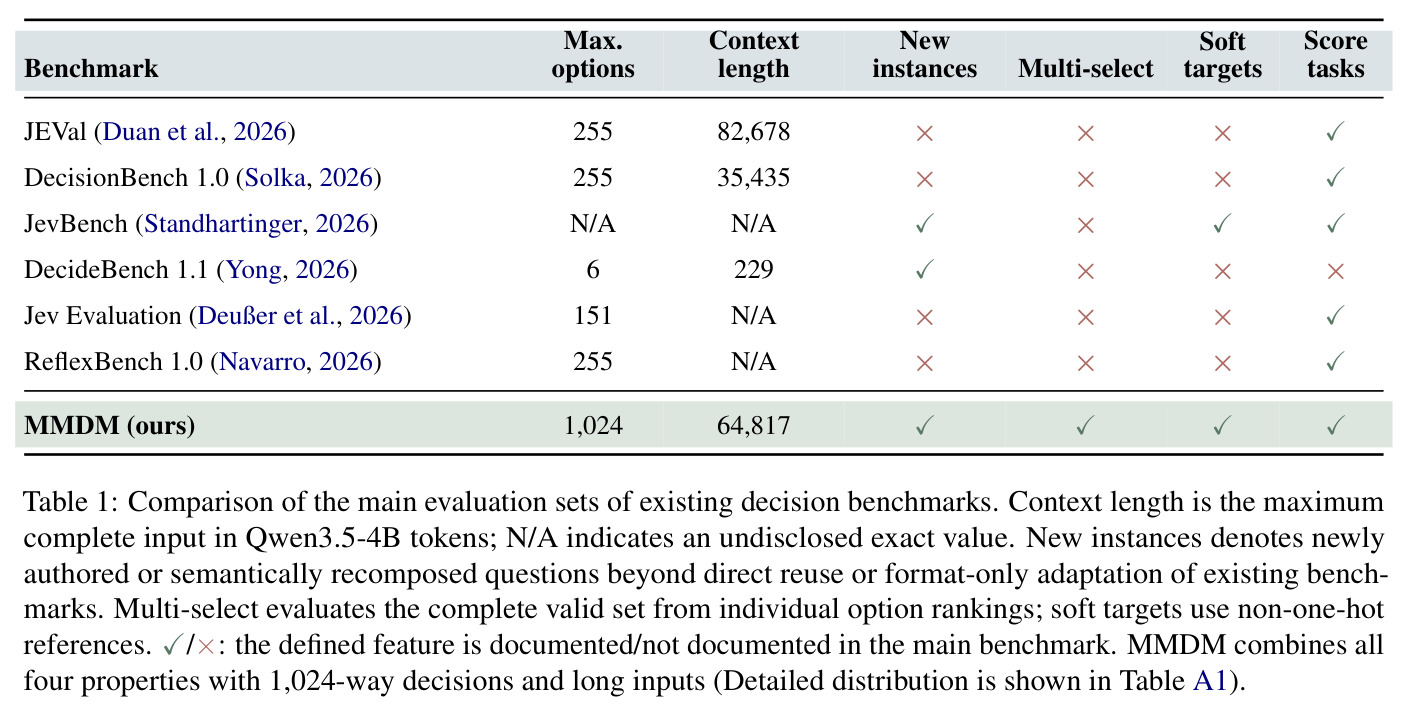
System-1 决策模型正被广泛用于意图分类、工具选择、rubric 打分等 agent 流水线,但现有评测有三个结构性缺陷。第一,测试材料污染:JEVal(36 个数据集、10 个领域)、DecisionBench(43 任务)、Jev Evaluation(37 个数据集)等主流评测大量直接复用公开基准,模型可能在预训练中见过原题,导致分数虚高。第二,能力覆盖不全:JEVal 与 DecisionBench 的选项上限仅 255,DecideBench 1.1 只有 6 个选项、229 token 输入,且多数基准完全不测 Hard Multi-select(找出全部合法选项)和软标签(非 one-hot 参考分布)任务。第三,真实决策同时涉及长上下文(如追踪 agent 状态、判断早先的审批是否因后续编辑而失效)、大选项空间(从上千个工具中选型)和选项间逻辑依赖(选项互指、有前置条件),而没有任何现有基准把这三类挑战组合在一起考察。
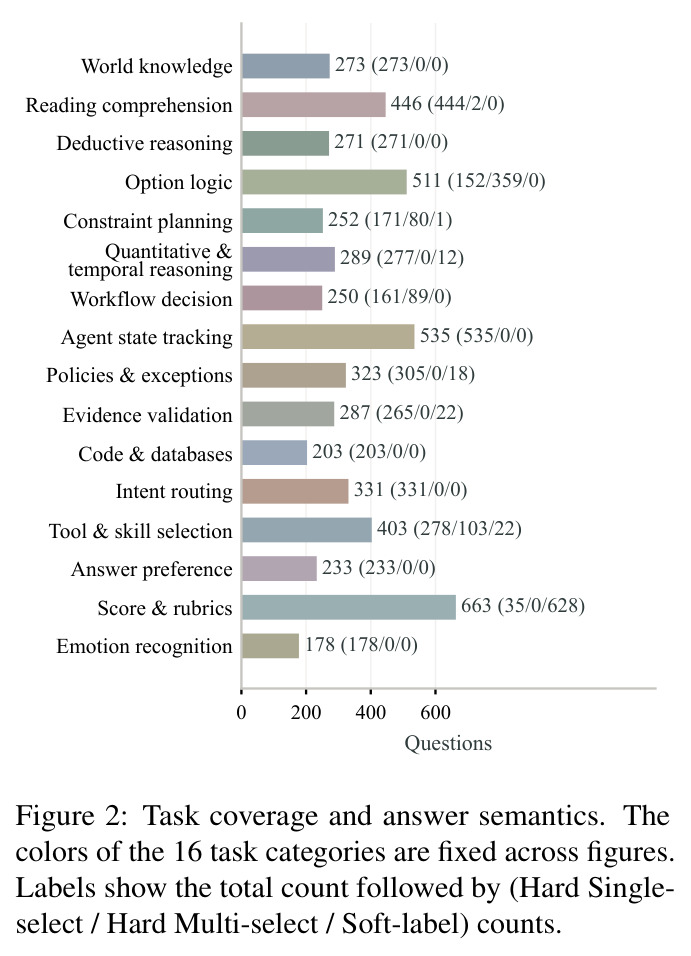
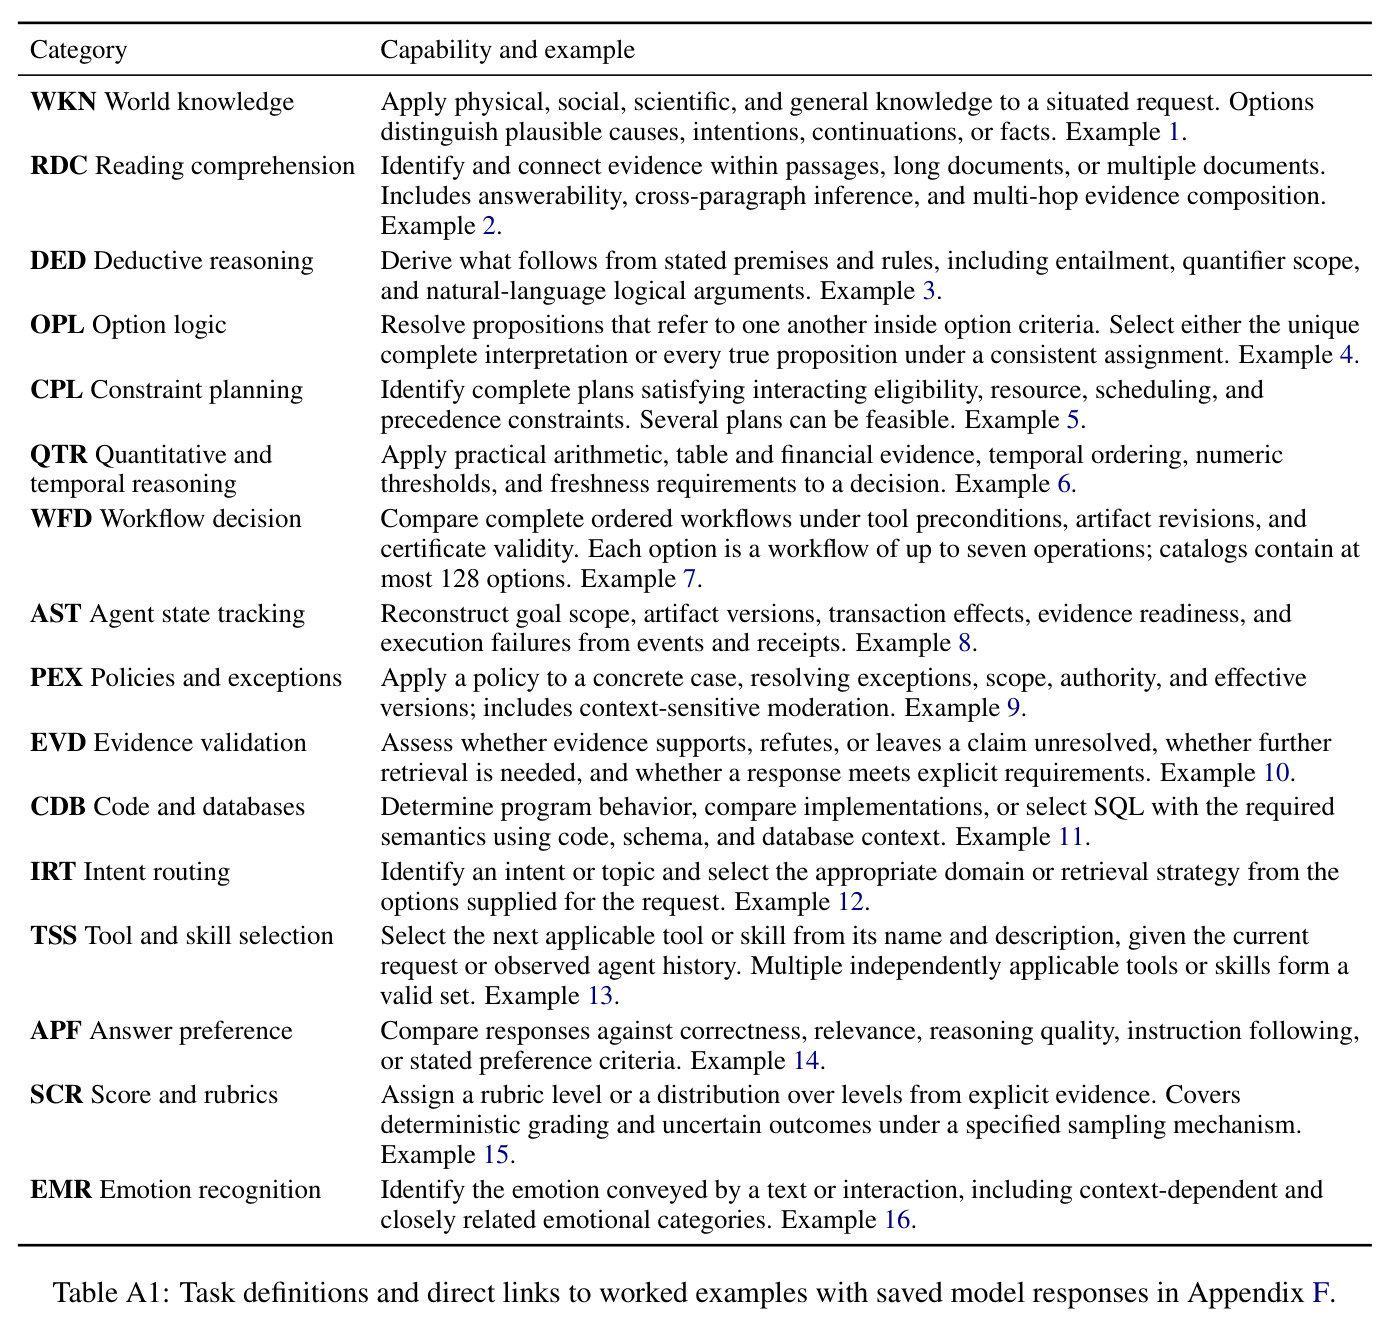
本文的目标是本文目标是构建一个名为 MMDM(Massive Multitask Decision Making)的基准,用 5,448 道高质量题目、16 个任务类别,在统一协议下评测文本型 System-1 决策模型的三种答案能力:Hard Single-select(唯一正确选项)、Hard Multi-select(完整合法集合)和 Soft-label(匹配参考概率分布)。基准需覆盖 2 到 1,024 个选项的选项空间和最长 64,817 token 的完整输入,并把新构造任务与基于源数据的重写任务结合以抑制记忆效应;同时提供单选正确率、多选完整率、SB-F、Soft Brier、Score nMAE、ECE 等统一指标和开源数据集与工具包,最终通过 28 个模型的系统评测揭示当前决策模型的真实能力缺口。
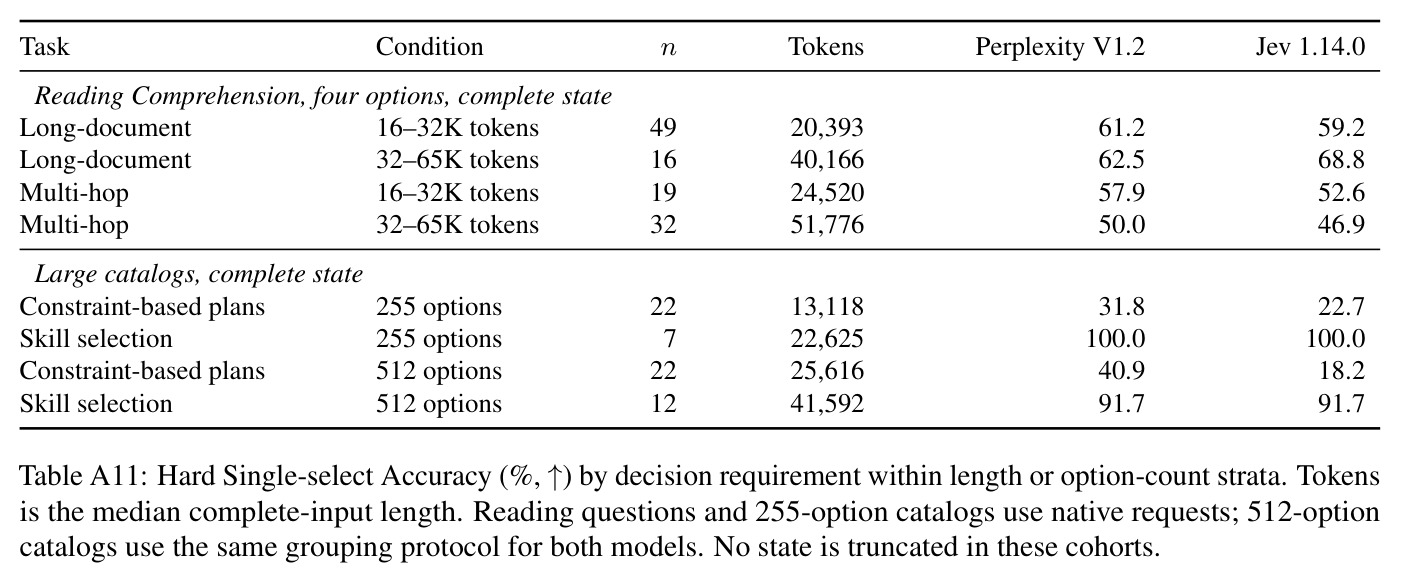
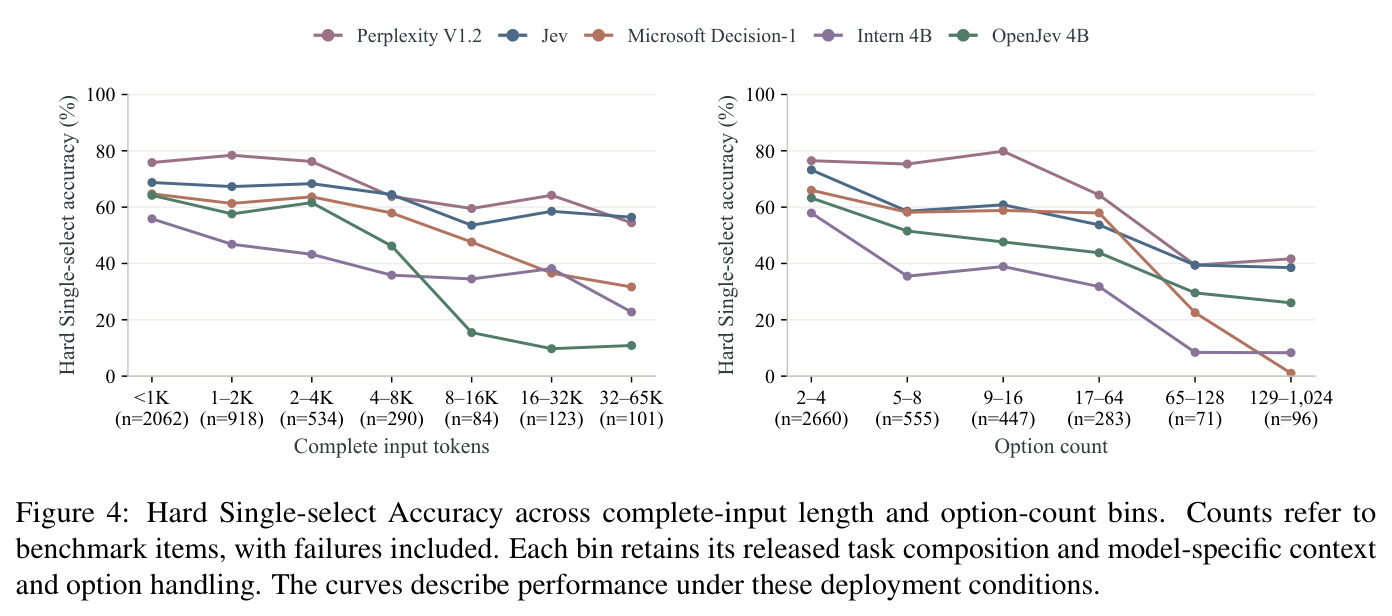
与已有工作不同的是,本文的独特切入角度有三点。第一,把“决策质量”拆成三个可分别测量的维度——选得对(硬单选)、选得全(多选完整恢复)、概率分布得准(软标签 Brier 与期望分误差),并用 SB-F 这类分布级指标揭示“选对一个但压住其余正确选项”的失败模式,这是以往只报 top-1 准确率的评测看不到的。第二,用机制化构造保证答案可验证:互指命题用真值表枚举、约束规划枚举全部可行计划、工作流用模拟器加独立 SQLite 重放校验、抽样 rubric 用精确组合计数导出参考分布,这与单纯改写公开题完全不同。第三,把长输入能力与大选项空间能力分开测量(如 8K–16K token 与 129–1,024 选项分箱),证明二者排序会反转,单一聚合分数掩盖这些差异。
核心方法
直觉上,MMDM 把一次“决策”标准化为一个三元组输入:状态 $s$(证据与当前处境)、查询 $q$(要做什么决定)、有序选项集 $O$(每个选项 $o_j = (a_j, c_j)$ 含名称和可选的判据,判据可以引用其他选项),模型输出选项分布 $p = f_\theta(x) \in \Delta_{K-1}$,$p_j \ge 0$ 且 $\sum_j p_j = 1$。技术路线分三步:第一步形式化三种答案语义——单选参考 $\pi_j = \mathbf{1}[j=y]$、多选参考 $\pi_j = \mathbf{1}[j \in G]/|G|$、软标签参考 $\pi_j = \sum_{\omega \in \Omega} P(\omega \mid x)\mathbf{1}[r(\omega)=j]$;第二步通过源数据重写、语义重组、机制化新构三条路线构建 5,448 题并用五模型筛查加人工复核质检;第三步定义统一评测协议(上下文截断保留查询与全部选项、超选项上限的递归分组、失败计入错误)和六类指标(单选/多选准确率、SB-F、Soft Brier、Score nMAE、ECE),对 28 个闭源与开源决策模型逐一评测。
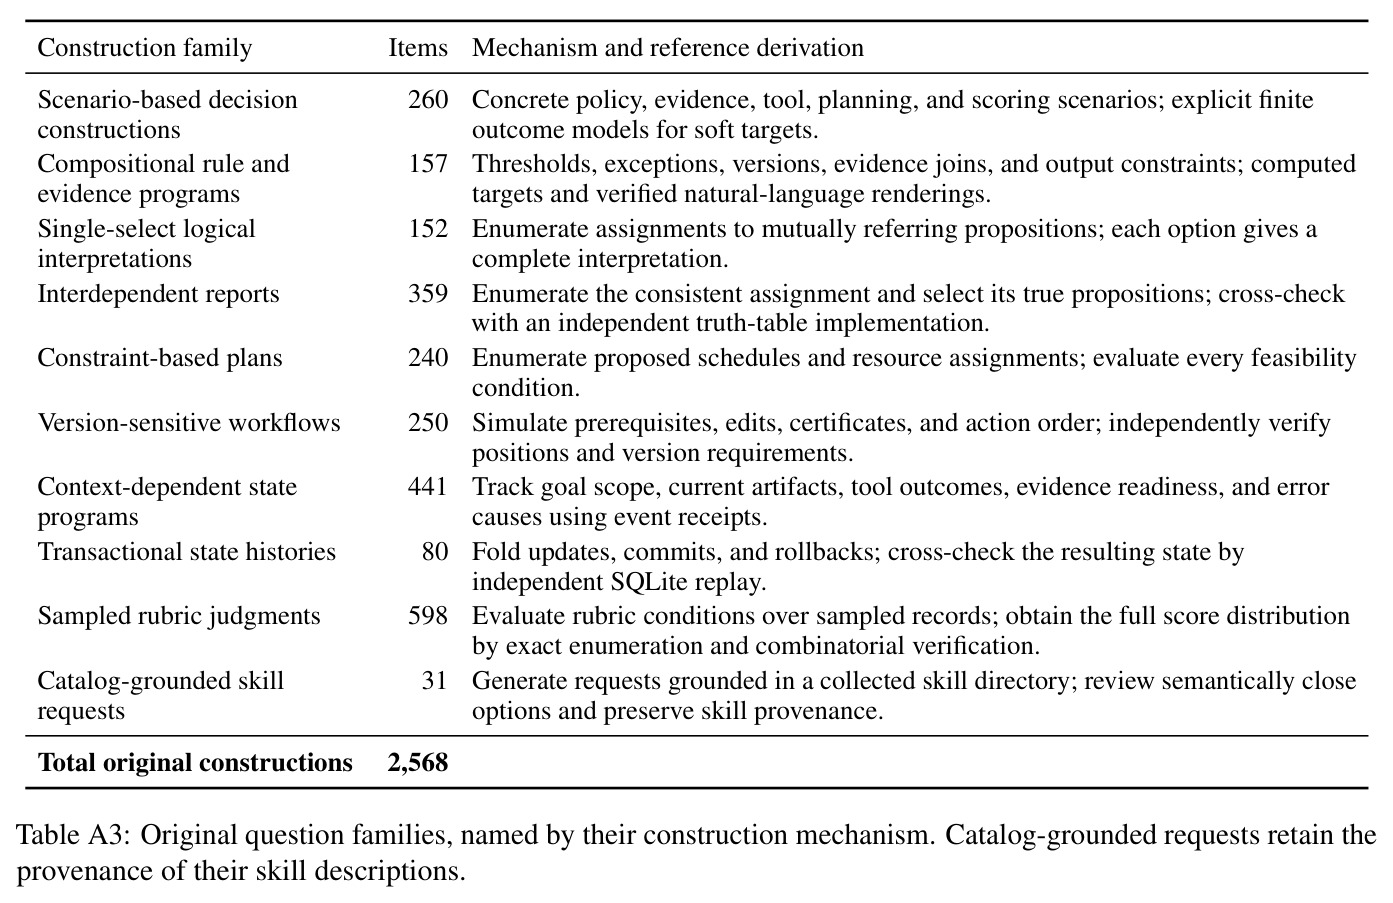
核心创新是把“完整多选恢复”和“分布保真”提升为一等评测目标,并配以可计算、可验证的参考答案。与已有方法的本质区别在于:JEVal、DecisionBench 等只考察单选正确性,参考答案来自人工标注或源数据集标签;MMDM 的很多题目的参考答案是由显式机制计算出来的——例如互指报告题先枚举唯一一致的真值指派再确定哪些命题为真,抽样 rubric 题按 $\pi_j = \frac{|\{S : |S|=m, r(S)=j\}|}{\binom{L}{m}}$ 精确枚举抽样分布,事务型状态题用独立 SQLite 重放交叉验证。同时,评测协议强制保留查询与全部选项名和判据(超预算时确定性移除状态中部),对超上限目录递归分组,且不向模型泄露参考基数 $|G|$ 或答案类型,使单选、多选、软标签共享同一预测接口。这使基准能同时测“选择、完整性、概率质量”三个此前未被联合考察的维度。
方法步骤详情
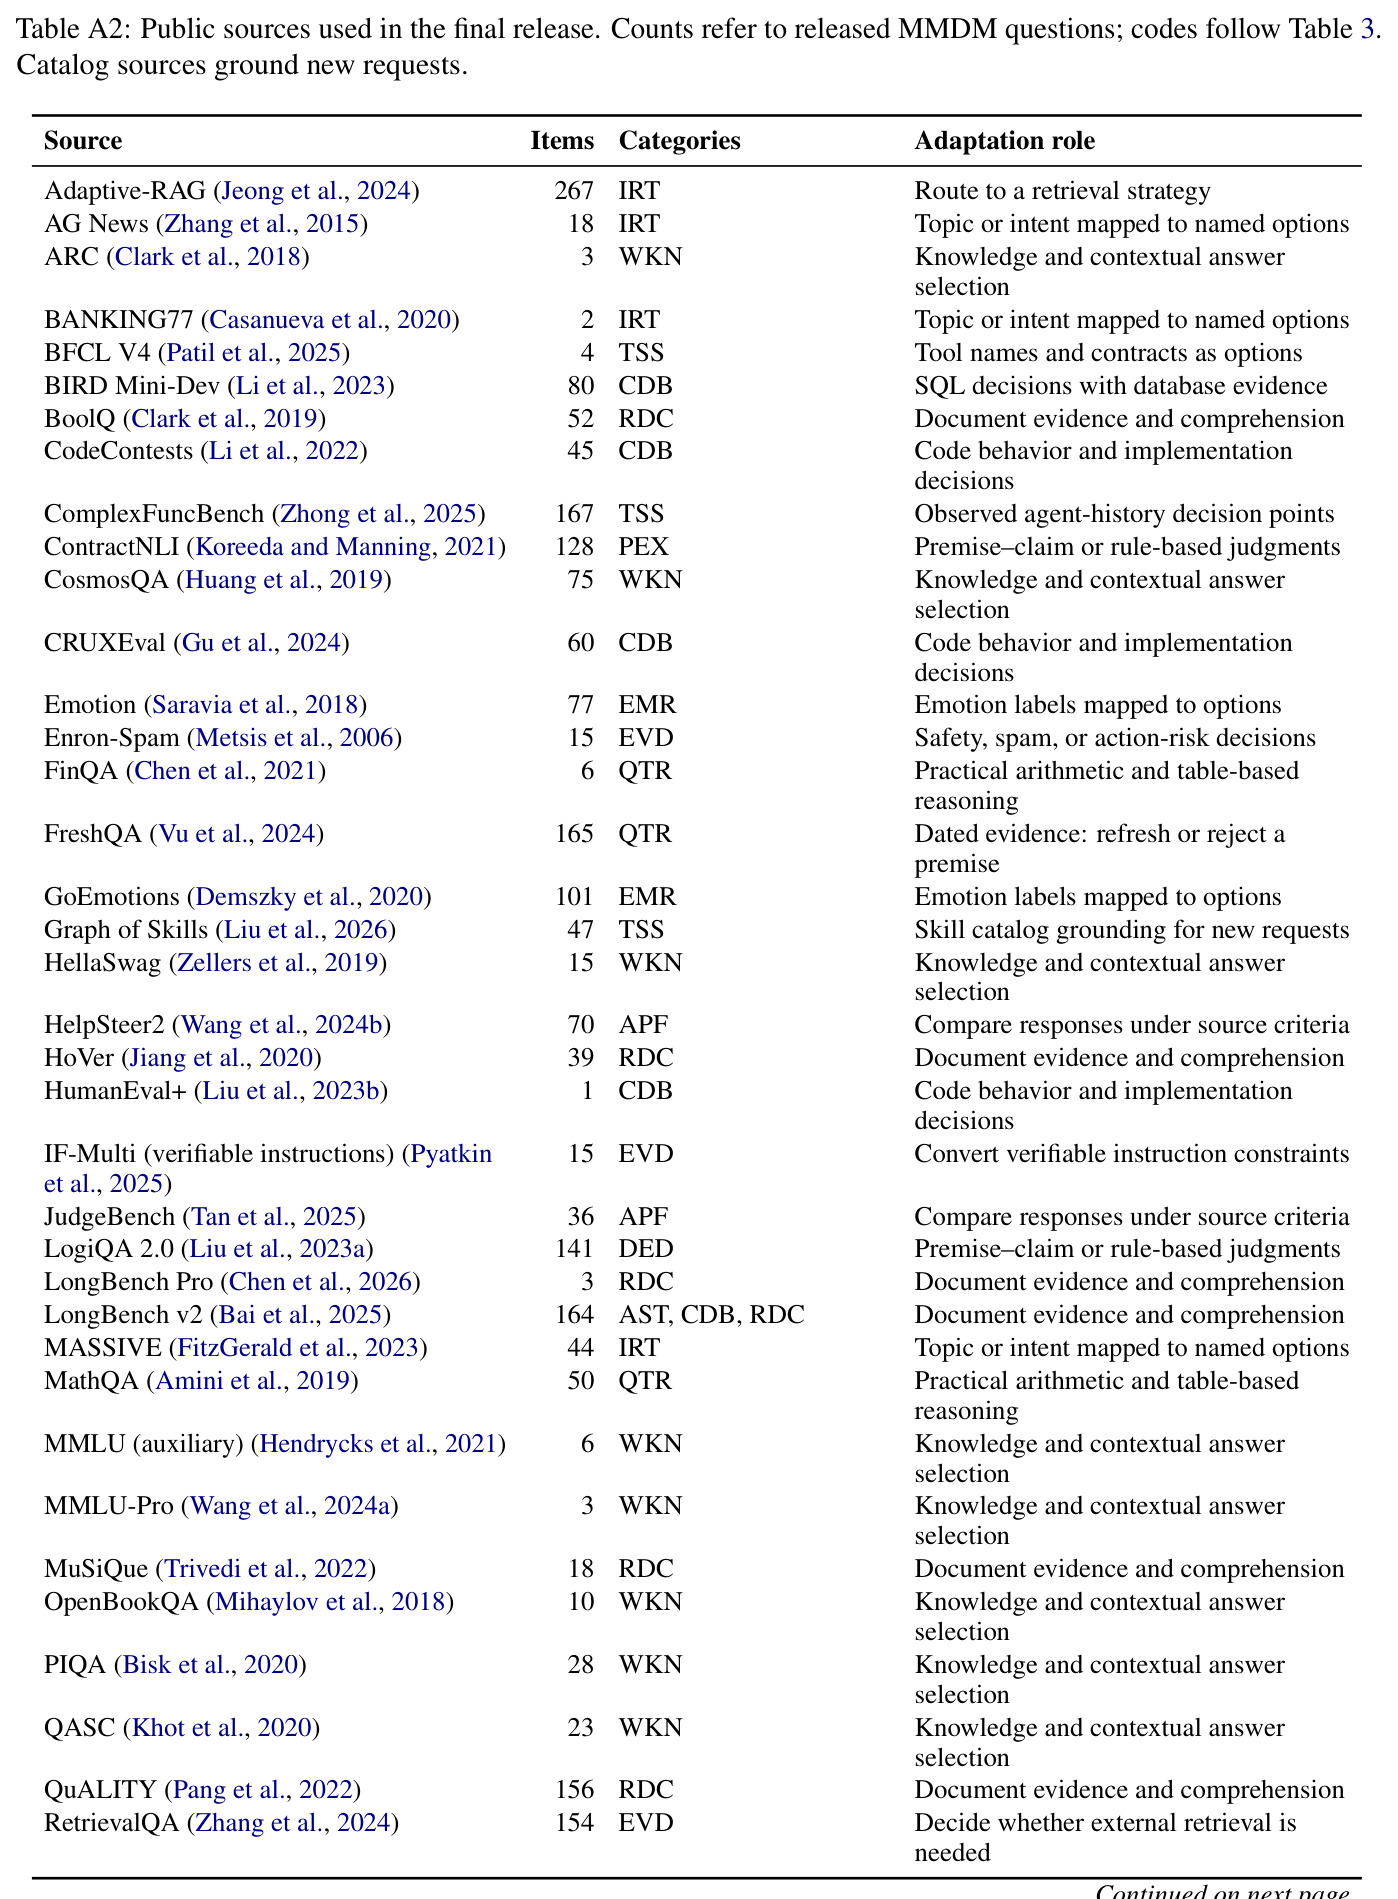
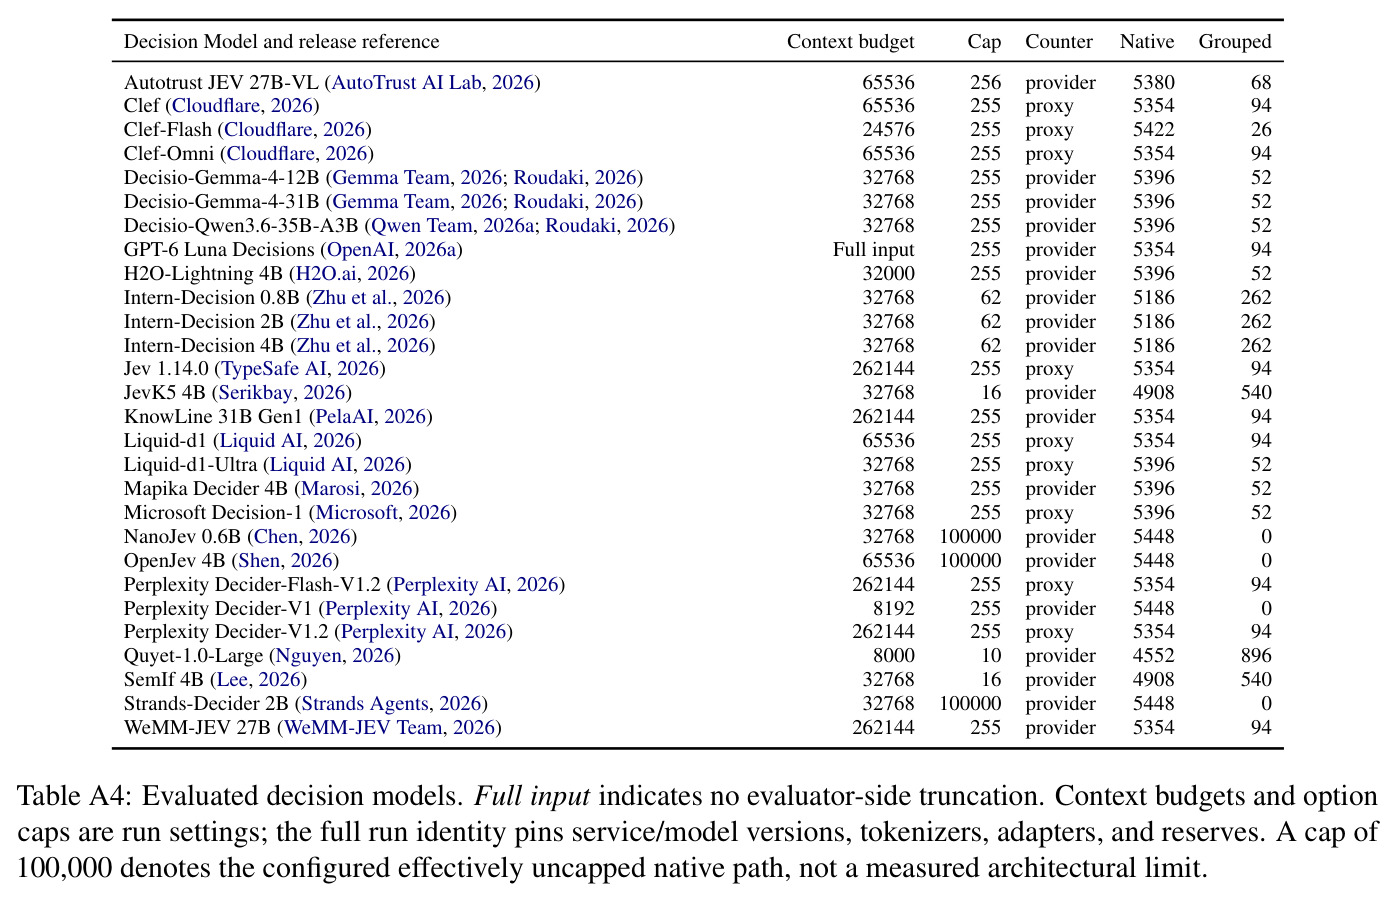
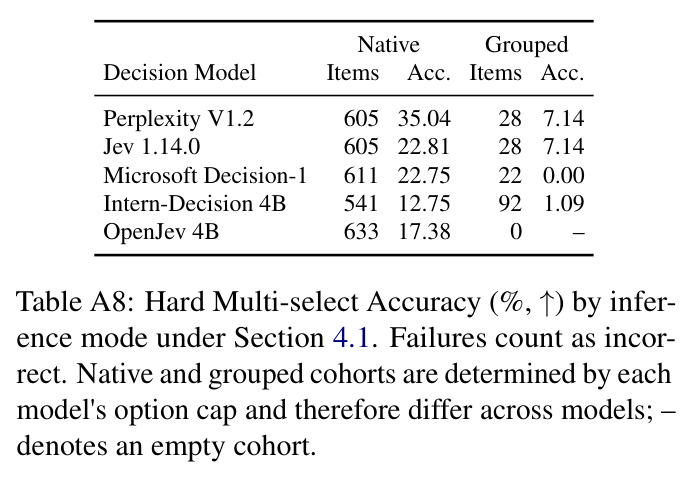
数据构建分四步。步骤一(收集):从 QuALITY、LongBench v2、BIRD、ComplexFuncBench、ToolTalk 等 62 个注册源收集带明确选项、答案可验证的题,初收 683,237 条,规范化去重后剩 669,135 条。步骤二(构造):源锚定重写保留原答案与证据、只改写状态/查询/干扰项;重组任务从源数据导出决策(如对 BIRD 的每个 SQL 选项在源库上执行验证);机制化新构 2,568 题,涵盖互指报告(359 题,真值表枚举)、约束计划(240 题)、版本敏感工作流(250 题,模拟器追踪版本与证书有效性)、抽样 rubric(598 题,精确组合计数)等 10 个家族,池达 744,723 条。步骤三(质检):先做表示与语义检查及 only-option 探针去捷径,再由 DeepSeek、GPT-6-Astra、Gemini-3.8-Flash、Qwen3.8-Max、GLM-5.2 五模型独立筛查,4–5 票自动通过 4,715 条,3–2 票的 928 条交两名人工评审按统一 SOP 独立复核(初始一致率 97.3%,分歧第三人仲裁),最终得到 5,448 题(4,112 单选、633 多选、703 软标签)。步骤四(评测):按各模型上下文预算与选项上限部署,超限时确定性移除状态中部、保留查询与全部选项;目录超上限时递归分组、组内最高概率选项晋级;六类指标按定义聚合,概率差 $\le 10^{-12}$ 的平局与失败请求均计错误。
技术新颖性
技术新颖性体现在四处。其一,规模与覆盖的组合是新的:1,024 个选项的上限(94 题超过 255 选项)和 64,817 token 的完整输入在决策基准中首次同时出现,且 62 个源、80 个类别–子类组合保证了多样性。其二,机制验证的答案:不同于重写题依赖源标签,新构题的答案由可执行机制计算并经独立实现交叉校验(真值表、SQLite 重放、组合计数),错误标签率可控。其三,指标体系创新:SB-F 把分离度 $S$(只有超过最强干扰项 $b$ 的概率才算分)与平衡度 $B$(正确集合内部分配的均衡性)相乘,能区分“认出一个正确项但其余被压制”与“集合整体排序正确但概率边缘极窄”两种失败;配套的 2,000 次 paired bootstrap(按源父组重采样)给出置信区间。其四,协议层面的容量归因:把选项分组推理与原生单次推理分开统计(Table A8),把任务条件化 ECE 与总体 ECE 分开(防止某任务过自信抵消另一任务的欠自信),这些都是现有评测没有的细粒度诊断。
实验结果
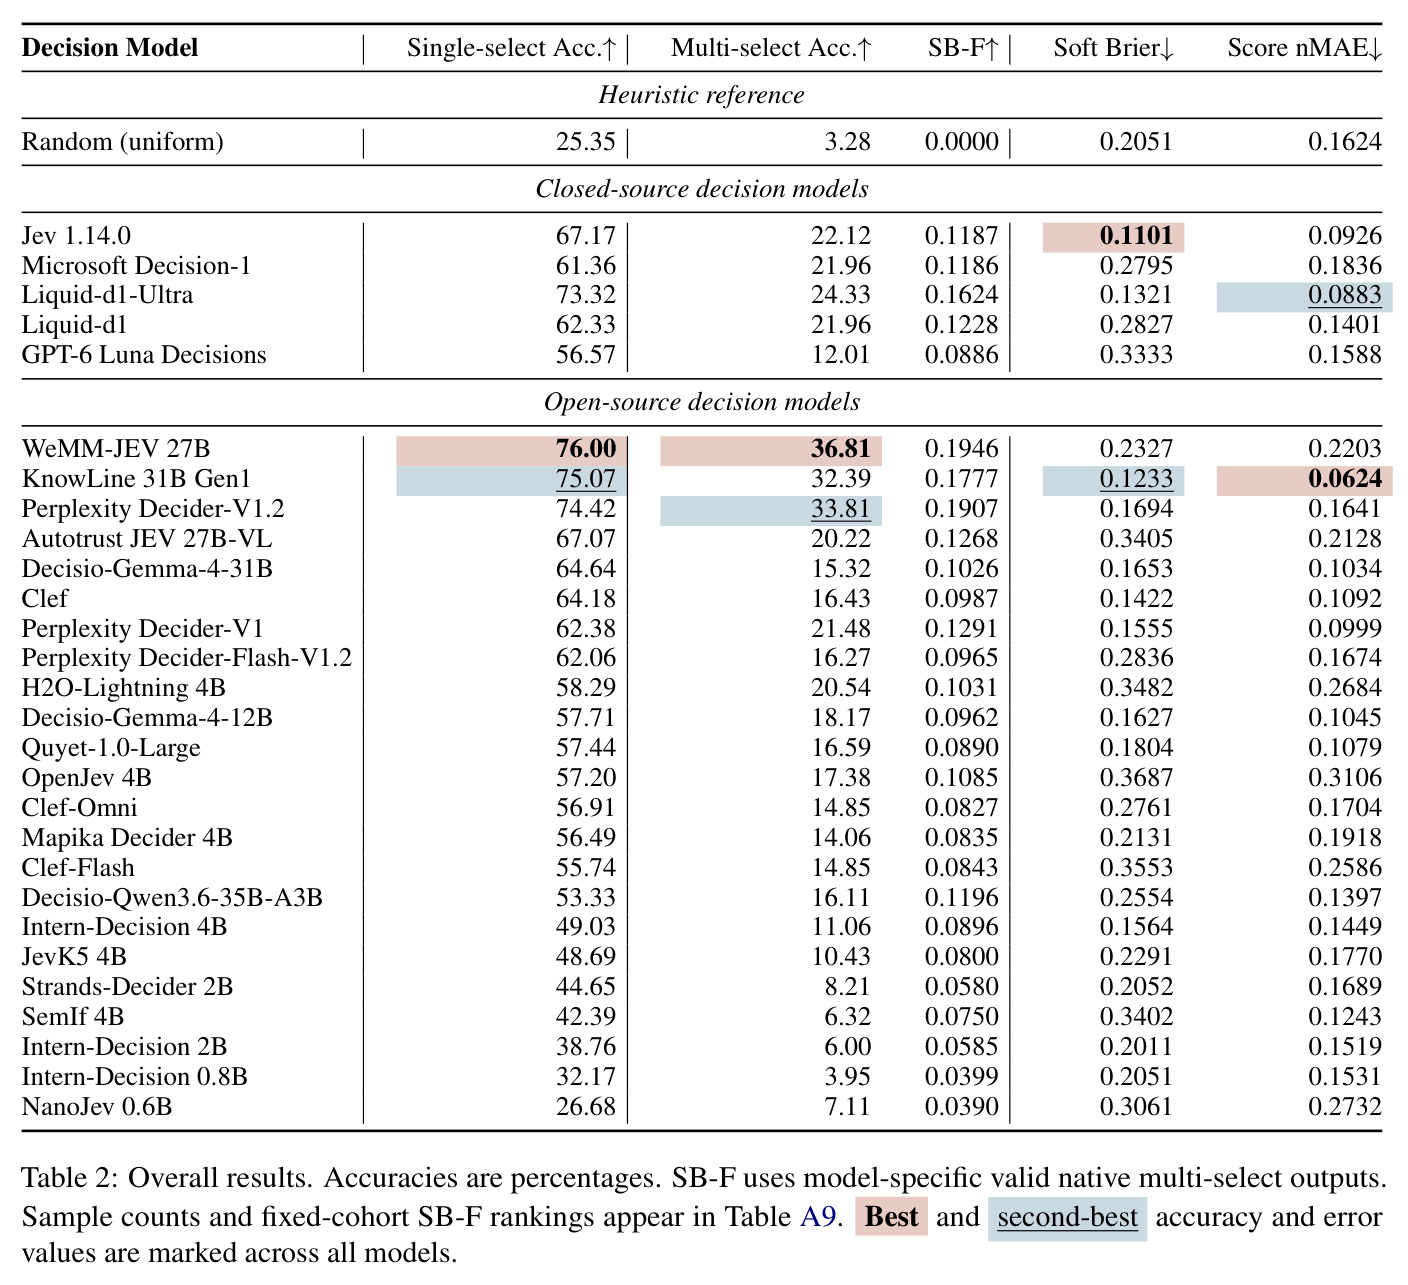
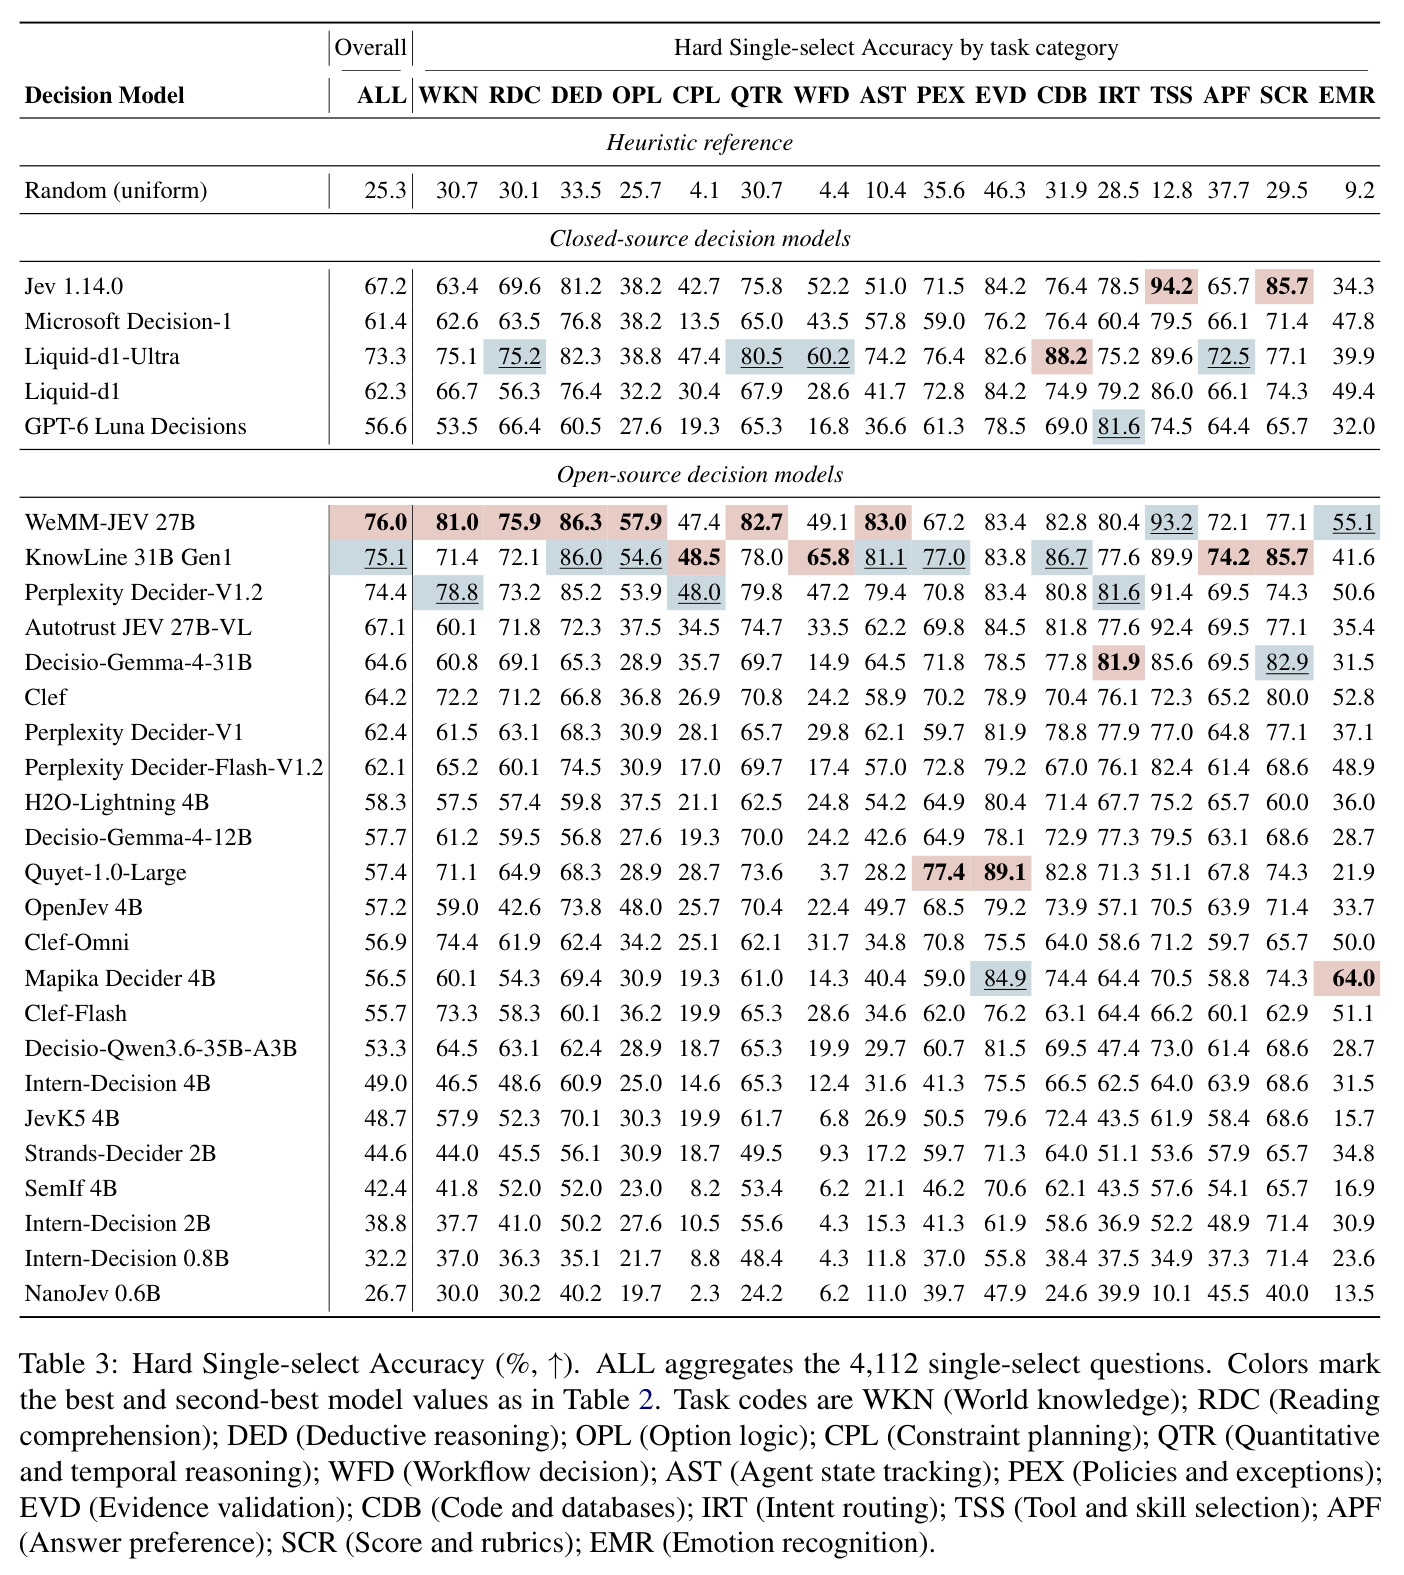
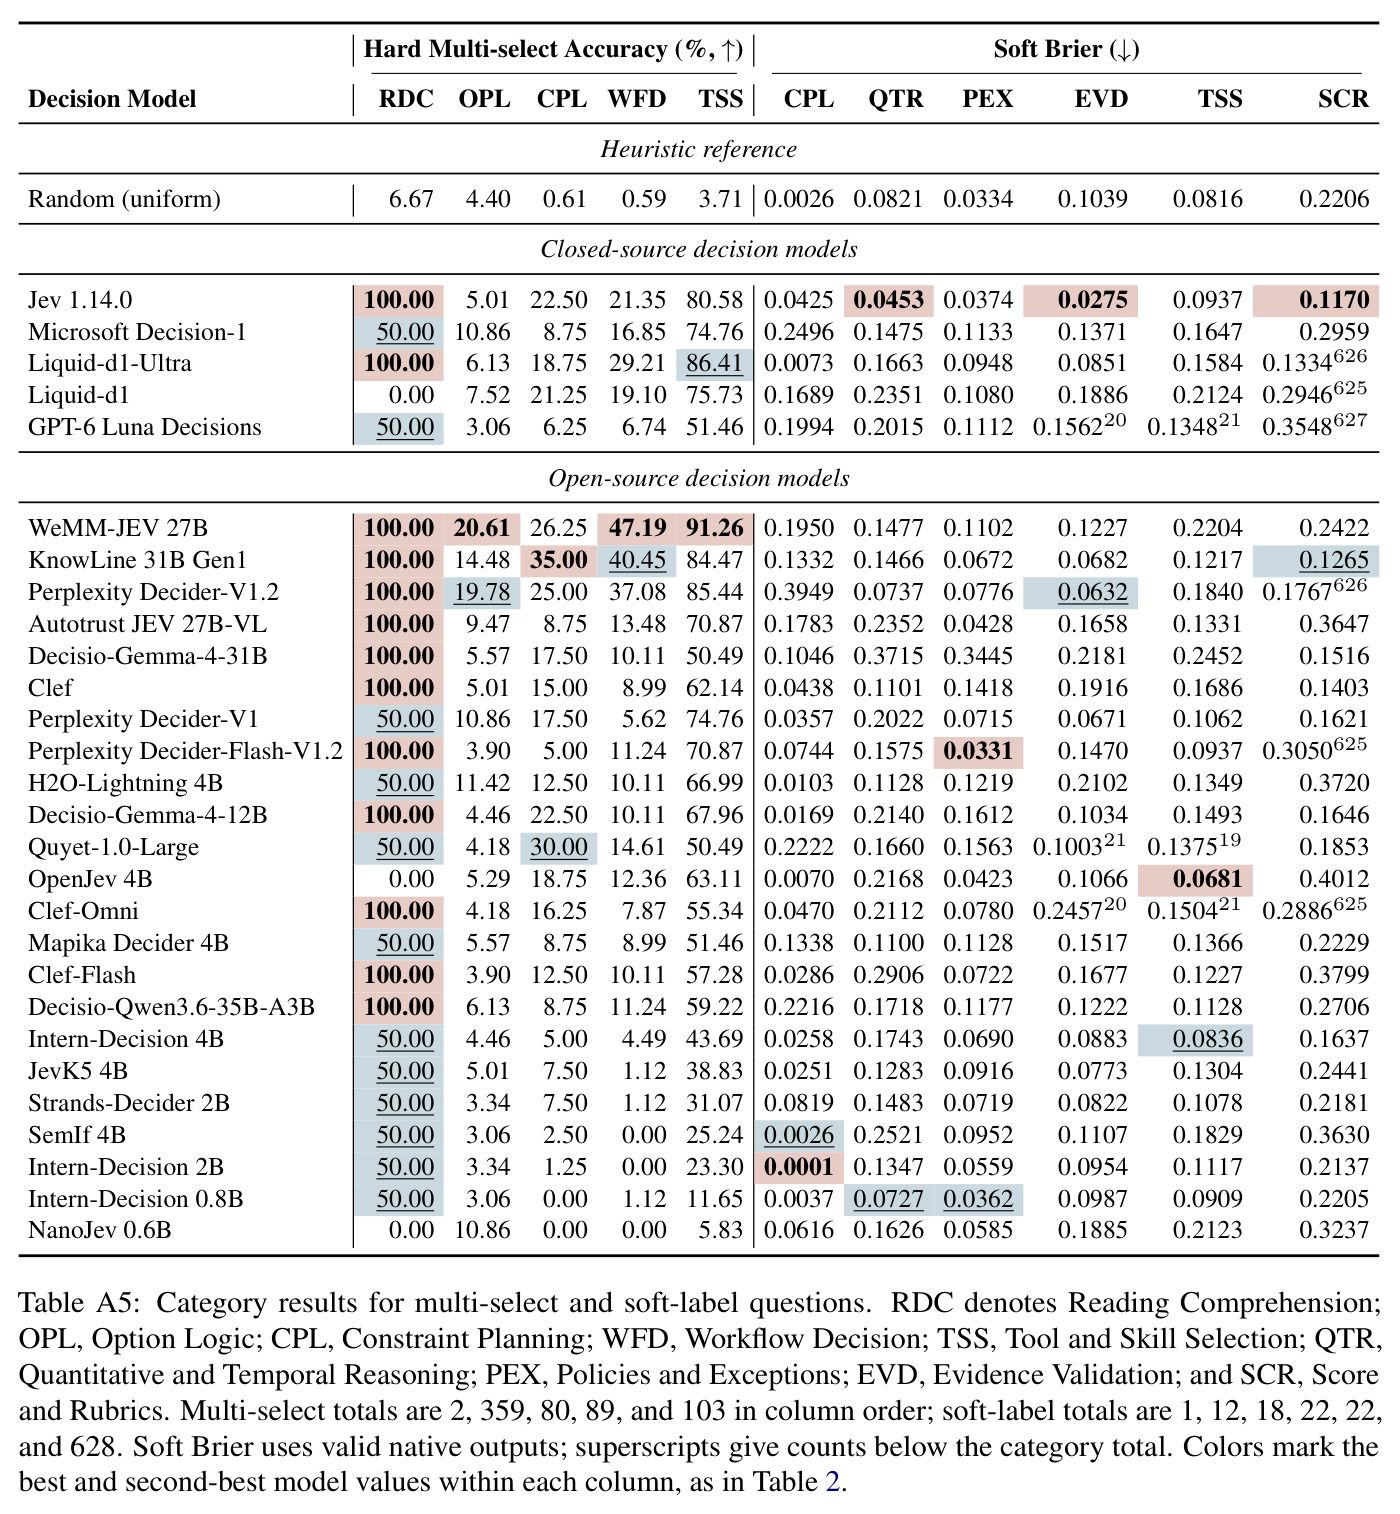
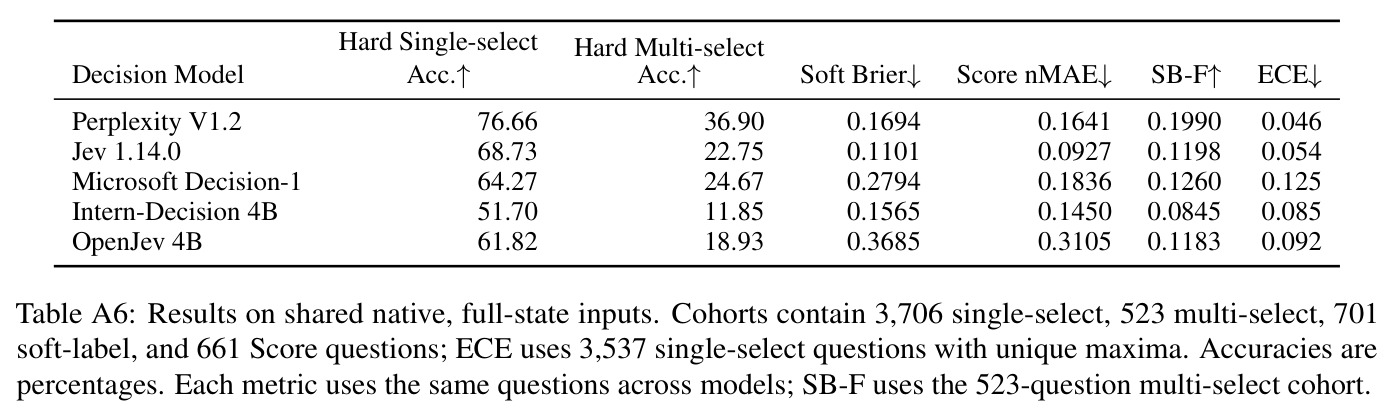
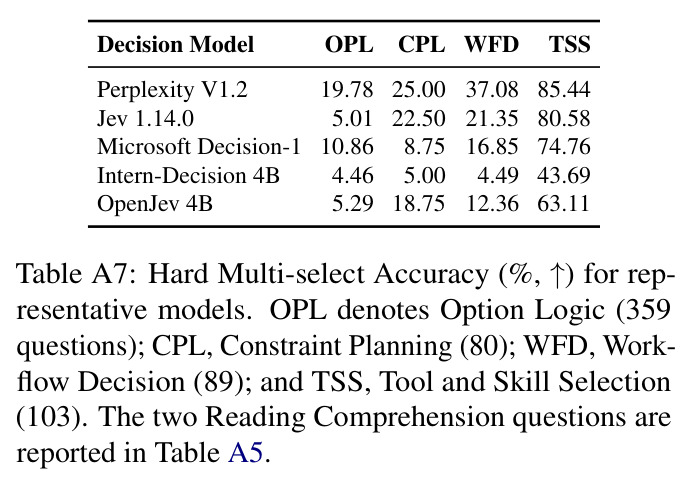
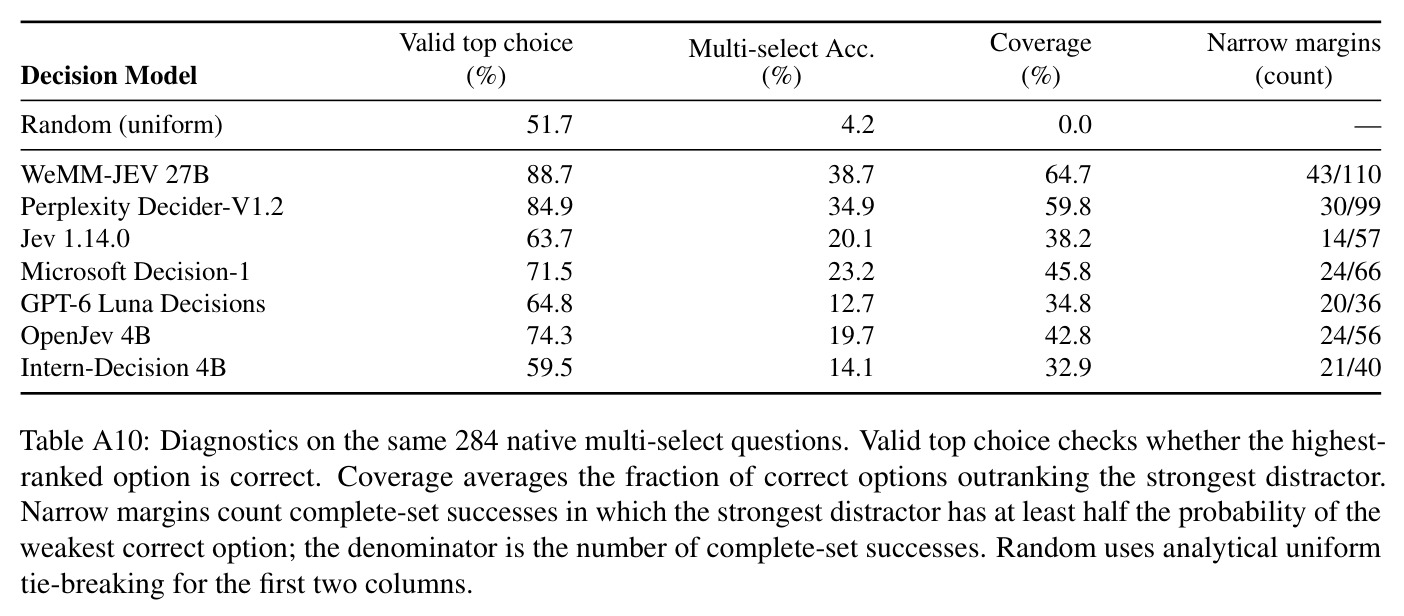
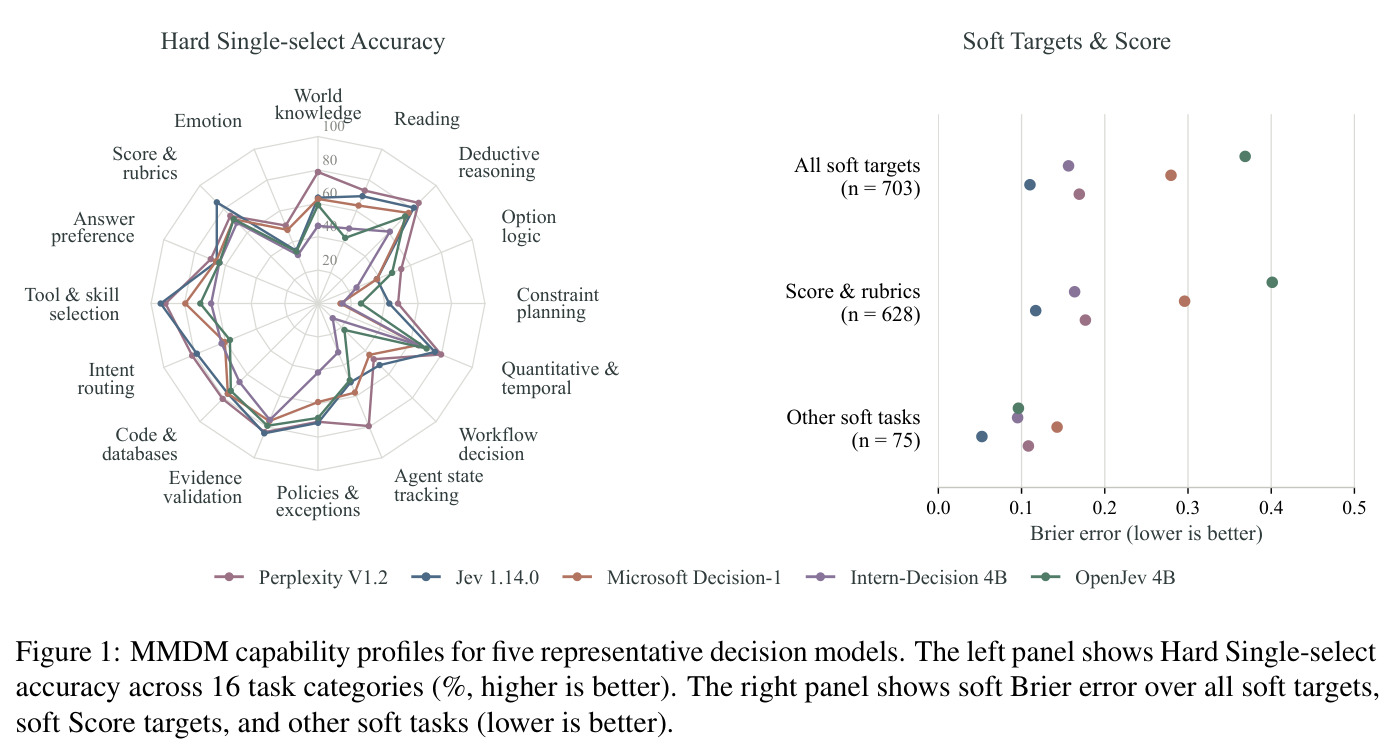
核心发现可按实验逐一梳理。(1)总体结果(Table 2,28 模型):WeMM-JEV 27B 取得最高 Hard Single-select 准确率 76.00% 和最高 Hard Multi-select 准确率 36.81%;KnowLine 31B 单选 75.07% 与其几乎持平,但 Soft Brier 只有 0.1233(WeMM-JEV 为 0.2327,近一半)、Score nMAE 0.0624(不足其三分之一),说明“相似准确率可伴随截然不同的概率质量”。闭源中 Liquid-d1-Ultra 最好(单选 73.32%);Jev 1.14.0 Soft Brier 全场最低 0.1101。所有模型 SB-F 均低于 0.20。(2)分类别单选(Table 3):Perplexity Decider-V1.2 世界知识 78.75%,但选项逻辑仅 53.95%、约束规划 47.95%;KnowLine 演绎推理 86.0% 而选项逻辑 54.6%、约束规划 48.5%,暴露联合一致性短板。类别冠军各不相同:Quyet 证据验证 89.1% 最高,Mapika 情绪识别 64.0% 最高,说明按 workload 选型必须看类别分。(3)校准(Figure 3):OpenJev 单选准确率高于 Intern-Decision,但匹配队列 ECE 更大(0.092 vs 0.085);Perplexity(0.046)与 Jev(0.054)最低,Microsoft Decision-1 最高 0.125;OpenJev 最高置信 bin 平均置信 0.97 而准确率 0.87。(4)规模扩展(Figure 4):Jev 与 Microsoft Decision-1 在 2–4 选项上仅差约 7 个百分点,在 129–1,024 选项上差距超 37 点;OpenJev 在每个选项数 bin 上都赢 Intern-Decision,但输入超 8K token 后反转——8K–16K 区间 15.5% vs 34.5%,证明长输入能力与大选项能力不可互相预测。(5)匹配队列(Table A6,n=3,706 单选/523 多选):Perplexity V1.2 比 Jev 高 7.93 个百分点(95% CI [6.41, 9.44]),而 Jev 的 Soft Brier 低 0.0592(CI [0.0515, 0.0661])。(6)多选诊断(Table A9/A10,284 题公共队列):模型间分离度中位数仅 0.113、平衡度 0.862、正确选项覆盖率中位数 37.8%;Jev 平衡 0.915 但分离仅 0.137;完整集合成功的案例中,干扰项概率达到最弱正确项一半以上的“窄边缘”比例中位数 45.6%(Luna 20/36、WeMM-JEV 43/110)。(7)案例研究(Figure 5):三模型在“先审批后编辑会使证书失效”的工作流上犯错或把假报告排在真报告之上;打分题参考分布 0.333/0.667,Perplexity 给 0.649/0.331、Jev 给 0.590/0.310,方向都反了。(8)任务条件化 ECE:Jev 总体 ECE 0.054 升到按任务加权后的 0.106,情绪识别上置信超准确 38.6%,工作流上低 29.0%。(9)期望分与分布脱节:596 道抽样 rubric 题上,nMAE ≤ 0.05 的预测其平均 TV 误差仍有 0.323(Jev)/0.306(Intern);独立准则近似保期望分(nMAE 近似为零)但 mean Brier 0.0127、TV 0.0690,说明准确期望分与准确分布需要不同的信息。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Hard Single-select(全部 4,112 题) | Accuracy(%) | 最佳模型 WeMM-JEV 27B:76.00 | Random 均匀参考 25.35;闭源最佳 Liquid-d1-Ultra 73.32 | 较随机基线 +50.65 个百分点,较最佳闭源 +2.68 个百分点 |
| Hard Multi-select(633 题) | Accuracy(%) | 最佳模型 WeMM-JEV 27B:36.81 | Random 3.28;匹配队列上最佳为 Perplexity V1.2 的 36.90 | 较随机基线 +33.53 个百分点,但绝对值低,是全文最大的能力缺口 |
| Soft-label(703 题) | Soft Brier(越低越好) | Jev 1.14.0:0.1101(全场最低) | Random 0.2051;微软 Decision-1 0.2795 | 较随机基线降低 0.0950,较微软降低 0.1694 |
| Score & rubrics 期望分(628 软标签 + 35 硬标签) | Score nMAE(越低越好) | KnowLine 31B Gen1:0.0624(全场最低) | Random 0.1624;WeMM-JEV 0.2203 | 较随机基线降低 0.1000,不足 WeMM-JEV 的三分之一 |
| 选项逻辑 / 约束规划(单选) | Accuracy(%) | Perplexity Decider-V1.2:选项逻辑 53.95、约束规划 47.95 | 同模型世界知识 78.75 | 相对其世界知识下降 24.8 与 30.8 个百分点,揭示联合一致性短板 |
| 大选项空间(129–1,024 选项,单选) | Accuracy(%) | Perplexity 在最大 bin 保持最高;OpenJev 26.0 | Intern-Decision 8.3;2–4 选项时 OpenJev 与 Intern 差距方向相反 | Jev 与 Microsoft 在大 bin 差距超 37 个百分点,而小选项 bin 仅约 7 个百分点 |
局限与改进
作者明确承认三点局限。第一,MMDM 只覆盖由固定 state–query–options 定义的文本决策,未涉及多模态输入与交互式轨迹,而真实 agent 决策常是动态多轮的。第二,633 道多选题集中在选项逻辑、约束规划、工作流和工具/技能选择四类,703 道软标签中 628 道来自 rubric 打分,主观判断(如人类评分的个体差异)的评测需要更好的参考分布。第三,虽然新构与重写降低了记忆效应,对底层公开材料的先前暴露仍可能发生,污染无法完全排除。我的补充观察:(1)多选准确率把 $|G|$ 同时用作评测截断和每组保留数,这一协议选择本身会影响分数的可比性;(2)容量失败依赖各模型不同的选项上限(16 到 100,000 不等),跨模型比较时任务组合并不完全对齐,尽管 Table A6 的固定队列部分缓解了这一点;(3)状态中部截断的中切策略对依赖长文档中部证据的模型可能不利;(4)模型版本快照式评测(如 Jev 1.14.0)在快速迭代的 API 模型上时效性有限;(5)软标签参考全部来自题目内显式机制,可能高估模型在真实模糊场景下应有的人类不确定性对齐难度。
独立分析的弱点
独立分析的弱点及改进方向如下。其一,多选题占比仅 11.6%(633/5,448)且类别集中,导致“完整集合恢复”这一关键结论的统计功效有限,改进方向是为互指命题、约束规划生成更大规模的机制化多选题族。其二,软标签的不确定性全部由题目显式给出(如“服务 70% 概率可用”),模型只需做条件概率计算而非真实世界的不确定性建模,改进方向是引入多人标注分布或校准的人类预测作为参考。其三,分组推理协议下多选准确率骤降(Perplexity/Jev 仅 7.14%,Microsoft 0.00%),说明递归归并对现有模型完全不友好,但论文未探索更优的目录缩减策略(如基于嵌入的预筛),这是协议与模型协同改进的机会。其四,SB-F 中分离度用 $\max(p_i - b, 0)$ 截断,对正确集合概率整体偏低的模型惩罚极重,可能低估其在排序意义上的能力,可报告排序版指标做敏感性分析。其五,重写题的“源保留”路线(2,880 题)仍是污染的可能通道,可引入 canary 字符串或 membership-inference 探针量化残余污染。其六,ECE 只在单选唯一最大值队列上计算(3,537 题),多选与软标签的校准评估缺失。
未来方向
作者在结论与局限中提出的方向包括:扩展到多模态输入与交互式轨迹;构造更好捕捉人类评估差异的软参考;持续更新榜单以跟踪快速迭代的决策模型。基于本文成果还可延伸:第一,把机制化构造(真值表枚举、约束枚举、SQLite 重放)做成自动出题引擎,用于决策模型的训练数据合成,直接针对多选完整恢复与联合一致性做后训练;第二,把 SB-F 的分离–平衡分解作为训练损失正则,鼓励模型在正确集合内均衡分配概率并拉开与干扰项的差距;第三,研究任务条件化校准(per-task temperature scaling 或 routing),因为论文证明同一置信阈值在不同任务上的错误率差异巨大(Jev 情绪上过自信 38.6%、工作流上欠自信 29.0%);第四,探索长输入与大选项空间的联合扩展律,回答“更长目录 + 更长状态”的双重要求下模型何时崩溃;第五,把 MMDM 嵌入端到端 agent 评测,验证单步决策质量与最终任务成功率的相关性。
复现评估
复现条件较好。数据集发布于 HuggingFace(shenjunhao/mmdm),评测工具包开源在 GitHub(mmdm-benchmark/mmdm),项目页 mmdm-benchmark.github.io 维护榜单;工具包支持下载数据或读本地 JSONL、断点续跑、导出预测与指标。评测侧:28 个模型约一半是闭源 API(Jev、Perplexity、Microsoft、GPT-6 Luna、Liquid、Clef 等),需 key 与费用;开源模型最大 31B(WeMM-JEV、KnowLine、Decisio-Gemma-4-31B),单张 80GB A100/H100 可部署,4B 级(OpenJev、Intern-Decision 等)消费级显卡可跑。协议细节充分:上下文预算、选项上限、分词器、分组种子、平局阈值 $10^{-12}$、失败计错规则均写入 Table A4 与附录 C。难点在数据构建侧——五模型筛查需五个前沿模型调用,928 例人工复核需评审人力,完整重建成本高;但用已发布数据复现评测是低难度的。总结:评测复现容易,构建复现中等偏难,工程量主要在多模型部署与 API 成本。
论文图表
三个定性案例:(a) 工作流前置条件——Perplexity V1.2 以 0.353 概率选择“先审批后编辑再发布”的无效流程(后续编辑使证书失效),Jev 与 Microsoft 选对;(b) 互指报告——Hazel 的报告在唯一一致解释下为假,但三个模型都把至少一个真报告排在它之下(pHazel 与最小 ptrue 分别 0.083/0.075、0.120/0.110、0.075/0.067);(c) 抽样打分——参考分布 Score3=0.333/Score4=0.667,Perplexity 给 0.649/0.331、Jev 给 0.590/0.310,主导档位方向反了,Microsoft 档位对但分布错。
把抽象指标翻译成可触摸的失败模式:接受冲突工作流、互指命题分辨失败、期望分对但分布错,是理解“多选与软标签为何难”的最直观材料。