BEND 2.0:评测 DNA 设计所需能力的基准 BEND 2.0: Benchmarking the Capabilities Needed to Design DNA
八项任务评测基因组模型的设计能力:平均效应预测强,情境与交互预测弱。
前置知识
基因组基础模型(DNA 语言模型)
在海量 DNA 上自监督预训练(掩码重建或下一词预测)的大型 Transformer,如 Evo2 20B、CENO、DNABERT-2、NTv3;部分模型(NTv3 post、AlphaGenome、Enformer)再用功能基因组数据监督训练,能直接输出剪接、可及性等功能 track。
全文评测的对象就是这些模型:模型选型、输入构造、读出方式(嵌入探针 vs 原生输出)是理解所有实验结果的前提。
MPRA(大规模并行报告分析)
把数十万条序列变体连同条形码批量转染进细胞,用 RNA 与 DNA 读数之比估计每条序列的功能活性(表达倍数、剪接 PSI、编辑效率),一次实验测完整个突变文库。本文 Siraj、OpenSplice、COMPASS、Atlas、K562 TRIP 均属此类。
理解任务标签从哪来、实验参考(用一组重复测量选择、另一组评估)如何构造、以及为何交互任务的复测相关(0.171)会限制模型分数的天花板。
线性读出(linear probe / 线性探针)
冻结模型参数,只在序列嵌入上拟合 ridge 线性头,检验嵌入中是否含某信息;变异效应拟合用变体与参考嵌入之差 $\Delta y = w^\top[\phi_\theta(x+\delta) - \phi_\theta(x)]$,与原生输出分开报告对照。
这是基准的主要评测通道;『线性读出可匹敌甚至超过原生输出』是本文核心发现之一,直接影响从业者该怎样使用模型。
上位性 / 遗传交互(epistasis)
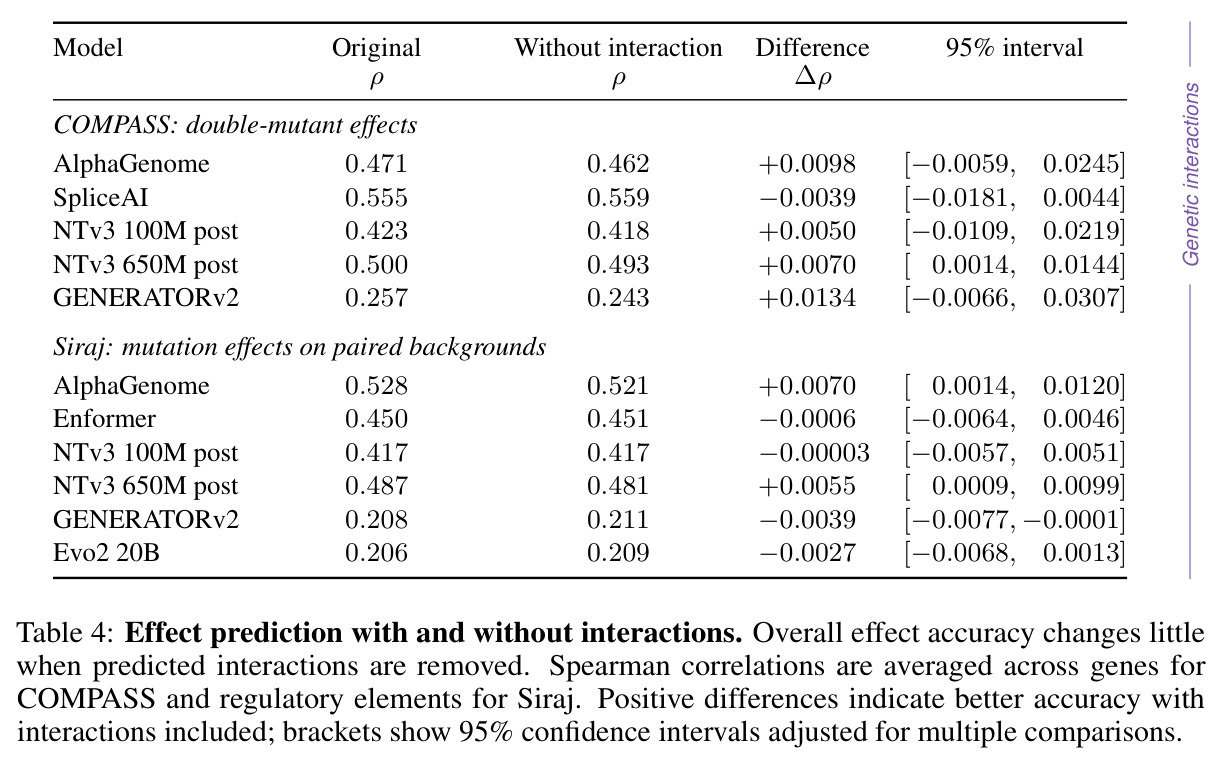
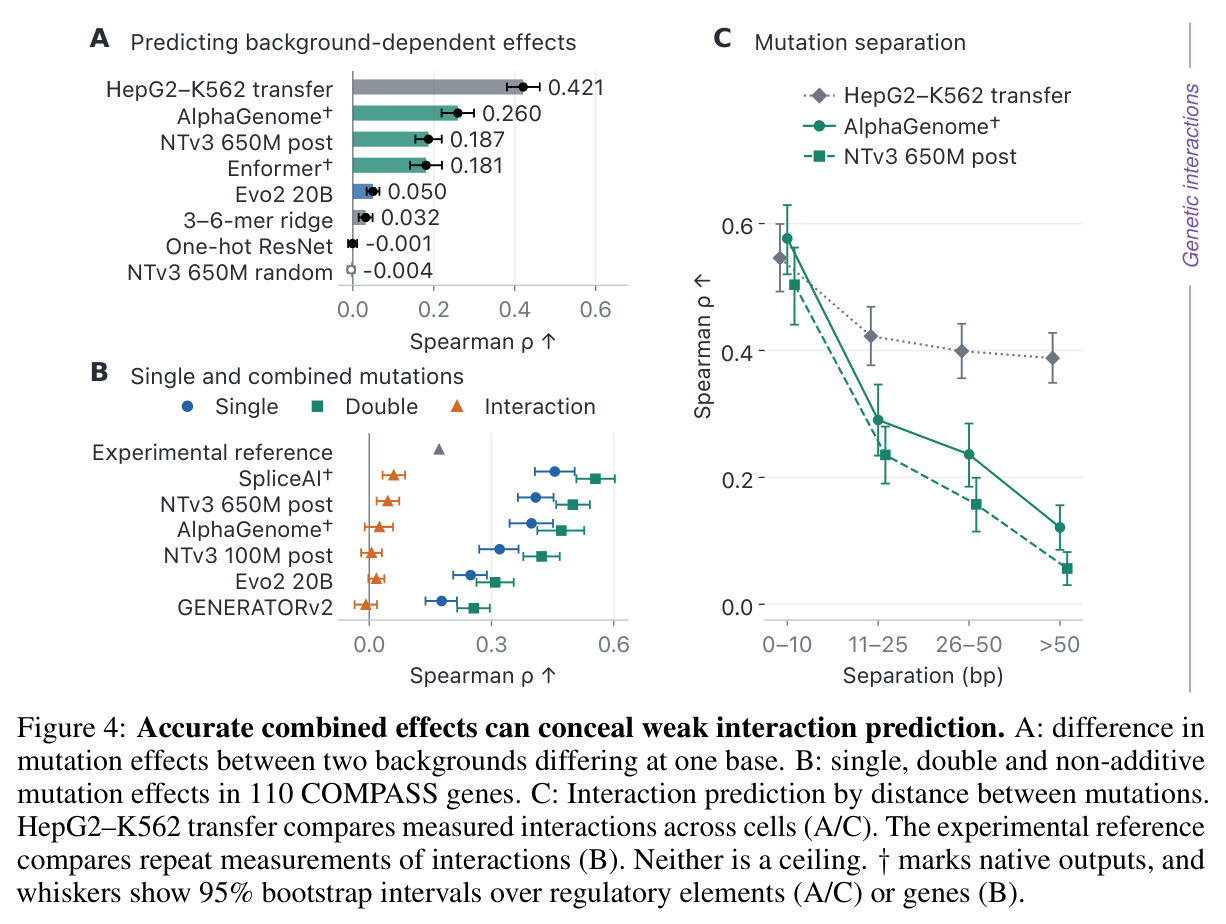
两个突变联合后偏离各自效应之和的非加性部分:$I_{1,2} = \Delta y_{1+2} - \Delta y_1 - \Delta y_2$。加性项预测准不代表交互预测准。本文将其单列为一类能力,并用『去掉预测的交互项后整体相关性几乎不变』这一干预实验来检测模型是否真学到了交互。
交互预测是本文最重要的反直觉发现(NTv3 交互相关仅 0.046),也是组合效应准确容易造成误判的根源。
macro 平均 Spearman 相关
Spearman $\rho$ 度量预测与测量的秩相关。本文先在每个基因/元件内计算,再对所有 $G$ 组等权平均 $\rho_{\text{macro}} = \frac{1}{G}\sum_g \rho_g$,避免大基因主导;置信区间用组块 bootstrap。
论文所有指标都按此口径报告(如『macro-gene Spearman 0.650』),是读懂 Table 1 与各图数字的前提。
序列先验与 bits/base
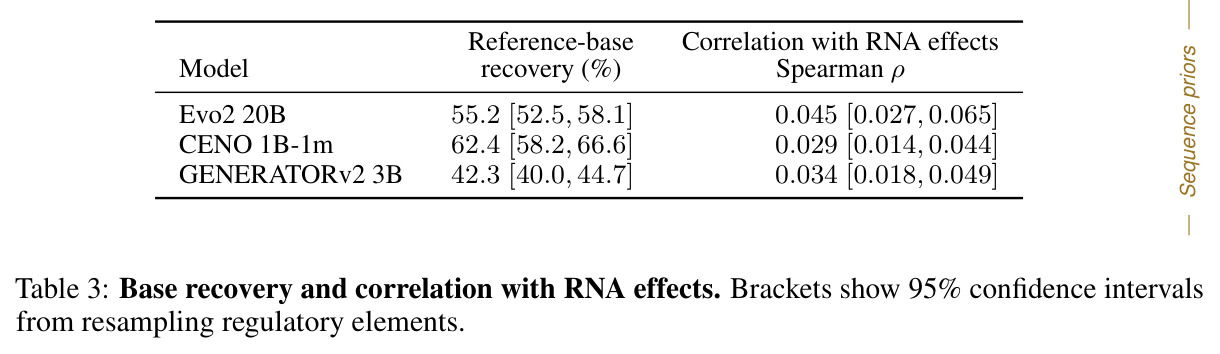
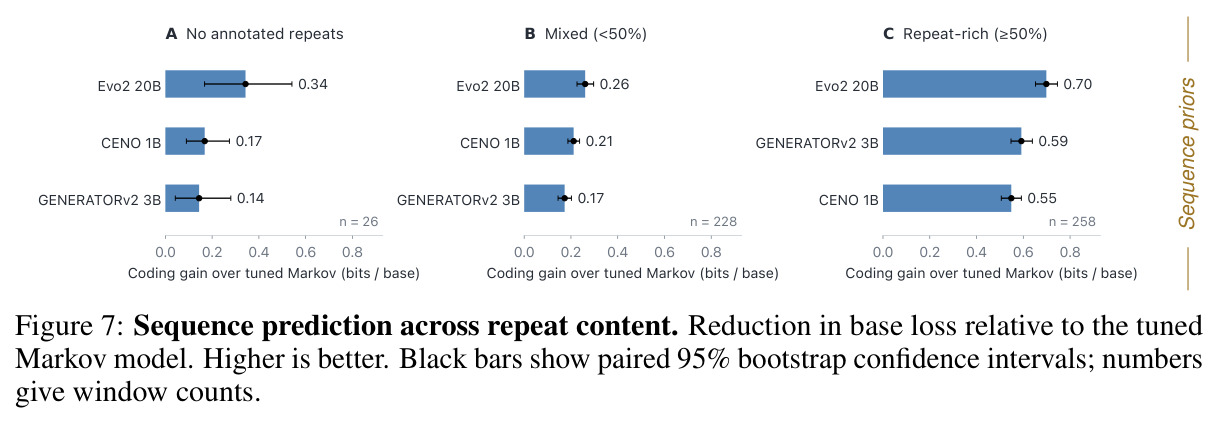
模型对 DNA 序列的概率质量:隐藏一个碱基,用 $-\log_2 p_\theta(x_i \mid \text{context})$ 度量,均匀猜测 2 bits,越低越强。先验强不等于懂功能:Evo2/CENO 重建 55.2%/62.4% 碱基,与表达效应相关仅约 0.03–0.05。
Prior 是五能力之首,也是『功能后训练反而损害先验可访问性』这一方法论发现的主战场(附加掩码、激活移位等技巧都由此而来)。
变异效应预测(VEP)与情境分解
预测突变对分子表型(剪接 $\Delta\Psi$、表达 $\log_2$ 变化、编辑效率)的影响,是设计的前置能力;情境分解把多细胞测量拆成 $y^c = \bar{y} + \kappa^c$,分别评均值与情境偏差 $\kappa^c$。
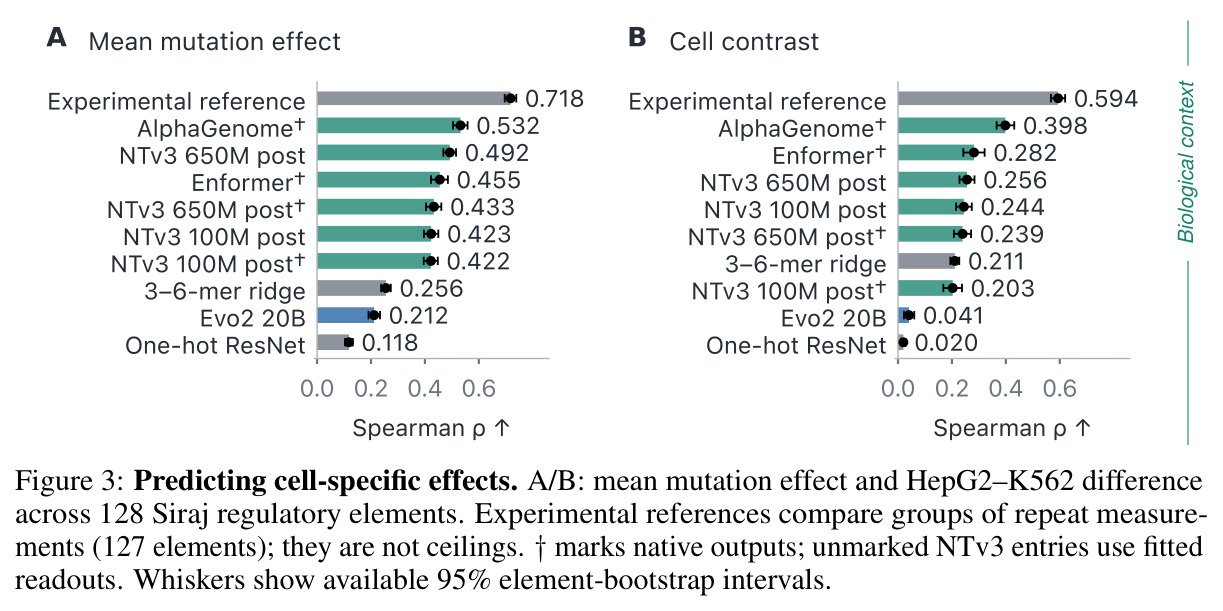
论文证明平均效应好预测而情境差难预测(AlphaGenome 0.532 vs 0.398),而细胞类型特异性设计恰恰依赖后者。
研究动机
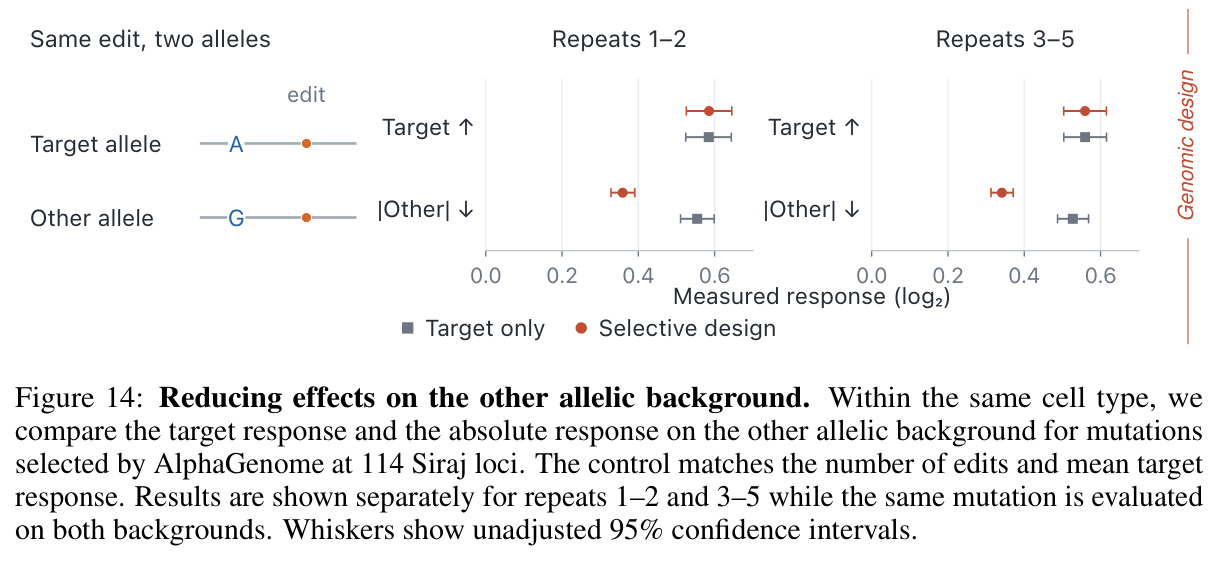
想微调一段调控序列活性的生物学家,往往面对数百个候选突变;而同一个突变在不同细胞类型(如 HepG2 与 K562)或仅差一个碱基的遗传背景上,效应可能截然不同。要帮实验者挑选,模型必须分辨细粒度、情境相关的差异。但现有评测(原版 BEND、GenBench、OmniGenBench)只报告整体预测精度,无法回答『模型到底学到了什么』:一个基于序列的分数可能只是识别了进化约束位点,却预测不了该突变在特定细胞类型中对表达的影响;单个突变预测准确,不能说明模型捕捉了突变间的交互或不同遗传背景下的效应变化;能区分高活性与低活性基因,也不代表知道哪个编辑会产生想要的表达改变。这些对设计至关重要的能力区分,此前从未被系统测量过。
本文的目标是本文要构建一个围绕『DNA 设计所需能力』的系统性基准 BEND 2.0(原版 BEND 的升级),回答两个问题:基因组模型究竟能预测什么?这些预测能否帮实验者从候选中选出产生目标响应的 DNA 序列?基准围绕五种互补能力组织:序列先验(Prior,DNA 有多大概率)、功能预测(Function,序列能否预测实验测量)、生物学情境(Context,功能如何依赖细胞类型/组织)、遗传交互(Interaction,一个突变是否改变另一个突变的效应)、基因组设计(Design,哪个候选能实现目标响应)。八个任务建立在五个实验数据集之上,同时纳入基因组基础模型、简单基线(k-mer ridge、one-hot ResNet)、专用模型(SpliceAI)与实验参考,使『模型帮了多少忙、还差多远』可以被量化比较。
与已有工作不同的是,本文的独特切入是把『预测评测』与『设计搜索』两条线接起来。原版 BEND、GenBench、OmniGenBench 只系统性评测下游任务的表征质量;NucleoBench 只评把预测模型当打分函数的搜索算法;Gosai 等人的模型引导设计实验证明了应用价值,却没有解剖能力边界。BEND 2.0 专门测量对设计最重要的预测区分:情境特异效应、突变间交互、候选间的功能差异。方法上做了三件前人未做的事:其一,在数学上把平均效应与情境偏差($y^c = \bar{y} + \kappa^c$)、加性预期与交互项($\Delta y_{1+2} = \Delta y_1 + \Delta y_2 + I_{1,2}$)分离,使『组合效应准但交互差』无所遁形;其二,对同一模型同时报告原生输出与冻结嵌入线性读出,揭示查询方式本身会改变测得的能力;其三,在每个设计任务中引入实验参考——用一组重复测量做选择、另一组评估——作为『库内还有多少提升空间』的经验标尺,且参考并非上限,模型有时可以超过它。
核心方法
BEND 2.0 把五种能力数学化。先验:掩码碱基预测的 $-\log_2 p_\theta(x_i \mid \text{context})$;功能:从 $(x, x+\delta)$ 估计实验效应 $\Delta y$,在留出基因上测跨 assay 迁移;情境:分解为均值与情境偏差 $y^c = \bar{y} + \kappa^c$;交互:单独打分加性预期之外的交互项 $I_{1,2}$;设计:求 $a^\star = \arg\min_{a \in C}\ \ell(\hat{y}(a), y_{\text{target}})$,在已测量候选库内选择。主要预测通道是冻结嵌入上的线性读出:变异效应拟合 $\Delta y = w^\top[\phi_\theta(x+\delta) - \phi_\theta(x)]$ 的 ridge 回归;相关先在基因/元件内计算再 macro 平均 $\rho_{\text{macro}} = \frac{1}{G}\sum_g \rho_g$;数据按基因、元件、位点或家族整组留出,用块 bootstrap 给置信区间。
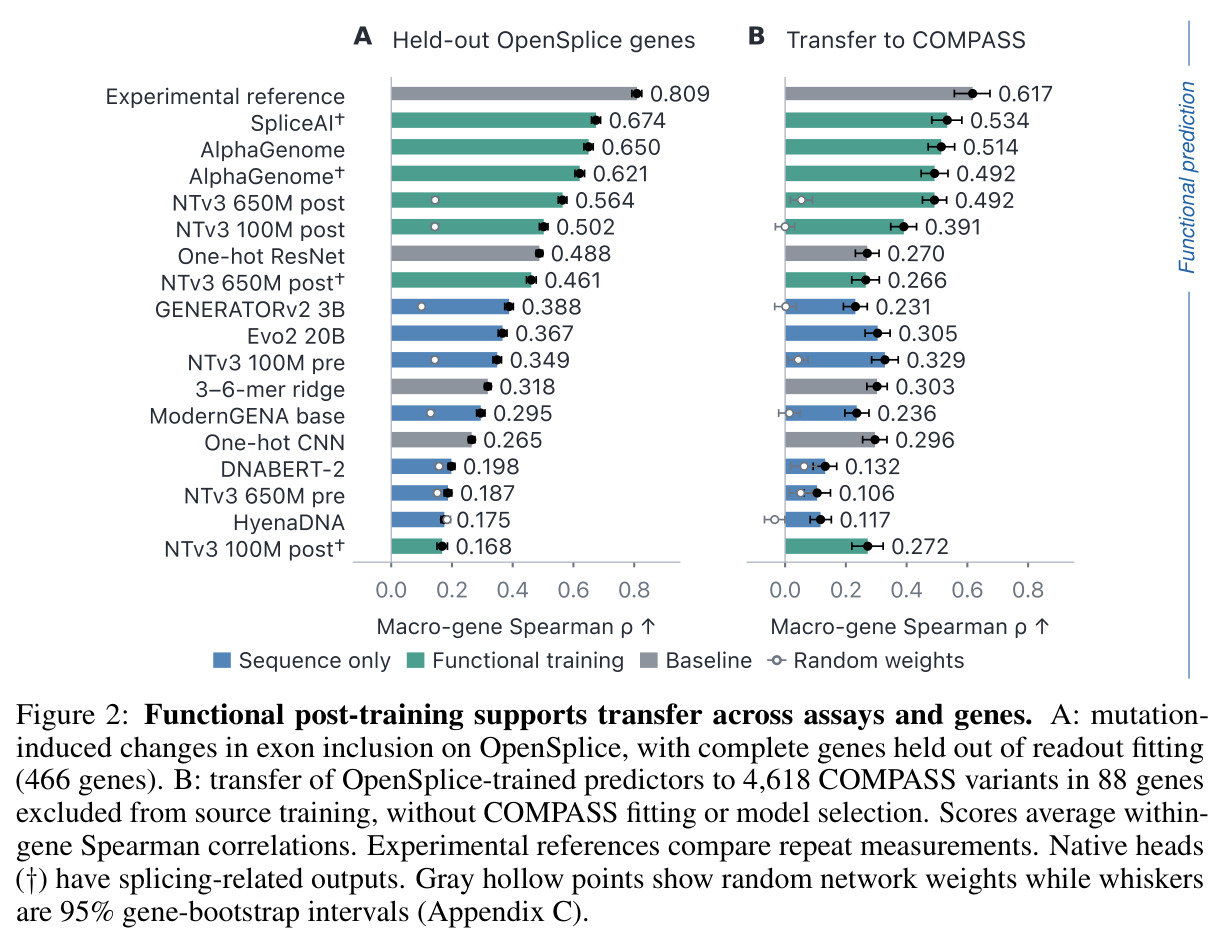
核心创新是『能力分解 + 双通道读出 + 实验参考』三位一体的评测设计。第一,分解式任务让混淆无处藏身:Siraj 数据同时测同一突变的平均效应与 HepG2−K562 差异,COMPASS 同时测单突变、双突变与扣除加性项后的交互 $I_{1,2}$——于是发现 NTv3 双突变相关 0.500、交互相关仅 0.046;再做干预实验:把预测交互项去掉(用两单突变之和代替双突变预测),双突变相关性只从 0.500 降到 0.493,证明模型基本没学到交互,组合效应的准确几乎全靠加性项。第二,原生输出与线性读出分开报告,发现读出常能匹敌甚至超越原生输出(AlphaGenome 剪接 0.650 vs 原生 0.621),且 NTv3 功能后训练的收益同样体现在嵌入中,说明后训练改变了模型本身而不仅是输出头。第三,每个设计任务都有实验对照:均匀选择、匹配预测效应的对照选择、以及用重复测量互验的实验参考,把『模型有用』量化为『比均匀/对照好多少、离实验参考还差多少』。
方法步骤详情
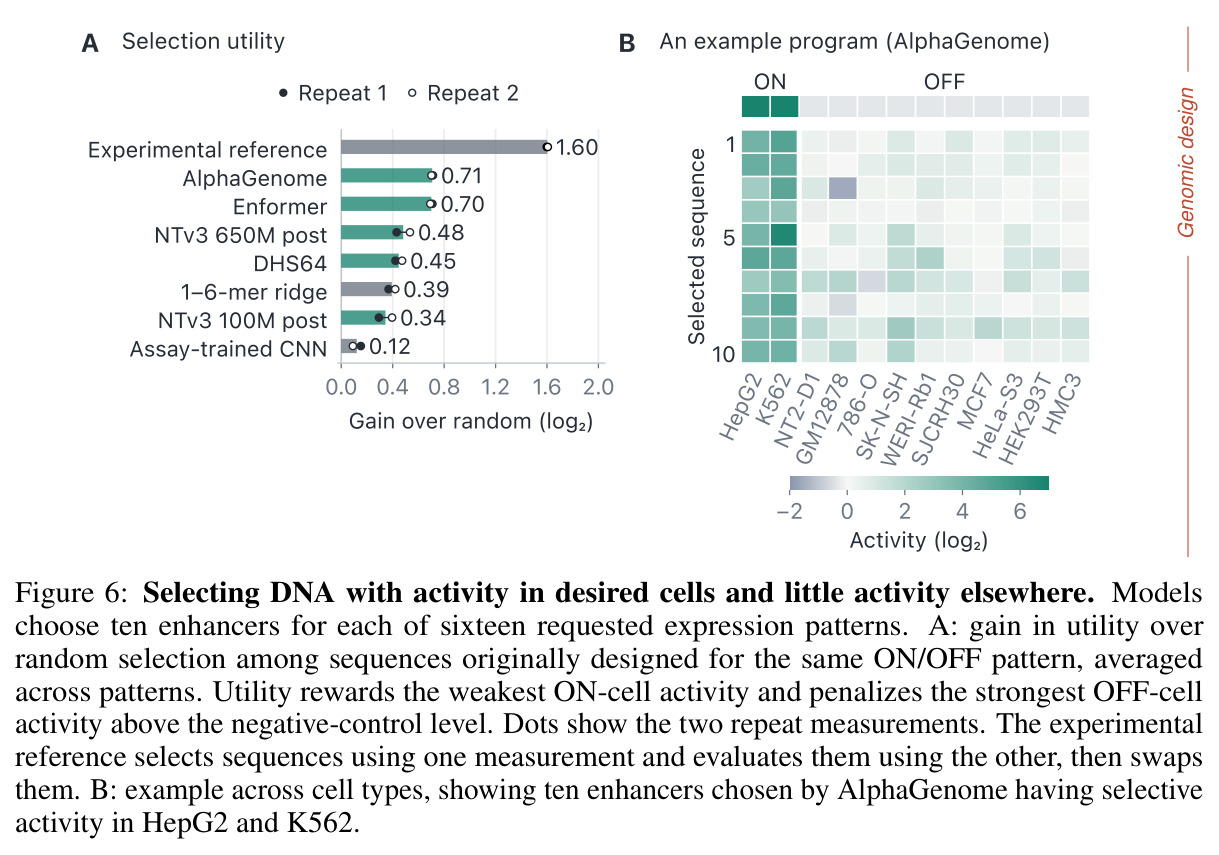
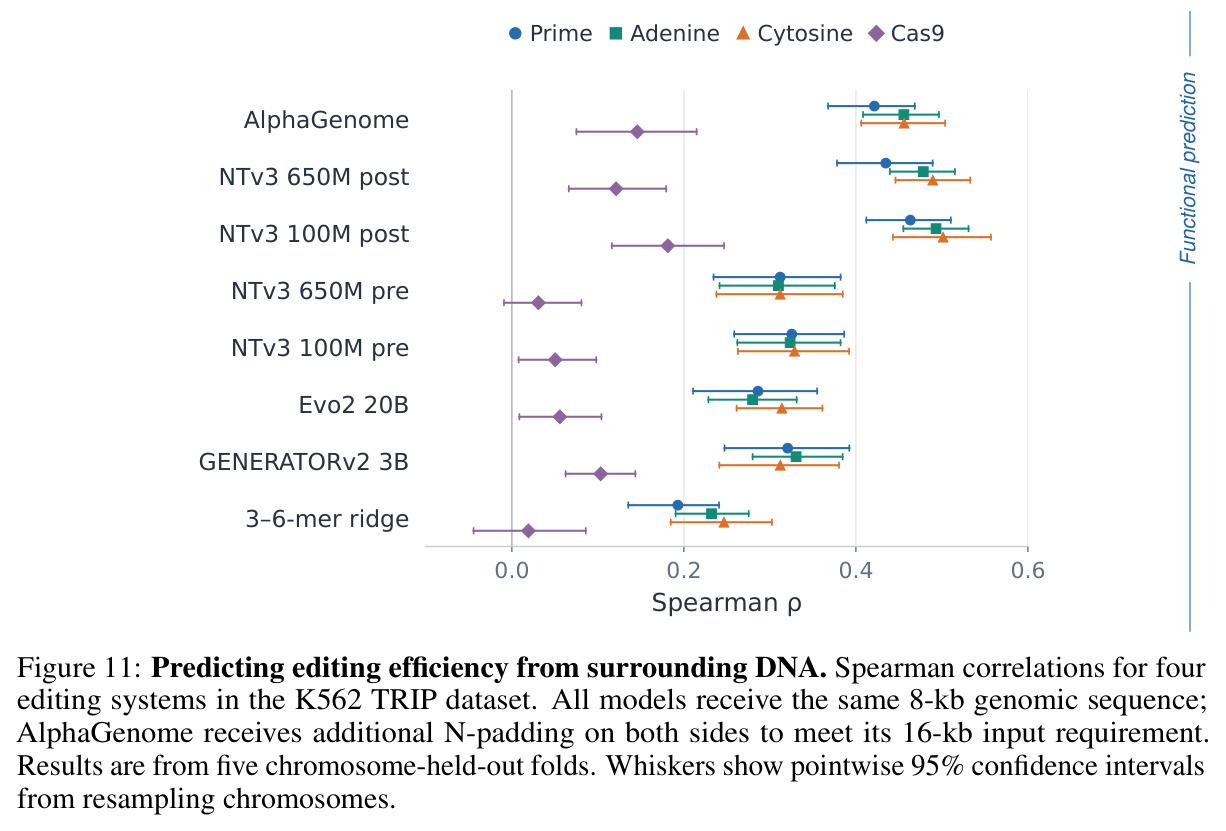
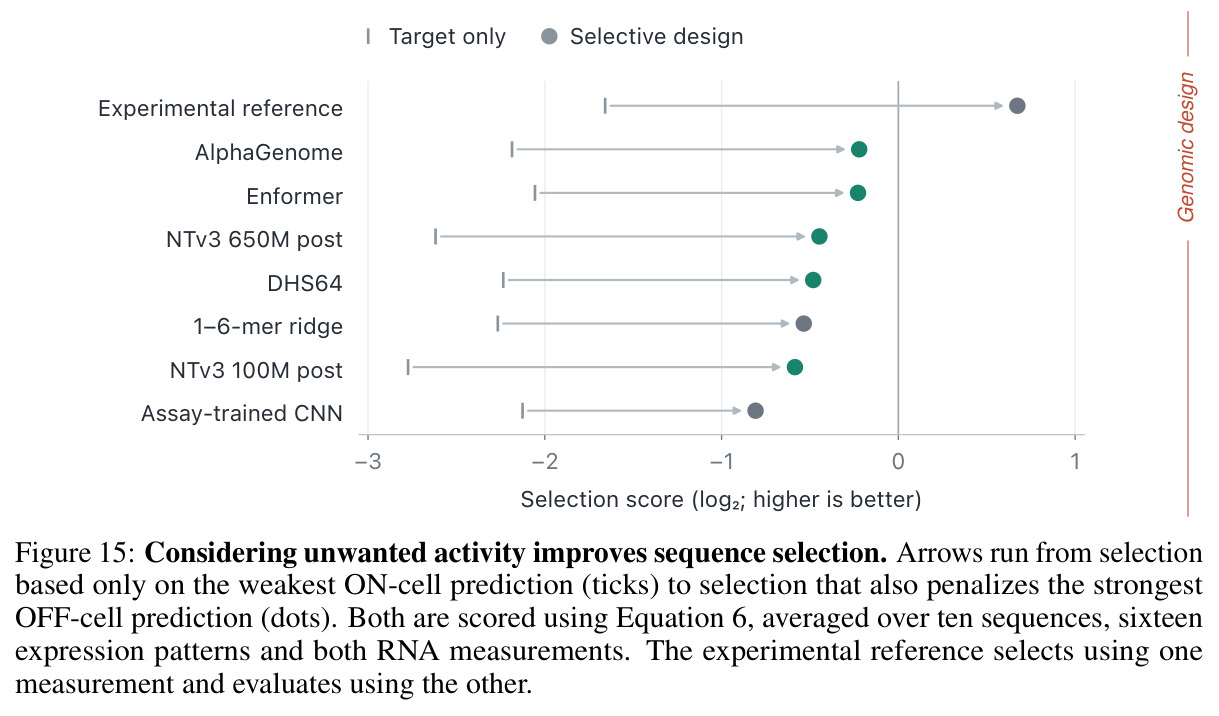
(1) 先验:512 个 1,200bp GRCh38 窗口隐藏中心碱基;NTv3 附加 12% 掩码。(2) 剪接:OpenSplice 590,104 突变 × 466 基因,整基因留出拟合 ridge。(3) 迁移:零适配测 COMPASS 4,618 变异 × 88 基因。(4) 编辑效率:K562 TRIP 1,196 位点 × 4 种编辑系统。(5) 细胞:Siraj 128 元件,评 HepG2/K562 平均效应与细胞差。(6) 组织:GTEx 5,782 基因 × 51 组织对比与识别。(7) 交互:Siraj 68,026 配对突变;COMPASS 110 基因 15,035 单 + 48,054 双突变。(8) 设计:单编辑匹配(331 目标);细胞选择性设计(167,958 替换 × 280 亲本,$U = t - \lambda|o|$);Atlas 多细胞选择(2,411 增强子、16 模式各选 10,$U_{\text{multi}} = \min_{\text{ON}} y - \max(0, \max_{\text{OFF}} y)$)。各配实验参考。
技术新颖性
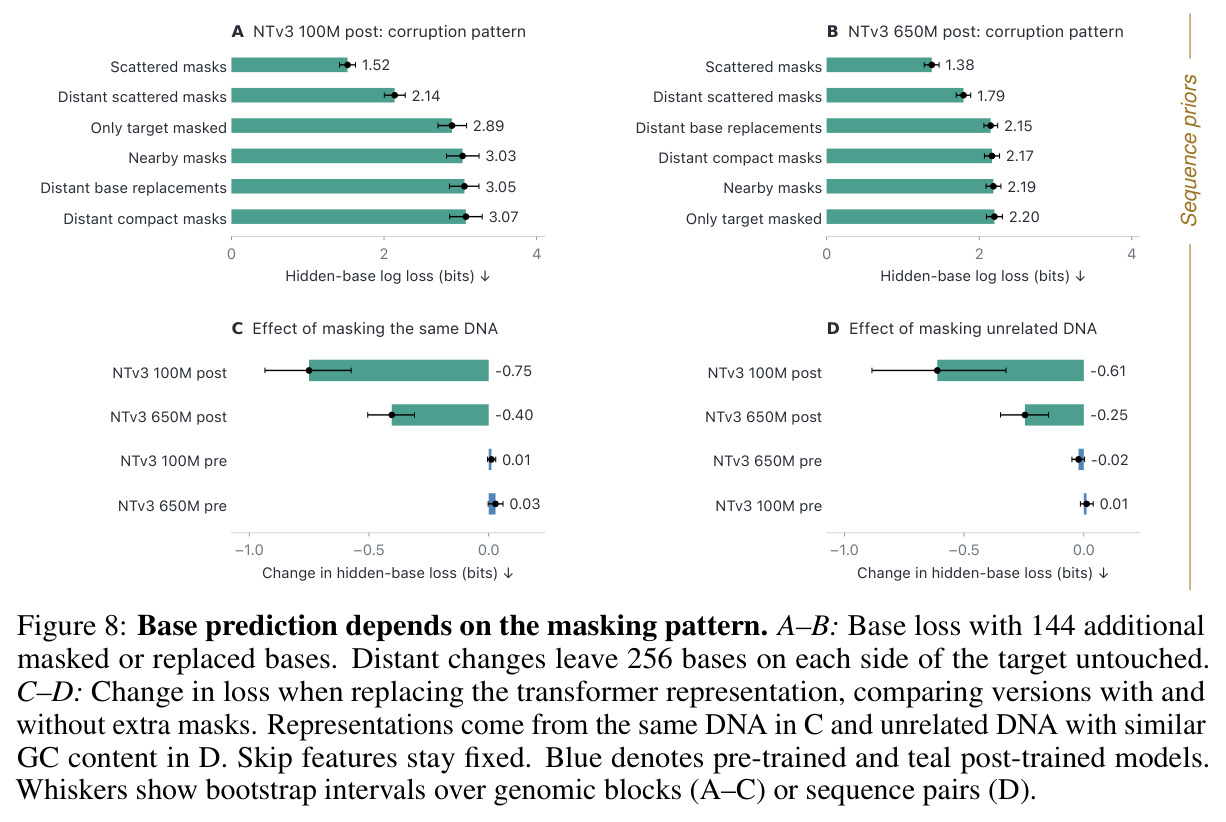
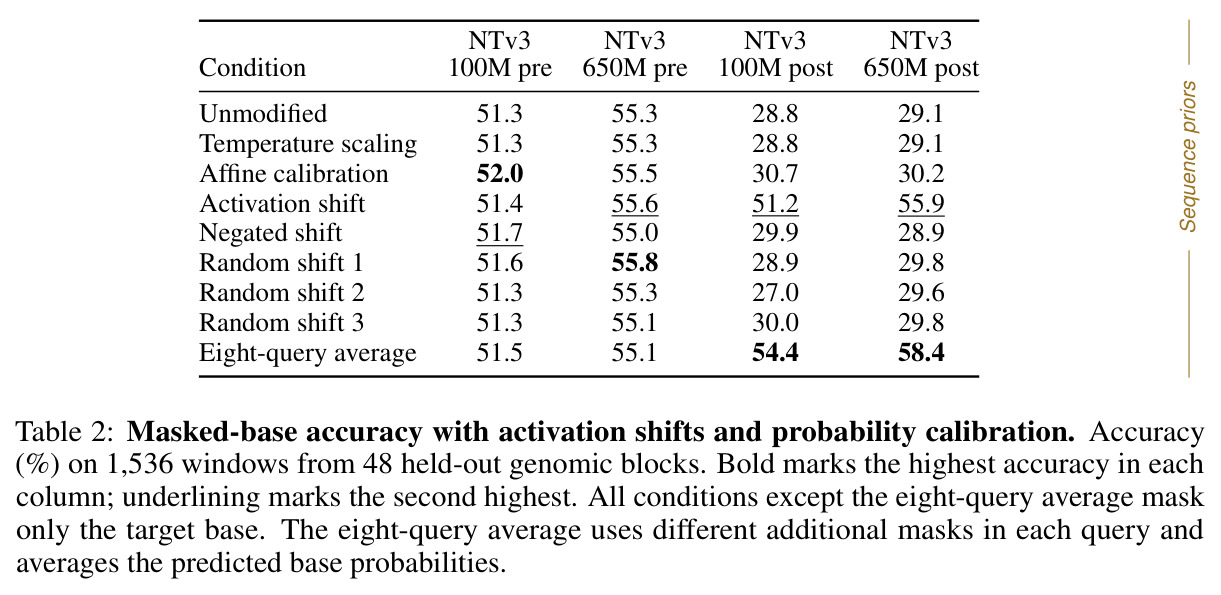
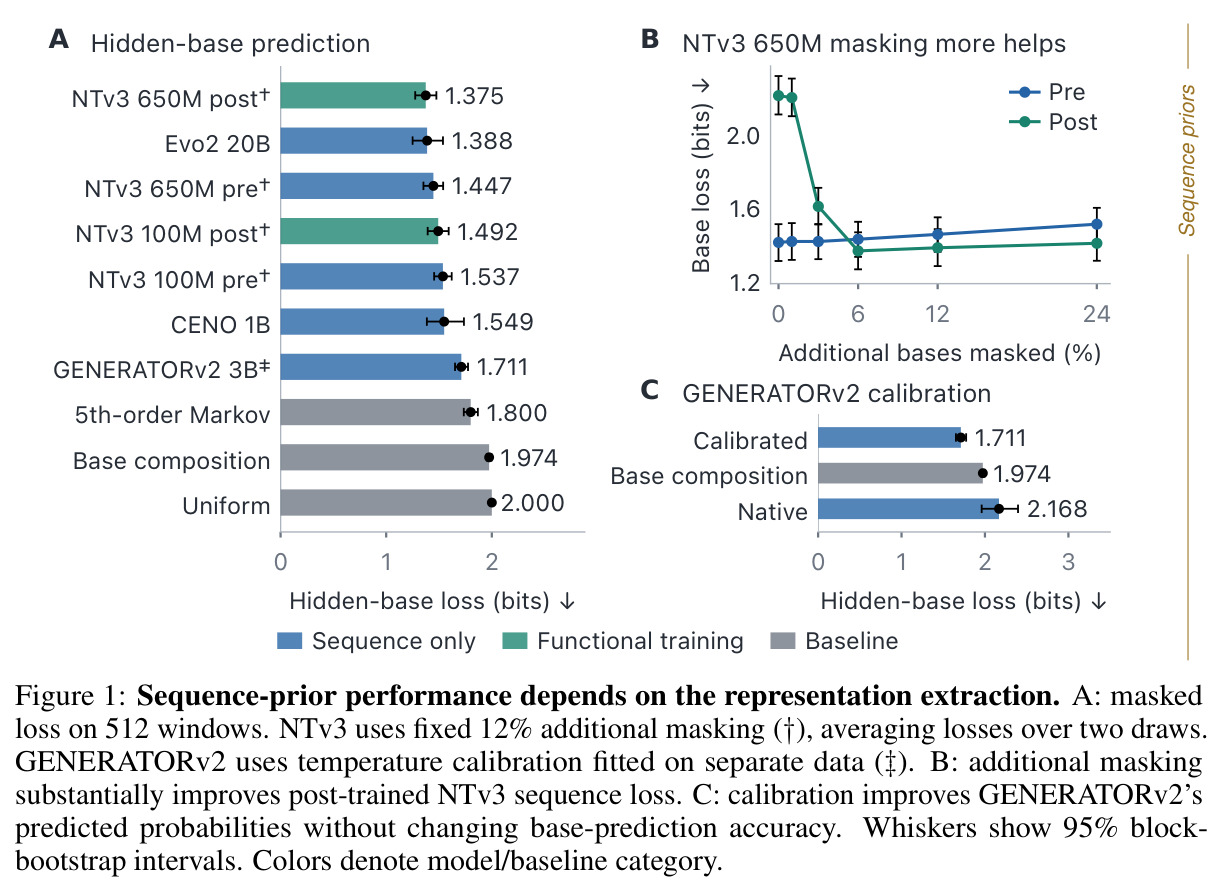
技术新颖性四点。其一,从『下游任务准确率』转向『设计能力』范式:Prior/Function/Context/Interaction/Design 五层递进,每层定位具体短板,是评测范式的升级。其二,揭示被忽视的『查询方式』变量:NTv3 post 仅掩中心碱基 loss 2.199 bits,附加 12% 掩码降到 1.375;固定激活移位向量 $\Delta_\ell = \frac{1}{NL}\sum_{n,t}(h^{\ell,t}_{\text{additional}} - h^{\ell,t}_{\text{single}})$ 就能把掩码碱基准确率从 29% 恢复到 56%;GENERATORv2 只做温度校准 $q_T(a \mid r) \propto q(a \mid r)^{1/T}$ 即把 loss 从 2.168 降到 1.711 而准确率不变——测得的『能力』部分是接口问题。其三,把实验测量当参照系而非真值:交互复测相关仅 0.171,难任务分数须结合实验可靠性解读。其四,统计严谨:块 bootstrap、Bonferroni 校正,主表附 95% 区间。
实验结果
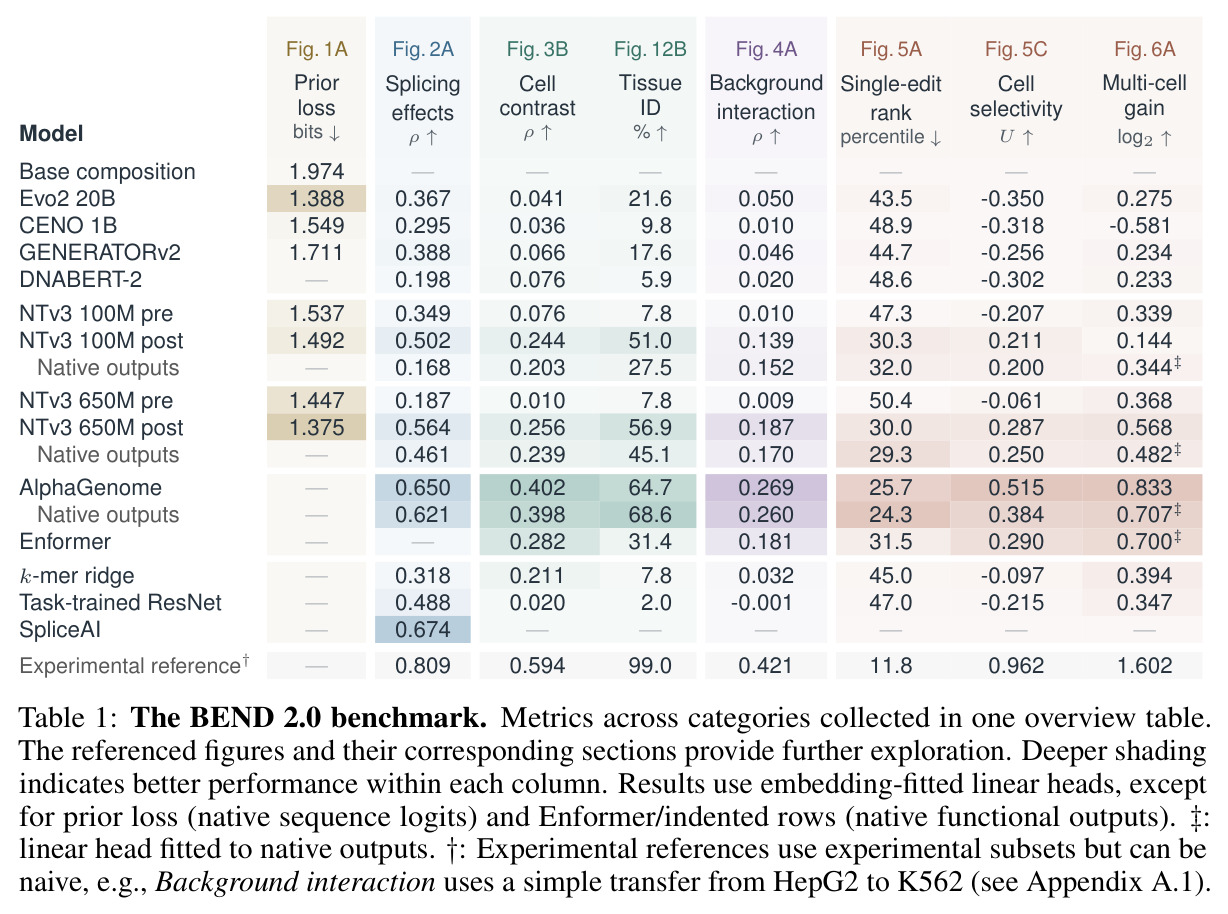
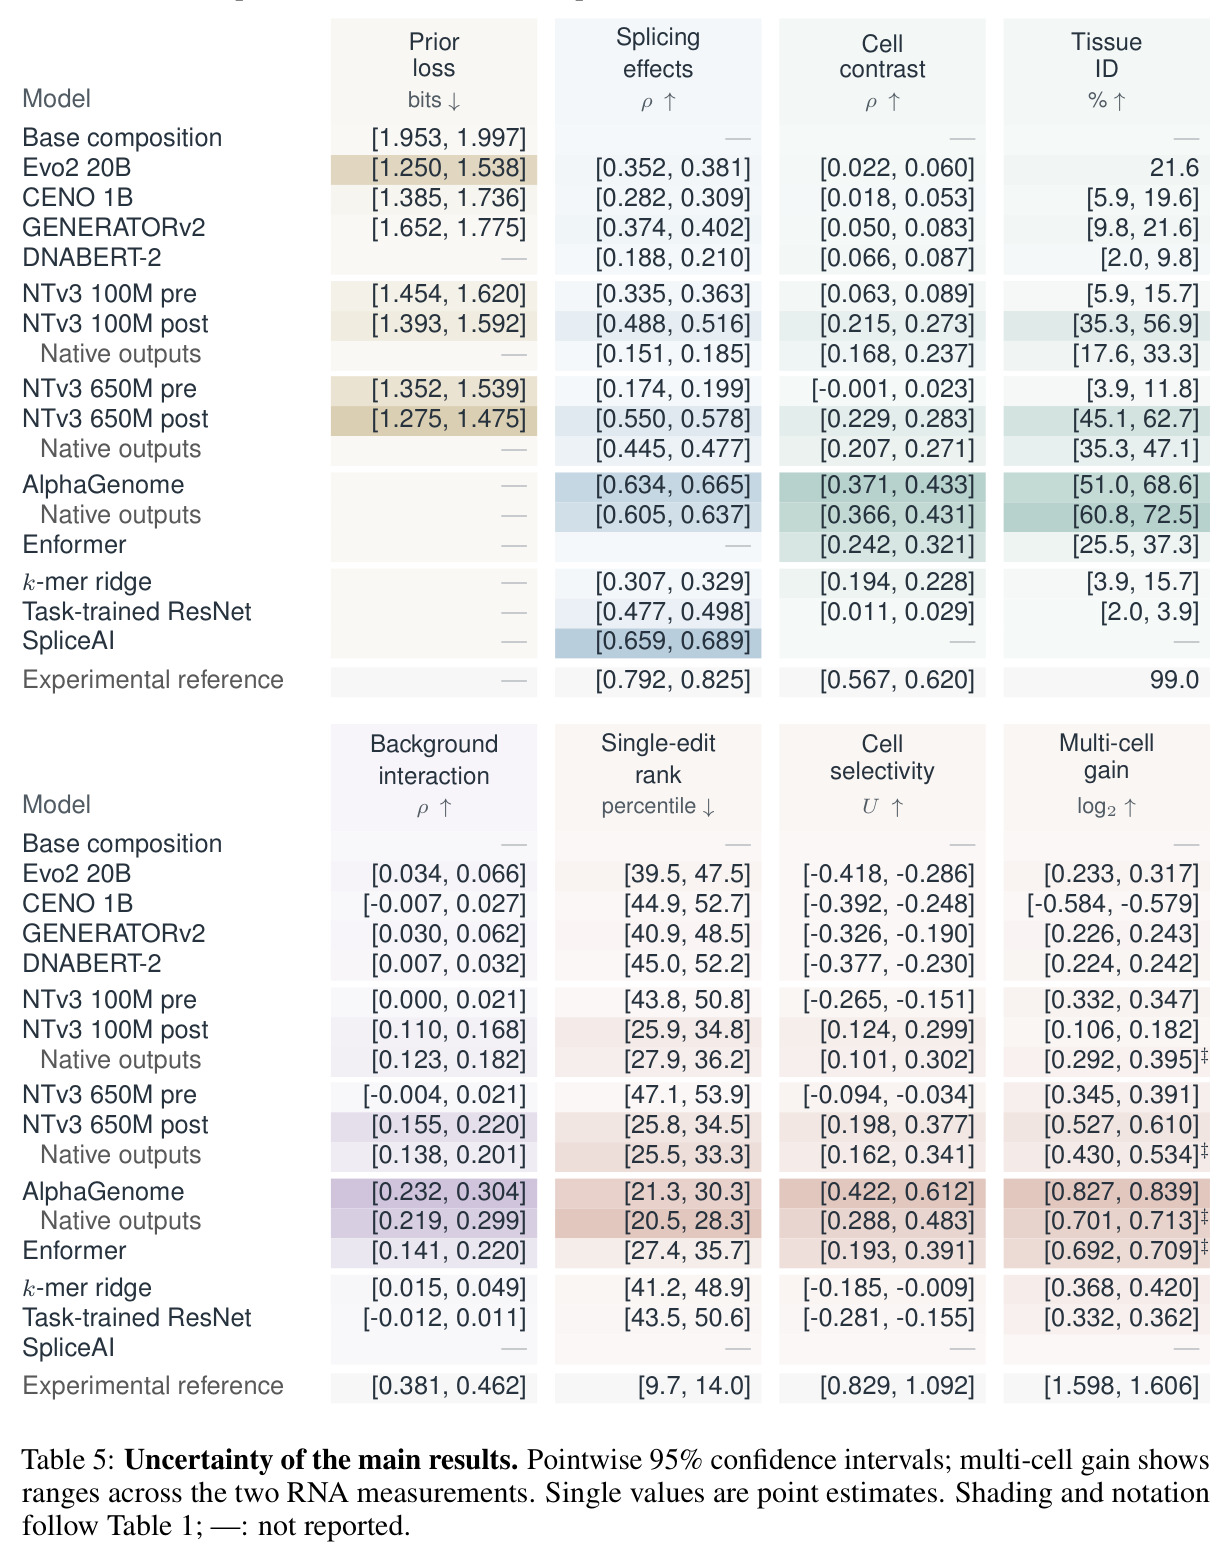
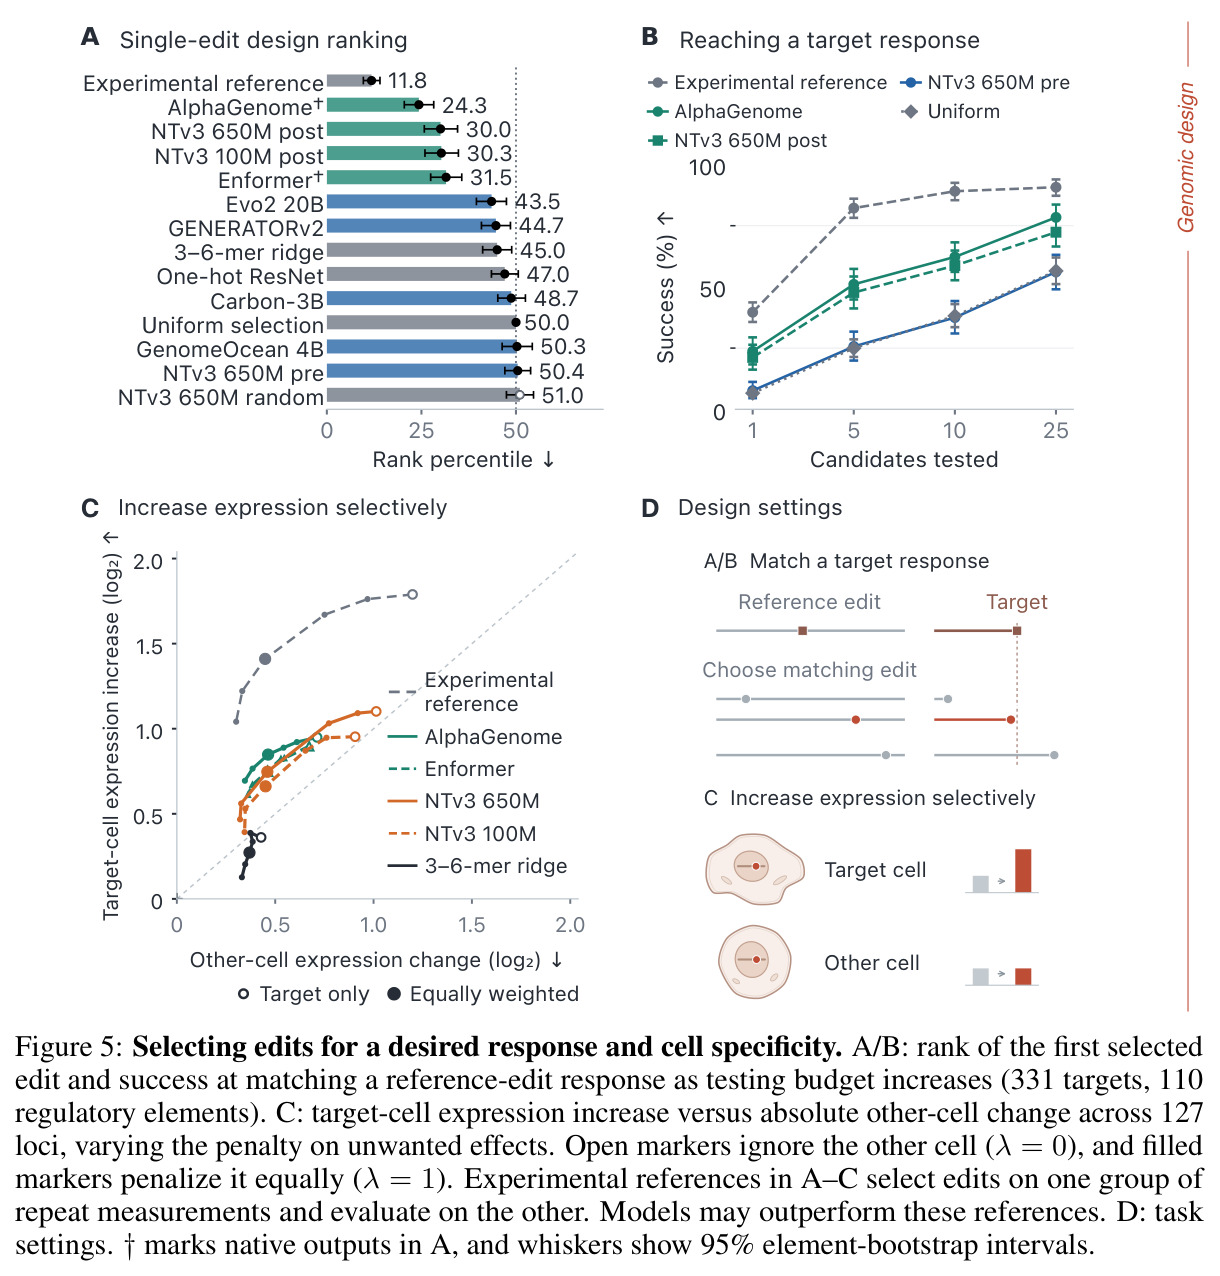
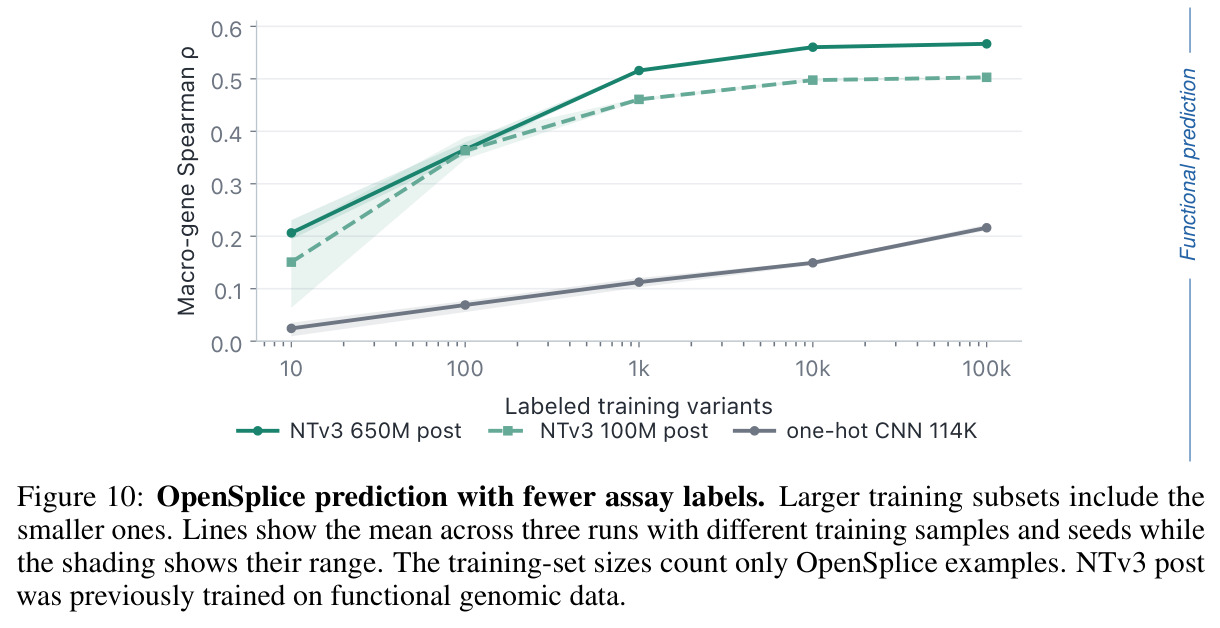
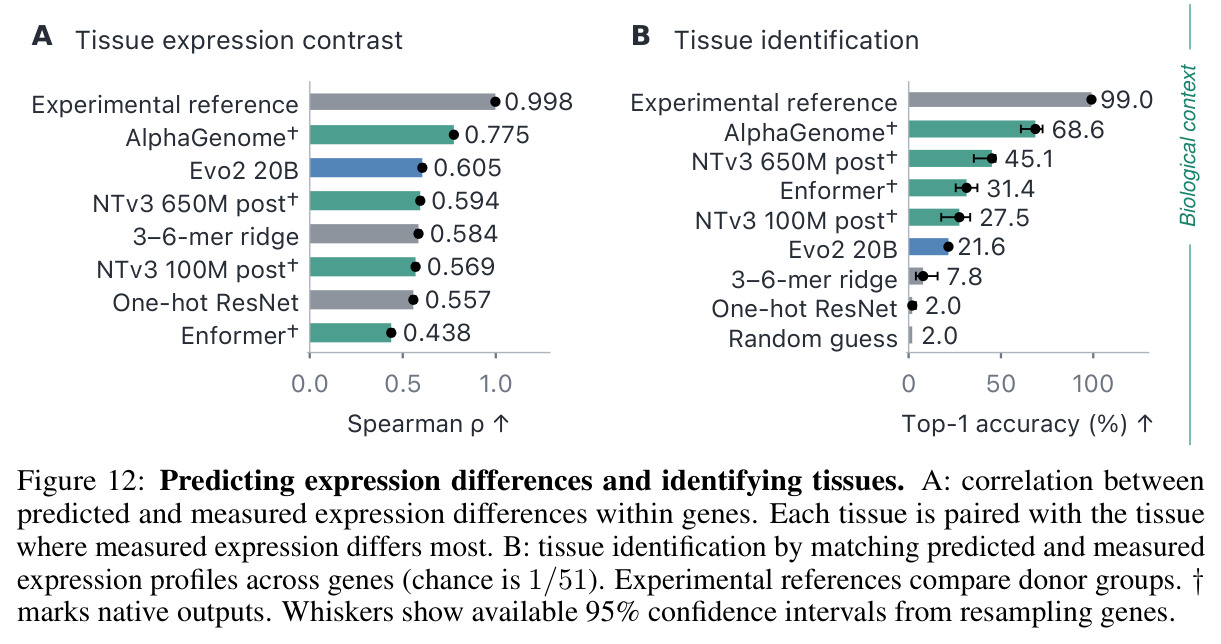
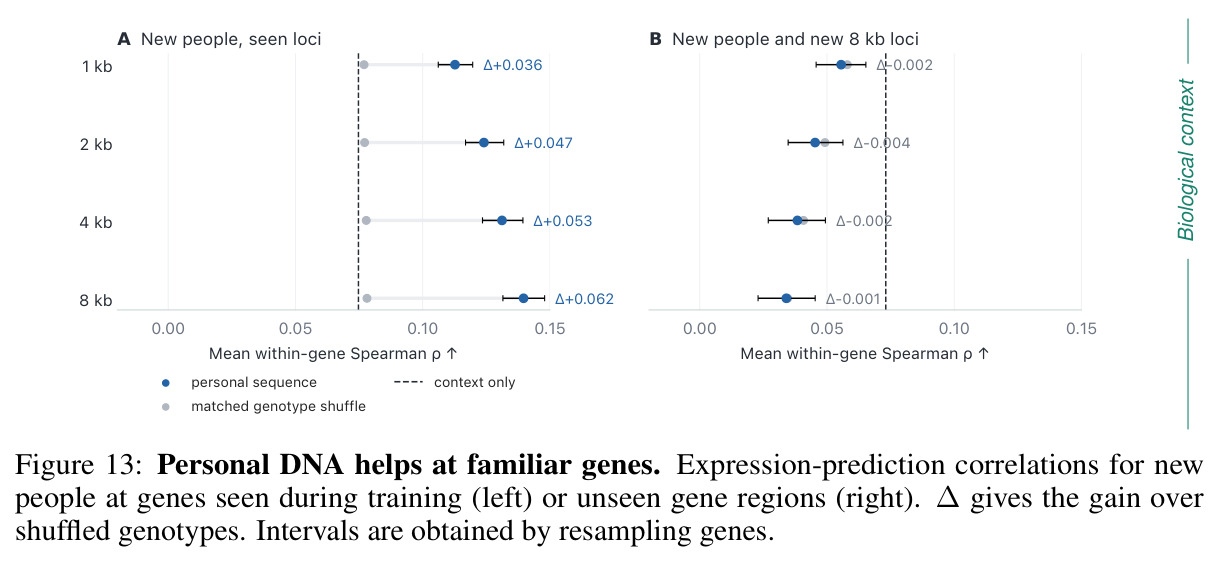
(1) 先验:NTv3 650M post 1.375 bits 最佳;但 Evo2/CENO 重建 55.2%/62.4% 碱基,与 RNA 效应相关仅 0.03–0.05——补全≠懂功能。(2) 功能:OpenSplice 上 AlphaGenome 0.650、SpliceAI 0.674 最高,NTv3 后训练 650M 0.187→0.564。(3) 情境:AlphaGenome 平均效应 0.532、细胞差 0.398,NTv3 0.492/0.256;组织识别 68.6%(参考 99%、随机 2%);个人 DNA 仅已见基因有增益(8kb +0.062)。(4) 交互:背景交互 AlphaGenome 0.260 vs 参考 0.421;COMPASS 交互仅 0.046(复测 0.171)。(5) 设计:单编辑百分位 AlphaGenome 24.3(均匀 50、参考 11.8),Top-10 命中 62% vs 38%;细胞选择性效用 0.515 vs 参考 0.962;多细胞增益 0.833 但效用为负(−0.096 vs +0.673)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 序列先验:隐藏碱基重建(512 个 1,200bp GRCh38 窗口) | bits/base(越低越好) | NTv3 650M post:1.375(附加 12% 掩码、两次采样平均);Evo2 20B:1.388 | base composition:1.974;均匀分布:2.000;调优 Markov:1.800 | 较 base composition 降低约 0.6 bits/base,但模型间差距大、性能未饱和 |
| 剪接变异效应预测(OpenSplice,590,104 突变 × 466 基因,整基因留出) | macro-gene Spearman ρ | AlphaGenome 线性读出 0.650(原生输出 0.621);NTv3 650M post 0.564 | NTv3 650M pre 0.187;随机权重读出 0.144;one-hot ResNet 0.488;SpliceAI 0.674 | 功能后训练带来 +0.377;但老牌专用模型 SpliceAI 仍以 0.674 居首 |
| 跨 assay 零适配迁移(OpenSplice 训练 → COMPASS 4,618 变异 × 88 基因) | 基因内 Spearman ρ 平均 | AlphaGenome 与 NTv3 650M post 保持接近原生 SpliceAI/AlphaGenome 的准确率 | 在 OpenSplice 上拟合的 3–6-mer ridge 基线 | 显著优于 k-mer 基线,证明模型捕捉了跨实验体系、跨基因可迁移的功能模式 |
| 细胞特异效应(Siraj,128 个调控元件,HepG2 vs K562) | Spearman ρ(平均效应 / 细胞间效应差) | AlphaGenome:0.532 / 0.398;NTv3 650M post:0.492 / 0.256 | 预训练 NTv3 细胞差接近 0;实验参考(重复测量互验)0.594 | 情境差预测系统性弱于平均效应,与实验参考尚差约 0.2–0.34 |
| 组织识别(GTEx,5,782 留出基因 × 51 组织) | Top-1 准确率 %(并列共享计分) | AlphaGenome 68.6%;NTv3 650M post 45.1% | 3–6-mer ridge 7.8%;随机 2.0%;实验参考(供体半分组间)99.0% | 远超随机与 k-mer,但距实验参考仍差约 30 个百分点 |
| 遗传背景交互(Siraj,68,026 对配对突变 × 114 元件) | 交互项 Spearman ρ | AlphaGenome 0.260;NTv3 650M post 0.187;Enformer 0.181 | Evo2 20B 0.050;3–6-mer ridge 0.032;HepG2→K562 朴素转移参考 0.421 | 最好的模型仍比朴素实验参考低约 0.16,交互预测是明确短板 |
| 突变交互(COMPASS,110 基因,15,035 单突变 + 48,054 双突变) | Spearman ρ(单突变 / 双突变 / 交互项) | NTv3 650M post:单 0.409、双 0.500、交互仅 0.046 | 交互测量复测相关仅 0.171;去掉预测交互项后双突变 0.500→0.493 | 组合效应准确但几乎不含可用的交互信息,加性项贡献了几乎全部精度 |
| 单编辑目标匹配设计(Siraj,331 目标 × 110 元件,每目标约 578–597 候选) | 首选编辑百分位(越低越好)/Top-10 命中率 | AlphaGenome 24.3/62%;NTv3 650M post 30.0/59% | 均匀选择 50.0/38%;实验参考 11.8 | 把找到匹配编辑所需的实验数大致减半,但与实验参考仍有明显差距 |
| 细胞选择性表达设计(Siraj,167,958 替换 × 280 亲本背景 × 127 位点) | 效用 $U = t - \lambda|o|$($\lambda=1$) | AlphaGenome 嵌入读出 0.515;校准后原生 AlphaGenome 0.384;NTv3 650M post 0.287 | 不编辑 = 0;AlphaGenome 超匹配对照 +0.086(95% CI 0.030–0.142);实验参考 0.962 | 优于各对照但不到实验参考的一半,情境特异设计空间远未被模型挖掘 |
| 多细胞表达程序选择(Atlas,2,411 个 145nt 增强子 × 16 种模式各选 10 个) | 相对同模式随机选择的效用增益(log2)/绝对效用 | AlphaGenome 嵌入读出增益 +0.833;Enformer +0.700;绝对效用 −0.096(AlphaGenome) | 同模式随机选择(增益 0);实验参考增益 +1.602、绝对效用 +0.673 | 增益为正但绝对效用为负:实验可达的表达模式就藏在候选库里,模型却选不出来 |
局限与改进
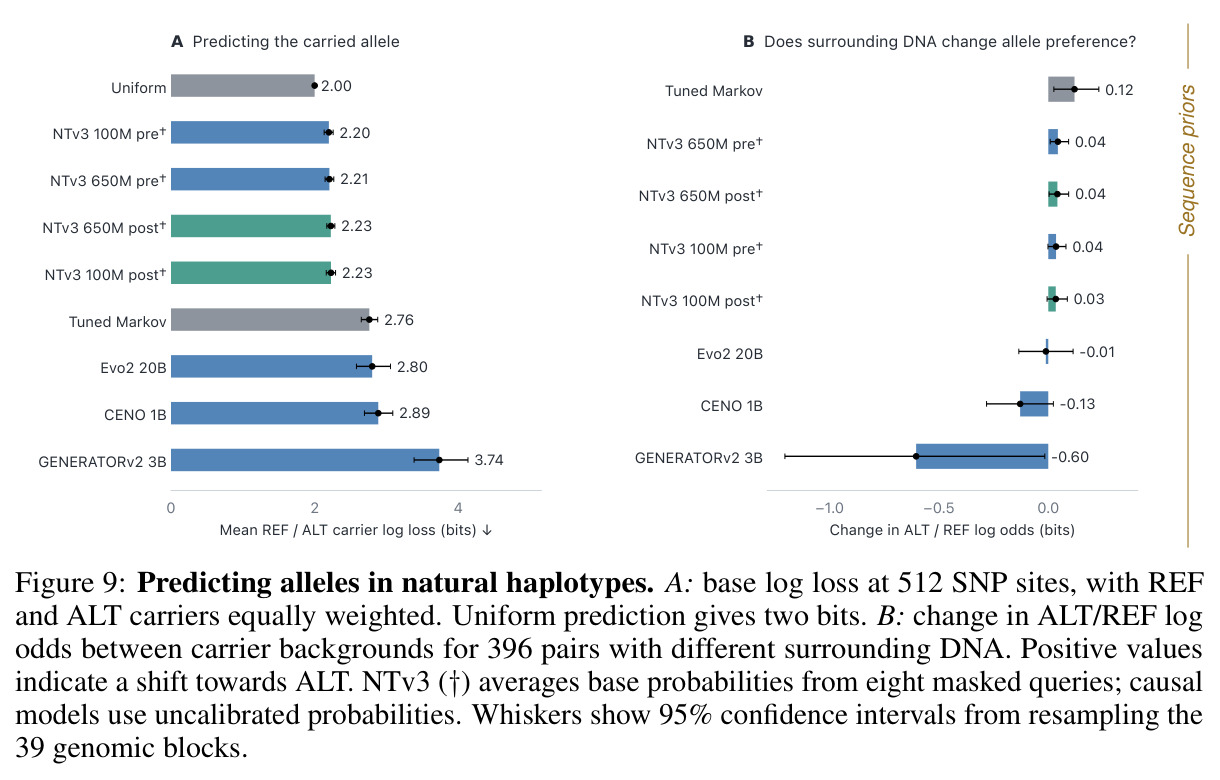
作者承认的局限:部分任务的实验一致性不高(COMPASS 交互复测相关仅 0.171),越难的任务往往实验噪声越大,模型表现必须结合实验可靠性解读;所选实验参考本身偏朴素(如背景交互参考只是把 HepG2 的测量搬到 K562),却仍然全面超过模型;线性读出可能受模型嵌入维度影响;不同模型输入上下文长度不同,可能影响任务可比性;留出数据并不保证未进入预训练语料。我的补充观察:其一,任务覆盖偏向 MPRA 类高通量实验,交互评测的实验天花板本身很低(复测 0.171),难以区分『模型不行』与『实验测不准』;其二,情境评测主要限于 HepG2/K562 两种细胞与 GTEx 静态表达,未覆盖刺激响应、发育等动态情境;其三,设计任务全部在已测量库内做单轮选择,无法评估 Evo2、CENO 等生成模型的真实生成能力或主动学习迭代的收益;其四,最警示的结果藏在附录——在自然单倍型上,所有模型的碱基预测 loss 都高于均匀分布的 2 bits,说明强序列先验还停留在参考基因组上。
独立分析的弱点
独立分析的弱点与改进方向。(1) 情境与交互薄弱是最大短板:NTv3 细胞差 0.256、COMPASS 交互 0.046,微调解码块也只提升效应(+0.065)不提升交互(−0.016)。改进:预训练加入成对/多重突变目标、把情境偏差 $\kappa^c$ 做成显式预测头、以细胞类型嵌入条件化架构。(2) 后训练损害先验可访问性:650M post 单掩码准确率从 55.3% 跌至 29.1%,须靠掩码技巧或激活移位恢复到 55.9%。改进:后训练保留语言建模目标、多任务联合训练。(3) 设计效用与实验参考差距悬殊(0.515 vs 0.962;多细胞绝对效用为负)。改进:按预测区间而非点估计排序、模型集成、直接以设计效用为目标的微调或 RL。(4) 接口不统一造成误判:NTv3 剪接原生 0.461 低于读出 0.564,只用原生接口会低估模型;先验任务上原生查询又会高估。改进:发布标准化 probe 协议与校准输出。(5) 自然单倍型先验失效(loss 全部高于 2 bits)。改进:纳入人群泛型变异、单倍型感知的数据增强。
未来方向
作者明确提出的方向:把强序列先验扩展到自然单倍型(附录 B.3 证明这是当前明显短板);希望基准能推动让设计搜索更有效的模型研发。基于本文成果可延伸的方向:(1) 闭环主动设计——基准是单轮选择,下一步应评测『提出候选→实验验证→更新模型』多轮循环中的样本效率提升;(2) 交互建模专项——COMPASS 显示交互几乎不可预测,可探索显式 $I_{1,2}$ 结构化输出头、突变对预训练任务、或从进化约束数据学习上位性规律;(3) 用基准指导预训练数据配比——NTv3 pre/post 对照已证明功能监督收益巨大(+0.377),值得系统扫描监督数据类型、数量与收益的规模定律;(4) 覆盖生成式设计——Evo2、CENO 等生成模型的输出质量、多样性与实验可行性需要同样的能力分解评测;(5) 校准驱动的风险感知实验设计——NTv3 效应预测校准斜率已达 0.98,可将预测区间直接用于候选排序;(6) 扩展到动态情境(刺激响应、发育时序)与非人类物种,检验能力边界的外推性。
复现评估
复现条件良好。代码开源于 GitHub(machinelearninglifescience/BEND2),数据固定托管 Hugging Face(yhsure/BEND2),另有在线排行榜;提供全部固定数据划分、评估脚本与附录级方法细节。算力上评测主体是冻结模型推理加 ridge 回归:拟合读出极轻量(CPU 可行),主要成本是对 AlphaGenome(16kb 输入)、Enformer(196kb)、NTv3、Evo2 20B 批量推理嵌入,单卡 GPU 可完成大部分任务;作者使用 Gefion 超算主要为多模型并行便利。数据需按原许可获取 OpenSplice、COMPASS、Siraj、Atlas、K562 TRIP 五个 MPRA 数据集及 GTEx、1000 Genomes、MAGE。难点在于为每个模型适配不同接口(原生 track 选择、嵌入抽取层、填充规则),附录有细节但工程量不小。总体难度中等:复现单任务容易,完整复现八任务需扎实工程投入,但把自己模型放上排行榜门槛不高。
论文图表