FLAMIA:面向 Blackwell 的快速且因果安全的微缩放注意力 FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
在 Blackwell GPU 上用 MXFP8/NVFP4 微缩放注意力实现因果安全的低精度加速
前置知识
微缩放浮点格式(MXFP8 / NVFP4)
微缩放格式把张量切小块,块内元素共享一个缩放因子,元素值 = 低比特编码 × 块缩放。MXFP4/6/8 用 32 元素块配 UE8M0(纯 2 的幂)缩放;NVFP4 用 16 元素块配 E4M3 缩放再加一层 FP32 张量级缩放。Blackwell 张量核的块缩放 MMA 指令可以直接吃这种「编码+缩放」操作数,在累加过程中硬件施加缩放,FP8/FP4 峰值吞吐分别是 BF16 的 2 倍和 4 倍。
本文的全部设计(token-block 缩放、缩放布局、泄漏分析)都围绕硬件块缩放 MMA 的约束展开:缩放组必须沿收缩轴分布、4-bit 指令要求 K-major 布局、E4M3 最大值 448 会被截断。不懂块缩放就无法理解为什么量化会引入因果泄漏和前向-反向不一致。
FlashAttention 与在线 softmax
标准注意力要显式物化 $S=QK^\top/\sqrt{d}$ 和 $P=\mathrm{softmax}(S)$ 两个 $L\times L$ 矩阵,显存和访存都吃不消。FlashAttention 用分块计算 + 在线 softmax 把中间瓦片留在片上内存,反向不存 $P$ 而是从 Q、K 和保存的行统计量重算;$D_i=\sum_j P_{ij}\,dP_{ij}$ 用保存的输出以 $D=dO\cdot O$ 计算。FA4 进一步为 Blackwell 做了 warp 专业化设计(load/MMA/softmax/correction/epilogue 各司其职,经 TMEM 交换数据)。
FLAMIA 直接扩展 FA4 的 warp 专业化框架;反向重算机制正是数值一致性问题的来源——反向必须逐位复现前向的量化表示、瓦片划分和指数求值,否则训练会失稳。
因果掩码与缩放诱导信息泄漏
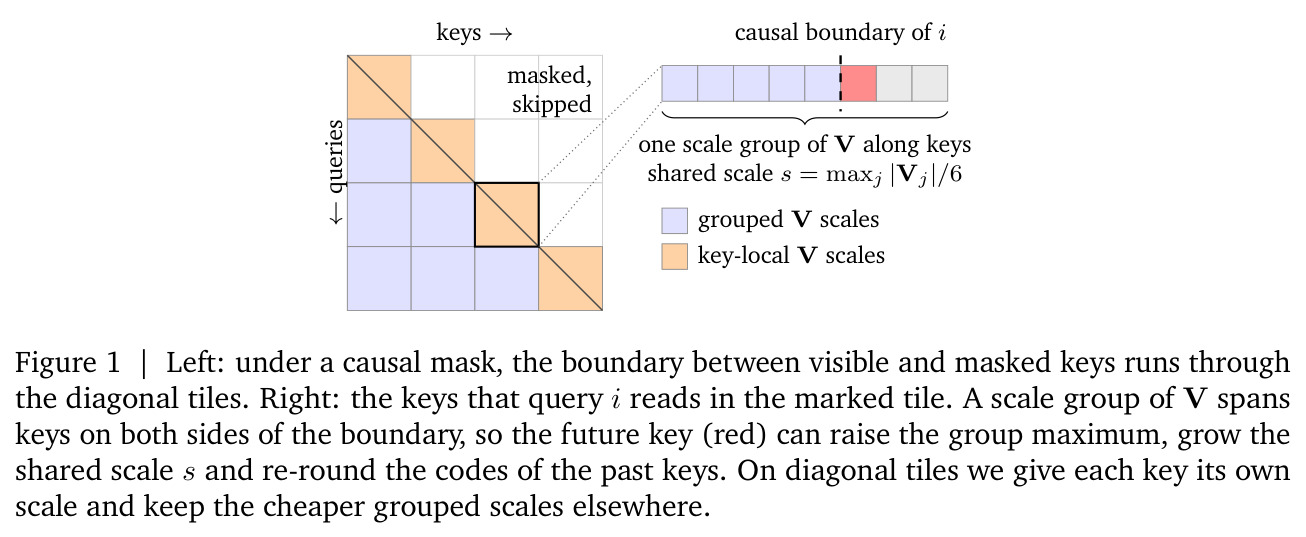
因果掩码让位置 $i$ 只能看见 $\le i$ 的键,数学上保证不偷看未来。但量化缩放是数据相关的:若一组位置共享缩放因子 $s=\max_j|v_j|/\text{code\_max}$,未来 token 加入该组会抬高 $\max$,从而改变组内早期 token 的重建值——信息经量化器绕过了掩码。逐张量缩放是极端情形:一个未来 token 可以影响所有更早输出。
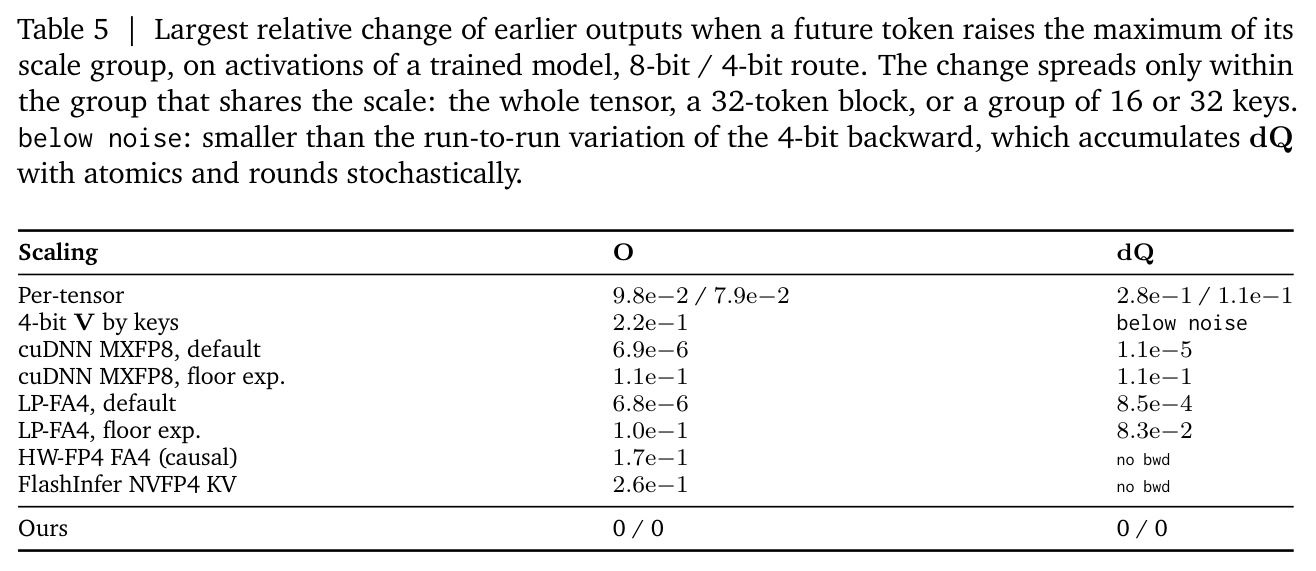
这是本文的核心问题之一:作者首次系统测量这种泄漏(Table 5 中逐张量缩放泄漏高达 9.8e-2),并给出消漏设计。读者必须理解「共享统计量 = 隐蔽通信信道」这一直觉,才能读懂 3.2 节。
注意力反向传播的六个操作数
反向计算 $dV=P^\top dO$、$dP=dO V^\top$、$dS=P\circ(dP-D)$、$dQ=dS\,K$、$dK=dS^\top Q$。可见 $Q,K,V,dO,P,dS$ 六个操作数各自参与两个矩阵乘,且两次收缩轴不同:如 $Q$ 在 $S$ 中沿头维 $d$ 收缩,在 $dQ$ 中沿 query 轴收缩;$V$ 在 $dP$ 中沿头维收缩,在 $PV$ 中沿 key 轴收缩。
这解释了低精度注意力的核心工程难题:硬件要求缩放组沿收缩轴,一维块缩放因此通常需要每个操作数两份量化拷贝;FLAMIA 的 token-block 缩放正是为了让一份编码同时服务两个方向,以及为何 dS 用 32×32 方块缩放。
packed 变长文档训练(变长注意力)
预训练把多个不等长文档首尾相接地拼进长度为 $T$ 的 token 行(packed layout),注意力必须尊重文档边界:跨文档位置要被掩掉,且不能靠 padding 对齐(否则 B200 上一次注意力调用峰值显存从 2.7 GB 涨到 16.8 GB)。变长还带来负载不均衡:长文档的瓦片比短文档贵得多,静态调度会让部分 CTA 空转。
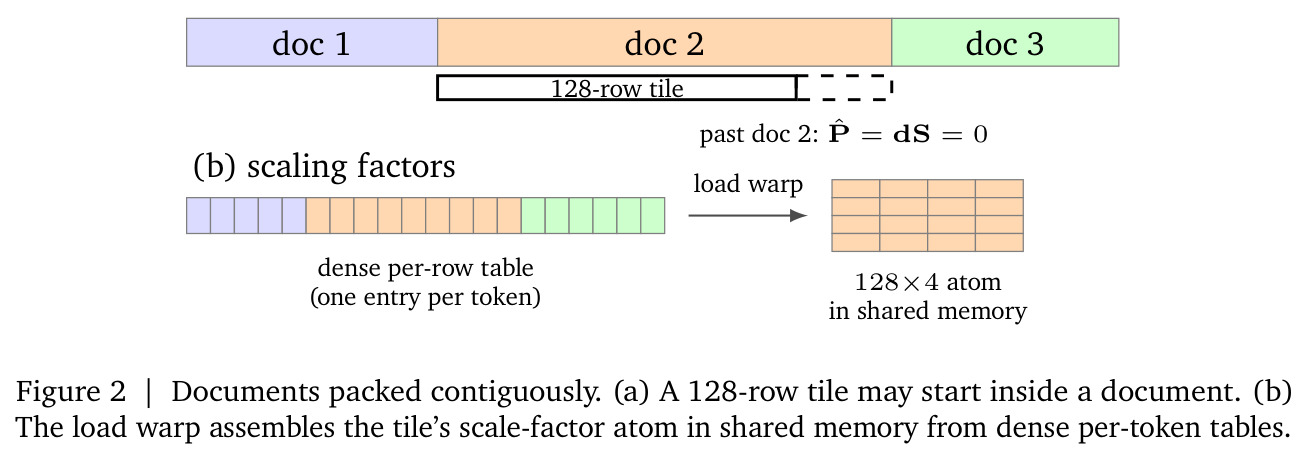
FLAMIA 的文档局部缩放、缩放因子原子(128×4 atom)在共享内存中的拼装、GPU 端归并排序 + CLC 动态调度,全是为了在不重打包的前提下高效处理 packed 输入,这是其相对 cuDNN MXFP8 等基线的关键差异。
研究动机
Softmax 注意力是 Transformer 训练的大头开销,长上下文下尤甚。NVIDIA Blackwell 张量核对 FP8 和 FP4 矩阵乘分别提供 2 倍和 4 倍于 BF16 的峰值吞吐,但 BF16 的 FlashAttention-4 并未利用这一红利;要在注意力训练中兑现它必须同时解决三个约束。其一,硬件块缩放要求缩放组沿收缩轴分布,而 $Q,K,V,dO,P,dS$ 六个操作数各参与两个沿不同轴收缩的乘积,常规一维块缩放需为每个操作数存两份量化表示,量化本身访存受限、开销可观。其二,跨位置共享的缩放因子会让未来 token 通过量化器影响更早位置的输出、绕过因果掩码(逐张量缩放下泄漏相对幅度可达 9.8e-2)。其三,反向必须与前向一致地重建量化中间量:瓦片或指数求值不一致时,即使单步 $dQ$ 余弦高达 0.945,梯度范数也会从 0.5 飙到 $2\times10^5$。此外预训练把变长文档打包进定长 token 行,现有实现或只支持打包前向(FlashInfer)、或用逐张量 FP8 缩放(cuDNN FP8)、或不支持因果掩码(Low Precision FA4)。
本文的目标是构建一套覆盖完整训练调用(前向 + 反向 + 量化)的 Blackwell 低精度注意力内核家族 FLAMIA,提供 MXFP8 与混合 NVFP4/FP8 两条默认训练路径,并明确要求:在不重打包的前提下直接处理 packed 变长文档、缩放统计保持在文档边界内;杜绝或严格限定缩放因子导致的因果泄漏;让前向与反向在量化表示、瓦片划分、对角处理、指数求值和行最大值约定上逐位一致;在 1B 参数 Llama-3 风格模型、100B FineWeb-Edu token 的预训练中验证训练稳定与质量保持;最终目标是让每个评测的因果 packed 工作负载上合并前向反向时延(含量化)低于所有被评基线(FA4 BF16/FP8、cuDNN BF16/FP8/MXFP8、FlashInfer、Low Precision FA4、HW-FP4 FA4、SDPA)。
与已有工作不同的是,已有低精度注意力工作(SageAttention 系列、SageBwd、Low Precision FA4、HW-FP4 FA4、Attn-QAT)大多把量化当作内核外的一个独立步骤,并以单步余弦相似度作为主要精度证据。FLAMIA 的独特切入是把缩放布局、因果正确性、前向-反向数值一致性与 GPU 调度当成一个联合设计问题:作者首次定义并量化了「缩放诱导泄漏」这一被忽视的失效模式,指出参考微缩放换算 $\lfloor\log_2\max_i|v_i|\rfloor-e_{max}$ 会造成截断饱和这一此前无人识别的泄漏通道,并实验证明单步精度既不蕴含因果正确性也不蕴含训练稳定性——泄漏内核用自身评测得到的验证损失(0.811–0.827)反而优于 BF16(0.852),换精确注意力评估却劣化到 0.888–0.940。这种「评测方式本身会撒谎」的洞察,加上逐键缩放折入、因果 dQ 缩放等靶向消漏手段,构成了与所有前作的本质区别。
核心方法
直觉上,FLAMIA 的原则是「为注意力的每个操作数只保留一份量化表示,并让它天然安全」,再把量化、softmax、矩阵乘与文档调度全部融进内核。技术路线分四层。缩放层:8 位路径用 token-block 缩放——每 32 个连续 token 与整个头维共享一个 2 的幂指数,使 E4M3 编码在转置下不变;dS 用 32×32 方块缩放,一份载荷同时服务沿 key 与沿 query 的收缩。精度层:混合路径让 $Q,K$ 以 NVFP4(每 token 每 16 个头维一个 E4M3 缩放)计算 $S=QK^\top/\sqrt{d}$ 及其反向重算,其余乘积用 E4M3。安全层:指数向上取整防截断、对角瓦片上 V 逐键缩放并折入 $\hat P$、K fold、可选因果 dQ 缩放。系统层:Hadamard 旋转 + 块统计 + 编码生成融合为单次 launch,softmax 用多项式模拟与对数域量化提速,反向采用两 CTA 协作与 FP16 dQ 部分和,packed 文档的负载均衡列表在 GPU 上用归并排序构建、偏斜负载经 CLC 动态认领。
核心创新有三。第一,token-block 缩放:常规微缩放沿收缩轴每 32 元素一组,而注意力的操作数各参与两个不同收缩方向的乘积,通常需要两份量化拷贝且量化是访存受限的;FLAMIA 让一个指数横跨 32 个连续 token 和全部头维 $d$,表示在转置下逐位不变,8 位 MMA 又同时支持 K-major 与 MN-major 布局,于是每个操作数只需一份编码。第二,因果安全缩放:作者揭示 floor 指数 + 饱和截断机制——缩放后组最大值可超过 E4M3 上限 448 而被 clamp,未来 token 抬高共享最大值会让早期元素解除 clamp、编码改变,从而泄漏;对策是指数向上取整、仅在对角瓦片给 V 逐键的 2 的幂缩放并折叠进 $\hat P$(组内缩放跨不出对角瓦片),反向对 $dP$ 中的 V 与 $dQ=dS\,K$ 中的 K 用同样的 K fold 封堵。第三,前向-反向一致性约定:同表示重算分数、复现瓦片与对角决策、用同一 $dO$ 表示计算 $D$、$dS$ 从 32×32 块最大绝对值定标,避免小梯度被大量舍入为零。
方法步骤详情
一次调用分六步。① 融合量化:对 $Q,K,V,dO$ 各发一次 launch,完成 Hadamard 旋转(头维 128 默认开)、块统计与编码生成,$dO$ 的 launch 顺带算 $D$ 并初始化 dQ 累加器——MXFP8 预处理由 789µs 降至 261µs、NVFP4 由 0.64ms 降至 0.11ms。② 前向:MXFP8 用无缩放 E4M3 MMA,行指数因子折入 softmax 缩放、列因子单独施加;128×128 瓦片用 FMA 多项式模拟部分指数、NVFP4 在对数域量化概率、B300 用 tcgen05.ld.red 融合行最大值归约,MMA warp 把 $QK^\top$ 拆成两个 64 键操作与 $\hat PV$ 交错发射。③ 反向:用与前向相同的量化表示复现分数、瓦片与对角决策;$dS$ 量化为 E4M3(32×32 块定标);两 CTA 协作共享 MMA 操作数;dQ 部分和以 FP16 bulk reduce-add 写出并乘数据相关的 2 的幂预缩放。④ 打包文档:逐 token 稠密缩放表由 load warp 在共享内存拼出 128×4 缩放因子原子,跨文档位置掩码、无效 query 行写无穷 log-sum-exp 哨兵。⑤ GPU 调度:归并排序按估计成本降序排工作项(131072 个单 token 文档耗时 0.26ms vs 参考实现 50.5ms),持久网格双向分配,偏斜负载用 CLC 即时认领。⑥ 输出梯度以 BF16 返回,可选 exact 选项与因果 dQ 缩放消除残余依赖。
技术新颖性
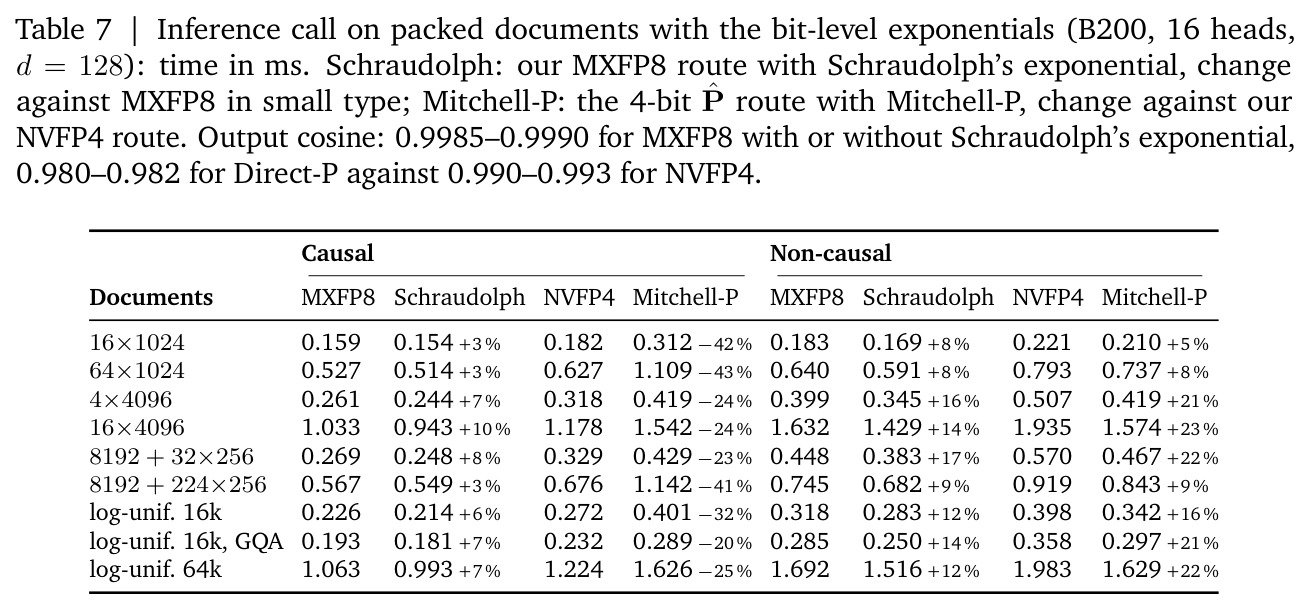
新颖性有四。其一,表示复用:用跨 token 共享指数 + 方形 dS 缩放把每操作数量化拷贝从 2 份降到 1 份,作者测得全 4-bit 路径量化六份拷贝占反向时间 45–52%、其验证损失比 BF16 高 0.012,首次量化证明「量化重复」是低精度注意力的主要瓶颈。其二,因果性形式化:首次给出泄漏测量协议(扰动未来 key、测早期输出相对变化,Table 5),识别出 floor 指数 + 饱和截断这一新泄漏通道,并证明「只用训练内核评估验证损失会掩盖泄漏」。其三,数值一致性工程:证明单步 $dQ$ 余弦 0.945 与梯度范数爆到 $2\times10^5$ 可以并存,列出必须对齐的四类约定(表示、瓦片、指数求值、行最大值),比 Attn-QAT 的量化一致性思想更系统。其四,系统级技巧:对数域概率量化利用 $\max_j 2^{x_j}=2^{\max_j x_j}$ 带来 NVFP4 前向 14–19% 提升;Mitchell 位级指数近似达 98.7% 编码匹配率(Direct-P 仅 63.3%);FP16 dQ 部分和 + 数据相关预缩放带来 23.8% 反向收益。这些都是量化理论与 Blackwell 微架构(tcgen05、TMEM、CLC)联合设计的产物。
实验结果
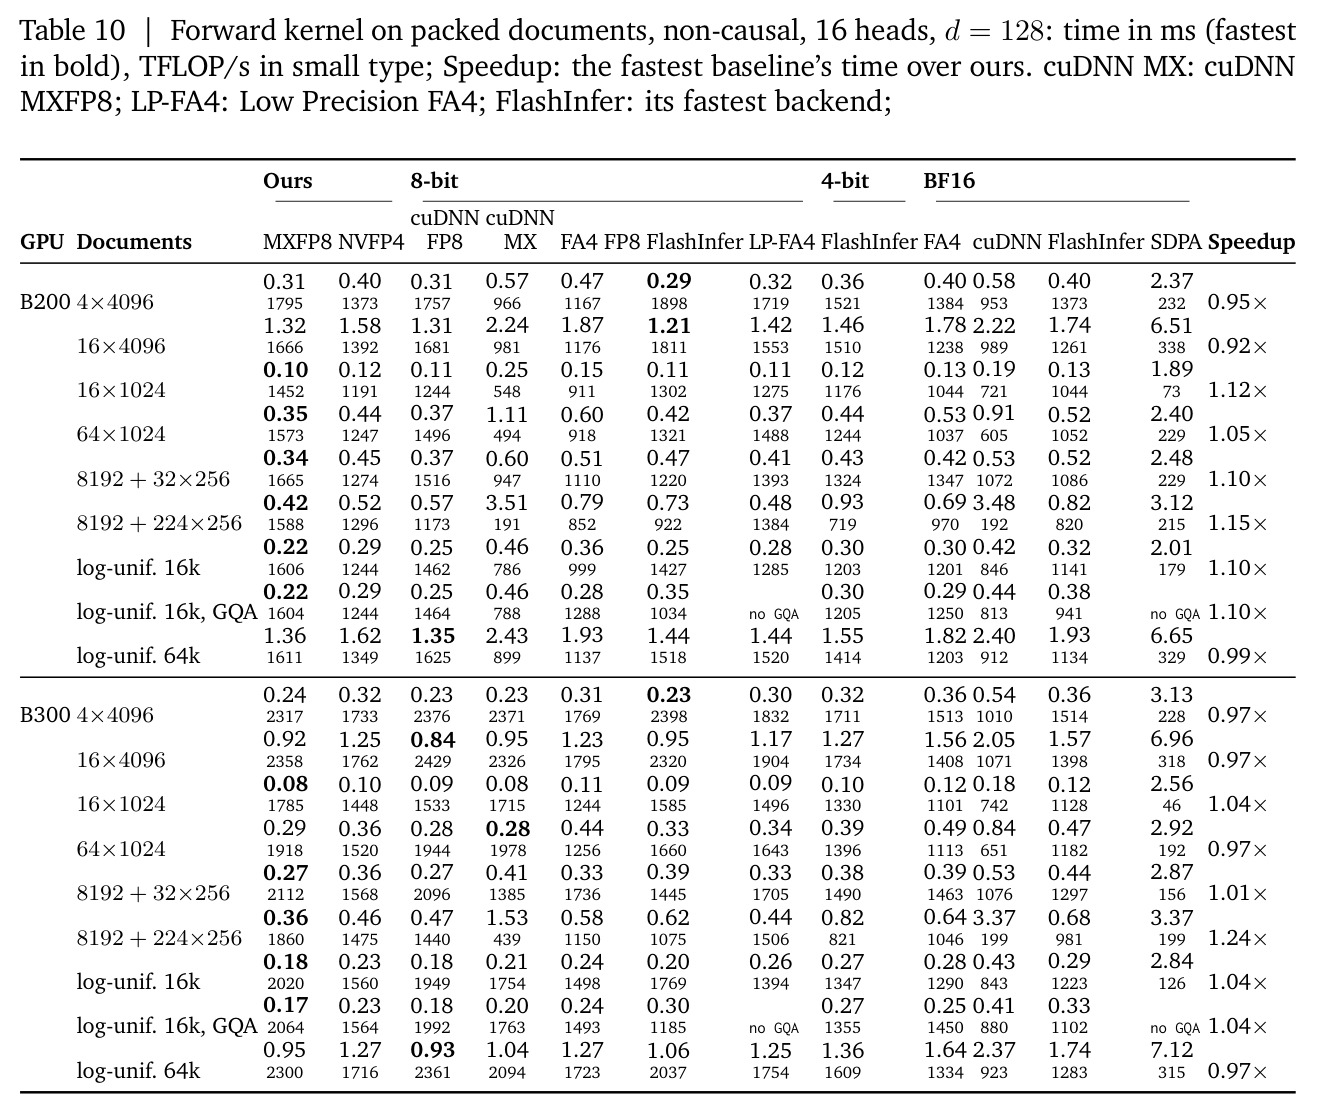
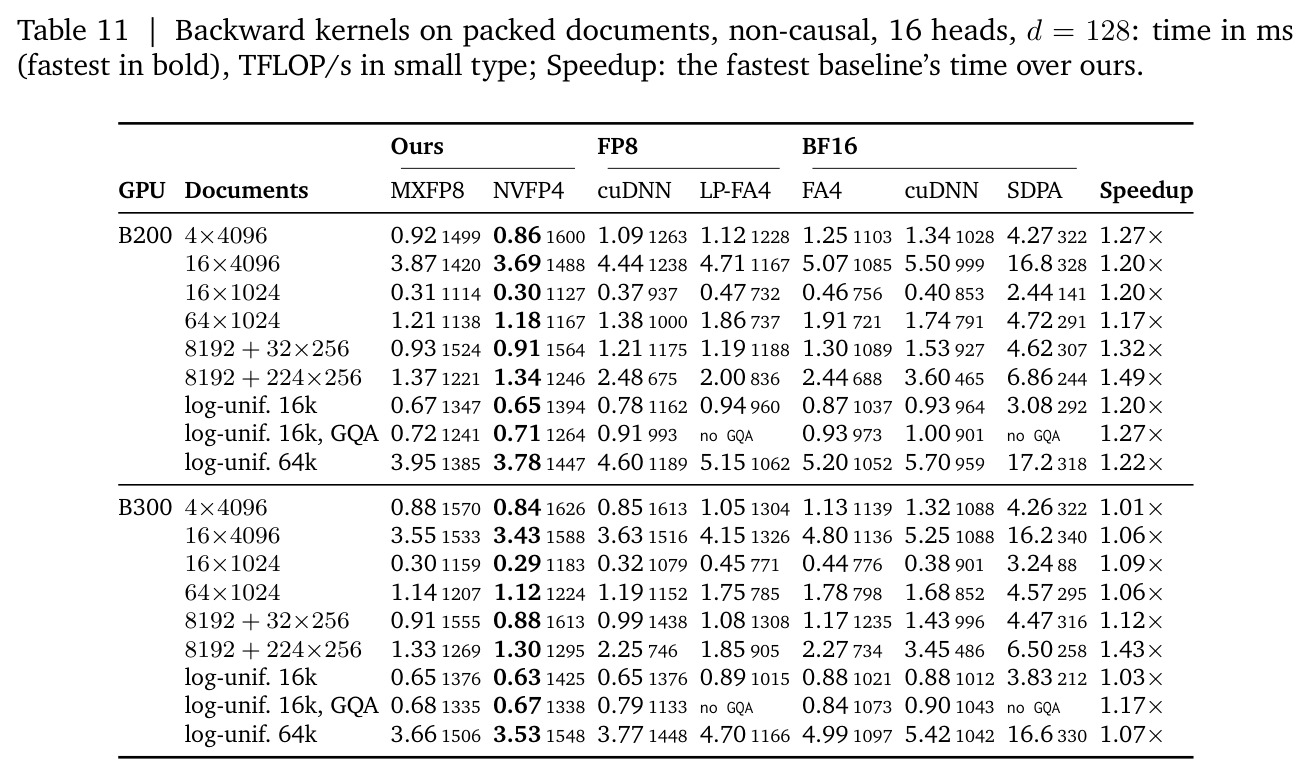
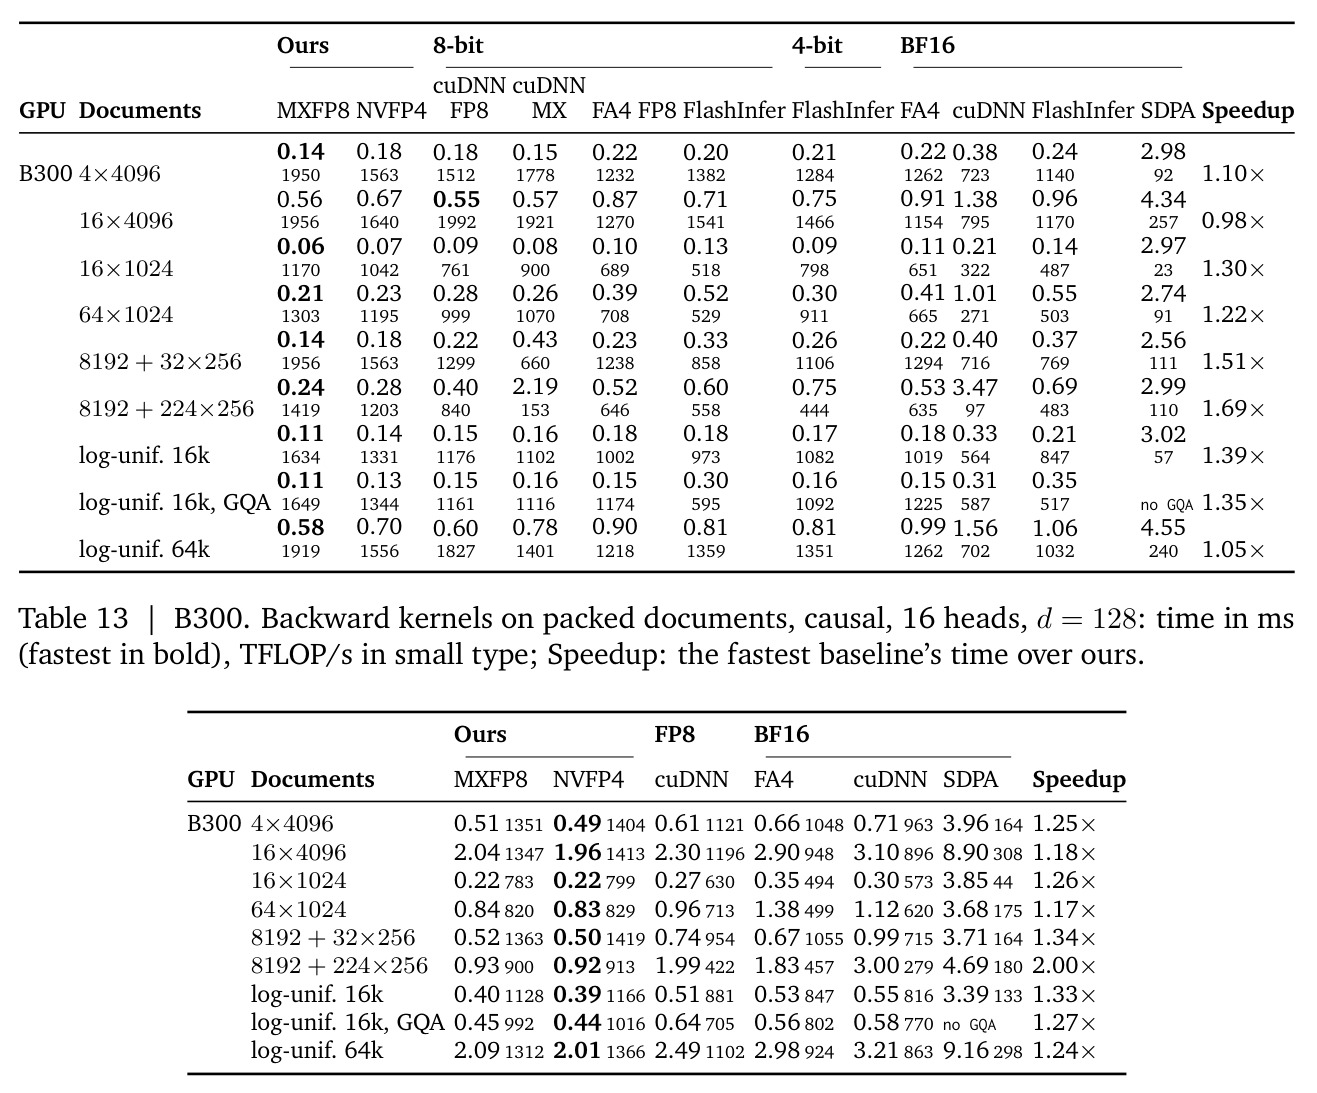
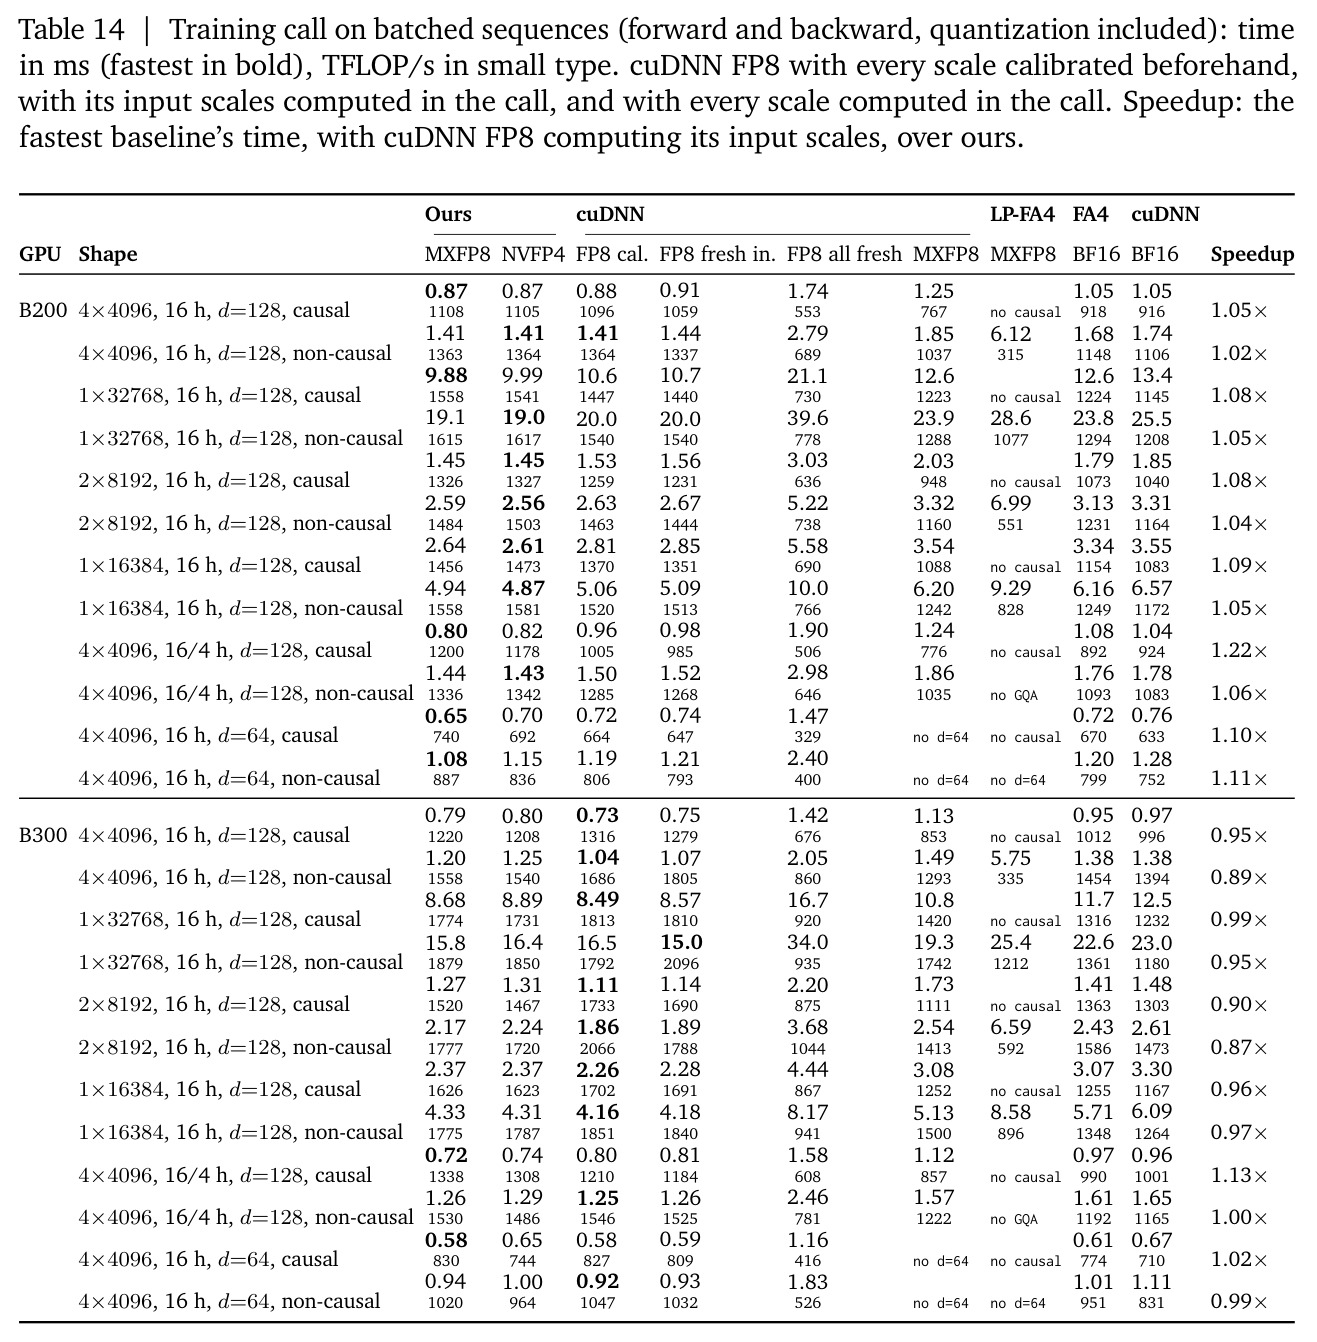
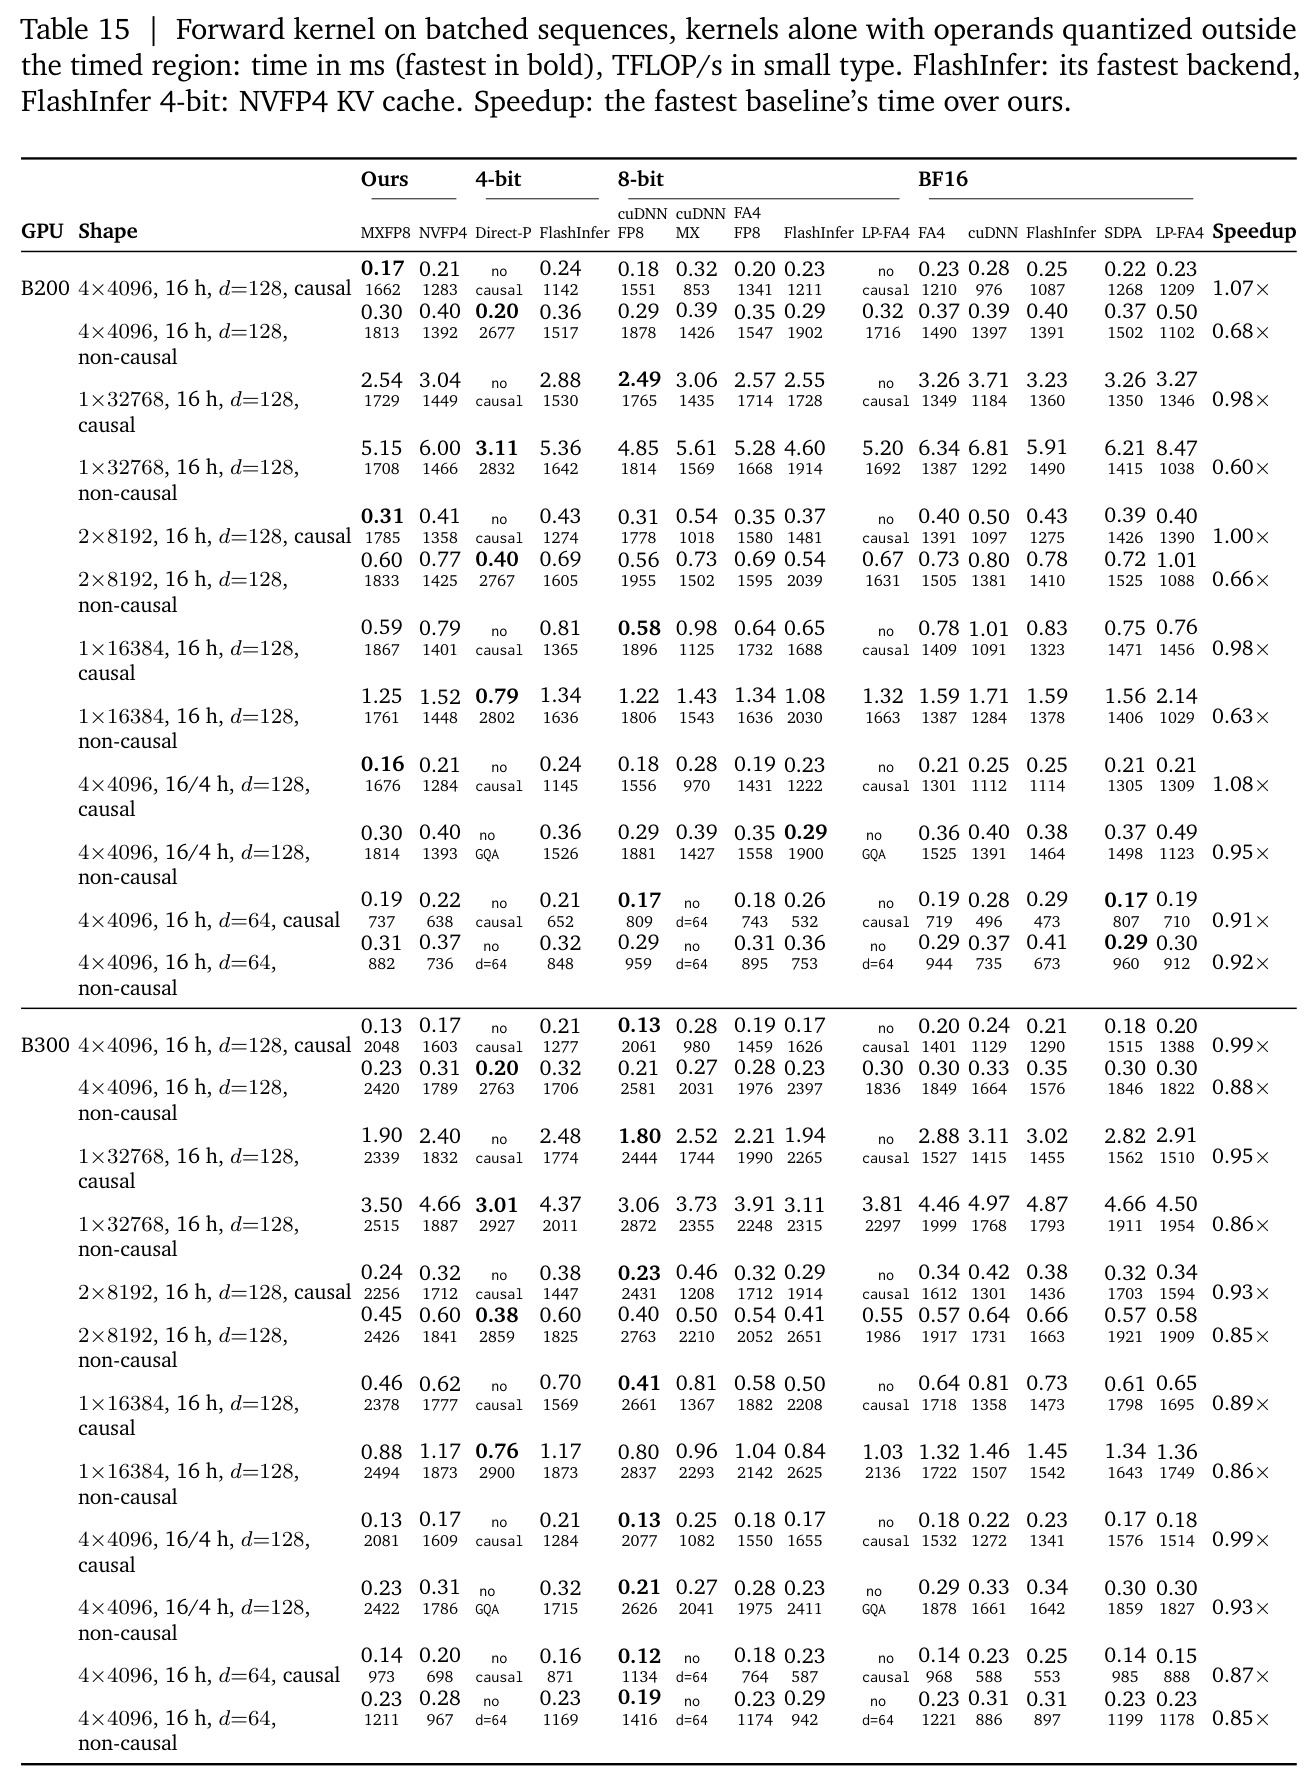
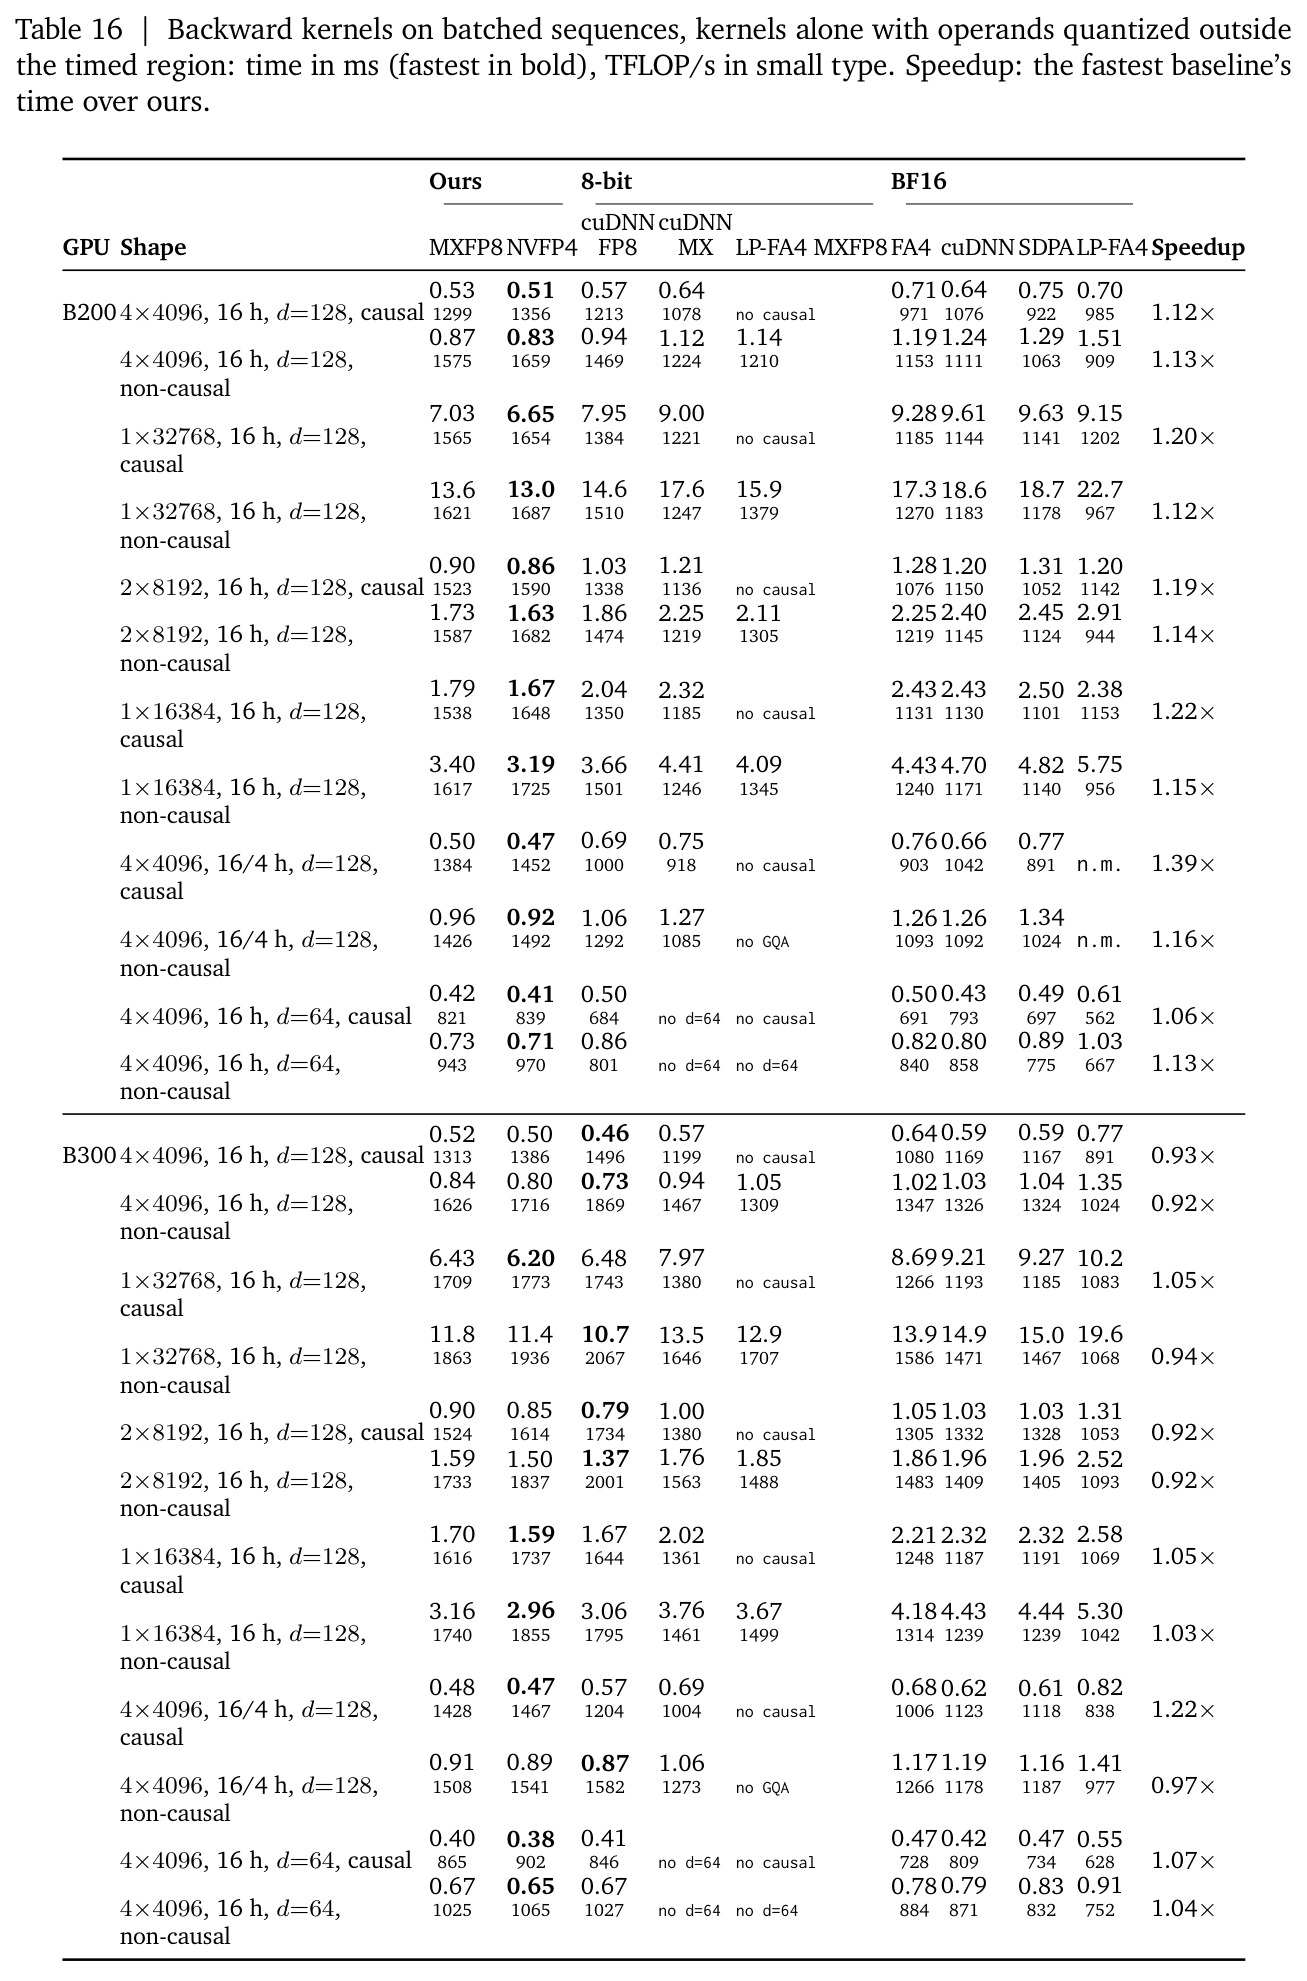
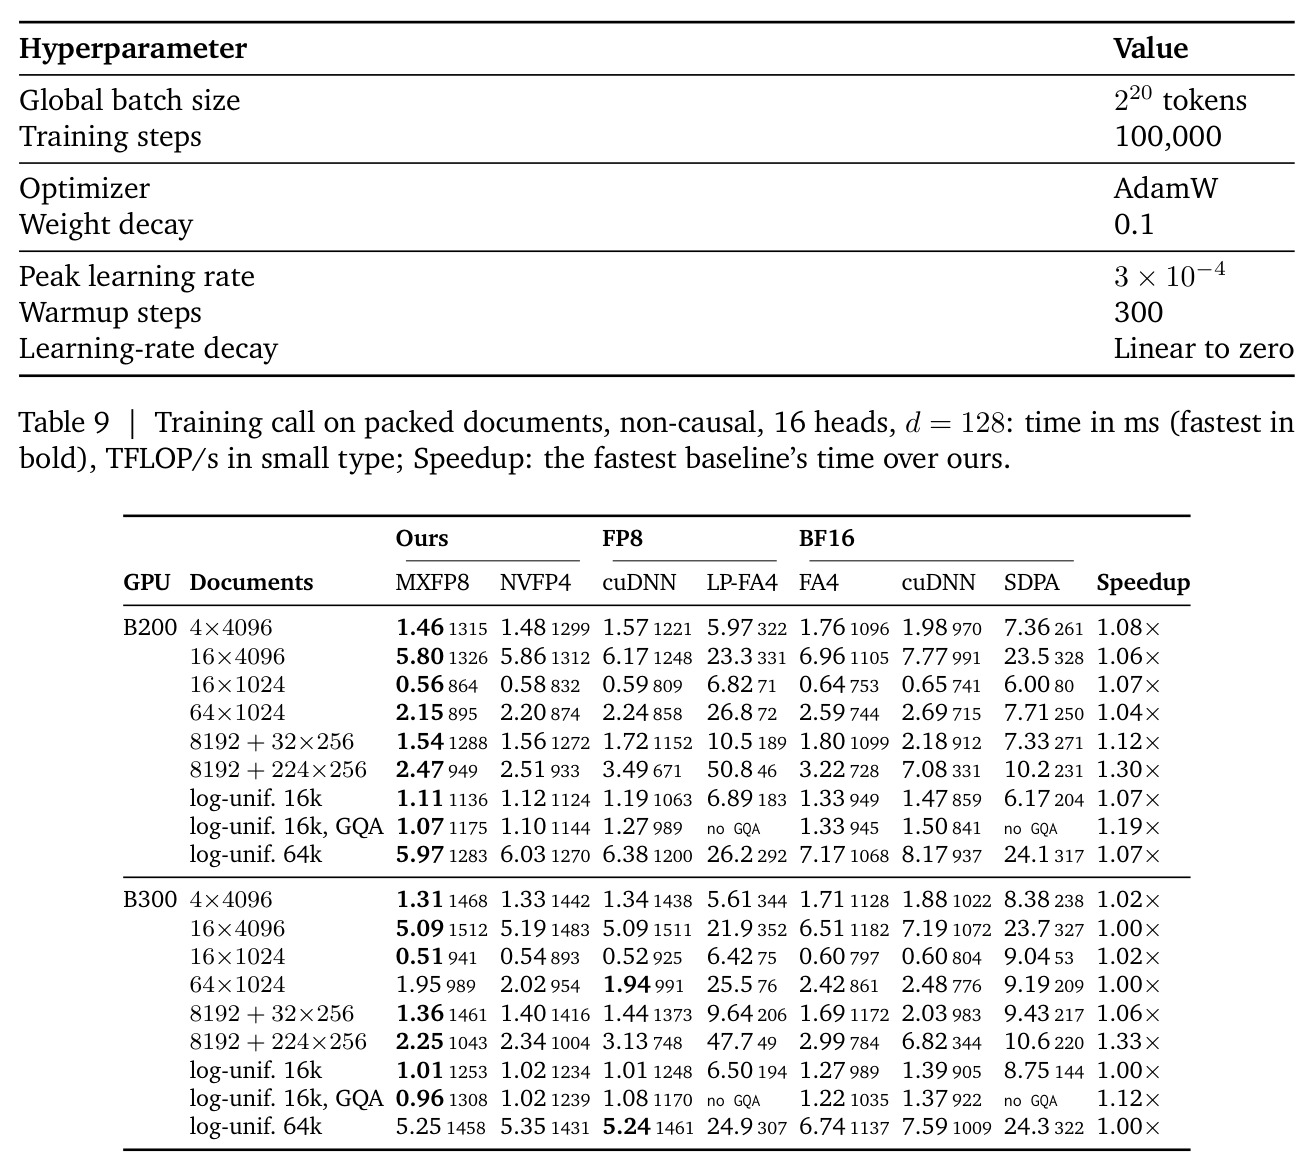
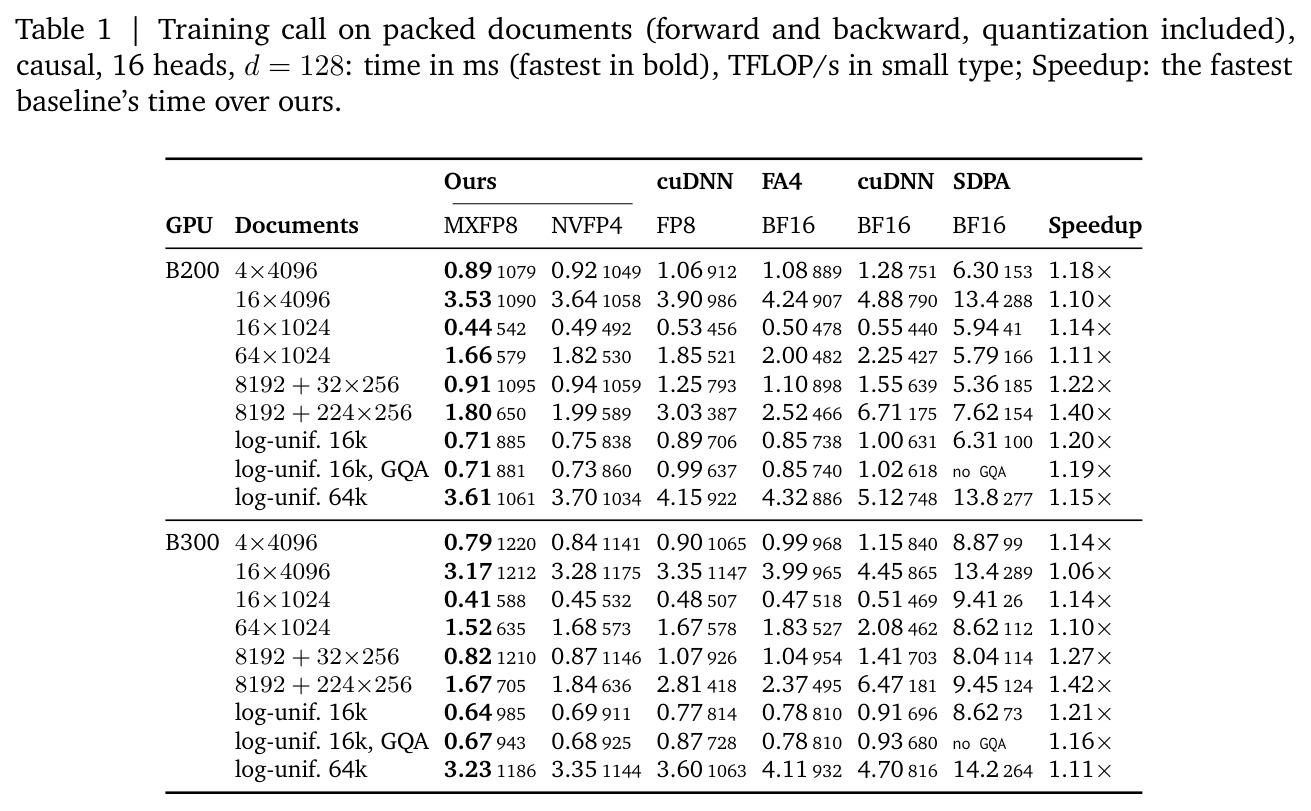
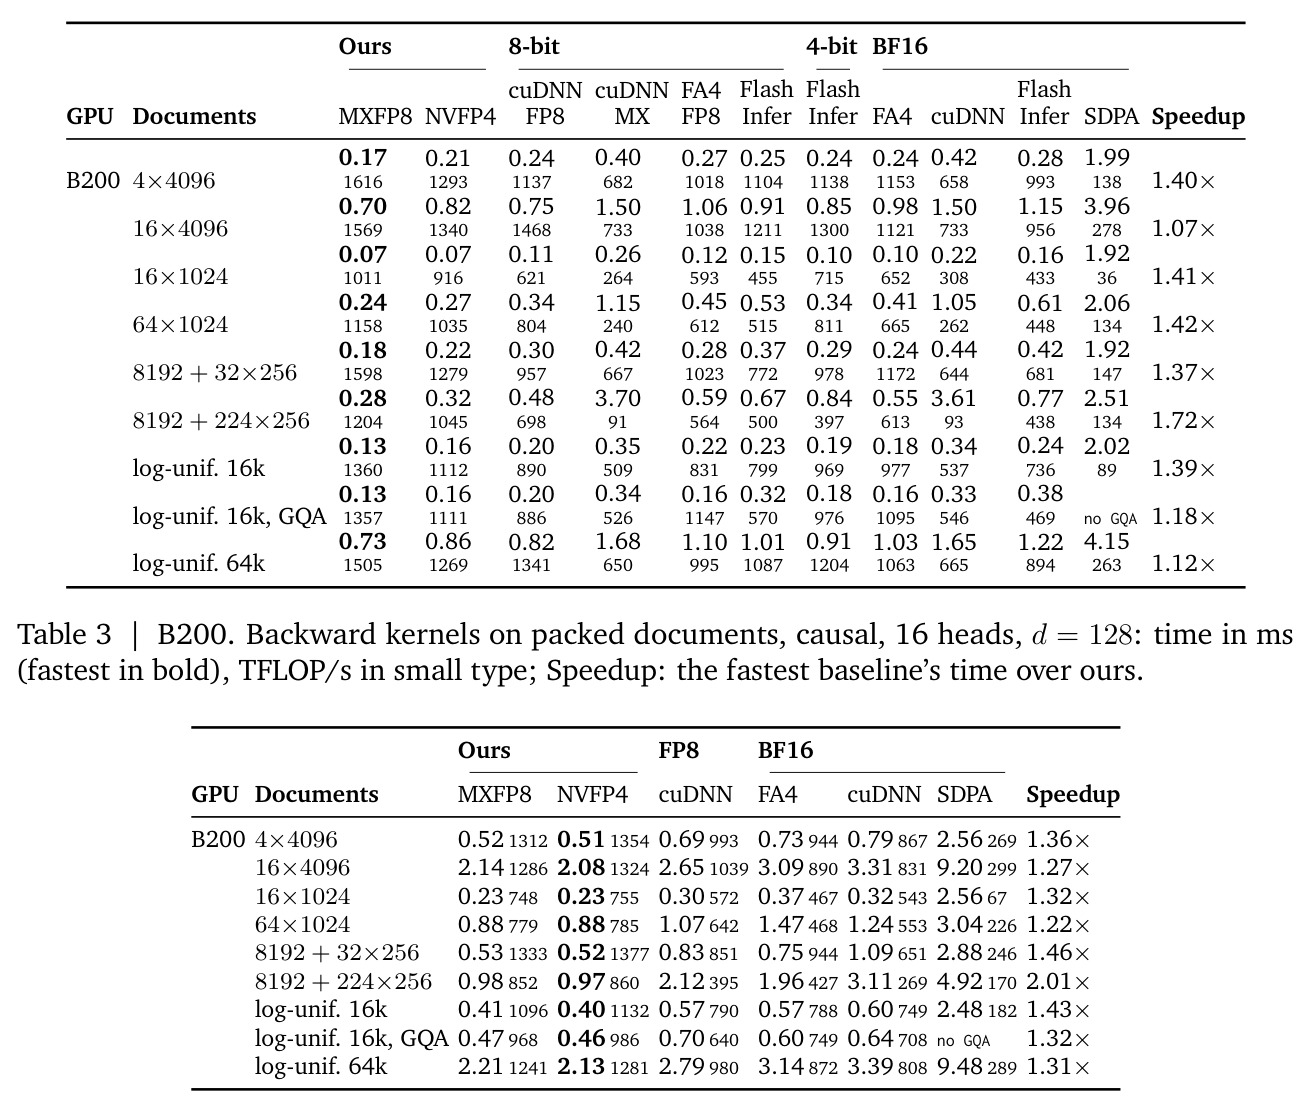
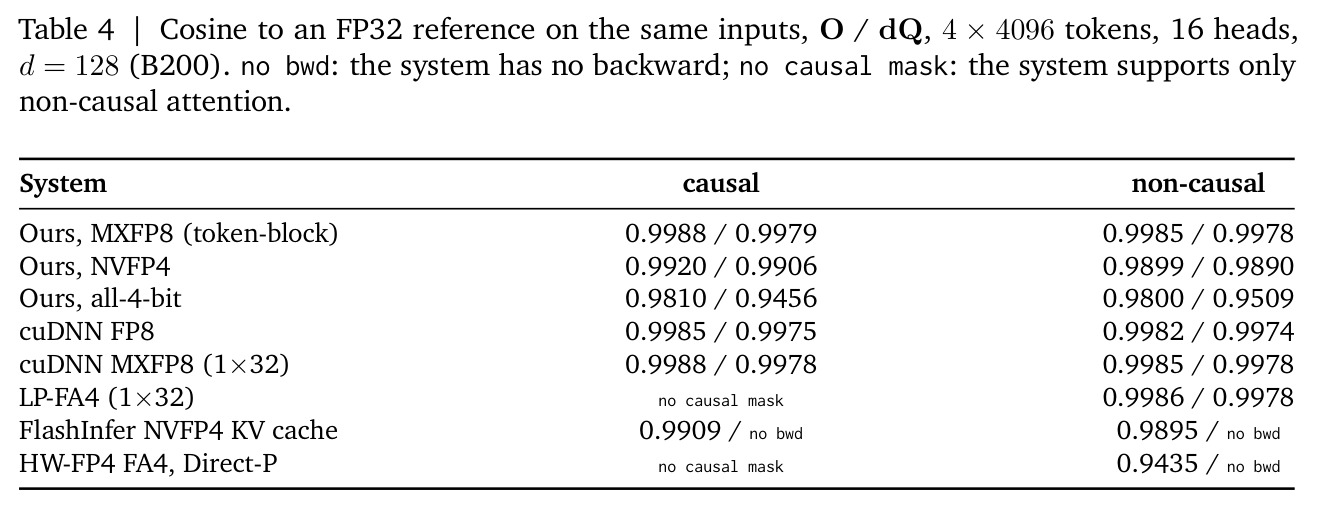
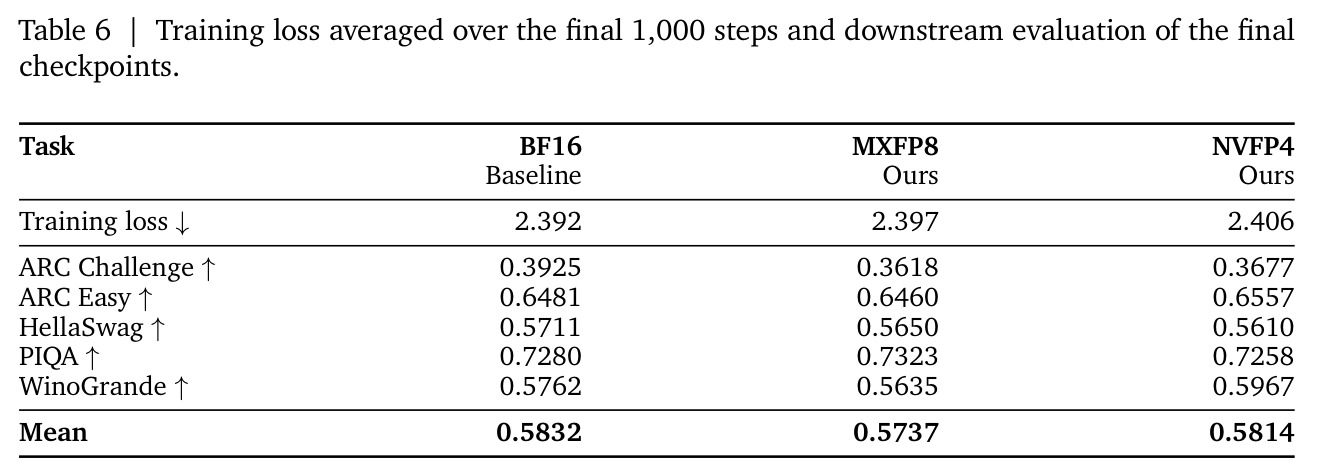
性能:全部 9 个因果 packed 负载上 MXFP8 训练调用(含量化)时延均最低——B200 加速 1.10–1.40×、B300 1.06–1.42×;最大收益在 8192+224×256 偏斜负载(B300 训练调用 1.42×、反向 2.00×)。内核级:NVFP4 反向全负载最低(B200 1.22–2.01×);MXFP8 前向 B200 全胜(1.07–1.72×),但 NVFP4 前向反而慢于 MXFP8。数值精度(因果 O/dQ 余弦):MXFP8 0.9988/0.9979 与 cuDNN FP8 的 0.9985/0.9975 持平,NVFP4 0.9920/0.9906 远高于 HW-FP4 Direct-P 的 0.9435。泄漏探针:本文 exact 选项为 0/0,逐张量缩放达 9.8e-2/2.8e-1,HW-FP4 FA4 因果路径 1.7e-1。训练验证(1B、100B token):损失 BF16 2.392、MXFP8 2.397、NVFP4 2.406,下游五任务均值 0.5832/0.5737/0.5814。消融:融合量化降预处理 66–83%;移除最长优先排序损失 10–65% 前向;FP16 dQ 部分和 +23.8% 反向;dS 定标不当使舍入为零比例从 0.4% 升至 29%、损失差从 0.0008 恶化到 0.049;泄漏内核在 enwik8 上自评损失 0.811–0.827 优于 BF16 的 0.852,精确评估却升至 0.888–0.940。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 因果 packed 训练调用(前向+反向+量化) | 时延加速比(vs 每负载最快基线) | MXFP8 全部 9 负载最低:B200 1.10–1.40×,B300 1.06–1.42× | cuDNN FP8 / FA4 BF16 / FlashInfer 等每负载最快者 | 8192+224×256 上 cuDNN FP8 需 1.68×、FA4 BF16 需 1.40–1.42× 本文时延 |
| 前向内核(packed、因果) | 内核时延 | MXFP8 在 B200 九负载全胜 1.07–1.72×;B300 0.98–1.69× | cuDNN MXFP8、FA4 FP8、FlashInfer 等 | 8192+224×256 达 1.72×(0.28ms vs 0.48ms) |
| 反向内核(packed、因果) | 内核时延 | NVFP4 全负载最低,B200 1.22–2.01×,B300 1.17–2.00× | cuDNN FP8、FA4 BF16 | 8192+224×256 上达 2.01×(0.98ms vs 1.96ms) |
| 数值精度(因果) | 对 FP32 参考的 O/dQ 余弦相似度 | MXFP8 0.9988/0.9979;NVFP4 0.9920/0.9906 | cuDNN FP8 0.9985/0.9975;HW-FP4 Direct-P 0.9435 | 8 位与最强 FP8 基线持平,NVFP4 大幅领先同类 4-bit 方案 |
| 因果泄漏探针(扰动未来 key) | 早期输出/dQ 最大相对变化 | 0 / 0(exact 选项 + 因果 dQ 缩放) | 逐张量缩放 9.8e-2/2.8e-1;HW-FP4 FA4 因果 1.7e-1;floor 指数 cuDNN MXFP8 1.1e-1 | 唯一在探针下完全无可观测泄漏的方案 |
| 1B Llama 风格预训练(100B token,8×B300) | 最终 1000 步平均损失 / 下游五任务均值 | MXFP8 2.397 / 0.5737;NVFP4 2.406 / 0.5814 | BF16 FA4 2.392 / 0.5832 | 损失仅 +0.005/+0.014,下游差异在噪声量级内 |
| 推理指数近似(4-bit 概率) | 编码匹配率 / 加速比 | Mitchell-P 匹配 98.7%,1.05–1.23× 加速 | HW-FP4 Direct-P 匹配 63.3% | 匹配率提升 35.4 个百分点 |
局限与改进
作者承认的局限:默认缩放仍保留 32 token 块内的残余依赖与反向的序列级 dQ 累加器依赖;能彻底消除泄漏的 exact 选项目前只覆盖受支持的 batched 因果配置,且因果 dQ 缩放有 8–11% 反向开销、K fold 占训练调用 2.7–4.0%、对角逐键 V 缩放在 4096 token 时前向放慢 1.17×;非因果场景 B300 上 MXFP8 只有五胜两平两小负;两个推理近似均不用于训练。我的补充观察:评测仅限 B200/B300 与头维 128,对 Hopper、消费级 GPU 及其他头维的迁移性未知;NVFP4 前向慢于 MXFP8,混合路径的收益集中在反向;预训练只有 2k 上下文、1B 规模,且下游均值差异(0.5737 vs 0.5832)未报告方差/多种子,难以断言与随机波动可区分;基线中 HW-FP4 FA4 缺因果掩码、LP-FA4 缺打包反向,部分对比先天不对等;加速比高度依赖工作负载形状(偏斜负载收益最大、等长负载仅 1.06–1.18×),长尾场景的普适性存疑。
独立分析的弱点
弱点一:残余泄漏窗口——默认路径仍允许未来 token 影响 32 token 块内的早期输出,跨租户混合训练等强隔离场景仍需 8–11% 反向开销换 exact;改进方向是把因果 dQ 缩放的行缩放表访问与现有 FP16 归约融合以摊薄成本。弱点二:调度启发式经验性强——最长优先排序移除会损失 10–65% 前向性能,CLC 启用阈值(最长文档 ≥ 4× 均值)是人工经验规则,极端或漂移的长度分布可能退化;可探索自适应或学习型调度。弱点三:4-bit V 的对角瓦片需逐键缩放,短上下文前向时延放大 1.17×(4096 token),全瓦片逐键更达 2.83×,说明 4-bit 路径在短序列收益有限;可按序列长度动态选择 V 精度。弱点四:FP16 dQ 累加器范围紧张,默认序列级最大值预缩放本身构成(已识别但默认保留的)依赖,因果版本又额外加载行缩放;可考虑分层 FP32 归约或逐块缩放累加。弱点五:端到端证据有限——只在 1B/2k 上下文验证,7B+ 模型的离群通道行为、RLHF 与超长上下文等 attention 占比更高的场景未测,且缺少 tokens/s、成本等吞吐级指标。
未来方向
作者指出的方向:把消除依赖的 exact 选项扩展到打包输入与非因果配置;结论强调「量化与内核执行联合设计」的方法论可推广到线性层 GEMM(与 Full-Stack FP4 等全栈 FP4 训练互补)。可延伸方向:其一,把 Mitchell-P/Schraudolph 位级指数近似与推测解码、KV 缓存量化结合,服务长上下文推理;其二,将 token-block 缩放复用思想移植到 Hopper(FP8)与下一代数据中心 GPU,检验跨代可移植性;其三,系统研究缩放粒度(逐张量 / 32 元素 / token 块 / 逐键)与优化器、学习率交互的训练动力学,解释为何「舍入为零比例」比范数误差更能预测损失退化;其四,在 RLHF、百万级上下文、多模态视频等 attention 占比更高的场景量化端到端收益;其五,把因果 dQ 缩放、逐键折叠等安全机制作为可插拔选项贡献给 TorchTitan/PyTorch 生态(作者已有 TorchTitan 集成基础);其六,让 NVFP4 前向的对数域技巧与逐键 V 缩放协调,压缩对角瓦片开销,使混合路径在前向也占优。
复现评估
代码已在 GitHub 开源(github.com/yandex-research/flamia-blackwell-attention),这是复现的最大利好。但硬件门槛极高:内核依赖 Blackwell 独有的 tcgen05、TMEM、CLC 特性,评测需要 B200/B300(B300 极少单位可得),完整预训练复现用了 8×B300 跑 TorchTitan、100B FineWeb-Edu token,普通实验室难以企及。相对易复现的部分:enwik8 上 6 层宽 1024 的 byte-level GPT、1024 字节上下文 6000 步,单卡算力即可完成泄漏与稳定性实验;泄漏探针(放大某文档激活 $10^4$ 倍观测其余文档 $dQ$ 变化,局部缩放余弦 0.99805 vs 逐张量缩放 0.99151)和余弦精度对比只需一次前向/反向捕获。综合评级:内核级基准 4/5(需 Blackwell、匹配的 CUDA/CUTLASS 版本、CUDA Graph 捕获),预训练级 5/5,数值与因果实验 2/5。作者在附录 D–J 提供了硬件软件版本、超参数、近似推导与三种 scale 校准策略对比,工程可复现性意识较强。
论文图表