基于结构感知内核的快速精确相对位置注意力 Fast and Exact Relative-Position Attention via Structure-Aware Kernels
用结构感知的分块内核精确加速四种相对位置注意力,8K 序列反向最高提速 21 倍
前置知识
FlashAttention 与在线 softmax
精确注意力的 IO 感知实现:把 $Q/K/V$ 切成小块(tile)搬进 GPU 片上 SRAM 计算,用在线 softmax 维护每行运行最大值 $m_i$ 与分母 $\ell_i$;反向重算分数而非存储 $N\times N$ 概率矩阵 $P$,消除对 HBM 的二次方访存。
本文的全部贡献就是把加性相对位置项无损地塞进这套分块前向/反向调度里,只有理解 FlashAttention 的 tile 结构与在线 softmax 状态,才能读懂“结构感知”从何而来、每处优化省在哪里。
加性相对位置注意力(Shaw/TXL/DeBERTa/T5)
在注意力打分上加一个依赖相对距离 $\delta=i-j$ 的可学习项:Shaw 用裁剪偏移的查询-关系投影,Transformer-XL 用 identity 映射加标量偏置 $b_r$,DeBERTa 同时用内容-位置与位置-内容两路投影,T5 只用对数分桶偏置,四者可统一为一个打分方程。
这是论文要加速的对象。只有理解四种机制共享的 $r=\phi(i,j)$ 只依赖偏移的结构,才能看懂统一的 tile 级优化为什么对它们全部适用。
RoPE 与参数无关位置编码
RoPE 对每个 token 的 query/key 做与绝对位置相关的旋转,可在融合内核里作为逐 token 变换无缝实现,几乎零开销;ALiBi 按距离给注意力加线性惩罚。它们计算高效,但外推到训练长度之外的能力常常不如可学习的相对偏置(如 T5 bias、TXL)。
这是论文的动机对比项:正因为 RoPE 能干净地融进内核而相对位置项不能,业界才出现“为效率弃质量、换 RoPE 从头重训”的做法(Flashzoi、FlashSwin、ModernBERT),本文要消除这个两难。
GPU 内存层级与原子加竞争
GPU 显存(HBM)带宽远低于片上 SRAM,内核性能常由访存量决定;多个线程同时对同一地址做 atomicAdd 会串行化且求和顺序不定。相对位置注意力的反向要把许多 $(i,j)$ 的 $\tau\,dS_{ij}$ 加进同一个表梯度条目 $dZ^Q_{ir}$,逐分数原子累加因此成为主要瓶颈。
理解 HBM/SRAM 层次才能明白“饱和 tile 广播单条目、按偏移单写者累加”为何同时提速、省显存并保证确定性——这三点正是本文相对 FlexAttention 的核心优势。
可编程注意力框架(FlexAttention 等)
让用户用 score_mod 等回调自定义注意力变体并自动推导反向、编译进融合内核(FlexAttention、FlashInfer 等)。但回调是逐 $(i,j)$ 的 pointwise 函数:无法跨 tile 复用关系条目、无法协调梯度所有权,位置项仍需逐分数查表与原子加。
它是本文最重要的对照系统。论文把本文的“关系分解式”塞进这些引擎(+ our decomposition)做对比,从而分离出“分解式本身”与“结构感知调度”各自的贡献。
研究动机
可学习相对位置注意力(Shaw、Transformer-XL、DeBERTa、T5)通过在注意力打分上加一个依赖相对距离 $i-j$ 的项来建模平移不变的位置关系,在语音识别(Parakeet、Canary、SeamlessM4T、Phi-4-multimodal)、文本编码与信息抽取(DeBERTa、GLiNER)、蛋白质与基因组建模(ProtTrans、Borzoi)中广泛使用。但与 RoPE 那种逐 token 旋转、可直接融进内核的做法不同,这些机制需要对每个 $(i,j)$ 对做偏移相关的查表或投影:朴素实现直接在 HBM 里构造稠密的 $N\times N$ 偏置矩阵,付出二次方显存与带宽——这正是 FlashAttention 当年要消灭的瓶颈。即便是 FlexAttention 这类可编程注意力框架,也只能把位置项当作逐分数的 pointwise 回调,无法感知 tile 级结构:前向重复访存同一表条目,反向用逐分数原子加累加表梯度,竞争严重且结果不确定。由于缺少高效内核,实践者常常干脆换掉位置编码——Flashzoi、FlashSwin 用 RoPE 替换后从头重训,ModernBERT 干脆改用 RoPE 方案。
本文的目标是本文目标是给出一个精确(exact,不做任何低秩/核化近似)、可直接替换(drop-in,无需改权重)、跨机制的 tiled attention 算法与高性能 Triton 内核,把加性相对位置项纳入 FlashAttention 式分块计算,同时消除三大开销:(1) 计算和存储根本不会被读到的投影列(identity 映射下约一半的 $Z^Q$ 列不可达);(2) 常数偏移区域($|\delta|\ge\Delta$)里的冗余索引与重复访存;(3) 反向传播中逐分数原子加导致的竞争、额外显存与不确定性。最终让这些机制在训练和推理上都更快、更省显存,并通过严格的 FP32 参考数值校验,使相对位置模型不再需要为了效率而被替换成 RoPE。
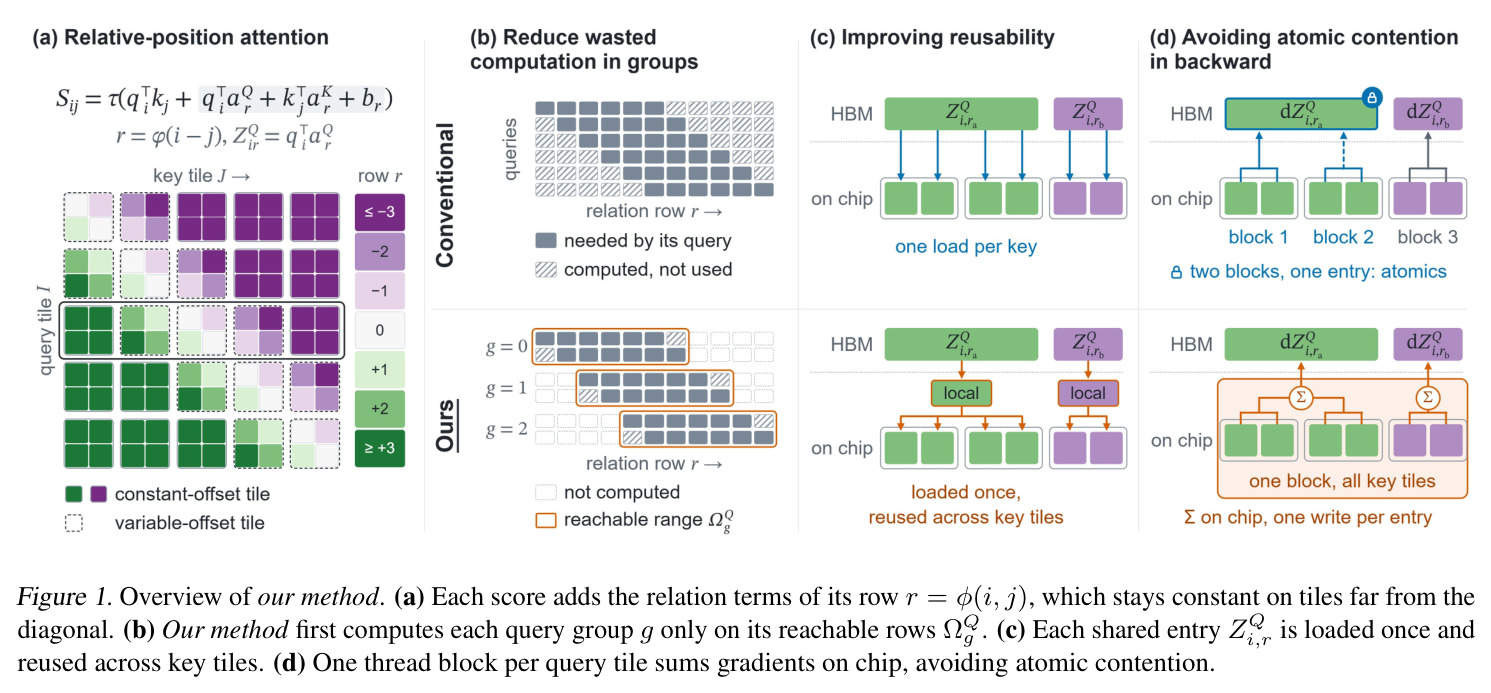
与已有工作不同的是,以往工作要么把偏置当黑盒稠密矩阵(eager PyTorch、SDPA),要么提供逐分数回调抽象(FlexAttention/FlashInfer/Flashlight),两者都把相对位置项看作与 $(i,j)$ 一一对应的元素级量,因而天然错过块级规律。本文的切入角度是反其道而行:利用相对距离在注意力矩阵上的块级结构——关系行号 $r=\phi(i,j)$ 只依赖偏移 $\delta=i-j$,在远离对角线的 tile 内是常数。论文先把 Shaw/TXL/DeBERTa/T5 统一成一个规范打分方程(Eq. 4,含 $A^Q/A^K/b$ 三类关系表与 identity/clipped/bucketed 三类映射),再首次在内核层面做三件事:只投影每个查询组可达的行号区间 $\Omega^Q_g$、在饱和 tile 里把秩一形式的位置项广播复用、反向按偏移 $\delta$ 而非行号 $r$ 分片累加梯度实现无原子确定性归约。这种“结构感知内核”与通用可编程框架的本质区别在于:优化发生在 tile/调度层,而不是逐分数回调层。
核心方法
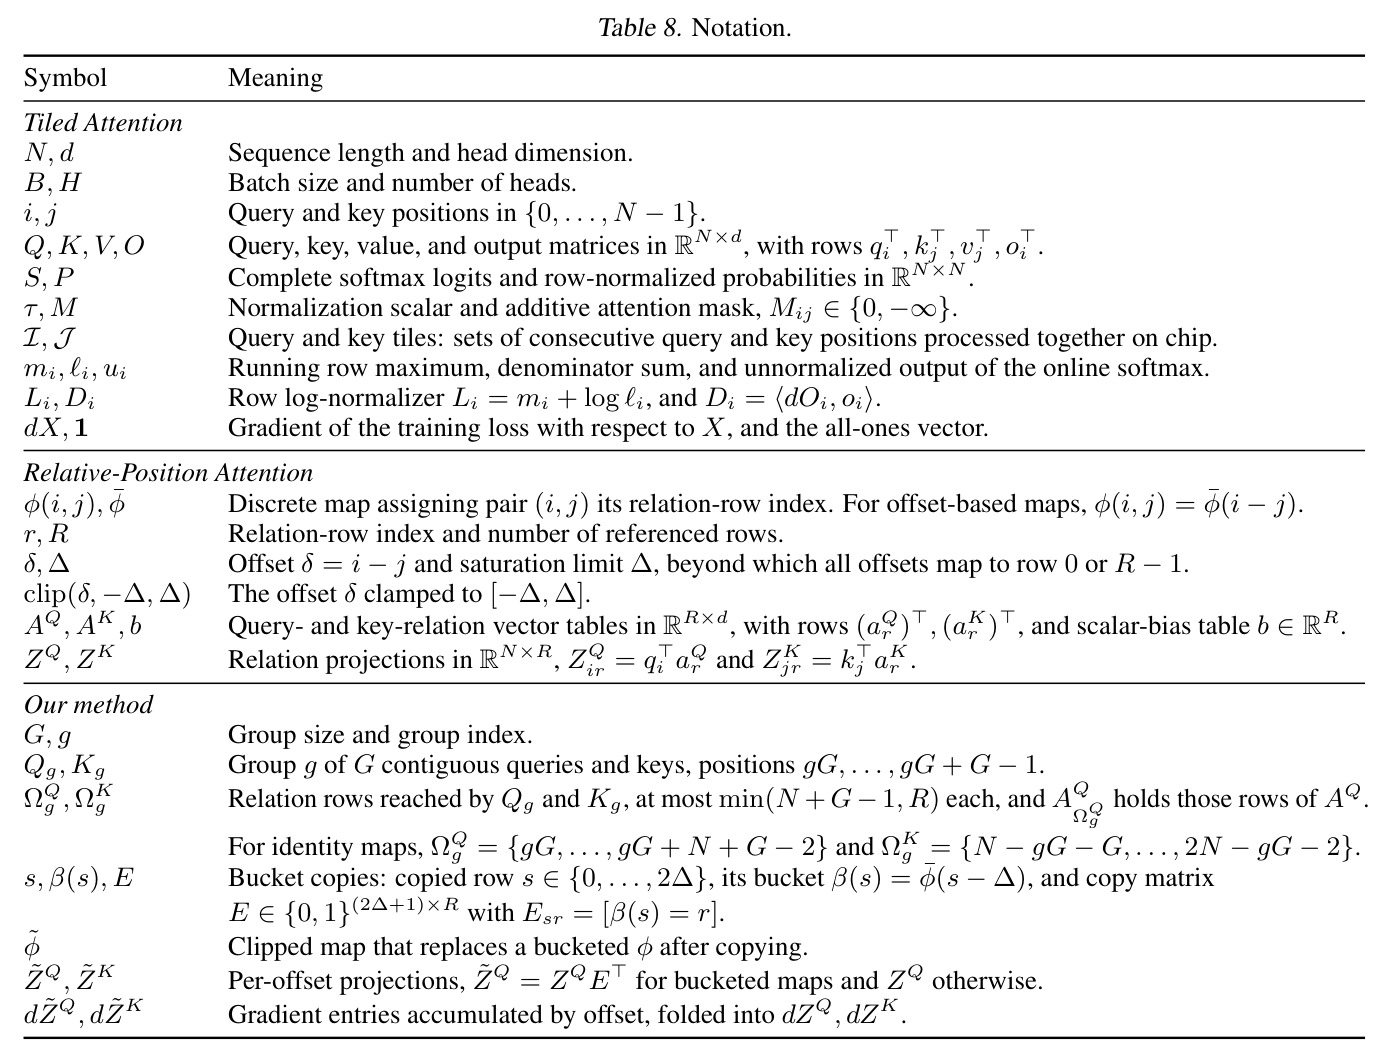
直觉上,相对位置项虽然形式上是 $N\times N$ 的成对项,信息量却只有 $N\times R$($R$ 为关系行数):每个位置项由“token 的投影”与“偏移映射到的行”唯一决定。技术路线分三步。第一步把打分改写为 $S_{ij}=\tau\,q_i^\top k_j+Z^Q_{i,\phi(i,j)}+Z^K_{j,\phi(i,j)}+b_{\phi(i,j)}+M_{ij}$,其中 $Z^Q_{ir}=q_i^\top a^Q_r$、$Z^K_{jr}=k_j^\top a^K_r$($Z^Q,Z^K\in\mathbb{R}^{N\times R}$)预先算好存进 HBM,每个 logit 只需最多三次标量查表而非 $d$ 维点积。第二步在前向分块循环内做两个结构优化:查询按 $G=128$ 分组,只投影组内可达的 $N+G-1$ 个连续关系行(identity 映射下投影工作量与存储近乎减半);对 $|\delta|\ge\Delta$ 的饱和 tile,每个查询/键只加载一个标量广播到整个 tile,只有对角带 $|\delta|<\Delta$ 内占比 $\to 0$ 的 pair 需要逐分数查表。第三步反向采用两遍调度(query-parallel 遍算 $dQ$ 与 $d\tilde Z^Q$,key-parallel 遍算 $dK,dV,d\tilde Z^K$),按偏移 $\delta$ 累加梯度:固定 $i$ 时 $j\mapsto\delta=i-j$ 是双射,每个梯度条目只有一个写者,彻底消除 $O(N^2)$ 次原子加并保证确定性。
核心创新是把“关系项的块级结构”变成内核的调度与访存策略,而非像 FlexAttention 那样把位置项当逐分数回调。三个互相配合的点:(1) 可达范围投影:查询组 $Q_g$ 与键组 $K_g$ 只会接触 $N+G-1$ 个连续偏移,故只需对 $A^Q_{\Omega^Q_g}$ 做一次稠密矩阵乘,$N\gg G$ 时投影工作与 HBM 存储几乎减半($G=128$ 在 $N=8K$ 时列开销仅 1.6%),且保持结果精确。(2) 常数区域复用:饱和 tile 中 relation 行号恒定,整个 tile 的位置项可写成秩一形式 $\tau z^Q\mathbf{1}^\top+\mathbf{1}(z^K)^\top+b_r\mathbf{1}\mathbf{1}^\top$,读 $|I|+|J|+1$ 个标量即可,代替 $3|I||J|$ 次查表;tile 是否饱和只需用端点算 $\delta_{\min},\delta_{\max}$ 做两次比较;bucketed 映射先把 $R$ 个桶复制展开成 $2\Delta+1$ 行,用裁剪代替查表,使三类映射统一处理。(3) 按偏移分片的无原子梯度累加:结合饱和区的两个边界 running sum,每 token 梯度条目从 $2N-1$ 降到 $\min(N+G-1,2\Delta+1)$,求和顺序固定、完全确定。这三点都是 tile 级推理,逐分数回调框架在原理上无法表达。
方法步骤详情
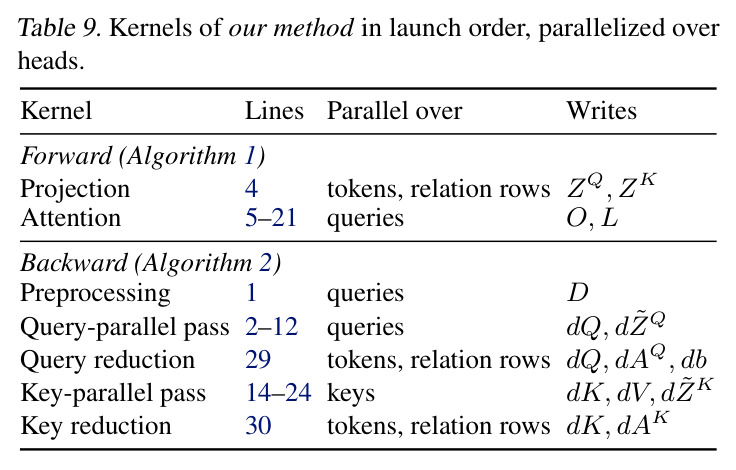
前向(Algorithm 1):bucketed 映射先复制表行使 $R=2\Delta+1$;投影内核对每个查询组算 $Z^Q_g=Q_g(A^Q_{\Omega^Q_g})^\top$(键组同理)存入 HBM,可选反向重算以省显存;注意力内核每个查询 tile 一个线程块,片上维护在线 softmax 状态,逐键 tile 算 $S^{IJ}=\tau Q_IK_J^\top+M^{IJ}$,用 tile 端点 $\delta_{\min},\delta_{\max}$ 两次比较判断整 tile 是否饱和($\delta_{\min}\ge\Delta$ 取行 $R-1$、$\delta_{\max}\le-\Delta$ 取行 0)——饱和则每查询/键广播一个标量,否则逐分数加 $Z^Q,Z^K,b$ 三个标量;最后写 $o_i=u_i/\ell_i$ 与 $L_i$。反向(Algorithm 2):query-parallel 遍重建 $S,P,dS$,累加 $dQ_I+=\tau\,dS^{IJ}K_J$ 并按偏移累加 $\tau\,dS_{ij}$(饱和部分并入边界 running sum);key-parallel 遍同理得 $dV,dK,d\tilde Z^K$;最后折叠 bucket 重复列,矩阵乘得 $dQ+=dZ^QA^Q$、$dA^Q=(dZ^Q)^\top Q$、$db=(dZ^Q)^\top\mathbf{1}$。Triton 实现:编译期按机制/映射/掩码/精度/tile 特化,tile 大小按 GPU 查表或自动调优,支持 padding/causal 掩码、变长 packing 与 dropout。
技术新颖性
技术新颖性有四点。(1) 统一形式化:把 Shaw/TXL/DeBERTa/T5 归约为同一规范方程与三类映射(identity/clipped/bucketed),一套内核服务所有架构——此前只有模型特定的 FlashDeBERTa/GLiNER4j(后者仅推理、前者反向数值不过关)。(2) 算法-内核协同设计:利用 $\phi$ 只依赖 $\delta$ 的单调性与饱和性做 tile 级分支(两次比较代替逐分数判断),把“查表问题”转成“区间问题”,这是 pointwise 回调抽象在原理上无法表达的调度自由度。(3) 确定性反向:按偏移分片的单写者归约替代原子加,同时固定求和顺序,训练可复现——注意力内核文献很少同时保证这两点。(4) 精度设计:投影即便输入是 BF16 也以 FP16 存储(舍入误差小 8 倍、clamp 到 $\pm65504$ 防溢出),片上统计量与累加器全 FP32,在线 softmax 用以 2 为底的指数;并定义了严格的通过标准(相对独立 FP32 参考逐元素 5% 相对、0.03 绝对误差内,或相对 $\ell_2$ 误差在 8 个舍入单位内)——实测所有生产系统的 DeBERTa 反向从 4K token 起全部不过关,而本文始终通过。此外“bucket 复制展开 + 裁剪化”是让饱和检测统一适用于三类映射的干净技巧。
实验结果
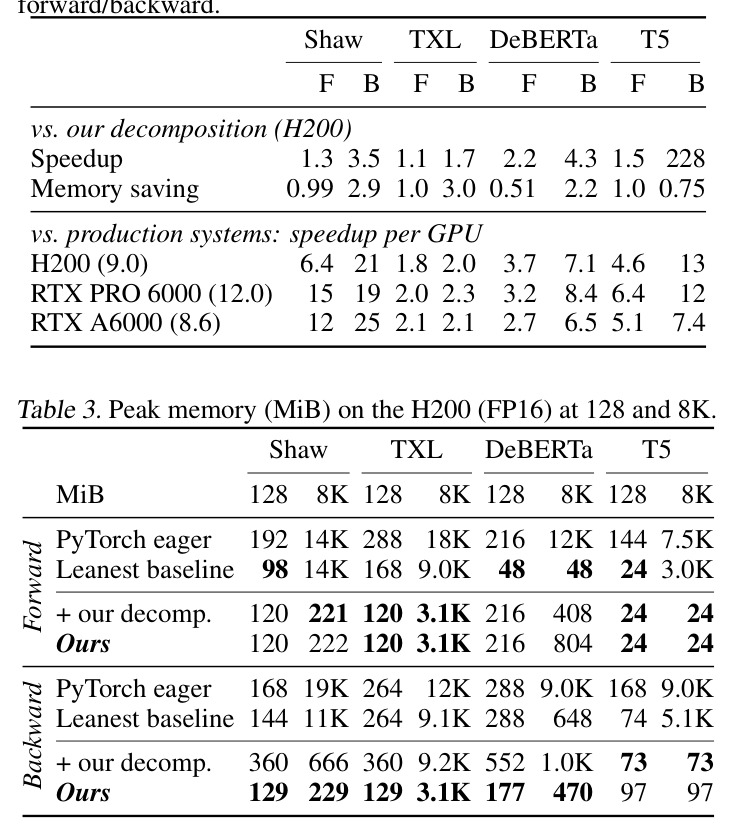
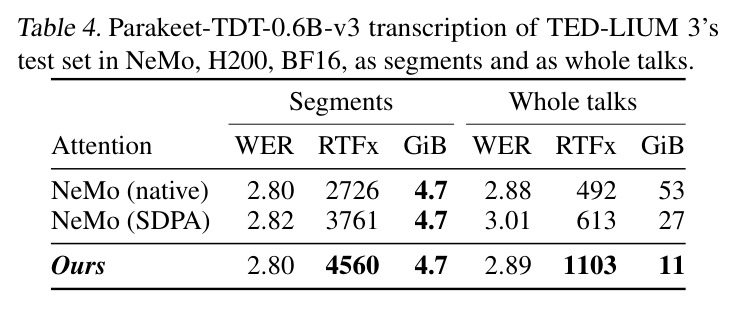
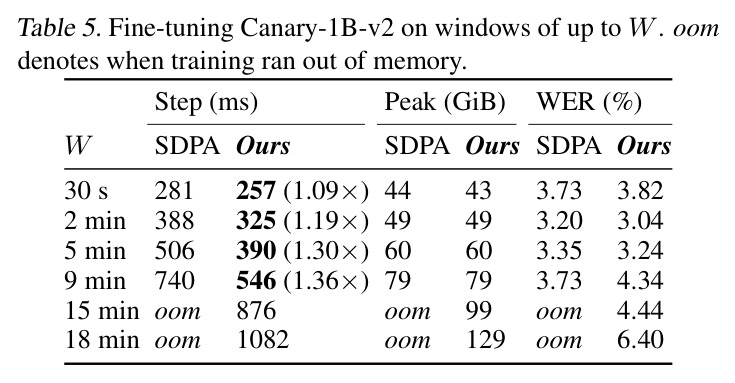
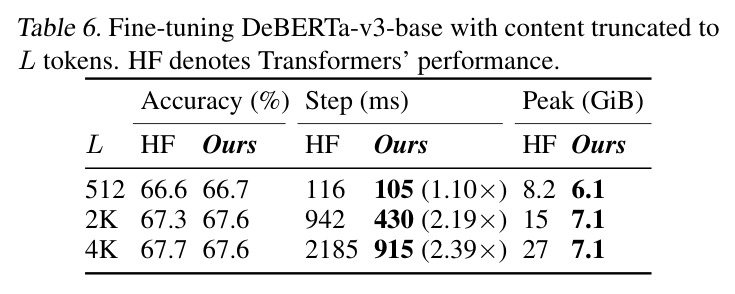
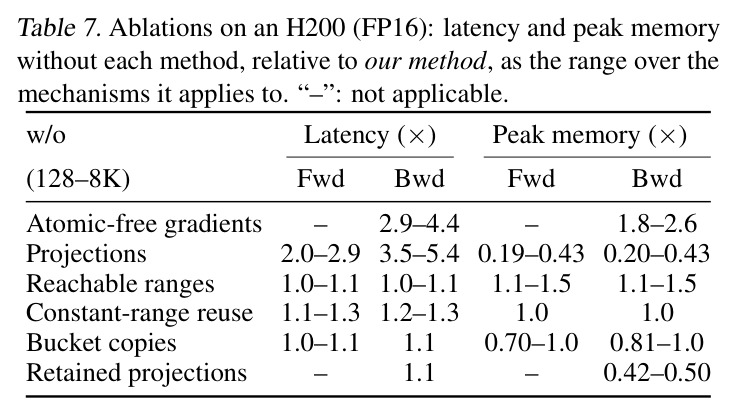
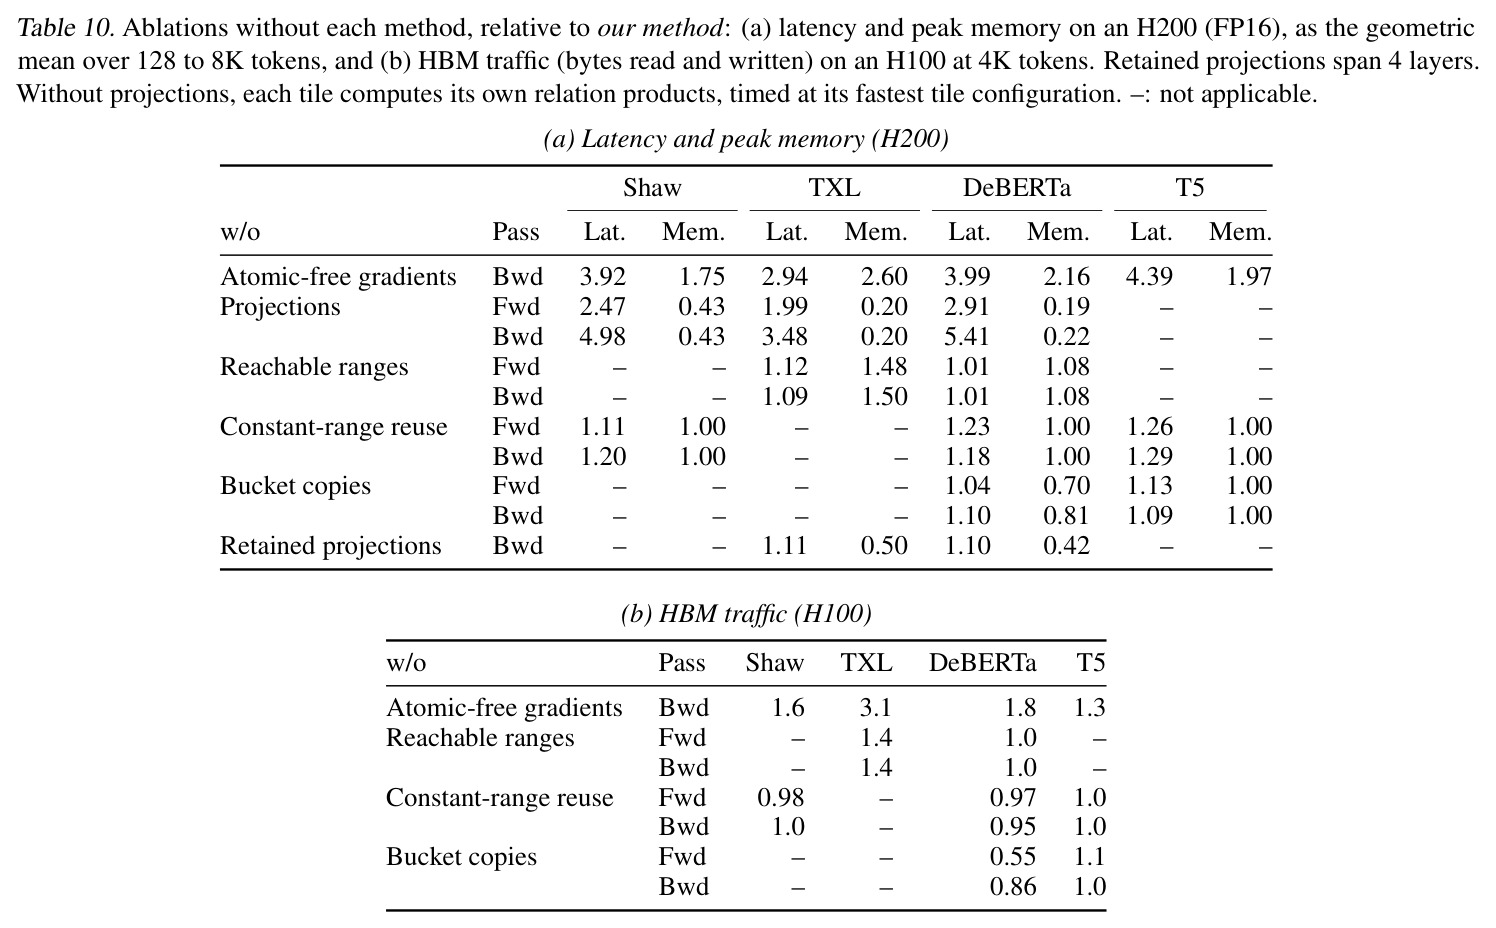
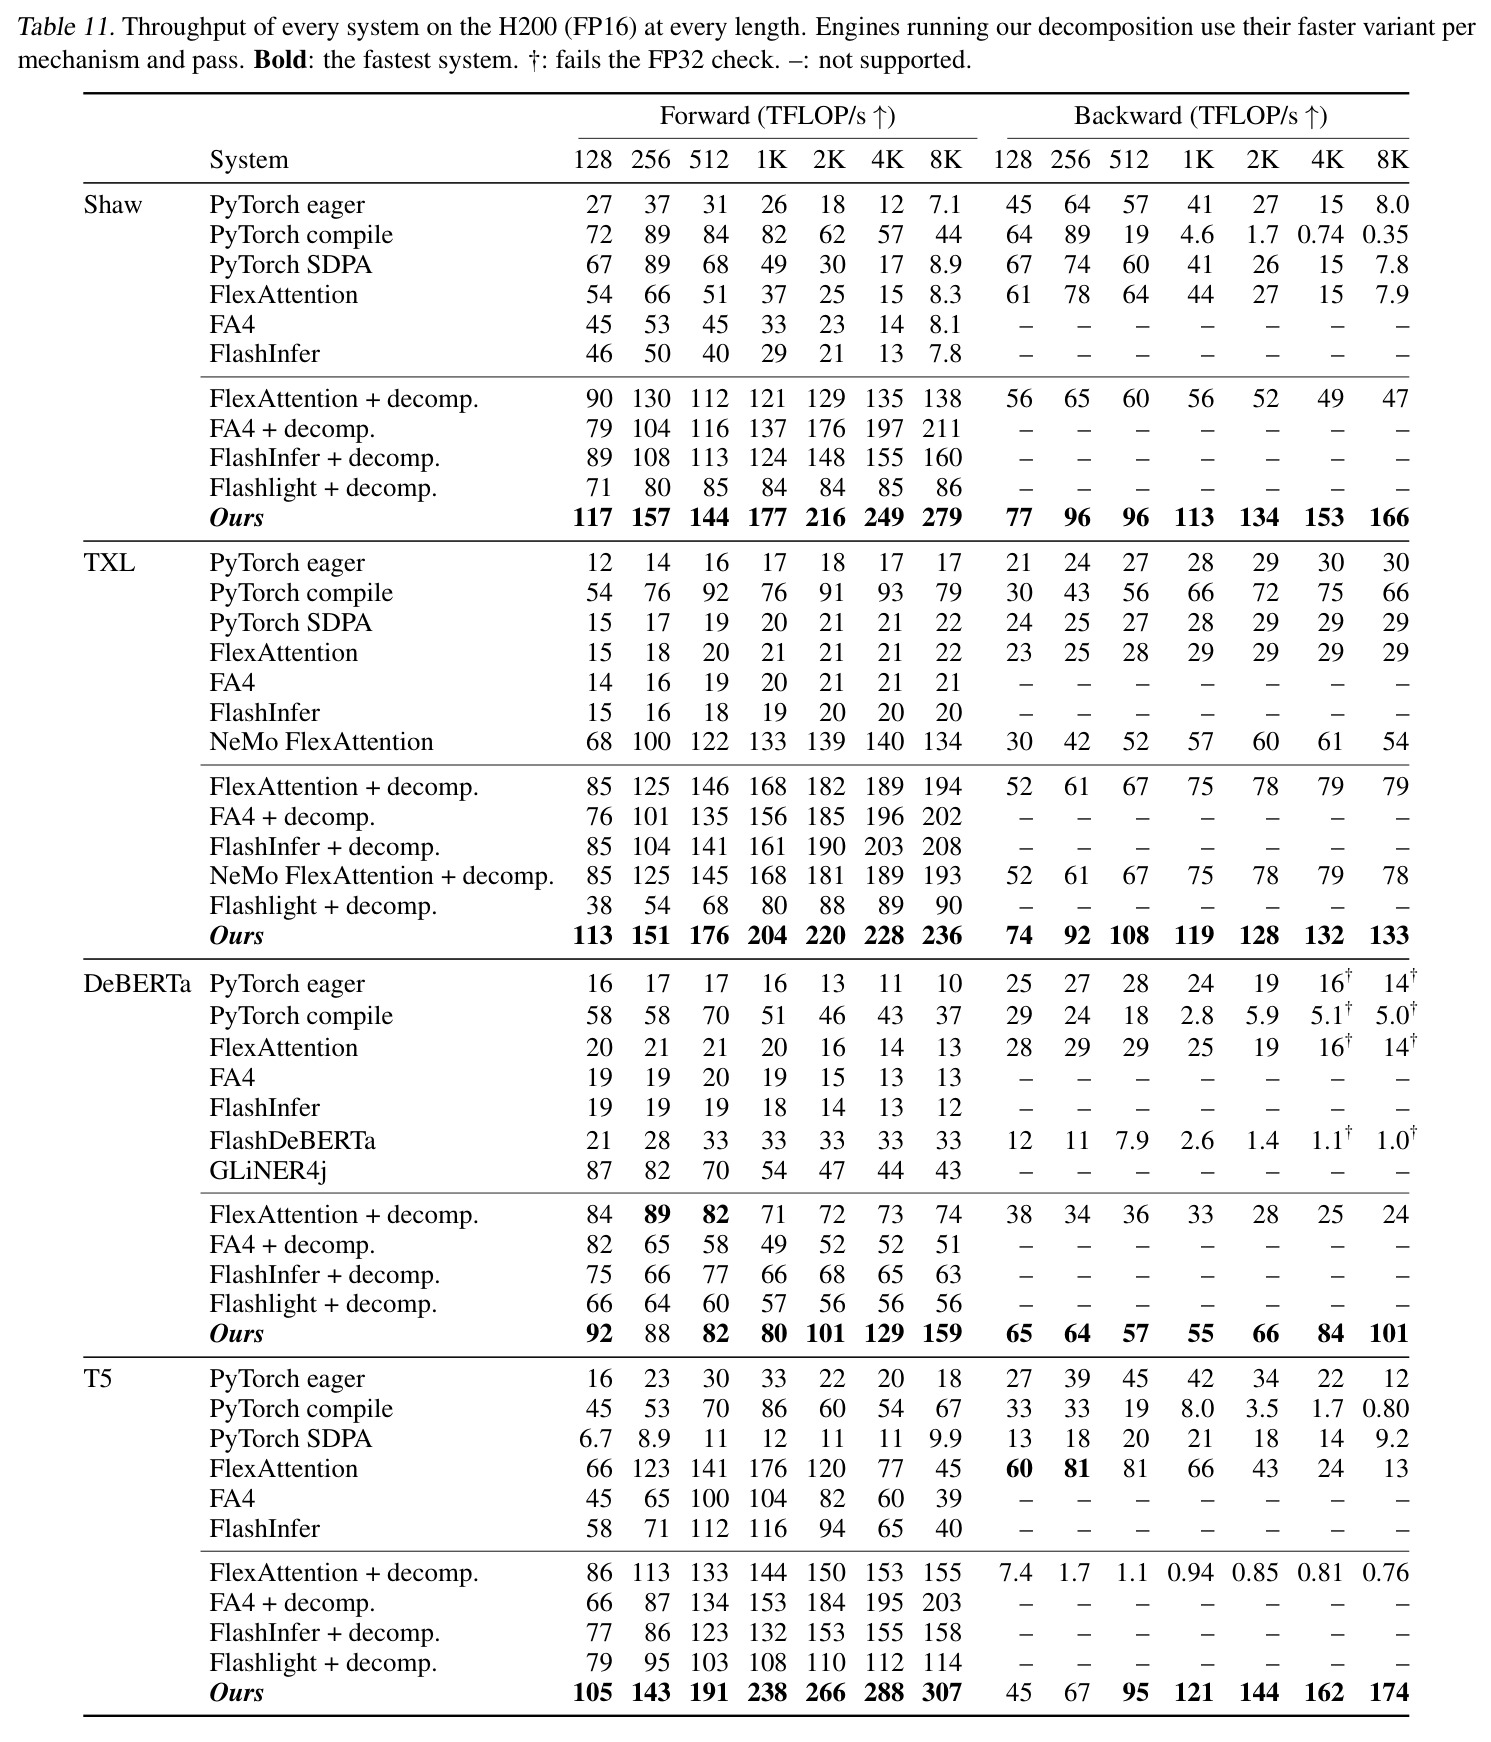
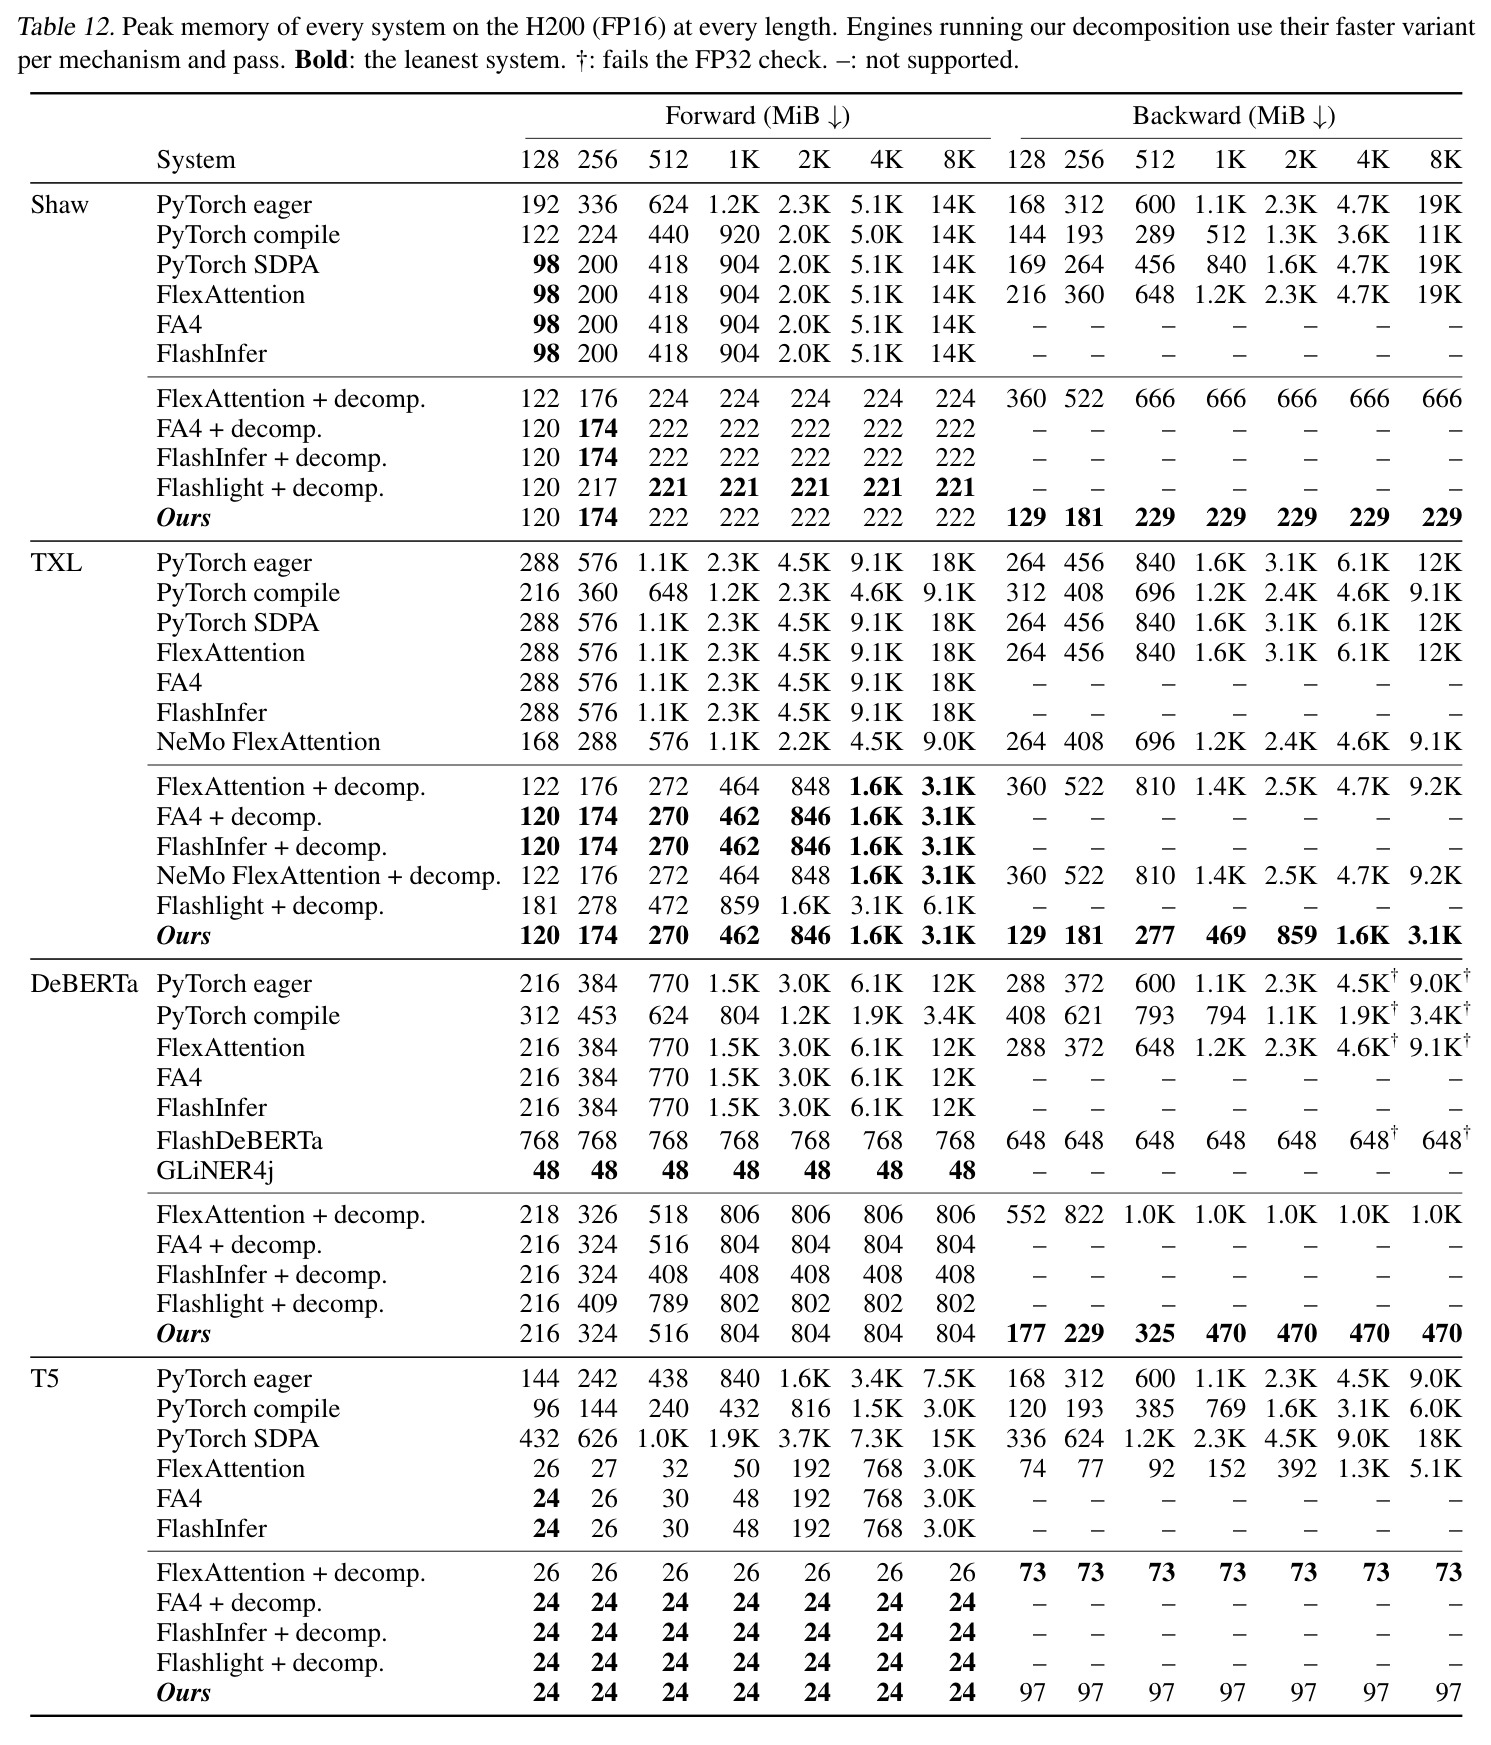
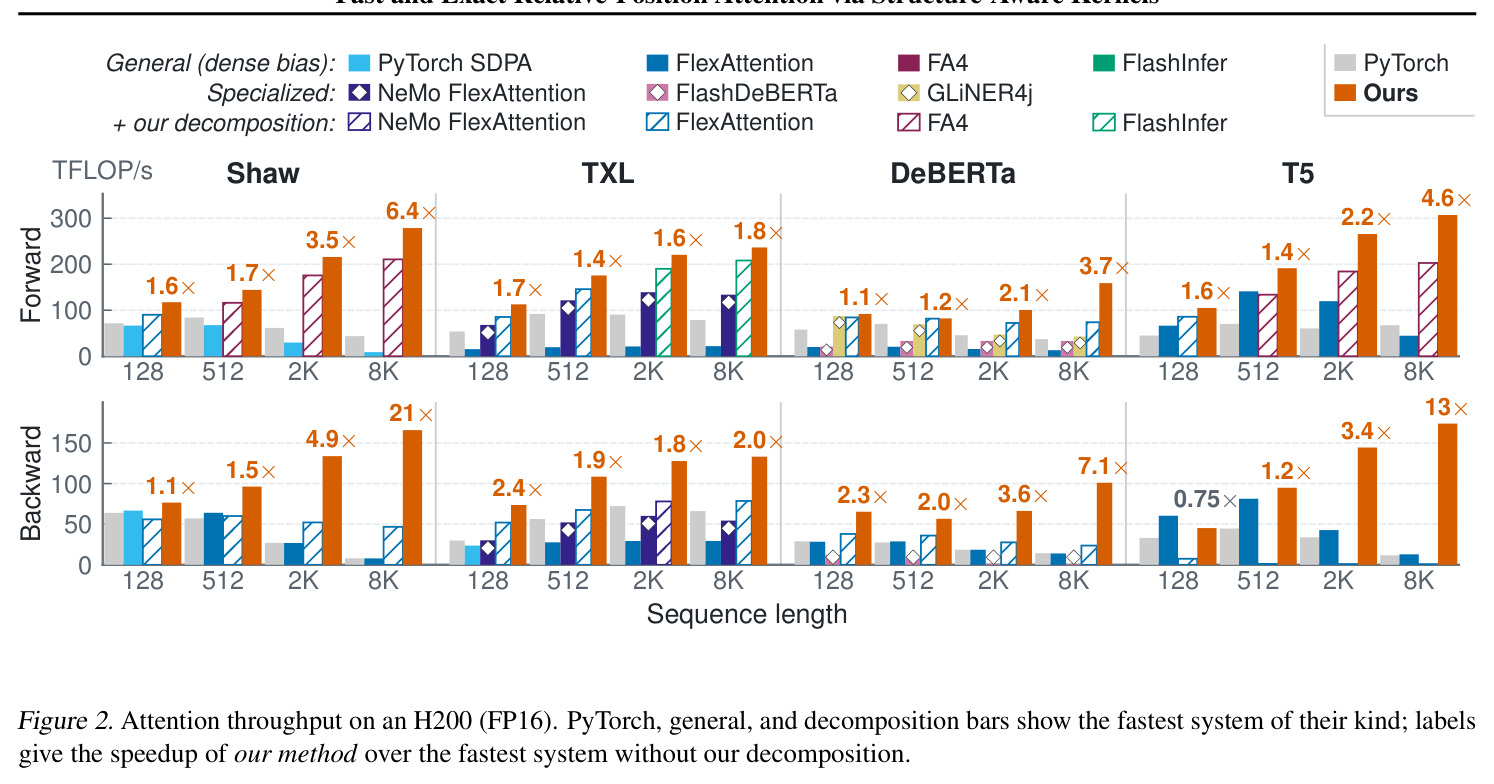
(1) 注意力层微基准(H200 FP16,128→8K):8K 时对每机制最强生产系统前向提速 1.8–6.4×、反向 2.0–21×(Shaw 6.4×/21×,TXL 1.8×/2.0×,DeBERTa 3.7×/7.1×,T5 4.6×/13×,前向最高 307 TFLOP/s);对加了本文分解式的引擎仍快 1.1–2.2×(前向)与 1.7–228×(反向);T5 反向 128/256 token 仅 0.75–0.82×。峰值显存 8K 前向省 2.9–128×、反向省 1.4–54×(如 Shaw 222 vs 14K MiB),例外是 DeBERTa 前向 GLiNER4j 用重算换更低显存但慢 3.7×。(2) 数值正确性:独立 FP32 参考下本文全过,生产系统的 DeBERTa 反向自 4K 起全不过关。(3) Parakeet 转写 TED-LIUM 3:WER 与原生持平(整场 2.89 vs 2.88),整场 RTFx 492→1103(约 2.2×)、显存 53→11 GiB。(4) Canary 长音频微调:可跑窗口提速 1.09–1.36×,15/18 分钟窗口 SDPA OOM 而本文靠反向重算投影跑通。(5) DeBERTa-v3-base 于 BIGPATENT:精度差 ≤0.3 点,2K/4K 步时提速 2.19×/2.39×,显存 15→7.1、27→7.1 GiB。(6) 消融:无原子梯度贡献反向 2.9–4.4× 提速、1.8–2.6× 省显存并保证确定性;投影预计算贡献前向 2.0–2.9×;tile 内重算换显存则减速 2–5×、显存降到 0.19–0.43×——这正是 15 分钟以上长窗口能训练的原因。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 注意力层前向吞吐(Shaw 映射,H200 FP16,8K token) | TFLOP/s | 279 | 最快生产系统 PyTorch compile 44 | 6.4× |
| 注意力层反向吞吐(Shaw,H200 FP16,8K) | TFLOP/s | 166 | 最快生产系统 PyTorch eager 8.0 | 21× |
| 注意力层前向吞吐(T5,H200 FP16,8K) | TFLOP/s | 307 | 最快生产系统 PyTorch compile 67 | 4.6× |
| 注意力层反向吞吐(DeBERTa,H200 FP16,8K) | TFLOP/s | 101(通过 FP32 校验) | 最快生产系统 FlexAttention 14(自 4K 起未通过校验) | 7.1× |
| 前向峰值显存(T5,H200 FP16,8K) | MiB | 24 | 最省生产系统 3.0K | 约 128× |
| 反向峰值显存(Shaw,H200 FP16,8K) | MiB | 229 | 最省生产系统 11K | 约 48×(论文报告范围 1.4–54×) |
| 整场语音转写(Parakeet-TDT-0.6B-v3,TED-LIUM 3,最长约 25 分钟) | RTFx / 显存 / WER | 1103 / 11 GiB / 2.89 | NeMo 原生 492 / 53 GiB / 2.88 | 约 2.2× 提速、4.8× 省显存,WER 持平 |
| 长音频微调(Canary-1B-v2,18 分钟窗口) | 步时 ms / 峰值 GiB / WER | 1082 / 129 / 6.40 | NeMo SDPA OOM | 唯一能训练的配置;两边均可跑时提速 1.09–1.36× |
| 长文档分类微调(DeBERTa-v3-base,BIGPATENT,4K token) | 步时 ms / 峰值 GiB / 准确率 % | 915 / 7.1 / 67.6 | HF Transformers 2185 / 27 / 67.7 | 2.39× 提速、约 3.8× 省显存,精度差距 ≤0.3 点 |
局限与改进
作者承认的局限(第 6 节):identity 映射(Transformer-XL)给每个偏移独立的关系行,投影工作量与空间仍随 $N$ 二次增长;改为 tile 内现算可把空间降为线性,但前向慢 2.0–2.9×。若映射的关系行不覆盖连续偏移区间(例如让 $\delta$ 与 $-\delta$ 共用一行,或依赖偏移以外的信息),只能回退到 FP32 原子累加——更慢且不确定(所评四种机制都不触发)。方法为跨机制/映射/GPU 的通用性牺牲了硬件特化:没有用 warp specialization、异步 bulk transfer 等原语,留作未来工作。我自己的观察:(1) 短序列开销明显,T5 反向在 128/256 token 只有 0.75–0.82×,$G=128$ 的分组与编译特化在小 $N$ 下得不偿失;(2) 端到端收益受注意力占比上限约束——Canary 因自回归解码器在 token 生成阶段几乎无收益,微调时 transducer loss 主导步时,加速有限;(3) bucketed/非偏移映射的回退路径意味着更奇异的位置方案(旋转+偏置混合、非单调桶)不在覆盖范围;(4) 长窗口 WER 差异(9 分钟以上 4.34 vs 3.73)虽归因于一两条长录音的重复循环,但长上下文行为的统计功效不足;(5) 投影以 FP16 存储并 clamp 到 $\pm65504$,极端离群值场景的数值边界需要使用者自行留意。
独立分析的弱点
独立分析的弱点:(1) identity 映射的二次性没有算法级解——TXL 类模型在超长序列(基因组、全卷音频)下 $Z^Q\in\mathbb{R}^{N\times(2N-1)}$ 的 HBM 占用与带宽仍是瓶颈;改进方向是利用 identity 映射的 Toeplitz/带状结构做分块投影,或把 $Z^Q$ 换成按需计算 + L2 友好调度。(2) 短序列退化:可为小 $N$ 提供融合的单内核路径,或与 SDPA 做运行时自动选择,避免 128–256 token 时的负收益。(3) 硬件未压榨:没有 TMA/warp specialization,H200 上 Shaw 前向 279 TFLOP/s 距 FA4 在标准注意力上的峰值仍有差距,可像 FA4 那样做算法-流水线协同设计。(4) 覆盖面限于“加性偏移”机制:FiLM 式位置调制、学习式非单调分桶、旋转+偏置混合方案都需扩展规范方程与回退路径。(5) 数值评估以逐 tensor 校验为主:FP16 投影在超长训练或 BF16 大动态范围下的累计影响缺少端到端长训收敛性对比;论文只测了 3 epochs 的微调任务。
未来方向
作者提出的:用架构特定原语(warp specialization、异步 bulk transfers,如 FA3/FA4 的做法)进一步提速。基于本文成果可延伸的方向:(1) 把关系分解作为标准前处理回馈 FlexAttention/FlashInfer 等框架——论文已证明“引擎+分解”仍比完整方法慢 1.1–2.2×(反向最多 228×),说明深度融合空间很大;(2) 为 identity 映射设计近线性的投影算法(Toeplitz 矩阵乘/分块卷积视角);(3) 扩展到交叉注意力与自回归解码的 KV 缓存场景,当前收益集中在编码器/prefill;(4) 与长上下文语音、基因模型结合,探索更大 $\Delta$、可学习 bucket 边界与混合映射;(5) 把“按偏移分片的无原子确定性归约”推广为通用原语,用于任何多对一梯度结构(可学习 ALiBi、稀疏掩码偏置、低秩偏置 FlashBias);(6) 在 Flashzoi/FlashSwin 这类被迫换 RoPE 重训的模型上直接验证“不换位置编码也能高效训练”的质量收益。
复现评估
论文承诺开源(附录 H):方法代码、基准与端到端脚本、全部结果文件(记录软件版本、tile 大小、GPU 遥测),脚本可从结果文件复现论文每张图表;代码内置 FP32 参考测试,覆盖 padding/packing/causal/dropout/各输入精度。评测全部基于公开模型与数据:Parakeet-TDT-0.6B-v3、Canary-1B-v2(NeMo 3.0.0 + PyTorch 2.9.1 + CUDA 12.8)、DeBERTa-v3-base(HF Transformers)、TED-LIUM 3、BIGPATENT。硬件门槛友好:主要结果单卡 H200,并给出 RTX PRO 6000(Blackwell)与 RTX A6000(Ampere)的完整结果;内核侧软件栈为 CUDA 13.0 + PyTorch 2.14.1 + Triton 3.8.0 + FA4 4.0.0b33 + FlashInfer 0.7.2 + FlashDeBERTa 0.0.7。编译+自动调优每模型一次性开销小于 3 分钟并缓存。复现难度评估:注意力层微基准中等偏低(协议写得极细:do_bench、每次测量清 L2、50ms 预热、≥10 次取中位数);端到端训练需 100 小时 TED-LIUM 3 微调 Canary(3 epochs)与 BIGPATENT 25K 文档 3 epochs,单卡 H200 可行但需数天。注意论文为 preprint under review,代码仓库尚未在文中给出链接,需关注作者后续发布。
论文图表
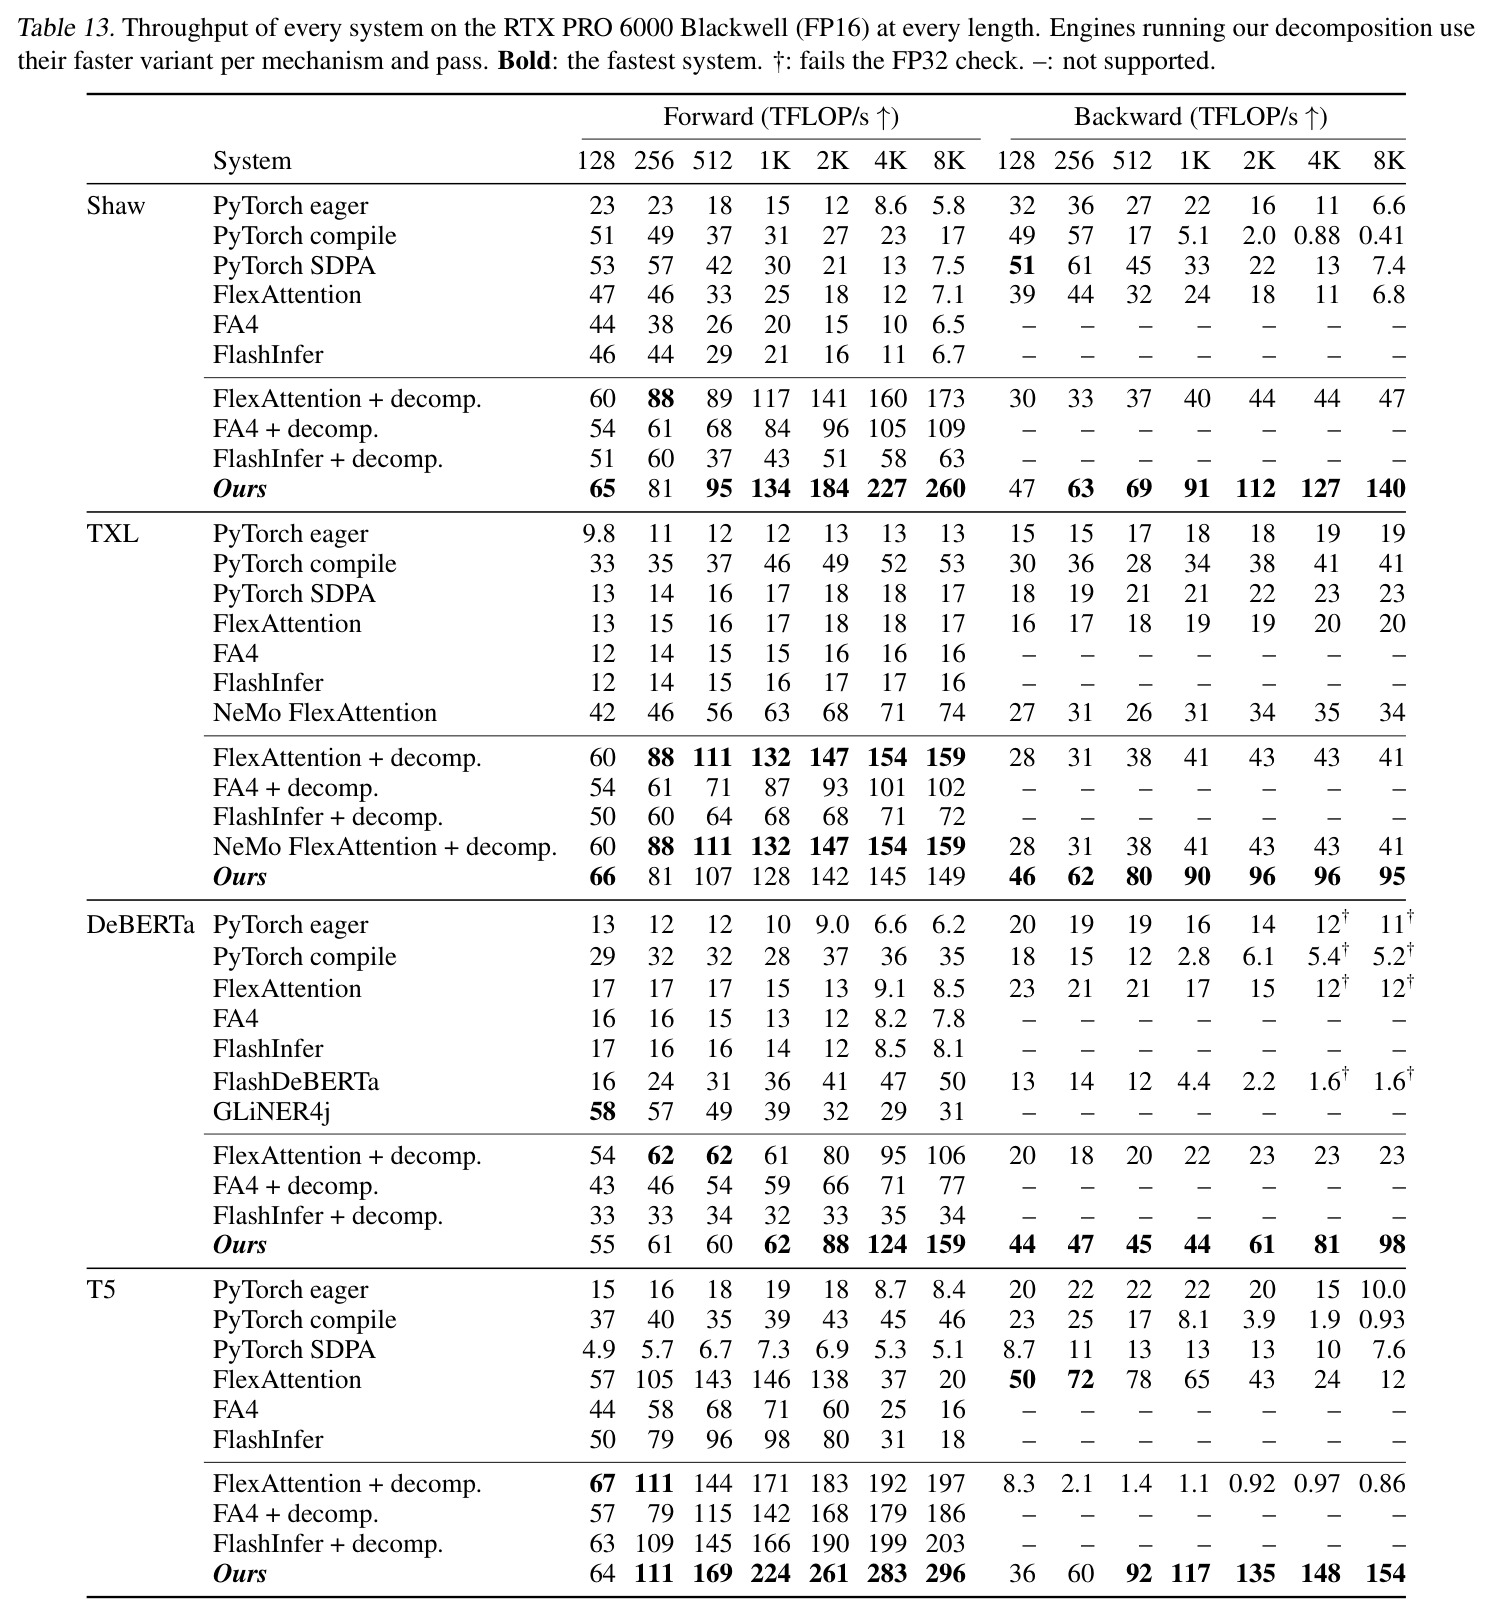
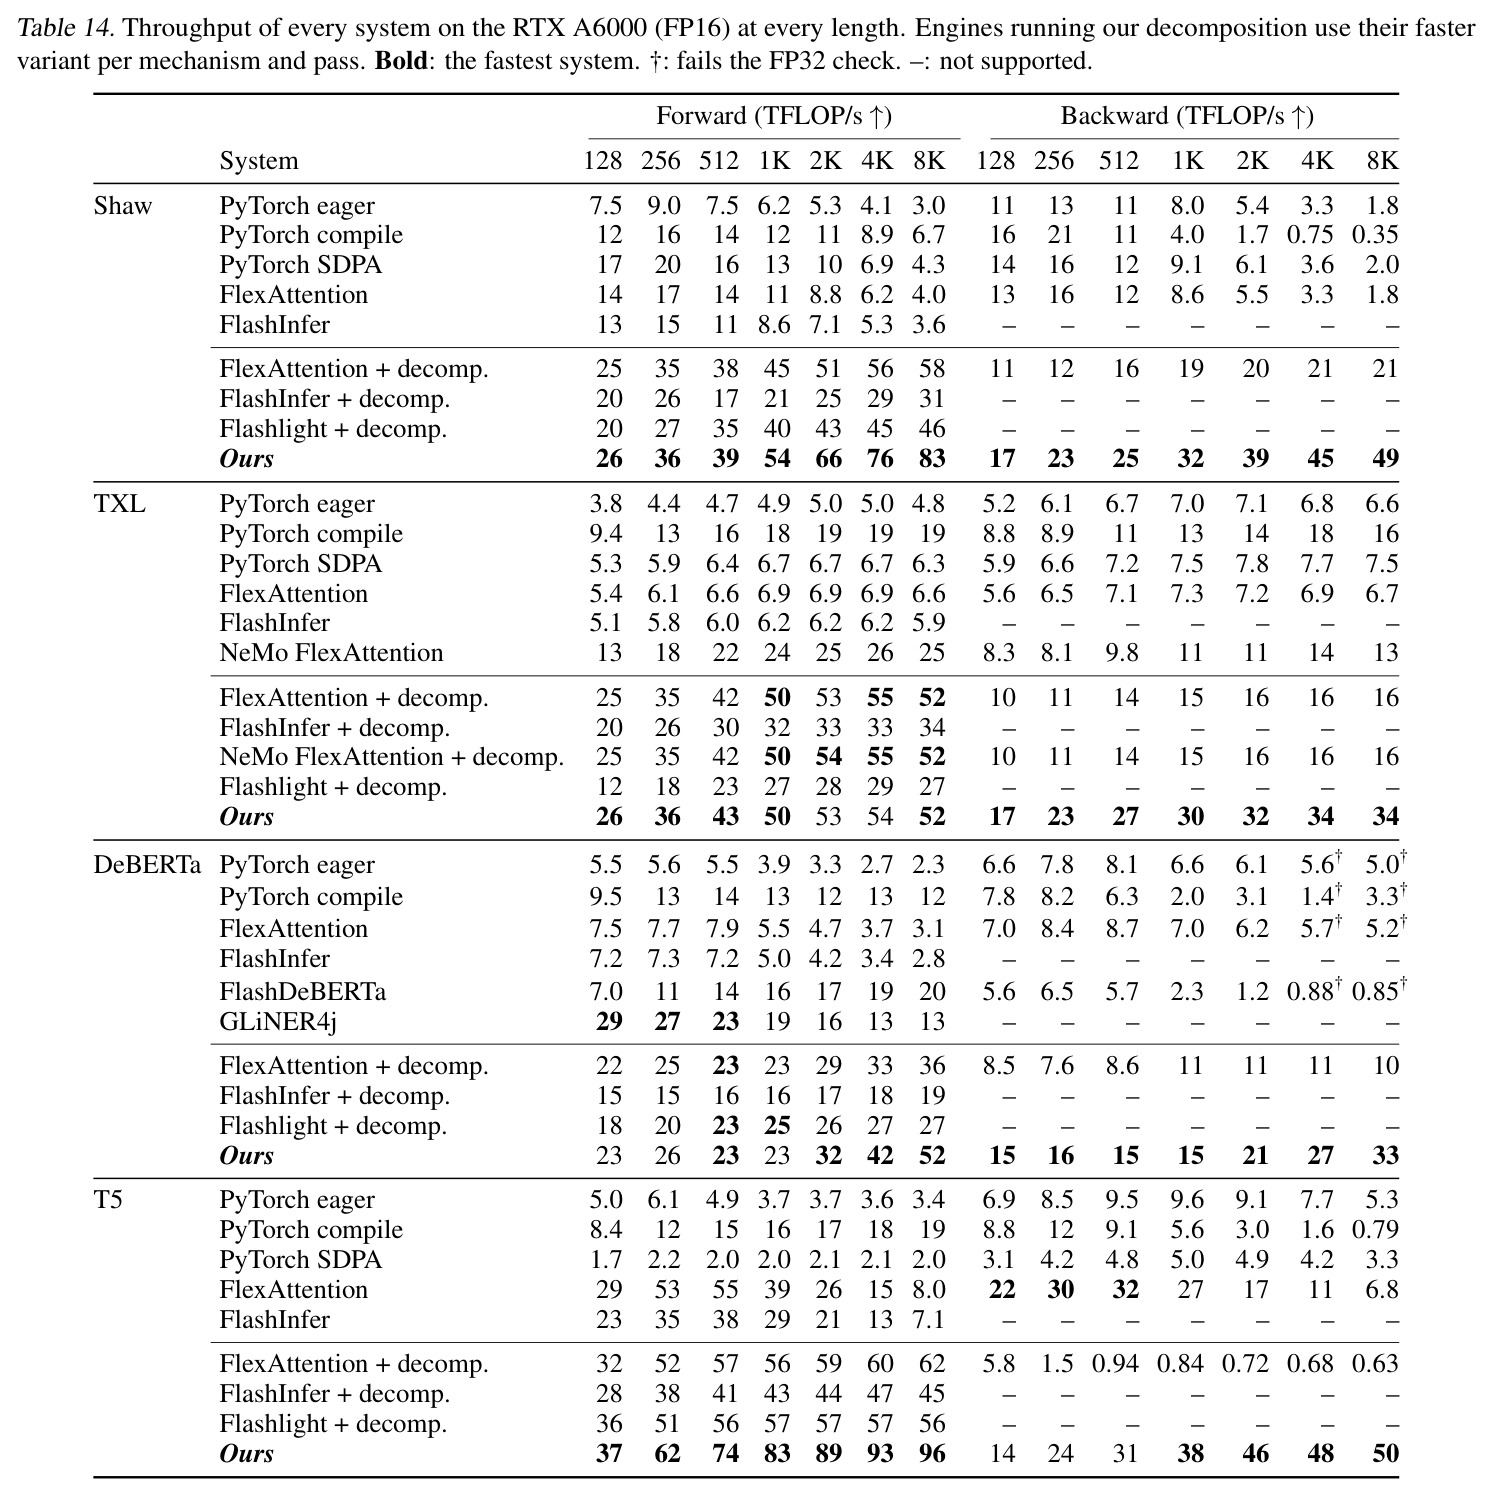
Ampere 卡上的完整吞吐:本文仍全面领先(Shaw 8K 反向 49 vs 基线 2.0 TFLOP/s、约 25×;T5 前向 8K 96 vs 20),说明即便在没有最新异步特性的 GPU 上结构感知调度依然有效。
补齐 Ampere 证据链,对算力有限的实验室最有参考价值:老卡上收益同样显著。