VC-Attention:面向低比特注意力的值平滑与 Softmax 概率直写 VC-Attention: Value Smoothing and Softmax Casting for Low-bit Attention
用值聚类平滑与 E4M3 概率直写,免训练让视频扩散低比特注意力又快又准
前置知识
扩散 Transformer(DiT)
视频扩散模型的主流架构:把视频压进潜空间后展平成一条时空 token 序列,每层都做完整自注意力。Wan2.2-14B 生成 5 秒 720p 视频约有 7 万个 token,注意力在 RTX 5090 上占 64% 以上生成时间。
本文的加速对象就是视频 DiT 中的注意力层,四个评测模型(Wan2.2、LongCat、HunyuanVideo、MiniMax-H3)全部是 DiT。
在线 softmax(FlashAttention)
FlashAttention 分块流式计算注意力:维护每行运行最大值 $m_i$、归一化子 $l_i$ 与分子累加器 $A_i$,新块到来时用 $\alpha_i=\exp(m_i-m'_i)$ 缩放历史累积,从不物化 $N\times N$ 矩阵。
V-Smooth 的块均值恢复和 ExpCast-FP8 都嫁接在这套在线递推上,不懂递推就看不懂式 (1)(6)(7)。
低比特量化与离群值
量化把高精度张量换成 FP8/INT4 等低比特表示,每个硬件块共享一个缩放因子 $s_X$。少数远大于其余元素的离群值会把 $s_X$ 撑大,让普通元素只剩极少有效比特,是精度损失的主要来源。
论文两大组件都在处理离群值:V-Smooth 处理 value 侧的 token 型离群值,ExpCast-FP8 约束 softmax 侧概率编码误差。
E4M3 浮点格式
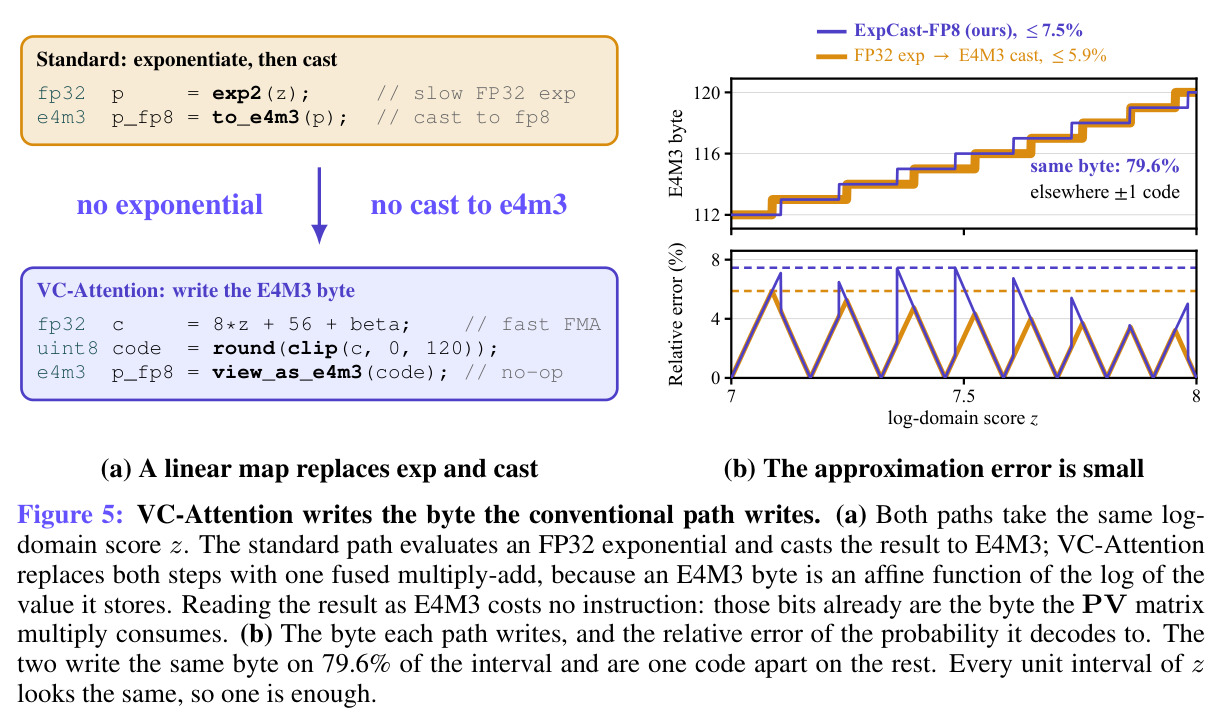
8 位浮点数:1 位符号、4 位指数(偏置 7)、3 位尾数。其字节按整数读出恰等于 $8\log_2 v+56+\varepsilon(m)$,即所存数值对数的仿射函数,这一性质是 ExpCast-FP8 免指数编码的理论基础。
ExpCast-FP8 直接从对数域分数写出 E4M3 字节,必须理解该格式才能看懂式 (7) 与 Proposition 3.1。
Tensor Core 与 MUFU
Tensor Core 是 GPU 的矩阵乘专用单元,FP8 峰值是 BF16 的两倍(RTX 5090 上 FP4 达 8 倍);MUFU(多功能单元)负责 exp 等超越函数,每时钟每 SM 只能发 16 次指数,两者速度严重脱节。
B200 上 FP32 指数的 MUFU 周期是 FP8 矩阵乘的两倍、softmax 成为最长流水段——这正是 ExpCast-FP8 的提速动机。
研究动机
视频扩散 Transformer 在高分辨率长时长下注意力占绝对主导:Wan2.2-14B 生成 5 秒 720p 视频约 7 万个 token,RTX 5090 上注意力占生成时间 64% 以上。低比特内核部署面临两道坎。精度上,量化块的缩放因子由块内最大元素决定,离群值让普通元素只剩极少有效比特;已有工作只平滑 query 和 key,而 value 的离群值集中在少数 token 上、尖峰通道随头/层/步漂移,Hadamard 旋转只混 token 内通道且保范数,离群 token 原样存活——Wan2.2 上经 QK 处理后 value 量化误差仍占输出误差 82%(图 3a)。速度上,低比特只加速 QK 与 PV 两个矩阵乘,中间的 FP32 指数与 FP32→FP8 转换反成最长流水段:H200 上指数的 MUFU 周期已与两个 FP8 矩阵乘相当,B200 的 Tensor Core 快一倍而 MUFU 不变,指数周期反是其两倍;SageAttention2 没有 Blackwell 内核,在 B200 上只有 BF16 FlashAttention-4 的 0.29×。
本文的目标是本文的目标是构建一个完全免训练(training-free)的低比特注意力内核,同时解决精度与速度两个瓶颈,把低比特 Tensor Core 的峰值吞吐真正转化为视频 DiT 的端到端加速。具体而言:在不重训模型、不需要模型专属校准数据的前提下,把注意力两侧——softmax 之后的 value 乘积与 softmax 本身的概率计算——都压到 8 比特(数据中心卡 FP8)乃至 4 比特(工作站卡 NVFP4),并在 Wan2.2、LongCat-Video、HunyuanVideo-1.5、MiniMax-H3 四个开源视频模型上做到:保真度(PSNR/SSIM/LPIPS,以同种子 BF16 FlashAttention-4 输出为参照)全面超过现有免训练基线;注意力内核比 BF16 FlashAttention-4 快 1.46–1.59×(数据中心卡)与 2.3–3.6×(工作站卡),端到端快 1.13–1.70×;且可部署到 B200、B300、H200、RTX PRO 6000、RTX 5090 五种 GPU。
与已有工作不同的是,已有的免训练低比特注意力几乎全部围绕打分乘积 QK 展开:SageAttention 系列平滑并缩放 Q/K,FlashAttention-3 对 FP8 通道做 Hadamard 旋转,但都把 value 量化器留在原始 token 序顺序上;Attn-QAT 靠重训弥补,代价是模型专属数据和 GPU 时间,免训练模式下在 B200 上最高只有 1.3× 加速。线性层量化方案(SmoothQuant/AWQ 等)需要静态权重承接离群值,DeltaQuant 的立方体划分固定在时空网格上,Quant VideoGen 面向自回归模型的 KV cache 且在注意力前重建,均不适用于 DiT 注意力的两个乘积;Sparse VideoGen 2 虽然也聚类置换 token,但目的是让整块注意力可跳过,而非让量化块获得值得减去的均值。内核侧,FA4 与 Attn-QAT 均指出 FP32 指数与转换卡在 B200 关键路径上,但没有工作利用 E4M3 格式的对数性质给出免拟合、可证明误差界的概率直写方案。本文同时填补 value 误差与 softmax 标量路径两个空缺。
核心方法
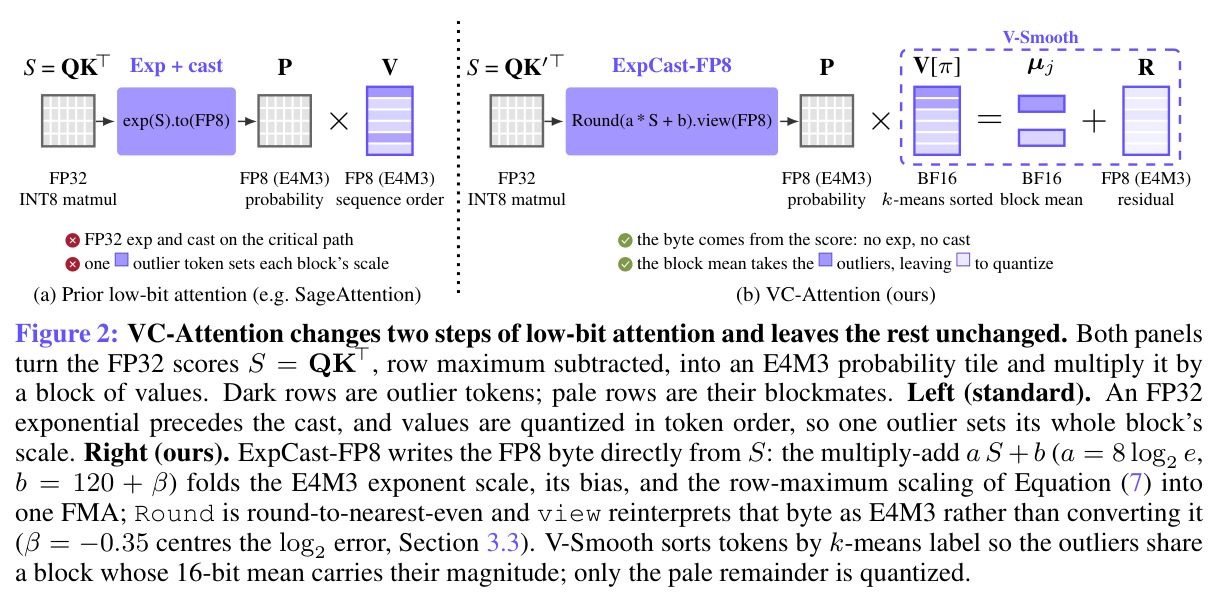
VC-Attention = V-Smooth(治精度)+ ExpCast-FP8(治速度),其余流水线不动。直觉上,value 的离群值不在固定通道而在少数 token 里,量化块的缩放被它们撑爆;若让「相像的 token 住进同一硬件块」再减块均值,离群值的量级就被 16 位均值吸收,残差便好量化。V-Smooth 用在线 k-means 给 value token 打标签,按标签把 K、V 一起置换($P'V'=PV$,输出严格不变),对每个 128 行块减均值 $\mu_j$、只量化残差,并在递推中用行和 $r_{ij}$ 一次外积恢复均值。ExpCast-FP8 利用 E4M3 字节是对数仿射编码,用一个乘加 $c=\mathrm{clip}(\mathrm{Round}(8(u+8)+56+\beta))$ 直接写出概率字节,免掉 FP32 指数和转换。工程上,融合内核把 RoPE、均值、gather、Hadamard、量化器全吸收进量化内核(提速 8.74×),摊销调度只在前 25% 步聚类、热启动复用质心,开销摊到 3–4%。
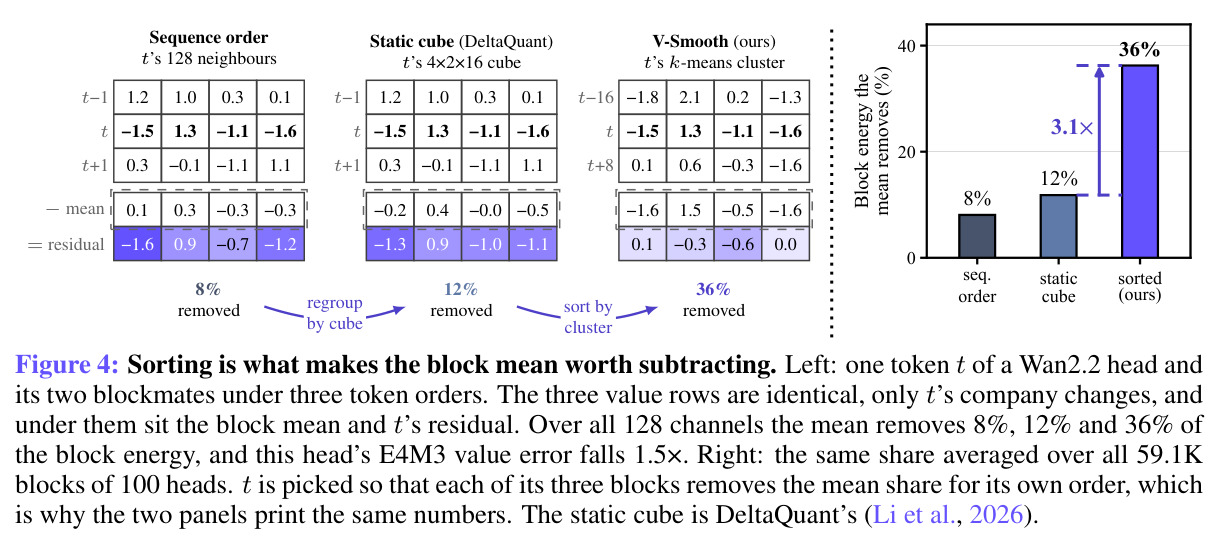
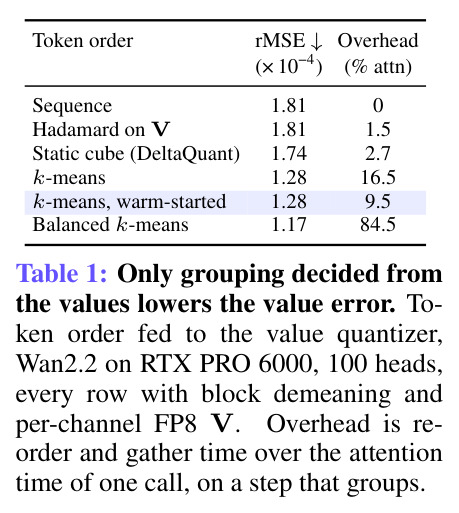
两条核心洞察,分别对应精度与速度。其一:减块均值只在块内 token 共享公共成分时才有意义,而公共成分是否存在取决于 token 的排布方式——论文实测同一 value 张量在序列顺序、DeltaQuant 固定立方体、k-means 排序三种排法下,块均值可移除的能量占比分别为 8%、12%、36%(图 4),该头 E4M3 value 误差降 1.5×;而 Hadamard 旋转保范数、离群 token 原样存活(rMSE 1.81→1.81,表 1),所以「按数据自适应聚类排序后再减均值」是与旋转、通道平滑本质不同的离群值处理方式,且置换 K/V 的输出不变性让排序本身数学上无损。其二:E4M3 字节按整数读恰为 $8\log_2 v+56+\varepsilon(m)$,是数值对数的仿射函数,故从对数域分数产生该字节只需一次乘加,指数与转换双双消失;式 (7) 的 8 与 56 直接从编码读出,$\beta=-0.35$ 是尾数替换误差 $\varepsilon(m)$ 的极小极大中心化,没有任何拟合常数,误差界(行级总变差 < 3.64%)来自格式本身、对所有模型成立。
方法步骤详情
四步。①分组:对每 batch/head 的 value token 在线 k-means 得标签,按 $\pi=\mathrm{argsort}(z)$ 置换 $K'$、$V'$;只在前 25% 去噪步聚类、热启动质心(16.5%→9.5%),窗口内复用置换。②分块量化:$V'$ 按 128 行切块,减块均值 $\mu_j$ 得残差 $R_j$,量化残差(8 比特每通道 E4M3、4 比特 NVFP4),均值折合 0.125 比特/元素。③在线恢复均值:递推改为 $A_i\leftarrow\alpha_i A_i+\tilde P_{q,ij}R_{q,j}+r_{ij}\mu_j^\top$,$r_{ij}=\tilde P_{ij}\mathbf{1}$ 是本就累加的行和,均值以一次外积精确还原,无需二次扫描。④ExpCast-FP8:对分数 $u=(s-m'_i)\log_2 e\le 0$,一次 FMA 算 $c=8(u+8)+56+\beta$,舍入裁剪到 $[0,120]$ 后按 E4M3 解释字节。所有预处理融合进内核,单次调用预处理 42.2 ms→4.8 ms。
技术新颖性
与四类既有方案划清界限。(1)旋转类(FA3 的 QK Hadamard):旋转在 token 内混通道且保范数,对「离群在 token 而非通道」的 value 无效(表 1:rMSE 1.81 不变),V-Smooth 改变 token 间组合方式。(2)静态划分(DeltaQuant 固定立方体):划分不随输入变化,均值只移除 12% 能量,k-means 达 36%。(3)重训类(Attn-QAT):免训练配置下反比 SageAttention2 低 3.4–6.7 dB,V-Smooth 零训练成本。(4)稀疏类(Sparse VideoGen 2):同样聚类置换 token 但目的不同——那边让注意力块可跳过,这边让量化块有值得减的均值。ExpCast-FP8 与快速指数近似(Mitchell/Schraudolph)的区别:目标是直接命中 FP8 内核要消费的字节而非近似 exp 数值,view 读取零开销,误差界(总变差 3.64% + 下溢尾 $\tau$)从格式推导、免每模型调参。置换不变性 $P'V'=PV$ 与均值精确恢复保证 V-Smooth 无系统偏置。
实验结果
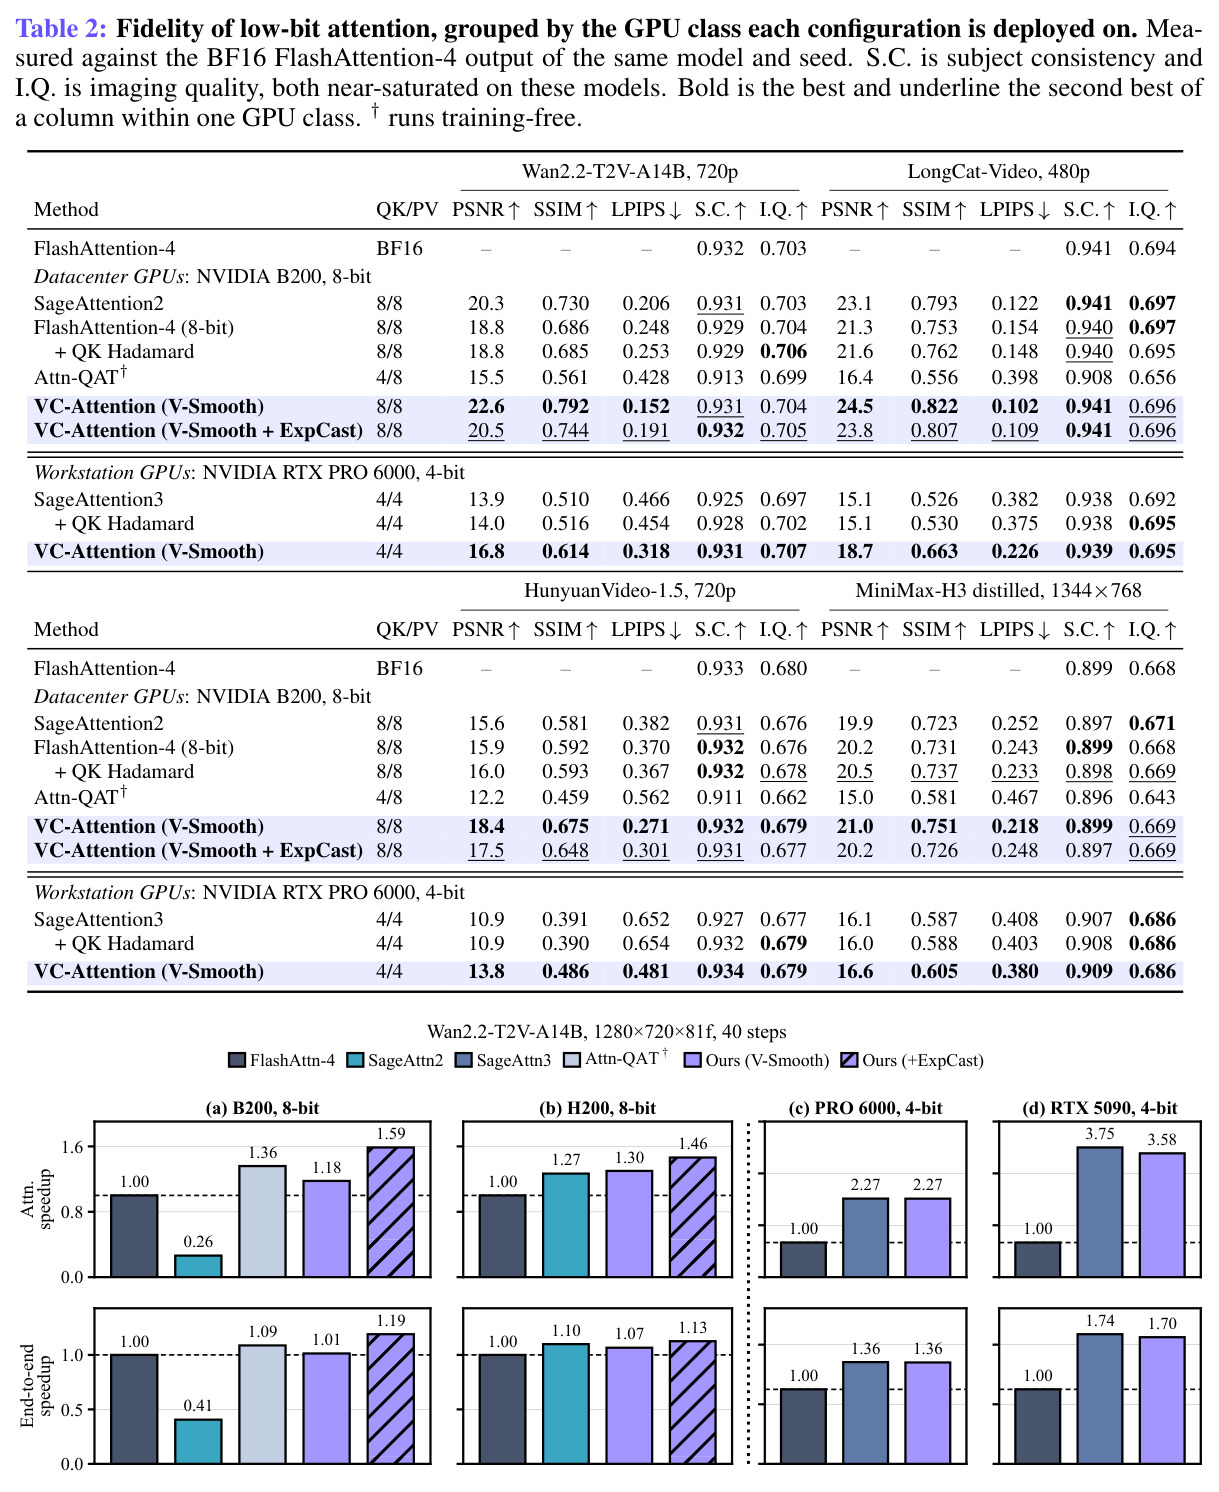
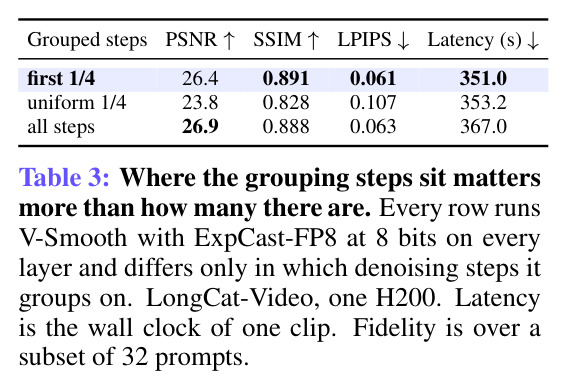
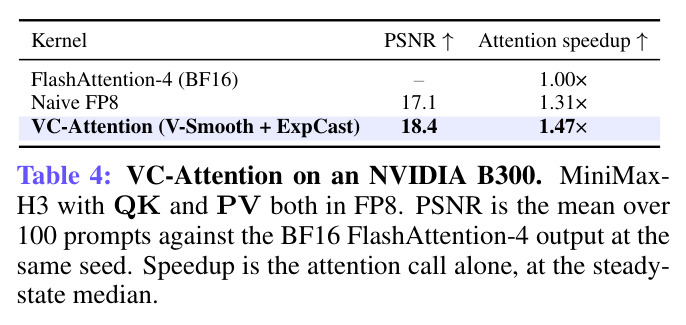
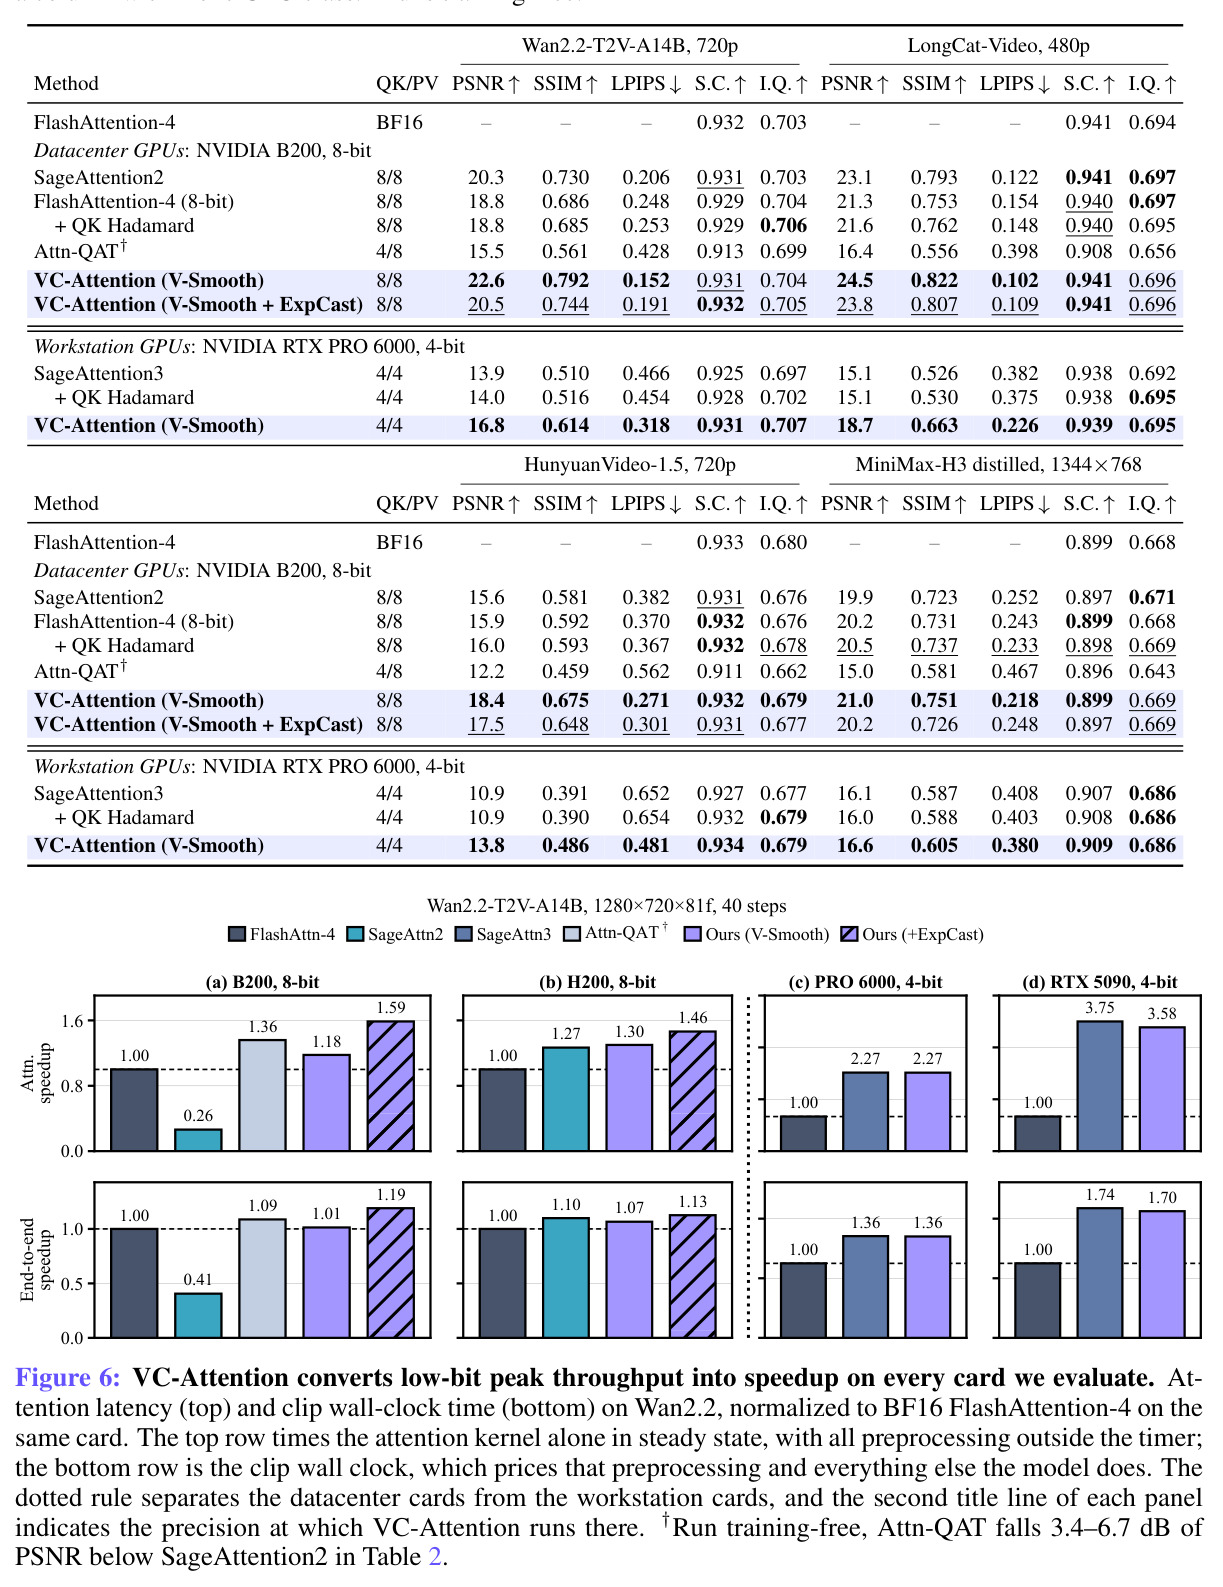
保真度(表 2):8 比特下 V-Smooth 四模型全列最优——Wan2.2 PSNR 22.6 dB(SageAttention2 20.3,+2.3 dB),HunyuanVideo-1.5 18.4 dB(+2.8),LPIPS 降 13–29%;融合 ExpCast 让 0.7–2.1 dB 换速度后仍领先。4 比特比 SageAttention3 高 2.9/3.6 dB(16.8 vs 13.9;18.7 vs 15.1)。速度(图 6):注意力相对 BF16 FA4 在 B200/H200/PRO 6000/RTX 5090 达 1.59×/1.46×/2.27×/3.58×,对 SageAttention2(仅 0.29×)达 6.02×;端到端 1.19×/1.13×/1.36×/1.70×。B300(表 4)双 FP8 达 1.47×/18.4 dB(朴素 FP8:1.31×/17.1 dB)。消融(表 3):聚类放前 25% 步 26.4 dB/351 s,≈全程聚类 26.9 dB/367 s;融合链(图 7)42.2 ms→4.8 ms,提速 8.74×。
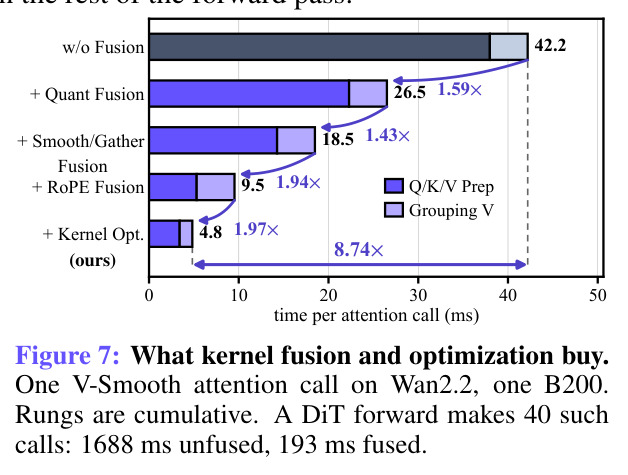
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Wan2.2-T2V-A14B 720p 视频生成保真度(8 比特,B200) | PSNR(对同种子 BF16 FlashAttention-4 输出) | V-Smooth 22.6 dB(融合 ExpCast 后 20.5 dB) | SageAttention2 20.3 dB;8-bit FA4 18.8 dB;Attn-QAT 免训练 15.5 dB | 较 SageAttention2 +2.3 dB,LPIPS 0.206→0.152 |
| HunyuanVideo-1.5 720p 保真度(8 比特) | PSNR | 18.4 dB(V-Smooth) | SageAttention2 15.6 dB | +2.8 dB,SSIM 0.581→0.675 |
| LongCat-Video 480p 保真度(RTX PRO 6000,4 比特) | PSNR | 18.7 dB(V-Smooth) | SageAttention3 15.1 dB | +3.6 dB,LPIPS 0.382→0.226(降 41%) |
| 注意力内核加速(Wan2.2,数据中心卡,8 比特) | 相对 BF16 FlashAttention-4 的加速倍数 | B200 1.59×,H200 1.46× | SageAttention2 在 B200 仅 0.29×(即本文对其 6.02×),在 H200 本文对其 1.16× | B200 上比 SageAttention2 快 6.02× |
| 注意力内核加速(Wan2.2,工作站卡,4 比特) | 相对 BF16 FA4 的加速倍数 | RTX PRO 6000 2.27×,RTX 5090 3.58× | SageAttention3 2.27× / 3.75× | 速度持平或差 5% 以内,但 PSNR 高 2.9–3.6 dB |
| 端到端单条视频生成提速(Wan2.2) | 相对 BF16 FA4 的墙钟加速倍数 | B200 1.19×,H200 1.13×,RTX PRO 6000 1.36×,RTX 5090 1.70× | BF16 FA4 = 1.00×(SageAttention2 在 B200 端到端仅 0.41×) | 最高 1.70×(RTX 5090) |
| B300 注意力(MiniMax-H3,QK/PV 双 FP8) | PSNR / 注意力加速 | 18.4 dB,1.47× | 朴素 FP8 内核 17.1 dB,1.31× | +1.3 dB 且快约 12% |
局限与改进
作者明说的限制:其一,数据中心卡上没有 4 比特配置——NVFP4 概率每 16 元素一个 scale,其计算落在 softmax 关键路径上,ExpCast-FP8 无法消掉(附录 A);其二,融合 ExpCast 要用 0.7–2.1 dB PSNR 换速度,且在 MiniMax-H3 上融合版(20.2 dB)只与三个最强免训练基线共处 0.6 dB 带内;其三,Proposition 3.1 的界包含下溢尾 $\tau$,有下溢的行界可达 17.8%(实测平均 1.6%);其四,摊销调度假设相邻去噪步注意力布局稳定,聚类与置换复用窗口可能对其他采样器或步数敏感。我自己的观察:聚类在分组步给注意力加 30% 时间、平均摊到 3–4%,若与稀疏注意力或量化线性层叠加、前向大幅缩短后占比会回升;评测全以 BF16 FA4 输出为真值、以像素级指标为主,VBench 两项已饱和(各方法差 <0.01),缺人评与下游证据;置换需对 K/V 做 gather,对因果注意力(LLM)是否无损未讨论;同时维护五种 GPU 的手写内核工程成本很高。
独立分析的弱点
弱点一:不平衡 k-means 是精度与开销的折中——平衡聚类能把 rMSE 从 1.28 再降到 1.17(再省 8.5% 误差),但代价 2.8× 分组时间、85% 注意力时间,作者直接放弃;改进方向是廉价均衡化,如贪心回填或只对跨界块局部交换。弱点二:ExpCast 的固定 $\beta=-0.35$ 是全区间极小极大解,仍有 20.4% 码位与标准路径差一格、融合后损失 0.7–2.1 dB;可按分数区间自适应选 $\beta$,或对高权重 tile 保留精确指数做混合精度 softmax。弱点三:4 比特概率量化在数据中心卡无解,若能把 NVFP4 的 per-16 scale 移出关键路径(如用前一 tile 的 scale 外推),即可打通 4 比特全流水,逼近 FP4 的 8 倍峰值。弱点四:聚类每步每头独立进行,未利用时间维冗余做跨步增量质心更新,布局漂移大时复用置换会掉点,可加漂移检测触发提前刷新。弱点五:保真度协议以 BF16 FA4 为真值,无法回答「两个低比特模型哪个更好看」;MiniMax-H3 依赖第三方蒸馏 LoRA,结论对原生多步模型的适用性待验证。
未来方向
作者方向:VC-Attention 不改变注意力模式与采样调度,明确宣称可与少步蒸馏、特征缓存、分布式切分、稀疏注意力、线性注意力等所有提效方向组合——把它叠上 Sparse VideoGen 2 的可跳块或量化线性层是最直接的下一步;对 B300 这类无 INT8 QK 乘法的卡,作者已示范双 FP8 配置,可继续向 FP4/FP6 格式扩展。基于成果可延伸:把「聚类置换 + 减均值」搬到大语言模型的 KV cache 量化,与 Quant VideoGen 的迭代减均值互补;对 ExpCast 推广到其他浮点格式(E2M1/E5M2),各自推导仿射系数与误差界;用 Proposition 3.1 的行级界做逐层误差预算,指导混合比特分配;把置换缓存与去噪调度器(如少步 LoRA)联合优化,压缩 3–4% 的摊销开销;以及在张量/流水并行的多卡场景验证分组跨设备一致性。
复现评估
复现难度中高。有利条件:四个评测模型全部开源(Wan2.2-T2V-A14B、LongCat-Video、HunyuanVideo-1.5、MiniMax-H3 加 Alibaba PAI 8 步蒸馏 LoRA),评测协议完全公开——MovieGen Bench 100 条 prompt、共享种子、以 BF16 FA4 同种子输出为参照,指标均可用标准库计算;方法免训练、无校准数据;论文给出全部关键常数($\beta=-0.35$、clip 到 $[0,120]$、$B_v=128$、前 25% 步聚类、热启动)与公式,Proposition 3.1 可直接数值验证。不利条件:内核是手写 CuTe/CUDA、从 FlashAttention-4/SageAttention 内核原地修改而来,覆盖 B200、B300、H200、RTX PRO 6000、RTX 5090 五种卡,普通实验室既难凑齐数据中心卡,也难短期复刻整套融合内核;节选未提及开源代码,若不发布,从零复现约需熟悉 CuTe 的工程师 1–2 个月;退一步用 PyTorch 原型只验证精度结论一两天即可。
论文图表
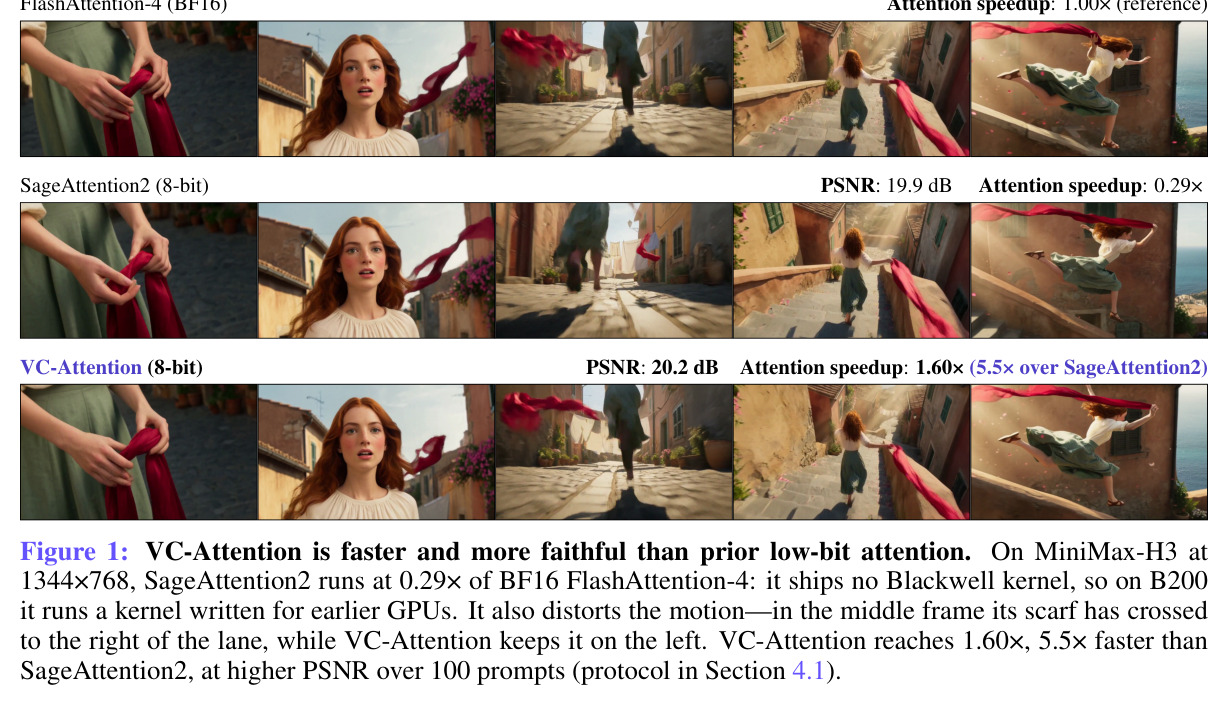
迷你示例图(teaser):MiniMax-H3 在 1344×768 生成「年轻女子沿海边小巷追逐深红丝巾」的五帧对比。SageAttention2(8 比特)只有 BF16 FlashAttention-4 的 0.29× 速度(无 Blackwell 内核)且中间帧丝巾跑到了车道右侧;VC-Attention(8 比特)达 1.60×(比 SageAttention2 快 5.5×),PSNR 20.2 dB,丝巾保持在左侧,100 条 prompt 统计。
一图立论:同时展示现有低比特注意力在最新 GPU 上「慢且跑偏」的两个痛点,正是本文两大组件分别对应要解决的问题。
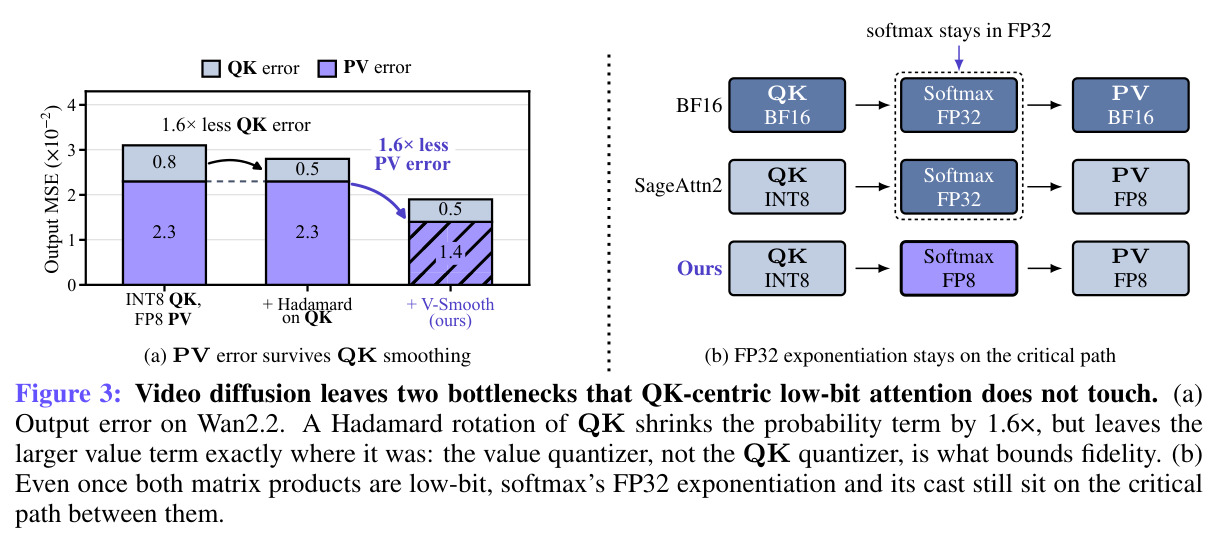
两张动机实验。(a) Wan2.2 输出误差分解:INT8 QK + FP8 PV 后再对 QK 加 Hadamard 只把概率项误差缩 1.6×,更大的 value 项(占 82%)纹丝不动;(b) 即便两个矩阵乘都已低比特,softmax 的 FP32 指数与转换仍卡在 QK 与 PV 之间的关键路径上。
用数据证明「value 误差与 softmax 标量路径」是 QK 中心方案 untouched 的两个瓶颈,直接支撑本文的问题定义。