MassAlloc 注意力:让注意力自行分配算力 MassAlloc Attention: Let Attention Allocate Its Own Compute
保留完整 QK 打分,用在线 softmax 归一化贡献决定每个 tile 是否执行后续计算
前置知识
FlashAttention 与分块(tiling)计算
FlashAttention 将 Q、K、V 切分为小块(tile),在 SRAM 中融合执行打分 $S_{ij}=Q_iK_j^\top$、softmax 与 $PV$ 累加的完整流程,避免把 $N_q\times N_k$ 的注意力矩阵写入 HBM,从而大幅降低显存 IO。它是现代大模型的标准注意力实现,但其执行模式仍是稠密的:每个合法因果 tile 都会走完后继路径。
MALA 的全部机制都定义在 FlashAttention 式的 tile 循环里,只有理解 tile 粒度和前/反向各自的后继计算路径,才能看懂它跳过了什么、省了什么。
Online Softmax 与归一化因子
在线 softmax 在逐 tile 扫描时维护运行最大值 $m$ 和平移后的部分和 $\ell$,增量合并新 tile:$\ell\leftarrow e^{m_{old}-m_{new}}\ell+\sum e^{S-m_{new}}$,扫描结束后一次归一化,真实归一化因子为 $Z=e^{m+\log\ell}$。这样无需物化整行分数即可得到精确 softmax。
MALA 前向用演化中的 $Z_q^{(t)}=e^{m+\log\ell}$ 作分母估计候选 tile 的贡献比,反向复用前向保存的最终 $\ell=\log Z_R$,其核心跳过判据完全建立在这个原生状态上。
注意力反向传播
给定输出梯度 $dO$,注意力 backward 需重算分数并重建概率 $P=\exp(S-\log Z)$,然后计算 $dP=VdO^\top$、$dS=P\circ(dP-\mathrm{rowsum}(O\circ dO)^\top)$,再经 $dQ=dSK$、$dK=dS^\top Q$、$dV=PdO$ 得到各梯度。其计算量通常高于前向,是长上下文训练的主要开销之一。
MALA 训练加速的大头来自跳过低贡献 tile 的反向后继计算(实测 3.0×),且其反向支持嵌套于前向支持之内的设计,必须理解反向数据流才能领会。
稀疏注意力与预算式选择
为降低长上下文注意力成本,常见做法是预先限定参与计算的位置集合:静态方法(滑动窗口、固定块、全局 token)按位置定义支持;动态方法(MoBA、NSA、DSA、SeerAttention 等)用路由、索引或学习打分选 Top-K 块/token。它们在精确注意力之前就限制支持集,因此能省掉被排除区域的 QK 计算,但需要掩码、索引或路由器等额外状态。
MALA 与这些方法的本质区别是保留完整 QK 打分、只分配 softmax 后计算且无固定预算;理解预算式方法的对照设计,才能体会其"分布自适应、免校准"的定位。
研究动机
上下文长度正从数千 token 扩展到数十万,以支撑长文档理解、多轮推理和仓库级代码生成,注意力随之成为计算与访存的主要瓶颈。FlashAttention 通过分块、融合与 online softmax 优化了 IO 效率,但没有改变稠密执行模式:每个合法因果 tile 在形成 QK 分数后仍要执行完整的后继计算——前向的 softmax 更新、V 加载与 PV 累加,反向的概率重建及 $dP$、$dS$、$dQ$、$dK$、$dV$ 计算。然而 FullAttn 高度不均匀:注意力质量往往集中在局部区域、sink token 和少量检索相关交互上,其余大量交互的归一化概率可忽略,稠密内核却在为这些低贡献 tile 白白付出算力。现有稀疏方案要么按位置固定支持(窗口、块模式),要么用路由/打分在注意力前做 Top-K 选择(MoBA、NSA、DSA 等),均需维护掩码、索引或路由状态,且固定预算难以随查询、头、层和输入自适应变化。
本文的目标是本文目标是构建一个融合的注意力原语,在不丢失任何合法因果交互打分机会的前提下,让注意力用自身产生的归一化贡献决定哪些 tile 值得执行后续计算。具体包括:(1)前向利用演化中的 online-softmax 归一化因子做在线分配,反向复用前向保存的最终归一化因子做离线分配,两者共享同一长度归一化容差 $\tau/L_q$;(2)不物化任何选择掩码、保留 tile 索引或路由状态,只使用标准注意力状态(输出 $O$ 与对数归一化因子 $\ell$);(3)训练前向、反向、推理 prefill 与自回归解码共用一个容差,让保留的工作量随每个执行上下文自适应;(4)在保持 FullAttn 级别的算子保真度、语言建模质量和长程检索能力的同时,切实降低训练与推理的注意力时延以及训练 FLOPs,并从 0.6B 到 14B/32B 规模验证该权衡不随模型变大而失效。
与已有工作不同的是,已有工作切入角度各异:静态稀疏按位置定义支持;动态方法(SeerAttention、MoBA、NSA、DSA、InfLLMv2)用学习打分或路由在注意力前选 token/块;Twilight 与 Double-P 用分层 top-p 按估计质量目标调整支持集;Top-Theta 为每层、每头、每个长度离线校准阈值;SpargeAttention 用预测注意力图加在线 softmax 感知过滤;BLASST 比较块最大值与运行最大值并校准长度相关阈值,主要面向 prefill 和解码。这些方法大多能在被排除区域省掉 QK 计算,但支持集由预算或离线校准决定,且依赖外部选择状态。MALA 的独特切入是把稀疏化重新表述为"分布条件下的算力分配":完整保留 QK 打分可及性,在注意力循环内部用精确分数和原生 softmax 统计量即时分配 softmax 后计算,并给出前向遗漏质量的解析保证和前后向配对的嵌套支持语义——这条"算子内、免校准、有保证、训练推理一体"的路线是已有工作未覆盖的。
核心方法
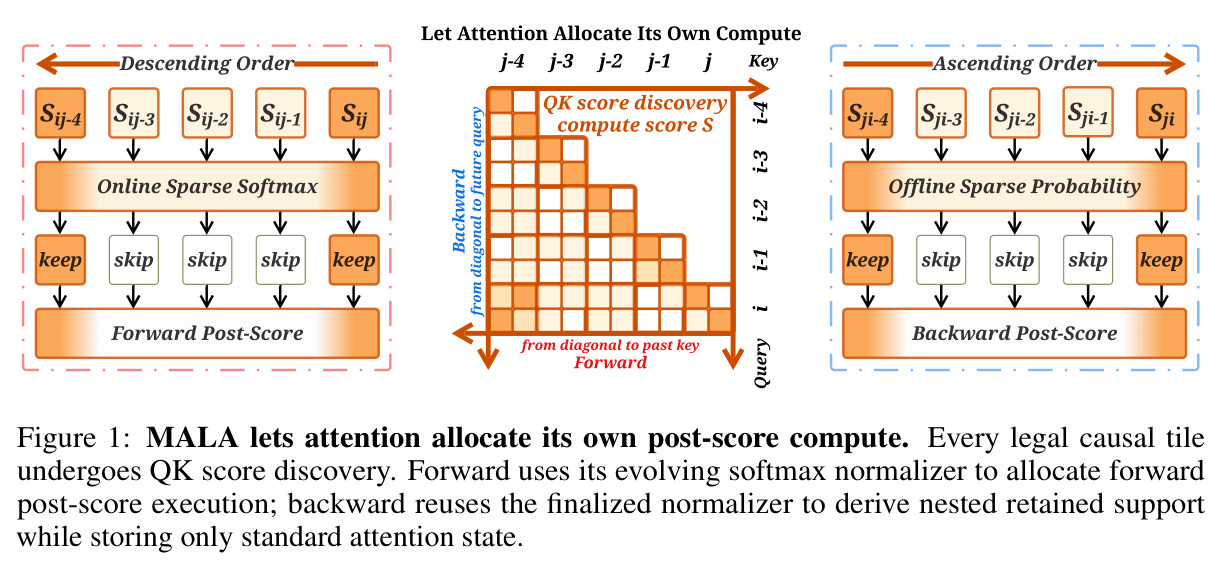
直觉上,注意力内核在决定"是否值得为一个 tile 计算 softmax 和 PV"时,手里已握有最好的判据——刚算出的 QK 分数和运行中的 softmax 归一化因子。MALA 把注意力显式建模为运行时算力分配器:将计算拆成 QK 打分发现与 softmax 后执行两个阶段,前者对所有合法因果 tile 无条件执行(保持二次复杂度与完整可及性),后者按归一化贡献决定执行与否。技术上,对查询行 $q$ 定义因果可见键数 $L_q$,以均匀注意力概率 $1/L_q$ 为参考、乘以共享无量纲容差 $\tau$,得到长度感知阈值 $\tau/L_q$。前向从对角线向历史方向遍历 tile,用演化中的归一化因子 $Z_q^{(t)}$ 检查候选 tile 的最大贡献比 $r_{qj}^{(t)}=\exp(\max_{k\in J_j\cap C_q}s_{qk})/Z_q^{(t)}$,若对 tile 内所有合法行都有 $r<\tau/L_q$ 则跳过该 tile 的 softmax 更新、V 加载与 PV 累加;反向改用前向保存的最终 $Z_{R,q}$ 做同样测试,跳过概率重建与 $dP,dS,dQ,dK,dV$ 路径。所有判断都嵌入普通 tiled attention 循环,不引入任何额外状态或离线校准。
核心创新是把"稀疏注意力"重构为"分布条件下的算力分配",并给出在线前向/离线反向的配对规则。与 top-p/top-k 类方法的本质区别有三。第一,没有预算:$\tau$ 规定的是可容忍的贡献水平而非计算量,保留多少工作完全由每个查询、头、层、输入的真实注意力分布决定——尖锐的行可跳过很多 tile,弥散的行自然保留更多。第二,只用原生状态:块级判据 $\mathrm{rowmax}(S_{ij})-m_i-\log\ell_i<\log(\tau/L_i)$ 中的 $m_i,\ell_i$ 正是 FlashAttention 本就要维护的 online-softmax 状态,前向只需在结束时把 $\ell_i\leftarrow m_i+\log\ell_i$(即 $\log Z_R$)存下来供反向使用,无需掩码或索引。第三,有可证保证:Proposition 1 证明被跳过位置的总概率质量满足 $\epsilon_q=Z_O/(Z_R+Z_O)\le\tau/(1+\tau)$,输出误差 $\|o-\hat{o}\|\le\frac{2\tau}{1+\tau}V_{max}$。反向用更大的最终分母测试(因 $Z_{R,q}\ge Z_q^{(t)}$),保证 backward 支持嵌套于 forward 支持之内。长度归一化 $L_q$ 让同一 $\tau$ 在不同位置与序列长度下语义一致,无需按层、头、长度分别校准。
方法步骤详情
前向(Algorithm 1):将 $Q,K,V$ 分块为 $B_q\times B_k$ 的 tile,逐查询块初始化 $O_i=0$、$\ell_i=0$、$m_i=-\infty$,并计算每行可见键数 $L_i$;按从对角到历史的降序遍历 key 块,先算 $S_{ij}=Q_iK_j^\top$ 并施加因果掩码,取行最大值 $\tilde m_{ij}$;若 $\tilde m_{ij}-m_i-\log\ell_i<\log(\tau/L_i)$ 对所有行成立则跳过该块,否则加载 $V_j$ 执行标准 online-softmax 更新:$m^{new}=\max(m,\tilde m_{ij})$,$\tilde P=\exp(S-m^{new})$,$\ell^{new}=e^{m-m^{new}}\ell+\mathrm{rowsum}(\tilde P)$,$O\leftarrow e^{m-m^{new}}O+\tilde P V_j$;遍历结束后归一化 $O\leftarrow\mathrm{diag}(\ell)^{-1}O$,并把 $\ell_i\leftarrow m_i+\log\ell_i$ 存盘。反向(Algorithm 2):key 主序遍历,重算 $S_{ji}=K_jQ_i^\top$,测试 $S_{ji}-\ell_i^\top<\log(\tau/L_i)^\top$,不满足则重建 $P_{ji}=\exp(S_{ji}-\ell_i^\top)$,计算 $dP=VdO^\top$、$dS=P\circ(dP-\mathrm{rowsum}(O\circ dO)^\top)$,累加 $dV\leftarrow dV+PdO$、$dK\leftarrow dK+dS^\top Q$、$dQ\leftarrow dQ+dSK_j$。解码复用前向规则;split-KV 时各 split 用自己的部分归一化因子测试(更保守),再按标准归一化感知规约合并部分输出。
技术新颖性
技术新颖性体现在四处。(1)分配时机:已有稀疏方法在 QK 之前做支持集选择,MALA 首次把决策放在 QK tile 形成之后、softmax 之前,用"精确分数 ÷ 演化归一化因子"这一在线量做判据,与 BLASST 的块最大值启发式和 SpargeAttention 的预测注意力图均不同。(2)前后向语义配对:前向用演化分母、反向用最终分母的统一容差设计,从 $Z_{R,q}\ge Z_q^{(t)}$ 直接导出 backward 支持嵌套于 forward 支持的性质,且反向无需存储前向掩码,这在稀疏注意力的可微训练中是新的。(3)理论保证:给出前向遗漏质量 $\epsilon_q\le\tau/(1+\tau)$ 与 $\|p-\hat p\|_1\le 2\tau/(1+\tau)$ 的解析界,而 Twilight/Double-P 只有经验质量目标、Top-Theta 依赖离线校准、多数动态方法无任何保证。(4)工程形态:全部逻辑融合进单个 kernel,训练、prefill、解码共用同一容差,实测峰值显存与 FullAttn 持平。代价也被诚实地声明:QK 打分保持二次复杂度,节省来自数据依赖的后继跳过,$\tau\to 0$ 时严格退化为 FullAttn。
实验结果
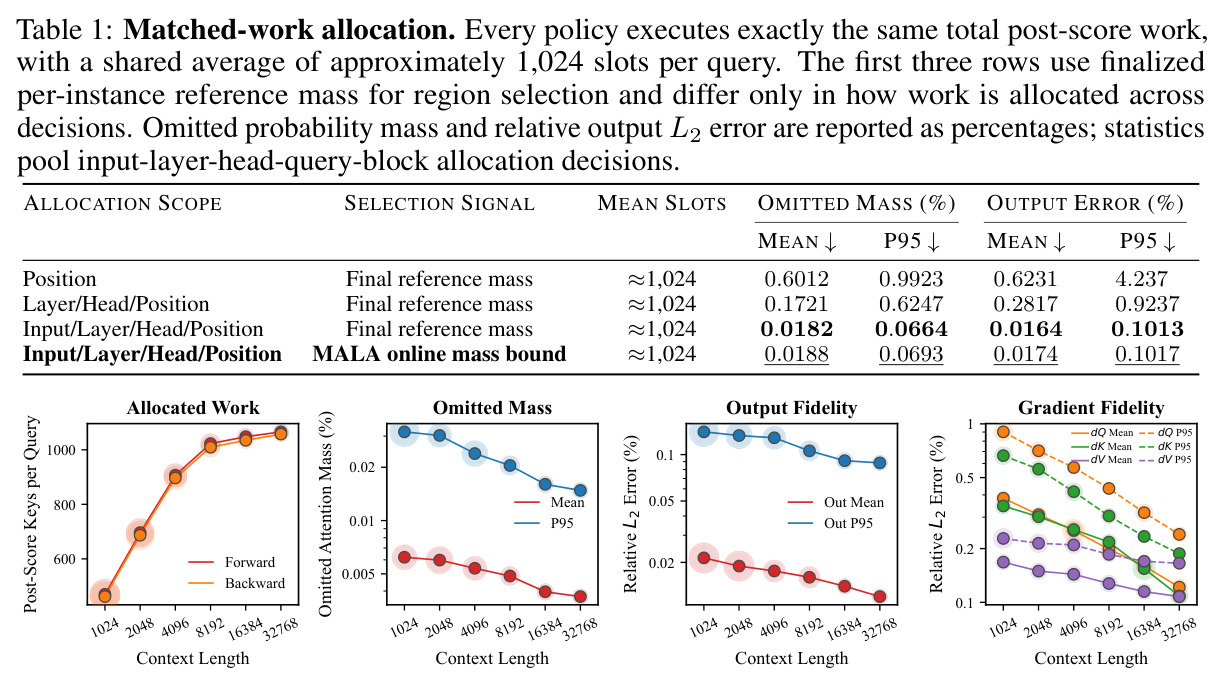
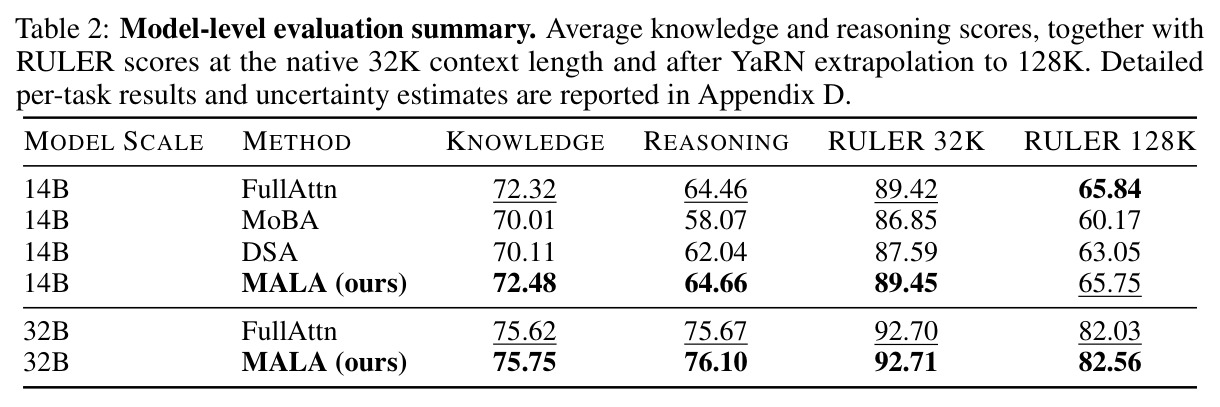
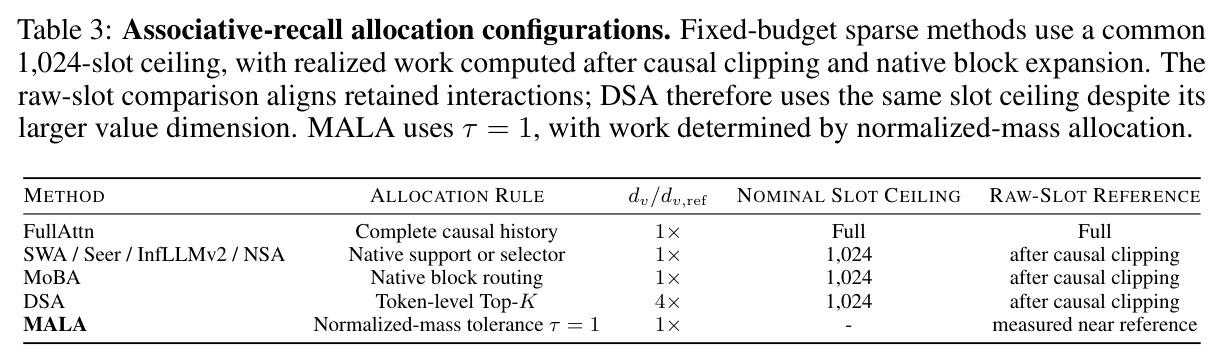
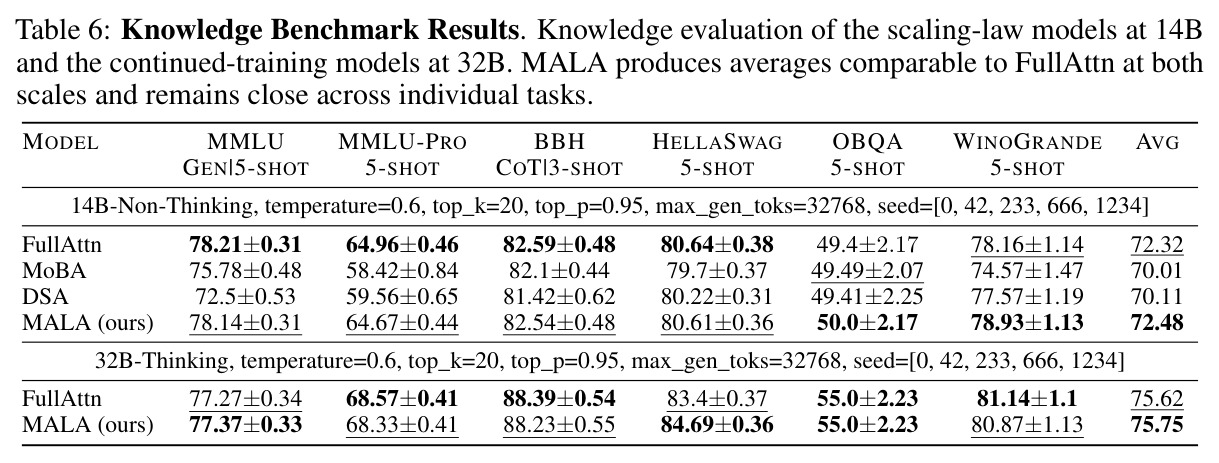
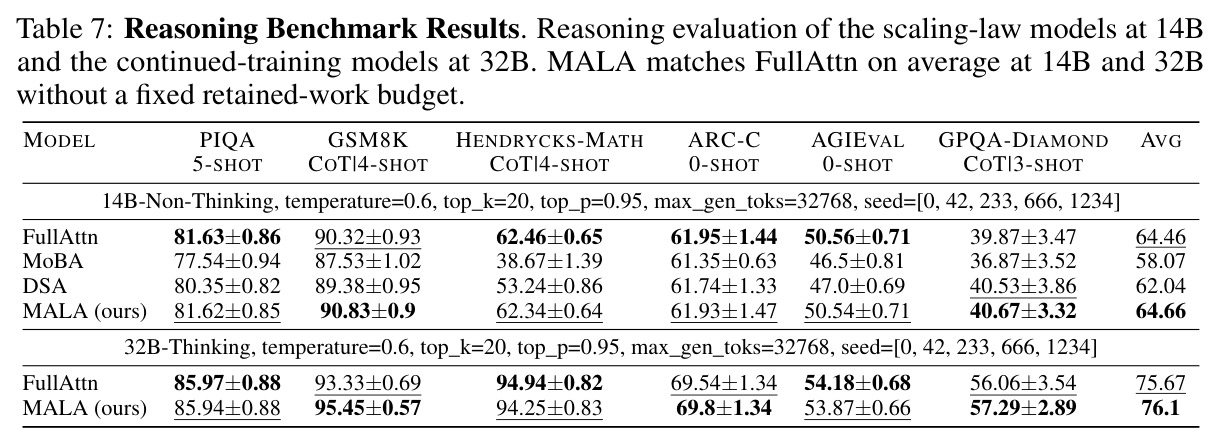
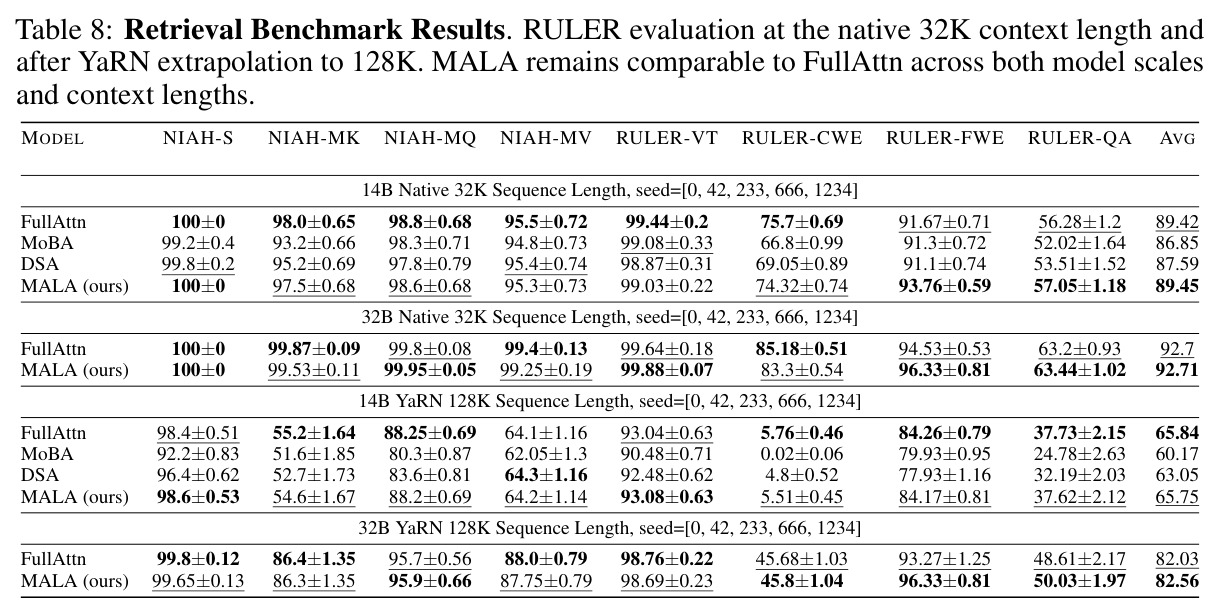
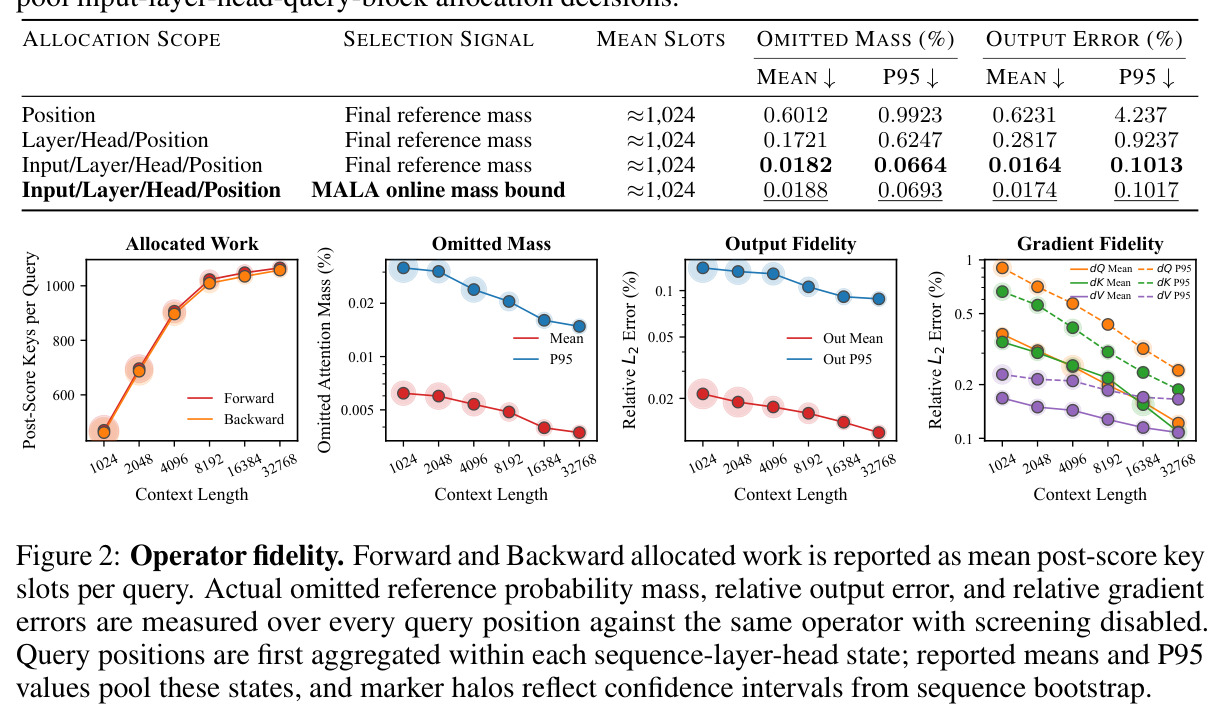
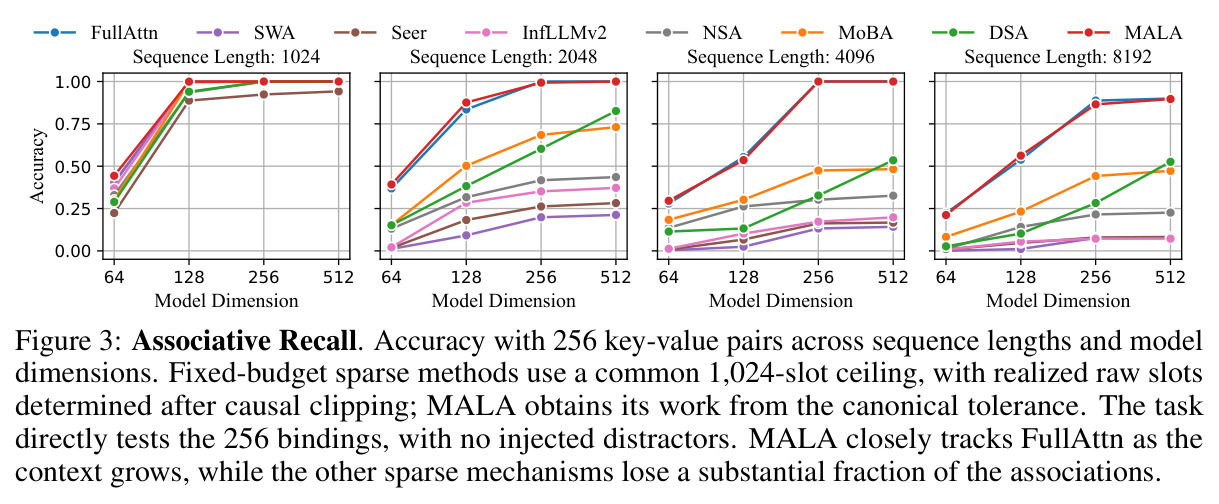
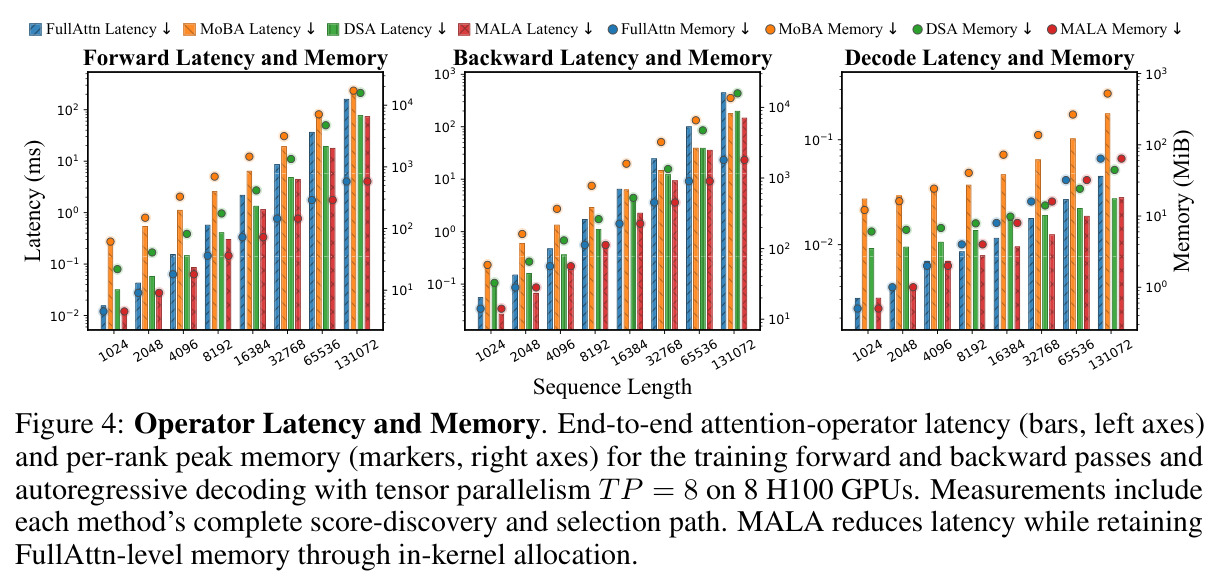
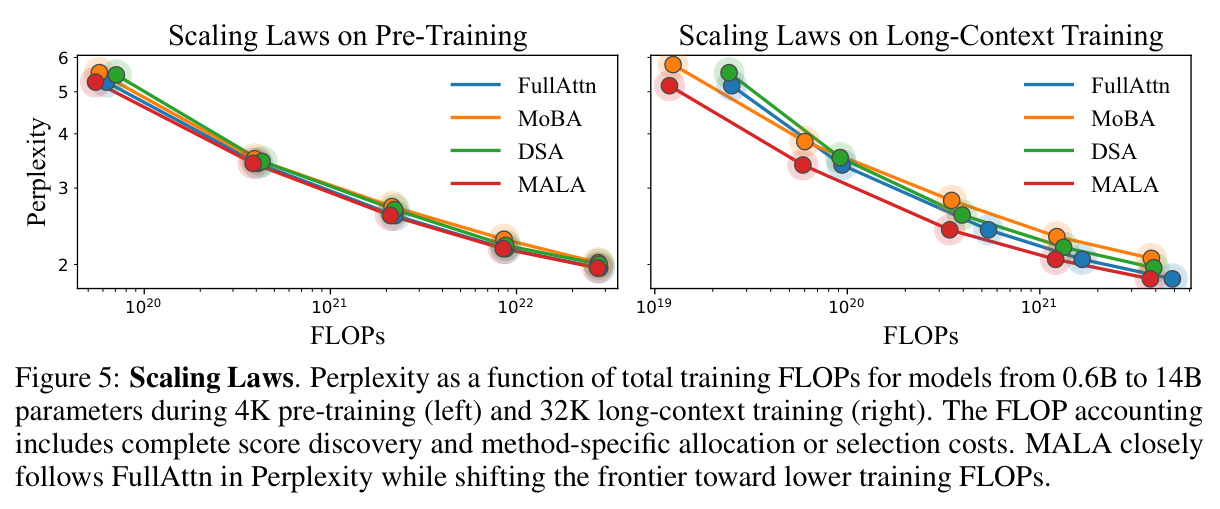
论文用层层递进的实验回答"分配是否保真、是否有效"。匹配工作量研究(8K 上下文、256 条序列、约 5,872 万个分配决策,平均约 1,024 slots/query):所有策略执行完全相同的后继工作量,MALA 仅凭在线状态就逼近每实例参考质量 oracle——平均遗漏质量 0.0188% vs 0.0182%,平均输出相对 L2 误差 0.0174% vs 0.0164%;而静态层-头-位置分配为 0.1721%/0.2817%,纯位置分配为 0.6012%/0.6231%,每实例分配比静态分配降低 9.5× 遗漏质量与 17.2× 输出误差,说明收益主要来自分布自适应本身。算子保真度(1K→32K):同一 $\tau=1$ 下前向工作从 470 增至 1,066 slots、反向从 462 至 1,058,8K 后稳定在 1,010–1,066;遗漏质量均值 ≤0.0062%、P95 ≤0.032%,输出误差均值 ≤0.021%、P95 ≤0.14%,$dQ/dK/dV$ 误差均值 ≤0.38%/0.35%/0.17%。受控联想召回(256 对键值,1K–8K,$d_{model}$ 64–512):8K、$d$=512 时 MALA 89.67% vs FullAttn 89.97%,DSA 52.61%、MoBA 47.25%、NSA 22.61%。算子基准(128K、8×H100、TP=8):训练前向/反向时延降 2.2×/3.0×,解码降 1.6×,峰值显存与 FullAttn 持平。Scaling laws(0.6B→14B,128×H100):14B 困惑度差 <0.001,4K 预训练省 2.5% FLOPs、32K 长上下文训练省 23.1%(FLOPs 统计已含完整打分与选择开销)。模型级评测:14B 知识 72.48 vs 72.32、推理 64.66 vs 64.46、RULER 32K 89.45 vs 89.42、YaRN 128K 65.75 vs 65.84;32B 继续训练后为 75.75 vs 75.62、76.10 vs 75.67、92.71 vs 92.70、82.56 vs 82.03,全面持平。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 匹配工作量分配研究(8K 上下文,≈1,024 slots/query) | 平均遗漏概率质量 / 输出相对 L2 误差 | MALA 在线分配:0.0188% / 0.0174% | 每实例参考质量 oracle:0.0182% / 0.0164%;静态层-头-位置 0.1721% / 0.2817%;纯位置 0.6012% / 0.6231% | 以纯在线状态逼近 oracle;较静态层-头-位置分配遗漏质量降约 9.2×、输出误差降约 16.2×,证明分布自适应是收益来源 |
| 算子保真度(1K–32K 上下文,τ=1) | 遗漏质量、输出与梯度相对 L2 误差 | 遗漏质量均值 ≤0.0062%(P95 ≤0.032%);输出误差 ≤0.021%;dQ/dK/dV 误差 ≤0.38%/0.35%/0.17% | 关闭筛选的参考 FullAttn 算子(误差为 0,但前反向工作量约为 4K–16K slots) | 上下文增长 32× 时误差保持低位,工作量稳定在约 1,010–1,066 slots/query |
| 受控联想召回(256 键值对,序列长 8,192,d_model=512) | 召回准确率 | 89.67% | FullAttn 89.97%;DSA 52.61%;MoBA 47.25%;NSA 22.61%(固定预算方法共用 1,024-slot 上限) | 在同等原始槽位预算下几乎追平 FullAttn,大幅领先固定支持/外部选择类稀疏方法 |
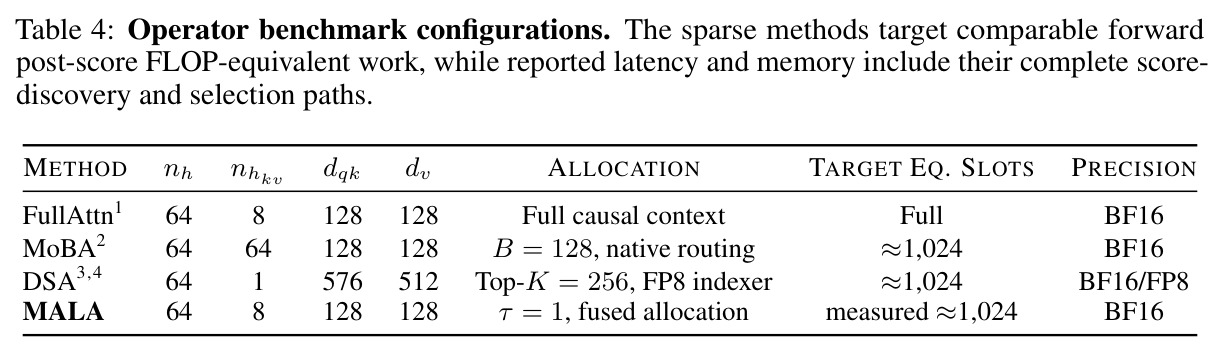
| 注意力算子基准(128K 序列,8×H100,TP=8,BF16) | 端到端算子时延与每卡峰值显存 | 训练前向快 2.2×、反向快 3.0×、解码快 1.6×(相对 FullAttn);峰值显存与 FullAttn 持平 | FullAttn;MoBA(≈1,024 原生槽);DSA(Top-K=256,≈1,024 等效槽,FP8 索引器) | 前向与反向时延为对比方法中最低;解码时延与 DSA 差距在 3% 以内 |
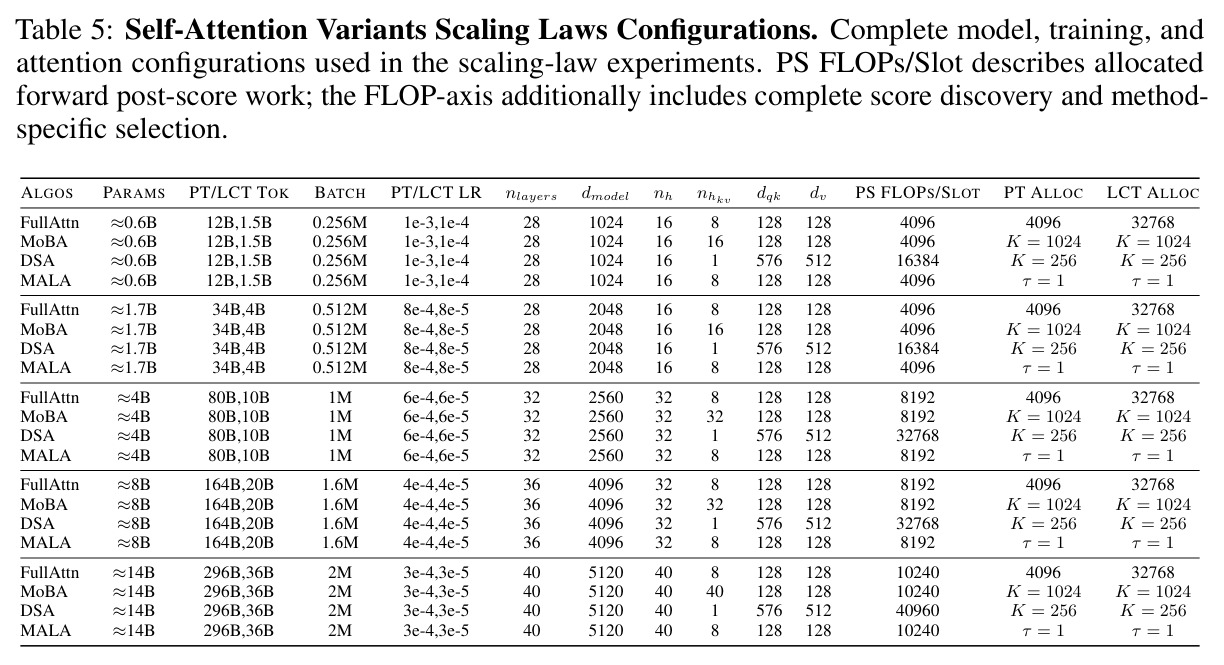
| Scaling-law 训练(0.6B–14B,32K 长上下文阶段) | 困惑度与总训练 FLOPs | 14B 困惑度与 FullAttn 差 <0.001;总 FLOPs 减少 23.1%(4K 预训练阶段减少 2.5%) | FullAttn(全因果);MoBA(K=1,024);DSA(K=256,等效约 1,024 槽) | 在质量-算力前沿上整体左移,且 FLOPs 统计已包含 MALA 完整 QK 打分与基线的路由/索引开销 |
| 模型级评测(14B scaling-law 模型与 32B 继续训练模型) | 知识/推理平均分、RULER 32K、YaRN 128K | 14B:72.48 / 64.66 / 89.45 / 65.75;32B:75.75 / 76.10 / 92.71 / 82.56 | FullAttn 14B:72.32 / 64.46 / 89.42 / 65.84;32B:75.62 / 75.67 / 92.70 / 82.03;MoBA 14B 知识 70.01、推理 58.07;DSA 14B 70.11 / 62.04 | 与 FullAttn 统计持平(多数任务差距 <0.3 分),显著优于同规模 MoBA 与 DSA |
局限与改进
作者坦承的局限:MALA 保留完整的二次 QK 打分发现,节省只来自数据依赖的后继计算跳过,不改变渐近复杂度,超长上下文中 QK 成本终将主导;反向并非前向算子的精确微分——backward 可能额外跳过前向保留的 tile,梯度误差还依赖 $dO$ 和 $V$,因此只能经验性评估;形式化保证在有限精度下只成立到舍入误差程度,且 $\tau=1$ 时 $\epsilon_q\le 1/2$ 的理论上界相当松(实测约 0.006%),保证更多是定性刻画而非紧致界。我的补充观察:tile 粒度的保守测试(一行否决即整块保留)会浪费工作;所有语言建模结论基于 SmolLMCorpus 预训练与 Qwen3-32B 继续训练,数据配方与领域偏斜的影响未知;解码仅 1.6× 加速且受限于必须全量打分,KV cache 完全未压缩,对推理服务最痛的显存问题没有帮助;基线统一锚定在 ≈1,024 等效槽——这个由 $\tau=1$ 诱导的工作点本身可调,论文未展示不同 $\tau$ 下的质量-算力曲线;与 FP8 KV、推测解码、上下文并行等系统特性的交互也未探索。
独立分析的弱点
独立分析三点弱点。其一,二次打分天花板:MALA 每个查询仍需对全部 $L_q$ 个键执行打分(反向还需重算),128K 时打分已占算子成本的相当比例,当上下文迈向 1M token 时相对收益会进一步稀释;改进方向是与支持集稀疏方法级联——先用廉价索引剪掉大片低分区域,再在剩余候选上跑 MALA 的精确分配,兼得两者的节省。其二,块级保守性:块内任一行满足保留条件就执行整块的 softmax+PV,而注意力尖锐程度在块内行间差异很大,实测约 1,024 slots 的均值中有相当部分由少数弥散行拉高;可在 kernel 内做行级掩码或在 V 加载后按行提前终止 PV 累加,进一步逼近行级 oracle。其三,执行路径不对称:前向用演化分母(偏小、偏宽松),split-KV 解码用部分分母(更保守),导致同一容差下不同执行路径保留的支持不同;论文论证了正确性与嵌套性,但训练与推理时的稀疏模式并不一致,长期训练动态(类似路由方法中的稀疏漂移)缺少分析;改进方向是研究 $\tau$ 随训练进度的自适应退火,或为解码设计稍紧的容差并实证其质量影响。
未来方向
作者方向之外还有较大延伸空间。理论上:目前只有前向遗漏质量界,梯度误差没有形式化界(仅给出 ≤0.38% 的经验值),结合 $dS=P\circ(dP-\mathrm{rowsum}(O\circ dO)^\top)$ 的结构推导梯度范数约束是自然的后续工作。系统上:MALA 为打分保留全部 KV,与 KV 缓存压缩正交,可探索"用低精度/压缩 KV 做打分筛选、命中后取原始 V"的两级方案;与上下文并行、专家并行、FP8 训练的联合优化也未触及。方法上:$\tau$ 目前是全局常数,让每层/每头学习各自的软阈值 $\tau$,或按验证困惑度自动调节,可能进一步改善质量-算力权衡;推广到双向注意力的 ViT 与交叉注意力也值得尝试(因果遍历假设需要重新设计)。应用上:32B 实验证明 FullAttn 模型可通过 64B token 继续训练适配 MALA(知识 75.75 vs 75.62),提示"存量 Dense 模型低成本稀疏化"的路线;更少 token、甚至免适配的算子级替换是否可行,以及与量化推理栈的结合,都是值得验证的方向。
复现评估
复现条件分层明显。代码已开源(flash-sparse-attention 仓库),前向/反向算法给出完整伪码(Algorithm 1、2),关键超参数只有一个 $\tau=1$,无需逐层校准,这对复现非常友好。算子层面的实验在 8×H100(TP=8)即可复现:匹配工作量研究用 256 条 8K 序列、约 5,872 万个分配决策,协议在附录 C.2–C.3 写得很细(Rademacher 梯度探针、序列级 bootstrap 置信区间);算子基准给出与 FlashAttention、MoBA、DSA 官方实现的对比配置(Table 4);联想召回是 250K 训练样本、100 epoch 的小模型训练,单机可完成。但语言模型级结论需要 128×H100:0.6B–14B 五个规模 × 4 种注意力 × 两阶段训练(最大 296B+36B token,SmolLMCorpus + Qwen3 tokenizer),加上 32B 继续训练(Qwen3-32B 初始、64B token、batch 4M),算力门槛对多数团队过高;不过 0.6B 规模(12B token)的 scaling 趋势复现单节点即可承受。综合评估:算子与小规模训练复现难度中等,完整 scaling 结论基本只能依赖其开源代码在自有集群上缩减规模验证。
论文图表
前向完整伪码:逐查询块初始化 $O_i=0$、$\ell_i=0$、$m_i=-\infty$,降序遍历 key 块,计算 $S_{ij}$ 后以 $\tilde m_{ij}-m_i-\log\ell_i<\log(\tau/L_i)$ 判定跳过,否则执行标准 online-softmax 更新;结束时归一化输出并保存 $\ell_i\leftarrow m_i+\log\ell_i$。
它是方法的可执行定义:展示了跳过判据如何完全复用 FlashAttention 既有状态、首合法 tile 必被保留(保证非空支持)、以及只需多存一个 ℓ 向量,是实现复现的直接依据。
反向完整伪码:key 主序遍历,重算 $S_{ji}=K_jQ_i^\top$ 后以 $S_{ji}-\ell_i^\top<\log(\tau/L_i)^\top$ 判定跳过,否则用保存的 $\ell$ 重建 $P_{ji}$,执行 $dP$、$dS$、$dV$、$dK$、$dQ$ 的标准累加路径。
它体现了反向设计的新颖点:不重放前向的部分归一化序列,而是直接用最终归一化因子离线测试,从而无需存储前向掩码即可获得嵌套的前后向支持。