FlashMask-3:高效且高表达力的掩码感知分布式注意力 FlashMask-3: Efficient and Expressive Mask-Aware Distributed Attention
用零通信掩码变换打通 Hopper 内核与多机上下文并行,长上下文训练端到端提速至 11%
前置知识
FlashAttention 与在线 softmax
FlashAttention 通过分块(tiling)和在线 softmax 计算精确注意力 $O=\mathrm{softmax}(QK^\top/\sqrt{d})V$,从不物化 $n\times n$ 分数矩阵,显存只需 $O(n)$。在线 softmax 维护运行最大值与归一化统计量,每到达一个新 KV 块就增量修正已累积的输出。FlashAttention-3(FA3)面向 Hopper GPU 加入 TMA 异步加载、WGMMA 矩阵乘指令与 warp 专业化流水线,峰值可达约 740 TFLOPs/s。
FlashMask-3 的单卡内核直接构建在 FA3 的 TMA/WGMMA 异步流水线上,只有理解该生产者—消费者流水线,才能明白论文为何要把掩码扫描作为第三个 warp 角色插入、而不是往主计算循环里塞内联分支。
列稀疏掩码表示(LTS/LTE/UTS/UTE)
FlashMask 从 key token 视角编码结构化掩码:把分数矩阵沿对角线分成下三角与上三角区域,用四个 $O(n)$ 边界向量 $\text{LTS},\text{LTE},\text{UTS},\text{UTE}\in\mathbb{Z}_{\ge0}^{N_K}$ 表示——它们按 key 位置索引、但存储 query 轴的区间端点,对每个 key $j$,被屏蔽的 query 行为 $[\text{LTS}_j,\text{LTE}_j)\cup[\text{UTS}_j,\text{UTE}_j)$。内核内沿 key 轴做块级 max/min 即可把每个 query–key 块分类为全屏蔽/部分屏蔽/无屏蔽。
这四个向量是全文的核心数据结构:零通信分布式掩码变换、负载估计、通信剪枝全部由它们推导。论文的关键定理正是利用其「按 key 索引、存 query 区间」的不对称性。
Warp 专业化与 Hopper 硬件特性
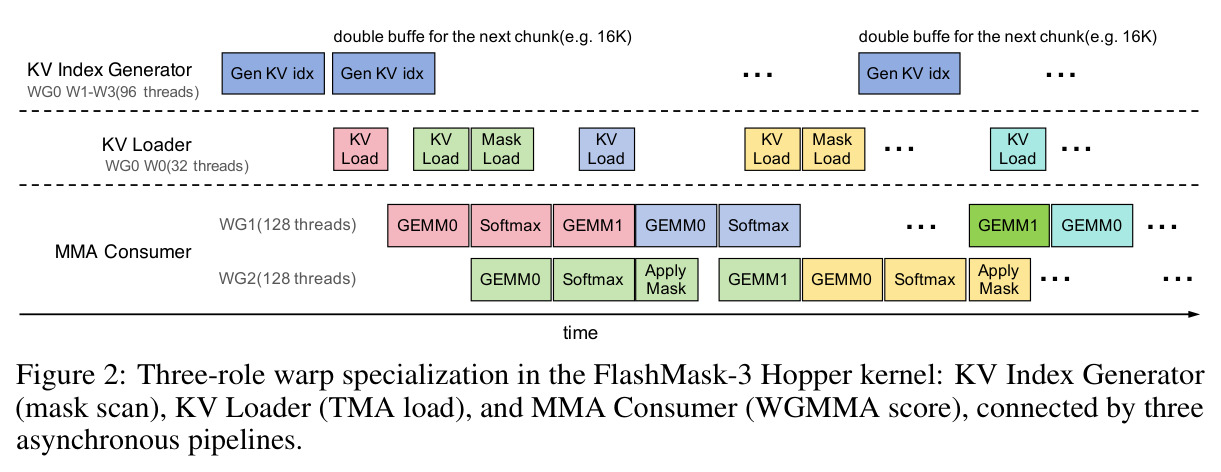
Hopper GPU 提供 TMA(张量内存加速器,异步批量搬运数据)与 WGMMA(warpgroup 级矩阵乘)指令;warp 专业化指让不同 warpgroup 分工扮演「生产者」(发 TMA 加载)与「消费者」(执行 WGMMA),经少量跨 warp 屏障与异步流水线重叠搬运和计算。FA3 的生产者 warpgroup 有 128 线程,但每次迭代只需 1 个线程发射 TMA 操作,其余线程空闲。
FlashMask-3 回收这 96 个空闲线程成立第三个角色 KV Index Generator 来扫描掩码,是其 Hopper 内核近零开销的关键设计;理解线程级分工才能读懂 Figure 2 与 Table 7 的消融。
上下文并行(Context Parallelism, CP)
CP 把 query 序列切分到 $P$ 个 rank,每卡只计算本地 query 对全局 K/V 的注意力,K/V 通过通信交换。Ring Attention 让 K/V 沿设备环轮转并与分块注意力重叠;Megatron CP 用 dual chunk(把序列首尾 query 块配对)平衡因果掩码负载,前向 all-gather 获取全局 K/V、反向 reduce-scatter 归还梯度。
FlashMask-3 的分布式扩展完全围绕 CP 展开:掩码本地化对应任意 chunk 分配、HCC-IPO 决定 chunk 到 rank 的映射、重叠方案针对前向 all-gather 与反向 reduce-scatter 两类通信。
计算—通信重叠
把分布式训练中的通信(all-gather/reduce-scatter)藏进计算时间以掩盖延迟:流级别用高优先级非阻塞流(如 Ring Attention 的双 CUDA 流),内核级别如 FLUX 把通信融合进 GEMM tile。注意力难以照搬 GEMM 的 tile 级融合,因为在线 softmax 要求逐块 rescaling,拆分 KV 会引入额外修正开销。
论文第三个核心组件就是掩码感知的重叠方案:通信剪枝、层次 all-gather、多阶段反向流水线都要回答「如何在不破坏在线 softmax 的前提下藏住通信」。
min-max 负载均衡与 LPT 贪心
把 $N$ 个权重为 $w_i$ 的任务分给 $P$ 个处理器、最小化最大负载(makespan),是经典 NP 难问题;下界为 $LB=\max(\lceil\sum_i w_i/P\rceil, \max_i w_i)$。LPT(Longest-Processing-Time first)贪心把最重任务分给最轻处理器,是最常用的近似;基数约束版本额外要求每个处理器恰好分到 $\kappa=N/P$ 个任务。
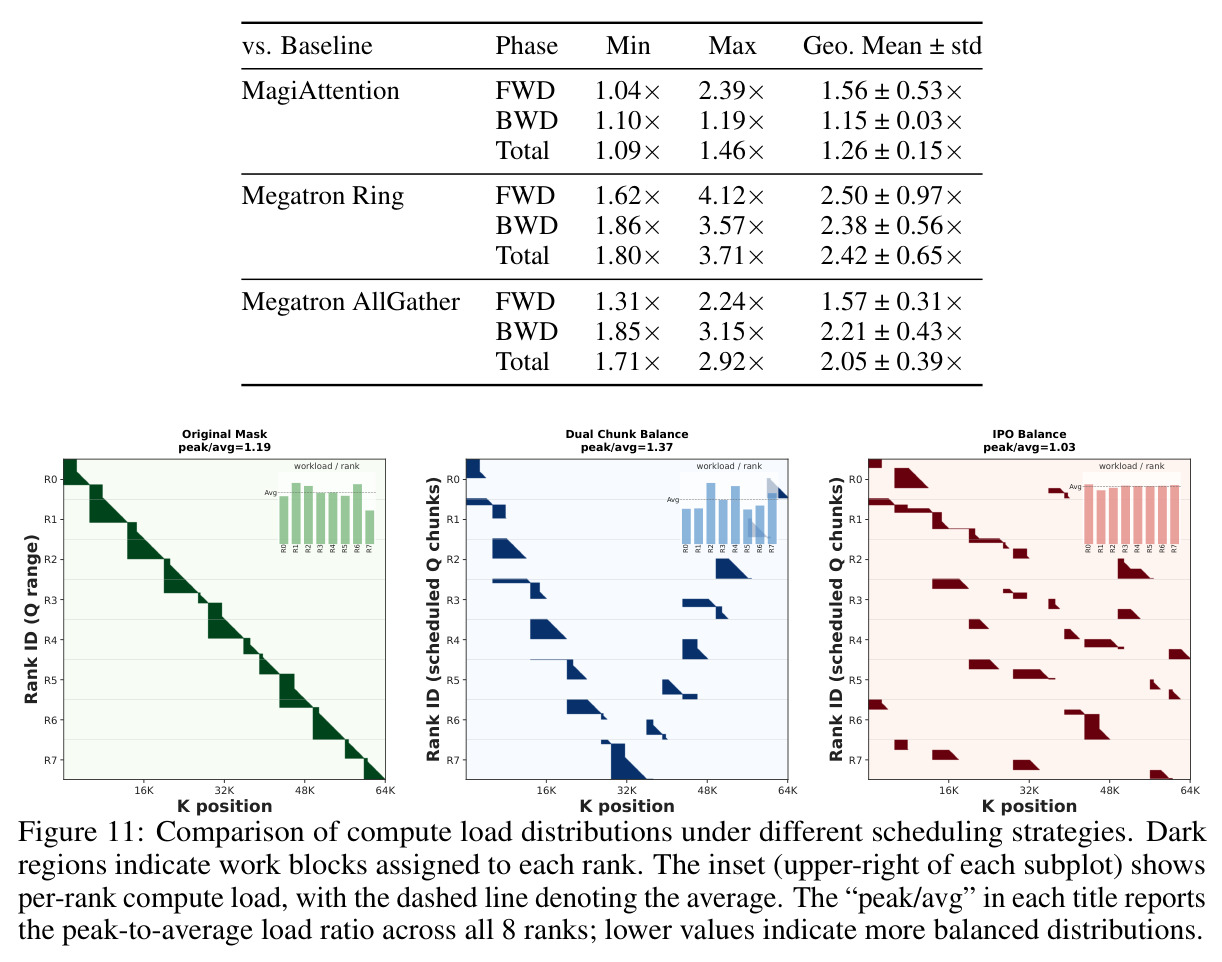
HCC-IPO 调度器的第一阶段就是基数约束 min-max 分区,其与 LPT、Dual Chunk 的差别是理解 Figure 7(b)、Figure 11 与 Table 3 消融的前提。
研究动机
长上下文大模型与多模态训练越来越依赖在打包 batch 内表达数据语义的结构化注意力掩码:文档掩码、prefix-LM、share-question(RLHF 多答案共享问题)、滑窗、块稀疏等。当上下文迈向数十万 token、训练扩展到多机上下文并行(CP)时,掩码成为一等公民瓶颈:$O(n^2)$ 掩码物化开销、掩码感知内核调度开销、掩码导致的跨卡负载不均开始支配整步训练时间。现有方案各有短板:FlexAttention 能表达任意掩码,但靠 torch.compile 逐掩码 JIT 编译、代码路径与 FA3 割离、Hopper 吞吐落后,且 CP 下每个 rank 要以 $O(QK/B^2)$ 代价重建本地块掩码;FA3 原生只支持 causal/full/varlen-document;FlashMask 用列稀疏表示解决了表达力与 $O(n)$ 存储,但实现在 Ampere 上,既没用上 Hopper 的 TMA/WGMMA 流水线,也没有任何分布式支持;MagiAttention 支持任意掩码分布式,但需逐 rank 物化 AttnSlice 切片并配专用 FFA 内核;Megatron dual chunk 的线性负载假设在 share-question、多文档等不规则掩码下失效,per-rank 利用率显著退化。
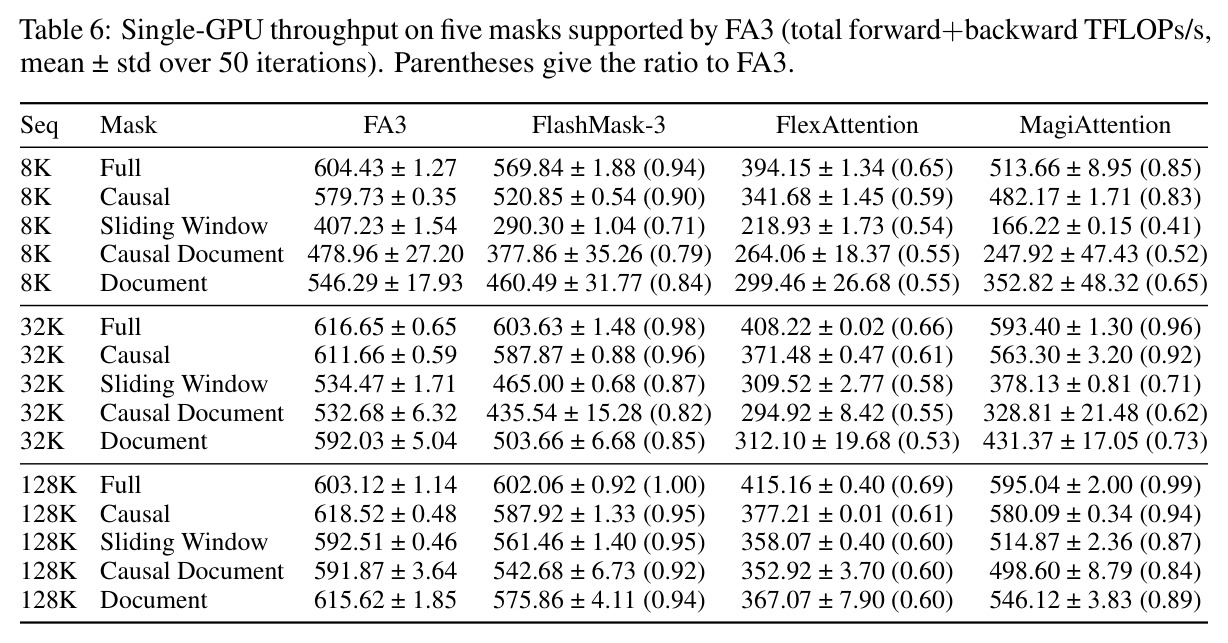
本文的目标是本文要构建一个同时覆盖单卡内核与多机分布式两个层面的掩码感知注意力系统 FlashMask-3,目标可拆成三点。第一,把 FlashMask 的列稀疏掩码扫描以近零开销整合进 FA3 的 TMA/WGMMA warp 专业化流水线,在 Hopper 上逼近 FA3 的峰值吞吐(在 FA3 原生支持的掩码上达到其 0.71×–1.00×),同时通过抢占式持久 tile 调度抹平不规则掩码造成的 SM 级长尾。第二,在任意多 chunk 的 CP 分配下,无需任何跨卡通信即可把全局掩码精确本地化到每个 rank,并保持与单卡内核完全相同的接口和二进制,即「一份掩码抽象、一个内核」通吃单机与多机。第三,解决掩码稀疏带来的跨卡计算不均衡与通信暴露:用稀疏感知的层次负载均衡和掩码驱动的通信剪枝、拓扑感知路由,把 all-gather/reduce-scatter 尽量藏进计算,最终在百亿参数 MoE 的 128K 上下文生产级训练上拿到可量化的端到端吞吐收益。
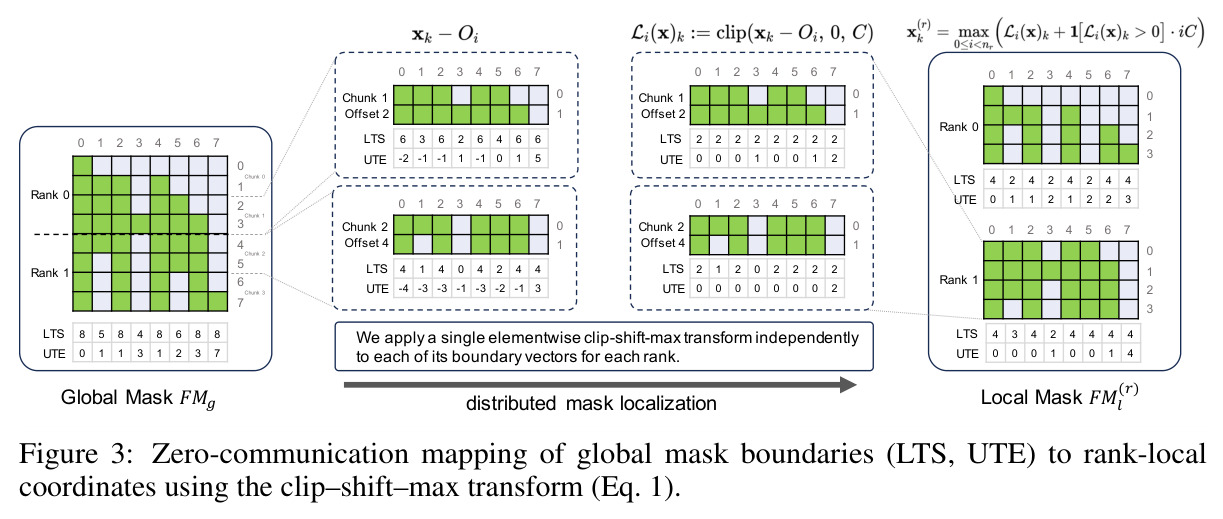
与已有工作不同的是,本文最独特的切入是一个被原作忽视的结构性质:列稀疏掩码「按 key 位置索引、却存储 query 轴区间」的不对称性。FlashMask 原文只把它当单卡显存优化,本文发现正因存储的是 query 轴区间,在任意多 chunk 的 CP 分配下,rank 级掩码本地化都可归结为对四个边界向量的逐元素 clip–shift–max 变换,且定理 1 证明结果与全局掩码逐位等价、零跨卡通信、输出直接兼容单卡内核。对比之下,FlexAttention 每 rank 需以 $O(QK/B^2)$ 重建块掩码,MagiAttention 需要 slice-cutting 物化每 rank 切片并重配内核——它们都在回答「每个 rank 如何重新描述自己的掩码」,而本文证明根本不需要重新描述,一个张量级变换就够。第二个独特视角是把同一套「全屏蔽/部分屏蔽/无屏蔽」块分类同时喂给内核调度、主机端负载估计和通信侧过滤三层执行栈,让掩码感知性像一条主线贯穿全栈,而非各层各自为政。
核心方法
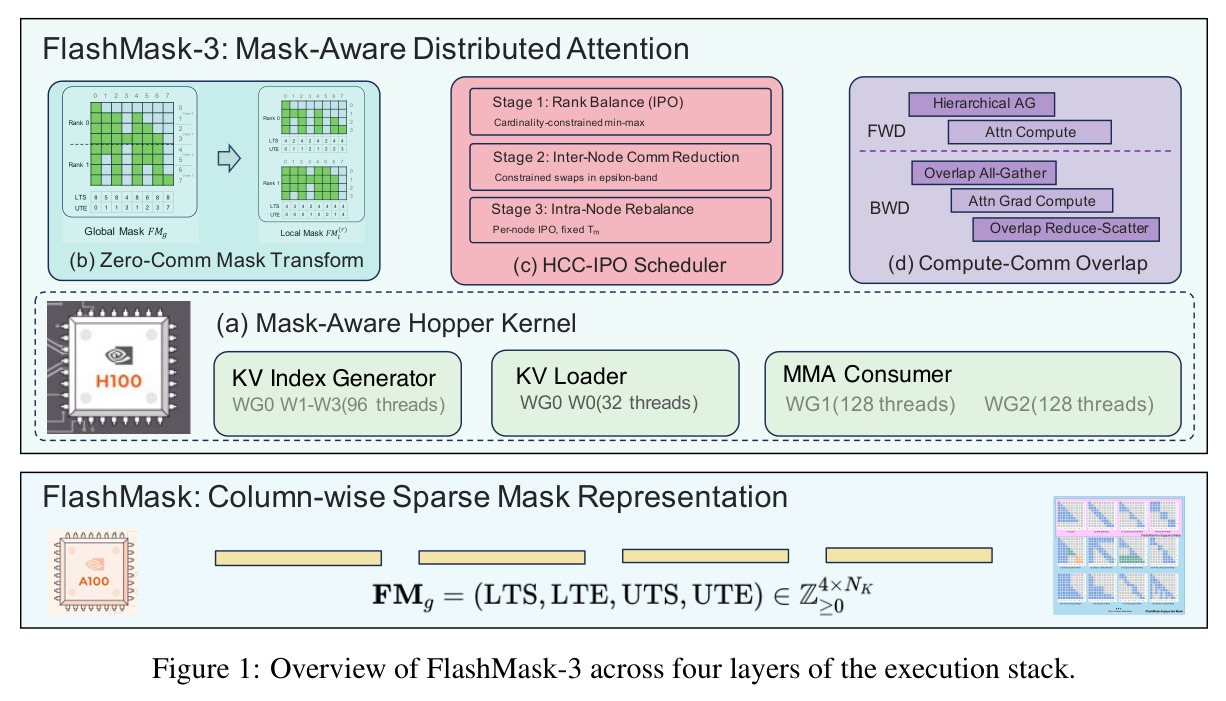
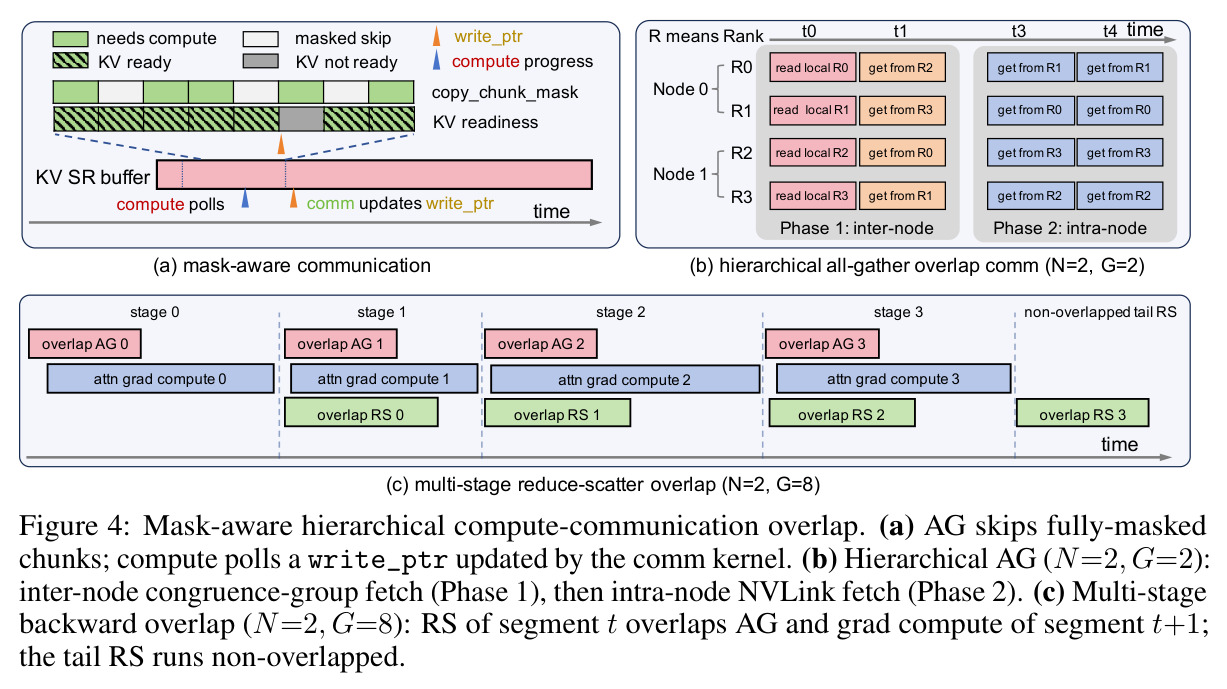
直觉上,FlashMask-3 的哲学是「掩码不是包袱而是元数据」:把结构化掩码压缩成四个 $O(n)$ 边界向量 $\text{LTS},\text{LTE},\text{UTS},\text{UTE}$ 后,同一份元数据可同时驱动内核级块分类(跳过全屏蔽块)、主机级负载估计(每 chunk 有效块数)与通信级剪枝(全屏蔽 KV chunk 不传输)。技术路线分四层。第一层掩码感知 Hopper 内核:三角色 warp 专业化——KV Index Generator 回收 FA3 生产者 warpgroup 每次迭代空闲的 96 线程做边界扫描,产出全屏蔽/部分屏蔽/无屏蔽的合法块队列;KV Loader 按队列发 TMA;MMA Consumer 跑 WGMMA 与在线 softmax,仅部分屏蔽块施加行区间掩码;另配 PPT 抢占式持久 tile 调度器让 CTA 经全局原子计数器认领 Q 块以抹平长尾。第二层零通信掩码本地化:对边界向量做 clip–shift–max 变换。第三层 HCC-IPO 层次负载均衡:三阶段交替优化跨卡计算均衡与跨节点通信量。第四层掩码感知计算—通信重叠:NVSHMEM 对称内存零拷贝、层次 all-gather、掩码驱动通信剪枝与多阶段反向流水线。四层复用同一套块分类;通信内核只占 4–8 个 SM,对注意力内核改动少于 20 行。
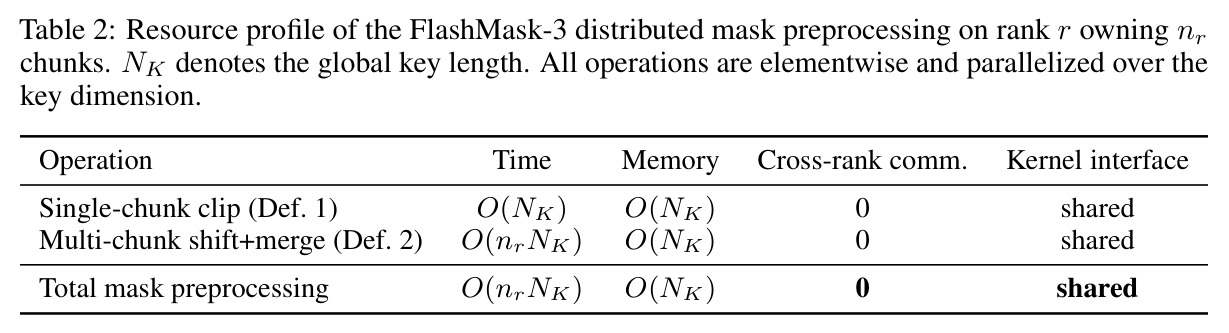
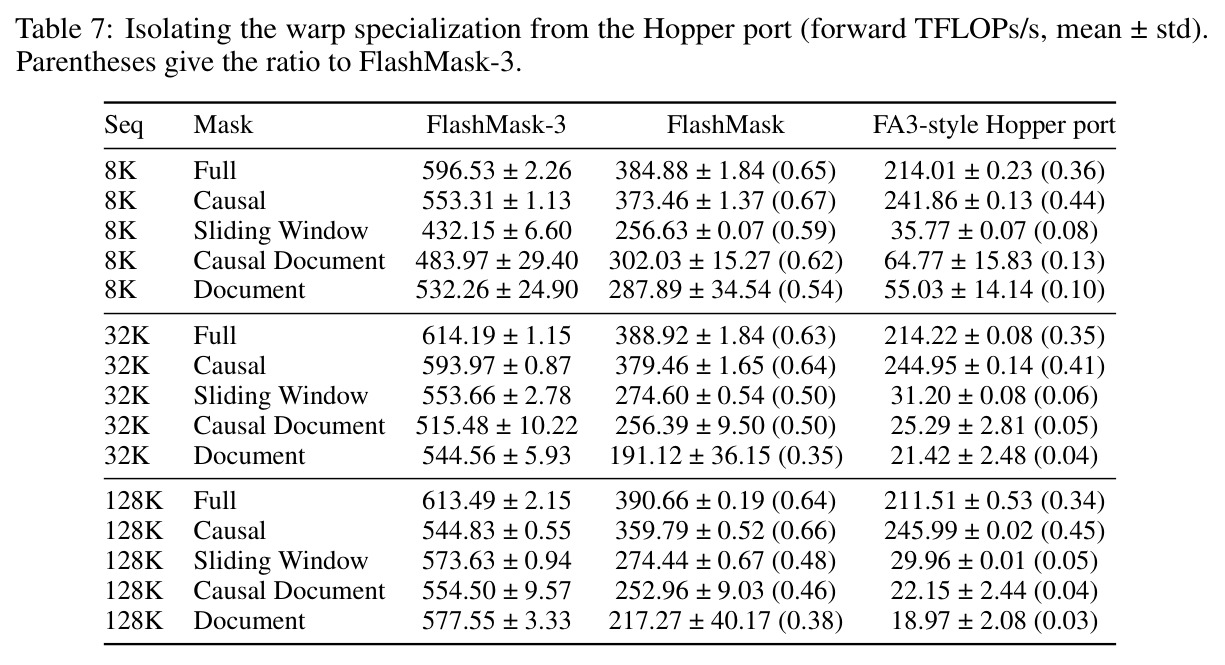
核心创新是把列稀疏掩码从「单卡存储优化」升维成「分布式注意力的正确接口」。已有分布式掩码方案都让每个 rank 重新描述自己的掩码:FlexAttention 每卡以 $O(QK/B^2)$ 重建块掩码且逐掩码 JIT 编译,MagiAttention 用 AttnSlice 三元组做 slice-cutting 物化并配专用内核;本文则证明 rank 级本地化只是一个逐元素变换 $$x^{(r)}_k=\max_{0\le i0]\cdot iC\big),\quad \mathcal{L}_i(x)_k=\mathrm{clip}(x_k-O_i,0,C)$$ 其中 $O_i$ 为 rank $r$ 第 $i$ 个 chunk 的全局偏移、$C$ 为 chunk 大小:clip 映射进 chunk 局部坐标,$+iC$ 嵌入秩本地拼接空间,指示函数防止空 chunk 污染最大值,max 保证只有持有该边界的 chunk 起作用。Table 2 显示预处理仅需 $O(n_rN_K)$ 时间、$O(N_K)$ 显存、0 跨卡通信,输出与单卡内核二进制直接兼容。第二个关键设计是把掩码扫描塞进 FA3 生产者 warpgroup 的空闲线程而不触碰 WGMMA 关键路径——Table 7 的反事实实验显示,没有 KV Index Generator 的 FA3 式移植在结构化掩码上崩塌到完整内核的 0.03–0.13 倍(寄存器溢出、非 MMA 指令堵塞流水线),证明收益来自 warp 专业化而非单纯换硬件。
方法步骤详情
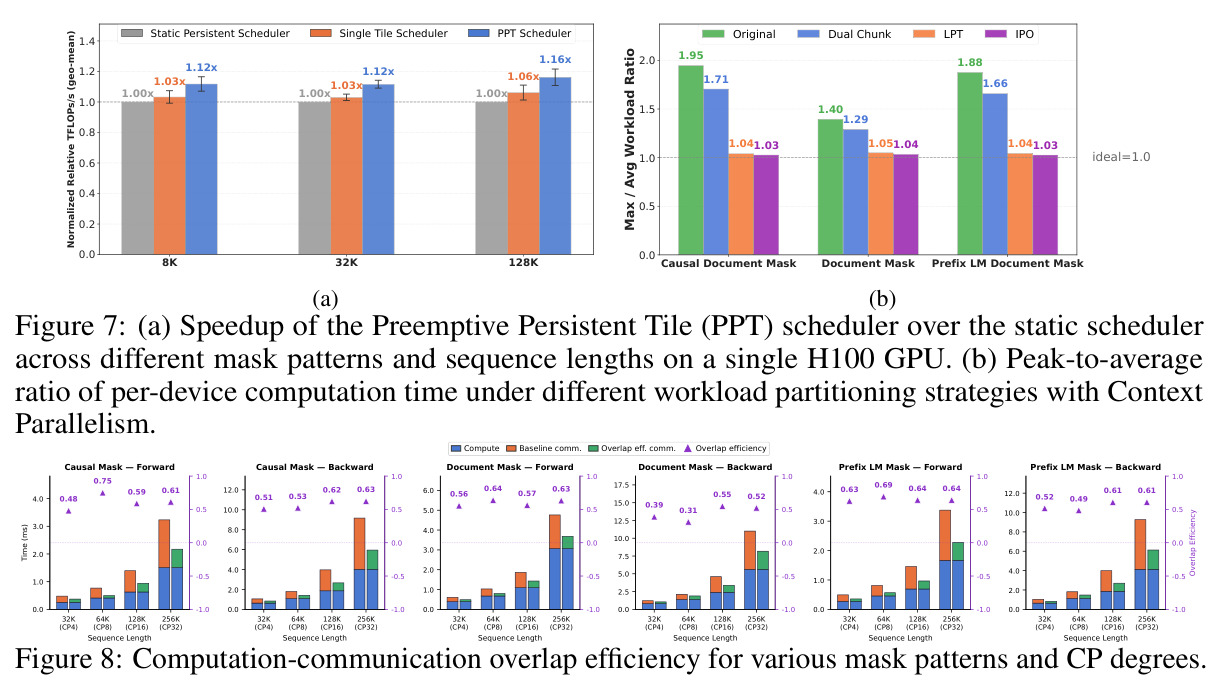
第一步(内核 §3.1):输入 $(Q,K,V)$ 与列稀疏掩码。KV Index Generator 用回收的 96 线程对 $\{\text{LTS},\text{LTE},\text{UTS},\text{UTE}\}$ 做块级 max/min 分类,产出合法 K 块队列;KV Loader 只对队列块发 TMA;MMA Consumer 跑 WGMMA 打分与在线 softmax,仅对部分屏蔽块施加行区间掩码;PPT 调度器由 Index Generator 代发原子认领,使 tile 声明与掩码扫描重叠、避开 WGMMA 关键路径,消融中较静态调度最高快 12%。第二步(本地化 §3.2):输入全局掩码 $FM^g$ 与 chunk 偏移 $\{O_i\}$,对四个边界向量各自做 clip–shift–max,输出秩本地 $FM^{(r)}_l$,形状 $4\times N_K$ 与语义不变($O(n_rN_K)$ 时间、0 通信),定理 1 保证与全局掩码逐位等价。第三步(均衡 §3.3):按块分类估每 chunk 负载 $w_i$(全屏蔽 0、部分屏蔽 $\alpha_p$、无屏蔽 $\alpha_u$),HCC-IPO 三阶段交替:(i) 跨 rank 基数约束 min-max 分区——LPT 初始化后迭代取最重 rank,用精确 2-way/3-way 子求解器重分,达到下界 $LB$ 即可 $O(N)$ 验证全局最优;(ii) 跨节点在 $\epsilon$ 容差内一换一 swap 压低最大节点间 KV 流量 $\mathrm{Comm}_{\max}$;(iii) 节点内 IPO 重均衡,且可证明不破坏 (ii)。第四步(重叠 §3.4):本地 KV 一次性拷入 NVSHMEM 对称 SR 缓冲;copy_chunk_mask 剔除全屏蔽 chunk(典型掩码省约 50% AG/RS 流量);前向 all-gather 走 congruence-group 两阶段路由(Phase 1 跨节点 RoCE 拉 $N-1$ 份、Phase 2 节点内 NVLink 补 $(G-1)N$ 份,$P{=}32$ 时跨节点拉取 24→3,降约 90%),计算经 write_ptr 前沿轮询就绪、一次扫完不做分段 softmax 重缩放;反向用 KV 列并行 + $T$ 段流水线(段大小 $C=2^{\lfloor\frac{1}{2}\log_2 P\rfloor}$,$P{=}16$ 时 $T{=}C{=}4$),段 $t$ 的 reduce-scatter 与段 $t+1$ 的 AG/梯度计算重叠,bitmask-AMO 同步生产者与归约消费者,前向 LSE 免跨段重缩放。通信内核仅占 4–8 个 SM,对注意力内核改动少于 20 行。
技术新颖性
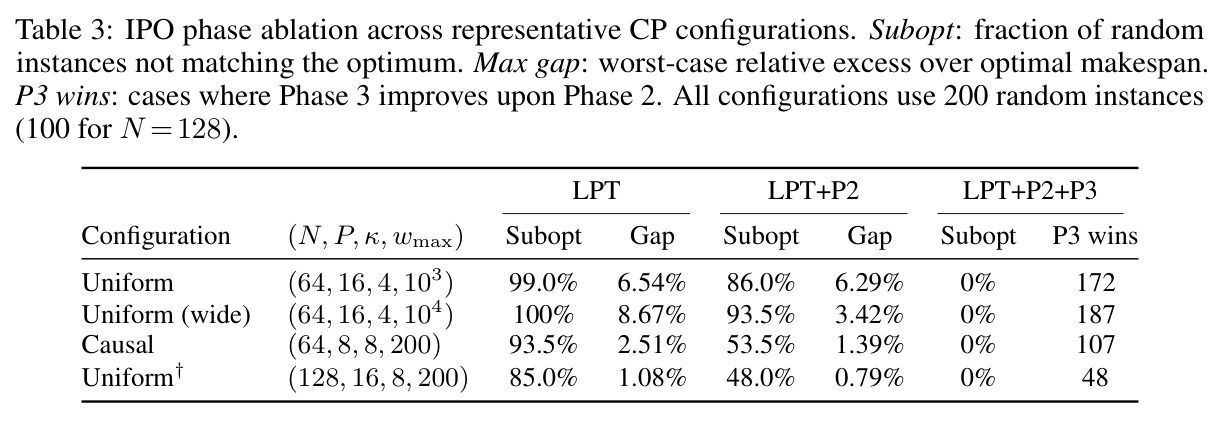
新颖性可归纳为四个「首次」。其一,首次证明列稀疏掩码的分布式本地化可归约为零通信逐元素变换并给出完整证明(定理 1 + Lemma 1 的跨 chunk 贡献界),把掩码分发成本降为 0;并证明指示函数 $\mathbb{1}[\cdot>0]$ 不可省略——没有它,空 clip 的 chunk 会贡献 $iC$ 污染最大值。这是与 FlexAttention/MagiAttention 最本质的分野。其二,首次把掩码处理做成 FA3 流水线中与生产者/消费者并列的第三个 warp 角色,复用生产者 warpgroup 空闲的 96 线程,同时避免内联掩码计算导致的寄存器溢出与关键路径阻塞;Table 7 的对照实验(移植版仅 0.03–0.13×)构成干净归因。其三,HCC-IPO 把计算均衡与通信拓扑联合建模,用精确 2-way/3-way 子求解器配合可 $O(N)$ 验证的最优性证书:Table 3 显示 LPT 次优率 85–100%、加 Phase 2 仍 48–93.5%、三阶段全开 100% 达 LB 认证最优,比 DCP 的超图求解器轻、比 MagiAttention 的 LPT 贪心强。其四,掩码驱动的通信剪枝、congruence-group 层次路由与 bitmask-AMO 反向同步,都是同一份 $O(n)$ 掩码元数据在通信层的新用法,且作者证明了阶段间互不干扰。
实验结果
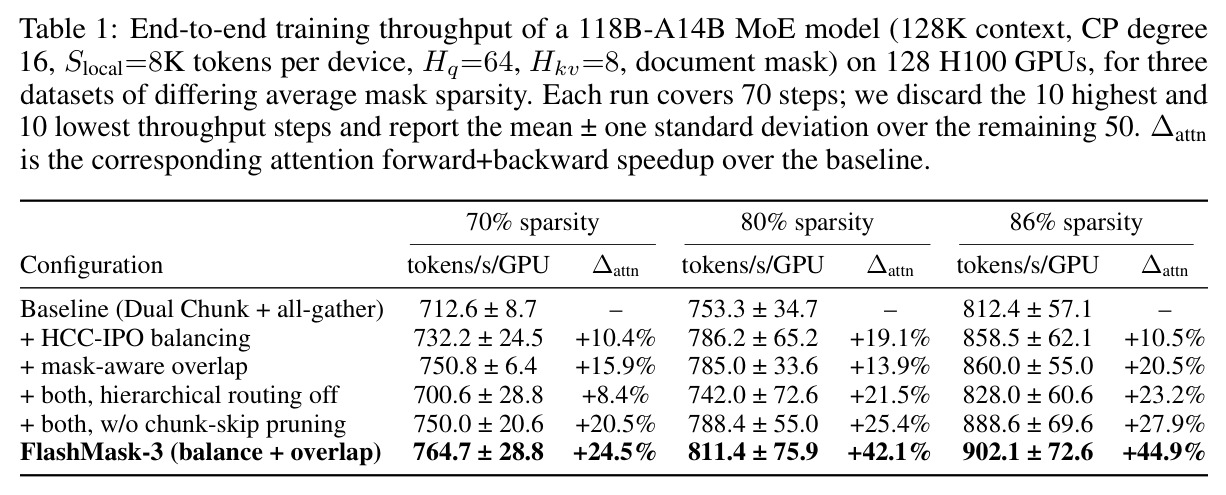
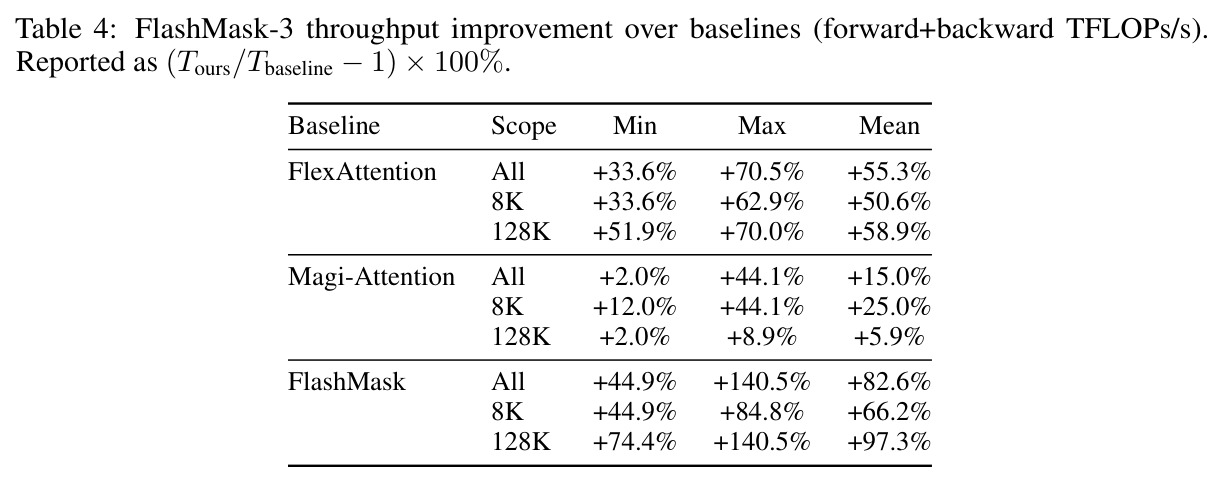
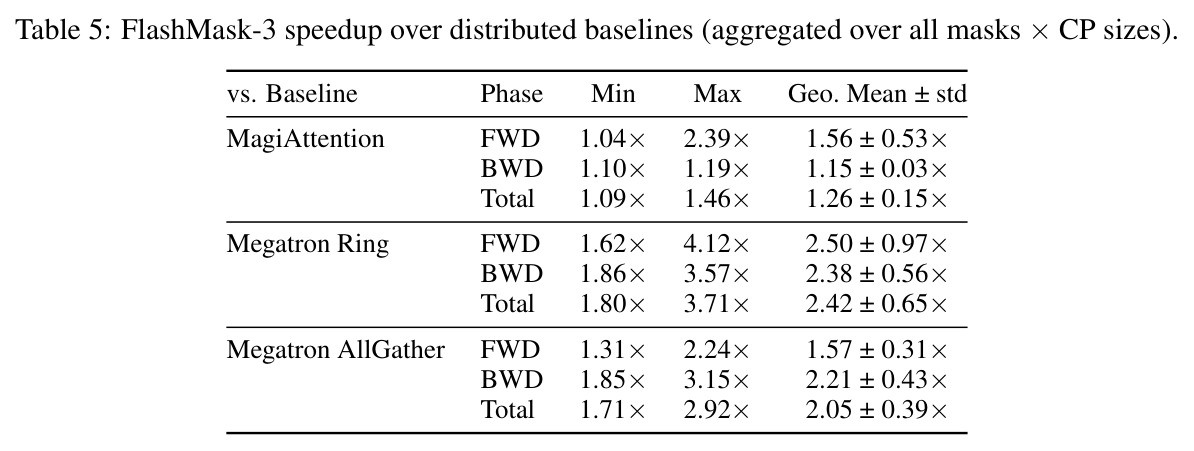
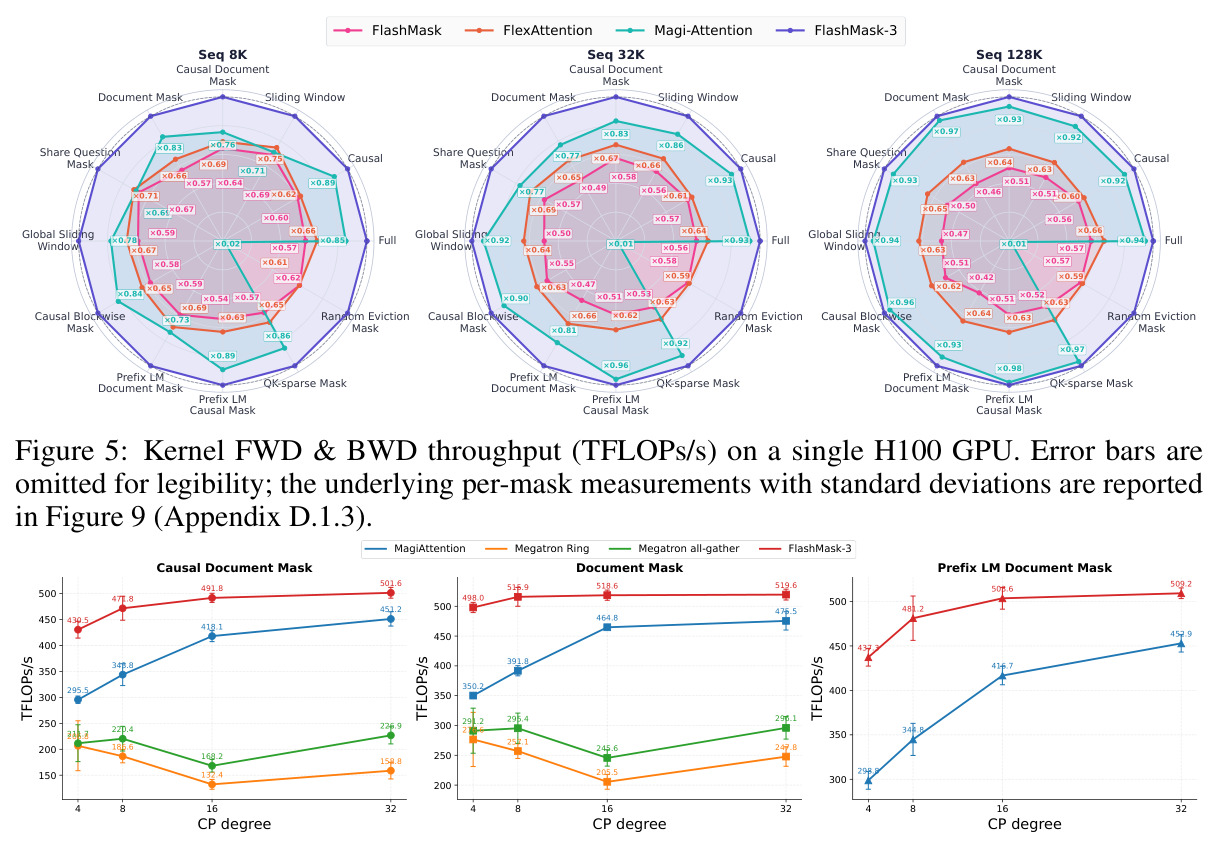
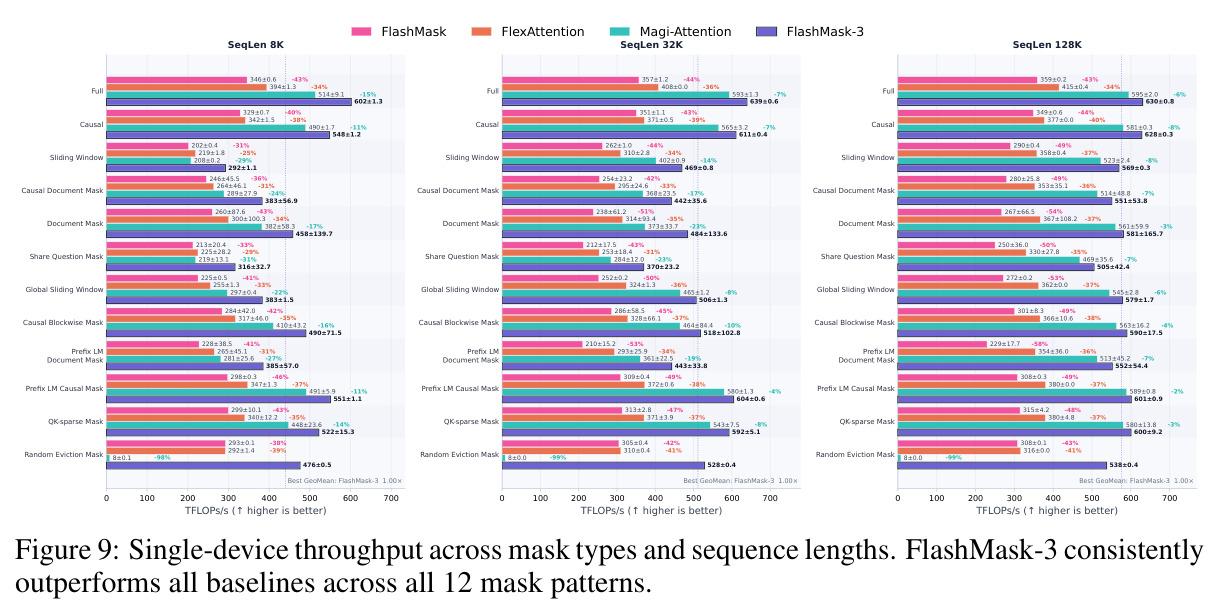
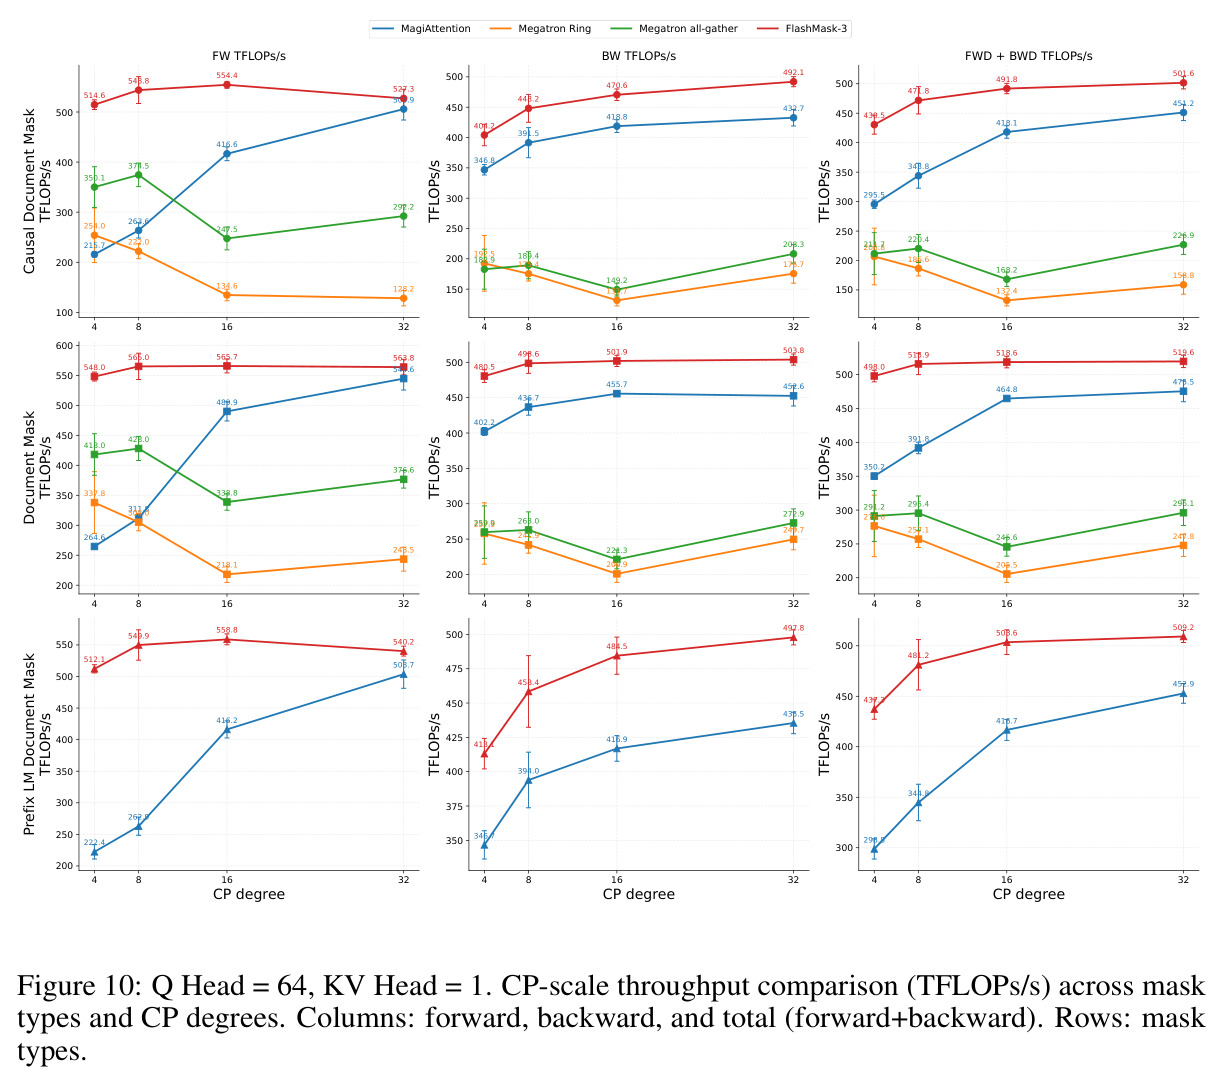
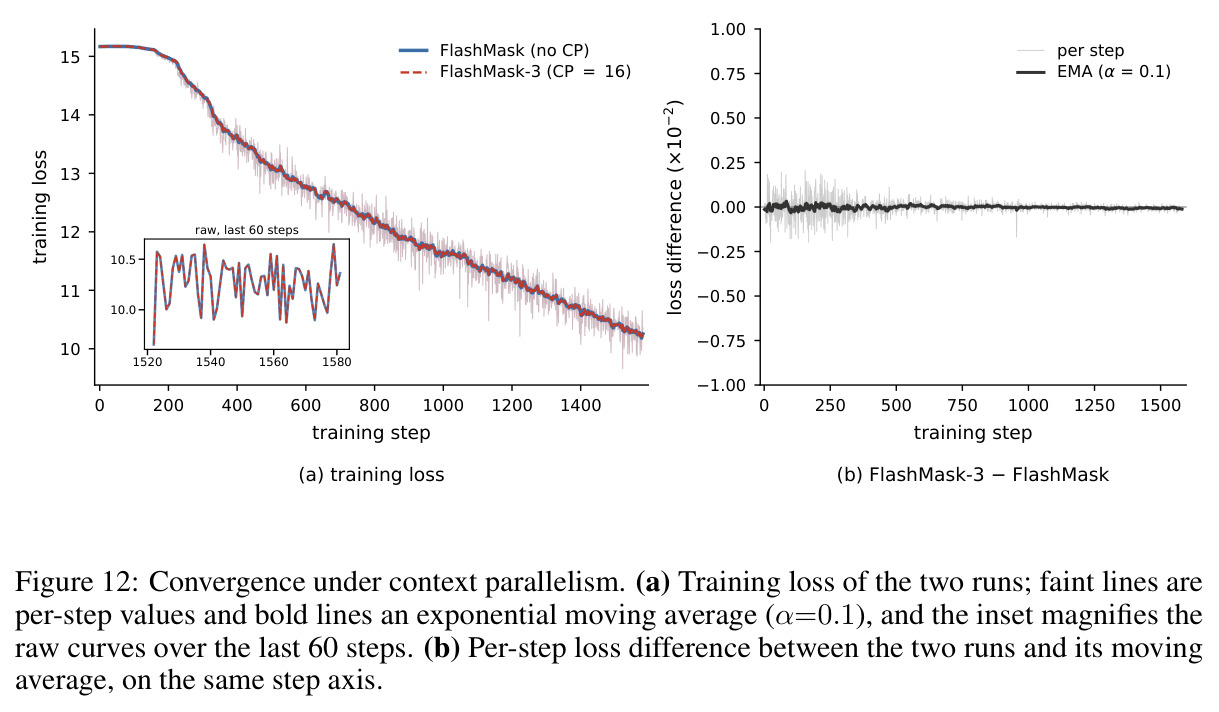
实验在 H100 集群(NVLink 节内 + RoCE 节间,BF16,$d{=}128$)分四组。①单卡(12 种掩码,4K–128K):对 FlashMask、FlexAttention、MagiAttention 提升 45%–141%(均值 +82.6%)、34%–71%(+55.3%)、2%–44%(剔除 Magi 慢 50 倍的 Random Eviction 后均值 +15.0%),全组合获胜且优势随长度扩大(对 FlashMask 8K +66.2%→128K +97.3%);Table 6 显示在 FA3 原生 5 种掩码上达 FA3 的 0.71×–1.00×(128K Full 602.1 vs 603.1 TFLOPs/s)。Table 7 反事实:无 KV Index Generator 的 Hopper 移植仅剩完整内核的 0.03–0.45×,归因于 warp 专业化。②CP 扩展(P=4–32,每卡 8K):Causal Document Mask 从 430.5 升至 501.6 TFLOPs/s,跨节点后仍强扩展;对 MagiAttention/Megatron all-gather/ring 加速 1.09×–1.46×/1.71×–2.92×/1.80×–3.71×;重叠效率 0.31–0.75。③端到端(118B-A14B MoE、128K、128 卡、CP=16、文档掩码):70%/80%/86% 稀疏度下吞吐 +7.3%/7.7%/11.0%(86% 时 812.4→902.1 tokens/s/GPU),注意力前反 +24.5%/42.1%/44.9%(70% 时每步 10900.5→8757.6ms);端到端增益小于注意力增益是因注意力只占前反时间 43.5%/25.8%/24.4% 且测量含未改动的梯度同步与优化器。组件分解:均衡 +2.8%/4.4%/5.7%、重叠 +5.4%/4.2%/5.9%、剪枝再 +2.0%/2.9%/1.5%;关层次路由后组合降至 −1.7%/−1.5%/+1.9%,说明两组件须靠拓扑路由才能叠加。④消融:PPT 最高 +12%(Figure 7a);IPO 峰均比 1.03 vs Dual Chunk 1.37(Figure 7b、11);Table 3 中 IPO 三阶段 100% 达 LB 认证最优;Figure 12 证明 CP 与否的损失曲线差异在浮点归约噪声内。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单卡稀疏注意力 FWD+BWD(12 种掩码 × 4K–128K,H100) | TFLOPs/s 相对提升(几何均值) | vs FlashMask 平均 +82.6%;vs FlexAttention 平均 +55.3%;vs MagiAttention 平均 +15.0%(剔除 Random Eviction) | FlashMask(Ampere 列稀疏内核)/ FlexAttention(PyTorch 2.8.0)/ MagiAttention | +45%–141% / +34%–71% / +2%–44%,且所有掩码×长度组合全胜 |
| FA3 原生支持的 5 种掩码(Full/Causal/Sliding Window/Causal Document/Document) | 相对 FA3 的 TFLOPs/s 比值 | 8K 时 0.71×–0.94×,128K 时 0.92×–1.00×(128K Full 602.1 vs FA3 603.1) | FlashAttention-3(Hopper 原生,仅支持该 5 种掩码) | 以近乎零损耗换来任意结构化掩码表达力 |
| KV Index Generator 消融(反事实:FA3 式 Hopper 移植) | 前向 TFLOPs/s 相对完整内核比值 | 完整 FlashMask-3 内核 | 无 KV Index Generator 的 FA3 式移植 | 移植版在 Full/Causal 仅 0.34–0.45×,结构化掩码仅 0.03–0.13×,证明 warp 专业化是收益来源 |
| 上下文并行扩展(P=4–32,每卡 8K,弱扩展) | 总吞吐加速比(聚合所有掩码×CP 度) | 对 MagiAttention 几何均值 1.26×、Megatron all-gather 2.05×、Megatron ring 2.42×;Causal Document Mask 430.5→501.6 TFLOPs/s(CP 4→32) | MagiAttention / Megatron-Core CP (all-gather) / Megatron-Core CP (ring) | 1.09×–1.46× / 1.71×–2.92× / 1.80×–3.71× |
| 计算—通信重叠效率(Flux 口径 $E=1-T_{exposed}/T_{comm}$) | 重叠效率 | 0.31–0.75(随掩码模式与 CP 度变化) | —(Figure 8 自比较) | 通信内核仅占 4–8 SM,前向 all-gather 跨节点拉取次数在 P=32 时 24→3(约降 90%) |
| 端到端训练:118B-A14B MoE,128K 上下文,128×H100,CP=16,文档掩码 | tokens/s/GPU(70 步取中位 50 步均值) | 764.7 / 811.4 / 902.1(70%/80%/86% 稀疏度,均衡+重叠全开) | Dual Chunk 均衡 + all-gather:712.6 / 753.3 / 812.4 | 端到端 +7.3%/7.7%/11.0%;注意力前反 +24.5%/42.1%/44.9%(70% 稀疏度每步 10900.5ms→8757.6ms) |
局限与改进
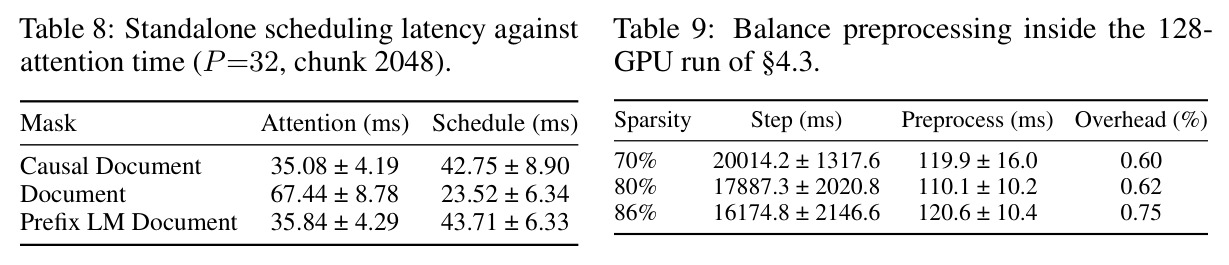
作者承认的局限(附录 A):(1) 只覆盖列稀疏掩码家族,屏蔽行集无法分解为两个区间的掩码(多区间/任意稀疏)需扩展表示;(2) 内核深度绑定 TMA/WGMMA,移植其他架构需重做 warp 专业化;(3) 层次重叠假设每节点 8 卡 NVLink 与同 rank RoCE/IB 拓扑;(4) 层次路由目前只用于前向 all-gather,反向 reduce-scatter 留作未来工作;(5) 实验偏生产规模,小上下文可能摊不平调度开销;(6) QKV 配置覆盖不全面。我的观察:其一,Table 8 显示 P=32 时 Causal Document Mask 的调度延迟 42.75ms 超过注意力本身 35.08ms(Prefix LM 亦 43.71 vs 35.84ms),均衡调度在注意力较短或强不规则掩码下会成为新瓶颈——论文靠约 20 秒的长步骤把摊销开销压到 0.6%–0.75%(Table 9),但短步骤、小模型或频繁换掩码的场景会放大该成本;其二,单卡基准用 MHA($H_{kv}{=}1$)而真实训练是 $H_{kv}{=}8$ 的 GQA,GQA 下开销结构未被单独刻画;其三,重叠效率下限仅 0.31,最坏配置大半通信仍暴露;其四,均衡与重叠深度耦合,关层次路由组合收益转负(−1.7%),部署对拓扑敏感;其五,未探索 FP8,FA3 的低精度红利未被继承。
独立分析的弱点
独立分析几个弱点并给改进方向。(1) 表示表达力边界:两区间假设排除多区间掩码(任意 token 级 dropout、多局部窗口)。可扩展为每列变长区间列表或分组边界向量,但保住零通信定理需更细组合条件,可探索「区间数 ≤ 常数」时的多组 clip–shift–max。(2) 调度延迟:HCC-IPO 精确 2-way/3-way 子求解器在 $\kappa$ 大时开销高(Table 8 中 42.75ms 超过注意力时间)且每步重算;可做增量调度(负载估计变化小于阈值时复用上步分配)、跨步缓存、学习式预测替代精确求解,或把调度异步藏进上一步注意力执行期。(3) 反向层次路由缺失:backward RS 是平坦 NVSHMEM put,跨节点带宽受限时可把 congruence-group 思想推广到 RS,或借鉴 Mesh-Attention 的 2D 分配把通信量降到 $O(Nd/\sqrt{P})$,两者正交。(4) 重叠效率与稀疏度强相关(0.31–0.75):极稀疏掩码计算不足以藏通信,可聚合多微批次共享 all-gather,或对高全屏蔽比例场景自适应切换 Ulysses 式 head 并行。(5) 平台绑定:可抽象 warp 角色接口层,降低向 Blackwell 等新架构的移植成本。(6) 精度维度:结合 FA3 的 FP8 路径有望再抬吞吐,但需处理部分屏蔽块的数值细节。
未来方向
作者明确提出的方向:把层次拓扑感知路由扩展到反向 reduce-scatter;对 batch size、query/KV 头比例等 QKV 配置做系统性扫描;支持两区间之外的掩码表示扩展。基于本文成果可自然延伸的方向:(1) 与 Mesh-Attention 的 2D 拓扑优化正交组合,进一步压跨节点流量;(2) 把 HCC-IPO 的稀疏感知负载估计与 MoE 的专家并行动态负载联合调度——同一训练步里注意力和专家路由都有不均衡,统一调度器可能比各自为政更优;(3) 推理侧迁移:prefill 的前缀缓存、滑窗、多文档 batch 同样产生结构化掩码,列稀疏表示 + 零通信变换可直接用于多副本推理服务的负载切分;(4) 与 NSA/MoBA 等可学习稀疏注意力互补——本文负责高效计算「预先给定的掩码」,可学习稀疏负责「决定掩码」,两者叠加可端到端训练硬件友好的动态稀疏模型;(5) 更大规模(>512 卡)与多维并行(CP×EP×DP 组合)下的验证,以及 FP8 低精度与结构化稀疏的结合。
复现评估
复现条件较好但有硬门槛。开源方面:源码已在 GitHub 公开(PaddlePaddle/FlashMask),论文给出单卡基准的完整张量配置($D{=}128$、MHA 32 头、batch 按 $B=\max(\lfloor128{\times}1024/S\rfloor,1)$ 饱和显存)、FLOPs 计费公式(含有效密度 $\rho$ 与系数 $\eta_{fwd}{=}1,\eta_{bwd}{=}2.5$)、软件栈版本(CUDA 12.4、CUTLASS commit afa177、NVSHMEM 3.2.5)以及各基线 commit 号(MagiAttention d97b72、PyTorch 2.8.0、Megatron 2.8.0),附录给出算法 1–3 完整伪代码与定理 1/2 的完整证明,理论部分可独立验证。算力方面:复现单卡内核基准只需 1 张 H100(若有无卡 A100 需重写内核则不可行),CP 扩展性实验需 4–32 张 H100 的 NVLink+RoCE 集群;完整复现端到端实验需要 128 张 H100(16 节点)训练 118B-A14B MoE,且论文未说明该模型权重与三个稀疏度数据集是否公开,普通实验室难以复现该组数字。综合评估:单卡与中小规模 CP 结果复现难度中等(代码+配置充分),端到端 128 卡结果复现难度很大(依赖生产级 MoE 基础设施与未公开的数据)。
论文图表
128 卡端到端训练中均衡预处理的摊销开销:三档稀疏度下每步约 110–120ms,占 16–20 秒步骤的 0.60%–0.75%。
与 Table 8 配合构成完整图景:调度裸开销可观但被长步骤摊薄到不到 1%,帮助读者准确判断该方法在自身训练场景(步骤时长)下的适用性。