Switch-SWE:同仓库多任务切换下的编码智能体焦点任务恢复能力基准 Switch-SWE: Do Coding Agents Hold Focus When Switching Between Unfinished Tasks?
首个测编码智能体在未完成任务间切换后恢复能力的基准:切换使解决率平均降11.5个百分点
前置知识
SWE-bench 与仓库级修复评测
SWE-bench 是仓库级代码修复的标准基准:给智能体一个真实 GitHub issue 和对应仓库快照,智能体生成补丁后用该 PR 自带的测试打分。其衍生版本不断扩展评测维度——SWE-bench-Live 持续收录新 issue,Multi-SWE-bench 扩展多语言,SWE-Touch 加入用户在活跃任务中的代码编辑,SWE-ContextBench 测相关任务经验的检索复用——但评测单元始终是“一个 issue 到一个补丁”的单次 episode。
Switch-SWE 的任务实例直接取自 SWE-bench 家族,打分协议也沿用其可执行验证;理解这条基准脉络才能看清本文把评测单元从 episode 升级为多任务 session 的核心创新。
Fail-to-Pass / Pass-to-Pass 测试
F2P 测试指在基线代码上运行失败、应用参考修复后通过的测试,用来验证新功能确实被实现;P2P 测试指在基线和修复后两种状态下都通过的测试,用来防止补丁破坏既有行为。判任务解决要求补丁能成功应用且所有 $u \in F_f \cup P_f$ 的测试都通过。
Switch-SWE 每对匹配会话用完全相同的 F2P/P2P 集合打分,只有最终焦点补丁通过全部测试才算解决,这是理解其验证公式和 gap 指标的基础。
Coding agent harness
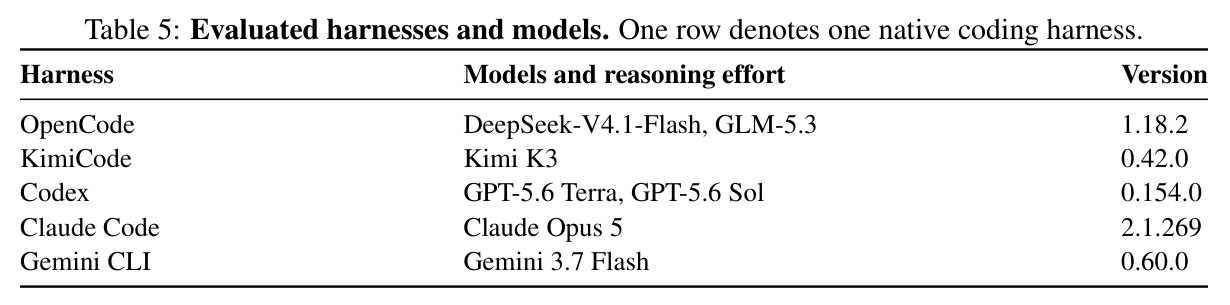
harness 是驱动模型执行编码任务的智能体外壳,提供文件读写、shell 执行、测试运行等工具并管理对话,如 OpenCode、Claude Code、Codex、Gemini CLI、KimiCode。同一个底座模型配不同 harness 表现会迥异,因为工具集、上下文压缩策略、系统提示都由 harness 决定。
本文 7 个评测配置都是“模型×harness”组合,RCM 也是以 OpenCode 插件形式实现;不懂 harness 就无法理解实验配置与方法的挂载位置。
上下文压缩
长会话中对话历史会超出模型上下文窗口,harness 通常自动把较旧的交互压缩成摘要以腾出空间。压缩是有损的:哪些信息被保留取决于压缩器策略,任务的关键需求或中间进度可能在压缩中丢失,这是长会话智能体出错的常见来源。
切换场景下共享对话被多个任务的交互撑爆,压缩更频繁且更易丢掉焦点任务状态;RCM 在压缩时还专门指示保留各任务未完成信息,理解压缩机制才能看懂这一设计。
匹配对照实验设计
指除目标变量外其他条件全部相同的成对实验。本文为每个焦点任务构造 $S_{base}$ 与 $S_{switch}$ 两条调度,保证投影等式 $\pi_A S_{switch}(A) = S_{base}(A)$ 成立,即焦点消息的载荷与顺序逐字一致,从而把解决率之差 $\mathrm{Gap} = \mathrm{Res}^{unint} - \mathrm{Res}^{switch}$ 干净地归因于插入的干扰工作。
gap 是全文核心指标,其说服力完全建立在匹配设计上;理解投影等式才能明白为什么平均 11.5 个百分点的下降确属任务切换所致。
研究动机
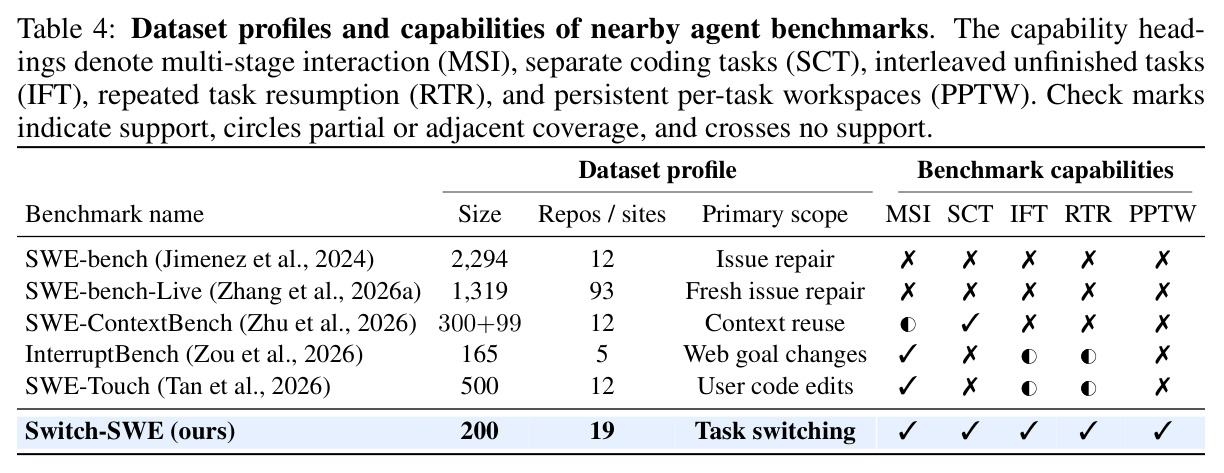
现有仓库级编码基准都以“单 issue → 单补丁”的 episode 为评测单元:SWE-bench(2,294 题、12 仓库)及其衍生 SWE-bench-Live(1,319 题)、SWE-Touch(500 题,测用户对活跃代码的编辑)、SWE-ContextBench(300+99 题,测相关任务经验复用)、InterruptBench(165 题,网页导航中的目标变更)都没有回答一个问题:当智能体在同一会话里先推进了同仓库其他未完成工作后,还能否可靠恢复并完成最初的焦点任务。真实使用恰恰相反——开发者常在一个会话里同时挂多个请求,功能开发到一半被插入的 bug 或评审打断,之后才回到原任务。最接近的已有工作也有本质区别:ContinuityBench 研究从保存的环境状态恢复被中断的智能体,Handoff Debt 测另一个智能体接手未完成任务的再发现成本,SWE-Together/SWE-INTERACT 关注需求随交互逐步展开。“同一智能体、同一会话、多个未完成编码任务、反复挂起-恢复”这一设定此前是空白,切换造成多大损失、以何种失败模式出现,均缺乏量化证据。
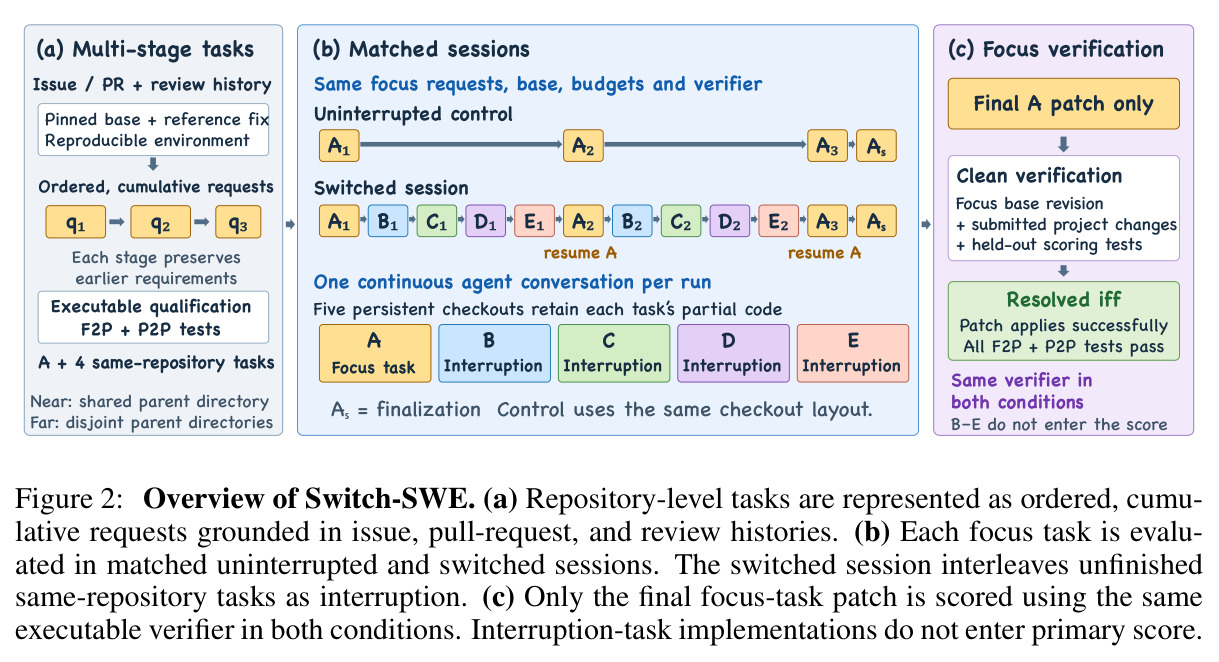
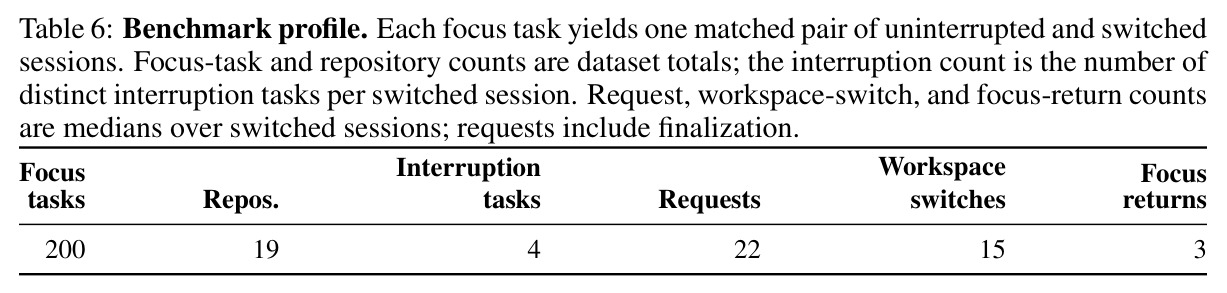
本文的目标是本文要为“同仓库多未完成任务的焦点恢复”建立可控、可复现的度量,目标分三层。第一层是设置:定义匹配会话评测——每个焦点任务 A 生成不间断对照 $S_{base}(A) = (A_1, \dots, A_{k_A}, A_{submit})$ 和插入四个同仓库未完成任务的切换调度 $S_{switch}(A)$,两者焦点需求、基线版本、checkout 布局、阶段预算与验证器完全一致,只对最终焦点补丁打分,以 $\mathrm{Gap} = \mathrm{Res}^{unint} - \mathrm{Res}^{switch}$ 度量切换损失。第二层是基准:从 19 个 Python 仓库构建 200 个多阶段焦点任务(100 near + 100 far),每个任务带从真实 issue/PR/评审历史重建的累积需求序列和可执行 F2P/P2P 验证器,形成 400 份会话规格。第三层是诊断与方法:在 7 个模型-harness 配置上量化 gap、成本与失败模式,分析轨迹中的恢复行为,并给出能收窄 gap 的即插即用上下文管理器 RCM。
与已有工作不同的是,本文的独特切入有三点。其一,评测单元从 episode 升级为同仓库会话:五个任务各自持有持久 checkout,切换只改变活动工作区而不动其他任务的文件,磁盘层面不存在覆盖冲突,因此共享对话成为唯一的跨任务状态通道——这把被测变量干净地隔离为“会话级上下文恢复”,而非环境破坏或代码合并冲突。其二,匹配投影设计 $\pi_A S_{switch}(A) = S_{base}(A)$ 对所有焦点消息载荷与顺序成立(包括 finalization),使平均 11.5 个百分点的 gap 有严格归因。其三,干扰不是随机的:干扰任务与焦点任务来自同一仓库且源文件不相交,再按是否共享直接父目录切成 near/far 两层,首次让“干扰代码的语义距离”成为可测维度。相比 handoff(换人接手)、用户编辑(改当前需求)、状态快照恢复等设定,本文研究的是同一个智能体在连续对话中的自我恢复,填补了能力测评的一块空白。
核心方法
直觉上人在多任务间切换会忘掉旧任务细节,智能体也一样——关键是控制其他因素不变来量化这种“遗忘”。技术路线分四步。第一步,可执行实例:从 SWE-bench 家族与额外 Python 仓库合并 PR 中筛选有固定基线、可追溯 issue/PR 记录、参考修复与可复现环境的候选,把参考改动拆成实现/测试补丁,验证至少一个 F2P 与稳定的 P2P 回归保护。第二步,需求重建:每个任务表示为 $t = (R_t, Q_t, V_t)$(基线快照、有序请求序列、可执行验证器),首阶段取自 issue 正文或 PR 描述,后续阶段按时间取自合并前的实质评审轮次。第三步,会话装配:为焦点任务 A 生成不间断调度 $S_{base}(A) = (A_1, \dots, A_{k_A}, A_{submit})$ 与插入四个干扰任务请求块的切换调度$S_{switch}(A) = (A_1, B_1, C_1, D_1, E_1, A_2, \dots, A_{submit})$,保证投影相等 $\pi_A S_{switch}(A) = S_{base}(A)$。第四步,执行与验证:Harbor 统一执行,每请求 900 秒预算,结束后解析焦点补丁、在干净环境应用并跑 held-out 测试,$\mathrm{Resolved}(f) = \mathbb{I}[\mathrm{Apply}(f) = 1 \wedge \bigwedge_{u \in F_f \cup P_f} \mathrm{Pass}(u) = 1]$。
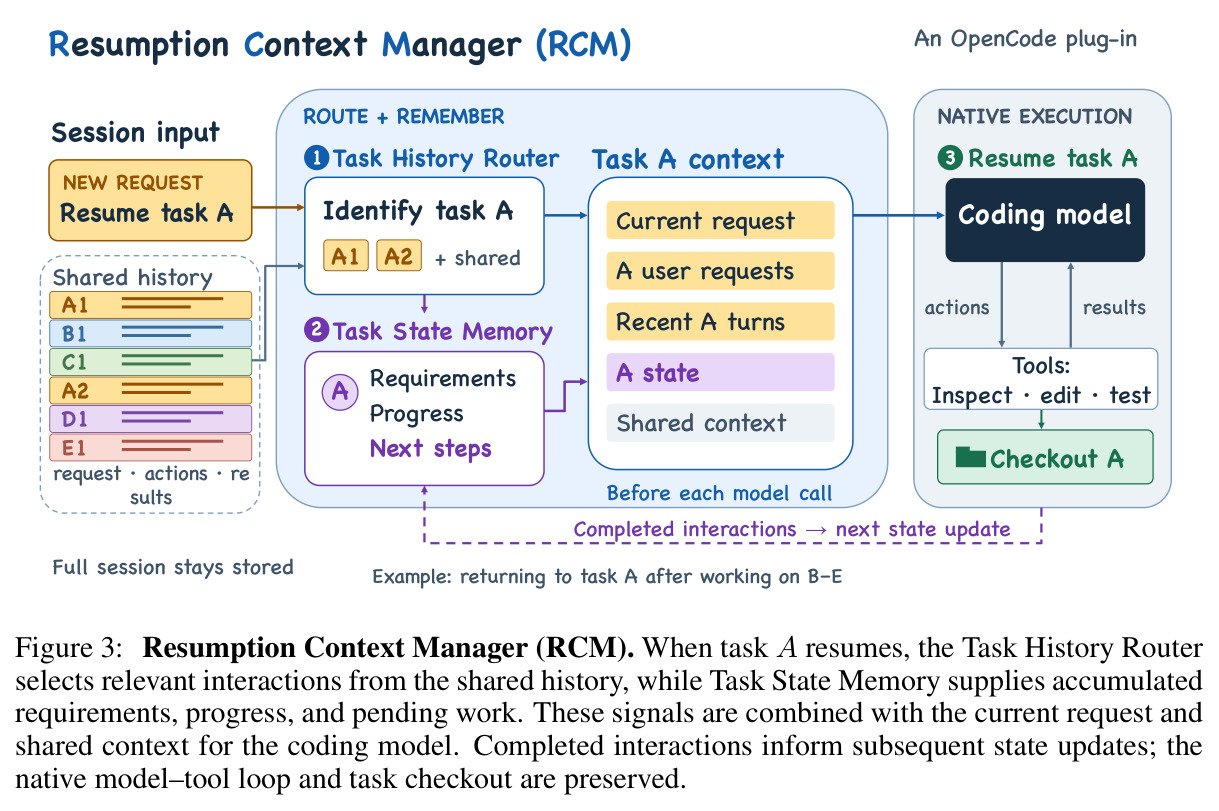
核心创新是“匹配会话 + 持久 checkout + 只评焦点补丁”三位一体的评测设计。与 SWE-bench 单 episode 相比,评测单元变成含 5 个未完成任务的连续会话;与 ChainSWE/SWE-Milestone 的顺序依赖任务相比,这里的任务彼此独立但共享一个对话上下文——干扰不是“上一个任务改变了代码”,而是“别的未完成任务占据了对话历史”。五个角色中立的持久 checkout 保证切换只改变活动工作区、不重置已访问任务的文件,因此磁盘状态无损,唯一的跨任务通道是共享会话;这使 11.5 个百分点的平均解决率下降可以干净归因于会话级上下文恢复失败,而非环境破坏。RCM 的思路与之呼应:既然瓶颈在共享对话,就在模型调用边界处按任务路由历史并维护显式任务状态记忆——上下文 $C_t = \mathrm{Assemble}(q_t, \mathrm{Route}(H_{<t}, Z_t), \{M_z\}_{z \in Z_t})$,其中 $M_z$ 是任务 $z$ 的状态记录,且不改智能体原生工作流与持久 checkout。
方法步骤详情
1) 可执行实例筛选:候选来自 SWE-bench 家族及额外合并 PR,要求可复现基线、可追溯记录、参考修复、固定环境;在基线和参考修复后两状态分别跑指定测试,保留至少 1 个 F2P 且 P2P 无回归的任务。2) 需求重建:首个实质请求取自 issue 标题+正文(无 issue 则 PR 描述);后续请求按时间合并表达同一需求更新的评审评论,剔除自动消息、重复评论与进度报告,只保留脱离参考实现仍可解释的阶段。3) 需求-验证器对齐审计:每个 F2P 行为都要对应规格中陈述的需求或公共契约,映射写入元数据。4) 干扰选择:令 $C_t$ 为参考修复改动的源文件路径集,$D_t = \{\mathrm{parent}(p) : p \in C_t\}$;要求 $C_f \cap C_b = \varnothing$,$D_f \cap D_b \neq \varnothing$ 记 near 否则 far;各选 100 个焦点任务,每个随机配 4 个同仓库干扰任务。5) 调度装配:为每个干扰任务选有序请求前缀并切块插入焦点请求之间,finalization 恒为最后一条,自动校验顺序与路径。6) 打分:每请求 900 秒预算(最多 3 次超时续跑),环境 4 vCPU/16GiB/30GiB;结束解析焦点补丁,干净环境应用并跑 held-out 测试,只有补丁可应用且全部 $F_f \cup P_f$ 测试通过才判解决。
技术新颖性
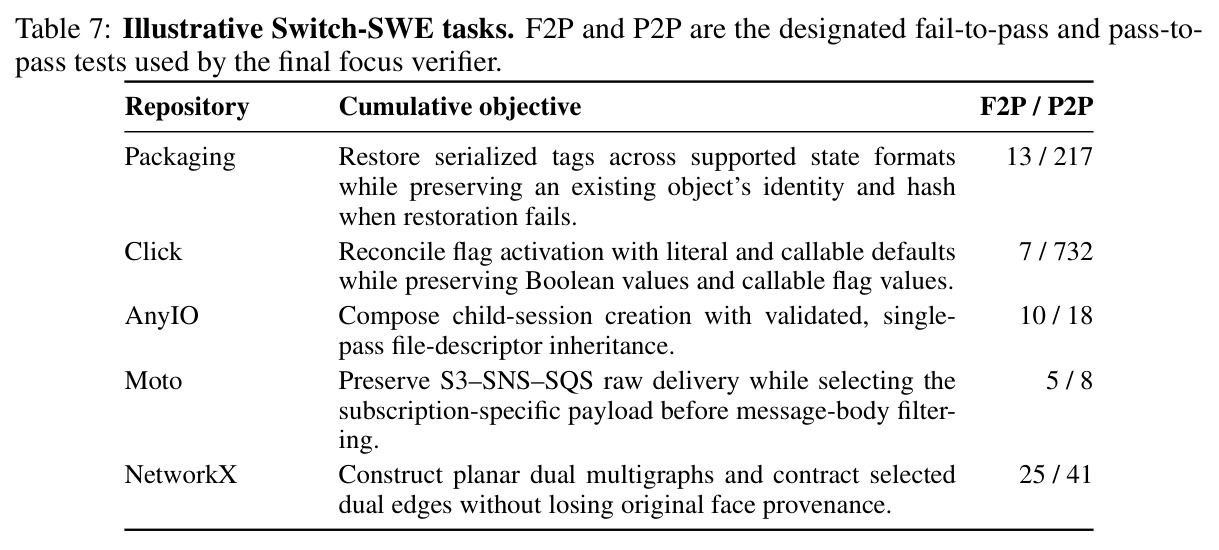
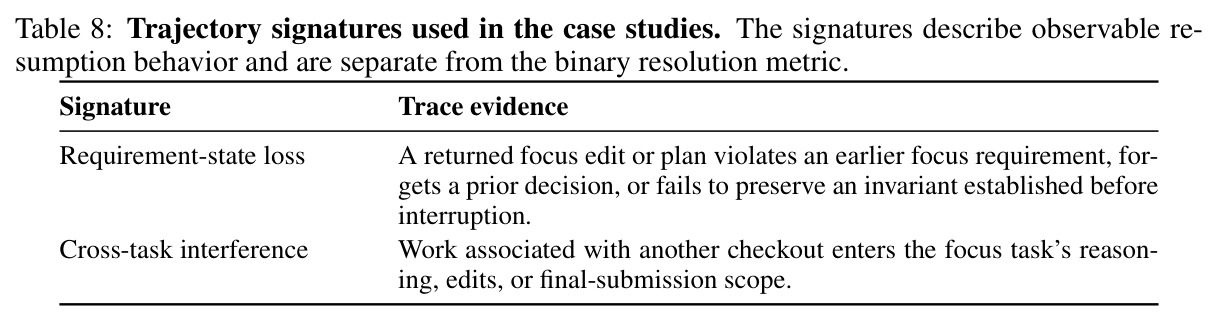
技术新颖性有五点。1) 首个把“同仓库、多未完成、反复挂起-恢复”作为评测单元的仓库级编码基准:Table 4 的能力矩阵中,交错未完成任务(IFT)、重复任务恢复(RTR)、每任务持久工作区(PPTW)三项只有 Switch-SWE 同时具备。2) 匹配投影等式使归因严格:焦点消息逐字相同、验证器相同、checkout 布局相同,gap 只能来自插入的干扰。3) 局部性分层:按共享直接父目录定义 near/far,提供了一个此前无人测量的维度——干扰代码的语义距离。4) 诊断层面提出两条可观察的轨迹签名:requirement-state loss(回到旧任务后的新编辑违反早前需求)与 cross-task interference(其他任务的文件或提交范围混入焦点任务推理),并用 Click、Moto、NetworkX 三个带代码证据的案例佐证。5) 方法上 RCM 是插件式上下文管理,不改原生工具循环,用路由置信度 0.8 阈值做保守回退(低于阈值保留全部历史),且 +Router 与 +RCM 两个消融档位可分离路由与记忆各自的贡献。
实验结果
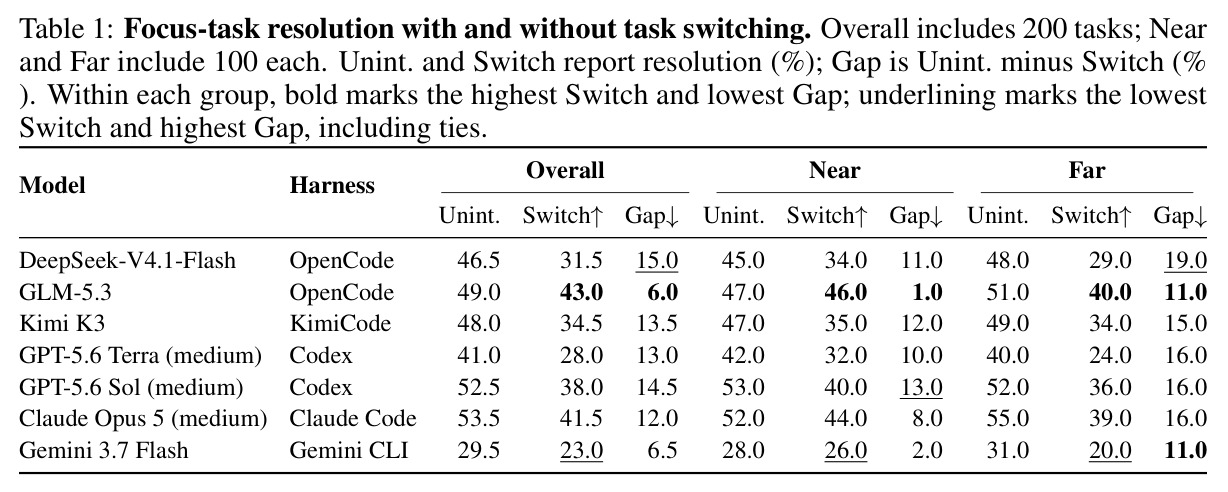
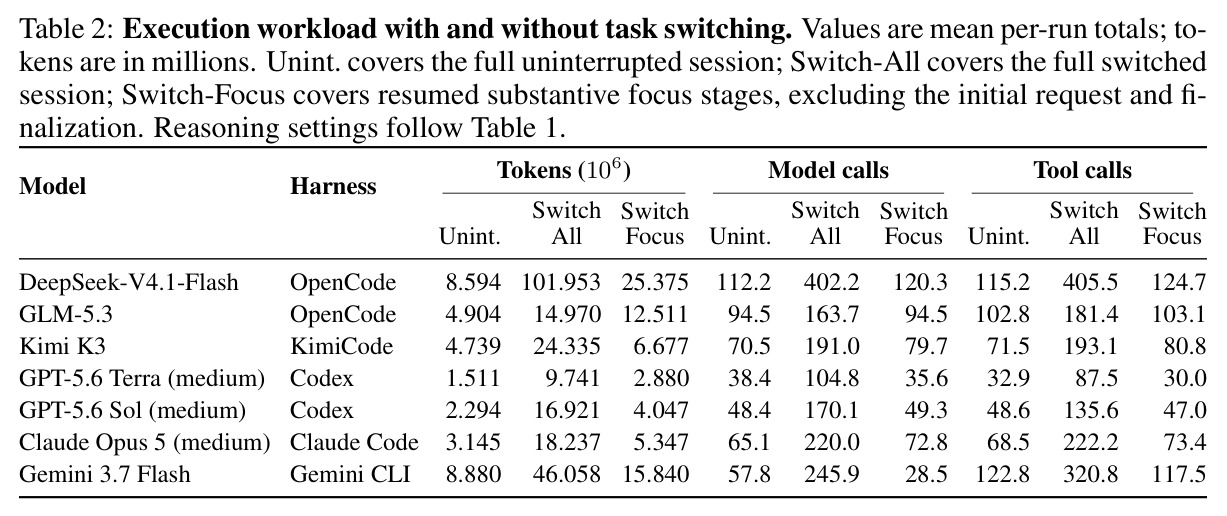
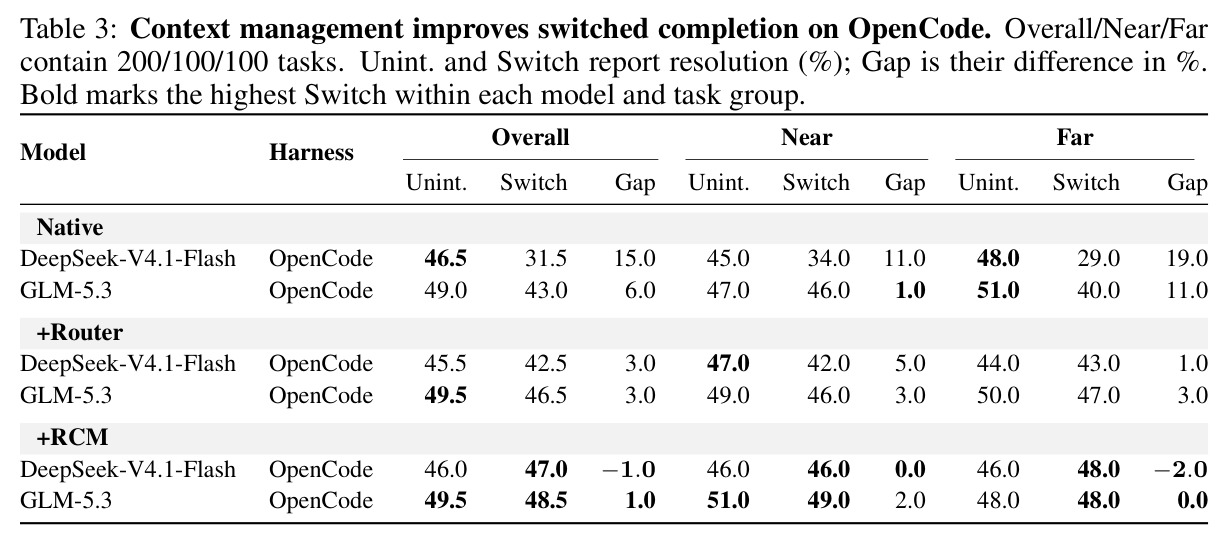
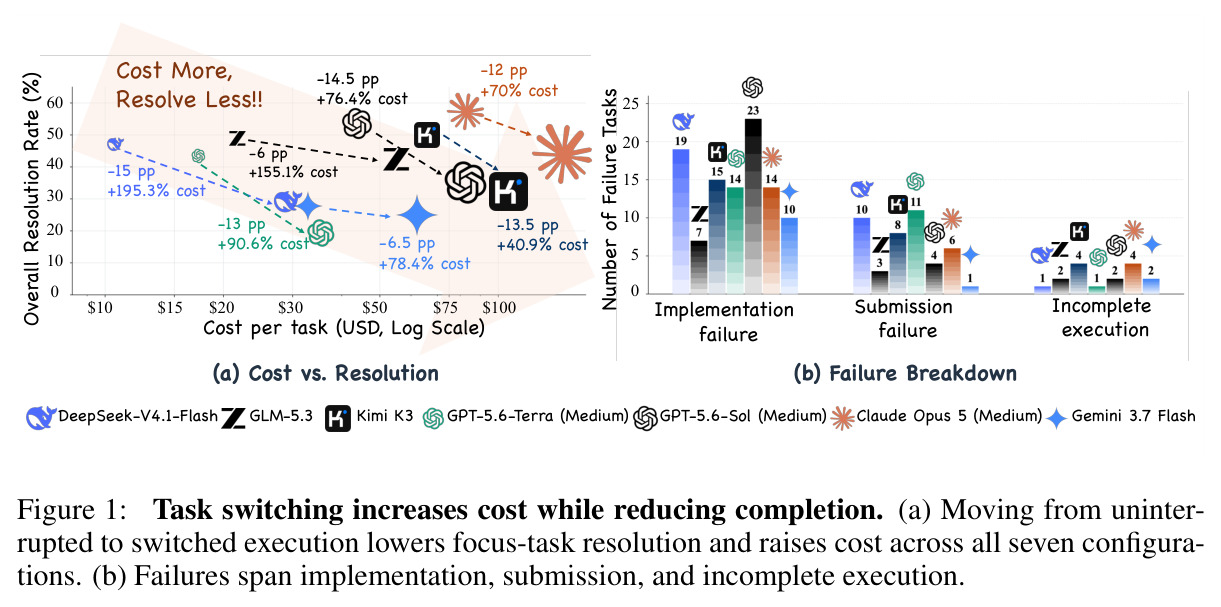
1) 切换一致降低解决率:7 个配置的 gap 全部为正,平均 11.5 个百分点、范围 6.0–15.0。DeepSeek-V4.1-Flash/OpenCode 从 46.5% 跌到 31.5%(相对下降 32.3%),GPT-5.6 Sol 与 Kimi K3 的 gap 分别为 14.5 和 13.5;排名被打乱——Claude Opus 5 不间断最高(53.5%)但切换下最高是 GLM-5.3(43.0%),GLM 与 Kimi 不间断只差 1.0 个点、切换后差 8.5 个点;小 gap 也不等于强,Gemini 3.7 Flash gap 仅 6.5 但切换解决率最低(23.0%)。2) 局部性效应:far 组 gap 一致更大,7/7 配置方向相同,near 平均 8.1%、far 平均 14.9%,组内差 3.0–10.0;GLM-5.3 从 near 的 1.0 涨到 far 的 11.0,且 5 个配置的不间断排序在切换下反转。3) 成本:完整切换会话消耗 4.5–11.1 倍 token、2.4–4.3 倍模型调用(如 DeepSeek 8.594M → 101.953M token);仅恢复后的焦点阶段也消耗不间断会话 1.41–2.95 倍 token;每任务成本上升约 40.9%–195.3%,失败横跨实现、提交与未完成执行。4) RCM:+Router 使 DeepSeek 切换解决率 +11.0(31.5→42.5)、GLM +3.5(43.0→46.5),不间断几乎不变;+RCM 再加 4.5/2.0,最终 DeepSeek 47.0%(gap −1.0,反超不间断)、GLM 48.5%(gap 1.0),增益集中在 far 组,较原生提升 5.5–15.5 个百分点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 焦点任务解决率(Overall,200 任务,DeepSeek-V4.1-Flash/OpenCode) | 解决率 (%) | +RCM 切换会话 47.0 | 原生切换 31.5(不间断 46.5) | +15.5 pp,gap 从 15.0 收窄到 −1.0 |
| 焦点任务解决率(Overall,GLM-5.3/OpenCode) | 解决率 (%) | +RCM 切换会话 48.5 | 原生切换 43.0(不间断 49.0) | +5.5 pp,gap 从 6.0 收窄到 1.0 |
| 任务切换的解决率损失(7 配置平均) | Unint − Switch gap (pp) | 平均 gap 11.5 | 无切换 gap = 0 | 各配置范围 6.0–15.0 pp |
| 干扰局部性对切换损失的影响 | 平均 gap (pp) | Far 组 14.9 | Near 组 8.1 | far 比 near 高 6.8 pp,7/7 配置方向一致 |
| 切换会话算力开销 | 相对不间断的倍数 | 4.5–11.1× token,2.4–4.3× 模型调用 | 1×(不间断会话) | 恢复后焦点阶段仍耗 1.41–2.95× token |
局限与改进
局限可从作者承认和独立观察两方面看。作者明确承认:near/far 两组包含不同的焦点任务,因此局部性结论只是关联而非因果,“结果与邻近工作提供更多可复用上下文的假设一致,但未确立该机制”;token 与调用倍数描述的是焦点加干扰的合并负载,并非切换的孤立成本;聚合用量也无法区分历史重处理与输出差异。本文观察到:1) 每格只跑一次,无重复采样,未报告置信区间,几个任务的翻转即可移动 0.5–1 个点;2) 干扰任务只投递请求前缀、完成质量不评分,智能体理论上可用“敷衍干扰任务、死守焦点任务”的策略压低 gap;3) RCM 只在 OpenCode 的两个模型上验证,泛化到 Claude Code/Codex 等 harness 未知,且辅助调用与编码调用共享执行预算,未单独报告辅助开销;4) 调度模板固定(如三阶段焦点任务一种交错模式),未扫描干扰密度等变量;5) 验证器沿用 SWE-bench 的 F2P/P2P 协议,补丁可能“通过指定测试但并非真正修复”;6) 仅覆盖 Python、19 个仓库。
独立分析的弱点
独立分析出以下弱点,均给出改进方向。1) 单次运行无方差:智能体输出有随机性,11.5 pp 的 gap 缺乏统计稳定性证据,建议每格至少 3 次采样并报告均值与置信区间。2) 干扰无质量约束:干扰任务的实现不进入评分,模型可能学会“应付干扰、专注焦点”来刷低 gap,这与真实用户期望相悖,建议给干扰任务设最低完成质量阈值并同时报告干扰完成率。3) 交互模式单一:请求由固定控制器按预排调度投递,没有用户追问、优先级变更或需求撤回,与真实多任务会话仍有距离,可加入用户澄清与动态调度。4) RCM 的路由阈值 0.8 是手调超参,路由错误可能引入新的上下文污染,建议报告路由准确率并做阈值敏感性分析。5) token 计费口径敏感:附录 B.5 说明同一上下文重复处理每次都计入,且含缓存输入,成本结论对口径敏感,建议同时报告去缓存口径。6) 局部性只是二元分层,共享父目录是粗糙代理,可能混入大量无关的“近邻”干扰。7) 基准只含 Python 且每任务一次提交时点,无法测多次迭代提交下的恢复行为。
未来方向
作者方向:将 RCM 从 OpenCode 推广到其他 harness,并持续扩大基准的语言与规模覆盖。基于成果可延伸的方向包括:1) 把 near/far 二元局部性做成连续变量(目录路径距离、import 依赖图距离),量化干扰“语义距离”的剂量效应;2) 干扰密度扫描——每个焦点配 1/2/4/8 个干扰任务的 scaling 曲线,找到恢复能力崩溃的临界点;3) 主动澄清式恢复:允许智能体在回归焦点任务时向用户确认状态(interactive resumption),测提问能否替代长历史检索;4) 对比“对话内任务记忆”(RCM)与“磁盘内任务记忆”(如每 checkout 写 NOTES.md)哪种恢复更可靠,成本更低;5) 把 Table 8 的两条轨迹签名自动化为失败分类器,大规模诊断商业智能体的切换失败模式;6) 训练侧:用多任务交错 rollout 做数据增广或把恢复成功率作为 RL 奖励信号,直接优化任务恢复能力;7) 将干扰从同仓库扩展到跨仓库、加入只读的评审/文档类干扰,逼近真实工作流。
复现评估
可复现性总体较好。代码与数据计划开源在 github.com/Miraclecsc/Switch-SWE,论文承诺公开发布基准数据与代码。数据全部来自公开来源(SWE-bench 家族与 GitHub 公开 issue/PR/评审),manifest 记录源 ID、基线 revision、清洗后请求、环境 recipe、测试 ID、验证结果与调度种子,任务选择与调度在评测前固定并随规格发布;执行层用 Harbor 容器(4 vCPU/16GiB RAM/30GiB disk),每请求 900 秒预算,harness 版本固定。主要门槛是算力:200 焦点任务 × 2 条件 × 7 配置 = 2800 个会话,外加 RCM 实验;切换会话平均消耗 9.7–102M token,Figure 1 显示单任务成本在 $10–$100 量级,全量复跑需数千至上万美元。最大难点不在跑评测而在重建任务管线:需求清洗、审计、需求-验证器对齐涉及大量人工判断,复用已发布数据跑评测则相当直接。总体难度中等偏高,卡点在预算而非技术。
论文图表