WideSWE:评测编码智能体跨仓库协同变更能力的基准 WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
首个跨仓库协同编码基准:120个真实任务,最强智能体组合仅解出42.5%
前置知识
F2P / P2P 测试
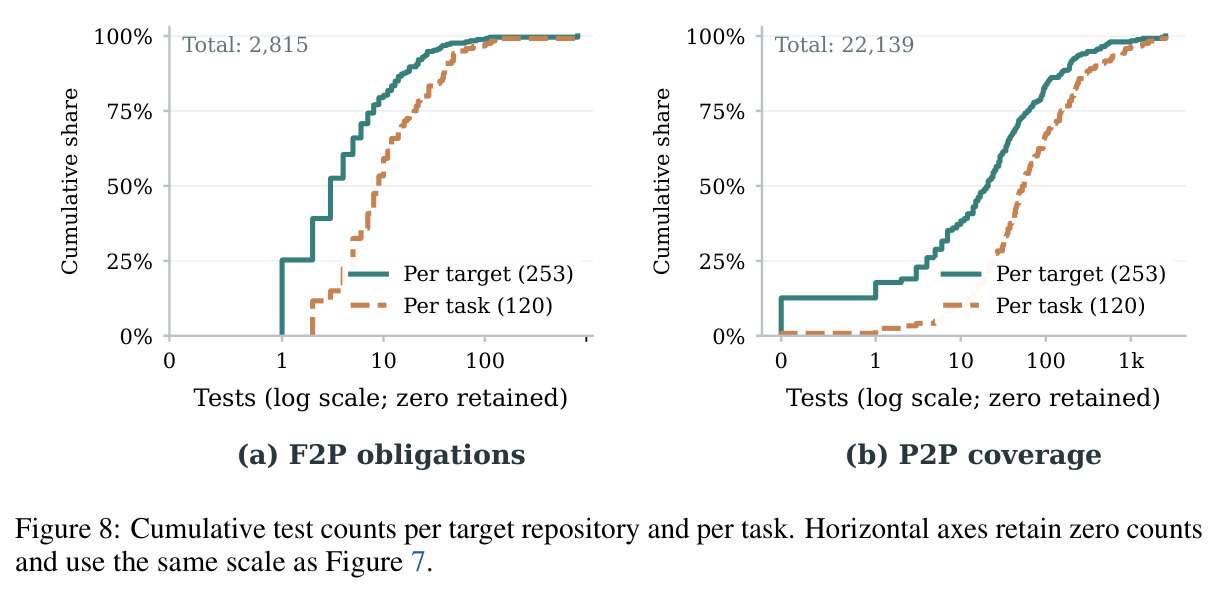
SWE-bench 式评测的验收标准。F2P(fail-to-pass)测试在原始代码上失败、在参考改动(Gold patch)合入后通过,用来验证需求确实被实现;P2P(pass-to-pass)测试在改动前后都通过,用来防止回归。WideSWE 的 120 个任务共含 2,815 个 F2P 和 22,139 个 P2P 测试,隐藏测试由评测器在干净 Base 快照上独立注入,智能体拿不到,也不能靠改测试文件作弊。
本文的任务成功定义(所有目标仓库的 F2P 全过且 P2P 全保)、仓库级指标和失败归因分析全部建立在这两类测试之上,不理解 F2P/P2P 就无法读懂 42.50% 这类数字的真正含义。
智能体脚手架(scaffold)
包裹大语言模型的工程框架,负责把模型接入真实仓库:提供文件读写、shell 执行、测试运行等工具接口,并管理多轮交互循环、上下文和权限。本文评测两种脚手架——Codex CLI v0.147.0 和 Claude Code v2.1.139,同一模型 GPT-5.6-sol 换脚手架后任务成功率从 42.50% 掉到 32.50%,平均 API 请求反而从 86.7 涨到 134.8。
论文评测的 7 种配置都是「脚手架 × 模型 × 推理强度」的组合,分清脚手架与模型各自的贡献是正确解读实验表格的前提。
软件生态(software ecosystem)
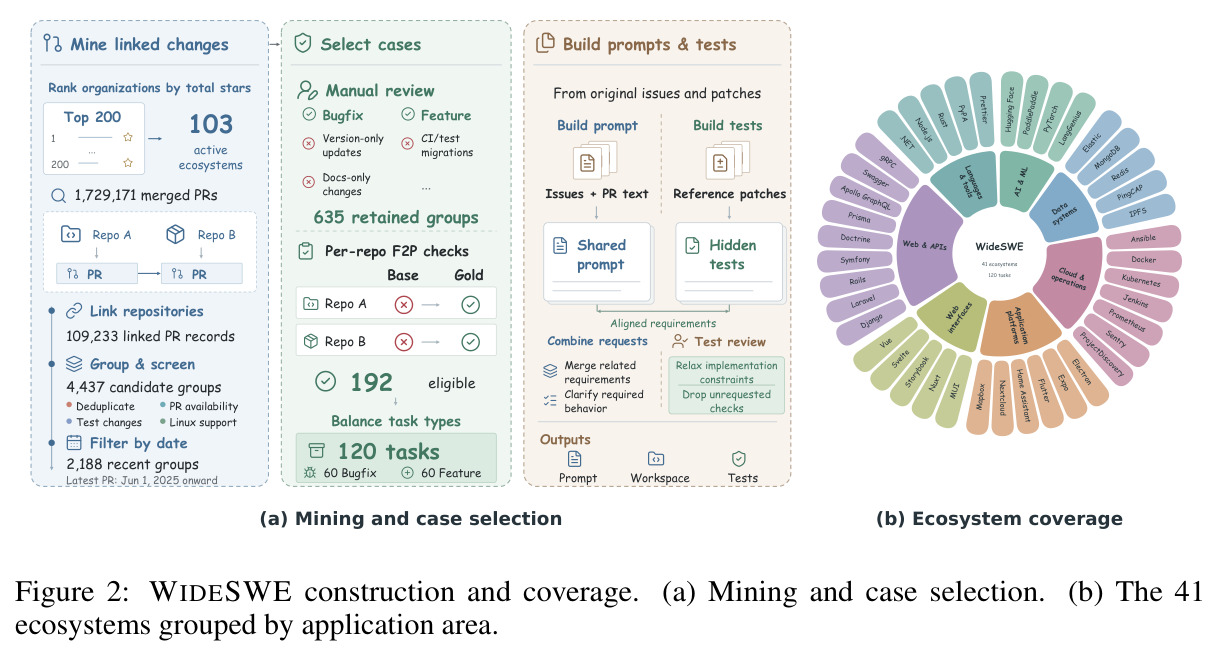
围绕同一产品、平台或技术协同演进的一组仓库,例如 Sentry 的 Go/Python/Ruby 三个语言 SDK(平行实现同一功能)、Kubernetes 与 kube-openapi(生产者—消费者依赖)。生态内改一个接口往往要在多个仓库同步落地。作者从 star 数前 200 的 GitHub 组织中筛出 103 个这样的活跃生态。
WideSWE 的 120 个任务全部从这些生态中挖掘而来,理解生态结构才能明白「跨仓库协同」不是人为构造的难题,而是真实且高频(约 6.3% 的 PR 涉及跨仓库链接)的日常工程活动。
历史工作区快照(historical workspace)
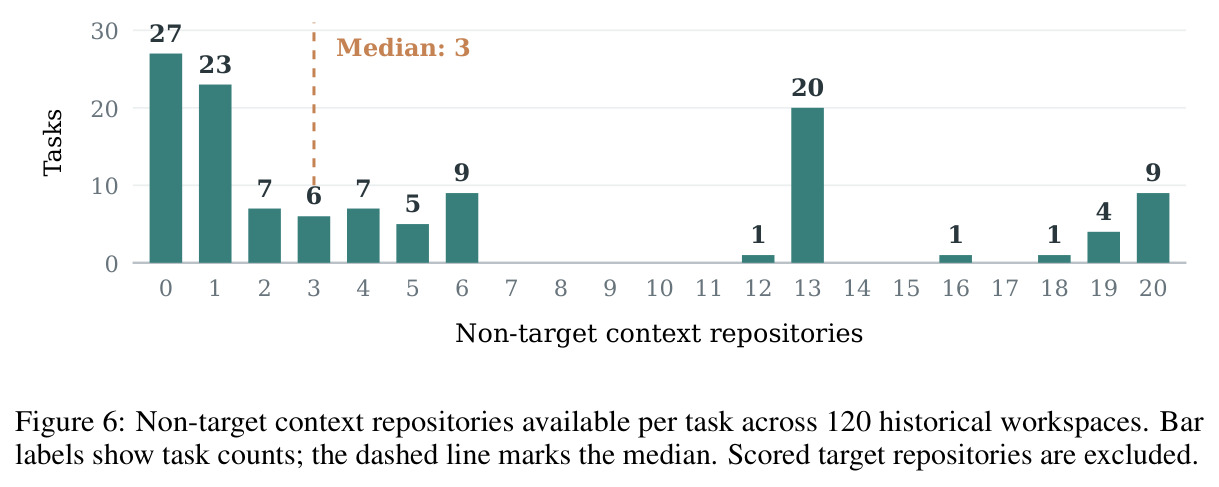
每个任务提供给智能体的完整代码环境:目标仓库固定在对应 PR 的 base commit,上下文仓库(每任务最多 20 个,中位数 3 个,27 个任务没有)使用不晚于最早目标 base 的快照以防未来信息泄露。智能体可以自由浏览并修改其中任何仓库,评分只看目标仓库。任务形式化为 $\Delta_c = \mathcal{A}(p_c, W_c)$。
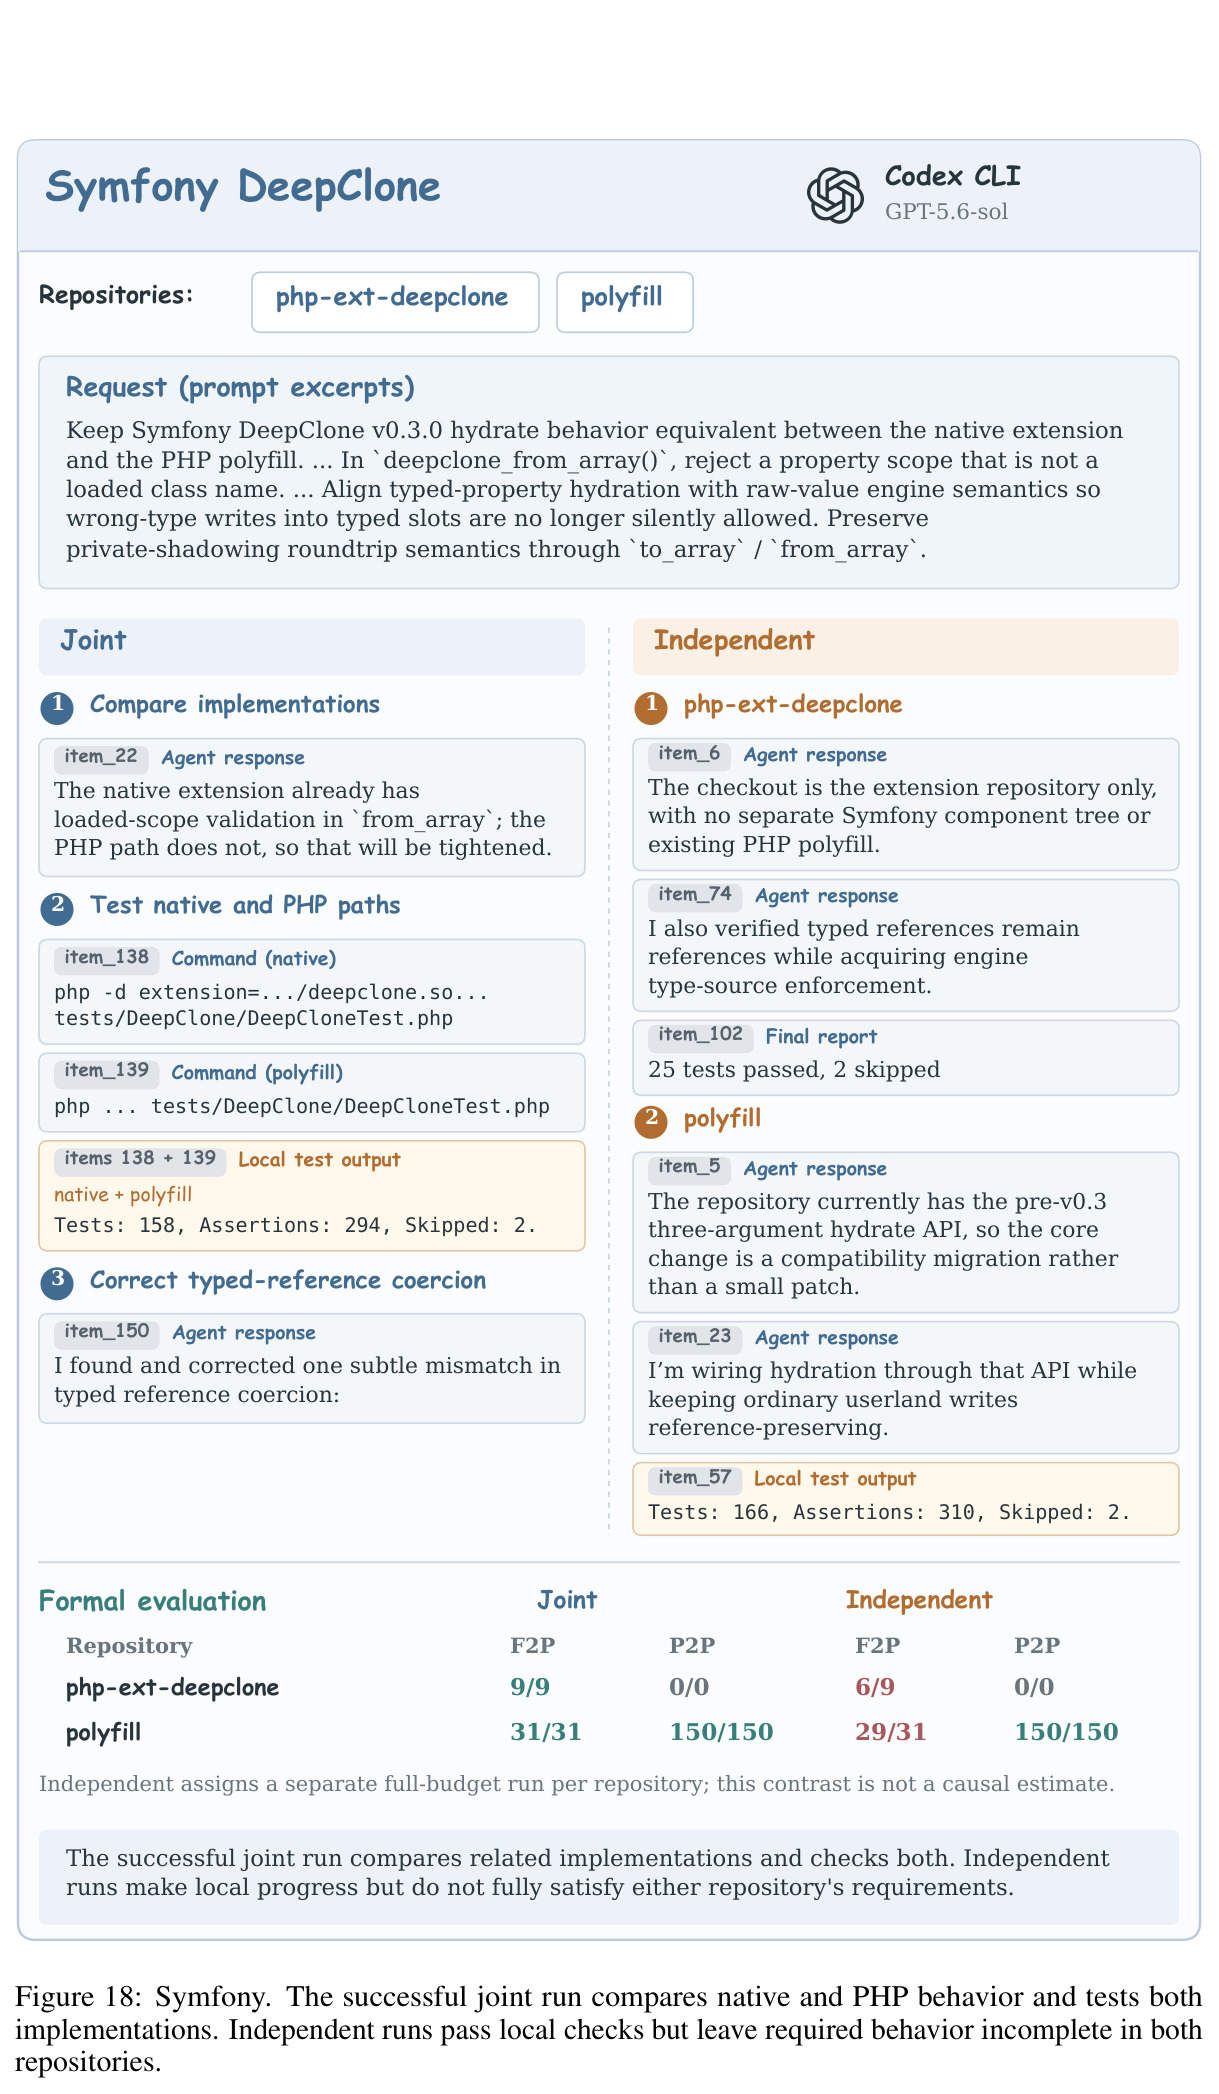
联合执行与独立执行的本质区别就在于单次运行暴露多少仓库,而上下文仓库是否能帮上忙(Ansible、Symfony 案例)直接支撑了论文的核心结论。
联合执行 vs 独立执行
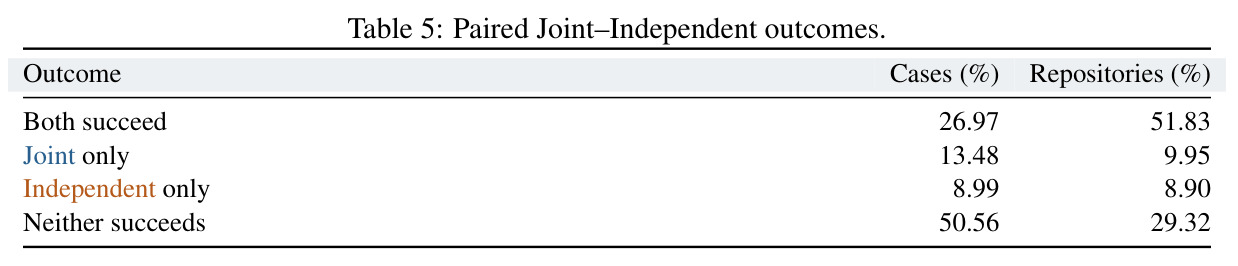
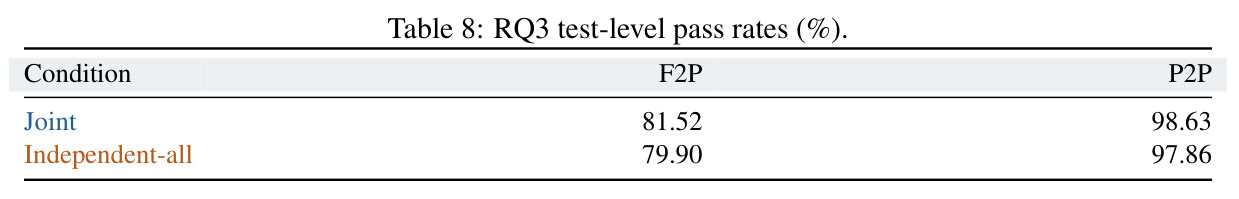
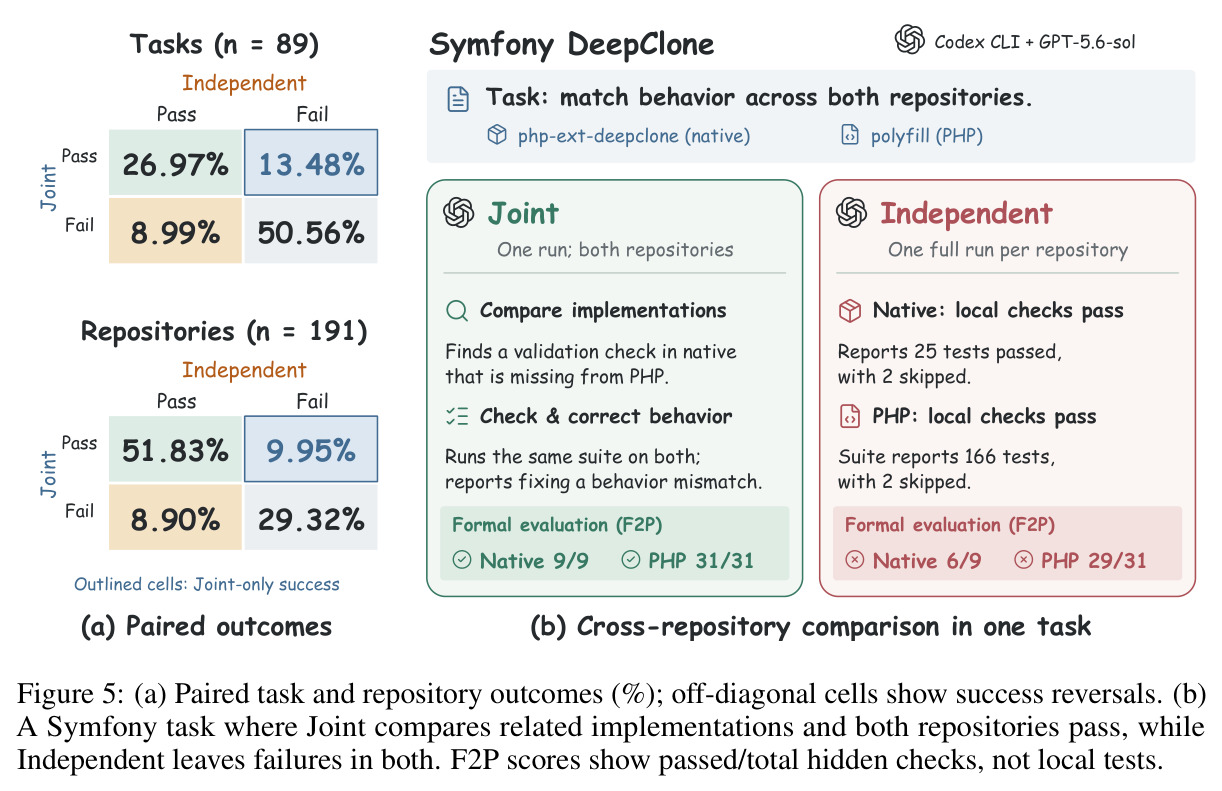
两种任务运行策略:联合执行(Joint)让一次智能体运行看到整个生态工作区并自主决定改哪些仓库;独立执行(Independent)沿用单仓库基准惯例,为每个目标仓库各分配一次拥有完整预算的独立运行,且要求所有仓库的运行都成功才算任务成功。作者在 89 个提示完全等价的案例上做了配对比较。
这是 RQ3 的核心对照实验,回答「把跨仓库任务拆成单仓库任务能否降低难度」。结论很有实用价值:独立执行能救回被遗漏的工作(bug 修复 34.48%→44.83%),却会丢掉跨仓库的实现事实与行为参照,对 feature 反而有害(43.33%→31.67%)。
研究动机
现有编码智能体评测几乎都在单一仓库内闭环:SWE-bench 给一个 GitHub issue、在一个代码库里改代码跑测试;Multi-SWE-bench、SWE-bench Multilingual 扩展了语言,SWE-Bench Pro、DeepSWE、SWE-EVO 扩展了任务长度,但评分范围仍是一个仓库。而真实软件生态中,一个功能或修复经常需要跨仓库协同:作者统计了 103 个软件生态自 2024 年 1 月以来合并的 1,729,171 个 PR,其中 109,233 个(约 6.3%)显式引用了同一生态的其他仓库。典型场景如给 Sentry 的 Go/Python/Ruby 三个语言 SDK 加同一特性需要三份独立实现;Sentry PHP SDK 的能力更新还要求两个下游依赖仓库同步适配。智能体在这种任务上的表现此前完全未知——它们可能只改一个仓库就宣布完成,也可能每个仓库都动了但行为仍不满足要求,单仓库评测根本无法暴露这类「协同失败」。
本文的目标是本文要把「用一个共享需求驱动多个仓库的协同变更」变成可执行的评测任务,并系统量化智能体的跨仓库协同能力。具体目标分三层:其一,构建 WideSWE 基准——从 star 数前 200 的 GitHub 组织出发筛出 103 个活跃生态,挖掘带跨仓库链接的合并 PR,经人工审查与可执行验证得到 120 个真实任务(60 个 bug 修复 + 60 个 feature),覆盖 41 个生态、253 个目标仓库、2,815 个 F2P 与 22,139 个 P2P 测试;其二,用 7 种智能体配置(Codex CLI / Claude Code 两种脚手架搭配 GPT-5.6-sol、Claude Opus 5、Gemini 3.8 Flash、DeepSeek V4 Pro、Qwen 3.8 Max、GLM 5.3)评测任务完成率,并分析任务类型、仓库数量、语言多样性的影响;其三,通过联合执行与独立执行的配对实验回答「逐仓库拆分能否缓解困难」。
与已有工作不同的是,本文的独特切入点是把「协同」本身作为被测能力,而不是背景噪声。已有工作的扩展方向都是「单仓库内更深更广」:扩语言、扩长程、扩到从可执行文件重建程序,评分对象始终是单个仓库。与本文最接近的 BeyondSWE CrossRepo 允许智能体参考外部仓库的代码与方案来修复目标仓库,但只对一个仓库计分;WideSWE 的关键差别在于所有目标仓库都必须完成同一个共享需求并通过各自的隐藏测试才算成功——相关仓库既是可以参考的上下文,也是必须交付变更并接受验证的评分对象。此外,作者在构建中发现从参考 PR 继承的测试常包含超出任务需求的实现细节约束(DeepSWE 也报告过类似现象但未系统解决),因此提出「需求对齐的测试审查」这一构建环节,用两条可操作的修订规则处理需求与测试的错配,这在跨仓库场景下尤为关键。
核心方法
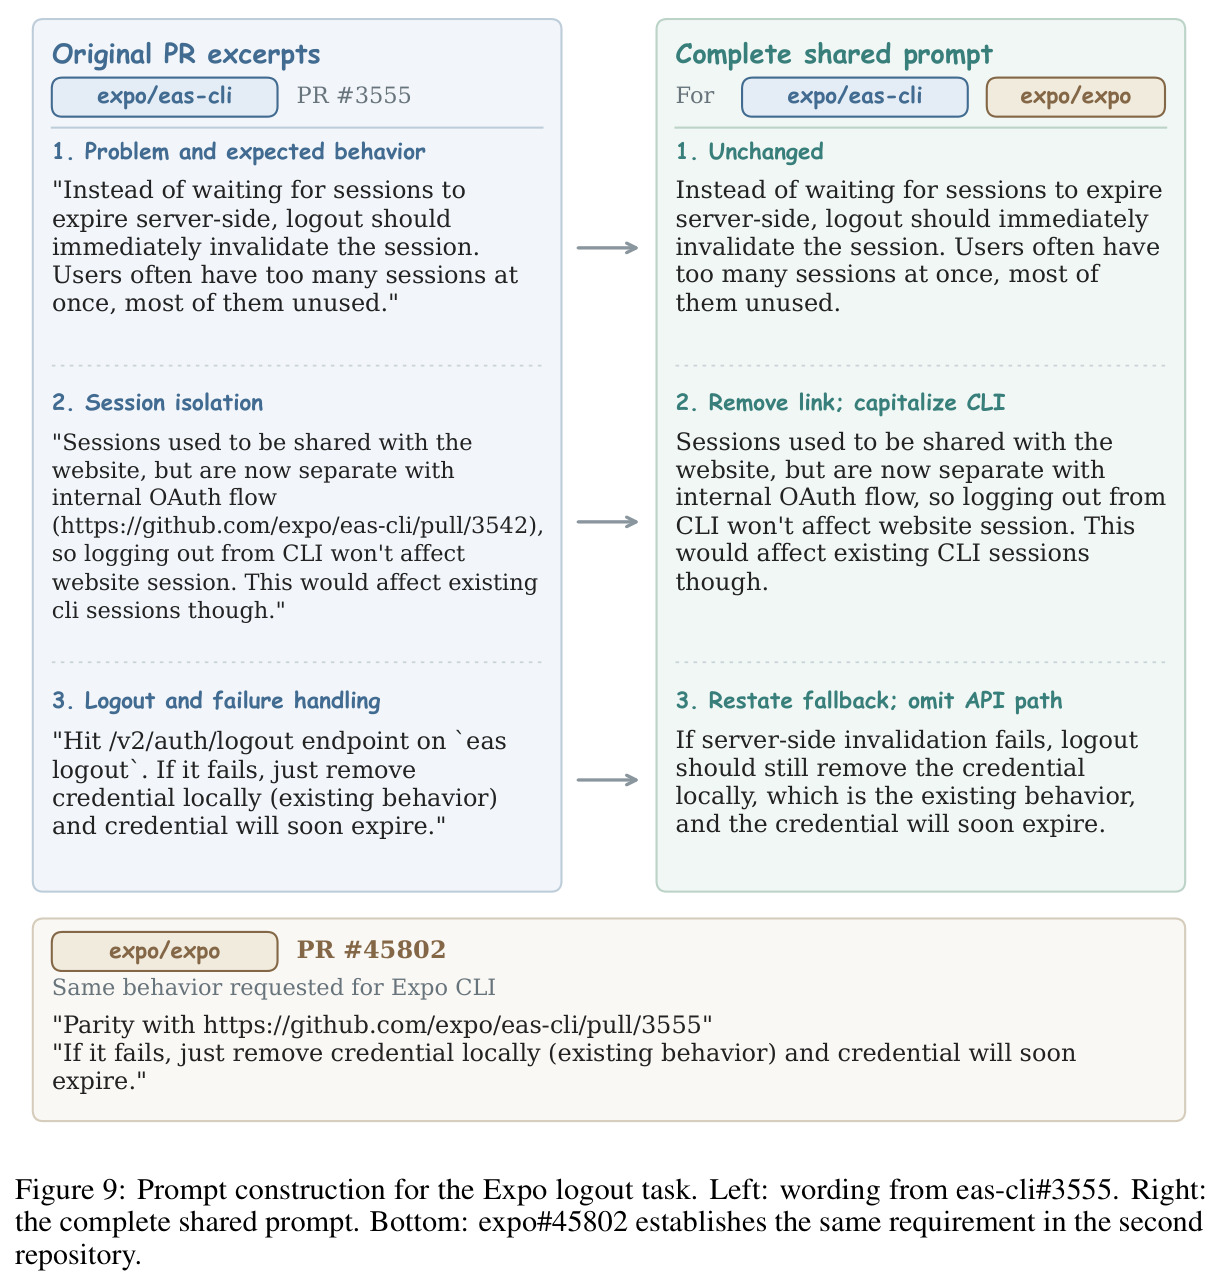
直觉上,WideSWE 把「一次功能开发或缺陷修复在真实世界中产生的完整涟漪」打包成一个任务:给智能体一个包含目标仓库与上下文仓库(最多 20 个,中位数 3 个)的历史工作区快照,加上从原始 issue 和 PR 合并改写的需求提示 $p_c$,让它自由检查和修改任何仓库,产出补丁集合 $\Delta_c = \mathcal{A}(p_c, W_c)$,应用后得到新工作区 $W'_c = W_c \oplus \Delta_c$。评分时对每个目标仓库 $r \in T_c$($|T_c| \geq 2$)检查 F2P 与 P2P 测试,任务成功要求全部目标仓库同时通过:$$\text{Success}(c) = \prod_{r \in T_c} y_{c,r}(W'_c)$$ 其中 $y_{c,r}=1$ 当且仅当该仓库所有 F2P 与 P2P 测试通过且无缺失或无效结果。技术路线分四步:生态与变更挖掘(1,729,171 个 PR → 109,233 个跨仓库链接记录 → 4,437 个候选组)、案例筛选(时间过滤 + 人工审查 + 可执行验证 → 192 个合格 → 平衡为 120 个)、提示与隐藏测试构建(保留 issue/PR 原话;两规则审查测试)、评测协议(统一权限、超时与资源限制,报告 Case/Repo/F2P/P2P/API 五类指标)。
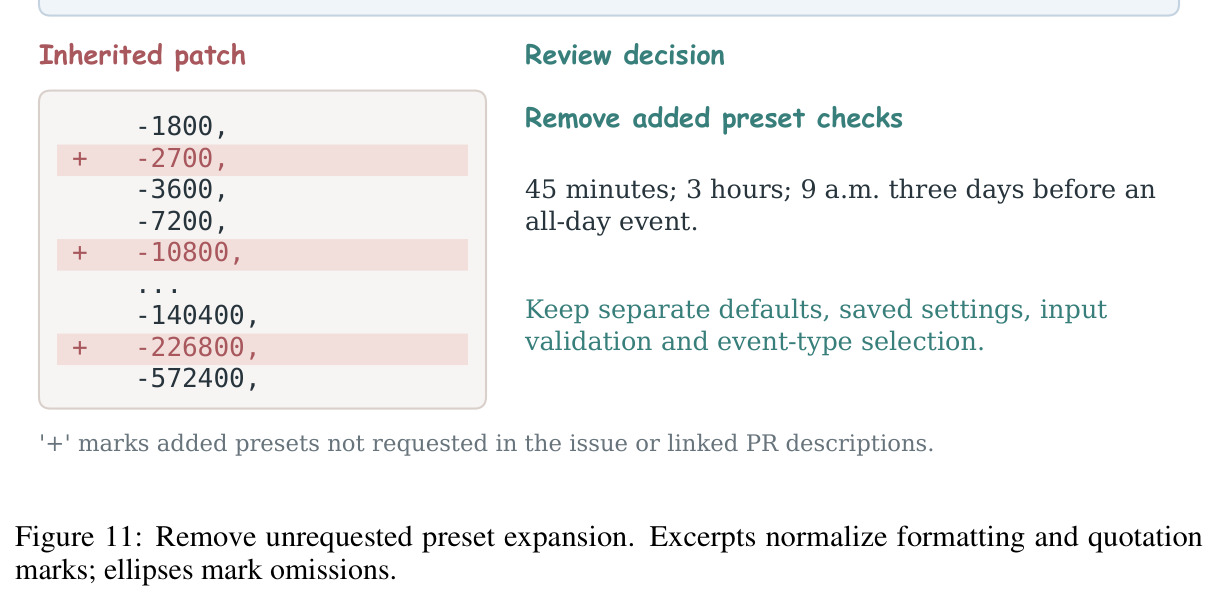
核心创新是「全有或全无」的联合评分,加上需求对齐的测试审查。与单仓库基准把每个仓库当作独立任务不同,WideSWE 把共享需求本身作为评测单元:只要有一个目标仓库没改对,整个任务记为失败,这直接度量了协同能力而非局部编码能力。第二个关键是测试审查:作者发现参考 PR 自带的测试经常强制执行任务并未要求的选择。例如 TensorDict 任务只要求「非法 generator 抛 TypeError」,继承测试却额外要求错误消息必须包含 "generator must be";Nextcloud 任务的继承测试还检查了三个 issue 里根本没提的三个提醒预设值(-2700、-10800、-226800)。作者用两条规则修订隐藏测试:放宽实现特定约束(保留异常类型、删除消息措辞限制)、删除未请求的功能检查(保留必要行为),共影响 88/120 个任务(87 个放宽、16 个删除、15 个两者兼有),修订后仍验证 Base 失败、Gold 通过,从而在保留必要行为的同时允许多种正确实现。
方法步骤详情
完整流水线如下。第一步,生态与变更挖掘:从 Gitstar Ranking star 数前 200 的组织选出 103 个活跃生态(要求至少两个非归档仓库、近 24 个月有活动),收集 2024-01-01 之后合并的 PR 并识别显式跨仓库链接,得 109,233 条链接记录;按「生态+源仓库+源 PR+涉及仓库集合」去重,过滤仅版本号/仅文档更新、测试类变更和 Linux 不兼容项,剩 4,437 个候选组。第二步,案例筛选:保留最新 PR 合并于 2025-06-01 之后的 2,188 组,人工审查确认「同一 feature/fix 且多仓库实质变更」后保留 635 组,可执行验证加终审得 192 个合格案例(每个目标仓库至少一个 F2P),最终保留全部 60 个 bug 修复、并从 132 个 feature 中按行为多样性选出 60 个(含全部 13 个三仓库案例),得 120 个任务。第三步,工作区与提示构建:目标仓库用对应 PR 的 base commit,上下文仓库快照不晚于最早目标 base 以防未来信息泄露;提示尽量保留 issue/PR 原文(如 Expo logout 任务三段中第一段原封不动),合并相关需求但不添加实现指导,由一人撰写、两人独立对照原始材料复核。第四步,测试审查与评测:按两规则修订隐藏测试;评测器在干净 Base 上独立注入测试以避免与智能体对公开测试文件的修改冲突。第五步,实验:7 种配置统一权限与超时;RQ3 在 89 个提示完全等价的案例上配对比较联合执行(一个 run 看全部仓库)与独立执行(每个目标仓库一个完整 run)。
技术新颖性
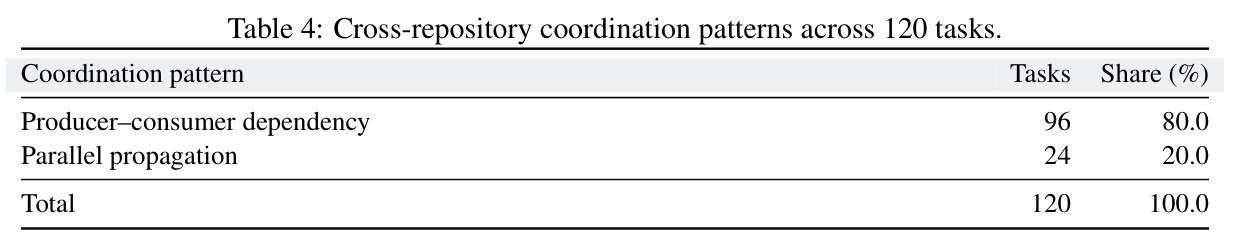
新颖性体现在三个层面。第一,任务形式化:首次把「跨仓库协同完成」作为被测能力,$T_c \subseteq R_c$ 且 $|T_c| \geq 2$,上下文仓库可看可改但不计分,这把 SWE-bench 式的「仓库内定位与修复」扩展为「生态级范围识别 + 多点交付 + 一致性保持」三重能力,任务级语义上还区分了生产者—消费者依赖(96 个任务,80%)与平行传播(24 个,20%)两种协同模式。第二,构建方法论:提出需求对齐的测试审查,识别「需求—测试错配」并给出两条可操作的修订规则,且修订流程有一人提议、两人独立评审、分歧讨论解决的质控(修订后验证 Base 失败/Gold 通过),对所有从真实 PR 继承测试的基准都有借鉴价值。第三,实验设计:用 89 个提示等价案例做联合/独立配对比较,把「拆分任务能否降低难度」变成受控对照;再配合两阶段失败标注协议(先看各仓库最终 diff 判断是否「改后失败」,再查轨迹区分「范围识别不全」与「识别了未交付」),标注者间一致性 91.2%、Cohen's $\kappa = 0.86$,使失败归因有据可查。
实验结果
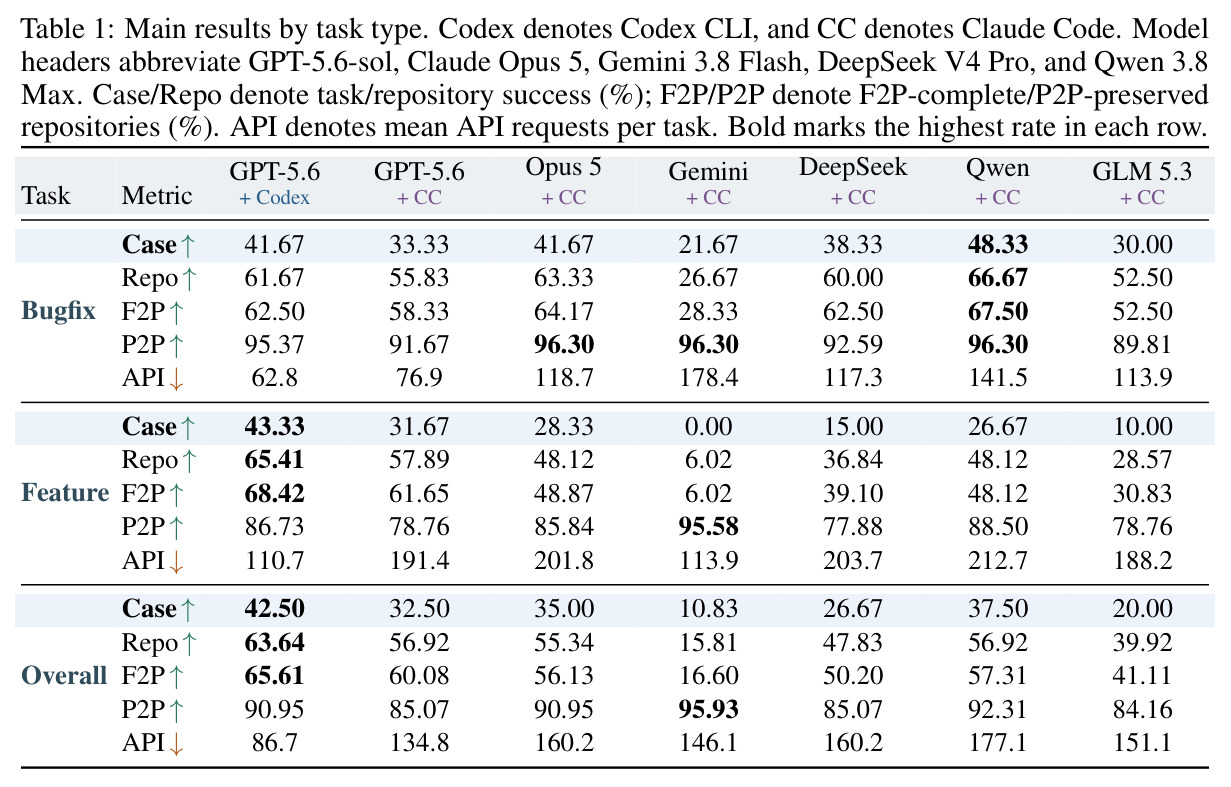
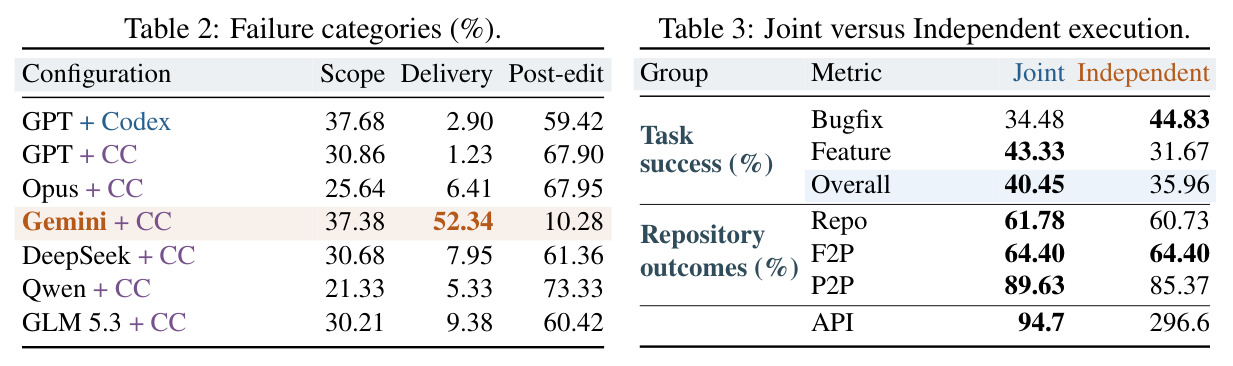
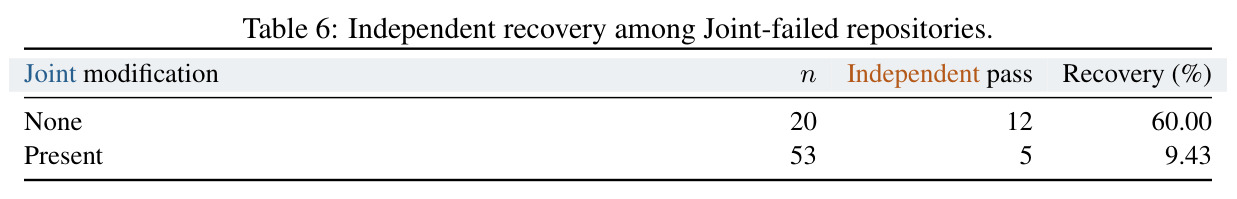
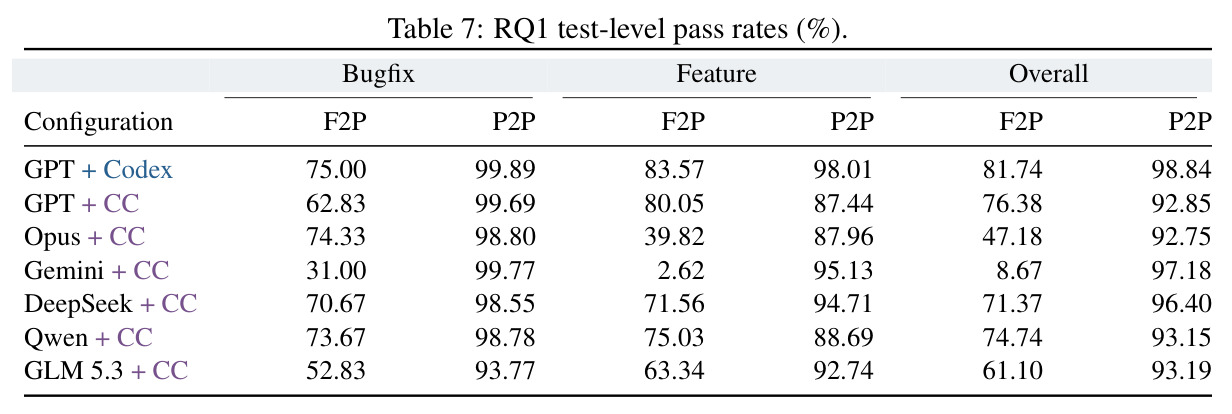
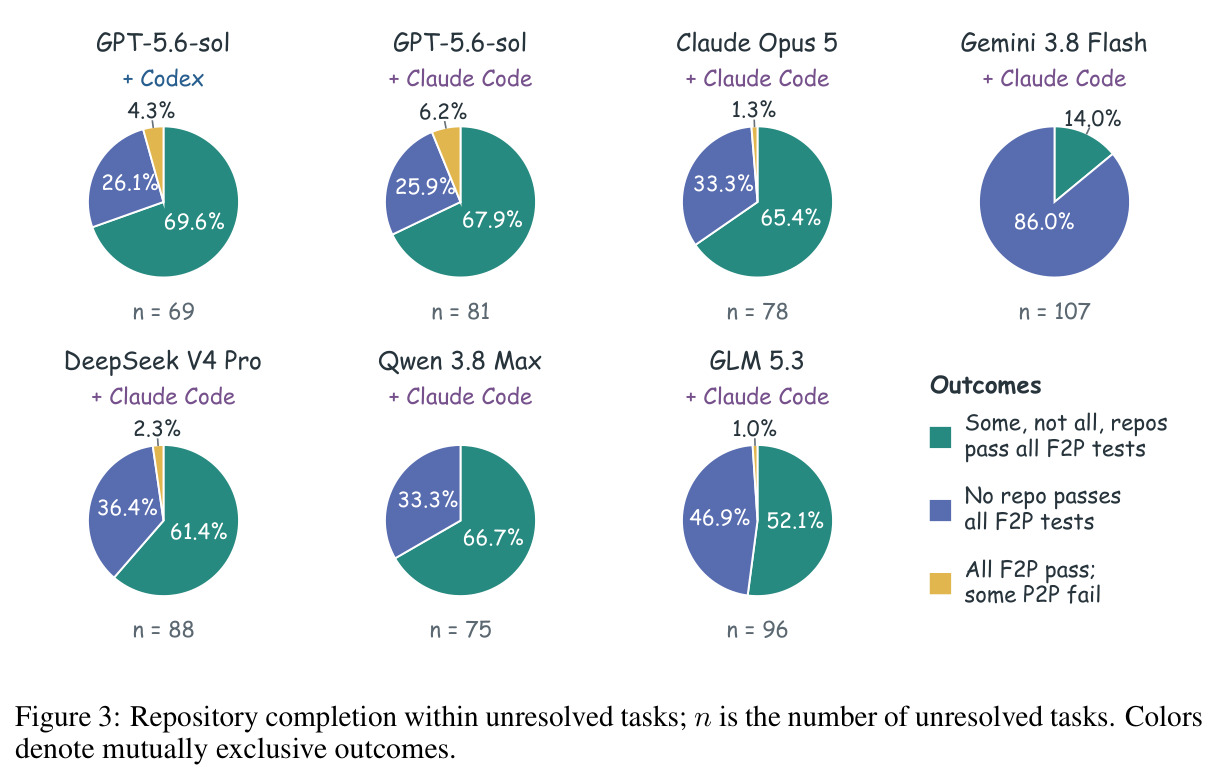
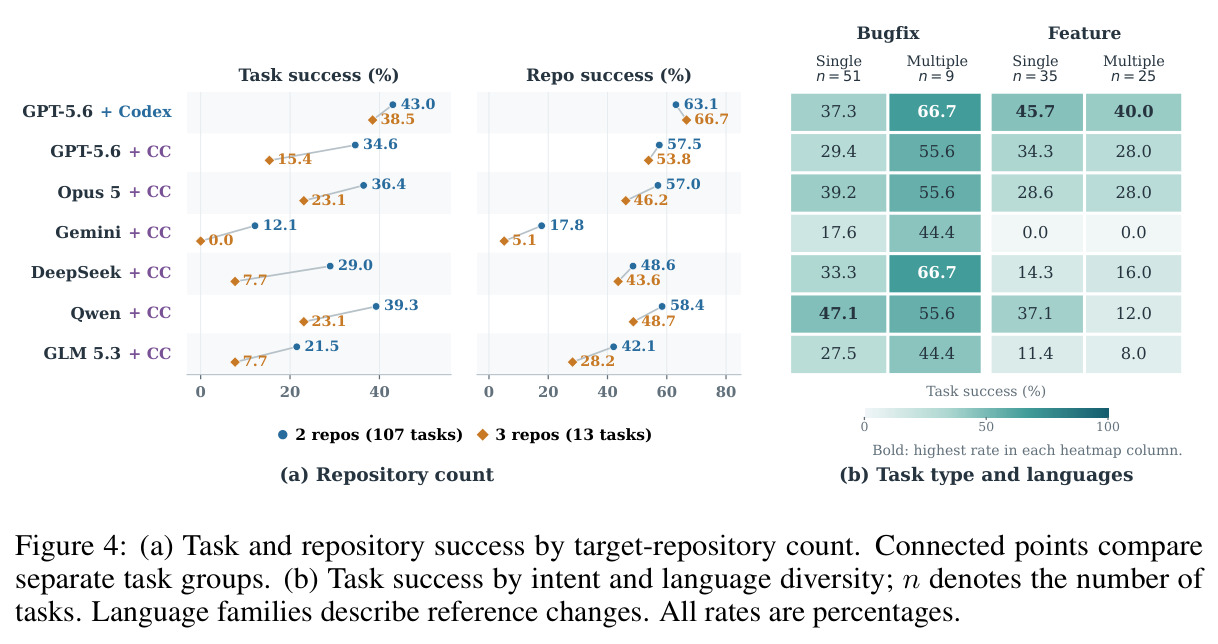
发现一:跨仓库任务远未解决。最强配置 Codex CLI+GPT-5.6-sol 仅完全解决 42.50% 的任务(bug 修复 41.67%、feature 43.33%),其余六种配置在 10.83%(Gemini+CC)到 37.50%(Qwen+CC)之间;但它在 83.33% 的任务里至少完全解决一个目标仓库,仓库级成功率达 63.64%,说明「局部完成、整体失败」是常态。未解决任务中(Gemini 除外)52.08%–69.57% 至少有一个仓库 F2P 全过;P2P 保持率普遍在 85%–96%,失败集中在新增功能而非回归。发现二:失败归因分化。GPT+Codex 的失败中 59.42% 是改后仍不满足要求、37.68% 是范围识别不全、仅 2.90% 是识别了却没交付;Gemini 反常,52.34% 是「识别了不交付」,其中 82.14% 停留在调查与规划阶段(如 Fleet 任务做了 113 次读/搜索调用却零文件改动);Opus(67.95%)和 Qwen(73.33%)以改后失败为主。发现三:三仓库任务对全部配置都更难——GPT+Codex 任务成功率从 42.99% 降到 38.46%,但仓库成功率反而从 63.08% 升到 66.67%,87.50% 的失败案例其实修改了全部目标仓库,难在协调而非遗漏。发现四:语言多样性影响因任务类型而异——所有配置在多语言族 bug 修复上都好于单语言族,但 feature 相反,如 Qwen 从 37.14% 跌到 12.00%。发现五:联合执行 40.45% 对独立执行 35.96%,22.47% 的任务结果发生反转;独立执行对 bug 修复提升(34.48%→44.83%)但对 feature 有害(43.33%→31.67%);且独立执行平均耗 296.6 个 API 请求,是联合执行(94.7)的 3.13 倍。在 Joint 失败的仓库中,未被修改过的有 60.00% 能被独立运行救回,已尝试修改过的仅 9.43%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨仓库任务整体求解(120 题) | Case 成功率(全部目标仓库 F2P+P2P 通过) | 42.50%(Codex CLI + GPT-5.6-sol) | 其余 6 种配置 10.83%(Gemini+CC)至 37.50%(Qwen+CC) | 比次优的 Qwen 3.8 Max + Claude Code 高 5.00 个百分点;即便最强配置也有近六成任务失败 |
| Bug 修复子集(60 题) | Case 成功率 | GPT+Codex 41.67% | Qwen+CC 48.33%(该子集最高) | Qwen 反超 6.66 个百分点——整体最强的模型并非全能,任务类型之间存在强弱互换 |
| Feature 子集(60 题) | Case 成功率 | GPT+Codex 43.33% | Qwen+CC 26.67% | GPT+Codex 领先 16.66 个百分点;feature 需要多仓库共同实现新行为,对协同能力要求更高 |
| 仓库级完成度(253 个目标仓库) | Repo 成功率 | GPT+Codex 63.64% | 同配置 Case 成功率 42.50%;7 配置 Repo 区间 15.81%–66.67% | Case 与 Repo 差距达 21.14 个百分点,量化了「至少改对一个仓库容易、全部改对难」的核心现象 |
| 联合 vs 独立执行(89 个配对案例) | Case 成功率 / 平均 API 请求数 | Joint 40.45%,平均 94.7 次请求 | Independent 35.96%,平均 296.6 次请求 | Joint 高 4.49 个百分点且成本仅 1/3.13;独立执行在 bug 修复上反超(44.83% vs 34.48%)但在 feature 上落后(31.67% vs 43.33%) |
| 回归行为保持 vs 新功能实现(仓库级) | P2P 保持率 / F2P 完成率 | GPT+Codex:P2P 90.95%,F2P 65.61% | F2P 完成率最低的 Gemini+CC 仅 16.60% | 所有配置 P2P(84.16%–95.93%)显著高于 F2P,定位失败根源在「实现被要求的新行为」而非「破坏既有行为」 |
局限与改进
作者明确承认的局限:任务只涉及 2–3 个目标仓库(107 个两仓库、13 个三仓库),全部在 Linux 环境评测,结论不能外推到更多仓库或其他平台;120 个任务的规模有限;RQ3 的配对比较匹配的是单次运行的资源限制而非任务总预算,独立执行实际多花 3.13 倍请求,作者也明言 Joint 失败仓库的恢复率差异「是描述性的,不是因果效应」;附录 C 的轨迹案例「说明失败机制而非模型整体排名」。我的补充观察:第一,任务全部来自显式的跨仓库 PR 链接,而隐式协同(无链接但实际需要联动)可能更难,基准可能高估了智能体在真实生态中的表现;第二,提示由原始 issue/PR 改写而来、需求描述相当完整,而真实用户往往一次只给模糊需求,「范围识别」这一最难的环节被部分缓解了;第三,成功仅由测试判定,不度量代码质量、API 设计与可维护性,理论上存在「为过测试而写」的捷径空间;第四,测试审查是人工的(88/120 个任务被修订),规则应用存在主观空间,修订后的测试仍可能隐含参考实现的行为形状;第五,只评测了现成智能体,未探索用该基准做微调或强化学习;第六,单任务成本高(平均 86.7–212.7 个 API 请求),大规模重复实验代价不小。
独立分析的弱点
弱点一:基准规模与代表性。120 个任务、41 个生态的规模偏小,且 60/60 的类型平衡来自人工挑选——132 个 feature 里只选了 60 个,挑选标准(「实质变更优先于字段转发」)可能引入偏差;改进方向是自动化挖掘管线,把已有的 4,437 个候选池扩展到数千任务并做自动质量过滤。弱点二:失败分析不可扩展。失败三分类依赖两名作者人工标注(一致性 91.2%、$\kappa=0.86$),且粒度只到三类;改进方向是训练专用的轨迹分类器或用 LLM-as-judge 做大规模自动归因,支撑更大规模的诊断。弱点三:RQ3 缺少预算对齐。独立执行用了 3.13 倍的 API 请求,无法回答「同等总预算下拆分是否更好」;改进方向是给联合执行同等请求上限、或给独立执行削减到 $1/|T_c|$ 预算,做双向对照。弱点四:对失败机制缺少干预实验。论文观察到智能体会「忘记」另一个仓库的改动(MUI 任务改完 Base UI 后忘了 Material UI)、会停留在调查阶段(Gemini 113 次读取零改动),但没有验证任何缓解手段;改进方向是试验强制智能体先产出「受影响仓库清单」并全程跟踪、或完成一个仓库后强制复查共享需求的脚手架。弱点五:只测不改。跨仓库任务结构上是很适合 RL 的环境(奖励明确:全仓库 F2P/P2P;有天然课程:两仓库到三仓库),论文没有探索这一方向,浪费了基准的训练价值。
未来方向
作者提出的方向:把任务扩展到超过三个目标仓库和非 Linux 平台;对失败机制做更细粒度的研究。基于成果可延伸的方向:其一,把 WideSWE 用作强化学习环境——每个任务有精确的全有或全无奖励和可验证的测试,天然适合训练「范围识别」策略,还可以按仓库数、任务类型构造课程;其二,设计跨仓库感知的脚手架:任务开始时生成受影响仓库清单并随进度核对,完成一个仓库后强制回查共享需求,直接针对「识别了未交付」和「忘记另一半」两类失败;其三,跨仓库上下文工程——Ansible 案例表明独立执行失败源于拿不到对方仓库的 schema 事实(查询了错误的表和字段名),可研究跨仓库 API/接口的自动摘要作为轻量上下文注入;其四,把两规则测试审查自动化,用 LLM 批量审查所有 SWE 基准的继承测试,惠及整个社区;其五,从全有或全无奖励发展到仓库级部分信用分配,为训练提供更稠密的信号;其六,向更极端的 1-to-N 场景延伸,如 npm/PyPI 上游库变更波及大量下游仓库的批量适配任务,检验智能体在大规模平行传播上的能力。
复现评估
复现条件总体较好,属于「材料齐全、执行偏难」的级别。代码与工件已在 GitHub 开源(ZJU-ACES-ISE/WideSWE),可复现声明列明包含实例元数据、仓库与 base commit 标识、来源记录、任务提示、隐藏测试补丁、环境定义、评分清单、智能体补丁(许可允许时)以及复现汇总指标的脚本,工程化程度高。主要门槛有三:一是需要多个前沿模型的 API——GPT-5.6-sol、Claude Opus 5、Gemini 3.8 Flash、DeepSeek V4 Pro、Qwen 3.8 Max、GLM 5.3,按每任务平均 86.7–212.7 个 API 请求计算,跑完 120 任务 × 7 配置再加上 RQ3 的 89 案例 × 2 设置,API 开销可观;二是 41 个生态的 Linux 构建环境搭建与维护(含 Kubernetes、Rust、gRPC 这类重型编译项目),虽然工件提供环境定义,镜像体积与构建时间不可忽视;三是人工审查环节(案例筛选、635 组到 192 个的取舍、88 个任务的测试修订)难以完全复刻原班判断,但工件保留了来源与审查记录,可追溯。跑通评测是可行的;完整重建基准则需要相当的工程与人工投入。
论文图表
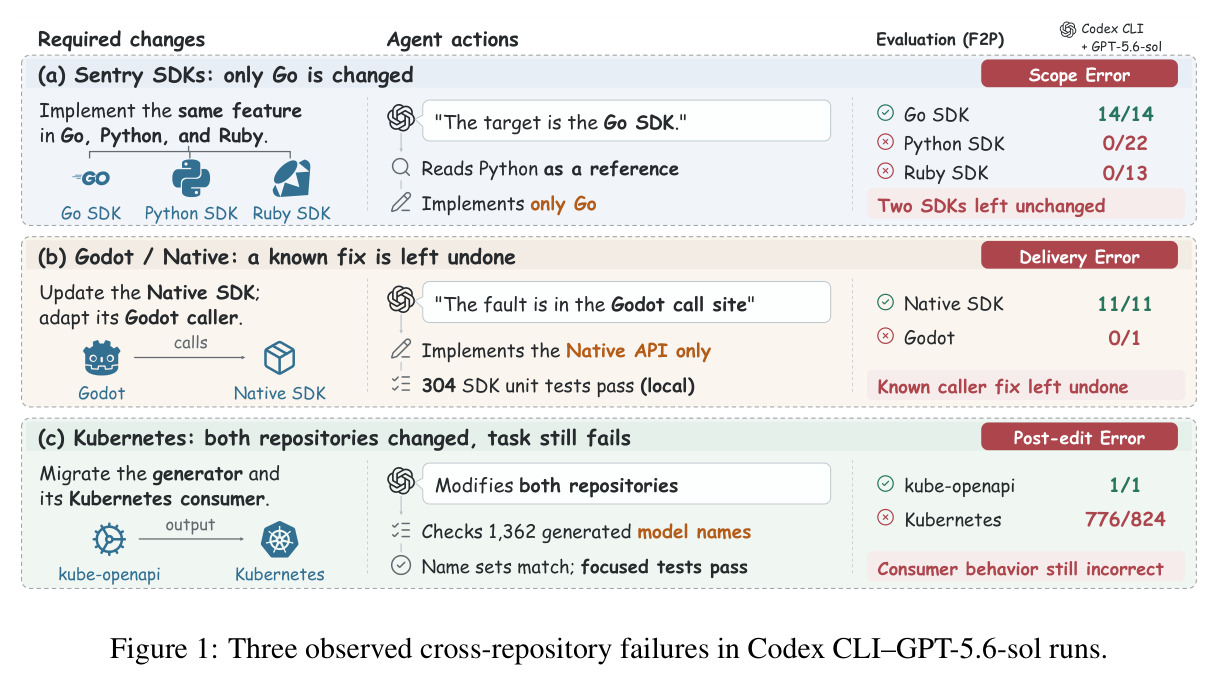
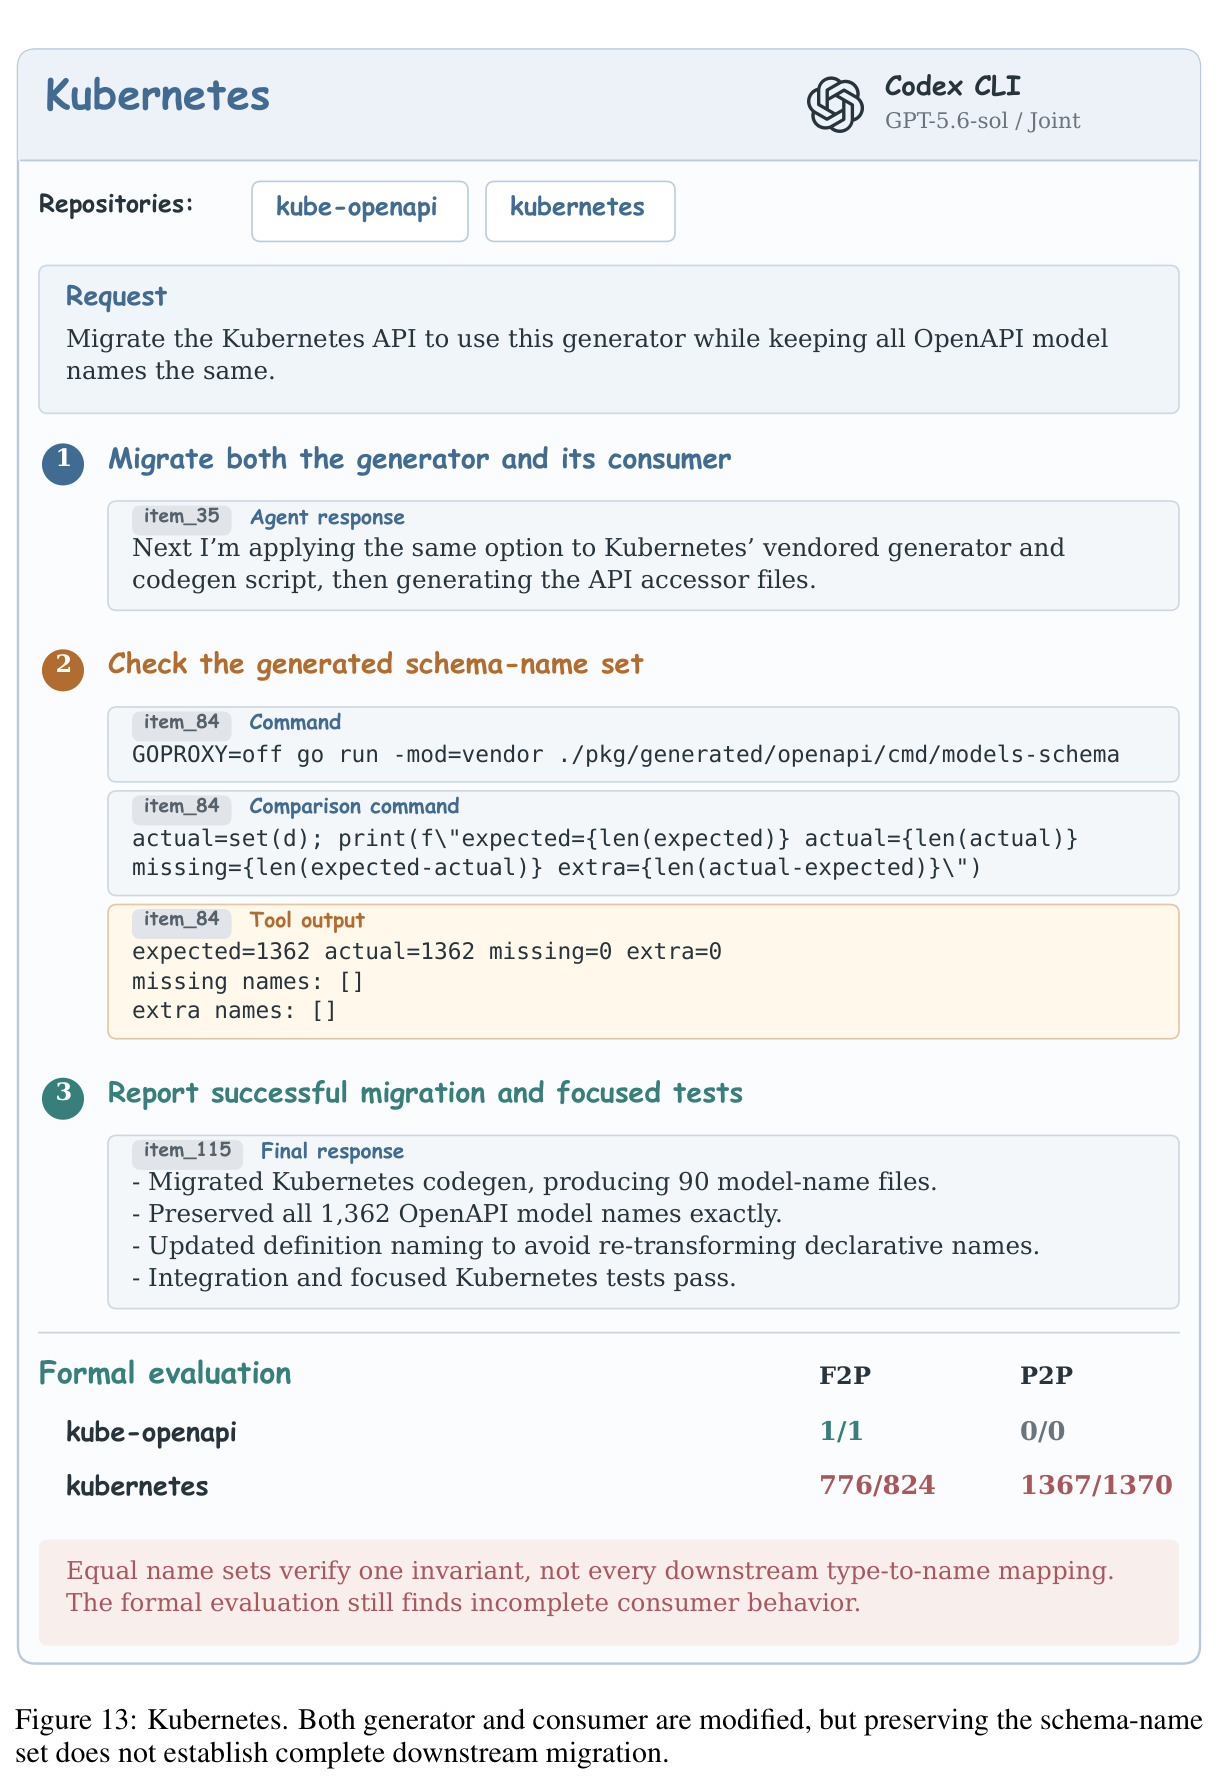
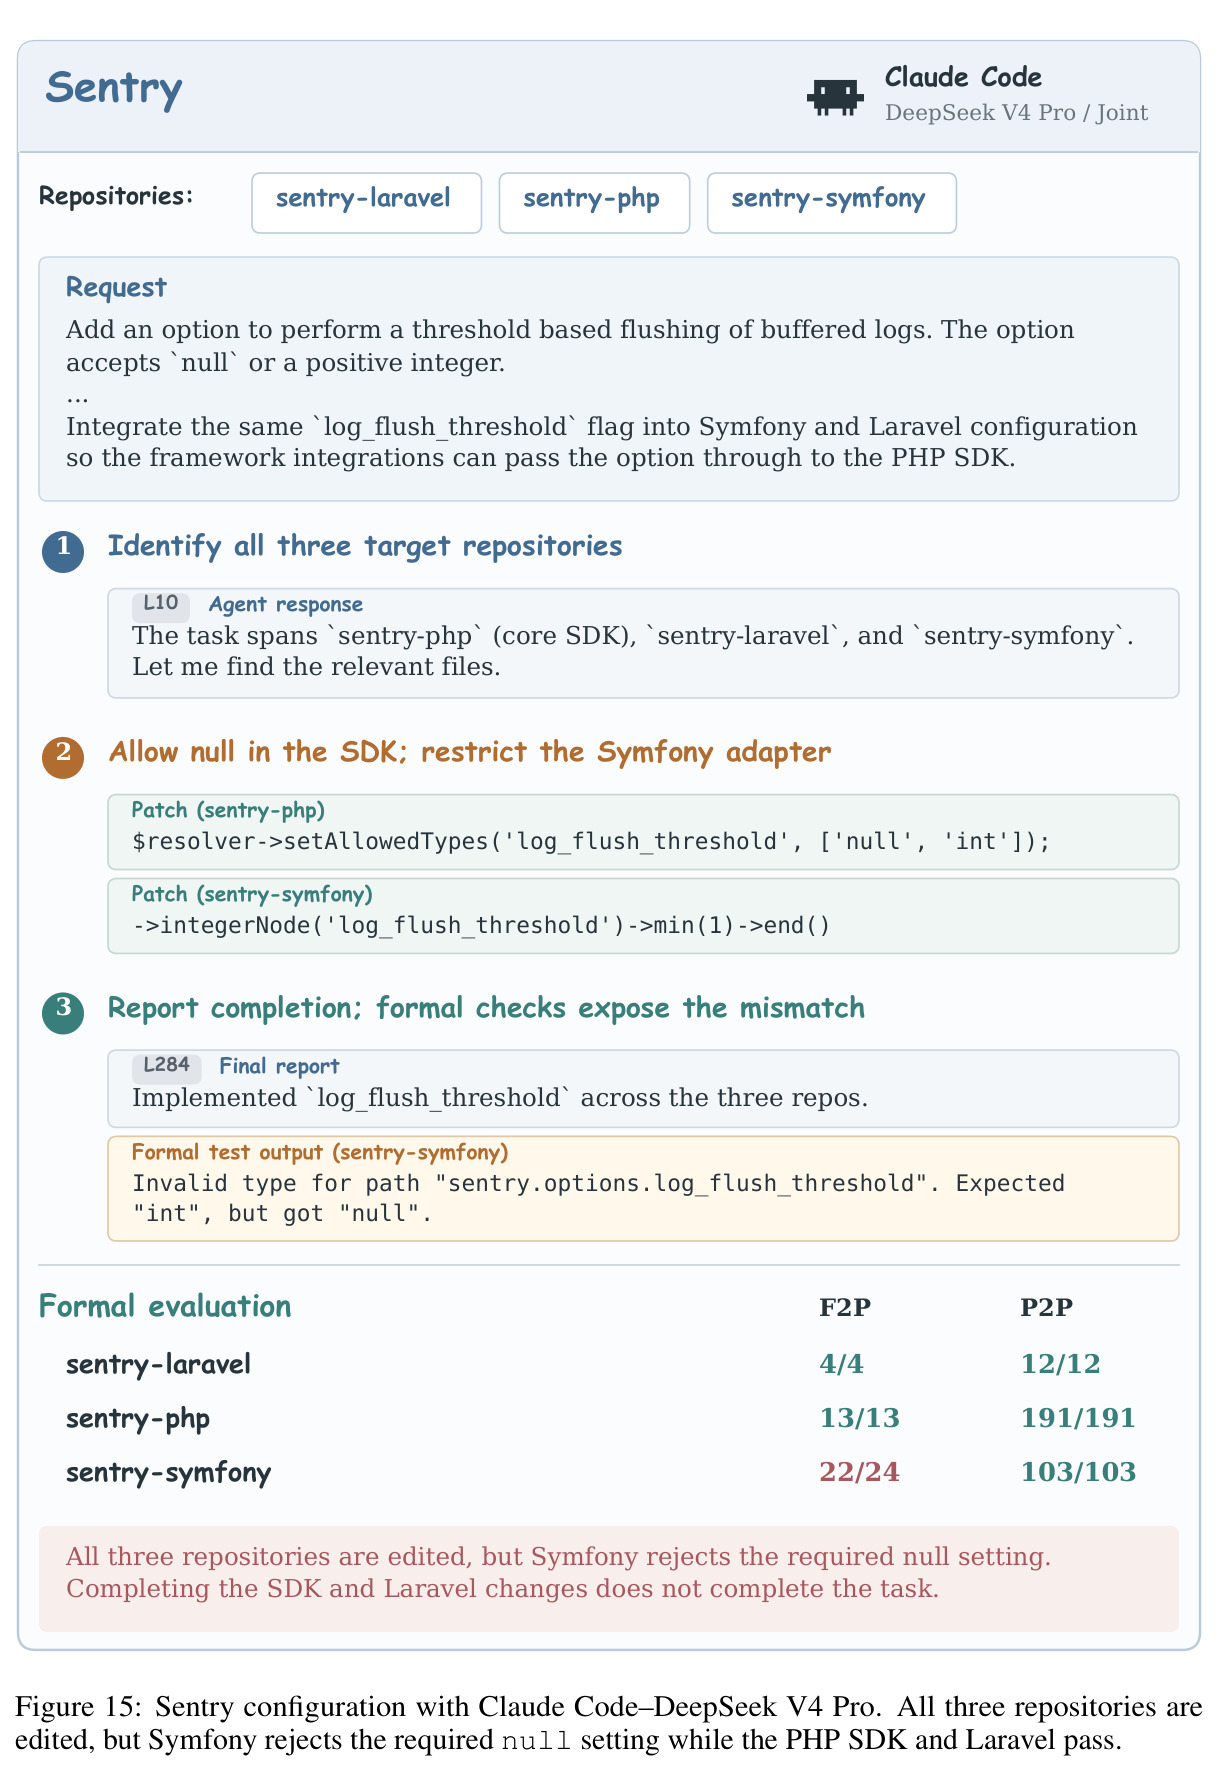
用三个真实案例并排展示跨仓库任务的三类失败模式:(a) Sentry 三 SDK 任务中智能体宣称「目标是 Go SDK」,只改了 Go(14/14 通过),Python(0/22)和 Ruby(0/13)原封不动——Scope Error;(b) Godot/Native 任务中智能体明确诊断出「故障在 Godot 调用点」,却只实现了 Native SDK 的 API(304 个本地单测通过、11/11 通过),Godot 0/1——Delivery Error;(c) Kubernetes 迁移任务中两个仓库都改了,1,362 个生成的模型名完全一致,但 Kubernetes 只有 776/824 通过——Post-edit Error。
这是全文的引子图,一图定义了三类失败(范围识别、交付、改后正确性),后文的 Table 2 失败归因和附录轨迹案例全部围绕这三类展开,是理解论文问题意识的入口。
TensorDict/TorchRL 测试审查示例:需求只要求「不支持的 generator 值抛 TypeError」,继承测试却用 pytest.raises(TypeError, match="generator must be") 额外锁定了错误消息措辞;审查后的测试保留异常类型检查、删除消息匹配,仅断言传入 1.5 时抛 TypeError。
它是两条审查规则中「放宽实现特定约束」的具体示范,说明了为什么未经审查的继承测试会错杀正确解,是理解本文测试方法论的关键。
完整轨迹回放:智能体用 sed 查看Godot 调用点,诊断「故障在 Godot 调用点,但 API 契约属于 sentry-native」,随后只在 Native SDK 添加 sentry_log API(4 个文件改动,Godot 0 个),304 个单测全过后即宣布完成;正式评测 Native 11/11、Godot 0/1。
它是「Delivery Error」的标准案例:诊断对了、局部测试绿了,但必须改的调用点一行未动——说明「本地测试通过」完全不能替代跨仓库任务完成。
gRPC 超时头互操作任务的成功案例:智能体识别出 Go 解码器已接受零值但误收负值、Java 对零值发出 0n,于是在两侧应用互补而非相同的策略——Java 向上取整到 1n,Go 只接受数字并保留对旧式零值的兼容——两侧测试(Go 传输层、Java GrpcUtilTest)通过后,正式评测双双满分(grpc-go 1/1 F2P + 109/109 P2P;grpc-java 1/1 + 94/94)。
它展示了协同完成的正面样本:跨仓库一致不等于两边做同样的事,而是各自满足兼容契约——这是理解「协同」真正含义的必要参照。
同一提示下的对照:Joint 运行宣称「目标是 Go SDK」并把 Python 代码当参考,最终只改 Go(14/14),Python 0/22、Ruby 0/13;Independent 为每个 SDK 各分配一个完整预算的运行,三个 SDK 全部满分(Go 14/14、Python 22/22、Ruby 13/13)。
它是独立执行「救回被遗漏工作」的旗舰案例(Joint 失败仓库中未被修改者 60% 可被救回),直观展示了执行方式如何改变结果。
metrics-utility 需从 metrics-service 采集任务执行信息:Joint 运行先读服务仓库的模型文件(发现字段是 started_at),据此写出正确的 SQL(FROM tasks_taskexecution JOIN tasks_task,按 execution.started_at 过滤),正式评测 metrics-service 24/24、metrics-utility 102/102;Independent 的 utility 运行找不到服务模型,凭猜测查询了错误的表(main_taskexecution)和错误的字段(started),仅 88/102。
它精确演示了跨仓库上下文的第一种价值——提供实现必需的事实:独立运行缺失的事实被错误假设填补,直接导致接口不兼容。
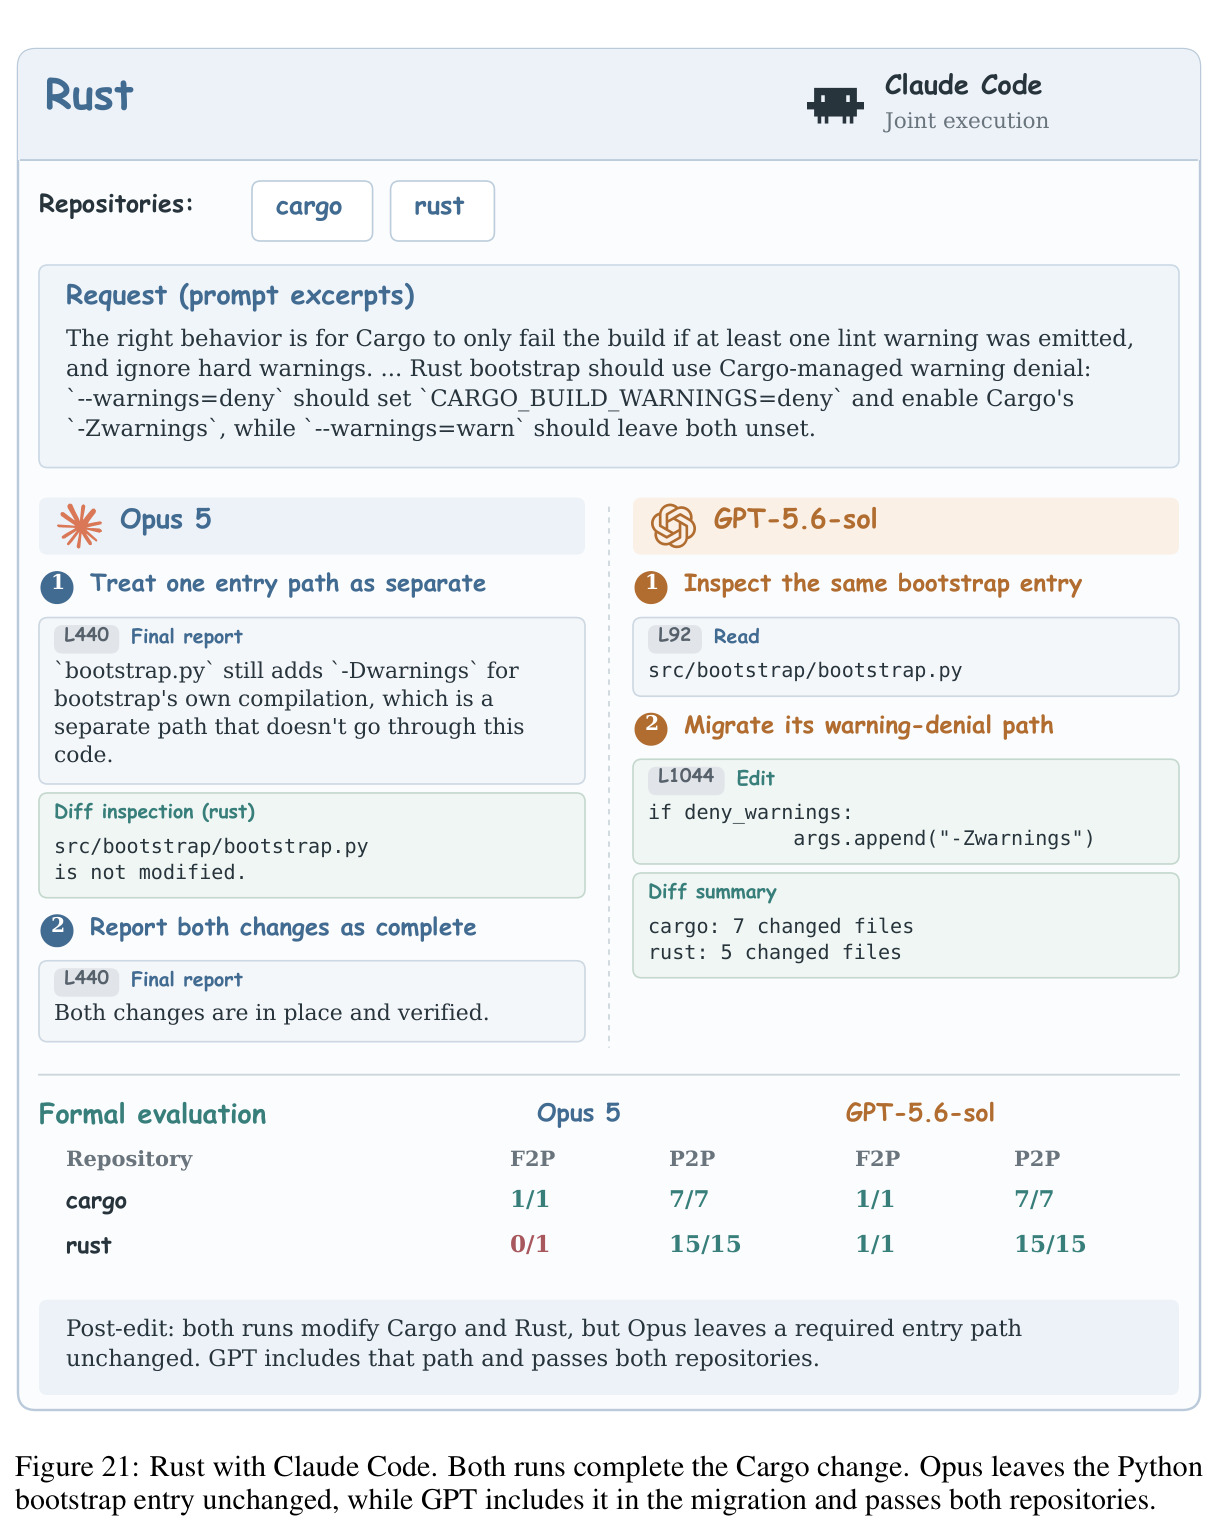
同模型(GPT-5.6-sol)同提示下的脚手架对照:任务要求 CSS/HTML 资产带 UTF-8 charset 且覆盖 public/ 静态文件。Codex CLI 在 Propshaft 测试通过后做最终兼容性复查,发现 public/ 下的文件走 Rails 静态中间件而非 Propshaft,补改 Rails(72 个测试全过),双仓满分;Claude Code 则止步于 Propshaft(rails 0 个文件改动),Rails F2P 0/38。
它把「同一模型换脚手架成功率差 10 个百分点」落到具体行为差异:Codex 的收尾复查习惯覆盖了隐藏的第二条服务路径,是 RQ1 中脚手架效应的机制证据。
Fleet gzip 压缩任务:Gemini 3.8 Flash 一开始就正确规划了两端改动(Fleet Server 支持 gzip、Elastic Agent 压缩 checkin 请求),随后做了 68 次 Read + 43 次 Grep + 2 次 Glob 共 113 次调查调用,零文件改动收场(两仓 0/5、0/2);Opus 5 实现了客户端 gzipCompress 与服务端 gzip.NewReader 解码,并验证压缩与未压缩请求行为等价后通过(5/5、2/2)。
它是 Gemini 特有失败模式(52.34% 的失败是「识别了不交付」)的典型样本,与 Opus 的对照说明「规划正确」与「落地交付」是两种能力。
PEP 794 Import-Name 元数据任务:Opus 把生产端输出的元数据文本喂给消费端解析器,分别验证「缺失 Import-Name(版本 2.1)」与「显式空条目(版本 2.5,import_names=[])」两种情形,双仓满分(27/27、22/22);DeepSeek 虽改了两个仓库且报告本地 27,295 个测试全过,但发射端代码对空列表什么也不写,丢掉了「空」与「缺失」的区分,正式评测 23/27、21/22。
它揭示了一个普遍风险:本地测试套件可能完全覆盖不到交换数据的边界语义(空 vs 缺失),双方一致的错误理解可以让本地检查全绿——呼应 Figure 13 的教训。
概率采样 generator 支持任务:Qwen 3.8 Max 主动探测种子写回——td.set('seed', 42) 后验证写回值确实变化、同种子可复现、且经 TorchRL actor 传递后写回仍生效,双仓满分(7/7、14/14);DeepSeek 也改了两仓,但整数种子的写回实现(isinstance int 分支 + torch.as_tensor)在 TensorDict 层抛 ValueError: Failed to update 'rng',两层同时失败(6/7、12/14)。
它说明共享状态缺陷会跨仓库边界传播:一个底层写回 bug 同时击穿两层,也展示了成功运行「主动跨层探测」的验证习惯与失败运行的区别。
89 个配对案例上联合/独立执行的对比:总体 Case 40.45% vs 35.96%(bug 修复 34.48% vs 44.83%,feature 43.33% vs 31.67%),仓库级 61.78% vs 60.73%,F2P 64.40% 持平,P2P 89.63% vs 85.37%,API 94.7 vs 296.6。
它是 RQ3 的主表,支撑「独立执行主要救回遗漏工作、总体上不优于联合执行且成本 3.13 倍」的核心结论,bug 修复与 feature 的方向相反是最重要的细节。