CrossSWE:面向编码智能体的跨仓库联合开发基准 CrossSWE: Benchmarking Cross-Repository Joint Development for Coding Agents
首个要求跨仓库协同修改的SWE基准,最强模型Pass@1仅58.48%
前置知识
SWE-Bench 与仓库级 issue 解决
SWE-Bench 把真实 GitHub issue 作为任务,要求智能体修改仓库代码并通过隐藏测试;后续 SWE-Bench Pro 加长任务时程,SWE-Bench ProMax 引入专家筛选的多语言大规模重构,构成一个持续加码单仓库复杂度的基准谱系。
CrossSWE 正是对这一谱系的反思与延伸,理解单仓库评测范式及其天花板才能看懂本文动机。
Pass@1
一次尝试即解决问题的比例:每个实例只允许智能体提交一次补丁,仅当全部评测测试通过才计为解决,是编码智能体评测中最常用的主指标。
论文 Table 1 的主结果和所有模型对比均以 Pass@1 为核心度量。
FAIL_TO_PASS 测试
修复前必须失败、应用正确补丁后必须通过的测试用例集合。SWE-Bench 式基准用它客观判定任务是否被真正解决,无需人工检查。
CrossSWE 的联合必要性验证就是在 2^N 种补丁组合上逐一执行 FAIL_TO_PASS 测试,这是全文方法的核心机制。
智能体脚手架(scaffold)
承载 LLM 与代码库交互的框架,负责工具调用、上下文管理和执行循环。论文采用的 mini-swe-agent 让模型通过迭代 shell 命令来检查、修改和测试代码库,是轻量级仓库级编码智能体框架。
五个模型的实验统一固定在 mini-swe-agent v2.4.6 上,这是保证公平比较、解读结果的前提。
依赖迁移与破坏性变更
上游库发布新版本导致 API、协议或行为不兼容,下游使用方必须同步修改才能继续工作。它是跨仓库联合开发最常见的来源之一,伴随 API 演进、provider–consumer、client–server 等关系出现。
它是 CrossSWE 候选收集阶段的核心关系线索,也是与 BeyondSWE、DepBench 等多仓库相关工作划清界限的关键概念。
研究动机
现有编码智能体评测几乎都把复杂度约束在单个仓库内。SWE-Bench 及其后续 SWE-Bench Pro(更长时程)、SWE-Bench ProMax(专家筛选的多语言大规模重构)不断加大单仓库任务的规模,但智能体需要理解的上下文和允许修改的范围仍被单一代码库封顶,复杂度增长存在天花板。近期 BeyondSWE 和 DepBench 虽把多仓库纳入画面,却只把其他仓库当作阅读上下文——智能体去理解某个 API 或依赖,但补丁和隐藏测试仍落在一个仓库里。而真实开发中,API 演进、依赖迁移、兼容性修复、功能灰度往往要求多个互依赖仓库同步修改。论文给出的 oauth2-proxy 与 Higress 真实案例中,会话刷新时多个 Set-Cookie 头被错误合并成单个 HTTP 头导致认证失败:修复必须一边把 cookie 保留为列表,另一边逐条解析并分别发送,只改任何一边都会留下接口不一致或 cookie 处理错误。
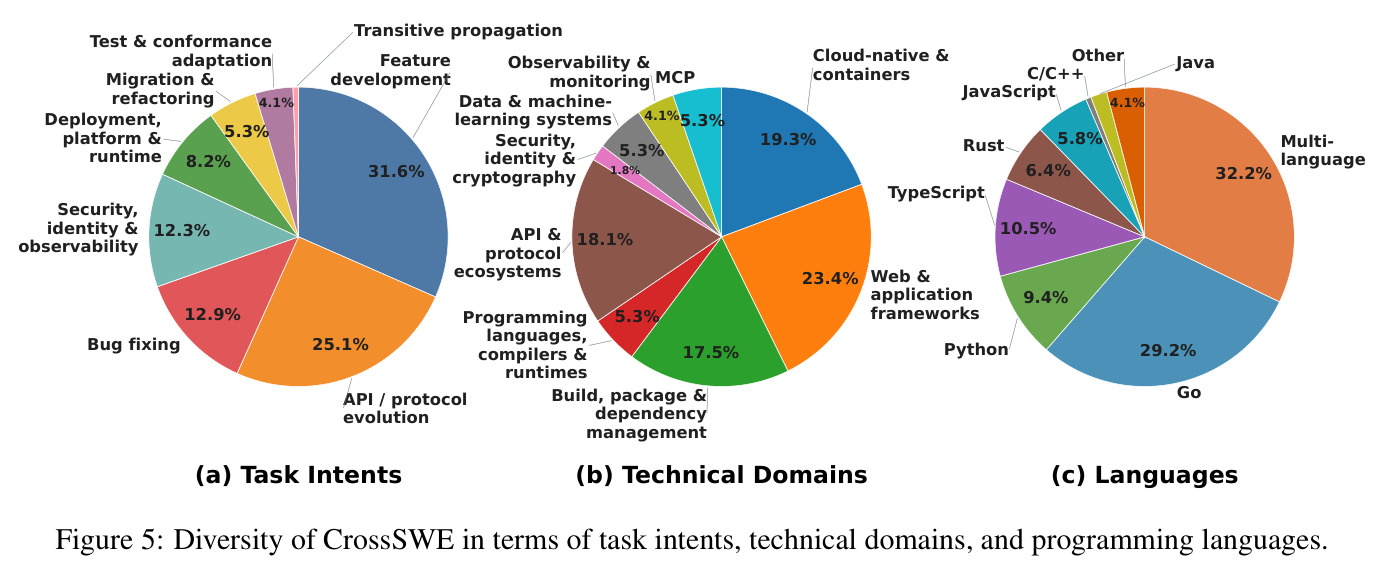
本文的目标是本文要构建并验证 CrossSWE:一个以'跨仓库联合开发'为被测能力的基准。具体目标包括:(1) 从真实 GitHub 开发历史中收集 171 个必须协同修改多个互依赖仓库才能解决的任务实例,覆盖 165 个仓库、20 个技术领域、13 种编程语言,其中 165 个实例涉及两个仓库、5 个涉及三个、1 个涉及五个;(2) 为每个实例提供单一可复现的 Docker 执行环境、自包含的问题陈述、验证目标跨仓库行为及既有行为的测试套件、各参与仓库的 gold patch;(3) 用可执行的方式证明部分仓库修改不足以达成目标行为,只有全部补丁齐备才能通过完整评测套件;(4) 在统一脚手架下评测五个前沿 LLM,量化联合开发的额外难度并剖析失败模式。
与已有工作不同的是,本文的独特切入是把'解决方案本身必须横跨多个互依赖仓库'定义为一维新的任务复杂度,而不是继续在单仓库内堆叠更长时程或更大改动量。与之配套的关键设计是联合必要性的可执行验证:对含 N 个仓库的实例穷举 $2^N$ 种补丁组合,两仓库情形要求 $(A_0,B_0)$、$(A_1,B_0)$、$(A_0,B_1)$ 三种部分配置下 FAIL_TO_PASS 测试全部失败、仅全补丁配置 $(A_1,B_1)$ 通过,从而把'这些仓库改动是否缺一不可'从主观判断变成组合测试断言。这使 CrossSWE 与 BeyondSWE/DepBench 形成本质区分:后者考核'理解跨仓库依赖'(他仓库仅提供证据),前者考核'写出彼此兼容、联合生效的多个补丁',是对智能体协调能力的直接测量。
核心方法
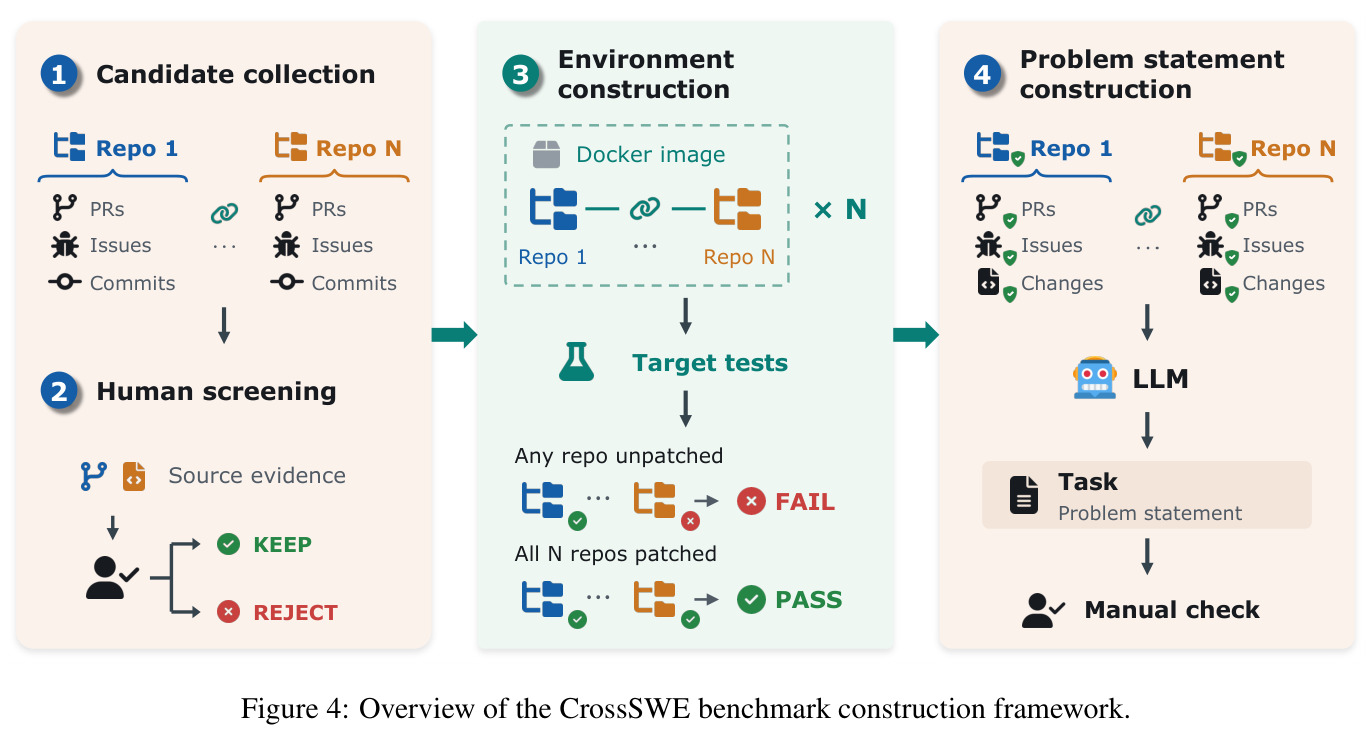
CrossSWE 采用四阶段流水线构建。阶段一候选收集:用 GitHub API 扫描 2025 年 1 月至 2026 年 9 月活跃仓库的开发历史,挖掘合并 PR、可重建变更的 issue、commit 及 release/兼容性讨论,关系线索包括 API 演进、依赖迁移、provider–consumer 与 client–server 关系,以及跨仓库的显式引用。阶段二人工筛查:对高召回的收集结果逐条检查源 PR/issue、开发时间线、被引用仓库和对应 commit,仅保留至少两个仓库都有与同一任务因果/依赖/协同相关的实质性实现变更的候选,排除仅文档、release note、changelog 的情形。阶段三环境构建与联合必要性验证:为每个实例构建包含全部参与仓库的专用 Docker 镜像,各仓库 checkout 到验证过的 base commit,随后穷举 $2^N$ 种补丁组合执行目标测试,验证单边修改不足。阶段四问题陈述构建:把 PR、issue 讨论、commit 信息改写为自包含的自然语言任务描述,并剥离实现细节线索。
核心创新是'联合必要性'的可执行验证协议。传统 SWE 基准只验证'改对了这一个仓库';CrossSWE 验证'只改任何单个仓库都不行、必须全改才通过'。技术上,实例的 $N$ 个仓库各有 base/patched 两种状态,评测者在同一 Docker 环境内穷举全部 $2^N$ 配置(如两仓库的 $(A_0,B_0)$、$(A_1,B_0)$、$(A_0,B_1)$、$(A_1,B_1)$),要求目标 FAIL_TO_PASS 测试仅在完全补丁状态下通过。另一个关键设计是单边对照任务的派生:从 165 个两仓库实例派生出 330 个只要求修改一个仓库的单边任务,执行环境与跨仓库上下文完全保留,从而把'拥有多仓库上下文'与'需要联合修改'两种挑战解耦,可以精确归因联合开发本身带来的性能损失。
方法步骤详情
构建流程逐步展开:(1) 候选收集——输入是 GitHub 活跃仓库 2025.01–2026.09 的开发历史,输出带跨仓库线索的候选变更集;(2) 人工筛查——输入候选及其源 PR/issue、时间线与被引用仓库,筛选标准是源证据指向具体代码变更且至少两个仓库含实质性关联实现,输出保留候选;(3) 环境构建——为每个候选制作 Docker 镜像并安装全部依赖,仓库保持干净 Git 状态,agent 侧镜像剥离 gold patch、隐藏测试和修复产物;随后为每个仓库重建 gold patch 并在同一环境内穷举 $2^N$ 配置执行 FAIL_TO_PASS 测试,联合必要性准则要求全 base 与一切部分补丁配置失败、全补丁配置通过;(4) 问题陈述构建——从修复前视角描述可观察故障、预期行为与跨仓库需求,删除函数名、字段名、文件路径等 gold-patch 特有信息,并人工核对陈述、源证据与测试三者一致。评测时统一使用 mini-swe-agent v2.4.6、high reasoning effort,每实例上限 300 步、成本上限 $10。
技术新颖性
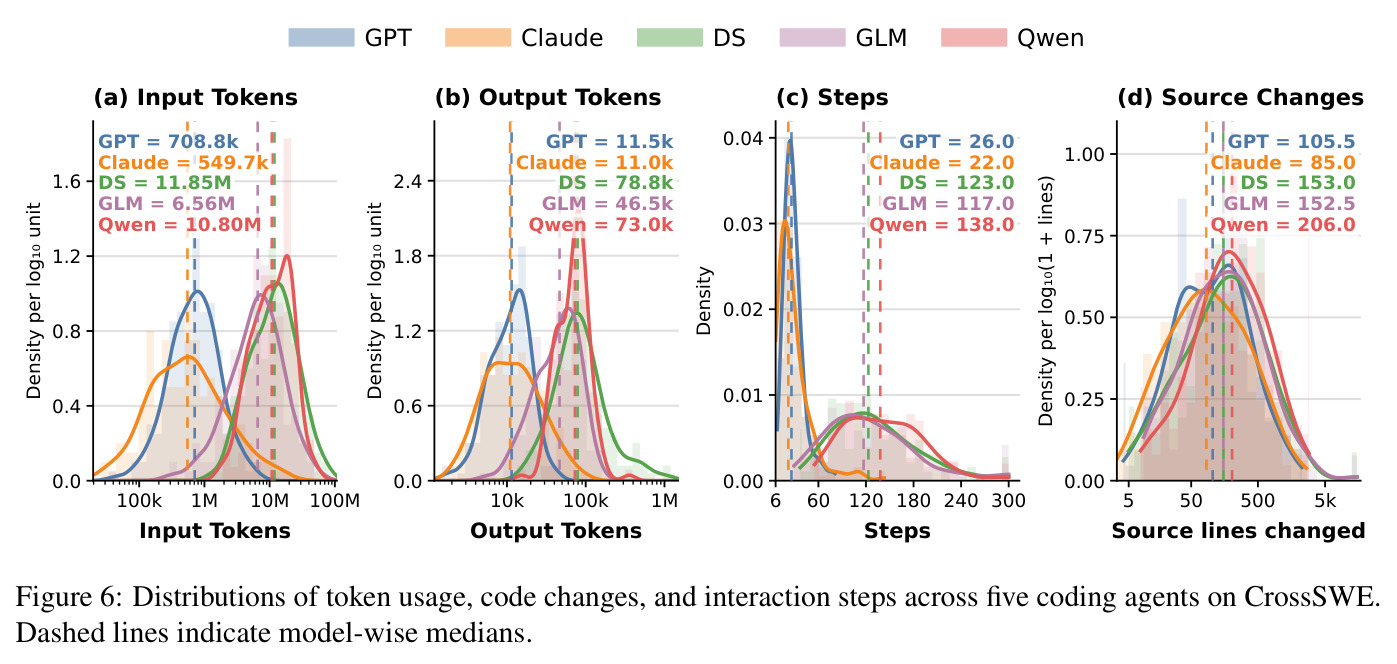
新颖性体现在三处。其一,验证协议:$2^N$ 配置穷举把'联合必要'变成组合测试断言,是此前 SWE 基准没有的机制,直接杜绝了'其实只改一个仓库就够'的伪跨仓库任务混入数据集。其二,单环境多仓库:所有参与仓库连同依赖置于同一 Docker 镜像,且 agent 镜像剥离 gold patch 与隐藏测试,保证每个实例只有单一、可复现的执行环境,所有评测由此展开。其三,受控实验设计:派生 330 个单边任务做对照,把增量挑战精确归因到'联合修改'本身而非多仓库上下文;同时用参考补丁规模与先前基准定量对标——CrossSWE 有 56.1% 的实例修改超过 10 个文件(SWE-bench Pro 为 6%、SWE-Bench ProMax 为 30%),66.7% 的实例改动超过 200 行(Pro 13%、ProMax 32%),在复杂度维度上拉开明显差距。
实验结果
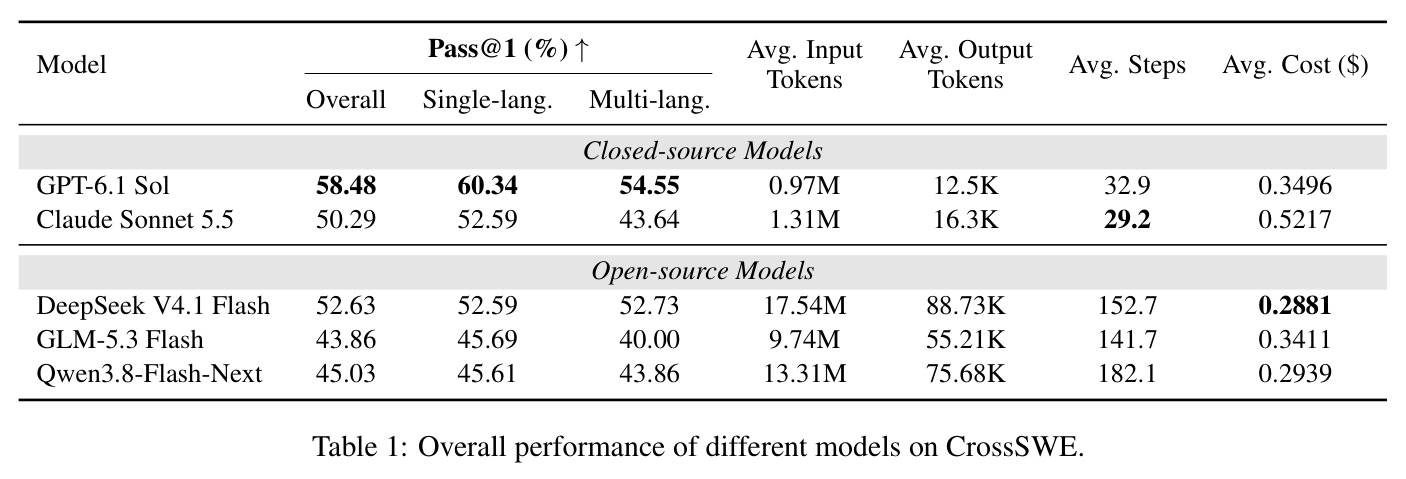
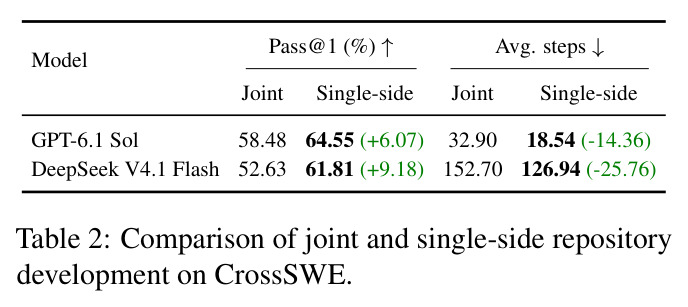
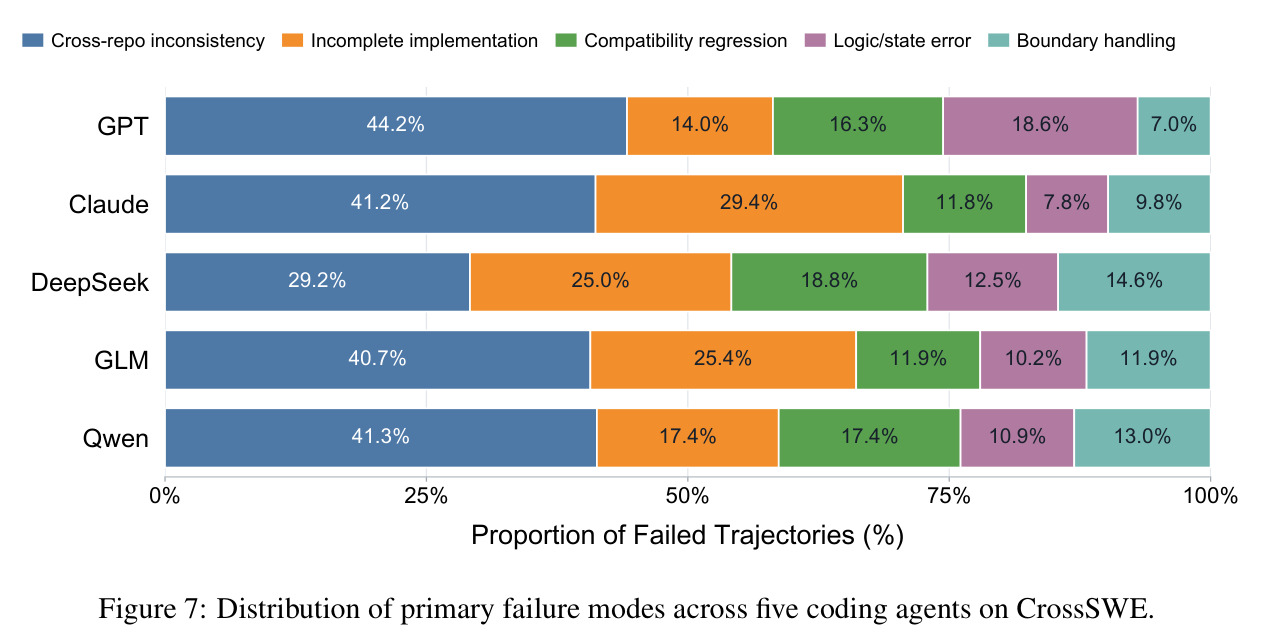
五个前沿模型在 CrossSWE 上都明显受挫。最强的 GPT-6.1 Sol 仅得 58.48% Pass@1(单语言 60.34%、多语言 54.55%),远低于其在单仓库基准 DeepSWE v1.1 上的 75.2%;DeepSeek V4.1 Flash 52.63%、Claude Sonnet 5.5 50.29%、Qwen3.8-Flash-Next 45.03%、GLM-5.3 Flash 43.86%。GPT-6.1 Sol 平均仅 32.9 步、$0.3496/实例,短轨迹抵消了高单价,Claude 则为 29.2 步、$0.5217。联合 vs 单边对照实验显示单边更易:GPT 升至 64.55%(+6.07pp,步数减 14.36),DeepSeek 升至 61.81%(+9.18pp,步数减 25.76)。失败归因中跨仓库不一致居首:GPT 44.2%、Qwen 41.3%、Claude 41.2%、GLM 40.7%、DeepSeek 29.2%;Claude 不完整实现占 29.4%,DeepSeek 兼容性回归 18.8%、边界处理 14.6%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨仓库联合开发(171 实例全量) | Pass@1 | GPT-6.1 Sol 58.48% | 同一模型在单仓库基准 DeepSWE v1.1 上为 75.2% | 下降 16.72 个百分点,说明跨仓库联合开发带来全新难度,而非单仓库能力的自然延伸 |
| 联合修改 vs 单边修改(GPT-6.1 Sol) | Pass@1 / 平均步数 | 联合 58.48%、32.90 步 | 单边任务 64.55%、18.54 步 | 单边高出 6.07pp 且步数减少 14.36,量化了联合修改的额外负担 |
| 联合修改 vs 单边修改(DeepSeek V4.1 Flash) | Pass@1 / 平均步数 | 联合 52.63%、152.70 步 | 单边任务 61.81%、126.94 步 | 单边高出 9.18pp 且步数减少 25.76,与 GPT 的结论交叉验证 |
| 参考补丁规模对比(修改 >10 文件的实例占比) | 实例比例 | CrossSWE 56.1%(>200 行占 66.7%) | SWE-bench Pro 6%(>200 行 13%);SWE-Bench ProMax 30%(>200 行 32%) | 任务改动面显著更大,确立 CrossSWE 在复杂度轴上的位置 |
局限与改进
作者承认三点局限:171 个实例中仅 6 个涉及三个及以上仓库,对大规模互依赖仓库网络的覆盖有限;实例直接提供参与仓库列表,回避了真实开发中'找出该改哪些仓库'的发现难题;统一采用以 Bash 交互为主的 mini-swe-agent 脚手架,结论对其他类型 harness 的适用性尚需直接验证,且设有 300 步与 $10 的上限。我的补充观察:其一,联合必要性验证需对每个实例跑 $2^N$ 次完整测试,成本随仓库数指数增长,这或许正是三仓库以上实例稀少的原因;其二,'跨仓库不一致'等失败类别依赖人工标注轨迹,与'兼容性回归'等类别的边界存在主观空间;其三,解决判定只看测试通过,无法区分'勉强凑过测试'与高质量协同实现,未度量修改的可维护性与接口设计质量。
独立分析的弱点
独立来看有几个薄弱点。第一,样本结构偏斜:165/171 为两仓库任务,五仓库仅 1 例,而'传递性变更传播'意图全库只有 1 个实例,结论对真正的多级依赖链几乎无统计效力——改进方向是按依赖图深度分层扩充样本。第二,给定了参与仓库集合,任务退化为'在已知范围内协调',与真实场景有差距,可加入干扰仓库或要求从生态中自行定位目标仓库。第三,失败模式完全靠人工阅读轨迹标注,缺乏可复用的自动化检测器;可以基于接口签名、协议/schema 的 diff 构建跨仓库一致性静态检查工具,为失败归因提供客观佐证。第四,仅检验 Bash 交互脚手架,未覆盖依赖编辑器、结构化 diff 的 agent,跨框架外推性存疑。第五,PASS 判定不含代码质量维度,可能奖励'打补丁式'修复而非干净的接口重构。
未来方向
作者提出的方向包括:扩展到更大的互依赖仓库网络;在任务中引入无关仓库以评测仓库发现与选择能力;在其他脚手架上直接验证结论的外推性。在此之上可以延伸:把联合必要性测试用作强化学习的奖励信号,训练跨仓库协调策略;利用 171 个 gold patch 研究'上游 API 变更→下游自动适配'的变更传播模型;构建跨仓库接口契约(schema/协议)的形式化检查并嵌入 CI 拦截不一致提交;研究 $N\ge 3$ 的长依赖链下的任务分解与补丁应用顺序策略;探索多智能体分工范式——每个仓库一个 agent、以共享接口规范为协调媒介,对照本文揭示的单体 agent 协调瓶颈。
复现评估
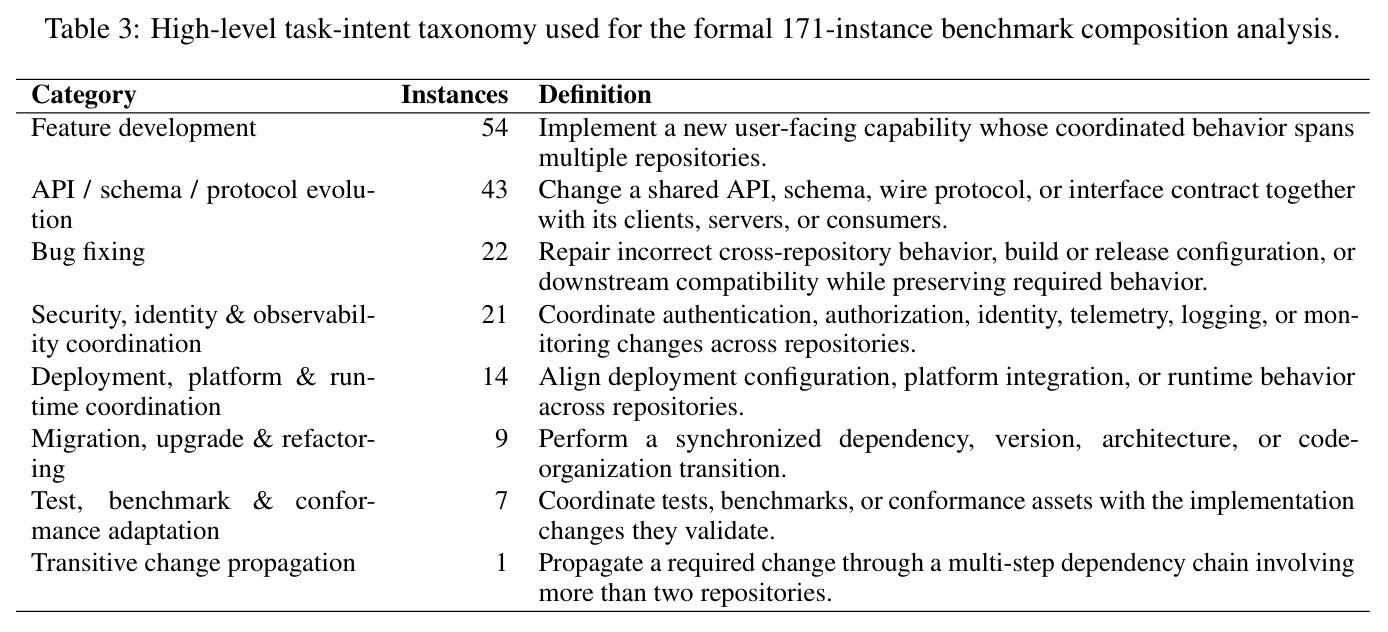
复现条件较好:数据集在 HuggingFace 公开(CrossSWE/CrossSWE-Bench),非代码材料采用 CC-BY-4.0,第三方源码遵循各自上游许可,165 个仓库的许可已逐一核查并记录(涉及商业授权的 MUI X 组件按官方文档允许非生产基准用途)。复现评测需要 Docker,每实例上限 300 步、$10;按 Table 1 的平均成本估计,跑一个模型约 $50–90(171 × $0.29–0.52),五个模型全量约 $300–450,属于中小规模实验预算。主要工程量在环境构建:需为每个实例复原多仓库 base commit 与依赖安装,并重跑 $2^N$ 配置验证联合必要性;人工筛查与失败标注环节难以完全自动化,从零重建基准成本高,但仅复用现成实例做模型评测则难度中等。附录 Table 3 的任务意图分类表也为复现分析提供了清晰口径。
论文图表
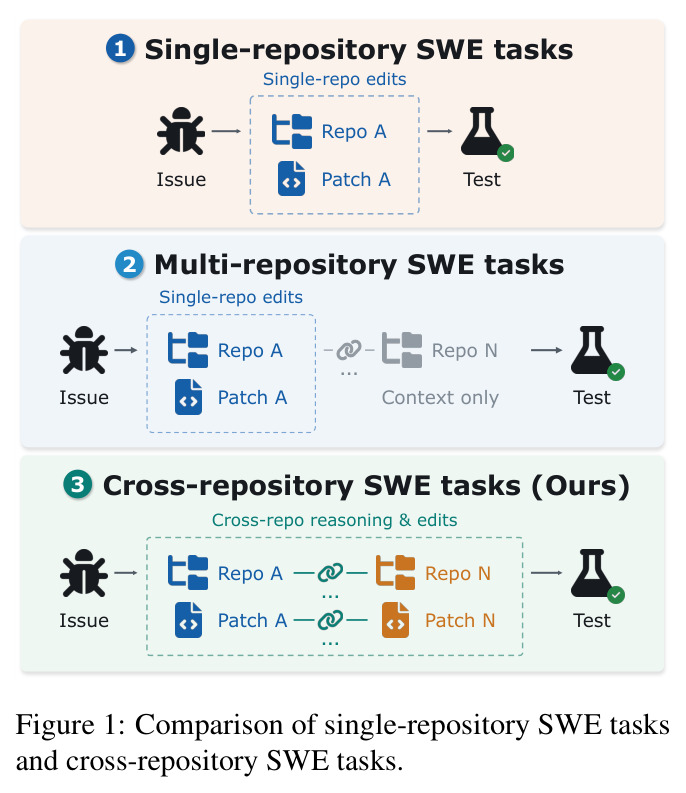
三层对比图:单仓库 SWE 任务中 issue 只需产出 Patch A 并通过单仓库测试;现有多仓库设定(如 BeyondSWE/DepBench)虽给智能体 Repo N 作上下文,但补丁与测试仍限单仓库;CrossSWE 则要求跨仓库推理与编辑,issue 同时产出 Patch A 和 Patch N 并由联合测试验证。
一图说清本文的任务定义与相关工作(单仓库 / 多仓库上下文 / 跨仓库联合)的本质差异,是理解全文定位的入口。
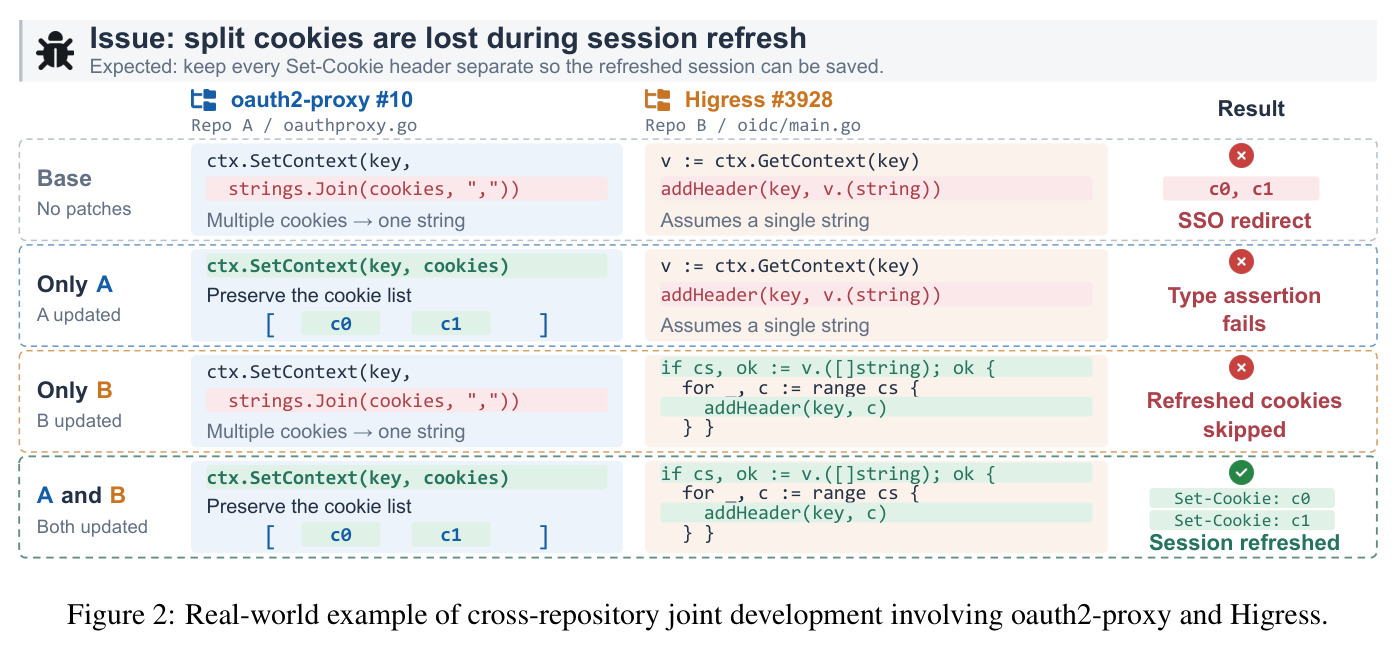
以 oauth2-proxy #10 与 Higress #3928 的真实联动修复为例,枚举四种补丁组合的结果:全 base 时多个 cookie 被合并导致 SSO 重定向失败;只改 oauth2-proxy(保留 cookie 列表)时 Higress 的类型断言失败;只改 Higress(逐条发送)时刷新后的 cookie 被跳过;两边都改才得到独立的 Set-Cookie: c0、Set-Cookie: c1,会话成功刷新。
用具体代码级例子直观证明'联合必要性'——单边修改各有不同的失败方式,这是整个基准设计哲学的最佳具象化。
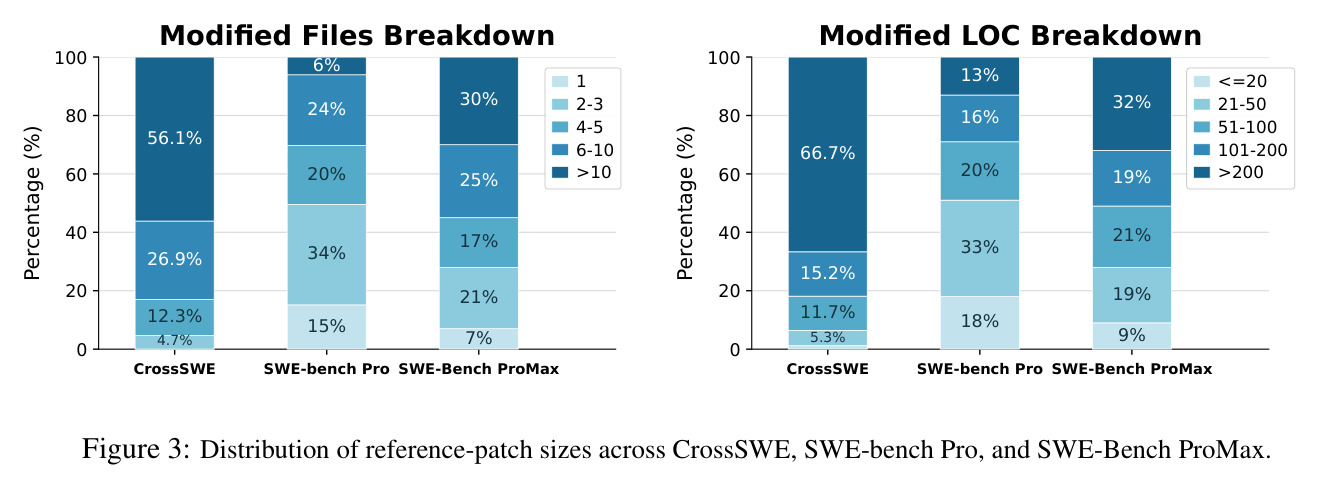
两组柱状图对比三个基准的参考补丁规模分布:CrossSWE 有 56.1% 实例修改超过 10 个文件(SWE-bench Pro 6%、ProMax 30%),66.7% 实例改动超过 200 行(Pro 13%、ProMax 32%)。
定量确立 CrossSWE 在改动面维度上显著超越现有基准,支撑'跨仓库任务天然更复杂'的论点。