编码智能体基准应匹配其用户的任务流 Coding-Agent Benchmarks Should Match Their Users' Task Flows
用真实IDE会话测得的任务流校准SWE基准的多轮交互层
前置知识
SWE-Bench 类 issue 基准
从开源仓库真实 issue 构建的编码智能体评测:给定仓库快照和一条 issue 描述,智能体提交补丁,由隐藏测试套件判定是否解决,核心指标是 resolve rate。SWE-Bench、SWE-Bench Pro、SWE-rebench、DeepSWE 等均属此类,交互形式被固定为“一条详细任务描述 + 一次终局打分”,基础设施和测试很有价值,但交互层从未被当作评测变量。
本文的 SWE-TaskFlow 就是对这类基准做改造:保留其仓库、环境与测试,只重造交互层,因此必须先理解它的结构与局限。
Jensen–Shannon 散度(JSD)
衡量两个概率分布差异的对称度量,可视为 KL 散度的对称化平滑版本,取值有界。以 2 为底时 $\mathrm{JSD}_2(P,Q)\in[0,1]$,取 0 当且仅当两分布完全一致。本文用它比较目标分布 $P_k$ 与基准分布 $Q_k$,定义分量分数 $S_k=1-\mathrm{JSD}_2(P_k,Q_k)$。
任务流对齐分数 TFAS 完全建立在 JSD 之上,是理解论文校准与选优机制的工具基础。
任务流(Task Flow)
本文核心概念:一个交互语料库的任务流形式化为三元组分布 $(P_L,P_T,P_R)$——会话长度分布、用户消息任务类型分布(16 种意图,如 bug 修复、新功能、解释代码、规划、评审、重构、执行等)、以及相邻消息类型间的有向转移分布。转移分布保留了标签直方图会丢失的顺序信息。
全文的测量、校准与评测都围绕任务流展开,它是把“交互是否真实”变成可计算对象的关键。
研究动机
主流编码智能体基准几乎都从 issue 派生:给智能体一条事先写好的详细任务描述,用一次终局补丁打分。作者拿到 JetBrains IDE 中真实工程师的 4,782 个智能体会话(约 14,000 条用户消息)对比后发现两个系统性错位。其一,任务类型分布完全不同:SWE-Bench Pro 中新功能(54.7%)与修 bug(39.1%)合计占 93.8%,而真实长会话中这两类只占 25.9% 和 18.9%,解释代码(EXPLAIN 6.1%)、通用提问(QUESTION 9.7%)、规划、评审、重构、执行等意图占了近半壁江山。其二,用户会在一个会话内不断切换意图:先提新功能需求,接着询问现有行为、做规划、再请求评审,而 issue 基准只测“按 upfront 规格一次性实现”,完全忽略需求逐步展开时的适配能力。更麻烦的是,作者把同一分类管线应用到 SWE-chat、SpecStory、DataClaw 三个公开交互语料,得到的任务流彼此明显不同,说明不存在普适的“真实”交互分布,在一个产品上测得的分布不能迁移到另一个。
本文的目标是论文的立场是:交互式基准必须明确声明自己代表谁的交互分布。为此它给出一套可操作的做法:先把语料级任务流形式化为三元组 $(P_L,P_T,P_R)$,以长会话(至少 3 条用户消息,占样本 33%)切片为实测目标;再提出 SWE-TaskFlow,一种把任何 issue 派生基准改造为多轮交互评测的通用方法——保留原任务已验证的仓库状态、执行环境与测试,只重新生成交互层(提示拆分 + 可验证的仓库问答),并以任务流对齐分数 TFAS 从候选轨迹中选出最贴近目标分布的组合;同时把单个终局分数换成逐轮可验证信号(拆分轮后对已披露需求跑测试、QA 轮对照参考答案评分)。最终在 700 个 SWE-Bench Pro 任务上做试点,检验交互协议本身是否改变测量结果。
与已有工作不同的是,已有工作要么沿用“单条 issue + 单次补丁”的协议(SWE-Bench 系列只是换数据不改交互),要么在反应式基准(隐藏需求、模拟用户、注入编辑)里临时拍定交互形态并引入模拟器假设。本文的独特切入点是把“测得的交互分布”变成设计目标与对齐对象:不发明多轮形式,而是先用统一的意图分类管线测量生产会话与公开语料的任务流,实证‘没有普适真实分布’,再要求基准点名目标用例并校准到其实测任务流。同时,改造对象限定为已验证的 SWE 任务,避免丢弃现有仓库状态、环境和测试投资。此外,SWE-TaskFlow 的交互层在推理前完全固定、可精确重放,支持严格配对比较;逐轮信号取代单一终局分数,这在 issue 派生基准谱系中是新的。
核心方法
直觉上,真实施工不是一次读完规格说明书:需求逐步披露,用户还会穿插提问和评审。因此方法分两层:任务层完全不动(仓库、要求的改动、环境、终局测试保持原样),只重造交互层。技术路线是两类增强加一个选择准则。第一,提示拆分:针对 issue 的过指定问题——一条消息写全目标、上下文、约束甚至做法——把一条 issue 拆成 $K=3$ 个有序、各自可执行的用户轮次,逼智能体在需求逐步展开时做适配;不过检的 issue 保持单轮。第二,仓库 QA:从“解决原 issue 的智能体轨迹 + 实时仓库状态”中挖掘 0–3 个关于仓库行为的可验证问题,注入基准缺失的 EXPLAIN 意图;每个候选带隐藏参考答案,须在干净仓库副本上通过可执行证明脚本。两类增强组合出每个任务 1–6 个用户轮次。第三,用 $\mathrm{TFAS}=100\cdot(S_L S_T S_R)^{1/3}$、$S_k=1-\mathrm{JSD}_2(P_k,Q_k)$ 度量候选与目标任务流的接近程度,在任务数与多样性约束下选 TFAS 最高的候选。评测统一用 mini-swe-agent 脚手架。
核心创新有三点。第一,把“交互协议”提升为一等评测维度并给出可优化的目标:TFAS 将会话长度、任务类型、类型转移三个分布对齐度的几何平均压缩成 0–100 的分数,使“更接近真实用户”从口号变成可计算的选优准则,这是与 SWE-rebench、DeepSWE 等只换数据不改交互的后续工作的本质区别。第二,与既有固定轨迹的改造不同,轨迹形态不是临时设定,而是校准到实测分布(长生产会话),所以拆分粒度、QA 数量与摆放位置都有量化依据,而非拍脑袋。第三,验证机制设计:QA 问题源自解题轨迹且要求“在补丁前后都成立、不泄漏解法、证明脚本可执行”,使一轮交互同时产出可验证信号——每个拆分轮后对已披露需求运行测试套件,每个 QA 轮由模型裁判对照参考答案评分;单轮轨迹只有 1 个二值信号,而 Split+QA 轨迹可产出密集的信号序列,直接支撑更细粒度的诊断与基于排序的训练。
方法步骤详情
流水线六步。第一步,测目标:取 4,782 个 JetBrains 生产会话(约 14,000 条用户消息),每条消息由开源权重 LLM 分类到 16 种意图,三模型一致率 76.1%,统计长会话切片(≥3 条消息,占 33%,75/90 分位为 3/8 条)的 $(P_L,P_T,P_R)$。第二步,提示拆分:LLM 把 issue 拆成 $K=3$ 个有序轮次,硬约束是保留全部原始需求、不引入新需求、技术产物逐字保留、每轮在前轮留下的仓库状态下可执行。第三步,QA 生成:从解题轨迹加实时仓库挖掘 0–3 个问题,候选须有隐藏参考答案、补丁前后均有效、不泄漏解法,并通过干净仓库副本上的证明脚本。第四步,摆放:问题置于 issue 轮之前、之间或之后,形成 1–6 轮候选,731 个公开任务保留 700 个。第五步,选择:计算 TFAS(剔除三类无法实例化的意图),在任务数与多样性约束下最大化它,选中方案把 TFAS 从纯拆分的 59.6 提到 77.8。第六步,评测:mini-swe-agent 统一脚手架,四个前沿模型各 3 次运行,记录成本、resolve rate 与逐轮信号。
技术新颖性
技术新颖性体现在组合与校准而非单点算法。提示拆分类似把长 prompt 切短,但本文给它加了“零信息增减 + 逐轮可执行”的硬约束,把过指定变成渐进披露的可控实验变量;仓库 QA 借鉴了 SWE-QA、SWE Atlas、RepoProbe 等仓库问答工作的思路,但这里的问题必须挂在已验证任务上、答案可机判、且不影响终局测试的有效性,评测价值与任务价值同时保住。TFAS 的设计也有讲究:用底 2 的 JSD 保证 $S_k\in[0,1]$;几何平均保证任一分量趋零会拖垮整体,强迫长度、类型、转移三类分布同时对齐而非只优化最容易的那一类;从 16 类中剔除 GREETING、META-QUESTION、OTHER 三类,避免无法实例化为仓库任务的意图引入噪声;并要求每个分量随聚合分数一起报告以防掩盖单分量失败。相比附录 D 中需要模拟器假设的反应式基准,静态可重放设计牺牲‘反应性’换取严格配对比较,作者明说了这是互补权衡。
实验结果
试点在 700 个 SWE-Bench Pro 任务(731 个公开任务经检查后保留 700 个)上进行。发现一:渐进披露稳定改变成本而不稳定改变成功率。同一批任务、同一脚手架、4 个模型各 3 次运行,Split 提示使平均每题智能体成本约翻倍(图 2 横轴为对数尺度美元),而 resolve rate 各模型有升有降,波动与运行间噪声相当,未建立稳定排序——交互协议改变的是智能体付出的努力而非任务难度。发现二:校准有效。按 TFAS 调优 QA 数量与位置后,对长会话生产目标的 TFAS 从纯 Split 的 59.6 升到 Split+QA 的 77.8(+18.2);QA 轮只增加适度成本,QA 顺序对 resolve rate 和答题准确率均无稳定影响。发现三:QA 提供第二可验证信号,四个模型在选定基准上的答案准确率为 69.8%–83.0%,把单轮轨迹的 1 个二值信号扩展成“每轮拆分后一次测试判定 + 每轮 QA 一次裁判评分”的密集信号序列。背景数据:生产会话 50.9% 只有单条消息,≥3 条占 33%,首条消息平均 30.7 词、后续 16–19 词。
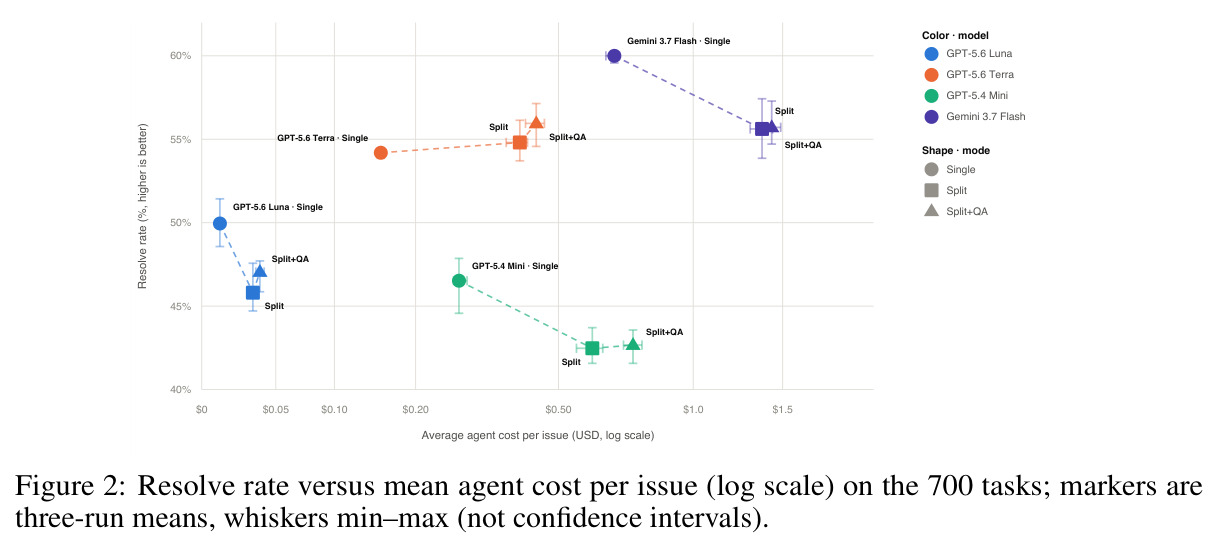
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 700 个 SWE-Bench Pro 任务上的多轮拆分求解 | resolve rate(3 次运行均值,min–max) | Split:与 Single 相比各模型升降不一,波动与运行间噪声相当,无稳定排序 | Single 单轮提示(原版交互协议) | 成功率无稳定变化(渐进披露改变成本而非难度) |
| 同一批任务的交互成本对比 | 平均每题智能体成本(USD,对数尺度) | Split 使成本约翻倍;Split+QA 在此之上仅适度增加 | Single 单轮提示 | 约 ×2 成本,换来逐轮可验证信号 |
| 交互层与长会话生产目标任务流的对齐 | TFAS(0–100) | 77.8(Split+QA,经校准选优后) | 59.6(纯 Split,无 QA) | +18.2 |
| 仓库 QA 轮的答题 | 答案准确率(模型裁判对照参考答案) | 69.8%–83.0%(四个模型区间) | 无对应基线(本文新增的第二可验证信号) | 在 resolve rate 之外提供逐轮诊断与训练信号 |
局限与改进
作者明确承认:长生产会话只是众多用例之一,方法可换任何实测目标但本文只做了这一个;意图分类器没有人工标注的准确率集合,只有 76.1% 的三模型一致率和逐意图人工抽查;部分 issue 无法通过拆分检验(731 个只保留 700 个);QA 难度依赖生成器质量;每条件仅 3 次运行,报告 min–max 而非置信区间,所有 resolve rate 对比只是方向性结论、无显著性检验。我的补充观察:其一,16 种意图里大多数(通用提问、规划、评审、重构、执行、无修复的调试等)尚无对应增强,作者也坦承如何自动验证一轮规划或评审仍是开放问题,所以当前基准只覆盖真实任务流的一角;其二,成本翻倍本身可能是干扰项——更贵的轨迹未必是更有价值的训练信号,论文没有拆解成本去向;其三,生产数据仅以匿名聚合统计发布,第三方无法独立复算目标任务流,只能信任作者报告的分布;其四,TFAS 用几何平均,若某个分量极低仍可能被另外两个高分量部分掩盖,须依赖‘分量随聚合一起报告’的纪律。
独立分析的弱点
第一,分类管线的可信度:意图标签完全依赖开源权重 LLM,没有人工金标集,76.1% 的一致率意味着约四分之一消息存在模型间分歧,而 $P_T$ 与 $P_R$ 都建立在这些标签上,TFAS 的目标分布本身可能带系统偏差。改进方向:构建数百条人工标注集,报告逐意图准确率并做目标分布的敏感度分析。第二,QA 裁判偏差:QA 答案由模型对照参考答案评分,裁判与被测模型可能同源,69.8%–83.0% 的准确率可能混入裁判偏差。改进方向:抽样人工复核裁判一致性,或把部分问题改造成可执行测试式的机判形式。第三,拆分质量不可控:LLM 拆分可能改变需求呈现顺序从而隐性提示解题路径,成本翻倍中多少来自‘真实渐进披露’、多少来自‘信息被切碎导致的重复探索’没有分离。改进方向:增加随机拆分对照消融。第四,生产会话只统计用户侧消息、忽略智能体回复,任务流不包含‘智能体表现如何触发下一轮用户意图’的信息;且全部结论基于 JetBrains 用户群体,对其他工具用户的外推性未知。改进方向:补充含助手侧的双向转移分析,并在第二家厂商数据上重复测量。
未来方向
作者提出的方向:为剩余意图设计各自的可验证增强——通用提问、规划、代码评审、重构、执行、无修复的调试等,其中“如何自动验证一轮规划或评审”是公开难题,需要新的弱验证器;静态与反应式机制互补,完整评测套件可以是校准过的静态核心加定向反应式切片(隐藏需求、模拟用户、注入编辑、求助行为);方法适用于任何实测目标分布,可为不同用户群体生成不同校准的基准版本。基于其成果可延伸的方向:其一,用密集逐轮信号做基于排序的强化学习或过程奖励模型训练,这是作者引用 ranking-based training 的直接用武之地,也是把评测资产转化为训练资产的最短路径;其二,把 TFAS 反向用于数据筛选——从真实会话日志中挑选与目标任务流匹配的轨迹做模仿学习;其三,把“成本翻倍”现象本身作为研究对象,分析交互协议如何改变智能体的探索策略与失败模式;其四,为规划/评审轮设计基于 rubric 或交叉模型评审的弱验证器,逐步逼近可机判;其五,在更多 issue 派生基准(SWE-rebench、DeepSWE 等)上实例化 SWE-TaskFlow,验证方法的基准无关性。
复现评估
复现条件中等偏有利。开源部分:全部生成任务作为一个公开数据集发布(附录 E);拆分与 QA 的生成方法学、流水线细节、TFAS 计算与选优消融分别在附录 E/F 完整描述;意图分类使用开源权重模型(附录 A 给出分类法、提示与鲁棒性检查);评测脚手架 mini-swe-agent 本身开源。算力方面:图 2 显示每题每次运行成本约在 $0.05–1.5 的对数区间内,试点规模约为 700 任务 × 3 模式 × 4 模型 × 3 次运行,用前沿 API 模型即可负担;数据构建阶段需要能解题的强模型轨迹来生成 QA,是主要算力门槛。不利部分:JetBrains 生产会话只发布匿名聚合统计,原始用户消息不公开,第三方无法独立复算 $P_L,P_T,P_R$,只能信任作者报告的分布;三个公开交互语料(SWE-chat、SpecStory、DataClaw)的处理细节在附录 B,其中部分语料的可用性取决于上游发布。总体而言:评测层复现容易(开源数据 + 开源脚手架 + 公开 API),目标分布的独立验证困难(依赖私有数据),这是此类‘以工业界数据为锚’的研究的通病。
论文图表
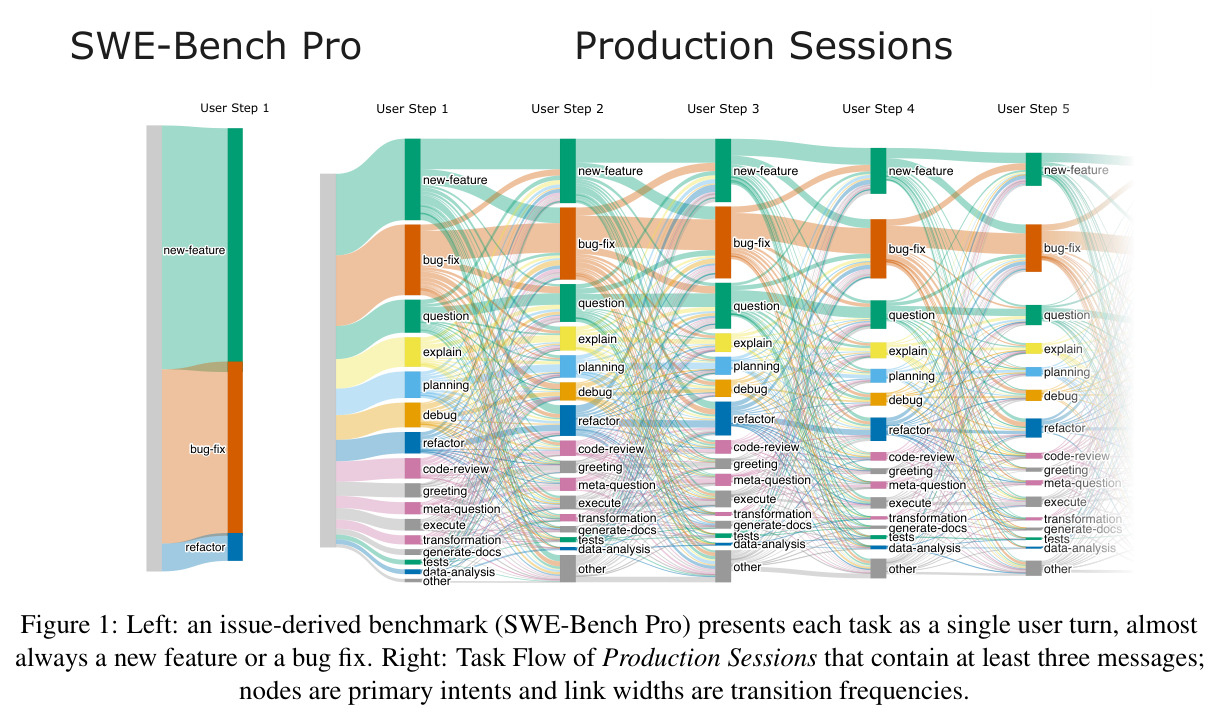
左半部分展示 issue 派生基准(SWE-Bench Pro)的交互形态:每个任务只有单条用户消息,意图几乎总是新功能(54.7%)或修 bug(39.1%)。右半部分是含至少 3 条消息的生产会话的任务流图:节点为 16 种主要意图(new-feature、bug-fix、question、explain、planning、debug、refactor、code-review、greeting、meta-question、transformation、execute、generate-docs、tests、data-analysis、other),连边宽度编码相邻消息间类型转移的频率;按步骤分列展示可见 bug-fix、question、explain、planning、debug 等意图在各位置持续出现。
一图概括全文动机:基准的单轮、实现主导的交互与真实用户多意图、频繁切换的任务流形成鲜明对比,是论文立场(‘没有普适真实的交互分布,须实测并校准’)的直观证据,也解释了为什么需要提示拆分与 QA 增强这两种特定的改造手段。