Flide:以精确状态分叉加速决策推理 Flide: Accelerating Decision Inference with Exact State Forking
Flide解耦决策请求的逻辑树与物理执行,精确分叉状态,最快提速9.5倍
前置知识
决策模型(Decision Model)与 System One 推理
一类不做自由文本生成、单次前向即输出离散选项概率分布的轻量模型(如 Jev、Open-Jev)。它读入一段长上下文状态(对话历史或 Agent 轨迹),并行回答多个关于该状态的问题,选项概率按 $p_i(o) = \exp(w_o^\top h_i) / \sum_{o' \in O_i} \exp(w_{o'}^\top h_i)$ 计算,供路由、响应评估、动作选择等下游模块用阈值直接消费。
本文全部设计目标都源于这类负载的三个特性:共享长前缀、一次多问、概率直接驱动阈值决策,因此引擎必须又快又精确。
KV 缓存与前缀共享(Prefix Sharing)
Transformer 推理时缓存每层的 key/value,使重复前缀不必重复计算。vLLM 的 prefix cache、SGLang 的 RadixAttention 等把前缀组织成树形缓存,多个请求命中同一前缀时复用其 KV,省去重复 prefill。其执行模式是时间分离的:先算完共享前缀写入缓存,每个问题再作为独立序列从缓存恢复执行。
Flide 的主要对比基线正是 prefix caching,理解其「先算前缀、再逐序列恢复」的模式,才能看出 Flide 单轮单次前向的本质差异。
混合架构与 Gated DeltaNet 循环状态
Qwen3.5 等混合模型在大部分层用 Gated DeltaNet 取代注意力:它把全部历史压缩进一个矩阵状态 $S_t$,按门控 delta 规则 $S_t = \alpha_t S_{t-1}(I - \eta_t k_t k_t^\top) + \eta_t v_t k_t^\top$、$o_t = S_t q_t$ 递推更新,前面还接一个短因果卷积。由于没有注意力矩阵可加掩码,共享序列中的两个分支无法在循环层内用掩码分离。
这是全文最难的技术点:如何在循环层让每个问题从树干的精确状态出发续接递推,ForkAttention 的两段式调用正是为此设计。
CUDA Graph 与图重放
GPU 逐个发起数千个 kernel 的 CPU 启动开销可达毫秒级,CUDA Graph 把整个前向的 launch 序列捕获成图,之后一次重放即可执行,大幅降低短请求时延;代价是捕获时每个 kernel launch 的形状被固定。传统方案靠把请求填充到静态形状来适配,但浪费算力且仍以单序列为执行单元。
决策请求只有几毫秒 GPU 时间,图重放是低时延的关键;Flide「图按流长度捕获、树写进 GPU 元数据」正是为了绕开形状固定的限制。
总变差距离与位级确定性(Batch-Invariant Inference)
总变差(TV)距离 $\mathrm{TV}(P,Q)$ 衡量两个离散分布的最大差异,论文用它度量各引擎输出与 float32 参考分布的偏离。动态批处理会改变浮点求和的归约顺序,导致同一输入在不同负载下答案漂移;batch-invariant 推理固定每个输出元素的求和顺序,使结果逐位一致。
Flide 的第二卖点是精确性:TV 距离最小、可选位级一致模式。没有这两个概念就无法理解它对 MIS 分隔符概率污染的批评。
研究动机
决策模型(如 Jev)正成为 LLM Agent 系统的 System One 执行层:给定一段长上下文(对话或 Agent 轨迹),模型对多个离散问题输出概率分布,供路由、响应评估、动作选择等模块消费,严格阈值直接作用在这些概率上。这类负载的特征是多个问题共享同一份状态。但现有推理引擎为文本生成设计,以单条线性序列为基本工作单元,处理决策请求时出现两类故障。其一,vLLM/SGLang 把每个问题当独立 prompt,同一上下文被渲染、tokenize、计算 n 次;即便 vLLM 新版预先算好共享前缀,混合架构上循环状态也只能在粗粒度 block 边界恢复,边界后的 token 仍被每个问题反复重算。其二,SGLang 的 multi-item scoring(MIS)把所有问题拼进一条序列并在每个问题前插入分隔符,这个额外 token 改变了隐藏状态,使输出概率相对孤立 prompt 发生偏移,阈值判决被翻转。此外动态批处理改变浮点求和顺序,同一请求在不同负载下给出波动答案。根因在于:决策请求的逻辑结构是一棵树(共享状态为干、问题为枝),而物理执行结构是单条序列,两者被现有引擎强行耦合。
本文的目标是构建一个既快又精确的决策模型推理引擎:在精确算术意义上,每个问题的计算结果必须与它作为孤立 prompt 单独前向时完全一致,不受同批其他问题、其他请求影响;同时把每轮计算量压到信息论下界 $P + \sum_i |q_i|$,即共享状态只算一次、每个问题的 token 也只算一次。可量化的目标包括:(1)在 Qwen3.5、Gemma 4 等混合与全注意力模型上,多问题共享状态的负载相对 vLLM/SGLang 取得数量级时延优势(最终达到最高 9.5 倍);(2)输出分布相对 float32 参考的总变差距离最小,阈值判决翻转率不超过约 2.3%;(3)提供可选位级确定模式,使任何负载下答案逐位一致;(4)支持 Agent 历史增量增长时从检查点恢复,边际成本控制在每千 token 约 1 毫秒量级。
与已有工作不同的是,已有工作分成两派且各有盲区。prefix caching 一派(RadixAttention、cascade attention、混合架构的 block 边界状态缓存)让共享前缀只算一次,但每个问题仍作为独立序列从缓存恢复执行,且强制「先算完前缀、再跑下游」的时间分离;对循环状态只能在粗粒度 block 边界物化,或要求预定义检查点位置。拼接派(SGLang MIS)确实让分支共享一次前向,却把树结构直接写进了序列本身——分隔符 token 进入每个分支的输入,破坏孤立语义,还需要 CPU 管理的分段、破坏 CUDA graph 捕获。投机解码的 tree attention 只服务 token 树而非请求树。本文的独特切入点是:逻辑树与物理布局可以彻底解耦——树保留为 GPU 端元数据,物理上压成一条无填充的扁平 token 流,用索引而非分隔符或独立序列表达分支关系,从而在混合模型的循环层内实现流内任意位置的零拷贝状态分叉,这一能力此前被循环结构排除(因为循环状态把所有历史折叠进一个矩阵,无法用掩码分离分支)。
核心方法
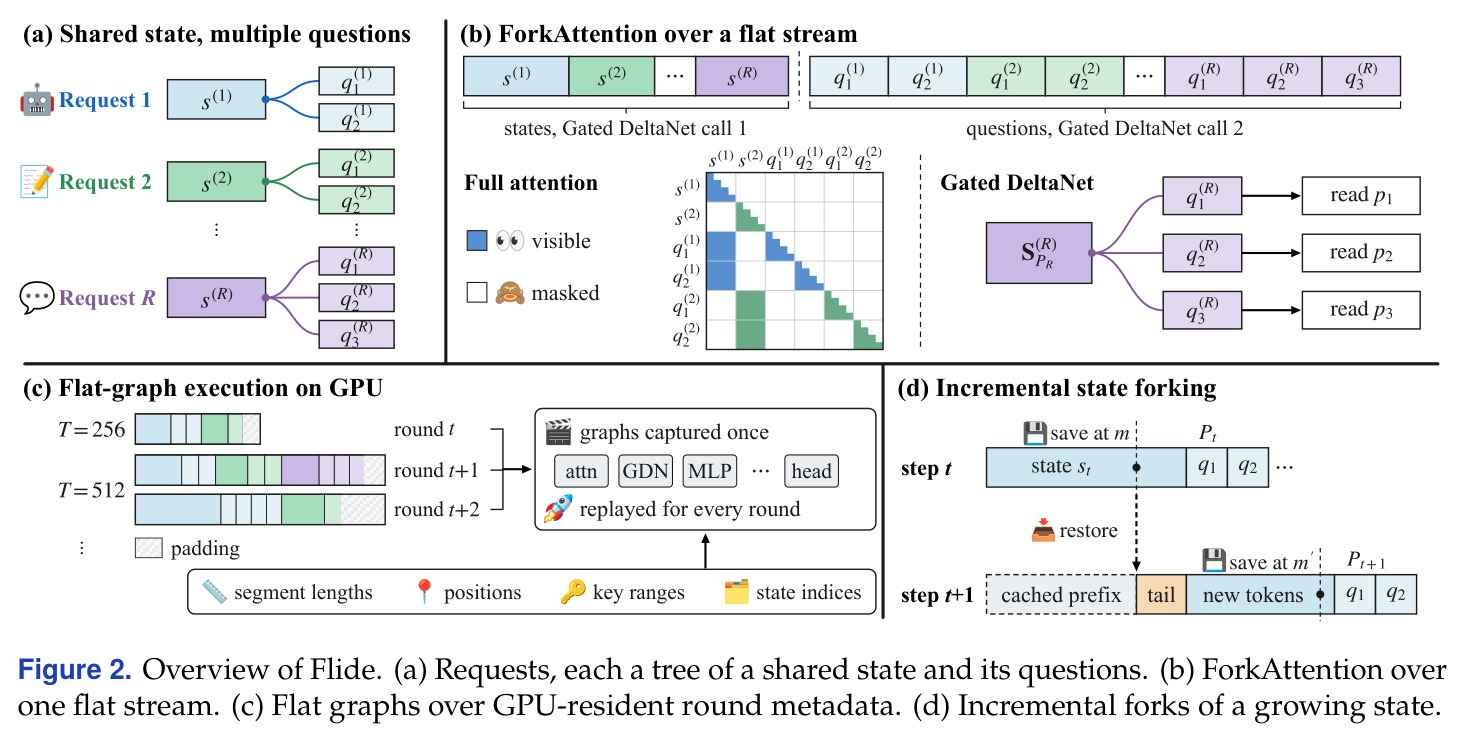
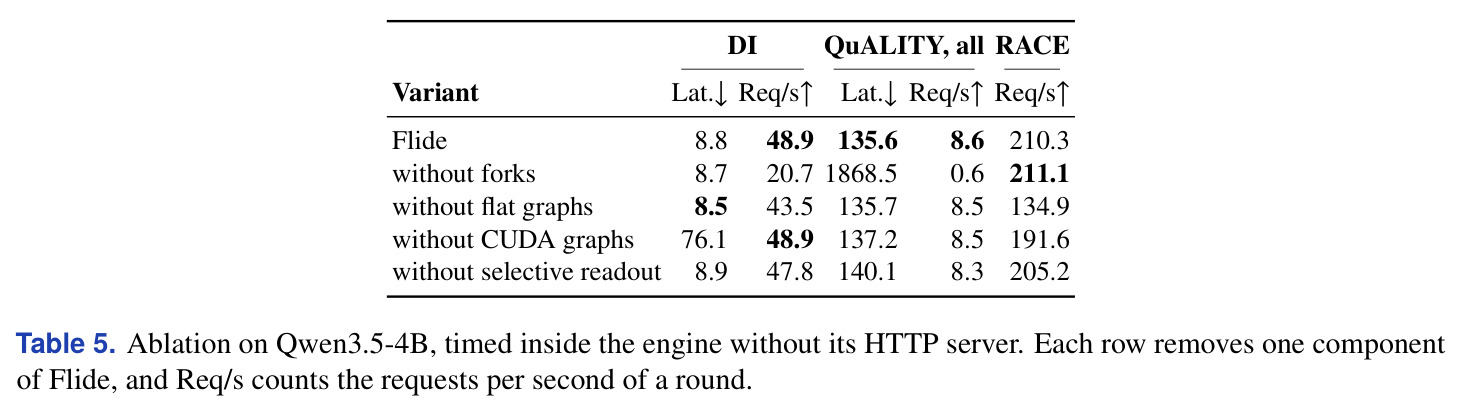
直觉上,一个决策请求像一棵树:共享状态 $s$ 是树干,$n$ 个问题是树枝,每根枝只需看到树干和自己。Flide 把「树长什么样」(逻辑)和「树怎么在 GPU 上跑」(物理)彻底分开。物理上,一整轮 R 个请求被压成一条连续 token 流:状态段在前、问题段在后,请求间不留填充;逻辑树则编码进 GPU 常驻元数据——每个 token 携带请求号 $j$、分支号 $c$($c=0$ 表示树干)、位置 $t$ 三个索引。token 混合层按元数据决定可见性:全注意力层用掩码让每个问题只看见自己的树干和自身;Gated DeltaNet 循环层分两次调用,第一次算完所有状态段得到各请求的末端状态 $S_P$,第二次所有问题段并行执行、各自经状态索引从自己的 $S_P$ 续接递归,不做状态拷贝。整个流的 launch 形状只取决于流长度 $T$,因此少量按 $T$ 分桶捕获的 CUDA graph 通过改写元数据缓冲区即可服务任意请求组合。输出头最后只在每个问题末 token 上做选择性读出。消融显示去掉扁平图短请求吞吐从 210.3 掉到 134.9 req/s,去掉 CUDA graph 短输入时延从 8.8ms 涨到 76.1ms,每个组件都必要。
核心创新是 ForkAttention 的精确状态分叉:让每个问题在同一次前向中,从其树干的精确内部状态出发,算出与孤立 prompt 完全一致的结果。与已有方法的本质区别有三。第一,与 prefix cache 类方案相比,Flide 不需要「先算共享前缀、缓存落盘、再逐序列恢复」的时间解耦——状态与所有问题在同一轮扁平流中一次算完,分支可在流的任意位置精确分叉,不受 block 边界限制;循环状态经 GPU 索引引用传递而非拷贝。第二,与 SGLang MIS 相比,分支输入零污染:没有分隔符进入问题输入,问题 token 的位置编码(RoPE 从 $P$ 继续编号)与孤立情形逐 token 对齐,概率不偏移——论文测得 MIS 的分隔符最高翻转 29% 的阈值判决,Flide 最多 2.3%。第三,与生成引擎把逻辑绑物理不同,Flide 把树写进数据:段长、位置、key 范围、状态索引都在设备缓冲区里,换一批请求只需重写缓冲区,捕获好的 CUDA graph 原样重放,同时保住小请求所需的图重放低开销与任意请求组合的灵活性。论文用命题 1(对层归纳证明)保证精确算术下每个 token 的隐藏状态与孤立前向逐点相等。
方法步骤详情
流程分四步。第一步,渲染与扁平化:按孤立语义渲染每个问题的 prompt,取所有 prompt 的最长公共前缀作为状态 $s$,保证 $s \oplus q_i$ 与孤立 prompt 逐 token 一致;把一轮请求按 $s^{(1)} | s^{(2)} | \cdots | q_1^{(1)} | \cdots | q_1^{(2)} | \cdots$ 排成一条流,每个 token 标注 $(j, c, t)$,问题位置从 $P$ 继续编号;若状态含图像,视觉编码器表征按状态替换占位符一次。第二步,ForkAttention 前向:逐点操作(线性层、归一化、MLP)天然与树无关;全注意力层按可见性规则 $j_y = j_x$、$c_y \in \{0, c_x\}$、$t_y \le t_x$ 构造掩码,滑动窗口层再加 $t_x - t_y < W$;Gated DeltaNet 层两次调用——第一次处理全部状态段、输出各请求的 $S_P$ 与卷积窗口,第二次处理全部问题段、各问题经状态索引续接各自的 $S_P$,因果卷积也经索引读取状态段末尾 token。第三步,扁平图重放:按流长度选最小的已捕获 graph,把段长、位置、key 范围、状态索引写入设备缓冲区后重放;超容量则按请求边界拆成多次重放。第四步,选择性读出:最终层只在每个问题末 token 的行上跑输出头,按公式 (1) softmax 得到概率。Agent 场景下还会在状态内部位置 $m$ 存检查点(float32 循环状态、卷积窗口、$m$ 前的 KV),下一步只算变化的短尾部与新增 token。
技术新颖性
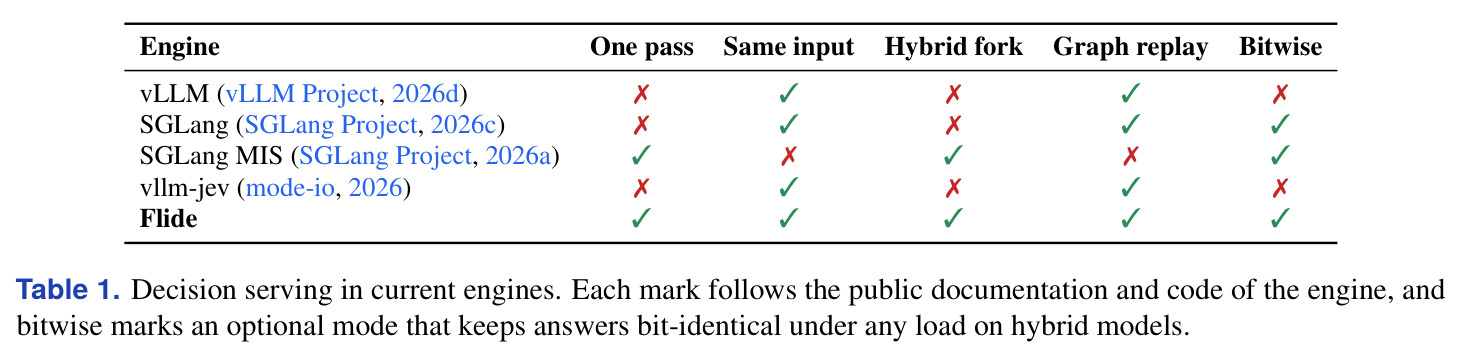
技术新颖性体现在三点。其一,状态分叉的粒度与位置:已有混合架构引擎把循环状态物化限制在 block 边界或预定义检查点,Flide 通过「两段式循环调用 + GPU 索引」实现流内任意位置的零拷贝分叉,这是此前被循环结构排除的能力。其二,结构即数据:树不再是调度器里的对象,而是设备端紧凑元数据,使「一次捕获、任意组合重放」成为可能——消融显示去掉 flat graphs 会让短 RACE 请求吞吐从 210.3 req/s 掉到 134.9 req/s。其三,同时满足五个此前互相冲突的性质(论文表 1):单轮单次前向、问题输入不被污染、混合架构任意分叉、CUDA graph 重放、可选位级确定模式——作为对照,SGLang 的 batch-invariant 内核在 Qwen3-8B 上慢 34%,vLLM 的 batch-invariant 模式无法执行循环 Gated DeltaNet 层,而 Flide 把精确性与速度统一在同一个扁平流执行模型里。
实验结果
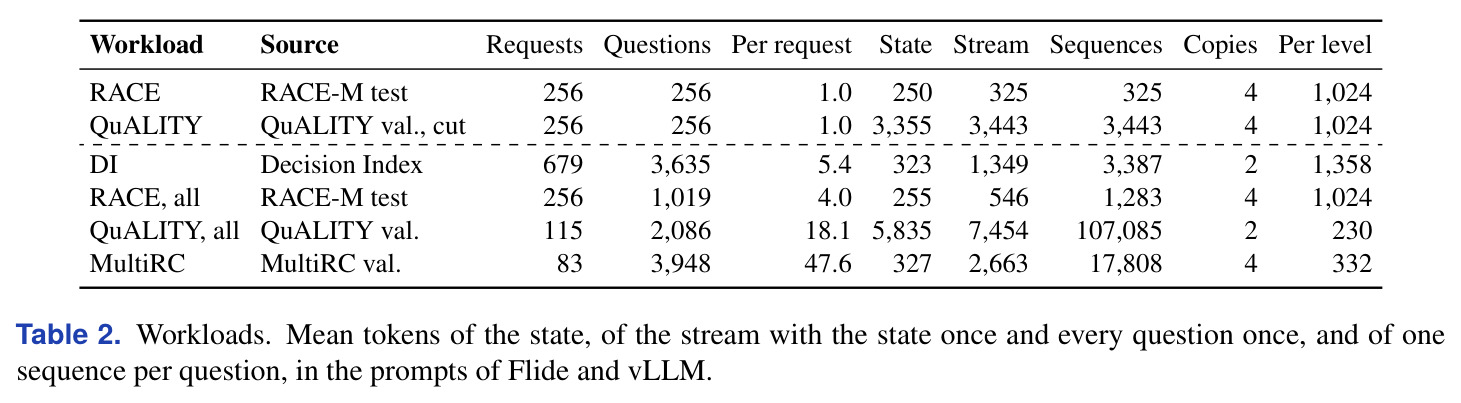
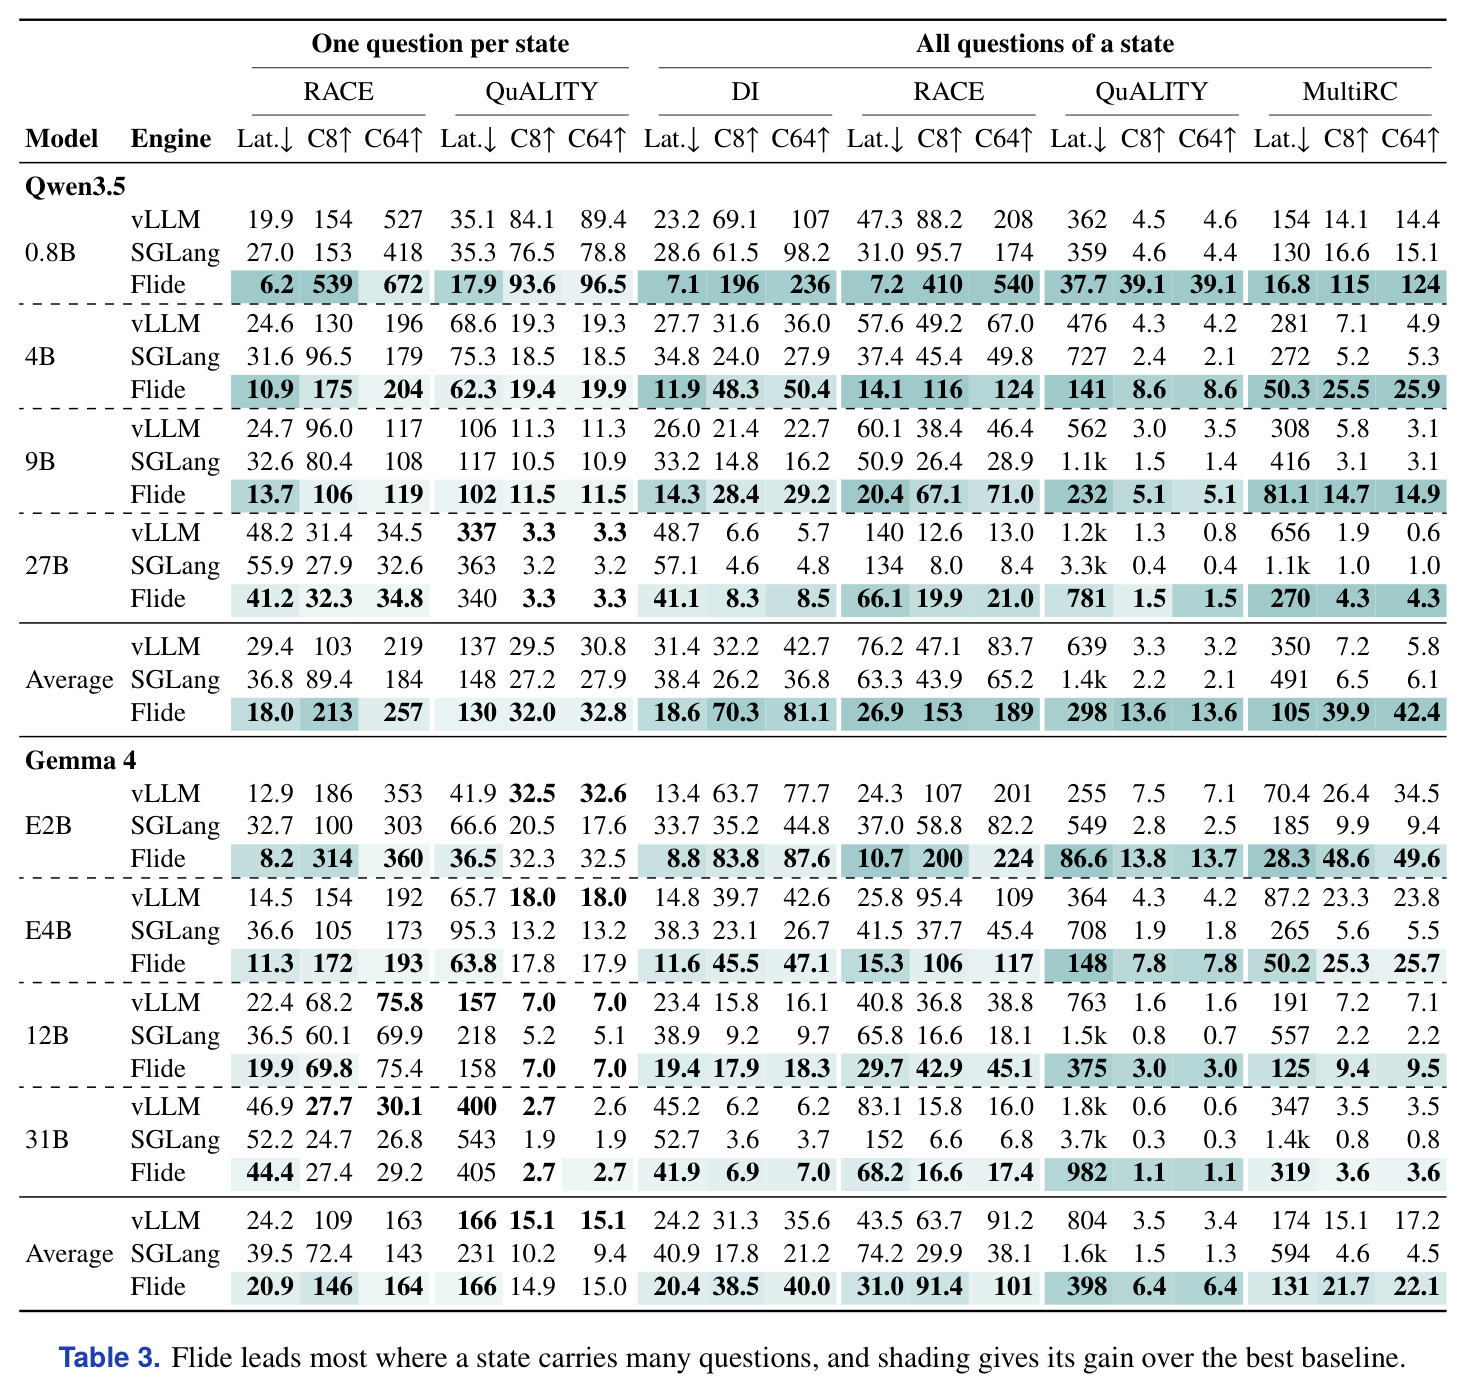
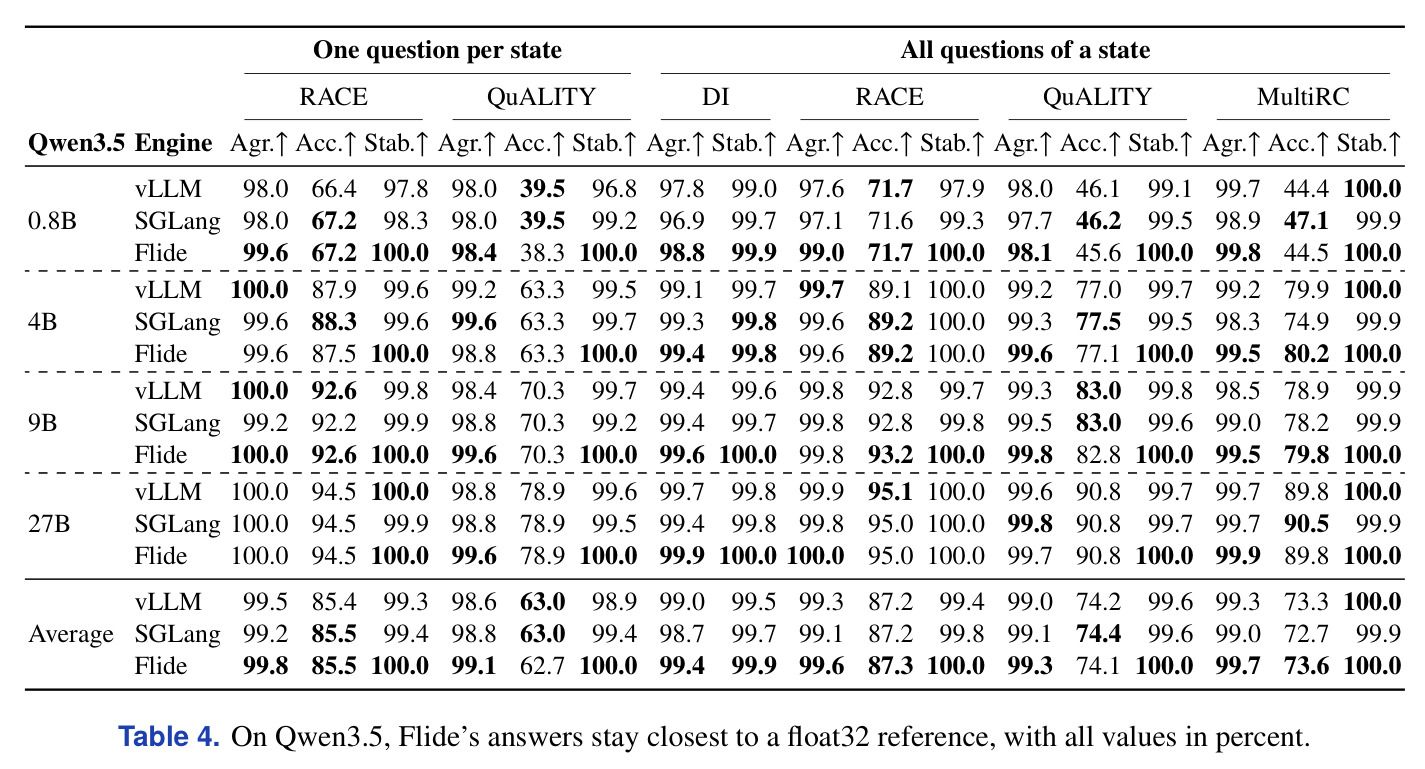
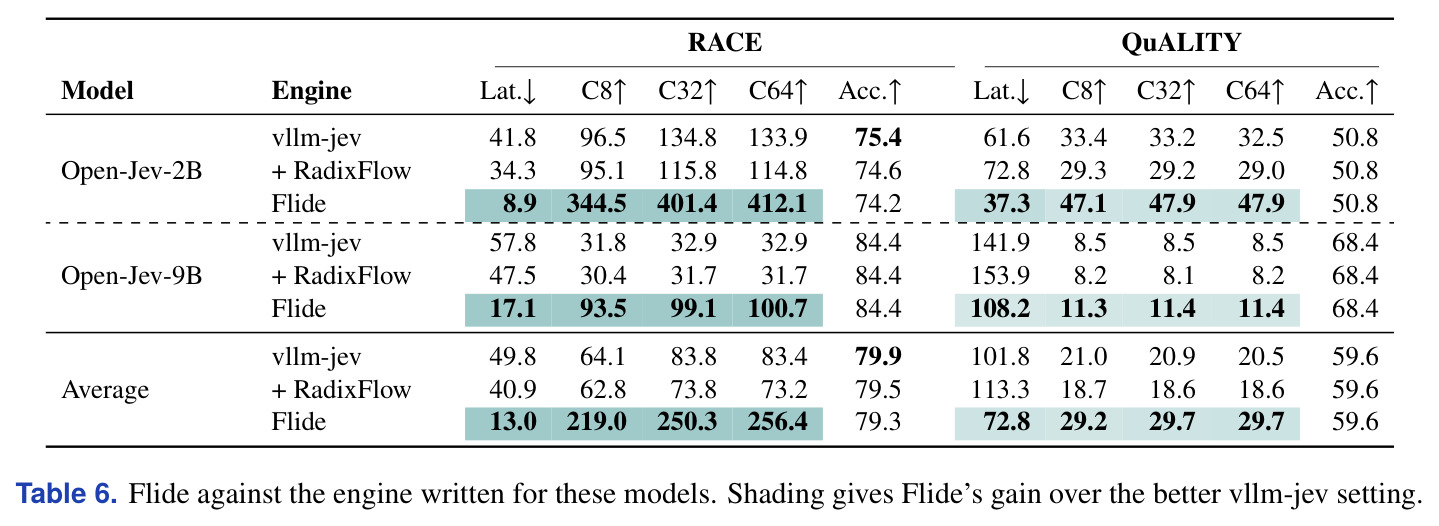
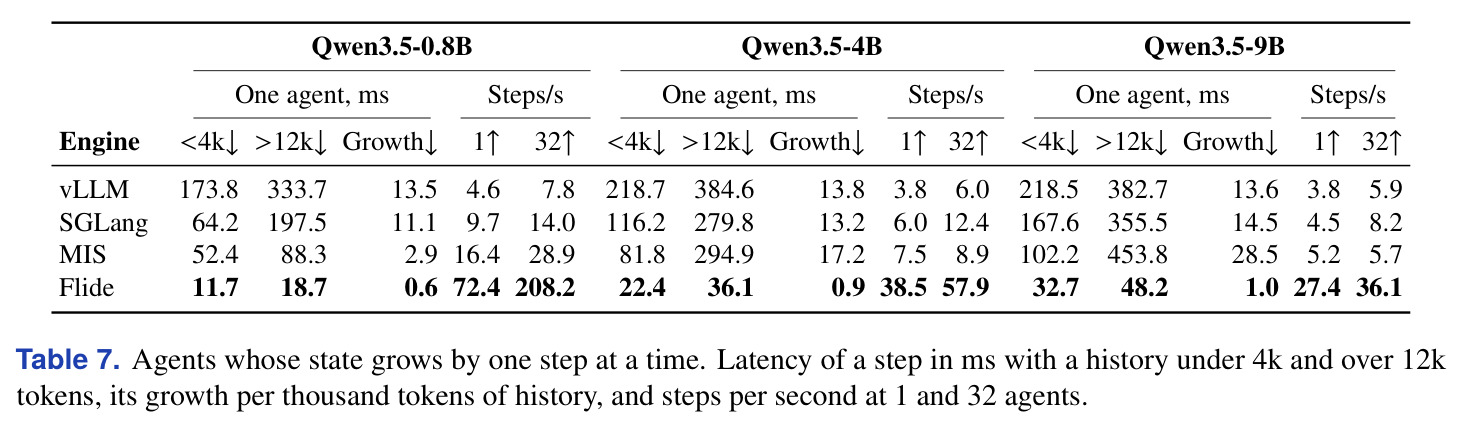
实验在单张 NVIDIA H200 上进行,覆盖 Qwen3.5(0.8B–27B)、Gemma 4(E2B–31B)与专用决策模型 Open-Jev-2B/9B,负载来自 RACE、QuALITY、MultiRC 和 Decision Index(DI),每状态问题数从 1.0 到平均 47.6 不等。四个核心发现。(1)速度:单问题每状态时 Flide 已更快——Qwen3.5-0.8B 单请求时延从 vLLM 的 19.9ms 降到 6.2ms(3.2 倍);多问题共享状态时优势放大,最高比最强基线低 9.5 倍时延、高 8.5 倍吞吐:Qwen3.5 平均在 RACE-all 上 153 req/s(vLLM 63.7)、QuALITY-all 时延 298ms(vLLM 804ms)、MultiRC 吞吐 39.9 req/s(vLLM 15.1);单状态挂 64 个问题时比 vLLM 快 12.7 倍。(2)保真:四尺寸平均,Flide 与 float32 参考的 top-1 一致率在所有负载上最高(如 RACE 99.8%),准确率与 vLLM 差距不超过 1.2 个点;1 到 64 并发答案变化最多 0.2%(vLLM 达 3.2%);位级确定模式下任意负载逐位一致。MIS 的 TV 距离中位数约为 Flide 的 12 倍,最高翻转 29% 的判决(Flide 最多 2.3%)。(3)消融:去掉状态分叉 QuALITY-all 从 135.6 掉到 20.7 req/s;去掉 CUDA graph 短输入时延从 8.8ms 涨到 76.1ms;去掉扁平图 RACE 吞吐从 210.3 降到 134.9 req/s。(4)专用模型与 Agent:Open-Jev-2B 上 RACE 时延 8.9ms vs vllm-jev 41.8ms(约 4.7 倍);SWE-agent 轨迹回放中每千 token 历史边际成本约 0.6–1.0ms,32 个并发 Agent 每秒步数是 SGLang 的约 4.4–7.2 倍。
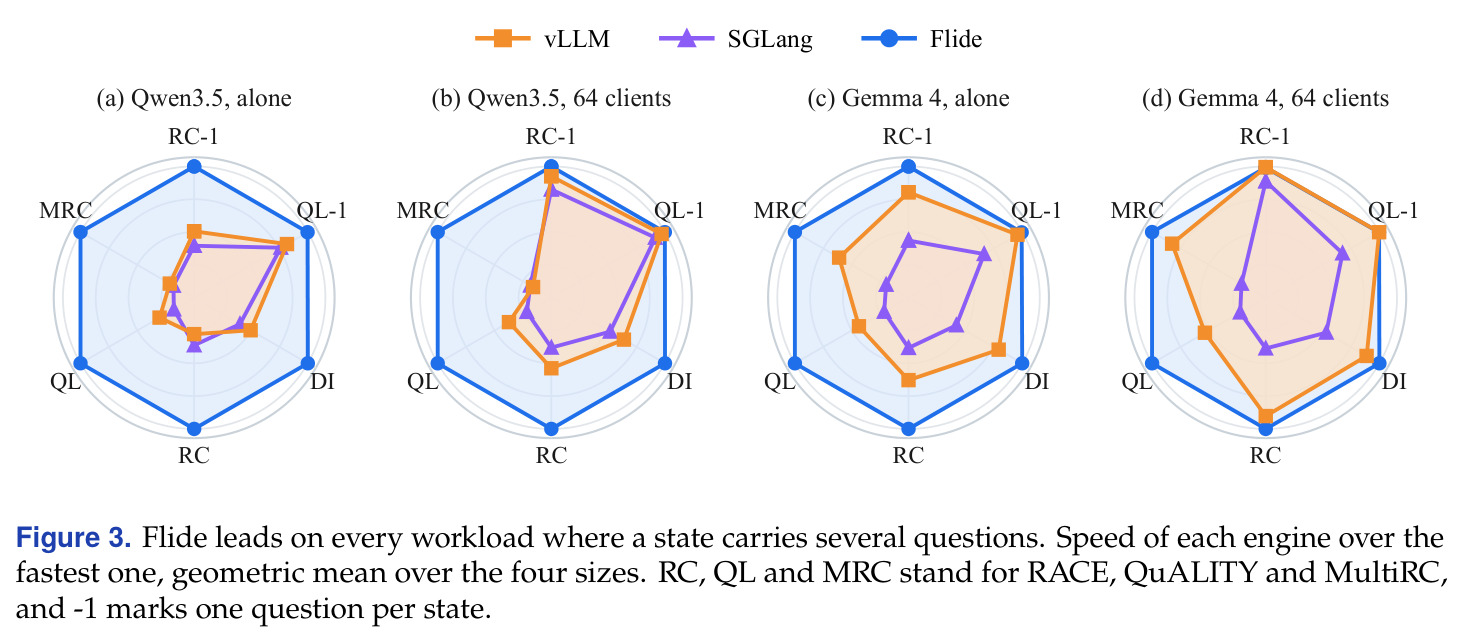
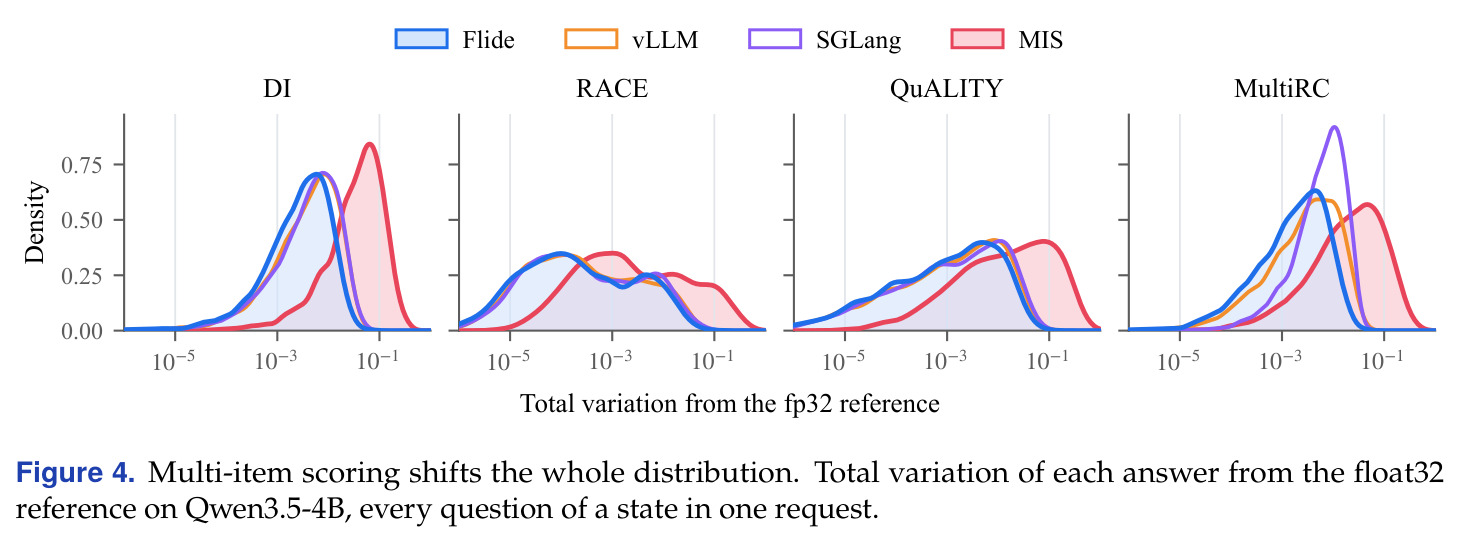
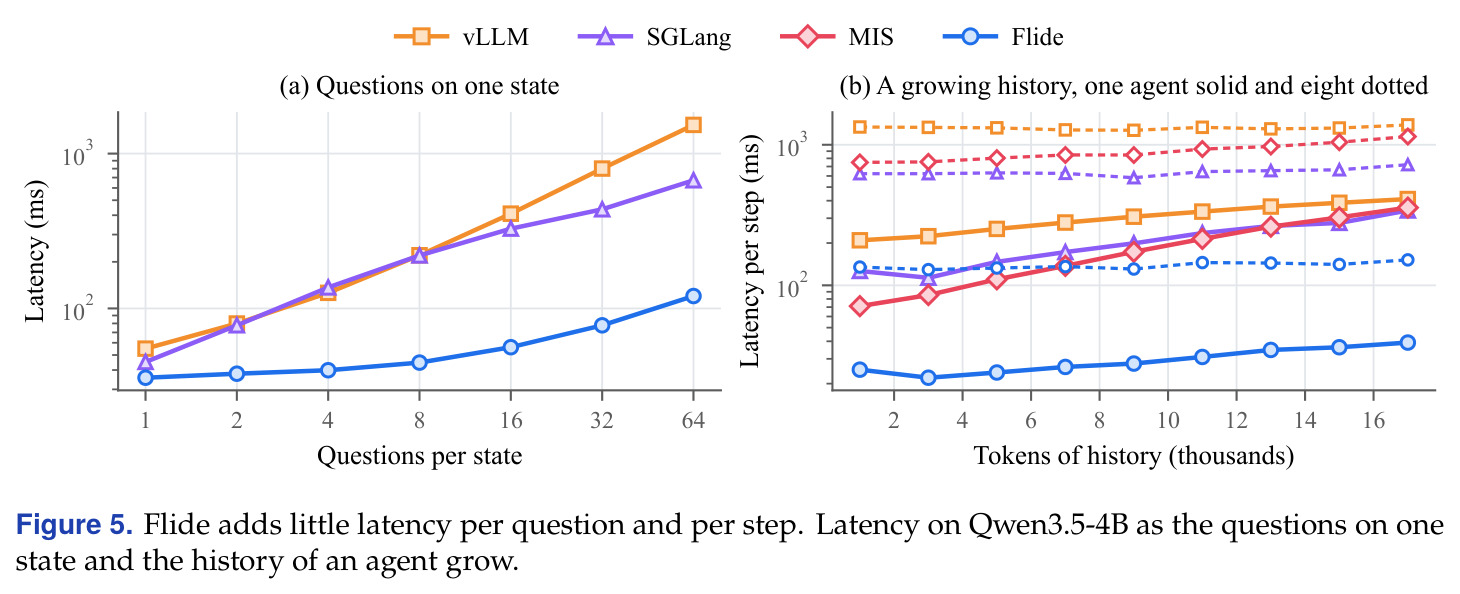
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多问题共享状态推理(QuALITY-all,Qwen3.5 平均) | C64 吞吐(req/s) | Flide 13.6 | vLLM 3.5 / SGLang 2.1 | 约 3.9 倍于 vLLM,峰值最高 8.5 倍 |
| 单状态 64 个问题(QuALITY,Qwen3.5-4B) | 时延(ms) | Flide 曲线近乎平坦 | vLLM 随问题数急剧上升 | 64 问时快 12.7 倍 |
| 单问题每状态(RACE,Qwen3.5-0.8B) | 单请求时延(ms) | 6.2 | vLLM 19.9 / SGLang 27.0 | 3.2 倍 |
| 答案保真(六负载平均,Qwen3.5 四尺寸) | 与 float32 参考的 top-1 一致率 / 1→64 并发答案稳定性 | Agr 最高(如 RACE 99.8%),Stab. 全部 100.0%,漂移 ≤0.2% | vLLM 漂移最高 3.2%,SGLang 最高 1.7% | 最接近 float32 参考,批负载下最稳定 |
| MIS 分隔符概率偏移(Qwen3.5-4B) | TV 距离中位数 / 阈值翻转率 | Flide TV 中位最小,翻转最高 2.3% | MIS TV 中位约为 Flide 12 倍,翻转最高 29% | TV 降低约一个数量级 |
| 专用决策模型(Open-Jev-2B,RACE) | 时延(ms) | 8.9 | vllm-jev 41.8 / +RadixFlow 34.3 | 约 3.8–4.7 倍 |
| 增长的 Agent 历史(SWE 轨迹,Qwen3.5-0.8B) | 每步时延 / 每秒步数 | <4k 历史 11.7ms,72.4 步/秒 | SGLang 64.2ms,9.7 步/秒 | 时延约 5.5 倍,吞吐 7.5 倍 |
| 消融:去掉状态分叉(QuALITY-all,Qwen3.5-4B) | req/s | 完整 Flide 135.6 | 无分叉 20.7 | 分叉贡献约 6.5 倍吞吐 |
局限与改进
作者承认的局限较为含蓄:命题 1 是精确算术陈述,浮点精度下只保证舍入级别的差异,位级一致需要显式开启可选模式,且该模式只在同一硬件与软件栈上成立;超过最大图容量的轮次要按请求边界拆分重放或退回无图执行。我的独立观察:(1)评测集中在单卡 H200、bfloat16 与特定模型家族(Qwen3.5、Gemma 4、Open-Jev),未覆盖多卡张量并行、MoE 或纯 SSM 架构,跨硬件的位级保证存疑;(2)性能假设「一个状态的所有问题在同一轮提交」,若问题流式到达(先问一个、随后再问下一个),增量检查点虽能缓解,但峰值收益会缩水到单问题场景的 3.2 倍以内;(3)检查点存储 float32 循环状态、卷积窗口与 $m$ 之前的全部 KV,多 Agent 并发、长轨迹下的显存占用论文未量化;(4)基线 prompt 模板不完全一致(SGLang、vllm-jev 用各自模板渲染),时延对比有轻微公平性折扣;(5)答案保真评测只对 Qwen3.5 系列报告了 TV/翻转统计,Gemma 4 未给出同等保真数据。
独立分析的弱点
弱点一:检查点显存成本。检查点保存每个 Gated DeltaNet 层的 float32 循环状态、卷积窗口及 $m$ 之前的全部 KV,多 Agent 并发、长轨迹下这些缓冲随活跃状态数线性增长,论文未给出显存占用与命中率的权衡曲线。改进方向:检查点淘汰与分级存储(显存/主机内存),或 bfloat16 状态加误差界分析。弱点二:单轮提交假设。9.5 倍的峰值收益主要来自「所有问题一起到齐」,而现实 Agent 系统常是逐步决策、问题间隔到达,此时每轮只有 1–2 个问题,收益回落到论文自测的单问题 3.2 倍以内。改进方向:跨轮问题合并的攒批调度器,或对延迟不敏感的问题做微批队列。弱点三:位级确定模式的开销未进主表——相关工作中 batch-invariant 内核在 SGLang 上慢 34%,Flide 的实现代价只在附录定性说明,主表全是默认模式数字。改进方向:主实验同时报告确定性模式的时延/吞吐百分比。弱点四:泛化范围未验证——索引与两段式调用机制深度绑定 Gated DeltaNet 形态的循环层,迁移到纯 Mamba-2、RWKV 或多 GPU 流水线可能需要重写 kernel,位级一致也强绑定同硬件同软件栈。改进方向:抽象出状态分叉接口,让不同循环层各自实现。
未来方向
作者方向上:把扁平图执行推广到更多混合与纯循环架构;把位级确定模式从可选项变为默认;扩展检查点管理以服务更长程的 Agent 记忆。基于成果可延伸的方向:(1)把「结构即元数据」思想推广到一般性一文多问场景——RAG 批量评估、多评委打分、A/B 测试评估,替代 cascade attention、sequence-tree 遍历等方案;(2)与投机解码结合:tree attention 验证的 draft token 树与 ForkAttention 的请求树同构,可能统一进同一个扁平流执行;(3)检查点机制可演化为 Agent 历史的持久化存储层,支持跨会话恢复、时间旅行回滚与多 Agent 共享前缀(如多分支轨迹探索);(4)对概率校准敏感的路由场景,研究精确分叉下 TV 距离的理论上界与 float32 参考的收敛保证;(5)多 GPU 与弹性扩缩下的扁平流切分策略,以及 MoE 模型下专家路由与树结构的交互。
复现评估
复现条件较好:论文给出项目页(flide.org)与开源代码(github.com/OmniJev/flide),评测负载全部来自公开数据集(RACE-M 测试集、QuALITY 验证集、MultiRC 验证集、Decision Index),模型为公开的 Qwen3.5(0.8B–27B)、Gemma 4(E2B–31B)、Open-Jev-2B/9B;附录 B 列出各引擎版本与设置,附录 C 详述负载构建,附录 G 提供每次引擎改动后的浮点一致性测试。算力上复现主表需要一张 H200;小模型(Qwen3.5-0.8B、Gemma 4 E2B)在 24GB 级消费卡上应可粗略复现。难度评估:跑通并得到量级一致的速度提升为中等偏易,前提是代码工程完整且支持相同模型;复现「精确等价」需按附录 G 的测试验证浮点一致性;位级确定模式则强绑定同一硬件与软件栈。风险点:对比的基线版本(2026 年的 vLLM/SGLang)迭代极快,复现数字会有出入,建议关注相对倍数而非绝对值;DI 工作负载依赖外部 Decision Index 数据集,需确认其持续可用性。
论文图表
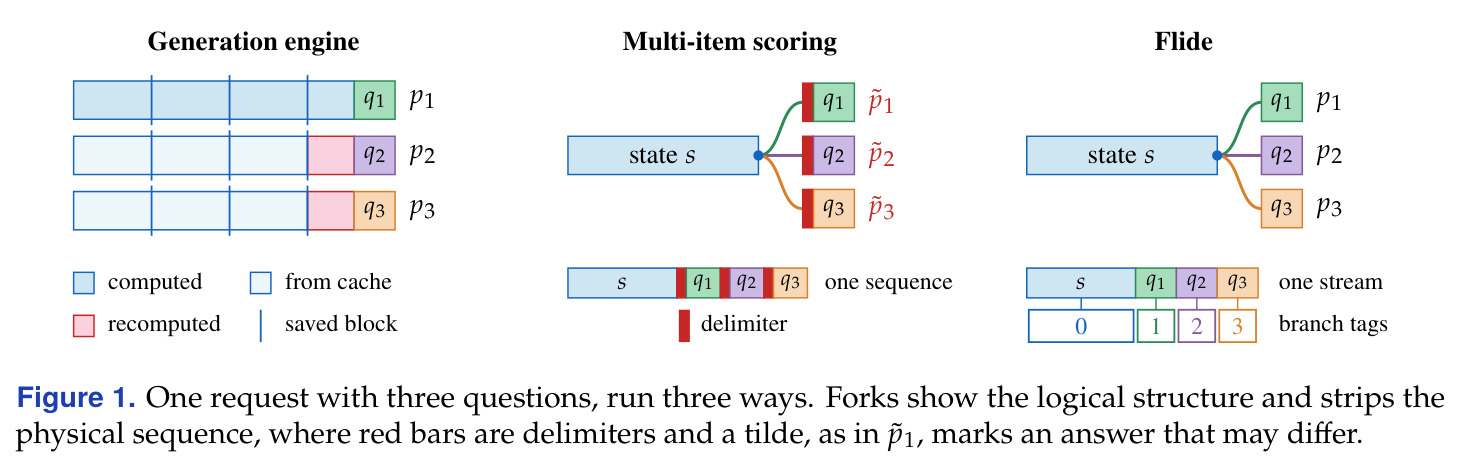
用一个请求(共享状态 s 加三个问题)并排对比三种执行方式:生成引擎把每个问题当独立序列(状态被重复计算或从缓存恢复)、multi-item scoring 把问题拼进一条序列并在前面加分隔符(概率记为 p̃ 表示偏移)、Flide 在单条扁平流中用分支标签(0/1/2/3)执行,状态只算一次且概率精确。
一眼看懂论文要解决的问题与方案的物理布局:红色分隔符与波浪号概率直观展示了 MIS 的失真与 Flide 的正确性,是全文的问题陈述图。