知思考何时失效:教会小型推理模型超越参数知识的FlyBy框架 Knowing When Thinking Is Not Enough: Teaching Small Reasoning Models to Reason Beyond Their Parametric Knowledge
小模型先推理再诊断知识瓶颈,按需分档求助强模型,4B低成本胜14B
前置知识
测试时计算扩展(Test-time Scaling)
指在推理阶段投入更多计算来提升性能的技术总称,包括生成更长的思考链、对同一问题重复采样、以及让模型自我修正。它与加大参数规模相对,用'想得更久'换取'长得更大',是小模型追赶大模型的主要路径。但其收益并非处处相同,随题目与当前推理状态变化很大。
本文的问题意识正建立在这一范式的边界之上:作者通过反事实干预证明额外思考并不总是正确的操作,理解测试时扩展的能力与局限才能看懂论文动机。
小型推理模型(sRM)
参数量在0.5B到十几B之间、经过推理强化训练的语言模型,如Qwen3-4B/8B。部署与服务成本低,但推理能力弱于大模型,其失败既源于推理执行能力弱,也源于参数知识缺口。本文以Qwen3-4B和Qwen3-8B为基座分别训练出FlyBy-4B和FlyBy-8B。
全文的干预分析与训练实验都围绕sRM展开,作者发现小模型'参数知识更少且利用外部帮助的能力更弱'的双重限制,是整个方法设计的直接依据。
认知言语化(Epistemic Verbalizations, EVs)
模型在推理链中自发写出的wait、hmm、alternatively等9个表达犹豫或检查的短语,标志它暂停并重新考虑当前推理。可作为一个固定词表来定位反思发生的位置,分为模型自发的内生EV和人为插入状态中的外生EV两类。
论文用EV词表定位反思点并测量其因果效应(价值增益$\Delta V$),是得出'反思只在执行型状态有效'这一关键结论的核心测量工具。
状态值与答案熵(V-H平面)
在状态$s$处追加线索后采样$N$次续写,正确答案占比即状态值$V_q(s)$,答案分布的熵为$\mathcal{H}_q(s)$。每个状态是平面上一点,有效推理朝$(V,\mathcal{H})=(1,0)$移动。
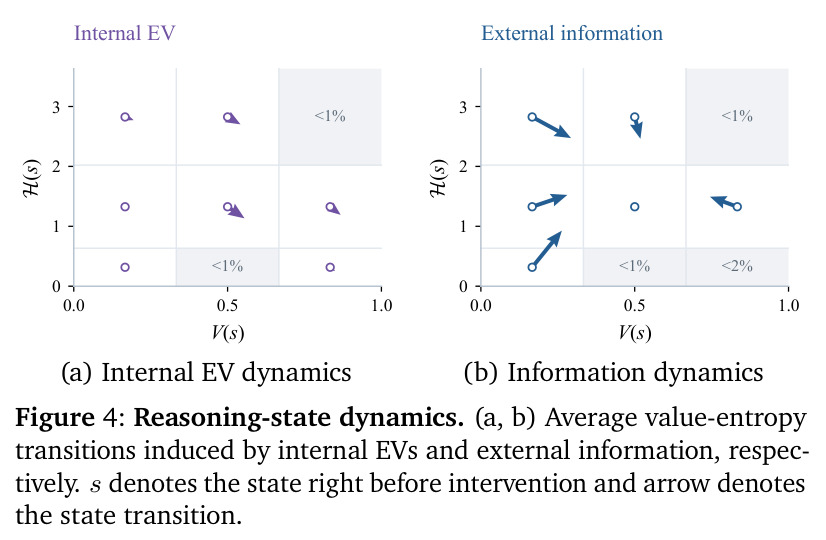
$V(s)>0$或$V(s)=0$是论文划分执行型/知识型瓶颈的操作化判据,所有干预实验、状态迁移可视化(图4)都建立在该平面上,不懂它就读不懂第3节的分析。
执行瓶颈与知识瓶颈
两类推理失败模式:执行瓶颈指正确解从当前状态出发仍然可达,只是模型没能可靠地实现它,继续反思或验证可以恢复;知识瓶颈指解题所需的信息无法通过内部推理获得或重建,必须注入相关外部信息才能使正确路径变得可达。有限采样下分别以$V(s)>0$和$V(s)=0$近似。
这一二分法是全文骨架:先诊断当前状态属于哪类瓶颈,才能决定策略应该'继续想'还是'向外问',FlyBy的训练目标直接由此导出。
GRPO与成本感知强化学习
GRPO(组相对策略优化)对同一提示采样一组轨迹,以组内相对优势更新策略,常配合DAPO式解耦裁剪稳定训练。本文把奖励改为$r(x,y)=\mathbb{I}[y=y^\star](1-\lambda\hat{C}(y))$,只对成功轨迹按归一化成本$\hat{C}$打折。
理解该奖励设计才能明白FlyBy为何能学会'只有成功才需要省钱、求助有时反而更省'的策略,而不是退化为便宜地失败,这是RL阶段成立的关键。
研究动机
测试时计算扩展(更长的推理链、重复采样、自我修正)是提升语言模型推理能力的有效手段,对服务成本低的小型推理模型(sRM)尤其诱人,因为它们希望靠'想得更久'而非'长得更大'来追平大模型。然而更多计算并非处处有用。作者在两个模型家族(Qwen3-0.6B/1.7B/4B/8B/14B与Gemma4-E2B/E4B/12B共8个模型)的中间推理状态上做反事实干预后发现:自我修正主要把概率质量固化到当前状态本就可达的解上,并不能让新解变得可达。推理失败因此分成两种情形:执行瓶颈——正确路径仍然可达,继续反思可以恢复;知识瓶颈——继续推理无效,必须引入相关外部信息才能打通路径。更进一步,sRM不仅参数知识更少、更常陷入知识型状态(科学题中远多于数学题),而且利用给定外部信息的能力也随模型规模下降,单纯'再想想''再检查一遍'根本无法弥补这一差距。
本文的目标是本文的核心问题是:小模型能否从不断演化的推理状态中区分这两类瓶颈,并据此判断'多想想'是否是正确的操作?如果不是,应当索取什么信息、又该花多少外部算力去获取?具体目标分三步。第一,通过配对反事实干预定量刻画自我修正与外部信息在执行型/知识型状态上的不同作用,回答'思考何时不够'。第二,基于这一诊断训练4B和8B的小模型FlyBy:先自主推理,再诊断残留未解的部分,在知识瓶颈处通过多深度查询动作向更强的外部模型(DeepSeek系列)精准求助,由模型自行决定是否查询、问什么、以及分配多少外部算力。第三,在6个基准共1158道难题上验证,让小模型以更低的部署成本超越更大的模型,例如FlyBy-4B以2.7倍更低的成本超过Qwen3-14B。
与已有工作不同的是,已有工作(Search-R1等检索式工具调用、动态sLM-LLM协作、成本感知工具编排)已经能学会何时以及如何调用外部帮助,但它们直接优化工具使用本身,并不显式诊断当前推理状态究竟是'内部可自救'还是'需要新信息'。本文的独特切入是把这一边界操作化到中间推理状态层面:用状态值$V(s)$与答案熵$\mathcal{H}(s)$刻画每个状态,用EV词表定位反思发生的位置,再以配对干预(继续反思、注入相关oracle信息、注入随机信息)做因果归因。由此得到的关键洞见——反思主要固化可达解而非扩大可达集,且小模型利用信息的能力反而更弱——直接催生了'先推理、再诊断、后求助'的训练框架,使'查询什么'与'花多少外部算力'成为策略学习的一等公民。这与推理前盲查一次的Query Opening、全程检索的Search-R1有本质区别。
核心方法
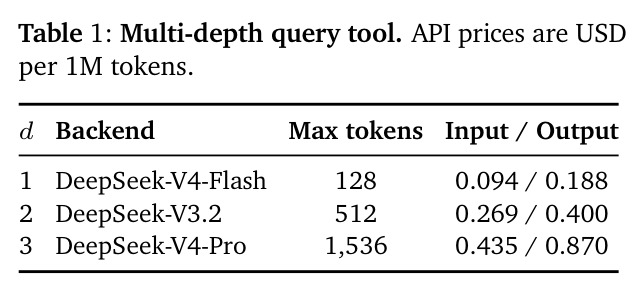
直觉上,FlyBy把小模型当作'认知核心':大部分时间依靠便宜的参数化推理,只在诊断出知识瓶颈时才付费向强模型购买一条精准提示。技术路线分分析、SFT引导、RL校准三段。分析阶段定义推理状态$s_t=(x,z_{0$视为执行型、$V(s)=0$视为知识型。训练阶段把外部模型封装成深度$d\in\{1,2,3\}$的多档查询工具(DeepSeek-V4-Flash/V3.2/V4-Pro,最大128/512/1536 token,价格随深度递增),且外部模型只看到查询文本、看不到原题,以防答案委托。SFT用'一次查询即可翻盘'的拯救轨迹引导出查询动作空间,随后80步成本感知GRPO让策略学会何时查询值得、问什么、花多少外部算力。
核心创新是'先诊断瓶颈、再决定求助方式'的策略结构,以及把'问什么'和'花多少'统一进一个多深度查询动作。与Search-R1等直接训练检索的方法不同,FlyBy的查询不含原题、只含推理中缺失的具体知识,外部回答平均仅105个输出token,远短于Search-R1平均2015字符的检索上下文,说明解决当前瓶颈靠的是信息的精准性而非数量。与Query Opening在推理前盲查一次不同,FlyBy先推理以识别知识缺口,问题越难其优势越大。奖励设计同样关键:$r(x,y)=\mathbb{I}[y=y^\star]\,(1-\lambda\hat{C}(y))$只对成功轨迹扣成本,防止策略学会'便宜地失败';同时允许'查询一条定理而非从头推导'这类省时省钱的求助,使RL把SFT阶段的一次性委托进化为多次廉价查询的迭代式信息获取,以接近最浅后端的成本达到接近最深后端的性能。
方法步骤详情
第一步,状态探测与瓶颈标注:对每个模型-题目组合采样16条rollout(32K token预算),保留经验解率在$[0.25,0.75]$的非平凡难题,收集13.4K个内生EV位置;每个位置用$N=8$次续写估计$V$与$\mathcal{H}$,共产生215K条反事实续写,加57K条信息条件续写合计272K条。第二步,SFT数据合成:从Qwen3-4B在ArXivMath-Training与SuperGPQA上的失败轨迹出发,合成'插入一次外部查询就能翻盘'的拯救轨迹,配以查询生成与观测整合的定向监督,再混入OpenThoughts3-1.2M通用推理数据训练FlyBy-4B-SFT。第三步,RL校准:在DAPO-17K-processed、ArXivMath-Training、GooseReason-0.7M的STEM子集和SuperGPQA上训练80步(与SFT数据不相交),采用DAPO式解耦裁剪、去掉标准差归一化,训练时把工具观测中的金答案片段涂黑防泄漏,并拒绝与原题n-gram重叠过多的查询。最终得到FlyBy-4B,并用同样流程从Qwen3-8B得到FlyBy-8B。
技术新颖性
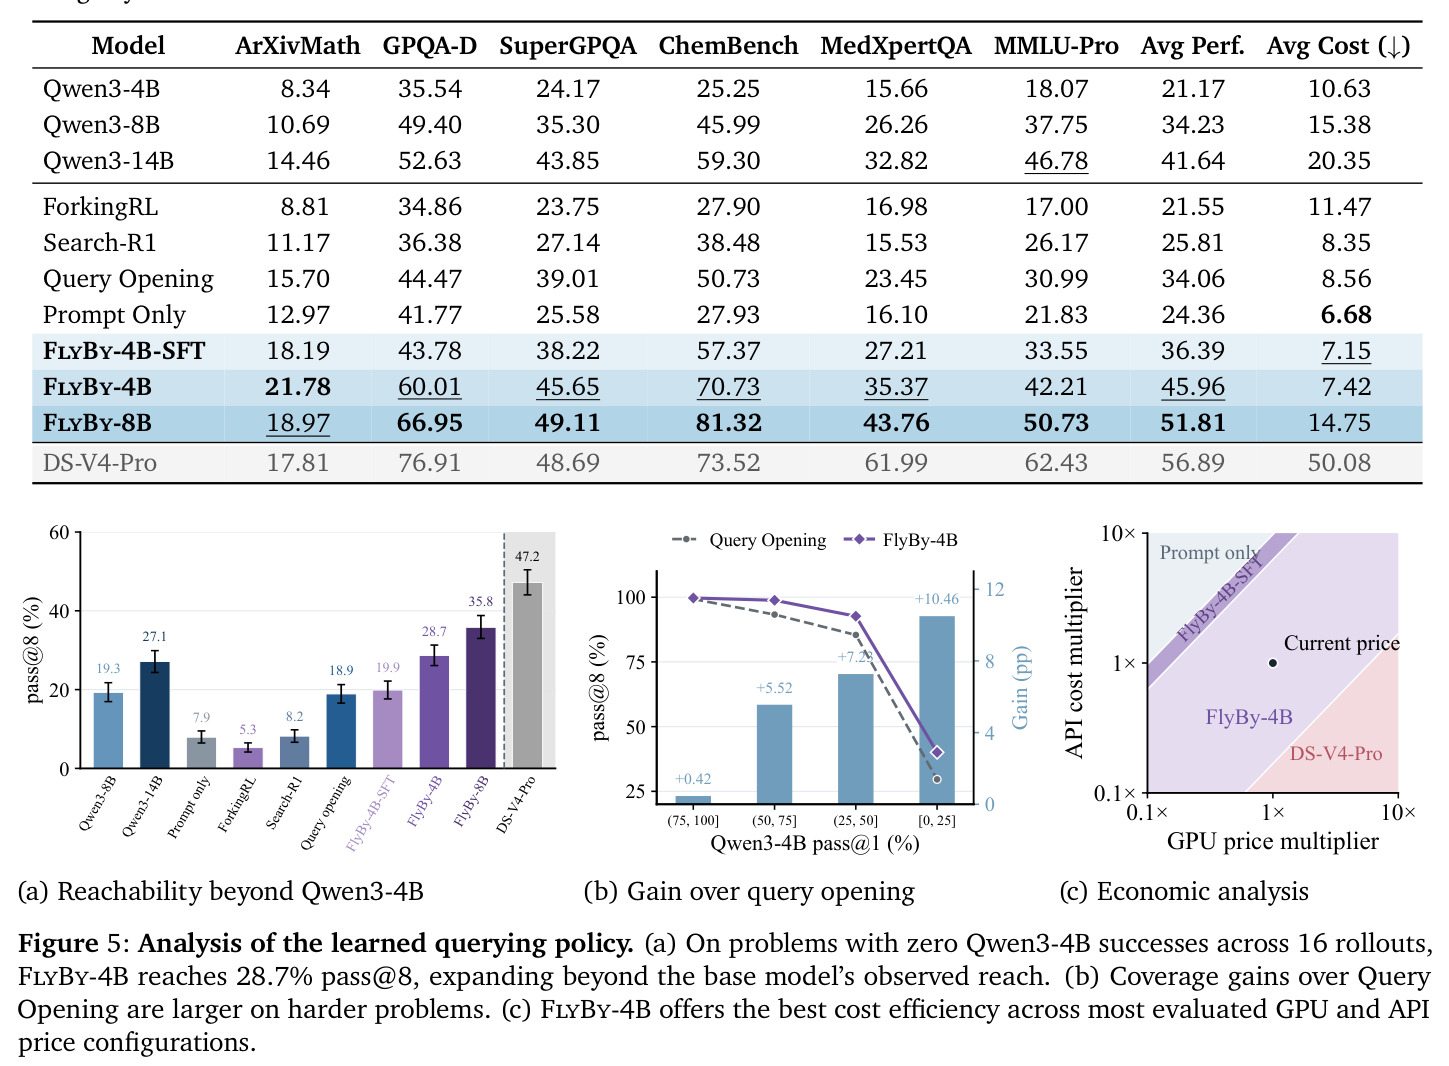
新颖性有四点。其一,首次把'该不该继续想'变成可操作的因果问题:用9个EV表达(wait、hmm、alternatively等)定位反思点,在相对位置$\alpha\in\{0.2,0.5,0.8,0.9\}$处施加配对干预,测得EV的价值增益随模型规模显著增长,且只在不确定、执行型状态有效。其二,发现小模型'双重受限':不仅更常陷入知识型状态(科学题中的比例远高于数学题),利用给定信息的能力还随规模下降,推翻了'小模型从外部帮助中获益空间最大'的直觉。其三,多深度查询动作把'选择外部算力强度'变成策略的一维,消融显示自适应分档(pass@8 46.0%)以接近固定D1的成本达到接近固定D3(46.9%)的性能。其四,成本感知奖励只罚成功轨迹的成本,且图5c的价格扫描证明GPU/API价格在较大范围内波动时FlyBy-4B始终保持单位成本性能最优,经济优势不依赖特定定价假设。
实验结果
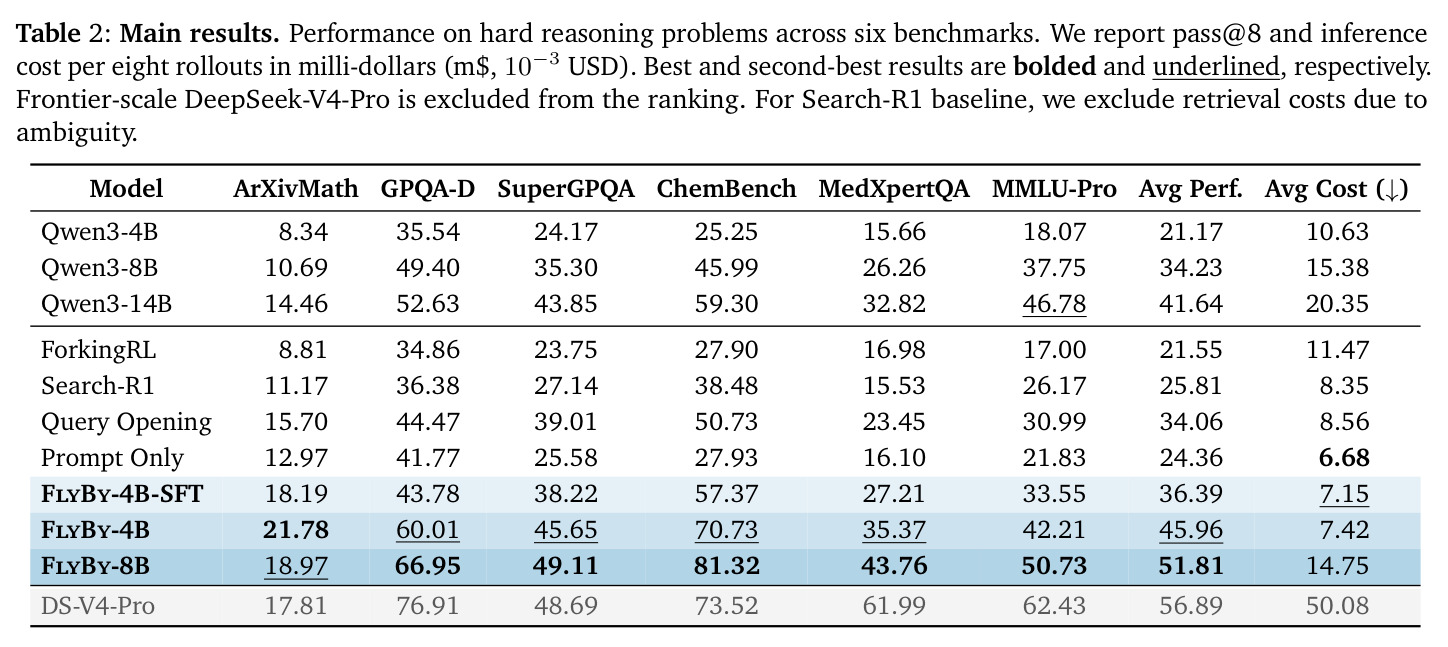
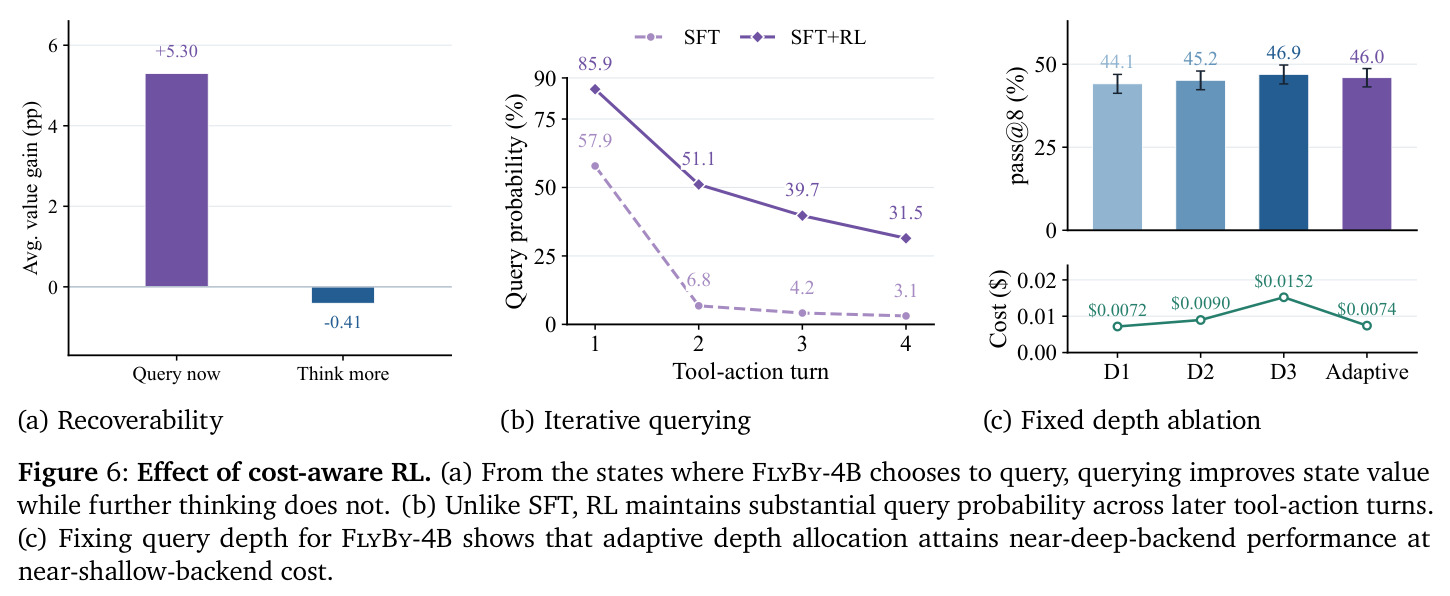
在1158道难题(基座pass@1≤0.25)上以16 rollout估计的pass@8评估:Qwen3-4B平均21.17%,FlyBy-4B-SFT升至36.39%,成本感知RL推到45.96%(7.42 m$),以2.7倍更低成本超过Qwen3-14B的41.64%(20.35 m$);FlyBy-8B达51.81%,较Qwen3-8B高17.58pp且成本低4.1%,逼近DS-V4-Pro的56.89%。FlyBy-4B六基准全面超基座(ChemBench最高70.73%,ArXivMath最低21.78%)。pass@1上FlyBy-4B以16.85%胜Qwen3-8B的15.31%,说明RL改善了单条轨迹质量。对基座16次全败难题,FlyBy-4B达28.7%,反超Qwen3-14B的27.1%。四个基线介于21.55%–34.06%,与最强者Query Opening的差距随难度扩大。机制上,对50道SuperGPQA题的查询状态做分支反事实:执行查询使状态值平均+5.30pp,强制继续思考约-0.41pp,策略恰在'再想也没用'处查询。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准平均(1158道难题) | hard-problem pass@8 | FlyBy-4B 45.96%(成本7.42 m$) | Qwen3-14B 41.64%(成本20.35 m$) | +4.32pp,服务成本低2.7× |
| 六基准平均 | hard-problem pass@8 | FlyBy-8B 51.81% | Qwen3-8B 34.23% | +17.58pp且成本低4.1% |
| 六基准平均 | pass@1 | FlyBy-4B 16.85% | Qwen3-8B 15.31% | +1.54pp,单轨迹质量更优 |
| GPQA-Diamond(开放式科学推理) | pass@8 | FlyBy-4B 60.01% | Qwen3-4B 35.54%;Search-R1 36.38% | 较基座+24.47pp |
| ChemBench(化学推理) | pass@8 | FlyBy-4B 70.73% | Qwen3-4B 25.25% | +45.48pp,全部基准中最大涨幅 |
| Qwen3-4B 16次rollout全败的难题子集 | pass@8 | FlyBy-4B 28.7% | Qwen3-14B 27.1% | 4B模型覆盖超出基座可达范围并反超14B |
| 查询状态反事实分支(50道SuperGPQA×8 rollout) | 状态值增益 | 执行所选招查询 +5.30pp | 抑制查询并强制继续思考 −0.41pp | 证明策略恰在内部推理失效处查询 |
局限与改进
作者承认FlyBy依赖外部模型,带来可用性、隐私与可靠性三方面隐患:服务方可能限流或下线,商业API会把查询内容发送给第三方,强模型的回答也可能出错从而误导下游推理(讨论见附录§I)。此外还有几点值得注意。第一,评测的'难题'由Qwen3-4B的pass@1≤0.25定义,这种以基座为参照的筛选可能让评测偏利于用同款基座训练的FlyBy。第二,多深度工具绑定DeepSeek系后端,虽有后端泛化实验(§G),但换用其他家族强模型的效果未系统报告。第三,成本模型依赖实测吞吐与第三方GPU/API报价(OpenRouter、Hyperbolic),真实部署中的网络延迟与失败重试未计入。第四,$V(s)=0$只是有限采样(16次rollout)下的知识型代理判据,32K token预算内'不可达'不等于理论不可达,作者在§B做了敏感性分析但根本不确定性仍在。第五,查询质量依赖模型先推理出正确缺口,若开局理解就错,针对性查询也可能问偏,这在ArXivMath上仅21.78%的表现中有所体现。
独立分析的弱点
独立分析几点弱点。其一,知识型/执行型的操作化判据$V(s)>0$依赖16次rollout的有限样本,在低解率难题上容易把'采样运气'误判为'执行瓶颈',改进方向是序贯采样或Clopper-Pearson置信区间给出可达性的概率化判据。其二,外部模型看不到原题的设计虽杜绝了答案委托,但也可能让强模型因缺上下文而给出泛泛提示,改用'可验证的脱敏上下文'或分级信息授权有望提高信息利用率。其三,成本惩罚$\lambda\hat{C}$是问题级归一化的标量,未区分'查询太贵'与'思考太长'两类浪费,未来可把深度选择与内部生成长度联合建模为显式预算分配问题。其四,训练数据集中在数学与STEM,MedXpertQA虽提升到35.37%仍远低于DS-V4-Pro的61.99%,临床等专业知识的瓶颈依旧明显,可加入领域检索或专家知识库作为第四档工具。其五,防泄漏手段只有n-gram重叠过滤和金答案涂黑,面对诱导外部模型直接解题的对抗性查询缺乏更细的审计与追溯机制。
未来方向
作者在结论与附录§I指出若干方向:用本地开源模型替代商业API以缓解隐私与可用性问题;让小模型与多个异构后端协作,做更细粒度的成本-质量路由;把'认知核心+选择性求助'扩展到长程智能体任务与多轮工具生态。基于本文成果还能延伸:第一,把$V\mathcal{H}$平面上的瓶颈诊断做成在线模块,用轻量探针实时估计当前状态属于执行型还是知识型,实现'反思还是查询'的自适应切换而非事后训练固化;第二,把多深度查询推广到检索、代码执行、符号求解器等多源求助的统一预算分配框架,与本文的成本感知GRPO天然兼容;第三,利用'外部信息先扩大可达集、反思再固化'的互补性,设计查询后强制验证的两阶段解码;第四,构建自提升闭环,用FlyBy的查询日志反向蒸馏回参数知识,逐步降低对外部模型的依赖;第五,把该范式迁移到多模态推理与科学发现场景,检验知识瓶颈在视觉与实验设计任务上的分布是否同样偏斜。
复现评估
复现条件较好。代码已开源(github.com/tally0818/FlyBy);分析阶段用到的8个模型(Qwen3-0.6B/1.7B/4B/8B/14B、Gemma4-E2B/E4B/12B)与6个评测基准均为公开资源;训练数据(ArXivMath-Training、SuperGPQA、OpenThoughts3-1.2M、DAPO-17K-processed、GooseReason-0.7M)也公开可得。主要门槛有二:一是RL阶段需要三档外部模型API(DeepSeek-V4-Flash/V3.2/V4-Pro,价格约0.094–0.435美元每百万输入token)配合vLLM本地推理,80步GRPO加上每次16条rollout的采样需要多卡GPU环境;二是论文中的m$成本数字依赖实测吞吐与第三方报价(OpenRouter、Hyperbolic),价格波动会使绝对值漂移,但图5c的经济性分析表明成本优势结论对价格扰动鲁棒。分析部分27.2万次续写的算力开销较大,资源有限时建议先复现4B规模的SFT+RL主结果。
论文图表
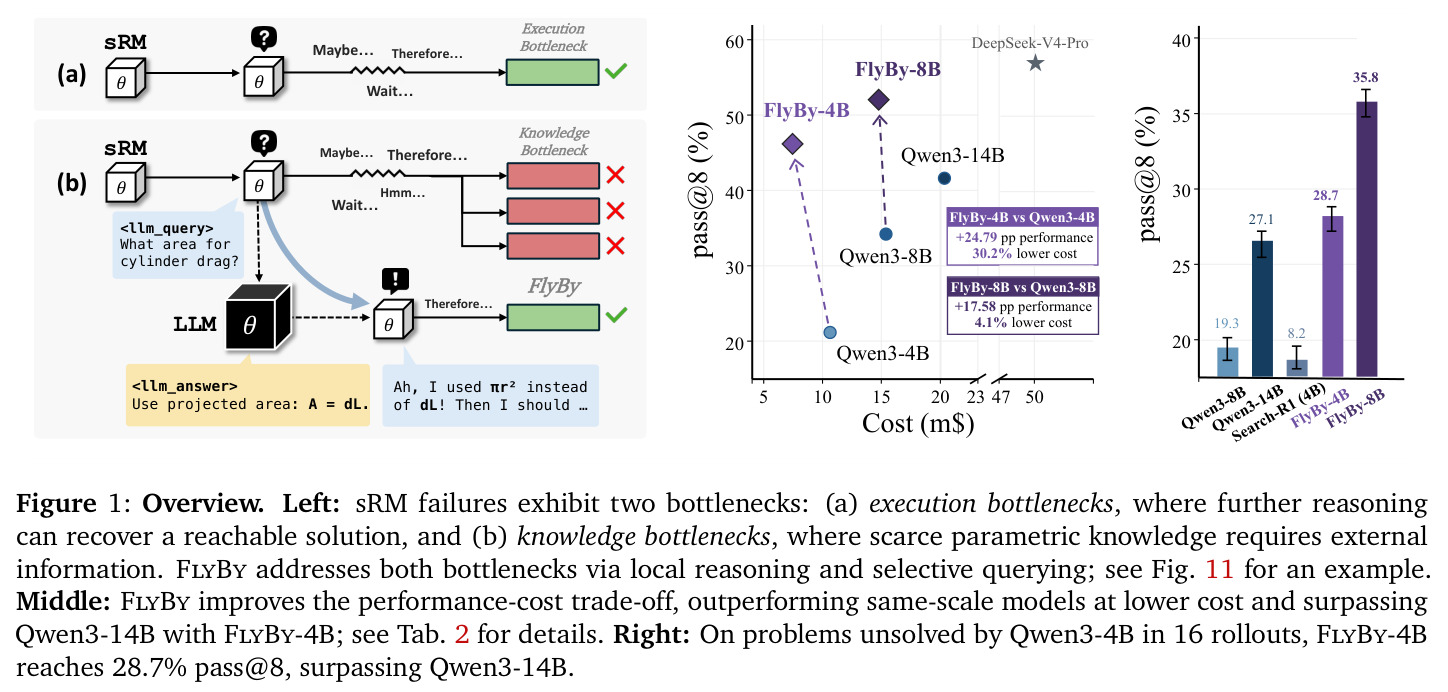
三联总览图。左图展示sRM失败的两种瓶颈:(a)执行瓶颈——继续反思可恢复可达解;(b)知识瓶颈——需要注入外部信息,FlyBy通过本地推理加选择性查询(<llm_query>…<llm_answer>循环)同时应对两类瓶颈。中图是性能-成本权衡:FlyBy-4B以45.96% pass@8、2.7×更低成本超越Qwen3-14B(41.64%),FlyBy-8B比Qwen3-8B高17.58pp且成本低4.1%。右图显示在Qwen3-4B十六次rollout全败的难题上,FlyBy-4B达到28.7% pass@8,反超Qwen3-14B的27.1%。
一图总览全文:动机(两类瓶颈)、方法(推理+选择性查询)与三大主结果全部浓缩在内,是快速把握论文贡献的最佳入口。
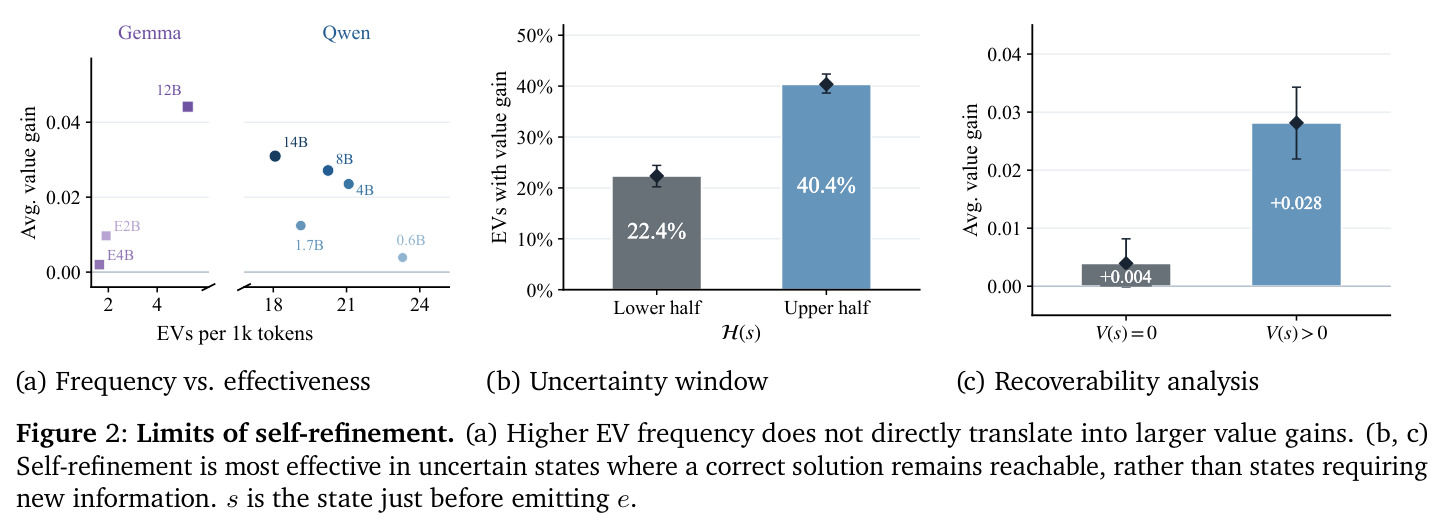
(a)EV出现频率与价值增益的关系:小模型EV频率并不低,但EV的因果价值增益$\Delta V$随模型规模显著增长,说明小模型的问题不是不会表达不确定,而是无法把反思转化为进展。(b)不确定性窗口:自我修正最有效的状态是答案熵较高的不确定状态。(c)可恢复性分析:EV增益集中在$V(s)>0$的执行型状态,在$V(s)=0$的知识型状态上几乎没有增益。
这一组图给出了'自我修正主要帮助实现内部已可达的解'(Takeaway 3.2)的直接证据,是全文分析部分的第一个核心论断。
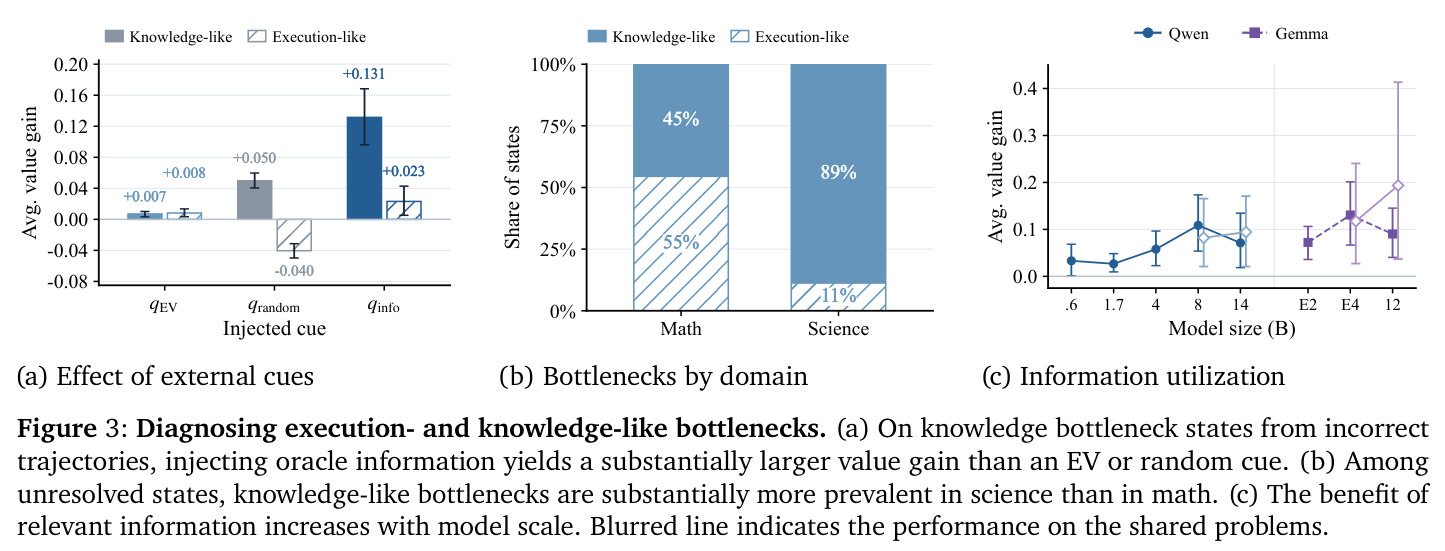
(a)在错误轨迹的知识型状态上注入不同线索的价值增益:oracle相关信息$q_{info}$远大于认知线索$q_{EV}$,随机线索$q_{random}$几乎没有用,且增益强依赖信息相关性。(b)未解状态中知识型瓶颈在科学题中的占比远高于数学题,符合科学题对事实性领域知识的依赖。(c)信息利用率随模型规模上升——小模型更不会利用给定的相关提示;最大模型上的回落由残差题目集变化引起,限制到共享题目后上升趋势保持。
直接证明'外部信息能扩大可达集而反思不能'以及'小模型双重受限'两大洞见,是从分析通向方法设计的桥梁,解释了为什么帮助寻求本身必须被学习。