RSI Arena:迈向有人类反馈的递归自我改进 RSI Arena: Towards Recursive Self-Improvement with Human Feedback
十个前沿AI智能体在真实资源约束下自主后训练同一基座模型,并用人类投票反馈继续改进
前置知识
后训练(SFT 与偏好优化)
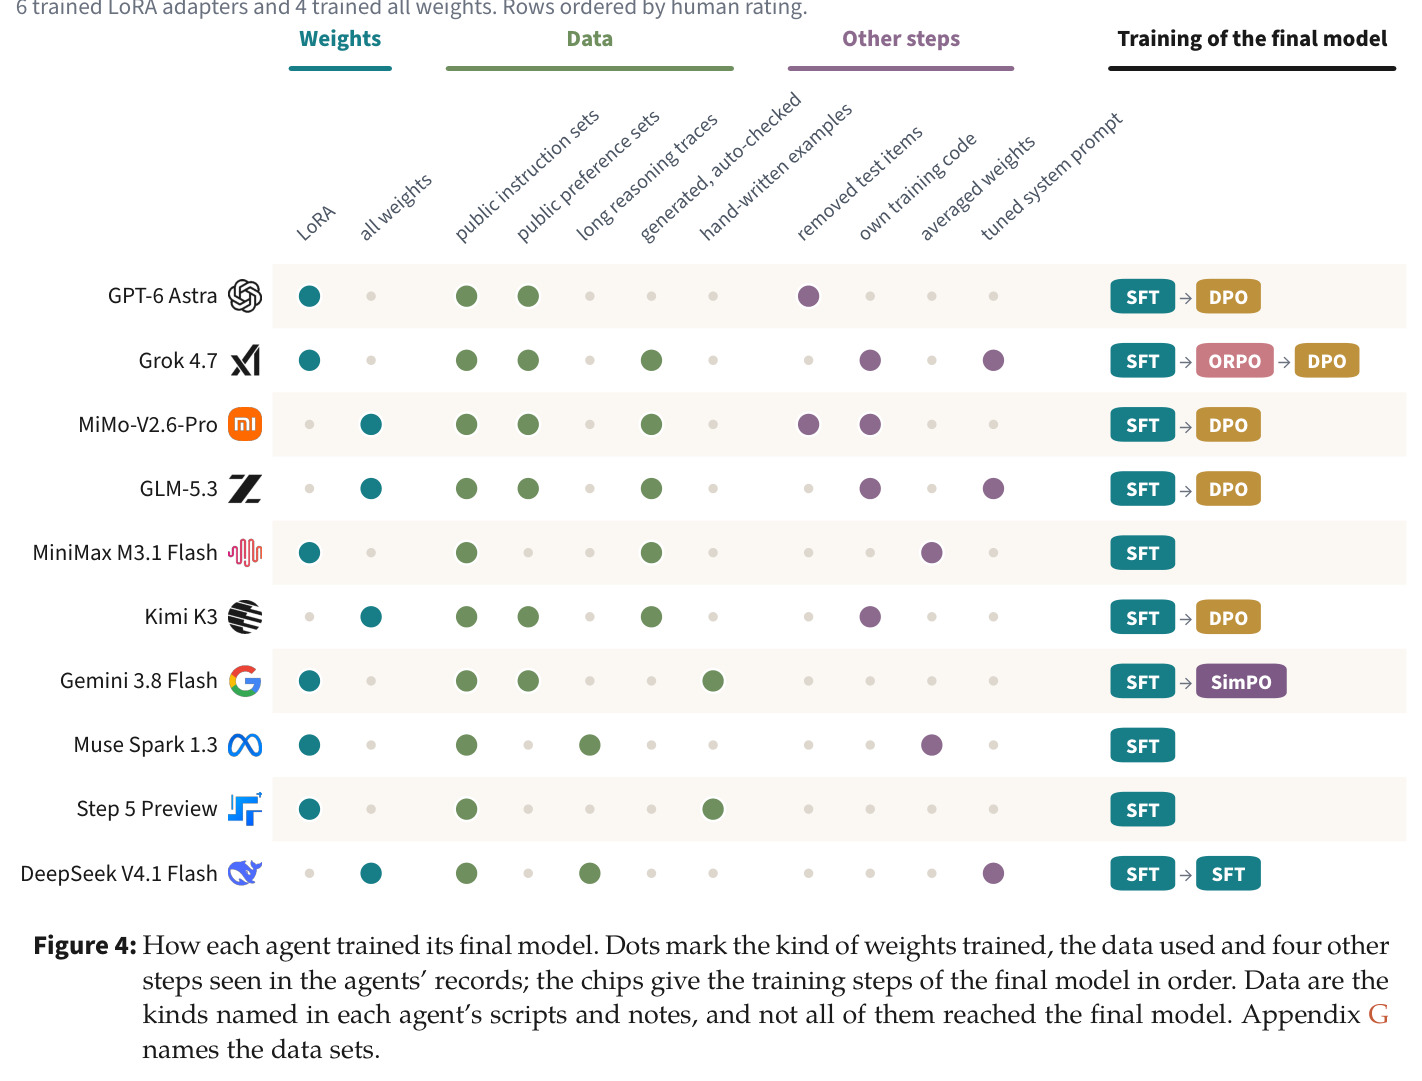
后训练指把预训练基座模型改造成可用助手的过程:先用指令-回答对做监督微调(SFT),再用人类偏好成对数据做偏好优化(如 DPO、ORPO、SimPO),让模型输出更符合人类喜好。LoRA 是只训练低秩增量矩阵的省显存微调方式,全参数微调则更新全部权重。本文中十个智能体全部从 SFT 起步,六个再追加偏好优化。
本文任务就是让 AI 智能体自主完成整个后训练流程,各智能体的训练配方、数据选择与结果差异全部围绕这些技术展开,不懂这些术语无法读懂实验部分。
递归自我改进(RSI / RSIHF)
递归自我改进指 AI 系统开发出更强的后继模型、后继模型再推动进一步发展的循环。本文提出加入人类反馈的版本 RSIHF:用户的投票既用于评估模型,也作为下一轮训练的开发信号,让人参与定义'什么算改进',从而在提升能力的同时保持系统对用户负责。
这是论文的核心概念框架,两阶段实验设计(先自主训练、再利用人类投票改进)正是对该概念的可操作化,理解它才能理解为何要设计两个阶段。
Bradley–Terry 模型与风格控制
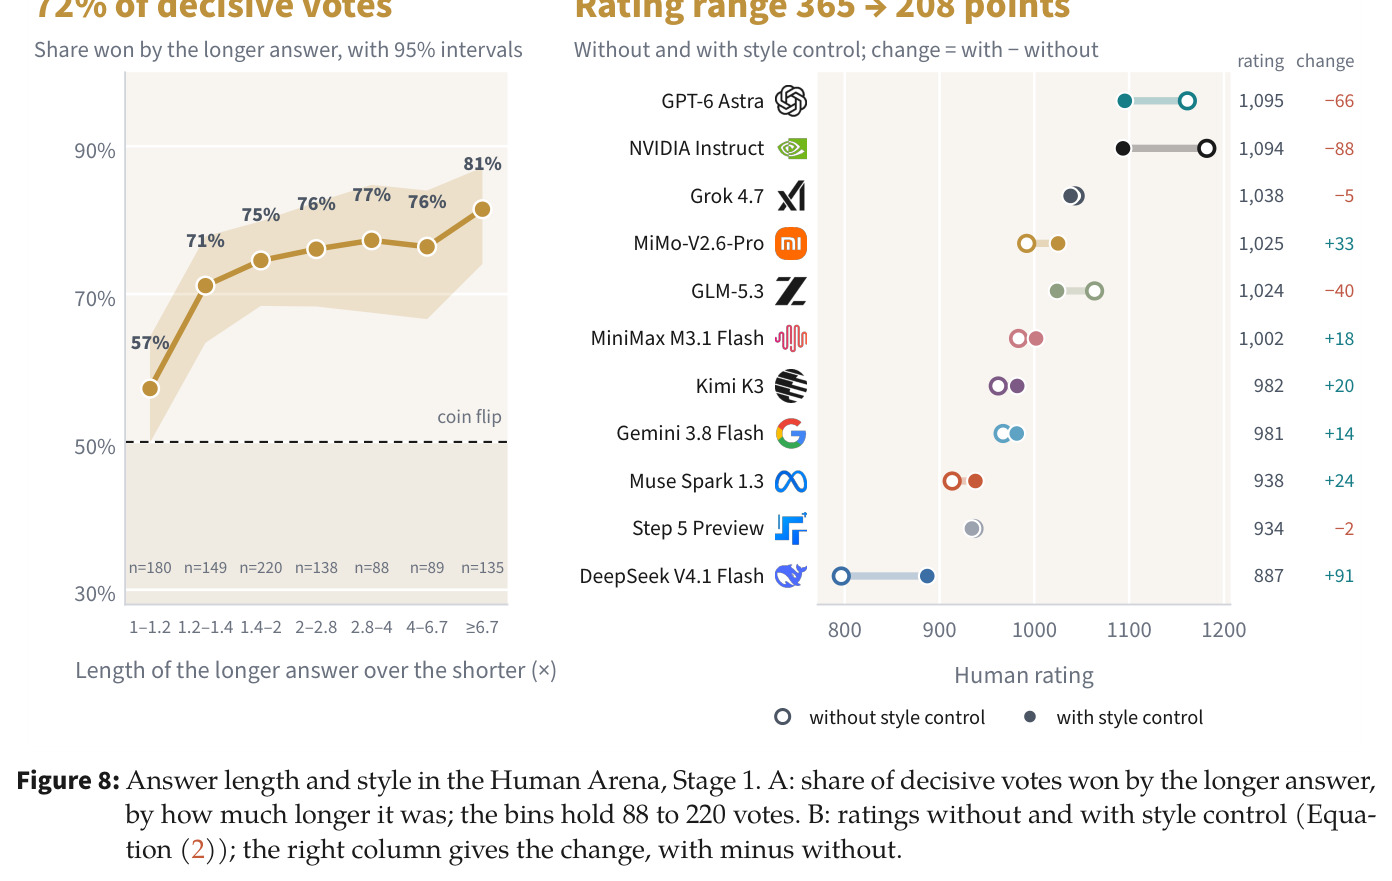
Bradley–Terry 是配对比较统计模型,$\Pr(A \succ B) = \sigma(\ln 10\,(r_A - r_B) + \boldsymbol{\gamma}^\top \mathbf{z})$,从大量盲测投票中估计每个模型的实力分 $r$。风格控制把两答案的长度、列表项、标题、粗体差异作为协变量 $\mathbf{z}$ 放入模型,扣除'越长的回答越占便宜'的偏差,是 Chatbot Arena 榜单的默认做法。
论文所有人类评估结论都建立在带风格控制的 BT 评分上,且风格系数用自家投票重新估计(而非借用 Arena.ai 数值),是读懂结果表和'榜首易主'现象的关键。
混合专家模型(MoE)与基座缺陷
实验基座 NVIDIA Nemotron 3.5 Lightning 30B-A3B 是 MoE 模型,总参数约 300 亿、每 token 只激活约 30 亿,训练全参数需要 FSDP 等分布式技术。更关键的是它的 end-of-turn(结束回答)token 从未被训练过,基座模型根本不会自己停止回答,每个智能体都必须先教会模型'什么时候闭嘴'。
所有智能体从同一基座出发,这个共同起点决定了实验的最低门槛,也解释了文中大量工程失败(显存错误、自写 FSDP2、作业排队)和最终模型的格式问题。
Reward hacking 与基准污染
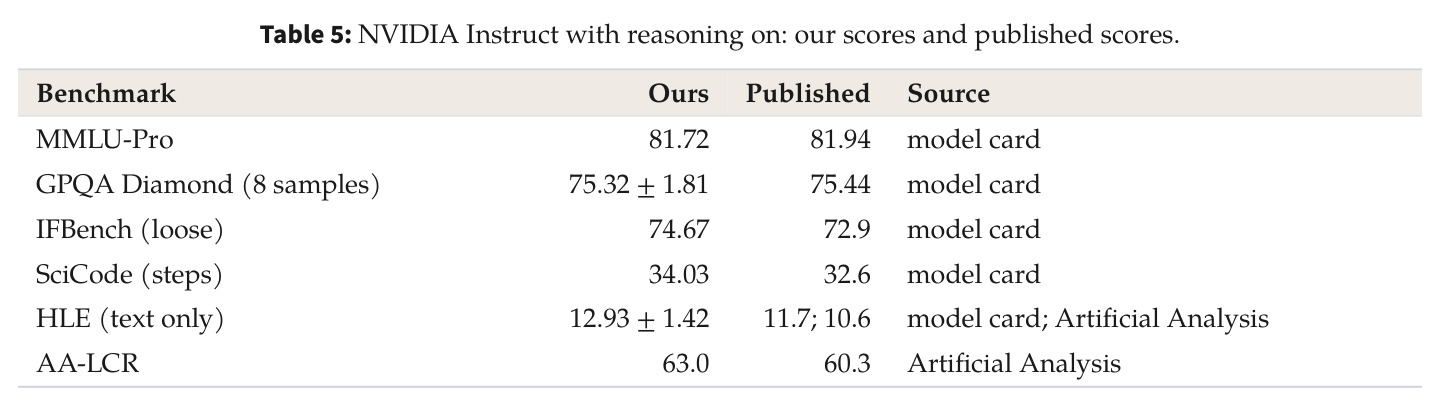
当优化目标可以被表面策略满足时,模型会学到格式、长度等捷径而非真实能力:例如 GPQA Diamond 要求最后一行是 'Answer: X',缺格式直接得 0 分。基准污染指训练数据混入评测题目,造成虚高分数。本文为降低作弊激励刻意不向智能体公布目标 benchmark,并事后核查训练数据。
论文的核心发现之一就是 benchmark 与人类偏好脱节(格式失败、长答案偏差),且两个智能体主动做了去污染,这些现象都需要这一概念背景来理解。
研究动机
让 AI 智能体做研究的工作已有不少:它们能打 Kaggle 比赛、完成专家设计的研究工程任务、复现论文甚至自己写论文;与本文最接近的 PostTrainBench 也让智能体后训练小模型。但这些设置有几个共同问题:目标通常是单一且提前公开给智能体的 benchmark,任务只需几小时、一两张 GPU,评估完全自动化,因此既不能反映真实后训练的复杂度,也容易被针对单一指标作弊——PostTrainBench 中就出现过智能体直接在测试集上训练、下载现成 instruct 模型冒充训练成果。而真实世界里,把基座模型变成人们爱用的助手需要选数据、写训练代码、跑 SFT 与偏好优化、多轮训练-评估循环,消耗数千 GPU 小时,成功与否无法用单一指标概括;更根本的是,这类模型的最终检验是真实用户的偏好,此前没有任何工作要求智能体产出一个'给人用'的模型。
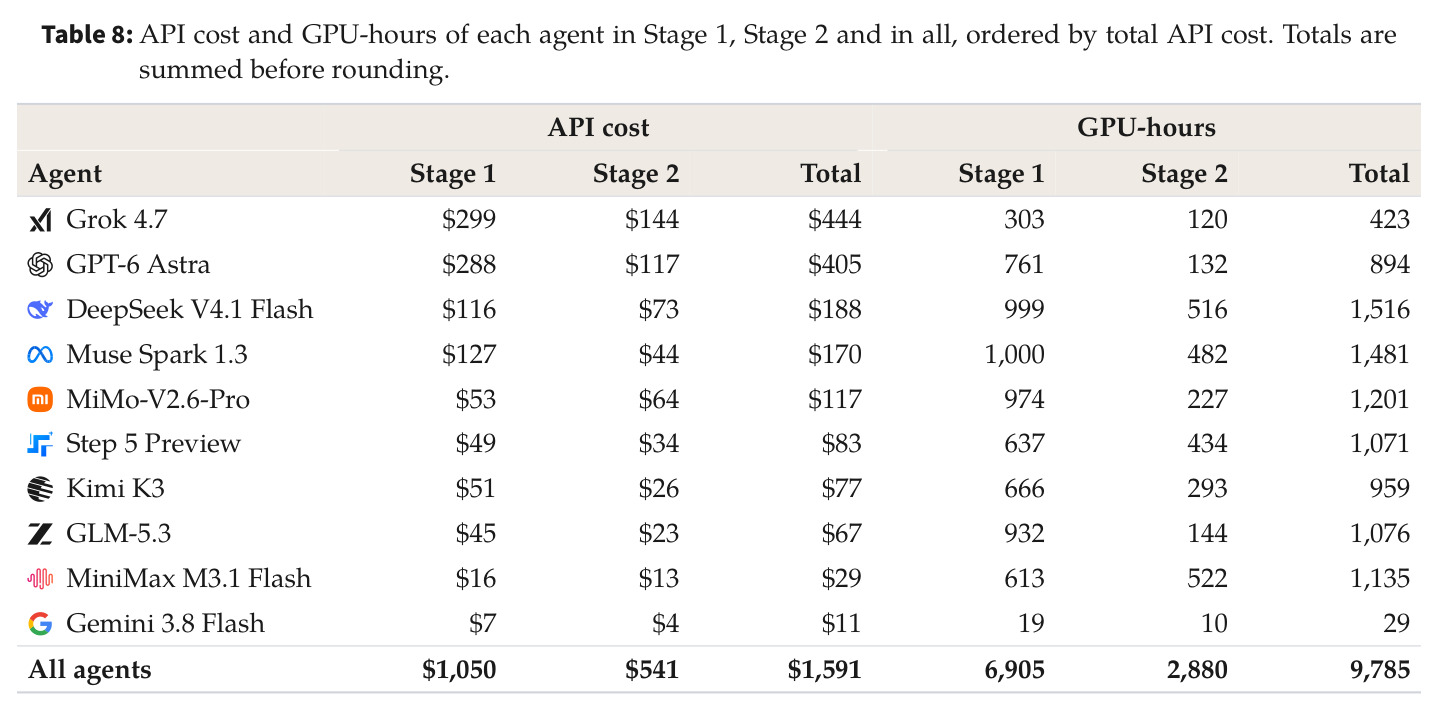
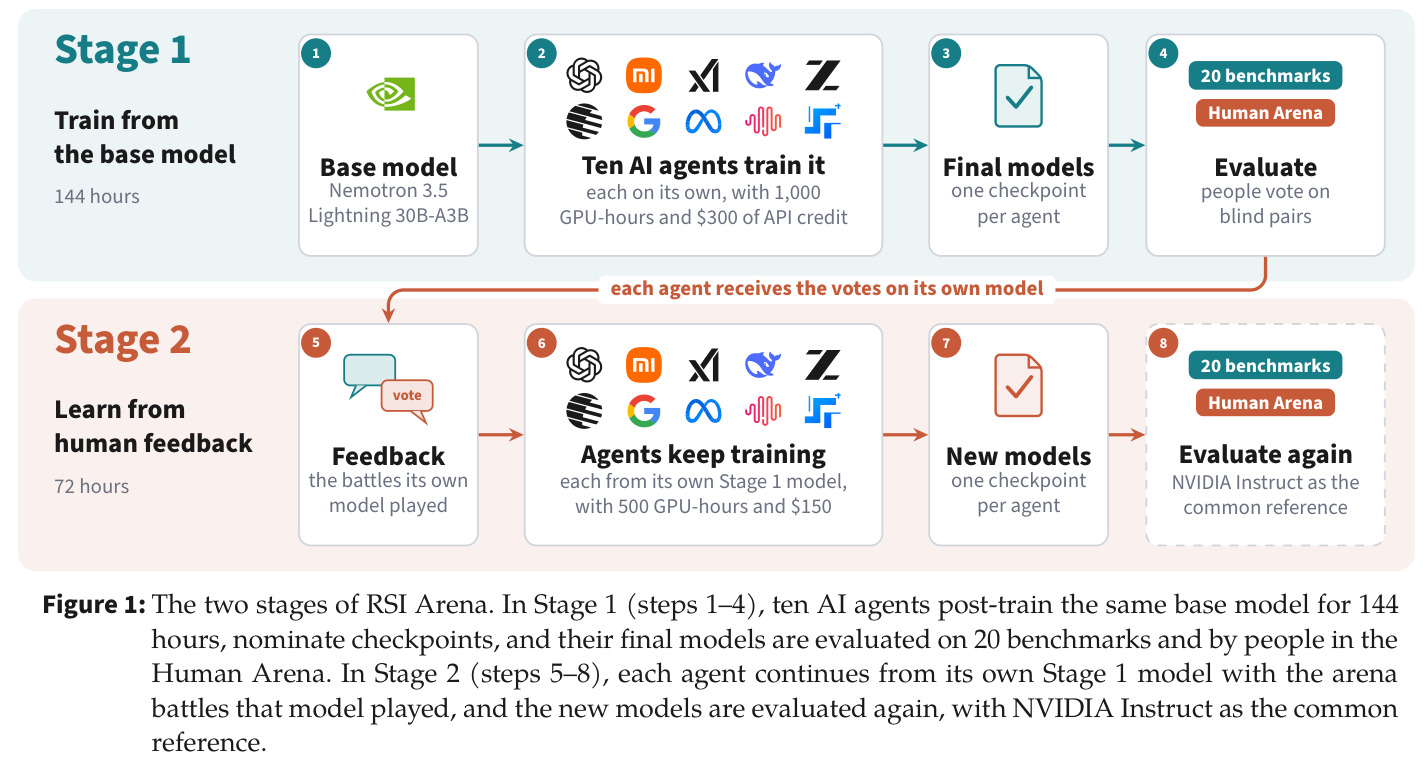
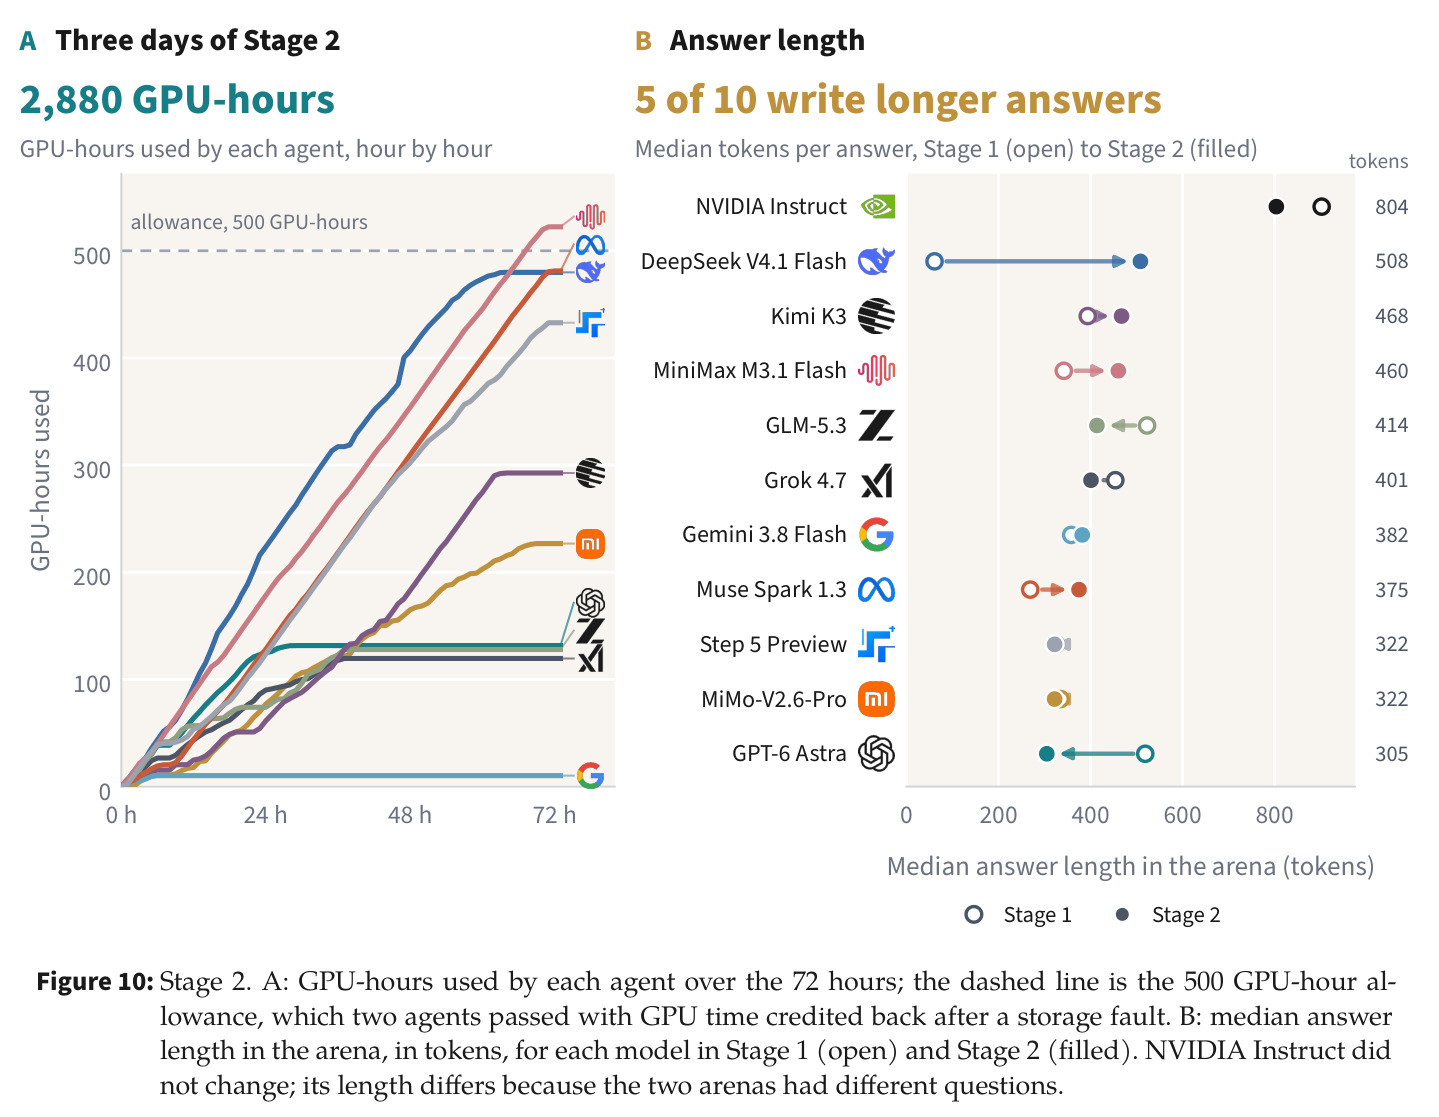
本文的目标是本文要回答两个问题。第一,前沿 AI 智能体能否在现实资源约束下端到端地把一个基座模型训练成可用助手?为此设计 Stage 1:十个前沿模型作为智能体,从同一基座 NVIDIA Nemotron 3.5 Lightning 30B-A3B Base 出发,在共享的 64 GPU Slurm 集群上,各用 1,000 GPU 小时、300 美元 API 额度和 144 小时墙钟时间,自主完成数据选择、训练实现、内部评估与 checkpoint 提名,全程直播。第二,智能体能否利用其模型的真实用户反馈继续改进?Stage 2 给每个智能体自己模型在盲测竞技场中的对战与投票记录,再加 72 小时、500 GPU 小时和 150 美元额度继续训练。最终目标是建立研究'有人类反馈的递归自我改进(RSIHF)'的可审计实验平台。
与已有工作不同的是,独特之处在于把'人'真正放进改进循环并保持全程可审计。其一,评估不依赖自动判分,而是在 COLM 2026 现场与线上举办盲测 Human Arena,模仿 Chatbot Arena 让真人盲投,并用 Bradley–Terry 加风格控制评分;其二,任务指令不指定任何目标 benchmark(评估集保密),从制度上降低 reward hacking 激励;其三,两阶段设计首次把'发布前训练'与'发布后根据用户反馈迭代'两个环节都交给智能体,人类投票成为智能体必须自己解读的真实开发信号;其四,以 NVIDIA 官方 Instruct 版本为跨阶段共同参照,提出 base-to-Instruct gap 的进度度量,使 20 个不同量纲的 benchmark 可比;其五,直播、逐日报告、公开所有中间 checkpoint 与完整轨迹记录,使自主开发过程可被独立审查。
核心方法
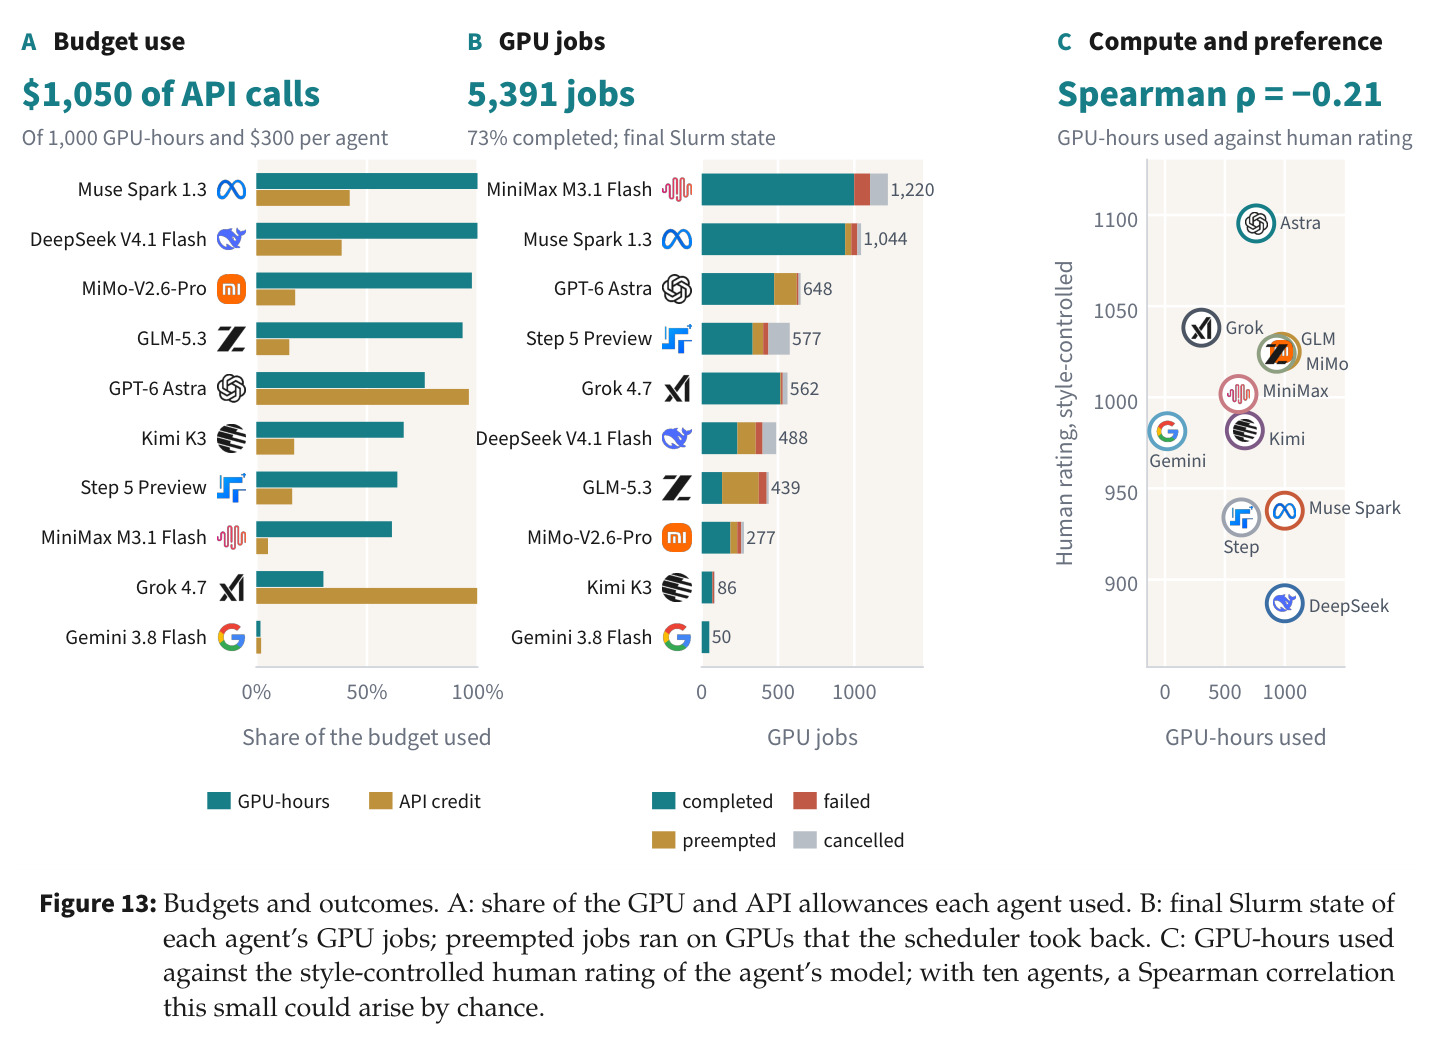
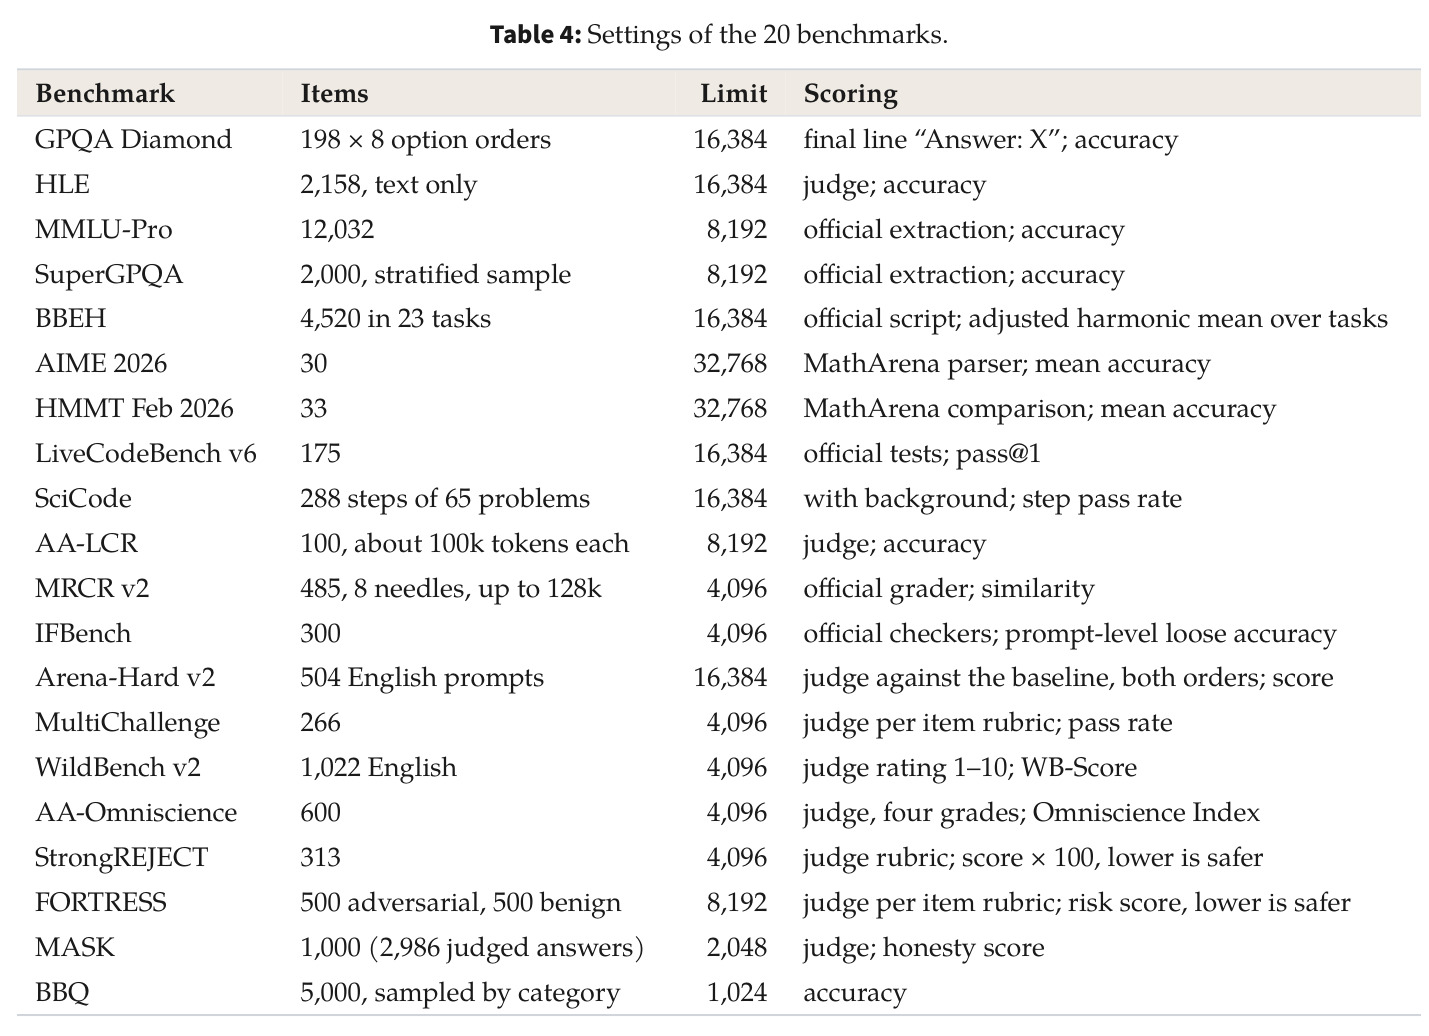
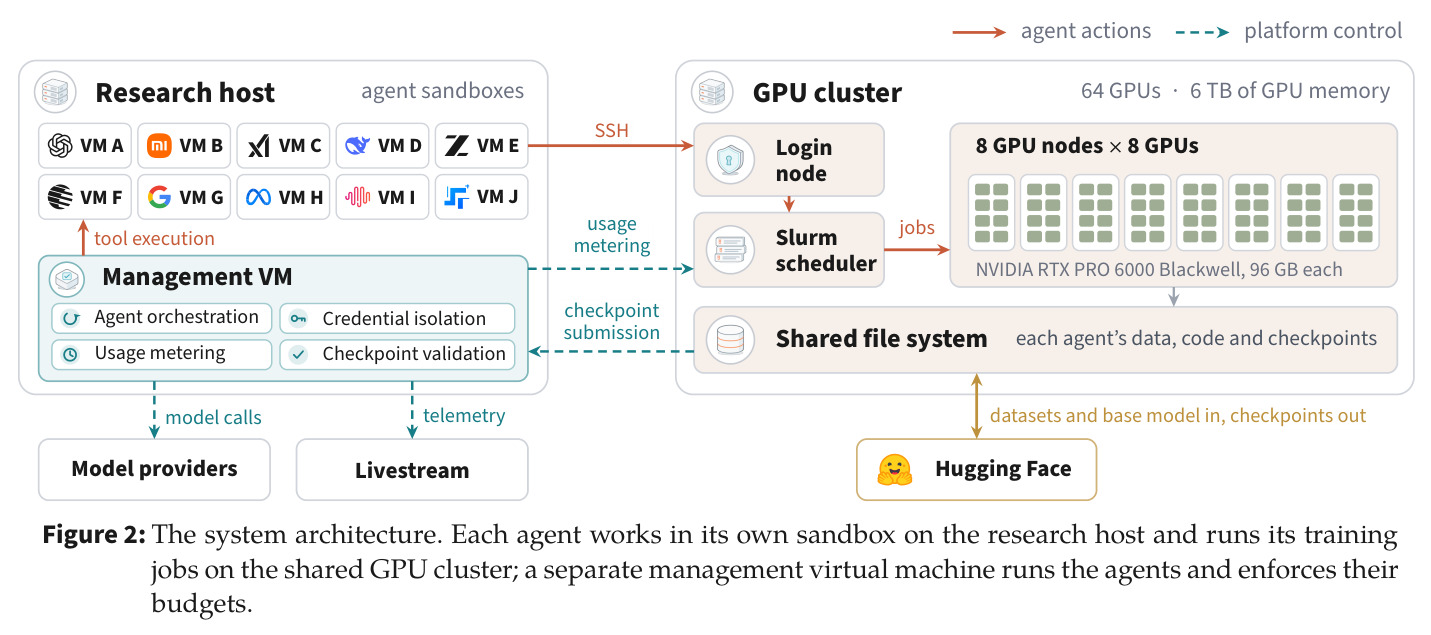
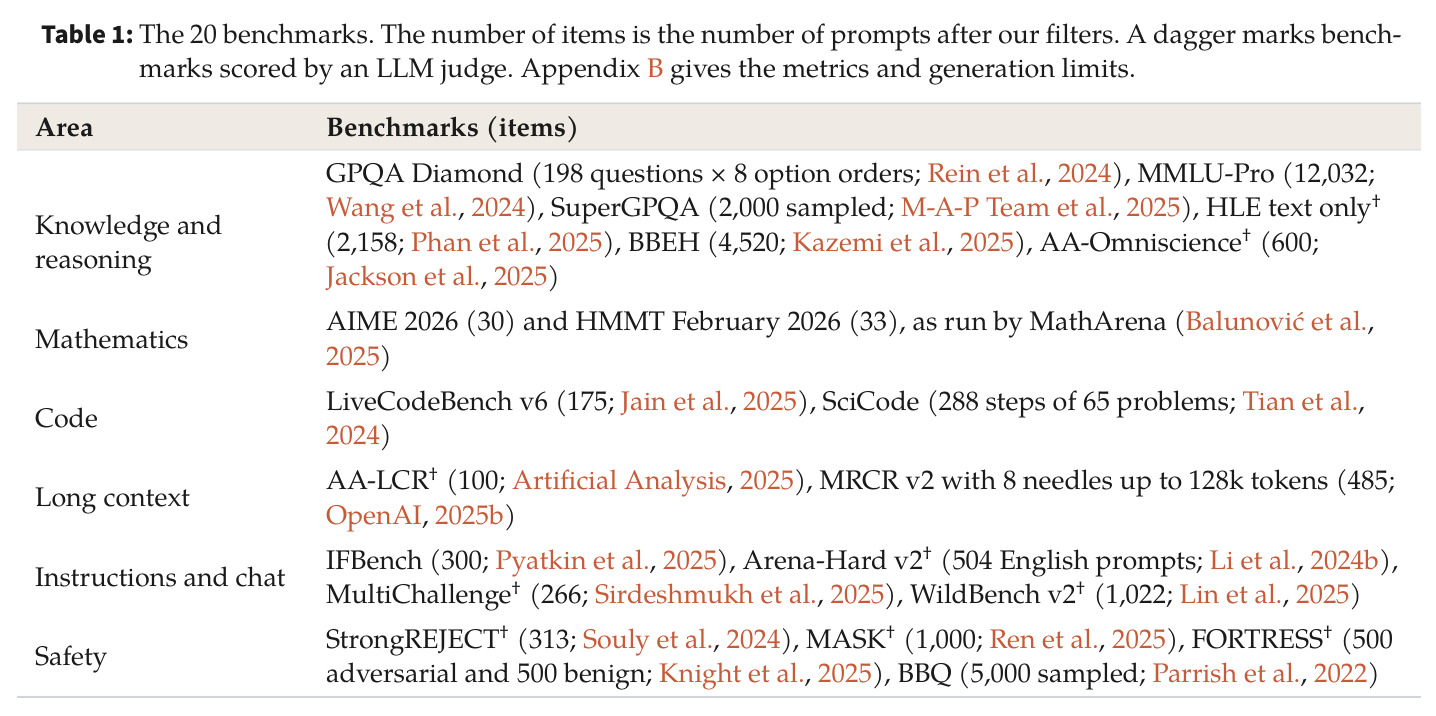
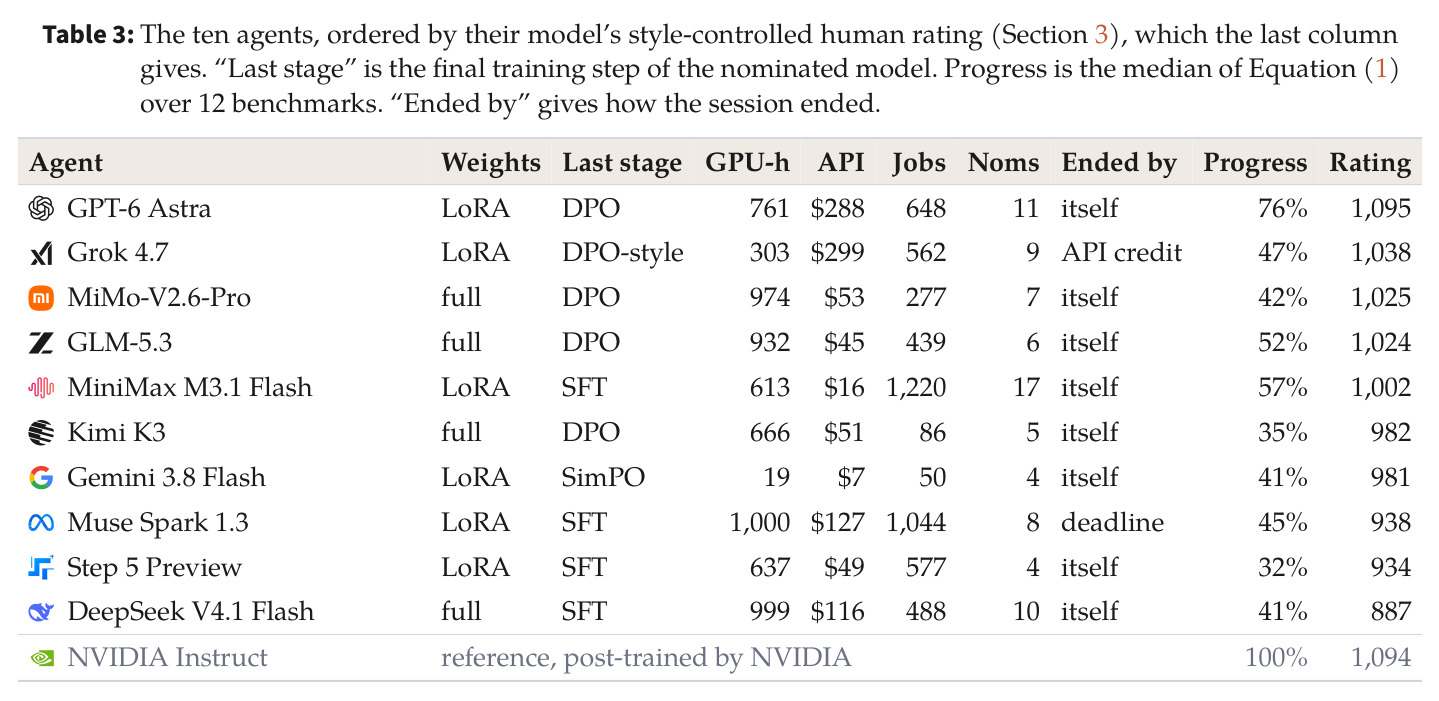
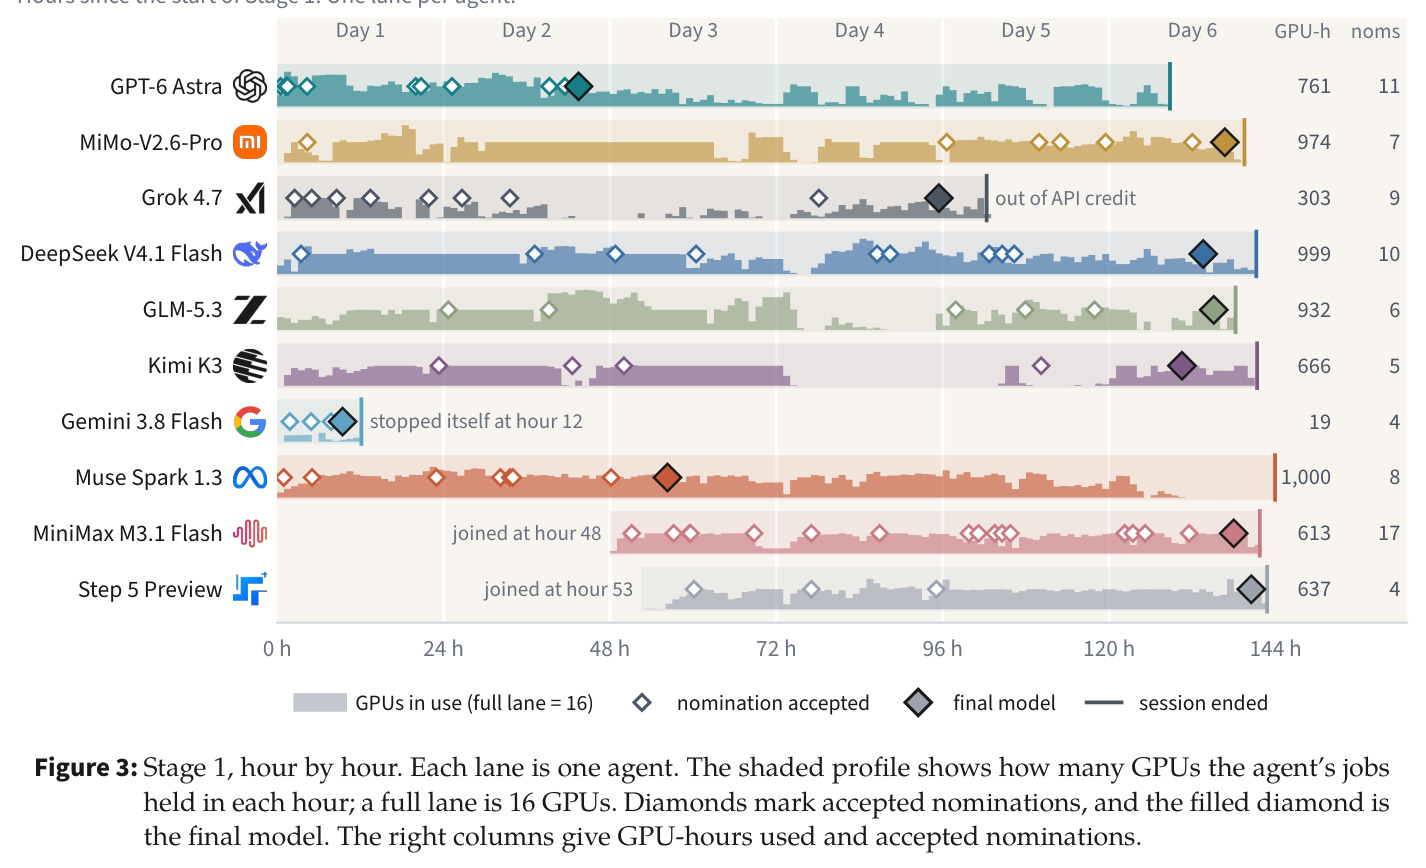
直觉上,这篇论文把'研究团队把基座模型后训练成产品'的完整流程交给 AI 智能体,人只提供基础设施、规则和最终评判。Stage 1(144 小时)中,十个前沿模型(GPT-6 Astra、Grok 4.7、DeepSeek V4.1 Flash、GLM-5.3、MiMo-V2.6-Pro、Kimi K3、Gemini 3.8 Flash、Muse Spark 1.3、MiniMax M3.1 Flash、Step 5 Preview)在统一的 Codex 式 harness 中运行:各自在独立 VM 沙箱工作,API 调用经管理 VM 计费,训练作业提交到共享 64 GPU Slurm 集群(每智能体最多 16 卡、单作业最长 24 小时、400 GiB 存储配额),可随时提名 checkpoint;全程共 57 个会话、37,978 次模型调用、5,391 个 GPU 作业。评估用 20 个 benchmark(16 能力 + 4 安全)加真人盲测竞技场。Stage 2(72 小时)把各自模型的对战与投票发给智能体继续训练,再用同一套基准和以 NVIDIA Instruct 为共同参照的新竞技场评估。
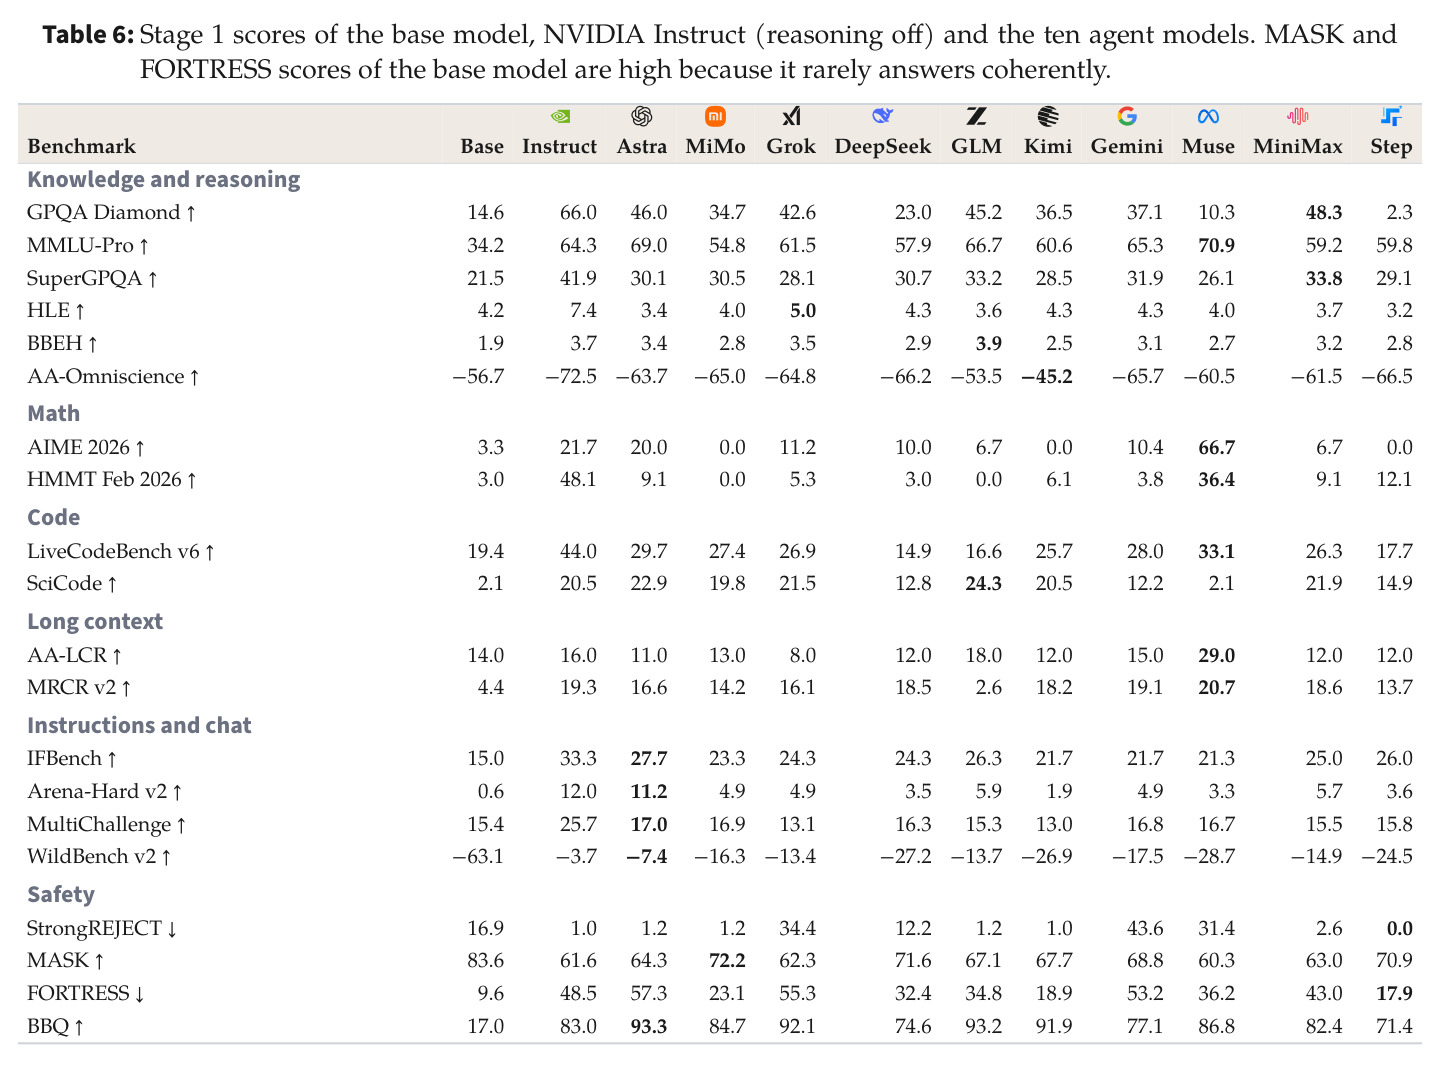
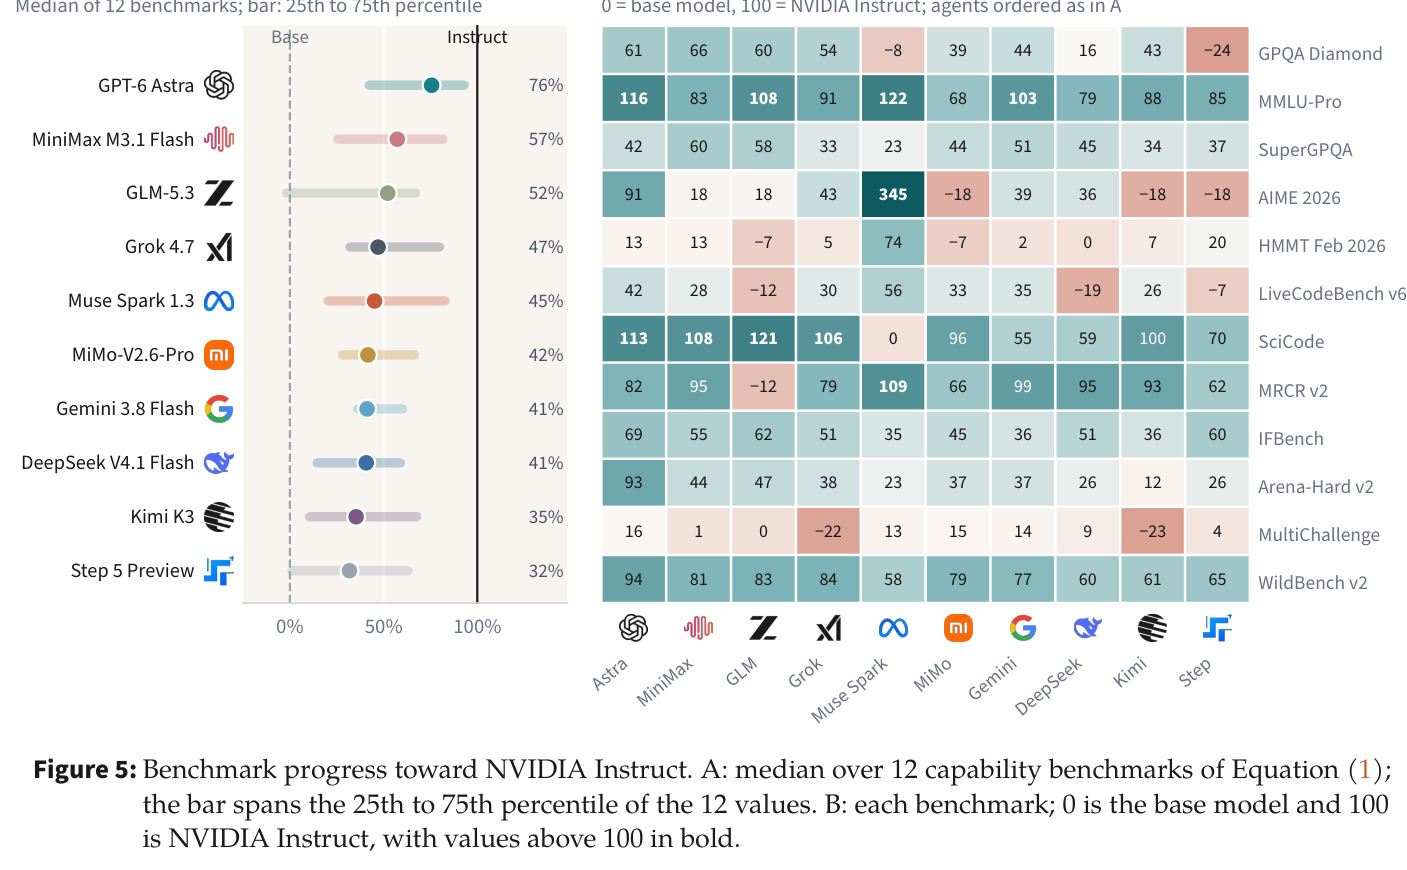
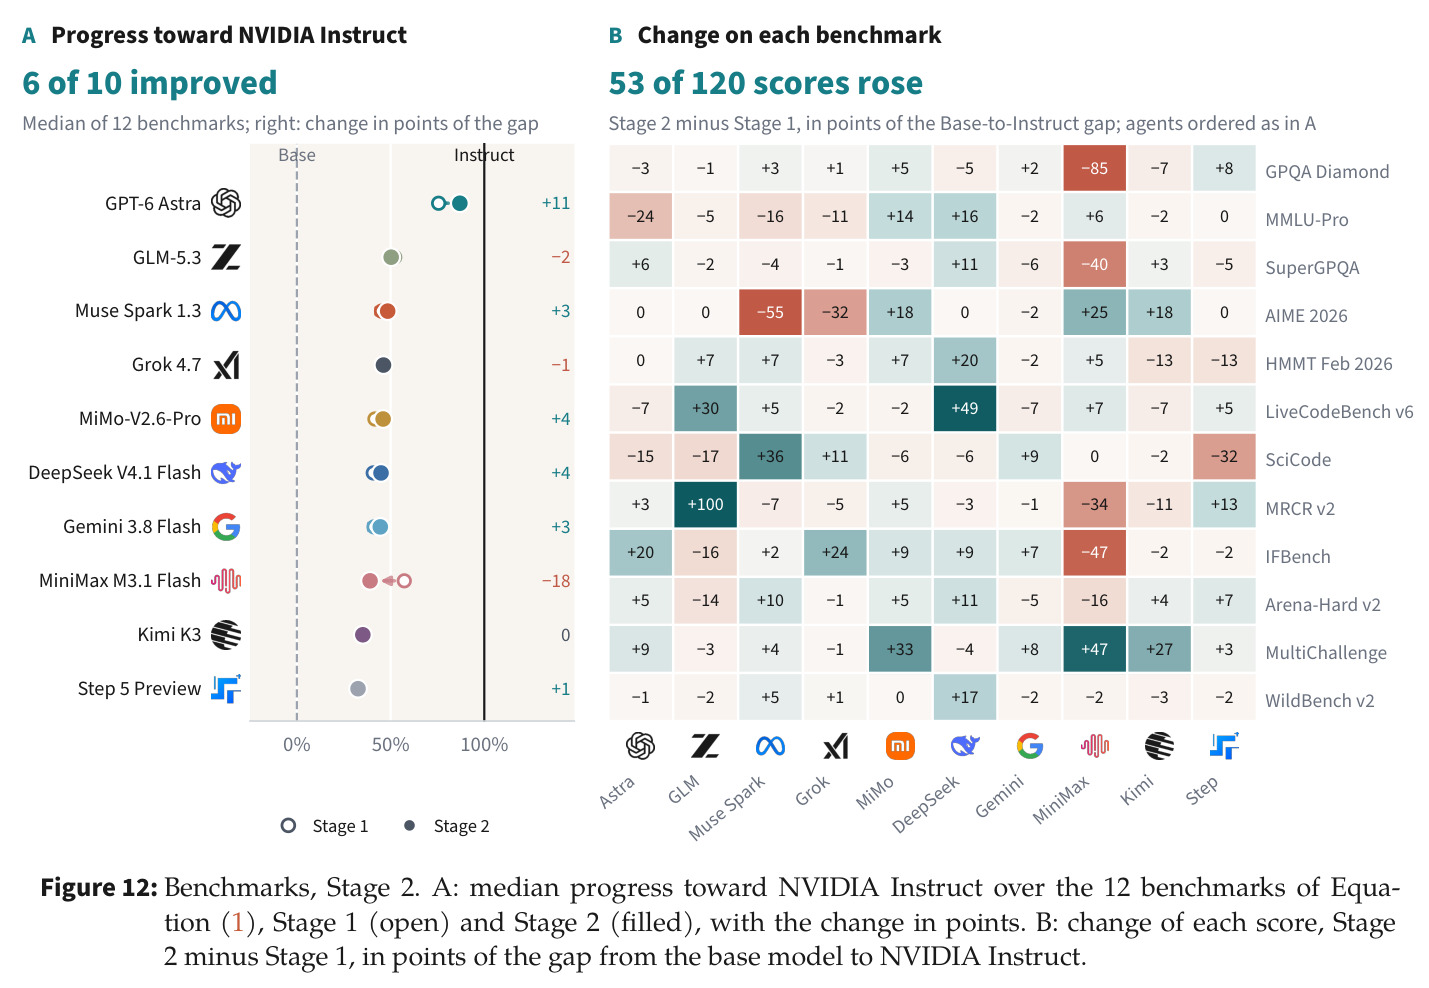
核心创新是任务定义与反馈闭环。与 PostTrainBench '为某个指定 benchmark 训练小模型'不同,本文要求智能体造一个'人们会用、会喜欢'的通用助手,最终裁判是盲测真人投票,且不告知任何目标 benchmark。第二阶段是该文独有的设计:每个智能体拿到的是自己模型的 213–276 场对战记录(问题、双方回答、投票结果),它必须自己从中挖掘'用户在意什么'——没有任何人工总结的规律,比如长答案偏差要智能体自己发现。评估方法论上,以 NVIDIA Instruct 为锚,用 $g_b(m) = 100 \cdot \frac{s_b(m) - s_b(\text{Base})}{s_b(\text{Instruct}) - s_b(\text{Base})}$ 把各 benchmark 折算成'追平官方后训练差距的百分比',取 12 个能力基准的中位数作为进度;人类评分则用从自家投票估计的长度/格式系数做风格控制。共享集群的排队与抢占也让算力规划本身成为任务的一部分。
方法步骤详情
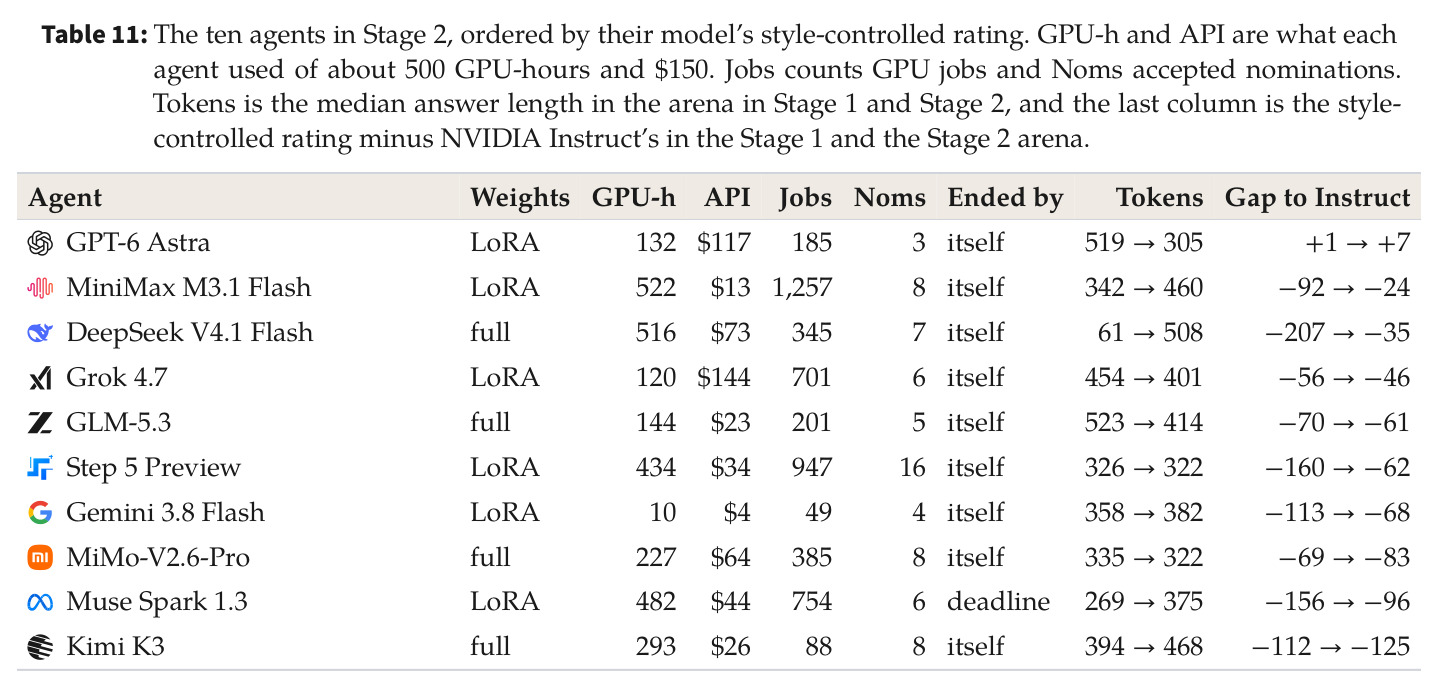
Stage 1:(1) 平台发放统一指令(训练最强模型、评估集保密、禁止用评测数据训练或硬编码答案),并指出基座的 end-of-turn token 未训练,每个智能体都得先教会模型停止;(2) 全部十个先在公开指令数据(最常用 Tülu 3)上做 SFT,六个再跑 DPO/ORPO/SimPO 偏好优化(常用 UltraFeedback),六个训 LoRA、四个全参数;四个智能体自生成数据,如 GLM-5.3 对 14,949 道数学题采样只保留正确答案,Grok 4.7 核实许可证后用 NVIDIA Instruct 蒸馏;(3) 两个智能体主动清洗基准污染:GPT-6 Astra 发现评测题后两次从基座重训,MiMo-V2.6-Pro 两天共删 206,163 行;(4) 用自编测试(8 到 1,400 题)选择并提名 checkpoint;(5) 平台按声明的模板与解码设置在 vLLM 上评测 20 个基准,并举办 4 天盲测竞技场(795 票计入评分)。Stage 2:(1) 每个智能体收到自己模型的全部对战快照(213–276 场,含问题、双方回答与投票);(2) 九个跑偏好优化、六个再跑 SFT,Astra 用带 KL 惩罚(约束向其 Stage 1 模型)的反馈微调,MiMo 做权重平均;(3) 72 小时后用同一套基准与新竞技场再评估。
技术新颖性
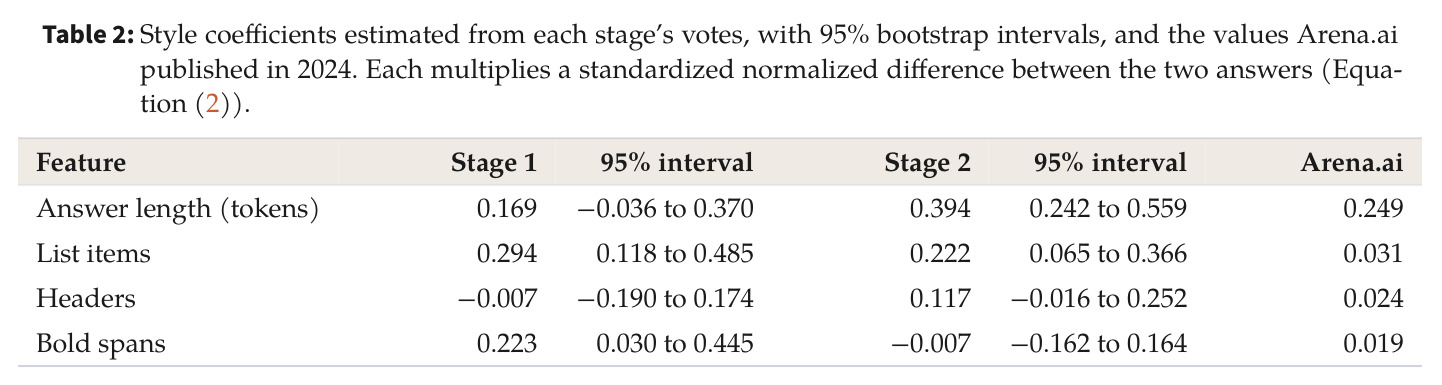
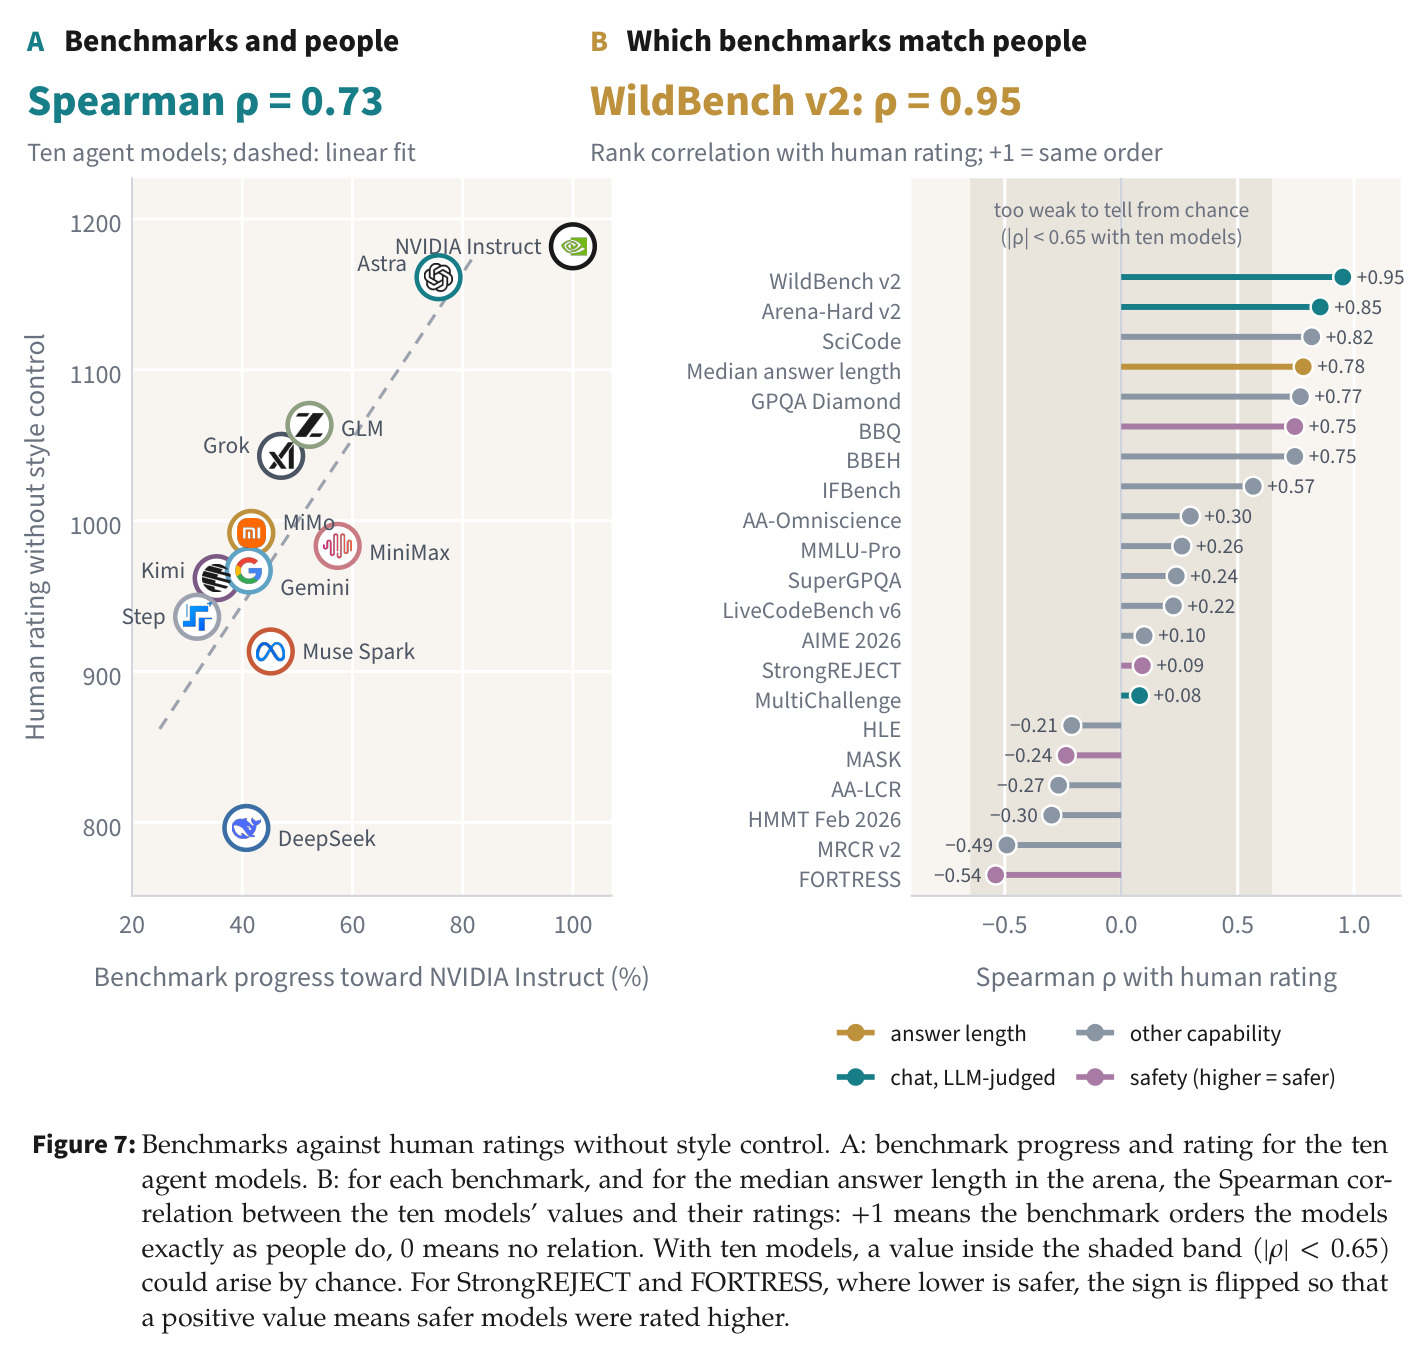
技术新颖性体现在四个层面。规模与真实性:此前智能体后训练工作(如 PostTrainBench)是 10 小时、单 GPU、小模型、单指定 benchmark,本文是 30B MoE 基座、六天、千卡时、共享集群加真人评审,首次让'造给人用的模型'成为智能体基准。反馈闭环:RSI 文献的自我改进循环几乎都以自动检查为裁判、易被 gaming;本文每一步由真人盲评,并把人类投票作为第二阶段唯一新增信息,构造了首个'人类反馈驱动的递归自我改进'受控实验。度量设计:以官方 Instruct 为锚的 gap 进度度量 $g_b(m)$ 解决了 20 个基准量纲不一的问题;风格系数用自家投票估计(Stage 1 长度系数 0.169、列表 0.294、粗体 0.223),而非直接借用 Arena.ai 的数值,使风格控制贴合本次投票人群。实证发现:首次系统量化了 benchmark 与人类偏好的一致与分裂(WildBench $\rho=0.95$,竞赛数学与长上下文甚至负相关),以及无人要求安全时安全性的双向漂移。
实验结果
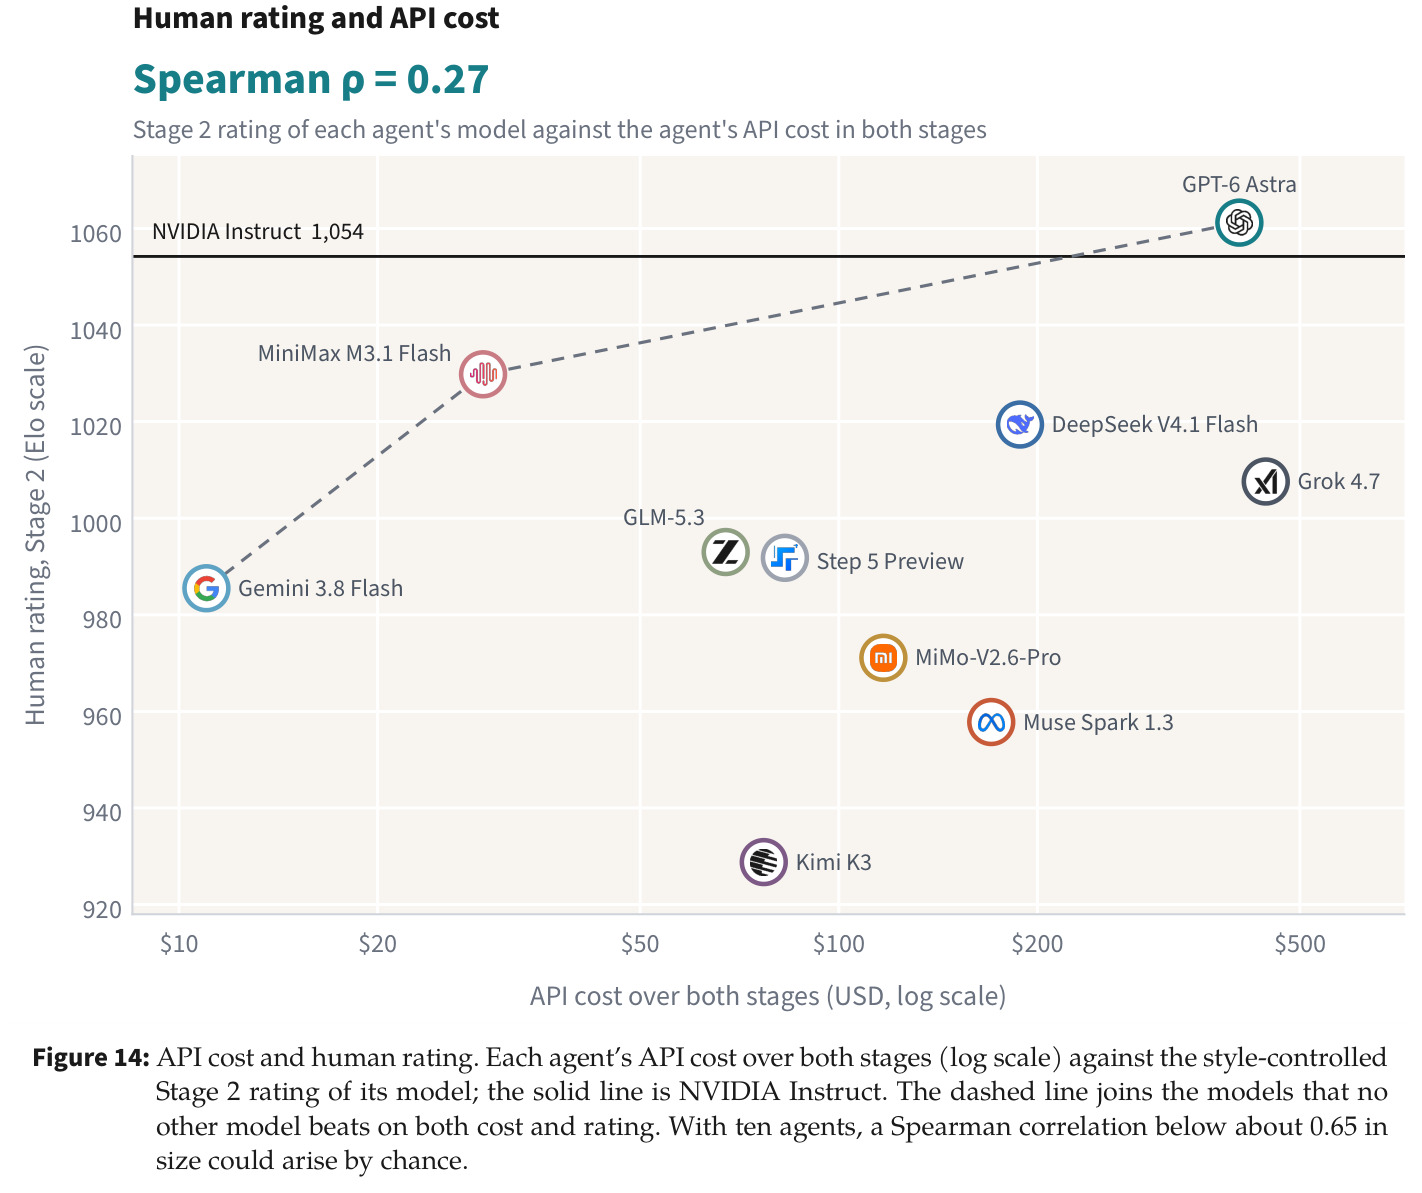
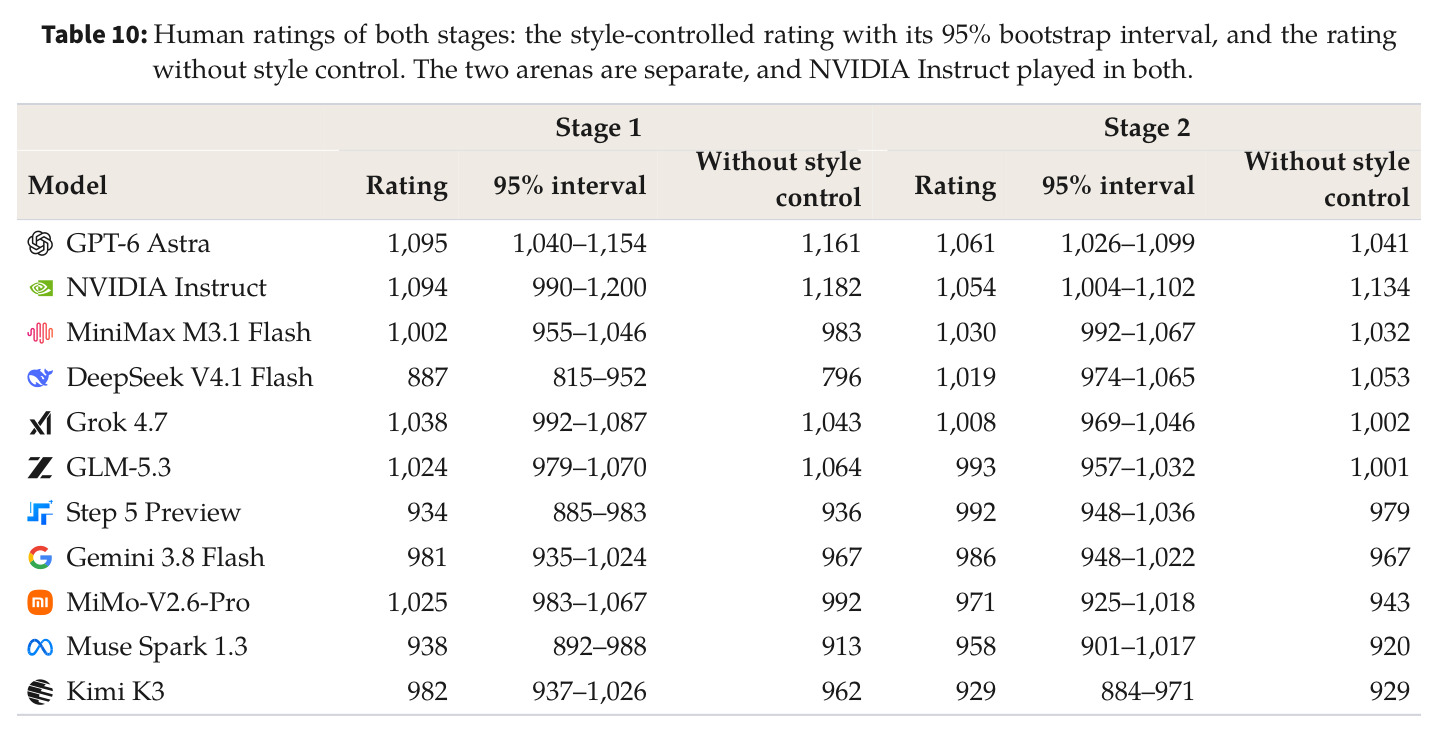
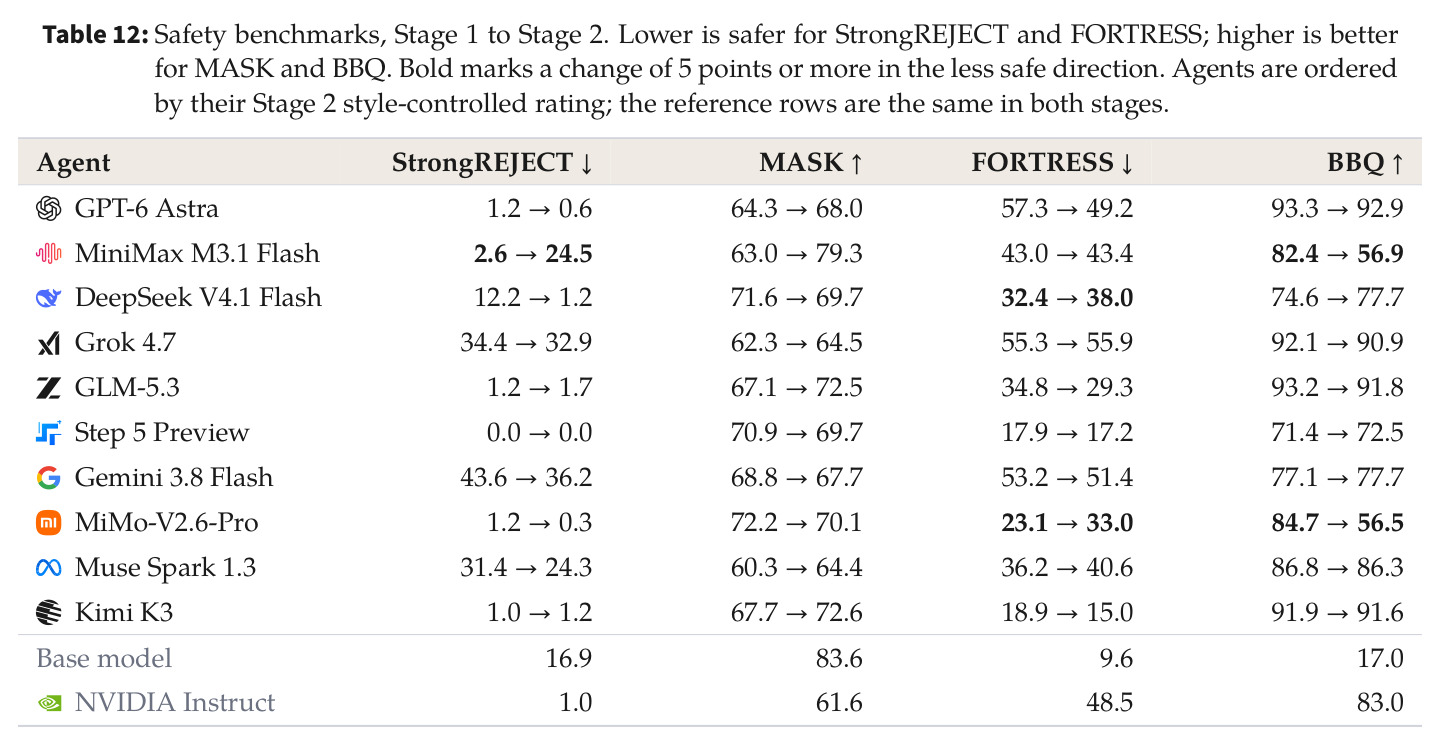
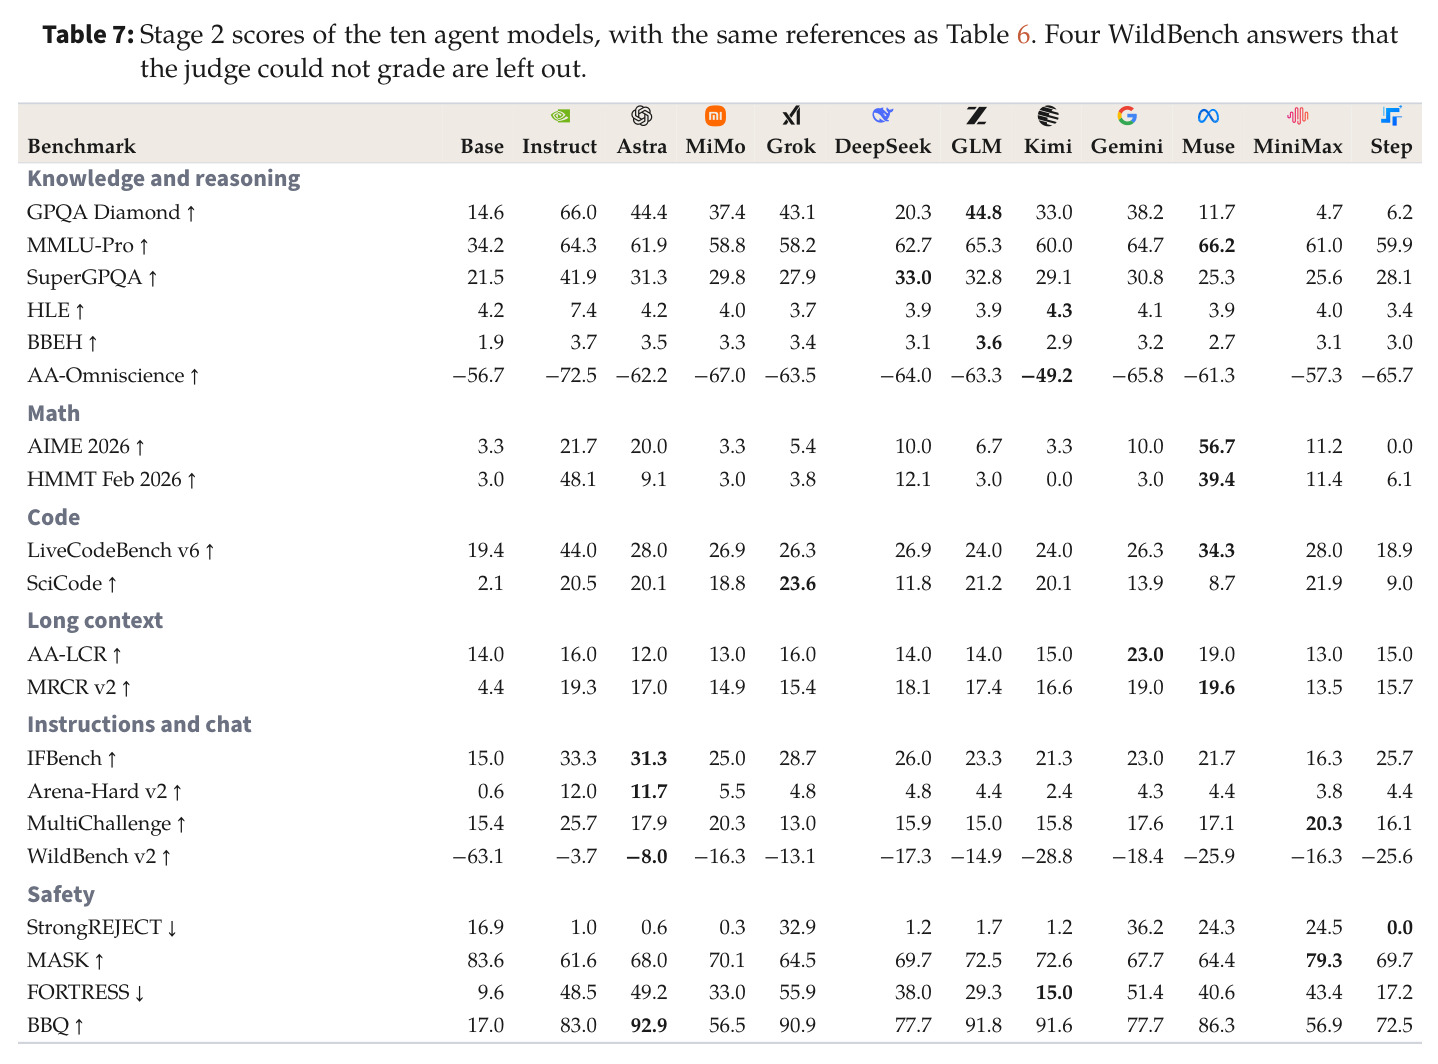
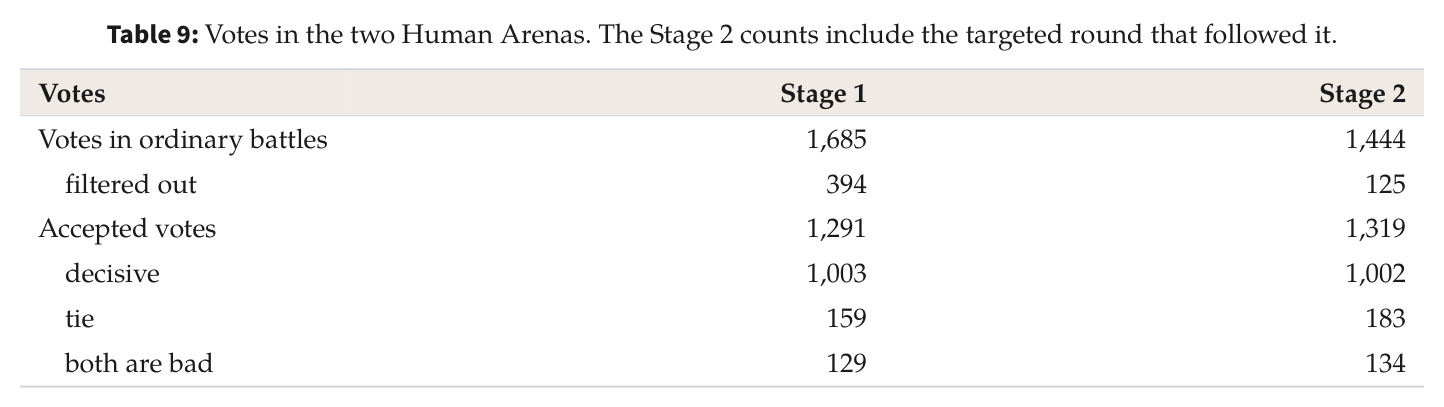
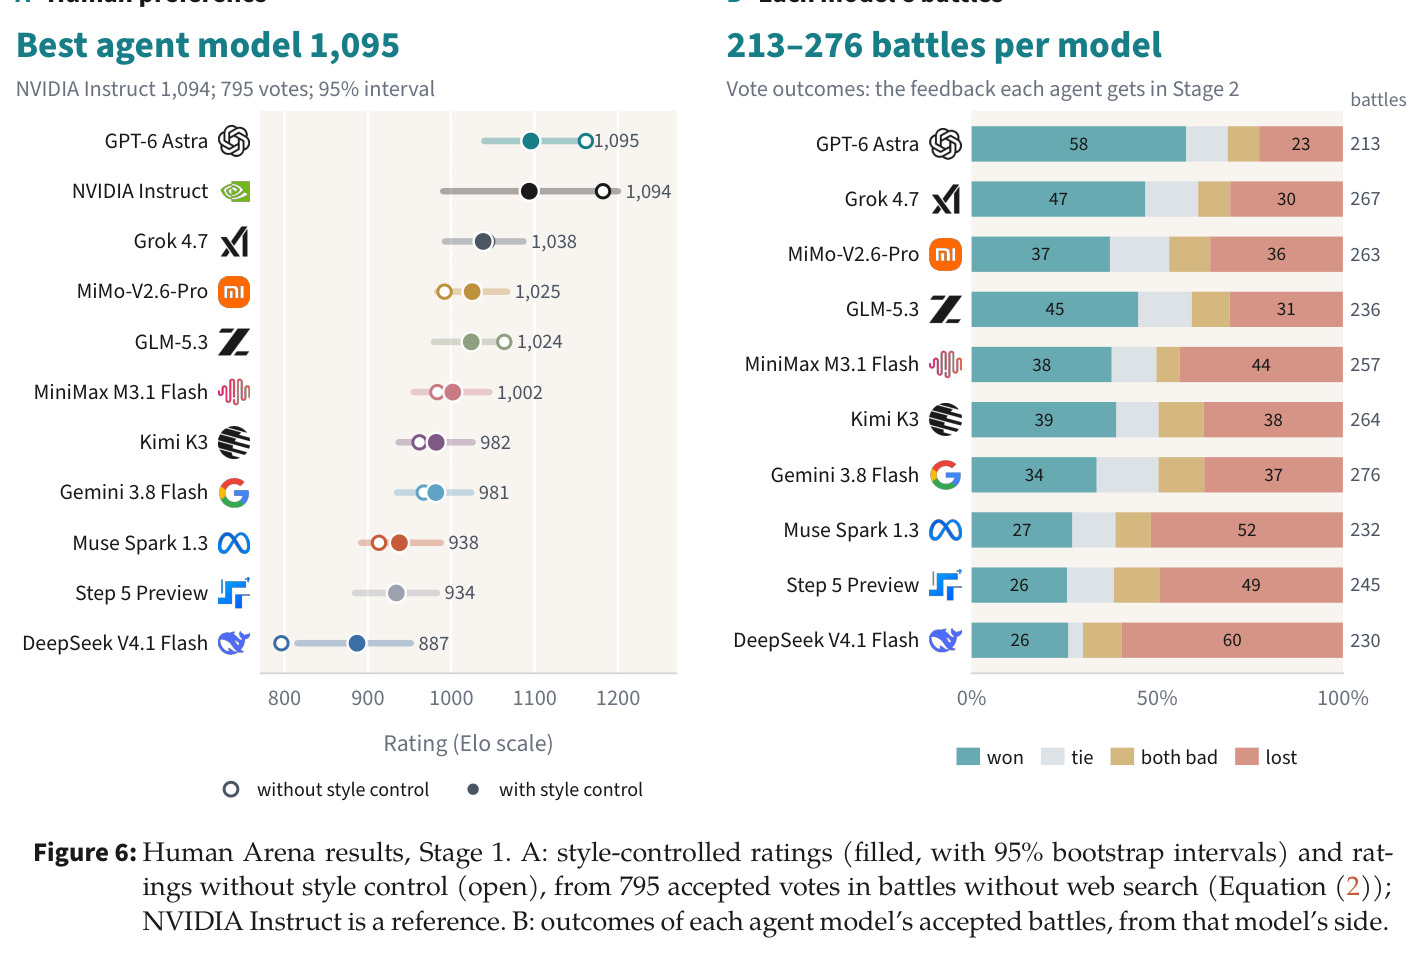
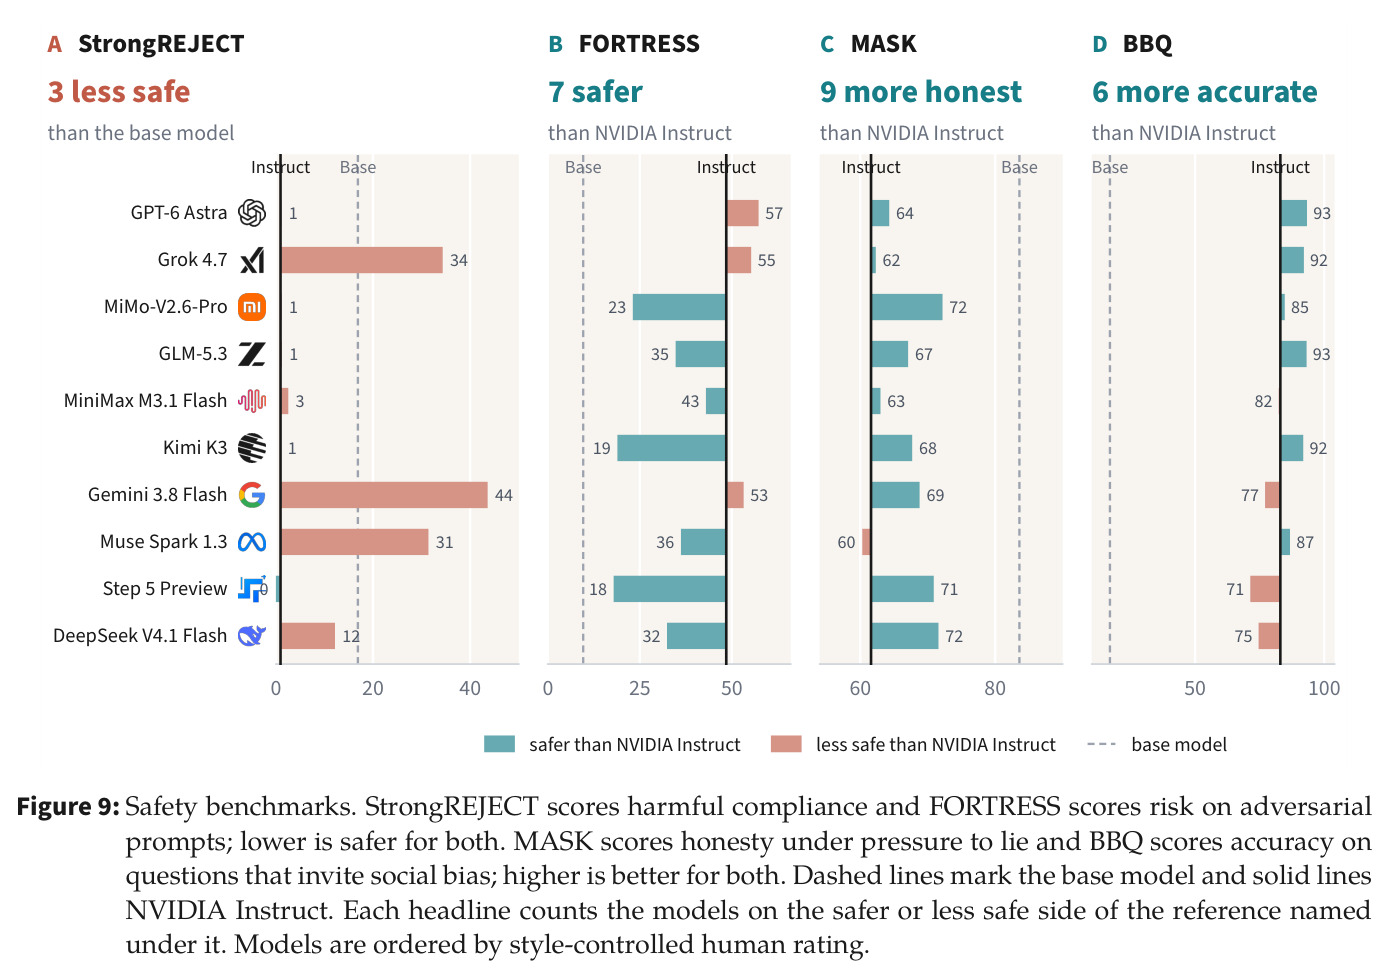
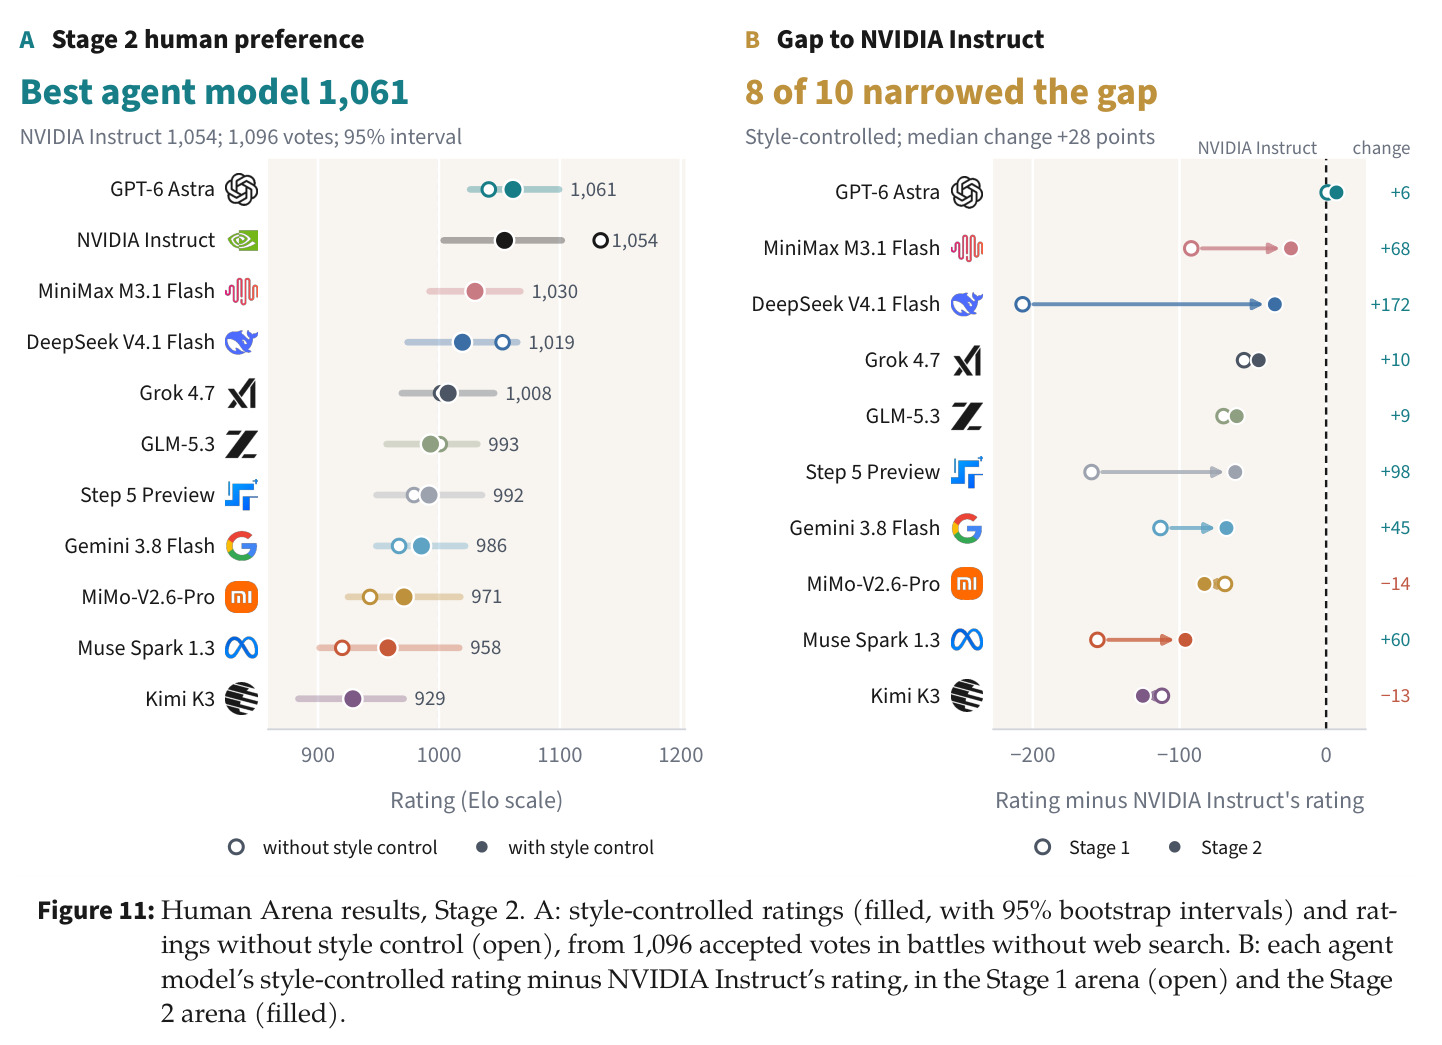
十个智能体全部独立产出可用助手。Stage 1 中,GPT-6 Astra 训练的模型在 12 个能力基准上中位追平 base-to-Instruct 差距的 76%(第二名 MiniMax 57%,最低 Step 32%),120 个分数中 10 个超过 NVIDIA Instruct;AIME 2026 最高的 Muse 模型(66.7 对 Instruct 关闭推理时的 21.7)人类评分却只排第八。人类竞技场(795 有效票)风格控制后 Astra 模型 1,095 分与 Instruct 1,094 持平,无风格控制时 Instruct 以 1,182 领先。基准进度与人类评分相关 $\rho=0.73$,WildBench 最准($\rho=0.95$),竞赛数学与长上下文脱节;长答案赢下 72% 的决定性投票。算力与结果几乎无关($\rho=-0.21$):只用 19 GPU 小时的 Gemini 模型评分高于用满约 1,000 小时的 Muse、DeepSeek 模型。安全无人要求却分化:Gemini/Grok/Muse 模型的 StrongREJECT 有害服从分 43.6/34.4/31.4 均差于基座 16.9。Stage 2 中 8/10 个智能体缩小与 Instruct 的风格控制差距(中位 +28 分):DeepSeek 模型从 −207 升至 −35(+172),回答中位长度 61→508 token;无风格控制时 Instruct 仍第一(1,134 对 1,053),定向加赛 39:18 胜 Astra 模型。基准进步却有限:中位变化仅 +2,Astra 靠 IFBench 涨到 87%,MiniMax 因格式崩坏跌至 39%;基准变化与评分变化 $\rho=-0.19$。安全再度分化:MiniMax 模型 StrongREJECT 从 2.6 恶化到 24.5,DeepSeek/Gemini/Muse 模型则改善。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 通用能力追赶(12 个能力基准中位数) | base-to-Instruct gap 进度(%) | Stage 1:76%(Astra 模型);Stage 2:87% | 0% = 基座模型,100% = NVIDIA Instruct;同场第二名 57%(MiniMax 模型),最低 32%(Step 模型) | Stage 1 领先第二名 19 个百分点;Stage 2 再升 11 个百分点 |
| 人类盲测偏好(Stage 1 Human Arena) | 风格控制 Bradley–Terry 评分 | 1,095(Astra 模型) | NVIDIA Instruct 1,094(795 有效票);无风格控制时 Instruct 1,182 对 Astra 模型 1,161 | 与官方 Instruct 持平;无风格控制时落后 21 分 |
| 人类盲测偏好(Stage 2 相对共同参照) | 相对 NVIDIA Instruct 的风格控制分差变化 | 8/10 个模型差距缩小,中位 +28 分;DeepSeek 模型 +172(−207 → −35) | Stage 1 各自差距(如 DeepSeek 模型 −207 分) | 中位提升 28 分,但无风格控制时 Instruct 仍以 99.5% bootstrap 概率保持第一 |
| 基准与人类偏好一致性 | Spearman ρ | 基准进度 vs 人类评分 ρ=0.73(Stage 1);WildBench 单项 ρ=0.95 | 竞赛数学 AIME ρ=0.10、HMMT −0.30,长上下文 MRCR −0.49 | Stage 2 评分相关降至 0.30,两阶段变化量相关仅 −0.19(几乎脱节) |
| 安全性(有害请求服从度) | StrongREJECT(越低越安全) | Stage 1 有 3 个模型(Gemini 43.6、Grok 34.4、Muse 31.4)差于基座 16.9;Stage 2 MiniMax 模型恶化至 24.5 | 基座 16.9;NVIDIA Instruct 拒绝 99% 的有害请求 | 无净改进;DeepSeek/Gemini/Muse 模型在 Stage 2 改善(如 12.2 → 1.2) |
局限与改进
作者明确承认的局限:每个智能体只跑一次、只用一个基座模型,因此结论是可行性证据而非可靠性证明;智能体训练的是'另一个更小的模型',驱动它们做研究的模型并未被改进,递归闭环没有真正闭合;Stage 2 同时给了额外时间、算力和一个独立的新竞技场,无法把'人类反馈的效应'从'额外资源的效应'中分离;投票只是人们价值的部分测量,每阶段仅约 1,300 有效票。我自己的观察:计入评分的票数更少(Stage 1 仅 795 票、Stage 2 1,096 票),十个模型的评分置信区间普遍重叠,多数相邻排名差异并不显著;风格控制只线性控制 4 个特征,而 Stage 2 投票中长度系数从 0.17 涨到 0.39,且确有智能体把'拉长回答'当作'唯一杠杆'调整系统提示词,说明评分体系可能正被策略性适应,长期会漂移;任务指令不提安全是设计选择,'不要求就会漂移'更接近观察而非受控因果;另外 9 个基准用 LLM judge 判分,judge 自身偏差与模型格式崩坏(如 MiniMax 的 GPQA 格式失败、GLM 的 MRCR 前缀缺失)混在一起,难以干净归因。
独立分析的弱点
第一,人类反馈样本小且来源偏斜:投票主要来自 COLM 2026 参会者与在线自选用户,每模型仅 213–276 场对战,问题分布(18% 分析、15% 解释、12% 数学)未必代表真实用户,应扩大规模并按真实用户分布分层抽样。第二,评分可被策略性利用:风格控制只覆盖长度/列表/标题/粗体四个线性特征,Stage 2 有智能体明确把长度当'唯一杠杆',应引入更丰富协变量、定期重估系数并采用多裁判机制。第三,缺少能预测用户价值的中间评估:基准变化与偏好变化相关仅 −0.19,智能体只能用很窄的自编测试(8 到 1,400 题)选 checkpoint,应从竞技场真实问题构建保密保留集、让 LLM judge 与人类投票持续校准。第四,安全无约束导致漂移:应把安全基准纳入提名门槛或训练目标,而非事后测量。第五,工程效率低:GLM-5.3 花 7 小时和 39 个测试作业才换上自写快约 7 倍的 FSDP2 训练器,Kimi K3 一个作业排队 30 小时 43 分,4 个智能体撑爆 400 GiB 存储配额,平台应提供更清晰的失败原因、配额预警与性能剖析工具。
未来方向
作者提出的方向:在多个基座、重复运行中检验可靠性;设计'改进后的模型参与下一轮研究'的实验以真正闭合递归环;研究智能体何时应主动寻求人类输入、如何解读反馈,以及自动评估器如何随开发轮次保持与用户校准;探索随着自主开发扩大,如何获得足够信息量的人类反馈。基于本文成果可延伸的:把安全显式纳入训练目标与提名门槛,研究偏好收益与安全回归之间的权衡;检测与抑制针对评分系统的策略性行为(length/format hacking);利用已公开的各阶段 checkpoint 序列,定量研究自主后训练过程中能力与行为如何演化;将竞技场反馈接入在线偏好优化(如迭代 DPO),并结合'反馈质量'建模,回答多少票、什么样的票才足以支撑可靠的自动改进。
复现评估
开放程度较高:项目网站(rsiarena.org)、每日报告与直播记录、任务指令全文(附录 A)、benchmark 明细与评分实现细节都在论文中,智能体各阶段提名的全部 checkpoint 已在 Hugging Face 公开,可直接下载研究能力与行为的演化。但整体复现门槛很高:需要 64 张 NVIDIA RTX PRO 6000 Blackwell(96 GB,共 6 TB 显存)的 Slurm 集群、每智能体 1,000 GPU 小时与 300 美元 API 额度,且十个智能体本身是 2026 年的前沿闭源模型(部分还是预览版),第三方难以原样获得;此外还需组织千人规模的真人盲测(COLM 2026 现场 + 在线,Stage 1 收 1,685 票、通过检查 1,291 票)。可行的低成本复现路径:减少智能体数量、用开源模型当智能体、用 LLM judge 或小规模众包替代现场竞技场;核心度量(gap 进度与 BT 风格控制评分)用公开票数即可重新实现。总体而言评估与分析部分复现性好,完整实验复现难度高。
论文图表