EvalResearchBench:AI 智能体能否为自己的递归自我改进构建评估反馈 EvalResearchBench: Can AI Agents Build Their Own Feedback for Recursive Self-Improvement?
首个让智能体在固定预算内自主设计评估器的基准,最好排序一致性75%仍低于91%天花板
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指 AI 系统自主改进自身的研究闭环:每一轮新的训练配方、数据集或程序都会产生一个需要评估的新版本,系统根据评估反馈决定下一步探索方向。评估反馈是整个闭环的“方向盘”,评估跑得越慢、越贵,迭代就越慢。本文关注的正是这个闭环中被人类把持的最后一环——评估工具本身的设计。
本文的核心问题是:智能体能否自己造出这个方向盘。不理解 RSI 对“便宜、可重复、信息量足够”的评估的需求,就无法理解为何要把评估设计单独拿出来做基准。
一致性相关系数(CCC)与 Score 指标
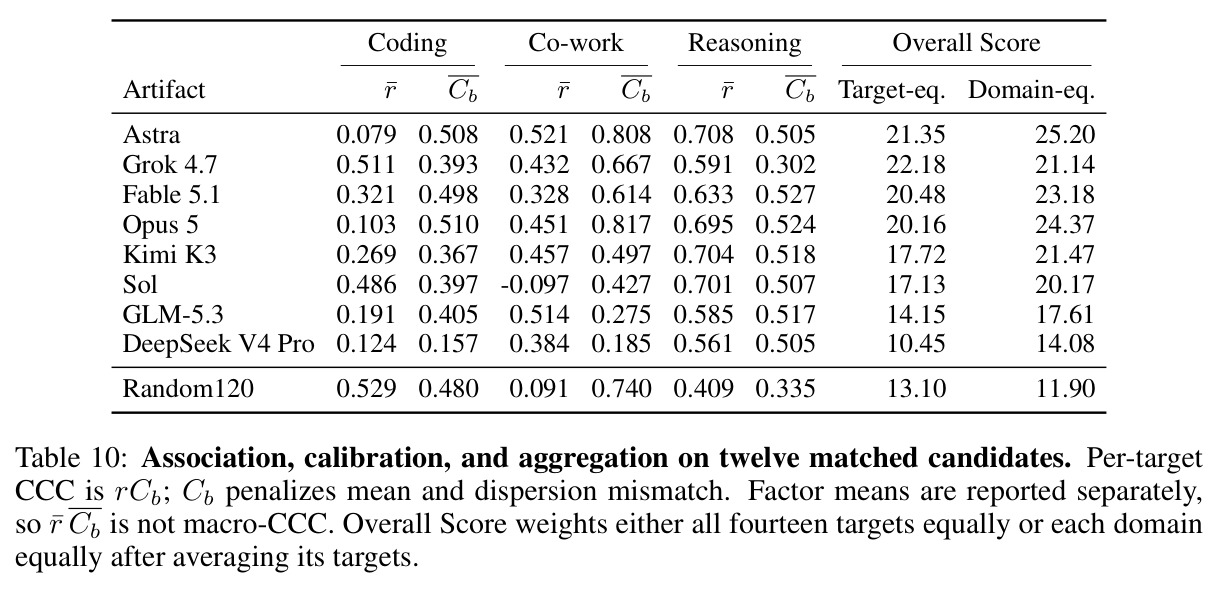
CCC(Lin, 1989)同时惩罚相关性的缺失和均值、方差的错位,定义为其分解 $\mathrm{CCC}=r\cdot C_b$,其中 $C_b=\frac{2s_xs_y}{s_x^2+s_y^2+(\bar{x}-\bar{y})^2}$ 度量位置与散布的吻合度。本文定义 $\mathrm{Score}_{a,t}=100\times\frac{2\,\mathrm{Cov}(x,y)}{\mathrm{Var}(x)+\mathrm{Var}(y)+(\bar{x}-\bar{y})^2}$,完全一致得 100,常数输出得 0,方向相反可为负。
Score 是本文两大主指标之一,只奖励排序的指标会被“分数整体偏高”的评估器钻空子,读懂 Score 才能理解为何 Astra 和 Grok 的领先领域不同。
成对一致性(Pairwise Agreement, PA)
PA 衡量候选模型排序的复现程度:对参考分数不相等的候选对 $(i,j)$,测得的分数差与参考分差同号记 1 分、测得持平记 0.5 分、颠倒记 0 分,$\mathrm{PA}_t=\frac{1}{|P_t|}\sum_{(i,j)\in P_t}\mathbf{1}\{(x_i-x_j)(y_i-y_j)>0\}+\tfrac{1}{2}\mathbf{1}\{x_i=x_j\}$。参考分持平的对被排除。
PA 是另一个主指标,与 Score 互补:本文发现复现分数水平与复现排序偏爱不同的设计(Astra 的 Score 最高、Grok 的 PA 最高),这种分离是全文的关键实证发现之一。
Researcher / Candidate / Target 三方角色与冻结提交
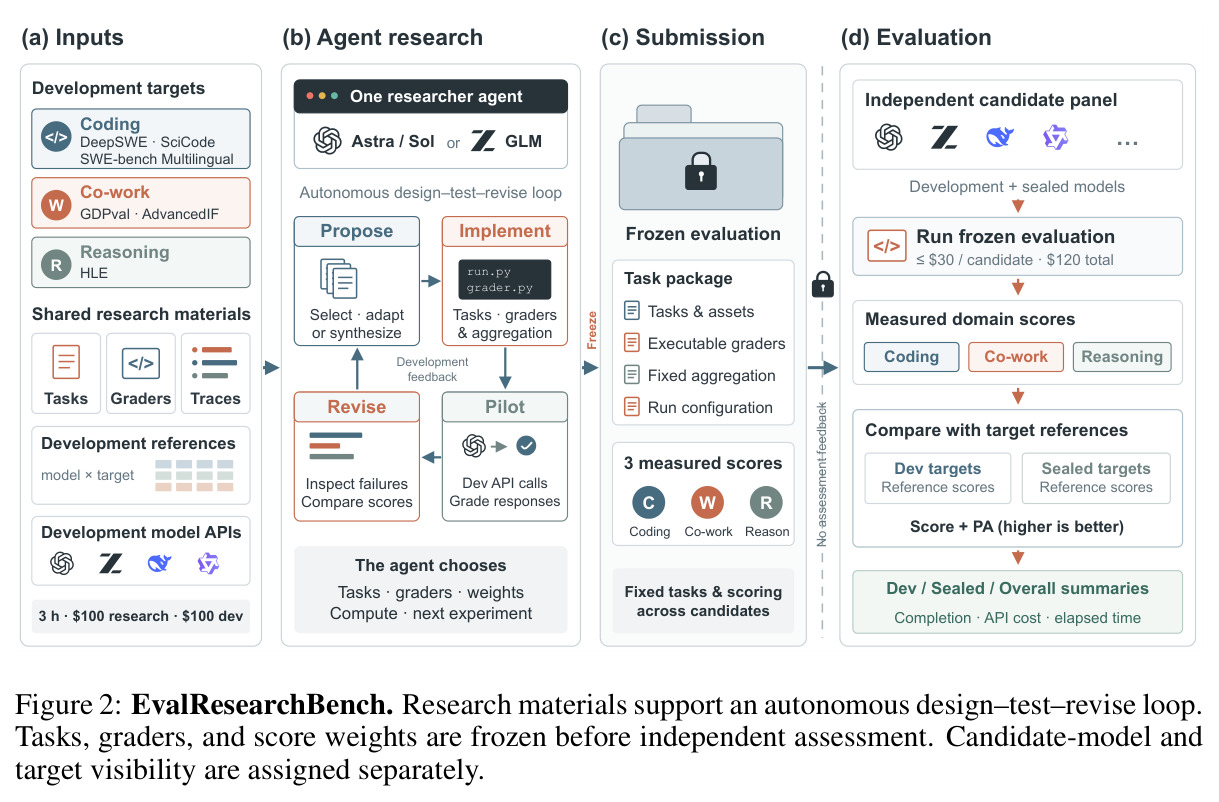
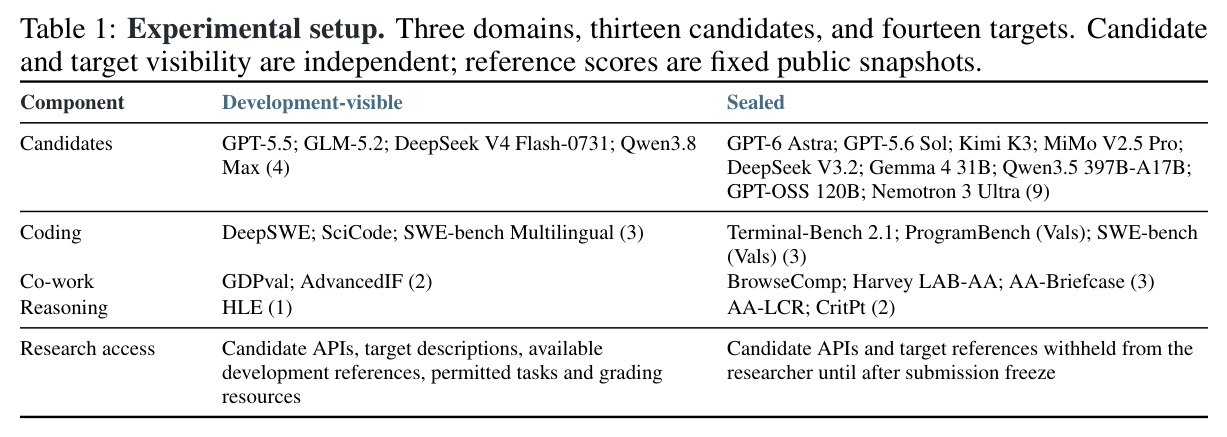
researcher 是在 Codex 或 Claude Code harness 里设计评估的 LLM 智能体;candidate 是被测的模型-执行配置(13 个,其中 4 个开发可见、9 个密封);target benchmark 提供应复现的参考分(14 个)。researcher 最终冻结一份可执行评估器(至少 100 道计分题 + 可执行打分器 + 固定聚合规则),由独立评估方在隔离预算下运行。
这是整篇论文的实验设定骨架:候选可见性与目标参考可见性独立分配、评分期禁止查候选身份,保证了“迁移到未见对象”这一检验的有效性。
开发目标与密封目标(Development / Sealed)
14 个目标基准分成 6 个开发目标( researcher 可见参考分,可反复对齐)和 8 个密封目标(参考分与部分候选在冻结前对 researcher 隐藏)。设计只在开发目标上拟合、却要在密封目标上打分,类似机器学习里的训练/测试划分。
Fable 5.1 在开发组 Score 最高(23.40)却在密封组不敌 Grok(20.87 vs 26.14),证明拟合可见参考不保证迁移——这是论文最重要的结论之一,没有这组概念就读不懂这个反转。
Random120 公开任务抽样基线
一条人类设计的强基线:维护者从 16 个公开来源(MBPP、HumanEval、LiveCodeBench、MMLU、GPQA、AIME25 等)筛出 21,083 道合格题,固定每个来源的配额,用种子 42 分层随机抽 40 编码 + 40 协作 + 40 推理共 120 题,等权聚合,全程不看任何目标参考分。
它编码了大量人类任务设计知识(来源筛选、配额、现成打分器),是检验“迭代研究”是否真有增量价值的标尺——8 个智能体评估器中只有 4 个在 PA 上超过它。
构建成本与执行成本的分离
评估器只构建一次,但每测试一个新候选都要再跑一遍。论文把花费拆成三段记账:researcher 推理($100)、开发/助手测试($100)、独立评估($120 总上限 + $30 每候选上限),并进一步把执行成本拆成候选生成(如 Fable 5.1 的 $75.44)与打分(rubric judge $33.97)等部分。
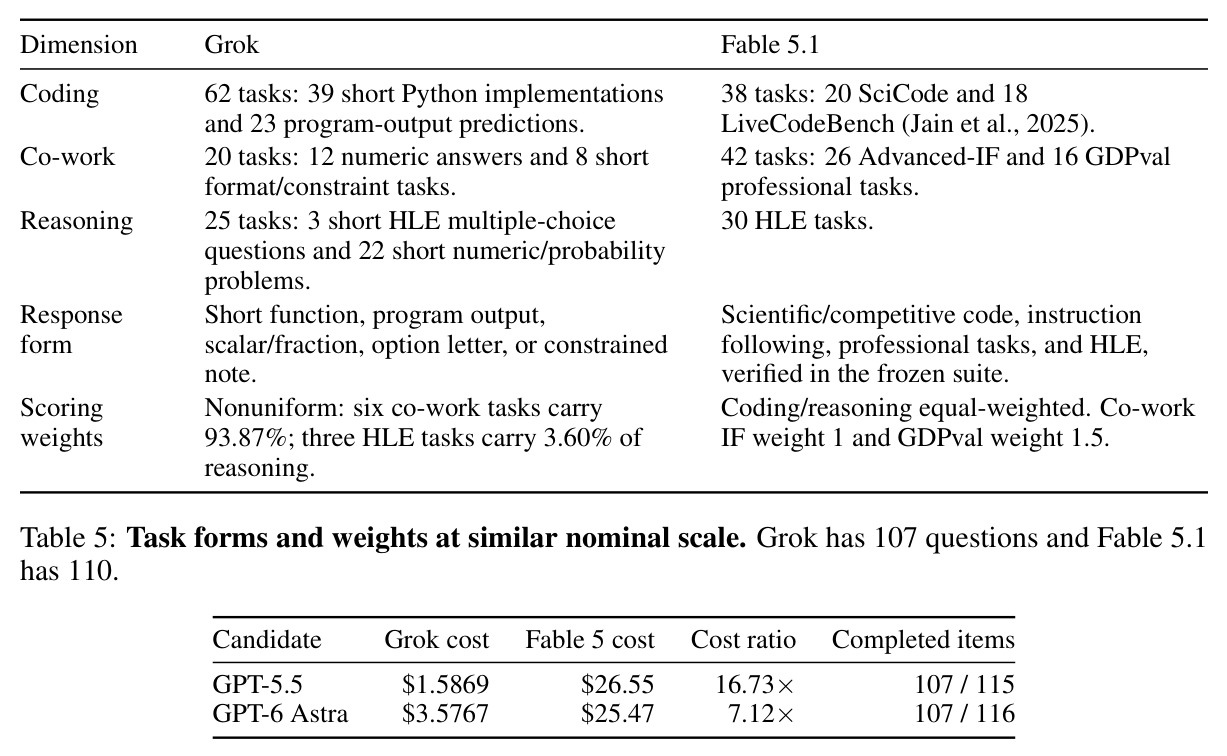
这一拆分解开了论文最有意思的性价比发现:Grok 执行成本最低($8.63)却拿下最高 PA,而题目数相近的 Fable 5.1 执行要 $109.41——题目数量根本不能预测运行成本。
研究动机
递归自我改进(RSI)的每一轮迭代——新训练配方、新数据集、新程序——都会产生一个需要评估的新版本,而反复运行复杂基准既昂贵又缓慢,尤其当评估需要长的工具调用轨迹或专门环境时。人类专家靠选取代表性子集或设计廉价代理(如 tinyBenchmarks)来降低成本,但现有自主研究系统都把这一步留给了人:PostTrainBench 里智能体选数据和后训练算法,但目标基准与评估 harness 是固定的;RSIBench-Data 让智能体修订训练数据策略,却依赖固定的评估服务返回 checkpoint 分数;AlphaEvolve 用用户提供的评估函数进化程序。即便是自动化评估设计的工作(PACE 只选便宜源题并校准、AutoBencher 与 BenchAgents 自动构建基准、BenchBench 只比较智能体设计套装的质量),也都没有把完整的研究问题交给智能体:自己选测量策略、在有限实验预算内花钱、反复修订可执行评估器直到能追踪复杂目标基准。换言之,RSI 闭环里“反馈仪器怎么造”这一环仍然是人类专属工作,每扩展到一个新领域都要人类重新设计评估。
本文的目标是本文要回答一个明确问题:一个拥有固定时间和 API 预算的智能体,能否造出一个能复现复杂目标基准如何打分和排序模型的评估器?作者将这种能力命名为“自主评估研究”(autonomous evaluation research),并构建 EvalResearchBench(ERB)来测量它。具体设定是:给 researcher 智能体提供目标描述、可用的原始任务与打分资源、历史执行轨迹、开发候选的参考分数以及计量网关的候选 API;它在三小时、$100 推理预算和 $100 开发测试预算内,跨编码、协作、推理三个领域选择或合成任务、实现打分器、通过试点测试修订任务/grader/权重/答案额度,然后冻结一份至少含 100 道计分题的可执行评估器;独立评估方在另外的预算($120 总上限、$30 每候选)下把冻结评估器跑遍 13 个候选,与 14 个目标基准比较打分一致性(Score)与排序一致性(PA),同时记录构建与执行两类成本。
与已有工作不同的是,本文的独特切入是把“评估设计”从被自动化的众多环节之一提升为完整的研究任务本身。与 AutoBencher、BenchAgents 等只自动化基准构建部分环节的工作不同,ERB 要求智能体端到端地完成整个测量研究:检查目标证据、决定选现有题还是造新题、验证打分器、并在试点失败时判断到底该加更难的题、换覆盖面、修 rubric、还是加大答案额度。方法论上有三个独到设计:其一,候选可见性与目标参考可见性独立分配,用密封目标和候选检验设计能否迁移到未见对象;其二,把一次性构建成本与每次运行的执行成本分开记账,因为评估器建一次却要反复跑;其三,用标签可知的 oracle 上限校准成绩解读——目标基准彼此之间在同一个候选上的排序就有冲突,任何单一严格排序的 PA 上限只有 91.20%,这为“最好成绩 75%”提供了公平的参照系。
核心方法
直觉上,这篇论文让 LLM 智能体扮演“评测研究员”:不写论文、不训练模型,而是造出一台能便宜、可重复地给其他模型打分的测量仪器。技术路线上,ERB 把一次研究定义为“一个模型 + 一个 harness 跑一个 episode”:9 个 researcher 配置(GPT-6 Astra、GPT-5.6 Sol、GLM-5.3、DeepSeek V4 Pro、Kimi K3、Fable 5.1、Opus 5、Grok 4.7、Fable 5;GPT 系与 Grok 用 Codex harness,其余用 Claude Code)各自在 3 小时内完成设计-试点-修订循环。输入材料包括目标描述、可用的原始任务与打分资源、历史轨迹、4 个开发可见候选(GPT-5.5、GLM-5.2、DeepSeek V4 Flash-0731、Qwen3.8 Max)的参考分,以及计量网关后的开发候选 API 和评估 SDK。智能体可以选题、合成新题、简化任务、修打分器、改题目权重、设答案额度,所有调用经计量网关计费。最终提交冻结的可执行评估器:至少 100 道互不相同的计分题、可执行 grader、固定聚合规则,评分时禁止查询候选身份或参考标签。独立评估方对全部 13 个候选(含 9 个密封模型)执行冻结程序,域分数按公式 $x_{a,m,d}=\frac{\sum_{i\in C_{a,m,d}}w_{a,i}s_{a,m,i}}{\sum_{i\in C_{a,m,d}}w_{a,i}}$ 聚合,再用 Score(100×CCC)与 PA 与 14 个目标参考比较。
核心创新在于把评估构建本身变成一个可独立测量、有预算约束、有明确验收标准的智能体能力。与已有工作的本质区别有三点。第一,任务完整性:PACE 只做便宜源题选择与校准,AutoBencher/BenchAgents 只自动化基准构建,BenchBench 只评估现成套装的质量,而 ERB 首次要求智能体自己决定测量策略、自付每次试点费用、并把“试点失败该怎么改”作为必须回答的决策——是加难题、换覆盖、修 rubric 还是加执行预算。第二,质量的双面定义:Score=100×CCC 同时奖励匹配分数水平与散布,PA 只看排序;论文用 CCC 分解 $\mathrm{CCC}=r\,C_b$ 证明有用的排序本身不保证忠实复现分数(Astra 与 GLM-5.3 协作域相关性相近,但 Astra 的尺度校准更好)。第三,成本结构:构建成本与执行成本分开评估,且执行成本进一步拆成候选生成与打分两条路径,因为 Grok 与 Fable 5.1 提交题量相近(107 vs 110 题),执行花费却差一个数量级($8.63 vs $109.41)。再加上人类设计、不看参考分的 Random120 强基线,ERB 能区分“迭代研究带来的增量”与“人类先验本身的贡献”。
方法步骤详情
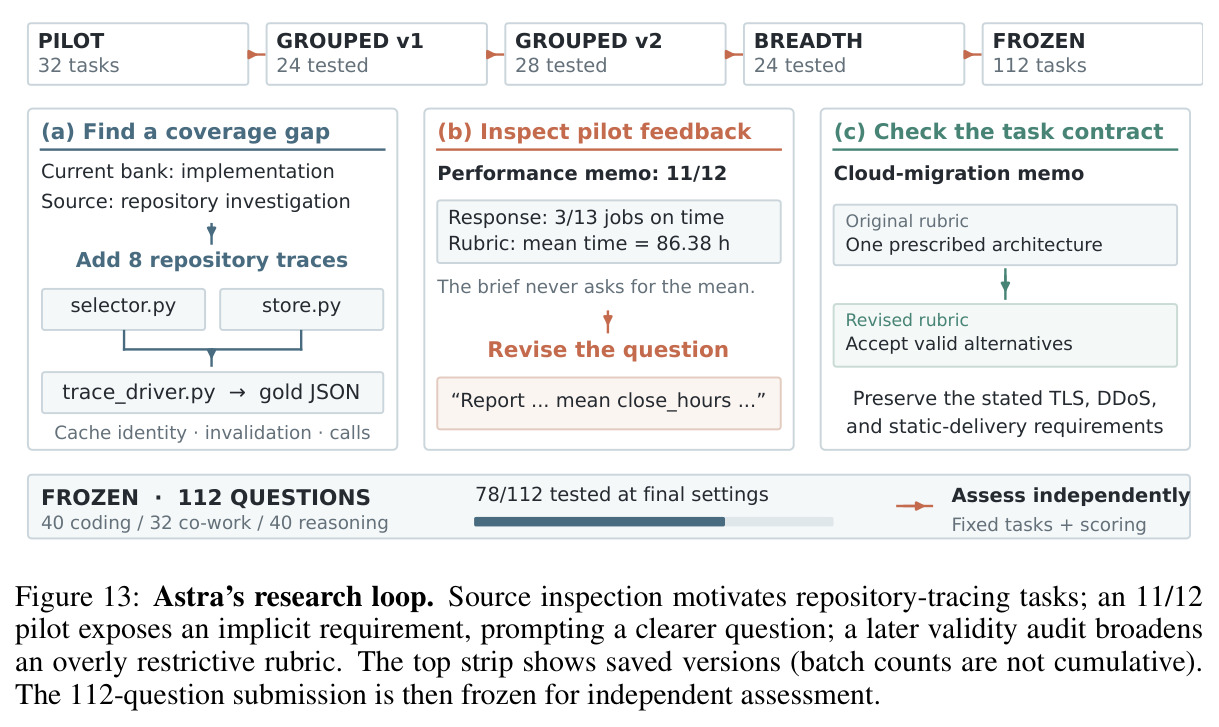
完整流程分五步。第一步,发放研究材料:智能体拿到任务契约、开发候选 API 与可见参考分、原始基准材料与轨迹、Python 评估 SDK(负责提交套件、记录逐项响应与成本、返回已完成开发测试的跨模型反馈)。第二步,自主设计-试点-修订循环:智能体在 3 小时、$100 推理 + $100 开发测试预算内自由分配探索、测试与修订,无固定流程;例如 Astra 从源码检查发现实现型编码题库缺少仓库级任务,构造 8 道多文件仓库追踪题;一道绩效备忘题试点得 11/12 后,Astra 发现题目从未要求 rubric 里的平均关闭时长,于是修订题面;Grok 的 HLE 难题试点耗尽答案额度且无可见输出,遂转向短代码、程序输出预测与本地打分的数值题。第三步,冻结提交:至少 100 道互不相同计分题 + 可执行 grader + 固定聚合规则;答错或超限的空答案都算已完成评分,基础设施故障才算未完成。第四步,独立评估:执行方在 $120 总上限、$30 每候选上限内把冻结程序跑遍 13 个候选,记录逐项奖励、终止原因与用量,结果不回传给 researcher。第五步,打分与记账:域分数按权重 $w_{a,i}\ge 0$ 加权平均,无完成正权题目的域记缺失;Score 取 $100\times\frac{2\mathrm{Cov}(x,y)}{\mathrm{Var}(x)+\mathrm{Var}(y)+(\bar{x}-\bar{y})^2}$(完全一致 100、常数 0、反向可为负),PA 按候选对方向一致计分(持平记半分);花费分 researcher 推理、开发测试、独立评估三段记账,未决预留单独列示。
技术新颖性
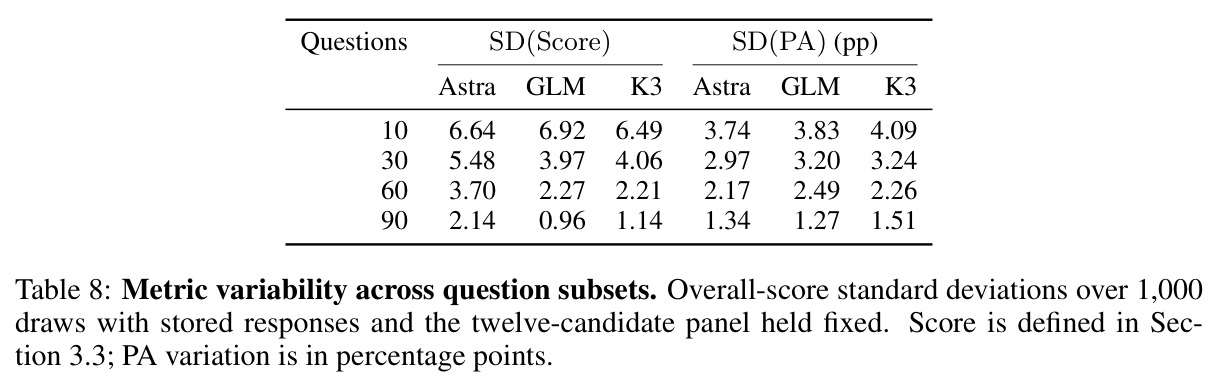
技术新颖性体现在五个层面。第一,新任务形式:这是首个把“评估元研究”作为端到端智能体任务的基准,此前没有工作同时要求选题、造题、实现 grader、预算内试点迭代并冻结可执行评估器。第二,新指标组合与天花板校准:论文不满足于报告原始分数,而是计算标签可知的 oracle——同一域内各目标参考彼此排序冲突,最优单一排序的 PA 上限为编码 92.36%、协作 88.72%、推理 93.03%、总体 91.20%;原始分数也有 oracle RMSE 下限(编码总体 0.303),因为 ProgramBench (Vals) 与 SWE-bench Multilingual 在共享 6 个候选上的均值差达 0.87,单独一个编码分数到两个参考的平方误差下限就有 0.4356。这使“75% PA”能被正确解读为距理论上限的差距而非绝对失败。第三,离线反事实分析:组件删除、嵌套子集重抽(1,000 次同域随机删除、10/30/60/90 题嵌套子集)、Grok 权重均匀化反事实等全部复用已存响应,不重跑模型,成本几乎为零。第四,健全性检查:常数 0.5 分评估器得 Score=0、PA=50%,证明指标不会被无信息评估器钻空。第五,过程透明度:附录保存了完整的试点轨迹(如 Astra 的 32→24→28→24→112 题版本链),使设计决策可审计。
实验结果
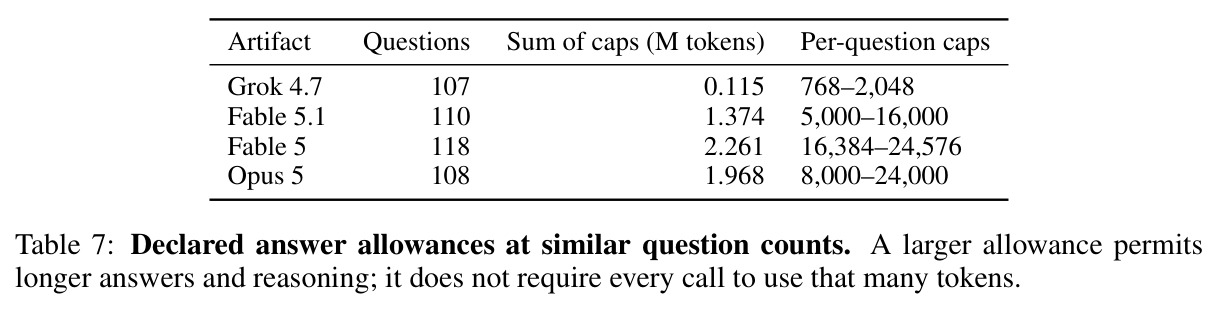
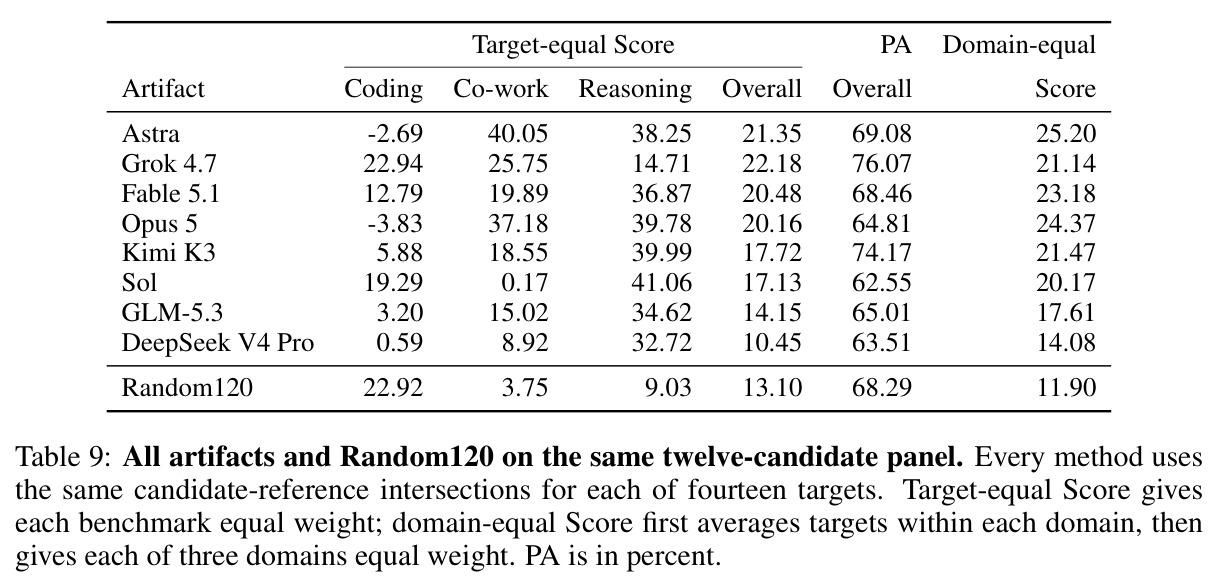
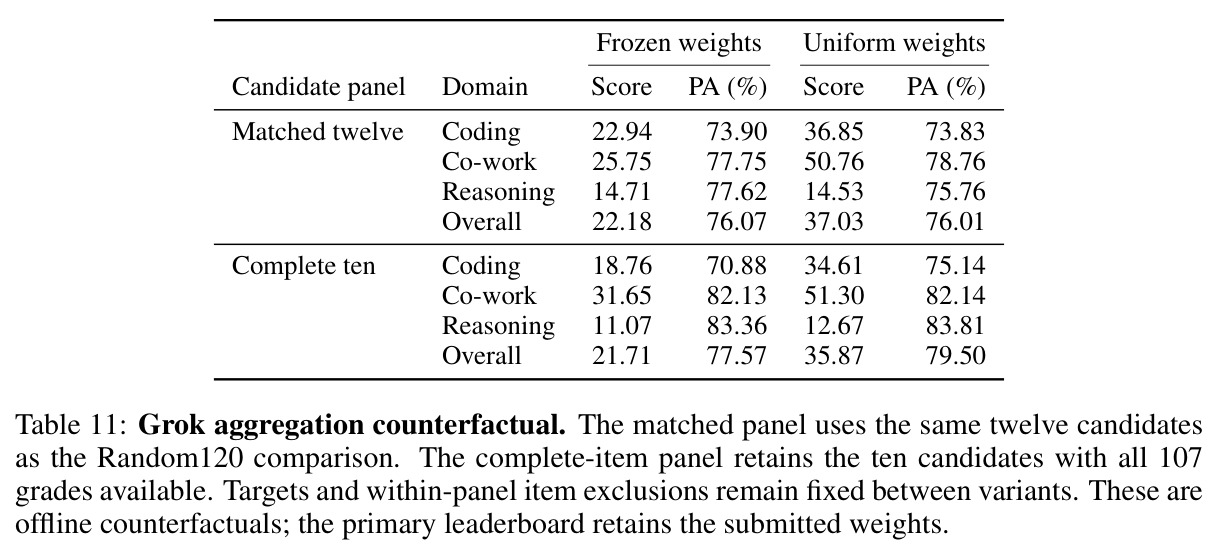
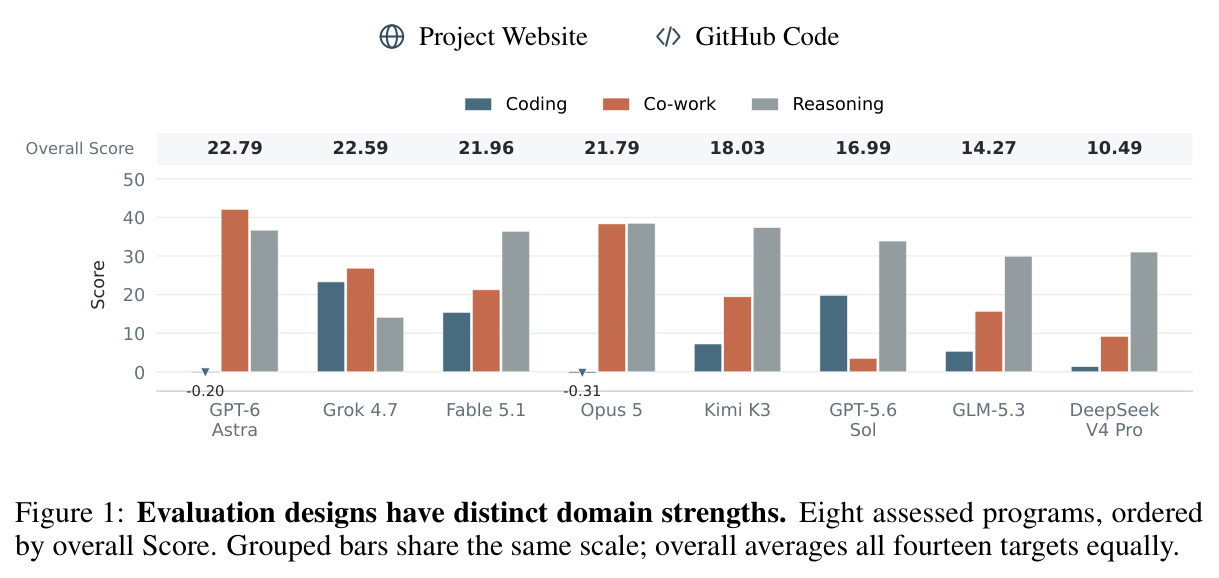
核心结果有六组。第一,总体排名:GPT-6 Astra 以总体 Score 22.79 居首,Grok 4.7 以 PA 74.87% 领先,两者不重合,说明复现分数水平与复现排序偏爱不同设计;域内也各有王者——Grok 编码 Score 最高(23.28)、Astra 协作最高(42.06)、Opus 5 推理最高(38.46),编码是大多数评估器的最弱域(Astra 编码 Score 甚至为 -0.20)。第二,天花板与差距:最佳 PA 74.87% 距目标间分歧决定的 91.20% oracle 上限仍有约 16 个百分点,说明评估器远未榨干参考面板的信息。第三,迁移反转:Fable 5.1 开发组 Score 23.40 最高,密封组却只有 20.87,被 Grok 的 26.14 反超——拟合可见参考不保证跨目标迁移。第四,Random120 强基线:它总体 Score 13.10、PA 68.29%;在相同 12 候选面板上,8 个智能体评估器中 7 个 Score 超过它但仅 4 个 PA 超过它;智能体的增量集中在协作(Astra +36.3 分)与推理(+29.2 分),编码反而普遍低于 Random120(Astra -25.6 分)。第五,成本效率:Grok 执行成本最低($8.63,107 题答案额度总和仅 0.115M tokens、打分零助手调用)却拿下最高 PA;Fable 5.1 执行 $109.41(候选 $75.44 + rubric 判官 $33.97),对同候选的成本是 Grok 的 7.12–16.73 倍而完成题数相差不到 10%。第六,诊断性发现:Grok 把 93.87% 协作权重压在 6 道题上,均匀重加权后 matched panel 总 Score 从 22.18 升至 37.03 而 PA 几乎不变,说明冻结套件里有被权重浪费的信号;题目数从 10 增到 90,Astra 的 Score 标准差从 6.64 降到 2.14,题量大同时提升均值与稳定性;组件审计显示删掉 Astra 的 8 道电子表格题使协作 Score 掉 31.94 分、PA 掉 12.57 个百分点;Fable 5 则在耗尽 $120 预算前只完成 20/39 份候选-域报告,被排除出主榜(插补场景 Score -13.18)。
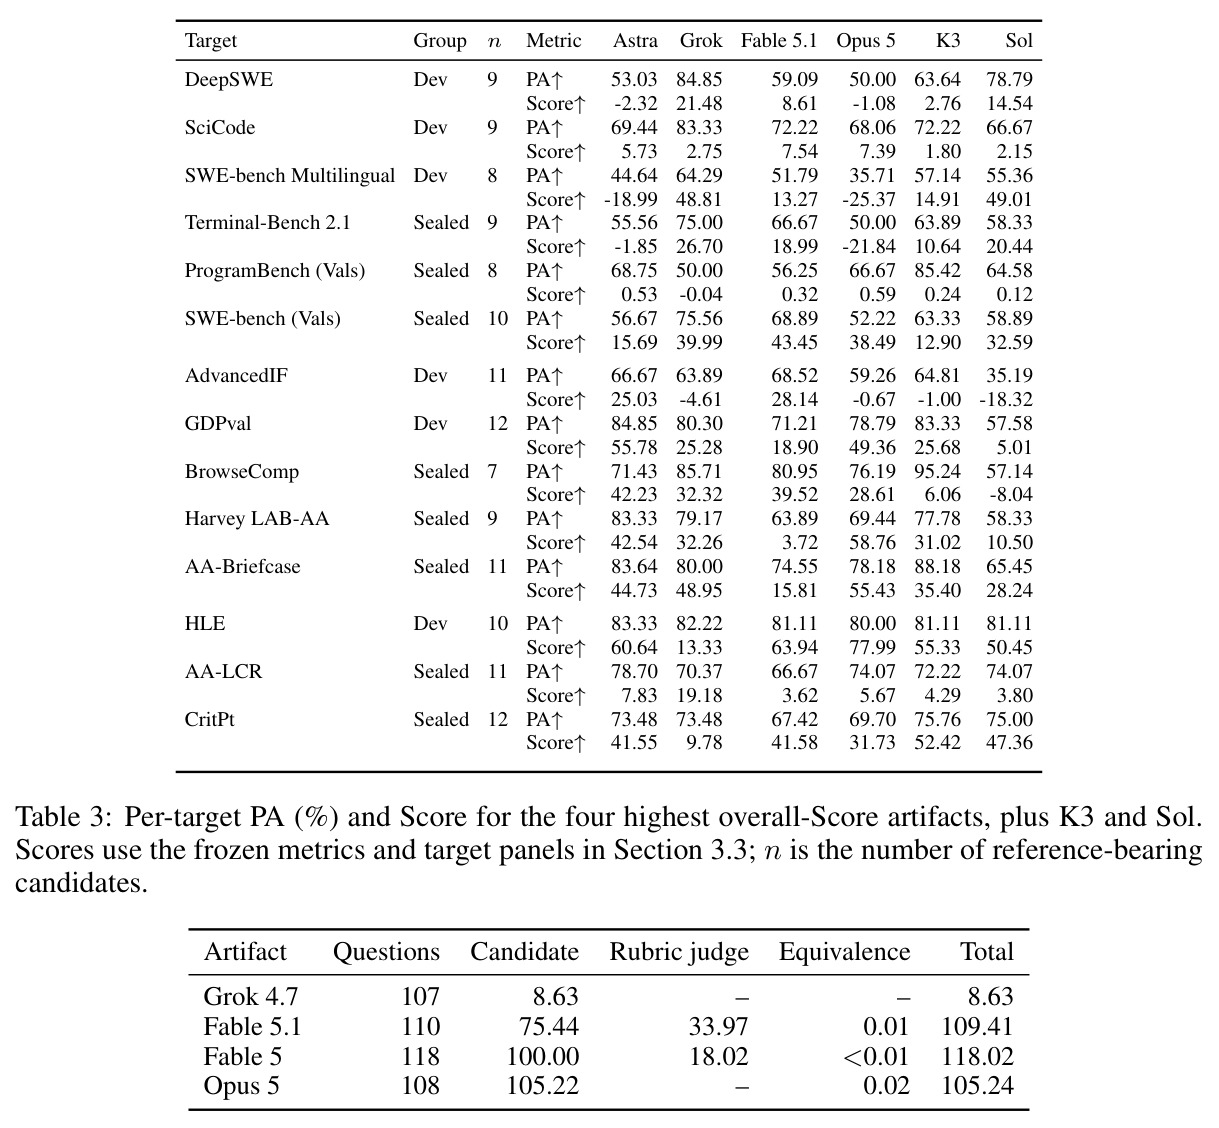
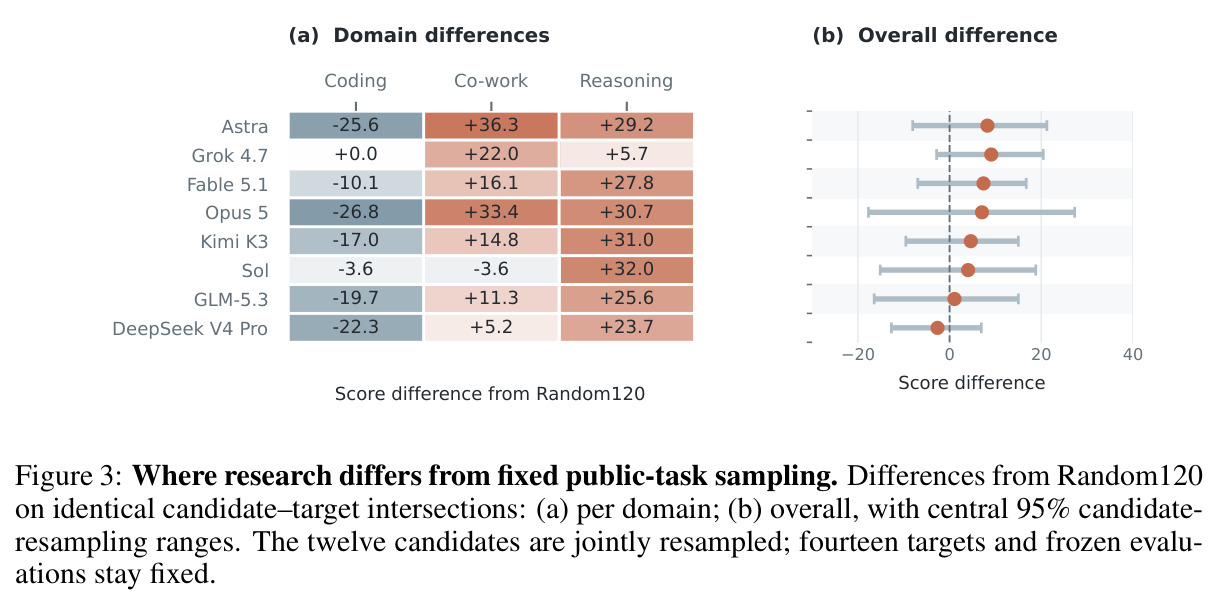
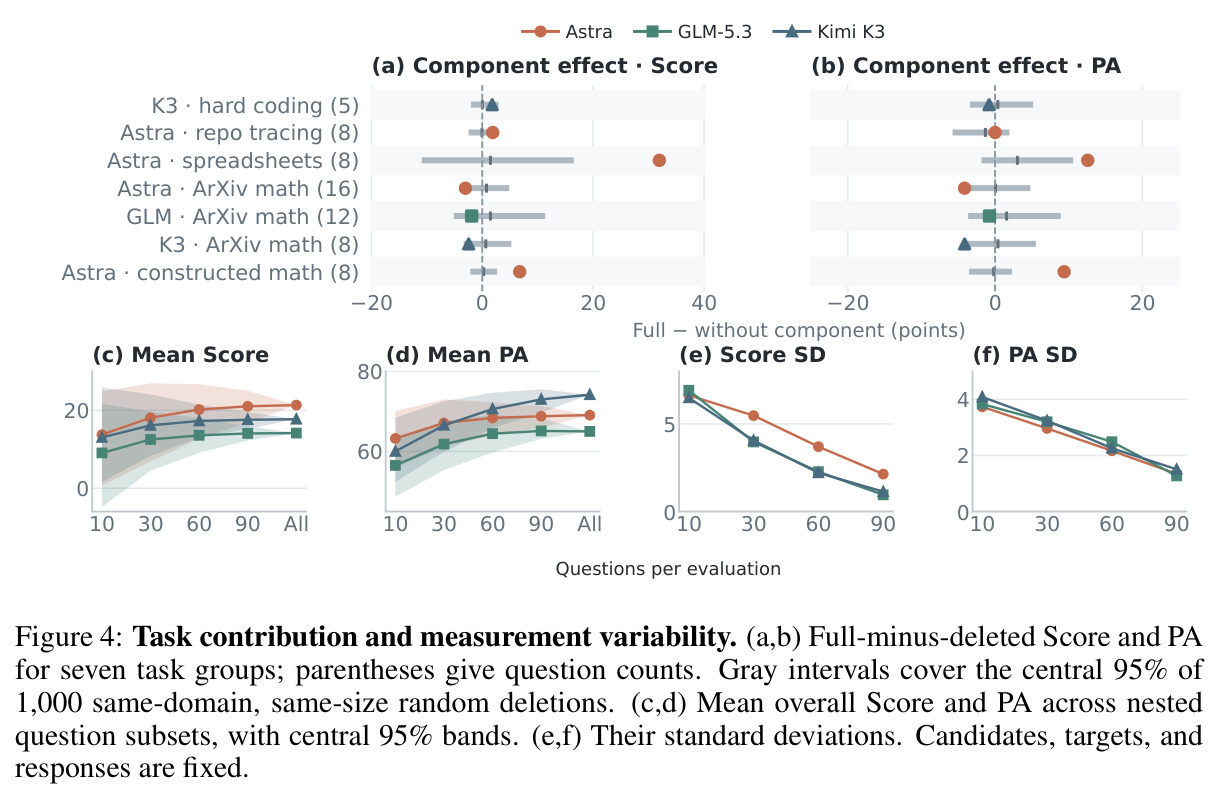
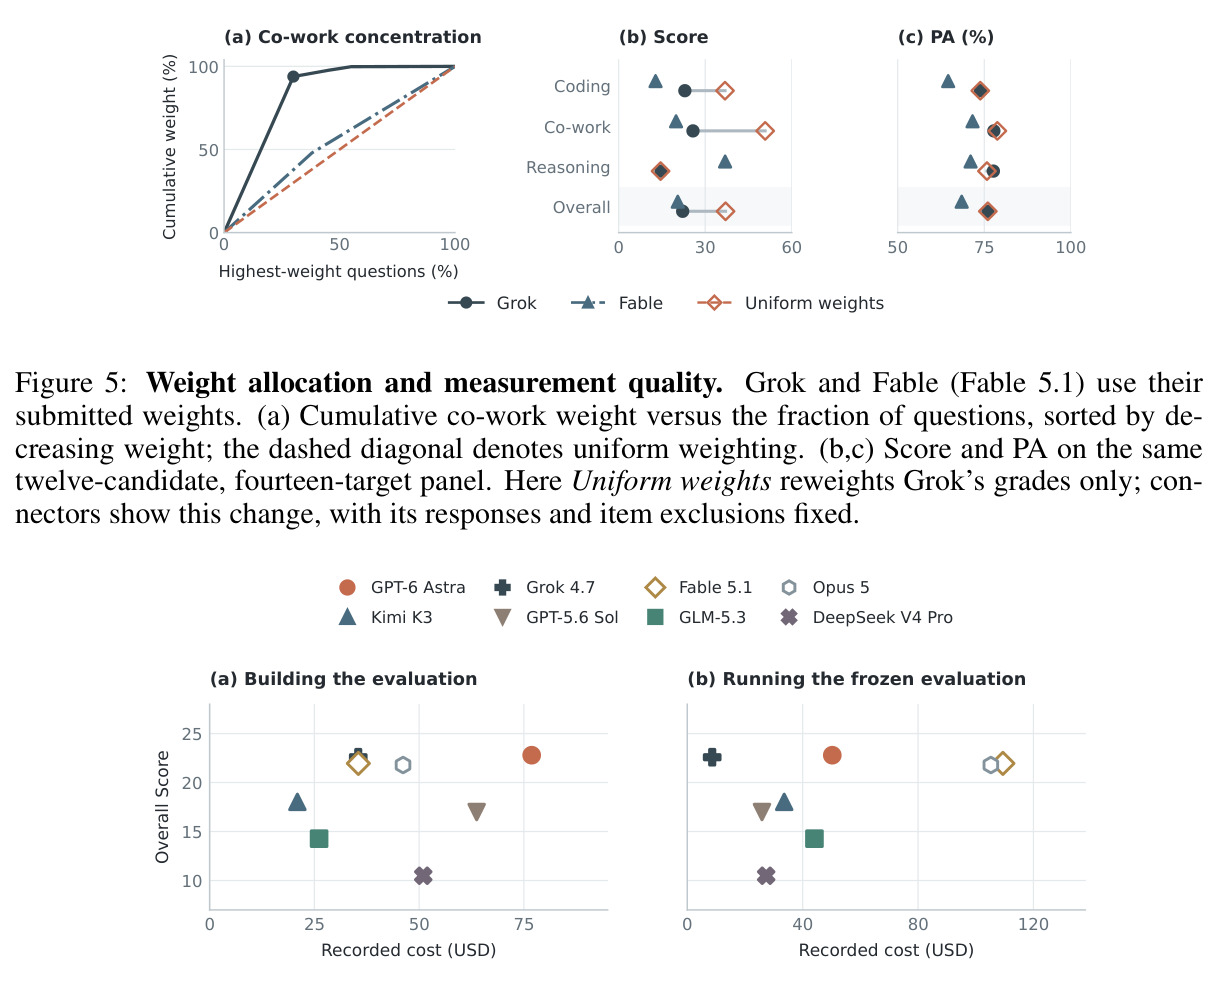
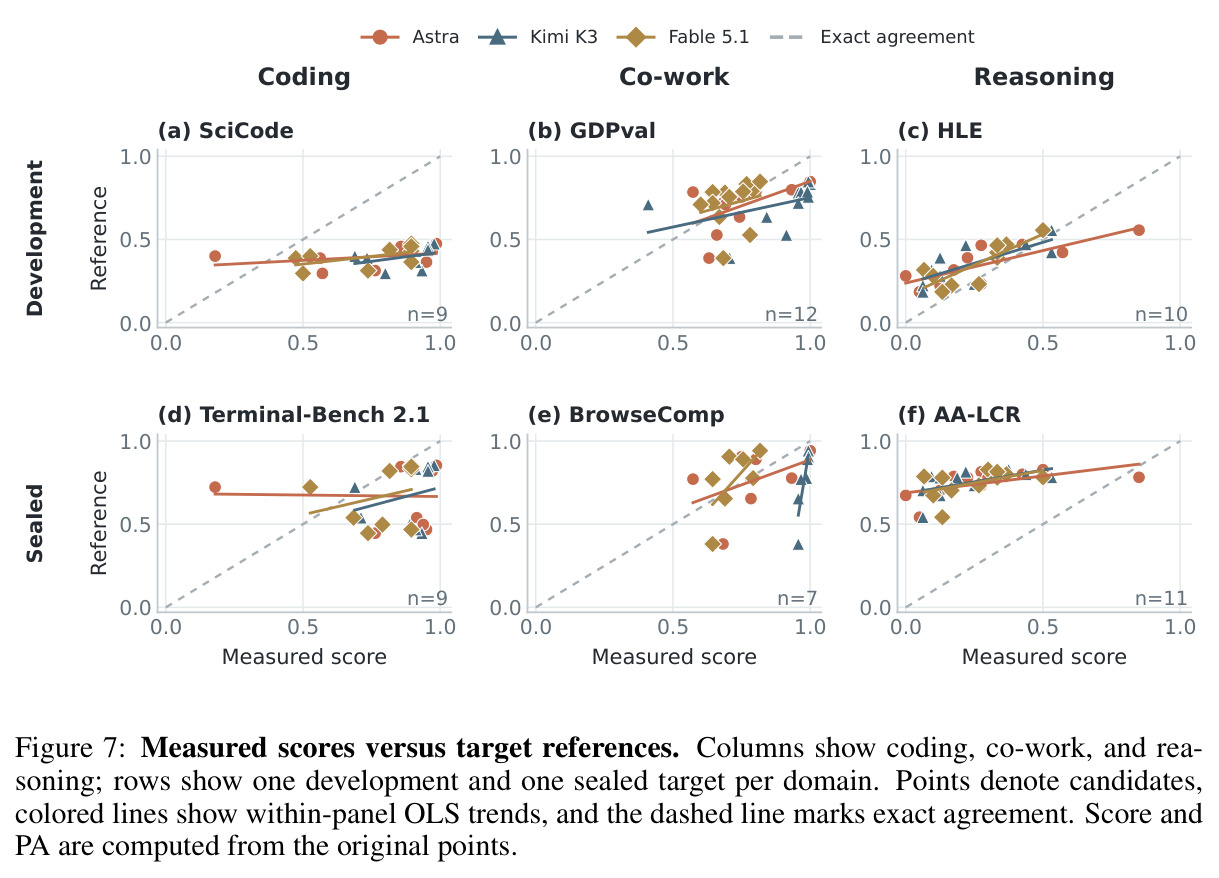
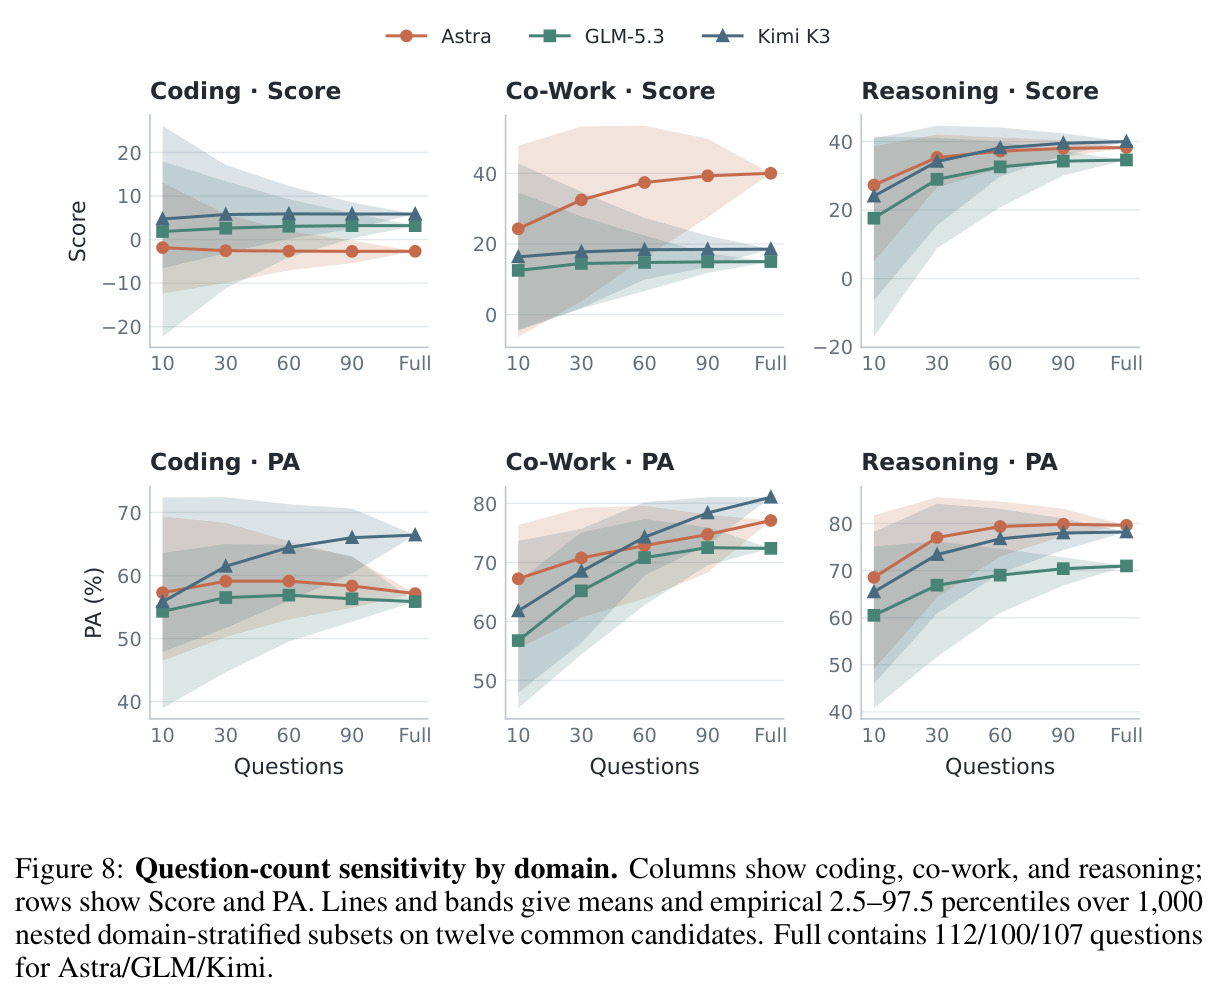
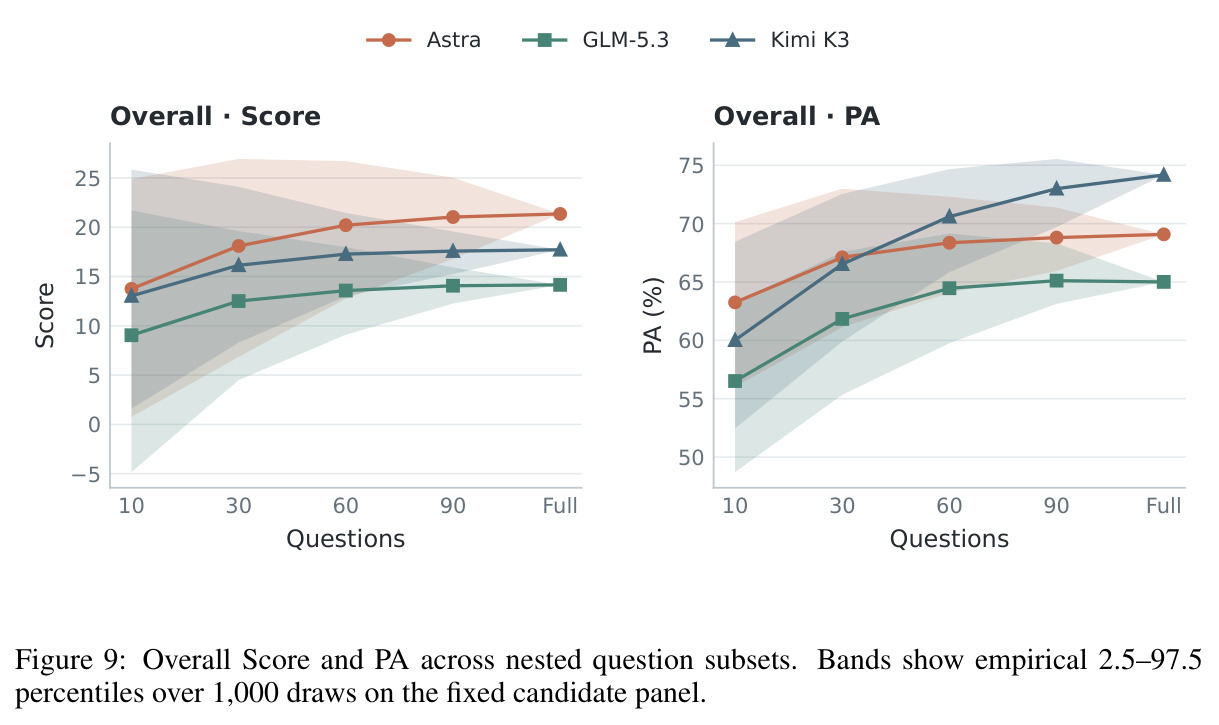
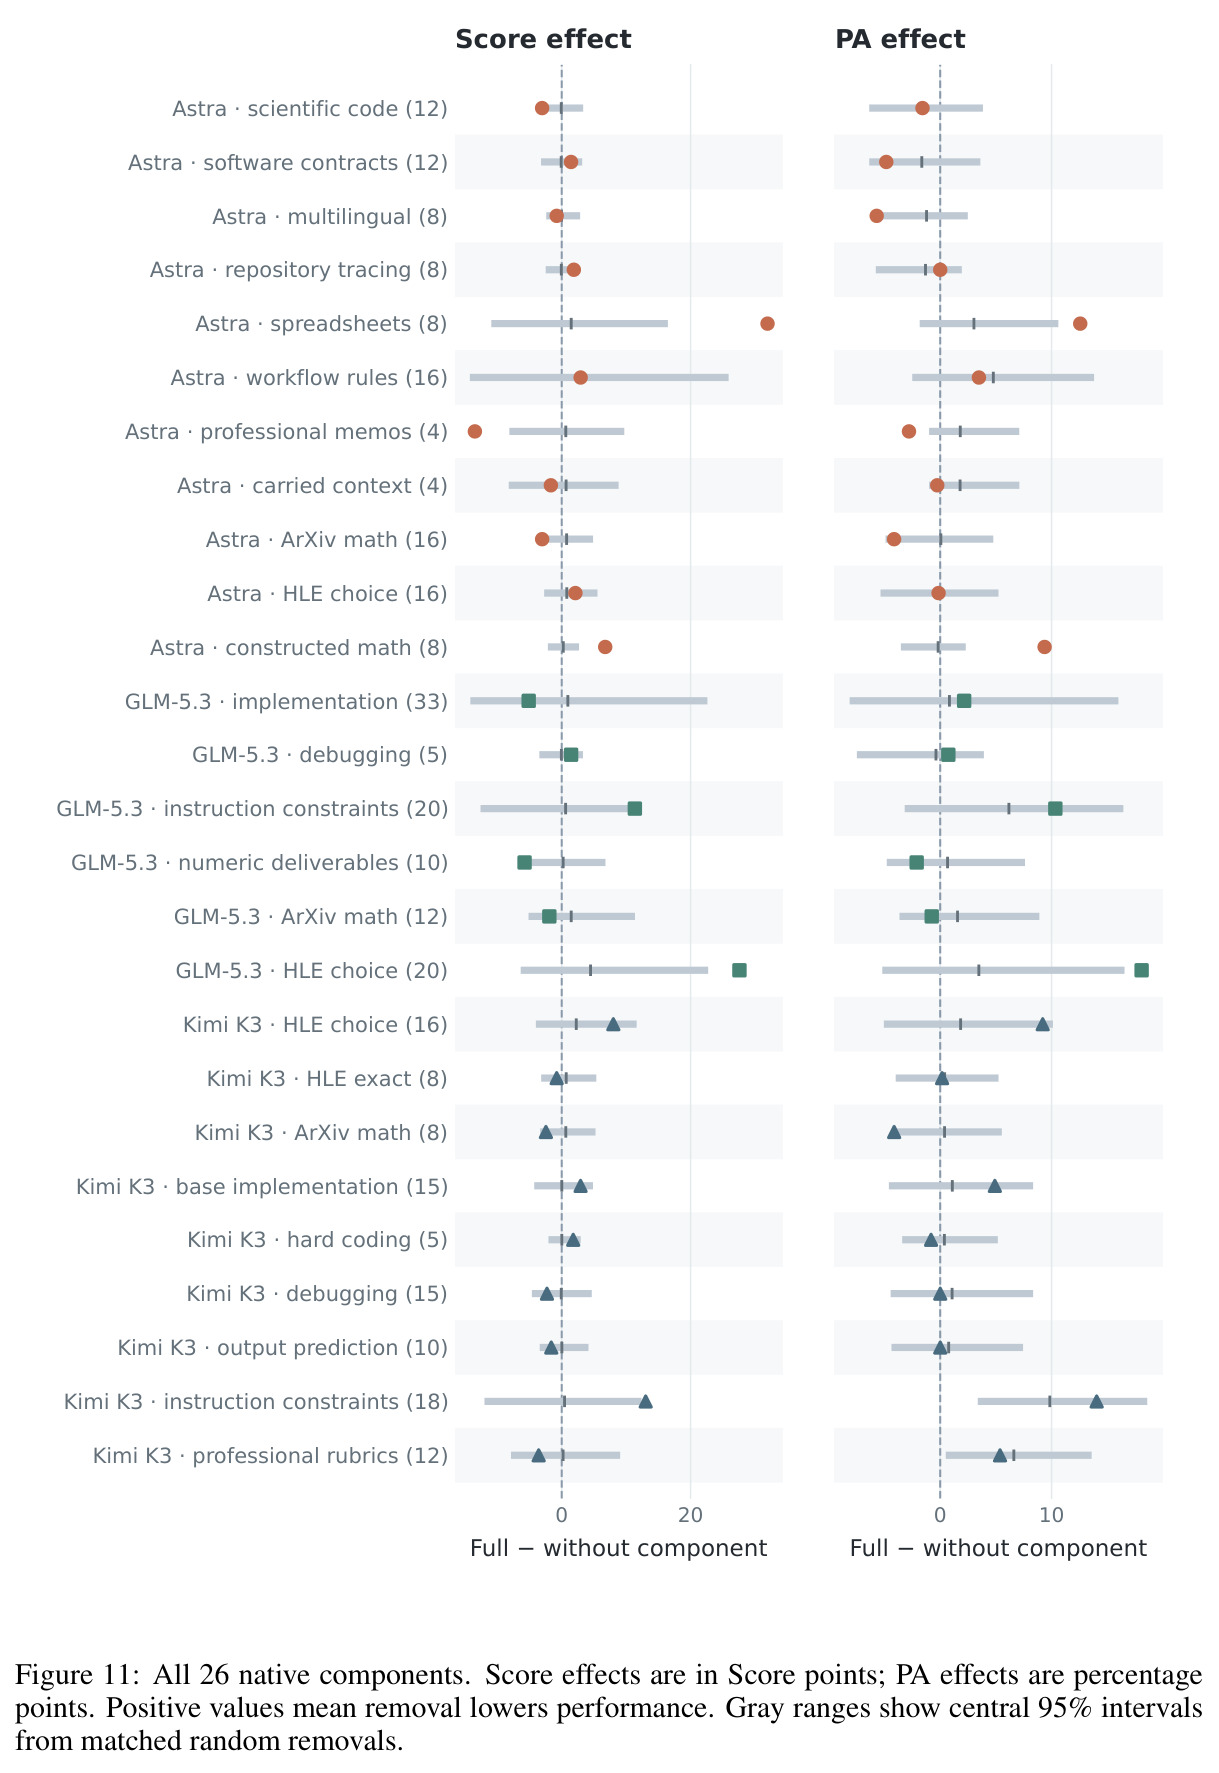
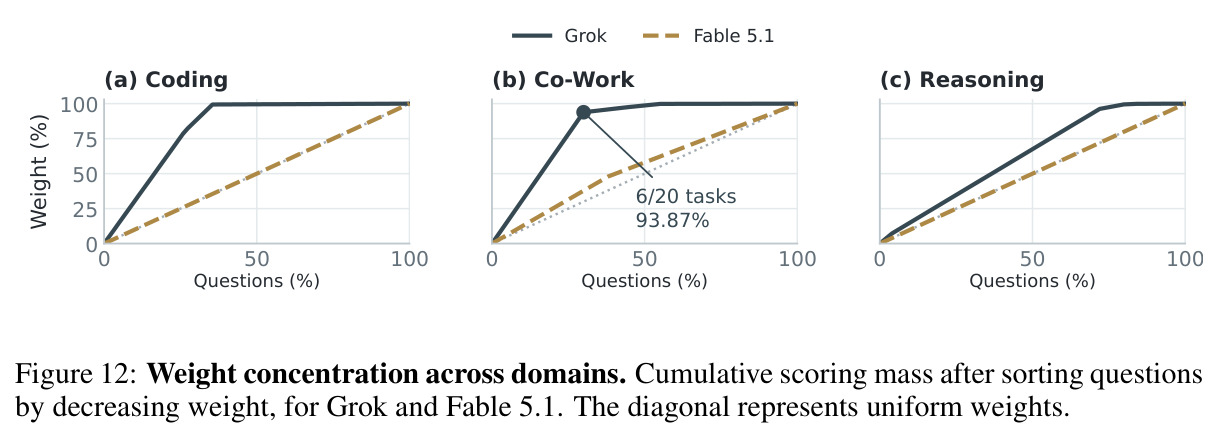
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总体排序复现(14 目标) | PA (%) | 74.87(Grok 4.7) | 68.29(Random120 同候选) | +6.58 pp;但 oracle 上限为 91.20%,距天花板仍差 16.33 pp |
| 总体分数复现(14 目标) | Score(100×CCC) | 22.79(GPT-6 Astra) | 13.10(Random120) | +9.69 分;8 个智能体评估器中 7 个超过基线 |
| 编码域分数复现 | Score | 23.28(Grok 4.7) | 22.92(Random120) | +0.36,几乎持平;多数智能体编码域反而落后基线(Astra -25.6) |
| 协作域分数复现 | Score | 42.06(GPT-6 Astra) | 3.75(Random120) | +38.31,智能体研究增量最大的域 |
| 推理域分数复现 | Score | 38.46(Opus 5) | 9.03(Random120) | +29.43 |
| 密封目标迁移(8 目标) | Score | 26.14(Grok 4.7) | 23.40(Fable 5.1,开发组冠军) | 开发组冠军在密封组被反超 2.74 分,证明拟合≠迁移 |
| 冻结评估器执行成本 | USD(13 候选全跑一遍) | $8.63(Grok 4.7,PA 最高) | $109.41(Fable 5.1)/ $118.02(Fable 5) | 便宜 12.7–13.7 倍,说明题量相近的设计执行成本可差一个数量级 |
| Grok 权重聚合反事实(12 候选面板) | Score | 37.03(均匀重加权) | 22.18(提交的集中权重) | +14.85 分且 PA 几乎不变(76.07%→76.01%),权重浪费了套件信号 |
局限与改进
作者明确承认的局限:第一,即使最好的评估器也只能按目标的方式给约 75% 的候选对排序,低于目标间分歧设定的 91% 上限,即当前智能体评估研究远未达到参考面板允许的天花板;第二,没有任何 researcher 在所有指标上领先,开发目标上最好的评估器在密封目标上未必最好,拟合可见参考不保证迁移;第三,人类设计的 Random120 公开题抽样仍是强基线,8 个智能体评估器中只有 4 个在 PA 上超过它;第四,智能体虽能通过试点反馈修复任务和打分器,但最终评估器仍会出现截断答案(Astra 电子表格组件 96 条响应中 46 条在输出上限处无最终答案、Opus 102 条中 36 条截断含 32 条空回复)、耗尽评估预算(Fable 5 在 $120 上限处只完成 20/39 份报告)、或让少数高权题目主导域分(Grok 6 道协作题占 93.87% 权重)。我自己的观察补充:每个 researcher 只跑一个 episode,没有重复方差,排行榜差异可能混入单次运行的偶然性;14 个目标参考来自三家排行榜(Mercor APEX、Vals AI、Artificial Analysis)的公开快照,分数尺度彼此不兼容(编码域 oracle RMSE 下限 0.303),Score 的绝对数值受目标组合选择影响——论文自己的敏感性子集上 Fable 5.1 反超 Astra 就是证据;此外 ≥100 题的提交下限与三域捆绑的 episode 设计都是人为约定,结论对这些协议参数的敏感性未系统报告。
独立分析的弱点
独立分析出的弱点及改进方向。第一,权重集中:Grok 的权重搜索按开发候选通过模式分组,把 93.87% 协作权重压在 6 道题上,权重等价题数 $N_w=1/\sum_i w_i^2$ 只有 6.78(名义 20 题),低权题照花执行成本;改进方向是在试点期引入权重熵下限或直接优化 $N_w$,并把论文的均匀重加权反事实变成提交前的自动校准步骤——仅此一步就能把总体 Score 从 22.18 提到 37.03。第二,答案截断失控:多个评估器在评分期才发现大量响应在输出上限处截断(Astra 电子表格 46/96、Opus 36/102),这些响应仍按已完成评分计分,系统性压低某些候选的分数;改进方向是把截断率作为试点期的显式诊断指标,自动触发答案额度上调,或对截断项单独标记为缺失而非零分。第三,评分便利性陷阱:DeepSeek V4 Pro 为省打分成本出的协作题直接把所需输出字符串写进题面(如给出答案再要求数字母数),导致其编码与协作均分很高但 CCC 校准因子极低($C_b$ 仅 0.157/0.185),分数挤在天花板附近丧失区分度;改进方向是要求每个任务族在冻结前通过开发候选间的分离度检验,把“容易打分”与“能区分能力”解耦。第四,统计功效不足:单一 episode 加上小型密封面板(部分目标只有 6–7 个参考候选),PA 的置信区间很宽;改进方向是多 episode 重复与配对显著性检验。第五,成本与质量脱钩:Score/PA 都不含执行成本,Grok 的性价比优势只能靠读者自己看图 6 发现;改进方向是定义成本调整指标(如 Score per dollar 或帕累托前沿排名)并纳入官方榜单。
未来方向
作者提出的方向:把 ERB 作为“评估设计能力”的可执行基准持续运营,用源码检查与试点审计追踪智能体如何修订任务与打分器。基于本文成果可以延伸的方向有:第一,接入真实 RSI 闭环——目前只测评估器与目标基准的吻合度,下一步应测量“用智能体造的评估器指导迭代改进,最终模型变好多少”,即反馈质量的下游效用;第二,多 episode 与多 harness 方差研究,区分模型能力与 harness 效应(本文 GPT 系用 Codex、其余用 Claude Code,混杂未分离);第三,自动权重校准与主动选题——把 Grok 暴露的权重集中问题和 tinyBenchmarks/IRT 式题目选择结合,在题目预算内最大化信息量;第四,成本感知指标与帕累托分析,把 Score/PA/执行成本放进统一榜单;第五,目标面板设计工具——论文的 oracle PA 上限(91.20%)和兼容参考子集筛选(RMSE≤0.25)本身就是评估目标选择的实用方法,可推广为“如何挑一组互相一致的参考基准”的指南;第六,把评估器构建与防污染结合——智能体目前只能用给定材料,未来可测试其面对训练数据污染时的题目原创能力。第七,执行力协议研究:答案额度、超时、重试策略如何影响测得的“能力”,本文表 7 显示各评估器每题上限从 768 到 24,576 tokens 不等,这本身就是被测对象的一部分。
复现评估
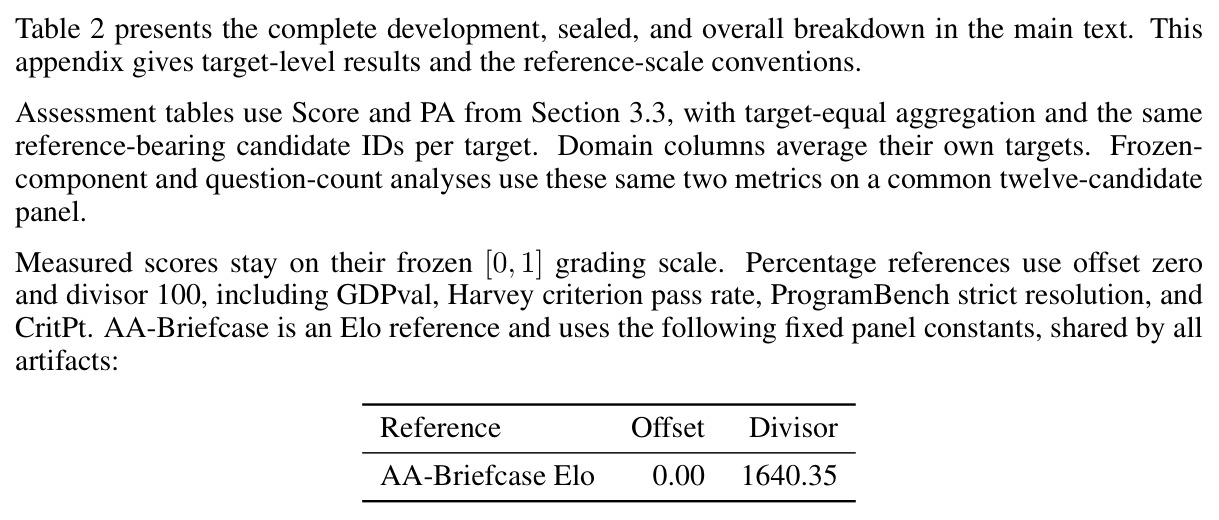
复现条件中等偏上。有利因素:论文提供项目网站与 GitHub 代码链接;评估框架、Random120 基线(16 个公开来源全部可获取,筛 21,083 题、种子 42 抽样、配额与打分器全部写明)、目标参考快照来源(9 个 Mercor APEX、2 个 Vals AI、3 个 Artificial Analysis)都公开可查;大部分分析性实验(组件审计、嵌套子集敏感性、Grok 权重反事实、固定分数 sanity check)只复用已保存的响应,不需要重跑模型,拿到冻结套件与响应后即可离线复现。困难因素:researcher 与候选都是前沿商业模型(GPT-6 Astra、Grok 4.7、Claude Fable/Opus 等),需要相应 API 权限;一次完整复现(9 个 researcher episode + 8 个完整独立评估)的 API 成本约 $2,760–$3,000(9×$200 研究侧 + 8×$120 评估侧,另加 Fable 5 部分执行与未决预留),单人可承受但非零;每个 episode 耗时 3 小时墙钟时间;9 个 researcher 只有一个 episode 意味着即使完整复现也无法验证排行榜排序的统计稳定性,这是数据层面而非资源层面的复现障碍。总体而言,协议描述极为详尽(预算、额度、Elo 尺度常数 offset 0/divisor 1640.35 都给出),代码与数据到位后复现分析结果难度不大,但完整重跑研究侧依赖商业模型可用性。
论文图表
八个评估器的总体 Score 对两类记录成本散点:(a) 构建成本(研究推理+开发测试),(b) 冻结评估执行成本。Grok 执行成本最低($8.63)且 PA 最高;Fable 系执行成本 $109–$118。
呈现论文的核心性价比发现:构建一次的成本与每次运行的 recurring 成本必须分开看,题量相近的设计执行成本可差一个数量级,任务形态(短数值题 vs 长专业交付物)才是执行成本的决定因素。
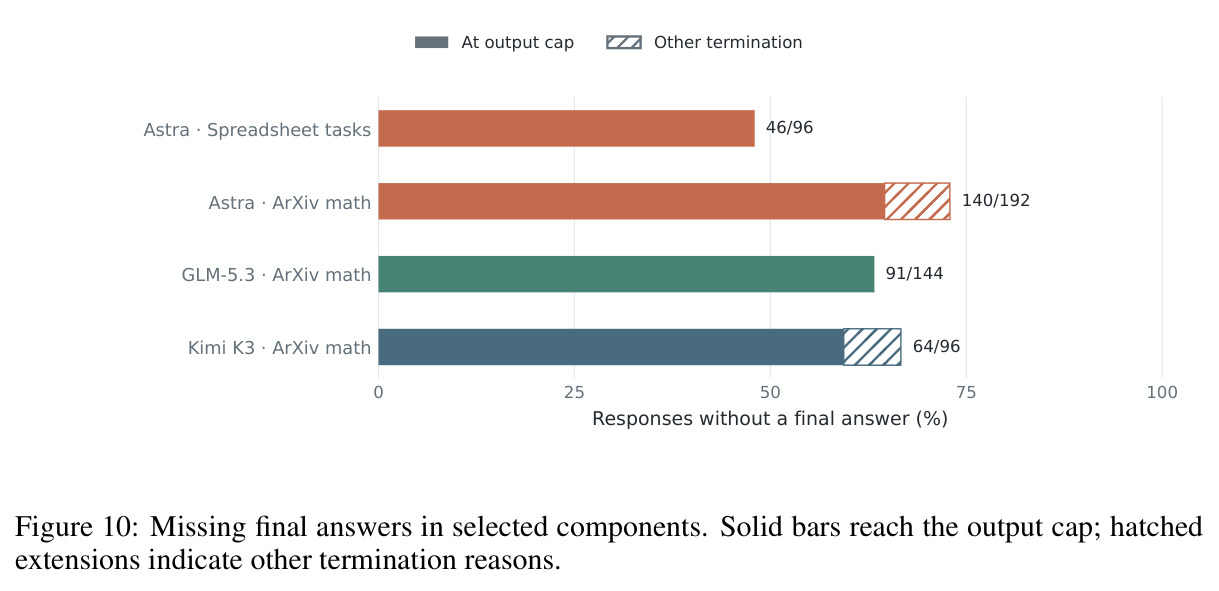
选定任务组中无最终答案响应的百分比:Astra 电子表格 46/96 在输出上限处截断,Astra/GLM/K3 的 ArXiv 数学组分别有 140/192、91/144、64/96 条响应无最终答案(实心为到 cap,斜线为其他终止原因)。
直视智能体评估器的执行缺陷:答案额度设置不当导致大量响应被截断仍计入评分,是“试点反馈能修任务但最终评估器仍有系统性问题”这一结论的最直接证据。
四个代表性评估器的执行成本分解(题量/候选生成/rubric 判官/等价判官/总计):Grok 107 题 $8.63(零助手调用);Fable 5.1 110 题 $109.41(候选 $75.44 + rubric $33.97);Fable 5 $118.02;Opus 5 $105.24。
执行成本的数量级差异($8.63 vs $109.41)来自“候选要产出什么”和“答案怎么判”两个设计决策,这张表是论文成本分析的核心证据。
同候选成本对照:对 GPT-5.5 与 GPT-6 Astra,Fable 5 的候选生成成本是 Grok 的 16.73 倍($26.55 vs $1.5869)与 7.12 倍($25.47 vs $3.5767),而完成题数只差不到 10%(107/115 与 107/116)。
控制候选后仍然有 7–17 倍成本差,干净地证明成本差距来自评估器设计本身(答案额度与任务形态)而非候选构成。