ParetoRSI-Gym:AI智能体能否跨多领域提升语言模型 ParetoRSI-Gym: Can AI Agents Improve Language Models Across Multiple Domains?
多领域后训练数据策划基准:评测智能体能否让模型在五域同时持续进步
前置知识
递归自我改进(RSI)
递归自我改进指一个智能体系统能够设计、训练并评估自己的后继系统,从而迭代地提升自身能力。经典设想源自 Schmidhuber 的 Gödel 机器(只有证明改动有益才修改自身代码),LLM 时代的实践把这一证明要求放宽为经验验证:系统改自己的脚手架或训练数据,保留分数更高的变体。数据为中心的后训练(自动策划训练数据)是这个闭环中的关键一环。
本文正是把 RSI 闭环中的一段——智能体自主策划后训练数据——形式化为可评测的基准,理解 RSI 才能明白评测对象是什么。
LoRA SFT
LoRA(Low-Rank Adaptation)是一种参数高效微调方法:冻结基座模型全部权重,只在注意力/投影层旁挂两个低秩矩阵 $A\in\mathbb{R}^{d\times r}$、$B\in\mathbb{R}^{r\times d}$,训练时只更新 $BA$,可训练参数量比全量微调小几个数量级。SFT(监督微调)则是用(指令, 回答)对做下一个 token 预测的监督训练。本文把 LoRA+AdamW、单 epoch 的 SFT 流水线整体固定,只留学习率、LoRA rank、batch size 等超参给智能体调。
固定训练流水线是本文控制变量的核心手段:所有轮次间的差异只能来自智能体策划的数据,LoRA 是这条固定流水线本身。
Pareto 前沿
在多目标优化中,一个解若在所有目标上都不劣于另一个解、且至少一个目标更优,则称其支配后者;所有未被其他解支配的解构成 Pareto 前沿。对应本文,每个检查点的成绩是五维向量 $s\in\mathbb{R}^5$(数学/科学/医疗/金融/代码),理想改进是整条前沿向右上方扩张,而非牺牲某个域去抬另一个域。
论文标题与核心目标都建立在 Pareto 概念上:智能体的任务被定义为推进五域能力向量的可达前沿,而不是最大化任何单一分数。
代理基准与泛化基准
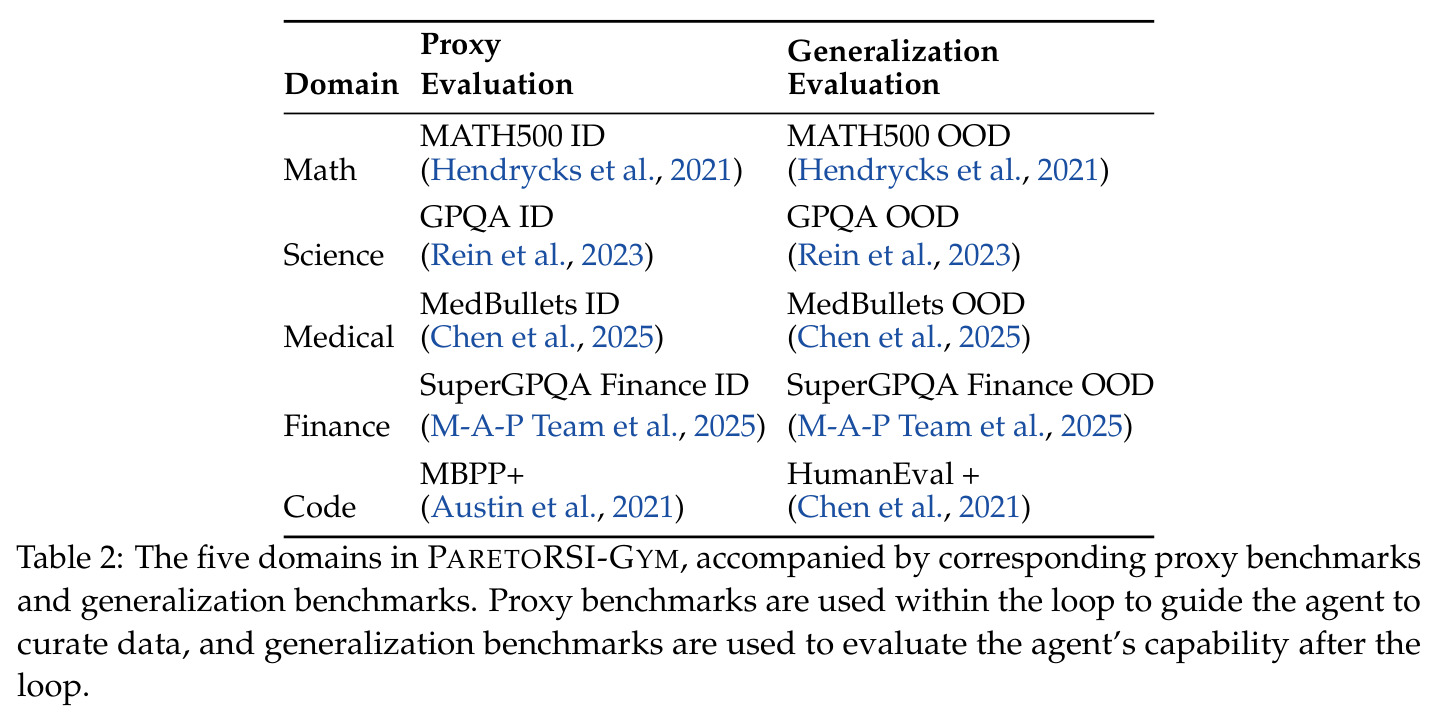
代理(proxy)基准是智能体在循环内每轮都能看到成绩的评测集,用作反馈信号;泛化(generalization)基准覆盖相同能力但与代理基准不共享任何题目,且在运行期间对智能体完全不可见,只在结束后评分。两者成对出现,如 MATH500-ID 对 MATH500-OOD、MBPP+ 对 HumanEval+。若模型只在代理上涨而泛化不涨,说明它拟合的是反馈信号本身,即 reward hacking。
这套双轨评测是本文区别于 PostTrainBench、RSIBench-Data 等单基准评测的关键设计,所有主要结论都以泛化基准成绩为准。
Jaccard 相似度
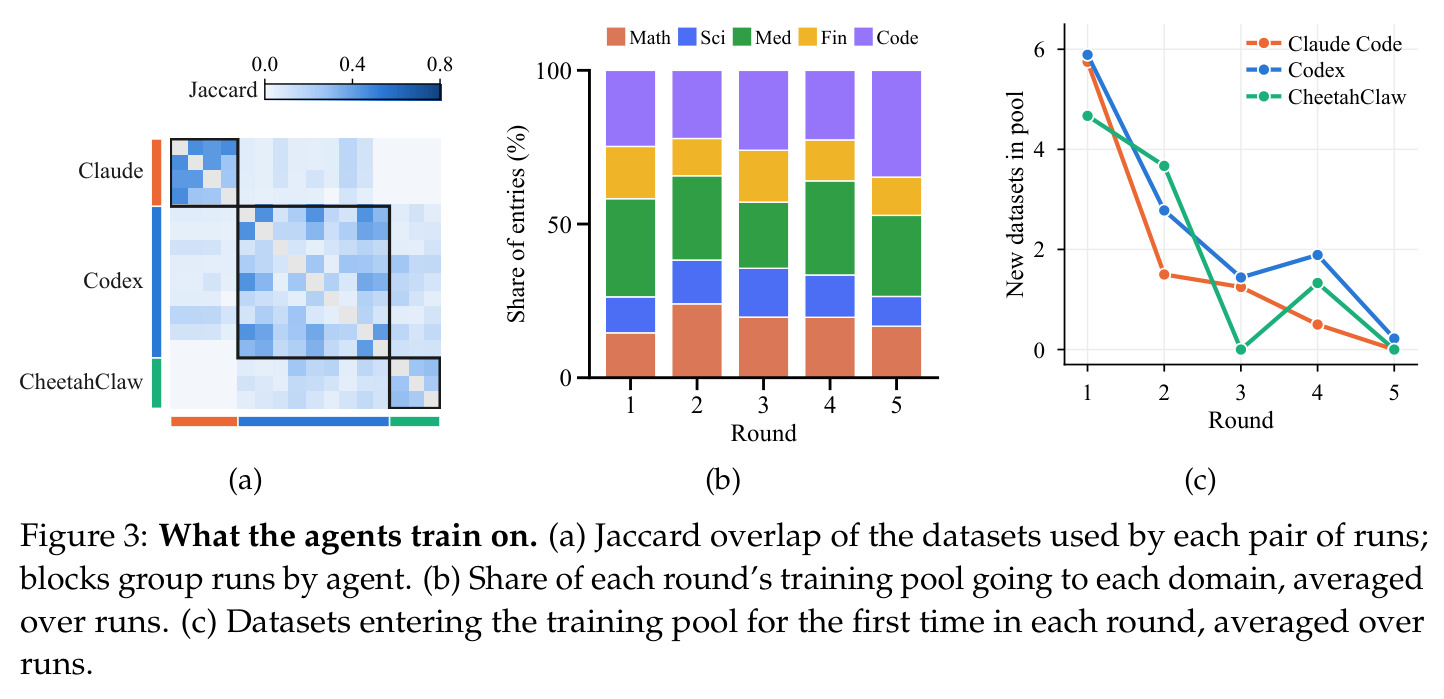
两个集合 $A$、$B$ 的 Jaccard 相似度定义为 $J(A,B)=|A\cap B|/|A\cup B|$,取值 0 到 1,衡量集合重叠程度。本文用它度量不同运行所选数据集列表的重叠:同一智能体两次运行约 0.24,不同智能体之间仅 0.07,说明每个智能体有自己独特的数据选择策略。
这是分析章节量化「智能体偏好是否随目标模型迁移」的核心指标,直接支撑了『当前智能体不适应目标模型』的结论。
研究动机
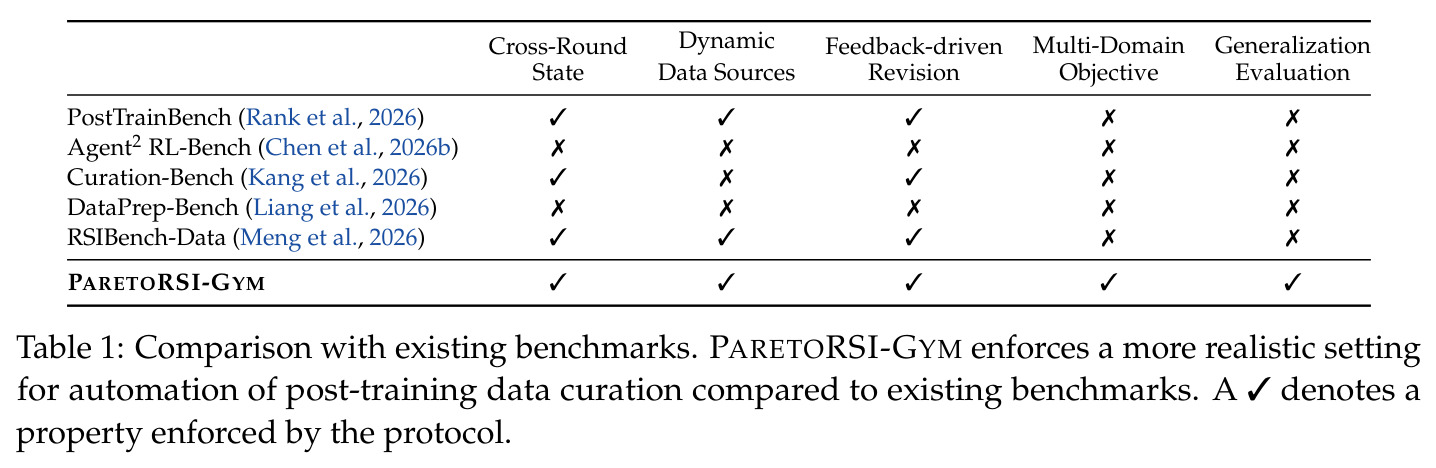
现有后训练数据自动策划的评测几乎都围绕单一基准展开:PostTrainBench 让智能体在受限算力下对单一基准做后训练,Curation-Bench 只要求智能体从固定数据池中挑出干净数据,RSIBench-Data 则围绕一个目标基准迭代增删数据,BenchEvolver 只做任务演化。这些设置与真实后训练相去甚远:发布模型需要在数学、代码、科学、金融、医疗等多个领域同时达标,而一个域上的提升往往以另一个域的回退为代价。更麻烦的是,在智能体可见的同一基准上反复优化会诱发 reward hacking——模型过拟合反馈信号而非真正获得能力,且数据可能直接污染评测集。已有基准普遍缺少跨轮次状态、动态数据源、多域目标和泛化评测这四项要素(Table 1 中五个属性无一同时满足),无法回答『智能体能否持续地、全面地改进模型』这一核心问题。
本文的目标是本文要构建一个贴近真实机器学习工程的基准 ParetoRSI-Gym,系统回答:LLM 智能体能否策划后训练数据,使一个基座模型在数学、代码、科学、医疗、金融五个领域的能力同时提升,并在多轮迭代中持续改进?具体而言,固定初始模型、五个域、工具集和 LoRA SFT 训练流水线,只把数据策划权交给智能体;每轮把五域代理分数连同逐题评测轨迹作为反馈返回;用智能体从未见过的泛化基准作为最终评分,以区分真实能力增益与对反馈的过拟合,并用显式拒绝标准剔除与评测数据过近的训练样本。实验设计上覆盖 3 个智能体系统、3 个基座模型、5 轮迭代和多种子,量化净增益、跨域权衡、轮次回退,以及对 harness 与数据选择策略的敏感性。
与已有工作不同的是,本文的独特切入是把『多域 Pareto 目标』和『隔离的泛化评测』同时引入 RSI 数据策划评测。与 PostTrainBench、RSIBench-Data 等围绕单一基准评分不同,ParetoRSI-Gym 要求智能体每轮看到完整的五维能力向量并推进整条 Pareto 前沿;与 Curation-Bench 的静态数据池不同,数据在运行时从 HuggingFace Hub 动态搜索、拉取;训练池、模型池和文字版原则跨轮持久存在,原则 $R$ 是轮与轮之间唯一的经验通道且预算受限,使『持续改进』本身成为被考察能力。评测上采用 ID/OOD 成对的代理与泛化基准,并显式拒绝与评测数据过近的样本防污染。Table 1 显示它是唯一同时满足跨轮状态、动态数据源、反馈修订、多域目标、泛化评测五项属性的基准。
核心方法
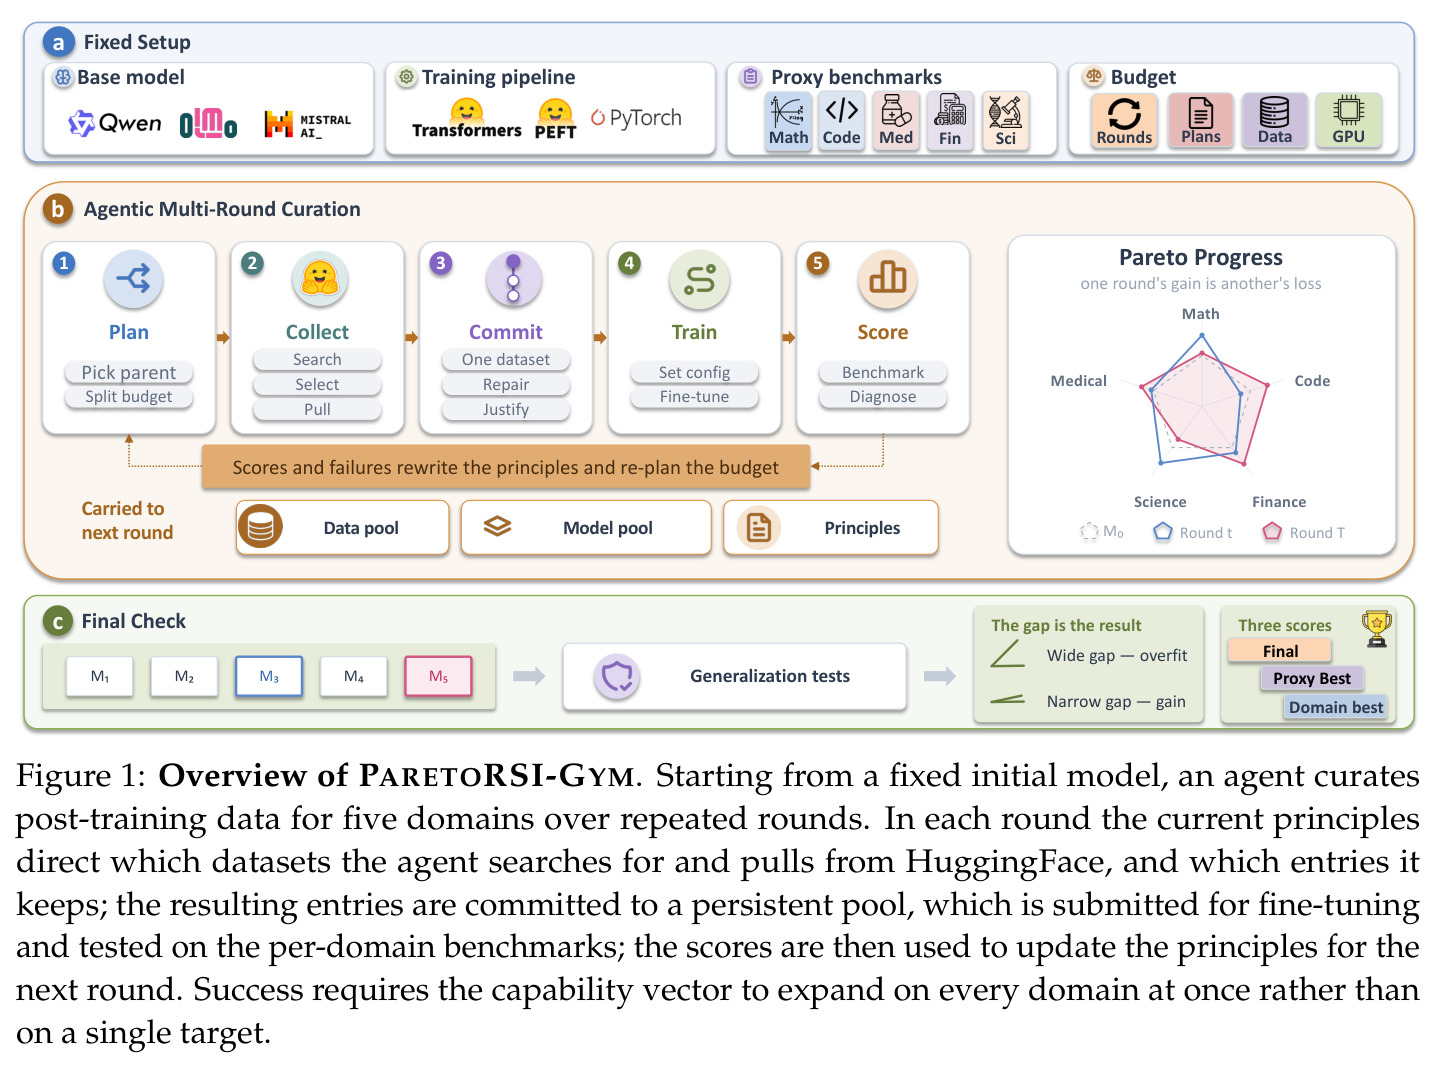
直觉上,ParetoRSI-Gym 把一个真实后训练工程师的日常工作压缩成一个游戏:你手里有一个未对齐的基座模型,可以在 HuggingFace 上找数据、挑数据,用固定的 LoRA SFT 流水线微调它,然后看五科成绩单,再决定下一轮怎么改,如此往复五轮,最后换一套你没见过的试卷考试。技术路线上,流程从初始模型 $M_0$ 和能力向量 $s_0=T_p(M_0)$ 出发:每轮智能体依据一组书面『原则』$R$ 和预算 $\beta$ 执行 SEARCH/SELECT/PULL 三种操作策划数据池 $P$,提交训练配置 $C$ 训出 $M_t$,在五域代理基准 $T_p$ 上评测得到 $s_t$;完整评测轨迹(含逐题生成)返回用于改写原则,并从模型池中选择下一轮起点。模型池、数据池、原则三类状态跨轮持久,预算 $\beta$ 限制经验积累量。运行 $T=5$ 轮后,在智能体从未见过的泛化基准 $T_g$ 上对末轮模型与代理最优模型分别评分。
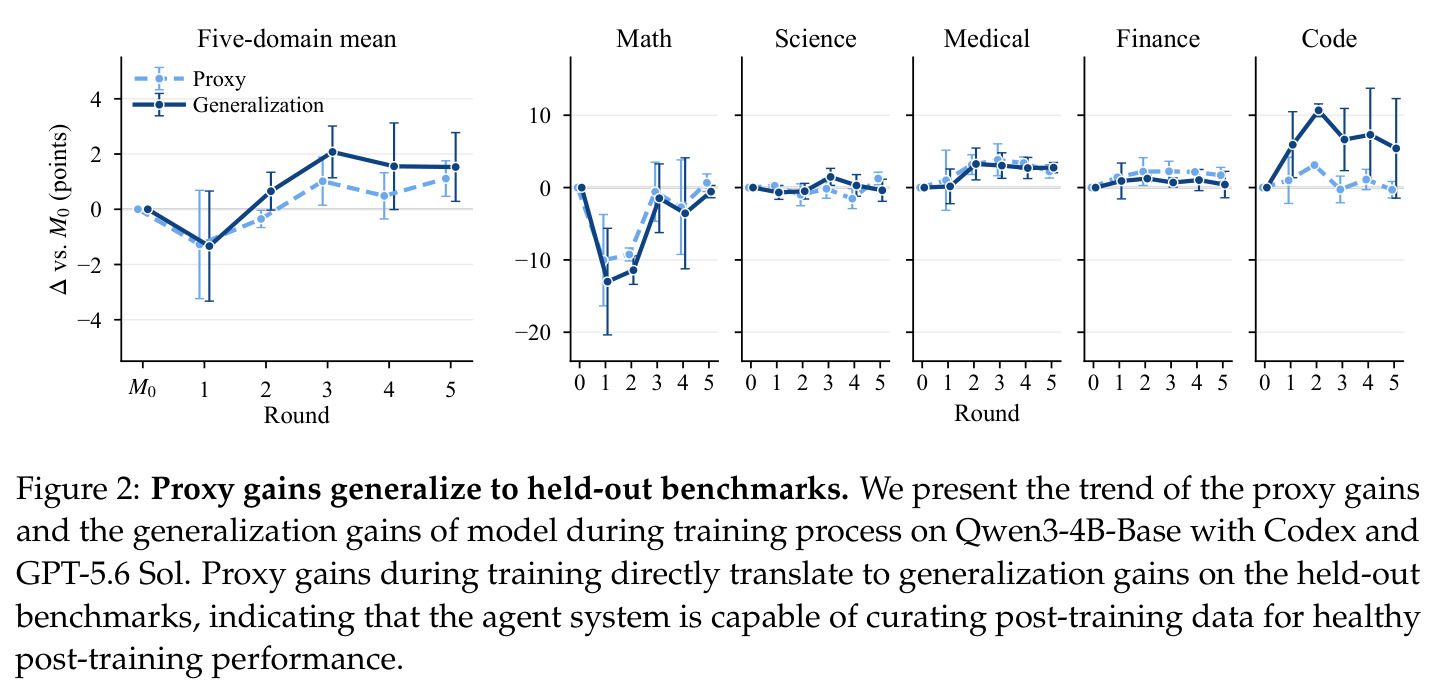
核心创新是『多域 Pareto 目标 + 隔离的泛化评测』的组合。已有工作要么让智能体优化单一标量分数,要么从固定池中挑选,智能体可以只推一个坐标,也可以靠记住评测题作弊。ParetoRSI-Gym 强制智能体每轮看到完整的五维分数向量 $s_t\in\mathbb{R}^N$ 与非支配检查点集合,目标是推进整条可达前沿而非任一坐标;最终分数只来自从未暴露的泛化基准 $T_g$,代理基准 $T_p$ 仅作过程反馈并连同逐题轨迹返回,使智能体能把失败归因到技能缺失还是格式错误而非盲猜。协议还显式拒绝与评测集过近的数据,防数据污染。机制上,原则 $R$ 是轮与轮之间唯一的经验载体,预算 $\beta$ 限制记忆量,因此『后期回合会不会抹掉早期收益』成为可测量的现象——这直接催生了 Final/Proxy Best/Domain Best 三种检查点的报告方式。
方法步骤详情
完整流程如下。初始化:模型池 $\mathcal{M}=\{M_0\}$,智能体基于初始能力向量 $s_0$ 与预算 $\beta_0$ 写下初始原则 $R_0$。第一轮策划:按 $R_0$ 调用 SEARCH(按关键词、标签、元数据检索 Hub,返回候选数据集及其卡片)、SELECT(挑选值得获取的数据集及子集)、PULL(下载并逐条审阅),把保留条目连同来源与提交理由写入持久数据池 $P$。训练:经固定流水线 $S$ 以 LoRA+AdamW 微调所选检查点一个 epoch;学习率、LoRA rank、batch size、序列长度、warmup 由智能体在固定范围内自选,每轮上限 15M 训练 token、40k 条目,得到 $M_1$ 并入模型池。评测反馈:在五域代理基准 $T_p$ 上评测得 $s_1$,完整评测轨迹返回。迭代:智能体决定下一轮从 $\mathcal{M}$ 中哪个检查点继续(可回退早期轮或重启 $M_0$),按反馈改写原则、更新数据池,重复至 $T=5$ 轮。最终在泛化基准上报告末轮(Final)与代理最优(Proxy Best)两个检查点。
技术新颖性
与 PostTrainBench 相比,本文多了多域目标与泛化评测两层;与 RSIBench-Data 相比,数据源从给定池变为运行时全库搜索,且必须做跨域权衡;与 Curation-Bench 的『从固定池挑干净数据』相比,这里智能体要自己决定找什么。设计上还有一个被此前工作忽视的点被形式化:跨轮状态(模型池、数据池、原则)的存在使『早期收益被后期回合抹掉』成为可测量现象,论文据此把『策划得差』(代理最优轮本身不够好)与『必须为五个域交回同一个模型』(最优域轮各不相同)两种代价用 Final/Proxy Best/Domain Best 三个量分开统计——后者在 45 个模型-域单元中占 43 个,平均损失 2.0 点。此外,把 harness 与骨干解耦(同一 DeepSeek V4.1 Flash Max 换三个 harness)的实验设计也是对『系统=模型+脚手架』视角的实证贡献。
实验结果
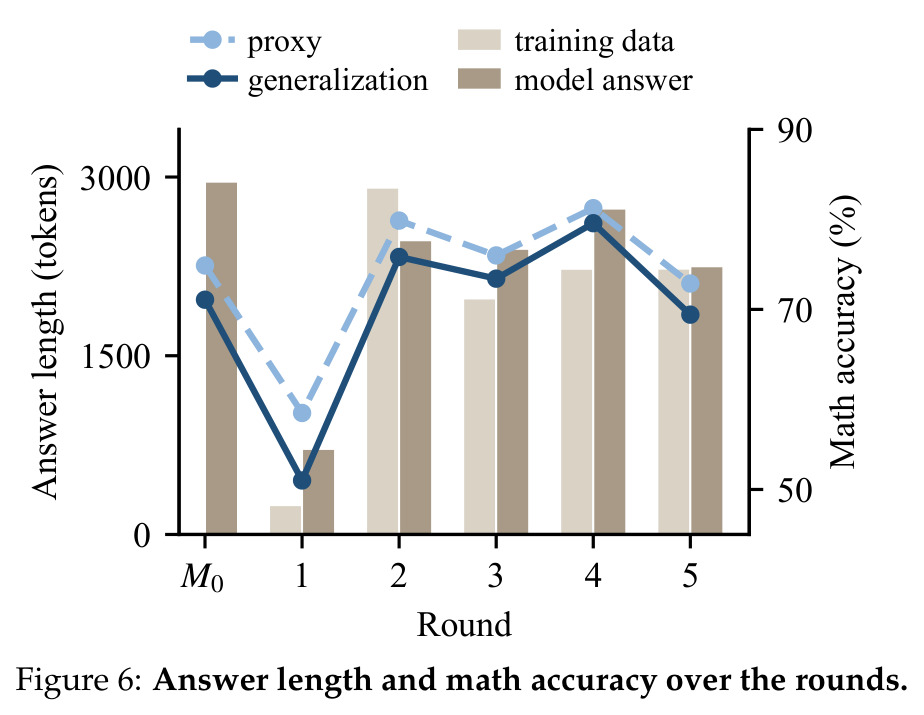
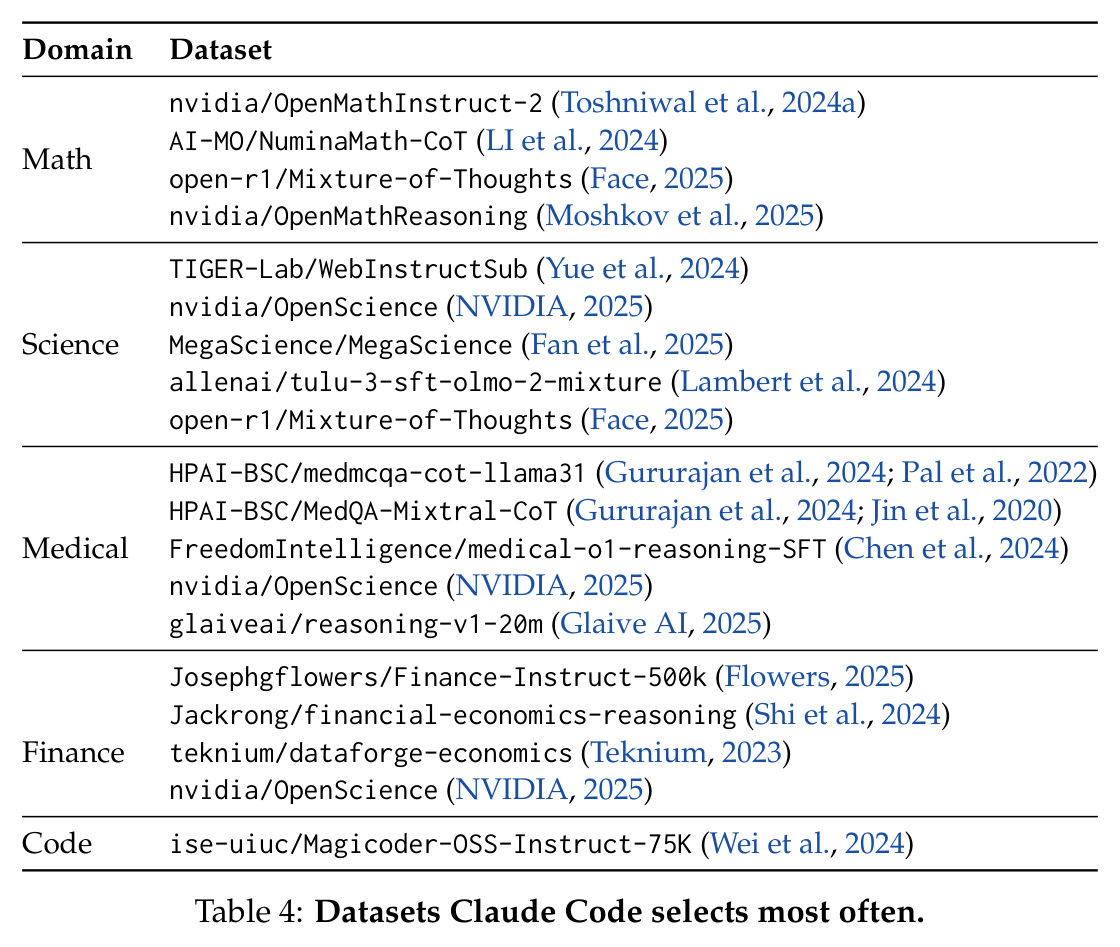
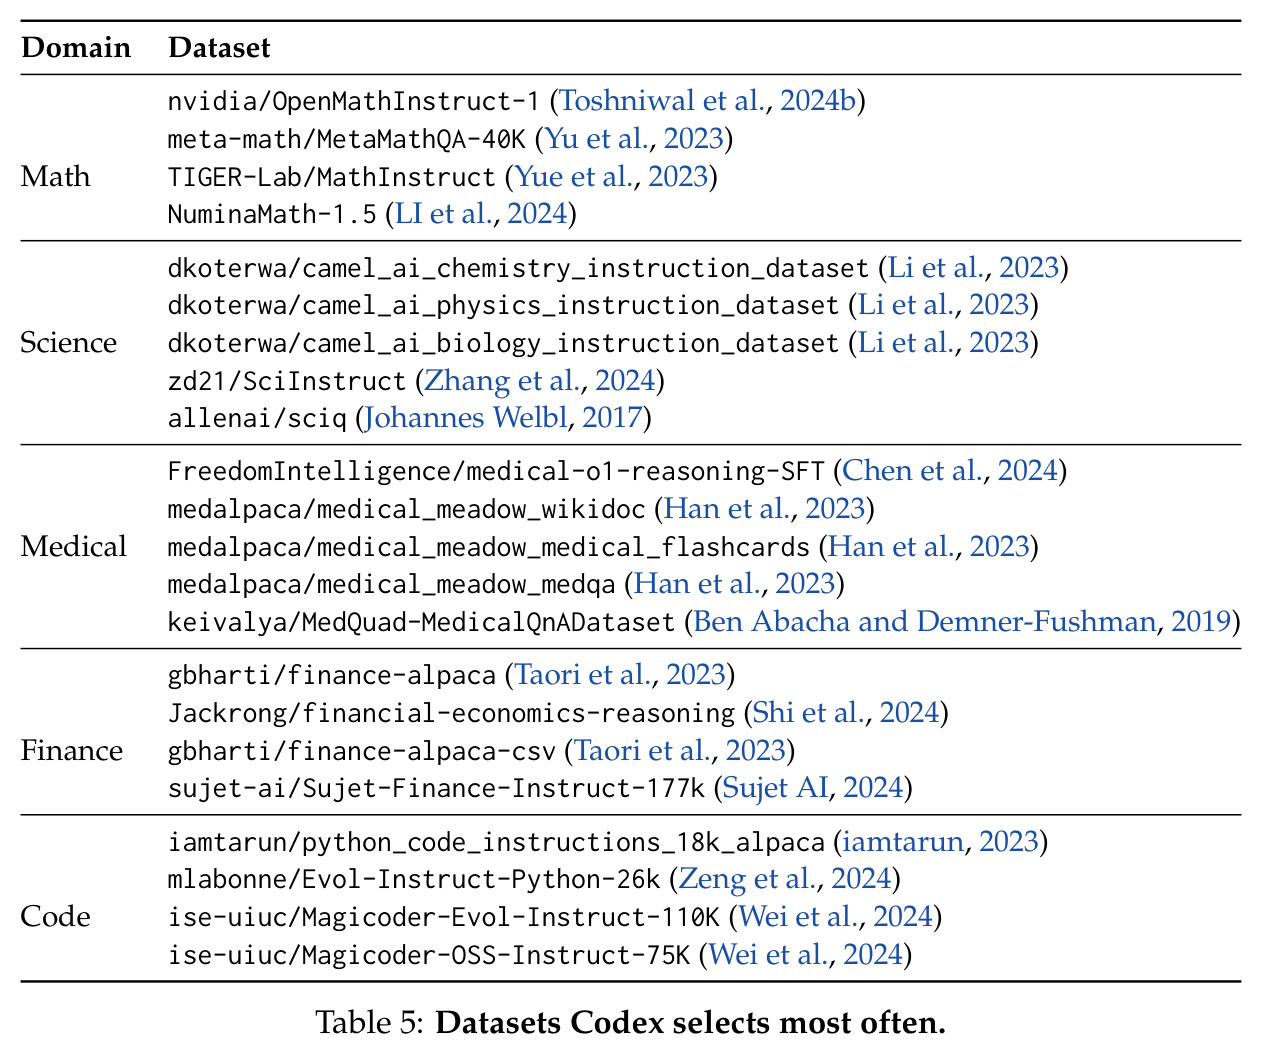
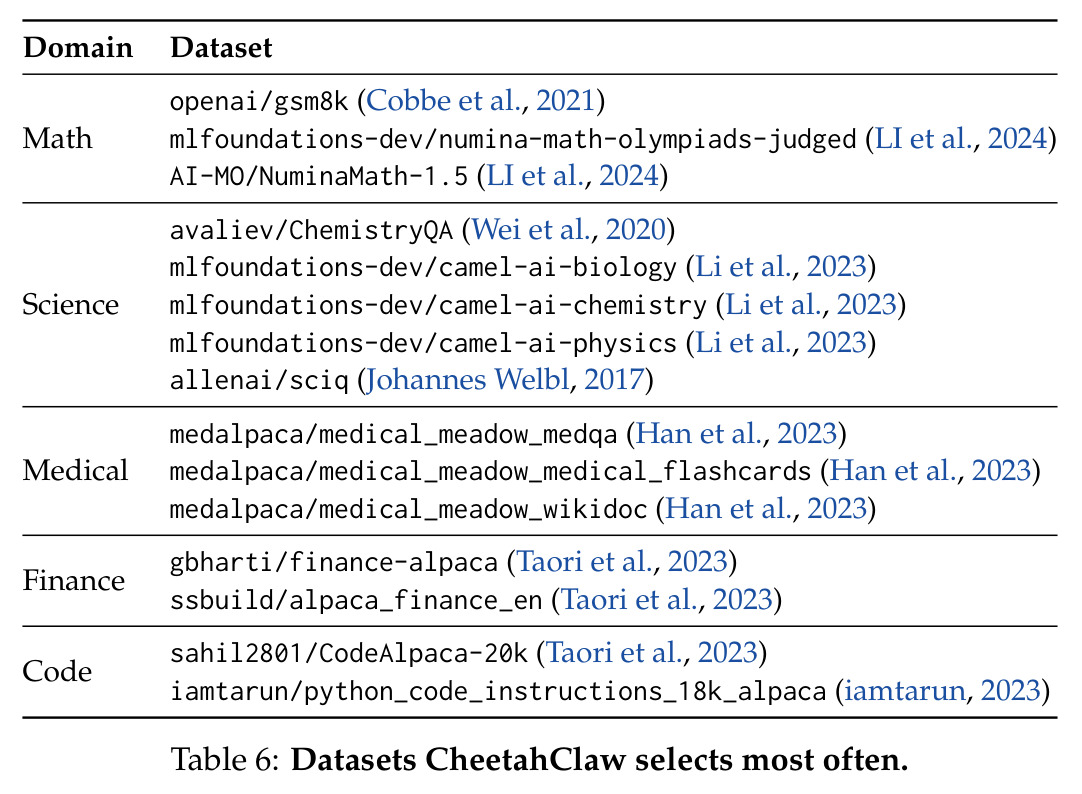
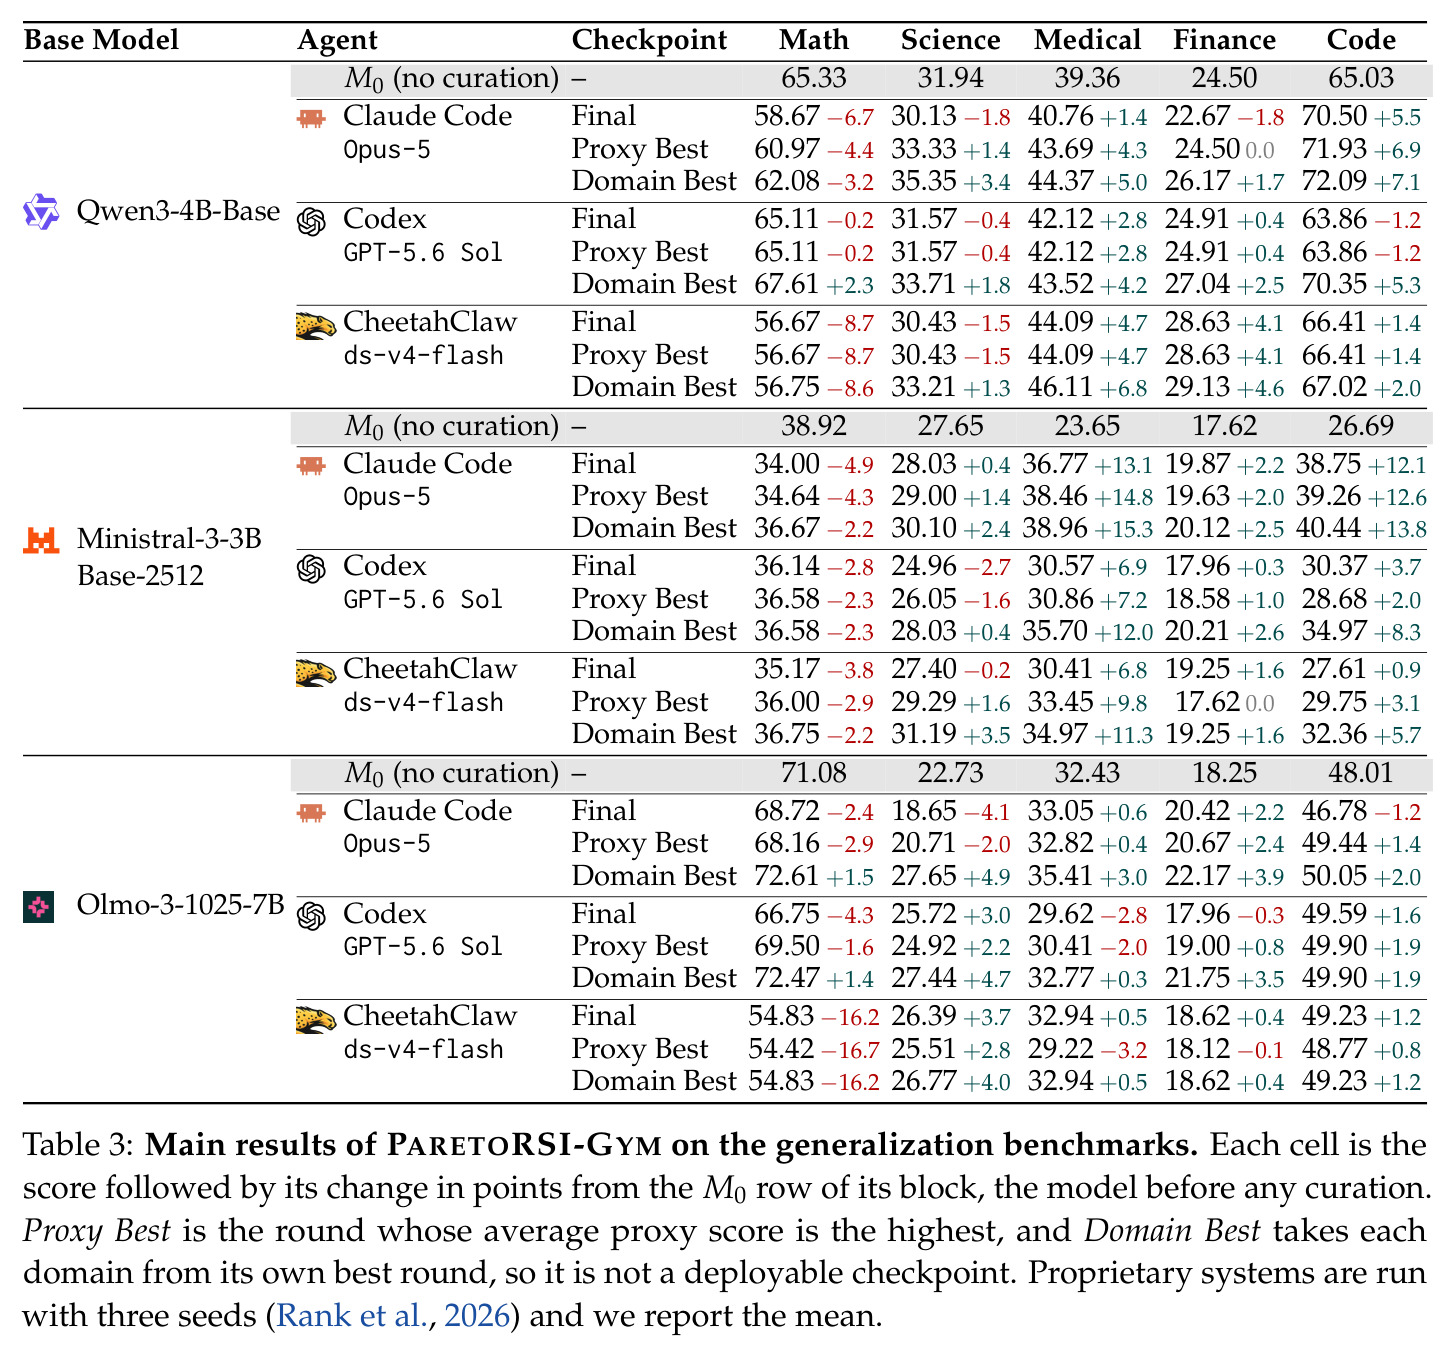
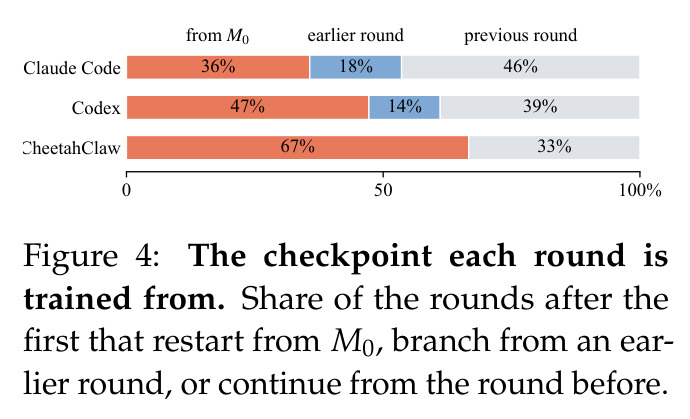
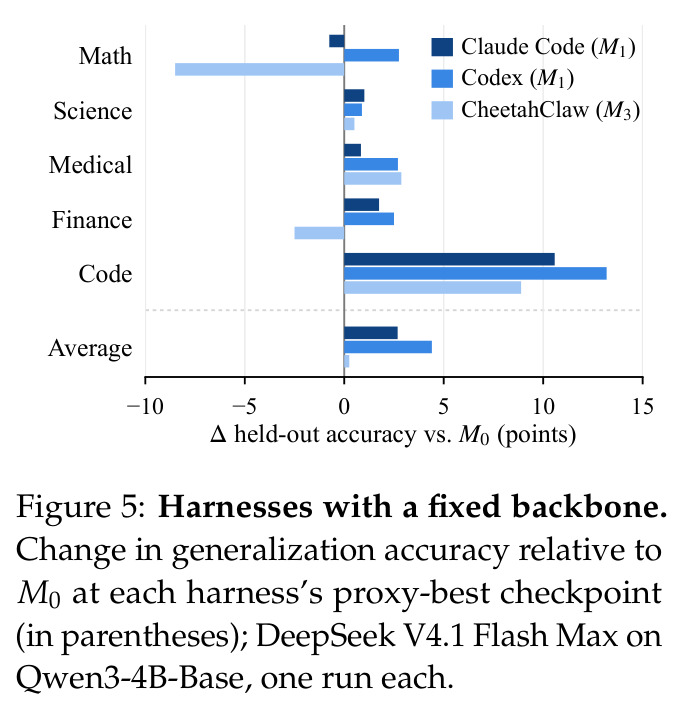
主实验覆盖 3 个智能体系统(Claude Code+Opus-5、Codex+GPT-5.6 Sol、CheetahClaw+deepseek-v4-flash)× 3 个基座(Qwen3-4B-Base、Ministral-3-3B、Olmo-3-1025-7B)× 5 轮,专有系统跑 3 个种子取均值。代理最优检查点上,Claude Code 泛化分数相对提升 9.2%(绝对 +2.3 点),Codex +3.1%,CheetahClaw +2.9%(绝对 −0.3 点);最大单域增益是 Ministral-3-3B 医疗 23.65→38.46(+14.8 点,+63%),但部分只是学会了用选项字母收尾的格式。增益集中在医疗(+4.3 点)与代码(+3.2 点),数学普遍负迁移(Qwen3 上 Claude Code 代理最优仍 −4.4 点)。行为分析:9 个配置中 7 个的代理最优轮不是最后一轮;45 个模型-域单元中 24 个相对代理最优轮回退;43/45 个单元中某域的最优轮不是智能体实际提交的轮,平均损失 2.0 点、最高 6.9 点。趋势上(Fig. 2)代理与泛化增益方向一致但幅度差很大:代码域代理增益 ≤3 点而泛化增益达 11 点。Harness 实验(Fig. 5,固定 DeepSeek V4.1 Flash Max):Codex +4.3、Claude Code +2.6、CheetahClaw +0.2,代码域最高 +13.2 点。数据层面(Fig. 3、4):同智能体两次运行 Jaccard 重叠 0.24、跨智能体仅 0.07 且不随共享基座上升;后期轮次新入池数据集持续减少;CheetahClaw 67% 轮次从 $M_0$ 重启。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五域平均泛化基准(3 基座 × 5 域,代理最优检查点) | 相对提升 %(vs M0) | Claude Code + Opus-5:+9.2%(绝对 +2.3 点) | Codex +3.1%;CheetahClaw +2.9%;M0 无策划 | 领先次优 Codex 6.1 个百分点 |
| 医疗(Ministral-3-3B,MedBullets-OOD) | 准确率 | 38.46(+14.8 绝对点) | M0:23.65 | +63% 相对提升(含格式学习成分) |
| 代码(Ministral-3-3B,HumanEval+) | pass@1 | 39.26(+12.6 绝对点) | M0:26.69 | 所有域中最稳定的增益来源之一 |
| 数学(Qwen3-4B,MATH500-OOD) | 准确率 | 60.97(−4.4 点,Claude Code 代理最优) | M0:65.33 | 负迁移:数学域普遍随训练下降 |
| Harness 对比(固定 DeepSeek V4.1 Flash Max 骨干) | 泛化基准平均变化(点) | Codex harness:+4.3 | Claude Code +2.6;CheetahClaw +0.2 | 代码域最高 +13.2 点 |
| 数据集选择重叠 | Jaccard 相似度 | 同智能体两次运行:0.24 | 不同智能体之间:0.07 | 差异约 3.4 倍,策略由智能体自身决定、不随目标模型迁移 |
局限与改进
作者承认的:只测了 3 个智能体系统和 3 个基座模型,规模有限;三个系统都是快速演进的移动目标,结论只是写作时版本的快照;只覆盖五个英文领域。我自己的观察:其一,医疗上最大增益有明显的格式学习成分(基座经常不以选项字母结尾),63% 的相对增益有水分;其二,Domain Best 是非支配检查点的 oracle 上界、不可交付,头条数字(+9.2%)相对乐观;其三,代理-泛化方向一致性只在单配置(Qwen3+Codex)的 Fig. 2 上验证过,且方向一致不代表幅度一致(代码上代理 ≤3 点 vs 泛化 11 点),智能体基于代理信号做决策的可靠性仍存疑;其四,训练预算每轮仅 15M token、40k 条目、LoRA 单 epoch,远小于真实后训练,结论对更大预算和更强训练方法的适用性未知;其五,与评测数据『过近』的拒绝标准具体阈值未在正文给出,可复现性有缺口。
独立分析的弱点
第一,智能体缺少对『何时该停下』的显式机制:24/45 个单元相对代理最优轮回退、7/9 个配置峰值出现在中途,协议未提供帕累托非支配性检查或早停激励,改进方向是把前沿保持性纳入评分或给智能体验证式选点工具。第二,原则 $R$ 的预算 $\beta$ 限制记忆,但论文没有定量分析原则实际如何演化(是否真被反馈改写、改写质量如何),可对轮间原则做 diff 分析。第三,泛化隔离强度不一致:代码用换基准(MBPP+→HumanEval+),其余四域用 ID/OOD 拆分,两者防污染强度不同,跨域结论不完全可比。第四,CheetahClaw 67% 轮次从 $M_0$ 重启且从不回溯早期轮,说明部分智能体根本没利用跨轮状态,协议可强制或度量状态利用质量。第五,开源系统单种子运行(CheetahClaw 每基座只跑一次),−16.7 点这类剧烈数字受随机性影响大;改进方向是至少多种子或报告方差。第六,智能体数据偏好不随基座变化(0.23 vs 0.25),暴露其不做目标模型诊断,可在观察中加入基座能力剖析步骤。
未来方向
作者提出的:扩展到更多智能体系统与更大规模模型,覆盖更多语言与领域(当前仅英文文本)。基于成果可延伸的:把『代理-泛化增益幅度差』形式化为校准性指标,衡量智能体被反馈信号误导的程度;研究原则 $R$ 的演化动力学与最优预算 $\beta$ 的设置;引入数据混合的自动优化器(如 DoReMi 类方法)作为强基线,量化智能体相对自动混合策略的超额收益;让多个智能体共享模型池与数据池,研究经验迁移;部分解冻训练流水线(加入 DPO、拒绝采样等)考察结论随训练自由度的变化;给智能体提供小型干净验证集,训练其『预判回退』的能力;对 0.24 vs 0.07 的 Jaccard 差异做归因分析,弄清偏好来自搜索词习惯还是筛选标准;将协议扩展到工具使用、长上下文等其他能力轴。
复现评估
论文声明代码开源(github.com/haojinw0027/ParetoRSI-Gym)。训练数据全部来自 HuggingFace Hub 公开数据集,评测基准(MATH500、GPQA、MedBullets、SuperGPQA、MBPP+、HumanEval+ 及其 OOD 版本)均为公开资源。算力门槛不高:每轮上限 15M token、40k 条目、LoRA 单 epoch,对 3B–7B 模型单卡或少量卡即可完成;真正的成本在智能体侧——主配置依赖闭源的 Opus-5 与 GPT-5.6 Sol,9 个配置 × 5 轮 × 3 种子需要可观的 API token 预算,且运行环境需沙箱并把网络限制到 HuggingFace Hub。开源替代路径可用 CheetahClaw+deepseek-v4-flash,但它是最弱配置且只跑单种子。评测需对多轮多个检查点在 5 域上推理,工作量中等。总体判断:协议和流水线可完整复刻,训练侧结果应能对齐;但智能体行为侧受模型版本演进影响,精确数字难以复现,属于中等复现难度。
论文图表