联合还是逐项?从1700万到10亿参数的闭集决策紧凑编码器 Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters
逐项评分仅在重排序器初始化下胜过联合读取,68M紧凑编码器即可超越435M零样本NLI分类器
前置知识
交叉编码器与重排序器
交叉编码器把查询和候选文档拼成一条序列送入Transformer,让两者在每个注意力层充分交互后输出一个相关性分数;与之相对的双编码器分别编码查询和文档再算相似度。重排序器是在(query, 相关文档)对上微调过的交叉编码器(如Ettin系列,基于ModernBERT),精度高但每个候选都要单独过一遍模型,通常用于检索精排阶段。
本文所有Crivo模型都从Ettin重排序器微调而来,而重排序器的(query, document)对输入格式正是论文发现的逐项评分优势的关键来源——初始化2×2实验的核心解释机制。
联合评分与逐项评分
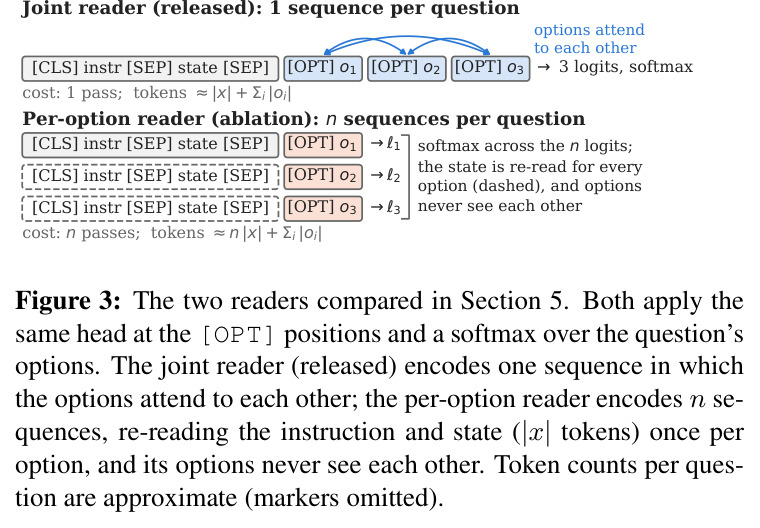
多选/闭集决策的两种经典读法。逐项评分把上下文与每个选项单独拼成一条序列,各得一个分数后跨选项softmax,是BERT多选头和NLI零样本分类的标准做法,代价是每选项一次前向。联合评分把上下文与所有选项放进同一条序列,在选项标记token处各读一个分数,一次前向完成,但选项会互相注意且对顺序敏感。
这两种读法的选择正是论文标题与研究问题本身:第5节的受控读取研究(reader study)就是要回答联合还是逐项,所有核心结论都围绕它展开。
知识蒸馏
让小模型(学生)除拟合金标签外,还模仿大模型(教师)的软概率分布,损失常写作 $\alpha\,\mathrm{CE} + (1-\alpha)\,\tau^2\,\mathrm{KL}(p^{teacher}_\tau \| p^{student}_\tau)$,温度 $\tau$ 软化教师分布以暴露类间相似性;软目标来自Hinton经典工作,注意力蒸馏(MiniLM)则模仿教师注意力矩阵。
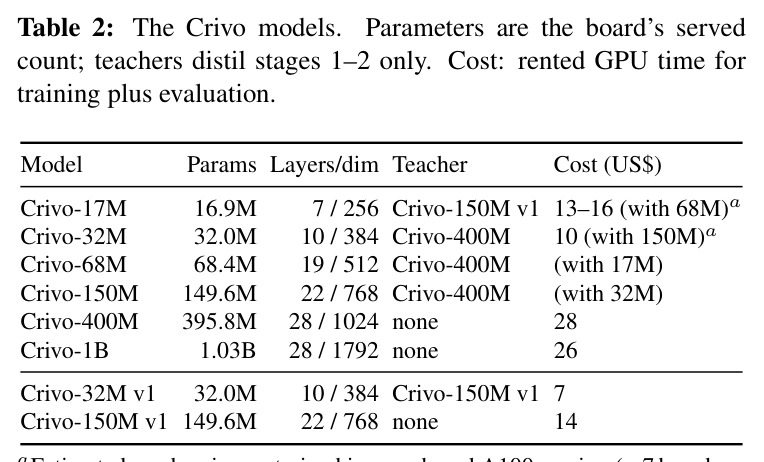
Crivo家族的17M/32M/68M/150M均从Crivo-400M蒸馏而来,训练损失为 $\alpha(\mathrm{CE}+0.5\,\mathrm{Brier})+(1-\alpha)\tau^2\mathrm{KL}$($\alpha=0.5$、$\tau=2$),读懂方法一节必须先掌握蒸馏。
NLI零样本分类
把任意候选标签verbalize成假设句,用MNLI等自然语言推理模型判断前提是否蕴含该假设,对蕴含logit做softmax得到每类概率。因标签集合在推理时才给出,无需为每个新任务微调,是零样本文本分类的标准基线(BART-large-MNLI、DeBERTa-v3 zs-v2),代价是每个标签一次前向。
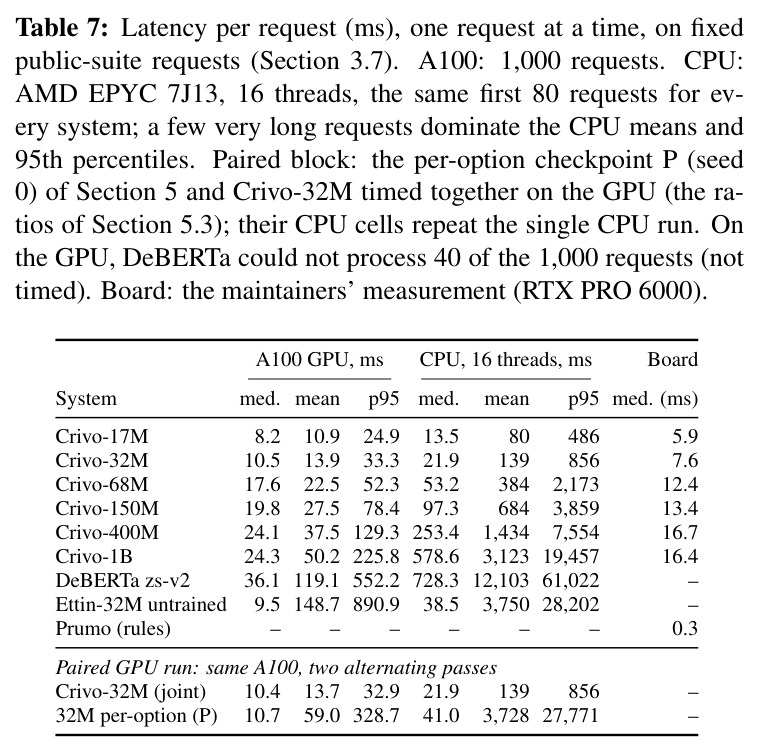
DeBERTa-v3-large zs-v2(435M)是本文主要外部基线,论文要证明68M小模型能击败它;其逐选项打分机制也解释了延迟差距(CPU中位728ms对13.5ms)。
校准指标 ECE 与 Brier 分数
期望校准误差(ECE)按置信度把预测分桶,计算每桶平均置信度与实际准确率之差的加权均值;多类Brier分数是预测概率与one-hot标签平方差的期望。两者越低越好,但恒定输出系统(如均匀猜测)的ECE也可能很低,需配合区分度(risk–coverage曲线下面积)一起解读。
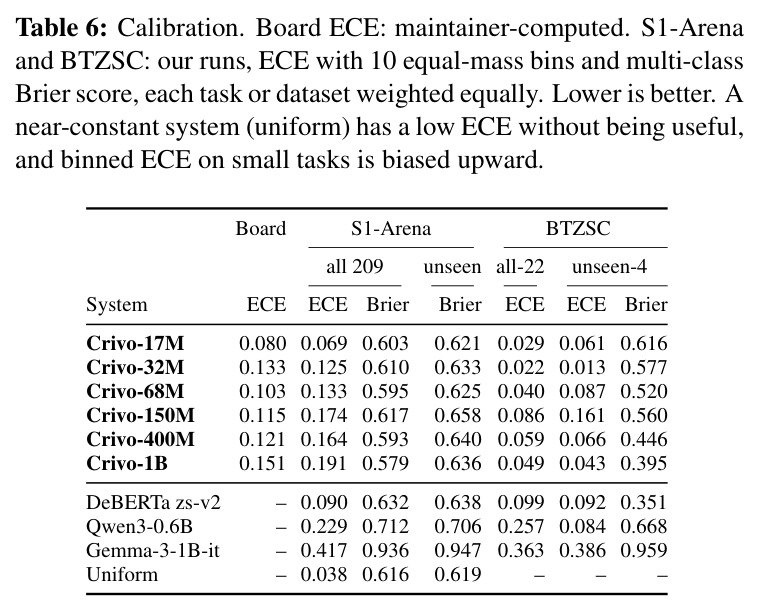
论文发现Crivo在未见任务上过度自信——Brier不优于均匀猜测的0.619,且ECE随规模从0.076升到0.158,这是模型可信度与部署安全性的核心证据。
数据污染审计与自适应保留集复用
测试集若泄漏进训练数据,评测即失效;污染审计通过字符串匹配、共同长段落、词8-gram重叠等检查训练数据与测试项的交集。自适应保留集复用指反复用同一保留集做模型选择导致过拟合(Dwork等人的经典警示);本文还报告一个变体:与训练数据同源的开发面板不再是新数据表现的独立估计。
论文的核心卖点之一是污染审计过的外部评测(审计563,686条测试问题),并用自家开发面板系统性高估私有分5.6–7.1分作为自适应复用的实证案例。
研究动机
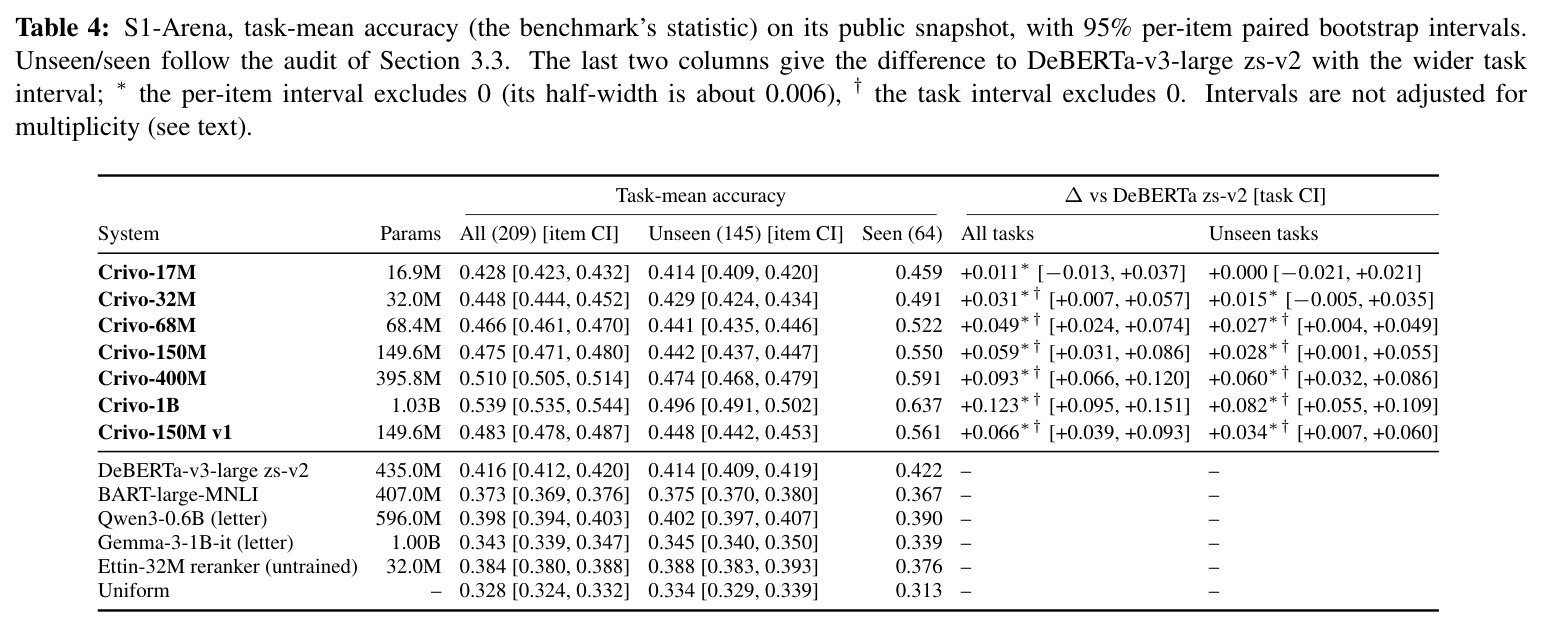
许多语言模型流水线的最后一步是从封闭选项集合中做决策:选哪个工具、检索段落是否支持论断、消息是哪种意图、四个答案选哪个,且标签集合随实例变化。现有三种做法各有痛点。(1) 提示大语言模型并解析输出——慢且对选项排列顺序敏感:本文实测两个用选项字母读出的小LLM在重排下翻转67–76%的答案,Gemma-3-1B-it在S1-Arena上甚至接近均匀猜测(准确率0.343,均匀猜测0.328)。(2) 用NLI模型把每个候选标签当假设逐个打分——每个选项一次前向(DeBERTa基线CPU中位延迟高达728ms),且选项之间无法直接比较。(3) 为每个任务微调分类器——无法迁移到新标签集合。与此同时,在这类'类型化决策'(Jev格式:结构化状态+类型化问题,输出每个允许选项的概率)这一新兴场景下,两个基本问题从未被受控比较过:这样的决策编码器能小到什么程度?上下文与选项应该联合读取还是逐项读取?已发布的紧凑决策模型(UniMC、Dinah-0等)都默认采用联合读取,但这一选择缺乏任何受控实验依据。
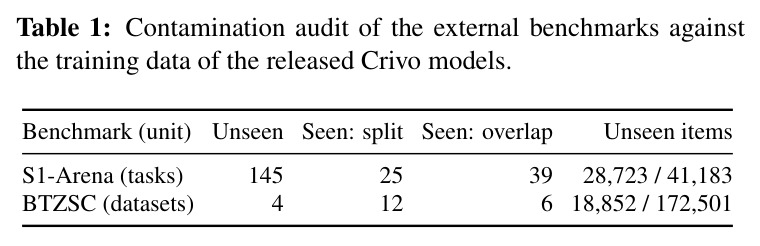
本文的目标是论文回答两个问题:闭集决策编码器能小到什么程度,选项应该联合读取还是逐项读取。具体目标包括:(1) 训练Crivo家族——六个从1,690万到10.3亿参数的联合编码器,从Ettin重排序器微调,采用改编自Dinah-0的[OPT]读出头,全部训练成本约80美元租用GPU时间(54美元有账单记录);(2) 在3,200万参数规模、每臂三个种子的受控网格中比较联合与逐项读取,除读取方式外一切固定,并分别用匹配优化器步数和匹配训练算力两种控制分离混淆因素;(3) 在污染审计过的两个外部基准上以同一协议对比命名基线——S1-Arena(类型化决策,209个任务、41,183个请求)与BTZSC(零样本文本分类,22个数据集);(4) 测量选项顺序鲁棒性、校准(ECE/Brier)与声明硬件上的延迟;(5) 以Decision Index榜单维护者运行的私有测试为辅助证据,并用无学习参数的规则引擎Prumo探测榜单究竟奖励什么。最终目标是给从业者一条明确的设计规则:读取方式应跟随可用的初始化检查点与请求延迟分布。
与已有工作不同的是,本文的独特切入有三点。第一,把读取方式问题从各说各话变成受控实验:UniMC/Dinah-0一系(联合读取)与NLI/BERT多选头一系(逐项读取)分属不同社区传统,从未在类型化决策上固定数据、超参、教师与评估集后只改变读取方式地比较;本文进一步做了初始化×读取方式的2×2因子设计,发现逐项优势完全依赖重排序器初始化——从原始编码器出发两种读取无差别,这是此前任何工作都没揭示的条件性结论。第二,评测方法学的严谨程度罕见:训练数据防火墙加563,686条套件测试问题的最终字符串审计、外部基准未见/已见分离报告、Holm多重比较校正、预注册的实验决策规则(带日期的实验日志),以及诚实的阴性结果报告——自家开发面板系统性高估私有测试5.6–7.1分,且把两个训练配方排错了顺序。第三,贡献了Prumo探测工具:一个约2.7千行Python、仅含527个手工常数(其中454个是棋子位置值)的无参数规则引擎,在榜单同技能私有测试上得15.78分,与17M神经模型的15.88分打平,暴露榜单部分奖励的是格式特定的解题捷径而非任务能力。
核心方法
直觉:闭集决策的输出空间固定,这类决策可以交给很小的编码器——问题只剩'多小'和'怎么读选项'。技术上,Crivo遵循Jev类型化决策格式:请求含状态(对话、文档、工具目录等)和类型化问题(choice多选、noul二元、score序数),每题渲染成一条序列 $[\mathrm{CLS}]\;\mathrm{instr}\;[\mathrm{SEP}]\;\mathrm{state}\;[\mathrm{SEP}]\;[\mathrm{OPT}]\,o_1\ldots[\mathrm{OPT}]\,o_n$;第 $i$ 个[OPT]的隐状态 $h_i$ 加问题类型嵌入 $e_t$,过fp32小头得logit,跨选项softmax:$p(o_i\mid x)=\exp f(h_i+e_t)/\sum_j \exp f(h_j+e_t)$,答案取argmax。骨干是Ettin重排序器(ModernBERT系,旋转位置编码,局部/全局交替注意力),训练到8,192 token、推理整读32,768 token不截断。三阶段训练(63.8万→16.9万→2.5万题),损失为交叉熵加0.5倍Brier加蒸馏;小模型从Crivo-400M蒸馏。
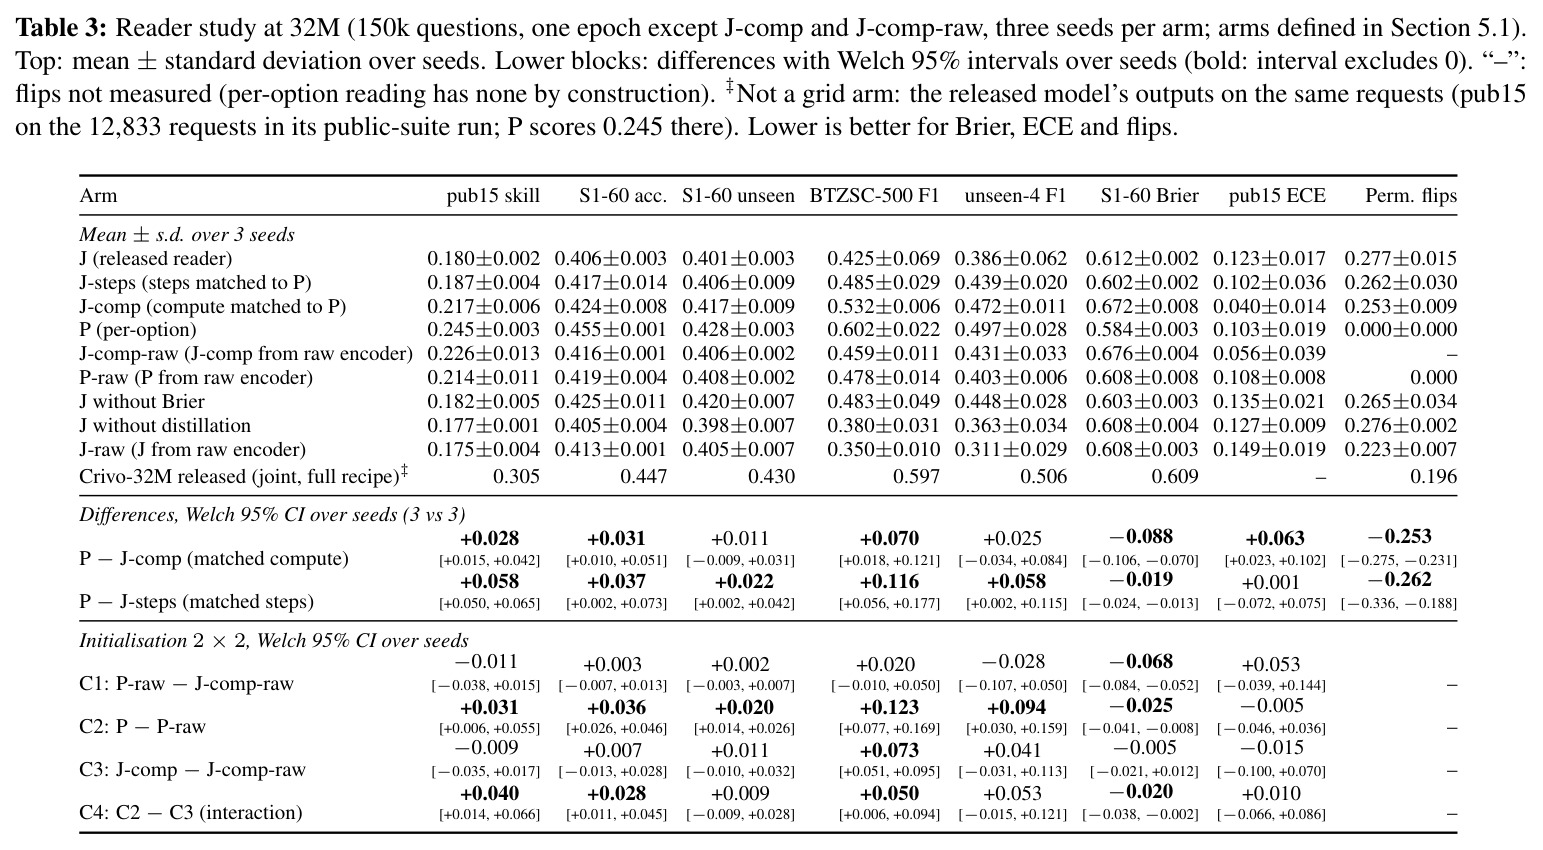
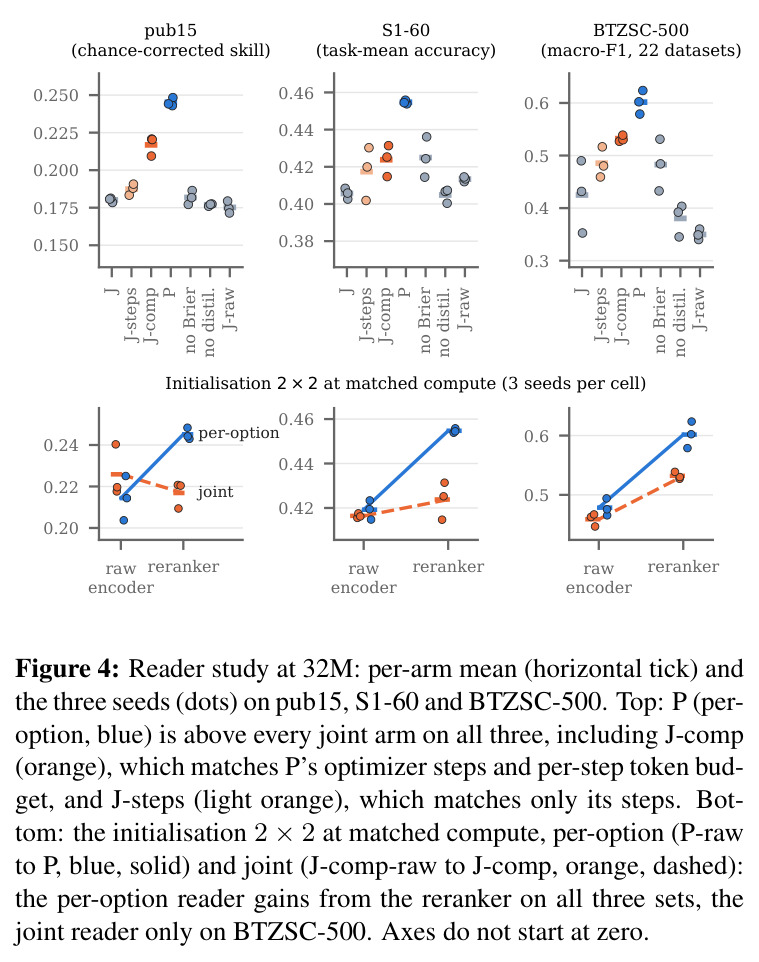
核心创新是读取方式的受控比较及其条件性发现。逐项读取天然匹配重排序器的训练格式——Ettin在(query, document)对上训练,逐项读取恰好把指令+状态当query、单个选项当document;而联合读取把所有选项塞进一条序列,对检查点是全新格式。为了把'读取方式'从'步数/算力差异'中分离,论文设计了两个联合控制臂:J-steps把联合读取的每步token预算缩小使其步数与逐项相同(P约3.25倍步数:6,858对2,112步),J-comp保持联合的每步预算但训练到逐项的步数(每行读约3.25遍,是重复控制;编码token 136.7M对161.3M仅差1.18倍)。2×2(重排序器/原始编码器 × 联合/逐项)进一步证明条件性:从原始Ettin编码器出发两种读取无差别(C1在pub15为−0.011 [−0.038, +0.015],含零),只有从重排序器出发逐项才更好,交互项C4在pub15为+0.040 [+0.014, +0.066]。这否定了'逐项读取本身更好'的简单叙事,给出格式匹配的机制解释;作者明确说明2×2并未检验该机制本身,只是建立了条件关系。
方法步骤详情
第一步,数据:混合含stage 1的638,306题、stage 2的169,437题、stage 3的24,635题,由Bekko数据(每子集≤1,200行)、328个tasksource任务族、程序化类型化决策(政策例外、日程、命题逻辑、执行代码)、合成工具调用对话及公共套件源数据集train划分(每源≤5,000行)组成;防火墙删除与测试行匹配的训练行,最终审计563,686条测试问题无匹配。第二步,训练:AdamW、bf16、头学习率为编码器的5–10倍(编码器从 $10^{-4}$ 降到 $5\times10^{-6}$),stage 1≤2,048 token带EMA,stage 3≤8,192 token只用金标签,每模型单张A100/H100。第三步,读取研究网格:32M、150,000题一个epoch、每臂3种子、相同数据/超参/教师logits,臂含J、P(逐项)、J-steps、J-comp、J-comp-raw、P-raw及去Brier、去蒸馏、原始编码器变体。第四步,评估:主终点为P−J-comp在pub15技能上的Welch区间(配对bootstrap B=2,000),评估集pub15(13,358请求)/S1-60/BTZSC-500,决策规则预注册于带日期实验日志。
技术新颖性
技术新颖性有四点。(1) 首次在类型化决策上受控比较联合与逐项读取:论文把读取方式效应分解为步数效应(J→J-steps仅+0.007)、算力效应(J-steps→J-comp为+0.029)与读取方式本身(+0.028)三个近似等分的成分,证明以往若直接对比两者会严重误读。(2) 初始化×读取的2×2因子设计揭示条件性结论——重排序器的对匹配格式是逐项优势的来源;旁证是未训练的Ettin-32M重排序器逐选项打分在S1-Arena上就有0.384准确率,超过两个小LLM。(3) 评测方法学系统而罕见:训练防火墙+全量字符串审计、未见/已见分离、Holm校正、把开发面板失效作为自适应保留集复用的实证案例(面板从0.459升到0.556的同时私有分从27.74跌到24.93)。(4) 发表负结果与诊断工具:无参数的Prumo揭示榜单格式捷径(CRUXEval公共技能0.997→私有0.28,BBH 0.47→0.07),为基准维护者提供了廉价的探针方法。与UniMC的区别在于新的头放在重排序器骨干上且在类型化决策而非转换的多选数据集上训练;与GLiClass类似之处是选项互相注意。
实验结果
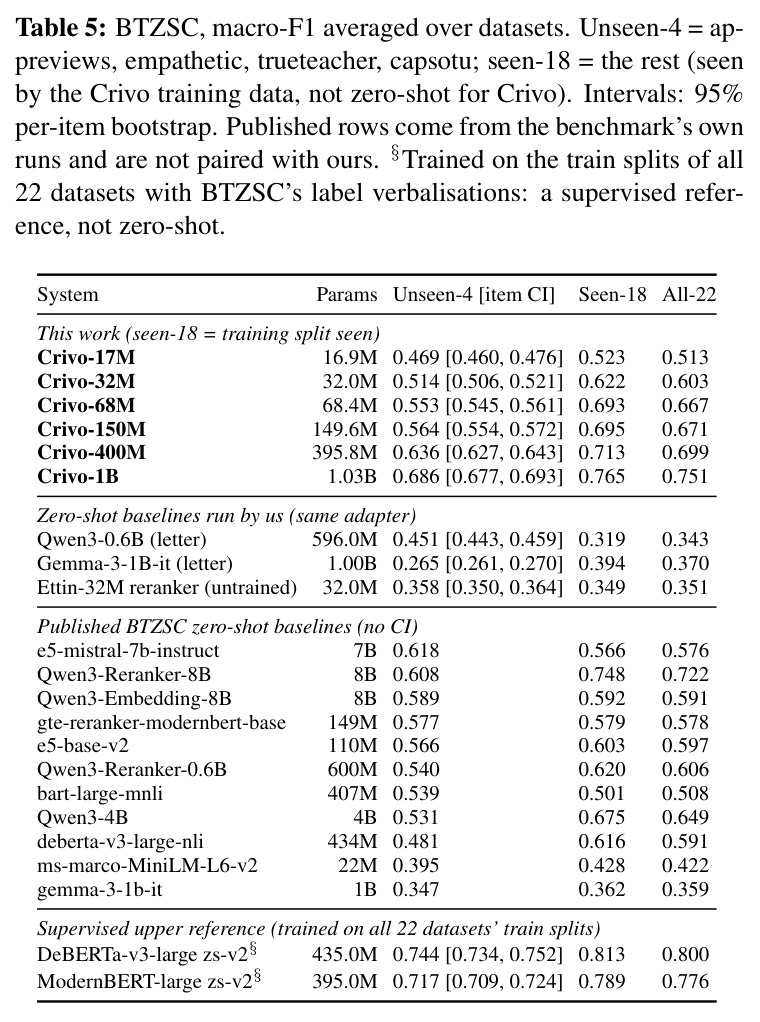
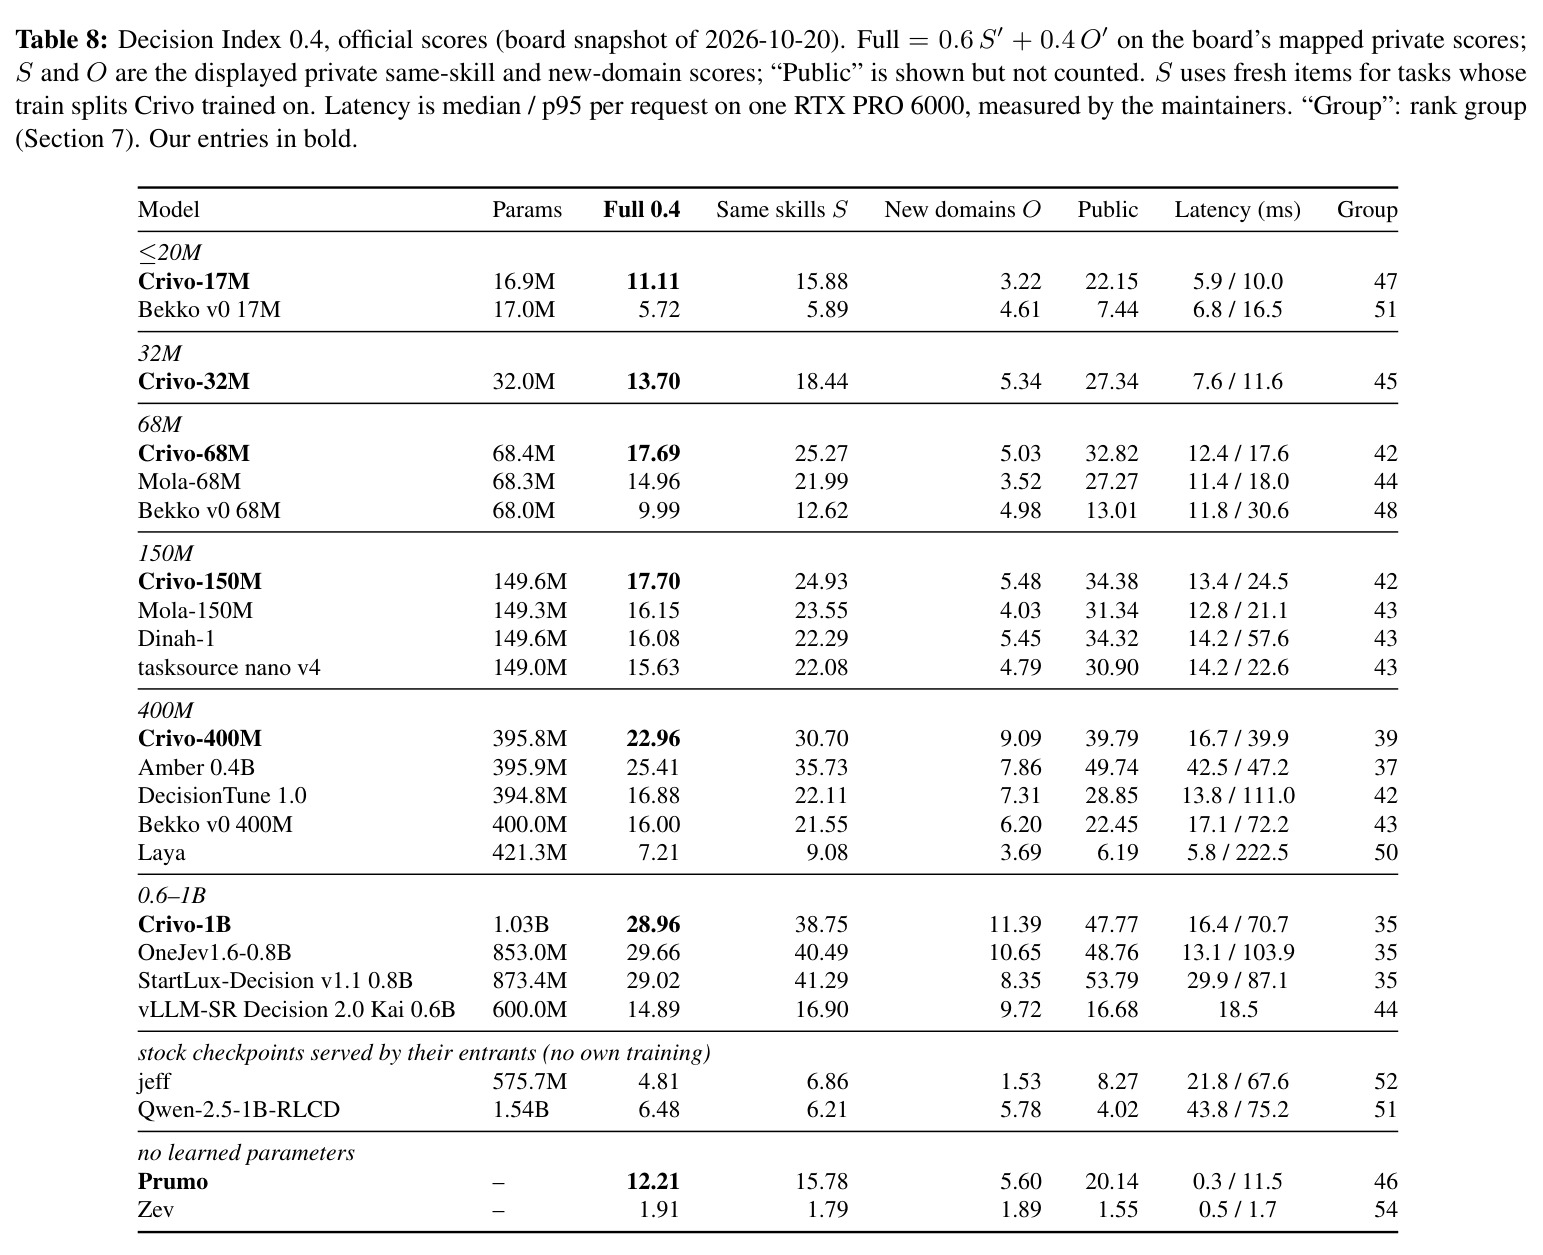
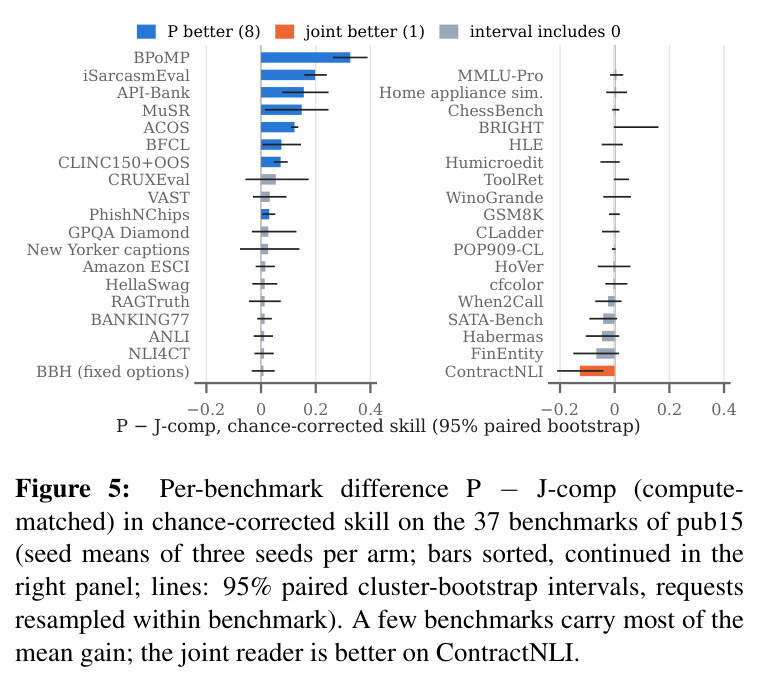
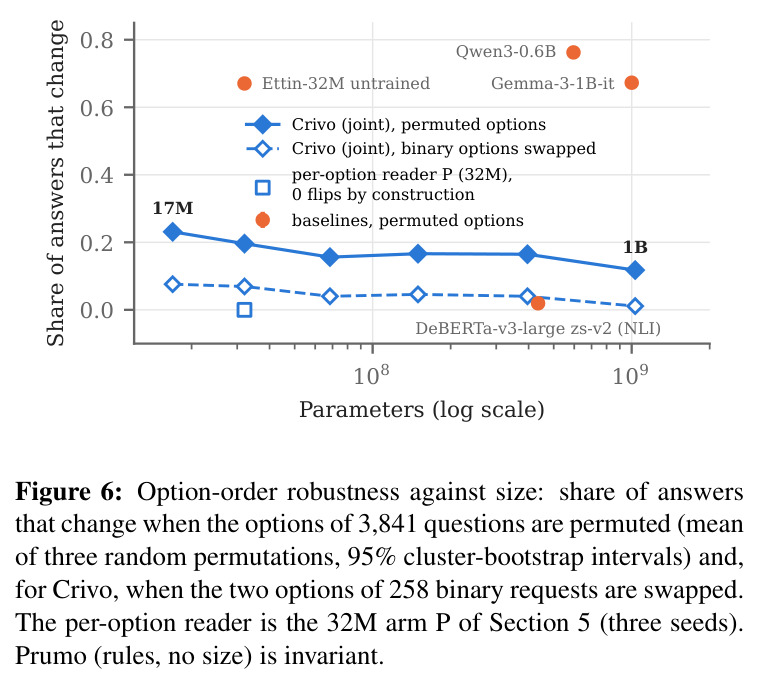
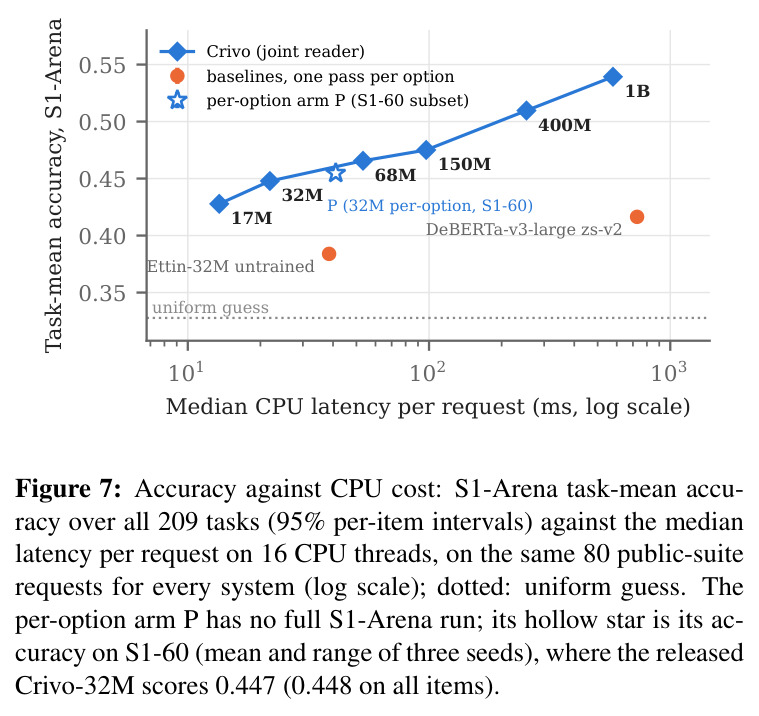
读取研究(32M,每臂3种子):匹配算力下逐项P优于联合J-comp——pub15技能+0.028(0.245对0.217)、S1-60准确率+0.031、BTZSC-500 F1 +0.070;匹配步数下差距更大(pub15 +0.058,P 0.245对J 0.180)。优势仅在重排序器初始化下存在:原始编码器下无差别(C1=−0.011含零),交互项C4=+0.040。增益集中:P在22/37基准更好、10个更差,显著的8胜1负(ContractNLI联合好−0.127),中位仅+0.009,五个基准(+0.12至+0.33)贡献大部分均值。发布模型:S1-Arena全部209任务上Crivo-68M 0.466、150M 0.475超435M DeBERTa zs-v2的0.416(Holm后仍显著),145未见任务+0.027/+0.028(读作持平),Crivo-1B 0.539(+0.123);BTZSC未见4数据集上1B 0.686超已发表最佳8B行(0.618)。鲁棒性:选项重排翻转Crivo 12–23%答案,逐项0%、DeBERTa 2%、LLM 67–76%。校准:未见任务上Brier不优于均匀猜测0.619,ECE随规模从0.076升至0.158。延迟:Crivo-17M中位8.2ms(GPU)/13.5ms(CPU),DeBERTa 36.1/728.3ms(约54倍);逐项代价是5.2–13.1倍前向、CPU均值27倍(3,728对139ms)。榜单:17M/32M/68M领先各自参数段(Full 11.11/13.70/17.69),1B的28.96为最高分编码器;Prumo同技能15.78≈Crivo-17M 15.88。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 决策套件公共测试 pub15(37个基准分层15%样本) | 机会校正技能 | 0.245(32M逐项读取器P) | 0.217(32M联合J-comp,匹配算力);0.187(J-steps,匹配步数) | +0.028 [95% CI +0.015, +0.042](对匹配算力);+0.058(对匹配步数) |
| S1-Arena 全部209个任务 | 任务均值准确率 | 0.475(Crivo-150M);最高0.539(Crivo-1B) | 0.416(DeBERTa-v3-large zs-v2,435M参数) | +0.059(150M)至 +0.123(1B),Holm校正后任务级显著 |
| S1-Arena 145个未见任务 | 任务均值准确率 | 0.442(Crivo-150M) | 0.414(DeBERTa zs-v2) | +0.028(任务区间不含零但未过Holm校正,作者读作持平而非提升) |
| BTZSC 未见4个数据集 | macro-F1(数据集均值) | 0.686(Crivo-1B);0.636(Crivo-400M) | 0.618(已发表最佳零样本行 e5-mistral-7b-instruct,7B) | +0.068(1B,与已发表行的跨运行非配对比较) |
| Decision Index 0.4 私有测试(≤420M参数段) | 官方 Full 分(0.6·同技能+0.4·新域) | 17.69(Crivo-68M,该参数段最高) | 14.96(Mola-68M);16.88(DecisionTune 1.0) | +2.73,领先该参数段所有非本工作条目 |
| 每请求延迟(16线程CPU,同批请求) | 中位延迟 | 13.5 ms(Crivo-17M) | 728.3 ms(DeBERTa-v3-large zs-v2) | 约54倍加速(均值对比为80 ms 对 12,103 ms) |
局限与改进
作者承认的局限:读取研究只在150k行一个子集、32M一个规模上做;J-comp靠重复行匹配算力(每行约3.25遍),约3.25倍不同行数据的联合臂才是更严格对照,作者留给未来工作;外部基线混合了骨干、读出和训练数据三个因素,只有读出被隔离,且未与最接近的同接口编码器(Bekko、Dinah-1、GLiClass)对比;私有测试每模型只能跑一次、逐项数据不可查;模型在未见任务上过度自信;训练与评测仅限英语;权重为CC BY-NC 4.0;延迟无批处理吞吐,80请求的CPU样本使均值受少数长请求支配。我的补充观察:三个种子的Welch区间自由度仅2–4且假设正态性,未见任务差异大多不显著,泛化结论证据较薄;机会校正技能+0.028的绝对量级可能被逐项读取最高27倍的CPU均值延迟在端到端抵消;榜单证据受0.9分排名组规则限制且竞品字段稀疏(204个有参数条目中仅24个≤420M、其中5个是作者自己的);联合读取12–23%的顺序翻转对需要稳定性的生产系统是实际风险。
独立分析的弱点
独立分析的弱点:(1) 联合读取的顺序敏感性——尽管训练时选项顺序被shuffle,答案仍随重排翻转12–23%;改进方向是UniMC式注意力掩码让选项互不可见,或Set-Encoder式置换不变注意力。(2) 未见任务过度自信——Brier与均匀猜测无异,直接部署会让路由/拦截阈值误触发(作者抽检70个Crivo-68M错误,最自信的错误是错误工具选择);改进方向是域外温度缩放、域扰动正则或基于risk–coverage曲线的弃权机制。(3) 逐项优势的机制未被检验——2×2只建立条件关系而非因果,'格式匹配'假设需要干预实验(如在重排序器上继续用联合格式预训练)验证。(4) 增益集中且中位数仅+0.009——五个基准撑起均值,对其他任务类型泛化存疑;改进方向是剖析这五类任务与逐项读取的共性并针对性扩充训练分布。(5) 长尾延迟——逐项读取CPU均值3,728ms对139ms,多选项长状态场景不可用;改进方向是混合路由(选项少时逐项、多时联合)或状态编码一次共享给各选项的缓存方案。
未来方向
作者明确提出的方向:用完整配方和32M以上规模训练逐项读取器并对比(论文第5.2节末尾称之为留给未来工作的更准确32M模型);与最接近的同接口编码器在同一污染审计协议下对比;扩大新域覆盖。基于本文成果可延伸的:(1) UniMC式掩码注意力联合读取,把'选项互不可见'与'状态被逐项重复编码'两个因素解耦,可能兼得联合读取的一次前向效率与逐项读取的顺序不变性;(2) 机制研究——为何(query, document)对匹配在32M时贡献约+0.028技能,该格式迁移效应在更大规模或更长微调下是否消失,能否通过在中预训练阶段引入联合格式的合成数据来弥合;(3) 把Prumo推广为榜单体检工具:给每个私有测试配无参数探针并公布'格式捷径指数';(4) 校准改进——域自适应温度缩放或训练时的域扰动;(5) 编码器与LLM的级联系统:17M模型做初筛、不确定样本升级到大模型,量化端到端成本-质量曲线(作者已证明17M中位延迟13.5ms);(6) 进一步蒸馏到17M以下并配合量化,探索边缘设备部署。
复现评估
复现条件极好。全部工件公开在Hugging Face Hub(账号tardellirs):六个Crivo权重及模型卡(CC BY-NC 4.0,v1模型以特定revision提供)、读取研究的三个逐项32M检查点及推理引擎、Prumo(Apache-2.0,GitHub开源,约2.7千行Python仅依赖python-chess)、完整实验代码(训练、基准适配器、污染审计、统计)、从榜单快照生成每张表每张图的脚本、记录预注册决策规则的带日期实验日志;榜单2026-10-20快照已存档。训练成本极低:每模型单张A100 40GB或H100 80GB,家族总计约80美元(54美元有账单),成对蒸馏共享一次A100会话(约7h/5h)。训练混合未再分发(部分源带许可),但来源构成描述完整可自行组装;S1-Arena、BTZSC与榜单套件全部公开,且作者验证了适配器与官方评测器逐数据集分数一致。注意事项:评测仅英语;作者披露使用Claude Code辅助写代码与修订文本并声明核实全部内容。总体难度低到中等:单GPU可复现训练,工程量主要在跑通各基准适配器与延迟测量环境。
论文图表
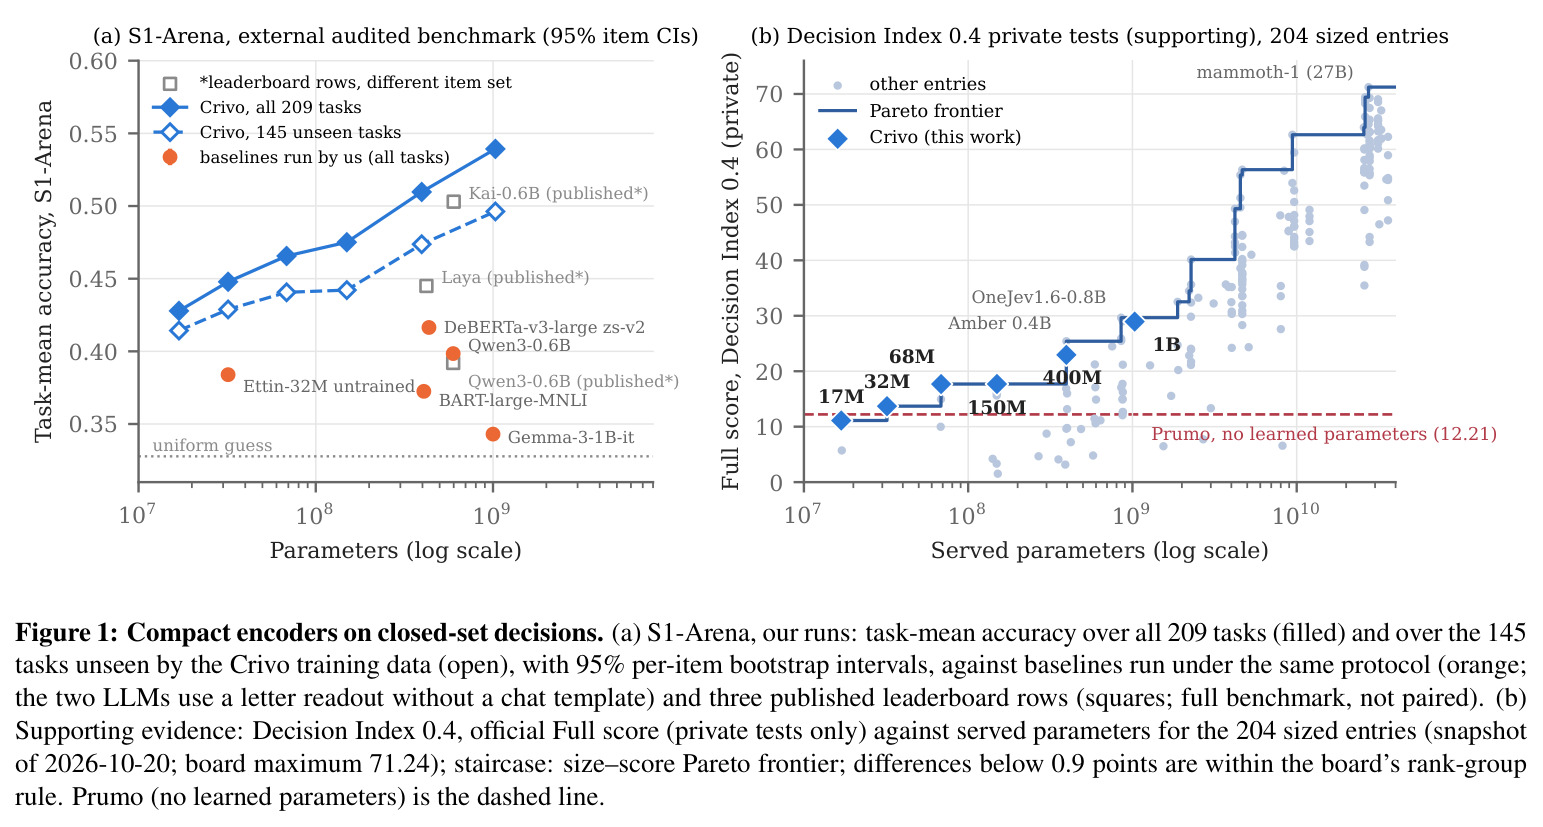
双面板总览图。(a) S1-Arena任务均值准确率对参数量(对数轴,95%逐项bootstrap区间):实心点为Crivo全部209任务(0.428–0.539),空心点为145个未见任务,橙色点为同协议基线(DeBERTa-v3-large zs-v2 0.416、BART-large-MNLI 0.373、Qwen3-0.6B 0.398、Gemma-3-1B-it 0.343、未训练Ettin-32M 0.384、均匀猜测0.328),方块为已发表榜单行(如Kai-0.6B 0.503、Laya 0.445);(b) Decision Index 0.4官方Full分(仅私有测试)对服务参数量,204个有参数条目,阶梯线为规模-分数Pareto前沿(从Crivo-17M开始),Prumo(无参数,12.21)为虚线,榜首是27B的mammoth-1(70分)。
一张图概括论文全部主要证据:外部基准上小参数量Crivo击败更大基线、私有测试上小模型领先各自参数段,直观呈现'能有多小'这一核心问题及准确率-规模权衡。
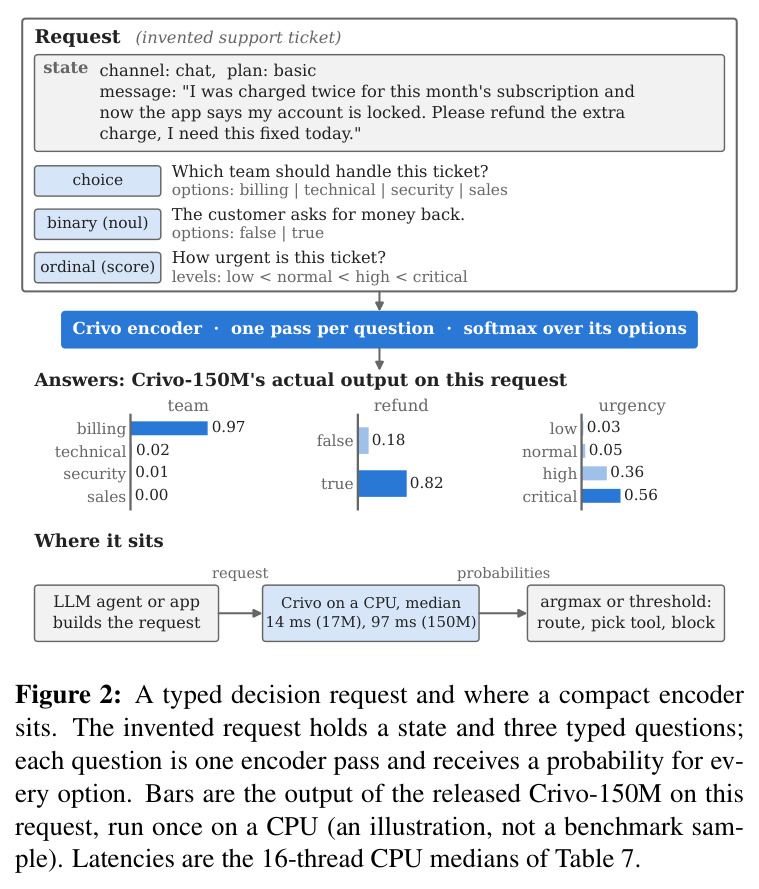
用一个虚构的支持工单展示类型化决策格式:状态通道(chat, plan: basic)加消息文本(重复扣费、账户被锁、要求退款),三个类型化问题——choice多选(哪个团队处理:billing/technical/security/sales)、noul二元(是否应退款:false/true)、score序数(紧急度:low<normal<high<critical);下半部分是Crivo-150M在该请求上的实际输出概率条形图(billing 0.97、refund true 0.82、urgency high 0.36),并标注CPU中位延迟:17M约14ms、150M约97ms。
让读者具体理解Jev请求格式、三种问题类型以及编码器在应用/LLM代理与下游规则之间的位置——全文所有实验都围绕这个格式展开。
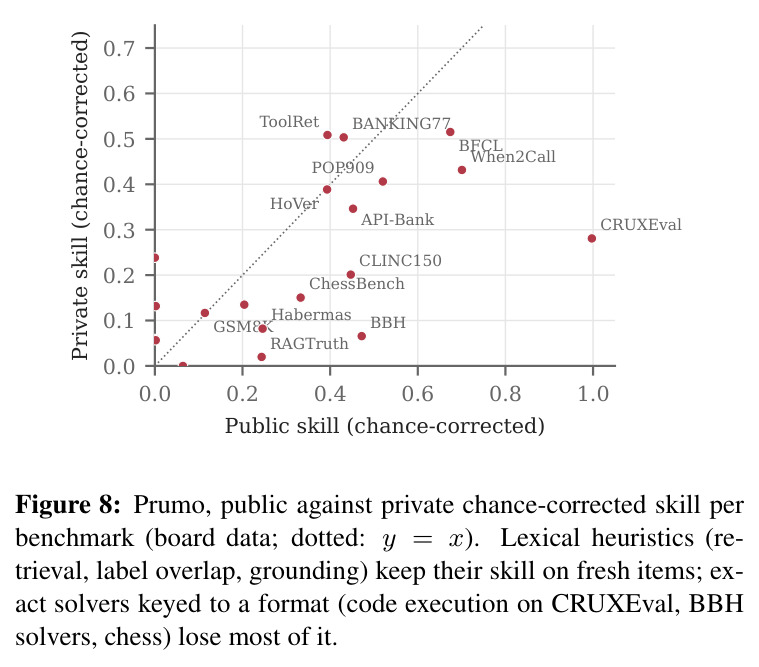
34个榜单基准上Prumo的公共技能对私有技能散点图(Pearson r=0.77,虚线为y=x):词法能力在新鲜项上保持——工具检索ToolRet公共0.39对私有0.51;而绑定公共格式的精确求解器崩塌——CRUXEval公共0.997对私有0.28、BBH公共0.47对私有0.07,推测原因是对公共格式精确解析的引擎在换一种呈现方式后就不再触发。
用无参数系统诊断榜单:证明榜单部分奖励格式特定解题而非任务能力,是论文把榜单降为辅助证据、并把该图归入评测方法学批判的依据。