LLM 即 Jev:大模型已是 Jev 式决策模型——何时及如何微调 LLM-as-Jev: LLMs Are Already Jev-Style Decision Models -- When and How to Fine-Tune Them
冻结大模型读括号编号后缀即是校准决策模型;微调只补短板,KL 锚点防行为退化
前置知识
因果语言模型的下一词概率
因果(自回归)语言模型在每个位置输出词表上的概率分布 $p_\theta(w \mid x)$,表示给定前文 $x$ 时下一个 token 的似然,多 token 连续生成概率为各步条件概率的连乘。LLM-as-Jev 正是利用这一机制:不给模型加任何分类头,而是把每个候选选项当作待生成的短后缀,用下一词概率的连乘直接给候选打分。
本文的免训练打分公式与树分解训练损失都建立在「决策概率 = 候选后缀的生成概率」这一等价之上,不理解下一词概率就无法理解整个方法。
Jev 式决策模型范式
指直接返回候选类别上的概率分布(choice 单选、noul 二元验证、score 序数打分三类任务)而不生成自由文本的模型,由 Almeida(2026)提出,配套 JevBench 排行榜(231 个公开评测项,另有密封集)。下游软件可直接消费概率分布,按置信度做低置信转人工等路由决策。
论文主题就是检验通用 LLM 能否开箱即用地充当 Jev 式决策模型,并在 JevBench 公开项上与 60 多个社区模型横向比较。
LoRA 低秩适配
冻结原模型权重,只训练注入每个decoder线性层的低秩增量 $\Delta W = BA$(秩 $r \ll d$)。本文设置 rank 16、$\alpha=32$,4B 模型仅 32.5M 可训参数,训练后合并回基座,推理延迟与原模型完全一致,是参数高效微调的标准做法。
论文的重要实验结论是在强底座(4B)上 LoRA 配 KL 锚点反而优于全参数微调(JevBench 84.0% vs 80.1%),不了解 LoRA 就无法理解这一推荐。
KL 散度(相对熵)
衡量两个概率分布差异的非对称度量 $\mathrm{KL}(p \Vert q) = \sum_v p(v) \log \frac{p(v)}{q(v)}$。本文用三个 KL 锚点把微调模型在非法 token、非答案位置上的预测分布钉在冻结参考模型 $p_0$ 附近,防止共享权重更新带偏无关生成行为;配合 top-64 截断与尾桶,可构造完整 KL 的严格下界。
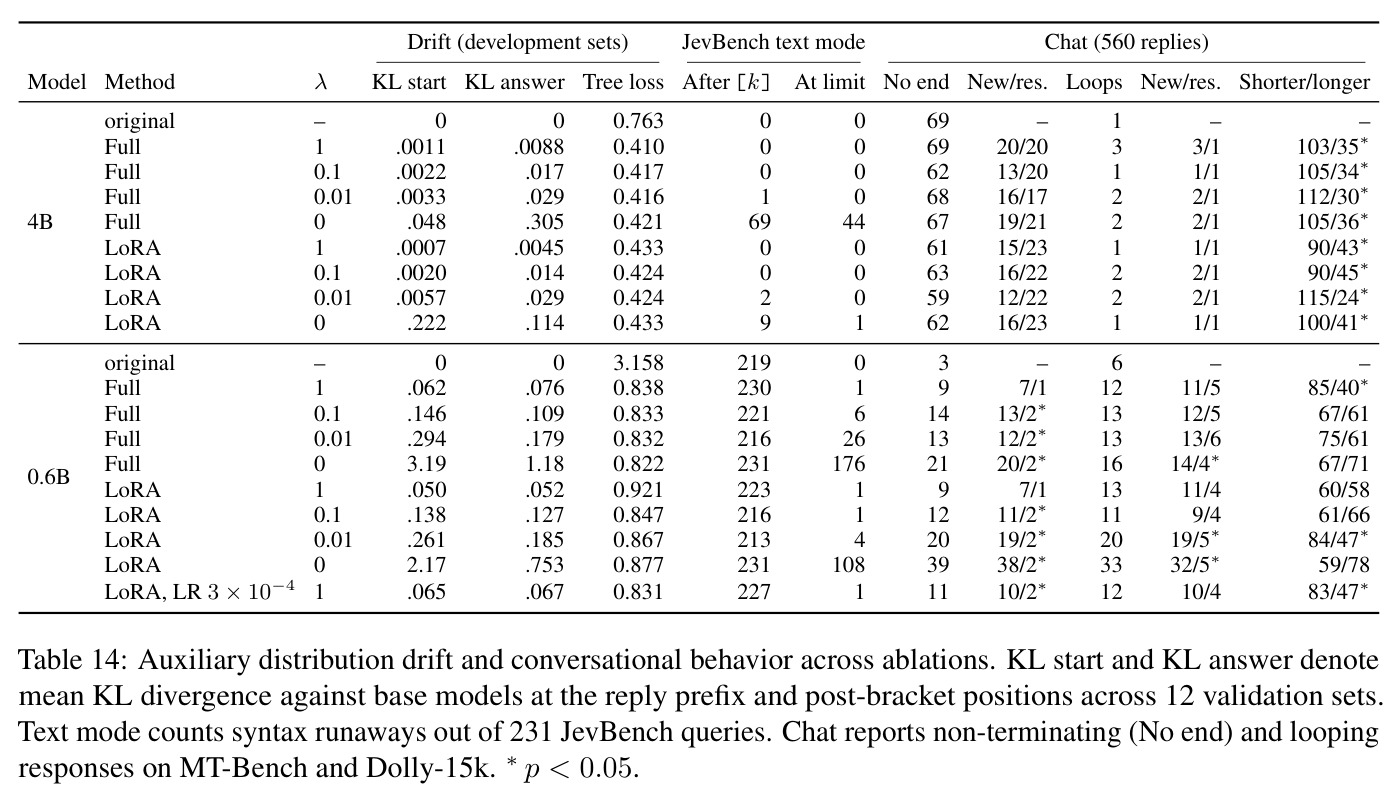
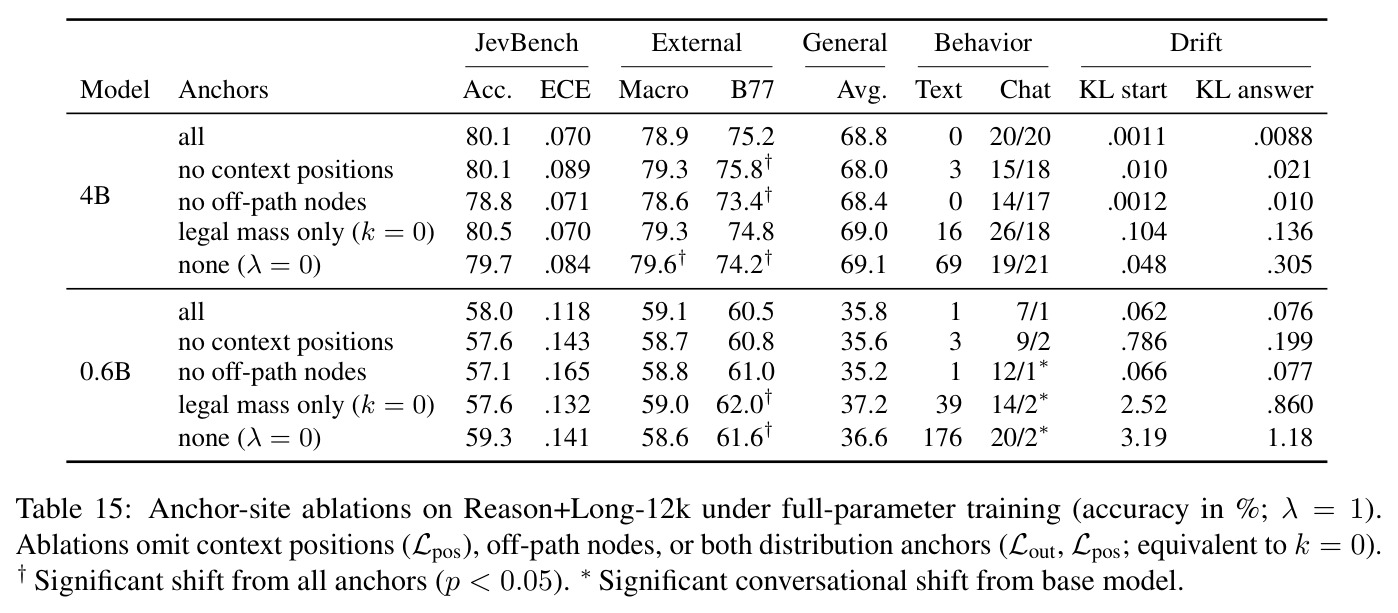
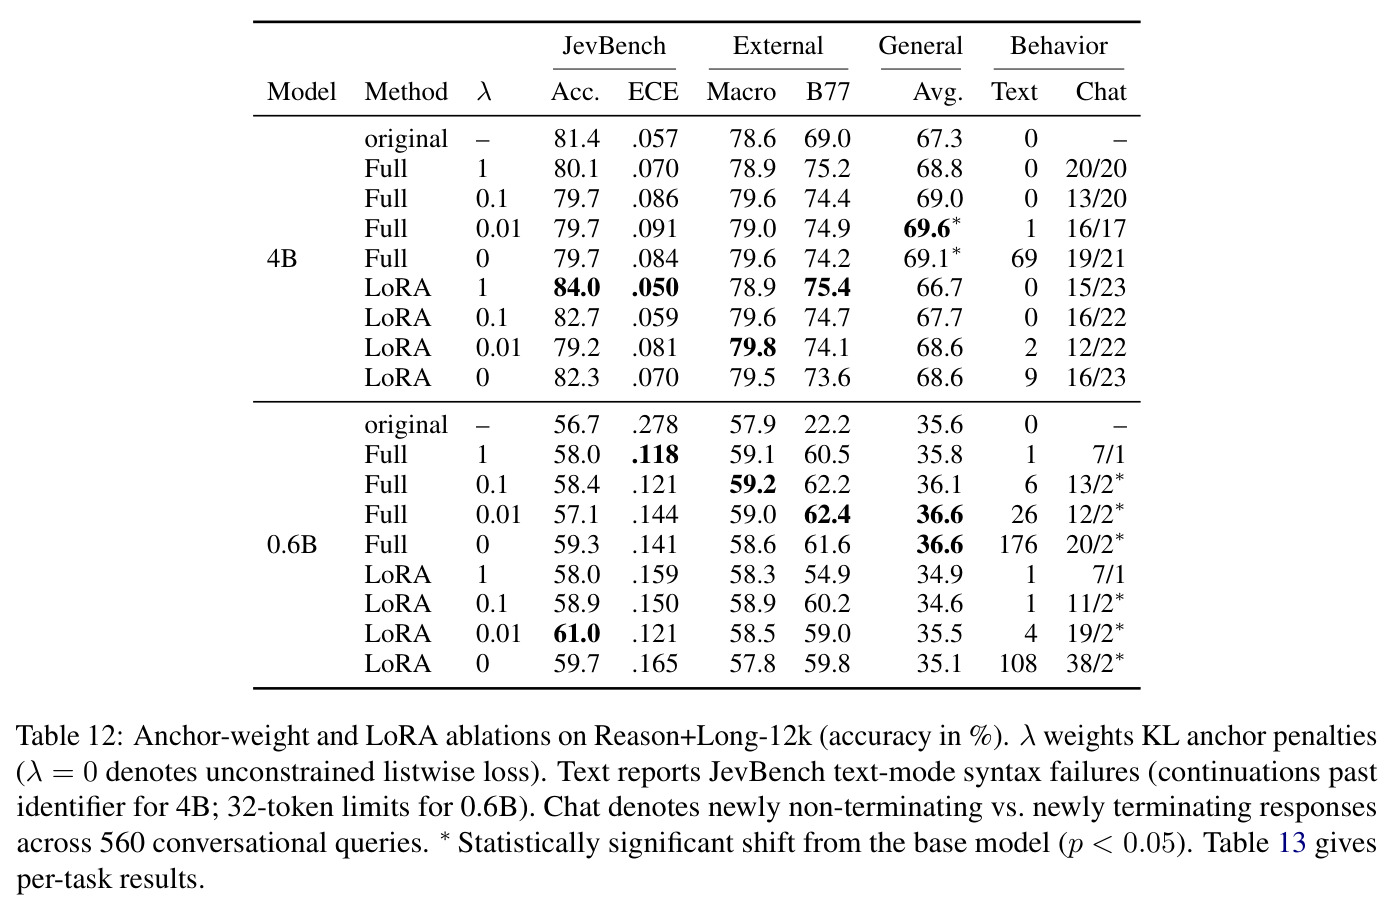
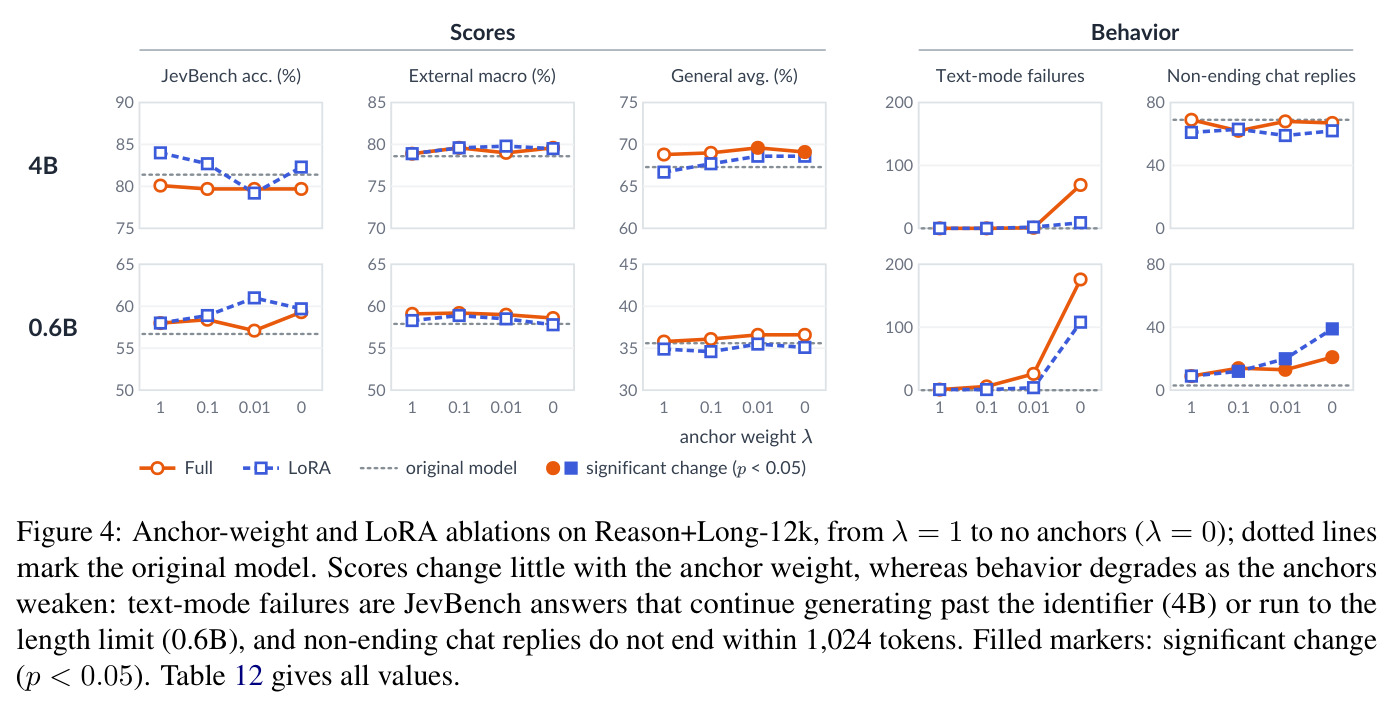
KL 锚点($\mathcal{L}_{mass}, \mathcal{L}_{out}, \mathcal{L}_{pos}$)是微调不塌缩的关键:消融显示去掉后 4B 文本失控从 0 升到 69/231 项,0.6B 对话不终止回复显著增加。
ECE 与 Brier 分数
期望校准误差(ECE)把预测按置信度分桶,计算桶内平均置信度与实际准确率之差的加权和;Brier 分数是预测概率向量与 one-hot 目标的均方误差。两者同时考察「选对」与「置信度可信」,越低越好,本文均在原始分布上计算、不做事后温度缩放。
决策系统需要可靠置信度驱动自动化与人工复核的分流;论文用这两个指标证明免训练 4B 校准已优于微调过的社区模型(0.057 vs 0.061/0.070)。
KV 缓存与 teacher forcing 并行打分
对 prompt 前缀做一次前向并缓存 Key/Value 激活,之后所有候选后缀共享该缓存并行前向(teacher forcing:直接喂入已知后缀而非逐 token 采样)。由于候选后缀事先已知,151 类任务也只需一次 prompt prefill 加至多三次短前向。
这是免训练配方又准又快的工程基础(4B 中位延迟 194ms),也是与 jev-local 等逐选项单独打分方法的本质效率差异。
研究动机
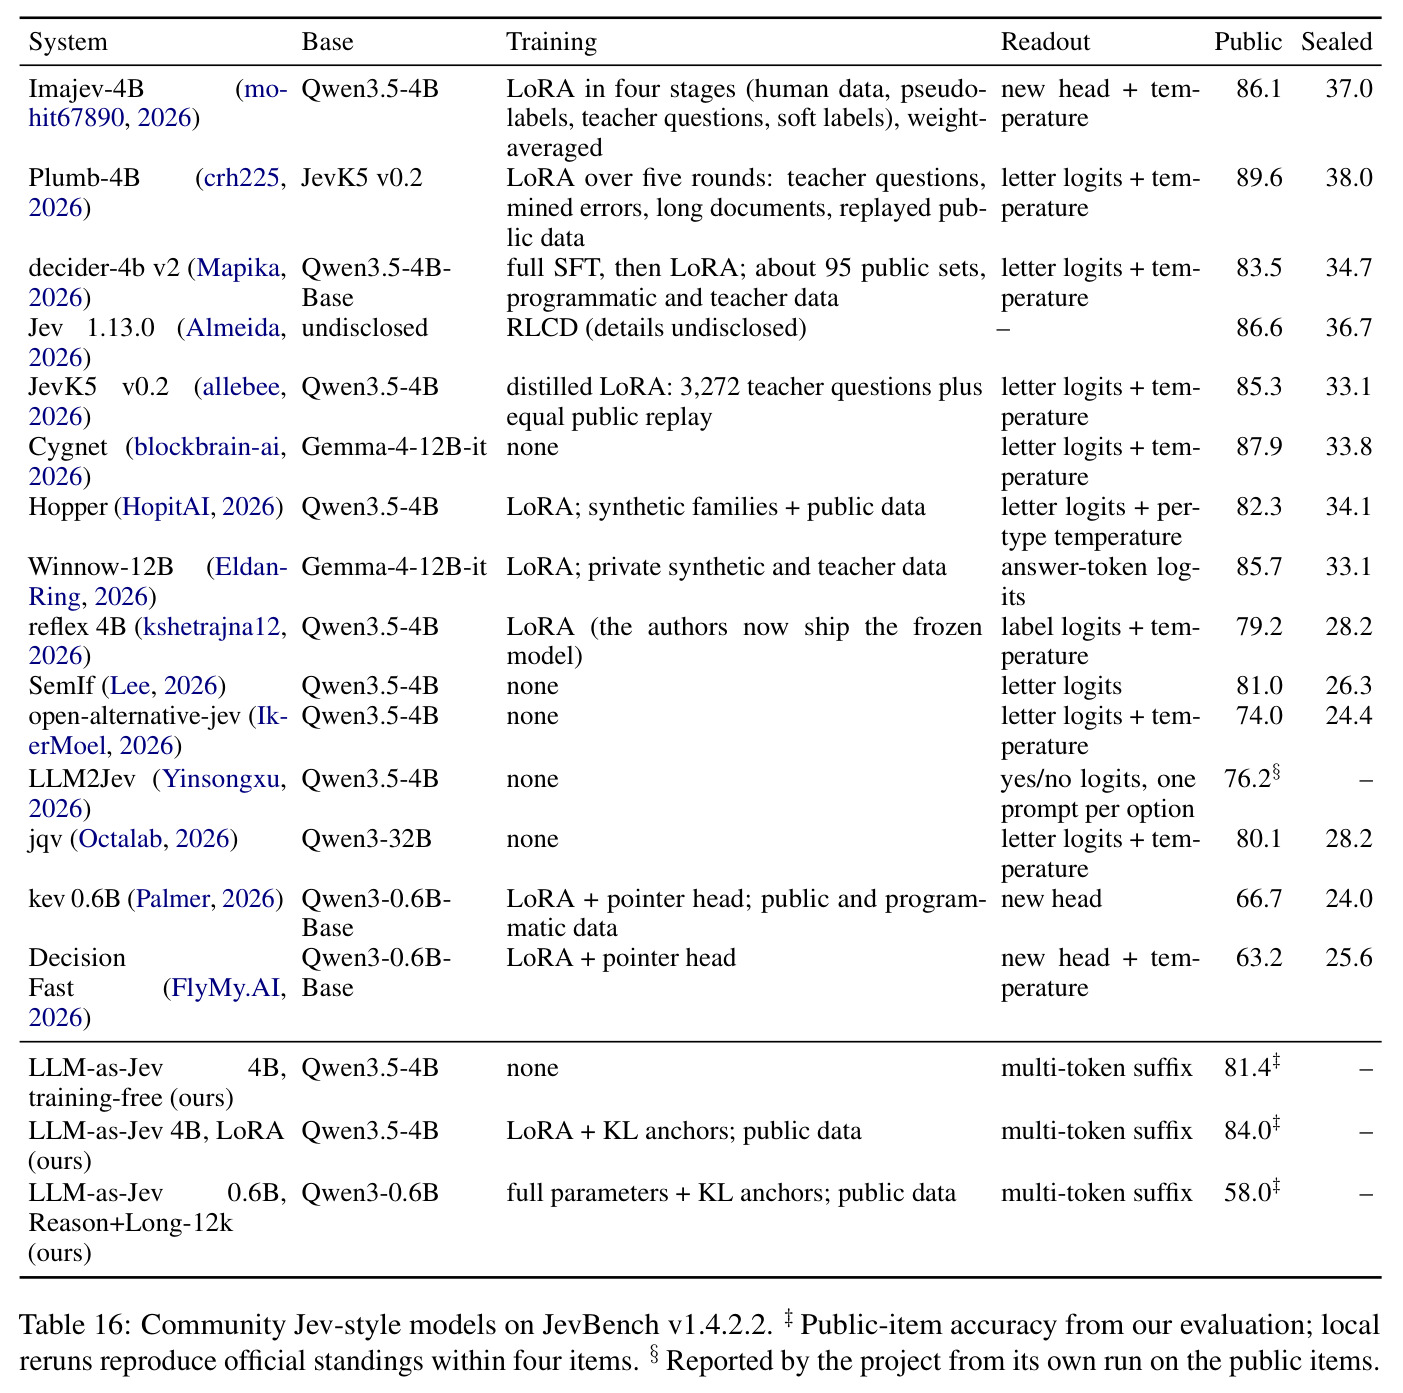
软件系统大量依赖在预定义选项上的决策:客服工单路由、用户意图识别、证据是否满足规则的判断等。标准聊天模型输出自由文本,必须再解析成结构化值,引入延迟并面临格式错误风险。Jev(Almeida, 2026)把决策形式化为在 $K$ 个候选上直接返回类别概率分布,JevBench 排行榜收录的社区模型已超 60 个。但社区做法效果差异巨大且路径混乱:Plumb 对 Qwen3.5-4B 做多轮 LoRA 微调(教师模型生成问题加难例挖掘)在公开 JevBench 达 89.6%,而同样基于 Qwen3.5-4B 的 Hopper 和 reflex 只有 82.3% 和 79.2%,与完全不动参数、只读选项字母 logits 的 SemIf(81.0%)几乎无异。许多方法还引入自定义分类头、指针头或保留 token,每换一个底座都要重训。预训练 LLM 本身到底有多少决策能力、微调何时才真正值得、如何微调才不伤模型,当时缺乏系统答案。
本文的目标是本文目标是回答三个递进问题:其一,不经任何微调,通用预训练 LLM 的决策能力有多强,概率校准如何,能否原生支持任意候选数乃至多模态输入;其二,微调在什么条件下才有实际收益,收益与训练数据覆盖度、输入长度分布、模型规模之间是什么关系;其三,若决定微调,应如何设计目标函数才能既提升任务准确率又不把通用底座毁成狭窄分类器。为此作者提出 LLM-as-Jev:一个不改架构、不改 tokenizer、不改词表的统一框架,同时给出免训练推理配方与带 KL 锚点的微调配方,并在 Qwen3.5-4B 与 Qwen3-0.6B 两个底座、六个训练配置、五个评测维度(外部基准、JevBench、通用语言能力、多模态、对话行为)上系统验证。
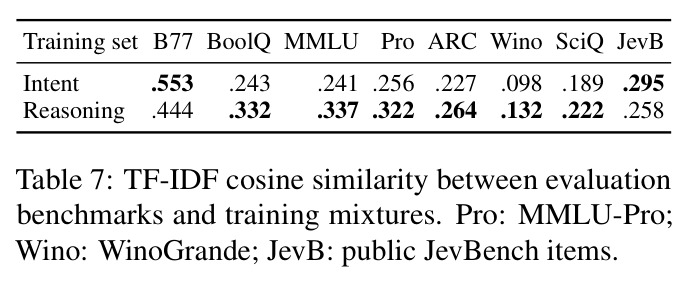
与已有工作不同的是,独特切入角度有三。第一,坚持「架构保留」:与社区普遍加分类头、指针头或保留 token(每个新底座都要重训)不同,本文用带闭合方括号的数字编号构造前缀无关候选后缀,从下一词概率直接读出分布,新模型发布即可零成本评测与微调。第二,把「微调收益是否与训练数据覆盖度对齐」上升为核心科学问题:通过精心构造的六组数据混合(意图/推理/长上下文),证明增益几乎只出现在训练覆盖的弱项上,未覆盖域纹丝不动,甚至纯短上下文数据加量会主动损害长文本决策——这在以往「微调总是有益」的默认叙事下是反直觉的。第三,用三个细粒度 KL 锚点(合法质量、非法分布、上下文位置)堵住 listwise 决策损失对其他生成行为无约束的漏洞,使微调后模型仍是完整可用的对话模型,而社区微调模型普遍缺少这类保护。
核心方法
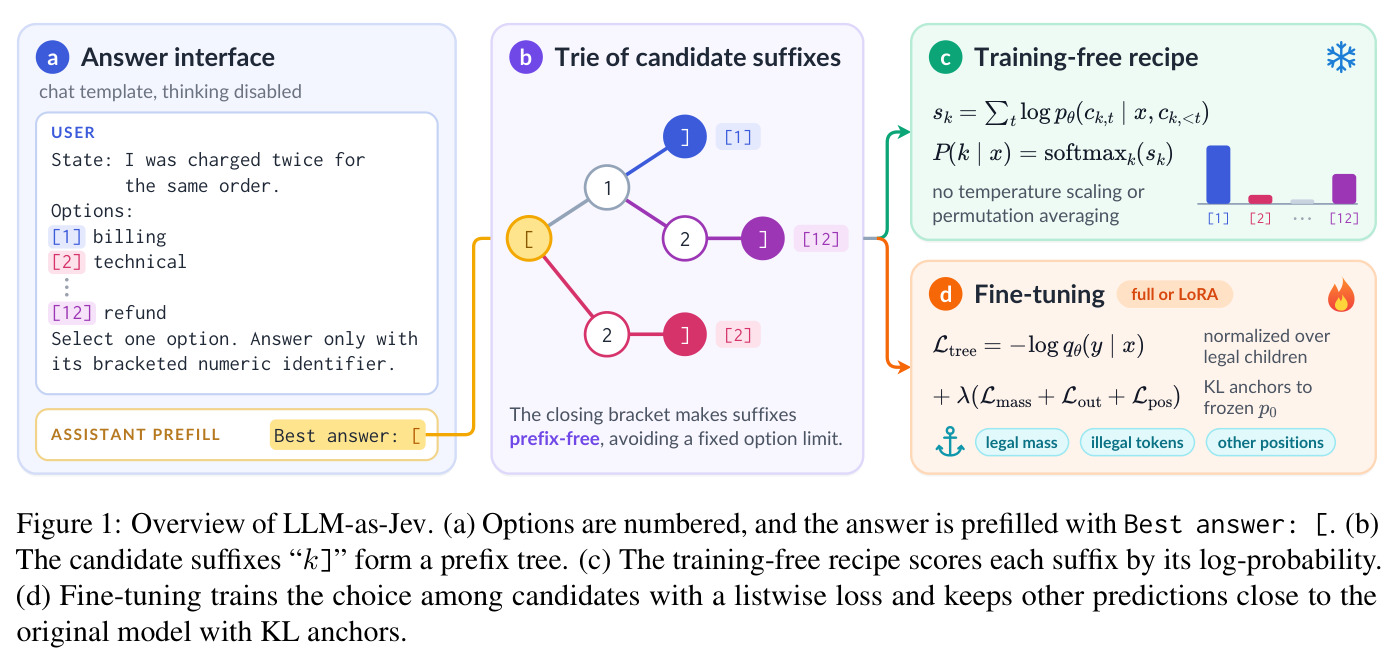
直觉:现代 LLM 在预训练中见过海量选择题式语料,其下一词分布本身已编码了对候选的相对比较;只要答题接口与模型的自然生成习惯对齐,就能免训练提取校准决策。技术路线分四层(Figure 1):(a) 接口层,把候选编号为 $[1]\ldots[K]$ 写入用户消息(State/Options/Select one option 模板),并在 assistant 侧固定前缀 Best answer: [ 上条件化,选中选项 $k$ 等价于生成后缀 $k]$;(b) 结构层,所有后缀构成一棵前缀树(trie),闭合方括号保证前缀无关;(c) 免训练配方,对每个后缀累加 log 概率 $s_k$ 再 softmax 得 $P(k \mid x)$;(d) 微调配方,用树分解 listwise 损失训练候选判别,加三个 KL 锚点把其他预测行为钉回冻结底座。两种配方共用同一接口,训练后的 4B 在打分模式与自回归生成模式下的选择在 231 项上完全一致,验证了接口与模型习惯的无缝对齐。
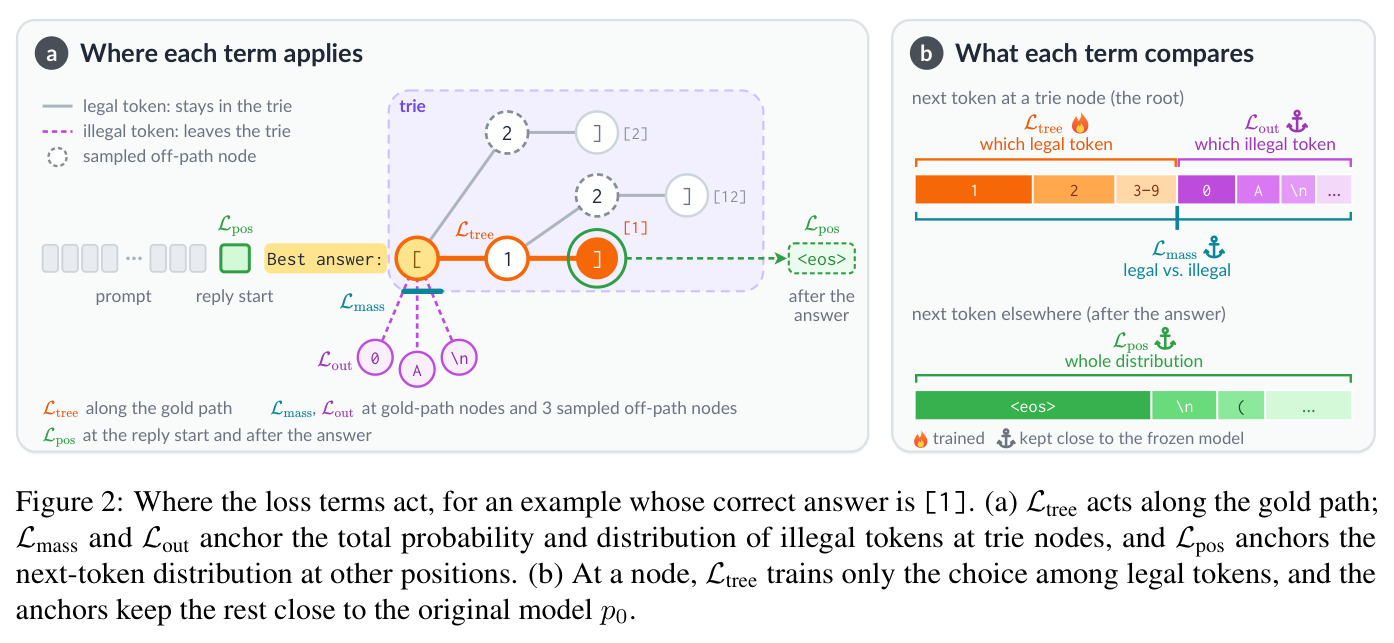
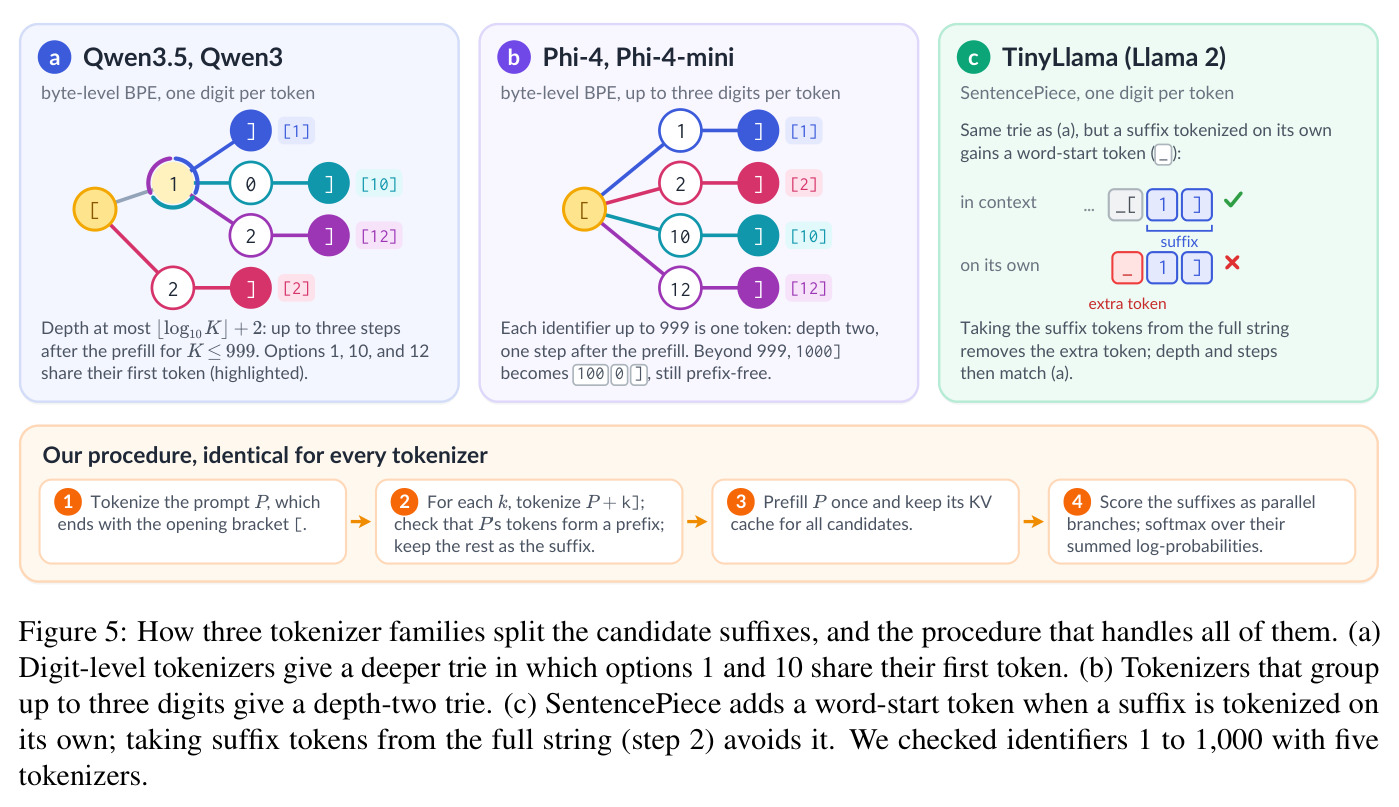
核心创新点及与已有方法的本质区别有三。一是前缀无关多 token 后缀:字母读法(A/B/…)受限于 16 或 26 个候选,本文的 $k]$ 因闭合方括号不可能互为前缀,天然支持任意 $K$,一次前向完成 Banking77 全部 77 类;树深受 tokenizer 控制,Qwen 逐位数字时深度至多 $\lfloor \log_{10} K \rfloor + 2$,三位分组 tokenizer 更是深度为二。二是联合条件化评分:与 jev-local、NLI 式逐对独立打分不同,所有候选在同一 prompt 下并行打分,模型对照完整候选集做比较,这是免训练即超过逐选项打分的 LLM2Jev(81.4% vs 76.2%)的关键。三是树分解 listwise 损失加 KL 锚点:$q_\theta(k \mid x)$ 在前缀树每个节点对合法续接 token 局部归一化,负对数似然 $\mathcal{L}_{tree} = -\log q_\theta(y \mid x)$ 等价于全部 $K$ 类上的交叉熵,却只需沿 gold path 计算便可处理 $K=151$;而 $\mathcal{L}_{mass}$、$\mathcal{L}_{out}$、$\mathcal{L}_{pos}$ 分别锚定合法/非法 token 的质量划分、非法 token 上的重归一化分布、回复起始与答案后位置的整分布,top-64 截断加尾桶把锚点缓存压到每分布约 0.5 KB,且由数据处理不等式构成完整 KL 的严格下界。
方法步骤详情
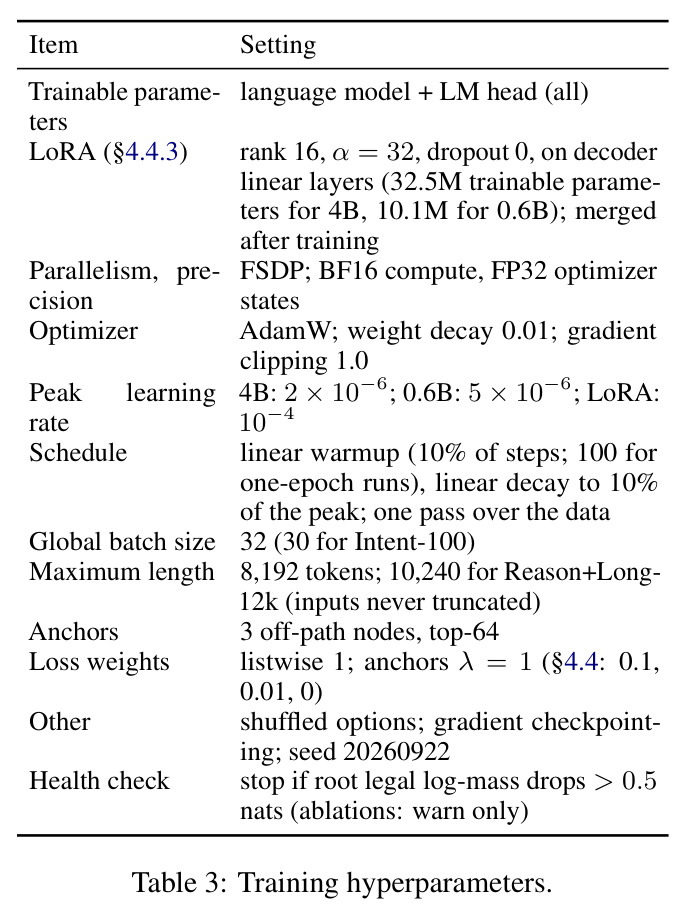
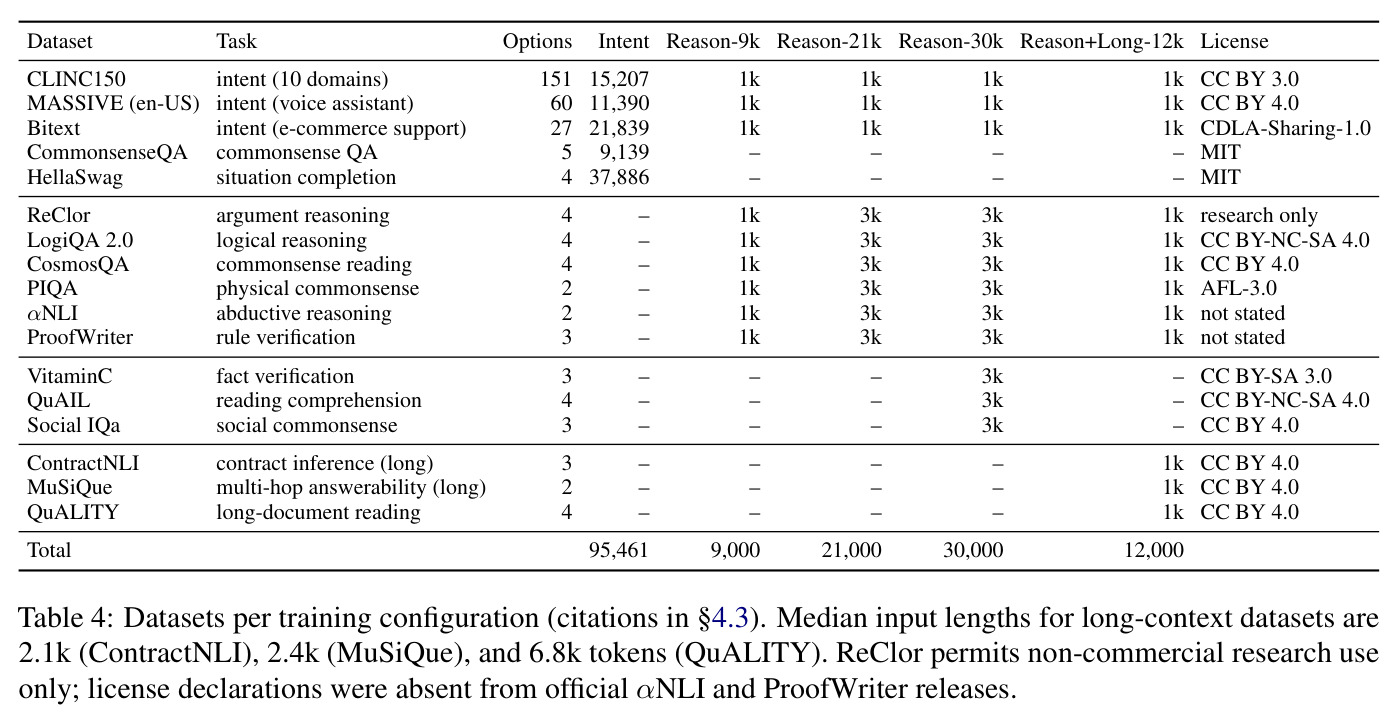
完整流程如下。推理时:用模型默认 chat template(关闭 thinking)构造用户消息,State 为状态文本,Options 逐行列出 $[k]\ \{o_k\}$,指令要求只答括号数字;打分模式在格式化 prompt 后追加 Best answer: [。对每个 $k$,对完整字符串 prompt $+\ k]$ 分词并校验 prompt token 是其严格前缀,取余下部分为后缀 token;一次 prefill 缓存 KV 后所有候选分支 teacher forcing 并行计算 $s_k=\sum_t \log p_\theta(c_{k,t} \mid x, c_{k,<t})$,softmax 归一化;文本模式贪心生成至多 32 token,要求以 $[k]$ 开头否则计解析失败。训练时:数据全部来自公开人工标注集(CLINC150、MASSIVE、Bitext、ProofWriter、CosmosQA、ReClor、LogiQA 2.0、PIQA、αNLI、VitaminC、QuAIL、Social IQa、ContractNLI、MuSiQue、QuALITY),经 13 词 n-gram 重叠过滤并随机打乱选项顺序;总损失 $\mathcal{L}=\mathcal{L}_{tree}+\lambda(\mathcal{L}_{mass}+\mathcal{L}_{out}+\mathcal{L}_{pos})$,锚点位置为 gold path 节点与 3 个随机采样的 off-path 节点(各占总权 0.5),以及回复起始位与闭合括号后位置(各 0.5);优化用 AdamW+FSDP+BF16,单 epoch,全局 batch 32,学习率 4B 为 $2\times 10^{-6}$、0.6B 为 $5\times 10^{-6}$、LoRA 为 $10^{-4}$;训练中健康检查监控根节点合法 log-mass,下降超过 0.5 nats 即自动停止。
技术新颖性
技术新颖性分析:与字母 logit 读取(SemIf、open-alternative-jev)相比,多 token 前缀无关后缀消除了候选数上限,使多 token 联合判别成为可能;与 AnyJev 的推理时循环置换平均相比,本文免训练配方既不做温度缩放也不做置换平均,仍取得 0.057 的 ECE,效率优先;与 Plumb、JevK5、reflex 等依赖教师模型合成数据的 LoRA 微调相比,本文只用公开人工标注数据,避免合成偏置且数据可得性好;与 decider 的重放样本答案分布正则相比,本文的 KL 锚点在 token 级三元组(合法质量/非法分布/上下文位置)上施加约束,粒度更细且截断版有可证明的下界保证;与 LLM2Jev 的逐选项独立 prompt 相比,联合评分单次前向完成且更准。工程上,论文系统处理了三类 tokenizer 差异(逐位数字、三位分组、SentencePiece 词首标记),给出「从完整字符串取后缀 token」的统一四步程序并在 1–1000 编号、五个 tokenizer 上验证前缀无关性,这在此类工作中少见;对 151 类任务的可行性(一次 prefill 加至多三次短前向、损失只沿 gold path)也是列表式决策微调的实用贡献。
实验结果
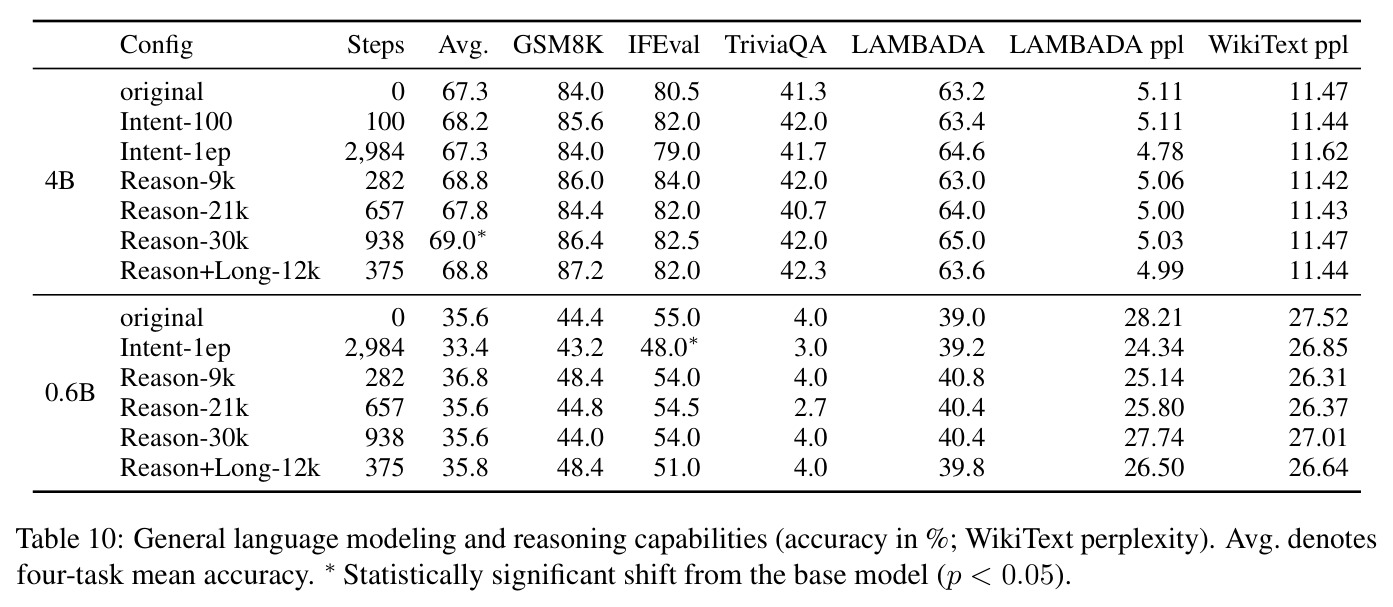
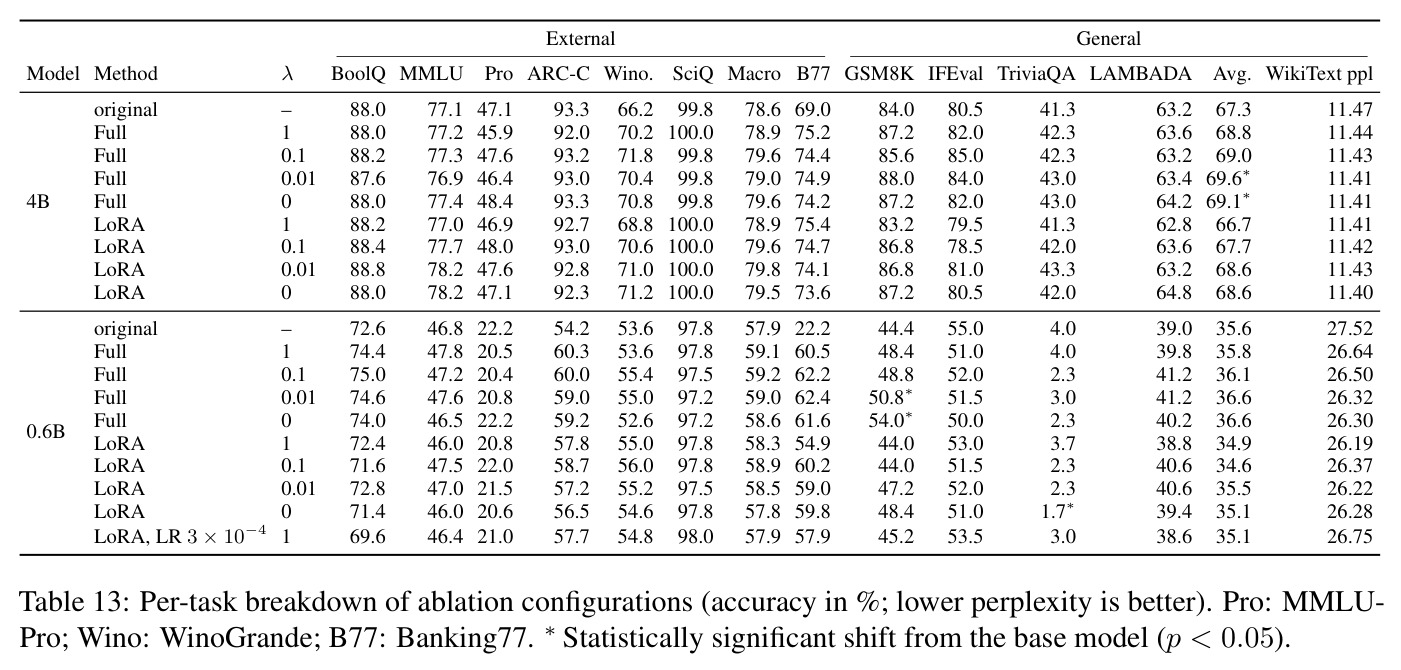
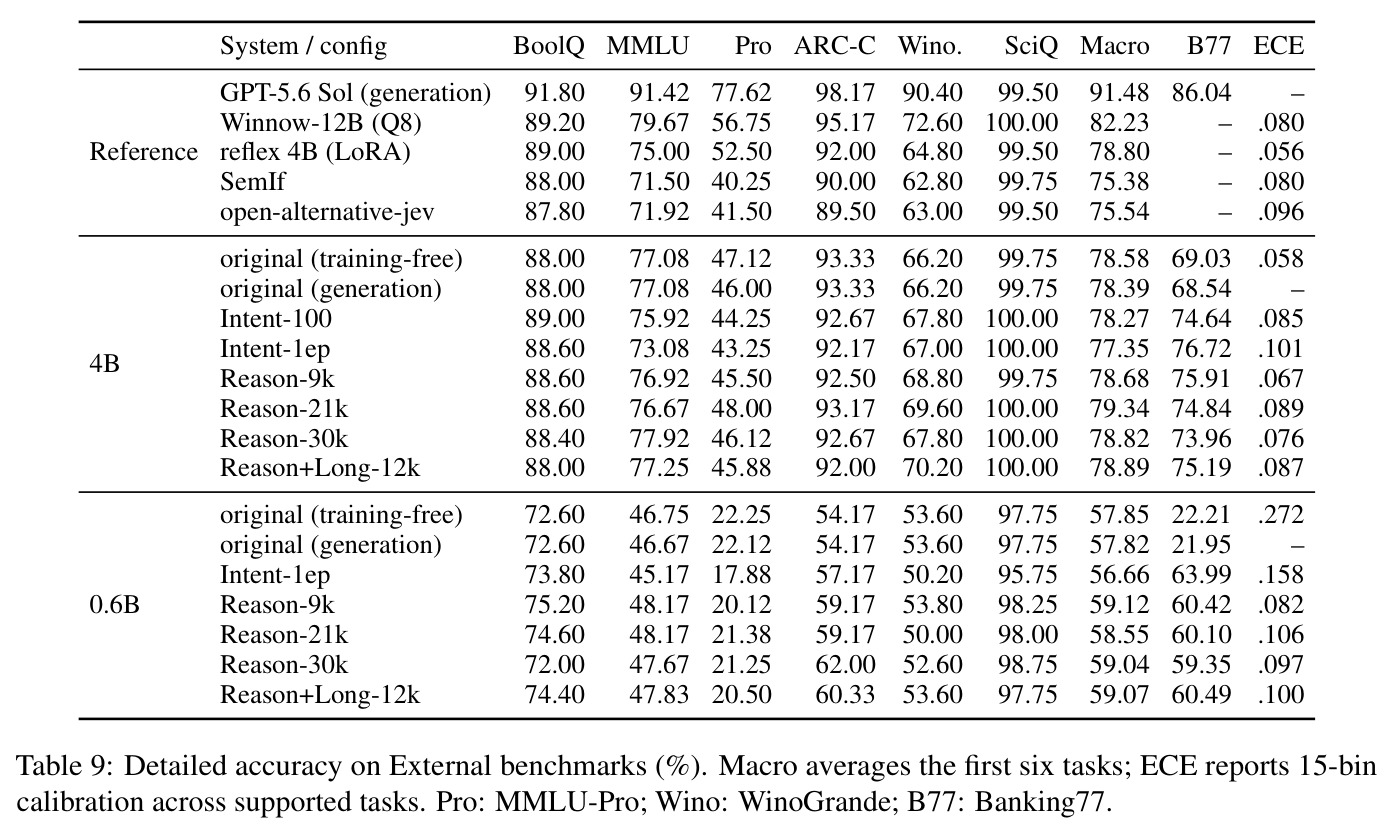
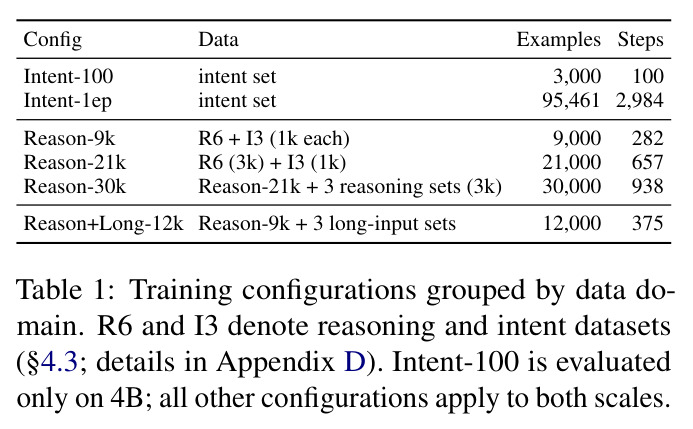
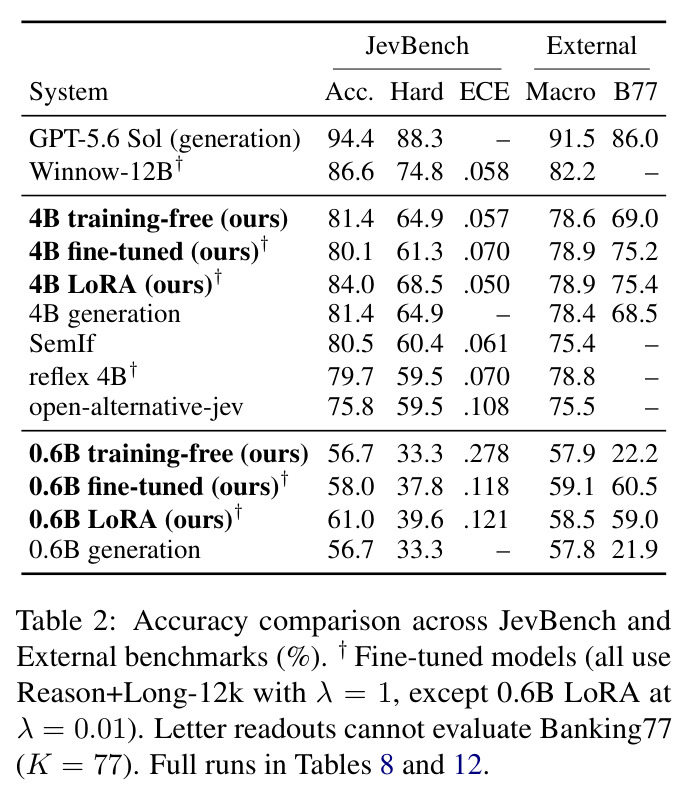
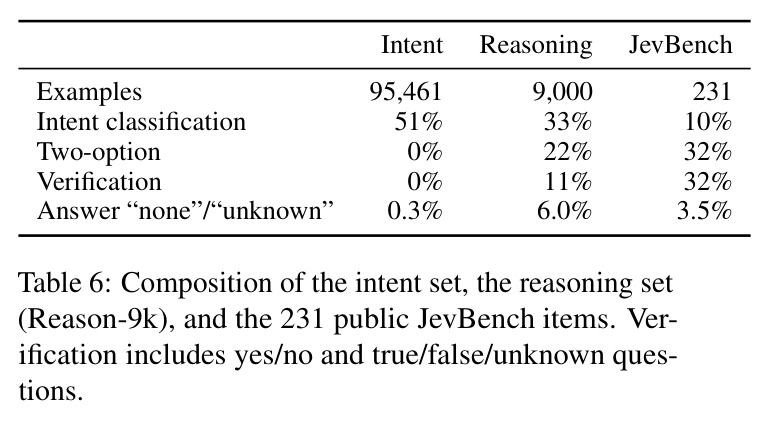
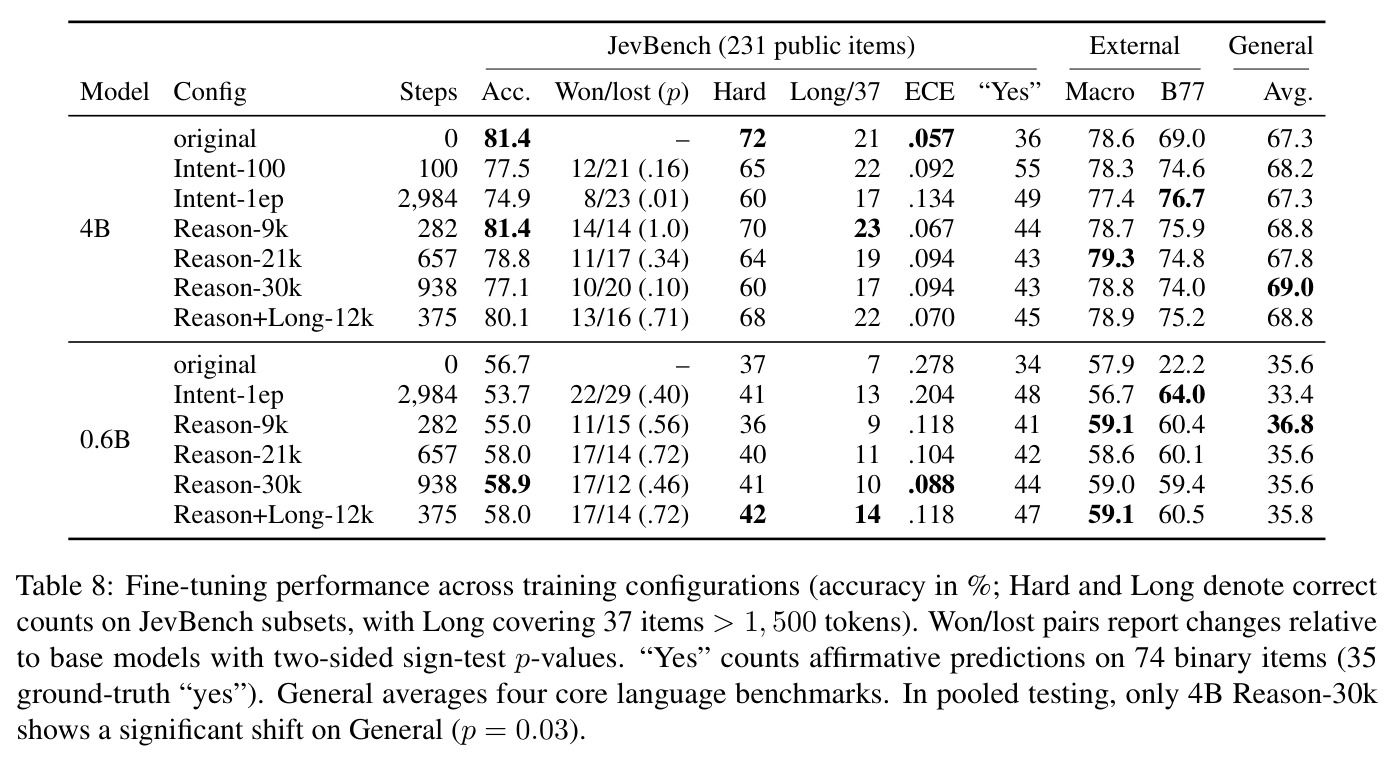
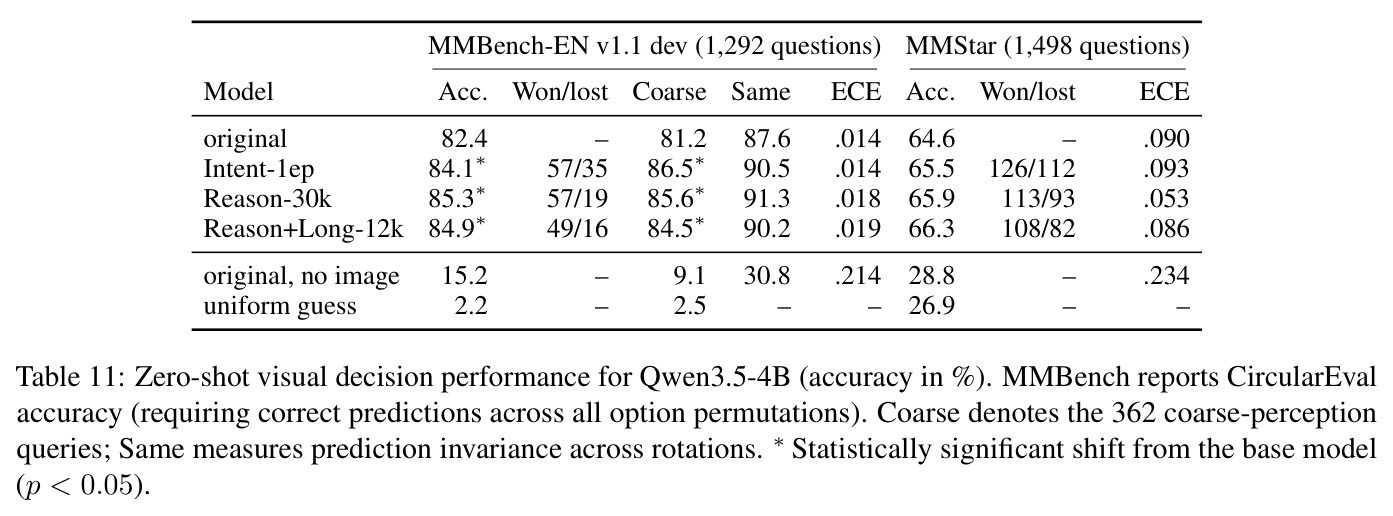
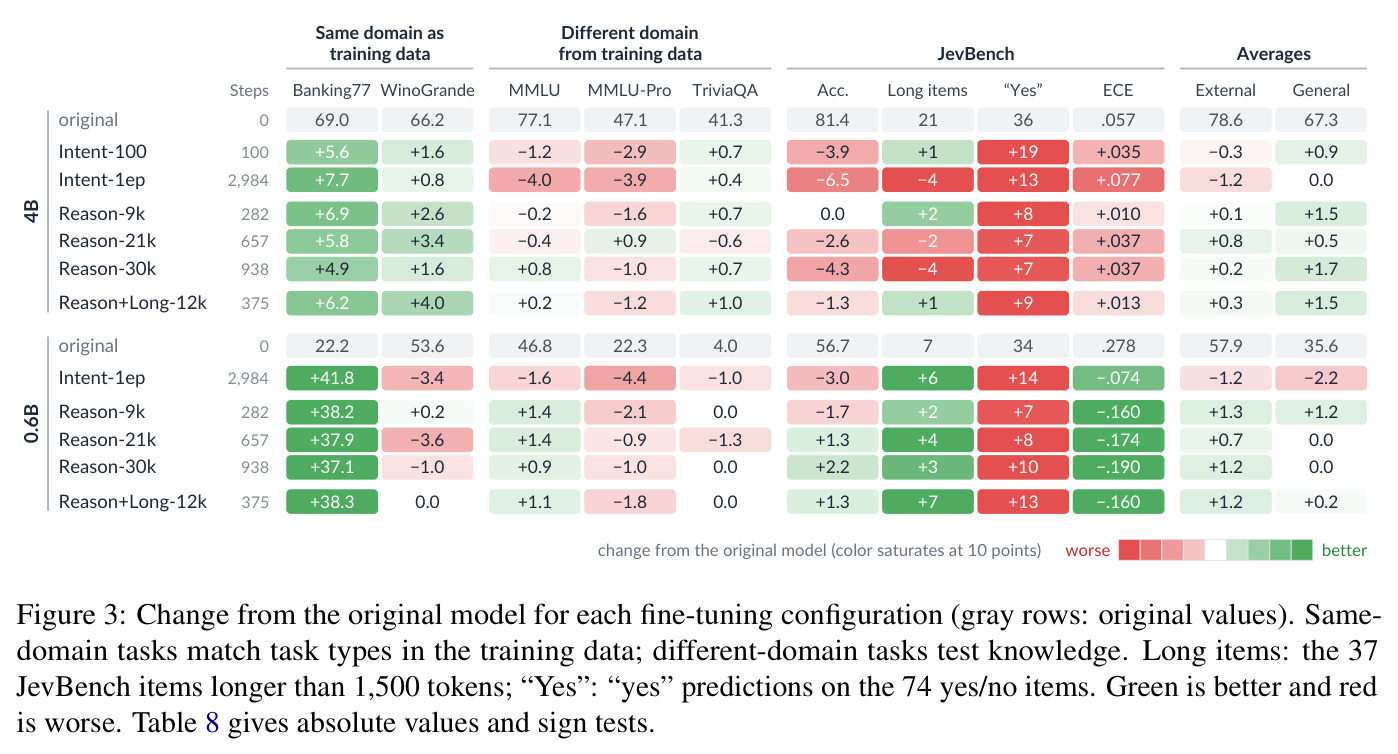
(1) 免训练 4B 已是有效决策模型:JevBench 231 个公开项准确率 81.4%(188/231,Hard 子集 72/111),与同底座 SemIf 打平(15 胜 13 负,$p=0.85$),超过 reflex 4B(79.7%)与 open-alternative-jev(75.8%),仅更大的 Winnow-12B(86.6%)和 GPT-5.6 Sol(94.4%)更高;外部七基准宏平均 78.6%,超 SemIf 3.2 个百分点(313 胜 154 负,$p<10^{-12}$)。(2) 校准开箱即优:ECE 0.057,优于 SemIf 的 0.061 与带官方校准映射的 reflex 的 0.070。(3) 高基数原生支持:Banking77 全部 77 类单次前向 69.0%,字母读法无法直接做到。(4) 打分与自回归生成在 231 项上完全一致、零解析失败。(5) 多模态零样本涌现:MMBench CircularEval 82.4%、MMStar 64.6%,去掉图像跌至 15.2%/28.8%。(6) 小模型免训练很差:0.6B 仅 56.7%、ECE 0.278、Banking77 22.2%,CLINC150 损失 6.9 nats 高于均匀猜测 $\ln 151 \approx 5.0$,219/231 项在标识符后冗余续写。(7) 微调收益与数据覆盖强绑定:意图数据使 Banking77 +7.7(4B)/+41.8(0.6B),但 4B JevBench 从 81.4% 跌至 74.9%、ECE 升至 0.134,出现 yes 偏置等四种失败模式;Reason-9k 修正偏置并保住 81.4%;纯短上下文数据加量(21k/30k)显著损害长项($p \le 0.03$);Reason+Long-12k 恢复长项,0.6B 长项 7→14($p=0.02$)。(8) 微调方式:4B 上 LoRA 配 $\lambda=1$ 达 84.0%(ECE 0.050),显著优于全参数微调($p=0.01$);0.6B 两种方式相当(LoRA $\lambda=0.01$ 最佳 61.0%);去掉锚点后 4B 有 69/231 项文本失控、0.6B 176 项生成到长度上限,$\lambda=1$ 为推荐默认。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| JevBench 公开 231 项决策 | Accuracy | 4B LoRA(λ=1)84.0%;免训练 81.4% | SemIf 80.5%(冻结字母 logit);reflex 4B 79.7%;Winnow-12B 86.6%;GPT-5.6 Sol 94.4% | LoRA 超 SemIf 3.5 个百分点;免训练即追平同底座微调模型 |
| JevBench Hard 子集(111 项) | Accuracy | 免训练 64.9%(72/111);4B LoRA 68.5% | SemIf 60.4%;reflex 59.5% | 免训练约 +4.5 个百分点 |
| External 七基准宏平均(六项) | Accuracy | 免训练 78.6% | SemIf 75.4% | +3.2 个百分点(313 胜 154 负,p<10^-12) |
| Banking77 意图路由(77 类) | Accuracy | 免训练 4B 69.0%;微调后 4B 75.4%(LoRA)、0.6B 60.5% | 0.6B 免训练 22.2%;字母 logit 方法因 K>26 无法支持 | 0.6B 微调 +38.3 个百分点(Reason+Long-12k) |
| JevBench 概率校准 | ECE(15 桶,无温度缩放) | 4B 免训练 0.057;4B LoRA λ=1 0.050 | SemIf 0.061;reflex 0.070(含官方校准映射);0.6B 免训练 0.278 | 0.6B 微调后 ECE 0.278→0.118 |
| 多模态视觉决策(MMBench CircularEval) | Accuracy | 82.4%(零样本);文本微调后最高 85.3% | 同一模型去掉图像输入仅 15.2% | 证明视觉决策真实涌现且文本微调不伤反而提升 |
| 对话行为(MT-Bench+Dolly 560 条回复) | 新增不终止回复数 | λ=1 时 4B 20/20、0.6B 7/1(均不显著) | λ=0 时 0.6B 新增 20 条不终止回复(显著,p<0.05) | KL 锚点以 λ=1 完全消除统计显著的行为漂移 |
局限与改进
作者承认的局限:评测仅用 JevBench 的 231 个公开项,密封与私有测试集不可得,报告的是诊断准确率而非官方榜位;错误分析驱动的数据迭代属于探索性(虽然 JevBench 严格未参与调参);推理延迟未优化(FP32 下 4B 中位 194ms,而 SemIf BF16 为 46ms);为效率省略了推理时置换平均,残余位置偏差仍在——训练后 MMLU-Pro 上选择从选项 10 移向共享首 token 的选项 1(45 次降到 24 次),原因未查明。我的补充观察:结论建立在 Qwen 两个底座上,未验证 Llama/Gemma/Phi 等家族,「LLM 已是决策模型」的普适性存疑,尤其 0.6B 免训练表现很差(56.7%、ECE 0.278)说明该论断强依赖底座能力;全部实验为单种子,1–2 个点的波动难以归因;训练与评测全为英文,跨语言场景未测;密封集上社区模型普遍从公开 80–90% 跌到 24–38%(如 Plumb 89.6% vs 38.0%),提示公开项过拟合是全生态问题,本文 84.0% 的密封集表现未知;KL 锚点需缓存参考模型统计量,虽然每分布仅约 0.5 KB,但增加了训练管线的实现复杂度。
独立分析的弱点
独立分析的弱点及改进方向:(1) 底座单一——只有 Qwen3.5-4B 与 Qwen3-0.6B,Figure 5 的 tokenizer 差异分析停留在理论验证层面,应在 Llama、Gemma、Phi 上复现接口与结论,才能支撑「任意因果 LLM」的声明。(2) 锚点权重 λ 是全局标量——不同锚点位置(回复起始、off-path 节点、答案后)敏感度不同(Table 15 显示各缺一项都有特异性退化),可探索按位置/层自适应权重或训练中的退火调度。(3) 数据构造是人工闭环——六组混合靠逐轮错误分析迭代而来,缺乏「自动检测缺陷→定向补数据」的主动学习管线,生产环境难以低成本复制。(4) 位置偏差缓解不彻底——训练时打乱选项只消除静态关联,MMLU-Pro 的 10→1 位移现象(净失 15 题)未给出解释,可研究轻量推理时校准或候选平衡化打分。(5) 统计功效有限——单种子、JevBench 仅 231 项,多个关键结论(如 LoRA 优势 p=0.01)处于显著边缘,需多种子与更大验证集确认。(6) 长尾校准未深入——Banking77 微调后准确率大涨,但未按类别报告校准,高基数下的类别级置信度质量未知。(7) 仅英文评测——多语意图路由数据(MASSIVE 覆盖 51 种语言)就在手边却未利用,跨语言决策是现成的延伸实验。
未来方向
作者提出的方向:在数据配方中引入指令多样化并剪掉可被浅层关键词匹配解决的平凡样本;以域外迁移探针而非域内损失做 checkpoint 选择,并在开放 prompt 上审计自回归行为;多模态方面已证明冻结视觉编码器、纯文本微调可零样本保留乃至提升视觉决策(MMBench 82.4%→85.3%),暗示多模态微调有扩展空间。基于成果可延伸的工作:把 KL 锚点思想推广到通用指令微调与 RLHF 的灾难性遗忘防护,作为比重放数据更便宜的替代方案;系统研究锚点强度与 LoRA 秩、学习率的交互,解释为何低秩约束与强锚点在强模型上叠加最优(LoRA learns less and forgets less 的机制视角);在密封测试集与真实生产流量上验证免训练配方的泛化;把接口扩展到 score/ordinal 任务与结构化输出(如 JSON 字段选择);研究置信度驱动的人机回退在真实客服系统中的端到端收益;以及探究高基数下共享首 token(选项 1 与 10)的 tokenizer 现象对打分的系统性影响。
复现评估
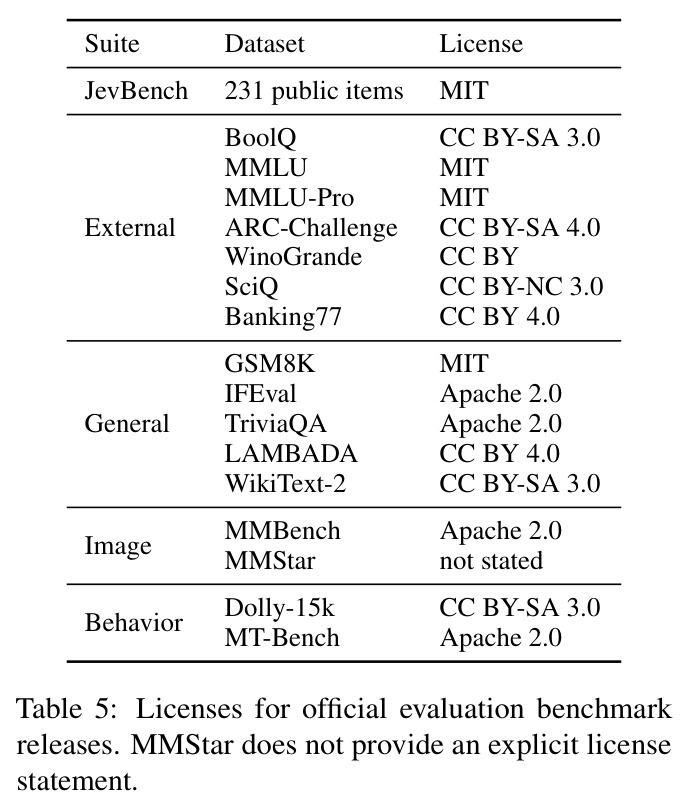
复现评估:数据完全公开且许可证明确(表 4/5 列出全部 15 个训练集与 12 个评测集的许可证及授权),超参完备(表 3:AdamW、FSDP、BF16、单 epoch、全局 batch 32、4B 学习率 $2\times 10^{-6}$、LoRA rank 16/$\alpha=32$、种子 20260922);算力门槛低——训练用 4 张 A100 80GB,Reason-9k 在 4B 上仅约 41 分钟(8.3 秒/步),LoRA 只训 32.5M 参数且训练后合并、推理零额外延迟;锚点统计只需冻结模型的 top-64 缓存(每分布约 0.5 KB,对比全词表 1.0 MB)。对比系统均使用作者官方实现,本地复现官方榜差距在 4 项以内,可信度高。注意点:论文引用的 Qwen3.5、JevBench v1.4.2.2 及社区模型属 2026 年生态,复现需能获取这些权重与榜单;推理在 FP32 下进行,部分图像下采样到 1,048,576 像素(影响 0.5%/2.7% 的 prompt);lm-evaluation-harness 的固定抽样需按附录 B 复刻;文中未给出代码仓库链接,训练/推理代码可能需按正文与附录自行实现(接口、损失、tokenizer 处理描述均足够详细)。总体复现难度中等偏低,核心免训练结果单张 RTX A5500 即可验证。
论文图表