SWIFT:基于目标外推的自引导弱到强扩散模型训练 SWIFT: Self-guided Weak-to-strong dIFfusion models via Target extrapolation
用冻结弱去噪器外推训练目标,把弱到强引导从推理期移入训练期,训练后丢弃引导且不增加推理开销。
前置知识
扩散模型与去噪回归目标
扩散模型对干净数据 $x_0$ 加高斯噪得到 $x_t = x_0 + \epsilon_t$,训练去噪器 $D_\theta(x_t, \sigma_t)$ 用加权 MSE 预测 $x_0$。在总体(无限数据)意义下,其最优解是后验均值 $D^\star(x_t,\sigma_t)=E[x_0 \mid x_t]$,采样时通过 Tweedie 公式把它换算成分数并积分概率流 ODE 生成样本。
本文唯一的改动就发生在这个回归目标上;理解『最优解是后验均值』才能看懂『故意偏离后验均值的有偏目标为何反而有用』这一核心反直觉点。
推理期引导:CFG 与 Autoguidance
引导在采样时修改预测方向。CFG 把条件预测与无条件预测外推组合为 $f + w(f-u)$,需要训练无条件分支;Autoguidance(AG)用一个小而弱的去噪器提供方向:$D_{AG} = (1+\alpha)D_{base} - \alpha D_{weak}$,即推着强模型离开弱模型的预测,但每次采样都要额外跑一遍弱模型。
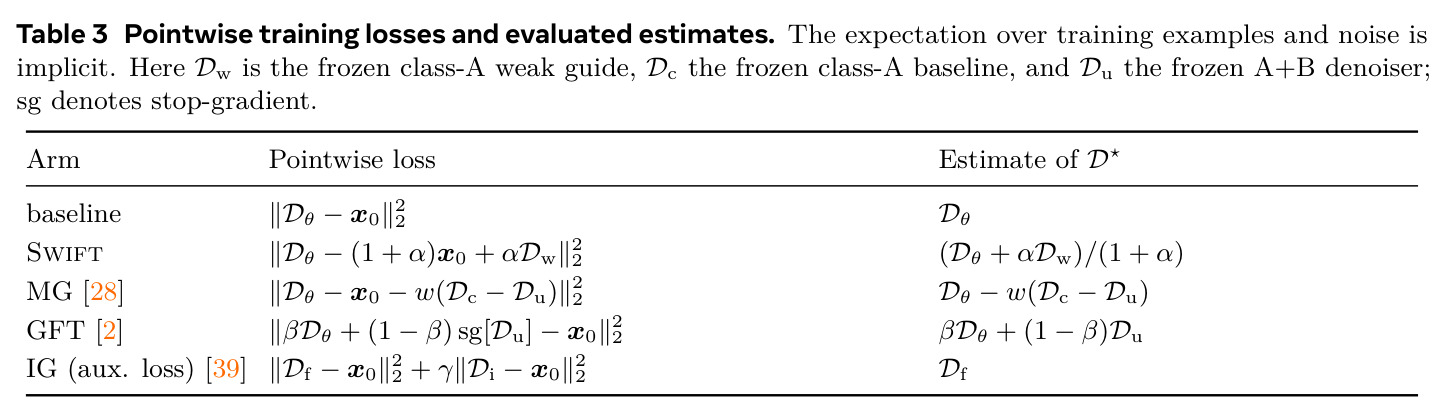
SWIFT 的目标构造正是把 AG 公式中『强模型预测』的位置换成真实干净样本 $x_0$,从而把弱到强外推从采样期搬进训练期,这是全文的问题起点。
RKHS 核梯度流与谱分析
在再生核希尔伯特空间中对平方损失做总体梯度流,预测演化由核算子 $L$ 决定:$d_s = H_s g$,其中响应算子 $H_s = I - e^{-sL}$ 对特征值 $\kappa$ 的模式按比例 $1-e^{-s\kappa}$ 学习。训练时间有限时每个模式只被学到一部分,残差呈谱结构。
定理 1 的证明完全建立在这套谱分解语言上,是理解『有限时间欠拟合为何能被外推部分抵消』的数学基础。
有限时间欠拟合与偏差—方差权衡
有限训练预算下模型学不满目标函数。外推目标 $g_\alpha = D^\star + \alpha(D^\star - D_{weak})$ 本身偏离后验均值(引入偏差 $\alpha^2\|D_{weak}-D^\star\|^2$),并把标签噪声放大 $(1+\alpha)^2$ 倍;但若基线残差与修正方向正向对齐,小幅外推可净降低误差,过大的 α 则会过冲。
这是论文理论的直觉核心,也直接解释了实验中 α 呈 U 形、必须取中等正值的现象。
FID 与多维生成评估指标
FID 用 5 万张生成图与训练集在 Inception 特征空间的 Fréchet 距离衡量分布差距。论文还辅以 sFID、precision/recall,以及 Inception、ConvNeXt、DINOv2、MAE、SigLIP 五个特征空间下的 FDr 与 MIND,交叉验证避免单一指标偏倚。
结论部分的主要证据都是这些数字;知道各指标衡量什么,才能判断 16%–49% 的 FID 改进与个别 precision 回退的实际意义。
研究动机
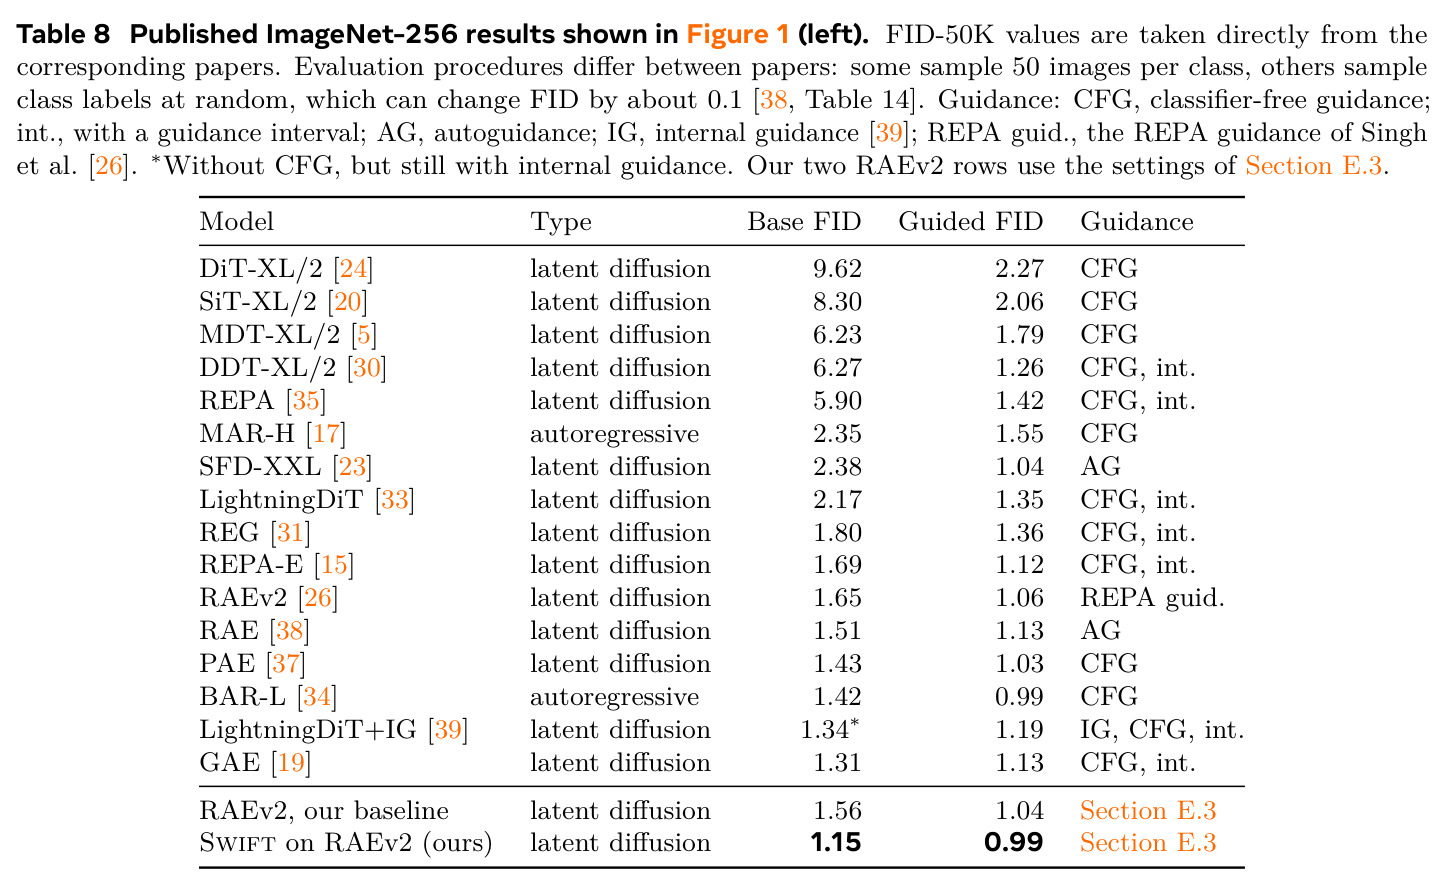
高质量扩散模型训练代价高昂,而当前最强的生成结果几乎都依赖推理期引导:CFG 需要训练无条件分支(标签 dropout)并在采样时做额外前向;Autoguidance(AG)证明故意训练一个弱去噪器可以在采样时以 $(1+\alpha)D_{base}-\alpha D_{weak}$ 的外推显著提升强模型(例如 DiT-XL/2 无引导 FID 9.62,CFG 后 2.27),但弱模型必须在推理时保留,每次采样预测都要额外一次前向,部署成本和引导调节都随之增加。另一些工作尝试把引导搬进训练(MG、SGG、IG、GFT),但它们的修正项依赖训练中不断变化的模型预测或 EMA 输出,需要额外去噪头或无条件预测,弱源与主模型联合优化,回归目标随主模型更新而漂移,推理时往往仍需辅助输出。更根本地,扩散训练的标准做法是直接回归干净样本 $x_0$,回归目标本身几乎从未被当作设计接口;有限训练预算导致的欠拟合(预测远离后验均值 $E[x_0 \mid x_t]$)一直被视为需要更多算力解决的问题,而不是可以利用的结构性资源。
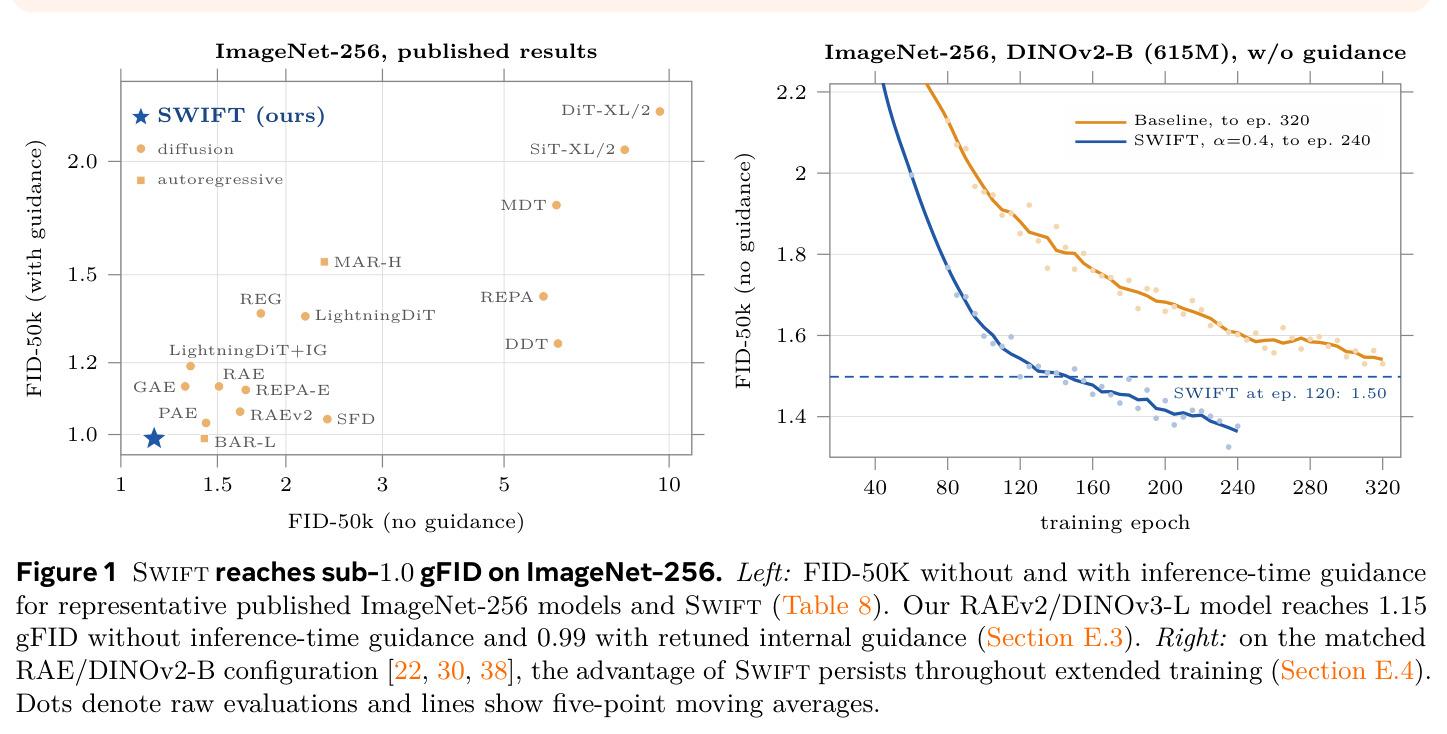
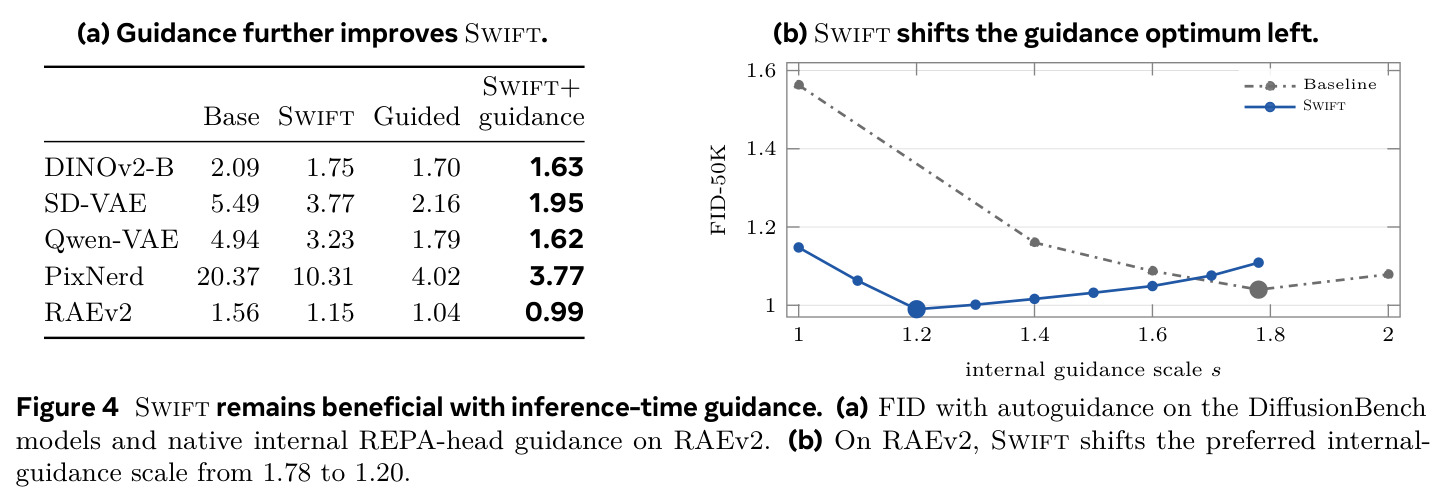
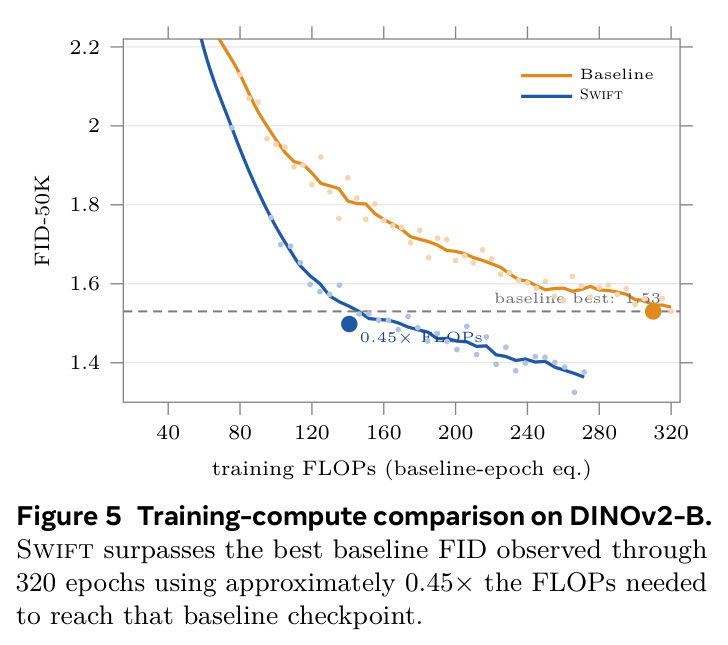
本文的目标是论文要把『弱到强外推』从推理期搬进训练期:让主去噪器在训练中直接吸收弱模型的修正,训练结束后把弱模型彻底丢弃,部署时只剩单一去噪器和原始采样器,条件与无条件生成都不需要标签 dropout 或无条件分支。具体可量化的目标包括:(1) 在相同训练预算下严格降低无引导 FID,且增益在更长训练中不消失;(2) 证明存在非空的正外推系数区间,使后验均值误差严格低于同预算标准训练(定理 1);(3) 一个固定配方($\alpha=0.4$、半宽冻结引导、预训练时长为主模型一半)在覆盖 VAE、RAE、端到端隐空间、像素空间的 18 个 DiffusionBench 配置上全部降低无引导 FID;(4) 计入引导准备成本后,用约一半总训练算力超过基线的最佳 FID;(5) 在 875M 的 RAEv2 上无引导 gFID 达 1.15、带内部引导达 0.99,进入 sub-1.0 区间。
与已有工作不同的是,本文的独特切入有三层。第一,把回归目标本身当作设计接口:与其在采样时外推预测,不如在训练时把目标写成 $y_\alpha = x_0 + \alpha(x_0 - D_{weak}(x_t,\sigma_t))$,即把观测到的干净样本放进 AG 公式中强模型预测的位置——目标被故意做成『有偏』的,这在此前的扩散训练文献中几乎未被触碰。第二,识别出有限时间欠拟合是可对齐的资源:弱模型因为训练得更少而欠拟合,外推离开它的预测恰好放大主模型同样欠拟合的方向;RKHS 谱分解下基线的有限时间残差 $-(I-H_T)D^\star$ 与修正项 $\alpha H_T(I-H_{T_g})D^\star$ 正向对齐,因此小幅外推可净抵消残差。第三,与训练期引导方法不同,弱引导被预先训练并冻结,对固定的样本与噪声实现,回归目标不随主模型参数变化,避免了联合优化的复杂性,也让干净的有限时间理论分析成为可能。
核心方法
直觉类比:与其在考试时才请一位较弱的同事指路(推理期引导),不如平时训练就把标准答案往『弱同事想不到的方向』再推一步,让强者从源头学会修正,出师后不再需要这位同事。技术路线:先用标准去噪损失 $\mathcal{L}_{base}=E[\lambda(t)\|D_\theta(x_t,\sigma_t)-x_0\|_2^2]$ 训练一个弱去噪器 $D_{weak}$——约为主模型四分之一参数量(ImageNet 上约 155M 对 615M,前向 FLOPs 之比 0.259;CIFAR-10 上通道基宽 64 对 128)、训练时长为主模型的一半——然后冻结。主训练最小化 $\mathcal{L}_{SWIFT}=E[\lambda(t)\|D_\theta(x_t,\sigma_t)-y_\alpha\|_2^2]$,外推目标 $y_\alpha = x_0 + \alpha(x_0 - D_{weak}(x_t,\sigma_t))$,$\alpha\ge 0$,$\alpha=0$ 退化为标准训练;速度参数化模型对速度做同样外推($v_{SWIFT}=(1+\alpha)v-\alpha v_g$),二者等价。弱模型只做无梯度前向,每步仅增加约 9% FLOPs;训练结束即丢弃,采样流程保持原样。
核心创新:把 autoguidance 的推理期外推改写为训练目标,并用『冻结的、类别匹配的弱参考』取代已有方法中随训练演化的预测。AG 在采样时计算 $(1+\alpha)D_{base}-\alpha D_{weak}$;SWIFT 则把观测干净样本 $x_0$ 放进 $D_{base}$ 的位置作为回归目标,等价于让网络拟合 $g_\alpha = D^\star + \alpha(D^\star - D_{weak})$(Lemma A.1)——一个故意有偏的目标,其总体最优解的后验均值误差为 $\alpha^2\|D_{weak}-D^\star\|^2$,比标准目标更差。关键在于训练是有限时间的:RKHS 谱分解下,基线逐模式残差为 $-e^{-T\kappa_j}$,SWIFT 额外学到修正项 $\alpha h_j(1-h_{g,j})$($h_j=1-e^{-T\kappa_j}$),两者方向一致,误差变为 $(-e^{-T\kappa_j}+\alpha b_j)^2$。定理 1 证明:只要基线预测非零,就存在 $\alpha^\star = 2A/C > 0$,使 $R(\alpha) < R(0)$ 在 $0<\alpha<\alpha^\star$ 上成立——『有偏目标 + 有限训练』反而更接近真正的后验均值。
方法步骤详情
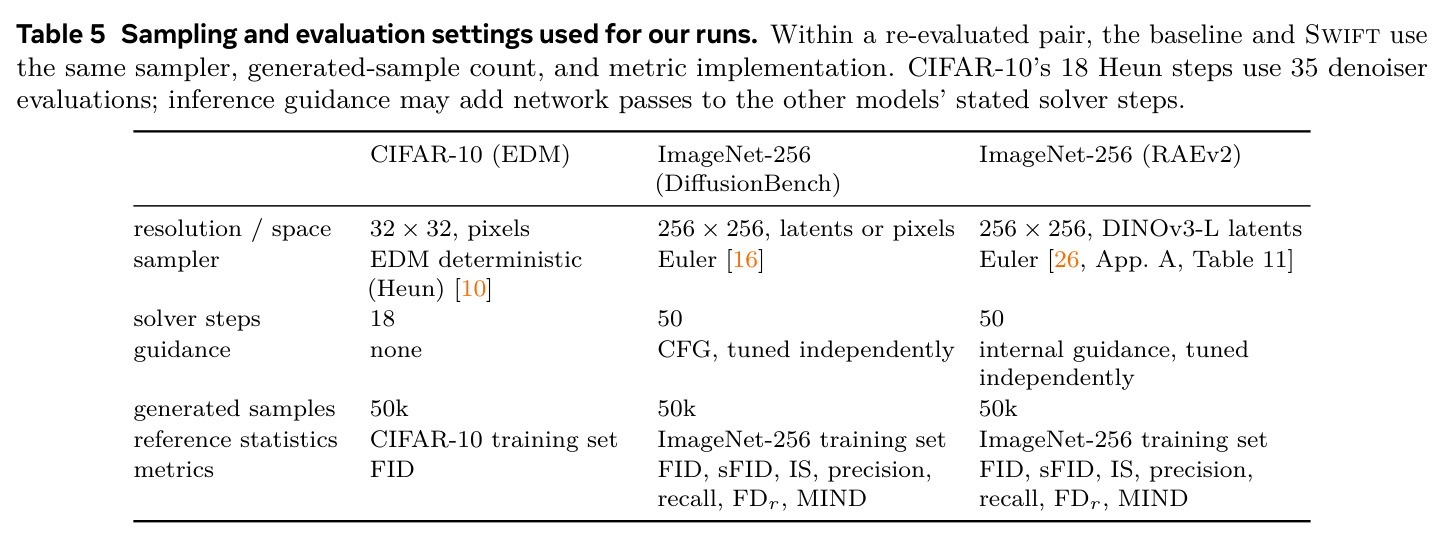
完整流程分四步。第一步(准备弱引导):在与主模型相同的数据和标准去噪目标下训练一个小模型——DiffusionBench 默认约 155M 参数、约为主模型前向 FLOPs 的 25.9%,训练 40 个基线等效 epoch(主时长一半);CIFAR-10 用通道基宽 64(学生 128);RAEv2 加载 GUIDE-w05 预训练检查点,然后冻结权重。第二步(主训练):每次迭代采样 $(x_0,t,\epsilon)$ 并构造 $x_t$;弱模型做一次无梯度前向得到 $D_{weak}(x_t,\sigma_t)$;计算外推目标 $y_?lpha$(速度参数化下先换算 $v_g$ 再算 $v_{SWIFT}$);用原损失权重与优化器回归主模型。目标对固定的样本与噪声实现是常数,不随参数更新。第三步(推理):删除引导,仅用训练好的 $D_ heta$ 与原采样器(CIFAR-10 为 18 步 EDM Heun,ImageNet 为 50 步 Euler ODE);可选 CFG 或内部引导,但强度需独立重调(RAEv2 最优尺度从 1.78 降到 1.20)。第四步(成本核算):主训练每步 +9% FLOPs(RAEv2 约 +12%),引导预训练约 10 个基线等效 epoch、可复用于多个运行,80 epoch 方案总计约 1.22 倍基线成本。
技术新颖性
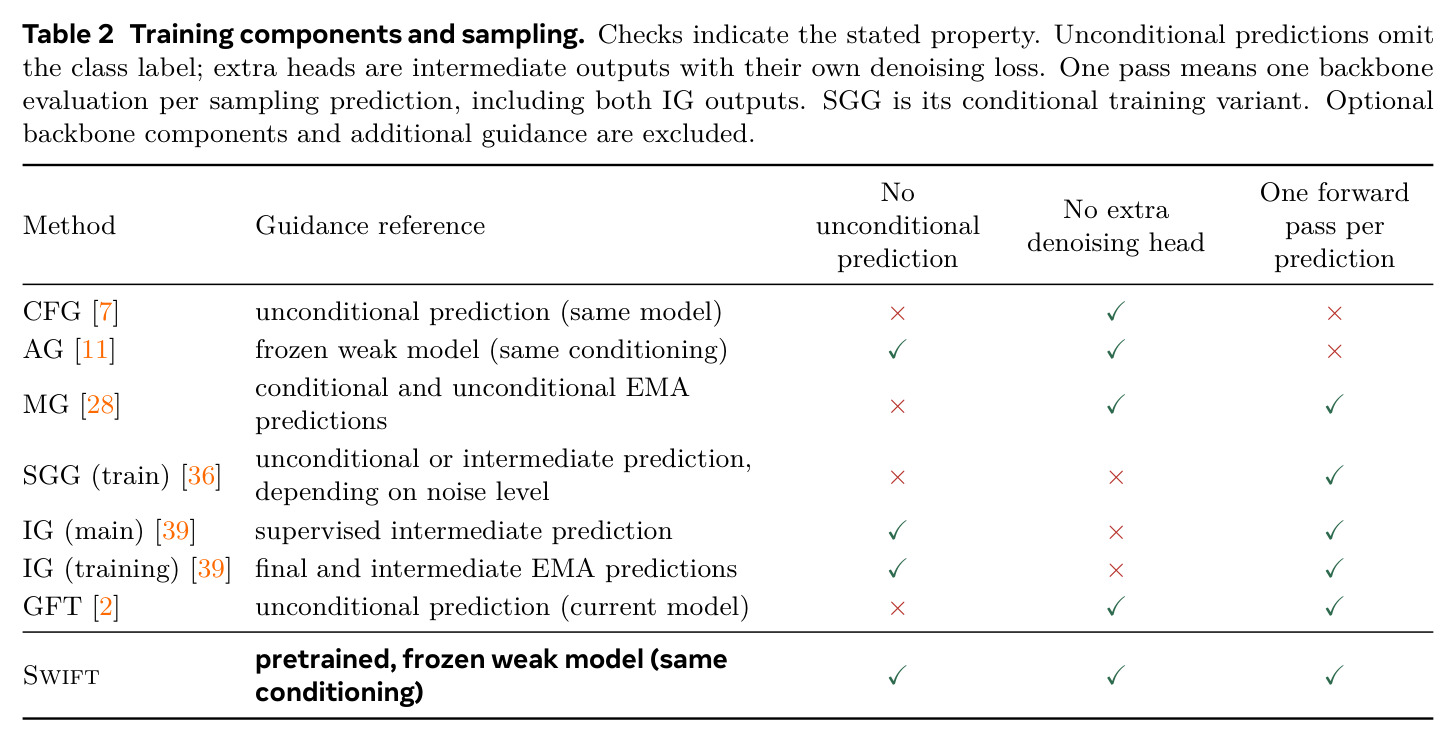
与已有技术的本质区别有三。(1) 与 AG 相比:外推从采样移到训练,部署只需单一模型;AG 的弱模型在推理时每次预测都要额外前向,SWIFT 训练后即丢弃。(2) 与 MG/SGG/IG/GFT 等『预测差目标』方法相比:它们的修正源是训练中演化的 EMA 或中间预测,需要额外去噪头或无条件输出,弱源与主模型联合变化;SWIFT 的 $D_{weak}$ 独立预训练并冻结,目标对固定数据与噪声是常数,无辅助头、无标签 dropout——Table 2 中唯一同时满足『冻结弱模型参考、无无条件预测、无额外去噪头、每次预测单次前向』四项的方法。(3) 理论上首次给出『有偏目标在有限训练下严格降低后验均值误差』的证明,并补充有限样本下的方差税修正(改善条件为 $A > V$)。附录 B 的恒等式 (B.3) 表明它与预测差目标在更新层面有重叠,但固定类匹配参考与有限预算分析是它独有的定位。
实验结果
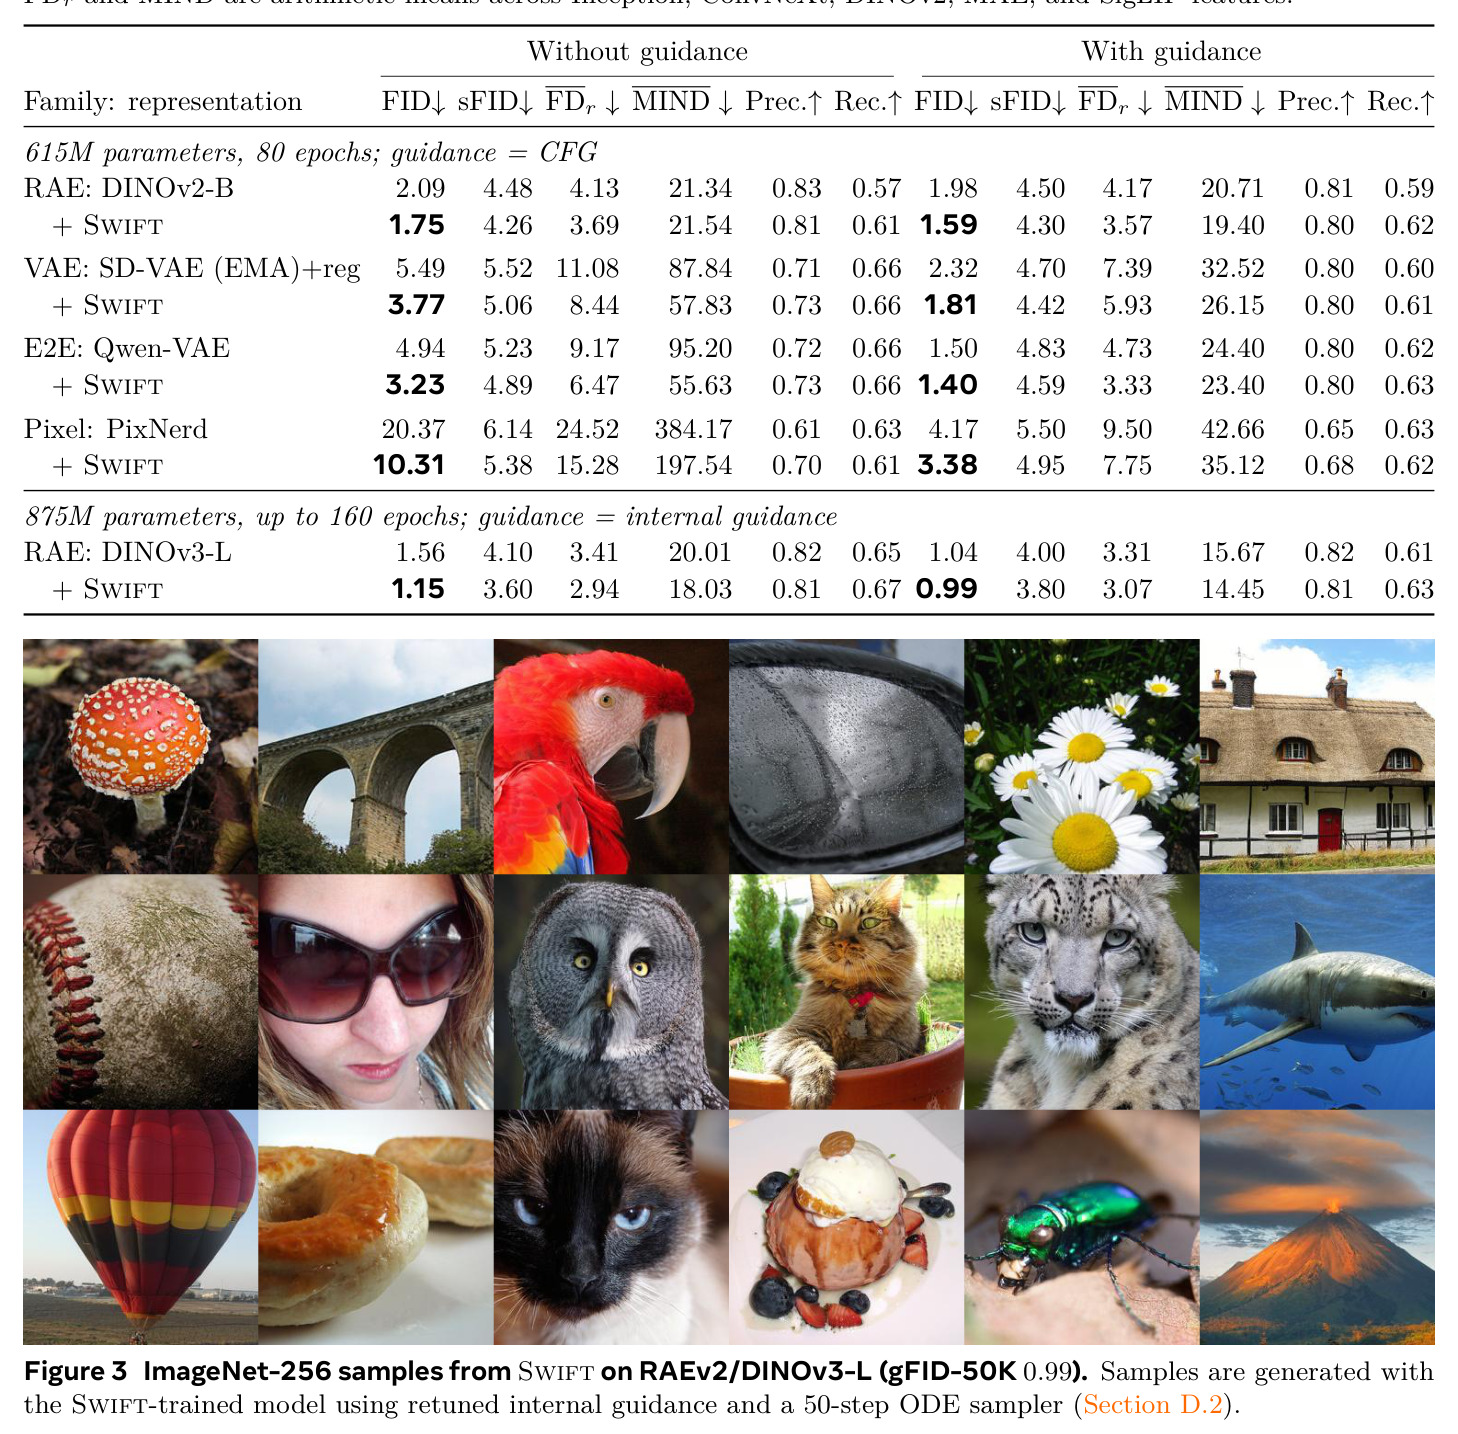
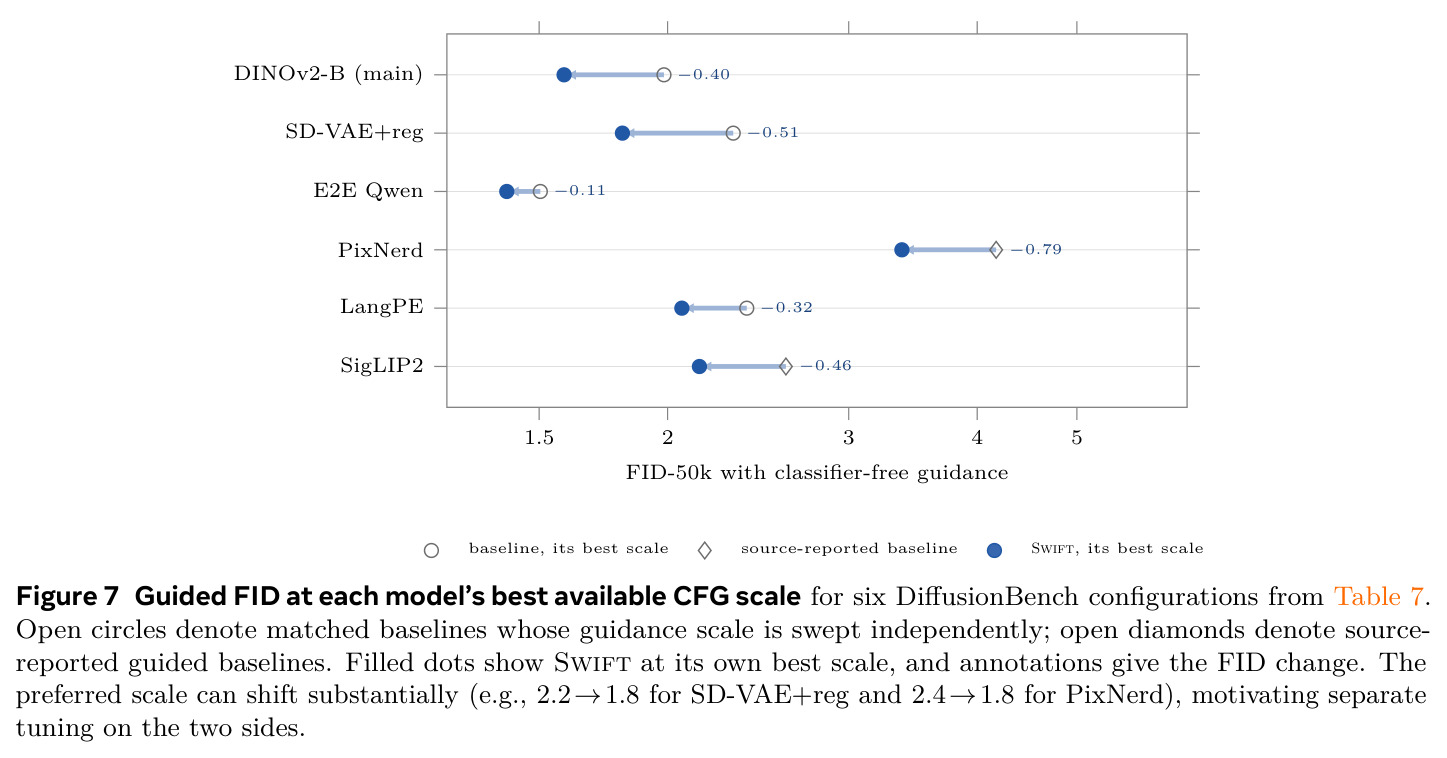
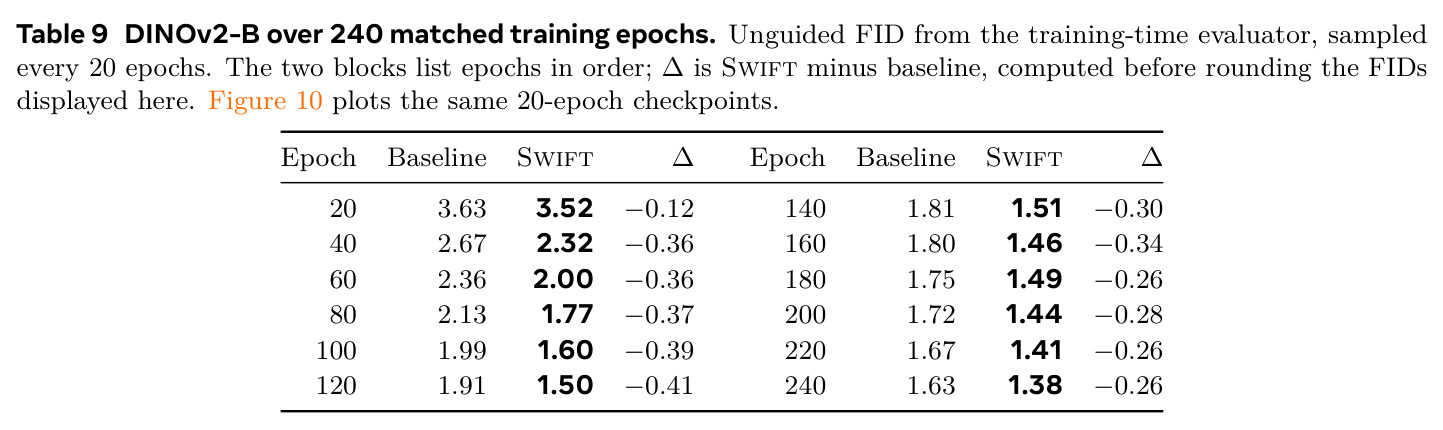
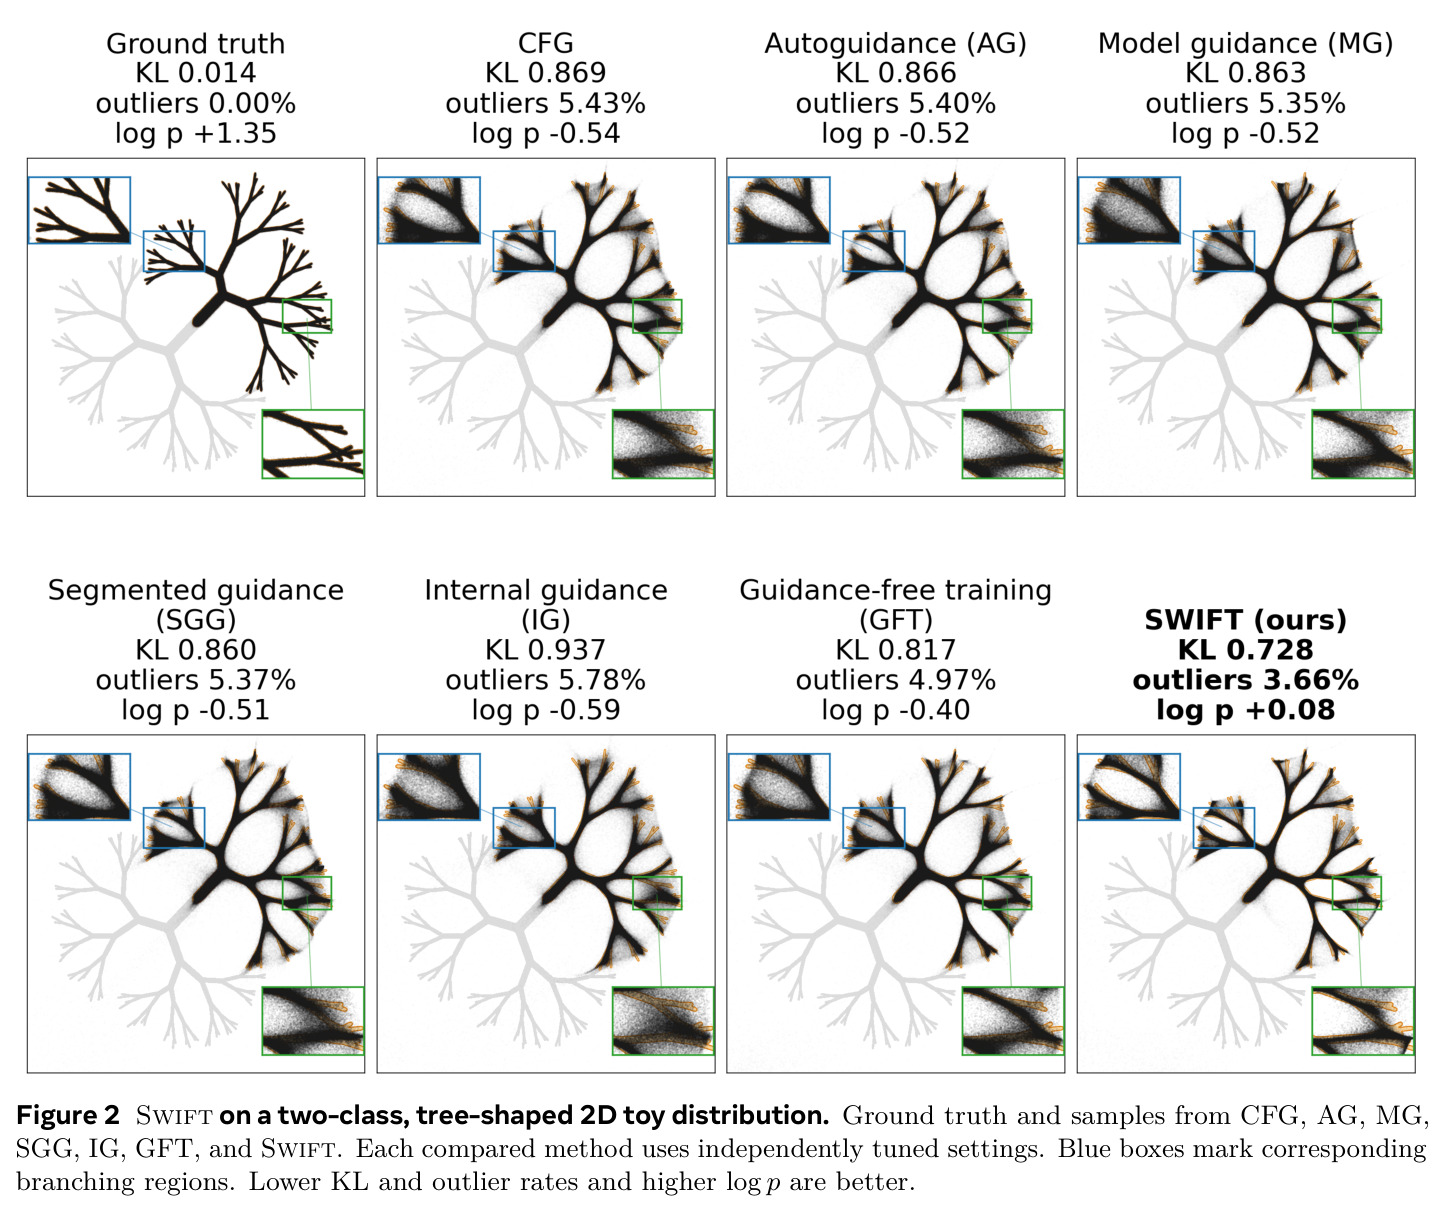
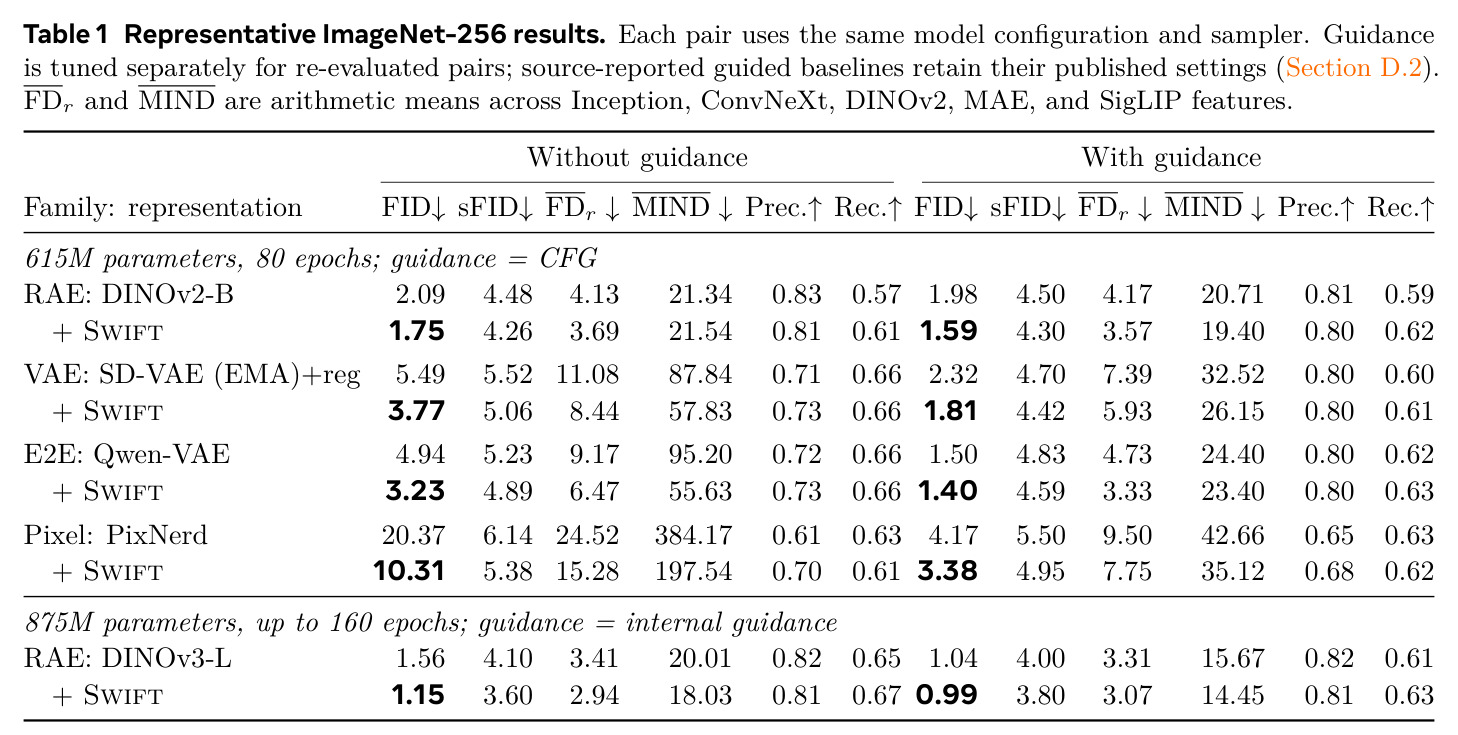
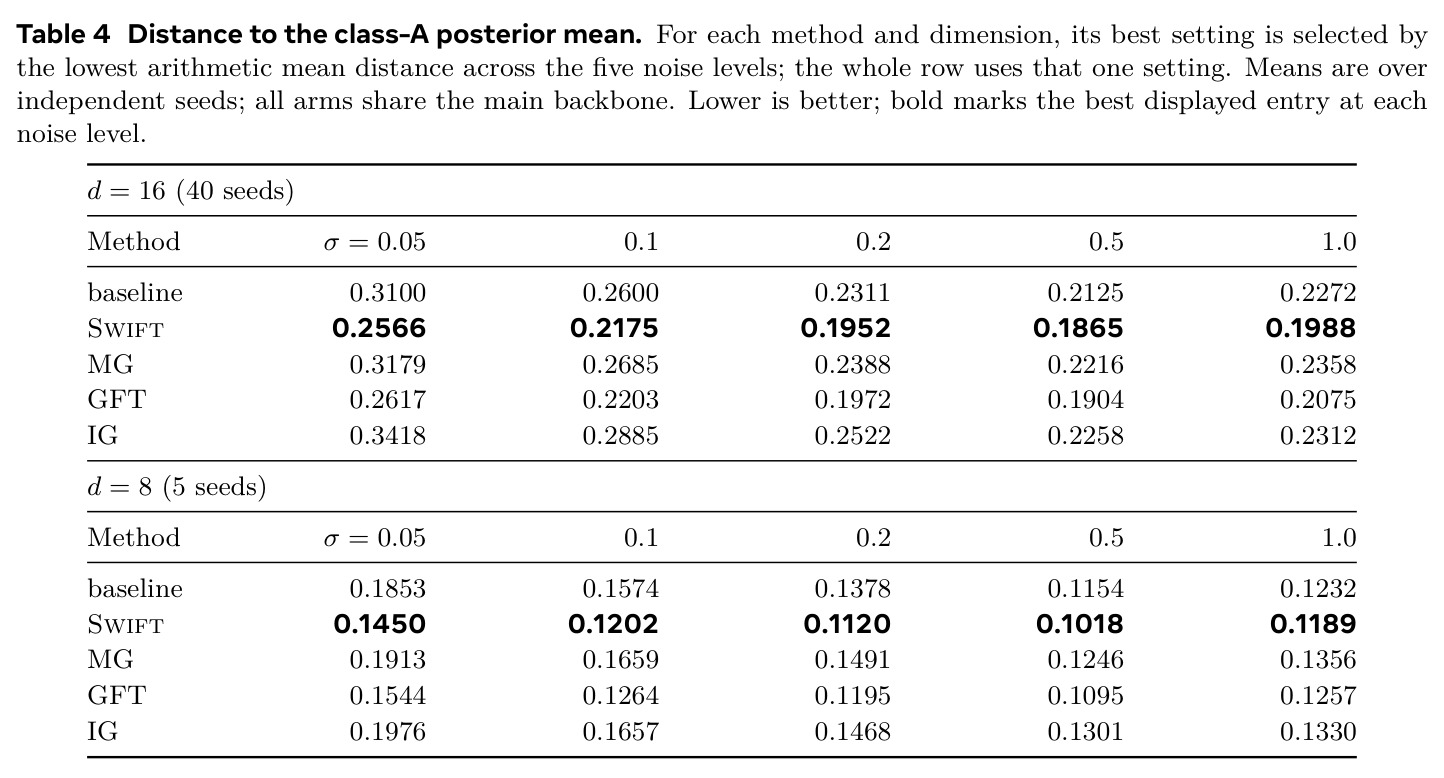
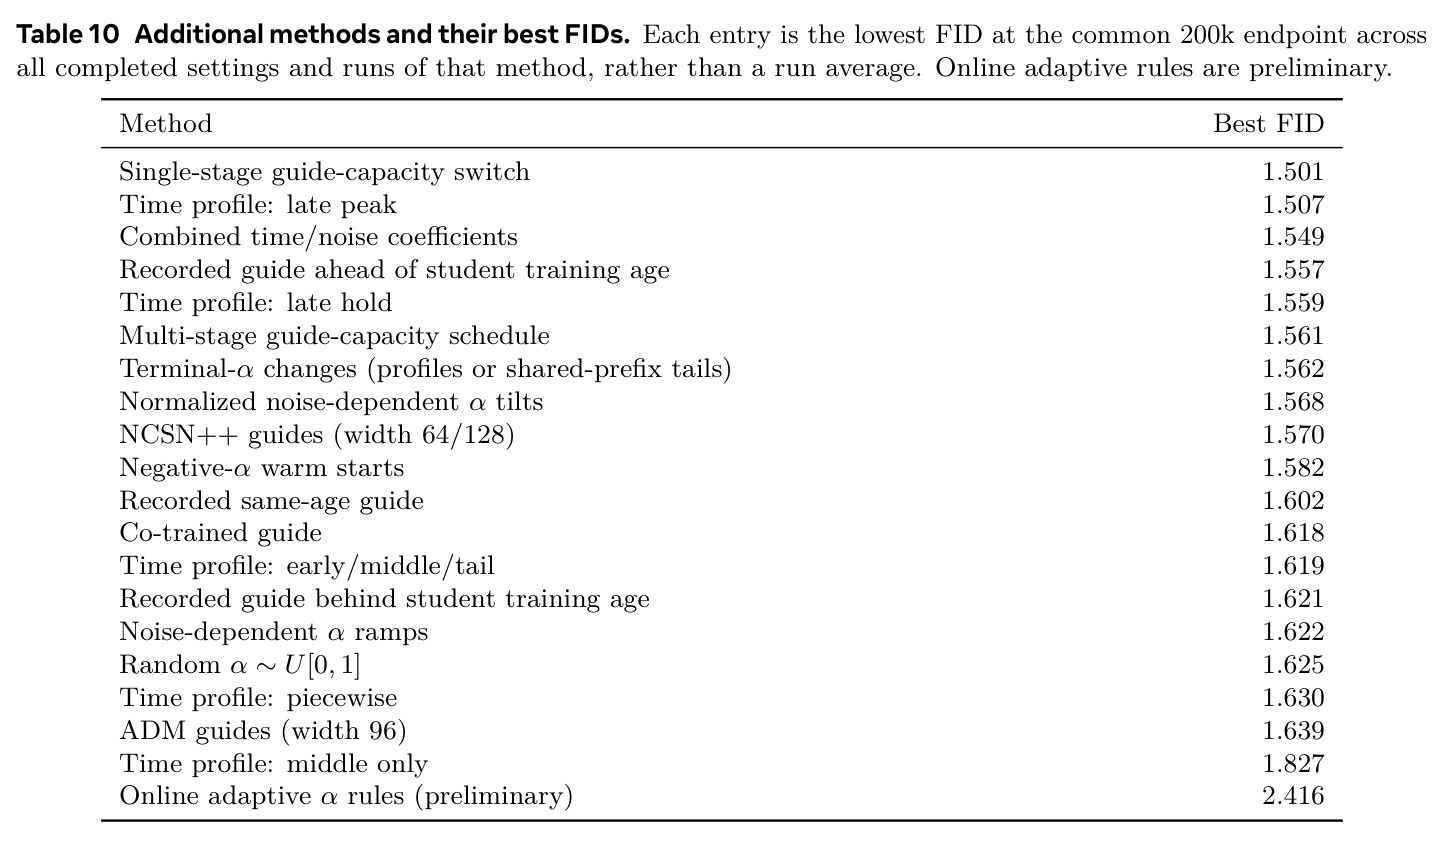
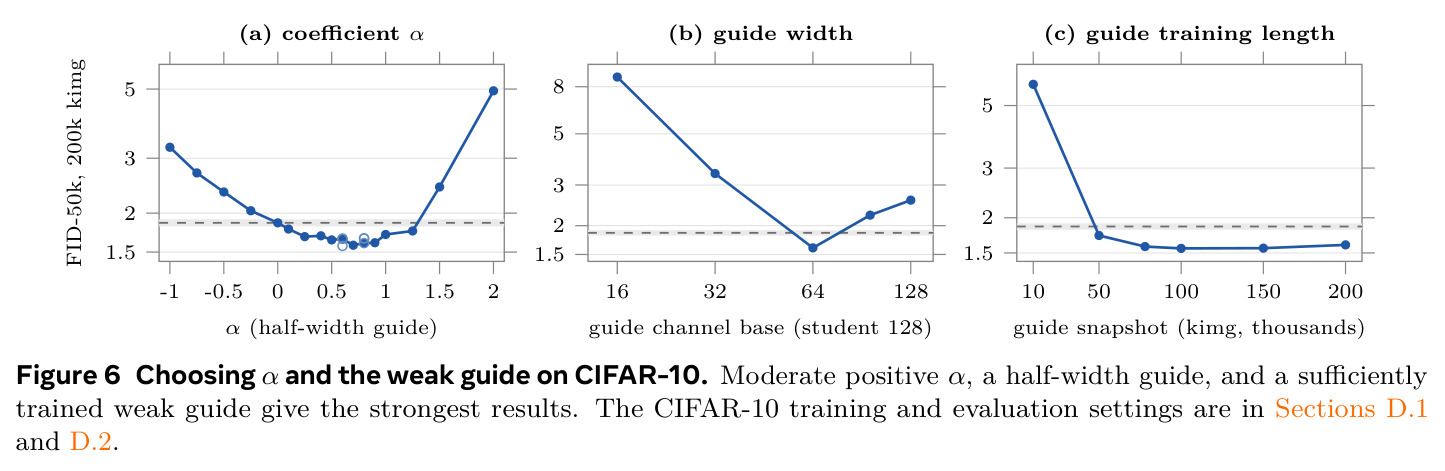
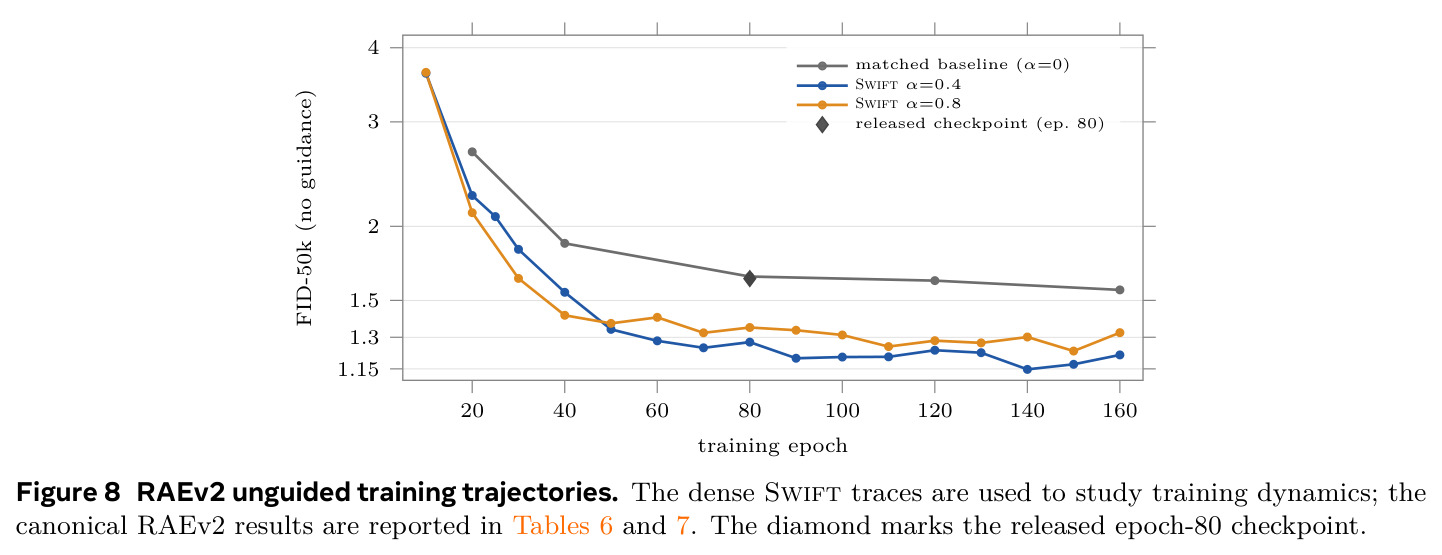
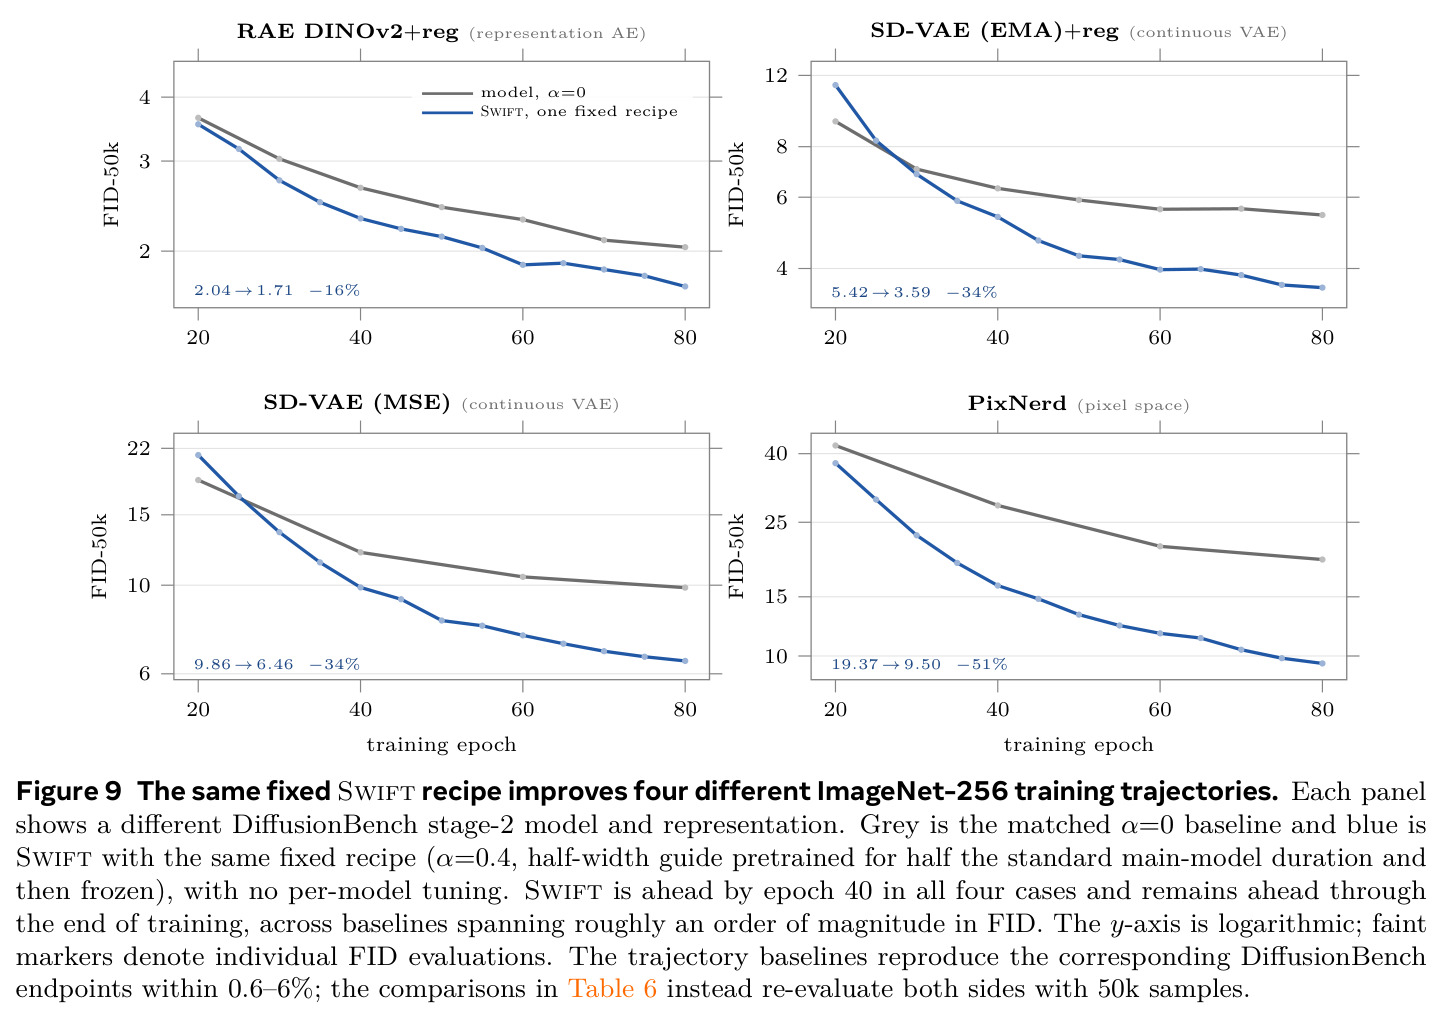
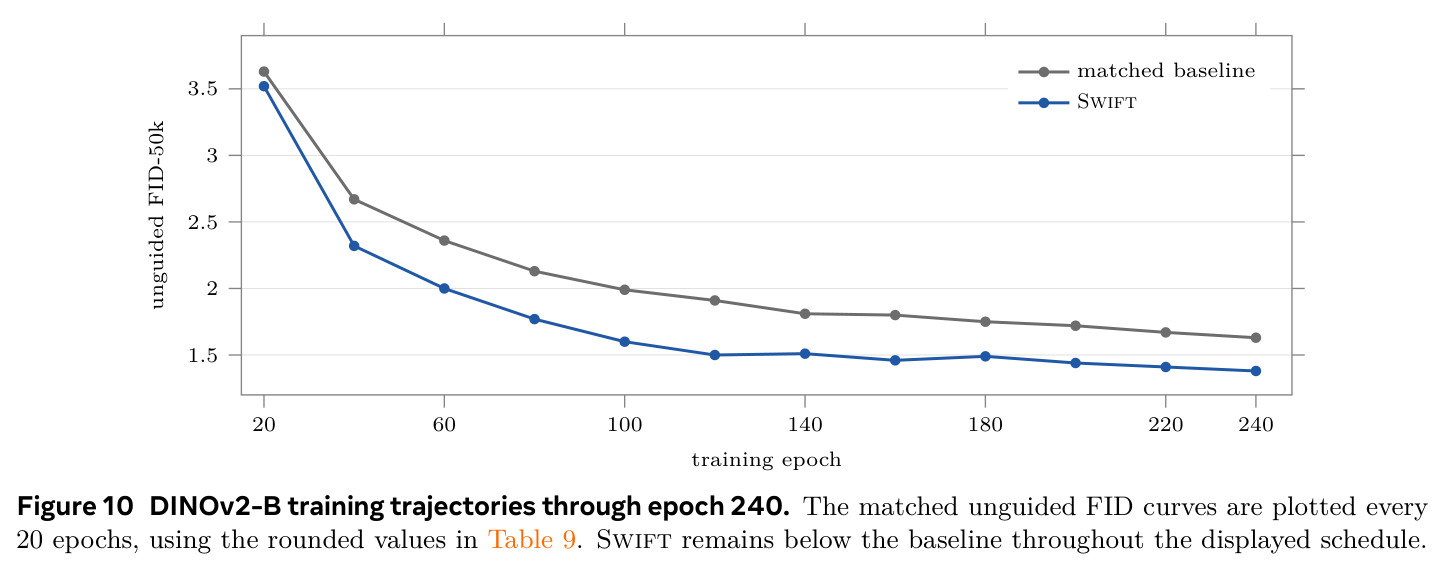
证据链覆盖四个层面。(1) 2D 树状分布(Figure 2):SWIFT 相对最强基线 GFT 把 KL 从 0.817 降到 0.728、离群率从 4.97% 降到 3.66%、$\log p$ 从 $-0.40$ 升到 $+0.08$,均为七方法最优。(2) 高斯混合受控实验(Table 4,$d=16$、40 种子,后验均值解析已知):SWIFT 在全部五个噪声水平上距离 $D^\star$ 最近,较基线降低 12.2%–17.2%,MG 与 IG 反而劣于基线。(3) ImageNet-256 广度(Table 6):固定配方($\alpha=0.4$、半宽冻结引导)在 18/18 个 DiffusionBench 配置降低无引导 FID,幅度 16.3%–49.4%(中位 31.3%):RAE/DINOv2-B 从 2.09 到 1.75,SD-VAE(EMA)+reg 从 5.49 到 3.77,像素空间 PixNerd 从 20.37 到 10.31;19 配置 285 项指标中 269 项偏向 SWIFT。(4) RAEv2/DINOv3-L(875M):无引导 FID 从 1.56 到 1.15,带内部引导从 1.04 到 0.99,最优引导强度从 1.78 左移到 1.20。(5) 长训稳健(Figure 10):DINOv2-B 配对训练到 240 epoch,SWIFT 在全部 36 次评估中领先(终点 1.38 对 1.63);基线练到 320 epoch 最佳 1.53,SWIFT 在 epoch 120 即达 1.50,仅用约 0.45 倍 FLOPs。(6) 消融(Figure 6/Table 10):$\alpha$ 呈 U 形、CIFAR-10 上 0.7–0.9 最佳;引导过弱迅速劣化(宽度 128→64 使 FID 从 2.58 到 1.60);联合训练引导(1.618)与在线自适应 $\alpha$(2.416)均无益。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-256 无引导类条件生成(RAE/DINOv2-B,615M,80 epochs) | FID-50k | 1.75 | 2.09 | −16.3%;五特征平均 FDr 同时从 4.13 降到 3.69 |
| ImageNet-256 无引导生成(RAEv2/DINOv3-L,875M) | FID-50k | 1.15 | 1.56 | −26.3%,超越全部已发表无引导结果 |
| ImageNet-256 带内部引导生成(RAEv2) | gFID-50k | 0.99 | 1.04 | −4.8%,最优引导强度从 1.78 降到 1.20 |
| ImageNet-256 全部 18 个 DiffusionBench 配置(RAE/VAE/E2E/像素) | 无引导 FID 相对降幅 | 18/18 全部下降,16.3%–49.4%(中位 31.3%) | 各配置同预算 α=0 基线 | FID 最低的三个基线也改善 16.3%–17.4%,且不逐配置调 α |
| ImageNet-256 像素空间生成(PixNerd) | FID-50k(无引导) | 10.31 | 20.37 | −49.4%,为所有配置中的最大单项降幅 |
| 训练效率对比(DINOv2-B,含引导准备成本) | 达到基线最佳 FID 所需 FLOPs | epoch 120 达 FID 1.50,约 0.45× 基线 FLOPs | 基线训至 320 epochs 最佳 1.53 | 约 2.2 倍算力效率;且基线在观察范围内从未达到 1.50 |
| CIFAR-10(EDM,200k kimg)引导宽度消融 | FID-50k | 1.60(半宽引导,通道基宽 64) | 2.58(与学生同宽引导,通道基宽 128) | −38% |
| 2D 树状分布七方法对比 | KL 散度 / 离群率 / log p | 0.728 / 3.66% / +0.08 | GFT(最强基线)0.817 / 4.97% / −0.40 | 三项指标均为七方法最优 |
局限与改进
作者承认的局限:定理 1 只比较固定噪声水平上的总体去噪 MSE 且不含引导准备成本,『不直接蕴含 FID 改善』;有限步分析假设固定特征,神经网络的特征学习不在覆盖范围(A.9 节明确声明);去噪 MSE 改善不保证迭代采样质量改善。实践层面:RAEv2 的头条数字 1.15/0.99 是在 160 epoch 预算内选择 epoch 140 检查点的结果,并非与基线同 epoch 的因果对比;19 个配置中有 9 项指标偏向基线(如 4 项 precision、2 项 IS),虽属边缘但非全维度占优;部分引导基线沿用原作者报告值,评估协议不完全统一(不同论文的采样方案可使 FID 相差约 0.1)。我的补充观察:α 的最优点与模型相关(CIFAR-10 约 0.7–0.9,ImageNet 广度实验固定 0.4 且未调优),实际使用仍需小幅扫描;引导必须『弱但称职』,过弱会迅速劣化,这引入了宽度、训练时长、冻结时机等新超参数;实验集中在 615M/875M 的类条件图像生成,文本条件与更大规模的泛化尚无证据。
独立分析的弱点
独立弱点分析:(1) 两阶段流程复杂化训练管线——需要先训练并保存引导检查点,虽然总成本仅约 1.22 倍且引导可复用,但对工程调度、断点续训和消融对照都是额外负担;改进方向是用主训练自身的 EMA 或早期检查点充当在线引导,但论文试过的『记录式引导』最佳 1.557,仍逊于独立引导的 1.501,说明此处仍有设计空间。(2) 理论与实证脱节——谱分析基于固定噪声水平、固定核的总体梯度流,解释不了 FID 级别的增益来源,也无法指导多噪声联合训练中如何分配 $\alpha(\sigma)$;改进方向是把响应算子分析推广到噪声混合与特征学习设定,或构造可实测的谱对齐代理指标(如 $A/C$)来预测最优 α。(3) 标签噪声放大是内在风险——目标噪声被放大 $(1+\alpha)^2$ 倍,有限样本定理要求 $A>V$ 才有正收益;在小数据或标签含噪场景外推可能放大伪影,应按噪声水平或数据质量自适应收缩 α。(4) 复杂调度普遍失败——156 个实验臂中容量切换、时变/噪声依赖 α、在线自适应规则大多不如固定配方(在线自适应 2.416 远差于 1.501),改进方向应是更稳健的自动化选择而非更复杂的调度。
未来方向
作者提出的方向:结论把回归目标定位为『设计接口』,明确提问『还有什么有用的修正可以写进目标里』——例如数据驱动的去偏、感知加权、与其他训练信号(表征对齐、蒸馏)的组合;训练期修正与推理期引导的互补机制值得进一步刻画(最优引导强度从 1.78 左移到 1.20 说明两者部分重叠但未完全吸收)。基于成果可延伸的方向:(1) 把 SWIFT 迁移到文本条件的大规模潜在扩散与视频生成,验证条件匹配引导在开放域文本下的行为;(2) 与流匹配/速度参数化大模型结合(论文已给出等价公式 $v_{SWIFT}=(1+?lpha)v-?lpha v_g$);(3) 自动化 α 与引导选择——用验证 FID 或谱对齐代理指标在线选择,替代网格扫描;(4) 理论延伸到特征学习、有限样本与多噪声水平耦合;(5) 探索弱模型的更一般来源:跨架构、跨数据集甚至跨模态的引导是否仍有效;(6) 把弱到强外推思想迁移到自回归与掩码生成模型等其他范式。
复现评估
复现评估:代码承诺『发表后公开』(撰写本文时未放出),但方法实现门槛极低——只改一行回归目标(Eq. 4/5),任意扩散训练代码库都可加入;速度参数化的等价实现在 D.1 节写得足够清楚。数据全部公开(CIFAR-10、ImageNet-256),配置记录异常详尽:D.1 给出引导架构(半宽、约 155M)、冻结点、α、训练预算与硬件;D.2 给出采样器、引导独立重调与检查点选择规则(并明确标注 RAEv2 头条数字选自 epoch 140);D.3 给出算力账目(4×B200 上 80 epoch 基线约 44 小时、SWIFT 主训练约 49 小时、引导预训练 12 小时);CIFAR-10 的 156 个实验臂有 DATA 台账可查。算力方面:CIFAR-10 级别复现单机多卡可完成,是验证方法的最短路径;完整的 19 配置 ImageNet 扫描需要多卡集群、数万 GPU 时量级。总体判断:方法复现容易(入门级改动),完整结果复现成本中等偏高,可信度因实验记录详尽而较高。
论文图表