FewStepRL:用强化学习微调少步扩散模型 FewStepRL: Fine-tuning Few-step Diffusion Models with Reinforcement Learning
系统地将五种扩散模型RL目标适配到少步蒸馏模型,统一代码库对比并给出选型指南
前置知识
少步扩散模型与平均速度流图
扩散/流匹配模型通常学习瞬时速度 $v(x_t,t)$,采样需 32–64 步数值积分。少步模型(MeanFlow、DMD、AnyFlow 等)直接学习一段区间上的平均速度 $u_\theta(x_t,t,r)=\frac{1}{t-r}\int_r^t v_\theta(x_\nu,\nu)\,d\nu$,可理解为采样轨迹割线的方向,一步完成精确跳转 $\hat{x}_r=\hat{x}_t-(t-r)u_\theta$,1–4 次网络评估即可生成图像或视频。
本文所有 RL 方法微调的对象正是这种平均速度网络,其输出与现有 RL 目标所需的瞬时速度不匹配,是全文要解决的核心矛盾。
MeanFlow 恒等式与自感应速度
平均速度与瞬时速度满足恒等式 $u(x_t,t,r)=v(x_t,t)-(t-r)\frac{du}{dt}$,对平均速度的定义微分消去积分即得。实现中用方向差分估计全导数,并记停止梯度的雅可比-向量项 $\mathcal{J}(u,t,r)=(t-r)\,\mathrm{sg}(\partial_t u)$;于是瞬时速度可由网络自身恢复:$v^{ind}=u^{old}+\mathcal{J}$,无需第二个网络。
这是 v-ind 估计器的基础,MeanFlowAWM、MeanFlowNFT、FewStepOPSD 都靠它把 RL 目标中的瞬时速度换成平均速度网络可计算的量。
GRPO 式组相对优势
对同一 prompt 采样 $K$ 个成员,用组内统计得到零均值有符号优势 $A^{(i)}=(R^{(i)}-\mathrm{mean}\{R\})/(\mathrm{std}\{R\}+\varepsilon)$,组均值充当 baseline,无需价值网络。FlowGRPO 进一步把确定性 ODE 采样器改成转移似然可解析的 SDE,再套 PPO 裁剪目标做策略优化。
FewStepGRPO、AWM、DiffusionNFT 三族方法都建立在这个优势信号上,区别只在把优势用作有符号乘子、混合权重还是分支权重,是理解实验分组的钥匙。
分布匹配蒸馏 DMD 与辅助网络
DMD 不使用回归目标,而是在线训练一个辅助速度场 $v_\phi$:用流匹配损失把它拟合到学生自己采样的分布上(目标是 $v_\phi(\tilde{x}_t,t)\approx\mathbb{E}[\epsilon-\hat{x}\mid\tilde{x}_t]$),教师速度与辅助速度之差给出反向 KL 的梯度方向,驱动学生分布逼近教师分布。AnyFlow 将其改造为对任意步数流图的 on-policy 蒸馏。
本文的 v-aux 估计器直接继承这一思路,DMDAWM/DMDNFT 用 $v_\phi$ 的预测作为奖励增强的 baseline 锚点,其开销与稳定性是实验效率分析的重点。
奖励黑客 reward hacking
RL 微调时策略可能学会钻奖励模型的空子刷分而非真正提升生成质量,典型表现为训练奖励持续上涨而留出指标(人类偏好、美学分、图文一致性)下降甚至崩塌。常见防御是向参考策略的 KL 正则、限制更新幅度的信任域或裁剪。
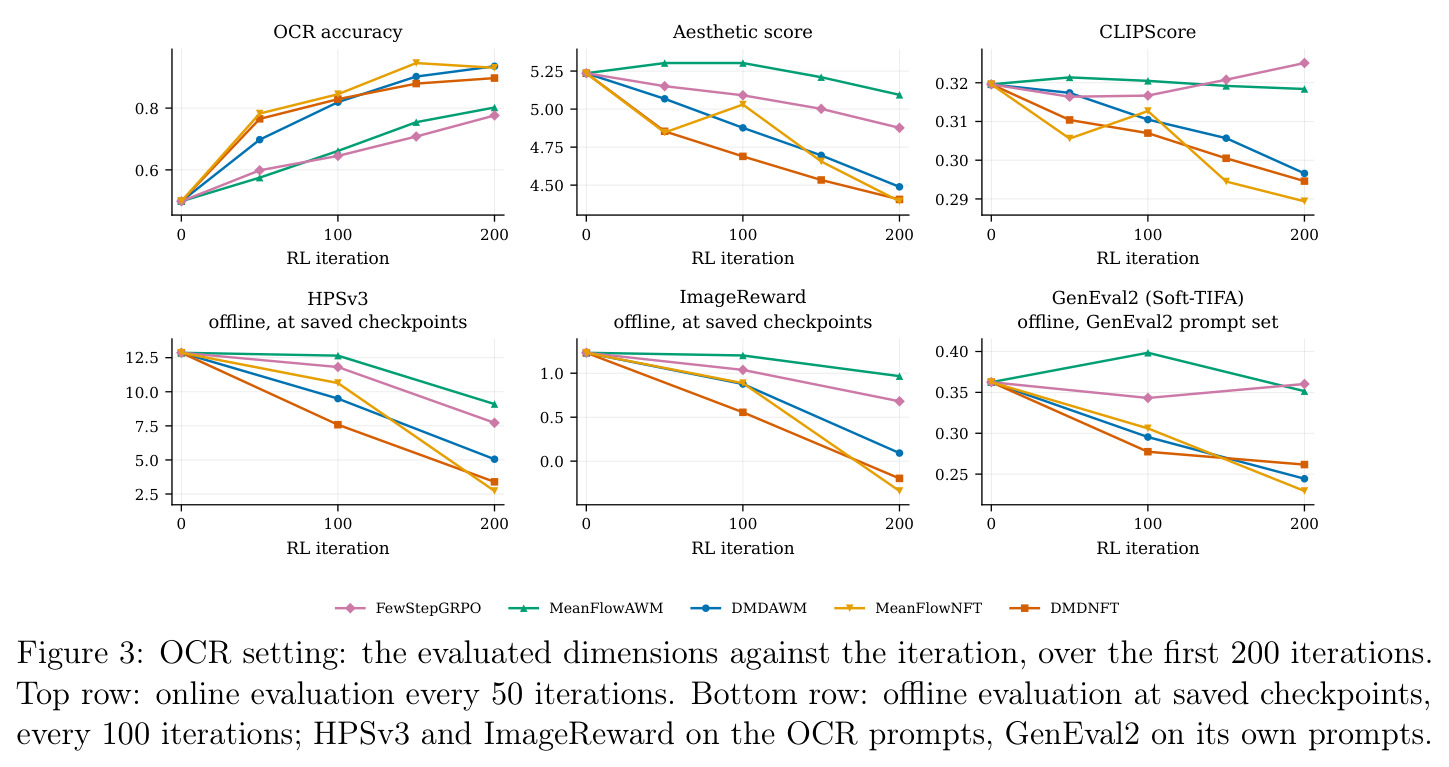
本文框架中自回归项(向旧策略锚点的回归)正是限制预测漂移、防御 reward hacking 的机制;实验里 OCR 设置中『奖励涨、留出崩』的现象反复出现,是解读结果表的关键背景。
研究动机
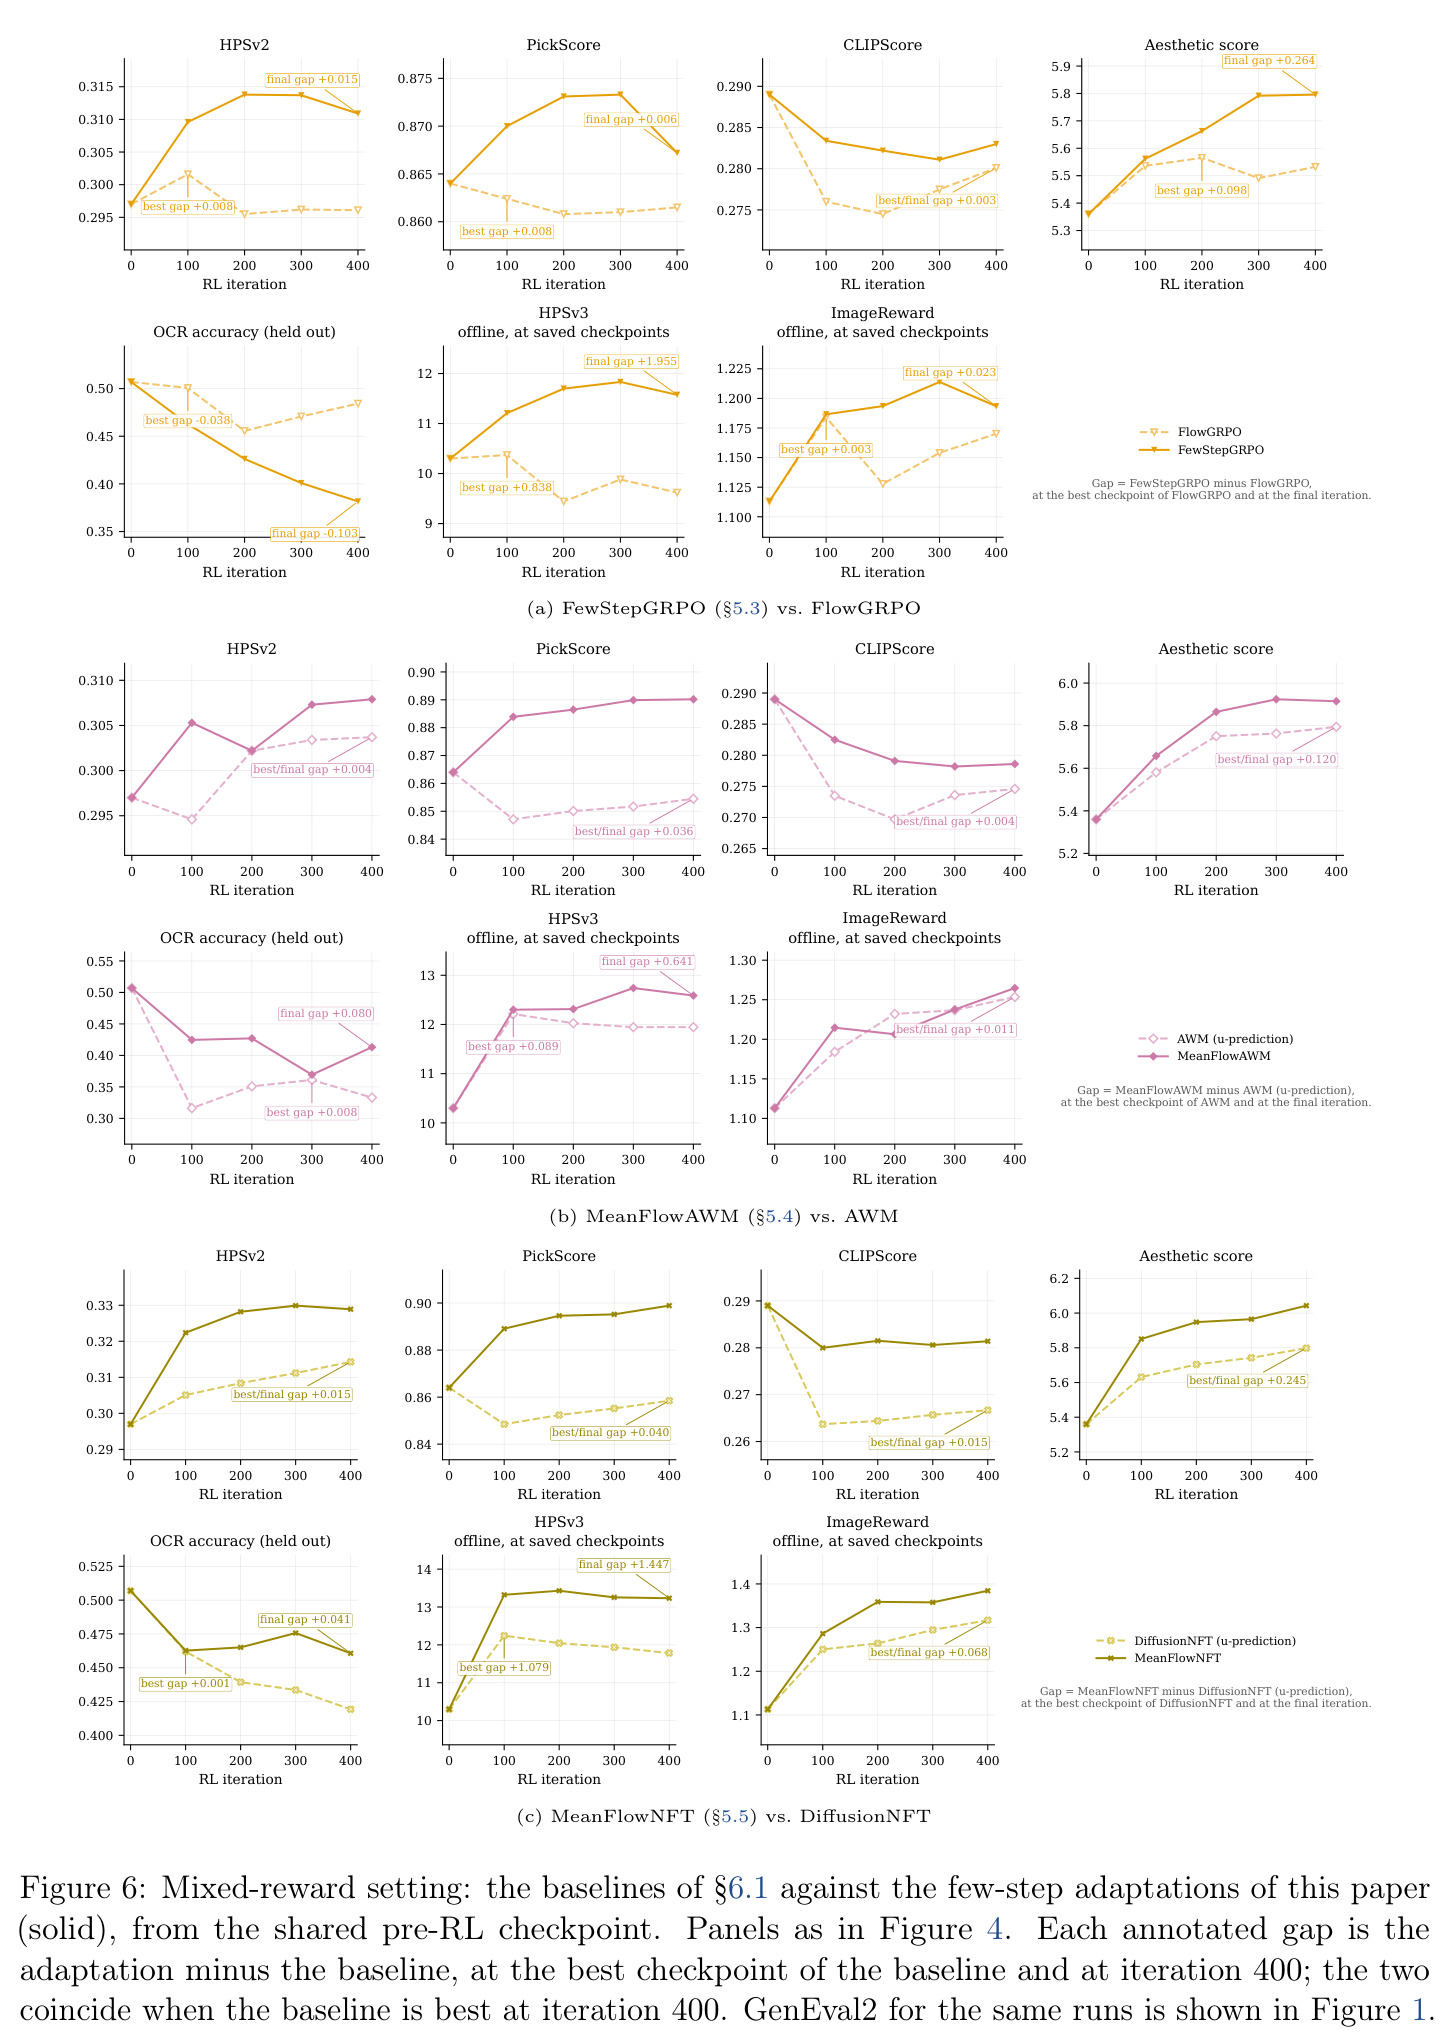
用强化学习(RL)后训练扩散模型已成为标配:FlowGRPO、AWM、DiffusionNFT、ReFL 等方法以人类偏好、文字渲染、组合性等奖励微调模型,确实能改善输出。但这些方法每次迭代都要用当前策略重新 rollout——在标准 32~64 步采样器下,rollout 占据训练的大部分时间与显存,视频长序列下更甚。少步模型(1~4 步生成)本可消除这笔开销,但它们建模的是区间上的平均速度,而现有 RL 目标全部为瞬时速度或多步采样器的转移似然设计。直接套用立刻遇到三个悬而未决的问题:应对网络的哪一次求值求导?旧策略(reference policy)的预测如何计算?区间上哪些部分被训练?论文 Figure 1 显示,把 FlowGRPO、AWM、DiffusionNFT 的原始目标不加修改地用于蒸馏模型(平均速度直接替换瞬时速度),混合奖励设置下的最佳留出 GenEval2 在全部三组对比中都低于本文的自适应版本;例如 FewStepGRPO 相对 FlowGRPO 留出 HPSv3 为 11.58 对 9.62,MeanFlowNFT 相对 u-prediction DiffusionNFT 的 GenEval2 最终差距 +0.013。此前的少步 RL 工作(Flow-Map GRPO、MeanFlowNFT、RTDMD)都是一次只适配一个目标,缺乏系统方案。
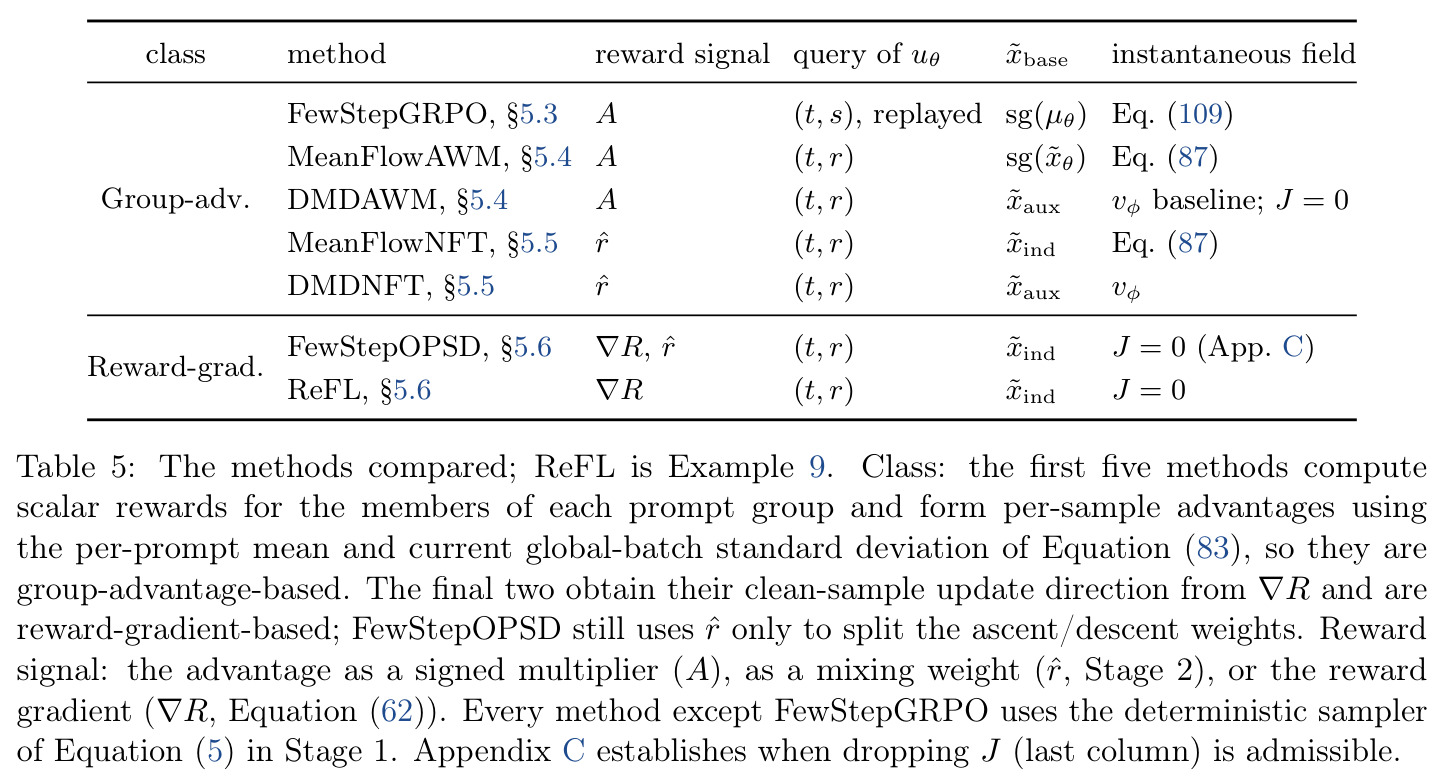
本文的目标是本文要建立一个系统性框架,把主流扩散 RL 目标——FlowGRPO、AWM、DiffusionNFT、DiffusionOPSD、ReFL——统一适配到少步(平均速度)模型上,并回答三个实际问题:(i) 在共享 rollout、奖励与评估代码的前提下,哪种奖励信号(组相对优势 vs 可微奖励梯度)与哪种瞬时速度估计方式(自感应 v-ind vs 辅助网络 v-aux)决定微调的效果与效率?(ii) 结论能否跨模态迁移(图像 SD3.5-Medium vs 视频 Wan2.1-T2V-1.3B)?(iii) 少步训练的模型在推理时增加采样步数能否提升质量(test-time scaling)?工程上要求七个训练器共享同一个训练步骤与模块化代码库,新变体只需指定锚点与权重;实验上在 OCR 不可微奖励与 CLIP+HPSv2+PickScore 混合可微奖励两种设置下完成同预算对比(图像 400 迭代、视频 250 迭代),并产出可操作的方法选型指南。
与已有工作不同的是,已有 RL-for-few-step 工作都是『一个目标对一种模型』的定点适配:Flow-Map GRPO 组合流图生成器的随机步,MeanFlowNFT 借自感应瞬时场把 DiffusionNFT 用于平均速度模型,RTDMD 优化奖励倾斜的分布匹配。它们留下一个被忽视的观察:这些目标在梯度层面可能是同构的。本文的独特切入是先把每个目标变换到 x 空间——利用线性噪声调度下速度诱导仿射映射 $X(x_t,v,r)=x_t-(t-r)v$ 的事实——再把梯度统一分解为『向参考的自回归项 + 含奖励的增强项』,从而把『设计新损失』化归为『选择三个锚点和三个权重』。在这个坐标系下,少步适配不再是一个目标一份推导,而是统一的锚点构造问题(u-form 端点式 vs v-form 切线式,瞬时速度取自网络自身或辅助网络)。『梯度级等价视角 + 模块化实现 + 消除实现差异的公平对比』这一组合是此前文献缺失的。
核心方法
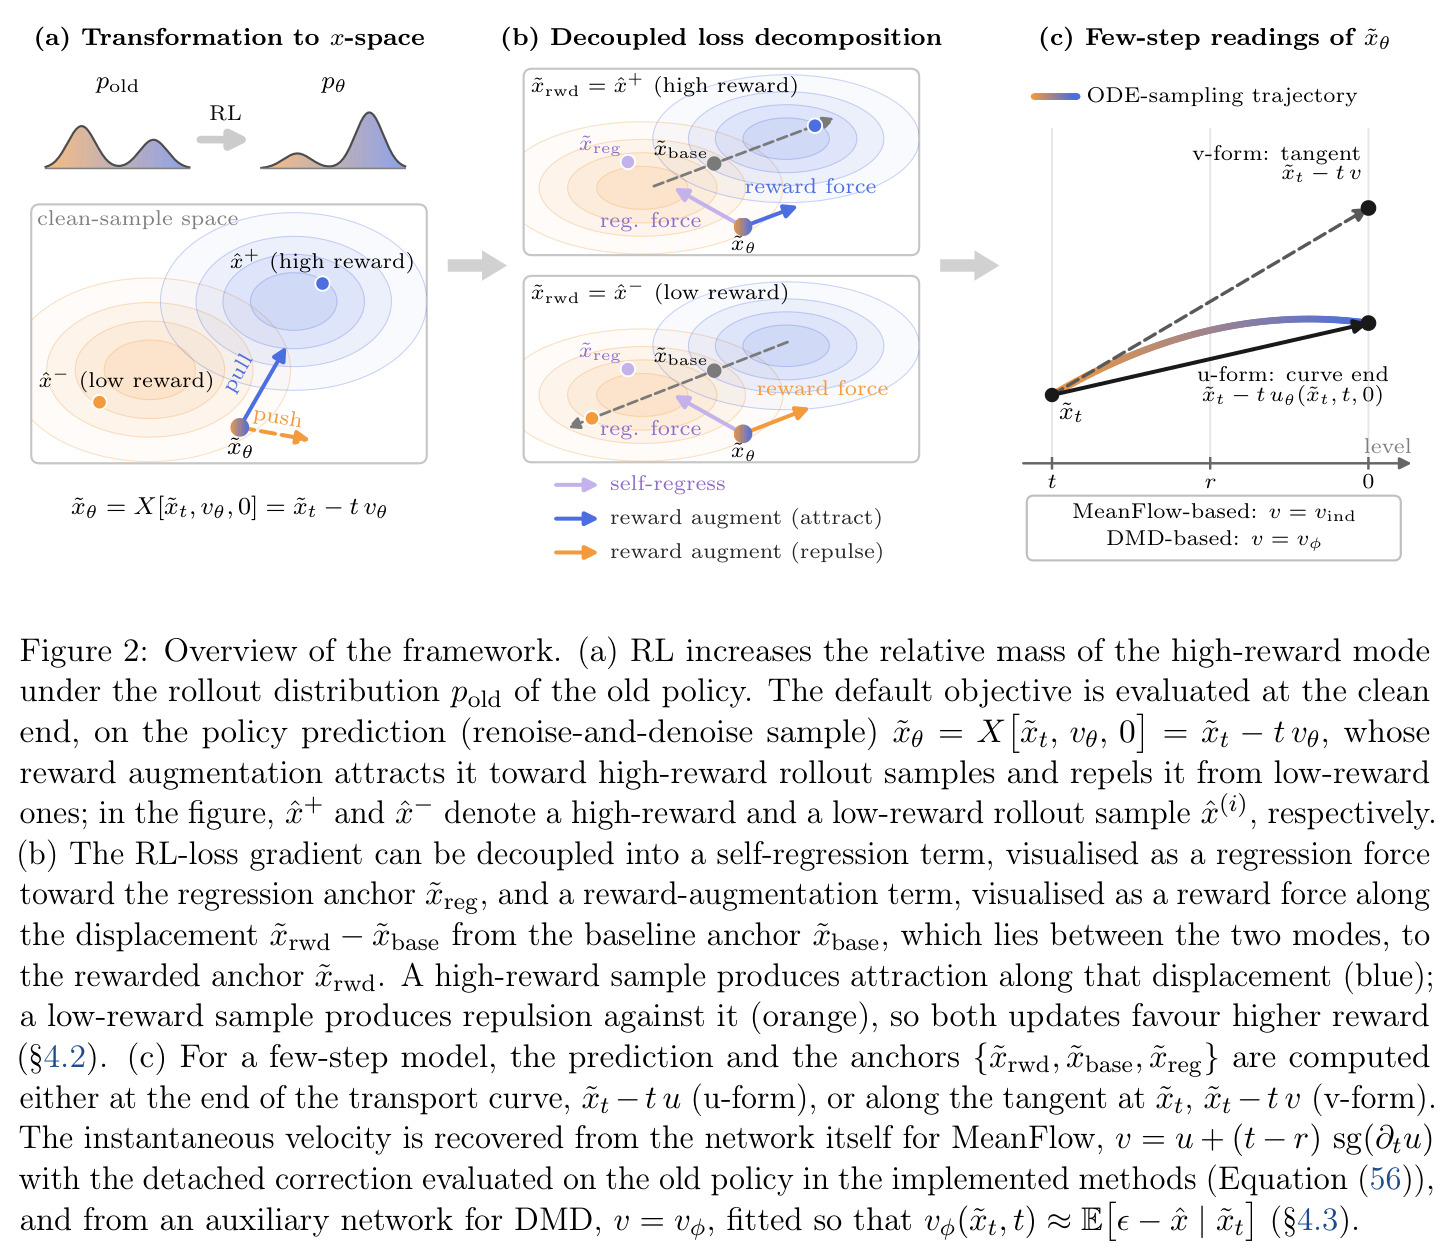
直觉上,这些 RL 方法都在做同一件事:把模型预测往高奖励样本方向拉、往低奖励样本方向推,同时用一条『缰绳』(向参考策略的回归)防止它跑飞。本文证明这个直觉在梯度层面严格成立。技术路线分三步(Figure 2):第一步变换到 x 空间——定义仿射传输 $X(x_t,v,r):=x_t-(t-r)v$,则速度均方误差等于 transported 点之间的缩放距离 $\|v_a-v_b\|^2=\frac{1}{(t-r)^2}\|X(x_t,v_a,r)-X(x_t,v_b,r)\|^2$,每个目标都可写成对同一策略预测 $\tilde{x}_\theta=\tilde{x}_t-t v_\theta$ 的比较,密度、速度、奖励三种表述从此可比。第二步分解梯度——每个损失的梯度都等于雅可比 $(\partial\tilde{x}_\theta/\partial\theta)^\top$ 作用在『自回归 $W_{reg}(\tilde{x}_\theta-\tilde{x}_{reg})$ 加上奖励增强 $-W_{rwd}\,\omega(\tilde{x}_{rwd}-\tilde{x}_{base})$』之和上,方法化归为锚点与权重的选择。第三步适配少步模型——锚点要么取传输曲线终点(u-form,$\tilde{x}_t-t\,u_\theta(\tilde{x}_t,t,0)$),要么取当前状态切线(v-form);v-form 又分自感应(MeanFlow 式 $v^{ind}=u^{old}+\mathcal{J}$)与辅助网络(DMD 式 $v_\phi$)两种瞬时速度恢复方式。最终得到 FlowGRPO、AWM、DiffusionNFT、DiffusionOPSD、ReFL 的少步版本,全部在一个代码库中实现。
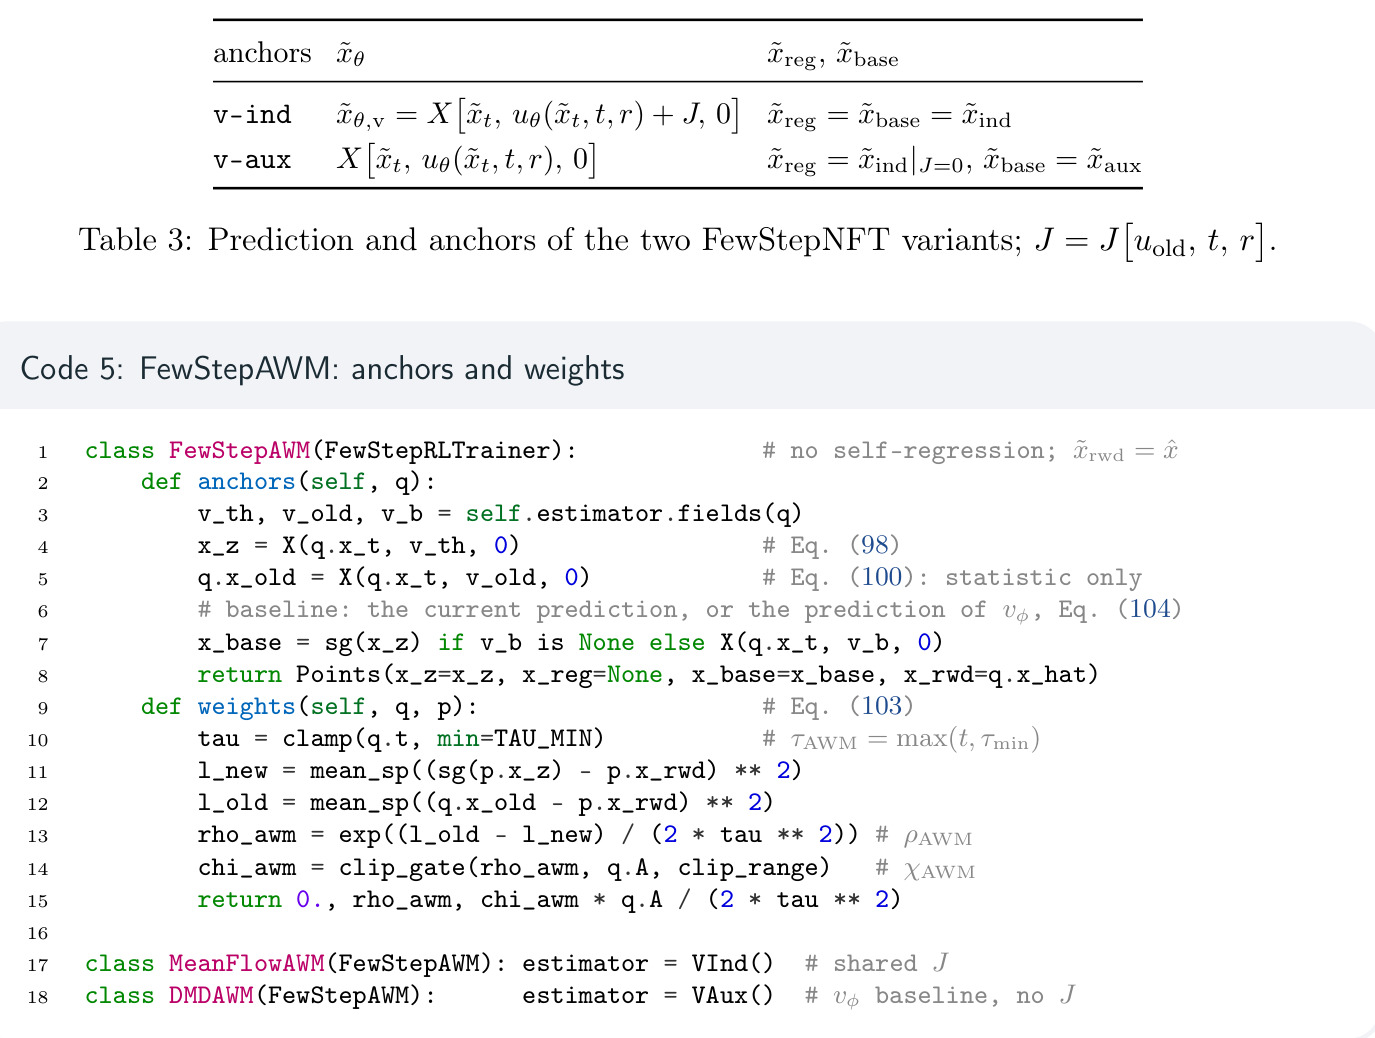
全文最核心的洞察是『梯度级解耦分解』:变换到 x 空间后,上述所有目标的梯度都归结为同一形式 $$\nabla_\theta\mathcal{L}^{(i)}=2\left(\frac{\partial\tilde{x}_\theta^{(i)}}{\partial\theta}\right)^{\!\top}\left[W_{reg}\big(\tilde{x}_\theta^{(i)}-\tilde{x}_{reg}^{(i)}\big)-W_{rwd}\,\omega^{(i)}\big(\tilde{x}_{rwd}^{(i)}-\tilde{x}_{base}^{(i)}\big)\right],$$ 即一个不含奖励的自回归项(把预测拉回锚点、限制奖励项能推多远、防御 reward hacking)加上一个沿位移 $\tilde{x}_{rwd}-\tilde{x}_{base}$ 的奖励增强项。于是『一个 RL 方法』在梯度层面化归为三个锚点($\tilde{x}_{reg},\tilde{x}_{rwd},\tilde{x}_{base}$)与三个权重($W_{reg},W_{rwd},\omega$)的选择:AWM 的 baseline 锚点是 detached 的当前预测且无自回归项;DiffusionNFT 的回归锚点与 baseline 锚点重合于旧策略预测、系数经 clip 在 $1/\beta$ 饱和;纯蒸馏(DMD/MeanFlow)则是 $\omega\equiv 1$、奖励锚点取教师预测的特例。与已有工作的本质区别:以前每个少步 RL 变体需要独立推导一份新损失,如今只需说明四个点如何从少步网络计算、流图的哪些条目 $u_\theta(\cdot,t,r)$ 通过 $\partial\tilde{x}_\theta/\partial\theta$ 收到梯度——适配成为统一坐标系下的锚点构造问题,而不是新的目标函数。
方法步骤详情
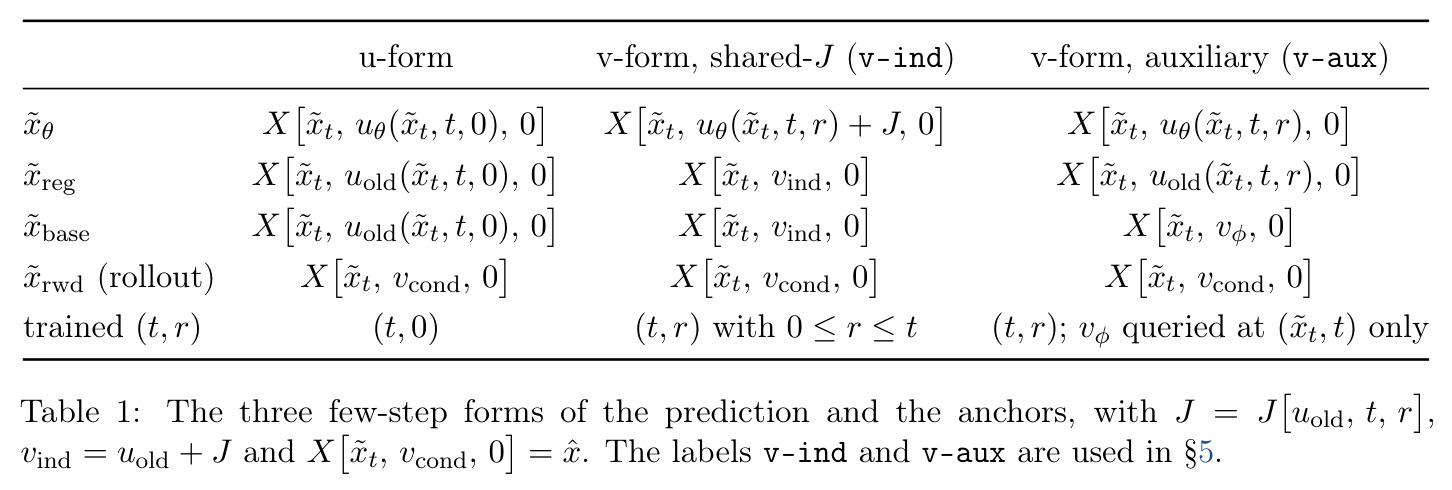
完整流程是一个外层迭代,七个训练器共享同一骨架:(1) Rollout:旧策略 $u^{old}$($u_\theta$ 的 EMA)为每个 prompt 采样 $K$ 个成员(图像 48 prompts × K=24 = 1152 rollout;视频 K=16、2048 rollout),除 FewStepGRPO 用随机 SDE 采样器(每步先跳到 $s_j\le t_{j+1}$ 再加噪并保留转移)外都用确定性跳转 $\hat{x}_r=\hat{x}_t-(t-r)u_\theta(\hat{x}_t,t,r)$;FewStepOPSD 额外做奖励耦合构造——从 $r=0$ 的旧策略预测出发沿 $\pm\nabla R$ 走 $M_{tgt}=2$ 步归一化梯度(步长在信任半径 $\kappa\|\tilde{x}^{old}\|$ 内投影),得到 detached 的构造点 $\tilde{x}^{\pm}$。(2) 奖励与优势:解码并打分 $R^{(i)}=R(D(\hat{x}^{(i)}),c)$,组内减均值、全局 batch 求标准差得 $A^{(i)}$,再压缩成有界混合权重 $\hat{r}^{(i)}=\frac12+\frac12\mathrm{clip}(A,-c_{adv},c_{adv})/c_{adv}\in[0,1]$。(3) 辅助拟合(仅 v-aux):更新策略前用流匹配损失拟合 $v_\phi$ 共 $n_{fm}=5$ 步。(4) 训练损失:$n_{it}=4$ 个内层迭代各抽查询 $(t,r)$($r|t\sim U(0,t)$,固定比例设 $r=t$ 与 $r=0$),计算预测与三锚点(v-ind 用方向差分估计 $\mathcal{J}$ 且一次共享于当前与旧策略;v-aux 用 $v_\phi$),累加解耦损失 $\mathcal{L}=W_{reg}\,\mathrm{meansp}\|\tilde{x}_\theta-\tilde{x}_{reg}\|^2+W_{rwd}\,\mathrm{meansp}\|\tilde{x}_\theta-\mathrm{sg}(\tilde{x}_\theta+g)\|^2+\lambda_{KL}\mathcal{L}_{KL}$,其中 $g=\omega(\tilde{x}_{rwd}-\tilde{x}_{base})$,最后取一次优化器步。(5) Refresh:$u^{old}\leftarrow$EMA$(u_\theta)$。各变体只覆写锚点/权重等钩子:FewStepGRPO 的预测是打分核均值 $\mu_\theta=\alpha_t x_t-b_t(u_\theta+\mathcal{J})$;ReFL 是 $M_{tgt}=1$、仅上升分支、$W_{reg}=0$ 的 FewStepOPSD 特例。
技术新颖性
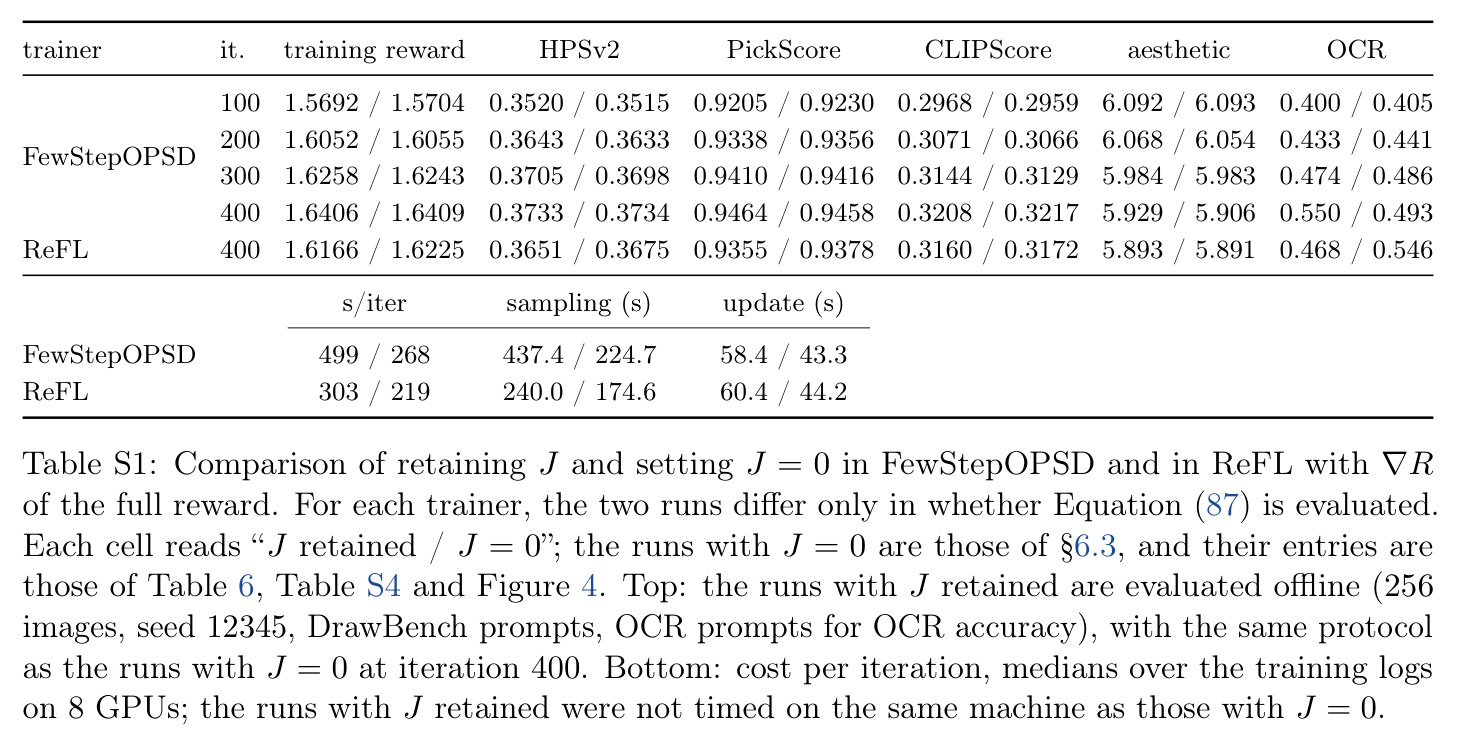
新颖性有四层。其一,统一的梯度级视角是新的:转移似然(FlowGRPO)、速度加权回归(AWM)、隐式策略对比(DiffusionNFT)、分布匹配(DMD)、奖励反传(ReFL)表面上完全不同,本文证明它们在 x 空间共享同一解耦梯度形式,把方法设计空间压缩为『锚点+权重』的离散选择。其二,少步适配是构造性的而非逐例推导:u-form 只训练流图 $r=0$ 边缘、v-form 通过重采样 $r$ 训练整个 $u_\theta(\cdot,t,r)$ 族;共享-J 技巧($\mathcal{J}$ 只在旧策略上估计一次,且在自回归差与 $\mathrm{sg}(\cdot)$ 内全部抵消)与 J-free $(t,r)$ 查询使 FewStepOPSD/ReFL 的损失完全不依赖 $\mathcal{J}$,省去每查询两次额外前向。其三,一个干净的理论发现:ReFL 恰是 DiffusionOPSD 框架在 $M_{tgt}=1$、$W_{reg}=0$、仅上升分支配置下的 detached 代理。其四,工程贡献:七个训练器在一个代码库里只覆写钩子,rollout、奖励、评估全部共享,消除了跨论文比较中实现差异的干扰——这种公平基准在 RL-for-diffusion 文献中少见。
实验结果
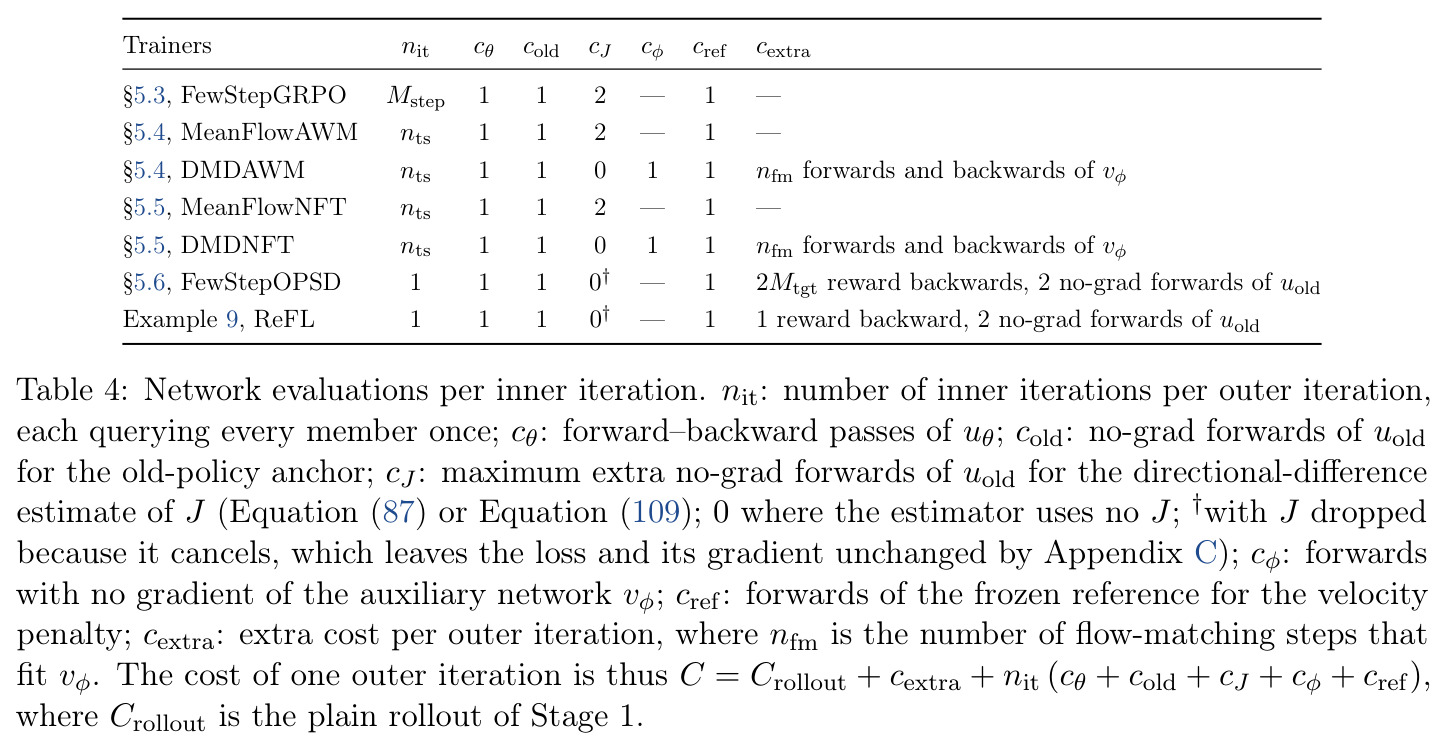
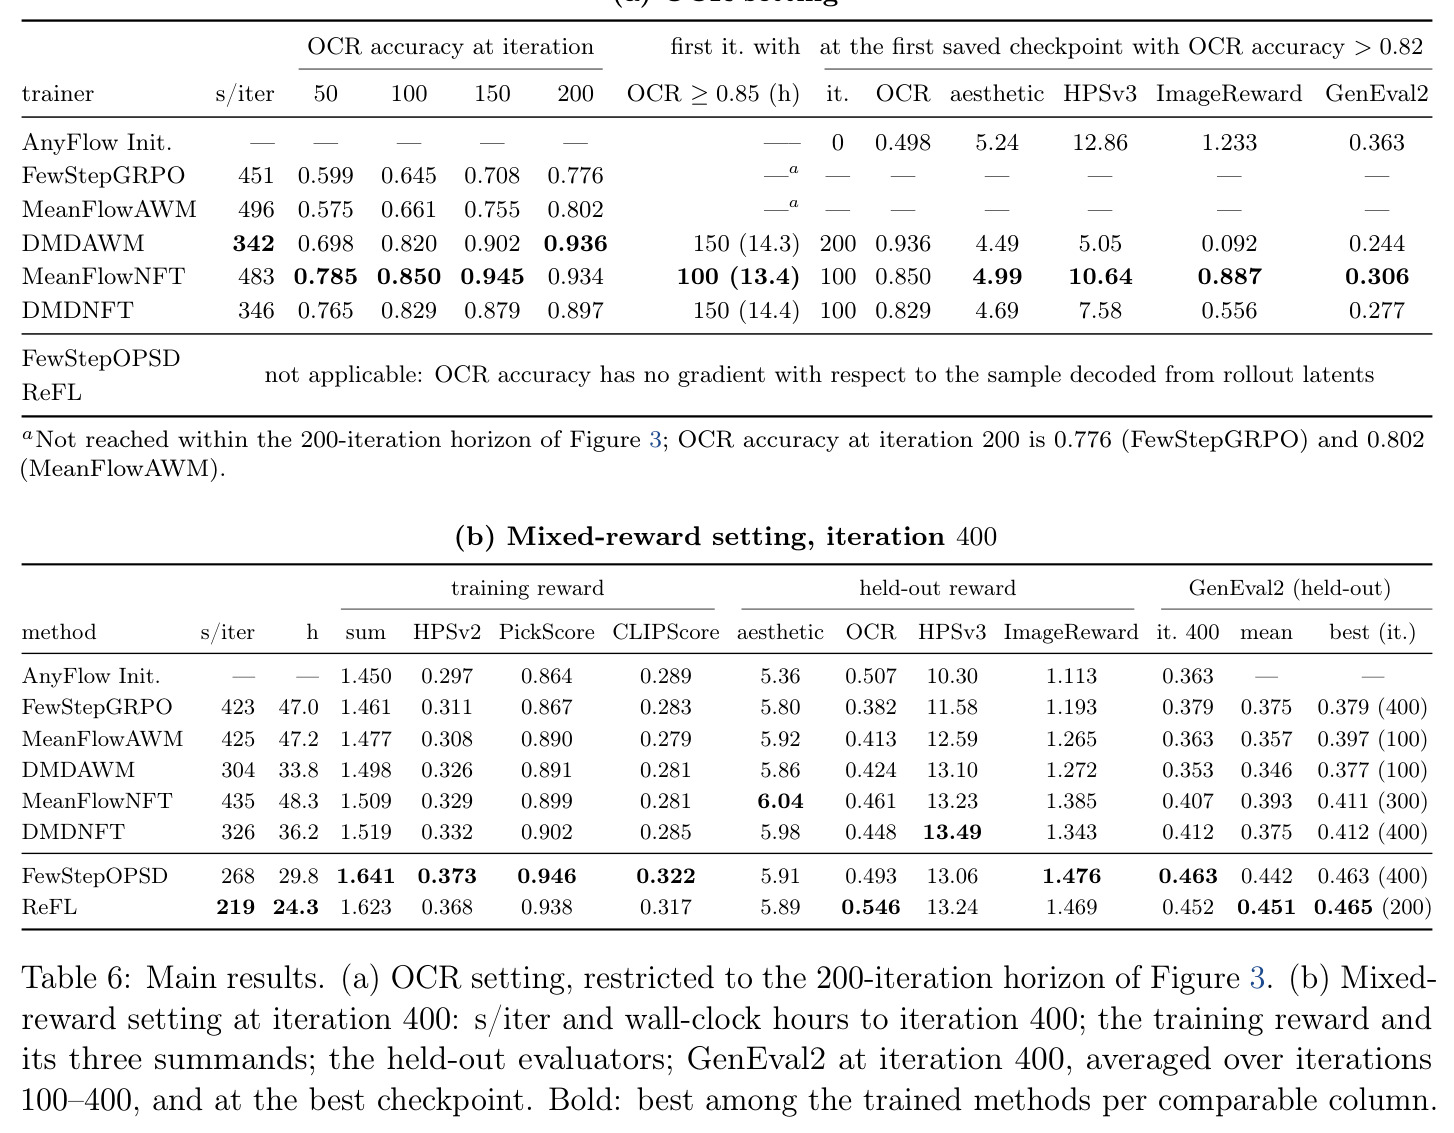
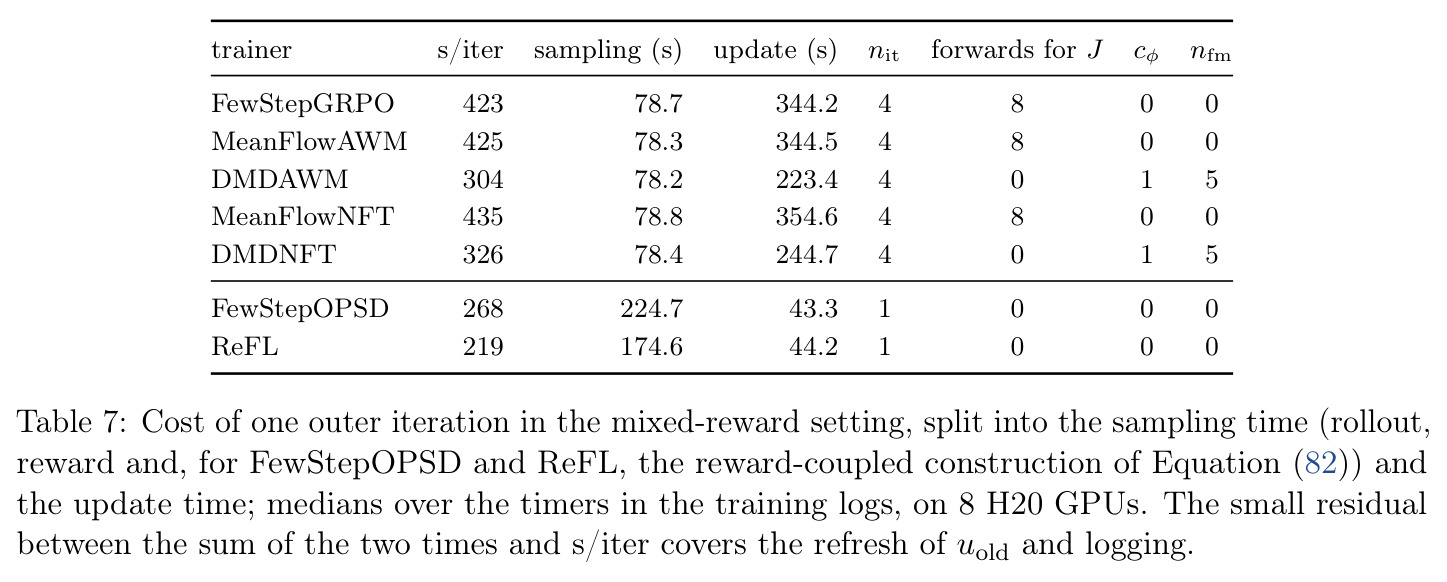
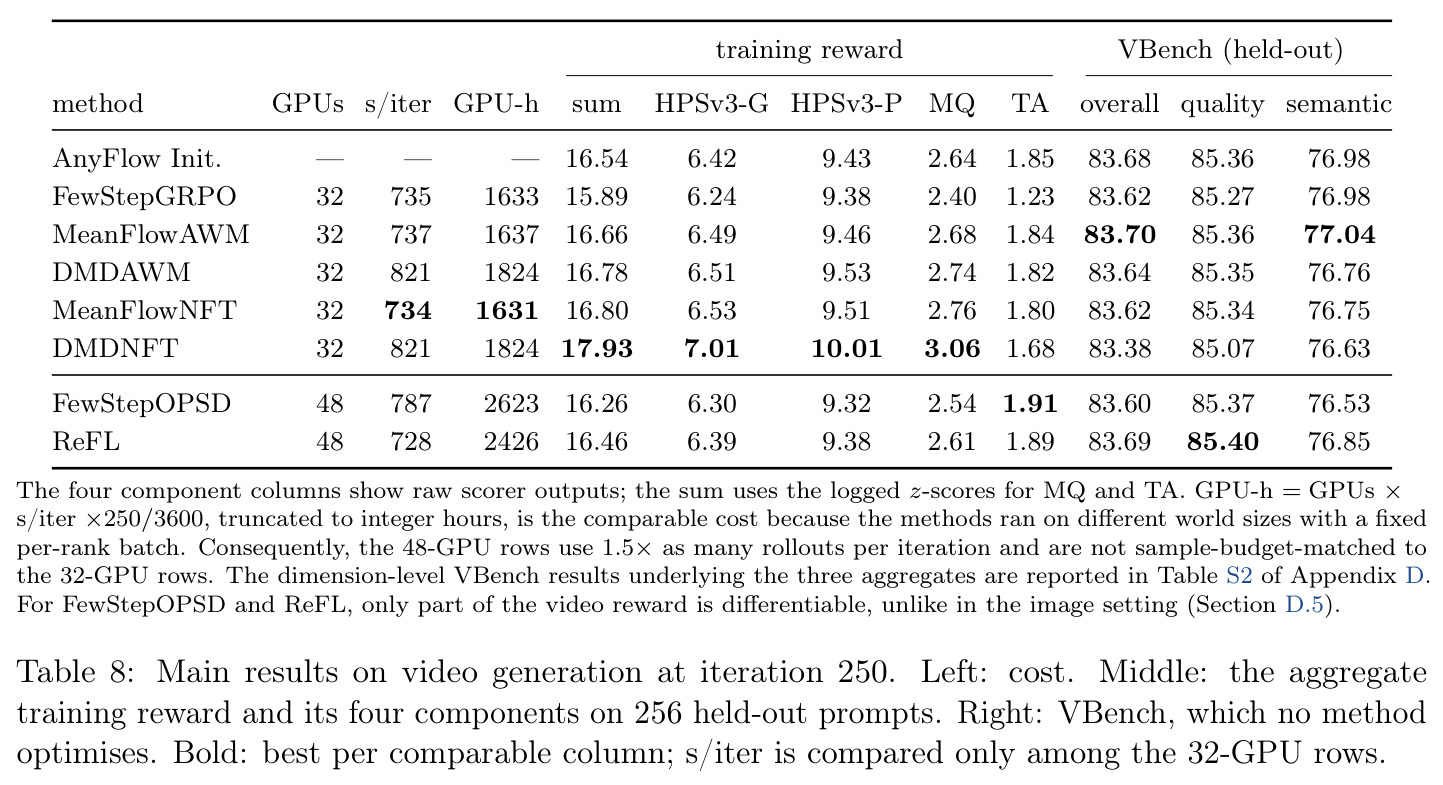
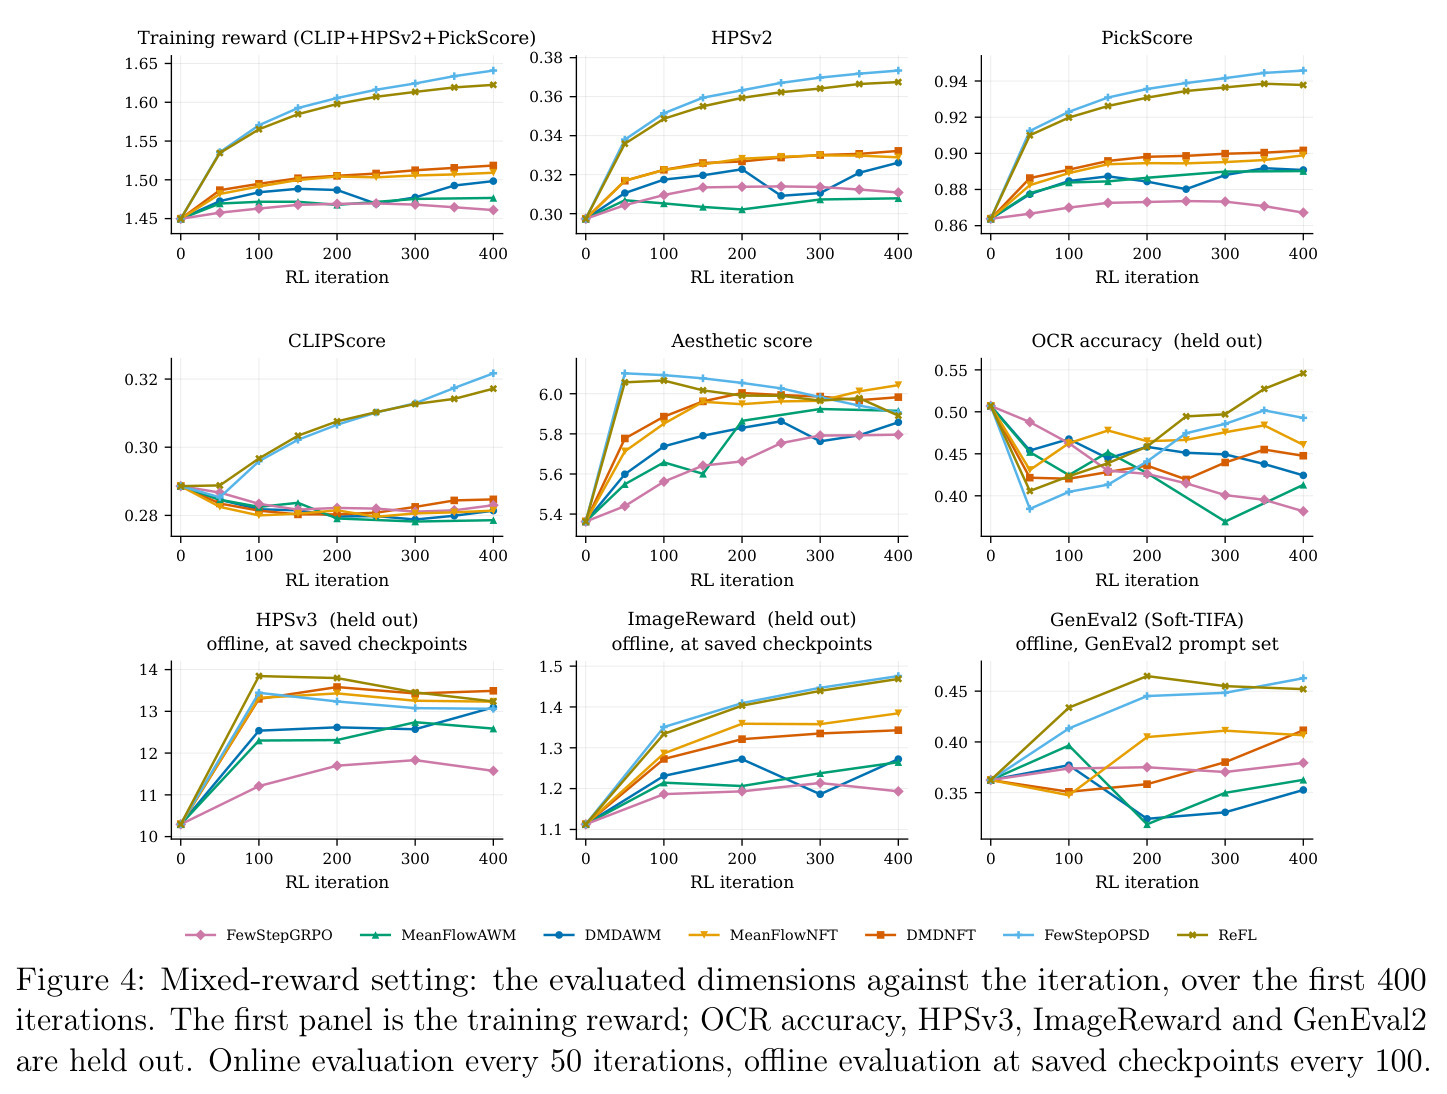
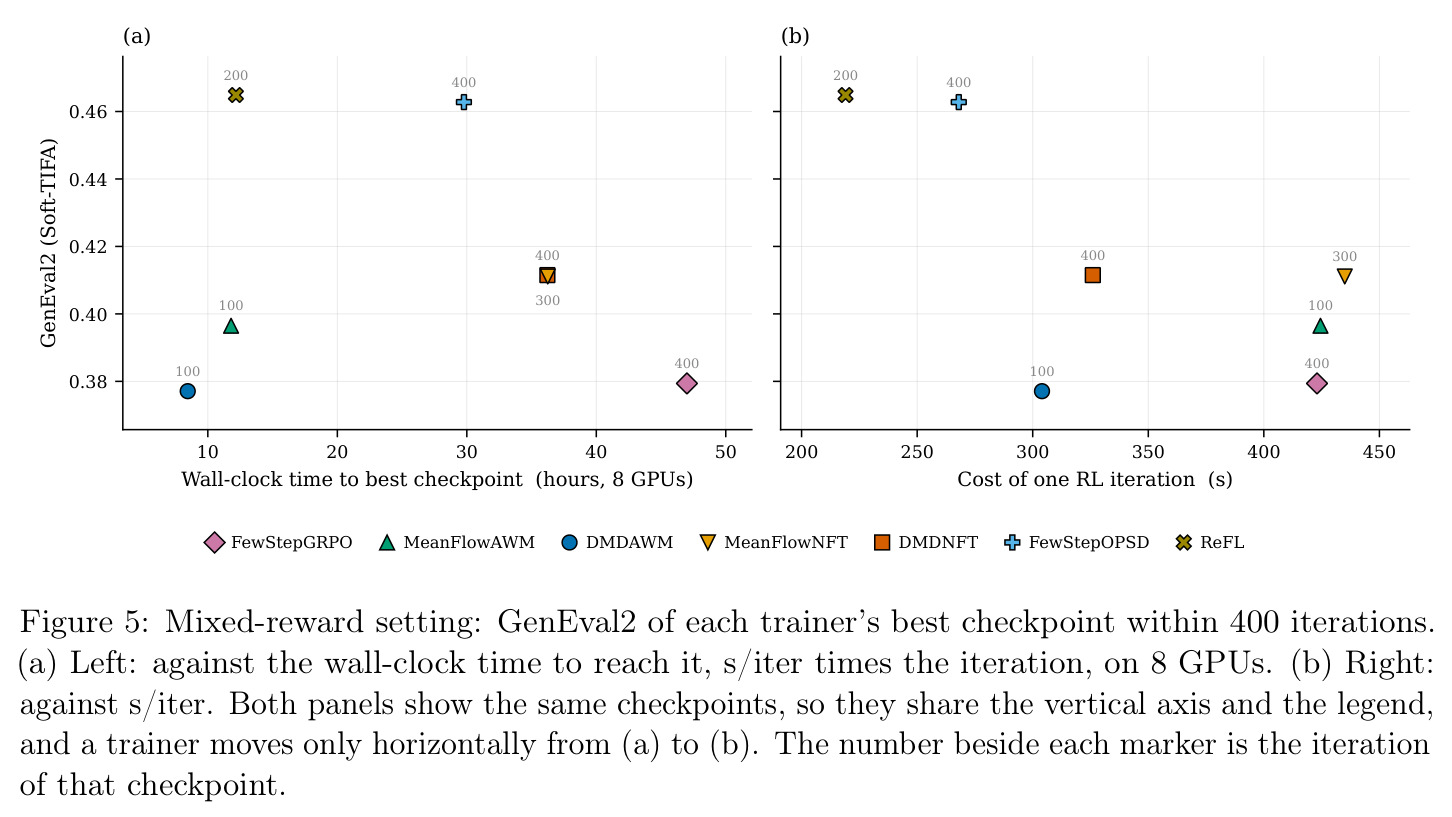
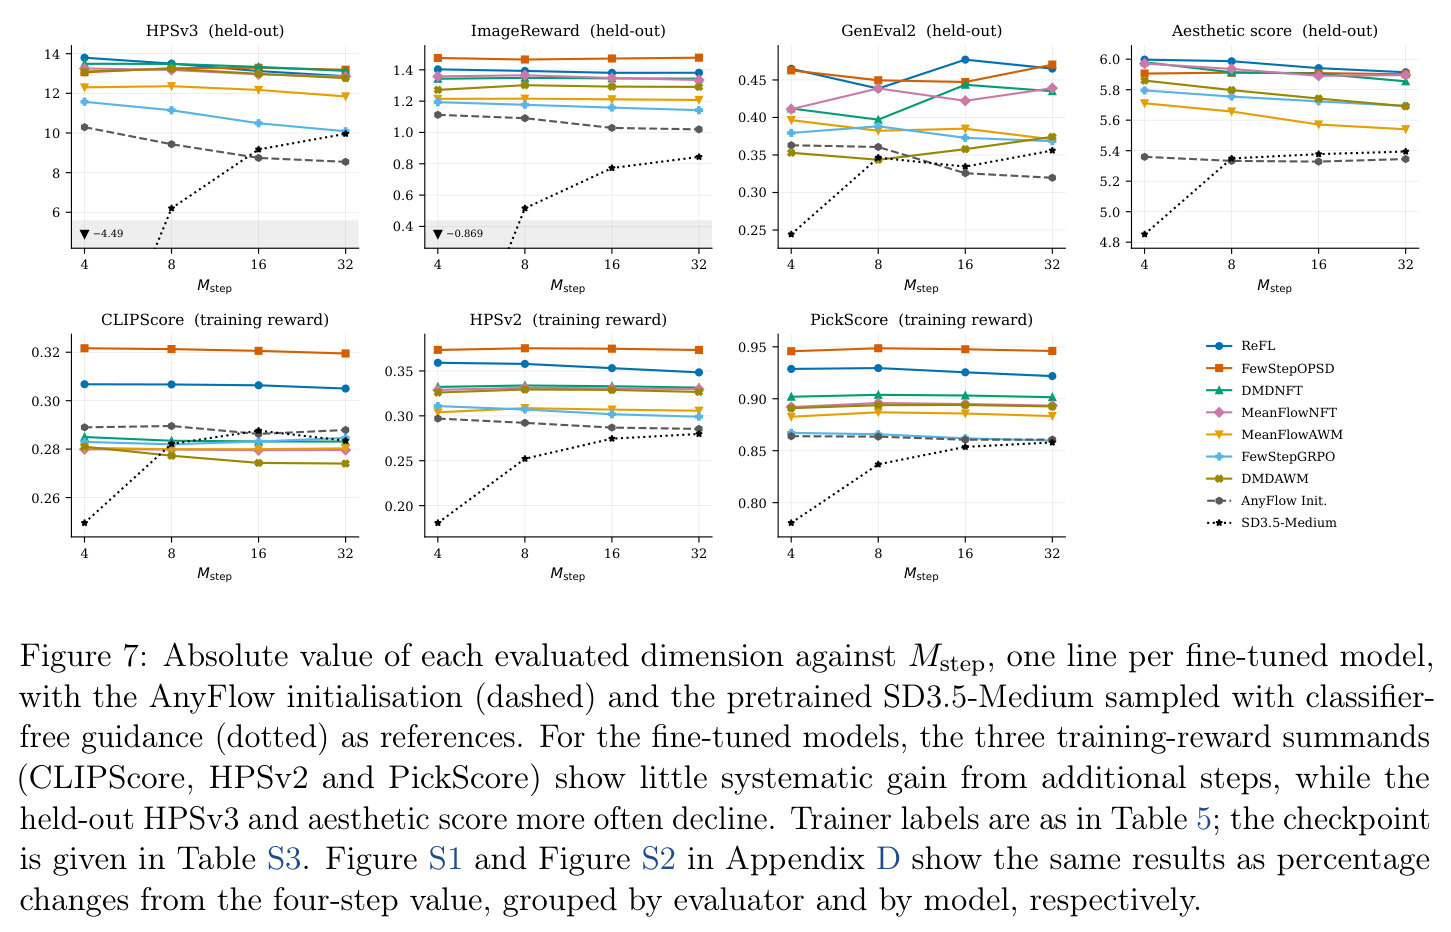
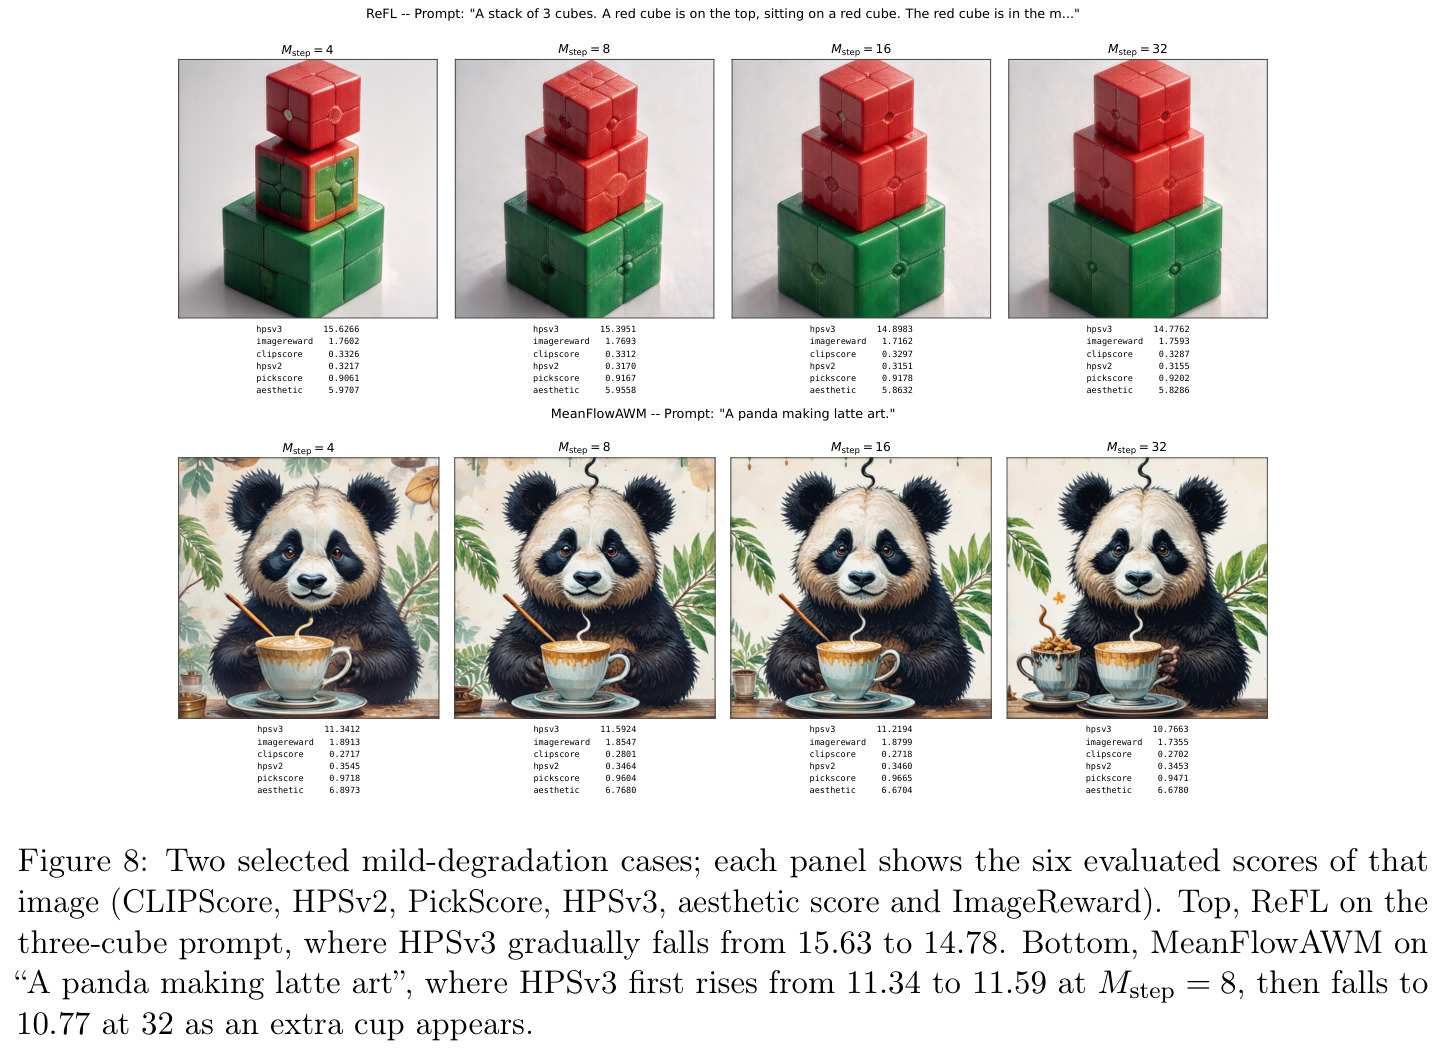
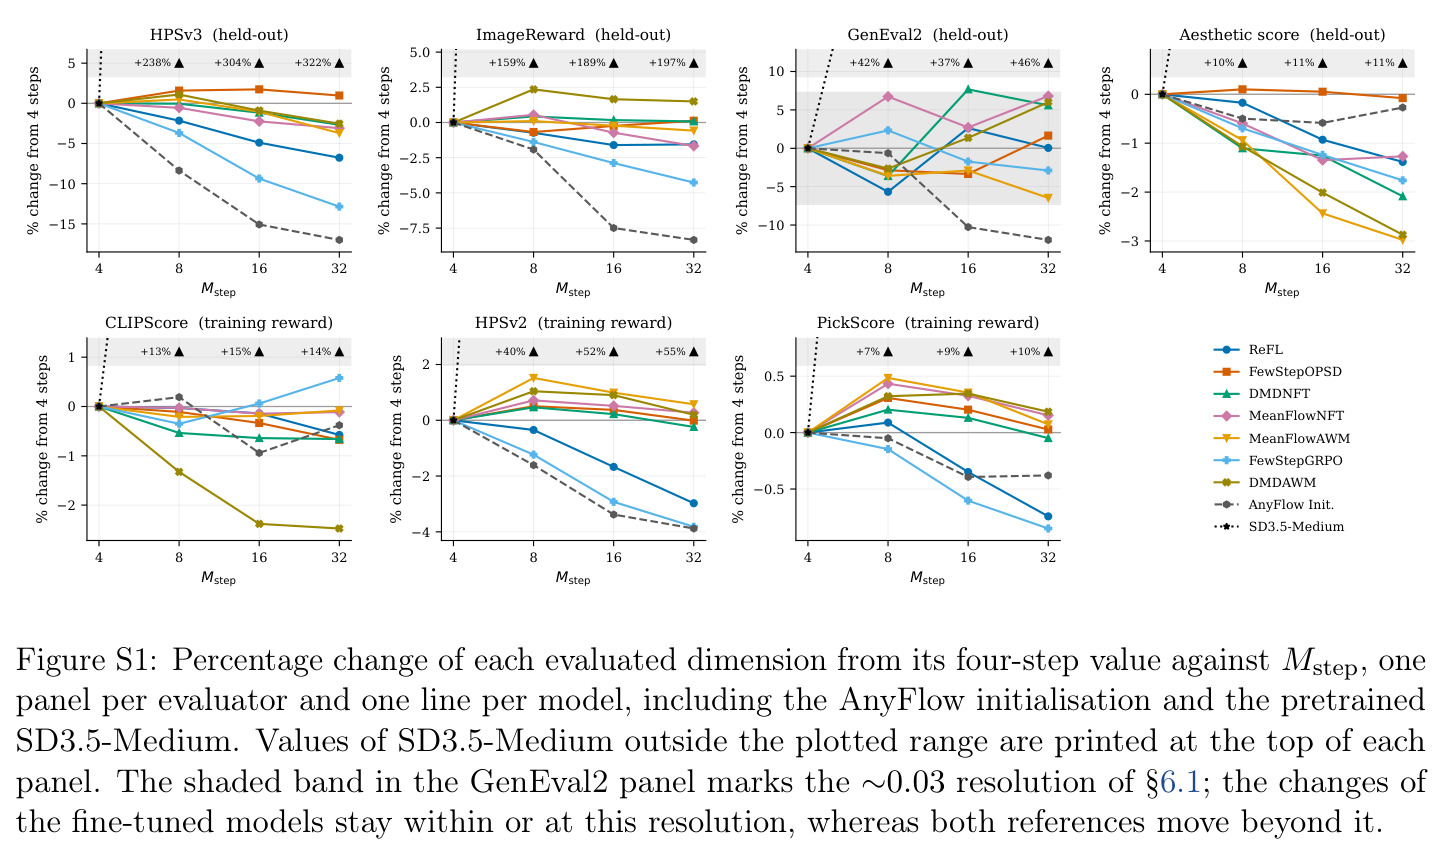
图像实验(AnyFlow 蒸馏的 SD3.5-Medium,4 步,512×512,LoRA rank 32,8×H20,400 迭代)分两个奖励设置。混合奖励(CLIP+HPSv2+PickScore,初始 1.450):可微奖励梯度类最强——FewStepOPSD 训练奖励 1.641、留出 ImageReward 1.476、GenEval2 0.463@400(最佳 0.463),ReFL 1.623、最佳 GenEval2 0.465@200,显著高于组优势类(1.461–1.519,GenEval2 0.379–0.412);且只有这两个方法提升了 CLIPScore(0.289→0.317/0.322),五个组优势方法反而降至 0.279–0.285。组优势类中 DiffusionNFT 族最好:MeanFlowNFT 训练奖励 1.509、HPSv3 13.23、ImageReward 1.385、GenEval2 0.411。适配本身的收益(Figure 1/6):FewStepGRPO 把留出 HPSv3 从 10.30 提到 11.58,而直接套用 FlowGRPO 降到 9.62;MeanFlowNFT 比 u-prediction DiffusionNFT 的 HPSv3 高 1.44(13.23 对 11.79)、最佳 GenEval2 高 0.012(0.411 对 0.399)。OCR 设置(初始 0.498):MeanFlowNFT 最早且最高(第 100 迭代达 0.85、第 150 迭代峰值 0.945),DMDAWM/DMDNFT 也在 100–150 迭代内超过 0.85,而 MeanFlowAWM(0.802)与 FewStepGRPO(0.776)到 200 迭代未达标;但 DMDAWM 的快速涨分伴随剧烈留出退化——在其首个 OCR>0.82 检查点,HPSv3 从 12.86 崩到 5.05、ImageReward 从 1.233 掉到 0.092。效率(s/iter,图像):ReFL 219 < FewStepOPSD 268 < DMDAWM 304 < DMDNFT 326 < FewStepGRPO 423 ≈ MeanFlowAWM 425 < MeanFlowNFT 435;v-ind 方向差分 $\mathcal{J}$(每查询 2 次额外前向)解释了 MeanFlow 系与 DMD 系约 120 秒的差距。视频实验(AnyFlow 蒸馏 Wan2.1-T2V-1.3B,4 步,480×832×81 帧,250 迭代):DMDNFT 训练奖励最高 17.93(初始 16.54,+1.39)但 VBench overall 最低 83.38、dynamic degree 53.33(MeanFlowAWM 为 58.89),大奖励增益伴随留出退化;FewStepGRPO 是唯一低于初始的方法(15.89,TA 1.85→1.23);FewStepOPSD/ReFL 在视频不再占优(16.26/16.46),且因奖励梯度需逐 latent token 反传、部分奖励(VideoAlign MQ/TA)不可微而成为 GPU-hours 最贵的两个(2623/2426 对约 1630),但 ReFL VBench 83.69 第二、quality 85.40 第一,留出退化最小。Test-time scaling(4→32 步采样,不重训):六个/七个训练器的留出 HPSv3 变化在 +1.0% 到 −6.8% 之间(AnyFlow 初始为 −17%),无系统性聚合收益;但 OCR 敏感样本出现极端崩溃——DMDNFT 与 MeanFlowNFT 在 32 步下 HPSv3 从 12.18/11.36 崩到 0.32,同时 CLIPScore 反升到 0.324/0.309(输出坍缩为纯文字);同时约 2–4 倍步数让不少个体样本肉眼可见地变好。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像·混合奖励(CLIP+HPSv2+PickScore) | 训练奖励 @400 迭代 | FewStepOPSD 1.641(ReFL 1.623) | AnyFlow 初始 1.450;最佳组优势方法 1.519 | +0.191(约 +13%) |
| 图像·混合奖励 | 留出 GenEval2 (Soft-TIFA) 最佳 | ReFL 0.465 / FewStepOPSD 0.463 | AnyFlow 初始 0.363;最佳组优势方法 0.412 | +0.05~0.10(远超 ~0.03 评估分辨率) |
| 图像·OCR 设置 | OCR 文字准确率 | MeanFlowNFT 0.945@150(首个 0.85@100) | 初始 0.498;FewStepGRPO 200 迭代仅 0.776 | +0.447 且收敛最快 |
| 图像·少步适配 vs 原目标直接套用 | 留出 HPSv3 | MeanFlowNFT 13.23 / FewStepGRPO 11.58 | u-pred DiffusionNFT 11.79 / FlowGRPO 9.62 | +1.44 / +1.96 |
| 视频·训练奖励(HPSv3-G+HPSv3-P+MQ+TA) | 四项奖励之和 @250 迭代 | DMDNFT 17.93 | AnyFlow 初始 16.54 | +1.39(但 VBench 最低,提示过拟合奖励) |
| 视频·留出质量 | VBench overall | ReFL 83.69(quality 85.40 第一) | 初始 83.68;DMDNFT 83.38(末位) | ≈持平,ReFL 守住质量且退化最小 |
| 图像·训练成本 | s/iter(8×H20) | ReFL 219 s / FewStepOPSD 268 s | MeanFlowNFT 435 s | 快约 1.6–2.0 倍 |
局限与改进
作者承认的局限:每个方法只跑一次(单 run,无方差/误差条);视频上 FewStepOPSD/ReFL 用 48 GPU、每迭代 rollout 多 1.5 倍,与 32 GPU 组非样本预算对齐,质量对比需谨慎解读;GenEval2 分辨率约 0.03,小于该阈值的差距(如 ReFL 与 FewStepOPSD 的 0.002)不构成方法分离;开放问题包括辅助网络 $v_\phi$ 的开销、视频奖励梯度不可微/不忠实(fp32 化与逐帧解码使梯度方向显著偏移)、标量组优势在混合奖励下部分分项失效、单步数训练无法 test-time scaling。我的独立观察:(1) 训练奖励全是偏好/美学类模型,方法排序很可能随奖励组合改变,『FewStepOPSD 最好』的结论对奖励选择敏感;(2) OCR 快速上涨与留出崩塌并存说明各方法都存在不同程度的 reward hacking,而 $\lambda_{KL}=10^{-4}$ 的约束力可疑——『选哪个方法』很大程度上是在选『谁黑客得慢』;(3) 只测了 4 步训练网格与 LoRA rank 32,未探索步数网格、rank 与全参数微调的交互;(4) 图像实验停留在 SD3.5-Medium(约 2B)规模,未验证更大骨干(SD3.5-Large、FLUX 级)上结论是否保持;(5) u-form/v-form 对比是在蒸馏既定的流图上进行的,未讨论 RL 是否破坏 AnyFlow 流图的多步一致性。
独立分析的弱点
(1) v-ind 的方向差分 $\mathcal{J}$ 每查询需 2 次额外 no-grad 前向,直接造成 MeanFlow 系比 DMD 系慢约 120 s/iter(图像);改进方向:由于旧策略在一个外层迭代内不变,可跨内层迭代缓存/复用 $\mathcal{J}$,或低频重估、或用小型网络参数化修正项。(2) 奖励梯度类方法在视频上需逐 latent token 反传并逐帧解码(仅 21/81 帧),既贵(GPU-h 最贵)又不忠实(fp32 化后梯度方向仍显著偏移);改进方向:训练 latent 空间奖励代理头绕过 VAE 解码、利用因果前缀缓存解码、或用随机投影近似全梯度。(3) 标量混合奖励的组优势无法同时推动各分项——五个组优势方法的 CLIPScore 全部下降;改进方向:对每个奖励分项分别标准化得到向量优势,按维度做 GRPO 或 Lagrangian 约束优化。(4) DMD 系的 $v_\phi$ 在视频上反超变慢(每迭代拟合约 144 s,净增 84–87 s),且其大奖励增益常伴随更大留出退化(如 DMDAWM 的 HPSv3 12.86→5.05);改进方向:EMA/低频更新 $v_\phi$、混合自感应与辅助估计、或对留出指标做早停。(5) test-time scaling 失效且 OCR-heavy prompt 在多步下崩溃成纯文字(HPSv3 12.18→0.32);改进方向:在多个步数网格上联合 RL 并加网格间一致性正则,或推理期步数自适应路由。(6) 全部实验为单 run 且视频 48-GPU 行非样本对齐;改进方向:至少 3 seeds 报告方差,并重跑对齐后的视频对比。
未来方向
作者列出的开放问题:(i) 降低辅助网络的拟合开销(前向、反向与显存);(ii) 为长 latent 序列设计更便宜、更忠实的奖励梯度;(iii) 构建更可靠、可泛化的组优势(分项加权、全局 batch 标准差重标定、组内小方差问题);(iv) 让单步数训练的模型在推理期更多步数下仍提升(多步数联合微调或免训练方案)。基于本文成果可延伸的方向:把『锚点+权重』的解耦语言推广到更新的 RL 目标(adjoint matching、偏好优化类),检验该视角的覆盖范围与边界;在更大规模骨干(FLUX、HunyuanVideo 级)与更多奖励类型(在线人类反馈)上复验选型结论;结合奖励模型集成或不确定性估计显式对抗 reward hacking,把自回归锚点强度从固定 $\lambda_{KL}$ 变为随留出退化自适应;探索少步 RL 与 test-time compute 的联合训练目标,使 4 步模型真正支持 2–4 倍步数的质量提升;将 FewStepOPSD 的信任域构造($\kappa$、$M_{tgt}$、$\eta$)做成随训练进度自适应的调度。
复现评估
开源情况:论文承诺代码分两库发布(fewsteprl-sd35 图像、fewsteprl-wan21 视频),checkpoint 计划上传 Hugging Face(标注 coming soon,撰写时未确认可用)。正文给出 Code 1–8 伪代码级的实现细节(训练器钩子、两个估计器类、解耦损失),附录含超参,复现信息非常充分。数据与模型:需要 SD3.5-Medium 预训练权重加 AnyFlow 蒸馏(两阶段:MeanFlow 恒等式训练 + on-policy 分布匹配),奖励模型全家桶(CLIPScore、HPSv2、PickScore、HPSv3、ImageReward、OCR、视频端 HPSv3/VideoAlign)与 GenEval2/VBench 评估栈,均为公开资源但组合工程量不小。算力:图像设置 8×H20 约 47 小时(400 迭代)即可跑主要对比,LoRA rank 32 显存友好;视频设置 32–48×H20、约 1630–2623 GPU 小时,门槛显著更高。综合评估:图像部分对拥有 8 卡 A100/H20 级资源的团队可复现(中高难度),视频部分适合工业级资源(高难度);若 AnyFlow 蒸馏 checkpoint 与作者代码如期开源,难度可下调一档。
论文图表
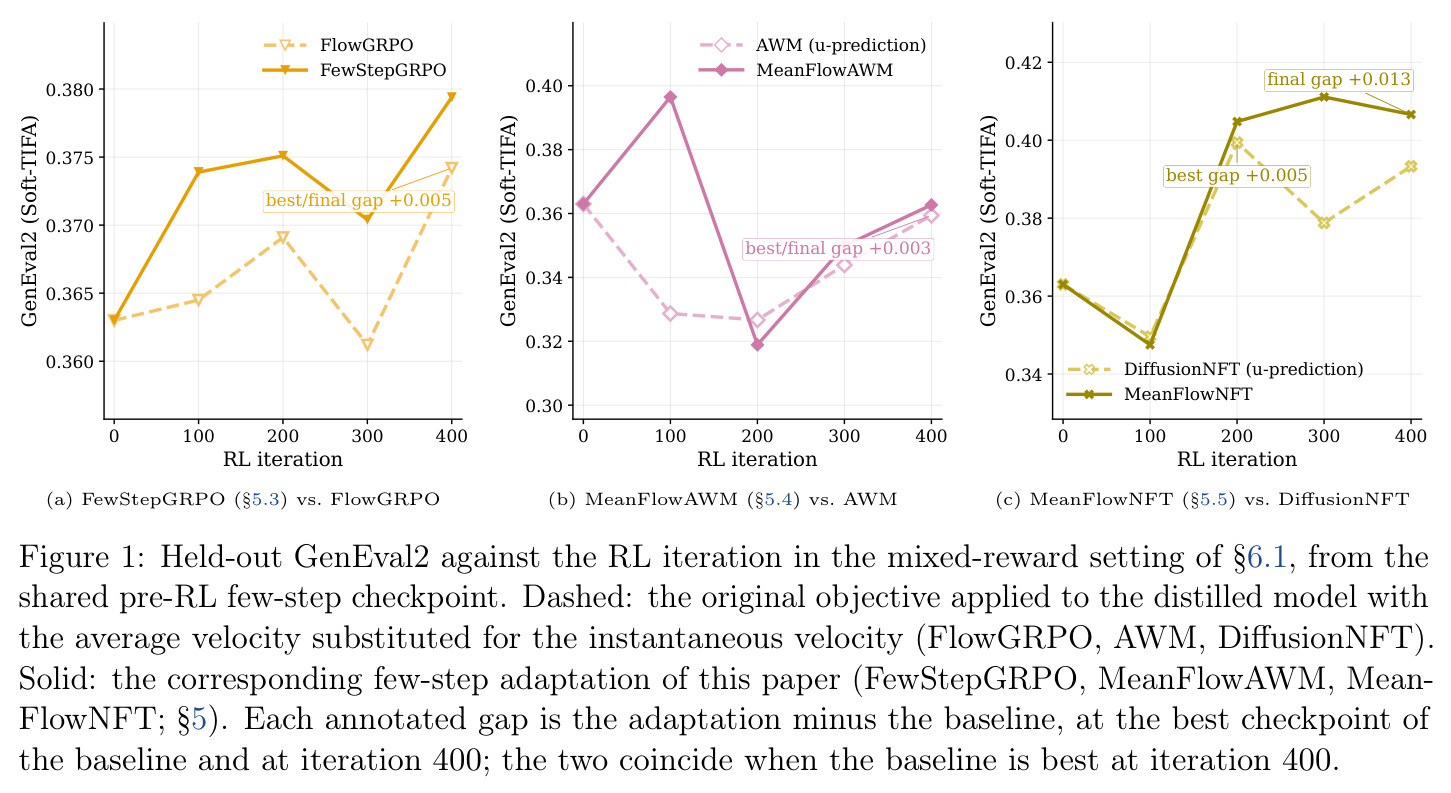
三条并列曲线图,从同一 pre-RL 少步 checkpoint 出发,比较『原始 RL 目标直接套用在蒸馏模型上(虚线)』与『本文少步适配版本(实线)』的留出 GenEval2 随 RL 迭代的变化,并标注最佳/最终差距(如 MeanFlowNFT 最终差距 +0.013、FewStepGRPO +0.005)。
这张图是动机部分的实验证据:直接把平均速度替换进为瞬时速度设计的 RL 目标会在三组对比中全部落后,证明『少步适配』不是纸面问题而是实际性能差距。
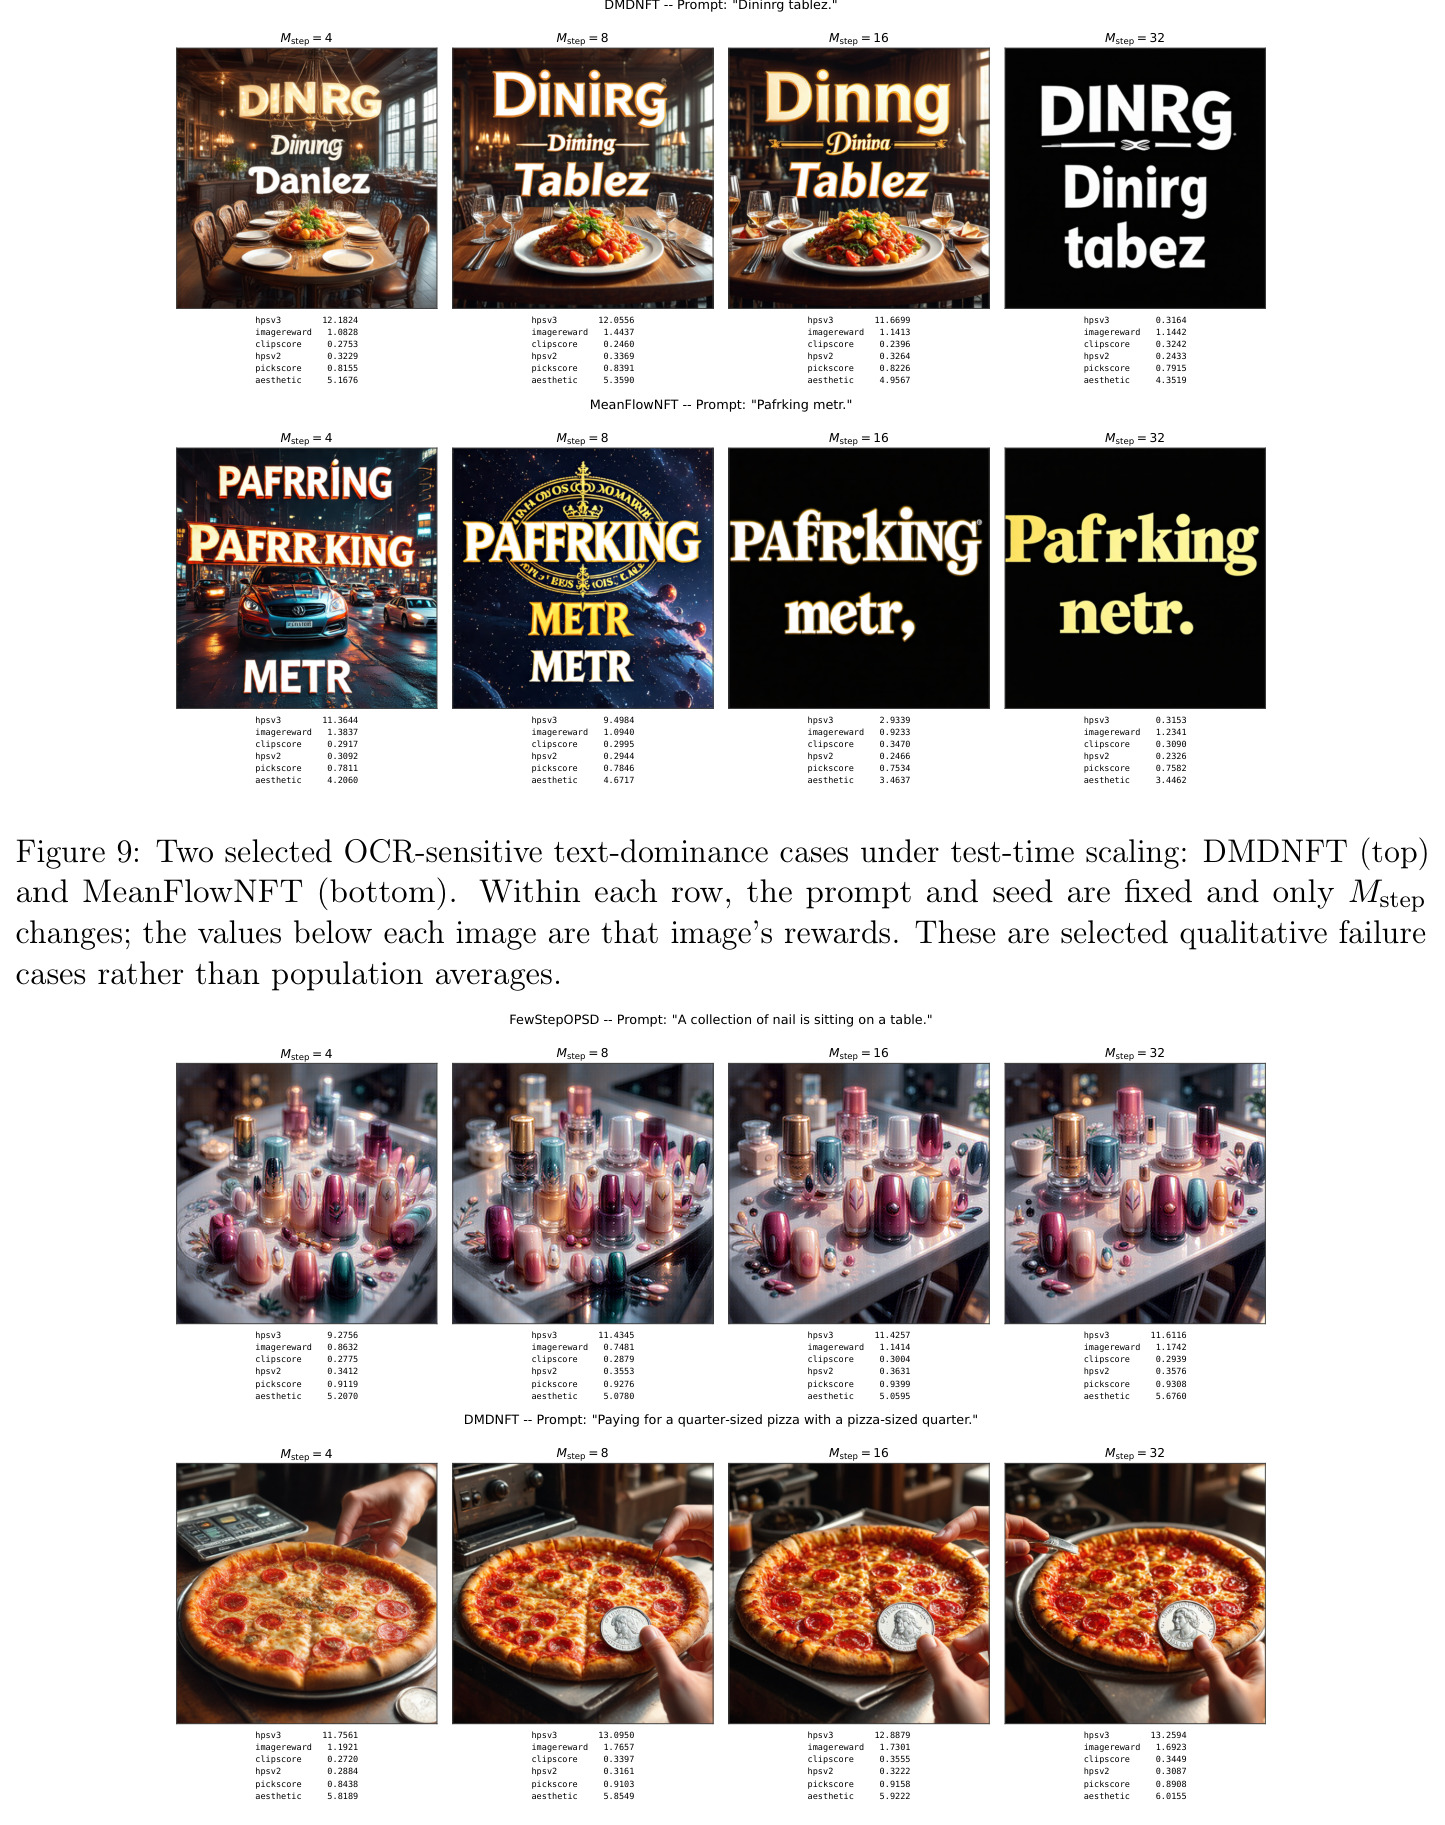
两个失败案例:拼写错误类 prompt(如 'Dininrg tablez.'、'Pafrking metr.')在 $M_{step}$ 增大时画面坍缩为几乎只有前景文字,DMDNFT 的 HPSv3 从 12.18 跌至 0.32、MeanFlowNFT 从 11.36 跌至 0.32,而 CLIPScore 反而升到 0.324/0.309。
揭示 test-time scaling 的尖锐失败模式与奖励模型的盲区(文字覆盖率高即得高分),是『多步不总更好』的最极端证据,也为部署时的步数选择敲响警钟。