扩散模型的纠正训练 Correction Training for Diffusion Models
训练纠正器迭代修正去噪预测,无需引导即大幅提升生成质量,并可蒸馏消除推理开销。
前置知识
扩散模型与流匹配 (Flow Matching)
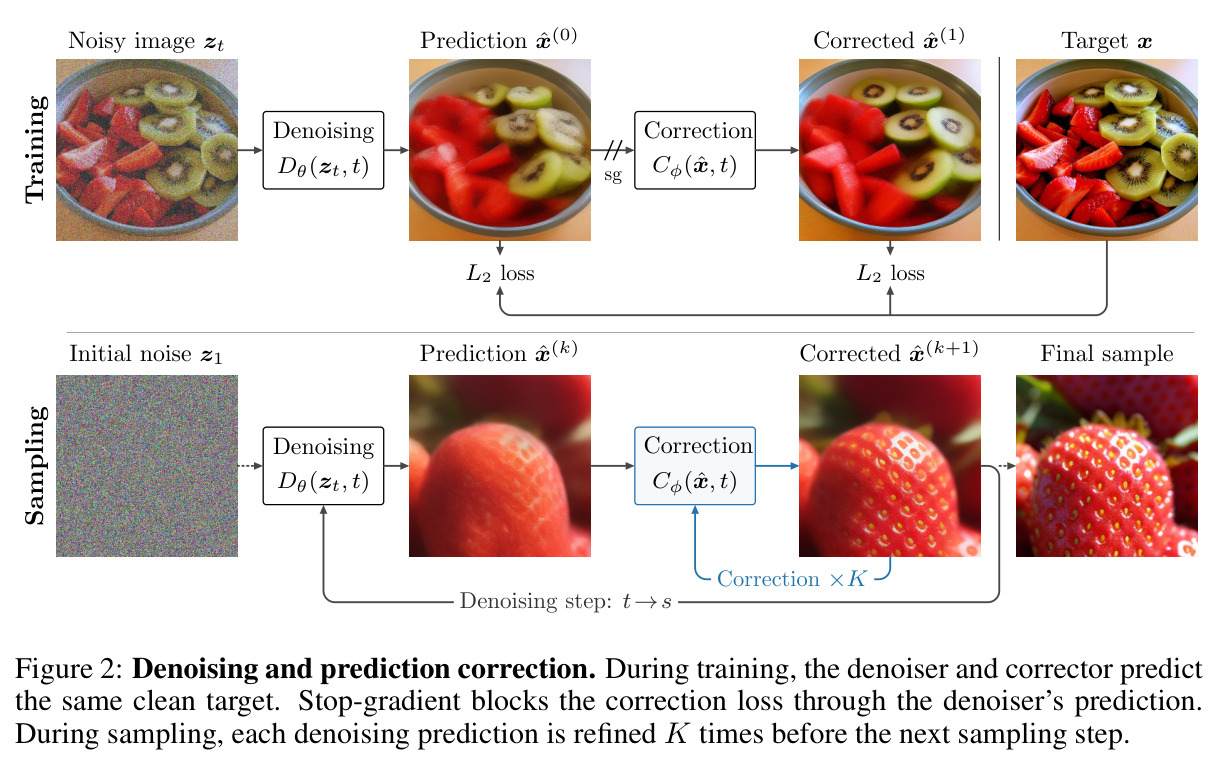
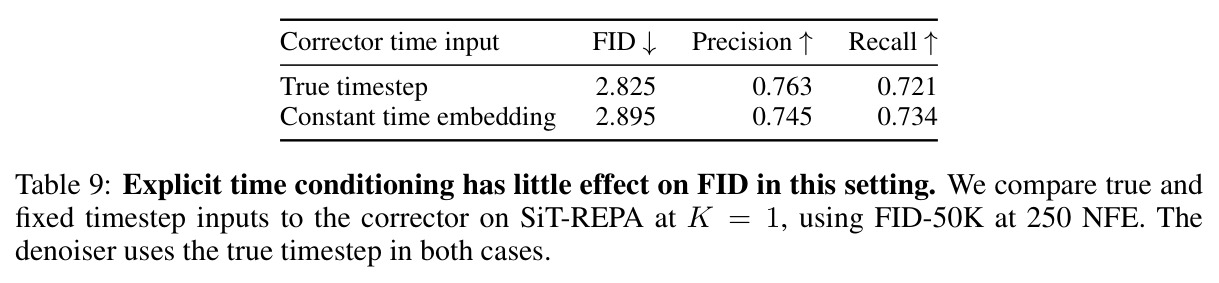
扩散模型通过逐步去噪来生成数据。流匹配是其现代形式:训练输入是真实图像与噪声的线性插值 $z_t = (1-t)x + t\epsilon$,其中 $t=0$ 对应数据、$t=1$ 对应噪声;网络 $D_\theta(z_t, t)$ 直接预测干净样本 $\hat{x}^{(0)}$,训练目标是 $\mathcal{L}_{denoise} = \mathbb{E}\|D_\theta(z_t, t) - x\|_2^2$。采样时每个 Euler 步按 $z_s = \frac{s}{t} z_t + (1-\frac{s}{t})\hat{x}^{(0)}$ 把当前带噪状态向数据端移动。DiT、SiT、JiT 等主流模型均属此类。
本文的全部方法、记号和采样公式都建立在这个框架上:纠正器就是在去噪器的预测 $\hat{x}^{(0)}$ 之上再训练的第二个网络,不理解去噪目标就无法理解纠正目标是什么。
曝光偏差与训练-推理差距 (Exposure Bias)
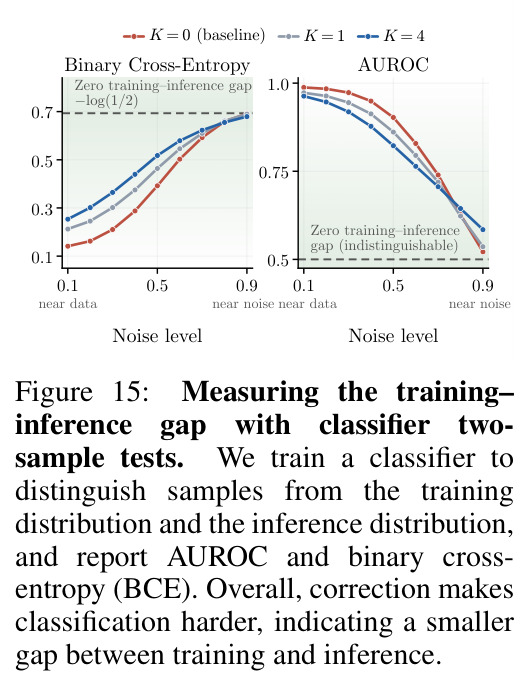
训练时去噪器只见过『真实图像 + 独立噪声』构造的输入 $z_t$;推理时输入却由模型自己早先的不完美预测一步步构造,分布逐渐偏离训练分布,误差沿去噪轨迹累积,产生结构混乱和伪影。可以用分类器二样本检验(C2ST)量化:训练一个分类器区分训练分布样本与推理轨迹上的中间状态,AUROC 越接近 0.5(随机猜)说明两者越难区分、差距越小。
这是本文要解决的核心问题,也是第 4.2 节解释『纠正为何有效』的关键证据来源——论文用它论证收益来自缩小训练-推理差距而非降低重构误差。
Classifier-Free Guidance (CFG)
推理时把条件预测与无条件预测之差放大 $w$ 倍再合成:$\tilde{x} = x_u + w(x_c - x_u)$,能显著提升样本质量与条件服从度,但代价是多样性下降、颜色过饱和,产生典型的『AI 生成感』。autoguidance 等是其变体,用另一个弱模型作为引导参照。
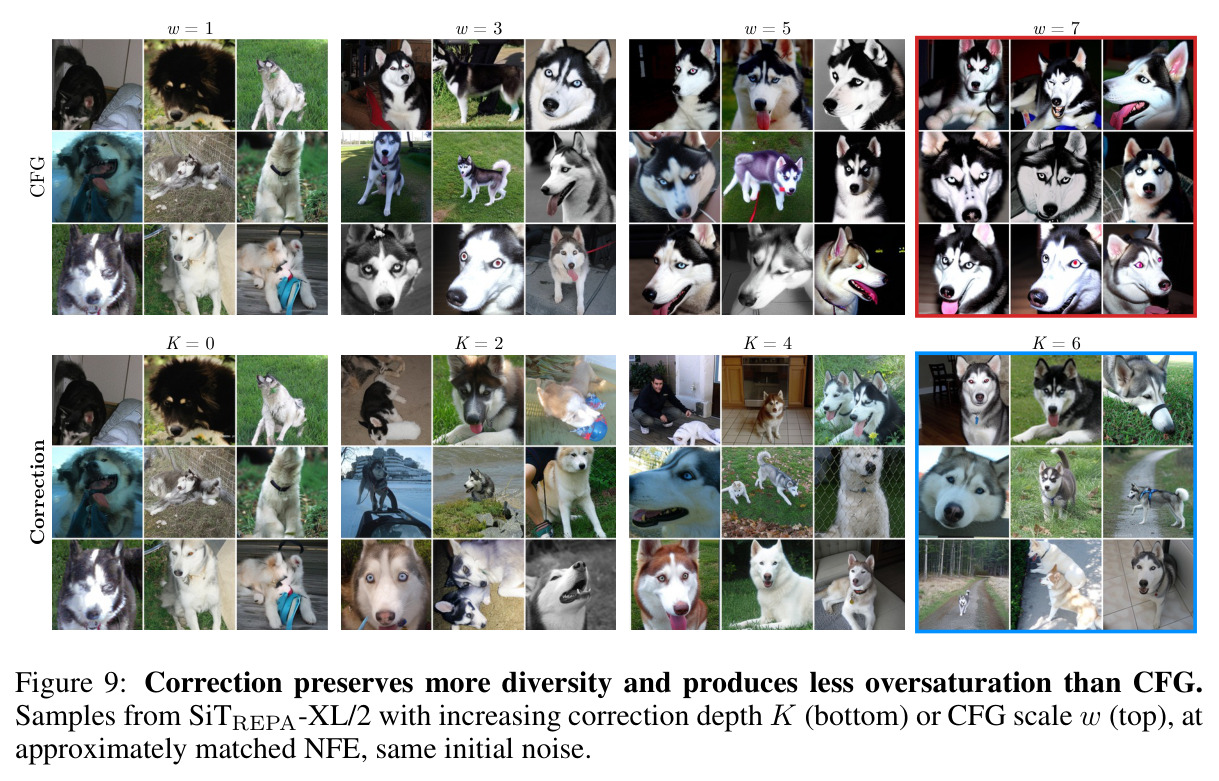
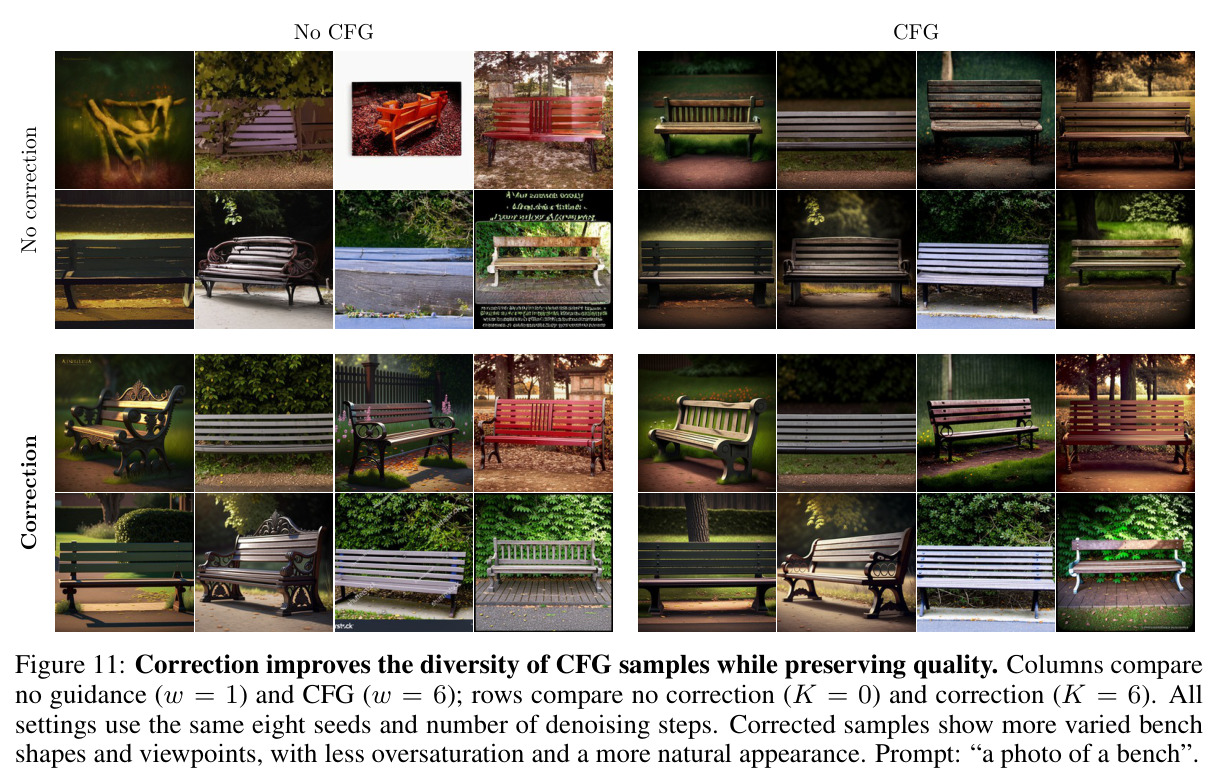
CFG 是本文的主要对照和互补手段:论文要证明无引导下纠正就能达到 CFG 级质量(Table 1、2),同时展示纠正能缓解 CFG 的过饱和与同质化(Fig. 9、11)。
FID 与 precision/recall
FID 用 Inception 网络特征衡量生成分布与真实分布的 Fréchet 距离,越低越好;precision 衡量生成样本『像不像真实图像』(质量),recall 衡量对真实分布的覆盖程度(多样性)。两者构成质量-多样性权衡的二维画像。
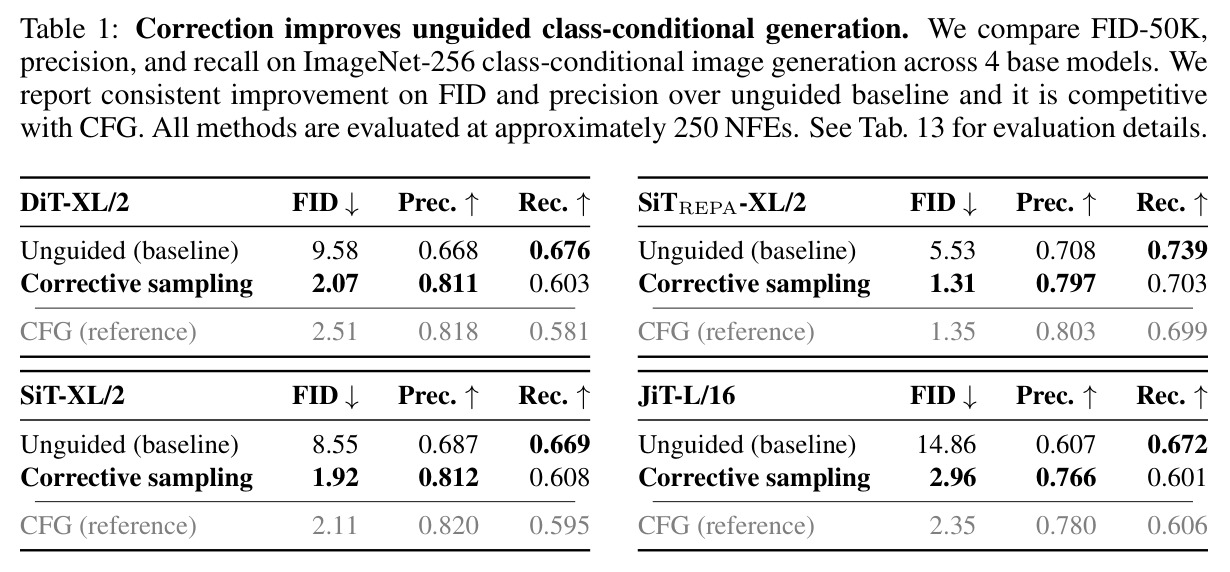
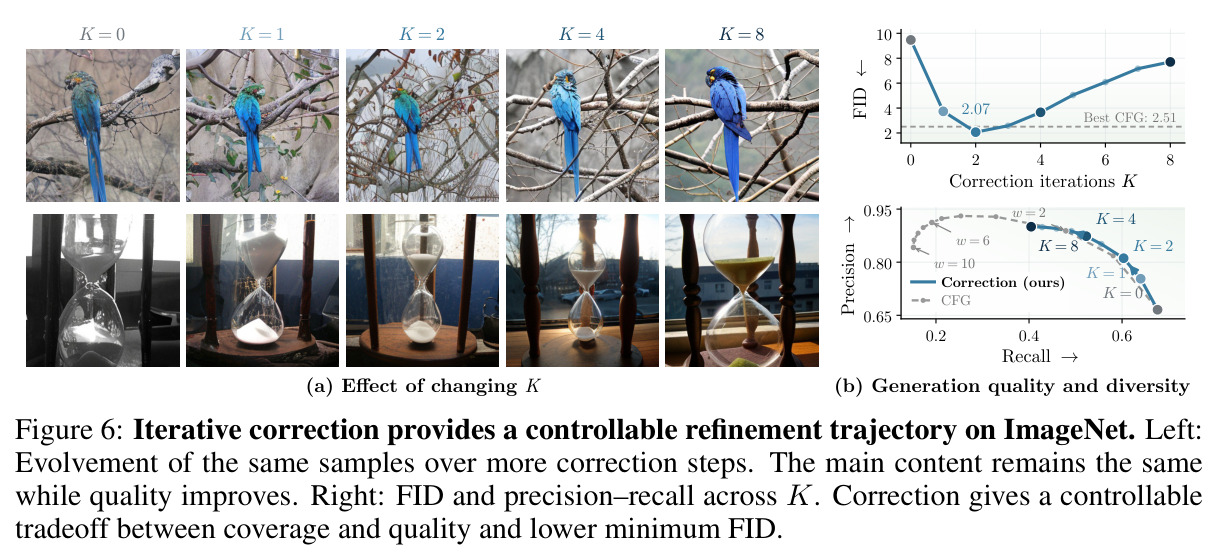
论文所有定量结论都用这三个指标加固定 NFE 表述,例如纠正把 DiT 的 FID 从 9.58 降到 2.07、precision 从 0.668 升到 0.811 但 recall 从 0.676 降到 0.603,读懂这些数字才能判断收益的性质。
NFE(函数评估次数)
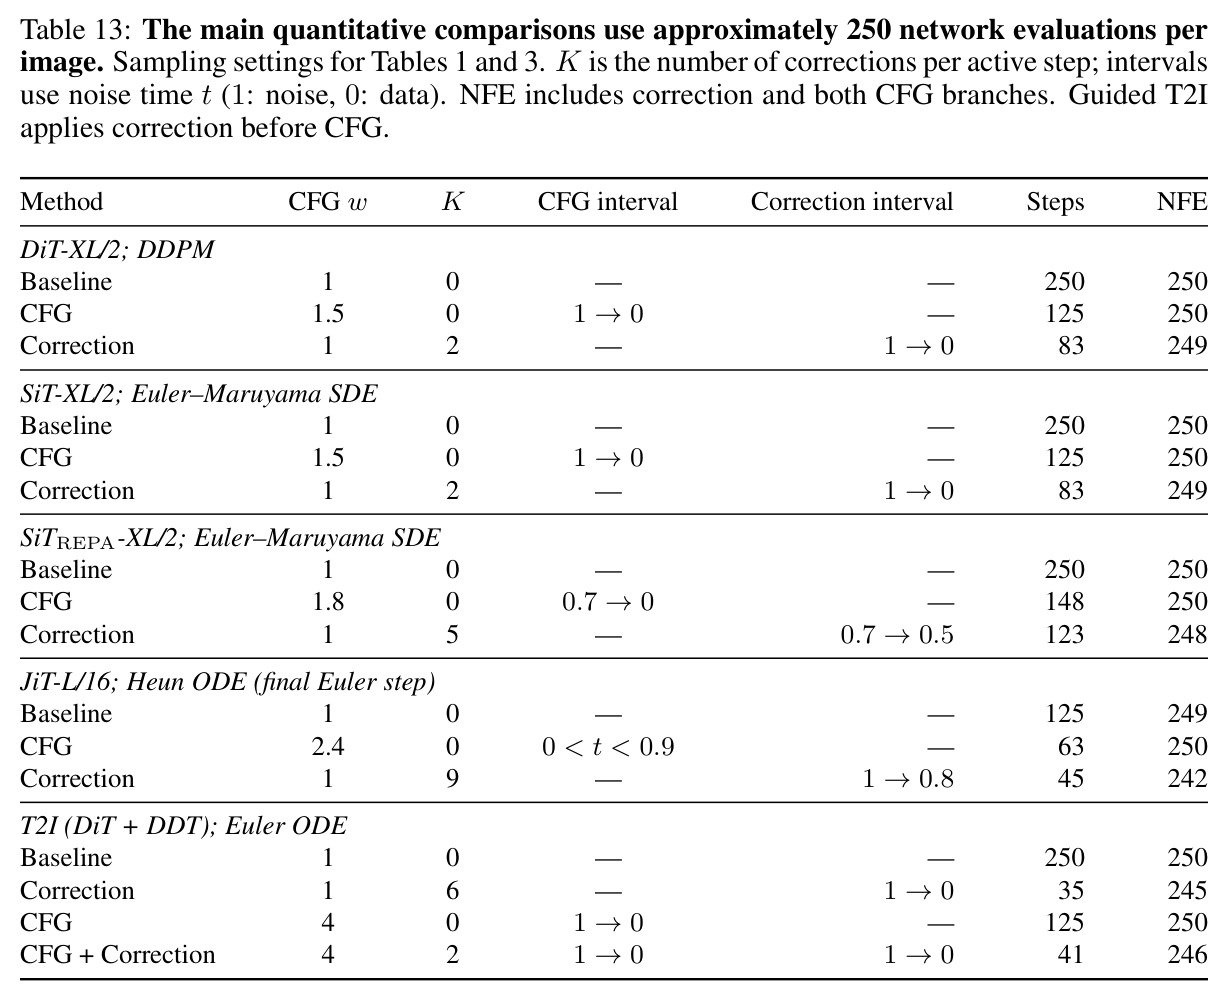
NFE(number of function evaluations)指采样过程中网络前向传播的总次数,约等于去噪步数乘以每步前向次数。纠正在每个去噪步额外做 $K$ 次前向,因此实验统一通过减少去噪步数把总 NFE 匹配到约 250,保证『纠正 vs 多走去噪步』的比较公平。
本文的核心卖点之一是『纠正是比增加去噪步数更划算的推理算力分配方式』,只有理解 NFE 匹配协议才能明白 Table 1 等结果为什么有说服力。
Stop-gradient 与知识蒸馏
Stop-gradient 在计算图中阻断梯度回传:本文纠正损失对去噪器的预测加 stop-gradient,使纠正损失只更新纠正器。蒸馏则让一个小模型(student)去拟合大模型或复杂流程的输出:本文 student 以速度空间 MSE(权重 $w(t)=1/t^2$)拟合教师经过 $k^*$ 步纠正后的预测,从而用单次前向复现多步纠正的效果。
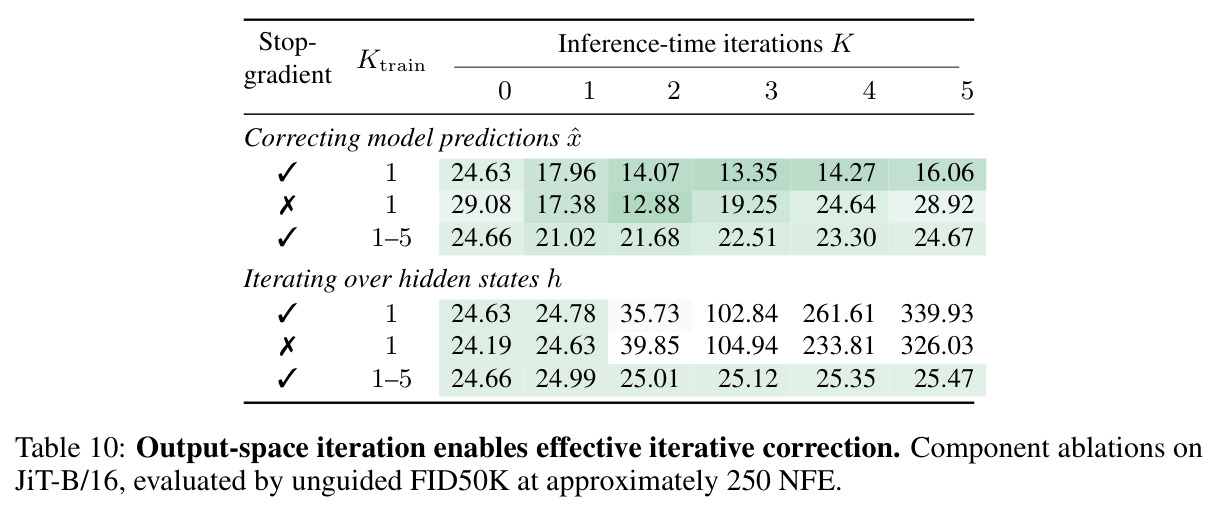
Stop-gradient 是训练稳定性和大 K 下不退化的关键设计(Table 10 消融);蒸馏是把纠正的额外推理开销降为零的手段(Table 6),两者都是方法落地不可缺少的部分。
研究动机
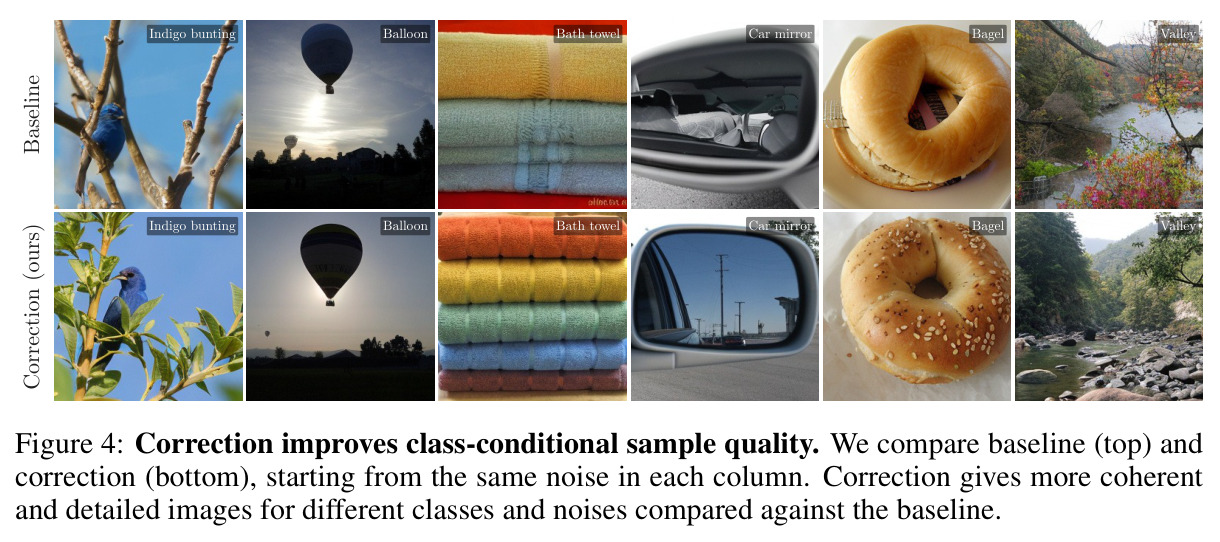
扩散模型在推理时通过一串去噪预测逐步生成图像,但存在一个由来已久的训练-推理差距:训练时去噪器的输入是真实图像与独立噪声的插值 $z_t=(1-t)x+t\epsilon$,而推理时输入却由模型自己早先的不完美预测构造而来,这类输入在训练中从未出现过。误差沿去噪轨迹不断累积(即曝光偏差):论文的 Fig. 3(a) 给出具体案例——早期预测中物体结构混乱,后续去噪步在这种错误骨架上继续添加牙齿、眼睛、舌头等细节,错误结构被一路固化到最终样本。后果在数字上非常明显:不加任何引导时,DiT-XL/2 在 ImageNet-256 上 FID 只有 9.58,JiT-L/16 高达 14.86,远差于 CFG 的 2.51 与 2.35。社区最常见的补救是 classifier-free guidance,它在推理时放大条件与无条件预测之差,虽然能大幅提升质量,但代价是样本多样性下降、颜色过饱和,产生千篇一律的『AI 味』;而 autoguidance 等替代方案仍需要额外模型或复杂采样流程。
本文的目标是本文的目标是绕开推理时的启发式引导,直接从训练层面消除误差累积的根源:把『纠正去噪器的预测』变成一个显式的监督学习任务。具体而言,训练一个纠正器 $C_\phi$,它以基础去噪器的预测 $\hat{x}^{(0)}$ 为输入、以同一张真实干净图像 $x$ 为目标,学习映射 $\hat{x}^{(0)} \to x$;采样时在每个去噪步内对预测迭代细化 $K$ 次,让早期结构错误在传给下一步之前就被修掉,阻止伪影固化到最终样本。作者希望借此在完全无引导的条件下,把类条件与无条件生成质量提升到与 CFG 相当的水平,同时保住多样性、避免过饱和;并通过权重共享与蒸馏把纠正带来的额外推理开销降到接近零。整个框架需要在 DiT、SiT、SiT-REPA、JiT 以及文本到图像等多种主流设置上得到系统验证。
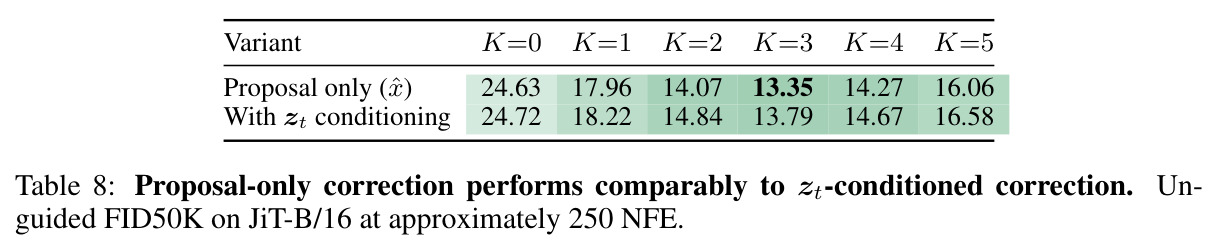
与已有工作不同的是,已有路线各有局限:CFG、perturbation guidance、autoguidance 都是推理时放大或组合已有预测的启发式方法,不改变模型本身;self-conditioning 把上一步预测作为去噪器的额外输入联合训练,但没有独立的纠正器;Idempotent Generative Networks 显式优化幂等性却替换了去噪目标;最接近的 Schiff et al. (2026) 只针对离散扩散语言模型。本文的独特切入有三点。其一,纠正器是独立网络,却只依赖预测 $\hat{x}^{(0)}$ 而不需要带噪输入 $z_t$(proposal-only,附录 Table 8 证明二者效果相当),因此可以直接复制去噪器权重初始化、完全不改架构。其二,训练只监督单步纠正,推理时却把同一映射反复外推到自身输出,作者用实验证明这种『超出监督深度的外推』正是质量大幅提升的关键来源。其三,作者通过参数匹配对照(28 层单体去噪器 vs 14+14 层去噪器-纠正器对)和分类器二样本检验等分析,把收益归因到『缩小训练-推理差距』而非『降低重构误差』,给出了超越方法本身的对扩散模型误差累积机制的实证理解。
核心方法
直觉上,去噪器输出的 $\hat{x}^{(0)}$ 本身就是一张『有瑕疵的干净图像』,与其把修图交给推理时的启发式引导,不如专门训练一个网络来修复它。技术上,本文在流匹配框架 $z_t=(1-t)x+t\epsilon$ 之上引入纠正器 $C_\phi$:它接收经 stop-gradient 的初始预测 $\hat{x}^{(0)}$ 与时间 $t$,输出修正后的预测 $\hat{x}^{(1)} = C_\phi(\mathrm{sg}(\hat{x}^{(0)}), t)$,并用与去噪完全相同的 L2 目标对齐真实图像:$\mathcal{L}_{corr} = \mathbb{E}_{x,\epsilon,t}\|C_\phi(\mathrm{sg}(\hat{x}^{(0)}), t) - x\|_2^2$。实施上从预训练去噪器出发,复制一份权重作为纠正器初值,以 $\mathcal{L}_{total} = \mathcal{L}_{denoise} + \lambda_{corr}\mathcal{L}_{corr}$ 联合微调 5 万到 10 万步,纠正器的训练输入由当前模型在线生成。采样时(Algorithm 2)每个去噪步先用 $D_\theta(z_t, t)$ 得到 $\hat{x}^{(0)}$,再连续应用 $K$ 次 $\hat{x}^{(k+1)} = C_\phi(\hat{x}^{(k)}, t)$,最后用细化后的预测做 Euler 更新 $z_s = \frac{s}{t}z_t + (1-\frac{s}{t})\hat{x}^{(K)}$。虽然训练只见过单步纠正,推理时纠正器可以对自身输出反复套用,把图像越修越清晰;总 NFE 通过减少去噪步数保持在约 250,与基线公平比较。
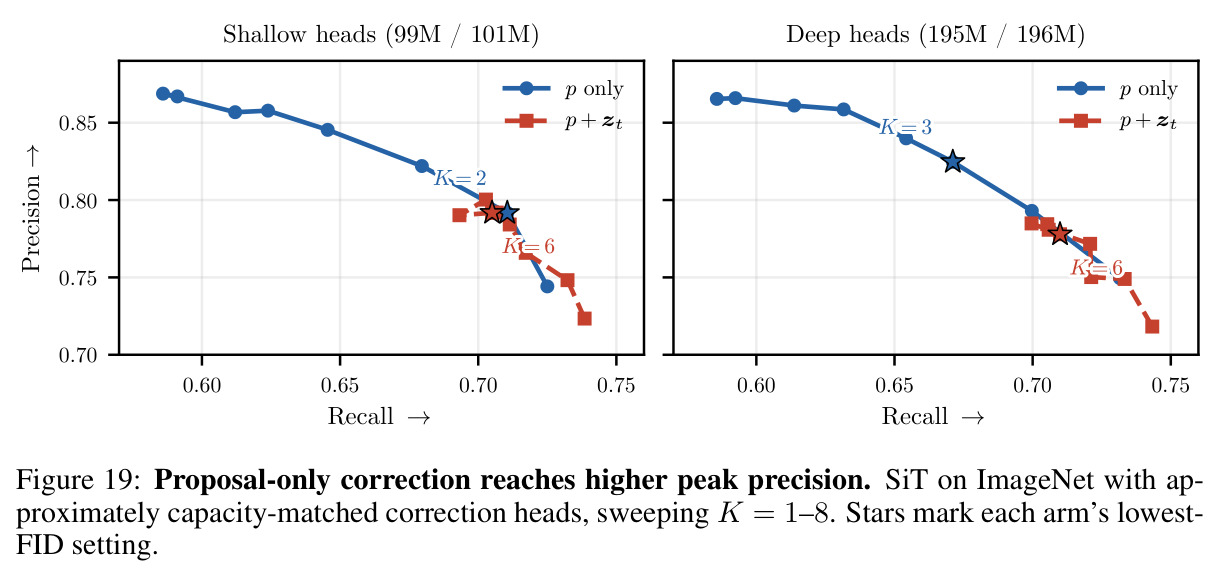
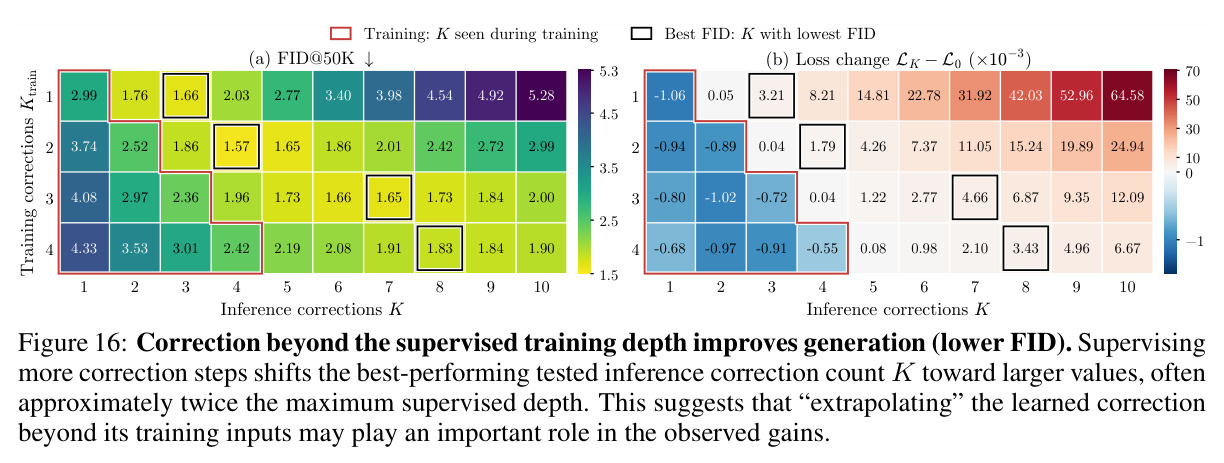
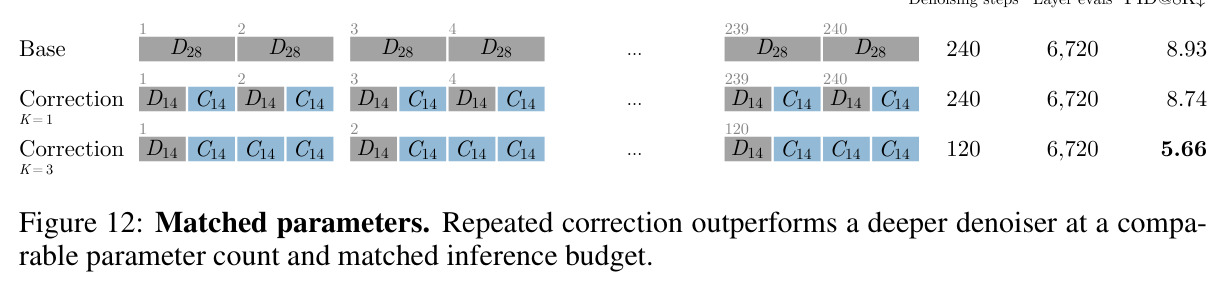
核心创新是『把纠正变成显式学习任务 + 推理时迭代外推』的组合,与已有方法的本质区别有三。第一,纠正器的训练输入由基础模型在线产生,纠正器始终面对当前去噪器的真实错误分布,而不是像 stacked generalization 那样用 held-out 预测离线训练高层模型——它学的是『当前模型会犯什么错』。第二,纠正器只看预测、不看带噪输入 $z_t$,修正可以更激进(附录 Fig. 19 显示 proposal-only 在相近 FID 下达到更高 precision),且免去任何架构改动。第三,也是最反直觉的一点:训练只监督从 $\hat{x}^{(0)}$ 到 $\hat{x}^{(1)}$ 的一步,推理时重复应用同一映射却能持续改善质量。作者在 Fig. 16 中证明收益恰恰来自把学习到的修正算子外推到训练分布之外——增大训练监督深度 $K_{train}$ 只是把最佳推理次数推向约两倍监督深度,最佳 FID 几乎不变。换言之,纠正暴露出了一个可复用的『细化算子』;参数匹配实验(单次纠正约等于更深一层的单体去噪器,迭代 3 次则显著超越)进一步说明价值不在参数更多,而在复用。
方法步骤详情
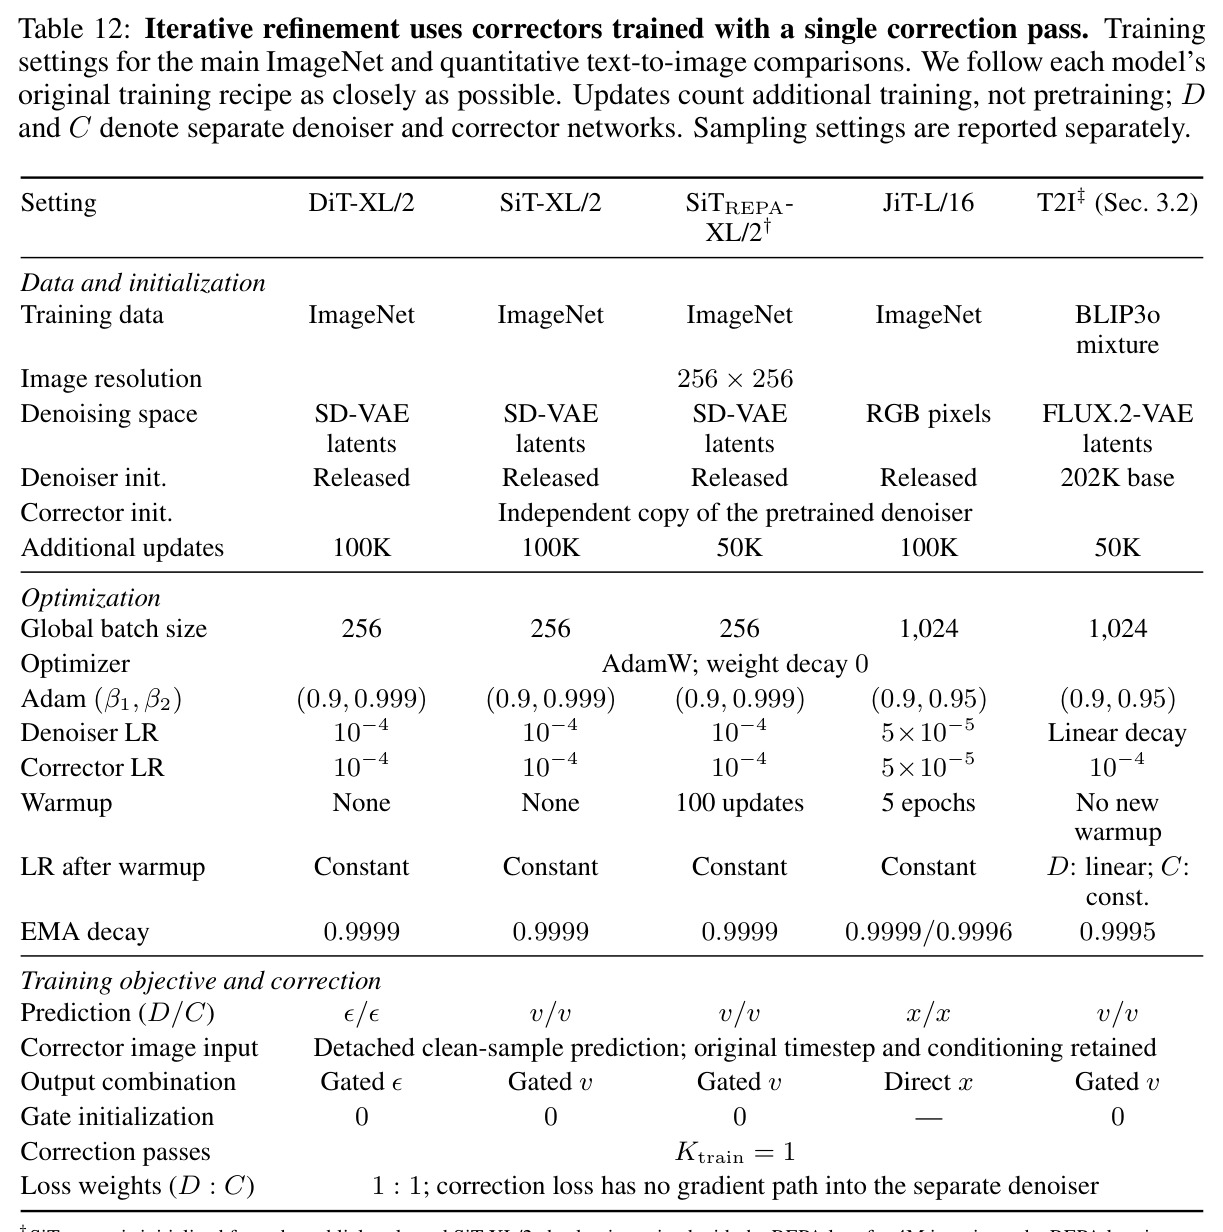
完整流程分四步。第一步初始化:从公开预训练 checkpoint(如 SiT-XL/2)加载去噪器,再独立复制一份同构网络作为纠正器 $C_\phi$(保留时间条件通路),latent 空间模型沿用原 VAE。第二步训练(Algorithm 1):对每个样本采样时间 $t$ 与噪声 $\epsilon$,构造 $z_t=(1-t)x+t\epsilon$;前向得到 $\mathrm{pred}=D_\theta(z_t,t)$ 与 $\mathrm{refined}=C_\phi(\mathrm{sg}(\mathrm{pred}),t)$;总损失 $\mathcal{L} = \mathrm{mse}(\mathrm{pred},x) + w\cdot\mathrm{mse}(\mathrm{refined},x)$。主要设置:batch 256(JiT 与文生图 1024)、AdamW、去噪器与纠正器学习率均 $10^{-4}$;DiT/SiT 训 10 万步,SiT-REPA 只需 5 万步(约其 400 万步预训练的 1.25%),文生图 5 万步。第三步采样(Algorithm 2):$z\sim\mathcal{N}(0,I)$;对每对相邻时间 $(t,s)$,先 $\mathrm{pred}=D_\theta(z,t)$,再循环 $K$ 次 $\mathrm{pred}=C_\phi(\mathrm{pred},t)$,计算速度 $v=(z-\mathrm{pred})/t$,更新 $z=z+(s-t)v$。$K$ 常取 2-8,同时把去噪步数从 250 减到约 60-125 以匹配总 NFE≈250。第四步配置细节:纠正宜集中于高噪声早期区间(JiT 上 $t\in[1.0,0.8]$ 最优,FID 6.79 优于全程 7.70);$\epsilon$ 或 $v$ 预测模型需先换算到 $x$-预测空间;可选共享骨干(只换轻量输入 embedder)或蒸馏(student 以 $w(t)=1/t^2$ 的速度空间 MSE 拟合教师 $k^*=2$ 步纠正后的预测)。
技术新颖性
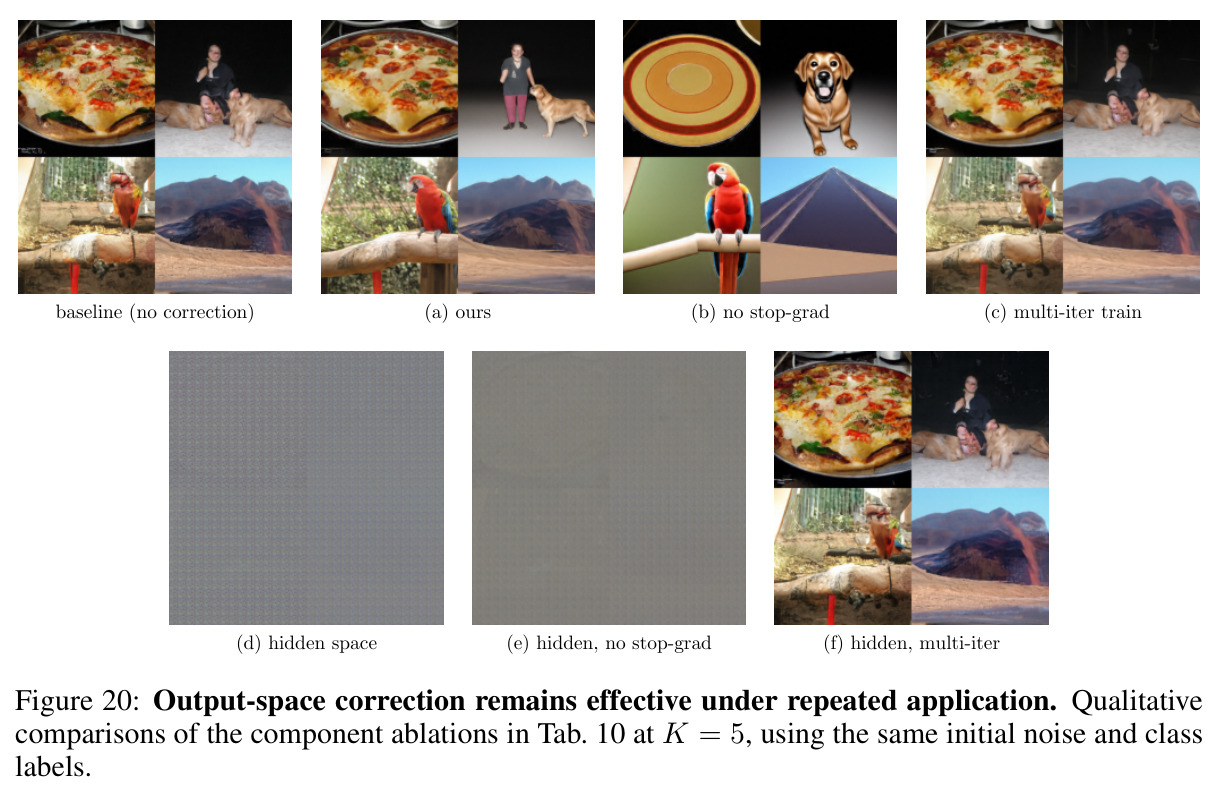
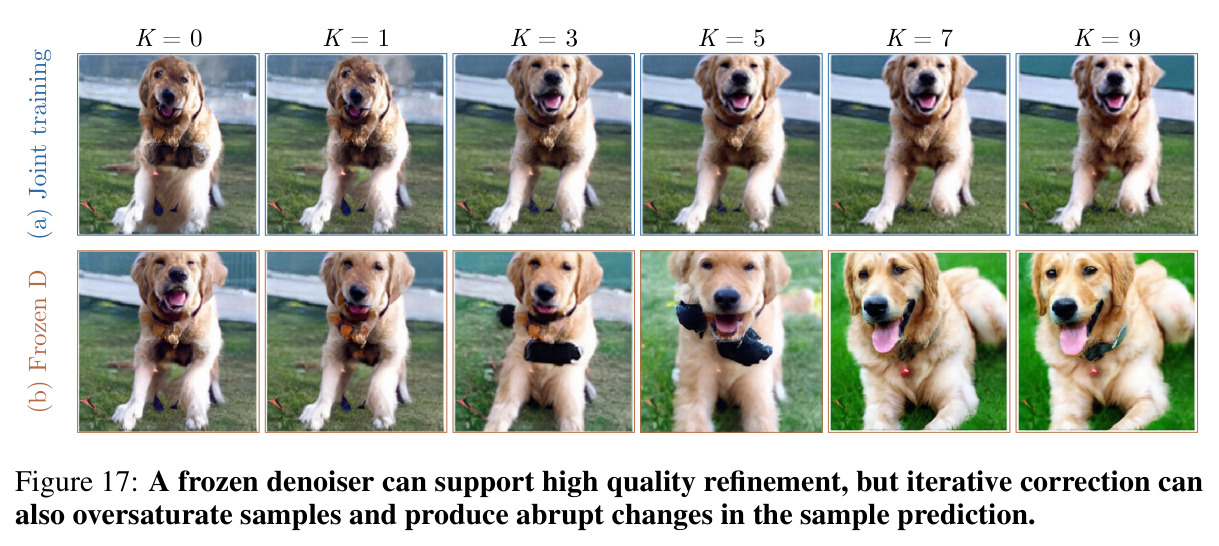
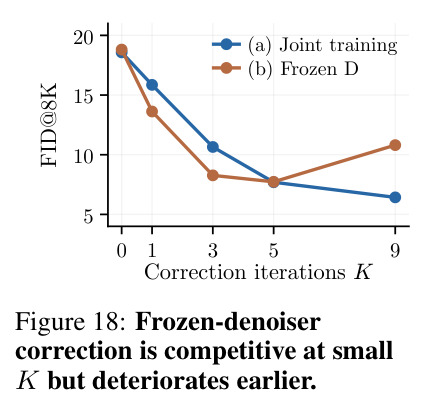
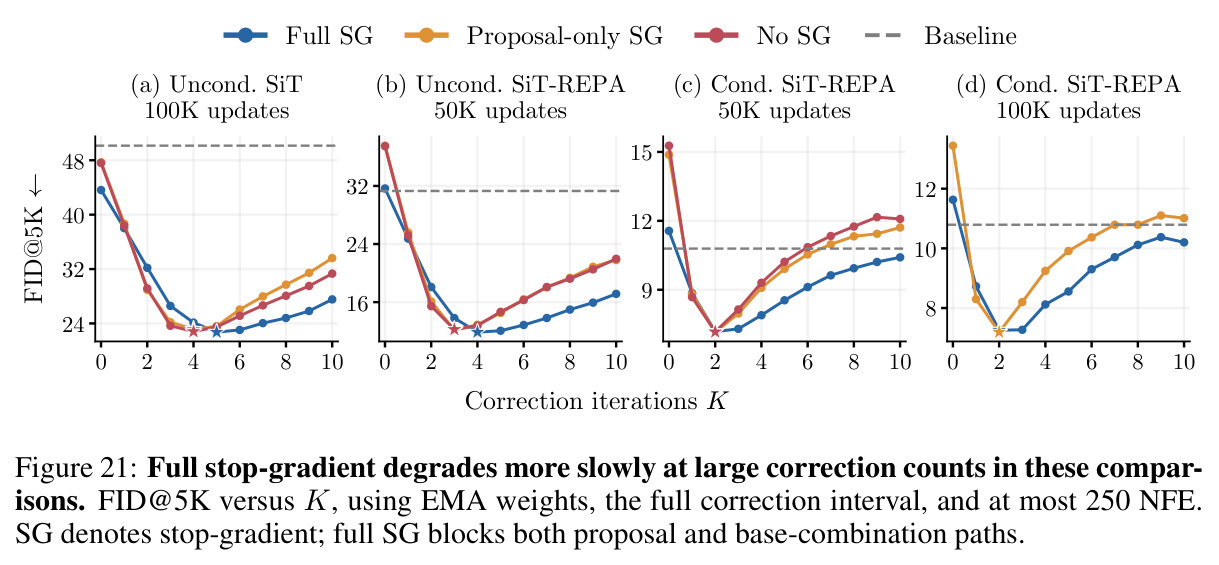
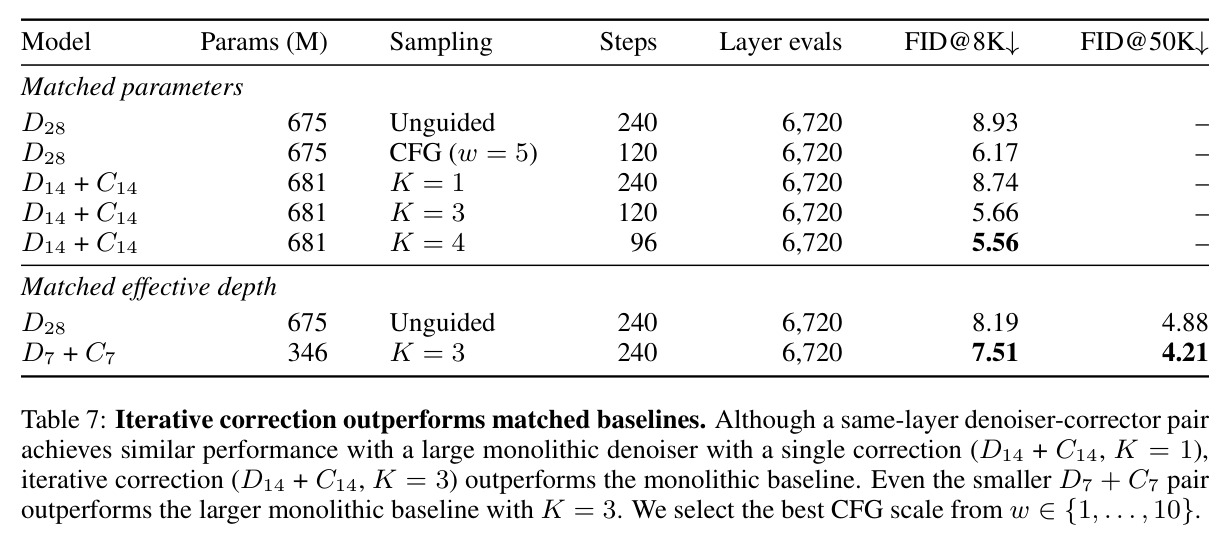
技术新颖性体现在四个层面。架构与接口层面:纠正器是预测空间(输出空间)上的残差修复器,无需带噪输入、无需新模块,可直接复制预训练权重——消融证明隐藏状态迭代完全不可行($K=5$ 时 FID 飙至 339.93,Table 10),输出空间迭代才是可复用细化的正确抽象。训练层面:stop-gradient 阻断纠正损失向去噪器的回传,换取大 $K$ 下更平缓的性能退化;联合训练(而非冻结去噪器)让纠正器见过『演化中』的多样错误,从而能泛化到自己的输出——冻结版本在小 K 时相当,大 K 时 FID 回升并出现过饱和。推理层面:单步监督、多步外推的用法在扩散模型中罕见,作者定量证明外推是主要收益来源——从零训练时单次纠正只追平参数匹配的单体去噪器(FID@8K 8.74 vs 8.93),迭代 3 次才拉开差距(5.66),而匹配『有效深度』时更小的 D7+C7(346M)仍胜过 D28(675M):FID@50K 4.21 vs 4.88。分析层面:用 C2ST 把『纠正缩小训练-推理差距』变成可测量的证据(AUROC 向 0.5 靠近),同时指出纠正会增大训练分布上的重构误差,这一『误差换分布』的反直觉现象对扩散模型理论而言是新观察。
实验结果
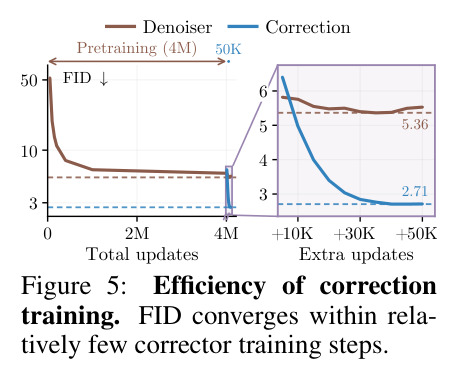
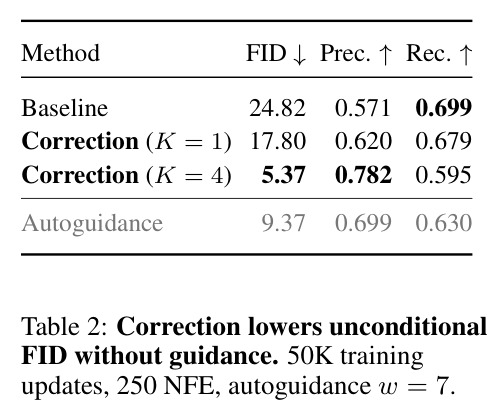
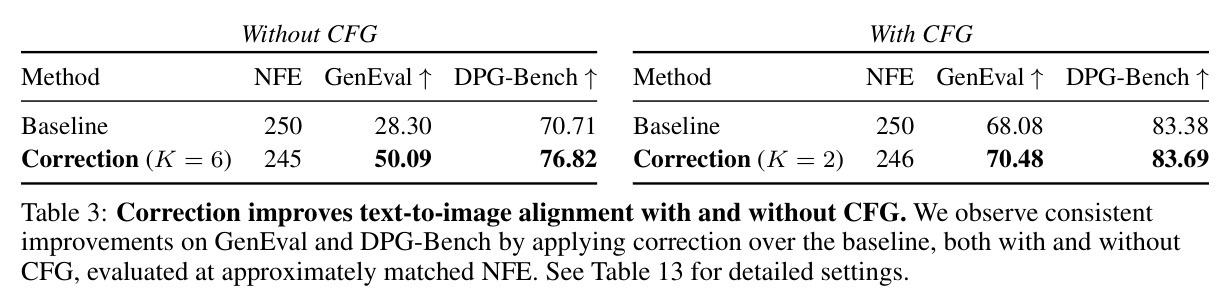
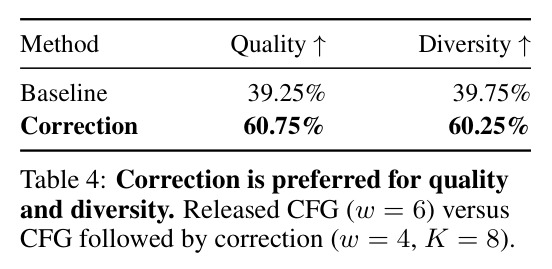
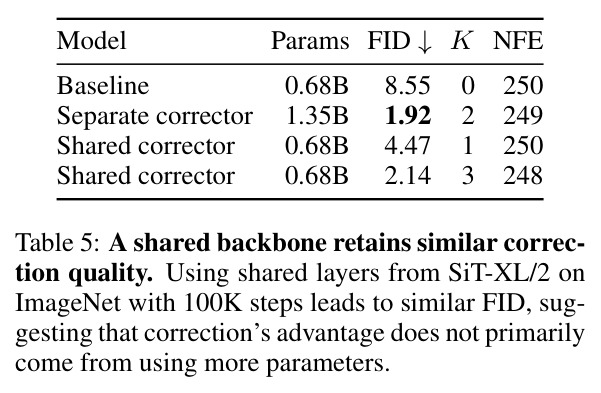
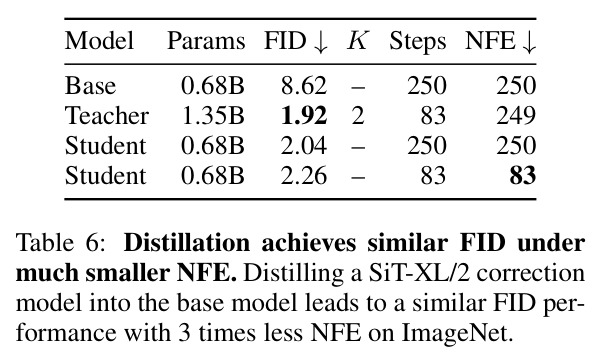
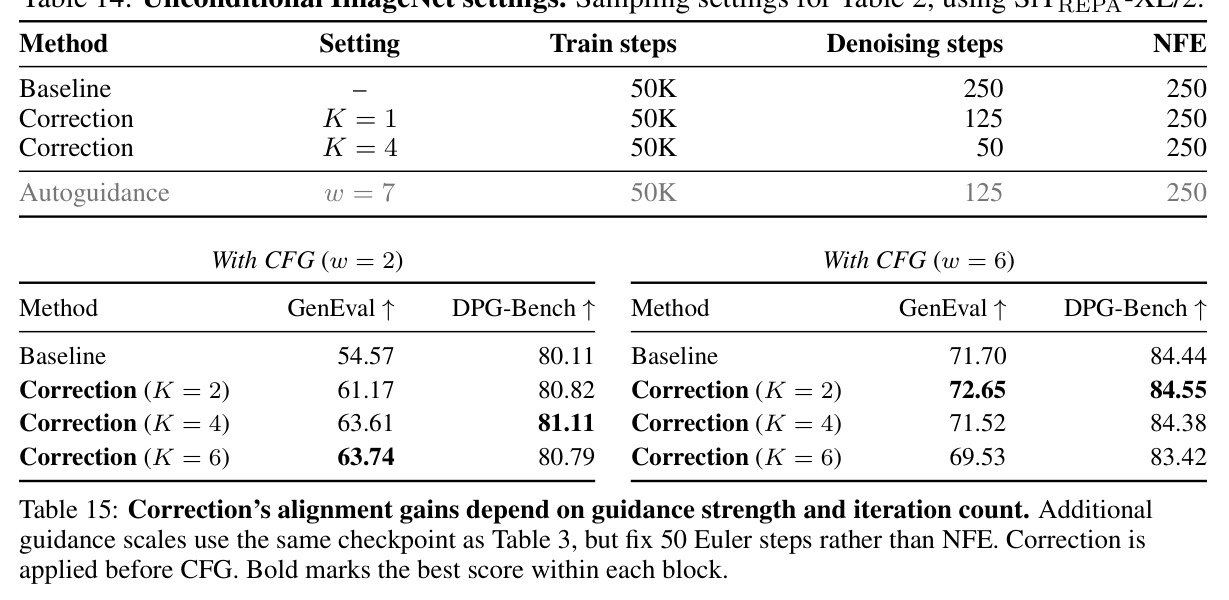
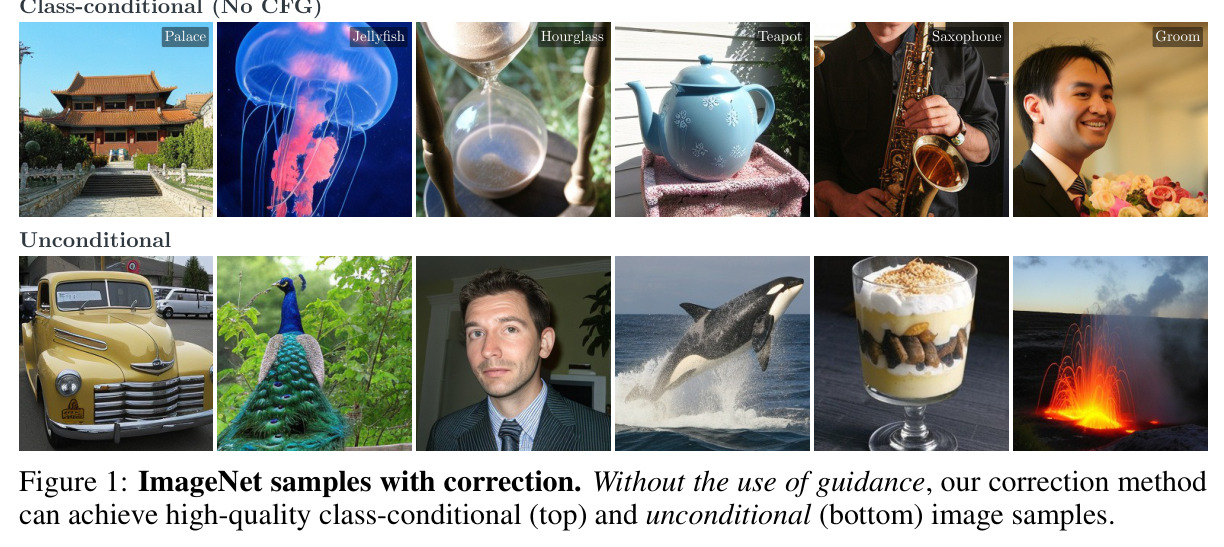
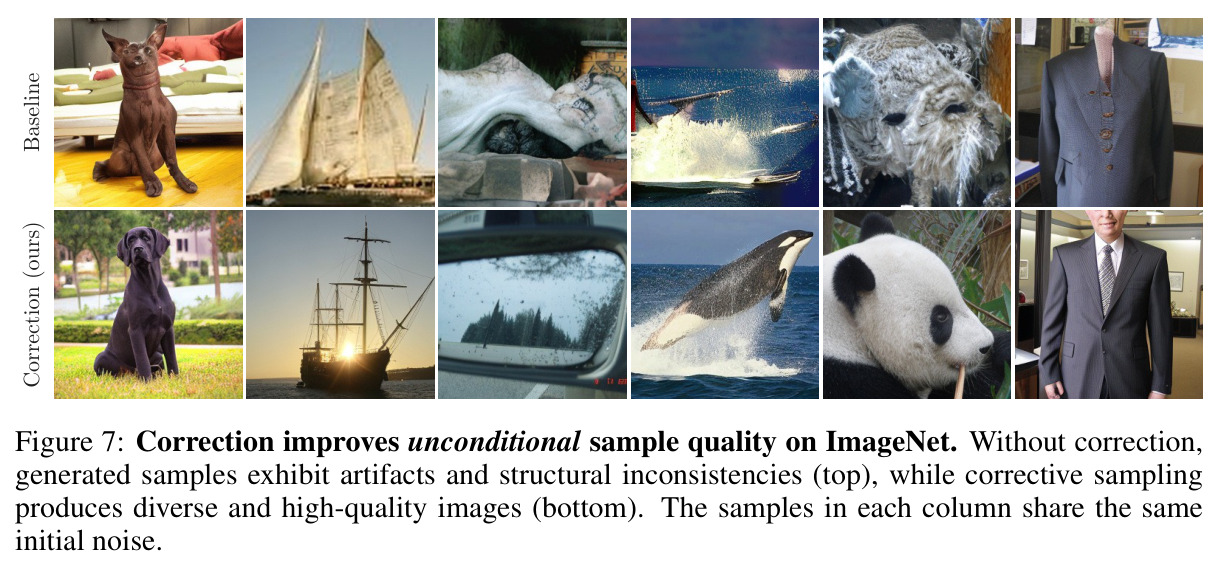
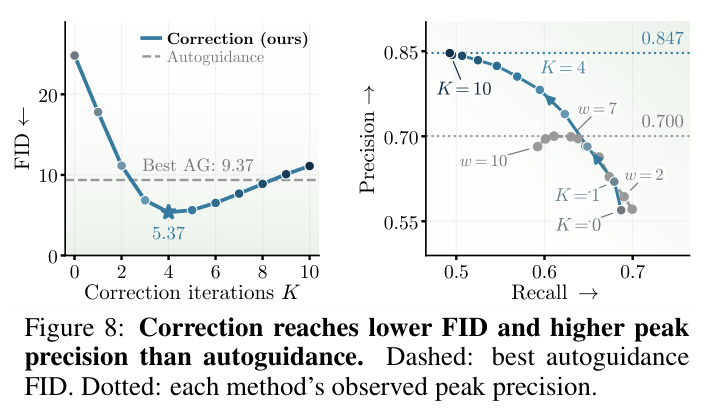
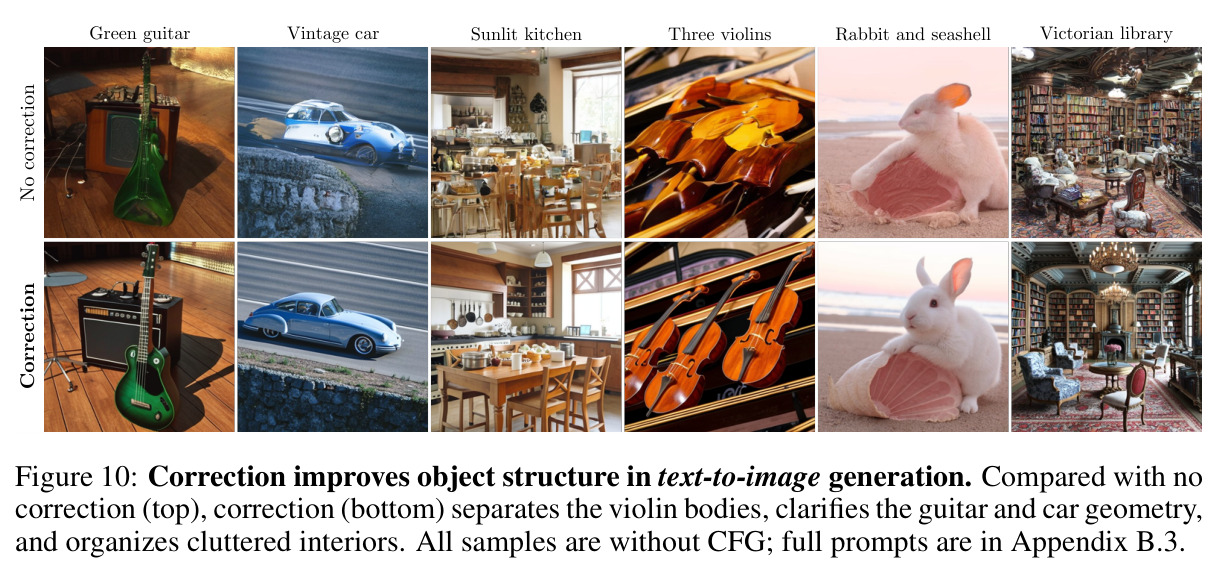
类条件 ImageNet-256 生成(Table 1,约 250 NFE):纠正带来一致的大幅改善并达到或超过 CFG 水平——DiT-XL/2 的 FID 从 9.58 降至 2.07(CFG 参照 2.51)、SiT-XL/2 从 8.55 降至 1.92(2.11)、SiT-REPA-XL/2 从 5.53 降至 1.31(1.35)、JiT-L/16 从 14.86 降至 2.96(2.35);precision 同步提升(DiT 0.668→0.811),recall 温和下降(0.676→0.603),质量-多样性权衡优于 CFG。训练开销极小:SiT-REPA 仅 5 万步更新,约为其 400 万步预训练的 1.25%(Fig. 5)。无条件生成(Table 2):baseline FID 24.82,纠正 K=1 降至 17.80,K=4 达 5.37,显著优于 autoguidance 最好的 9.37(w=7),precision 0.782 也高于 AG 的 0.699(Fig. 8)。文生图(Table 3,NanoGen 框架、50K 步微调):无 CFG 时 GenEval 28.30→50.09、DPG-Bench 70.71→76.82(K=6);叠加 CFG 时 68.08→70.48、83.38→83.69(K=2),并缓解 CFG 的同质化(Fig. 11)。人类偏好(Table 4,80 个 GenEval 提示、Rapidata 平台):CFG+纠正获 60.75% 质量、60.25% 多样性偏好,对照 39.25%/39.75%。机制分析(第 4 节):参数匹配实验显示单次纠正约等于更深单体去噪器(8.74 vs 8.93)而迭代 3 次大幅领先(5.66,Table 7);C2ST 显示纠正使训练/推理分布更难区分(Fig. 15);但纠正后训练分布上的去噪误差在 K≥3 时反而上升(Fig. 14);Fig. 16 表明最佳推理次数随监督深度约两倍增长,外推是收益关键。效率:共享骨干 0.68B 参数、K=3 达 FID 2.14(独立纠正器 1.35B 为 1.92,Table 5);蒸馏 student FID 2.04(250 NFE)接近教师 1.92(249 NFE),NFE 减少约 67%(Table 6)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-256 类条件生成(DiT-XL/2,无引导) | FID-50K ↓ / Precision ↑ / Recall ↑ | 纠正采样:FID 2.07 / Prec 0.811 / Rec 0.603(250 NFE) | 无引导基线:FID 9.58 / Prec 0.668 / Rec 0.676 | FID 降低 78.4%(9.58→2.07),precision +0.143,并超过 CFG 参照(FID 2.51) |
| ImageNet-256 类条件生成(SiT-XL/2,无引导) | FID-50K ↓ | 1.92(Prec 0.812 / Rec 0.608) | 8.55(无引导);CFG 参照 2.11 | FID 降低 77.5%,优于 CFG 的 2.11 |
| ImageNet-256 类条件生成(SiT-REPA-XL/2,无引导) | FID-50K ↓ | 1.31(Prec 0.797 / Rec 0.703),仅需 50K 步微调(预训练的 1.25%) | 5.53(无引导);CFG 参照 1.35 | FID 降低 76.3%,追平 CFG 的 1.35 且 recall 更高(0.703 vs 0.699) |
| ImageNet-256 类条件生成(JiT-L/16,无引导) | FID-50K ↓ | 2.96(Prec 0.766 / Rec 0.601) | 14.86(无引导);CFG 参照 2.35 | FID 降低 80.1%,接近 CFG 的 2.35 |
| ImageNet-256 无条件生成(SiT-REPA-XL/2) | FID-50K ↓ / Precision ↑ | K=4:FID 5.37 / Prec 0.782 | 无引导基线 FID 24.82;autoguidance 最好 9.37(w=7,Prec 0.699) | 较 autoguidance FID 降低 42.7%,precision +0.083,且无需引导信号 |
| 文本到图像生成(NanoGen,无 CFG) | GenEval ↑ / DPG-Bench ↑ | 纠正 K=6(245 NFE):50.09 / 76.82 | 基线(250 NFE):28.30 / 70.71 | GenEval +21.79 分(+77%),DPG-Bench +6.11 分 |
| 文本到图像生成(NanoGen,CFG 开启) | GenEval ↑ / DPG-Bench ↑ | 纠正 K=2(246 NFE):70.48 / 83.69 | 基线(250 NFE):68.08 / 83.38 | GenEval +2.40 分,DPG-Bench +0.31 分,且样本多样性更高、过饱和更少 |
| 参数匹配对照(从零训练,LightningDiT 80K 步) | FID@8K ↓(6720 层评估预算) | D14+C14(681M)K=3:5.66;有效深度匹配下 D7+C7(346M)FID@50K 4.21 | 单体 D28(675M)无引导 8.93;D28 FID@50K 4.88 | 迭代纠正较同参数单体去噪器 FID 降低 36.6%,更小模型仍胜出 13.7% |
| 纠正蒸馏(SiT-XL/2 类条件,k*=2) | FID ↓ / NFE | student:FID 2.04(250 NFE)、2.26(83 NFE) | 教师(1.35B,83 步去噪 + K=2 纠正,249 NFE):FID 1.92;原基座 8.62 | 以 0.68B 参数、单次前向复现教师质量,NFE 减少约 67% |
局限与改进
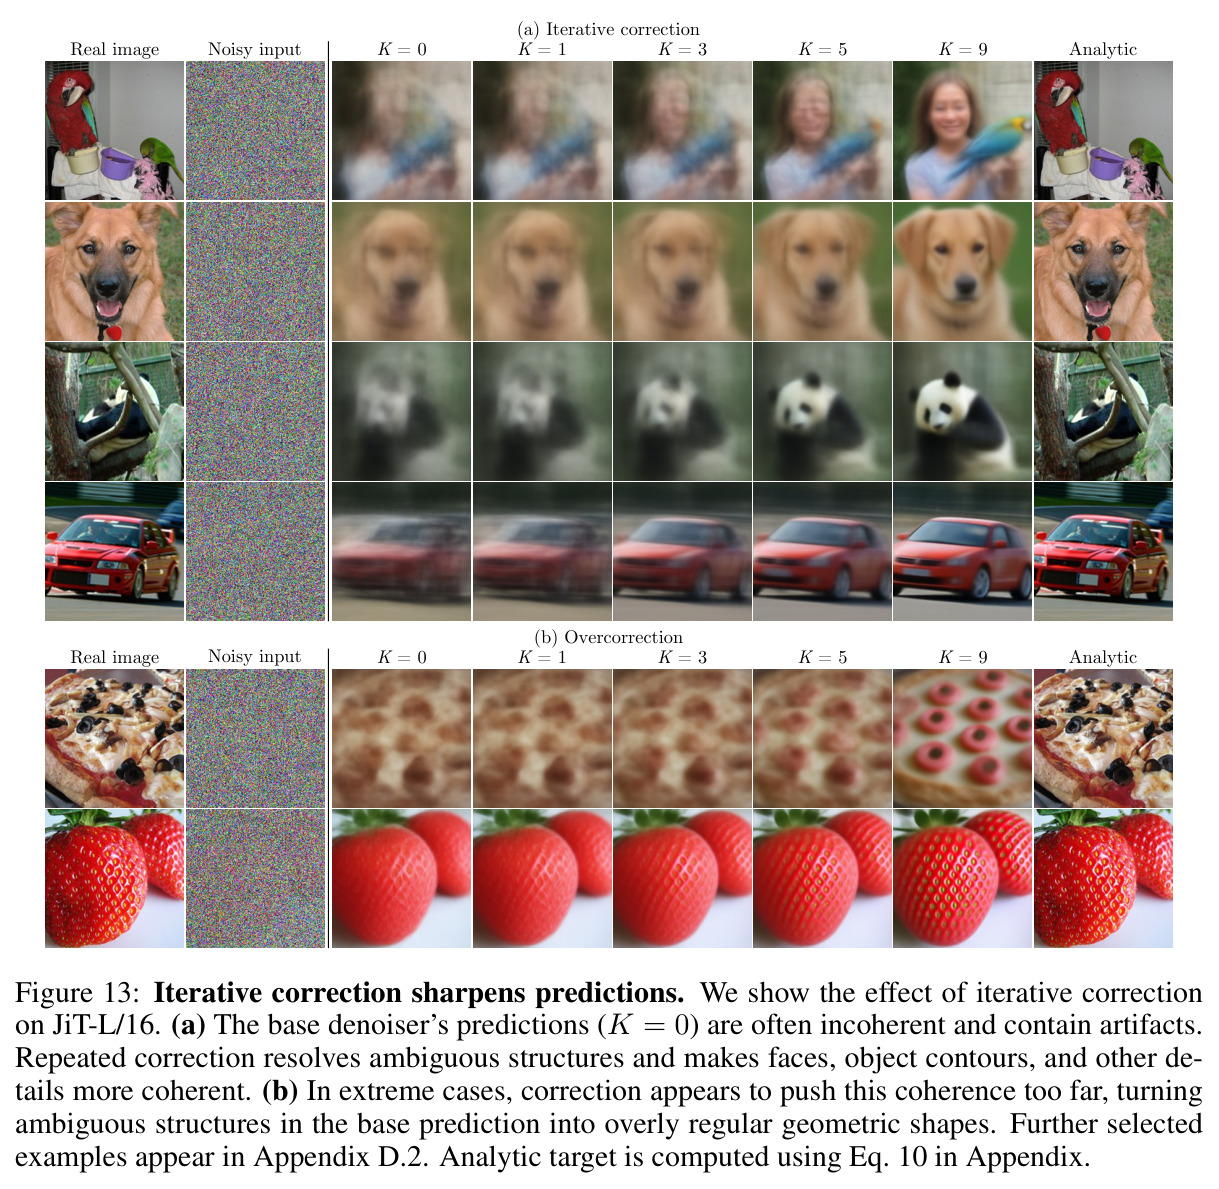
作者明确承认两点局限:其一,纠正为什么在增大训练分布重构误差(K≥3 时 $L_{denoise}^{(k)} > L_{denoise}$,Fig. 14)的同时显著改善生成质量,缺乏理论解释,作者在结论中将其列为 open question;其二,过度纠正会把模糊结构『锐化』过头,产生过于规则的几何伪影(Fig. 13(b) 中披萨配料变成圆盘、草莓籽排成规则网格)。我的补充观察:第一,K 存在依赖模型与设置的最优点,超过后 FID 回升(如 JiT-B/16 从 K=3 的 13.35 升至 K=5 的 16.06,Table 10),实际部署需要逐模型调参;第二,纠正区间需要选择,Table 11 显示全程纠正(7.70)反而劣于仅早期 $t\in[1.0,0.8]$(6.79),增加了配置复杂度;第三,蒸馏仅在类条件 SiT 上验证,student(FID 2.04)仍略逊教师(1.92),文生图与高分辨率场景未验证;第四,文生图无引导的绝对水平仍明显落后于 CFG(GenEval 50.09 vs 68.08),说明纠正并未完全替代引导的作用;第五,所有评估集中在 256×256 分辨率,冻结去噪器场景下大 K 还会出现类似高 CFG 的过饱和与 FID 回升(Fig. 18),提示方法在部分配置下并不稳健。
独立分析的弱点
第一,推理开销与超参敏感性:每步 K 次纠正最多让前向成本翻倍,且最优 K、纠正区间、$\lambda_{corr}$ 都依赖模型与任务(JiT 的最佳区间是 $[1.0,0.8]$,其他模型未必),实践中需要昂贵的扫描验证。改进方向:用相邻两次纠正预测间的变化率或不确定性估计做自适应早停,让模型自己决定每步的纠正深度;把区间选择做成随时间可学习的门控。第二,过纠正伪影:重复应用同一映射缺乏收敛保障,会过度放大模型的『锐化先验』,产生圆盘、网格等规则假象。改进方向:在训练中加入多步一致性或幂等正则(借鉴 IGN 思想),或限制单步修正幅度(残差缩放),并研究纠正迭代的不动点性质以给出安全停止准则。第三,理论空白:重构误差上升与 FID 下降并存的机制不明,难以预判方法在新架构、新数据上的失效边界。改进方向:从最优输运或分布偏移角度形式化『纠正=把推理轨迹拉回训练流形』的假说,并将 C2ST 差距度量发展为训练过程中的在线诊断信号。第四,蒸馏验证不足:仅在 SiT 类条件上做了 $k^*=2$ 的实验,student 与教师仍有 0.12 的 FID 差距,多步纠正(大 $k^*$)与文生图未测。改进方向:结合分布匹配蒸馏处理多步纠正的分布目标,在文生图上复验,并探索把蒸馏后的模型作为新基座再训纠正器的自举循环。第五,规模局限:全部实验在 256×256,文生图基于较小的 base 模型,文本对齐类指标提升幅度有限。改进方向:在 FLUX 级大模型与 1024 分辨率上验证,并扩展到视频扩散的时序结构纠正。
未来方向
作者提出的方向:为纠正的有效性与迭代行为建立理论理解——这是论文结尾明示的 open question,包括为什么纠正在增大重构误差的同时改善样本质量、迭代外推为何不发散。基于其成果可自然延伸的方向包括:(1)自适应纠正——根据预测不确定性、相邻两次纠正的变化量或 C2ST 代理信号自动决定每步的 K 与纠正区间,消除对人工调参的依赖;(2)纠正与引导的统一理论——本文显示两者都通过『锐化』预测改善质量但多样性代价不同,理论上刻画二者关系可能产生兼具质量与多样性的新采样规则;(3)蒸馏闭环——把多步纠正蒸馏回基座后,再以新基座重训纠正器,形成自我提升循环,并与一致性模型、分布匹配蒸馏结合压平成本曲线;(4)模态扩展——将预测纠正迁移到视频扩散(时序结构错误正是累积误差的重灾区)、3D 生成与离散扩散语言模型(与 Schiff et al. 2026 互相印证),检验『可复用细化算子』是否是跨模态的普遍现象;(5)过纠正治理——研究幂等正则或收敛性约束,使迭代纠正可以安全进行更多次;(6)把纠正器推广为处理条件输入的通用『错误修复器』,用于图像编辑、修复与可控生成任务。
复现评估
复现条件相当友好。方法本身只需两份网络副本与 L2 损失,所有基础模型(DiT-XL/2、SiT-XL/2、SiT-REPA-XL/2、JiT-L/16)均使用公开发布的 checkpoint;文生图基于 NanoGen 框架、FLUX.2 VAE 与公开的 BLIP3o 数据子集(JourneyDB/短/长 caption);论文给出了完整的训练与采样超参(Table 12、13:batch 256-1024、AdamW、学习率 $10^{-4}$、5-10 万步更新、约 250 NFE 评估协议)。作者提供项目主页(sunovivid.github.io/correction-training),附录包含详尽的组件消融与配置表。额外训练成本极低——SiT-REPA 的 5 万步仅为其预训练更新的 1.25%。主要门槛在评估而非训练:需要 ImageNet FID-50K/precision/recall 评估管线(论文使用 DiffusionBench 原生管线)以及能容纳 XL 级模型 batch 256 微调的多卡 GPU(估计 8×A100 数天量级);人类评估用了 Rapidata 平台,可用标准用户研究替代。整体而言,有扩散模型训练经验的小团队约一至两周可复现主要类条件结果,文生图部分因框架链路较长难度略高;若代码完全开源则难度进一步降低。
论文图表
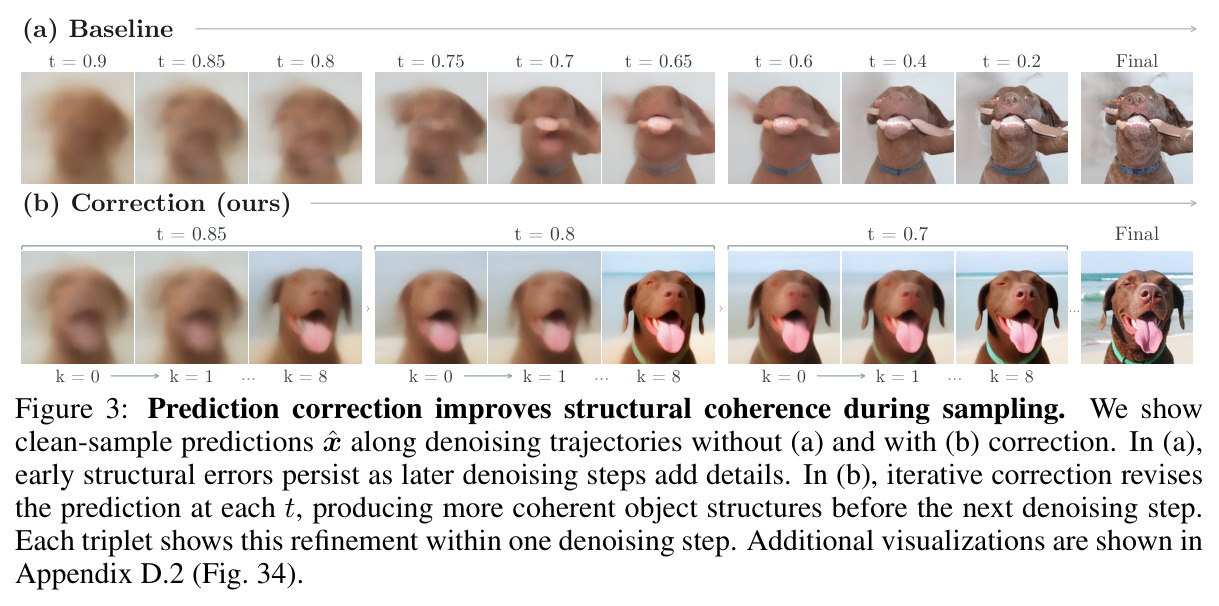
对比去噪轨迹上的干净预测:(a) 基线从 t=0.9 到最终样本,早期结构错误被后续细节一路保留;(b) 纠正版在 t=0.85、0.8、0.7 等每步内展示 k=0 到 k=8 的细化过程,物体结构在进入下一步前被修正。
直观展示问题的本质(错误结构固化)与方法的作用点(在中间步修正预测),是动机与方法的桥梁。
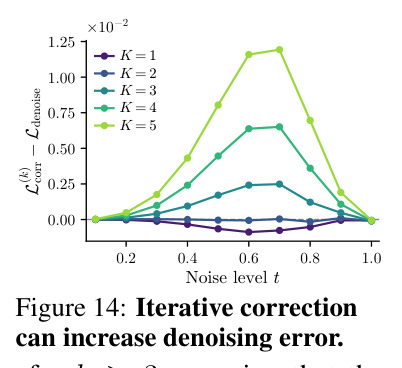
去噪误差差值 $L_{denoise}^{(k)} - L_{denoise}$ 随噪声水平 t 的曲线:K≥3 时差值为正,说明纠正后的预测在训练分布上反而离真实干净图像更远。
揭示论文最反直觉的发现:视觉质量的提升不以降低重构误差为途径,逼读者接受『纠正改善的是分布而非逐点误差』的解释。