DiffusionART:扩散模型的高效、稳定与可扩展强化学习 DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models
聚合奖励方向加漂移自适应恢复,让扩散RL后训练又快又稳
前置知识
流匹配与速度场
扩散/流匹配模型把高斯噪声逐步去噪成图像或视频。Rectified flow 用线性插值 $x_t = \alpha_t x_0 + \sigma_t \epsilon$,训练时回归速度目标 $u_t = x_0 - \epsilon$,生成时沿速度场做 ODE 采样,参数化从 $t=1$(噪声)到 $t=0$(干净样本)。
本文所有 RL 更新都直接作用在速度场上,正逆过程的区别(前向加噪 vs 反向去噪)是理解两派方法对立的前提。
在线扩散RL与信用分配
用不可微的黑盒奖励(如人类偏好模型)在线微调扩散模型:采样完整输出、打分、再更新参数。核心难点是信用分配——奖励只在最后给出,却要把它分配到几十个去噪状态上,决定每个状态该怎么改。
DiffusionART 的聚合引导本质上是一种新的信用分配方案,理解问题才能理解创新点。
反向过程RL(Flow-GRPO)
在真实反向采样路径上取状态,把确定性 ODE 转成 SDE 得到可处理的转移似然,用组内奖励优势加权策略梯度更新。优点是训练状态真实来自生成器,缺点是似然计算昂贵且每个转移只部分决定轨迹级优势,效率低。
它是本文对比的主要基线之一,论文的效率倍数(如 11.72×)多相对于它或其加速版计算。
前向过程RL(DiffusionNFT)
对生成的干净样本做前向加噪,把奖励映射为 $r \in [0,1]$ 的好坏权重,用 $r\|v_{\theta,+}-u_t\|^2 + (1-r)\|v_{\theta,-}-u_t\|^2$ 的正负目标回归速度。无需似然、高效,但依赖正负联合训练和 EMA rollout 策略两个稳定器。
本文的核心工作是诊断并修复 DiffusionNFT 的不稳定性,方法建立在对其损失的分析之上。
EMA 滚动策略
指数滑动平均维护一个滞后的旧策略 $\theta_{old} \leftarrow \eta\theta_{old} + (1-\eta)\theta$ 用于 rollout 和提供损失中的 $v_{old}$ 锚点。保留率 $\eta$ 相当于控制恢复强度,必须逐任务调参。
论文证明 EMA 的价值在恢复力而非 off-policy 数据,并用两次更新+漂移自适应恢复将其取代。
信任域与PPO裁剪
限制单次策略更新幅度防止崩溃,PPO 通过裁剪重要性比率实现。但 ODE 采样是确定性的,没有可用的 KL 散度来衡量策略变化,需要另想办法度量漂移。
DiffusionART 针对这一问题构造了基于速度差均值的 KL 代理 $m(s_t)$,是实现稳定性的最后一道保险。
研究动机
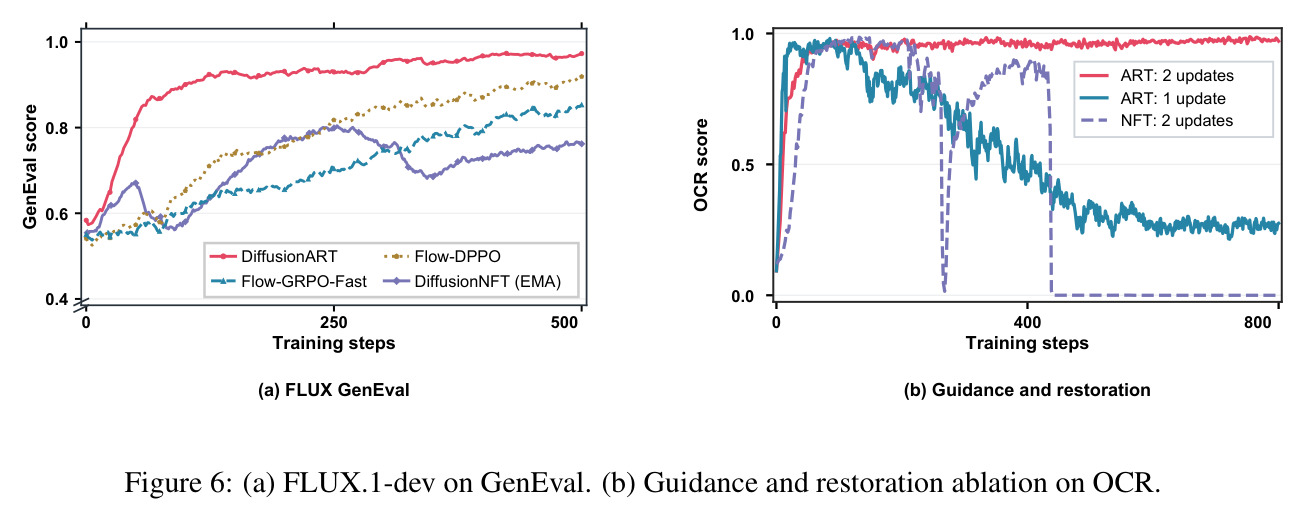
在线扩散 RL 用黑盒奖励微调扩散模型,奖励只在完整生成后给出,必须把输出级反馈分配到几十个去噪状态上(信用分配问题)。现有两派方法都不理想:反向过程方法如 Flow-GRPO 在真实采样路径上训练,但需把 ODE 转成 SDE 才能得到可处理的似然,且每个转移的策略梯度由轨迹级优势加权——该转移只部分决定这个优势,信用分配差、效率受限;前向过程方法如 DiffusionNFT 对干净样本做前向加噪、用奖励加权正负目标回归速度,无需似然、效率高,但稳定性完全依赖两个辅助手段:正负分支联合训练与 EMA 滞后 rollout 策略。EMA 调度必须逐任务调:默认 $\eta=\min(0.001i, 0.5)$ 在 OCR 任务上不稳定、需把最大保留率调到 0.999;纯 on-policy 更新直接崩溃;把 GenEval 上调好的 EMA 与 $\beta$ 迁到 FLUX.1-dev 上也会剧烈波动甚至崩溃。没有一族方法能同时做到高效、稳定且免调参。
本文的目标是本文的目标是先从理论上诊断前向过程扩散 RL 不稳定的根源,再据此构造一个既高效又稳定、无需逐任务调参的在线扩散强化学习算法。具体拆成三问:为什么 DiffusionNFT 的正负分支缺一不可、任一分支单独训练都崩溃?EMA 到底通过什么机制稳定训练——是 off-policy 的滞后数据还是损失里保留的旧策略锚点?能否设计一个不依赖可微奖励模型、不需要 EMA 调度、每个 prompt 只需很少样本(甚至一对偏好比较)就能稳定工作的算法?最终在文本到图像(SD3.5-M、FLUX.1-dev 12B)、文本到视频(HunyuanVideo-13B)和图到视频(Wan2.1-I2V-14B)上验证:在不调参的前提下,用数量级更少的 GPU 小时追平并超越精调超参的 DiffusionNFT (EMA) 与 Flow-GRPO-Fast。
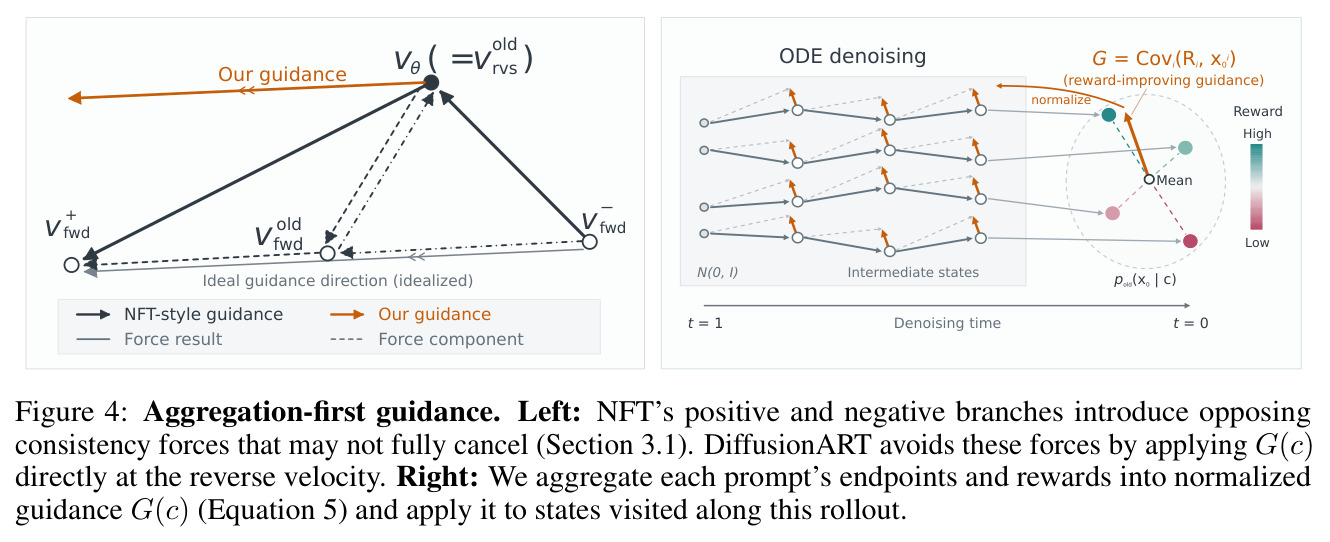
与已有工作不同的是,本文的独特切入是一个看似矛盾的现象:NFT 的正负分支共享同一个理想奖励改进方向,按理任一分支单独都该有效,实际上任一分支单独训练都崩溃。作者由此深挖,发现 NFT 的回归目标由前向加噪端点构造,隐含假设模型自身的采样速度等于端点诱导的理想前向速度,两者之差 $e = v^{fwd}_{old} - v^{rvs}_{old}$ 构成一个隐藏的前向-逆向一致性力;正分支以权重 $q$ 把速度拉向 $v^{fwd}_{old}$,负分支以权重 $1-q$ 推离,联合训练只能靠跨样本的奖励中心化部分抵消,无法在每个状态上精确抵消。另一个新视角是证明 EMA 稳定训练靠的是对滞后参考的恢复力而非 off-policy 数据本身。基于这两个诊断,本文从构造上消除一致性力,并用随漂移增长的第二次更新取代需要调参的 EMA。
核心方法
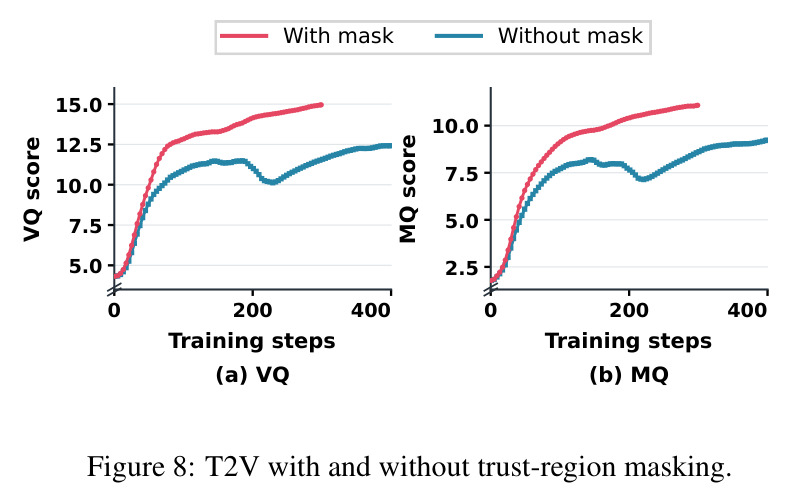
直觉上,与其让每个去噪状态通过似然比接收一个它只部分决定的标量优势(Flow-GRPO 一派),或让回归目标隐含模型自身并不满足的前向速度假设(DiffusionNFT 一派),不如先在 prompt 级把 K 个样本及奖励聚合成一个共享的奖励改进方向,再直接加到反向 rollout 状态的速度预测上。技术路线分三个组件:其一,聚合优先引导——用组内奖励与生成端点的协方差经 RMS 归一化得到 $G(c)$,冻结回归目标 $v^{tgt}_{ART}(s_t) = v^{(0)}_\theta(s_t) + G(c)$,其中 $v^{(0)}_\theta = v_{old}$ 是 rollout 时缓存的速度预测;其二,两次更新恢复——把 rollout 批次切成两个不相交 minibatch 各做一步 MSE 回归,第二次更新的输出力 $G(c) - d(s_t)$ 自带随漂移 $d(s_t) = v_\theta - v^{(0)}_\theta$ 增长的恢复分量,取代 EMA;其三,PPO 式信任域掩码,用 KL 代理 $m(s_t)$ 掩掉过度外向漂移。
核心创新是把奖励引导从状态级似然加权改成 prompt 级聚合方向,从构造上消除一致性力。Lemma 2 证明指数倾斜分布 $p^\tau(x_0|c) \propto p_{old}(x_0|c)\exp(\tau R)$ 的端点均值在 $\tau=0$ 处的导数正是奖励-端点协方差;在 rectified flow 下 $u_t = x_0 - \epsilon$ 且 $\epsilon$ 与 $x_0$ 独立,该协方差在任何噪声水平都等于 $u_t$ 的协方差。于是用 $\mathrm{Cov}(R,x_0|c) = \frac{1}{K}\sum_{i=1}^{K}(R_i - \bar{R}_c)(x^{(i)}_0 - \bar{x}_{0,c})$ 估计方向并做 RMS 归一化。因为目标从不涉及前向速度,Proposition 1 中力 $F_{NFT} = 2g + (2q-1)e$ 的有害项 $(2q-1)e$ 按构造消失。区别在于:NFT 依赖跨样本部分抵消、EMA 靠滞后参考提供恢复,DiffusionART 给每个状态显式奖励方向,用漂移自适应恢复取代两者。
方法步骤详情
Algorithm 1 单次迭代:第一步(rollout),用当前策略 $v^{(0)}_\theta$ 做 ODE 采样,每个 prompt $c$ 收集 K 个端点 $x^{(i)}_0$、奖励 $R_i$、状态 $s_t$ 及缓存预测 $v^{(0)}_\theta(s_t)$。第二、三步,计算 $G(c)$ 并冻结目标 $v^{tgt}_{ART}(s_t) = v^{(0)}_\theta(s_t) + G(c)$。第四步(训练),把样本切成两个不相交 minibatch。第五步,各做一步带权 MSE 回归:$\mathcal{L} = w \cdot \mathrm{MSE}(v_\theta, v^{tgt}_{ART})$;第一次更新的输出力为 $G(c)$,第二次为 $G(c) - d(s_t)$,即引导加恢复。按 ODE-to-SDE 定义 KL 代理 $m(s_t)$:当 $m \ge \delta = 10^{-5}$ 且位移与 $G(c)-d(s_t)$ 同向时把该状态权重置零。Pairwise 变体把端点配成 K/2 对,以 1/0 胜负标签替换标量奖励。
技术新颖性
新颖性体现在四层。理论诊断层:Lemma 1 证明理想 NFT 引导等价于条件奖励协方差 $g = \mathrm{Cov}_{Q_{old}}(r, u_t | s_t)$;Proposition 1 把实际力分解为 $2g + (2q-1)e$,首次指出前向-逆向差 $e$ 是不稳定根源;Proposition 2 把 NFT 损失改写为线性引导项加二次恢复项 $-2\beta(2r-1)\langle d, h\rangle + \beta^2\|d\|_2^2$,证明 EMA 的价值在恢复而非 off-policy 数据,并用两个消融(去掉锚点仍崩溃;无 EMA 双更新不崩但慢 15.2×)验证。机制设计层:聚合优先引导把信用分配从似然比改为共享协方差方向,天然支持不可微的成对偏好模型;漂移自适应恢复无需任何调度超参。工程层:针对 ODE 确定性采样没有可用 KL 的问题构造 KL 代理并只掩外向漂移。实证层:发现恢复的输出力 RMS 比引导小 9.4× 但参数梯度范数反而大 4.9×,提示异质引导跨状态大量抵消而恢复在聚合后占主导。
实验结果
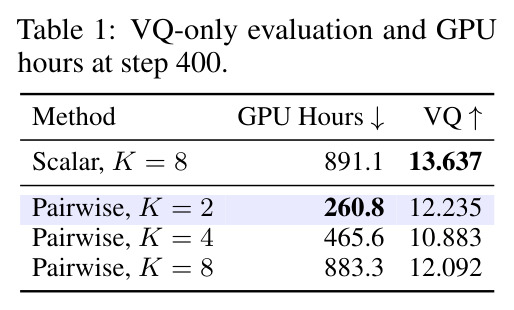
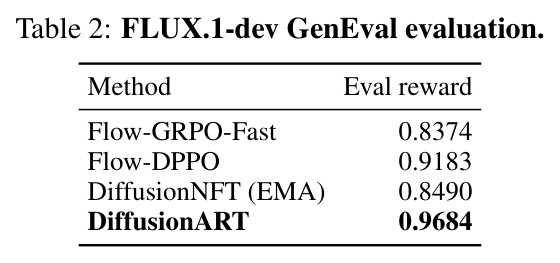
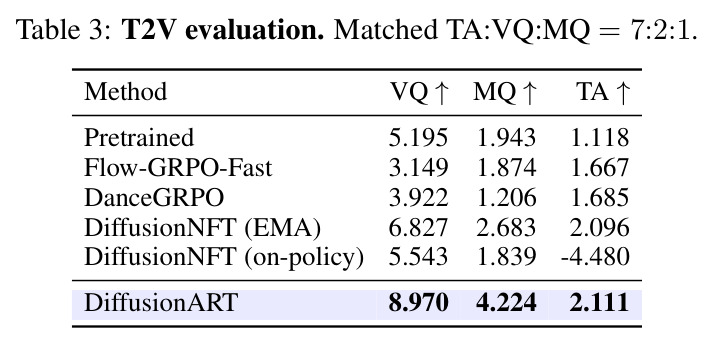
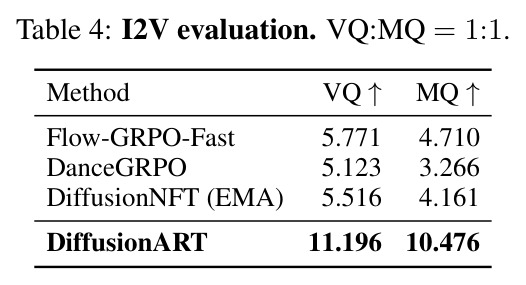
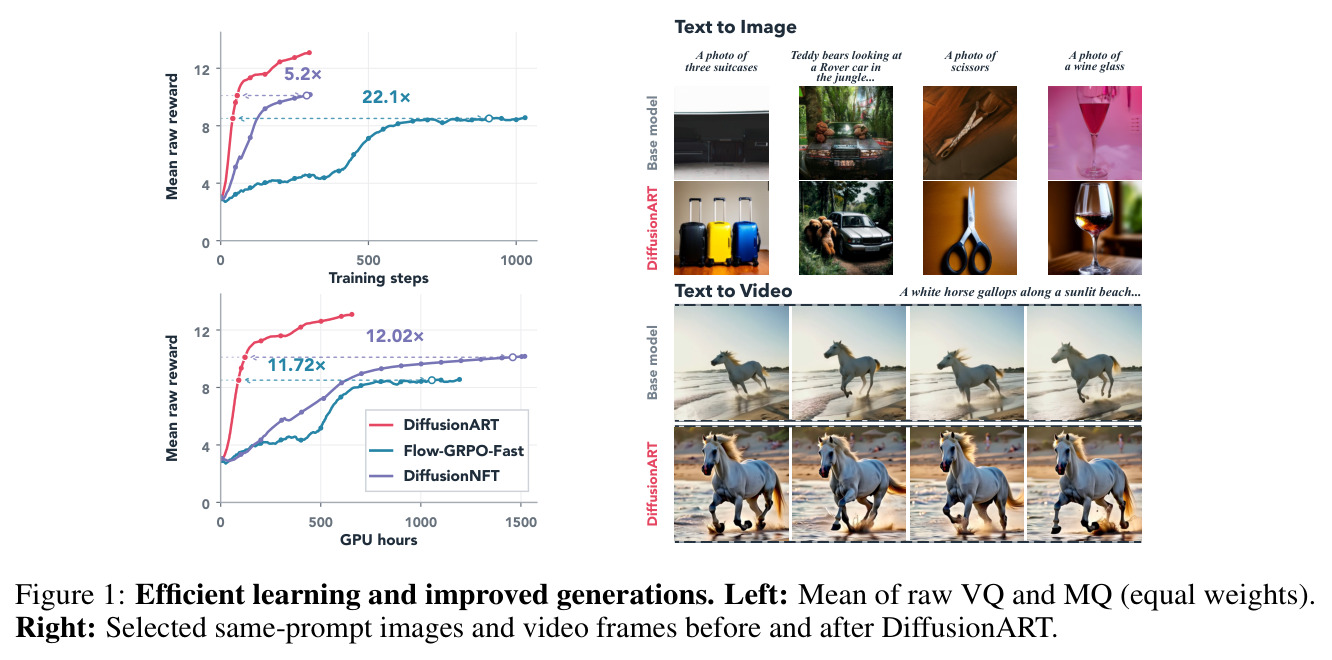
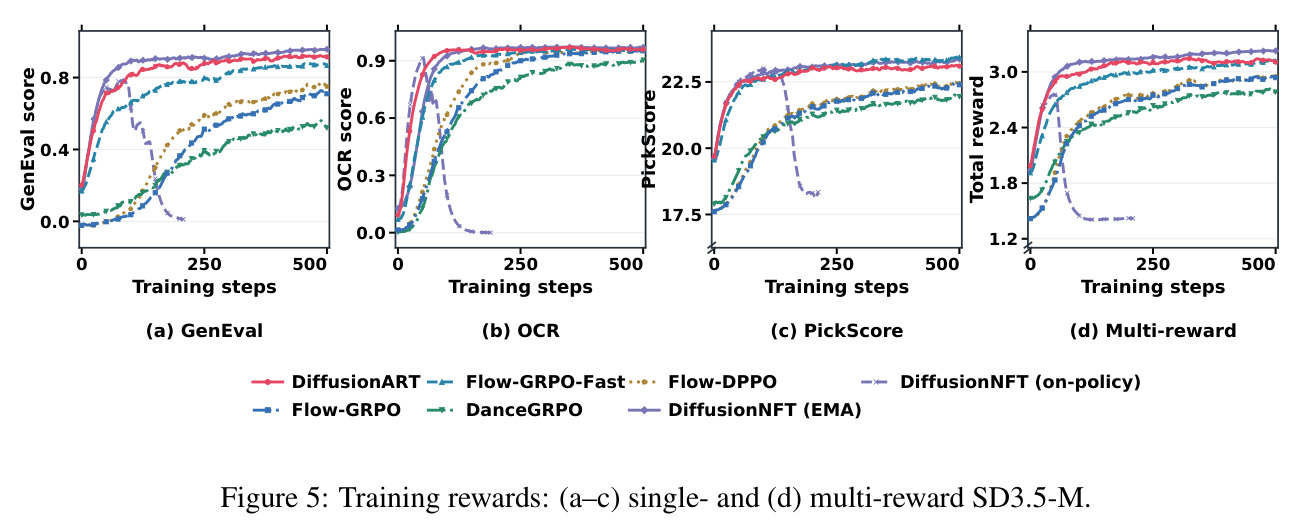
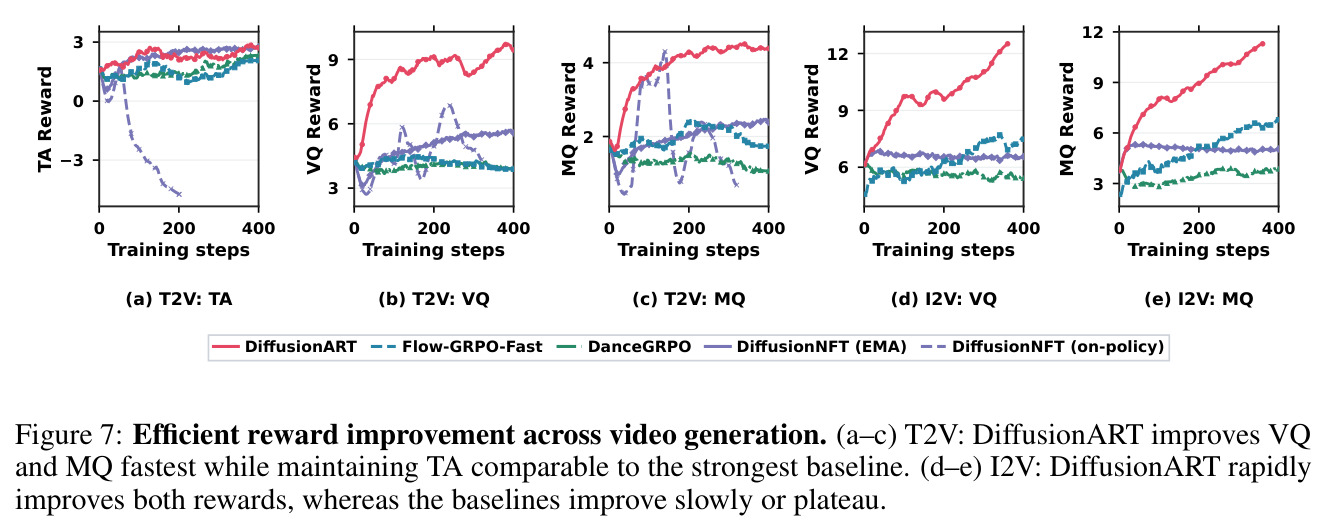
文生图(SD3.5-M):在 GenEval/OCR/PickScore 上分别用少 10.0×、5.2×、9.6× 步数追平 Flow-GRPO 500 步奖励;FLUX.1-dev 上 DiffusionNFT 迁移超参则剧烈波动,本文免调参最快。文生视频(HunyuanVideo-13B):训练 VQ/MQ 达 6/3 只需 29/46 步;VQ 达 5.5 需 24 步 63.4 GPU 小时,DiffusionNFT (EMA) 需 273 步 1401.4 小时,省 11.4× 步数与 22.1× 算力;400 步评测 VQ 8.970、MQ 4.224,较基线高 31.4%/57.4%;VQ:MQ=1:1 下以少 12.02×/11.72× 算力追平基线均值且高 28.8%/53.0%。图生视频(Wan2.1-I2V-14B):MQ 达 6 需 45.8 小时,Flow-GRPO-Fast 需 220.3,省 4.8×。消融:去信任域掩码后 VQ 约 200 步跌落;Pairwise K=2 仅 260.8 小时、VQ 12.235,不劣于 K=8(883.3 小时)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文本到视频(HunyuanVideo-13B,TA:VQ:MQ=7:2:1) | 训练 VQ 达到 5.5 所需 GPU 小时 | 63.4 GPU 小时(24 步) | DiffusionNFT (EMA):1401.4 GPU 小时(273 步) | 22.1× 更少 GPU 小时,11.4× 更少训练步数 |
| 文本到视频(HunyuanVideo-13B,400 步评测) | 评测 VQ / MQ | VQ 8.970 / MQ 4.224 | 最强基线(DiffusionNFT EMA / Flow-GRPO-Fast 等) | VQ +31.4%,MQ +57.4% |
| 文本到视频(HunyuanVideo-13B,VQ:MQ=1:1) | 追平基线后期均值奖励所需 GPU 小时 | DiffusionART(12.02× / 11.72× 更少) | DiffusionNFT / Flow-GRPO-Fast | GPU 小时省 12.02× / 11.72×,均值奖励高 28.8% / 53.0% |
| 文本到图像(SD3.5-M) | 达到 Flow-GRPO 500 步奖励所需训练步数 | GenEval / OCR / PickScore 分别节省 10.0× / 5.2× / 9.6× | Flow-GRPO | 最高 10.0× 步数效率 |
| 图到视频(Wan2.1-I2V-14B,VQ:MQ=1:1) | 训练 MQ 达到 6 所需 GPU 小时 | 45.8 GPU 小时 | Flow-GRPO-Fast:220.3 GPU 小时 | 4.8× 更少 GPU 小时 |
| 文本到视频(Pairwise 偏好反馈,400 步) | GPU 小时与 VQ-only 评测 | K=2:260.8 GPU 小时,VQ 12.235 | Pairwise K=8:883.3 GPU 小时,VQ 12.092 | 3.4× 更少 GPU 小时且 VQ 不降 |
局限与改进
作者承认的局限:恢复力在参数空间聚合后反而占主导(输出力 RMS 小 9.4× 但参数梯度范数大 4.9×)这一反直觉现象的详细机理被明确留作未来工作;信任域阈值 $\delta = 10^{-5}$ 全程固定,未讨论其敏感性。我的补充观察:其一,训练与评测奖励高度重合(多用 VideoReward 本身),存在奖励黑客风险,缺少人类评测或独立外部基准验证;其二,$G(c)$ 是 prompt 级单一方向,施加于该 prompt 的所有状态,可能压缩组内多样性,论文未报告多样性或召回类指标;其三,T2I 仅用 rank 32 的 LoRA,T2V/I2V 依赖特定蒸馏模型(CFG 蒸馏的 HunyuanVideo、步数蒸馏的 Wan2.1),对其他模型族、分辨率和采样步数的迁移性未验证;其四,K 很小(如 K=2)时协方差的蒙特卡洛估计方差很大,理论误差未被量化;其五,时间戳显示这是早期版本,部分附录结论(如 Table 2–4 细节)正文仅简述。
独立分析的弱点
第一,评测独立性不足:训练奖励(VideoReward 的 VQ+MQ 加权)与评测指标高度重合,若奖励模型存在盲区,算法可能只是在逼近奖励模型的上限而非真实生成质量,改进方向是引入人类偏好评测或与训练无关的基准(如 VBench、独立 GenEval 评审)。第二,多样性风险:$G(c)$ 对同 prompt 全部状态施加同一方向,K=2 时协方差估计噪声极大,虽然实验显示 VQ 不降,但未测生成多样性,改进方向是加入方向扰动或按噪声水平分组的多方向引导。第三,恢复项分析不完整:论文只给出聚合层面的经验测量(恢复输出力小 9.4× 但参数梯度大 4.9×),缺少按模块(attention 与 FFN)或层深的力分解,改进方向是做逐参数组的力谱分析并据此设计逐层信任域。第四,信任域 KL 代理依赖 $\sigma_{ref}(t)$ 的具体形式,$\delta$ 固定,而各实验采样步数从 4 到 16 不等,漂移尺度天然不同,改进方向是把 $\delta$ 与每步漂移的自适应分位数挂钩。
未来方向
作者明确提出的方向:详细分析为何异质的每样本引导在跨状态聚合时大量抵消、而恢复力得以存活并主导参数更新(Section 3.2 留给未来工作)。基于本文成果可延伸:一是把聚合优先引导与可验证奖励(文字渲染、排版精确性)结合,检验其在非偏好类奖励上的表现;二是多奖励场景下的方向冲突处理——目前多奖励只是隐式混合各分项协方差,可探索分组聚合或帕累托方向集合;三是把漂移自适应恢复推广到 DPO、蒸馏等其他后训练范式,恢复项本质是参数空间正则,可与 KL 正则统一成一套框架;四是继续扩大模型规模与视频时长分辨率,验证论文的可扩展性主张;五是在理论上量化小 K 协方差估计的方差并设计收缩或贝叶斯估计器;六是研究 $G(c)$ 在多轮自迭代生成-评估闭环中的传递与衰减。
复现评估
复现条件评估:代码在 GitHub 开源(github.com/vanzll/DiffusionART),并有项目页展示生成样例;Algorithm 1 伪代码与关键公式完整,正文给出 LoRA rank/α(32/64)、学习率(T2I 为 $3\times10^{-4}$,T2V/I2V 为 $10^{-5}$)、rollout 步数(10/16/4)、分辨率与帧数、组规模(32 prompts × K 视频)、信任域阈值 $\delta=10^{-5}$ 等关键超参,附录含理论证明与消融细节,对照调试可行性高。算力门槛较高:T2V/I2V 需全参微调 13B/14B 模型,单 rollout 需生成 32×8 个 53 帧视频并由 VideoReward 在线打分,400 步约耗 260–900 GPU 小时(K=2 到 K=8),T2I 的 FLUX 实验也需要 12B 级模型。对个人友好的一点是算法对组大小 K 不敏感,K=2 可省 3.4× 算力,且 T2I 任务用 LoRA 即可复现核心结论。总体难度中高:核心算法复现不难,完整视频实验需要多卡集群与视频奖励模型部署。
论文图表
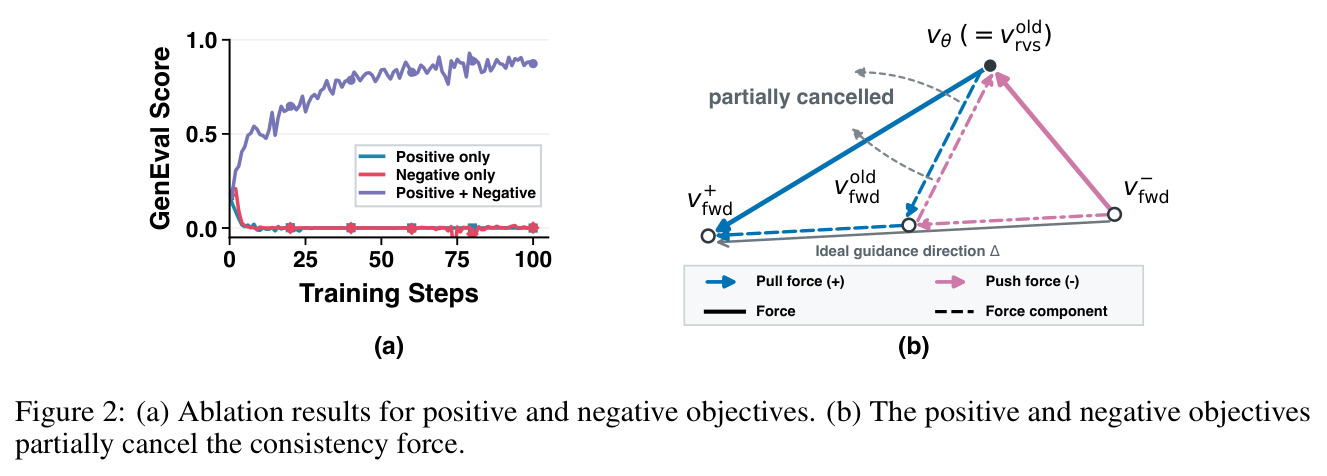
子图 是正/负/联合训练目标的消融曲线:任一分支单独训练都崩溃,联合训练有效;子图 (b) 是力分解示意图,展示正分支沿一致性差 $e$ 方向的拉力与负分支的推力如何相互抵消、沿理想引导方向如何相互增强,仅残留 $(2q-1)e$。
这是引出全文核心诊断——隐藏前向-逆向一致性力——的关键实验与图示证据,理解这张图才能理解方法的设计动机。
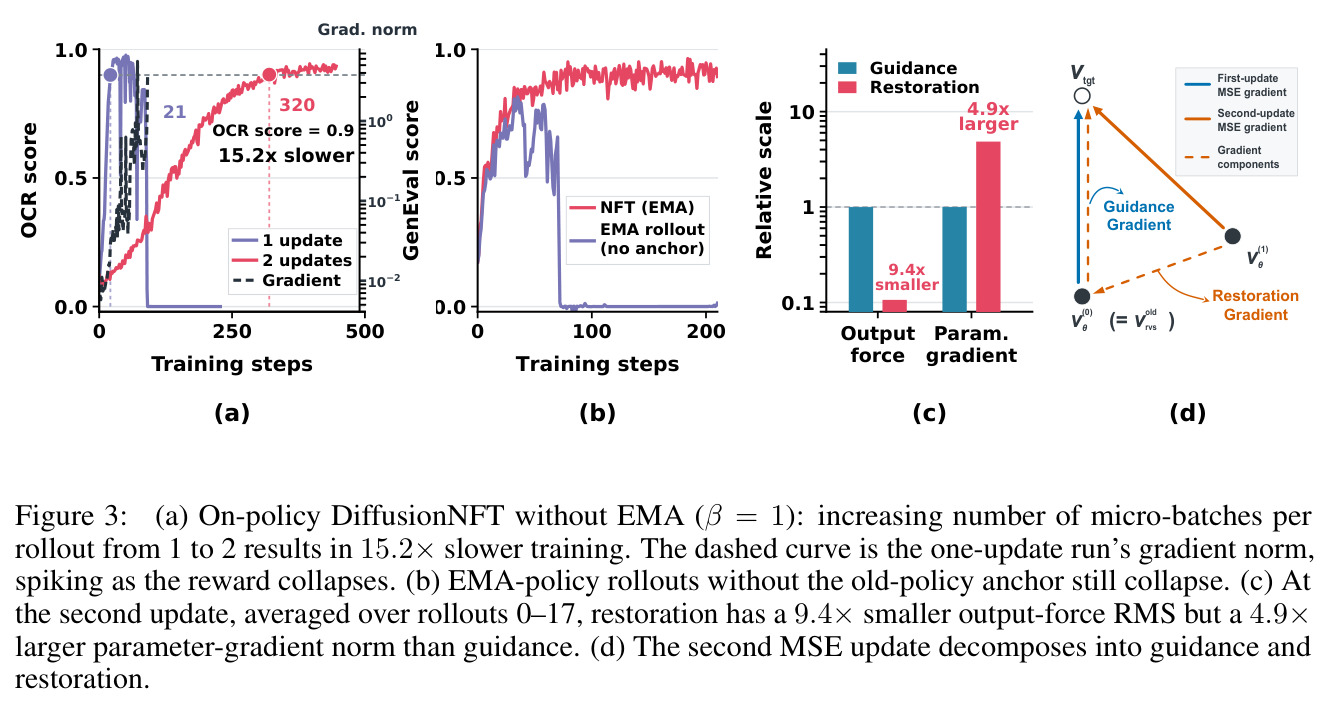
四个子图分别:(a) 无 EMA 的纯 on-policy NFT 崩溃,且每 rollout 两次更新使训练慢 15.2×;(b) 保留 EMA rollout 数据但从梯度中移除旧策略锚点仍崩溃;(c) 第二次更新中恢复力输出 RMS 比引导小 9.4× 但参数梯度范数大 4.9×;(d) 第二次 MSE 更新在输出空间分解为引导与恢复两个分量。
证明 EMA 稳定训练的机制是对滞后参考的恢复而非 off-policy 数据,这一发现直接催生了 DiffusionART 用漂移自适应恢复取代 EMA 的设计。