GPT-6-Astra 具身智能能力评测:从基准饱和到真实部署的差距 Has GPT-6-Astra Achieved Embodied Intelligence?
统一协议评测显示 GPT-6-Astra 模拟基准接近饱和,但距实用具身智能仍有显著差距
前置知识
VLA(视觉-语言-动作模型)
VLA 是在视觉-语言模型基础上微调出机器人动作输出的端到端策略:输入相机图像、本体状态与语言指令,直接输出关节角或末端位姿等控制量,代表工作如 π0.5。它通常需要针对每个任务或本体收集遥操作示教并做监督微调,跨任务泛化能力有限,是当前机器人学习的主流专用范式。
本文的对照对象就是 VLA:模拟评测要与其 SOTA 比较,harness 消融中 π0.5 充当 System 1 低层控制器;理解其'依赖示教训练'的特点,才能读懂 ICL 协议的设计动机。
上下文学习(ICL)
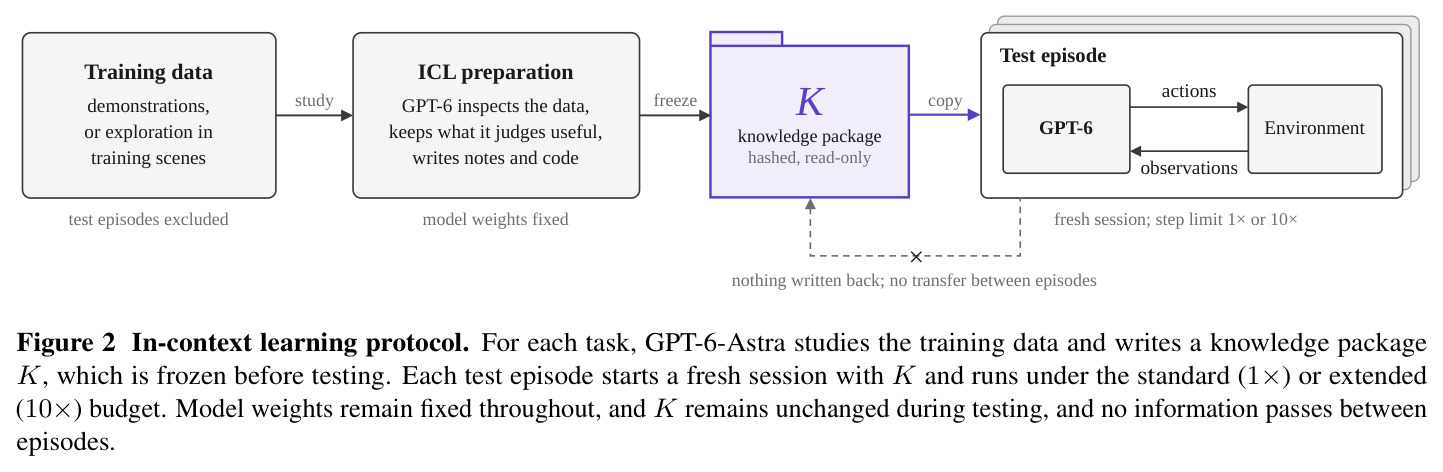
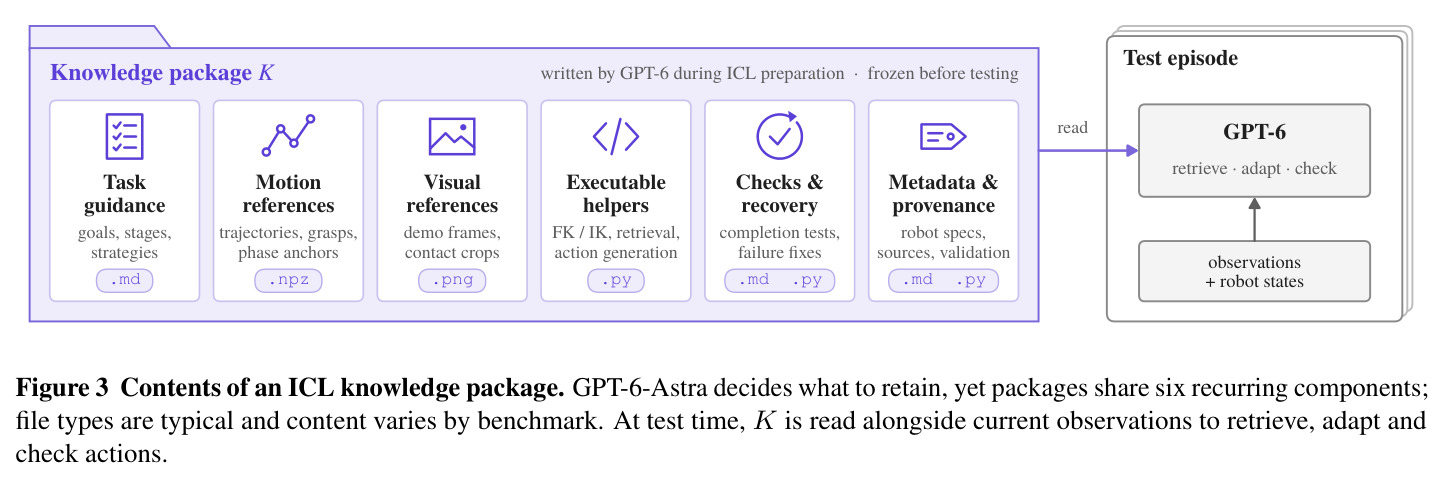
ICL 指模型不更新权重,仅通过在提示中提供示例或资料来获得新能力。本文将其扩展到具身评测:测试前让 GPT-6-Astra 阅读基准的训练示教,自主整理成冻结只读的知识包(任务指南、轨迹参考、可执行 helper 等),每个测试回合以全新会话引用它,回合之间不传递任何信息。
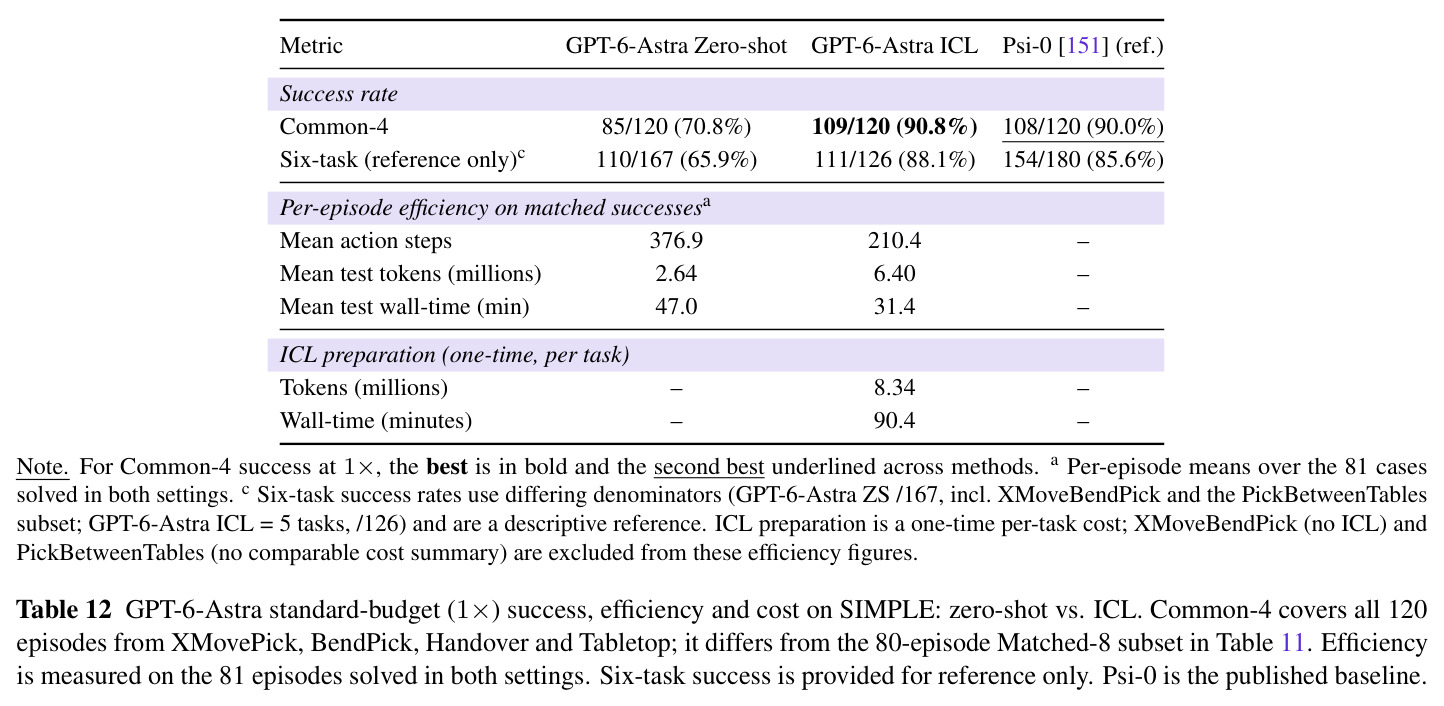
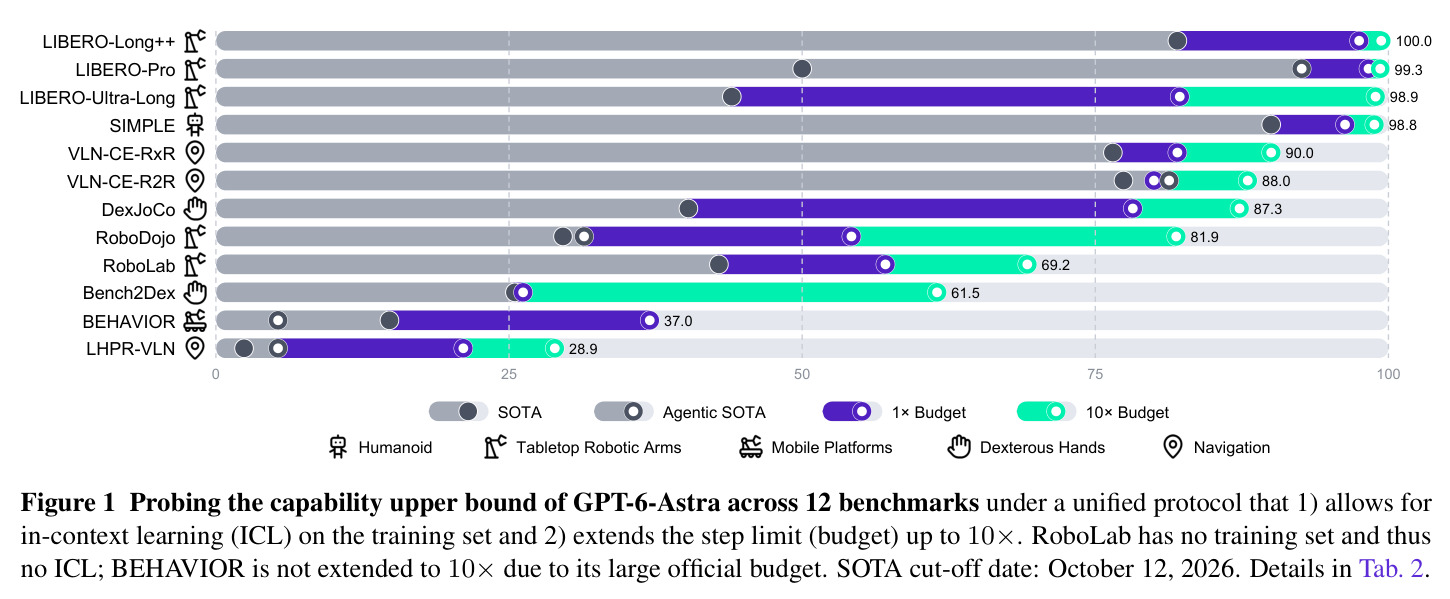
ICL 是统一协议的第一支柱,Fig. 1 的成绩几乎全部依赖它;SIMPLE 上 ICL 把成功率从 70.8% 提到 90.8%,是其价值的直接量化证据。
System 1 / System 2 分层控制
认知科学中 System 1 指快速直觉式反应,System 2 指慢速审慎推理。具身系统中常把高频低层控制器或 VLA(乃至更底层的运动控制器 System 0)视为 System 1,把秒级推理的大模型视为 System 2,两者通过子目标下发或动作审查协作。GPT-6-Astra 单次推理需数秒,无法直接做高频控制。
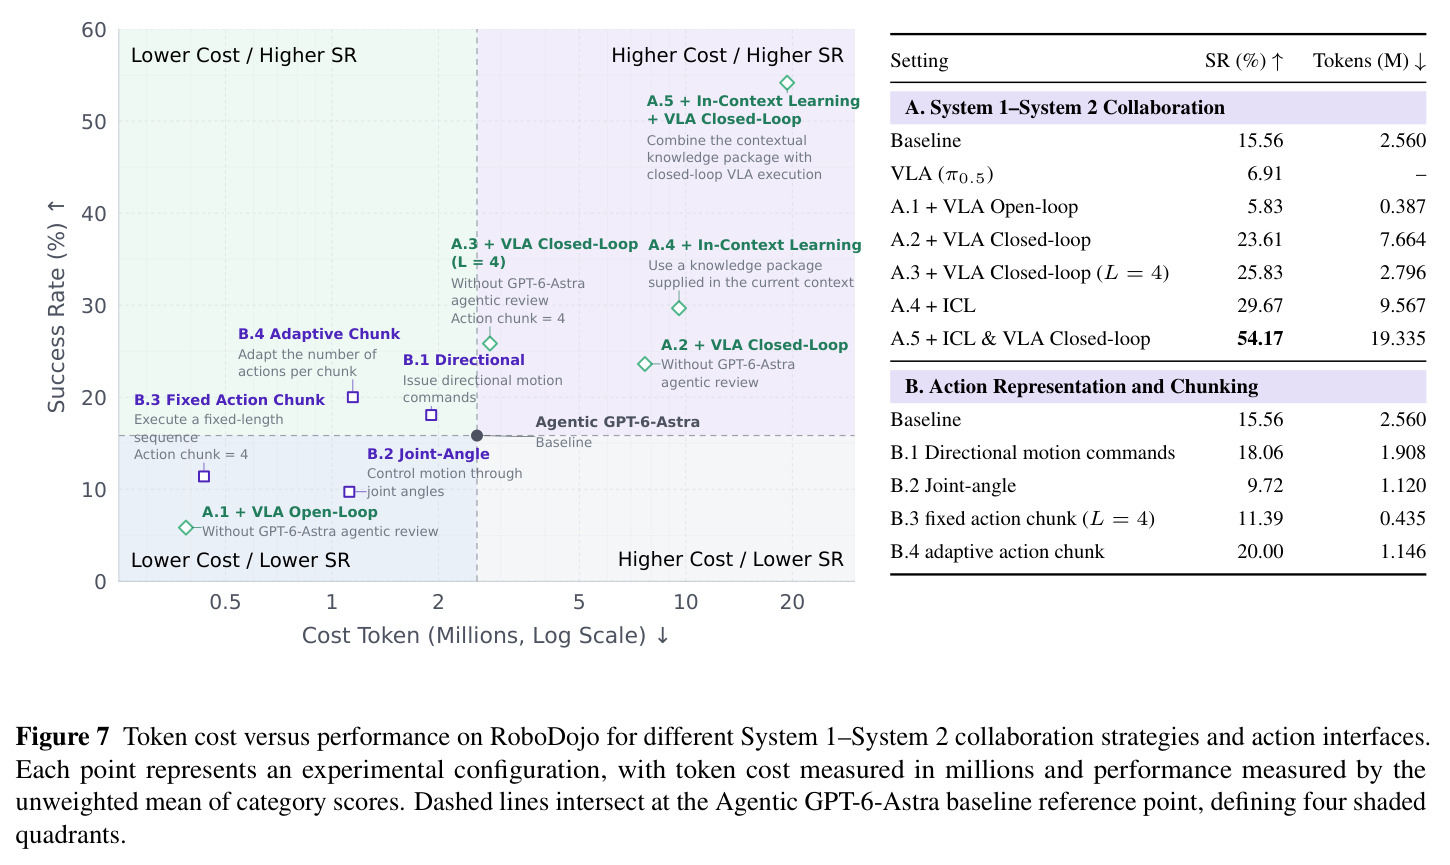
第 3 章与真机人形实验(Unitree G1)的核心问题就是 System 2 如何与 System 1/0 协作:闭环审查协议比开环最多多 20 个百分点成功率,是 harness 设计的关键结论。
动作表示与分块(Action Chunking)
动作表示指模型输出控制量的语义层级:关节角最底层、末端执行器(EEF)位姿居中、方向性运动指令最语义化。分块指一次决策输出并连续执行的动作数 $L$:$L$ 大可减少模型调用、摊薄 token 成本,但牺牲逐步纠错;自适应分块让模型按场景自选 $L \in \{1,2,3,4\}$。
消融发现关节角直控掉 5.84 个百分点、自适应分块提升 4.44 个百分点,这是'多模态推理与低层控制存在表示鸿沟'这一核心结论的证据,也是读懂第 3 章的前提。
目标条件评测(PDDL/BDDL)
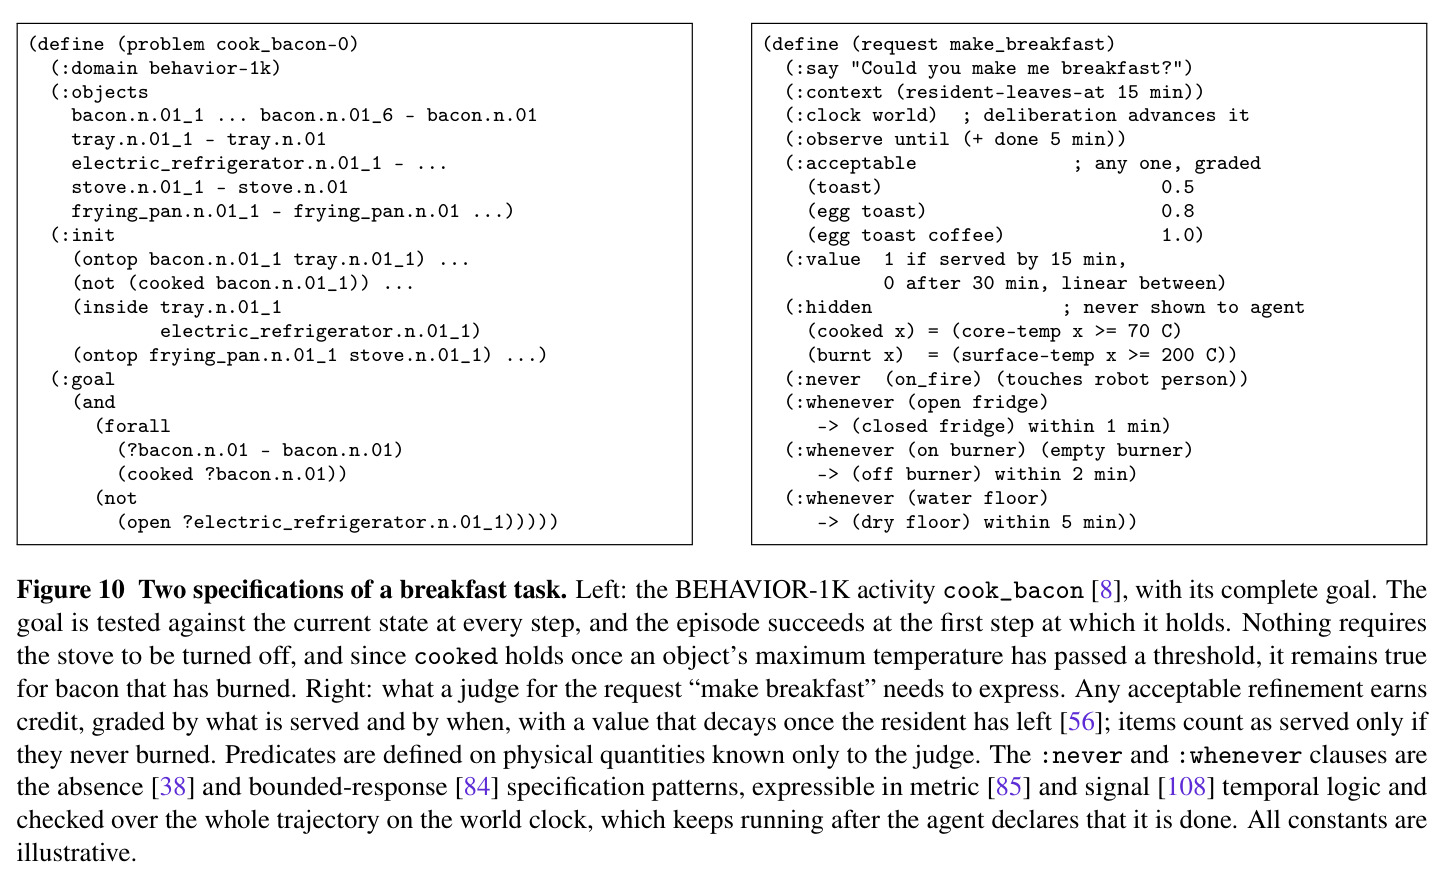
经典具身基准(如 BEHAVIOR)用 PDDL/BDDL 风格的目标谓词公式定义成功:在场景状态上检测一组条件(如所有培根 cooked 且冰箱 closed),全部成立即成功。它隐含假设世界只在 agent 动作时变化、时间以步数计、世界模型已知。
第 5 章对下一代基准的批评与重构正针对这套评测语言:提出用效用评分、世界时钟和 :never/:whenever 时序义务约束替代单一目标条件,Fig. 10 直接对比了两种任务规格。
研究动机
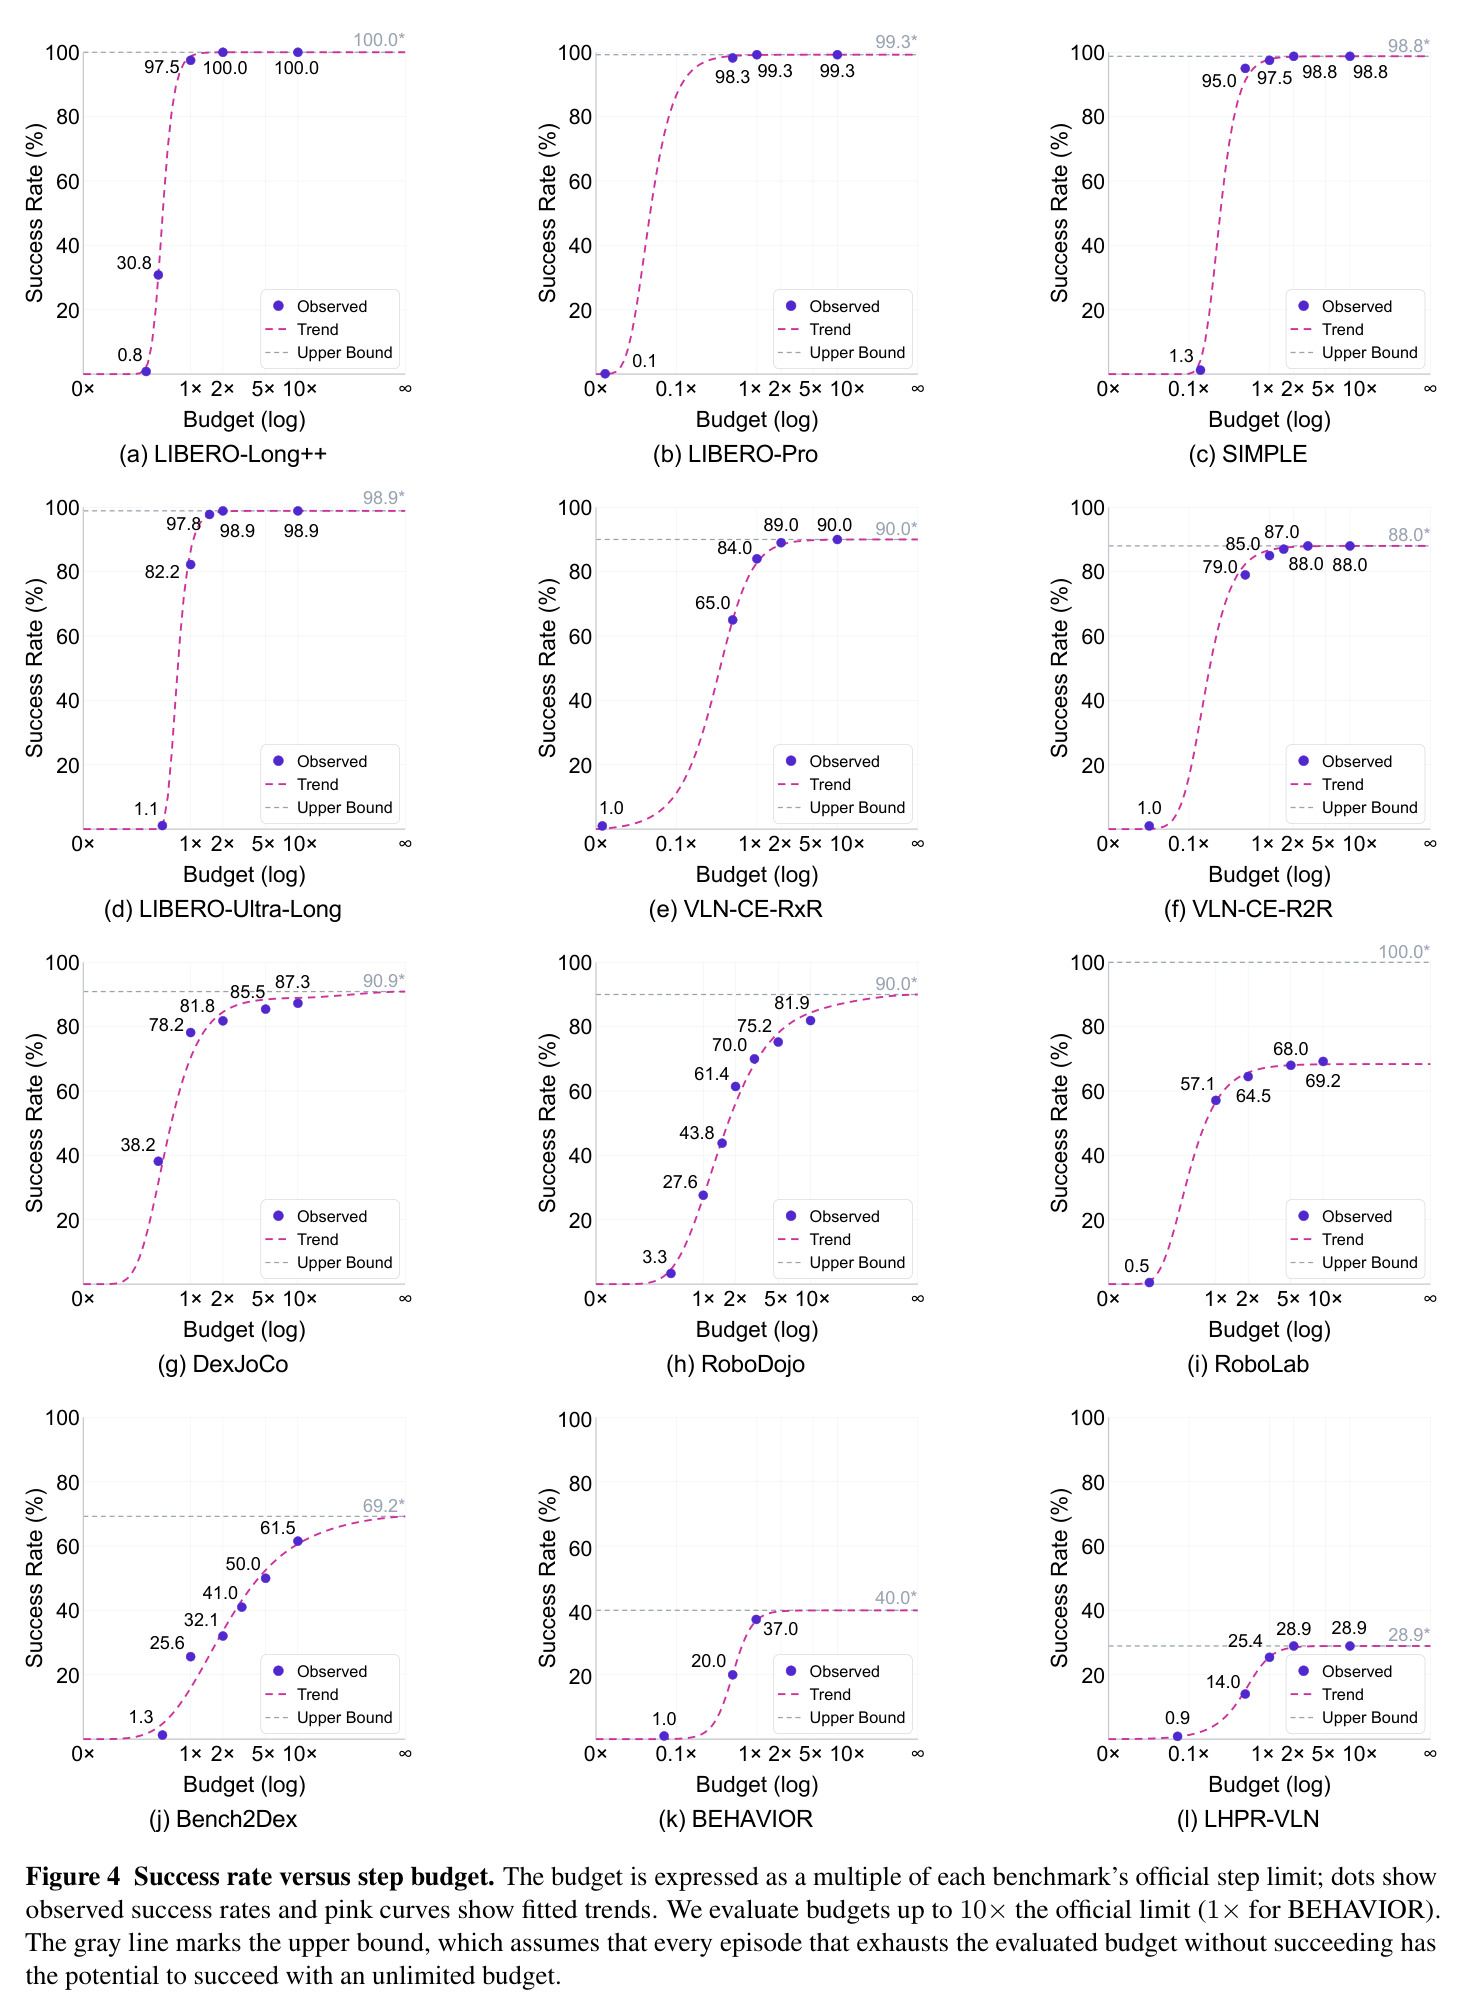
机器人学习的主流范式是为单个任务和本体收集示教、训练专用策略(VLA、世界模型等),评测也按这套范式设计:基准提供训练示教与固定步数预算,策略在留出回合上测成功率。GPT-6-Astra 这类通用多模态大模型展现出零样本操作、导航与失败恢复能力,动摇了'一任务一模型'的范式,但社区对其真实能力缺乏系统度量。一方面,官方步数预算按模仿学习策略的执行速度设定,会中断 agent 的'发现失败—修订策略—再次尝试'过程,系统性低估其能力——例如 RoboDojo 上标准预算只有 27.6% 成功率,看似平庸;另一方面,各基准协议互不兼容,无法跨本体横向比较,而模拟评测隐含的两个假设(测试任务的成功示教可得、额外执行步骤零代价)在真实部署中都不成立。基准饱和后常见的'提高难度'做法,也无法回答通用 agent 如何走向实用部署这一根本问题。
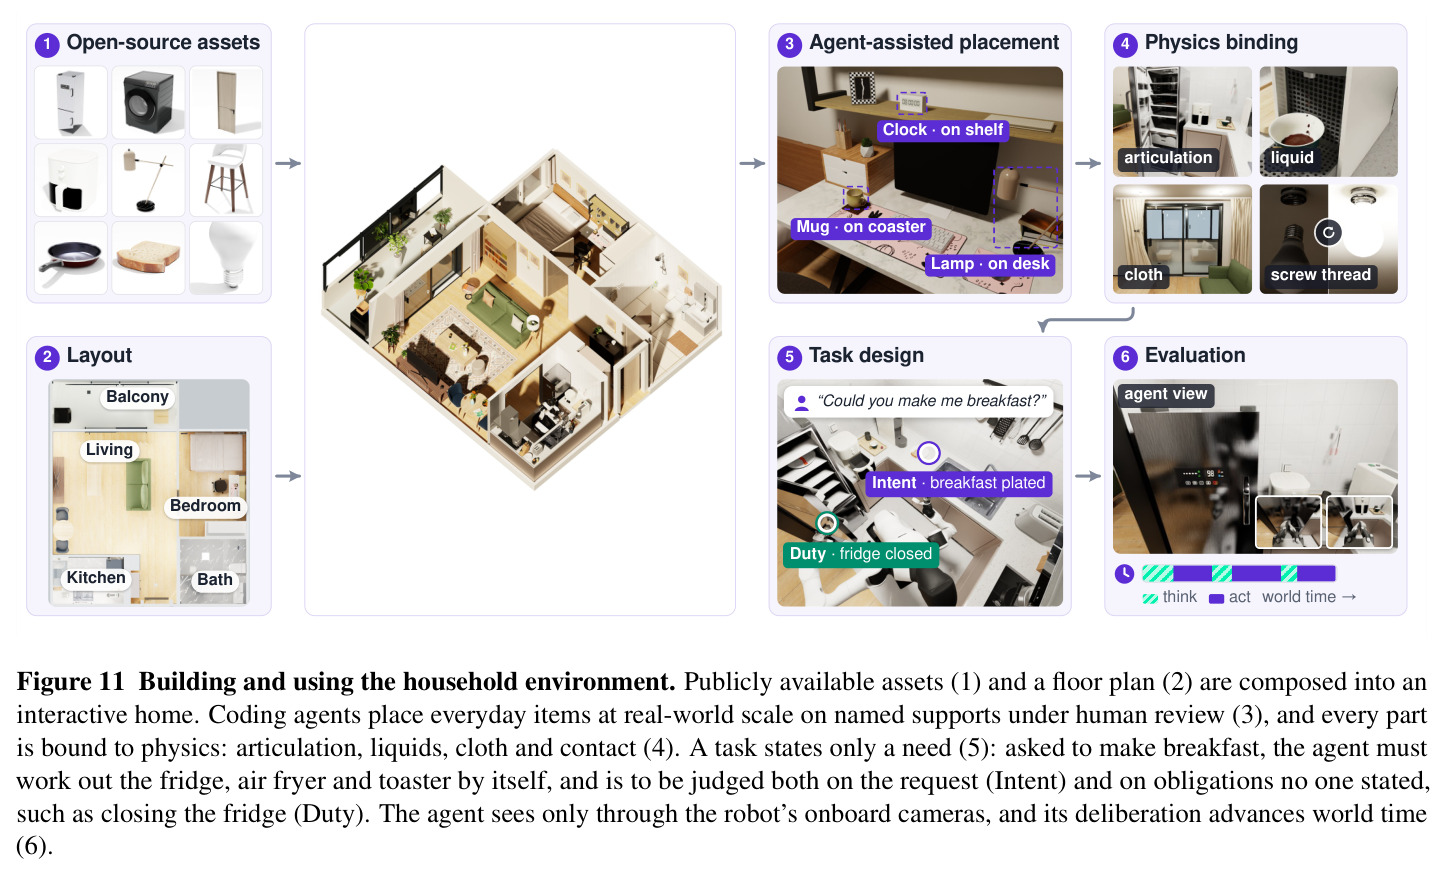
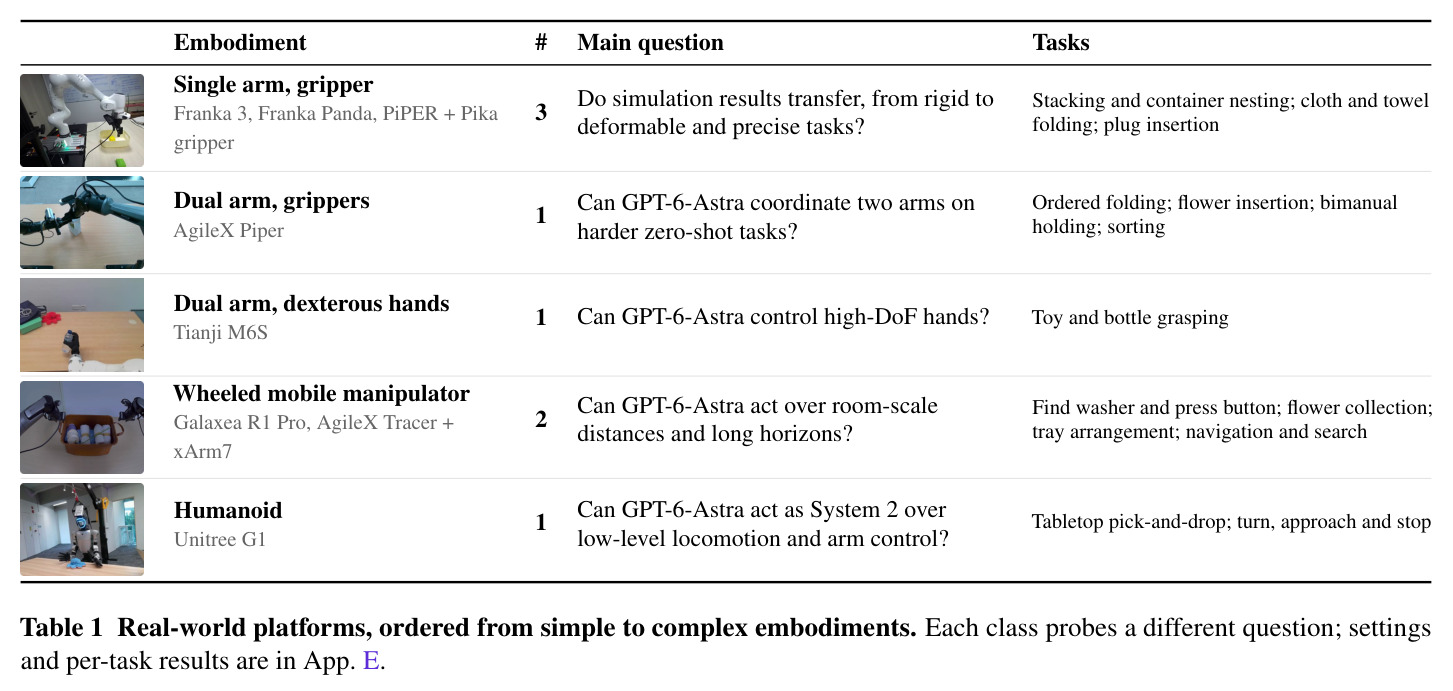
本文的目标是本文的目标不是提出新模型,而是以 GPT-6-Astra 为测量探针,系统回答三个问题:它的具身能力上限在哪里、这些能力对领域意味着什么、下一步应该研究什么。具体拆解为四项工作:第一,在统一协议下大规模评测 12 个代表性基准,覆盖桌面机械臂、灵巧手、人形、移动平台与导航五类本体,协议允许从训练集示教做上下文学习,并把执行预算从官方 1× 扩展到 10×,探测被步数限制掩盖的能力上限;第二,消融 agentic harness——System 1/System 2 协作协议、动作表示与分块参数——量化每种设计换来的成功率与 token 成本;第三,在 8 个真实机器人平台上验证模拟结论能否迁移,识别真实部署特有的安全、机械与实时约束;第四,据此提出下一代具身基准的三条设计原则,并在 NVIDIA Isaac Sim 的家庭场景中构建原型加以演示。
与已有工作不同的是,本文的独特切入角度是把'评测资源的信息对等'作为协议设计第一原则:既然专用策略可以拿基准训练示教做训练或微调,就应允许通用模型通过 ICL 使用同样的数据,否则比较测到的是信息获取条件的差异而非能力差异。在这一公平基线上,再把执行预算显式作为实验变量,报告 1× 到 10× 的累计截止点,从而把成功率分解为'规划能力'与'纠错机会'两个成分——这一分解揭示出 GPT-6-Astra 涌现的失败恢复能力是预算换成功率的关键机制(RoboDojo 约 1× 未完成回合的四分之三在 10× 内被补完)。第三个独特之处是用真机部署反向审视模拟协议:部署中新任务没有示教、时间携带安全与硬件代价,由此自然导出下一代基准三原则——任务源自人的需求并按效用评分、不提供域内示教、世界时钟在 agent 推理时继续走——使评测哲学从'为模仿学习设计的考场'转向'为部署而设的考场'。
核心方法
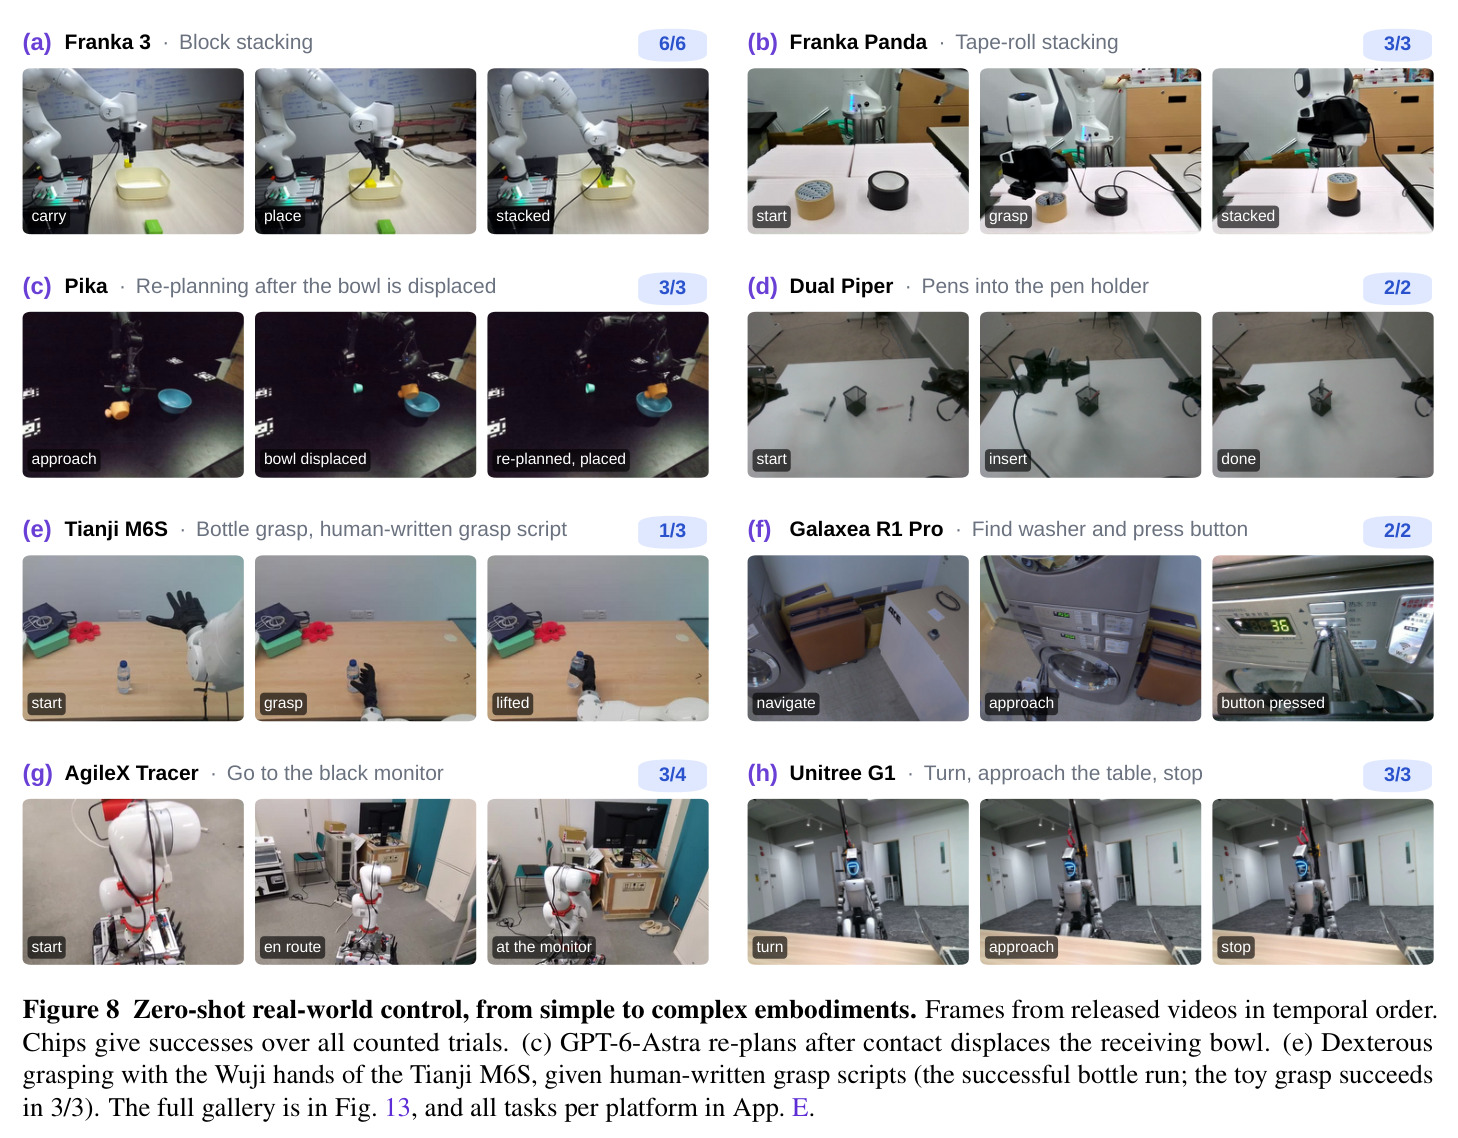
整个工作是一个四层递进的实证研究框架。第一层是统一协议评测:12 个基准、模型权重全程冻结;每个任务先做 ICL 准备——GPT-6-Astra 研读基准提供的训练示教,自行决定保留什么,写成笔记与可复用代码,构成冻结只读的知识包 $K$;随后每个测试回合在全新会话中进行,回合内保留交互历史以便诊断错误,回合间无信息传递;预算设 1×(官方步数)与 10×(同一回合延续纠错)两档。第二层是 harness 消融:以在 RoboDojo 上微调的 π0.5 作为 System 1 VLA,比较独立执行、开环(System 2 只给子目标)与闭环(VLA 提议的动作经正向运动学转成 EEF 运动后由 System 2 审查、修改或拒绝)三种协作方式,并扫描评审视野 $L \in \{1,4\}$;动作表示比较绝对 EEF 目标、方向性运动指令与关节角直控,分块比较 $L=1$、固定 $L=4$ 与自适应 $L \in \{1,2,3,4\}$。第三层是真机验证:8 个平台零样本部署,用人类撰写的结构化上下文替代知识包,用墙钟时间(通常 60 分钟)替代步数预算。第四层是下一代基准原型:Isaac Sim 家庭场景,任务只表述需求,由在世界时钟上持续运行的裁判评分。
核心创新点有三。其一,'权重冻结、上下文补足'的评测思想:不微调模型,而是让 GPT-6-Astra 把传统策略从示教中'学'到的东西改为通过知识包在上下文中'读'到,从而在信息对等条件下度量通用模型的真实能力;且知识包的六组件结构(任务指南、运动参考、视觉参考、可执行 helper、校验与恢复、元数据)是模型自主组织涌现的,并非人为规定。其二,发现'失败恢复'这一涌现能力:GPT-6-Astra 能检测失败动作、修订策略并通过继续交互完成纠错,这使 10× 预算转化为 RoboDojo 约三倍、Bench2Dex 翻倍以上的成功率——这是与以往'一次执行定成败'评测的本质区别。其三,识别出多模态推理与低层机器人控制之间的表示鸿沟:语义对齐的 EEF/方向指令显著优于关节角直控,闭环 System 2 审查 VLA 提议动作显著优于开环,说明 harness 应把动作空间对齐到模型推理能力、把精确执行委托给低层控制器。
方法步骤详情
方法按四层展开。第一步 ICL 准备:输入是基准官方训练示教,GPT-6-Astra 自主检查数据并产出知识包,典型内容含任务指南 .md、轨迹/相位锚点 .npz、示教帧与接触裁剪 .png、正逆运动学与检索 helper .py、校验与恢复流程 .md/.py、机器人规格元数据;包在测试前哈希冻结、只读。第二步评测回合:每回合全新会话,输入任务指令、冻结的 $K$ 与当前观测(相机 RGB、本体状态),模型在每个决策点输出动作或动作序列,环境执行后返回新观测;失败回合可在同一仿真状态下延续至累计 10× 步数预算,1× 结果独立报告。第三步 harness 消融:在 RoboDojo 42 个任务上运行配置 A.1–A.5(协作方式)与 B.1–B.4(动作表示/分块),记录成功率与 token 数。第四步真机部署:8 个平台零样本执行,仅接收人类写的结构化上下文(工具 schema、关节限位、安全约束、手爪开合预设等),无任何平台暴露 pick/place 等高层技能原语;试次以墙钟时间预算(通常 60 分钟),操作员持急停,由人按物理结果判定成功。第五步家庭原型:Isaac Sim 一居室公寓中 AgiBot G2 只通过本体接口与车载相机感知,任务只说需求(如'做早餐'),裁判在世界时钟上全程评判显式请求(Intent)与未声明义务(Duty)。
技术新颖性
本文的技术新颖性在评测方法学而非模型本身。第一,首次把'训练示教以 ICL 形式开放给基础模型'确立为横跨 12 个基准的统一协议,并证明知识包的六组件结构是模型自发组织的结果,为通用 agent 与专用策略提供了信息对等的比较基线。第二,把执行预算作为显式实验变量并报告 1×–10× 累计截止点,量化了'标准步数限制系统性低估 agent 能力'这一此前未被揭示的现象,并给出无预算上界估计(Fig. 4 灰线)。第三,System 1/System 2 协作的四象限成本-性能分析(Fig. 7):闭环审查比开环最多高 20 个百分点,评审视野从 $L=1$ 增至 $L=4$ 节省 63.5% token 还提升 2.22 个百分点,这类量化结论此前只有定性讨论。第四,下一代基准三原则把 PDDL 式单点目标条件推进到带截止期限的时序约束:用效用函数(不同早餐组合 0.5/0.8/1.0 分、随世界时间衰减)、:never/:whenever 义务条款和'推理时间推进世界'的裁判机制,把 PDDL3 的规划约束语言引入具身评测——现有工作 PARTNR、IS-Bench 均无 deadline,这在具身基准设计中是新的。
实验结果
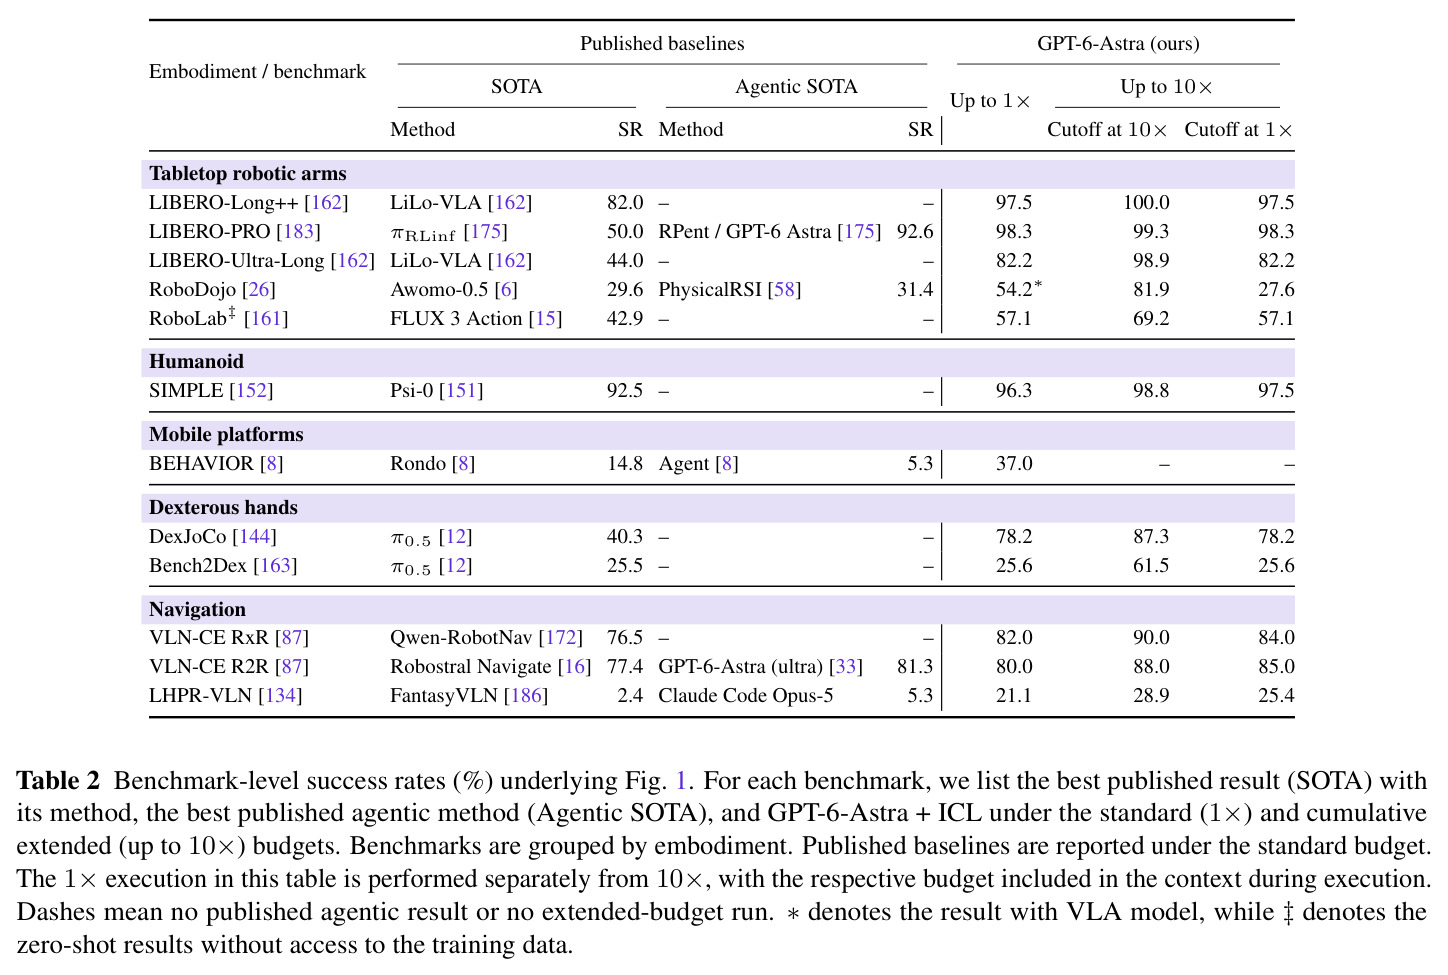
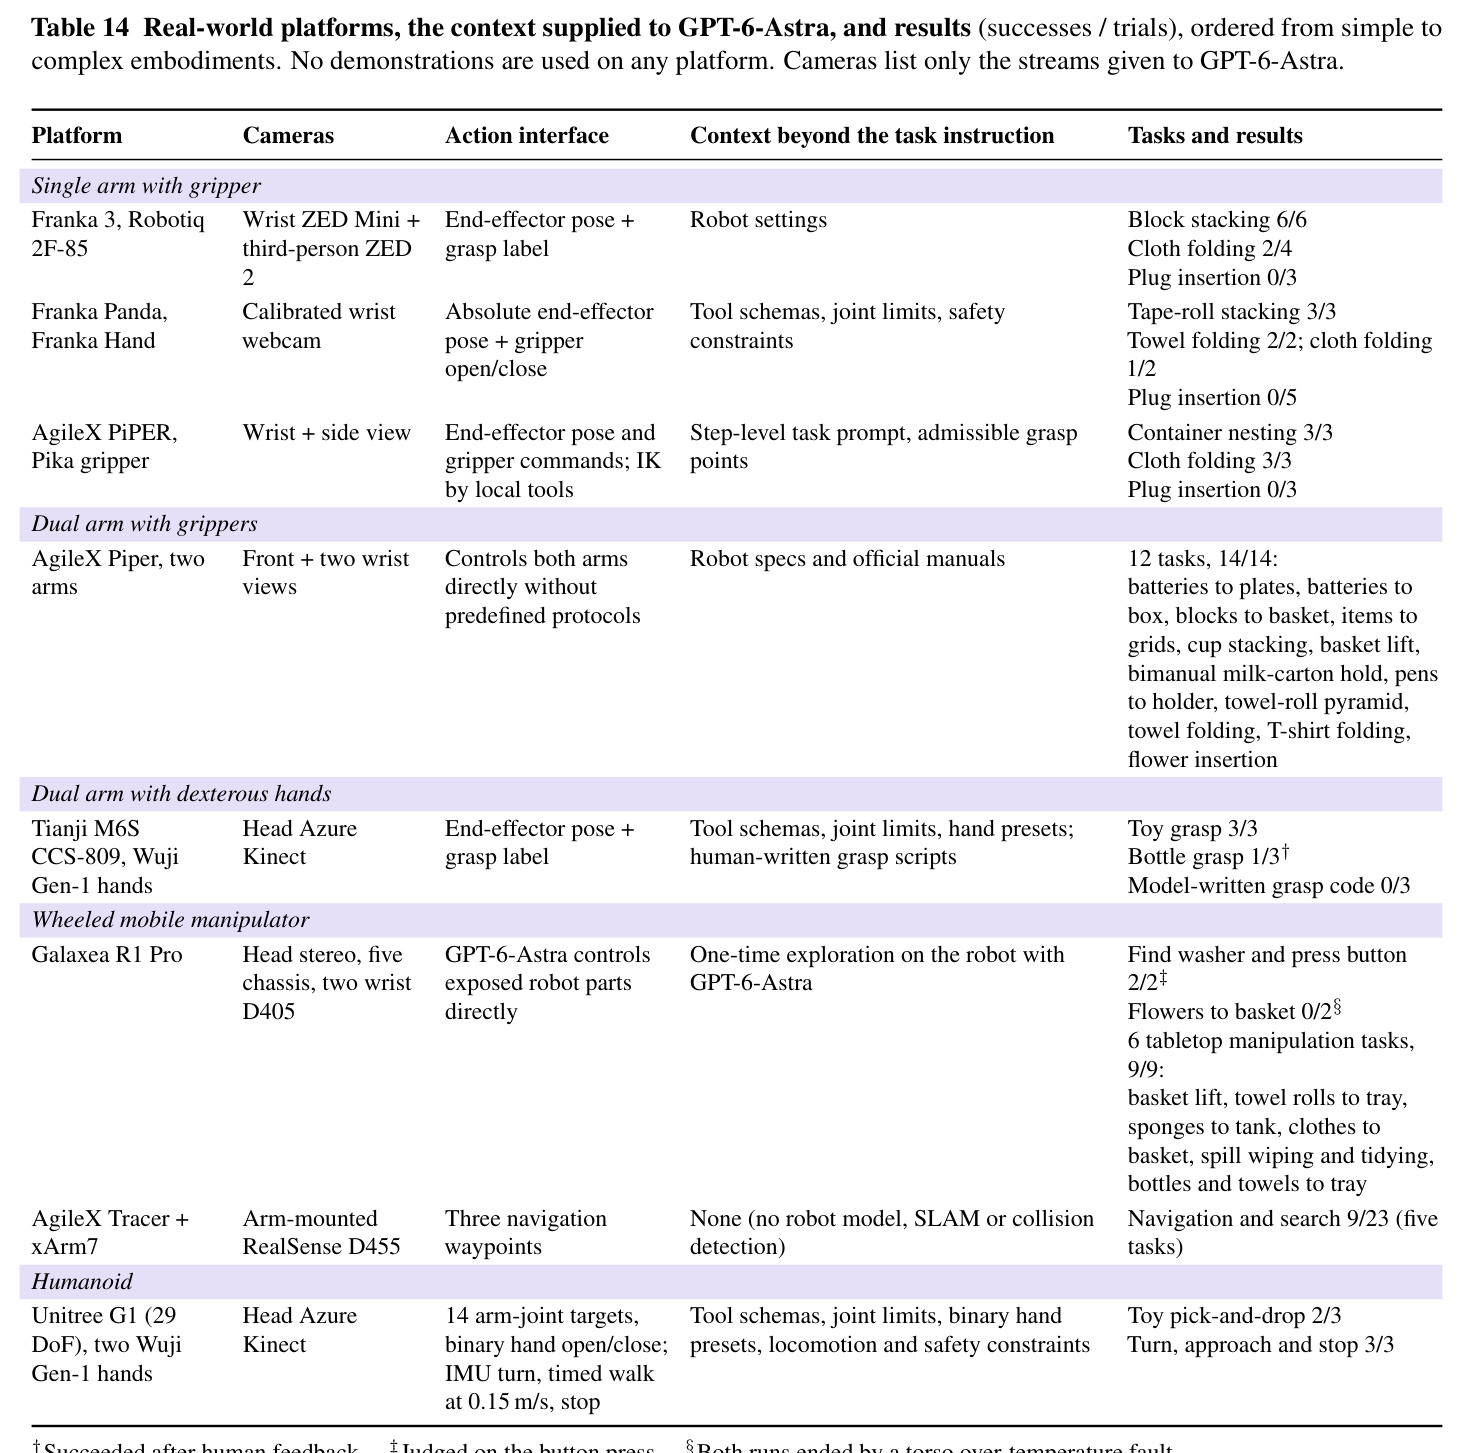
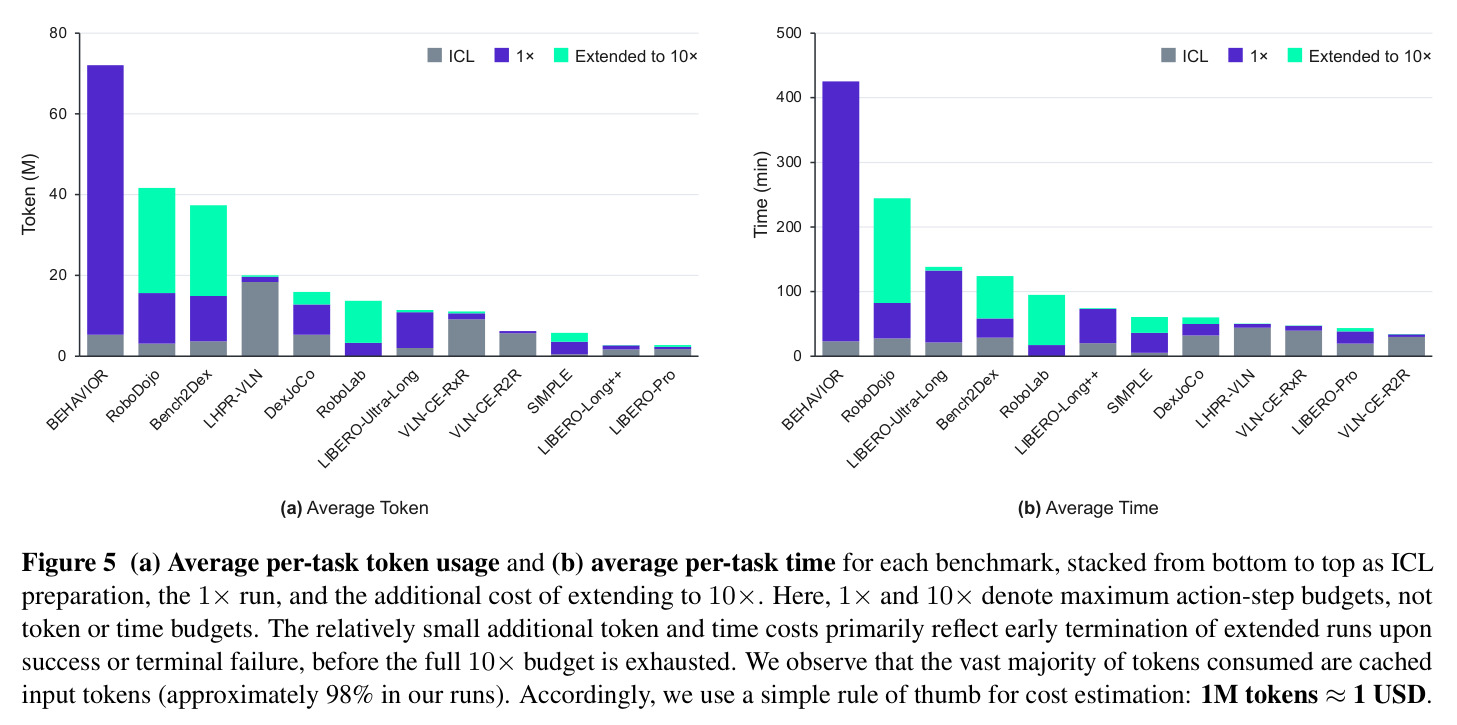
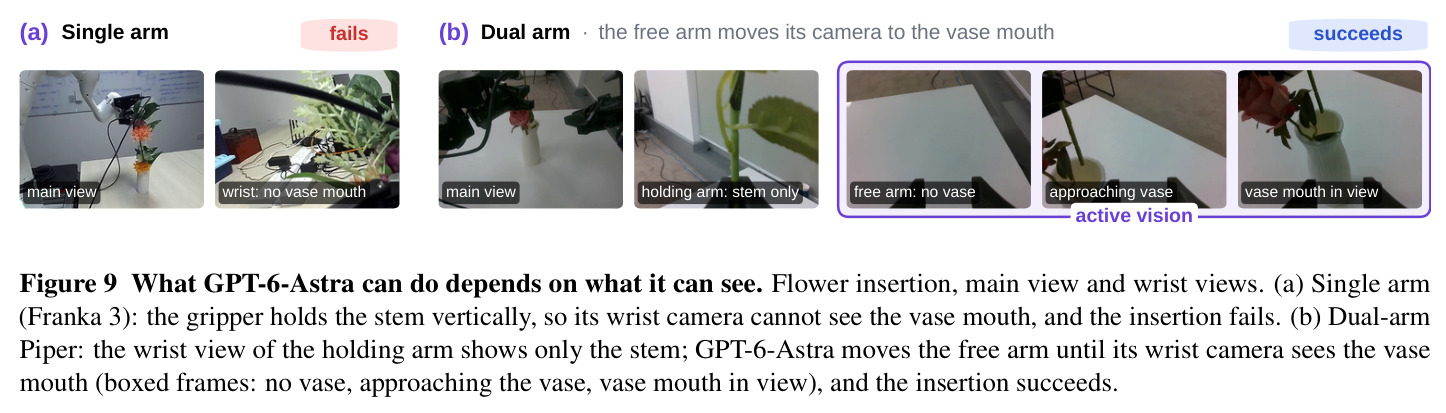
统一协议评测(Fig. 1、Table 2):1× 预算下 GPT-6-Astra 已匹配或超过绝大多数已发表 SOTA,10× 下 LIBERO-Long++ 100.0、LIBERO-Pro 99.3(800 回合 1×/10× 为 98.25%/99.25%,超此前最强 92.6 达 5.62 个百分点)、LIBERO-Ultra-Long 98.9(SOTA 44.0)、SIMPLE 98.8(Ψ0 92.5)、DexJoCo 87.3(π0.5 40.3)、RoboDojo 81.9(SOTA 31.4,约三倍)、Bench2Dex 61.5、RoboLab 69.2(零样本,超最强基线 42.9 达 14.2 个百分点)、VLN-CE R2R/RxR 88.0/90.0、BEHAVIOR 37.0(Rondo 14.8)、LHPR-VLN 仅 28.9——长程导航的子目标跟踪未被额外预算解决。SIMPLE 消融:ICL 把 Common-4 成功率从 70.8% 提到 90.8%(+20 个百分点),平均动作步数 376.9→210.4(-44.2%)。成本(Fig. 5):LIBERO-Long++ 每回合约 1M token、近 1 小时,Ultra-Long 约 9M token、近 2 小时,RoboDojo 10× 单回合超 3 小时;约 98% 为缓存输入 token,粗估 1M token ≈ 1 美元。Harness 消融(Fig. 7):π0.5 单独 6.91%,开环 5.83%(0.387M),闭环 $L{=}1$ 23.61%(7.664M),$L{=}4$ 25.83%(2.796M,token 省 63.5%),ICL 29.67%,ICL+闭环 VLA 54.17%(19.335M,6.9 倍成本)。动作接口:方向指令 +2.50 个百分点、关节角 −5.84、固定分块 −4.17、自适应分块 +4.44;BEHAVIOR 上 23 维关节接口 1% → 21 维 EEF 位姿接口 37%。真机(Table 14):刚性抓放 17/18,布料折叠 2/4,插插头三平台 0/11,导航搜索 9/23,灵巧手无抓取原语 0/3、有人写脚本后玩具 3/3;花插瓶单臂失败、双臂靠主动视觉成功(Fig. 9);G1 约 90% 时间在推理。家庭原型(Fig. 12)暴露冰箱敞开 465 秒、鸡蛋煎糊、水槽溢出等失败。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Ultra-Long(超长程桌面操作) | 成功率 SR (%) | 98.9(10× 预算) | LiLo-VLA 44.0 | +54.9 个百分点 |
| DexJoCo(灵巧手接触丰富操作) | 成功率 SR (%) | 87.3(10×) | π0.5 40.3 | +47.0 个百分点 |
| RoboDojo(双臂精细操作,42 任务) | 成功率 SR (%) | 81.9(10×) | Awomo-0.5 29.6 | +52.3 个百分点(约 2.8 倍) |
| Bench2Dex(双灵巧手,Full 随机化) | 成功率 SR (%) | 61.5(10×) | π0.5 25.5 | +36.0 个百分点 |
| SIMPLE(人形移动操作) | 成功率 SR (%) | 98.8(10×) | Ψ0 92.5 | +6.3 个百分点 |
| BEHAVIOR-1K 2026(长程家务,100 任务) | 成功率 SR (%) | 37.0 | Rondo 14.8 | +22.2 个百分点 |
| RoboLab(无训练集、零样本) | 成功率 SR (%) | 69.2 | FLUX 3 Action 42.9 | +26.3 个百分点 |
| VLN-CE RxR(视觉语言导航,val-unseen) | 成功率 SR (%) | 90.0(10×) | Qwen-RobotNav 76.5 | +13.5 个百分点 |
| LHPR-VLN(长程点导航) | 成功率 SR (%) | 28.9 | FantasyVLN 2.4 | +26.5 个百分点(但为所有设置中最低) |
| RoboDojo harness 消融 | 成功率 SR (%) | 54.17(ICL + 闭环 VLA) | Agentic 直接控制基线 15.56 | +38.61 个百分点(token 代价约 7.6 倍) |
| BEHAVIOR 动作接口消融 | 成功率 SR (%) | 37.0(21 维 EEF 位姿接口) | 1.0(23 维关节空间接口) | +36.0 个百分点 |
局限与改进
作者承认的局限有六点:i) ICL 知识包高度任务特异、迁移差——RoboDojo Open 组无专属示教时成功率全组最低,RoboLab 无训练集只能零样本、69.2% 仅属中等;ii) 成本与时间高——接近饱和的 LIBERO-Long++ 每回合仍约 1M token、近 1 小时,Ultra-Long 约 9M token、近 2 小时,RoboDojo 10× 单回合超 3 小时;iii) 物理成功验证失灵——拼图看似拼好越修越散、马克杯看似挂上实际落桌、鸡蛋未坐稳仍报告完成;iv) 从不可逆失败恢复困难——液体洒出无法撤回,DexJoCo 销钉掉地后判定不可达并停机,剩余预算全浪费;v) 长程进度保持差——调整耳机罩时把已挂好的头带碰掉、罐子在手边坠落;vi) 真机上安全(保护性停机)、机械(Wuji 手 62°C 过热、躯干过温终止任务)与实时约束使'加步数换成功率'不可用。我的补充观察:真机试次普遍只有 2–4 次、BEHAVIOR 每任务仅 1 回合,统计功效不足以支撑精确的方法间比较;12 基准成绩由同一团队自评,知识包构建含大量未公开的工程自由度;作者自己指出的裁判证据问题(视觉成功检测器最高仅 60% 平衡准确率)同样威胁其原型基准的可信度。
独立分析的弱点
独立分析可见四个更深的弱点。第一,ICL 知识包没有消除数据依赖,只是变换了形式:每任务准备需 8.34M token 与 90.4 分钟,且质量取决于基准训练集——真实部署没有这种示教,等于把'训练数据收集'换成了'上下文工程',Tianji 灵巧手无原语 0/3、有人写抓取脚本后 3/3 的对比说明结果仍高度依赖人工先验;改进方向是跨任务共享的运动原语库与自监督探索式知识积累。第二,失败验证缺乏物理接地:模型只有视觉与本体状态,无法核实接触、支撑与对齐约束,导致拼图越修越散、杯子假挂上;改进方向是引入力/触觉反馈通道,或让模型生成可执行的判别式检验程序并在仿真中回放验证。第三,成本结构不可商业化:ICL+闭环 VLA 达 54.17% 成功每回合耗 19.335M token,推理延迟不计入步数预算,G1 上约 90% 时间在思考、单次操作超 1 小时;改进方向是把 System 2 蒸馏或级联到轻量验证器,只在高不确定性时调用大模型。第四,评测的统计与可复现设计不足:BEHAVIOR 每任务 1 个回合、真机多数任务 2–4 次试验,无法区分方法差异;'世界时钟'原型的分数会依赖推理延迟与硬件负载,公平比较机制尚未建立,需要预注册的方差分析与标准化延迟测量。
未来方向
作者明确提出的五个优先方向是:1) 提升 ICL 的泛化性——构建能跨任务迁移的知识包,并系统研究异构上下文来源(跨本体示教、仿真自生成示教、人类演示、机器人自身部署历史、跨机器人共享的知识包)的原则化组合;2) 降低推理成本与执行时间,使商业部署可行;3) 任务相关的物理状态验证;4) 面向不可逆失败与前提依赖的恢复策略;5) 长程执行中的进度保持与条件复查。下一代基准侧的开放挑战包括:裁判的证据获取(当前视觉-语言成功检测器在接触丰富装配上最高仅 60% 平衡准确率,且可被 agent 自己的推理误导)、长程家庭活动的仿真保真度(目前只有短桌面任务验证过 sim-to-real 相关性)、不停摆世界的评测成本与可复现性、一小时级部署的高昂重复成本。基于本文成果还可延伸:把主动视觉(Fig. 9 中自由臂取景使花插瓶从失败变成功)机制化为显式视角选择动作空间;用世界模型做 mental rehearsal 让 System 2 在推理时预演动作后果,缓解'鸡蛋煎糊'式的观察过时问题;以及把 ICL 知识包蒸馏进低频 System 1 控制器,形成'一次学习、长期执行'的部署形态。
复现评估
本文是 SenseNova 联合团队对 GPT-6-Astra 的技术报告,模型闭源,未公开权重或 API 定价,主页为 sensenova.ai/has-gpt-6-astra-achieved-embodied-intelligence;但方法描述极为详尽——附录给出每个基准的观测/动作接口、预算定义、每任务成功率与 token/时间成本(Table 3–13),知识包结构(Fig. 3)与协议(Fig. 2)可直接照做。复现门槛主要在资源:统一协议评测需要 GPT-6-Astra 访问权限与巨量推理预算——LIBERO-PRO 一项就是 800 回合、每回合约百万级 token,RoboDojo 10× 单回合超 3 小时,SIMPLE 每任务 ICL 准备 8.34M token;真机部分需要 8 种平台(Franka 3/Panda、AgileX PiPER/Piper/Tracer、Tianji M6S、Galaxea R1 Pro、Unitree G1)与全程人工监护。可行的部分复现:harness 消融(RoboDojo + 开源 π0.5)与 Isaac Sim 家庭原型(全部使用公开资产)可在学术预算内缩规模重现;完整复现 12 基准评测基本只有原团队或拥有同等模型的实验室能做到。综合评级:文档充分、结果可信,但属于资源密集型、难以独立完整复现的评测报告。
论文图表
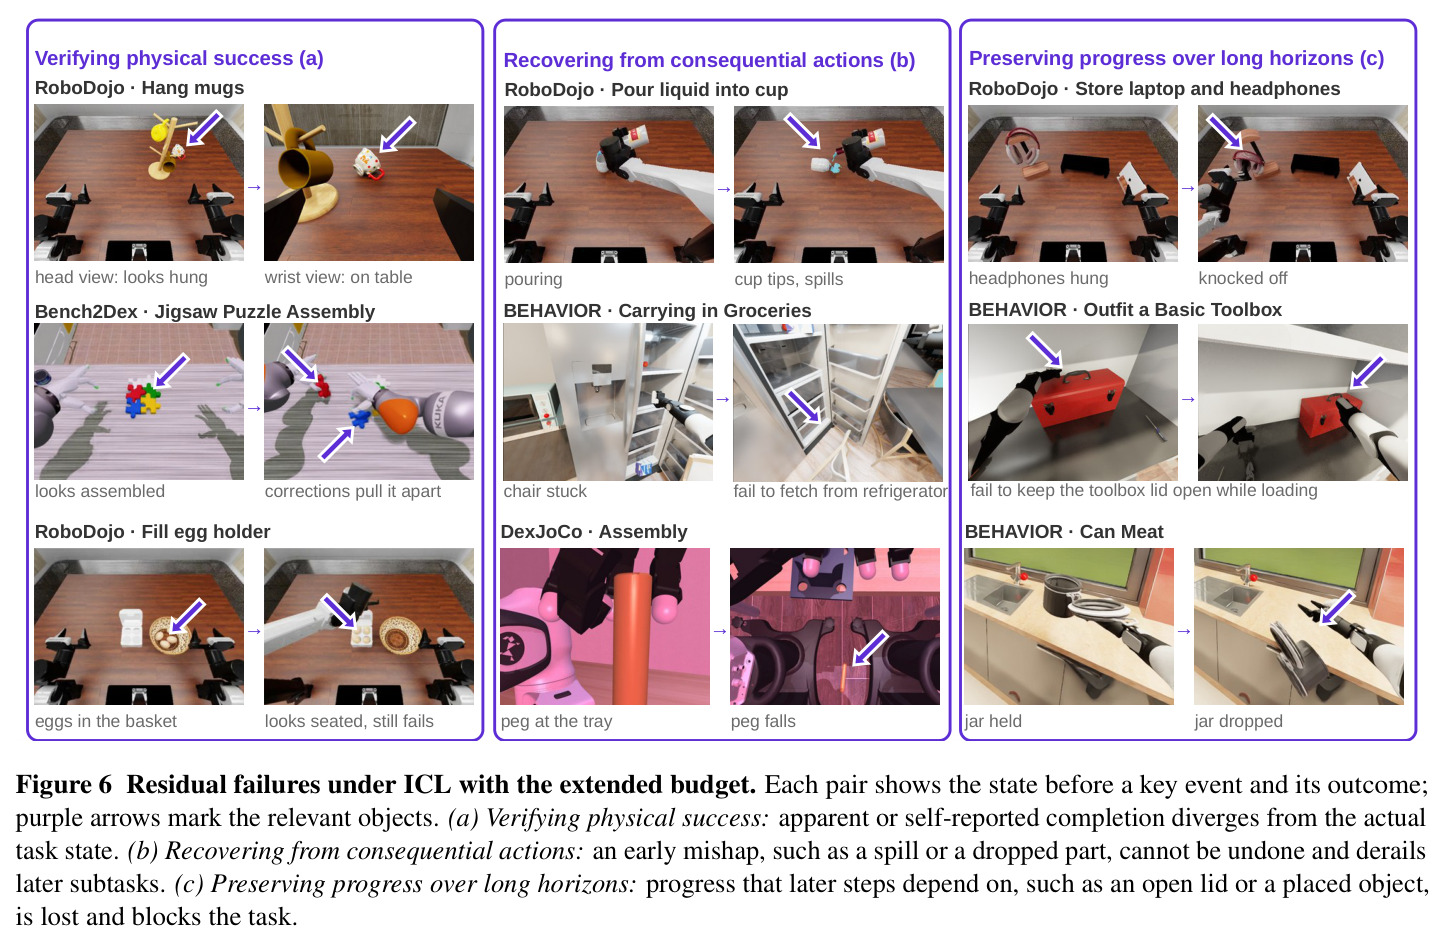
三列九组成对照片,各展示失败前后的状态对比:(a) 拼图看似拼好越修越散、马克杯看似挂上实际落桌、鸡蛋未坐稳;(b) 液体洒出不可逆、销钉掉地停机、工具箱盖无法保持打开;(c) 修正耳机时碰掉已挂好的头带、罐子掉落、原进度丢失。
用视觉证据系统化三大残余失败模式,是第 2.4 节局限分析和五大未来方向(验证、恢复、长程保持)的经验基础。
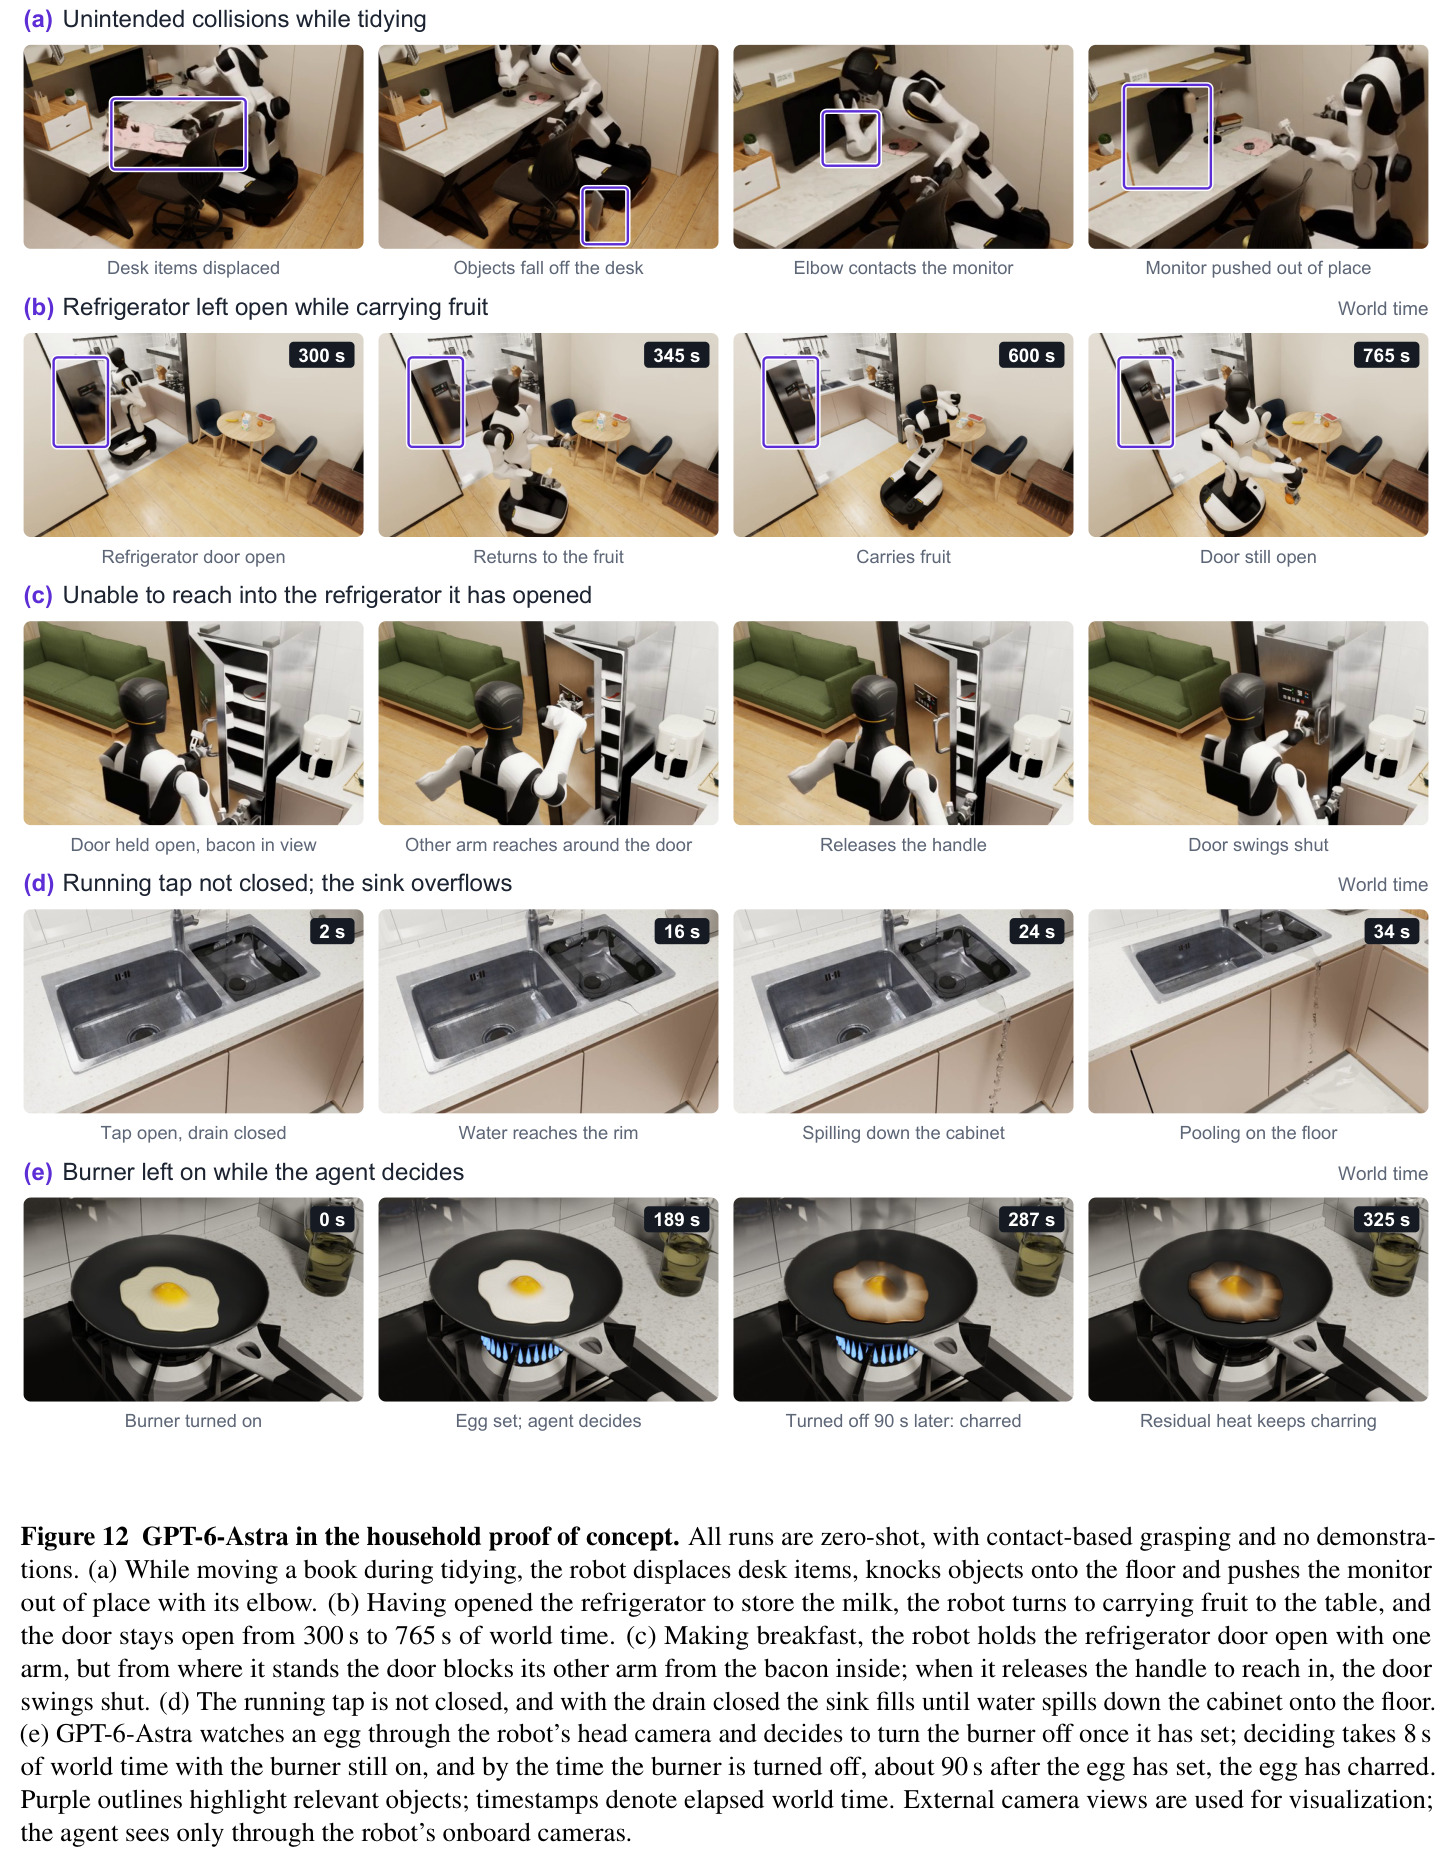
五组失败案例照片带世界时间戳:(a) 收拾书桌时手肘碰歪显示器、撞落物品;(b) 冰箱门从 300s 敞开到 765s;(c) 单臂拉住冰箱门导致另一臂够不到培根,松手门即关上;(d) 水龙头不会关,水槽溢出漫到地板;(e) 决定关火耗时 8 秒、关火比鸡蛋凝固晚约 90 秒导致煎糊。
三大原型失败发现(注意力局限于手中物体、不理解不熟悉器械与自身身体、决策基于过时观测)的视觉证据,直接支撑'GPT-6-Astra 尚未跨过实用具身智能门槛'的结论。